Майнинг организаций с использованием онлайн-социальных сетей
Аннотация
Зрелые сервисы социальных сетей представляют собой один из ценнейших ресурсов современных организаций. Однако этот ценный ресурс также может представлять угрозу для конфиденциальности организации. Участники сайтов социальных сетей раскрывают не только свою личную информацию, но и детали об организациях, в которых они работают. В данной статье мы анализируем несколько коммерческих организаций путем майнинга данных, которые их сотрудники раскрыли на Facebook, LinkedIn и в других общедоступных источниках. Используя разработанный для этой цели web crawler, мы извлекаем сеть неформальных социальных связей между сотрудниками заданной целевой организации. Наши результаты, полученные с использованием анализа centrality и методов Machine Learning, примененных к структуре сети неформальных связей, показывают, что можно идентифицировать leadership roles внутри организации исключительно этим путем. Также возможно получить ценные нетривиальные сведения о структуре организации путем кластеризации ее социальной сети и сбора общедоступной информации о сотрудниках внутри каждого кластера. Организации, желающие скрыть свою внутреннюю структуру, идентичность leaders, местоположение и специализацию филиалов и т.д., должны проводить строгую политику для контроля использования социальных сетей своими сотрудниками. Ключевые слова. Organizational data mining, Social network data mining, Social networks privacy, Organizational social network privacy, Facebook, LinkedIn, Machine learning, Leadership roles detection
1 Введение
В последние годы онлайн-социальные сети выросли в масштабах и разнообразии и сегодня предоставляют людям возможность публично заявлять о себе, обмениваться идеями с друзьями или коллегами и расширять свои сетевые связи. Например, социальная сеть Facebook11 1 http://www.facebook.com насчитывает более 1,11 миллиарда активных пользователей в месяц, причем каждый месяц регистрируются новые пользователи. Согласно последним статистическим данным, опубликованным Facebook, в среднем 655 миллионов пользователей Facebook заходят на этот сайт ежедневно, и каждый день публикуется более 4,75 миллиарда единиц контента (веб-ссылки, новостные сюжеты, записи в блогах, заметки, фотоальбомы и т. д.) [7]. С одной стороны, социальные сети создают новые возможности для развития дружеских отношений, обмена идеями и ведения бизнеса. С другой стороны, многие пользователи социальных сетей раскрывают личные сторонние данные о себе и своих социальных связях через страницы своих профилей [1, 3], а также конфиденциальную деловую информацию и сведения о месте своей работы.
В данном исследовании мы анализируем общедоступные данные социальной сети с целью выявления внутренней организационной структуры шести высокотехнологичных компаний разного масштаба. Аналогичный анализ был выполнен Тайлером и др. для организации Hewlett-Packard [42]. Однако их анализ основывался на защищенных организационных данных, то есть журналах электронной почты. Мы показываем, что можно использовать только общедоступные данные, такие как данные из Facebook и LinkedIn,22 2 http://www.linkedin.com, чтобы достичь аналогичных результатов для нескольких организаций.
Вклад данной работы заключается в следующем: во-первых, мы представляем метод выявления топологии неформальной социальной сети организации исключительно на основе общедоступных данных. Во-вторых, мы используем структуру организации для обнаружения скрытых ролей лидерства внутри нее и выявления сообществ внутри организации. Наконец, мы проводим качественный анализ этих ролей лидерства и сообществ и демонстрируем, что можно получить значимые инсайты об организации и роли каждого сообщества, не имея вообще никакого доступа к внутренним данным организации.
1.1 Наш подход в двух словах
Предложенные в этой статье методы organizational mining были применены к шести известным высокотехнологичным компаниям различного масштаба: от небольших компаний с несколькимистами сотрудниками до крупных предприятий с сотнями тысяч работников. Для каждой компании процесс добычи данных включал три основных этапа. Сначала мы получили топологию неформальной социальной сети организации из общедоступных источников, как подробно описано в разделе 3. В рамках этого процесса мы собрали информацию о структуре компании, которую сотрудники раскрыли в Facebook. Представленный метод organizational data mining позволяет получить широкий спектр топологий социальных сетей организаций, которые ранее были недоступны исследовательскому сообществу..
Затем мы использовали различные метрики центральности для выявления скрытых ролей лидеров внутри каждой организации. В разделе 4 мы выделяем метрики центральности с наибольшей точностью в определении лидеров. Мы дополнительно использовали алгоритмы Machine Learning для классификации управленческих ролей в каждой организации.
На третьем шаге мы использовали современный алгоритм для кластеризации социальной сети организации на непересекающиеся сообщества, а также сопоставили выявленных лидеров и сообщества с информацией, полученной из LinkedIn (см. раздел 5). Это позволило нам определить роли многих сообществ внутри организации, предоставив важные сведения об организации. Такие сведения включали, например, географическое размещение организации, структуру ее различных подразделений, взаимосвязи между подразделениями, ранее приобретенные компании и исследовательский фокус организации. Эти детали могут помочь нам лучше понять как структуру, так и схемы коммуникации внутри организации. Они также подчеркивают необходимость для организаций осознавать уязвимость своих социальных сетей и разрабатывать политики для контроля этого воздействия по мере необходимости.
Остальная часть этой статьи организована следующим образом. В разделе 2 мы приводим краткий обзор предыдущих релевантных исследований по анализу социальных сетей с особым акцентом на организационный анализ социальных сетей. В разделе 3 мы описываем методы, используемые для получения структуры организационной социальной сети, и показываем различные полученные организационные наборы данных. В разделе 4 мы представляем методы выявления руководящих ролей организации. Затем наши методы, используемые для обнаружения ролей сообществ внутри каждой организации, описаны в разделе 5. Наконец, в разделе 6 мы представляем наши выводы и предлагаем направления будущих исследований..
2 Предыстория
В этом разделе мы описываем предыдущие работы в областях онлайн-социальных сетей и организационных социальных сетей. Мы также представляем обзор исследований, в которых использовались различные типы данных для выявления неформальных связей между сотрудниками организации с целью обнаружения социальной сети организации..
2.1 Онлайн-социальные сети
В последние годы использование онлайн-социальных сетей растет в геометрической прогрессии. Онлайн-социальные сети, такие как Facebook, Twitter,33 3 http://www.twitter.com LinkedIn, Flickr,44 4 http://www.flickr.com и YouTube55 5 http://www.youtube.com, ежедневно обслуживают миллионы пользователей. С ростом использования возникли новые проблемы конфиденциальности. Эти опасения связаны с тем, что пользователи онлайн-социальных сетей часто публикуют информацию о себе и своих местах работы. В 2007 году исследование, проведенное Dwyer et al. [10], показало, что 100% людей, участвовавших в исследовании, использовали настоящие имена в своих учетных записях Facebook, а 98,6% добавили свои фотографии в свои учетные записи Facebook. Более того, в 2011 году Boshmaf et al. [3] собрали и проанализировали более 250 ГБ данных пользователей Facebook и оценили объем личной информации, раскрываемой пользователями. Они пришли к выводу, что многие пользователи Facebook раскрывают подробную личную информацию, включая дату рождения, место работы, адрес электронной почты, семейное положение и номер телефона. Используя общедоступные данные из Facebook и сопоставляя их с другими общедоступными источниками данных в сети, такими как Google66 6 http://www.google.com и LinkedIn, можно сделать вывод о дополнительных деталях пользователя Facebook, таких как конкретный опыт работы и области знаний. Например, Pipl77 7 http://pipl.com и PeekYou88 8 http://www.peekyou.com способны искать информацию о человеке в разных социальных сетях. Эти поисковые системы по людям агрегируют полученные результаты и представляют полностью детализированный личный профиль.
В данном исследовании мы использовали общедоступные данные из Facebook для того, чтобы определить, какие пользователи Facebook работали в определенной организации. Затем мы сопоставили данные пользователей с LinkedIn, результатами поиска Google и собственной веб-страницей компании, чтобы выявить должности пользователей в организации.
2.2 Организационные социальные сети
За последние шесть десятилетий значительный объем исследований был посвящен анализу и пониманию моделей общения между людьми внутри организаций. В 1951 году Джейкоوبсон и Сишор [19] одними из первых исследовали модели общения среди сотрудников федеральных ведомств. В 1968 году Пью и др. [34] изучили пять основных измерений организационной структуры, примененных к 52 различным организациям в Англии. В 1969 году Аллен и Коэн [2] исследовали модели технического общения и их влияние в двух научно-исследовательских и опытно-конструкторских лабораториях в Массачусетском технологическом институте. В 1979 году Тичи и др. [41] представили метод анализа организаций с использованием сетевой структуры, которая включала множество структурных свойств сети, таких как центральность, кластеризация и плотность. Тичи и др. использовали эту структуру для проведения сравнительного анализа двух организаций с несколькимистами сотрудниками. В 1991 году Спарроу [39] представил метод использования структурного анализа социальных сетей для лучшего понимания преступных организаций. В 2002 году, после трагических событий 11 сентября 2001 года, Кребс [23] изучил структурные свойства организационной сети Аль-Каиды и преуспел в выявлении лидера заговорщика с использованием структурных свойств степени и близости вершин. В 2003 году Кэмпбелл и др. [5] представили алгоритмы для определения экспертизы с использованием моделей общения по электронной почте. Их алгоритмы были оценены на двух разных организациях. В нашем собственном исследовании мы показываем, что экспертиза, лидерство и роли сообществ могут быть идентифицированы с использованием общедоступных источников данных даже без доступа к внутренним данным организации, таким как журналы электронной почты. С 2004 года, после публикации около 500 000 писем сотрудников компании Enron [37], многие исследователи использовали этот набор данных внутренней электронной почты, чтобы лучше понять социальную сеть корпорации Enron и обнаружить различные идеи об организации [8, 9, 25, 38, 44].
В последние годы с ростом популярности использования онлайн-социальных сетей многие исследования были посвящены использованию и преимуществам как публичных, так и внутренних служб социальных сетей для организаций. В 2009 году Штайнфилд и др. [40] исследовали связь между социальным капиталом и использованием служб социальных сетей, развернутых внутри организаций. В том же году Руксби и др. опубликовали подробный отчет о том, как онлайн-социальные сети используются в контексте рабочего места [35]. Всесторонние обзоры организационных социальных сетей могут предоставить дополнительные сведения [21, 33, 20].
2.3 Обнаружение социальной сети организации по неформальным связям
Работа, представленная в этой статье, тесно связана с внутренним исследованием организации Hewlett-Packard, проведенным в 2004 году Тайлером и др. [42]. Анализируя корпус электронной почты организации, который содержал более миллиона сообщений, они обнаружили топологию организационной социальной сети и выявили сообщества внутри организации. Авторы использовали метрику центральности по посредничеству [15] для выявления лидерских ролей в организации. Они также применили версию алгоритма Уилкинсона и Хубермана [43], которая разделяет социальную сеть организации на сообщества. Результаты оценивались путем опроса нескольких сотрудников о сообществе, в которое они были автоматически помещены алгоритмом обнаружения сообществ. Наддаф и Мутяла [28] представили похожее исследование в 2010 году. Они продемонстрировали метод извлечения неформальных социальных сетей, образуемых сотрудниками организации на основе записей их электронной почты. Они протестировали свой метод на крупном клиенте из государственного сектора и определили авторитет сотрудников с помощью меры PageRank [32]. Кроме того, Наддаф и Мутяла использовали алгоритм Fast Modularity [6] для выявления сообществ в организационной социальной сети своего клиента.
3 Краулер социальной сети организации
Многие различные типы веб-краулеров были разработаны для сбора данных из крупномасштабных онлайн-социальных сетей [27, 3, 16, 14]. Краулеры социальных сетей обычно начинают с нескольких начальных профилей и постепенно расширяют набор полученных профилей, используя, например, обход в ширину (BFS) или другие методы, такие как случайные блуждания [16].
К сожалению, стандартные методы обхода социальных сетей недостаточны для сбора данных, ориентированных на конкретную организацию. В ходе предварительного исследования, выполненного с использованием обхода BFS, мы собрали множество нерелевантных профилей и часто пропускали пользователей Facebook, которые работали в нашей целевой организации. Для решения проблемы целевого сбора профилей из онлайн-социальных сетей мы разработали организационный краулер, который оптимизирует сбор данных от пользователей, связанных с определенной группой или организацией. Наш организационный краулер использует принцип гомофилии [26]. Согласно принципу гомофилии, человек с большей вероятностью работал в определенной организации, если многие из его друзей также работали в этой же организации..
Для извлечения профилей сотрудников выбранной целевой организации из социальной сети наш веб-краулер функционировал в соответствии с алгоритмом, представленным в Algorithm 1. Обход начинается с набора начальных страниц профилей, изначально идентифицированных как принадлежащие сотрудникам целевой организации. Исходный набор начальных страниц может быть получен с помощью поисковой системы. Эти страницы используются для инициализации очереди с приоритетом (строка 2). Все начальные страницы имеют начальный приоритет, равный нулю. Позже приоритет страниц профилей в очереди увеличивается с каждым другом, который работает в целевой организации (строки 11-12).
Мы продолжили работу, итеративно обрабатывая следующую страницу профиля с наивысшим приоритетом (то есть с наибольшей вероятностью принадлежности к сотруднику целевой организации), до тех пор, пока в очереди с приоритетами не останется потенциально ценных профилей (строки 4–5). Каждая обработанная страница профиля была загружена (строка 7) и проанализирована автоматически. Мы использовали эвристический подход, чтобы попытаться выяснить, принадлежит ли в данный момент обрабатываемая страница профиля сотруднику целевой организации. Эта эвристика сопоставляла различные ключевые слова, связанные с организацией, с полуструктурированными данными, которые отображаются в общедоступном профиле пользователя в Facebook. Например, чтобы идентифицировать пользователей из факультета инженерии информационных систем Университета Бен-Гуриона, краулер искал на собранной странице профиля такие строки, как «Ben-Gurion Information System Engineering», «BGU ISE» или «ISE BGU». Если мы не находили совпадений ни с одним из ключевых слов, мы переходили к следующему профилю в очереди с приоритетами. Если же мы обнаруживали, что извлеченная из очереди страница профиля принадлежит человеку, работающему в целевой организации, мы собирали список его или ее друзей на Facebook (строки 8–9).
Профили друзей Facebook, которые уже были обработаны, игнорировались (строка 10). Мы увеличили приоритеты всех друзей, ожидающих в очереди с приоритетом (строки 11-13). После этого мы добавили всех новообнаруженных друзей Facebook текущего обрабатываемого профиля в очередь с приоритетом, установив приоритет равным единице (строки 14-16). Этот процесс повторялся со следующей страницей профиля, извлеченной в соответствии с обновленными приоритетами.
Краулер, псевдокод которого описан в алгоритме 1, останавливается, когда очередь пуста. Мы будем называть этот краулер Версией 1. Мы также оценили оптимизированную версию краулера организации. Эта версия отслеживала количество друзей в целевой организации для каждого профиля пользователя в очереди с приоритетом, а также количество сотрудников организации, обнаруженных за последние итерации. Мы останавливали процесс сбора данных, если все пользователи в очереди с приоритетом имели не более одного друга в целевой организации и если последняя тысяча профилей, полученных из Facebook, не принадлежала сотрудникам организации. Мы будем называть краулер с этим более строгим условием остановки Версией 2.
3.1 Этические аспекты
В ходе данного исследования мы использовали наши организационные веб-краулеры для сбора значительного объема данных из открытых источников, касающихся изучаемых организаций и их сотрудников. Насколько нам известно, правила Университета имени Бен-Гуриона в Негеве не требуют получения специального одобрения этического комитета для исследований, в которых используются данные, собранные из открытых источников. Тем не менее, чтобы защитить конфиденциальность сотрудников организаций и обнаруженные конфиденциальные сведения об организациях, мы анонимизировали названия организаций на протяжении всей данной статьи. Кроме того, в приложенных опубликованных наборах данных мы анонимизировали идентификаторы сотрудников в Facebook, случайным образом заменив идентификаторы пользователей Facebook последовательностью целых чисел..
3.2 Собранные организационные датасеты
Для проверки методов сбора организационных данных, описанных в Разделе 3, мы использовали наш web crawler для социальных сетей организаций с целью сбора общедоступных данных из шести широко известных высокотехнологичных компаний.
Результаты обхода организации представлены в таблице 1, где все данные об организациях были получены в течение 2012 года.
Мы сгруппировали компании по их размеру: Малые (S), в которых в настоящее время работает от 500 до 2 000 человек; Средние (M), в которых работает от 4 000 до 20 000 человек; и Крупные (L), в которых работает более 50 000 человек. Данные по одной компании каждого масштаба были получены с использованием каждой версии краулера организации. Мы обозначаем три компании, на которые были нацелены Версия 1 и Версия 2 краулера, как S1, M1, L1; и S2, M2 и L2 соответственно..
В следующих подразделах мы подробно описываем свойства каждого собранного набора данных организации (см. Таблицу 2). Мы использовали программное обеспечение Cytoscape [36] для визуализации социальных сетей, сформированных сотрудниками каждой организации.99 9 Все графы организаций, представленные в данной статье, встроены в виде изображений в формате масштабируемой векторной графики (SVG), что позволяет читателю приближать и просматривать каждый узел на каждом графе. Цвета вершин на Рисунках 1-6 представляют различные роли кластеров, как будет объяснено в Разделе 5. Результаты анализа этих сетей представлены в Разделах 4 и 5.⟧.
| Org. | Crawler | #Total Crawled | #Org. Crawled | Precision | |
|---|---|---|---|---|---|
| Version | Profiles | Profiles | |||
| S1 | Version 1 | 22,992 | 165 | 0.7% | |
| S2 | Version 2 | 3,312 | 320 | 9.6% | |
| M1 | Version 1 | 11,247 | 1,429 | 12.7% | |
| M2 | Version 2 | 7,422 | 3,862 | 52.0% | |
| L1 | Version 1 | 13,505 | 5,793 | 42.9% | |
| L2 | Version 2 | 18,810 | 5,524 | 29.3% | |
| Total | - | 77,288 | 17,096 | 22.1% |
3.2.1 Небольшая аппаратная компания (S1)
Компания S1 является публичной компанией, специализирующейся на разработке сетевого оборудования. Согласно веб-странице компании, в ней работает от 500 до 1000 человек, а ее главные офисы расположены в Северной Америке и Азии. Мы использовали organization crawler для выявления 726 неформальных связей среди 165 пользователей Facebook, которые, судя по их страницам в Facebook, работали в компании (см. рисунок 1). Мы также собрали информацию о 84 должностях сотрудников внутри компании. Из этих 84 сотрудников мы выделили 20 человек, занимающих руководящие должности. Большинство обнаруженных сотрудников компании занимали должности в сфере R&D, а большинство выявленных менеджеров являлись тимлидами R&D.
3.2.2 Маленькая программная компания (S2)
Компания S2 является международной публичной компанией, специализирующейся на разработке программного обеспечения. Согласно общедоступным источникам, в компании работает от 1000 до 2000 сотрудников, а ее офисы расположены в Северной Америке, Европе, Азии, Австралии и на Ближнем Востоке. Мы использовали наш web crawler для выявления 2369 неформальных связей среди 320 пользователей Facebook, которые указали в своих профилях Facebook, что работают в компании (см. рисунок 2). Мы также собрали информацию о должностях 168 сотрудников компании. Из этих 168 человек 76 занимали руководящие должности. Хотя многие сотрудники компании занимали должности менеджеров проектов (PM), мы также выделили ряд разработчиков, специалистов по обеспечению качества (QA) и сотрудников службы поддержки.
3.2.3 Средняя телекоммуникационная сервисная компания (M1)
M1 — это международная технологическая компания, расположенная в Северной Америке, которая специализируется на телекоммуникационных услугах. Согласно веб-странице компании, в настоящее время в M1 работает от 2000 до 10 000 сотрудников. Мы использовали организационный crawler и выявили 32 876 неформальных связей среди 1429 пользователей Facebook, которые, судя по страницам их профилей в Facebook, работали в компании (см. рисунок 3). Когда мы также собрали информацию о должностях 461 сотрудника, мы выяснили, что 227 занимали руководящие должности. В ходе сбора данных были выявлены самые разные должности внутри компании: высшее руководство, сотрудники отдела продаж и маркетинга, PMs, разработчики, IT-инженеры, инженеры техподдержки, технические писатели и т. д..
3.2.4 Средний поставщик программного обеспечения и аутсорсинговая компания (M2)
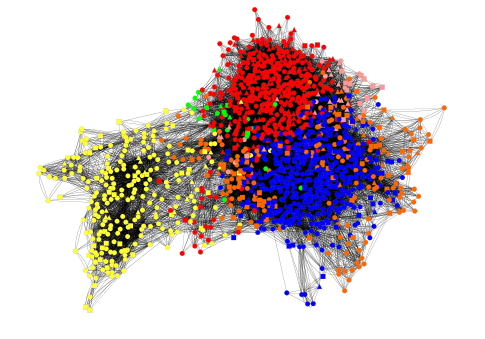
M2 — международный поставщик программного обеспечения и услуг аутсорсинга, который специализируется на телекоммуникационных услугах и обслуживает глобальную клиентскую базу. На веб-странице компании указано, что ее штат составляет от 10 000 до 20 000 сотрудников. Мы использовали организационный crawler для сбора данных о штаб-квартире компании, расположенной в Южной Азии. Мы остановили процесс сканирования после выявления 87 324 неформальных связей среди 3 862 пользователей Facebook, которые указали в своих профилях Facebook, что работают в M2 (см. рисунок 4). Нам также удалось собрать информацию о должностях внутри компании для 1 511 сотрудников. В ходе сканирования были выявлены различные должности: старшие менеджеры, разработчики, должности в сфере продаж и маркетинга, ИТ, PMs, инженеры поддержки, технические писатели и т. д. Из 1 511 сотрудников 230 занимали руководящие должности.
3.2.5 Крупная корпорация информационных технологий (L1)
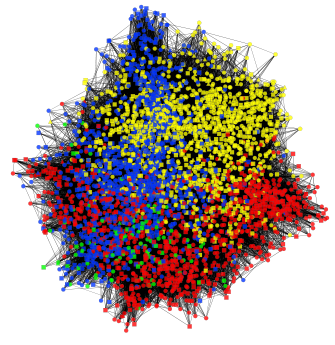
L1 is an information technology corporation that provides products and services to customers around the world. As indicated on the company’s web page, L1 currently employs more than 50,000 people. Our organization crawler collected data on corporation employees in North and South America, Asia, and Eastern Europe. We identified 45,266 informal links among 5,793 Facebook users who, according to their Facebook profile page, worked for the corporation (see Figure 5). We also were able to gather information on the positions of 1,619 employees. Out of these 1,619 employees, we succeeded in identifying 463 holding management positions. A broad range of positions were identified, spread throughout the world: senior managers, sales and pricing positions, marketing positions, technical writers, developers, IT, PMs, support engineers, etc.
3.2.6 Крупная технологическая корпорация ⟦K0⟧)
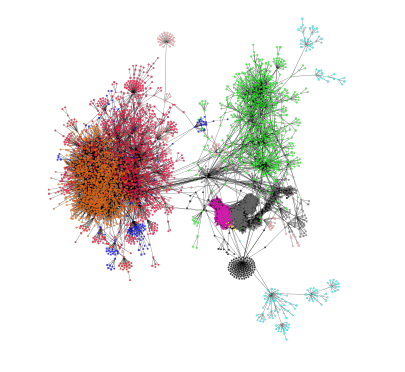
Корпорация L2 поставляет аппаратно-программные продукты, инфраструктуру и другие технологические услуги клиентам по всему миру. Согласно веб-странице компании, в настоящее время в ней работает более 50 000 сотрудников. Мы использовали наш организационный web crawler для сбора данных о сотрудниках корпорации в Северной и Южной Америке, Азии и Восточной Европе. Мы остановили процесс обхода после выявления 94 219 неформальных связей среди 5 524 пользователей Facebook, которые указали в своих профилях Facebook, что работают в корпорации (см. Рисунок 6). Нам также удалось собрать информацию о должностях в компании для 1 131 сотрудника, из которых 461 занимал руководящие должности. В ходе обхода мы обнаружили широкий спектр должностей внутри компании: руководящие должности высшего звена, PMs, должности в сфере продаж и маркетинга, разработчики, ИТ, инженеры технической поддержки, технические писатели и т. д..
| Org. | Size | Discovered Employees | Links | Employees Disclosing Positions on Facebook |
|---|---|---|---|---|
| S1 | 500-1K | 165 | 726 | 54(32.7%) |
| S2 | 1K-2K | 320 | 2,369 | 104(32.5%) |
| M1 | 2K-10K | 1,429 | 32,876 | 383(26.8%) |
| M2 | 10K-20K | 3,862 | 87,324 | 1,531(39.6%) |
| L1 | 50K+ | 5,793 | 45,266 | 1,601(27.6%) |
| L2 | 50K+ | 5,524 | 94,219 | 1,131(20.5%) |
| Total | - | 17,093 | 262,780 | 4,804(28.1%) |
4 Определение ролей организационного лидерства
После того как организационный вебреллер завершает сбор данных из профилей Facebook сотрудников целевой организации, мы можем проанализировать организационную социальную сеть, созданную с помощью неформальных связей в Facebook. В этом разделе мы демонстрируем, что можно точно определить лидерские роли исключительно путем анализа структуры неформальной социальной сети сотрудников организации.
Пусть представляет собой неформальную социальную сеть, где узел является пользователем Facebook, работавшим в целевой организации, а представляет собой связь дружбы в Facebook между двумя пользователями. Чтобы определить роли лидеров, мы выполнили следующие шаги: Во-первых, для каждого пользователя в неформальной социальной сети мы рассчитали восемь мер центральности. Затем для каждой меры центральности мы изучили топ-10 и топ-20 пользователей, получивших максимальный балл. Изучив профили выбранных сотрудников в Facebook и LinkedIn и проверив заявленный ими статус занятости, мы вручную классифицировали, занимал ли пользователь руководящую должность (тимлид, менеджер проекта, вице-президент и т. д.) или нет. Однако во многих случаях информации в профиле пользователя было недостаточно для выявления конкретной должности пользователя внутри организации. Чтобы преодолеть эту проблему, мы сопоставили личные данные пользователя с другими общедоступными онлайн-источниками, такими как поисковые системы Google. Используя эти методы, во многих случаях нам удавалось выявить должность пользователя внутри организации.
Наконец, мы использовали несколько алгоритмов Machine Learning для построения классификаторов, которые могут автоматически определять управленческие роли внутри организации на основе различных мер центральности вершин в неформальной социальной сети. Используя эти классификаторы, мы можем выявлять более широкий спектр управленческих ролей, отвечающих сложным критериям мер центральности. Важно отметить, что такие методы классификации могут использоваться для компрометации конфиденциальности пользователей путем раскрытия непубличных должностей внутри организации. Кроме того, аналогичные методы могут помочь в выявлении различной статистики об организации, тем самым раскрывая и потенциально ставя под угрозу конфиденциальность организации. Например, используя вышеуказанные методы, мы оценили процент руководящих должностей и количество сотрудников внутри каждой организации (см. таблицы 2 и 4). В во многих частных компаниях этот тип данных может быть конфиденциальной организационной информацией.
4.1 Меры центральности
Используя датасеты организации, описанные в разделе 3.2, мы приступили к выявлению ролей лидеров внутри организации с использованием нескольких мер центральности. Для каждого узла в социальной сети неформальной организации мы рассчитали восемь мер центральности:1010 10 Меры центральности были рассчитаны с использованием пакета Networkx [17] для Python. Центральность по степени (DG), центральность по близости (CL) [29], центральность по посредничеству (BC) [15], HITS (H) [22], PageRank (PR) [32], собственная центральность (EC), центральность достижимости (CC) [13] и центральность по нагрузке (LC) [31]. Затем мы отсортировали список пользователей сканированной организации в соответствии с различными мерами центральности.
Мы вручную изучили топ-20 профилей пользователей по каждой мере центральности, чтобы определить позиции сотрудников внутри целевой организации. Поскольку значительная доля пользователей Facebook не указывает свои должности на странице профиля, мы использовали другие онлайн-источники, такие как LinkedIn или результаты поисковой системы Google, чтобы вручную классифицировать, занимает ли конкретный сотрудник руководящую должность. Мы будем называть руководителей, которые не указывают свою должность на Facebook, скрывающими свою руководящую должность. Мы установили, что положение сотрудника в неформальной социальной сети организации с высокой точностью раскрывает его или ее управленческую роль внутри организации, даже если она не была указана на Facebook.
В таблице 3 представлена точность идентификации лидерства для 10 (T-10) и 20 (T-20) наиболее значимых профилей пользователей для различных показателей центральности. Результаты показывают, что каждый из рассчитанных показателей центральности может помочь в выявлении руководителей внутри организаций. Показатель близости продемонстрировал самую высокую среднюю точность на уровне 20 (0,76), в то время как PageRank получил самый низкий балл (0,70).).
| Org. | Cat. | DG | CL | BC | H | PR | EC | CC | LC |
|---|---|---|---|---|---|---|---|---|---|
| S1 | T-10 | 0.50 | 0.40 | 0.60 | 0.30 | 0.50 | 0.30 | 0.30 | 0.60 |
| T-20 | 0.35 | 0.30 | 0.30 | 0.30 | 0.25 | 0.30 | 0.30 | 0.30 | |
| S2 | T-10 | 0.80 | 0.90 | 0.80 | 0.90 | 0.70 | 0.90 | 0.90 | 0.80 |
| T-20 | 0.70 | 0.75 | 0.75 | 0.70 | 0.75 | 0.70 | 0.75 | 0.75 | |
| M1 | T-10 | 1 | 1 | 0.80 | 1 | 1 | 1 | 1 | 0.80 |
| T-20 | 1 | 0.95 | 0.85 | 1 | 0.85 | 1 | 1 | 0.85 | |
| M2 | T-10 | 0.83 | 0.71 | 0.86 | 0.83 | 0.86 | 0.83 | 0.83 | 0.88 |
| T-20 | 0.73 | 0.82 | 0.69 | 0.80 | 0.71 | 0.80 | 0.80 | 0.69 | |
| L1 | T-10 | 0.55 | 0.80 | 0.80 | 0.78 | 0.60 | 0.78 | 0.78 | 0.80 |
| T-20 | 0.65 | 0.75 | 0.70 | 0.56 | 0.65 | 0.56 | 0.56 | 0.70 | |
| L2 | T-10 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 |
| T-20 | 0.92 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | |
| Avg. | T-10 | 0.78 | 0.8 | 0.81 | 0.80 | 0.78 | 0.80 | 0.80 | 0.81 |
| T-20 | 0.725 | 0.76 | 0.715 | 0.73 | 0.70 | 0.73 | 0.735 | 0.715 |
В таблице 4 приведено количество скрытых управленческих ролей, которые могут быть обнаружены с использованием меры близости. Из 85 руководителей, выявленных путем фокусировки на 20 пользователях Facebook с наивысшим показателем центральности по близости в рамках неформальной социальной сети их организации, 40% не указали свои должности в Facebook..
| Org. | Classified | Classified | Closeness T20 | Hidden T20 |
|---|---|---|---|---|
| Employee | Management | Management | Management | |
| Positions | Positions | Positions | Positions | |
| S1 | 84 | 20 (23.80%) | 6 | 5 (83.33%) |
| S2 | 168 | 76 (45.20%) | 15 | 4 (26.66%) |
| M1 | 461 | 227 (49.20%) | 19 | 10 (47.40%) |
| M2 | 1,511 | 223 (14.76%) | 14 | 2 (14.30%) |
| L1 | 1,619 | 463 (28.60%) | 15 | 3 (20%) |
| L2 | 924 | 461 (49.90%) | 16 | 10 (62.50%) |
| Total | 4,767 | 1,470 (30.80%) | 85 | 34 (40%) |
Согласно этим результатам, высокая центральность в неформальной социальной сети организации является хорошим показателем лидерской роли внутри организации. Однако этот простой общий метод позволяет определить руководящие роли сотрудников только с относительно высокими показателями центральности; другие руководящие роли с более сложными критериями центральности, следовательно, не будут определены с помощью этого метода. Для преодоления проблемы сложных критериев центральности мы использовали современные Machine Learning алгоритмы для классификации руководящих ролей в каждой организации (см. раздел 4.2).
4.2 Machine Learning
Используя передовые методы Machine Learning, мы создали классификаторы, способные определять руководящие должности внутри каждой организации. Это позволило нам выявить сотрудников с управленческими ролями, которые соответствуют более сложным критериям centrality. Более того, применение схожих методов и приемов помогает различать различные типы должностей, такие как позиции высшего руководства и R&D инженерные роли.
Для того чтобы использовать Machine Learning алгоритм, нам сначала потребовалось создать обучающий набор, состоящий из достаточного количества обучающих примеров. Каждый обучающий пример представляет собой собранного пользователя в организации. Целевой атрибут является бинарным атрибутом, который указывает, занимал ли пользователь руководящую роль внутри организации или нет, в то время как признаки экземпляра представляют собой различные извлеченные centrality measures. Мы создали достаточное количество обучающих примеров, быстро просмотрев данные пользователей, извлеченные из их профилей Facebook. Анализируя просканированные с помощью web crawler пользовательские профили организаций, мы обнаружили, что в среднем 28.1% собранных пользователей внесли по крайней мере частичную информацию о своих предыдущих и текущих должностях в свои профили Facebook (см. Таблицу 2). Для каждого пользователя, который указал свой предыдущий или текущий опыт работы, мы попытались определить, занимал ли пользователь руководящую должность внутри организации. В некоторых случаях мы также проводили более глубокую проверку пользователя путем перекрестной проверки опыта работы пользователя с данными, полученными из других источников, таких как LinkedIn. Используя этот метод, мы просмотрели и классифицировали профили 4,767 пользователей. Из 4,767 вручную классифицированных должностей мы выделили 1,470 пользователей, занимавших руководящие должности (см. Таблицу 4). Все эти профили были переданы в WEKA [18], популярный набор программного обеспечения Machine Learning, в качестве обучающих примеров. Используя WEKA, мы протестировали множество различных алгоритмов Machine Learning, таких как OneR (OR), K-Nearest-Neighbors (IBk) с , Naive-Bayes (NB), Decision tree (J48), Logistic (LG) и RandomForest (RF). Наконец, мы оценили каждый классификатор, используя метод 10-кратной перекрестной проверки и вычислив Accuracy, F-measure и AUC (Area Under the ROC curve) (см. Таблицу 5). Мы использовали T-тесты с уровнем значимости 0.05 для сравнения различных классификаторов. Согласно результатам T-теста, для каждой организации, кроме S1, все классификаторы показали лучшие результаты Accuracy по сравнению с наивным классификатором ZeroR (ZR). Более того, в большинстве случаев простого классификатора OneR вполне достаточно для получения близкой к максимальной Accuracy. Тем не менее, лучшие результаты AUC и F-measure были получены с использованием более продвинутых классификаторов, таких как Logistic и RandomForest классификаторы.
| Org. | Measure | ZR | OR | J48 | NB | IBK | IBK | IBK | LG | RF |
|---|---|---|---|---|---|---|---|---|---|---|
| K=1 | K=3 | K=10 | ||||||||
| S1 | Accuracy | 76.11 | 68.36 | 71.93 | 72.96 | 65.28 | 74.32 | 75.17 | 73.63 | 67.67 |
| F-measure | 0 | 0.11 | 0.01 | 0.29 | 0.25 | 0.27 | 0.15 | 0.08 | 0.24 | |
| AUC | 0.50 | 0.49 | 0.46 | 0.57 | 0.53 | 0.64 | 0.61 | 0.37 | 0.57 | |
| S2 | Accuracy | 54.78 | 60.45 | 62.2 | 63.03 | 63.33 | 61.34 | 65.13 | 60.99 | 58.75 |
| F-measure | 0 | 0.55 | 0.50 | 0.42 | 0.57 | 0.55 | 0.65 | 0.48 | 0.55 | |
| AUC | 0.50 | 0.60 | 0.60 | 0.66 | 0.63 | 0.64 | 0.66 | 0.64 | 0.60 | |
| M1 | Accuracy | 50.76 | 65.73 | 66.47 | 63.3 | 61.63 | 67.34 | 65.09 | 70.72 | 64.67 |
| F-measure | 0 | 0.63 | 0.59 | 0.47 | 0.60 | 0.64 | 0.64 | 0.66 | 0.64 | |
| AUC | 0.50 | 0.66 | 0.71 | 0.74 | 0.62 | 0.69 | 0.72 | 0.76 | 0.69 | |
| M2 | Accuracy | 85.24 | 85.13 | 85.96 | 82.24 | 79.14 | 82.69 | 86.45 | 87 | 83.46 |
| F-measure | 0 | 0.22 | 0.22 | 0.32 | 0.26 | 0.26 | 0.29 | 0.33 | 0.30 | |
| AUC | 0.50 | 0.24 | 0.40 | 0.43 | 0.61 | 0.43 | 0.30 | 0.7 | 0.58 | |
| L1 | Accuracy | 71.4 | 69.15 | 71.61 | 70.79 | 64.40 | 67.36 | 68.43 | 72.2 | 66.28 |
| F-measure | 0 | 0.28 | 0.27 | 0.19 | 0.37 | 0.34 | 0.33 | 0.11 | 0.37 | |
| AUC | 0.50 | 0.49 | 0.53 | 0.55 | 0.58 | 0.60 | 0.65 | 0.59 | 0.61 | |
| L2 | Accuracy | 50.22 | 49.91 | 52.92 | 53.9 | 57.11 | 58.53 | 58.66 | 58.88 | 55.71 |
| F-measure | 0 | 0.48 | 0.38 | 0.23 | 0.57 | 0.58 | 0.61 | 0.55 | 0.57 | |
| AUC | 0.50 | 0.33 | 0.44 | 0.29 | 0.39 | 0.28 | 0.24 | 0.50 | 0.57 |
5 Сообщества, образованные сотрудниками
5.1 Алгоритм обнаружения сообществ
Чтобы лучше понять структуру каждой организации, мы использовали реализацию быстрого жадного алгоритма Жирвана — Ньюмана в Cytoscape [6] для разделения каждой неформальной социальной сети на непересекающиеся сообщества. Каждое сообщество отмечено отдельным цветом на рисунках 1-6. Формы узлов на этих рисунках указывают на то, занимал ли конкретный сотрудник руководящую должность в организации. Треугольные узлы представляют тех, кто, насколько нам известно, занимал руководящие должности, в то время как квадратные узлы представляют пользователей, которые не занимали никаких руководящих должностей. Круги обозначают сотрудников, занимающих неизвестную должность в организации.
5.2 Анализ роли в сообществе
После разделения неформальной социальной сети каждой организации на непересекающиеся сообщества мы проанализировали роль всех основных сообществ внутри организации (см. Таблицу 6). Мы сопоставили членов сообществ с описаниями должностей и местами жительства из их профилей на Facebook. Мы также случайным образом выбрали несколько десятков пользователей из каждого сообщества. Для этих выбранных пользователей мы вручную проверили их должности в организации, используя общедоступные источники, такие как LinkedIn. В ходе этого процесса мы просмотрели профили нескольких тысяч сотрудников и определили организационные позиции 4767 пользователей. Роль каждого сообщества в организации определялась по преобладанию должностей членов сообщества, их географическому положению и истории занятости. Например, если большинство выбранных пользователей сообщества жили в Нью-Йорке и работали разработчиками программного обеспечения внутри организации, то мы определяли, что сообщество является частью подразделения R&D организации в Нью-Йорке. Поняв роль каждого сообщества, мы сделали выводы об организации и нанятых ею людях. Роли различных сообществ в целевых организациях представлены в Разделах 5.2.1 - 5.2.6.
5.2.1 S1 Сообщества
Алгоритм обнаружения сообществ разделил социальную сеть организации S1 на пять основных сообществ (см. Рисунок 1). Анализ ролей в сообществах показал, что S1 имеет несколько филиалов в Азии, большинство из которых состоят из сотрудников R&D. Существовало четыре сообщества R&D, состоящих из сотрудников с различными наборами навыков. В то время как три сообщества включали в основном разработчиков программного обеспечения (синее, красное и серое сообщества на Рисунке 1), одно сообщество состояло в основном из разработчиков аппаратного обеспечения (желтое сообщество). Более того, изучив общедоступную историю занятости пользователей, мы выделили ранее приобретенную стартап-компанию (оранжевое сообщество) и социальные связи между сотрудниками приобретенной компании и сотрудниками S1.
5.2.2 Сообщества S2
Организационная социальная сеть S2 была разделена алгоритмом кластеризации на семь сообществ (см. рисунок 2). Анализируя должности сотрудников S2 внутри организации и географическое расположение пользователей, мы обнаружили, что у S2 есть один головной офис на Ближнем Востоке (синее, красное и оранжевое сообщества на рисунке 2) и еще один в Северной Америке (фиолетовое сообщество). Мы также обнаружили, что деятельность компании охватывает четыре континента по всему миру. Руководители проектов (желтое сообщество) проживают более чем в семи различных крупных городах мира. Структура сообществ S2 указывает на то, что у компании есть два штаба, сосредоточенных на R&D и глобальных операциях, которыми управляют различные руководители проектов в каждой стране.
5.2.3 Сообщества ⟦K0⟧
Алгоритм кластеризации разделил организационный граф социальной сети M1 на пять тесно связанных сообществ (Рисунок 3). Мы обнаружили два штаба компании, оба расположенных в Северной Америке (зеленое сообщество на Рисунке 3), а также два крупных подразделения R&D (синее и оранжевое сообщества). Более того, нам удалось выделить сообщество высшего руководства компании (желтое сообщество) и обнаружить неформальные связи между топ-менеджерами компании. Выявление сообщества высшего руководства может помочь в определении ключевых позиций внутри организации M1, которые во многих случаях были недоступны через общедоступные ресурсы..
5.2.4 M2 Сообщества
Граф организационной социальной сети M2 был разделен на четыре тесно связанных сообщества (Рисунок 4). Каждое сообщество представляет собой группу сотрудников R&D и SDE, работающих в южноазиатском филиале компании. Каждая из четырех групп сотрудников была хорошо связана с другими группами сотрудников внутри той же компании, которые находились в разных частях земного шара. Например, южноазиатская группа сотрудников, обозначенная желтым цветом, имела тесные связи с другой группой сотрудников, расположенной в Африке, в то время как красная группа сотрудников была хорошо связана с сотрудниками в Австралии, Европе и Северной Америке..
5.2.5 L1 Сообщества
Используя алгоритм обнаружения сообществ, мыделили социальную сеть L1 на 21 сообщество (Рисунок 5). Четыре из этих сообществ представляли девять различных ролей внутри организации. Исследуя только информацию о месте жительства и должности этих сообществ, можно точно определить группу инженеров поддержки в Южной Америке (синее сообщество на Рисунке 5). Нам также удалось обнаружить маркетинговый и сбытовой отделы компании в Восточной Европе (желтое и фиолетовое сообщества), а также научно-исследовательские подразделения компании в Северной Америке и Восточной Азии (черное сообщество). Более того, мы обнаружили часть научно-исследовательской группы компании на Ближнем Востоке и часть североамериканской управленческой и сбытовой группы (зеленое сообщество).
5.2.6 Сообщества L2
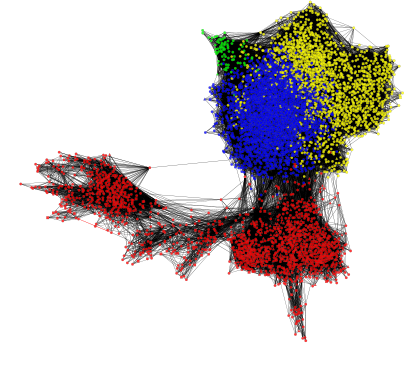
Наш алгоритм обнаружения сообществ разделил социальную сеть уровня L2 на четыре сообщества (Рисунок 6). Два хорошо связанных сообщества включают в себя множество сотрудников отдела R&D компании, консультантов и менеджеров из штаб-квартиры в Восточной Азии (синее и желтое сообщества на Рисунке 6). Мы также выявили одну из любительских спортивных команд компании (зеленое сообщество). Более того, нам удалось успешно обнаружить международное высшее руководство корпорации и их неформальные связи на четырех континентах и более чем в 20 крупных городах (красное сообщество). Анализируя сообщество международного высшего руководства компании, мы смогли обнаружить трансатлантические связи между различными филиалами корпорации.
| Org. | Comm. | #Users | #Links | Number of | Number of | Description |
| Color | Facebook Profiles | Classified Users’ | ||||
| with Positions | Positions | |||||
| S1 | Blue | 30 | 96 | 6 | 16 | R&D and administration groups in Asia |
| Red | 62 | 234 | 24 | 37 | Mainly hardware verification engineers and chip designers in Asia | |
| Yellow | 10 | 13 | 3 | 8 | Hardware R&D | |
| Orange | 46 | 197 | 13 | 21 | Acquired startup company | |
| Gray | 17 | 29 | 5 | 11 | R&D in Asia | |
| S2 | Blue | 10 | 16 | 5 | 6 | IT group in the Middle East |
| Red | 109 | 645 | 25 | 45 | R&D groups in the Middle East | |
| Orange | 48 | 230 | 16 | 26 | R&D groups in the Middle East | |
| Yellow | 100 | 575 | 39 | 58 | Managers and international PM | |
| Purple | 4 | 5 | 1 | 1 | Group in North America | |
| Gray | 4 | 6 | 1 | 1 | European group | |
| Cyan | 39 | 155 | 15 | 27 | R&D teams in Australia and the Middle East | |
| M1 | Blue | 467 | 7,685 | 100 | 163 | R&D division |
| Red | 425 | 11,706 | 86 | 129 | Senior management | |
| Orange | 217 | 2,526 | 46 | 75 | R&D divisions | |
| Yellow | 254 | 3,023 | 47 | 51 | International consultants and support engineers | |
| Green | 23 | 95 | 4 | 7 | North American Headquarter | |
| M2 | Blue | 1,329 | 23,549 | 504 | 498 | R&D and SDE connected to North American and Asian employees |
| Red | 1,071 | 16,637 | 437 | 430 | R&D and SDE connected to Australia, Europe and North America | |
| Yellow | 1,348 | 24,080 | 556 | 551 | R&D and SDE connected to Africa, North America, and Asia | |
| Green | 921 | 1,058 | 33 | 32 | R&D and SDE connected to North America and Asia employees | |
| L1 | Blue | 141 | 148 | 45 | 50 | South America support engineers |
| Red | 1,461 | 1,934 | 471 | 473 | South American Branch (IT, PM, Support engineers, and Analysts) | |
| Yellow | 15 | 172 | 6 | 7 | Eastern European Pricing Analysts | |
| Orange | 1,613 | 7,407 | 448 | 422 | South American Branch (Management, Sales, Marketing, PM, Support engineers, and Administration) | |
| Purple | 443 | 13,837 | 100 | 110 | Eastern European (Marketing, Sales and Pricing) consultants and support engineers | |
| Green | 921 | 1,482 | 243 | 246 | Middle East R&D and North American Headquarters (Management and Sales) | |
| Gray | 774 | 17,247 | 201 | 175 | European Consultants and Sales and South Asian Analysts. | |
| Cyan | 154 | 151 | 46 | 67 | East Asian - R&D | |
| Black | 143 | 146 | 9 | 9 | North American Branch, East Asian - R&D | |
| L2 | Blue | 2,285 | 42,230 | 220 | 140 | East Asian Headquarter (management and consultants) |
| Red | 1,573 | 19,841 | 605 | 449 | International Senior management (Senior management, Senior researchers) | |
| Yellow | 1,588 | 19,023 | 264 | 218 | East Asian Headquarter (R&Ds and consultants) | |
| Green | 78 | 1,478 | 4 | 1 | The company’s amateur sports team |
6 Выводы
В этой статье представлены методы и алгоритмы, которые могут быть использованы для сбора данных из общедоступных источников и анализа социальных сетей организаций. Для сбора наборов данных организаций мы использовали алгоритмы краулинга, основанные на принципе гомофилии (см. Алгоритм 1), которые могут собирать организационные данные из таких онлайн-социальных сетей, как Facebook, за считанные часы. Используя эти алгоритмы краулинга, мы собрали данные из профилей Facebook сотрудников, работавших в шести различных организациях. В отличие от краулера социальных сетей BFS, который неэффективно собирал данные об организациях, краулер социальных сетей организаций, представленный в данной статье, успешно собрал данные о 17 096 пользователей социальных сетей из шести организаций со средним показателем точности 22,1% (Таблица 1).⟧).
Затем мы использовали собранные организационные данные для построения и анализа неформальной социальной сети среди сотрудников каждой организации. Вычислив восемь centrality measures для каждого выбранного сотрудника (т.е. пользователя Facebook), мы смогли выявить leadership roles внутри организации (Раздел 4). Мы обнаружили, что те лица, которые получили относительно высокие значения в одном из centrality measures, с большей вероятностью занимали management positions внутри организации. Более того, closeness centrality measure показал наилучшую precision at 20 results, со средним precision at 20 в 76% (см. Таблицу 3). Также используя closeness centrality measure, мы выделили 85 management positions, причем 40% из этих позиций были скрытыми management roles и не фигурировали в профилях пользователей в Facebook (см. Таблицу 4).
В разделе 4.2 мы представили более сложный метод выявления руководящих должностей в организации путем применения алгоритмов Machine Learning. Используя программное обеспечение WEKA, мы протестировали и оценили несколько алгоритмов на наборах данных, которые основывались исключительно на вычисленных centrality measures. Все оцениваемые классификаторы показали лучшие результаты точности по сравнению с тривиальным классификатором ZeroR. Более того, лучшие результаты AUC и F-measure были получены с использованием более продвинутых классификаторов, таких как Logistic, RandomForest и IBk (см. таблицу 5). Мы полагаем, что эти результаты классификации можно улучшить, добавив в алгоритм классификации дополнительные признаки, такие как возраст и пол сотрудника, а также стаж работы сотрудника. Кроме того, аналогичные методы Machine Learning могут применяться для выявления конкретных должностей внутри организации, таких как разработчики, торговые представители, инженеры поддержки или высшие руководители.
В данном исследовании мы также использовали алгоритм обнаружения сообществ для разделения социальной сети каждой организации на непересекающиеся сообщества (см. Рисунки 1- 6). Определив должности более четырех тысяч сотрудников в исследуемых организациях, мы выявили специфические роли сообществ и их географическое положение на основе должностей и мест проживания большинства пользователей сообщества. Используя этот метод, нам удалось сделать множество выводов о каждой организации. Для каждой организации мы определили географическое положение ее филиалов и квалификацию рядовых сотрудников в каждом филиале. Мы также получили другие нетривиальные сведения о каждой компании. Например, хотя исследуемая компания S1 приобрела начинающую R&D-компанию, приобретенная компания продолжала функционировать как отдельная структура практически без социальных связей с S1 в целом. Такого рода открытия могут использоваться руководством организации для выявления проблем в социальной структуре компании, таких как структурные дыры [4]. В случае компании S2 мы обнаружили, что в этой организации было много руководителей проектов, работавших в разных странах мира. В компаниях M1 и L2 мы выявили сообщество высшего руководства и их неформальные дружеские связи. Обнаружение сообщества высшего руководства организации может помочь в выявлении неафишируемого руководства и ключевых позиций внутри организации. Кроме того, понимая взаимоотношения между высшими менеджерами компании, мы можем выявить связи между различными филиалами организации. В азиатском филиале M2 мы смогли определить методы работы, при которых каждая выявленная группа внутри азиатского филиала состояла из сотрудников R&D и Specific Domain Expert, работавших с сотрудниками компании на разных континентах. Мы обнаружили подразделения поддержки компании L1 в Южной Америке, а также подразделение продаж и маркетинга компании в Восточной Европе.
Мы полагаем, что данное исследование открывает несколько направлений для будущих изысканий. Одно из возможных направлений заключается в создании многоклассовых организационных социальных сетей путем сопоставления онлайн-социальной сети организации с другими социальными сетями, связанными с этой организацией, такими как сеть, сформированная на основе электронной почты организации [42]. Эти многоклассовые социальные сети могут предоставить ценные аналитические данные и помочь лучше понять организацию в целом. Другое возможное направление заключается в объединении различных алгоритмов обнаружения сообществ с целью улучшения результатов выявления сообществ в организации и обнаружения большего числа сообществ внутри каждой организации. Еще одно возможное направление состоит в обогащении собираемых данных об пользователях организации путем автоматического добавления пользовательских данных из различных общедоступных источников, таких как LinkedIn и поисковые системы по людям. Добавление более подробной информации о пользователях организации может улучшить результаты при определении ролей в сообществе внутри организации. Дальнейшее направление для будущего исследования, предложенное Greg Lindsay [24], заключается в использовании собранной организационной социальной сети для выявления изолированных команд внутри организации..
Исследовательское направление, которое мы уже начали развивать, заключается в изучении последствий использования злоумышленниками собранной организационной социальной сети путем сбора дополнительной информации об организации. Такие пользователи могут отправлять серию запросов на добавление в друзья сотрудникам компании [11] или атаковать конкретного сотрудника внутри целевой организации [12].
7 Доступность данных
Анонимизированные версии топологий социальных сетей шести организаций, использованные в нашем исследовании, были созданы путем случайного заменения идентификаторов Facebook сотрудников на последовательность смежных целых чисел. Они доступны для использования другими исследователями и могут быть найдены на веб-сайте нашей исследовательской группы http://proj.ise.bgu.ac.il/sns/.
Список литературы
- ⟦[1] A. Acquisti and R. Gross. Imagined communities: Awareness, Information sharing, and privacy on the Facebook. 2006.
- ⟦[2] Т. Аллен и С. Коен. Информационный поток в научно-исследовательских и опытно-конструкторских лабораториях. Административ сайнс куотерли, страницы 12–19, 1969.
- [3] Y. Boshmaf, I. Muslukhov, K. Beznosov, and M. Ripeanu. The socialbot network: When bots socialize for fame and money. 2011.
- ⟦[4] Р. Барт. Структурные дыры: социальная структура конкуренции. Гарвард Юнив Пр, 1995.
- ⟦[5] C. Campbell, P. Maglio, A. Cozzi, and B. Dom. Expertise identification using email communications. In Proceedings of the twelfth international conference on Information and knowledge management, pages 528–531. ACM, 2003.
- [6] A. Clauset, M. Newman, and C. Moore. Finding community structure in very large networks. Physical review E, 70(6):066111, 2004.
- ⟦[7] Дж. Констайн. Рост Facebook с момента IPO в двенадцати ключевых показателях. TechCrunch, 2013.
- ⟦[8] C. P. Diehl, G. Namata, and L. Getoor. Relationship identification for social network discovery. In AAAI, volume 22, pages 546–552, 2007.
- ⟦[9] Й. Диснер, Т. Л. Франц и К. М. Карли. Коммуникационные сети из корпуса электронной почты Enron: «все всегда сводится к людям. Enron ничем не отличается». Computational & Mathematical Organization Theory, 11(3):201–228, 2005.
- ⟦[10] C. Dwyer, S. Hiltz, and K. Passerini. Trust and privacy concern within social networking sites: A comparison of facebook and myspace. In Proceedings of AMCIS, pages 1–12. Citeseer, 2007.
- ⟦[11] A. Elishar, M. Fire, D. Kagan, and Y. Elovici. Organizational intrusion. ASE Cyber Security Conference (CyberSecurity), 2012.
- ⟦[12] A. Elishar, M. Fire, D. Kagan, and Y. Elovici. Homing socialbots: Intrusion on a specific organization’s employee using socialbots. International Workshop on Social Network Analysis in Applications (SNAA), 2013.
- ⟦[13] Э. Эстрада и Х. Родригес-Веласкес. Центральность по подграфам в сложных сетях. Физический ревью E, 71(5):056103, 2005.
- [14] М. Фаир, О. Тененбойм, Л. Пузис, Р. Лессер, Л. Рокач и Й. Эловичи. Вычислительно эффективное предсказание связей в различных социальных сетях. 2012.
- ⟦[15] Л. Фриман. Набор мер центральности, основанных на посредничестве. Социометрия, страницы 35–41, 1977.
- ⟦[16] М. Джока, К. Баттс, М. Курант и А. Маркопулоу. Многографовая выборка из онлайн-социальных сетей. Selected Areas in Communications, IEEE Journal on, 29(9):1893–1905, 2011.
- ⟦[17] A. A. Hagberg, D. A. Schult, and P. J. Swart. Exploring network structure, dynamics, and function using networkx. In Proceedings of the 7th Python in Science Conference (SciPy2008), 2008.
- ⟦[18] M. Hall, E. Frank, G. Holmes, B. Pfahringer, P. Reutemann, and I. H. Witten. The weka data mining software: an update. SIGKDD Explor. Newsl., 11:10–18, November 2009.
- [19] Э. Джейкобсон и С. Сишор. Практика коммуникации в сложных организациях. Журнал социальных проблем, 7(3):28–40, 1951.
- ⟦[20] М. Килдафф и Д. Брасс. Исследования организационных социальных сетей: основные идеи и ключевые дискуссии. Зе Анналы оф Зе Академи оф Менеджмент, 4(1):317–357, 2010.
- [21] М. Килдафф и В. Цай. Социальные сети и организации. Сейдж Пабликейшнз Лтд, 2003.
- ⟦[22] J. Kleinberg. Authoritative sources in a hyperlinked environment. Journal of the ACM (JACM), 46(5):604–632, 1999.
- ⟦[23] В. Кребс. Картирование сетей террористических ячеек. Коннекшнс, 24(3):43–52, 2002.
- ⟦[24] Г. Линдси. Проектирование счастливой случайности. Нью-Йорк Таймс, 2013.
- ⟦[25] A. McCallum, A. Corrada-Emmanuel, and X. Wang. Topic and role discovery in social networks. Computer Science Department Faculty Publication Series, page 3, 2005.
- ⟦[26] M. McPherson, L. Smith-Lovin, and J. Cook. Birds of a feather: Homophily in social networks. Annual review of sociology, pages 415–444, 2001.
- ⟦[27] A. Mislove, M. Marcon, K. P. Gummadi, P. Druschel и B. Bhattacharjee. Измерение и анализ онлайн-социальных сетей. В трудах 5-й конференции ACM/Usenix по измерению параметров сети (IMC’07), Сан-Диего, Калифорния, октябрь 2007 г..
- ⟦[28] Y. Naddafa and S. Mutyalab. Social network analysis and community mining in organizations based on email records. 2010.
- [29] М. Ньюман. Мера центральности по посредничеству на основе случайных блужданий. Социальные сети, 27(1):39–54, 2005.
- ⟦[30] M. Newman. The mathematics of networks. The New Palgrave Encyclopedia of Economics, 2, 2008.
- [31] М. Ньюман и др. Сети научного сотрудничества. II. Кратчайшие пути, взвешенные сети и центральность. Physical Review Series E-, 64(1; PART 2):16132–16132, 2001.
- ⟦[32] L. Page, S. Brin, R. Motwani, and T. Winograd. The pagerank citation ranking: Bringing order to the web. 1999.
- [33] К. Прован, А. Фиш и Дж. Сидов. Межорганизационные сети на сетевом уровне: обзор эмпирической литературы по целостным сетям. Журнал менеджмента, 33(3):479–516, 2007.
- ⟦[34] Д. Пью, Д. Хиксон, К. Хинингс и К. Тернер. Измерения организационной структуры. Административный научный ежеквартальник, страницы 65–105, 1968.
- ⟦[35] J. Rooksby, A. Kahn, J. Keen, I. Sommerville, and J. Rooksby. Social networking and the workplace. The UK Large Scale Complex IT Systems Initiative, pages 1–39, 2009.
- ⟦[36] P. Shannon, A. Markiel, O. Ozier, N. Baliga, J. Wang, D. Ramage, N. Amin, B. Schwikowski, and T. Ideker. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome research, 13(11):2498–2504, 2003.
- ⟦[37] J. Shetty and J. Adibi. The enron email dataset database schema and brief statistical report. Information sciences institute technical report, University of Southern California, 4, 2004.
- [38] J. Shetty and J. Adibi. Discovering important nodes through graph entropy the case of enron email database. In Proceedings of the 3rd international workshop on Link discovery, pages 74–81. ACM, 2005.
- ⟦[39] М. Спэрроу. Применение сетевого анализа к криминальной разведке: Оценка перспектив. Социальные сети, 13(3):251–274, 1991.
- ⟦[40] К. Стайнфилд, Дж. ДиМикко, Н. Эллисон и К. Лампе. Боулинг онлайн: социальные сети и социальный капитал внутри организации. В материалах четвертой международной конференции «Сообщества и технологии», страницы 245–254. Ассоциация вычислительной техники, 2009.
- ⟦[41] N. Tichy, M. Tushman, and C. Fombrun. Social network analysis for organizations. Academy of Management Review, pages 507–519, 1979.
- ⟦[42] Й. Тайлер, Д. Уилкинсон и Б. Хуберман. Электронная почта как спектроскопия: Автоматическое обнаружение структуры сообществ внутри организаций. Информационное общество, 21(2):143–153, 2005.
- ⟦[43] Д. Уилкинсон и Б. Хуберман. Метод поиска сообществ родственных генов. Труды Национальной академии наук Соединенных Штатов Америки, 101(Приложение 1):5241, 2004.
- [44] G. Вилсон и В. Банцхаф. Обнаружение сетей электронной связи из корпуса Enron с помощью генетического алгоритма с использованием анализа социальных сетей. В сборнике: IEEE Congress on Evolutionary Computation, 2009. CEC’09., страницы 3256–3263. IEEE, 2009.