Объединение Machine Learning и анализа социальных сетей для выявления организационных структур
Аннотация
Формирование иерархии внутри организации является естественным способом распределения обязанностей, делегирования ответственности и оптимизации информационных потоков. Только для самых маленьких компаний возможно отсутствие иерархии, то есть плоская структура. Тем не менее, по мере их роста внедрение иерархии неизбежно. Чаще всего ее существование приводит к различной природе задач и обязанностей ее участников, находящихся на различных организационных уровнях или в ее отдаленных частях. С другой стороны, сотрудники часто отправляют десятки электронных писем каждый день и, делая это, а также участвуя в другой деятельности, естественным образом формируют неформальную социальную сеть, где узлами являются отдельные лица, а ребрами — связывающие их действия. Сначала такая социальная сеть кажется отличной от организационной. Однако анализ этой сети может привести к воспроизведению организационной иерархии компаний. Это связано с тем, что люди, занимающие схожие позиции в иерархии, возможно, разделяют также схожий стиль поведения и общения, обусловленный их ролью. Ключевой концепцией данной работы является оценка того, насколько показатели социальной сети в сочетании с другими признаками, полученными в результате инжиниринга признаков, согласуются с классификацией членов организационной социальной сети. В качестве метода для ответа на этот исследовательский вопрос был задействован аппарат machine learning. Здесь для задачи классификации были оценены Decision Trees, Random Forest, Neural Networks и Support Vector Machines, а также алгоритм collective classification, который также предложен в этой работе. Использованный подход позволил сравнить, насколько традиционные методы классификации machine learning при поддержке social network analysis проявили себя по сравнению с типичным графовым алгоритмом. Результаты показывают, что социальная сеть, построенная с использованием метаданных о коммуникации, в высокой степени обнажает организационную структуру.
ключевые слова: анализ социальных сетей, организационные структуры, machine learning, коллективная классификация, анализ электронной переписки, интеллектуальный анализ графов, корпоративная иерархия
анализ социальных сетей; классификация; организационная иерархия; machine learningВроцлавский университет науки и технологии, 50-370 Вроцлав, Польша; mateusz.nurek@pwr.edu.pl††соответствующий: Корреспонденция: radoslaw.michalski@pwr.edu.pl††название статьи: Ссылки
parsep=6pt,itemsep=0pt,leftmargin=*,labelsep=5.5mm \setenumerateparsep=6pt,itemsep=0pt,leftmargin=*,labelsep=5.5mm \setlist[description]itemsep=0mm \historyReceived: 7 января 2020 г.; Accepted: 21 февраля 2020 г.; Published: 2 марта 2020 г. \updatesyes
1 Введение
Люди по всему миру отправляют сотни электронных писем для обмена информацией внутри организаций. Как неявный результат этого, каждое из таких взаимодействий формирует связь в социальной сети. Эта сеть может быть ценным источником знаний о поведении людей, и, более того, проведение анализа может выявить группы сотрудников со схожими моделями коммуникации. Эти группы обычно совпадают с различными уровнями иерархии организации, и, кроме того, сотрудники, занимающие одну и ту же должность, как правило, имеют сопоставимый круг обязанностей. Для организаций характерно соблюдение определенной иерархии, поскольку формально организованная структура помогает лучше управлять сотрудниками и получать преимущество на рынке. Таким образом, анализ сети, созданной на основе набора электронных писем, может извлечь ценные данные о внутренних корпоративных процессах и воссоздать организационную структуру. Интересной и перспективной идеей представляется комбинация сетевых метрик и дополнительных признаков, извлеченных из сообщений для задач классификации. Social network analysis (SNA) обладает потенциалом для улучшения алгоритмов machine learning в области обнаружения структуры организации, поэтому учет связей между данными представляется очень важным для такого рода наборов данных..
Обратный инжиниринг корпоративной структуры организации может восприниматься двояко. С одной стороны, в случае успеха это может раскрыть структуру компании, имея на руках только метаданные, и это создает риск в том случае, когда структура намеренно держится в секрете, например, для сохранения конкурентного преимущества или защиты сотрудников от поглощения другими компаниями. С другой стороны, это может привести к реконструкции структуры злонамеренных организаций, когда доступна лишь частичная информация о них..
В литературе существует несколько работ, описывающих обнаружение организационных структур. Однако большинство из них используют набор данных Enron McCallum et al. (2007) или фокусируются скорее на сетевом подходе и опускают стандартные алгоритмы обучения с учителем. Следует отметить, что каждая организация управляется немного по-разному, что означает, что модели коммуникации могут различаться внутри каждой из них. Эти различия подразумевают, что некоторые решения могут давать лучшие или худшие результаты в зависимости от специфики сети; важно, чтобы исследования иерархии организации не ограничивались только одним набором данных..
Авторы работы Palus et al. (2012); Michalski et al. (2011) представили концепцию сопоставления формальной организационной структуры и социальной сети, созданной на основе переписки по электронной почте. Эксперименты проводились на сообщениях производственной компании, расположенной в Польше, а также на широко известном наборе данных Enron. Результаты исследования показали, что в обоих случаях некоторые сетевые метрики способны выявлять организационную иерархию лучше, чем другие. В данной работе также затрагивалась проблема того, что формальная структура иногда может существенно отличаться и не совпадать с повседневной реальностью..
Идея объединения сетевых метрик и других признаков, извлеченных из набора данных электронной почты для выявления корпоративной иерархии, представлена в Reference Creamer et al. (2009). Авторы представили собственную метрику под названием «социальный балл», которая определяет важность каждого сотрудника в сети. Эта метрика определяется как взвешенное среднее всех признаков и используется в алгоритме группировки. Метод группировки представляет собой простой алгоритм разделения по уровням прямой шкалы, который распределяет сотрудников по заданным интервалам на основе социального балла..
Исследование по использованию сетевых метрик в качестве входных признаков для алгоритмов классификации было представлено в Reference Fire and Puzis (2015). Основная концепция этой работы была сосредоточена на восстановлении корпоративной иерархии на основе сети, созданной из учетных записей сотрудников в социальных сетях. Авторы показали, что показатели центральности и коэффициенты кластеризации в сочетании с другими признаками, извлеченными из социальных сетей, позволяют выявлять лидеров в корпоративной структуре. Однако в этом исследовании использовались индивидуальные характеристики человека, такие как пол, родной город или количество друзей, вместо признаков, полученных на основе рабочей деятельности и взаимодействия между сотрудниками. Другие статьи, описывающие сочетание SNA и стандартных методов классификации, — это Reference Namata et al. (2006); Zhang et al. (2009). Обе они работают с использованием набора данных Enron и признаков, основанных на количестве отправленных/полученных сообщений. В Reference Wang et al. (2013) было описано использование некоторых сетевых метрик в качестве входных данных для алгоритмов классификации и кластеризации. Кроме того, результаты сравнивались с новым показателем под названием Human Rank (улучшение Page Rank). Тем не менее, использование классификации на основе признаков социальных сетей не ограничивается только корпоративной средой. Например, следуя идеям изучения социальных сетей преступников Coles (2001), авторы Reference Shaabani et al. (2015) использовали признаки социальной сети соучастников арестов для прогнозирования возможности совершения будущих насильственных преступлений. Аналогичная концепция также использовалась в Reference Tayebi et al. (2014) для анализа сетей соучастия в преступлениях. В этой работе был разработан алгоритм прогнозирования соучастия в преступлениях с использованием supervised learning. Тем не менее, классификация в социальных сетях, основанная на коммуникации или поведении в социальных сетях, может относиться к совершенно другим областям, таким как выявление бедности Sundsøy et al. (2016), обнаружение черт личности Kosinski et al. (2013) или рода занятий Huang et al. (2015). Все это возможно, поскольку наши цифровые следы действительно различаются в зависимости от нашей роли или статуса..
В области решаемой проблемы также существует множество решений, сосредоточенных главным образом на классификации с точки зрения графов. Например, идентификация ключевых участников социальной сети на основе энтропии Ortiz-Arroyo (2009), применение графических моделей McCallum et al. (2007) или моделей факторных графов Dong et al. (2015)⟧.
Данная работа посвящена выявлению организационной структуры на основе девятимесячной переписки по электронной почте между сотрудниками производственной компании, расположенной в Польше, а также набора данных Enron. В исследовании для классификации использовались алгоритмы дерева решений, случайного леса, нейронной сети и метода опорных векторов (SVM), кроме того, было изучено влияние минимальной активности сотрудников. Полученные результаты сравнивались с простым графовым алгоритмом коллективной классификации, также предложенным в данной статье. Слабостью этого подхода является тот факт, что условие независимых и одинаково распределенных величин (IID) трудно выполнить из-за сетевых метрик, которые были рассчитаны один раз до разделения данных на обучающую и тестовую выборки. В анализе социальных сетей полное соблюдение условия IID труднодостижимо, поскольку, если бы мы построили независимые сети для обучающих и тестовых данных, мы получили бы совершенно разные сетевые метрики, и значимость каждого узла могла бы быть искажена. Тем не менее, сетевые метрики могут быть ценными признаками для алгоритмов машинного обучения с точки зрения учета связей между данными. Результаты показали, что сочетание алгоритма классификации и анализа социальных сетей позволяет выявить организационные структуры, однако небольшие изменения в сети могут изменить эффективность алгоритмов. Кроме того, графовый подход, такой как коллективная классификация, способен хорошо классифицировать данные даже при ограниченных знаниях о метках узлов..
2 Материалы и методы
В этом разделе, после вводных разделов по обучению с учителем и анализу социальных сетей, подробно описывается предложенное решение, а также используемые наборы данных. Представленное решение создано с помощью языка Python, а также библиотеки NetworkX для создания социальной сети и Scikit-learn для всех задач машинного обучения..
2.1 Обучение с учителем
Machine learning можно рассматривать как приложение искусственного интеллекта, которое предоставляет системам способность автоматически обучаться и совершенствоваться на основе опыта без явного программирования Jordan and Mitchell (2015). Набор инструментов, полученных из области статистики, дает возможность выполнять множество задач, значительно превосходящих человеческие способности или простые алгоритмы в различных дисциплинах, начиная от анализа текста, компьютерного зрения, медицины и других. В machine learning классификация — это подход обучения с учителем, при котором алгоритм обучается на предоставленных ему входных данных, а затем использует это обучение для классификации новых наблюдений. Здесь под обучением с учителем мы подразумеваем предоставление алгоритму примеров объектов, которые были отнесены к определенному классу, и требование к нему разработать метод для адекватной классификации других объектов с неизвестным классом. Для достижения этой цели за последние десятилетия было разработано и настроено множество алгоритмов, таких как логистическая регрессия Hosmer Jr et al. (2013), наивный байесовский классификатор Maron (1961), метод ближайших соседей Altman (1992), Support Vector Machines Cortes and Vapnik (1995), деревья решений Utgoff (1989), случайные леса Breiman (2001) или нейронные сети Ayodele (2010). Каждый из этих методов по-разному подходит к задаче. Что касается методов, используемых в данной работе, деревья решений строят дерево, состоящее из проверок признаков: каждая ветвь представляет результат проверки, а каждый листовой узел представляет метку класса. Случайный лес расширяет концепцию деревьев решений, создавая их множество и выводя класс, который является модой классов отдельных деревьев. О чем можно сказать в отношении этих двух методов, так это о том, что правила классификации прозрачны и легко интерпретируемы. Что касается двух других методов, оцениваемых в этой работе, Support Vector Machine строит гиперплоскость или набор гиперплоскостей в пространстве высокой или бесконечной размерности, которые могут быть использованы для классификации. Нейронные сети пытаются имитировать человеческий мозг с точки зрения того, как информация передается и анализируется. Здесь нейронная сеть основана на совокупности соединенных единиц или узлов, называемых нейронами. Каждое соединение, подобно синапсам в биологическом мозге, может передавать сигнал другим нейронам. Искусственный нейрон, который получает сигнал, затем обрабатывает его и может подавать сигнал нейронам, соединенным с ним. Нейроны сгруппированы в слои, и сигнал, проходящий через слои, преобразуется нейронами в тот, на основе которого на конечном (выходном) слое будет принято решение о принадлежности к классу. Это создает архитектуру нейронной сети. В отличие от деревьев решений и случайных лесов, Support Vector Machines и нейронные сети не так легко интерпретируемы с точки зрения важности признаков Molnar (2019).
Все эти методы объединяет то, что они обычно требуют соблюдения принципа IID, а именно: выборки должны быть независимыми и одинаково распределенными. К сожалению, это не всегда так, особенно когда речь идет о любых данных, связанных с сетями. Например, в социальных сетях люди склонны объединяться в группы по схожим интересам McPherson et al. (2001) или менять свое мнение под влиянием мнения других Friedkin and Johnsen (1990). В этом случае сложно считать выборки IID, поэтому был разработан другой набор подходов: коллективная классификация, которая пытается использовать сетевую структуру данных Sen et al. (2008).
Другой проблемой классификации является то, что экземпляры редко распределены по всем классам равномерно. Эта проблема называется несбалансированными данными, и существует множество методов для ее решения, которые в основном относятся к одной из двух групп: уменьшение выборки и увеличение выборки Sun et al. (2009); Krawczyk (2016). При уменьшении выборки доминирующие группы сокращаются до уровня ранее недопредставленных классов. Напротив, увеличение выборки генерирует синтетические экземпляры, принадлежащие к недопредставленному классу, что приводит к более сбалансированным данным. Одним из наиболее заметных методов увеличения выборки является SMOTE, который основан на ближайших соседях, определяемых по евклидову расстоянию между точками данных в пространстве признаков, и выполняет векторные операции для генерации новых точек данных Chawla et al. (2002); Fernández et al. (2018). Использование этого метода обеспечивает более репрезентативные и менее смещенные выборки по сравнению со случайным увеличением выборки.
2.2 Анализ социальных сетей
Область анализа социальных сетей может быть понята как набор методов, извлекающих знания о человеческих взаимоотношениях на основе связей, которые они формируют — обычно являясь членами социальных сетей различного рода. Эти сети могут относиться к семье, друзьям, компаниям или организациям, сотрудниками или членами которых они являются, либо к социальным сетям, в которых они участвуют. Более формально, социальная сеть состоит из конечного множества или множеств акторов и отношения или отношений, определенных на них Wasserman et al. (1994). Чтобы помочь понять это определение социальной сети, следует объяснить некоторые другие понятия, которые в данном случае являются фундаментальными. Актор — это отдельная индивидуальная, корпоративная или коллективная социальная единица Wasserman et al. (1994). Это может быть человек в группе людей, отдел внутри компании или нация в мировой системе. Акторы связаны друг с другом социальными узами, и эти отношения составляют ядро подхода социальных сетей. Социальные сети представляются с использованием графовых структур, где узлы — это акторы, а рёбра — это связи между ними. Следовательно, могут быть применены все методы и измерения теории графов. Граф может быть неориентированным, что означает отсутствие различия между двумя вершинами, связанными с каждым ребром, или его рёбра могут быть направленными от одной вершины к другой. Граф обычно определяется как упорядоченная пара , где — это вершины или узлы, а — это рёбра. В дополнение к этому множество методов используется для извлечения знаний о членах сети или самой сети, таких как меры центральности Friedkin (1991), обнаружение сообществ Pujol et al. (2006), моделирование эволюции Michalski et al. (2011) или обнаружение влиятельных узлов Michalski and Kazienko (2015). Как описано в Разделе 1, анализ социальных сетей также стал применяться в организациях, где его часто называют организационным сетевым анализом Michalski and Kazienko (2014).
2.3 Наборы данных
В данной работе мы оценили два набора данных, содержащих как метаданные о коммуникации, так и организационную структуру в компаниях. Это позволило использовать признаки, извлеченные из социальной сети, построенной на основе данных о коммуникации, в качестве признаков для классификаторов. Затем эти классификаторы определяли уровень сотрудника в корпоративной иерархии. Подробное описание наборов данных приведено ниже.
2.3.1 Производственная компания
Проанализированный набор данных содержит девятимесячный обмен сообщениями между конторскими служащими производственной компании, расположенной в Польше Michalski et al. (2011). Набор данных состоит из двух файлов: первый содержит иерархию компании, второй хранит историю коммуникации. Анализируемая компания содержит трехуровневую иерархию: первый уровень управления, второй уровень управления и рядовые сотрудники. Файл с электронной почтой состоит из отправителей и получателей, а также даты и времени отправленных сообщений. Кроме того, в этот файл также включены электронные письма от бывших сотрудников и учетных записей технического персонала. Из-за отсутствия данных о руководители, бывшие сотрудники и технические аккаунты были удалены из дальнейшего исследования. Окончательная организационная структура для анализа показана на рисунке 1 и в таблице 1. Важно отметить, что набор данных не содержит никакой переписки с кем-либо за пределами компании, кроме того, структура компании была стабильной в течение рассматриваемого периода времени и не претерпевала никаких изменений.
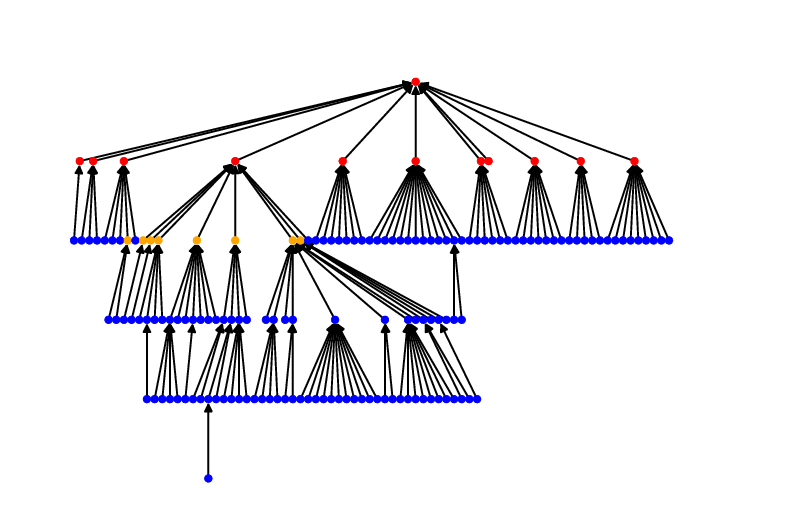
| Hierarchy Level | Number |
| The first management level | 12 |
| The second management level | 8 |
| Regular employees | 134 |
2.3.2 Энрон
Второй проанализированный набор данных получен от компании Enron McCallum et al. (2007). Enron представляла собой крупное американское энергетическое предприятие, основанное в 1985 году, которое впоследствии приобрело известность в конце 2001 года из-за финансового мошенничества. В ходе расследования набор данных был обнародован, однако организационная иерархия никогда не была официально подтверждена. Несмотря на это ограничение, корпус электронных писем Enron стал предметом многих исследований, которые позволили частично реконструировать структуру компании. Авторы данной работы решили использовать обработанную версию этого набора данных, в которую уже включены должности сотрудников. В этом наборе данных представлена семиуровневая иерархия, однако для снижения сложности этой структуры авторы предложили более общую трехуровневую иерархию, показанную в Таблице 2, такую же, как и в наборе данных производственной компании. Примененный подход позволил лучше разграничить руководящие и исполнительные должности от рядовых сотрудников. Анализируемый период охватывает сообщения за более чем 3 года, и в связи с ограниченными знаниями о внутренних процессах компании авторы предположили, что организационная структура оставалась стабильной в течение этого времени.
| Flattened | Original | Number |
| The first management level | CEO | |
| President | 40 | |
| Vice President | ||
| The second management level | Director | |
| Managing Director | 37 | |
| Manager | ||
| Regular employee | Employee | |
| In House Lawyer | 53 | |
| Trader |
Оба набора данных доступны для оценки или дальнейших исследований, см. Supplementary Materials.
2.4 Сеть
Сеть была построена на основе обмена электронной почтой ее участников, где узлами являлись сотрудники, а ребрами — сообщения. Было решено использовать ориентированный граф, определяемый следующим образом: Социальная сеть представляет собой кортеж , где — множество вершин, а — множество ребер между ними. Каждая вершина представляет отдельного сотрудника , и каждое ребро соответствует направленным социальным отношениям от к , таким что и . Веса ребер определяются в соответствии со следующей формулой:
| (1) |
где представляет собой сумму сообщений, отправленных от узла к узлу , а — общую сумму сообщений, отправленных от узла . Все петли (self loops) были удалены.
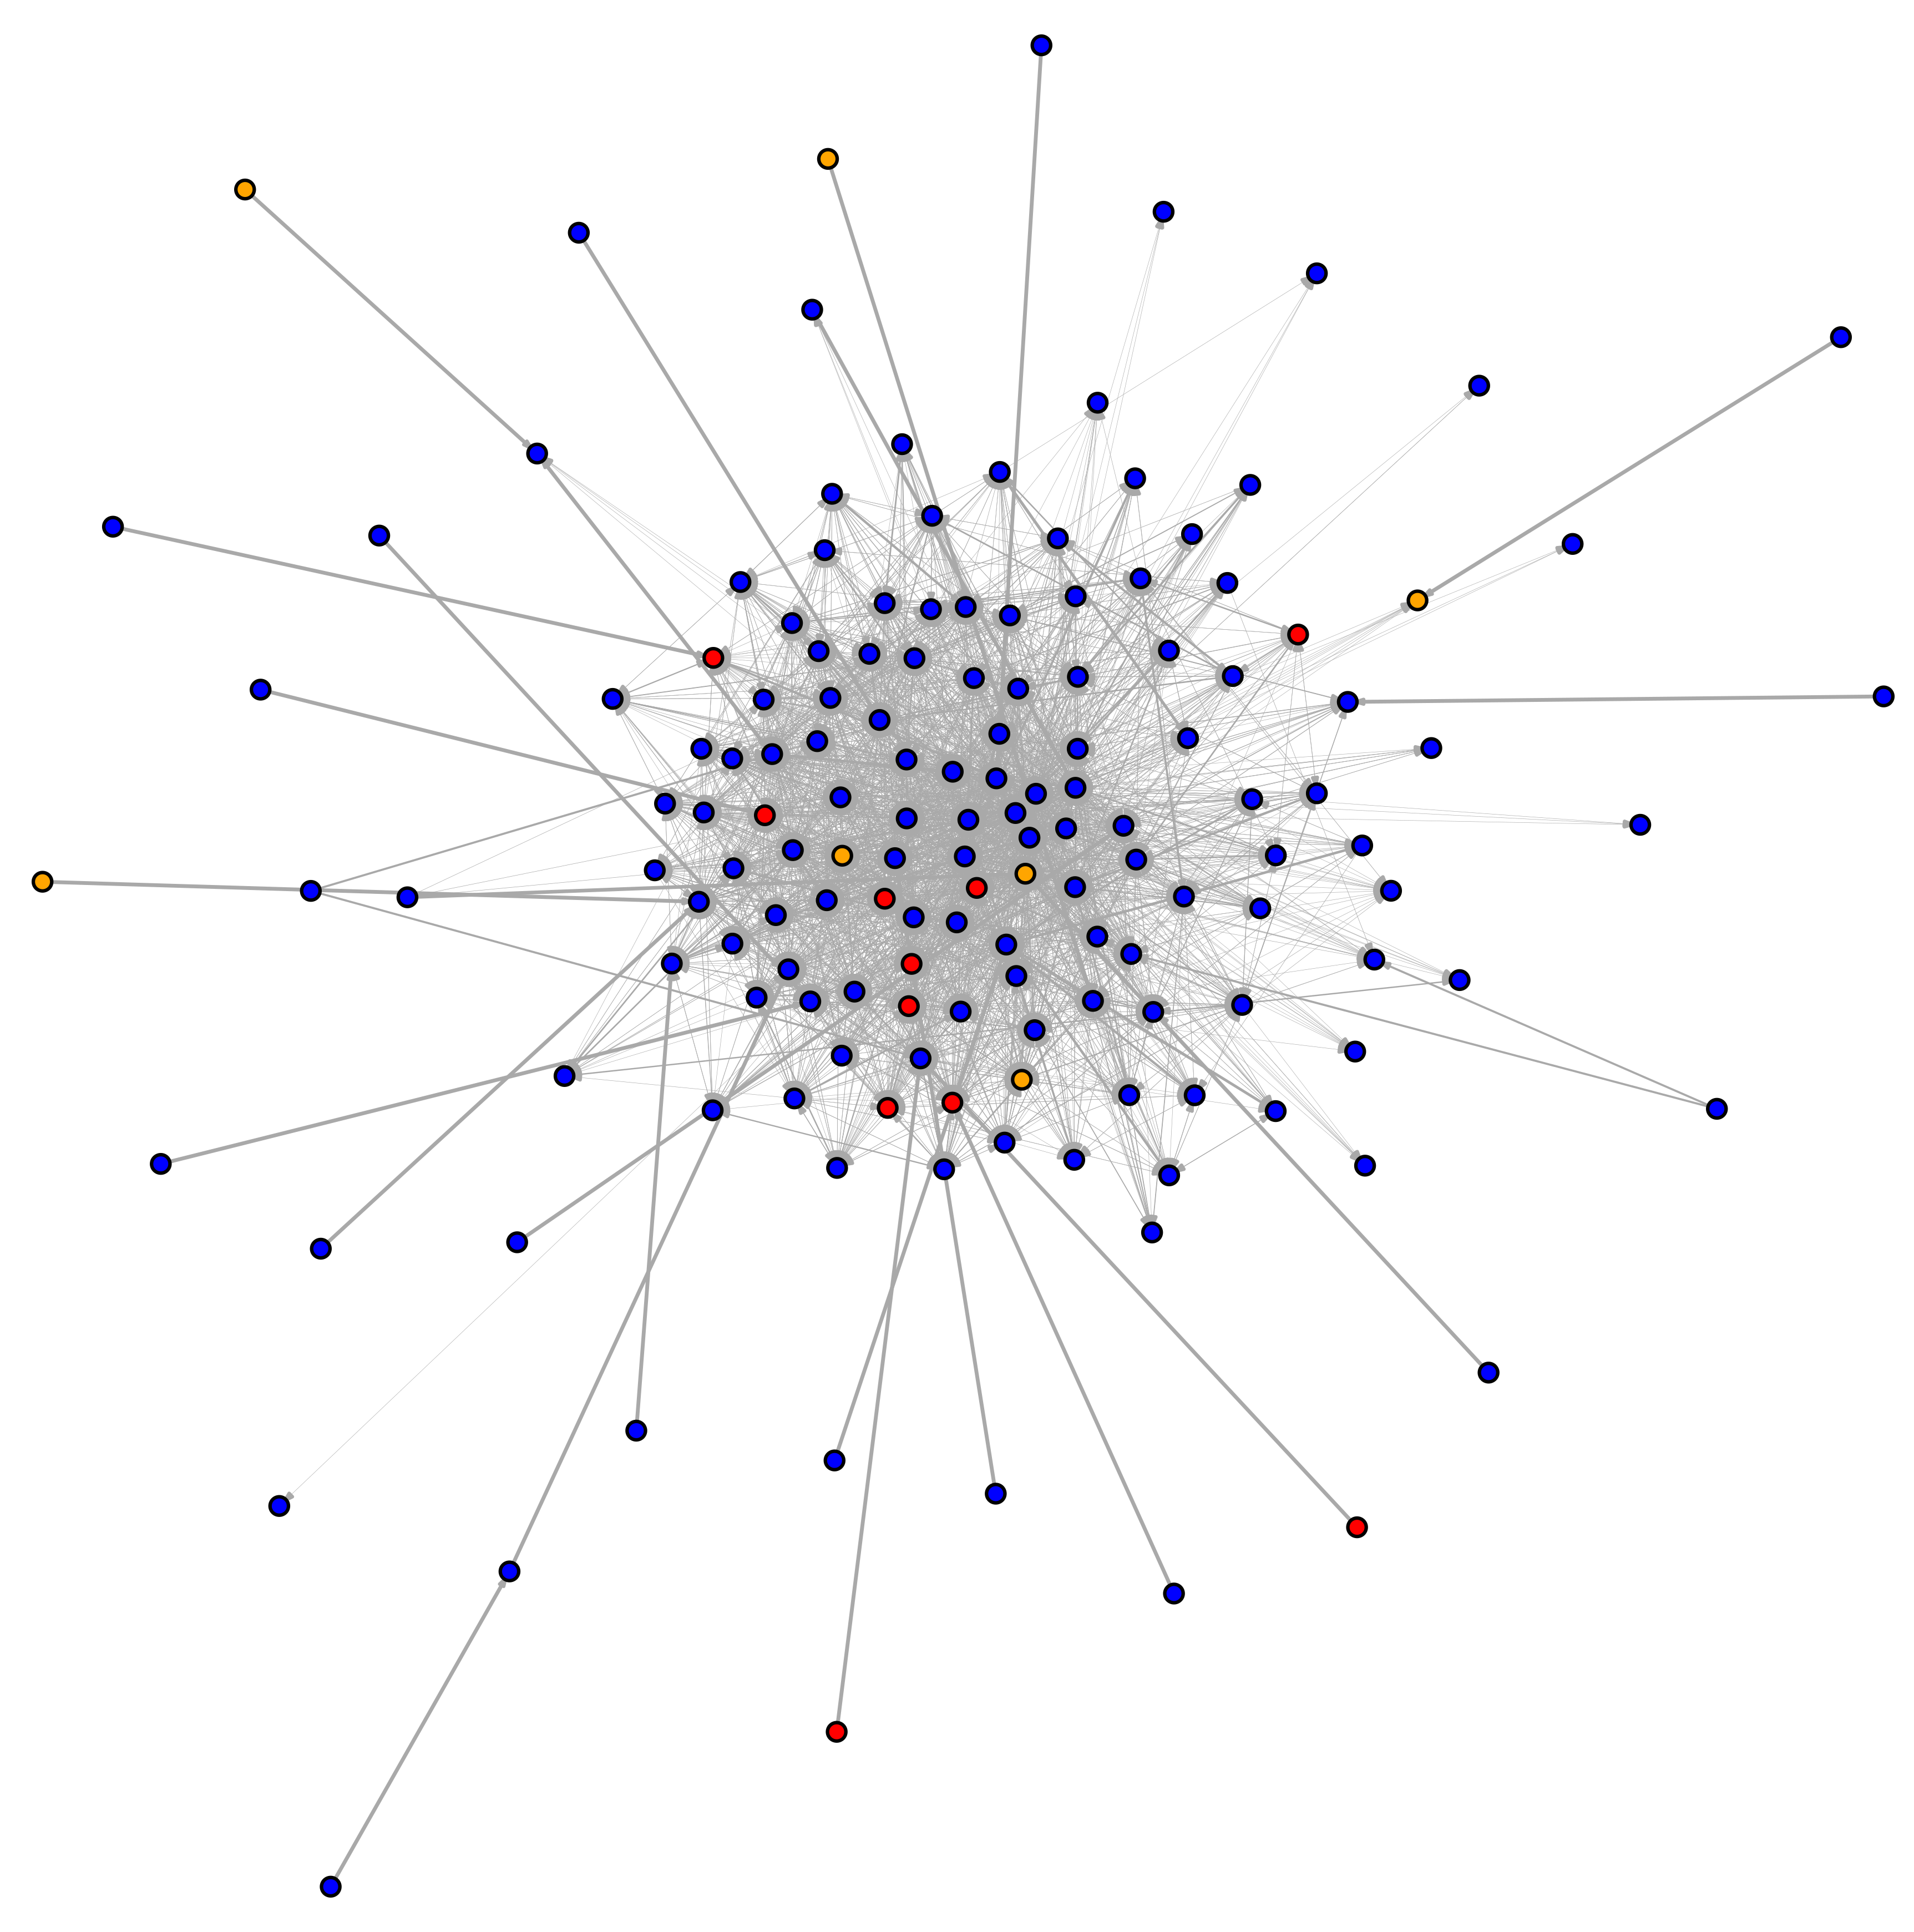
На рисунке 2 изображена взвешенная ориентированная сеть, построенная на основе электронной переписки в производственной компании. Можно заметить, что позиции менеджмента первого и второго уровня не всегда занимают центральное положение в этой сети. В результате использование мер центральности будет недостаточно для определения позиций в организационной иерархии. Причины отсутствия прямой корреляции между позицией в социальной сети и организационными сетями могут быть самыми разными, например, руководящие должности не требуют интенсивного общения, использования других форм коммуникации или наличия вспомогательного персонала для общения от имени руководства.
2.5 Признаки
В созданной социальной сети представленные ниже меры центральности были рассчитаны в качестве входных признаков для алгоритмов классификации. Эти меры также кратко описаны в таблице 3.
- ⟦•
центральность по входящей степени:
где представляет собой ребро, идущее от каждого узла к оцениваемому узлу .(1) - ⟦•
исходящая центральность:
где — это ребро, идущее от оцениваемого узла к каждому другому узлу в сети.(2) - ⟦•
посредническая центральность:
где — количество кратчайших путей между узлами и , проходящих через узел , а — количество всех кратчайших путей между и ⟧.(3) - ⟦•
близость центральности:
где — количество вершин в сети, а — расстояние между вершинами и ⟧.(4) - ⟦•
собственная центральность:
где — матрица смежности графа, а — константа.(5) - ⟦•
page rank:
где и являются константами, а — это исходящая степень узла , если такая степень положительна, или , если исходящая степень узла равна нулю. Опять же, — это матрица смежности графа.(6) - ⟦•
центральность хаба:
где — матрица смежности графа, а — центральность авторитетности узла (см. уравнение (8)), — константа.(7) - ⟦•
центральность авторитетности:
где — матрица смежности графа, а — центральность хаба узла (см. уравнение (7)), — константа.(8)
Более того, для каждого узла был рассчитан локальный коэффициент кластеризации, который позволяет оценить плотность связей между соседями, а также две дополнительные характеристики, связанные с кликами:
| (9) |
где — это количество пар соседей узла , которые соединены между собой. В формуле это связано с количеством возможных пар соседей узла , которое равно , где — это степень узла ⟧.
Кликой называется полностью связный подграф, что означает, что каждый узел имеет направленные связи со всеми остальными узлами в клике. Первый признак — это общее количество клик, в которые включен сотрудник, а второй — размер самой большой клики для конкретного узла. В источнике Barabási and Posfai (2016) содержится более подробная информация обо всех представленных выше показателях..
Следующие признаки были основаны на вариативности соседства, которая определяется тремя способами: вариативность отправленного соседства, вариативность полученного соседства и общая вариативность соседства. В целом, вариативность соседства определяется как разница между множествами соседей, с которыми конкретный узел взаимодействует в предыдущем и следующем месяце. Вариативность отправленного соседства учитывает множество соседей, которым данный узел отправлял сообщения. Вариативность полученного соседства рассматривает множество соседей, от которых данный узел получал сообщения. Общая вариативность соседства использует множество соседей, с которыми узел взаимодействует, не различая отправку и получение сообщений. Коэффициент Jaccard использовался для вычисления разницы между множествами, поэтому коэффициент принимает значения от 0 до 1, где 0 означает полностью различные множества, а 1 означает идентичные множества. Коэффициент Jaccard вычислялся для каждой пары чередующихся месяцев. Более того, если сотрудник не был активен в непосредственно следующем месяце, рассматривался ближайший следующий месяц. Например: сотрудник был активен в январе, но не в феврале, и снова был активен в марте; следовательно, коэффициент вычислялся бы между множествами соседей в январе и марте. Кроме того, вариативность соседства вычислялась как средний коэффициент Jaccard для каждого узла на основе предыдущих частных коэффициентов. Формально, показатель вариативности отправки может быть определен следующим образом:
| (10) |
где — это множество соседей, которым определенный узел отправлял сообщения в месяце , а — это множество соседей, которым определенный узел отправлял сообщения в месяце , или, если в сообщения не отправлялись, то рассматриваются . Аналогичным образом можно определить показатели изменчивости полученных и общих соседских связей, заменив множества соседей на соседей, которые либо отправляли сообщения узлу (изменчивость полученных), либо на множество соседей, с которыми контакт происходил в любом направлении и включал (общая изменчивость)).
Кроме того, учитывались такие признаки, как количество отработанных выходных и объем сверхурочной работы. Для сверхурочной работы учитывалось время с 16:00 до 06:00. Следует отметить, что сверхурочная работа рассчитывалась только для набора данных производственной компании. Из-за ограниченности знаний о наборе данных Enron было невозможно узнать, следует ли учитывать разные часовые пояса, поскольку даты были заданы в формате POSIX, а у Enron были филиалы, расположенные в разных часовых поясах..
В качестве резюме все использованные для классификации признаки представлены в таблице 3.
| Feature Name | Defined in | Brief Description |
| indegree centrality | Equation (1) | a number of incoming links to a given node |
| outdegree centrality | Equation (2) | a number of outgoing links from a given node |
| betweenness centrality | Equation (3) | the frequency of a node appearing in shortest paths in the network |
| closeness centrality | Equation (4) | the length of the shortest paths between the node and all other nodes in the graph |
| eigenvector centrality | Equation (5) | a relative measure of importance dependent on the importance of neighbouring nodes in the network |
| page rank centrality | Equation (6) | relative measure of importance also based on eigenvectors of an adjacency matrix, more tunable |
| hubs centrality | Equation (7) | indication of position in relevance to important nodes—authorities |
| Feature Name | Defined in | Brief Description |
| authorities centrality | Equation (8) | importance of node based on being referred to by hubs |
| clustering coefficient | Equation (9) | degree to which nodes in a graph tend to cluster together |
| the total numbers of cliques | Section 2.5 | total numbers of cliques in which an employee is assigned |
| the biggest clique | Section 2.5 | size of the biggest clique for the specific node |
| sent neighborhood variability | Equation (10) | difference between sets of neighbours a node sends emails to in consecutive months |
| received neighborhood variability | Equation (10) | difference between sets of neighbours a node receives emails from in consecutive months |
| general neighborhood variability | Equation (10) | difference between sets of neighbours a node communicates with in consecutive months |
| overtime | Section 2.5 | a number of days an employee worked overtime (only for manufacturing company) |
| the number of weekends worked | Section 2.5 | how many times an employee worked over weekends |
2.6 Классификация
Задача классификации выполнялась с использованием алгоритмов Decision Tree Utgoff (1989), Random Forest, Neural Network (многослойный перцептрон) с оптимизатором L-BFGS и SVM с полиномиальным ядром для различных настроек следующих параметров эксперимента: количества распознаваемых групп сотрудников, минимального количества активных месяцев, а также процента используемых признаков.
Первый параметр относится к ранее упомянутой трехуровневой иерархии сотрудников, которую также можно свести всего к двум уровням — уровню руководства и рядовым сотрудникам. Эксперимент был проведен с двумя значениями этого параметра, чтобы посмотреть, как меняется производительность алгоритмов при распознавании двух и трех групп сотрудников..
Значение второго параметра проверяется на предмет того, как активность человека может влиять на результат классификации, и поэтому было исследовано, соответствуют ли более высокие минимальные месяцы активности сотрудников лучшим результатам. Существует предположение, что для выявления некоторых паттернов поведения требуется больше времени, поэтому классификация запускалась пять раз, начиная с минимальной активности в один месяц и заканчивая минимальной активностью в 5 месяцев. Для каждого значения сеть приходилось пересоздавать, а признаки пересчитывать, так как некоторые узлы исключались из сети..
Третий параметр исследует влияние исключения наиболее значимых признаков. Для этого параметра эксперимент проводился девять раз, начиная со всех признаков и доходя до десяти процентов признаков с постоянным уменьшением на десять процентов. Важность признаков для алгоритмов Decision Tree и Random Forest определялась на основе параметра важности Джини из предварительно обученной модели. Алгоритмы Neural Network и SVM не так легко интерпретируемы, и важность признаков не может быть получена из результатов модели. В этом случае важность признаков должна определяться до обучения модели. Для этой цели использовался метод одномерного отбора признаков на основе критерия хи-квадрат.
В проанализированном наборе данных производственной компании существовала проблема несбалансированности размеров классов, что является обычным для структуры компании, где группа рядовых сотрудников является наиболее многочисленной, а управленческий уровень насчитывает меньше участников. Тем не менее, датасет Enron является гораздо более сбалансированным в каждой группе, что может указывать на другую модель управления в этой компании. Для решения этой проблемы использовалась техника оверсэмплинг, поэтому для выравнивания размера всех минорных классов по размеру мажоритарного класса рядовых сотрудников применялся алгоритм SMOTE. Чтобы предотвратить утечку данных, оверсэмплинг выполнялся только на обучающем наборе.
В общем, для каждой комбинации вышеупомянутых параметров модель обучалась с использованием алгоритма поиска по сетке с 5-кратной перекрестной проверкой, поэтому все возможные комбинации из диапазона заданных значений были протестированы, и была возвращена лучшая по f-мере макросредней. Пространство поиска гиперпараметров показано в Таблице 26, а также лучшие для каждой модели в Таблицах 27–30⟧.
2.7 Коллективная классификация
Коллективное классифицирование представляет собой иной способ выявления корпоративной иерархии с точки зрения графов. Этот подход использует связи между узлами для распространения меток по всей сети. Алгоритм распространения веры с петлями является примером коллективного классифицирования, подробно описанным в литературе Sen et al. (2008); Kajdanowicz et al. (2016). Поэтому в данной работе представлена упрощенная версия этого алгоритма для сравнения со стандартными алгоритмами классифицирования.
Предложенный метод коллективного классифицирования представлен в виде алгоритма 1. Первым шагом этого алгоритма является выбор оценки полезности и сортировка всех узлов в соответствии с ней (строка 1). Оценка полезности может быть одним из вычисленных признаков из предыдущего раздела. Следующим шагом является раскрытие меток для заданного процента узлов каждого класса с наивысшей оценкой полезности (строка 2). Эти узлы отмечаются как известные (их метки постоянны) и получают метки , в то время как остальные узлы рассматриваются как неизвестные и неразмеченные. Кроме того, распространение меток начинается в цикле до тех пор, пока не будет выполнено условие остановки или пока количество итераций не превысит заданное максимальное число итераций. За одну итерацию каждый размеченный узел отправляет сообщение всем своим соседям, рассматривая ребра как неориентированные (строка 5); более того, все полученные метки на данной итерации сохраняются для каждого узла в счетчике (строка 6). Обновление меток начинается после того, как все узлы отправят сообщение своим соседям, поэтому порядок отправки не влияет на результат. Если узел получал одну метку чаще остальных (строка 13), эта метка будет присвоена ему (строка 14), и узел дополнительно будет считаться размеченным (строка ) (строка 15), в противном случае для этого узла счетчик будет увеличен (строка 18). Если превышает максимальное значение (строка 20), он будет сброшен (строка 26), и узлу будет присвоена метка с наивысшей позицией в иерархии компании среди меток с наибольшим количеством (строки 22 – 24). В конце итерации всегда проверяются условия остановки, и они определяются как разница между наборами предыдущих и текущих меток, поэтому, если коэффициент Жаккара больше заданного минимального значения Жаккара и всем узлам назначена метка, алгоритм завершится (строка 29). Кроме того, в случае несбалансированных классов алгоритм позволяет определить . На этапе подсчета того, сколько раз каждая метка была получена узлом, результат для мажоритарного класса будет разделен на этот порог для предотвращения доминирования данного класса. (строка 11)
Алгоритм коллективной классификации был запущен с тремя параметрами: количеством распознанных групп сотрудников, минимальным количеством активных месяцев и процентным соотношением известных узлов. Первые два идентичны параметрам из предыдущего раздела, но последний определяет процент известных (размеченных) узлов. Девять значений этого параметра использовались в диапазоне от 90% до 10% с шагом уменьшения в десять процентов. Набор данных производственной компании требовал установки порогового значения, в отличие от набора данных Enron, где это было не нужно. Кроме того, для поиска наилучшего показателя полезности был проведен эксперимент для всех рассчитанных признаков, а также выбраны наилучшее значение по Jaccard и пороговое значение из диапазона различных величин. Пространство поиска гиперпараметров показано в Таблице 31, а также лучшие из них для каждой модели в Таблицах 33–41.
1.5
3 Результаты
Рассматриваемую проблему можно считать бинарной классификацией для двух групп сотрудников и многоклассовой классификацией для трех групп. Поэтому для оценки решения была использована метрика f-score macro average, так как требовался единый показатель для сравнения обоих результатов. Эта мера позволяет обрабатывать вышеуказанные случаи, более того, как было написано в Reference Özgür et al. (2005), она хорошо справляется с проблемой несбалансированных классов. Самым большим преимуществом этой меры является равное отношение ко всем классам, что означает, что результат не доминирует за счет мажоритарного класса..
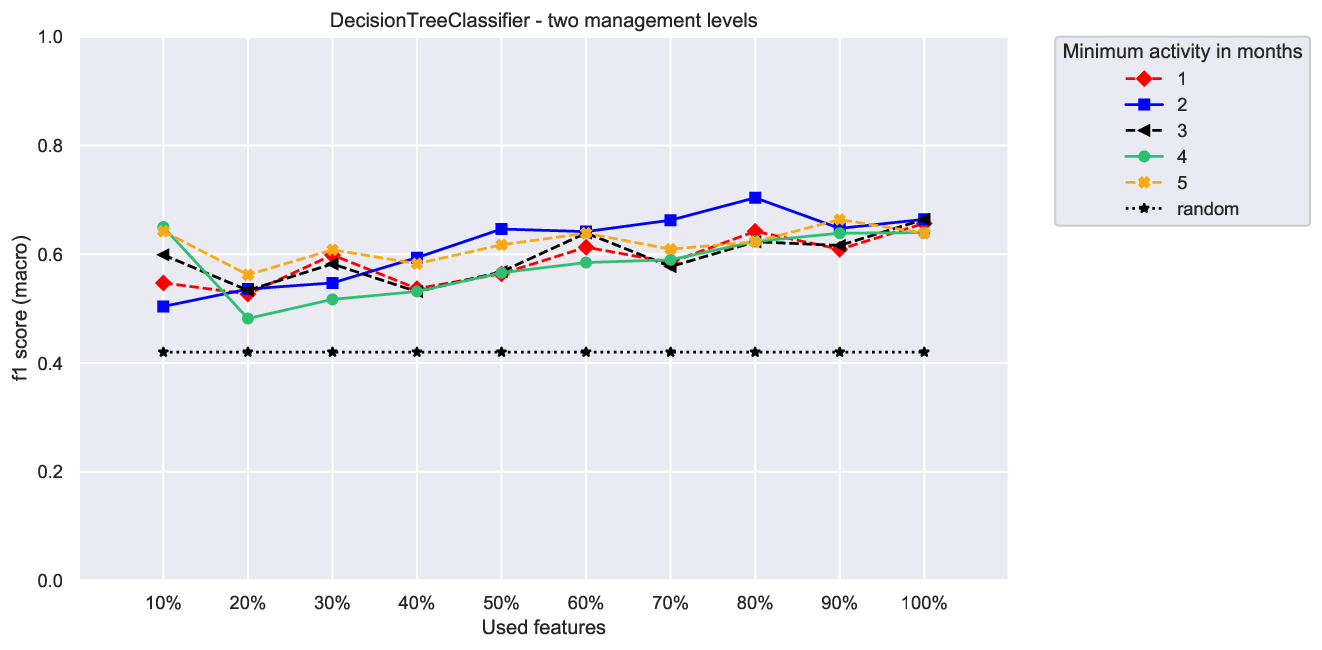
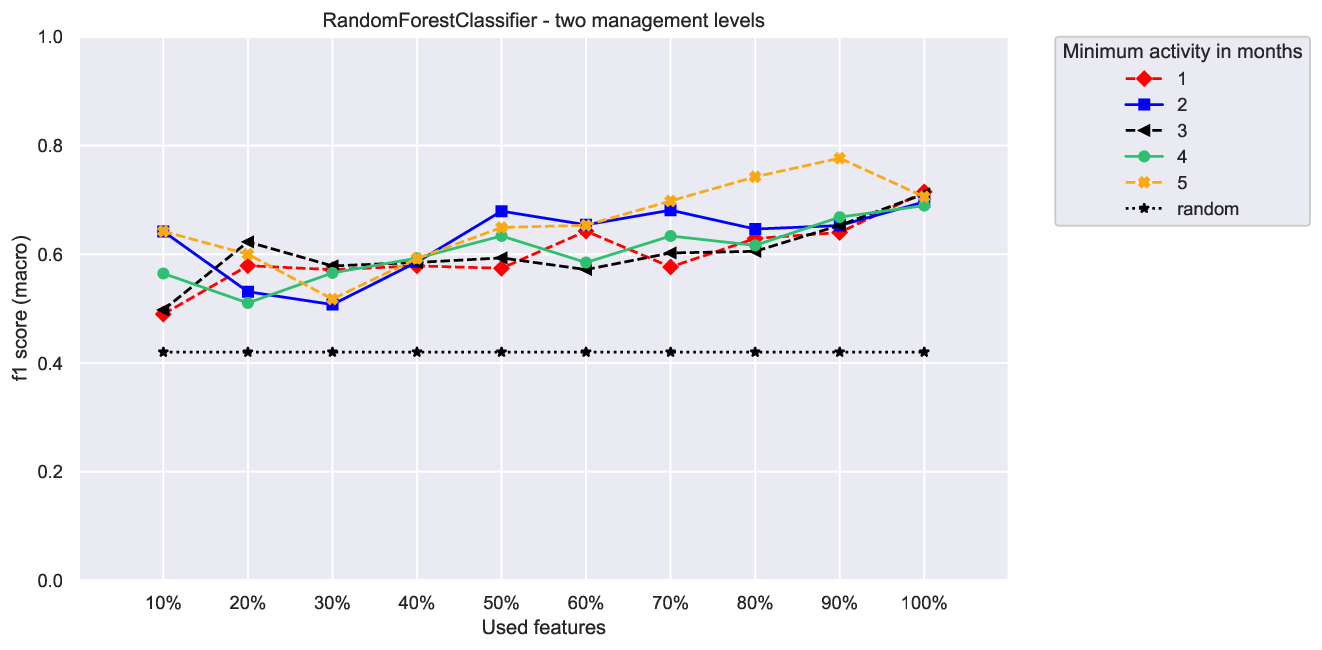
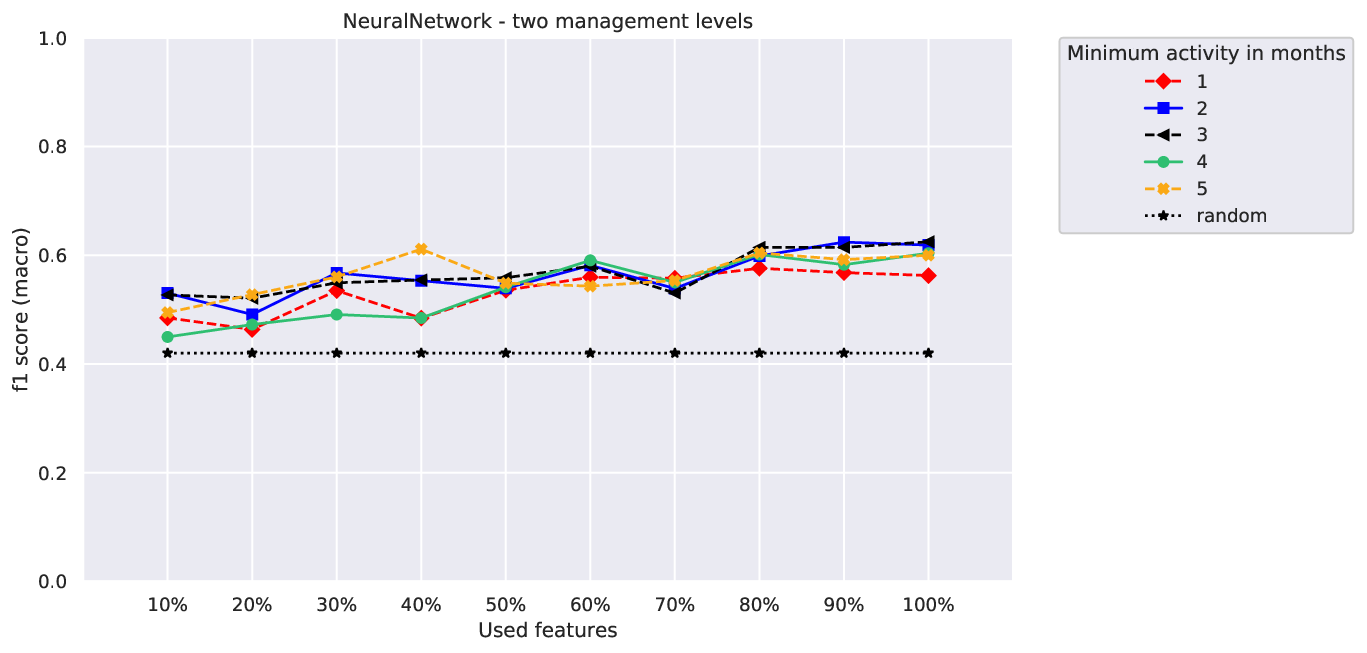
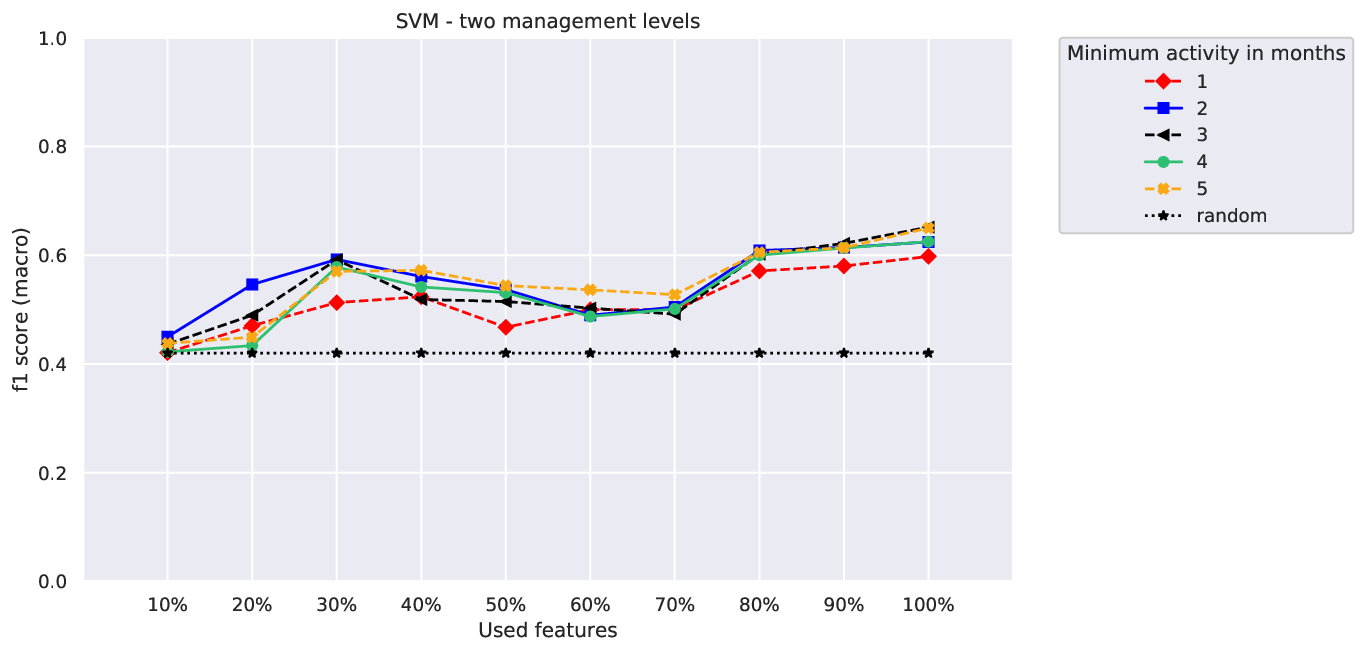
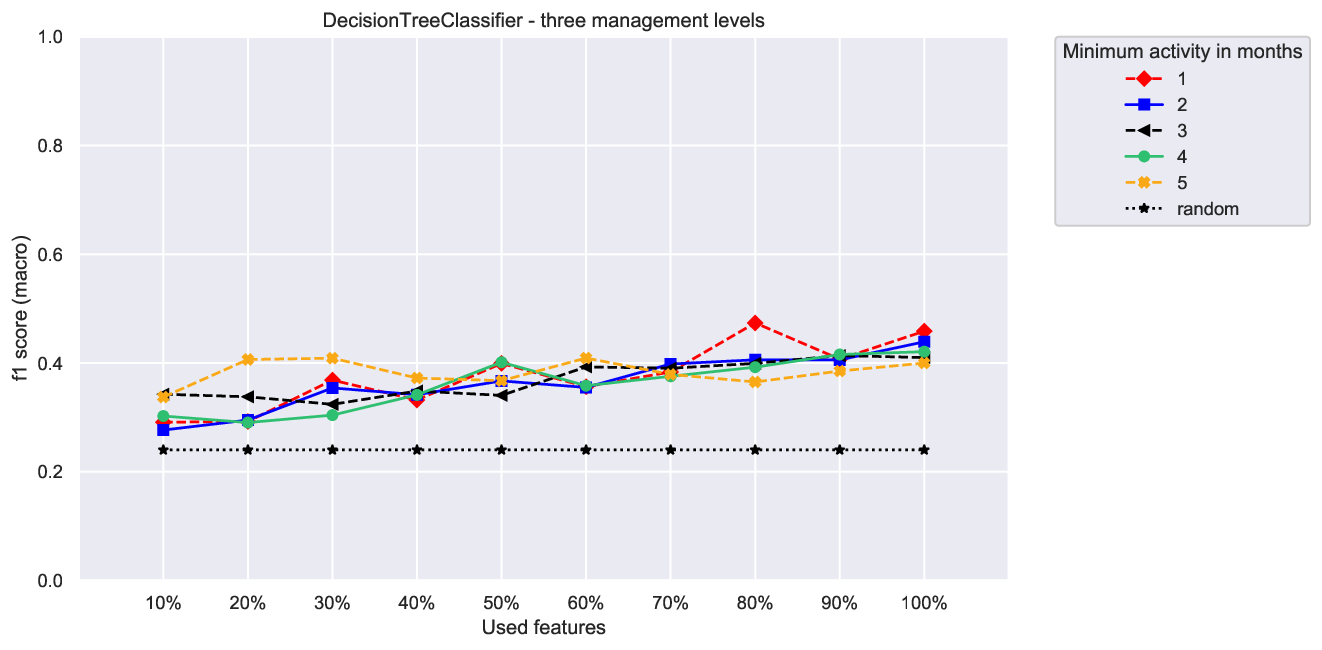
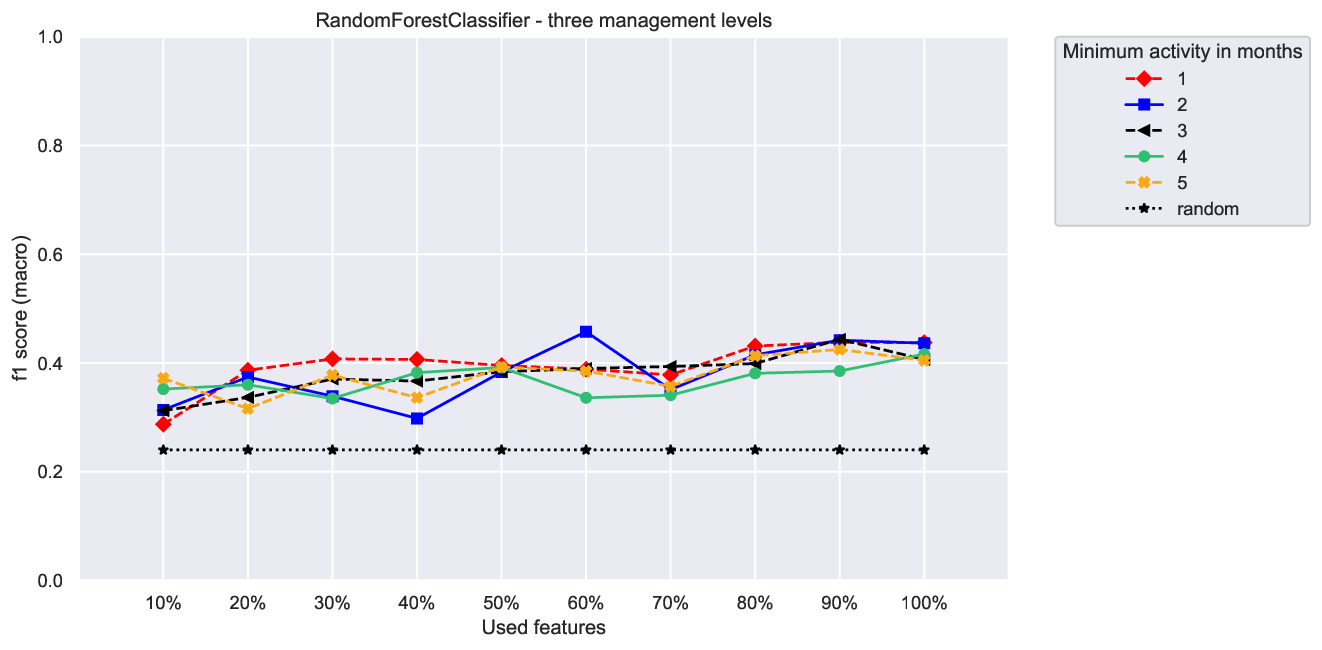
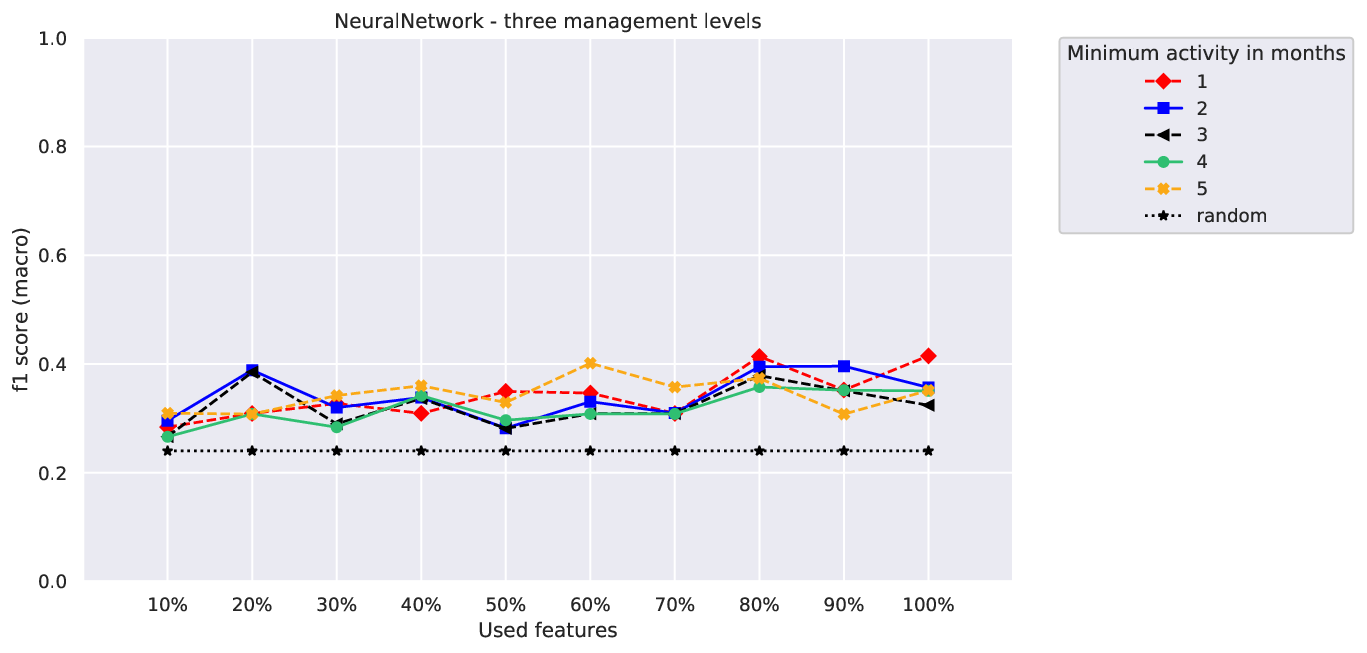
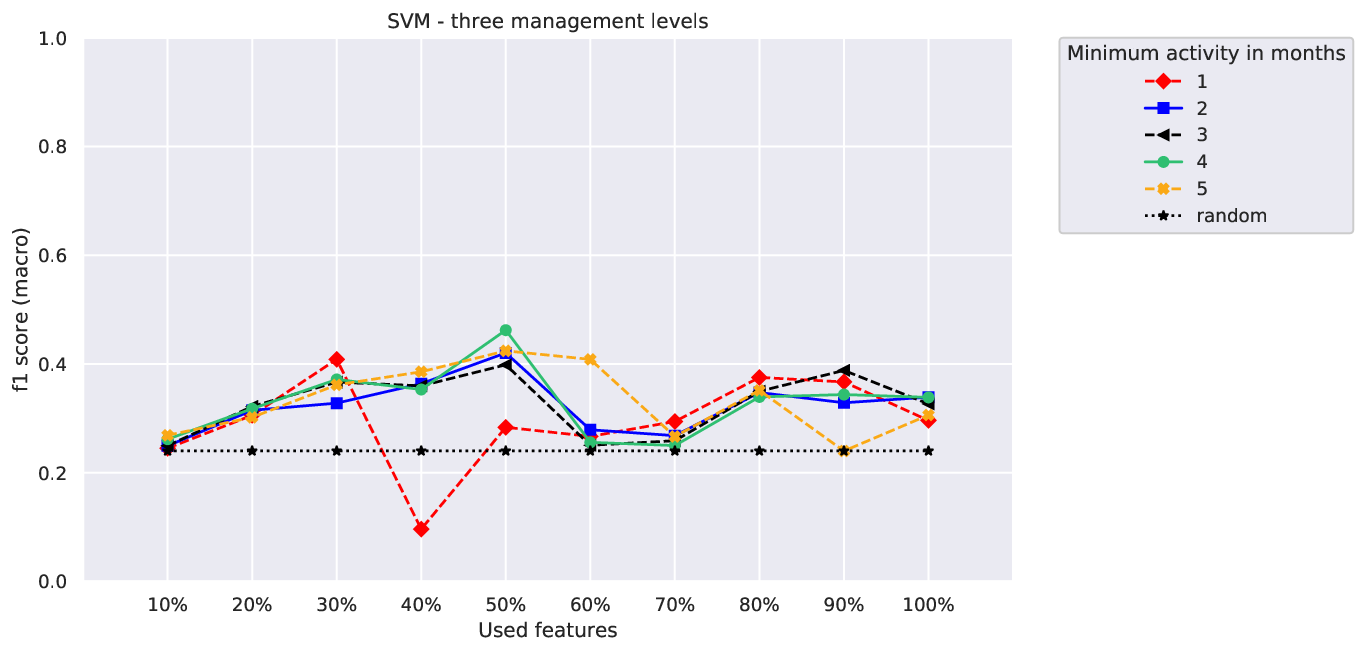
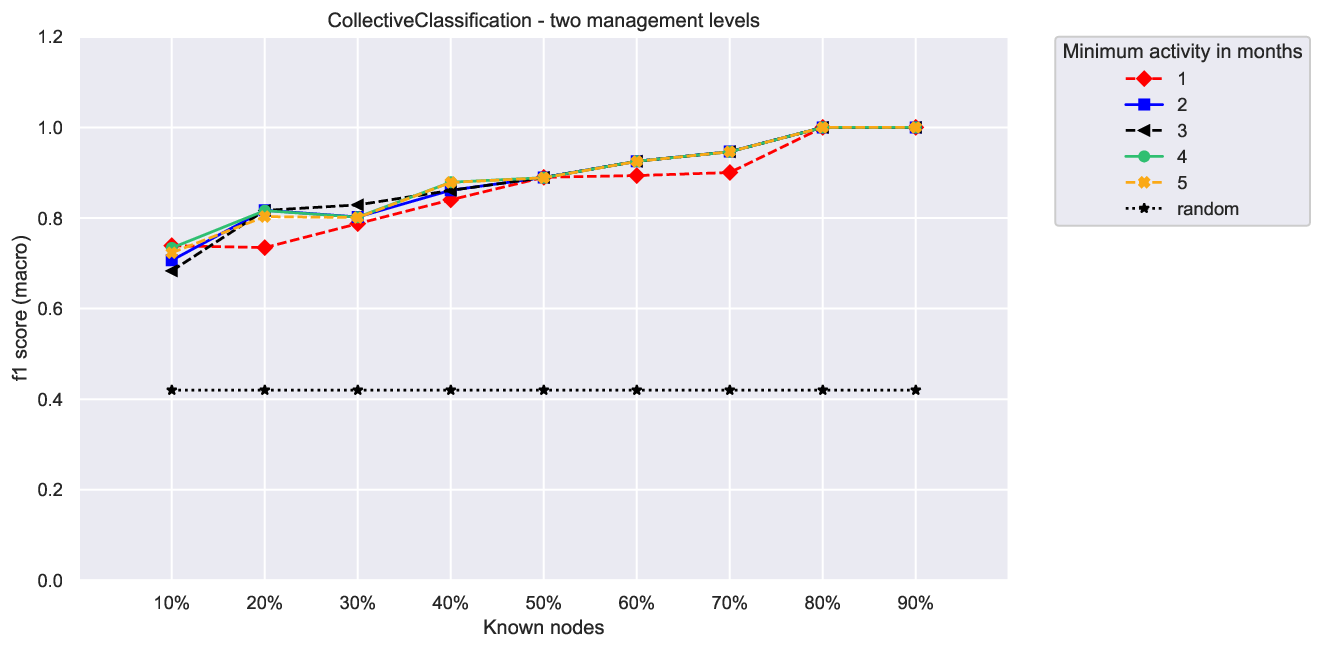
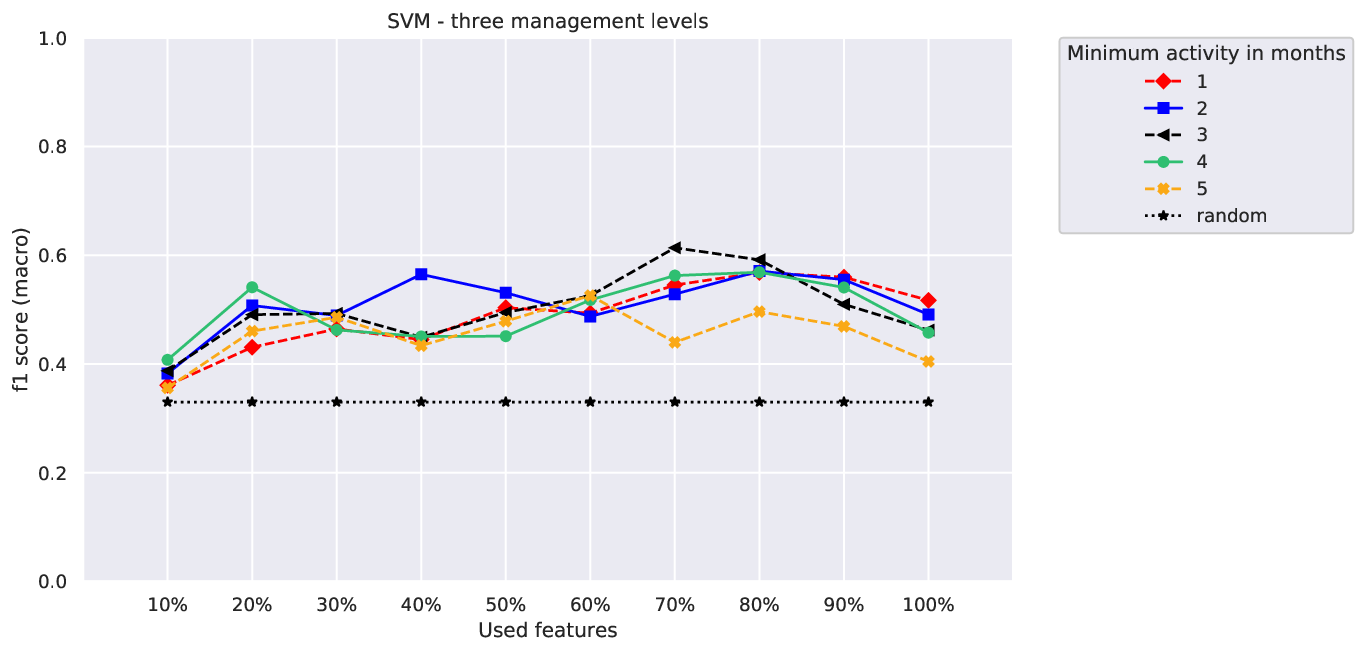
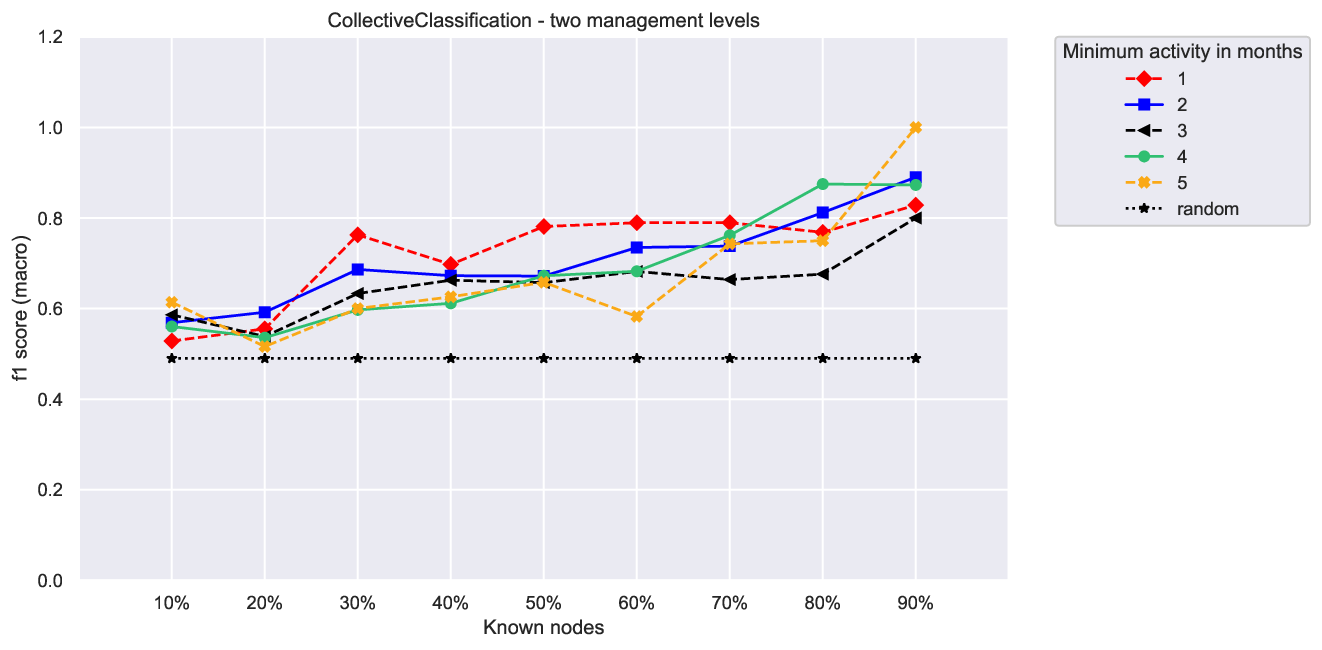
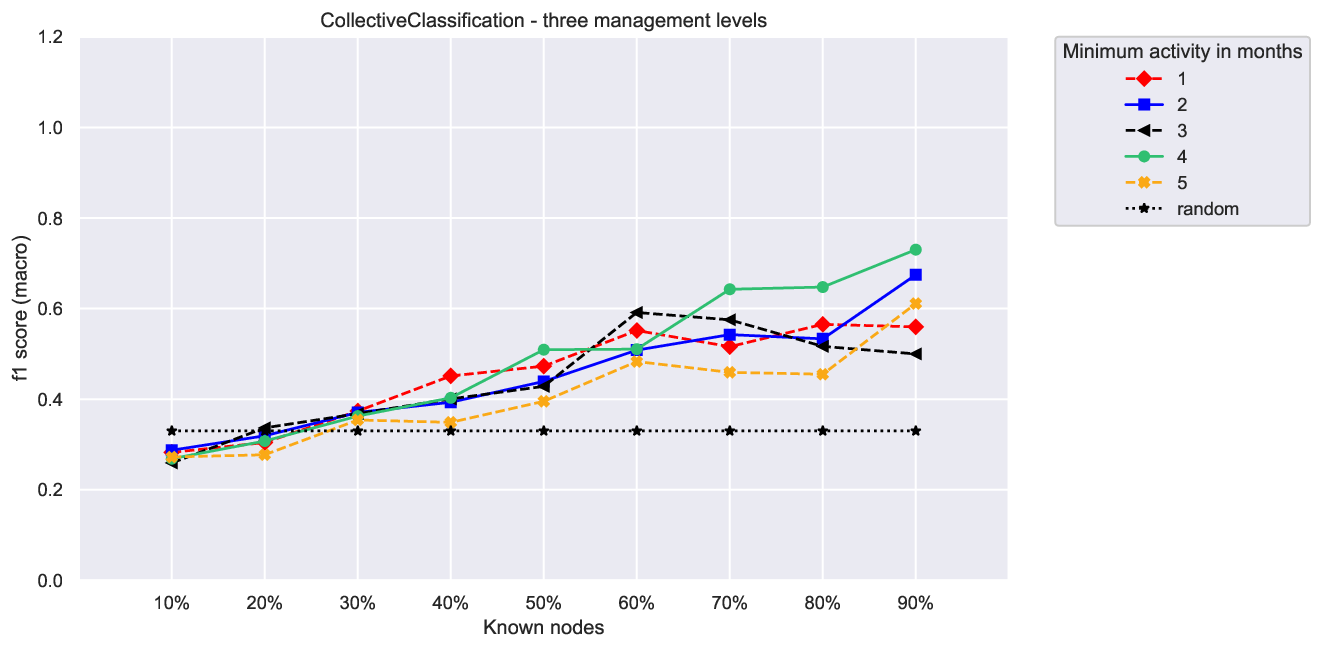
Результаты для набора данных производственной компании представлены на рисунках 4, 6 и 8. Макро-усредненная f-score для случайно назначенных меток составляет около 0,42 для двух уровней иерархии и 0,24 для трех уровней иерархии; для сравнения, лучший результат для двух уровней составил 0,7768, полученный с помощью Random Forest, а для трех уровней — 0,4737, достигнутый с помощью Decision Tree. Значительно более высокий балл, полученный для двух групп классификации, можно объяснить несбалансированностью классов. Классификация трех групп показала худшие результаты из-за малого количества выборок, которого было недостаточно для различения двух уровней управления, даже при использовании оверсэмплинга. Кроме того, Random Forest показал немного лучшие результаты, особенно для двух групп сотрудников. Можно наблюдать странный феномен, когда сокращение наиболее важных признаков иногда приводит к лучшему результату; это означает, что среди признаков может присутствовать некоторый шум, который влияет на границу принятия решений. Потенциальное объяснение этого явления может быть связано с проблемой, описанной в источнике Palus et al. (2012), поэтому наблюдаемое изменение может быть результатом того, что иерархия, возникающая из повседневных обязанностей, не совпадает с организационной структурой на бумаге. Это несоответствие может быть источником некоторого шума в используемых признаках, что влияет на полученный результат; следовательно, изменение структуры сети путем исключения некоторых узлов, а также удаление наиболее важных признаков, может привести к смещению границы принятия решений. Также заметно, что параметр минимальной активности сотрудника также влияет на классификацию, но трудно указать наилучшее значение, поскольку четкая закономерность не прослеживается; однако большинство лучших результатов получено при минимальной активности более одного месяца. Лучшие результаты для двух и трех групп сотрудников были получены с помощью алгоритма коллективной классификации, который был способен классифицировать узлы, даже если более половины меток были неизвестны..
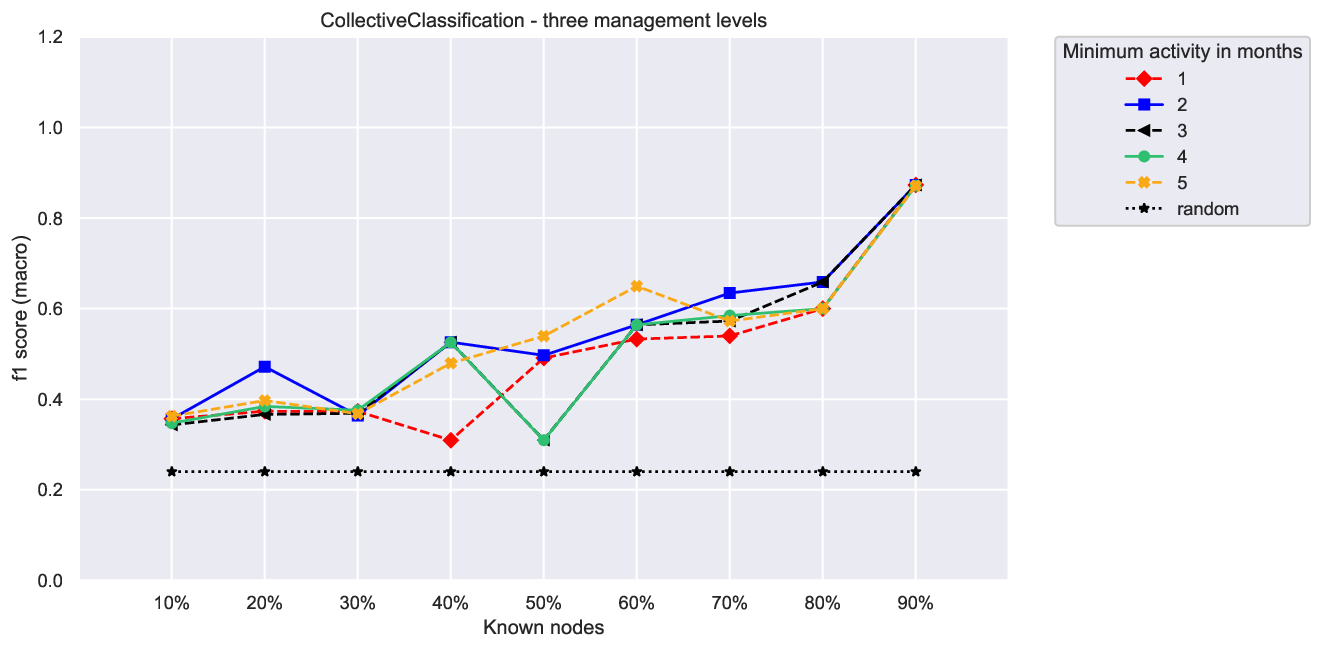
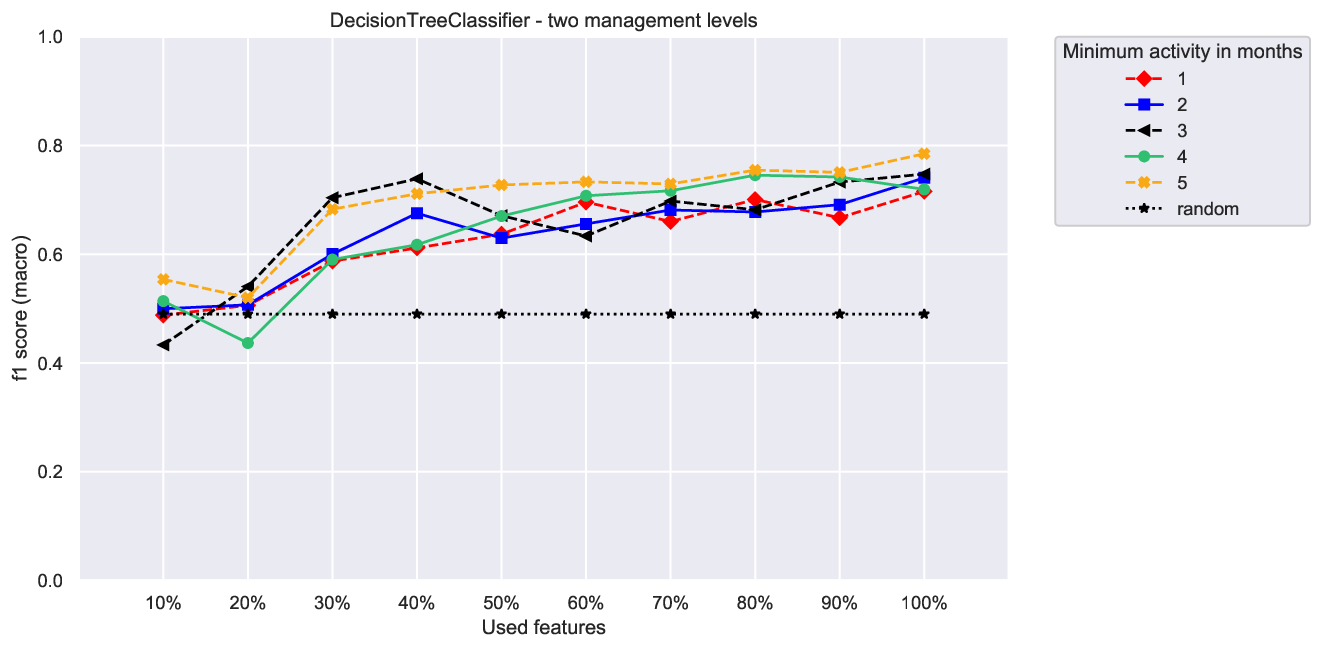
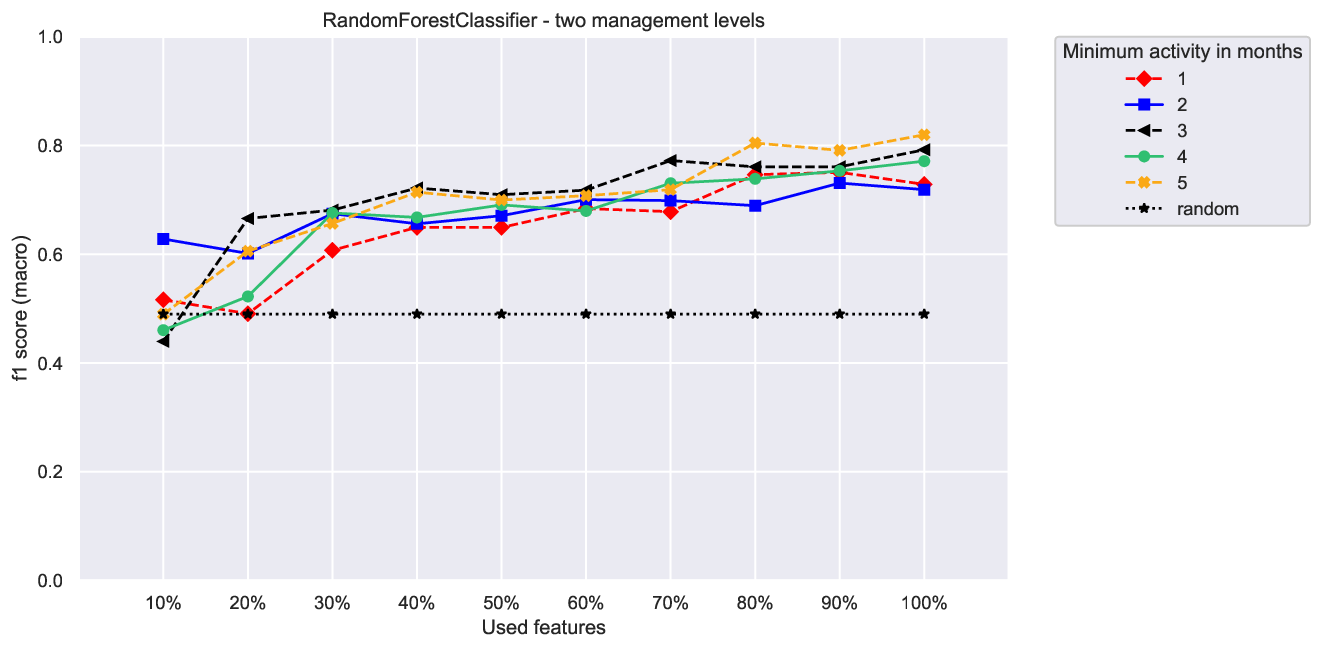
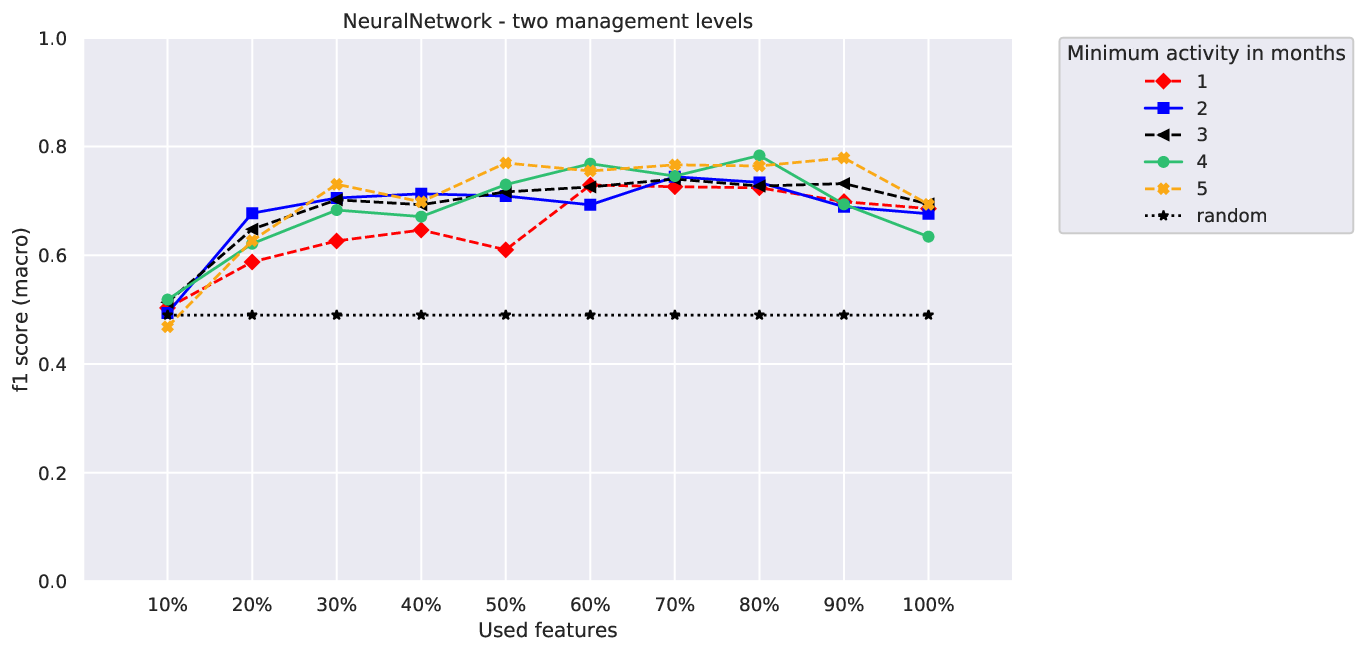
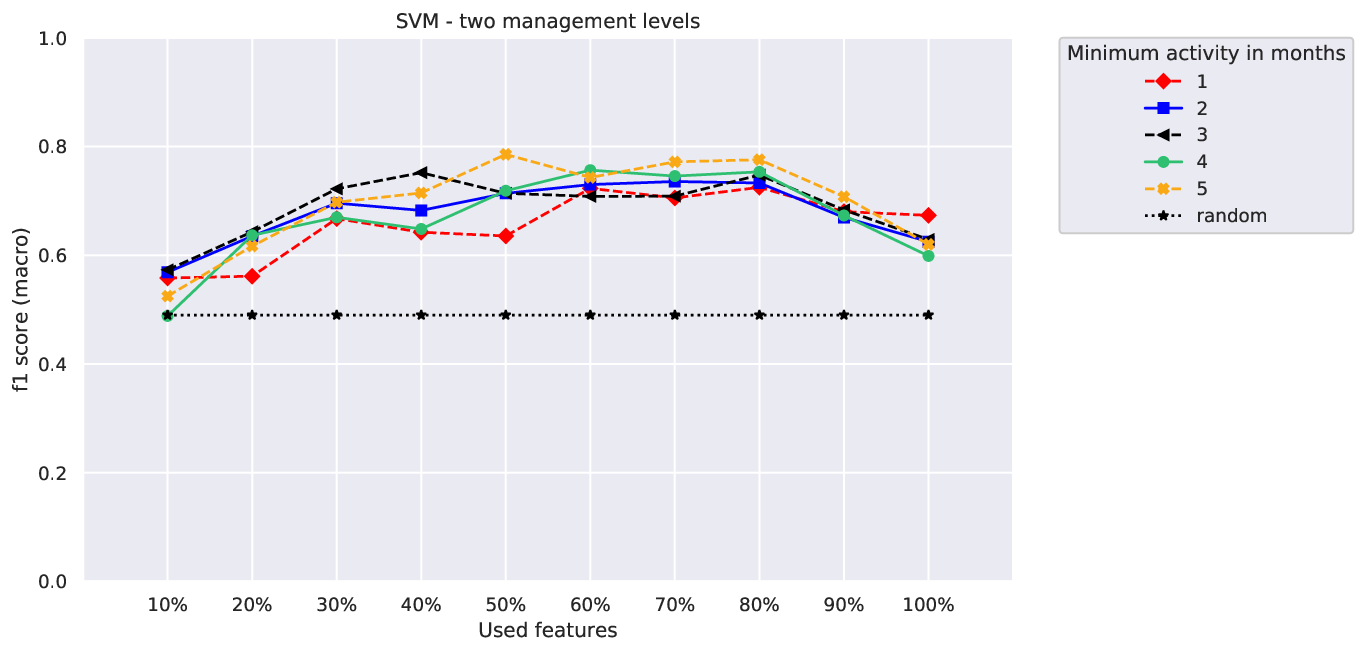
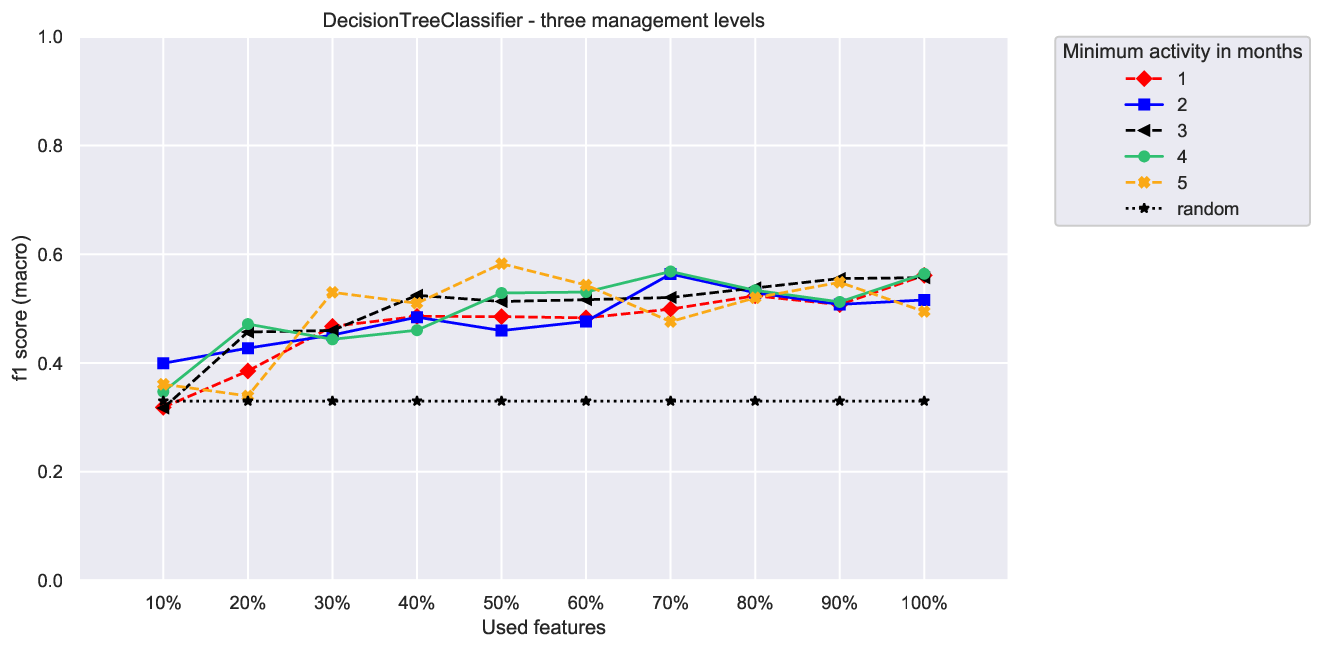
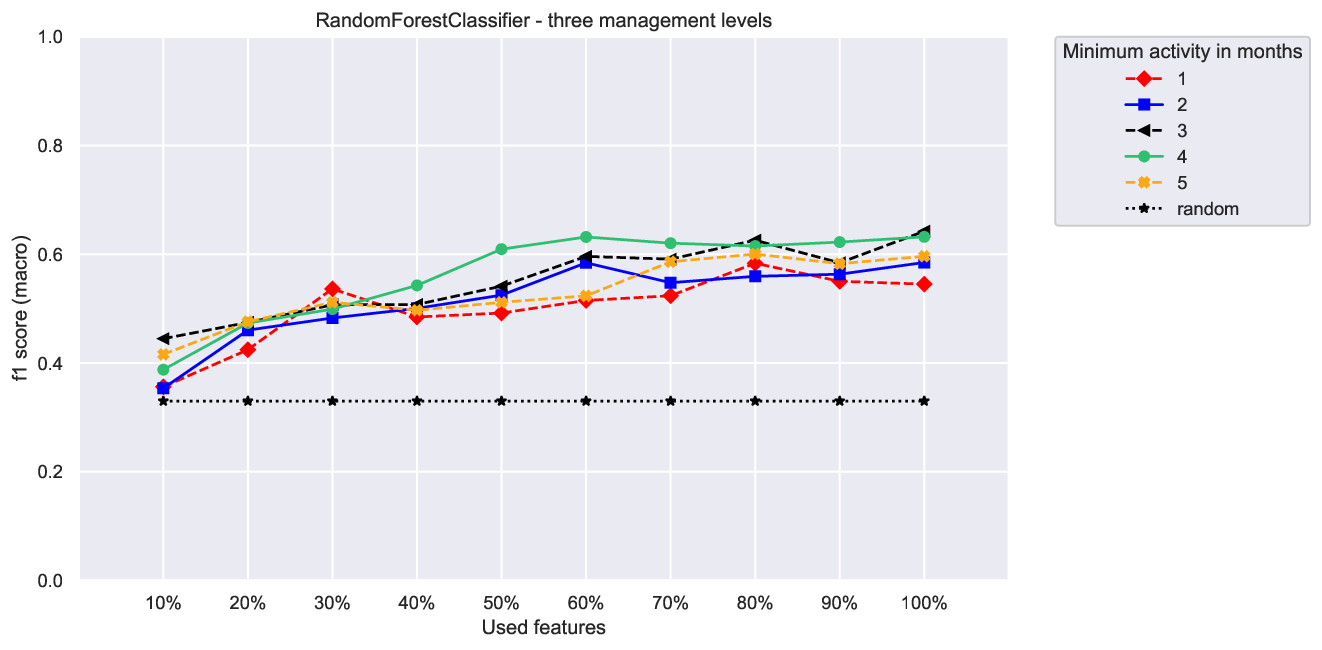
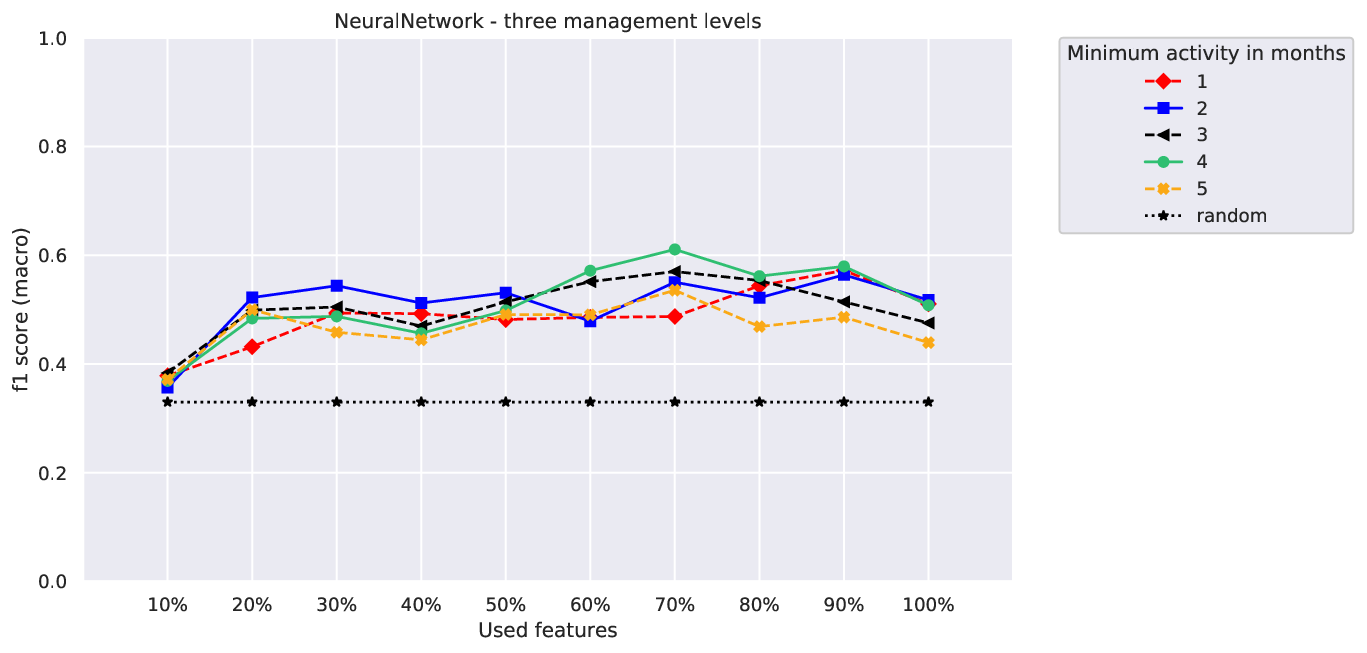
На рисунках 10, 12 и 13 представлены результаты для датасета Enron, которые аналогичны результатам для предыдущего датасета. Результат, полученный с помощью случайных меток, составил 0.49 для двух уровней иерархии и 0.33 для трех уровней. Наилучший f1-score для методов обучения с учителем был достигнут алгоритмом Random Forest и составил 0.8198 для двух уровней иерархии и 0.6423 для трех уровней. Результаты алгоритма collective classification были выше результатов стандартной классификации, если доля известных меток узлов превышала 70%. Ниже этого значения результаты были схожи со стандартной классификацией, более того, для трех групп при падении доли известных узлов ниже 40% результаты существенно ухудшались. Видно, что чрезмерное сокращение признаков или известных узлов приводит к результатам, близким к случайным. Кроме того, схожесть результатов важна, так как показывает, что представленное решение хорошо работает для различных моделей организационного управления. На производственном предприятии большинство сотрудников являются рядовыми конторскими работниками в отличие от небольшой группы руководства. В датасете Enron ситуация противоположная, поэтому соотношение между первым и вторым уровнями руководства и рядовыми сотрудниками сбалансировано.
Подводя итог, лучшие результаты, полученные алгоритмами supervised learning, представлены в Таблице 5. Кроме того, все числовые результаты можно найти в Приложении в Таблицах 6–25.
| Dataset | Number of Levels | Algorithm | F1-Score | Min. Activity | % of Features |
| manufacturing company | 2 | Decision Tree | 0.7039 | 2 months | 80% |
| Random Forest | 0.7768 | 5 months | 90% | ||
| Neural Network | 0.6247 | 3 months | 100% | ||
| SVM | 0.6517 | 3 months | 100% | ||
| 3 | Decision Tree | 0.4737 | 1 month | 80% | |
| Random Forest | 0.4575 | 2 months | 60% | ||
| Neural Network | 0.4149 | 1 month | 100% | ||
| SVM | 0.4622 | 4 months | 50% | ||
| Enron | 2 | Decision Tree | 0.7849 | 5 months | 100% |
| Random Forest | 0.8198 | 5 months | 100% | ||
| Neural Network | 0.7835 | 4 months | 80% | ||
| SVM | 0.7855 | 5 months | 50% | ||
| 3 | Decision Tree | 0.5827 | 5 months | 50% | |
| Random Forest | 0.6423 | 3 months | 100% | ||
| Neural Network | 0.6107 | 4 months | 70% | ||
| SVM | 0.6137 | 3 months | 70% |
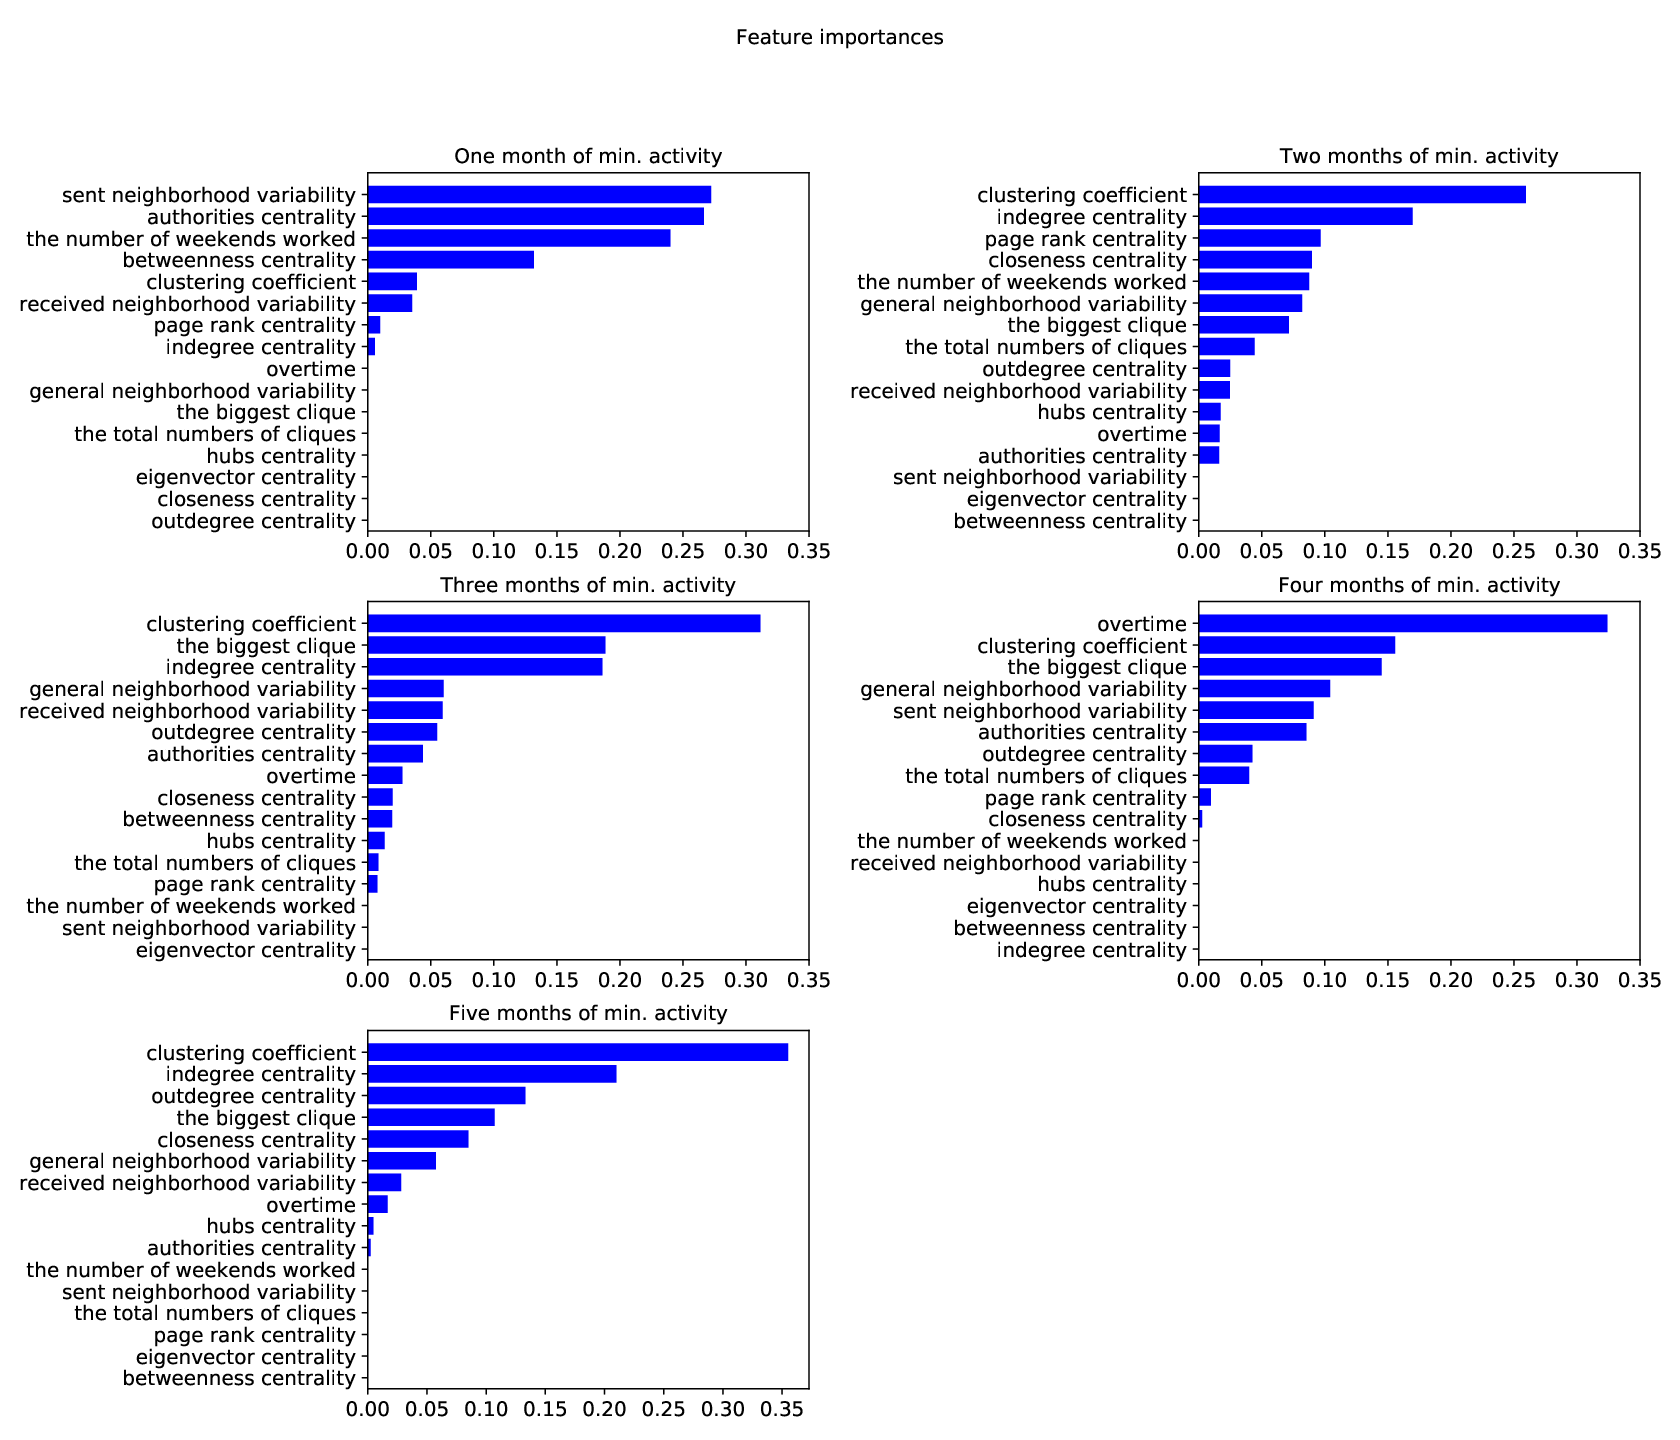
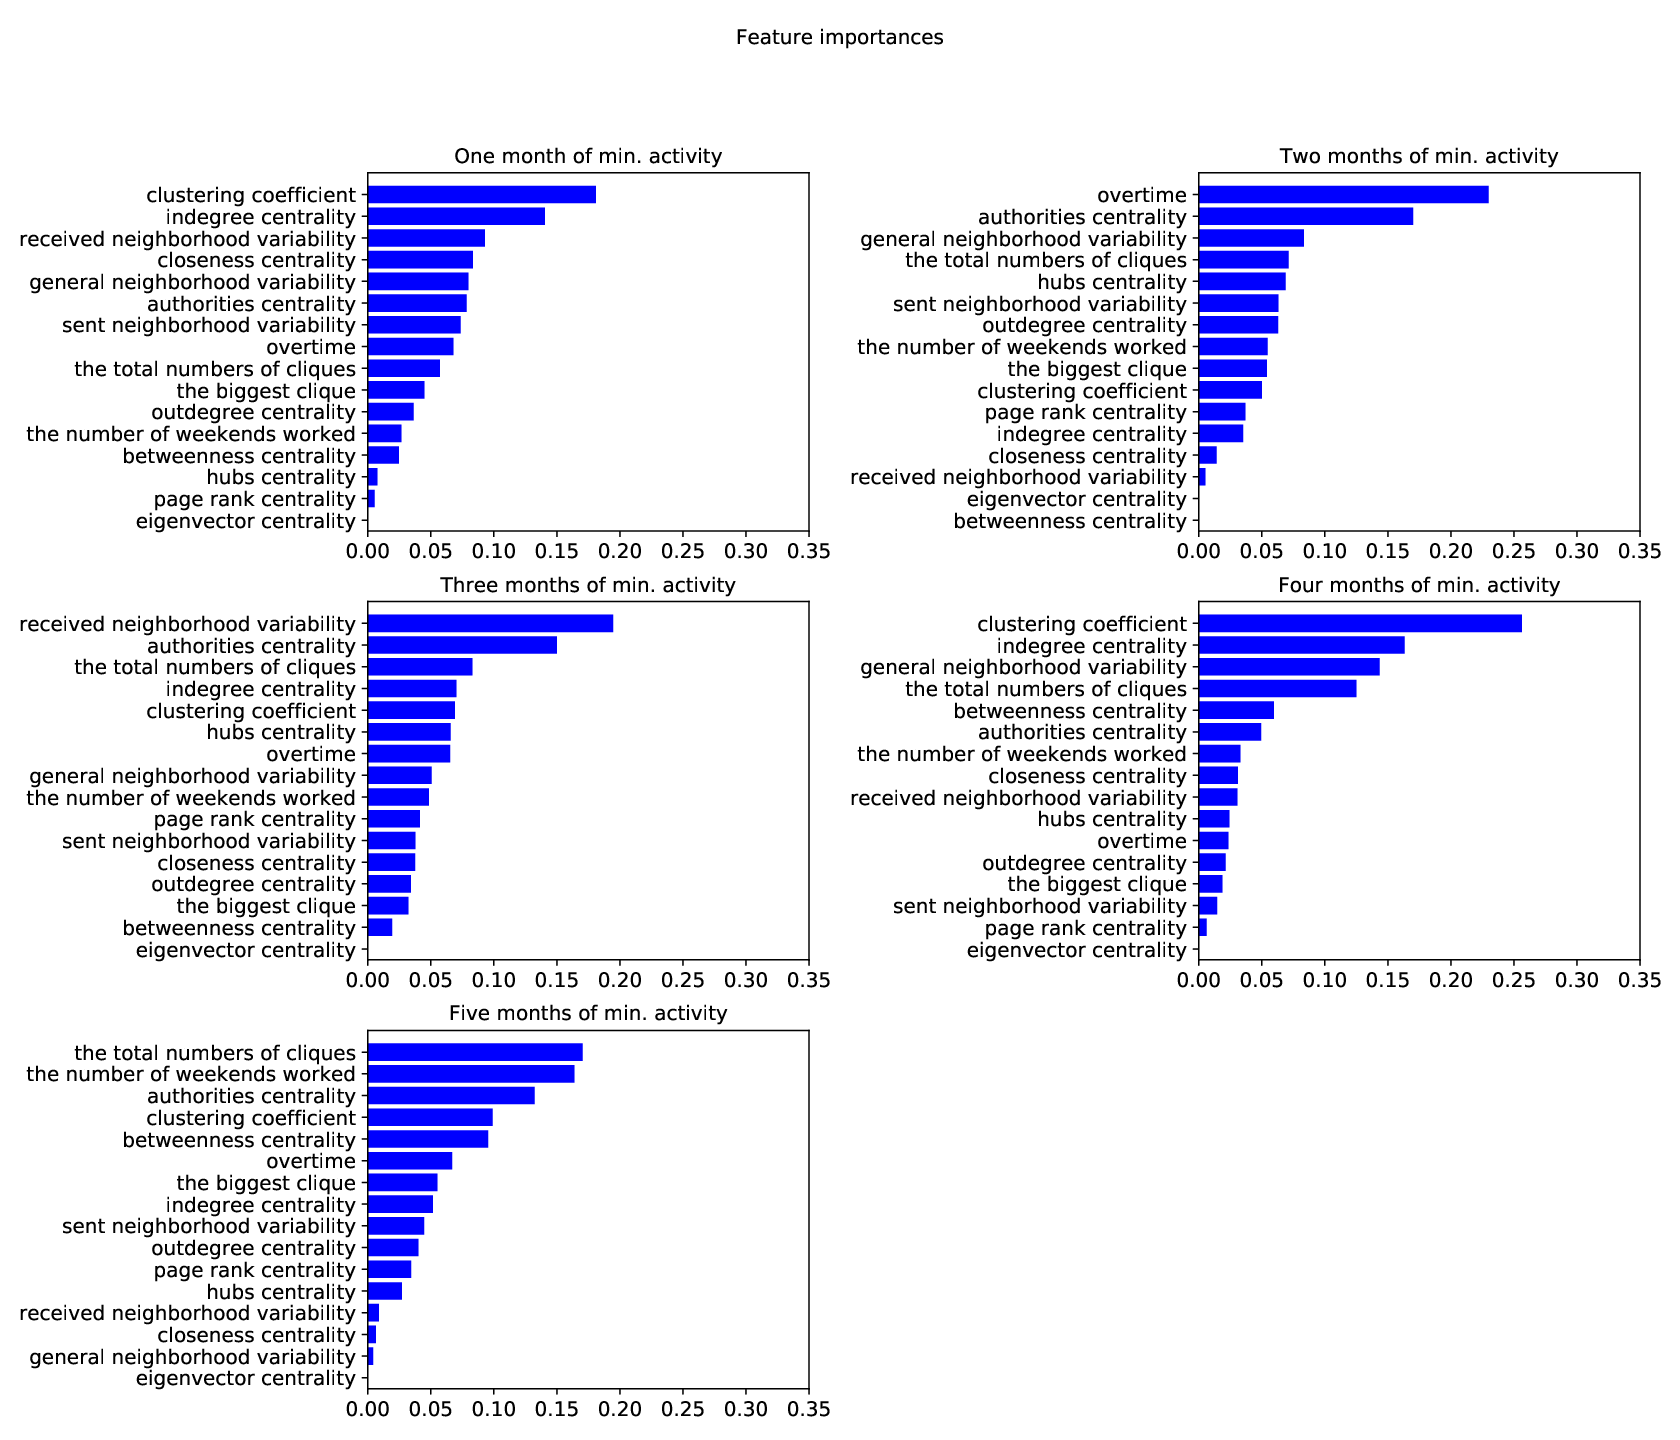
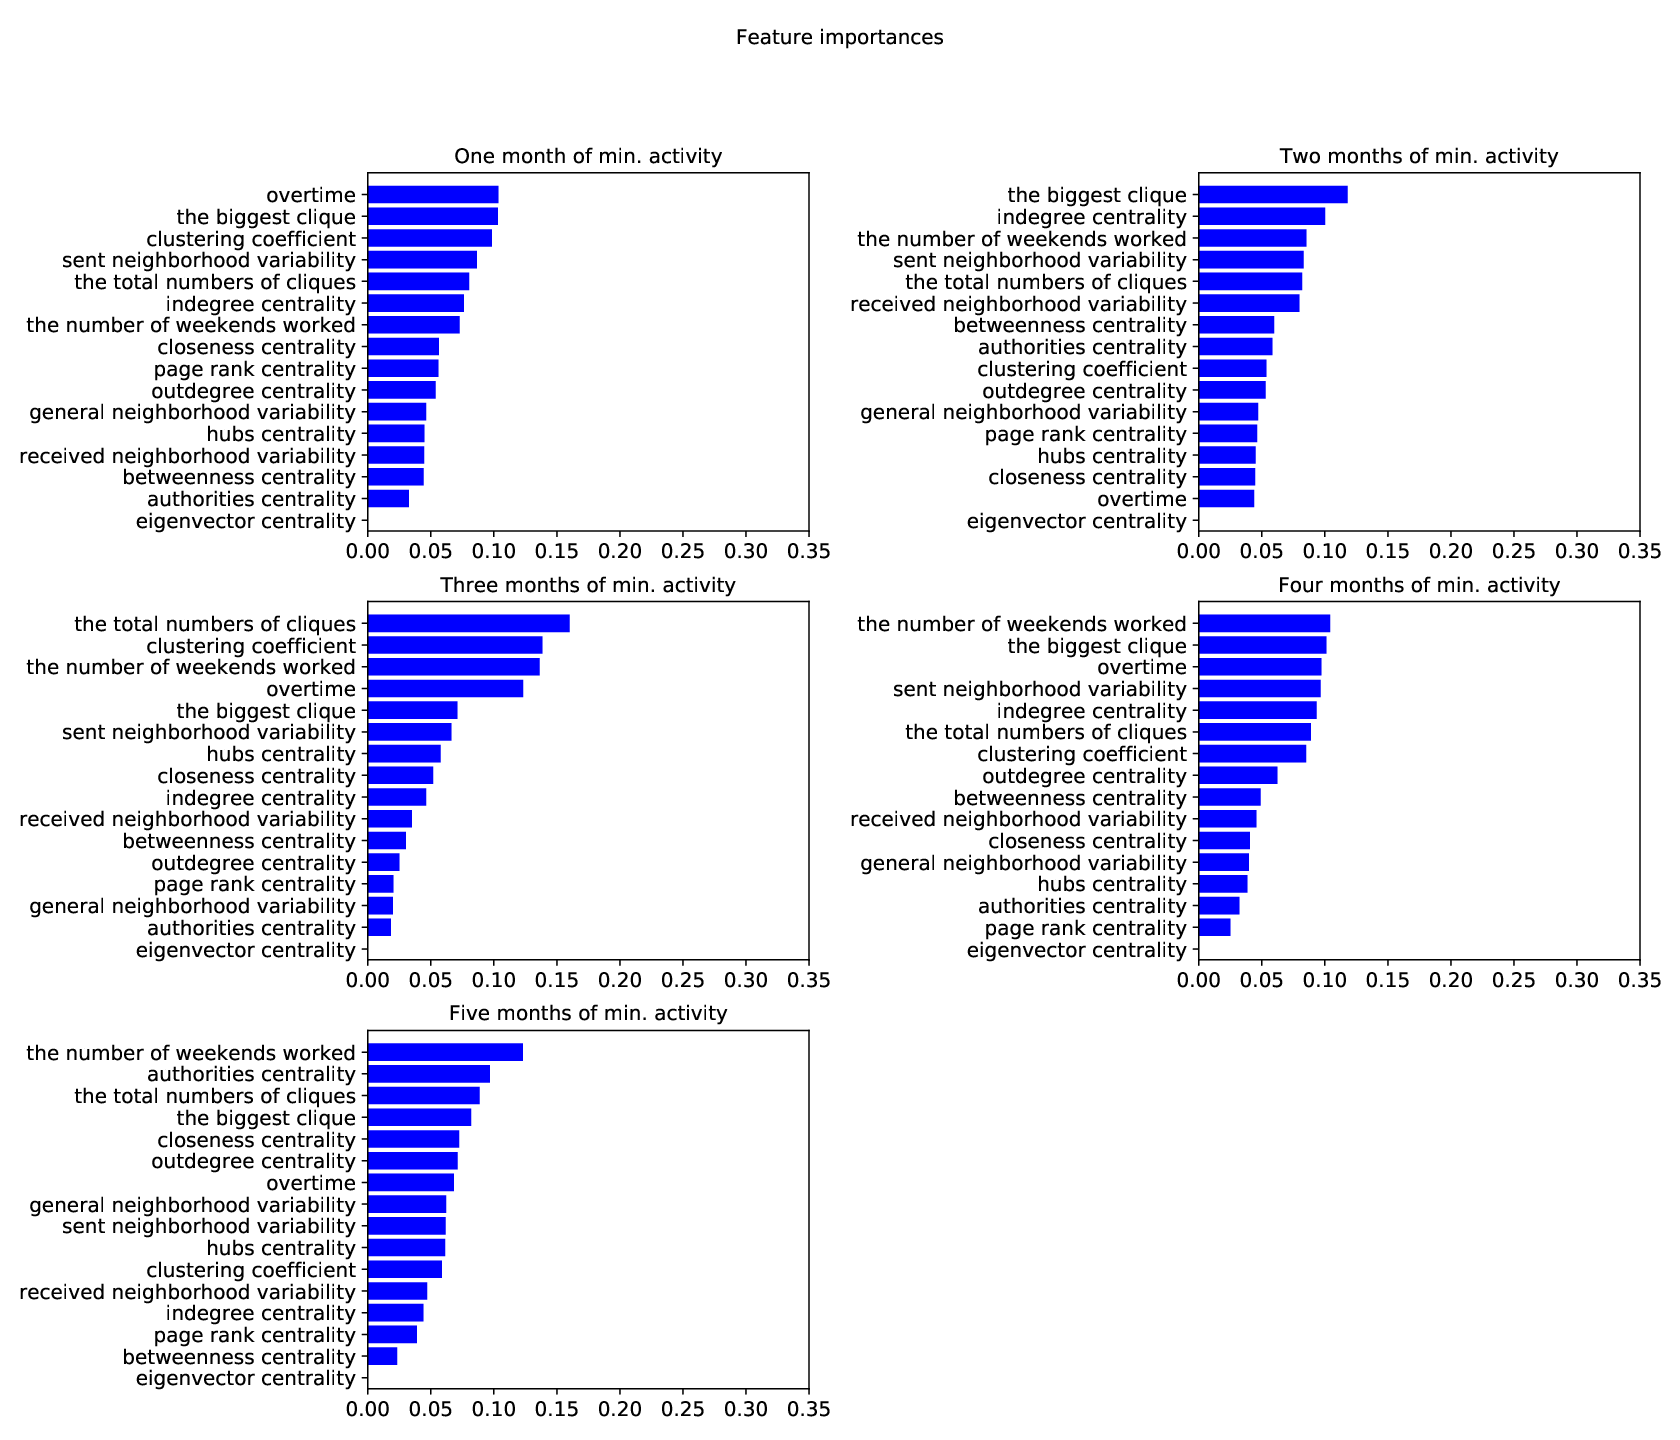
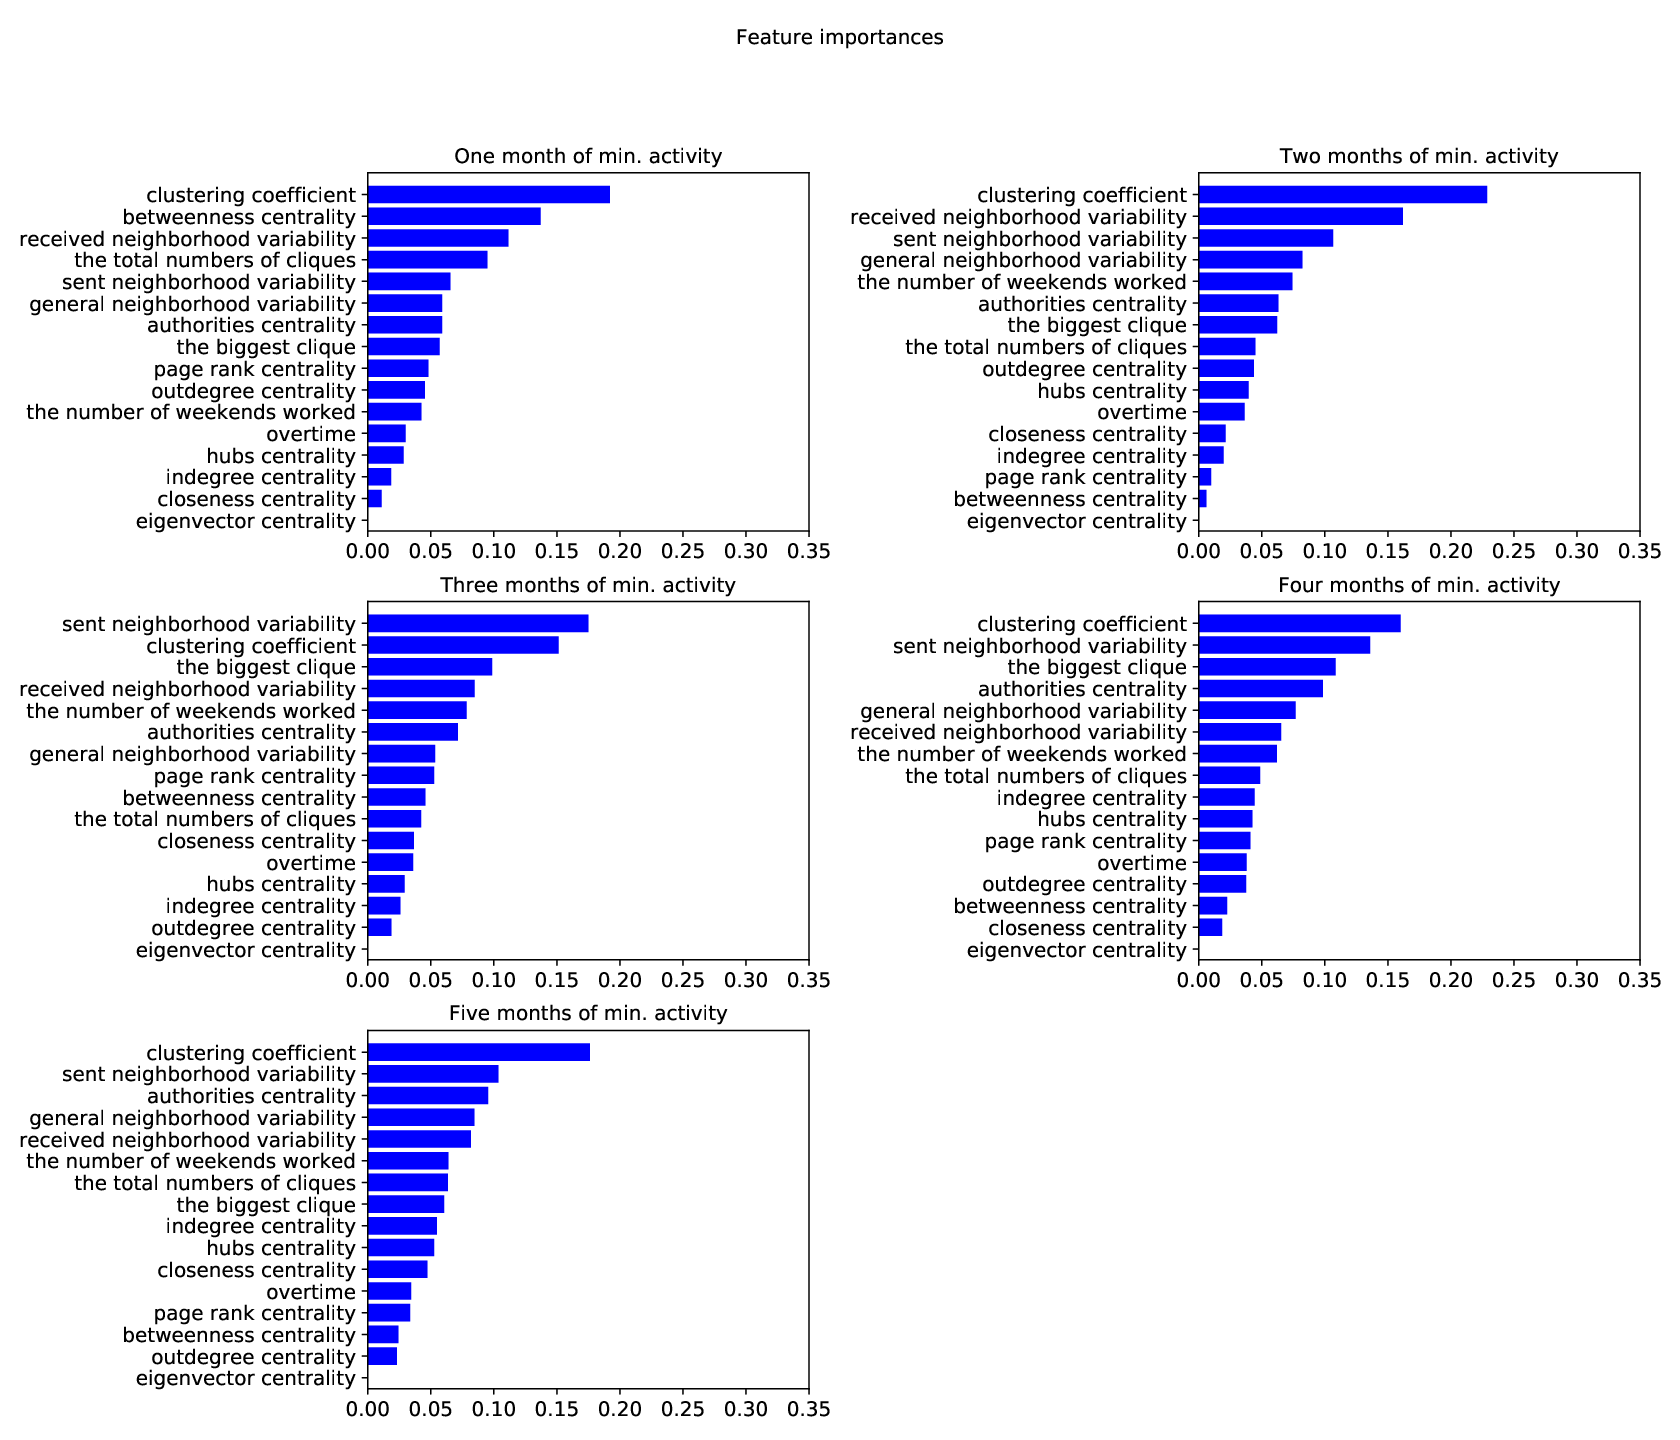
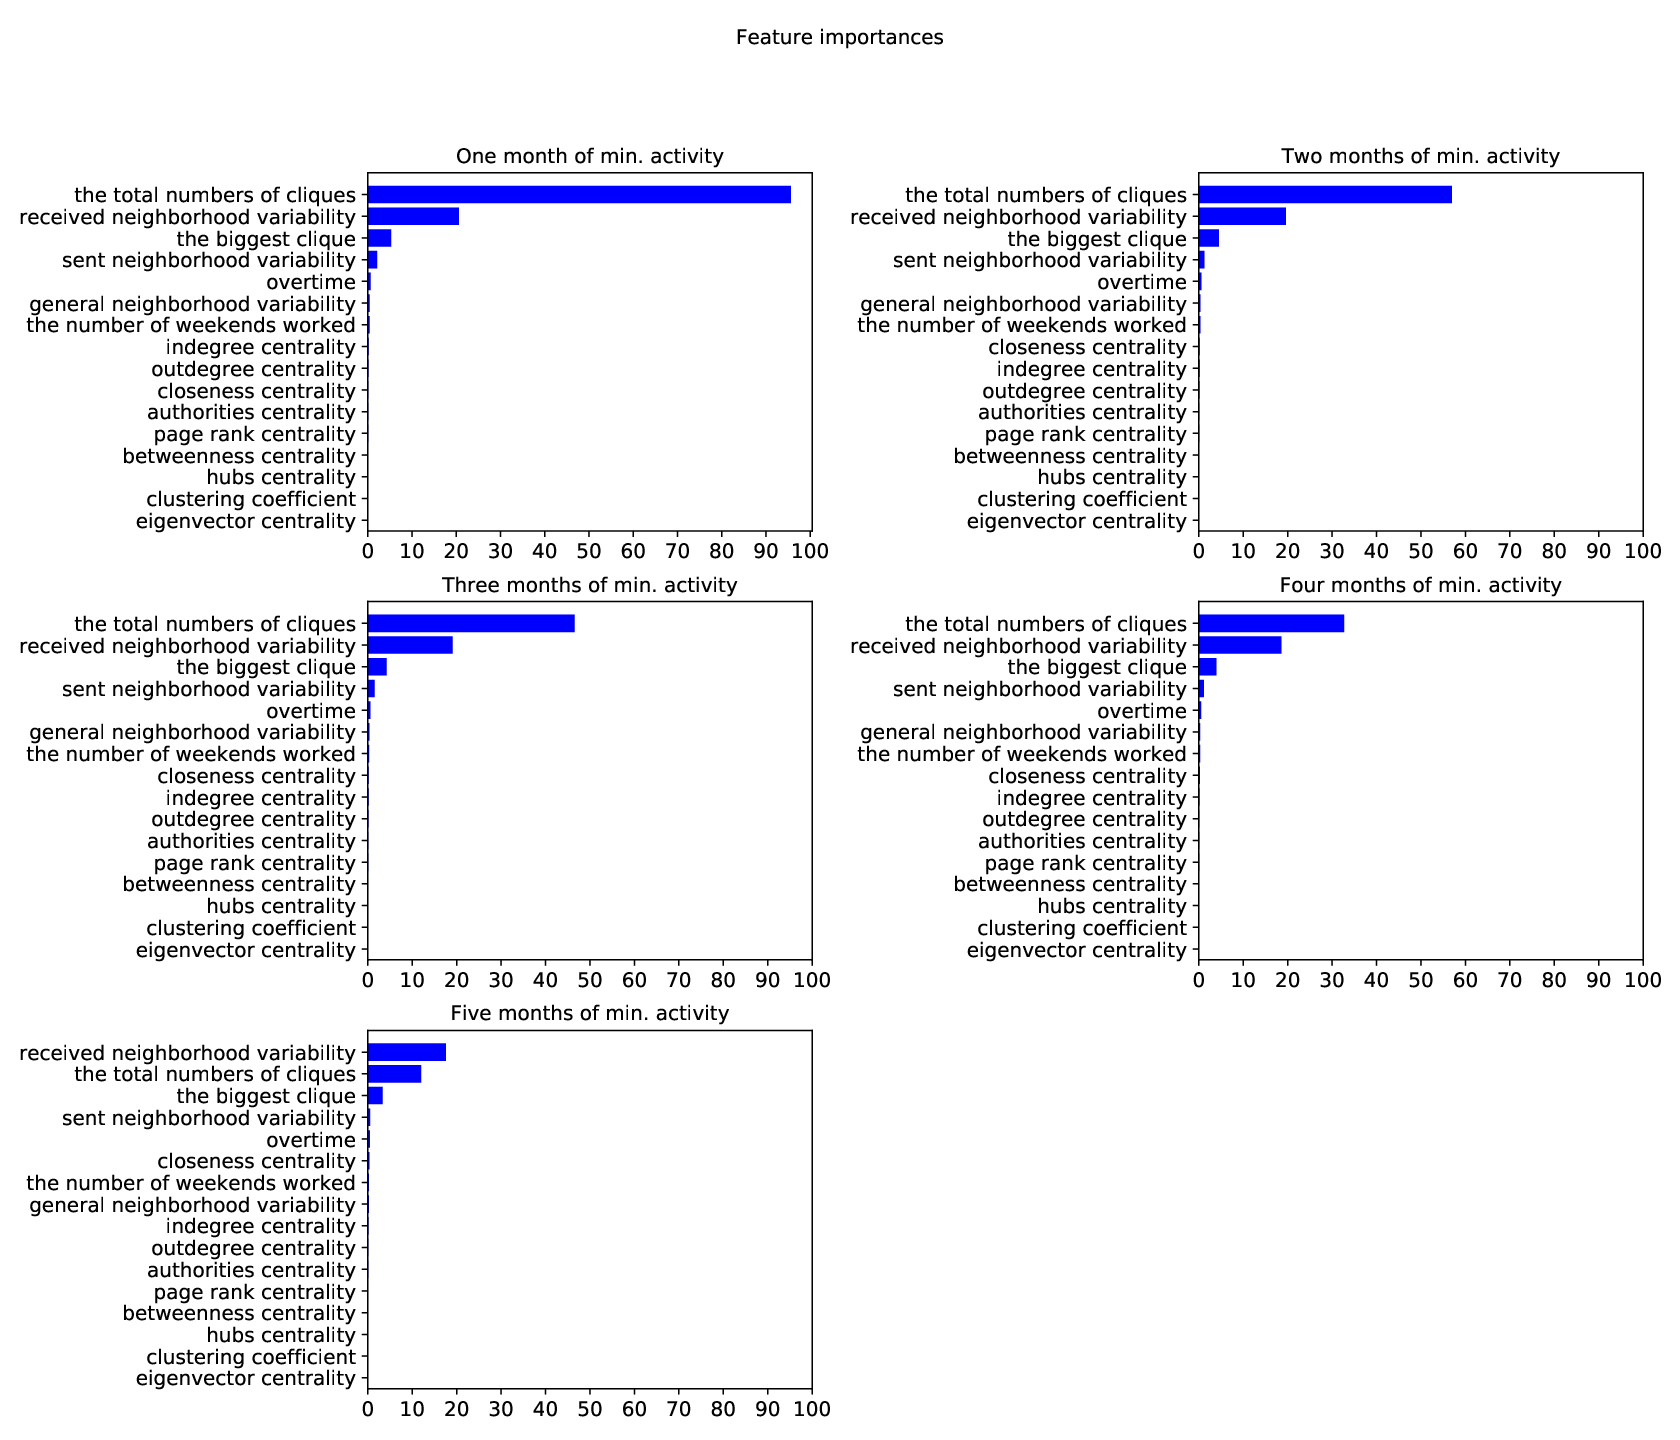
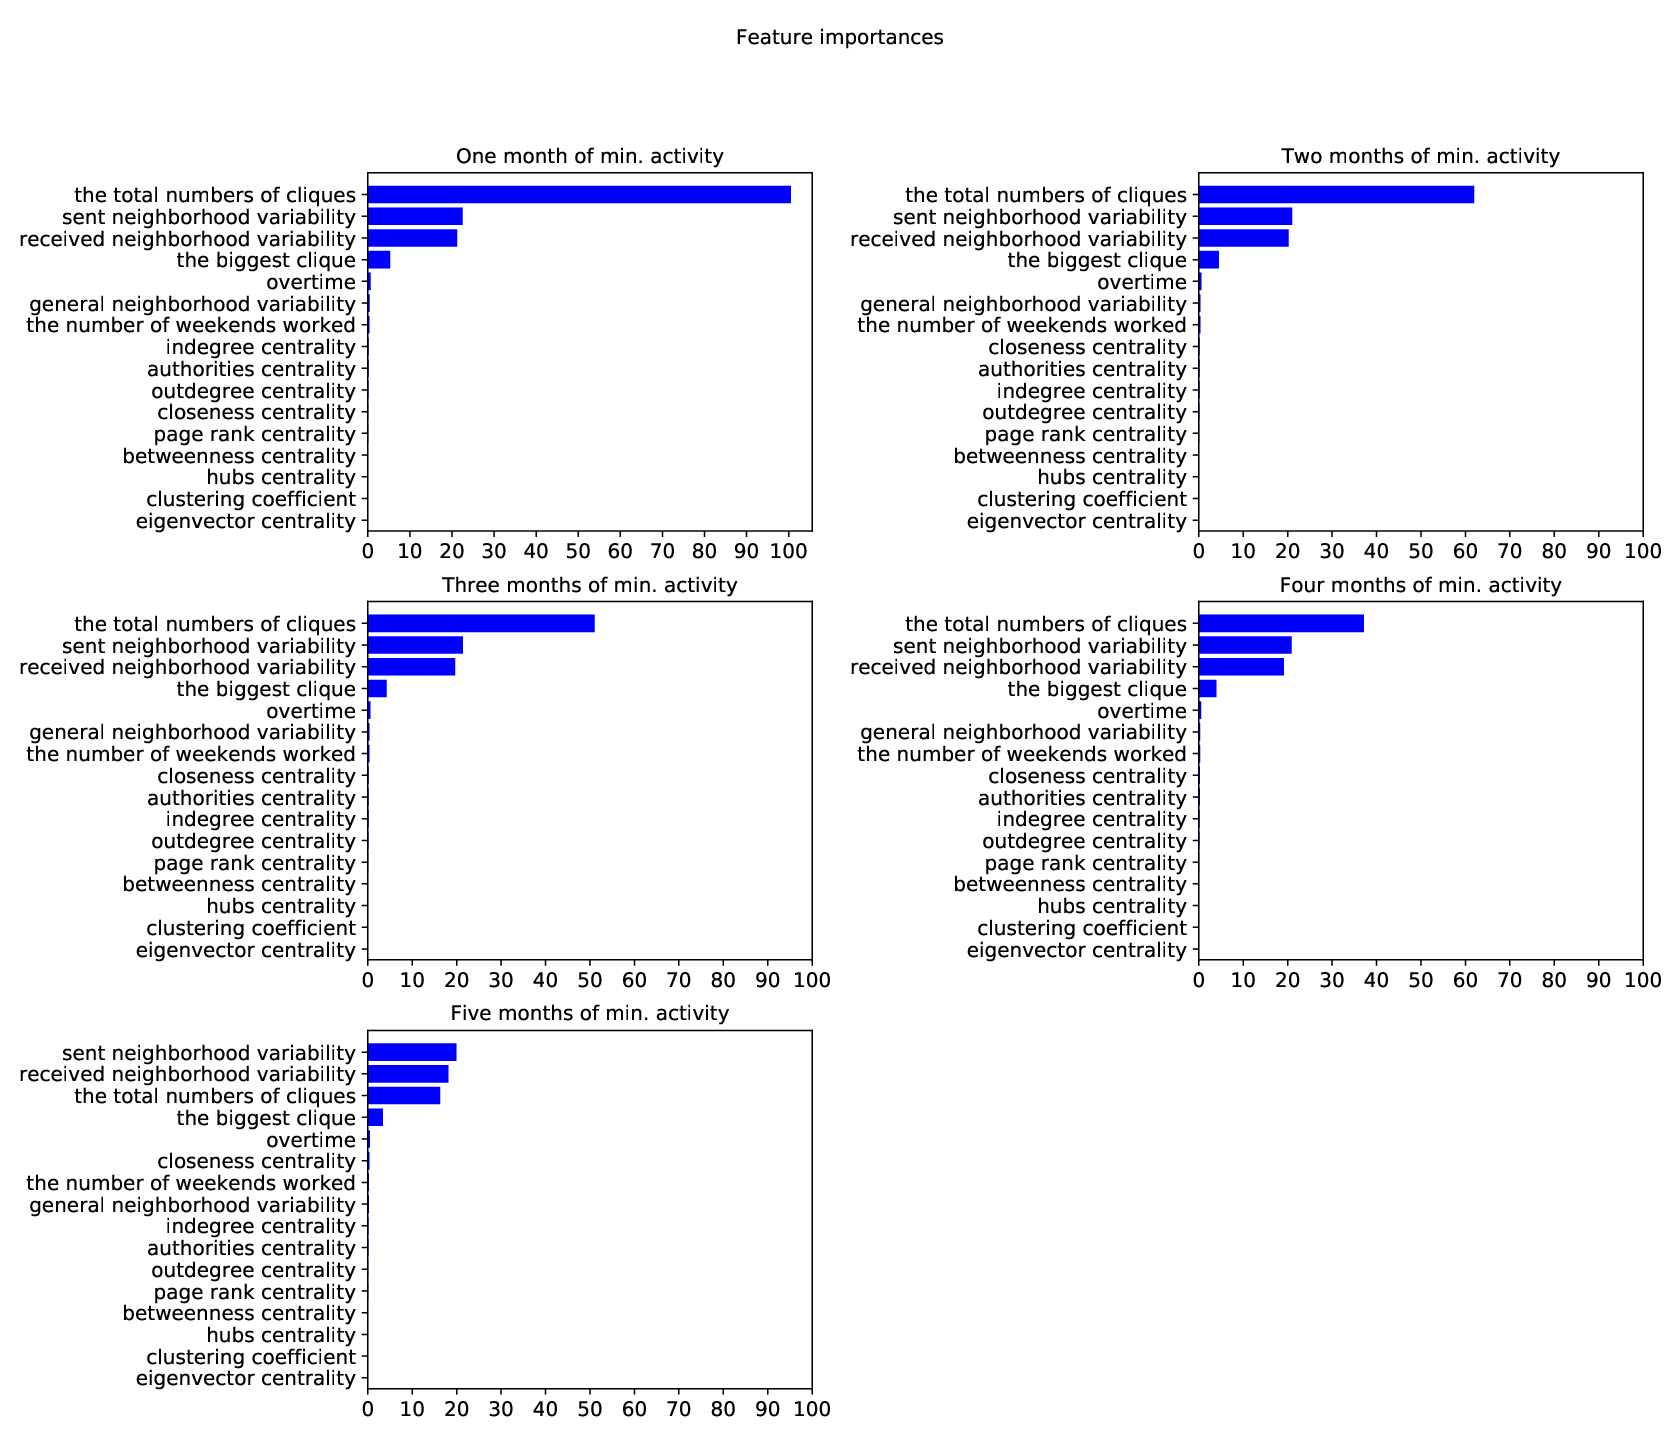
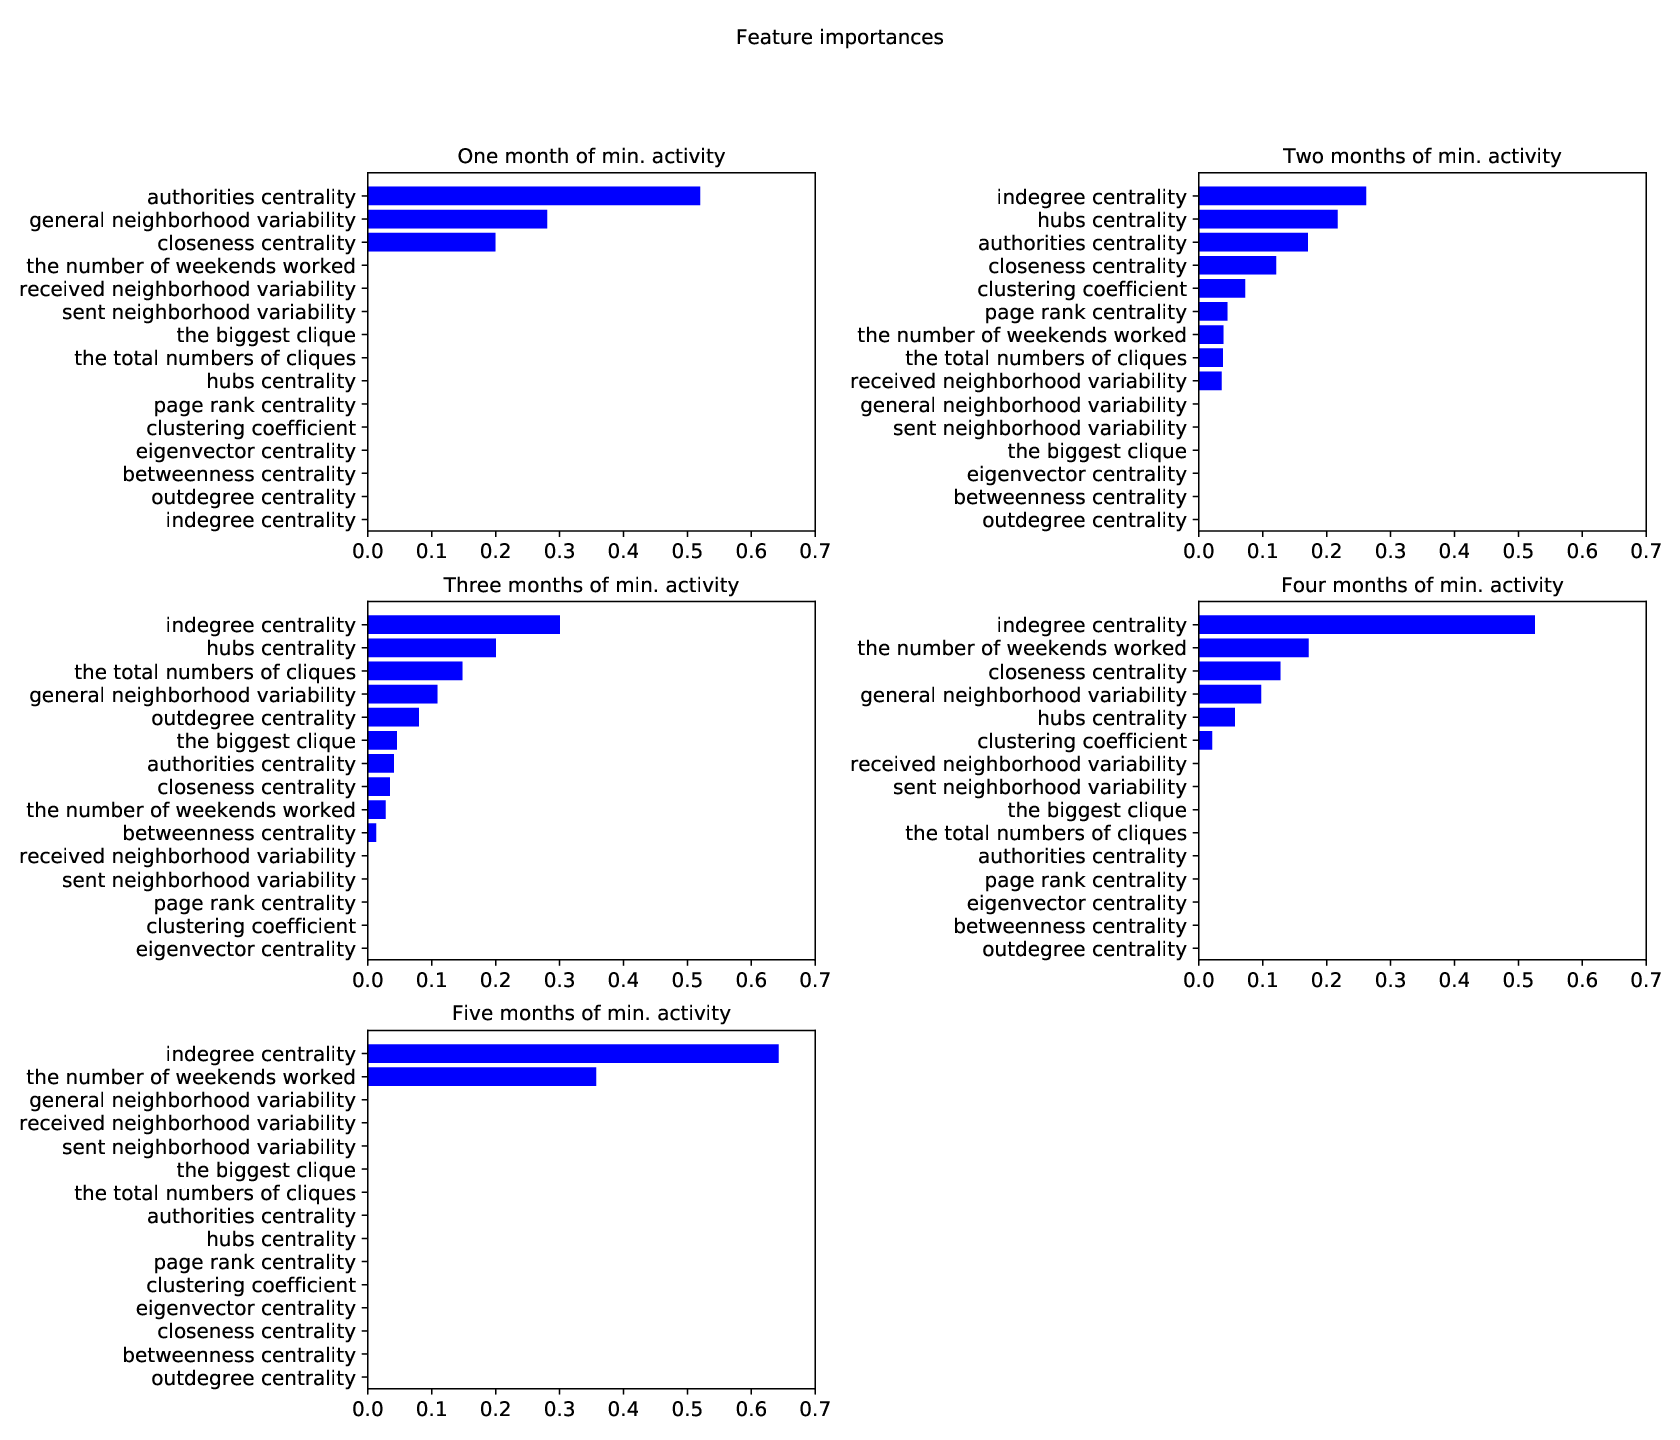
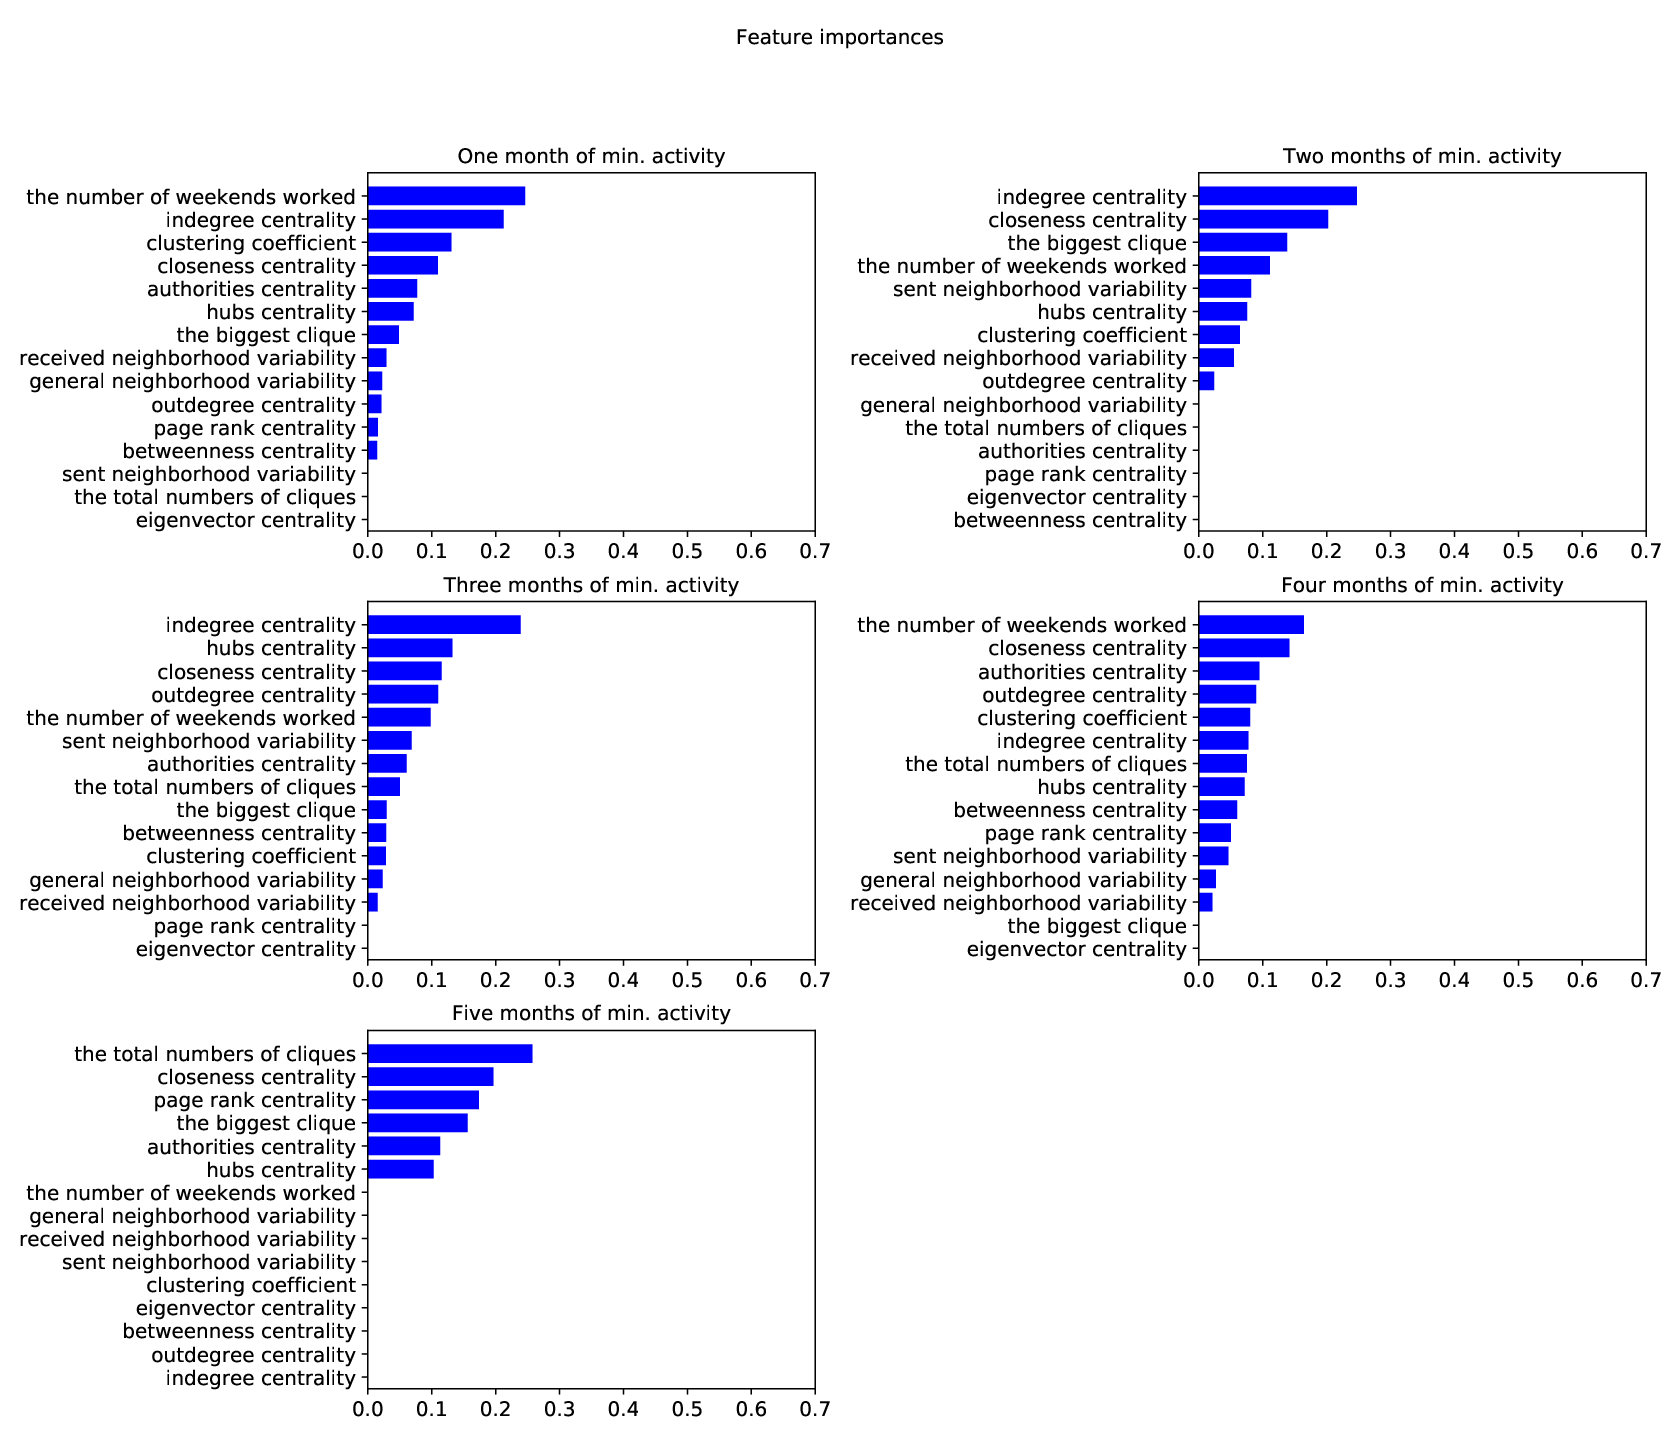
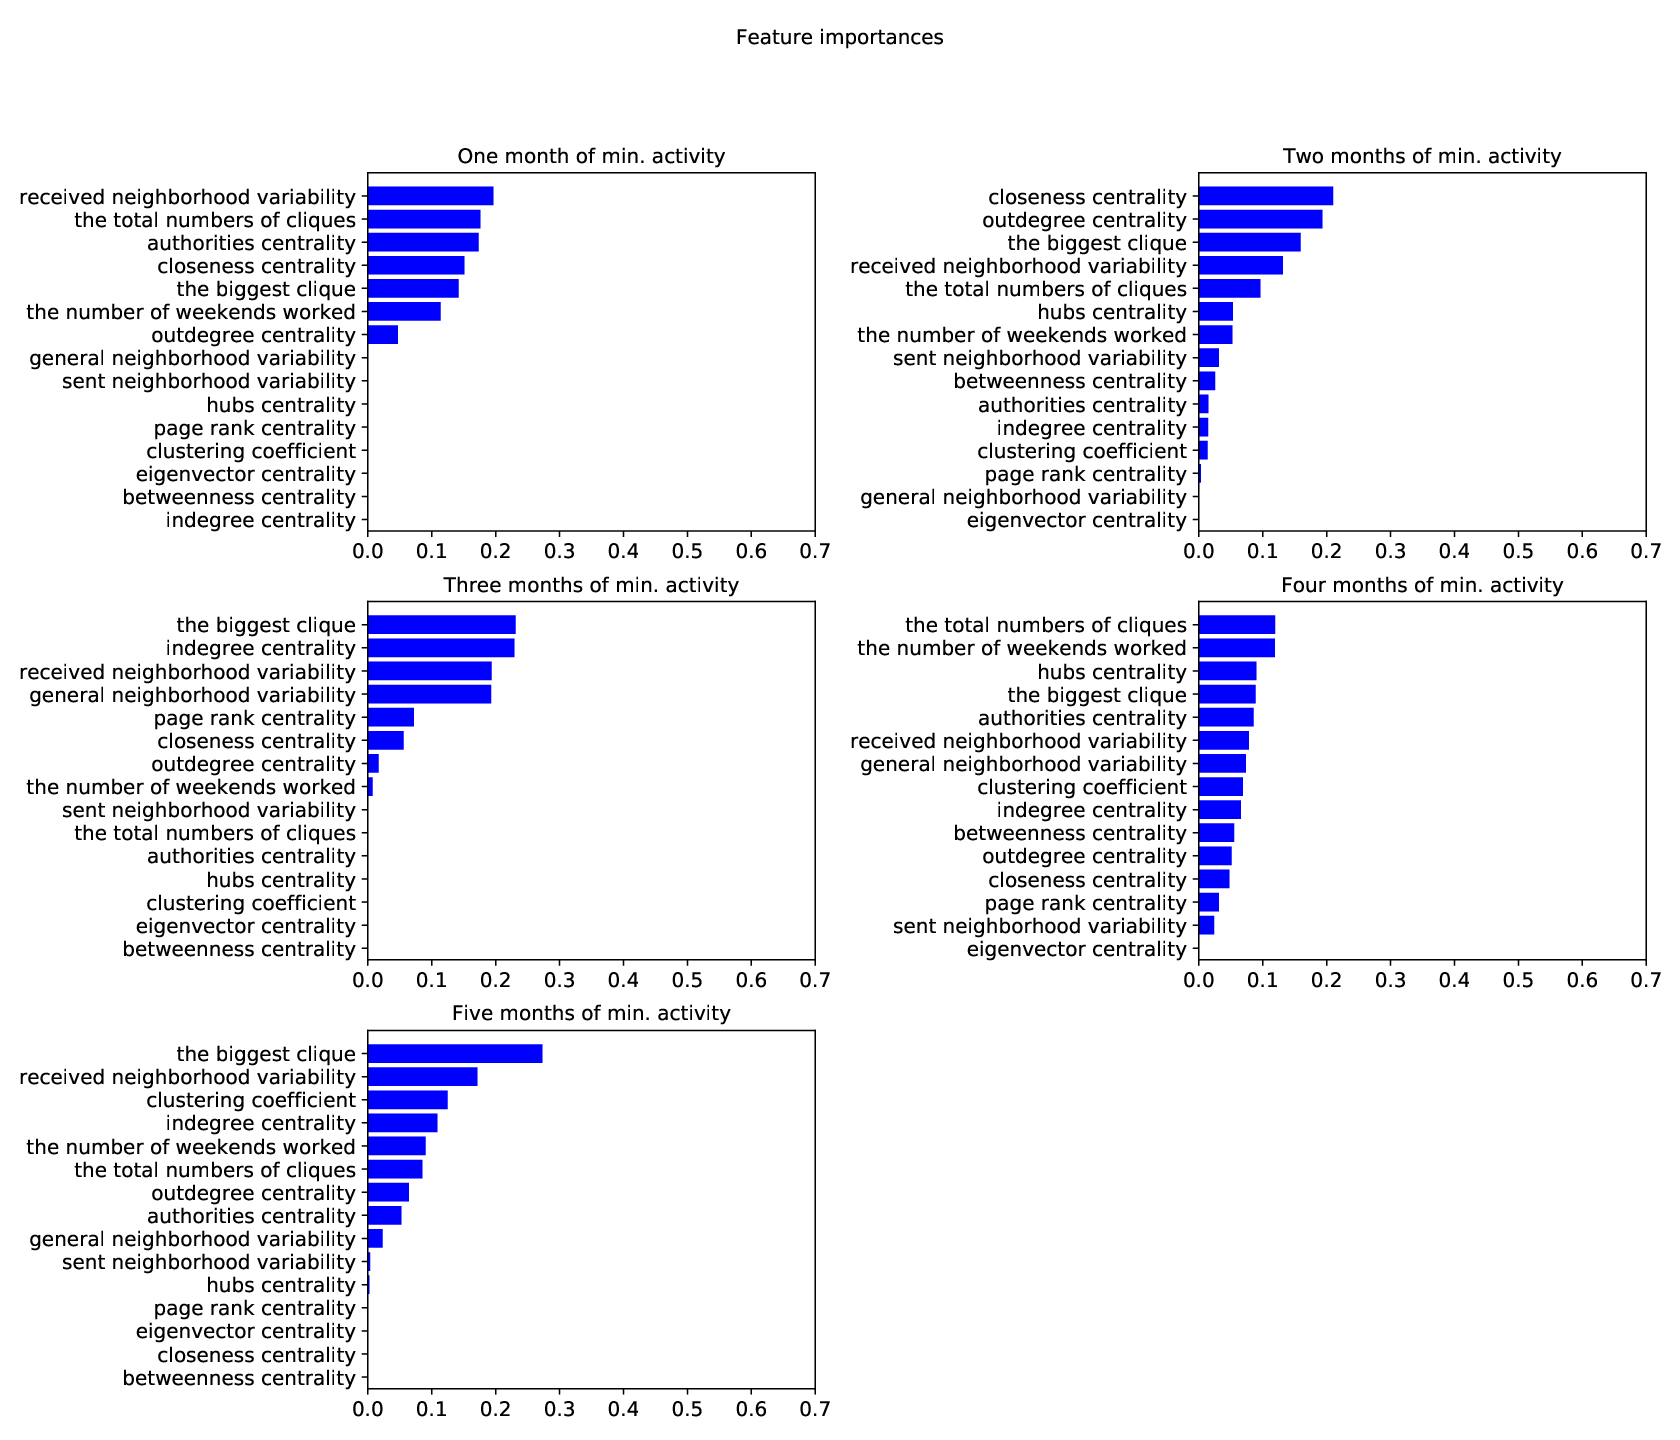
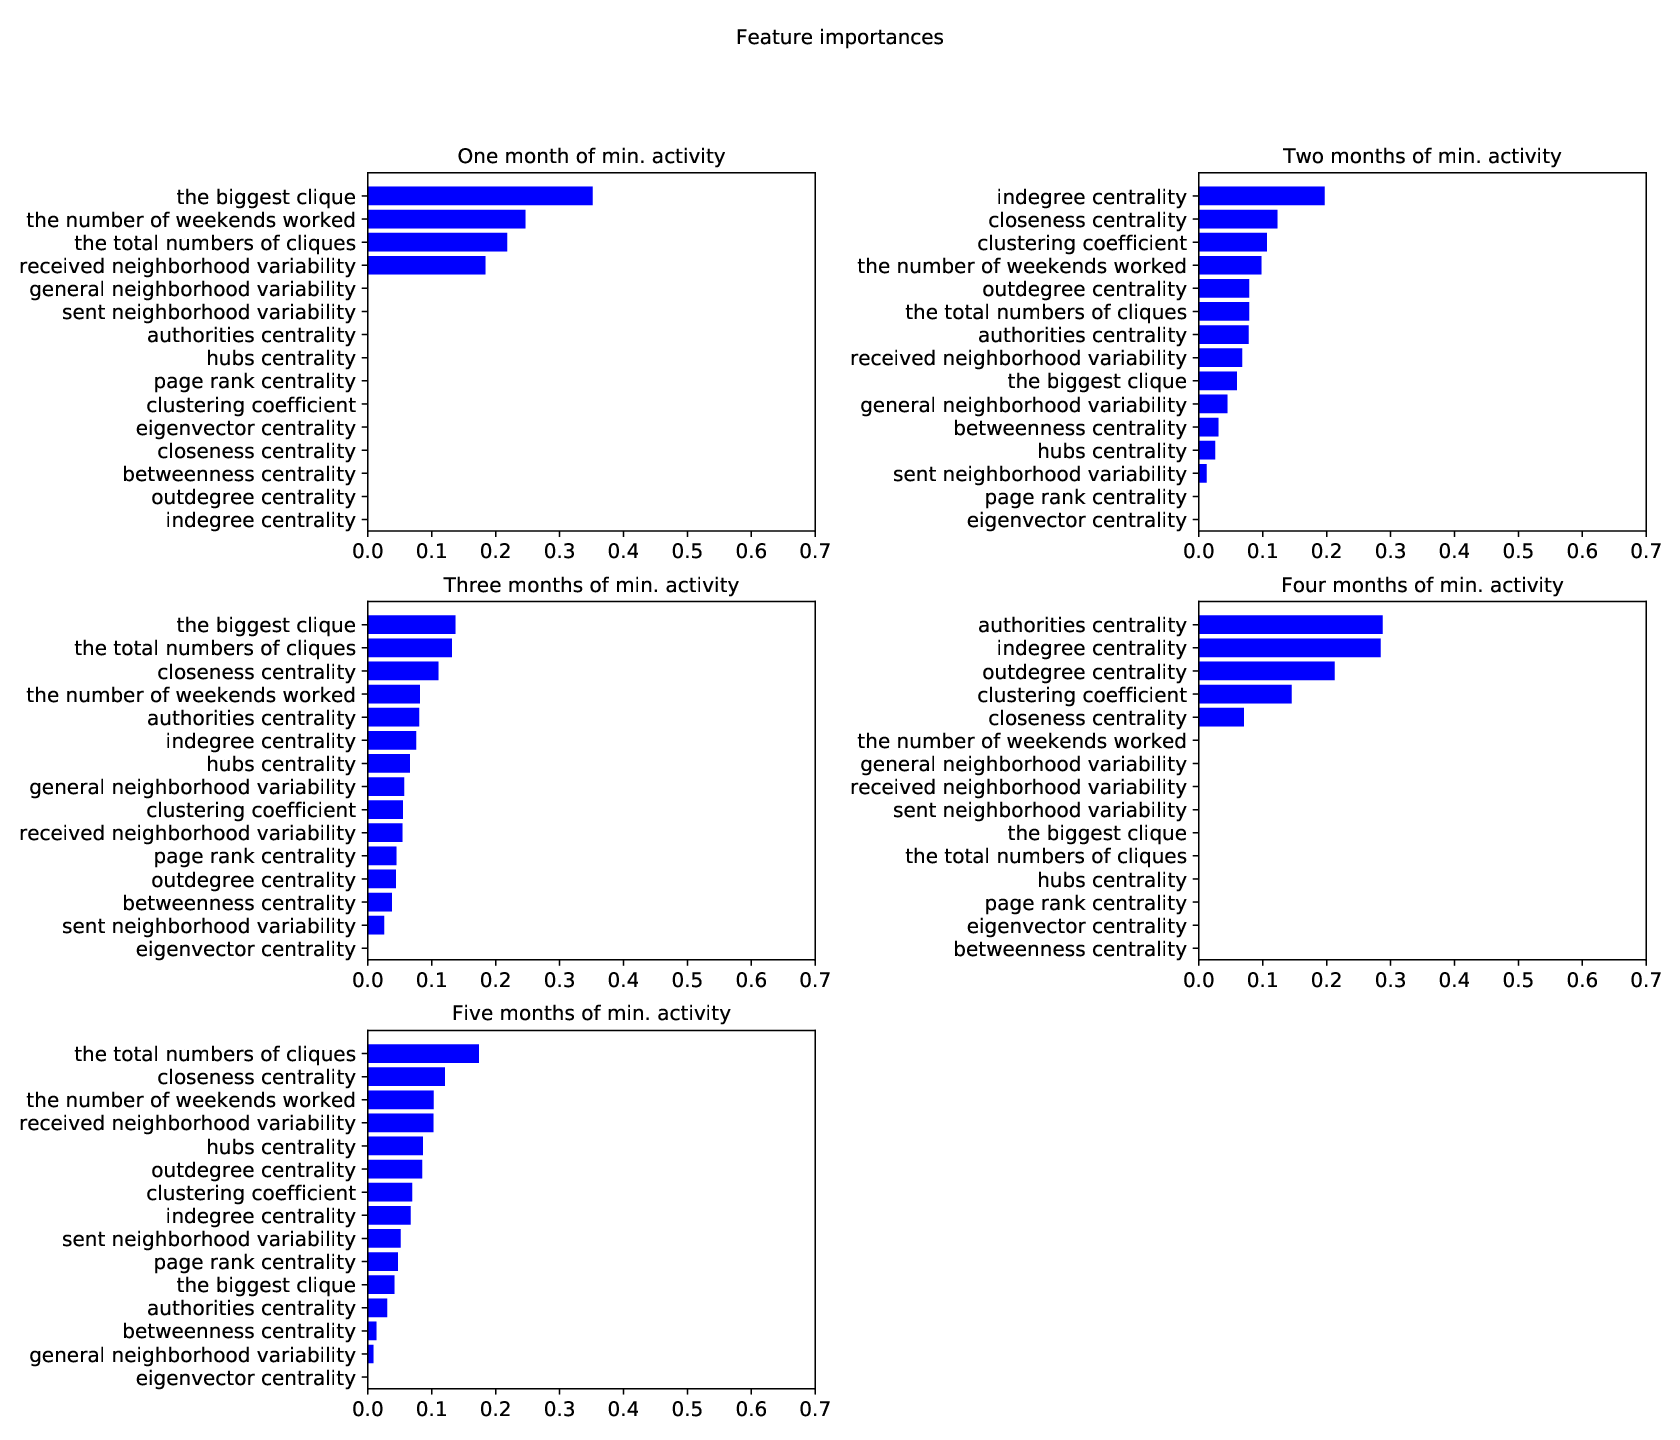
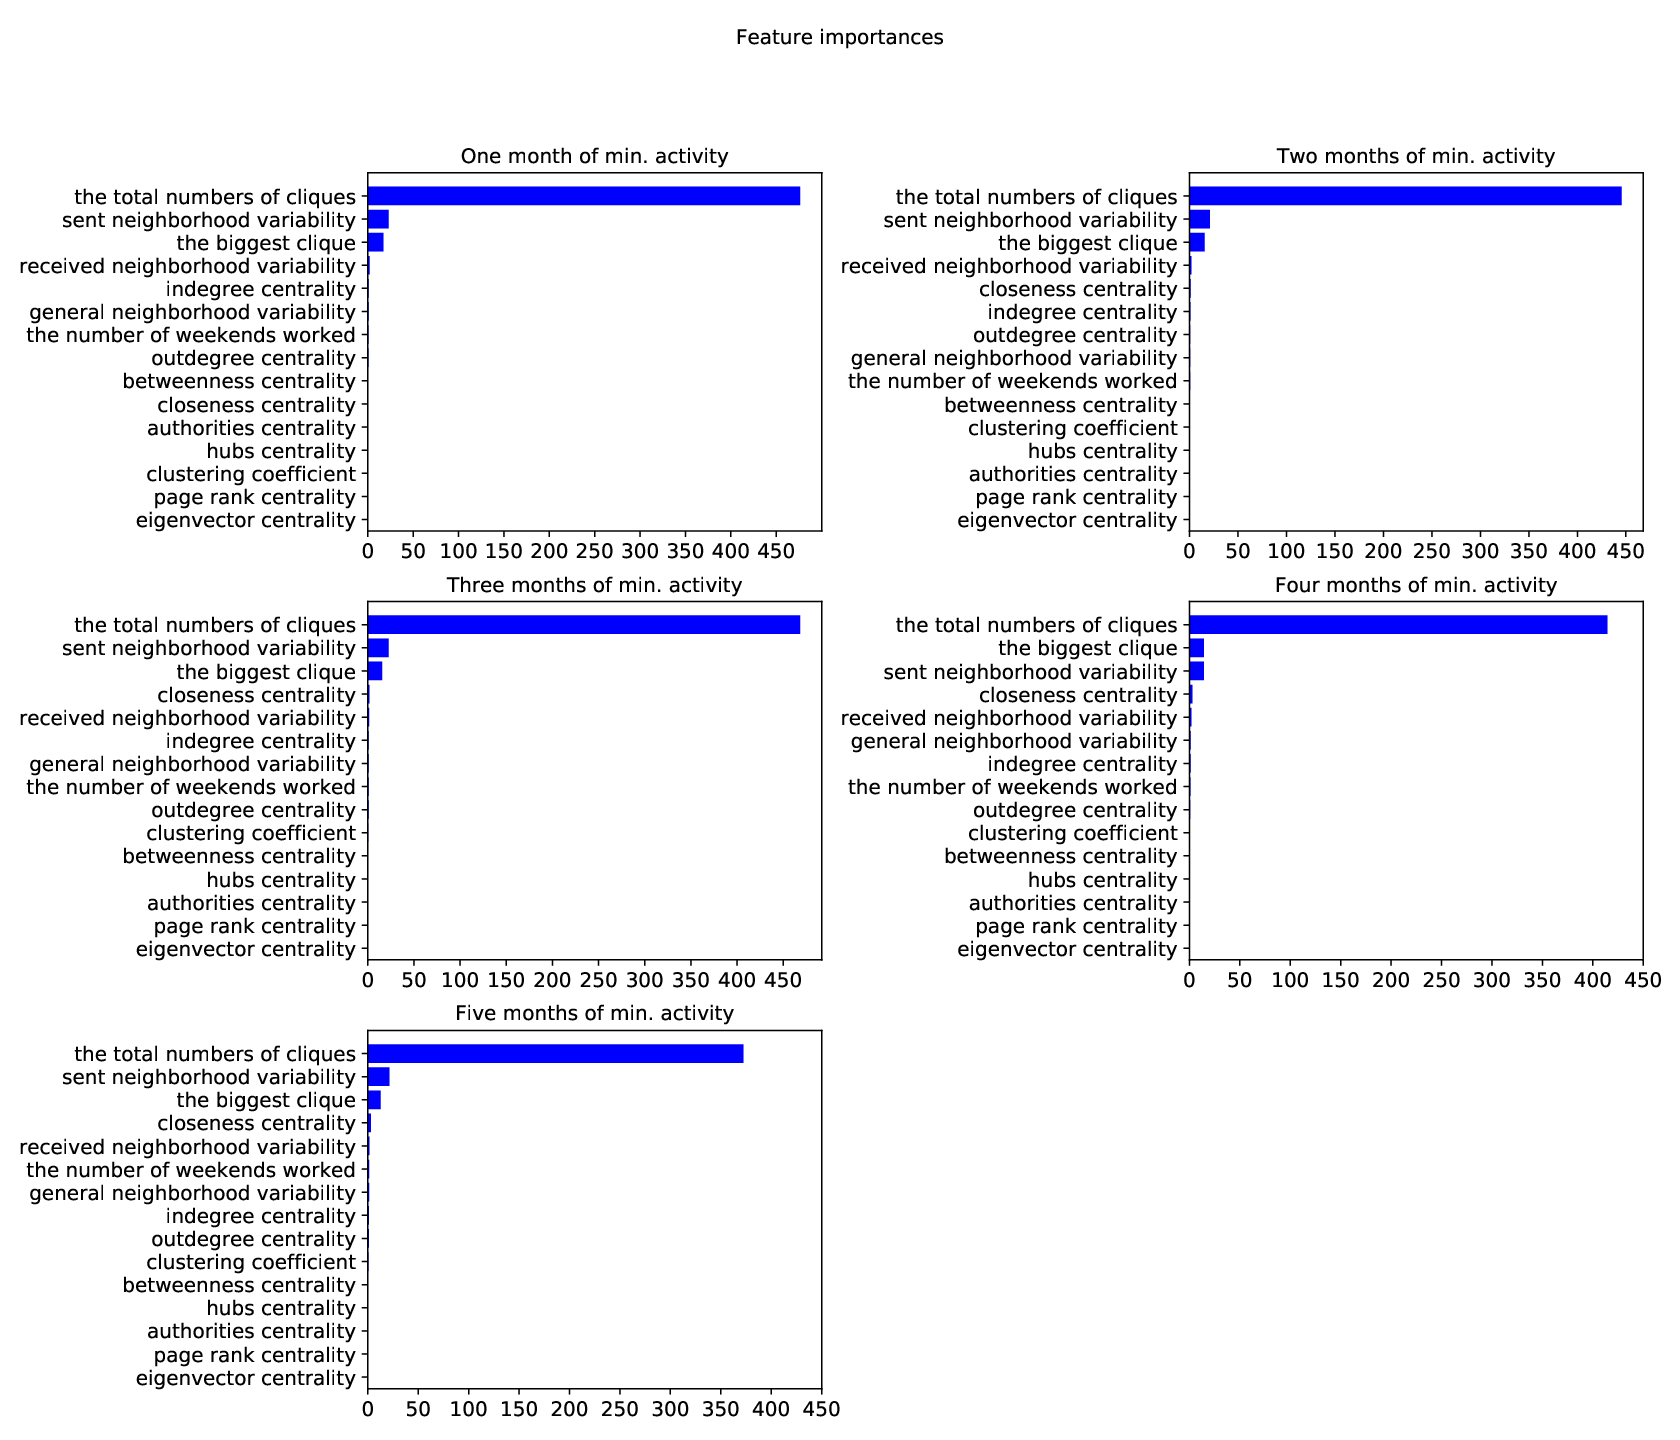
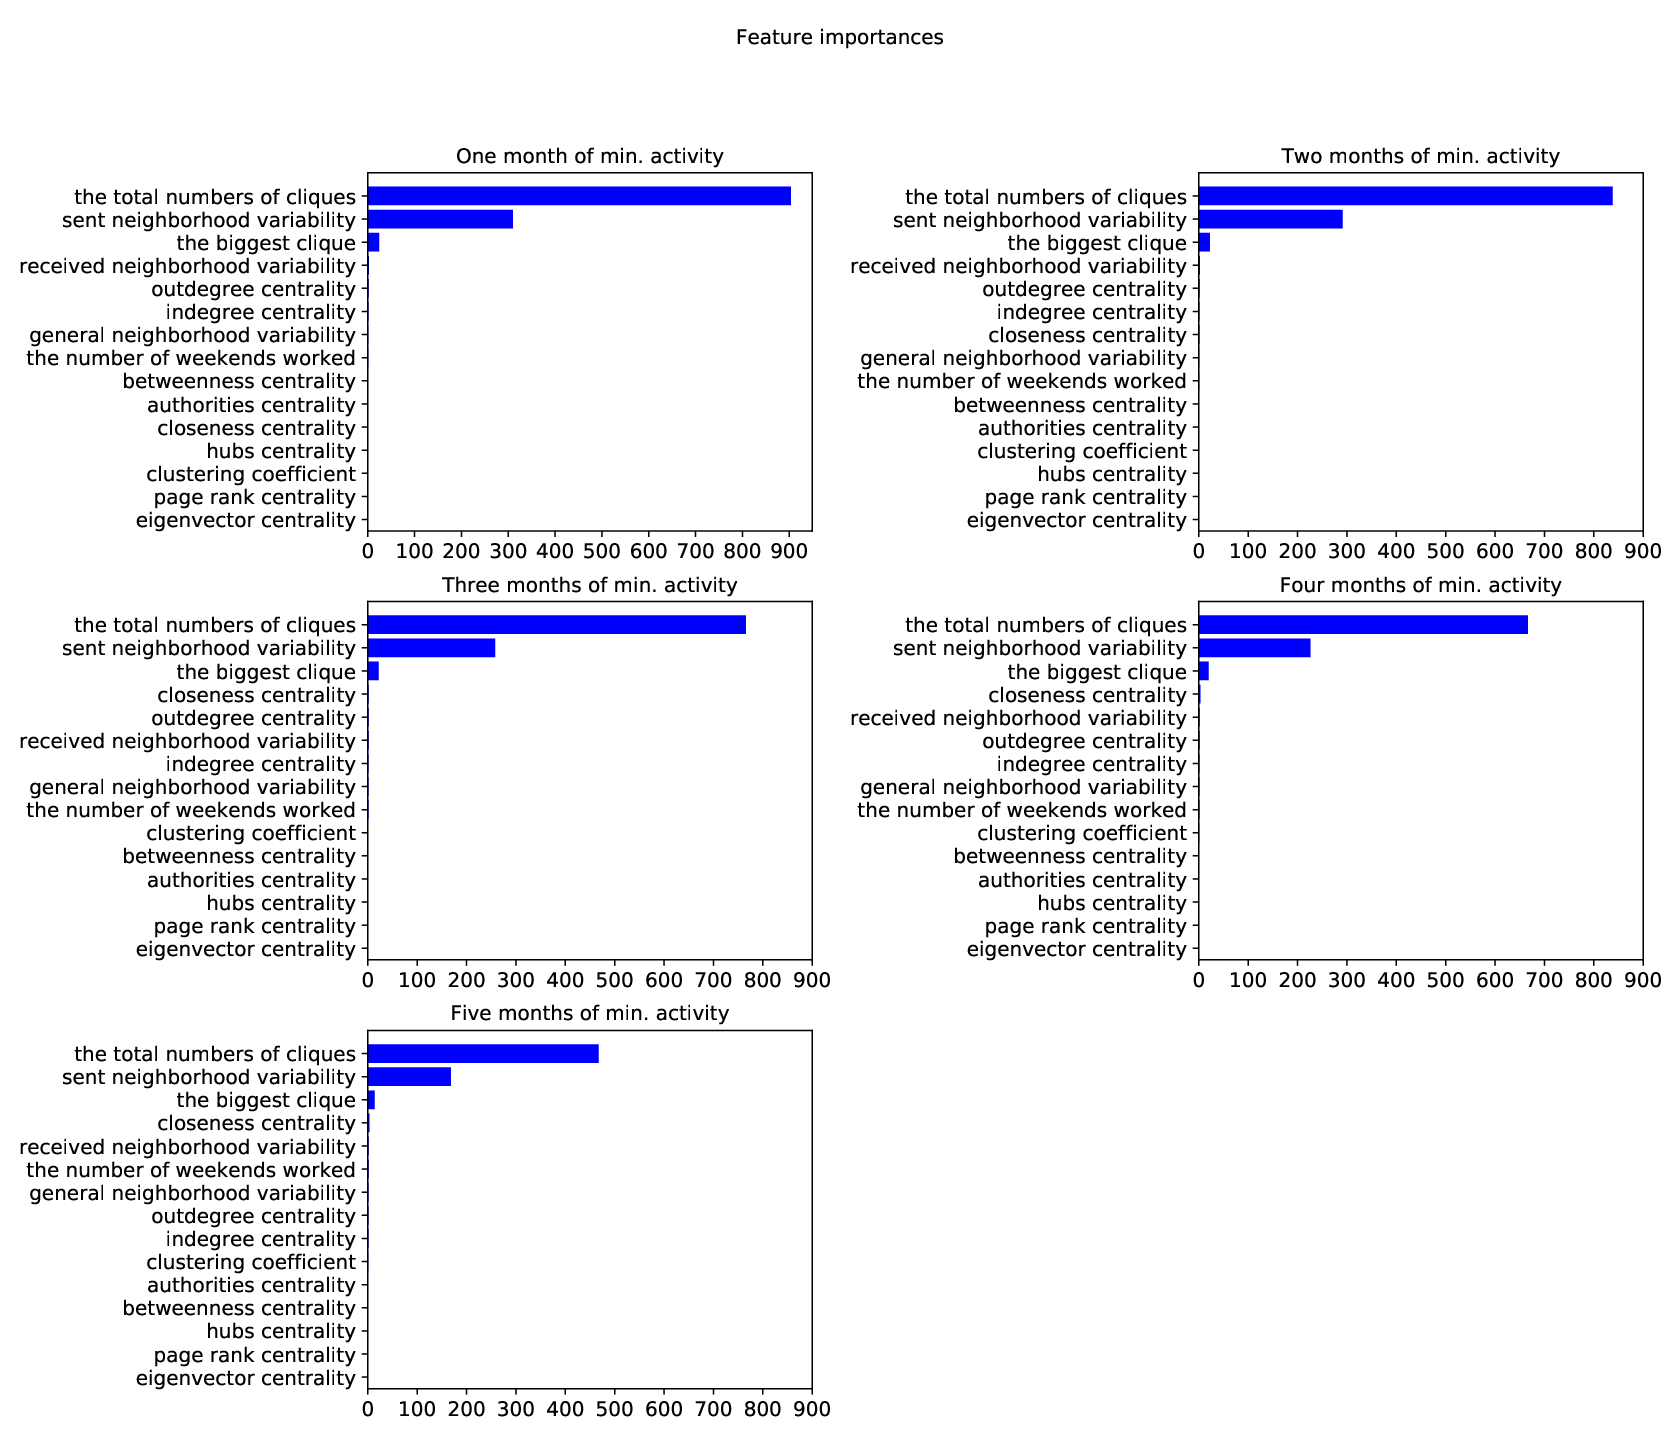
Интересные выводы об обученных моделях можно сделать из рисунков 14–25, на которых представлена важность признаков для моделей, использовавших набор всех признаков. Прежде всего, следует отметить, что Дерево решений и Случайный лес используют множество признаков, однако ни один из признаков существенно не выделяется по степени важности. Тем не менее, коэффициент кластеризации можно выделить для производственной компании, а входящую центральность для набора данных Enron, поскольку во многих случаях эти признаки имеют немного большую важность, чем остальные. Для нейронной сети и алгоритма SVM общее количество клик явно является лучшим для обоих наборов данных. Более того, вариативность отправленных и полученных окрестностей также в некоторых случаях является значительной, следовательно, это показывает, что в задаче классификации важны не только меры центральности сети, но и признаки, созданные на основе поведения сотрудников. Общим элементом для всех алгоритмов является тот факт, что для всех параметров эксперимента худшим признаком всегда является центральность по собственному вектору. Кроме того, в таблицах 33–41 показана наилучшая оценка полезности в зависимости от различных комбинаций параметров эксперимента. В отличие от контролируемых методов, трудно определить наиболее различающий признак для коллективной классификации, поскольку широкий спектр их используется в качестве оценки полезности.
4 Обсуждение
Сравнение результатов для стандартных алгоритмов классификации и коллективной классификации показывает, что первые из них лучше справляются со сбалансированными данными, такими как датасеты Enron. Проведенные эксперименты также показывают, что Decision Tree и Random Forest, а также Neural Network и алгоритм SVM смогли получить схожие результаты. Однако в организационной среде возможность интерпретации результатов может высоко цениться, поэтому первые два алгоритма являются лучшим решением, если мы хотим глубоко понять особенности коммуникативного поведения на различных уровнях организационной иерархии. Кроме того, представленный алгоритм коллективной классификации показал лучшие результаты в случае несбалансированного датасета. Эти результаты показывают, что графовый алгоритм способен уменьшать влияние мажоритарных классов и делать хорошие прогнозы в отличие от стандартных алгоритмов классификации. Кроме того, в будущих исследованиях следует изучить, связано ли вышеупомянутое влияние неравных классов с некоторыми скрытыми характеристиками сети. Кроме того, было показано, что минимальная длина периода, в течение которого сотрудник был активен, влияет на результат, однако идеальное значение минимальной активности зависит от анализируемого датасета, а также от других параметров..
Сеть, созданная на основе обмена электронной почтой, может различаться от организации к организации, особенно в отношении размера компании и различных моделей управления, например: крупная международная компания со множеством сотрудников и сложной иерархией может создать социальную сеть со свойствами, совершенно отличными от небольшого стартапа с горсткой сотрудников и простой структурой. Более того, в некоторых компаниях общение по электронной почте может быть лишь одним из многих способов передачи сообщений, поэтому набор данных электронной почты не обязательно должен содержать полную информацию о связях между сотрудниками в компании. Эти различия могут вызывать определенные паттерны поведения, приписанные к определенному уровню иерархии, которые не обязательно должны проявляться в построенной социальной сети..
Будущие исследования должны быть сосредоточены на изучении коммуникации из различных типов компаний, более того, дальнейшие исследования должны определить, какие организационные структуры могут обеспечить наилучшие результаты задачи классификации. Следовательно, лучшие результаты могут быть следствием некоторых скрытых свойств графа, соответствующих способу управления организацией, поэтому будущие исследования также должны быть сосредоточены на изучении структуры сети и выявлении ее характеристик. Самой большой проблемой может быть получение данных для исследований в связи с тем, что внутренняя коммуникация компании является конфиденциальной и должна быть анонимизирована перед передачей. Другим интересным подходом является попытка использовать графовые эмбеддинги вместо обычных признаков, предоставляемых алгоритмам обучения с учителем. Таким образом, свойства узлов будут закодированы в виде векторов, что делает их более подходящими в качестве прямого входа для алгоритмов. Что касается коллективной классификации, то вместо анализа отдельных признаков в качестве входных данных для оценки полезности можно использовать латентное размещение Дирихле для создания оценки полезности, объединяющей признаки. Наконец, читатель заметит, что социальная сеть, использованная в данном исследовании, была агрегированной. Это было связано главным образом с тем, что организационная структура производственной компании не претерпевала никаких изменений за период, охватываемый набором данных, а в случае с Enron структура была выведена из электронной почты и никакая другая информация известна не была. Тем не менее, для применения предложенного подхода в организациях рекомендуется проверить возможности темпорального подхода: как в области метрик, так и в области сетей.
Дополнительные материалы
Набор данных электронной почты производственной компании вместе с корпоративной иерархией был опубликован авторами данной рукописи в Harvard Dataverse, см. https://doi.org/10.7910/DVN/6Z3CGX. Набор данных Enron доступен в ссылке McCallum et al. (2007).
Вклад авторов
Концептуализация, Р.М. и М.Н.; методология, Р.М. и М.Н.; программное обеспечение, М.Н.; валидация, Р.М.; исследование, Р.М. и М.Н.; кураторство данных, Р.М. и М.Н.; подготовка черновика рукописи, М.Н. и Р.М.; рецензирование и редактирование, Р.М.; визуализация, М.Н.; научное руководство, Р.М.; администрирование проекта, Р.М.; привлечение финансирования, Р.М. Все авторы прочитали и одобрили опубликованную версию рукописи..
Финансирование
Данная работа была поддержана Национальным научным центром Польши, проект № 2015/17/D/ST6/04046, а также программой Европейского союза по исследованиям и инновациям Horizon 2020 в рамках соглашения о предоставлении гранта № 691152 (RENOIR) и фондом Министерства науки и высшего образования Польши для поддержки проектов с международным софинансированием в 2016–2019 годах (соглашение № 3628/H2020/2016/2).
Конфликты интересов
Авторы заявляют об отсутствии конфликта интересов.
В данной рукописи используются следующие сокращения:
SNA
Анализ социальных сетей
Независимые и одинаково распределенные
Независимое и одинаковое распределение
SVM
Метод опорных векторов
L-BFGS
ограниченно-памяти алгоритм Бройдена — Флетчера — Гольдфарба — Шанно
Appendix A
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.5472 | 0.5270 | 0.5987 | 0.5368 | 0.5641 | 0.6130 | 0.5850 | 0.6422 | 0.6092 | 0.6568 |
| 2 months | 0.5040 | 0.5360 | 0.5473 | 0.5938 | 0.6464 | 0.6417 | 0.6627 | 0.7039 | 0.6476 | 0.6642 | |
| 3 months | 0.5989 | 0.5336 | 0.5822 | 0.5312 | 0.5678 | 0.6391 | 0.5772 | 0.6230 | 0.6162 | 0.6642 | |
| 4 months | 0.6502 | 0.4818 | 0.5170 | 0.5315 | 0.5660 | 0.5848 | 0.5898 | 0.6234 | 0.6388 | 0.6398 | |
| 5 months | 0.6423 | 0.5622 | 0.6083 | 0.5826 | 0.6174 | 0.6387 | 0.6094 | 0.6231 | 0.6640 | 0.6388 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.4899 | 0.5789 | 0.5717 | 0.5786 | 0.5742 | 0.6426 | 0.5766 | 0.6290 | 0.6401 | 0.7146 |
| 2 months | 0.6421 | 0.5311 | 0.5075 | 0.5857 | 0.6793 | 0.6542 | 0.6811 | 0.6464 | 0.6528 | 0.6963 | |
| 3 months | 0.4977 | 0.6228 | 0.5785 | 0.5849 | 0.5933 | 0.5718 | 0.6024 | 0.6054 | 0.6532 | 0.7111 | |
| 4 months | 0.5647 | 0.5104 | 0.5657 | 0.5928 | 0.6337 | 0.5848 | 0.6336 | 0.6164 | 0.6683 | 0.6895 | |
| 5 months | 0.6423 | 0.6000 | 0.5176 | 0.5923 | 0.6493 | 0.6533 | 0.6981 | 0.7425 | 0.7768 | 0.7057 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.4848 | 0.4635 | 0.5349 | 0.4842 | 0.5356 | 0.5595 | 0.5577 | 0.5760 | 0.5680 | 0.5627 |
| 2 months | 0.5303 | 0.4910 | 0.5674 | 0.5532 | 0.5391 | 0.5814 | 0.5388 | 0.5986 | 0.6241 | 0.6187 | |
| 3 months | 0.5270 | 0.5210 | 0.5493 | 0.5544 | 0.5586 | 0.5798 | 0.5304 | 0.6144 | 0.6144 | 0.6247 | |
| 4 months | 0.4497 | 0.4725 | 0.4909 | 0.4845 | 0.5412 | 0.5906 | 0.5500 | 0.6013 | 0.5826 | 0.6037 | |
| 5 months | 0.4946 | 0.5275 | 0.5601 | 0.6112 | 0.5486 | 0.5431 | 0.5534 | 0.6042 | 0.5919 | 0.6000 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.4209 | 0.4703 | 0.5128 | 0.5236 | 0.4675 | 0.4998 | 0.4997 | 0.5711 | 0.5802 | 0.5977 |
| 2 months | 0.4499 | 0.5461 | 0.5922 | 0.5609 | 0.5368 | 0.4896 | 0.5047 | 0.6087 | 0.6142 | 0.6245 | |
| 3 months | 0.4364 | 0.4896 | 0.5917 | 0.5186 | 0.5149 | 0.5027 | 0.4915 | 0.6018 | 0.6218 | 0.6517 | |
| 4 months | 0.4223 | 0.4338 | 0.5783 | 0.5416 | 0.5312 | 0.4873 | 0.5012 | 0.6001 | 0.6134 | 0.6250 | |
| 5 months | 0.4379 | 0.4493 | 0.5703 | 0.5722 | 0.5441 | 0.5363 | 0.5274 | 0.6053 | 0.6139 | 0.6501 | |
| Percentage of the Known Nodes | ||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | ||
| Min. activity | 1 month | 0.7389 | 0.7347 | 0.7876 | 0.8402 | 0.8899 | 0.8937 | 0.9005 | 1.0000 | 1.0000 |
| 2 months | 0.7067 | 0.8172 | 0.8023 | 0.8613 | 0.8895 | 0.9253 | 0.9466 | 1.0000 | 1.0000 | |
| 3 months | 0.6834 | 0.8168 | 0.8290 | 0.8610 | 0.8895 | 0.9253 | 0.9463 | 1.0000 | 1.0000 | |
| 4 months | 0.7340 | 0.8163 | 0.8019 | 0.8790 | 0.8891 | 0.9253 | 0.9463 | 1.0000 | 1.0000 | |
| 5 months | 0.7233 | 0.8031 | 0.8010 | 0.8786 | 0.8887 | 0.9250 | 0.9463 | 1.0000 | 1.0000 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.2910 | 0.2924 | 0.3685 | 0.3319 | 0.3992 | 0.3564 | 0.3835 | 0.4737 | 0.4071 | 0.4585 |
| 2 months | 0.2766 | 0.2950 | 0.3541 | 0.3416 | 0.3670 | 0.3550 | 0.3981 | 0.4058 | 0.4057 | 0.4390 | |
| 3 months | 0.3425 | 0.3378 | 0.3239 | 0.3484 | 0.3404 | 0.3928 | 0.3903 | 0.3993 | 0.4136 | 0.4100 | |
| 4 months | 0.3024 | 0.2904 | 0.3041 | 0.3413 | 0.4014 | 0.3582 | 0.3755 | 0.3923 | 0.4156 | 0.4208 | |
| 5 months | 0.3373 | 0.4064 | 0.4089 | 0.3723 | 0.3674 | 0.4091 | 0.3790 | 0.3651 | 0.3852 | 0.3999 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.2872 | 0.3867 | 0.4075 | 0.4065 | 0.3954 | 0.3886 | 0.3780 | 0.4312 | 0.4380 | 0.4374 |
| 2 months | 0.3137 | 0.3742 | 0.3389 | 0.2981 | 0.3834 | 0.4575 | 0.3510 | 0.4149 | 0.4420 | 0.4363 | |
| 3 months | 0.3122 | 0.3367 | 0.3705 | 0.3667 | 0.3839 | 0.3899 | 0.3935 | 0.3990 | 0.4435 | 0.4064 | |
| 4 months | 0.3520 | 0.3599 | 0.3347 | 0.3822 | 0.3917 | 0.3360 | 0.3407 | 0.3810 | 0.3852 | 0.4163 | |
| 5 months | 0.3720 | 0.3160 | 0.3778 | 0.3362 | 0.3925 | 0.3850 | 0.3571 | 0.4133 | 0.4249 | 0.4048 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.2838 | 0.3090 | 0.3273 | 0.3090 | 0.3494 | 0.3465 | 0.3090 | 0.4138 | 0.3520 | 0.4149 |
| 2 months | 0.2957 | 0.3886 | 0.3197 | 0.3383 | 0.2818 | 0.3306 | 0.3097 | 0.3950 | 0.3959 | 0.3567 | |
| 3 months | 0.2662 | 0.3848 | 0.2898 | 0.3365 | 0.2814 | 0.3084 | 0.3084 | 0.3785 | 0.3506 | 0.3241 | |
| 4 months | 0.2660 | 0.3081 | 0.2836 | 0.3417 | 0.2965 | 0.3081 | 0.3081 | 0.3576 | 0.3517 | 0.3505 | |
| 5 months | 0.3093 | 0.3077 | 0.3419 | 0.3600 | 0.3291 | 0.4014 | 0.3574 | 0.3736 | 0.3077 | 0.3513 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.2449 | 0.3055 | 0.4085 | 0.0962 | 0.2835 | 0.2667 | 0.2941 | 0.3752 | 0.3669 | 0.2960 |
| 2 months | 0.2493 | 0.3147 | 0.3279 | 0.3637 | 0.4203 | 0.2789 | 0.2681 | 0.3474 | 0.3286 | 0.3389 | |
| 3 months | 0.2495 | 0.3218 | 0.3666 | 0.3597 | 0.3984 | 0.2504 | 0.2588 | 0.3497 | 0.3881 | 0.3265 | |
| 4 months | 0.2615 | 0.3177 | 0.3715 | 0.3530 | 0.4622 | 0.2558 | 0.2499 | 0.3393 | 0.3437 | 0.3385 | |
| 5 months | 0.2688 | 0.3018 | 0.3615 | 0.3856 | 0.4241 | 0.4084 | 0.2666 | 0.3514 | 0.2399 | 0.3060 | |
| Percentage of the Known Nodes | ||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | ||
| Min. activity | 1 month | 0.3570 | 0.3735 | 0.3731 | 0.3095 | 0.4910 | 0.5328 | 0.5397 | 0.6000 | 0.8730 |
| 2 months | 0.3564 | 0.4718 | 0.3640 | 0.5260 | 0.4969 | 0.5642 | 0.6344 | 0.6589 | 0.8730 | |
| 3 months | 0.3433 | 0.3665 | 0.3689 | 0.5258 | 0.3099 | 0.5642 | 0.5726 | 0.6589 | 0.8730 | |
| 4 months | 0.3472 | 0.3841 | 0.3757 | 0.5255 | 0.3095 | 0.5642 | 0.5846 | 0.6000 | 0.8713 | |
| 5 months | 0.3626 | 0.3972 | 0.3678 | 0.4795 | 0.5394 | 0.6496 | 0.5726 | 0.6000 | 0.8713 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.4880 | 0.5061 | 0.5874 | 0.6116 | 0.6369 | 0.6959 | 0.6602 | 0.7007 | 0.6672 | 0.7156 |
| 2 months | 0.4997 | 0.5070 | 0.6003 | 0.6755 | 0.6297 | 0.6559 | 0.6814 | 0.6778 | 0.6912 | 0.7406 | |
| 3 months | 0.4332 | 0.5405 | 0.7040 | 0.7388 | 0.6710 | 0.6336 | 0.6979 | 0.6818 | 0.7328 | 0.7475 | |
| 4 months | 0.5138 | 0.4367 | 0.5903 | 0.6175 | 0.6702 | 0.7076 | 0.7168 | 0.7455 | 0.7421 | 0.7194 | |
| 5 months | 0.5538 | 0.5201 | 0.6829 | 0.7113 | 0.7275 | 0.7332 | 0.7294 | 0.7548 | 0.7506 | 0.7849 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.5162 | 0.4907 | 0.6073 | 0.6496 | 0.6493 | 0.6841 | 0.6784 | 0.7464 | 0.7507 | 0.7286 |
| 2 months | 0.6281 | 0.6015 | 0.6747 | 0.6560 | 0.6709 | 0.7005 | 0.6987 | 0.6894 | 0.7310 | 0.7189 | |
| 3 months | 0.4397 | 0.6658 | 0.6812 | 0.7218 | 0.7096 | 0.7180 | 0.7724 | 0.7608 | 0.7609 | 0.7922 | |
| 4 months | 0.4604 | 0.5224 | 0.6759 | 0.6678 | 0.6908 | 0.6797 | 0.7307 | 0.7387 | 0.7535 | 0.7713 | |
| 5 months | 0.4897 | 0.6057 | 0.6567 | 0.7142 | 0.6998 | 0.7078 | 0.7188 | 0.8047 | 0.7911 | 0.8198 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.5032 | 0.5877 | 0.6263 | 0.6464 | 0.6100 | 0.7291 | 0.7260 | 0.7241 | 0.6985 | 0.6858 |
| 2 months | 0.4938 | 0.6774 | 0.7053 | 0.7130 | 0.7089 | 0.6927 | 0.7443 | 0.7340 | 0.6892 | 0.6763 | |
| 3 months | 0.5135 | 0.6478 | 0.7019 | 0.6930 | 0.7165 | 0.7256 | 0.7402 | 0.7273 | 0.7318 | 0.6944 | |
| 4 months | 0.5184 | 0.6212 | 0.6831 | 0.6710 | 0.7299 | 0.7684 | 0.7456 | 0.7835 | 0.6937 | 0.6342 | |
| 5 months | 0.4684 | 0.6268 | 0.7305 | 0.6982 | 0.7697 | 0.7550 | 0.7663 | 0.7642 | 0.7790 | 0.6936 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.5580 | 0.5615 | 0.6673 | 0.6423 | 0.6354 | 0.7230 | 0.7054 | 0.7249 | 0.6802 | 0.6733 |
| 2 months | 0.5687 | 0.6350 | 0.6958 | 0.6824 | 0.7138 | 0.7300 | 0.7356 | 0.7329 | 0.6696 | 0.6249 | |
| 3 months | 0.5731 | 0.6430 | 0.7221 | 0.7519 | 0.7139 | 0.7082 | 0.7087 | 0.7475 | 0.6833 | 0.6290 | |
| 4 months | 0.4883 | 0.6367 | 0.6698 | 0.6483 | 0.7186 | 0.7565 | 0.7456 | 0.7534 | 0.6731 | 0.5987 | |
| 5 months | 0.5248 | 0.6167 | 0.6975 | 0.7146 | 0.7855 | 0.7430 | 0.7718 | 0.7757 | 0.7077 | 0.6200 | |
| Percentage of the Known Nodes | ||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | ||
| Min. activity | 1 month | 0.5285 | 0.5554 | 0.7629 | 0.6976 | 0.7812 | 0.7896 | 0.7896 | 0.7684 | 0.8286 |
| 2 months | 0.5689 | 0.5920 | 0.6865 | 0.6727 | 0.6718 | 0.7350 | 0.7380 | 0.8120 | 0.8901 | |
| 3 months | 0.5863 | 0.5385 | 0.6334 | 0.6627 | 0.6573 | 0.6821 | 0.6641 | 0.6761 | 0.8000 | |
| 4 months | 0.5605 | 0.5359 | 0.5972 | 0.6117 | 0.6725 | 0.6824 | 0.7618 | 0.8750 | 0.8730 | |
| 5 months | 0.6141 | 0.5163 | 0.6003 | 0.6260 | 0.6581 | 0.5826 | 0.7429 | 0.7500 | 1.0000 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.3183 | 0.3853 | 0.4674 | 0.4857 | 0.4853 | 0.4830 | 0.4991 | 0.5236 | 0.5074 | 0.5613 |
| 2 months | 0.3995 | 0.4273 | 0.4514 | 0.4843 | 0.4596 | 0.4765 | 0.5637 | 0.5293 | 0.5078 | 0.5159 | |
| 3 months | 0.3170 | 0.4570 | 0.4598 | 0.5245 | 0.5131 | 0.5164 | 0.5205 | 0.5380 | 0.5554 | 0.5568 | |
| 4 months | 0.3471 | 0.4716 | 0.4435 | 0.4603 | 0.5287 | 0.5305 | 0.5683 | 0.5337 | 0.5123 | 0.5641 | |
| 5 months | 0.3609 | 0.3393 | 0.5300 | 0.5099 | 0.5827 | 0.5434 | 0.4761 | 0.5199 | 0.5484 | 0.4946 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.3562 | 0.4244 | 0.5364 | 0.4846 | 0.4919 | 0.5150 | 0.5237 | 0.5835 | 0.5502 | 0.5451 |
| 2 months | 0.3535 | 0.4604 | 0.4828 | 0.5005 | 0.5248 | 0.5843 | 0.5477 | 0.5594 | 0.5633 | 0.5849 | |
| 3 months | 0.4447 | 0.4745 | 0.5070 | 0.5076 | 0.5413 | 0.5961 | 0.5910 | 0.6258 | 0.5842 | 0.6423 | |
| 4 months | 0.3877 | 0.4735 | 0.4991 | 0.5427 | 0.6094 | 0.6318 | 0.6204 | 0.6151 | 0.6224 | 0.6320 | |
| 5 months | 0.4158 | 0.4758 | 0.5117 | 0.4970 | 0.5116 | 0.5235 | 0.5862 | 0.6004 | 0.5826 | 0.5963 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.3783 | 0.4316 | 0.4938 | 0.4925 | 0.4817 | 0.4857 | 0.4872 | 0.5439 | 0.5721 | 0.5104 |
| 2 months | 0.3566 | 0.5221 | 0.5439 | 0.5121 | 0.5310 | 0.4787 | 0.5504 | 0.5217 | 0.5639 | 0.5176 | |
| 3 months | 0.3835 | 0.4990 | 0.5048 | 0.4696 | 0.5142 | 0.5514 | 0.5700 | 0.5535 | 0.5142 | 0.4754 | |
| 4 months | 0.3688 | 0.4838 | 0.4875 | 0.4563 | 0.4983 | 0.5716 | 0.6107 | 0.5615 | 0.5795 | 0.5080 | |
| 5 months | 0.3714 | 0.4998 | 0.4583 | 0.4443 | 0.4909 | 0.4904 | 0.5356 | 0.4687 | 0.4860 | 0.4393 | |
| Percentage of the Used Features | |||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | 100% | ||
| Min. activity | 1 month | 0.3607 | 0.4308 | 0.4644 | 0.4448 | 0.5035 | 0.4934 | 0.5452 | 0.5682 | 0.5596 | 0.5171 |
| 2 months | 0.3825 | 0.5075 | 0.4891 | 0.5648 | 0.5310 | 0.4874 | 0.5284 | 0.5708 | 0.5551 | 0.4910 | |
| 3 months | 0.3874 | 0.4907 | 0.4929 | 0.4492 | 0.4946 | 0.5256 | 0.6137 | 0.5915 | 0.5097 | 0.4622 | |
| 4 months | 0.4075 | 0.5411 | 0.4626 | 0.4505 | 0.4511 | 0.5177 | 0.5626 | 0.5687 | 0.5407 | 0.4576 | |
| 5 months | 0.3559 | 0.4604 | 0.4859 | 0.4337 | 0.4787 | 0.5259 | 0.4397 | 0.4962 | 0.4691 | 0.4046 | |
| Percentage of the Known Nodes | ||||||||||
| 10% | 20% | 30% | 40% | 50% | 60% | 70% | 80% | 90% | ||
| Min. activity | 1 month | 0.2826 | 0.3044 | 0.3739 | 0.4514 | 0.4730 | 0.5517 | 0.5160 | 0.5654 | 0.5596 |
| 2 months | 0.2874 | 0.3193 | 0.3708 | 0.3933 | 0.4393 | 0.5084 | 0.5426 | 0.5333 | 0.6746 | |
| 3 months | 0.2593 | 0.3368 | 0.3681 | 0.4007 | 0.4284 | 0.5915 | 0.5753 | 0.5166 | 0.5000 | |
| 4 months | 0.2687 | 0.3077 | 0.3628 | 0.4031 | 0.5094 | 0.5105 | 0.6427 | 0.6476 | 0.7302 | |
| 5 months | 0.2725 | 0.2774 | 0.3542 | 0.3489 | 0.3954 | 0.4832 | 0.4593 | 0.4551 | 0.6111 | |
| Values | ||
| Decision Tree | max_depth | 1, 2, 3, …, 20 |
| max_features | 1, 2, 3, …, 16 (manufacturing company); 1, 2, 3, …, 15 (Enron) | |
| Random Forest | max_depth | 1, 2, 3, …, 20 |
| max_features | 1, 2, 3, …, 16 (manufacturing company); 1, 2, 3, …, 15 (Enron) | |
| n_estimators | 1, 2, 4, 8, 16, 32, 64, 100, 200 | |
| Neural Network | alpha | 0.0001, 0.001, 0.01, 1 |
| hidden_layer_sizes | (13), (9), (4), (13, 9), (13, 4), (9, 4), (13, 9, 4), (4, 9, 4), (9, 13, 9), (9, 13, 4), (4, 9, 13, 9, 4) | |
| SVM | degree | 3, 4, 5, 6, 7, 8, 9, 10, 15, 20 |
| C | 1, 2, 3, 4, 5, 10, 15, 20, 25, 50, 100, 150, 200 |
| Min. Activity | ||||||
| 1 month | 2 months | 3 months | 4 months | 5 months | ||
| Decision Tree | max_depth | 4 | 8 | 8 | 10 | 5 |
| max_features | 3 | 2 | 1 | 9 | 1 | |
| Random Forest | max_depth | 8 | 6 | 6 | 10 | 6 |
| max_features | 2 | 2 | 12 | 3 | 2 | |
| n_estimators | 32 | 16 | 16 | 16 | 8 | |
| Neural Network | alpha | 0.0001 | 0.01 | 0.0001 | 0.001 | 0.01 |
| hidden_layer_sizes | (13, 4) | (13) | (13, 9, 4) | (13, 9) | (13, 9) | |
| SVM | degree | 20 | 20 | 20 | 15 | 20 |
| C | 150 | 200 | 200 | 200 | 200 | |
| Min. Activity | ||||||
| 1 Month | 2 Months | 3 Months | 4 Months | 5 Months | ||
| Decision Tree | max_depth | 10 | 7 | 12 | 13 | 8 |
| max_features | 1 | 8 | 2 | 1 | 8 | |
| Random Forest | max_depth | 7 | 5 | 7 | 10 | 10 |
| max_features | 3 | 11 | 14 | 6 | 7 | |
| n_estimators | 2 | 4 | 16 | 32 | 8 | |
| Neural Network | alpha | 0.001 | 0.0001 | 0.01 | 0.01 | 0.001 |
| hidden_layer_sizes | (9, 13, 4) | (4, 9, 13, 9, 4) | (4, 9, 13, 9, 4) | (13, 9, 4) | (13, 9, 4) | |
| SVM | degree | 15 | 20 | 20 | 20 | 20 |
| C | 200 | 200 | 200 | 200 | 150 | |
| Min. Activity | ||||||
| 1 Month | 2 Months | 3 Months | 4 Months | 5 Months | ||
| Decision Tree | max_depth | 2 | 8 | 7 | 3 | 2 |
| max_features | 1 | 9 | 3 | 4 | 12 | |
| Random Forest | max_depth | 2 | 5 | 3 | 9 | 4 |
| max_features | 3 | 7 | 5 | 2 | 2 | |
| n_estimators | 4 | 2 | 2 | 16 | 2 | |
| Neural Network | alpha | 0.01 | 0.001 | 0.0001 | 0.001 | 0.0001 |
| hidden_layer_sizes | (13, 9) | (4, 9, 4) | (4, 9, 4) | (4, 9, 13, 9, 4) | (9) | |
| SVM | degree | 6 | 3 | 7 | 3 | 6 |
| C | 20 | 10 | 20 | 100 | 50 | |
| Min. Activity | ||||||
| 1 Month | 2 Months | 3 Months | 4 Months | 5 Months | ||
| Decision Tree | max_depth | 5 | 4 | 5 | 8 | 4 |
| max_features | 7 | 8 | 11 | 9 | 13 | |
| Random Forest | max_depth | 2 | 4 | 7 | 2 | 3 |
| max_features | 2 | 12 | 2 | 14 | 14 | |
| n_estimators | 2 | 4 | 8 | 2 | 16 | |
| Neural Network | alpha | 0.001 | 0.01 | 0.01 | 0.0001 | 0.001 |
| hidden_layer_sizes | (4, 3) | (13) | (13) | (9) | (13, 9, 4) | |
| SVM | degree | 9 | 3 | 3 | 6 | 3 |
| C | 5 | 20 | 200 | 150 | 4 | |
| Parameter | Values |
| utility score | all features from Table 3 |
| threshold | 1, 2, 3, 4, 5, 6, 7, 8, 9, 10 |
| Jaccard value | 0.7, 0.8, 0.9, 0.99 |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 1 month | 90% | hubs centrality | 4 | 0.7 |
| clustering coefficient | 5 | 0.7 | ||
| overtime | 4 | 0.7 | ||
| 80% | hubs centrality | 4 | 0.9 | |
| 70% | indegree centrality | 4 | 0.7 | |
| the total numbers of cliques | 4 | 0.7 | ||
| the biggest clique | 4 | 0.7 | ||
| 60% | indegree centrality | 4 | 0.7 | |
| outdegree centrality | 4 | 0.7 | ||
| the total numbers of cliques | 4 | 0.7 | ||
| the biggest clique | 4 | 0.7 | ||
| 50% | indegree centrality | 4 | 0.7 | |
| outdegree centrality | 4 | 0.7 | ||
| 40% | the total numbers of cliques | 4 | 0.7 | |
| 30% | page rank centrality | 4 | 0.7 | |
| 20% | betweenness centrality | 5 | 0.7 | |
| 10% | the number of weekends worked | 4 | 0.7 | |
| 2 months | 90% | closeness centrality | 4 | 0.7 |
| hubs centrality | 4 | 0.7 | ||
| clustering coefficient | 5 | 0.7 | ||
| 80% | hubs centrality | 4 | 0.9 | |
| the biggest clique | 4 | 0.7 | ||
| 70% | indegree centrality | 4 | 0.7 | |
| the total numbers of cliques | 4 | 0.7 | ||
| the biggest clique | 4 | 0.7 | ||
| 60% | indegree centrality | 4 | 0.7 | |
| outdegree centrality | 4 | 0.7 | ||
| the total numbers of cliques | 4 | 0.7 | ||
| 50% | indegree centrality | 4 | 0.9 | |
| 40% | the total numbers of cliques | 4 | 0.7 | |
| 30% | authorities centrality | 4 | 0.9 | |
| 20% | betweenness centrality | 5 | 0.7 | |
| 10% | the number of weekends worked | 4 | 0.7 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 3 months | 90% | closeness centrality | 4 | 0.7 |
| hubs centrality | 4 | 0.7 | ||
| clustering coefficient | 5 | 0.7 | ||
| 80% | hubs centrality | 4 | 0.9 | |
| the biggest clique | 4 | 0.7 | ||
| 70% | indegree centrality | 4 | 0.7 | |
| the total numbers of cliques | 4 | 0.7 | ||
| the biggest clique | 4 | 0.7 | ||
| 60% | indegree centrality | 4 | 0.7 | |
| outdegree centrality | 4 | 0.7 | ||
| the total numbers of cliques | 4 | 0.7 | ||
| 50% | received neighborhood variability | 4 | 0.7 | |
| 40% | the total numbers of cliques | 4 | 0.7 | |
| 30% | eigenvector centrality | 4 | 0.7 | |
| 20% | betweenness centrality | 5 | 0.7 | |
| 10% | eigenvector centrality | 4 | 0.7 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 4 month | 90% | outdegree centrality | 3 | 0.7 |
| eigenvector centrality | 3 | 0.7 | ||
| hubs centrality | 4 | 0.7 | ||
| clustering coefficient | 5 | 0.7 | ||
| 80% | hubs centrality | 4 | 0.9 | |
| the biggest clique | 4 | 0.7 | ||
| 70% | indegree centrality | 4 | 0.7 | |
| the total numbers of cliques | 4 | 0.7 | ||
| the biggest clique | 4 | 0.7 | ||
| 60% | outdegree centrality | 4 | 0.7 | |
| the total numbers of cliques | 4 | 0.7 | ||
| 50% | the biggest clique | 4 | 0.99 | |
| received neighborhood variability | 4 | 0.7 | ||
| 40% | the total numbers of cliques | 4 | 0.7 | |
| 30% | authorities centrality | 4 | 0.9 | |
| 20% | betweenness centrality | 5 | 0.7 | |
| 10% | authorities centrality | 4 | 0.7 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 5 months | 90% | outdegree centrality | 3 | 0.7 |
| betweenness centrality | 3 | 0.7 | ||
| closeness centrality | 4 | 0.7 | ||
| hubs centrality | 4 | 0.7 | ||
| clustering coefficient | 5 | 0.7 | ||
| 80% | hubs centrality | 4 | 0.9 | |
| the biggest clique | 4 | 0.7 | ||
| 70% | indegree centrality | 4 | 0.7 | |
| the total numbers of cliques | 4 | 0.7 | ||
| the biggest clique | 4 | 0.7 | ||
| 60% | the total numbers of cliques | 4 | 0.7 | |
| 50% | the biggest clique | 4 | 0.99 | |
| received neighborhood variability | 4 | 0.7 | ||
| 40% | the total numbers of cliques | 4 | 0.7 | |
| 30% | authorities centrality | 4 | 0.7 | |
| 20% | betweenness centrality | 5 | 0.7 | |
| 10% | the number of weekends worked | 4 | 0.7 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 1 month | 90% | the number of weekends worked | 7 | 0.7 |
| 80% | overtime | 4 | 0.7 | |
| 70% | overtime | 5 | 0.7 | |
| 60% | hubs centrality | 5 | 0.7 | |
| 50% | the number of weekends worked | 5 | 0.7 | |
| 40% | closeness centrality | 5 | 0.7 | |
| clustering coefficient | 2 | 0.7 | ||
| the number of weekends worked | 4 | 0.7 | ||
| 30% | closeness centrality | 2 | 0.7 | |
| 20% | received neighborhood variability | 3 | 0.7 | |
| 10% | the biggest clique | 2 | 0.7 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 2 months | 90% | the number of weekends worked | 7 | 0.7 |
| 80% | overtime | 5 | 0.7 | |
| 70% | betweenness centrality | 5 | 0.7 | |
| 60% | hubs centrality | 5 | 0.7 | |
| 50% | the number of weekends worked | 5 | 0.7 | |
| 40% | general neighborhood variability | 5 | 0.7 | |
| 30% | closeness centrality | 2 | 0.7 | |
| 20% | clustering coefficient | 3 | 0.7 | |
| 10% | the biggest clique | 2 | 0.7 | |
| 3 months | 90% | the number of weekends worked | 7 | 0.7 |
| 80% | overtime | 5 | 0.7 | |
| 70% | hubs centrality | 5 | 0.7 | |
| 60% | hubs centrality | 5 | 0.7 | |
| 50% | hubs centrality | 4 | 0.7 | |
| clustering coefficient | 2 | 0.7 | ||
| the number of weekends worked | 3 | 0.7 | ||
| 40% | general neighborhood variability | 5 | 0.7 | |
| 30% | hubs centrality | 2 | 0.7 | |
| 20% | received neighborhood variability | 3 | 0.7 | |
| 10% | page rank centrality | 4 | 0.7 | |
| the number of weekends worked | 5 | 0.7 | ||
| 4 months | 90% | the number of weekends worked | 7 | 0.7 |
| 80% | betweenness centrality | 4 | 0.7 | |
| overtime | 4 | 0.7 | ||
| 70% | betweenness centrality | 4 | 0.7 | |
| 60% | hubs centrality | 5 | 0.7 | |
| 50% | closeness centrality | 5 | 0.7 | |
| eigenvector centrality | 4 | 0.7 | ||
| hubs centrality | 4 | 0.7 | ||
| clustering coefficient | 2 | 0.7 | ||
| the number of weekends worked | 2 | 0.7 | ||
| 40% | general neighborhood variability | 5 | 0.7 | |
| 30% | hubs centrality | 2 | 0.7 | |
| 20% | received neighborhood variability | 3 | 0.7 | |
| 10% | page rank centrality | 4 | 0.7 | |
| the number of weekends worked | 5 | 0.7 | ||
| 5 months | 90% | the number of weekends worked | 7 | 0.7 |
| 80% | betweenness centrality | 4 | 0.7 | |
| 70% | eigenvector centrality | 5 | 0.7 | |
| 60% | betweenness centrality | 6 | 0.7 | |
| 50% | sent neighborhood variability | 5 | 0.7 | |
| 40% | betweenness centrality | 6 | 0.7 | |
| 30% | hubs centrality | 2 | 0.7 | |
| 20% | received neighborhood variability | 3 | 0.7 | |
| 10% | the number of weekends worked | 5 | 0.7 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 1 month | 90% | page rank centrality | 1 | 0.7 |
| 80% | authorities centrality | 1 | 0.7 | |
| 70% | authorities centrality | 1 | 0.7 | |
| 60% | indegree centrality | 1 | 0.8 | |
| 50% | the biggest clique | 1 | 0.7 | |
| 40% | indegree centrality | 1 | 0.7 | |
| 30% | indegree centrality | 1 | 0.7 | |
| 20% | general neighborhood variability | 1 | 0.7 | |
| 10% | closeness centrality | 1 | 0.7 | |
| 2 months | 90% | received neighborhood variability | 1 | 0.7 |
| 80% | closeness centrality | 1 | 0.7 | |
| hubs centrality | 1 | 0.7 | ||
| 70% | closeness centrality | 1 | 0.7 | |
| 60% | the biggest clique | 1 | 0.7 | |
| 50% | the biggest clique | 1 | 0.7 | |
| 40% | indegree centrality | 1 | 0.7 | |
| 30% | indegree centrality | 1 | 0.7 | |
| 20% | general neighborhood variability | 1 | 0.99 | |
| 10% | general neighborhood variability | 1 | 0.7 | |
| 3 months | 90% | hubs centrality | 1 | 0.7 |
| 80% | authorities centrality | 1 | 0.7 | |
| 70% | authorities centrality | 1 | 0.7 | |
| 60% | the biggest clique | 1 | 0.99 | |
| 50% | the biggest clique | 1 | 0.7 | |
| 40% | indegree centrality | 1 | 0.7 | |
| 30% | indegree centrality | 1 | 0.7 | |
| 20% | received neighborhood variability | 1 | 0.7 | |
| 10% | general neighborhood variability | 1 | 0.7 | |
| 4 months | 90% | closeness centrality | 1 | 0.7 |
| hubs centrality | 1 | 0.7 | ||
| 80% | indegree centrality | 1 | 0.7 | |
| 70% | indegree centrality | 1 | 0.99 | |
| 60% | the biggest clique | 1 | 0.8 | |
| 50% | betweenness centrality | 1 | 0.7 | |
| 40% | betweenness centrality | 1 | 0.7 | |
| 30% | page rank centrality | 1 | 0.7 | |
| 20% | general neighborhood variability | 1 | 0.99 | |
| 10% | eigenvector centrality | 1 | 0.7 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 5 months | 90% | authorities centrality | 1 | 0.7 |
| hubs centrality | 1 | 0.7 | ||
| 80% | indegree centrality | 1 | 0.7 | |
| 70% | outdegree centrality | 1 | 0.7 | |
| 60% | outdegree centrality | 1 | 0.7 | |
| 50% | betweenness centrality | 1 | 0.7 | |
| 40% | betweenness centrality | 1 | 0.7 | |
| 30% | betweenness centrality | 1 | 0.7 | |
| 20% | betweenness centrality | 1 | 0.7 | |
| 10% | the biggest clique | 1 | 0.7 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 1 month | 90% | the biggest clique | 1 | 0.7 |
| 80% | hubs centrality | 1 | 0.7 | |
| 70% | page rank centrality | 1 | 0.7 | |
| 60% | outdegree centrality | 1 | 0.7 | |
| 50% | eigenvector centrality | 1 | 0.7 | |
| 40% | the total numbers of cliques | 1 | 0.7 | |
| 30% | indegree centrality | 1 | 0.7 | |
| 20% | eigenvector centrality | 1 | 0.7 | |
| 10% | general neighborhood variability | 1 | 0.7 | |
| 2 months | 90% | received neighborhood variability | 1 | 0.7 |
| 80% | hubs centrality | 1 | 0.7 | |
| 70% | eigenvector centrality | 1 | 0.7 | |
| 60% | outdegree centrality | 1 | 0.7 | |
| 50% | outdegree centrality | 1 | 0.7 | |
| 40% | hubs centrality | 1 | 0.7 | |
| 30% | indegree centrality | 1 | 0.7 | |
| 20% | authorities centrality | 1 | 0.7 | |
| 10% | the total numbers of cliques | 1 | 0.99 | |
| Hyperparameters | ||||
| Min. Activity | % of the Known Nodes | Utility Score | Threshold | Jaccard Value |
| 3 months | 90% | the biggest clique | 1 | 0.7 |
| 80% | hubs centrality | 1 | 0.7 | |
| 70% | closeness centrality | 1 | 0.7 | |
| 60% | outdegree centrality | 1 | 0.7 | |
| 50% | the biggest clique | 1 | 0.7 | |
| 40% | authorities centrality | 1 | 0.7 | |
| 30% | outdegree centrality | 1 | 0.7 | |
| 20% | sent neighborhood variability | 1 | 0.7 | |
| 10% | the total numbers of cliques | 1 | 0.9 | |
| 4 months | 90% | closeness centrality | 1 | 0.7 |
| 80% | authorities centrality | 1 | 0.7 | |
| 70% | outdegree centrality | 1 | 0.7 | |
| 60% | betweenness centrality | 1 | 0.7 | |
| 50% | outdegree centrality | 1 | 0.7 | |
| 40% | general neighborhood variability | 1 | 0.7 | |
| 30% | betweenness centrality | 1 | 0.7 | |
| 20% | general neighborhood variability | 1 | 0.7 | |
| 10% | received neighborhood variability | 1 | 0.7 | |
| 5 months | 90% | the biggest clique | 1 | 0.7 |
| 80% | the biggest clique | 1 | 0.8 | |
| 70% | outdegree centrality | 1 | 0.7 | |
| 60% | closeness centrality | 1 | 0.7 | |
| 50% | the biggest clique | 1 | 0.7 | |
| 40% | the number of weekends worked | 1 | 0.7 | |
| 30% | the number of weekends worked | 1 | 0.8 | |
| 20% | outdegree centrality | 1 | 0.7 | |
| 10% | clustering coefficient | 1 | 0.7 | |
References
- McCallum et al. (2007) McCallum, A.; Wang, X.; Corrada-Emmanuel, A. Topic and Role Discovery in Social Networks with Experiments on Enron and Academic Email. J. Artif. Intell. Res. 2007, 30, 249–272. CrossRef]
- Palus et al. (2012) Palus, S.; Kazienko, P.; Michalski, R. Evaluation of Corporate Structure Based on Social Network Analysis. In Social Development and High Technology Industries; IGI Global: Hershey, PA, USA, 2012; pp. 58–69. CrossRef]
- Michalski et al. (2011) Michalski, R.; Palus, S.; Kazienko, P. Matching Organizational Structure and Social Network Extracted from Email Communication. In Business Information Systems; Springer: Berlin/Heidelberg, Germany, 2011; pp. 197–206. CrossRef]
- Creamer et al. (2009) Creamer, G.; Rowe, R.; Hershkop, S.; Stolfo, S.J. Segmentation and Automated Social Hierarchy Detection through Email Network Analysis. In Advances in Web Mining and Web Usage Analysis; Springer: Berlin/Heidelberg, Germany, 2009; pp. 40–58. CrossRef]
- Fire and Puzis (2015) Fire, M.; Puzis, R. Organization Mining Using Online Social Networks. Networks Spat. Econ. 2015, 16, 545–578. CrossRef]
- Namata et al. (2006) Namata, G.; Getoor, L.; Diehl, C. Inferring formal titles in organizational email archives. In Proceedings of the ICML Workshop on Statistical Network Analysis, Pittsburgh, PA, USA, 29 June 2006.
- Zhang et al. (2009) Zhang, C.; Hurst, W.B.; Lenin, R.B.; Yuruk, N.; Ramaswamy, S. Analyzing Organizational Structures Using Social Network Analysis. In Lecture Notes in Business Information Processing; Springer: Berlin/Heidelberg, Germany, 2009; pp. 143–156. CrossRef]
- Wang et al. (2013) Wang, Y.; Iliofotou, M.; Faloutsos, M.; Wu, B. Analyzing Communication Interaction Networks (CINs) in enterprises and inferring hierarchies. Comput. Netw. 2013, 57, 2147–2158. CrossRef]
- Coles (2001) Coles, N. It’s not what you know—It’s who you know that counts. Analysing serious crime groups as social networks. Br. J. Criminol. 2001, 41, 580–594. CrossRef]
- Shaabani et al. (2015) Shaabani, E.; Aleali, A.; Shakarian, P.; Bertetto, J. Early identification of violent criminal gang members. In Proceedings of the 21th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, Sydney, NSW, Australia, 10–13 August 2015; pp. 2079–2088.
- Tayebi et al. (2014) Tayebi, M.A.; Ester, M.; Glässer, U.; Brantingham, P.L. Spatially embedded co-offence prediction using supervised learning. In Proceedings of the 20th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, New York, NY, USA, 24–27 August 2014; pp. 1789–1798.
- Sundsøy et al. (2016) Sundsøy, P.; Bjelland, J.; Reme, B.A.; Iqbal, A.M.; Jahani, E. Deep learning applied to mobile phone data for individual income classification. In Proceedings of the 2016 International Conference on Artificial Intelligence: Technologies and Applications, Bangkok, Thailand, 24–25 January 2016; Atlantis Press: Paris, France, 2016.
- Kosinski et al. (2013) Kosinski, M.; Stillwell, D.; Graepel, T. Private traits and attributes are predictable from digital records of human behavior. Proc. Natl. Acad. Sci. USA 2013, 110, 5802–5805. CrossRef]
- Huang et al. (2015) Huang, Y.; Yu, L.; Wang, X.; Cui, B. A multi-source integration framework for user occupation inference in social media systems. World Wide Web 2015, 18, 1247–1267. CrossRef]
- Ortiz-Arroyo (2009) Ortiz-Arroyo, D. Discovering Sets of Key Players in Social Networks. In Computer Communications and Networks; Springer: London, UK, 2009; pp. 27–47. CrossRef]
- Dong et al. (2015) Dong, Y.; Tang, J.; Chawla, N.V.; Lou, T.; Yang, Y.; Wang, B. Inferring Social Status and Rich Club Effects in Enterprise Communication Networks. PLoS ONE 2015, 10, e0119446. CrossRef]
- Jordan and Mitchell (2015) Jordan, M.I.; Mitchell, T.M. Machine learning: Trends, perspectives, and prospects. Science 2015, 349, 255–260. CrossRef]
- Hosmer Jr et al. (2013) Hosmer, D.W., Jr.; Lemeshow, S.; Sturdivant, R.X. Applied Logistic Regression; John Wiley & Sons: Hoboken, NJ, USA, 2013; Volume 398.
- Maron (1961) Maron, M.E. Automatic indexing: An experimental inquiry. J. ACM (JACM) 1961, 8, 404–417. CrossRef]
- Altman (1992) Altman, N.S. An introduction to kernel and nearest-neighbor nonparametric regression. Am. Stat. 1992, 46, 175–185.
- Cortes and Vapnik (1995) Cortes, C.; Vapnik, V. Support-vector networks. Mach. Learn. 1995, 20, 273–297. CrossRef]
- Utgoff (1989) Utgoff, P.E. Incremental induction of decision trees. Mach. Learn. 1989, 4, 161–186. CrossRef]
- Breiman (2001) Breiman, L. Random forests. Mach. Learn. 2001, 45, 5–32. CrossRef]
- Ayodele (2010) Ayodele, T.O. Types of machine learning algorithms. In New Advances in Machine Learning; IntechOpen: London, UK, 2010; pp. 19–48.
- Molnar (2019) Molnar, C. Interpretable Machine Learning; Lulu Press, Inc.: Morrisville, NC, USA, 2019.
- McPherson et al. (2001) McPherson, M.; Smith-Lovin, L.; Cook, J.M. Birds of a feather: Homophily in social networks. Annu. Rev. Sociol. 2001, 27, 415–444. CrossRef]
- Friedkin and Johnsen (1990) Friedkin, N.E.; Johnsen, E.C. Social influence and opinions. J. Math. Sociol. 1990, 15, 193–206. CrossRef]
- Sen et al. (2008) Sen, P.; Namata, G.; Bilgic, M.; Getoor, L.; Galligher, B.; Eliassi-Rad, T. Collective classification in network data. AI Mag. 2008, 29, 93. CrossRef]
- Sun et al. (2009) Sun, Y.; Wong, A.K.; Kamel, M.S. Classification of imbalanced data: A review. Int. J. Pattern Recognit. Artif. Intell. 2009, 23, 687–719. CrossRef]
- Krawczyk (2016) Krawczyk, B. Learning from imbalanced data: Open challenges and future directions. Prog. Artif. Intell. 2016, 5, 221–232. CrossRef]
- Chawla et al. (2002) Chawla, N.V.; Bowyer, K.W.; Hall, L.O.; Kegelmeyer, W.P. SMOTE: Synthetic minority over-sampling technique. J. Artif. Intell. Res. 2002, 16, 321–357. CrossRef]
- Fernández et al. (2018) Fernández, A.; Garcia, S.; Herrera, F.; Chawla, N.V. SMOTE for learning from imbalanced data: Progress and challenges, marking the 15-year anniversary. J. Artif. Intell. Res. 2018, 61, 863–905. CrossRef]
- Wasserman et al. (1994) Wasserman, S.; Faust, K. Social Network Analysis: Methods and Applications; Cambridge University Press: Cambridge, UK, 1994; Volume 8.
- Friedkin (1991) Friedkin, N.E. Theoretical foundations for centrality measures. Am. J. Sociol. 1991, 96, 1478–1504. CrossRef]
- Pujol et al. (2006) Pujol, J.M.; Béjar, J.; Delgado, J. Clustering algorithm for determining community structure in large networks. Phys. Rev. E 2006, 74, 016107. CrossRef] PubMed]
- Michalski et al. (2011) Michalski, R.; Palus, S.; Bródka, P.; Kazienko, P.; Juszczyszyn, K. Modelling social network evolution. In Proceedings of the International Conference on Social Informatics, Singapore, 6–8 October 2011; Springer: Berlin/Heidelberg, Germany, 2011, pp. 283–286.
- Michalski and Kazienko (2015) Michalski, R.; Kazienko, P. Maximizing social influence in real-world networks—the state of the art and current challenges. In Propagation Phenomena in Real World Networks; Springer: Berlin/Heidelberg, Germany, 2015; pp. 329–359.
- Michalski and Kazienko (2014) Michalski, R.; Kazienko, P., Social Network Analysis in Organizational Structures Evaluation. In Encyclopedia of Social Network Analysis and Mining; Springer: New York, NY, USA, 2014; pp. 1832–1844. CrossRef]
- Adai et al. (2004) Adai, A.T.; Date, S.V.; Wieland, S.; Marcotte, E.M. LGL: Creating a map of protein function with an algorithm for visualizing very large biological networks. J. Mol. Biol. 2004, 340, 179–190. CrossRef] PubMed]
- Barabási and Posfai (2016) Barabási, A.L.; Posfai, M. Network Science; Cambridge University Press: Cambridge, UK, 2016.
- Kajdanowicz et al. (2016) Kajdanowicz, T.; Michalski, R.; Musial, K.; Kazienko, P. Learning in unlabeled networks–An active learning and inference approach. AI Commun. 2016, 29, 123–148. CrossRef]
- Özgür et al. (2005) Özgür, A.; Özgür, L.; Güngör, T. Text categorization with class-based and corpus-based keyword selection. In Proceedings of the International Symposium on Computer and Information Sciences, Istanbul, Turkey, 26–28 October 2005; Springer: Berlin/Heidelberg, Germany, 2005; pp. 606–615.