Глубокое обучение для облаков точек LiDAR
в автономном вождении: обзор
Аннотация
Недавний прогресс глубокого обучения в обучении различительным признакам по данным 3D LiDAR привел к быстрому развитию в области автономного вождения. Однако автоматизированная обработка неоднородных, неструктурированных, зашумленных и массивных 3D облаков точек является сложной и утомительной задачей. В данной статье мы приводим систематический обзор существующих убедительных архитектур глубокого обучения, применяемых к облакам точек LiDAR, с подробным описанием для конкретных задач в автономном вождении, таких как сегментация, обнаружение и классификация. Хотя несколько опубликованных научных работ фокусируются на отдельных темах компьютерного зрения для автономных транспортных средств, на сегодняшний день не существует общего обзора глубокого обучения, применяемого к облакам точек LiDAR для автономных транспортных средств. Таким образом, цель данной статьи — сократить разрыв в этой области. Более ключевых вкладов за последние пять лет обобщены в этом обзоре, включая веховые 3D архитектуры глубокого обучения, впечатляющие применения глубокого обучения в 3D семантической сегментации, обнаружении объектов и классификации; конкретные наборы данных, метрики оценки и актуальные достижения производительности. Наконец, мы завершаем рассмотрение оставшихся проблем и будущих исследований.
Индексные термины:
Автономное вождение, LiDAR, облака точек, обнаружение объектов, сегментация, классификация, глубокое обучение.I Введение
Точное восприятие окружающей среды и точная локализация являются критически важными требованиями для надежной навигации, принятия информационных решений и безопасного вождения автономных транспортных средств (AVs) в сложных динамических средах[1, 2]. Эти две задачи требуют получения и обработки высокоточноcтных и информационно насыщенных данных о реальных средах [3]. Для получения таких данных на AVs или картографических транспортных средствах оснащают несколько датчиков, таких как LiDAR и цифровые камеры [4], чтобы собирать и извлекать целевой контекст. Традиционно изображательные данные, полученные цифровой камерой и характеризующиеся двумерным представлением на основе визуального вида, низкой стоимостью и высокой эффективностью, чаще всего используются в задачах восприятия [5]. Однако изображательные данные не содержат трехмерной геопривязанной информации [6]. Поэтому используются плотные, геопривязанные и точные трехмерные облака точек, собранные LiDAR. Кроме того, LiDAR не чувствителен к изменениям условий освещения и может работать днем и ночью, даже при бликах и тенях [7]⟧.
Применение облаков точек LiDAR для беспилотных автомобилей можно описать в двух аспектах: (1) восприятие среды и обработка в реальном времени для понимания сцены и обнаружения объектов [8]; (2) генерация и построение высокоточных (HD) карт и городских моделей для надежной локализации и привязки [2]. Эти применения имеют некоторые схожие задачи, которые можно примерно разделить на три типа: сегментация облака точек в трех измерениях, обнаружение и локализация объектов в трех измерениях, а также классификация и распознавание объектов в трех измерениях. Такая технология привела к растущей и неотложной потребности в автоматическом анализе облаков точек в трех измерениях [9] для беспилотных автомобилей.
Под влиянием прорывов, обеспеченных методами глубокого обучения (DL), и доступностью трехмерных облаков точек, трехмерные структуры DL были исследованы на основе расширения двумерных архитектур DL до трехмерных данных и демонстрируют заметную последовательность эмпирических успехов. Эти структуры могут быть применены к ряду задач, в частности для AV, таких как: сегментация и понимание сцены [10, 11, 12], обнаружение объектов [13, 14] и классификация [10, 15, 16]. Таким образом, мы представляем систематический обзор в данной работе, который специально посвящен формированию облаков точек LiDAR для задач сегментации, обнаружения и классификации при автономном вождении с использованием методов DL.
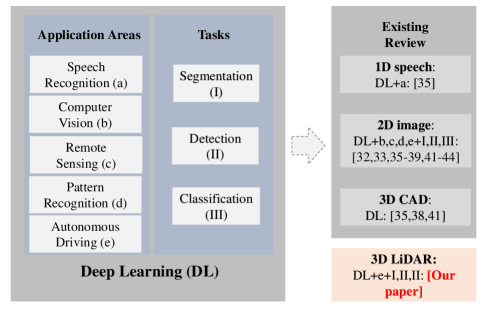
Несколько связанных обзорных исследований по глубинному обучению (DL) были опубликованы в последние годы. Базовые и всесторонние знания о DL подробно описаны в [17, 18]. Обычно эти обзоры сосредоточивались на рассмотрении приложений DL в визуальных данных [19, 20] и изображениях дистанционного зондирования [21, 22]. Некоторые из них нацелены на более узкие задачи, такие как обнаружение объектов [23, 24], семантическая сегментация [25], распознавание [26]. Хотя DL в трехмерных данных рассматривалось в [27, 28, 29], эти трехмерные данные в основном представляют собой 3D CAD модели [30]. В [1] рассматриваются задачи, наборы данных и методы компьютерного зрения для AV. Однако приложения DL в данных облаков точек LiDAR не были всесторонне рассмотрены и проанализированы. Мы обобщаем эти обзоры, связанные с DL, на рис.1⟧.
Также опубликовано несколько обзорных работ по облакам точек LiDAR. В [31, 32, 33, 34] вводятся 3D сегментация объектов дороги, обнаружение и классификация по данным мобильного LiDAR, но акцент сделан на общих методах, а не на моделях, специфичных для DL. В [35] анализируются всеобъемлющие 3D дескрипторы. В [36, 37] подводятся итоги подходов к 3D обнаружению объектов, применяемых для автономного вождения. Однако DL модели, используемые в этих задачах, не были всесторонне проанализированы. Таким образом, цель данной статьи — выполнить систематический обзор DL, применяемого к облакам точек LiDAR в области автономного вождения для конкретных задач, таких как сегментация, обнаружение/локализация и классификация.
Основные вклады нашей работы можно кратко сформулировать как:
- ⟦• Подробный и структурированный обзор ключевых достижений моделей 3D глубокого обучения и всесторонний обзор методов DL, ориентированных на задачи, такие как сегментация, обнаружение объектов/локализация и классификация/распознавание в AV, их происхождение и их вклад.
- ⟦• Всесторонний обзор существующих наборов данных LiDAR, которые могут быть использованы при обучении моделей DL для AV.
- ⟦• Подробное введение в количественные метрики оценивания и сравнение производительности для сегментации, обнаружения и классификации.
- ⟦Список оставшихся проблем и будущих исследований, которые помогают продвигать развитие глубокого обучения в области автономного вождения.
Оставшаяся часть данной статьи организована следующим образом: в Разделе II вводятся задачи автономного вождения и проблемы применения DL с использованием данных облаков точек LiDAR. В Разделе III описываются краткий обзор существующих наборов данных облаков точек LiDAR и оценочные метрики. Затем в Разделе IV рассматриваются веховые 3D-нейронные модели с четырьмя представлениями данных облаков точек LiDAR. Приложения DL для сегментации, обнаружения объектов/локализации и классификации/распознавания для AV на основе облаков точек LiDAR рассматриваются и обсуждаются в Разделе V. В Разделе VI предлагается список оставшихся проблем для будущих исследований. Наконец, в Разделе VII мы делаем выводы по статье..
II Задачи и вызовы
II-A Задачи
В модуле восприятия автономных транспортных средств семантическая сегментация, обнаружение объектов, локализация объектов и классификация/распознавание составляют основу надежной навигации и точных решений [38]. Эти задачи описываются соответственно следующим образом:
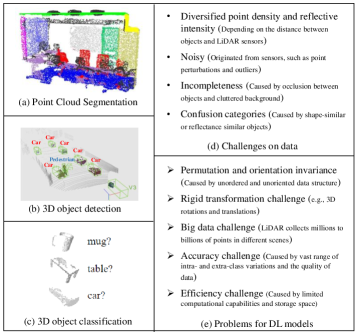
- ⟦• Семантическая сегментация облака точек: сегментация облака точек — это процесс кластеризации входных данных на несколько однородных областей, где точки в одной области имеют одинаковые атрибуты [39]. Каждая входная точка предсказывается с семантической меткой, такой как ground, tree, building. Задачу можно сформулировать так: given a set of ordered 3D points with и a candidate label set , assign each input point с one of the k semantic labels [40]. Результаты сегментации могут дополнительно поддерживать обнаружение объектов и классификацию, как показано на Fig.2(a).
- ⟦• Обнаружение/локализация трехмерных объектов: при произвольных данных облака точек цель обнаружения трехмерных объектов состоит в том, чтобы обнаружить и локализовать экземпляры заранее заданных категорий (например, автомобили, пешеходы и велосипедисты, как показано на рис.2(b)), а затем вернуть их геометрическое трехмерное положение, ориентацию и семантическую метку экземпляра [41]. Такая информация может быть представлена грубо с помощью трехмерного ограничивающего прямоугольника, который плотно охватывает обнаруженный объект [42, 42, 13]. Этот прямоугольник обычно представляют как , где обозначает положение центра объекта (ограничивающего прямоугольника), представляет размер ограничивающего прямоугольника по ширине, длине и высоте, а — ориентацию объекта. Под ориентацией понимается жесткое преобразование, которое согласует обнаруженный объект с его экземпляром в сцене, а именно: переносы в каждом из направлений x, y и z, а также поворот вокруг каждой из этих трех осей [43, 44]. представляет собой семантическую метку этого ограничивающего прямоугольника (объект).
- ⟦3D object classification/recognition: При наличии нескольких групп облаков точек объективность классификации / распознавания заключается в определении категории (например, кружка, стол или автомобиль, как показано на рис. Fig.2(c)), к которой принадлежат точки группы. Задачу 3D object classification можно определить следующим образом: дано множество упорядоченных 3D точек с и множеством кандидатов меток , сопоставить всему множеству точек одну из меток [45]⟧.
II-B Проблемы и вызовы
Для сегментации, обнаружения и классификации общих объектов с использованием DL для AV с надежной и различающей способностью производительностью необходимо решить несколько задач и проблем, как показано на рис.2. Вариативность условий сенсинга и неконтролируемая среда приводят к сложностям с данными. Нерегулярный формат данных и требования как к точности, так и к эффективности создают проблемы, которые DL-модели должны решать.
II-B1 Проблемы с облаками точек LiDAR
Изменения в условиях восприятия и в неконтролируемых средах оказывают драматическое влияние на внешний вид объектов. В частности, объекты, снятые в разных сценах или в разных экземплярах, образуют набор вариаций. Даже для одной и той же сцены времена сканирования, расположения, погодные условия, типы сенсоров, расстояния восприятия и фоны приводят ко внутриклассовым различиям. Все эти условия порождают существенные вариации как для внутриклассовых, так и для внеклассовых объектов в данных LiDAR point cloud данных:
- ⟦Плотность точек с разной детализацией и интенсивность отражения. Из-за режима сканирования LiDAR плотность и интенсивность для объектов сильно различаются. Распределение этих двух характеристик в значительной степени зависит от расстояния между объектами и LiDAR-датчиками [46, 47, 48]. Кроме того, на их распределение и интенсивность влияют возможности LiDAR-датчиков, ограничения по времени сканирования и требуемое разрешение.
- ⟦Шум. Все датчики шумные. Существуют несколько типов шума, включая точечные возмущения и выбросы [49]. Это означает, что точка с некоторой вероятностью находится внутри сферы заданного радиуса вокруг места, в котором она была отобрана (возмущения), или же она может появиться в случайной позиции в пространстве [50].
- ⟦Неполнота. Данные облака точек, полученные с помощью LiDAR, обычно неполны [51]. Это в основном связано с перекрытием между объектами [50], загромождённым фоном на городских сценах [49, 46] и неудовлетворительной отражательной способностью материала поверхности. Такие проблемы особенно существенны при съёмке движущихся объектов в режиме реального времени, когда существуют большие зияющие пустоты и значительное недостаточное выборочное покрытие.
- ⟦Категории путаницы. В естественной среде объекты, имеющие сходную форму или одинаковую отражательную способность, создают помехи при обнаружении и классификации объектов. Например, некоторые искусственно созданные объекты, такие как коммерческие рекламные щиты, имеют сходные формы и отражательную способность с дорожными знаками.
II-B2 Проблемы для моделей 3D DL
Нерегулярный формат данных и требования к точности и эффективности при выполнении задач создают некоторые новые трудности для моделей DL. Дискриминативная и универсальная 3D-модель DL должна решить следующие проблемы при проектировании и построении своей структуры:
- ⟦Непрерывность перестановок и ориентационная инвариантность. По сравнению с пикселями двумерной сетки облака точек LiDAR представляют собой множество точек с нерегулярным порядком и без заданной ориентации [52]. В пределах одной и той же группы точек сеть должна передавать N! перестановок в порядке, чтобы обеспечивать инвариантность. Кроме того, отсутствует ориентация наборов точек, что создает большую задачу для распознавания объектных шаблонов [53].
- ⟦Жесткая трансформационная задача. Существуют различные жесткие преобразования среди наборов точек, такие как повороты в трех измерениях и перемещения в трех измерениях. Эти преобразования не должны влиять на производительность сетей [12, 52].
- ⟦• Большая проблема данных. LiDAR собирает миллионы или миллиарды точек в различных городских или сельских средах с природными сценами [49]. Например, в наборе данных Kitti [54] каждый кадр, снятый лазерными сканерами 3D Velodyne, содержит 100k точек. Самая маленькая собранная сцена имеет 114 кадров, что соответствует более чем 10 миллионам точек. Такие объемы данных создают трудности в хранении данных.
- ⟦• Проблема точности. Точная перцепция объектов дороги имеет решающее значение для АВ. Однако различия как внутри классов, так и между классами объектов, а также качество данных создают трудности для точности. Например, объекты одной категории представлены набором различных экземпляров по различным материалам, формам и размерам. Кроме того, модель должна быть устойчивой к неравномерно распределенным, разреженным и отсутствующим данным.
- ⟦Эффективностная задача. По сравнению с изображениями в двумерном формате обработка большого количества облаков точек приводит к высокой вычислительной сложности и затратам по времени. Кроме того, вычислительные устройства в AV имеют ограниченные вычислительные возможности и объем памяти [55]. Таким образом, критически важно наличие эффективной и масштабируемой модели глубокой нейронной сети.
III Наборы данных и метрики оценки
III-A Наборы данных
Наборы данных прокладывают путь к быстрому развитию приложений с трехмерными данными и их использованию с применением сетей глубокого обучения. Существуют две роли надежных наборов данных: одна — обеспечивать сравнение для конкурирующих алгоритмов, другая — продвигать соответствующие области к более сложным и требовательным задачам [23]. По мере роста применения LiDAR в различных областях, таких как автономное вождение, дистанционное зондирование, фотограмметрия, увеличивается число крупномасштабных наборов данных, содержащих более миллионов точек. Эти наборы ускоряют ключевые прорывы и непредвиденные улучшения в сегментации облака точек, обнаружении трехмерных объектов и классификации. Помимо мобильных данных LiDAR, некоторые различающие наборы данных [56], полученные при наземном лазерном сканировании (TLS) статическим LiDAR, также используются, поскольку они предоставляют высококачественные данные облака точек.
| Dataset | Format |
|
|
# Classes | Sparsity | Highlight | |||||||||||
| Segmentation | |||||||||||||||||
| Semantic3D [56] | ASCII |
|
|
8 | Dense |
|
|||||||||||
| Oakland [57] | ASCII | X, Y, Z, Class |
|
5 | Sparse |
|
|||||||||||
| iQmulus [58] | PLY |
|
|
22 | Moderate | training & testing | |||||||||||
| Paris-Lille-3D [59] | PLY |
|
|
50 | Moderate |
|
|||||||||||
| Localization/Detection | |||||||||||||||||
|
- |
|
|
3 | Sparse |
|
|||||||||||
| Classification/Recognition | |||||||||||||||||
|
ASCII |
|
588 objects | 14 | Sparse |
|
|||||||||||
|
ASCII |
|
|
|
Dense |
|
|||||||||||
Как показано в таблице I, мы классифицируем существующие наборы данных, относящиеся к нашей теме, на три типа: наборы данных на основе сегментации, наборы данных на основе обнаружения, наборы данных на основе классификации. Кроме того, также обобщен набор данных для долгосрочной автономности.
- ⟦• Датасеты, основанные на сегментации
Semantic3D [56]. Semantic3D является существующим крупнейшим набором данных LiDAR для задач сегментации уличных сцен, содержащим более 4 миллиардов точек и около 110,000, покрывающих площадь. Этот набор данных размечен по 8 классам и разделен на обучающую и тестовую выборки почти равного размера. Данные получены с помощью статического LiDAR с высокой разрешающей способностью измерений и с покрытием на большие расстояния измерений. Основные трудности для этого набора данных связаны с массивными облаками точек, неравномерно распределенной плотностью точек и серьезными перекрытиями. Чтобы разместить высоковычислительные алгоритмы, вводится сокращенный набор данных reduced-8 для обучения и тестирования, который использует одни и те же обучающие данные, но содержит меньше тестовых данных по сравнению с Semantic3D.
Набор данных Oakland 3-D Point Cloud Dataset [57]. Этот набор данных получен в более ранний год по сравнению с двумя вышеперечисленными наборами данных. Для сканирования городской среды используется мобильная платформа, оснащенная LiDAR, которая сформировала около 1,3 миллиона точек, при этом 100 000 точек разбиты на набор валидации. Весь набор данных размечен 5 классами, такими как wire, vegetation, ground, pole/tree-trunk и facade. Этот набор данных небольшой, поэтому он подходит для легковесных нейросетей. Кроме того, этот набор данных можно использовать для тестирования и настройки архитектур сетей без большого времени на обучение перед окончательным обучением на других наборах данных.
Состязание IQmulus & TerraMobilita [58]. Этот набор данных также получен с помощью мобильной системы LiDAR в городской среде в Париже. В этом наборе данных более 300 миллионов точек, охвачено 10 км улиц. Данные разделены на 10 отдельных зон и помечены более чем 20 детализированными классами. Однако этот набор данных также имеет сильные перекрытия.
Paris-Lille-3D [59]. По сравнению с Semantic3D [56], Paris-Lille-3D содержит меньше точек (140 миллионов точек) и покрываемую область (55,000). Основное различие этого набора данных состоит в том, что его данные получены с помощью системы Mobile LiDAR в двух городах: Paris и Lille. Таким образом, точки в этом наборе данных разрежены и по сравнению с Semantic3D [56] имеют сравнительно низкое измерительное разрешение. Но этот набор данных ближе по своим характеристикам к данным LiDAR, полученным с помощью AV. Весь набор данных полностью размечен по 50 классам, распределённым неравномерно в трёх сценах: Lille1, Lille2 и Paris. Для простоты эти 50 классов объединены в 10 укрупнённых классов для сложных.
| Metric | Equation | Description | ||||
|
|
|
|||||
|
|
Mean IoU, where N is the number of classes | |||||
|
|
Overall accuracy | |||||
|
|
|
|||||
|
|
|
|||||
|
|
|
|||||
|
|
|
|||||
|
|
Average Precision, where represents the recall, represents the precision | |||||
|
|
Average Orientation Similarity | |||||
|
|
|
- ⟦• Наборы данных на основе обнаружения
Набор данных KITTI для обнаружения объектов/ориентированного сверху вида [60]. В отличие от вышеупомянутых наборов данных LiDAR, которые предназначены для задач сегментации, набор данных KITTI получен с платформы автономного вождения и записывает шесть часов движения с помощью цифровых камер, LiDAR, системы инерциальной навигации GPS/IMU. Таким образом, помимо данных LiDAR, также предоставляются соответствующие данные изображений. И набор данных для обнаружения объектов, и Bird’s Eye View Benchmark содержат 7481 обучающее изображение и 7518 тестовых изображений, а также соответствующие облака точек. Из-за режима движущегося сканирования данные LiDAR в этом наборе данных являются крайне разреженными. Таким образом, размечены только три типа объектов с рамками: автомобили, пешеходы и велосипедисты.
- ⟦• Наборы данных, основанные на классификации
Набор данных Sydney Urban Objects [61]. Этот набор данных содержит набор общих городских дорожных объектов, отсканированных с помощью LiDAR в центре делового района Сиднея, Австралия. Он включает 588 размеченных объектов, классифицированных по 14 категориям, таким как транспортные средства, пешеходы, дорожные знаки и деревья. Весь набор данных разделён на четыре сегмента для обучения и тестирования. Подобно другим наборам данных LiDAR, собранные объекты в этом наборе данных разрежены и имеют неполную форму. Хотя он небольшой и не идеален для задачи классификации, это наиболее часто используемый бенчмарк из-за ограничений трудоёмкого процесса разметки.
ModelNet [30]. Этот набор данных является существующим крупнейшим тестовым стендом для распознавания трехмерных объектов. В отличие от Sydney Urban Objects Dataset [61], который содержит дорожные объекты, собранные с помощью сенсоров LiDAR, этот набор данных состоит из общих объектов в моделях CAD с равномерно распределенной плотностью точек и полной формой. Примерно 130K размеченных моделей в общей сложности по 660 категориям (например, car, chair, clock). Наиболее часто используемые тестовые стенды — ModelNet40, содержащий 40 общих объектов, и ModelNet10 с 10 общими объектами. Веховые трехмерные глубокие архитектуры обычно обучают и испытывают на этих двух наборах данных из‑за доступной вычислительной нагрузки и времени.
Долгосрочная автономность: Для решения задач долгосрочной автономности компанией Maddern и соавт. представлен новый набор данных для автономного вождения [64]. Они собрали изображения, данные LiDAR и GPS во время проезда 1 000 км в центральной части Оксфорда в Великобритании в течение одного года. Это позволило им зафиксировать различные варианты внешнего вида сцен при разных условиях освещения, погоды и сезона, включая динамические объекты и строительные конструкции. Такие долгосрочные наборы данных позволяют проводить углубленное исследование проблем, которые сдерживают реализацию автономных транспортных средств, таких как локализация в разное время года.
III-B Метрики оценки
Чтобы оценить производительность предложенных методов, для этих задач предлагается несколько метрик, как обобщено в Таблице II: сегментация, обнаружение и классификация. Подробности этих метрик приведены ниже.
Для задачи сегментации наиболее часто используемые оценочные метрики — это метрика Intersection over Union (IoU) и общая точность (OA) [62]. IoU определяет количественно процент перекрытия между целевой маской и выходом предсказания [56]⟧.
Для задач обнаружения и классификации результаты обычно анализируют по регионам. Для оценки производительности обычно используются точность, полнота, -score и коэффициент корреляции Мэтьюса (MCC) [65]. Точность представляет собой долю правильно обнаруженных объектов во всем результате обнаружения, тогда как полнота означает процент правильно обнаруженных объектов в разметке истинных значений, -score передает баланс между точностью и полнотой, MCC является объединенным отношением обнаруженных и необнаруженных объектов и не-объектов.
Для задачи локализации и обнаружения трехмерных объектов наиболее часто используемые метрики: Average Precision () [66], и Average Orientation Similarity (AOS) [36]. Средняя точность используется для оценки точности локализации и обнаружения путем вычисления усредненных допустимых пересечений ограничивающих рамок, которые превышают заданные значения. Для оценки ориентации сходства ориентации с разными пороговыми значениями допустимых пересечений ограничивающих рамок усредняются, чтобы сообщить о производительности.
IV Общий 3D-кадр глубокого обучения
В этом разделе мы рассматриваем важнейшие DL-фреймворки для трехмерных данных. Эти фреймворки являются первопроходцами в решении задач, определенных в разделе II. Кроме того, их стабильная и эффективная работа делает их подходящими в качестве базового фреймворка для задач обнаружения, сегментации и классификации. Хотя трехмерные данные, получаемые с помощью LiDAR, часто имеют вид облаков точек, вопрос о том, как представлять облако точек, и какие DL-модели использовать для обнаружения, сегментации и классификации, остается открытой проблемой [41]. Большинство существующих моделей 3D DL обрабатывают облака точек главным образом в виде воксельных решеток [30, 67, 68, 69], облаков точек [10, 12, 70, 71], графов [72, 73, 74, 75] и двумерных изображений [76, 15, 77, 78]. В этом разделе мы подробно анализируем фреймворки, характеристики и проблемы этих моделей.
IV-A Воксельные модели
Обычно сверточные нейронные сети применяются в основном к данным с регулярной структурой, таким как двумерный массив пикселей [79]. Таким образом, чтобы применять CNN к неупорядоченным данным трехмерного облака точек, такие данные разбивают на регулярные сетки с определенным размером, чтобы описать распределение данных в трехмерном пространстве. Обычно размер сетки связан с разрешением данных [80]. Преимущество воксельного представления состоит в том, что оно позволяет кодировать трехмерную форму и информацию о ракурсе, классифицируя занятые воксели на несколько типов, таких как видимые, закрытые и само-закрытые. Кроме того, операции трехмерной свертки (Conv) и объединения (pooling) можно непосредственно применять в воксельных сетках [69].
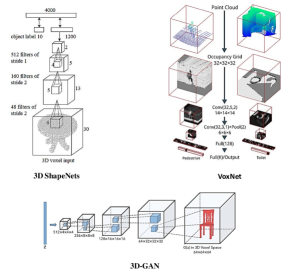
3D ShapeNet [30], предложенный Wu et al. и показанный на рис.3, является пионером в использовании 3D объемных данных с помощью сверточной глубокой сети доверия. Распределение вероятностей бинарных переменных используется для представления геометрической формы 3D воксельной сетки. Затем эти распределения подаются на вход сети, которая в основном состоит из трех Conv-слоев. Эта сеть сначала предварительно обучается поуровневым способом, а затем обучается с помощью процедуры генеративного дообучения. Входные данные и Conv-слои моделируются на основе Contrastive Divergence, при этом выходной слой обучался на основе Fast-Persistent Contrastive Divergence. После обучения входные тестовые данные выводятся в виде одной карты глубины, а затем преобразуются для представления воксельной сетки. ShapeNet демонстрирует заметные результаты на вокселях низкого разрешения. Однако вычислительная стоимость возрастает кубически с увеличением размера входных данных или разрешения, что ограничивает производительность модели на крупномасштабных или плотных данных точечных облаков. Кроме того, информация с нескольких масштабов и множества ракурсов из данных используется не полностью, что препятствует улучшению выходных результатов.
VoxNet [67] предложен Maturana et al. для проведения распознавания трехмерных объектов с использованием трехмерных сверточных фильтров на основе представления объемных данных, как показано на рис.3. Занятостьные сетки, представленные трехмерной решеткой случайных величин, применяются для отображения состояния среды. Затем используется вероятностная оценка для вычисления занятости этих сеток, которая поддерживается как априорное знание. Проводятся эксперименты с тремя различными моделями занятостьных сеток, такими как двоичная занятостьная сетка, сетка плотности и сетка попаданий, чтобы выбрать наилучшую модель. Эта сетевая архитектура в основном состоит из сверточных (Conv) слоев, слоя подвыборки (pooling) и полностью связанных (FC) слоев. И ShapeNet [30], и VoxNet используют аугментацию вращением для обучения. По сравнению с ShapeNet [30], VoxNet имеет меньшую архитектуру с числом параметров менее 1 миллиона. Однако не все занятостьные сетки содержат полезную информацию, а только увеличивают вычислительную стоимость.
3D-GAN [68] объединяет достоинства как general-adversarial network (GAN) [81], так и volumetric convolutional networks [67], чтобы изучать признаки 3D-объектов. Эта сеть состоит из генератора и дискриминатора, как показано на рис.3. Адверсариальный дискриминатор используется для классификации объектов на синтезированные и реальные категории, поскольку generative-adversarial criterion имеет преимущество в извлечении структурных различий между двумя 3D-объектами. А применение generative-adversarial loss помогает избежать возможного критериально-зависимого переобучения. Генератор стремится ввести дискриминатор в заблуждение. И генератор, и дискриминатор состоят из пяти volumetric fully Conv слоев. Эта сеть обеспечивает мощный 3D-описатель формы с обучением без учителя при распознавании 3D-объектов. Однако плотность данных влияет на качество работы адверсариального дискриминатора при точном извлечении наиболее тонких признаков. Вследствие этого этот адаптивный метод подходит для равномерно распределенных данных point cloud.
В заключение, существуют некоторые ограничения этого общего представления объемных трехмерных данных:
- ⟦Сначала не все представления вокселей полезны, потому что они содержат занятые и незанятые части сканируемой среды. Таким образом, высокая потребность в компьютерном хранилище на самом деле не является необходимой при этом неэффективном представлении данных [69].
- ⟦Во-вторых, размер сетки трудно задать, что влияет на масштаб входных данных и может нарушить пространственную взаимосвязь между точками.
- • Во‑вторых, вычислительные и требования к памяти растут по кубическому закону с разрешением [69]. Таким образом, существующие модели на основе вокселей сохраняются при низких 3D‑разрешениях, а наиболее часто используемый размер составляет для каждой сетки.[69].
Более продвинутое представление данных на основе вокселей — это октречные сетки [69, 82], которые используют адаптивный размер, чтобы разделять трехмерное облако точек на кубы. Это иерархическая структура данных, которая рекурсивно разлагает корневые воксели на несколько листовых вокселей.
OctNet [69] предложен Riegler et al. и использует разреженность входных данных. Руководствуясь наблюдением о том, что границы объектов с наибольшей вероятностью приводят к получению максимальных откликов по всем картам признаков, сформированным сетью на разных слоях, они иерархически разбили трехмерное пространство на набор несбалансированных октодеревьев [83] на основе плотности входных данных. В частности, узлы октодерева, содержащие облака точек, рекурсивно разделяются в своей области определения, пока не будет достигнуто самое детальное разрешение дерева. Таким образом, размер листовых узлов различается. Для каждого листового узла те признаки, которые активируют соответствующий им воксел, объединяются (пулируются) и сохраняются. Затем сверточные фильтры выполняются в этих деревьях. В [82] глубокая модель строится путем обучения структуры октодерева и представленного значения занятости для каждой ячейки сетки. Такая октодеревная форма представления данных в значительной степени сокращает вычислительные затраты и объем памяти для архитектур DL, что обеспечивает лучшие результаты на высокоразрешенных трехмерных данных по сравнению с воксельными моделями. Однако недостаток данных октодерева, как и у вокселей, состоит в том, что они не позволяют в полной мере использовать геометрические признаки трехмерных объектов, особенно внутренние характеристики паттернов и поверхностей [29].
IV-B Модели на основе облаков точек
В отличие от объемного представления трехмерных данных, данные облака точек могут сохранять трехмерную геопространственную информацию и внутреннюю локальную структуру. Кроме того, модели на основе вокселей, которые сканируют пространство с фиксированными шагами, ограничены локальными полями рецептивности. Но для облаков точек входные данные и метрика определяют диапазон полей рецептивности, что обеспечивает высокую эффективность и точность.
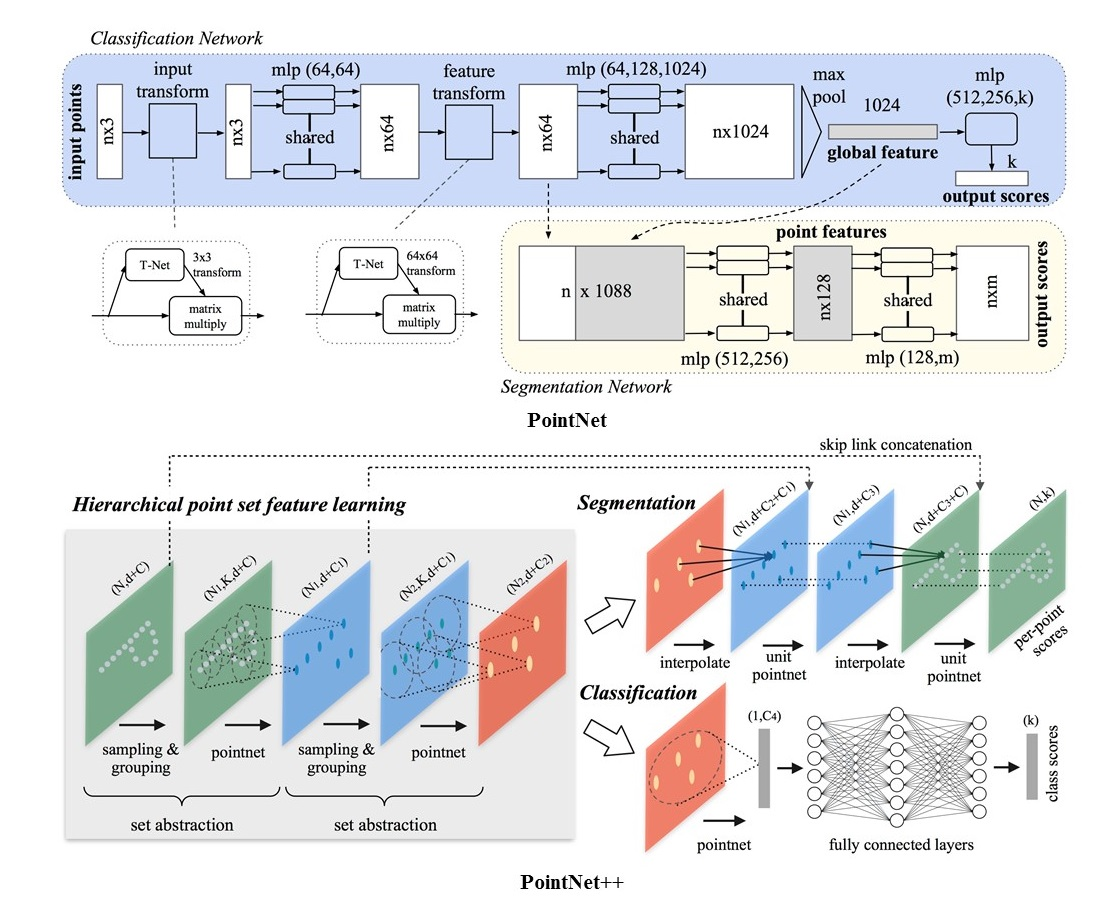
PointNet [10], как пионер в прямом потреблении 3D облаков точек для глубоких моделей, учит пространственную характеристику каждой точки независимо через слои MLP, а затем накапливает их характеристики посредством max-pooling. Данные облака точек подаются непосредственно в PointNet, который предсказывает метку для каждой точки или метку для объекта; его структура показана на рис.4. В PointNet разработаны пространственная трансформационная сеть и симметричная функция, чтобы повысить инвариантность к перестановкам. Пространственная характеристика каждой входной точки была изучена через сети. Затем изученные характеристики собираются по всей области облаков точек. Превосходная производительность PointNet была достигнута в задачах классификации и сегментации 3D объектов. Однако индивидуальные характеристики точек группируются и агрегируются с помощью max-pooling, что не позволяет сохранять локальную структуру. В результате PointNet неустойчив к детально различимым шаблонам и сложным сценам.
PointNet++ был предложен позже Qi et al. [12], которые компенсируют проблемы локального извлечения признаков в PointNet. При подаче на вход в виде исходных неупорядоченных облаков точек эти точки сначала разделяются на перекрывающиеся локальные области с использованием евклидовой метрики расстояния. Эти разбиения определяются как окрестностные шары в этом метрическом пространстве и маркируются местоположением центроида и масштабом. Чтобы выполнять выборку точек равномерно по всему набору точек, применяется алгоритм farthest point sampling (FPS). Локальные признаки извлекаются из небольших окрестностей вокруг выбранных точек с использованием методов K-nearest-neighbor (KNN) или поиска query-ball. Эти окрестности собираются в более крупные кластеры и используются для извлечения признаков высокого уровня с помощью сети PointNet [10]. Модуль выборки и группирования повторяется до тех пор, пока не будут изучены локальные и глобальные признаки всех точек, как показано на рис.4. Эта сеть, которая превосходит сеть PointNet [10] в задачах классификации и сегментации, извлекает локальные признаки для точек на разных масштабах. Однако признаки из локальных соседних точек на разных слоях выборки изучаются изолированно. Кроме того, операция max-pooling на основе PointNet [10] для извлечения признаков высокого уровня в PointNet++ не сохраняет пространственную информацию между точками локальной окрестности.
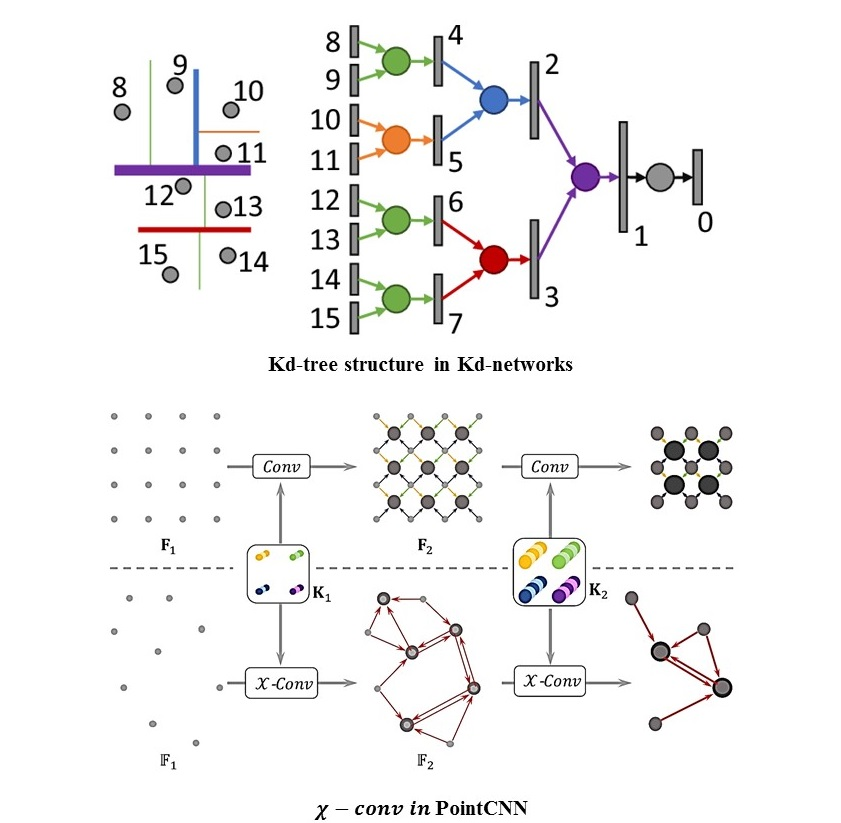
Kd-networks [70] использует kd-дерево для создания порядка входных точек, что отличается от PointNet [10] и PointNet++ [12], поскольку оба они используют симметричную функцию для решения задачи перестановки. Klokov и соавт. использовали максимальный диапазон координат точек вдоль оси координат, чтобы рекурсивно разделять облака точек определенного размера на подмножества в нисходящем порядке, конструируя kd-дерево. Как показано на рис.5, это kd-дерево заканчивается на фиксированной глубине. В рамках этой сбалансированной структуры дерева в каждом узле вычисляются векторные представления, которые представляют разбиение вдоль некоторой оси, с помощью kd-networks. Затем эти представления используются для обучения линейного классификатора. Эта сеть демонстрирует более высокую производительность, чем PointNet [10] и PointNet++ [12], в задаче классификации малых объектов. Однако она не является устойчивой к вращениям и шуму, поскольку эти изменения могут приводить к изменению структуры дерева. Кроме того, ей не хватает перекрывающегося воспринимающего поля, что снижает пространственную корреляцию между листовыми узлами.
PointCNN, предложенная Li et al. [71], решает проблемы перестановки и преобразования входных точек на основе операции -Conv, как показано на рис.5. Они предложили преобразование , которое изучается по входным точкам путем взвешивания признаков входных точек и перестановки точек в скрытый и потенциально канонический порядок. Затем традиционные операторы свертки применяются к признакам преобразования , изученным моделью. Эти пространственно-локальные корреляционные признаки в каждом локальном диапазоне агрегируются для построения иерархической архитектуры сверточной нейронной сети. Однако эта модель все еще не использовала корреляции различных геометрических признаков и их различающую информацию для получения результатов, что ограничивает производительность.
Глубокие модели на основе облака точек в основном ориентированы на решение задач перестановок. Хотя они рассматривают точки независимо в локальных масштабах, чтобы сохранять инвариантность к перестановкам. Однако эта независимость игнорирует геометрические связи между точками и их соседями, что представляет собой фундаментальное ограничение, приводящее к отсутствию локальных признаков.
IV-C Графовые модели
Графы — это тип неевклидовой структуры данных, которую можно использовать для представления данных облака точек. Их вершина соответствует каждой входной точке, а ребра отражают взаимосвязь между соседними точками. Графовые нейронные сети в итеративном порядке распространяют состояния вершин до наступления равновесия [75]. С развитием CNN существует рост применения графовых сверточных сетей к данным трех измерений. Эти графовые CNN определяют свертки непосредственно на графе в спектральной и несспектральной (пространственной) области, выполняя операции над группами пространственно близких соседей [84]. Преимущество графовых моделей заключается в том, что используются геометрические взаимосвязи между точками и их соседями. Таким образом, извлекаются более пространственно-локальные корреляционные признаки из сгруппированных реберных связей на каждой вершине. Но есть две задачи при построении глубинных моделей на основе графов:
- ⟦• Прежде всего, определим оператор, подходящий для динамически задаваемых окрестностей и обеспечивающий схему разделения весов, характерную для CNN [75].
- • Во-вторых, использование пространственных и геометрических отношений между соседями каждой вершины.
SyncSpecCNN [72] использовал спектральное разложение по собственным значениям графового Лапласиана для генерации свёрточного фильтра, применяемого к облакам точек. Yi и др. построили SyncSpecCNN на основе двух соображений: первое — совместное использование коэффициентов и многомасштабный анализ графов; второе — обмен информацией между связанными, но различными графами. Они решили эти две задачи, построив операцию свёртки в спектральной области: сигнал наборов точек в евклидовом пространстве определяется метриками на узлах графа, а операция свёртки в евклидовом пространстве связана с масштабированием сигналов на основе собственных значений. По сути, такая операция является линейной и применима только к весам графа, сгенерированным по собственным векторам графового Лапласиана. Несмотря на то, что SyncSpecCNN показал отличную производительность в задаче сегментации частей 3D-форм, у него есть несколько ограничений:
- ⟦• Зависит от базиса. Коэффициенты изученного спектрального фильтра не подходят для другой предметной области с иным базисом.
- ⟦• Вычислительно дорого. Спектральная фильтрация вычисляется на основе всех входных данных, что требует высокой вычислительной мощности.
- ⟦• Отсутствуют локальные признаки ребер. Локальное окружение графа содержит полезную и отличительную локальную структурную информацию, которая не используется.
Сверточная операция с учетом граней (ECC) [73] рассматривает информацию о гранях при построении свертрочных фильтров на основе сигнала графа в пространственной области. Метки граней в окрестности вершины обуславливаются для генерации весов фильтра Conv. Кроме того, чтобы решить задачу, зависящую от базиса, они динамически обобщили оператор свертки для произвольных графов с различными размерами и связностью. Вся сеть следует общей структуре сети прямого распространения с чередующимися свертками и операциями подвыборки, за которыми следуют глобальная подвыборка и полносвязные (FC) слои. Таким образом, признаки из локальных окрестностей извлекаются последовательно на этих наложенных слоях, что увеличивает воспринимающее поле. Хотя метки граней фиксированы для заданного графа, изучаемые интерпретационные сети могут различаться на разных слоях. ECC изучает динамический шаблон локальных окрестностей, который является масштабируемым и эффективным. Однако вычислительная стоимость остается высокой, и это не подходит для крупномасштабных графов с непрерывными метками граней.
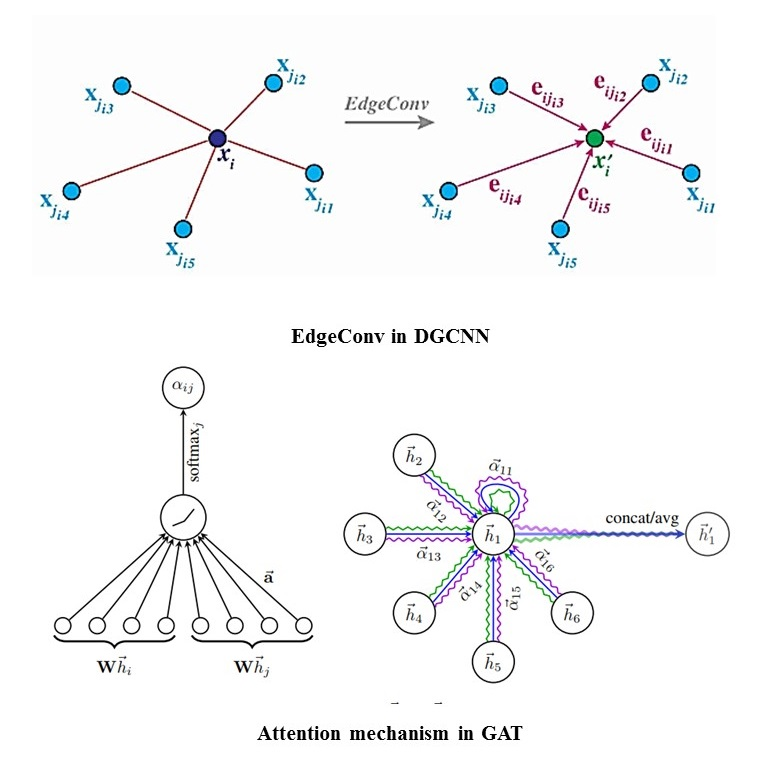
DGCNN [74] также построила локальный граф окрестности для извлечения локальных геометрических признаков и применяла операции, подобные Conv, под названием EdgeConv, которое показано на рис.6, на ребрах, соединяющих соседние пары каждой точки. В отличие от ECC [73], EdgeConv динамически обновляет заданный фиксированный граф операциями, подобными Conv, для каждого выходного слоя. Таким образом, DGCNN может научиться извлекать локальные геометрические структуры и группировать облака точек. Эта модель принимает точек на вход, а затем находит K окрестностей каждой точки, чтобы вычислить реберный признак между точкой и ее K окрестностями в каждом слое EdgeConv. Подобно архитектуре PointNet[34], признаки, свернутые в последнем слое EdgeConv, агрегируются глобально для построения глобального признака, в то время как все выходы EdgeConv рассматриваются как локальные признаки. Локальные и глобальные признаки объединяются конкатенацией для формирования итоговой оценочной величины. Эта модель извлекает отличительные реберные признаки из окрестностей точек, которые могут быть применены в различных задачах, связанных с облаками точек. Однако фиксированный размер реберных признаков ограничивает производительность модели при работе с облаками точек разного масштаба и разрешения.
ECC [73] и DGCNN [74] предлагают обобщенные свертки по узлам графа и их информации о ребрах, которые изотропны относительно входных признаков. Однако не все входные признаки вносят равный вклад в ее узлы. Таким образом, вводятся механизмы внимания для работы с входными данными переменного размера и для фокусировки на наиболее релевантных частях соседей узлов при принятии решений [75].
Graph Attention Networks (GAT) [75]. Ключевая идея GAT заключается в вычислении скрытых представлений каждой вершины графа путем присвоения различных весов внимания разным соседям, следуя стратегии самовнимания. В рамках набора признаков вершин, подаваемого на вход, к каждой вершине применяется общая линейная трансформация, параметризованная матрицей весов. Затем применяется самовнимание, общий механизм внимания, показанный на рис.6, который используется для вычисления коэффициентов внимания. Эти коэффициенты указывают на важность соответствующих признаков соседних вершин и далее нормируются, чтобы их можно было сравнивать между разными вершинами. Эти локальные признаки объединяются в соответствии с весами внимания, чтобы сформировать выходные признаки для каждой вершины. Чтобы повысить устойчивость механизма самовнимания, применяется многоголовое внимание: оно выполняет k независимых схем внимания, которые затем конкатенируются для формирования итоговых выходных признаков для каждой вершины. Такая архитектура внимания является эффективной и позволяет извлекать детализированные представления для каждой вершины графа, присваивая различающиеся веса соседям. Однако локальные пространственные соотношения между соседями не учитываются при вычислении весов внимания. Чтобы дальнейшим образом улучшить производительность, Wang et al. [85] предложили graph attention convolution (GAC), чтобы генерировать веса внимания, учитывая различные соседние точки и каналы признаков.
| Model |
|
Hightlights | Disadvanatges |
|
|
||||||||||||
| Voxel | |||||||||||||||||
|
voxels |
|
|
12 | 84.7 | ||||||||||||
|
voxels |
|
|
1.0 | 85.9 | ||||||||||||
|
voxels |
|
|
7 | 83.3 | ||||||||||||
|
|
|
|
0.4 | 86.5 | ||||||||||||
| Point Clouds | |||||||||||||||||
|
|
|
|
40 | 89.2 | ||||||||||||
|
|
|
|
12 | 90.7 | ||||||||||||
|
|
|
|
120 | 91.8 | ||||||||||||
|
|
|
|
4.5 | 92.2 | ||||||||||||
| Graph | |||||||||||||||||
|
graphs |
|
|
0.8 | - | ||||||||||||
|
graphs |
|
|
- | 87.4 | ||||||||||||
|
graphs |
|
|
21 | 92.2 | ||||||||||||
|
graphs |
|
|
- | - | ||||||||||||
| 2D View | |||||||||||||||||
|
12 views |
|
|
99 | 90.1 | ||||||||||||
|
20 views |
|
Geometric information are not exploited. | 16.6 | 91.4 | ||||||||||||
|
20 views |
|
|
- | - | ||||||||||||
|
12 views |
|
Not suitable for per-point processing tasks. | 59 | 97.37 | ||||||||||||
IV-D Модели, основанные на представлении
Последний тип представления данных MLS — это двумерные представления, полученные из трехмерных облаков точек с разных направлений. С использованием проецированных двумерных представлений могут быть задействованы традиционные, хорошо зарекомендовавшие себя сверточные нейронные сети (CNN) и предварительно обученные сети на наборах изображений, такие как AlexNet [86], VGG [87], GoogLeNet [88], ResNet [89]. По сравнению с моделями на основе вокселей эти методы могут улучшать производительность для различных задач трехмерного моделирования за счет получения многовидовых изображений объекта или сцен интереса, а затем слияния или голосования результатов для окончательного предсказания. По сравнению с тремя указанными выше типами представления трехмерных данных, модели, основанные на видах, могут достигать почти оптимальных результатов, как показано в Таблице III. Su et al. [90] провели эксперимент и выяснили, что многовидовые методы обладают оптимальной обобщающей способностью даже без использования предварительно обученных моделей по сравнению с моделями представления облаков точек и воксельных данных. Преимущества моделей, основанных на видах, по сравнению с трехмерными моделями можно сформулировать как:
- • Эффективность. По сравнению с трехмерными представлениями данных, такими как point clouds или voxel grids, сокращение одной размерности информации может существенно снизить вычислительные затраты, но при этом повысить разрешение [76].
- ⟦Эксплуатация устоявшихся двумерных глубоких архитектур и наборов данных. Хорошо разработанные двумерные архитектуры глубокого обучения могут лучше использовать локальную и глобальную информацию из проецированных двумерных изображений представлений [91]. Кроме того, существующие двумерные базы изображений (например, ImageNet [92]) могут быть использованы для обучения двумерных архитектур глубокого обучения.
Многопредставленческая сверточная сеть (MVCNN) [76] является пионером в использовании двумерных моделей глубокого обучения для изучения трехмерного представления. Множество представлений трехмерных объектов извлекается без определенного порядка с использованием слоя объединения представлений. В этой статье предлагаются и тестируются две различные модели сверточной сети. Первая модель сверточной сети принимает 12 представлений, отрисованных с объекта путем размещения 12 виртуальных камер на равном расстоянии вокруг объектов в качестве входных данных, в то время как вторая модель сверточной сети принимает 80 представлений, отрисованных аналогичным образом, в качестве входных данных. Эти представления сначала изучаются отдельно, а затем объединяются посредством операции max-pooling, чтобы извлечь наиболее репрезентативный признак среди всех представлений для всей трехмерной формы. Эта сеть эффективна и экономична по сравнению с представлением объемных данных. Однако операция max-pooling учитывает только наиболее важные представления и отбрасывает информацию из остальных представлений, что приводит к неспособности сохранять исчерпывающую визуальную информацию.
MVCNN-MultiRes был предложен Qi и соавт. [15] для улучшения многовидовых сверточных сетей. В отличие от традиционных методов формирования вида, трехмерная форма проецируется на двумерное изображение с помощью операции свертки на основе анизотропного зондирующего ядра, применяемого к трехмерному объему. Затем многократное объединение по различным ориентациям объединяется для улучшения способности извлекать структуру трехмерного объекта. После этого применяется MVCNN [76] для классификации полученных двумерных проекций. По сравнению с MVCNN [76] вводится многомасштабная трехмерная фильтрация для извлечения информации на разных масштабах. Выполняется сферическое формирование изображений при различных разрешениях объема, чтобы добиться инвариантности к виду и повысить устойчивость к потенциальному шуму и нерегулярностям. Эта модель обеспечивает лучшие результаты в задаче классификации трехмерных объектов по сравнению с MVCNN [76].
3DMV [77] объединяет геометрию и данные изображений как входные данные для обучения совместной трехмерной глубокой архитектуры. Карты признаков, извлеченные из данных изображений, сначала извлекаются, а затем отображаются в трехмерные признаки, извлеченные из данных объемной сетки, полученных из дифференцируемого слоя обратной проекции. Поскольку существует избыточная информация между несколькими ракурсами, применяется подход объединения по нескольким ракурсам (multiview pooling), чтобы извлечь полезную информацию из этих ракурсов. Эта сеть достигла впечатляющих результатов в классификации трехмерных объектов. Однако по сравнению с моделями, использующими один источник данных, такой как точки LiDAR или изображения RGB, вычислительная стоимость этого метода выше.
RotationNet [78] предлагается исходя из допущения, что когда объект наблюдается зрителем из частичного набора полных мультивидовых изображений, направление наблюдения должно быть распознано, чтобы корректно определить категорию объекта. Таким образом, мультивидовые изображения объекта подаются на RotationNet, который выводит его позу и категорию. Наиболее представительная особенность RotationNet заключается в том, что она рассматривает ракурсы, соответствующие наблюдениям обучающих изображений, как скрытые переменные. Затем выполняется обучение без учителя позам объектов на несогласованном наборе данных объектов, что может устранить процесс нормализации позы, чтобы уменьшить шум и индивидуальные вариации формы. Вся сеть построена как дифференцируемая сеть MLP с слоями softmax в качестве последнего слоя. Выходами являются вероятности категорий ракурса, которые соответствуют заданным дискретным ракурсам для каждого входного изображения. Эти правдоподобия оптимизируются выбранной позой объекта.
Однако существует некоторое ограничение у моделей, основанных на двумерном представлении.:
- ⟦• Первое: проекция из трехмерного пространства на двумерные представления может терять некоторые пространственные сведения, связанные с геометрией.
- ⟦Второе — избыточная информация между несколькими представлениями.
IV-E Обработка и аугментация трехмерных данных
Из-за огромного объема данных и утомительного процесса разметки существуют ограниченные надежные 3D-наборы данных. Чтобы лучше использовать архитектуру глубоких сетей и улучшить способность модели к обобщению, обычно выполняют аугментацию данных. Аугментацию можно применять как в пространстве данных, так и в пространстве признаков, при этом наиболее распространенная аугментация выполняется в первом пространстве. Такой тип аугментации не только обогащает вариации данных, но и может генерировать новые образцы за счет выполнения преобразований существующих 3D-данных. Существует несколько типов преобразований, таких как перенос, поворот и масштабирование. Некоторые требования к аугментации данных обобщены как:
- ⟦• Должны существовать схожие признаки между исходными дополненными данными, такими как форма;
- ⟦• Должны существовать различные признаки между исходными и дополненными данными, например ориентация.
На основе этих существующих методов можно сделать вывод, что классическое увеличение данных для облаков точек может быть:
- ⟦Поверни оси и с заданной вероятностью [59, 93]
- ⟦• Вращение вокруг оси z на определенные времена и под определенными углами[59, 94, 93, 13]
- • Случайные (равномерные) дрожания высоты или позиции в определённом диапазоне [95, 93, 67]
- • Случайное масштабирование с определенным соотношением [59, 13]
- ⟦Случайные окклюзии или случайная понижающая дискретизация точек в пределах заданного соотношения [59]
- ⟦Случайные артефакты или случайное понижение выборки точек в пределах заданного соотношения [59]
- ⟦Случайным образом добавляя шум, следуя определенному распределению, к координатам точек и локальным признакам [59, 96, 45].
V Глубокое обучение для облаков точек LiDAR в автономных транспортных средствах
Применение облаков точек LiDAR для AV можно свести к трем типам: сегментация облака точек в трех измерениях, обнаружение и локализация объектов в трех измерениях, а также классификация и распознавание объектов в трех измерениях. Цели этих задач различаются: например, сегментация сцены ориентирована на прогнозирование меток для каждой точки, тогда как обнаружение и классификация сосредоточены на интегрированном присваивании меток набору точек. Однако всем им требуется использовать входные представления признаков точек до выполнения встраивания признаков и построения сети.
Сначала мы выполняем обзор представлений признаков облака входных точек, применяемых в архитектурах DL для всех трех задач, таких как локальная плотность и кривизна. Эти признаки являются представлениями конкретной 3D точки или положения в 3D-пространстве, которые описывают геометрические структуры и признаки на основе извлеченной информации вокруг точки. Эти признаки можно разделить на два типа: один выводится непосредственно из данных датчиков, таких как координаты и интенсивность; мы называем их непосредственными представлениями признаков точки; второй извлекается из информации, предоставляемой соседями каждой точки; мы называем их гео-локальными представлениями признаков точки.
V-1 Непосредственный ввод: точечные представления признаков
Прямые исходные точки представлений признаков в основном предоставляются лазерными сканерами, которые включают координаты , и , а также другие характеристики (например, интенсивность, угол и количество возвратов). Выбираются два наиболее часто используемых признака, применяемые в DL:
- ⟦XYZ coordinate. Самое прямое представление признака точки — координата , предоставляемая датчиками, что означает положение точки в координатах реального мира.
- ⟦Интенсивность. Интенсивность отражает характеристики отражения материала поверхности, что является одной общей характеристикой лазерных сканеров [97]. Различные объекты обладают разной отражательной способностью, поэтому создают различную плотность в облаках точек. Например, дорожные знаки имеют более высокую интенсивность, чем растительность.
V-2 Гео-локальные точечные признаки
Локальные входные точечные признаки встраивают пространственные соотношения точек и их окрестностей, что играет существенную роль в сегментации облаков точек [12], обнаружении объектов [42] и классификации [74]. Кроме того, найденную локальную область можно использовать для некоторых операций, таких как CNNs [98]. Два наиболее представительных и широко используемых метода поиска окрестностей — это k-nearest neighbors (KNN) [12, 96, 99] и сферическая окрестность [100]⟧.
Геолокальные представления признаков обычно формируются из найденной области с использованием двух описанных выше алгоритмов поиска соседей. Они составляются из собственных значений (например, , и ()) или собственных векторов (например, , и ), путем разложения матрицы ковариации, заданной в найденной области. Мы перечисляем пять наиболее часто используемых трехмерных локальных дескрипторов признаков, применяемых в DL:
- • Локальная плотность. Локальная плотность обычно определяется количеством точек в выбранной области [101]. Как правило, плотность точек уменьшается, когда расстояние объектов до датчика LiDAR увеличивается. В моделях на основе вокселей локальная плотность точек связана с заданием размеров вокселей [102].
- ⟦Локальная нормаль. Она определяет направление нормали в некоторой точке на поверхности. Уравнение о извлечении нормали можно найти в [65]. В [103] собственный вектор из в выбирается как вектор нормали для каждой точки. Однако в [10] все собственные векторы , и выбираются в качестве векторов нормали точки .
- • Локальная кривизна. Локальная кривизна определяется как скорость изменения направления единичного вектора касательной. Подобно вычислению локальной нормали в [65], изменение кривизны поверхности в [103] можно оценить по собственным значениям, полученным из собственно-значимого разложения:
- ⟦Локальная линейность. Это локальная геометрическая характеристика для каждой точки, указывающая на линейность ее локальной геометрии [104]: .
- • Локальная планарность. Она описывает плоскостность соседей заданной точки. Например, группы точек имеют более высокую планарность по сравнению с точками дерева [104]:
V-A Семантическая сегментация точечных облаков LiDAR
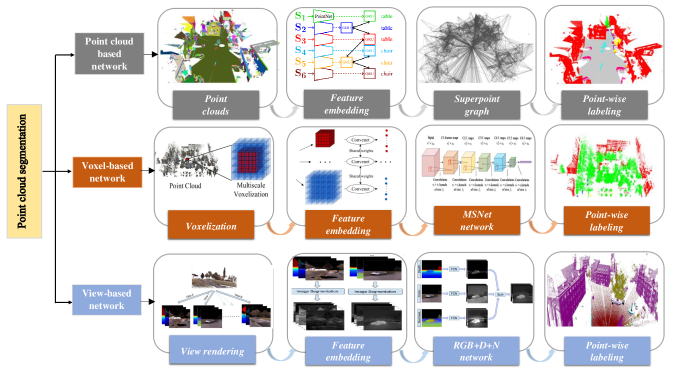
Цель семантической сегментации — пометить каждую точку как принадлежащую определенному семантическому классу. Для задач сегментации AVs эти классы могут включать улицу, здания, автомобили, пешеходов, деревья или светофоры. При применении DL для сегментации облака точек требуется классификация малых объектов [38]. Однако 3D-точечные облака LiDAR обычно получаются в большом масштабе и имеют неправильную форму с изменяющимся пространственным содержимым. В обзоре статей за последние пять лет, относящихся к данной области, мы сгруппировали их по трем схемам в соответствии с типами представления данных: модели на основе облака точек, модели на основе вокселей и модели на основе многовидового представления. Исследований, ориентированных на графовые модели, немного, поэтому мы объединяем графовые модели и модели на основе облака точек, чтобы показать их парадигмы. Каждый тип модели представлен убедительной глубокой архитектурой, как показано на рис.7.
.
V-A1 Сети на основе облаков точек
Для сетей на основе облаков точек они в основном состоят из двух частей: встраивания признаков и построения сети. Для различающего признакового представления, как локальные, так и глобальные признаки продемонстрировали свою ключевую роль для успеха CNN [12]. Однако для применения обычных CNN требуется различающая сеть встраивания признаков, чтобы решить проблему перестановки и ориентации для неупорядоченных и неориентированных точек. Кроме того, легковесное, эффективное и действенное построение глубокой сети является еще одним ключевым модулем, который влияет на качество сегментации.
Локальный признак обычно извлекается из окрестностей точек [104]. Наиболее часто используемые локальные признаки — локальная нормаль и кривизна [10, 12]. Чтобы улучшить воспринимаемое поле, было доказано, что PointNet [10] представляет собой убедительную архитектуру для извлечения семантических признаков из неупорядоченных наборов точек. Таким образом, в [12, 108, 105, 109] упрощенный PointNet используется для абстрагирования локальных признаков из выборочных наборов точек в высокоуровневые представления. Landrieu и др. [105] предложили superpoint graph (SPG) для представления больших 3D облаков точек как набора взаимосвязанных простых форм, введенных как superpoints, затем PointNet применяется к этим superpoints, чтобы встраивать признаки.
Для решения задачи перестановки и извлечения локальных признаков Huang et al. [40] предложили новый слой slice pooling для извлечения локального контекстного слоя из входных признаков точек и получения упорядоченной последовательности агрегированных признаков. Для этого входные точки сначала группируются на срезы, а затем для каждого среза формируется глобальное представление путем объединения признаков точек внутри среза. Преимущество этого слоя slice pooling заключается в низкой вычислительной стоимости по сравнению с локальными признаками на основе точек. Однако размер среза чувствителен к плотности данных. В [110] применяются двусторонние слои Conv (BCL) для выполнения сверток по занятым областям решетки с целью иерархического обучения признакам с учетом пространственной структуры. Сначала BCL отображает входные точки на разреженную решетку и выполняет операции свертки на разреженной решетке, а затем отфильтрованный сигнал плавно интерполируется, чтобы восстановить исходные входные точки.
Чтобы снизить вычислительные затраты, в [108] применяется схема кодирование-декодирование. Признаки, извлеченные в одном масштабе абстракции, объединяются, а затем с помощью 3D деконволюций повышаются до требуемой плотности выборки выходных данных; в итоге выполняется интерполяция по ближайшим соседям в скрытом пространстве, чтобы сформировать метку для каждой точки. Однако операции по понижению и повышению дискретизации сложно сохраняют информацию о границах, поэтому не позволяют извлекать детальные признаки. В [40] к задаче применяется RNN для моделирования зависимостей упорядоченного глобального представления, полученного из slice pooling. Подобно данным последовательности, каждый slice рассматривается как один момент времени, а информация о взаимодействии с другими slice также следует моментам времени в единицах RNN. Эта операция позволяет модели формировать зависимости между slice.
Хотя Zhang et al. [65] предложили ReLu-NN для обучения встроенным точечным признакам, представляющим собой архитектуру MLP из четырех слоев. Однако для объектов без различительных признаков, таких как кустарники или деревья, их локальная пространственная взаимосвязь используется не в полной мере. Чтобы лучше задействовать богатую пространственную информацию об объектах, Wang et al. построили легкую и эффективную глубокую нейронную сеть с пространственным объединением (DNNSP) [111] для обучения точечных признаков. Они сгруппировали входные данные в группы, а затем применили объединение на основе минимального остовного дерева по расстоянию, чтобы извлечь пространственную информацию между точками в сгруппированных наборах точек. Наконец, для классификации с этими признаками используется MLP. Для достижения нескольких задач, таких как instance segmentation и object detection с простой архитектурой, Wang et al. [109] предложили сеть предложений групп сходства SGPN. В рамках извлеченных локальных и глобальных точечных признаков с помощью PointNet сеть извлечения признаков формирует матрицу, которая затем разделяется на три подмножества, каждое из которых проходит через один слой PointNet, чтобы получить три матрицы сходства. Эти три матрицы используются для получения матрицы сходства, карты достоверности и карты семантической сегментации.
V-A2 Сетевые модели на основе вокселей
В воксельных сетях сначала облака точек вокселизируют в сетки, а затем обучают извлекать признаки из этих сеток. В заключение строят глубокую нейронную сеть, чтобы сопоставить эти признаки сегментационным маскам.
Wang et al. [106] провели многомасштабный метод вокселизации для извлечения пространственной информации объектов на разных масштабах с целью формирования комплексного описания. На каждом масштабе для заданной точки [112] строится соседний куб с выбранной длиной. Затем куб делится на сеточные воксели разного размера как на фрагменты (patch). Чем меньше размер, тем более детальным является масштаб. Плотность точек и заполняемость выбираются для представления каждого вокселя. Преимущество такой вокселизации состоит в том, что она может учитывать объекты разных размеров, не теряя их пространственную информацию. В [113] вероятности классов для каждого вокселя предсказываются с помощью 3D-FCNN, после чего они переносятся обратно на исходные 3D-точки на основе трилинейной интерполяции. В [106], после многомасштабной вокселизации облаков точек, признаки на разных масштабах и пространственных разрешениях изучаются набором CNN с общими весами, которые затем объединяются для итогового предсказания.
В задаче сегментации точечного облака на основе вокселей существует два способа разметки каждой точки: (1) Использование воксельной метки, полученной из argmax прогнозируемых вероятностей; (2) Дальнейшая глобальная оптимизация классовой метки всего точечного облака на основе пространственной согласованности. Первый метод прост, но результат задаётся на уровне вокселей и неизбежно подвержен влиянию шума. Второй метод точнее, но сложнее, поскольку требует дополнительных вычислений. Поскольку присущая инвариантность сетей свёрточного типа (CNN) к пространственным преобразованиям влияет на точность сегментации [25]. Для извлечения тонких деталей в представлениях объёмных данных на этапе постобработки обычно применяется условное случайное поле (Conditional Random Field, CRF) [114, 113, 106]. CRF обладает преимуществом при объединении информации низкого уровня, такой как взаимодействия между точками, чтобы выполнять многоклассовый вывод для задач разметки по классам для каждой точки, что компенсирует тонкие локальные детали, которые CNN не способны корректно улавливать.
V-A3 Многовидовые сети
Что касается многовидовых моделей, то для задач сегментации важны два ключевых модуля: рендеринг видов и построение глубокой архитектуры. Первый модуль используется для генерации структурированных и хорошо организованных 2D-сеток, которые могут использовать существующие CNN-ориентированные глубокие архитектуры. Второй модуль предлагается для построения наиболее подходящих и порождающих моделей для различных данных.
Для одновременного извлечения локальных и глобальных признаков применяются некоторые вручную разработанные описатели признаков для извлечения репрезентативной информации. В [65, 111] используется дескриптор spin image для представления локальных признаков на основе точек; он содержит глобальное описание объектов с частичных ракурсов и «загрязнений» локальным описанием формы. В [107] точечное сплэттирование было применено для генерации изображений ракурса путем проецирования точек с функцией растекания на плоскость изображения. Сначала точка проецируется в координаты изображения виртуальной камеры. Для каждой спроецированной точки сохраняется соответствующее значение глубины и векторы признаков, такие как нормаль.
После того как точки проецируются в многовидовые двумерные изображения, могут быть использованы некоторые дискриминативные двумерные глубокие сети, такие как VGG16 [87], AlexNet [86], GoogLeNet [88] и ResNet [89]. В [25] эти глубокие сети были подробно проанализированы для двумерной семантической сегментации. Среди этих методов VGG16 [87], состоящая из 16 слоев, используется наиболее часто. Ее основное преимущество заключается в использовании уложенных друг на друга Conv-слоев с небольшими полями рецептивности, что создает легковесную сеть с ограниченным числом параметров и повышенной нелинейностью [25, 115, 107].
V-A4 Оценка сегментации облака точек
Из-за большого объема облаков точек, которые создают серьезную проблему для вычислительных возможностей, мы выбираем модели, протестированные на наборе данных Reduced-8 Semantic3D, чтобы сравнить их производительность, как показано в Таблице IV. Reduced-8 использует те же обучающие данные, что и semantic-8, но только небольшую часть тестовых данных, что также подходит для алгоритма с высокой вычислительной стоимостью при конкуренции. Метрики, используемые для сравнения этих моделей, это , и . Вычислительная эффективность этих алгоритмов не сообщается и не сравнивается из-за различий в вычислительных возможностях, выбранном обучающем наборе данных и архитектуре модели.
| Method | Input | Backbone | IoU | mIoU |
|
Highlights | ||||||||||||||||||||
| IoU1 | IoU2 | IoU3 | IoU4 | IoU5 | IoU6 | IoU7 | IoU8 | |||||||||||||||||||
|
|
|
0.974 | 0.926 | 0.879 | 0.44 | 0.932 | 0.31 | 0.635 | 0.762 | 0.732 | 94.0 |
|
|||||||||||||
|
voxels |
|
0.83 | 0.672 | 0.838 | 0.367 | 0.924 | 0.313 | 0.500 | 0.782 | 0.653 | 88.4 |
|
|||||||||||||
|
|
|
0.876 | 0.803 | 0.818 | 0.364 | 0.922 | 0.241 | 0.426 | 0.566 | 0.627 | 90.3 |
|
|||||||||||||
|
voxels | FCNN | 0.839 | 0.66 | 0.86 | 0.405 | 0.911 | 0.309 | 0.275 | 0.643 | 0.613 | 88.1 |
|
|||||||||||||
|
images | CNN | 0.82 | 0.773 | 0.797 | 0.229 | 0.911 | 0.184 | 0.373 | 0.644 | 0.591 | 88.6 |
|
|||||||||||||
|
images |
|
0.856 | 0.832 | 0.742 | 0.324 | 0.897 | 0.185 | 0.251 | 0.592 | 0.585 | 88.9 |
|
|||||||||||||
V-B Обнаружение объектов в трехмерном пространстве (локализация)
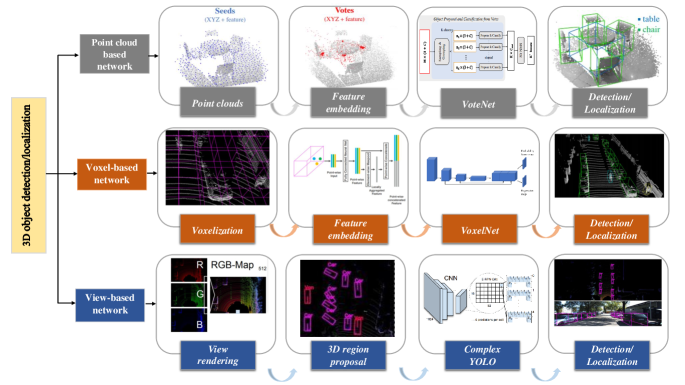
Обнаружение (и локализация) 3D-объектов в облаках точек LiDAR можно свести к предсказанию ограничивающих рамок и предсказанию объектности [14]. В данной статье мы в основном рассматриваем парадигму LiDAR-only, которая использует точную геопривязанную информацию. В целом, в этой парадигме существует два способа представления данных: один — обнаруживает и локализует 3D-объекты непосредственно по облакам точек [118]; другой — сначала преобразует 3D-точки в регулярные сетки, такие как voxel grids или изображения bird’s eye view, а также фронтальные виды, и затем применяет архитектуры 2D-детекторов для извлечения объектов из изображений; результаты 2D-детекции в итоге обратно проецируются в 3D-пространство для окончательной оценки местоположения 3D-объекта [50]. Рис.8 показывает представительные сетевые фреймворки для перечисленных выше представлений данных.
V-B1 Обнаружение (локализация) трехмерных объектов по облакам точек
Сложности детектирования трехмерных объектов по разреженным и крупномасштабным облакам точек подытожены как:
- ⟦Обнаруженные объекты занимают лишь очень ограниченный объем всех входных данных.
- ⟦Центроид трехмерного объекта может быть далеко от любой точки поверхности, поэтому точно регрессировать его за один шаг сложно [42].
- ⟦• Отсутствие точек центров трехмерных объектов. Поскольку датчики LiDAR фиксируют только поверхности объектов, центры трехмерных объектов, вероятно, находятся в пустом пространстве, далеко от любой точки.
Таким образом, типовая процедура трехмерного обнаружения и локализации объектов по крупномасштабным облакам точек состоит из следующих процессов: во-первых, вся сцена грубо сегментируется, а затем примерно предлагается грубое местоположение интересующего объекта; во-вторых, для каждой предложенной области извлекается признак; наконец, локализация и класс объекта предсказываются с помощью сети прогнозирования ограничивающих рамок Bounding-Box Prediction Network [118, 119].
В [119] PointNet++ [12] применяется для формирования признаков на уровне каждой точки во всем входном наборе облака точек. В отличие от [118], каждая точка рассматривается как эффективное предложение, что сохраняет информацию о локализации. Затем выполняются предсказания локализации и обнаружения на основе извлеченных признаков предложений на основе точек, а также информации о локальном соседнем контексте, полученной за счет увеличения воспринимаемого поля и признаков входных точек. Эта сеть сохраняет более точную информацию о локализации, но имеет более высокую вычислительную стоимость при работе непосредственно с множествами точек.
В [118] применяется 3D CNN с тремя слоями Conv и несколькими слоями FC для изучения различительных и устойчивых признаков объектов. Затем к сцене применяется алгоритм интеллектуального оконного просмотра (EW). Метка точки, относящейся к EW, предсказывается с использованием предварительно обученной 3D CNN. Далее результат оценки вводится в deep Q-network (DQN) для настройки размера и положения EW. Затем новая EW оценивается с помощью 3D CNN и DQN до тех пор, пока EW не будет содержать только один объект. В отличие от традиционного ограничивающего прямоугольника области интереса (RoI), EW может изменять форму и автоматически менять центр окна, что подходит для объектов с различными масштабами. Как только положение объекта найдено, объект во входном окне предсказывается с использованием изученных признаков. В [118] признаки объекта извлекаются на основе моделей 3D CNN, а затем подаются в residual RNN [120] для маркировки по категориям.
Qi et al. [42] предложили VoteNet — глубокую нейросеть для обнаружения объектов в трехмерном пространстве на основе голосования по Hough. Необработанные облака точек подаются на PointNet++ [12], чтобы изучить признаки точек. На основе этих признаков выбирается группа опорных точек и формируются голоса по признакам их соседей. Затем эти опорные точки собираются для кластеризации центров объектов и генерации предложений ограничивающих рамок для окончательного решения. По сравнению с двумя вышеупомянутыми архитектурами VoteNet устойчив к разреженным и крупномасштабным облакам точек. Кроме того, он с высокой точностью локализует центр объекта.
V-B2 Обнаружение 3D-объектов (локализация) из регулярной воксельной сетки
Чтобы лучше использовать CNN, некоторые подходы разлагают трехмерное пространство на воксельную сетку, которая представляется скалярным значением, таким как занятость, или векторными данными, извлеченными из вокселей [8]. В [121, 122] трехмерное пространство сначала дискретизируют на сетки фиксированного размера, а затем каждую занятую ячейку преобразуют в вектор признаков фиксированной размерности. Незанятые ячейки без каких-либо точек представляются нулевыми векторами признаков. Для описания вектора признаков используются двоичная занятость, среднее и дисперсия отражательной способности, а также три фактора формы. Для простоты в [14] вокселизованные сетки представляются четырехмерным массивом длины, ширины, высоты и каналов, причем двоичное значение одного канала используется для представления статуса наблюдения точек в соответствующих сетках. Zhou et al. [13] вокселизировали трехмерные облака точек вдоль координат с заданным расстоянием и группировали точки в каждой сетке. Затем предлагается слой воксельного кодирования признаков (VFE) для обеспечения взаимодействия между точками внутри вокселя путем объединения признаков каждой точки и признаков локальных соседей. Объединение многомасштабных слоев VFE позволяет этой архитектуре изучать различительные признаки на основе локальной информации о форме.
Схема голосования принята в [121, 122] для выполнения разреженной свёртки по вокселизированным сеткам. Эти сетки, взвешенные свёрточными ядрами, а также их окружающими ячейками в рецептивном поле, накапливают голоса от своих соседей, переворачивая ядро CNN вдоль каждого измерения, и в итоге выводят оценочные значения голосования для потенциально интересующих объектов. На основе этой схемы голосования Engelcke et al. [122] затем использовали нелинейность ReLU, чтобы получить новую разреженную трёхмерную репрезентацию этих сеток. Этот процесс итеративно повторяется и объединяется в обычных операциях CNN и в итоге выводит прогнозирующие оценки для каждого предложения. Однако схема голосования требует высокой вычислительной нагрузки при голосовании. Поэтому модифицированные сети предложений областей (RPN) используются в [13] для обнаружения объектов, чтобы уменьшить вычисления. Эта RPN состоит из трёх блоков слоёв Conv, которые применяются для понижающей дискретизации, фильтрации признаков и повышающей дискретизации входной карты признаков, и для формирования карты вероятностей, а также регрессионной карты для обнаружения и локализации объектов.
V-B3 Обнаружение 3D-объектов (локализация) по 2D-представлениям
Некоторые подходы также проецируют облака точек LiDAR в двумерные представления. Эти подходы в основном состоят из двух шагов: первый — это проекция трехмерных точек; второй — обнаружение объектов на спроецированных изображениях. Существует несколько типов методов генерации представлений для проекции трехмерных точек в двумерные изображения: BEV images [43, 123, 124, 116], front view images [123], spherical projections [50] и cylindral projection [9].
Отличаясь от [50], в [43, 123, 124, 116] данные облака точек разделяются на сетки фиксированного размера, а затем преобразуются в изображение вида сверху (BEV) с соответствующими тремя каналами, которые кодируют информацию о высоте, интенсивности и плотности. С учетом эффективности и производительности только максимальная высота, максимальная интенсивность и нормализованная плотность среди сеток преобразуются в единое изображение birds-eye-view RGB-карты [116]. В [125] выбираются только значения максимума, медианы и минимума высоты, чтобы представить каналы изображения BEV, используя обычные 2D RGB-модели глубокого обучения без модификаций. Dewan et al. [16] выбрали диапазон, интенсивность и значения высоты для представления трех каналов. В [8] представление признаков для каждого пикселя BEV составляется из значения занятости и значения отражательной способности.
Однако из-за разреженности облаков точек проекция облаков точек на двумерную плоскость изображения приводит к разреженной двумерной карте точек. Таким образом, Chen et al. [123] добавили представление с фронтального вида, чтобы компенсировать отсутствующую информацию на изображениях BEV. Облака точек проецируются на цилиндрическую плоскость для получения плотных изображений фронтального вида. Чтобы сохранить трехмерную пространственную информацию при проекции, точки проецируются под многовидовыми углами, которые равномерно выбираются на сфере [50]. Pang et al. сначала дискретизировали трехмерные точки на ячейки фиксированного размера. Затем сцена дискретизируется для генерации многовидовых изображений, чтобы сформировать положительные и отрицательные обучающие выборки. Преимущества такого подхода к генерации набора данных заключаются в том, что пространственные отношения и признаки сцены могут быть лучше использованы. Однако эта модель не является устойчивой к новой сцене и не может извлекать новые признаки из построенного набора данных.
V-B4 Оценка для локализации и обнаружения объектов в трехмерном пространстве
Для сравнения глубоких моделей локализации и детектирования трехмерных объектов выбраны бенчмарк KITTI bird’s eye view и бенчмарк KITTI 3D object detection [60]. Как сообщается в [60], оцениваются все объекты , которые не имеют полной или частичной сильной окклюзии, не являются сильно окклюдированными и при этом не подвергнуты усечению и не меньше 40 px по высоте. Усеченные или окклюдированные объекты не учитываются как ложные срабатывания. Для измерений детектирования, локализации и оценки ориентации учитывается только перекрытие ограничивающих рамок как минимум для пешехода и велосипедиста и для автомобиля. Кроме того, этот бенчмарк классифицирует сложности задач на три типа: easy, moderate и hard.
И точность, и время выполнения сравниваются для оценки этих алгоритмов, поскольку обнаружение и локализация в реальном времени критически важны для AVs [127]. Для задачи локализации выбран бенчмарк KITTI bird’s eye view в качестве оценочного бенчмарка, а результаты сравнения показаны в Таблице V. Трехмерное обнаружение оценивается на бенчмарке KITTI 3D object detection. Таблица V показывает время выполнения и среднюю точность () на наборе валидации. Для каждого пересечения ограничивающих рамок только 3D IoU, превышающий 0.25, считается допустимым ящиком для локализации/обнаружения [127].
| Method | Input |
|
|
Evaluation on AP (%) | Highlights | ||||||||||||||||||||||||||
| object detection | object localization | ||||||||||||||||||||||||||||||
| 0.25 | 0.5 | 0.7 | 0.5 | 0.7 | |||||||||||||||||||||||||||
| E | M | H | E | M | H | E | M | H | E | M | H | E | M | H | |||||||||||||||||
|
voxels | 1 | N/A | 89.0 | 81.1 | 75.9 | 67.9 | 57.6 | 52.6 | 15.2 | 13.7 | 16.0 | 79.7 | 63.8 | 62.8 | 40.1 | 32.1 | 30.5 |
|
||||||||||||
|
images | 0.6 |
|
N/A | N/A | N/A | N/A | N/A | N/A | N/A | N/A | N/A | 79.3 | 80.2 | 80.1 | 54.9 | 60.1 | 60.9 |
|
||||||||||||
|
images | 0.36 |
|
96.5 | 89.6 | 88.9 | 96.0 | 89.1 | 88.4 | 71.3 | 62.7 | 56.6 | 96.3 | 89.4 | 88.7 | 86.6 | 78.1 | 76.7 |
|
||||||||||||
|
voxels | 0.23 |
|
N/A | N/A | N/A | N/A | N/A | N/A | 82.0 | 65.5 | 62.9 | N/A | N/A | N/A | 89.6 | 84.8 | 78.6 |
|
||||||||||||
|
|
0.09 |
|
89.5 | 81.0 | 81.2 | 89.0 | 80.6 | 80.9 | 72.9 | 61.6 | 64.4 | 89.4 | 80.9 | 81.2 | 88.3 | 79.9 | 80.4 |
|
||||||||||||
V-C Классификация 3D-объектов
Семантическая классификация/распознавание объектов имеет решающее значение для безопасного и надежного управления автономными транспортными средствами в неструктурированных и неконтролируемых реальных условиях [67]. Существующие методы обнаружения 3D-объектов в основном ориентированы на данные CAD (например, ModelNet40 [30]) или данные RGBD (например, NYUv2 [128]). Однако эти данные имеют равномерное распределение точек, полные формы, ограниченный уровень шума, частичное закрытие и фоновые помехи, что создает ограниченные сложности для 3D-классификации по сравнению с облаками точек LiDAR [10, 12, 129]. Эти убедительные глубокие архитектуры, применяемые к данным CAD, были проанализированы в виде четырех типов представлений данных в разделе III. В этой части мы в основном рассматриваем глубокие модели на основе данных LiDAR для задачи классификации.
V-C1 Объемные архитектуры
Вокселизация облаков точек зависит от пространственного разрешения данных, ориентации и начала координат [67]. Эта операция, которая может предоставить достаточно распознаваемую информацию, но не увеличивает вычислительную стоимость, имеет решающее значение для моделей DL. Таким образом, для данных LiDAR в [67] используется воксель с пространственным разрешением, например , чтобы вокселизировать входные точки. Затем для каждого вокселя вычисляются двоичная карта занятости, карта плотности и карта попаданий, чтобы оценить его занятость. Входной слой, сверточный слой, слой объединения и полносвязный слой объединяются, чтобы построить CNN. Такая архитектура может использовать пространственную структуру данных и извлекать глобальные признаки посредством объединения. Однако полносвязный слой дает высокую вычислительную стоимость и теряет пространственную информацию между вокселями. В [130] на основе VoxNet [67] в качестве входа берется трехмерная сетка вокселей, которая содержит два сверточных слоя с трехмерными фильтрами, за которыми следуют два полносвязных слоя. В отличие от других задач классификации на уровне категорий, они рассматривают эту задачу как задачу с несколькими подзадачами, где оценка ориентации и предсказание метки класса выполняются параллельно.
Для простоты и эффективности Zhi et al. [93, 131] приняли двоичную сетку [67], чтобы снизить вычислительные затраты. Однако они рассматривают только воксели внутри поверхности, игнорируя различие между неизвестным и свободным пространством. Нормали, которые содержат гео-локальную позиционную и ориентационную информацию, продемонстрировали более сильные результаты, чем двоичная сетка, в [132]. Аналогично [130], классификация рассматривается как две задачи: метка класса объектного вокселя и прогноз его ориентации. Для извлечения локальных и глобальных признаков в первой задаче предусмотрены две подзадачи: первая подзадача заключается в прогнозировании метки объекта с отсылкой ко всей входной форме, а вторая — в прогнозировании метки объекта по части формы. Прогноз ориентации предлагается для использования схемы аугментации ориентации. Вся сеть состоит из трех слоев 3D Conv и двух слоев 3D max-pooling, она легковесная и демонстрирует устойчивость к перекрытиям и захламлению.
V-C2 Мультивидовые архитектуры
Достоинство методов, основанных на многовидовых представлениях, заключается в их способности использовать как локальные, так и глобальные пространственные соотношения между точками. Luo et al. [45] разработали три описателя признаков для извлечения локальных и глобальных признаков из облаков точек: первый описатель фиксирует горизонтальную геометрическую структуру, второй извлекает вертикальную информацию, а последний предоставляет полную пространственную информацию. Чтобы лучше использовать многовидовые представления данных, You et al. [91] объединили достоинства данных облака точек и многовидовых данных и добились результатов лучше, чем MVCNN [76], в задаче классификации в трехмерном пространстве. Кроме того, признаки высокого уровня, извлеченные из многовидовых представлений на основе MVCNN [76], встраиваются в схему объединения с вниманием, чтобы компенсировать локальные признаки, извлеченные из представлений данных облака точек. Было доказано, что такие признаки с учетом внимания эффективно представляют различительную информацию трехмерных данных.
Однако для разных объектов процесс генерации вида различается. Поскольку специальные атрибуты объектов могут способствовать экономии вычислений и повышению точности. Например, в задачах извлечения разметки дорог высота, полученная в основном из координаты , почти не влияет на алгоритм. Но дорожное покрытие на самом деле является двумерной структурой. В результате Wen et al. [47] непосредственно спроецировали трехмерные облака точек на горизонтальную плоскость и оформили их как двумерное изображение. Luo et al. [45] отдельно подают полученные трехракурсные дескрипторы на вход, чтобы улавливать низкоуровневые признаки для JointNet. Затем эта сеть изучает высокоуровневые признаки посредством операции свёртки на основе входных признаков и, наконец, объединяет оценки предсказаний. Вся архитектура состоит из пяти свёрточных слоёв, слоя пространственного пирамидального объединения (SPP) [133] и двух полносвязных слоёв, а также слоя reshape. Результаты вывода объединяются через свёрточные слои и слои многовидового объединения. Хорошо продуманные дескрипторы видов помогают сети достигать убедительных результатов в задачах классификации объектов.
Другой представительный архитектурный подход в двухмерных моделях глубокого обучения — это архитектура кодер — декодер. Благодаря понижающей дискретизации и повышающей дискретизации можно помочь сжать информацию между пикселями, чтобы выделить наиболее представительные признаки. В [47] Wen и соавт. предложили модифицированную модель U-net для классификации дорожной разметки. Данные облаков точек сначала отображаются в изображения интенсивности. Затем применяется иерархический модуль U-net для классификации дорожной разметки посредством многомасштабной кластеризации с помощью CNN. Поскольку при такой понижающей дискретизации и повышающей дискретизации сложно сохранять детализированные шаблоны, используется сеть GAN для преобразования разметки малого размера, разорванных линий полос движения и отсутствующей разметки с учетом контекстных знаний эксперта. Эта архитектура использует эффективность U-net и полноту GAN для классификации дорожной разметки с высокой эффективностью и точностью.
V-C3 Оценка для классификации трехмерных объектов
Для задачи классификации трехмерных объектов опубликовано ограниченное число бенчмарков наборов точек LiDAR. Поэтому выбран набор данных Sydney Urban Objects, поскольку доступна производительность нескольких современных методов. Показатель используется для оценки этих опубликованных алгоритмов [45], как показано в Таблице VI⟧.
| Method | Input |
|
Highlights | ||||||||
|
voxels | 72.0 |
|
||||||||
|
voxels | 75.5 |
|
||||||||
|
voxels | 77.8 |
|
||||||||
|
images | 74.9 |
|
VI Исследовательские вызовы и возможности
Архитектуры глубокого обучения, разработанные за последние пять лет с использованием облаков точек LiDAR, достигли значительных успехов в области автономного вождения, применительно к детальному выполнению задач трехмерной сегментации, обнаружения и классификации. Однако по-прежнему существует огромный разрыв между самыми современными результатами и уровнем производительности человека. Несмотря на то, что предстоит сделать еще многое, мы в основном обобщаем оставшиеся задачи, характерные для данных, глубоких архитектур и для самих задач, следующим образом:
VI-1 Слияние данных из нескольких источников
Чтобы компенсировать отсутствие семантических данных в двух измерениях, текстовой и неполной информации в трехмерных точках, изображениях, облаках точек LiDAR и данных радара, их можно объединять, чтобы обеспечить точные, геопривязанные и насыщенные информацией подсказки для навигации и принятия решений автономных транспортных средств [134]. Кроме того, существует объединение данных, полученных датчиками низкого уровня LiDAR (например, Velodyne HDL-16E) и датчиками высокого уровня LiDAR (например, Velodyne HDL-64E). Однако при объединении этих данных существуют несколько проблем: Первая — разреженность облаков точек приводит к несогласованным и отсутствующим данным при объединении многомодальных данных. Вторая — существующая схема объединения данных, использующая знания DL, обрабатывается по отдельной линии, что не является сквозной схемой. [41, 119, 135].
VI-2 Надёжное представление данных
Неструктурированный и неупорядоченный формат данных [10, 12] представляет собой большую сложность для надежных приложений 3D DL. Хотя существуют несколько эффективных представлений данных, таких как voxels [67], point clouds [10, 12], graphs [74, 129], 2D views [78] или новые 3D-представления данных [136, 137, 138], до сих пор не достигнуто согласия по поводу надежного и экономичного по памяти представления 3D-данных. Например, хотя voxels решают проблему упорядочивания, вычислительная стоимость увеличивается кубически при увеличении разрешения вокселей [30, 67]. Что касается point clouds и graphs, инвариантность к перестановкам и вычислительные возможности ограничивают количество точек, которые можно обрабатывать, что неизбежно ограничивает производительность глубоких моделей [10, 74].
VI-3 Эффективные и более эффективные глубокие фреймворки
Из-за ограничений памяти и вычислительных ресурсов платформы, встроенной в AV, эффективные и результативные архитектуры DL имеют решающее значение для широкого применения автоматизированных AV-систем. Хотя в 3D-моделях DL достигнуты значительные улучшения, такие как PointNet [10], PointNet++ [12], PointCNN [71], DGCNN [74], RotationNet [78] и другие работы [139, 52, 140, 141]. Некоторые ограниченные модели способны выполнять задачи сегментации, обнаружения и классификации в реальном времени. Исследования должны быть сосредоточены на проектировании легких и компактных архитектур.
VI-4 Извлечение контекстных знаний
Из-за разреженности облаков точек и неполноты оцифрованных объектов подробная контекстная информация для объектов используется не полностью. Например, семантические контексты на дорожных знаках являются важными подсказками для навигации автономных транспортных средств, но существующие глубокие модели не могут полностью извлекать такую информацию из облаков точек. Хотя подходы к слиянию признаков в нескольких масштабах [142, 143, 144] продемонстрировали существенные улучшения в извлечении контекстной информации. Кроме того, GAN [47] можно использовать для повышения полноты 3D-облаков точек. Однако эти фреймворки не могут решать проблемы разреженности и неполноты для извлечения контекстной информации в сквозном, обучаемом от начала до конца режиме..
VI-5 Многозадачное обучение
Подходы, связанные с облаками точек LiDAR для АВ, состоят из нескольких задач, таких как сегментация сцены, обнаружение объектов (например, автомобилей, пешеходов, светофоров и т. д.) и классификация (например, дорожной разметки, дорожных знаков). Все эти результаты обычно объединяются и передаются в систему принятия решений для окончательного управления [1]. Однако существует немного архитектур глубокого обучения, которые объединяют эти множественные задачи облаков точек LiDAR [15, 130]. Таким образом, присущая им взаимосвязанная информация используется не в полной мере, что ограничивает возможность обобщать модели лучше при меньших вычислениях.
VI-6 Слабонаблюдаемое/ненаблюдаемое обучение
Существующие современные глубокие модели обычно строятся в рамках обучения с учителем, используя размеченные данные с ограничивающими рамками для трехмерных объектов или масками сегментации для каждой точки [74, 119, 8]. Однако есть некоторые ограничения у полностью контролируемых моделей. Во-первых, ограниченная доступность высококачественных, крупномасштабных и огромных наборов данных и эталонов для обобщенных объектов. Во-вторых, обобщающая способность полностью контролируемой модели, которая не является устойчивой к ранее не виденным или не обученным объектам. Следует разработать слабоконтролируемое [145] или несупервизорное обучение [146, 147], чтобы повысить способность модели к обобщению и решить проблему отсутствия данных.
VII Заключение
В этой статье мы предоставили систематический обзор уровня техники архитектур глубокого обучения с использованием облаков точек LiDAR в области автономного вождения для конкретных задач, таких как сегментация, обнаружение и классификация. Были обобщены и выполнено оценивание моделей 3D глубокого обучения для трех указанных задач, а также проведено сравнение их достоинств и недостатков. Были перечислены исследовательские вызовы и возможности для продвижения потенциального развития DL в области автономного вождения.
Благодарности
Авторы хотели бы поблагодарить профессоров Жозе Маркато Жуниора и Уесли Нунес Гонсалвеса за тщательную вычитку. Кроме того, мы также хотели бы поблагодарить анонимных рецензентов за их проницательные замечания и предложения.
Ссылки
- ⟦[1] J. Janai, F. Güney, A. Behl, and A. Geiger, “Компьютерное зрение для автономных транспортных средств: проблемы, наборы данных и современное состояние,” arXiv:1704.05519, 2017.
- ⟦J. Levinson, J. Askeland, J. Becker, J. Dolson, D. Held, S. Kammel, J. Z. Kolter, D. Langer, O. Pink, V. Pratt и др., “К полностью автономному вождению: системы и алгоритмы,” в IEEE Intell. Vehicles Symp., 2011, стр. 163–168.
- [3] J. Ван Брюммелен, М. О’Брайен, Д. Груйер и Х. Наджараан, «Восприятие автономного транспортного средства: технологии сегодняшнего и завтрашнего дня», Transp. Res. Part C Emerg. Technol., т. 89, с. 384–406, 2018.
- ⟦[4] X. Хуан, С. Чэн, Ц. Гэн, Б. Цао, Д. Чжоу, П. Ван, Ю. Лин и Р. Ян, «Набор данных аполлоскейп для автономного вождения», в: Proc. IEEE CVPR Workshops, 2018, стр. 954–960.
- ⟦R. P. D. Vivacqua, M. Bertozzi, P. Cerri, F. N. Martins, and R. F. Vassallo, «Самолокализация на основе карт разметки полос движения по данным визуальной информации: точный и недорогой подход для автономного вождения», IEEE Trans. Intell. Transp. Syst, vol. 19, no. 2, pp. 582–597, 2018.
- ⟦F. Remondino, “Heritage recording and 3d modeling with photogrammetry and 3d scanning,” Remote Sens., т. 3, № 6, с. 1104–1138, 2011.
- ⟦B. Wu, A. Wan, X. Yue, and K. Keutzer, “Squeezeseg: Сверточные нейронные сети с рекуррентной crf для сегментации дорожных объектов в реальном времени по точечному облаку 3d lidar,” in IEEE ICRA, 2018, pp. 1887–1893.
- [8] Б. Ян, У. Луо и Р. Уртазун, «Pixor: Реал-тайм 3d обнаружение объектов из облаков точек», в Proc. IEEE CVPR, 2018, стр. 7652–7660.
- [9] B. Li, T. Zhang, and T. Xia, «Vehicle detection from 3d lidar using fully convolutional network», arXiv:1608.07916, 2016.
- ⟦C. R. Qi, H. Su, K. Mo, and L. J. Guibas, “Pointnet: Deep learning on point sets for 3d classification and segmentation,” in Proc. IEEE CVPR, 2017, pp. 652–660.
- [11] A. Boulch, B. Le Saux и N. Audebert, «Семантическая разметка неструктурированных облаков точек с использованием глубоких сетей сегментации». в 3DOR, 2017.
- ⟦C. R. Qi, L. Yi, H. Su и L. J. Guibas, «Pointnet++: Глубокое иерархическое извлечение признаков на множествах точек в метрическом пространстве», в Adv Neural Inf Process Syst, 2017, стр. 5099–5108.
- ⟦Y. Zhou and O. Tuzel, “Voxelnet: End-to-end learning for point cloud based 3d object detection,” in Proc. IEEE CVPR, 2018, pp. 4490–4499.
- [14] Б. Ли, “3d fully convolutional network for vehicle detection in point cloud,” в IEEE/RSJ IROS, 2017, стр. 1513–1518.
- ⟦[15] C. R. Qi, H. Su, M. Nießner, A. Dai, M. Yan, и L. J. Guibas, “Volumetric and multi-view cnns for object classification on 3d data,” в Proc. IEEE CVPR, 2016, стр. 5648–5656.
- [16] А. Диван, Г. Л. Оливейра и В. Бургард, «Глубокая семантическая классификация для данных 3d лидара», в IEEE/RSJ IROS, 2017, стр. 3544–3549.
- ⟦Y. LeCun, Y. Bengio, and G. Hinton, “Deep learning,” Nature, vol. 521, no. 7553, p. 436, 2015.
- [18] V. Sze, Y.-H. Chen, T.-J. Yang, and J. S. Emer, “Efficient processing of deep neural networks: A tutorial and survey,” Proc. IEEE, vol. 105, no. 12, pp. 2295–2329, 2017.
- ⟦[19] Y. Го, Y. Лю, А. Оерлеманс, С. Лао, С. У, и М. С. Лью, «Глубокое обучение для зрительного понимания: обзор», Neurocomput, т. 187, стр. 27–48, 2016.
- [20] A. Voulodimos, N. Doulamis, A. Doulamis, and E. Protopapadakis, “Deep learning for computer vision: A brief review,” Comput Intell Neurosci., vol. 2018, pp. 1–13, 2018.
- ⟦L. Zhang, L. Zhang, и B. Du, “Deep learning for remote sensing data: A technical tutorial on the state of the art,” IEEE Geosci. Remote Sens. Mag., т. 4, вып. 2, стр. 22–40, 2016.
- ⟦[22] X. X. Zhu, D. Tuia, L. Mou, G.-S. Xia, L. Zhang, F. Xu, and F. Fraundorfer, “Deep learning in remote sensing: A comprehensive review and list of resources,” IEEE Geosci. Remote Sens. Mag., vol. 5, no. 4, pp. 8–36, 2017.
- ⟦L. Liu, W. Ouyang, X. Wang, P. Fieguth, J. Chen, X. Liu, and M. Pietikäinen, “Deep learning for generic object detection: A survey,” arXiv:1809.02165, 2018.
- ⟦Z.-Q. Zhao, P. Zheng, S.-t. Xu, и X. Wu, «Обнаружение объектов с помощью глубокого обучения: обзор», IEEE Trans Neural Netw Learn Syst., 2019.
- [25] А. Гарсия-Гарсия, С. Орц-Эсколано, С. Опреа, В. Вильенна-Мартинес и Дж. Гарсия-Родригес, «Обзор методов глубокого обучения, применяемых к семантической сегментации», arXiv:1704.06857, 2017.
- ⟦[26] W. Liu, Z. Wang, X. Liu, N. Zeng, Y. Liu, and F. E. Alsaadi, “A survey of deep neural network architectures and their applications,” Neurocomput, vol. 234, pp. 11–26, 2017.
- [27] М. М. Бронштейн, Дж. Бруна, Й. ЛеКун, А. Сзлам, и П. Вандергейнст, «Геометрическое углублённое обучение: выход за пределы евклидовых данных», IEEE Signal Process Mag., т. 34, № 4, стр. 18–42, 2017.
- [28] A. Ioannidou, E. Chatzilari, S. Nikolopoulos, and I. Kompatsiaris, “Deep learning advances in computer vision with 3d data: A survey,” ACM CSUR, vol. 50, no. 2, p. 20, 2017.
- [29] E. Ahmed, A. Saint, A. E. R. Shabayek, K. Cherenkova, R. Das, G. Gusev, D. Aouada, and B. Ottersten, “Deep learning advances on different 3d data representations: A survey,” arXiv:1808.01462, 2018.
- ⟦Z. Wu, S. Song, A. Khosla, F. Yu, L. Zhang, X. Tang, and J. Xiao, “3d shapenets: A deep representation for volumetric shapes,” in Proc. IEEE CVPR, 2015, pp. 1912–1920.
- ⟦[31] L. Ma, Y. Li, J. Li, C. Wang, R. Wang и M. Chapman, «Мобильное лазерное сканирование облаков точек для обнаружения и извлечения объектов на дорогах: обзор», Remote Sens., т. 10, № 10, с. 1531, 2018.
- ⟦[32] H. Guan, J. Li, S. Cao, and Y. Yu, “Use of mobile lidar in road information inventory: A review,” Int J Image Data Fusion, vol. 7, no. 3, pp. 219–242, 2016.
- ⟦[33] E. Che, J. Jung, and M. J. Olsen, “Object recognition, segmentation, and classification of mobile laser scanning point clouds: A state of the art review,” Sensors, vol. 19, no. 4, p. 810, 2019.
- [34] R. Wang, J. Peethambaran и D. Chen, «Lidar point clouds to 3-d urban models a review», IEEE J. Sel. Topics Appl. Earth Observ. Remote Sens., т. 11, № 2, с. 606–627, 2018.
- [35] X.-F. Хана, Дж. С. Цзинь, Дж. Сие, М.-Дж. Ван и У. Цзян, «Всесторонний обзор дескрипторов трехмерных облаков точек», arXiv:1802.02297, 2018.
- ⟦E. Arnold, O. Y. Al-Jarrah, M. Dianati, S. Fallah, D. Oxtoby, and A. Mouzakitis, “A survey on 3d object detection methods for autonomous driving applications,” IEEE Trans. Intell. Transp. Syst, 2019.
- ⟦[37] W. Liu, J. Sun, W. Li, T. Hu, and P. Wang, “Обучение глубоким моделям на облаках точек и его применение: обзор,” Sens., т. 19, вып. 19, с. 4188, 2019.
- [38] М. Тремль, Й. Архона-Медина, Т. Унтертхинер, Р. Дурджеш, Ф. Фридманн, П. Шуберт, А. Майр, М. Хойзель, М. Хофмархер, М. Видрих и др., «Ускорение семантической сегментации для автономного вождения», в MLITS, NIPS Workshop, т. 1, 2016, с. 5.
- [39] А. Нгуен и Б. Ле, «Сегментация облака точек в трехмерном пространстве: обзор», в RAM, 2013, стр. 225–230.
- ⟦Q. Huang, W. Wang, and U. Neumann, “Recurrent slice networks for 3d segmentation of point clouds,” in Proc. IEEE CVPR, 2018, pp. 2626–2635.
- ⟦C. R. Qi, W. Liu, C. Wu, H. Su, и L. J. Guibas, “Frustum pointnets for 3d object detection from rgb-d data,” в Proc. IEEE CVPR, 2018, стр. 918–927.
- ⟦[42] C. R. Qi, O. Litany, K. He, and L. J. Guibas, “Deep hough voting for 3d object detection in point clouds,” arXiv:1904.09664, 2019.
- [43] J. Beltrán, C. Guindel, F. M. Moreno, D. Cruzado, F. García, and A. De La Escalera, “Birdnet: a 3d object detection framework from lidar information,” in ITSC, 2018, pp. 3517–3523.
- ⟦K0 А. Kundu, Y. Li и J. M. Rehg, “3d rcnn: Instance-level 3d object reconstruction via render-and-compare,” in Proc. IEEE CVPR, 2018, pp. 3559–3568.
- [45] Z. Luo, J. Li, Z. Xiao, Z. G. Mou, X. Cai, and C. Wang, “Learning high-level features by fusing multi-view representation of mls point clouds for 3d object recognition in road environments,” ISPRS J. Photogramm. Remote Sens., vol. 150, pp. 44–58, 2019.
- ⟦Z. Wang, L. Zhang, T. Fang, P. T. Mathiopoulos, X. Tong, H. Qu, Z. Xiao, F. Li, и D. Chen, “A multiscale and hierarchical feature extraction method for terrestrial laser scanning point cloud classification,” IEEE Trans. Geosci. Remote Sens., vol. 53, no. 5, pp. 2409–2425, 2015.
- ⟦C. Wen, X. Sun, J. Li, C. Wang, Y. Guo, and A. Habib, “A deep learning framework for road marking extraction, classification and completion from mobile laser scanning point clouds,” ISPRS J. Photogramm. Remote Sens., vol. 147, pp. 178–192, 2019.
- ⟦[48] T. Хакель, Й. Д. Вегнер и К. Шиндлер, «Совместная классификация и извлечение контуров крупных трехмерных облаков точек», ISPRS J. Photogramm. Remote Sens., т. 130, с. 231–245, 2017.
- ⟦[49] B. Kumar, G. Pandey, B. Lohani, and S. C. Misra, “A multi-faceted cnn architecture for automatic classification of mobile lidar data and an algorithm to reproduce point cloud samples for enhanced training,” ISPRS J. Photogramm. Remote Sens., vol. 147, pp. 80–89, 2019.
- ⟦[50] Г. Панг и У. Нойманн, «обнаружение объектов в облаке точек в трехмерном пространстве с помощью сверточной нейронной сети по нескольким видам», в IEEE ICPR, 2016, стр. 585–590.
- ⟦[51] A. Тальяcаччи, Х. Чжан и Д. Коэн-Ор, «Извлечение скелета кривой из неполного облака точек», в ACM Trans. Graph, т. 28, вып. 3, 2009, с. 71.
- ⟦[52] Y. Liu, B. Fan, S. Xiang, and C. Pan, “Relation-shape convolutional neural network for point cloud analysis,” arXiv:1904.07601, 2019.
- [53] H. Huang, D. Li, H. Zhang, U. Ascher, and D. Cohen-Or, “Консолидация неупорядоченных облаков точек для реконструкции поверхности,” ACM Trans. Graph, vol. 28, no. 5, p. 176, 2009.
- ⟦[54] А. Гейгер, П. Ленц, К. Стиллер и Р. Уртасун, «Зрение встречается с робототехникой: набор данных kitti», Int. J Rob Res, т. 32, вып. 11, стр. 1231–1237, 2013.
- ⟦[55] К. Джо, Дж. Ким, Д. Ким, С. Джанг и М. Санву, «Разработка автономного автомобиля — часть ii: тематическое исследование по внедрению системы автономного вождения на основе распределённой архитектуры», IEEE Trans. Aerosp. Electron., т. 62, вып. 8, стр. 5119–5132, 2015.
- [56] T. Hackel, N. Savinov, L. Ladicky, J. D. Wegner, K. Schindler, and M. Pollefeys, “Semantic3d. net: A new large-scale point cloud classification benchmark,” arXiv:1704.03847, 2017.
- [57] D. Munoz, J. A. Bagnell, N. Vandapel и M. Hebert, “Contextual classification with functional max-margin markov networks,” in Proc. IEEE CVPR, 2009, pp. 975–982.
- [58] B. Vallet, M. Brédif, A. Serna, B. Marcotegui, and N. Paparoditis, “Terramobilita/iqmulus urban point cloud analysis benchmark,” Comput. Graph, vol. 49, pp. 126–133, 2015.
- [59] Икс. Ройнар, Ж.-Э. Дешо, и Ф. Гулетт, «Классификация сцен облаков точек с мульти- масштабной воксельной глубокой сетью», arXiv:1804.03583, 2018.
- [60] А. Гайгер, П. Ленц и Р. Уртасун, «Готовы ли мы к автономному вождению? набор ориентировочного тестирования для компьютерного зрения kitti», в Proc. IEEE CVPR, 2012, стр. 3354–3361.
- ⟦[61] М. Де Деуге, А. Квадрос, К. Хунг и Б. Дуйяр, «Обучение признаков без учителя для классификации наружных 3d-сканов», в ACRA, т. 2, 2013, стр. 1.
- [62] М. Эверингем, С. А. Эслэмий, Л. Ван Гул, К. К. Уильямс, Дж. Винн и А. Зиссерман, «Задача Pascal по визуальным классам объектов: ретроспектива», Int. J. Comput. Vision, т. 111, № 1, с. 98–136, 2015.
- [63] Л. Ян, Ц. Ли, Х. Лю, Дж. Тан, С. Чжао и С. Чэнь, «Обнаружение и классификация объектов, похожих на столбы, на дороге по данным мобильного лидара в условиях автомагистрали», Opt Laser Technol, т. 97, с. 272–283, 2017.
- ⟦W. Maddern, G. Pascoe, C. Linegar, and P. Newman, “1 year, 1000 km: The oxford robotcar dataset,” Int J Rob Res, vol. 36, no. 1, pp. 3–15, 2017.
- [65] L. Zhang, Z. Li, A. Li, and F. Liu, “Large-scale urban point cloud labeling and reconstruction,” ISPRS J. Photogramm. Remote Sens., vol. 138, pp. 86–100, 2018.
- ⟦X. Chen, K. Kundu, Y. Zhu, H. Ma, S. Fidler, and R. Urtasun, “3d object proposals using stereo imagery for accurate object class detection,” IEEE Trans. Pattern Anal. Mach. Intell., vol. 40, no. 5, pp. 1259–1272, 2018.
- ⟦D. Maturana and S. Scherer, “Voxnet: A 3d convolutional neural network for real-time object recognition,” in IEEE/RSJ IROS, 2015, pp. 922–928.
- ⟦J. Wu, C. Zhang, T. Xue, B. Freeman, and J. Tenenbaum, “Learning a probabilistic latent space of object shapes via 3d generative-adversarial modeling,” in Adv Neural Inf Process Syst, 2016, pp. 82–90.
- ⟦G. Риглер, А. Осман Улусой и А. Гейгер, «Octnet: Обучение глубоких трёхмерных представлений с высоким разрешением», в Proc. IEEE CVPR, 2017, стр. 3577–3586.
- [70] Р. Клоков и В. Лемпицкий, «Побег из клеток: глубокие kd-сети для распознавания моделей трехмерных облаков точек», в Proc. IEEE ICCV, 2017, стр. 863–872.
- ⟦Y. Li, R. Bu, M. Sun, W. Wu, X. Di, and B. Chen, “Pointcnn: Convolution on x-transformed points,” in NeurIPS, 2018, pp. 820–830.
- [72] Л. Йи, Х. Су, Х. Го и Л. Дж. Гибас, «Syncspeccnn: Синхронизированная спектральная cnn для сегментации 3d-форм», в Proc. IEEE CVPR, 2017, стр. 2282–2290.
- [73] М. Simonovsky и N. Komodakis, «Динамические фильтры с условием на ребрах в сверточных нейронных сетях на графах», в Proc. IEEE CVPR, 2017, стр. 3693–3702.
- ⟦Y. Wang, Y. Sun, Z. Liu, S. E. Sarma, M. M. Bronstein, and J. M. Solomon, “Dynamic graph cnn for learning on point clouds,” arXiv:1801.07829, 2018.
- ⟦P. Veličković, G. Cucurull, A. Casanova, A. Romero, P. Lio, and Y. Bengio, “Graph attention networks,” arXiv:1710.10903, 2017.
- ⟦H. Su, S. Maji, E. Kalogerakis, and E. Learned-Miller, “Multi-view сверточные нейронные сети для распознавания трехмерных форм,” in Proc. IEEE ICCV, 2015, pp. 945–953.
- [77] A. Dai and M. Nießner, “3dmv: Joint 3d-multi-view prediction for 3d semantic scene segmentation,” in ECCV, 2018, pp. 452–468.
- [78] A. Канэзаки, Я. Мацуcита и Й. Нисида, «Rotationnet: Совместная категоризация объектов и оценка позы с использованием многовидовых данных из неразмеченных ракурсов», в Proc. IEEE CVPR, 2018, стр. 5010–5019.
- [79] J. Long, E. Shelhamer, and T. Darrell, “Полностью сверточные сети для семантической сегментации,” in Proc. IEEE CVPR, 2015, pp. 3431–3440.
- [80] G. Vosselman, B. G. Gorte, G. Sithole, and T. Rabbani, “Recognising structure in laser scanner point clouds,” Int. Arch. Photogramm. Remote Sens. Spat. Inf. Sci., vol. 46, no. 8, pp. 33–38, 2004.
- ⟦[81] I. И. Гудфеллоу, Ж. Пуже-Абади, М. Мирза, Б. Сюй, Д. Уорд-Фарли, С. Озайр, А. Курвиль и Й. Бенджио, «Генеративные состязательные сети», в Adv Neural Inf Process Syst, 2014, стр. 2672–2680.
- [82] М. Татартченко, А. Досовицкий и Т. Брокс, «Сети генерации октадеревьев: Эффективные сверточные архитектуры для высокоразмерных 3d-выходов», в Proc. IEEE ICCV, 2017, стр. 2088–2096.
- ⟦A. Miller, V. Jain, и J. L. Mundy, «Рендеринг в реальном времени и динамическое обновление 3-d объемных данных», в Proc. GPGPU, 2011, стр. 8.
- [84] C. Wang, B. Samari, and K. Siddiqi, “Local spectral graph convolution for point set feature learning,” in ECCV, 2018, pp. 52–66.
- [85] Л. Ван, И. Хуан, Ю. Хоу, С. Чжан и Дж. Шань, «Свёртка с вниманием по графам для семантической сегментации точечных облаков», в Proc. IEEE CVPR, 2019, стр. 10 296–10 305.
- [86] А. Кричевский, И. Сатскевер и Г. Э. Хинтон, «Классификация Imagenet с использованием глубоких сверточных нейронных сетей», в Adv Neural Inf Process Syst, 2012, стр. 1097–1105.
- [87] К. Симонян и А. Зиссерман, “Очень глубокие сверточные сети для крупномасштабного распознавания изображений,” arXiv:1409.1556, 2014.
- [88] C. Szegedy, W. Liu, Y. Jia, P. Sermanet, S. Reed, D. Anguelov, D. Erhan, V. Vanhoucke и A. Rabinovich, «Погружаясь глубже с помощью свёрток», в Proc. IEEE CVPR, 2015, стр. 1–9.
- [89] К. Хэ, Х. Чжан, С. Жэнь и Дж. Сан, «Глубокое остаточное обучение для распознавания изображений», в Proc. IEEE CVPR, 2016, стр. 770–778.
- ⟦J.-C. Su, M. Gadelha, R. Wang, and S. Maji, “A deeper look at 3d shape classifiers,” in ECCV, 2018, pp. 0–0.
- ⟦H. You, Y. Feng, R. Ji, and Y. Gao, “Pvnet: A joint convolutional network of point cloud and multi-view for 3d shape recognition,” in 2018 ACM Multimedia Conference on Multimedia Conference, 2018, pp. 1310–1318.
- [92] O. Russakovsky, J. Deng, H. Su, J. Krause, S. Satheesh, S. Ma, Z. Huang, A. Karpathy, A. Khosla, M. Bernstein и др., “Imagenet large scale visual recognition challenge,” Int. J. Comput. Vision, т. 115, № 3, с. 211–252, 2015.
- ⟦S. Zhi, Y. Liu, X. Li, и Y. Guo, «К стремлению к распознаванию 3d объектов в реальном времени: легкий объемный cnn-фреймворк с многоцелевым обучением», Comput Graph, т. 71, с. 199–207, 2018.
- ⟦——, “Lightnet: A lightweight 3d convolutional neural network for real-time 3d object recognition.” in 3DOR, 2017.
- [95] A. Dai, D. Ritchie, M. Bokeloh, S. Reed, J. Sturm, and M. Nießner, “Scancomplete: Large-scale scene completion and semantic segmentation for 3d scans,” in Proc. IEEE CVPR, 2018, pp. 4578–4587.
- ⟦J. Li, B. M. Chen, and G. Hee Lee, “So-net: Self-organizing network for point cloud analysis,” in Proc. IEEE CVPR, 2018, pp. 9397–9406.
- ⟦P. Huang, M. Cheng, Y. Chen, H. Luo, C. Wang, and J. Li, “Traffic sign occlusion detection using mobile laser scanning point clouds,” IEEE Trans. Intell. Transp. Syst, vol. 18, no. 9, pp. 2364–2376, 2017.
- [98] H. Ли, Н. Акхтар и А. Миан, «Сферическая сверточная нейронная сеть для трехмерных облаков точек», arXiv:1805.07872, 2018.
- ⟦F. Engelmann, T. Kontogianni, J. Schult, and B. Leibe, “Know what your neighbors do: 3d semantic segmentation of point clouds,” in ECCV, 2018, pp. 0–0.
- ⟦[100] М. Вайнманн, Б. Юцци, С. Хинц и К. Маллет, «Интерпретация семантических облаков точек на основе оптимальных окрестностей, релевантных признаков и эффективных классификаторов», ISPRS J. Photogramm. Remote Sens., т. 105, стр. 286–304, 2015.
- [101] E. Che and M. J. Olsen, “Fast ground filtering for tls data via scanline density analysis,” ISPRS J. Photogramm. Remote Sens., vol. 129, pp. 226–240, 2017.
- [102] A.-V. Vo, L. Truong-Hong, D. F. Laefer, and M. Bertolotto, “Octree-based region growing for point cloud segmentation,” ISPRS J. Photogramm. Remote Sens., vol. 104, pp. 88–100, 2015.
- ⟦R. B. Rusu and S. Cousins, “Point cloud library (pcl),” in 2011 IEEE ICRA, 2011, pp. 1–4.
- [104] H. Thomas, F. Goulette, J.-E. Deschaud, и B. Marcotegui, «Семантическая классификация облаков точек 3d с многомасштабными сферическими окрестностями», в 3DV, 2018, стр. 390–398.
- [105] Л. Ландрье и М. Симоновский, «Семантическая сегментация облаков точек в крупном масштабе с графами суперпикселей», в: Proc. IEEE CVPR, 2018, стр. 4558–4567.
- ⟦L. Wang, Y. Huang, J. Shan, and L. He, “Msnet: Multi-scale convolutional network for point cloud classification,” Remote Sens., vol. 10, no. 4, p. 612, 2018.
- [107] F. J. Lawin, M. Danelljan, P. Tosteberg, G. Bhat, F. S. Khan, и M. Felsberg, «Глубокая проективная трехмерная семантическая сегментация», в CAIP, 2017, стр. 95–107.
- ⟦D. Rethage, J. Wald, J. Sturm, N. Navab, и F. Tombari, “Полностью свёрточные точечные сети для крупномасштабных точечных облаков,” в ECCV, 2018, стр. 596–611.
- ⟦W. Wang, R. Yu, Q. Huang, and U. Neumann, «Sgpn: Similarity group proposal network for 3d point cloud instance segmentation», in Proc. IEEE CVPR, 2018, pp. 2569–2578.
- ⟦[110] H. Су, В. Джампани, Д. Сан, С. Маджи, Э. Калогеракис, М.-Х. Ян, и Дж. Каутц, «Splatnet: Sparse lattice networks for point cloud processing», in Proc. IEEE CVPR, 2018, pp. 2530–2539.
- [111] З. Ван, Л. Чжан, Л. Чжан, Р. Ли, Ю. Чжэн и Ч. Чжу, «Глубокая нейронная сеть с пространственным пулингом (dnnsp) для классификации трехмерных облаков точек», IEEE Trans. Geosci. Remote Sens., т. 56, № 8, с. 4594–4604, 2018.
- ⟦J. Huang and S. You, “Point cloud labeling using 3d convolutional neural network,” in ICPR, 2016, pp. 2670–2675.
- ⟦[113] L. Tchapmi, C. Choy, I. Armeni, J. Gwak, and S. Savarese, “Segcloud: Semantic segmentation of 3d point clouds,” in 3DV, 2017, pp. 537–547.
- [114] Дж. Лэфферти, А. МакКоллум и Ф. Перейра, «Условные случайные поля: Вероятностные модели для сегментации и разметки последовательных данных», 2001.
- [115] Р. Чжан, Г. Ли, М. Ли и Л. Ван, «Слияние изображений и облаков точек для семантической сегментации крупномасштабных 3d-сцен на основе глубокого обучения», ISPRS J. Photogramm. Remote Sens., т. 143, с. 85–96, 2018.
- [116] M. Simony, S. Milzy, K. Amendey, и H.-M. Gross, «Complex-yolo: euler-region-proposal для обнаружения трехмерных объектов в реальном времени по облакам точек», в ECCV, 2018, стр. 0–0.
- [117] A. Liaw, M. Wiener и др., “Классификация и регрессия с помощью randomforest”, R news, т. 2, № 3, с. 18–22, 2002.
- ⟦[118] Л. Чжан и Л. Чжан, «Классификация и реконструкция жилых сцен на основе глубокого обучения по данным крупномасштабных облаков точек», IEEE Trans. Geosci. Remote Sens., т. 56, № 4, с. 1887–1897, 2018.
- ⟦Z. Yang, Y. Sun, S. Liu, X. Shen, and J. Jia, “Ipod: Intensive point-based object detector for point cloud,” arXiv:1812.05276, 2018.
- ⟦B. Zoph, V. Vasudevan, J. Shlens, and Q. V. Le, “Learning transferable architectures for scalable image recognition,” in Proc. IEEE CVPR, 2018, pp. 8697–8710.
- [121] D. Z. Wang and I. Posner, “Voting for voting in online point cloud object detection.” in RSS, vol. 1, no. 3, 2015, pp. 10–15 607.
- [122] M. Engelcke, D. Rao, D. Z. Wang, C. H. Tong, and I. Posner, “Vote3deep: Fast object detection in 3d point clouds using efficient convolutional neural networks,” in IEEE ICRA, 2017, pp. 1355–1361.
- ⟦X. Chen, H. Ma, J. Wan, B. Li и T. Xia, “Multi-view 3d object detection network for autonomous driving,” в Proc. IEEE CVPR, 2017, стр. 1907–1915.
- ⟦[124] J. Ku, M. Mozifian, J. Lee, A. Harakeh и S. L. Waslander, «Совместная генерация 3d предложений и обнаружение объектов по данным агрегации видов», в IEEE/RSJ IROS, 2018, стр. 1–8.
- [125] С.-Л. Юй, Т. Вестфехтель, Р. Хамада, К. Оно и С. Тадокоро, «Обнаружение и локализация транспортных средств на изображениях с возвышением с вида сверху с использованием сверточной нейронной сети», в IEEE SSRR, 2017, стр. 102–109.
- ⟦[126] S. Ren, K. He, R. Girshick и J. Sun, «Faster r-cnn: Towards real-time object detection with region proposal networks», in Adv Neural Inf Process Syst, 2015, pp. 91–99.
- ⟦[127] Y. Zeng, Y. Hu, S. Liu, J. Ye, Y. Han, X. Li, and N. Sun, “Rt3d: Real-time 3-d vehicle detection in lidar point cloud for autonomous driving,” IEEE Robot. Autom. Lett, vol. 3, no. 4, pp. 3434–3440, 2018.
- [128] Н. Зильберман, Д. Хойем, П. Коли и Р. Фергюс, «Разметка помещений и вывод поддержки по изображениям rgbd», в ECCV, 2012, стр. 746–760.
- ⟦[129] Y. Xu, T. Fan, M. Xu, L. Zeng, and Y. Qiao, “Spidercnn: Deep learning on point sets with parameterized convolutional filters,” in ECCV, 2018, pp. 87–102.
- ⟦[130] N. Sedaghat, M. Zolfaghari, E. Amiri, and T. Brox, “Orientation-boosted voxel nets for 3d object recognition,” arXiv:1604.03351, 2016.
- ⟦C. Ma, Y. Guo, Y. Lei, and W. An, “Binary volumetric convolutional neural networks for 3-d object recognition,” IEEE Trans. Instrum. Meas., no. 99, pp. 1–11, 2018.
- [132] C. Wang, M. Cheng, F. Sohel, M. Bennamoun, and J. Li, “Normalnet: A voxel-based cnn for 3d object classification and retrieval,” Neurocomput, vol. 323, pp. 139–147, 2019.
- [133] K. He, X. Zhang, S. Ren и J. Sun, «Spatial pyramid pooling in deep convolutional networks for visual recognition», IEEE Trans. Pattern Anal. Mach. Intell., т. 37, № 9, с. 1904–1916, 2015.
- [134] М. Лян, Б. Ян, С. Ван и Р. Уртасун, «Deep continuous fusion for multi-sensor 3d object detection», in ECCV, 2018, pp. 641–656.
- [135] Д. Сю, Д. Ангуелов и А. Джайн, «Pointfusion: глубокое слияние сенсоров для оценки трехмерных ограничительных рамок», в Proc. IEEE CVPR), июнь 2018.
- [136] T. He, H. Huang, L. Yi, Y. Zhou и S. Soatto, «Geonet: Deep geodesic networks for point cloud analysis», arXiv:1901.00680, 2019.
- ⟦L. Mescheder, M. Oechsle, M. Niemeyer, S. Nowozin, and A. Geiger, “Occupancy networks: Learning 3d reconstruction in function space,” arXiv:1812.03828, 2018.
- [138] T. Le and Y. Duan, “PointGrid: A Deep Network for 3D Shape Understanding,” Proc. IEEE CVPR, June 2018.
- [139] Дж. Ли, Ю. Би и Дж. Х. Ли, «Дискретная ротационная эквивариантность для распознавания облаков точек», arXiv:1904.00319, 2019.
- ⟦D. Worrall and G. Brostow, “Cubenet: Equivariance to 3d rotation and translation,” in ECCV, 2018, pp. 567–584.
- ⟦[141] K. Фудзивара, И. Сато, М. Амбаи, Ю. Ёсидa и Й. Сакaкура, «Каноническое и компактное представление облака точек для классификации форм», arXiv:1809.04820, 2018.
- ⟦Z. Dong, B. Yang, F. Liang, R. Huang, и S. Scherer, «Иерархическая регистрация неупорядоченных точечных облаков tls на основе двоесимвольного контекстного дескриптора формы», ISPRS J. Photogramm. Remote Sens., т. 144, с. 61–79, 2018.
- ⟦H. Deng, T. Birdal, and S. Ilic, “Ppfnet: Global context aware local features for robust 3d point matching,” in Proc. IEEE CVPR, 2018, pp. 195–205.
- [144] S. Xie, S. Liu, Z. Chen, and Z. Tu, “Attentional shapecontextnet for point cloud recognition,” in Proc. IEEE CVPR, 2018, pp. 4606–4615.
- ⟦Z. J. Yew and G. H. Lee, “3dfeat-net: Weakly supervised local 3d features for point cloud registration,” in ECCV, 2018, pp. 630–646.
- ⟦J. Sauder и B. Sievers, «Предсказание контекста для обучения без учителя глубоких нейронных сетей по облакам точек», arXiv:1901.08396, 2019.
- ⟦M. Shoef, S. Fogel, и D. Cohen-Or, “Pointwise: An unsupervised point-wise feature learning network,” arXiv:1901.04544, 2019.
 |
Ying Li received the M.Sc. degree in remote sensing from Wuhan University, China, in 2017. She is currently working toward the Ph.D. degree with the Mobile Sensing and Geodata Science Laboratory, Department of Geography and Environmental Management, University of Waterloo, ON, Canada. Her research interests include autonomous driving, mobile laser scanning, intelligent processing of point clouds, geometric and semantic modeling, and augmented reality. |
 |
Lingfei Ma (S’18) received the B.Sc. and M.Sc. degrees in geomatics engineering from the University of Waterloo, Waterloo, ON, Canada, in 2015 and 2017, respectively. He is currently working toward the Ph.D. degree in photogrammetry and remote sensing with the Mobile Sensing and Geodata Science Laboratory, Department of Geography and Environmental Management, University of Waterloo. His research interests include autonomous driving, mobile laser scanning, intelligent processing of point clouds, 3-D scene modeling, and machine learning. |
 |
Zilong Zhong (S’15) Zilong Zhong received the Ph.D. in systems design engineering, specialized in machine learning and intelligence, from the University of Waterloo, Canada, in 2019. He is a postdoctoral fellow with the School of Data and Computer Science, Sun Yat-Sen University, China. His research interests include computer vision, deep learning, graph models and their applications involving large-scale image analysis. |
 |
Fei Liu received the B.Eng. degree from Yanshan University, China, in 2011. Since then, she has been working in the sectors of vehicular electronics and control, artificial intelligence, deep learning, FPGA, advanced driver assistance systems, and automated driving. She is currently working at Xilinx Technology Beijing Limited, Beijing, China, focusing on development of automated driving technologies and data centers. |
 |
Dongpu Cao o (M’08) received the Ph.D. degree from Concordia University, Canada, in 2008. He is the Canada Research Chair in Driver Cognition and Automated Driving, and currently an Associate Professor and Director of Waterloo Cognitive Autonomous Driving (CogDrive) Lab at University of Waterloo, Canada. His current research focuses on driver cognition, automated driving and cognitive autonomous driving. He has contributed more than 200 publications, 2 books and 1 patent. He received the SAE Arch T. Colwell Merit Award in 2012, and three Best Paper Awards from the ASME and IEEE conferences. |
 |
Jonathan Li (00’ M- 11’ SM) received the Ph.D. degree in geomatics engineering from the University of Cape Town, South Africa. He is currently a Professor with the Departments of Geography and Environmental Management and Systems Design Engineering, University of Waterloo, Canada. He has coauthored more than 420 publications, more than 200 of which were published in refereed journals, including the IEEE Transactions on Geoscience and Remote Sensing, IEEE Transactions on Intelligent Transportation Systems, IEEE Journal of Selected Topics in Applied Earth Observations and Remote Sensing, ISPRS Journal of Photogrammetry and Remote Sensing, Remote Sensing of Environment, as well as leading artificial intelligence and remote sensing conferences including CVPR, AAAI, IJCAI, IGARSS and ISPRS. His research interests include information extraction from LiDAR point clouds and from earth observation images. |
 |
Michael A. Chapman received the Ph.D. degree in photogrammetry from Laval University, Canada. He was a Professor with the Department of Geomatics Engineering, University of Calgary, Canada, for 18 years. Currently, he is a Professor of geomatics engineering with the Department of Civil Engineering, Ryerson University, Canada. He has authored or coauthored over 200 technical articles. His research interests include algorithms and processing methodologies for airborne sensors using GNSS/IMU, geometric processing of digital imagery in industrial environments, terrestrial imaging systems for transportation infrastructure mapping, and algorithms and processing strategies for biometrology applications. |