Классификация рациона коров на основе спектров среднего инфракрасного диапазона молока: соревнование по анализу данных
на «Международном семинаре ⟦K0⟧
Спектроскопия и хемометрика 2022”
Аннотация
В апреле 2022 года исследовательский центр Vistamilk SFI организовал вторую редакцию «Международного семинара по спектроскопии и хемометрике – Применения в пищевой промышленности и сельском хозяйстве». В рамках этого мероприятия среди участников семинара был организован конкурс данных. Целью такого соревнования по анализу данных была разработка прогностической модели для классификации рациона молочных коров на основе спектральной информации молока, собранной в среднеинфракрасной области. Фактически, разработка точной и надежной дискриминантной модели рациона молочных коров может предоставить важные инструменты аутентификации для переработчиков молочной продукции, чтобы гарантировать происхождение продуктов для производителей молочных продуктов из молока животных, получавших травяной корм. В ходе семинара были применены различные статистические подходы и подходы машинного обучения, с использованием различных этапов предварительной обработки и различной степенью сложности. Настоящая статья направлена на описание статистических методов, принятых участниками для разработки такой модели классификации..
Ключевые слова: хемометрика, среднеинфракрасная спектроскопия с преобразованием Фурье, машинное обучение, качество молока, аутентичность пищевых продуктов
1 Введение
Использование спектроскопии в среднем инфракрасном диапазоне (MIRS) стало актуальной темой в агропродовольственных науках благодаря ее способности регулярно и рентабельно количественно определять широкий спектр важных характеристик. В частности, в настоящее время MIRS широко применяется для мониторинга и количественной оценки параметров качества молока, таких как концентрации жира, белка, казеина и лактозы. Эти параметры используются для систем оплаты на основе качества молока, генетической и геномной селекции, а также в качестве инструмента поддержки фермеров. Спектральная информация, полученная в результате анализа MIRS, также доказала свою эффективность в прогнозировании детальных параметров качества молока, включая белковые фракции, свободные аминокислоты [Bonfatti et al.,, 2011; McDermott et al.,, 2016], отдельные жирные кислоты и их группы [Soyeurt et al.,, 2006; Fleming et al.,, 2017], технологические свойства молока [Ferragina et al.,, 2013; Visentin et al.,, 2015], характеристики, связанные с животным [McParland et al.,, 2014; Shetty et al.,, 2017; Ho et al.,, 2019], и может использоваться в качестве инструмента для проверки подлинности сельскохозяйственных продуктов питания [Cozzolino,, 2012]. Более обширный список применений MIRS в рамках молочного животноводства можно найти в обзорах De Marchi et al., [2014] и Tiplady et al., [2020]⟧.
Двухдневное мероприятие «Международный семинар по спектроскопии и хемометрике» было организовано исследовательским центром Vistamilk SFI в апреле 2022 года вслед за первым выпуском, состоявшимся в 2021 году [Frizzarin et al., 2021a, ]. Семинар был посвящен описанию основных проблем и областей применения ближней и средней инфракрасной спектроскопии в пищевой, животноводческой и сельскохозяйственной науках с участием признанных на международном уровне исследователей. Кроме того, участникам на добровольной основе был предоставлен большой набор данных, содержащий спектры молока отдельных коров с единственной информацией о рационе животных для хемометрического конкурса данных. Такие данные представляли множество проблем с методологической и статистической точек зрения из-за высокой размерности спектральных матриц и сильной коллинеарности между соседними спектральными длинами волн. Таким образом, хемометрический конкурс способствовал вовлечению участников с различным опытом и навыками и потребовал применения различных статистических стратегий и стратегий machine learning..
Целью этого дата-соревнования была разработка модели для предсказания рациона молочных коров с использованием информации средней инфракрасной спектроскопии. Участникам или группам участников нужно было применить разработанную модель к тестовому набору, содержащему только индивидуальные спектры молока, и представить свои предсказания рациона животных. Несмотря на то, что участие в хемометрическом соревновании было чрезвычайно массовым, только шесть лучших работ по точности предсказания и методологической новизне были отозваны для представления своих результатов как на воркшопе, так и в настоящей рукописи..
2 Описание данных и задача
Набор данных, состоящий из 4364 индивидуальных спектров молока от 120 коров, был собран в период с мая по август в 2015, 2016 и 2017 годах [O’Callaghan et al.,, 2016]. Образцы были получены от голштино-фризских коров разной лактации из ирландского молочного исследовательского стада в Тегаск Мурпарк, Фермой, графство Корк. Было оценлено три группы рационов, причем в каждый год к каждой группе было приписано по 54 коровы. Эти три варианта рациона представляли собой пастбищную траву (GRS), состоящую только из райграса пастбищного, клевер (CLV), состоящий из райграса пастбищного с 20% травостоя однолетнего клевера, и полнорационную кормовую смесь (TMR), при которой коров кормили травяным силосом, кукурузным силосом и концентратами, содержащимися в помещении в течение всего сезона. Пробы молока отбирались во время утренней (AM) и вечерней (PM) дойки; впоследствии пробы AM+PM объединялись и анализировались еженедельно с использованием прибора Pro-FOSS FT6000 (FOSS). Было собрано в общей сложности 1060 точек данных коэффициента пропускания в диапазоне от 925 см-1 до 5000 см-1.
Набор данных был разделен на обучающие (3275 спектров) и тестовые (1089 спектров) данные; для последних была предоставлена только спектральная информация, в то время как информация о рационе, используемая в качестве переменной классификации, была доступна для обучающего набора. Обучающие данные включали 1094 спектра для GRS, 1120 спектров для CLV и 1061 спектр для TMR. В обучающем или тестовом наборах не было пропущенных значений. Конкретная информация о волновых числах не передавалась участникам.
Три группы рационов были тщательно отобранны на основе их характеристик. Как описано в Frizzarin et al., 2021b [], пастбищные рационы легко отличить от рационов TMR, в то время как различение рационов GRS и CLV представляет значительно большую сложность из-за схожести состава травостоя, приводящей к схожему составу молока. Тем не менее, в условиях растущего давления с целью снижения использования удобрений и внедрения многовидовых травостоев, разработка надежной дискриминантной модели для классификации спектров молока по рациону имеет первостепенное значение.
После анализа участники представили свои прогнозируемые значения для тестового набора данных и краткое описание использованной методологии. Лучшие методы были выбраны на основе новизны вклада и точности предсказаний для тестового набора данных. Точность рассчитывалась как доля правильно классифицированных образцов, деленная на общее количество образцов в тестовом наборе данных.
3 Подходы к моделированию и результаты
3.1 Участник 1
Данные были проанализированы с использованием различных стратегий моделирования, с акцентом как на методы, учитывающие упорядоченность длин волн, так и на методы, которые этого не делают. Все анализы были проведены преимущественно с использованием библиотек Python pandas, sklearn, sktime и matplotbib [see Pedregosa et al.,, 2011, and references therein]: код доступен по адресу https://github.com/mlgig/vistamilk_diet_challenge⟧.
В качестве первого шага были вычислены некоторые описательные статистики и удалены выбросы в соответствии как с рекомендациями, данными перед началом соревнования, так и с визуальным осмотром данных. На следующем этапе размеченный набор данных был разделен в соответствии со стратегией 3-кратной перекрестной проверки (3CV). Таким образом, лучшая модель была выбрана на основе точности перекрестной проверки, а затем обучена на полном обучающем наборе и использована для выполнения прогнозирования на предоставленном неразмеченном тестовом наборе..
Для прогнозирования рациона были рассмотрены следующие стратегии классификации:
- ⟦• Табличные модели: каждый образец рассматривается как вектор неупорядоченных признаков. В частности, были протестированы Ridge Classifier и Linear Discriminant Analysis (LDA). Далее эти методы были объединены как со стратегиями отбора признаков, так и со случайными полиномиальными преобразованиями признаков. Последний подход, основанный на генерации новых полиномиальных переменных из исходных, был направлен на проверку того, улучшают ли нелинейные взаимодействия точность классификации. В частности, представлен новый подход, целью которого является диверсификация полиномиальных признаков при сохранении низких вычислительных требований..
- ⟦• Модели глубоких нейронных сетей: было протестировано семейство подходов на основе глубоких нейронных сетей, как полносвязных, так и сверточных. Эта стратегия неявно генерирует сложные взаимодействия признаков, заложенные в архитектуре сети.
Обратите внимание, что ранее полученные результаты [Frizzarin et al., 2021a, ] показывают, что табличные методы работают довольно хорошо с данными спектроскопии. Более того, следуя рекомендациям в Frizzarin et al., 2021b [], стратегии отбора признаков были совмещены с информацией о наличии областей воды в спектрах. Кроме того, были протестированы современные алгоритмы классификации временных рядов, такие как ROCKET [Dempster et al.,, 2020], MiniROCKET [Dempster et al.,, 2021], MrSQM [Nguyen and Ifrim,, 2021; Nguyen and Ifrim,, 2022] и FreshPrince [Middlehurst and Bagnall,, 2022]. Наконец, были применены ансамблевые методы, направленные на объединение моделей временных рядов и табличных моделей для совмещения их предсказаний и сильных сторон. Тем не менее, эти подходы уступили по эффективности вышеупомянутым, поэтому соответствующие результаты не приводятся в следующих разделах..
3.1.1 Табулярные модели, выбор признаков и трансформация
В Таблице 1 представлены результаты для лучших табличных методов. Как должным образом настроенный ridge classifier, так и LDA показали себя весьма неплохо, обладая при этом чрезвычайно высокой скоростью обучения. Тем не менее, выбор некоторых конкретных длин волн, по-видимому, позволил дополнительно повысить точность. Фактически, как удаление зашумленных водных областей, так и управляемый данными выбор признаков (выполненный с использованием процедуры SelectFromModel в Python), обеспечивают лучшие результаты.
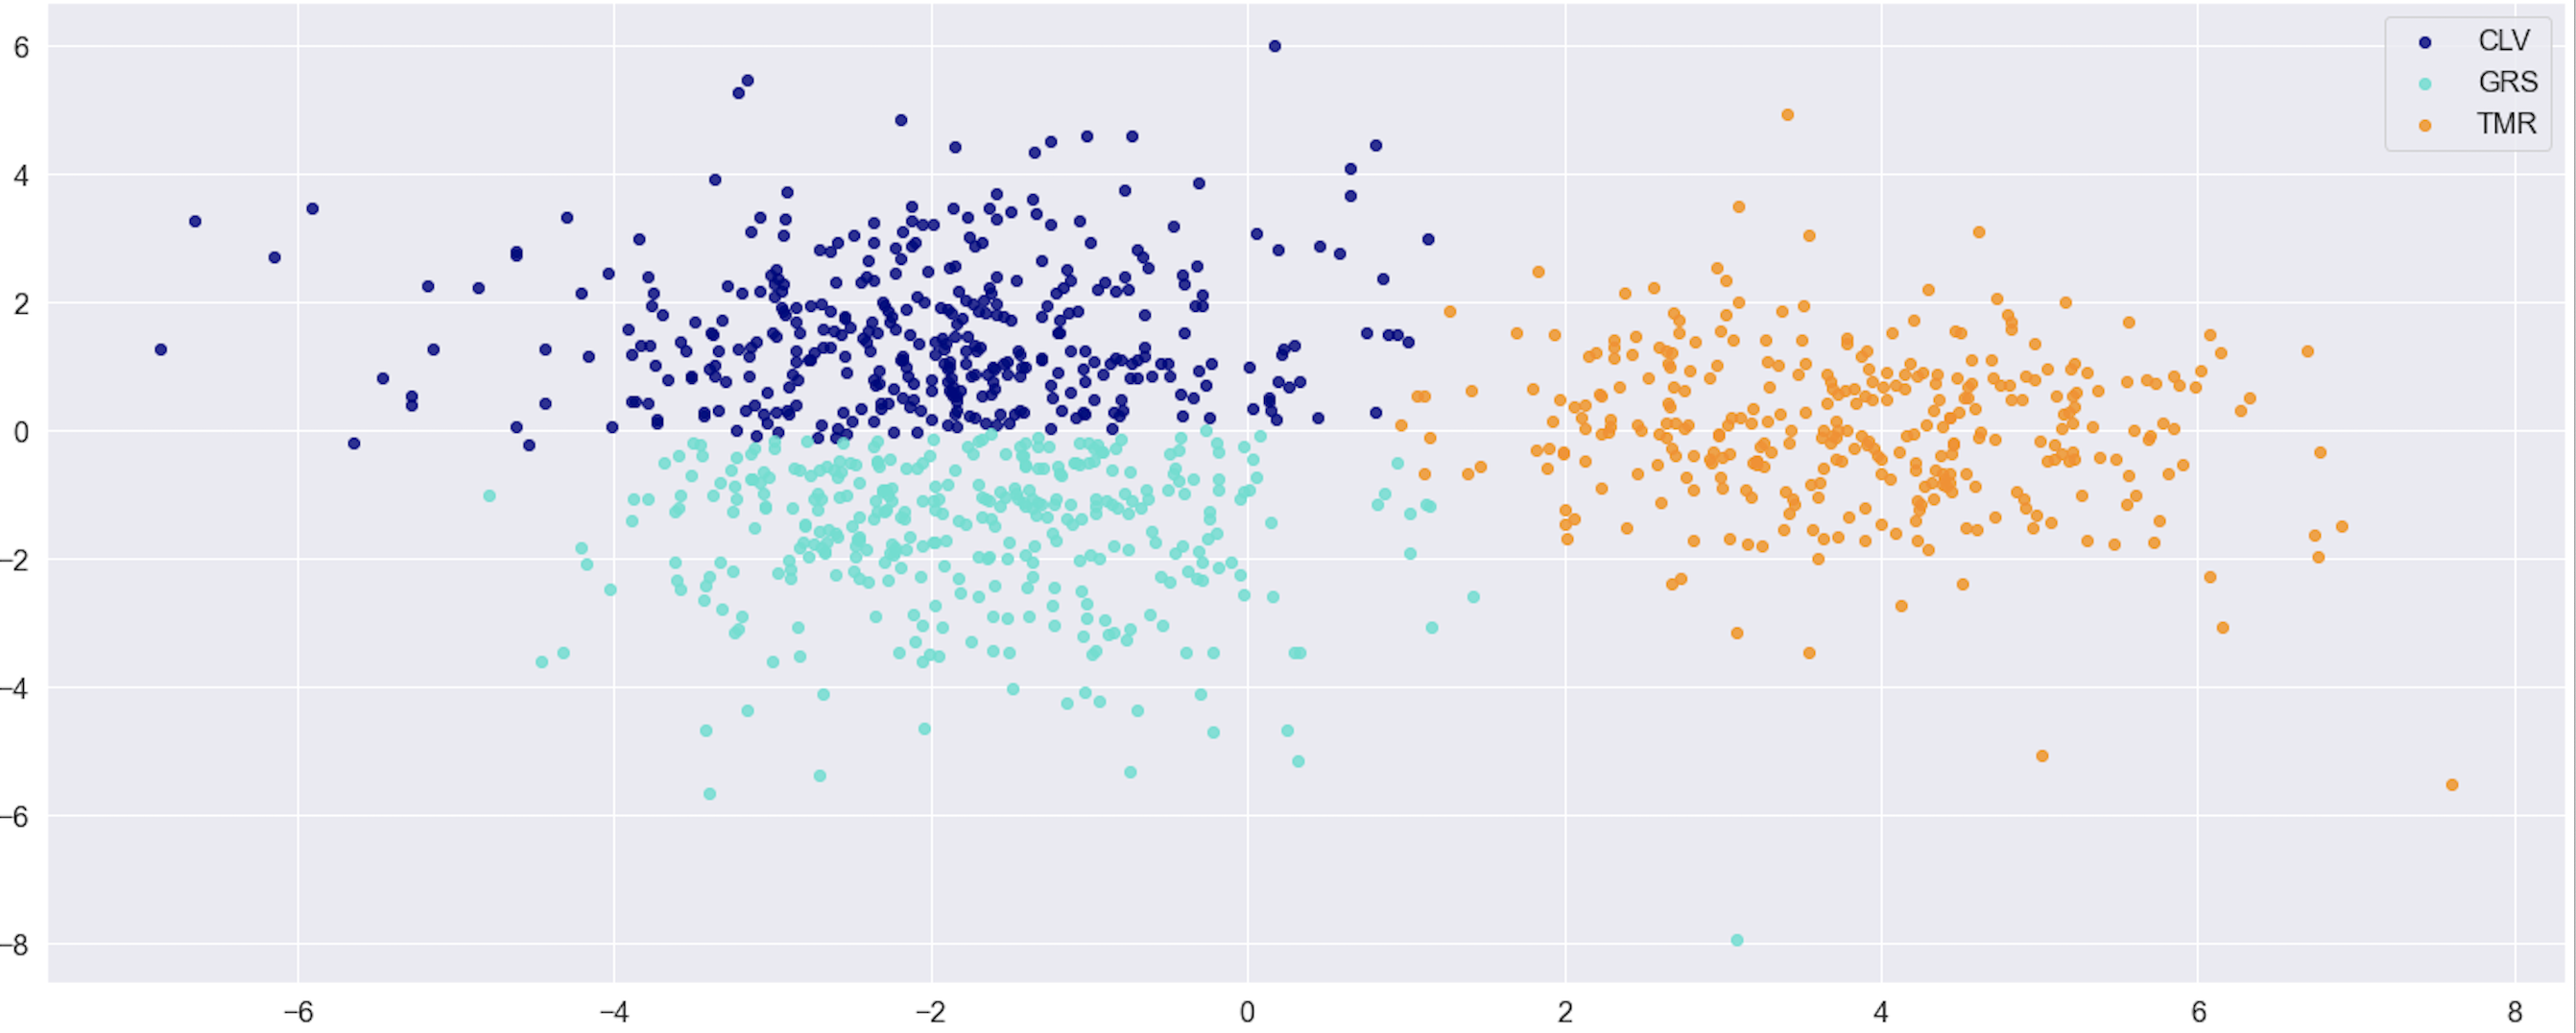
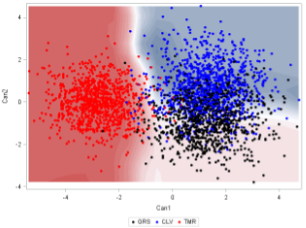
Тем не менее, все эти подходы кружат вокруг точности в 80%, поэтому для её повышения данные были дополнены с учетом полиномиальных признаков второй степени (с использованием метода sklearn PolynomialFeatures(degree = 2)). Это привело к увеличению точности до 84.4%. Визуализация компонент LDA для модели с Feature Selection и Polynomial Features, примененная к неразмеченному тестовому набору данных, показана на Рисунке 1, и на ней отчетливо видна хорошая дискриминация между тремя классами.
| Method | Accuracy |
| Ridge Classifier | 0.760 |
| LDA | 0.747 |
| Feature Selection + Ridge Classifier | 0.777 |
| Feature Selection + LDA | 0.778 |
| No water + Ridge Classifier | 0.777 |
| No water + LDA | 0.783 |
| Feature Selection + Polynomial Features + LDA | 0.844 |
| No water + Feature Selection + Polynomial Features + LDA | 0.844 |
Улучшения, полученные при учете полиномиальных признаков, достигаются ценой увеличения вычислительных требований. Фактически, начиная с 1060 исходных длин волн, добавление полиномиальных признаков второй степени привело к такому общему количеству переменных, что задача оценки модели стала невыполнимой. Для решения этой проблемы в данной работе был предложен новый подход Random Polynomial Features (далее RPolyTransformer). Ключевая идея заключалась в реализации случайной выборки в пространстве нелинейных признаков. Это привело к существенным преимуществам, так как общее количество признаков можно контролировать, и оно может учитывать как полиномиальные признаки более высокой степени (), так и сложные математические функции (например, cosine, exp).
Эта стратегия сначала генерировала случайных арифметических выражений (примеры см. в таблице 2), которые затем используются для вычисления нелинейных признаков. Из новых и исходных признаков переменных выбираются с помощью SelectKBest из sklearn. Гиперпараметры и оптимизировались с помощью кросс-валидации в финальной модели (см. последнюю строку таблицы 3).
| Method | Accuracy |
| Region: FULL | |
| RPolyTransformer + Ridge Classifier | 0.717 |
| RPolyTransformer + LDA | 0.619 |
| SelectFromModel + RPolyTransformer + SelectKBest + LDA | 0.848 |
| Region: [925:1585, 1720:2989] | |
| RPolyTransformer + Ridge Classifier | 0.805 |
| RPolyTransformer + LDA | 0.847 |
| SelectFromModel + RPolyTransformer + SelectKBest + LDA | 0.843 |
| Region: [925:1585, 1720:2989, 3738:3807] | |
| RPolyTransformer + Ridge Classifier | 0.811 |
| RPolyTransformer + LDA | 0.833 |
| SelectFromModel + RPolyTransformer + SelectKBest + LDA | 0.835 |
| Optimized model | |
| Region: [925:1585, 1720:2989] | |
| RPolyTransformer() + SelectKBest() + LDA | 0.864 |
В таблице 3 представлены результаты, полученные с помощью этого метода, снова в сочетании с различными классификаторами и подходами к отбору признаков, протестированные на полных данных и на данных после удаления области воды. Сначала при объединении RpolyTransformer с классификатором наблюдалось значительное снижение точности по сравнению с простыми табличными моделями. Ridge был точнее, чем LDA, но все еще значительно отставал от предыдущих результатов. Однако при тщательной фильтрации признаков, либо автоматически с помощью SelectFromModel, либо вручную путем удаления областей воды, результаты заметно улучшились. В этих экспериментах LDA стабильно превосходит Ridge. По сравнению с методом PolynomialFeatures, предложенный здесь метод работает быстрее (несколько секунд против нескольких минут) и столь же точен. Однако первоначальные результаты без снижения уровня шума (т.е. отбора признаков) позволяют предположить, что эта стратегия более чувствительна к шуму в данных..
3.1.2 Модели глубокого обучения
При рассмотрении моделей глубокого обучения задача расширения пространства признаков и изучения их взаимодействий полностью возлагается на нейронную сеть, не требуя каких-либо этапов проектирования признаков. В свою очередь, глубокие нейронные сети требуют тщательного процесса проектирования, чтобы избежать переобучения и определить наилучшую архитектуру модели и модальность входных данных..
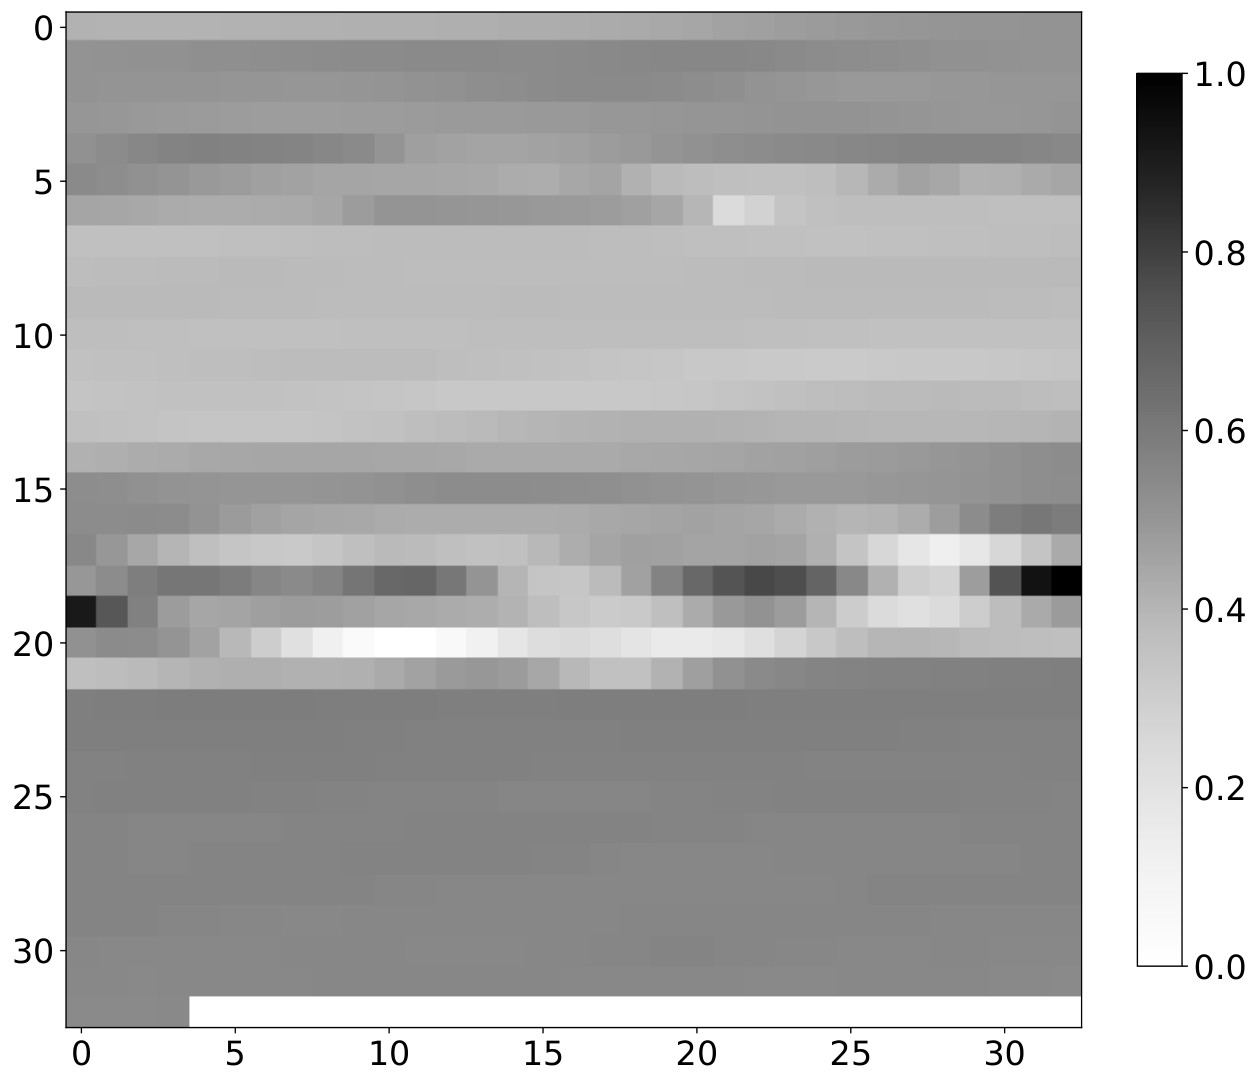
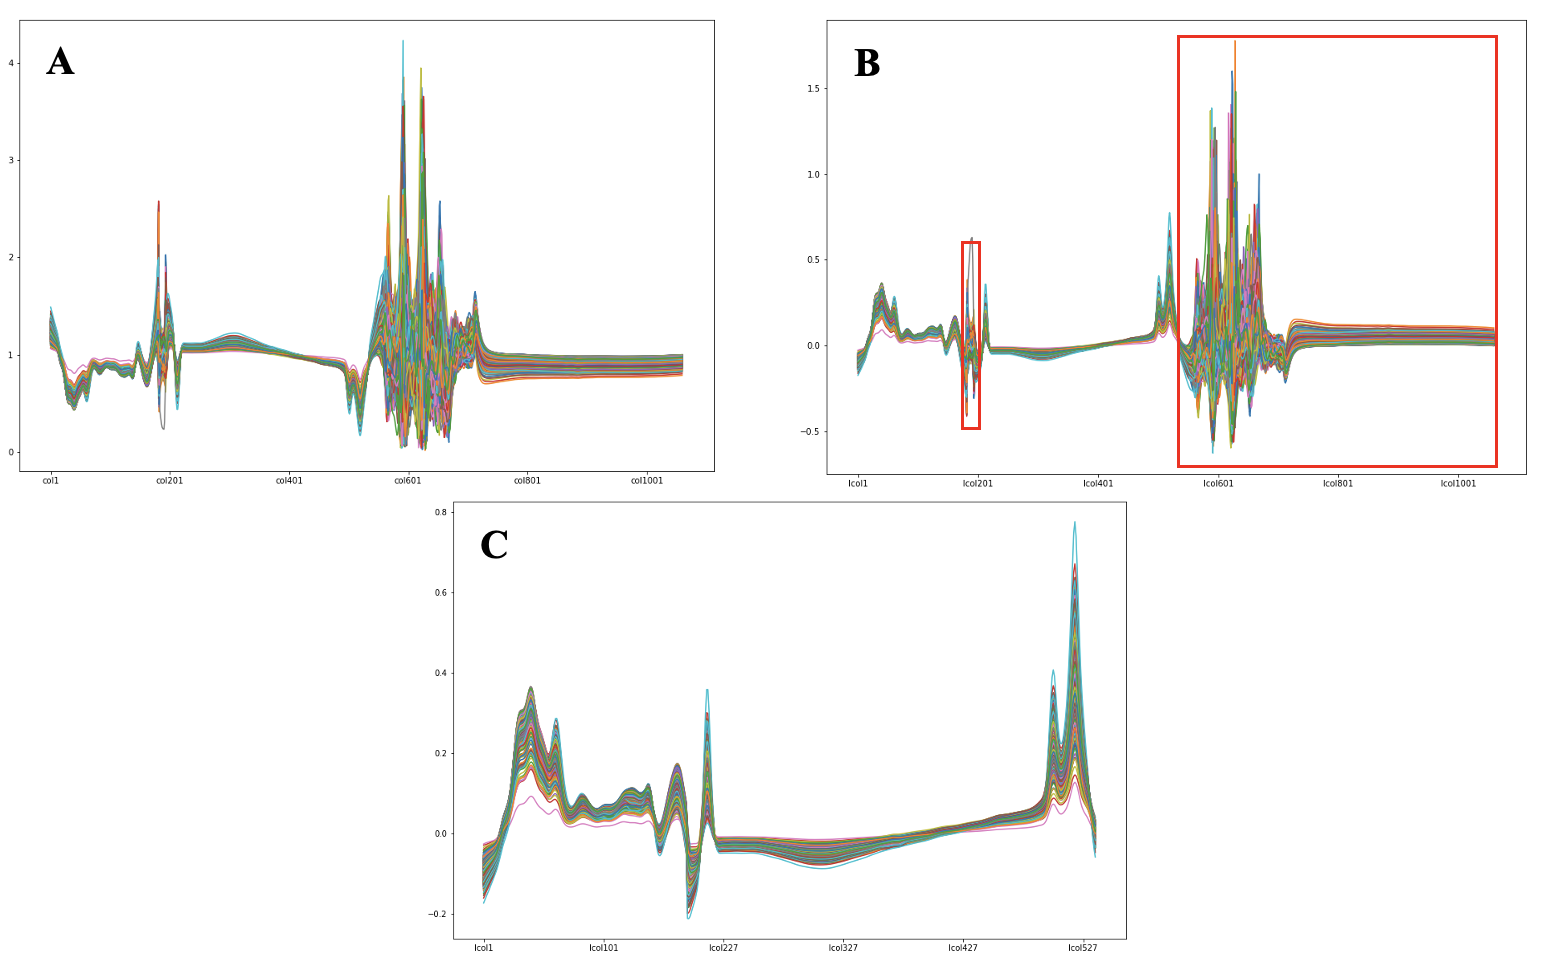
Рассматриваемые здесь архитектуры моделей можно разделить на две основные категории: полносвязные нейронные сети (FCNs) и сверточные нейронные сети (CNNs). FCNs не требуют какой-либо манипуляции или адаптации входных данных, поскольку каждая отдельная длина волны рассматривается как независимый признак и подается на входной узел. Напротив, CNNs требуют, чтобы данные были представлены в виде двумерных матриц, подобных изображениям, так как они обычно используются для решения задач классификации изображений. Для этого семейства сетей входные волны должны быть вертикально сгруппированы в виде 2D-массивов и, следовательно, для приведения к ближайшему квадратному размеру дополнены нулями в конце. Пример того, как спектроскопические последовательности могут быть представлены для CNNs, приведен на Рисунке 2. Кроме того, для данной задачи тестируется третья группа моделей, а именно CNNs на основе расширенных ядер (далее обозначаемые как CNN_DILATED). В то время как обычные CNNs извлекают признаки с помощью компактных квадратных фильтров или локальных рецептивных полей, сеть CNN_DILATED использует фильтры, которые пространственно расширены с фиксированным коэффициентом [Yu and Koltun,, 2015]. Расширенные ядра обычно используются в семантической сегментации изображений.
Все модели в этой группе были обучены как на полном наборе обучающих данных, так и на наборе с уменьшенным содержанием воды. При обучении моделей CNN полные данные преобразовывались в изображения размером 33x33 с дополнением 29 значений, в то время как уменьшенные данные преобразовывались в изображения размером 23x23 с дополнением 11 значений. Как уже упоминалось, все значения дополнения были нулевыми, и они добавлялись к исходным последовательностям..
Полная последовательность (33x33)
Области без воды (23x23)
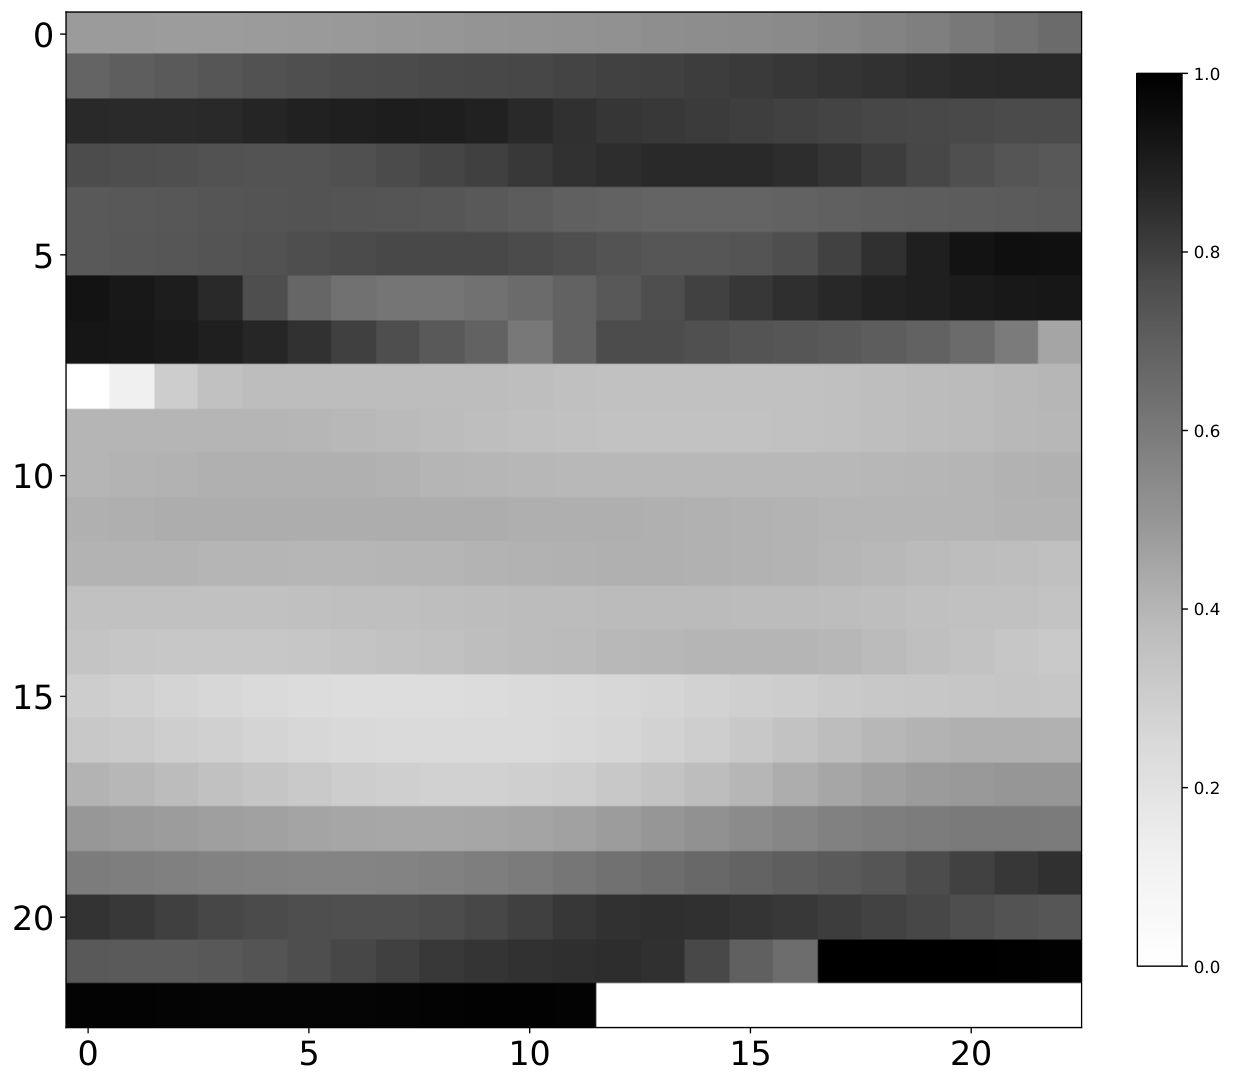
Полный список реализованных архитектур представлен в Таблице 11 в Приложении A.1. Эксперименты проводились на ранее описанных разбиениях для 3-кратной перекрестной проверки; обратите внимание, что для каждого разбиения 20% обучающих данных откладывались для целей валидации, чтобы определить гиперпараметры сети, такие как количество эпох обучения, начальная скорость обучения или коэффициенты регуляризации. Модели обучались в течение 50 000 эпох, при этом использовалась политика ранней остановки для отслеживания функции потерь на валидации с целью обнаружения переобучения и экономии времени на этапе обучения. Итоговая модель, использованная для классификации предоставленных неизвестных данных, была выбрана как архитектура с наилучшими общими показателями и обучена на полных обучающих данных в течение количества эпох, установленного как среднее значение эпох, достигнутых во время обучения 3CV..
Все модели были реализованы с использованием TensorFlow [Abadi et al.,, 2016] и обучены на рабочей станции, оснащенной одним графическим процессором модели Nvidia Titan XP. Результаты представлены в таблице 4, которая содержит показатели эффективности обучения, полученные в ходе экспериментальной кампании с 3-кратной перекрестной проверкой. Для всех протестированных архитектур исключение областей воды из входных волн привело к повышению производительности примерно на 12-13%. Модель FCN, работающая с данными после удаления областей воды, достигла наивысшей точности по всем 3 разбиениям, в среднем составив 84,7%. Аналогичные неопубликованные результаты были получены также при рассмотрении стратегии валидации с одним разбиением, что, кроме того, продемонстрировало, что сверточные модели имеют тенденцию довольно быстро переобучаться на входных данных..
| Model | Data | Split 1 | Split 2 | Split 3 | Average |
| FCN | FULL | 0.670 | 0.677 | 0.675 | 0.674 |
| NO WATER | 0.854 | 0.851 | 0.837 | 0.847 | |
| CNN | FULL | 0.686 | 0.684 | 0.670 | 0.680 |
| NO WATER | 0.806 | 0.836 | 0.832 | 0.824 | |
| CNN_DILATED | FULL | 0.678 | 0.684 | 0.652 | 0.671 |
| NO WATER | 0.824 | 0.812 | 0.807 | 0.814 |
3.2 Участник 2
Все этапы обработки и реализация алгоритма были выполнены с использованием MATLAB [MATLAB,, 2018]. После импорта набора данных в табличной форме выбросы были определены как наблюдения, имеющие более трех масштабированных медианных абсолютных отклонений от медианы набора данных. Классификация была выполнена с использованием набора алгоритмов, таких как Support Vector Machine (SVM), K-Nearest Neighbors (KNN) и Linear Discriminant Analysis (LDA). Настройка гиперпараметров и оценка точности классификации были выполнены посредством 5-кратной перекрестной проверки..
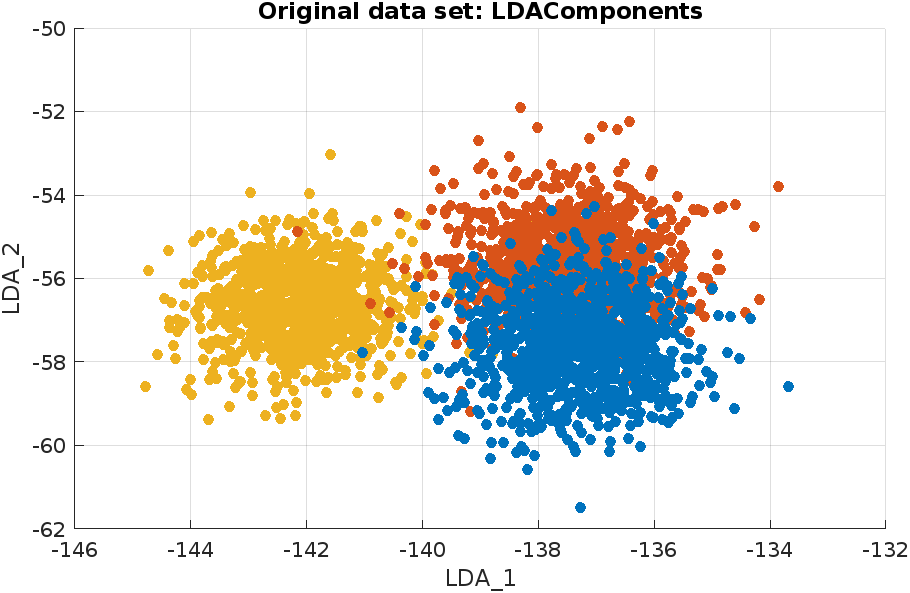
Наилучшие результаты были получены с использованием LDA, которая смогла отличить молоко коров на пастбищном вскармливании от TMR с точностью 95%, в то время как различение травы и клевера происходило с точностью 68%. Рисунок 3 позволяет визуализировать границы классов путем построения проекций спектров в латентном пространстве, охватываемом двумя дискриминантными функциями. На рисунке видна четкая граница между классами стойлового и пастбищного содержания, в то время как между классами GRS и CLV наблюдается значительное перекрытие. Следовательно, извлеченные компоненты затем рассматривались как входные данные для линейной модели SVM для улучшения классификации между классами пастбищного содержания. Комбинация двух классификаторов (LDA + SVM), представляющая собой двухэтапный подход, значительно улучшила общую точность классификации (87,1%), а также точность классификации между классами, как показано в Таблице 5.
| Predicted class | ||||
| CLV | GRS | TMR | ||
| CLV | 83.5% | 17.4% | 0.7% | |
| True class | GRS | 15.8% | 81.6% | 0.8% |
| TMR | 0.7% | 1.1% | 98.5% |
3.3 Участник 3
Настоящая работа была выполнена независимо тремя участниками группы после проведения общего предварительного анализа спектральных данных. Результаты прогнозирования на тестовой выборке, предоставленной для хемометрического конкурса, были затем сопоставлены для оценки согласованности между тремя различными примененными статистическими подходами..
3.3.1 Предварительная обработка спектральных данных
Данные правки были выполнены над сырыми спектральными данными как в обучающем, так и в тестовом наборах с использованием Python. Спектры, выраженные в коэффициенте пропускания, были преобразованы в оптическую плотность путем взятия обратной величины коэффициента пропускания. Впоследствии спектральные длины волн, связанные с поглощением воды, а также неинформативные области, были удалены. Это привело к получению уменьшенной версии набора данных, которая использовалась для последующих анализов, с 511 оставшимися длинами волн в областях от 2994 до 1682 см-1 и от 1578 до 926 см-1. Графическое представление этой процедуры приведено в дополнительном материале (Рисунок 9).
3.3.2 Первый подход
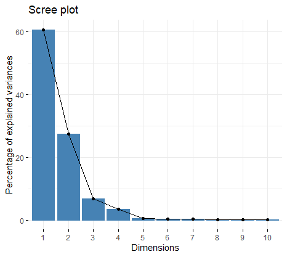
Для изучения многомерной структуры набора данных был применен метод главных компонент (PCA) на обучающем наборе данных с использованием функции prcomp в пакете stats и пакета factoextra [Kassambara and Mundt,, 2020] в среде R R Core Team, [2020]. Анализ показал, что большая часть изменчивости данных объясняется первыми двумя главными компонентами (PC), на которые в совокупности приходится общей дисперсии (см. график каменистой осыпи на верхней левой панели на Рисунке 4).
Затем возможные выбросы были обнаружены с использованием алгоритма, предложенного Filzmoser et al., [2008] и реализованного в пакете mvoutlier [Filzmoser and Gschwandtner,, 2021]; из обучающего набора данных были удалены только те наблюдения, которые являлись выбросами как по положению, так и по разбросу. В результате из обучающего набора данных было удалено в общей сложности 63 наблюдения.
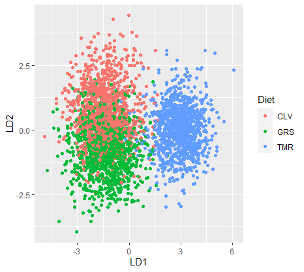
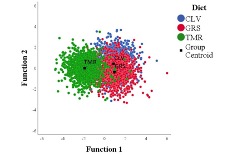
После удаления выбросов был рассмотрен линейный дискриминантный анализ с использованием функции lda в пакете MASS [Venables and Ripley,, 2002]. Для проверки его точности на первом этапе дискриминантные функции были применены к обучающему набору данных с целью сравнения предполагаемой классификации с фактической. Следовательно, LDA был сначала применен для максимизации различий между TMR и CLV+GRS (далее именуемой группой PAST). LDA вернул одну функцию линейного дискриминанта (LD), которая затем была применена к обучающему набору данных для отнесения рациона TMR к наблюдениям. После этого LDA был применен снова, причем в обучающем наборе оставались только наблюдения, принадлежащие группе PAST. Полученная функция LD затем применялась ко всему обучающему набору данных для разделения рационов CLV и GRS, ранее отнесенных к категории PAST. Вектор с предсказанными классами затем сравнивался с вектором фактической классификации групп в обучающем наборе данных, что позволило вычислить точность обучения. Этот подход привел к общей точности обучения модели, равной 83.3% (см. Таблицу 6); диаграмма рассеяния значений первого и второго линейных измерений представлена на верхней правой панели Рисунка 4. Наконец, функции LD, полученные на обучающем наборе данных, позволили классифицировать неизвестные наблюдения в тестовом наборе данных, результаты чего приведены в Таблице 6⟧.
| Member 1 | Member 2 | Member 3 | |
| Brief description | Two steps DA in R | Canonical DA with stepwise method in SAS | DA with stepwise methods in SPSS |
| Number of samples (training set) | 3180 | 3116 | 3153 |
| Number of wavelengths retained | 511 | 88 | 16 |
| Accuracy (training set) | 83.30% | 81.32% | 71% |
Предсказанный рацион для образцов в тестовом наборе данных (n случаев) TMR 344 326 365 CLV 367 342 326 GRS 366 353 386
Согласованность между подходами, примененными к тестовому набору данных Участник 1 Участник 2 84,21% Участник 3 72,90% 70,84%
3.3.3 Второй подход
Метод главных компонент (PROC PRINCOMP, SAS Institute Inc., ver. 9.4) был выполнен на обучающей выборке, как указано в Разделе 3.3.2. Последовательно, удаление выбросов было затем проведено путем расчета расстояния Махаланобиса (MD) как нескорректированной суммы квадратов первых четырех центрированных и масштабированных PC скоров, объясняющих до 98,21% общей спектральной дисперсии. Выбросы определялись как образцы, чье MD превышало 97,5-й процентиль распределения с 4 степенями свободы [Brereton,, 2015]. Следуя этому подходу, в общей сложности 127 образцов были исключены из обучающей выборки.
Дискриминантная модель была разработана с использованием многоэтапного подхода. Сначала был проведен пошаговый дискриминантный анализ с целью выявления наиболее значимых длин волн, связанных с тремя различными типами кормления, с использованием PROC STEPDISC. В общей сложности 88 длин волн были отобраны и использованы для последующего канонического дискриминантного анализа, который был выполнен посредством PROC DISCRIM. Доля правильно классифицированных образцов составила 73.38% (CLV), 73.70% (GRS) и 97.62% (TMR), при общей точности модели 81.32%. Диаграмма рассеяния значений первой и второй канонических переменных представлена на нижней левой панели Рисунка 4. Волновые числа с наибольшими (по абсолютному значению) коэффициентами канонической дискриминантной функции находились в диапазонах от 1,154 до 1,162 см-1, а также 2,843 см-1, 2,874 см-1 и 2,882 см-1, что обеспечивает получение потенциально релевантной информации для изучения с целью оценки того, какие химические характеристики молока в наибольшей степени зависят от режима питания. Затем дискриминантная модель была применена к тестовой выборке для получения прогноза рациона коров по неизвестным спектрам молока.
3.3.4 Третий подход
Стандартные допущения, необходимые для многомерного анализа, были проверены перед переходом к основному анализу. Для выявления выбросов среди предикторов и зависимых переменных использовались две диагностические меры; в первом случае для обнаружения многомерных выбросов применялось расстояние Махаланобиса (MD), в то время как во втором рассматривались студентизированные остатки. Образцы, у которых MD превышало 97,5-й процентиль распределения MD, а студентизированные остатки были больше 2,5, были удалены. В ходе этого процесса было идентифицировано и исключено в общей сложности 90 выбросов. Потенциальная мультиколлинеарность затем проверялась с помощью толерантности и факторов инфляции дисперсии. Кроме того, проверялось соотношение между количеством наблюдений и предикторов как показатель достаточности размера выборки; предлагается соотношение 20 наблюдений на каждую переменную-предиктор, причем размер наименьшей группы превышает количество независимых переменных [Meloun and Militkỳ,, 2011; Pituch and Stevens,, 2015].
Затем LDA был выбран в качестве основного дискриминативного подхода. Пошаговый метод с использованием лямбды Уилкса в качестве критерия был принят для снижения мультиколлинеарности и увеличения соотношения наблюдений и предикторов, что повысило адекватность размера выборки. Тест Бокса и логарифмические детерминанты рассматривались для проверки равенства ковариационных матриц. Каноническая корреляция и доля межгрупповой дисперсии, обусловленная каждой переменной, использовались в качестве мер размера эффекта [Pituch and Stevens,, 2015], в то время как производительность LDA оценивалась с помощью статистики, связанной с классификацией, и leave-one-out CV [Hahs-Vaughn,, 2016]. Команда Scoring Wizard в конечном итоге использовалась для применения дискриминантных функций (DF) к тестовому набору данных, а прогнозируемая вероятность рассчитывалась для оценки его производительности. Анализы выполнялись с помощью программного обеспечения SPSS [IBM Corp.,, 2017].
Стандартизированные канонические коэффициенты DF для переменных, выбранных с помощью DA, и показатели размера эффекта приведены в Таблице 12 в Дополнительных материалах. Более 90% общей разницы между группами приходилось на первый DF, причем значение Лямбда Уилкса (0.330) указывает на его высокую дискриминационную способность (p-значение < 0.001). Волновые числа 2,851 см-1 и 2,890 см-1 внесли наибольший вклад в разделение рационов коров. Второй DF объяснял лишь 6% общей дисперсии, оставаясь при этом статистически значимым (Лямбда Уилкса = 0.902; p-значение < 0.001). Центроиды (Таблица 13) и график оценок DF (нижняя правая панель на Рисунке 4) показали, что первый DF эффективно отделяет группу TMR от остальных (то есть CLV и GRS). С другой стороны, разделение групп по второму DF оказалось слабым; в частности, кластеры CLV и GRS не были четко разграничены. Процедура кросс-валидации показала общую точность модели на уровне 71% (см. Таблицу 6) с различной чувствительностью между группами: более 90% для образцов TMR и менее 65% для образцов CLV и GRS. Применение DF для прогнозирования рациона коров на тестовом наборе данных продемонстрировало аналогичную тенденцию с ожидаемой чувствительностью 64%, 63% и 87% для рационов CLV, GRS и TMR соответственно (Таблица 14⟧).
3.4 Участник 4
Использовался стандартный конвейер машинного обучения, состоящий из выбора признаков (т.е. длин волн) и классификации, при этом из исходного набора данных не удалялись выбросы. Методы снижения размерности, такие как метод главных компонент (PCA) и метод независимых компонент (ICA), а также расширенная мультипликативная коррекция рассеяния (EMSC) и подход к аугментации данных были протестированы для улучшения результатов классификации [Bjerrum et al.,, 2017]. EMSC представляет собой метод предварительной обработки, который устраняет мультипликативные эффекты, потенциально вызванные физическими явлениями, такими как рассеяние света, что обычно наблюдается в спектроскопии отражения, тем самым упрощая моделирование химических эффектов. С другой стороны, схема аугментации данных увеличивает набор данных в десять раз путем девятикратного добавления случайных вариаций смещения, умножения и наклона к каждому образцу..
Впоследствии был использован ряд различных классификаторов, которые ранее успешно применялись к данным инфракрасной спектроскопии. В частности, рассматривались следующие модели: K-nearest Neighbour [Balabin and Safieva,, 2011, K-NN;], Random Forest [Chen et al.,, 2021, RF;], Support Vector Classification [Ji-yong et al.,, 2013, SVC;], Multilayer-perceptron [Balabin and Safieva,, 2008, MLP;], Linear Discriminant Analysis [Khuwijitjaru et al.,, 2020, LDA;], Decision Tree Classification [Geronimo et al.,, 2019], Nu-Support Vector Classification [Terouzi et al.,, 2013, NuSVC;], AdaBoost Classification [Wu et al.,, 2017], Gradient Boosting Classification [Munera et al.,, 2021], Gaussian Naive Bayes [Bhati and Bhattacharya,, 2020] и Quadratic Discriminant Analysis [Oravec et al.,, 2019, QDA;]. Другие исследованные методы прогнозирования относились к группе методов deep Learning (DL), в частности к одномерным (1D) Convolutional Neural Network (CNN). 1D CNN использует шесть одномерных сверточных слоев, а также ряд слоев max pooling, batch normalization и dropout. За каждым слоем 1D CNN следует слой max-pooling и batch normalization. One-dimensional CNN применялась только к исходным спектрам с целью сохранения последовательности данных, что не требуется для PCA и ICA.
Перед проведением анализов набор данных был разделен на обучающую выборку (80% данных) для обучения различных моделей и валидационную выборку (оставшиеся 20% данных), используемую для оптимизации гиперпараметров и определения наилучшего метода для финального тестирования..
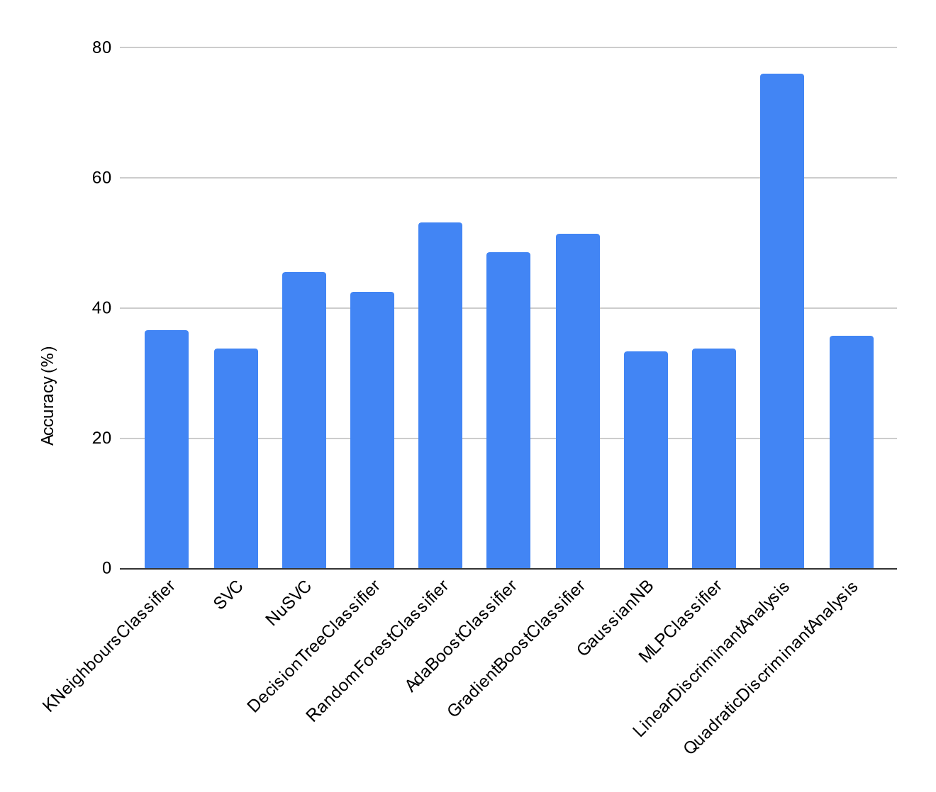
Первоначальный эксперимент был проведен на всех классификаторах без использования аугментации данных или отбора признаков. Это было выполнено для изучения того, какой метод классификации показывает лучшие результаты при работе с необработанными спектральными данными. На рисунке 5 представлены результаты, полученные на начальном этапе с использованием разбиения 80/20 для обучения/валидации для различных классификаторов. Все полученные результаты представляют собой средние значения, рассчитанные по трем прогнозам обучения и валидации для каждой модели. LDA показал наилучшие результаты с точностью 76%, в то время как MLP и SVC продемонстрировали одни из худших показателей с точностью около 33%.
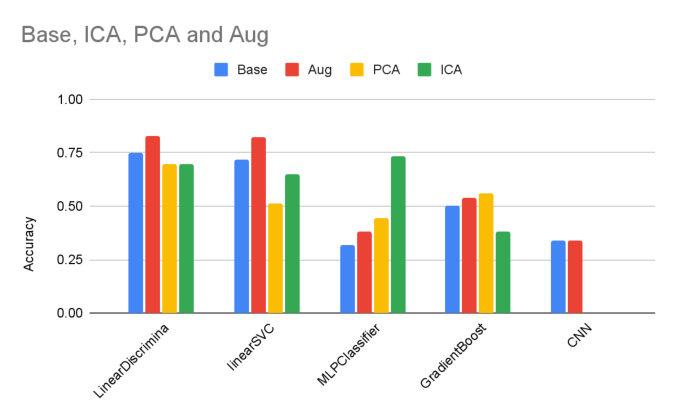
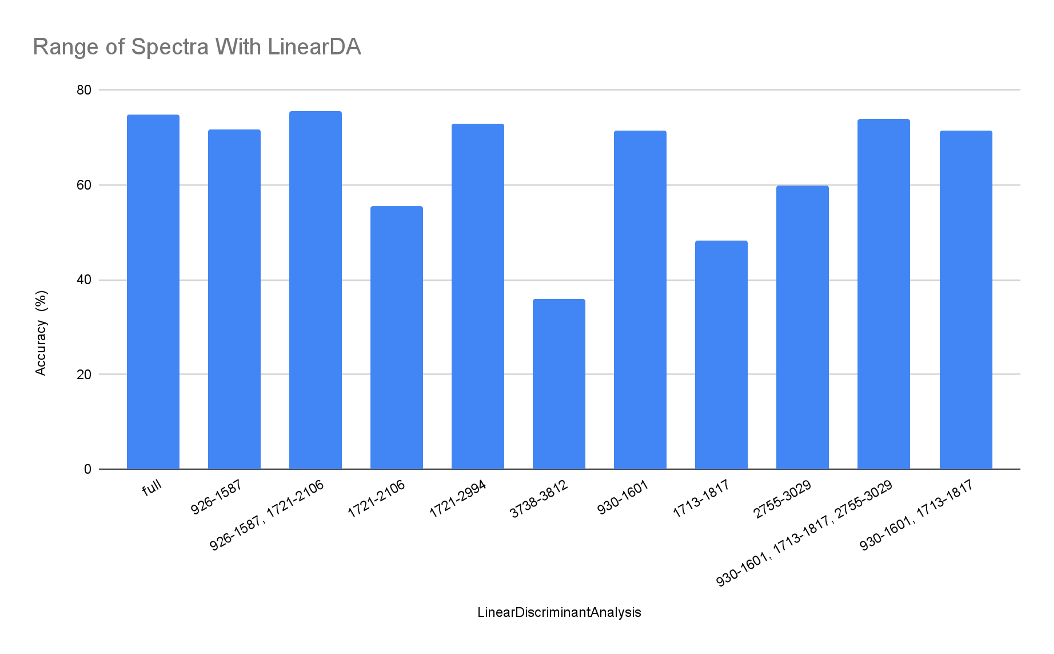
На втором этапе классификаторы тестировались в сочетании с PCA, ICA (использовались методы PCA и FastICA из scikit-learn [Pedregosa et al.,, 2011]) или аугментацией данных. Использование PCA и ICA изменяло данные путем уменьшения размерности, в то время как аугментация данных увеличивала количество образцов. Для аугментации данных использовалась функция data augment из Bjerrum et al., [2017]. Это увеличило количество обучающих образцов с 3 244 до 19 464. На данном этапе рассматривалось только подмножество ранее протестированных моделей, основываясь на их эффективности на предыдущем шаге. На рисунке 6 представлены результаты каждого классификатора с каждым методом предварительной обработки (базовый, ICA, PCA, аугментация данных (Aug)). Исходя из этих результатов, было отмечено, что LDA после аугментации данных достиг наивысшей точности в 82,7%. Наибольшее улучшение прогнозов наблюдалось при использовании MLP после ICA (улучшение на 41%). Затем был проведен дополнительный эксперимент только с использованием модели LDA. Это было сделано для того, чтобы показать важность областей внутри спектров, и было протестировано несколько различных диапазонов длин волн. Таким образом, на рисунке 7 показаны результаты LDA при удалении различных спектральных областей..
При использовании аугментации данных наблюдалось общее повышение точности по сравнению с базовым подходом, за единственным исключением в виде CNN. Что касается выбора длин волн, заметного увеличения точности при фокусировке на конкретной области спектра не наблюдалось. Тем не менее, большая часть релевантной информации находилась в диапазоне от 925 см-1 до 1597 см-1, и наблюдалось небольшое увеличение точности прогнозирования примерно на 1% при использовании диапазонов от 925 до 1585 см-1 и от 1717 до 2103 см-1 по сравнению с полным набором длин волн..
3.5 Участник 5
Для подготовки набора данных к прогностическому анализу была проведена предварительная обработка. Согласно указаниям организаторов конкурса, выбросы в спектрах были удалены, в результате чего набор данных составил 3243 спектра пропускания, охватывающих 1060 длин волн. Впоследствии спектры были преобразованы в значения поглощения путем взятия от величины, обратной значениям пропускания. Кроме того, следуя Frizzarin et al., 2021b [], подмножество из 534 длин волн, которые находились вне областей с высоким уровнем шума, связанных с водой, было определено как значимое для прогнозирования рациона коровы, хотя области, связанные с водой, на данном этапе анализа исключены не были..
Для обеспечения надежной оценки набор данных был разделен на обучающую и валидационную выборки. В данном случае валидационная выборка была сформирована для контроля влияния эффекта партии, который может искажать оценки при прогнозировании на новых данных [Soneson et al.,, 2014]. Анализ набора данных показал, что строки были упорядочены таким образом, что содержали несколько последовательных наблюдений для каждого рациона. Следовательно, было сделано допущение, что каждый набор последовательных наблюдений рациона относится к одной партии. Таким образом, было идентифицировано 90 партий, по 30 для каждого рациона. Кроме того, данные собирались в течение трех лет [Frizzarin et al., 2021b, ], поэтому было принято, что первые 30 партий были собраны в первый год исследования, следующие 30 — во второй год, а последние 30 — в третий. Исходя из этих допущений, валидационная выборка состояла из 996 спектров из 30 партий, собранных в третий год исследования, что включало десять партий для каждого рациона, в то время как модели обучались на оставшихся 2247 спектрах. Обучающие данные были случайным образом разделены на фолдов, при этом каждый фолд включал две партии для каждого рациона. Возможный эффект партии от повторных измерений для одной коровы не учитывался..
Для описания прогностической модели, используемой в данном анализе, пусть обозначает наблюдаемые данные, где зависимая переменная представляет рацион -й коровы, а ковариаты представляют соответствующий спектр поглощения молока. Заметим, что в данном анализе рассматриваются рационов, длин волн и обучающих наблюдений. Целью предлагаемых прогностических моделей является изучение , то есть вероятности того, что данный образец молока получен от коровы, питавшейся травой, клевером или TMR, при заданном спектре для этого образца..
Первым шагом при построении прогностической модели является определение детерминированной функции отображения для с , которая описывает процедуру извлечения признаков. Здесь были рассмотрены два подхода к извлечению признаков. Первый заключается в простом выборе релевантных длин волн, определенных с помощью Frizzarin et al., 2021b [], таким образом, что является -м спектром поглощения после удаления областей воды с высоким уровнем шума и стандартизации каждой длины волны. Второй подход основан на вейвлет-преобразовании — популярном методе обработки сигналов, который может применяться для сжатия данных, сглаживания и многомасштабного анализа [Nason,, 2008], и выполняется в три этапа. После установки значений областей с высоким уровнем шума каждого спектра на 0, пороговое вейвлет-преобразование предоставляет набор вейвлет-коэффициентов. Вектор признаков представляет собой вектор вейвлет-коэффициентов, которые являются ненулевыми по крайней мере для одного из спектров, в данном случае . Пороговое вейвлет-преобразование доступно в R-пакете wavethresh [Nason,, 2016] с использованием наименее симметричного вейвлета Добеши в качестве материнского вейвлета и байесовского подхода к пороговой обработке вейвлет-коэффициентов [Abramovich et al.,, 1998]. Обратите внимание, что установка длин волн в областях с высоким уровнем шума на 0 означает, что вейвлет-преобразование сохраняет спектральное расстояние между длинами волн, гарантируя при этом, что соответствующие вейвлет-коэффициенты равны 0.
Учитывая вектор признаков , была принята мультиномиальная регрессионная модель для рациона, такая что
| (1) |
для , где , неявно предполагая, что включает член пересечения. Пакет glmnet [Friedman et al.,, 2010] эффективно подгоняет эту модель под данные. Для простоты была подогнана модель LASSO, в которой 10-кратная перекрестная проверка на обучающих данных определяет гиперпараметр штрафа.
Наконец, прогностическая эффективность предложенных моделей была сравнена путем анализа их логарифмической функции потерь на валидационном наборе данных. То есть, для валидационного набора данных и модели для , логарифмическая функция потерь определяется как
| (2) |
где — количество наблюдений в валидационном наборе, — обычная индикаторная функция, которая равна 1, когда истинно, и 0 в противном случае, а — вероятность при того, что при условии . Логарифмическая функция потерь является надлежащим правилом оценки для анализа прогностических моделей [Gneiting and Raftery,, 2007], где меньшие значения являются лучшими, что стимулирует выражение истинного представления о данных. Также довольно просто установить ориентиры для оценки качества прогнозов априори. Например, для любого средняя логарифмическая функция потерь, равная 0, представляет собой идеальную прогностическую эффективность, в то время как, когда , как в рассматриваемом случае, средняя логарифмическая функция потерь, равная , представляет собой «угадывание», при котором мы прогнозируем каждую категорию равномерно случайным образом. Для полноты картины также была оценена точность классификации .
Результаты этого анализа представлены в Таблице 7. Первой рассмотренной моделью была мультиномиальная регрессия с LASSO-штрафом для спектров сырого молока в зависимости от рационов питания, в которой области спектра с высоким уровнем шума были исключены, а длины волн стандартизованы. Настраиваемый параметр , управляющий силой штрафа, был выбран путем минимизации мультиномиальной девианты (статистического показателя, пропорционального среднему значению log-loss) с помощью 10-кратной перекрестной проверки. Значение log-loss этой модели на обучающем наборе составляло 0,57, что соответствует точности классификации рациона в 77%. Более детальный анализ прогнозов показал, что при объединении CLV и GRS в одну категорию (кормление на пастбище) можно было прогнозировать TMR с точностью 94%. При попытке предсказать, получала ли корова корм CLV, при условии ее пастбищного содержания, была достигнута точность 72%. Прогностические характеристики на валидационном наборе оказались значительно хуже: общий показатель log-loss составил 0,82, что соответствует точности 58%. Модель прогнозировала TMR с точностью 88%. Однако для коров, которые, как известно, содержались на пастбище, она предсказывала CLV с точностью 49%.
Во второй модели рассматривалась мультиномиальная регрессия ненулевых пороговых коэффициентов вейвлет-преобразования спектров молока в зависимости от рационов. Как и выше, модель подгонялась путем максимизации пенализированного логарифмического правдоподобия с использованием 10-кратной перекрестной проверки для настройки . Для этой модели логарифмические потери на обучающем наборе были равны 0.74, что соответствует точности 69%, хотя она предсказывала TMR с точностью 88%. Для коров пастбищного содержания она предсказывала CLV с точностью 68%. Как и в случае с первой моделью, производительность снизилась для валидационного набора. Логарифмические потери составили 0.88, а точность TMR — 79%. Учитывая, что корова находилась на пастбищном содержании, точность CLV составила 47%. Эти результаты суммированы в Таблице 7.
Полученные результаты наглядно показали, что спектры молока содержат сигнал, позволяющий отличать коров на пастбищном вскармливании от TMR, однако различить CLV и GRS оказалось затруднительно. Тем не менее, прогностическая эффективность на валидационном наборе данных оказалась значительно хуже, чем на обучающем, что указывает на то, что принятые модели не обеспечивали надежных прогнозов вне выборки. Без тщательного учета потенциальных искажающих факторов батч-эффекта в исследованных спектрах мы, вероятно, переоценим производительность наших моделей вне выборки. Сбор данных от большего числа коров в течение более длительного периода времени должен решить эту проблему и позволить разработать более надежные модели.
Наконец, не было обнаружено никаких свидетельств того, что спектры после вейвлет-преобразования предоставили полезную информацию о рационе коров. Тем не менее, это не значит, что какое-то альтернативное разложение базиса не могло бы улучшить текущие предиктивные модели. Фактически, учитывая больше данных о взаимосвязи между спектрами молока и рационом, разработка моделей, допускающих нелинейные зависимости между длинами волн, может оказаться перспективным направлением для будущих исследований..
| Model | In-sample log-loss | Validation log-loss |
| Raw Spectra | 0.57 | 0.82 |
| Wavelet Coefficents | 0.74 | 0.88 |
3.6 Участник 6
В качестве первого шага обучающая выборка была центрирована и масштабирована, и та же трансформация была применена к тестовой выборке. В последующих анализах выбросы не удалялись, в то время как все спектры были преобразованы из коэффициента пропускания в оптическую плотность. Длины волн из спектральных областей с высоким уровнем шума между 1720 и 1592 см-1, между 3698 и 2996 см-1 и более 3818 см-1 были исключены из анализа в соответствии с Frizzarin et al., 2021b [].
Оценка Фишера, представляющая собой отношение межгрупповой дисперсии к внутригрупповой дисперсии рациона, была рассчитана для всех длин волн в обучающей выборке. Для длины волны оценка Фишера определяется как:
где обозначает индекс длины волны, обозначает спектры, причем является количеством спектров в обучающем наборе, обозначает группу рационов с , является индикатором спектров группы рационов , представляет собой среднее значение длины волны для всех спектров , представляет собой среднее значение длины волны в группе рационов . Длина волны с наибольшим критерием Фишера в каждой из отброшенных областей была сохранена в анализе. Длины волн с критерием Фишера ниже 0,002 были исключены из дальнейшего анализа, в результате чего осталось 380 длин волн. Для сравнения алгоритмов и выполнения дальнейшего отбора признаков обучающий набор был случайным образом разделен в соотношении 75/25 на обучающую и тестовую выборки с стратификацией по рациону. Генетический алгоритм [Holland,, 1992], реализованный в библиотеке genalg [Willighagen and Ballings,, 2022], использовался в качестве метода стохастического поиска для нахождения оптимального подмножества входных длин волн для классификации. Осуществлялось представление особей в популяции GA в виде бинарных строк, обозначающих длины волн, которые должны быть включены или исключены для прогнозирования. Целевая функция была задана как средняя точность по результатам десяти кросс-валидированных подгонок линейного дискриминантного анализа (LDA) обучающего подмножества. GA выполнялся в течение 200 итераций при размере популяции 200. На рисунке 8 показаны оптическая плотность спектров и соответствующие им значения критерия Фишера, причем точки обозначают длины волн, выбранные с помощью GA.
Наилучшая конфигурация из финальной популяции GA включала 70 длин волн. Эти длины волн использовались в качестве входных данных для следующих алгоритмов классификации:
- ⟦• Линейный дискриминантный анализ (LDA), библиотека MASS [Venables and Ripley,, 2002]⟧;
- • Дискриминантный анализ на основе частичных наименьших квадратов (PLS-DA) [Mevik et al.,, 2020];
- ⟦• Метод наименьшего абсолютного сужения и выбора [Tibshirani,, 1996, LASSO;], библиотека glmnet [Friedman et al.,, 2010]⟧;
- ⟦• Elastic net [Zou and Hastie,, 2005, EN;], библиотека glmnet;
- ⟦• Random Forest [Breiman,, 2001, RF;], библиотека ranger [Wright and Ziegler,, 2017]⟧;
- ⟦• Метод опорных векторов [Vapnik,, 1998], библиотека kernlab [Karatzoglou et al.,, 2004]⟧;
- • Байесовский классификатор на основе ядерной проекции [Domijan and Wilson,, 2011, BKPC], библиотека BKPC [Domijan,, 2018].
Все анализы были выполнены с использованием R [R Core Team,, 2020], код доступен в репозитории github https://github.com/domijan/KD_Vistamilk2022.
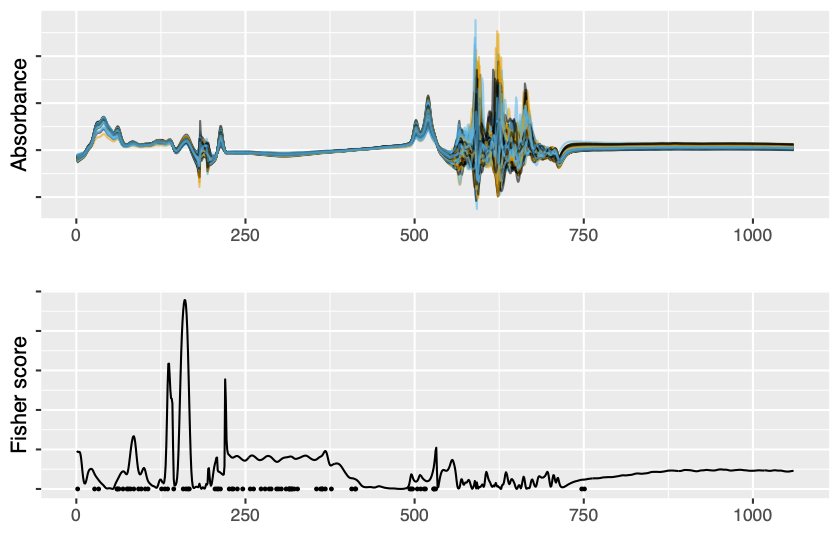
Обучающая выборка была случайным образом разделена на десять дополнительных обучающих/тестовых наборов равного размера, стратифицированных по рациону. Средняя точность и стандартное отклонение по десяти случайным разбиениям для всех алгоритмов классификации приведены в таблице 8. Наилучшие показатели продемонстрировал LDA со средней точностью 77,4%. Общая точность PLS-DA и EN составила 76,9% и 76,5% соответственно. Алгоритмы были настроены с использованием дополнительной кросс-валидации обучающих наборов. Для BKPC и SVM наилучшие результаты были получены с линейным ядром. Прогнозы LDA были представлены на конкурс. Более того, генетический алгоритм позволил отобрать значительно меньшее подмножество длин волн без потери эффективности классификации..
| Accuracy | LDA | PLS | EN | BKPC | SVM | LASSO | RF |
| Mean | 0.774 | 0.769 | 0.765 | 0.759 | 0.738 | 0.736 | 0.509 |
| SD | 0.008 | 0.009 | 0.007 | 0.008 | 0.007 | 0.006 | 0.014 |
4 Обсуждение
Хотя набор данных, предоставленный для соревнования по анализу данных, включал три различных класса для распознавания (т.е. TRM, GRS и CLV), основная сложность текущего соревнования заключалась в различении рационов GRS и CLV. Фактически, способность различать пастбищный рацион и рацион TMR уже задокументирована [Frizzarin et al., 2021b, ], причем разделение обусловлено главным образом различным содержанием жирных кислот (FA) в молоке [Agradi et al.,, 2020]. В частности, молоко при пастбищном рационе обычно богаче насыщенными FA, такими как линолевая кислота, беднее насыщенными FA и имеет более низкое соотношение омега-6 и омега-3 [Chilliard et al.,, 2007; Dewhurst et al.,, 2006; Ferlay et al.,, 2013; Ferlay et al.,, 2017, see e.g.]. Поскольку метод MIR способен предсказывать с определенной степенью точности различные FA в молоке [Soyeurt et al.,, 2011], спектральные данные, следовательно, также способны различать рационы TMR и пастбищный рацион.
С другой стороны, поскольку рационы питания GRS и CLV различались лишь включением 20% однолетнего клевера в травостой многолетнего райграса для рациона CLV, вызванные различия в FA могли быть менее выраженными. В результате для различения GRS и CLV с использованием исключительно спектральной информации потребовалась тщательная и точная настройка параметров моделирования. В связи с этим интересно отметить, что некоторые участники предложили двухэтапные подходы к классификации, причем первый этап был сосредоточен на рационах на основе TMR и пастбищных кормов, в то время как второй был направлен на отделение образцов CLV от GRS. Например, участник 2 указал на потенциально значительный прирост точности при использовании ансамблевого подхода, в котором компоненты, извлеченные из LDA, использовались для обучения линейного SVM, что позволило лучше различать GRS и CLV. Кроме того, в Разделе 3.3.2 были подогнаны две последовательные модели LDA, причем первая использовалась для разделения TMR и пастбища, а вторая, используя дискриминантную функцию только для образцов пастбища, была обучена классифицировать GRS и CLV.
Вообще говоря, линейные подходы обеспечивают повышение интерпретируемости результатов, но ценой снижения точности. Тем не менее, обзор различных подходов, представленных в данной статье, показал, что высокая производительность достигается за счет использования линейных классификаторов. Фактически, замечательные результаты были получены при применении подходов на основе LDA (см., например, участников 1, 2, 4 и 6), которые несомненно доказали свою эффективность в различении рационов TMR и пастбищного содержания и, как отмечалось выше, также использовались в качестве основы для перспективных двухэтапных процедур. Тем не менее, подходы, представленные в разделах 3.1.1 и 3.1.2, которые достигли наилучшей точности прогнозирования на тестовом наборе, как показано в Таблице 9, указали на необходимость учета нелинейностей, особенно когда целью является различие между GRS и CLV. Это подтверждается матрицей ошибок, приведенной в Таблице 10, где показано, что эти два различных режима кормления различаются весьма успешно, особенно если учитывать их сходство с точки зрения состава. Обратите внимание, что, хотя при использовании FCN интерпретация результатов и исследование наиболее информативных длин волн затруднены, подход в Разделе 3.1.1, в котором снова используется LDA в качестве финального классификатора, как правило, является более прозрачным. Тем не менее, предложенная хитрая генерация случайных полиномиальных переменных имеет тенденцию порождать новые признаки, которые трудно интерпретировать с химической точки зрения. Следовательно, как это часто бывает в современных процедурах анализа данных, применяемые подходы должны быть адаптированы под конкретную преследуемую цель, часто имея дело со стандартным компромиссом между точностью и интерпретируемостью.
Преобразование данных широко используется в анализе ближней инфракрасной области, поскольку анализируемые образцы, как правило, более зашумлены. В отличие от этого, образцы, анализируемые с помощью MIRS, обычно менее зашумлены, поэтому данные преобразования, за исключением преобразования длин волн из коэффициента пропускания в оптическую плотность, широко не применяются. В настоящем исследовании были протестированы некоторые преобразования данных, однако полученные результаты подтвердили, что они не оказывают существенного влияния на качество результатов прогнозирования. В отличие от преобразования данных, удаление спектральных областей, связанных с водой, имеет фундаментальное значение, о чем сообщили участники, которые тестировали свои методы прогнозирования до и после их удаления. Например, результаты из раздела 3.1 показали улучшение на 11,6% и 25,7% при использовании гребневой регрессии и LDA соответственно в сочетании с генерацией новых полиномиальных переменных после удаления областей воды. Кроме того, в разделе 3.1.2 показано улучшение эффективности прогнозирования от 17,5% (CNN) до 20,5% (FCN) после удаления областей воды, в том числе при использовании методов deep learning. Участник 1 также продемонстрировал возможность выбора важных переменных непосредственно из спектров; фактически, они достигли наилучших результатов прогнозирования, используя подход выбора переменных, исходя из всей спектральной информации (см. таблицу 1). Выбор переменных также был протестирован в разделе 3.6, где генетический алгоритм использовался для выбора меньшего подмножества длин волн без существенной потери эффективности классификации..
| Actual | ||||
| CLV | GRS | TMR | ||
| CLV | 312 | 55 | 5 | |
| Predicted | GRS | 61 | 300 | 5 |
| TMR | 6 | 7 | 326 |
В разделе 3.3 участники исследовали попарное согласие между тремя различными подходами, выполнив расчет путем сравнения наблюдений и количественной оценки процента классификаций, совпадающих от общего числа наблюдений (Таблица 6). Методы, примененные участниками 1 и 2, дали схожие прогнозы (согласие 84,21%), тогда как согласие между прогнозами участника 3 находилось в диапазоне от 70,84% (с участником 2) до 72,90% (с участником 1). Несмотря на высокую степень, расхождения между тремя прогнозами могут быть обусловлены: i) различным количеством образцов, оставленных для разработки модели, и ii) различным количеством предикторов (т.е. длин волн), использованных для обучения, учитывая, что первый участник использовал все отредактированные спектры, в то время как второй и третий применяли различные алгоритмы для выбора длин волн. Это исследование третьего участника позволяет понять, что различия в редактировании данных и различные методологии, выбранные для прогнозирования, даже при их схожести, привели к существенно различающимся прогнозам классов..
Заключительный пункт дискуссии касался создания тестового набора данных. Набор данных был создан организаторами, которые разделили исходный набор данных на 75% обучающей и 25% тестовой выборки, учитывая корректное распределение классов по годам между двумя наборами данных. Дискуссия вращалась вокруг того, стоит ли делить набор данных на 75% обучающей и 25% тестовой выборки или же разделять набор данных в соответствии с временными компонентами, например, сохраняя образцы, записанные в 2015 и 2016 годах, в обучающем наборе данных, а образцы, записанные в 2017 году, — в тестовом наборе данных. Такое временное разделение позволило бы понять, могут ли образцы, записанные в предыдущие годы, предсказывать будущую информацию..
5 Заключение
Благодаря большому количеству участников с различным опытом, предоставивших свои результаты прогнозирования, соревнование по анализу данных стало поводом для глубоких размышлений и обсуждения некоторых проблем, возникающих при анализе спектральных данных, а также предоставило ценные указания.
Как упоминалось в статье и как было ранее показано в Frizzarin et al., 2021b [], более выраженные различия в составе между рационом на основе пастбищного корма и рационом на основе полнорационной кормосмеси способствовали более легкой дискриминации между соответствующими классами. Это в целом привело к хорошим общим показателям точности для принятых методов (см. таблицу 9). С другой стороны, разграничение образцов молока, полученных от GRS и CLV, оказалось более сложной задачей. Тем не менее, как показано в таблице 10, некоторые специально предложенные для этого соревнования стратегии ручной разработки продемонстрировали более чем многообещающие результаты при использовании для выявления различий в составе между различными режимами пастбищного кормления. В частности, нелинейные преобразования исходных длин волн и двухэтапные подходы к классификации, описанные в разделах 3.1 и 3.3, оказались эффективными при решении этой проблемы..
Предварительная обработка, как правило, не приносила пользы для улучшения уравнений прогнозирования, в то время как удаление спектральных областей, связанных с водой (путем ручного выбора этих областей или с помощью процедур автоматического выбора переменных), улучшило результаты прогнозирования. Использование линейных моделей, в частности LDA, обеспечило одни из лучших результатов, а наилучшее общее прогнозирование было достигнуто с использованием LDA, примененного после выбора длин волн и генерации случайных полиномов, как это показано в таблице 9. При проведении спектрального анализа важно знать не только наилучшие статистические методы для использования в анализе, но и то, какая подготовка данных является оптимальной для таких данных..
Appendix A Дополнительные материалы
A.1 Архитектура глубокой нейронной сети
| Model Architecture | Parameters | Input Data and Shape | ||||||||||||
|
1,785,923 |
| ||||||||||||
|
55,332,419 |
| ||||||||||||
|
41,176,643 |
|
A.2 Участник 3
| Wavenumber, cm-1 | Function | |
| 1 | 2 | |
| 1069 | 2.899 | 0.298 |
| 1130 | -3.790 | 0.416 |
| 1181 | -2.003 | 5.371 |
| 1269 | -7.321 | -2.495 |
| 1292 | 10.544 | -3.045 |
| 1377 | -5.860 | -0.482 |
| 1416 | -5.885 | 1.267 |
| 1439 | 12.710 | 1.112 |
| 1474 | -4.689 | 3.714 |
| 1539 | -3.816 | -2.385 |
| 1577 | 4.442 | 1.247 |
| 1752 | 11.958 | 6.035 |
| 2782 | -1.459 | 0.875 |
| 2851 | -15.686 | -13.612 |
| 2890 | 16.085 | 3.459 |
| 2932 | -4.166 | 0.916 |
| Eigenvalue | 1.732 | 0.109 |
| & of variance | 94.1% | 5.9% |
| Canonical correlation | 0.796 | 0.313 |
| Diet | Function | |
| 1 | 2 | |
| CLV | 0.872 | 0.403 |
| GRS | 0.954 | -0.400 |
| TMR | -1.895 | -0.012 |
| Diet | Predicted Group Membership | Total | ||||
| CLV | GRS | TMR | ||||
| Originala | Count | CLV | 629 | 363 | 83 | 1075 |
| GRS | 323 | 668 | 62 | 1053 | ||
| TMR | 39 | 44 | 942 | 1025 | ||
| % | CLV | 58.5 | 33.8 | 7.7 | 100.0 | |
| GRS | 30.7 | 63.4 | 5.9 | 100.0 | ||
| TMR | 3.8 | 4.3 | 91.9 | 100.0 | ||
| Cross-validatedb | Count | CLV | 620 | 369 | 86 | 1075 |
| GRS | 326 | 663 | 64 | 1053 | ||
| TMR | 39 | 47 | 939 | 1025 | ||
| % | CLV | 57.7 | 34.3 | 8.0 | 100.0 | |
| GRS | 31.0 | 63.0 | 6.1 | 100.0 | ||
| TMR | 3.8 | 4.6 | 91.6 | 100.0 | ||
Благодарности
Эта публикация стала результатом исследования, проведенного при финансовой поддержке Научного фонда Ирландии (SFI) и Департамента сельского хозяйства, продовольствия и морских ресурсов от имени правительства Ирландии в рамках гранта номер (16/RC/3835), Исследовательского центра SFI Insight в рамках гранта номер (SFI/12/RC/2289_P2) и исследовательского гранта для начинающих исследователей SFI «Инфракрасный спектральный анализ молока как недорогое решение для определения эффективных и прибыльных молочных коров» (18/SIRG/5562).
Декларация о конфликте интересов
Авторы заявляют об отсутствии известных конфликтов финансовых интересов или личных отношений, которые могли бы повлиять на работу, представленную в этой статье.
Список литературы
- ⟦Abadi et al., [2016] Абади, М., Агарвал, А., Бархэм, П., Бревдо, Э., Чен, З., Ситро, К., Коррадо, Г. С., Дэвис, А., Дин, Дж., Девин, М., Гемават, С., Гудфеллоу, И. Дж., Харп, А., Ирвинг, Г., Исард, М., Цзя, И., Юзефович, Р., Кайзер, Л., Кудлур, М., Левенберг, Дж., Мане, Д., Монга, Р., Мур, С., Мюррей, Д. Г., Ола, К., Шустер, М., Шленс, Дж., Штайнер, Б., Суцкевер, И., Талвар, К., Такер, П. А., Ванхуке, В., Васудеван, В., Вьегас, Ф. Б., Виньялс, О., Уорден, П., Ваттенберг, М., Вике, М., Ю, Ю., и Чжэн, Х. (2016). Tensorflow: Масштабируемое машинное обучение в гетерогенных распределенных системах. CoRR, abs/1603.04467.
- ⟦Abramovich et al., [1998] Abramovich, F., Sapatinas, T., and Silverman, B. W. (1998). Wavelet thresholding via a Bayesian approach. Journal of the Royal Statistical Society: Series B, 60(4):725–749.
- ⟦Agradi et al., [2020] Агради, С., Куроне, Г., Негрони, Д., Виго, Д., Бреккья, Г., Бронцо, В., Пансери, С., Кьеза, Л. М., Перич, Т., Данес, Д. и Менкетти, Л. (2020). Определение профиля жирных кислот в молочных продуктах от коров породы бурая швицкая и взаимосвязь с альпийской пастбищной системой ведения хозяйства. Animals, 10(7):1231.
- Balabin and Safieva, [2008] Balabin, R. M. and Safieva, R. Z. (2008). Gasoline classification by source and type based on near infrared (NIR) spectroscopy data. Fuel, 87(7):1096–1101.
- Balabin and Safieva, [2011] Балабин, Р. М. и Сафиева, Р. З. (2011). Классификация биодизеля по типу базового сырья (растительное масло) с использованием данных спектроскопии в ближней инфракрасной области. Analytica Chimica Acta, 689(2):190–197.
- ⟦Bhati and Bhattacharya, [2020] Bhati, I. and Bhattacharya, M. (2020). An IOT-based system for classification and identification of plastic waste using near infrared spectroscopy. In Proceedings of the 2nd International Conference on Communication, Devices and Computing, pages 697–703. Springer.
- Bjerrum et al., [2017] Bjerrum, E. J., Glahder, M., and Skov, T. (2017). Data augmentation of spectral data for convolutional neural network (CNN) based deep chemometrics. arXiv preprint arXiv:1710.01927.
- ⟦Bonfatti et al., [2011] Бонфатти, В., Ди Мартино, Г. и Карнье, П. (2011). Эффективность спектроскопии в среднем инфракрасном диапазоне для прогнозирования детального белкового состава и содержания генетических вариантов белков индивидуального молока коров симментальской породы. Журнал молочной науки, 94(12):5776–5785.
- ⟦Breiman, [2001] Брейман, Л. (2001). Случайные леса. Машинное обучение, 45(1):5–32.
- ⟦Brereton, [2015] Бреретон, Р. Г. (2015). Расстояние Махаланобиса и его связь с оценками главных компонент. Журнал хемометрики, 29(3):143–145.
- Chen et al., [2021] Чэнь, Г., Чжан, С., Ву, З., Су, Дж., и Цай, Г. (2021). Эффективный алгоритм классификации качества чая на основе спектроскопии в ближней инфракрасной области и случайного леса. Журнал пищевой инженерной обработки, 44(1):e13604.
- ⟦Chilliard et al., [2007] Шильяр, И., Глассер, Ф., Ферле, А., Бернар, Л., Руэль, Ж. и Доро, М. (2007). Рацион, рубцовая биогидрогенизация и пищевая ценность молочного жира коров и коз. Европейский журнал науки и технологии липидов, 109(8):828–855.
- ⟦Cozzolino, [2012] Cozzolino, D. (2012). Recent trends on the use of infrared spectroscopy to trace and authenticate natural and agricultural food products. Applied Spectroscopy Reviews, 47(7):518–530.
- De Marchi et al., [2014] De Marchi, M., Toffanin, V., Cassandro, M., and Penasa, M. (2014). Invited review: Mid-infrared spectroscopy as phenotyping tool for milk traits. Journal of Dairy Science, 97(3):1171–1186.
- ⟦Dempster et al., [2020] Dempster, A., Petitjean, F., and Webb, G. I. (2020). ROCKET: exceptionally fast and accurate time series classification using random convolutional kernels. Data Mining and Knowledge Discovery, 34(5):1454–1495.
- Dempster et al., [2021] Dempster, A., Schmidt, D. F., and Webb, G. I. (2021). Minirocket: A very fast (almost) deterministic transform for time series classification. In Proceedings of the 27th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, page 248–257. Association for Computing Machinery.
- Dewhurst et al., [2006] Dewhurst, R., Shingfield, K., Lee, M., , and Scollan, N. (2006). Increasing the concentrations of beneficial polyunsaturated fatty acids in milk produced by dairy cows in high-forage systems. Animal Feed Science and Technology, 131(3-4):168–206.
- ⟦Domijan, [2018] Домиян, К. (2018). BKPC: Байесовский классификатор проекции ядра. Версия пакета R 1.0.1.
- ⟦Domijan and Wilson, [2011] Домиян, К. и Уилсон, С. П. (2011). Байесовские ядерные проекции для классификации высокоразмерных данных. Статистика и вычисления, 21(2):203–216.
- ⟦Ferlay et al., [2013] Ferlay, A., B, G., and Y, C. (2013). Управление содержанием жирных кислот и витаминных соединений в коровьем молоке с помощью питания. INRAE Productions Animales, 26(2):177––192.
- ⟦Ferlay et al., [2017] Ferlay, A., Bernard, L., Meynadier, A., and Malpuech-Brugère, C. (2017). Производство транс- и конъюгированных жирных кислот у молочных жвачных животных и их предполагаемое воздействие на здоровье человека: Обзор. Biochimie, 141:107–120.
- ⟦Ferragina et al., [2013] Феррагина, А., Чиполат-Готет, К., Чеккинато, А., и Биттанте, Г. (2013). Использование инфракрасной спектроскопии с преобразованием Фурье для прогнозирования выхода сыра и показателей извлечения питательных веществ или потерь сыворотки из необработанных проб коровьего молока. Журнал молочной науки, 96(12):7980–7990.
- ⟦Filzmoser and Gschwandtner, [2021] Филцмозер, П. и Гшвандтнер, М. (2021). mvoutlier: Многомерное обнаружение выбросов на основе робастных методов. Версия пакета R 2.1.1.
- ⟦Filzmoser et al., [2008] Филцмозер, П., Маронна, Р., и Вернер, М. (2008). Идентификация выбросов в пространствах высокой размерности. Computational Statistics & Data Analysis, 52(3):1694–1711.
- ⟦Fleming et al., [2017] Флеминг, А., Шенкель, Ф., Чен, Дж., Малькьоди, Ф., Бонфатти, В., Али, Р., Маллард, Б., Корредиг, М., и Мильо, Ф. (2017). Прогнозирование содержания жирных кислот в молоке с помощью средневолновой инфракрасной спектроскопии у канадского молочного скота с использованием наборов для разработки моделей с различным распределением. Journal of Dairy Science, 100(6):5073–5081.
- ⟦Friedman et al., [2010] Фридман, Дж., Хасти, Т. и Тибширани, Р. (2010). Пути регуляризации для обобщенных линейных моделей посредством покоординатного спуска. Журнал статистического программного обеспечения, 33(1):1.
- ⟦[27] Фриззарин, М., Бевилакуа, А., Дариял, Б., Домиян, К., Ферраччоли, Ф., Хейс, Э., Ифрим, Г., Конколевска, А., Нгуен, Т. Л., Мбака, У., Ранзато, Г., Сингх, А., Стефануччи, М., и Каса, А. (2021a). Среднеинфракрасная спектроскопия и показатели качества молока: конкурс по анализу данных на международном семинаре по спектроскопии и хемометрике 2021”. Chemometrics and Intelligent Laboratory Systems.
- ⟦[28] Фриззарин, М., О’Каллаган, Т., Мерфи, Т., Хеннесси, Д., и Каса, А. (2021b). Применение методов machine-learning к спектрам среднего инфракрасного диапазона молока для различения коровьего молока, полученного при пастбищном содержании или при кормлении полнорационной кормосмесью. Journal of Dairy Science, 104(12):12394–12402.
- ⟦Geronimo et al., [2019] Джеронимо, Б. К., Мастелини, С. М., Карвальо, Р. Х., Джуниор, С. Б., Барбин, Д. Ф., Шимокомаки, М., и Ида, Е. И. (2019). Система компьютерного зрения и ближняя инфракрасная спектроскопия для идентификации и классификации куриного мяса с дефектом «деревянная грудка», а также физико-химическая и технологическая характеристика. Infrared Physics & Technology, 96:303–310.
- ⟦Gneiting and Raftery, [2007] Гнейтинг, Т. и Рафтери, А. Э. (2007). Строго правильные правила оценки, прогнозирование и оценивание. Журнал Американской статистической ассоциации, 102(477):359–378.
- ⟦Hahs-Vaughn, [2016] Хас-Вон, Д. Л. (2016). Прикладные многомерные статистические концепции. Рутледж.
- ⟦Ho et al., [2019] Хо, П., Бонфатти, В., Люк, Т., и Прайс, Дж. (2019). Классификация фертильности молочных коров с использованием спектроскопии молока в средней инфракрасной области. Журнал молочной науки, 102(11):10460–10470.
- ⟦Holland, [1992] Холланд, Дж. Г. (1992). Адаптация в естественных и искусственных системах: вводный анализ с приложениями к биологии, управлению и искусственному интеллекту. Издательство Массачусетского технологического института.
- ⟦IBM Corp., [2017] Корпорация Ай-Би-Эм (2017). Ай-Би-Эм Эс-Пи-Эс-Эс Статистикс для Виндоус, Версия 25.0. Фонд Р для статистических вычислений, Армонк, штат Нью-Йорк.
- Ji-yong et al., [2013] Ji-yong, S., Xiao-bo, Z., Xiao-wei, H., Jie-wen, Z., Yanxiao, L., Limin, H., and Jianchun, Z. (2013). Быстрое определение общего содержания кислоты и классификация различных типов уксуса на основе спектроскопии ближнего инфракрасного диапазона и метода опорных векторов наименьших квадратов. Food Chemistry, 138(1):192–199.
- ⟦Karatzoglou et al., [2004] Каратзоглу, А., Смола, А., Хорник, К., и Зейлейс, А. (2004). kernlab – S4 пакет для ядерных методов в R. Journal of Statistical Software, 11(9):1–20.
- ⟦Kassambara and Mundt, [2020] Кассамбара, А. и Мундт, Ф. (2020). factoextra: Извлечение и визуализация результатов многомерного анализа данных. Версия пакета R 1.0.7.
- ⟦Khuwijitjaru et al., [2020] Хувиджитджару, П., Буньяписомпарн, К., и Хак, К. (2020). Ближняя инфракрасная спектроскопия с линейным дискриминантным анализом для сортировки зеленых зерен кофе «робуста». Международный журнал исследований пищевых продуктов, 27(2):287–294.
- ⟦MATLAB, [2018] MATLAB (2018). версия 9.4 (R2018a). The MathWorks Inc., Натик, Массачусетс.
- ⟦McDermott et al., [2016] Макдермотт, А., Висентин, Г., Де Марки, М., Берри, Д., Фенелон, М., О’Коннор, П., Кенни, О., и Макпарланд, С. (2016). Прогнозирование содержания отдельных молочных белков, включая свободные аминокислоты, в коровьем молоке с использованием спектроскопии в средней инфракрасной области и их корреляции с технологическими характеристиками молока. Journal of Dairy Science, 99(4):3171–3182.
- ⟦McParland et al., [2014] McParland, S., Lewis, E., Kennedy, E., Moore, S., McCarthy, B., O’Donovan, M., Butler, S. T., Pryce, J., and Berry, D. (2014). Mid-infrared spectrometry of milk as a predictor of energy intake and efficiency in lactating dairy cows. Journal of Dairy Science, 97(9):5863–5871.
- ⟦Meloun and Militkỳ, [2011] Meloun, M. and Militkỳ, J. (2011). Statistical data analysis: A practical guide. Woodhead Publishing Limited.
- ⟦Mevik et al., [2020] Mevik, B.-H., Wehrens, R., and Liland, K. H. (2020). pls: Partial Least Squares and Principal Component Regression. R package version 2.7-3.
- ⟦Middlehurst and Bagnall, [2022] Middlehurst, M. and Bagnall, A. (2022). The freshprince: A simple transformation based pipeline time series classifier. CoRR, abs/2201.12048.
- Munera et al., [2021] Мунера, С., Гомес-Санчис, Х., Алеишос, Н., Вила-Франсес, Х., Колелли, Г., Куберо, С., Солер, Е., и Бласко, Х. (2021). Дискриминация распространенных дефектов плодов мушмулы сорта «Алжирская» с использованием гиперспектральной визуализации и методов machine learning. Постхарвест Биолоджи энд Технолоджи, 171:111356.
- ⟦Nason, [2016] Нейсон, Г. (2016). wavethresh: Вейвлетная статистика и преобразования. Пакет R версии 4.6.8.
- ⟦Nason, [2008] Насон, Г. П. (2008). Вейвлет-методы в статистике с использованием R. Шпрингер.
- ⟦Nguyen and Ifrim, [2021] Нгуен, Т. Л. и Ифрим, Г. (2021). Mrsqm: Быстрая классификация временных рядов с использованием символьных представлений. arXiv preprint arXiv:2109.01036.
- ⟦Nguyen and Ifrim, [2022] Нгуен, Т. Л. и Ифрим, Г. (2022). Краткое руководство по классификации временных рядов и их интерпретации с помощью mrsqm. Software Impacts, 11:100197.
- Oravec et al., [2019] Оравец, М., Беганович, А., Гал, Л., Чеппан, М., и Хак, К. В. (2019). Судебная классификация черных струйных отпечатков с использованием спектроскопии в ближней инфракрасной области с преобразованием Фурье и линейного дискриминантного анализа. Международная судебная медицина, 299:128–134.
- ⟦O’Callaghan et al., [2016] O’Callaghan, T. F., Hennessy, D., McAuliffe, S., Kilcawley, K. N., O’Donovan, M., Dillon, P., Ross, R. P., and Stanton, C. (2016). Effect of pasture versus indoor feeding systems on raw milk composition and quality over an entire lactation. Journal of Dairy Science, 99(12):9424–9440.
- ⟦Pedregosa et al., [2011] Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., et al. (2011). Scikit-learn: Machine learning in python. Journal of Machine Learning Research, 12:2825–2830.
- ⟦Pituch and Stevens, [2015] Питуч, К. А. и Стивенс, Дж. П. (2015). Прикладная многомерная статистика для социальных наук: Анализ с помощью SAS и IBM SPSS. Рутледж.
- ⟦R Core Team, [2020] R Core Team (2020). R: Язык и среда для статистических вычислений. R Foundation for Statistical Computing, Вена, Австрия.
- ⟦Shetty et al., [2017] Шетти, Н., Диффорд, Г., Лассен, Й., Лёвендаль, П., и Буйтенхёйс, А. (2017). Прогнозирование выбросов метана у лактирующих коров датской голштинской породы с использованием фурье-спектроскопии в среднем инфракрасном диапазоне молока. Журнал молочной науки, 100(11):9052–9060.
- ⟦Soneson et al., [2014] Сонесон, К., Герстер, С., и Делоренци, М. (2014). Смешение эффектов партии приводит к сильному смещению в оценках производительности, полученных с помощью перекрестной проверки. PloS one, 9(6):e100335.
- Soyeurt et al., [2006] Soyeurt, H., Dardenne, P., Dehareng, F., Lognay, G., Veselko, D., Marlier, M., Bertozzi, C., Mayeres, P., and Gengler, N. (2006). Estimating fatty acid content in cow milk using mid-infrared spectrometry. Journal of Dairy Science, 89(9):3690–3695.
- Soyeurt et al., [2011] Soyeurt, H., Dehareng, F., Gengler, N., McParland, S., Wall, E., Berry, D., Coffey, M., and Dardenne, P. (2011). Mid-infrared prediction of bovine milk fatty acids across multiple breeds, production systems, and countries. Journal of Dairy Science, 94(4):1657–1667.
- ⟦Terouzi et al., [2013] Terouzi, W., Platikanov, S., de Juan Capdevila, A. and Oussama, A. (2013). Classification of olives from moroccan regions by using direct ft-ir analysis: Application of support vector machines (svm). International Journal of Innovation and Applied Studies, 3(2):493–503.
- Tibshirani, [1996] Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B, 58(1):267–288.
- ⟦Tiplady et al., [2020] Типлади, К., Лопделл, Т., Литтлджон, М. и Гаррик, Д. (2020). Эволюционирующая роль спектроскопии в среднем инфракрасном диапазоне с преобразованием Фурье в генетическом улучшении молочного скота. Журнал животноводства и биотехнологий, 11(1):1–13.
- ⟦Vapnik, [1998] Вапник, В. Н. (1998). Теория статистического обучения. Уайли.
- ⟦Venables and Ripley, [2002] Venables, W. N. and Ripley, B. D. (2002). Modern Applied Statistics with S. Springer, New York, fourth edition. ISBN 0-387-95457-0.
- ⟦Visentin et al., [2015] Визентин, Г., Макдермотт, А., Макпарланд, С., Берри, Д., Кенни, О., Бродкорб, А., Фенелон, М., и Де Марки, М. (2015). Прогнозирование технологических свойств коровьего молока на основе анализа спектроскопии в среднем инфракрасном диапазоне у молочных коров. Журнал молочной науки, 98(9):6620–6629.
- ⟦Willighagen and Ballings, [2022] Уиллихаген, Э. и Баллингс, М. (2022). genalg: Генетический алгоритм на базе R. Версия пакета R 0.2.1.
- ⟦Wright and Ziegler, [2017] Райт, М. Н. и Циглер, А. (2017). ranger: Быстрая реализация random forests для многомерных данных на C++ и R. Journal of Statistical Software, 77(1):1–17.
- ⟦Wu et al., [2017] Wu, X., Fu, H., Tian, X., Wu, B., and Sun, J. (2017). Prediction of pork storage time using fourier transform near infrared spectroscopy and Adaboost-ULDA. Journal of Food Process Engineering, 40(6):e12566.
- ⟦Yu and Koltun, [2015] Ю, Ф. и Колтун, В. (2015). Агрегация контекста в нескольких масштабах с помощью расширенных сверток. arXiv preprint arXiv:1511.07122.
- ⟦Zou and Hastie, [2005] Зоу, Х. и Хасти, Т. (2005). Регуляризация и отбор переменных с помощью elastic net. Journal of the Royal Statistical Society: Series B, 67(2):301–320.