Оценка причинно-следственных эффектов, значимых для политики, при наличии интерференции с применением к налогу на напитки в Филадельфии
Аннотация
Для всесторонней оценки вмешательства в рамках публичной политики исследователям необходимо учитывать эффекты политики не только в реализующем ее регионе, но и в близлежащих, косвенно затронутых регионах. Например, было показано, что акцизный налог на подслащенные напитки в Филадельфии связан не только со снижением объемов продаж облагаемых налогом напитков в самой Филадельфии, но и с увеличением продаж в приграничных округах, на которые налог не распространяется. Последняя связь может объясняться поведением жителей Филадельфии, совершающих покупки через границу, и указывать на причинно-следственный эффект налога на близлежащие регионы, который может нивелировать общий эффект вмешательства. Чтобы оценить причинно-следственные эффекты в таких условиях, мы расширяем методологию difference-in-differences с учетом подобного interference между регионами и производим коррекцию на потенциальные confounding факторы, присутствующие в квазиэкспериментальных оценках. Наши doubly robust estimators для среднего эффекта лечения на traités и соседние контрольные группы ослабляют стандартные предположения об interference и спецификации моделей. Мы применяем эти методы для оценки изменения объемов продаж облагаемых налогом напитков в 231 магазине Филадельфии и приграничных округов в связи с введением налога на напитки в Филадельфии. Мы также используем наши методы для исследования heterogeneity эффектов в зависимости от географических особенностей.
Препринт
Ключевые слова Difference-in-Differences Doubly Robust Health Policy Spillover
1 Введение
В январе 2017 года город Филадельфия, штат Пенсильвания (ПА), ввел акцизный налог в размере 1,5 цента за унцию на напитки с добавлением сахара и искусственных подсластителей с целью получения доходов для образовательных инициатив, включая расширение программы подготовки к школе и программы общественных школ города (City of Philadelphia (2016)). Это решение также частично мотивировалось исследованиями, связавшими акцизные налоги со снижением потребления облагаемых налогом напитков (Brownell et al. (2009); Cabrera Escobar et al. (2013)). Разработчики городской политики надеялись сократить потребление таких напитков, учитывая данные, связывающие потребление подслащенных напитков с негативными последствиями для здоровья, такими как ожирение и сахарный диабет 2 типа (Hu (2013)). Несмотря на получение более чем миллионов долларов дохода в период с января 2017 года по июнь 2021 года (Rhynhart (2022)), в последнее время предпринимаются попытки отменить налог, мотивированные заявлениями о несоразмерном экономическом бремени и падении прибыли ритейлеров. С другой стороны, несколько исследований показали пользу налога на напитки в Филадельфии (PBT) в снижении продаж, что, предположительно, привело к сокращению потребления (Roberto et al. (2019); Lawman et al. (2020); Bleich et al. (2021); Edmondson et al. (2021); Petimar et al. (2022)).
Для оценки причинно-следственных эффектов государственной политики и акцизных сборов исследователи часто используют подход difference-in-differences (DiD), который оценивает эффект вмешательства путем вычисления разницы в динамике результатов между сопоставимыми регионами с исследуемым вмешательством и без него (Ashenfelter (1978); Ashenfelter and Card (1984)). В предыдущих исследованиях методы DiD применялись для сравнения Филадельфии (области воздействия) с Балтимором, штат Мэриленд (контрольной областью), в результате чего было обнаружено, что объем продаж подслащенных напитков на уровне города сократился на в Филадельфии в течение года после введения налога (Roberto et al. (2019)), причем имеются свидетельства устойчивого снижения через два года после введения налога (Petimar et al. (2022)⟧).
В основе казуальной интерпретации фреймворка DiD лежат строгие предположения об идентификации, включая ключевое, но непроверяемое предположение о контрфактических параллельных трендах, которое требует, чтобы средние исходы в группе воздействия развивались параллельно со средними исходами в контрольной группе, если бы вмешательство никогда не произошло (Heckman et al. (1997)). Предыдущие авторы разработали методы для ослабления этого предположения с целью оценки среднего эффекта воздействия на подвергнутых воздействию (ATT), требуя, чтобы контрфактические параллельные тренды выполнялись только после кондиционирования по наблюдаемым конфаундерам до вмешательства. Heckman et al. (1997) представили методы для коррекции конфаундинга с помощью моделирования регрессии исходов или сопоставления по склонности, требующие правильно специфицированных моделей исходов или склонности соответственно. Abadie (2005) использовали модель оценки склонности для разработки оценщика взвешивания обратной вероятностью воздействия (IPW). Недавние работы Li and Li (2019) и Sant’Anna and Zhao (2020) дополнительно ослабили предположения о спецификации моделей за счет разработки дважды робастных оценщиков для ATT, которые требуют лишь того, чтобы по крайней мере одна из моделей исходов или склонности была специфицирована верно.
Многие оценки политик сталкиваются с дополнительной сложностью, заключающейся в том, что индивиды могут избегать налогов и ограничений, перемещаясь в соседние регионы, где данная политика не действует. Свидетельства такого поведения широко распространены на практике для акцизов и налогов с продаж (Asplund et al. (2007)), законов об оружии (Raifman et al. (2020)), ограничений на марихуану (Hao and Cowan (2020)) и других мер. Оценки акцизов на подслащенные напитки в целом выявили наличие значительных трансграничных покупок за редким исключением (Andreyeva et al. (2022)). При изучении эффектов PBT авторы Roberto et al. (2019) и Petimar et al. (2022) использовали методы DiD для сравнения округов, граничащих с Филадельфией, с Балтимором и оценили, что от общего эффекта PBT на объем продаж нивелируется трансграничным шопингом. Такое поведение подпадает под категорию, называемую interference, и нарушает допущение об стабильности значений отклика для единицы наблюдения (SUTVA) из формулировки Рубина для фреймворка потенциальных исходов в causal inference (Rubin (1980)). Хотя в литературе это нарушение также синонимично называют spillover, нам кажется более интуитивным зарезервировать этот термин для ситуаций, когда в соседнем регионе наблюдается прямое распространение эффекта воздействия с интервенированного региона, например, когда мандат на вакцинацию обеспечивает дополнительный уровень защиты близлежащим регионам. И наоборот, желаемые эффекты политики в упомянутых выше исследованиях политик, вероятнее всего, снижаются из-за того, что индивиды пересекают региональные границы, чтобы обойти ограничения. Соответственно, здесь мы называем этот подмножество interference эффектом обхода (bypass effect).
Значительные достижения были сделаны в разработке методов идентификации и оценки прямых эффектов и эффектов перетока в контролируемых и обсервационных исследованиях, где предполагается наличие интерференции между индивидуумами определенной группы, но не между этими группами (Hudgens and Halloran (2008); Tchetgen and VanderWeele (2012); Liu et al. (2019); Papadogeorgou et al. (2019); Huber and Steinmayr (2021)). Однако в литературе крайне мало публикаций о методах DiD, которые специально нацелены на эффекты обхода при оценке политик, когда вмешательство вводится для всей группы в целом, а эффекты обхода возникают между группами. В рабочих документах авторов Clarke (2017) и Butts (2021) были определены целевые причинные эстиманды и предположения об идентификации для общих потенциальных исходов в условиях интерференции, однако они опираются на модель двунаправленных фиксированных эффектов (TWFE), которая налагает строгие параметрические предположения и предположения об однородности эффектов для идентификации несмещенного эффекта воздействия (de Chaisemartin and D’Haultfoeuille (2022)).
В этой работе мы разрабатываем гибкую методологию для надежной оценки причинно-следственных эффектов PBT как для Филадельфии, так и для ее соседних округов в условиях интерференции с одновременной коррекцией на смещение. Эта методология является дважды робастной в том смысле, что наши оценки являются состоятельными, если по крайней мере одна из моделей вероятности получения воздействия или моделей исходов, которые могут быть оценены непараметрически, специфицирована верно. Наш последующий анализ служит основой для исследователей, изучающих политику, подверженную эффектам обхода, а также предоставляет дополнительные доказательства влияния PBT на объем продаж в Филадельфии и ее соседних регионах.
Далее, в Разделе 2 представлены данные исследования PBT. В Разделе 3 мы представляем соответствующую нотацию, рассматриваем фреймворк потенциальных исходов в условиях интерференции, предлагаем модифицированное SUTVA и представляем doubly robust оценки для эффектов воздействия и обхода. В Разделе 4 мы проводим анализ PBT, чтобы получить новые выводы о комплексном причинном эффекте налога. Мы проводим имитационные исследования для сравнения характеристик на конечной выборке и эмпирической проверки свойств устойчивости различных DiD методов в реалистичных сценариях в Разделе 5. В заключение мы приводим обсуждение в Разделе 6.
2 Данные налога на напитки в Филадельфии
Данные о ценах на напитки и продажах были приобретены у исследовательской компании Information Resources Inc (IRI), которая получает данные от крупных американских ритейлеров, описанных в другом источнике (Muth et al. (2016)). Для нашего исследования мы использовали данные о розничных продажах, представленные за 4-недельные периоды для напитков, проданных с 1 января 2016 года по 31 декабря 2017 года в магазинах Филадельфии, других округов штата Пенсильвания и Балтимора. Балтимор был выбран в качестве города для сравнения из-за его демографического и географического сходства с Филадельфией и не подвергался прямому или косвенному влиянию акциза на напитки. Данные были предоставлены на уровне отдельных напитков на основе уникального универсального кода продукта и агрегированы на уровне магазинов. Категоризация магазинов и напитков, а также агрегирование цен и продаж проводились так, как описано в Roberto et al. (2019).
Для каждого магазина мы наблюдали записи о ценах и продажах в 26 временных точках (13 до и 13 после введения налога) для нескольких категорий напитков, облагаемых и не облагаемых налогом, объем продаж которых составил 14,3 миллиарда долларов и 19,9 миллиарда долларов соответственно. Мы также объединили классификации магазинов в две категории: одна охватывает супермаркеты, продуктовые магазины и магазины массовой торговли (SGMs), а другая предназначена для аптек, которые часто демонстрируют покупательское поведение потребителей, отличное от SGMs. Среди 558 магазинов в нашем исследовании 180 были магазинами Филадельфии (40 SGMs, 140 аптек), 318 были магазинами из других округов штата Пенсильвания (123 SGMs, 195 аптек) и 60 были магазинами Балтимора (15 SGMs, 45 аптек). Мы дополнительно связали социально-экономические и расовые данные переписного населения на уровне почтовых индексов за 2016 год с каждым из магазинов в нашем исследовании. Данные IRI не содержали пропущенных данных.
3 Методология DiD для оценки причинно-следственных эффектов в отношении подвергнутых воздействию и соседних контрольных регионов
Здесь мы разрабатываем дважды робастные оценки как для эффекта вмешательства в политику, так и для эффекта обхода. Чтобы представить наш предложенный подход, мы сначала вводим представление потенциальных исходов при наличии интерференции, называемое отображением экспозиции (Aronow and Samii (2017)), и определяем соответствующие оцениваемые параметры в рамках этого представления. Затем мы приводим условия, необходимые для идентификации этих параметров, и представляем наши предложенные DiD оценки..
3.1 Картирование воздействия для потенциальных исходов в условиях интерференции
Предположим, у нас есть совокупность единиц, , наблюдаемых в периоды до и после воздействия, . Для простоты мы сначала представим методологию в условиях одного наблюдения на период воздействия, то есть одной временной точки до и после введения налога, и, таким образом, единственное релевантное временное измерение охватывает различные периоды воздействия, которые мы называем -временем. Затем мы расширим этот метод до условий с множественными наблюдениями на период воздействия в разделе 3.5.
Для каждой единицы наблюдения мы фиксируем вектор базовых ковариат и бинарный индикатор группы воздействия . Далее, пусть представляет статус воздействия для единицы в периоде . Мы обозначаем векторы воздействия и статуса воздействия для всей совокупности как и . Наконец, мы обозначаем результат в каждом периоде для каждой единицы как .
Каждая единица имеет потенциальный результат в каждом периоде воздействия при каждом распределении воздействия в популяции, , что приводит к потенциальным результатам на единицу в период. Это число обычно сокращается до путем применения SUTVA, которое требует, чтобы потенциальный результат конкретной единицы не зависел от статуса воздействия других единиц, то есть . Однако наличие трансграничных покупок нарушает это допущение в наших условиях, поскольку магазины, по-видимому, имели бы разные объемы продаж в зависимости от налоговой политики соседних магазинов..
Чтобы решить эту проблему, Aronow and Samii (2017) ввели модифицированное SUTVA, которое сокращает количество потенциальных исходов, при этом учитывая наличие интерференции. Их концепция предполагает, что статус воздействия на популяцию может влиять на потенциальный исход единицы в момент времени только через собственный статус воздействия единицы в , и некоторую известную скалярную функцию . Эта функция, называемая отображением экспозиции, представляет уровень воздействия, полученный единицей не напрямую через собственный статус воздействия. Обозначив как статус экспозиции единицы в момент времени и используя это модифицированное SUTVA, мы можем записать потенциальные исходы для любого возможного вектора назначения воздействия как:
| (A1) |
В нашем исследовании мы предполагаем, что продажи магазина в момент времени зависят от налоговой политики только через собственный налоговый статус магазина и наличие поблизости магазина с иным налоговым статусом. В частности, мы предполагаем, что (A1) выполняется при:
| (2) |
Данное отображение воздействия сокращает количество потенциальных исходов для каждого магазина с до , при этом позволяя продажам подслащенных напитков в конкретном магазине зависеть от трансграничных покупок в соседние регионы или из них. В постналоговый период нашего исследования мы наблюдаем контрольный статус воздействия, , для Балтимора и других магазинов округа штата Пенсильвания, не граничащих с Филадельфией (не приграничные); статус воздействия для экспериментальной группы, , для магазинов Филадельфии; и статус воздействия для соседней контрольной группы, , для других магазинов округа штата Пенсильвания, граничащих с Филадельфией (приграничные).).
3.2 Релевантные для политики причинно-следственные оценки
Наша цель здесь — определить причинно-следственные оценки, представляющие два вопроса, значимых для политики. Сначала мы задаемся вопросом: какова была бы средняя разница между продажами подслащенных напитков в магазинах Филадельфии в 2017 году при наличии и отсутствии внедренного PBT? Этот вопрос соответствует ATT и может быть определен через потенциальные исходы как:
| (3) |
где мы опускаем индекс, специфичный для единицы наблюдения, , для удобства и определяем аналогично . Второе равенство справедливо в силу того, что ни одна из единиц наблюдения в нашем исследовании не имеет .
Мы дополнительно задаемся вопросом: какова была бы средняя разница между продажами подслащенных напитков для приграничных магазинов в 2017 году при наличии и при отсутствии внедренного PBT? Этот вопрос соответствует тому, что мы называем средним эффектом воздействия на соседние контрольные группы (ATN), и может быть определен через потенциальные исходы как:
| (4) |
3.3 Идентифицируемость в рамках подхода DiD
Поскольку мы не наблюдаем потенциальные исходы после налогообложения для единицы при всех возможных комбинациях , мы не можем напрямую идентифицировать ATT и ATN без дополнительных допущений. В рамках структуры DiD и предложенного нами отображения воздействия мы требуем выполнения вышеупомянутых допущений о контрфактических параллельных трендах между группами воздействия, подвергшимися и не подвергшимися вмешательству, для идентификации (3):
| (A2) |
а также между соседними контрольными группами и группами воздействия для идентификации 4):
| (A3) |
при этом, опираясь на допущения, обусловленные наблюдаемыми ковариатами, мы учитываем наблюдаемые факторы смещения, часто присутствующие в квазиэкспериментальных условиях. В нашем исследовании допущения о контрфактических параллельных трендах были бы нарушены, если бы, например, (i) более обеспеченные слои населения с меньшей вероятностью потребляли подслащенные напитки в период после введения налога, чем в период до его введения, независимо от налогового статуса, (ii) распределение благосостояния варьировалось бы по регионам, и (iii) было бы верно хотя бы одно из следующих утверждений: (a) мы не наблюдаем этот показатель благосостояния или (b) распределение благосостояния меняется между налоговыми периодами. В противном случае допущения по-прежнему оставались бы в силе.
В дополнение к A1, A2 и A3 мы также требуем выполнения допущений о согласованности и позитивности, которые соответственно гласят, что наблюдаемый результат равен потенциальному результату при наблюдаемом статусе воздействия и что все единицы исследования имеют ненулевую вероятность назначения на каждое из воздействий при заданных наблюдаемых ковариатах.
3.4 Оценщики DiD для ATT и ATN
Здесь мы расширяем существующие doubly robust оценщики для ATT в условиях SUTVA, чтобы оценить как ATT, так и ATN в рамках нашей модифицированной SUTVA с отображением бинарного воздействия, . Для этого мы обозначаем как бинарный индикатор, представляющий отнесение к группе интересующего воздействия для конкретной целевой оценки, а — как индикатор, представляющий статус этого соответствующего воздействия в момент времени . В частности, относится к группе лечения в сравнении ATT и соседней контрольной группе в сравнении ATN, тогда как относится к контрольной группе в обоих случаях. Мы сосредоточены на методах для продольных панельных данных, что соответствует нашему примеру данных. Тем не менее, эти методы могут быть легко адаптированы к условиям, когда данные до и после налогообложения собираются по разным популяциям, то есть к кросс-секционным данным (Sant’Anna and Zhao (2020)).
3.4.1 Двусторонняя фиксированная статистика
Мы начинаем с обзора часто применяемого подхода TWFE, который постулирует линейную модель исхода:
| (7) |
где может быть коррелирован внутри единицы . В условиях с двумя периодами воздействия, двумя группами воздействия и одним наблюдением на период воздействия было показано, что коэффициент эквивалентен классическому оценщику разности средних DiD (Bertrand et al. (2004)) и, таким образом, может оценивать ATT или ATN при безусловных аналогах (A2) и (A3), где математические ожидания не обусловлены ⟧.
Однако линейная аддитивная модель исхода ограничена строгими параметрическими допущениями. Кроме того, в многочисленных недавних работах упоминаются проблемы, связанные с ее неявным допущением об однородности эффекта воздействия (de Chaisemartin and D’Haultfoeuille (2022)). Мы приводим простой пример смещения, вызванного этим подходом при наличии изменяющихся во времени факторов смешения и неоднородных эффектов воздействия, в Приложении A⟧.
3.4.2 Оценщики регрессии исхода
В качестве альтернативы можно попытаться восстановить контрфактические тренды исходов для подвергшейся воздействию группы путем моделирования динамики исходов при контрольном воздействии. Здесь мы можем применить оценщик регрессии исходов (OR), впервые разработанный для ATT в Heckman et al. (1997), чтобы оценить ATT и ATN в наших условиях. Оценщик подставляет оценку для в:
| (8) |
где обозначает эмпирическое среднее по популяции подвергнутой воздействию группы. В отличие от (7), обычно оценивается с использованием только данных контрольной группы, чтобы избежать спецификации динамики эффекта воздействия, и может быть оценена с помощью более гибких моделей. Тем не менее, этот подход полностью опирается на корректную спецификацию модели, связывающей ковариаты со сложной динамикой исходов.
3.4.3 Оценщики взвешивания по обратной вероятности
Вместо моделирования динамики исходов можно использовать взвешенную оценку для балансировки смешивающих факторов между экспериментальной и контрольной группами. Здесь мы можем применить полупараметрическую оценку IPW для ATT с помощью Abadie (2005) для оценки ATT и ATN в наших условиях. Оценка опирается на показатель склонности, или вероятность назначения интересующего воздействия, . В случае панельных данных веса рассчитываются как:
| (9) |
и используются для оценки причинно-следственного эффекта после оценки как:
| (10) |
где эмпирическое среднее теперь берется по всей исследуемой совокупности, включающей как экспериментальную, так и контрольную группы. Несмотря на гибкость, подходы на основе IPW могут быть нестабильными в выборках конечного объема или в случаях отсутствия перекрытия, когда показатель склонности близок к единице для определенных единиц наблюдения..
3.4.4 Дважды робастные оценки
Вместо выбора между подходами OR и IPW, мы предлагаем применять основанные на функции влияния (IF) оценки DiD, разработанные для ATT Li and Li (2019) и Sant’Anna and Zhao (2020), для оценки как ATT, так и ATN при нашем бинарном отображении воздействия. Помимо свойств двойной робастности (DR), эти оценки также являются асимптотически нормальными и приближаются к полупараметрической границе эффективности, когда обе мешающие функции специфицированы верно. Для более глубокого технического обсуждения, а также доказательств свойств этих оценок, мы отсылаем читателя к Sant’Anna and Zhao (2020).
Дважды робастный (DR) плагин-оценщик затем включает оценки как для показателя склонности, так и для тренда исхода при отсутствии воздействия для оценки причинно-следственного эффекта с использованием:
| (11) |
где и определены так же, как и в предыдущих оценщиках. В отличие от подхода TWFE, подходы IPW, OR и DR могут легко включать непараметрическое оценивание этих мешающих функций с использованием машинного обучения.
3.5 Расширение для случая множественных наблюдений
До сих пор мы представляли методы для данных с одним наблюдением на период воздействия. Однако, как отмечалось ранее, наше исследование включает 13 различных временных точек как в периоды до, так и после введения налога. В этом разделе мы представляем простой, но надежный подход для распространения этих методов на случай множественных временных точек. Предлагаемый подход оказывается частным случаем общего подхода, предложенного Callaway and Sant’Anna (2021), когда отсутствует вариация во времени начала воздействия..
Пусть индексирует моменты времени в период после введения налога. Тогда мы будем называть временное измерение в рамках периода воздействия -временем. Обозначая наблюдения, специфичные для -времени, путем добавления подстрочного индекса к нашему предыдущему обозначению, мы можем определить специфичные для -времени эффекты как:
| (12) |
Затем мы можем усреднить эти -специфичные для времени эффекты, чтобы обобщить общий эффект:
| (13) |
В нашем исследовании наблюдения проводятся с интервалом в 4 недели и приходятся на одно и то же календарное время в периоды до (2016) и после (2017) введения налога. Таким образом, мы рассматриваем данные для каждой из этих пар как сравнение двух периодов воздействия с одним наблюдением на период, и поэтому требуем выполнения условий контрфактических параллельных трендов в каждый момент для идентификации (12) и, следовательно, (13) в качестве причинно-следственных эффектов. Наконец, мы определяем наши мешающие функции для каждого момента как и .
4 Анализ налога на напитки в Филадельфии
| Philadelphia | Baltimore | Border | Non-Border | |
| SGMs | (n=40) | (n=15) | (n=19) | (n=51) |
| Price (/ oz) | 5.85 (0.62) | 5.56 (0.47) | 5.41 (0.52) | 5.76 (0.81) |
| White () | 54.9 (29.5) | 42.2 (27.3) | 81.8 (15.2) | 89.2 (6.1) |
| Black () | 34.2 (31.3) | 52.8 (30.1) | 10.3 (15.5) | 5.1 (3.8) |
| Income () | 43.8 (12.4) | 51.2 (13.3) | 79.9 (19.4) | 81.3 (20.0) |
| House Value () | 173.3 (76.6) | 174.3 (57.5) | 318.4 (86.5) | 298.8 (91.8) |
| Mass Merchandiser () | 35.0 | 13.3 | 21.1 | 33.3 |
| Pharmacies | (n=140) | (n=45) | (n=32) | (n=78) |
| Price (/ oz) | 7.52 (0.58) | 6.85 (0.59) | 7.00 (0.58) | 7.55 (0.49) |
| White () | 48.1 (28.9) | 36.4 (24.7) | 69.1 (24.9) | 89.7 (5.5) |
| Black () | 40.1 (31.2) | 59.3 (26.9) | 23.5 (25.2) | 4.9 (3.4) |
| Income () | 43.6 (16.2) | 44.9 (15.5) | 73.2 (21.3) | 81.9 (18.5) |
| House Value () | 182.4 (103.3) | 174.9 (60.2) | 272.3 (104.9) | 308.8 (82.5) |
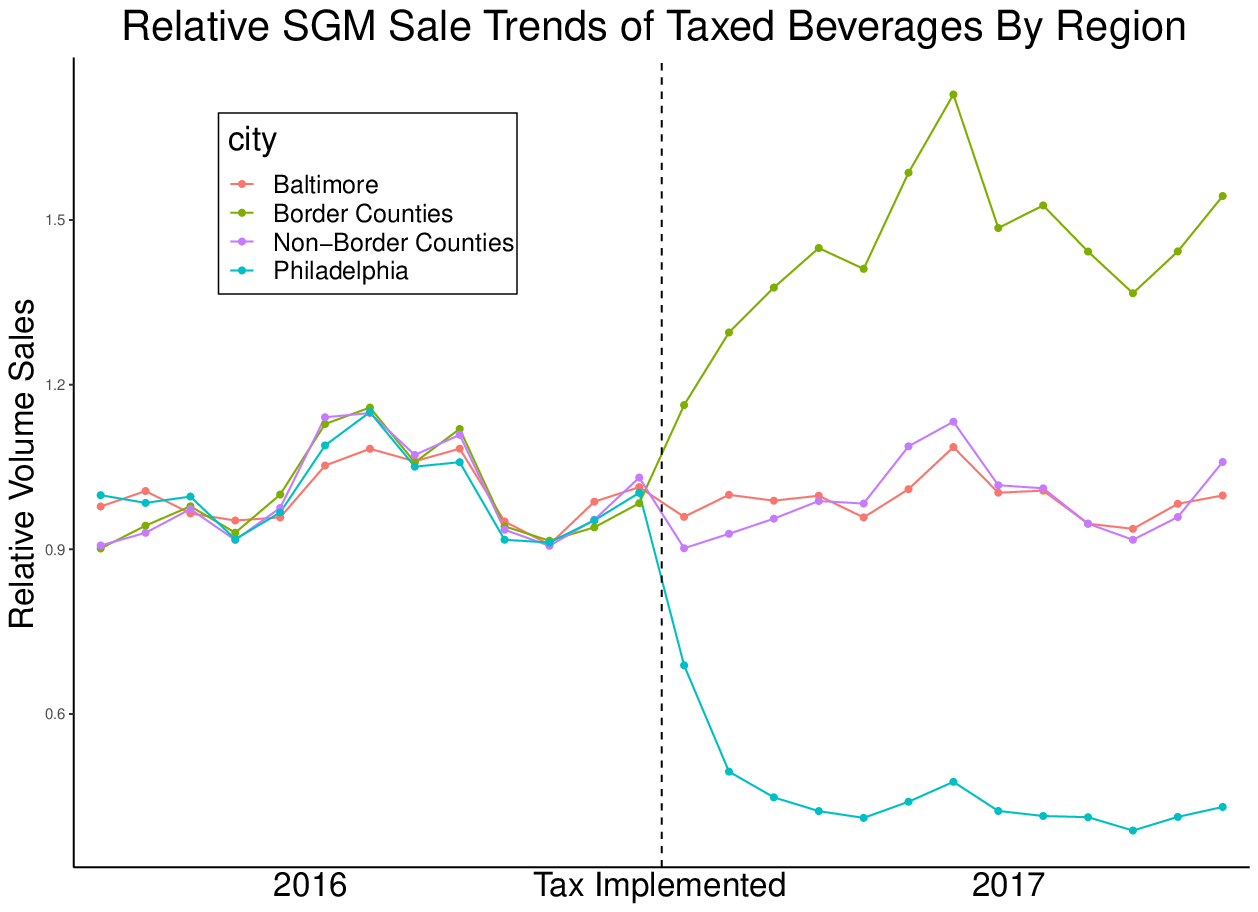
4.1 Описательные анализы
Мы начали с группировки магазинов по регионам (Филадельфия, Балтимор, приграничные, не приграничные) и типу (SGM, аптеки). Мы проанализировали SGM и аптеки отдельно из-за ожидаемых различий в динамике продаж, которые может быть трудно адекватно моделировать (Roberto et al. (2019)). Ковариаты до начала воздействия для нашего исследования обобщены в таблице 1. Примечательно, что ковариаты на региональном уровне схожи между Филадельфией и Балтимором, а также между приграничными и не приграничными регионами, но не между Филадельфией и не приграничными или приграничными и Балтиморскими регионами. Поэтому мы использовали магазины Балтимора в качестве контрольной группы для магазинов Филадельфии при сравнении ATT, а не приграничные магазины — в качестве контрольной группы для приграничных магазинов при сравнении ATN..
Регионы, затронутые PBT напрямую или через эффекты перетекания, демонстрируют явное нарушение объемов продаж подслащенных напитков в период между годом до и после внедрения налога по сравнению с нашими контрольными регионами, как показано на Рисунке 1. Продажи в супермаркет бакалейных магазинах и аптеках Филадельфии снизились соответственно на и в период с 2016 по 2017 год, в то время как в соседних супермаркет бакалейных магазинах и аптеках они увеличились на и . Это резко контрастирует с относительно постоянными продажами напитков в супермаркет бакалейных магазинах в Балтиморе (снижение на ) и в магазинах вне приграничной зоны (снижение на ), а также с небольшим снижением продаж напитков в аптеках ( в Балтиморе, вне приграничной зоны)).
4.2 Оценка эффектов воздействия
Сезоны определяются в хронологическом порядке: Зима — это первые 3 наблюдения календарного года, Весна — следующие 3, Лето — последующие 3, а Осень — последние 4.
| ATT | ATN | |||
|---|---|---|---|---|
| TWFE | DR | TWFE | DR | |
| SGMs (million oz.) | ||||
| Winter | -1.90 | -1.83 | 0.88 | 0.87 |
| (-2.44, -1.41) | (-2.50, -1.14) | (0.56, 1.26) | (0.55, 1.23) | |
| Spring | -2.41 | -2.57 | 1.14 | 1.13 |
| (-3.10, -1.74) | (-3.47, -1.86) | (0.66, 1.71) | (0.68, 1.66) | |
| Summer | -2.64 | -2.50 | 1.29 | 1.29 |
| (-3.47, -1.87) | (-3.39, -1.71) | (0.77, 1.89) | (0.79, 1.89) | |
| Fall | -2.28 | -2.30 | 1.23 | 1.23 |
| (-3.00, -1.60) | (-3.11, -1.55) | (0.72, 1.78) | (0.78, 1.77) | |
| Annual | -2.30 | -2.30 | 1.14 | 1.14 |
| (-2.99, -1.66) | (-2.98, -1.64) | (0.68, 1.66) | (0.72, 1.64) | |
| Pharmacies (thousand oz.) | ||||
| Winter | -5.7 | -14.1 | 29.3 | 35.4 |
| (-16.1, 5.0) | (-26.8, 0.1) | (16.3, 46.4) | (17.4, 55.5) | |
| Spring | -24.6 | -27.8 | 34.3 | 40.8 |
| (-36.0, -12.1) | (-39.0, -15.0) | (20.4, 51.9) | (24.0, 61.2) | |
| Summer | -34.1 | -36.3 | 32.5 | 40.5 |
| (-46.5, -21.6) | (-48.0, -24.5) | (18.6, 51.6) | (22.2, 66.2) | |
| Fall | -18.3 | -18.9 | 35.1 | 41.0 |
| (-30.1, -6.4) | (-31.5, -5.5) | (21.2, 54.3) | (23.5, 64.8) | |
| Annual | -20.5 | -23.9 | 33.0 | 39.5 |
| (-30.3, -10.3) | (-34.4, -12.1) | (19.8, 50.9) | (23.1, 61.1) | |
Мы оценили ATT и ATN, используя как стандартный подход TWFE, требующий стандартных безусловных контрфактических параллельных трендов, так и наш предлагаемый подход DR, требующий условных контрфактических параллельных трендов. Для оценки ATT и ATN с использованием подхода TWFE мы оценили специфичные для времени эффекты воздействия с помощью линейной модели в (7) для каждого . Для оценки ATT и ATN с помощью наших предлагаемых методов doubly robust мы подобрали отдельную модель линейной регрессии для каждого и модель логистической регрессии для каждого с членами для наших наблюдаемых ковариат (Stuart et al. (2014)).
Для оценки доверительных интервалов для наших оценок эффекта мы реализовали стратифицированный непараметрический подход бутстрэп-выборки (Efron and Tibshirani (1993)). Для каждого из четырех регионов мы выполнили повторную выборку с возвращением из эмпирического распределения региональной подвыборки, при которой повторно выбирается весь вектор наблюдаемых данных магазина. Стратификация по регионам ограничивает экстремальные выборки бутстрэпа, в которых некоторые регионы могут иметь лишь несколько репрезентативных элементов, что имеет место в нашем исследовании. Затем мы оценили и процентили среди 500 реплик бутстрэпа в качестве границ нашего интервала. Краткое обсуждение и сравнение возможных подходов к доверительным интервалам представлены в Приложении D.
Чтобы укрепить достоверность Допущения (A1) в рамках (2), мы исключили магазины, не находящиеся на границе, в почтовых индексах Пенсильвании в радиусе 6 миль от границы Филадельфии (138 магазинов). Мы приняли это решение после оценки небольшого, но отличного от нуля ATN для этих магазинов с использованием нашей методологии DR в ходе предварительного анализа (Таблица 4), что позволяет предположить, что эта группа может содержать смесь магазинов с контрольным и соседним контрольным воздействиями. Допущение (A1) также подразумевает, что воздействие не оказывает причинного эффекта до его реализации, что часто формализуется как допущение об отсутствии антиципации, которое было бы нарушено в нашем исследовании, если бы жители Филадельфии делали запасы подслащенных напитков в месяцы, предшествовавшие налогу. Для оценки этого допущения мы использовали нашу методологию DR для оценки ATT для SGM и аптек между первым моментом наблюдения до введения налога и моментом наблюдения до введения налога , , для (Таблица 5). Наши доверительные интервалы включали нулевой эффект, за исключением аптек, который был статистически значимым, но отрицательным, что скорее позволяет предположить, что потребители осуществляли опережающие трансграничные покупки, а не делали запасы.
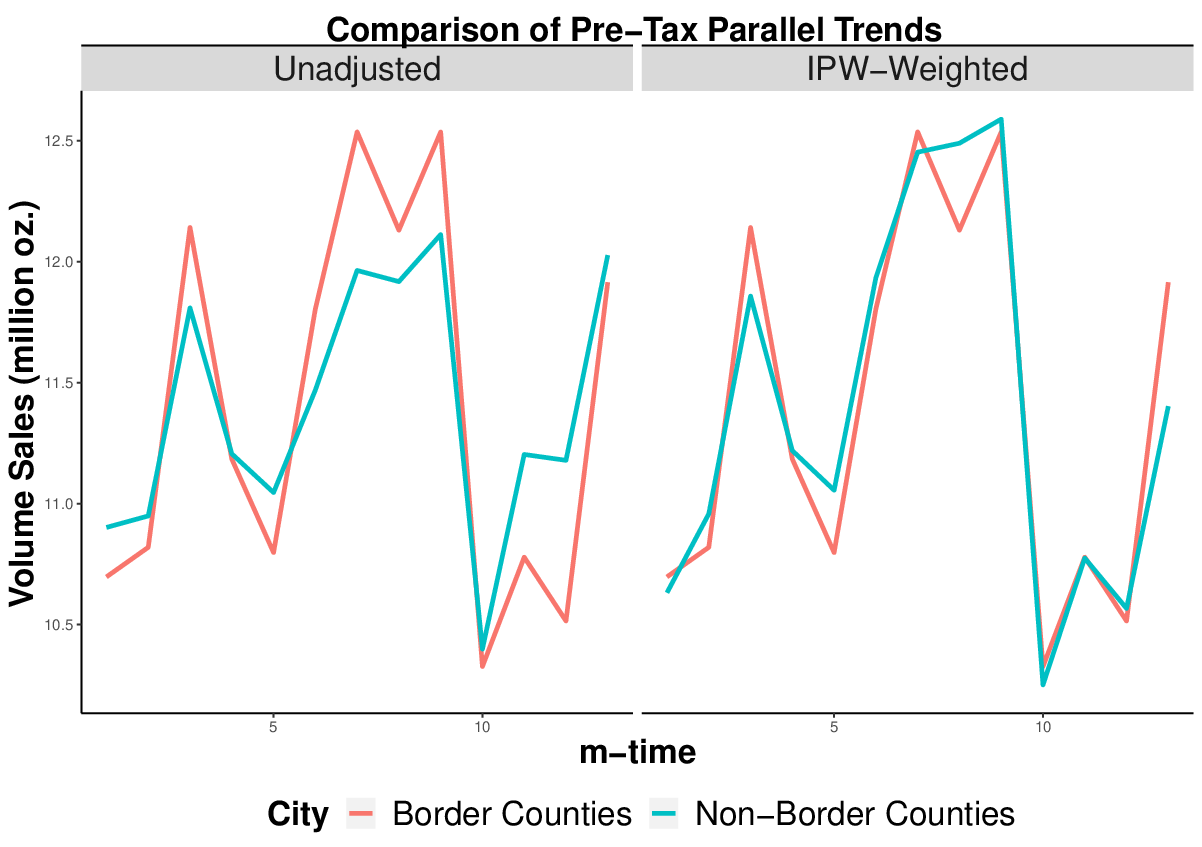
Исследователи часто используют тесты на параллельные тренды до начала воздействия для оценки правдоподобности допущения о контрфактических параллельных трендах в исследованиях методом "разность разностей" (Bilinski and Hatfield (2018)). В нашей постановке задачи эти тесты могут быть проведены робастным образом для оценки Допущений (A2) и (A3) с использованием предложенной нами методологии для оценки и аналогичного для . Если тренды исхода до начала воздействия являются параллельными между группами воздействия, эти эффекты будут равны нулю. Как отмечают Bilinski and Hatfield (2018), практики должны с осторожностью проводить эти тесты при нулевой гипотезе о параллельных трендах, поскольку это поощряет высоконеопределенные тесты, которые не могут исключить крупные нарушения параллельных трендов. Поэтому мы приводим доверительные интервалы таких тестов в качестве свидетельства для отклонения нарушений параллельных трендов за пределами оцененных границ. Эти интервалы, приведенные в Таблице 5, в значительной степени включают . Наглядный пример того, как условные параллельные пре-тренды могут быть более правдоподобными, чем безусловный аналог, приведен на Рисунке 2. Тем не менее, эти тесты являются ограниченным прокси-показателем для требуемых контрфактических параллельных трендов и опираются на предположение, что параллельные тренды в периоде до начала воздействия могут быть экстраполированы на контрфактические тренды между налоговыми периодами.
Оценки ATT и ATN для продаж подслащенных напитков в SGM и аптеках, агрегированные по сезонам и годам, приведены в Таблице 2. В год после введения налога в Филадельфии наблюдается среднее сокращение продаж в SGM на 2,26 млн унций (95% ДИ: (1,54; 2,95)) за 4-недельный период и прирост на 1,20 млн унций (95% ДИ: (0,79; 1,70)) в соседних магазинах. В аптеках наблюдается среднее сокращение продаж на 22,9 тыс. унций (95% ДИ: (11,2; 32,5)) в Филадельфии за 4-недельный период и прирост на 38,3 тыс. унций (95% ДИ: (23,6; 56,9)) в соседних магазинах..
Интересно, что величина ATN больше, чем ATT для аптек. Поскольку наш анализ проводится на уровне магазинов, нам необходимо учитывать общее количество магазинов в каждом регионе, чтобы оценить относительные величины на региональном уровне. Кроме того, некоторые потребители в Филадельфии могут отреагировать на PBT, переключив свои покупки подслащенных напитков с SGM в Филадельфии на аптеки в приграничных округах..
Наши результаты показывают значительную гетерогенность эффектов между сезонами как для ATT, так и для ATN, причем эффекты наиболее выражены в теплое время года. Эффекты ATT наиболее сильны летом для SGM и аптек, с оценочным снижением на 2,47 миллиона унций (95% ДИ: (1,64, 3,29)) и 34,8 тысячи унций (95% ДИ: (20,8, 46,1)) соответственно из-за налога. Эффекты ATN наиболее сильны для SGM летом (увеличение на 1,35 миллиона унций, 95% ДИ: (0,86, 1,90)), но наибольшие эффекты для аптек оцениваются осенью (увеличение на 42,0 тысячи унций, 95% ДИ: (26,3, 60,9)). В связи с этим, эффекты ATT наиболее слабы зимой со снижением на 1,93 миллиона унций для SGM (95% ДИ: (1,37, 2,52)) и 12,7 тысячи унций для аптек (95% ДИ: (0,7, 23,5)). Это справедливо и для ATN в отношении SGM (увеличение на 0,90 миллиона унций, 95% ДИ: (0,57, 1,27)) и аптек (увеличение на 35,4 тысячи унций, 95% ДИ: (20,5, 53,2)). Такая гетерогенность соответствует нашим ожиданиям, поскольку более высокие температуры и общий рост продаж подслащенных напитков в теплые месяцы могут дополнительно стимулировать потребителей совершать поездки, чтобы избежать PBT. Однако ослабление налоговых эффектов зимой также может указывать на постепенную реакцию потребителей на PBT..
Оценки DR тесно коррелируют с оценками, полученными с использованием стандартной методологии TWFE для SGM. Это может указывать на некоторую правдоподобность допущения о безусловных параллельных трендах между группами воздействия для этих магазинов, но также отражает тот факт, что наши доступные ковариаты были недостаточно информативны для прогнозирования результата для данной группы магазинов. Для аптек методы DR дают оценки эффекта большей величины, чем их аналоги TWFE, что может свидетельствовать о том, что смешивающие факторы маскируют часть налогового эффекта в стандартных анализах. Например, наши модели результатов для связывают более низкий процент белых жителей с более значительным снижением продаж напитков в аптеках Балтимора в период с 2016 по 2017 год. Поскольку аптеки Филадельфии находятся в почтовых индексах с более высоким процентом белых жителей, мы бы недооценили контрфактические продажи подслащенных напитков после введения налога в магазинах Филадельфии, не выполнив надлежащую корректировку по расовому признаку. Примечательно, что за счет учета смешивающих факторов доверительные интервалы DR для зимнего ATT в аптеках не включают ноль, в отличие от доверительных интервалов TWFE..
4.3 Оценка эффектов по географической близости
Хотя эффекты на уровне популяции полезны, стратегии могут оказывать различное воздействие на субпопуляции внутри каждого региона. Понимание того, на кого стратегии влияют сильнее всего, особенно полезно для лиц, принимающих решения, при определении необходимости продолжения стратегий, способов устранения неравенства, вызванного стратегиями, и методов реализации стратегий в регионах с различным составом населения..
Чтобы помочь понять, как эффекты политики могут варьироваться в зависимости от географической близости к не облагаемым налогом регионам, мы сначала определили подгруппы почтовых индексов Филадельфии в соответствии с их приграничным статусом — граничащие с Пенсильванией, граничащие с Нью-Джерси и не граничащие, которые визуализированы на Рисунке 3 желтым, фиолетовым и оранжевым цветами соответственно. Затем мы использовали нашу предложенную методологию DR для оценки ежегодного относительного эффекта продаж для аптек в каждой из этих подгрупп. Коэффициент продаж обеспечивает сопоставимую шкалу для субпопуляций, которые могут различаться по объему продаж подслащенных напитков, более подробное обсуждение представлено в Приложении E. Подгруппы содержали 58, 26 и 56 аптек с оценочными эффектами -33% (95% ДИ: (-39%, -26%)), -10% (-24%, +5%) и -6% (-17%, +6%) соответственно, что позволяет предположить, что аптеки Филадельфии, граничащие с Пенсильванией, испытали большее снижение, чем те, что прилегают только к Нью-Джерси или другим почтовым индексам Филадельфии, для которых обходной путь может быть менее практичным (например, требует оплаты проезда для въезда). Эти результаты дополняют предыдущие исследования, которые обнаружили снижение налоговых эффектов для жителей Филадельфии, проживающих дальше от границы города (Cawley et al. (2019)).
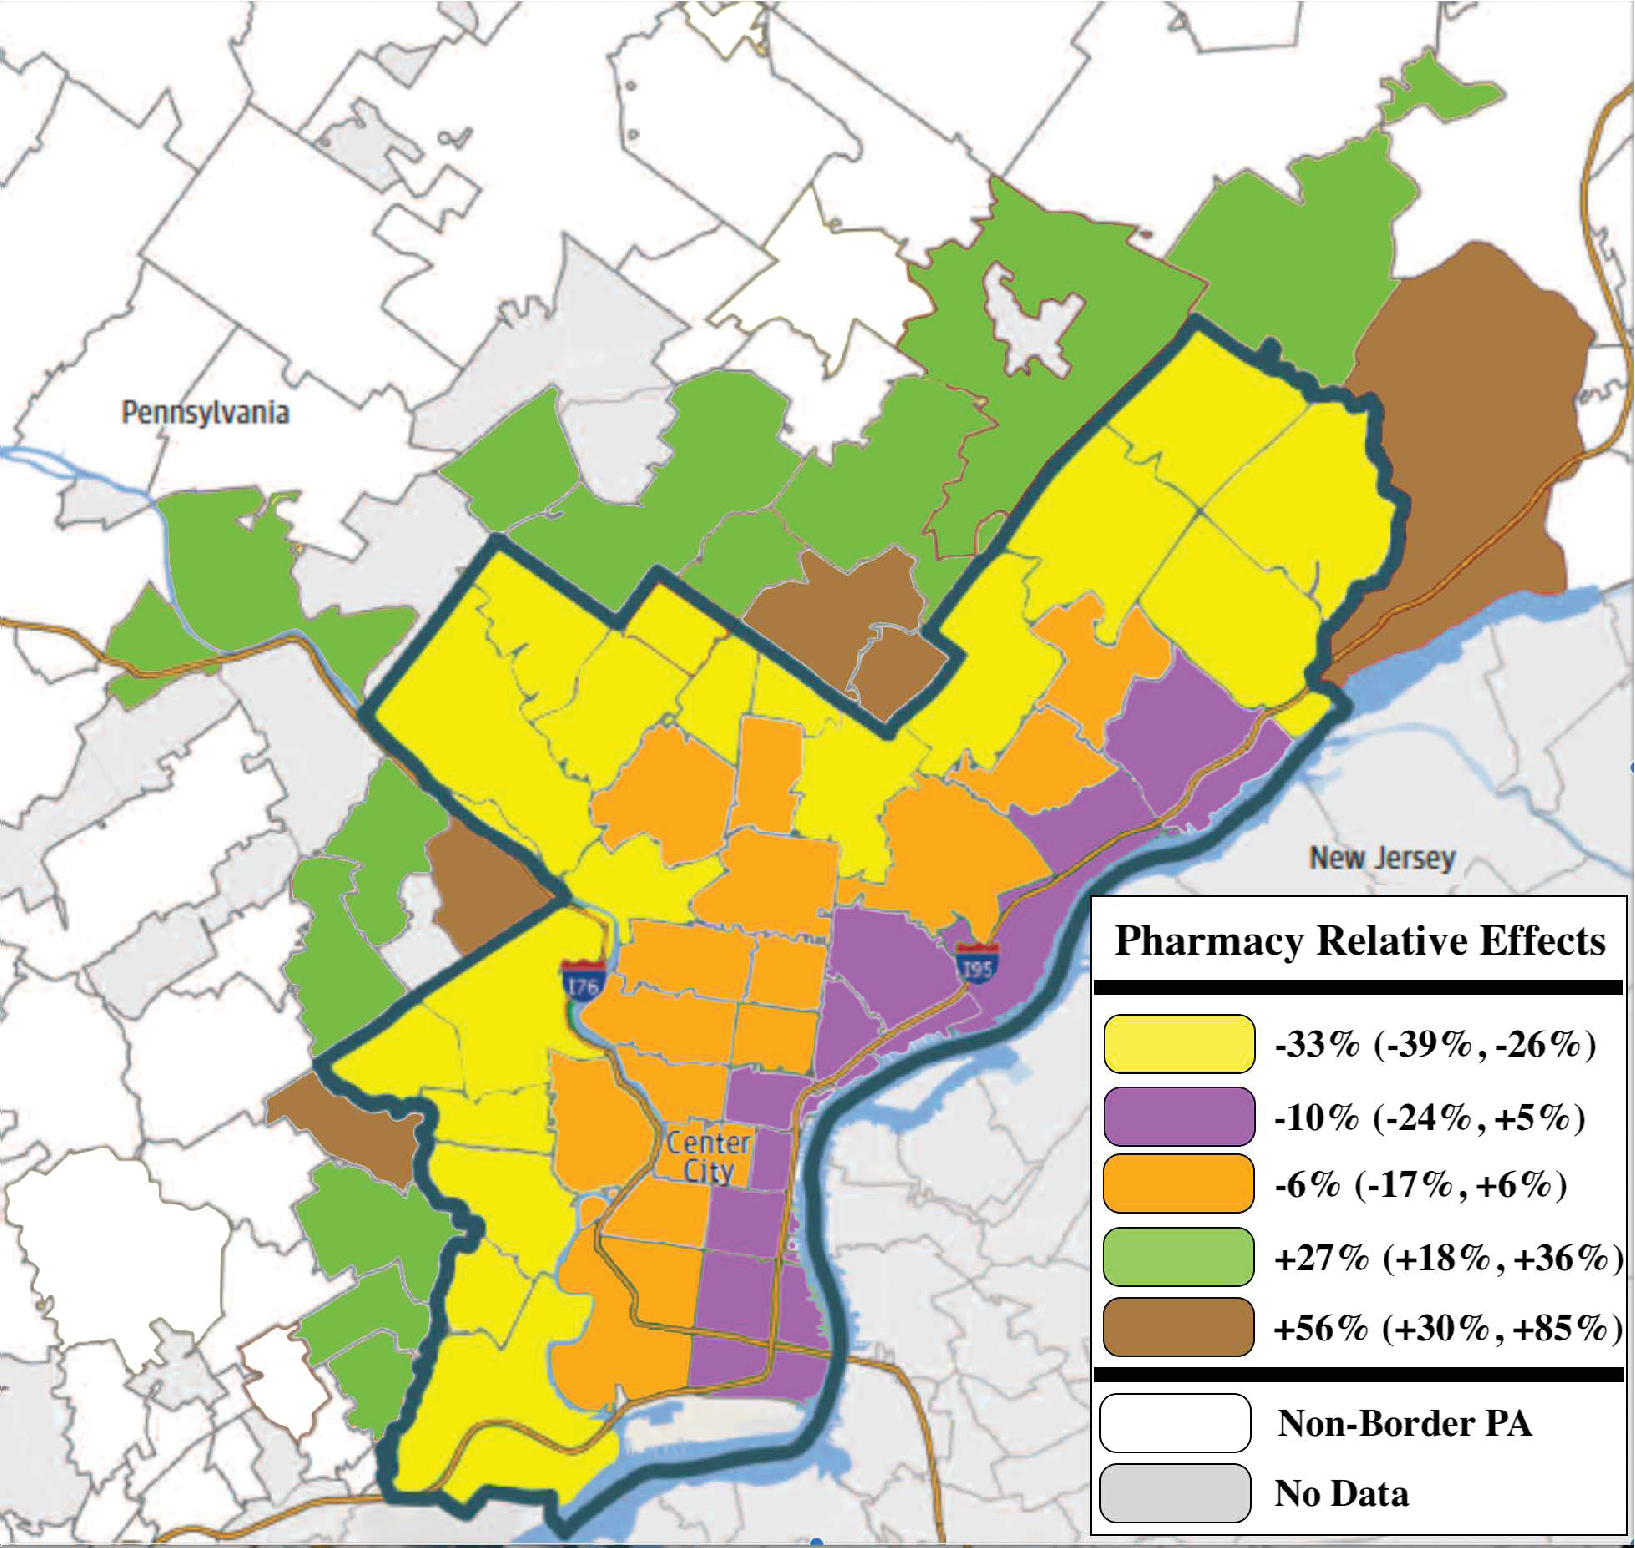
Для дальнейшего понимания влияния географической гетерогенности на эффекты обхода (bypass effects), мы также определили подгруппы почтовых индексов приграничных округов (Border county zip codes) в соответствии с показателями проксимального налогооблагаемого населения и межгодовыми (YtY) различиями в продажах облагаемых налогом напитков среди этих групп населения. В частности, мы взяли общую численность населения и межгодовую разницу для каждого почтового индекса Филадельфии, граничащего с Пенсильванией, и разделили эти показатели на количество почтовых индексов приграничных округов, с которыми они граничат, в качестве прокси-переменных для объема трафика и продаж, «доступных» из облагаемого налогом почтового индекса. Затем для каждого почтового индекса приграничного округа мы суммировали эти показатели по всем прилегающим почтовым индексам Филадельфии в качестве прокси-переменной для объема доступного трафика и продаж из близлежащих облагаемых налогом магазинов. Мы использовали кластеризацию методом K-средних (K-means clustering) для распределения этих почтовых индексов по группам с низким и высоким объемами доступного трафика и продаж. Используя наш предложенный метод, мы оценили существенно более низкие эффекты в почтовых индексах приграничных округов с низким доступным трафиком и продажами из облагаемых налогом магазинов (увеличение на 27%, 95% ДИ: (18%, 36%)), чем в тех, где доступный трафик и продажи из облагаемых налогом магазинов были высокими (увеличение на 56%, 95% ДИ: (30%, 85%)), хотя доверительные интервалы в последней группе довольно широки, что, вероятно, связано с небольшим размером подгруппы (10 аптек) и высокой гетерогенностью наших прокси-показателей внутри этой подгруппы. Хотя эти разведочные анализы демонстрируют потенциальную географическую гетерогенность в эффектах политики, мы не можем различить гетерогенность эффектов, обусловленную географическими факторами, и гетерогенность, вызванную другими динамическими процессами населения, связанными с географией, путем оценки причинно-следственных эффектов (causal effects) для различных подгрупп населения.
5 Имитационные исследования
5.1 Дизайн
Мы провели имитационные исследования, мотивированные исследованием PBT, чтобы оценить эффективность различных оценок в реалистичных сценариях. Для генерации наших выборок мы сначала моделируем для каждой единицы . Мы принудительно задаем изменение одной из ковариат во времени путем установки и моделирования для . Затем мы применяем преобразование из Kang and Schafer (2007) к , чтобы получить :
⟦,
⟦,
В каждой симуляции наши оценщики используют наблюдаемые ковариаты, . Однако набор ковариат, используемый для генерации воздействия, , и исхода, , варьируется в зависимости от сценария. Единицы наблюдения распределяются между сравнениями ATT и ATN в соотношении 43:57, чтобы имитировать некоторую несбалансированность, наблюдаемую в нашем наборе данных. Воздействие в рамках каждого сравнения затем моделируется в соответствии с биномиальными моделями с и . Для единиц с мы дополнительно моделируем переменную, представляющую расстояние до границы Филадельфии, , и ограничиваем ее значениями от 0,1 до 0,9. Эта переменная используется для создания гетерогенности эффекта воздействия в ATN.
Результаты генерируются с помощью линейной модели вида: . Здесь соответствуют случайным интерсептам для конкретных единиц наблюдения, — фиксированный эффект для группы воздействия, и — фиксированные эффекты для каждого времени наблюдения и периода лечения, — индикаторная функция, а — независимые и одинаково распределенные члены ошибки. ATT для всего периода исследования определяется как среднее значение указанных параметров по . ATN на уровне популяции варьируется в зависимости от и определяется путем усреднения по . Примечательно, что наш подход допускает наличие гетерогенных конфаундеров () и эффектов лечения () во времени , а также гетерогенных эффектов лечения в зависимости от конфаундеров, таких как расстояние в данном контексте. Параметры, использованные для симуляций, можно найти в Приложении F.
Симуляции были сгенерированы в соответствии с тремя различными комбинациями размера выборки () и количества моментов наблюдения () – (1) , (2) и (3) . Мы рассматриваем четыре различных сценария в зависимости от набора ковариат, используемых для спецификации моделей воздействия () и исхода () – (a) , , (b) , , (c) , и (d) , . Таким образом, наша модель исхода корректно специфицирована в (a) и (b), но неверно специфицирована в (c) и (d), в то время как наша модель оценки склонности корректно специфицирована в (a) и (c), но неверно специфицирована в (b) и (d).).
В каждом сценарии мы генерируем 1000 репликаций для оценки эффективности описанных методов TWFE, IPW, OR и DR. Для оценки мы подбираем модель линейной регрессии для разности результатов, , для контрольной группы, используя отдельную модель для . Для оценки мы подбираем единую инвариантную во времени модель логистической регрессии. Доверительные интервалы оцениваются с помощью вышеупомянутого стратифицированного метода бутстрепа..
5.2 Результаты
| Bias () | Std. Err | Coverage () | ||||||||||
| Scenario | TWFE | OR | IPW | DR | TWFE | OR | IPW | DR | TWFE | OR | IPW | DR |
| ATT | ||||||||||||
| 1a | -12.784 | -0.069 | 0.929 | -0.103 | 0.564 | 0.045 | 0.389 | 0.047 | 91.9 | 94.1 | 98.5 | 95.0 |
| 1b | -39.051 | -0.067 | -2.251 | -0.096 | 0.571 | 0.045 | 0.49 | 0.047 | 72.0 | 95.3 | 96.5 | 96.3 |
| 1c | -7.286 | -9.348 | -0.225 | -2.754 | 0.597 | 0.386 | 0.492 | 0.472 | 93.2 | 93.5 | 97.7 | 95.3 |
| 1d | 22.566 | 28.382 | 35.917 | 32.824 | 0.624 | 0.397 | 0.538 | 0.453 | 88.0 | 72.8 | 73.3 | 70.3 |
| 2a | -10.887 | -0.002 | -0.003 | 0.032 | 0.226 | 0.038 | 0.209 | 0.040 | 83.4 | 94.7 | 95.3 | 94.3 |
| 2b | -45.221 | -0.062 | -1.576 | -0.059 | 0.224 | 0.037 | 0.148 | 0.038 | 1.7 | 94.7 | 91.0 | 95.0 |
| 2c | -5.278 | -8.913 | -0.391 | -0.745 | 0.208 | 0.138 | 0.199 | 0.187 | 90.6 | 75.2 | 94.6 | 93.7 |
| 2d | 19.201 | 29.893 | 35.902 | 33.978 | 0.206 | 0.134 | 0.171 | 0.141 | 35.8 | 0.6 | 1.1 | 0.0 |
| ATN | ||||||||||||
| 1a | -58.815 | 0.078 | 0.005 | 0.186 | 0.502 | 0.037 | 0.347 | 0.042 | 75.2 | 100.0 | 98.6 | 100.0 |
| 1b | -13.883 | -0.166 | -24.357 | -0.082 | 0.497 | 0.039 | 0.801 | 0.043 | 93.2 | 99.7 | 98.2 | 99.7 |
| 1c | 45.954 | -28.936 | -0.928 | -4.004 | 0.519 | 0.359 | 0.561 | 0.526 | 84.8 | 88.6 | 97.0 | 93.7 |
| 1d | 10.542 | -53.447 | -63.872 | -49.881 | 0.539 | 0.355 | 0.750 | 0.405 | 93.8 | 64.4 | 85.2 | 72.8 |
| 2a | -49.862 | -0.051 | 0.064 | 0.013 | 0.194 | 0.031 | 0.128 | 0.033 | 27.2 | 98.2 | 95.7 | 98.0 |
| 2b | -26.739 | 0.026 | -28.104 | 0.018 | 0.193 | 0.032 | 0.420 | 0.035 | 71.7 | 97.0 | 66.8 | 97.5 |
| 2c | 52.672 | -28.980 | 0.132 | -0.578 | 0.174 | 0.127 | 0.139 | 0.193 | 14.7 | 37.1 | 94.6 | 93.2 |
| 2d | -5.510 | -51.219 | -58.066 | -42.967 | 0.175 | 0.120 | 0.233 | 0.200 | 84.8 | 0.4 | 2.7 | 11.8 |
Результаты моделирования обобщены в таблице 3, а результаты для сценария 3 представлены в таблице 8. Мы оцениваем каждый метод в соответствии со средним смещением и стандартной ошибкой наших точечных оценок, а также покрытием наших доверительных интервалов..
Как для ATT, так и для ATN оценки, полученные с использованием стандартного подхода TWFE, сильно смещены во всех сценариях, поскольку данный метод не учитывает конфаундеры, изменяющиеся во времени. Оценки, полученные с использованием подходов OR и IPW, являются несмещенными в сценариях, где соответствующая модель специфицирована верно, тогда как оценки, полученные с помощью подхода DR, являются несмещенными в сценариях (a)-(c). Все подходы дают смещенные результаты в сценарии (d), когда обе модели специфицированы неверно. Хотя подход IPW кажется относительно несмещенным для ATT в сценарии (b), когда модель оценки склонности специфицирована неверно, мы предостерегаем, что это является следствием конкретного механизма генерации данных, и отмечаем, что такое случайное поведение не ожидается в общем случае, как видно из сравнения ATN. Тем не менее, небольшое смещение подхода DR в сценарии (c) при меньших объемах выборки — это то, что отмечалось в предыдущих работах (Li and Li (2019); Sant’Anna and Zhao (2020)), поскольку подход DR представляется более зависимым от спецификации модели исхода, чем от модели оценки склонности..
Подходы OR и DR приводят к наименьшим стандартным ошибкам, при этом подход OR является несколько более эффективным в данных условиях конечной выборки, но значительно менее устойчивым к неверной спецификации. Более высокая эффективность модели исхода при ее правильной спецификации также была отмечена Li and Li (2019) и Sant’Anna and Zhao (2020). Примечательно, что подход IPW имеет относительно большие стандартные ошибки даже при правильно специфицированной модели, что хорошо задокументировано в литературе как результат нестабильности весов в условиях конечной выборки..
Бутстрэп-подходы для CIs работают хорошо в данных симуляциях, примерно достигая номинальной вероятности покрытия при правильной спецификации моделей. Интервалы слегка завышены в условиях малых выборок (Сценарий 1) и для ATN. Последнее наблюдение может быть результатом немоделированной гетерогенности эффекта воздействия, ведущей к потере эффективности. Тем не менее, при правильной спецификации моделей CIs имеют тенденцию быть консервативными.
6 Обсуждение
Эффекты обхода часто возникают, когда политика накладывает ограничения на отдельных лиц, что зачастую существенно нивелирует предполагаемые результаты этой политики. Понимание данных эффектов имеет решающее значение для лиц, определяющих политику, и оценщиков. В данной работе мы предлагаем структуру для оценки причинно-следственных эффектов, значимых для политики, в условиях такого вмешательства путем объединения идей отображений воздействия и doubly robust DiD оценок. Мы применили наши методы для оценки причинно-следственных эффектов PBT в Филадельфии и прилегающих к ней округах, учитывая как вмешательство, так и смешивающие факторы. Примечательно, что мы оценили более выраженные эффекты налога на аптеки, чем методы, использованные в предыдущих исследованиях. Кроме того, мы использовали наши методы для выявления новых данных, касающихся неоднородности эффектов в зависимости от сезона и географической близости..
Важно отметить, что у нас не было доступа к данным о продажах в магазинах на границе штата Нью-Джерси, где также могут наблюдаться эффекты обхода, но, возможно, в меньшей степени. Кроме того, наши оценки не показывают, что произошло бы в контрфактическом сценарии, если бы налог был введен как в Филадельфии, так и в прилегающих к ней округах — ситуация, которая может быть весьма актуальна для лиц, определяющих политику. В будущих анализах было бы интересно надежно учесть остаточную пространственную корреляцию между магазинами одного региона или автокорреляцию между оценками эффектов, специфичных для конкретного времени. Наконец, для этого и многих других исследований были бы полезны doubly robust методы, работающие с непрерывными и многомерными отображениями воздействия вместо известного бинарного отображения. Помимо повышения эффективности, такие методы усилили бы анализ субпопуляций, позволяя исследователям гибко и эффективно понимать, как эффекты политики варьируются в пространстве и/или в зависимости от других факторов. На практике эти выводы могут пролить свет на то, почему в некоторых городах, таких как Сиэтл, наблюдались менее существенные эффекты обхода, что, как считается, является следствием географических границ между соседними округами (Powell and Leider (2020)). Однако сбор и включение точных и релевантных географических и транспортных данных (например, доступ к автомобилю или общественному транспорту) все еще может представлять сложность..
Благодарности
Данная работа была поддержана грантом NSF 2149716 (главные исследователи: Митра и Ли).
Доступный код
Код и пример смоделированного набора данных предоставлены на GitHub по адресу https://github.com/garyhettinger/DiD-interference.
Литература
- ⟦City of Philadelphia [2016] Город Филадельфия. Налог на сахаросодержащие напитки, 2016.
- ⟦Brownell et al. [2009] Келли Д. Браунелл, Томас Фарли, Уолтер К. Уиллетт, Барри М. Попкин, Фрэнк Дж. Чалупка, Джозеф У. Томпсон и Дэвид С. Людвиг. Общественное здравоохранение и экономические выгоды от налогообложения напитков с добавлением сахара. Медицинский журнал Новой Англии, 361(16):1599–1605, 10 2009. ISSN 0028-4793. doi:10.1056/NEJMhpr0905723.
- ⟦Cabrera Escobar et al. [2013] Мария А. Кабрера Эскобар, Дж. Леннерт Вирман, Стивен М. Толлман, Мелани И. Бертрам и Карен Дж. Хофман. Доказательства того, что налог на подслащенные сахаром напитки снижает уровень ожирения: метаанализ. BMC Public Health, 13(1):1072, 12 2013. ISSN 1471-2458. doi:10.1186/1471-2458-13-1072.
- ⟦Hu [2013] Ф. Б. Ху. Решено: имеется достаточное научное доказательство того, что снижение потребления напитков с добавлением сахара уменьшит распространенность ожирения и заболеваний, связанных с ожирением. Obesity Reviews, 14(8):606–619, 8 2013. ISSN 14677881. doi:10.1111/obr.12040.
- ⟦Rhynhart [2022] Ребекка Райнхарт. Публикация данных: Доходы и расходы от налога на напитки. Технический отчет, Офис контролера, Филадельфия, 1 2022.
- ⟦Roberto et al. [2019] Кристина А. Роберто, Ханна Г. Лоуман, Майкл Т. ЛеВассер, Нандита Митра, Ана Петерханс, Брэдли Херринг и Сара Н. Блейч. Связь налога на напитки с добавлением сахара и искусственных подсластителей с изменениями цен на напитки и объемов продаж в сетевых розничных магазинах в условиях крупного города. JAMA, 321(18):1799, 5 2019. ISSN 0098-7484. doi:10.1001/jama.2019.4249.
- ⟦Lawman et al. [2020] Ханна Лоуман, Сара Блейч, Цзяли Янь, София Хуа, Кейтлин Лоуэри, Ана Питерханс, Майкл ЛеВассер, Нандита Митра, Лора Гибсон и Кристина Роберто. Годовые изменения в объемах покупок потребителей сахаросодержащих напитков после введения налога на напитки: лонгитюдный квазиэксперимент. Американский журнал клинического питания, 112(3):644–651, 9 2020. ISSN 0002-9165. doi:10.1093/ajcn/nqaa158.
- ⟦Bleich et al. [2021] Сара Н. Блейч, Кэролайн Г. Данн, Марк Дж. Сото, Цзяли Янь, Лора А. Гибсон, Ханна Г. Лоуман, Нандита Митра, Кейтлин М. Лоуэри, Ана Петерханс, София В. Хуа и Кристина А. Роберто. Связь налога на подслащенные напитки с покупками напитков и продуктов с высоким содержанием сахара в независимых магазинах Филадельфии. JAMA Network Open, 4(6):e2113527, 6 2021. ISSN 2574-3805. doi:10.1001/jamanetworkopen.2021.13527.
- ⟦Edmondson et al. [2021] Эмма К. Эдмондсон, Кристина А. Роберто, Эмили Ф. Грегори, Нандита Митра и Сенбагам Вирудачалам. Связь налога на подслащенные напитки с потреблением газировки среди учащихся старших классов. JAMA Pediatrics, 175(12):1261, 12 2021. ISSN 2168-6203. doi:10.1001/jamapediatrics.2021.3991.
- ⟦Petimar et al. [2022] Джошуа Петимар, Лора А. Гибсон, Цзяли Янь, Сара Н. Блейч, Нандита Митра, Марша Л. Трего, Ханна Г. Лоуман и Кристина А. Роберто. Устойчивое влияние налога на напитки в Филадельфии на цены и продажи напитков в течение 2 лет. Американский журнал превентивной медицины, 62(6):921–929, 6 2022. ISSN 07493797. doi:10.1016/j.amepre.2021.12.012.
- ⟦Ashenfelter [1978] Орли Эшенфельтер. Оценка влияния программ обучения на заработную плату. Ревью оф экономикс энд статистикс, 60(1):47, 2 1978. ISSN 00346535. doi:10.2307/1924332.
- ⟦Ashenfelter and Card [1984] Орли Ашенфелтер и Дэвид Кард. Использование продольной структуры заработных плат для оценки эффекта программ обучения. Технический отчет, Национальное бюро экономических исследований, Кембридж, Массачусетс, 11 1984.
- ⟦Heckman et al. [1997] J. J. Heckman, H. Ichimura, and P. E. Todd. Matching As An Econometric Evaluation Estimator: Evidence from Evaluating a Job Training Programme. The Review of Economic Studies, 64(4):605–654, 10 1997. ISSN 0034-6527. doi:10.2307/2971733.
- ⟦Abadie [2005] Альберто Абади. Полупараметрические оценки разности разностей. Обзор экономических исследований, 72(1):1–19, 1 2005. ISSN 1467-937X. doi:10.1111/0034-6527.00321.
- ⟦Li and Li [2019] Фан Ли и Фан Ли. Двойная робастная оценка в методе «разность разностей» с применением к оценке безопасности дорожного движения. Обервейшнл Студиз, 5(1):1–23, 2019. ISSN 2767-3324. doi:10.1353/obs.2019.0009.
- ⟦Sant’Anna and Zhao [2020] Педро Х.С. Сант'Анна и Джун Чжао. Двойно надежные оценщики разности разностей. Журнал эконометрики, 219(1):101–122, 11 2020. ISSN 03044076. doi:10.1016/j.jeconom.2020.06.003.
- ⟦Asplund et al. [2007] Маркус Асплунд, Ричард Фриберг и Фредрик Виландер. Спрос и расстояние: Данные о трансграничном шопинге. Журнал государственной экономики, 91(1-2):141–157, 2 2007. ISSN 00472727. doi:10.1016/j.jpubeco.2006.05.006.
- ⟦Raifman et al. [2020] Julia Raifman, Elysia Larson, Colleen L Barry, Michael Siegel, Michael Ulrich, Anita Knopov, and Sandro Galea. Минимальный возраст для приобретения огнестрельного оружия в штатах США и показатели самоубийств среди подростков: анализ с использованием регрессивного разрыва и difference-in-differences. BMJ, page m2436, 7 2020. ISSN 1756-1833. doi:10.1136/bmj.m2436.
- Hao and Cowan [2020] Чжуан Хао и Бенджамин В. Коуан. Эффекты трансграничного перетока легализации рекреационной марихуаны. Economic Inquiry, 58(2):642–666, 4 2020. ISSN 0095-2583. doi:10.1111/ecin.12764.
- ⟦Andreyeva et al. [2022] Татьяна Андреева, Кит Марпл, Саманта Маринелло, Тимоти Е. Мур и Лиза М. Пауэлл. Результаты после введения налога на напитки с добавлением сахара. JAMA Network Open, 5(6):e2215276, 6 2022. ISSN 2574-3805. doi:10.1001/jamanetworkopen.2022.15276.
- ⟦Rubin [1980] DB Rubin. Comment on: "Randomisation analysis of experimental data in the fisher randomisation test" by D. Basu. Journal of American Statistical Association, 75:591–593, 1980.
- ⟦Hudgens and Halloran [2008] Майкл Г. Хадженс и М. Элизабет Халлоран. На пути к причинно-следственному выводу при наличии интерференции. Журнал Американской статистической ассоциации, 103(482):832–842, 6 2008. ISSN 0162-1459. doi:10.1198/016214508000000292.
- ⟦Tchetgen and VanderWeele [2012] Эрик Дж. Тчетген Тчетген и Тайлер Дж. Вандервил. О причинно-следственном выводе при наличии интерференции. Статистические методы в медицинских исследованиях, 21(1):55–75, 2 2012. ISSN 0962-2802. doi:10.1177/0962280210386779.
- ⟦Liu et al. [2019] Лан Лю, Майкл Г. Хадженс, Брэдли Сол, Джон Д. Клеменс, Мохаммад Али и Майкл Э. Эмч. Дважды робастное оценивание в обсервационных исследованиях с частичным вмешательством. Stat, 8(1), 1 2019. ISSN 2049-1573. doi:10.1002/sta4.214.
- ⟦Papadogeorgou et al. [2019] Джорджия Пападогеоргу, Фабриция Меалли и Корвин М. Зиглер. Причинно-следственный вывод при наличии интерференции между единицами наблюдения для программ распределения воздействия на уровне кластеров и популяций. Biometrics, 75(3):778–787, 9 2019. ISSN 0006-341X. doi:10.1111/biom.13049.
- ⟦Huber and Steinmayr [2021] Мартин Хубер и Андреас Штайнмайр. Структура для разделения индивидуальных эффектов воздействия и эффектов перелива. Журнал бизнес- и экономической статистики, 39(2):422–436, 4 2021. ISSN 0735-0015. doi:10.1080/07350015.2019.1668795.
- ⟦Clarke [2017] Дамиан Кларк. Оценка разности разностей при наличии побочных эффектов. Мюнхенский личный архив RePEc, (81604), 2017.
- ⟦Butts [2021] Кайл Баттс. Оценка разности разностей с пространственными побочными эффектами. arXiv:2105.03737, 5 2021. doi:https://doi.org/10.48550/arXiv.2105.03737.
- ⟦de Chaisemartin and D’Haultfoeuille [2022] Клеман де Шезмартен и Ксавье Д’Офёй. Двухфакторные модели с фиксированными эффектами и метод «разность разностей» при неоднородных эффектах воздействия: обзор. Технический отчет, Национальное бюро экономических исследований, Кембридж, Массачусетс, 1 2022.
- ⟦Muth et al. [2016] М. К. Мут, М. Свейтцер, Д. Браун, К. Капогросси, С. Карнс, Д. Левин, А. Окрент, П. Сигел и К. Жен. Понимание данных сканирования домохозяйств и магазинов IRI, 4 2016.
- ⟦Aronow and Samii [2017] Питер М. Аронов и Сайрус Самии. Оценка средних причинно-следственных эффектов при наличии общего вмешательства с применением к эксперименту в социальной сети. The Annals of Applied Statistics, 11(4), 12 2017. ISSN 1932-6157. doi:10.1214/16-AOAS1005.
- ⟦Bertrand et al. [2004] М. Бертран, Э. Дюфло и С. Муллаинатхан. Насколько мы должны доверять оценкам метода разности разностей? Ежеквартальный журнал экономики, 119(1):249–275, 2 2004. ISSN 0033-5533. doi:10.1162/003355304772839588.
- ⟦Callaway and Sant’Anna [2021] Брэнтли Каллавей и Педро Х.С. Санта-Анна. Разность разностей с несколькими временными периодами. Журнал эконометрики, 225(2):200–230, 12 2021. ISSN 03044076. doi:10.1016/j.jeconom.2020.12.001.
- ⟦Stuart et al. [2014] Элизабет А. Стюарт, Хайден А. Хаскамп, Кеннет Дакворт, Джеффри Симмонс, Зируи Сонг, Майкл Е. Чернев и Колин Л. Барри. Использование оценок склонности в моделях "разность разностей" для оценки эффектов изменения политики. Методология исследований медицинских услуг и исходов, 14(4):166–182, 12 2014. ISSN 1387-3741. doi:10.1007/s10742-014-0123-z.
- ⟦Efron and Tibshirani [1993] B. Efron and R. J. Tibshirani. An Introduction to the Bootstrap. Chapman & Hall, New York, NY, 1993.
- ⟦Bilinski and Hatfield [2018] Алисса Билински и Лора А. Хэтфилд. Здесь не на что смотреть? Подходы к проверке отсутствия значимых различий для параллельных трендов и других модельных допущений. arXiv:1805.03273, 5 2018. doi:https://doi.org/10.48550/arXiv.1805.03273.
- ⟦Cawley et al. [2019] Джон Коули, Дэвид Фрисволд, Анна Хилл и Дэвид Джонс. Влияние налога на напитки в Филадельфии на закупки и потребление среди взрослых и детей. Journal of Health Economics, 67:102225, 9 2019. ISSN 01676296. doi:10.1016/j.jhealeco.2019.102225.
- ⟦Kang and Schafer [2007] Джозеф Канг и Джозеф Шафер. Развенчание двойной робастности: сравнение альтернативных стратегий оценки среднего значения совокупности по неполным данным. Statistical Science, 22(4), 11 2007. ISSN 0883-4237. doi:10.1214/07-STS227.
- ⟦Powell and Leider [2020] Лиза М. Пауэлл и Жюльен Лейдер. Влияние налога на подслащенные напитки в Сиэтле на цены на напитки и объем продаж. Economics & Human Biology, 37:100856, 5 2020. ISSN 1570677X. doi:10.1016/j.ehb.2020.100856.
Appendix A Проблемы подхода TWFE при наличии гетерогенных эффектов воздействия
Многие работы указывают на проблемы подхода TWFE в исследованиях, где различные группы населения получают воздействие в разное время, то есть при поэтапном внедрении, а эффекты воздействия неоднородны для этих групп. Хотя проблема поэтапного внедрения воздействия не относится к нашим условиям, поскольку все магазины подвергаются налогообложению в один и тот же момент времени, примечательно, что прямое расширение модели TWFE для учета изменяющихся во времени факторов смешения:
| (14) |
не является устойчивым к эффектам воздействия, которые неоднородны по ⟧.
Чтобы продемонстрировать это ограничение, мы рассматриваем простую модельную ситуацию. Сначала мы генерируем . Затем мы моделируем . Наконец, мы моделируем . В условиях гомогенного эффекта воздействия для всех . В условиях гетерогенного эффекта воздействия мы устанавливаем .
Тогда истинный ATT равен 4 в условиях с однородным эффектом воздействия, но в условиях с неоднородными эффектами воздействия. Мы проводим 1000 симуляций с и подбираем линейную модель , где оценка для является оцененным ATT.
Когда эффект воздействия является однородным, расширенная модель TWFE в (14) определяет надлежащий эффект с систематической ошибкой менее 0,1%. Однако, когда эффект воздействия является неоднородным, модель TWFE в (14) определяет эффект с систематической ошибкой более 8%. Ошибка возникает из-за неверной спецификации динамики эффекта в модели, поскольку и , и поглощают часть эффекта , а не только . Подходы OR и DR позволяют избежать спецификации эффекта воздействия в модели, так как они моделируют только результат при контрольном воздействии, что делает их более устойчивыми к данному сценарию..
Appendix B Тестирование эффекта для близлежащих магазинов PA, не граничащих с Филадельфией
| SGM (million oz.) | Pharmacy (thousand oz.) | |
|---|---|---|
| Winter | 0.08 (-0.02, 0.18) | 7.5 (2.3, 12.2) |
| Spring | 0.12 (0.01, 0.26) | 2.0 (-2.6, 6.5) |
| Summer | 0.20 (0.08, 0.33) | 6.2 (1.8, 10.4) |
| Fall | 0.15 (0.06, 0.26) | 8.8 (4.6, 13.1) |
| Annual | 0.14 (0.05, 0.25) | 6.3 (3.2, 9.5) |
Appendix C Тестирование допущения о параллельных трендах
| SGM (million oz.) | Pharmacy (thousand oz.) | |||
|---|---|---|---|---|
| ATT | ATN | ATT | ATN | |
| Period 2 | (-0.60, -0.11) | (-0.08, 0.37) | (-9.0, 3.9) | (-6.0, 2.9) |
| Period 3 | (-0.34, 0.25) | (-0.15, 0.35) | (-18.7, 8.9) | (-8.8, 11.4) |
| Period 4 | (-0.62, 0.08) | (-0.16, 0.43) | (-7.6, 10.9) | (-7.0, 7.4) |
| Period 5 | (-0.42, 0.25) | (-0.15, 0.37) | (-6.0, 7.0) | (-3.4, 9.6) |
| Period 6 | (-0.32, 0.41) | (-0.35, 0.28) | (-8.4, 11.1) | (-2.7, 13.9) |
| Period 7 | (-0.23, 0.63) | (-0.25, 0.30) | (-8.0, 13.2) | (-0.4, 14.6) |
| Period 8 | (-0.53, 0.29) | (-0.28, 0.42) | (-11.3, 13.3) | (0.7, 14.2) |
| Period 9 | (-0.96, 0.07) | (-0.22, 0.45) | (-10.0, 7.6) | (-1.9, 14.7) |
| Period 10 | (-0.81, 0.03) | (-0.19, 0.38) | (-9.8, 9.0) | (0.5, 13.1) |
| Period 11 | (-0.58, 0.07) | (-0.23, 0.25) | (-12.8, 2.9) | (-9.4, 7.0) |
| Period 12 | (-0.64, 0.28) | (-0.24, 0.13) | (-18.6, -0.3) | (-6.7, 5.6) |
| Period 13 | (-0.49, 0.20) | (-0.32, 0.20) | (-29.8, 0.9) | (-28.0, 6.6) |
Appendix D Создание доверительных интервалов
В наших реальных анализах данных и симуляциях мы используем бутстрэп-подход для генерации CIs, который, как мы находим, весьма полезен в нашей работе. Во-первых, он гиббок к подходу моделирования данных и учитывает неопределенность в наших оценках, возникающую из-за оценки nuisance function. Во-вторых, этот подход позволяет нам без труда оценивать дополнительные сложные estimands, такие как мультипликативный estimand, представленный в Appendix E. Наконец, путем повторной выборки всего наблюдаемого вектора магазина бутстрэп автоматически учитывает корреляцию между специфичными для времени оценками эффектов при агрегировании для сезонных или годовых оценок.
Тем не менее, данный подход может быть нестабильным в исследованиях с малыми выборками и вычислительно затратным в других случаях. Sant’anna and Zhao (2020) предоставляют параметрические оценщики дисперсии для состоятельной оценки CI при строгих модельных допущениях и при условии, что хотя бы одна из мешающих функций специфицирована верно. Однако вывод формулы для дисперсии в наших условиях с множественными эффектами, специфичными для времени, не является тривиальным без допущения о том, что эффекты, специфичные для времени, являются независимыми и нормально распределенными. Наконец, поскольку стратифицированный bootstrap-подход может повысить стабильность на конечных выборках за счет ограничения экстремальных выборок, байесовский bootstrap-подход может аналогичным образом помочь, позволяя при этом избежать ручного определения интересующих страт..
Сравнение длин CI по данным трем подходам при оценке годовых эффектов приведено в Таблице 6. Параметрический подход к оценке дисперсии заметно точнее любого из подходов на основе бутстрапа из-за дополнительных предположений о форме модели и независимости эффектов во времени, которые могут не выполняться на практике. Наш предложенный стратифицированный подход бутстрапа дает более узкие CI по сравнению с байесовским бутстрапом, за исключением Pharmacy ATT. Стратификация по регионам требует постоянных размеров выборок в каждой группе воздействия, что может объяснять более узкие границы доверительных интервалов по сравнению с потенциально более вариативными размерами выборок группы воздействия, генерируемыми байесовским бутстрапом. Тем не менее, байесовский бутстрап превосходит стандартный бутстрап, который часто дает сбой из-за сгенерированных выборок с нулевыми или близкими к нулю размерами групп воздействия и поэтому не показан.
| SGM (million oz.) | Pharmacy (thousand oz.) | |||
|---|---|---|---|---|
| ATT | ATN | ATT | ATN | |
| Stratified Bootstrap | 1.41 | 0.91 | 21.3 | 33.3 |
| Parametric Variance | 0.41 | 0.28 | 7.0 | 11.4 |
| Bayesian Bootstrap | 1.62 | 1.27 | 21.2 | 41.5 |
Appendix E Оценка относительного эффекта
В анализе реальных данных мы отметили сезонные тренды в эффекте налога на напитки в Филадельфии. Хотя эти тренды могут быть обусловлены сезонными или временными паттернами в поведении потребителей, они также могут быть результатом трендов в объеме продаж напитков. Например, налог может более последовательно влиять на процент продаж, а не на чистый объем продаж в конкретном магазине с течением времени. Таким образом, фокусировка исключительно на аддитивном эффекте может дать неполную картину влияния налоговой политики. В таком случае представляет интерес оценка относительного эффекта продаж, например.,
| (15) |
и соответствующая аналогия для . Поскольку это относительные эффекты, они также могут быть полезны при сравнении эффектов между регионами, как в разделе 4.3.
Для идентификации таких эффектов мы отмечаем, что числитель является наблюдаемым и может быть оценен с помощью выборочного среднего,
Отмечая, что разность числителя и знаменателя в (15) равна аддитивному эффекту воздействия, тот же самый IF-оценщик и идентифицирующие допущения могут быть использованы для оценки члена знаменателя. Перегруппировав члены, мы видим:
— это дважды робастная оценка для знаменателя. Наш оценщик для мультипликативного эффекта тогда равен . Поскольку этот оценщик основан на делении двух компонентов, метод бутстрепа становится особенно полезным для оценки доверительных интервалов.
Оценки для регионов Филадельфии и приграничных округов обобщены в таблице 7. Мы оцениваем ежегодный для SGM как 0.46 (95% ДИ: (0.37, 0.60)), а для аптек как 0.85 (95% ДИ: (0.78, 0.92)), что соответствует снижению продаж на 54% и 15% соответственно. Мы оцениваем ежегодный для SGM как 1.44 (95% ДИ: (1.28, 1.59)), а для аптек как 1.39 (95% ДИ: (1.26, 1.54)), что соответствует увеличению продаж на 44% и 39% соответственно. Сезонные оценки демонстрируют схожую картину с оценками аддитивного эффекта, что может указывать на то, что на налог больше влияют временные закономерности в поведении потребителей, чем временные закономерности в продажах подслащенных напитков..
| SGM (million oz.) | Pharmacy (thousand oz.) | |||
|---|---|---|---|---|
| ATT | ATN | ATT | ATN | |
| Winter | 0.54 | 1.35 | 0.91 | 1.36 |
| (0.47, 0.64) | (1.23, 1.47) | (0.85, 1.00) | (1.22, 1.50) | |
| Spring | 0.42 | 1.42 | 0.82 | 1.36 |
| (0.34, 0.56) | (1.24, 1.58) | (0.74, 0.89) | (1.23, 1.49) | |
| Summer | 0.43 | 1.46 | 0.78 | 1.37 |
| (0.33, 0.58) | (1.29, 1.63) | (0.71, 0.86) | (1.23, 1.52) | |
| Fall | 0.44 | 1.51 | 0.87 | 1.47 |
| (0.34, 0.59) | (1.33, 1.68) | (0.78, 0.96) | (1.31, 1.65) | |
| Annual | 0.46 | 1.44 | 0.85 | 1.39 |
| (0.37, 0.60) | (1.28, 1.59) | (0.78, 0.92) | (1.26, 1.54) | |
Appendix F Настройки параметров моделирования
Для всех сценариев мы устанавливаем , , , и . Кроме того, мы устанавливаем и для контрольной и экспериментальной групп ATT, а также и для контрольной и экспериментальной групп ATN..
Для сценария 1 мы задаем и . Для сценария 2 мы задаем и . Для сценария 3 мы задаем и . Мы задаем для каждого сценария.
Appendix G Ковариаты модели
Ковариаты, выбранные для различных моделей мешающих функций при анализе реальных данных, приведены здесь. Для модели исхода в исследовании ATT SGM в данной работе мы используем среднюю стоимость жилья в почтовом индексе (house value), индикатор для массового ритейлера и продажи налогооблагаемых напитков до вычета налогов. Для модели оценки склонности в данном исследовании мы используем средневзвешенную цену налогооблагаемых напитков до вычета налогов (weighted price), процент населения почтового индекса магазина, идентифицированного как белое (percent White), и средний доход на домохозяйство в почтовом индексе (income).
Для модели исхода в исследовании ATN SGM мы используем взвешенную цену, индикатор для массового ритейлера, объем продаж до вычета налогов, стоимость дома, процент белого населения и взаимодействие между взвешенной ценой и статусом массового ритейлера. Для модели оценки склонности в этом исследовании мы используем взвешенную цену, процент белого населения и стоимость дома..
Для модели исхода в исследовании аптек ATT мы используем процент белого населения, доход и продажи до уплаты налогов. Для модели склонности в этом исследовании мы используем взвешенную цену, процент белого населения и доход. В подгрупповых анализах этого исследования мы сократили набор ковариат модели склонности до процента белого населения и дохода для учета меньших размеров выборок.
Для модели исхода в исследовании ATN SGM мы используем взвешенную цену, доход и объем продаж до вычета налогов. Для модели оценки склонности в этом исследовании мы используем взвешенную цену, процент белого населения, стоимость жилья и взаимодействие между взвешенной ценой и стоимостью жилья. Для модели оценки склонности в подгрупповом анализе этого исследования мы использовали взвешенную цену, процент белого населения и стоимость жилья для группы с низким доступным трафиком и продажами из соседних областей с введенными налогами, а также процент чернокожего населения и стоимость жилья для группы с высокими показателями.
Appendix H Дополнительные результаты моделирования
В Таблице 8 мы приводим результаты моделирования для сценария (3), где и . Результаты показывают выводы, согласующиеся с другими нашими сценариями, причем асимптотические свойства ожидаемо сильнее, чем в сценарии (1), где , но слабее, чем в сценарии (2), где ⟧.
| Bias () | Std. Err | Coverage () | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Scenario | TWFE | IPW | OR | DR | TWFE | IPW | OR | DR | TWFE | IPW | OR | DR |
| ATT | ||||||||||||
| 3a | -11.976 | 0.128 | 0.713 | 0.139 | 0.423 | 0.057 | 0.353 | 0.059 | 90.5 | 93.1 | 97.1 | 93.8 |
| 3b | -43.696 | 0.152 | -1.364 | 0.187 | 0.436 | 0.058 | 0.33 | 0.059 | 45.4 | 92.5 | 94.8 | 94.0 |
| 3c | -5.75 | -9.288 | -0.239 | -2.410 | 0.394 | 0.279 | 0.620 | 0.451 | 93.7 | 88.7 | 95.0 | 92.8 |
| 3d | 18.497 | 27.495 | 34.590 | 32.256 | 0.400 | 0.253 | 0.352 | 0.288 | 83.2 | 42.4 | 42.9 | 34.1 |
| ATN | ||||||||||||
| 3a | -51.2 | -0.080 | 0.005 | -0.166 | 0.357 | 0.048 | 0.229 | 0.051 | 72.2 | 98.7 | 96.7 | 98.4 |
| 3b | -23.631 | -0.040 | -24.953 | -0.021 | 0.369 | 0.044 | 0.590 | 0.048 | 89.4 | 99.0 | 94.5 | 98.9 |
| 3c | 50.125 | -30.159 | -0.983 | -7.144 | 0.353 | 0.247 | 0.249 | 0.304 | 69.9 | 77.8 | 95.9 | 93.1 |
| 3d | -1.775 | -51.697 | -59.399 | -46.790 | 0.352 | 0.243 | 0.426 | 0.330 | 94.6 | 41.8 | 49.0 | 55.6 |