Распознавание места на основе LiDAR для автономного вождения: обзор
Аннотация
Распознавание местоположений на основе LiDAR (LPR) играет ключевую роль в автономном вождении, помогая системам одновременной оценки местоположения и построения карты (Simultaneous Localization and Mapping, SLAM) уменьшать накопленные ошибки и обеспечивать надежную локализацию. Однако существующие обзоры в основном сосредоточены на методах распознавания местоположений на основе изображений (VPR). Несмотря на недавний замечательный прогресс в LPR, насколько нам известно, в данной области не существует специализированного систематического обзора. Эта статья восполняет пробел, предоставляя всесторонний обзор методов распознавания местоположений, использующих сенсоры LiDAR, тем самым способствуя и поощряя дальнейшие исследования. Мы начинаем с рассмотрения формулировки задачи распознавания местоположений, изучаем существующие трудности и описываем связи с предыдущими обзорами. Затем мы проводим углубленный обзор соответствующих исследований, который предлагает подробные классификации, сильные и слабые стороны, а также архитектуры. В завершение мы обобщаем существующие наборы данных, часто используемые показатели оценки и результаты комплексной оценки, полученные различными методами на общедоступных наборах данных. Эта статья может служить ценным учебным пособием для новичков, входящих в область распознавания местоположений, а также для исследователей, заинтересованных в долгосрочной локализации роботов. Мы обязуемся поддерживать актуальность проекта на нашем веб-сайте https://github.com/ShiPC-AI/LPR-Survey.
Ключевые слова:
SLAM, распознавание места на основе LiDAR, обнаружение петлевого замыкания, локализация карты.1 Введение
Распознавание места [1, 2, 3, 4, 5, 6, 7, 8] — это сложная и продолжающаяся исследовательская задача, направленная на идентификацию ранее посещённых мест в различных ракурсах и условиях. Эта задача имеет большое значение для различных робототехнических приложений. Во-первых, долгосрочная локализация [9, 10, 11] и извлечение мест [12, 13, 14] решают проблему локализации в изменяющихся средах. Во-вторых, распознавание места[15, 16, 17, 18] облегчает обнаружение замыкания петель в реальном времени (LCD), чтобы создавать глобальные карты без дрейфа. В-третьих, метрическая локализация [19, 20, 21] в предшествующих картах обеспечивает надёжный способ восстановить позы похищенного транспортного средства.
Методы, основанные на наблюдениях датчиков, [22, 23, 24, 25, 26, 27] превосходят традиционные глобальные системы позиционирования (GPS)[28, 29, 30], блоки инерциального измерения (IMU)[31, 32, 33, 34] и колесные одометры[35] по автономности, гибкости, устойчивости к помехам, независимости от сигналов геомагнитного поля и экономической эффективности. Несмотря на значительные достижения в исследованиях и появление множества методов в последние годы, распознавание местности по-прежнему остается сложной задачей из-за различий в ракурсах, перекрытий, вариаций данных, долгосрочных изменений и вычислительной сложности. Чтобы облегчить и поощрить дальнейшие исследования, ученые занимались классификацией методов[36], оценкой производительности[37, 38], обобщением задач[39] и прогнозированием перспектив[40] на основе текущего прогресса в этой области. Однако существующие работы в первую очередь ориентированы на визуальное распознавание местности (VPR), что требует всестороннего и систематического обзора распознавания местности на основе LiDAR (LPR), чтобы восполнить этот пробел.
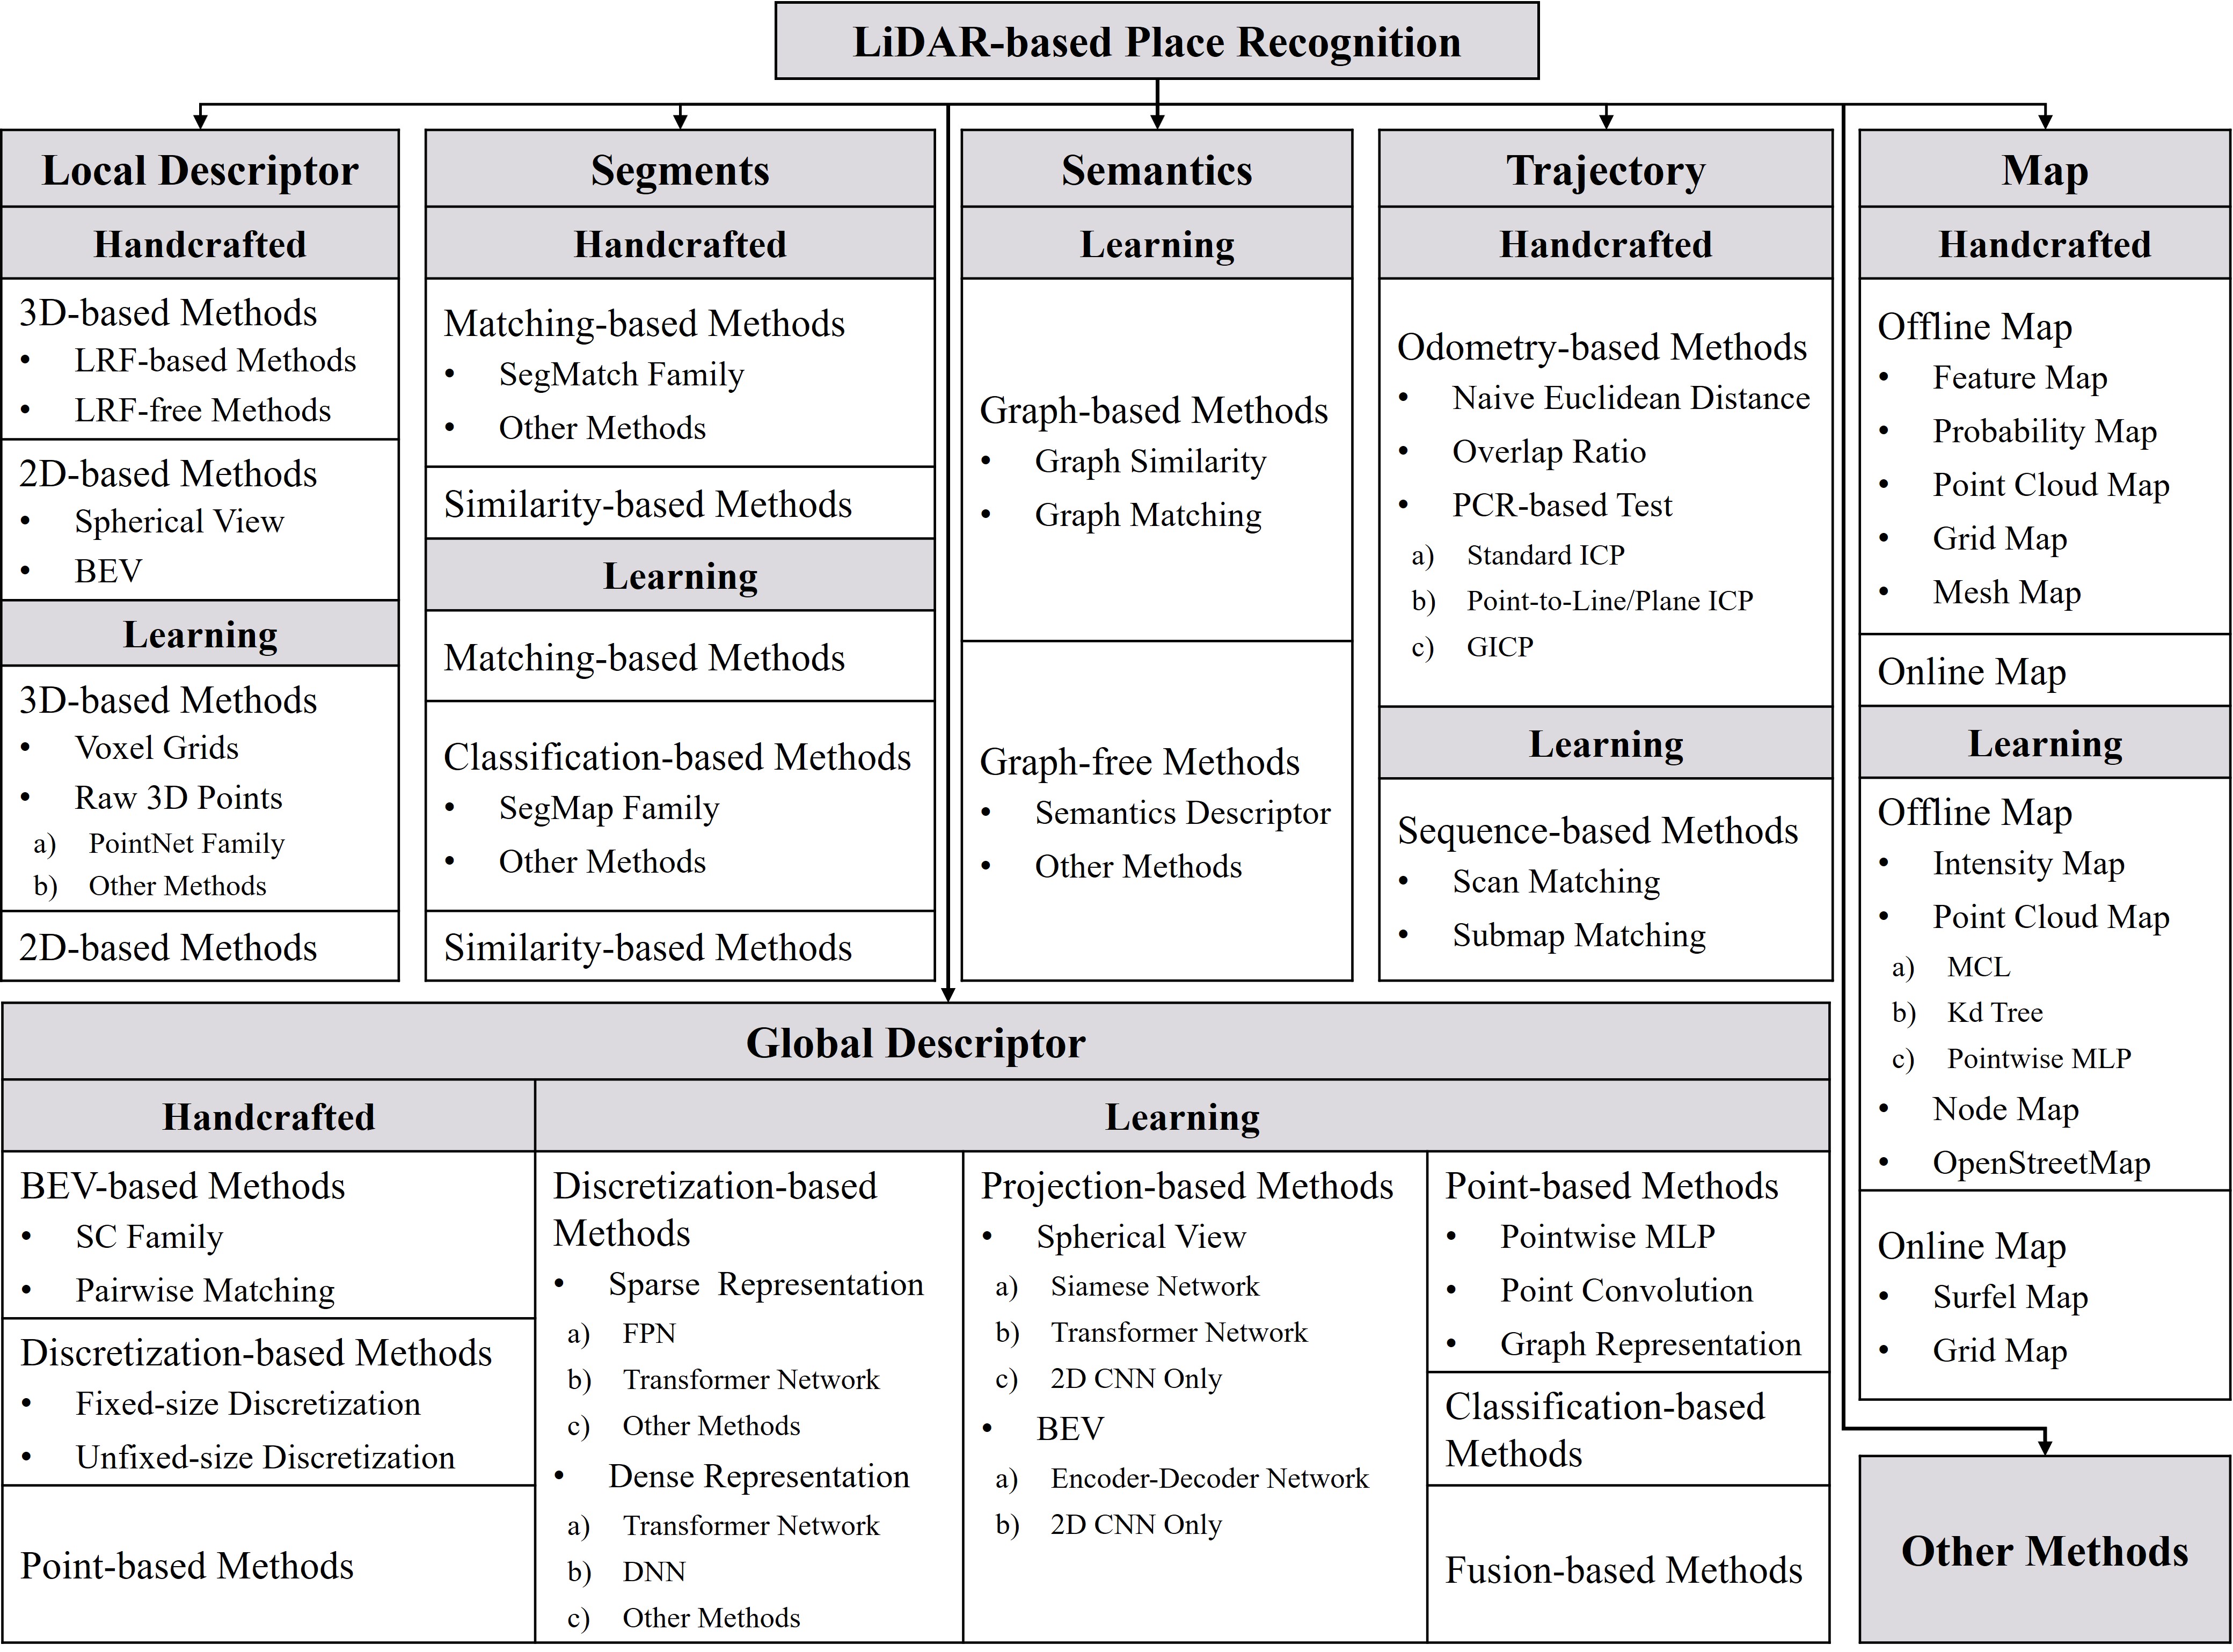
В данной статье мы представляем всесторонний обзор исследований LPR, сопровождаемый подробной методологической таксономией, изображенной на Рисунке 1. Мы классифицируем методы на типы, основанные на ручном конструировании, и на типы, основанные на обучении, далее подразделяя их, а также приводим детальные введения в пионерские работы. Такая хорошо организованная структура повышает эффективность чтения и способствует более глубокому пониманию применяемых технологий для распознавания на местности. Наши основные вкладом являются следующими:
- ⟦• Насколько нам известно, эта статья является первым обзором, исключительно посвященным распознаванию местоположения на основе 3D LiDAR. Мы подробно рассматриваем постановку задачи, сложности и связь с предыдущими обзорами.
- ⟦Мы приводим подробный обзор LPR, охватывающий как традиционные, вручную созданные описатели, так и передовые методы глубокого обучения. Мы классифицируем существующие методы на семь категорий и описываем их преимущества и ограничения.
- ⟦• Мы включаем многочисленные рисунки и таблицы, чтобы помочь читателям понять открытый исходный код, базовые сети, типы признаков, метрики сходства, затраты памяти, стратегии обучения, эффективность выполнения и возможности локализации этих методов.
- ⟦• Мы обобщаем существующие наборы данных и показатели оценки, одновременно всесторонне сравнивая существующие методы на нескольких общедоступных наборах данных. Кроме того, мы также предоставляем регулярно обновляемый проект.
Структура данной статьи следующая. Раздел 1 суммирует наши вклады и структуру статьи. Раздел 2 описывает исследовательский фон. Начиная с раздела 3 и до 9, мы всесторонне рассматриваем последние методы и предлагаем подробные классификации. Раздел 10 собирает существующие наборы данных, метрики оценки и сравнения производительности на общедоступных наборах данных. Наконец, раздел 11 представляет перспективные направления будущих исследований, а раздел 12 завершает статью.
2 Фон
2.1 Постановка проблемы
Задача распознавания места обычно подразделяется на три основные группы: извлечение места, LCD и локализация по карте. При наличии данных запроса и базы данных ссылок извлечение места и LCD можно сформулировать как:
| (1) |
где представляет собой подходящего кандидата для и , а является наиболее точно соответствующим. — это показатель сходства или совпадения. Обычно размещение извлечения создает автономные базы данных из предварительно собранных или сгенерированных последовательностей, тогда как LCD использует данные одновременной локализации и картографирования (SLAM) в реальном времени для построения баз данных.
Локализация на карте предполагает использование карты высокой точности (HD Map) и методов сопоставления данных для вычисления глобальной позы, сформулированной как:
| (2) |
где — это преобразование с шестью или тремя степенями свободы (DoF). База данных обычно состоит из априорной карты и справочных данных. Этот метод позволяет выполнять прямое сравнение поз, что делает его применимым в одиночных и многороботных системах.
2.2 Проблемы LPR
С развитием технологий обработки изображений[41] и появлением доступного оборудования за последние десятилетия возникло множество методов, основанных на компьютерном зрении[42, 1, 43, 44]. Однако они сталкиваются с такими трудностями, как вариации освещения, изменения ракурса, неблагоприятные погодные условия и неоднозначность масштаба. В отличие от этого, сенсоры LiDAR активно излучают лазерные сигналы для захвата высокодетализированных 3D-точек и превосходно обеспечивают точную и подробную геометрическую информацию[45] даже в условиях низкой освещенности. Кроме того, быстрый прогресс технологий 3D-сканирования дополнительно усиливает интерес к исследованиям распознавания места с использованием сенсоров LiDAR.
Многочисленные недавние методы LPR изучали такие приемы, как bird-eye-view (BEV) [4, 46, 47], гистограммы[48, 49], представления изображений[50, 9] и теория графов [51, 52, 53], чтобы повысить производительность. Они достигают инвариантности к вращению за счет полного перебора[4, 46] и анализа в частотной области[47, 54]. Дополнительные подходы используют близость поз[55, 56], сопоставление последовательностей[6, 57] и методы регистрации облака точек (PCR)[58, 59, 60] для повышения точности распознавания. Однако эти методы испытывают трудности в динамических средах с высокой степенью перекрытия. Традиционные методы опираются на низкоуровневые признаки (координаты[61], нормали[62], интенсивности[63, 64, 65], дальность[66] и плотность[67]), тогда как подходы, основанные на обучении, постепенно демонстрируют многообещающие результаты, используя нейронные сети[68, 69], механизмы внимания[70, 71], семантику[72, 73] и классификаторы[74]. Кроме того, различные представления карт, такие как облака точек[75], семантика[76] и сетка[77], успешно применялись для локализации на карте. Несмотря на впечатляющие результаты, заявленные этими методами, сохраняется ряд задач, требующих дальнейшего внимания:
- ⟦Искажения движения: распространённое предположение о постоянной скорости движения [78, 79] неточно для выравнивания искажённых сканов, особенно в высокоскоростных приложениях.
- ⟦• Различия точки зрения: на уровне полосы могут существовать горизонтальные отклонения, когда робот возвращается в историческое место из разных направлений. Хотя некоторые методы [4, 9, 46, 51] рассматривают инвариантность к вращению, они игнорируют влияние трансляции на распознавание места.
- ⟦• Условия погоды: лазерные сигналы демонстрируют различное поведение при разных погодных условиях[80]. В солнечные дни они ослабляются в меньшей степени и распространяются дальше, но заметно затухают в дождливую и туманную погоду.
- • Переотражение восприятия: Различные места в тесных коридорах[81, 82] могут демонстрировать сходные данные облака точек, что приводит к неоднозначной интерпретации.
- ⟦• Изменения внешнего вида: Долгосрочные навигационные приложения[9, 10, 38, 11] часто связаны со значительными изменениями в окружающей среде, что приводит к возможным отказам.
- ⟦Характеристики сенсора. Механический LiDAR[83, 58] формирует облака точек в формате нескольких сканирующих линий, что приводит к вертикальной разреженности. Твердотельный LiDAR[84] обеспечивает ограниченное горизонтальное поле зрения (FOV) и требует специальных соображений в процессе распознавания.
2.3 Связь с предыдущими обзорами
В последние годы наблюдается распространение обзоров по технологиям визуальной робототехники, охватывающих различные темы, такие как распознавание мест[37, 40, 36, 39], локализация[85, 86], слежение[87, 88] и SLAM [89, 90, 91]. Хотя эти обзоры внесли существенный вклад в развитие исследований в робототехнике и автономном вождении, к сожалению, они пренебрегли технологией датчиков LiDAR.
Cadena et al.[92] подробно рассмотрели текущее состояние SLAM и изучили потенциальные будущие направления. Yin et al.[93] представили исчерпывающий обзор распознавания места с охватом камер, LiDAR, радара и совместных датчиков. Однако раздел, посвященный обсуждению LiDAR, был относительно ограниченным. Yin et al.[94] предложили информативный обзор недавнего прогресса и достижений в LiDAR-based global localization, но это лишь представляло собой специализированную ветвь распознавания места. В отличие от предыдущих работ, наш обзор был посвящен исключительно исследованиям распознавания места на основе LiDAR. Он предоставил всесторонний обзор формулировки проблемы, задачных сложностей, классификаций методов, существующих наборов данных, метрик оценки, экспериментальных результатов и будущих направлений.
| Handcrafted Methods | ||||||||
| Methods | Year | Feature | Size | Metric | Code | |||
| 3D-based Methods | LRF-free | Spin Image[95] | 1999 | Density | 153 | L2 Distance | ✓ | |
| 3DSC[96] | 2004 | Density | 1980 | L2 Distance | ✓ | |||
| PFH[97] | 2008 | Angle+Distance | 125 | Kullback-Leibler Distance | ✓ | |||
| FPFH[98] | 2009 | Angle+Distance | 33 | Euclidean Distance | ✓ | |||
| 3DGestalt[61] | 2013 | Height | 3210 | Voting | ||||
| NBLD[99] | 2016 | Density | 1648 | Voting | ||||
| GLAROT-3D [3] | 2017 | Orientation+Range | 1880 | Rotated L1 Norm | ||||
| HoPPF[100] | 2020 | Angle+Distance | 600 | |||||
| LRF-based | USC[101] | 2010 | Density | 1960 | Euclidean Distance | ✓ | ||
| RoPS[102] | 2013 | Density | 135 | L2 Distance | ✓ | |||
| SHOT[103] | 2014 | Angle | 352 | Euclidean Distance | ✓ | |||
| TOLDI[104] | 2017 | Depth | 32020 | |||||
| ISHOT[63] | 2019 | Angle+Intensity | 1344 | Voting | ✓ | |||
| Sunet al.[105] | 2020 | Height | 2020 | Euclidean Distance | ||||
| 2D-based Methods | Spherical View | Steder et al.[106] | 2010 | Range+Curvature | Euclidean Distance | |||
| Steder et al.[15] | 2011 | Range+Curvature | 36 | Manhattan Distance | ||||
| Zhuang et al.[107] | 2013 | Space | Matching Score | |||||
| Cao et al. [108] | 2018 | Position | 600391 | L1-Norm | ||||
| Shan et al.[109] | 2021 | Intensity | 1024128 | L1 Distance+Hamming Distance | ✓ | |||
| BEV | BVMatch[54] | 2021 | Density | 666 | 2D Rigid Pose | ✓ | ||
| HOPN[49] | 2022 | Normal+Density | 666 | 2D Rigid Pose | ✓ | |||
| Learning-based Methods | ||||||||
| Methods | Year | Backbone | Size | Loss | EtE | Code | ||
| 3D-based Methods | Voxel Grids | 3DShapeNet[110] | 2015 | Convolutional BDN | 242424 | Contrastive Divergence | ✓ | |
| VolumetricCNN[111] | 2016 | CNN | 512 | Classification | ✓ | |||
| 3DMatch[112] | 2017 | 3D ConvNet | 512 | Contrastive | ✓ | |||
| FCGF[113] | 2019 | ResUNet | 32 | Hardest-contrastive and Hardest-triplet | ||||
| 3DSmoothNet[114] | 2019 | CNN | 16 | Batch Hard | ✓ | |||
| SpinNet[115, 116] | 2021 | Transformer+3DCCN | 32 | Contrastive | ✓ | ✓ | ||
| Raw 3D Points | PointNet[117] | 2017 | CNN | 1024 | Regularization Softmax | ✓ | ||
| PointNet++[118] | 2017 | PointNet | Cross Entropy | ✓ | ✓ | |||
| CGF[119] | 2017 | DNN | 32 | Triplet | ||||
| PPFNet[120] | 2018 | PointNet | 64 | N-tuple | ||||
| PPF-FoldNet[121] | 2018 | MLP | 512 | N-tuple | ||||
| DeepVcp[122] | 2019 | PointNet++ | 32 | L1+L2 | ✓ | ✓ | ||
| RelativeNet[123] | 2019 | PPF-FoldNet | Chamfer | ✓ | ||||
| D3feat[124] | 2020 | KPConv | Contrastive+Triplet | ✓ | ||||
| L3Ds[125] | 2022 | TNet+PointNet | 32 | Contrastive | ✓ | |||
| Poiesiet al.[126] | 2022 | QNet+PointNet++ | 32 | Hardest-contrastive | ✓ | |||
| LEAD[127] | 2022 | Spherical CNN | 512 | Chamfer Distance | ✓ | |||
| 2D-based Methods | LORAX[25] | 2017 | DNN | 1032 | Pixel-wise Error+ICP | ✓ | ||
| MVDesc[128] | 2018 | MatchNet | 32 | Double-margin Contrastive | ||||
| Li et al.[129] | 2020 | CNN | 32 | Batch-hard triplet | ✓ | ✓ | ||
| Gojcic et al.[130] | 2020 | FCGF | 32 | Hardest Contrastive | ✓ | ✓ | ||
| DeLightLCD[131] | 2022 | DNN | 130032 | Binary Cross Entropy | ✓ | |||
3 Методы LPR: Локальные дескрипторы
Локальный дескриптор представляет собой компактное представление областей или точек, фиксирующее отличительные характеристики, такие как текстура, цвет, плотность или форма. Методы на основе локальных дескрипторов обычно выделяют ключевые точки и используют локальные дескрипторы для описания окружающего контекста. Как правило, они относились либо к категориям 3D, либо к категориям 2D в зависимости от природы дескрипторов. Таблица I содержала систематизированное обобщение. Рисунок 2 описывал несколько репрезентативных методов.
3.1 Ручные методы
3.1.1 Методы на основе трехмерных данных
Мы примерно подразделяем самодельные 3D локальные дескрипторы на две группы в зависимости от локальной системы отсчета (LRF).
Методы на основе LRF. LRF была нацелена на жесткое преобразование фрагмента в его каноническое представление путем выбора точек окрестности для построения матрицы ковариации и вычисления собственного вектора как опорных осей. Хотя изначально она была разработана для PCR, она также применялась для распознавания положения. Некоторые методы были сосредоточены на кодировании геометрической информации, такой как normal[103, 63], height[105] и mesh[102], внутри LRF, чтобы добиться точных геометрических описаний. Другие повышали устойчивость LRF за счет взвешенных векторов проекции[104] или устранения неоднозначности знака[101].
Методы без LRF. Другие методы обеспечивали инвариантность к вращению, избегая построения LRF и сосредоточиваясь исключительно на базовой геометрии локальной поверхности. Ранние методы непосредственно подсчитывали окружающую геометрическую информацию, такую как высота[61], расстояние[97, 98, 3] и плотность[95], как описания локальной поверхности. Затем несколько методов кодировали распределение точек[96, 100] и разреженные триангулированные опорные точки[99]⟧.
3.1.2 Методы на основе двухмерных данных
Эти методы проецировали облако точек на двумерное изображение и строили ручные локальные дескрипторы по изображению, после чего решали задачу сопоставления изображений. Сферический обзор и вид сверху (BEV) были двумя репрезентативными подходами к проекции.
Сферический обзор. Проецирование облаков точек в сферическое или радинговое изображение с использованием модели угла пеленга (BA) эффективно устранило неоднозначность ориентации. Steder et al.[106] первыми предложили проецирование облаков точек в радинговые изображения для распознавания места. Они извлекли вектор локального дескриптора [132] и оценили кандидатные преобразования с помощью перепроецирования ключевых точек. Затем несколько работ расширили метод[106], применяя радиальные признаки, согласованные по нормали (NARF) [15], ускоренные робастные признаки (SURF) [107] и ORB[108, 109].
BEV. Несколько работ включили в сопоставление изображений признаки, основанные на предложении, из BEV-изображений. BVMatch[54] извлекла карту максимальных индексов[133] из откликов фильтра Log-Gabor, используя преобразование BEV-признаков и BoW для распознавания мест. Этот подход обеспечил относительные позы и эффективно преодолел разреженность и искажение интенсивности. Luo et al.[49] применили признаки детекторов accelerated segment test (FAST)[134] к BEV-изображению и построили дескриптор HOPN с использованием 3D-нормалей. Он продемонстрировал превосходную способность к локализации в сценариях крупномасштабного масштаба.
3.2 Обучаемые методы
3.2.1 Методы на основе трехмерных данных
Обучаемые 3D локальные дескрипторы обычно используют 3D CNN для кодирования фрагментов облака точек, разделяя их на воксельные сетки и исходные 3D точки в соответствии с входными данными сети.
Сетка из вокселей. Пионерская работа 3DMatch[112] преобразовала патчи в сетки из вокселей усеченной функции знакового расстояния (TSDF) и использовала восемь слоев свёртки, чтобы изучать локальные дескрипторы. Затем несколько работ расширили эту идею до более информативных способов кодирования, таких как двоичная заполняемость[111], многометочная заполняемость [110], разреженное тензорное представление[113], сглаженное значение плотности[114] и сферическая вокселизация[115, 116]⟧.
Сырые трехмерные точки. В качестве альтернативного метода использовалась прямая обработка данных исходного облака точек.
Семейство PointNet. PointNet[117] был пионерской работой по обучению на неупорядоченных облаках точек, которая изучала симметричную функцию, аппроксимируемую многослойным перцептроном (MLP), для обработки детальных форм. Затем PointNet++ [118] представил улучшенную версию, использующую поиск по области в виде шара для рекурсивного применения PointNet[117] и агрегирования признаков на нескольких масштабах. Несколько работ расширили PointNet[117] за счёт включения нормалей[120], декодера FoldingNet[121], ориентации[123], LRF[125, 126] и семантики[122].
2) Другие методы. Compact Geometric Features (CGF)[119] обучал глубокую сеть для отображения из многомерного пространства сферических гистограмм в низкоразмерное евклидово пространство. D3Feat[124] разработал двухцелевую полностью сверточную сеть, которая с высокой плотностью предсказывала как оценки детекции, так и признаки описания. Local equivariant descriptor (LEAD)[127] объединял сферические сверточные сети для изучения эквивариантного представления и использовал декодеры с плоскостной свёрткой для обучения без учителя.
3.2.2 Методы на основе двух измерений
Несколько работ вывели локальные дескрипторы, используя хорошо зарекомендовавшие себя 2D CNN из спроецированных 2D изображений. Они продемонстрировали превосходящую производительность в задаче распознавания и извлечения 3D форм. LORAX[25] и DeLightLCD[131] использовали, соответственно, глубокую нейронную сеть (DNN) автоэнкодер и внимание, чтобы повысить информативность дескрипторов на 2D изображениях глубины. Другая линия исследований объединяла многовидовые признаки в локальные дескрипторы с помощью soft-view pooling[129], графической модели[128] и спектральной релаксации[130]⟧.
3.3 Сводка
В этом разделе рассмотрены некоторые представительные методы и более всеобъемлющие обзоры локальных дескрипторов, доступные в [135, 136, 137]. Хотя локальные дескрипторы нашли широкое применение в задачах, таких как PCR и распознавание объектов, они не были предпочтительными методами для распознавания места. В основном были следующие причины:
- ⟦Изменения точки зрения могут повлиять на точность 3D ключевых точек[138], делая их неподходящими для сопоставления. Кроме того, они могут неэффективно справляться с шумом данных и перекрытием объектов.
- ⟦Использование 3D локальных дескрипторов[61, 99] могло быть сложным, поскольку требовалось плотное облако точек, что было вычислительно затратным и, возможно, плохо подходило для датчиков, таких как Velodyne VLP-16[66], которые формировали разреженное облако точек.
- ⟦При преобразовании облаков точек в изображения [106, 54, 131] можно было бы использовать зрелые методы обработки изображений, однако это привело к потере геометрической информации, из-за чего данный подход оказался непригодным для сценариев большого масштаба.
4 Техники LPR: глобальный дескриптор
Глобальный дескриптор фиксирует общие признаки сцены, обеспечивая целостное представление данных, а не фокусируясь на конкретных областях или точках. Таблица II содержит систематизированное обобщение методов на основе глобального дескриптора.
| Handcrafted Methods | ||||||||
| Methods | Year | Metric | Size | Feature | Code | |||
| BEV | SC[4] | 2018 | L0 Norm+Cosine Distance | 6020 | Height | ✓ | ||
| ISC[46] | 2020 | Cosine Distance | 6020 | Intensity | ||||
| LiDAR Iris [47] | 2020 | Hamming Distance | 80360 | Height | ✓ | |||
| Shi et al.[139] | 2021 | Cosine Distance | 6020 | Height | ||||
| WSC[140] | 2021 | Cosine Distance+Euclidean Distance | Height+Intensity | |||||
| SC++[7] | 2021 | L1 Norm+Cosine Distance | 6020 | Height | ✓ | |||
| RING[141] | 2022 | Circular Cross-correlation | 120120 | Occupancy | ||||
| RING++[142] | 2022 | Circular Cross-correlation | 120120 | Height+Occupancy | ✓ | |||
| FSC[143] | 2022 | F-Norm | Height+Intensity | |||||
| PGHCI [67] | 2022 | JS Divergence+Pixel Values | 4020 | Height | ||||
| FreSCo[144] | 2022 | L1 Norm+Cosine Distance | 20120 | Height | ✓ | |||
| Ou et al.[145] | 2023 | Cosine Distance | 52060 | Density+Height | ||||
| Discretization | Magnussonet al.[146] | 2009 | Euclidean Distance | Shape | ||||
| DELIGHT[64] | 2018 | Chi-squared Test | 256 | Intensity | ||||
| Lin et al. [84] | 2019 | Normalized Cross-correlation | 6060 | Shape | ✓ | |||
| Mo et al. [147] | 2020 | L2-Norm+Chi-square Test | 192+256 +6020 | Density+Intensity+Height | ✓ | |||
| Cao et al.[148] | 2021 | Euclidean Distance | 360180 | Context+Layout | ||||
| Point | Z-Projection [62] | 2011 | Distance+Sørensen Distance | 101 | Normal | |||
| Fast Histogram [48] | 2015 | Wasserstein Metric | 80 | Height | ||||
| M2DP[149] | 2016 | L2-Norm | 192 | Density | ✓ | |||
| C-M2DP[150] | 2019 | L2 Distance | 576 | Color+Shape | ||||
| Learning-based Methods | ||||||||
| Methods | Year | Backbone | Aggregator | Size | Loss | EtE | ||
| Point | Pointwise MLP | Pointnetvlad[12] | 2018 | PointNet | NetVLAD | 256 | Lazy triplet and quadruplet | ✓ |
| PCAN[70] | 2019 | PointNet | NetVLAD | 256 | Lazy quadruplet | ✓ | ||
| SOE-Net[151] | 2021 | PointOE | NetVLAD | 256 | HPHN quadruplet | ✓ | ||
| LCD-Net[152] | 2022 | PV-RCNN | NetVLAD | 256 | Triplet | ✓ | ||
| Point Convolution | DH3D[71] | 2020 | FlexConv+SE block | NetVLAD | 256 | N-tuple | ✓ | |
| EPC-Net[69] | 2022 | PPCNN | VLAD | 256 | Lazy quadruplet | |||
| Graph | LPD-Net[5] | 2019 | PointNet | NetVLAD | 256 | Lazy quadruplet | ✓ | |
| DAGC[13] | 2020 | ResGCN | NetVLAD | 256 | Lazy quadruplet | ✓ | ||
| SR-Net[153] | 2020 | SGC+SAM | NetVLAD | 1024 | Lazy quadruplet | ✓ | ||
| vLPD-Net[154] | 2021 | LPD-Net+S-ARN | MinkPool | Joint loss | ||||
| PPT-Net[155] | 2021 | Transformer | VLAD | 256 | Lazy quadruplet | |||
| Discretization | Sparse Volumetric | MinkLoc3D[156] | 2021 | FPN | GeM | 256 | Triplet margin | |
| MinkLoc++[157] | 2021 | ResNet18+FPN | GeM | 256 | Triplet margin | |||
| EgoNN[158] | 2021 | CNN | GeM | 256 | Triplet margin | |||
| TransLoc3D[159] | 2021 | Transformer | NetVLAD | 256 | Triplet margin | ✓ | ||
| MinkLoc3Dv2[160] | 2022 | FPN | GeM | 256 | Modified Smooth-AP | |||
| MinkLoc3D-SI[161] | 2022 | FPN | GeM | 256 | Triplet margin | |||
| SVTNet[8] | 2022 | Transformer | GeM | 256 | Triple | |||
| LoGG3D-Net[162] | 2022 | U-Net | O2P+ePN | 256 | Contrastive+Quadruplet | ✓ | ||
| Dense Discretization | SpoxelNet[163] | 2020 | CNN | NetVLAD | Lazy quadruplet | ✓ | ||
| VBRL[164] | 2020 | Modality norm | ||||||
| HiTPR[165] | 2022 | Transformer | Max pooling | 1024 | Lazy quadruplet | |||
| NDT-Transformer[166] | 2022 | Transformer | NetVLAD | 256 | Lazy quadruplet | ✓ | ||
| Projection | Spherical View | Yin et al.[167] | 2017 | DNN | Contrastive | |||
| MMCS-Net[168] | 2022 | Siamese CNNs | NetVLAD | Contrastive | ✓ | |||
| SeqOT[169] | 2022 | Transformer | GeM | 256 | Triplet | ✓ | ||
| OverlapTransformer[170] | 2022 | Transformer | NetVLAD | 256 | Lazy triplet | ✓ | ||
| AttDLNet[171] | 2021 | DarkNet53 | Max pooling | 1024 | Cosine similarity | |||
| OREOS[50] | 2019 | CNN | Triplet | |||||
| BEV | SCI[9] | 2019 | LeNet | Categorical cross-entropy | ✓ | |||
| DiSCO[68] | 2021 | U-Net | 1024 | Quadruplet+KL divergence | ✓ | |||
| Fusion | PIC-Net[172] | 2020 | Resnet50+PointNet | NetVLAD | 512 | Lazy quadruplet | ||
| CORAL[18] | 2021 | ResNet18+FPN | NetVLAD | 256 | Lazy quadruplet | ✓ | ||
| Bernreiteret al.[173] | 2021 | Spherical CNN | Triplet | ✓ | ||||
| Adafusion[174] | 2022 | CNN | GAP | 256 | Pairwise margin | ✓ | ||
4.1 Ручные методы
Изготовленные вручную глобальные дескрипторы обычно использовали один дескриптор для описания всего облака точек. В зависимости от типа разбиения пространства их можно было разделить на методы, основанные на BEV, методы, основанные на дискретизации, и методы, основанные на точках. Три репрезентативных метода показаны на рисунке 3.
4.1.1 Методы на основе BEV
Проекция BEV привлекла значительное внимание в сообществе робототехники благодаря своей способности повышать эффективность алгоритмов за счет снижения размерности, что делает ее особенно подходящей для приложений в реальном времени. Семейство Scan Context (SC)[4] и попарное сопоставление были двумя основными методами.
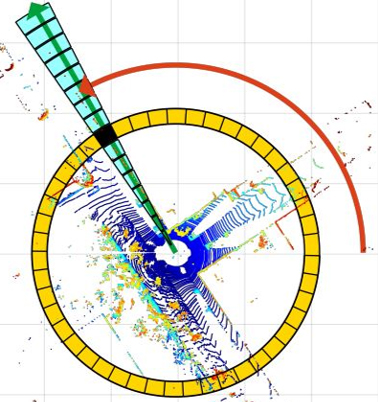
SC Family. Как показано на рисунке 3(a), новаторская работа SC[4] разделила горизонтальное пространство на дискретные ячейки, при этом сохраняя максимальную высоту точек, чтобы сформировать двумерный матричный дескриптор. Для поиска потенциальных соответствий использовался ring key, а затем выполнялось сравнение по столбцам для определения ближайшего варианта. Этот подход продемонстрировал многообещающую производительность, но мог не справиться при наличии значительных боковых смещений. Впоследствии исследователи предложили ряд вариантов методов на основе SC, которые использовали полярный и карт контекст[7], интенсивности[46, 140], область частот[144], локальную систему отсчёта (LRF)[139], F-норм[143] и пространственный двоичный паттерн (SBP)[145] для повышения производительности. Кроме того, некоторые исследования [175, 176, 177] включали методы на основе SC в модуль LCD в рамках LiDAR SLAM, чтобы повысить производительность локализации и построения карты.
Парное сопоставление. LiDAR Iris[47] черпала вдохновение из человеческих сигнатур радужной оболочки, используя фильтрацию и пороговую обработку LoG-Gabor для создания двоичных изображений сигнатур, а затем измеряя сходство дескрипторов с помощью расстояния Хэмминга. Некоторые методы также применяли взвешенные расстояния[67] и метрики инвариантности к ориентации[141, 142] для вычисления парного сходства.
4.1.2 Методы дискретизации
Дискретизирующая обработка преобразовала облако точек в трехмерные дискретные представления, разделенные на подходы фиксированного и нефиксированного размера..
Фиксированная размерность дискретизации. Magnussonet al.[146] сопоставили облако точек преобразованию вокселей NDT (преобразование нормального распределения) и создали гистограмму на основе функции плотности вероятности локальной поверхности. Они вычислили сходства дескрипторов, используя взвешенные евклидовы расстояния. Этот метод продемонстрировал потенциал дескрипторов NDT для распознавания места. Затем исследователи предложили техники вроде кластеризации k-means++[178] и метрики нормализованной взаимной корреляции[84, 179] для повышения обобщения. Cao et al.[148] также сгенерировали числовой дескриптор, обнаруживая контуры и вычисляя спектральные энергии из клиновидных вокселей.
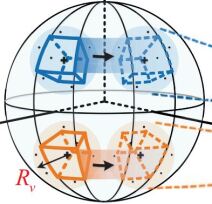
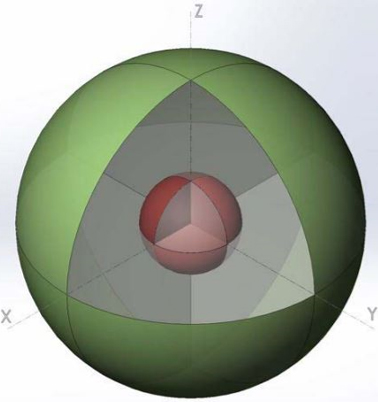
Дискретизация с нефиксированным размером. Как показано на рисунке 3(b), DELIGHT [64, 147] разделила область поддержки на две концентрические сферы и получила непересекающиеся бины за счет горизонтальных и азимутальных разделений. Она вычислила гистограммы интенсивности для каждого бина и оценила сходство дескрипторов с помощью χ²-тестов. Отметим, что дескриптор мог быть локальным или глобальным в зависимости от радиуса дескриптора и опорной точки.
4.1.3 Методы, основанные на точках
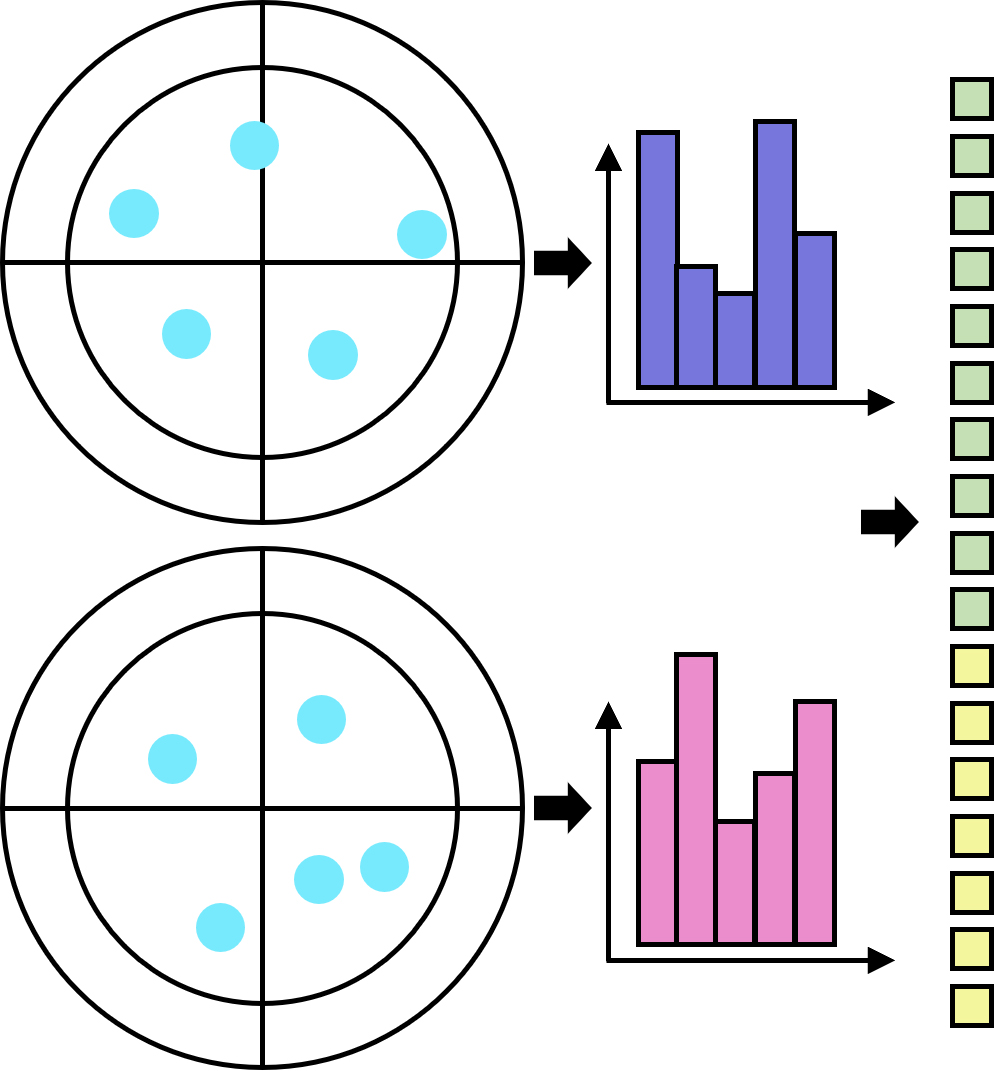
Несколько методов рассматривали распознавание положения как задачу сопоставления гистограмм, кодируя информацию об угле[62] и высоте[48] и вычисляя сходство гистограмм с использованием метрики Уассерштейна[48], расстояний Соренсена[62] и [62]. Они обеспечили инвариантность к поворотам и преодолели шумы. Как показано на рисунке 3(c), параллельно развивалось направление работ, следовавшее проекционной схеме. M2DP[149] и C-M2DP[150] проецировали облако точек на несколько двумерных плоскостей, используя углы азимута и элевации, подсчитывая атрибуты плотности точек, чтобы создать дескриптор. Вычисление многовидовых сигнатур плотности позволяло получать точные описания при меньших вычислительных ресурсах, что делало этот подход особенно эффективным для разреженных облаков точек.
4.2 Обучаемые методы
Этот раздел исследовал методы, основанные на обучении, для получения глобальных дескрипторов, сгруппированные в пять категорий в зависимости от архитектуры сети и механизма модели: методы на основе точек, основанные на дискретизации, основанные на классификации, основанные на проекциях и методы слияния.
4.2.1 Точечно-ориентированные методы
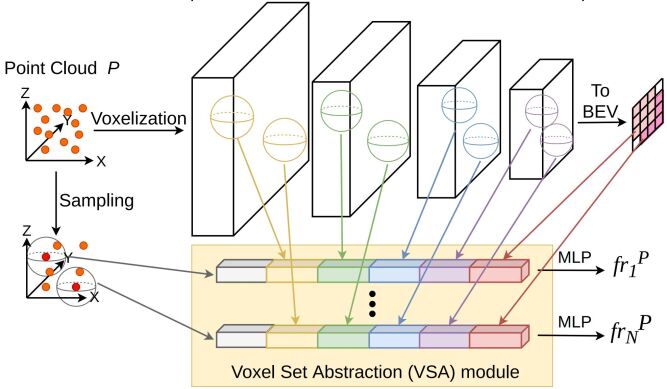
Один из распространенных подходов напрямую использует присущую трехмерную пространственную информацию для обработки облака точек LiDAR, применяя по-точечный MLP, точечную свертку и представление в виде графа, как показано на рисунке 4.
Покомпонентный MLP. В новаторской сквозной работе PointNetVLAD [12] объединили PointNet [117] для извлечения локальных признаков и NetVLAD[43] для генерации глобального дескриптора. Она применяла метрическое обучение [180] и ввела ленивые функции потерь для тройки и четверки, чтобы повысить общность глобальных дескрипторов. Затем PCAN[70] и SOE-Net[151] улучшили представление высокоразмерных признаков, включив механизмы внимания. Как показано на рисунке 4(a), LCD-Net[152] использовала архитектуру PointVoxel-RCNN (PV-RCNN)[181] и объединила возможности извлечения признаков глубокой нейронной сетью с алгоритмами теории переноса.
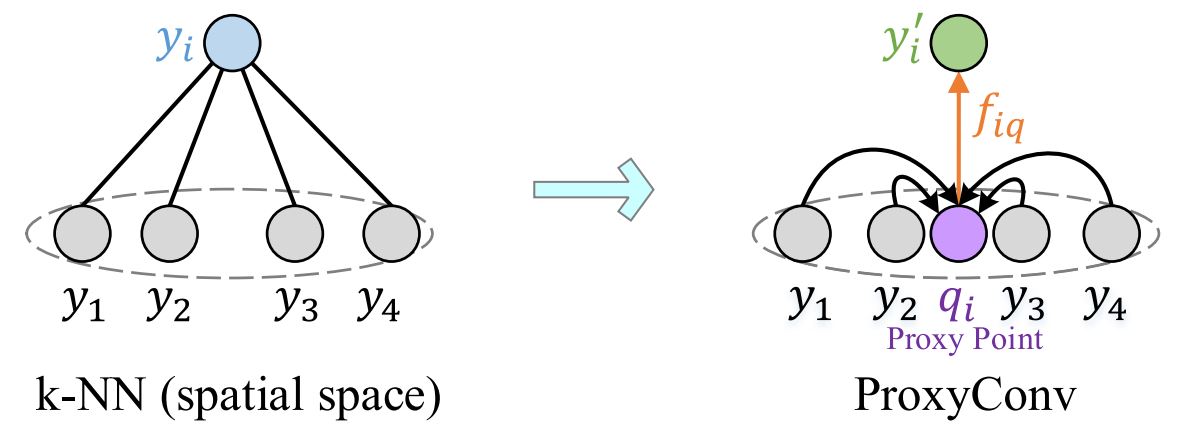
Точечная свертка. DH3D[71] представила сиамскую сеть для локального обнаружения признаков, описания и извлечения глобального дескриптора за один прямой проход. Она использовала многоуровневую пространственную контекстную информацию и корреляции признаков по каналам с помощью гибкой свертки (FlexConv)[182] и сверточного возбуждения и сжатия (squeeze-and-excitation, SE)[183]. Как показано на рисунке 4(b), EPC-Net[69] представляла собой компактную модель на основе edge convolution, упрощая процесс с помощью матриц пространственно смежных элементов и прокси-точек. Она обеспечила отличную производительность при значительном снижении вычислительной памяти.
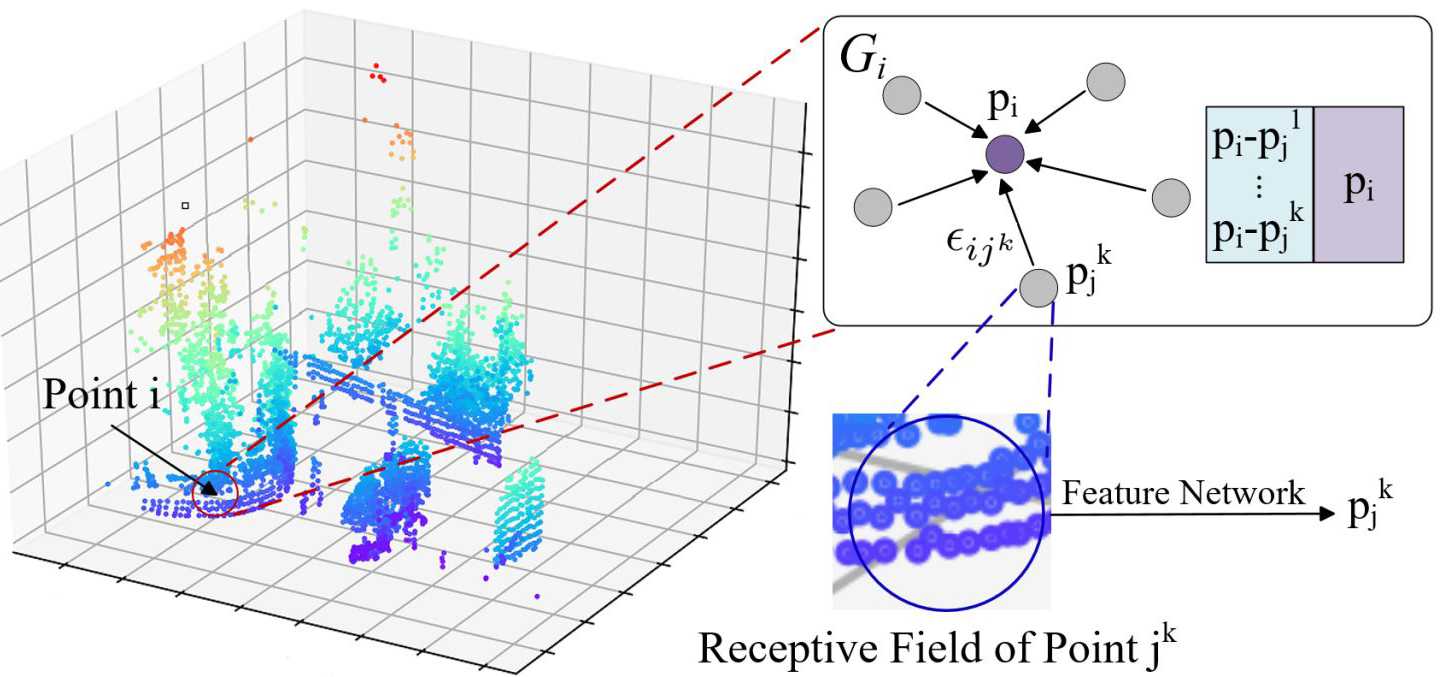
Графовое представление. Графовые сети эффективно улавливают лежащие в основе геометрические и формообразующие свойства, обеспечивая результативную обработку и сравнение признаков на различных участках внутри графов. Как показано на рисунке 4(c), LPD-Net[5] и vLPD-Net[154] объединили адаптивное извлечение локальных признаков с модулем агрегирования соседства на основе графа. Они извлекали несколько локальных признаков, включая кривизну, высоту и плотность, и использовали графовую нейронную сеть (GNN) для агрегирования признаков. В ряде работ был добавлен модуль внимания, чтобы выделять признаки, значимые для задачи[13], изучать пространственные взаимосвязи между областями[155] и уменьшать влияние подвижных помех[153].
4.2.2 Методы дискретизации
Мы разделили методы, основанные на дискретизации, на разреженные и плотные представления в зависимости от плотности вокселей.
Спарсное представление. Три подхода к формированию глобальных дескрипторов с помощью 3D CNN на разреженных объемных представлениях — это feature pyramid network (FPN), transformer network и другие методы.
1) FPN. MinkLoc3D[156], новаторская работа, основанная на разреженной вокселизации, использовала архитектуру 3D FPN[184] и обобщённое среднее (GeM)[185] пулингование для генерации глобального дескриптора. Она продемонстрировала простую и элегантную архитектуру, подчёркивая потенциал разреженного вокселизированного представления и разреженных свёрток для эффективного извлечения трёхмерных признаков. Позднее работы расширили MinkLoc3D[156], включив интенсивность[161], изображение[157] и внимание[158, 160], чтобы повысить качество распознавания.
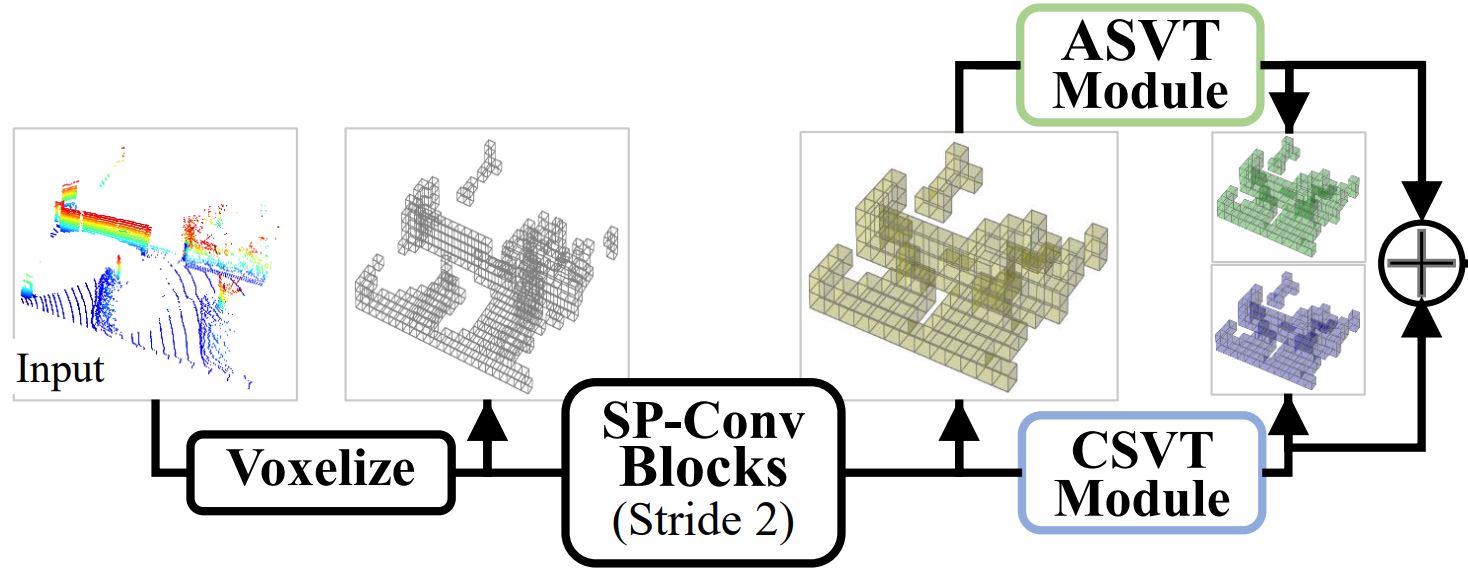
2) Сеть Transformer. TransLoc3D[159] переупорядочила признаки из нескольких рецептивных масштабов с помощью карты внимания и включила внешние слои внимания для захвата информации дальнего контекста. SVT-Net[8], показанная на рисунке 5(a), представила два типа transformers для захвата локальных признаков ближнего радиуса и признаков дальнего контекста соответственно. Несмотря на неглубокую архитектуру сети, она сгенерировала описательные дескрипторы.
3) Другие методы. LoGG3D-Net[162] использовала разреженную U-Net[186] для встраивания признаков высокой размерности и ввела локальную функцию потерь согласованности для максимизации сходства признаков. Она продемонстрировала превосходную сквозную производительность, работая практически в реальном времени.
Плотное представление. Аналогично, мы в общих чертах классифицировали подходы на основе плотного представления на подходы, основанные на трансформерных сетях, DNN, и другие методы.
1) Сеть Transformer. HiTPR [165] использовала трансформер на коротком радиусе для извлечения локальных признаков внутри ячеек и трансформер на дальнем радиусе для кодирования глобальных взаимосвязей между ячейками. Это повысило релевантность локальных соседей и глобальных контекстных зависимостей, демонстрируя превосходную эффективность. Как показано на рисунке 5(b), NDT-Transformer[166] представил новую сеть с тремя последовательно расположенными энкодерами трансформера, обучающую глобальному дескриптору на основе дискретных NDT-ячеек. Он нашёл ценное равновесие между уровнем производительности на уровне современного состояния (SOTA) и временем выполнения, что сделало его ценным дополнением к методам SLAM и MCL на основе NDT.
2) DNN. SpoxelNet[163] сферически разложила облако точек, представив занятость вокселей с помощью троичных значений. Она извлекла многомасштабные структурные признаки и сгенерировала глобальное описание путем объединения признаков из различных направлений. Этот метод эффективно справлялся с перекрытиями и движущимися объектами в многолюдных помещениях внутри зданий.
3) Другие методы. Обучение представления на основе вокселей (Voxel-based representation learning, VBRL)[164] решало распознавание местности на длительных временных интервалах за счет совместного изучения важности вокселей и модальностей признаков с использованием структурированных норм, побуждающих к разреженности. Оно интегрировало все признаки в единую задачу регуляризованной оптимизации.
4.2.3 Методы, основанные на классификации
Несколько подходов решали задачу распознавания места с помощью классификаторов. FastLCD [65] кодировал многомодальные признаки в глобальный дескриптор, обнаруживая предполагаемые замыкания петель с использованием обучения с учителем и отклоняя ложные срабатывания посредством кросс-валидации и последующей проверки. С другой стороны, Habich и др.[187] использовали компактный глобальный дескриптор[188] для кодирования каждого скана LiDAR, выполняли поиск замыканий петель в пределах переменного радиуса на основе наибольшего собственного значения матрицы ковариации положения и предсказывали события замыканий с помощью классификатора AdaBoost[189].
4.2.4 Методы, основанные на проекциях
Следуя таксономии обучаемых двумерных локальных дескрипторов (Раздел 3.1.2), этот раздел также классифицирует методы проекции на методы для сферического обзора и BEV.
Сферический обзор. Используя изображения с сферической проекцией в качестве входных данных, три представительных метода включали сиамскую сеть, трансформерную сеть и 2D CNN только.
1) Сиамская нейронная сеть. Yin et al.[167] преобразовали облако точек в изображение с одним каналом, используя распределение диапазонов и сферические координаты. Они применили сиамскую сверточную сеть, чтобы преобразовать LCD в задачу моделирования сходства, повысив эффективность поиска за счет объединения евклидовой метрики и kd-tree. MMCS-Net[168] включала сиамскую сверточную сеть с слиянием признаков shallow-deep и каскадным механизмом внимания для работы с псевдоизображениями. Она эффективно кодировала целевые признаки для сложных сцен, обеспечивая благоприятный баланс между результативностью и эффективностью.
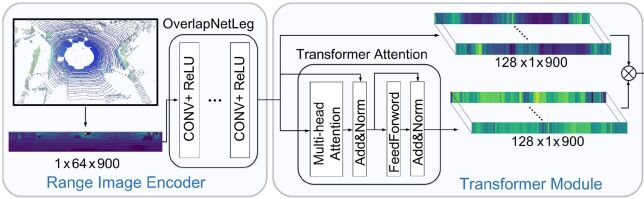
2) Сеть Transformer. SeqOT[169] использовал многомасштабные transformers для генерации подописателей, которые объединяют пространственную и временную информацию из последовательных диапазонных изображений LiDAR. Архитектура, инвариантная к повороту по рысканию, обеспечила устойчивость к изменениям точки зрения и порядку сканирования, позволяя надежное распознавание места даже в противоположных направлениях. Как показано на Рисунке 6(a), OverlapTransformer[170] применил модифицированный OverlapNetLeg для извлечения признаков из диапазонных изображений и интегрировал модуль transformer для захвата относительных местоположений признаков и глобальной информации. Он продемонстрировал высокую скорость работы и устойчивую обобщающую способность в различных средах. Сеть глубокого обучения на основе внимания (AttDLNet)[171] также включала четырехслойную сеть внимания для захвата дальнего контекста и взаимосвязей между признаками.
3) Только 2D CNN. OREOS[50] использовала слои 2D свёртки и максимального пулинга, чтобы извлекать признаки из 2D изображений диапазона, улучшая производительность дескриптора за счёт тройной функции потерь и стратегии жёсткого негативного майнинга. Она эффективно вычисляла дескриптор, обеспечивая долговременную метрическую локализацию с 3-DoF в наружных условиях..
BEV. Два репрезентативных метода на основе BEV: сеть кодировщик—декодер и только 2D CNN.
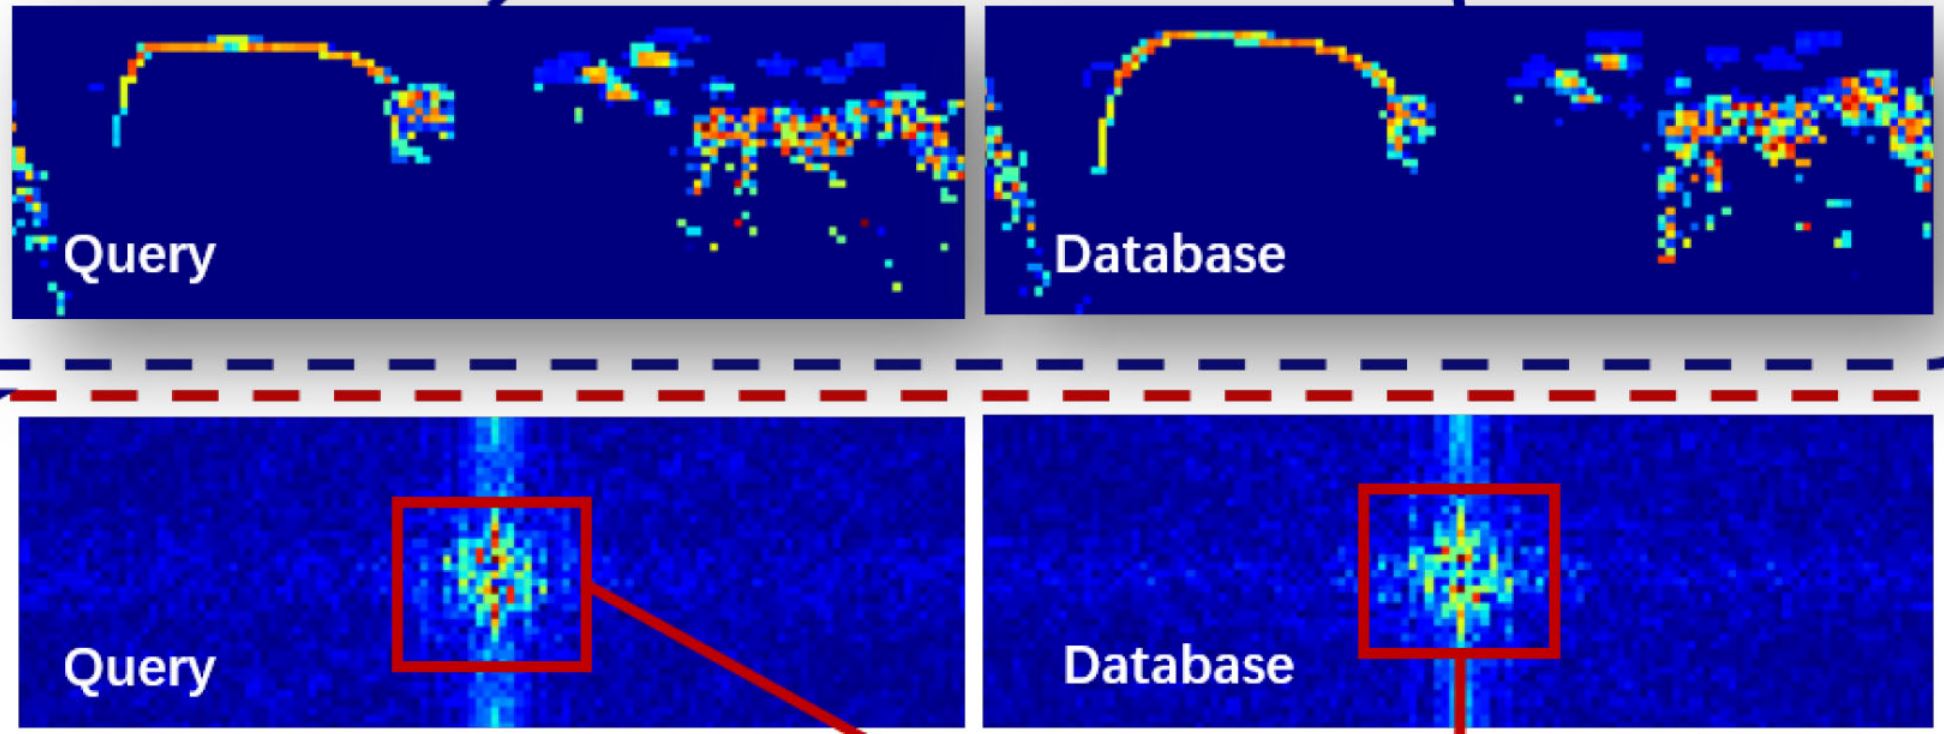
1) Сеть Encoder-Decoder. Как показано на Рисунке 6(b), DiSCO[68] — дифференцируемое сканирование контекста с ориентацией — применяла сеть encoder-decoder для извлечения дескрипторов и оценки относительной ориентации с помощью преобразования Fourier-Mellin и дифференцируемой фазовой корреляции. Это повысило интерпретируемость и эффективность извлекателя признаков.
2) Только 2D CNN. Сканирование контекстного изображения (SCI)[9] расширенным SC[4] в три канала, позволяющее локализацию робота на сеточной карте с помощью сверточной нейронной сети для классификации места. Она продемонстрировала надежную локализацию в течение всего года при обучении всего в один день.
4.2.5 Методы, основанные на слиянии
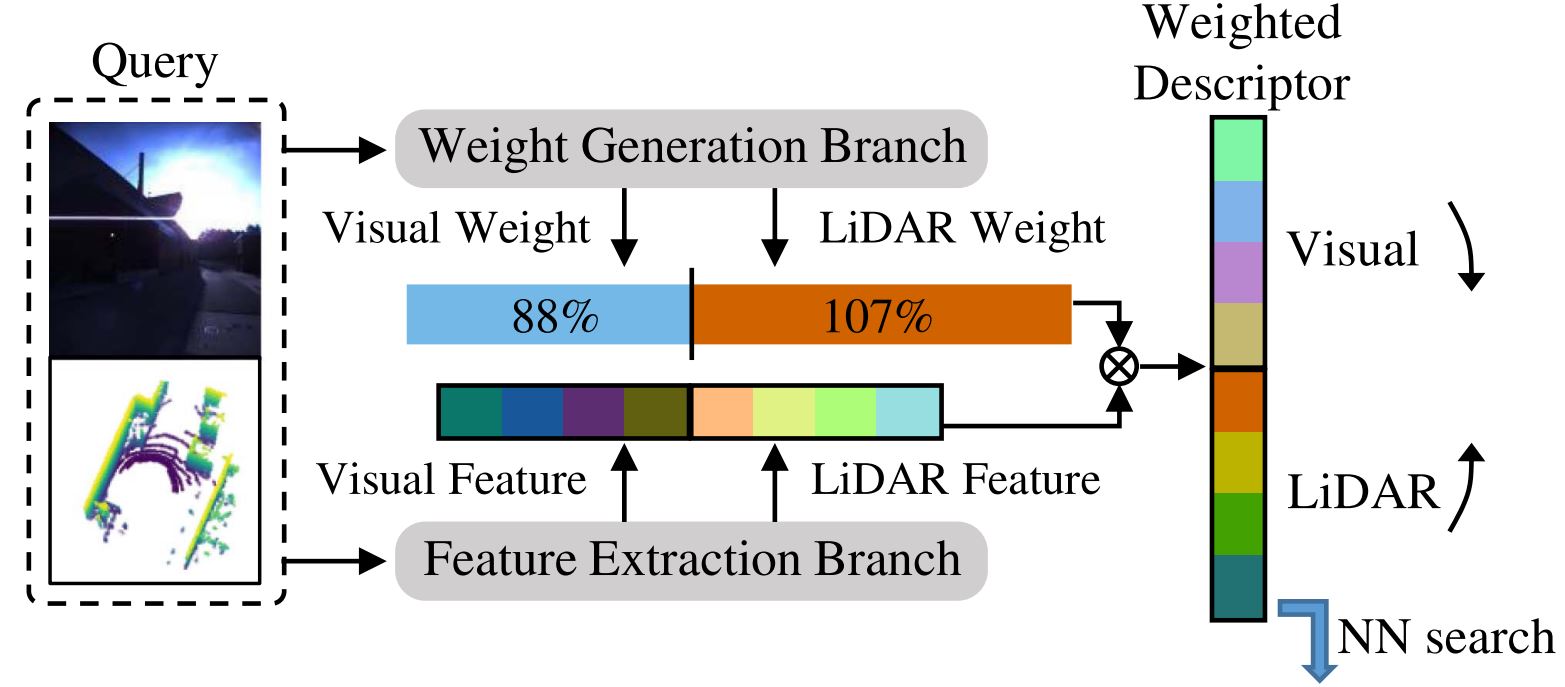
Эти методы в сочетании использовали признаки LiDAR и изображения для усиления возможностей дескриптора. В ряде работ облако точек преобразовывали в изображение и для извлечения дескриптора применяли только двумерную сеть. CORAL[18] использовала ResNet18[190] для извлечения многомасштабных признаков из высотных и визуальных изображений. Bernreiteret al.[173] применяли сферические CNNs[191, 192, 193], чтобы изучить многомодальный дескриптор на основе сферических и визуальных изображений. Как показано на рисунке 7, другое направление исследований включало использование одновременно двумерных и трехмерных сетей. Adafusion[174] и PIC-Net[172] включали механизм внимания для изучения адаптивных весов признаков и создавали составной дескриптор, используя два типа сетей.
4.3 Сводка
Глобальные дескрипторы в настоящее время были самым популярным методом распознавания места, который мог предоставлять информацию обо всей сцене, не затрагиваемой локальными изменениями. Прогресс глубокого обучения в 3D компьютерном зрении проложил путь к методам, основанным на данных, в LPR. Были обобщены следующие наблюдения::
Для рукотворной части:
- ⟦• BEV[4, 7, 46, 140] продемонстрировала превосходную производительность в плоских структурных средах, но имеет три основные ограничения: (1) Когда в глобальной системе координат менялась ось z LiDAR, могли возникать плохие результаты, потому что эти методы предполагали локальное планарное движение автомобиля. (2) Большие поперечные смещения могут приводить к пропуску петель или к сбою повторной локализации. (3) Сопоставление вращения могло вычислять только углы тангажа по курсу, что приводит к потенциальным проблемам локального оптимума, если использовать это как исходные положения для итеративного ближайшего точки (ICP)[194].
- ⟦Методы, основанные на дискретизации[146, 84, 148], могли бы описывать локальную поверхность с использованием надежных математических теорий. Однако увеличение разрешения существенно увеличит значительную вычислительную нагрузку.
- ⟦Методы на основе точек [62, 48, 149, 150] были самыми базовыми методами глобального описания. Однако для установления топологических соотношений им требовался дорогостоящий поиск соседей. Кроме того, операции проецирования [149, 150] могли приводить к потере информации и вызывать потенциальные ложноположительные результаты.
Для части обучения:
- ⟦• Обучающие методы обеспечили впечатляющую эффективность и точное распознавание, но в значительной степени полагались на достаточное количество обучающих образцов и масштабную очистку данных. Реальные условия эксплуатации создавали дополнительные трудности, включая шум, перекрытия и неопределенности в измерениях LiDAR. Следовательно, для конкретных приложений может потребоваться transfer learning.
- ⟦Transformers [165, 166, 169, 170, 171] продемонстрировали выдающиеся способности к улавливанию дальних зависимостей и контекстных взаимосвязей, обеспечивая надежное распознавание в захламленных средах. Однако их значительные вычислительные затраты ограничили размер батча для метрического обучения.
- ⟦Sparse convolutional architectures[156, 161, 157, 160] демонстрировали отличные результаты при формировании информативных локальных признаков, однако испытывали трудности с различением размера признаков в динамических сценариях. Кроме того, простое последовательное наращивание слоёв свёртки может приводить к игнорированию дальнего контекстуального взаимодействия.
- ⟦Методы на основе точек [12, 70, 151, 71, 5, 13] были инвариантны к перестановкам и могли обрабатывать неупорядоченные облака точек, но не имели явного учета локальных пространственных соотношений. Методы на основе классификации [65, 187] при обучении присваивали более высокие веса информативным признакам, делая акцент на различительных признаках. Однако конкретный вклад каждого слабого классификатора в общую предсказательную модель может быть менее интерпретируемым.
- ⟦Методы, основанные на проекциях[168, 50, 68, 9], имели более низкую вычислительную сложность и обеспечивали более интерпретируемые результаты. Однако они могли страдать от потери информации из-за снижения размерности. Методы, основанные на слиянии[18, 174, 173], использовали взаимодополняющие сильные стороны различных сенсоров. Тем не менее, обеспечение согласованной привязки данных в динамических средах оставалось сложной задачей.
5 Техники LPR: сегменты
Сегменты — это осмысленные разбиения области, характеризующиеся сходными геометрическими свойствами. Эти методы делят облако точек на сегменты, и показаны три представительных метода на Рисунке 8.
5.1 Ручные методы
Эти подходы обычно извлекали признаки сегментов для распознавания места и могли быть разделены на методы, основанные на сопоставлении, и методы, основанные на сходстве.
5.1.1 Методы, основанные на сопоставлении
Сегментное сопоставление для поиска соответствий в основном включало семейство SegMatch[74] и другие методы.
Семейство SegMatch. Пионерская работа SegMatch[74], показанная на рисунке 8(a), применяла евклидовую кластеризацию, чтобы разбить облако точек на сегменты, и извлекала признаки на основе собственных значений. Она эффективно выявляла потенциальные соответствия с использованием случайного леса и геометрической верификации на основе random sample consensus (RANSAC)[197]. Dubé et al.[198] усовершенствовали SegMatch[74], отслеживая один сегмент с помощью инкрементальной сегментации на основе region-growing. Кроме того, некоторые исследования эффективно интегрировали SegMatch[74] в традиционный LiDAR SLAM[199] и многороботные системы [200].
Другие методы. DL-SLAM [201] использовал k-means для извлечения сегментов из 2.5D heightmap и определил пять дескрипторов, чтобы облегчить сопоставление сегментов. RDC-SLAM[202] объединил дескриптор сегмента на основе собственных значений, поиск по k ближайшим соседям (KNN) и верификацию на основе RANSAC[197] для уточнения относительных поз. Он точно объединял информацию от нескольких роботов без предварительных знаний. Gong et al.[203] построили граф пространственных отношений для представления сегментов, эффективно фиксируя общие пространственные связи между нерегулярными кластерами.
5.1.2 Методы, основанные на сходстве
5.2 Обучаемые методы
Применение нейронной сети на сегментах в первую очередь связано с сопоставлением, классификацией и вычислением сходства.
5.2.1 Методы, основанные на сопоставлении
Tinchev et al.[205] кодировали геометрические свойства и распределение точек отрезков, чтобы извлекать повторяемые ориентированные ключевые позы, которые сопоставлялись с использованием надежных дескрипторов формы и Random Forest. Однако существенные изменения в точке зрения датчика могли отрицательно повлиять на производительность сопоставления отрезков. Tinchev et al.[206] использовали convolution[207] для получения пространства встраиваний, подходящего для городских и природных сценариев. Затем они оценивали качество совпадения с помощью вероятностной геометрической валидации.
5.2.2 Методы, основанные на классификации
Несколько работ вычисляли категорию сегментов, выполняя классификацию в пространстве дескрипторов. Отнесены к семейству SegMap[195, 208] и другим методам.
1) Семейство SegMap. Как показано на рисунке 8(b), новаторская работа SegMap[195, 208] инкрементально кластеризовала облака точек, чтобы создать глобальную карту сегментов. Она использовала сегментно-зависимый поиск KNN с извлекателем дескрипторов, зависящим от данных, включающим три сверточных и два полносвязных слоя, затем присваивала классификационный балл с помощью полносвязной сети. Это позволило достигать высоких коэффициентов сжатия при реконструкции среды и облегчило крупномасштабную 3D LiDAR SLAM. Затем исследователи успешно интегрировали SegMap [195] в LiDAR SLAM[209] и сегментно-ориентированную систему картографирования[210].
2) Другие методы. Wietrzykowski et al.[211] предложили DNN, которая улучшила сегментно-ориентированные дескрипторы, обучаясь визуальному контексту по синтетическим изображениям интенсивности LiDAR. Они утверждали, что использование самых современных изображений LiDAR и окружающей сцены может привести к дополнительным улучшениям производительности. OneShot[66] применял метод на основе дальностной (range) карты[212] для извлечения сегментов и специально адаптированную нейронную сеть для извлечения дескрипторов LiDAR-Vision.
5.2.3 Методы, основанные на сходстве
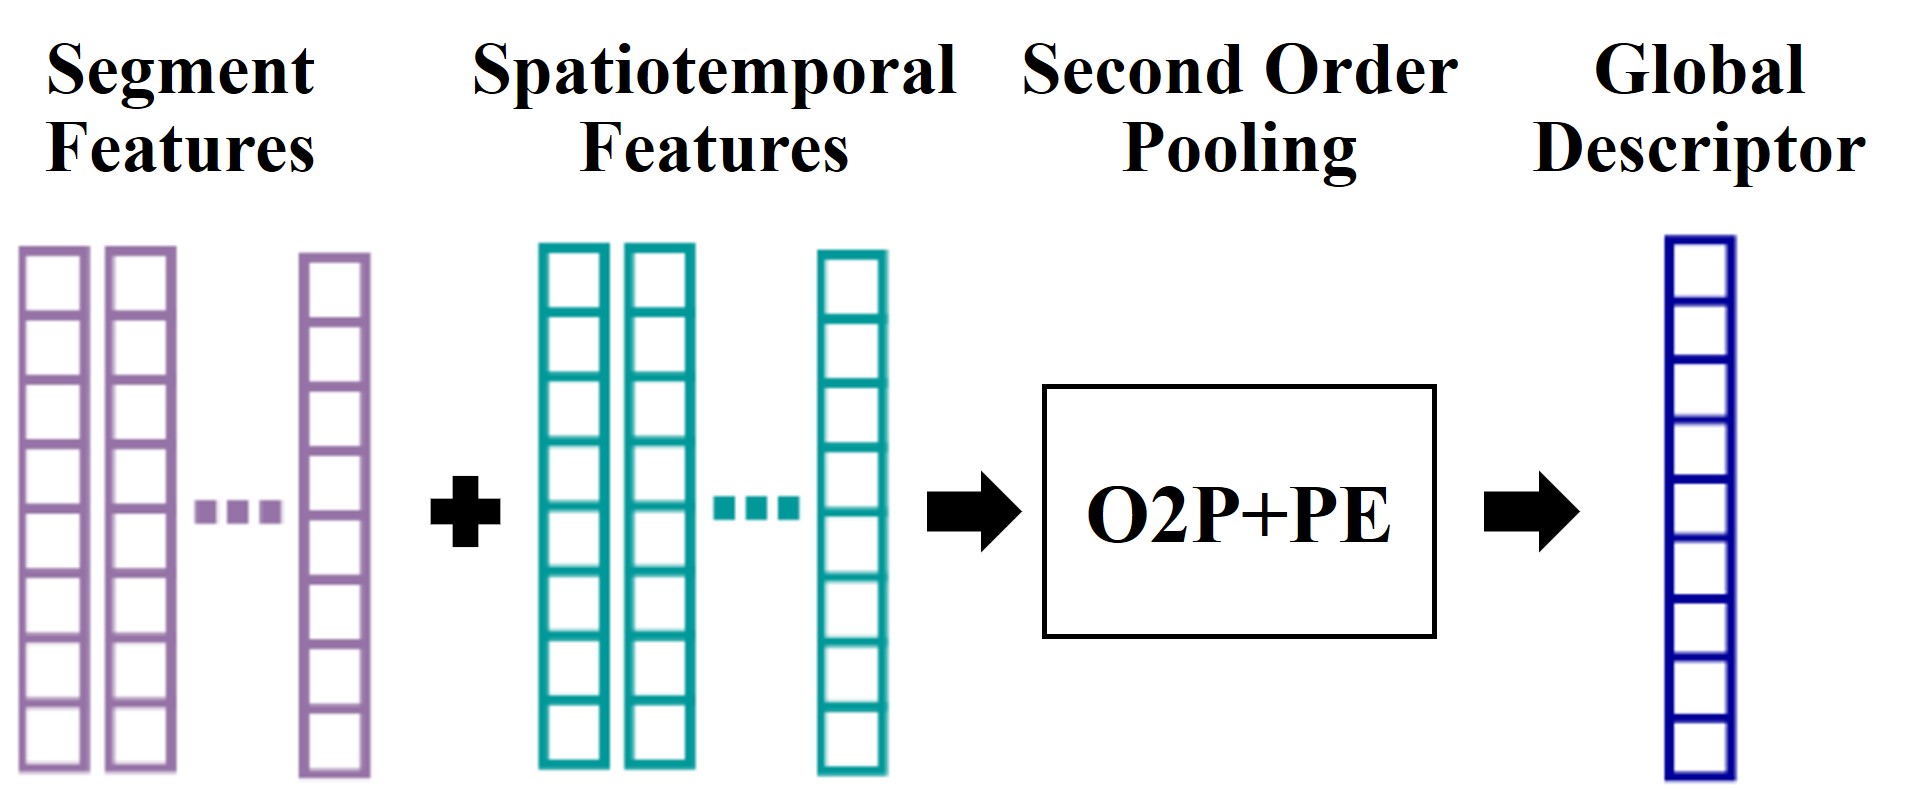
Другой подход построил сегментные дескрипторы и оценил их сходство, тем самым объединив преимущества сегментов и глобальных дескрипторов. Deep scan context (DSC)[213] представил эгоцентрическую сегментацию для вычисления собственных значений и центроидов сегментов, используя GNN для агрегации этих признаков в дескриптор. Он превзошёл традиционную евклидову кластеризацию по эффективности и надёжности при обработке разреженных облаков точек. Как показано на Рисунке 8(c), Locus [196] закодировал топологическую и временную информацию сегментов, чтобы создать глобальный дескриптор с помощью второго порядка пулинга и нелинейного преобразования. Он избегал построения глобальной карты и поиска KNN по сегментам, обеспечив устойчивость к изменениям точки зрения и окклюзиям.
5.3 Сводка
Традиционные описатели облака точек полагались на низкоуровневые свойства[62, 48, 64, 46, 106] для кодирования облака точек, но локальные описатели не обладали способностью к описанию, а глобальные описатели испытывали трудности с инвариантностью к вращению и переносу. К счастью, сегменты обеспечили хороший компромисс между тем и другим. Несколько наблюдений были обобщены следующим образом:
- ⟦Сегменты[74, 195, 208, 210] предложили потенциальное решение для снижения вычислений признаков за счет отказа от обработки всей облачности точек. Тем не менее несколько подходов опирались на агрегирование облачности точек или построение карты, что приводило к неэффективности при работе с крупномасштабными средами.
- ⟦Сегментно-ориентированные методы продемонстрировали перспективы в повышении точности за счет включения геометрической, цветовой и семантической информации сегментов. Однако они требовали богатых структур трехмерной геометрии для сегментации, которые могут быть доступны не всегда, что, возможно, ограничивает их применимость.
- ⟦Методы, основанные на сегментации по сегментам, были хорошо известны своей устойчивостью к изменениям окружающей среды, включая освещение, погоду и сезонные колебания. Однако они давали ограниченное понимание лежащих в основе 3D-структур, что приводило к недостаточно качественной производительности сегментации в сценариях долгосрочной локализации при наличии множества движущихся объектов.
6 Техники LPR: Семантика
Семантика относится к меткам или категориям, которые с помощью обучающейся технологии сегментации разделяют облака точек на различные экземпляры, обеспечивая распознавание мест на семантическом уровне. Таким образом, распознавание мест на основе семантики относится к категории обучающихся методов. В зависимости от используемого подхода для установления семантических соответствий их можно классифицировать на два типа: графовые и бесграфовые.
6.1 Обучаемые методы
6.1.1 Графовые методы
Семантические графы интуитивно отображали расположение и топологическую информацию объектов. Сходство графов и сопоставление графов были двумя типичными операциями над графами.
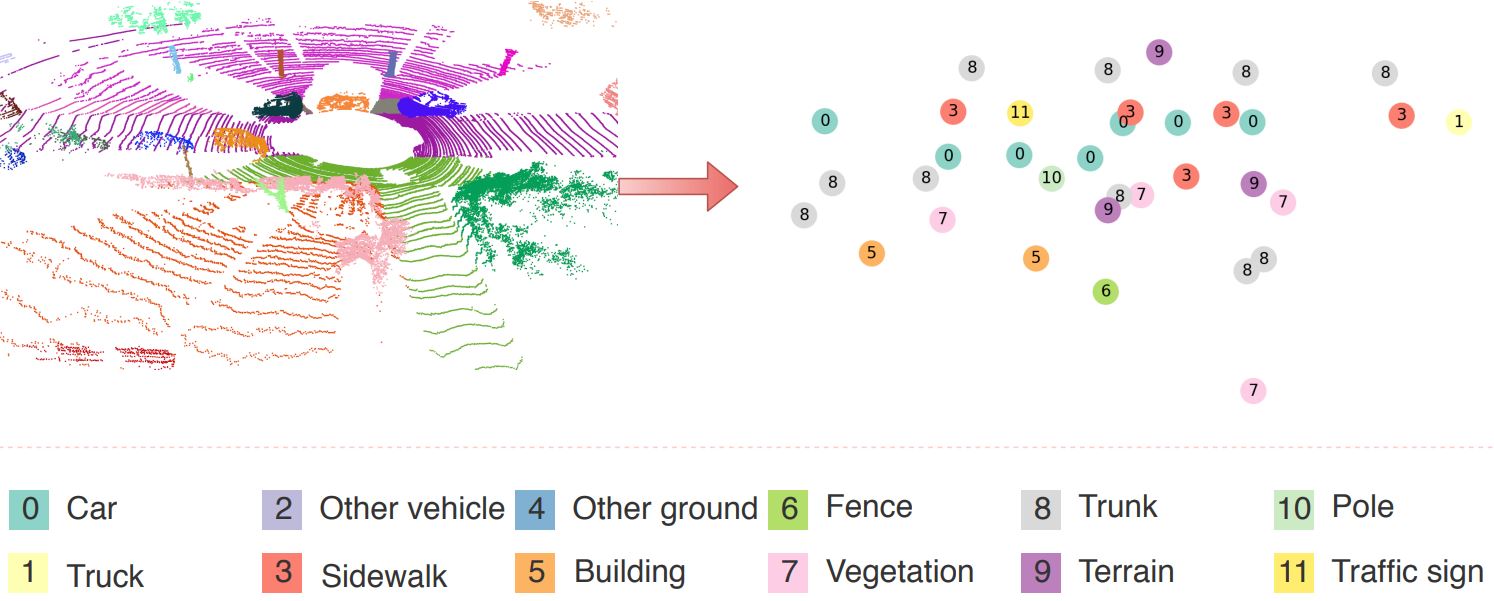
Графовое сходство. X-view[214] вычислял случайные блуждания для каждого узла графа и определял оценку сходства на основе количества одинаковых случайных блужданий. Он был универсальным при семантическом вводе и снижал высокие вычислительные затраты. Как показано на Рисунке 9(a), SGPR[51, 53] представлял семантические категории и центроиды точек как узлы, передавая соотношения признаков узлов через рёбра. Он разработал графовую сеть на базе GNN с встраиванием узлов, встраиванием графа и взаимодействием граф-граф для вычисления сходства графов. SGPR продемонстрировал устойчивость к закрытиям и изменениям точки зрения, особенно для обратных петель.
Сопоставление графов. GOSMatch[52] представил объектно-ориентированный подход распознавания места для городских условий, который использовал графовые дескрипторы для поиска кандидатов и вершинные дескрипторы для вычисления взаимно-однозначного соответствия. BoxGraph[215] хранил формы объектов в вершинах и упростил распознавание места до задачи оптимального присваивания вершин. Он применял ограничивающие рамки как встраивания внешнего вида для вершинных сущностей и расширял их для оценивания позы.
6.1.2 Методы без графов
Другие работы избегали построения семантического графа и в основном относились к двум категориям: семантические дескрипторы и другие методы.
Семантические дескрипторы. Как показано на рисунке 9(b), семантический сканирующий контекст (SSC) [73, 216] улучшал SC [4] за счет использования семантики [217] вместо высоты. Сканирующий контекст объекта (OSC) [218] улучшал SC [4] за счет построения дескриптора вокруг равномерно распределенных объектов (например, уличных фонарей и мусорных баков). Это сделало дескриптор независимым от положения LiDAR и устранило проблему далеких облаков точек. Seq-Ndt[219] расширял дескриптор гистограммы на основе NDT[220] путем включения семантической информации и использовал дивергенцию kullback-leibler (KL) для измерения сходства. RINet[221] разработал легковесную сиамскую сеть с сверточными слоями, понижающей дискретизацией и механизмами внимания для вычисления сходства дескрипторов. Она отдавала приоритет обучению сцены вместо ориентации облака точек и была весьма эффективной, что позволяло развертывание на платформах с ограниченными ресурсами.
6.2 Сводка
Под влиянием человеческого восприятия семантически-ориентированные методы использовали заранее заданные базы знаний, чтобы классифицировать объекты и определять их топологические взаимосвязи. Однако эти методы всё ещё были относительно новыми и недостаточно зрелыми, поскольку требовали передовых технологий семантической сегментации. Ниже были обобщены несколько ключевых наблюдений:
- ⟦• Методы на основе графов[51, 53, 52, 215] обеспечили более удобное понимание облаков точек, но выявили три ограничения: (1) Возможная потеря отдельных признаков, например размера объекта. (2) Неспособность различать части одной и той же категории, что приводит к потере информации. (3) Вычисление метрик между двумя графами остается NP-complete, что препятствует точному вычислению расстояния в разумные сроки.
- ⟦• Семантические метки[217] показали превосходство, используя только геометрические признаки, обеспечивая более интерпретируемые и интуитивные результаты. Они продемонстрировали большую устойчивость к перекрытию и изменениям ракурса, особенно в reverse LCD. Однако заранее заданные семантические метки в тестовых наборах данных были ограничены, не охватывая различные категории в реальных сценариях.
- ⟦• В динамических или загромождённых средах использование объектов и их топологической информации может повысить точность распознавания. Эти методы в значительной степени опирались на результаты семантической сегментации, что может приводить к недостаточно хорошей работе в различных сценариях. Несмотря на эти трудности, они представляли перспективы для применений, где традиционные методы оказывались недостаточно эффективными.
7 Техники LPR: Траектория
Информация о траектории позволяет сопоставлять текущие и недавние исторические сканы для распознавания местоположения. Одометрия (ручная) и последовательность (обучение) — два распространенных метода применения исторических данных.
7.1 Методы, основанные на одометрии
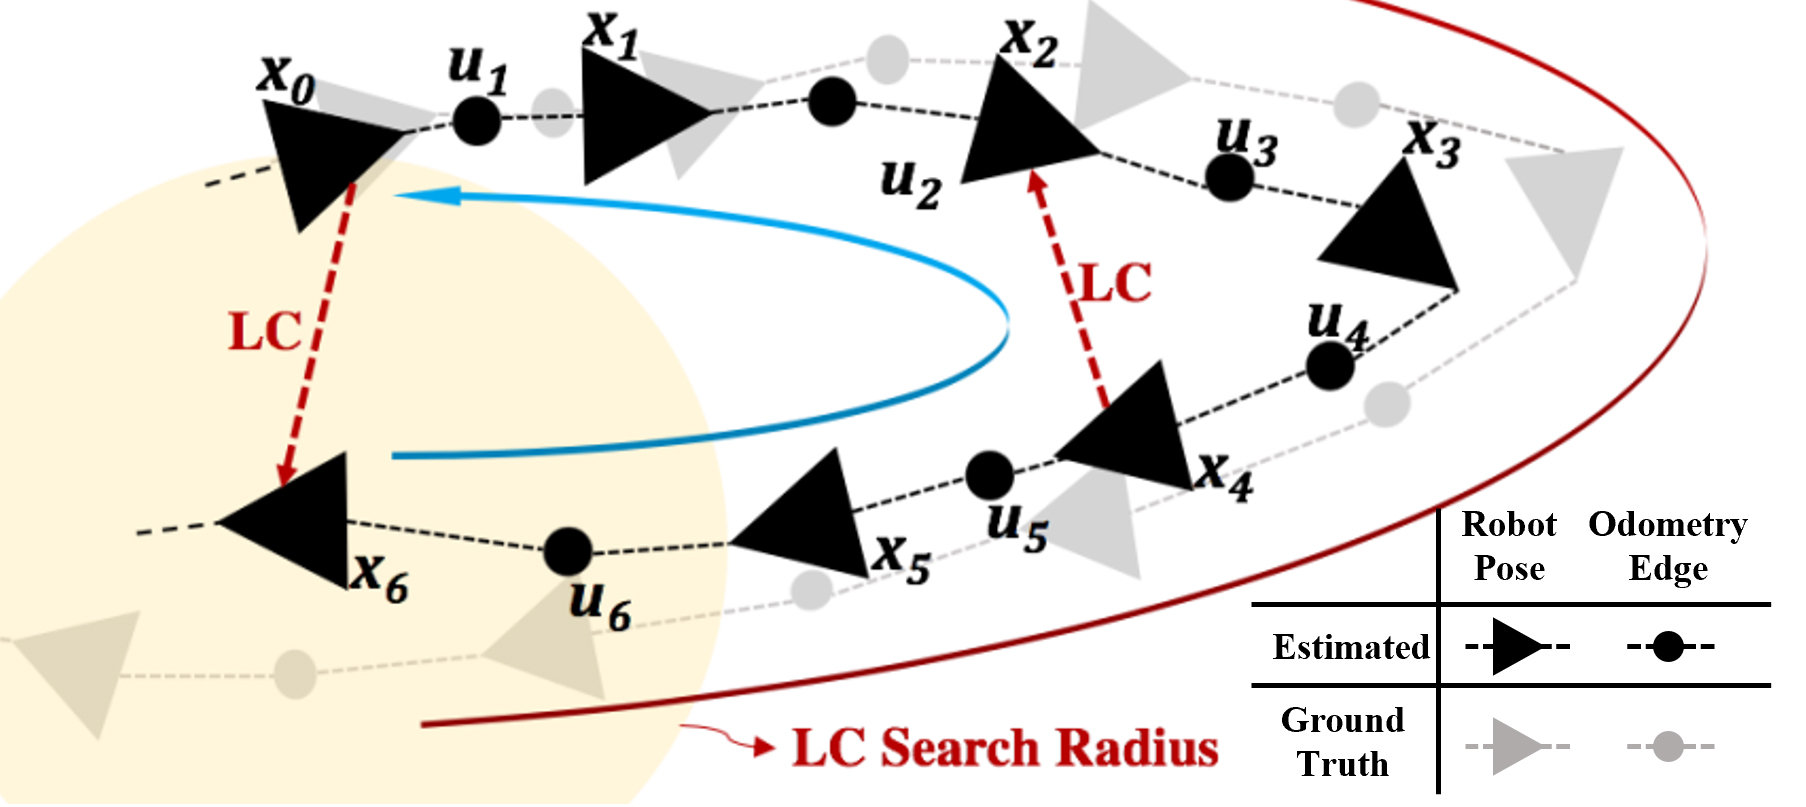
Системы SLAM с модулями LCD часто используют самодельные подходы, применяя фронтендные позы или традиционные методы регистрации для распознавания места, чтобы снизить сложность системы. Их можно дополнительно классифицировать на наивное евклидово расстояние, отношение перекрытия и тесты на основе PCR.
7.1.1 Наивное евклидово расстояние
Сравнение евклидова расстояния между позами в реальном времени и историческими позами позволило выполнить грубое обнаружение замыкания петель. В некоторых работах для сравнения сходства поз используются кусочно-заданные функции ориентации[228] и глобальные факторные графы[55], в то время как другие применяют калибровку и построение карты[229].
7.1.2 Overlap Ratio
Коэффициент перекрытия мог оценивать сходство позиций, при более высоком значении указывающем на более близкое расположение. S4-SLAM[230] реализовал расположенно-ориентированный LCD, сохраняя исторические позы с использованием kd tree и оценивая кандидатов на циклы по коэффициенту перекрытия. Этот подход обеспечивал баланс между работой в реальном времени и точностью, демонстрируя устойчивость даже при ограниченном числе опорных точек и высоких скоростях движения. Mendes et al.[231] использовали критерий перекрытия для генерации новых ключевых кадров и реализовали графовую модель поверх LiDAR odometry, чтобы уменьшать дрейфы за счет замыкания циклов на уровне графа. Жесткое отклонение на основе углов нормалей эффективно предотвращало неожиданные дрейфы, возникающие из-за растительности.
7.1.3 Тест на основе полимеразной цепной реакции
Методы ПЦР проверяли кандидата циклов с использованием относительных поз, таких как стандартный ICP, ICP точка–линия/плоскость и обобщенный ICP (GICP).
Стандартный ICP. IN2LAAMA[232] разработала автономную вероятностную основу, охватывающую локализацию, построение карты и калибровку. Она определяла замыкания петель, используя позы, и подтверждала кандидатов с помощью опционального теста ICP ICP[194], эффективно справляясь с искажениями движения без явной модели движения.
ICP «точка-строка/плоскость». Lego-LOAM [58] вычислял оценки одометрии, используя двухэтапную оптимизацию Левенберга—Марквардта, сопоставляя исторические сканы с ограничениями позы и уточняя преобразования с помощью ICP [194]. Это была новаторская работа по включению LCD в LiDAR SLAM, что сделало систему хорошо подходящей для задач навигации в течение длительного времени. Впоследствии LILO[56] расширил эту идею на систему LiDAR—IMU. Другие работы повышали устойчивость регистрации, используя графы плоскостей[233], интуитивное взвешивание[234] и KL divergence[235] соответственно.
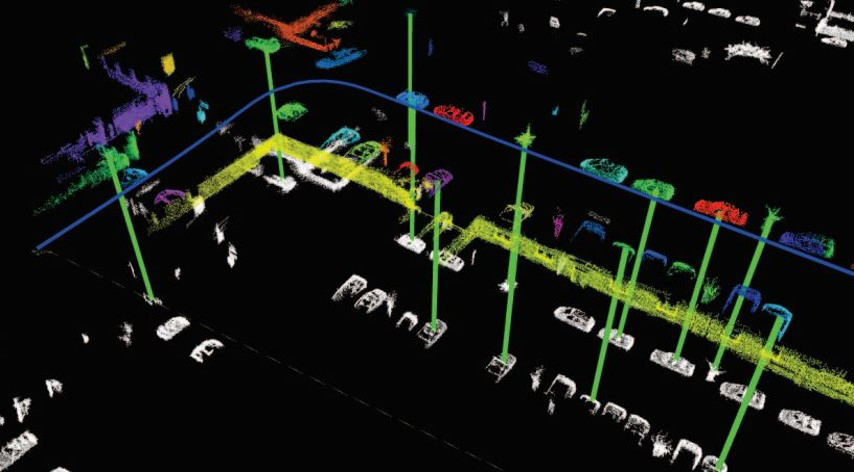
GICP. Как показано на рисунке 10, LAMP [227] разработала многороботную систему LiDAR SLAM для сложных подземных сред, которая использовала GICP[236] для регистрации близлежащих сканов и предложила максимизацию множества инкрементальных согласованных измерений (ICM)[237] для отклонения выбросных замыканий петель. Аналогично, LAMP 2.0 [238] объединила TEASER++ [239] и GICP [236] для вычисления относительного преобразования и фильтрации плохих совпадений. SPC-SLAM[240] использовала предположение о геометрической жесткости-постоянстве[241] и оценку регистрации подкарт[236] для подтверждения замыкания петель, решая задачи высокоточного картографирования в средах без GNSS.
7.2 Методы, основанные на последовательностях
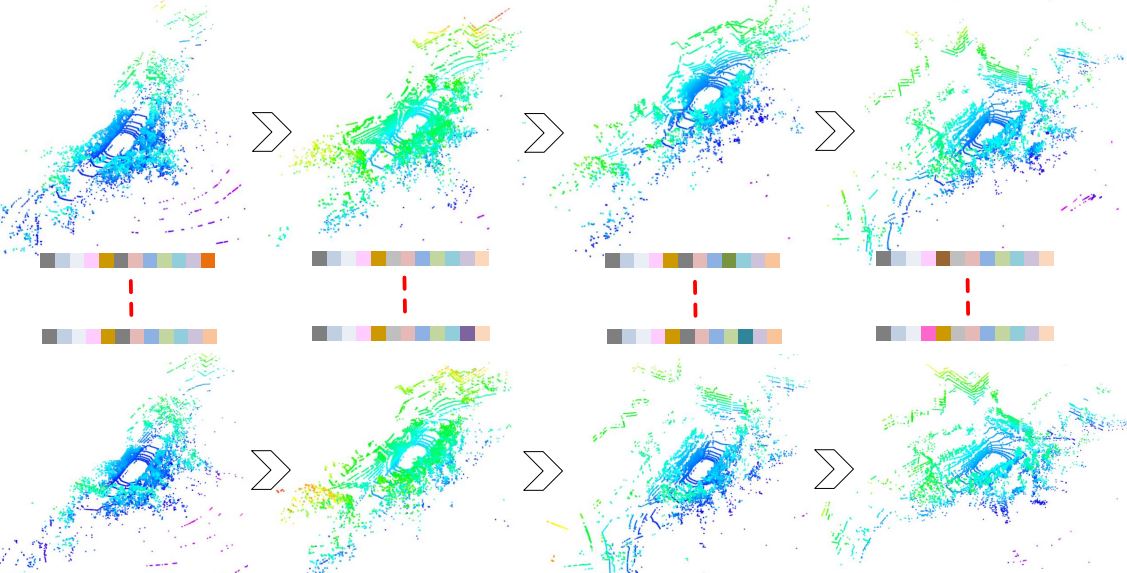
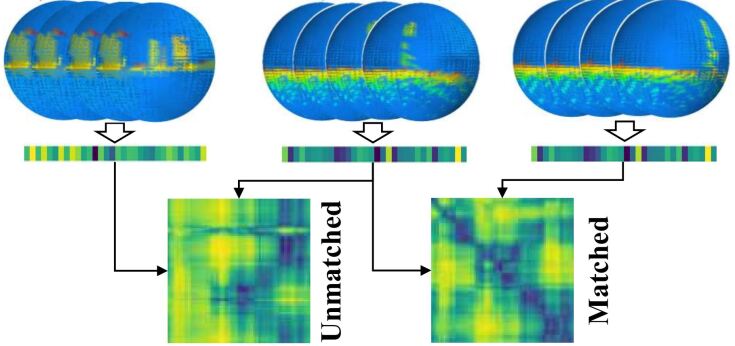
SeqSLAM[243] инициировал сравнения визуального сходства признаков во времени, чтобы интегрировать последовательностную информацию и определить наилучшее соответствие внутри локальных последовательностей, демонстрируя исключительную производительность при экстремальных изменениях окружающей среды и предоставляя сведения для решений на основе LiDAR. Сопоставление последовательностей облаков точек приводило к более высоким вычислительным затратам, чем альтернативы, основанные на изображениях. В результате подходы, такие как scan matching и submap matching, интегрировали нейронные сети с GPU для повышения эффективности.
7.2.1 Сопоставление сканов
Как показано на рисунке 11(a), SeqLPD [242] использовал LPD-Net [5] для извлечения глобального дескриптора и выбирал супер ключевые кадры на основе распределения в пространстве признаков. Он объединял грубое сопоставление на основе супер ключевых кадров с локальным уточняющим сопоставлением последовательностей, чтобы повысить точность и эффективность обнаружения. Этот метод достиг передовых результатов без опоры на данные одометрии. Обученная модель могла быть непосредственно применена в реальных сценариях без дополнительного обучения, что способствовало практическим применениям.
7.2.2 Сопоставление подмапров
Chen et al.[244] интегрировали LPD-Net[5] с сопоставлением на основе последовательностей и представили алгоритм сопоставления под-карт, управляемый плоскостью, для вычисления относительных преобразований. Этот метод использовал интервальное прокалывание для поиска преобразований переноса, демонстрируя практически вычисления в реальном времени. Как показано на рисунке 11(b), SeqSphereVLAD[6] и Yin et al.[57] использовали модуль сферической свертки для извлечения локальных признаков, эквивариантных к ориентации, на нескольких слоях сферических перспектив. Он эффективно справлялся с изменяющимися ракурсами и решал задачи SLAM в масштабе больших объемов. FusionVLAD[245] предложила многовидовую сеть слияния, которая кодировала признаки верхнего обзора и сферического вида из локальной карты, улучшая объединение признаков за счет параллельного модуля слияния для сквозного обучения. Она хорошо подходила для задач картографирования в масштабе больших объемов при ограниченных вычислительных ресурсах.
7.3 Итог
Традиционные методы сравнения между кадрами обеспечивали интуитивную оценку сходства, однако предполагали снижение эффективности в замкнутых, симметричных и динамических средах. Траекторные подходы включали как пространственную, так и временную информацию для устранения этого ограничения. Далее были обобщены два наблюдения следующим образом:
- ⟦LiDAR SLAM[227, 240] применял простой LCD-метод, основанный на близости поз, с последующим использованием PCR для вычисления относительных преобразований. Несмотря на удовлетворительные результаты, оставались два ограничения: (1) Накопленные ошибки влияли на надежность одометрических поз в сценариях крупномасштабного характера. (2) Локальная оптимальность PCR препятствовала интеграции ограничений петель в глобальную оптимизацию.
- ⟦• Методы, основанные на последовательностях, демонстрировали универсальность, поскольку они эффективно включали различные методы распознавания по месту, такие как локальные и глобальные дескрипторы[242, 57], семантику и сегменты. Хотя методы визуальных последовательностей были хорошо изучены, подходы, основанные на LiDAR, все еще находились на ранних стадиях. Кроме того, дорогостоящие вычисления, необходимые для сопоставления и слияния признаков, ограничивали их практическую применимость.
8 Техники LPR: Map
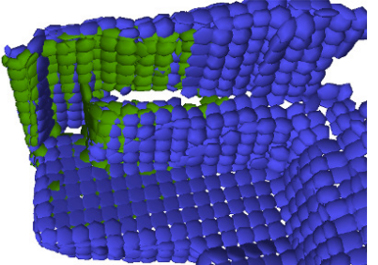
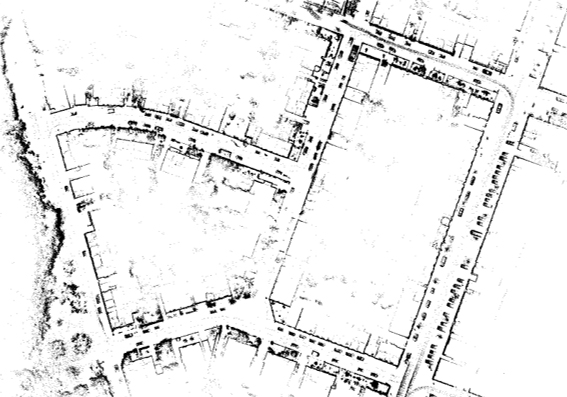
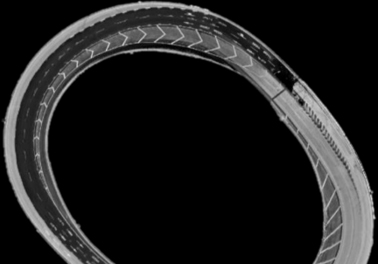
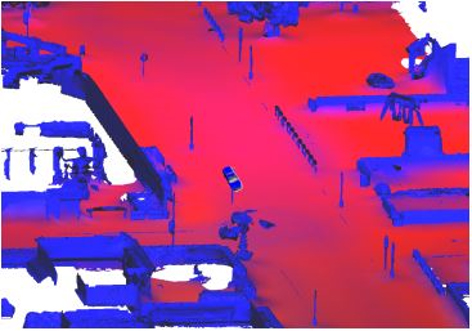
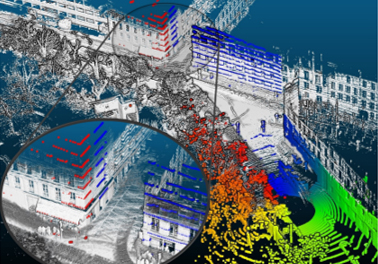
Методы, использующие помощь карты, обеспечивают глобальную локализацию метрики для достижения распознавания места. Обычно они делятся на две группы в зависимости от момента построения карты: офлайн-карты и онлайн-карты. Рисунок 12 иллюстрирует несколько репрезентативных карт.
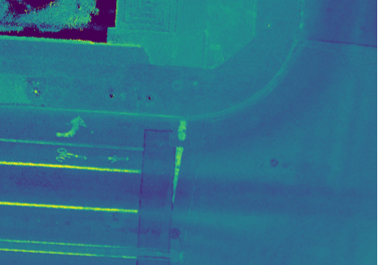
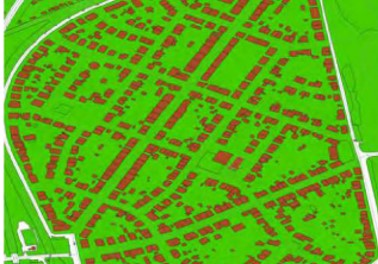
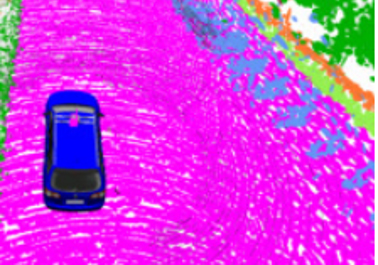
8.1 Изготовленные вручную методы
8.1.1 Офлайн методы на основе картографии
Пока транспортное средство двигалось, статическая офлайн-карта ограничивала его перемещение заданными заранее границами. Изготовленные вручную методы в основном включали пять типов карт: признаков, вероятностную, точечное облако, сетку и полигональную сетку.
Карта признаков. Dong et al.[10] использовал извлечение полюсов на основе изображений диапазонов, чтобы построить глобальную карту, и применил локализацию методом Монте-Карло (MCL) для обновления весов частиц на основе сопоставления полюсов. Это продемонстрировало точное извлечение полюсов в различных средах, улучшив долгосрочную производительность локализации. Shi et al.[81] объединил RANSAC[197] и евклидовую кластеризацию для извлечения стен из автономной карты и текущих сканов, применяя ограничения расстояния «точка–точка» и «точка–линия» для вычисления позиций транспортного средства.
Карта вероятностей. Как показано на Рисунке 12(a), Schmiedel et al.[22] охарактеризовали поверхностные фрагменты на картах NDT с использованием кривизны и формы объекта. Они сопоставили дескрипторы между онлайн-сканами и глобальной картой, применили RANSAC [197] для обнаружения выбросов и оценили совпадения, используя нормированное отношение инлайеров.
Карта облака точек. Xu et al.[75] представили дескриптор контекста формы поперечного сечения (CSSC), который описывал пространственное распределение с использованием высоты и плотности точек, улучшая показатели распознавания за счет двухэтапной оценки сходства и отношения ближайшего расстояния до кластера. Как показано на рисунке 12(b), Shi et al. [82, 249] создали офлайн-базу данных карт с деревом kd для моделирования ориентаций транспортных средств и разработали двоичную функцию потерь для повышения точности локализации..
Карта сетки. Как показано на рисунке 12(c), Aldibaja et al.[246] преобразовали сканы LiDAR в похожие на изображения представления дорожных покрытий, включая данные о высоте и облучении. Они использовали общую матрицу корреляции XY на основе общего идентификатора для представления событий замыкания контуров между узлами карты, что облегчает обработку карт в крупном масштабе и обнаружение событий объединения карт, независимое от траектории движения.
Карта сетки. Как показано на рисунке 12(d), Chen et al.[77] использовали реконструкцию поверхности по Пуассону для генерации карты сетки, разработав модель наблюдения для фреймворка MCL. Она продемонстрировала надежную обобщаемость на разных сенсорах LiDAR, исключив необходимость в дополнительных данных обучения в различных средах.
8.1.2 Онлайн-картографические методы
SLAM динамически строил и обновлял онлайн-карту облака точек окружающей среды по мере того, как транспортное средство двигалось по неизвестной местности. Как показано на рисунке 12(e), Multi-metric linear least square (MULLS)[79] включал TEASER[239] для проверки петли и использовал map-to-map ICP[194] для усиления ребер между подкарты с точными преобразованиями. Непрерывновременной ICP (CT-ICP)[59] проецировал локальную карту на изображение рельефа, оценивал 2D-преобразование с помощью RANSAC [197] и вычислял позу с 6 степенями свободы посредством ICP [194], чтобы выявлять потенциальные замыкания петель. Liu et al.[250] представили в реальном времени 6D SLAM для крупномасштабных природных ландшафтов, который объединял сопоставление гистограмм поворотов с ICP[194] на основе поиска branch and bound, чтобы обеспечить real-time LCD.
8.2 Обучаемые методы
8.2.1 Офлайн-методы на основе карт
Исследователи изучали три типа автономных карт в обучаемой задаче локализации на карте: интенсивность, облако точек и узел.
Карта интенсивности. Как показано на рисунке 12(f), Barsan et al.[247] встроили карты интенсивности LiDAR и онлайн-сканы в общее пространство, используя эффективное свёрточное сопоставление для определения положения транспортного средства. Этот метод обеспечил точность на уровне сантиметров, продемонстрировал устойчивость при работе с некалиброванными данными и успешно обобщался на различные датчики LiDAR.
Карта облака точек. В этом контексте три репрезентативных метода: монте-карло локализация (MCL), kd tree и точечная MLP.
1) MCL. LocNet[251, 19] представила полу-ручную DNN и фреймворк MCL для глобальной локализации, используя модель гауссовых смесей для представления нескольких гипотез распознавания местоположения. Опираясь на обученные представления и позы транспортного средства, она построила априорную карту, добившись высокой точности и эффективности для долгосрочной локализации. Sun et al.[252] совместили эффективный вывод с использованием глубокой детерминированной модели с строгой геометрической верификацией с применением подхода Bayes-filter, устранив проблему неконъюгированности между Gaussian и MCL.
2) Дерево Kd. Jin et al.[253] включили дескриптор D3feat[124] с самоконтролируемой детекторной функцией потерь для сопоставления признаков. Они использовали kd-дерево для хранения дескрипторов карты и улучшили эффективность поиска за счет механизма голосования от грубого к точному и двухфазной стратегии поиска.
3) Строчно-точечная MLP. L3-Net[26] использовала mini-PointNet для извлечения признаковых дескрипторов и регуляризовала объем стоимости с помощью трехмерных сверток. Она вычисляла вероятности согласования для оптимальной оценки и улавливала динамику временного движения с помощью глубоких рекуррентных нейронных сетей (RNN). L3-Net достигала сопоставимой точности локализации с методами SOTA и хорошо подходила для слияния данных от нескольких сенсоров. Retriever[14] извлекал компактные признаки с помощью энкодера и сети распространения признаков, агрегируя их с помощью perceiver для распознавания места в сжатых картах облаков точек. Она повышала вычислительную эффективность, избегая вычислительно затратного распаковывания.
Карта узлов. S4-SLAM2[254] построила карту узлов, включающую данные облака точек, вектор признаков и информацию о местоположении. Она извлекала геометрические и статистические признаки, чтобы сформировать многомодальные дескрипторы, и выполняла классификацию петель замыкания с помощью классификатора случайного леса.
OpenStreetMap. OSM, глобальная карта с открытым исходным кодом, предоставляла исчерпывающие географические сведения, такие как улицы, железные дороги, водные системы и здания. Ruchti et al.[255] создали дорожную сеть и классифицировали среды как дорожные или недорожные, используя эту классификацию для взвешивания частиц MCL. Несколько подходов[256, 257] интегрировали семантическую информацию, извлеченную из OSM, в рамки частичного фильтра. Как показано на рисунке 12(g), Cho et al.[248] сгенерировали дескриптор, вычисляя расстояния до зданий под регулярными углами.
8.2.2 Онлайн-картографические методы
Эти методы примерно разделялись на методы на основе сплошных поверхностей и методы на основе решетчатых карт.
1) Карта сурфелов. Как показано на рисунке 12(h), SuMa[258] и SuMa++[76] использовали изображения диапазонов и карты на основе сурфелов для ассоциации данных, обнаруживая кандидаты замыканий путем объединения радиального поиска и регистрации ICP[194] кадр-к-модели. Они проверяли замыкания путем отслеживания поз, что обеспечило надежное обнаружение даже при низком перекрытии и позволило получить глобально согласованные карты.
2) Сетка-отображение. Yin et al.[259] сгенерировали BEV-карту из локальной карты занятости, учитывая ошибки движения транспортного средства. Кроме того, они ввели дополнительную GAN [260] с уменьшением условной энтропии для улучшения обучения неосознанных признаков в задачах распознавания на длительных интервалах.
8.3 Краткое резюме
Карты[26, 252, 82] широко применялись в робототехнической локализации и планировании пути, поскольку они обеспечивали точные и подробные представления об окружении. Примечательно, что методы на основе карт превосходили в распознавании топологически схожей локализации, предоставлении информации о позе и эффективном восстановлении похищенных роботов. Ниже были обобщены несколько наблюдений:
- ⟦• Отображения, обогащённые глобальной согласованностью, и уменьшенными ошибками локализации. Однако их большие требования к памяти приводили к длительным операциям загрузки, передачи данных и обработки.
- ⟦• Методы на основе карт преодолевают шум и частичные перекрытия, обеспечивая надежное распознавание даже в сложных сценариях. Однако существенная разница в плотности затрудняла регистрацию онлайн-сканов на карты.
- ⟦• Надёжная априорная карта способствовала долгосрочной локализации робота в согласованной среде. Однако существенные изменения в окружающей среде могли привести к тому, что существующая карта станет устаревшей, что вызывало ошибки локализации и распознавания.
| Year | Name | Seq | Trajectory (KM) | Type | Sensor Modilty | Model of LiDAR | Loop | GT | LT | Public |
| 2009 | Hannover2[146] | 1 | 1.24 | Outdoor | LiDAR | S+O | ✓ | ✓ | ||
| 2010 | Freiburg[106] | 1 | 0.723 | Outdoor | LiDAR | SICK LMS | S | ✓ | ✓ | |
| 2011 | Ford Campus[261] | Outdoor | Camera+LiDAR | Velodyne HDL-64E | ✓ | ✓ | ||||
| 2012 | KITTI Odometry[262] | 22 | 39.2 | Outdoor | Camera+LiDAR | Velodyne HDL-64E | S+O | ✓ | ✓ | |
| 2016 | NCLT[263] | 27 | 147.4 | Indoor+Outdoor | Camera+LiDAR | Velodyne HDL-32+Hokuyo UTM-30LX+Hokuyo URG-04LX | S+O | ✓ | ✓ | ✓ |
| 2017 | Oxford RobotCar[264] | 130 | 1000 | Outdoor | Camera+LiDAR | SICK LD-MRS+SICK LMS-151 | S+O | ✓ | ✓ | ✓ |
| 2018 | Complex Urban [265] | 19 | 158.82 | Outdoor | LiDAR | Velodyne VLP-16+SICK LMS-511 | S+O | ✓ | ✓ | |
| 2018 | In-House[12] | 3 | Outdoor | LiDAR | Velodyne HDL-64E | ✓ | ✓ | ✓ | ||
| 2019 | Semantic KITTI [266] | 22 | 39.2 | Outdoor | LiDAR | Velodyne HDL-64E | S+O | ✓ | ✓ | |
| 2019 | Apollo-SouthBay [26] | 380 | Outdoor | LiDAR | Velodyne HDL-64E | ✓ | ✓ | ✓ | ||
| 2020 | MulRan[267] | 12 | 41.2 | Outdoor | LiDAR+Radar | Ouster OS1-64 | S+O | ✓ | ✓ | ✓ |
| 2020 | USyd[268] | 50 | Outdoor | Camera+LiDAR | Velodyne VLP-16 | S+O | ✓ | ✓ | ✓ | |
| 2020 | Oxford Radar Robotcar[269] | 32 | 280 | Outdoor | Camera+LiDAR +Radar | Velodyne HDL-32E+SICK LMS-151+Navtech CTS350-X | S+O | ✓ | ✓ | ✓ |
| 2021 | DUT-AS[148] | 30 | Outdoor | LiDAR | SICK LMS 511 | S+O | ✓ | ✓ | ||
| 2021 | CMU Dataset[225] | 11 | 2.0 | Outdoor | Camera+LiDAR | Velodyne VLP-16 | ✓ | |||
| 2021 | Pittsburgh Dataset[225] | 12 | 12.0 | Outdoor | Camera+LiDAR | Velodyne VLP-16 | ✓ | |||
| 2022 | HAOMO [170] | 5 | Outdoor | Camera+LiDAR | HESAI PandarXT-32 | S+O | ✓ | ✓ | ✓ | |
| 2022 | Campus[57] | 11 | 2 | Outdoor | LiDAR | Velodyne-VLP 16 | ✓ | |||
| 2022 | City[57] | 13 | 11 | Outdoor | LiDAR | Velodyne-VLP 16 | ✓ | |||
| 2022 | KITTI-360[270] | 9 | 73.7 | Outdoor | Camera+LiDAR | Velodyne HDL-64E | S+O | ✓ | ✓ | |
| 2022 | CHDloop[143] | 5 | 1.519 | Outdoor | LiDAR | RoboSense RS-Ruby 128 | S+O | ✓ | ||
| 2019 | HKUST[84] | Indoor+Outdoor | Livox-MID40 | ✓ | ||||||
| 2022 | LGSVL[168] | Outdoor | Velodyne HDL-64E | ✓ | ✓ | |||||
| 2022 | Real Vehicle[168] | Outdoor | Camera+LiDAR | Velodyne VLP-32C | S+O | ✓ |
9 Техники LPR: Другие методы
InCloud[271] дистиллировала угловую взаимосвязь между глобальными представлениями, сохраняя сложную структуру пространства вложений между шагами обучения. Она эффективно решала проблему катастрофического забывания, позволяя моделям обновляться с новыми доменами без переобучения сети на всех данных из прошлых задач. Granström et al. [188] закодировали облако точек, используя геометрические признаки и гистограммы диапазонов, обнаруживая петли обученным классификатором AdaBoost [189]. Достигнув высоких показателей точности и полноты, этот метод требовал упорядоченного облака точек.
10 Бенчмаркинг
В этом разделе мы обобщили существующие наборы данных и показатели оценки, одновременно сравнив существующие методы на общедоступных наборах данных.
10.1 Наборы данных
Было собрано большое количество наборов данных для оценки производительности методов LPR. В таблице III приведено обобщение этих наборов данных. Их характеристики были обобщены следующим образом:
Долгосрочный сбор. [263, 264, 269] многократно собирал одну и ту же сценарию по похожим маршрутам в разные сезоны или в разное время.
Многомодальные данные. В дополнение к лидара-датчикам радар использовался в [267, 269], а камеры были установлены в [261, 262, 263, 264, 268, 269, 225, 170, 270]. Также была доступна семантическая информация в [266]⟧.
Скудность LiDAR. Эти наборы данных охватывали различные по плотности датчики LiDAR, такие как механические 16-линейные[265, 268], 32-линейные[263, 269], 64-линейные[261, 262] и 128-линейный LiDAR[143], а также твердотельный LiDAR[84]⟧.
10.2 Метрики оценки
Для тестирования методов LPR было предложено несколько различных метрик оценки, обобщение которых приведено ниже:
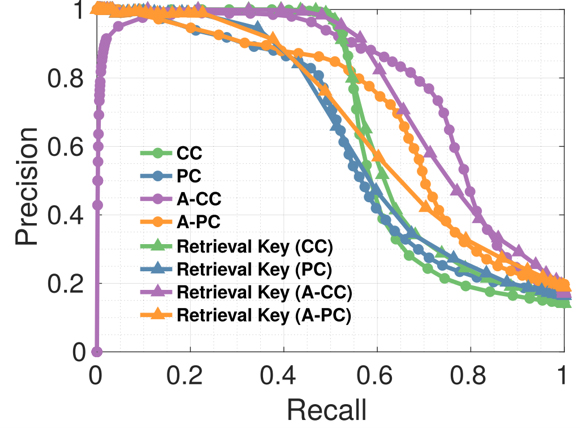
Пересмотр критериев. Перед оцениванием был задан порог расстояния, чтобы определить, принадлежали ли запрос и кандидат к одному и тому же месту.
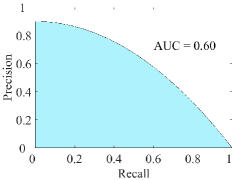
Кривые точность-восстановление (PR)[272]. Как показано на рисунке 13(a), эта кривая измеряла связь между точностью (P) и полнотой (R) при различных параметрах порога. P измеряла долю правильных совпадений от общего числа предсказанных положительных экземпляров, тогда как R характеризовала долю реальных положительных случаев, корректно идентифицированных как положительные совпадения:
| (3) |
| (4) |
где , и представляли соответственно истинно положительные, ложно положительные и ложно отрицательные значения.
Площадь под кривой PR (AUC)[9, 72]. Как показано на рисунке 13(b), это отражало различительную способность метода распознавания мест, и большее значение AUC означало, что было распознано больше мест с меньшим числом ошибок. Однако это не сохраняло никакой информации о признаках исходной PR-кривой.
Recall @Top-N. Он оценивал точность методов распознавания мест по выявлению правильных мест среди top-k извлечённых совпадений. Более высокое значение указывало на лучшее качество работы. TOP 1 [54] и TOP 1 [141] были двумя наиболее часто используемыми метриками.
⟦ Оценка. Это была гармоническая средняя величина точности и полноты. Высокое значение указывало на то, что система достигла хорошего баланса между ними, как показано далее:
| (5) |
где и соответственно представляли точность и полноту. был параметром, который определял веса для полноты и точности. оценка [51, 72, 73, 203, 65, 196, 213, 215] была наиболее часто используемым показателем:
| (6) |
где рассматривался и как одинаково важные. Затем был вычислен максимальный балл ():
| (7) |
где параметр переменной может принимать разные роли, например, параметр алгоритма, порог, представляющий то же место, или число извлеченных кандидатов.
Удлиненная точность (EP). Она обеспечила более полные сведения, одновременно учитывая нижнюю и верхнюю границы производительности метода LPR [273, 73, 196, 213]:
| (8) |
где была точность при минимальной полноте, а — максимальная полнота при 100 точности.
Эффективность выполнения. Время выполнения имело решающее значение для онлайн-систем SLAM. Методы на основе дескрипторов обычно включали извлечение признаков и поиск, тогда как методы на основе карт требовали обработки карты и сопоставления. С другой стороны, методы, основанные на данных, требовали обучения и вывода.
10.3 Результаты оценки
| Year | Method | Type | Code | Source | Maximum | EP | Time (ms) | ||||||||||
| 00 | 02 | 05 | 06 | 07 | 08 | 00 | 02 | 05 | 06 | 07 | 08 | ||||||
| 2015 | Fast Histogram[48] | H | [19, 170] | 0.44 | 0.43 | 0.46 | 2 | ||||||||||
| 2016 | M2DP[149] | H | ✓ | [149, 73] | 0.71 | 0.72 | 0.60 | 0.79 | 0.56 | 0.07 | 0.62 | 0.60 | 0.61 | 0.68 | 0.59 | 0.50 | 366 |
| 2018 | PointNetVLAD[12] | L | ✓ | [73] | 0.78 | 0.73 | 0.54 | 0.85 | 0.63 | 0.04 | 0.64 | 0.69 | 0.54 | 0.77 | 0.59 | 0.50 | |
| SC[4] | H | ✓ | [73] | 0.75 | 0.78 | 0.90 | 0.97 | 0.66 | 0.61 | 0.61 | 0.63 | 0.80 | 0.92 | 0.55 | 0.57 | 5 | |
| SuMa[258] | H | [258, 223] | 0.85 | 48 | |||||||||||||
| SuMa++[76] | L | ✓ | [76] | 0.70 | 0.29 | ||||||||||||
| 2019 | LPD-Net[5] | L | [131] | 0.85 | 23 | ||||||||||||
| 2020 | ISC[46] | H | ✓ | [73] | 0.66 | 0.71 | 0.77 | 0.84 | 0.64 | 0.41 | 0.63 | 0.61 | 0.73 | 0.82 | 0.64 | 0.54 | 4 |
| SGPR[51] | L | ✓ | [51, 73] | 0.82 | 0.75 | 0.75 | 0.66 | 0.87 | 0.75 | 0.50 | 0.50 | 0.53 | 0.50 | 0.72 | 0.52 | 9 | |
| OverlapNet[72, 223] | L | ✓ | [73, 170] | 0.87 | 0.83 | 0.92 | 0.93 | 0.82 | 0.37 | 0.56 | 0.64 | 0.80 | 0.74 | 0.59 | 0.50 | 3238 | |
| LocNet[19] | L | [19] | 0.70 | 0.60 | 0.70 | ||||||||||||
| LocNet-r[19] | L | [19] | 0.68 | 0.70 | 0.68 | ||||||||||||
| 2021 | NDT-Transformer[166] | L | ✓ | [170] | 0.85 | 16 | |||||||||||
| MinkLoc3D[156] | L | ✓ | [170] | 0.87 | 24 | ||||||||||||
| Locus[196] | L | ✓ | [213, 221] | 0.98 | 0.76 | 0.98 | 0.99 | 1.00 | 0.93 | 0.83 | 0.92 | 0.91 | 0.83 | 0.74 | 1210 | ||
| SSC-RN[73] | L | ✓ | [73] | 0.94 | 0.89 | 0.94 | 0.99 | 0.87 | 0.88 | 0.83 | 0.75 | 0.90 | 0.97 | 0.77 | 0.73 | 5 | |
| SSC-SK[73] | L | ✓ | [73] | 0.95 | 0.89 | 0.95 | 0.99 | 0.88 | 0.94 | 0.85 | 0.75 | 0.90 | 0.97 | 0.81 | 0.93 | 5 | |
| DiSCO[68] | L | ✓ | [221] | 0.96 | 0.89 | 0.96 | 0.99 | 0.90 | 0.90 | 4310 | |||||||
| Gong et al.[203] | L | [203] | 1.00 | 0.94 | 0.99 | 1.00 | 0.99 | 0.97 | 448 | ||||||||
| LiDAR Iris[47] | H | ✓ | [47, 73] | 0.67 | 0.76 | 0.77 | 0.91 | 0.63 | 0.48 | 0.63 | 0.67 | 0.75 | 0.79 | 0.65 | 0.56 | 231 | |
| AttDLNet-E3A4[171] | L | ✓ | [171] | 0.94 | 0.82 | 0.90 | 1.00 | 0.10 | 0.75 | 20 | |||||||
| AttDLNet-E5A4[171] | L | ✓ | [171] | 0.95 | 0.69 | 0.86 | 0.99 | 0.10 | 0.72 | 20 | |||||||
| 2022 | BG-RN[215] | L | [215] | 0.99 | 0.97 | 0.96 | 1.00 | 1.00 | 0.79 | 0.99 | 0.93 | 0.95 | 0.99 | 1.00 | 0.79 | ||
| BG-SK[215] | L | [215] | 1.00 | 0.96 | 0.97 | 1.00 | 1.00 | 0.96 | 0.99 | 0.89 | 0.97 | 1.00 | 1.00 | 0.93 | |||
| SC-LPR[226] | L | ✓ | [226] | 0.97 | 0.95 | 0.93 | 0.99 | 0.99 | 0.88 | 224 | |||||||
| SC-LPR-K[226] | L | ✓ | [226] | 0.93 | 0.93 | 0.93 | 0.99 | 0.99 | 0.83 | 224 | |||||||
| RINet-CY[221] | L | ✓ | [221] | 0.98 | 0.95 | 0.92 | 0.98 | 0.97 | 0.87 | 211 | |||||||
| RINet-SK[221] | L | ✓ | [221] | 0.99 | 0.95 | 0.95 | 1.00 | 1.00 | 0.96 | 211 | |||||||
| DSC[213] | L | [213] | 0.88 | 0.84 | 0.78 | 0.86 | 0.82 | 0.85 | 0.70 | 0.68 | 0.63 | 0.73 | 0.58 | 0.65 | 50 | ||
| OverlapTransformer[170] | L | ✓ | [170] | 0.88 | 2 | ||||||||||||
| LOGG3D-Net[162] | L | ✓ | [162] | 0.95 | 0.89 | 0.98 | 0.98 | 1.00 | 0.84 | 90 | |||||||
| CSSC[75] | H | ✓ | [75] | 0.37 | 0.76 | 0.56 | |||||||||||
| CSSC-TS[75] | H | ✓ | [75] | 0.91 | 0.93 | 0.90 | |||||||||||
| DeLightLCD[131] | L | [131] | 0.90 | 2 | |||||||||||||
| Year | Method | Code | Source | Oxford | U.S. | R.A. | B.D. | Time (ms) | Paras (Mb) | |||||
| @1 | @1 | @1 | @1 | @1 | @1 | @1 | @1 | |||||||
| 2018 | PointNetVLAD[12] | Baseline | ✓ | [12, 160] | 80.3 | 62.8 | 72.6 | 63.2 | 60.3 | 56.1 | 65.3 | 57.2 | 15 | 19.8 |
| Refine | ✓ | [12] | 80.1 | 63.3 | 90.1 | 86.1 | 93.1 | 82.7 | 86.5 | 80.1 | ||||
| PointNetMax[12] | Baseline | ✓ | [12] | 73.4 | 64.6 | 51.9 | 49.1 | |||||||
| Refine | ✓ | [12] | 73.9 | 54.2 | 79.3 | 62.2 | 75.1 | 60.2 | 69.5 | 58.6 | ||||
| PointNetSTD[12] | Baseline | ✓ | [12] | 46.5 | 61.1 | 49.1 | 53.0 | |||||||
| Refine | ✓ | [12] | 46.5 | 31.9 | 57.0 | 45.7 | 59.8 | 44.3 | 53.0 | 44.5 | ||||
| 2019 | PCAN[70] | Baseline | ✓ | [70, 156] | 83.8 | 69.1 | 79.1 | 62.4 | 71.2 | 57.0 | 66.8 | 58.1 | 55 | 20.4 |
| Refine | ✓ | [70] | 86.4 | 70.7 | 94.1 | 83.7 | 92.5 | 82.5 | 87.0 | 80.3 | ||||
| SeqLPD[242] | [242] | 95.8 | 87.2 | 19 | 2.0 | |||||||||
| LPD-Net[5] | Baseline | [160, 156] | 94.9 | 86.3 | 96.0 | 87.0 | 90.5 | 83.1 | 89.1 | 82.5 | 24 | 19.8 | ||
| Refine | [160] | 94.9 | 86.6 | 98.9 | 94.4 | 96.4 | 90.8 | 94.4 | 90.8 | |||||
| 2020 | DAGC[13] | Baseline | [13] | 87.5 | 83.5 | 75.7 | 71.2 | |||||||
| Refine | [13] | 87.8 | 71.4 | 94.3 | 86.3 | 93.4 | 82.8 | 88.5 | 81.3 | |||||
| DH3D[71] | ✓ | [71, 69] | 84.3 | 73.3 | 81.5 | 64.4 | 72.1 | 57.9 | 68.4 | 60.1 | 36 | 18.9 | ||
| PIC-NET[172] | [157] | 98.2 | ||||||||||||
| SR-Net[153] | Baseline | [153] | 94.6 | 86.8 | 94.3 | 86.8 | 89.2 | 80.2 | 83.5 | 77.3 | ||||
| Refine | [153] | 95.3 | 88.5 | 98.5 | 93.5 | 93.6 | 86.8 | 90.8 | 85.9 | |||||
| 2021 | PPT-Net[155] | Baseline | ✓ | [155] | 98.1 | 93.5 | 97.5 | 90.1 | 93.3 | 84.1 | 90.0 | 84.6 | 22 | 13.1 |
| Refine | ✓ | [155] | 98.4 | 99.7 | 99.5 | 95.3 | ||||||||
| SOE-Net[151] | Baseline | ✓ | [69] | 93.4 | 84.2 | 91.1 | 80.0 | 87.0 | 75.9 | 83.8 | 77.2 | 59 | 19.4 | |
| Refine | ✓ | [151] | 96.4 | 89.3 | 97.7 | 91.8 | 95.9 | 90.2 | 92.6 | 89.0 | ||||
| MinkLoc3D[156] | Baseline | ✓ | [156] | 98.5 | 94.8 | 99.7 | 97.2 | 99.3 | 96.7 | 96.7 | 94.0 | 21 | 1.1 | |
| Refine | ✓ | [156, 160] | 98.5 | 94.8 | 99.7 | 97.2 | 99.3 | 96.7 | 96.7 | 94.0 | ||||
| MinkLoc++[157] | ✓ | [157] | 99.1 | 96.7 | 99.5 | 96.5 | 98.5 | 95.3 | 95.5 | 91.8 | ||||
| NDT-Transformer[166] | ✓ | [161] | 97.7 | 93.8 | 34 | |||||||||
| DiSCO[68] | ✓ | [68] | 75.0 | 88.4 | 9 | |||||||||
| CORAL[18] | [18] | 96.1 | 88.9 | 11 | ||||||||||
| vLPD-Net[154] | ✓ | [154] | 73.1 | 53.5 | ||||||||||
| TransLoc3D[159] | Baseline | [159] | 98.5 | 95.0 | 94.9 | 91.5 | 88.4 | |||||||
| Refine | [159] | 98.5 | 95.0 | 99.8 | 97.5 | 99.7 | 97.3 | 97.4 | 94.8 | |||||
| 2022 | SVT-Net[8] | Baseline | [8] | 97.8 | 93.7 | 96.5 | 90.1 | 92.7 | 84.3 | 90.7 | 85.5 | 13 | 0.9 | |
| Refine | [8] | 98.4 | 94.7 | 99.9 | 97.0 | 99.5 | 95.2 | 97.2 | 94.4 | 13 | 0.9 | |||
| ASVT-Net[8] | Baseline | [8] | 98.0 | 93.9 | 96.1 | 87.9 | 92.0 | 83.3 | 88.4 | 82.3 | 11 | 0.4 | ||
| Refine | [8] | 98.3 | 94.6 | 99.6 | 97.5 | 98.9 | 95.0 | 97.0 | 94.5 | 11 | 0.4 | |||
| CSVT-Net[8] | Baseline | [8] | 97.7 | 93.1 | 95.5 | 88.3 | 92.3 | 82.7 | 89.5 | 83.3 | 12 | 0.8 | ||
| Refine | [8] | 98.6 | 94.8 | 99.8 | 96.6 | 98.7 | 96.2 | 97.3 | 94.3 | 12 | 0.8 | |||
| EPC-Net[69] | ✓ | [69] | 94.7 | 86.2 | 96.5 | 88.2 | 88.6 | 80.2 | 84.9 | 78.1 | 33 | 4.7 | ||
| EPC-Net-L[69] | ✓ | [69] | 86.5 | 73.0 | 82.9 | 68.9 | 76.9 | 62.5 | 72.2 | 64.0 | 26 | 0.4 | ||
| EPC-Net-L-D[69] | ✓ | [69] | 92.2 | 80.3 | 87.2 | 74.9 | 80.0 | 66.8 | 75.5 | 67.0 | 26 | 0.4 | ||
| HiTPR[165] | [165] | 93.7 | 86.6 | 90.2 | 80.9 | 87.2 | 78.2 | 79.8 | 74.3 | 36 | 2.7 | |||
| HiTPR-S8[165] | [165] | 93.6 | 86.6 | 85.6 | 75.8 | 75.0 | 63.1 | 71.3 | 64.5 | 36 | 2.7 | |||
| HiTPR-F8[165] | [165] | 94.6 | 87.8 | 94.0 | 86.0 | 89.1 | 81.3 | 88.3 | 81.8 | |||||
| MinkLoc3D-I[161] | ✓ | [161] | 98.1 | 93.6 | ||||||||||
| MinkLoc3D-S[161] | ✓ | [161] | 92.0 | 79.9 | ||||||||||
| MinkLoc3D-SI[161] | ✓ | [161] | 93.4 | 82.2 | 11 | |||||||||
| Retriever[14] | [14] | 91.9 | 91.9 | 87.4 | 85.5 | |||||||||
| MinkLoc3Dv2[160] | Baseline | ✓ | [160] | 98.9 | 96.3 | 96.7 | 90.9 | 93.8 | 86.5 | 91.2 | 86.3 | |||
| Refine | ✓ | [160] | 99.1 | 96.9 | 99.7 | 99.0 | 99.4 | 98.3 | 99.1 | 97.6 | ||||
Чтобы помочь исследователям понять производительность каждого метода, мы в значительной степени собрали экспериментальные оценки по общедоступным наборам данных. Как кратко показано в Таблице IV, мы собрали год публикации, тип метода, код, источник результатов, максимальный балл , EP[273] и время выполнения на KITTI Odometry [262]. Кроме того, в Таблице V главным образом обобщены год публикации, код, источник результатов, средняя полнота (AR), время выполнения и размер параметров методов, основанных на обучении, на наборах данных Oxford [264] и In-house[12].
Оценки KITTI Odometry показали, что Locus[196], Gong et al.[203], BoxGraph[215], RINet[221] и LoGG3D-Net[162] достигли значений F1 более 0.97 в нескольких последовательностях. В части точности EP лучшие результаты продемонстрировали BoxGraph[215], SSC[73] и Locus[196]. Для набора данных Oxford RobotCar MinkLoc++[157], TransLoc3D[159] и MinkLoc3Dv2[160] достигли среднего значения полноты (recall) (@1 и @1) выше 95. Аналогично, MinkLoc3D[156], TransLoc3D[159], SVT-Net[8], ASVT-Net[8], CSVT-Net[8] и MinkLoc3Dv2[160] достигли среднего значения полноты более 93 на In-house datasets.
11 Будущие направления
В этом разделе мы представляем несколько многообещающих направлений будущей эволюции, чтобы способствовать и облегчить дальнейшие исследования.
11.1 Мультимодальная информация
Мультимодальная информация предоставляет возможность использовать взаимодополняющие признаки и повысить устойчивость распознавания местоположения и локализации. Представлены несколько новых решений::
WiFi. Локализация на основе WiFi извлекает адреса управления доступом к среде (MAC) маршрутизаторов через клиентское устройство (например, мобильный телефон) для вычисления позиций. Это решение обеспечивает широкое покрытие и позволяет достигать точной внутренней локализации, преодолевая ограничения сигналов GPS. Кроме того, его легко развернуть, и оно обеспечивает быструю локализацию, обладая значительным потенциалом для развития отраслей внутренней локализации.
Голос. Голосовая локализация на основе микрофонных решеток использует захват аудиосигналов с помощью микрофонных массивов, применяя оценку задержек или спектральный анализ для определения местоположений источников звука. Она обеспечивает преимущества, такие как низкие вычислительные затраты, высокая скрытность и надежная совместимость. Кроме того, она может бесшовно интегрироваться с системами взаимодействия человек—компьютер, умными домами и другими приложениями голосового управления, повышая осведомленность автомобиля об обстановке.
Радиочастотная идентификация (RFID). RFID использует радиосигналы для идентификации и отслеживания объектов без физического контакта. Его устойчивость к помехам обеспечит надежное автономное вождение в суровых условиях. Кроме того, длительный срок службы может повысить стабильность систем долговременной локализации. Применение криптографического шифрования к данным меток может усилить безопасность системы.
11.2 Инновационные решения
Освобождение от традиционных решений и внедрение междисциплинарных новых технологий в автономное вождение открывает потенциал для непредвиденных улучшений:
Облачные вычисления. Облачные вычисления предлагают пользователям высокопроизводительные совместно используемые вычислительные ресурсы. Перенос вычислительных задач на облачные серверы повышает эффективность локализации роботов. Благодаря доступу к мощным вычислительным ресурсам роботы могут обрабатывать разнообразные высокоточные данные сенсоров, тем самым улучшая свои возможности локализации.
Квантовые технологии. Квантовые технологии революционизируют вычисление, кодирование и передачу информации. Квантовые датчики могут улавливать едва заметные изменения, обеспечивая сверхвысокоточные измерения. Интеграция таких датчиков в роботизированную навигацию существенно повысит точность локализации и построения карт в сложных средах.
Бионическая локализация. Бионическая навигация и групповое поведение дают новые идеи для локализации роботов. Вдохновленные поведением черепах при навигации, роботы могут повысить устойчивость локализации, используя датчики магнитного поля. Многороботные системы могут улучшить стабильность формирования, имитируя кооперативное поведение, наблюдаемое в стаях птиц.
11.3 Усовершенствованные сенсоры
Оснащение роботов передовыми датчиками может повысить их навигационные возможности. Ниже мы представляем несколько перспективных датчиков следующим образом:
Твердотельный LiDAR. В отличие от механического LiDAR, твердотельный LiDAR использует микроэлектромеханическую систему (MEMS), оптическую фазированную решетку (OPA) или флэш-технологию для передачи и приема сигнала. Он отличается компактными размерами, высокой разрешающей способностью, быстрой скоростью сканирования и расширенным диапазоном измерений. Он позволяет точно идентифицировать здания, пешеходов, транспортные средства и дорожные знаки, эффективно обеспечивая безопасность автономного вождения, поддерживая сбор данных для интеллектуального транспорта и мониторинг дорожно-транспортных происшествий.
Событийная камера. Вместо традиционного фиксированного частотного сбора данных собыйтийные камеры исключительно генерируют асинхронный поток событий только при возникновении заметных изменений в изображении. Они обеспечивают множество преимуществ, включая высокое временное разрешение, низкую задержку, широкий динамический диапазон и низкое энергопотребление. Оснащение транспортных средств собыйтийными камерами повышает способность избегать препятствий в сценариях с высокой скоростью, позволяет осуществлять навигацию по сценам с резкими изменениями освещения и облегчает реагирование на экстренные ситуации.
Радар миллиметрового диапазона. Радар миллиметрового диапазона использует сигналы частотно-модулированной непрерывной волны (FMCW) и смесители для измерения скорости, расстояния и направления, обеспечивая экономичность, точное продольное определение дальности, точное обнаружение объектов, устойчивость к погодным условиям и высокую пропускную способность. Он найдет широкое применение в обнаружении слепых зон, обнаружении и отслеживании объектов, помощи при парковке и адаптивном круиз-контроле.
11.4 Значимые применения
По мере развертывания новой научной и технологической революции робототехника будет выступать движущей силой прогресса в нескольких ключевых областях, формирующих судьбу человечества:
Исследование космоса. В негостеприимных средах, таких как Луна, роботы возьмут на себя роль людей, выполняя задачи, такие как картографирование местности, идентификация полезных ископаемых, строительство домов и 3D-печать. Они помогут человеческому пониманию глубокого космоса и других планет.
Полярные исследования. Роботы продвигают полярные исследования, усиливая возможности сбора данных. Они собирают данные о ледниках, погоде и температуре, способствуя непрерывному экологическому мониторингу. Высокоточное картографирование полярной топографии помогает выявлять изменения рельефа, движение ледников и геологические процессы.
Подводные роботы. Подводные роботы — это передовые подводные аппараты, созданные для экстремальных подводных операций. Волоконно-оптический гироскоп и допплеровский лаг значительно повысят точность позиционирования, что будет полезно при строительстве портов и для морской обороны. Технология обнаружения с помощью сонаров дополнительно повысит эффективность выполнения задач, таких как подводное спасение и обслуживание трубопроводов.
11.5 Оценки подходов
Всесторонняя и тщательная оценка имеет решающее значение для адаптации робототехнических продуктов, алгоритмов и сценариев. Вот три ключевых соображения для будущей оценки алгоритмов.
Масштабируемость и эффективность. Рост доступности и снижение стоимости LiDAR-датчиков стимулировали спрос на распознавание местности в масштабах крупных систем. Это требует разработки масштабируемых алгоритмов для обработки больших наборов точек и проектирования эффективных алгоритмов для обработки данных облака точек в реальном времени на платформах с ограниченными вычислительными ресурсами.
Долгосрочное распознавание местоположений. Долгосрочное распознавание местоположений относится к способности системы распознавать места в течение длительных периодов, несмотря на изменения внешнего вида и погодные условия. Это критически важная возможность для автономной навигации. Разработка алгоритмов, которые могут справляться с сезонами, погодой, изменениями внешнего вида и динамическими объектами, будет способствовать существенным достижениям в этой области.
Стандартизированные наборы данных. Хороший набор данных должен обладать достаточным объемом, данными высокого качества, надежными истинными значениями, аннотациями или метками, этическими соображениями, нормализованным представлением и четкими инструкциями. Создание разнообразных данных, охватывающих различные модальности сенсоров, условия окружающей среды и изменения погоды, также весьма ценно.
11.6 Обучаемое улучшение
Обучаемые методы LPR продемонстрировали впечатляющие результаты, и мы намечаем перспективные направления для улучшения их работы следующим образом:
Дизайн сети. Трансформерные сети [166, 170, 155, 165, 169] требуют больших вычислительных затрат на крупномасштабных наборах данных. Чтобы решить эту проблему, можно использовать такие методы, как сжатие модели и эффективные механизмы внимания, чтобы снизить вычислительные требования.
12 Выводы
Настоящая статья является первым всеобъемлющим обзором, специально посвящённым исследованиям LPR, насколько нам известно. Она предоставляет обширное обсуждение фона задачи распознавания места, выделяя ключевые проблемы в текущих исследованиях. Мы проводим всестороннюю классификацию методов и сравнительное оценивание производительности, раскрывая их архитектуры, сильные и слабые стороны. Кроме того, мы обобщаем часто используемые наборы данных, метрики оценивания и перспективные будущие направления.
Ссылки
- [1] А. Тории, Дж. Сивик, М. Окутоми и Т. Пайдла, «Распознавание визуальных мест с повторяющимися структурами», IEEE Transactions on Pattern Analysis and Machine Intelligence, т. 37, вып. 11, стр. 2346–2359, 2015.
- [2] S. Lowry and M. J. Milford, “Supervised and unsupervised linear learning techniques for visual place recognition in changing environments,” IEEE Transactions on Robotics, vol. 32, no. 3, pp. 600–613, 2016.
- [3] D. L. Rizzini, “Place recognition of 3d landmarks based on geometric relations,” in 2017 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2017, pp. 648–654.
- ⟦[4] G. Ким и А. Ким, «Скан-контекст: Эгоцентрическое пространственное описание для распознавания места в 3d-картографической точечной облачной карте», в 2018 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS). IEEE, 2018, стр. 4802–4809.
- ⟦Z. Liu, S. Zhou, C. Suo, P. Yin, W. Chen, H. Wang, H. Li, and Y.-H. Liu, “Lpd-net: обучение 3d облаков точек для распознавания местоположений в больших масштабах и анализа среды,” в Proceedings of the IEEE/CVF International Conference on Computer Vision, 2019, стр. 2831–2840.
- ⟦P. Yin, F. Wang, A. Egorov, J. Hou, J. Zhang, and H. Choset, “Seqspherevlad: Sequence matching enhanced orientation-invariant place recognition,” in 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2020, pp. 5024–5029.
- ⟦[7] G. Kim, S. Choi, and A. Kim, “Scan context++: Structural place recognition robust to rotation and lateral variations in urban environments,” IEEE Transactions on Robotics, 2021.
- ⟦[8] Z. Fan, Z. Song, H. Liu, Z. Lu, J. He, и X. Du, “Svt-net: Super light-weight sparse voxel transformer для крупномасштабного распознавания местоположений,” в Трудах конференции AAAI по искусственному интеллекту, т. 36, вып. 1, 2022, стр. 551–560.
- [9] G. Kim, B. Park, and A. Kim, “1-day learning, 1-year localization: Long-term lidar localization using scan context image,” IEEE Robotics and Automation Letters, vol. 4, no. 2, pp. 1948–1955, 2019.
- ⟦H. Dong, X. Chen и C. Stachniss, “Online range image-based pole extractor for long-term lidar localization in urban environments,” в 2021 European Conference on Mobile Robots (ECMR). IEEE, 2021, стр. 1–6.
- [11] F. Cao, H. Wu, and C. Wu, “An end-to-end localizer for long-term topological localization in large-scale changing environments,” IEEE Transactions on Industrial Electronics, pp. 1–10, 2022.
- [12] М. А. Уй и Г. Х. Ли, “Pointnetvlad: Deep point cloud based retrieval for large-scale place recognition,” в Proceedings of the IEEE conference on computer vision and pattern recognition, 2018, стр. 4470–4479.
- [13] Q. Sun, H. Liu, J. He, Z. Fan, and X. Du, “Dagc: Employing dual attention and graph convolution for point cloud based place recognition,” in Proceedings of the 2020 International Conference on Multimedia Retrieval, 2020, pp. 224–232.
- [14] L. Wiesmann, R. Marcuzzi, C. Stachniss и J. Behley, “Retriever: Point cloud retrieval in compressed 3d maps,” в 2022 International Conference on Robotics and Automation (ICRA), 2022, стр. 10 925–10 932.
- [15] B. Steder, M. Ruhnke, S. Grzonka, and W. Burgard, “Place recognition in 3d scans using a combination of bag of words and point feature based relative pose estimation,” in 2011 IEEE/RSJ International Conference on Intelligent Robots and Systems, 2011, pp. 1249–1255.
- [16] A. Тории, Р. Аранджелович, Дж. Сивич, М. Окутоми и Т. Паядла, «Распознавание 24/7 по виду с помощью синтеза ракурсов», IEEE Transactions on Pattern Analysis and Machine Intelligence, т. 40, вып. 2, стр. 257–271, 2018.
- [17] А. Халик, С. Эхсан, Ц. Чэнь, М. Милфорд и К. Макдональд-Майер, «A holistic visual place recognition approach using lightweight cnns for significant viewpoint and appearance changes», IEEE transactions on robotics, vol. 36, no. 2, pp. 561–569, 2019.
- [18] Y. Pan, X. Xu, W. Li, Y. Cui, Y. Wang и R. Xiong, «Coral: Colored structural representation for bi-modal place recognition», в 2021 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS), 2021, стр. 2084–2091.
- [19] H. Инь, Ю. Ван, С. Дин, Л. Тан, С. Хуан и Р. Сюн, «Глобальная локализация на основе 3d lidar с использованием сиамской нейронной сети», IEEE Transactions on Intelligent Transportation Systems, т. 21, вып. 4, стр. 1380–1392, 2020.
- [20] S.-Y. An and J. Kim, “Extracting statistical signatures of geometry and structure in 2d occupancy grid maps for global localization,” IEEE Robotics and Automation Letters, vol. 7, no. 2, pp. 4291–4298, 2022.
- ⟦Y. Li, Y. Cai, Z. Li, S. Feng, H. Wang, and M. A. Sotelo, “Map-based localization for intelligent vehicles from bi-sensor data fusion,” Expert Systems with Applications, vol. 203, p. 117586, 2022.
- [22] Т. Шмидель, Э. Эйнхорн и Х.-М. Гросс, «Iron: Быстрый дескриптор опорных точек интереса для надежного сопоставления ndt-map и его применение для локализации роботов», в 2015 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS). IEEE, 2015, стр. 3144–3151.
- ⟦H. Song, W. Choi, and H. Kim, “Robust vision-based relative-localization approach using an rgb-depth camera and lidar sensor fusion,” IEEE Transactions on Industrial Electronics, vol. 63, no. 6, pp. 3725–3736, 2016.
- ⟦[24] А. Ю. Хата и Д. Ф. Вольф, «Обнаружение признаков для локализации транспортных средств в городских условиях с использованием многослойного лидара», IEEE Transactions on Intelligent Transportation Systems, том 17, № 2, стр. 420–429, 2016.
- ⟦G. Elbaz, T. Avraham, and A. Fischer, “3d point cloud registration for localization using a deep neural network auto-encoder,” in Proceedings of the IEEE conference on computer vision and pattern recognition, 2017, pp. 4631–4640.
- [26] В. Лу, Ю. Чжоу, Г. Ван, С. Хоу и С. Сонг, «L3-net: в сторону обучения на основе локализации лидара для автономного вождения», в Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, стр. 6389–6398.
- ⟦[27] H. Ванг, С. Ванг и Л. Сюй, «Легковесная трехмерная локализация и построение карты для твердотельного лидара», IEEE Robotics and Automation Letters, т. 6, вып. 2, стр. 1801–1807, 2021.
- [28] D. Шляйхер, Л. М. Бергаса, М. Ока́ньа, Р. Барея, и М. Э. Ло́пес, «Быстрая иерархическая автономная система slam на открытом воздухе в реальном времени на основе стереовидения и объединения gps,» IEEE Transactions on Intelligent Transportation Systems, т. 10, № 3, с. 440–452, 2009.
- ⟦[29] О. Высоцкая, Т. Насеер, Л. Спинелло, В. Бургард и К. Штахнисс, «Эффективное и результативное сопоставление последовательностей изображений при существенных изменениях внешнего вида с использованием gps-предпосылок», в 2015 IEEE International Conference on Robotics and Automation (ICRA), 2015, стр. 2774–2779.
- ⟦[30] K. Pargieła и A. Rzonca, «Определение оптимальной фотограмметрической корректировки изображений, полученных с фиксированного самолётного беспилотного летательного аппарата», The Photogrammetric Record, т. 36, № 175, с. 285–302, 2021.
- ⟦[31] Y. Ян и Г. Хуан, «Анализ наблюдаемости наведённых решений с разнородными признаками точек, линий и плоскостей», IEEE Transactions on Robotics, т. 35, вып. 6, стр. 1399–1418, 2019.
- [32] K.-W. Chiang, G.-J. Tsai, H.-J. Chu, and N. El-Sheimy, “Performance enhancement of ins/gnss/refreshed-slam integration for acceptable lane-level navigation accuracy,” IEEE Transactions on Vehicular Technology, vol. 69, no. 3, pp. 2463–2476, 2020.
- [33] J. J. Morales and Z. M. Kassas, “Tightly coupled inertial navigation system with signals of opportunity aiding,” IEEE Transactions on Aerospace and Electronic Systems, vol. 57, no. 3, pp. 1930–1948, 2021.
- ⟦M. Bagherbandi, A. Jouybari, F. Nilfouroushan, и J. Ågren, “Отклонение вертикального эффекта при прямом геореференсировании в воздушных системах мобильного картографирования: пример из Швеции,” The Photogrammetric Record, т. 37, № 179, с. 285–305, 2022.
- ⟦G. P. C. Júnior, A. M. C. Rezende, V. R. F. Miranda, R. Fernandes, H. Azpúrua, A. A. Neto, G. Pessin, and G. M. Freitas, “Ekf-loam: Аn adaptive fusion of lidar slam with wheel odometry and inertial data for confined spaces with few geometric features,” IEEE Transactions on Automation Science and Engineering, vol. 19, no. 3, pp. 1458–1471, 2022.
- [36] S. Lowry, N. Sünderhauf, P. Newman, J. J. Leonard, D. Cox, P. Corke и M. J. Milford, «Распознавание места по визуальным признакам: обзор», IEEE Transactions on Robotics, т. 32, вып. 1, стр. 1–19, 2016.
- [37] Р. Пауэр, М. Заффар, Б. Феррарини, М. Милфорд, К. Макдональд-Майер и С. Эхсан, «Сравнение эталонных показателей методов распознавания визуальных мест для ресурсоограниченных встроенных платформ», препринт arXiv arXiv:2109.11002, 2021.
- [38] J. Peltomäki, F. Alijani, J. Puura, H. Huttunen, E. Rahtu, and J.-K. Kämäräinen, “Evaluation of long-term lidar place recognition,” in 2021 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2021, pp. 4487–4492.
- ⟦[39] К. А. Цинтотас, Л. Бампис и А. Гастератос, «Проблема повторного обхода в одновременной локализации и построении карты: обзор по обнаружению визуального замыкания цикла», IEEE Transactions on Intelligent Transportation Systems, т. 23, вып. 11, стр. 19 929–19 953, 2022.
- [40] X. Zhang, L. Wang, and Y. Su, “Визуальное распознавание места: обзор с точки зрения deep learning,” Pattern Recognition, т. 113, с. 107760, 2021.
- ⟦J. Li, W. Xu, P. Shi, Y. Zhang, and Q. Hu, “Lnift: Locally normalized image for rotation invariant multimodal feature matching,” IEEE Transactions on Geoscience and Remote Sensing, vol. 60, pp. 1–14, 2022.
- ⟦J. Wu and J. M. Rehg, “Centrist: A visual descriptor for scene categorization,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 33, no. 8, pp. 1489–1501, 2011.
- [43] Р. Аранджелович, П. Гронат, А. Тории, Т. Пайдла и Дж. Сивич, «Netvlad: Cnn архитектура для распознавания мест с слабым контролем», в материалах конференции IEEE по компьютерному зрению и распознаванию образов, 2016, стр. 5297–5307.
- ⟦R. Wang, Y. Shen, W. Zuo, S. Zhou, and N. Zheng, “Transvpr: Transformer-based place recognition with multi-level attention aggregation,” in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, pp. 13 648–13 657.
- ⟦P. Shi, Q. Ye, and L. Zeng, “A novel indoor structure extraction based on dense point cloud,” ISPRS International Journal of Geo-Information, vol. 9, no. 11, p. 660, 2020.
- ⟦[46] H. Wang, C. Wang, and L. Xie, “Intensity scan context: Coding intensity and geometry relations for loop closure detection,” in 2020 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2020, pp. 2095–2101.
- ⟦[47] Y. Wang, Z. Sun, C.-Z. Xu, S. E. Sarma, J. Yang, and H. Kong, «Лидарная радужка для обнаружения замыканий петель», в 2020 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS). IEEE, 2020, стр. 5769–5775.
- [48] Т. Рёхлинг, Й. Мак, и Д. Шульц, «Быстрая гистограммная мера сходства для обнаружения замыканий петель в данных 3-d lidar», в 2015 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS). IEEE, 2015, стр. 736–741.
- [49] Л. Люо, С.-Й. Цао, Ц. Шэн и Х.-Л. Шэнь, «Глобальная локализация на основе LiDAR с использованием гистограммы ориентаций главных нормалей», IEEE Transactions on Intelligent Vehicles, т. 7, № 3, с. 771–782, 2022.
- ⟦L. Schaupp, M. Bürki, R. Dubé, R. Siegwart и C. Cadena, “Oreos: Ориентированное распознавание 3d облаков точек в наружных сценариях,” в 2019 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2019, стр. 3255–3261.
- [51] X. Kong, X. Yang, G. Zhai, X. Zhao, X. Zeng, M. Wang, Y. Liu, W. Li и F. Wen, «Semantic graph based place recognition for 3d point clouds», в 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2020, стр. 8216–8223.
- [52] Y. Zhu, Y. Ma, L. Chen, C. Liu, M. Ye, and L. Li, “Gosmatch: Graph-of-semantics matching для обнаружения замыканий петель в данных 3d lidar,” в 2020 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS). IEEE, 2020, стр. 5151–5157.
- [53] Л. Ли, С. Кун, С. Чжао, В. Ли, Ф. Вэнь, Х. Чжан и Ю. Лю, «Sa-loam: Semantic-aided lidar slam with loop closure», в 2021 IEEE Международной конференции по робототехнике и автоматизации (ICRA). IEEE, 2021, стр. 7627–7634.
- [54] L. Ло, С.-Ы. Цао, Б. Хан, Х.-Л. Шэнь и Дж. Ли, «Bvmatch: распознавание места на основе лидара с использованием изображений в перспективе сверху вниз», IEEE Robotics and Automation Letters, том 6, номер 3, стр. 6076–6083, 2021.
- [55] Т. Шан, Б. Энглот, Д. Майерс, У. Ванг, К. Ратти и Д. Рус, «Lio-sam: тесно связанная лидар- инерциальная одометрия посредством сглаживания и картографирования», в 2020 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS), 2020, стр. 5135–5142.
- ⟦[56] Y. Zhang, «Lilo: новый лидар-имю SLAM-система с оптимизацией петель», IEEE Transactions on Aerospace and Electronic Systems, 2021.
- ⟦P. Yin, F. Wang, A. Egorov, J. Hou, Z. Jia, and J. Han, “Fast sequence-matching enhanced viewpoint-invariant 3-d place recognition,” IEEE Transactions on Industrial Electronics, vol. 69, no. 2, pp. 2127–2135, 2022.
- [58] T. Шан и Б. Энглот, «Lego-loam: Lightweight and ground-optimized lidar odometry and mapping on variable terrain,» в 2018 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2018, стр. 4758–4765.
- ⟦P. Dellenbach, J.-E. Deschaud, B. Jacquet, и F. Goulette, “Ct-icp: Real-time elastic lidar odometry with loop closure,” в 2022 International Conference on Robotics and Automation (ICRA), 2022, стр. 5580–5586.
- [60] J. Li, P. Shi, Q. Hu, and Y. Zhang, “Qgore: Quadratic-time guaranteed outlier removal for point cloud registration,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023.
- ⟦[61] M. Bosse and R. Zlot, “Place recognition using keypoint voting in large 3d lidar datasets,” in 2013 IEEE International Conference on Robotics and Automation, 2013, pp. 2677–2684.
- [62] Н. Мухаммад и С. Лакруа, «Обнаружение замыкания петель с использованием небольших сигнатур по данным 3d lidar», в 2011 IEEE International Symposium on Safety, Security, and Rescue Robotics. IEEE, 2011, стр. 333–338.
- ⟦[63] J. Guo, P. V. Borges, C. Park, and A. Gawel, “Local descriptor for robust place recognition using lidar intensity,” IEEE Robotics and Automation Letters, vol. 4, no. 2, pp. 1470–1477, 2019.
- [64] K. P. Cop, P. V. Borges и R. Dubé, «Delight: An efficient descriptor for global localisation using lidar intensities», в 2018 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2018, стр. 3653–3660.
- ⟦[65] H. Xiang, W. Shi, W. Fan, P. Chen, S. Bao, and M. Nie, “Fastlcd: Быстрый и компактный подход к обнаружению замыканий цикла с использованием 3d point cloud для внутреннего мобильного картографирования,” International Journal of Applied Earth Observation and Geoinformation, vol. 102, p. 102430, 2021.
- ⟦S. Ratz, M. Dymczyk, R. Siegwart, and R. Dubé, “Oneshot global localization: Instant lidar-visual pose estimation,” in 2020 IEEE International conference on Robotics and Automation (ICRA). IEEE, 2020, pp. 5415–5421.
- ⟦[67] Д. Сю, Дж. Лю, Дж. Хийппя, Й. Лианг и В. Тао, «Решение для распознавания местоположения на основе гетерогенной 3d карты с использованием виртуального лидара и полярного грид кодирующего изображения», ISPRS Journal of Photogrammetry and Remote Sensing, том 183, стр. 1–18, 2022.
- ⟦[68] X. Xu, H. Yin, Z. Chen, Y. Li, Y. Wang, и R. Xiong, “Disco: Differentiable scan context with orientation,” IEEE Robotics and Automation Letters, том 6, вып. 2, стр. 2791–2798, 2021.
- [69] Л. Хуэй, М. Чэн, Дж. Сие, Дж. Ян и М.-М. Чэн, «Эффективное обучение признаков облака 3d-точек для распознавания мест в крупном масштабе», IEEE Transactions on Image Processing, т. 31, с. 1258–1270, 2022.
- ⟦W. Zhang and C. Xiao, “Pcan: 3d attention map learning using contextual information for point cloud based retrieval,” in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, pp. 12 436–12 445.
- [71] J. Ду, Р. Ванг и Д. Кремерс, “Dh3d: Deep hierarchical 3d descriptors for robust large-scale 6dof relocalization,” in European Conference on Computer Vision. Springer, 2020, pp. 744–762.
- [72] X. Chen, T. Lbe, A. Milioto, T. Rhling, и C. Stachniss, “Overlapnet: Loop closing for lidar-based slam,” в Robotics: Science and Systems 2020, 2020.
- [73] Л. Ли, С. Конг, С. Чжао, Т. Хуан, В. Ли, Ф. Вэнь, Х. Чжан и Й. Лю, «Ssc: Semantic scan context for large-scale place recognition», в 2021 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2021, стр. 2092–2099.
- ⟦[74] R. Dubé, D. Dugas, E. Stumm, J. Nieto, R. Siegwart и C. Cadena, «Segmatch: Распознавание местоположения на основе сегментов в трехмерных облаках точек», в 2017 IEEE Международной конференции по робототехнике и автоматизации (ICRA), 2017, стр. 5266–5272.
- ⟦[75] Д. Сю, Цз. Лю, И. Лян, С. Лу и Дж. Хийппя, «Решение для глобальной локализации за один снимок на основе лидара с дескриптором контекста сечений по форме», ISPRS Journal of Photogrammetry and Remote Sensing, том 189, с. 272–288, 2022.
- ⟦X. Chen, A. Milioto, E. Palazzolo, P. Giguere, J. Behley, and C. Stachniss, “Suma++: Efficient lidar-based semantic slam,” in 2019 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2019, pp. 4530–4537.
- ⟦X. Chen, I. Vizzo, T. Läbe, J. Behley, and C. Stachniss, “Range image-based lidar localization for autonomous vehicles,” in 2021 IEEE International Conference on Robotics and Automation (ICRA), 2021, pp. 5802–5808.
- ⟦H. Wang, C. Wang, C.-L. Chen, and L. Xie, “F-loam : Fast lidar odometry and mapping,” in 2021 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2021, pp. 4390–4396.
- ⟦[79] Y. Pan, P. Xiao, Y. He, Z. Shao, and Z. Li, “Mulls: Versatile lidar slam via multi-metric linear least square,” in 2021 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2021, pp. 11 633–11 640.
- [80] K. Żywanowski, A. Banaszczyk, and M. R. Nowicki, “Comparison of camera-based and 3d lidar-based place recognition across weather conditions,” in 2020 16th International Conference on Control, Automation, Robotics and Vision (ICARCV), 2020, pp. 886–891.
- ⟦P. Ши, Q. Е, Z. Шаомин, и Д. Хайфэн, «Инициализация локализации для многорамочного лидара с учетом особенностей внутренней сцены», Acta Geodaetica et Cartographica Sinica, т. 50, с. 1594–1604, 2021.
- ⟦P. Ши, Ц. Ли и И. Чжан, «Локализация LiDAR на 100 fps: глобальный метод, основанный на карте и дескрипторах шаблона», International Journal of Applied Earth Observation and Geoinformation, т. 120, с. 103336, 2023.
- ⟦J. Zhang и S. Singh, “Low-drift and real-time lidar odometry and mapping,” Autonomous Robots, том 41, номер 2, стр. 401–416, 2017.
- [84] J. Lin and F. Zhang, “A fast, complete, point cloud based loop closure for lidar odometry and mapping,” arXiv preprint arXiv:1909.11811, 2019.
- [85] Д. Уилсон, X. Чжан, У. Султани и С. Вшах, «Визуальная и объектная гео-локализация: всесторонний обзор», препринт arXiv arXiv:2112.15202, 2021.
- ⟦E. Mahdi and H. Xinming, “A survey on visual map localization using lidars and cameras,” arXiv preprint arXiv:2208.03376, 2022.
- ⟦F. Chen, X. Wang, Y. Zhao, S. Lv, and X. Niu, “Visual object tracking: A survey,” Computer Vision and Image Understanding, vol. 222, p. 103508, 2022.
- ⟦S. M. Marvasti-Zadeh, L. Cheng, H. Ghanei-Yakhdan, and S. Kasaei, “Deep learning for visual tracking: A comprehensive survey,” IEEE Transactions on Intelligent Transportation Systems, 2021.
- ⟦[89] I. A. Kazerouni, L. Fitzgerald, G. Dooly, и D. Toal, “Обзор современного уровня в визуальной SLAM”, Expert Systems with Applications, с. 117734, 2022.
- [90] S. Zhang, S. Zhao, D. An, J. Liu, H. Wang, Y. Feng, D. Li, and R. Zhao, “Visual slam for underwater vehicles: A survey,” Computer Science Review, vol. 46, p. 100510, 2022.
- [91] К. Хуан, С. Чжан, Д. Чжан и Д. Тао, «Сопоставление и локализация в одно и то же время на основе событий: всесторонний обзор», препринт arXiv, arXiv:2304.09793, 2023.
- ⟦[92] C. Кадена, Л. Карлоне, Х. Каррильо, Y. Латиф, Д. Скарамуцца, Дж. Нейра, И. Рид, и Дж. Дж. Леонард, “Прошлое, настоящее и будущее одновременной локализации и картографирования: к эпохе устойчивого восприятия,” IEEE Transactions on robotics, т. 32, № 6, стр. 1309–1332, 2016.
- ⟦P. Yin, S. Zhao, I. Cisneros, A. Abuduweili, G. Huang, M. Milford, C. Liu, H. Choset и S. Scherer, “Обзор общего распознавания места: к эпохе автономности в реальном мире,” препринт arXiv arXiv:2209.04497, 2022.
- ⟦[94] Г. Ин, С. Сюй, С. Лу, С. Чэнь, Р. Сюн, С. Шэнь, К. Штахнисс и Ю. Ван, «Обзор глобальной лазерной локализации: проблемы, достижения и открытые вопросы», препринт arXiv arXiv:2302.07433, 2023.
- [95] А. Е. Джонсон и М. Хеберт, «Использование спиновых изображений для эффективного распознавания объектов в загромождённых 3d-сценах», IEEE Transactions on pattern analysis and machine intelligence, т. 21, № 5, с. 433–449, 1999.
- ⟦A. Frome, D. Huber, R. Kolluri, T. Bülow, and J. Malik, “Recognizing objects in range data using regional point descriptors,” in European conference on computer vision. Springer, 2004, pp. 224–237.
- ⟦R. B. Rusu, N. Blodow, Z. C. Marton, and M. Beetz, “Aligning point cloud views using persistent feature histograms,” in 2008 IEEE/RSJ international conference on intelligent robots and systems. IEEE, 2008, pp. 3384–3391.
- [98] Р. Б. Русу, Н. Блодоу и М. Бец, «Быстрые гистограммы точечных признаков (fpfh) для 3d-регистрации», в 2009 IEEE международной конференции по робототехнике и автоматизации. IEEE, 2009, стр. 3212–3217.
- [99] Т. Чеслевски, Э. Штумм, А. Гавель, М. Боссе, С. Линен и Р. Зигварт, «Описатели облака точек для распознавания местоположения с использованием разреженной визуальной информации», в 2016 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2016, стр. 4830–4836.
- ⟦H. Zhao, M. Tang, and H. Ding, “Hoppf: A novel local surface descriptor for 3d object recognition,” Pattern Recognition, т. 103, с. 107272, 2020.
- ⟦F. Tombari, S. Salti, and L. Di Stefano, “Unique shape context for 3d data description,” in Proceedings of the ACM workshop on 3D object retrieval, 2010, pp. 57–62.
- ⟦Y. Guo, F. Sohel, M. Bennamoun, M. Lu, and J. Wan, “Rotational projection statistics for 3d local surface description and object recognition,” International journal of computer vision, vol. 105, no. 1, pp. 63–86, 2013.
- ⟦[103] S. Salti, F. Tombari, и L. Di Stefano, «Shot: Уникальные сигнатуры гистограмм для описания поверхности и текстуры», Computer Vision and Image Understanding, том 125, с. 251–264, 2014.
- [104] J. Ян, Ц. Чжан, Ю. Сяо и З. Цао, «Toldi: Эффективный и надежный подход к описанию трехмерной локальной формы», Pattern Recognition, т. 65, с. 175–187, 2017.
- [105] T. Сун, Г. Лю, С. Лю, Ф. Мэн, Л. Цзэн и Р. Ли, «Эффективный и компактный 3d локальный дескриптор на основе взвешенного высотного изображения», Information Sciences, т. 520, с. 209–231, 2020.
- [106] B. Steder, G. Grisetti, and W. Burgard, “Robust place recognition for 3d range data based on point features,” in 2010 IEEE International Conference on Robotics and Automation. IEEE, 2010, pp. 1400–1405.
- ⟦[107] Y. Zhuang, N. Jiang, H. Hu, and F. Yan, “3-d-laser-based scene measurement and place recognition for mobile robots in dynamic indoor environments,” IEEE Transactions on Instrumentation and Measurement, vol. 62, no. 2, pp. 438–450, 2013.
- ⟦[108] F. Cao, Y. Zhuang, H. Zhang, and W. Wang, “Robust place recognition and loop closing in laser-based slam for ugvs in urban environments,” IEEE Sensors Journal, vol. 18, no. 10, pp. 4242–4252, 2018.
- [109] T. Шан, Б. Энглот, Ф. Дуарте, К. Ратти и Д. Рус, «Надёжное распознавание местоположения с использованием изображающего лидара», в 2021 IEEE International Conference on Robotics and Automation (ICRA), 2021, стр. 5469–5475.
- ⟦Z. Wu, S. Song, A. Khosla, F. Yu, L. Zhang, X. Tang, and J. Xiao, “3d shapenets: A deep representation for volumetric shapes,” in 2015 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2015, pp. 1912–1920.
- ⟦[111] C. R. Ци, Х. Су, М. Ниесснер, А. Дай, М. Ян и Л. Дж. Гуибас, «Объемные и многовидовые cnns для классификации объектов по данным 3d», в Proceedings of the IEEE conference on computer vision and pattern recognition, 2016, стр. 5648–5656.
- [112] A. Zeng, S. Song, M. Nießner, M. Fisher, J. Xiao, and T. Funkhouser, “3dmatch: Learning local geometric descriptors from rgb-d reconstructions,” in 2017 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2017, pp. 199–208.
- ⟦[113] C. Choy, J. Park, and V. Koltun, “Fully convolutional geometric features,” in 2019 IEEE/CVF International Conference on Computer Vision (ICCV), 2019, pp. 8957–8965.
- ⟦Z. Gojcic, C. Zhou, J. D. Wegner, and A. Wieser, “The perfect match: 3d point cloud matching with smoothed densities,” in 2019 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019, pp. 5540–5549.
- [115] С. Ао, Ц. Ху, Б. Ян, А. Маркам, и Ю. Го, “Spinnet: Learning a general surface descriptor for 3d point cloud registration,” в материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, 2021, стр. 11 753–11 762.
- [116] S. Ao, Y. Guo, Q. Hu, B. Yang, A. Markham, and Z. Chen, “Вы тренируетесь только один раз: обучение общим и различительным 3d локальным дескрипторам,” IEEE Transactions on Pattern Analysis and Machine Intelligence, том 45, номер 3, стр. 3949–3967, 2023.
- ⟦C. R. Qi, H. Su, K. Mo и L. J. Guibas, “Pointnet: Deep learning on point sets for 3d classification and segmentation,” in Proceedings of the IEEE conference on computer vision and pattern recognition, 2017, стр. 652–660.
- [118] C. R. Qi, L. Yi, H. Su, and L. J. Guibas, “Pointnet++: Deep hierarchical feature learning on point sets in a metric space,” Advances in neural information processing systems, vol. 30, 2017.
- ⟦M. Хури, Ц.-Ю. Чжоу и В. Колтун, «Обучение компактных геометрических признаков», в Proceedings of the IEEE international conference on computer vision, 2017, стр. 153–161.
- [120] H. Deng, T. Birdal и S. Ilic, «Ppfnet: Global context aware local features for robust 3d point matching», in 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2018, стр. 195–205.
- [121] ——, “Ppf-foldnet: Unsupervised learning of rotation invariant 3d local descriptors,” in Proceedings of the European Conference on Computer Vision (ECCV), 2018, pp. 602–618.
- ⟦K0⟩ W. Lu, G. Wan, Y. Zhou, X. Fu, P. Yuan, и S. Song, «Deepvcp: сквозная глубокая нейронная сеть для регистрации облака точек», в Proceedings of IEEE/CVF International Conference on Computer Vision, 2019, стр. 12–21.
- ⟦[123] H. Deng, T. Birdal, and S. Ilic, “3d local features for direct pairwise registration,” in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, pp. 3244–3253.
- ⟦X. Bai, Z. Luo, L. Zhou, H. Fu, L. Quan, and C.-L. Tai, “D3feat: Joint learning of dense detection and description of 3d local features,” in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2020, pp. 6359–6367.
- [125] Y. Zhou, Y. Wang, F. Poiesi, Q. Qin, and Y. Wan, “Loop closure detection using local 3d deep descriptors,” IEEE Robotics and Automation Letters, vol. 7, no. 3, pp. 6335–6342, 2022.
- ⟦F. Поези и Д. Боскани, «Обучение общих и различительных 3d локальных глубоких дескрипторов для регистрации облаков точек», IEEE Transactions on Pattern Analysis and Machine Intelligence, т. 45, вып. 3, стр. 3979–3985, 2022.
- [127] М. Маркон, Р. Шпезиалетти, С. Салти, Л. Силва и Л. Д. Стефано, «Нейконтролируемое обучение локальных эквивариантных дескрипторов для облаков точек», IEEE Transactions on Pattern Analysis and Machine Intelligence, том. 44, вып. 12, стр. 9687–9702, 2022.
- [128] L. Zhou, S. Zhu, Z. Luo, T. Shen, R. Zhang, M. Zhen, T. Fang, и L. Quan, «Обучение и сопоставление многовидовых дескрипторов для регистрации облаков точек», в Proceedings of the European Conference on Computer Vision (ECCV), 2018, стр. 505–522.
- [129] Л. Ли, С. Чжу, Х. Фу, П. Тан и C.-Л. Тай, «Сквозное обучение локальных многовидовых дескрипторов для 3d облаков точек», в 2020 IEEE/CVF Конференции по компьютерному зрению и распознаванию образов (CVPR), 2020, стр. 1916–1925.
- ⟦Z. Gojcic, C. Zhou, J. D. Wegner, L. J. Guibas, and T. Birdal, “Learning multiview 3d point cloud registration,” in 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020, pp. 1756–1766.
- [131] H. Xiang, X. Zhu, W. Shi, W. Fan, P. Chen, and S. Bao, “Delightlcd: A deep and lightweight network for loop closure detection in lidar slam,” IEEE Sensors Journal, vol. 22, no. 21, pp. 20 761–20 772, 2022.
- [132] B. Steder, G. Grisetti, M. Van Loock, and W. Burgard, “Robust on-line model-based object detection from range images,” in 2009 IEEE/RSJ International Conference on Intelligent Robots and Systems. IEEE, 2009, pp. 4739–4744.
- [133] J. Li, Q. Hu, and M. Ai, “Rift: Multi-modal image matching based on radiation-variation insensitive feature transform,” IEEE Transactions on Image Processing, vol. 29, pp. 3296–3310, 2020.
- ⟦[134] E. Rosten and T. Drummond, “Machine learning for high-speed corner detection,” in Computer Vision–ECCV 2006: 9th European Conference on Computer Vision, Graz, Austria, May 7-13, 2006. Proceedings, Part I 9. Springer, 2006, pp. 430–443.
- ⟦Y. Guo, M. Bennamoun, F. Sohel, M. Lu, and J. Wan, “3d object recognition in cluttered scenes with local surface features: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 36, no. 11, pp. 2270–2287, 2014.
- [136] J. Yang, S. Quan, P. Wang, and Y. Zhang, “Evaluating local geometric feature representations for 3d rigid data matching,” IEEE Transactions on Image Processing, vol. 29, pp. 2522–2535, 2020.
- [137] Y. Guo, M. Bennamoun, F. Sohel, M. Lu, J. Wan, и N. M. Kwok, «Всеобъемлющая оценка производительности дескрипторов локальных признаков 3d», International Journal of Computer Vision, т. 116, с. 66–89, 2016.
- ⟦Y. Zhong, “Intrinsic shape signatures: A shape descriptor for 3d object recognition,” in 2009 IEEE 12th international conference on computer vision workshops, ICCV Workshops. IEEE, 2009, pp. 689–696.
- ⟦X. Shi, Z. Chai, Y. Zhou, J. Wu, and Z. Xiong, “Global place recognition using an improved scan context for lidar-based localization system,” in 2021 IEEE/ASME International Conference on Advanced Intelligent Mechatronics (AIM), 2021, pp. 498–503.
- ⟦X. Cai and W. Yin, “Weighted scan context: Global descriptor with sparse height feature for loop closure detection,” in 2021 International Conference on Computer, Control and Robotics (ICCCR). IEEE, 2021, pp. 214–219.
- ⟦S. Lu, X. Xu, H. Yin, Z. Chen, R. Xiong и Y. Wang, «One ring to rule them all: Radon sinogram for place recognition, orientation and translation estimation», в 2022 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2022, стр. 2778–2785.
- ⟦X. Xu, S. Lu, J. Wu, H. Lu, Q. Zhu, Y. Liao, R. Xiong, and Y. Wang, “Ring++: Roto-translation invariant gram for global localization on a sparse scan map,” arXiv preprint arXiv:2210.05984, 2022.
- ⟦[143] W. Wang, H. Min, X. Wu, X. Hou, Y. Li, and X. Zhao, “High accuracy and low complexity lidar place recognition using unitary invariant frobenius norm,” IEEE Sensors Journal, 2022.
- ⟦[144] Y. Fan, X. Du, L. Luo и J. Shen, «Fresco: Frequency-domain scan context for lidar-based place recognition with translation and rotation invariance», in 2022 17th International Conference on Control, Automation, Robotics and Vision (ICARCV). IEEE, 2022, pp. 576–583.
- ⟦[145] F. Ou, Y. Li, и Z. Miao, «Распознавание местоположения на больших масштабах неструктурированных садов с картами оценок внимания», IEEE Robotics and Automation Letters, 2023.
- ⟦[146] М. Магнуссон, Х. Андреассон, А. Нухтер и А. Дж. Лилиенталь, «Обнаружение циклов по внешнему виду по данным 3d лазера с использованием нормального преобразования распределений», в 2009 IEEE International Conference on Robotics and Automation. IEEE, 2009, стр. 23–28.
- [147] J. Mo and J. Sattar, “A fast and robust place recognition approach for stereo visual odometry using lidar descriptors,” in 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2020, pp. 5893–5900.
- [148] Ф. Цао, Ф. Ян, С. Ван, Ю. Чжуан и В. Ван, «Положение лидара с распознаванием, устойчивым к сезонным изменениям и допускающим различные точки зрения, в средах, где отсутствует gps», IEEE Transactions on Industrial Electronics, т. 68, вып. 1, с. 563–574, 2021.
- ⟦[149] Л. Хэ, Х. Ван и Х. Чжан, «M2dp: Новое 3d-описание для облака точек и его применение в обнаружении циклического замыкания», в: 2016 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS). IEEE, 2016, стр. 231–237.
- [150] Л. Пердому, Д. Питтоль, М. Мантелли, Р. Маффеи, М. Колберг и Э. Престес, «c-m2dp: Быстрый дескриптор облака точек с информацией о цвете для выполнения обнаружения замыкания контура», в 2019 IEEE 15-й Международной конференции по автоматизации и наукам об инженерии (CASE). IEEE, 2019, стр. 1145–1150.
- [151] Y. Xia, Y. Xu, S. Li, R. Wang, J. Du, D. Cremers, and U. Stilla, “Soe-net: A self-attention and orientation encoding network for point cloud based place recognition,” in 2021 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). IEEE, 2021, pp. 11 343–11 352.
- ⟦[152] D. Cattaneo, M. Vaghi, и A. Valada, «Lcdnet: Deep loop closure detection and point cloud registration for lidar slam», IEEE Transactions on Robotics, т. 38, вып. 4, стр. 2074–2093, 2022.
- ⟦Z. Fan, H. Liu, J. He, Q. Sun, and X. Du, “Srnet: A 3d scene recognition network using static graph and dense semantic fusion,” in Computer Graphics Forum, vol. 39, no. 7. Wiley Online Library, 2020, pp. 301–311.
- ⟦Z. Qiao, H. Hu, W. Shi, S. Chen, Z. Liu, and H. Wang, “A registration-aided domain adaptation network for 3d point cloud based place recognition,” in 2021 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2021, pp. 1317–1322.
- [155] L. Hui, H. Yang, M. Cheng, J. Xie, and J. Yang, “Pyramid point cloud transformer for large-scale place recognition,” in Proceedings of the IEEE/CVF International Conference on Computer Vision, 2021, pp. 6098–6107.
- [156] J. Komorowski, “Minkloc3d: Point cloud based large-scale place recognition,” в Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision, 2021, стр. 1790–1799.
- [157] J. Komorowski, M. Wysoczańska, и T. Trzcinski, «Minkloc++: Lidar и моноокулярное изображение для слияния при распознавании местоположения», в 2021 International Joint Conference on Neural Networks (IJCNN), 2021, стр. 1–8.
- [158] Дж. Коморовский, М. Вышоцанска, и Т. Тржциньски, «Egonn: Egocentric neural network for point cloud based 6dof relocalization at the city scale», IEEE Robotics and Automation Letters, т. 7, № 2, с. 722–729, 2021.
- [159] Т.-Х. Сюй, Ю.-Ц. Го, Ю.-К. Лай и С.-Х. Чжан, «Transloc3d: распознавание местоположений в масштабе на основе облаков точек с использованием адаптивных рецептивных полей», препринт arXiv, arXiv:2105.11605, 2021.
- ⟦[160] Дж. Коморовски, «Улучшение распознавания места на основе облака точек с помощью ранжирующей потери и крупномасштабного обучения», в 2022 26-й Международной конференции по распознаванию образов (ICPR). IEEE, 2022, стр. 3699–3705.
- [161] K. Żywanowski, A. Banaszczyk, M. R. Nowicki и J. Komorowski, «Minkloc3d-si: 3d lidar place recognition with sparse convolutions, spherical coordinates, and intensity», IEEE Robotics and Automation Letters, т. 7, вып. 2, стр. 1079–1086, 2022.
- [162] К. Виданапатхирана, М. Рамезани, П. Могадам, С. Сридхарана и К. Фукес, «Logg3d-net: Locally guided global descriptor learning for 3d place recognition», в 2022 International Conference on Robotics and Automation (ICRA). IEEE, 2022, стр. 2215–2221.
- [163] М. Ю. Чанг, С. Ёон, С. Рю и Д. Ли, «Spoxelnet: Spherical voxel-based deep place recognition for 3d point clouds of crowded indoor spaces», в 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2020, стр. 8564–8570.
- [164] S. Siva, Z. Nahman, and H. Zhang, “Voxel-based representation learning for place recognition based on 3d point clouds,” in 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2020, pp. 8351–8357.
- ⟦[165] Z. Hou, Y. Yan, C. Xu, и H. Kong, «Hitpr: Иерархический transformer для распознавания местоположения в облаке точек», в 2022 International Conference on Robotics and Automation (ICRA). IEEE, 2022, стр. 2612–2618.
- ⟦Z. Zhou, C. Zhao, D. Adolfsson, S. Su, Y. Gao, T. Duckett, and L. Sun, “Ndt-transformer: Large-scale 3d point cloud localisation using the normal distribution transform representation,” in 2021 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2021, pp. 5654–5660.
- [167] H. Yin, X. Ding, L. Tang, Y. Wang, and R. Xiong, “Efficient 3d lidar based loop closing using deep neural network,” in 2017 IEEE International Conference on Robotics and Biomimetics (ROBIO). IEEE, 2017, pp. 481–486.
- [168] D. Кун, С. Ли, Ю. Цен, Ц. Сюй и А. Ван, «Одновременное обнаружение замыкания контура, инвариантного к точке зрения и условиям, на основе дескриптора лидара для наружных крупномасштабных сред», IEEE Transactions on Industrial Electronics, т. 70, № 2, с. 2117–2127, 2023.
- ⟦[169] J. Ma, X. Chen, J. Xu и G. Xiong, «Seqot: пространственно-временная трансформер-сеть для распознавания мест по последовательным данным лидара», IEEE Transactions on Industrial Electronics, 2022.
- ⟦J. Ma, J. Zhang, J. Xu, R. Ai, W. Gu, and X. Chen, “Overlaptransformer: An efficient and yaw-angle-invariant transformer network for lidar-based place recognition,” IEEE Robotics and Automation Letters, vol. 7, no. 3, pp. 6958–6965, 2022.
- ⟦[171] T. Barros, L. Garrote, R. Pereira, C. Premebida, и U. J. Nunes, “Attdlnet: Внимательно-ориентированная dl сеть для распознавания местоположения 3d lidar,” препринт arXiv arXiv:2106.09637, 2021.
- ⟦Y. Lu, F. Yang, F. Chen, and D. Xie, “Pic-net: Point cloud and image collaboration network for large-scale place recognition,” arXiv preprint arXiv:2008.00658, 2020.
- ⟦L. Бернрайтер, Л. Отт, Х. Ньето, Р. Зигварт и К. Кадена, «Сферическое распознавание местоположения для разнородных сенсорных систем», в 2021 IEEE Международной конференции по робототехнике и автоматизации (ICRA). IEEE, 2021, стр. 1743–1750.
- ⟦H. Lai, P. Yin и S. Scherer, «Adafusion: Visual-lidar fusion with adaptive weights for place recognition», IEEE Robotics and Automation Letters, том. 7, вып. 4, стр. 12 038–12 045, 2022.
- [175] М. Фрози и М. Маттеуччи, “Art-slam: Accurate real-time 6dof lidar slam,” IEEE Robotics and Automation Letters, т. 7, № 2, стр. 2692–2699, 2022.
- [176] L. Liao, C. Fu, B. Feng и T. Su, «Optimized sc-f-loam: Optimized fast lidar odometry and mapping using scan context», в 2022 6th CAA International Conference on Vehicular Control and Intelligence (CVCI), 2022, стр. 1–6.
- [177] W. Chen, Y. Wang, H. Chen, and Y. Liu, “Eil-slam: Depth-enhanced edge-based infrared-lidar slam,” Journal of Field Robotics, vol. 39, no. 2, pp. 117–130, 2022.
- [178] М. Магнуссон, Т. П. Кучнер, С. Г. Шахбанди, Х. Андреассон и А. Дж. Лилиенталь, «Полуконтролируемая 3d-классификация местоположений по признаковому кластерингу», в 2017 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS). IEEE, 2017, стр. 620–625.
- ⟦[179] Q. Мэн, Х. Го, С. Чжао, Д. Цао и Х. Чэнь, «Обнаружение замыкания петли с модой гистограммы многомасштабного облака точек в лидарной одометрии и картировании для интеллектуальных транспортных средств», IEEE/ASME Transactions on Mechatronics, т. 26, № 3, стр. 1307–1317, 2021.
- ⟦S. Chopra, R. Hadsell, and Y. LeCun, «Learning a similarity metric discriminatively, with application to face verification,» in 2005 IEEE Computer Society Conference on Computer Vision and Pattern Recognition (CVPR’05), vol. 1. IEEE, 2005, pp. 539–546.
- ⟦S. Ши, Ц. Го, Л. Цзян, Ц. Ван, Дж. Ши, С. Ван и Х. Ли, «Pv-rcnn: Набор абстракции признаков точка-объём для обнаружения объектов в 3D», в Трудах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, 2020, стр. 10 529–10 538.
- [182] Ф. Грох, П. Визхоллек и Х. П. Ленш, «Гибкая свёрточность: обучение облаков точек в масштабе миллионов за пределами сеточных миров», в Computer Vision–ACCV 2018: 14-я Азиатская конференция по компьютерному зрению, Перт, Австралия, 2–6 декабря 2018 года, переработанные избранные материалы, часть I 14. Springer, 2019, стр. 105–122.
- [183] J. Hu, L. Shen и G. Sun, «Сжимающие и возбуждающие сети», в Трудах конференции IEEE по компьютерному зрению и распознаванию образов, 2018, стр. 7132–7141.
- [184] Т.-Й. Лин, П. Доллар, Р. Гиршик, К. Хе, Б. Харихаран и С. Белонгиа, «Сети пирамид признаков для обнаружения объектов», в материалах конференции IEEE по компьютерному зрению и распознаванию образов, 2017, стр. 2117–2125.
- ⟦T.-Y. Lin, P. Dollar, R. Girshick, K. He, B. Hariharan, and S. Belongie, “Feature pyramid networks for object detection,” in Proceedings of the IEEE conference on computer vision and pattern recognition, 2017, pp. 2117–2125.
- ⟦H. Tang, Z. Liu, S. Zhao, Y. Lin, J. Lin, H. Wang, and S. Han, “Поиск эффективных архитектур для трехмерных данных с разреженной точечно-объемной сверткой,” in Computer Vision–ECCV 2020: 16th European Conference, Glasgow, UK, August 23–28, 2020, Proceedings, Part XXVIII. Springer, 2020, pp. 685–702.
- ⟦T.-L. Habich, M. Stuede, M. Labbé, and S. Spindeldreier, “Have i been here before? learning to close the loop with lidar data in graph-based slam,” in 2021 IEEE/ASME International Conference on Advanced Intelligent Mechatronics (AIM). IEEE, 2021, pp. 504–510.
- [188] К. Гранстрем и Т. Б. Шён, «Обучение замыкать контур по 3d точечным облакам», в 2010 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам, 2010, стр. 2089–2095.
- ⟦Y. Freund and R. E. Schapire, “A decision-theoretic generalization of on-line learning and an application to boosting,” Journal of computer and system sciences, vol. 55, no. 1, pp. 119–139, 1997.
- [190] K. Хэ, X. Чжан, С. Жэнь и Ц. Сун, «Глубокое остаточное обучение для распознавания изображений», в: 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016, стр. 770–778.
- [191] T. S. Cohen, M. Geiger, J. Köhler, and M. Welling, “Spherical cnns,” arXiv preprint arXiv:1801.10130, 2018.
- ⟦C. Эстевеш, C. Аллен-Бланшетт, А. Макадия и К. Даниилидис, «Обучение эквивариантным представлениям с сферическими cnns», в материалах Европейской конференции по компьютерному зрению (ECCV), 2018, стр. 52–68.
- [193] N. Perraudin, M. Defferrard, T. Kacprzak, and R. Sgier, “Deepsphere: Efficient spherical convolutional neural network with healpix sampling for cosmological applications,” Astronomy and Computing, vol. 27, pp. 130–146, 2019.
- ⟦[194] P. Besl and N. D. McKay, “A method for registration of 3-d shapes,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 14, no. 2, pp. 239–256, 1992.
- [195] Р. Дюбе, А. Крамариюк, Д. Дюгас, Х. Ньето, Р. Зигварт и К. Кадена, «Segmap: трехмерное сегментное отображение с использованием данных, описывающих признаки», в Robotics: Science and Systems, 2018.
- [196] K. Виданапатхирана, P. Могхадэм, B. Харвуд, M. Чжао, S. Сридхарана и C. Фукс, «Locus: распознавание местоположения на основе лидара с использованием спатиотемпорального более высокого порядка объединения», в 2021 IEEE Международной конференции по робототехнике и автоматизации (ICRA). IEEE, 2021, стр. 5075–5081.
- ⟦M. A. Fischler and R. C. Bolles, “Random sample consensus: a paradigm for model fitting with applications to image analysis and automated cartography,” Communications of the ACM, vol. 24, no. 6, pp. 381–395, 1981.
- [198] Р. Дюбэ, М. Г. Голлуб, Х. Зоммер, И. Гилицшенски, Р. Зигварт, С. Кадена и Дж. Ньето, «Локализация на основе инкрементальной сегментации в трехмерных облаках точек», IEEE Robotics and Automation Letters, том 3, № 3, стр. 1832–1839, 2018.
- [199] X. Джи, Л. Цзо, С. Чжан и Ю. Лю, «Lloam: Lidar odometry and mapping with loop-closure detection based correction», в 2019 IEEE Международной конференции по мехатронике и автоматизации (ICMA). IEEE, 2019, стр. 2475–2480.
- ⟦R. Dubé, A. Gawel, H. Sommer, J. Nieto, R. Siegwart, and C. Cadena, “An online multi-robot slam system for 3d lidars,” in 2017 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2017, pp. 1004–1011.
- [201] J. Li, J. Zhao, Y. Kang, X. He, C. Ye, and L. Sun, “Dl-slam: Direct 2.5d lidar slam for autonomous driving,” in 2019 IEEE Intelligent Vehicles Symposium (IV), 2019, pp. 1205–1210.
- ⟦Y. Xie, Y. Zhang, L. Chen, H. Cheng, W. Tu, D. Cao, и Q. Li, “Rdc-slam: Система распределенного совместного SLAM в реальном времени на основе 3d lidar,” IEEE Transactions on Intelligent Transportation Systems, 2021.
- [203] Y. Gong, F. Sun, J. Yuan, W. Zhu, and Q. Sun, “двухуровневая схема для распознавания места с использованием 3d lidar на основе графа пространственных отношений,” Pattern Recognition, vol. 120, p. 108171, 2021.
- [204] Y. Fan, Y. He, and U.-X. Tan, “Seed: A segmentation-based egocentric 3d point cloud descriptor for loop closure detection,” in 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2020, pp. 5158–5163.
- [205] G. Tinchev, S. Nobili и M. Fallon, «Видеть лес за деревьями: Надежная локализация в городских и природных средах», в 2018 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS), 2018, стр. 8239–8246.
- ⟦[206] G. Tinchev, A. Penate-Sanchez, and M. Fallon, “Learning to see the wood for the trees: Deep laser localization in urban and natural environments on a cpu,” IEEE Robotics and Automation Letters, vol. 4, no. 2, pp. 1327–1334, 2019.
- [207] Y. Li, R. Bu, M. Sun, W. Wu, X. Di, и B. Chen, «Pointcnn: Convolution on x-transformed points», in NeurIPS, 2018.
- ⟦R. Dube, A. Cramariuc, D. Dugas, H. Sommer, M. Dymczyk, J. Nieto, R. Siegwart, and C. Cadena, “Segmap: Segment-based mapping and localization using data-driven descriptors,” The International Journal of Robotics Research, том 39, № 2-3, с. 339–355, 2020.
- ⟦[209] D. Rozenberszki и A. L. Majdik, «Lol: Одометрия и локализация только по Lidar на картах облаков точек в 3d», в 2020 IEEE International Conference on Robotics and Automation (ICRA), 2020, стр. 4379–4385.
- [210] А. Крамариюк, Ф. Цхопп, Н. Алатур, С. Бенц, Т. Фальк, М. Брюльмайер, Б. Ханн, Дж. Ньето и Р. Зигварт, «Semsegmap–3d segment-based semantic localization», в 2021 IEEE/RSJ Международной конференции по Интеллектуальным роботам и системам (IROS). IEEE, 2021, стр. 1183–1190.
- ⟦[211] Дж. Ветшиковский и П. Скжыпчиньски, «О описательной мощности изображений интенсивности лидара для замыкания циклов на основе сегментов в 3-d slam», в 2021 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS), 2021, стр. 79–85.
- [212] I. Богославский и С. Стахнисс, “Быстрая сегментация на основе изображений диапазона разреженных 3D лазерных сканов для онлайн-работы,” в 2016 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS), 2016, стр. 163–169.
- [213] J. Cui, Y. Cai, T. Huang, J. Zhao, L. Xiong, and Z. Yu, «Dsc: Deep scan context descriptor for large-scale place recognition», in 2022 IEEE International Conference on Multisensor Fusion and Integration for Intelligent Systems (MFI). IEEE, 2022, pp. 1–7.
- [214] А. Гавель, С. Дел Дон, Р. Зигварт, Дж. Ньето и К. Кадена, «X-view: графовая семантическая многовидовая локализация», IEEE Robotics and Automation Letters, т. 3, вып. 3, стр. 1687–1694, 2018.
- ⟦[215] Г. Праматаров, Д. Де Мартини, М. Гэдд и П. Ньюман, «Boxgraph: семантическое определение места и оценка позы по 3d lidar», препринт arXiv arXiv:2206.15154, 2022.
- ⟦L. Li, X. Kong, X. Zhao, T. Huang, и Y. Liu, “Semantic scan context: a novel semantic-based loop-closure method for lidar slam,” Autonomous Robots, т. 46, вып. 4, стр. 535–551, 2022.
- [217] A. Milioto, I. Vizzo, J. Behley, and C. Stachniss, “Rangenet++: Fast and accurate lidar semantic segmentation,” in 2019 IEEE/RSJ international conference on intelligent robots and systems (IROS). IEEE, 2019, pp. 4213–4220.
- ⟦H. Yuan, Y. Zhang, S. Fan, X. Li, and J. Wang, “Object scan context: Object-centric spatial descriptor for place recognition within 3d point cloud map,” arXiv preprint arXiv:2206.03062, 2022.
- ⟦[219] A. Zaganidis, A. Zerntev, T. Duckett, и G. Cielniak, «Семантически направленное замыкание контура в slam с использованием ndt-гистограмм», в 2019 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS). IEEE, 2019, стр. 4562–4568.
- ⟦M. Magnusson, H. Andreasson, A. Nuchter, и A. J. Lilienthal, “Automatic appearance-based loop detection from three-dimensional laser data using the normal distributions transform,” Journal of Field Robotics, т. 26, № 11-12, с. 892–914, 2009.
- ⟦L. Li, X. Kong, X. Zhao, T. Huang, W. Li, F. Wen, H. Zhang, and Y. Liu, “Rinet: Efficient 3d lidar-based place recognition using rotation invariant neural network,” IEEE Robotics and Automation Letters, vol. 7, no. 2, pp. 4321–4328, 2022.
- ⟦L. Бернрайтер, А. Гавель, Х. Зоммер, Дж. Ньето, Р. Зигварт и К. С. Лерма, «Семантическое отображение с множеством гипотез для надежного ассоциирования данных», IEEE Robotics and Automation Letters, том 4, вып. 4, стр. 3255–3262, 2019.
- ⟦X. Chen, T. Läbe, A. Milioto, T. Röhling, J. Behley, and C. Stachniss, “Overlapnet: a siamese network for computing lidar scan similarity with applications to loop closing and localization,” Autonomous Robots, vol. 46, no. 1, pp. 61–81, 2022.
- ⟦X. Chen, T. Läbe, L. Nardi, J. Behley, and C. Stachniss, “Learning an overlap-based observation model for 3d lidar localization,” in 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2020, pp. 4602–4608.
- [225] П. Ин, Л. Сюй, З. Фэн, А. Егоров и Б. Ли, «Pse-match: Метод распознавания местоположения без учета точки зрения с параллельным семантическим встраиванием», IEEE Transactions on Intelligent Transportation Systems, 2021.
- ⟦[226] D. Dai, J. Wang, Z. Chen, and P. Bao, “Sc-lpr: Spatiotemporal context based lidar place recognition,” Pattern Recognition Letters, vol. 156, pp. 160–166, 2022.
- [227] К. Эбади, Ю. Чанг, М. Палиери, А. Стивенс, А. Хаттеланд, Э. Хейден, А. Тхакур, Н. Фунабики, Б. Моррелл, С. Вуд, Л. Карлоне и А.-а. Агха-мохаммади, “Lamp: Large-scale autonomous mapping and positioning for exploration of perceptually-degraded subterranean environments,” в 2020 IEEE International Conference on Robotics and Automation (ICRA), 2020, стр. 80–86.
- ⟦[228] Н. Роттманн, Р. Брудер, А. Швайкард и Э. Рюккер, «Обнаружение замыкания цикла в закрытых средах», в 2019 European Conference on Mobile Robots (ECMR). IEEE, 2019, стр. 1–8.
- [229] C. Wen, Y. Dai, Y. Xia, Y. Lian, J. Tan, C. Wang, и J. Li, «Toward efficient 3-d colored mapping in gps-/gnss-denied environments,» IEEE Geoscience and Remote Sensing Letters, т. 17, № 1, стр. 147–151, 2020.
- [230] B. Zhou, Y. He, K. Qian, X. Ma и X. Li, «S4-slam: система 3d lidar slam в реальном времени для наземных/водных поверхностей в многосценарных наружных приложениях», Autonomous Robots, т. 45, вып. 1, стр. 77–98, 2021.
- ⟦[231] E. Mendes, P. Koch и S. Lacroix, «Icp-based pose-graph slam», в 2016 IEEE International Symposium on Safety, Security, and Rescue Robotics (SSRR). IEEE, 2016, стр. 195–200.
- ⟦[232] C. Le Gentil, T. Vidal-Calleja и S. Huang, «In2laama: Inertial lidar localization autocalibration and mapping», IEEE Transactions on Robotics, т. 37, № 1, с. 275–290, 2020.
- [233] Д. Цзян, Д. Ван, П. Ван, П. Бао и З. Чэнь, «Lipmatch: замыкание петель на основе плоскости облака точек Lidar», IEEE Robotics and Automation Letters, т. 5, № 4, с. 6861–6868, 2020.
- [234] M. Yokozuka, K. Koide, S. Oishi, and A. Banno, “Litamin: Lidar-based tracking and mapping by stabilized icp for geometry approximation with normal distributions,” in 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2020, pp. 5143–5150.
- [235] ——, “Litamin2: Ultra light lidar-based slam using geometric approximation applied with kl-divergence,” in 2021 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2021, pp. 11 619–11 625.
- [236] А. Segal, D. Haehnel и S. Thrun, «Generalized-icp.» в Robotics: science and systems, т. 2, № 4. Seattle, WA, 2009, стр. 435.
- ⟦J. G. Mangelson, D. Dominic, R. M. Eustice и R. Vasudevan, «Попарно согласованная максимизация набора измерений для надежного объединения карт нескольких роботов», в 2018 IEEE International Conference on Robotics and Automation (ICRA), 2018, стр. 2916–2923.
- ⟦Y. Chang, K. Ebadi, C. E. Denniston, M. F. Ginting, A. Rosinol, A. Reinke, M. Palieri, J. Shi, A. Chatterjee, B. Morrell, A.-a. Agha-mohammadi, and L. Carlone, “Lamp 2.0: A robust multi-robot slam system for operation in challenging large-scale underground environments,” IEEE Robotics and Automation Letters, vol. 7, no. 4, pp. 9175–9182, 2022.
- [239] H. Yang, J. Shi, and L. Carlone, “Teaser: Fast and certifiable point cloud registration,” IEEE Transactions on Robotics, vol. 37, no. 2, pp. 314–333, 2021.
- ⟦[240] Z. Gong, J. Li, Z. Luo, C. Wen, C. Wang, и J. Zelek, «Mapping and semantic modeling of underground parking lots using a backpack lidar system», IEEE Transactions on Intelligent Transportation Systems, т. 22, № 2, с. 734–746, 2021.
- ⟦R. Kümmerle, G. Grisetti, H. Strasdat, K. Konolige, and W. Burgard, “g2o: A general framework for graph optimization,” in 2011 IEEE International Conference on Robotics and Automation. IEEE, 2011, pp. 3607–3613.
- [242] Z. Liu, C. Suo, S. Zhou, F. Xu, H. Wei, W. Chen, H. Wang, X. Liang и Y.-H. Liu, «Seqlpd: Sequence matching enhanced loop-closure detection based on large-scale point cloud description for self-driving vehicles», в 2019 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2019, стр. 1218–1223.
- ⟦M. J. Milford and G. F. Wyeth, “Seqslam: Visual route-based navigation for sunny summer days and stormy winter nights,” in 2012 IEEE international conference on robotics and automation. IEEE, 2012, pp. 1643–1649.
- ⟦W. Chen, H. Zhao, Q. Shen, C. Xiong, S. Zhou, and Y.-H. Liu, “Inertial aided 3d lidar slam with hybrid geometric primitives in large-scale environments,” in 2021 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2021, pp. 11 566–11 572.
- ⟦P. Yin, L. Xu, J. Zhang и H. Choset, “Fusionvlad: A multi-view deep fusion networks for viewpoint-free 3d place recognition,” Ieee Robotics and Automation Letters, том 6, выпуск 2, стр. 2304–2310, 2021.
- ⟦M. Aldibaja, N. Suganuma, R. Yanase, L. Cao, K. Yoneda, и A. Kuramoto, «Стратегия обнаружения замыкания контура и объединителя карт на основе отражательной способности лидара и карт высот», в 2020 IEEE 23-й Международной конференции по интеллектуальным транспортным системам (ITSC). IEEE, 2020, стр. 1–7.
- [247] I. А. Барсан, С. Ван, А. Покровский и Р. Уртазун, «Обучение локализации с использованием карты интенсивности лидара», в Conference on Robot Learning. PMLR, 2018, стр. 605–616.
- ⟦[248] Y. Cho, G. Kim, S. Lee и J.-H. Ryu, «Глобальная и локальная локализация лидара на основе Openstreetmap в городской среде без предварительной карты лидара», IEEE Робототехника и Автоматизация Письма, т. 7, вып. 2, стр. 4999–5006, 2022.
- ⟦[249] П. Ши, Дж. Ли и Ю. Чжан, «Быстрый метод распознавания места и локализации лидара путем объединения локального и глобального поиска», ISPRS Journal of Photogrammetry and Remote Sensing, т. 202, стр. 637–651, 2023.
- ⟦Z. Liu, H. Chen, H. Di, Y. Tao, J. Gong, G. Xiong, and J. Qi, “Real-time 6d lidar slam in large scale natural terrains for ugv,” in 2018 IEEE Intelligent Vehicles Symposium (IV). IEEE, 2018, pp. 662–667.
- [251] H. Yin, L. Tang, X. Ding, Y. Wang, and R. Xiong, “Locnet: Глобальная локализация в трехмерных облаках точек для мобильных транспортных средств,” in 2018 IEEE Intelligent Vehicles Symposium (IV). IEEE, 2018, pp. 728–733.
- ⟦L. Sun, D. Adolfsson, M. Magnusson, H. Andreasson, I. Posner, and T. Duckett, «Локализация быстрее: Эффективная и точная локализация робота на основе lidar в крупномасштабных средах», в 2020 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2020, стр. 4386–4392.
- ⟦Y. Jin, Q. Chen, J. Qian, J. Liu, and J. Zhang, “Global localization for single 3d point cloud using voting mechanism,” in 2021 6th IEEE International Conference on Advanced Robotics and Mechatronics (ICARM). IEEE, 2021, pp. 771–776.
- ⟦[254] B. Zhou, Y. He, W. Huang, X. Yu, F. Fang, и X. Li, «Распознавание и навигация места для уличных мобильных роботов на основе обучения случайным лесом с 3d lidar», Journal of Intelligent & Robotic Systems, т. 104, № 4, стр. 1–26, 2022.
- ⟦P. Ruchti, B. Steder, M. Ruhnke, and W. Burgard, “Localization on openstreetmap data using a 3d laser scanner,” in 2015 IEEE international conference on robotics and automation (ICRA). IEEE, 2015, pp. 5260–5265.
- [256] B. Сьюгер и У. Бургард, «Глобальная навигация за пределами городской застройки с OpenStreetMap», в 2017 IEEE Международной конференции по робототехнике и автоматизации (ICRA). IEEE, 2017, стр. 1417–1422.
- ⟦F. Yan, O. Vysotska и C. Stachniss, “Глобальная локализация по OpenStreetMap с использованием 4-битных семантических дескрипторов”, в 2019 European Conference on Mobile Robots (ECMR). IEEE, 2019, стр. 1–7.
- [258] J. Behley and C. Stachniss, “Efficient surfel-based slam using 3d laser range data in urban environments.” in Robotics: Science and Systems, vol. 2018, 2018, p. 59.
- ⟦P. Yin, L. Xu, Z. Liu, L. Li, H. Salman, Y. He, W. Xu, H. Wang, and H. Choset, “Stabilize an unsupervised feature learning for lidar-based place recognition,” in 2018 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2018, pp. 1162–1167.
- [260] K. Хэ, X. Чжан, С. Жэнь и Ц. Сун, «Глубокое остаточное обучение для распознавания изображений», в материалах конференции IEEE по компьютерному зрению и распознаванию образов, 2016, стр. 770–778.
- [261] G. Pandey, J. R. McBride, and R. M. Eustice, “Ford campus vision and lidar data set,” The International Journal of Robotics Research, vol. 30, no. 13, pp. 1543–1552, 2011.
- [262] А. Гейгер, П. Ленц и Р. Уртазун, «Готовы ли мы к автономному вождению? набор задач kitti для визуального бенчмаркинга», в 2012 IEEE Конференции по компьютерному зрению и распознаванию образов, 2012, стр. 3354–3361.
- ⟦[263] Н. Карлеварис-Бьянко, А. К. Ушани и Р. М. Эустис, «Университет Мичиган северный кампус долгосрочное видение и набор данных лидара», The International Journal of Robotics Research, т. 35, № 9, с. 1023–1035, 2016.
- ⟦W. Maddern, G. Pascoe, C. Linegar, and P. Newman, “1 year, 1000 km: The oxford robotcar dataset,” The International Journal of Robotics Research, vol. 36, no. 1, pp. 3–15, 2017.
- ⟦J. Jeong, Y. Cho, Y.-S. Shin, H. Roh и A. Kim, “Complex urban lidar data set,” in 2018 IEEE International Conference on Robotics and Automation (ICRA), 2018, pp. 6344–6351.
- [266] J. Behley, M. Garbade, A. Milioto, J. Quenzel, S. Behnke, C. Stachniss, and J. Gall, “Semantickitti: A dataset for semantic scene understanding of lidar sequences,” in Proceedings of the IEEE/CVF International Conference on Computer Vision, 2019, pp. 9297–9307.
- [267] G. Ким, Й. С. Парк, Й. Чо, Дж. Джонг и А. Ким, «Mulran: Multimodal range dataset for urban place recognition», в 2020 IEEE International Conference on Robotics and Automation (ICRA), 2020, стр. 6246–6253.
- ⟦W. Zhou, J. S. Berrio, C. De Alvis, M. Shan, S. Worrall, J. Ward, и E. Nebot, «Разработка и проверка надежной автономности: набор данных кампуса университета Сиднея», IEEE Intelligent Transportation Systems Magazine, том 12, номер 4, стр. 23–40, 2020.
- ⟦D. Barnes, M. Gadd, P. Murcutt, P. Newman, and I. Posner, “The oxford radar robotcar dataset: A radar extension to the oxford robotcar dataset,” in 2020 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2020, pp. 6433–6438.
- [270] Y. Ляо, Дж. Се, и А. Гейгер, «Kitti-360: Новый набор данных и тестовые задачи для понимания городских сцен в 2d и 3d», IEEE Transactions on Pattern Analysis and Machine Intelligence, 2022.
- ⟦J. Knights, P. Moghadam, M. Ramezani, S. Sridharan, and C. Fookes, “Incloud: Incremental learning for point cloud place recognition,” in 2022 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2022, pp. 8559–8566.
- [272] D. Gálvez-López и J. D. Tardos, “Bags of binary words for fast place recognition in image sequences,” IEEE Transactions on Robotics, том 28, вып. 5, стр. 1188–1197, 2012.
- ⟦B. Ferrarini, M. Waheed, S. Waheed, S. Ehsan, M. J. Milford, and K. D. McDonald-Maier, “Exploring performance bounds of visual place recognition using extended precision,” IEEE Robotics and Automation Letters, vol. 5, no. 2, pp. 1688–1695, 2020.