PIGEON: Прогнозирование геолокаций изображений
Аннотация
Геолокализация изображений в планетарном масштабе остается сложной задачей из-за разнообразия изображений, поступающих из любой точки мира. Хотя подходы, основанные на трансформерах зрения, достигли значительного прогресса в точности геолокализации, успех в предыдущих работах ограничен узкими распределениями изображений достопримечательностей, и производительность не обобщается на невидимые места. Мы представляем новую систему геолокализации, которая объединяет создание семантических геоячеек, многозадачное контрастивное предобучение и новую функцию потерь. Кроме того, наша работа является первой, выполняющей поиск по кластерам местоположений для уточнения предположений. Мы обучаем две модели для оценки на данных уровня улиц и общей геолокализации изображений; первая модель, PIGEON, обучена на данных из игры Geoguessr и способна размещать более 40% своих предположений в пределах 25 километров от целевого местоположения по всему миру. Мы также разрабатываем бота и развертываем PIGEON в слепом эксперименте против людей, занимая место в топ-0.01% игроков. Мы дополнительно бросаем вызов одному из ведущих мировых профессиональных игроков в Geoguessr в серии из шести матчей с миллионами зрителей, выиграв все шесть игр. Наша вторая модель, PIGEOTTO, отличается тем, что обучена на наборе данных изображений из Flickr и Wikipedia, достигая передовых результатов на широком спектре эталонов геолокализации изображений, превосходя предыдущий SOTA на целых 7.7 процентных пункта на уровне точности города и на целых 38.8 процентных пункта на уровне страны. Наши результаты показывают, что PIGEOTTO является первой моделью геолокализации изображений, которая эффективно обобщается на невидимые места, и что наш подход может проложить путь к высокоточным системам геолокализации изображений планетарного масштаба. Наш код доступен на GitHub.111.
Ключевые слова Геолокализация изображений Визуальное распознавание мест Геолокализация фото Компьютерное зрение Семантические геоячейки Многозадачное предобучение Гаверсинус Уточнение местоположения Кластеризация Вороного Мультимодальный Geoguessr
1 Введение
Онлайн-игра Geoguessr недавно достигла 65 миллионов игроков Lucas (2023), привлекая мировую аудиторию пользователей, пытающихся решить одну задачу: по изображению Street View, сделанному где-то в мире, определить его местоположение. Проблема выявления географических координат по визуальным данным более формально известна в компьютерном зрении как геолокализация изображений, и, как и в игре Geoguessr, она остаётся чрезвычайно сложной. Масштаб и разнообразие нашей планеты, сезонные изменения внешнего вида, а также воздействие изменения климата — лишь некоторые из многих причин, по которым геолокализация изображений остаётся нерешённой проблемой..
За последнее десятилетие исследователи продвинули эту область, представив геолокализацию изображений как задачу классификации Weyand et al. (2016), разработав иерархические подходы к моделированию проблемы Müller-Budack et al. (2018); Pramanick et al. (2022); Clark et al. (2023), а также используя визуальные трансформеры Pramanick et al. (2022); Clark et al. (2023) и контрастивное предварительное обучение Luo et al. (2022). Однако, несмотря на этот прогресс, наиболее способные модели сильно зависели от выравнивания распределений между обучающими и тестовыми данными, не справляясь с обобщением на более разнообразные наборы данных, которые в основном включают невидимые ранее локации Clark et al. (2023).⟧.
В данной работе мы представляем двухкомпонентный подход многозадачного моделирования, который демонстрирует ведущую в мире производительность в игре Geoguessr и достигает современного уровня точности на широком спектре эталонных наборов данных для геолокализации изображений. Во-первых, мы представляем PIGEON — модель, обученную исключительно на планетарном масштабе данных Street View, принимающую на вход четырёхизображенную панораму. PIGEON является первой моделью компьютерного зрения, которая надёжно превосходит самых опытных игроков в Geoguessr, уверенно входя в топ-0.01% игроков, а также побеждая одного из лучших профессиональных игроков мира в шести из шести игр при миллионах зрителей. Наша модель достигает впечатляющих результатов геолокализации изображений для уличных снимков по всему миру, помещая 40.4% своих предсказаний географических координат в радиус 25 километров от правильного местоположения..
Впоследствии мы развиваем нашу модель до PIGEOTTO, которая отличается от PIGEON тем, что принимает на вход одно изображение и обучается на более крупном и чрезвычайно разнообразном наборе данных из более чем 4 миллионов фотографий, полученных из Flickr и Wikipedia, без использования данных Street View. PIGEOTTO достигает самых современных результатов на широком спектре эталонных наборов данных, включая IM2GPS Hays & Efros (2008), IM2GPS3k Vo et al. (2017), YFCC4k Vo et al. (2017), YFCC26k Müller-Budack et al. (2018) и GWS15k Clark et al. (2023). Модель сокращает медианную ошибку расстояния примерно вдвое на трех эталонных наборах данных и более чем в пять раз уменьшает медианную ошибку на GWS15k, который включает изображения из преимущественно неизвестных мест. PIGEOTTO — это первая модель, устойчивая к смещению местоположения и распределения изображений, благодаря выявлению общих пространственных подсказок на изображениях, о чем свидетельствует часто двузначный процентный прирост производительности на больших радиусах оценки. Показывая хорошие результаты на наборах данных, не входящих в распределение, PIGEOTTO устраняет серьезный пробел в предыдущей литературе, который необходим для решения задачи геолокализации изображений..
Поскольку PIGEON и PIGEOTTO различаются только в данных обучения и настройках гиперпараметров, эффективность нашего подхода имеет важные последствия для геолокализации изображений планетарного масштаба. Наши вклады, такие как семантические геоячейки, мультизадачное контрастивное предобучение, новая функция потерь и последующее уточнение догадок, — все это способствует минимизации ошибок расстояния, как показано в наших абляционных исследованиях в Section 4. Тем не менее, важно, чтобы будущие исследования касались безопасности технологий геолокализации изображений, обеспечивая ответственный прогресс в разработке систем компьютерного зрения..
2 Связанные работы
2.1 Постановка задачи геолокализации изображений
Геолокализация изображений относится к задаче сопоставления изображения с координатами, которые определяют, где оно было сделано. Эта задача, особенно планетарного масштаба, остается очень сложной областью компьютерного зрения. Не только глобальная постановка задачи делает ее неразрешимой, но и точная геолокализация изображений затруднительна из-за изменений времени суток, погоды, сезонов, времени, освещения, климата, трафика, угла обзора и многих других факторов..
Первая современная попытка геолокализации изображений в планетарном масштабе приписывается IM2GPS (2008) Hays & Efros (2008), подходу, основанному на поиске с использованием ручных признаков. Зависимость от методов поиска ближайших соседей Zamir & Shah (2014) с использованием ручных визуальных признаков Crandall et al. (2009) означала, что для точной геолокализации в планетарном масштабе потребовалась бы огромная база эталонных изображений, что невозможно. Следовательно, последующие работы решили ограничить географический охват, сосредоточившись вместо этого на конкретных городах Wu & Huang (2022), таких как Орландо и Питтсбург Zamir & Shah (2010) или Сан-Франциско Berton et al. (2022); конкретных странах, таких как Соединенные Штаты Suresh et al. (2018); и даже горных хребтах Baatz et al. (2012); Saurer et al. (2016); Tomešek et al. (2022), пустынях Tzeng et al. (2013) и пляжах Cao et al. (2012).⟧.
2.2 Трансформеры зрения и многозадачное обучение
С появлением глубокого обучения методы геолокализации изображений перешли от ручных признаков к сквозному обучению Masone & Caputo (2021). В 2016 году Google опубликовал статью PlaNet Weyand et al. (2016), в которой впервые применил сверточные нейронные сети (CNN) Krizhevsky et al. (2012) к геолокализации. Она также впервые представила задачу как задачу классификации по «геоячейкам» в ответ на исследования, показывающие, что моделям глубокого обучения трудно напрямую предсказывать географические координаты с помощью регрессии de Brebisson et al. (2015); Theiner et al. (2021). Это было связано с тонкостями распределения географических данных и сложной взаимозависимостью между широтами и долготами. Улучшения, достигнутые с помощью глубокого обучения, побудили исследователей пересмотреть IM2GPS Vo et al. (2017), применить CNN к массивным наборам данных мобильных изображений Howard et al. (2017) и развернуть свои модели в игре Geoguessr против игроков-людей Suresh et al. (2018); Luo et al. (2022). Предыдущая литература также объединяла подходы классификации и поиска Kordopatis-Zilos et al. (2021); наша работа модернизирует этот подход с помощью иерархического механизма поиска по кластерам местоположений, эквивалентного прототипическим сетям Snell et al. (2017) с фиксированными параметрами..
После успеха трансформеров Vaswani et al. (2017) в обработке естественного языка архитектура трансформеров нашла применение в компьютерном зрении. Предобученные визион-трансформеры (ViT) Kolesnikov et al. (2021) и мультимодальные производные, такие как CLIP от OpenAI Radford et al. (2021) и GPT-4V OpenAI (2023), были успешно применены для геолокализации изображений Agarwal et al. (2021); Pramanick et al. (2022); Wu & Huang (2022); Luo et al. (2022); Zhu et al. (2022); OpenAI (2023). Наш подход является новым, поскольку он предобучает CLIP специально для задачи геолокализации изображений в многозадачном режиме с помощью вспомогательных географических, демографических и климатических данных. Ранее было показано, что вспомогательные данные помогают в геолокализации изображений Hays & Efros (2008); Pramanick et al. (2022), но наша работа является первой, использующей вспомогательные данные для контрастивного предобучения, сохраняя исключительные способности CLIP к обобщенному zero-shot в домене, которые критически важны для производительности геолокализации Haas et al. (2023).⟧.
2.3 Разбиение на геоячейки
Поскольку геолокализация изображений рассматривается как задача классификации, выбранный метод разделения мира на географические классы, или «геоячейки», может оказать огромное влияние на последующую производительность. Предыдущие подходы опираются на геоячейки, которые являются либо просто прямоугольными, прямоугольными с учетом кривизны Земли и примерно сбалансированными по размеру класса Müller-Budack et al. (2018) (как в случае библиотеки S2 от Google222https://code.google.com/archive/p/s2-geometry-library.), либо геоячейки, которые являются фактически произвольными в результате комбинаторного разделения, инициализации ячеек случайным образом, но с корректировкой их формы на основе распределения обучающего набора данных Seo et al. (2018). Иерархические подходы к созданию геоячеек, как в сетях отдельных сцен (ISNs) Müller-Budack et al. (2018); Theiner et al. (2021), могут помочь сохранить семантическую информацию и использовать иерархические знания на разных геопространственных разрешениях, например, классифицируя геоячейки на уровне города, региона и страны..
Хотя семантическое построение геоячеек было признано важным для геолокализации изображений Theiner et al. (2021), даже недавно опубликованные статьи продолжают использовать библиотеку S2 Kordopatis-Zilos et al. (2021); Pramanick et al. (2022); Clark et al. (2023). Одна из возможных причин такого выбора заключается в том, что для больших наборов данных даже самые детализированные семантические геоячейки содержат слишком много точек данных, что приводит к сильному дисбалансу задачи классификации. Наша работа решает эту проблему с помощью нового метода создания семантических геоячеек, сочетающего иерархические подходы с кластеризацией на основе распределения обучающих данных и триангуляцией Вороного как недостающим звеном между ними. Впервые наш подход делает семантические геоячейки полезными для наборов данных любого размера и географического распределения..
2.4 Дополнительная работа
Другие известные академические работы упоминают эффективность перекрестной геолокализации изображений, особенно для сельских регионов с редкими геотегированными фотографиями на уровне земли. Подходы с перекрестными видами могут комбинировать атрибуты земного покрова и изображения с уровня земли и сверху, чтобы повысить устойчивость за счет трансферного обучения Lin et al. (2013); Yang et al. (2021); Zhu et al. (2022). Использование земельных карт в частности является важным направлением для будущих исследований; однако в нашей работе мы стремимся продемонстрировать производительность наших моделей, полагаясь исключительно на изображения с уровня земли из разнообразных условий..
3 Прогнозирование геолокаций изображений
Наша система геолокации изображений состоит как из параметрических, так и из непараметрических компонентов. В этом разделе сначала объясняется наш конвейер предварительной обработки данных, а затем рассматривается, как мы формулируем геолокацию как задачу классификации с учетом расстояния. Затем мы описываем этапы предобучения и обучения, и наконец описываем, как мы уточняем предсказания местоположения для улучшения производительности угадывания на уровне улиц..
3.1 Создание геоячеек
Современные методы все рассматривают геолокализацию изображений как задачу классификации, полагаясь на геоячейки для дискретизации поверхности Земли на заданное количество классов. Наша работа экспериментирует с двумя типами методов создания геоячеек..
Наивные геоячейки.
Сначала мы используем наивные прямоугольные геоячейки, вдохновленные библиотекой S2, которая подразделяет каждую геоячейку до достижения примерно сбалансированных размеров классов. В отличие от разбиения S2, наши прямоугольные геоячейки не имеют одинакового географического размера, создавая еще более сбалансированные классы..
семантические геоячейки.
Одним из ограничений библиотеки S2 и наших наивных геоячеек является то, что границы геоячеек являются полностью произвольными и, следовательно, бессмысленными в контексте геолокализации изображений. В идеале каждая геоячейка должна отражать отличительные характеристики заключенной в ней географической области. Политические и административные границы хорошо служат этой цели, поскольку они часто не только фиксируют информацию, специфичную для страны или региона (например, дорожную разметку и уличные знаки), но и следуют природным границам, таким как течения рек и горные цепи, которые кодируют геологическую информацию..
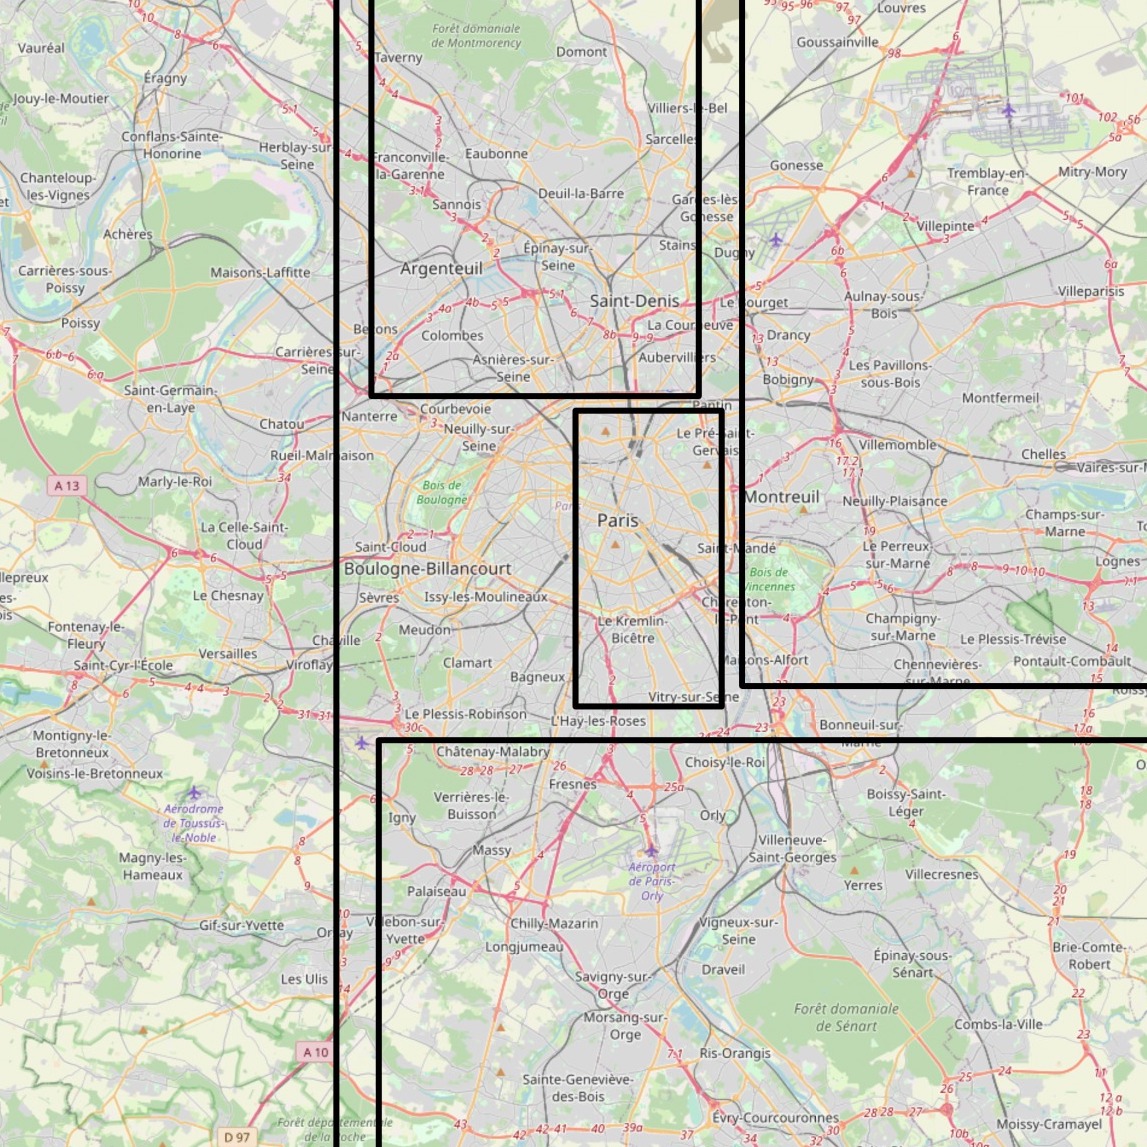
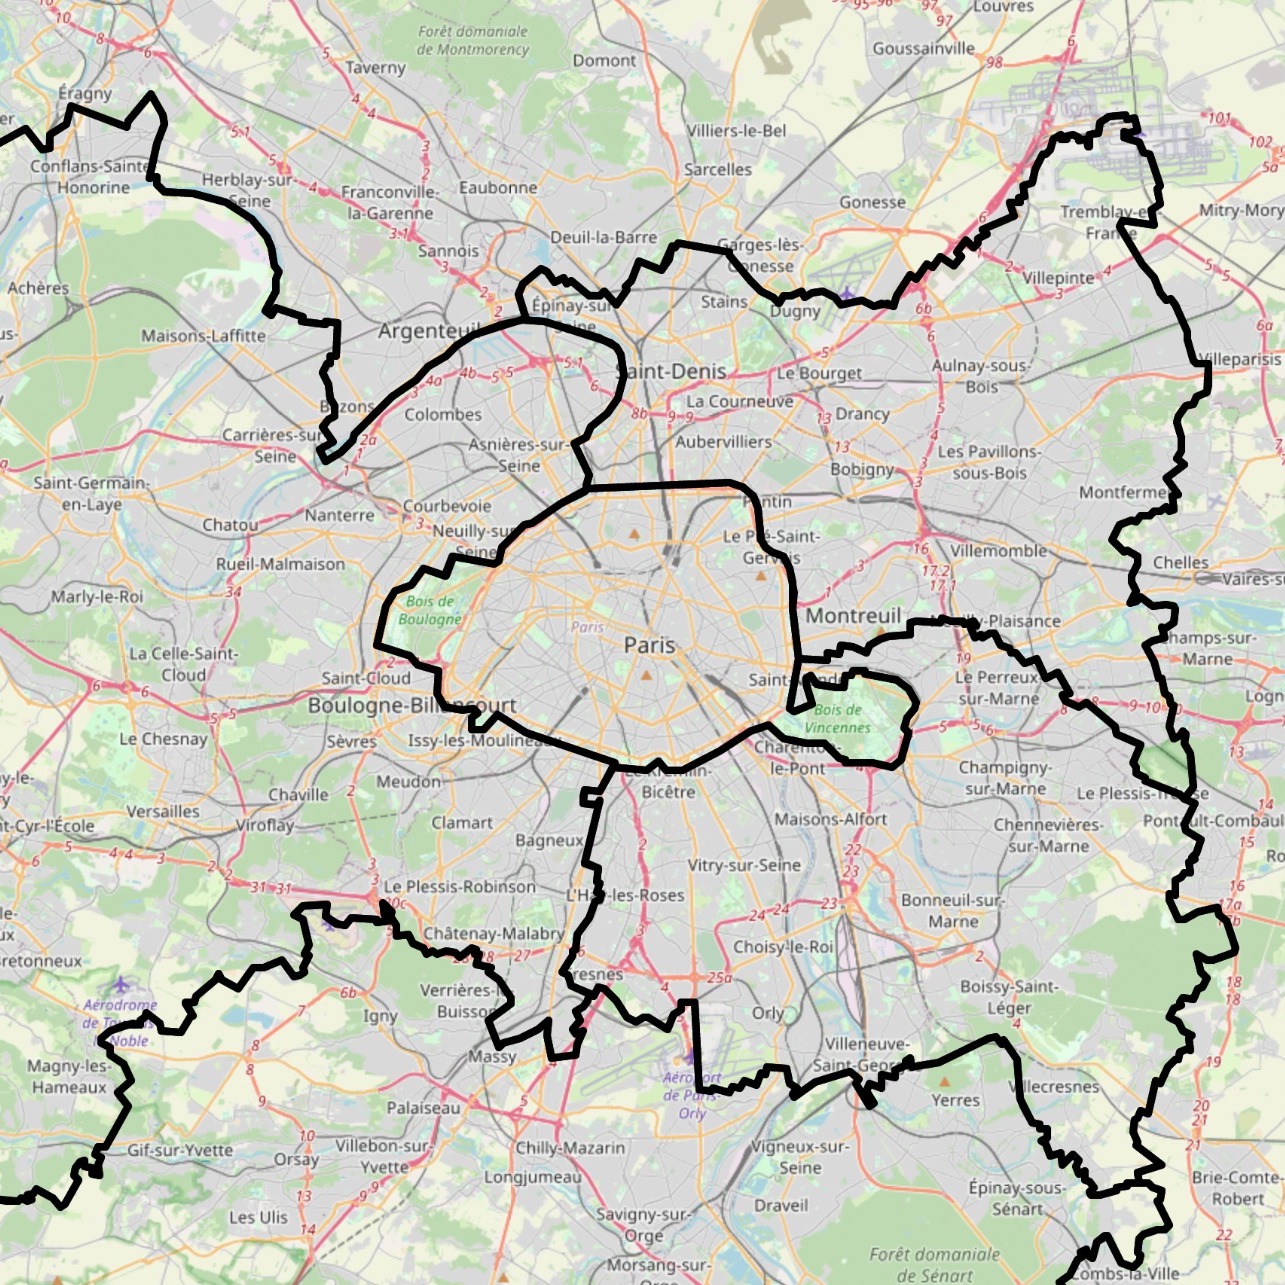
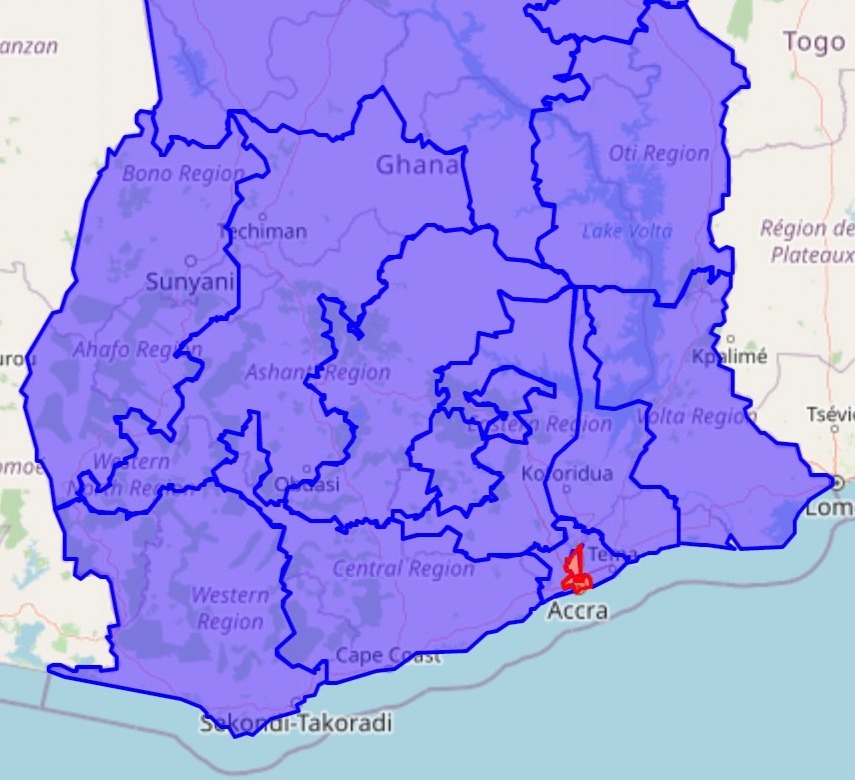
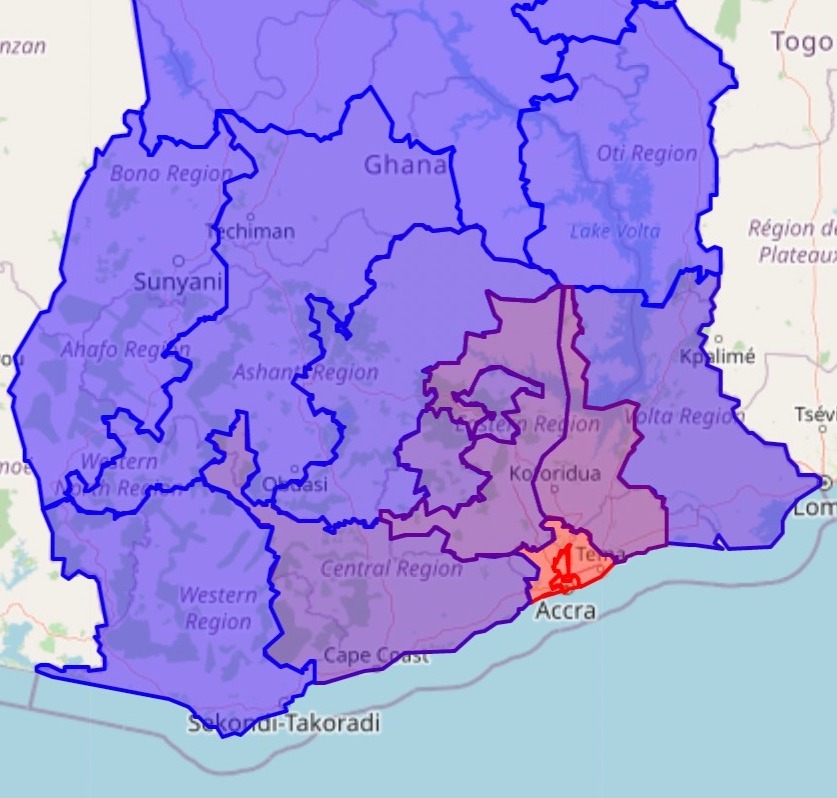
По аналогии с Theiner et al. (2021), мы полагаемся на планетарные открытые административные данные для нашего семантического геочейла, используя непересекающиеся политические шейп-файлы трех уровней административных границ (уровни страны, admin 1 и admin 2), полученные из GADM (2022). Начиная с самого детального уровня (admin 2), наш алгоритм объединяет соседние полигоны уровня admin 2 так, чтобы каждая геочейла содержала как минимум минимальное количество обучающих примеров. Наш метод стремится сохранить иерархию, заданную границами уровня admin 1, никогда не объединяет ячейки через границы стран (определяемые различными кодами стран ISO) и, в отличие от Theiner et al. (2021), допускает более детальные иерархии. Figure 2 показывает пример нашего семантического геочейла, сохраняющего семантику городского Парижа и его окрестностей.
Кластеризация OPTICS и тесселяция Вороного.
Мы дополнительно рассматриваем одно из основных ограничений в семантическом геосотовом дизайне Theiner et al. (2021), которое заключается в том, что некоторые области уровня admin 2 недостаточно детализированы, чтобы получить сбалансированный набор данных для классификации. Это особенно актуально для больших обучающих наборов данных, где количество обучающих примеров для одной городской области уровня admin 2 может значительно превышать минимальный размер класса, что требует осмысленного дальнейшего разделения областей admin 2. Важное наблюдение состоит в том, что географическое распределение наших обучающих данных уже дает нам указание на то, как осмысленно подразделить наши геосоты, поскольку оно кластеризуется вокруг популярных мест и достопримечательностей. Мы извлекаем эти кластеры с помощью алгоритма кластеризации OPTICS Ankerst et al. (1999). Наконец, мы назначаем все еще не назначенные точки данных их ближайшим кластерам и применяем тесселяцию Вороного для определения смежных геосот для каждого извлеченного кластера..
3.2 Иерархическая геолокализация изображений с использованием сглаживания меток на основе расстояния
Дискретизируя проблему геолокализации изображений, достигается компромисс между гранулярностью геоячеек и точностью предсказаний. Более гранулированные геоячейки позволяют делать детализированные предсказания, но также усложняют задачу классификации из-за более высокой мощности. Существующая литература решает эту проблему путем генерации отдельных предсказаний геолокализации на нескольких уровнях географической гранулярности, уточняя догадки на каждом последующем уровне Müller-Budack et al. (2018); Pramanick et al. (2022); Clark et al. (2023). Pramanick et al. (2022) и Clark et al. (2023) дополнительно предлагают архитектуры, которые разделяют некоторые параметры модели между различными уровнями иерархии, улучшая производительность геолокализации. Удивительно, но все предыдущие работы страдают от одного и того же ограничения: модели фигурально угадывают вслепую, так как не знают, какие геоячейки расположены рядом друг с другом, изучая их представления изолированно..
Наш подход устраняет это основное ограничение и улучшает предыдущие работы за счет совместного использования всех параметров между множественными неявными уровнями географических иерархий. Мы достигаем этого с помощью новой функции потерь, которая связывает соседние ячейки геосетки друг с другом, смещая метку на основе расстояния по гаверсинусу, которое вычисляет расстояние между двумя точками на поверхности Земли. Даны две точки, и с долготой и широтой , мы определяем расстояние по гаверсинусу в километрах следующим образом:
| (1) |
Затем мы “сглаживаем по хаверсинусу" исходную one-hot метку классификации геоячеек, используя эту метрику расстояния, согласно следующему уравнению для заданного образца и геоячейки ⟧:
| (2) |
где — координаты центроида полигона геосоты ячейки , — координаты центроида истинной геосоты, — истинные координаты примера, для которого вычисляется метка, а — температурный параметр, который в наших экспериментах установлен равным 75 для PIGEON и 65 для PIGEOTTO. Важно отметить, что наше «сглаживание по формуле гаверсинуса» отличается от классического «сглаживания меток», поскольку метки затухают не с использованием постоянного коэффициента, а на основе как расстояния до правильной геосоты, так и истинного местоположения. Поскольку для каждого обучающего примера несколько геосот будут иметь целевое значение , значительно превышающее ноль, наша модель одновременно учится предсказывать правильную геосоту, а также еще более грубый уровень географической детализации. Мы разрабатываем следующую функцию потерь на основе сглаживания по формуле гаверсинуса для конкретного обучающего примера .⟧:
| (3) |
где — это вероятность, которую наша модель присваивает геоячейке для образца . Дополнительным преимуществом использования потери Equation 3 является то, что она способствует обобщению, поскольку определения иерархии различаются в каждом обучающем образце. Кроме того, если образец находится близко к границе двух геоячеек, этот факт будет отражен через примерно равные целевые метки для этих двух геоячеек. Это особенно полезно для более крупных, часто сельских, геоячеек. Более того, поскольку каждая целевая метка теперь является непрерывной, и сложность задачи классификации может свободно регулироваться с помощью , можно использовать произвольное количество геоячеек, при условии, что геоячейки по-прежнему являются контекстуально значимыми и содержат минимальное количество образцов. Наконец, мы замечаем, что наша классификационная потеря теперь напрямую основана на расстоянии до истинного местоположения данного образца, обходя трудности регрессии, с которыми сталкивались в предыдущей литературе de Brebisson et al. (2015); Theiner et al. (2021).⟧.
3.3 Контрастивное предобучение для геолокализации
Для создания визуальных представлений для последующего проецирования на наши геоячейки наша архитектура использует модель OpenAI CLIP ViT-L/14 336 в качестве основы, которая является мультимодальной моделью, предварительно обученной на наборе данных из 400 миллионов изображений и подписей Radford et al. (2021). Причина, по которой мы используем CLIP, заключается в том, что было показано, что она исключительно хорошо работает в обобщенных условиях zero-shot обучения Radford et al. (2021), что является желательным свойством для геолокализации изображений как видимых, так и невидимых мест..
В наших экспериментах мы добавляем линейный слой поверх визуального энкодера CLIP для предсказания геоячеек. Для версий модели с несколькими входными изображениями (т.е. панорама из четырех изображений для PIGEON) мы усредняем эмбеддинги всех изображений. Усреднение эмбеддингов привело к более высокой производительности по сравнению с объединением нескольких эмбеддингов через многоголовое внимание или дополнительные слои трансформера..
В Haas et al. (2023) авторы демонстрируют, что продолжение предварительного обучения CLIP с использованием доменно-специфических синтетических подписей, полученных из шаблонов подписей, улучшает обобщенную производительность zero-shot на задачах геолокализации изображений. Мы дополнительно улучшаем их работу путем продолжения предварительного обучения CLIP в многозадачном режиме..
С этой целью мы дополняем наши обучающие наборы данных географическими, климатическими и вспомогательными данными о направлении. Эти данные используются для создания синтетических подписей для каждого изображения путем выборки компонентов подписей из различных шаблонов категорий и их объединения. Для PIGEOTTO мы используем компоненты подписей на основе местоположения, климата и направления движения. В то же время для PIGEON метаданные Street View позволяют нам дополнительно определять направление по компасу и время года. Примеры компонентов подписей, полученных из метаданных изображения, включают:
- • Местоположение: “Фотография, которую я сделал в регионе Гаутенг в Южной Африке”."
- • Климат: «Это место имеет умеренный океанический климат»."
- • Направление по компасу: «Это фото обращено на север»."
- • Сезон (месяц): “Это фото было сделано в декабре"."
- • Движение: «В этом месте люди ездят по левой стороне дороги»."
Все вышеперечисленные компоненты подписей содержат информацию, важную для геолокализации изображения. Следовательно, наше непрерывное контрастивное предварительное обучение создает неявную многозадачную среду и гарантирует, что модель изучает богатые представления данных, одновременно усваивая признаки, релевантные задаче геолокализации изображений..
3.4 Многозадачное обучение с климатическими данными
Мы также экспериментируем с явным представлением нашей многозадачной установки путем создания специфичных для задачи прогностических голов для вспомогательных меток и адаптируем нашу функцию потерь в соответствии с Equation 4, где соответствует loss в Equation 3. Наша многозадачная установка дополнительно включает задачу классификации с перекрестной энтропией () 28 различных климатических зон Кёппена-Гейгера Beck et al. (2018), задачу классификации месяца (сезона) с перекрестной энтропией () и шесть задач регрессии среднеквадратичной ошибки (MSE) (объединенных в ), которые пытаются предсказать значения, связанные с температурой, осадками, высотой над уровнем моря и плотностью населения для заданного местоположения..
| (4) |
Мы размораживаем последний слой CLIP, чтобы разрешить разделение параметров между задачами с целью наблюдения положительного переноса от наших вспомогательных задач к нашей задаче геолокализации и изучить более общие представления изображений, снижая риск переобучения на тренировочном наборе данных. Регулируя и , наша функция потерь взвешивает задачу геолокализации настолько же, насколько все вспомогательные задачи вместе взятые, учитывая величину потерь каждой задачи. Новый вклад нашей работы заключается в том, что мы используем в общей сложности восемь вспомогательных задач прогнозирования вместо всего двух по сравнению с предыдущими исследованиями Pramanick et al. (2022)⟧.
3.5 Уточнение через извлечение кластеров местоположений
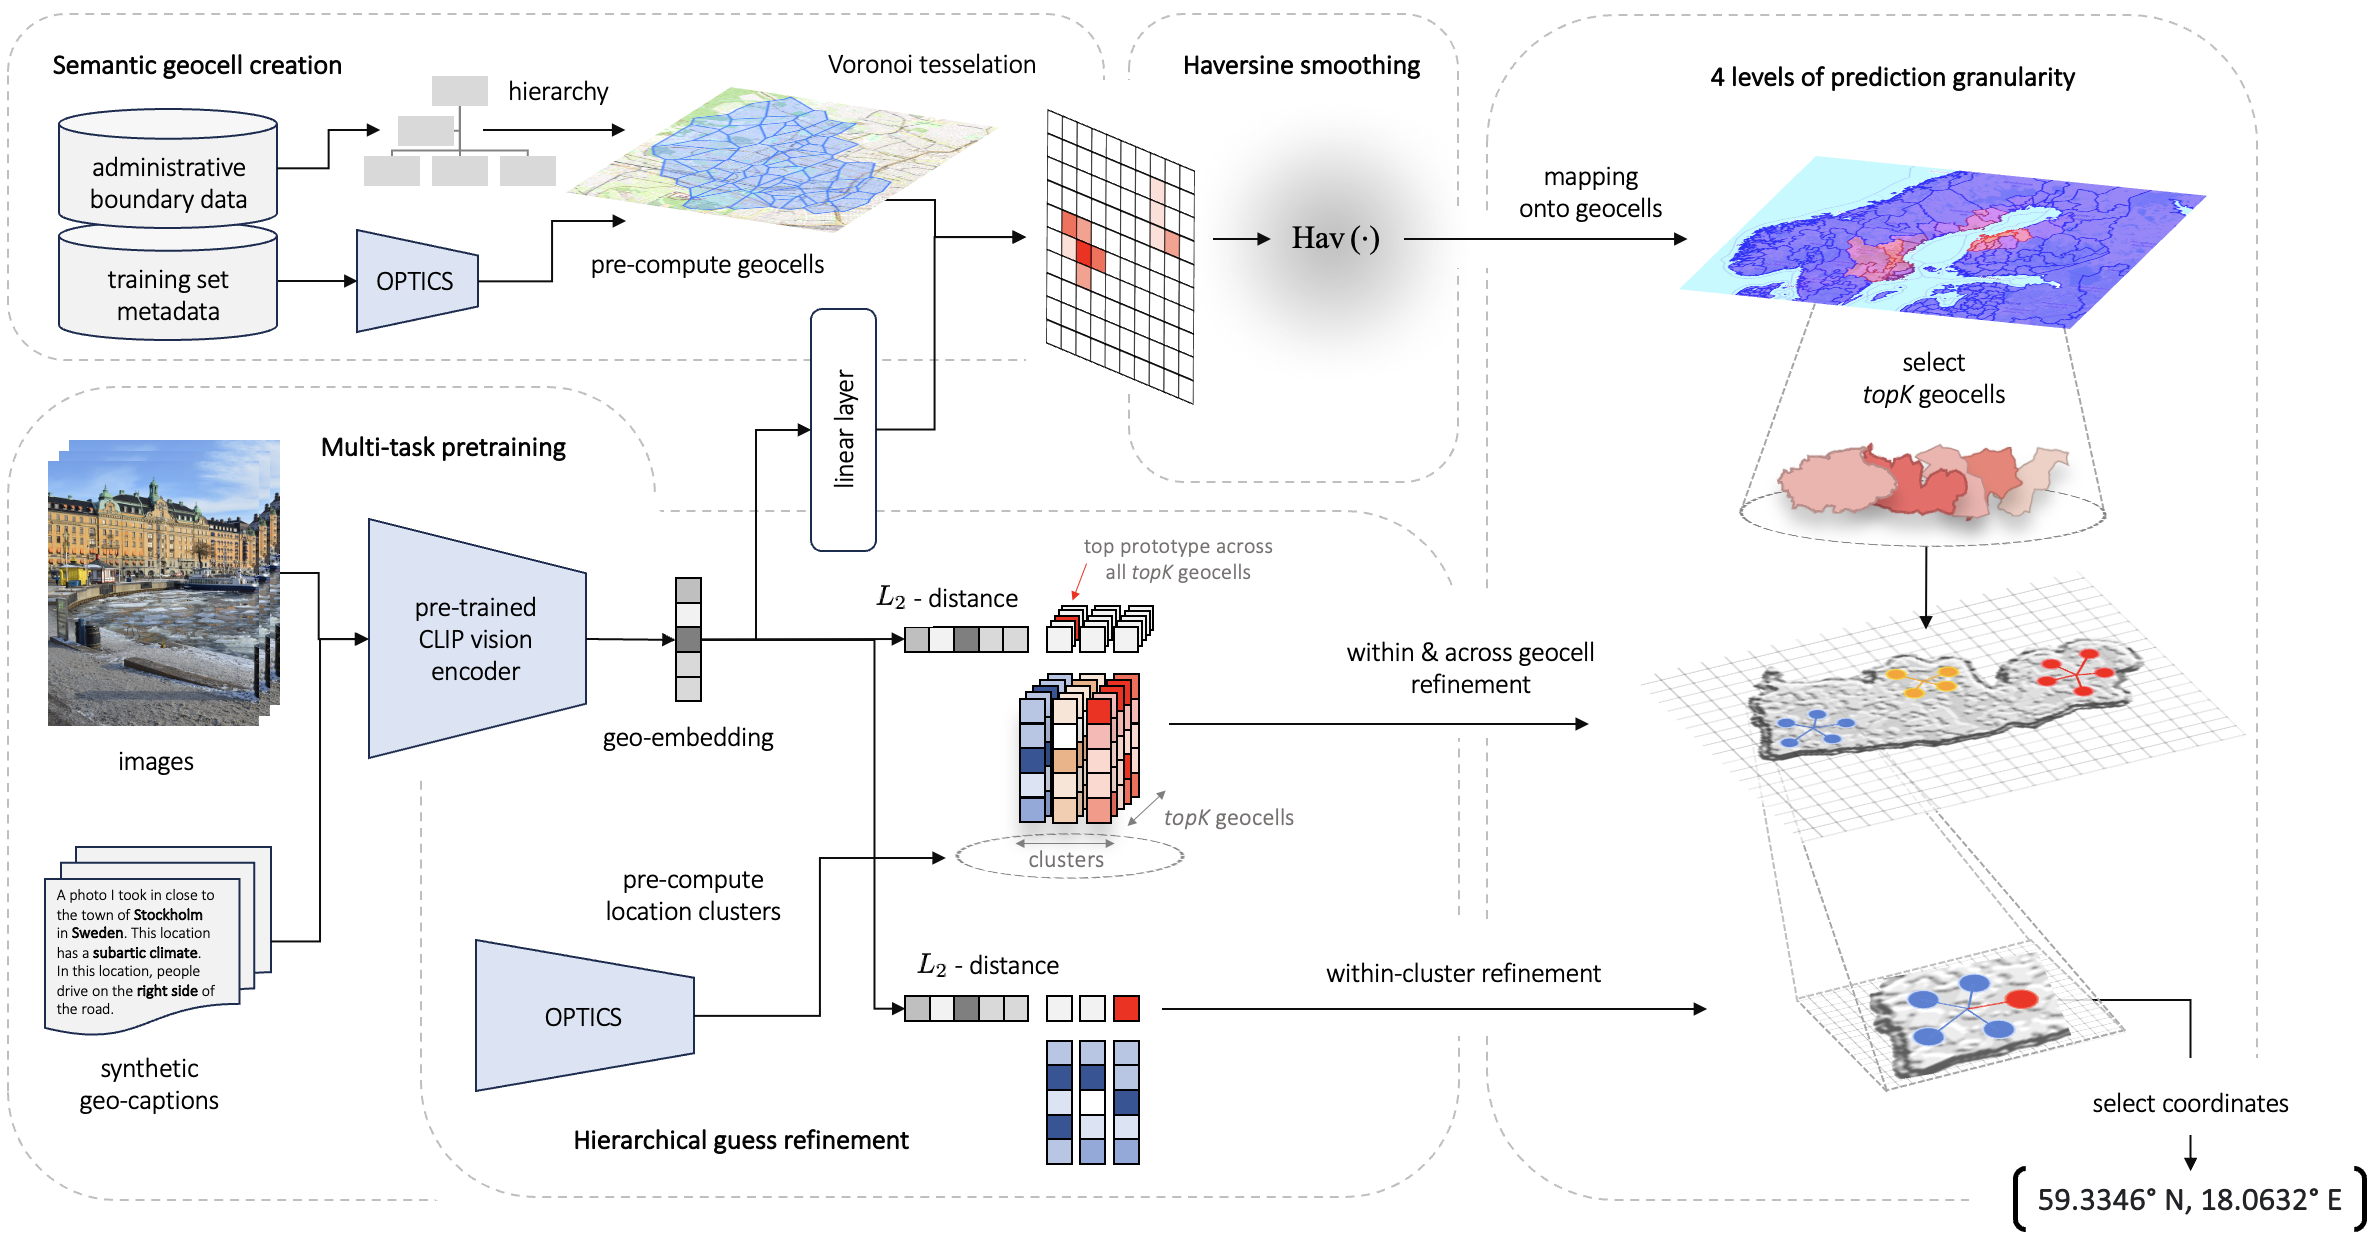
Для дальнейшего уточнения предположений нашей модели в пределах геоячейки и улучшения производительности на уровне улиц и городов, вместо простого предсказания средних широты и долготы всех точек внутри геоячейки Pramanick et al. (2022), мы выполняем уточнение внутри геоячейки. С этой целью мы разрабатываем иерархический механизм поиска по кластерам местоположений, аналогичный прототипическим сетям Snell et al. (2017) с фиксированными параметрами. Мы снова используем алгоритм кластеризации OPTICS Ankerst et al. (1999) для кластеризации всех точек внутри геоячейки и таким образом предлагаем кластеры местоположений , представлением которых является среднее всех соответствующих эмбеддингов изображений. Для вычисления всех эмбеддингов изображений мы используем нашу предварительно обученную модель CLIP , описанную в Section 3.3, отображая каждое изображение в кластере в его эмбеддинг .⟧.
| (5) |
Во время инференса мы предсказываем кластер местоположения входного изображения , выбирая кластер с минимальным евклидовым расстоянием между эмбеддингом изображения и эмбеддингом входного изображения . После того как кластер определен, мы дополнительно уточняем нашу догадку, выбирая единственное наилучшее местоположение внутри кластера, снова путем минимизации евклидова расстояния между эмбеддингами. Поиск по кластерам местоположений и уточнение внутри кластера добавляют два дополнительных уровня иерархии предсказаний в нашу систему, при этом количество уникальных потенциальных догадок равно размеру обучающего набора данных.
Хотя иерархическое уточнение с помощью поиска само по себе является новой идеей, наша работа идет на шаг дальше. Вместо уточнения прогноза геолокализации в пределах одной ячейки, наш механизм оптимизирует по множеству ячеек, что дополнительно повышает производительность. Во время инференса наша модель классификации геоячеек выводит topK прогнозируемых геоячеек (5 для PIGEON, 40 для PIGEOTTO), а также соответствующие вероятности модели для этих ячеек. Затем модель уточнения выбирает наиболее вероятное местоположение в каждой из topK предложенных геоячеек, после чего вычисляется softmax по topK евклидовым расстояниям эмбеддингов изображений. Мы используем температурный softmax с температурой, тщательно откалиброванной на валидационных наборах данных, чтобы сбалансировать вероятности по разным геоячейкам. Наконец, эти вероятности уточнения умножаются на начальные topK вероятности геоячеек для определения финального кластера местоположений, и выполняется уточнение внутри кластера, как показано на Figure 1.
4 Экспериментальные результаты и анализ
4.1 Экспериментальная установка
Обучение PIGEON и PIGEOTTO.
Основываясь на нашей технической методологии, описанной в Section 3, мы обучаем две модели для различных целей последующей оценки..
Сначала, вдохновленные Geoguessr, мы обучаем PIGEON (Predicting Image Geolocations). Мы собираем оригинальный набор данных из 100 000 случайно выбранных местоположений из Geoguessr и загружаем набор из четырех изображений, охватывающих целую "панораму" в заданном месте, или 360-градусный обзор, всего 400 000 обучающих изображений. Для каждого местоположения мы начинаем с произвольного направления компаса и делаем четыре изображения, разделенных 90 градусами, тщательно создавая непересекающиеся фрагменты изображения.
Во-вторых, мотивированные возможностями геолокализации изображений PIGEON, мы обучаем PIGEOTTO (Predicting Image Geolocations with Omni-Terrain Training Optimizations). В отличие от PIGEON, PIGEOTTO не является локализатором фотографий Street View, а скорее общим геолокатором изображений. С этой целью мы обращаемся к набору данных MediaEval 2016 Larson et al. (2017), состоящему из геотегированных изображений Flickr со всего мира, и получаем 4 166 186 изображений, учитывая, что некоторые изображения стали недоступны с 2016 года. Кроме того, признавая важность геолокации достопримечательностей для общих возможностей геолокализации изображений, мы добавляем 340 579 изображений из набора данных Google Landmarks v2 Weyand et al. (2020) в нашу обучающую смесь, все из которых получены из Wikipedia. Важно отметить, что в обучающих данных, которые мы используем, нет пересечения между PIGEON и PIGEOTTO, поскольку модели служат разным конечным целям. В отличие от PIGEON, PIGEOTTO принимает на вход одно изображение на местоположение, так как получение панорамы из четырех изображений часто невозможно в условиях общей геолокализации изображений..
Наборы данных для оценки и метрики.
Наша работа определяет медианную ошибку расстояния до правильного местоположения как основную и составную метрику. В соответствии с предыдущей литературой по геолокализации изображений, мы дополнительно оцениваем статистику «% @ км» в нашем анализе как более детальную метрику. Для заданного набора данных статистика «% @ км» определяет процент догадок, попадающих в заданное километровое расстояние от истинного местоположения. Как и в предыдущей работе, мы оцениваем пять радиусов расстояния: 1 км (примерно точность уровня улицы), 25 км (уровень города), 200 км (уровень региона), 750 км (уровень страны) и 2500 км (уровень континента).).
Для PIGEON мы провели оценку на отложенном наборе данных, собранном из Geoguessr, состоящем из 5000 местоположений Street View. Мы также отдельно провели обширные слепые эксперименты в Geoguessr, сравнивая PIGEON с игроками-людьми различного уровня мастерства, а также отдельный матч против профессионального игрока мирового класса. Чтобы количественно оценить, какие части нашей модели влияют на производительность, мы провели восемь отдельных абляционных исследований..
Для PIGEOTTO мы сосредотачиваем наши оценки непосредственно на эталонных наборах данных, установленных в литературе. А именно, мы рассматриваем IM2GPS Hays & Efros (2008), IM2GPS3k Vo et al. (2017), YFCC4k Vo et al. (2017) и YFCC26k Müller-Budack et al. (2018) (на основе набора данных MediaEval 2016 Larson et al. (2017)), и GWS15k Clark et al. (2023). Поскольку последний набор данных на момент написания этой статьи не был опубликован, мы восстанавливаем набор данных, точно повторяя процедуру генерации набора данных, описанную в Clark et al. (2023).
4.2 Оценка Street View с помощью PIGEON
Мы представляем результаты нашей оценки PIGEON и абляций нашего вклада в Table 1 и Table 2. Как показывают наши результаты, каждая последующая абляция ухудшает большинство метрик, указывая на синергетическую природу ансамбля методов в нашей системе геолокализации..
| Country | Mean | Median | Geoguessr | |
|---|---|---|---|---|
| Ablation | Accuracy | Error | Error | Score |
| PIGEON | 91.96 | 251.6 | 44.35 | 4,525 |
| Freezing Last CLIP Layer | 91.82 | 255.1 | 45.47 | 4,531 |
| Hierarchical Guess Refinement | 91.14 | 251.9 | 50.01 | 4,522 |
| Contrastive CLIP Pretraining | 89.36 | 316.9 | 55.51 | 4,464 |
| Semantic Geocells | 87.96 | 299.9 | 60.63 | 4,454 |
| Multi-task Prediction Heads | 87.90 | 312.7 | 61.81 | 4,442 |
| Fine-tuning Last CLIP Layer | 87.64 | 315.7 | 60.81 | 4,442 |
| Four-image Panorama | 74.74 | 877.4 | 131.1 | 3,986 |
| Haversine Smoothing | 72.12 | 990.0 | 148.0 | 3,890 |
| Distance (% @ km) | |||||
|---|---|---|---|---|---|
| Ablation | Street | City | Region | Country | Continent |
| 1 km | 25 km | 200 km | 750 km | 2,500 km | |
| PIGEON | 5.36 | 40.36 | 78.28 | 94.52 | 98.56 |
| Freezing Last CLIP Layer | 4.84 | 39.86 | 78.98 | 94.76 | 98.48 |
| Hierarchical Guess Refinement | 1.32 | 34.96 | 78.48 | 94.82 | 98.48 |
| Contrastive CLIP Pretraining | 1.24 | 34.54 | 76.36 | 93.36 | 97.94 |
| Semantic Geocells | 1.18 | 33.22 | 75.42 | 93.42 | 98.16 |
| Multi-task Prediction Heads | 1.10 | 32.74 | 75.14 | 93.00 | 97.98 |
| Fine-tuning Last CLIP Layer | 1.10 | 32.50 | 75.32 | 92.92 | 98.00 |
| Four-image Panorama | 0.92 | 24.18 | 59.04 | 82.84 | 92.76 |
| Haversine Smoothing | 1.28 | 24.08 | 55.38 | 80.20 | 92.00 |
Начиная с самой нижней строки обеих таблиц, соответствующей простому кодировщику CLIP с головой предсказания геоячеек, мы видим, что с введением сглаживания хаверсинуса средняя ошибка расстояния уменьшается на 112,6 километра — с 990,0 до 877,4 километра. Однако наибольший прирост производительности достигается за счёт внедрения панорамы из четырёх изображений вместо одного: точность определения страны повышается на 12,9 процентных пункта, а медианная ошибка в километрах сокращается более чем вдвое — с 131,1 до 60,8 километра. Хотя дообучение последнего слоя CLIP и разделение параметров в многозадачном режиме незначительно улучшают показатели модели, гораздо более ощутимый подъём наблюдается после внедрения наших семантических геоячеек: медианная ошибка снижается с 60,6 до 55,5 километра. Если дополнительно предварительно обучить CLIP на наших синтетических подписях, мы получаем ещё 1,7 процентного пункта прироста в точности определения страны на больших расстояниях. В сочетании с нашим иерархическим уточнением кластеров местоположений точность на уровне улиц на коротких расстояниях возрастает с 1,3% до 4,8%. Наконец, мы снова замораживаем последний слой CLIP и, таким образом, предотвращаем разделение параметров между головами предсказания геоячеек и многозадачного прогнозирования, поскольку наша процедура предварительного обучения уже включает многозадачную тренировку. В результате получаем итоговые метрики PIGEON: точность определения страны 92,0% и медианная ошибка расстояния 44,4 километра..
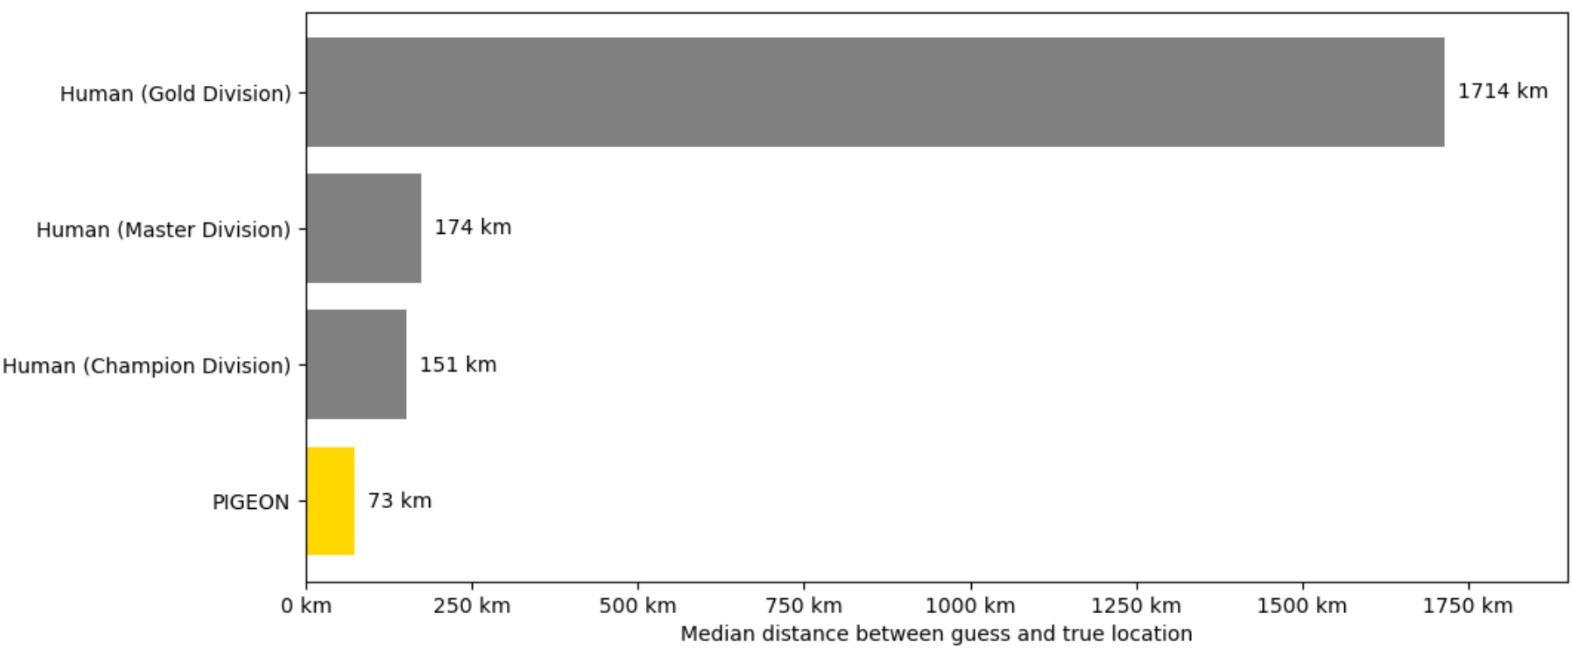
Помимо наших абляций, мы сравниваем производительность PIGEON с людьми в игре Geoguessr. Для этого мы разрабатываем бота в виде расширения Chrome, который имеет доступ к PIGEON через API, и развертываем нашу систему в слепом эксперименте на 458 матчах, каждый из которых состоит из нескольких раундов. PIGEON с легкостью превосходит игроков в чемпионском дивизионе Geoguessr, состоящем из лучших 0,01% игроков-людей. Результаты показаны в Figure 4, подчеркивая способность PIGEON побеждать игроков любого уровня мастерства. Примечательно, что лучшие игроки Geoguessr показывают результаты на порядки лучше, чем игроки, оцененные в Seo et al. (2018).⟧.
В рамках нашего финального тестирования мы бросили вызов одному из ведущих мировых профессиональных игроков в Geoguessr и одержали победу в шести из шести планетарных многораундовых игр.333Ссылка удалена для анонимности. PIGEON — первая модель, надежно побеждающая профессионала Geoguessr..
4.3 Оценка бенчмарка с PIGEOTTO
| Benchmark | Method | Median | Distance (% @ km) | ||||
|---|---|---|---|---|---|---|---|
| Error | Street | City | Region | Country | Continent | ||
| km | 1 km | 25 km | 200 km | 750 km | 2,500 km | ||
| IM2GPS Hays & Efros (2008) | PlaNet Weyand et al. (2016) | 8.4 | 24.5 | 37.6 | 53.6 | 71.3 | |
| CPlaNet Seo et al. (2018) | 16.5 | 37.1 | 46.4 | 62.0 | 78.5 | ||
| ISNs(M,,) Müller-Budack et al. (2018) | 16.9 | 43.0 | 51.9 | 66.7 | 80.2 | ||
| Translocator Pramanick et al. (2022) | 19.9 | 48.1 | 64.6 | 75.6 | 86.7 | ||
| GeoDecoder Clark et al. (2023) | 25 | 22.1 | 50.2 | 69.0 | 80.0 | 89.1 | |
| PIGEOTTO (Ours) | 70.5 | 14.8 | 40.9 | 63.3 | 82.3 | 91.1 | |
| (% points) | -7.3 | -9.3 | -5.7 | +2.3 | +2.0 | ||
| IM2GPS3k Vo et al. (2017) | PlaNet Weyand et al. (2016) | 8.5 | 24.8 | 34.3 | 48.4 | 64.6 | |
| CPlaNet Seo et al. (2018) | 10.2 | 26.5 | 34.6 | 48.6 | 64.6 | ||
| ISNs(M,,) Müller-Budack et al. (2018) | 10.5 | 28.0 | 36.6 | 49.7 | 66.0 | ||
| Translocator Pramanick et al. (2022) | 11.8 | 31.1 | 46.7 | 58.9 | 80.1 | ||
| GeoDecoder Clark et al. (2023) | 12.8 | 33.5 | 45.9 | 61.0 | 76.1 | ||
| PIGEOTTO (Ours) | 147.3 | 11.3 | 36.7 | 53.8 | 72.4 | 85.3 | |
| (% points) | -1.5 | +3.2 | +7.9 | +11.4 | +9.2 | ||
| YFCC4k Vo et al. (2017) | PlaNet Weyand et al. (2016) | 5.6 | 14.3 | 22.2 | 36.4 | 55.8 | |
| CPlaNet Seo et al. (2018) | 7.9 | 14.8 | 21.9 | 36.4 | 55.5 | ||
| ISNs(M,,) Müller-Budack et al. (2018) | 6.7 | 16.5 | 24.2 | 37.5 | 54.9 | ||
| Translocator Pramanick et al. (2022) | 8.4 | 18.6 | 27.0 | 41.1 | 60.4 | ||
| GeoDecoder Clark et al. (2023) | 10.3 | 24.4 | 33.9 | 50.0 | 68.7 | ||
| PIGEOTTO (Ours) | 383.0 | 10.4 | 23.7 | 40.6 | 62.2 | 77.7 | |
| (% points) | +0.1 | -0.7 | +6.7 | +12.2 | +9.0 | ||
| YFCC26k Müller-Budack et al. (2018) | PlaNet Weyand et al. (2016) | 2,500 | 4.4 | 11.0 | 16.9 | 28.5 | 47.7 |
| ISNs(M,,) Müller-Budack et al. (2018) | 2,500 | 5.3 | 12.3 | 19.0 | 31.9 | 50.7 | |
| Translocator Pramanick et al. (2022) | 7.2 | 17.8 | 28.0 | 41.3 | 60.6 | ||
| GeoDecoder Clark et al. (2023) | 10.1 | 23.9 | 34.1 | 49.6 | 69.0 | ||
| PIGEOTTO (Ours) | 333.3 | 10.5 | 25.8 | 42.7 | 63.2 | 79.0 | |
| (% points) | +0.4 | +1.9 | +8.6 | +13.6 | +10.0 | ||
| GWS15k Clark et al. (2023) | ISNs(M,,) Müller-Budack et al. (2018) | 2,500 | 0.05 | 0.6 | 4.2 | 15.5 | 38.5 |
| Translocator Pramanick et al. (2022) | 2,500 | 0.5 | 1.1 | 8.0 | 25.5 | 48.3 | |
| GeoDecoder Clark et al. (2023) | 2,500 | 0.7 | 1.5 | 8.7 | 26.9 | 50.5 | |
| PIGEOTTO (Ours) | 415.4 | 0.7 | 9.2 | 31.2 | 65.7 | 85.1 | |
| (% points) | +0.0 | +7.7 | +22.5 | +38.8 | +34.6 | ||
Результаты наших оценок PIGEOTTO на эталонных наборах данных показаны в Table 3. PIGEOTTO достигает современной (SOTA) производительности на каждом отдельном эталонном наборе данных и на большинстве гранулярностей на основе расстояния. На IM2GPS он позволяет улучшить современный уровень точности как на уровне страны, так и на уровне континента на 2 процентных пункта или более. Его относительно слабая производительность на более мелких гранулярностях может быть объяснена природой IM2GPS, основанной только на ориентирах, и его небольшим размером в 237 изображений. На более крупном и общем наборе данных IM2GPS3k PIGEOTTO показывает гораздо лучшие результаты, достигая SOTA по всем метрикам, кроме метрики уровня улицы, с впечатляющим улучшением на 11,4 процентных пункта на уровне страны и гораздо более низкой медианной ошибкой в 147,3 километра. В то же время на YFCC4k и YFCC26k PIGEOTTO превосходит текущий современный уровень по 9 из 10 метрик, в том числе на 12,2 процентных пункта на уровне страны на YFCC4k и на 13,6 процентных пункта на YFCC26k, более чем вдвое уменьшая предыдущую SOTA медианную ошибку. Наконец, мы наблюдаем очень значительные улучшения на самом недавно опубликованном эталоне GWS15k, состоящем исключительно из изображений Street View. Критически важно, что GWS15k является самым сложным набором данных в эталонном наборе. Если определить, что изображения сделаны в одном и том же месте, если они находятся менее чем в 100 метрах друг от друга, то 92% мест в GWS15k не совпадают с местами из обучающих данных MediaEval 2016 Larson et al. (2017), на которых обучались предыдущие SOTA модели и наша система. Для сравнения, этот показатель колеблется от 23% до 42% для других четырех эталонных наборов данных, что подчеркивает уникальную сложность GWS15k. Отмечая, что PIGEOTTO не обучался на каких-либо изображениях Street View, это говорит о том, что PIGEOTTO действительно имеет планетарный масштаб, демонстрирует устойчивое поведение к сдвигам распределения и является первой моделью геолокализации, которая эффективно обобщается на невидимые места..
5 Этические соображения
Геолокализация изображений представляет собой поддисциплину компьютерного зрения, которая сопряжена как с потенциальными выгодами для общества, так и с рисками злоупотребления. Хотя предыдущие работы в этой области редко затрагивают этические последствия, мы считаем, что потенциальное злоупотребление и негативные долгосрочные последствия систем геолокализации изображений заслуживают отдельного раздела для обсуждения в данной статье..
С одной стороны, точная геометка изображений открывает возможности для различных полезных приложений, далеко выходящих за рамки игры Geoguessr, включая помощь в понимании изменений конкретных мест с течением времени. Геолокализация изображений нашла применение в автономном вождении, навигации, обучении географии, разведке по открытым источникам и визуальных расследованиях в журналистике..
С другой стороны, однако, применение геолокализации изображений может нести риски, особенно если точность таких систем значительно улучшится в будущем. Насколько нам известно, это первая современная работа по геолокализации изображений за последние пять лет, которая не финансируется военными контрактами. Недавно опубликованные работы были поддержаны грантами Министерства обороны Pramanick et al. (2022) и Армии США Clark et al. (2023). Любые попытки разработать технологию геолокализации изображений для военных целей должны подвергаться особой проверке. Также существуют риски для приватности; например, было показано, что некоторые методы, использующие изображения Street View, способны выводить местный уровень дохода, расу, образование и структуру голосования Gebru et al. (2017)⟧.
Технологии геолокализации изображений сопряжены с рисками двойного использования Henderson et al. (2023), и необходимо приложить усилия для минимизации вредных последствий. С этой целью мы решили не публиковать веса модели публично и публикуем только наш код для академической проверки. Хотя основным ограничением современных технологий геолокализации изображений (включая нашу) является то, что они не могут надежно делать прогнозы на уровне улиц, исследователям следует тщательно учитывать риск потенциального неправильного использования их работы по мере того, как такие технологии становятся все более точными..
6 Заключение:
Мы предлагаем новый многозадачный подход на основе глубокого обучения для геолокализации изображений планетарного масштаба, который достигает результатов на уровне современных бенчмарков, оставаясь устойчивым к смещениям распределения..
Чтобы подтвердить эффективность нашего подхода, мы обучаем и оцениваем две различные модели геолокализации изображений. Сначала мы собираем глобальный набор данных Street View для обучения PIGEON — многозадачной модели, которая попадает в топ 0,01% среди игроков-людей в игре Geoguessr. На отложенном наборе данных из 5000 местоположений Street View 40,4% предсказаний PIGEON географических координат попадают в радиус 25 километров от истинного местоположения. Затем мы собираем набор данных планетарного масштаба из более чем 4 миллионов изображений, полученных с Flickr и Wikipedia, для обучения более общей модели PIGEOTTO, значительно улучшая современное состояние дел на широком спектре эталонных наборов данных по геолокализации..
В будущем еще предстоит выяснить, будут ли прикладные технологии геолокализации изображений действительно планетарного масштаба или же сосредоточены на четко определенном узком распределении. В любом случае, наши выводы о важности создания семантических геоячеек, мультимодального контрастивного предобучения и точной внутригеоячеечной доработки, среди прочего, указывают на важные строительные блоки для таких систем. Тем не менее, развертывание любой последующей технологии геолокализации изображений должно будет балансировать между потенциальными выгодами и возможными рисками, обеспечивая ответственное развитие будущих систем компьютерного зрения..
Список литературы
- Agarwal et al. (2021) Агарвал С., Крюгер Г., Кларк Дж., Рэдфорд А., Ким Дж. У., Брандейдж М. Оценка CLIP: к характеристике более широких возможностей и последствий, 2021.
- Ankerst et al. (1999) Анкерст, М., Бройниг, М. М., Кригель, Х.-П., и Сандер, Дж. OPTICS: Упорядочивание точек для определения структуры кластеризации. В трудах международной конференции ACM SIGMOD 1999 по управлению данными, SIGMOD ’99, стр. 49–60, Нью-Йорк, штат Нью-Йорк, США, 1999. Ассоциация вычислительной техники. ISBN 1581130848. doi:10.1145/304182.304187. URL https://doi.org/10.1145/304182.304187.
- Baatz et al. (2012) Baatz, G., Saurer, O., Köser, K., and Pollefeys, M. Крупномасштабная визуальная геолокализация изображений в горной местности. В: Fitzgibbon, A., Lazebnik, S., Perona, P., Sato, Y., and Schmid, C. (ред.), Computer Vision – ECCV 2012, стр. 517–530, Берлин, Гейдельберг, 2012. Springer Berlin Heidelberg. ISBN 978-3-642-33709-3.
- Beck et al. (2018) Beck, H. E., Zimmermann, N. E., McVicar, T. R., Vergopolan, N., Berg, A., and Wood, E. F. Современные и будущие карты климатической классификации Кёппена-Гейгера с разрешением 1 км. Научные данные, 5(1):180214, Окт 2018. ISSN 2052-4463. doi:10.1038/sdata.2018.214. URL https://doi.org/10.1038/sdata.2018.214.
- Berton et al. (2022) Бертон, Дж., Мазоне, К., и Капуто, Б. Переосмысление визуальной геолокации для крупномасштабных приложений, 2022. URL https://arxiv.org/abs/2204.02287.
- Cao et al. (2012) Cao, L., Smith, J. R., Wen, Z., Yin, Z., Jin, X., и Han, J. BlueFinder: Оценка места, где была сделана фотография пляжа. В трудах 21-й Международной конференции по Всемирной паутине, WWW ’12 Companion, стр. 469–470, Нью-Йорк, штат Нью-Йорк, США, 2012. Ассоциация вычислительной техники. ISBN 9781450312301. doi:10.1145/2187980.2188081. URL https://doi.org/10.1145/2187980.2188081.
- Clark et al. (2023) Clark, B., Kerrigan, A., Kulkarni, P. P., Cepeda, V. V., and Shah, M. Где мы находимся и на что смотрим: глобальная геолокация изображений на основе запросов с использованием иерархий и сцен, 2023.
- Crandall et al. (2009) Crandall, D., Backstrom, L., Huttenlocher, D., and Kleinberg, J. Картографирование фотографий мира. В WWW ’09: Труды 18-й Международной конференции по Всемирной паутине, стр. 761–880, 2009.
- de Brebisson et al. (2015) де Бребиссон, А., Симон, Э., Овола, А., Винсент, П., и Бенжио, Й. Искусственные нейронные сети, примененные к прогнозированию пункта назначения такси, 2015. URL https://arxiv.org/abs/1508.00021.
- GADM (2022) GADM. GADM Версия 4.1, 2022. URL https://gadm.org/about.html.
- Gebru et al. (2017) Gebru, T., Krause, J., Wang, Y., Chen, D., Deng, J., Aiden, E. L., and Fei-Fei, L. Использование глубокого обучения и Google Street View для оценки демографического состава районов по всей территории Соединенных Штатов. Труды Национальной академии наук, 114(50):13108–13113, 2017. doi:10.1073/pnas.1700035114. URL https://www.pnas.org/doi/abs/10.1073/pnas.1700035114⟧.
- Haas et al. (2023) Хаас, Л., Альберти, С., и Скрета, М. Обучение обобщенных zero-shot обучающихся для геолокализации изображений в открытых предметных областях, 2023.
- Hays & Efros (2008) Хейс, Дж. и Эфрос, А. А. IM2GPS: оценка географической информации по одному изображению. В трудах конференции IEEE по компьютерному зрению и распознаванию образов (CVPR), 2008..
- ⟦Henderson et al. (2023) Хендерсон, П., Митчелл, Э., Мэннинг, К. Д., Юрафски, Д., и Финн, К. Самоуничтожающиеся модели: повышение стоимости вредного двойного использования фундаментальных моделей, 2023.
- Howard et al. (2017) Howard, A. G., Zhu, M., Chen, B., Kalenichenko, D., Wang, W., Weyand, T., Andreetto, M., and Adam, H. MobileNets: Эффективные сверточные нейронные сети для приложений мобильного зрения, 2017. URL https://arxiv.org/abs/1704.04861.
- Kolesnikov et al. (2021) Kolesnikov, A., Dosovitskiy, A., Weissenborn, D., Heigold, G., Uszkoreit, J., Beyer, L., Minderer, M., Dehghani, M., Houlsby, N., Gelly, S., Unterthiner, T., and Zhai, X. Изображение стоит 16×16 слов: Трансформеры для крупномасштабного распознавания изображений. 2021.
- Kordopatis-Zilos et al. (2021) Кордопатис-Зилос, Г., Галопулос, П., Пападопулос, С., и Компатсиарис, И. Использование EfficientNet и контрастивного обучения для точной глобальной оценки местоположения, 2021. URL https://arxiv.org/abs/2105.07645.
- Krizhevsky et al. (2012) Krizhevsky, A., Sutskever, I., and Hinton, G. E. Классификация ImageNet с помощью глубоких сверточных нейронных сетей. В Pereira, F., Burges, C., Bottou, L., and Weinberger, K. (ред.), Advances in Neural Information Processing Systems, том 25. Curran Associates, Inc., 2012. URL https://proceedings.neurips.cc/paper/2012/file/c399862d3b9d6b76c8436e924a68c45b-Paper.pdf.
- Larson et al. (2017) Larson, M., Soleymani, M., Gravier, G., Ionescu, B., and Jones, G. J. Инициатива бенчмаркинга для мультимедийной оценки: MediaEval 2016. IEEE MultiMedia, 24(1):93–96, 2017. doi:10.1109/MMUL.2017.9.
- Lin et al. (2013) Lin, T.-Y., Belongie, S., and Hays, J. Кросс-видовая геолокализация изображений. В 2013 конференции IEEE по компьютерному зрению и распознаванию образов, стр. 891–898, 2013. doi:10.1109/CVPR.2013.120⟧.
- Lucas (2023) Lucas, J. Географическая игра обрела свою первую суперзвезду. Сможет ли она пережить свой первый бунт игроков?, 2023. URL https://www.theinformation.com/articles/a-geography-game-has-its-first-superstar-can-it-survive-its-first-player-revolt.
- ⟦Luo et al. (2022) Luo, G., Biamby, G., Darrell, T., Fried, D., and Rohrbach, A. G^3: Геолокация через обоснование путеводителя. В сборнике трудов Ассоциации вычислительной лингвистики: EMNLP 2022, стр. 5841–5853, Абу-Даби, Объединенные Арабские Эмираты, декабрь 2022. Ассоциация вычислительной лингвистики. URL https://aclanthology.org/2022.findings-emnlp.430.
- Masone & Caputo (2021) Мазоне, К. и Капуто, Б. Обзор по глубокому распознаванию мест по изображениям. IEEE Access, 9:19516–19547, 2021. doi:10.1109/ACCESS.2021.3054937⟧.
- Müller-Budack et al. (2018) Мюллер-Будак, Э., Пусту-Ирен, К., и Эверт, Р. Оценка геолокации фотографий с использованием иерархической модели и классификации сцен. В Ferrari, V., Hebert, M., Sminchisescu, C., и Weiss, Y. (ред.), Computer Vision – ECCV 2018, стр. 575–592, Чам, 2018. Springer International Publishing. ISBN 978-3-030-01258-8.
- OpenAI (2023) OpenAI. GPT-4V(ision) System Card, Сентябрь 2023.
- Pramanick et al. (2022) Pramanick, S., Nowara, E. M., Gleason, J., Castillo, C. D., and Chellappa, R. Где в мире находится это изображение? Геолокализация на основе трансформера в естественных условиях, 2022.
- Radford et al. (2021) Radford, A., Kim, J. W., Hallacy, C., Ramesh, A., Goh, G., Agarwal, S., Sastry, G., Askell, A., Mishkin, P., Clark, J., Krueger, G., and Sutskever, I. Обучение переносимых визуальных моделей на основе естественного языка, 2021.
- Saurer et al. (2016) Saurer, O., Baatz, G., Köser, K., Ladický, L., and Pollefeys, M. Геолокализация по изображениям в Альпах. Международный журнал компьютерного зрения, 116(3):213–225, Февраль 2016. ISSN 1573-1405. doi:10.1007/s11263-015-0830-0. URL https://doi.org/10.1007/s11263-015-0830-0⟧.
- Seo et al. (2018) Seo, P. H., Weyand, T., Sim, J., and Han, B. CPlaNet: Улучшение геолокализации изображений с помощью комбинаторного разбиения карт, 2018.
- Snell et al. (2017) Snell, J., Swersky, K., and Zemel, R. S. Прототипические сети для обучения с малым количеством примеров. CoRR, abs/1703.05175, 2017. URL http://arxiv.org/abs/1703.05175.
- Suresh et al. (2018) Суреш, С., Чодош, Н., и Абелло, М. ДипГео: Фото Локализация с глубокой нейронной сетью, 2018. URL https://arxiv.org/abs/1810.03077.
- Theiner et al. (2021) Тайнер, Дж., Мюллер-Будак, Э., и Эверт, Р. Интерпретируемая семантическая фотогеолокация, 2021.
- Tomešek et al. (2022) Томешек, Й., Чадик, М., и Брейха, Й. CrossLocate: Кросс-модальная крупномасштабная визуальная геолокализация в природных средах с использованием рендерированных модальностей. В трудах зимней конференции IEEE/CVF по приложениям компьютерного зрения (WACV), стр. 3174–3183, январь 2022..
- ⟦Tzeng et al. (2013) Tzeng, E., Zhai, A., Clements, M., Townshend, R., and Zakhor, A. Геолокация пользователем немаркированных пустынных изображений с использованием цифровых моделей рельефа. В 2013 году на семинарах конференции IEEE по компьютерному зрению и распознаванию образов, pp. 237–244, 2013. doi:10.1109/CVPRW.2013.42.
- Vaswani et al. (2017) Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., and Polosukhin, I. Внимание — это всё, что вам нужно, 2017.
- Vo et al. (2017) Vo, N., Jacobs, N., and Hays, J. Пересмотр IM2GPS в эпоху глубокого обучения, 2017.
- Weyand et al. (2016) Вейанд, Т., Костриков, И., и Филбин, Дж. PlaNet - Фотогеолокация с помощью сверточных нейронных сетей. В Европейской конференции по компьютерному зрению (ECCV), 2016.
- Weyand et al. (2020) Weyand, T., Araujo, A., Cao, B., and Sim, J. Google Landmarks Dataset v2 – A Large-Scale Benchmark for Instance-Level Recognition and Retrieval, 2020. URL https://arxiv.org/abs/2004.01804.
- Wu & Huang (2022) Ву, М. и Хуанг, К. IM2City: Геолокализация изображений с помощью мультимодального обучения. В трудах 5-го международного семинара ACM SIGSPATIAL по ИИ для географического открытия знаний, GeoAI ’22, стр. 50–61, Нью-Йорк, Нью-Йорк, США, 2022. Ассоциация вычислительной техники. ISBN 9781450395328. doi:10.1145/3557918.3565868. URL https://doi.org/10.1145/3557918.3565868.
- Yang et al. (2021) Ян, Х., Лу, С., и Чжу, Й. Кросс-вью геолокализация с трансформером слой-к-слою. В Ранцато, М., Бейгельцимер, А., Дофин, Й., Лян, П. и Воэн, Дж. У. (ред.), Достижения в нейронных системах обработки информации, том 34, стр. 29009–29020. Curran Associates, Inc., 2021. URL https://proceedings.neurips.cc/paper/2021/file/f31b20466ae89669f9741e047487eb37-Paper.pdf.
- Zamir & Shah (2010) Замир, А. Р. и Шах, М. Точная локализация изображений на основе Google Maps Street View. В Данилидис, К., Марагос, П. и Парагиос, Н. (ред.), Computer Vision – ECCV 2010, стр. 255–268, Берлин, Гейдельберг, 2010. Springer Berlin Heidelberg. ISBN 978-3-642-15561-1.
- Zamir & Shah (2014) Замир А. Р. и Шах М. Геолокализация изображений на основе сопоставления признаков по множеству ближайших соседей с использованием обобщенных графов. Труды IEEE по анализу образов и машинному интеллекту, 36(8):1546–1558, 2014. doi:10.1109/TPAMI.2014.2299799.
- Zhu et al. (2022) Чжу, С., Шах, М., и Чен, К. TransGeo: Трансформер — это всё, что нужно для геолокализации изображений с перекрестных видов, 2022.
Приложение
Мы включаем дополнительные детали в это приложение. В частности, мы расширяем следующие темы.:
A. Создание семантических геочеек
B. Детали реализации
C. Вспомогательные источники данных
D. Абляционные исследования не-дистанционных метрик
E. Дополнительные анализы
F. Развертывание в Geoguessr
Appendix A Создание семантических геоячеек
В основной части нашей работы мы описали, как на высоком уровне работает наш алгоритм создания семантических геоячеек. Как и в подходах из предыдущей литературы, таких как Theiner et al. (2021), мы создаем иерархию административных областей и объединяем смежные геоячейки до достижения заданного минимального количества обучающих образцов на геоячейку. Однако это приводит к сильно несбалансированной задаче классификации, особенно для более крупных обучающих наборов данных. Основной вклад нашей работы заключается в том, что мы определяем метод разделения более крупных геоячеек на более мелкие, но все еще семантически значимые ячейки, используя информацию, содержащуюся в геолокациях обучающих данных. Ключевая идея в том, что местоположения из большинства обучающих распределений имеют тенденцию группироваться вокруг популярных мест и достопримечательностей, и эти кластеры можно извлечь.
Algorithm 1 показывает слегка упрощенную версию того, как мы разделяем большие геоячейки на множество меньших без помощи информации об административных границах, что приводит к гораздо более сбалансированному набору данных классификации геоячеек. Как можно видеть, алгоритм зависит только от границ геоячеек или определений форм , обучающего набора данных , алгоритма кластеризации OPTICS с параметрами (может иметь параметры, специфичные для раунда ), и минимального размера ячейки MINSIZE. Алгоритм VORONOI принимает на вход набор точек и выводит новую форму геоячейки, определяемую этими точками, которая может быть удалена из исходной формы ячейки..
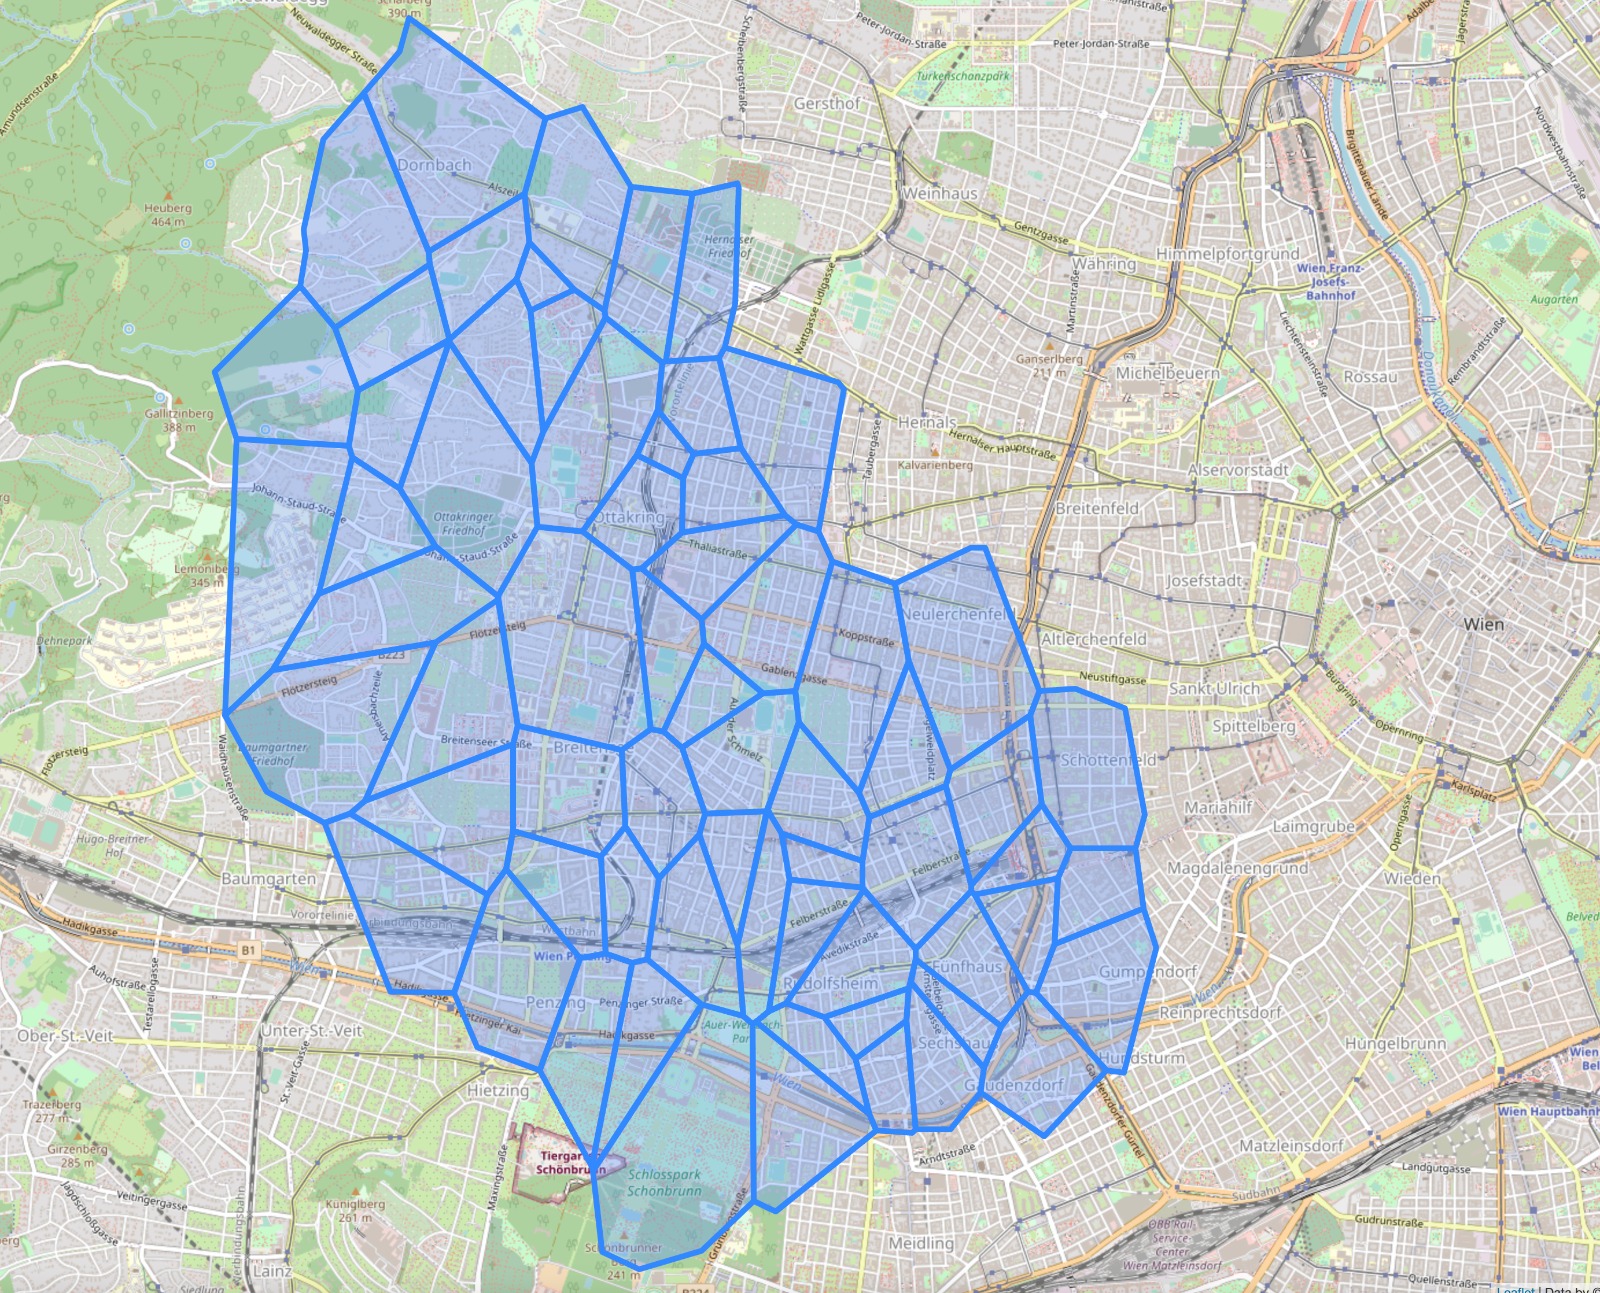
Figure 5 показывает небольшую геоячейку, которая была извлечена из более крупной геоячейки, покрывающей весь город Вена, Австрия, с помощью триангуляции Вороного. Разделения внутри синих геоячеек являются результатом алгоритма триангуляции Вороного, присваивающего каждому обучающему образцу всю географическую область, к которой он ближе всего..
Appendix B Детали реализации
В этом разделе мы описываем детали реализации PIGEON и PIGEOTTO и далее поясняем, чем эти две модели отличаются друг от друга..
B.1 Вход модели
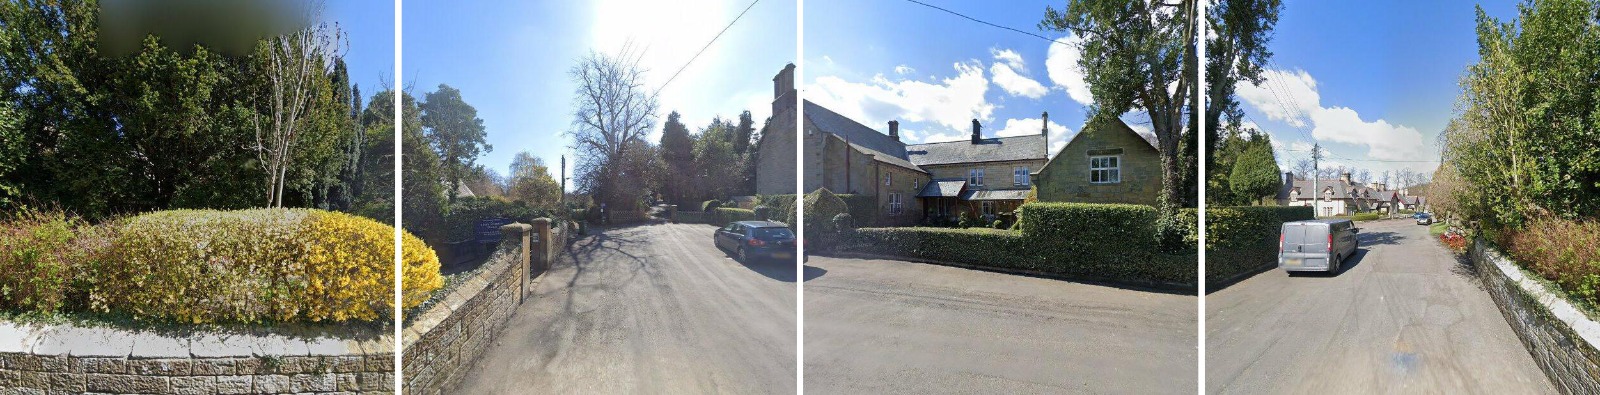
Самая большая разница между PIGEON и PIGEOTTO заключается в том, что PIGEON принимает на вход четырехизображенную панораму Street View, тогда как PIGEOTTO принимает одно изображение. Изображения всегда обрезаются до квадратного соотношения сторон перед подачей в модели. Figure 6 показывает репрезентативный вход для PIGEON, изображающий 360-градусную четырехизображенную панораму Street View из места в Пегсвуде, Англия..
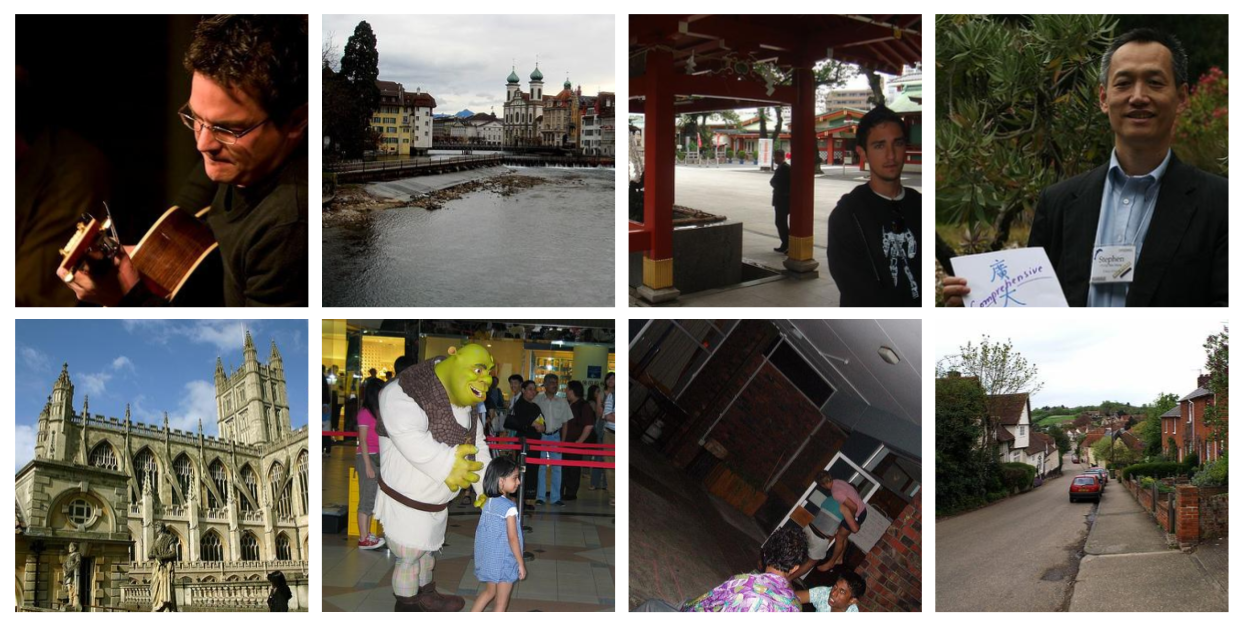
Обучающий набор данных PIGEOTTO кардинально отличается от входных данных Street View модели PIGEON; модель принимает на вход одно изображение и была обучена на сильно разнородном наборе данных для геолокализации изображений. Figure 7 показывает восемь изображений, отобранных из набора данных MediaEval 2016 Larson et al. (2017), который был получен из загруженных пользователями изображений Flickr. Отчетливо видно, что некоторые изображения чрезвычайно сложно геолокализовать, например, потому что они были сделаны в помещении..
B.2 Предварительное обучение
Table 4 показывает настройки гиперпараметров, используемые для контрастивного предобучения CLIP для задач геолокализации изображений. Веса CLIP были инициализированы предобученными весами реализации CLIP от OpenAI.444https://huggingface.co/openai/clip-vit-large-patch14-336.
| Parameter | PIGEON | PIGEOTTO |
|---|---|---|
| GPU Type | A100 80GB | A100 80GB |
| Number of GPUs | 4 | 4 |
| Dataset Source | Street View | Flickr |
| Dataset Size (Samples) | 1M | 4.2M |
| Batch Size | 32 | 32 |
| Gradient Accumulation Steps | 8 | 8 |
| Optimizer | AdamW | AdamW |
| Learning Rate | ||
| Weight Decay | ||
| Warmup (Epochs) | 0.2 | 0.02 |
| Training Epochs | 3 | 2 |
| Adam | 0.9 | 0.9 |
| Adam | 0.98 | 0.98 |
B.3 дообучение
Тонкая настройка PIGEON и PIGEOTTO состоит в добавлении линейного слоя поверх предварительно обученного кодировщика изображений, отображающего вложения изображений в фиксированное количество геоячеек. В ходе этого процесса веса кодировщика изображений остаются замороженными. Table 5 показывает гиперпараметры, использованные на этом этапе обучения. И PIGEON, и PIGEOTTO обучались до сходимости..
| Parameter | PIGEON | PIGEOTTO |
|---|---|---|
| GPU Type | A100 80GB | A100 80GB |
| Number of GPUs | 1 | 1 |
| Dataset Source | Street View | Flickr + Wikipedia |
| Dataset Size (Samples) | 100k | 4.5M |
| Number of Geocells | 2,203 | 2,076 |
| Batch Size | 256 | 256 |
| Gradient Accumulation Steps | 1 | 1 |
| Optimizer | AdamW | AdamW |
| Learning Rate | ||
| Weight Decay | 0.01 | 0.01 |
| Training Epochs | Convergence | Convergence |
| Adam | 0.9 | 0.9 |
| Adam | 0.999 | 0.999 |
B.4 Иерархическое уточнение
Мы используем иерархический механизм поиска по кластерам местоположений для уточнения предсказаний. В качестве первого шага кластеры местоположений предварительно вычисляются с помощью алгоритма кластеризации OPTICS. Затем во время инференса выбирается кластер в соответствии с Equation 5. Наконец, предположение о местоположении уточняется в пределах выбранного верхнего кластера. Процесс уточнения также зависит от ряда параметров, наиболее важные из которых перечислены в Table 6 и сравниваются между PIGEON и PIGEOTTO..
| Parameter | PIGEON | PIGEOTTO |
| Number of Geocell Candidates | 5 | 40 |
| Maximum Refinement Distance (km) | 1,000 | None |
| Distance Metric | Euclidian | Euclidian |
| Softmax Temperature | 1.6 | 0.6 |
| OPTICS Min Samples (Cluster Creation) | 3 | 10 |
| OPTICS xi (Cluster Creation) | 0.15 | 0.1 |
Appendix C Вспомогательные источники данных
Наша работа опирается на широкий спектр вспомогательных данных, которые мы можем извлечь из метаданных местоположения каждого изображения. В этом разделе подробно описываются внешние наборы данных, которые мы используем в процессе создания меток или многозадачного обучения..
Полигоны административных районов.
Мы получаем данные о площадях стран из Database of Global Administrative Areas (GADM) GADM (2022). Кроме того, мы получаем данные о нескольких гранулярностях политических границ административных областей, опубликованные The William & Mary Geospatial Evaluation and Observation Lab на GitHub. Эти источники данных используются как при создании меток геообластей, так и для генерации синтетических подписей предварительного обучения. Политические границы используются в процессе создания семантических геообластей с помощью тесселяции Вороного, как показано в Figure 5.⟧.
климатические зоны Кёппена-Гейгера.
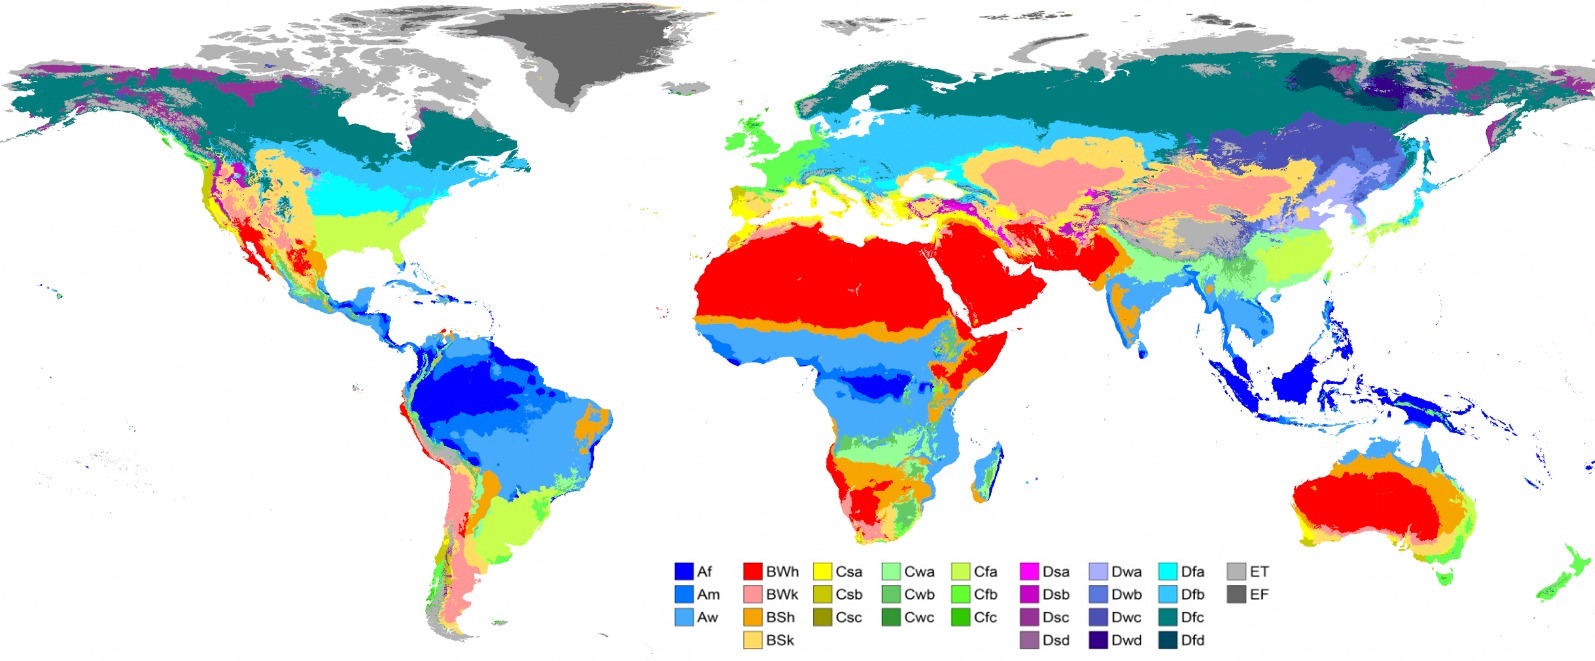
Мы получаем данные о глобальных климатических зонах через систему классификации климата Кёппена-Гейгера Beck et al. (2018), данные доступны here. Наши данные о климатических зонах планетарного масштаба визуализированы в Figure 8. Мы используем данные о климатических зонах как для генерации синтетических подписей для предтренировки, так и при экспериментах с многозадачными прогностическими головками. В последнем случае прогнозирование климатической зоны становится задачей классификации..
Повышение.
Мы получаем данные о высоте над уровнем моря через United States Geological Survey’s Earth Resources Observation and Science (EROS) Center. Поскольку данные о высоте отсутствовали для нескольких местоположений в нашем наборе данных, мы дополнили наши данные недостающими значениями из частей Аляски и частей Европы, при этом данные для Аляски доступны here, а данные для Европы доступны here. Мы используем данные о высоте исключительно в условиях многозадачного прогнозирования с помощью регрессии с логарифмическим преобразованием..
плотность населения GHSL.
Мы получаем данные о плотности населения через Global Human Settlement Layer (GHSL). Эти данные также используются в многозадачном прогнозировании с помощью логарифмически преобразованной регрессии..
WorldClim 2 температура и осадки.
Мы получаем данные о средней температуре, годовом диапазоне температур, среднем количестве осадков и годовом диапазоне осадков через WorldClim 2. Аналогично, данные используются в многозадачной регрессионной установке, однако значения температуры не подвергаются логарифмическому преобразованию перед обучением..
Сторона дороги для движения.
Мы получаем наши данные о стороне движения по дороге через WorldStandards. Эти данные используются исключительно для генерации синтетических подписей для предварительного обучения модели..
Appendix D Абляционные исследования на метриках, не основанных на расстоянии
Помимо основанного на расстоянии анализа PIGEON, описанного в основной части статьи, мы также проводим абляционные исследования по неметрикам расстояния, связанным с вспомогательными данными, описанными в Appendix C. В Table 7 мы наблюдаем, что наша финальная версия модели PIGEON на самом деле не показывает наилучших результатов по неметрикам расстояния, связанным с высотой местности, плотностью населения, временем года и климатом. Причина в том, что PIGEON не разделяет обучаемые веса модели между многозадачными головами предсказания и задачами предсказания местоположения, поскольку совместное многозадачное обучение уже было выполнено неявно на этапе предварительного обучения с помощью синтетических подписей. При совместном использовании параметров между головами предсказания (абляция «Freezing Last Clip Layer») наблюдается положительный перенос между задачами, и достигаются лучшие результаты на этих вспомогательных задачах предсказания..
Ключевой вывод из Table 7 остается в том, что географические, климатические, демографические и геологические особенности можно определить по изображениям Street View с потенциальным применением в исследованиях климата..
| Elevation | Pop. Density | Temp. | Precipitation | Month | Climate Zone | |
| Ablation | Error | Error | Error | Error | Accuracy | Accuracy |
| PIGEON | 149.6 | 1,119 | 1.26 | 15.08 | 45.42 | 75.22 |
| Freezing Last CLIP Layer | 132.8 | 1,072 | 1.18 | 12.82 | 50.64 | 75.76 |
| Contrastive CLIP Pretraining | 147.1 | 1,064 | 1.36 | 14.71 | 45.74 | 74.66 |
| Semantic Geocells | 141.7 | 1,094 | 1.37 | 14.48 | 45.74 | 74.10 |
Appendix E Дополнительные анализы
E.1 Городская и сельская производительность
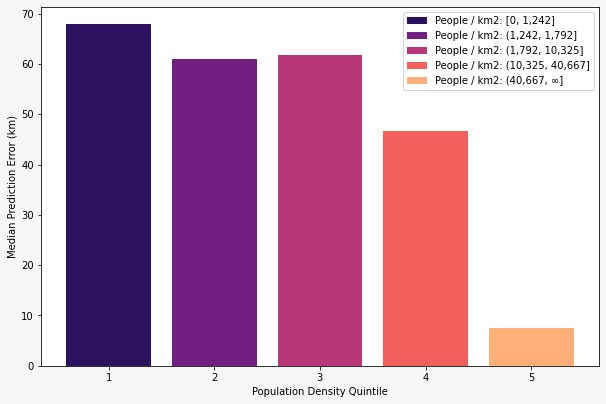
Чтобы прояснить интересные закономерности в поведении нашей модели, мы исследуем, существует ли разница в производительности PIGEON при определении местоположения городских и сельских изображений. Предположительно, плотность релевантных подсказок должна быть выше в изображениях Street View из городских локаций. Наш анализ сосредоточен на PIGEON, поскольку он обучался на множестве сельских изображений, тогда как PIGEOTTO в основном обучался на снятых пользователями городских изображениях..
Мы разделили наш удержанный набор данных Street View на квинтили по плотности населения и визуализируем медианную ошибку в километрах PIGEON. На рисунке 9 мы наблюдаем, что более высокая плотность населения действительно коррелирует с гораздо более точными предсказаниями местоположения, достигая медианной ошибки менее 10 километров для 20 процентов местоположений с наибольшей плотностью населения..
E.2 Примеры атрибуции внимания
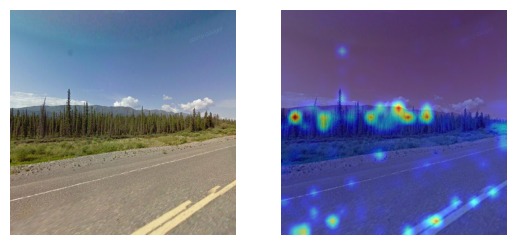
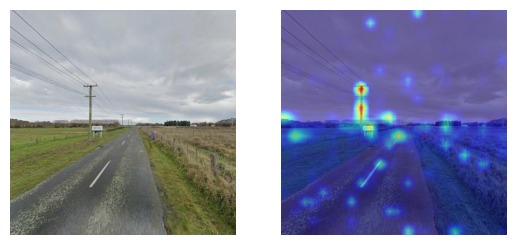
Контрастивное предварительное обучение, используемое CLIP, дает модели более глубокое семантическое понимание сцен и тем самым позволяет ей обнаруживать стратегии, которые интерпретируемы человеком. Как мы поняли, модель смогла выучить стратегии, которые преподаются в онлайн-руководствах по Geoguessr, без прямого обучения этим стратегиям..
Для визуализаций на рисунке 10 мы сгенерировали карты атрибуции для изображений из валидационного набора данных и соответствующей истинной подписи, например, «Это фото сделано в Канаде». Действительно, модель обращает внимание на признаки, которые профессиональные игроки Geoguessr считают важными, например, растительность, дорожную разметку, столбы и указатели. Это делает высокую производительность модели объяснимой и может также позволить открыть новые стратегии, о которых профессиональные игроки еще не знают..
E.3 Случаи сбоев
Несмотря на высокую точность нашей модели при оценке геолокаций изображений, было несколько сценариев, в которых наша модель показывала худшие результаты. Вычислив энтропию по вероятностям всех геоячеек для каждой локации в нашем валидационном наборе, мы смогли определить изображения, в отношении которых наша модель была наиболее неопределенной. Для PIGEOTTO это были почти исключительно поврежденные изображения, оставшиеся в исходном обучающем корпусе Flickr. Для PIGEON, однако, который обучался исключительно на изображениях Street View, мы можем наблюдать некоторые интересные случаи неудач в Figure 11⟧.
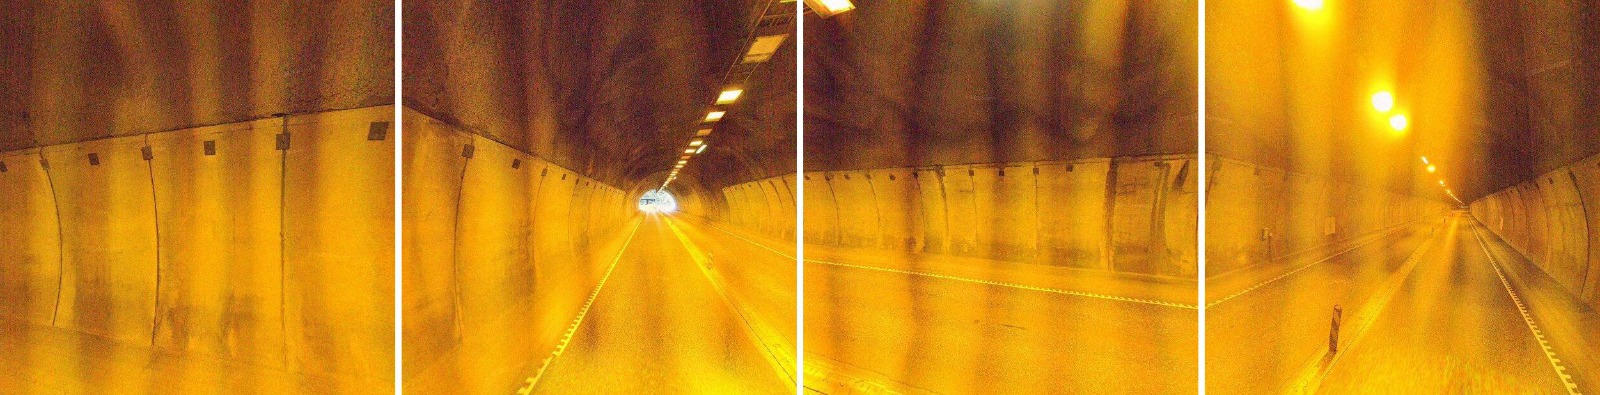
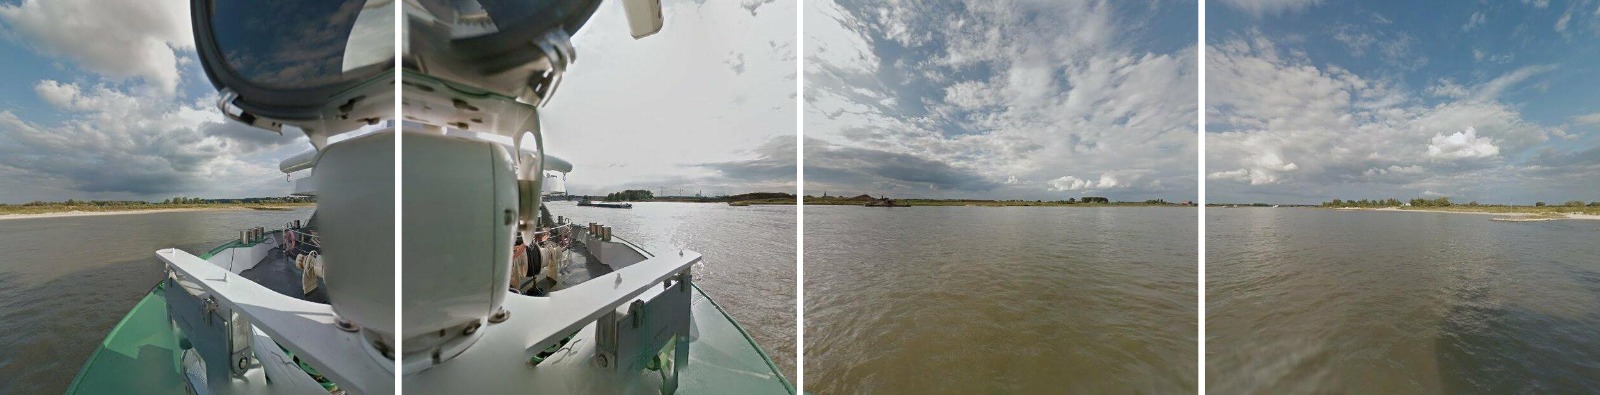
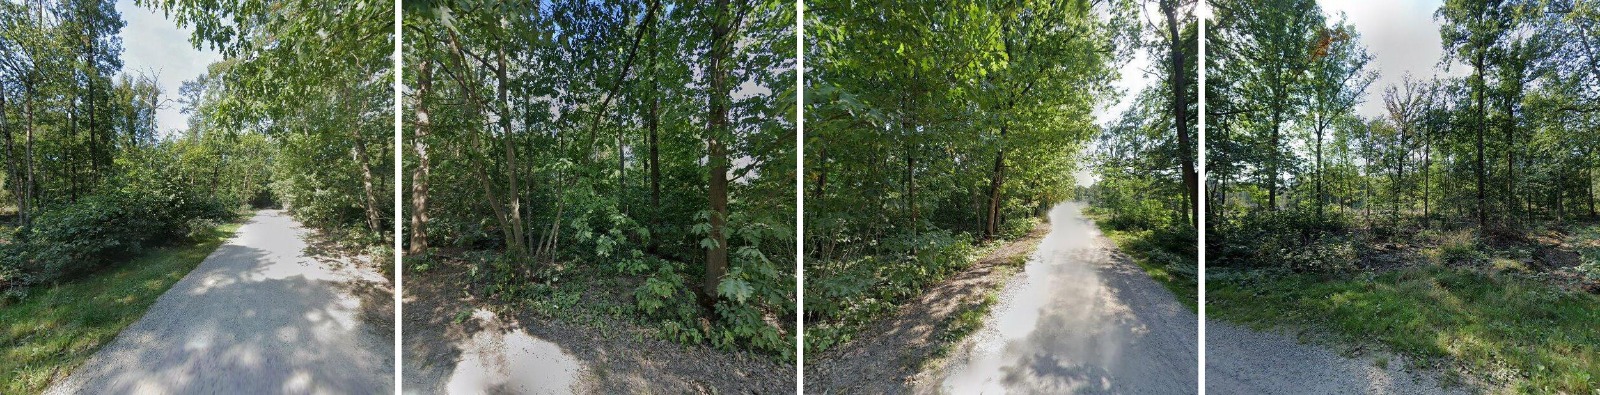
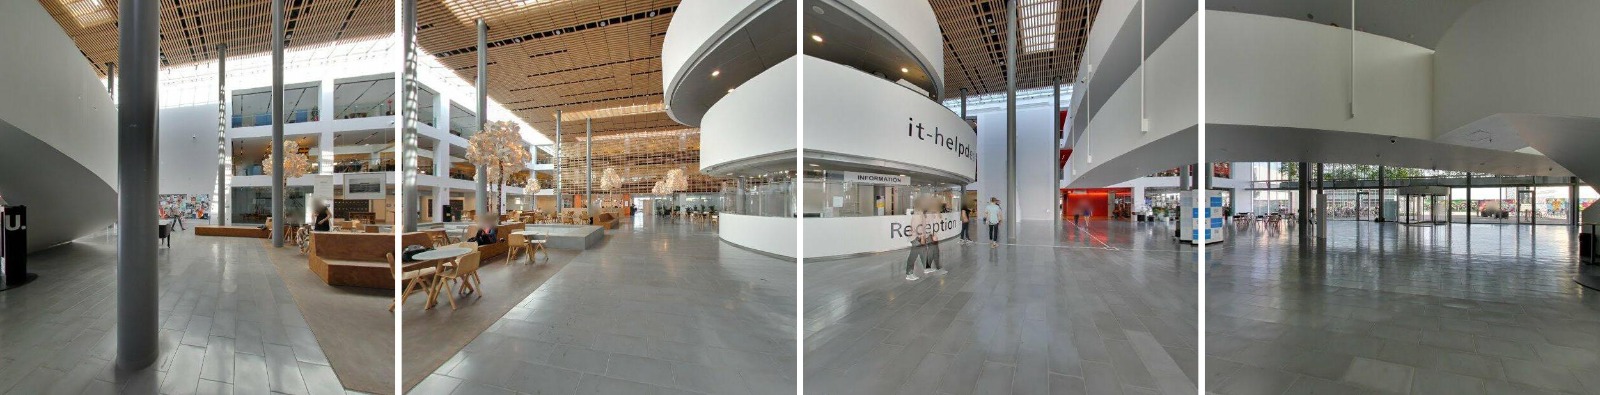
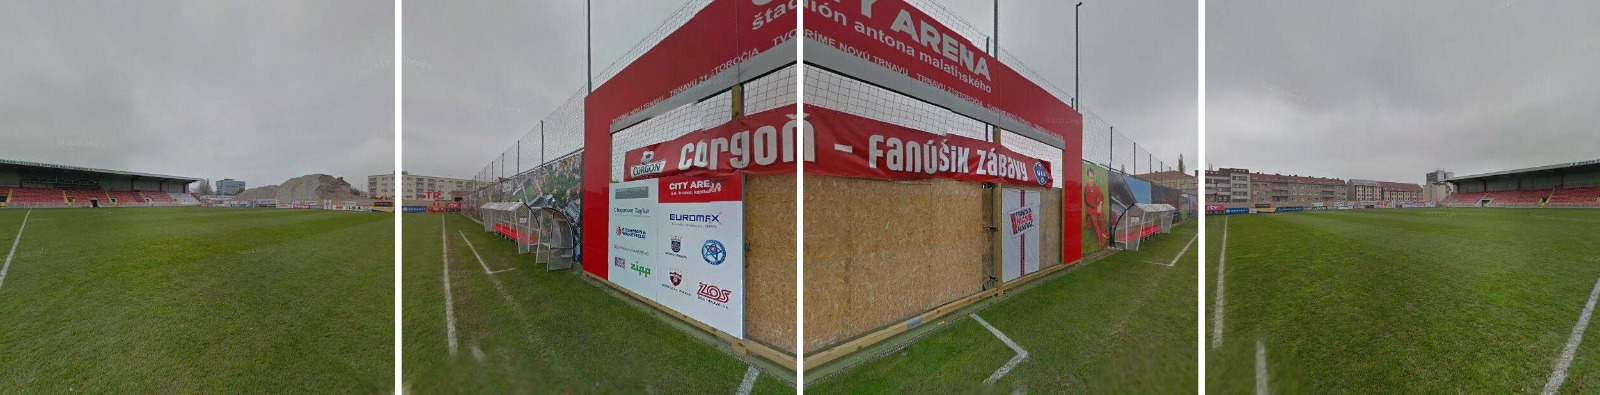
Особенности плохо классифицированных изображений согласуются с нашими интуитивными представлениями и предыдущей литературой о сложных условиях для геолокации изображений. Рисунок 11 показывает, что изображения туннелей, водоемов, плохо освещенных зон, лесов, помещений и футбольных стадионов входят в число снимков, которые наиболее сложно географически точно определить для модели, обученной на данных Street View..
Appendix F Развертывание в Geoguessr
В рамках количественной оценки PIGEON по сравнению с игроками-людьми мы разрабатываем бот расширения Chrome, который использует вывод координат PIGEON для непосредственного размещения предположений в игре. Этот раздел представляет собой общий обзор нашего конвейера обслуживания модели..
F.1 Игровой режим
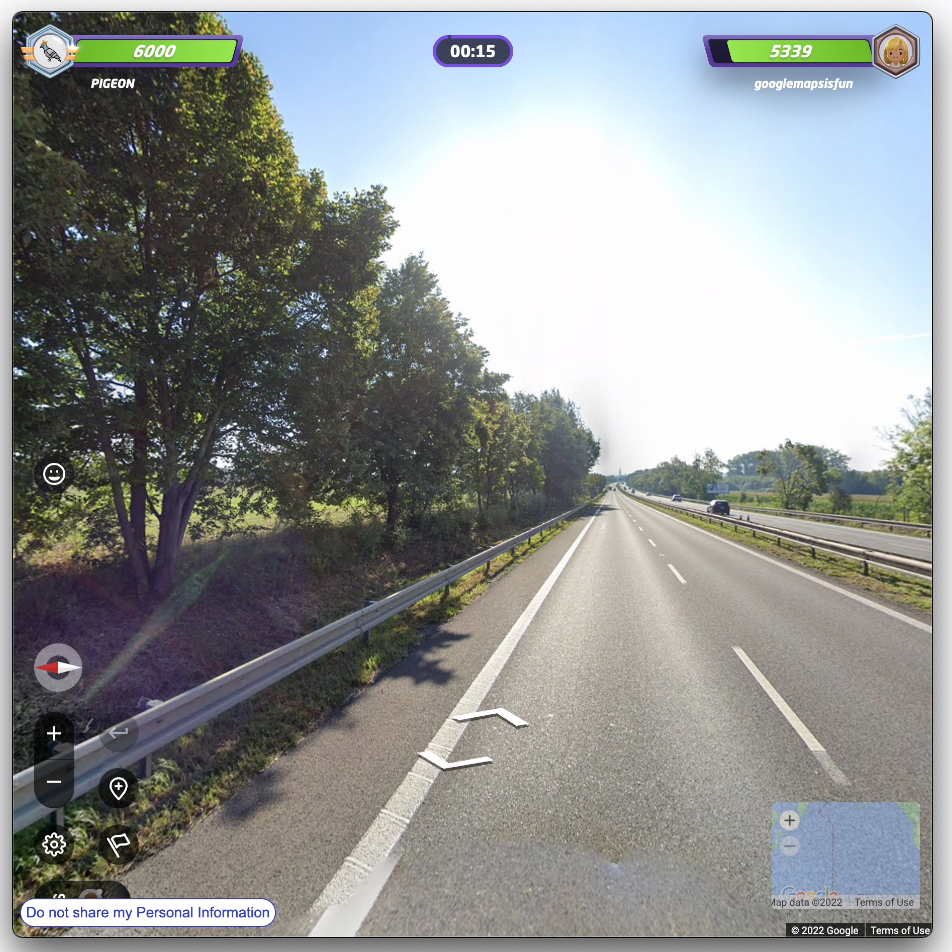
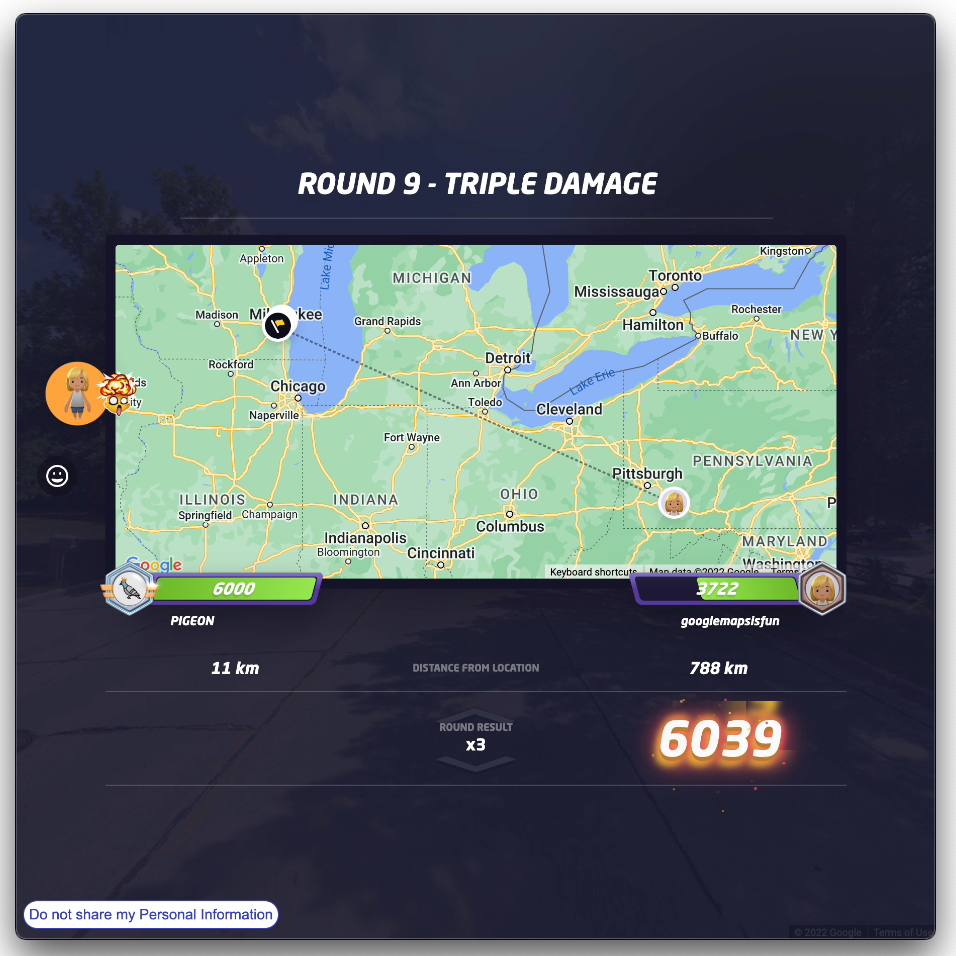
Geoguessr можно играть как в одиночном, так и в многопользовательском режимах. В нашей оценке производительности PIGEON мы решили сосредоточиться на режиме Competitive Duels в Geoguessr, в котором пользователь напрямую соревнуется с противником в многокруговой игре с возрастающей сложностью раундов. Каждое предположение преобразуется в оценку Geoguessr, формулу которой мы восстановили, записывая результаты игры. Формула оценки Geoguessr на мировой карте приблизительно равна
| (6) |
где является ошибкой прогноза в километрах.
Чтобы обеспечить лучшее понимание игры Geoguessr, Figure 12 показывает два скриншота. Скриншоты были сделаны при развертывании PIGEON в игре против человека-противника в слепом эксперименте..
F.2 Расширение Chrome
Мы разрабатываем расширение Geoguessr для Chrome, которое автоматически активируется, как только обнаруживает, что игра началась. Затем оно автономно делает предположения в последующих раундах, получая координаты предположений от API модели PIGEON. Процедура размещения предположения в игре работает следующим образом и повторяется для каждого раунда до тех пор, пока один из игроков – PIGEON или его противник-человек – не одержит победу.:
- 1. Измените размер окна Chrome на квадратное соотношение сторон..
- 2. Дождитесь полной загрузки сцены Street View.
- 3. Повторите следующее для всех четырех сторон света: (a) Скрыть все элементы интерфейса. (b) Сделать скриншот. (c) Показать все элементы интерфейса. (d) Повернуть на с помощью имитации кликов.
- 4. Выполните POST-запрос к нашему серверу с четырьмя скриншотами, закодированными в Base64, в теле запроса..
- 5. Получить прогнозируемые широту и долготу с нашего сервера.
- 6. Опционально: случайная задержка для более человеческого поведения..
- 7. Разместите догадку с координатами в игре, отправив запрос к внутреннему API Geoguessr через браузер..
- 8. Собирайте статистику о фактическом местоположении и производительности человека и отправляйте их на сервер с помощью дополнительного POST-запроса.
F.3 Инференс API
Чтобы предоставлять прогнозы геолокализации изображений для нашего расширения Chrome, мы пишем код для обслуживания PIGEON через API на удаленной машине с GPU A100. Мы используем библиотеку Python FastAPI для реализации двух конечных точек API.:
- • Инференс-эндпоинт. POST-эндпоинт, который принимает одно или четыре изображения, пропускает их через конвейер предварительной обработки, а затем выполняет инференс на GPU. Кроме того, он временно сохраняет изображения на диск для последующей оценки. Наконец, API возвращает клиенту предсказания широты и долготы от PIGEON..
- • Статистический endpoint. POST endpoint, который принимает статистику о правильном местоположении, оценке и расстоянии нашей догадки, а также о человеческой производительности. Эти данные сохраняются на диск и позже используются в наших оценках..
Следовательно, наша работа демонстрирует, что PIGEON может эффективно применяться в сценариях реального времени как система, способная к сквозной геолокализации изображений в планетарном масштабе..