Извлечение сетевых структур из организационных диаграмм корпораций с использованием эвристической обработки изображений
Аннотация
Организационная структура корпораций обладает потенциалом для понимания динамики и эффективности корпоративных операций. Однако эта тема оставалась неизученной из-за отсутствия легкодоступных наборов данных организационных сетей. Чтобы преодолеть этот пробел, мы разработали новый эвристический метод обработки изображений для извлечения и реконструкции данных организационных сетей из опубликованных организационных диаграмм. Наш метод анализирует PDF-файл корпоративной организационной диаграммы и обнаруживает текстовые метки, блоки, соединительные линии и другие объекты с помощью многократных этапов эвристически реализованной обработки изображений. Обнаруженные компоненты реорганизуются в объект NetworkX Graph в Python для визуализации, валидации и дальнейшего сетевого анализа. Мы применили разработанный метод к организационным диаграммам всех листинговых компаний Японии, представленных в «Справочнике организационных диаграмм и системных диаграмм», опубликованном компанией Diamond, Inc. в период с 2008 по 2011 год. Из 10 008 PDF-файлов организационных диаграмм наш метод смог реконструировать 4 606 организационных сетей (успешность сбора данных: 46%). Для каждой реконструированной организационной сети мы измерили несколько сетевых диагностических показателей, которые будут использоваться для дальнейшего статистического анализа с целью исследования их потенциальных корреляций с корпоративным поведением и эффективностью..
Государственный университет Нью-Йорка, Бингемтон, Нью-Йорк, 13902-6000, США, и Инновационная лаборатория Васэда, Университет Васэда, Синдзюку, Токио, 169-8050, Япония ,
1 Введение
Формальная организационная структура корпораций, которая представляет официальные отношения между сотрудниками и официальные пути корпоративной субординации, имеет потенциал для понимания динамики и эффективности корпоративных операций [1, 2, 3]. Однако эта тема еще не до конца исследована с использованием вычислительных методов в области организационной науки, науки об управлении, анализа социальных сетей, науки о данных и науки о сложных системах, в первую очередь из-за отсутствия легкодоступных наборов данных корпоративных сетей. Большая часть информации о корпоративных организационных структурах публикуется в виде графических организационных диаграмм, которые могут использоваться для небольшого числа ручных кейс-стади, но не подходят для крупномасштабного количественного статистического анализа. Из-за этого ограничения в доступности данных более ранние исследования обычно использовали лишь довольно простые косвенные данные (например, краткое описание стиля управления [4], ответы на опросы [5]) в качестве суррогатной переменной для представления организационной структуры. Исследования более детальных топологических свойств организационной структуры поэтому остаются редкими и фрагментарными [6, 7].
Чтобы преодолеть вышеупомянутый пробел в исследованиях корпоративных организаций, мы разработали новый эвристический метод обработки изображений для извлечения и реконструкции данных организационных сетей из опубликованных организационных диаграмм. Мы ожидаем, что такие машиночитаемые сетевые наборы данных окажутся весьма полезными для исследований корпоративных организаций, особенно для поиска потенциальных корреляций между подробными свойствами организационной сети и динамикой/эффективностью деятельности корпорации. Мы также надеемся, что эта работа представляет собой контрпредложение текущим основным тенденциям в области искусственного интеллекта (AI) / Machine Learning (ML), предоставляя конкретный пример того, что можно сделать, когда обучающие данные недоступны для решаемой проблемы.
2 Набор данных
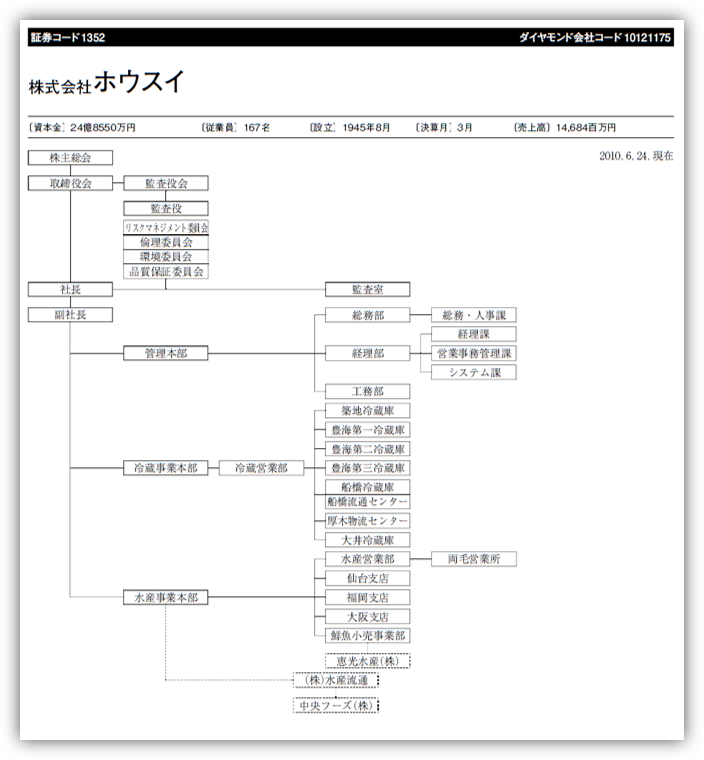
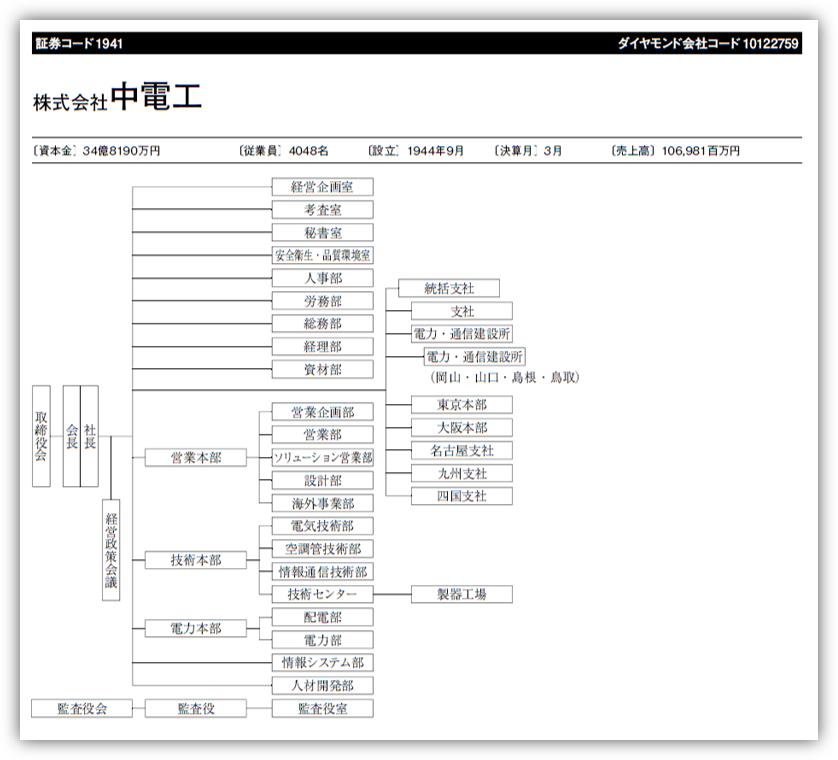
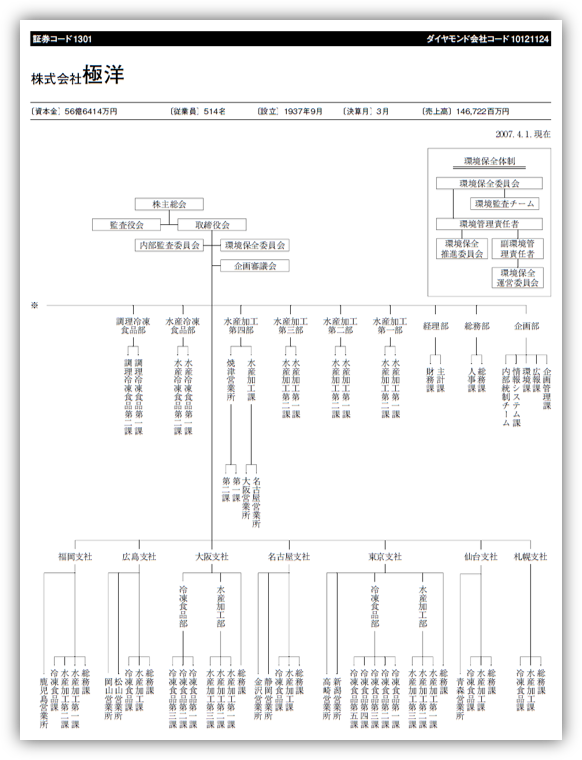
Данные, из которых мы стремимся извлечь сетевые структуры, представляют собой организационные диаграммы всех листинговых компаний Японии с 2008 по 2011 год, которые были предоставлены в «Справочниках организационных диаграмм/системных схем» (оригинальное японское название: «Soshikizu-Keitouzu Binran»), опубликованных компанией Diamond, Inc. Эти книги (и их электронные версии на CD-ROM) включали в общей сложности 10 008 PDF-файлов с организационными диаграммами. По-видимому, эти диаграммы были нарисованы вручную в свободном формате без строгого шаблона или аннотаций. Некоторые примеры организационных диаграмм показаны на рис. 1. Каждая из этих диаграмм была предоставлена в наборе данных просто как отдельный PDF-файл без каких-либо дополнительных машиночитаемых аннотаций о структуре ее организационной сети..
3 Метод
В настоящее время популярные методы извлечения информации из изображений основаны на AI/ML и, как правило, включают сверточные нейронные сети (CNNs). Однако такие методы не подходят для задач, подобных той, которую мы пытаемся решить в данном исследовании, из-за отсутствия обучающих наборов данных. Чтобы применить методы AI/ML, основанные на обучении, нам потребовалось бы большое количество пар изображений организационных диаграмм и их аннотированных сетевых представлений. Это ограничение предполагает, что нам необходимо использовать другой, более логически обоснованный, разработанный вручную эвристический подход..
В данном исследовании мы разработали и внедрили полностью автоматизированный метод, который позволяет анализировать PDF-файл с корпоративной организационной структурой и обнаруживать текстовые метки, блоки, соединительные линии и другие объекты посредством 10 этапов обработки изображений. Приложение было написано на Python 3 с использованием нескольких пакетов, перечисленных в таблице 1. Обнаруженные компоненты реорганизуются в объект графа NetworkX в Python для визуализации, проверки и дальнейшего сетевого анализа. Подробное описание 10 этапов разработанного метода приведено ниже..
| Name | Purpose |
|---|---|
| pdf2image | To convert a PDF to a bitmap image |
| PIL | For image manipulation |
| OpenCV | For image manipulation |
| NetworkX | For network representation, visualization and analysis |
| pdfminer | To extract text labels within a PDF |
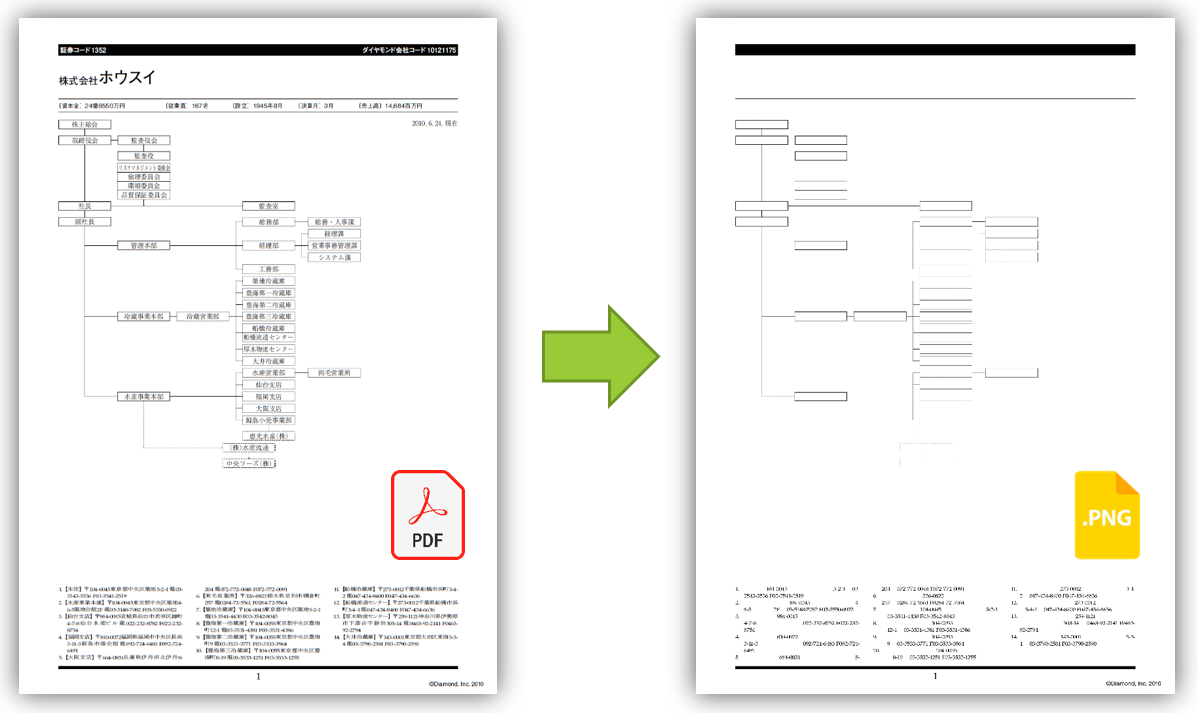
Первым шагом является преобразование исходного файла PDF в растровый формат изображения (PNG) с использованием pdf2image (Рис. 2). Этот шаг автоматически удаляет все японские символы из изображения, поскольку набор японских символов не поддерживался pdf2image, что оказалось удобным свойством для дальнейших этапов обработки изображений..
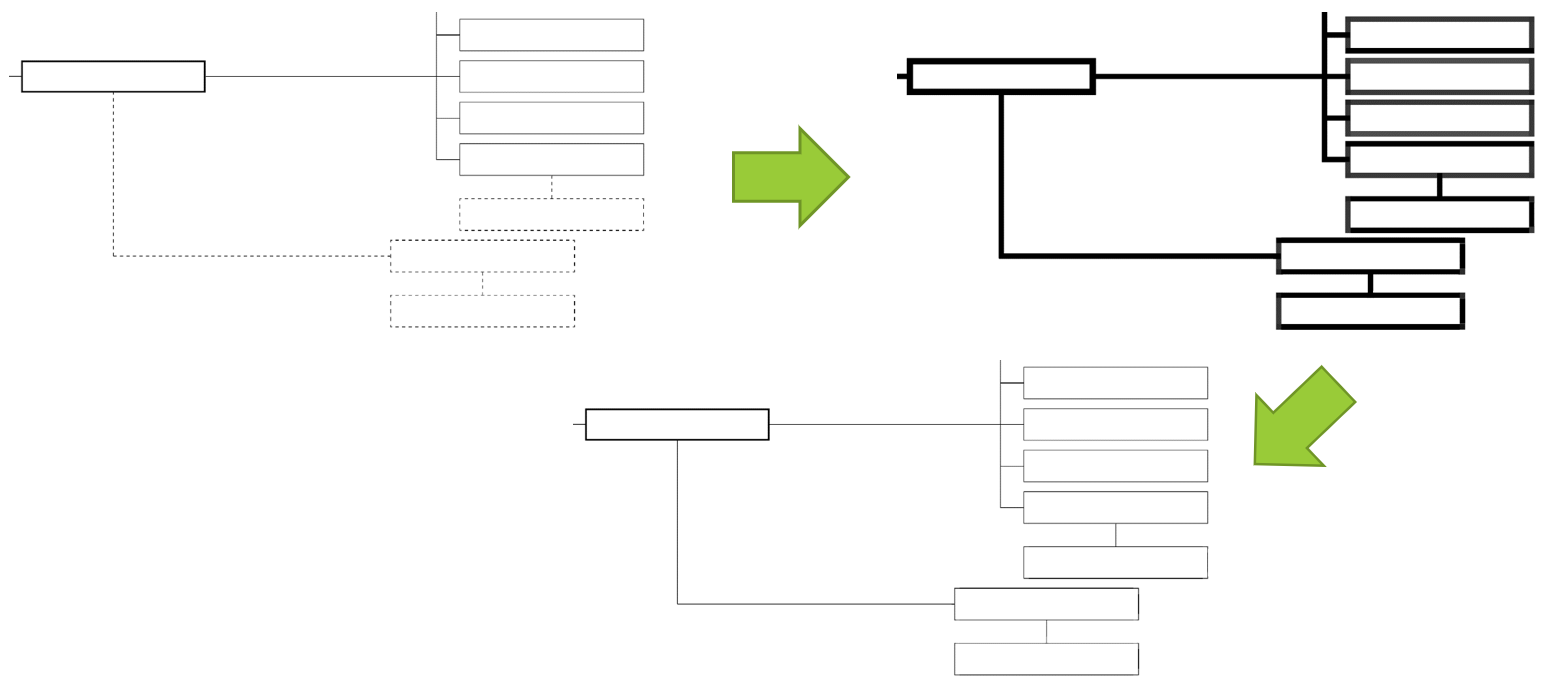
Второй этап заключается в использовании операций дилатации и эрозии изображения для соединения пунктирных/штриховых линий в сплошные (Рис. 3). Этот шаг был необходим, поскольку во многих организационных диаграммах для обозначения связей и блоков использовались пунктирные/штриховые линии.
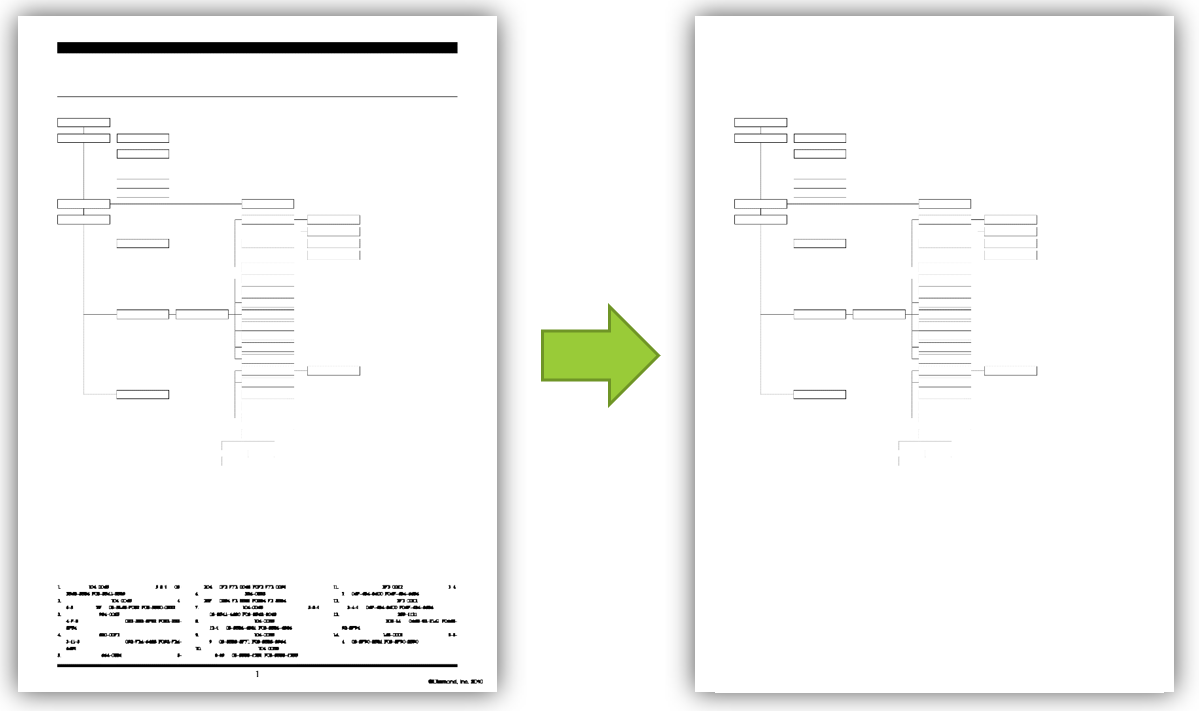
Третий шаг заключается в удалении областей верхнего и нижнего колонтитулов, которые не содержат информации об организационной структуре (Рис. 4). Размер верхнего колонтитула был одинаковым для всех схем в этом наборе данных, поэтому мы просто стерли любое содержимое в верхней части каждого изображения. В то же время размер нижнего колонтитула варьировался от схемы к схеме, поэтому мы просканировали изображение, чтобы обнаружить значительный разделительный промежуток (т.е. существенное количество пустых горизонтальных строк на изображении) между схемой и нижним колонтитулом, и стерли любое содержимое под ним. После этого шага полученное изображение содержит только сетевую диаграмму, отображающую организационную структуру (Рис. 4, справа).
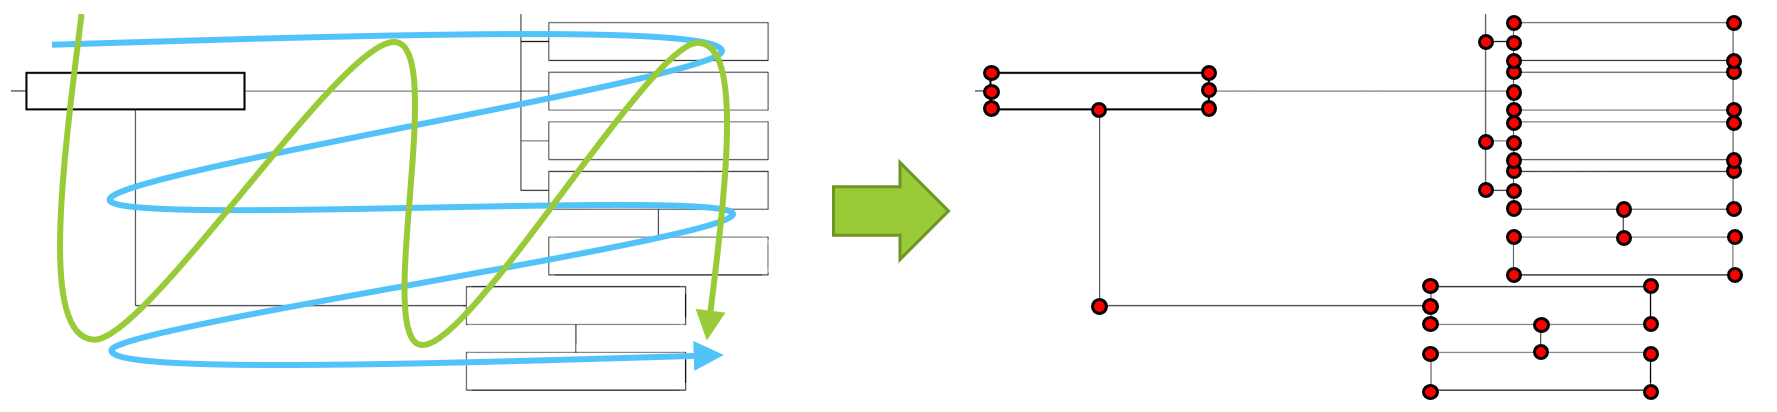
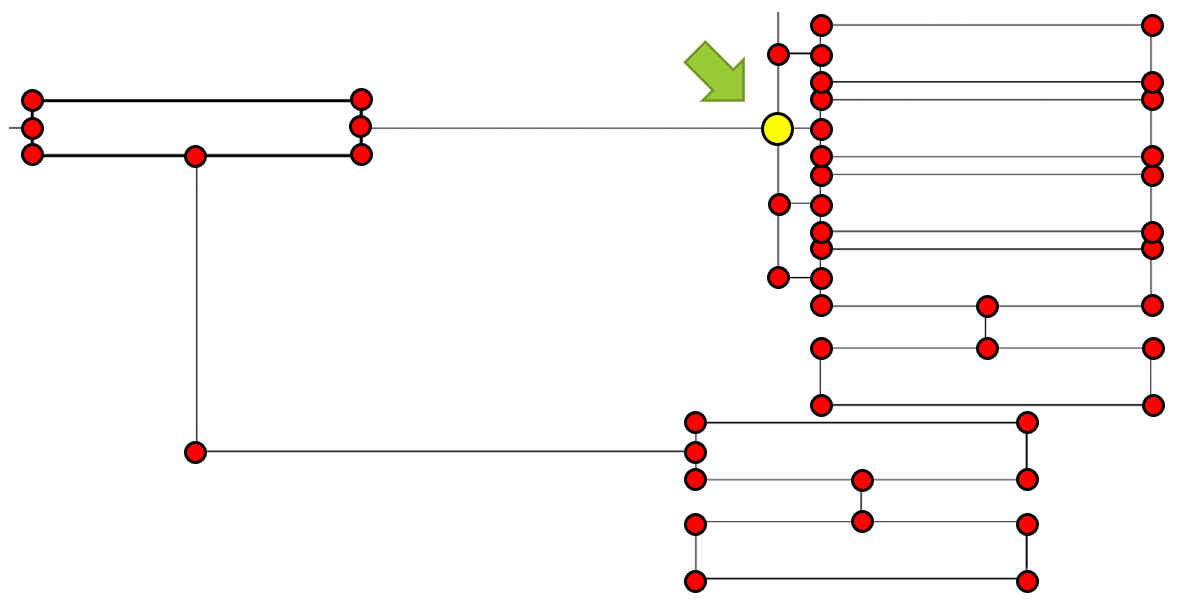
Четвертый шаг заключается в обнаружении всех горизонтальных и вертикальных линейных сегментов в качестве ребер на изображении. Это было выполнено путем двукратного сканирования изображения, по горизонтали и вертикали, и обнаружения всех последовательных рядов черных пикселей в качестве ребер (Рис. 5). На этом этапе физически очень близкие узлы объединялись в один узел, а любые случайно созданные петли удалялись. Эти исправления повторялись несколько раз, пока подобные случаи не перестали встречаться в ребрах..
Пятым шагом является добавление новых узлов в места пересечения горизонтальных и вертикальных ребер (рис. 6).
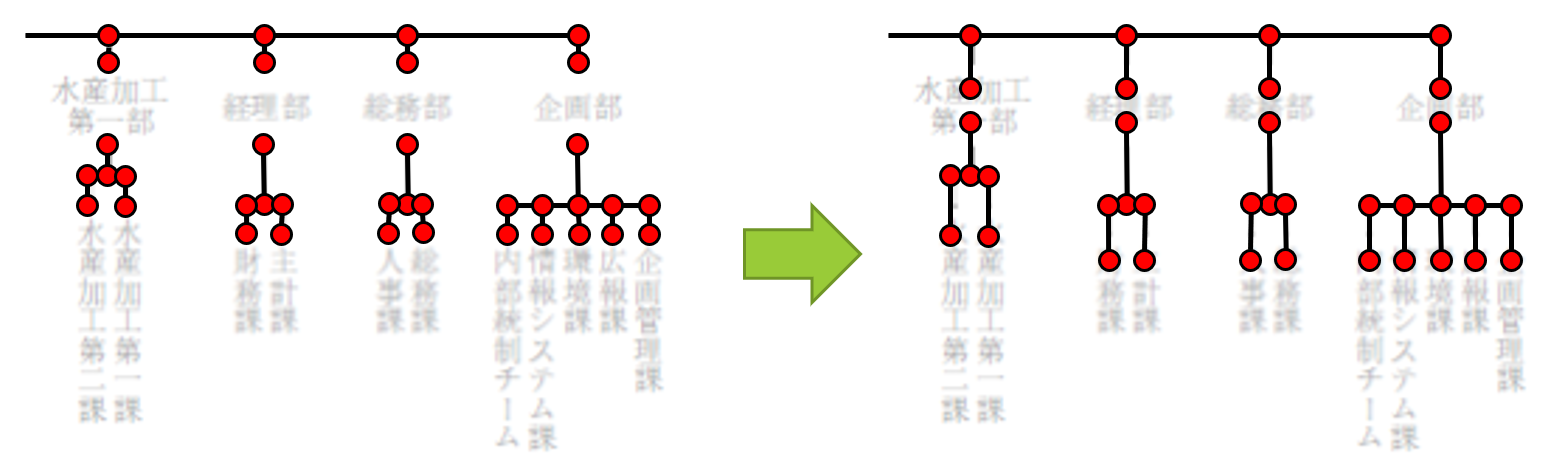
Шестой шаг заключается в том, чтобы немного продлить ребра, инцидентные узлам степени 1, наружу (рис. 7). Этот шаг необходим для того, чтобы сопоставление узлов с текстовыми полями (описываемое далее) стало более надежным, особенно для текстовых меток без рамки.
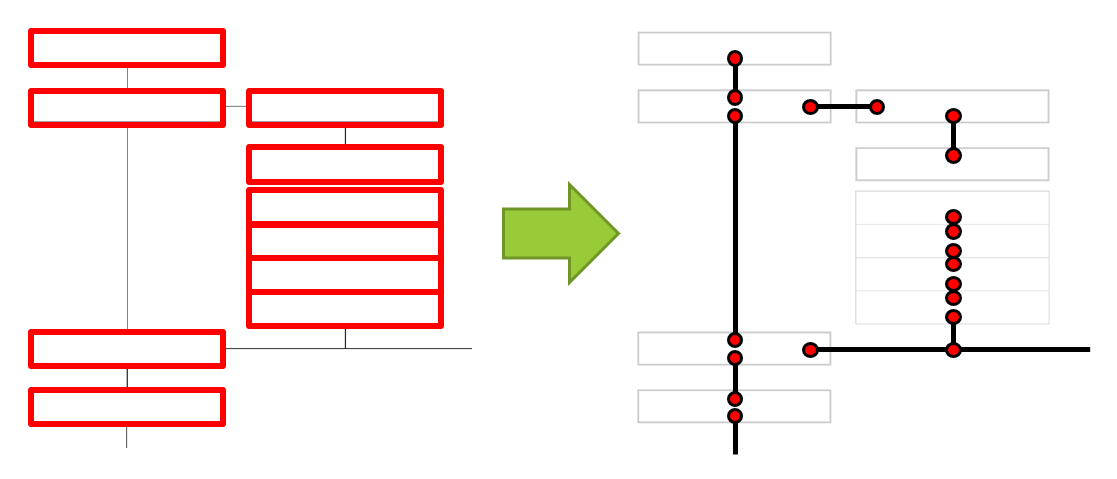
Седьмой шаг заключается в обнаружении блоков (минимальных циклов в базисе циклов) и соответствующей замене их единичными узлами (рис. 8). Этот шаг был необходим, поскольку ребра в таких блоках отражали не организационную структуру, а лишь визуальные границы блоков. Более подробная информация об этом шаге приведена ниже:
- ⟦• Внешнее ребро, соединяющееся с прямоугольным кругом, было соединено напрямую с внутренней областью прямоугольника.
- ⟦• Два прямоугольника с общей границей заменяются новым ребром, соединяющим две области этих прямоугольников.
- ⟦• Прямоугольники без внешних соединений представлены как изолированный узел.
- ⟦• После всего вышеперечисленного все минимальные оставшиеся циклы удаляются.
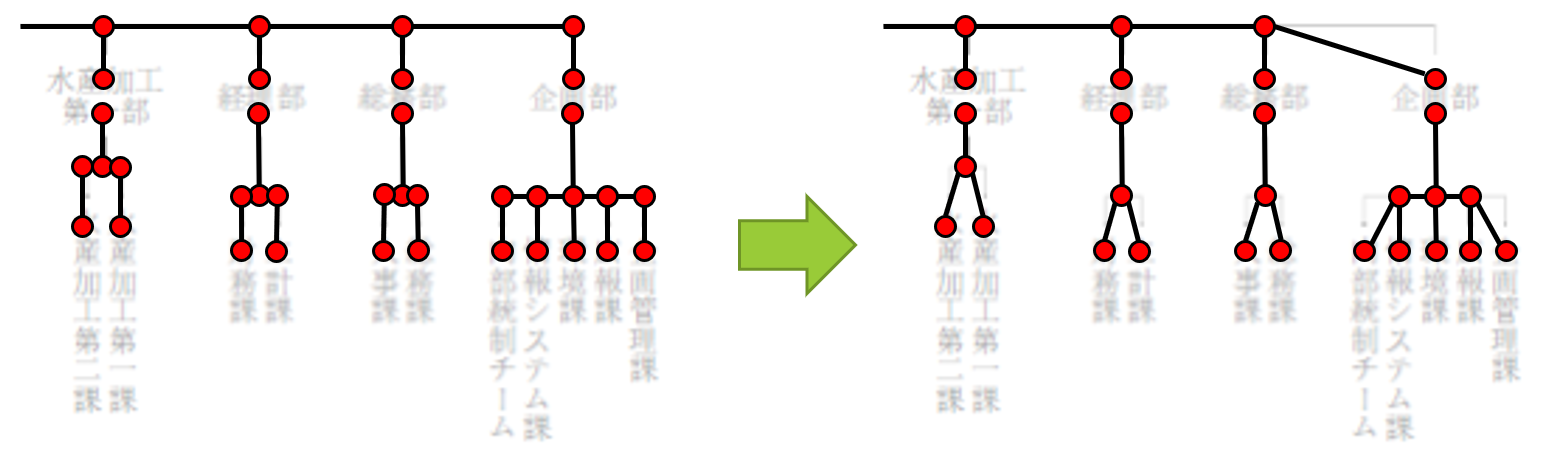
Восьмым шагом является удаление всех узлов степени 2 и непосредственное соединение их соседей (Рис. 9). Это было необходимо, поскольку такие узлы были топологически избыточными в структуре организационной сети.
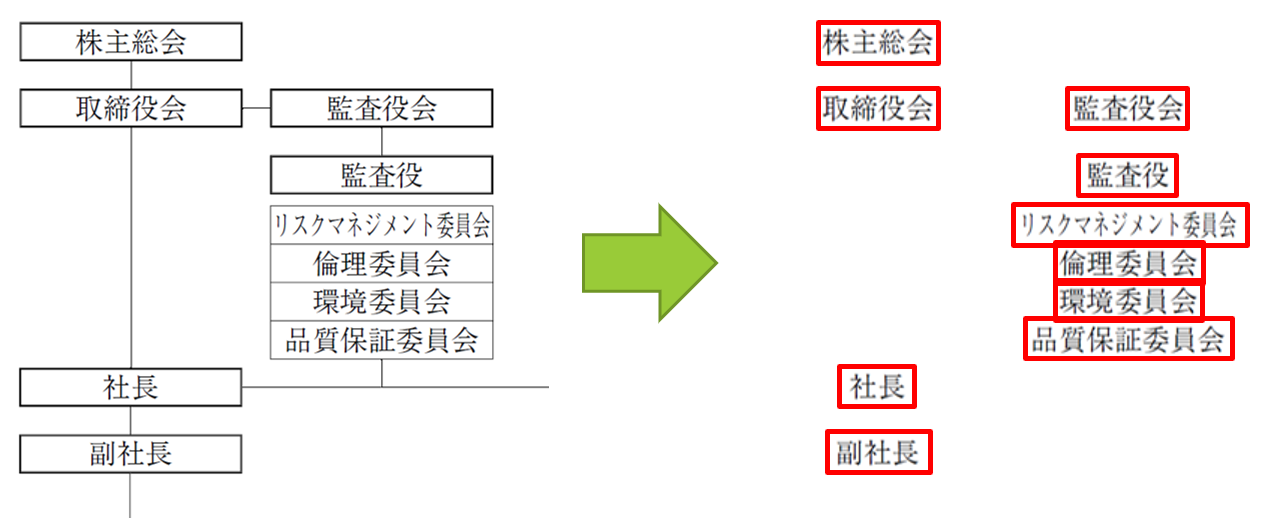
Девятый шаг заключается в обнаружении всех текстовых блоков в оригинальном PDF и записи их содержимого, положения и размера (Рис. 10). Некоторые текстовые блоки включали несколько строк с несколькими метками узлов, которые были автоматически разделены на несколько текстовых блоков.
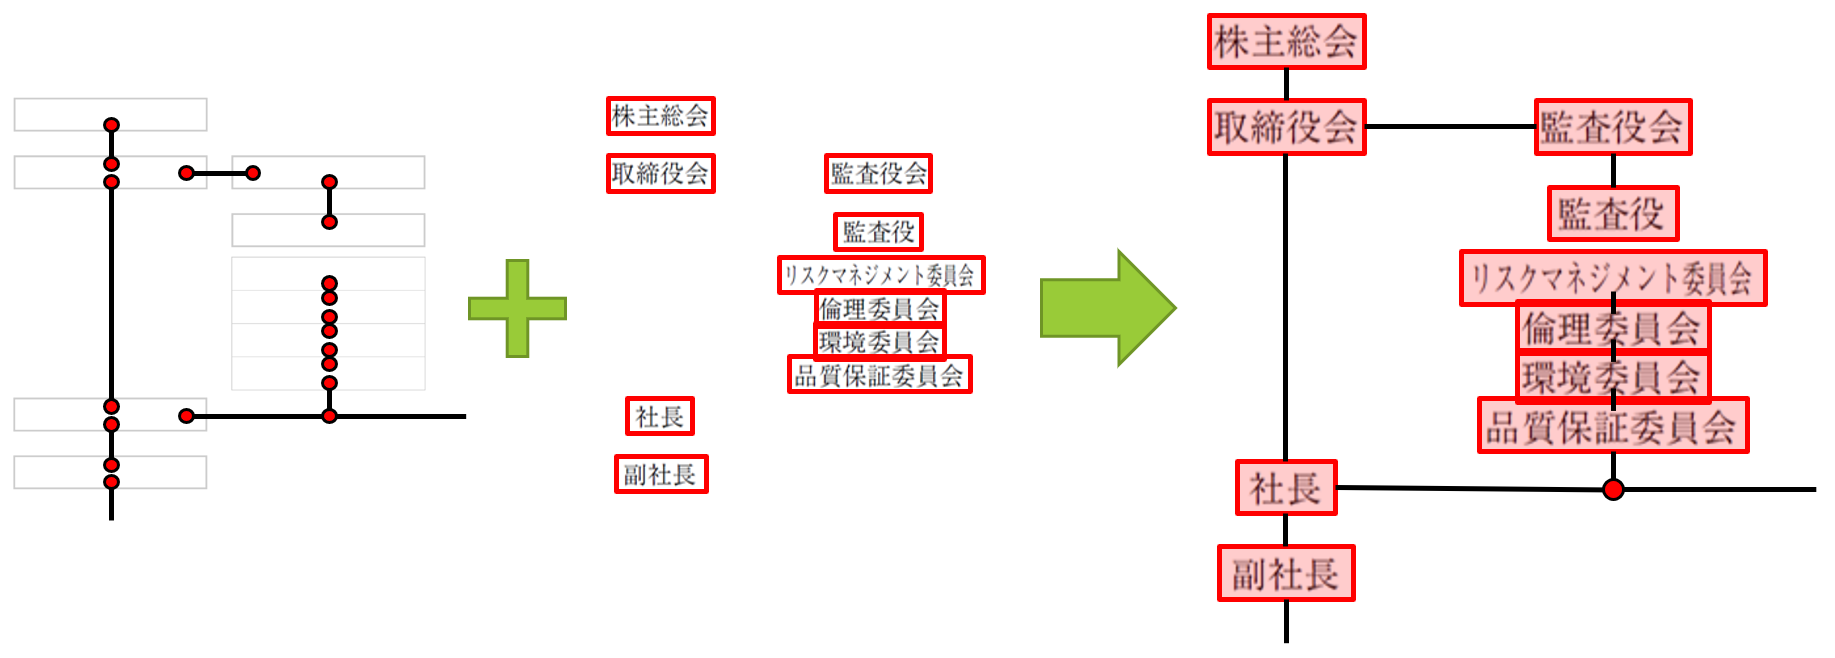
Наконец, десятым шагом является объединение обнаруженных сетевых узлов и текстовых полей в соответствии с их позициями (Рис. 11). Это приводит к единому сетевому представлению исходной организационной диаграммы.
4 Результаты
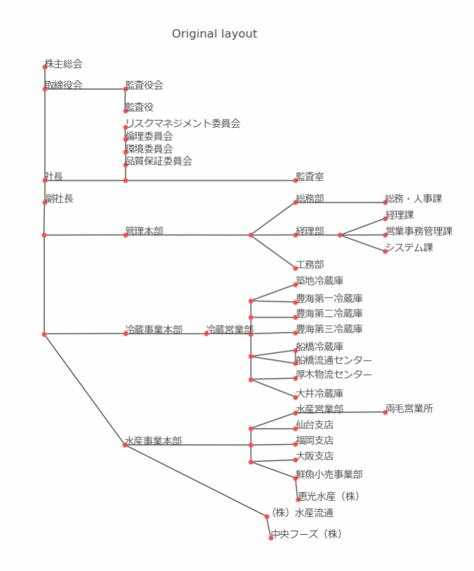
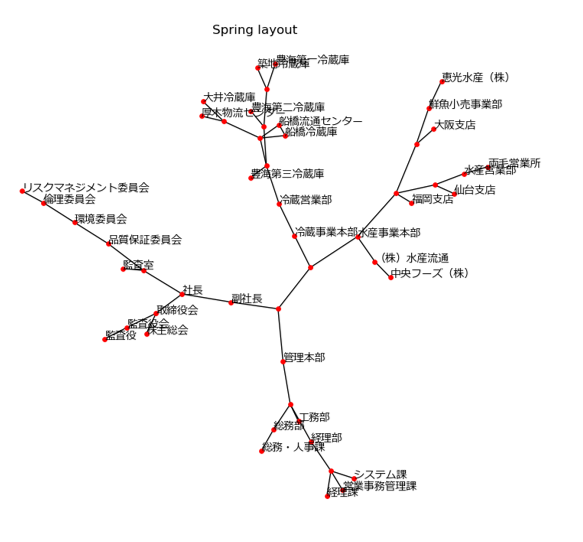
Мы применили разработанный метод ко всем организационным диаграммам, опубликованным в [8]. Многие диаграммы не соответствовали типичному формату организационных схем, и поэтому наш метод на них не сработал. Тем не менее, из 10 008 PDF-файлов организационных диаграмм наш метод смог реконструировать 4 606 организационных сетей, в результате чего показатель успешности сбора данных составил 46%. Хотя других методов для сравнения нет, мы считаем этот показатель успешности очень высоким, учитывая, что метод был спроектирован и реализован полностью на основе логики и эвристики, без использования каких-либо инструментов AI/ML. Некоторые из извлеченных сетей показаны на рис. 12.⟧.
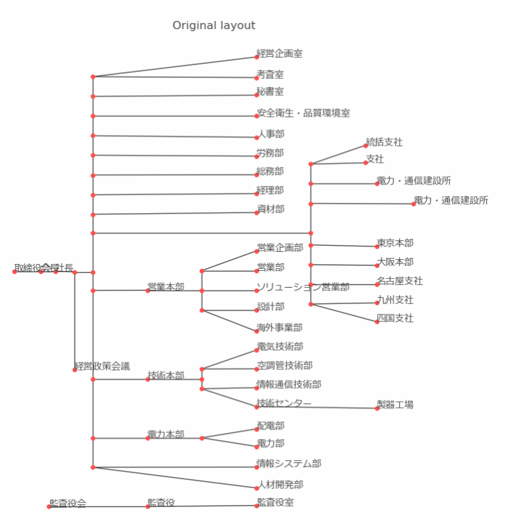
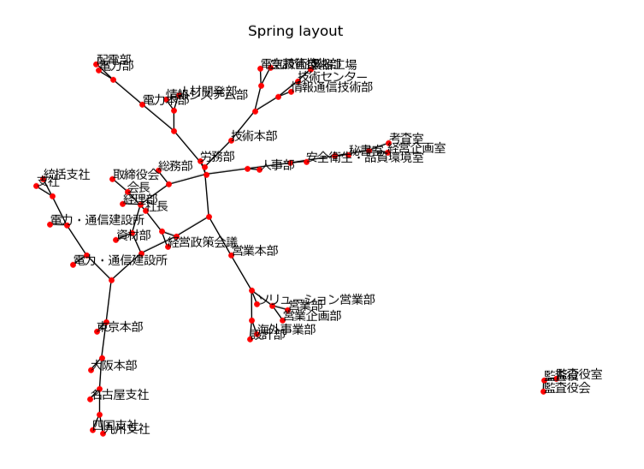
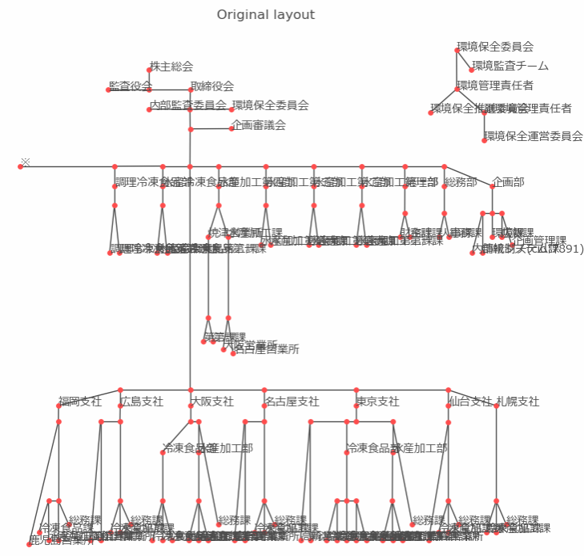
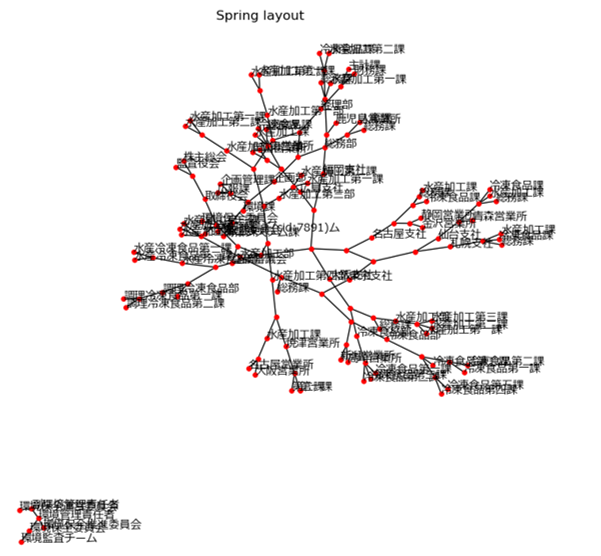
Для каждой реконструированной организационной сети мы измерили несколько сетевых диагностических показателей, включая количество узлов, количество ребер, плотность, средний коэффициент кластеризации, количество связанных компонентов, среднюю длину кратчайшего пути и алгебраическую связность. В настоящее время мы исследуем потенциальные корреляции между этими сетевыми диагностическими показателями, а также корпоративным поведением и производительностью, о чем будет сообщено в другой работе [9].
5 Выводы
Здесь мы сообщили об алгоритмических деталях эвристического метода обработки изображений, разработанного нами для автоматического извлечения сетевых структур из организационных диаграмм. Он достиг близкого к 50-процентному уровню успеха сбора данных на реальных организационных диаграммах листинговых компаний в Японии, что служит доказательством того, что такие логические подходы к разработке инструментов и анализу данных могут быть полезны, когда обучающие данные отсутствуют или вообще недоступны. Мы отмечаем, что наш метод все еще ограничен, поскольку он обнаруживает только горизонтальные/вертикальные линии в качестве ребер, и он тестировался только на японских организационных диаграммах, опубликованных в [8]. Подобные инструменты должны быть разработаны и протестированы для более сложных, многоязычных диаграмм в будущем.
Благодарности
Мы благодарим доктора Самикшу Шуклу из Университета Крайст за ее постоянную поддержку и помощь в подготовке данной рукописи..
Список литературы
- ⟦(1) Минцберг, Г.: Структурирование организаций (стр. 322-352). Макмиллан Эдьюкейшн, Великобритания (1989)).
- ⟦(2) Аргирес, Н. С., Силверман, Б. С.: НИОКР, организационная структура и развитие корпоративных технологических знаний. Strategic Management Journal, 25(8‐9), 929–958 (2004)).
- ⟦(3) Reitzig, M. Становитесь лучше в горизонтальных структурах. Springer International Publishing (2022)).
- ⟦(4) Csaszar, F. A.: Организационная структура как детерминанта эффективности: данные паевых инвестиционных фондов. Strategic Management Journal, 33(6), 611–632 (2012).
- (5) Gentile-Lüdecke, S., Torres de Oliveira, R., Paul, J.: Does organizational structure facilitate inbound and outbound open innovation in SMEs?. Small Business Economics, 55(4), 1091–1112 (2020).
- (6) Reitzig, M., Maciejovsky, B.: Corporate hierarchy and vertical information flow inside the firm—A behavioral view. Strategic Management Journal, 36(13), 1979–1999 (2015).
- (7) Joseph, J., Gaba, V.: Organizational structure, information processing, and decision-making: A retrospective and road map for research. Academy of Management Annals 14(1), 267–302 (2020).
- (8) Даймонд, Инк.: Справочники организационной структуры/системных диаграмм (2008-2011). Опубликовано на японском языке. https://iss.ndl.go.jp/books?any=%E7%B5%84%E7%B9%94%E5%9B%B3%E3%83%BB%E7%B3%BB%E7%B5%B1%E5%9B%B3%E4%BE%BF%E8%A6%A7&mediatype=1&op˙id=1
- ⟦(9) Яманой, Д., Саяма, Х.: Рукопись в процессе подготовки.