Направление распределения усилий в проектах с открытым исходным кодом с использованием анализа фактора автобуса
Аннотация.
Критической проблемой, с которой сталкиваются проекты открытого программного обеспечения, является риск ухода ключевых сотрудников из проекта. Этот риск усугубляется в крупных проектах, которые находятся в разработке в течение длительного времени и столкнулись с ростом своих команд разработчиков. Один из способов количественно оценить этот риск заключается в измерении концентрации знаний о проекте среди его разработчиков. Формально это известной как Bus Factor (BF) проекта и определяется как «количество ключевых разработчиков, которые должны выйти из строя, чтобы проект не смог продолжаться» (1). Большинство предлагаемых алгоритмов для расчета BF измеряют знания разработчика о файле на основе количества коммитов. В этой работе мы предлагаем использовать другие метрики, такие как изменения строк кода (LOCC) и косинусное различие строк кода (change-size-cos), для расчета BF. Мы используем эти метрики для расчета BF для пяти проектов с открытым исходным кодом на GitHub, используя алгоритм CST и алгоритм RIG, который основан на git-blame. Кроме того, мы рассчитываем BF для подкаталогов проектов, в которых в последнее время наблюдалась наиболее активная разработка. Наконец, мы сравниваем результаты двух алгоритмов по точности, сходству результатов, времени выполнения и тенденциям значений BF с течением времени.
Ключевые слова:
Фактор автобуса, Открытый код, Владение кодом, Управление рисками, Интеллектуальный анализ репозиториев GitHub1. Введение
Если мы посмотрим на наше повседневное использование интернета, мы поймем, что мы поглощены использованием программного обеспечения и приложений. Разработка и поддержка всех этих программных проектов основаны на знаниях, которыми обладают их разработчики. Это делает процесс разработки программного обеспечения наиболее зависимым от его разработчиков. Учитывая это, разработчики становятся важным ресурсом для проектных организаций и команд проектных команд open-source. Это также делает скорость ухода разработчиков из программного проекта критическим вопросом и риском. Чтобы снизить этот риск, важно, чтобы руководители проектов или ведущие разработчики отслеживали и количественно оценивали концентрацию знаний о проекте среди его разработчиков (2) Интересной мерой, используемой в этой связи, является так называемый Bus Factor (BF), который определяется как минимальное количество ключевых разработчиков, уход которых сделает проект неспособным или затруднительным для продолжения (2) Меньшее значение bus factor будет означать, что максимальные знания о проекте сосредоточены среди них, и проект подвергается более высокому риску, если некоторые или все эти разработчики покидают проект, компанию или уходят в отпуск и т. д. Bus factor, равный единице, был бы худшим сценарием. И наоборот, высокий bus factor означает меньший риск для проекта в случае, если некоторые из разработчиков в конечном итоге уйдут.
Когда речь заходит об open-source software проектах, фактор автобуса имеет гораздо большую важность. Большинство людей, работающих над этими проектами, делают свой вклад на добровольной основе. Волонтерство означает, что разработчики или контрибьюторы не имеют финансовых выгод, связанных с этими проектами. Это подвергает open-source software проекты более высокому риску developer turnover (2). Учитывая важность измерения фактора автобуса в проектах разработки open-source software, были предложены алгоритмы для его расчета с использованием данных, собранных из систем контроля версий, таких как GitHub (1, 3, 4). Насколько нам известно, большинство этих алгоритмов основаны на коммитах, то есть алгоритмы анализируют данные коммитов из репозиториев контроля версий. Более того, существующие работы в основном предлагают алгоритмы расчета фактора автобуса и представляют соответствующие инструменты. Лишь немногие исследования пытаются валидировать результаты этих алгоритмов. (2) представляет собой эмпирическое и сравнительное исследование, в котором валидируются три алгоритма фактора автобуса, однако в нем использовались только инструменты и метрики, предоставленные исходными авторами..
Поэтому в данной работе мы рассматриваем два алгоритма: (a) первый был предложен Cosentino et al. (2), который вычисляет bus factor каждого файла и агрегирует его до уровня ветки, директории или проекта; (b) второй, предложенный Rigby et al. (4), который использует подход на основе git-blame для вычисления bus factor. Инструмент, основанный на первом алгоритме, находится в открытом доступе (1), однако авторы предоставили лишь псевдокод второго. Используя соглашение, принятое в (2), мы называем первый алгоритм CST, а второй — RIG. Среди этих двух алгоритмов CST является алгоритмом на основе коммитов, и мы хотели использовать его с другими метриками, такими как изменения строк кода (LOCC) и косинусное расстояние для строк кода (change-size-cos). Для этого мы реализовали его, разобрав алгоритм, упомянутый в (1). Алгоритм RIG пришлось реализовать самостоятельно, так как его код или какой-либо связанный с ним инструмент не находятся в открытом доступе. Мы реализовали и протестировали оба алгоритма на пяти open-source проектах и сравнили их результаты. Мы также получили отзывы от ведущих разработчиков этих проектов для валидации результатов. Наконец, мы использовали инструмент, предоставленный в (1), чтобы получить результаты bus factor для выбранных проектов.
Подводя итог, мы стремимся ответить на следующие исследовательские вопросы:
- ⟦(1) Как различные метрики, такие как строки измененного кода и косинусное расстояние, влияют на расчет коэффициента автобуса?
- ⟦(2) Как фактор автобуса может помочь ведущим разработчикам или менеджерам распределить усилия по найму или передаче знаний среди существующей команды разработчиков?
- ⟦(3) Чем алгоритмы фактора автобуса отличаются с точки зрения точности и производительности?
Исходя из этого, наши результаты можно сформулировать следующим образом:
- ⟦• Реализован алгоритм CST (с использованием изменений строк кода и косинусного расстояния строк кода) и алгоритм RIG, а также проведено сравнение их результатов.
- ⟦• Получены отзывы от ведущих разработчиков пяти выбранных проектов для валидации наших результатов.
- • Рассчитан BF выбранных проектов с помощью инструмента алгоритма CST на основе коммитов, предоставленного в (1), для сравнения с нашими результатами.
- ⟦• Рассчитан коэффициент автобуса для выбранных проектов за последние пять лет, чтобы увидеть тенденцию изменения значений коэффициента автобуса.
2. Существующая литература
В этом разделе сначала мы описываем два алгоритма для измерения коэффициента автобуса, которые мы будем использовать в качестве части нашего исследования в данной статье. Ближе к концу мы описываем другие алгоритмы, которые являются частью существующей литературы, но не реализованы в нашем исследовании.
2.1. Алгоритм CST
Алгоритм CST предложен в рамках статьи об инструменте (1) авторами Cosentino et al. Алгоритм вычисляет знания разработчиков по каждому файлу и на основе этого определяет bus factor для каждого файла. Кроме того, выполняется агрегация с уровня файлов до уровня каталогов, ветвей или проектов для получения знаний разработчиков. Агрегация выполняется путем простого сложения знаний по каждому файлу и масштабирования с учетом количества файлов в каталоге, ветке или проекте. Авторы предложили четыре метрики для расчета знаний разработчика о файле. Метрика last change takes it all назначает 100% знаний о файле последнему разработчику, который его изменил, а в метрике multiple changes equally considered знания разработчика рассчитываются путем деления количества коммитов, сделанных разработчиком для файла, на общее количество коммитов, когда-либо сделанных для этого файла. Третьей метрикой является non-consecutive changes, которая учитывает только непоследовательные коммиты разработчика в файле и объединяет последовательные коммиты в один. Последняя метрика является расширением третьей метрики, называется weighted non-consecutive changes и присваивает возрастающий вес более поздним коммитам в файле.
После того как знания разработчика об артефактах, то есть файле, каталоге, ветке или проекте, вычислены, автобусный фактор для каждого из этих артефактов измеряется с использованием двух групп разработчиков. Первая группа называется основными разработчиками, которые обладают минимальными знаниями об артефакте. Вторая группа называется второстепенными разработчиками, которые обладают хотя бы некоторой степенью знаний об артефакте, где меньше, чем . Порог для выбора основных разработчиков устанавливается равным , где — это общее число разработчиков, которые внесли изменения в артефакт на сегодняшний день. устанавливается равным половине для выбора второстепенных разработчиков. Количество разработчиков в объединении обеих этих групп дает нам автобусный фактор для конкретного артефакта.
Поскольку CST является алгоритмом на основе коммитов, мы используем тот же алгоритм с LOCC и change-size-cos. Детали того, как мы собираем и используем эти данные для проектов с открытым исходным кодом на GitHub, приведены в последующих разделах.
Данные git-blame для каждого файла в проекте Результат BFset (разработчики BF), g (Bus Factor)
2.2. Алгоритм RIG
Алгоритм RIG был предложен Ригби и соавторами (4), в котором они адаптируют меры управления финансовыми рисками к контексту текучести кадров разработчиков для оценки риска, создаваемого для проекта уходом разработчиков. В отличие от алгоритма CST, RIG использует подход, основанный на атрибуции авторства кода, для расчета владения кодом разработчиками. Функция атрибуции реализована в системах контроля версий таким образом, что команда git-blame назначает каждую строку в файле тому разработчику, который изменил ее последним. Авторы алгоритма утверждают, что такой подход позволяет им отслеживать владение кодом с более высокой степенью детализации. Согласно алгоритму, строка считается заброшенной, если она приписана разработчику, который больше не является частью проекта, а файл считается заброшенным, когда 90% его строк являются заброшенными. Этот высокий порог гарантирует, что разработчики с незначительным вкладом исключаются. Алгоритм 1 показывает псевдокод для алгоритма RIG. Алгоритм начинается с варьирования количества разработчиков от 1 до 200, которые покидают проект, как показано в строке 1. Строка 3 показывает случайную выборку разработчиков в количестве , которые покидают проект, и эта случайная выборка повторяется 1000 раз для каждого значения . Мы ограничиваем эти итерации 10 вместо 1000, потому что алгоритм выполняется долго на относительно крупных проектах, которые мы выбрали. Более того, следуя (2), мы возвращаем наименьшее значение , которое привело к статусу заброшенности более 50% файлов, как показано в строках 5-7. Авторы в оригинальной статье (4) также рассчитывают вероятность ухода каждой группы разработчиков из проекта между строками 3-4, но мы опускаем это, поскольку мы Заметной характеристикой этого алгоритма является его недетерминированная природа, то есть для каждого выполнения алгоритма создаются разные результаты из-за случайной выборки разработчиков. Кроме того, алгоритм может не вернуть допустимый результат, как видно из строки 10, что происходит, когда ни один BFset не приводит к тому, что более 50% файлов становятся заброшенными..
| Project | Release Year | Contributors | Language | Description |
|---|---|---|---|---|
| PETSc(5) | 1994 | 207 | C | Portable, Extensible Toolkit for Scientific Computation. |
| Spack(6) | 2014 | 1,164 | Python | Multi-platform package manager. |
| Hypre(7) | 2004 | 34 | C | Library of high performance pre-conditioners and solvers. |
| Lammps(8) | 2016 | 224 | C++ | Large-scale Atomic/Molecular Massively Parallel Simulator. |
| NWChem(9) | 1994 | 44 | Fortran | Open Source High-Performance Computational Chemistry. |
2.3. Другие алгоритмы Bus Factor
Еще один алгоритм, основанный на коммитах, был предложен Авелино и соавторами и вычисляет степень авторства (DOA) каждого файла для идентификации ключевых разработчиков (3). Значение DOA для файла инициализируется при его создании определенным разработчиком . DOA увеличивается, когда вносит больше коммитов в , в то время как оно уменьшается, если другие разработчики вносят коммиты в . Наконец, значения DOA нормализуются для каждого файла так, что разработчик с самым высоким DOA равен 1. Разработчики с DOA более 0,75 считаются авторами этого файла. Мы не реализовывали этот алгоритм в рамках нашего исследования и выбрали только один алгоритм, основанный на коммитах, а именно алгоритм CST, описанный в разделе 2.1.
Первый алгоритм для автоматизированного расчета BF на основе систем контроля версий был предложен Зазворкой и соавторами (10), в котором каждый разработчик, внесший изменения в файл, независимо от количества коммитов, считается автором этого файла. Более того, для поиска BF они рассматривают каждую комбинацию разработчиков в диапазоне от 1 до (общее количество разработчиков). BF — это наибольшая комбинация разработчиков, которую проект может потерять, при условии, что оставшиеся разработчики все еще обладают знаниями хотя бы о части файлов проекта. Поскольку алгоритм проверяет каждую комбинацию, в (11) показано, что он масштабируется максимум до 30 разработчиков. Также в (2) упоминается, что этот алгоритм не завершал работу на проектах даже после выполнения в течение более трех дней. Следовательно, мы не включили этот алгоритм в наше исследование, так как общее количество разработчиков во всех наших проектах превышает 30..
3. Дизайн исследования
В следующих подразделах мы подробно обсудим базу данных проектов GitHub, которую мы используем в данном исследовании, алгоритмы bus factor, которые мы реализуем, и то, как мы валидируем результаты bus factor. Для алгоритма RIG мы выполнили экспериментальные запуски в Google Colaboratory и на сервере.
3.1. База данных с данными GitHub для HPC-проектов и другие метрики
В данной работе мы использовали данные GitHub из пяти проектов программного обеспечения с открытым исходным кодом для высокопроизводительных вычислений (HPC). В таблице 1 представлены некоторые подробности об этих проектах. Данные GitHub для ряда проектов с открытым исходным кодом, включая эти, были сохранены, систематизированы и проанализированы нами в базе данных SQL для использования в различных исследовательских проектах. База данных содержит вычисления для количества измененных строк кода (LOCC) и косинусной разности изменений кода (change-size-cos), которые используются для расчета коэффициента автобуса (bus factor) в нашем исследовании для алгоритма CST..
Как упоминалось в разделе 2, алгоритмы AVL и CST основаны на коммитах. Однако коммиты не являются отличной метрикой для оценки владения кодом. Одной из причин является различие в стилях программирования у разных людей: некоторые часто делают коммит после каждого небольшого изменения, в то время как другие предпочитают делать коммит один раз после завершения задачи. Более того, подход, основанный на коммитах, будет считать коммит, состоящий из удалений, равным коммиту с добавлениями, независимо от фактического вклада (4). Также удаление лишает разработчика авторства определенного фрагмента кода и, следовательно, снижает уровень знаний разработчика..
При использовании LOCC каждый файл анализируется на основе количества строк, внесенных автором в коммит. Однако этот метод также учитывает добавление и удаление пустых строк или комментариев как значимый вклад. Для косинусного различия изменений используется пакет textdistance на языке Python, позволяющий исследовать текстовые различия. Он добавляет все слова из измененных строк в банк слов, размещает добавленные слова в столбце, а удаленные — в строке. Затем он сравнивает столбцы и строки и присваивает числовое значение того, насколько сильно была изменена строка. Учитывая это, изменение имени переменной будет считаться очень малым изменением согласно косинусной метрике, но может оказаться более значительным изменением согласно LOCC. Следовательно, использование косинусного различия между измененными строками кода учитывает только тот вклад, который оказывает реальное влияние на файлы, что дает всестороннее понимание вклада разработчика..
Авторы алгоритма RIG приводят аналогичное обоснование отказа от подхода, основанного на коммитах, и вместо этого отмечают, что подход, основанный на blame, позволяет им изучать владение кодом с большей детализацией (4).
Входные данные cMetric, cstMetric, timeRange (opt.), directory (opt.), branch(es) (opt.) Результат primaryDev, secondaryDev, busFactor
3.2. Реализация алгоритмов фактора автобуса
После изучения литературы по алгоритму CST (1), мы стремились применить этот алгоритм к двум новым метрикам. Перед этим мы решили вычислить BF для выбранных нами проектов, используя инструменты, предоставленные авторами алгоритма CST. Для расчета BF проекта требуются два инструмента, предоставленных авторами. Первый называется Gitana11 1 https://github.com/valeriocos/Gitana, который импортирует все данные из репозитория GitHub в базу данных SQL, а затем экспортирует их в файл JSON (12). Второй инструмент, веб-инструмент для расчета bus factor22 2 https://github.com/SOM-Research/busfactor, принимает файл JSON в качестве входных данных и вычисляет BF на основе выбранной метрики CST и пороговых значений. Стоит отметить, что экспорт данных из базы данных с помощью Gitana занимает значительно больше времени, чем импорт данных из GitHub. Например, запуск Gitana для наименьшего проекта, Hypre, занял более 8 часов.
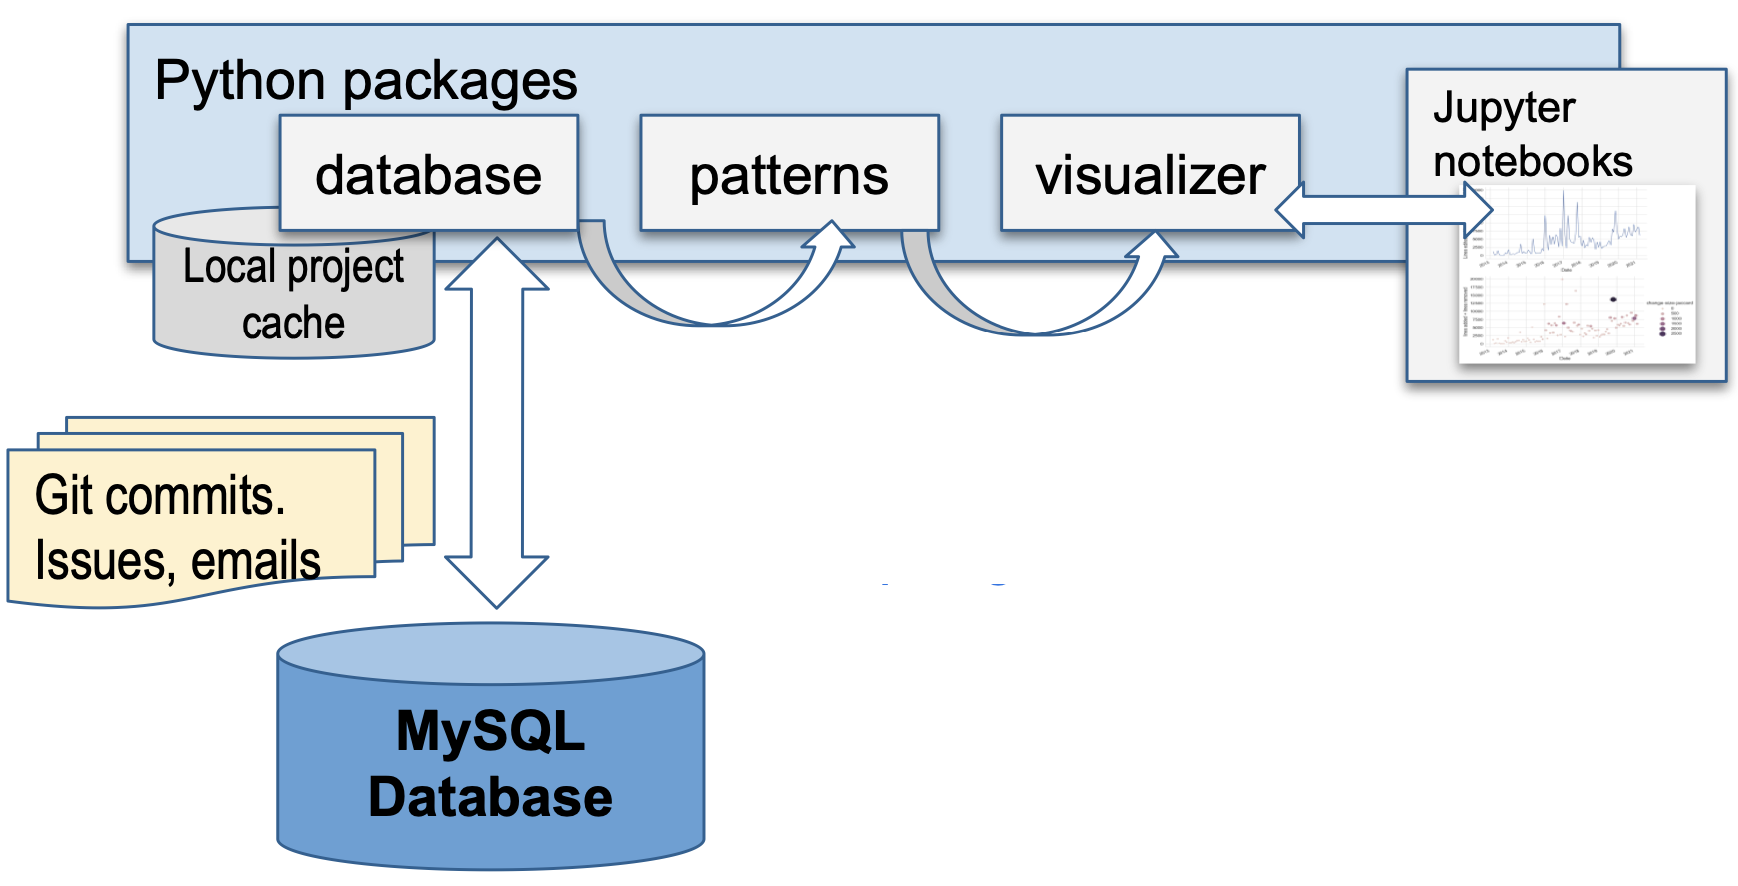
Более того, мы реализовали алгоритм CST как часть программного обеспечения для анализа и интеллектуального анализа репозиториев Git (GReMCat)33 3 https://github.com/HPCL/ideas-uo. Проект реализации полной программной инфраструктуры можно увидеть на Рисунке 1. Алгоритм CST реализован в пакете patterns и может быть использован из Jupiter Notebook44 4 https://tinyurl.com/CSTnotebook путем вызова объекта визуализатора. Авторы CST не предоставляют псевдокод для предложенного ими алгоритма в своей статье (1). Мы реализовали его на основе пояснений в (1) и (2), а его псевдокод для нашей реализации метрики равного учета множественных изменений представлен в Алгоритме 2. Вместо использования количества коммитов мы использовали значения LOCC или change-size-cos для каждого коммита, которые предварительно вычисляются в нашей базе данных. Алгоритм позволяет пользователю вводить ветку, каталог, период времени, метрику CST и предлагаемые метрики данных, которые они хотят использовать для расчета BF. Периодом времени может быть год-год, месяц-месяц, конкретный год или месяц.
Как упоминалось в разделе 2.2, алгоритм RIG не основан на коммитах, и из-за размера и постоянно меняющегося характера данных git blame мы не храним их в нашей базе данных. Фактически, мы реализовали RIG, представленный в алгоритме 1, за пределами GReMCat и выполнили его для выбранных нами проектов в Google Colaboratory и на сервере. Авторы алгоритма RIG не предоставляют общедоступный инструмент или его код, но его было довольно легко понять и реализовать на основе их объяснения в (4), а также используя псевдокод, предоставленный в (2).
3.3. Обработка внешнего кода и псевдонимов
GReMCat уже содержал реализацию удаления внешнего кода и библиотек из данных коммитов проектов в базе данных на основе имен директорий. Мы использовали её для алгоритма CST и применили ту же методологию к алгоритму RIG. Более того, GReMCat использует пакет Python fuzzywuzzy (13) для идентификации множества различных имен и адресов электронной почты, связанных с одним и тем же автором. Мы использовали эту реализацию как для алгоритмов CST, так и для RIG для обработки псевдонимов.
| Project | Key developers | Loss tolerance |
|---|---|---|
| PETSc | 7 | 4 |
| Hypre | 17 | 3 |
| Lammps | 4 | - |
| NWChem | 4 | 2 |
3.4. Валидация результатов фактора автобуса
Для проверки результатов показателя Bus Factor мы связались с основными разработчиками пяти проектов по электронной почте и задали им три вопроса: (а) Можете ли вы оценить общее число ключевых разработчиков в проекте? Если ваша оценка относится к определенному периоду времени, пожалуйста, укажите годы. (б) Кого вы считаете своими главными контрибьюторами в целом или за определенный период времени (пожалуйста, укажите годы)? (в) Какое количество ключевых разработчиков вы могли бы потерять (в худшем случае), чтобы проект все еще продолжал успешно функционировать? Мы получили ответы от четырех проектов из пяти, при этом некоторые предпочли не называть разработчиков. Полученные нами ответы приведены в таблице 2, где ключевые разработчики соответствуют ответам на пункт (а), а толерантность к потерям соответствует ответам на пункт (с).
Кроме того, мы также использовали инструмент, предоставленный авторами алгоритма CST, для получения результатов BF для проектов. Нам удалось выгрузить данные GitHub в файлы JSON для трех проектов, при этом результаты BF были получены только для двух из них. Инструменты продолжали выполняться для более крупных проектов, таких как PETSc(5) и Lammps(8), в течение более 48 часов, не выдавая результатов.
| Project | CST (cos) | CST (LOCC) | RIG | CST (commits) |
|---|---|---|---|---|
| PETSc | 32 | 28 | - | - |
| Hypre | 12 | 10 | 29 | 5 |
| Lammps | 24 | 23 | - | - |
| NWChem | 13 | 13 | - | 7 |
| Spack | 211 | 172 | - | - |
4. Результаты
В этом разделе сначала мы сравниваем результаты ⟦BROKEN_K0⟧ на уровне проекта и директории для двух алгоритмов с отзывами, полученными от ведущих разработчиков, и сопоставляем результаты различных метрик ⟦BROKEN_K1⟧. Во-вторых, мы рассматриваем динамику значений bus factor за последние пять лет. Наконец, мы анализируем производительность алгоритма ⟦BROKEN_K2⟧, сравнивая его результаты на уровне директорий.
4.1. Сравнение точности результатов
В этом подразделе мы отвечаем на первый из исследовательских вопросов, который фокусируется на влиянии различных метрик на вычисление фактора автобуса. Факторы автобуса, рассчитанные по алгоритму CST с использованием наших предложенных метрик данных, инструменту CST, предоставленному авторами (на основе коммитов), и нашей реализации алгоритма RIG, представлены в таблице 3. Приведенные значения основаны на метрике mul-changes-equal CST. Инструменту для алгоритма CST потребовалось более 8 часов для получения результатов по каждому из двух проектов: Hypre и NWChem. Вызовы к базе данных SQL, содержащей данные о коммитах, привели к превышению времени ожидания для остальных трех проектов из-за их большого объема. Более того, алгоритм RIG вернул фактор автобуса только для проекта Hypre, который является наименьшим по количеству файлов и, следовательно, по данным git-blame. Для проектов с большим количеством файлов и авторов алгоритм продолжал выполнение более 24 часов. Таким образом, отсутствующие результаты в таблице 3 подчеркивают ограничения алгоритма RIG и инструментов алгоритма CST при работе с проектами большого размера..
Как упоминалось в Разделе 3.4, для точности результатов и валидации значений bus factor в Таблице 3 мы связались с ведущими разработчиками каждого из проектов и записали их ответы в Таблицу 2. Сравнивая значения bus factor в Таблице 2 и 3, можно заметить, что значения, предоставленные разработчиками, не полностью совпадают со значениями ни одного из алгоритмов. Тем не менее, погрешность для проекта Hypre, которая рассчитывается следующим образом:
| (1) |
является наименьшим для CST-алгоритма на основе change-size-cos () и LOCC (), реализованного в рамках данного исследования. для CST-алгоритма на основе коммитов (1) и алгоритма RIG (4). Наконец, мы рассмотрели результаты работы CST-алгоритма на основе коммитов и заметили, что они не совпадают с пороговыми значениями, упомянутыми в (1) для основных и второстепенных разработчиков, отсюда и высокое значение ошибки.
Наряду с сопоставлением значений коэффициента bus factor, мы также оценили точность каждого алгоритма в определении разработчиков, которые входят в состав этого коэффициента. Лишь главные разработчики проектов Lammps и NWChem поделились именами участников, составляющих bus factor. Из соображений конфиденциальности мы не будем публиковать эти имена в данной статье. Тем не менее, по результатам нашего сравнительного исследования мы можем утверждать, что разработчики, указанные главными разработчиками для обоих проектов (Lammps и NWChem), находятся на вершине отсортированного списка для алгоритмов change-size-cos и CST на основе LOCC. Главный разработчик, определенный инструментом в (1) для NWChem, даже не входит в число разработчиков, названных главным разработчиком NWChem. Это показывает, что порог для основных и второстепенных разработчиков в (1) не является оптимальным, а также что алгоритм change-size-cos и CST на основе LOCC обладает большей точностью. RIG показал худший результат, правильно определив лишь 5 разработчиков из 12 (для change-size-cos) или 5 из 10 (для LOCC) для проекта Hypre. Важно отметить, что пять проектов, выбранных для этого исследования, являются крупными по количеству файлов, числу разработчиков, коммитов и данных git-blame. Это подчеркнуло ограничение (12), (14) и (15) при работе с крупными проектами на GitHub, поскольку для трех более крупных проектов результаты возвращены не были.
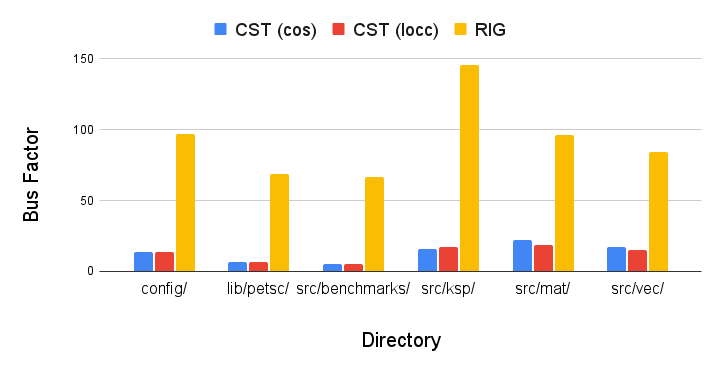
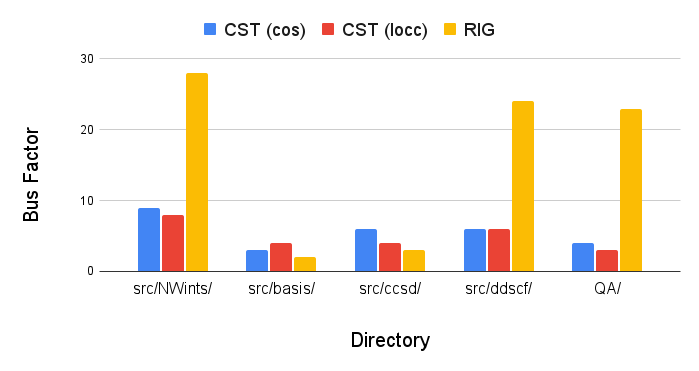
На рисунке 2 мы исследуем bus factor для наиболее недавно обновленных директорий проектов PETSc и NWChem. Мы сравниваем значения bus factor алгоритма change-size-cos и CST на основе LOCC с алгоритмом RIG. Можно отчетливо видеть, что результаты алгоритма RIG существенно отличаются и выше не только алгоритма CST, но и данных, предоставленных ведущими разработчиками проектов. Следовательно, мы обнаружили, что алгоритм RIG демонстрирует наихудшую производительность.
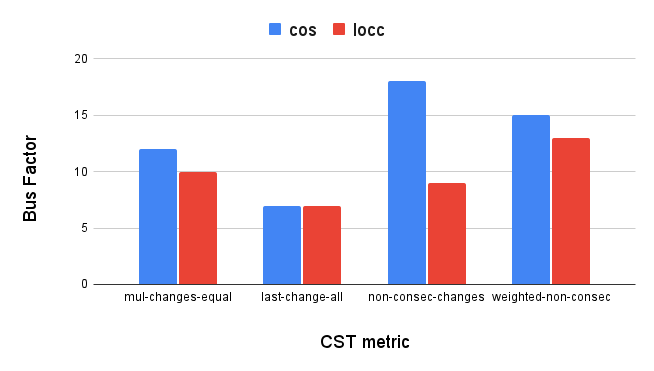
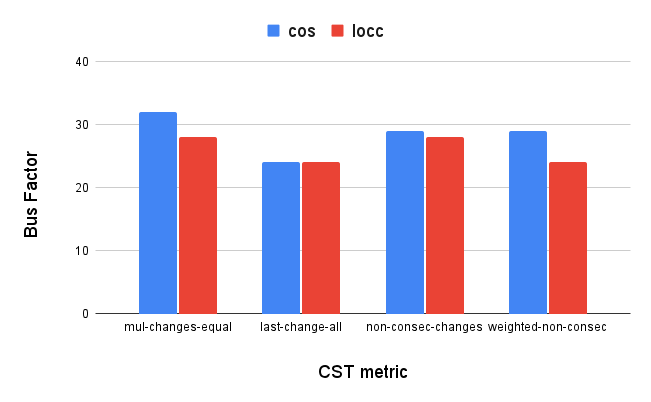
Кроме того, мы представляем сравнительные графики для четырех метрик алгоритма CST, описанных в Разделе 2.1, а также двух метрик данных change-size-cos и LOCC на Рисунке 3 для Hypre и PETSc. Из графиков видно, что результаты для каждой комбинации существенно не варьируются. Учитывая эту информацию, мы сосредоточили наше исследование на метрике mul-changes-equal. Однако, как упомянуто в (1), метрика CST может быть выбрана в соответствии с требованиями и процессами, используемыми организацией для контроля версий.
4.2. Динамика коэффициентов автобусного фактора во времени
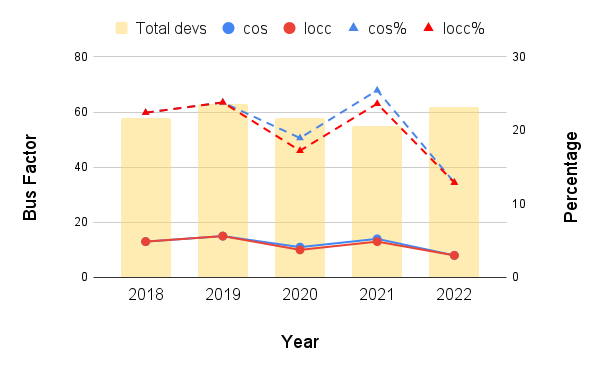
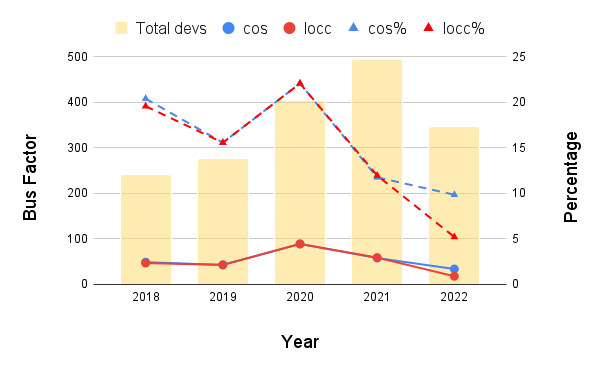
В этом подразделе мы стремимся найти ответ на второй исследовательский вопрос, а именно о роли bus factor в управлении распределением усилий при найме и передаче знаний. Намерение состоит в том, чтобы изучить применимость bus factor и те рекомендации, которые эти результаты дают ключевым разработчикам и менеджерам. Интуитивно понятно, что bus factor проекта или директории будет указывать на концентрацию знаний у определенного количества людей. Если это число невелико, то ключевые разработчики или менеджеры проектов могут работать над распределением усилий по найму новых людей для работы над этим проектом. Еще одна вещь, которую можно сделать, это обеспечить передачу знаний другим разработчикам внутри организации. Для нашего исследования мы рассмотрели динамику изменения bus factor за последние пять лет для выбранных проектов. На рисунке 4 показана динамика bus factor с 2018 года для PETSc и Spack. Желтые полосы представляют общее количество разработчиков; левая ось y вместе с сплошными линиями представляет значение bus factor, в то время как правая ось y и штриховые линии предназначены для процентного соотношения разработчиков, которые входят в состав bus factor. Для обоих проектов мы можем видеть, что количество разработчиков с более глубокими знаниями проектов уменьшается в последние годы, достигая минимального значения в 2022 году. Знание этой тенденции может помочь ключевым разработчикам или менеджерам нанять новых людей или инициировать процесс передачи знаний другим существующим разработчикам для этих проектов.
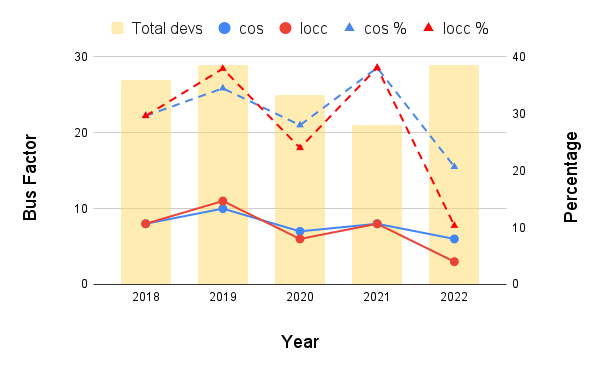
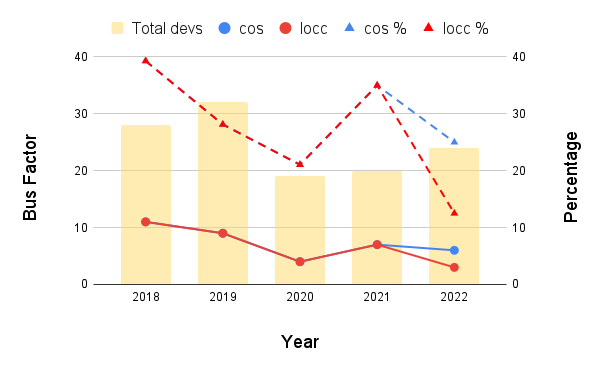
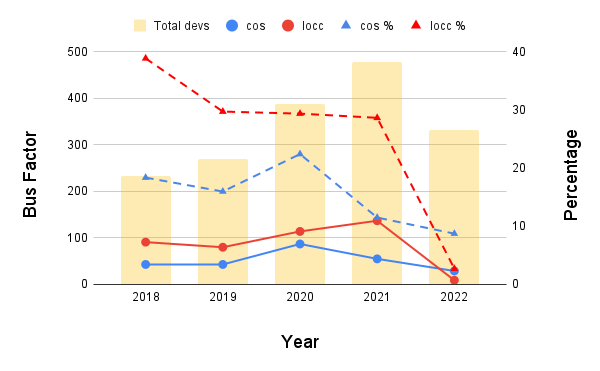
Иногда анализ динамики bus factor для всего проекта в целом не дает наилучшего представления о концентрации знаний и рисках проекта с точки зрения текучести кадров. Учитывая это, более полезным является рассмотрение отдельных каталогов или важных частей проектов. На рисунке 5 показана динамика значений bus factor для основных каталогов PETSc и Spack. Такой детализированный взгляд позволяет принимать более обоснованные решения в отношении ключевых частей проектов. На рисунке 5 (c) отчетливо видно резкое падение значения bus factor для каталога var/spack/ проекта, которое невозможно заметить при общем обзоре, представленном на рисунке 4 (b).
4.3. Сравнение производительности алгоритмов BF
Данный подраздел посвящен ответам на исследовательский вопрос о точности результатов и производительности алгоритмов bus factor. Для этого мы хотели рассмотреть каждый алгоритм, чтобы сравнить и сопоставить результаты. Большая часть этого вопроса освещена для алгоритма CST в разделе 4.1, где мы сравнили результаты алгоритма CST с RIG, используя рисунок 2, поэтому здесь мы сосредоточились на алгоритме RIG и его недетерминированной природе.
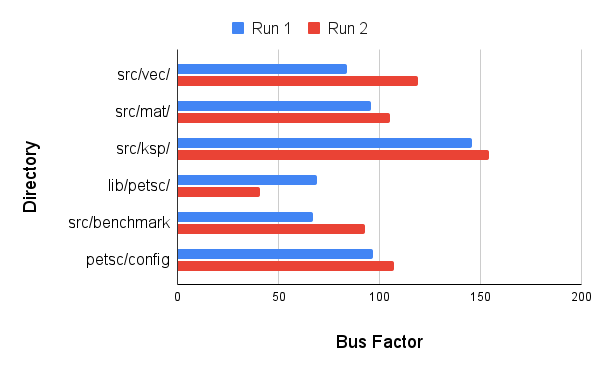
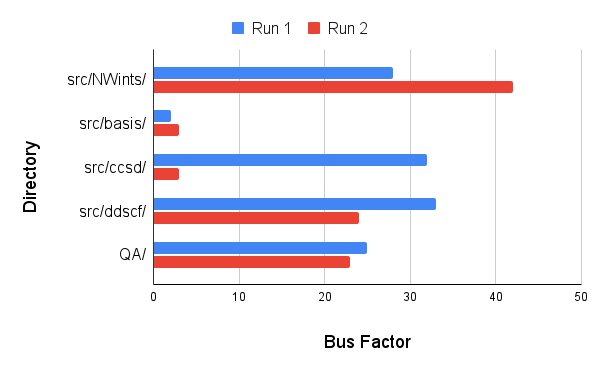
Как упоминалось в разделе 2.2, алгоритм RIG является недетерминированным, то есть он не дает одинаковых результатов при разных запусках. Мы собрали данные по двум запускам для различных директорий пяти проектов, чтобы увидеть вариативность результатов работы алгоритма RIG. На рисунке 6 мы показываем результаты для двух проектов, PETSc и NWChem. Видно, что ни один из запусков не привел к одинаковому результату ни для одной из директорий. Разница значительна для некоторых из них, включая petsc/src/vec в (a) и nwchem/src/ccd в (b). Мы также изучили имена разработчиков, полученные в результате работы алгоритма для каждого запуска, и не обнаружили общей закономерности сходства между результатами, что дополнительно подтверждает случайный характер алгоритма RIG.
Недетерминированная и случайная природа алгоритма RIG автоматически делает алгоритм CST лучшим выбором. Это дополнительно подтверждается ответами ведущих разработчиков, как показано в Таблице 3, и меньшими ошибками для алгоритма CST. Более того, Ригби с соавторами сами утверждают в (4), что сценарии фактора автобуса, рассчитанные с использованием процентов потерь, нереалистичны.
5. Будущие направления работы
У этой работы много перспективных направлений. Один из способов продолжить ее — изучить влияние различных пороговых значений для алгоритмов с предлагаемыми метриками данных. Поскольку авторы алгоритмов CST и RIG не обосновывают выбор всех выбранных пороговых и отсечных значений, это может стать интересным исследованием. Полученные результаты могут помочь сделать более осознанный выбор этих значений с приведением обоснований. Кроме того, использование более ориентированного на данные подхода для валидации результатов с помощью обученных моделей machine learning может помочь устранить угрозы достоверности процесса валидации. Большой объем извлеченных данных из GitHub может быть использован в целях обучения..
6. Заключение
Для проектов с открытым исходным кодом характерно сталкиваться с риском ухода ключевых разработчиков из проекта. Этот риск еще выше в долгосрочных и крупных проектах. Чтобы оценить риск, создаваемый для проектов, или его серьезность, можно измерить концентрацию знаний среди его разработчиков. Это измерение известное как фактор автобуса проекта, и существует несколько алгоритмов, предложенных для его расчета. Большинство этих алгоритмов используют данные коммитов из систем контроля версий. Мы предложили использовать две другие метрики, а именно: строки измененного кода и косинусную разницу строк кода и протестировали их с алгоритмом CST. Мы также использовали алгоритм RIG на основе git-blame для нашего прецедента из пяти высокопроизводительных вычислительных проектов на GitHub. Наряду с полными проектами, мы также рассмотрели значения фактора автобуса основных каталогов в каждом из них. Мы провели сравнительное исследование точности, сходства результатов и тенденции значений фактора автобуса по двум алгоритмам, а также предложенным нами метрикам. Мы подтвердили наши результаты у главных разработчиков выбранных проектов, которые показали, что метрики строк измененного кода и косинусная разница строк кода более точны, чем коммиты. Наша реализация алгоритма CST является масштабируемой по сравнению с доступными в сети инструментами Косентино и др. Наконец, мы продемонстрировали на примерах, как изучение динамики изменения значений фактора автобуса с течением времени может помочь основным разработчикам в распределении усилий.
Ссылки
- ⟦[1] Валерио Косентино, Хавьер Кановас Искьердо и Хорди Кабот. Оценка фактора автобуса git-репозиториев. 03 2015.
- ⟦[2] Мивиан Феррейра, Марко Тулио Валенте и Кесия Феррейра. Сравнение трех алгоритмов для вычисления коэффициентов критической зависимости (truck factors). В материалах 25-й Международной конференции IEEE/ACM по пониманию программ (ICPC) 2017 года, страницы 207–217, 2017.
- ⟦[3] Г. Авелино, Л. Пассос, А. Хора и М. Валенте. Новый подход к оценке коэффициента автобуса. В материалах 2016 IEEE 24th International Conference on Program Comprehension (ICPC), страницы 1–10, Лос-Аламитос, Калифорния, США, май 2016 г. IEEE Computer Society.
- ⟦[4] Питер К. Ригби, Юэ Цай Чжу, Сэмюэл М. Донаделли и Одриc Моккус. Количественная оценка и смягчение последствий потери знаний, вызванной текучестью кадров: тематические исследования Chrome и проекта в Avaya. В материалах 38-й Международной конференции по программной инженерии, ICSE ’16, страницы 1006–1016, Нью-Йорк, штат Нью-Йорк, США, 2016. Ассоциация вычислительной техники.
- ⟦[5] Проект Petsc. Доступно онлайн по адресу: https://github.com/petsc/petsc.
- ⟦[6] Проект Spack. Доступно онлайн по адресу: https://github.com/spack/spack.
- ⟦[7] Проект Hypre. Доступно онлайн по адресу: https://github.com/hypre-space/hypre.
- ⟦[8] Проект Lammps. Доступно онлайн по адресу: https://github.com/lammps/lammps.
- ⟦[9] Проект Nwchem. Доступно онлайн по адресу: https://github.com/nwchemgit/nwchem⟧.
- ⟦[10] Нико Зазворка, Кай Штапель, Эрик Кнаусс, Форрест Шулл, Виктор Р. Базили и Курт Шнайдер. Соответствуют ли разработчики процессу: исследование методологии XP. В трудах Международного симпозиума ACM-IEEE 2010 года по эмпирической инженерии программного обеспечения и измерениям, ESEM ’10, Нью-Йорк, штат Нью-Йорк, США, 2010 год. Ассоциация вычислительной техники.
- ⟦[11] Филиппо Рикка, Алессандро Маркетто и Марко Торкиано. О сложности вычисления фактора грузовика. том 6759, страницы 337–351, 06 2011.
- ⟦[12] Валерио Косентино, Хавьер Кановас Искьердо и Хорди Кабот. Gitana: инспектор программных проектов. Science of Computer Programming, 153, 12 2017.
- ⟦[13] SeatGeek Inc. fuzzywuzzy: Нечеткое сопоставление строк в Python, 2014.
- ⟦[14] Валерио Козентино, Хавьер Кановас Искьердо и Жорди Кабот. Гитана: инспектор активности проектов на основе SQL. Доступно онлайн по адресу: https://github.com/SOM-Research/Gitana.
- ⟦[15] Валерио Козентино. Анализатор фактора автобуса. Доступно онлайн по адресу: https://github.com/SOM-Research/busfactor.