Универсальное воспроизведение хаотических характеристик с помощью классического и квантового машинного обучения
Аннотация
Воспроизведение хаотических характеристик нелинейной динамики с помощью машинного обучения (ML) в последнее время привлекает широкое внимание. В данной работе мы предлагаем модель ML, обученную прогнозировать состояние на один шаг вперед на основе нескольких последних исторических состояний, которая способна точно воспроизводить бифуркационную диаграмму и показатели Ляпунова дискретных динамических систем. Характеристики для различных значений гиперпараметров универсально охватываются единой моделью ML, в то время как в предыдущих работах рассматривалось обучение модели ML независимо путем фиксации гиперпараметров на конкретных значениях. Наши тесты на одномерных и двумерных логистических отображениях показывают, что вариационные квантовые схемы могут воспроизводить долгосрочные характеристики с более высокой точностью, чем long short-term memory (хорошо известная классическая модель ML). Наша работа выявляет существенное различие между ML для хаотических характеристик и ML для стандартных задач с точки зрения взаимосвязи между производительностью и сложностью модели. Наши результаты показывают, что модель квантовых схем демонстрирует потенциальные преимущества в снижении переобучения, достигая более высокой точности и стабильности..
Введение.— В какой степени модель машинного обучения (ML) может обучаться на динамических данных хаотической системы? Хаос относится к кажущемуся беспорядочным, но детерминированному поведению динамических систем Kantz and Schreiber 2004; Strogatz 2018, которое проявляется в широком спектре реалистичных сценариев, считающихся высоконелинейными (таких как рост популяции May 1976 и атмосфера Lorenz 1963). Хаотическая система обладает рядом экзотических свойств, включая высокую чувствительность к начальным условиям и возмущениям Kantz and Schreiber 2004; Strogatz 2018. Это делает прогнозирование временных рядов (TPS), особенно после длительной эволюции, практически невыполнимым.
Машинное обучение продемонстрировало свою эффективность как мощный подход для прогнозирования временных рядов. Например, нейронные сети, такие как широко признанные сети долгой краткосрочной памяти (LSTM) Hochreiter and Schmidhuber 1997; Yu et al. 2019 и модели transformers, разработанные совсем недавно Vaswani et al. 2017, демонстрируют отличные результаты, например, в прогнозировании погоды Bi et al. 2023; Chen et al. 2023. Прогнозирование временных рядов на основе машинного обучения для хаотических систем включает две ключевые проблемы: (i) краткосрочное прогнозирование состояний системы Pathak et al. 2018; Herzog et al. 2019; Borra et al. 2020 и (ii) долгосрочное прогнозирование/воспроизведение статистических/эргодических динамических характеристик Pathak et al. 2017; Lu et al. 2018; Antonik et al. 2018; Fan et al. 2020; Sun et al. 2023. Сосредоточившись на второй проблеме, предыдущие работы в основном пытались выполнить воспроизведение путем фиксации гиперпараметров динамической системы на определенных значениях (см., например, ссылки Pathak et al. 2017; Lu et al. 2018; Antonik et al. 2018). Использование единой модели машинного обучения для универсального охвата характеристик при изменении гиперпараметров в нетривиальном диапазоне представляет собой более сложную и важную задачу, которая остается открытой..
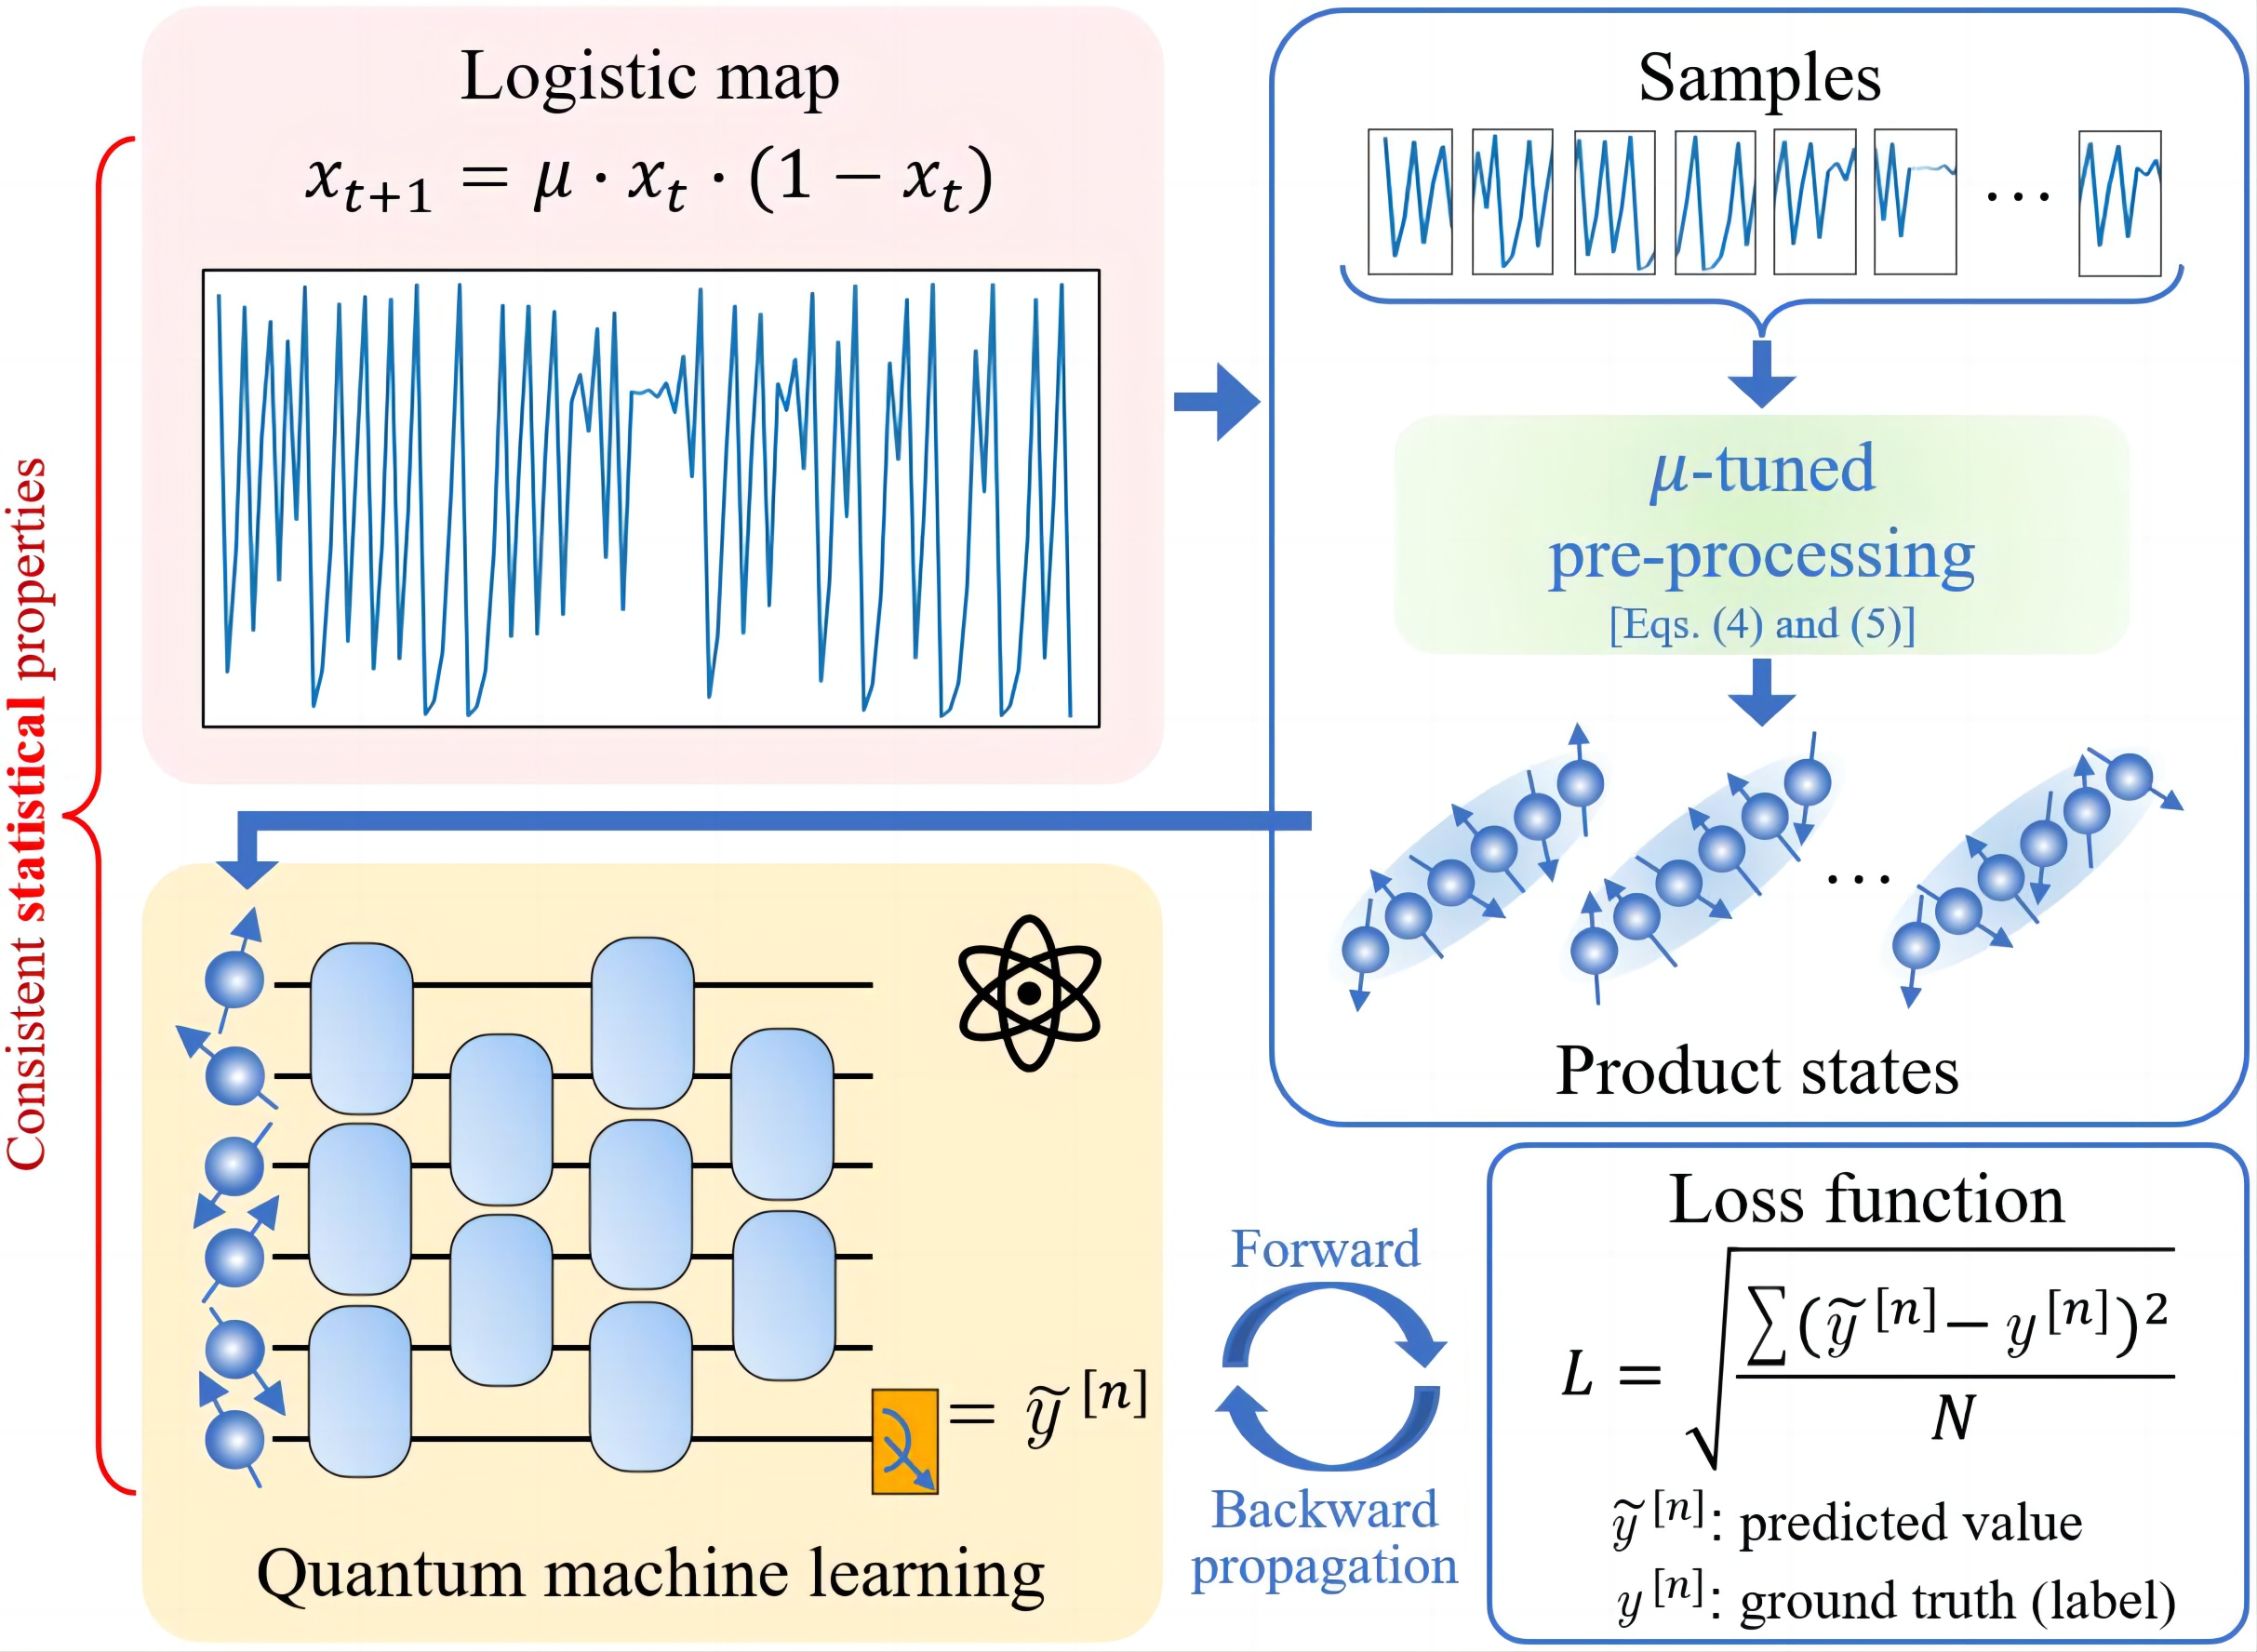
В данной работе мы показываем, что модель ML, обученная предсказывать состояние на один шаг вперед на основе последних исторических состояний, способна воспроизводить долгосрочные хаотические характеристики дискретных динамических систем. Мы используем как классические, так и квантовые модели ML, а именно LSTM Hochreiter and Schmidhuber 1997; Yu et al. 2019 и вариационную квантовую схему Peruzzo et al. 2014; Cerezo et al. 2021 (в частности, автоматически дифференцируемую квантовую схему Zhou et al. 2021, сокращенно ADQC), для обучения на одномерных и двумерных логистических отображениях May 1976; Yuan et al. 1983; Ferretti and Rahman 1988. Долгосрочные характеристики, включая бифуркационную диаграмму и показатели Ляпунова, моделируются путем итерации отображения ML в течение достаточного количества шагов. Эти характеристики, для которых гиперпараметр логистического отображения варьируется от устойчивых до хаотических областей, успешно воспроизводятся единой моделью ML..
Наши результаты показывают, что повышение сложности модели, как правило, не дает положительного эффекта для улучшения точности воспроизведения долгосрочных характеристик из-за высокой чувствительности к переобучению. ADQC достигает значительно более высокой точности и стабильности, чем LSTM, особенно при воспроизведении показателей Ляпунова. Эти результаты демонстрируют обоснованность и потенциальное преимущество моделей квантовых схем в снижении переобучения при воспроизведении хаотических характеристик..
Классическое и квантовое машинное обучение для прогнозирования временных рядов.— Динамическая система в общем виде может быть записана как отображение , где называется состоянием системы в (дискретный) момент времени . Здесь мы берем в качестве примера одномерное логистическое хаотическое отображение, которое является фундаментальной нелинейной динамической системой (см. верхнюю левую панель рис. 1), имеющей широкое применение в понимании хаотических явлений и генерации случайных чисел May 1976. Отображение удовлетворяет
| (1) |
с гиперпараметром.
Модель ML также по сути является отображением. Рассматривая прогнозирование состояния на один шаг вперед на основе последних исторических состояний, отображение ML можно формально записать как
| (2) |
где обозначает все вариационные параметры модели ML. Временной ряд, генерируемый динамической системой , используется для обучения модели ML. Соответственно, выборка ML представляет собой фрагмент временного ряда с данными о состояниях, а меткой этой выборки является истинное значение состояния на один шаг вперед, заданное , то есть . Состояние в выборке также называется признаком на языке ML.
Модель ML может быть обучена путем минимизации ошибки прогнозирования на так называемых обучающих выборках. Мы дискретизируем гиперпараметр на 50 различных значений в диапазоне . Для каждого значения мы генерируем 2000 выборок в качестве обучающего набора, где каждая выборка получается путем итеративного применения динамического отображения к случайному состоянию раз. Вариационные параметры оптимизируются путем минимизации среднеквадратичной ошибки (RMSE)
| (3) |
где обозначает предсказание ML модели для -го образца, обозначает истинное значение (метку этого образца), а суммирование по охватывает весь обучающий набор. Метод градиентного спуска используется для обновления вариационных параметров как , где — малая положительная константа, известная как градиентный шаг или скорость обучения..
Мы здесь рассматриваем LSTM и ADQC для ML. LSTM — это признанная классическая модель ML для TSP. Она относится к разновидностям рекурсивных нейронных сетей Lipton et al. 2015; Salehinejad et al. 2018 и решает проблемы исчезающих и взрывающихся градиентов путем введения так называемых функций вентилей. ADQC относится к вариационным квантовым схемам. Ее главное преимущество заключается в универсальном способе параметризации квантовых вентилей, благодаря чему нет необходимости указывать типы (вращение, фазовый сдвиг, контролируемое НЕ и т. д.) вентилей, а нужно лишь спроектировать структуру схемы. Мы используем структуру «кирпичной стены», как показано на нижней левой панели рис. 1. Прогноз получается путем измерения последнего кубита квантового состояния после реализации ADQC.
Для универсального воспроизведения характеристик динамической системы с изменяющимся гиперпараметром [скажем, в уравнении (1)] с использованием единой ML модели, мы предлагаем внедрить обучаемую предварительную обработку, настраиваемую с помощью , для выборок перед их подачей в ML модель. Наша идея заключается в отображении каждого признака (который является скаляром) в вектор посредством обучаемого отображения, настраиваемого с помощью , скажем , где — это -й признак -й выборки, а — заданная размерность. Таким образом, выборка отображается в набор векторов. Заметим, что как LSTM, так и ADQC могут принимать набор векторов в качестве входных данных..
Карта предварительной обработки также зависит от некоторых вариационных параметров, которые будут оптимизированы на этапе обучения. Мы определяем карту предварительной обработки здесь как
| (4) |
-мерный тензор будет оптимизирован при обучении ML модели. Векторы и , которые оба являются -мерными, получаются с помощью следующего отображения, преобразующего скаляр в нормализованный вектор Stoudenmire and Schwab 2016. Для заданного скаляра (скажем, ), -й элемент результирующего вектора удовлетворяет
| (5) |
Параметр также будет оптимизирован (независимо от и выборок) на этапе обучения. Заметим, что поскольку обучающие выборки получены из динамики, принимающей различные значения , следует принять в уравнении (4) равным соответствующему значению для -й выборки.
Отображение предварительной обработки может быть обобщено до динамической системы, которая содержит несколько переменных и гиперпараметров. Мы всегда можем использовать Eq. (5) и отобразить эти переменные (гиперпараметры) в несколько -мерных векторов. Более подробную информацию о наборе данных и ML моделях, включая предварительную обработку, прямое и обратное распространение, прогнозирование и настройки гиперпараметров, можно найти в приложениях..
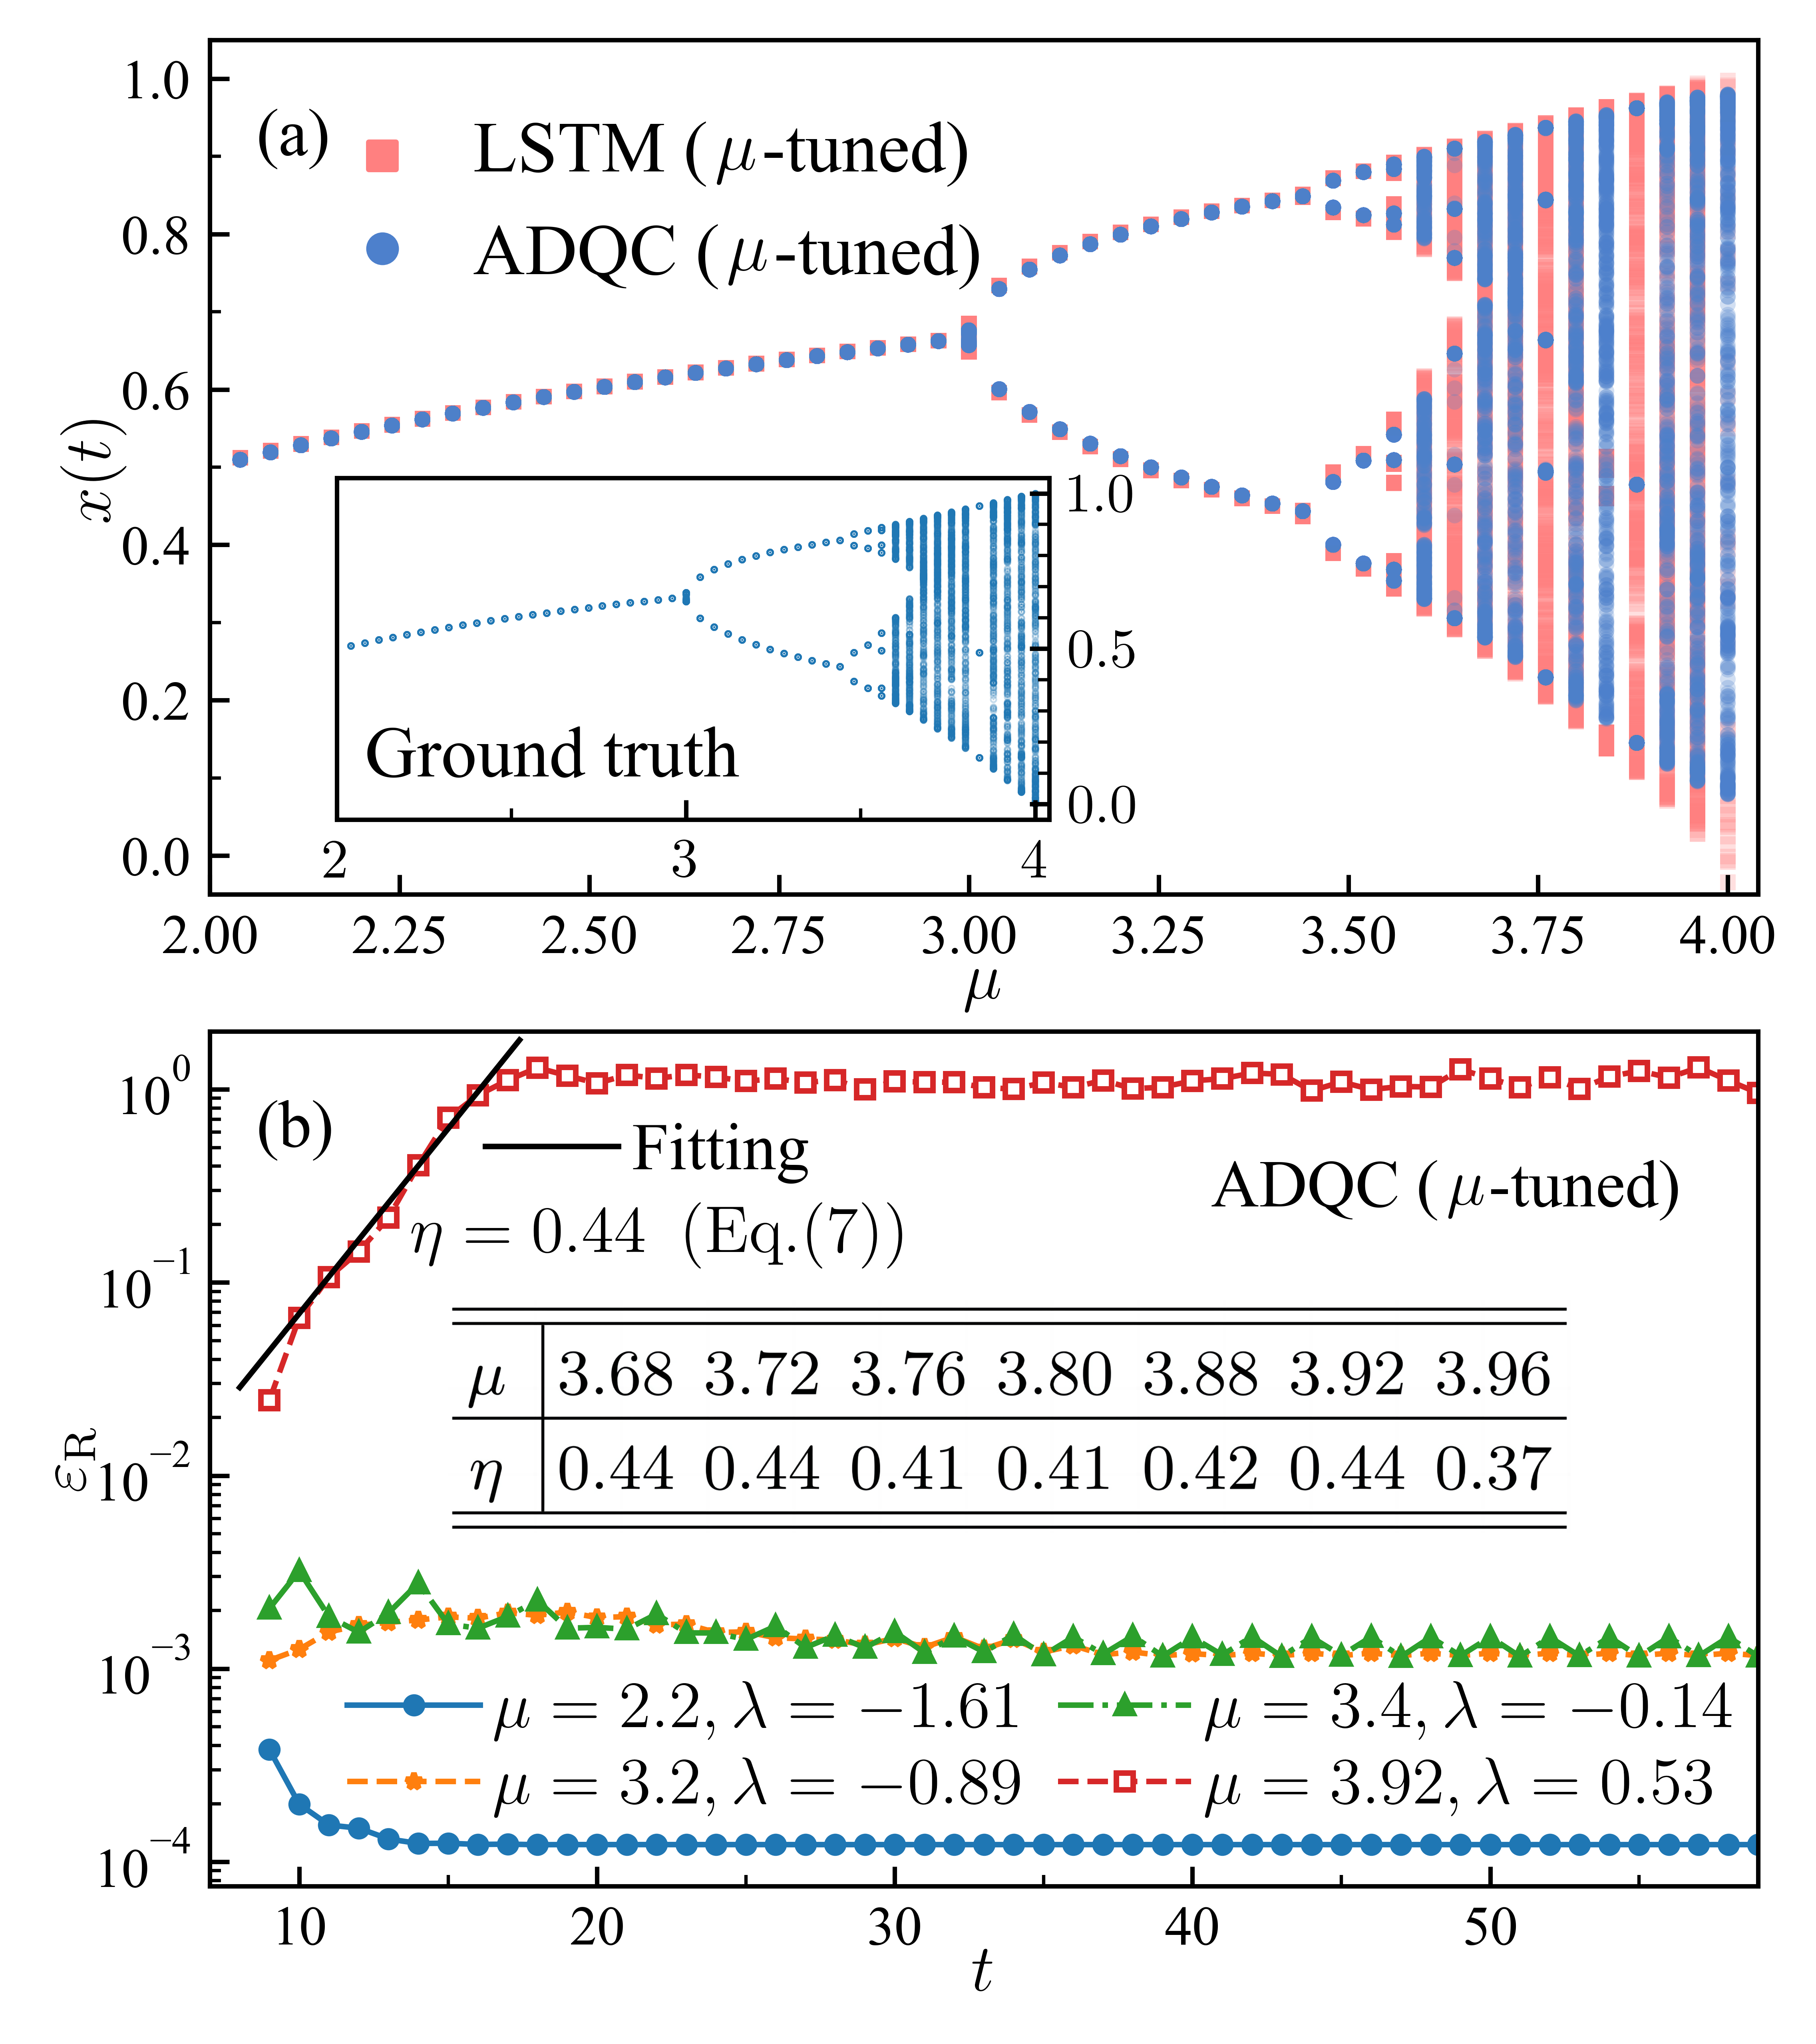
Численные результаты и обсуждения.— На рис. 2 продемонстрирована способность LSTM и ADQC к прогнозированию состояний с различными значениями . На (а) представлены диаграммы бифуркаций, полученные с помощью ADQC и LSTM, которые согласуются с диаграммой, полученной для логистического отображения (см. врезку). Каждая точка данных на диаграммах получена путем итерации отображения (логистического отображения или отображений моделей ML) более 200 раз (что является достаточно большим числом), начиная со случайного состояния. Мы берем 500 случайных состояний для каждого значения , которые отличаются от состояний в обучающей выборке. Плотность точек данных обозначена интенсивностью цвета. Заметим, что мы определяем выборки, сгенерированные этими начальными состояниями, как тестовый набор. Поскольку эти выборки не используются для обучения модели ML, тестовый набор используется для выявления так называемой способности к обобщению, которая относится к эффективности модели ML при работе с неизученными выборками..
Сходство между двумя бифуркационными диаграммами может быть охарактеризовано с помощью пикового отношения сигнала к шуму (PSNR) , которое широко используется в области компьютерного зрения для характеристики сходства между двумя изображениями Kotevski and Mitrevski 2010. Мы получили и путем сравнения эталонной диаграммы, полученной с помощью логистического отображения, с диаграммами, полученными с помощью LSTM и ADQC соответственно. Такая согласованность между бифуркационными диаграммами не требует точного прогнозирования состояний, но требует достоверности точного воспроизведения распределения состояний после долгосрочной эволюции..
На рис. 2(b) мы показываем относительную ошибку для ADQC в зависимости от дискретного времени для различных значений . Заметим, что модели ML всегда обучаются для прогнозирования состояния на один шаг вперед. Суммирование в проводится по тестовой выборке. Различные значения выбраны таким образом, чтобы система находилась в областях сходимости (), бифуркации (), квадрифуркации () и хаоса (). Значения показателя Ляпунова (LE) Parker and Chua 2012; Moon 2008 приведены в легенде, который вычисляется как
| (6) |
В наших численных симуляциях мы берем , что является достаточно большим.
Наши результаты показывают, что для прогнозирования состояния в сходящихся и бифуркационных областях (с отрицательным LE), ADQC может успешно предсказывать состояние системы после длительной эволюции с относительной ошибкой . Когда система находится в хаотической области (с положительным LE), предыдущие работы указывают на то, что прогнозирование состояния справедливо в течение короткого промежутка времени, обычно характеризуемого временем Ляпунова Bezruchko and Smirnov 2010. Наши результаты показывают, что растет экспоненциально с , прежде чем сходится к , что подчиняется
| (7) |
Таблица на рис. 2(b) показывает, что показатель экспоненты составляет около . Заметим, что система является хаотической для Andrecut 1998.
Вышеприведенные результаты демонстрируют способность моделей ML воспроизводить характеристики вместо прогнозирования состояний. Такая способность дополнительно подтверждается сравнением LE одномерного логистического отображения и отображений ML (обученных LSTM и ADQC), как показано на рис. 3 (a). LE моделей ML получается путем замены дифференциального члена в уравнении 6 на при .
Значения LE при различных , полученные с помощью LSTM и ADQC с предварительной обработкой, настроенной по (зеленая и синяя линии с символами), согласуются со значениями, полученными с помощью логистического отображения (эталонные данные, показанные красной сплошной линией). Для сравнения, гораздо худшее соответствие достигается стандартной LSTM без предварительной обработки, настроенной по (черная штрихпунктирная линия). Это демонстрация улучшения, достигнутого благодаря нашей предварительной обработке, настроенной по . Две горизонтальные полосы указывают, дает ли LSTM и ADQC, настроенные по , LE с правильным (зеленый) или неправильным (красный) знаком. В целом точность воспроизведения знака LE высока. Неправильные знаки появляются в хаотической области.
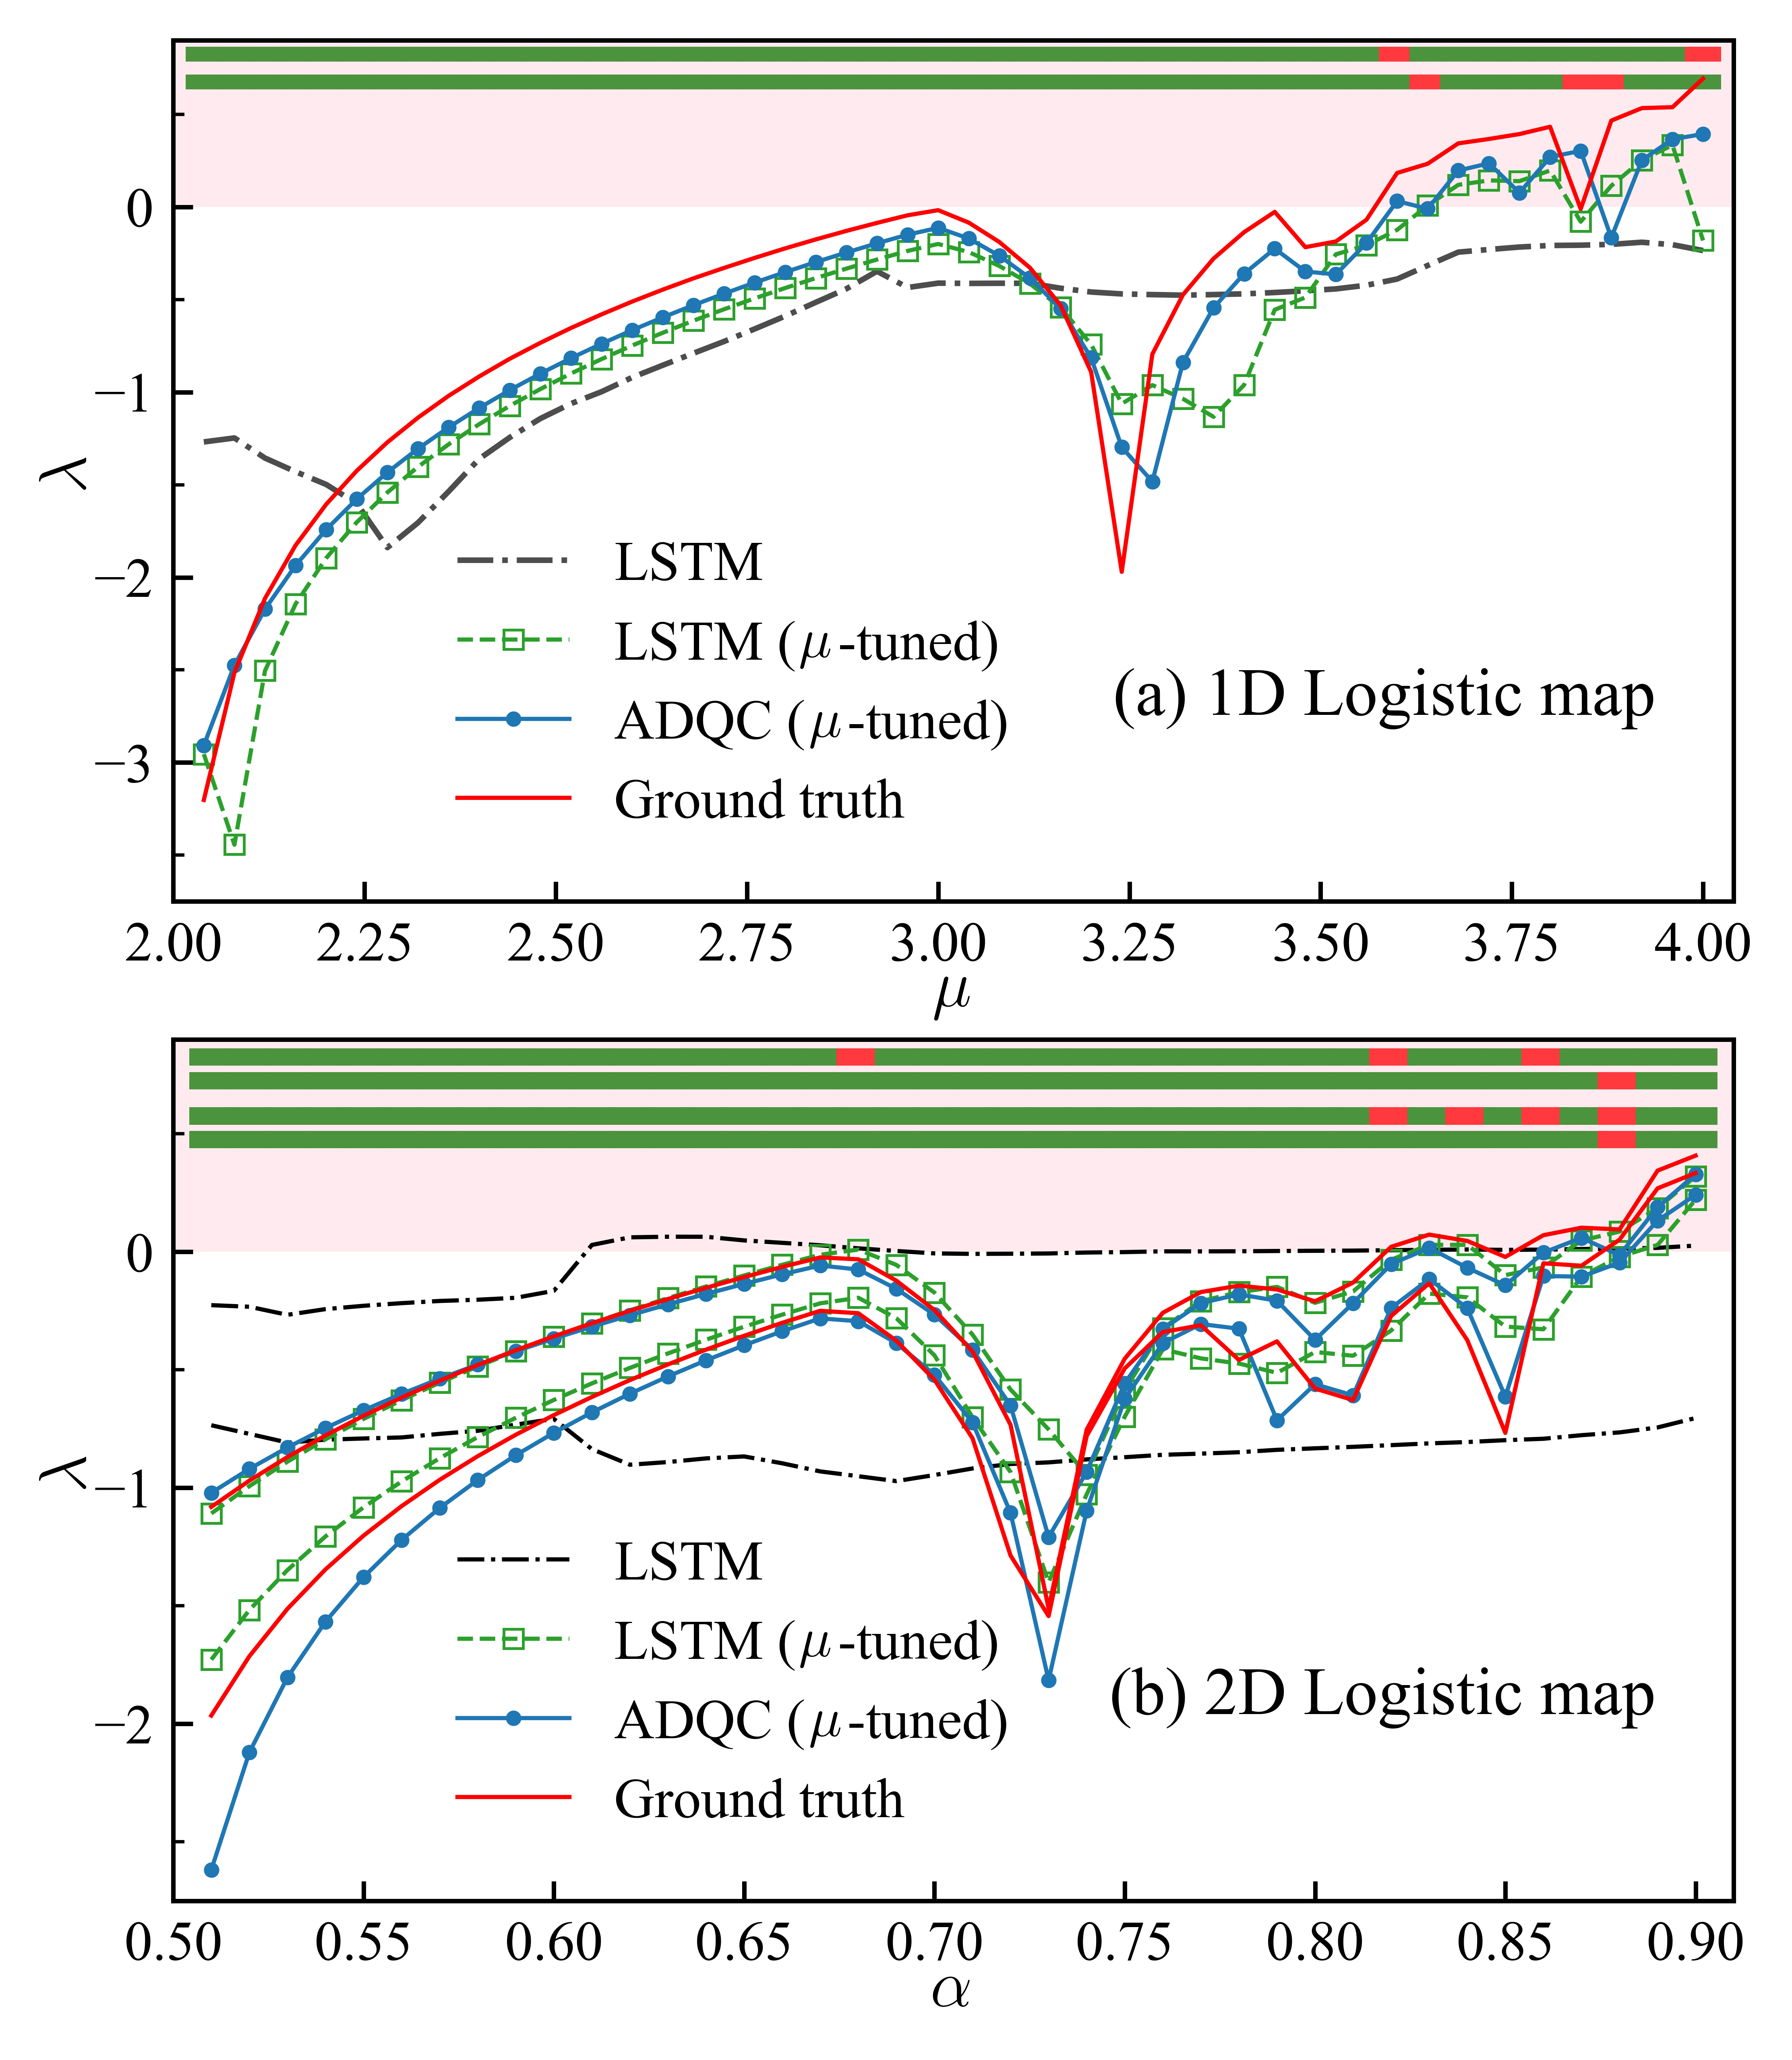
Аналогичные результаты получены для двумерного (2D) логистического отображения [см. рис. 3 (b)], которое представляет собой более сложную нелинейную систему с более богатым динамическим поведением за счет включения члена линейной связи Yuan et al. 1983; Ferretti and Rahman 1988. Две переменные отображаются как
Мы берем и фиксируем для простоты. Определены два показателя Ляпунова. Очевидно, что воспроизведение показателей Ляпунова двумерного логистического отображения является гораздо более сложной задачей, чем в одномерном случае. Следовательно, LSTM без предварительной обработки, настроенной с помощью , становится практически неэффективной. Благодаря предварительной обработке, настроенной с помощью , ADQC достигает более высокой точности, чем LSTM..
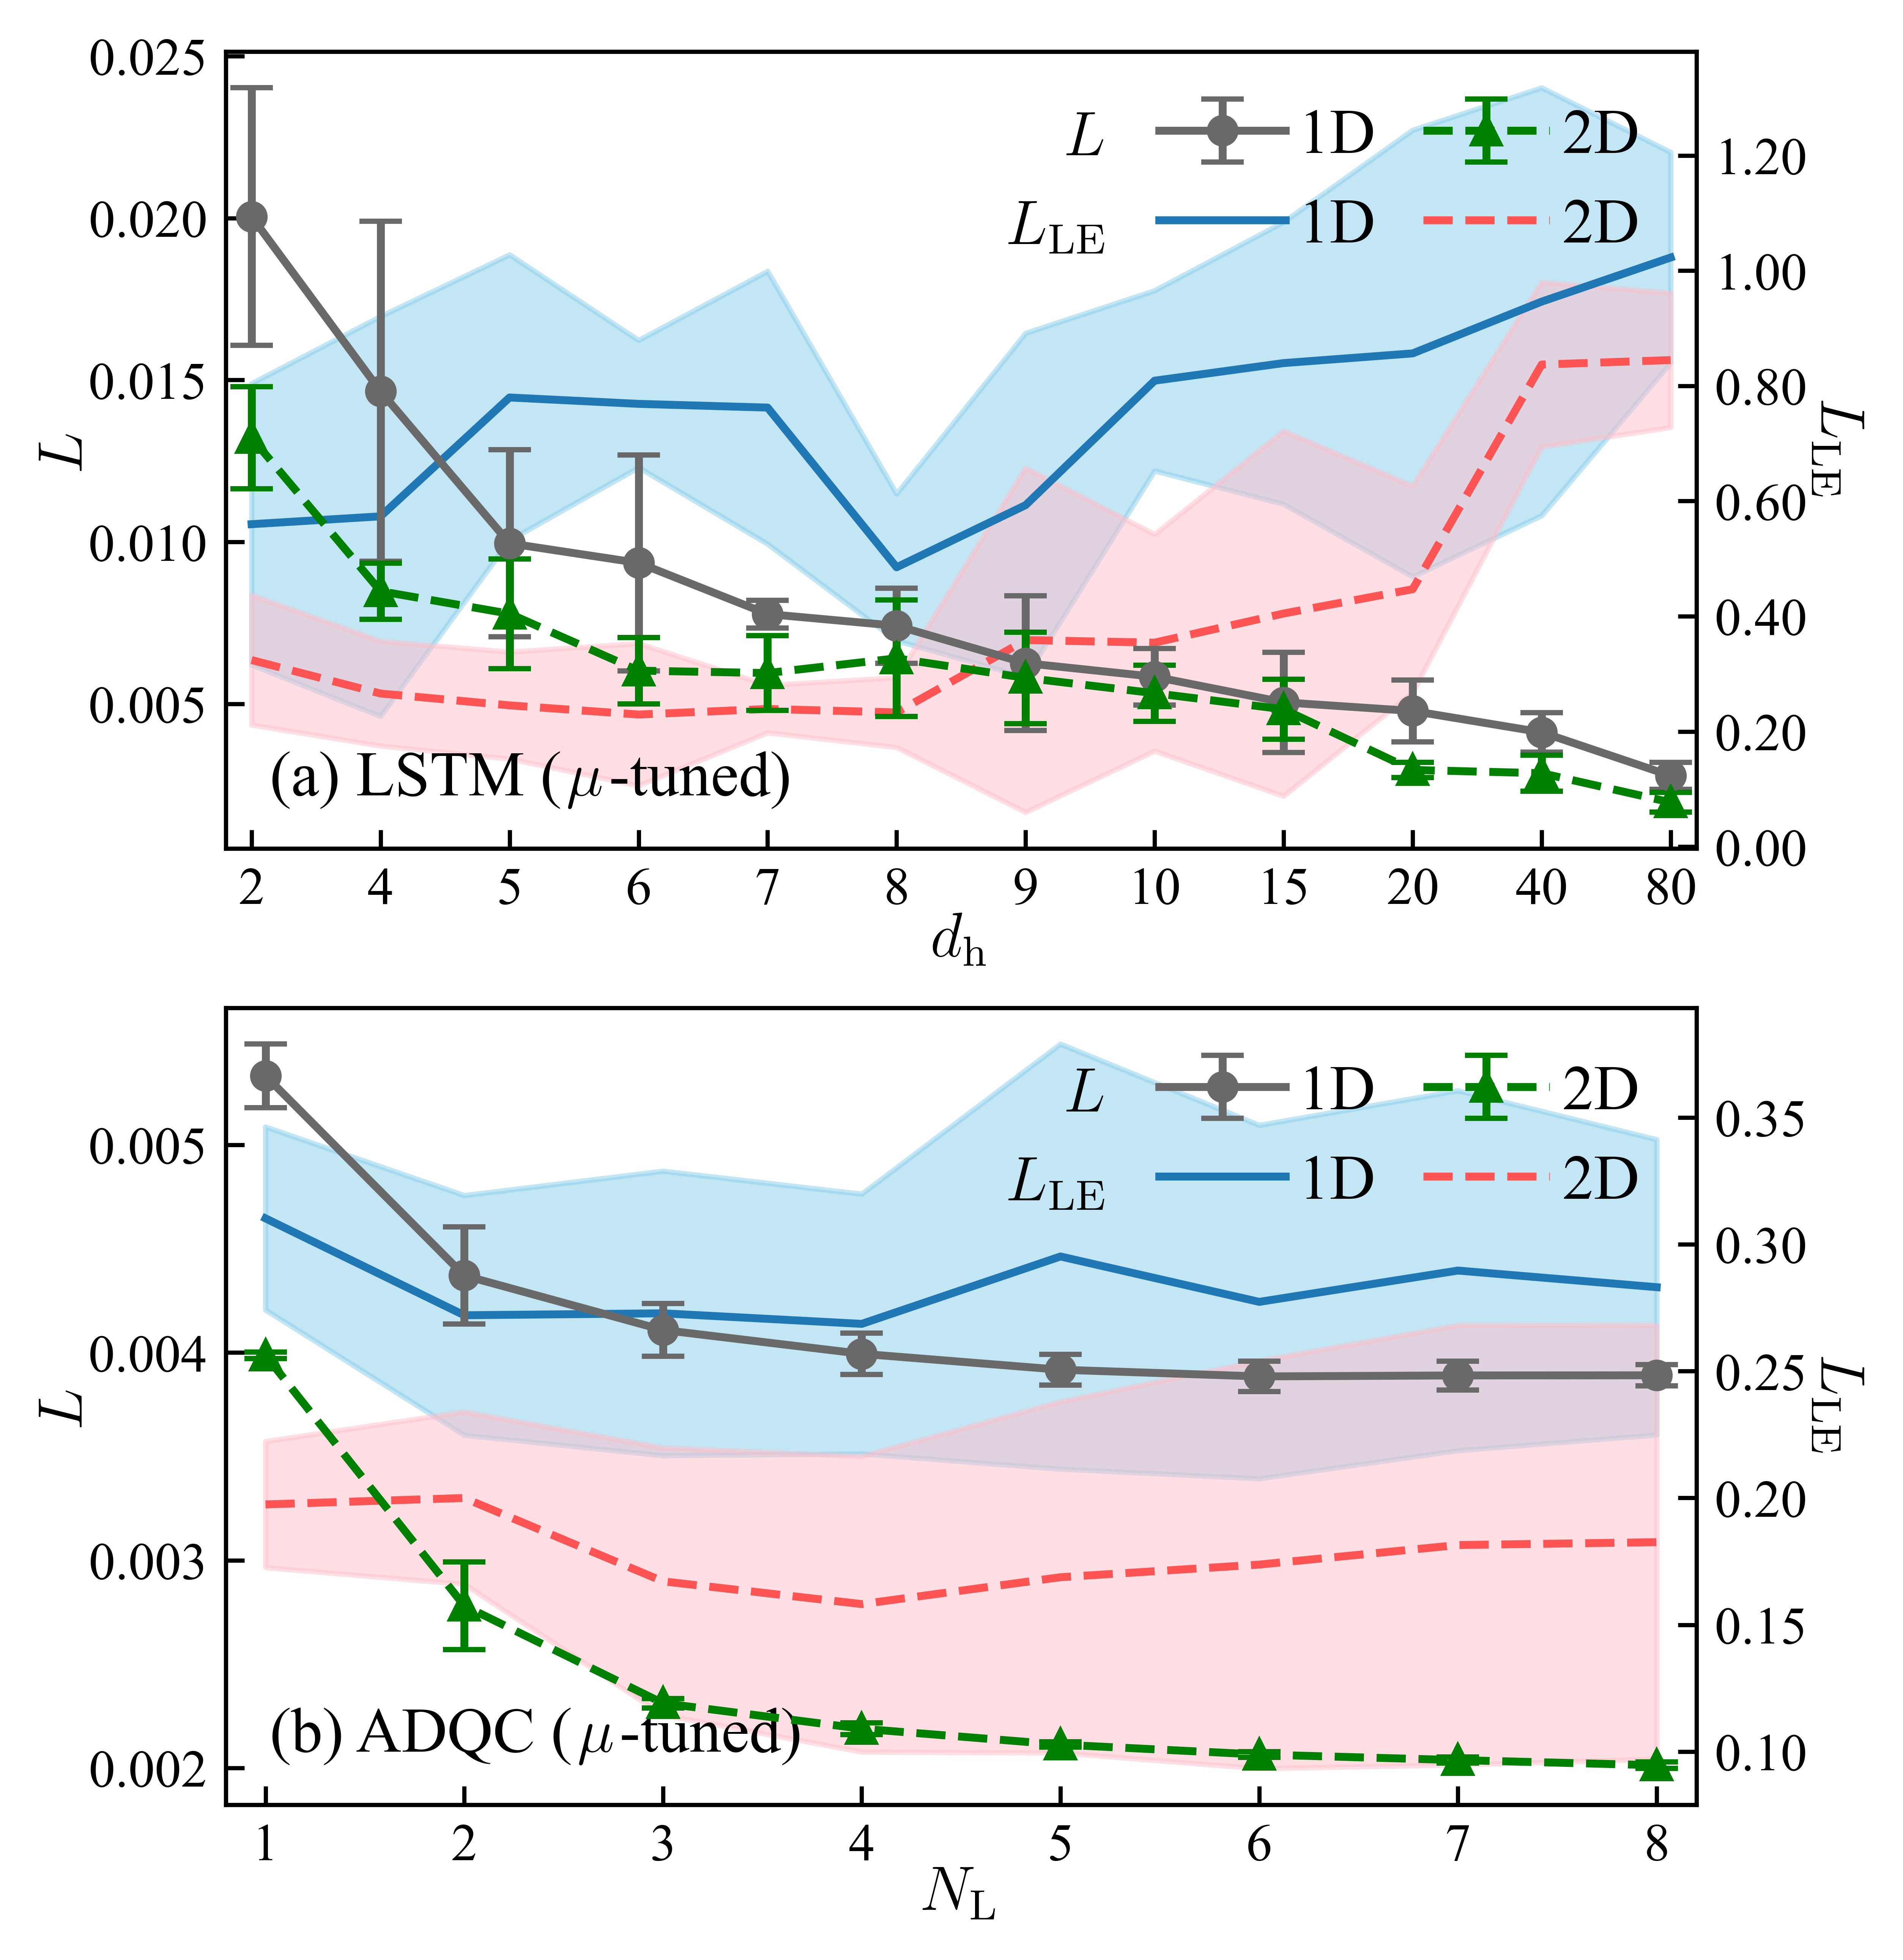
Обычный способ улучшения производительности модели машинного обучения заключается в увеличении ее сложности. Однако такой подход, возможно, не сработает в нашем случае. Следует отметить, что, хотя динамическая система может содержать лишь небольшое количество гиперпараметров (например, один параметр в одномерном логистическом отображении), изучение ее динамики является серьезной проблемой, и ключевым фактором, определяющим производительность модели машинного обучения при воспроизведении долгосрочных характеристик, не должна быть сложность ее параметров. Мы ожидаем высокую чувствительность к проблеме переобучения..
Рис. 4 подтверждает это ожидание. Увеличение сложности параметров, как правило, снижает ошибку при краткосрочном прогнозировании (например, при предсказании состояния на один шаг вперед). Для одномерных и двумерных логистических отображений на рис. 4 (a) показано, что RMSE [Уравнение (3)], полученное с помощью LSTM, постепенно уменьшается примерно с до при увеличении скрытой размерности с до . Аналогичное наблюдение получено для ADQC, где снижается примерно до (для одномерного логистического отображения) или (для двумерного логистического отображения) при увеличении количества слоев схемы до ⟧.
Среднеквадратичная ошибка показателя Ляпунова (обозначенного как ) ведет себя иначе, чем ошибка . вычисляется так же, как , с использованием определения среднеквадратичной ошибки [Eq. (3)]. Для LSTM колеблется примерно в диапазоне . Увеличение для LSTM не позволяет повысить точность воспроизведения показателя Ляпунова. Для ADQC, хотя мы не наблюдаем явного снижения при увеличении , изменяется гораздо более плавно, примерно в диапазоне (), что значительно ниже, чем у LSTM. Заметим, что все данные на рис. 4 вычислены с использованием тестового набора..
Наши результаты показывают, что ключом к повышению точности прогнозирования долгосрочных динамических характеристик является разработка моделей ML, которые лучше справляются с переобучением. Это отличается от задач ML, таких как классификация и краткосрочное прогнозирование, где точность обычно можно повысить за счет увеличения сложности модели. Наша работа демонстрирует превосходную способность вариационных квантовых схем смягчать переобучение, что согласуется с предыдущими исследованиями по другим, но релевантным темам, таким как генерация изображений Han et al. 2018; Cheng et al. 2019 и сжатие моделей Gao et al. 2020; Qing et al. 2023. Для сравнения, LSTM страдает от серьезной проблемы переобучения, хотя эта модель широко признана мощной, обладающей замечательной способностью к обобщению и незначительной проблемой переобучения при решении многих других задач ML..
Аннотация.— В данной работе раскрывается способность моделей машинного обучения (ML), обученных прогнозировать состояние на один шаг вперед на основе определенных исторических данных, воспроизводить долгосрочные характеристики дискретных динамических систем. В сравнении с предыдущими работами, характеристики при различных значениях гиперпараметров универсально воспроизводятся единой моделью ML. Наши результаты указывают на высокую чувствительность к проблеме переобучения при воспроизведении долгосрочных динамических характеристик. На примере одномерных и двумерных логистических отображений показано, что вариационные квантовые схемы демонстрируют превосходную эффективность при воспроизведении бифуркационной диаграммы и показателей Ляпунова. Наши выводы дополняют потенциальные преимущества моделей квантовых схем в достижении высокой точности и стабильности для задач ML, чувствительных к переобучению..
Благодарности. SCB выражает признательность Qing lv, Peng-Fei Zhou, Yong Qing, Zhang-Xu Chen, Guo-Dong Cheng, Ke Li, Rui Hong, Ying Lu, Yi-Cheng Tang и Yu-Jia An за полезные дискуссии. Данная работа была частично поддержана NSFC (грант № 12004266), Пекинским фондом естественных наук (грант № 1232025), Тяньцзиньским фондом естественных наук Китая (грант № 20JCYBJC00500) и Академией междисциплинарных исследований Столичного педагогического университета..
Appendix A Детали набора данных и предварительной обработки
В качестве примера мы рассматриваем одномерное (1D) логистическое отображение . Мы берем гиперпараметр , варьирующийся от до , и дискретизируем его до значений с интервалом . Для каждого значения мы случайным образом генерируем 3000 обучающих выборок и 500 тестовых выборок. Каждая выборка (скажем, ) генерируется путем реализации динамического отображения для случайно взятого начального состояния (скажем, ) в течение раз. Таким образом, выборка содержит признаков с , где означает реализацию в течение раз.
Модель ML обучается прогнозировать значение из этой выборки. Истинное значение (сгенерированное самой динамической системой) называется меткой -го образца. Для различных независимых симуляций мы случайным образом берем обучающих выборок из обучающего набора для каждого значения , чтобы обучить модели ML. Если не указано иное, мы берем , и все данные, такие как бифуркационная диаграмма и показатели Ляпунова в основном тексте, вычисляются с использованием тестового набора..
Вводится предварительная обработка с настройкой для отображения каждого образца в набор векторов. В частности, -й признак -го образца отображается в вектор как , где размерность является предустановленным гиперпараметром. В результате образец отображается в векторов.
Мы определяем отображение предварительной обработки как зависящее от и некоторых вариационных параметров, которые будут оптимизированы на этапе обучения. Здесь отображение предварительной обработки [см. также Ур. (4) основного текста] определяется как
| (11) |
-мерный тензор и скаляр являются вариационными параметрами, которые оптимизируются на этапе обучения. Векторы и , каждый из которых является -мерным, получаются с помощью следующего отображения, преобразующего скаляр в нормализованный вектор [также см. Eq. (5) основного текста]. Для заданного скаляра (скажем, ), -й элемент результирующего вектора удовлетворяет
| (12) |
Поскольку мы обучаем модель машинного обучения с различными значениями , следует принять за соответствующее значение для -го образца.
Для двумерного логистического отображения мы принимаем гиперпараметр как дискретные значения от до с интервалом . Для каждого значения мы случайным образом генерируем 3000 обучающих выборок и 500 тестовых выборок. Поскольку оно содержит две переменные ( и ), мы определяем -й образец как и принимаем в наших симуляциях. Предварительная обработка отображения применяется аналогичным образом для преобразования признаков в образце в векторы .
Appendix B Автоматически дифференцируемая квантовая схема для прогнозирования временных рядов
Входные данные квантовой схемы с автоматическим дифференцированием (ADQC) Zhou et al. 2021 обычно представляют собой квантовое состояние из кубитов. С помощью описанной выше предварительной обработки выборка отображается в набор векторов, а именно из в . Эти векторы затем отображаются в произведение состояний как
| (13) |
Другими словами, элементы удовлетворяют ⟧.
ADQC представляет собой унитарное преобразование (обозначаемое как ), которое отображает входное состояние в конечное состояние, обычно являющееся запутанным. Формально мы имеем для состояния, соответствующего выборке , где можно рассматривать как -мерную унитарную матрицу. Для вариационной квантовой схемы, включающей ADQC, записывается как произведение нескольких локальных гейтов. Как показано на нижней левой панели рис. 1 основного текста, мы выбираем гейты, являющиеся двухчастичными, которые представляют собой -мерные унитарные матрицы (обозначаемые как для , где — общее количество гейтов).
Для одномерного логистического отображения прогноз от ADQC задается измерением конечного состояния , удовлетворяющим
| (14) |
В квантовом языке — это вероятность проецирования последнего кубита в состояние спин-вверх. Для одномерного логистического отображения предсказания двух переменных определяются как
| (15) | |||||
| (16) |
Это вероятности проецирования предпоследнего и последнего кубитов на состояние спин-вверх соответственно.
Для ADQC каждый унитарный вентиль параметризуется -мерной матрицей, называемой латентными вентилями (обозначаются как ). Иными словами, латентные вентили являются вариационными параметрами ADQC. Чтобы удовлетворить условию унитарности , латентные вентили отображаются в унитарные вентили посредством сингулярного разложения (SVD) как
| (17) | |||
| (18) |
Основное преимущество ADQC заключается в том, что любой унитарный вентиль может быть параметризован одинаковым образом с помощью матрицы (латентного вентиля) тех же размерностей. Следовательно, нам нужно лишь задать структуру схемы, такую как размерности вентилей (например, количество спинов, на которые воздействует один вентиль, и количество уровней для каждого спина) и способы их соединения друг с другом. Для других моделей вариационных квантовых схем необходимо дополнительно указывать типы вентилей (такие как вентили вращения и фазового сдвига). Различные типы вентилей параметризуются разными способами Gill et al. 2022.
Скрытые вентили (и все остальные вариационные параметры) обновляются методом градиентного спуска на этапах обучения, как с в качестве скорости обучения. Мы выбираем в качестве среднеквадратичной ошибки (см. Eq. (3) основного текста). Поскольку отображение из скрытых вентилей в унитарные вентили является дифференцируемым, можно использовать стандартную технику обратного распространения ошибки в ML для получения градиентов..
Appendix C Показатель Ляпунова
Показатель Ляпунова Parker and Chua 2012; Moon 2008 является важной мерой для описания хаотической природы динамической системы. Он отражает скорость экспоненциального роста малых возмущений в системе, количественно определяя чувствительность к начальным условиям и усиление неопределенностей..
Рассмотрим дискретную динамическую систему с одной переменной (такую как одномерное логистическое отображение). Можно предположить экспоненциальную форму для разности между состояниями с возмущением начального состояния и без него, где имеет место
| (19) |
где означает рекурсивное применение отображения раз. Показатель Ляпунова определяется как экспоненциальный индекс в пределе и . В практических симуляциях показатель Ляпунова может быть вычислен как
| (20) |
путем выбора достаточно большого . В данной работе мы берем .
Для двумерного случая мы применяем метод QR-разложения Geist et al. 1990; McDonald and Higham 2001 для вычисления показателей Ляпунова. Рассмотрим отображение с двумя переменными . Отображение (которое имеет две компоненты) может быть в общем виде записано как и . Матрица Якоби в дискретный момент времени определяется как
Два показателя Ляпунова могут быть вычислены как
| (24) |
с или , и матрицей , полученной путем выполнения QR-разложения . Мы по-прежнему берем в наших симуляциях, что является достаточно большим значением.
Appendix D Пиковые отношения сигнала к шуму
Пиковое отношение сигнала к шуму (PSNR) Kotevski and Mitrevski 2010 представляет собой меру сходства между двумя изображениями (двумерными данными), которая применяется для оценки качества при шумоподавлении и сжатии. Рассматривая два изображения и , с единицей измерения в децибелах (дБ) определяется как
| (25) |
где и — ширина и длина изображений, а 255 — максимальное значение пикселя. В данной статье вычисляется с использованием полутоновых изображений, считанных как 8-битные данные. Рассматривая сжатие изображений в качестве примера, значение PSNR около дБ или выше обычно указывает на качественное сжатие Kotevski and Mitrevski 2010. Чем больше , тем ближе два изображения друг к другу.
В данной работе каждая точка данных на бифуркационной диаграмме [см. рис. 2(a) основного текста] получена путем итерации отображения (логистического отображения или отображений моделей ML) более 200 раз (что является достаточно большим числом), начиная со случайного состояния. Мы берем 500 случайных состояний для каждого значения , которые отличаются от состояний в обучающих выборках. Плотность точек данных обозначена интенсивностью цвета. PSNR используется для характеристики сходства между двумя бифуркационными диаграммами..
Appendix E Дополнительные результаты и гиперпараметры
Таблица A1 показывает RMSE для LE , полученные с помощью LSTM и ADQC на одномерных и двумерных логистических отображениях. Можно сделать три наблюдения:
- ⟦1. можно значительно уменьшить как для LSTM, так и для ADQC путем внедрения предварительно настроенного отображения предобработки;
- ⟦2. Аналогичный результат достигается на обучающей и тестовой выборках, что указывает на достаточную способность к обобщению при работе с неизученными данными;
- ⟦3. Благодаря предварительной обработке, настроенной с помощью , ADQC достигает гораздо более низкого , чем LSTM, что подразумевает, что ADQC лучше справляется с проблемой переобучения, чем LSTM. Это также согласуется с результатами, представленными в основном тексте (рис. 4).
| LSTM | LSTM () | ADQC | ADQC () | ||
| 1D | Training | 0.8278 | 0.4845 | 1.1486 | 0.2688 |
| std | 0.3193 | 0.1280 | 0.0471 | 0.0510 | |
| Testing | 0.8273 | 0.4837 | 1.1486 | 0.2686 | |
| std | 0.3190 | 0.1281 | 0.0471 | 0.0512 | |
| 2D | Training | 0.8050 | 0.2333 | 1.2195 | 0.1588 |
| std | 0.2320 | 0.0610 | 0.1389 | 0.0584 | |
| Testing | 0.8048 | 0.2332 | 1.2189 | 0.1582 | |
| std | 0.2317 | 0.0606 | 0.1388 | 0.0583 | |
Если не указано иное, настройки гиперпараметров LSTM и ADQC, используемые в данной работе, приведены в Таблице A2.
| 1D | LSTM | |
|---|---|---|
| LSTM () | ||
| ADQC | ||
| 2D | LSTM | |
| LSTM () | ||
| ADQC |
Список литературы
- ⟦Kantz and Schreiber (2004) Г. Канц и Т. Шрайбер, Нелинейный анализ временных рядов, том 7 (Издательство Кембриджского университета, 2004).
- ⟦Strogatz (2018) С. Г. Строгац, Нелинейная динамика и хаос с руководством по решению задач для студентов: С приложениями к физике, биологии, химии и инженерии (издательство Си-Ар-Си Пресс, 2018).
- ⟦May (1976) Р. М. Мэй, Простые математические модели с очень сложной динамикой, Nature 261, 459 (1976)⟧.
- ⟦Lorenz (1963) Э. Н. Лоренц, Детерминированный непериодический поток, Journal of Atmospheric Sciences 20, 130 (1963)⟧.
- ⟦Hochreiter and Schmidhuber (1997) С. Хохрайтер и Ю. Шмидхубер, Долгая краткосрочная память, Neural Computation 9, 1735 (1997)⟧.
- ⟦Yu et al. (2019) Ю. Ю, С. Си, К. Ху и Дж. Чжан, Обзор рекуррентных нейронных сетей: ячейки LSTM и архитектуры сетей, Neural Computation 31, 1235 (2019).
- ⟦Vaswani et al. (2017) А. Васвани, Н. Шазир, Н. Пармар, Дж. Ушкорейт, Л. Джонс, А. Н. Гомес, Л. у. Кайзер и И. Полосухин, Внимание — это всё, что вам нужно, в сборнике «Достижения в системах обработки нейронной информации», том 30, под редакцией И. Гайона, У. В. Люксбурга, С. Бенджио, Х. Уоллаха, Р. Фергуса, С. Вишванатана и Р. Гарнетта (Curran Associates, Inc., 2017)).
- ⟦He and Droppo (2016) Т. Хэ и Дж. Дроппо, Использование структуры lstm в глубоких нейронных сетях для распознавания речи, в 2016 IEEE international conference on acoustics, speech and signal processing (ICASSP) (IEEE, 2016) стр. 5445–5449.
- ⟦Bhaskar and M. (2023) С. Бхаскар и Т. Т. М., Модель Lstm для распознавания визуальной речи по мимике лица, Multimedia Tools and Applications 82, 5455 (2023)⟧.
- ⟦Bi et al. (2023) К. Би, Л. Се, Х. Чжан, С. Чен, С. Гу и К. Тянь, Точное среднесрочное глобальное прогнозирование погоды с помощью трехмерных нейронных сетей, Nature 619, 533 (2023).
- ⟦Chen et al. (2023) Л. Чен, Х. Чжун, Ф. Чжан, Ю. Чэн, Ю. Сюй, Ю. Ци и Х. Ли, Фуси: каскадная система машинного обучения для 15-дневного глобального прогнозирования погоды, npj Climate and Atmospheric Science 6, 190 (2023).
- ⟦Pathak et al. (2018) Дж. Патак, Б. Хант, М. Гирван, З. Лу и Э. Отт, Бесструктурное прогнозирование крупномасштабных пространственно-временных хаотических систем на основе данных: подход с использованием резервуарных вычислений, Phys. Rev. Lett. 120, 024102 (2018).
- ⟦Herzog et al. (2019) С. Херцог, Ф. Вёрготтер и У. Парлиц, Гибрид сверточного автокодировщика и условных случайных полей для прогнозирования пространственно-временного хаоса, Chaos 29, 123116 (2019).
- ⟦Borra et al. (2020) Ф. Борра, А. Вульпиани и М. Ченчини, Эффективные модели и предсказуемость хаотических многомасштабных систем с помощью машинного обучения, Phys. Rev. E 102, 052203 (2020).
- ⟦Pathak et al. (2017) Дж. Патак, З. Лу, Б. Р. Хант, М. Гирван и Э. Отт, Использование машинного обучения для воспроизведения хаотических аттракторов и вычисления показателей Ляпунова на основе данных, Chaos 27, 121102 (2017).
- ⟦Lu et al. (2018) З. Лу, Б. Р. Хант и Э. Отт, Реконструкция аттрактора с помощью машинного обучения, Chaos 28, 061104 (2018)⟧.
- ⟦Antonik et al. (2018) П. Антоник, М. Гулина, Дж. Пауэлс и С. Массар, Использование резервуарного компьютера для обучения хаотическим аттракторам, с приложениями к синхронизации хаоса и криптографии, Phys. Rev. E 98, 012215 (2018).
- ⟦Fan et al. (2020) Х. Фань, Дж. Цзян, К. Чжан, С. Ван и Ю.-Ч. Лай, Долгосрочное прогнозирование хаотических систем с помощью машинного обучения, Phys. Rev. Res. 2, 012080 (2020).
- ⟦Sun et al. (2023) Ю. Сунь, Л. Чжан и М. Яо, Прогнозирование хаотических временных рядов нелинейных систем на основе различных моделей нейронных сетей, Chaos, Solitons & Fractals 175, 113971 (2023)⟧.
- ⟦Peruzzo et al. (2014) А. Перуццо, Дж. Макклин, П. Шадболт, М.-Х. Юнг, Х.-К. Чжоу, П. Дж. Лав, А. Аспуру-Гузик и Дж. Л. О’Брайен, Вариационный решатель собственных значений на фотонном квантовом процессоре, Nature Communications 5, 4213 (2014).
- ⟦Cerezo et al. (2021) М. Черезо, А. Аррасмит, Р. Баббуш, С. К. Бенджамин, С. Эндо, К. Фудзии, Дж. Р. Макклин, К. Митараи, Х. Юань, Л. Синсио и П. Дж. Коулс, Вариационные квантовые алгоритмы, Nature Reviews Physics 3, 625 (2021).
- ⟦Zhou et al. (2021) П.-Ф. Чжоу, Р. Хонг и С.-Дж. Ран, Автоматически дифференцируемая квантовая схема для подготовки состояний многих кубитов, Phys. Rev. A 104, 042601 (2021).
- ⟦Yuan et al. (1983) Дж.-М. Юань, М. Тунг, Д. Х. Фенг и Л. М. Нардуччи, Неустойчивость и нерегулярное поведение связанных логистических уравнений, Phys. Rev. A 28, 1662 (1983).
- ⟦Ferretti and Rahman (1988) А. Ферретти и Н. Рахман, Исследование связанных логистических отображений и их приложения в химической физике, Chemical Physics 119, 275 (1988)⟧.
- ⟦Lipton et al. (2015) З. К. Липтон, Дж. Берковиц и К. Элкан, Критический обзор рекуррентных нейронных сетей для обучения на последовательностях (2015), arXiv:1506.00019 [cs.LG] .
- ⟦Salehinejad et al. (2018) Х. Салехинеджад, С. Санкар, Дж. Барфетт, Э. Колак и С. Валаи, Последние достижения в области рекуррентных нейронных сетей (2018), arXiv:1801.01078 [cs.NE] .
- ⟦Stoudenmire and Schwab (2016) Э. Стауденмайер и Д. Дж. Шваб, Обучение с учителем с помощью тензорных сетей, в Достижениях в системах обработки нейронной информации, том 29, под редакцией Д. Ли, М. Сугиямы, У. Люксбурга, И. Гайона и Р. Гарнетта (Кёрран Ассошиэйтс, Инк., 2016).
- ⟦Andrecut (1998) М. Андрекут, Логистическое отображение как генератор случайных чисел, International Journal of Modern Physics B 12, 921 (1998)⟧.
- ⟦Kotevski and Mitrevski (2010) З. Котевски и П. Митревски, Экспериментальное сравнение метрик psnr и ssim для оценки качества видео, в ICT Innovations 2009, под редакцией Д. Давцева и Дж. М. Гомеса (Springer Berlin Heidelberg, Берлин, Гейдельберг, 2010) стр. 357–366.
- ⟦Parker and Chua (2012) Т. С. Паркер и Л. Чуа, Практические численные алгоритмы для хаотических систем (Шпрингер Сайенс энд Бизнес Медиа, 2012)).
- ⟦Moon (2008) Ф. К. Мун, Хаотическая и фрактальная динамика: введение для прикладных ученых и инженеров (Джон Уайли и сыновья, 2008)).
- ⟦Bezruchko and Smirnov (2010) Б. Безручко и Д. Смирнов, Извлечение знаний из временных рядов: введение в нелинейное эмпирическое моделирование, Серия Шпрингера по синергетике (Шпрингер Берлин Гейдельберг, 2010) стр. 56–57.
- ⟦Han et al. (2018) З.-Ю. Хан, Дж. Ван, Х. Фан, Л. Ван и П. Чжан, Неконтролируемое генеративное моделирование с использованием матричных произведений состояний, Phys. Rev. X 8, 031012 (2018)⟧.
- ⟦Cheng et al. (2019) С. Ченг, Л. Ван, Т. Сян и П. Чжан, Древовидные тензорные сети для генеративного моделирования, Phys. Rev. B 99, 155131 (2019).
- ⟦Gao et al. (2020) З.-Ф. Гао, С. Чэн, Р.-К. Хэ, З. И. Се, Х.-Х. Чжао, З.-И. Лу и Т. Сян, Сжатие глубоких нейронных сетей с помощью операторов матричного произведения, Phys. Rev. Res. 2, 023300 (2020).
- ⟦Qing et al. (2023) Й. Цин, П.-Ф. Чжоу, К. Ли и С.-Дж. Ран, Сжатие нейронной сети с помощью тензорной сети с экспоненциально меньшим количеством вариационных параметров (2023), arXiv:2305.06058 [cs.LG]⟧ .
- ⟦Gill et al. (2022) С. С. Гилл, А. Кумар, Х. Сингх, М. Сингх, К. Каур, М. Усман и Р. Буйя, Квантовые вычисления: таксономия, систематический обзор и будущие направления, Software: Practice and Experience 52, 66 (2022).
- ⟦Geist et al. (1990) К. Гайст, У. Парлиц и В. Лаутерборн, Сравнение различных методов вычисления показателей Ляпунова, Progress of Theoretical Physics 83, 875 (1990)⟧.
- ⟦McDonald and Higham (2001) Э. Дж. Макдональд и Д. Дж. Хайэм, Анализ погрешностей алгоритмов qr для вычисления показателей Ляпунова, ETNA - Electronic Transactions on Numerical Analysis 12, 234 (2001)⟧.