Машинное обучение для прогнозирования хаотических систем
Аннотация
Прогнозирование хаотических динамических систем имеет решающее значение во многих научных областях, таких как прогнозирование погоды, но является сложной задачей из-за характерной чувствительной зависимости от начальных условий. Традиционные подходы к моделированию требуют обширных предметных знаний, что часто приводит к переходу к методам, основанным на данных, с использованием machine learning. Однако существующие исследования дают неоднозначные результаты относительно того, какие методы machine learning лучше всего подходят для прогнозирования хаотических систем. В этой статье мы сравниваем различные легковесные и тяжеловесные архитектуры machine learning, используя обширные существующие базы данных для benchmarking, а также новую базу данных, которая позволяет проводить uncertainty quantification в результатах benchmarking. В дополнение к современным методам из литературы мы также представляем новые выгодные варианты уже существующих методов. Настройка гиперпараметров корректируется в зависимости от вычислительных затрат, при этом больше ресурсов настройки выделяется менее затратным методам. Кроме того, мы вводим кумулятивную максимальную ошибку — новую метрику, которая сочетает в себе желаемые свойства традиционных метрик и адаптирована для хаотических систем. Наши результаты показывают, что хорошо настроенные простые методы, а также ненастроенные базовые методы часто превосходят современные модели deep learning, но их эффективность может значительно варьироваться при различных экспериментальных установках. Эти выводы подчеркивают важность согласования методов прогнозирования с характеристиками данных и предостерегают от неразборчивого использования чрезмерно сложных моделей..
1 Введение
Хаос — это повсеместное явление в природе и технике, возникающее вследствие нелинейности, сложных взаимодействий или обратных связей внутри системы [Ott02, Str24]. Прогнозирование поведения таких динамических систем является важнейшей целью во многих научных дисциплинах. Хаотические системы характеризуются своей чувствительной зависимостью от начальных условий, что делает их крайне трудными для прогнозирования и создает серьезную проблему для исследователей, изучающих их..
Традиционный подход к решению этой проблемы предполагает использование предметно-ориентированных знаний для моделирования динамической системы. Однако такой подход требует детального понимания конкретной системы, что зачастую невозможно. В последние годы в качестве жизнеспособной альтернативы появились не зависящие от системы подходы, основанные на данных. Эти методы, использующие инструментарий статистики и machine learning, обучаются на наблюдаемых данных для прогнозирования будущего поведения системы..
Эти алгоритмы варьируются от относительно простых и вычислительно недорогих методов, таких как подбор полиномов, до высокотехнологичных моделей, использующих сложные архитектуры нейронных сетей, требующих значительных вычислительных мощностей для обучения. Для оценки этих подходов были проведены различные сравнительные исследования..
Например, [Han+21] фокусируются на сложных моделях machine learning, преимущественно с классическими архитектурами нейронных сетей. Они не включают в себя сложную модель transformers [Vas+17], которая приобрела популярность благодаря своей эффективности для LLM. Такие модели рассматриваются в [Wen+23], где анализируются различные варианты моделей transformers для прогнозирования временных рядов. Примечательно, что [Zen+23] демонстрируют, как простые линейные методы могут превосходить эти сложные модели. Кроме того, [Vla+20] сравнивают reservoir computers (RCs) и recurrent neural networks (RNNs), отдавая предпочтение RNNs, тогда как [SFC22] проводят аналогичное сравнение, добавляя другие методы machine learning и приходя к выводу, что RCs являются предпочтительными..
Предыдущие исследования, как правило, сравнивают методы на ограниченном количестве систем. Однако [Gil21, Gil23] подчеркивают необходимость использования обширных баз данных и эталонных тестов для оценки эффективности различных методов. Они представляют базу данных из более чем 130 различных хаотических динамических систем и в своем сравнительном исследовании обнаруживают, что сложный метод NBEATS [Ore+20] показывает наилучшие результаты. Настройка гиперпараметров в этом исследовании минимальна, несмотря на ее важность для производительности алгоритма..
В целом, в научной литературе отсутствует консенсус относительно того, какой метод следует предпочесть. Даже различие в качестве результатов между легковесными и тяжеловесными методами не является очевидным. Помимо использования лишь нескольких систем (и зачастую различных данных в каждом исследовании), недостаточная надежность существующих сравнений может быть обусловлена присущей оценкам случайностью. Результаты используемых метрик ошибки могут варьироваться при применении различных начальных условий. Если эксперименты повторяются лишь несколько раз со случайно выбранными начальными условиями, результаты все равно могут оказаться недостаточно надежными. Если проводится только одна попытка, то неопределенность даже невозможно оценить..
В данной работе мы стремимся ответить на ряд вопросов, оставшихся открытыми в предыдущих исследованиях. Мы сравниваем различные легковесные и тяжеловесные алгоритмы, включая простые статистические методы, которые продемонстрировали многообещающую эффективность, но получили ограниченное внимание [RH17]. Мы также представляем модификации алгоритмов, основанные на оценках карт пропагаторов, таких как RCs, где мы фокусируемся на приращении вместо следующего состояния, и показываем их преимущества для определенных задач прогнозирования. Мы настраиваем гиперпараметры, руководствуясь вычислительной стоимостью каждого алгоритма, что позволяет более широко исследовать наборы гиперпараметров для легковесных методов для обеспечения более справедливого сравнения с тяжеловесными моделями..
В качестве одного из источников синтетических данных мы используем базу данных Dysts [Gil21], что позволяет проводить тестирование на широком спектре хаотических систем и осуществлять прямое сравнение с результатами в [Gil23]. Кроме того, мы представляем новую базу данных DeebLorenz, которая охватывает три вариации хорошо известной системы Lorenz63 [Lor63], что упрощает сравнение с другими исследованиями по системе Lorenz63. Наша база данных включает повторений моделируемых временных рядов для каждой системы, чтобы повысить устойчивость результатов и обеспечить количественную оценку неопределенности. База данных также содержит непараметрическую версию Lorenz63 для оценки эффективности алгоритмов аппроксимации на основе полиномов применительно к неполиномиальным целевым функциям. Все исследованные системы имеют размерности фазового пространства в диапазоне от до , что позволяет классифицировать их как низкоразмерные. Для каждой системы используются различные схемы наблюдения, чтобы изучить влияние шума и интервалов временных шагов на производительность. Более того, мы предлагаем новую метрику ошибки для задач прогнозирования в динамических системах — кумулятивную максимальную ошибку (). Она объединяет преимущества интегральных метрик ошибки (используемых, например, в [Gil23, God+21]) и показателей горизонта прогнозирования, таких как время достоверности [Ren+09, Pat+18]⟧.
Наше исследование демонстрирует значительно более высокую эффективность различных настроенных и ненастроенных простых методов по сравнению со сложными моделями machine learning в задачах прогнозирования для низкоразмерных хаотических систем. Кроме того, мы обнаружили, что относительная эффективность методов сильно зависит от экспериментальной установки, хотя некоторые тенденции, такие как высокая эффективность простых методов, остаются неизменными. Примечательно, что введение случайных временных шагов между последовательными наблюдениями кардинально меняет результаты. В этом случае метод на основе Gaussian process [RW05, Hei+18], который занимает средние позиции при постоянных временных шагах, превосходит все остальные методы..
Оставшиеся части статьи структурированы следующим образом: Section 2 описывает базы данных, задачу прогнозирования, сравниваемые методы, метрику ошибки и настройку гиперпараметров. Результаты и ключевые выводы имитационного моделирования описаны в Section 3, за которыми следует краткое заключение в Section 4. Appendix A содержит дополнительные сведения о базах данных, за которыми следует обсуждение методов оценки в Appendix B. Наконец, дополнительные таблицы и графики с подробными результатами имитационного моделирования доступны в Appendix D⟧.
2 Методология
2.1 Данные
Мы используем две различные базы данных: DeebLorenz11 1 Эталон для оценки дифференциальных уравнений – Лоренц, доступный по адресу https://doi.org/10.5281/zenodo.12999941, база данных, созданная специально для этого исследования, и база данных Dysts22 2 https://github.com/williamgilpin/dysts, https://github.com/williamgilpin/dysts_data из [Gil21]. Обзор их структуры приведен в Figure 1, а более подробная информация описана ниже.
Обе базы данных состоят из решений автономных обыкновенных дифференциальных уравнений первого порядка, то есть , где является производной , а — векторным полем обыкновенного дифференциального уравнения, описывающим динамику системы. Все рассматриваемые системы являются хаотическими, то есть они демонстрируют чувствительную зависимость от начальных условий, апериодическое долгосрочное поведение и фрактальную структуру в фазовом пространстве [Ott02, Str24].
Эти две базы данных дополняют друг друга по своей природе. Dysts состоит из множества различных хаотических систем, содержащих только один временной ряд на систему и набор данных, а также довольно небольшое количество выборок на временной ряд. DeebLorenz фокусируется на различных версиях системы Lorenz63, используя несколько различных схем наблюдения и на порядок больше выборок на временной ряд, чем Dysts. Это позволяет провести более детальное тематическое исследование прогнозирования хаотических систем, в частности с использованием системы Lorenz63, а также дает возможность исследовать влияние различных настроек в напрямую сопоставимых условиях. Поскольку доступно 100 временных рядов на систему и схему наблюдения со случайно выбранными начальными условиями, параметрами системы и значениями шума, оценка методов может быть сделана надежной в статистическом смысле. Чтобы получить хоть какую-то надежность при оценке с использованием Dysts, мы должны агрегировать данные по всем ее различным системам, что делает результаты сильно и несколько неочевидно зависимыми от систем, выбранных для Dysts.
2.1.1 ДибЛоренц
Все три системы, рассматриваемые в DeebLorenz, связаны с системой Lorenz63 [Lor63], в которой представляет собой разреженный полином 2-й степени с 3 параметрами. В Lorenz63std параметры зафиксированы на значениях по умолчанию, используемых в литературе. В Lorenz63random параметры выбираются случайным образом. В Lorenz63nonpar параметры изменяются в зависимости от состояния с использованием случайной непараметрической функции, выбранной из гауссовского процесса. Примеры эталонных данных из этих систем см. в Figure 2. Примечательно, что Lorenz63nonpar представляет новый подход к случайной выборке неполиномиальных динамических систем, все из которых, по-видимому, демонстрируют хаотическое поведение..
Данные генерируются в рамках различных схем наблюдения: во всех случаях начальные условия выбираются случайным образом из аттрактора системы. Для моментов времени , состояние записывается либо непосредственно как , либо со случайной ошибкой измерения , то есть . Моменты времени наблюдения либо имеют постоянный шаг, так что , либо шаги по времени выбираются случайным образом из экспоненциального распределения , . Все комбинации этих вариантов шага по времени и измерений составляют четыре различные схемы наблюдения для DeebLorenz.
Для каждой комбинации из трех систем и четырех схем наблюдения генерация обучающих данных , , с (в ожидании, если временные шаги случайны), и (незашумленных) тестовых данных , , , с , повторяется с использованием различных случайных начальных чисел для создания валидационного набора данных (10 повторений) и тестового набора данных (100 повторений). Дополнительные подробности можно найти в Section A.2.
| – Lorenz63std | – Lorenz63random | – Lorenz63nonpar |
|---|---|---|
2.1.2 Динамические системы
База данных Dysts [Gil21] состоит из 133 хаотических систем с размерностями от 3 до 10, наблюдаемых с постоянными временными шагами, т.е. , и двумя различными настройками шума: одна без шума , ; другая с системным шумом, т.е. с
| (1) |
где — стандартное броуновское движение, а — масштаб шума. Для обеих схем наблюдения данные доступны в валидационном наборе данных и тестовом наборе данных, каждый из которых состоит из одного повторения сгенерированных обучающих данных с и тестовых данных с для каждой из 133 систем.
2.2 Задача прогнозирования и оценка
Для всех систем, схем наблюдений, наборов данных и повторений мы ставим следующую задачу: учитывая наблюдения прошлого, в интервале времени (время обучения) и истинное текущее состояние , предсказать будущие состояния в заданные моменты времени (время прогнозирования) для .
Предоставление методам прогнозирования возможности знать истинное текущее состояние — даже в случае зашумленных наблюдений — устраняет зависимость наших результатов моделирования от (случайного) конкретного значения шума последнего наблюдения. Это критически важно для повышения надежности нашего сравнительного исследования, поскольку ошибки прогнозирования в хаотических системах обычно растут экспоненциально со временем. Кроме того, это позволяет нам сосредоточиться исключительно на задаче прогнозирования (предсказании будущих состояний), а не на задаче ассимиляции данных (оценке истинного значения зашумленно наблюдаемого состояния).).
Мы применяем и сравниваем различные статистические методы и методы машинного обучения для решения этой задачи. Методы описаны ниже в Section 2.3. Для каждого конкретного метода мы сначала настраиваем его гиперпараметры на валидационном наборе данных для каждой системы индивидуально: для каждого временного ряда в валидационном наборе данных мы обучаем заданный метод и комбинацию гиперпараметров на обучающих данных и вычисляем описанные ниже метрики ошибки на валидационных данных. Мы выбираем комбинацию гиперпараметров с наилучшей (наименьшей) средней совокупной максимальной ошибкой (, см. Section 2.4), что формирует настроенный метод. Затем для каждого временного ряда тестового набора данных мы оцениваем производительность таким же образом, как и в валидационном наборе данных: мы обучаем (настроенный) метод на обучающих данных и создаем прогнозы для времени прогнозирования. Прогнозы сравниваются с эталонными данными с использованием различных метрик..
Мы вычисляем следующие три метрики для сравнения оценки с эталонными данными во время прогнозирования ⟧:
- ⟦•
Время валидности , например [Ren+09, Pat+18], для заданного порога определяется как длительность, при которой нормализованная ошибка остается ниже , то есть
где обозначает евклидову норму, а — стандартное отклонение на интервале , то есть(2)
Если порог не достигается, мы устанавливаем . В нашей оценке мы устанавливаем порог равным . Заметим, что нормализация, то есть деление на , в литературе иногда выполняется иначе: [Ren+09] не интегрируют, а нормализуют на , а [Pat+18] не вычитают среднее значение в (3). Однако только версия, описанная в (2) и (3), является инвариантной к сдвигу, что является преимуществом, как описано в Section 2.4 ниже.(3) - ⟦•
Симметричная средняя абсолютная процентная ошибка , например, [Gil23, God+21], определяется как
Это стандартная средняя абсолютная ошибка, симметрично нормализованная относительно прогноза и фактических данных и выраженная в процентах. Значение , равное 0, представляет собой идеальный прогноз, а прогноз, который стремится к бесконечности, приближается к значению , равному , см. Appendix C.(4) - ⟦•
Для данного исследования мы разрабатываем новую метрику ошибки — кумулятивную максимальную ошибку . Она определяется как
где соответствует (3). Она объединяет преимущества и , подробности см. в Section 2.4.(5)
На практике применяются канонические версии этих метрик для дискретного времени, то есть интегралы заменяются соответствующими суммами.
2.3 Методы оценки
Мы применяем широкий спектр различных методов. Кроме того, для версии базы данных Dysts без шума мы также включаем в наш бенчмарк методы, оцененные в [Gil23] (предварительно рассчитанные прогнозы для зашумленной версии недоступны). Названия этих эталонных методов начинаются с символа подчеркивания, например, _NBEAT. В этом разделе мы приводим общее описание методов, примененных специально для данного исследования. Более подробное описание можно найти в Appendix B.
Методы можно разделить на пропагаторы, рекуррентные архитектуры, сглаживатели решений и другие методы, которые не относятся ни к одной из первых трех групп.
Мы начинаем с последней категории, которая также содержит наши базовые модели ⟦BROKEN_K0⟧:
- ⟦• ConstM (постоянное среднее, также называемое климатологией): Прогноз представляет собой постоянное среднее наблюдаемых состояний, то есть .
- ⟦• ConstL (постоянное последнее значение, также называемое персистентностью): В нашей задаче прогнозирования истинное состояние без шума в момент времени всегда доступно методам, даже при схеме наблюдения с шумом. Для этого метода мы устанавливаем для всех .
- ⟦• Аналог: Для метода аналогов мы находим наблюдаемое состояние с наименьшим евклидовым расстоянием до и прогнозируем или его линейную интерполяцию, если временные шаги не являются постоянными.
- ⟦• Node1, Node32: Для нейронного ODE [Che+18] нейронная сеть подбирается к данным таким образом, что решение ODE минимизирует ошибку .
- ⟦• Trafo, TrafoT: Применяется нейронная сеть transformer [Vas+17], которая использует слои внимания для вычисления следующего состояния на основе последовательности предыдущих состояний. Суффикс T в TrafoT указывает на то, что временной шаг добавляется к вектору наблюдений , что является важным, если временные шаги не являются постоянными.
Методы ConstM, ConstL и Analog можно рассматривать как тривиальные базовые модели, поскольку они не требуют подгонки или обучения..
Далее мы рассматриваем группу пропагаторов: для этих методов основная идея заключается в поиске оценки так называемого отображения пропагатора
| (6) |
где решает задачу с начальными условиями , . Эта задача может быть сформулирована как задача регрессии на данных при условии постоянных временных шагов . После того как пропагатор оценен, рекурсивное применение дает прогнозы
| (7) |
Все перечисленные далее методы являются вариациями этой базовой идеи. Некоторые из них представлены в различных вариантах, отмеченных суффиксами S, D и/или T в их названии: S указывает на следующее состояние как на целевое, см. (6), тогда как D означает, что разностное отношение
| (8) |
оценивается, и формула прогнозирования адаптируется соответствующим образом. Последний подход аналогичен остаточному обучению, обычно используемому в литературе по глубокому обучению. Если T является частью суффикса, временной шаг доступен для метода в качестве входных данных для прогнозирования . Это не полезно для постоянных временных шагов, но критически важно для случайных временных шагов. Символ * ниже указывает на то, что метод доступен в различных вариантах, обозначаемых суффиксами T, S, D или их комбинацией..
- ⟦• PgGp*, PgNet*, PgLl*: аппроксимация с помощью гауссовского процесса [RW05], полносвязной нейронной сети [RHW86] или локального линейного оценщика [RW94] соответственно.
- ⟦• Lin*: Пропагатор оценивается посредством гребневой регрессии [Has+09, chapter 3.4.1] с использованием полиномиальных признаков. Для прогноза значения состояния в моменты времени , при фиксированном доступны в качестве входных данных для полиномиальных признаков. Этот метод также называется нелинейной векторной авторегрессионной моделью [Gau+21]⟧.
- ⟦• LinPo4, LinPo6, LinPoLinPo4T, LinPo6T: версии LinD и LinDT, не требующие настройки, с линейной регрессией (параметр штрафа гребневой регрессии равен ), без использования прошлых состояний в качестве предикторов () и с фиксированной степенью полинома, равной и соответственно..
- ⟦• RaFe*: Для случайных признаков [RR08] признаки создаются из предикторов (текущих переменных состояния) путем применения однажды случайно созданной и необученной нейронной сети. Затем применяется гребневая регрессия [Has+09, chapter 3.4.1] для оценки отображения от признаков к целевым значениям (следующему состоянию).
Рекуррентные архитектуры схожи с пропагаторами, поскольку они, по сути, также оценивают отображение пропагатора . Однако вместо того, чтобы рассматривать задачу исключительно как стандартную проблему регрессии, где порядок данных не влияет на результат, эти методы поддерживают внутреннее состояние, которое обновляется при последовательной обработке данных, упорядоченных по времени. Внутреннее состояние влияет на предсказание следующего состояния системы..
- ⟦• Esn*: Сеть эхо-состояний (ESN) [Jae01] представляет собой специфический тип резервуарных вычислений. Она схожа со случайными признаками, однако признаки предыдущего временного шага также являются входными данными для вычисления признаков текущего временного шага. Такая структура создает внутреннее состояние, позволяя ESN сохранять память об информации из предыдущих входных данных..
- ⟦• Rnn, RnnT: Рекуррентная нейронная сеть (RNN) [She20] имеет циклические связи нейронов, позволяющие информации из предыдущих входных данных сохраняться для будущих прогнозов.
- ⟦• Lstm, LstmT: Сеть долгой краткосрочной памяти (LSTM) [HS97] представляет собой разновидность стандартной RNN, разработанную для улавливания долгосрочных зависимостей в последовательных данных посредством использования механизмов вентилей для регулирования потока информации и предотвращения таких проблем, как затухающие градиенты.
- ⟦• Gru, GruT: Gated Recurrent Unit (GRU) [Cho+14] представляет собой упрощенный вариант LSTM, который использует механизмы вентилей для управления потоком информации, но с меньшим количеством параметров, что делает его более эффективным, при этом решая проблему затухающего градиента в последовательных данных.
Последняя категория методов — это сглаживатели решений [RH17, chapter 8]. В определенных условиях (которые несколько отличаются от наших экспериментов) эти методы показывают себя как оптимальные, см. [Sch24, section 4] и [SS24, section 4]. Сглаживатели решений работают в три этапа: во-первых, оценивают во время наблюдения с помощью регрессионного оценщика . Затем рассматривают данные как наблюдения и используют второй регрессионный оценщик для получения оценки . Наконец, решают ОДУ на временном интервале с начальными условиями ⟧.
- ⟦• PwNn: Наблюдаемое решение интерполируется кусочно-линейной функцией , из которой с помощью интерполяции ближайшими соседями генерируется .
- ⟦• SpNn: Как и PwNn, но представляет собой кубическую сплайн-интерполяцию [For+77]⟧.
- ⟦• LlNn: Как и PwNn, но представляет собой локальную линейную регрессию [Fan93]⟧.
- ⟦• SpPo: Как и SpNn, но представляет собой гребневую регрессию [Has+09, chapter 3.4.1] с полиномиальными признаками.
- ⟦• SpPo2, SpPo4: версия SpPo без настройки параметров с использованием линейной регрессии (параметр гребневой регуляризации равен ) и с фиксированной степенью полинома 2 и 4 соответственно.
- ⟦• SpGp: Как и SpNn, но представляет собой регрессию на основе гауссовских процессов [RW05]⟧.
- ⟦• GpGp: Как и SpGp, но также представляет собой регрессию на основе гауссовских процессов. Метод аналогичен предложенному в [Hei+18].
- ⟦• SINDy, SINDyN: Как и SpPo без -штрафа, но разреженность обеспечивается для полиномиальной посредством пороговой обработки [BPK16]. Как и для всех остальных методов, нормализация данных применяется перед непосредственным методом оценки для SINDyN. Только для SINDy она отключена, чтобы не нарушить потенциальную разреженность в исходных данных. Название SINDy является сокращением от Sparse Identification of Nonlinear Dynamics.
Далее мы дополнительно классифицируем методы в соответствии с их центральной вычислительной концепцией:
- ⟦• : Прогнозы для ConstL, ConstM, Analog вычисляются непосредственно на основе наблюдений.
- ⟦• : Node*, Trafo*, PgNet*, Rnn*, Lstm*, Gru* обучаются с использованием варианта градиентного спуска.
- ⟦• : Lin*, LinPo2, LinPo4, RaFe*, Esn*, PgGp*, PgLl* подбирают отображение пропагатора путем решения системы линейных уравнений.
- ⟦• : PwNn, SpNn, LlNn, SpPo, SpPo2, SpPo4, SpGp, GpGp, SINDy, SINDyN подбирают решение и/или векторное поле путем решения системы линейных уравнений.
2.4 Кумулятивная максимальная ошибка – CME
Хотя для оценки результатов этого имитационного исследования рассчитываются различные метрики ошибок, мы фокусируемся на (5), которую мы впервые вводим для данного исследования. Если время дискретно, (5) принимает вид
| (9) |
где
| (10) |
Подобно , ошибки интегрируются с течением времени, и подобно , время и ошибка наихудшего прогноза на данный момент имеют решающее значение для значения общей метрики ошибки. обладает многими желательными свойствами:
- ⟦(i) Он инвариантен к сдвигу и масштабу, в отличие от и версии валидного времени, используемой в [Ren+09, Pat+18], но схож с нашим определением . Это желательно, поскольку любую систему обыкновенных дифференциальных уравнений можно модифицировать — без увеличения сложности — для создания любого сдвига и масштабирования её решений. Таким образом, оценка качества аппроксиматора не должна зависеть от положения и масштаба системы..
- ⟦(ii) Мы фокусируемся на задаче, которая включает оценку точного состояния в интервале ближайшего будущего, как в прогнозировании погоды. В отличие от этого, можно также рассмотреть задачу, где долгосрочное поведение прогноза должно соответствовать истинным данным без акцента на ошибке в любой отдельный момент времени, как в климатическом моделировании. Для первой задачи предсказательная способность быстро ухудшается со временем из-за хаотической природы рассматриваемых систем. Поэтому, если интервал прогнозирования велик, нас в первую очередь интересуют начальные моменты времени, когда точное прогнозирование возможно. Точные прогнозы в начале интервала не должны обесцениваться из-за расхождения в конце, где точные прогнозы в любом случае невозможны. Это требование отражено в и, в некоторой степени, в , но не в ⟧.
- ⟦(iii) Значение всегда находится в диапазоне от 0 до 1, где 0 достигается только при идеальном прогнозировании. В отличие от этого, масштаб сильно зависит от временного масштаба системы, а наилучшее значение может быть достигнуто при неидеальных прогнозах.
- ⟦(iv) Обработка пропущенных значений при расчете является канонической: если недоступно для некоторого , мы устанавливаем значение минимума в (5) равным . Соответственно, если все предсказание отсутствует, мы устанавливаем равным .
- ⟦(v) не требует параметров, в отличие от , где необходимо задать пороговое значение .
- ⟦(vi) Если время дискретно, может принимать только конечное число значений. Напротив, для всех значений в существует прогноз такой, что принимает это значение. Более того, и могут иметь одинаковое , но для всех . Если время дискретно, мы даже можем иметь для всех , в то время как . Это не может произойти с : если для всех для некоторого и для всех , мы имеем ⟧.
Давайте также опишем потенциальные недостатки .
- ⟦(i) не является симметричной, в общем случае, в отличие от . Однако в нашем случае использования отношение между двумя её аргументами и также не является симметричным. Таким образом, симметрия, по-видимому, не дает преимуществ..
- ⟦(ii) Если является константой, то и (5) не являются корректными. В этом случае разумным определением будет установить равным для всех , за исключением идеального прогноза , для которого является подходящим значением. Заметим, что (и в некоторой степени ) также подвержены этой проблеме деления на ноль..
- ⟦(iii)
Если прогноз сильно отклоняется от , но восстанавливается в более поздний момент времени, это восстановление не учитывается в . Поскольку будущие состояния в наших динамических системах не зависят от прошлого при известном настоящем (марковское свойство), момент времени с хорошим прогнозом, следующий за моментом с плохим прогнозом, следует считать ложным и приписывать случайности, а не мастерству. Это особенно верно для хаотических систем, где зависимость будущего от настоящего выражена особенно сильно. Однако заметьте, что одно и то же расстояние может соответствовать разной предсказуемости будущего в моменты времени для различных состояний или , . То есть мы можем иметь
для , даже если .(11) - ⟦(iv) С одной стороны, значение в -члене (5) может быть заменено пороговым параметром , как в , что устраняет преимущество отсутствия параметров для . С другой стороны, является естественным выбором для (в отличие от ), поскольку тривиальный базовый метод ConstM, , достигает в среднем. Более того, для каждого константного прогноза существует конечная точка во времени такая, что для , и является наибольшим значением с этим свойством.
- ⟦(v) Значение зависит от длительности тестирования (подобно , но в отличие от ). Это можно смягчить путем установки и умножения подынтегрального выражения в (5) на весовую функцию , например, , однако это вводит новый выбор параметра . Чтобы сделать выбор весов независимым и адаптируемым к временному масштабу, необходимо устанавливать в зависимости от , например, как обратное время корреляции.
2.5 Настройка гиперпараметров
Каждая пара динамической системы и схемы наблюдения представлена в виде набора данных для валидации и набора данных для тестирования. Для настройки гиперпараметров используется только набор данных для валидации. Каждый такой набор данных состоит из (Dysts) или (DeebLorenz) повторений/временных рядов. Каждое повторение состоит из данных для обучения и валидации..
Для заданного метода с гиперпараметрами мы обучаем его, выполняем прогнозирование и вычисляем для различных . Обозначим среднее значение всех повторений как , а лучшие гиперпараметры среди протестированных — как . Затем применяется к тестовому набору данных для получения окончательных результатов, представленных в Section 3. Описание настроенных гиперпараметров для каждого метода см. в Appendix B..
Чтобы определить, какие гиперпараметры оценивать, мы следуем процедуре локального сеточного поиска: для заданного метода оценки решите, какие параметры должны быть настроены . Каждый параметр имеет область возможных значений . Область может быть категориальной или скалярной. Для категориальных параметров решите, являются ли они постоянными (всегда оценивать все варианты) или уступающими (оценивать только лучшие). Для скалярных параметров выберите линейную или экспоненциальную шкалу и шаг . Определите конечные наборы начальных значений гиперпараметров . Теперь для шага в процедуре оптимизации оцените все элементы сетки гиперпараметров , которые не были оценены ранее. Если таковых нет, остановите поиск. Обозначьте лучшую комбинацию гиперпараметров, оцененную на данный момент, как . Сгенерируйте из следующим образом: Если -я переменная является категориальной, установите для постоянных параметров и для уступающих. Если -я переменная является скалярной, установите , если она имеет линейную шкалу, и , если шкала экспоненциальная..
Локальный сеточный поиск находит локально оптимальные комбинации гиперпараметров при разумном количестве оценок, при условии, что количество настраиваемых гиперпараметров достаточно мало. В данном исследовании алгоритм применяется к гиперпараметрам для ограничения вычислительных затрат. Мы настраиваем больше параметров в случае методов с низкими вычислительными требованиями и ограничиваемся одной категориальной переменной (без адаптивного поиска) для наиболее ресурсоемких методов. См. основные результаты Tables 3, 1 и 2 в следующем разделе (столбец Tune) относительно вычислительных затрат на настройку гиперпараметров. Регулируя количество оцениваемых гиперпараметров, мы стараемся сделать сравнение более справедливым с точки зрения общих вычислительных затрат. Итоговое общее время вычислений все еще может существенно различаться между методами. Это частично связано с адаптивной природой алгоритма локального сеточного поиска (т.е. общее количество прогнозов невозможно узнать заранее), а частично — с отсутствием значимых настраиваемых гиперпараметров для некоторых методов (в частности, для очень простых методов, которые обычно имеют низкие вычислительные затраты). Кроме того, идеальная справедливость кажется недостижимой, поскольку выбор настраиваемых гиперпараметров, выбор начальных гиперпараметров и дизайн шкал — все это влияет на результат..
В отличие от нашего подхода, [Gil23] настраивают один гиперпараметр для каждого метода, независимо от вычислительных затрат. Выбранный параметр всегда связан с количеством элементов временного ряда из прошлого, которые являются входными данными для прогнозирования следующего шага. Заметим, что теоретически для прогнозирования будущего состояния требуется только текущее состояние (марковское свойство), если отсутствует шум измерений и если есть доступ ко всем переменным системы..
3 Результаты и 10 ключевых выводов
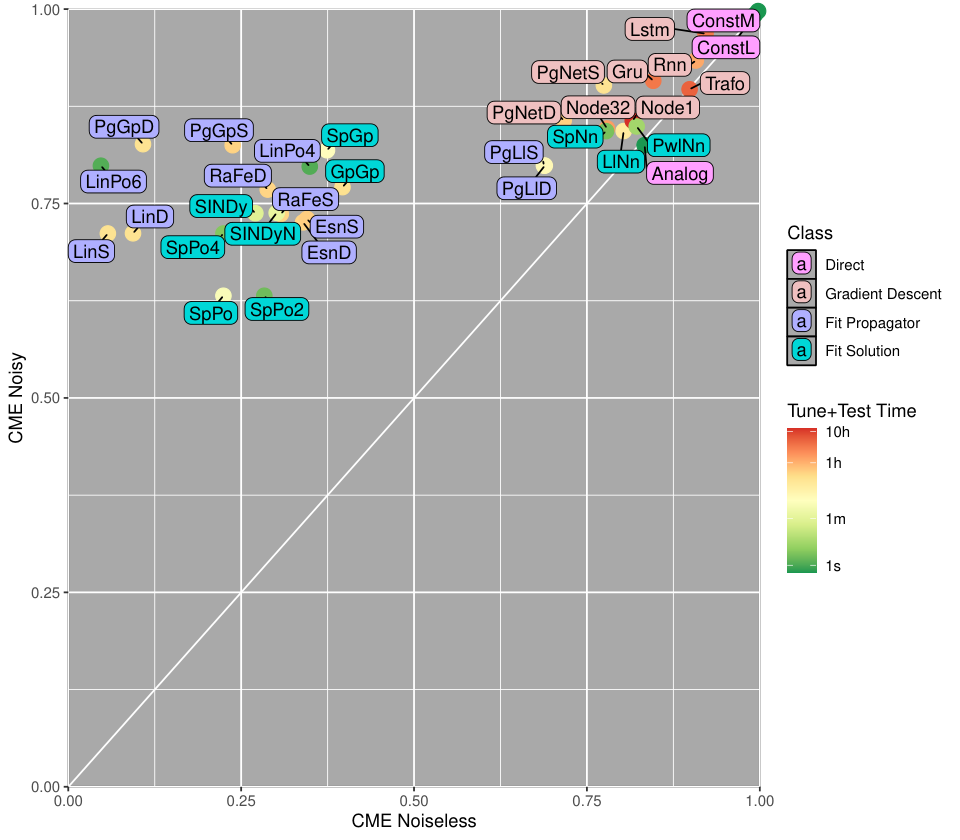
Примеры обучающих данных и прогнозирования лучших методов показаны в Figure 3 для DeebLorenz. Результаты имитационного исследования с точки зрения метрики ошибки представлены в Table 1 для DeebLorenz с постоянным шагом по времени, в Table 2 для DeebLorenz со случайным шагом по времени и в Table 3 для базы данных Dysts. Дополнительные сведения, включая значения оценок и ранги для метрик ошибки , и , можно найти в приложении Tables 7, 8, 9, 10, 11, 12, 14 и 13. Наконец, Figure 4 показывает результаты для нешумных и зашумленных тестовых данных с постоянным шагом по времени системы Lorenz63random из базы данных DeebLorenz. Ниже мы описываем 10 ключевых выводов, которые позволяют сделать эти результаты. Дальнейшие подробности о результатах можно найти в Appendix D.
| Method | Compute | Noisefree | Noisy | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Name | Class | Model | Variant | Test | Tune | S# | R# | N# | S# | R# | N# | ||
| LinPo6 | Fit Prop. | Lin | Poly6 | 1s | 1 | 1 | 8 | 15 | 14 | 15 | |||
| LinD | Fit Prop. | Lin | D | 7s | 17m | 2 | 3 | 2 | 4 | 5 | 6 | ||
| LinS | Fit Prop. | Lin | S | 4s | 17m | 3 | 2 | 4 | 5 | 4 | 4 | ||
| SpPo4 | Fit Solu. | Spline | Poly4 | 4s | 4 | 6 | 14 | 9 | 3 | 1 | |||
| SpPo | Fit Solu. | Spline | Poly | 5s | 3m | 5 | 5 | 7 | 2 | 1 | 5 | ||
| SINDy | Fit Solu. | SINDy | 6s | 51s | 6 | 8 | 11 | 11 | 9 | 2 | |||
| SpPo2 | Fit Solu. | Spline | Poly2 | 2s | 7 | 9 | 28 | 1 | 1 | 26 | |||
| PgGpD | Fit Prop. | GP | D | 9s | 17m | 8 | 4 | 1 | 14 | 20 | 19 | ||
| SINDyN | Fit Solu. | SINDy | norm | 5s | 1m | 9 | 11 | 16 | 10 | 10 | 8 | ||
| LinPo4 | Fit Prop. | Lin | Poly4 | 1s | 10 | 15 | 15 | 13 | 13 | 12 | |||
| EsnD | Fit Prop. | ESN | D | 5s | 27m | 11 | 13 | 9 | 8 | 6 | 7 | ||
| PgGpS | Fit Prop. | GP | S | 15s | 28m | 12 | 7 | 3 | 24 | 18 | 17 | ||
| RaFeD | Fit Prop. | RandFeat | D | 5s | 27m | 13 | 10 | 6 | 6 | 11 | 9 | ||
| EsnS | Fit Prop. | ESN | S | 6s | 32m | 14 | 14 | 10 | 7 | 7 | 3 | ||
| RaFeS | Fit Prop. | RandFeat | S | 5s | 28m | 15 | 12 | 5 | 3 | 8 | 11 | ||
| GpGp | Fit Solu. | GP | GP | 19s | 18m | 16 | 17 | 13 | 12 | 12 | 10 | ||
| SpGp | Fit Solu. | Spline | GP | 10s | 3m | 17 | 16 | 12 | 19 | 17 | 18 | ||
| PgNetD | Gr. Desc. | NeuralNet | D | 7m | 23m | 18 | 20 | 17 | 22 | 26 | 22 | ||
| PgLlD | Fit Prop. | LocalLin | D | 8s | 5m | 19 | 19 | 19 | 17 | 15 | 13 | ||
| PgLlS | Fit Prop. | LocalLin | S | 8s | 5m | 20 | 18 | 18 | 16 | 16 | 14 | ||
| PgNetS | Gr. Desc. | NeuralNet | S | 6m | 11m | 21 | 21 | 22 | 29 | 28 | 27 | ||
| LlNn | Fit Solu. | LocalLin | NN | 1m | 9m | 22 | 24 | 21 | 20 | 22 | 21 | ||
| SpNn | Fit Solu. | Spline | 3s | 23 | 22 | 20 | 25 | 21 | 20 | ||||
| Node32 | Gr. Desc. | NODE | bs32 | 11m | 1h | 24 | 23 | 26 | 21 | 23 | 24 | ||
| PwlNn | Fit Solu. | PwLin | NN | 10s | 25 | 26 | 23 | 23 | 24 | 23 | |||
| Node1 | Gr. Desc. | NODE | bs1 | 1h | 10h | 26 | 25 | 25 | 27 | 25 | 25 | ||
| Analog | Direct | Analog | <1s | 27 | 27 | 24 | 18 | 19 | 16 | ||||
| Gru | Gr. Desc. | GRU | 44m | 2h | 28 | 28 | 27 | 28 | 29 | 29 | |||
| Trafo | Gr. Desc. | Transformer | 57m | 4h | 29 | 29 | 29 | 26 | 27 | 28 | |||
| Rnn | Gr. Desc. | RNN | 14m | 59m | 30 | 30 | 31 | 31 | 30 | 31 | |||
| Lstm | Gr. Desc. | LSTM | 46m | 2h | 31 | 31 | 30 | 30 | 31 | 30 | |||
| ConstL | Direct | Const | Last | <1s | 32 | 32 | 32 | 32 | 32 | 32 | |||
| ConstM | Direct | Const | Mean | <1s | 33 | 33 | 33 | 33 | 33 | 33 | |||
| Method | Compute | Noisefree | Noisy | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Name | Class | Model | Variant | Test | Tune | S# | R# | N# | S# | R# | N# | ||
| GpGp | Fit Solu. | GP | GP | 19s | 16m | 1 | 1 | 1 | 1 | 1 | 2 | ||
| SpPo2 | Fit Solu. | Spline | Poly2 | 2s | 2 | 2 | 19 | 21 | 21 | 25 | |||
| SpPo4 | Fit Solu. | Spline | Poly4 | 4s | 3 | 4 | 3 | 20 | 19 | 24 | |||
| SpPo | Fit Solu. | Spline | Poly | 5s | 3m | 4 | 3 | 6 | 22 | 20 | 23 | ||
| SINDy | Fit Solu. | SINDy | 6s | 53s | 5 | 6 | 4 | 23 | 22 | 22 | |||
| SINDyN | Fit Solu. | SINDy | norm | 5s | 47s | 6 | 8 | 5 | 24 | 24 | 21 | ||
| SpGp | Fit Solu. | Spline | GP | 10s | 3m | 7 | 5 | 2 | 18 | 12 | 17 | ||
| PgGpDT | Fit Prop. | GP | DT | 8s | 32m | 8 | 7 | 8 | 28 | 28 | 28 | ||
| LinDT | Fit Prop. | Lin | DT | 4s | 6m | 9 | 14 | 12 | 25 | 30 | 20 | ||
| LinPo4T | Fit Prop. | Lin | Poly4T | 1s | 10 | 10 | 10 | 29 | 26 | 30 | |||
| LinPo6T | Fit Prop. | Lin | Poly6T | 2s | 11 | 12 | 18 | 32 | 31 | 26 | |||
| EsnDT | Fit Prop. | ESN | DT | 5s | 28m | 12 | 17 | 16 | 4 | 5 | 5 | ||
| PgNetDT | Gr. Desc. | NeuralNet | DT | 6m | 17m | 13 | 13 | 11 | 26 | 25 | 29 | ||
| SpNn | Fit Solu. | Spline | 3s | 14 | 9 | 7 | 16 | 14 | 15 | ||||
| PgLlDT | Fit Prop. | LocalLin | DT | 7s | 7m | 15 | 18 | 15 | 30 | 29 | 31 | ||
| RaFeDT | Fit Prop. | RandFeat | DT | 5s | 27m | 16 | 15 | 14 | 3 | 6 | 3 | ||
| Node1 | Gr. Desc. | NODE | bs1 | 1h | 9h | 17 | 11 | 13 | 7 | 4 | 4 | ||
| LinST | Fit Prop. | Lin | ST | 12s | 12m | 18 | 19 | 23 | 5 | 2 | 8 | ||
| PwlNn | Fit Solu. | PwLin | NN | 10s | 19 | 20 | 17 | 12 | 11 | 11 | |||
| PgGpST | Fit Prop. | GP | ST | 15s | 31m | 20 | 21 | 22 | 10 | 8 | 7 | ||
| Analog | Direct | Analog | <1s | 21 | 16 | 9 | 6 | 3 | 1 | ||||
| LlNn | Fit Solu. | LocalLin | NN | 1m | 9m | 22 | 23 | 21 | 8 | 10 | 10 | ||
| PgNetST | Gr. Desc. | NeuralNet | ST | 9m | 23m | 23 | 22 | 20 | 11 | 9 | 9 | ||
| RaFeST | Fit Prop. | RandFeat | ST | 5s | 30m | 24 | 25 | 24 | 2 | 7 | 6 | ||
| PgLlST | Fit Prop. | LocalLin | ST | 9s | 5m | 25 | 24 | 26 | 13 | 16 | 14 | ||
| EsnST | Fit Prop. | ESN | ST | 6s | 29m | 26 | 26 | 25 | 9 | 13 | 12 | ||
| TrafoT | Gr. Desc. | Transformer | T | 1h | 6h | 27 | 28 | 28 | 15 | 17 | 16 | ||
| GruT | Gr. Desc. | GRU | T | 44m | 2h | 28 | 27 | 27 | 14 | 15 | 13 | ||
| RnnT | Gr. Desc. | RNN | T | 15m | 58m | 29 | 29 | 29 | 17 | 18 | 18 | ||
| LstmT | Gr. Desc. | LSTM | T | 52m | 2h | 30 | 30 | 30 | 19 | 23 | 19 | ||
| ConstL | Direct | Const | Last | <1s | 31 | 31 | 31 | 27 | 27 | 27 | |||
| ConstM | Direct | Const | Mean | <1s | 32 | 32 | 32 | 31 | 32 | 32 | |||
| Method | Compute | Noisefree | Noisy | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Name | Class | Model | Variant | Test | Tune | # | medi | # | medi | ||
| SpPo | Fit Solu. | Spline | Poly | 3s | 2m | 1 | 0.00 | 9 | 0.78 | ||
| LinS | Fit Prop. | Lin | S | <1s | 49s | 2 | 0.01 | 6 | 0.77 | ||
| LinD | Fit Prop. | Lin | D | <1s | 48s | 3 | 0.01 | 8 | 0.77 | ||
| SpPo4 | Fit Solu. | Spline | Poly4 | 5s | 4 | 0.01 | 21 | 0.85 | |||
| RaFeD | Fit Prop. | RandFeat | D | <1s | 3m | 5 | 0.02 | 19 | 0.84 | ||
| EsnD | Fit Prop. | ESN | D | 1s | 3m | 6 | 0.02 | 1 | 0.73 | ||
| RaFeS | Fit Prop. | RandFeat | S | <1s | 3m | 7 | 0.03 | 15 | 0.80 | ||
| EsnS | Fit Prop. | ESN | S | 1s | 4m | 8 | 0.03 | 3 | 0.76 | ||
| SINDy | Fit Solu. | SINDy | 2s | 3m | 9 | 0.03 | 24 | 0.87 | |||
| LinPo4 | Fit Prop. | Lin | Poly4 | <1s | 10 | 0.04 | 20 | 0.84 | |||
| SINDyN | Fit Solu. | SINDy | norm | 2s | 4m | 11 | 0.12 | 25 | 0.87 | ||
| LinPo6 | Fit Prop. | Lin | Poly6 | 2s | 12 | 0.19 | 29 | 0.91 | |||
| SpPo2 | Fit Solu. | Spline | Poly2 | 1s | 13 | 0.21 | 10 | 0.79 | |||
| PgGpD | Fit Prop. | GP | D | 3s | 48s | 14 | 0.22 | 26 | 0.88 | ||
| PgNetD | Gr. Desc. | NeuralNet | D | 1m | 4m | 15 | 0.26 | 12 | 0.80 | ||
| Gru | Gr. Desc. | GRU | 4m | 19m | 16 | 0.40 | 2 | 0.75 | |||
| Node1 | Gr. Desc. | NODE | bs1 | 19m | 1h | 17 | 0.42 | 7 | 0.77 | ||
| Node32 | Gr. Desc. | NODE | bs32 | 4m | 29m | 18 | 0.44 | 13 | 0.80 | ||
| PgGpS | Fit Prop. | GP | S | 2s | 47s | 19 | 0.44 | 23 | 0.86 | ||
| PgNetS | Gr. Desc. | NeuralNet | S | 1m | 2m | 20 | 0.46 | 11 | 0.80 | ||
| SpGp | Fit Solu. | Spline | GP | 3s | 35s | 21 | 0.54 | 30 | 0.92 | ||
| _NBEAT | Dysts | NBEATS | 22 | 0.56 | |||||||
| PgLlS | Fit Prop. | LocalLin | S | 3s | 10s | 23 | 0.57 | 16 | 0.81 | ||
| Analog | Direct | Analog | <1s | 24 | 0.60 | 17 | 0.81 | ||||
| PwlNn | Fit Solu. | PwLin | NN | 1s | 25 | 0.60 | 18 | 0.83 | |||
| PgLlD | Fit Prop. | LocalLin | D | 3s | 10s | 26 | 0.61 | 14 | 0.80 | ||
| SpNn | Fit Solu. | Spline | 1s | 27 | 0.62 | 22 | 0.85 | ||||
| Rnn | Gr. Desc. | RNN | 2m | 7m | 28 | 0.62 | 5 | 0.77 | |||
| Trafo | Gr. Desc. | Transformer | 13m | 1h | 29 | 0.63 | 4 | 0.77 | |||
| GpGp | Fit Solu. | GP | GP | 3s | 2m | 30 | 0.64 | 28 | 0.90 | ||
| _RaFo | Dysts | RandForest | 31 | 0.69 | |||||||
| _NHiTS | Dysts | NHiTS | 32 | 0.70 | |||||||
| LlNn | Fit Solu. | LocalLin | NN | 6s | 19s | 33 | 0.73 | 27 | 0.88 | ||
| _RNN | Dysts | RNN | 34 | 0.76 | |||||||
| _Node | Dysts | NeuralOde | 35 | 0.79 | |||||||
| _Esn | Dysts | Esn | 36 | 0.79 | |||||||
| _Nvar | Dysts | Nvar | 37 | 0.80 | |||||||
| _XGB | Dysts | XGB | 38 | 0.81 | |||||||
| _Trafo | Dysts | Transformer | 39 | 0.81 | |||||||
| _LinRe | Dysts | LinearReg | 40 | 0.84 | |||||||
| _NLin | Dysts | NLinear | 41 | 0.88 | |||||||
| _BlRNN | Dysts | BlockRNN | 42 | 0.90 | |||||||
| _DLin | Dysts | DLinear | 43 | 0.90 | |||||||
| Lstm | Gr. Desc. | LSTM | 5m | 16m | 44 | 0.91 | 32 | 0.96 | |||
| _TCN | Dysts | TCN | 45 | 0.94 | |||||||
| ConstL | Direct | Const | Last | <1s | 46 | 0.96 | 31 | 0.96 | |||
| _Kalma | Dysts | 47 | 0.98 | ||||||||
| ConstM | Direct | Const | Mean | <1s | 48 | 1.00 | 33 | 1.00 | |||
Накопленная максимальная ошибка для тестовых данных Lorenz63random с постоянным шагом по времени
3.1 Легковесные методы превосходят тяжеловесные методы
Во всех сценариях почти все лучшие методы (топ-5) являются сравнительно простыми (например, SpPo, LinS, EsnS) и имеют низкие вычислительные затраты, поскольку они не полагаются на обучение методом градиентного спуска. Напротив, вычислительно более сложные методы обучения (например, Node*, Trafo, Rnn) показывают довольно низкие результаты. Единственными исключениями являются Gru и Trafo для зашумленных данных Dysts, а также Node1 для Lorenz63random и Lorenz63nonpar в условиях шума со случайными временными шагами. Тем не менее, в этих отдельных случаях также доступны простые методы с аналогичной или более высокой эффективностью. См. также Figure 4 для иллюстрации этого различия на примере Lorenz63random с постоянным временным шагом. Кроме того, Table 19 показывает, что легковесные методы также превосходят тяжеловесные методы при различных размерах выборки (по крайней мере, для системы Lorenz63std с постоянным временным шагом).).
Даже некоторые методы, не требующие настройки (SpPo2, SpPo4, PwNn, SpNn, LinPo4, LinPo6), в большинстве случаев имеют более низкие показатели ошибок, чем тяжеловесные алгоритмы. Мы рекомендуем использовать по крайней мере некоторые из этих методов в качестве базовых для задач, подобных тем, что представлены в данном исследовании, поскольку эти методы концептуально просты, легко реализуемы, имеют пренебрежимо малые вычислительные затраты и демонстрируют хорошую производительность..
В совокупности производительность, вычислительные затраты и сложность реализации явно свидетельствуют в пользу легковесных методов. Это ставит под сомнение использование сложных алгоритмов машинного обучения для прогнозирования низкоразмерных хаотических динамических систем..
3.2 Полиномиальные аппроксимации данных без шума являются точными эмуляторами
⟦LinPo6, примененный к данным Lorenz63std без шума, обеспечивает практически идеальные прогнозы, достигая , равного (см. Table 7). Этот метод использует полином шестой степени для аппроксимации карты пропагатора . Наши результаты согласуются с экспериментами на системе Lorenz63, представленными в [Gau+21], из которых был адаптирован LinS (аппроксимация полиномиального пропагатора с временной задержкой), хотя LinPo6 не использует временную задержку. LinS достигает , равного , в наших условиях..
Хотя векторное поле ОДУ в Lorenz63std является полиномом второй степени, само отображение пропагатора не обязательно является полиномиальным. Однако, поскольку пропагатор получен в результате решения ОДУ с гладким векторным полем, он является гладкой функцией. Теорема Тейлора гарантирует, что полиномы могут обеспечивать все более точные аппроксимации таких гладких функций. Заметим, что мы получаем нашу эталонную траекторию , используя решатель Рунге-Кутты 4-го порядка с постоянным шагом решателя , где — это шаг наблюдения, чтобы гарантировать наличие членов высшего порядка в . Если бы мы вместо этого использовали метод Эйлера с шагом решателя, равным , то пропагатор действительно был бы полиномом второй степени..
В Figure 5 мы демонстрируем, что LinPo6 работает практически так же эффективно, как прямое решение ОДУ для Lorenz63std, исходя из начальных условий, заданных с 9 значащими цифрами. Это показывает, что LinPo6 превосходит точность 32-битной машинной арифметики одинарной точности, которая обеспечивает от 7 до 8 значащих цифр точности. Более того, поскольку наше имитационное исследование сохраняет данные в CSV файлах только с 8 цифрами после десятичной точки, LinPo6 близка к достижению наилучшей возможной точности с учетом ограничений данных (для Lorenz63std без шума).
3.3 Выбор метода и оптимизация гиперпараметров являются существенными ⟦K0⟧
По сравнению с результатами [Gil23] (названия методов, начинающиеся с символа подчеркивания в Table 3), несколько рассмотренных здесь методов имеют значительно меньшие ошибки: для данных Dysts без шума медианная метода _NBEAT, показавшего наилучшие результаты в [Gil23], составляет 0,56. Наименьшая ошибка, достигнутая в наших симуляциях, составляет 0,0041 (SpPo, Table 14).
Одной из причин улучшенной производительности является более обширная настройка гиперпараметров в нашем исследовании по сравнению с [Gil23], где для каждого метода оптимизировался только один параметр. Для методов с низкими вычислительными затратами мы оптимизируем несколько параметров. Чтобы проиллюстрировать этот эффект, мы сравниваем медианное значение (в скобках) для выбранных методов на наборе данных для тестирования без шума из Dysts, как показано в Table 3 и Table 14: нелинейная векторная авторегрессия _Nvar (0.80) и эхо-сеть _Esn (0.79) из [Gil23] по сути такие же, как наши LinS (0.0054) и EsnS (0.030) соответственно. Наши симуляции дают медианное значение , которое на порядки ниже, чем для соответствующих методов в [Gil23]. Это указывает на то, что оптимизация ключевых гиперпараметров имеет решающее значение для достижения высокой производительности в этих методах..
Однако обратите внимание, что SpPo4 и LinPo4 являются методами, не требующими настройки, и достигают медианных значений , равных 0,0079 и 0,040 соответственно. Более того, из всех методов [Gil23] только _NBEAT превосходит базовый метод Analog. Это подчеркивает критическую роль выбора подходящих методов и базовых показателей для конкретной задачи..
3.4 Влияние шума и проектирования временных шагов на абсолютную и относительную производительность
При отсутствии шума прогнозирование становится задачей интерполяции, тогда как зашумленные наблюдения приводят к задаче регрессии. Как правило, вполне ожидаемо, что производительность всех методов значительно снижается при добавлении шума к наблюдениям. Более того, методы, которые лучше всего подходят для задачи интерполяции без шума, как правило, не являются лучшими для задачи регрессии с шумом. Это различие очевидно при сравнении столбцов без шума и с шумом в Tables 1, 2 и 3⟧.
Сеть эхо-состояний Esn* имеет доступ к состояниям прошлого, в то время как схожий метод случайных признаков RaFe* — нет. Из-за марковской природы наших динамических систем знание прошлого не требуется в случае отсутствия шума, поскольку следующее состояние равно (истинному) пропагатору, примененному к текущему состоянию. Это отражено в наших результатах моделирования, где RaFe* имеет тенденцию работать лучше, чем Esn* в условиях отсутствия шума, и наоборот — в условиях с шумом измерений. Поскольку зашумленные системы Dysts создаются с системным шумом, они являются марковскими. Удивительно, но Esn*, по-видимому, имеет преимущество перед RaFe* и здесь..
В условиях шума сглаживающее решение на основе полинома более низкой степени SpPo2 показывает себя относительно лучше, чем полином более высокой степени SpPo4, и наоборот в случае отсутствия шума. Переобучение на шуме, которое невозможно в случае отсутствия шума, по-видимому, является причиной данного наблюдения..
Существует заметная разница в эффективности методов между фиксированными и случайными временными шагами (Tables 1 и 2). Как правило, случайные временные шаги для обучающих данных затрудняют прогнозирование (при фиксированных временных шагах). Но также меняется ранжирование методов в соответствии с их : метод на основе гауссовских процессов GpGp выходит в лидеры при случайных временных шагах. Для фиксированных временных шагов этот метод показывает лишь посредственные результаты..
Как и ожидалось, методы пропагатора, в которых временной шаг не является входным параметром, показывают плохие результаты, если временной шаг не является постоянным. При наличии дополнительных сведений о временном шаге (*ST и *DT) производительность улучшается (Table 15).
Сочетание случайного временного шага с зашумленными наблюдениями, по-видимому, делает задачу обучения чрезвычайно сложной. В случае Lorenz63random только GpGp (сглаживатель решений на основе гауссовских процессов) и LinST (гребневая регрессия полиномиального пропагатора) имеют лучшие показатели, чем базовый метод Analog. Для Lorenz63nonpar ни один метод не превосходит Analog.
3.5 Повторение экспериментов имеет решающее значение для надежной оценки
Поскольку в базе данных Dysts доступен только один временной ряд для каждой системы, сообщаемые различия в эффективности методов могут быть не вполне устойчивыми для одной и той же системы. Кроме того, доверительные интервалы, основанные на результатах для 133 систем, трудно обосновать, так как обычно приходится предполагать независимое и одинаковое распределение рассматриваемых значений, тогда как выбор конкретных систем для Dysts был детерминированным и зависимым процессом. Однако следует отметить, что код для генерации дополнительных данных для Dysts доступен в соответствующем репозитории..
Напротив, для DeebLorenz эксперименты для той же системы и схемы наблюдений повторяются 100 раз со случайным выбором начальных условий, значений шума и временных шагов (если применимо). Это позволяет нам судить о том, являются ли сообщаемые различия в значениях статистически значимыми. В Figure 7 мы визуализируем результаты парных -тестов для нулевой гипотезы . Если нулевая гипотеза может быть отвергнута, это показывает, что Method1 значительно лучше Method2 в данной системе при данной схеме наблюдений с использованием в качестве метрики ошибки. Мы видим, что ранжирование алгоритмов, показанное в Table 10, в основном устойчиво, за исключением перестановки двух или трех последовательных рангов. Для сравнения, Figure 8 показывает, что только 10 повторений привели бы к практически неразличимым результатам..
В целом, представляется целесообразным повторить эксперименты для получения более надежных результатов и возможности оценить степень уверенности в этих результатах.
3.6 Оценка лишена надежности при анализе только фиксированной системы
Хотя Lorenz63std и Lorenz63random имеют одинаковую функциональную форму векторного поля и различаются только полиномиальными коэффициентами, абсолютные ошибки и относительные ранги методов существенно варьируются между этими двумя системами (Tables 1 и 2).⟧).
Настройка для Lorenz63random (и Lorenz63nonpar) сложна тем, что настроенные гиперпараметры должны показывать хорошие результаты при различных, случайно выбранных параметрах системы. В отличие от этого, Lorenz63std имеет фиксированную динамику, что позволяет не только функциональной форме , но и конкретным полиномиальным коэффициентам быть (частично) выведенными в процессе настройки..
Таким образом, низкое значение ошибки для Lorenz63random является более надежным индикатором способности метода к обобщению, чем низкое значение ошибки для Lorenz63std.
3.7 Функциональная форма параметрического метода должна соответствовать системе
Большинство систем в Dysts и все системы, за исключением Lorenz63nonpar в DeebLorenz, имеют векторное поле , представляющее собой полином низкой степени. Таким образом, неудивительно, что методы, основанные на этом допущении, такие как SpPo (сглаживатель полиномиальных решений) и SINDy (аналогичен SpPo, но предполагает разреженность целевого полинома), показывают хорошие результаты в этих задачах. Заметим, что полиномиальное векторное поле не означает, что пропагатор для заданного временного шага также является полиномиальным. Тем не менее, может существовать приемлемая полиномиальная аппроксимация, что объяснило бы высокую эффективность Lin* (подгонка полиномиального пропагатора методом гребневой регрессии).).
Для Lorenz63std и Lorenz63random векторное поле представляет собой квадратичный многочлен. Для этих систем SpPo2, который аппроксимирует такой многочлен, работает очень хорошо (за исключением крайне сложной комбинации случайных временных шагов и зашумленных наблюдений). Однако метод демонстрирует низкую эффективность для неполиномиальной системы Lorenz63nonpar. То же самое верно в условиях отсутствия шума и постоянного временного шага для методов, способных аппроксимировать многочлены более высокой степени (SpPo, SpPo4, SINDy, SINDyN). В зашумленных условиях, где производительность в целом хуже, этот эффект не наблюдается, вероятно, из-за того, что полиномиальная аппроксимация (теорема Тейлора) достаточно точна по сравнению с другими методами..
Метод SINDyN (с нормализацией) обычно хуже, чем SINDy. Это логично, поскольку многие исследуемые здесь системы обладают разреженной полиномиальной динамикой, а нормализация (которая в нашем случае включает вращение) разрушает разреженность..
В целом, полиномиальная аппроксимация низкой степени работает хорошо только в том случае, если целевая функция может быть достаточно точно описана таким полиномом. По своей сути непараметрические методы, такие как GpGp или PgGp*, которые оба используют Gaussian processes, представляются более подходящими, если целевая функция не является полиномиальной..
3.8 Выбор правильного варианта пропагаторов улучшает производительность
Как и ожидалось, ошибки пропагаторов с входным параметром временного шага и без него (*T, Table 15) схожи, когда временной шаг постоянен. Исключение наблюдается для LinD, LinPo4 и LinPo6, которые аппроксимируют полиномиальный пропагатор с использованием гребневой регрессии в случае отсутствия шума, где производительность снижается, когда временной шаг (излишне) включается в качестве дополнительного входного параметра. Это снижение, вероятно, связано с численными проблемами, возникающими из-за коллинеарных предикторов. Однако для случайных временных шагов предоставление информации о временном шаге в большинстве случаев улучшает результаты..
Между версиями оценок пропагатора по состоянию (*S*) и по разностному отношению (*D*) (Table 16) нет явного лидера. Однако в случае случайных временных шагов без шума методы, основанные на разностном отношении, неизменно дают меньшие ошибки. Это может быть связано с уменьшением зависимости целевой переменной от временного шага при оценке разностного отношения. Кроме того, как PgGp*, так и PgNet*, которые аппроксимируют отображение пропагатора с помощью гауссовского процесса и нейронной сети соответственно, демонстрируют явное предпочтение разностного отношения в качестве целевой переменной (за исключением зашумленных условий со случайными временными шагами).).
Чтобы объяснить это предпочтение, отметим, что состояния системы изменяются плавно во времени, поэтому прогнозы на один шаг вперед должны быть близки к персистентности (где будущие состояния равны текущему состоянию). Когда целью является состояние, персистентность достигается с помощью тождественной функции в качестве пропагатора. Когда целью является разностное отношение, персистентность соответствует константной нулевой функции. Гауссовский процесс PgGp* имеет априорное распределение, центрированное в нуле, что смещает его в сторону персистентности в схеме с разностным отношением. Напротив, когда целью является состояние, его прогнозы смещены в сторону среднего значения наблюдений (климатологии), поскольку входные данные нормализованы. Для нейронной сети PgNet* константную нулевую функцию легче выучить, так как только веса в последнем слое должны иметь подходящие значения, в то время как тождественная функция требует соответствующих весов во всех слоях. Таким образом, как гауссовский процесс, так и нейронная сеть лучше подходят для схемы с разностным отношением из-за их внутреннего смещения в сторону нуля..
3.9 Использование кумулятивной максимальной ошибки является преимуществом
При ранжировании различных методов на основе их эффективности метрики ошибок , и , как правило, дают схожие результаты. Однако заметное различие возникает при использовании для более сложных задач, где высокие начальные показатели могут быть нивелированы последующим расхождением прогноза (вместо, например, перехода к константе), см. Table 13. Как видно из явных значений ошибок в Table 14, менее эффективна для различения хорошо работающих методов, когда длительность тестирования слишком мала или пороговый параметр слишком мягкий, поскольку несколько методов могут достичь максимального допустимого времени. не имеет ни одного из этих ограничений..
3.10 Недостаток данных для валидации может привести к перенастройке ⟦K0⟧
Неудивительно, что показатели ошибки настроенных методов, как правило, лучше на валидационном наборе данных, чем на тестовых наборах, см. Table 14. Для некоторых методов эта разница довольно велика (для Echo State Network EsnS мы имеем медиану , равную на валидационных данных Dysts без шума и на тестовых данных). В сочетании с большим количеством параметров, протестированных для этих методов (для EsnS на данных Dysts без шума — в среднем на систему), это говорит о том, что настройка гиперпараметров может привести к переобучению на валидационных данных. Это влияет на Dysts сильнее, чем на DeebLorenz, поскольку для первого существует гораздо меньше данных для настройки и отсутствуют повторения, что делает ошибки валидации менее устойчивыми..
4 Заключение
Медиана рангов в зависимости от времени вычислений для DeebLorenz
В данном исследовании представлен всесторонний анализ различных методов прогнозирования временных рядов для ряда низкоразмерных хаотических динамических систем, демонстрирующий, что легковесные, простые методы стабильно превосходят более сложные, вычислительно затратные алгоритмы (см. Figure 6). Методы, основанные на подходе сглаживания решений или простых оценщиках карт пропагатора, показали как высокую прогностическую эффективность, так и низкие вычислительные затраты. Напротив, более сложные machine learning модели, обученные с использованием градиентного спуска, в целом показали худшие результаты..
Оптимизация гиперпараметров показана как ключевой фактор для повышения точности в некоторых методах, при этом оптимизированные методы достигают ошибок на несколько порядков ниже, чем те, что были представлены в предыдущем исследовании с ограниченной настройкой. Кроме того, было обнаружено, что шум и случайные схемы временных шагов существенно влияют на производительность, при этом различные методы показывают лучшие результаты в разных условиях..
Более того, данная работа подчеркивает важность надежных методов оценки. Повторение экспериментов необходимо для обеспечения статистической значимости. Использование соответствующих метрик ошибки, таких как недавно введенная кумулятивная максимальная ошибка (), необходимо для выявления значимых различий в производительности..
В целом, содержательная оценка эффективности метода требует тщательно разработанного плана исследования, который включает соответствующую оптимизацию гиперпараметров, актуальные базовые методы, информативные метрики ошибок, количественную оценку неопределенности и методы честного сравнения. Однако многие существующие исследования не учитывают один или несколько из этих аспектов, в то время как мы стремимся придерживаться данных принципов. Наши результаты ставят под сомнение растущий акцент на сложных, вычислительно затратных моделях machine learning и показывают, что эти модели часто плохо подходят для прогнозирования низкоразмерных chaotic systems. Вместо этого более простые и эффективные подходы, адаптированные к конкретной предметной области, зачастую демонстрируют превосходную производительность..
Appendix A Базы данных
A.1 Динамические системы
База данных Dysts состоит из 133 хаотических систем с размерностью фазового пространства от до , см. Table 4. Подробное описание базы данных Dysts приведено в [Gil21]. Здесь мы прокомментируем некоторые особенности базы данных, в частности зашумленную версию.
| dimension | 3 | 4 | 5 | 6 | 10 |
| # systems | 102 | 19 | 2 | 3 | 7 |
- ⟦(i) В зашумленной версии данных система MacArthur является расходящейся (колебательные значения состояний порядка и выше). Более того, для CircadianRhythm и DoublePendulum дисперсия решений увеличивается на несколько порядков величины при переходе от версии без шума к зашумленной версии..
- ⟦(ii) Любопытно, что осциллирующее поведение системы Макартура делает ее довольно предсказуемой в зашумленном случае с лучшим равным , достигнутым EsnS, что ниже, чем лучший без шума, равный , достигнутый PgNetD.
- ⟦(iii) Для тестового набора данных без шума наиболее сложными для обучения системами оказались LidDrivenCavityFlow, IkedaDelay, DoublePendulum и ForcedVanDerPol. Все они имеют значения для лучших методов в данном исследовании, в то время как из систем имеют ниже для лучшего метода.
- ⟦(iv) Для следующих систем из набора данных с шумом обучение представляется невозможным (лучший метод с ): ArnoldBeltramiChildress, ArnoldWeb, BickleyJet. Из зашумленных систем, имеют ниже , а имеют выше ⟧.
A.2 ДибЛоренц
База данных DeebLorenz состоит из трех систем и четырех схем наблюдения и разделена на данные для настройки и тестирования с 10 и 100 повторениями соответственно..
Каждая система описывается автономным трехмерным обыкновенным дифференциальным уравнением первого порядка вида
где представляет собой векторное поле , а решение описывает состояние системы с течением времени. Для трех систем векторные поля создаются следующим образом:
- ⟦•
Lorenz63std:
Система Lorenz63 в ее стандартном определении [Lor63], а именно:
с , , ⟧.(12) - ⟦•
Lorenz63random:
Как и Lorenz63std, но для каждой репликации три параметра выбираются случайным образом из интервала с равномерным распределением,
Эти интервалы выбраны таким образом, чтобы результирующие системы демонстрировали хаотическое поведение.(13) - ⟦• Lorenz63nonpar: Как и Lorenz63std, но параметры зависят от состояния, , , . Для каждой репликации функции выбираются из гауссовского процесса таким образом, чтобы значения (неконстантных) параметров находились в (или, по крайней мере, были близки к) интервалах, выбранных в (13). Чтобы убедиться, что выбранные векторные поля приводят к интересным системам, мы отбрасываем результаты, в которых траектория заданных начальных состояний, по-видимому, приближается к неподвижной точке. Все полученные траектории демонстрируют хаотическое поведение.
Заметьте, что векторные поля Lorenz63std и Lorenz63random представляют собой полиномы второй степени, в которых 23 из 30 коэффициентов равны нулю, тогда как экземпляры векторных полей Lorenz63nonpar не могут быть описаны полиномом конечной степени.
Для получения одной репликации одной из систем задается или выбирается случайным образом, как описано выше. Затем начальные условия выбираются равномерно случайным образом из аттрактора Lorenz63 (в качестве аппроксимации для аттракторов других вариаций системы Lorenz63). Задача с начальными значениями , решается с использованием численного решателя ОДУ четвертого порядка Рунге-Кутты (RK4)33 3 Функция R deSolve::ode(..., method = "rk4") с постоянным шагом по времени (на порядок меньше, чем шаги наблюдения). Если шаги по времени случайны, они выбираются из экспоненциального распределения с параметром интенсивности и . Если размер шага постоянен, мы устанавливаем . Мы устанавливаем и . Последнее наблюдение выбирается таким образом, что , где . Количество наблюдений равно (точно для постоянных шагов по времени и в среднем для случайных шагов по времени). Для зашумленных наблюдений мы извлекаем независимый шум из многомерного нормального распределения со стандартным отклонением , где — это единичная матрица. Для схемы наблюдений без шума мы устанавливаем . Затем наблюдения представляют собой . Для тестирования мы также записываем , где , и ⟧.
Appendix B Методы
B.1 Реализация
Все методы реализованы на языке R [R C24], за исключением Node, который реализован на языке Julia [Bez+17]. Кроме того, PgNet*, Trafo*, Rnn*, Lstm*, Gru* используют Keras [Cho+15] (через его R-интерфейс). Все методы обучались на центральных процессорах (Intel Xeon Processor E5-2667 v3), за исключением методов, указанных в Table 19, которые используют графические процессоры (NVIDIA H100). Весь код для запуска методов доступен в публичных репозиториях git на GitHub, как указано в Table 5. Прогнозы для тестовых и валидационных данных доступны по адресу https://doi.org/10.5281/zenodo.12999941.
| chroetz/DEEBdata | generation of DeebLorenz |
|---|---|
| chroetz/DEEBcmd | command line interface for the other packages |
| chroetz/DEEBesti | estimation methods |
| chroetz/DEEBeval | evaluate predictions |
| chroetz/DEEBtrajs | handling the csv-files containing observations and predictions |
| chroetz/DEEB.jl | the Julia implementation of the neural ODE |
| chroetz/ConfigOpts | handling the json-files containing settings for methods |
B.2 Нормализация
Для всех методов, за исключением SINDy, мы вычисляем аффинную линейную нормализацию на основе обучающих данных: Пусть — эмпирическое среднее, а — эмпирическая ковариационная матрица. Тогда нормализованные данные представляют собой
| (14) |
Она имеет нулевое среднее значение и единичную ковариационную матрицу. Прогноз , полученный с помощью заданного метода, обученного на нормализованных данных, преобразуется обратно посредством
| (15) |
Чтобы не нарушить потенциальную разреженность, мы масштабируем входные данные для SINDy только путем умножения на величину, обратную квадратному корню из .
B.3 Различные варианты методов
Для методов, основанных на пропагаторах, изучается отображение из текущего состояния в следующее. Целью является либо непосредственно следующее состояние (суффикс S), либо приращение, масштабированное обратной величиной временного шага (суффикс D). В дополнение к текущему (и, возможно, прошлым) состоянию(-ям), временной шаг также может служить предиктором (суффикс T). См. также Section 2.3.
B.4 Ручная настройка и сетки гиперпараметров
Представленные ниже сетки гиперпараметров выбраны таким образом, чтобы обеспечить эффективную работу во всех системах при сохранении ограниченных вычислительных затрат. Многие передовые модели машинного обучения, такие как transformers, рекуррентные сети и neural ODEs, имеют множество вариантов. В данном исследовании мы используем стандартные, готовые архитектуры для всех методов, применяя минимальные ручные настройки и полагаясь на автоматическую настройку гиперпараметров, как подробно описано ниже. Хотя тщательная донастройка конкретных вариантов моделей потенциально могла бы улучшить производительность для отдельных систем, наш подход отдает приоритет справедливости при сравнении моделей. Такая архитектура также подходит для специалистов с ограниченным временем и вычислительными ресурсами при применении машинного обучения к данным из динамических систем..
B.5 Аналоговый
- ⟦• Параметры: отступ ⟧
- ⟦• настройка: категориальная, устойчивая: ⟧.
- ⟦• Описание: Инициализируйте и . Пусть . Установите для , . Если прогноз временного ряда еще не завершен, повторите с и ⟧.
B.6 Узел1, Узел32
- ⟦• Параметры: – количество скрытых слоев: – ширина скрытых слоев: – функция активации: swish – коэффициент затухания весов – шаги решателя ODE для функции потерь: – размер пакета: или , как указано в суффиксе названия метода (и один эксперимент, отмеченный * в Table 19 с ) – эпохи: – оптимизатор: AdamW – скорость обучения: – внутреннее разделение на обучение и валидацию для использования весов с наименьшей ошибкой валидации: 85% – 15%%
- ⟦• Настройка: – категориальный, дающий: – скалярный, экспоненциальный (множитель ): ,
- ⟦• Описание: См. [Che+18]. Мы используем реализацию на языке Julia.
- ⟦• Примечание о размере пакета для переменных временных шагов: Размер пакета, превышающий , требует равного количества вычислительных шагов для всех элементов внутри пакета. Когда временные шаги различаются между разными сегментами обучающего временного ряда, это требование не выполняется. Принудительное обучение в таких случаях путем установки временного шага на постоянное значение приводит к значительно большим значениям ошибки по сравнению с использованием размера пакета, равного единице. Следовательно, мы не приводим результаты для Node32 в случае случайных временных шагов.
- ⟦• Примечание о более крупных сетях: Мы оценили более широкие и глубокие сети, используя валидационный набор данных Lorenz63std. Однако эти более крупные архитектуры либо приводили к увеличению ошибок, либо давали снижение ошибок, которое не было статистически значимым (⟧).
B.7 PgGp*
B.8 PgNet*
- ⟦• Параметры: – размер пакета: (и один эксперимент, отмеченный * в Table 19 с ) – эпохи: , – разделение на обучающую и валидационную выборки: 90% – 10% – архитектура (кортеж ширины слоев): – функция активации: swish – скорость обучения
- ⟦• Настройка: категориальная, дающая: ⟧
- ⟦• Описание: Оценщик пропагатора (раздел B.3) с использованием стандартной нейронной сети прямого распространения, реализованной на Keras.
B.9 PgLl*
- ⟦• Параметры: – ядерная функция: – ширина полосы пропускания: – соседи:
- ⟦• Настройка: – скалярный, экспоненциальный (коэффициент ): ,
- ⟦• Описание: Оценщик пропагатора (раздел B.3), использующий локально-линейный оценщик. Локальность вводится с помощью весов ядра и ограничения -ближайших соседей. Последнее используется для снижения вычислительных затрат.
B.10 Лин*
- ⟦• Параметры: – предыдущие шаги – шаги пропуска – степень полинома – штраф ⟧
- ⟦• Настройка: – скалярная, линейная (шаг ): , – скалярная, линейная (шаг ): , – скалярная, линейная (шаг ): , – скалярная, экспоненциальная (коэффициент ): , ⟧
- ⟦• Описание: Оценщик пропагатора (раздел B.3), использующий Ridge регрессию (линейную регрессию с -штрафом с весом ) на полиномиальных признаках степени не более от текущего состояния в момент времени и прошлых состояний , .
B.11 LinPo4, LinPo6, LinPo4T, LinPo6T
B.12 RaFe*
- ⟦• Параметры: – количество нейронов: – масштаб входных весов – штраф – пропуск вперед – случайное начальное число ⟧
- ⟦• Настройка: – скалярная, экспоненциальная (коэффициент ): , – скалярная, экспоненциальная (коэффициент ): , – скалярная, экспоненциальная (коэффициент ): , – категориальная, персистентная:
- ⟦• Описание: Оценщик пропагатора (раздел B.3), использующий регрессию на случайных признаках, то есть Ridge регрессию на признаках, созданных с помощью необученной стандартной нейронной сети прямого распространения с 1 слоем из нейронов. Пропуск вперед модифицирует целевую переменную до , что может помочь в случаях высокого уровня шума измерений и малых шагов..
B.13 Esn*
B.14 Trafo*
- ⟦• Параметры: – длина контекста: , – размерность позиционного кодирования: – размер головы: – количество голов: – количество блоков: – количество нейронов в слоях MLP: – параметр dropout: – скорость обучения: – разделение на обучающую и валидационную выборки: 90% – 10% – эпохи: – размер пакета: (и один эксперимент, отмеченный * в Table 19 с ) – позиционное кодирование: синусоидальное – функция потерь: MSE – оптимизатор: Adam
- ⟦• Настройка: Мы тестируем комбинации гиперпараметров , приведенные в строках Table 6⟧.
- ⟦• Описание: Мы используем реализацию сети transformers на базе Keras. В качестве входных данных мы берем состояния в моменты времени и добавляем синусоидальное позиционное кодирование размерности , присоединяя его к каждому из векторов состояний. Сеть состоит из последовательных блоков, включающих слой внимания (за которым следует нормализация слоя) и плотный MLP-слой с активацией ReLu (за которым следует нормализация слоя). Слои внимания имеют голов размерности .
B.15 PwNn
- ⟦• Параметры: отсутствуют.
- ⟦• Настройка: отсутствует.
- ⟦• Описание: Сглаживатель решений, использующий кусочно-линейную интерполяцию для оценки решения и интерполяцию ближайшего соседа для оценки векторного поля ⟧.
B.16 SpNn
- ⟦• Параметры: отсутствуют.
- ⟦• Настройка: отсутствует.
- ⟦• Описание: Сглаживатель решений, использующий кубическую сплайн-интерполяцию для оценки решения и интерполяцию методом ближайшего соседа для оценки векторного поля .
B.17 LlNn
- ⟦• Параметры: – ядерная функция: – ширина полосы пропускания: ⟧
- ⟦• Настройка: – скалярное, экспоненциальное (коэффициент ): ,
- ⟦• Описание: Сглаживатель решений, использующий локальную линейную регрессию для оценки решения и интерполяцию ближайших соседей для оценки векторного поля ⟧.
B.18 SpPo
- ⟦• Параметры: – степень полинома – штраф
- ⟦• Настройка: – скалярная, линейная (шаг ): , – скалярная, экспоненциальная (коэффициент ): ,
- ⟦• Описание: Сглаживатель решений, использующий кубическую сплайн-интерполяцию для оценки решения и Ridge регрессию с полиномиальными признаками для оценки векторного поля .
B.19 SpPo2, SpPo4
B.20 SpGp
- ⟦• Параметры: – ширина полосы пропускания: – соседи: – ядерная функция: – регуляризация:
- ⟦• Настройка: – скаляр, экспоненциальный (множитель ): , – скаляр, экспоненциальный (множитель ): , ⟧
- ⟦• Описание: Сглаживатель решений, использующий кубическую сплайн-интерполяцию для оценки решения и регрессию гауссовских процессов для оценки векторного поля . Чтобы сделать гауссовский процесс вычислительно эффективным, мы локализуем его, учитывая только ближайших соседей для оценки.
B.21 GpGp
- ⟦• Параметры: – ширина полосы пропускания: – соседи: – ядерная функция: – регуляризация: – ширина полосы пропускания решения: – регуляризация решения
- ⟦• Настройка: – скаляр, экспоненциальный (множитель ): , – скаляр, экспоненциальный (множитель ): , – скаляр, экспоненциальный (множитель ): , ⟧
- ⟦• Описание: Сглаживатель решений, использующий регрессию на основе гауссовских процессов для оценки решения и регрессию на основе гауссовских процессов для оценки векторного поля . Чтобы сделать второй гауссовский процесс вычислительно эффективным, мы локализуем его, учитывая только ближайших соседей для оценки.
B.22 SINDy, SINDyN
- ⟦• Параметры: – степень полинома: – итерации пороговой обработки: – порог
- ⟦• Настройка: – скалярный, экспоненциальный (множитель ): ,
- ⟦• Описание: Сглаживатель решений, использующий кубическую сплайн-интерполяцию для оценки решения и разреженную линейную регрессию с полиномиальными признаками для оценки векторного поля . См. [BPK16]⟧.
B.23 Рекуррентная нейронная сеть*, Lstm*, Gru*
- ⟦• Параметры: – размер пакета: 32 (и один эксперимент, отмеченный * в Table 19 с ) – эпохи: 100, – разделение на обучающую и валидационную выборки: 90% – 10% – архитектура (кортеж ширины слоев): – функция активации: swish – скорость обучения
- ⟦• Настройка: категориальная, дающая: ⟧
- ⟦• Описание: Архитектуры рекуррентных нейронных сетей, реализованные с использованием Keras.
Appendix C О симметричной средней абсолютной процентной ошибке
В этом разделе мы демонстрируем некоторые математические свойства симметричной средней абсолютной процентной ошибки, .
Пусть и . Пусть — измеримые функции такие, что не существует , для которого . Тогда определяется как
где обозначает евклидову норму. Заметим, что случай должен быть исключен, чтобы избежать деления на ноль.
обладает следующими свойствами:
- ⟦(i)
- ⟦(ii) Симметрия: ⟧
- ⟦(iii) тогда и только тогда, когда почти для всех ⟧
- ⟦(iv) тогда и только тогда, когда существует такое, что почти для всех ⟧
- ⟦(v) Если для образует последовательность функций с и , то
Доказательство.
- ⟦(i) Неотрицательность и неравенство треугольника для евклидовой нормы.
- ⟦(ii) Тривиальный.
- ⟦(iii) Очевидно, что тогда и только тогда, когда почти для всех ⟧.
- ⟦(iv) С одной стороны, если такая функция существует, мы имеем . Таким образом, . С другой стороны, если , мы должны иметь почти для всех . Поскольку неравенство треугольника может быть равенством только для линейно зависимых векторов, должно существовать такое, что . Более того, должно быть неположительным, так как мы требуем .
- ⟦(v)
Пусть и . Тогда
∎
Appendix D Дополнительные сведения о результатах
В этом разделе мы приводим дополнительные таблицы и графики, которые более подробно демонстрируют результаты имитационного моделирования. Средние значения ошибок (, , ) для DeebLorenz представлены в Tables 7, 8 и 9. Соответствующие ранги отображены в Tables 10, 11 и 12. Кроме того, в Table 13 показаны ранги для всех метрик ошибок в сопоставлении друг с другом и выделены наиболее значимые расхождения. Для Dysts медианные значения ошибок по всем системам приведены в Table 14. Эти таблицы также включают значения метрик ошибок на данных для настройки. В Table 15 и Table 16 подробно описана производительность различных вариантов методов, основанных на пропагаторах. Результаты статистических тестов для различения производительности методов на DeebLorenz показаны в Figure 7 и Figure 8. Figures 9, 10, 11, 12 и 13 демонстрируют варианты Figure 4 для других систем и схем наблюдения DeebLorenz. Наконец, в Table 19 представлены результаты для системы Lorenz63std из DeebLorenz с уменьшенным и увеличенным объемом данных..
Список литературы
- ⟦[Bez+17] Джефф Безансон, Алан Эдельман, Стефан Карпински и Вирал Шах «Julia: новый подход к численным вычислениям» В SIAM review 59.1 SIAM, 2017, стр. 65–98 DOI: 10.1137/141000671
- ⟦[BPK16] Стивен Брантон, Джошуа Проктор и Дж. Кутц «Открытие управляющих уравнений на основе данных путем разреженной идентификации нелинейных динамических систем» В материалах Национальной академии наук 113.15 Материалы Национальной академии наук, 2016, стр. 3932–3937 DOI: 10.1073/pnas.1517384113
- ⟦[Che+18] Рики Чен, Юлия Рубанова, Джесси Беттенкурт и Дэвид Дювено «Нейронные обыкновенные дифференциальные уравнения» В сборнике трудов 32-й Международной конференции по нейронным системам обработки информации, NIPS’18 Монреаль, Канада: Curran Associates Inc., 2018, стр. 6572–6583
- ⟦[Cho+14] Кюнхён Чо, Барт ван Мерриенбур, Чаглар Гюльчехре, Дмитрий Багданов, Фетхи Бугарес, Хольгер Швенк и Йошуа Бенджио «Изучение представлений фраз с использованием RNN Encoder-Decoder для статистического машинного перевода» В материалах конференции 2014 года по эмпирическим методам в обработке естественного языка, EMNLP 2014, 25–29 октября 2014 г., Доха, Катар, собрание SIGDAT, специальной группы по интересам ACL ACL, 2014, стр. 1724–1734 DOI: 10.3115/V1/D14-1179
- ⟦[Cho+15] Франсуа Шолле “Keras”, https://keras.io, 2015
- ⟦[Fan93] Цзяньцин Фань «Локально-линейные регрессионные сглаживатели и их минимаксная эффективность» В Ann. Statist. 21.1, 1993, стр. 196–216 DOI: 10.1214/aos/1176349022
- ⟦[For+77] Джордж Форсайт «Компьютерные методы для математических вычислений» Прентис-холл, 1977
- ⟦[Gau+21] Дэниел Готье, Эрик Боллт, Аарон Гриффит и Вендсон Барбоза «Резервуарные вычисления нового поколения» В Nature Communications 12.1 Springer ScienceBusiness Media LLC, 2021 DOI: 10.1038/s41467-021-25801-2
- ⟦[Gil21] Уильям Гилпин «Хаос как интерпретируемый эталон для прогнозирования и моделирования на основе данных» В материалах трека по наборам данных и эталонным тестам конференции Neural Information Processing Systems 1, NeurIPS Datasets and Benchmarks 2021, декабрь 2021 г., виртуально, 2021 г.
- ⟦[Gil23] Уильям Гилпин «Масштаб модели против предметных знаний в статистическом прогнозировании хаотических систем» В Phys. Rev. Res. 5 Американское физическое общество, 2023, стр. 043252 DOI: 10.1103/PhysRevResearch.5.043252
- ⟦[God+21] Ракшита Годахева, Кристоф Бергмайр, Джеффри Уэбб, Роб Хайндман и Пабло Монтеро-Мансо «Архив прогнозирования временных рядов Монаша» В материалах Тридцать пятой конференции по нейронным системам обработки информации, трек наборов данных и сравнительного анализа (Раунд 2), 2021 г. URL: https://openreview.net/forum?id=wEc1mgAjU-
- ⟦[Han+21] Чжунъян Хань, Цзюнь Чжао, Генри Люн, Кинг Ма и Вэй Ван «Обзор моделей глубокого обучения для прогнозирования временных рядов» В IEEE Sensors Journal 21.6, 2021, стр. 7833–7848 DOI: 10.1109/JSEN.2019.2923982
- ⟦[Has+09] Тревор Хасти, Роберт Тибширани, Джером Фридман и Джером Фридман «Элементы статистического обучения: интеллектуальный анализ данных, логический вывод и прогнозирование» Шпрингер, 2009
- ⟦[Hei+18] Маркус Хейнонен, Чагатай Йылдыз, Хенрик Маннерстрём, Юкка Интосалми и Харри Ляхдесмяки «Изучение неизвестных моделей обыкновенных дифференциальных уравнений с помощью гауссовских процессов» В материалах 35-й Международной конференции по машинному обучению 80, Материалы исследований в области машинного обучения PMLR, 2018, стр. 1959–1968
- ⟦[HS97] Сепп Хохрайтер и Юрген Шмидхубер «Долгая краткосрочная память» В журнале Neural Computation 9.8, 1997, стр. 1735–1780 DOI: 10.1162/neco.1997.9.8.1735
- ⟦[Jae01] Герберт Йегер «Подход «состояния эха» к анализу и обучению рекуррентных нейронных сетей — с примечанием об опечатках» В Бонне, Германия: Технический отчет 148.34 Немецкого национального исследовательского центра информационных технологий GMD Бонн, 2001, стр. 13
- ⟦[Lor63] Эдвард Лоренц «Детерминированные непериодические потоки» В журнале Journal of the Atmospheric Sciences 20.2 Американское метеорологическое общество, 1963, стр. 130–141 DOI: 10.1175/1520-0469(1963)020<0130:dnf>2.0.co;2
- ⟦[Ore+20] Борис Орешкин, Дмитрий Карпов, Николя Шападос и Йошуа Бенджио «N-BEATS: Анализ разложения на нейронные базисы для интерпретируемого прогнозирования временных рядов» В сборнике Международной конференции по обучению представлений, 2020 URL: https://openreview.net/forum?id=r1ecqn4YwB
- ⟦[Ott02] Эдвард Отт «Хаос в динамических системах» Издательство Кембриджского университета, Кембридж, 2002, стр. xii+478 DOI: 10.1017/CBO9780511803260
- ⟦[Pat+18] Джайдип Патак, Александр Викнер, Ребекка Фасселл, Сартак Чандра, Брайан Хант, Мишель Гирван и Эдвард Отт «Гибридное прогнозирование хаотических процессов: использование машинного обучения в сочетании с моделью, основанной на знаниях» В журнале Chaos: An Interdisciplinary Journal of Nonlinear Science 28.4 AIP Publishing, 2018
- ⟦[R C24] R Core Team «R: Язык и среда для статистических вычислений», 2024 R Foundation for Statistical Computing URL: https://www.R-project.org/
- ⟦[Ren+09] Хунли Жэнь, Цзифань Чжоу, Цзяньпин Хуан и Пэйцюнь Чжан «Теоретические основы и применение аналого-динамической модели в системе Лоренца» В Adv. Atmos. Sci. 26.1 Springer ScienceBusiness Media LLC, 2009, стр. 67–77
- ⟦[RH17] Джеймс Рэмси и Джайлс Хукер «Анализ динамических данных» Моделирование данных с помощью дифференциальных уравнений, Серия статистических изданий Шпрингера, Springer Шпрингер, Нью-Йорк, 2017, стр. xvii+230 DOI: 10.1007/978-1-4939-7190-9
- ⟦[RHW86] Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс «Изучение внутренних представлений посредством распространения ошибки, параллельная распределенная обработка, исследования микроструктуры познания, под ред. де Румельхарта и Дж. Макклелланда. том 1. 1986» В Biometrika 71.599-607, 1986, стр. 6
- ⟦[RR08] Али Рахими и Бенджамин Рехт «Равномерная аппроксимация функций с помощью случайных базисов» В материалах 46-й ежегодной конференции Allerton по коммуникациям, управлению и вычислениям, 2008 г., стр. 555–561 DOI: 10.1109/ALLERTON.2008.4797607
- ⟦[RW05] Карл Расмуссен и Кристофер Уильямс «Гауссовские процессы в машинном обучении» Издательство Массачусетского технологического института, 2005 DOI: 10.7551/mitpress/3206.001.0001
- ⟦[RW94] Д. Рапперт и М. Уэнд «Многомерная локально взвешенная регрессия наименьших квадратов» В Ann. Statist. 22.3, 1994, стр. 1346–1370 DOI: 10.1214/aos/1176325632
- ⟦[Sch24] Кристоф Шётц «Непараметрическое оценивание обыкновенных дифференциальных уравнений: Snake and Stubble», 2024 DOI: 10.48550/arXiv.2407.14989
- ⟦[SFC22] Шахрох Шахи, Флавио Фентон и Элизабет Черри «Прогнозирование хаотических временных рядов с использованием рекуррентных нейронных сетей и методов резервуарных вычислений: сравнительное исследование» В Machine Learning with Applications 8, 2022, стр. 100300 DOI: 10.1016/j.mlwa.2022.100300
- ⟦[She20] Алекс Шерстинский «Основы рекуррентных нейронных сетей (RNN) и сетей с долговременной краткосрочной памятью (LSTM)» В журнале Physica D: Nonlinear Phenomena 404, 2020, стр. 132306 DOI: 10.1016/j.physd.2019.132306
- ⟦[SS24] Кристоф Шётц и Максимилиан Зибель «Нижние границы для непараметрического оценивания обыкновенных дифференциальных уравнений», 2024 DOI: 10.48550/arXiv.2407.14993
- ⟦[Str24] Стивен Строгац «Нелинейная динамика и хаос» Нью-Йорк: ChapmanHall/CRC, 2024 DOI: 10.1201/9780429398490
- ⟦[Vas+17] Ашиш Васвани, Ноам Шазир, Ники Пармар, Якоб Ушкорейт, Ллион Джонс, Эйдан Гомес, Лукаш Кайзер и Илья Полосухин «Attention is All you Need» В сборнике Advances in Neural Information Processing Systems 30 Curran Associates, Inc., 2017
- ⟦[Vla+20] Пантелис-Рафаил Влахас, Джайдип Патак, Брайан Хант, Фемистокл Сапсис, Мишель Гирван, Эдвард Отт и Петрос Кумуцакос «Алгоритмы обратного распространения ошибки и резервуарные вычисления в рекуррентных нейронных сетях для прогнозирования сложной пространственно-временной динамики» В журнале Neural Networks 126 Elsevier, 2020, стр. 191–217
- ⟦[Wen+23] Цинсун Вэнь, Тянь Чжоу, Чаоли Чжан, Вэйци Чэнь, Цзыцин Ма, Цзюньчи Янь и Лян Сунь «Трансформеры в анализе временных рядов: обзор», секция обзоров В материалах Тридцать второй международной объединенной конференции по искусственному интеллекту, IJCAI-23 Организация международных объединенных конференций по искусственному интеллекту, 2023 г., стр. 6778–6786 DOI: 10.24963/ijcai.2023/759
- ⟦[Zen+23] Эйлинг Зенг, Муси Чен, Лей Чжан и Цян Сюй «Эффективны ли transformers для прогнозирования временных рядов?» В материалах конференции AAAI по искусственному интеллекту 37.9, 2023, стр. 11121–11128
| Constant | Random | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Noisefree | Noisy | Noisefree | Noisy | ||||||||||
| Method | Median | S | R | N | S | R | N | S | R | N | S | R | N |
| GpGp | 0.60 | 0.18 | 0.40 | 0.40 | 0.68 | 0.77 | 0.71 | 0.22 | 0.52 | 0.52 | 0.69 | 0.78 | 0.80 |
| SpPo | 0.65 | 0.0033 | 0.22 | 0.30 | 0.54 | 0.63 | 0.67 | 0.37 | 0.67 | 0.68 | 0.99 | 0.98 | 0.98 |
| SpPo4 | 0.66 | 0.0023 | 0.22 | 0.51 | 0.66 | 0.71 | 0.66 | 0.37 | 0.67 | 0.64 | 0.98 | 0.98 | 0.98 |
| LinDT | 0.66 | 0.000078 | 0.11 | 0.18 | 0.60 | 0.71 | 0.62 | 0.48 | 0.83 | 0.80 | 0.99 | 0.99 | 0.97 |
| SINDy | 0.66 | 0.0088 | 0.27 | 0.37 | 0.67 | 0.74 | 0.66 | 0.39 | 0.71 | 0.65 | 0.99 | 0.98 | 0.98 |
| SINDyN | 0.67 | 0.014 | 0.30 | 0.64 | 0.67 | 0.74 | 0.68 | 0.40 | 0.73 | 0.66 | 0.99 | 0.98 | 0.98 |
| EsnDT | 0.70 | 0.044 | 0.35 | 0.34 | 0.63 | 0.72 | 0.66 | 0.67 | 0.85 | 0.84 | 0.75 | 0.88 | 0.87 |
| LinST | 0.71 | 0.00019 | 0.057 | 0.23 | 0.60 | 0.71 | 0.63 | 0.71 | 0.87 | 0.90 | 0.76 | 0.83 | 0.90 |
| SpGp | 0.72 | 0.24 | 0.37 | 0.38 | 0.77 | 0.82 | 0.80 | 0.45 | 0.68 | 0.62 | 0.97 | 0.93 | 0.95 |
| RaFeDT | 0.73 | 0.052 | 0.29 | 0.28 | 0.65 | 0.77 | 0.70 | 0.69 | 0.84 | 0.81 | 0.75 | 0.88 | 0.85 |
| EsnD | 0.73 | 0.046 | 0.34 | 0.31 | 0.65 | 0.73 | 0.68 | 0.74 | 0.85 | 0.84 | 0.78 | 0.89 | 0.86 |
| LinD | 0.74 | 0.000043 | 0.094 | 0.18 | 0.63 | 0.71 | 0.67 | 0.76 | 0.87 | 0.84 | 0.99 | 0.99 | 0.99 |
| PgGpDT | 0.74 | 0.014 | 0.11 | 0.16 | 0.76 | 0.79 | 0.81 | 0.47 | 0.72 | 0.72 | 0.99 | 0.99 | 0.98 |
| RaFeST | 0.75 | 0.073 | 0.28 | 0.27 | 0.65 | 0.77 | 0.73 | 0.90 | 0.96 | 0.93 | 0.74 | 0.90 | 0.90 |
| RaFeD | 0.76 | 0.052 | 0.29 | 0.27 | 0.64 | 0.77 | 0.70 | 0.74 | 0.87 | 0.83 | 0.80 | 0.90 | 0.87 |
| SpPo2 | 0.76 | 0.0099 | 0.28 | 0.87 | 0.54 | 0.63 | 0.87 | 0.33 | 0.65 | 0.87 | 0.98 | 0.98 | 0.98 |
| LinPo4T | 0.77 | 0.24 | 0.47 | 0.58 | 0.75 | 0.80 | 0.77 | 0.55 | 0.78 | 0.78 | 0.99 | 0.99 | 0.98 |
| LinPo4 | 0.78 | 0.019 | 0.35 | 0.56 | 0.75 | 0.80 | 0.76 | 0.72 | 0.86 | 0.83 | 0.99 | 0.99 | 0.98 |
| PgLlDT | 0.78 | 0.61 | 0.69 | 0.69 | 0.75 | 0.80 | 0.77 | 0.68 | 0.86 | 0.81 | 1.0 | 0.99 | 0.99 |
| Analog | 0.79 | 0.74 | 0.83 | 0.79 | 0.76 | 0.83 | 0.80 | 0.76 | 0.84 | 0.78 | 0.77 | 0.85 | 0.79 |
| PgLlD | 0.79 | 0.56 | 0.69 | 0.66 | 0.75 | 0.80 | 0.77 | 0.77 | 0.88 | 0.85 | 1.0 | 0.99 | 0.99 |
| SpNn | 0.80 | 0.67 | 0.78 | 0.70 | 0.83 | 0.84 | 0.81 | 0.68 | 0.78 | 0.71 | 0.94 | 0.94 | 0.94 |
| EsnST | 0.80 | 0.12 | 0.31 | 0.34 | 0.61 | 0.74 | 0.66 | 0.91 | 0.96 | 0.93 | 0.86 | 0.93 | 0.92 |
| LinS | 0.81 | 0.00019 | 0.057 | 0.23 | 0.63 | 0.71 | 0.67 | 0.91 | 0.95 | 0.94 | 0.91 | 0.96 | 0.94 |
| LinPo6T | 0.81 | 0.54 | 0.64 | 0.80 | 0.74 | 0.79 | 0.85 | 0.61 | 0.82 | 0.87 | 1.0 | 0.99 | 0.98 |
| PgGpST | 0.82 | 0.048 | 0.24 | 0.22 | 0.81 | 0.82 | 0.80 | 0.76 | 0.89 | 0.89 | 0.88 | 0.91 | 0.90 |
| PgNetDT | 0.82 | 0.56 | 0.69 | 0.62 | 0.81 | 0.86 | 0.84 | 0.68 | 0.82 | 0.79 | 0.99 | 0.98 | 0.98 |
| PgGpD | 0.82 | 0.014 | 0.11 | 0.16 | 0.75 | 0.83 | 0.81 | 0.78 | 0.88 | 0.86 | 0.99 | 0.97 | 0.99 |
| EsnS | 0.82 | 0.067 | 0.35 | 0.32 | 0.65 | 0.73 | 0.66 | 0.92 | 0.97 | 0.94 | 0.91 | 0.96 | 0.94 |
| Node1 | 0.82 | 0.71 | 0.82 | 0.79 | 0.85 | 0.86 | 0.87 | 0.70 | 0.82 | 0.81 | 0.83 | 0.87 | 0.86 |
| RaFeS | 0.82 | 0.072 | 0.31 | 0.26 | 0.61 | 0.74 | 0.73 | 0.91 | 0.96 | 0.94 | 0.92 | 0.96 | 0.93 |
| LlNn | 0.83 | 0.67 | 0.80 | 0.74 | 0.77 | 0.84 | 0.82 | 0.80 | 0.91 | 0.88 | 0.84 | 0.92 | 0.91 |
| PwlNn | 0.83 | 0.70 | 0.82 | 0.75 | 0.80 | 0.85 | 0.83 | 0.75 | 0.88 | 0.84 | 0.90 | 0.93 | 0.91 |
| LinPo6 | 0.84 | 0.0000066 | 0.047 | 0.31 | 0.75 | 0.80 | 0.77 | 0.93 | 0.91 | 0.88 | 1.0 | 1.0 | 0.99 |
| PgNetD | 0.84 | 0.54 | 0.72 | 0.64 | 0.80 | 0.86 | 0.82 | 0.79 | 0.90 | 0.87 | 0.99 | 0.99 | 0.98 |
| PgLlST | 0.85 | 0.50 | 0.67 | 0.62 | 0.76 | 0.80 | 0.77 | 0.91 | 0.96 | 0.94 | 0.90 | 0.95 | 0.93 |
| PgGpS | 0.86 | 0.048 | 0.24 | 0.22 | 0.81 | 0.82 | 0.80 | 0.89 | 0.95 | 0.93 | 0.89 | 0.96 | 0.93 |
| PgLlS | 0.86 | 0.56 | 0.69 | 0.65 | 0.75 | 0.80 | 0.77 | 0.94 | 0.97 | 0.95 | 0.92 | 0.96 | 0.93 |
| PgNetST | 0.88 | 0.67 | 0.77 | 0.76 | 0.88 | 0.89 | 0.87 | 0.83 | 0.90 | 0.88 | 0.89 | 0.91 | 0.91 |
| Node32 | 0.89 | 0.68 | 0.78 | 0.79 | 0.79 | 0.85 | 0.85 | 0.96 | 0.97 | 0.96 | 0.94 | 0.97 | 0.95 |
| GruT | 0.91 | 0.79 | 0.86 | 0.86 | 0.87 | 0.91 | 0.89 | 0.94 | 0.96 | 0.95 | 0.91 | 0.95 | 0.92 |
| PgNetS | 0.92 | 0.65 | 0.77 | 0.75 | 0.88 | 0.90 | 0.88 | 0.93 | 0.96 | 0.94 | 0.93 | 0.96 | 0.94 |
| TrafoT | 0.92 | 0.85 | 0.91 | 0.88 | 0.86 | 0.90 | 0.89 | 0.94 | 0.96 | 0.95 | 0.94 | 0.96 | 0.95 |
| Trafo | 0.92 | 0.85 | 0.90 | 0.89 | 0.84 | 0.90 | 0.89 | 0.95 | 0.96 | 0.95 | 0.95 | 0.96 | 0.96 |
| Gru | 0.93 | 0.78 | 0.85 | 0.84 | 0.87 | 0.91 | 0.89 | 0.94 | 0.97 | 0.95 | 0.95 | 0.96 | 0.96 |
| RnnT | 0.94 | 0.85 | 0.91 | 0.90 | 0.92 | 0.93 | 0.92 | 0.95 | 0.97 | 0.97 | 0.95 | 0.97 | 0.96 |
| Rnn | 0.95 | 0.85 | 0.91 | 0.91 | 0.92 | 0.93 | 0.93 | 0.97 | 0.97 | 0.96 | 0.96 | 0.97 | 0.96 |
| LstmT | 0.96 | 0.88 | 0.92 | 0.91 | 0.92 | 0.94 | 0.92 | 0.97 | 0.98 | 0.97 | 0.98 | 0.98 | 0.97 |
| Lstm | 0.97 | 0.86 | 0.92 | 0.91 | 0.92 | 0.97 | 0.92 | 0.97 | 0.98 | 0.97 | 0.97 | 0.98 | 0.97 |
| ConstL | 0.99 | 0.99 | 0.99 | 0.98 | 0.99 | 0.99 | 0.98 | 0.99 | 0.99 | 0.98 | 0.99 | 0.99 | 0.98 |
| ConstM | 1.0 | 1.0 | 1.0 | 0.99 | 1.0 | 1.0 | 0.99 | 1.0 | 1.0 | 0.99 | 1.0 | 1.0 | 0.99 |
| Constant | Random | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Noisefree | Noisy | Noisefree | Noisy | ||||||||||
| Method | Median | S | R | N | S | R | N | S | R | N | S | R | N |
| GpGp | 38 | 9.4 | 23 | 24 | 42 | 47 | 42 | 13 | 31 | 35 | 46 | 50 | 59 |
| SpPo | 39 | 0.072 | 12 | 16 | 33 | 38 | 39 | 21 | 40 | 40 | 75 | 79 | 66 |
| SpPo4 | 39 | 0.058 | 12 | 31 | 40 | 44 | 40 | 20 | 39 | 39 | 76 | 76 | 66 |
| LinDT | 40 | 0.0017 | 4.8 | 9.2 | 38 | 43 | 37 | 28 | 54 | 48 | 66 | 130 | 56 |
| SINDyN | 41 | 0.39 | 16 | 37 | 42 | 44 | 40 | 23 | 45 | 38 | 75 | 75 | 63 |
| SINDy | 42 | 0.20 | 14 | 21 | 57 | 48 | 39 | 22 | 45 | 40 | 110 | 120 | 100 |
| EsnDT | 44 | 1.5 | 19 | 19 | 40 | 45 | 38 | 43 | 63 | 55 | 49 | 63 | 84 |
| EsnD | 46 | 2.0 | 18 | 18 | 39 | 44 | 39 | 48 | 55 | 51 | 55 | 62 | 56 |
| LinST | 46 | 0.0039 | 2.6 | 11 | 38 | 43 | 37 | 48 | 60 | 55 | 51 | 53 | 56 |
| RaFeDT | 46 | 1.6 | 15 | 16 | 39 | 48 | 42 | 45 | 53 | 61 | 49 | 61 | 54 |
| SpPo2 | 46 | 0.24 | 15 | 54 | 33 | 38 | 54 | 18 | 39 | 54 | 86 | 79 | 75 |
| LinD | 47 | 0.00090 | 4.6 | 9.2 | 40 | 43 | 40 | 51 | 57 | 51 | 150 | 66 | 52 |
| LinPo4T | 47 | 12 | 27 | 35 | 49 | 51 | 45 | 33 | 48 | 47 | 66 | 64 | 54 |
| PgGpDT | 47 | 0.28 | 5.5 | 8.2 | 53 | 49 | 48 | 28 | 45 | 46 | 85 | 82 | 68 |
| SpGp | 48 | 13 | 21 | 23 | 52 | 51 | 52 | 28 | 43 | 44 | 81 | 77 | 76 |
| RaFeST | 48 | 2.0 | 14 | 15 | 39 | 47 | 43 | 77 | 150 | 130 | 50 | 120 | 91 |
| LinS | 49 | 0.0039 | 2.6 | 11 | 40 | 44 | 39 | 65 | 68 | 53 | 64 | 67 | 53 |
| RaFeD | 49 | 1.6 | 15 | 15 | 41 | 47 | 40 | 52 | 55 | 50 | 56 | 62 | 56 |
| SpNn | 49 | 42 | 47 | 40 | 56 | 52 | 49 | 43 | 48 | 42 | 75 | 72 | 65 |
| EsnS | 49 | 2.2 | 17 | 16 | 39 | 44 | 39 | 69 | 120 | 68 | 80 | 68 | 54 |
| LinPo4 | 49 | 0.50 | 20 | 33 | 49 | 50 | 45 | 48 | 55 | 48 | 65 | 64 | 54 |
| PgLlDT | 49 | 40 | 41 | 41 | 51 | 51 | 46 | 44 | 54 | 47 | 170 | 180 | 170 |
| RaFeS | 49 | 2.0 | 16 | 15 | 37 | 44 | 43 | 68 | 66 | 54 | 66 | 68 | 56 |
| Analog | 50 | 49 | 53 | 46 | 49 | 52 | 46 | 51 | 52 | 44 | 51 | 52 | 46 |
| LinPo6T | 50 | 34 | 38 | 47 | 50 | 49 | 50 | 38 | 51 | 51 | 65 | 64 | 54 |
| LinPo6 | 51 | 0.00014 | 2.1 | 17 | 52 | 49 | 45 | 63 | 61 | 49 | 65 | 64 | 53 |
| PgNetDT | 52 | 35 | 41 | 36 | 56 | 56 | 52 | 43 | 52 | 47 | 120 | 120 | 110 |
| PgLlST | 52 | 29 | 41 | 36 | 50 | 50 | 46 | 67 | 93 | 99 | 67 | 70 | 54 |
| PgLlD | 53 | 34 | 43 | 38 | 51 | 50 | 46 | 54 | 61 | 57 | 170 | 180 | 170 |
| Node1 | 53 | 47 | 50 | 48 | 60 | 55 | 54 | 46 | 53 | 49 | 58 | 56 | 53 |
| EsnST | 53 | 5.1 | 15 | 17 | 37 | 45 | 38 | 65 | 84 | 68 | 62 | 110 | 100 |
| Node32 | 53 | 43 | 48 | 47 | 53 | 53 | 51 | 69 | 64 | 54 | 68 | 65 | 53 |
| PgLlS | 53 | 36 | 42 | 37 | 51 | 50 | 46 | 130 | 140 | 130 | 67 | 69 | 56 |
| PwlNn | 54 | 45 | 52 | 45 | 54 | 54 | 50 | 49 | 57 | 54 | 70 | 69 | 66 |
| LlNn | 54 | 42 | 50 | 43 | 51 | 53 | 49 | 55 | 70 | 67 | 58 | 67 | 63 |
| PgGpD | 55 | 0.28 | 5.5 | 8.2 | 50 | 72 | 48 | 54 | 59 | 55 | 74 | 110 | 74 |
| PgNetD | 55 | 32 | 44 | 38 | 56 | 55 | 51 | 53 | 61 | 55 | 120 | 120 | 100 |
| PgGpS | 55 | 1.7 | 12 | 12 | 54 | 57 | 48 | 63 | 70 | 55 | 62 | 73 | 56 |
| PgGpST | 56 | 1.7 | 12 | 12 | 54 | 57 | 48 | 57 | 65 | 56 | 62 | 81 | 71 |
| PgNetST | 57 | 43 | 47 | 45 | 65 | 61 | 56 | 57 | 62 | 55 | 65 | 66 | 57 |
| Gru | 60 | 52 | 55 | 52 | 62 | 62 | 58 | 68 | 68 | 58 | 69 | 67 | 57 |
| PgNetS | 60 | 42 | 48 | 46 | 65 | 63 | 58 | 67 | 67 | 55 | 67 | 67 | 55 |
| Trafo | 61 | 58 | 61 | 55 | 60 | 61 | 55 | 73 | 70 | 59 | 72 | 70 | 62 |
| GruT | 62 | 55 | 57 | 54 | 63 | 62 | 59 | 70 | 67 | 61 | 66 | 69 | 61 |
| TrafoT | 62 | 59 | 62 | 54 | 61 | 62 | 56 | 71 | 72 | 62 | 72 | 72 | 60 |
| ConstM | 64 | 65 | 64 | 52 | 65 | 64 | 52 | 65 | 64 | 52 | 65 | 64 | 53 |
| LstmT | 64 | 64 | 62 | 56 | 67 | 64 | 55 | 73 | 69 | 57 | 67 | 68 | 58 |
| Lstm | 64 | 63 | 62 | 54 | 66 | 70 | 56 | 73 | 68 | 56 | 70 | 70 | 54 |
| RnnT | 65 | 61 | 63 | 61 | 67 | 67 | 61 | 69 | 69 | 63 | 72 | 70 | 58 |
| Rnn | 66 | 62 | 65 | 63 | 67 | 67 | 62 | 72 | 69 | 59 | 71 | 69 | 59 |
| ConstL | 73 | 74 | 73 | 64 | 74 | 73 | 64 | 74 | 73 | 64 | 74 | 74 | 64 |
| Constant | Random | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Noisefree | Noisy | Noisefree | Noisy | ||||||||||
| Method | Median | S | R | N | S | R | N | S | R | N | S | R | N |
| ConstM | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| ConstL | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| Lstm | 0.2 | 0.9 | 0.6 | 0.6 | 0.6 | 0.2 | 0.5 | 0.1 | 0.1 | 0.1 | 0.1 | 0.1 | 0.1 |
| LstmT | 0.2 | 0.7 | 0.6 | 0.7 | 0.5 | 0.4 | 0.5 | 0.1 | 0.1 | 0.1 | 0.1 | 0.1 | 0.1 |
| Rnn | 0.3 | 1.0 | 0.7 | 0.7 | 0.4 | 0.5 | 0.5 | 0.2 | 0.1 | 0.2 | 0.2 | 0.1 | 0.2 |
| RnnT | 0.3 | 1.0 | 0.7 | 0.7 | 0.4 | 0.5 | 0.5 | 0.2 | 0.1 | 0.2 | 0.2 | 0.2 | 0.2 |
| Gru | 0.4 | 1.7 | 1.2 | 1.2 | 0.8 | 0.6 | 0.8 | 0.2 | 0.2 | 0.2 | 0.2 | 0.2 | 0.2 |
| Trafo | 0.5 | 1.0 | 0.7 | 0.8 | 1.0 | 0.7 | 0.8 | 0.2 | 0.2 | 0.2 | 0.2 | 0.2 | 0.1 |
| TrafoT | 0.5 | 1.0 | 0.6 | 0.8 | 0.9 | 0.7 | 0.7 | 0.3 | 0.2 | 0.2 | 0.3 | 0.2 | 0.2 |
| GruT | 0.5 | 1.6 | 1.0 | 1.1 | 0.8 | 0.6 | 0.8 | 0.3 | 0.2 | 0.3 | 0.4 | 0.3 | 0.4 |
| PgNetS | 0.6 | 2.6 | 1.8 | 1.8 | 0.7 | 0.8 | 0.8 | 0.3 | 0.2 | 0.3 | 0.4 | 0.2 | 0.3 |
| Node32 | 0.6 | 2.5 | 1.8 | 1.6 | 1.4 | 1.1 | 1.2 | 0.2 | 0.1 | 0.2 | 0.2 | 0.2 | 0.2 |
| PgNetST | 0.8 | 2.4 | 1.8 | 1.9 | 0.7 | 0.8 | 0.9 | 1.2 | 0.7 | 0.9 | 0.6 | 0.6 | 0.7 |
| PgLlS | 0.9 | 3.7 | 2.6 | 2.9 | 1.7 | 1.4 | 1.6 | 0.3 | 0.2 | 0.2 | 0.4 | 0.2 | 0.3 |
| PgGpS | 1.0 | 9.4 | 7.2 | 7.4 | 1.3 | 1.4 | 1.5 | 0.6 | 0.3 | 0.3 | 0.6 | 0.2 | 0.4 |
| PgLlST | 1.0 | 4.0 | 2.8 | 3.3 | 1.8 | 1.4 | 1.6 | 0.5 | 0.3 | 0.4 | 0.7 | 0.3 | 0.4 |
| PwlNn | 1.1 | 2.4 | 1.3 | 1.9 | 1.3 | 1.1 | 1.2 | 1.9 | 0.9 | 1.1 | 0.6 | 0.5 | 0.7 |
| LlNn | 1.2 | 2.6 | 1.5 | 2.0 | 1.6 | 1.1 | 1.2 | 1.4 | 0.6 | 0.9 | 1.1 | 0.5 | 0.7 |
| PgNetD | 1.2 | 3.8 | 2.4 | 2.9 | 1.4 | 1.1 | 1.2 | 1.5 | 0.8 | 0.9 | 0.0 | 0.1 | 0.1 |
| RaFeS | 1.2 | 8.9 | 6.7 | 7.1 | 2.8 | 2.1 | 2.0 | 0.3 | 0.2 | 0.3 | 0.4 | 0.2 | 0.3 |
| LinPo6 | 1.3 | 10.0 | 9.4 | 6.7 | 1.8 | 1.6 | 1.8 | 0.6 | 0.7 | 0.9 | 0.0 | 0.0 | 0.0 |
| Node1 | 1.3 | 2.3 | 1.3 | 1.5 | 1.1 | 1.0 | 1.0 | 2.2 | 1.4 | 1.4 | 1.3 | 1.0 | 1.0 |
| PgGpST | 1.4 | 9.4 | 7.2 | 7.4 | 1.3 | 1.4 | 1.5 | 1.9 | 0.8 | 0.9 | 0.7 | 0.6 | 0.8 |
| PgNetDT | 1.4 | 3.6 | 2.5 | 3.1 | 1.3 | 1.0 | 1.2 | 2.7 | 1.4 | 1.5 | 0.0 | 0.1 | 0.1 |
| PgGpD | 1.4 | 9.9 | 8.7 | 8.1 | 1.8 | 1.4 | 1.4 | 1.8 | 0.8 | 1.1 | 0.0 | 0.1 | 0.0 |
| EsnS | 1.4 | 9.3 | 6.3 | 6.9 | 2.6 | 2.2 | 2.5 | 0.3 | 0.2 | 0.3 | 0.5 | 0.2 | 0.3 |
| LinPo6T | 1.4 | 3.8 | 3.0 | 1.5 | 1.8 | 1.5 | 1.1 | 2.9 | 1.4 | 0.8 | 0.0 | 0.0 | 0.1 |
| SpNn | 1.4 | 2.6 | 1.7 | 2.5 | 1.1 | 1.0 | 1.2 | 2.6 | 1.7 | 2.4 | 0.2 | 0.3 | 0.3 |
| LinS | 1.4 | 10.0 | 9.3 | 7.5 | 2.9 | 2.4 | 2.5 | 0.4 | 0.3 | 0.3 | 0.5 | 0.2 | 0.3 |
| PgLlD | 1.5 | 3.7 | 2.6 | 3.0 | 1.7 | 1.4 | 1.6 | 1.7 | 0.9 | 1.1 | 0.0 | 0.1 | 0.1 |
| EsnST | 1.5 | 8.5 | 6.7 | 6.5 | 2.9 | 2.0 | 2.5 | 0.5 | 0.3 | 0.3 | 1.0 | 0.4 | 0.5 |
| PgLlDT | 1.5 | 3.1 | 2.6 | 2.4 | 1.7 | 1.4 | 1.6 | 2.4 | 1.1 | 1.4 | 0.0 | 0.1 | 0.1 |
| Analog | 1.5 | 1.8 | 1.2 | 1.6 | 1.7 | 1.3 | 1.5 | 1.8 | 1.1 | 1.5 | 1.7 | 1.0 | 1.4 |
| LinPo4 | 1.6 | 9.8 | 6.1 | 3.8 | 1.7 | 1.6 | 1.8 | 2.3 | 1.0 | 1.2 | 0.0 | 0.1 | 0.1 |
| LinPo4T | 1.7 | 6.6 | 4.8 | 3.5 | 1.7 | 1.6 | 1.8 | 3.7 | 1.7 | 1.7 | 0.0 | 0.1 | 0.1 |
| RaFeD | 1.8 | 9.2 | 6.8 | 7.0 | 2.8 | 1.8 | 2.0 | 1.9 | 0.9 | 1.2 | 1.5 | 0.7 | 0.8 |
| RaFeST | 1.9 | 8.9 | 7.0 | 7.0 | 2.7 | 1.9 | 2.0 | 0.6 | 0.3 | 0.5 | 1.8 | 0.6 | 0.7 |
| RaFeDT | 1.9 | 9.2 | 6.7 | 6.9 | 2.7 | 1.8 | 2.0 | 2.3 | 1.3 | 1.5 | 1.7 | 0.8 | 0.9 |
| PgGpDT | 1.9 | 9.9 | 8.7 | 8.1 | 1.6 | 1.5 | 1.4 | 4.5 | 2.3 | 2.2 | 0.0 | 0.0 | 0.0 |
| LinD | 2.0 | 10.0 | 8.8 | 7.8 | 2.9 | 2.3 | 2.5 | 1.6 | 0.8 | 1.2 | 0.0 | 0.1 | 0.0 |
| SpPo2 | 2.0 | 9.9 | 6.7 | 0.9 | 3.7 | 3.1 | 0.9 | 5.8 | 3.1 | 0.9 | 0.1 | 0.1 | 0.1 |
| EsnD | 2.1 | 9.4 | 6.2 | 6.5 | 2.6 | 2.4 | 2.3 | 1.9 | 1.1 | 1.1 | 1.5 | 0.8 | 0.9 |
| SpGp | 2.2 | 7.0 | 5.8 | 5.9 | 1.7 | 1.4 | 1.4 | 4.8 | 2.7 | 3.3 | 0.1 | 0.5 | 0.3 |
| LinST | 2.2 | 10.0 | 9.3 | 7.5 | 3.2 | 2.4 | 2.8 | 2.1 | 0.9 | 0.7 | 1.6 | 1.2 | 0.6 |
| EsnDT | 2.4 | 9.4 | 6.1 | 6.2 | 2.8 | 2.3 | 2.5 | 2.6 | 1.1 | 1.2 | 1.6 | 0.8 | 0.9 |
| SINDy | 2.6 | 9.9 | 6.9 | 5.9 | 2.6 | 2.1 | 2.6 | 5.3 | 2.4 | 2.8 | 0.1 | 0.1 | 0.1 |
| SINDyN | 2.6 | 9.9 | 6.6 | 3.0 | 2.7 | 2.1 | 2.5 | 5.2 | 2.3 | 2.8 | 0.1 | 0.1 | 0.1 |
| SpPo4 | 2.8 | 10.0 | 7.5 | 4.5 | 2.8 | 2.4 | 2.5 | 5.5 | 2.8 | 3.0 | 0.1 | 0.1 | 0.1 |
| LinDT | 2.8 | 10.0 | 8.7 | 7.8 | 3.2 | 2.4 | 3.2 | 4.3 | 1.4 | 1.5 | 0.1 | 0.0 | 0.1 |
| SpPo | 3.0 | 10.0 | 7.5 | 6.7 | 3.7 | 3.1 | 2.7 | 5.5 | 2.9 | 2.7 | 0.1 | 0.1 | 0.1 |
| GpGp | 3.4 | 7.7 | 5.5 | 5.5 | 2.5 | 1.8 | 2.2 | 7.1 | 4.3 | 4.4 | 2.3 | 1.7 | 1.5 |
| Constant | Random | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Noisefree | Noisy | Noisefree | Noisy | ||||||||||
| Method | Median | S | R | N | S | R | N | S | R | N | S | R | N |
| LinST | 4.5 | 4 | 2 | 7 | 4 | 3 | 2 | 18 | 22 | 31 | 5 | 2 | 10 |
| LinDT | 7.0 | 3 | 5 | 3 | 3 | 4 | 1 | 9 | 14 | 12 | 38 | 48 | 33 |
| SpPo | 7.5 | 7 | 8 | 13 | 2 | 1 | 9 | 4 | 3 | 6 | 35 | 33 | 36 |
| SpPo4 | 7.5 | 6 | 9 | 22 | 15 | 5 | 5 | 3 | 4 | 3 | 33 | 32 | 37 |
| GpGp | 8.5 | 24 | 25 | 21 | 18 | 18 | 15 | 1 | 1 | 1 | 1 | 1 | 2 |
| EsnDT | 10.5 | 14 | 22 | 17 | 9 | 8 | 4 | 12 | 18 | 18 | 4 | 5 | 7 |
| SINDy | 12.0 | 8 | 12 | 19 | 17 | 12 | 6 | 5 | 6 | 4 | 36 | 35 | 35 |
| LinS | 12.5 | 5 | 3 | 8 | 8 | 6 | 8 | 34 | 33 | 38 | 17 | 20 | 22 |
| RaFeD | 14.0 | 18 | 15 | 11 | 10 | 17 | 13 | 21 | 21 | 17 | 8 | 8 | 6 |
| RaFeDT | 14.0 | 19 | 16 | 12 | 12 | 15 | 14 | 16 | 15 | 14 | 3 | 6 | 3 |
| EsnD | 14.5 | 15 | 20 | 15 | 14 | 9 | 11 | 20 | 17 | 20 | 7 | 7 | 5 |
| LinD | 14.5 | 2 | 4 | 4 | 7 | 7 | 10 | 24 | 23 | 19 | 44 | 41 | 50 |
| RaFeST | 14.5 | 22 | 13 | 10 | 11 | 16 | 16 | 32 | 36 | 33 | 2 | 9 | 8 |
| SINDyN | 14.5 | 12 | 17 | 27 | 16 | 13 | 12 | 6 | 8 | 5 | 37 | 37 | 34 |
| PgGpDT | 15.0 | 10 | 6 | 1 | 28 | 20 | 29 | 8 | 7 | 8 | 43 | 45 | 42 |
| EsnST | 16.5 | 23 | 18 | 18 | 6 | 14 | 3 | 36 | 37 | 34 | 11 | 15 | 14 |
| PgGpST | 19.5 | 16 | 10 | 5 | 35 | 29 | 26 | 23 | 27 | 30 | 12 | 10 | 9 |
| EsnS | 20.0 | 20 | 21 | 16 | 13 | 10 | 7 | 37 | 42 | 36 | 18 | 23 | 20 |
| RaFeS | 20.0 | 21 | 19 | 9 | 5 | 11 | 17 | 33 | 35 | 35 | 21 | 22 | 19 |
| SpPo2 | 20.0 | 9 | 14 | 43 | 1 | 1 | 39 | 2 | 2 | 26 | 34 | 34 | 38 |
| LinPo4 | 21.5 | 13 | 23 | 23 | 20 | 23 | 18 | 19 | 20 | 16 | 46 | 42 | 44 |
| LinPo4T | 23.0 | 26 | 26 | 24 | 21 | 22 | 19 | 10 | 10 | 10 | 45 | 43 | 45 |
| SpGp | 24.5 | 25 | 24 | 20 | 30 | 28 | 28 | 7 | 5 | 2 | 31 | 14 | 26 |
| Analog | 25.0 | 41 | 41 | 37 | 29 | 31 | 25 | 25 | 16 | 9 | 6 | 3 | 1 |
| PgGpS | 25.5 | 16 | 10 | 5 | 35 | 29 | 26 | 31 | 32 | 32 | 13 | 25 | 17 |
| PgLlST | 26.0 | 27 | 28 | 25 | 27 | 21 | 23 | 35 | 34 | 37 | 16 | 18 | 16 |
| LinPo6 | 26.5 | 1 | 1 | 14 | 23 | 24 | 24 | 38 | 31 | 29 | 51 | 50 | 46 |
| PgGpD | 26.5 | 10 | 6 | 1 | 22 | 32 | 29 | 27 | 26 | 23 | 41 | 31 | 47 |
| Node1 | 27.0 | 40 | 39 | 38 | 40 | 37 | 38 | 17 | 11 | 13 | 9 | 4 | 4 |
| PgLlS | 27.5 | 32 | 29 | 29 | 24 | 26 | 22 | 41 | 44 | 44 | 20 | 21 | 18 |
| LinPo6T | 28.0 | 29 | 27 | 40 | 19 | 19 | 36 | 11 | 12 | 24 | 49 | 49 | 39 |
| PgLlD | 28.0 | 30 | 31 | 30 | 25 | 25 | 21 | 26 | 25 | 22 | 50 | 46 | 49 |
| SpNn | 28.0 | 36 | 36 | 32 | 38 | 33 | 31 | 14 | 9 | 7 | 25 | 16 | 21 |
| PgLlDT | 28.5 | 33 | 30 | 31 | 26 | 27 | 20 | 15 | 19 | 15 | 47 | 47 | 48 |
| PwlNn | 29.0 | 39 | 40 | 35 | 34 | 36 | 34 | 22 | 24 | 21 | 15 | 13 | 13 |
| LlNn | 30.5 | 35 | 38 | 33 | 31 | 34 | 32 | 29 | 30 | 28 | 10 | 12 | 12 |
| PgNetST | 32.0 | 37 | 34 | 36 | 45 | 40 | 40 | 30 | 28 | 27 | 14 | 11 | 11 |
| PgNetD | 33.0 | 28 | 33 | 28 | 33 | 38 | 33 | 28 | 29 | 25 | 39 | 40 | 40 |
| PgNetDT | 33.5 | 31 | 32 | 26 | 37 | 39 | 35 | 13 | 13 | 11 | 40 | 39 | 43 |
| Node32 | 37.0 | 38 | 37 | 39 | 32 | 35 | 37 | 46 | 45 | 45 | 24 | 29 | 25 |
| PgNetS | 37.0 | 34 | 35 | 34 | 44 | 42 | 41 | 39 | 39 | 39 | 22 | 24 | 23 |
| Trafo | 40.5 | 44 | 44 | 45 | 39 | 41 | 42 | 45 | 40 | 40 | 27 | 26 | 30 |
| TrafoT | 41.5 | 47 | 46 | 44 | 41 | 43 | 43 | 40 | 41 | 42 | 23 | 19 | 24 |
| Gru | 42.0 | 42 | 42 | 41 | 42 | 44 | 44 | 43 | 43 | 43 | 26 | 27 | 27 |
| GruT | 42.0 | 43 | 43 | 42 | 43 | 45 | 45 | 42 | 38 | 41 | 19 | 17 | 15 |
| RnnT | 45.5 | 45 | 45 | 46 | 48 | 46 | 48 | 44 | 46 | 47 | 28 | 28 | 29 |
| Rnn | 47.0 | 46 | 47 | 49 | 47 | 47 | 49 | 47 | 47 | 46 | 29 | 30 | 28 |
| Lstm | 48.0 | 48 | 49 | 48 | 46 | 49 | 46 | 48 | 49 | 49 | 30 | 38 | 31 |
| LstmT | 48.0 | 49 | 48 | 47 | 49 | 48 | 47 | 49 | 48 | 48 | 32 | 36 | 32 |
| ConstL | 50.0 | 50 | 50 | 50 | 50 | 50 | 50 | 50 | 50 | 50 | 42 | 44 | 41 |
| ConstM | 51.0 | 51 | 51 | 51 | 51 | 51 | 51 | 51 | 51 | 51 | 48 | 51 | 51 |
| Constant | Random | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Noisefree | Noisy | Noisefree | Noisy | ||||||||||
| Method | Median | S | R | N | S | R | N | S | R | N | S | R | N |
| LinST | 5.5 | 4 | 2 | 6 | 6 | 5 | 1 | 20 | 24 | 33 | 5 | 3 | 18 |
| LinDT | 6.5 | 3 | 5 | 4 | 5 | 3 | 2 | 8 | 16 | 13 | 23 | 49 | 16 |
| SpPo | 7.5 | 7 | 8 | 14 | 1 | 1 | 8 | 4 | 4 | 5 | 39 | 39 | 36 |
| LinS | 10.0 | 5 | 3 | 5 | 11 | 8 | 9 | 35 | 38 | 22 | 14 | 20 | 4 |
| SpPo4 | 10.5 | 6 | 11 | 22 | 14 | 9 | 10 | 3 | 2 | 3 | 41 | 37 | 37 |
| LinD | 11.5 | 2 | 4 | 3 | 12 | 4 | 11 | 23 | 22 | 18 | 49 | 15 | 2 |
| EsnDT | 13.5 | 14 | 22 | 18 | 13 | 13 | 4 | 12 | 29 | 29 | 3 | 8 | 44 |
| PgGpDT | 14.5 | 10 | 6 | 1 | 31 | 19 | 28 | 9 | 8 | 9 | 44 | 42 | 39 |
| RaFeDT | 14.5 | 16 | 14 | 12 | 8 | 17 | 15 | 16 | 15 | 42 | 2 | 5 | 9 |
| SINDyN | 14.5 | 12 | 19 | 27 | 17 | 11 | 12 | 6 | 6 | 2 | 40 | 36 | 33 |
| GpGp | 15.0 | 24 | 25 | 21 | 16 | 16 | 14 | 1 | 1 | 1 | 1 | 1 | 27 |
| RaFeD | 15.0 | 15 | 17 | 11 | 15 | 15 | 13 | 24 | 19 | 17 | 8 | 7 | 22 |
| SINDy | 15.0 | 8 | 12 | 19 | 38 | 18 | 7 | 5 | 7 | 4 | 46 | 48 | 48 |
| LinPo6 | 16.0 | 1 | 1 | 16 | 28 | 21 | 18 | 32 | 25 | 15 | 16 | 10 | 5 |
| EsnD | 17.5 | 19 | 21 | 17 | 9 | 6 | 6 | 19 | 18 | 20 | 7 | 6 | 21 |
| RaFeST | 18.5 | 20 | 13 | 9 | 7 | 14 | 17 | 50 | 51 | 50 | 4 | 45 | 45 |
| EsnST | 19.0 | 23 | 15 | 15 | 4 | 12 | 3 | 34 | 47 | 48 | 11 | 44 | 46 |
| LinPo4 | 19.0 | 13 | 23 | 23 | 20 | 25 | 19 | 18 | 20 | 14 | 19 | 13 | 10 |
| Analog | 19.5 | 41 | 41 | 37 | 18 | 29 | 21 | 22 | 13 | 8 | 6 | 2 | 1 |
| LinPo4T | 19.5 | 25 | 26 | 24 | 19 | 26 | 20 | 10 | 9 | 10 | 20 | 12 | 11 |
| LinPo6T | 19.5 | 29 | 27 | 38 | 21 | 20 | 33 | 11 | 11 | 19 | 17 | 11 | 13 |
| SpPo2 | 20.0 | 9 | 16 | 45 | 2 | 1 | 39 | 2 | 3 | 24 | 45 | 40 | 42 |
| EsnS | 20.5 | 22 | 20 | 13 | 10 | 7 | 5 | 40 | 49 | 47 | 42 | 21 | 8 |
| RaFeS | 20.5 | 21 | 18 | 10 | 3 | 10 | 16 | 38 | 33 | 25 | 21 | 22 | 20 |
| Node1 | 26.0 | 40 | 39 | 40 | 39 | 35 | 40 | 17 | 14 | 16 | 9 | 4 | 7 |
| PgLlST | 26.0 | 27 | 29 | 25 | 22 | 24 | 23 | 37 | 48 | 49 | 24 | 29 | 14 |
| PgGpS | 26.5 | 17 | 9 | 7 | 32 | 37 | 26 | 31 | 42 | 27 | 13 | 34 | 17 |
| PgGpD | 27.0 | 10 | 6 | 1 | 23 | 50 | 28 | 26 | 23 | 32 | 37 | 43 | 41 |
| SpGp | 27.0 | 26 | 24 | 20 | 29 | 28 | 36 | 7 | 5 | 7 | 43 | 38 | 43 |
| PgLlS | 27.5 | 32 | 31 | 28 | 26 | 22 | 25 | 51 | 50 | 51 | 26 | 27 | 19 |
| PgLlDT | 28.5 | 33 | 30 | 32 | 27 | 27 | 22 | 15 | 17 | 12 | 51 | 51 | 50 |
| PgLlD | 30.0 | 30 | 32 | 30 | 25 | 23 | 24 | 27 | 26 | 37 | 50 | 50 | 51 |
| Node32 | 31.0 | 38 | 36 | 39 | 30 | 31 | 35 | 41 | 31 | 23 | 28 | 14 | 6 |
| PgGpST | 31.0 | 17 | 9 | 7 | 32 | 37 | 26 | 30 | 32 | 34 | 12 | 41 | 40 |
| LlNn | 32.0 | 35 | 38 | 33 | 24 | 32 | 30 | 28 | 43 | 46 | 10 | 19 | 32 |
| SpNn | 32.0 | 36 | 34 | 31 | 36 | 30 | 31 | 13 | 10 | 6 | 38 | 33 | 35 |
| PwlNn | 32.5 | 39 | 40 | 34 | 34 | 33 | 32 | 21 | 21 | 26 | 31 | 26 | 38 |
| PgNetDT | 33.0 | 31 | 28 | 26 | 35 | 36 | 37 | 14 | 12 | 11 | 48 | 47 | 49 |
| PgNetST | 33.0 | 37 | 35 | 35 | 46 | 39 | 45 | 29 | 28 | 31 | 18 | 16 | 24 |
| PgNetD | 33.5 | 28 | 33 | 29 | 37 | 34 | 34 | 25 | 27 | 30 | 47 | 46 | 47 |
| PgNetS | 35.0 | 34 | 37 | 36 | 45 | 44 | 46 | 36 | 34 | 28 | 25 | 17 | 15 |
| ConstM | 35.5 | 50 | 49 | 42 | 44 | 45 | 38 | 33 | 30 | 21 | 15 | 9 | 3 |
| Gru | 40.0 | 42 | 42 | 41 | 42 | 42 | 47 | 39 | 36 | 38 | 29 | 18 | 23 |
| Trafo | 41.0 | 44 | 44 | 47 | 40 | 40 | 42 | 47 | 44 | 39 | 34 | 30 | 31 |
| GruT | 42.0 | 43 | 43 | 43 | 43 | 41 | 48 | 43 | 35 | 41 | 22 | 25 | 30 |
| LstmT | 43.0 | 49 | 45 | 48 | 48 | 46 | 41 | 46 | 41 | 36 | 27 | 23 | 26 |
| TrafoT | 43.0 | 45 | 46 | 46 | 41 | 43 | 43 | 44 | 45 | 43 | 35 | 32 | 29 |
| Lstm | 44.0 | 48 | 47 | 44 | 47 | 49 | 44 | 48 | 37 | 35 | 30 | 28 | 12 |
| RnnT | 45.0 | 46 | 48 | 49 | 49 | 47 | 49 | 42 | 40 | 44 | 33 | 31 | 25 |
| Rnn | 46.0 | 47 | 50 | 50 | 50 | 48 | 50 | 45 | 39 | 40 | 32 | 24 | 28 |
| ConstL | 50.0 | 51 | 51 | 51 | 51 | 51 | 51 | 49 | 46 | 45 | 36 | 35 | 34 |
| Constant | Random | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Noisefree | Noisy | Noisefree | Noisy | ||||||||||
| Method | Median | S | R | N | S | R | N | S | R | N | S | R | N |
| LinST | 4.5 | 1 | 2 | 5 | 4 | 4 | 2 | 19 | 23 | 31 | 5 | 2 | 13 |
| SpPo | 6.5 | 7 | 8 | 14 | 1 | 1 | 3 | 3 | 3 | 6 | 34 | 32 | 32 |
| GpGp | 7.0 | 24 | 25 | 21 | 18 | 18 | 13 | 1 | 1 | 1 | 1 | 1 | 1 |
| LinDT | 7.0 | 1 | 5 | 3 | 3 | 5 | 1 | 9 | 13 | 13 | 38 | 49 | 31 |
| SpPo4 | 7.5 | 6 | 9 | 22 | 11 | 3 | 6 | 4 | 4 | 3 | 32 | 36 | 32 |
| EsnDT | 11.5 | 15 | 23 | 18 | 10 | 9 | 9 | 13 | 17 | 18 | 6 | 5 | 5 |
| LinS | 12.0 | 1 | 2 | 5 | 6 | 7 | 7 | 36 | 34 | 38 | 17 | 21 | 19 |
| SINDy | 13.0 | 8 | 13 | 19 | 16 | 13 | 4 | 5 | 6 | 4 | 36 | 35 | 36 |
| SINDyN | 13.0 | 12 | 19 | 27 | 14 | 11 | 5 | 6 | 8 | 5 | 35 | 34 | 35 |
| LinD | 13.5 | 1 | 4 | 3 | 5 | 8 | 8 | 27 | 25 | 19 | 47 | 37 | 50 |
| RaFeST | 13.5 | 21 | 12 | 10 | 12 | 15 | 15 | 32 | 33 | 32 | 2 | 11 | 9 |
| RaFeDT | 14.0 | 20 | 17 | 12 | 13 | 16 | 16 | 16 | 15 | 12 | 3 | 7 | 6 |
| EsnD | 14.5 | 14 | 21 | 17 | 15 | 6 | 12 | 20 | 16 | 21 | 8 | 6 | 4 |
| EsnST | 15.0 | 23 | 15 | 16 | 7 | 14 | 9 | 35 | 36 | 35 | 11 | 15 | 14 |
| RaFeD | 15.0 | 19 | 14 | 11 | 9 | 17 | 17 | 21 | 21 | 16 | 7 | 8 | 7 |
| PgGpDT | 16.5 | 10 | 6 | 1 | 30 | 23 | 29 | 8 | 7 | 8 | 49 | 50 | 47 |
| EsnS | 19.0 | 18 | 20 | 13 | 17 | 10 | 11 | 39 | 41 | 37 | 18 | 23 | 20 |
| PgGpST | 19.0 | 16 | 10 | 7 | 36 | 25 | 26 | 22 | 27 | 25 | 12 | 9 | 8 |
| RaFeS | 21.0 | 22 | 18 | 9 | 8 | 12 | 14 | 37 | 40 | 34 | 21 | 22 | 21 |
| LinPo4 | 21.5 | 13 | 22 | 23 | 23 | 21 | 19 | 17 | 20 | 17 | 46 | 45 | 39 |
| SpPo2 | 21.5 | 9 | 16 | 43 | 2 | 1 | 39 | 2 | 2 | 27 | 37 | 32 | 37 |
| SpGp | 23.0 | 25 | 24 | 20 | 28 | 31 | 28 | 7 | 5 | 2 | 30 | 14 | 22 |
| LinPo4T | 23.5 | 26 | 26 | 24 | 23 | 20 | 18 | 10 | 9 | 9 | 45 | 44 | 41 |
| LinPo6 | 23.5 | 1 | 1 | 15 | 21 | 19 | 20 | 31 | 29 | 26 | 50 | 48 | 46 |
| PgLlST | 24.5 | 27 | 28 | 25 | 22 | 24 | 24 | 34 | 32 | 33 | 13 | 17 | 16 |
| Analog | 25.0 | 41 | 41 | 38 | 29 | 32 | 25 | 25 | 18 | 10 | 4 | 3 | 2 |
| PgGpD | 25.0 | 10 | 6 | 1 | 20 | 30 | 29 | 24 | 26 | 23 | 42 | 31 | 49 |
| PgGpS | 25.0 | 16 | 10 | 7 | 36 | 25 | 26 | 33 | 35 | 36 | 15 | 25 | 17 |
| Node1 | 27.5 | 40 | 40 | 39 | 39 | 37 | 38 | 18 | 12 | 15 | 9 | 4 | 3 |
| PgLlD | 27.5 | 30 | 31 | 28 | 26 | 27 | 21 | 26 | 22 | 20 | 44 | 43 | 45 |
| PgLlS | 28.0 | 31 | 29 | 29 | 26 | 27 | 21 | 40 | 43 | 41 | 20 | 20 | 18 |
| PwlNn | 28.0 | 38 | 39 | 34 | 34 | 36 | 32 | 23 | 24 | 22 | 14 | 13 | 12 |
| LinPo6T | 29.5 | 29 | 27 | 40 | 19 | 22 | 37 | 11 | 14 | 30 | 48 | 46 | 40 |
| PgLlDT | 29.5 | 33 | 30 | 32 | 25 | 29 | 23 | 15 | 19 | 14 | 43 | 42 | 44 |
| SpNn | 29.5 | 35 | 37 | 31 | 38 | 38 | 33 | 14 | 10 | 7 | 28 | 16 | 23 |
| LlNn | 31.0 | 36 | 38 | 33 | 31 | 33 | 35 | 29 | 31 | 29 | 10 | 12 | 10 |
| PgNetD | 32.0 | 28 | 33 | 30 | 33 | 34 | 31 | 28 | 28 | 24 | 39 | 41 | 42 |
| PgNetST | 32.0 | 39 | 34 | 35 | 45 | 41 | 40 | 30 | 30 | 28 | 16 | 10 | 11 |
| PgNetDT | 33.5 | 32 | 32 | 26 | 35 | 39 | 36 | 12 | 11 | 11 | 40 | 39 | 43 |
| Node32 | 35.5 | 37 | 36 | 37 | 32 | 35 | 34 | 46 | 47 | 45 | 26 | 29 | 26 |
| PgNetS | 36.5 | 34 | 35 | 36 | 44 | 40 | 41 | 38 | 37 | 40 | 22 | 24 | 24 |
| TrafoT | 41.5 | 44 | 47 | 44 | 41 | 42 | 45 | 41 | 39 | 43 | 23 | 19 | 25 |
| GruT | 42.0 | 43 | 43 | 42 | 42 | 45 | 43 | 42 | 38 | 39 | 19 | 18 | 15 |
| Trafo | 42.0 | 45 | 44 | 45 | 40 | 43 | 42 | 45 | 42 | 42 | 27 | 28 | 30 |
| Gru | 42.5 | 42 | 42 | 41 | 43 | 44 | 44 | 43 | 44 | 44 | 24 | 27 | 28 |
| RnnT | 45.5 | 46 | 45 | 46 | 48 | 46 | 48 | 44 | 45 | 47 | 25 | 26 | 27 |
| Rnn | 46.5 | 47 | 46 | 48 | 49 | 47 | 49 | 47 | 46 | 46 | 29 | 30 | 29 |
| LstmT | 47.5 | 49 | 48 | 47 | 47 | 48 | 47 | 49 | 48 | 48 | 33 | 38 | 38 |
| Lstm | 48.0 | 48 | 49 | 49 | 46 | 49 | 46 | 48 | 49 | 49 | 31 | 40 | 34 |
| ConstL | 50.0 | 50 | 50 | 50 | 50 | 50 | 50 | 50 | 50 | 50 | 41 | 47 | 48 |
| ConstM | 51.0 | 51 | 51 | 51 | 51 | 51 | 51 | 51 | 51 | 51 | 51 | 51 | 51 |
| Constant | Random | |||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Noisefree | Noisy | Noisefree | Noisy | |||||||||
| Method | S | R | N | S | R | N | S | R | N | S | R | N |
| Analog | 41,41,41 | 41,41,41 | 37,37,38 | 29,18,29 | 31,29,32 | 25,21,25 | 25,22,25 | 16,13,18 | 9,8,10 | 6,6,4 | 3,2,3 | 1,1,2 |
| ConstL | 50,51,50 | 50,51,50 | 50,51,50 | 50,51,50 | 50,51,50 | 50,51,50 | 50,49,50 | 50,46,50 | 50,45,50 | 42,36,41 | 44,35,47 | 41,34,48 |
| ConstM | 51,50,51 | 51,49,51 | 51,42,51 | 51,44,51 | 51,45,51 | 51,38,51 | 51,33,51 | 51,30,51 | 51,21,51 | 48,15,51 | 51,9,51 | 51,3,51 |
| EsnD | 15,19,14 | 20,21,21 | 15,17,17 | 14,9,15 | 9,6,6 | 11,6,12 | 20,19,20 | 17,18,16 | 20,20,21 | 7,7,8 | 7,6,6 | 5,21,4 |
| EsnDT | 14,14,15 | 22,22,23 | 17,18,18 | 9,13,10 | 8,13,9 | 4,4,9 | 12,12,13 | 18,29,17 | 18,29,18 | 4,3,6 | 5,8,5 | 7,44,5 |
| EsnS | 20,22,18 | 21,20,20 | 16,13,13 | 13,10,17 | 10,7,10 | 7,5,11 | 37,40,39 | 42,49,41 | 36,47,37 | 18,42,18 | 23,21,23 | 20,8,20 |
| EsnST | 23,23,23 | 18,15,15 | 18,15,16 | 6,4,7 | 14,12,14 | 3,3,9 | 36,34,35 | 37,47,36 | 34,48,35 | 11,11,11 | 15,44,15 | 14,46,14 |
| GpGp | 24,24,24 | 25,25,25 | 21,21,21 | 18,16,18 | 18,16,18 | 15,14,13 | 1,1,1 | 1,1,1 | 1,1,1 | 1,1,1 | 1,1,1 | 2,27,1 |
| PgGpD | 10,10,10 | 6,6,6 | 1,1,1 | 22,23,20 | 32,50,30 | 29,28,29 | 27,26,24 | 26,23,26 | 23,32,23 | 41,37,42 | 31,43,31 | 47,41,49 |
| PgGpDT | 10,10,10 | 6,6,6 | 1,1,1 | 28,31,30 | 20,19,23 | 29,28,29 | 8,9,8 | 7,8,7 | 8,9,8 | 43,44,49 | 45,42,50 | 42,39,47 |
| PgGpS | 16,17,16 | 10,9,10 | 5,7,7 | 35,32,36 | 29,37,25 | 26,26,26 | 31,31,33 | 32,42,35 | 32,27,36 | 13,13,15 | 25,34,25 | 17,17,17 |
| PgGpST | 16,17,16 | 10,9,10 | 5,7,7 | 35,32,36 | 29,37,25 | 26,26,26 | 23,30,22 | 27,32,27 | 30,34,25 | 12,12,12 | 10,41,9 | 9,40,8 |
| Gru | 42,42,42 | 42,42,42 | 41,41,41 | 42,42,43 | 44,42,44 | 44,47,44 | 43,39,43 | 43,36,44 | 43,38,44 | 26,29,24 | 27,18,27 | 27,23,28 |
| GruT | 43,43,43 | 43,43,43 | 42,43,42 | 43,43,42 | 45,41,45 | 45,48,43 | 42,43,42 | 38,35,38 | 41,41,39 | 19,22,19 | 17,25,18 | 15,30,15 |
| LinD | 2,2,1 | 4,4,4 | 4,3,3 | 7,12,5 | 7,4,8 | 10,11,8 | 24,23,27 | 23,22,25 | 19,18,19 | 44,49,47 | 41,15,37 | 50,2,50 |
| LinDT | 3,3,1 | 5,5,5 | 3,4,3 | 3,5,3 | 4,3,5 | 1,2,1 | 9,8,9 | 14,16,13 | 12,13,13 | 38,23,38 | 48,49,49 | 33,16,31 |
| LinPo4 | 13,13,13 | 23,23,22 | 23,23,23 | 20,20,23 | 23,25,21 | 18,19,19 | 19,18,17 | 20,20,20 | 16,14,17 | 46,19,46 | 42,13,45 | 44,10,39 |
| LinPo4T | 26,25,26 | 26,26,26 | 24,24,24 | 21,19,23 | 22,26,20 | 19,20,18 | 10,10,10 | 10,9,9 | 10,10,9 | 45,20,45 | 43,12,44 | 45,11,41 |
| LinPo6 | 1,1,1 | 1,1,1 | 14,16,15 | 23,28,21 | 24,21,19 | 24,18,20 | 38,32,31 | 31,25,29 | 29,15,26 | 51,16,50 | 50,10,48 | 46,5,46 |
| LinPo6T | 29,29,29 | 27,27,27 | 40,38,40 | 19,21,19 | 19,20,22 | 36,33,37 | 11,11,11 | 12,11,14 | 24,19,30 | 49,17,48 | 49,11,46 | 39,13,40 |
| LinS | 5,5,1 | 3,3,2 | 8,5,5 | 8,11,6 | 6,8,7 | 8,9,7 | 34,35,36 | 33,38,34 | 38,22,38 | 17,14,17 | 20,20,21 | 22,4,19 |
| LinST | 4,4,1 | 2,2,2 | 7,6,5 | 4,6,4 | 3,5,4 | 2,1,2 | 18,20,19 | 22,24,23 | 31,33,31 | 5,5,5 | 2,3,2 | 10,18,13 |
| LlNn | 35,35,36 | 38,38,38 | 33,33,33 | 31,24,31 | 34,32,33 | 32,30,35 | 29,28,29 | 30,43,31 | 28,46,29 | 10,10,10 | 12,19,12 | 12,32,10 |
| PgLlD | 30,30,30 | 31,32,31 | 30,30,28 | 25,25,26 | 25,23,27 | 21,24,21 | 26,27,26 | 25,26,22 | 22,37,20 | 50,50,44 | 46,50,43 | 49,51,45 |
| PgLlDT | 33,33,33 | 30,30,30 | 31,32,32 | 26,27,25 | 27,27,29 | 20,22,23 | 15,15,15 | 19,17,19 | 15,12,14 | 47,51,43 | 47,51,42 | 48,50,44 |
| PgLlS | 32,32,31 | 29,31,29 | 29,28,29 | 24,26,26 | 26,22,27 | 22,25,21 | 41,51,40 | 44,50,43 | 44,51,41 | 20,26,20 | 21,27,20 | 18,19,18 |
| PgLlST | 27,27,27 | 28,29,28 | 25,25,25 | 27,22,22 | 21,24,24 | 23,23,24 | 35,37,34 | 34,48,32 | 37,49,33 | 16,24,13 | 18,29,17 | 16,14,16 |
| Lstm | 48,48,48 | 49,47,49 | 48,44,49 | 46,47,46 | 49,49,49 | 46,44,46 | 48,48,48 | 49,37,49 | 49,35,49 | 30,30,31 | 38,28,40 | 31,12,34 |
| LstmT | 49,49,49 | 48,45,48 | 47,48,47 | 49,48,47 | 48,46,48 | 47,41,47 | 49,46,49 | 48,41,48 | 48,36,48 | 32,27,33 | 36,23,38 | 32,26,38 |
| PgNetD | 28,28,28 | 33,33,33 | 28,29,30 | 33,37,33 | 38,34,34 | 33,34,31 | 28,25,28 | 29,27,28 | 25,30,24 | 39,47,39 | 40,46,41 | 40,47,42 |
| PgNetDT | 31,31,32 | 32,28,32 | 26,26,26 | 37,35,35 | 39,36,39 | 35,37,36 | 13,14,12 | 13,12,11 | 11,11,11 | 40,48,40 | 39,47,39 | 43,49,43 |
| PgNetS | 34,34,34 | 35,37,35 | 34,36,36 | 44,45,44 | 42,44,40 | 41,46,41 | 39,36,38 | 39,34,37 | 39,28,40 | 22,25,22 | 24,17,24 | 23,15,24 |
| PgNetST | 37,37,39 | 34,35,34 | 36,35,35 | 45,46,45 | 40,39,41 | 40,45,40 | 30,29,30 | 28,28,30 | 27,31,28 | 14,18,16 | 11,16,10 | 11,24,11 |
| Node1 | 40,40,40 | 39,39,40 | 38,40,39 | 40,39,39 | 37,35,37 | 38,40,38 | 17,17,18 | 11,14,12 | 13,16,15 | 9,9,9 | 4,4,4 | 4,7,3 |
| Node32 | 38,38,37 | 37,36,36 | 39,39,37 | 32,30,32 | 35,31,35 | 37,35,34 | 46,41,46 | 45,31,47 | 45,23,45 | 24,28,26 | 29,14,29 | 25,6,26 |
| PwlNn | 39,39,38 | 40,40,39 | 35,34,34 | 34,34,34 | 36,33,36 | 34,32,32 | 22,21,23 | 24,21,24 | 21,26,22 | 15,31,14 | 13,26,13 | 13,38,12 |
| RaFeD | 18,15,19 | 15,17,14 | 11,11,11 | 10,15,9 | 17,15,17 | 13,13,17 | 21,24,21 | 21,19,21 | 17,17,16 | 8,8,7 | 8,7,8 | 6,22,7 |
| RaFeDT | 19,16,20 | 16,14,17 | 12,12,12 | 12,8,13 | 15,17,16 | 14,15,16 | 16,16,16 | 15,15,15 | 14,42,12 | 3,2,3 | 6,5,7 | 3,9,6 |
| RaFeS | 21,21,22 | 19,18,18 | 9,10,9 | 5,3,8 | 11,10,12 | 17,16,14 | 33,38,37 | 35,33,40 | 35,25,34 | 21,21,21 | 22,22,22 | 19,20,21 |
| RaFeST | 22,20,21 | 13,13,12 | 10,9,10 | 11,7,12 | 16,14,15 | 16,17,15 | 32,50,32 | 36,51,33 | 33,50,32 | 2,4,2 | 9,45,11 | 8,45,9 |
| Rnn | 46,47,47 | 47,50,46 | 49,50,48 | 47,50,49 | 47,48,47 | 49,50,49 | 47,45,47 | 47,39,46 | 46,40,46 | 29,32,29 | 30,24,30 | 28,28,29 |
| RnnT | 45,46,46 | 45,48,45 | 46,49,46 | 48,49,48 | 46,47,46 | 48,49,48 | 44,42,44 | 46,40,45 | 47,44,47 | 28,33,25 | 28,31,26 | 29,25,27 |
| SpGp | 25,26,25 | 24,24,24 | 20,20,20 | 30,29,28 | 28,28,31 | 28,36,28 | 7,7,7 | 5,5,5 | 2,7,2 | 31,43,30 | 14,38,14 | 26,43,22 |
| SpNn | 36,36,35 | 36,34,37 | 32,31,31 | 38,36,38 | 33,30,38 | 31,31,33 | 14,13,14 | 9,10,10 | 7,6,7 | 25,38,28 | 16,33,16 | 21,35,23 |
| SpPo | 7,7,7 | 8,8,8 | 13,14,14 | 2,1,1 | 1,1,1 | 9,8,3 | 4,4,3 | 3,4,3 | 6,5,6 | 35,39,34 | 33,39,32 | 36,36,32 |
| SpPo2 | 9,9,9 | 14,16,16 | 43,45,43 | 1,2,2 | 1,1,1 | 39,39,39 | 2,2,2 | 2,3,2 | 26,24,27 | 34,45,37 | 34,40,32 | 38,42,37 |
| SpPo4 | 6,6,6 | 9,11,9 | 22,22,22 | 15,14,11 | 5,9,3 | 5,10,6 | 3,3,4 | 4,2,4 | 3,3,3 | 33,41,32 | 32,37,36 | 37,37,32 |
| SINDy | 8,8,8 | 12,12,13 | 19,19,19 | 17,38,16 | 12,18,13 | 6,7,4 | 5,5,5 | 6,7,6 | 4,4,4 | 36,46,36 | 35,48,35 | 35,48,36 |
| SINDyN | 12,12,12 | 17,19,19 | 27,27,27 | 16,17,14 | 13,11,11 | 12,12,5 | 6,6,6 | 8,6,8 | 5,2,5 | 37,40,35 | 37,36,34 | 34,33,35 |
| Trafo | 44,44,45 | 44,44,44 | 45,47,45 | 39,40,40 | 41,40,43 | 42,42,42 | 45,47,45 | 40,44,42 | 40,39,42 | 27,34,27 | 26,30,28 | 30,31,30 |
| TrafoT | 47,45,44 | 46,46,47 | 44,46,44 | 41,41,41 | 43,43,42 | 43,43,45 | 40,44,41 | 41,45,39 | 42,43,43 | 23,35,23 | 19,32,19 | 24,29,25 |
| Validation | Test | |||||
|---|---|---|---|---|---|---|
| Method | ||||||
| Analog | 0.61 | 37 | 0.10 | 0.60 | 34 | 0.13 |
| ConstL | 0.95 | 110 | 0.010 | 0.96 | 110 | 0.010 |
| ConstM | 1.0 | 110 | 0 | 1.0 | 100 | 0 |
| EsnD | 0.0047 | 0.16 | 1.0 | 0.022 | 0.67 | 1.0 |
| EsnS | 0.0040 | 0.12 | 1.0 | 0.030 | 0.96 | 1.0 |
| GpGp | 0.26 | 13 | 0.33 | 0.64 | 36 | 0.20 |
| Gru | 0.28 | 13 | 0.42 | 0.40 | 18 | 0.37 |
| LinD | 0.0013 | 0.066 | 1.0 | 0.0079 | 0.41 | 1.0 |
| LinPo4 | 0.033 | 1.5 | 1.0 | 0.040 | 1.1 | 1.0 |
| LinPo6 | 0.47 | 19 | 0.49 | 0.19 | 12 | 0.55 |
| LinS | 0.0011 | 0.035 | 1.0 | 0.0054 | 0.23 | 1.0 |
| LlNn | 0.64 | 38 | 0.12 | 0.73 | 48 | 0.085 |
| Lstm | 0.77 | 56 | 0.055 | 0.91 | 85 | 0 |
| Node1 | 0.18 | 8.9 | 0.59 | 0.42 | 14 | 0.39 |
| Node32 | 0.26 | 12 | 0.46 | 0.44 | 24 | 0.28 |
| PgGpD | 0.052 | 1.9 | 0.98 | 0.22 | 8.1 | 0.55 |
| PgGpS | 0.13 | 5.3 | 0.74 | 0.44 | 20 | 0.35 |
| PgLlD | 0.32 | 20 | 0.41 | 0.61 | 40 | 0.29 |
| PgLlS | 0.31 | 12 | 0.41 | 0.57 | 35 | 0.23 |
| PgNetD | 0.15 | 8.3 | 0.65 | 0.26 | 12 | 0.46 |
| PgNetS | 0.27 | 14 | 0.45 | 0.46 | 19 | 0.32 |
| PwlNn | 0.61 | 33 | 0.13 | 0.60 | 35 | 0.16 |
| RaFeD | 0.0036 | 0.14 | 1.0 | 0.022 | 0.92 | 1.0 |
| RaFeS | 0.0039 | 0.19 | 1.0 | 0.029 | 0.84 | 1.0 |
| Rnn | 0.49 | 27 | 0.23 | 0.62 | 39 | 0.19 |
| SINDy | 0.010 | 0.37 | 1.0 | 0.035 | 1.4 | 1.0 |
| SINDyN | 0.058 | 2.3 | 0.96 | 0.12 | 6.0 | 0.76 |
| SpGp | 0.26 | 14 | 0.37 | 0.54 | 28 | 0.28 |
| SpNn | 0.63 | 38 | 0.13 | 0.62 | 36 | 0.16 |
| SpPo | 0.0022 | 0.061 | 1.0 | 0.0041 | 0.18 | 1.0 |
| SpPo2 | 0.21 | 4.0 | 0.45 | 0.21 | 3.8 | 0.71 |
| SpPo4 | 0.012 | 0.35 | 1.0 | 0.0079 | 0.40 | 1.0 |
| Trafo | 0.45 | 26 | 0.13 | 0.63 | 40 | 0.15 |
| _BlRNN | 0.90 | 90 | 0.025 | |||
| _DLin | 0.90 | 76 | 0.025 | |||
| _Esn | 0.79 | 93 | 0.12 | |||
| _Kalma | 0.98 | 120 | 0 | |||
| _LinRe | 0.84 | 64 | 0.060 | |||
| _NBEAT | 0.56 | 27 | 0.13 | |||
| _NHiTS | 0.70 | 38 | 0.10 | |||
| _NLin | 0.88 | 74 | 0.020 | |||
| _Node | 0.77 | 44 | 0.045 | |||
| _Nvar | 0.80 | 51 | 0.065 | |||
| _RaFo | 0.69 | 49 | 0.060 | |||
| _RNN | 0.76 | 52 | 0.090 | |||
| _TCN | 0.94 | 110 | 0.015 | |||
| _Trafo | 0.81 | 58 | 0.015 | |||
| _XGB | 0.81 | 71 | 0.050 | |||
| Validation | Test | |||||
|---|---|---|---|---|---|---|
| Method | ||||||
| Analog | 0.76 | 52 | 0.010 | 0.81 | 57 | 0.0050 |
| ConstL | 0.96 | 94 | 0.010 | 0.96 | 100 | 0.010 |
| ConstM | 1.0 | 100 | 0 | 1.0 | 110 | 0 |
| EsnD | 0.36 | 17 | 0.18 | 0.73 | 54 | 0.095 |
| EsnS | 0.38 | 17 | 0.19 | 0.76 | 52 | 0.090 |
| GpGp | 0.63 | 41 | 0.050 | 0.90 | 85 | 0.020 |
| Gru | 0.63 | 44 | 0.10 | 0.75 | 54 | 0.095 |
| LinD | 0.49 | 25 | 0.18 | 0.77 | 58 | 0.065 |
| LinPo4 | 0.84 | 68 | 0.045 | 0.84 | 65 | 0.045 |
| LinPo6 | 0.89 | 77 | 0.030 | 0.91 | 78 | 0.025 |
| LinS | 0.46 | 25 | 0.16 | 0.77 | 57 | 0.055 |
| LlNn | 0.79 | 54 | 0.045 | 0.88 | 75 | 0.025 |
| Lstm | 0.81 | 73 | 0.035 | 0.96 | 110 | 0 |
| Node1 | 0.61 | 43 | 0.095 | 0.77 | 56 | 0.085 |
| Node32 | 0.69 | 44 | 0.075 | 0.80 | 60 | 0.065 |
| PgGpD | 0.67 | 45 | 0.060 | 0.88 | 72 | 0.030 |
| PgGpS | 0.67 | 43 | 0.055 | 0.86 | 68 | 0.030 |
| PgLlD | 0.63 | 49 | 0.085 | 0.80 | 68 | 0.065 |
| PgLlS | 0.63 | 44 | 0.070 | 0.81 | 66 | 0.060 |
| PgNetD | 0.73 | 47 | 0.070 | 0.80 | 55 | 0.080 |
| PgNetS | 0.74 | 59 | 0.085 | 0.80 | 63 | 0.050 |
| PwlNn | 0.80 | 55 | 0.050 | 0.83 | 65 | 0.050 |
| RaFeD | 0.45 | 19 | 0.11 | 0.84 | 69 | 0.050 |
| RaFeS | 0.45 | 19 | 0.11 | 0.80 | 72 | 0.050 |
| Rnn | 0.71 | 49 | 0.085 | 0.77 | 60 | 0.070 |
| SINDy | 0.86 | 100 | 0.045 | 0.87 | 96 | 0.035 |
| SINDyN | 0.83 | 60 | 0.055 | 0.87 | 70 | 0.035 |
| SpGp | 0.81 | 51 | 0.035 | 0.92 | 82 | 0.020 |
| SpNn | 0.81 | 60 | 0.040 | 0.85 | 63 | 0.035 |
| SpPo | 0.65 | 40 | 0.095 | 0.78 | 52 | 0.065 |
| SpPo2 | 0.79 | 54 | 0.055 | 0.79 | 51 | 0.050 |
| SpPo4 | 0.81 | 67 | 0.060 | 0.85 | 62 | 0.045 |
| Trafo | 0.63 | 43 | 0.030 | 0.77 | 57 | 0.040 |
| Constant | Random | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Noisefree | Noisy | Noisefree | Noisy | ||||||||||
| Method | S | R | N | S | R | N | S | R | N | S | R | N | |
| 22% | 50% | 39% | 28% | 61% | 44% | 94% | 83% | 89% | 83% | 78% | 72% | ||
| EsnD | 67% | 0.05 | -0.03 | -0.07 | 0.03 | 0.00 | 0.03 | 0.10 | -0.01 | 0.01 | 0.03 | 0.01 | -0.01 |
| EsnS | 75% | -0.57 | 0.12 | -0.05 | 0.05 | -0.02 | 0.01 | 0.00 | 0.01 | 0.01 | 0.06 | 0.03 | 0.02 |
| Gru | 50% | -0.02 | -0.02 | -0.02 | 0.00 | 0.00 | 0.00 | 0.00 | 0.01 | 0.00 | 0.04 | 0.01 | 0.03 |
| LinD | 75% | -0.57 | -0.13 | 0.00 | 0.04 | 0.00 | 0.09 | 0.45 | 0.06 | 0.05 | 0.01 | -0.01 | 0.02 |
| LinPo4 | 42% | -1.70 | -0.29 | -0.03 | 0.00 | 0.00 | 0.00 | 0.26 | 0.09 | 0.06 | 0.00 | 0.00 | 0.00 |
| LinPo6 | 67% | -2.00 | -1.73 | -0.89 | 0.01 | 0.01 | -0.09 | 0.41 | 0.11 | 0.01 | 0.00 | 0.00 | 0.01 |
| LinS | 100% | 0.00 | 0.00 | 0.00 | 0.04 | 0.00 | 0.05 | 0.24 | 0.09 | 0.05 | 0.18 | 0.15 | 0.04 |
| Lstm | 50% | -0.02 | 0.00 | 0.00 | 0.00 | 0.03 | 0.00 | 0.00 | 0.00 | 0.00 | -0.01 | 0.00 | 0.00 |
| PgGpD | 42% | 0.00 | 0.00 | 0.00 | -0.01 | 0.04 | 0.00 | 0.49 | 0.20 | 0.17 | 0.00 | -0.02 | 0.01 |
| PgGpS | 50% | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.16 | 0.06 | 0.05 | 0.01 | 0.05 | 0.04 |
| PgLlD | 58% | -0.10 | 0.00 | -0.04 | 0.00 | 0.00 | 0.00 | 0.12 | 0.03 | 0.04 | 0.00 | 0.00 | 0.00 |
| PgLlS | 83% | 0.12 | 0.03 | 0.05 | -0.01 | 0.00 | 0.00 | 0.03 | 0.01 | 0.01 | 0.02 | 0.01 | 0.01 |
| PgNetD | 50% | -0.05 | 0.04 | 0.03 | -0.02 | -0.01 | -0.02 | 0.16 | 0.09 | 0.10 | 0.00 | 0.00 | 0.00 |
| PgNetS | 75% | -0.03 | 0.01 | -0.01 | 0.00 | 0.01 | 0.01 | 0.12 | 0.06 | 0.07 | 0.04 | 0.05 | 0.04 |
| RaFeD | 58% | -0.01 | -0.01 | -0.03 | 0.00 | 0.00 | 0.00 | 0.08 | 0.04 | 0.02 | 0.06 | 0.02 | 0.02 |
| RaFeS | 58% | 0.00 | 0.09 | -0.01 | -0.05 | -0.04 | 0.00 | 0.01 | 0.00 | 0.00 | 0.22 | 0.06 | 0.04 |
| Rnn | 75% | 0.00 | 0.00 | 0.01 | 0.00 | 0.00 | 0.01 | 0.02 | 0.00 | -0.01 | 0.01 | 0.00 | 0.00 |
| Trafo | 42% | 0.00 | -0.01 | 0.01 | -0.03 | -0.01 | 0.00 | 0.02 | 0.00 | 0.00 | 0.01 | 0.01 | 0.02 |
| Dysts | DeebLorenz | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Constant | Constant | Random | |||||||||||||
| Noisefree | Noisy | Noisefree | Noisy | Noisefree | Noisy | ||||||||||
| Method | Median | Median | S | R | N | S | R | N | S | R | N | S | R | N | |
| 67% | 33% | 92% | 50% | 67% | 58% | 58% | 58% | 100% | 100% | 100% | 25% | 33% | 33% | ||
| Esn | 86% | 0.31 | 0.04 | 0.36 | 0.02 | 0.02 | 0.00 | 0.01 | -0.02 | 0.22 | 0.13 | 0.11 | 0.16 | 0.08 | 0.08 |
| EsnT | 75% | 0.93 | -0.13 | 0.00 | -0.03 | 0.02 | 0.00 | 0.31 | 0.11 | 0.11 | 0.13 | 0.07 | 0.05 | ||
| Lin | 43% | -0.38 | 0.00 | 1.24 | -0.48 | 0.24 | 0.00 | 0.00 | -0.01 | 0.18 | 0.08 | 0.11 | -0.09 | -0.03 | -0.05 |
| LinT | 58% | 0.82 | -0.60 | 0.24 | 0.00 | 0.00 | 0.03 | 0.39 | 0.05 | 0.12 | -0.26 | -0.19 | -0.08 | ||
| PgGp | 57% | 0.67 | -0.02 | 1.12 | 0.75 | 0.28 | 0.07 | 0.00 | -0.01 | 0.14 | 0.07 | 0.08 | -0.10 | -0.01 | -0.06 |
| PgGpT | 67% | 1.12 | 0.75 | 0.28 | 0.06 | 0.04 | -0.01 | 0.47 | 0.21 | 0.20 | -0.11 | -0.08 | -0.09 | ||
| PgLl | 50% | -0.08 | 0.01 | 0.01 | 0.00 | -0.02 | 0.00 | 0.00 | 0.00 | 0.19 | 0.10 | 0.12 | -0.08 | -0.04 | -0.06 |
| PgLlT | 42% | -0.20 | -0.03 | -0.11 | 0.00 | 0.00 | 0.00 | 0.28 | 0.11 | 0.15 | -0.10 | -0.04 | -0.07 | ||
| PgNet | 71% | 0.56 | 0.00 | 0.20 | 0.08 | 0.16 | 0.10 | 0.05 | 0.07 | 0.16 | 0.06 | 0.08 | -0.06 | -0.03 | -0.04 |
| PgNetT | 75% | 0.18 | 0.11 | 0.20 | 0.09 | 0.03 | 0.04 | 0.21 | 0.09 | 0.10 | -0.10 | -0.08 | -0.08 | ||
| RaFe | 71% | 0.28 | -0.04 | 0.33 | 0.06 | -0.04 | -0.05 | -0.04 | 0.03 | 0.20 | 0.09 | 0.12 | 0.14 | 0.06 | 0.07 |
| RaFeT | 67% | 0.32 | -0.04 | -0.06 | 0.00 | 0.00 | 0.03 | 0.26 | 0.13 | 0.14 | -0.02 | 0.02 | 0.05 | ||
| DeebLorenz (100 repetitions), , -test, -values | ||||
| Constant | Random | |||
| Noisefree | Noisy | Noisefree | Noisy | |
 |
 |
 |
 | |
 |
 |
 |
 | |
 |
 |
 |
 | |
| DeebLorenz (10 repetitions), , -test, -values | ||||
| Constant | Random | |||
| Noisefree | Noisy | Noisefree | Noisy | |
 |
 |
 |
 | |
 |
 |
 |
 | |
 |
 |
 |
 | |
Накопленная максимальная ошибка для тестовых данных Lorenz63std с постоянным шагом по времени
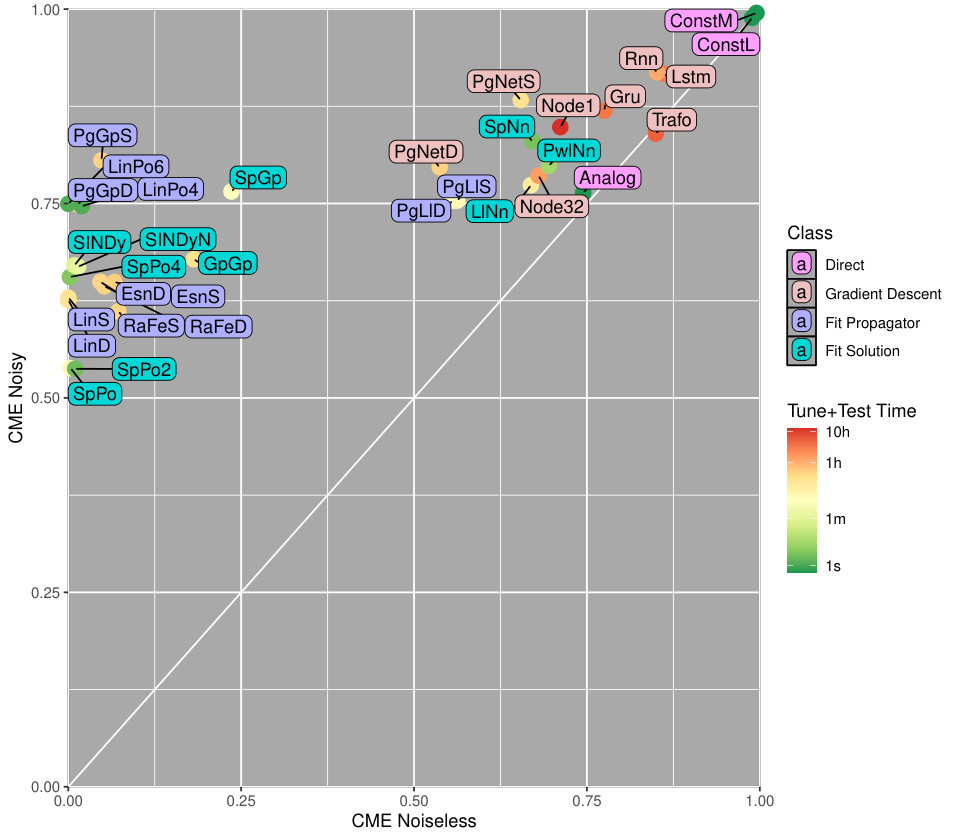
Накопленная максимальная ошибка для тестовых данных Lorenz63nonpar с постоянным шагом по времени
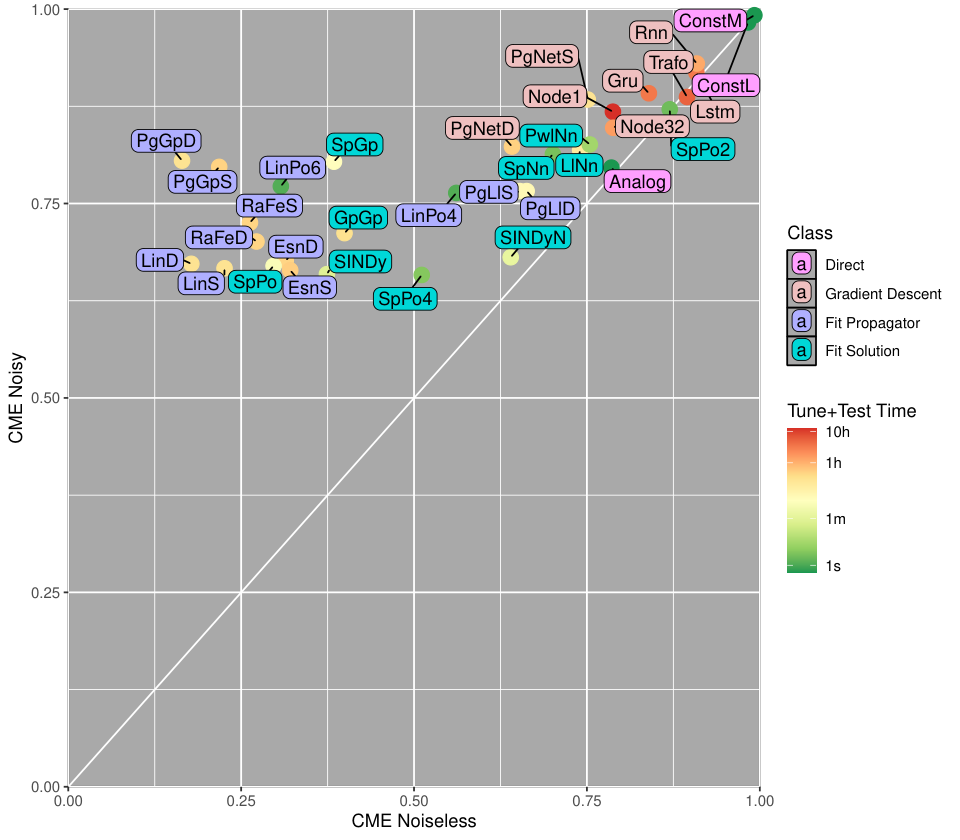
Накопленная максимальная ошибка для тестовых данных Lorenz63std со случайным шагом по времени
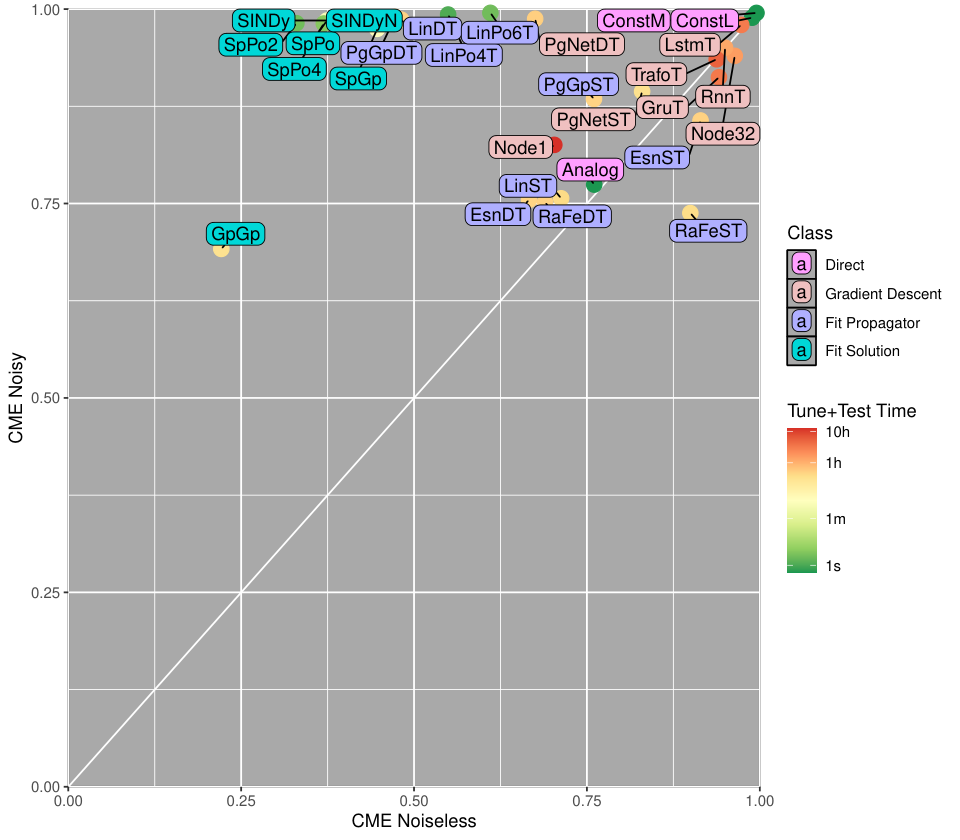
Накопленная максимальная ошибка для тестовых данных Lorenz63random с произвольным временным шагом
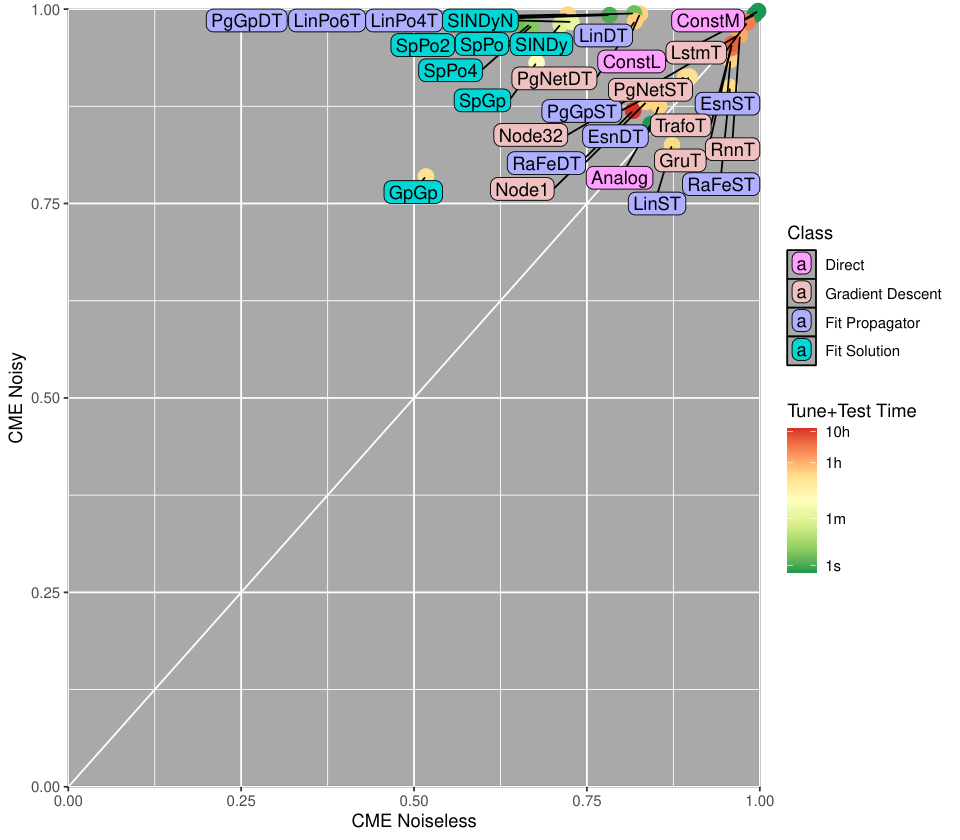
Накопленная максимальная ошибка для тестовых данных Lorenz63nonpar со случайным временным шагом
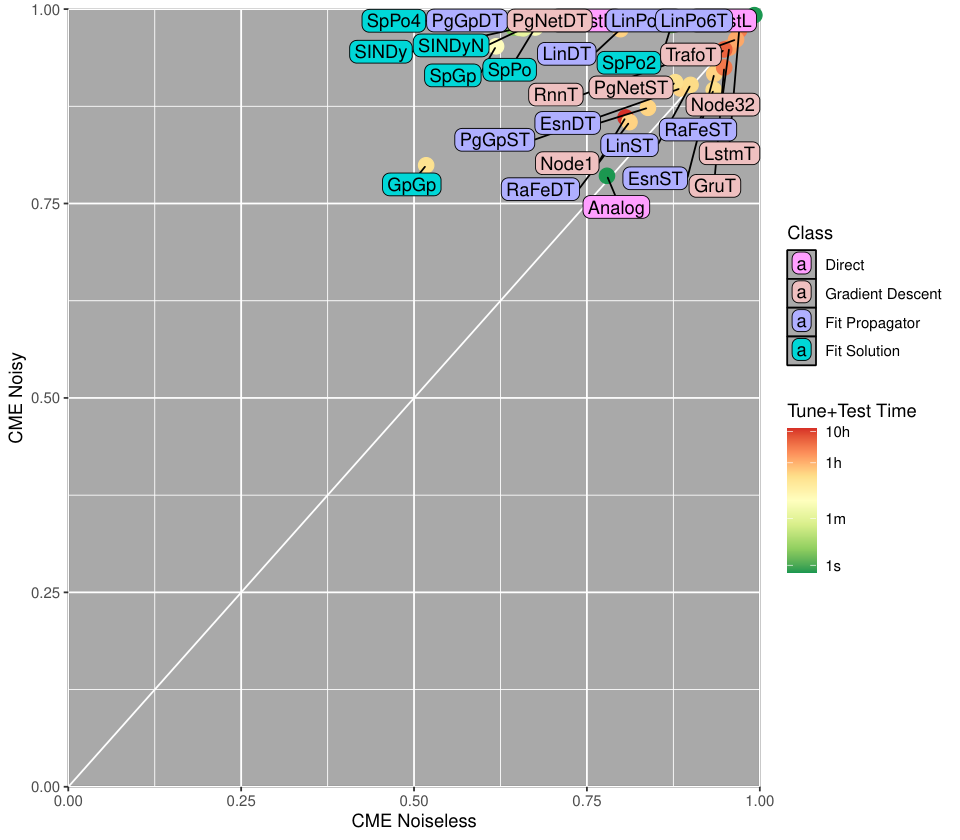
| Noisefree | Noisy | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Name | Class | Model | Variant | # | # | # | # | # | # | ||||||
| LinPo6 | Fit Prop. | Lin | Poly6 | 9 | 0.15 | 1 | 0.0000086 | 1 | 0.000024 | 19 | 0.85 | 14 | 0.76 | 14 | 0.74 |
| LinD | Fit Prop. | Lin | D | 1 | 0.010 | 2 | 0.000038 | 2 | 0.000056 | 4 | 0.65 | 4 | 0.58 | 4 | 0.56 |
| LinS | Fit Prop. | Lin | S | 2 | 0.021 | 3 | 0.00021 | 3 | 0.00024 | 3 | 0.65 | 3 | 0.58 | 3 | 0.56 |
| SpPo4 | Fit Solu. | Spline | Poly4 | 6 | 0.044 | 4 | 0.0034 | 6 | 0.0039 | 9 | 0.78 | 7 | 0.64 | 8 | 0.62 |
| SpPo | Fit Solu. | Spline | Poly | 4 | 0.021 | 5 | 0.0041 | 7 | 0.0039 | 1 | 0.61 | 2 | 0.53 | 1 | 0.54 |
| SINDy | Fit Solu. | SINDy | 7 | 0.050 | 6 | 0.011 | 9 | 0.011 | 14 | 0.83 | 10 | 0.66 | 6 | 0.60 | |
| PgGpD | Fit Prop. | GP | D | 13 | 0.26 | 7 | 0.012 | 4 | 0.00047 | 13 | 0.83 | 19 | 0.77 | 16 | 0.75 |
| SpPo2 | Fit Solu. | Spline | Poly2 | 3 | 0.021 | 8 | 0.014 | 10 | 0.014 | 1 | 0.61 | 1 | 0.53 | 1 | 0.54 |
| SINDyN | Fit Solu. | SINDy | norm | 8 | 0.068 | 9 | 0.020 | 11 | 0.015 | 12 | 0.83 | 11 | 0.67 | 23 | 0.79 |
| LinPo4 | Fit Prop. | Lin | Poly4 | 5 | 0.038 | 10 | 0.026 | 12 | 0.025 | 10 | 0.80 | 13 | 0.75 | 15 | 0.74 |
| PgGpS | Fit Prop. | GP | S | 15 | 0.41 | 11 | 0.030 | 8 | 0.0090 | 15 | 0.83 | 22 | 0.78 | 20 | 0.77 |
| RaFeD | Fit Prop. | RandFeat | D | 12 | 0.19 | 12 | 0.054 | 15 | 0.072 | 7 | 0.70 | 6 | 0.64 | 7 | 0.61 |
| EsnS | Fit Prop. | ESN | S | 14 | 0.27 | 13 | 0.060 | 14 | 0.069 | 5 | 0.65 | 12 | 0.68 | 9 | 0.64 |
| EsnD | Fit Prop. | ESN | D | 11 | 0.18 | 14 | 0.065 | 17 | 0.12 | 6 | 0.69 | 8 | 0.66 | 10 | 0.64 |
| RaFeS | Fit Prop. | RandFeat | S | 10 | 0.18 | 15 | 0.084 | 16 | 0.074 | 8 | 0.71 | 5 | 0.62 | 5 | 0.58 |
| GpGp | Fit Solu. | GP | GP | 16 | 0.71 | 16 | 0.17 | 5 | 0.0030 | 11 | 0.82 | 9 | 0.66 | 11 | 0.65 |
| SpGp | Fit Solu. | Spline | GP | 19 | 0.75 | 17 | 0.20 | 13 | 0.034 | 18 | 0.84 | 18 | 0.77 | 13 | 0.73 |
| PgNetD | Gr. Desc. | NeuralNet | D | 17 | 0.72 | 18 | 0.51 | 21 | 0.51* | 23 | 0.87 | 25 | 0.82 | 22 | 0.77* |
| PgLlS | Fit Prop. | LocalLin | S | 23 | 0.82 | 19 | 0.56 | 19 | 0.34 | 16 | 0.84 | 16 | 0.76 | 18 | 0.76 |
| PgLlD | Fit Prop. | LocalLin | D | 22 | 0.82 | 20 | 0.56 | 18 | 0.34 | 17 | 0.84 | 15 | 0.76 | 17 | 0.76 |
| Node32 | Gr. Desc. | NODE | bs32 | 21 | 0.82 | 21 | 0.63 | 22 | 0.58* | 22 | 0.87 | 20 | 0.78 | 21 | 0.77* |
| PgNetS | Gr. Desc. | NeuralNet | S | 18 | 0.75 | 22 | 0.65 | 23 | 0.60* | 24 | 0.87 | 28 | 0.87 | 29 | 0.85* |
| SpNn | Fit Solu. | Spline | 24 | 0.84 | 23 | 0.66 | 20 | 0.49 | 25 | 0.87 | 24 | 0.82 | 27 | 0.82 | |
| PwlNn | Fit Solu. | PwLin | NN | 25 | 0.84 | 24 | 0.69 | 25 | 0.65 | 20 | 0.86 | 21 | 0.78 | 25 | 0.81 |
| Analog | Direct | Analog | 27 | 0.89 | 25 | 0.75 | 24 | 0.63 | 26 | 0.89 | 17 | 0.76 | 12 | 0.71 | |
| LlNn | Fit Solu. | LocalLin | NN | 29 | 0.90 | 26 | 0.77 | 27 | 0.73 | 28 | 0.90 | 23 | 0.79 | 19 | 0.76 |
| Gru | Gr. Desc. | GRU | 20 | 0.79 | 27 | 0.77 | 26 | 0.67* | 21 | 0.86 | 27 | 0.87 | 24 | 0.79* | |
| Trafo | Gr. Desc. | Transformer | 28 | 0.89 | 28 | 0.83 | 29 | 0.81* | 27 | 0.89 | 26 | 0.84 | 26 | 0.81* | |
| Rnn | Gr. Desc. | RNN | 26 | 0.85 | 29 | 0.85 | 28 | 0.77* | 29 | 0.90 | 29 | 0.92 | 28 | 0.83* | |
| Lstm | Gr. Desc. | LSTM | 30 | 0.90 | 30 | 0.88 | 30 | 0.90* | 30 | 0.93 | 30 | 0.93 | 30 | 0.93* | |
| ConstL | Direct | Const | Last | 31 | 0.99 | 31 | 0.99 | 31 | 0.99 | 31 | 0.99 | 31 | 0.99 | 31 | 0.99 |
| ConstM | Direct | Const | Mean | 32 | 0.99 | 32 | 1.0 | 32 | 1.0 | 32 | 0.99 | 32 | 1.0 | 32 | 1.0 |
*Размер пакета 1024. Обучено на GPU.