Совершенствование анализа поведения сотрудников с помощью синтетических данных: использование ABMs, GANs и статистических моделей для повышения организационной эффективности
Аннотация
Успех в современной корпоративной среде, основанной на данных, требует глубокого понимания поведения сотрудников. Компании стремятся повысить удовлетворенность сотрудников, увеличить производительность и оптимизировать workflow. Данное исследование посвящено созданию синтетических данных, мощного инструмента, который позволяет всесторонне понять эффективность работы, гибкость, сотрудничество и командную динамику сотрудников. Синтетические данные предоставляют детальную и точную картину деятельности сотрудников, защищая при этом конфиденциальность каждого человека благодаря передовым методам, таким как agent-based models (ABMs), Generative Adversarial Networks (GANs) и статистические модели. Создавая различные ситуации, этот метод предлагает ценные идеи относительно усиления командной работы, улучшения адаптивности и ускорения общей производительности. Мы рассматриваем, как синтетические данные превратились из узкоспециализированной области в важнейший ресурс для исследования поведения сотрудников и повышения эффективности управления. Ключевые слова: Agent-Based Model, Generative Adversarial Network, workflow optimization, organizational success
1 Введение
Поведение сотрудников на рабочем месте является не просто фактором, а краеугольным камнем, который существенно влияет на культуру, производительность и успех организации. В people analytics активное и энергичное поведение сотрудников полезно и крайне важно для достижения организациями своих целей[1]. Synthetic data — это искусственные данные, создаваемые для имитации точных данных с помощью вычислительных методов и симуляций для различных целей, таких как тестирование, обучение моделей и исследования. Для достижения организационных целей и задач сотрудники играют важнейшую роль в использовании этого и других ресурсов, таких как технологии, финансы, информация и другие управленческие инструменты[2]. Сложность генерации synthetic data может варьироваться от простых математических уравнений до полностью смоделированных виртуальных сред[3]. Использование искусственно созданных данных в области организационной структуры сотрудников помогает сохранять конфиденциальную информацию при анализе без раскрытия личных данных сотрудников, тем самым защищая конфиденциальность сотрудников и соблюдая правила защиты данных. Эти искусственно созданные данные могут быть получены из реального набора данных, или может быть сгенерирован совершенно новый набор данных, если реальные данные недоступны. Вновь сгенерированные данные практически идентичны исходным данным. В этой исследовательской статье мы использовали этот метод для получения информации о сотрудниках с помощью некоторых платформ с открытым исходным кодом и сгенерировали данные, специфичные для сотрудников, используя методологии.
2 Преимущества синтетических данных в области аналитики персонала
2.1 Конфиденциальность и реализм
Имитация сценария реальных данных, генерация искусственных данных и репликация данных с теми же статистическими свойствами, распределениями и взаимосвязями, что и актуальные данные. Прямые идентификаторы, такие как имена, идентификаторы сотрудников или контактная информация, удаляются или заменяются случайными идентификаторами. Группировка схожих характеристик снижает детализацию данных, затрудняя их отслеживание до конкретных индивидов.
2.2 Масштабируемость и генерация без предвзятости
Генерация синтетических данных позволяет создавать обширные, непредвзятые наборы данных даже в областях с их дефицитом, что является значительным преимуществом в people analytics. Это дает возможность формировать большие репрезентативные наборы данных, которые отражают потенциальное поведение сотрудников, заполняя пробелы там, где точные данные представлены недостаточно..
2.3 Экономическая эффективность и универсальность
Генерация синтетических данных является экономически эффективным решением, значительно более дешевым, чем сбор больших объемов реальных данных. Эта экономическая эффективность приносит финансовые выгоды проектам организации, основанным на данных. Универсальность заключается в легкости, с которой их можно модифицировать или перегенерировать для удовлетворения конкретных потребностей..
3 Методология
3.1 Статистические методы
3.1.1 Многомерный метод
Статистический метод, исследующий несколько переменных и их взаимодействия одновременно, улавливает их взаимозависимости. Этот метод помогает генерировать данные, которые сохраняют характеристики исходного набора данных. Он моделирует совместное распределение нескольких нормально распределенных переменных. Это отражает корреляции между несколькими переменными, обеспечивая надежный процесс генерации данных. Данные подчиняются нормальному распределению, что делает процесс простым и эффективным. При применении к поведению сотрудников, где задействованы такие факторы, как производительность, вовлеченность в командную работу, сотрудничество и гибкость, многомерный метод позволяет нам генерировать синтетические данные, имитирующие реальные взаимосвязи между этими факторами..
где и являются стандартными отклонениями и соответственно.
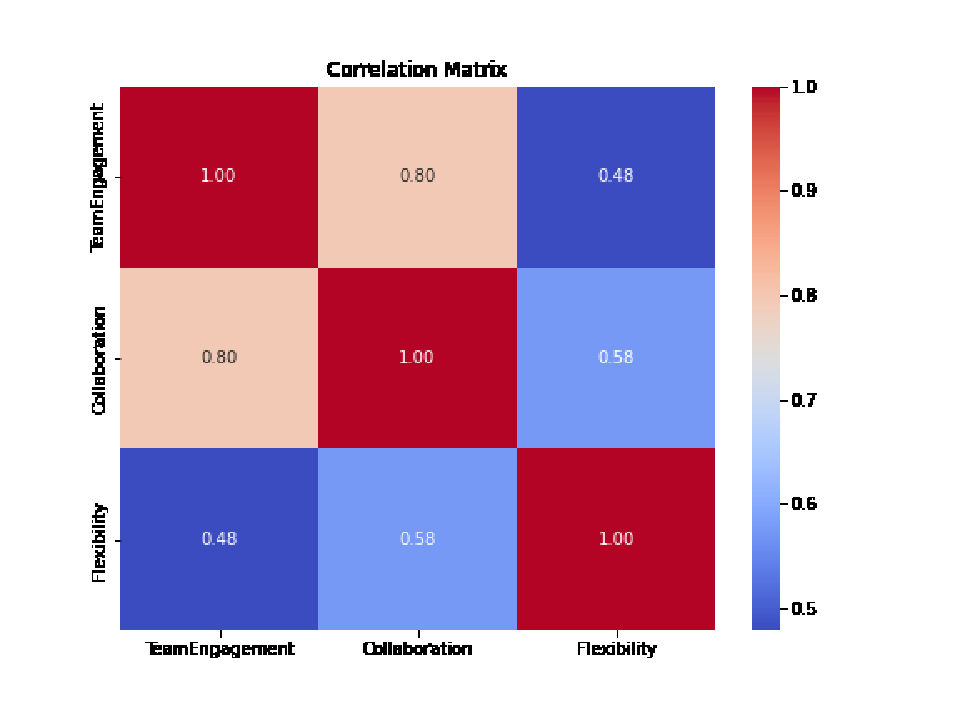
Сильная корреляция (0,8) между командной вовлеченностью и коллаборацией указывает на то, что коллаборация естественным образом улучшается в рабочей среде, где команды более вовлечены. Умеренные корреляции предполагают, что, хотя гибкость положительно связана с командной вовлеченностью и коллаборацией, эта связь не столь сильна. Это указывает на то, что гибкость может зависеть от других факторов, не представленных в этой матрице, или иметь менее прямую связь с вовлеченностью и коллаборацией.
3.1.2 Метод бутстрэппинга
Метод бутстрэпа, представленный Брэдли Эфроном в 1979 году, представляет собой непараметрический подход к статистическому выводу. Этот метод включает в себя создание множества «бутстрэп-выборок» из исходного набора данных путем повторной выборки с возвращением. Повторно выбирая исходные данные с возвращением и вычисляя интересующую статистику по множеству бутстрэп-выборок, мы можем с уверенностью оценивать изменчивость статистики. Эта способность точно оценивать изменчивость является ключевым преимуществом метода, позволяя вам строить доверительные интервалы, проверять гипотезы или оценивать стабильность модели с высокой степенью надежности. Бутстрэп предполагает повторную выборку данных о производительности с возвращением для создания synthetic data. К каждой переменной добавляется шум, чтобы сделать данные более реалистичными.
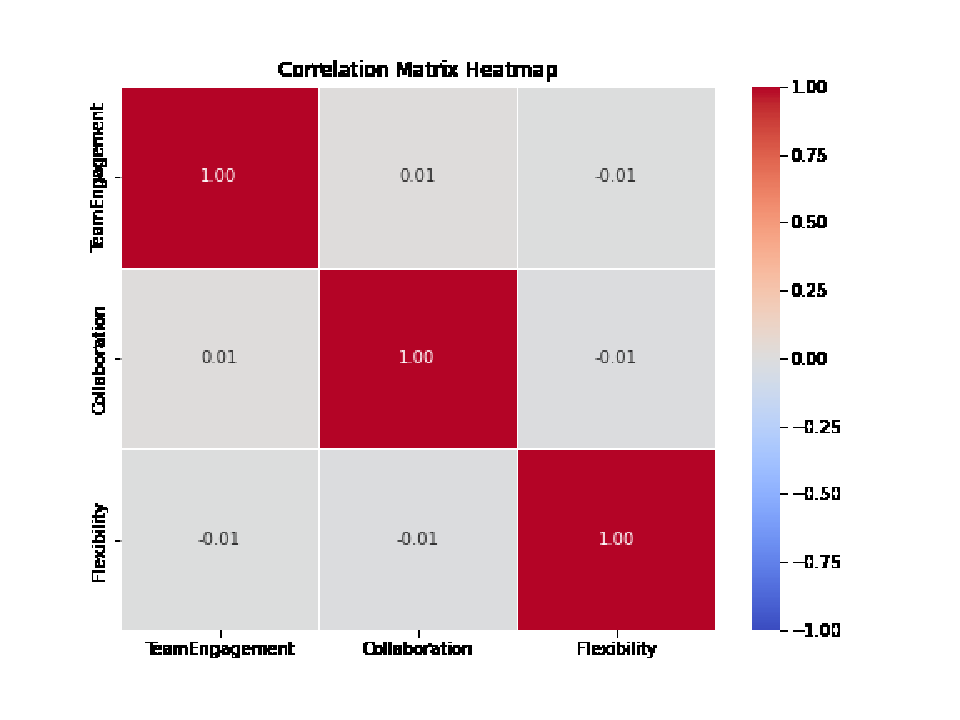
На тепловой карте видно, что синтетические данные для вовлеченности команды, коллаборации и гибкости не демонстрируют сильных корреляций. Корреляции близки к нулю, что означает отсутствие значимых линейных взаимосвязей между этими переменными в данном наборе данных..
3.1.3 Метод копул
Копулы — это функции, которые позволяют моделировать зависимость между случайными величинами отдельно от их маргинального распределения. Поведение сотрудников, такое как вовлеченность в командную работу, сотрудничество и гибкость, часто взаимозависимо, и статистические методы копул для поведения сотрудников используются.
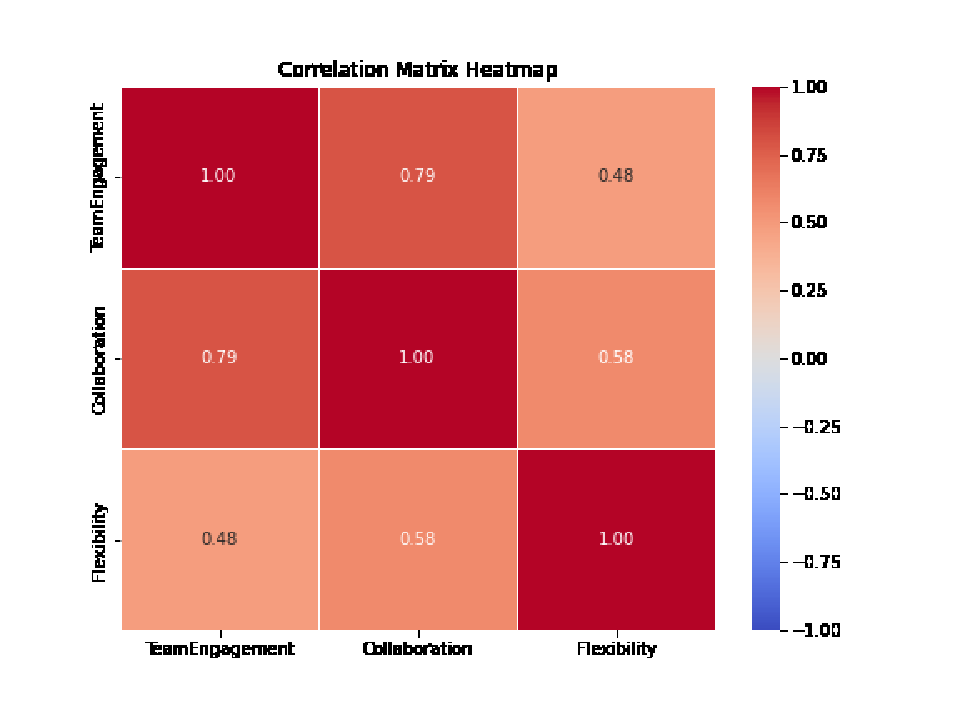
Тепловая карта показывает сильные положительные корреляции между поведением сотрудников, в частности между показателями ”Team Engagement” и ”Collaboration” (0.79), что указывает на тенденцию вовлеченных сотрудников к более активному сотрудничеству. Корреляции между ”Team Engagement” и ”Flexibility” (0.48), а также между ”Collaboration” и ”Flexibility” (0.58) являются умеренными, что предполагает положительную, но менее выраженную взаимосвязь этих поведенческих факторов. Данный инсайт может лечь в основу целевых интервенций для повышения вовлеченности и коллаборации при сохранении гибкости.
3.2 Метод на основе агентов
Агентное моделирование (ABM) — это метод симуляции, который может генерировать синтетические данные для сложных систем, таких как поведение сотрудников в организации. ABM предполагает создание агентов (индивидуальных сущностей, таких как сотрудники), которые взаимодействуют в соответствии с набором правил внутри симулируемой среды.
Этот подход позволяет генерировать реалистичные synthetic data, отражающие изменения в поведении сотрудников на основе оценок производительности, которые в дальнейшем могут быть проанализированы или использованы для training моделей machine learning. Использование нормально распределенных случайных величин вносит естественную вариативность, имитирующую реальные различия в поведении.
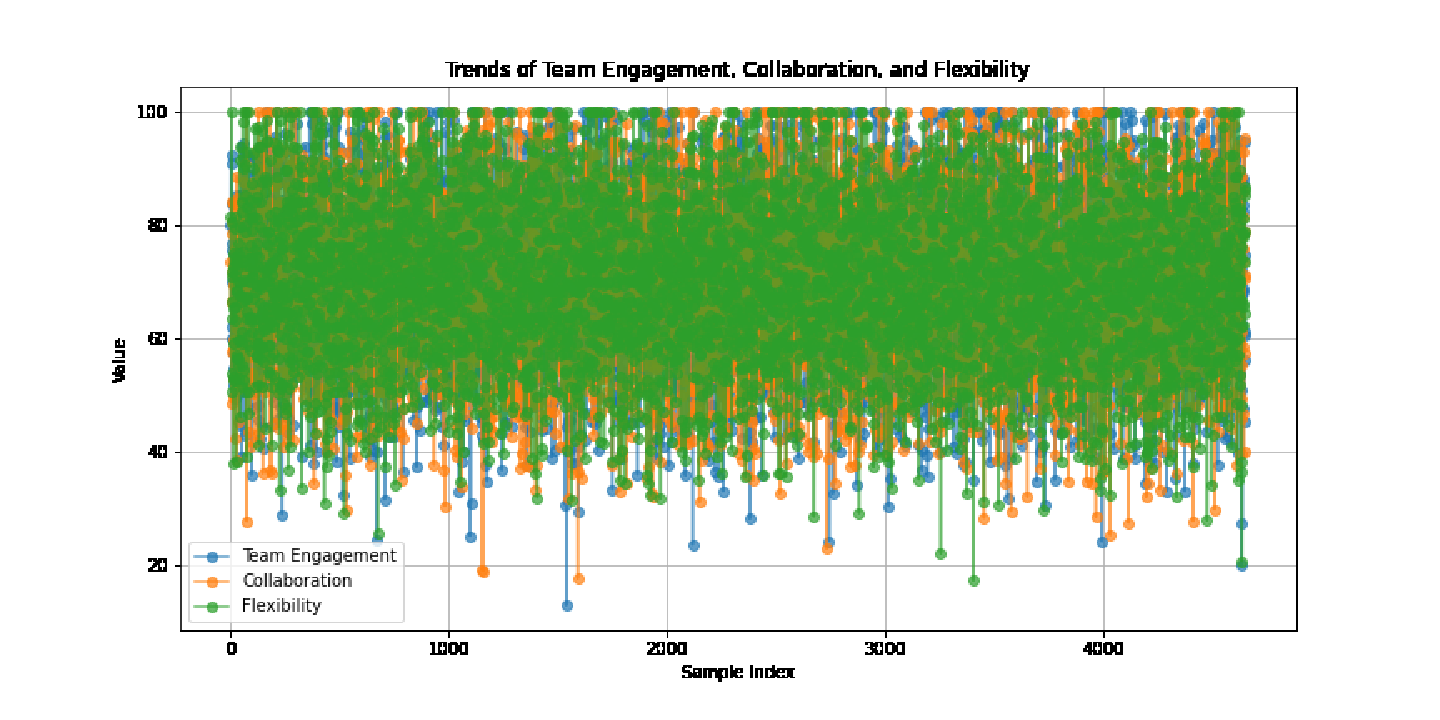
График показывает динамику трех метрик синтетического поведения — Вовлеченность команды, Коллаборация и Гибкость, сгенерированных с использованием агентного моделирования (ABM). На графике представлено распределение метрик синтетического поведения — Вовлеченность команды, Коллаборация и Гибкость, полученных с помощью агентного моделирования. Каждая метрика широко распределена в диапазоне от 0 до 100, причем плотные перекрывающиеся точки указывают на значительную вариативность. На графике отсутствуют четкие тенденции, что отражает случайный характер процесса генерации данных, при котором поведение каждого сотрудника независимо зависит от его оценки эффективности. Общая картина предполагает реалистичное моделирование разнообразного поведения сотрудников.
3.3 Генеративно-состязательная сеть
Ян Гудфеллоу представил его как тип модели глубокого обучения, используемый в основном для генерации новых данных, имитирующих заданный набор данных. В ходе состязательного процесса между генератором и дискриминатором GANs могут производить реалистичные данные, часто неотличимые от реальных. Процесс обучения GAN является состязательным, поскольку генератор и дискриминатор конкурируют:
- ⟦• Генератор пытается обмануть дискриминатор, создавая все более реалистичные данные.
- ⟦• Дискриминатор пытается улучшить свою способность обнаруживать поддельные данные.
Этот процесс продолжается до тех пор, пока генератор не начнет производить данные, неотличимые от реальных данных. Использование генеративно-состязательной сети (GAN) для генерации синтетических данных о поведении сотрудников дает ряд преимуществ, особенно в сценариях, где конфиденциальность данных, нехватка данных или потребность в разнообразии и реалистичности данных являются ключевыми факторами. Генератор(G)
Где z — это входной вектор шума, W1, W2 и W3 — весовые матрицы, b1, b2 и b3 — векторы смещения, а ReLU(x)=max(0,x) — функция активации.
Где x — данные, W’1, W’2, W’3 — весовые матрицы дискриминатора, B’1, B’2, B’3
G(z) — это синтетические данные, сгенерированные генератором, а D(x) — прогноз дискриминатора.
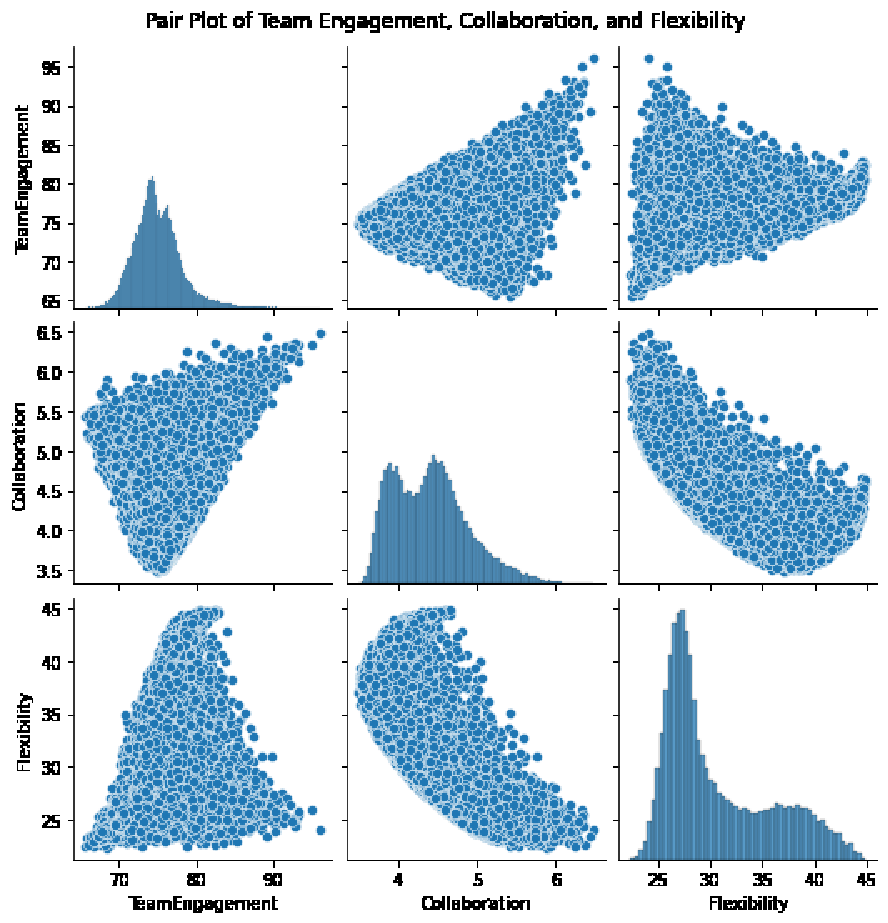
График попарных распределений (pair plot) демонстрирует, что GAN эффективно уловила распределения и сложные нелинейные взаимосвязи между вовлеченностью команды (Team Engagement), коллаборацией (Collaboration) и гибкостью (Flexibility). Гистограммы показывают, что синтетические данные тесно соответствуют распределению исходных данных. Точечные диаграммы (scatter plots) демонстрируют реалистичные, разнообразные результаты, позволяя избежать таких проблем, как коллапс мод (mode collapse). В целом, данные, сгенерированные GAN, сохраняют целостность и вариативность исходного набора данных, что делает их пригодными для дальнейшего анализа и аугментации данных. Это подчеркивает успех GAN в воспроизведении ключевых характеристик метрик поведения сотрудников..
4 Заключение
Это исследование посвящено созданию и применению синтетических данных для анализа поведения сотрудников, подчеркивая их важную роль в современном организационном управлении. Используя передовые методы, такие как Generative Adversarial Networks (GANs), Agent-Based Models (ABMs) и статистические методы, такие как копулы и бутстрэп, синтетические данные могут точно имитировать реальное поведение сотрудников, сохраняя при этом конфиденциальность и решая проблему нехватки данных. Анализ синтетических данных дает ценные сведения о ключевых поведенческих метриках, таких как производительность, командная вовлеченность, сотрудничество и гибкость, которые необходимы для повышения продуктивности и оптимизации workflow в организациях. Результаты показывают, что синтетические данные не только сохраняют статистические характеристики реальных данных, но также обеспечивают надежное сценарное тестирование и обучение моделей, что делает их незаменимым инструментом для анализа поведения сотрудников и повышения организационной эффективности..
Вот ссылка на мой репозиторий на GitHub: GitHub Repository
Список литературы
- ⟦[1] Jayashankar, R., & Balan, M. (2024). Unveiling the dynamics of employee behavior through Wolfram’s cellular automata. arXiv. Retrieved from https://arxiv.org/abs/2407.09581
- ⟦[2] Arimie, J. C., & Oronsaye, A. O. Assessing employee relations and organizational performance: A literature review.
- ⟦[3] Moez, M. (2024). Synthetic Data is the Future of Artificial Intelligence. Medium. Retrieved from https://moez-62905.medium.com/synthetic-data-is-the-future-of-artificial-intelligence-6fcfd2ce1a14⟧
- ⟦[4] Neuhausen, M., Herbers, P., & König, M. (2020). Using Synthetic Data to Improve and Evaluate the Tracking Performance of Construction Workers on Site. Applied Sciences, 10(14), 4948. Retrieved from https://doi.org/10.3390/app10144948
- ⟦[5] SDV: Synthetic Data Vault. (2018). Retrieved from https://dai.lids.mit.edu/wp-content/uploads/2018/03/SDV.pdf
- [6] Howe, B., Stoyanovich, J., Ping, H., Herman, B., & Gee, M. Synthetic Data for Social Good. University of Washington and Drexel University.
- ⟦[7] Генерация синтетических данных. (2024). Блог IndikaAI. Получено из https://www.indikaai.com/blog/synthetic-data-generation