Иерархическая архитектура резервирования для высокорисковых систем онлайн-вывода Machine LearningDOI: XXXXXXX.XXXXXXXКонференция: От прототипа к промышленной эксплуатации: Развертывание реальных AI / ML моделей в финансовой индустрии; 03–05 июня 2018 г.; Вудсток, штат Нью-ЙоркМеждународный стандартный книжный номер: 978-1-4503-XXXX-X/18/06CCS: Вычислительные методологииCCS: Организация компьютерных систем Архитектура систем реального времениCCS: Организация компьютерных систем Архитектуры
Аннотация.
Приложения машинного обучения на базе Open Banking требуют новых подходов к обеспечению устойчивости для работы со сложными стрессовыми сценариями и отказами. В данной статье мы предлагаем иерархическую архитектуру резервирования для повышения устойчивости в высокорисковых приложениях машинного обучения с акцентом на финансовую сферу. Мы определяем общие сценарии отказов, часто встречающиеся при online inference, которые зависят от внешних поставщиков данных, и подробно описываем, как применять иерархическую архитектуру резервирования для их устранения. Наконец, мы приводим реальный пример ее применимости в отрасли для оценки риска транзакционного мошенничества в режиме, близком к реальному времени, с использованием данных Open Banking и в условиях экстремальных стрессовых сценариев..
Ключевые слова:
Онлайн машинное обучение, устойчивость, резервная модель, переключение на резерв, безопасность машинного обучения, машинное обучение в финансах, открытый банкинг1. Введение
Недавние достижения в области AI/ML и расширение сфер их применения во многих отраслях существенно трансформировали и оптимизировали бизнес-результаты. Хотя положительные примеры освещаются чаще, проявилось и множество аспектов технических недостатков, учитывая, что основные системы большинства организаций изначально не были рассчитаны на принятие решений в режиме реального времени. Эти системы могут неожиданно давать сбои самыми разными способами. В частности, приложения, полагающиеся на online inference, подвержены неспособности соответствовать ожидаемым рабочим процедурам, при этом теперь им дополнительно приходится выполнять трудоемкие вычислительные задачи для этих AI/ML приложений, что обычно приводит к тайм-аутам, сбоям инфраструктуры и, зачастую, отказам во внешних зависимостях, таких как сторонние поставщики данных (внешние API calls) (Sculley et al. 2015). Когда к базовым приложениям машинного обучения предъявляются строгие требования к robustness, необходимы стратегии fallback или fall-over для поддержания работоспособности даже в случае непредвиденных сбоев. В финансах, особенно в приложениях, требующих принятия решений по снижению рисков в режиме реального времени, нехватка ресурсов систем чревата существенными финансовыми потерями, что делает robustness этих систем обязательной. Если ML система дает сбой и ошибочно одобряет рискованный кредит или мошенническую транзакцию, финансовое учреждение (FI) может понести серьезный ущерб. Проблема усугубляется, если учесть, что многие современные ML системы, используемые при принятии финансовых решений, в настоящее время зависят от данных Open Banking (Long et al. 2020). Финансовые учреждения работают как внешние поставщики данных в контексте Open Banking, предоставляя актуальную информацию для множества вариантов использования, включая оценку рисков. В качестве иллюстрации: если финансовое учреждение не предоставляет данные Open Banking, необходимые для оценки того, является ли транзакция мошеннической, оценка рисков должна содержать стратегии fallback, чтобы поддерживать достаточный уровень robustness для предотвращения извлечения выгоды мошенниками из потенциальных простоев. Один из возможных подходов заключается в разработке ML моделей с учетом robustness, чтобы они могли выдавать релевантный inference даже при отсутствии части признаков или наличии в них неточностей (Myllyaho et al. 2022). Однако robustness часто трудно гарантировать на этапе разработки модели (Einziger et al. 2019), а сама ML модель может быть недоступна из-за внутреннего сбоя. В ситуациях, когда недоступность ML модели сохраняется, другим подходом является перенаправление запроса на fallback модель. Fallback модель представляет собой вариант основной модели, разработанный с учетом сценария сбоя. Например, если вызов внешнего поставщика данных завершается неудачей, ожидается, что это затронет определенную группу признаков. Fallback модель может быть обучена без затронутой группы признаков и, таким образом, не будет зависеть от сбоя. Кроме того, fallback модель представляет собой прокси для избыточности инфраструктуры, что может быть полезно, если основная инфраструктура сталкивается с простоем..
В данной работе мы рассматриваем следующие сценарии сбоев: когда некоторые данные, необходимые для ML модели, (1) отсутствуют из-за недоступности у поставщика данных или (2) повреждены вследствие других типов сбоев, (3) сам процесс вывода модели недоступен или (4) возникают скачки задержки. Мы предлагаем иерархическую архитектуру резервного копирования для устранения всех рассмотренных сценариев сбоев при соблюдении строгих ограничений по времени отклика. Наша архитектура выделяет одну основную модель, которая выполняет запросы в штатном режиме, и несколько резервных моделей, которые активируются в сценариях сбоев. Мы описываем, как разрабатывать резервные модели и организовывать их работу в сочетании с политиками повторных попыток в условиях онлайн вывода. Мы представляем тематическое исследование, в котором обсуждается эффективность нашей иерархической архитектуры резервного копирования на примере реального кейса оценки рисков с использованием данных Open Banking..
Статья структурирована следующим образом: в разделе 2 представлен обзор литературы по устойчивости и обсуждаются альтернативные варианты. В разделе 3 описывается иерархическая архитектура с резервными компонентами и разработка резервных моделей. В разделе 4 обсуждаются проблемы и ограничения нашего подхода с учетом реального сценария использования платежей Open Banking в Trustly в стрессовых ситуациях, а также приводятся заключительные замечания..
2. Контекст
В литературе можно найти разнообразные методы обеспечения устойчивости в машинном обучении. Предыдущие работы были сосредоточены на том, как внедрять свойства устойчивости на этапе разработки модели (Einziger et al. 2019). Некоторые подходы используют состязательные методы для создания моделей, устойчивых к поврежденным данным (Narodytska et al. 2018). В целом, трудно гарантировать, что модель достаточно устойчива. Как мы упоминали, ML может давать сбои неожиданным образом, и предусмотреть их все сложно. Валидация устойчивости и гарантии для ML остаются открытой проблемой, поэтому даже если применяется метод обеспечения устойчивости, он не может гарантировать, что модель будет вести себя должным образом во всех сценариях сбоев. Более того, свойства устойчивости на этапе разработки модели могут справиться только со сбоями в вышестоящих источниках данных, нашими типами сбоев (1) и (2), и не решают проблемы со сбоями в инфраструктуре модели, нашими типами сбоев (3) и (4). Несмотря на значимые результаты по повышению надежности ML, устойчивость в ML в основном фокусировалась на тестировании моделей ML, а не на системах в целом, которые используют ML (Zhang et al. 2020). Недавние исследования с участием профессионалов из различных отраслей предлагают избыточные и резервные модели в качестве перспективной архитектуры для устойчивых систем ML (Myllyaho et al. 2022). Избыточные резервные модели полезны, когда основная модель сталкивается с простоем. Мы также утверждаем, что резервные модели более предсказуемы, чем методы обеспечения устойчивости, применяемые к основной модели на этапе разработки. Например, в случае, если группа признаков затронута сбоем, на прогнозную эффективность резервной модели, которая не включает признаки из затронутой группы, это не повлияет. С другой стороны, невозможно предвидеть падение производительности модели, которая использует затронутую группу признаков, несмотря на наличие некоторых свойств устойчивости..
3. Метод
На рисунке 1 представлена предложенная архитектура, состоящая из основной модели и трех резервных этапов, отвечающих за обработку различных сценариев сбоев. Первый этап направлен на работу с отсутствующими входными данными из-за недоступности у поставщика данных, что может привести к недоступности одной или нескольких групп признаков. Для обработки такого типа сбоев мы переключаемся на аналогичную модель, которая была обучена без данной группы признаков. По сути, для каждой критической группы признаков у нас имеется версия модели, доступная для использования в качестве резервной в случае сбоя, где веса признаков перекалиброваны в соответствии с их доступностью для каждой модели, что способствует максимизации извлечения сигнала. Такой подход гарантирует, что в случае резервного переключения из-за сбоя поставщика данных мы будем использовать наилучшую доступную версию модели для принятия решения..
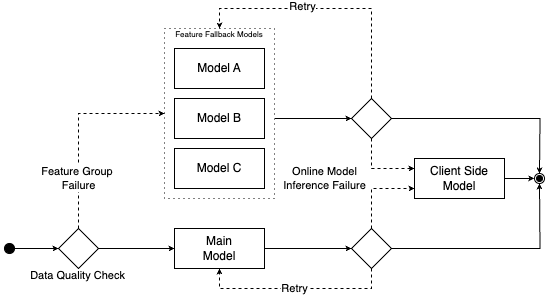
Второй этап резервирования применяет оптимизацию избыточности с использованием любой из доступных моделей, политика повторных попыток направлена на смягчение проблем кратковременной недоступности сервиса или скачков задержки. Решение о повторной попытке принимается во время транзакции и учитывает информацию о транзакции, вероятность последующего сбоя, а также дополнительное время при анализе рисков. Такой подход гарантирует, что в случае, если сам вывод модели недоступен из-за некоторой кратковременной нестабильности, решение о повторной попытке использования основной модели перед переходом к резервной учитывает другие факторы риска..
Последним резервным этапом является модель резервирования на стороне клиента, которая используется только тогда, когда все остальные этапы недоступны. В нашей текущей архитектуре все модели машинного обучения используются из одного и того же основного программного обеспечения. В данном случае мы внедрили модель оценки рисков, встроенную в основное программное обеспечение, которую мы называем моделью резервирования на стороне клиента. Эта модель использует меньше признаков, что приводит к выделению меньшего объема памяти, гарантируя, что даже в наихудшем сценарии эта модель может быть выполнена должным образом..
Обратите внимание, что несколько групп признаков могут выйти из строя одновременно, поэтому, если мы хотим охватить все возможные сценарии сбоев, это подразумевает необходимость обучения нескольких резервных моделей с учетом всех комбинаций групп признаков, которые могут оказаться недоступными. В практическом сценарии эксплуатационные расходы на поддержку этих моделей могут не окупиться, поэтому необходим критерий для выбора минимального количества резервных альтернатив. Допустим, у вас есть набор групп признаков, тогда максимальное количество резервных моделей равно факториалу . Заметим, что минимальное количество резервных моделей для покрытия всех сценариев сбоя групп признаков равно количеству групп признаков, так как вы всегда будете сохранять резервные модели, использующие только одну группу признаков. Например, рассмотрим три группы признаков: A, B и C. Если мы разрабатываем резервные модели с учетом того, что любая из групп признаков может быть недоступна, мы получаем 6 резервных моделей: одна использует только A и B, другая — B и C, третья — A и C, и еще 3 модели используют только A, B и C соответственно. Интуитивно понятно, и поскольку производительность этих моделей может быть оценена заранее, рекомендуется сохранять только небольшой набор моделей, демонстрирующих более высокую производительность, избегая дополнительных накладных расходов. Если мы оценим производительность всех 6 моделей и поймем, что модель, использующая только группу признаков C, имеет эквивалентную производительность по сравнению с моделью, использующей B и C, нам следует оставить только модель, использующую группу признаков C. Этот процесс аналогичен групповому отбору признаков (Kuzudisli et al. 2023) и требует от специалиста по Machine Learning указания порога допустимости, чтобы определить, имеют ли две модели эквивалентную производительность..
Когда инцидент открыт и группа признаков помечена как неисправная, перенаправить запросы на соответствующую резервную модель не составляет труда, однако ситуация меняется, если внешние поставщики данных работают исправно, а основная служба модели сталкивается с резкими скачками задержки или полной недоступностью. В сценариях, когда служба модели находится под нагрузкой, например, из-за сезонных или непредвиденных событий, вызывающих внезапный рост объема запросов, дисперсия времени отклика может увеличиться, что приведет к более длительному ожиданию и потенциальным тайм-аутам. Этот сценарий мы называем скачками задержки, когда для небольшого числа запросов службе модели требуется значительно больше времени для ответа. Если время отклика не соответствует SLA клиента, клиент прервет ожидание по тайм-ауту и перестанет ждать ответа от службы модели. Поскольку основная модель все еще может отвечать за приемлемое время для большинства запросов, нам не следует перенаправлять весь трафик на резервные модели; вместо этого мы можем применить политику повторных попыток для повторного вызова основной модели. Заметим, что существует нетривиальный компромисс между порогом тайм-аута и максимальным количеством повторных попыток. Чем выше порог тайм-аута, то есть время ожидания ответа от службы модели, тем меньше вероятность возникновения тайм-аута, однако в случае его возникновения у вас останется меньше времени на повторные попытки. Для иллюстрации рассмотрим общий SLA времени отклика, равный 300 мс. Если вы укажете 100 мс в качестве порога тайм-аута, вы сможете выполнить не более 2 повторных попыток, поскольку если модель выдаст тайм-аут во всех 3 попытках, их сумма составит ваш SLA. В качестве альтернативы, если модель выдает тайм-аут при всех повторных попытках, вы можете использовать лучшую резервную альтернативу. Поскольку все модели независимы друг от друга, их можно вызывать параллельно с основной моделью. Таким образом, если основная модель не отвечает, у вас уже есть готовые резервные оценки, что позволяет избежать увеличения общего времени отклика. С другой стороны, параллельный вызов всех моделей может быть пустой тратой инфраструктурных ресурсов, так как вы дублируете всю рабочую нагрузку ради сокращения времени отклика для небольшого числа транзакций. Один из подходов к сокращению избыточных ресурсов заключается в выборочном определении на основе атрибутов запроса тех из них, для которых вы хотите обеспечить такой уровень избыточности. Например, в финансовой сфере часто встречаются приложения, где финансовая ценность каждого вывода модели может существенно различаться. Финансовые потери от пропуска мошеннической операции или рискованного кредита прямо пропорциональны сумме платежа или кредитной операции. Разумно стремиться к более высокой надежности для выводов модели, связанных с высокой финансовой ценностью, поэтому в таких случаях мы можем выборочно предпочесть более высокую избыточность..
4. Платежи в рамках Open Banking и заключение
Мы применили предложенную нами иерархическую архитектуру резервирования для повышения устойчивости платежного продукта Trustly. Trustly является лидером в сфере Open Banking платежей в Северной Америке. Компания использует данные Open Banking для проведения анализа рисков для миллионов платежей ежемесячно. Trustly подключается к более чем 99% финансовых институтов в США. Каждый из них представляет собой внешнего поставщика данных, ключевого для LLM inference. Финансовые институты разнообразны, и, следовательно, некоторые из них могут быть более надежными, чем другие, с точки зрения уровней обслуживания. В случае сбоя или недоступности финансового института группы признаков могут быть затронуты или стать полностью недоступными, что потенциально снижает производительность модели. Чтобы защитить операцию от потенциальных внешних факторов, мы применили нашу архитектуру резервирования. Во-первых, мы сопоставили все группы признаков с потенциальным сценарием сбоя. Сопровождая каждую основную модель риска, нам удалось создать резервные модели, каждая из которых учитывает отсутствие заданной группы признаков. Кроме того, чтобы учесть сценарии серьезных сбоев инфраструктуры, при которых все модели, включая резервные, становятся недоступными, мы также создали Client-side резервную модель, которая жестко закодирована на сервере приложений. В худшем случае, когда работает только основной сервер приложений, мы все равно будем выполнять оценку рисков..
Одним из недостатков нашей иерархической архитектуры резервирования является то, что от резервных моделей ожидается более низкая производительность по сравнению с основной моделью. Мы заметили, что наибольший разрыв в производительности между основной моделью и резервной моделью составил около 9,09% по метрике Precision-Recall Area Under the Curve (PR-AUC) и 58,06% при сравнении с жестко запрограммированной резервной моделью. Хотя влияние на производительность при использовании жестко запрограммированной резервной модели является значительным, важно отметить, что менее 0,00001% от общего объема фактически подвергается данному сценарию..
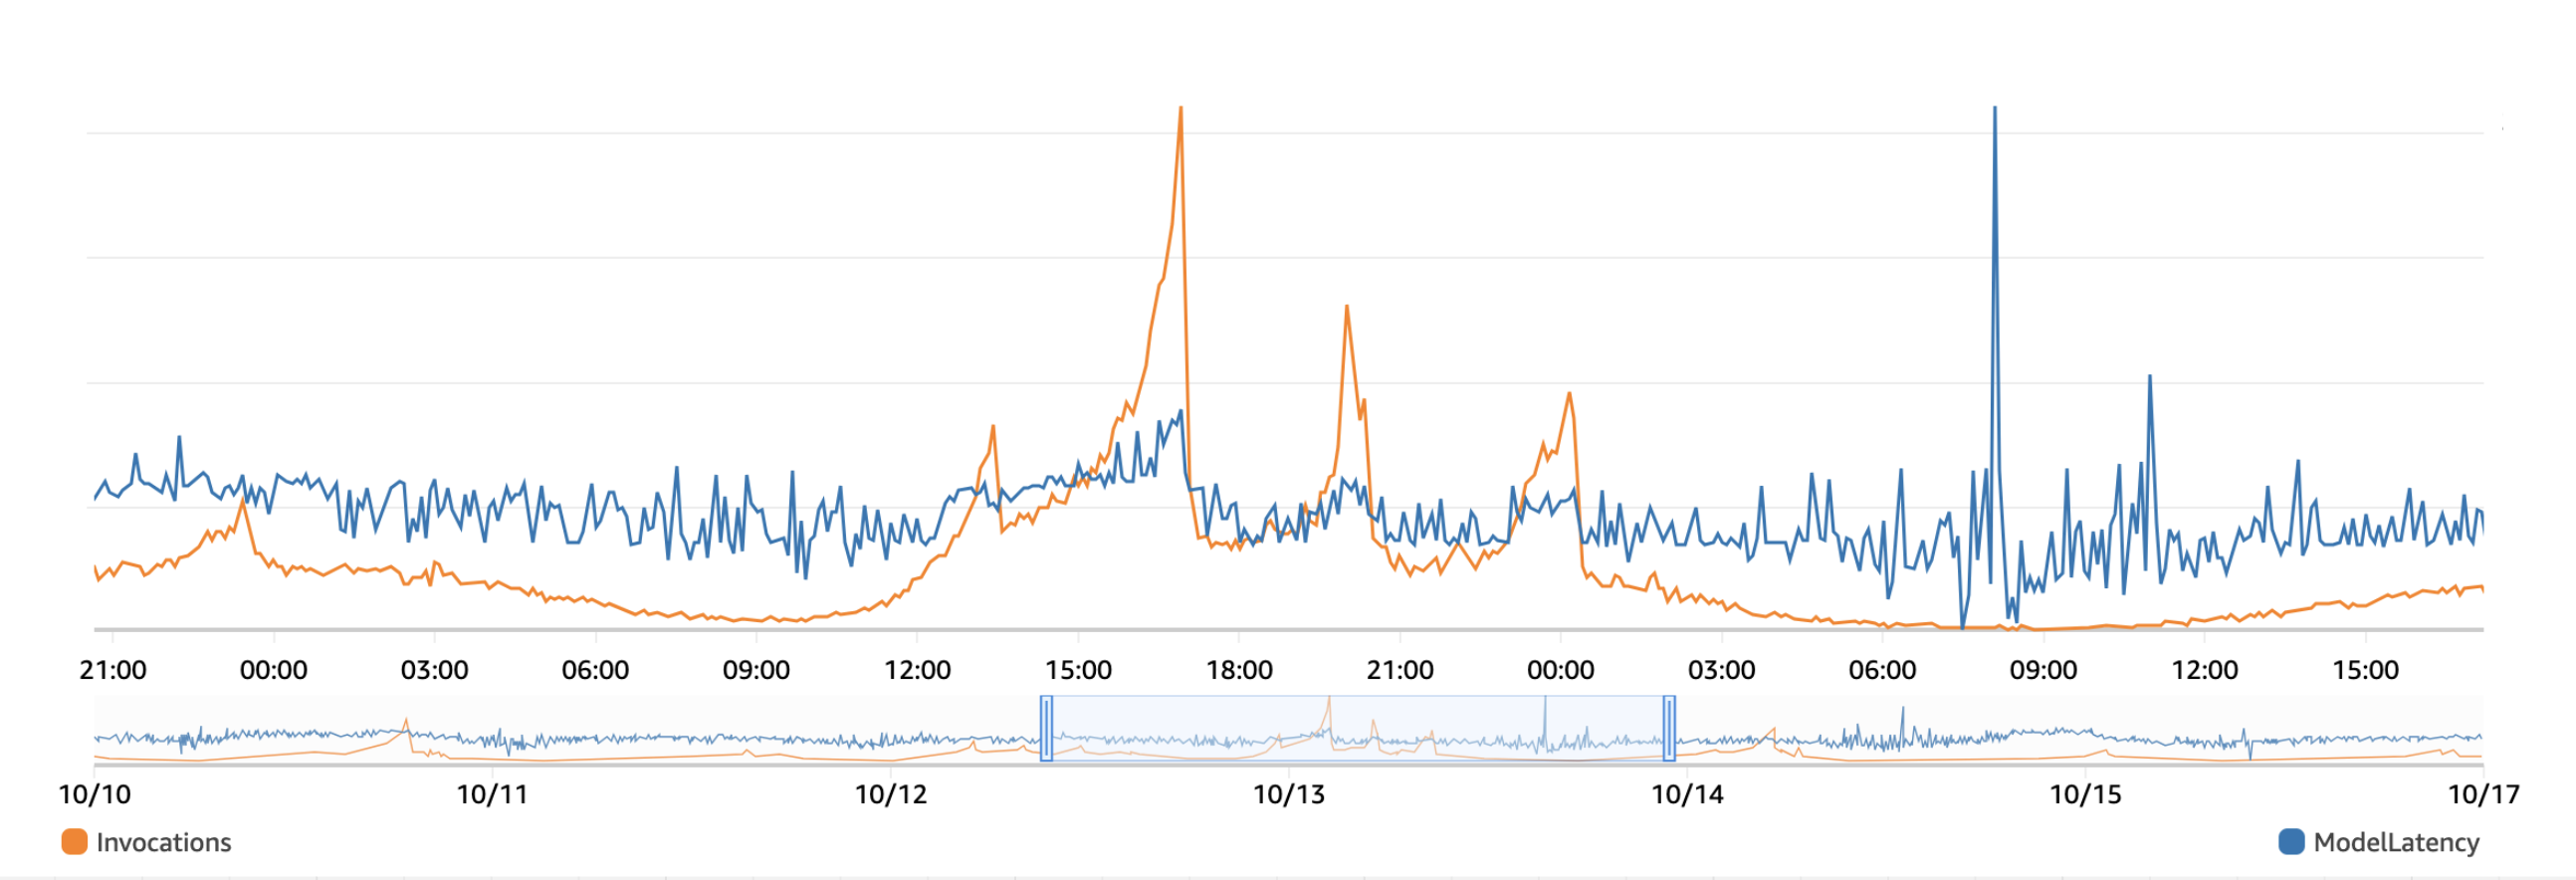
Наши наиболее востребованные модели работают и поддерживают стабильную производительность запросов в секунду (RPS) в обычных бизнес-условиях, а также способны демонстрировать значительно увеличенную пропускную способность во время крупных событий, таких как Супербоул, для наших клиентов в сфере гейминга. На рисунке 2 показан резкий рост объема запросов к сервису моделей, вызванный обычными выходными матчей НФЛ. Сезонные события зависят от бизнес-вертикали, и их трудно точно предсказать. Даже в периоды низкого объема запросов небольшое количество запросов может столкнуться с тайм-аутами и завершиться ошибкой. Наша иерархическая структура резервного копирования способствует снижению потенциальных рисков и обеспечивает надежную работу ML даже в условиях экстремальных нагрузок..
Будущие исследования должны быть сосредоточены на улучшении и оценке политик повторных попыток и эвристик. Определение пороговых значений времени ожидания и максимального количества повторных попыток для различных стрессовых сценариев является нетривиальной задачей. Мы считаем, что будущие исследования должны предоставить механизмы оценки, основанные на моделировании, для надлежащей оценки политик повторных попыток. Наша иерархическая архитектура резервного копирования также должна выиграть от процедур оценки, основанных на моделировании. Наконец, выбор желаемых резервных моделей для балансировки компромисса между снижением производительности и охватом сценариев сбоев является нетривиальной задачей. Будущие подходы должны исследовать методы исследования операций, такие как максимальное покрытие (Nemhauser et al. 1978).
Благодарности.
Авторы данной работы хотели бы поблагодарить Trustly за всестороннюю поддержку.Список литературы
- ⟦(1)⟧
- ⟦Einziger et al. (2019) Гил Айнцигер, Мааян Голдштейн, Янив Саар и Итай Сегалл. 2019. Верификация устойчивости градиентно-бустированных моделей. В материалах Тридцать третьей конференции AAAI по искусственному интеллекту, Тридцать первой конференции по инновационным приложениям искусственного интеллекта и Девятого симпозиума AAAI по образовательным достижениям в области искусственного интеллекта (Гонолулу, Гавайи, США) (AAAI’19/IAAI’19/EAAI’19). AAAI Press, Статья 302, 8 страниц. https://doi.org/10.1609/aaai.v33i01.33012446
- ⟦Kuzudisli et al. (2023) Джихан Кузудисли, Бурджу Бакир-Гунгор, Нуртен Булут, Бахджат Какиш и Малик Юсеф. 2023. Обзор подходов к отбору признаков, основанных на группировке признаков. PeerJ 11 (07 2023), e15666. https://doi.org/10.7717/peerj.15666⟧
- ⟦Long et al. (2020) Гуодун Лонг, Юэ Тан, Цзин Цзян и Чэнци Чжан. 2020. Федеративное обучение для открытого банкинга. В книге: Федеративное обучение, под редакцией Цяна Яна, Лисиня Фана и Хана Ю. Конспекты лекций по информатике, том 12500. Шпрингер, 240–254. http://dblp.uni-trier.de/db/series/lncs/lncs12500.html#LongT0Z20
- ⟦Myllyaho et al. (2022) Lalli Myllyaho, Mikko Raatikainen, Tomi Männistö, Jukka K. Nurminen, and Tommi Mikkonen. 2022. О некорректном поведении и отказоустойчивости в системах машинного обучения. Journal of Systems and Software 183 (2022), 111096. https://doi.org/10.1016/j.jss.2021.111096
- ⟦Narodytska et al. (2018) Нина Народицкая, Шива Касивисванатхан, Леонид Рыжик, Мули Сагив и Тоби Уолш. 2018. Верификация свойств бинаризованных глубоких нейронных сетей. В материалах Тридцать второй конференции Ассоциации по развитию искусственного интеллекта (AAAI) и Тридцатой конференции по инновационным приложениям искусственного интеллекта, а также Восьмого симпозиума Ассоциации по развитию искусственного интеллекта по образовательным достижениям в области искусственного интеллекта (Новый Орлеан, Луизиана, США) (AAAI’18/IAAI’18/EAAI’18). Издательство AAAI, статья 810, 10 страниц.
- ⟦Nemhauser et al. (1978) Г. Л. Немхаузер, Л. А. Уолси и М. Л. Фишер. 1978. Анализ аппроксимаций для максимизации субмодулярных функций множества–I. Math. Program. 14, 1 (дек. 1978), 265–294. https://doi.org/10.1007/BF01588971
- ⟦Sculley et al. (2015) Дэвид Скалли, Гэри Холт, Дэниел Головин, Юджин Давыдов, Тодд Филлипс, Дитмар Эбнер, Винай Чаудхари, Майкл Янг, Жан-Франсуа Креспо и Дэн Деннисон. 2015. Скрытый технический долг в системах машинного обучения. Достижения в системах нейронной обработки информации 28 (2015)).
- ⟦Zhang et al. (2020) Jie M Zhang, Mark Harman, Lei Ma, and Yang Liu. 2020. Тестирование машинного обучения: обзор, ландшафты и горизонты. IEEE Transactions on Software Engineering 48, 1 (2020), 1–36.