Переосмысление ранней остановки: уточните, затем откалибруйте
Аннотация
Классификаторы машинного обучения часто выдают вероятностные прогнозы, которые критичны для точного и интерпретируемого принятия решений в различных областях. Качество этих прогнозов обычно оценивают с помощью корректных потерь, таких как cross-entropy, которые раскладываются на две составляющие: calibration error оценивает общую недо- или переуверенность, тогда как refinement error измеряет способность различать разные классы. В этой статье мы приводим теоретические и эмпирические свидетельства того, что эти две ошибки не минимизируются одновременно в процессе обучения. Выбор наилучшей эпохи обучения по величине валидационной потери приводит тем самым к точке компромисса, которая является неоптимальной как для calibration error, так и, что особенно важно, для refinement error. Для решения этой задачи мы вводим новую метрику для ранней остановки и настройки гиперпараметров, которая позволяет минимизировать refinement error во время обучения. Calibration error минимизируется после завершения обучения с использованием стандартных методов. Наш метод без труда встраивается в любую архитектуру и стабильно улучшает качество работы на разнообразных задачах классификации.
1 Введение
Точное классифицирование лежит в основе многих задач машинного обучения — от медицинской диагностики до систем автономного вождения. Современные классификаторы предсказывают не только метку класса, но и вектор вероятностей, отражающий уверенность модели в том, что данный объект относится к каждому из классов. Такая вероятностная выдача критически важна для последующего принятия решений. Несмотря на широкое применение, многие модели машинного обучения, особенно сложные, такие как нейронные сети, склонны формировать плохо откалиброванные вероятности (Guo et al., 2017), то есть предсказанная уверенность не соответствует реальным вероятностям.
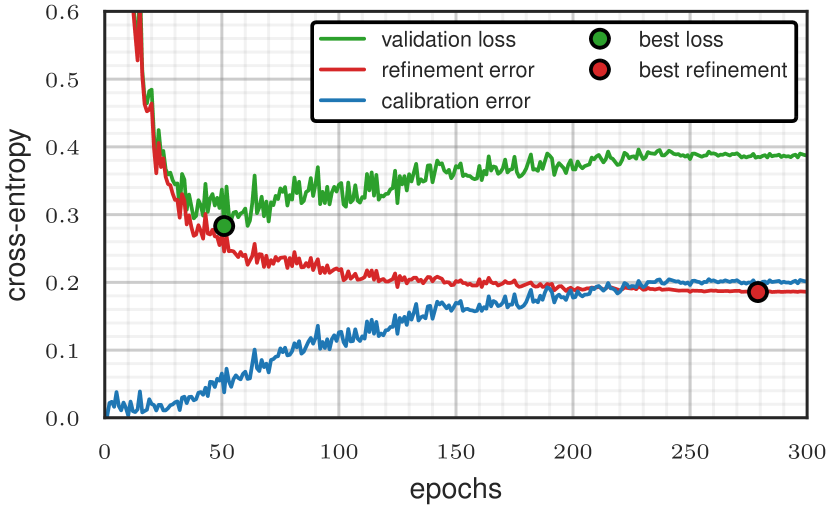
Этот вопрос в основном рассматривался через призму постфактумной калибровки, которая заключается в настройке предсказанных вероятностей после обучения с использованием небольшой выделенной части набора данных. Упущенным аспектом проблемы является то, что ошибка калибровки вносит вклад в общую функцию потерь классификатора (Bröcker, 2009). В Figure 1 мы показываем разложение классификационной функции потерь (здесь перекрёстная энтропия) на ошибку калибровки и ошибку уточнения в ходе обучения для глубокой нейронной сети. Мы наблюдаем, что две величины не минимизируются одновременно. В результате минимизатор функции потерь на валидации имеет ненулевую ошибку калибровки и является неоптимальным для уточнения. Это наблюдение указывает на возможность улучшения того, как мы обучаем классификаторы машинного обучения.
В разделах 2 и 3 мы предлагаем минимизировать только ошибку уточнения во время обучения и ошибку калибровки после обучения. Эта новая парадигма может быть безупречно использована с любой моделью машинного обучения, просто используя наш новый оцениватель уточнения, приведенный в пакете github.com/dholzmueller/probmetrics, в качестве метрики остановки. В Section 4 мы приводим эмпирические доказательства снижения потерь, достигнутого на различных задачах. В разделах 5 и 6 мы изучаем логистическую регрессию на двоичной гауссовой модели данных, показывая, что эта проблема существует даже в простых условиях, и что наш метод минимизирует как ошибки уточнения, так и ошибки калибровки.
2 Декомпозиция калибровка-уточнение
Мы начинаем с обзора разложения собственных (корректных) потерь на ошибки калибровки и уточнения. Также мы представляем новую вариационную формулировку этого разложения, которая позволяет по-новому интерпретировать уточнение как потери после оптимальной постобработки.
Обозначение.
Рассмотрим классификацию с классами. Пусть обозначает вероятностный симплекс , а — пространство однохотированных меток , где , если истинный класс равен , и в противном случае. Предположим, что имеется случайная величина (вектор признаков), такая что существует неизвестное совместное распределение вероятностей на . Мы делаем вероятностные предсказания относительно значения истинной метки , используя статистическую модель .
2.1 Разложение потерь
Мы оцениваем предсказания с помощью функции потерь . является неотрицательной функцией и , такой что оценивает качество предсказания для метки . Известные примеры включают оценку Брайера и кросс-энтропию (logloss) . Предположим, что метка выбирается из распределения . Мы используем ту же нотацию для обозначения ожидаемой величины потерь, получаемых при выполнении предсказания : . Естественным требованием является то, что минимизируется (только) в ; в этом случае называется (строго) правильной.
Пусть — случайная величина, измеряющая математическое ожидание при заданном предсказании. Надлежащие потери удовлетворяют следующему разложению риска (Bröcker, 2009):
| (1) |
где и соответственно являются дивергенцией и энтропией, связанными с (мы называем их -дивергенцией и -энтропией). Для различных выборов функции потерь классификации мы восстанавливаем хорошо известные функции энтропии и дивергенции.
| Proper loss | Divergence | Entropy |
| Logloss | KL divergence | Shannon entropy |
| Brier score | Squared distance | Gini index |
Первый член в разложении (1) — это калибровочная ошибка , связанная с . Второй член, обозначаемый , — это ошибка уточнения для . Ошибка уточнения иногда дополнительно разлагается на неприводимую ошибку (риск оптимального классификатора ) и ошибку группировки (Kull & Flach, 2015; Perez-Lebel et al., 2023).
2.2 Ошибка калибровки
Калибровке уделялось много внимания само по себе, не всегда в контексте разложения калибровки и уточнения. Модель считается откалиброванной, если почти наверное. Когда это выполняется, для заданного прогноза ожидаемый исход согласован с . Это желательное свойство, поскольку оно позволяет интерпретировать предсказания модели как вероятности того, что принадлежит каждой из классов.
Ошибка калибровки.
Таким образом, ошибка неверной калибровки измеряется ожидаемым разрывом между и . Выбор функции расстояния или расхождения порождает различные понятия ошибки калибровки: . Популярным выбором для является расстояние , что приводит к ожидаемой ошибке калибровки (ECE, Naeini et al., 2015). Отметим, что при выборе расстояния или расхождения KL мы получаем «корректные» ошибки калибровки (Gruber & Buettner, 2022), которые появляются в разложении показателя Brier score и logloss. На практике распределение данных известно лишь через конечный набор выборок и делает непрерывные прогнозы . Для вычисления ошибки калибровки часто оценивают путем группирования (binning) прогнозов на симплексе, что приводит к оценкам, которые смещены и несостоятельны (Kumar et al., 2019; Vaicenavicius et al., 2019; Roelofs et al., 2022). В многоклассовом случае проклятие размерности делает оценивание еще более сложным. Более слабые понятия, такие как поклассовая или калибровка по верхней метке (top-label calibration error), часто используются (Kumar et al., 2019; Kull et al., 2019).
Постфактум калибровка.
Многие классификаторы машинного обучения страдают от проблем с калибровкой, что привело к появлению семейства методов, известных как «постфактум калибровка». Эти методы уменьшают ошибку калибровки после обучения с использованием выделенного набора образцов , называемого «набор калибровки». Среди прочего, изотоническая регрессия и температурное масштабирование широко используются.
Изотоническая регрессия (IR, Zadrozny & Elkan, 2002) находит монотонную функцию , которая минимизирует риск на калибровочном наборе. Это популярная калибровочная техника для двоичных классификаторов. Однако многоклассовые расширения имеют существенные недостатки, однако.
Температурное масштабирование (TS, Guo et al., 2017) оптимизирует скалярный параметр для перерасчета лог-вероятностей. Формально, оно обучает функцию на калибровочном наборе со {IEEEeqnarray*}+rCl+x* g_β(p) & ≔ softmax(βlog(p)), β^* ≔ argmin_β∈R_+ L(β), L(β) ≔ ∑_(x, y) ∈C ℓ(g_β(f(x)), y) . \IEEEyesnumber Для нейронных сетей это сводится к масштабированию последнего слоя на . TS имеет множество преимуществ: оно эффективно, применимо к многоклассовым задачам, не влияет на точность и устойчиво к переобучению, поскольку имеет только один параметр.
Заинтересованного читателя отсылаем к Silva Filho et al. (2023) для подробного обзора калибровки. В Appendix A мы также более внимательно рассматриваем литературу по данной теме и другие связанные работы.
2.3 Ошибка уточнения
Учитывая привлекательность откалиброванных предсказаний, было приложено значительное усилие для оценивания и уменьшения ошибки калибровки. Однако тот факт, что она взаимодействует с другим членом, образуя общую величину риска классификатора, получил гораздо меньше внимания. отчасти это связано с тем, что ошибка уточнения почти не известна. Так что же такое ошибка уточнения??
При разложении (1) это выглядит как ожидаемая -энтропия при заданном : . При наличии простого интуитивного понимания функций энтропии мы видим, что если полностью определяется , то не имеет энтропии, и ошибка уточнения равна нулю. Напротив, если столь же случайно, как , оно максимально. Таким образом, ошибка уточнения количественно оценивает, сколько вариативности в захвачено : меньшая ошибка указывает на большую информативность. Подобно ошибке классификации, она оценивает способность различать классы независимо от калибровочных проблем, таких как пере-/недоувренность. Однако она обеспечивает гораздо более всеобъемлющую меру, поскольку рассматривает всю распределённость , а не одну дискретизацию. Это достигается ценой того, что, как и ошибка калибровки, её гораздо труднее оценить.
2.4 Вариационная формулировка
В Приложении B мы представляем новые вариационные формулировки для членов разложения (1), наиболее важно:
Theorem 2.1.
Ошибка уточнения для правильной функции потерь заключается в
где минимум берется по всем измеримым функциям . Он достигается в ⟦K1⟩⟧.
Калибровочная ошибка оценивает, насколько популяционный риск можно уменьшить оптимальным переназначением меток исходных прогнозов. Это оптимальное переназначение меток задается калиброванной оценкой . Это вполне интуитивно: такое переназначение меток устанавливает калибровочную ошибку в ноль, оставляя только член уточнения в разложении риска (1). Таким образом, ошибка уточнения измеряет оставшийся риск после оптимального переназначения меток, что соответствует риску калиброванных оценок. Эта новая вариационная формулировка показывает, что ошибку уточнения можно оценивать, используя риск после постфактумной калибровки.
3 Наша методика: остановка на основе уточнения
3.1 Остановка обучения по ранней проверке на основе уточнения: интуиция
Два различных минимизатора.
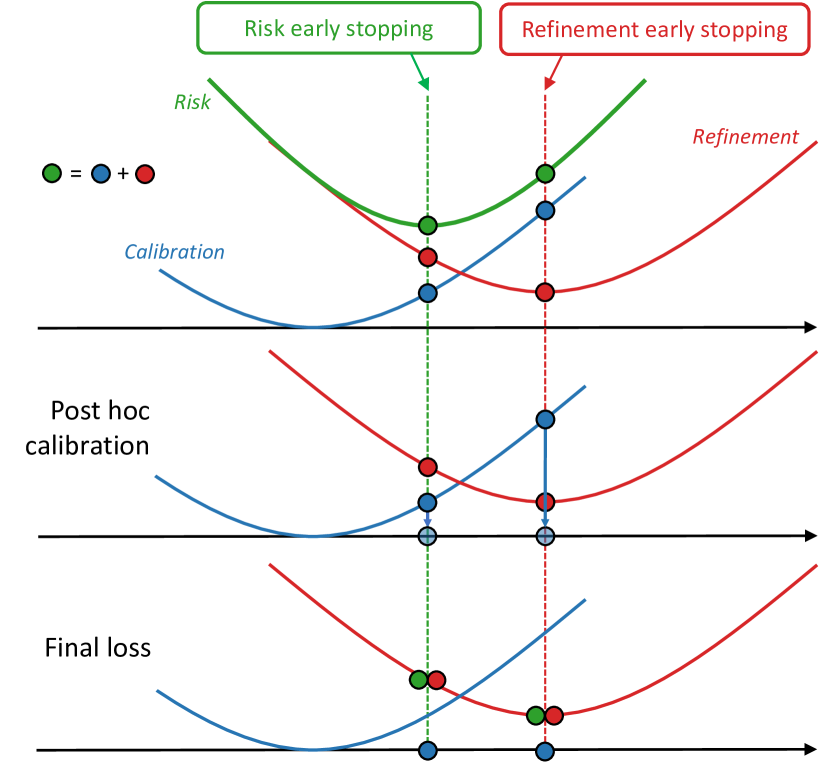
Минимизация риска классификатора сводится к одновременной минимизации ошибок уточнения и калибровки. Эмпирически эти две ошибки не минимизируются одновременно в процессе обучения, как в Figure 1. Один возможный сценарий состоит в том, что обучающая выборка становится хорошо разделимой, заставляя модель делать весьма уверенные предсказания, чтобы удерживать калибровочную ошибку обучения небольшой. В случае разрыва обобщения train-test модель становится чрезмерно уверенной (Carrell et al., 2022), в то время как ошибка уточнения может продолжать уменьшаться. Мы наблюдаем раздельные точки-минимумы у различных моделей машинного обучения, будь то при итеративном обучении или при настройке параметра регуляризации. В Section 6 мы теоретически анализируем это явление для высокомерной логистической регрессии, показывая, что оно проявляется даже в очень простых условиях. Следствием является то, что ранняя остановка, основанная на риске, находит компромиссную точку между двумя конфликтующими целями: минимизацией калибровочной ошибки и минимизацией ошибки уточнения. Это подтверждает широко известное наблюдение о том, что многие модели оказываются плохо откалиброванными после обучения (Guo et al., 2017).
Уточните, затем откалибруйте.
Возникает вопрос: как получить модель, оптимальную и для калибровки, и для уточнения? В целом строго возрастающие постобработочные техники калибровки, такие как TS, оставляют уточнение неизменным. Berta et al. (2024) показало, что бинарное IR сохраняет ROC выпуклую оболочку, являющуюся приближением для уточнения. Учитывая, что ошибка калибровки минимизируется после обучения, без влияния на уточнение, мы утверждаем, что обучение следует посвятить только последнему. Мы предлагаем выбирать лучший эпох по ошибке уточнения на валидации вместо потерь на валидации как новую парадигму обучения для классификаторов машинного обучения. Как показано на рисунке 2, эта процедура приводит к меньшим потерям после постобработочной калибровки. По сравнению со стандартной парадигмой, которая минимизирует и уточнение, и калибровку во время обучения, мы предлагаем уточнять во время обучения, затем выполнять калибровку постфактум.
|
|
|
|||
|---|---|---|---|---|---|
|
|
|
|||
|
|
|
3.2 Остановка на основе уточнения, реализованная на практике
Оценка уточнения.
Как обсуждалось ранее, оценщики ошибки калибровки смещены, непоследовательны и дают сбой в многоклассовом случае. Поскольку уточнение равно разности между риском и калибровкой, эти проблемы переносятся и на оценивание уточнения. Можно обойти это, используя прокси, например точность на валидации. Теорема 2.1 дает более удачную альтернативу: ошибка уточнения равна риску после оптимального перевыставления меток . Таким образом, нам нужно оценить, насколько малым может стать риск на валидации при перевыставлении меток предсказаний. Поскольку валидационный набор конечен, минимизация по всем измеримым функциям привела бы к резкому переобучению. Однако, учитывая класс функций , который мы намерены использовать для постфактум калибровки, мы можем оценить ошибку уточнения, решая:
после каждой эпохи. Это сводится к ранней остановке на основе валидационной “loss после постфактум калибровки”, которая является смещённой оценкой ошибки уточнения. По сравнению с Theorem 2.1, мы ограничиваемся функциями класса . Возникает компромисс по отношению к размеру . Чем больше класс, тем меньше смещение нашей оценки, но тем выше вероятность переобучения на валидационном наборе, что приводит к плохой оценке истинной ошибки уточнения. Для работы нашего метода нам нужно выбрать небольшой класс , который насколько возможно близок к оптимальному ре-мэппингу .
Уточнение TS для нейронных сетей.
Мы называем TS-refinement оценивателем, получаемым, когда — это класс функций, порождаемых температурным масштабированием. Он параметризован одним скалярным параметром, что существенно ограничивает способность к переобучению на валидационном наборе. Кроме того, TS очень эффективно снижает калибровочную ошибку нейронных сетей (какой бы большой она ни была), не изменяя уточнение. Это подтверждается множеством эмпирических свидетельств (Guo et al., 2017; Wang et al., 2021). Мы показываем в Section 5, что при сделанных предположениях о распределении логитов оптимальное повторное отображение достигается с помощью TS, делая TS-refinement несмещённым оценивателем. На практике при обучении нейронной сети мы рекомендуем выбирать лучший эпоху с точки зрения валидационной потери после температурного масштабирования. Возвращаясь к примеру в Figure 1, эта процедура выбрала бы более позднюю эпоху (красная точка), для которой валидационная потеря (зелёная кривая) выше, но валидационная потеря после TS (красная кривая) меньше. Поскольку в любом случае нам предстояло использовать TS для постфактумной калибровки, эта простая процедура гарантирует меньший валидационный риск.
Улучшение реализаций TS.
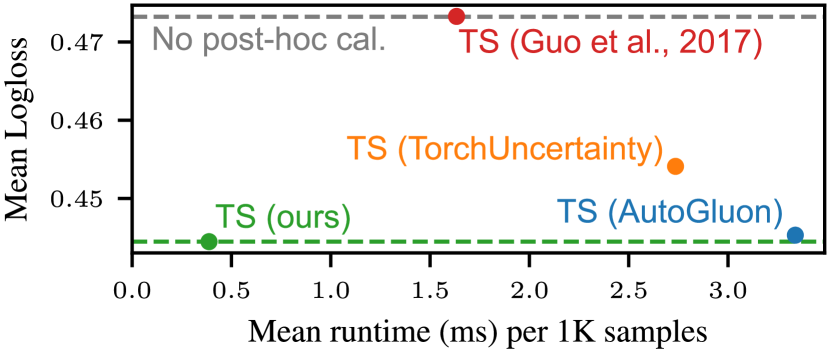
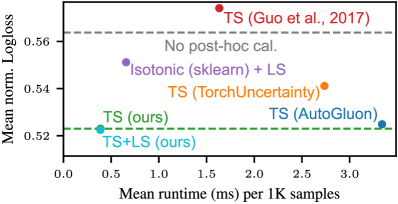
Использование TS-refinement для ранней остановки требует быстрой и надежной реализации масштабирования температуры. Анализ существующих кодовых баз показал, что есть существенное поле для улучшений как с точки зрения скорости, так и с точки зрения производительности. Для logloss целевая функция в уравнении (2.2) является выпуклой. Существующие реализации применяют L-BFGS (Liu & Nocedal, 1989) для оптимизации , что является унимодальным, но невыпуклым. Кроме того, выбор шага для L-BFGS иногда приводил к неоптимальной производительности. Вместо этого, поскольку возрастает вследствие выпуклости , мы предлагаем использовать двоичный поиск, чтобы найти ноль . Figure 3 показывает, что на бенчмарке из Section 4 наша реализация обеспечивает меньшую тестовую потерю и существенно быстрее альтернатив из Guo et al. (2017), TorchUncertainty и AutoGluon (Erickson et al., 2020). Подробности приведены в Приложении E.
Другие оценщики.
Наш метод применим к широкому спектру моделей машинного обучения. Он может помочь выбрать наилучший шаг в любой итерационной процедуре обучения (например, бустинге) или величину регуляризации для неитерационных моделей. Уточнение не обязательно должно оцениваться с помощью TS-refinement; может быть выбрана любая доступная прокси-оценка. Для не нейронных сетей TS может быть менее эффективным. В бинарном случае использование риска после изотонической регрессии (IR-refinement) может быть хорошим вариантом. Он существенно менее смещён, чем TS-refinement, поскольку класс содержит все монотонные функции. Однако риск переобучения становится больше, и это необходимо тщательно учитывать.
4 Эксперименты
Компьютерное зрение.
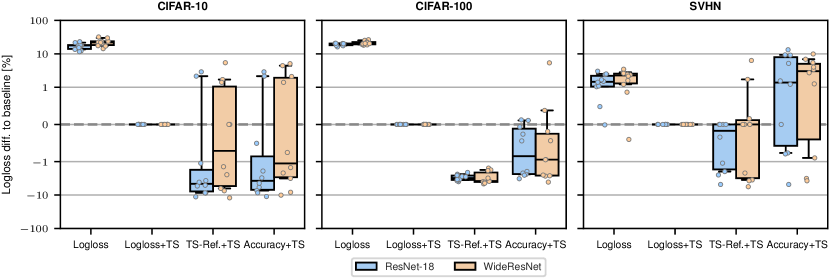
Мы оцениваем наш метод, обучая ResNet-18 (He et al., 2016) и WideResNet (WRN) (Zagoruyko, 2016) на наборах данных CIFAR-10, CIFAR-100 и SVHN (Krizhevsky et al., 2009; Netzer et al., 2011). Мы выделяем 10% обучающего набора для валидации. Мы обучаем в течение 300 эпох, используя SGD с моментумом, затуханием весов и планировщиком пошаговой скорости обучения. Мы применяем случайное обрезание, горизонтальные отражения и cutout (DeVries, 2017). Для справки: эти процедуры обучения позволяют достичь точности на CIFAR-10 для ResNet-18 и более для WRN. Мы обучаем модели десять раз на каждом наборе данных. Код для запуска бенчмарка доступен по адресу github.com/eugeneberta/RefineThenCalibrate-Vision. На графических процессорах NVIDIA V100 бенчмарк занял около 300 GPU-часов. Мы приводим в Figure 4 относительные различия в тестовой logloss, полученные при использовании различных процедур обучения. После ранней остановки по потере на валидации (первый столбец) использование TS приводит к значительному улучшению (второй столбец). Ранняя остановка по TS-refinement вместо потери на валидации дает еще более хорошие результаты (третий столбец). Мы также сравниваем с ранней остановкой, основанной на точности валидации (четвертый столбец), еще одним прокси для уточнения, показывая, что TS-refinement более последовательно приводит к меньшей потере.
Мы эмпирически наблюдали, что планировщик скорости обучения и сила регуляризации влияют на поведение ошибки калибровки во время обучения. Это отражается на эффекте, наблюдаемом с нашим методом. В целом, однако, уточнение TS на валидации остается наилучшей доступной оценкой для тестовой потери после temperature scaling. Brier score, еще одна корректная функция потерь, менее чувствителен к резким вариациям ошибки калибровки, чем logloss, и может быть хорошей альтернативой для ранней остановки для практиков, которые хотят избежать подгонки TS на каждой эпохе. Заинтересованного читателя мы отсылаем к Приложению F для подробностей о нашей процедуре обучения и полных результатах.
Табличные данные, где — это вектор разнородных числовых и/или категориальных признаков, повсеместны в приложениях ML. Мы берем 196 наборов данных для бинарной и многоклассовой классификации из бенчмарка по Ye et al. (2024), содержащих от 1K до 100K примеров после подсэмплинга крупнейших наборов данных, см. Appendix G. Мы оцениваем три метода:
- ⟦XGBoost (Chen & Guestrin, 2016) — популярная реализация градиентного бустинга решающих деревьев, демонстрирующая высокие результаты на табличных бенчмарках (Grinsztajn et al., 2022). Из‑за итеративной оптимизации ранняя остановка релевантна и для XGBoost.
- • MLP — это простая многослойная персептронная сеть, аналогичная популярной базовой модели MLP от Gorishniy et al. (2021).
- ⟦RealMLP (Holzmüller et al., 2024) — это недавняя модель глубокого обучения на уровне современного состояния для табличных данных (Ye et al., 2024), которая улучшает стандартный MLP во многих аспектах.
Для каждого набора данных сообщаем среднее значение потерь по пяти случайным разбиениям на 64% обучающих, 16% валидационных и 20% тестовых данных. Для каждого разбиения запускаем 30 случайных конфигураций гиперпараметров и выбираем ту, которая дает наилучший показатель на валидации. Валидационный набор данных также используется для остановки и постфактум калибровки. Вычисления заняли около 40 часов на процессоре с 32 ядрами (для XGBoost) и на четырех видеокартах RTX 3090 (для НС).).
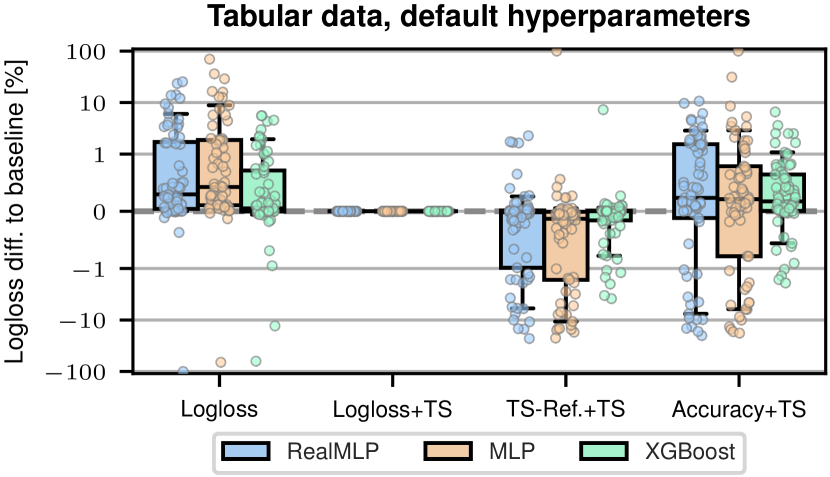
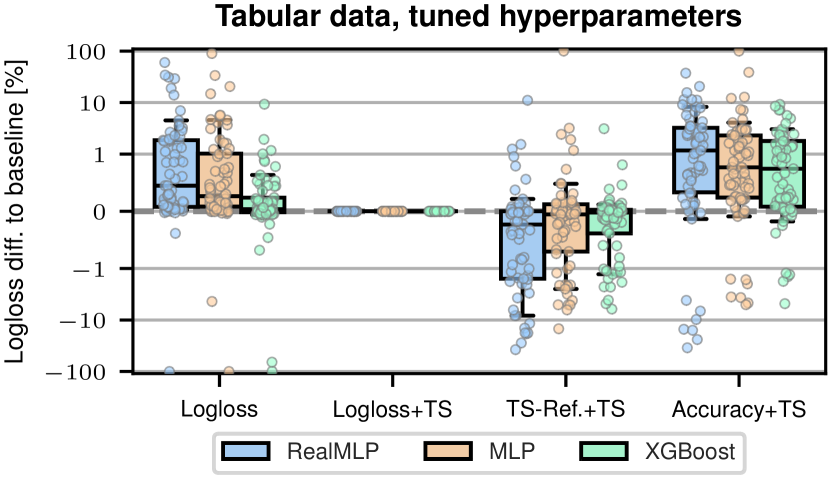
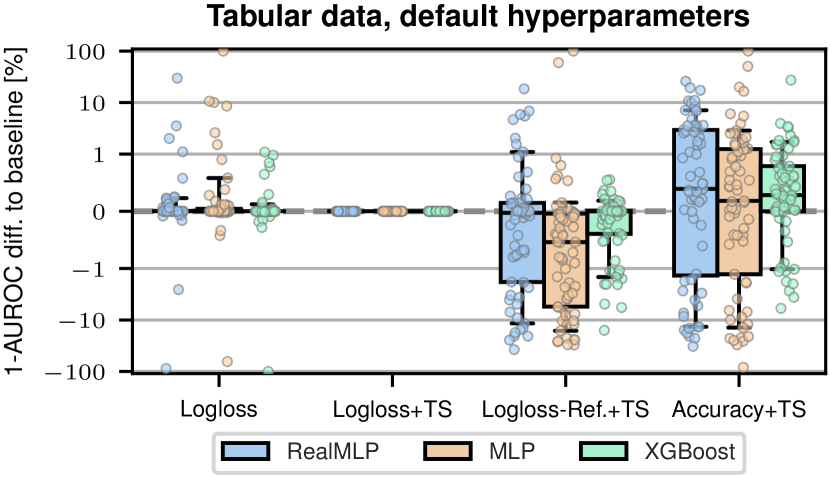
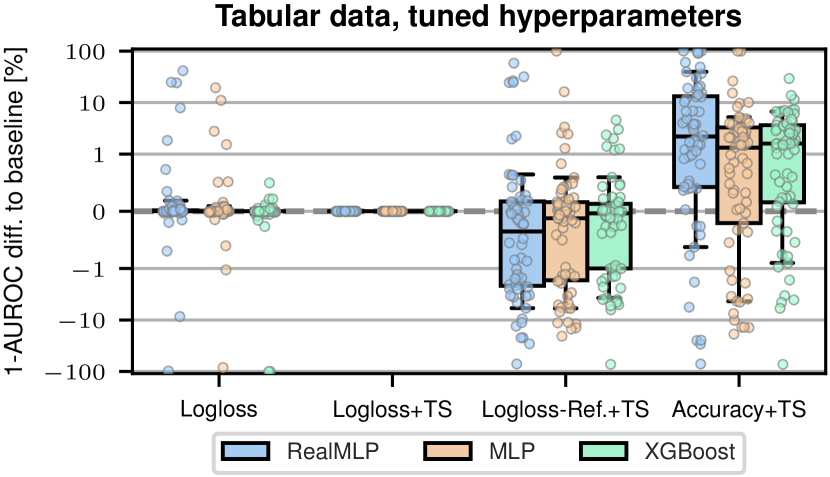
⟦Figure 5 показывает результаты на наборах данных с как минимум 10K образцами. В целом мы наблюдаем, что TS, а также остановка/настройка на TS-Refinement помогают на большинстве наборов данных, тогда как остановка по точности часто приводит к плохому logloss даже после TS. Наш расширенный анализ в Appendix G показывает, что результаты более шумные и менее ясные для небольших или простых наборов данных. Однако остановка на TS-Refinement часто дает лучшую точность и AUC, чем остановка на logloss, и тем самым обеспечивает отличное равновесие между различными метриками.
5 Разложение в гауссовой модели данных
В этом разделе и в следующем мы приступаем к теоретическому анализу, который дает понимание декомпозиции калибровка—уточнение. Мы показываем, что даже при простой модели данных и предикторе ошибки калибровки и уточнения не минимизируются одновременно. Это подчеркивает значимость ранней остановки на основе уточнения и указывает на широкое влияние проблемы, которую мы рассматриваем.
Мы используем следующую упрощенную модель. Рассмотрим случайные величины признаков и меток в рамках двухклассовой гауссовой модели , если и , если для некоторого среднего и ковариации . Кроме того, мы предполагаем, что классы сбалансированы, . В рамках этой модели данных с и обозначает сигмоидальную функцию. Форма сигмоидальной функции хорошо подходит для описания апостериорной вероятности по . Отметим, что это верно для любой пары из одного и того же экспоненциального семейства (Jordan, 1995). Доказательства для этого раздела отложены до Appendix C⟧.
Мы заинтересованы в калибровочных и уточняющих ошибках линейной модели . Вектор весов можно изучить с помощью таких методов, как логистическая регрессия или линейный дискриминантный анализ (Fisher, 1936). Обозначая через и , частота ошибок линейной модели записывается , где является функцией кумулятивного распределения стандартного нормального распределения. Обратите внимание, что инвариантна при масштабировании . Она измеряет согласованность с наилучшей моделью независимо от нормы вектора весов. Мы называем «уровнем экспертизы» нашей модели . Интересно, что также появляется в калибровочных и уточняющих ошибках для этой простой модели.
Theorem 5.1.
Для надлежащей функции потерь , ошибки калибровки и уточнения нашей модели
где матожидание взято по .
Обратите внимание, что ошибка уточнения является убывающей функцией , точно так же, как и частота ошибок. Более того, она зависит от только через , и поэтому инвариантна при пере масштабировании вектора весов. В отличие от этого, ошибка калибровки не инвариантна при пере масштабировании . Она минимизируется и достигает нуля при . Чем больше норма вектора весов , тем больше предсказанные вероятности , поэтому можно интерпретировать как «уровень уверенности» модели. Модель калибрована, когда этот уровень уверенности равен уровню экспертности . Следствием является то, что всегда существует такое пере масштабирование вектора весов, при котором ошибка калибровки обнуляется.
Theorem 5.2.
Пере шкалированный вектор весов с дает нулевую ошибку калибровки при сохранении ошибки уточнения ⟧.
Обратите внимание, что такое перенормирование вектора весов точно соответствует масштабированию температуры. Для классификаторов вроде логистической регрессии или нейронных сетей, использующих сигмоиду для получения вероятностей, Theorem 5.2 устанавливает, что при допущении, будто распределение логитов является смесью гауссианов, TS задаёт калибровочную ошибку, равную нулю, при сохранении уточнения. Насколько нам известно, это первая теоретическая гарантия для масштабирования температуры. Немедленное следствие этого и Theorem 2.1 состоит в том, что ошибка уточнения равна риску после масштабирования температуры: .
Remark 5.3.
Для нецентрированных или несбалансированных данных добавление параметра свободного члена в TS необходимо для достижения того же результата. Аналогичный анализ можно вывести для многоклассового случая, что приводит к постфактум калибровке с матричным масштабированием.
Это поддерживает идею о том, что в процессе обучения мы должны минимизировать уточнение. Масштабирование вектора весов до корректного уровня доверия достаточно, чтобы устранить калибровочную ошибку после обучения. По нашему анализу, кажется очевидным, что минимизаторы калибровочной и уточняющей ошибок не должны совпадать. Уровень доверия ни в какой мере не ограничен равенством экспертности . Мы эмпирически наблюдали, что минимизаторы потерь и уточнения можно разделить. Можем ли мы продвинуть анализ дальше, чтобы теоретически продемонстрировать это?
6 Высокомерные асимптотики логистической регрессии
В этом разделе мы помещаем себя в условия регуляризованной логистической регрессии, чтобы изучить влияние калибровки и уточнения на риск в ходе обучения. Доказательства и отсутствующие технические детали приведены в Appendix D.
Рассмотрите пары из бимодели модели данных Section 5 и , а также вектор весов, выученный при решении регуляризованной логистической регрессии
для заданной силы регуляризации .
Мы воспользуемся известными результатами по в высокоразмерной асимптотической постановке при постоянном соотношении . Мы предполагаем, что средние значения классов по каждой размерности выбираются независимо и одинаково распределёнными из распределения, удовлетворяющего , так что для некоторой константы , которая задаёт разделимость классов в задаче. Чтобы упростить формулы, мы предполагаем, что диагональная. Мы также предполагаем, что её собственные значения выбираются независимо и одинаково распределёнными из положительного ограниченного спектрального распределения . Mai et al. (2019) дают следующую характеристику
где являются единственными решениями нелинейной системы уравнений, параметризованной и . Для вычисления ошибок калибровки и уточнения, появляющихся в Theorem 5.1, нас интересуют и ⟧.
Proposition 6.1.
Для ,
где сходимость происходит по вероятности.
Remark 6.2.
Результаты из Dobriban & Wager (2018) позволяют получить аналогичные результаты для регуляризованного LDA и Ridge, что приводит к более простым формулировкам ошибок уточнения и калибровки. Мы опускаем эти результаты из соображений ограниченного объема.
Параметр отделимости данных трудно интерпретировать; вместо этого мы используем , долю ошибок оптимального классификатора .
Proposition 6.3.
Поскольку ,
⟦ обеспечивает общую и интерпретируемую шкалу сложности задачи независимо от формы спектрального распределения. Для заданного спектрального распределения Proposition 6.3 дает простое соотношение между и . Мы можем выбрать любое ограниченное и положительное распределение в наших формулах для вычисления и . Мы выбираем , где обозначает распределение Beta с параметрами формы , а — небольшой параметр сдвига, чтобы было строго положительным (при том, что всегда конечно, мы фиксируем ). Это позволяет нам исследовать различные формы спектральных распределений с помощью единой математической модели, изменяя и . Используя предложения 6.1 и 6.3, мы получаем формулы для и , см. Appendix D.
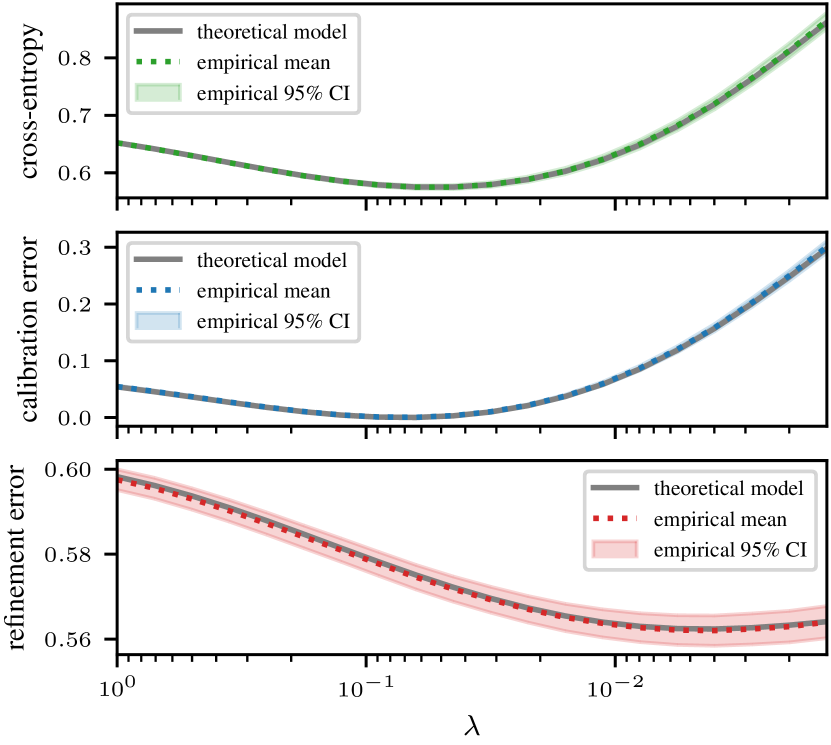
Для заданной силы регуляризации , отношения размерностей к объему выборки , оптимальной частоты ошибок и спектрального распределения (управляемого ), мы можем вычислить , решив систему, заданную Mai et al. (2019). Используя Proposition 6.1 и Theorem 5.1, мы получаем ошибки калибровки и уточнения. Мы приводим быстрое внедрение этого метода при github.com/eugeneberta/RefineThenCalibrate-Theory. Для фиксированного набора параметров мы можем построить кривую обучения для логистической регрессии, изменяя величину регуляризации . Мы наблюдаем вклад ошибок калибровки и уточнения в общую logloss модели, как в Figure 6⟧.
В этом примере ошибки калибровки и уточнения не минимизируются совместно, в результате чего минимизатор потерь оказывается где-то между ними, что приводит к неоптимальности для обеих ошибок. Поскольку мы можем легко установить ошибку калибровки равной нулю (Theorem 5.2), наша математическая модель предсказывает, что уточняющая по основе ранняя остановка дает снижение на в последующей кросс-энтропии на этом примере.
Мы можем исследовать влияние параметров задачи на это явление. Мы исследуем три формы спектрального распределения (первая строка). Для каждой из них мы строим в Figure 7 разрыв между минимизатором ошибки калибровки и минимизатором ошибки уточнения (вторая строка) и относительные выигрыши по перекрёстной энтропии (), полученные при остановке на уточнении вместо потерь (третья строка), как функцию от отношения (ось x) и сложности задачи (ось y)).
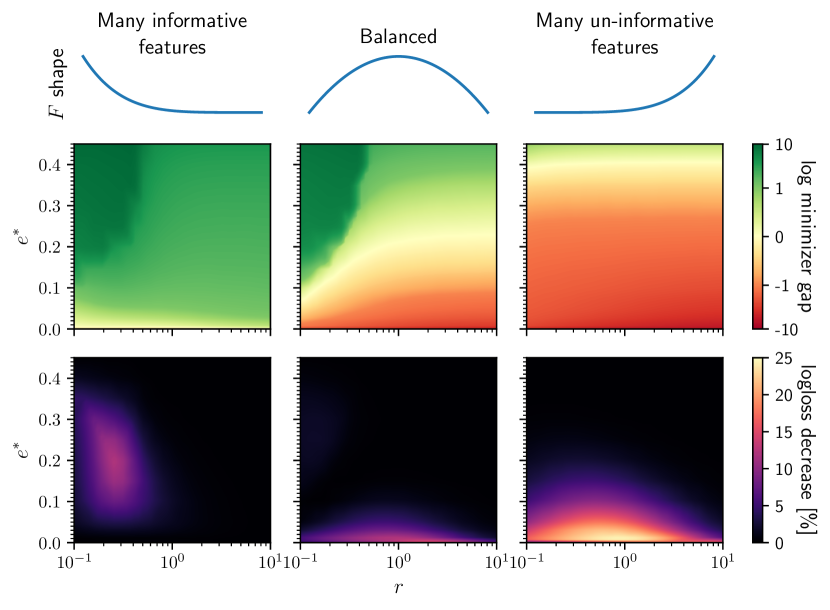
Чтобы интерпретировать формы спектрального распределения, отметим, что небольшое собственное значение соответствует малой «внутриклассовой дисперсии» и, следовательно, более разделимым данным на соответствующей оси. Меньшие собственные значения соответствуют более информативным признакам. Левая колонка изображает сценарий, в котором большинство признаков одинаково информативны. Центральная колонка имеет широкое распределение как хороших, так и плохих признаков. В правой колонке большинство признаков плохие, а лишь несколько «скрытых» хороших компонент. В первом сценарии калибровка сходится раньше почти везде в пространстве параметров; это соответствует режиму, который мы наблюдаем в компьютерном зрении. Однако когда информативных признаков мало, уточнение минимизируется раньше (правая колонка). Это может повлиять на практические настройки, такие как геномика или гистопатология. Когда спектральное распределение более сбалансировано, мы видим сосуществование обоих сценариев в зависимости от параметров задачи. Прекращение обучения по ранней остановке на основе уточнения всегда дает меньшую потерю; в областях, где два минимизатора находятся далеко друг от друга (какая бы ошибка ни минимизировалась первой), выигрыши являются существенными, с уменьшением потерь до .
Remark 6.4.
⟦Bartlett et al. (2020) устанавливают, что доброкачественное переобучение возникает для линейной регрессии в сходной модели данных при некоторых условиях на спектральное распределение матрицы ковариаций. Перспективное направление для будущих исследований — изучить, как это переносится на классификацию, и связь с разложением калибровки и уточнения.
7 Заключение
Мы показали, что выбор наилучшей эпохи и гиперпараметров на основе ошибки уточнения решает проблему, возникающую при использовании валидационной потери. Мы установили, что ошибку уточнения можно оценивать по потере после постфактум калибровки. Это позволило нам использовать TS-уточнение для ранней остановки, обеспечив улучшение тестовой потери на различных задачах машинного обучения. Наш оцениватель доступен в пакете probmetrics github.com/dholzmueller/probmetrics и может использоваться без ощутимых затруднений с любой архитектурой. Одно ограничение состоит в том, что TS-уточнение может быть более чувствительным к переобучению на небольших наборах валидации. В этом случае могут быть полезны кросс-валидация, ансамблирование и регуляризованные постфактум калибраторы. Еще одна малоисследованная область — влияние параметров обучения, таких как оптимизаторы, планировщики и регуляризация, на калибровочную и уточняющую ошибки во время обучения. Это поднимает вопрос о том, как интегрировать раннюю остановку, основанную на уточнении, с этими параметрами, чтобы максимизировать эффективность. Хотя остановка, основанная на уточнении, релевантна в сценариях, где данные ограничены и высок риск переобучения, она также может оказаться полезной для донастройки foundation models, где обучение намного дольше минимума потери может быть полезным (Ouyang et al., 2022; Carlsson et al., 2024). Кроме того, хотя мы исследуем ее полезность для оптимизации моделей, наш оцениватель уточнения может быть ценным диагностическим показателем, особенно в несбалансированных многоклассовых настройках, где точность и площадь под ROC-кривой менее уместны.
Благодарности
Авторы хотели бы поблагодарить Сашу Брауна, Этьена Готье, Себастьяна Грубера и Александра Переса-Лебеля за плодотворные обсуждения, касающиеся данной работы.
Эта публикация является частью кафедры «Рынки и обучение», поддерживаемой Air Liquide, BNP PARIBAS ASSET MANAGEMENT Europe, EDF, Orange и SNCF, спонсорами Фонда Inria.
Эта работа получила поддержку от правительства Франции, осуществляемую Национальным агентством исследований, в рамках программы France 2030 по грантовому соглашению с номером “PR[AI]RIE-PSAI” (ANR-23-IACL-0008).
Профинансировано Европейским союзом (ERC-2022-SYG-OCEAN-101071601). Высказанные взгляды и мнения принадлежат исключительно(целиком) автору(ам) и не обязательно отражают точку зрения Европейского союза или Европейского исследовательского совета Исполнительного агентства. Ни Европейский союз, ни орган, предоставивший грант, не несут ответственности за них.
Ссылки
- Bach (2024) Бах, Ф. Высокомерный анализ двойного спуска для линейной регрессии с случайными проекциями. SIAM Journal on Mathematics of Data Science, 6(1):26–50, 2024.
- Bartlett et al. (2020) Бартлетт, P. L., Лонг, P. M., Лугози, G., и Циглер, A. Доброкачественное переобучение в линейной регрессии. Труды Национальной академии наук, 117(48):30063–30070, 2020.
- ⟦Berta, E., Bach, F., and Jordan, M. Калибровка классификатора с ROC-регуляризованной изотонической регрессией. В материалах Международной конференции по искусственному интеллекту и статистике, 2024.
- Błasiok & Nakkiran (2024) Блазиок, Дж. и Наккиран, П. Сглаженная ECE: обоснованные диаграммы надежности с помощью сглаживания ядром. На Международной конференции по обучению представлениям, 2024.
- ⟦Когда оптимизация корректной функции потерь дает калибровку? Neural Information Processing Systems, 36, 2024.
- Boyd & Vandenberghe (2004) Бойд, С. и Ванденберхе, Л. Выпуклая оптимизация. Издательство Кембриджского университета, 2004.
- Brehmer & Gneiting (2020) Бреммер, Дж. Р. и Гнейтинг, Т. Правильностное преобразование: построение правильных правил скоринга через байесовские действия. Труды Института математической статистики, 72:659–673, 2020.
- Brier (1950) Brier, G. W. Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1):1–3, 1950.
- Bröcker (2009) Брёкер, Й. Надёжность, достаточность и разложение корректных оценок. Quarterly Journal of the Royal Meteorological Society, 135(643):1512–1519, 2009.
- Carlsson et al. (2024) Карлссон, Ф., Лю, Ф., Уорд, Д., Курфали, М., и Нивре, Дж. Феномен переобучения: заточка и стабилизация llms для генерации открытого текста. arXiv:2412.04318, 2024.
- ⟦Carrell et al. (2022) Carrell, A. M., Mallinar, N., Lucas, J., and Nakkiran, P. Разрыв калибровочной обобщаемости. arXiv:2210.01964, 2022.
- Chen & Guestrin (2016) Чен, Т. и Гесстрин, К. XGBoost: масштабируемая система бустинга деревьев. In Proceedings of the International Conference on Knowledge Discovery and Data Mining, pp. 785–794, 2016.
- ⟦Chidambaram & Ge (2024) Чидамбарам, М. и Ге, Р. Переоценка того, как сравнивать и улучшать калибровку моделей машинного обучения. arXiv:2406.04068, 2024.
- ⟦Couillet et al. (2018) Кулле, Р., Ляо, З., и Май, X. Асимптотики классификации в режиме случайных матриц. В Европейской конференции по обработке сигналов, стр. 1875–1879. IEEE, 2018.
- DeVries (2017) Де Фрис, Т. Улучшенная регуляризация сверточных нейронных сетей с помощью cutout. arXiv:1708.04552, 2017.
- ⟦Dobriban & Wager (2018) Добрибан, Э. и Уэйджер, С. Асимптотика предсказаний в высоких размерностях: Ridge regression и classification. The Annals of Statistics, 46(1):247–279, 2018.
- ⟦Erickson, N., Mueller, J., Shirkov, A., Zhang, H., Larroy, P., Li, M., and Smola, A. Autogluon-tabular: Надежный и точный automl для структурированных данных. arXiv:2003.06505, 2020.
- Ferrer & Ramos (2024) Феррер, Л. и Рамос, Д. Оценка апостериорных вероятностей: теория решений, надлежащие правила оценочного прогнозирования и калибровка. arXiv:2408.02841, 2024.
- Fisher (1936) Фишер, Р. А. Использование нескольких измерений в таксономических задачах. Annals of Eugenics, 7(2):179–188, 1936.
- Gneiting & Raftery (2007) Гнётинг, Т. и Рафферти, А. Э. Строго правильные правила оценивания, предсказание и оценивание. Журнал Американской статистической ассоциации, 102(477):359–378, 2007.
- ⟦Gorishniy, Y., Rubachev, I., Khrulkov, V., and Babenko, A. Пересмотр глубоких моделей обучения для табличных данных. Neural Information Processing Systems, 34:18932–18943, 2021.
- ⟦Grinsztajn et al. (2022) Гринштейн, Л., Ойаллон, Э., и Вароаксо, Ж. Почему модели на основе деревьев по-прежнему превосходят глубокое обучение на типичных табличных данных? Neural Information Processing Systems, 35:507–520, 2022.
- ⟦Gruber & Buettner (2022) Грубер, С. и Бюттнер, Ф. Лучшее согласование неопределенности с помощью надлежащих оценочных функций для классификации и далее. Нейронная обработка информации (Neural Information Processing Systems), 35:8618–8632, 2022.
- Gruber & Bach (2024) Грубер, С. Г. и Бах, Ф. Оптимизация оценок квадратичных ошибок калибровки в классификации. arXiv:2410.07014, 2024.
- ⟦Грюнвальд, П. Д. и Давид, А. П. Теория игр, максимальная энтропия, минимальное расхождение и робастная байесовская теория принятия решений. The Annals of Statistics, 32(4):1367–1433, 2004.
- Guo et al. (2017) Го, С., Плейсс, Г., Сун, Ю., и Вайнбергер, К. Q. О калибровке современных нейронных сетей. На Международной конференции по машинному обучению, 2017.
- ⟦He et al. (2016) Хе, К., Чжан, X., Рен, С., и Сун, Дж. Глубокое остаточное обучение для распознавания изображений. В материалах конференции по компьютерному зрению и распознаванию образов, 2016.
- Holzmüller et al. (2024) Хольцмюллер, Д., Гринштейн, Л., и Штайнварт, И. Лучше по умолчанию: сильно предварительно настроенные MLP и бустированные деревья на табличных данных. В Neural Information Processing Systems, 2024.
- Jordan (1995) Джордан, М. И. Почему логистическая функция? учебное обсуждение вероятностей и нейронных сетей. Технический отчет по вычислительной когнитивной науке 9503, 1995.
- Kechris (1995) Кечрис, А. С. Классическая описательная теория множеств, том 156 из «Математических вводных текстов для аспирантов». Springer, 1995.
- Krizhevsky et al. (2009) Krizhevsky, A., Hinton, G., et al. Обучение извлечению признаков на нескольких уровнях из небольших изображений. 2009.
- ⟦K0 Kull, M. и Flach, P. Новые разложения корректных правил начисления для классификации: Корректировка оценки как предшественник калибровки. В Машинном обучении и обнаружении знаний в базах данных: Европейская конференция, 2015.
- ⟦Kull et al. (2017) Kull, M., Silva Filho, T., and Flach, P. Калибровка вероятностей: обоснованное и легко реализуемое улучшение для логистической калибровки бинарных классификаторов. В журнале по Искусственному интеллекту и статистике, стр. 623–631. PMLR, 2017.
- Kull et al. (2019) Kull, M., Perello Nieto, M., Kängsepp, M., Silva Filho, T., Song, H., and Flach, P. Помимо температурного скейлинга: получение хорошо откалиброванных многоклассовых вероятностей с помощью дирихлетовской калибровки. В Advances in Neural Information Processing Systems, 2019.
- Kumar et al. (2019) Kumar, A., Liang, P. S., and Ma, T. Проверенная калибровка неопределенности. В «Трудах по достижениям в обработке нейронной информации», 2019.
- Liu & Nocedal (1989) Лю, Д. C. и Ноцедал, Дж. О методе bfgs с ограниченной памятью для оптимизации крупномасштабных задач. Математическое программирование, 45(1):503–528, 1989.
- ⟦Mai et al. (2019) Май, X., Ляо, Z., и Куйийе, R. Крупномасштабный анализ логистической регрессии: асимптотическая производительность и новые выводы. В Международной конференции по акустике, речевой и сигнальной обработке (ICASSP), 2019.
- ⟦Manokhin (2017) Манохин, В. Многоклассовая вероятностная классификация с использованием индуктивных и кросс Venn–Abers предикторов. В книге «Конформное и вероятностное предсказание и приложения», с. 228–240. PMLR, 2017.
- ⟦McElfresh, D., Khandagale, S., Valverde, J., Prasad C, V., Ramakrishnan, G., Goldblum, M., and White, C. Когда нейронные сети превосходят бустинговые деревья на табличных данных? Neural Information Processing Systems, 36, 2024.
- Minderer et al. (2021) Minderer, M., Djolonga, J., Romijnders, R., Hubis, F., Zhai, X., Houlsby, N., Tran, D., and Lucic, M. Пересмотр калибровки современных нейронных сетей. Neural Information Processing Systems, 34:15682–15694, 2021.
- Murphy (1973) Мерфи, А. Х. Новая векторная разбиение для вероятностной оценки. Журнал прикладной метеорологии и климатологии, 12(4):595–600, 1973.
- Naeini et al. (2015) Нaeini, M. P., Cooper, G., and Hauskrecht, M. Получение хорошо откалиброванных вероятностей с использованием bayesian binning. In Proceedings of the AAAI Conference on Artificial Intelligence, 2015.
- ⟦Netzer et al. (2011) Netzer, Y., Wang, T., Coates, A., Bissacco, A., Wu, B., Ng, A. Y., et al. Чтение цифр на естественных изображениях с обучением признаков без учителя. На семинаре NIPS по глубокому обучению и обучению признаков без учителя, том 2011, стр. 4, 2011.
- Oron & Flournoy (2017) Oron, A. P. and Flournoy, N. Центрированная изотоническая регрессия: точечная и интервальная оценка для исследований зависимости «доза–ответ». Statistics in Biopharmaceutical Research, 9(3):258–267, 2017.
- ⟦Orseau & Hutter (2023) Орезо, Л. и Хаттер, М. Поиск по линиям для выпуклой минимизации. arXiv:2307.16560, 2023.
- Ouyang et al. (2022) Оуян, Л., У, Д., Цзян, X., Алмейда, Д., Уэйнрайт, С., Мишкин, П., Чжан, С., Агарвал, С., Слама, К., Рэй, А., и др. Обучение языковых моделей следованию инструкциям с опорой на обратную связь от человека. Neural Information Processing Systems, 35:27730–27744, 2022.
- Pedregosa et al. (2011) Педрогоса, Ф., Вароаксо, Ж., Грамфорт, А., Мишель, В., Тирьон, Б., Гризель, О., Блондел, М., Преттенхофер, П., Вайсс, Р., Дюбур, В., и др. Scikit-learn: Machine learning in python. Журнал исследований в области машинного обучения, 12:2825–2830, 2011.
- ⟦Perez-Lebel et al. (2023) Переc-Лебель, А., Ле Морван, М., и Варо-Ксо, Ж. За пределами калибровки: оценка группирующей потери современных нейронных сетей. В Международной конференции по обучению представлениям, 2023.
- ⟦Platt et al. (1999) Платт, Дж. и др. Вероятностные выходные данные для опорных векторных машин и сравнение с методами регуляризованного правдоподобия. Труды по достижениям в классификаторах большой маржи, 10(3):61–74, 1999.
- Pohle (2020) Поле, М.-О. Разложение Мерфи и принцип калибровка-разрешение: Новый взгляд на оценку прогнозов. arXiv:2005.01835, 2020.
- ⟦Robertson et al. (1988) Робертсон, Т., Райт, Ф., и Дайкстра, Р. Ограниченный порядок статистического вывода. Серия «Вероятность и статистика». Wiley, 1988. ISBN 978-0-471-91787-8.
- ⟦Roelofs, R., Cain, N., Shlens, J., and Mozer, M. C. Смягчение смещения при оценивании ошибки калибровки. В Международной конференции по искусственному интеллекту и статистике, 2022.
- Salehi et al. (2019) Салехи, Ф., Аббаси, Э., и Хасиби, Б. Влияние регуляризации на логистическую регрессию высокой размерности. Труды по достижениям в системах нейронной обработки информации, 2019.
- ⟦Sanders (1963) Сандерс, Ф. «О субъективном прогнозировании вероятностей». Journal of Applied Meteorology and Climatology, 2(2):191–201, 1963.
- ⟦Silva Filho et al. (2023) Силва Фильо, Т., Сонг, Х., Перелло-Ньето, М., Сантос-Родригес, Р., Кулл, М., и Флач, П. Калибровка классификатора: обзор того, как оценивать и улучшать предсказанные вероятности классов. Machine Learning, 112(9):3211–3260, 2023.
- ⟦Tao et al. (2024) Тao, L., Zhu, Y., Guo, H., Dong, M., и Xu, C. Эталонное исследование по калибровке. В Международной конференции по обучению представлениям, 2024.
- ⟦Vaicenavicius et al. (2019) Вайценавичюс, Й., Видманн, Д., Андерссон, К., Линдстен, Ф., Ролл, Дж., и Шён, Т. Оценка калибровки модели в классификации. В Международной конференции по искусственному интеллекту и статистике, 2019.
- Vovk et al. (2015) Вовк, В., Пе́тей, И., и Федорова, В. Крупномасштабные вероятностные предикторы с гарантиями корректности и без них. Neural Information Processing Systems, 28, 2015.
- ⟦Wang, D.-B., Feng, L., and Zhang, M.-L. Переосмысление калибровки глубоких нейронных сетей: не бойтесь чрезмерной уверенности. В материалах «Neural Information Processing Systems», 2021.
- Ye et al. (2024) Е, Х.-Дж., Лю, С.-Й., Цай, Х.-Р., Чжоу, Ц.-Л., и Чжан, Д.-Ц. Более пристальный взгляд на методы глубокого обучения для табличных наборов данных. arXiv:2407.00956, 2024.
- ⟦Zadrozny & Elkan (2002) Задрозны, Б. и Элкан, С. Преобразование оценок классификатора в точные оценки вероятностей для многоклассовой классификации. В материалах Международной конференции по поиску знаний и анализу данных, 2002.
- ⟦Zagoruyko, S. Широкие остаточные сети. arXiv:1605.07146, 2016.
Appendix A Сопутствующие работы
Правила пропорционального начисления баллов.
Правильные правила скоринга использовались в метеорологии для оценки качества прогнозов, см. Gneiting & Raftery (2007) для обзора. Их также можно обосновать с точки зрения теории принятия решений: последующая функция потерь для лица, принимающего решения, которое выбирает Bayes, то есть действия, оптимальные если предсказание верно, является правильным правилом скоринга (Grünwald & Dawid, 2004). Эта конструкция также позволяет привести к правильности непарные правила скоринга (Brehmer & Gneiting, 2020)⟧.
Разложения корректных оценок.
Для Brier score (Brier, 1950) была предложена декомпозиция calibration-refinement, представленная Sanders (1963), а декомпозиция calibration-sharpness (см. Appendix B) была предложена Murphy (1973). Bröcker (2009) обобщил эти декомпозиции для других корректных правил скоринга. Kull & Flach (2015) переписывает эти декомпозиции исключительно в терминах дивергенций между различными случайными величинами и вводит больше членов, таких как irreducible, epistemic и grouping loss. Pohle (2020) также предоставляет альтернативные формулировки. Однако ни одна из этих формулировок не является вариационной.
Калибровка.
⟦Guo et al. (2017) отметил, что в то время нейронные сети часто были неверно откалиброваны, и что logloss может переобучаться намного раньше, чем accuracy, хотя степень неверной калибровки может зависеть от архитектурных и других деталей (Minderer et al., 2021; Tao et al., 2024). Многие последующие калибровки предложены для решения этой проблемы. Некоторые методы представляют собой формы логистической регрессии, как в Platt scaling (Platt et al., 1999), Temperature/Vector/Matrix scaling (Guo et al., 2017), Beta calibration (Kull et al., 2017) и Dirichlet calibration (Kull et al., 2019). Другая группа методов берет начало в изотонической регрессии (Robertson et al., 1988; Zadrozny & Elkan, 2002; Oron & Flournoy, 2017; Vovk et al., 2015; Manokhin, 2017; Berta et al., 2024). Подходы, основанные на группировке по бинам, также существуют (e.g., Naeini et al., 2015), но, возможно, они более популярны для оценки калибровочных ошибок. Wang et al. (2021) показывают, что изменение функции потерь может улучшить калибровку до, но не после пост-обработочной калибровки.
Постобработка калибровки и корректные оценки.
⟦Gruber & Buettner (2022) использует величину, подобную потере, для сравнения постфактум методов калибровки, и Gruber & Bach (2024) предлагает вариационную постановку для оптимизации оценок квадратичных ошибок калибровки. Ferrer & Ramos (2024) предлагает рассматривать улучшение значения потери при постфактум перекалибровке как меру ошибки калибровки. Подчеркивается важность оптимизации общей потери, а не только ошибки калибровки, например, Perez-Lebel et al. (2023), Chidambaram & Ge (2024) и Ferrer & Ramos (2024). В то время как мы используем уточняющую оценку, Perez-Lebel et al. (2023) предлагает оценку групповой потери, которая может быть применима в нашем случае, поскольку невосстанавливаемая в нашем случае потеря не зависит от . Однако оценка групповой потери труднее в оценивании, чем оценка уточнения, поскольку оценка групповой потери может быть использована для оценки невосстанавливаемой потери .
Высокомерные асимптотики классификации.
Наш анализ ошибок классификации и уточнения для регуляризованной логистической регрессии в многомерной постановке опирается на богатую литературу. В частности Dobriban & Wager (2018); Mai et al. (2019) изучает ошибку классификации с той же моделью данных и предоставляет асимптотические результаты, непосредственно применимые к нашему анализу. Couillet et al. (2018); Salehi et al. (2019) исследует смежные сценарии, которые мы экспериментально проверяли. Bach (2024) предлагает новый взгляд на эти многомерные результаты через призму самовозникающей регуляризации, что может оказаться релевантным для интерпретации формул, полученных для ошибок калибровки и уточнения.
Appendix B Калибровка, уточнение и резкость
Далее мы доказываем Theorem B.1, что является более общей версией Theorem 2.1. Figure B.1 иллюстрирует связь между терминами в этих разложениях. В частности, она включает калибровочно-резкостное разложение (Bröcker, 2009), задаваемое {IEEEeqnarray*}+rCl+x* Risk(f) = E[ℓ(f(X), Y)] = e_ℓ(E[Y]) -⏟E[d_ℓ(E[Y], C)])_Sharpness S_ℓ(f) + ⏟E[d_ℓ(f(X), C)]_Calib. error K_ℓ(f) .
Для следующих результатов мы используем более технически точное определение корректных потерь. Мы следуем (Gneiting & Raftery, 2007), но меняем знак на противоположный так, чтобы корректные потери следовало минимизировать, а не максимизировать. Мы рассматриваем потери такие, что является -квазиинтегрируемой для всех . Последнее условие необходимо, чтобы было определено. Условия можно дополнительно ослабить, чтобы использовать выпуклые подмножества , однако мы опускаем это для простоты.
Theorem B.1 (Расширенные вариационные переформулировки).
Пусть , пусть образуют корректную функцию потерь, и пусть измерима, где снабжено борелевской -алгеброй. Тогда, {IEEEeqnarray*}+rCl+x* R_ℓ(f) & = min_g Risk(g ∘f) , K_ℓ(f) = Risk(f) - min_g Risk(g ∘f) , S_ℓ(f) = min_c constant Risk(c) - min_g Risk(g ∘f) , e_ℓ(E[Y]) = min_c constant Risk(c) . Здесь минимумы берутся по измеримым функциям и . Они достигаются и . Если строго корректна, минимизаторы единственны с точностью до -нулевых множеств.
Доказательство.
Пусть , так что почти наверное. Тогда, {IEEEeqnarray*}+rCl+s* R_ℓ(f) & = E[e_ℓ(C)] = E[ℓ(C, C)] = E[ℓ(g_C(f(X)), E[Y—f(X)])] (по определению) = E[ℓ(g_C(f(X)), Y)] (по Lemma B.6) = min_g E[ℓ(g(f(X)), Y)] . (по Lemma B.7 с )
Это показывает представление ошибки уточнения, и Lemma B.7 также показывает, что является минимизатором, который почти наверное единственный. Представление калибровочной ошибки следует непосредственно из разложения калибровки-уточнения (Bröcker, 2009).
Теперь пусть будет равномерным распределением (следует интерпретировать как константную случайную величину). Тогда для {IEEEeqnarray*}+rCl+s* e_ℓ(E[Y]) & = ℓ(E[Y], E[Y]) = ℓ(¯p, E[Y]) = E[ℓ(¯p, Y)] ( аффинно по второму аргументу) = min_g E[ℓ(g(Z), Y)] (по Lemma B.7) = min_c константная E[ℓ(c(f(X)), Y)] . Снова Lemma B.7 показывает, что минимизатор есть .
Для резкости, мы имеем {IEEEeqnarray*}+rCl+s* S_ℓ(f) & = E[d_ℓ(E[Y], C)] = E[ℓ(E[Y], C)] - E[ℓ(C, C)] = E[ℓ(E[Y], E[Y—f(X)])] - R_ℓ(f) по определению. Мы уже показали выше, что . Для другого члена мы используем то, что является аффинной функцией по второму аргументу, чтобы получить {IEEEeqnarray*}+rCl+x* E[ℓ(E[Y], E[Y—f(X)])] & = ℓ(E[Y], E[E[Y—f(X)]]) = e_ℓ(E[Y]) . ∎
Remark B.2 (Альтернативные разложения по Kull & Flach (2015)).
⟦Kull & Flach (2015) обеспечивает немного иную декомпозицию калибровка-уточнение:
Альтернативная ошибка уточнения {IEEEeqnarray*}rCl ~R_ℓ(f) = E[d_ℓ(C, Y)] & = E[ℓ(C, Y)] - E[ℓ(Y, Y)] = R_ℓ(f) - E[ℓ(Y, Y)] равно если , что имеет место для logloss и Brier loss. В этом случае неснижаемая и группировочная ошибка в Figure B.1 также равны определениям Kull & Flach (2015) в их разложении
Интуитивно, группирующая потеря описывает потерю, которая возникает, когда но .
Редуцируемая потеря в Figure B.1 называется эпистемической потерей в Kull & Flach (2015)⟧.
Remark B.3 (Расширение определений калибровки, уточнения и резкости).
⟦Theorem 2.1 показывает, что для корректных потерь ошибка калибровки является не только расхождением относительно заданной целевой величины (), но также потенциальным уменьшением потерь за счет постобработки. Последняя точка зрения была предложена Ferrer & Ramos (2024) без демонстрации эквивалентности первой. С одной стороны, преимущество первой точки зрения состоит в том, что она распространяется на недивергенции, такие как расстояние . С другой стороны, преимущество второй точки зрения заключается в том, что она может быть использована для расширения понятия ошибки калибровки, ошибки уточнения и остроты на некорректные потери (при изменении заданной цели) или даже на непро- вероятностные условия, такие как регрессия с loss MSE. Более того, ошибку уточнения и остроту можно определить даже тогда, когда не принадлежит нужному пространству для функции потерь, например потому что это представление скрытого слоя в нейронной сети. Вариационная постановка также позволяет определить более связанные величины, используя различные классы функций и рассматривая {IEEEeqnarray*}rCl inf_g ∈G Risk(g ∘f) . Например, рассматривая соответствующий вариант ошибки калибровки для функций 1-Lipschitz, мы получаем разрыв постобработки из Blasiok et al. (2024). В бинарном случае, используя возрастающие функции, мы получаем наилучший возможный риск, достижимый с помощью изотонической регрессии.
⟦Theorem B.1 также подразумевает некоторые дополнительные свойства калибровки, уточнения и резкости:
Corollary B.4.
Пусть , пусть будет надлежащей функцией потерь, и пусть будет измеримой, где снабжено борелевской -алгеброй.
- ⟦(a) Если откалиброван, то его популяционный риск нельзя уменьшить посредством постобработки, то есть . Обратное верно, если строго собственный (Blasiok et al., 2024)⟧.
- ⟦(b) Пусть измерима. Тогда, , и .
- ⟦Пусть будет измеримой и инъективной. Тогда , и . (Похожий результат был показан в Предложении 4.5 из Gruber & Buettner (2022).)
- ⟦Предположим, что является инъективным и имеет измеримую левую обратную (см. Theorem B.5 для достаточного условия). Тогда группировочная потерь равна нулю, то есть и .
Доказательство.
- ⟦По определению, калибрована тогда и только тогда, когда почти наверное. По Theorem B.1, минимизируется , при этом равенство выполняется почти наверное. Следовательно, . Для обратного утверждения, по Theorem B.1, если строго корректна, минимизатор единственен с точностью до -нулевых множеств; отсюда для почти всех , следовательно, почти наверное.
-
⟦Так как измерима для всех измеримых , получаем
Неравенство на остроту следует аналогично. -
(c)
Пусть . Тогда по Theorem B.5 существует измеримая левая обратная матрица для .
Тогда,
которая вместе с (b) дает утверждение для уточнения. Довод о точности аналогичен. - (d) Это следует аналогично (c). ∎
Theorem B.5 (Существование измеримых левых обратных отображений).
Пусть будут полными сепарабельными метрическими пространствами с соответствующей борелевской -алгеброй, и пусть будет измеримым и инъективным. Тогда существует измеримое с .
Доказательство.
По следствию 15.2 в (Kechris, 1995), является борелевым изоморфизмом из в , значит, его обратное отображение измеримо. Но тогда, для фиксированного ,
является измеримой левой обратной функцией к , доказывая утверждение. ∎
Lemma B.6.
Пусть — случайные величины с распределением и пусть — собственная величина. Тогда,
Доказательство.
Так как является пространством Радона, существует регулярное условное распределение вероятностей , с помощью которого мы получаем {IEEEeqnarray*}+rCl+x* E[ℓ(g(Z), E[Y—Z])] & = ∫ℓ(g(z), ∫y P_Y—Z( dy—z)) dP_Z(z) = ∬ℓ(g(z), y) P_Y—Z( dy—z) dP_Z(z) (так как является аффинной функцией во втором аргументе) = ∫ℓ(g(z), y) dP(y, z) = E[ℓ(g(Z), Y)] . ∎
Следующая лемма, используемая в доказательстве Theorem B.1, дает формальную версию хорошо известного результата.
Lemma B.7.
Пусть будут случайными величинами, а — правильными. Тогда для измеримых , {IEEEeqnarray*}+rCl+x* Risk(g) ≔E[ℓ(g(Z), Y)] минимизируется с помощью . Если строго правильная, то является единственным минимизатором с точностью до множеств нулевой меры относительно .
Доказательство.
Мы имеем {IEEEeqnarray*}+rCl+s* E[ℓ(g(Z), Y)] & = E[ℓ(g(Z), E[Y—Z])] (по Lemma B.6) ≥ E[ℓ(E[Y—Z], E[Y—Z])] ( является корректным) = E[ℓ(E[Y—Z], Y)] (по Lemma B.6) = E[ℓ(g^*(Z), Y)] .
Если для неравенство выше может быть строгим только для в множестве меры , равном нулю. Если строго правильно, то неравенство нарушается всякий раз, когда . ∎
Appendix C Доказательства для раздела 5
Под моделью данных, введенной в Section 5, с и .
Доказательство.
С . ∎
Мы теперь доказываем следующие леммы, которые мы будем использовать для демонстрации Theorem 5.1.
Lemma C.1.
.
Lemma C.2.
.
Доказательство.
| Using that the affine transformation of a multivariate normal dist. is a normal dist. () | ||||
По пути мы вывели распределение :
∎
См. 5.1
Доказательство.
Ошибка уточнения записывает
| Using Lemma C.1 and Lemma C.2, | ||||
| Taking in the first integral and in the second, we get | ||||
является антисимметричным относительно нуля; предполагая, что симметричен относительно , два члена равны, что упрощает выражение,
Аналогично для ошибки калибровки
является антисимметричным относительно нуля, при условии , симметричного относительно , два члена равны,
∎
См. 5.2
Доказательство.
не меняется при масштабировании. При наличии имеем, что . Выражение для погрешности уточнения в Theorem 5.1 зависит от только через , поэтому уточнение не меняется при масштабировании.
Калибровочная ошибка записывает:
Поскольку инвариантна при масштабировании, взятие дает
∎
Appendix D Доказательства для Section 6
В этом разделе мы в значительной степени опираемся на следующий результат от Mai et al. (2019) о предельном распределении вектора весов для регуляризованной логистической регрессии при силе регуляризации , когда при фиксированном отношении ⟧:
Смотри 6.1
Доказательство.
⟦ следует нормальному распределению со средним и дисперсией . Сначала рассмотрим дисперсию:
Используя независимость между и и сильный закон больших чисел
Так сосредоточен на своем среднем:
Изучение требует немного больше работы. Обозначая ,
∎
См. 6.3
Доказательство.
∎
Вывод формул для , и ⟧
Вместе с тем
Lemma D.1.
Обозначая гипергеометрическую функцию, бета-распределение и бета-функцию,
Используя уравнения в Lemma D.1 и линейность матожидания, получаем, что
Аналогично,
Решение нелинейной системы в (Mai et al., 2019) также требует вычисления :
Мы предоставляем эффективную реализацию решателя нелинейных систем с нашей конкретной моделью данных и функциями для вычисления результирующих ошибок калибровки и уточнения в github.com/eugeneberta/RefineThenCalibrate-Theory.
Appendix E Реализация масштабирования температуры и TS-уточнение
Для логлосса целевая функция является выпуклой, что следует из того, что является выпуклой (Boyd & Vandenberghe, 2004). В частности, мы используем 30 шагов бисекции, чтобы приблизить , а затем найти . Если требуются реализации еще быстрее, могут помочь более продвинутые методы линейного поиска для выпуклых функций (Orseau & Hutter, 2023), методы второго порядка, стохастическая оптимизация или дообучение с прогревом (warm-starting). Чтобы защититься от переобучения в случаях с 100% точностью на валидации, где бисекция может эффективно приближать , мы вводим некоторую форму сглаживания Лапласа (LS) как , где — равномерное распределение, а — число образцов в калибровочном наборе. Эта версия используется для наших основных экспериментов за исключением Figure 3.
Расширенное сравнение.
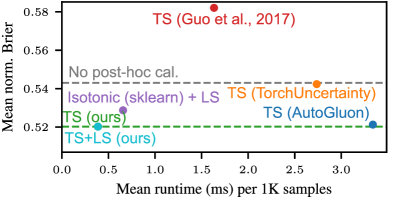
⟦Figure E.1 показывает сравнение большего числа методов постобработочной калибровки. В то время как Figure 3 использует среднее logloss для простоты, это может чрезмерно выделять многоклассовые наборы данных, тогда как в несбалансированных наборах данных им уделяется меньше веса. Чтобы компенсировать это, в Figure E.1 мы делим потери (logloss или Brier loss) для каждого набора данных на потери лучшего константного предиктора, которые можно записать как .
Наша добавка сглаживания Лапласа (LS) к TS дает небольшую выгоду для логлосса. Мы также сравниваем наши результаты с изотонической регрессией, где мы включаем LS, чтобы избежать бесконечного логлосса, поскольку IR может предсказать вероятность ноль.111IVAP (Vovk et al., 2015) — это вариант изотонической регрессии, который не предсказывает нулевые вероятности, но мы обнаружили, что он примерно на два порядка медленнее, чем изотоническая регрессия, поэтому не считали его особенно привлекательным компонентом уточняющего оценивателя. Хотя реализация IR из scikit-learn (Pedregosa et al., 2011) почти так же быстра, как наша реализация TS, она заметно хуже работает на нашем наборе тестов. Для Brier loss преимущество TS в целом выражено менее заметно, и лишь хорошие реализации улучшают результаты по сравнению с отсутствием постобработочной калибровки.
Валидация.
Мы заинтересованы в минимизации популяционного риска откалиброванных оценивателей. Чтобы достоверно оценить популяционный риск, можно использовать кросс-валидацию или метод удержания, обучая калибратор на части валидационного набора, а его потери на оставшейся части использовать в качестве оценки для уточнения. Однако в Figure G.2 мы экспериментально наблюдаем, что аппроксимация и оценивание температурного масштабирования на всем валидационном наборе работает столь же хорошо, возможно, потому что при этом подбирается только один параметр. Ниже мы используем последний подход, поскольку он более эффективен по сравнению с кросс-валидацией.
Appendix F Эксперименты по компьютерному зрению
Мы обучаем ResNet-18 (He et al., 2016) и WideResNet (Zagoruyko, 2016) на наборах данных CIFAR-10, CIFAR-100 и SVHN (Krizhevsky et al., 2009; Netzer et al., 2011). Мы обучаем в течение 300 эпох, используя SGD с моментумом , затуханием весов и планировщиком скорости обучения, который делит скорость обучения на десять каждые 100 эпох. Мы используем случайное обрезание ( обрезков после дополнения изображений отступом пикселей), горизонтальные отражения (pytorch значение по умолчанию) и cutout (DeVries, 2017) (одно отверстие на изображение во время обучения). Мы обучаем каждую модель десять раз на каждом наборе данных. 10% обучающего набора сохраняется для валидации. Мы выбираем лучшую эпоху на основе различных метрик, вычисляемых на валидационном наборе: logloss, Brier score, точность и logloss после уточнения с помощью temperature scaling (TS-refinement). Для Table F.1 (ResNet-18) и Table F.2 (WideResNet) мы сообщаем средние значения logloss, brier score, точности, ECE и smooth ECE (Błasiok & Nakkiran, 2024), полученные для каждой метрики остановки. Figure 1 генерируется с тем же обучающим рецептом, но с планировщиком cosine annealing вместо него, чтобы избежать больших скачков в ландшафте потерь, и без затухания весов, чтобы усилить калибровочное переобучение. Смотрите github.com/eugeneberta/RefineThenCalibrate-Vision.
| Logloss | Brier | Accuracy | ECE | smECE | ||
| Dataset | Stopping metric | |||||
| CIFAR-10 | Logloss | |||||
| Brier score | ||||||
| Accuracy | ||||||
| TS-refinement | ||||||
| CIFAR-100 | Logloss | |||||
| Brier score | ||||||
| Accuracy | ||||||
| TS-refinement | ||||||
| SVHN | Logloss | |||||
| Brier score | ||||||
| Accuracy | ||||||
| TS-refinement |
| Logloss | Brier | Accuracy | ECE | smECE | ||
| Dataset | Stopping metric | |||||
| CIFAR-10 | Logloss | |||||
| Brier score | ||||||
| Accuracy | ||||||
| TS-refinement | ||||||
| CIFAR-100 | Logloss | |||||
| Brier score | ||||||
| Accuracy | ||||||
| TS-refinement | ||||||
| SVHN | Logloss | |||||
| Brier score | ||||||
| Accuracy | ||||||
| TS-refinement |
Appendix G Табличные эксперименты
Далее мы приводим дополнительные сведения и анализы для наших табличных экспериментов. Эксперименты заняли около 40 часов на рабочей станции с процессором AMD Threadripper PRO 3975WX с 32 ядрами и четырьмя графическими процессорами NVidia RTX 3090. Код бенчмарка доступен по адресу github.com/dholzmueller/pytabkit.
G.1 Зависимость размера набора данных
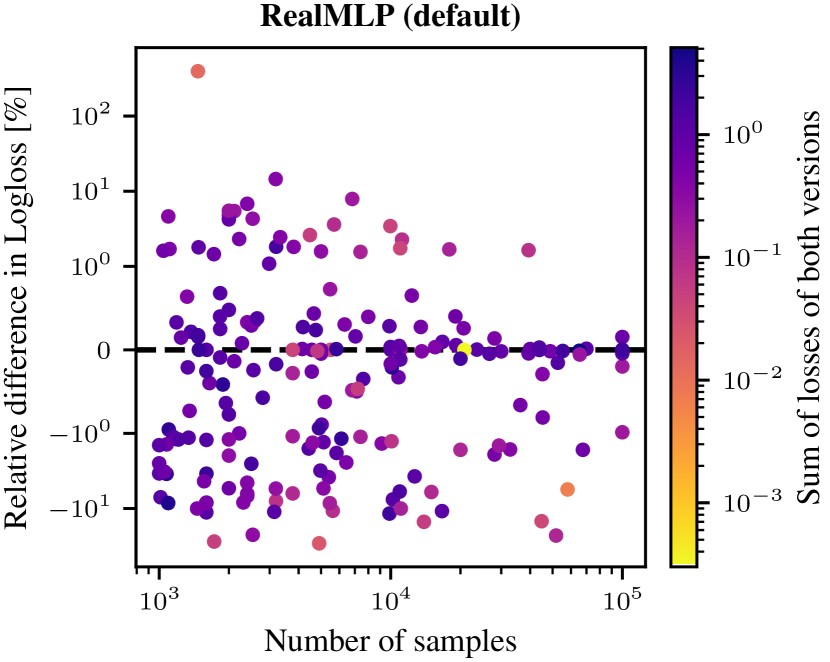
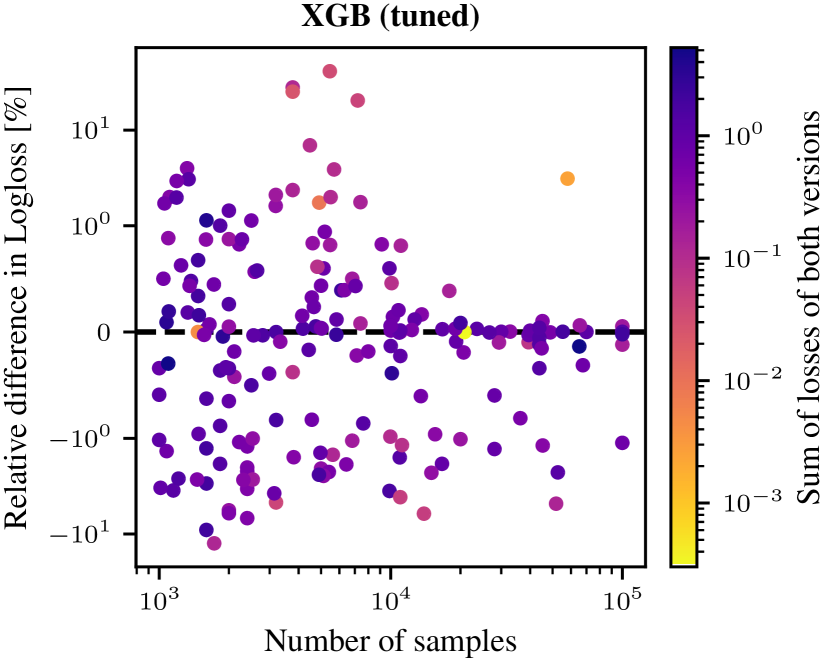
⟦Figure G.1 показывает, как относительная эффективность остановки на основе уточнения по сравнению с остановкой по logloss зависит от размера набора данных. Хотя для небольших наборов данных ситуация весьма шумная, для более крупных наборов данных ухудшение в худшем случае гораздо менее выражено, чем улучшения в лучшем случае. Преимущества TS-уточнения становятся заметными примерно при 10K образцов, что соответствует размеру валидационного набора 1,600. Для XGB и MLP есть один крупный выбросной набор данных, где остановка на основе уточнения и остановка по logloss обе дают низкую величину потерь, но отношение потерь является высоким.
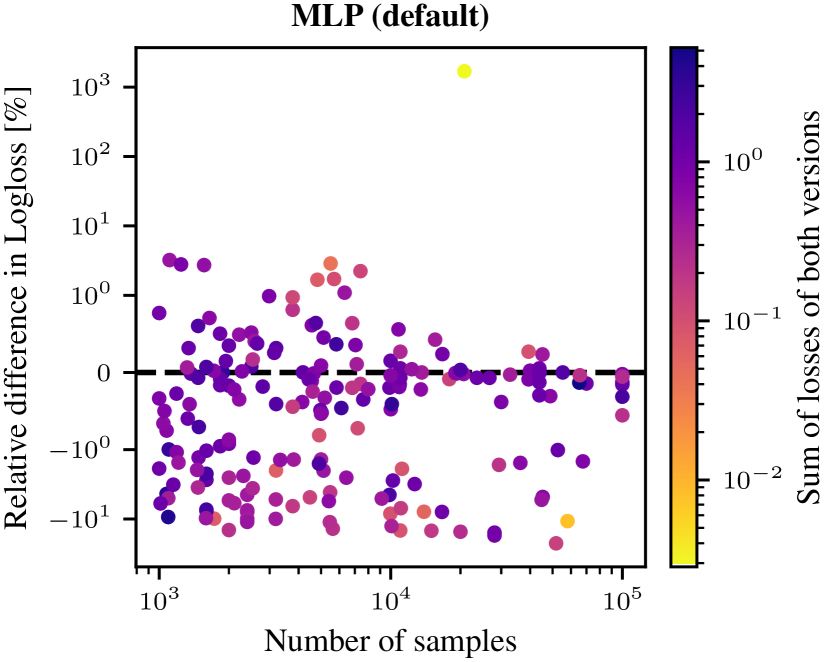
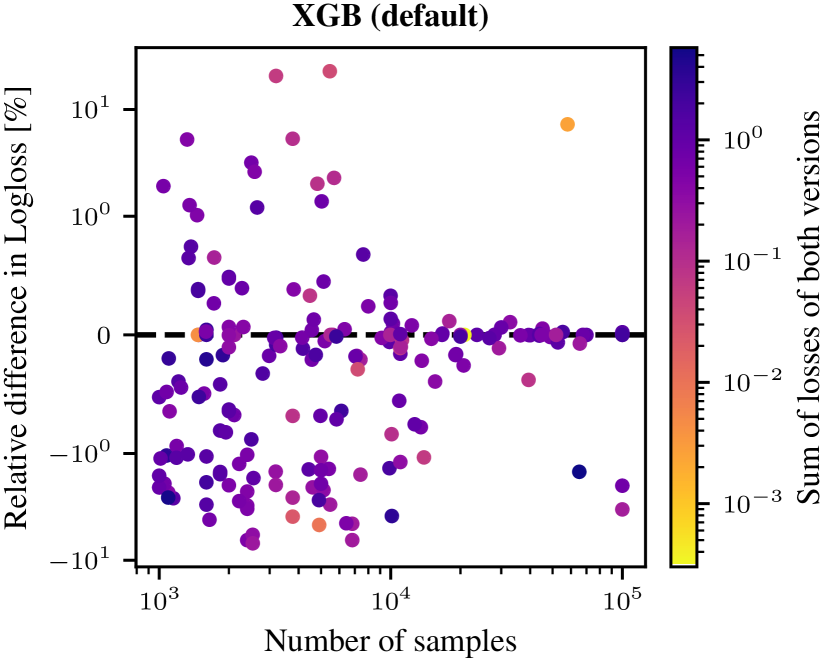
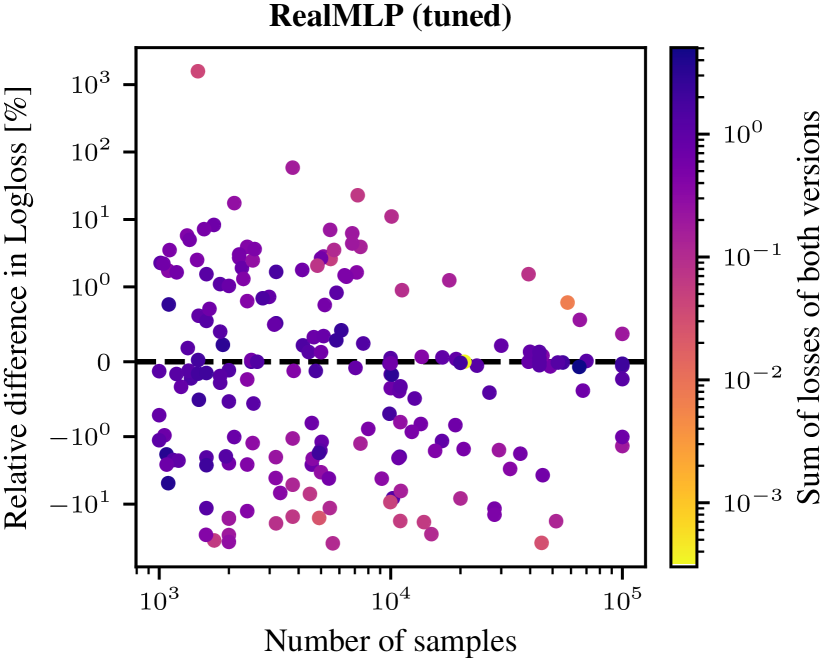
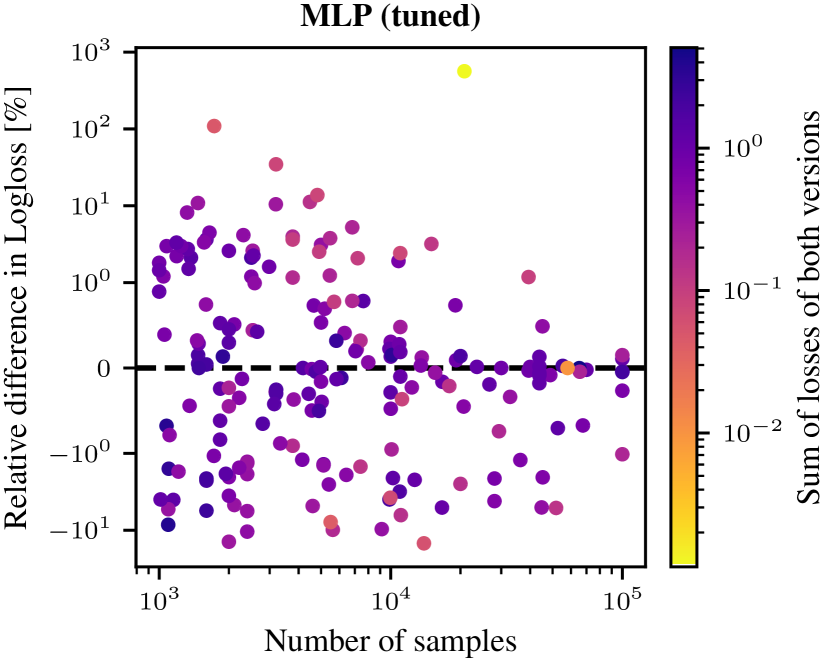
G.2 Другие показатели остановки
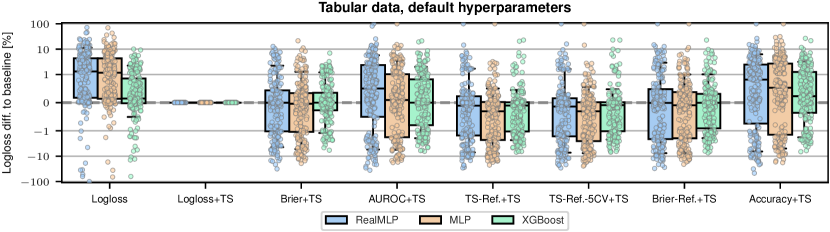
В Figure G.2 мы приводим результаты для дополнительных метрик остановки, таких как AUROC, Brier loss, Brier loss после температурного масштабирования, а также вариант TS-Refinement из Appendix E с пятикратной перекрёстной проверкой. TS-Refinement и его более дорогая версия с перекрёстной проверкой показывают наилучшие результаты. Из остальных метрик Brier loss до или после температурного масштабирования сопоставим с logloss, тогда как AUROC хуже, чем logloss для RealMLP.
G.3 Влияние на другие метрики
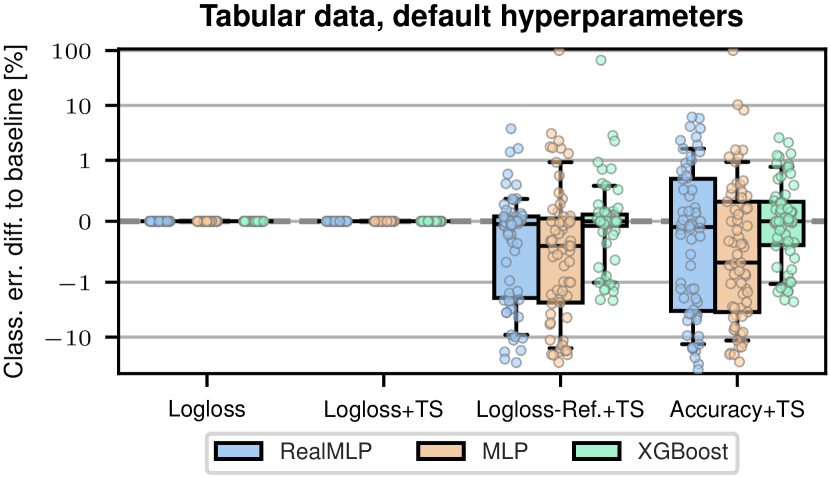
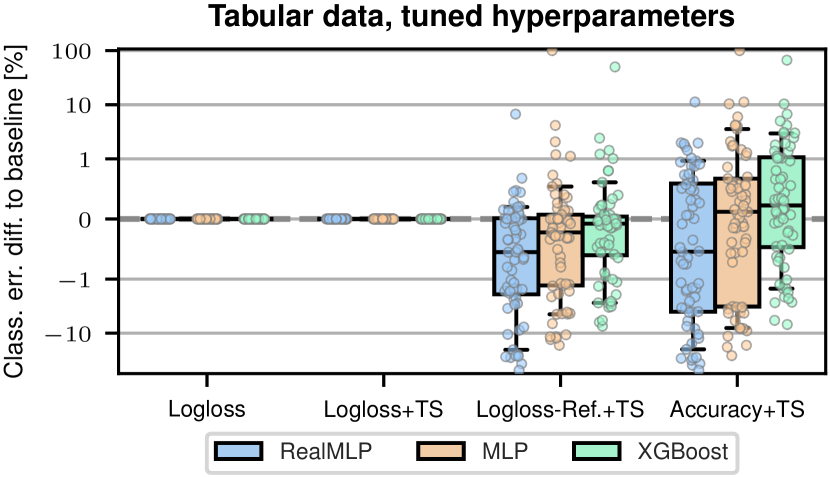
⟦Figure G.3 показывает, что настройка TS-Refinement в среднем может улучшить точность на последующих этапах по сравнению с настройкой logloss, а иногда даже по сравнению с настройкой accuracy напрямую. То же самое справедливо для AUROC в Figure G.4, где настройка accuracy часто работает очень плохо. Проведение temperature scaling не влияет на точность на последующих этапах, но может влиять на AUROC на последующих этапах в наборах данных с несколькими классами.
G.4 Времена остановки
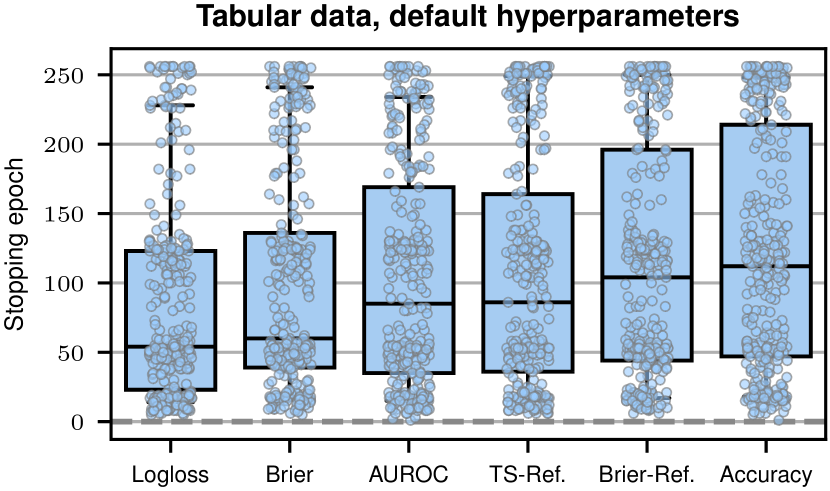
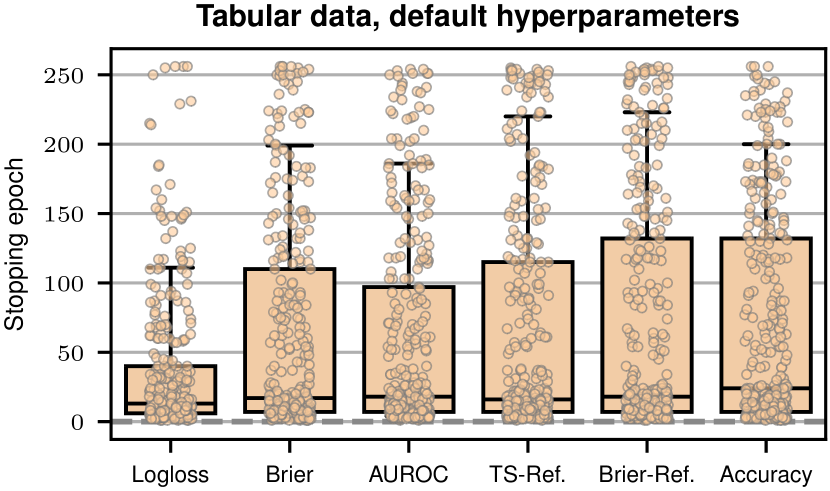
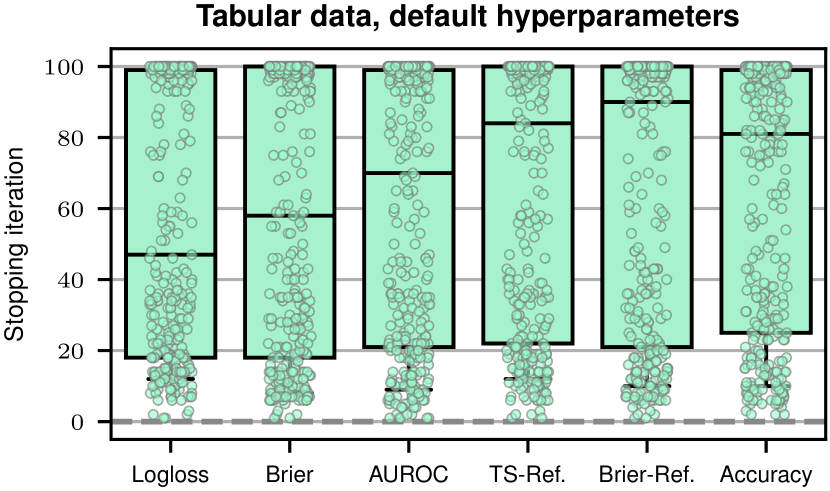
⟦Figure G.5 показывает лучшие эпохи или итерации, найденные для различных метрик для моделей с параметрами по умолчанию. Мы можем заметить несколько тенденций в разных моделях:
- ⟦• Logloss останавливается первым в среднем.
- ⟦Brier loss останавливается позже, чем logloss, также при рассмотрении потерь после масштабирования температуры.
- • Потери после масштабирования температуры останавливаются позже, чем потери до масштабирования температуры.
- ⟦Точность перестает расти поздно, а AUROC — где-то посередине.
G.5 Методы
Из одного обучения метода мы извлекаем результаты для наилучшей эпохи (для НС) или итерации (для XGBoost) с учетом всех рассмотренных метрик. Для этого мы всегда обучаем на максимальное число эпох/итераций и не прерываем обучение досрочно на основании одной из метрик.
Параметры по умолчанию
Для MLP мы немного упрощаем параметры по умолчанию (Gorishniy et al., 2021), как показано в Table G.3. Для XGBoost мы берем параметры по умолчанию библиотеки. Для RealMLP мы берем параметры по умолчанию из Holzmüller et al. (2024), но отключаем сглаживание меток, поскольку это приводит к тому, что функция потерь становится некорректной.
Настройка гиперпараметров
Для настройки гиперпараметров мы применяем 30 шагов случайного поиска, сопоставимого с McElfresh et al. (2024). Использование случайного поиска позволяет обучить 30 случайных моделей один раз, а затем выбрать наилучшую для каждой метрики. Для MLP мы выбираем небольшое пространство поиска, показанное в Table G.4, чтобы охватить настройки простого базового уровня. Для XGBoost мы выбираем типичное, относительно крупное пространство поиска, показанное в Table G.1. Для RealMLP мы слегка изменяем исходное пространство поиска из Holzmüller et al. (2024).
| Hyperparameter | Distribution |
| tree_method | hist |
| n_estimators | 1000 |
| early_stopping_rounds | 1000 |
| max_depth | UniformInt[1, 11] |
| learning_rate | LogUniform[1e-3, 0.7] |
| subsample | Uniform[0.5, 1] |
| colsample_bytree | Uniform[0.5, 1] |
| colsample_bylevel | Uniform[0.5, 1] |
| min_child_weight | LogUniformInt[1e-5, 100] |
| alpha | LogUniform[1e-5, 5] |
| lambda | LogUniform[1e-5, 5] |
| gamma | LogUniform[1e-5, 5] |
| Hyperparameter | Distribution |
| Num. embedding type | Choice([None, PBLD, PL, PLR]) |
| Use scaling layer | Choice([True, False], p=[0.6, 0.4]) |
| Learning rate | LogUniform([2e-2, 3e-1]) |
| Dropout prob. | Choice([0.0, 0.15, 0.3], p=[0.3, 0.5, 0.2]) |
| Activation fct. | Choice([ReLU, SELU, Mish]) |
| Hidden layer sizes | Choice([[256, 256, 256], [64, 64, 64, 64, 64], [512]], p=[0.6, 0.2, 0.2]) |
| Weight decay | Choice([0.0, 2e-3, 2e-2]) |
| Num. emb. init std. | LogUniform([0.05, 0.5]) |
| Label smoothing | Choice([0.0, 0.1]) |
| Hyperparameter | Distribution |
| Number of layers | 4 |
| Hidden size | 256 |
| Activation function | ReLU |
| Learning rate | 1e-3 |
| Dropout | 0.0 |
| Weight decay | 0.0 |
| Optimizer | AdamW |
| Preprocessing | Quantile transform + one-hot encoding |
| Batch size | 256 |
| Number of epochs | 256 |
| Learning rate schedule | constant |
| Hyperparameter | Distribution |
| Learning rate | LogUniform[1e-4, 1e-2] |
| Dropout | Choice([0.0, 0.1, 0.2, 0.3]) |
| Weight decay | Choice([0.0, 1e-5, 1e-4, 1e-3]) |
G.6 Наборы данных
Мы берем наборы данных из Ye et al. (2024) и применяем следующие изменения:
- ⟦• Образцы, содержащие отсутствующие значения в числовых признаках, удаляются, поскольку не все методы нативно поддерживают обработку этих значений.
- ⟦• Наборы данных, содержащие менее 1K образцов после предыдущих шагов, удаляются. Удаляются следующие наборы данных: analcatdata_authorship, Pima_Indians_Diabetes_Database, vehicle, mice_protein_expression и eucalyptus. Два последних набора данных содержали образцы с отсутствующими числовыми признаками.
- ⟦Наборы данных с более чем 100K образцами подвергаются по выборке до 100K образцов.