Развитие методов обнаружения финансового мошенничества с использованием глубокого обучения в динамике по годам: систематический обзор литературы
Аннотация
В данной статье представлен систематический обзор достижений в области методов глубокого обучения (DL) для обнаружения финансовых мошенничеств, что является критически важной проблемой в финансовом секторе. С использованием подхода систематического литературного обзора Kitchenham было проанализировано 57 исследований, опубликованных в период с 2019 по 2024 год. В обзоре подчеркивается эффективность различных моделей глубокого обучения, таких как сверточные нейронные сети, долгая краткосрочная память и transformers, в таких областях, как транзакции по кредитным картам, страховые выплаты и аудит финансовой отчетности. Были оценены такие показатели производительности, как точность, полнота, F1-мера и AUC-ROC. Ключевые исследуемые темы включают влияние структур конфиденциальности данных, а также достижения в области проектирования признаков и предварительной обработки данных. В исследовании подчеркиваются такие проблемы, как несбалансированные наборы данных, интерпретируемость моделей и этические соображения, наряду с возможностями автоматизации и методами сохранения конфиденциальности, такими как интеграция блокчейна и метод главных компонент. Изучая тенденции за последние пять лет, данный обзор выявляет критические пробелы и перспективные направления для развития приложений DL в обнаружении финансовых мошенничеств, предлагая практические выводы для исследователей и специалистов..
ключевые слова: обнаружение финансового мошенничества, глубокое обучение, систематический обзор литературы, обнаружение аномалий, несбалансированные данные, сохранение конфиденциальности, финансовые технологии
Финансовое мошенничество, машинное обучение, глубокое обучение, несбалансированные наборы данных, конфиденциальность и соответствие требованиям, систематический обзор1 Введение
Финансовое мошенничество охватывает обманные практики, такие как мошенничество с кредитными картами, страховое мошенничество и отмывание денег, что приводит к значительным финансовым потерям и подрыву доверия к финансовым системам. Согласно глобальным оценкам, организации теряют 5% годовой выручки из-за мошенничества, что эквивалентно триллионам долларов. Традиционные методы обнаружения, такие как ручная проверка и системы, основанные на правилах, становятся все менее эффективными против сложных схем и резкого роста числа цифровых транзакций, количество которых в Соединенных Штатах в 2023 году превысило 2,7 миллиарда [22].
Машинное обучение (ML) предлагает масштабируемые решения посредством анализа больших наборов данных для выявления сложных схем мошенничества. Передовые методы, включая сверточные нейронные сети (CNNs), сети с долговременной краткосрочной памятью (LSTM) и обработку естественного языка (NLP), обеспечивают обнаружение аномалий в режиме реального времени и адаптацию к меняющимся угрозам. Эти системы также соответствуют таким нормативным актам, как Общий регламент по защите данных Европейского союза (GDPR) и Закон штата Калифорния о конфиденциальности потребителей (CCPA), отвечая требованиям конфиденциальности и соблюдения нормативных стандартов..
Хотя ML преобразовало сферу обнаружения мошенничества, такие проблемы, как качество данных, интерпретируемость и этические аспекты, остаются актуальными. В данном исследовании рассматриваются последние достижения в методах ML для обнаружения мошенничества, основное внимание уделяется областям применения, эффективности и соблюдению нормативных требований, а также предлагаются идеи для будущих исследований..
2 Метод исследования
2.1 Дизайн исследования
В данном исследовании используется систематическая методология Китченхэма, известная своим структурированным подходом к оценке достижений в динамично развивающихся областях. Она способствует всестороннему анализу литературы, выявлению пробелов, тенденций и проблем при применении deep learning для обнаружения финансовых мошенничеств. Ключевые этапы, включая отбор исследований, извлечение данных и синтез, адаптированы для учета междисциплинарного характера и алгоритмического разнообразия данной области. Обеспечивая прозрачность, воспроизводимость и объективность результатов, данная методология создает прочную основу для определения перспектив и формирования направлений будущих исследований..
2.2 Вопросы исследования
В данном обзоре исследуются критические аспекты применения глубокого обучения для обнаружения финансовых мошенничеств посредством следующих вопросов:
- ⟦1. Какие тенденции можно наблюдать в типах финансового мошенничества, рассматриваемых с использованием deep learning в последние годы?
- ⟦2. Как достижения в области проектирования признаков, методов предварительной обработки данных с акцентом на работу с несбалансированными данными, а также автоматизация с использованием deep learning улучшили производительность и время обнаружения в системах выявления финансовых мошенничеств??
- ⟦3. Какие достижения были сделаны в моделях глубокого обучения для обнаружения финансовых мошенничеств?
- ⟦4. Какие тенденции можно наблюдать в эталонных тестах и метриках оценки, используемых для определения эффективности моделей глубокого обучения в различных финансовых секторах?
- ⟦5. Как изменения в области конфиденциальности данных, анонимизации и нормативно-правового регулирования повлияли на разработку и применение моделей deep learning для обнаружения финансовых мошенничеств??
Эти вопросы соответствуют целям исследования, предоставляя исследователям и практикам ценную информацию для стимулирования инноваций в области обнаружения финансовых мошенничеств..
2.3 Критерии поиска
Была разработана комплексная стратегия поиска для выявления соответствующих исследований, отвечающих на исследовательские вопросы. Выбранные базы данных: PubMed, SSRN, IEEE Xplore, ACM Digital Library, ScienceDirect и Scopus — благодаря их междисциплинарному и техническому охвату предметной области: Поисковый запрос использовал булевы операторы (”AND”, ”OR”) для объединения ключевых слов по трем основным доменам:
- ⟦• Ключевые слова метода: Machine Learning ИЛИ Artificial Intelligence ИЛИ Data Mining ИЛИ Deep Learning ИЛИ Anomaly ИЛИ Algorithm
- ⟦• Ключевые слова финансового сектора: банк ИЛИ финансовый ИЛИ страхование ИЛИ кредит ИЛИ налог ИЛИ инвестиции ИЛИ заем ИЛИ ипотека ИЛИ платеж ИЛИ отмывание денег ИЛИ крипто ИЛИ блокчейн ИЛИ членство ИЛИ подписка
- ⟦• Ключевые слова мошенничества: fraud OR risk OR scam
Для уточнения результатов и поддержания актуальности были применены следующие меры:
- ⟦• Исключены обзорные статьи и исследования для концентрации на оригинальных научных работах.
- ⟦• Ограничены предметные области: информатика, бизнес-менеджмент и бухгалтерский учет, экономика, эконометрика и финансы, науки о принятии решений и инженерия, чтобы сфокусироваться на исследованиях на стыке технологий и финансов.
Процесс поиска был задокументирован для обеспечения воспроизводимости и прозрачности, при этом все запросы и результаты обрабатывались с использованием системы управления библиографией для облегчения дедупликации и отбора..
2.4 Критерии отбора
Исследование обеспечило актуальность и качество путем применения строгих критериев включения и исключения.:
2.4.1 Критерии включения
- ⟦• Дата публикации: Статьи с 2019 по 2024 год для отражения последних достижений.
- ⟦• Фокус на глубоком обучении: исследования, использующие такие методы, как CNN, RNN, LSTM или transformers в обнаружении финансовых мошенничеств.
- ⟦• Рецензируемые: высококачественные статьи из авторитетных журналов или конференций.
2.4.2 Критерии исключения
- ⟦• Язык: Статьи не на английском языке.
- ⟦• Область: Исследования, не связанные с финансовыми услугами (например, банковское дело, страхование, мошенничество с кредитными картами).
- ⟦• Отсутствие глубокого обучения: исследования, в которых не применяются методы глубокого обучения.
2.5 Извлечение и анализ данных
Для обеспечения согласованности и полноты была разработана структурированная форма извлечения данных, стандартизирующая сбор и синтез информации в рамках различных исследований. Это позволило проводить четкие сравнения, минимизируя при этом субъективность..
Анализ данных проводился с использованием Python с такими библиотеками, как Pandas для обработки данных, Matplotlib для визуализации и Scikit-learn для задач машинного обучения и статистических вычислений. VOSviewer дополнительно улучшил процесс за счет визуализации сетевых графов совместного появления ключевых слов, выявляя связи и тенденции среди ключевых терминов в проанализированных статьях. Такой комплексный подход обеспечил надежный и глубокий анализ..
3 Результаты
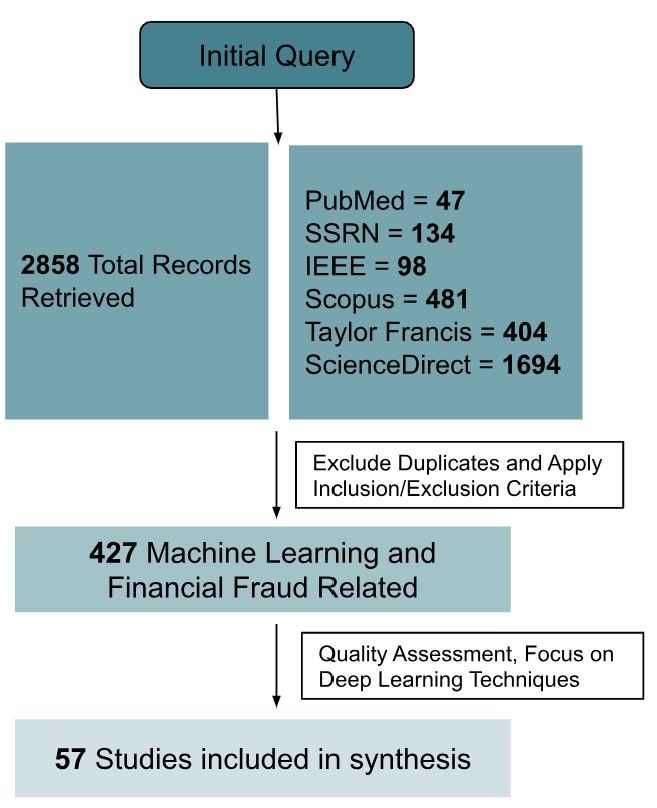
Первоначальный поисковый запрос по всем базам данных позволил выявить в общей сложности 2 858 статей. После устранения дубликатов и строгого применения критериев включения и исключения для дальнейшей оценки было отобрано 427 релевантных работ. Чтобы обеспечить качество и актуальность отобранных исследований, авторы провели детальный процесс отбора, в конечном итоге сузив выборку до 57 высококачественных статей, которые соответствовали целям и стандартам обзора. Процесс показан на Рисунке 1 ниже..
3.1 Исследовательский вопрос 1
Какие тенденции можно наблюдать в типах финансового мошенничества, рассматриваемых с использованием глубокого обучения в последние годы?
На рисунке 2 проиллюстрировано количество рецензируемых научных статей, опубликованных ежегодно в области обнаружения финансовых мошенничеств с использованием методов deep learning в период с 2019 по 2024 год. С 2019 по 2021 год наблюдается устойчивый рост числа соответствующих работ, что отражает растущий интерес к применению методов deep learning в обнаружении финансовых мошенничеств. Значительное увеличение количества статей можно наблюдать начиная с 2022 года. В частности, наблюдается резкий подъем с 2023 по 2024 год. Ежегодная тенденция может быть потенциально обусловлена достижениями в технологиях deep learning, растущей обеспокоенностью, связанной с финансовыми мошенничествами, и нормативно-правовым регулированием. Исследование ежегодной тенденции по секторам показывает, что кредитные карты и банковское дело являются двумя основными секторами, которые вносят вклад в этот значительный рост..
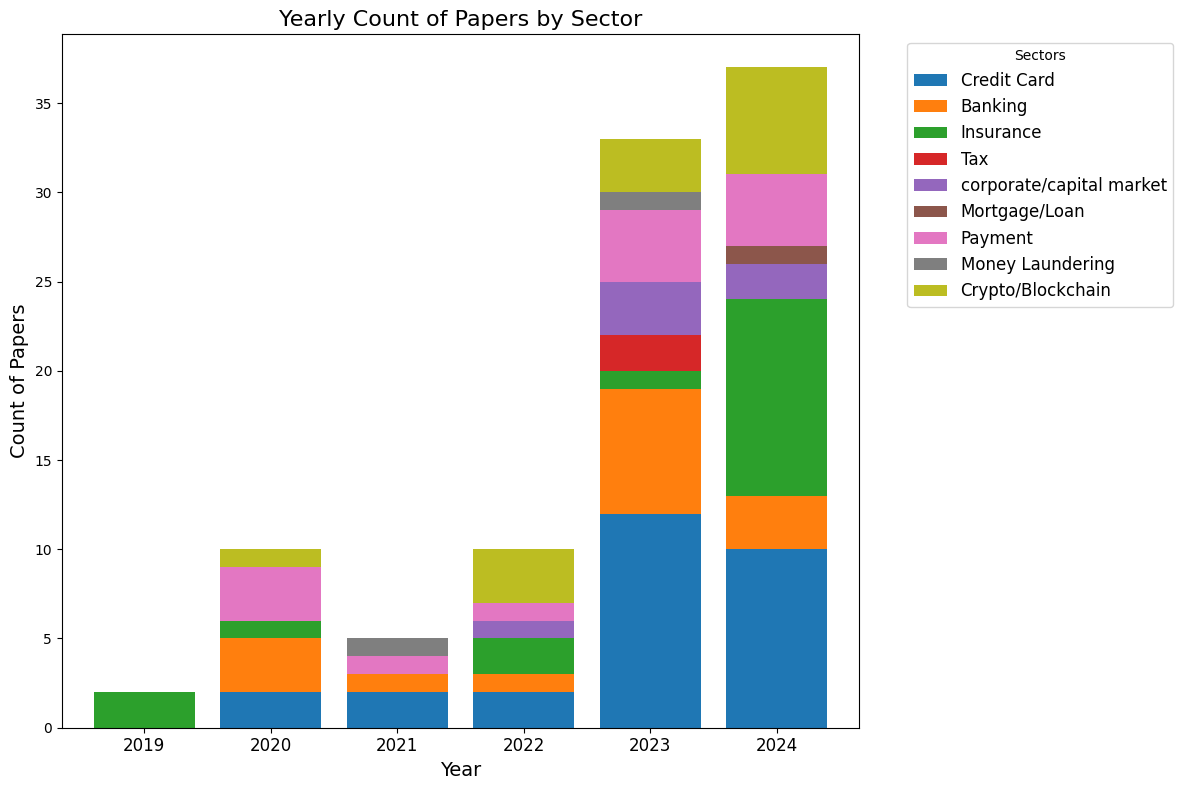
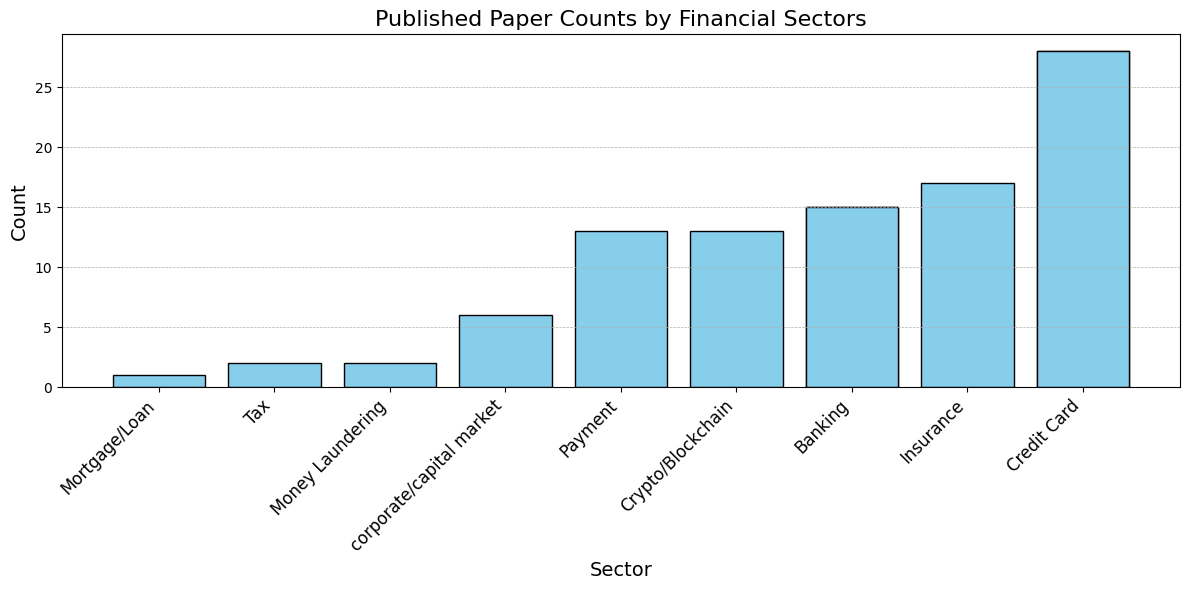
Рисунок 3 отражает распределение наиболее актуальных научных статей по различным финансовым секторам. Значительное количество публикаций относится к сектору кредитных карт [35], что отражает растущую осведомленность о выявлении мошенничества при транзакциях по кредитным картам. Публичная доступность наборов данных, связанных с кредитными картами, таких как набор данных European Credit Card Transactions на Kaggle [39], вероятно, способствовала этой тенденции, поскольку она предоставляет исследователям чистые и стандартизированные данные для разработки и оценки современных моделей deep learning..
Кроме того, банковский и страховой секторы демонстрируют высокую степень внимания в соответствующих исследованиях, подчеркивая растущую потребность в борьбе с мошенничеством при цифровых платежах [55, 21, 50], требованиях по автострахованию [40, 26], требованиях по медицинскому страхованию [53, 52].
Развивающиеся области, такие как криптовалюты/блокчейн и платежные системы, демонстрируют значительное количество исследований, что указывает на растущее внимание к предотвращению мошенничества в цифровых валютах [47]. Однако в таких секторах, как налогообложение, ипотечное кредитование/займы и отмывание денег, публикаций относительно меньше, что может быть связано с ограниченным доступом к специализированным наборам данных или сложностью выявления моделей мошенничества в этих областях [9].
Согласно отчетам Сети потребительского контроля, опубликованным Федеральной торговой комиссией, банковские переводы и платежи составили наибольшие совокупные убытки в 2023 году (1,86 миллиарда долларов), за ними с небольшим отрывом следует криптовалюта (1,41 миллиарда долларов), в то время как кредитные карты чаще всего указывались в качестве способа оплаты в отчетах о мошенничестве. Кроме того, в сфере страхового мошенничества наблюдался заметный рост на 26% по сравнению с предыдущим годом [22]. Огромные масштабы и быстрый рост финансового мошенничества в этих секторах значительно способствовали наблюдаемому всплеску исследовательского интереса и инноваций в данной области..
3.2 Исследовательский вопрос 2
Как достижения в области проектирования признаков, методов предварительной обработки данных с акцентом на работу с несбалансированными данными и автоматизации с использованием deep learning улучшили производительность и время обнаружения в системах выявления финансовых мошенничеств?
Обнаружение финансовых мошенничеств сталкивается со значительными трудностями из-за несбалансированных наборов данных, в которых мошеннические транзакции составляют лишь малую часть от общего объема [13]. Из 57 рассмотренных статей в 48 сообщалось о проблемах несбалансированности данных, что приводит к тому, что традиционные модели машинного обучения отдают предпочтение мажоритарному классу и показывают низкую эффективность при выявлении мошеннических случаев. Решение этой проблемы требует применения передовых методов предварительной обработки и автоматизации..
3.2.1 Методы предварительной обработки
Методы передискретизации, такие как метод синтетической избыточной выборки меньшинства (SMOTE), генерируют синтетические выборки путем интерполяции экземпляров миноритарного класса, эффективно повышая разнообразие классов и устойчивость модели [4, 40]. SMOTE также доказал свою эффективность при работе с несбалансированными наборами данных с пропущенными значениями [30].
Стратифицированная выборка, вероятностный метод, разделяет данные на страты на основе временных меток для учета нестационарных изменений в характеристиках мошенничества с транзакциями. Это обеспечивает более высокое представительство недавних мошеннических транзакций при сохранении случайности [16].
Передовые подходы, такие как Generative Adversarial Networks (GANs) и Variational Autoencoders (VAEs), создают реалистичные синтетические данные, сохраняя при этом исходное распределение, что дополнительно поддерживает обучение моделей в сценариях экстремального дисбаланса классов [32]. Методы импутации данных, такие как k-Nearest Neighbors (kNN), устраняют пропущенные значения для повышения общего качества данных..
Преобразования признаков, включая масштабирование и нормализацию, играют решающую роль в снижении систематических ошибок и улучшении обнаружения моделей мошенничества. Такие методы, как адаптивная синтетическая выборка (ADASYN), фокусируются на образцах, которые труднее классифицировать, в то время как кластерная избыточная выборка генерирует синтетические данные, адаптированные к контекстам конкретной предметной области, обеспечивая соответствие реальным сложностям..
3.2.2 Методы автоматизации
Автоматизация значительно ускоряет обнаружение мошенничества за счет сокращения ручного вмешательства и обеспечения существенной экономии затрат [11]. Методы субдискретизации эффективно выбирают репрезентативные наборы данных, минимизируя вычислительные затраты при сохранении корреляций признаков [51]. Алгоритм Very Fast Decision Tree (VFDT) эффективно обрабатывает потоки данных в реальном времени и достигает исключительной производительности при интеграции с технологией блокчейн, обеспечивая безопасные и масштабируемые обновления [19].
Блокчейн обеспечивает децентрализованный, безопасный обмен данными и автоматизированное обнаружение мошенничества с помощью смарт-контрактов [10], гарантируя быстрое реагирование и адаптивность моделей [28, 8]. Такие методы, как Stochastic Gradient Descent (SGD), позволяют оптимизировать модели инкрементально [45], в то время как автоматическая настройка параметров [60] и гибридные методы перевыборки [48, 31] повышают точность обнаружения..
Дистилляция знаний переносит инсайты из сложных моделей в облегченные, обеспечивая эффективное обнаружение в режиме реального времени [54]. Конвейеры обнаружения мошенничества оптимизируют процессы, объединяя предобработку и обучение моделей в целостные системы. Ансамбли стекинга повышают устойчивость за счет объединения классификаторов [59], при этом такие методы, как Random Forest Quantile Classifier, оптимизируют чувствительность и специфичность для несбалансированных данных [15]. Эти достижения обеспечивают масштабируемые, адаптируемые и точные системы обнаружения мошенничества, способные справляться со сложностями финансового мошенничества..
3.3 Исследовательский вопрос 3
Какие достижения были сделаны в моделях машинного обучения для обнаружения финансовых мошенничеств? Мы определили следующие модели глубокого обучения, модели машинного обучения, модели и гибридные модели, которые широко используются при обнаружении мошенничества.
3.3.1 Модели глубокого обучения
Сверточные нейронные сети (CNNs): Анализируя высокоразмерные признаки, такие как эмбеддинги временных рядов и тепловые карты транзакций, CNNs выявляют аномалии, связанные с необычными моделями расходов или рисками, специфичными для продавцов. Они не требуют сложной предварительной обработки данных во время обучения, поскольку внутренне фиксируют ключевые признаки и выполняют снижение размерности признаков [3]. Установлено, что глубокие признаки, извлеченные с помощью CNNs, улучшают обнаружение мошенничества при объединении CNN с традиционными моделями (SVM, KNN, NB, DT) [40]⟧.
Рекуррентные нейронные сети (RNNs): RNNs обрабатывают последовательные данные, сохраняя контекст предыдущих входных сигналов, что делает их полезными для анализа закономерностей в истории транзакций. Однако их возможности ограничены проблемами затухающих и взрывающихся градиентов. Gated Recurrent Unit (GRU) и Long Short-Term Memory (LSTM) являются специализированными RNN, и как GRU, так и LSTM смягчают проблемы затухающих и взрывающихся градиентов в RNNs [7].
Многослойные перцептроны (MLPs): MLPs, состоящие из взаимосвязанных слоев, моделируют зависимости в структурированных данных. MLP является конкурентоспособным выбором для обнаружения мошенничества, особенно при профилировании на основе сумм и в сценариях, требующих обработки нелинейных зависимостей в данных [14].
Transformers: В отличие от CNN и RNN, которые обрабатывают все точки во входной последовательности пошагово, Transformers обрабатывают все точки одновременно. Механизм self-attention и feed-forward networks в Transformers позволяют моделировать сложные взаимосвязи и извлекать значимые признаки из последовательных данных, что очень полезно для распознавания паттернов в транзакционных данных, поведении пользователей или сетевых взаимодействиях при обнаружении мошенничества..
Обработка естественного языка (NLP): NLP расширяет возможности обнаружения мошенничества за счет анализа неструктурированных текстовых данных, таких как финансовые отчеты [59], соблюдение налогового законодательства и финансовое регулирование [12], а также описания претензий [23]. Ключевые методы включают анализ тональности, метрики читабельности и извлечение признаков (например, Bag-of-Words, TF-IDF и word embeddings). Эти признаки интегрируются с традиционными индикаторами мошенничества в моделях машинного обучения, повышая точность и полноту [59].
Вариационные автокодировщики (VAEs) и генеративно-состязательные сети (GANs): GANs и VAEs — это два популярных типа генеративных моделей, используемых в deep learning [27]. GANs превосходно справляются с генерацией высококачественных, реалистичных выборок, но их сложнее обучать из-за состязательной динамики, и им не хватает интерпретируемого латентного пространства. VAEs лучше подходят для обучения представлений и вероятностного моделирования, обладая хорошо структурированным латентным пространством, но генерируют выборки более низкого качества по сравнению с GANs. Объединение сильных сторон VAEs и GANs может устранить ограничения каждой из них при работе с несбалансированными данными для обнаружения мошенничества [20]⟧.
Графовые нейронные сети (GNNs): GNNs крайне эффективны в обнаружении мошенничества, поскольку они способны моделировать сложные взаимодействия и взаимосвязи между объектами (например, транзакциями, отзывами) в виде графов [25]. Обнаружение мошенничества часто включает анализ этих взаимосвязей для выявления закономерностей и аномалий, указывающих на мошенническую активность [49]. GCNs — это специфический тип GNN, который применяет концепцию свертки к графам. Исследование показывает, что GCNs превосходят традиционные модели, такие как логистическая регрессия (LR), случайный лес (RF) и градиентный бустинг (GBMs), в обнаружении мошеннических транзакций [57].
Глубинные сети доверия (DBNs): DBNs являются одним из фундаментальных методов глубокого обучения для обнаружения мошенничества, ценящимся за свои возможности извлечения признаков и классификации. Однако их использование ограничено по сравнению с более продвинутыми методами, такими как CNNs, которые демонстрируют более высокую точность и масштабируемость при выполнении задач обнаружения мошенничества [3]⟧.
3.3.2 Модели машинного обучения
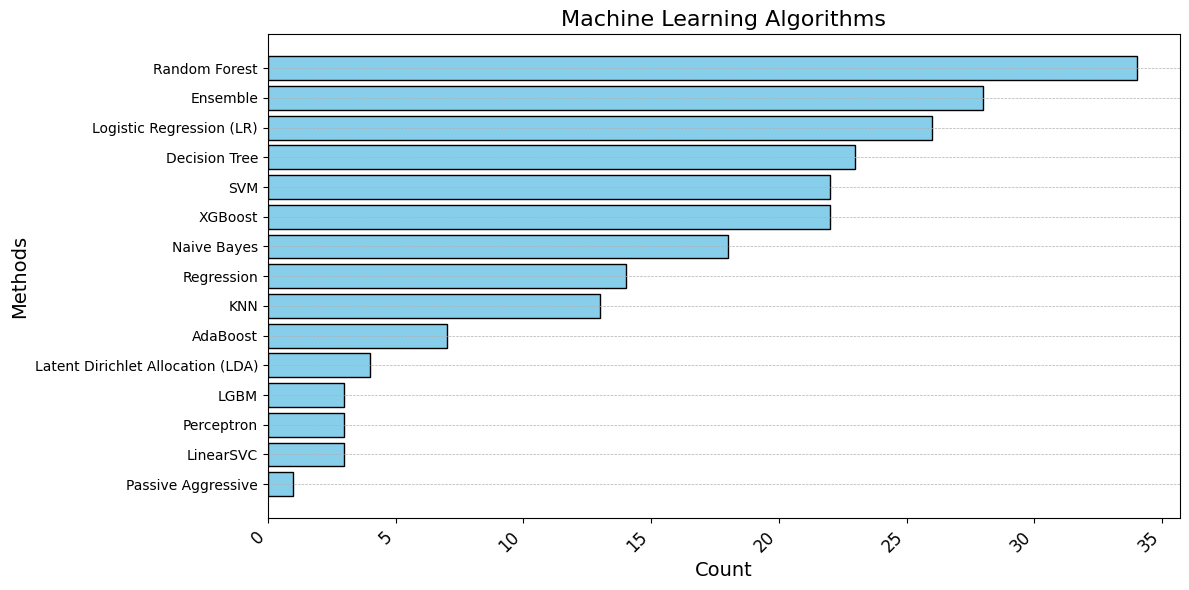
Модели машинного обучения могут выступать в качестве базовых или быть частью гибридной модели: традиционные алгоритмы машинного обучения служат важными эталонами для обнаружения финансовых мошенничеств [17]. Логистическая регрессия (LR) обеспечивает простоту и интерпретируемость, что идеально подходит для бинарной классификации. LinearSVC эффективно обрабатывает линейные данные, в то время как KNN обнаруживает аномалии на основе близости, хотя ему не хватает масштабируемости для больших наборов данных..
Ансамблевые методы, такие как случайные леса и градиентный бустинг (XGBoost, LightGBM), повышают точность за счет объединения нескольких моделей. Случайные леса устойчивы к переобучению, в то время как градиентный бустинг эффективно работает с несбалансированными наборами данных. Адаптивный бустинг (AdaBoost) итеративно усиливает слабые классификаторы для решения задач, специфичных для обнаружения мошенничества..
Метод опорных векторов (SVMs) превосходно работает в пространствах высокой размерности, эффективно выявляя выбросы. Деревья решений, несмотря на склонность к переобучению, остаются интерпретируемыми и фундаментальными для ансамблевых моделей.
Хотя эти алгоритмы менее адаптивны, чем deep learning, они служат ценными эталонами, предоставляя информацию о производительности структурированных данных и направляя развитие систем обнаружения мошенничества..
3.3.3 Гибридные модели
Гибридные модели объединяют взаимодополняющие сильные стороны различных алгоритмов для решения сложных задач, таких как обнаружение финансового мошенничества. Adaptive Sampling and Aggregation-Based Graph Neural Network (ASA-GNN) улучшает традиционные фреймворки GNN за счет интеграции адаптивной выборки и агрегации на основе энтропии, что устраняет основные ограничения стандартных GNN при обнаружении мошенничества. Сосредоточившись на релевантных соседях и борьбе с чрезмерным сглаживанием, ASA-GNN предоставляет надежное и масштабируемое решение для идентификации сложных паттернов мошенничества в данных с графовой структурой [56]⟧.
Обучение с подкреплением с использованием глубокой Q-сети (RDQN) объединяет глубокое обучение (DNN) и обучение с подкреплением (Q-обучение). Благодаря использованию теории грубых множеств для сокращения признаков и применению обучения с подкреплением, модель RDQN обеспечивает более быструю обработку и более высокую точность, что делает ее масштабируемым и эффективным решением для реальных задач обнаружения мошенничества. RDQN превосходит традиционные модели, такие как SVM, ANN и DT, а также гибридные модели, такие как IFDTC4.5, SAE-GAN и CNN-SVM-KNN [55].
Модель Transformer-LOF-Random Forest уникальным образом сочетает в себе передовое извлечение признаков с помощью Transformer, локальное обнаружение аномалий с помощью LOF (local outlier factor) и ансамблевое обучение Random Forest для эффективного выявления сложных и редких мошеннических паттернов. Она превосходит современные модели, такие как XGBoost, LightGBM и LSTM, за счет решения проблемы дисбаланса данных, сокращения количества ложноположительных и ложноотрицательных результатов, а также адаптации к новым методам мошенничества [38].
Встроенный в ResNeXt блок GRU (RXT-J) объединяет возможности извлечения признаков ResNeXt и преимущества последовательного обучения GRU. Модель RXT-J значительно превосходит существующие модели, включая BERT (Transformer), ANN и логистическую регрессию [7].
CatBoost-Deep Neural Networks объединяет CatBoost и Deep Neural Networks (DNN) для использования их соответствующих сильных сторон. CatBoost превосходно справляется с обработкой категориальных признаков, несбалансированными наборами данных и сложными взаимосвязями в структурированных данных [36], в то время как DNN фокусируется на изучении закономерностей в необработанных признаках и адаптации к условиям разреженных данных. Гибридная модель значительно превосходит другие, такие как случайные леса и ансамблевые методы, например LSTM-based AdaBoost [44].
Автоэнкодер-LSTM представляет собой комбинацию двух моделей глубокого обучения: автоэнкодера и LSTM. Автоэнкодер выполняет снижение размерности, сохраняя при этом ключевые признаки и устраняя шум. Сеть LSTM моделирует временные зависимости и классифицирует транзакции как мошеннические или легитимные. Комбинированная модель демонстрирует превосходную производительность по сравнению с традиционными методами машинного обучения и автономными моделями LSTM [61].
3.3.4 Тенденции в использовании моделей
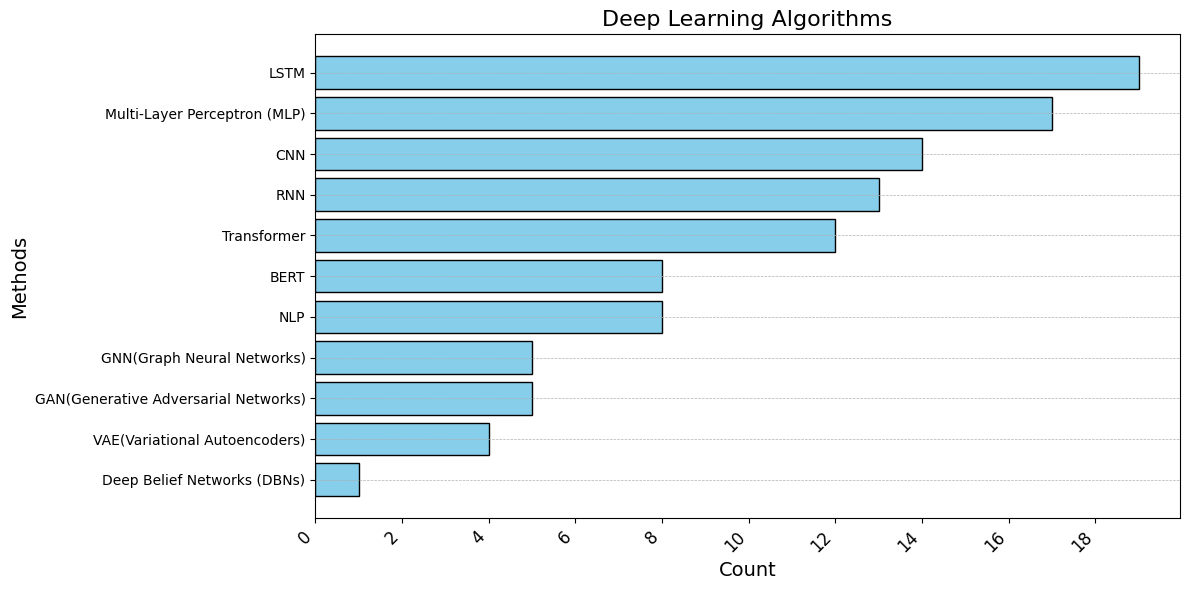
Мы наблюдаем общую закономерность частоты применения моделей глубокого обучения на рисунке 4. Наиболее широко используются LSTM, MLP, CNN и RNN. Методы NLP, такие как модель Bidirectional Encoder Representations from Transformer (BERT), умеренно применяются для текстовых наборов данных. Кроме того, для обнаружения мошенничества были применены более специализированные методы, включая GNN, GAN, VAE. Поскольку наборы данных для обнаружения мошенничества сильно несбалансированы, а GAN применяются умеренно, их потенциал в моделировании взаимосвязей и создании синтетических наборов данных для обнаружения мошенничества может стимулировать дальнейшие исследования в этих областях..
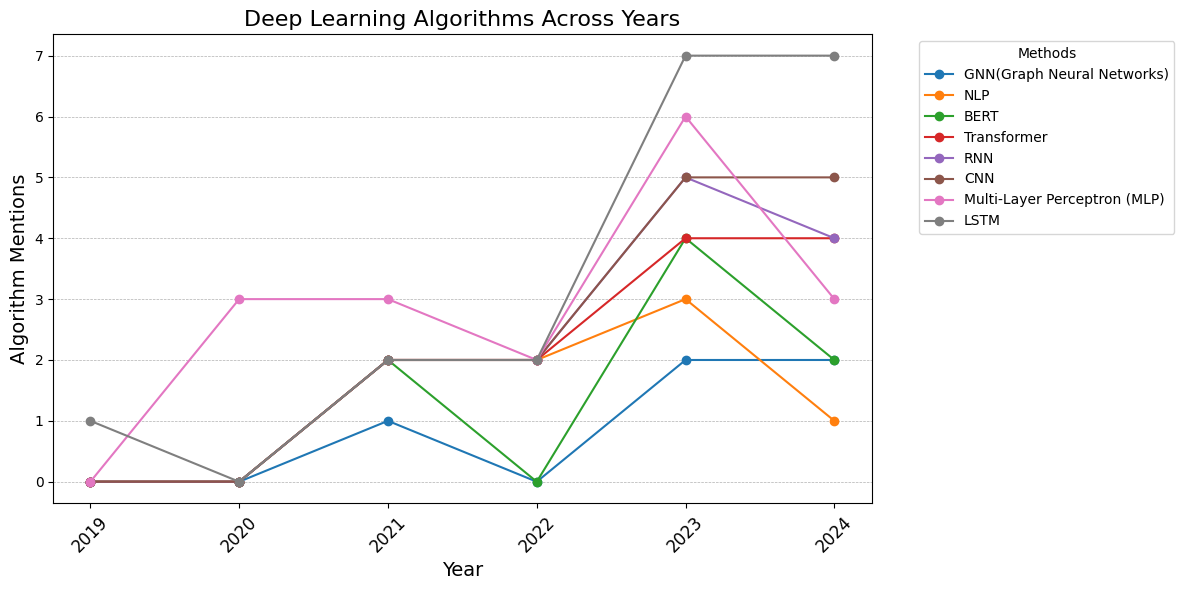
Базовые методы. В данном исследовании анализируется ежегодная динамика алгоритмов глубокого обучения в сфере обнаружения мошенничества. Как показано на рисунке 5, в целом вариативность моделей глубокого обучения с годами увеличилась. LSTM демонстрирует наиболее значительный и устойчивый рост на протяжении многих лет, достигнув резкого скачка в период с 2022 по 2024 год. Эта тенденция может быть обусловлена последовательной природой наборов данных о мошенничестве. Модели MLP и CNN сохраняют стабильный тренд. Эти модели универсальны и эффективны при изучении сложных взаимосвязей между признаками в финансовых наборах данных..
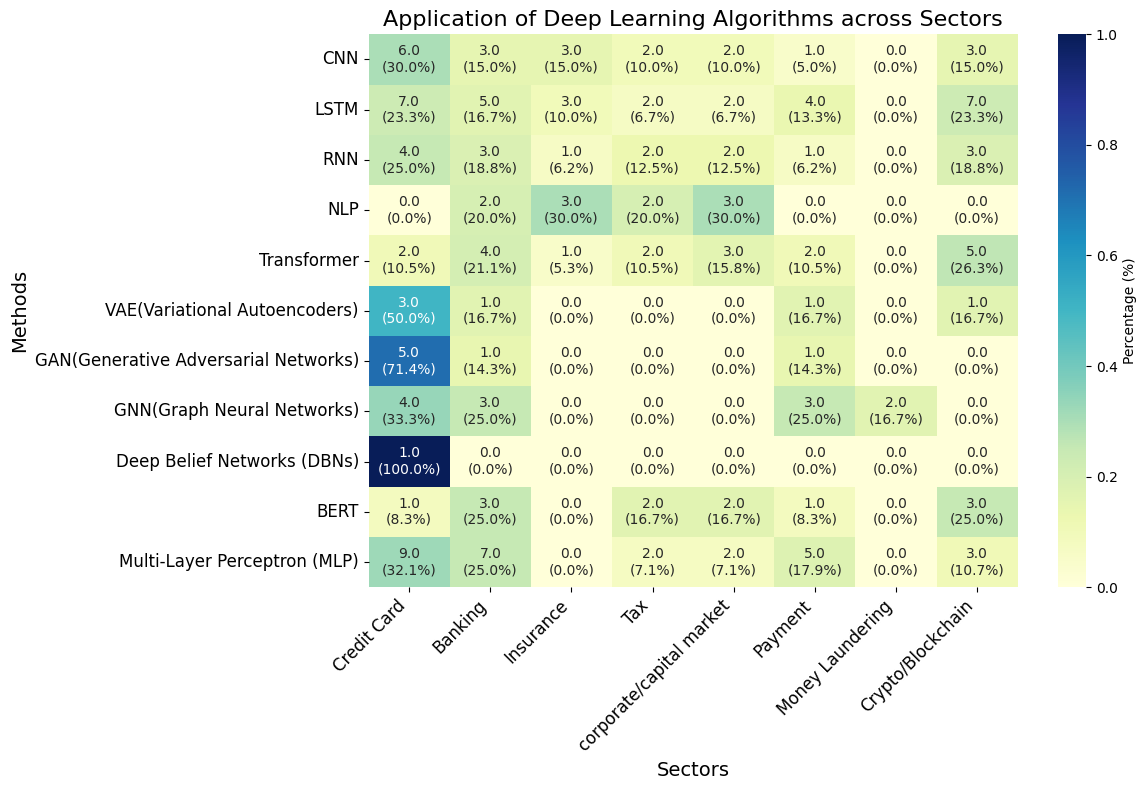
Методы глубокого обучения в различных секторах. На рисунке 8 показано распределение и частота использования различных алгоритмов глубокого обучения, применяемых для обнаружения финансовых мошенничеств в различных финансовых секторах. Как в секторе кредитных карт, так и в банковском секторе широко применяются разнообразные методы глубокого обучения. В частности, чаще всего использовались MLP, LSTM и CNN. LSTM и GNN демонстрируют значительное применение, вероятно, из-за последовательной и графовой структуры данных блокчейна, что требует методов, способных моделировать взаимосвязи между транзакциями. В таких секторах, как налогообложение и отмывание денег, применение методов глубокого обучения минимально..
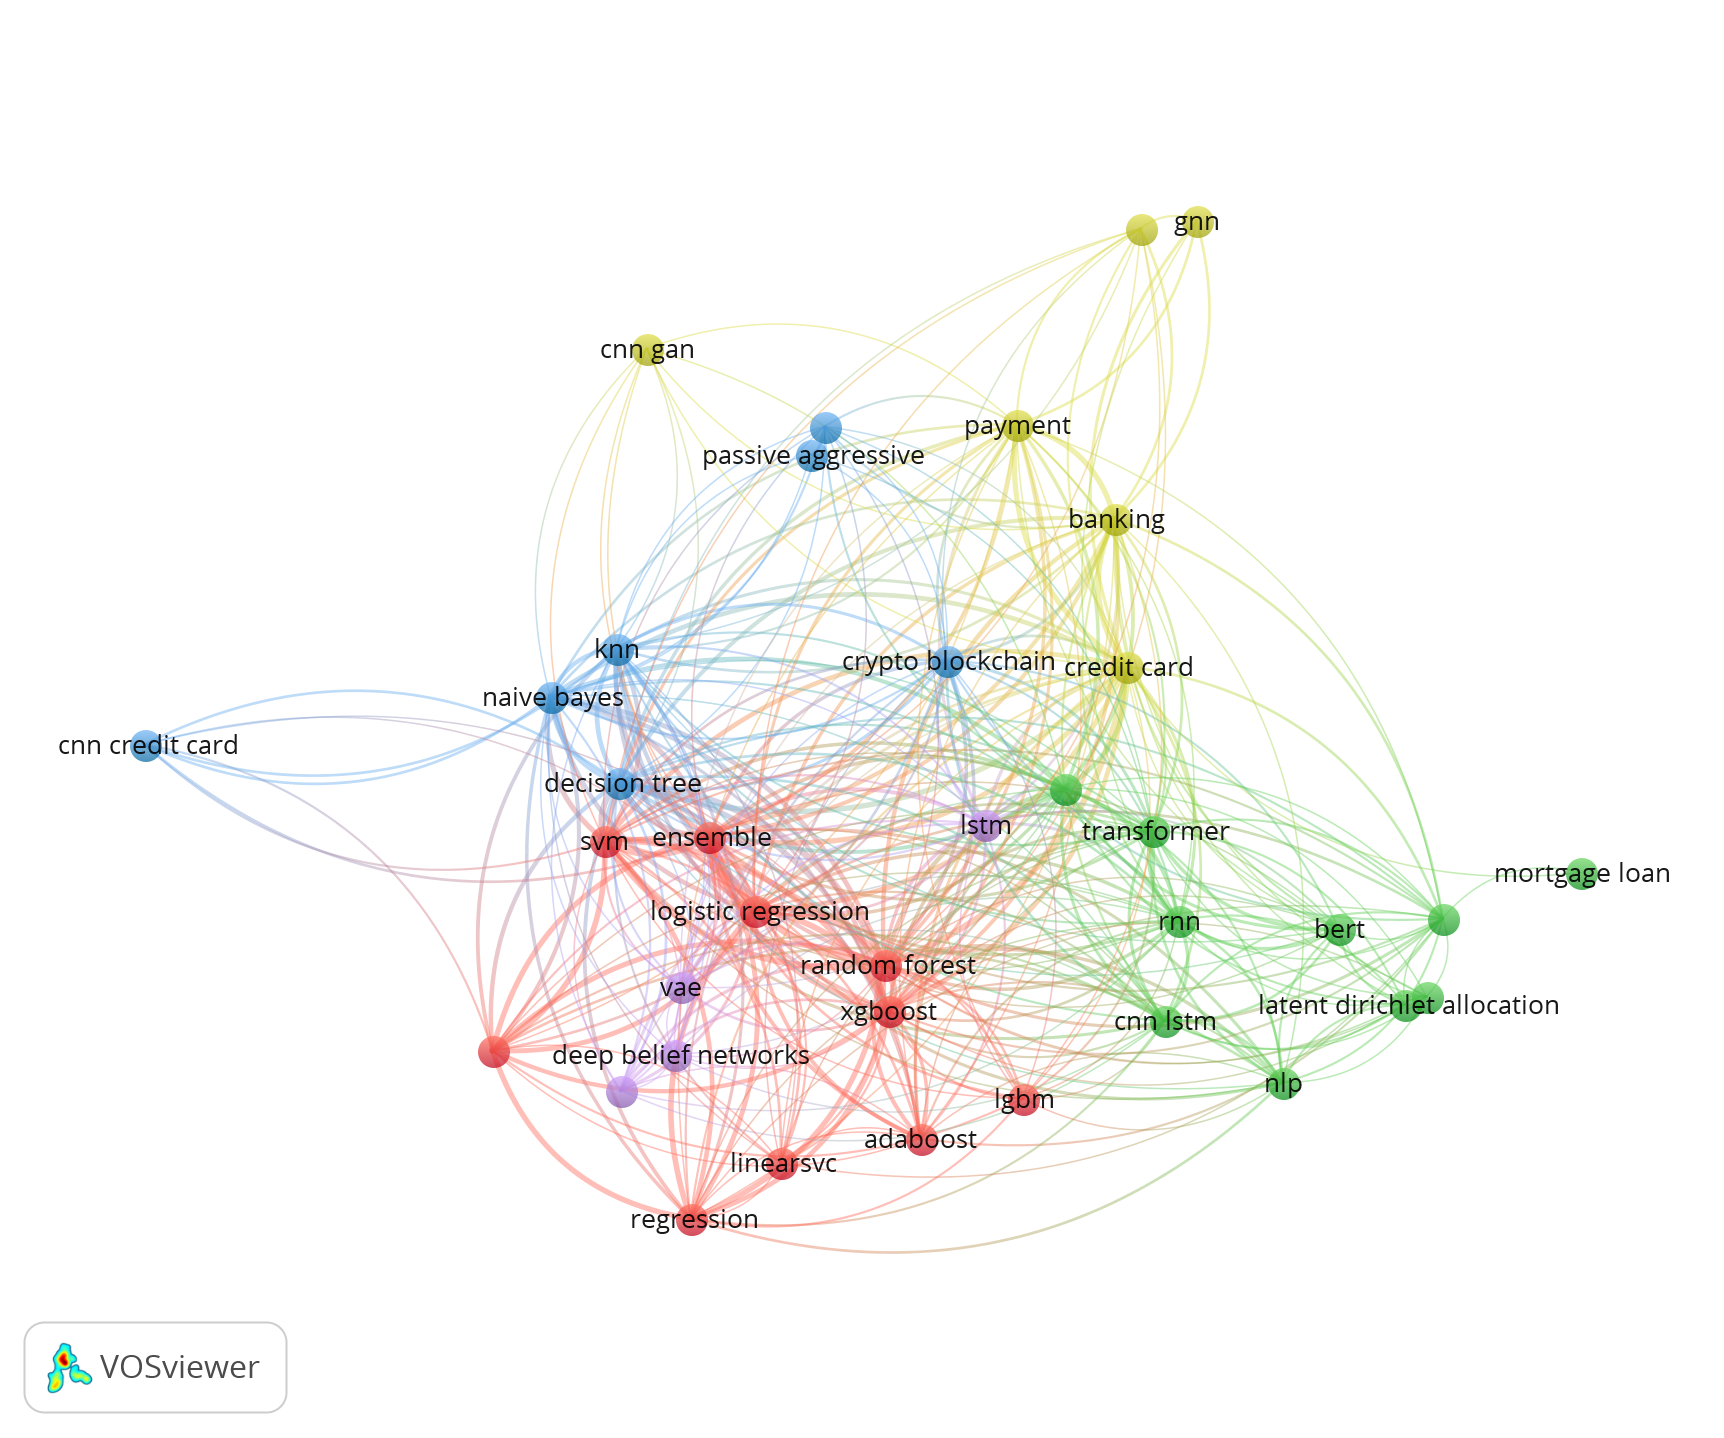
Для изучения взаимосвязи между различными методами и областями в данном исследовании проводится семантический сетевой анализ на Рисунке 9:
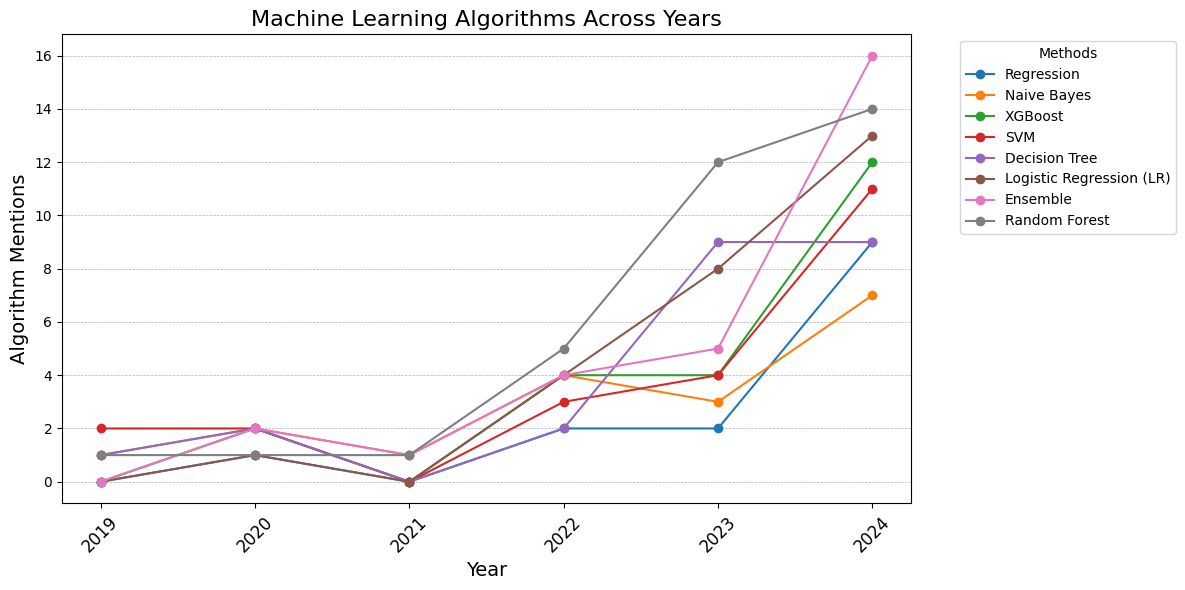
Кластер 1 (выделен красным цветом) содержит 10 ключевых слов, относящихся к моделям машинного обучения, включая Random Forest, Logistic Regression, SVM, Ensemble, Decision Tree и т.д. Random forest (с 32 связями и силой связи 234) и logistic regression (с 31 связью и силой связи 191) являются двумя наиболее релевантными ключевыми словами. Эти две традиционные модели машинного обучения наиболее часто связаны с ключевыми словами, представляющими deep learning, что указывает на то, что данные модели часто используются в качестве базовых или гибридных моделей..
Кластер 2 (выделен зеленым цветом) содержит 10 ключевых слов, относящихся к моделям глубокого обучения, включая Transformer, BERT, RNN и другие. MLP (с 27 связями и силой связи 103) является наиболее релевантным ключевым словом. Оно хорошо связано с CNN, LSTM, SVM и Random Forest.
Кластер 3 (выделен синим цветом) содержит 7 ключевых слов, относящихся к легковесным моделям, включая Naive Bayes, KNN, деревья решений. Этот небольшой кластер представляет легковесные модели, используемые для простых наборов данных.
Кластер 4 (выделен желтым цветом) содержит 6 ключевых слов, относящихся как к финансовым секторам, так и к моделям deep learning. Кредитная карта является наиболее значимым узлом с 30 связями и силой связей 160. Он также включает алгоритмы deep learning, такие как CNN и GAN, что указывает на популярную тенденцию использования CNN и GNN в обнаружении мошенничества, особенно в сфере кредитных карт и банковских услуг..
Кластер 5 (окрашен в фиолетовый цвет) содержит 4 ключевых слова, относящихся к более специализированным моделям глубокого обучения, таким как GAN, VAE. Это демонстрирует формирующуюся тенденцию применения GAN для генерации синтетических данных с целью решения проблемы несбалансированных наборов данных..
Подводя итог, классические методы ML (например, Random Forest, SVM) остаются фундаментальными для обнаружения мошенничества в структурированных данных. Такие методы, как LSTM, Transformers и BERT, демонстрируют растущее применение для анализа последовательных и текстовых данных о мошенничестве. GNN и GAN набирают популярность в специализированных областях мошенничества, таких как блокчейн и генерация синтетических данных. Различные алгоритмы адаптированы к потребностям конкретных финансовых секторов (например, CNN для мошенничества с кредитными картами, GNN для блокчейна).
3.4 Исследовательский вопрос 4
Какие тенденции можно наблюдать в эталонных тестах и метриках оценки, используемых для определения эффективности моделей deep learning в различных финансовых секторах?
Традиционные метрики сталкиваются с ограничениями при работе с несбалансированными наборами данных, где случаи мошенничества редки. Такие метрики, как Accuracy, часто вводят в заблуждение, отдавая предпочтение мажоритарному классу и упуская из виду мошенничество. Precision минимизирует ложноположительные результаты, но может снизить Recall, который выявляет реальные случаи мошенничества. Высокий Recall, хотя и является критически важным, может увеличить False Positive Rate (FPR) и операционные расходы. F1 Score балансирует между Precision и Recall, но не учитывает экономические последствия..
Метрики, такие как уровень ложноотрицательных результатов (FNR) и уровень ложноположительных результатов (FPR), подчеркивают специфические проблемы, например, убытки от необнаруженного мошенничества или неэффективность из-за ложных срабатываний. AUC-PR (кривая точности-полноты) более актуальна, чем AUC-ROC, для несбалансированных наборов данных, так как она фокусируется на эффективности обнаружения мошенничества. Метрики и их формулы представлены в таблице 1 ниже..
Экономические показатели, такие как стоимость ложноположительных и стоимость ложноотрицательных результатов, оценивают операционное и финансовое воздействие, помогая организациям оптимизировать стратегии обнаружения. Например, точность является приоритетной при выявлении мошенничества с криптовалютой для минимизации затрат на соблюдение нормативных требований, в то время как полнота имеет решающее значение при выявлении налогового мошенничества для предотвращения потери доходов..
В заключение, эффективное обнаружение мошенничества все больше опирается на специализированные метрики, которые учитывают несбалансированные наборы данных, операционные расходы и отраслевые потребности, дополняя фундаментальные метрики, такие как Accuracy и F1 Score, предметно-ориентированными эталонными показателями..
| Metrics Name | Formula | Description |
|---|---|---|
| Accuracy | Measures the proportion of correctly classified instances (both fraud and non-fraud) out of the total instances. High accuracy is not always reliable in fraud detection due to class imbalance. | |
| Precision | Measures the proportion of correctly predicted fraud cases out of all predicted fraud cases. High precision indicates fewer false positives (legitimate transactions flagged as fraud). | |
| Recall (Sensitivity) | Measures the proportion of actual fraud cases correctly identified by the model. High recall indicates fewer false negatives (fraudulent transactions missed by the model). | |
| F1 Score | The harmonic mean of precision and recall. It balances precision and recall, making it useful when both false positives and false negatives are costly. | |
| AUC-ROC | Area under the ROC curve (TPR vs FPR) | TPR (True Positive Rate) is plotted against FPR (False Positive Rate) at various thresholds. AUC-ROC measures the model’s ability to distinguish between fraud and non-fraud cases. Higher AUC-ROC indicates better performance. |
| AUC-PR | Area under the Precision-Recall curve (Precision vs Recall) | Precision is plotted against Recall at various thresholds. AUC-PR is especially useful for imbalanced datasets (common in fraud detection) as it focuses on the performance of the positive class (fraud). Higher AUC-PR indicates better performance. |
| False Positive Rate (FPR) | Measures the proportion of legitimate transactions incorrectly flagged as fraud. Lower FPR is desirable to reduce customer inconvenience. | |
| False Negative Rate (FNR) | Measures the proportion of fraudulent transactions missed by the model. Lower FNR is critical in fraud detection to minimize financial losses. | |
| Cost of False Positives | Represents the financial or operational cost associated with incorrectly flagging legitimate transactions as fraud (e.g., customer dissatisfaction, manual review costs). | |
| Cost of False Negatives | Represents the financial loss or risk associated with failing to detect fraudulent transactions (e.g., chargebacks, lost revenue). This is typically higher than the cost of false positives in fraud detection. |
3.5 Исследовательский вопрос 5
Как изменения в конфиденциальности данных, анонимизации и нормативно-правовых актах повлияли на разработку и применение моделей deep learning для обнаружения финансовых мошенничеств?
Из 57 рассмотренных статей 36 имеют общедоступные наборы данных, а 24 — непубличные наборы данных. 19 статей затрагивают проблему, касающуюся конфиденциальности..
Метод главных компонент (PCA) повышает конфиденциальность данных при обнаружении мошенничества за счет сокращения данных высокой размерности до представлений с более низкой размерностью, сохраняя критически важную информацию при минимизации потерь данных [3]. Это преобразование обеспечивает анонимизацию транзакционных данных, удаляя идентифицируемую личную информацию и обеспечивая безопасный обмен данными между учреждениями без раскрытия конфиденциальных деталей. Кроме того, PCA способствует соблюдению нормативных требований по защите данных за счет снижения рисков повторной идентификации и сохранения только тех существенных признаков, которые необходимы для обнаружения мошенничества, что уменьшает ненужное раскрытие конфиденциальных деталей транзакций. Однако из-за изменения исходных признаков PCA может снизить интерпретируемость модели, потенциально ограничивая понимание взаимосвязей между переменными [6]. Несмотря на это, его способность балансировать между конфиденциальностью и производительностью делает его ценным инструментом для безопасной обработки данных..
Блокчейн повышает конфиденциальность данных при обнаружении финансовых мошенничеств благодаря своей децентрализованной и неизменяемой природе, устраняя необходимость в централизованных посредниках. [18, 41] Конфиденциальные данные, такие как личные идентификаторы и финансовые транзакции, безопасно распределяются по зашифрованному реестру, предотвращая несанкционированный доступ. Псевдонимность обеспечивается криптографическими адресами, что дополнительно защищает личную информацию [29].
Как Общий регламент по защите данных (GDPR), так и Закон штата Калифорния о конфиденциальности потребителей (CCPA) оказывают значительное влияние на применение машинного обучения в сфере обнаружения финансовых мошенничеств, устанавливая строгие требования к конфиденциальности, безопасности и прозрачности данных. GDPR обязывает организации получать согласие, анонимизировать конфиденциальные данные и придерживаться этических стандартов, делая упор на прозрачность, подотчетность и минимизацию данных [42]. Аналогичным образом, CCPA предоставляет физическим лицам право на доступ, удаление или отказ от использования данных, требуя от моделей ML анонимизировать или псевдонимизировать данные для защиты личности..
Важным требованием GDPR является «право на объяснение», которое гарантирует, что решения ИИ, такие как результаты обнаружения мошенничества, являются интерпретируемыми [34]. Это создает проблему для сложных моделей, таких как глубокие нейронные сети, что стимулирует разработку методов объяснимости для достижения баланса между соблюдением нормативных требований и производительностью. CCPA аналогичным образом делает акцент на контроле со стороны потребителей и минимизации данных, создавая проблемы для ML систем, полагающихся на обширные наборы данных. Для соблюдения обоих регламентов стали необходимы такие методы, как анонимизация данных, federated learning и безопасные многосторонние вычисления. Несоблюдение требований влечет за собой риск штрафов в рамках обеих систем, что побуждает организации инвестировать в безопасные, прозрачные и сохраняющие конфиденциальность ML системы, которые в конечном итоге повышают доверие, масштабируемость и эффективность обнаружения мошенничества..
Совет по кооперативному медицинскому страхованию (CCHI) регулирует частное медицинское страхование в Саудовской Аравии, обеспечивая предотвращение мошенничества, целостность данных и доступность медицинского обслуживания. В рамках программы «Видение Саудовской Аравии 2030» CCHI требует ведения подробного учета случаев мошенничества, способствуя прозрачности и подотчетности среди страховщиков и поставщиков услуг [43].
Инициативы CCHI, такие как Национальная платформа для услуг обмена данными в сфере здравоохранения и страхования (NPHIES), повышают безопасность данных и функциональную совместимость. Используя передовые технологии, включая машинное обучение, платформа улучшает обнаружение мошенничества и эффективность обработки, что соответствует целям по снижению затрат на мошенничество и соблюдению стандартов защиты данных и этических норм в медицинском страховании..
4 Обсуждение
Обнаружение мошенничества с использованием передовых методов имеет решающее значение в финансовом секторе из-за все более изощренной мошеннической деятельности. В данном исследовании рассматривается использование deep learning в финансовых областях, при этом выделяются общие методы и специфические для сектора проблемы. В следующих разделах обсуждаются ключевые приложения и достижения в области обнаружения мошенничества с кредитными картами, страхового мошенничества, интеграции blockchain и банковских систем..
4.1 Кредитная карта
Обнаружение мошенничества с кредитными картами стало широко исследуемой областью с применением deep learning. Благодаря доступу к общедоступным крупномасштабным наборам данных, применение передовых моделей deep learning и machine learning достигло значительных успехов. Такие методы, как глубокие нейронные сети и аугментация данных, могут сыграть ключевую роль в преодолении дисбаланса данных и повышении производительности моделей. Обнаружение мошенничества с кредитными картами часто требует принятия решений в режиме реального времени или почти в реальном времени. Модели deep learning могут быстро и точно обрабатывать большие объемы транзакционных данных, что делает их идеальными для этих приложений [46, 1].
4.2 Страхование
Страховое мошенничество создает серьезные проблемы из-за обширного обмена данными между пациентами, поставщиками услуг и страховщиками, что повышает уязвимость к таким угрозам, как утечки данных и неточности. Правила конфиденциальности, такие как HIPAA и GDPR, дополнительно усложняют обмен данными, налагая строгие меры защиты на личную медицинскую информацию [18].
Методы глубокого обучения эффективно анализируют сложные наборы данных для обнаружения аномалий и прогнозирования мошенничества. Federated learning обеспечивает совместное обучение моделей между страховщиками и провайдерами без раскрытия конфиденциальных данных, обеспечивая соблюдение правил конфиденциальности и повышая эффективность обнаружения [29]. В сочетании с интеллектуальной автоматизацией эти инновации решают ключевые проблемы в предотвращении мошенничества и операционной сложности..
4.3 Блокчейн
Блокчейн обеспечивает безопасный децентрализованный реестр, который гарантирует целостность и конфиденциальность данных, а также прозрачность, повышающую эффективность обнаружения мошенничества и возможность проведения аудита, особенно в сфере медицинского страхования [28]. Интеграция блокчейна с машинным обучением улучшает обнаружение мошенничества за счет использования неизменяемых наборов данных для поиска аномалий и прогнозирования [37]⟧.
Разрешенные блокчейны обеспечивают безопасный обмен данными посредством распределенных реестров, повышая точность и прозрачность [19, 5]. В страховом секторе сочетание блокчейна с моделями ML, такими как XGBoost и VFDT, повысило точность обнаружения и снизило уровень ошибок на 7% по сравнению с традиционными методами [19, 24]. Кроме того, смарт-контракты оптимизируют обработку претензий, сокращая количество ошибок и время обработки [5, 33]. Несмотря на такие проблемы, как масштабируемость и соответствие нормативным требованиям, эти технологии весьма эффективны при выявлении страхового мошенничества и закладывают основу для безопасных и эффективных систем.
4.4 Банковское дело и платежи
Банковский сектор сталкивается со все более изощренным мошенничеством из-за роста онлайн-банкинга и разнообразных платежных каналов, особенно в сфере отмывания денег, что оказывает влияние на экономику на многих уровнях. Традиционные системы, основанные на правилах, часто не способны адаптироваться к меняющимся моделям мошенничества, что приводит к высокому уровню ложноположительных результатов. Модели глубокого обучения, такие как LLM, анализируют сложные данные для выявления аномалий в транзакциях и моделях расходов, эффективно помечая потенциальное мошенничество [58, 46]. Ключевые проблемы включают обнаружение в режиме реального времени, управление крупномасштабными транснациональными сетями и интеграцию разнообразных источников данных, таких как профили Know Your Customer (KYC). Решение этих проблем требует инновационных, масштабируемых подходов для эффективной борьбы с финансовым мошенничеством [57]⟧.
5 Ограничения и будущие направления
В данном исследовании систематически рассматриваются достижения в области глубокого обучения для обнаружения финансовых мошенничеств, однако подход имеет ряд ограничений. Во-первых, выборка исследований за период с 2019 по 2024 год исключает более ранние фундаментальные работы, которые могли бы обеспечить дополнительный контекст. Во-вторых, хотя фокус на общедоступной литературе обеспечивает прозрачность, это оставляет за рамками проприетарные модели и отраслевые практики, которые могли бы предложить инновационные идеи. В-третьих, несоответствия в методах обработки данных и системах оценки в проанализированных исследованиях затрудняют сопоставление полученных результатов. Кроме того, опора на публикации на английском языке ограничивает понимание ситуации в регионах, где преобладают другие языки, что потенциально приводит к упущению локализованных достижений или способов применения..
Будущие исследования должны уделять первостепенное внимание стандартизации на протяжении всего жизненного цикла Data Science для повышения воспроизводимости и обобщаемости в области обнаружения финансовых мошенничеств. Ключевые области внимания включают:
- ⟦• Подготовка данных: Разработка унифицированных конвейеров предварительной обработки, которые решают проблему несбалансированных наборов данных с помощью передовых методов, таких как GANs, SMOTE и масштабирование признаков, для повышения надежности моделей в различных исследованиях.
- ⟦• Разработка моделей: поощрять сотрудничество между научными кругами и промышленностью для преодоления разрыва между исследованиями и практической реализацией, внедряя передовые методы, такие как объяснимый искусственный интеллект и автоматическая настройка параметров для масштабируемого развертывания.
- ⟦• Оценка моделей: создание комплексных эталонных тестов, адаптированных к конкретным финансовым областям, с интеграцией экономических и операционных показателей для более точного отражения реальных затрат и последствий.
- ⟦• Операционное развертывание: фокус на интеграции моделей глубокого обучения с существующими системами, с упором на надежные API, обнаружение мошенничества в режиме реального времени и соблюдение нормативных требований по защите данных.
- ⟦• Мониторинг и техническое обслуживание: продвижение адаптивных структур, которые позволяют выполнять непрерывную настройку и дообучение моделей, гарантируя, что системы развиваются параллельно с появлением новых методов мошенничества и изменениями в нормативно-правовой базе..
Решая эти задачи, будущие исследования смогут предложить более практичные, масштабируемые и соответствующие нормативным требованиям решения, способствуя дальнейшему развитию применения deep learning в области обнаружения мошенничества..
6 Заключение
Результаты данного систематического обзора литературы подчеркивают преобразующую роль глубокого обучения в обнаружении финансовых мошенничеств. Анализ последних достижений показывает, что модели глубокого обучения, включая CNNs, LSTMs, transformers и ансамблевые методы, значительно расширили возможности выявления сложных схем мошенничества в различных финансовых секторах. Эти модели в сочетании с надежными методами предварительной обработки и проектирования признаков позволяют решать ключевые проблемы, такие как несбалансированные наборы данных и операционная масштабируемость, что ведет к созданию более точных и эффективных систем обнаружения мошенничества..
Более того, интеграция методов сохранения конфиденциальности, таких как блокчейн, PCA и соблюдение глобальных нормативных требований, например GDPR и CCPA, гарантирует, что эти достижения соответствуют этическим и правовым стандартам. Эти меры не только защищают конфиденциальные финансовые и персональные данные, но и укрепляют доверие среди заинтересованных сторон, а также способствуют более широкому внедрению передовых решений по обнаружению мошенничества. Исследование методов автоматизации, включая настройку параметров и субдискретизацию, дополнительно ускорило время обнаружения, сделав возможным смягчение последствий мошенничества в режиме реального времени в условиях высокого риска..
По мере развития систем обнаружения мошенничества будущие исследования должны быть сосредоточены на повышении интерпретируемости моделей, выявлении новых схем мошенничества и улучшении межотраслевого сотрудничества посредством federated learning и безопасных структур обмена данными. Это обеспечит устойчивость и адаптивность систем deep learning в постоянно меняющемся финансовом ландшафте. Выводы данного исследования служат основой для совершенствования как технических, так и операционных аспектов обнаружения мошенничества, способствуя созданию более безопасной и надежной финансовой экосистемы..
Список литературы
- ⟦Abbassi et al., [2023] Аббасси, Х., Беркауи, А., Элмендили, С. и Гахи, Ю. (2023). Сквозная архитектура реального времени для обнаружения мошенничества в онлайн-цифровых транзакциях. Международный журнал передовых компьютерных наук и приложений (IJACSA), 14(6):749–756.
- ⟦Ahmad and Aujla, [2023] Ахмад, Х. и Аудла, Г. С. (2023). Верификация соответствия GDPR посредством ориентированного на пользователя блокчейн-подхода в мультиоблачной среде. Computers and Electrical Engineering.
- ⟦Alarfaj et al., [2022] Alarfaj, F. K., Malik, I., Khan, H. U., Almusallam, N., Ramzan, M., and Ahmed, M. (2022). Обнаружение мошенничества с кредитными картами с использованием передовых алгоритмов машинного обучения и deep learning. IEEE Access.
- ⟦Aliefw et al., [2023] Aliefw, R. N., Rachmawati, S. M., Lee, J. M., and Kim, D.-S. (2023). Классификация вредоносных учетных записей с использованием CNN для учетных записей блокчейна Ethereum. The Journal of Korean Institute of Communications and Information Sciences.
- ⟦Aljofey et al., [2022] Альжофей, А., Расул, А., Цзян, Ц., и Цюй, Ц. (2022). Основанный на признаках надежный метод обнаружения аномальных контрактов в блокчейне ethereum. Electronics, 11(3):456.
- ⟦Almarshad et al., [2023] Алмаршад, Ф. А., Гашгари, Г. А., и Альзахрани, А. И. А. (2023). Новый подход на основе генеративно-состязательных сетей для обнаружения мошенничества в наборе данных европейских держателей карт 2013 года. IEEE Access.
- ⟦Almazroi and Ayub, [2023] Алмазрой, А. А. и Аюб, Н. (2023). Модель обнаружения мошенничества при онлайн-платежах с использованием методов машинного обучения. IEEE Access.
- ⟦Alshawi, [2023] Алшави, Б. (2023). Использование GAN для обнаружения мошенничества с кредитными картами: сравнение алгоритмов обучения с учителем. Engineering, Technology & Applied Science Research.
- ⟦Aras and Guvensan, [2023] Арас, М. Т. и Гувенсан, М. А. (2023). Мультимодальная система профилирования для обнаружения мошенничества при выявлении подозрительных операций с авиабилетами. Applied Sciences.
- ⟦Ashfaq et al., [2022] Ашфак, Т., Халид, Р., Яхая, А. С., Аслам, С., Азар, А. Т., Альсафари, С., и Хамид, И. А. (2022). Эффективный механизм обнаружения мошенничества на основе машинного обучения и блокчейна. Sensors.
- ⟦Aslam et al., [2022] Аслам, Ф., Хунжра, А. И., Фитити, З., Лухичи, У. и Шамс, Т. (2022). Выявление страхового мошенничества: свидетельства применения искусственного интеллекта и машинного обучения. Research in International Business and Finance.
- ⟦Bajpai, [2023] Баджпай, А. (2023). Оценка влияния искусственного интеллекта на повышение соблюдения налогового законодательства и финансового регулирования. Международный журнал междисциплинарных исследований и технологий.
- ⟦Bisen et al., [2024] Бисен, В., Падвад, Х., Кесвани, Г., Агравал, Й., Тивари, Р. и Тивари, В. (2024). Анализ мошенничества с кредитными картами на основе автокодировщиков: всесторонний обзор. Международный журнал интеллектуальных систем и приложений в инженерии (IJISAE)).
- ⟦Can et al., [2020] Кан, Б., Явуз, А. Г., Карслигил, Э. М. и Гувенсан, М. А. (2020). Более пристальный взгляд на характеристики мошеннических карточных транзакций. IEEE Access.
- ⟦Carracedo et al., [2024] Карраседо, П., Эрвас, Д., и Сориано-Гонсалес, Р. (2024). Дисбаланс классов в моделях обнаружения страхового мошенничества. Препринт, представленный в Insurance Mathematics and Economics.
- ⟦Charizanos et al., [2024] Чаризанос, Г., Демирхан, Х. и Ичен, Д. (2024). Онлайн-система нечеткого обнаружения мошенничества для транзакций по кредитным картам. Expert Systems With Applications.
- ⟦Cherkaoui et al., [2024] Черкауи, О., Анун, Х., и Майзате, А. (2024). Сравнительный анализ обнаружения мошенничества в медицинском страховании с использованием методов машинного обучения. Международный журнал искусственного интеллекта (IJ-AI).
- ⟦Devaguptam et al., [2024] Девагуптам, С., Горти, С. С., Акшая, Т. Л., и Камат, С. С. (2024). Автоматизированная система обработки медицинского страхования с интеллектуальным обнаружением мошенничества, классификацией рисков и прогнозированием страховых взносов. SN Computer Science.
- ⟦Dhieb et al., [2020] Dhieb, N., Ghazzai, H., Besbes, H., and Massoud, Y. (2020). Безопасная архитектура на основе искусственного интеллекта для автоматизированных страховых систем: обнаружение мошенничества и измерение рисков. IEEE Access, 8:58546–58558.
- ⟦Ding et al., [2023] Динг, И., Канг, В., Фенг, Дж., Пенг, Б., и Янг, А. (2023). Обнаружение мошенничества с кредитными картами на основе улучшенной генеративно-состязательной сети с вариационным автокодировщиком. IEEE Access.
- ⟦Faridpour and Moradi, [2020] Фаридпур, М. и Моради, А. (2020). Новый метод обнаружения мошеннических банковских транзакций с использованием многослойных нейронных сетей с адаптивной скоростью обучения. Международный журнал нелинейного анализа и приложений.
- ⟦Federal Trade Commission, [2023] Федеральная торговая комиссия (2023). Сеть потребительского дозора: Книга данных 2023. Технический отчет, Федеральная торговая комиссия. Дата обращения: 2025-01-27.
- ⟦Fursov et al., [2022] Фурсов, И., Ковтун, Е., Ривера-Кастро, Р., Зайцев, А., Хасянов, Р., Спиндлер, М., и Бурнаев, Е. (2022). Векторные представления последовательностей помогают обнаруживать страховое мошенничество. IEEE Access.
- ⟦Gaikwad et al., [2023] Гайквад, В. М., Мехер, К., Дасс, Р., Джониста, А. С., Д’Соуза, Дж. и Виктор, Р. (2023). Обнаружение мошенничества с использованием машинного обучения и блокчейна. Международный журнал о последних и инновационных тенденциях в вычислительной технике и коммуникациях, 11(5):45–50.
- ⟦Innan et al., [2023] Иннан, Н., Саваика, А., Дор, А., Дутта, С., Тота, С., Гокал, Х., и Беннаи, М. (2023). Обнаружение финансовых мошенничеств с использованием квантовых графовых нейронных сетей. Квантовое машинное обучение.
- ⟦Jaiswal et al., [2024] Джайсвал, Р., Гупта, С., и Тивари, А. К. (2024). Система поддержки принятия решений на основе больших данных и машинного обучения для изменения прогнозирования страховых выплат. Technological Forecasting & Social Change.
- ⟦Jiang et al., [2023] Цзян, С., Дун, Р., Ван, Дж. и Ся, М. (2023). Обнаружение мошенничества с кредитными картами на основе сети обучения без учителя с механизмом внимания для выявления аномалий. Systems.
- ⟦Kaafarani et al., [2024] Каафарани, Р., Исмаил, Л., и Заве, О. (2024). Автоматическая рекомендательная система платформ разработки для решений по выявлению мошенничества в медицинском страховании на основе смарт-контрактов. Журнал медицинских интернет-исследований, 26:e45678.
- ⟦Kapadiya et al., [2022] Кападия, К., Патель, У., Гупта, Р., Алшехри, М. Д., Танвар, С., Шарма, Г., и Бокоро, П. Н. (2022). Обнаружение мошенничества в медицинском страховании с использованием блокчейна и искусственного интеллекта. IEEE Access, 10:103173–103184.
- ⟦Khalil et al., [2024] Халил, А. А., Лю, З., Фатхалла, А., Али, А. и Салах, А. (2024). Метод на основе machine learning для обнаружения страхового мошенничества на наборах данных с дисбалансом классов и пропущенными значениями. IEEE Access.
- ⟦Khashan, [2024] Хашан, О. А. (2024). Слияние блокчейна и машинного обучения для улучшенного обнаружения вредоносных узлов в беспроводных сенсорных сетях. Knowledge-Based Systems.
- ⟦Kotzian, [2021] Котциан, П. (2021). Применение машинного обучения и искусственного интеллекта для обеспечения соответствия корпоративной социальной ответственности: Концептуальная база с иллюстрациями. Технический отчет, Рабочий документ SSRN.
- ⟦Krishnan et al., [2023] Кришнан, Л. П., Вакилиния, И., Реддивари, С. и Ахуджа, С. (2023). Мошенничество и решения в сфере криптовалют: обзор, анализирующий существующие модели машинного обучения. Information, 14(2):78.
- ⟦Kurshan et al., [2021] Куршан, Э., Шен, Х. и Ю, Х. (2021). Выявление финансовых преступлений и мошенничества с использованием графовых вычислений: соображения по применению и перспективы. Возможно, не опубликовано или представлено на конференции.
- ⟦Lebichot et al., [2021] Лебишо, Б., Верхельст, Т., Ле Борнь, И.-А., Хе-Гелтон, Л., Обле, Ф., и Бонтемпи, Г. (2021). Стратегии transfer learning для обнаружения мошенничества с кредитными картами. IEEE Access.
- ⟦Lokanan and Maddhesia, [2024] Локанан, М. и Маддхесия, В. (2024). Прогнозирование мошенничества в цепочках поставок с помощью машинного обучения и искусственного интеллекта. Международный журнал производственных исследований.
- ⟦Mavundla et al., [2024] Мавундла, К., Тхакур, С., Адетиба, Э. и Абайоми, А. (2024). Прогнозирование перекрестных продаж продуктов медицинского страхования с использованием методов машинного обучения. Журнал компьютерных информационных систем, 64(1):123–134.
- ⟦Miao, [2024] Мяо, З. (2024). Обнаружение и предотвращение финансового мошенничества: автоматизированный подход на основе deep learning. Журнал организационных и пользовательских вычислений.
- ⟦Mienye and Sun, [2023] Мьенье, И. Д. и Сун, Ю. (2023). Ансамбль глубокого обучения с передискретизацией данных для обнаружения мошенничества с кредитными картами. IEEE Access.
- ⟦Ming et al., [2024] Минг, Р., Абдельрахман, О., Иннаб, Н., и Ибрагим, М. Х. К. (2024). Улучшение обнаружения мошенничества в автостраховании и транзакциях по кредитным картам: новый подход, объединяющий CNN и алгоритмы машинного обучения. PeerJ Computer Science.
- ⟦Mohammed et al., [2024] Мохаммед, М. А., Лакхан, А., Зебари, Д. А., Гани, М. К. А., Мархун, Х. А., Абдулкарим, К. Х., и Мартинек, Р. (2024). Обеспечение безопасности медицинских данных в промышленных киберфизических системах с использованием комбинации deep learning и технологии blockchain. Engineering Applications of Artificial Intelligence.
- ⟦Mwangi, [2024] Мванги, Э. (2024). Применение искусственного интеллекта и машинного обучения для выявления и предотвращения мошенничества в страховой отрасли. Возможно, не опубликовано или представлено на конференции.
- ⟦Nabrawi and Alanazi, [2023] Набрави, Э. и Аланази, А. (2023). Обнаружение мошенничества в заявках на медицинское страхование с использованием машинного обучения. Risks, 11(9):160.
- ⟦Nguyen et al., [2022] Нгуен, Н., Дуонг, Т., Чау, Т., Нгуен, В.-Х., Тринь, Т., Тран, Д., и Хо, Т. (2022). Предложенная модель для обнаружения мошенничества с картами на основе CatBoost и глубокой нейронной сети. IEEE Access.
- ⟦Palivela et al., [2024] Паливела, Х., Ришивал, В., Бхушан, С., Алотаиби, А., Агарвал, У., Кумар, П., и Ядав, М. (2024). Оптимизация модели на основе deep learning для идентификации мошенничества с кредитными картами. IEEE Access.
- ⟦Paramesha et al., [2024] Парамеша, М., Рейн, Н. Л. и Рейн, Дж. (2024). Искусственный интеллект, machine learning, deep learning и блокчейн в финансовых и банковских услугах: всесторонний обзор. Partners Universal Multidisciplinary Research Journal (PUMRJ), 1(2):68–79.
- ⟦Pranto et al., [2022] Pranto, T. H., Hasib, K. T. A. M., Rahman, T., Haque, A. K. M. B., Islam, A. K. M. N., and Rahman, R. M. (2022). Блокчейн и машинное обучение для обнаружения мошенничества: подход, основанный на сохранении конфиденциальности и адаптивном стимулировании. IEEE Access.
- ⟦Salam et al., [2024] Салам, М. А., Фуад, К. М., Эльбабли, Д. Л. и Эльсайед, С. М. (2024). Модель Federated learning для обнаружения мошенничества с кредитными картами с использованием методов балансировки данных. Neural Computing and Applications.
- ⟦Shehnepoor et al., [2024] Шехнепур, С., Тогнери, Р., Лю, В., и Беннамун, М. (2024). Обучение пространственно-временных графовых представлений для обнаружения групп мошенников. IEEE Transactions on Neural Networks and Learning Systems.
- ⟦Shen and Kurshan, [2020] Шен, Х. и Куршан, Э. (2020). Политика адаптивного выбора порога оповещения на основе Deep Q-network для систем предотвращения мошенничества с платежами в розничном банкинге. В материалах Международной конференции ACM по искусственному интеллекту в финансах (ICAIF ’20).
- ⟦Siddamsetti and Srivenkatesh, [2024] Siddamsetti, S. and Srivenkatesh, M. (2024). Глубинный блокчейн-подход для обнаружения аномалий в сети биткоин. Международный журнал интеллектуальных систем и приложений в инженерии.
- ⟦Sowah et al., [2019] Sowah, R. A., Kuuboore, M., Ofoli, A., Kwofie, S., Asiedu, L., Koumadi, K. M., and Apeadu, K. O. (2019). Система поддержки принятия решений для обнаружения мошенничества в заявках на медицинское страхование с использованием генетических машин опорных векторов (GSVMs). Journal of Engineering.
- ⟦Sun et al., [2019] Сунь, К., Ли, К., Ли, Х., Ши, И., Чжан, С. и Го, В. (2019). Выявление мошенников в сфере медицинского страхования на основе дивергенции кластеров пациентов. IEEE Access.
- ⟦Tang and Liu, [2024] Танг, Ю. и Лю, З. (2024). Распределенная структура дистилляции знаний для обнаружения финансового мошенничества на основе transformer. IEEE Access.
- ⟦Tekkali and Natarajan, [2023] Теккали, К. Г. и Натараджан, К. (2023). Rdqn: Ансамбль глубоких нейронных сетей с обучением с подкреплением в классификации на основе теории грубых множеств для обнаружения цифрового транзакционного мошенничества. Complex & Intelligent Systems.
- ⟦Tian et al., [2024] Тянь, Ю., Лю, Г., Ван, Дж. и Чжоу, М. (2024). Asa-gnn: Графовая нейронная сеть на основе адаптивной выборки и агрегации для обнаружения мошенничества с транзакциями. IEEE Transactions on Computational Social Systems.
- ⟦Usman et al., [2023] Усман, А., Навид, Н., и Мунавар, С. (2023). Интеллектуальный контроль мошенничества по борьбе с отмыванием денег с использованием графовой модели машинного обучения для финансовой сферы. Журнал кейсов по информационным технологиям.
- ⟦Xu, [2024] Сюй, Дж. (2024). Генеративный искусственный интеллект и LLM для финансовых организаций: Корпоративный стратегический обзор. SSRN Scholarly Paper No. 4988118.
- ⟦Zhang et al., [2022] Чжан, З., Ма, И. и Хуа, И. (2022). Выявление финансового мошенничества на основе алгоритма ансамблевого обучения стекинг: внедрение текстовой информации из md&a. Computational Intelligence and Neuroscience.
- ⟦Zhao, [2024] Чжао, Ю. (2024). Анализ данных прогнозирования операционных рисков предприятия на основе machine learning: Инновации и улучшения в стратегиях управления рисками корпоративного права. Journal of Organizational and End User Computing.
- ⟦Zioviris et al., [2024] Зиовирис, Г., Коломватсос, К., и Стамулис, Г. (2024). Интеллектуальная модель последовательного обнаружения мошенничества на основе deep learning. The Journal of Supercomputing.