Чем больше, тем веселее:
логические и многоступенчатые процессоры в скоринге кредитоспособности
Аннотация
Алгоритмы машинного обучения (ML) повсеместно применяются в ключевых контекстах принятия решений, таких как организационная справедливость или здравоохранение, что породило большой спрос на справедливость в этих процедурах. В данной статье мы сосредоточимся на применении справедливого ML в финансах, более конкретно — на использовании методов справедливости при кредитном скоринге. Статья вносит два вклада. С одной стороны, она закрывает существующий разрыв в отношении применения в литературе установленных методов к случаю нескольких чувствительных переменных за счет использования новой техники, называемой логическими процессорами (LP). С другой стороны, она также исследует новый метод многостадийных процессоров (MP), чтобы выяснить, могут ли комбинации методов справедливости работать синергически, обеспечивая решения с улучшенной справедливостью или точностью. Кроме того, мы изучаем пересечение этих двух направлений исследований, исследуя интеграцию методов справедливости в многомерном случае. Результаты весьма обнадеживают и указывают на то, что логические процессоры являются подходящим способом обработки нескольких чувствительных переменных. Кроме того, многостадийные процессоры способны улучшать производительность существующих методов.
ключевые слова:
алгоритмическая справедливость , машинное обучение , смягчение предвзятости , несколько чувствительных признаков , многоступенчатый процессор , логический процессор[inst2]organization=Department of Statistics. Universidad Carlos III de Madrid,country=Spain \affiliation[inst3]organization=uc3m-Santander Big Data Institute. Universidad Carlos III de Madrid,country=Spain
1 Введение
В последние десятилетия учреждения все чаще полагаются на искусственный интеллект (ИИ) и машинное обучение (МО) для содействия принятию решений. От подбора персонала [1] до здравоохранения [2] интеллектуальные системы стали повсеместными в критически важных контекстах [3], что объясняет растущий спрос на социально осведомленные модели и, соответственно, основания существования справедливого ИИ [4]. Кроме того, взаимосвязь между дискриминацией и калибровкой указывает, что построение модели, избегающее ложных взаимосвязей между переменными, может повысить надежность [5]. В данной работе будет рассмотрено применение моделей справедливого МО в финансовом контексте для решения проблемы скоринга кредитоспособности, который играет ключевую роль при одобрении кредитов [6]. Хотя в литературе предложено множество метрик и моделей для смягчения смещений, вокруг этой темы по-прежнему существует множество открытых задач. Более конкретно, данная работа заинтересована в исследовании двух конкретных пробелов в исследованиях. С одной стороны, существует потребность в методах, которые позволяют обрабатывать несколько чувствительных переменных как с этической, так и с правовой точек зрения [7]. Кроме того, существуют опасения относительно уникальной дискриминации, с которой некоторые люди сталкиваются из-за принадлежности к пересечениям защищаемых групп [8]. С другой стороны, существующие механизмы справедливости действуют на одной стадии конвейера МО: они реализуются либо при обработке данных (предобработчики), во время обучения (встроенные механизмы) либо после выполнения прогнозов (постобработчики) [9]. Насколько нам известно, в литературе нет работ по гибридным методам, включающим несколько стадий процесса разработки алгоритма. Это может быть перспективным направлением для лучшего понимания компромиссов между справедливостью и качеством [10]. Для ответа на эти вопросы работа структурирована следующим образом. Сначала, в Разделе 2, мы рассмотрим теоретические основы, необходимые для понимания идей, которые представляем, объясним метрики, которые будут использоваться для количественной оценки смещений, а также рассмотрим механизмы, которые были разработаны для противодействия дискриминации [11]. Затем, в Разделе 3, будут представлены две основные идеи данной работы. С одной стороны, мы предлагаем логические механизмы — метод, основанный на использовании побитовых операций для сведения задачи с несколькими чувствительными переменными к одномерному случаю. Это позволяет повысить гибкость при выборе и проектировании механизмов справедливости и решает один из крупнейших пробелов в текущей литературе; а именно обобщение методов справедливости на многомерный случай [12]. С другой стороны, мы рассмотрим многопроходные механизмы, то есть использование нескольких техник справедливости, которые влияют на разные части конвейера МО в попытке найти синергетические комбинации, способные привести к улучшению справедливости или точности. Это представление о гибридных методах уже предлагалось [10], но, насколько нам известно, результаты в этом направлении не получены. Кроме того, анализируется взаимодействие логических и многопроходных механизмов с целью достижения лучших результатов с точки зрения справедливости. Раздел 4 содержит обширное эмпирическое исследование, чтобы понять реализуемость и эффективность идей, представленных в Разделе 3. Анализ будет разделен на две части. Сначала будет проведено имитационное исследование, аналогичное тому, которое предложено в [13], чтобы проверить, как наши методы проявляют себя в контролируемой среде. Затем будет выполнено тематическое исследование с использованием набора данных German111https://archive.ics.uci.edu/dataset/144/statlog+german+credit+data, чтобы лучше понять компромиссы, связанные с применением новых техник. Наконец, Раздел 5 представляет выводы и намечает направления для будущих исследований.
2 Основы справедливости
Этот раздел закладывает теоретическую основу статьи согласно [11]. Обзор сформулирует задачу ML-справедливости в более широком контексте статистической классификации и рассмотрит метрики, которые были предложены в литературе для решения задачи измерения смещения и предвзятости.
2.1 Задача классификации при справедливой точечной постановке
Предположим, что набор данных состоит из множества атрибутов , целевой переменной и множества чувствительных переменных . Работа [11] предполагает, что и отклик, и чувствительные переменные являются двоичными; то есть . Кроме того, мы ограничиваемся случаем, где представляет собой один-единственный чувствительный атрибут. Тогда цель статистической классификации заключается в разработке модели , которая получает название классификатора, при максимизации ее точности (или, эквивалентно, при минимизации ее коэффициента ошибок),
| (1) |
где обозначает вероятность события. При обращении к эмпирическим вероятностям будет использоваться символ . Однако в контексте справедливости более разумно максимизировать сбалансированную точность, то есть среднюю точность по группам,
| (2) |
Другие важные показатели производительности — это элементы матрицы ошибок:
- ⟦1. Доля истинно положительных: .
- 2. Истинно отрицательное соотношение: .
- 3. Ложноположительный коэффициент: .
- ⟦False negative ratio: .
В контексте кредитного скоринга переменная отклика представляет собой то, будет ли конкретный человек погашать кредит. Если человек, по прогнозу, допускает дефолт, то говорят, что у него плохая кредитная оценка или плохой кредитный риск, а если, по прогнозу, он погашает кредит, то говорят, что у него хорошая кредитная оценка или хороший кредитный риск. Более широкая интерпретация соответствующих переменных вместе с их значениями приведена в таблице 1. В любом случае модель получается путем пороговой обработки показателя , который ранжирует разных клиентов в соответствии с их вероятностью дефолта. Формально задается порог , а классификатор строится путем пороговой обработки показателя , то есть если и в противном случае.
| Expression | Interpretation |
| The individual belongs to the privileged group | |
| The individual belongs to the unprivileged group | |
| The individual defaults (bad outcome) | |
| The individual repays the loan (good outcome) | |
| The individual is predicted to default (bad credit risk) | |
| The individual is predicted to repay the loan (good credit risk) |
Теперь единственный вопрос, который остается, — как измерять предвзятость и предубеждение.
2.2 Критерии справедливости
В литературе предложено множество метрик справедливости. Однако большинство из них можно свести всего к трем [11]: независимость, разделение и достаточность.
2.2.1 Независимость
Считается, что оценка удовлетворяет независимости при пороге , если
| (3) |
То есть независимость требует, чтобы распределение классификатора не зависело от . Однако это допущение может быть контрпродуктивным, если лежащее в основе распределение данных само по себе не является независимым; в таком случае принуждение к этой метрике может привести к неточной модели [14]. Чтобы избежать дискриминации при сохранении этой метрики, некоторые учреждения предлагают ограничивать отношение величин в (3), обычно сверху величиной , которую обычно называют правилом 80% [15]. Тем не менее использование метрики справедливости должно определяться конкретным вариантом применения, хотя мы вернемся к этому вопросу в конце данного раздела. Независимость можно измерить по абсолютному значению отклонения в приведенных выше вероятностях,
| (4) |
Поэтому положительное значение для подразумевает отклонение от равенства в (3). Следовательно, чем ближе к нулю, тем ниже различимость.
2.2.2 Разделение
Оценка , как говорят, удовлетворяет разделению на пороге , если
| (5a) | |||
| (5b) | |||
То есть показатель соответствует разделению, если у всех групп равны доли ошибок. Положительный результат не предполагается распределённым поровну, но в идеале доли ошибок по группам населения выравниваются для разных значений отклика; то есть классификатор, нацеленный на разделение, не пытается повышать общую точность ценой неверной классификации людей из меньшинства. Этот показатель также называется equal odds. Ослабление можно найти в equal opportunity, при котором удовлетворяется только уравнение (5a) [16]. Разделение можно измерять с помощью не взвешенного среднего значения модуля отклонения для показателей истинно положительных и истинно отрицательных ошибок,
| (6) |
⟦ имеет аналогичную интерпретацию с : чем ближе к нулю, тем лучше классификатор достигает разделения и тем ниже дискриминация.
2.2.3 Достаточность
Считается, что оценка удовлетворяет достаточности при пороге , если
| (7) |
То есть это требует, чтобы вся информация о целевой переменной содержалась в оценке. В любом случае, достаточность можно измерить как абсолютное значение отклонения указанных вероятностей,
| (8) |
2.2.4 Какая метрика нужна?
Выбор метрики справедливости зависит от варианта использования. Согласно [14], и независимость, и достаточность неуместны в контексте кредитного скоринга, и рекомендуется использовать разделение. Независимость не учитывает неравномерное распределение платежей по займам. Кроме того, последствия дефолта более тяжкие для клиента, чем для учреждения, поэтому требование независимости усугубило бы дискриминацию, а не решило бы проблему. С другой стороны, достаточность позволяет осуществлять дискриминацию посредством разделения. Наконец, разделение устраняет эти недостатки и учитывает различные издержки неверной классификации, что делает его особенно подходящим для кредитного скоринга.
2.3 Модули для обеспечения справедливости
В этом разделе будут представлены различные процессоры справедливости, которые рассматривались в данном исследовании. Их можно классифицировать по положению в конвейере ML. В целом выделяют три категории: pre-processors, in-processors и post-processors [9]. Выбранные методы будут кратко объяснены, чтобы обеспечить необходимый контекст.
2.3.1 Предварительная обработка
Справедливые предварительные преобразователи изменяют исходные данные, чтобы снизить любое имеющееся смещение; идея заключается в том, что классификатор, обученный на несмещенных данных, не будет усваивать каких-либо дискриминационных закономерностей. Описанный в [17] метод перевзвешивания стремится достичь независимости путем повторной выборки данных с возвращением с использованием весов. Эти веса предполагают, что лежащие в основе данные независимы, и они корректируют частоты выборки так, чтобы получить новый набор данных, который не отклоняется от прежнего предположения. Мы можем оценить эти веса, используя эмпирические доли
| (9) |
где обозначает ожидаемую вероятность при допущении независимости, а обозначает фактическую вероятность.
Вторым предобработчиком, который будет рассмотрен, является Disparate Impact Remover [18]. Эта процедура восстанавливает набор данных, преобразуя его в новую версию, , которая удаляет всю информацию о чувствительной переменной из остальных атрибутов. Критерий восстановления основан на медианном распределении, , функций условных квантилей каждого атрибута, ,
| (10) |
Однако эта процедура в значительной степени ухудшает прогностические возможности любого классификатора, который обучается на этих данных. Этого можно избежать, используя распределение, сгенерированное как геометрическая интерполяция между медианной квантильной функцией, , и соответствующей условной квантилью , . Этот процесс управляется параметром , который позволяет в некоторой степени контролировать компромисс между справедливостью и точностью.
2.3.2 В процессе обработки
Встроенные модули активно управляют этапом обучения, чтобы получить справедливый классификатор. Эта идея лежит в основе противодействующего устранения смещений [13]. Она основана на введении противника, который будет пытаться предсказать чувствительный признак, используя некоторые данные. Эти данные зависят от выбранной метрики справедливости. Функция потерь исходного классификатора, , модифицируется, чтобы предотвратить максимизацию потерь противника, . Цель этой модификации — разработать предсказатель, который сохраняет высокую точность при одновременном минимизировании объёма информации, которую он передаёт о чувствительных переменных. Правило, которое используется для обновления весов,
| (11) |
где — это гиперпараметр, служащий в качестве скорости обучения и который может варьироваться на каждом шаге, обозначает градиент в весах предиктора, и — это член проекции, который предотвращает обновление весов в направлении, выгодном противнику. Последний член — это потери противника, которые классификатор теперь будет стараться минимизировать.
Другой способ создания справедливых алгоритмов — через добавление регуляризатора. Это идея [19], где они обучают модель логистической регрессии с параметрами , основанную на обычном принципе максимизации логарифмического правдоподобия:
| (12) |
где апостериорные вероятности получаются с помощью логистической модели. Справедливость учитывается путем добавления регуляризатора, который измеряет взаимную информацию чувствительного признака и ответа с помощью функции, , на основе Prejudice Index,
| (13) |
которую можно аппроксимировать выражением:
| (14) |
Включение в качестве регуляризационного члена в функции потерь классификатора штрафует общую информацию между предсказаниями и чувствительными атрибутами. Его влияние на функцию потерь можно регулировать параметром в зависимости от требуемого уровня справедливости. Итоговая функция потерь при добавлении функции потерь (12), регуляризатора, задаваемого (14), и обычной штрафующей :
| (15) |
Наконец, мы рассмотрим мета-алгоритм в [20]. В целом, он предлагает включение ограничения справедливости в задачу минимизации доли ошибок классификатора. Идея состоит в том, чтобы выразить справедливость через меру групповой результативности, , для . Эта групповая результативность должна быть записана как вероятность, , где , являются событиями. Затем, на задачу оптимизации накладывается определенное -правило, путем включения минимального частного групповых результативностей в задачу оптимизации
| (16) |
Выбор и определяет метрику справедливости, которую мы реализуем. Несколько примеров:
- ⟦Если , , то будет измерять независимость.
- ⟦Если , , то будет измерять равные возможности.
- ⟦Если , и , , то будет измерять разделение.
- ⟦Если , , то будет измерять достаточность.
2.3.3 Постобработка
Постобработчики срабатывают после того, как классификация выполнена, изменяя предсказанные метки, чтобы достичь справедливости. Это относится к классификатору варианта отказа, предложенному в [12]. Этот метод переназначает предсказания с апостериорными вероятностями, близкими к (то есть к менее надежным), присваивая положительную метку не привилегированным лицам и отрицательную метку привилегированным лицам. Формально процесс переназначения контролируется параметром , который задает полосу вокруг таким образом, что переназначение применяется только к наблюдениям, чьи апостериорные вероятности лежат в этой полосе. Полоса определяется как
| (17) |
Тот факт, что только те переклассифицированные индивидуумы находятся вблизи границы решения, минимизирует понесённую ошибку.
Другой постпроцессор — процессор равных шансов, описанный в [16]. Этот метод предлагает построить производный классификатор, , из заданного классификатора, , или оценки, . Чтобы обеспечить разделение, производный классификатор будет выбирать компромиссы по точности, которые принадлежат пересечению всех -условных ROC-кривых классификатора или оценки. Формально авторы вводят последовательность векторов, которые хранят группу и классификатора , . Затем они определяют , выпуклую оболочку образа -условных ROC-кривых. Наконец, производный классификатор является решением задачи минимизации
| (18) |
Последний постобработчик, который мы рассматриваем, основан на идее калибровки. Калибровка по группам эквивалентна достаточности [11]. Один из способов получить оценку из классификации, которая уже выполнена, заключается в использовании Platt scaling [21]. Поэтому выполнение Platt scaling по группам (то есть ограничение наблюдений каждой из чувствительных групп) приводит к откалиброванной оценке. Platt scaling состоит в подгонке модели логистической регрессии к предсказаниям классификатора для получения апостериорных вероятностей.
3 Расширение справедливости
В этом разделе рассматриваются новые вклады статьи. Сначала мы вводим логические процессоры — новую технику для обработки случая нескольких чувствительных переменных, расширяющую область применения процессоров, которые были разработаны. Затем мы изучим взаимодействие между различными типами процессоров посредством многостадийных процессоров.
3.1 Множественные чувствительные переменные и логические процессоры
Один из самых больших разрывов в справедливом ML связан со случаем нескольких чувствительных переменных [12, 11]. Многие из алгоритмов, предложенных в литературе, не могут обрабатывать несколько чувствительных переменных или несколько меток. Это проблематично в некоторых правовых рамках. Например, финансовые организации по закону обязаны обеспечивать справедливость одновременно по нескольким критериям [7]. Кроме того, с общественной точки зрения особенно важно признавать и устранять предвзятость, которую конкретный человек может испытывать из‑за совокупного опыта принадлежности к нескольким чувствительным группам. Это явление известно как compounded prejudice и хорошо задокументировано в литературе [8]. Чтобы рассмотреть случай нескольких чувствительных признаков, мы предлагаем логические процессоры (LP), которые применяют логическую функцию к чувствительным переменным, чтобы закодировать их информацию в одной двоичной переменной. Формально, рассмотрим множество чувствительных признаков . Тогда логический процессор — это функция . То есть он отображает все признаки в одну двоичную переменную, что позволяет нам использовать все инструменты, которые были разработаны для работы с этой ситуацией. Самый простой пример LP — рассмотреть OR‑сумму двух чувствительных признаков. Получившаяся переменная указывает на наличие чувствительного признака у данного человека. Однако обратите внимание, что используемая нами операция имеет глубокие последствия. Предположим, например, что чувствительные признаки — это раса и пол. Их OR‑сумма признает, что человек может быть человеком цвета или женщиной, но не различает эти два случая, что может быть ошибкой, поскольку разные меньшинства могут сталкиваться с разными типами дискриминации [22]. Кроме того, она не может выявить женщин цвета, что проблематично из‑за compounded prejudice. Вот почему необходимо рассматривать множество различных логических процессоров и их последствия. В частности, мы рассмотрим двувариантный случай и обсудим:
- ⟦1. ИЛИ: Наличие одной или нескольких конфиденциальных переменных. Человек считается не наделённым полномочиями, если у него есть любой из двух конфиденциальных признаков. Такой подход не учитывает накопленную предвзятость.
- ⟦И: Эксклюзивное наличие нескольких чувствительных переменных. Индивид считается не имеющим привилегий, если он имеет два чувствительных признака. Это особенно полезно для выявления и устранения накопленных предубеждений, но не учитывает индивидуальную предвзятость.
- ⟦XOR: Исключительное наличие одной чувствительной переменной. Человек не считается не имеющим привилегий, если у него есть несколько чувствительных признаков. Этот подход полностью игнорирует накопленную предвзятость, но он может помочь в решении индивидуальной дискриминации.
Большинство процессоров справедливости из раздела 2.3 могут обрабатывать несколько чувствительных признаков. Однако наше предложение обеспечивает большую гибкость при выборе или разработке метода справедливости: любую одномерную идею можно без труда расширить на многомерный случай. Кроме того, реализовать LP гораздо проще, чем адаптировать заданный алгоритм или метрику.
3.2 Многостадийные процессоры
Комбинация методов обеспечения справедливости, атакующих разные этапы конвейера ML, уже упоминалась [10], но пока не была реализована на практике. Однако взаимодействие между различными процессорами может привести к синергическому взаимодействию, которое обеспечивает улучшенную справедливость или точность. Мы вводим и формализуем это понятие через мультистадийные процессоры (MP), которые определяются как процессор обеспечения справедливости, включающий несколько стадий конвейера ML. Приведенное выше определение обеспечивает большую гибкость при проектировании MP, но исследование будет ограничено комбинацией двух процессоров обеспечения справедливости, которые затрагивают разные части процесса формирования алгоритма. В частности, будут рассмотрены следующие типы MP:
- ⟦1. PI, включающий предварительный обработчик и обработчик в процессе.
- ⟦PP, включающая предварительный процессор и последующий процессор.
- ⟦IP, включая процессорную обработку и постобработку.
4 Экспериментальная установка
Этот раздел содержит подробное описание методологии и экспериментов, выполненных для изучения свойств логических и многоэтапных процессоров. Анализ состоит из двух частей: сначала имитационное исследование, предназначенное для проверки возможностей предложенных идей в контролируемой среде. Затем — кейс-исследование на основе набора данных german [23], чтобы установить свойства методов в реальных условиях. Код, использованный для реализации этой методологии, можно найти в репозитории Github222https://github.com/arturo-perez-peralta/FairMLIntegration. Данные имитационного исследования генерируются аналогично игрушечному сценарию из [13], хотя для обработки нескольких чувствительных переменных потребовались некоторые модификации. Схема имитации выглядит следующим образом: пусть с выбираются равномерно случайным образом. Они представляют чувствительные переменные. Пусть является неточным измерением чувствительных переменных, — двумя независимыми и несвязанными атрибутами, а — их средним значением. Пусть — две независимые переменные. представляет собой неточное измерение , и его знак определяет переменную отклика: . С другой стороны, — это другое зашумленное измерение , которое служит прокси для . Наконец, смоделированный набор данных — с , , . Имитация выполняется раз, а данные агрегируются с помощью медианы. С другой стороны, набор данных german включает иное число признаков, описывающих каждого претендента на кредит. Целевая переменная является бинарной и отражает, выплачивает ли человек кредит или допускает дефолт, тем самым классифицируя их как кредитоспособных () или кредиторисковых (). В одномерном случае мы следовали [24] и использовали возраст как чувствительную переменную, предполагая привилегии для тех, чей возраст был больше , и дискриминацию тех, кто моложе. При работе с двумя чувствительными атрибутами также использовался пол, предполагая дискриминацию женщин. В обоих наборах данных рассматривались два сценария в зависимости от использования одной или нескольких чувствительных переменных. Кроме того, многомерный случай был разделен на три случая в зависимости от того, какая из трех LP применяется (OR, AND, XOR). Таким образом, существует четыре различных случая, чтобы учесть: одна чувствительная переменная, OR, AND, XOR. Соответствующие характеристики для каждого случая приведены в Таблице 2.
|
|
Features |
|
|
|
|
|
|
||||||||||||||||
| Simulation | ||||||||||||||||||||||||
| German |
Данные разделены на обучающую, валидационную и тестовую выборки. Модели обучаются рассчитывать показатель на обучающем наборе, при этом порог выбирается для максимизации сбалансированной точности (2) на валидации. Наконец, метрики, рассмотренные в Разделе 2, оцениваются на тесте, при этом особое внимание уделяется точности как показателю производительности и разделению как показателю справедливости. При работе с несколькими чувствительными переменными метрики справедливости вычисляются по отношению к той же чувствительной переменной, что и в случае одномерного анализа, с идеей проверить, как использование LP усиливает или уменьшает дискриминацию по этой самой переменной. Восемь процессоров справедливости, показанных в Разделе 2.3, были реализованы со значениями для гиперпараметров. Затем MPs, состоящие из всех комбинаций, показанных в Разделе 3.2, были обучены без изменения гиперпараметров, с идеей наблюдать взаимодействия между методами такими, какими они были. В обоих случаях предобработчики и постобработчики обучались с использованием модели логистической регрессии, если только они не входили в MP, который также включал an in-processor.
4.1 Имитационное исследование
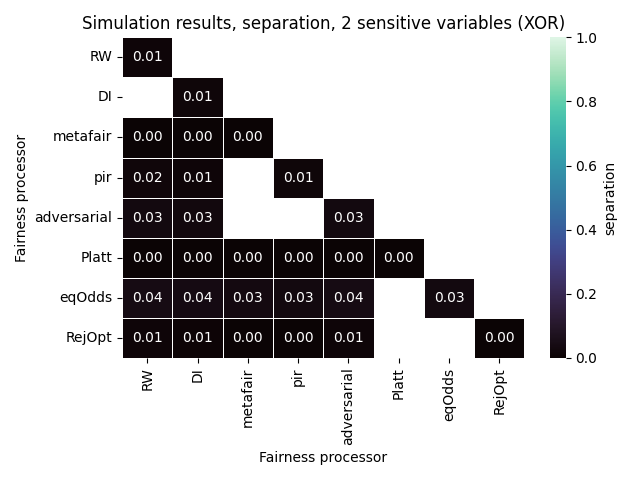
Результаты моделирующего исследования обобщены на рисунках 1–5. Мы начинаем анализ с проверки медианной точности методов для симуляций, которую можно визуализировать на рисунках 1 и 2⟧.
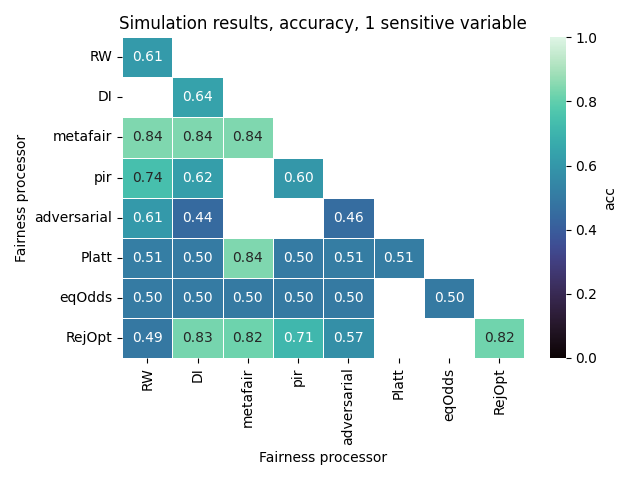
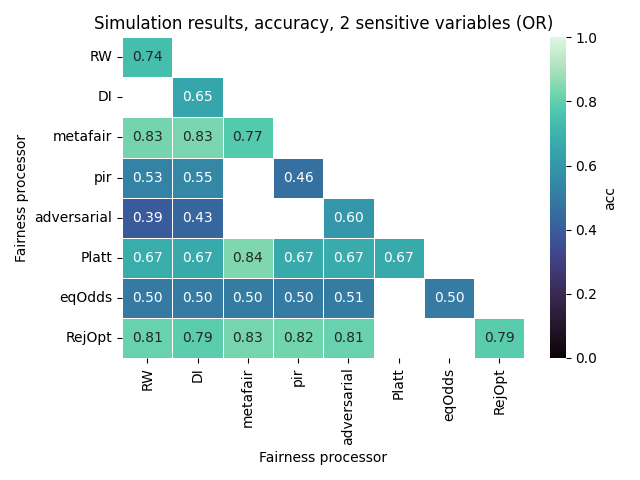
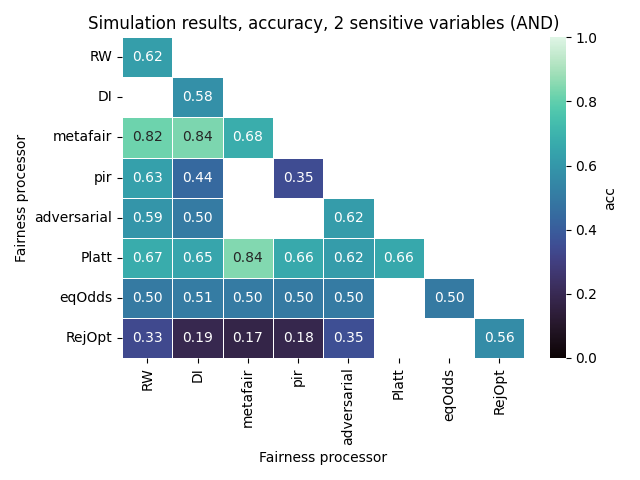
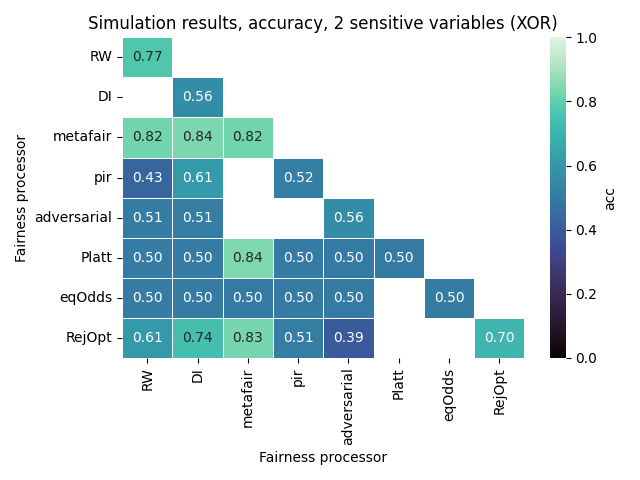
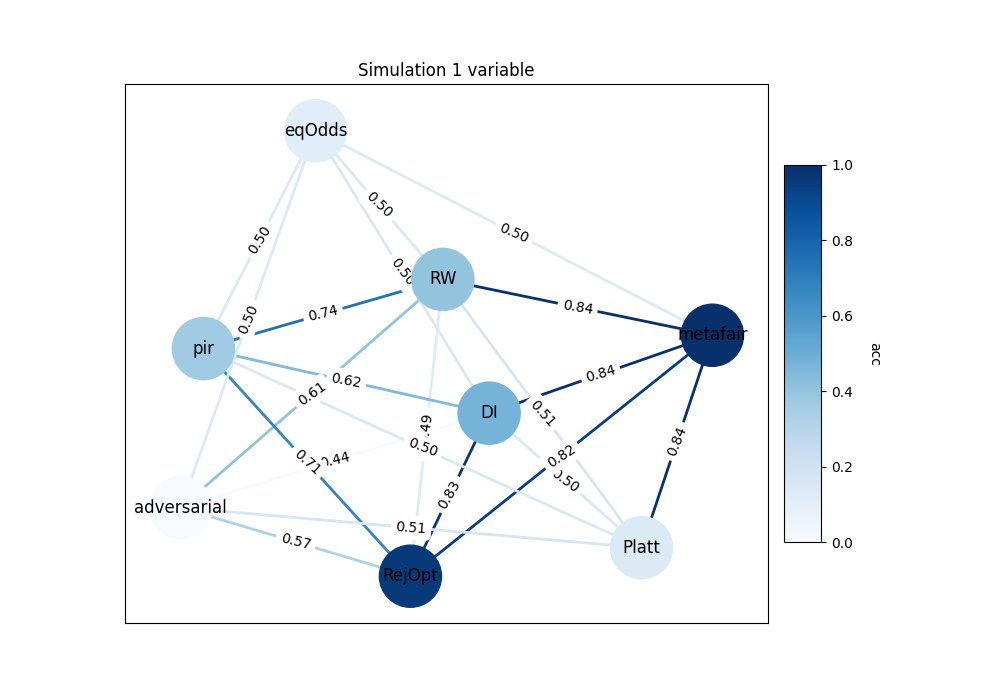
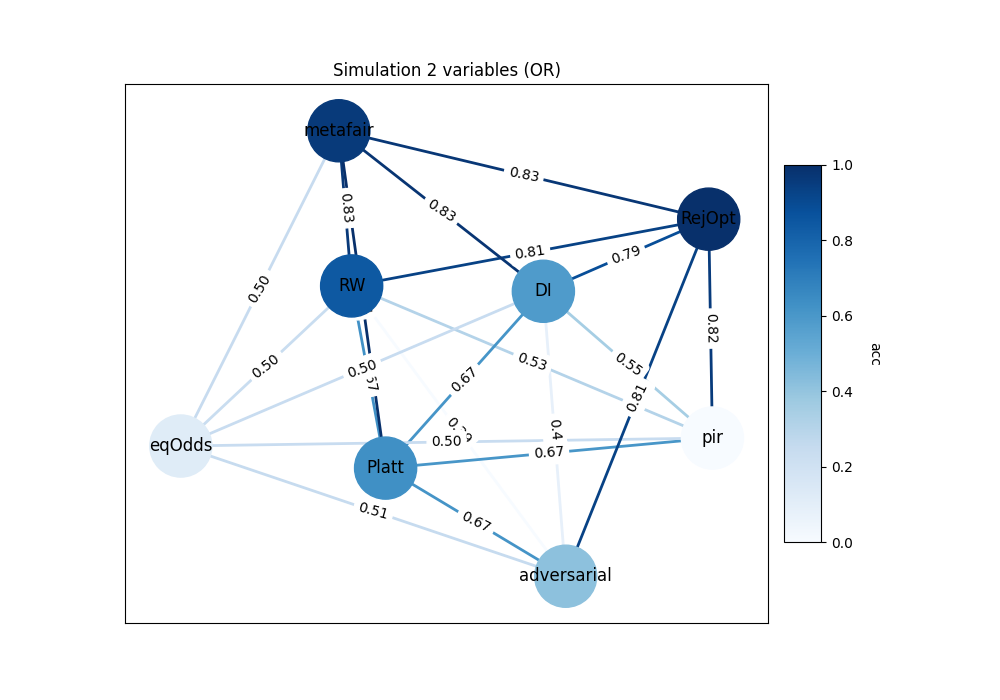
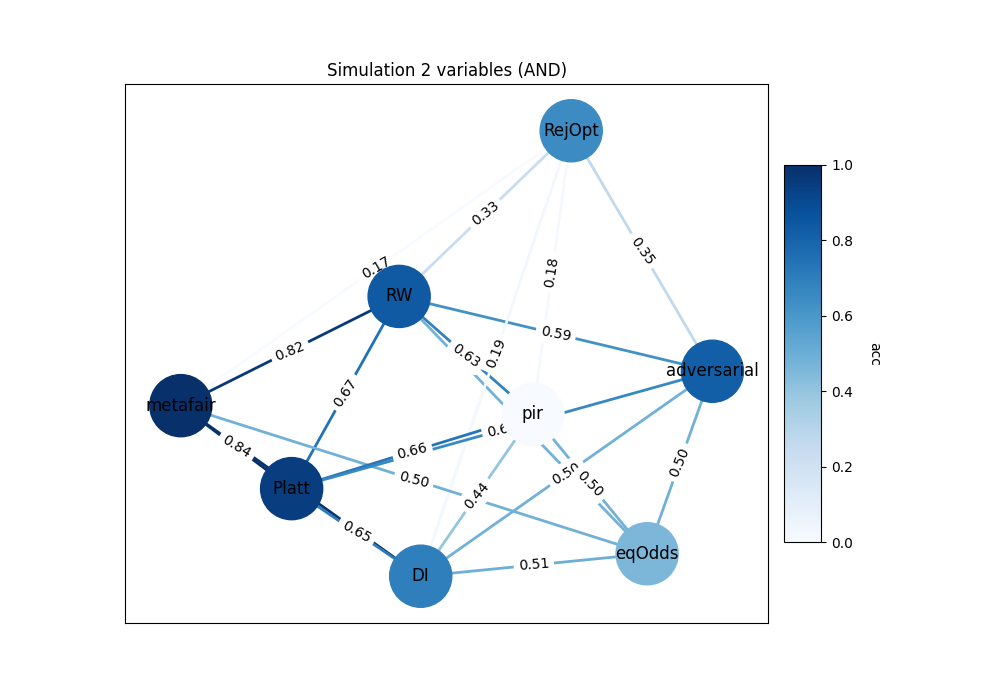
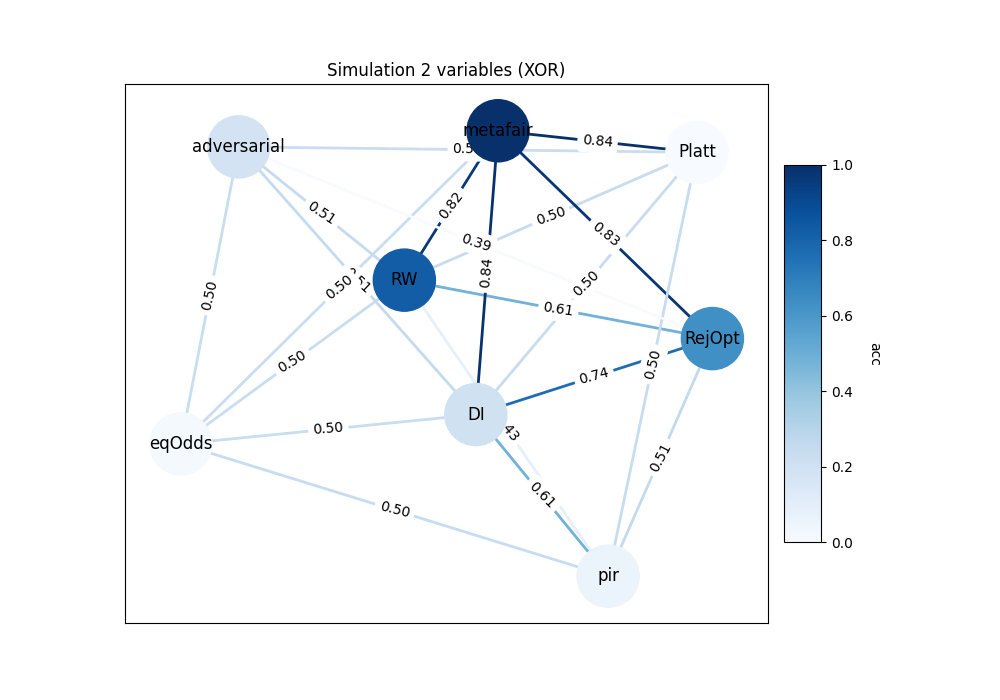
На первый взгляд, моделирование демонстрирует умеренный успех: совместное применение процессоров справедливости может приводить к улучшению производительности. Это относится к MP, состоящему из переназначения весов и регуляризатора индекса предвзятости. Эти два процессора имеют медианную точность порядка в унимерном случае. Однако MP, который объединяет их, достигает уровня точности ; то есть улучшения примерно на . Эти результаты предполагают, что взаимодействие процессоров справедливости может приводить к улучшению производительности, что само по себе является многообещающим. Кроме того, их можно использовать для достижения наивысшей производительности в наборе данных: это относится как к сценариям обработки OR, так и AND, где ни один отдельный метод не может обеспечить наивысшие точности. В более общем смысле, производительность MP не ограничена сверху или снизу точностью его составляющих. Мы только что увидели пример первого; для второго можно взять переназначение весов (), вариант с отклонением () и их комбинацию (). Однако MP с более низкой точностью, чем у их составляющих, похоже, составляют меньшинство, и объединение двух методов можно ожидать как минимум не хуже, чем худшая из двух его составляющих.
Комбинации процессоров по ПИ, по-видимому, дают наиболее стабильные результаты в целом как в унимодальном, так и в многомерном случаях. Взаимодействие препроцессоров и инпроцессоров обеспечивает наилучшую производительность при использовании классификатора metafair, тогда как методы, включающие регуляризатор индекса предвзятости или алгоритмы противодействия смещению, дают неоднозначные результаты: их точность зависит от выбора LP. Процессор, который действует последним (инпроцессор в комбинациях по ПИ и постпроцессоры в обоих вариантах ПП и ИП), судя по всему, сильно влияет на производительность результирующего МП, демонстрируя своего рода доминирующее поведение. Это явление особенно заметно при использовании постпроцессора, особенно при Platt scaling, при котором все методы, его использующие, имеют точность около . Применение опции Reject может приводить к крайне вариативным результатам, вплоть до уровней точности порядка при AND processsing и до в сценарии OR. В целом инпроцессоры обеспечивают лучшую производительность, чем постпроцессоры.
Выбор логического процессора может быть значительной причиной вариаций для некоторых процессоров. Например, вариант с отклонением (reject option) кажется наиболее эффективным при использовании процедуры OR, при этом его производительность слегка ухудшается при рассмотрении XOR и становится крайне плохой, если мы выбираем обработку AND. Другие процессоры, такие как комбинации с метаfair-классификатором, судя по всему, довольно стабильны, достигая сопоставимой точности во всех сценариях. В любом случае выбор LP не является тривиальным и должен быть тщательно изучен вместе с каждым рассматриваемым процессором.
.png)
.png)
.png)
.png)
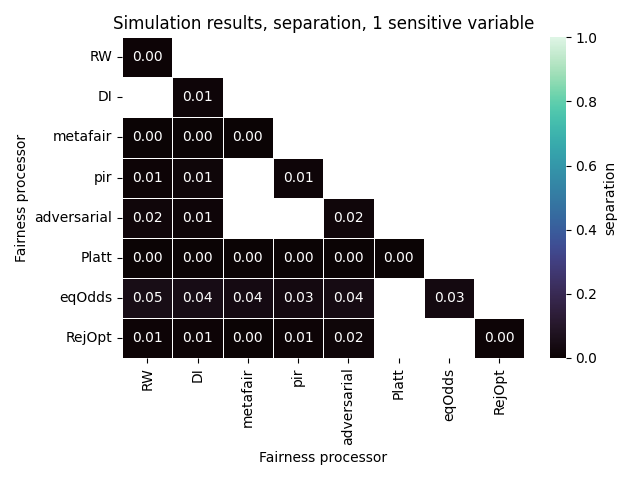
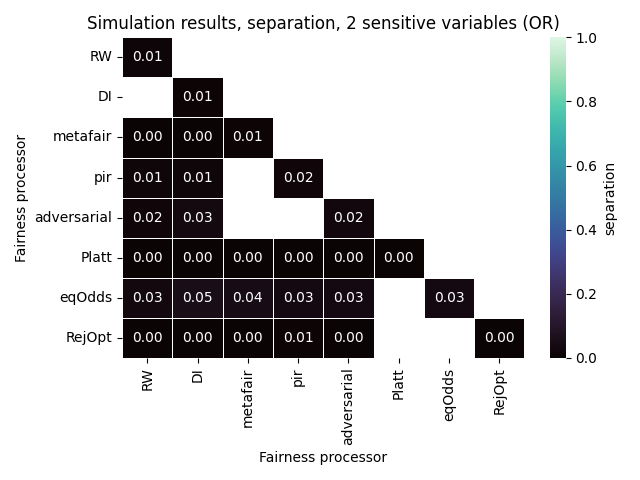
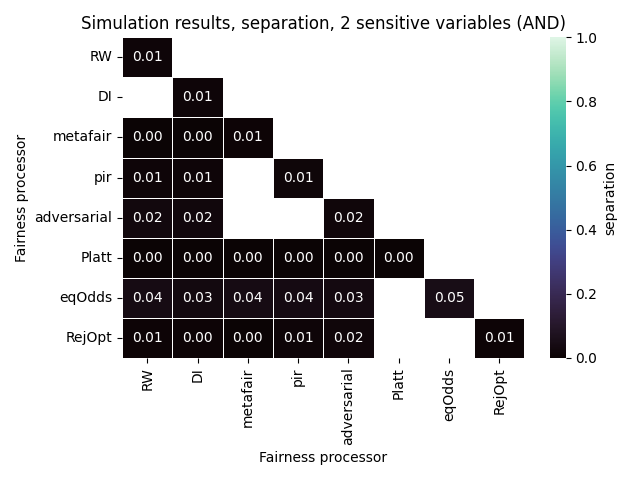
Теперь мы переходим к анализу разделения с помощью рисунков 3 и 4. В целом результаты очень однородны, достигая уровня разделения, близкого к во всех случаях. Как и точность, разделение MP не ограничено снизу (возьмите комбинацию из disparate impact remover и metafair classifier в унимариантном случае) и не ограничено сверху (возьмите комбинацию из reweighting и reject option в унимариантном случае) справедливостью его составляющих. В любом случае использование MP также может приводить к повышению справедливости. В частности, некоторые MP представляются особенно многообещающими: возьмите комбинацию disparate impact remover и metafair classifier при использовании OR processsing. Таблица 3 показывает, как их взаимодействие приводит к одному из лучших решений: они являются лидерами и по точности (они демонстрируют наилучшую точность при использовании OR processing), и по справедливости (обеспечивая идеальное разделение), несмотря на то, что их составляющие показывают худшую точность.
| Processor | Accuracy | Fairness |
| Disparate impact remover | ||
| Metafair classifier | ||
| Combination |
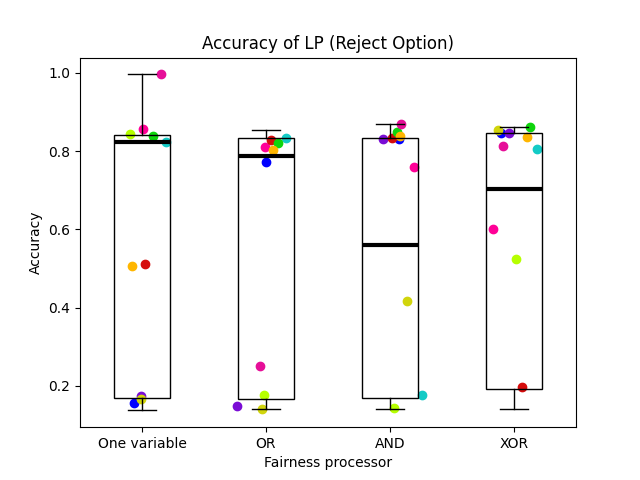
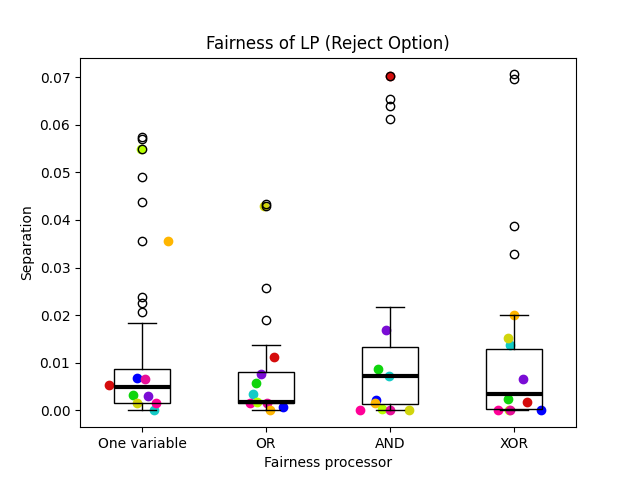
Наконец, на Рисунке 5 мы более подробно изучаем влияние MPs и LPs с помощью диаграмм размаха, которые позволяют проанализировать распределение как точности, так и разделения. Кроме того, чтобы лучше изучить взаимосвязи между различными методами, мы выделяем десять отдельных симуляционных экземпляров, выбранных случайным образом, с разным цветом. Для изучения MPs мы обращаем внимание на сочетание переназначения весов с регуляризатором индекса предубеждений, которое дало хорошие результаты как с точки зрения справедливости, так и точности. Чтобы изучить LPs, мы используем классификатор с вариантом отклонения, который оказался особенно чувствительным к изменениям в LP.
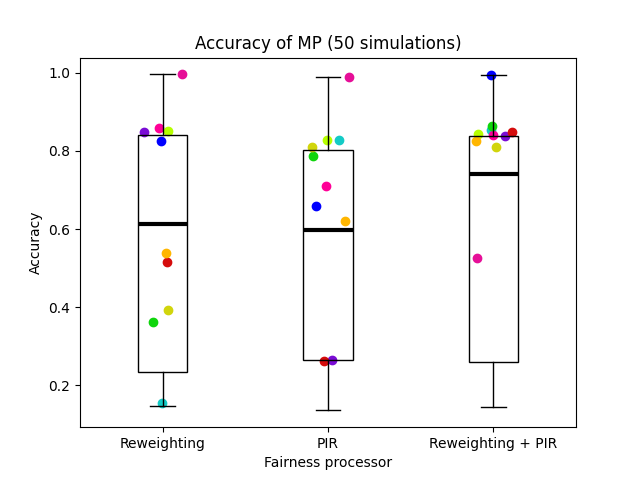
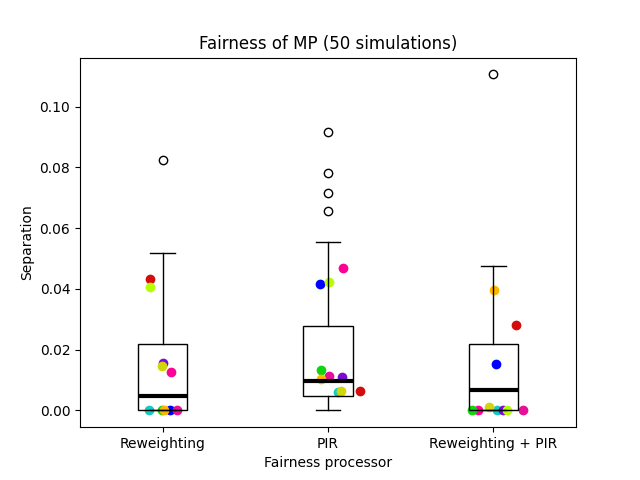
Результаты по переразвешиванию и регуляризатору индекса предвзятости показывают, что эти классификаторы в среднем не демонстрируют столь плохих результатов, как на выбранном нами экземпляре симуляции, и что их комбинация не превосходит их столь же резко, как это было в том случае. Тем не менее тот факт остается: их комбинация дает заметное улучшение точности. Если обратить внимание на отдельные точки, можно найти некоторые случаи, в которых применение MP дает значимое улучшение по сравнению с отдельными процессорами индивидуальной справедливости. Это особенно примечательно для красной точки, которая формирует очень точный классификатор в ситуации, где оба индивидуальных процессора работают относительно плохо, и для синей точки, где два точных алгоритма при объединении дают идеальную точность. В целом улучшение заметно, но умеренно; в худшем сценарии применение MP может привести к резкому снижению точности, что и наблюдается для розовой точки. С точки зрения справедливости применение одного лишь переразвешивания дает результаты, которые немного более справедливы с точки зрения разделения, однако это улучшение не столь значимо. При более внимательном рассмотрении большинство экземпляров симуляции лежат близко к нулю для всех трех методов. Особенно примечателен случай решений вроде зеленых, которые по отдельности относительно несправедливы и неточны, но при объединении становятся идеально справедливыми и показывают наилучшие результаты. Однако встречаются и ситуации вроде оранжевой точки, которая порождает относительно несправедливое решение из справедливых составляющих. В целом, если рассматривать масштаб графика, становится ясно, что все решения близки к идеальному разделению. В целом, комбинация этих двух методов, по-видимому, приводит к более качественному, справедливому классификатору.
Обратим внимание на результаты для варианта с опцией отказа: видно, что при учёте нескольких чувствительных переменных производительность стабильно ухудшается, хотя этот эффект зависит от выбора LP: при OR-обработке точность почти не снижается, XOR приводит к падению производительности примерно на , а использование AND даёт потерю почти в точности. С другой стороны, отметим, что применение LP, по-видимому, приводит к меньшей дисперсии распределения точности. При рассмотрении отдельных решений особенно заметно, как использование некоторых логических процессоров может ухудшать точность некоторых классификаторов (например, розовая точка при OR-обработке или зеленоватая точка при XOR). Однако примечательно, что некоторые случаи демонстрируют скачки точности просто за счёт применения логической обработки. Так, жёлтая точка, показавшая ужасную работу (около ) в одномерном случае, при использовании XOR-обработки демонстрирует увеличение точности почти на , тем самым улучшая свою точность до ; и для синей точки, которая аналогично повышается при OR-обработке. В любом случае, общая тенденция такова, что отдельные решения ухудшают свою производительность как минимум в одном из случаев. С точки зрения справедливости различия, хотя и менее выраженные, всё же сохраняются. И OR, и XOR дают лучшие результаты по справедливости по сравнению со случаем одной чувствительной переменной: при этом первый обеспечивает наименьшее разделение; тогда как использование AND, напротив, приводит к худшему классификатору с точки зрения справедливости. При рассмотрении отдельных экземпляров можно видеть, как некоторые логические процессоры могут затруднять разделение. Это относится к красной точке: её справедливость нарушается настолько, что при AND-обработке она становится выбросом. С другой стороны, такие экземпляры, как оранжевый, находят большие улучшения при любом типе логической обработки. В целом, наиболее подходящим инструментом для работы с несколькими чувствительными переменными для опции отказа, по-видимому, является OR-обработка.
Это имитационное исследование служит удовлетворительной демонстрацией того, что логические и многоступенчатые процессоры могут сохранять как справедливость, так и точность и, кроме того, улучшать их. Однако сделанные нами выводы являются результатом агрегирования нескольких имитационных экземпляров. Чтобы лучше понять производительность различных методов в индивидуальной постановке, мы включили результаты для одного имитационного экземпляра в Приложение. В целом результаты имитаций весьма оптимистичны и дали полезные сведения, которые будут проверены в рамках тематического исследования.
4.2 Пример из практики: немецкий набор данных
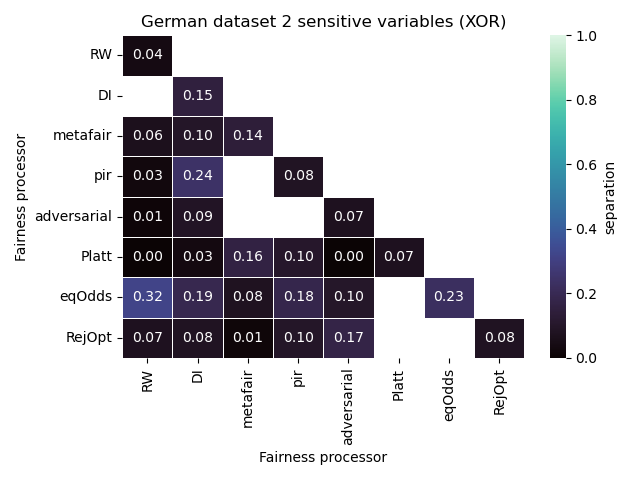
Результаты обобщены на рисунках 6–11. Анализ начинается снова с проверки точности процессоров, которую можно визуализировать на рисунках 6 и на рисунке 7⟧.
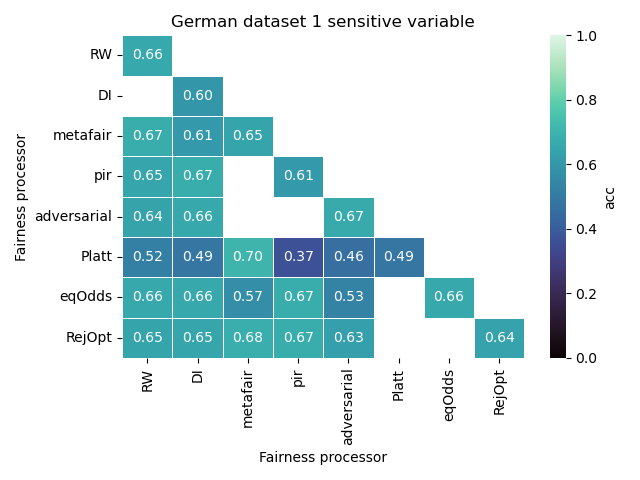
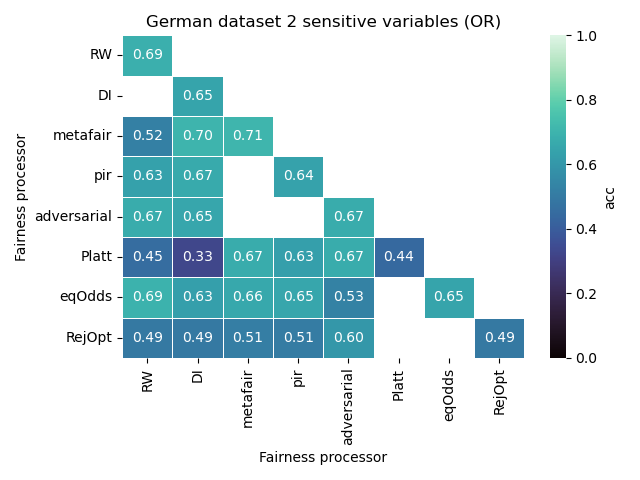
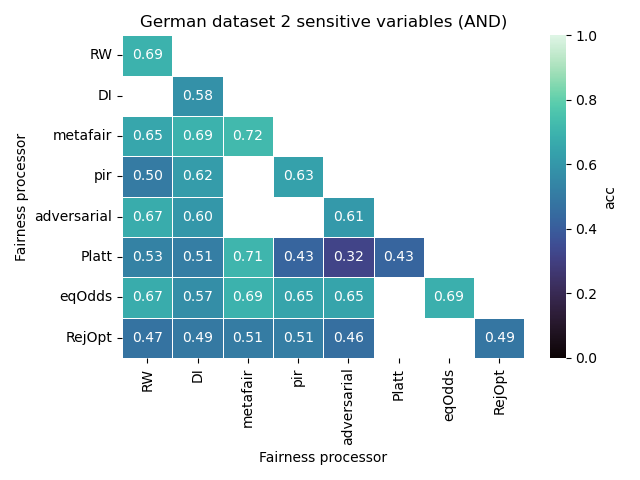
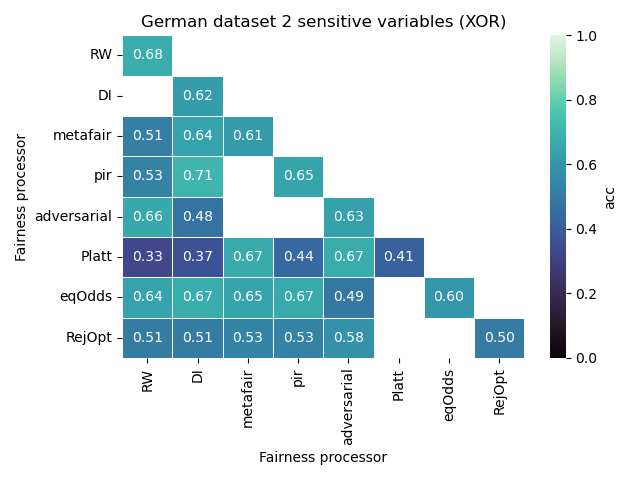
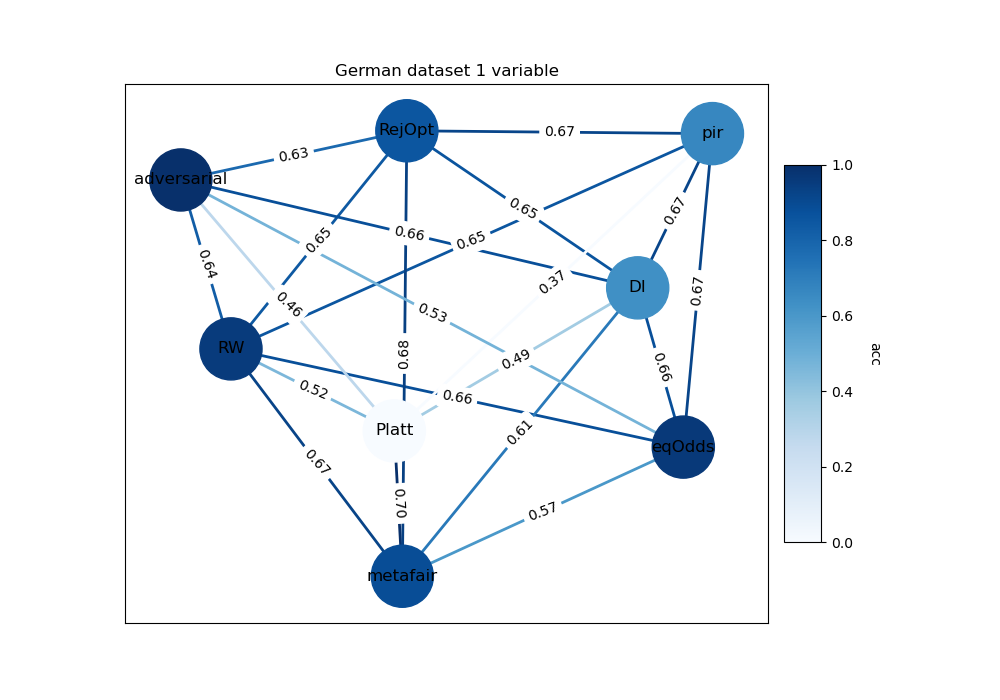
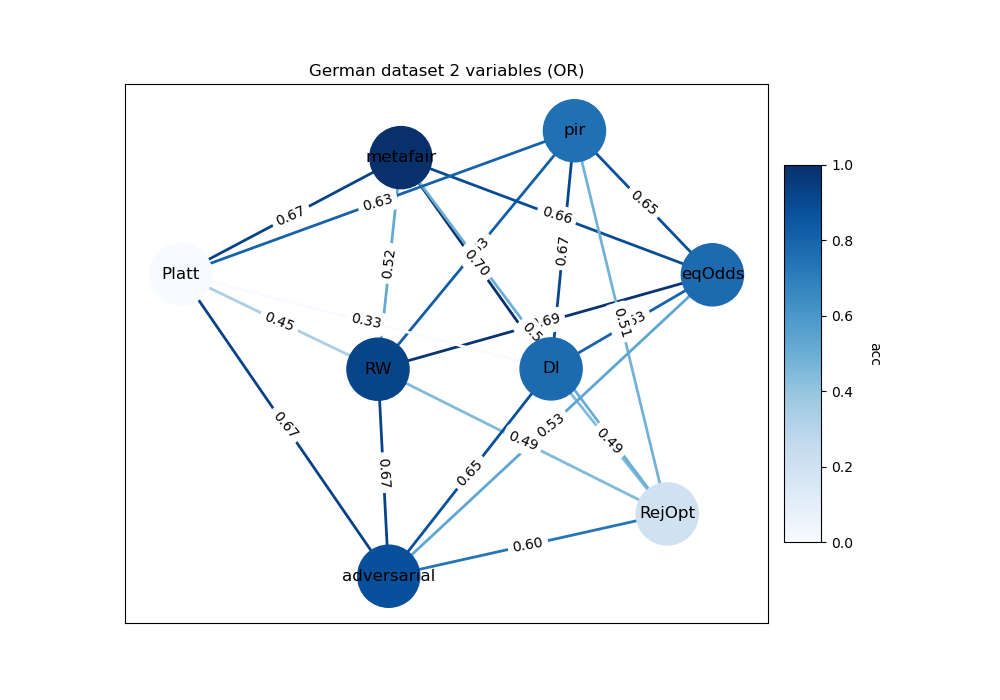
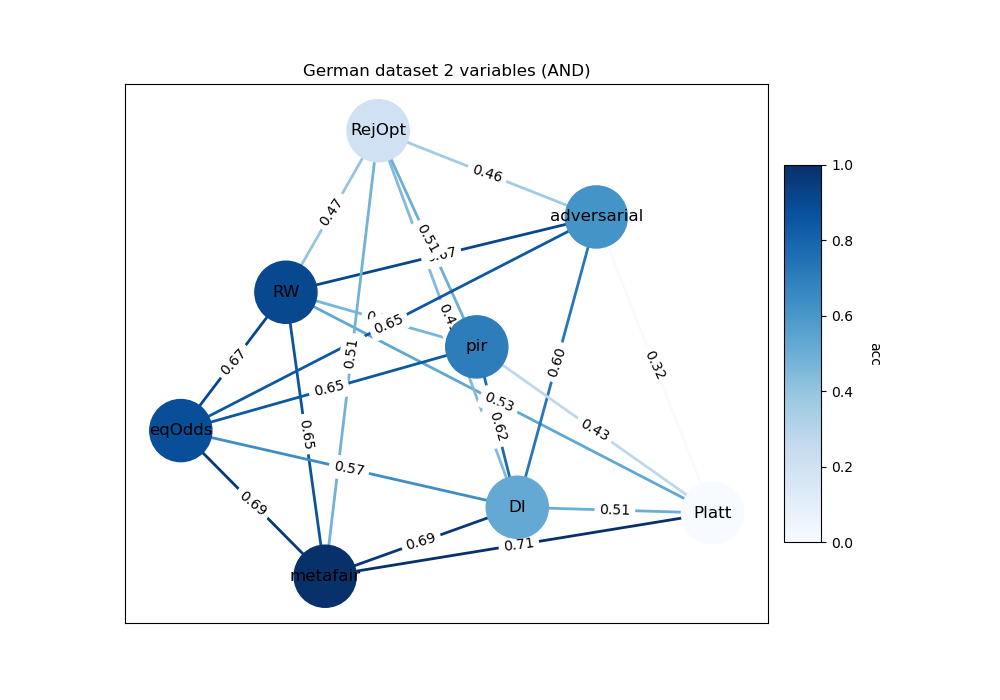
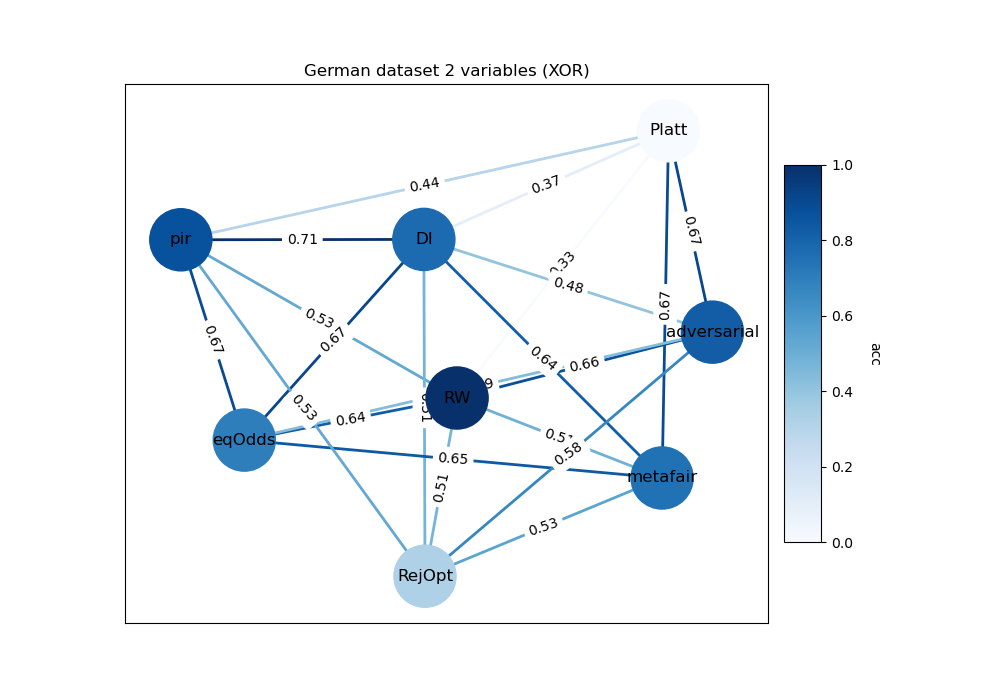
В целом результаты теперь гораздо более равномерны во всех аспектах: нет крайних выбросов ни в одну, ни в другую сторону. Кроме того, подтверждается, что точность многоступенчатого процессора не ограничена сверху (например, комбинация предвзятости индекса регуляризатора, , и варианта с отказом, , в случае одной чувствительной переменной) и не ограничена снизу (например, комбинация предвзятости индекса регуляризатора, , и масштабирования Платта, , в одномерном случае) по отношению к производительности его составляющих. Это подтверждает предыдущие выводы. Кроме того, в некоторых сценариях наиболее точным процессором является многоступенчатый; рассмотрим, например, случай одной чувствительной переменной: наивысшая точность достигается при объединении классификатора metafair, , с масштабированием Платта, .
Комбинации PI обеспечивают наиболее согласованную производительность во всех комбинациях: процедуры PP и IP могут снижать точность до уровней, близких к , но худшие по результатам PI-процессоры находятся примерно на , а самый худший — это комбинация разнородного воздействия и adversarial debiasing на . В одномерном случае половина методов PI улучшает производительность своих составляющих. Однако в многомерном случае результаты демонстрируют большую вариативность, при этом выбор LP сильно влияет на производительность. Похоже, что процессоры OR и AND сохраняют точность, а иногда даже улучшают ее (например, комбинация DI и metafair). С другой стороны, XOR LP дает крайне вариативные результаты: этот метод отвечает за наиболее точный PI в сочетании разнородного воздействия remover и регуляризатора prejudice index, а также за худшую производительность в паре с разнородного воздействия remover и adversarial debiasing. Методы PP лучше всего работают в одномерном сценарии. Тем не менее, по крайней мере половина всех процессоров имеет точность или ниже при использовании LP. Худшие методы в этой категории обычно те, которые включают Platt scaling, что, по-видимому, ухудшает производительность. Тем не менее некоторые комбинации все еще выглядят перспективно, например те, что связаны с equal odds, которые обычно сохраняют точность и даже улучшают ее при сочетании с разнородным воздействием в случае XOR. Процессоры IP, напротив, демонстрируют синергетические связи между различными методами обеспечения справедливости. Возьмем для примера комбинации с Platt scaling. В целом Platt scaling — это процессор с худшей производительностью, но при паре с классификатором metafair он всегда улучшает точность и иногда даже превосходит производительность процессора в варианте in-processor. Эта связь позволяет сделать данную комбинацию лучшим исполнителем в индивидуальном случае и обеспечивает хорошие результаты во всех остальных сценариях. Однако комбинация может также оказаться вредной. Так происходит с другими методами IP, включающими Platt scaling, которые могут снижать точность до уровней, близких к . В любом случае результаты процедур IP — это неоднозначная картина, и они в основном зависят от выбора post-processor. Этот вывод можно распространить и на комбинации PP, и это еще один пример доминирующего поведения, наблюдавшегося в исследовании моделирования, хотя теперь оно более сдержано. В целом комбинации, включающие Platt scaling, могут демонстрировать сильную вариативность и во многих случаях существенно ухудшать точность, хотя некоторые конкретные комбинации могут приводить к исключительным результатам. MP с equal odds дает в целом хорошую производительность, тогда как варианты с reject option несколько ухудшают справедливость в многомерном случае, при этом точность остается согласованной.
Производительность классификатора не изменяется столь сильно, как в исследовании моделирования при использовании LP. Это означает, что логические процессоры являются подходящим инструментом для работы с несколькими чувствительными переменными, поскольку они позволяют достигать сопоставимых уровней точности по сравнению со случаем одной переменной. Однако выбор логической операции может существенно влиять на производительность: Возьмем, например, многостадийный процессор, который сочетает adversarial debiasing с Platt scaling. Использование OR LP повышает производительность примерно на , тогда как AND procesor приводит к снижению почти на . В целом результаты более согласованы при использовании OR LP.
.png)
.png)
.png)
.png)
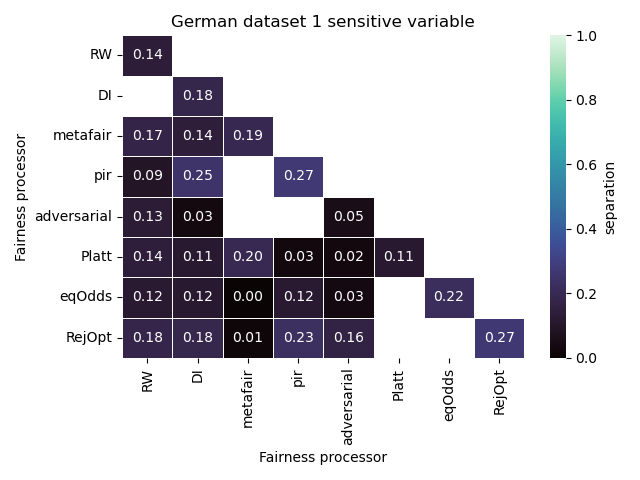
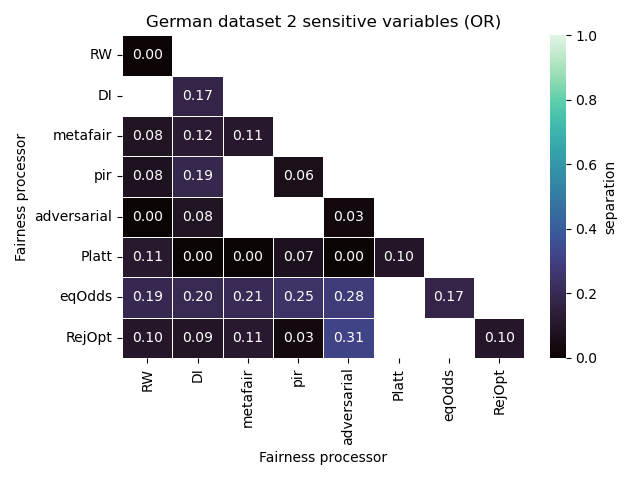
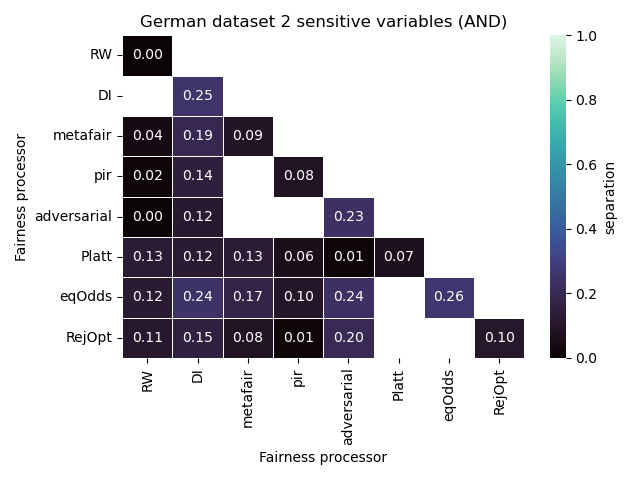
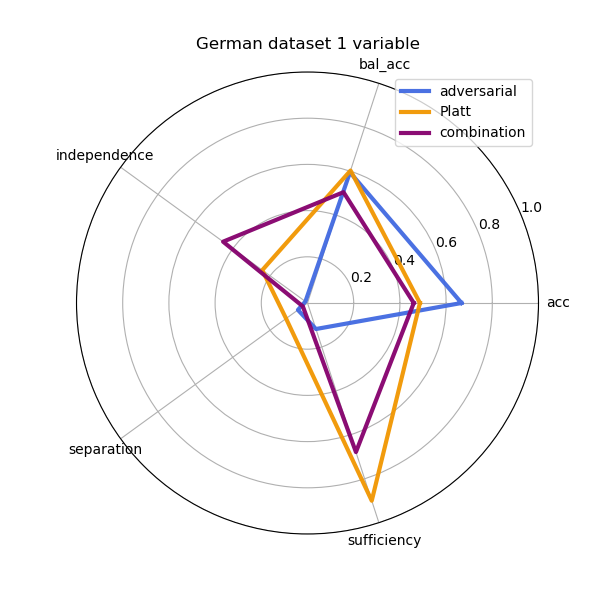
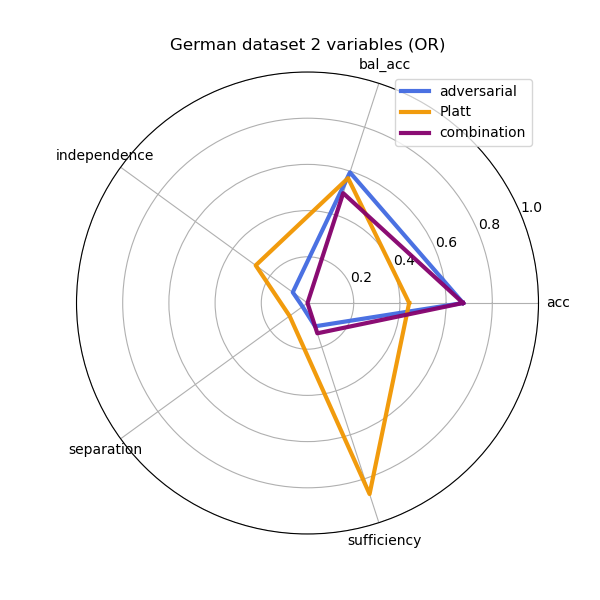
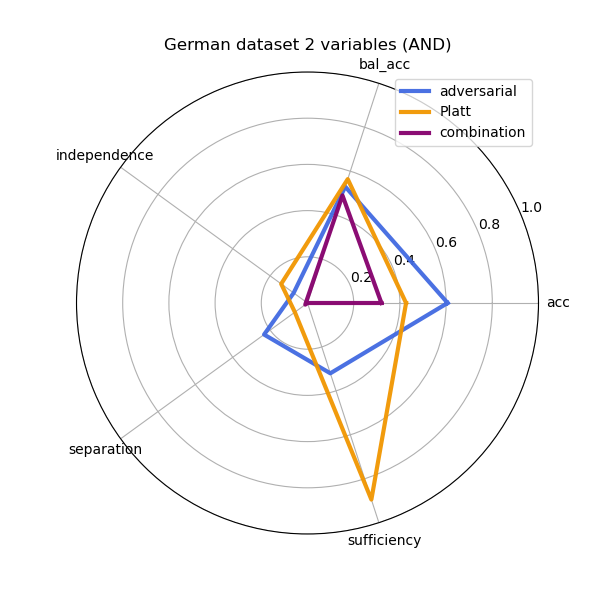
Исследование теперь продолжается с анализом разделения. Оно опирается на Рисунок 8 и Рисунок 9. Справедливость снова не нарушается при использовании MP или LP. Более того, их применение приводит к улучшению справедливости в некоторых случаях. Это особенно позитивно в ситуациях, когда MP двух среднеэффективных методов приводит к исключительно справедливому процессору; например, комбинация предиктного индекса регуляризатора с Platt scaling, , в случае одной чувствительной переменной. Кроме того, эти MP могут быть лидерами как по справедливости, так и по точности; например, adversarial debiasing и Platt scaling в случае двух чувствительных атрибутов с OR LP, чьи показатели можно увидеть на Рисунке 10.
В целом MPs меньше всего дискриминируют в многомерном случае, при этом правильный выбор зависит от каждого процессора. Комбинации PI в наибольшей степени уменьшают дискриминацию, когда они включают пере-взвешивание. Худшая пара методов в этой категории задаётся MP, состоящим из средства для удаления несоразмерного воздействия (disparate impact remover) и регуляризатора индекса предвзятости, оба в одномерном случае, , и при использовании XOR, . С другой стороны, наилучшая пара задаётся пере-взвешиванием и противодействующим устранением предвзятости (adversarial debiasing) как с OR, , так и с AND, , LPs.
Выбор пост-обработчика, по-видимому, оказывает большое влияние на разделение PP и IP. Самые худшие сочетания возникают при использовании равных шансов, тогда как лучшие в основном включают Platt scaling, хотя важно учитывать компромисс по точности. Сочетание PP-перевзвешивания и процессора с равными шансами дает худший результат в целом с точки зрения разделения, в то время как наиболее смещенный IP получается при adversarial debiasing и использовании reject option. В целом результаты по справедливости более однородны, чем они были по точности.
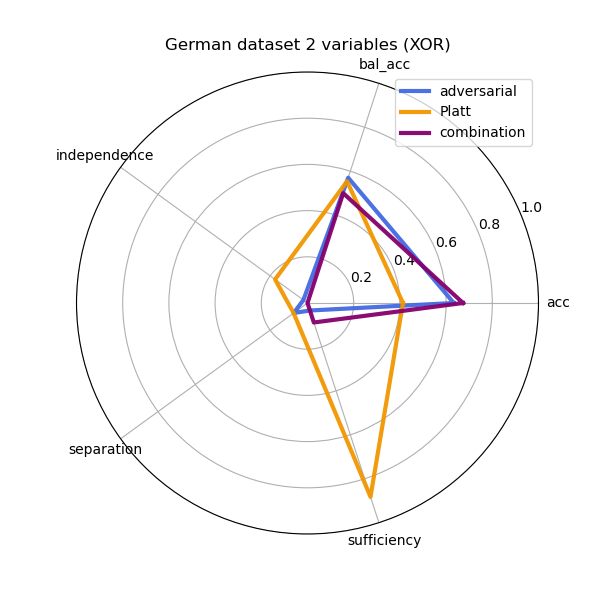
Теперь мы проанализируем взаимодействие одного единственного MP, противодействия смещению и Platt scaling с помощью радарных графиков, представленных на рисунке 10. Выбор LP влияет на результаты: комбинация метода превосходит по точности как обе свои составляющие при использовании OR и XOR LPs. Однако она уступает обоим им в двух других сценариях. В любом случае разделение всегда улучшается при использовании этой комбинации, что указывает на то, что взаимодействие этих двух процессоров существенно повышает справедливость в этом показателе.
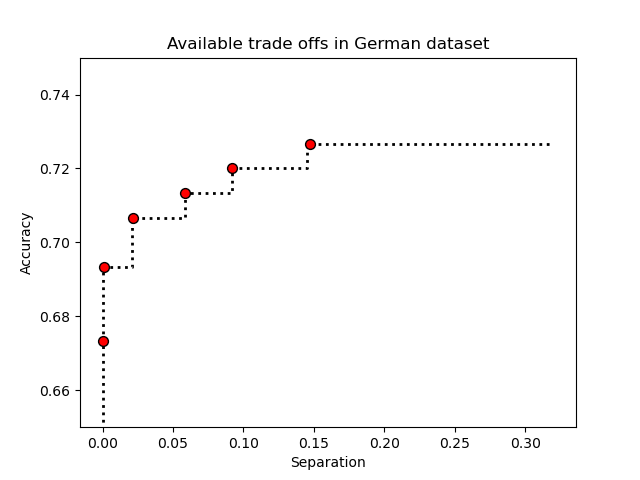
Наконец, доступные компромиссы между точностью и разделением можно визуализировать через эффективную по Парето границу на рисунке 11, которая показывает, что можно получить улучшение разделения почти на при потере менее чем по точности; иными словами, можно едва пойти на компромисс по производительности, одновременно добиваясь больших улучшений справедливости.
5 Выводы и дальнейшие исследования
Настоящая статья поставила целью представить две новые методики в контексте справедливого машинного обучения для скоринга кредитоспособности.
Первый вклад — логические процессоры или LP, которые предоставляют способ легко обрабатывать несколько чувствительных атрибутов. Результаты, полученные как в ходе моделирования, так и в рамках кейс-исследования, показывают, что этот метод сохраняет и точность, и справедливость, что делает его подходящим для поставленной задачи. Кроме того, их легко развернуть, и они могут быть реализованы как этап предварительной обработки, что облегчает разработку новых справедливых алгоритмов без необходимости беспокоиться о том, можно ли их применить к нескольким чувствительным переменным. Тем не менее, в данной работе исследовался только двумерный случай, поэтому важно изучить масштабируемость этого инструмента для обработки более чем двух чувствительных переменных.
Второй вклад вносят многостадийные процессоры или MPs, которые атакуют несколько стадий справедливого конвейера, чтобы повысить справедливость и точность. В частности, мы искали синергические сочетания методов, которые уже были установлены в литературе. Результаты показывают, что эти новые процессоры обеспечивают новые компромиссы между справедливостью и производительностью, что необходимо для лиц, принимающих решения, и дает новые способы работы с несправедливыми данными или моделями. Кроме того, некоторые случаи этих MPs приводят к улучшенному разделению и точности, превосходя существующие методы.
Наконец, результаты этого исследования можно распространить на области, далеко выходящие за рамки кредитного скоринга: предложенные нами идеи не ограничиваются этой задачей. Кроме того, другие области могут извлечь пользу из удобства, которое LPs обеспечивают для обработки нескольких конфиденциальных переменных, или из новых решений по справедливости, найденных в MPs.
Некоторые потенциальные направления для расширения наших исследований включают:
5.1 Больше процессоров
Эта статья рассматривает ограниченную выборку многостадийных и логических процессоров. Однако остается неясным, можно ли улучшить результаты, используя новые, более оригинальные многостадийные процессоры, которые задействуют данную основу уникальными способами, а не просто объединяют процессоры, обеспечивающие справедливость. С другой стороны, хотя мы показали эффективность логических процессоров при работе с несколькими чувствительными переменными, остается неясным, насколько хорошо они обобщаются при наличии трех или более чувствительных атрибутов. Кроме того, при обработке более двух защищенных переменных возможное количество логических процессоров резко возрастает, что ставит вопрос о том, как сделать подходящий выбор.
5.2 Интерпретация и объяснения
Показанные результаты являются положительными и позволяют нам сформировать определенные интуиции о многостадийных процессорах. Однако остается много вопросов о взаимосвязях и взаимодействиях между процедурами обеспечения справедливости: улучшает ли применение этого конкретного предварительного процессора прогнозы этого процессора внутри? Почему или почему нет? В каких сценариях? Ответы на эти вопросы могли бы углубить наше понимание того, почему и как работают MPs. С другой стороны, выводы, сделанные для LPs, кажутся оптимистичными, но, возможно, при работе с другими чувствительными атрибутами, такими как раса или религия, результаты могут измениться по социологическим причинам. Более тщательный обзор последствий использования логических процессоров в более разнообразных контекстах мог бы пролить свет на наше понимание логических процессоров.
5.3 Подбор гиперпараметров
Статья исследует взаимодействие различных модулей обеспечения справедливости при фиксированных гиперпараметрах. Однако это означает, что не изучено одно направление: проверить, могут ли эти новые многоэтапные процессоры превзойти свои индивидуальные аналоги, если их гиперпараметры настроены. Кроме того, результаты покажут оптимальные конфигурации при объединении процессоров, что должно пролить свет на то, как именно они взаимодействуют.
Благодарности
Это исследование является частью проектов НИОКР и инноваций PDC2022-133359, PID2022-137243OB-I00 и PID2022-137818OB-I00, финансируемых Ministerio de Ciencia, Innovación y Universidades/AEI/10.13039/501100011033 и Европейским союзом NextGenerationEU/PRTR. Данная инициатива также была частично выполнена в рамках фондов Плана восстановления, трансформации и устойчивости, финансируемого Европейским союзом (Next Generation) посредством гранта ANTICIPA и ENIA 2022 Chairs для создания университетско-промышленных кафедр в AI-AImpulsa: UC3M-Universia.
Appendix A Анализ отдельного экземпляра моделирования
Мы приводим результаты для одного экземпляра имитационного исследования, чтобы изолировать производительность и справедливость рассматриваемых методов в этих условиях, с идеей лучше понять поведение процессоров на одном наборе данных. Эти результаты обобщены на рисунке 12 – на рисунке 14. Анализ мы начинаем с проверки точности методов, которую можно визуализировать на рисунке 12⟧.
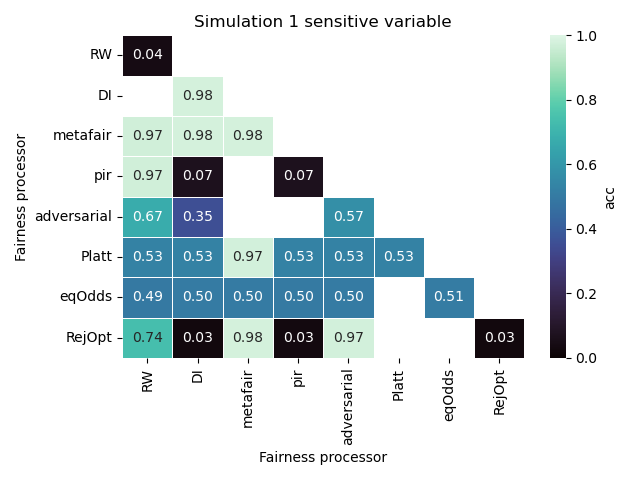
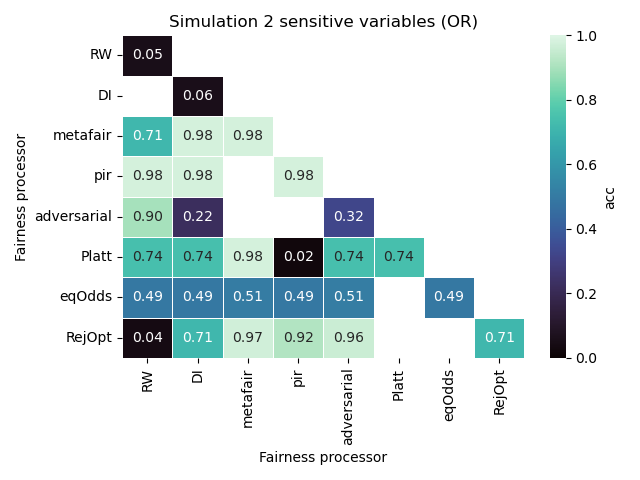
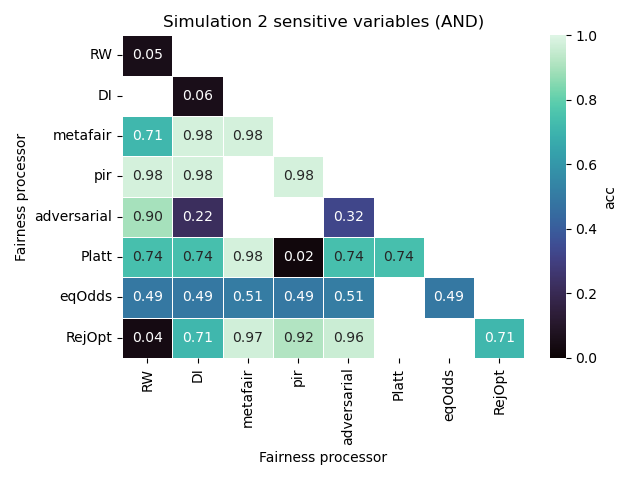
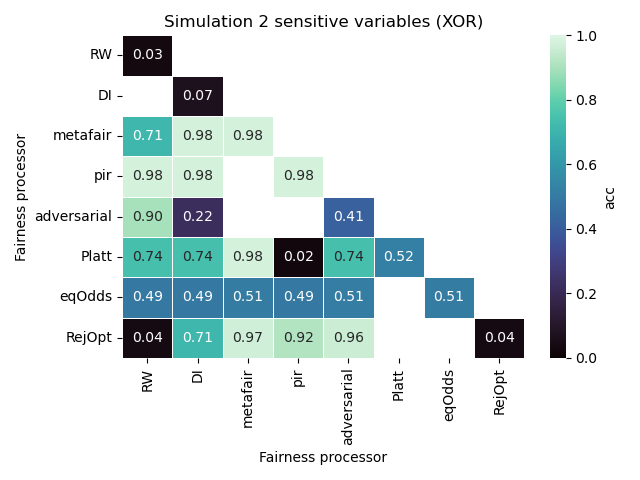
На первый взгляд симуляция кажется безоговорочно успешной: совместное использование процессоров справедливости может приводить к значительным улучшениям производительности. Это относится к MP, состоящему из переназначения весов и регуляризатора индекса предвзятости. Эти два процессора являются одними из худших по результатам в унимерном случае при уровне точности ниже . Однако MP, который объединяет их, достигает одной из лучших точностей в пакете, достигая . Однако есть некоторые MP, которые показывают худшие результаты по сравнению со своими составляющими, хотя, по-видимому, их меньшинство.
Использование пост-обработчика (как для PP, так и для IP) представляется оказывающим большое влияние на производительность результирующего MP, демонстрируя доминирующее поведение, которое мы ранее предполагали. Особенно это ясно в случае процессора равных шансов, где каждый MP, включающий его, имеет точность около .
Выбор логического процессора, по-видимому, не оказывает большого влияния на общее качество прогнозов классификаторов, но является причиной значительных вариаций для некоторых процессоров. Например, масштабирование Платта, по-видимому, работает лучше всего при использовании процедур AND или OR, тогда как противодействующее устранение смещений выполняется лучше всего при использовании процессора XOR.
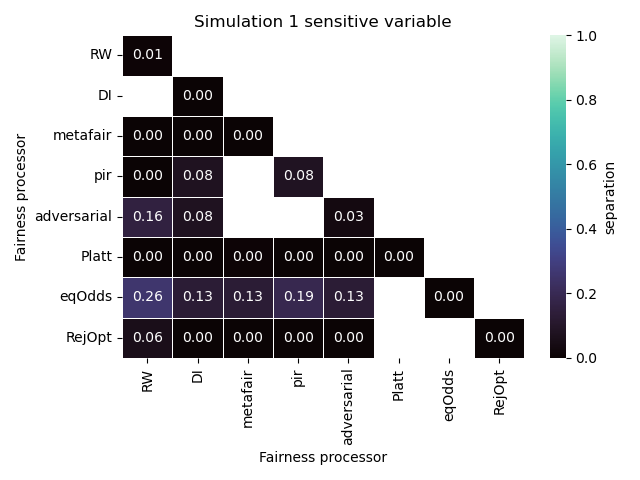
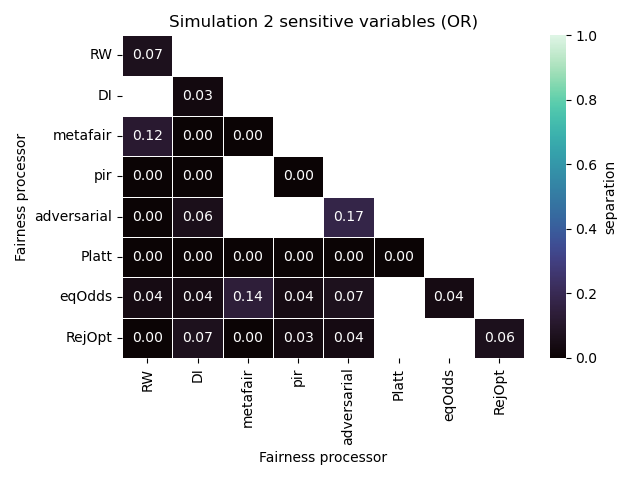
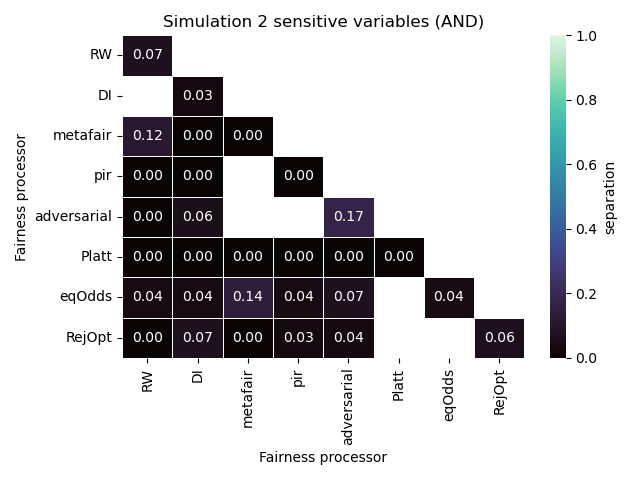
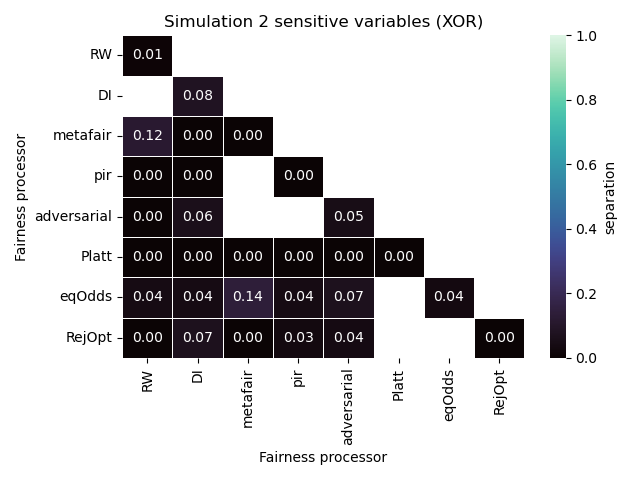
Разделение методов можно наглядно представить на Рисунке 13. В целом во всех ситуациях достигается высокий уровень справедливости: уровень разделения в целом близок к . В любом случае применение MPs также может приводить к улучшению справедливости. В частности, в унимодальном случае сочетание переразвешивания и регуляризатора индекса предвзятости представляется особенно перспективным. Таблица 4 показывает, как их взаимодействие приводит к одному из лучших решений, являясь лидером по точности (в унимодальном случае у него вторая по величине точность) и справедливости (достигается идеальное разделение), даже несмотря на то, что их составляющие демонстрируют низкую точность.
| Processor | Accuracy | Fairness |
| Reweighting | ||
| Prejudice index regularizer | ||
| Combination |
Обратив внимание на LP, их использование не ухудшает справедливость и даже улучшает разделение для процессоров с равными шансами. В любом случае выбор LP в данном случае, похоже, не имеет значения, поскольку он отвечает лишь за небольшие различия в некоторых процессорах, таких как adversarial debiasing.
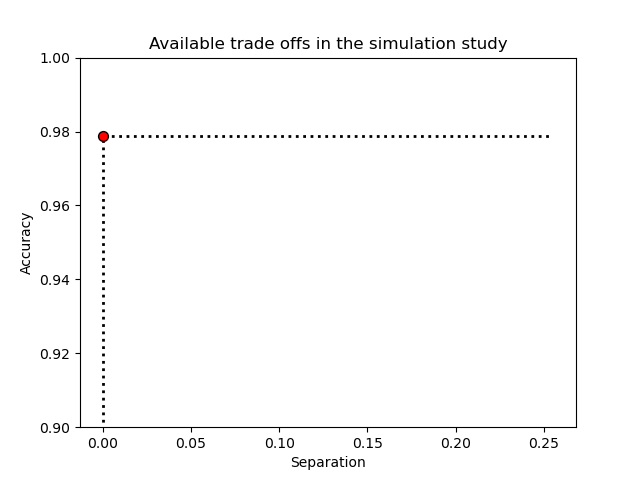
Наконец, мы можем визуализировать доступные компромиссы между справедливостью и точностью с помощью эффективной по Парето границы на рисунке 14. Действительно, плоская форма границы указывает на отсутствие доступных компромиссов, что является следствием высоких уровней справедливости и точности, которые можно достичь.
Ссылки
- [1] Н. Р. Кунсел, Д. М. Клиегер, Д. С. Уонес, При найме алгоритмы побеждают интуицию, Harvard business review 92 (5) (2014) стр. 32–32.
- [2] C.-W. Park, S. W. Seo, N. Kang, B. Ko, B. W. Choi, C. M. Park, D. K. Chang, H. Kim, H. Kim, H. Lee, et al., Artificial intelligence in health care: current applications and issues, Journal of Korean medical science 35 (42) (2020).
- [3] P. Birzhandi, Y.-S. Cho, Применение справедливости к здравоохранению, организационной справедливости и финансам: обзор, Expert Systems with Applications 216 (2023) 119465.
- [4] A. Катлер, М. Прбич, Л. Хамфри, Повседневная этика для искусственного интеллекта, PDF, IBM Corporation (2019).
- ⟦G. A. Diamond, Какова цена совершенства? калибровка и различение клинических прогностических моделей, Journal of clinical epidemiology 45 (1) (1992) 85–89.
- [6] Л. Дж. Местер и др., В чем смысл скоринга кредитоспособности, Business review 3 (сентябрь/октябрь) (1997) 3–16.
- ⟦[7] S. Caton, C. Haas, Справедливость в машинном обучении: обзор, ACM Computing Surveys 56 (7) (2024) 1–38.
- ⟦T. H. Malloy, Стандарты для устранения усугубленной дискриминации: случай пересечения «меньшинств внутри меньшинств» или почему универсальные правовые стандарты должны взаимодействовать с понятием культуры, в: Double Standards Pertaining to Minority Protection, Brill Nijhoff, 2010, cc. 259–296.
- [9] T. P. Pagano, R. B. Loureiro, F. V. Lisboa, R. M. Peixoto, G. A. Guimarães, G. O. Cruz, M. M. Araujo, L. L. Santos, M. A. Cruz, E. L. Oliveira, et al., Смещения и несправедливость в моделях машинного обучения: систематический обзор наборов данных, инструментов, метрик справедливости, а также методов выявления и смягчения, Big data and cognitive computing 7 (1) (2023) 15.
- [10] Y. Ли, М. Ду, Р. Сун, Х. Ван, Y. Ван, Обзор по вопросам справедливости в больших языковых моделях, препринт arXiv arXiv:2308.10149 (2023).
- ⟦[11] S. Barocas, M. Hardt, A. Narayanan, Fairness and machine learning: Limitations and opportunities, MIT press, 2023.
- [12] F. Камайран, А. Карим, X. Чжан, Теория решений для классификации с учетом дискриминации, в: 2012 IEEE 12-я международная конференция по анализу данных, IEEE, 2012, стр. 924–929.
- [13] Б. Х. Чжан, Б. Лемуан, М. Митчелл, Снижение нежелательных смещений с помощью состязательного обучения, в: Материалы конференции 2018 AAAI/ACM по искусственному интеллекту, этике и обществу, 2018, стр. 335–340.
- [14] N. Kozodoi, J. Jacob, S. Lessmann, Fairness in credit scoring: Assessment, implementation and profit implications, European Journal of Operational Research 297 (3) (2022) 1083–1094.
- ⟦[15] R. B. Rubin, The uniform guidelines on employee selection procedures: compromises and controversies, Cath. UL Rev. 28 (1978) 605.
- [16] М. Хардт, Э. Прайс, Н. Сребро, Равенство возможностей в контролируемом обучении, Труды по усовершенствованию нейронной обработки информации 29 (2016).
- [17] T. Калдерс, Ф. Камиран, М. Печенизкий, «Построение классификаторов с ограничениями независимости», in: 2009 IEEE международная конференция по семинарам по анализу данных, IEEE, 2009, стр. 13–18.
- ⟦[18] С. Фридлер, К. Шайдеггер, С. Венкатасубраманиан, «Сертификация и устранение несоразмерного неблагоприятного воздействия», препринт arXiv, arXiv:1412.3756 (2014).
- [19] T. Kamishima, S. Akaho, H. Asoh, J. Sakuma, Fairness-aware classifier with prejudice remover regularizer, в: Machine Learning and Knowledge Discovery in Databases: European Conference, ECML PKDD 2012, Bristol, UK, 24–28 сентября 2012 г. Proceedings, Part II 23, Springer, 2012, стр. 35–50.
- ⟦[20] L. E. Celis, L. Huang, V. Keswani, N. K. Vishnoi, Классификация с ограничениями по справедливости: метаалгоритм с доказуемыми гарантиями, в: Материалах конференции по вопросам справедливости, подотчетности и прозрачности, 2019, стр. 319–328.
- [21] J. Platt, и др., Вероятностные выходные данные для опорных векторных машин и сравнение с методами регуляризованного правдоподобия, Advances in large margin classifiers 10 (3) (1999) 61–74.
- [22] А. Е. Ро, К.-Х. Чои, Социальный статус и связь с сообщениями о гендерной дискриминации и расовой дискриминации среди женщин с расовым разнообразием, Women & health 49 (1) (2009) 1–15.
- ⟦Немецкий набор данных, https://archive.ics.uci.edu/dataset/144/statlog+german+credit+data, доступ: 2024-12-04.
- [24] F. Kamiran, T. Calders, Classifying without discriminating, in: 2009 2nd international conference on computer, control and communication, IEEE, 2009, pp. 1–6.