Языковое моделирование для будущего финансов: количественный обзор метрик, задач и возможностей данных
Аннотация
Недавние достижения в области языкового моделирования привели к растущему интересу к применению методов Natural Language Processing (NLP) для решения финансовых задач, что открывает новые подходы к анализу и принятию решений. Чтобы систематически изучить эту тенденцию, мы рассматриваем 374 научные статьи по NLP, опубликованные в период с 2017 по 2024 год на 38 конференциях и семинарах, с фокусным анализом 221 статьи, которые непосредственно касаются задач, связанных с финансами. Мы оцениваем эти работы по 11 качественным и количественным измерениям, выявляя ключевые тенденции, такие как растущее использование LLM общего назначения, устойчивый прогресс в анализе тональности и извлечении информации, а также новые усилия в области объяснимости и методов сохранения конфиденциальности. Мы также обсуждаем использование метрик оценки, подчеркивая важность предметно-ориентированных метрик для дополнения стандартных метрик машинного обучения. Наши выводы подчеркивают потребность в более доступных, адаптивных наборах данных и указывают на значимость включения периодов финансового кризиса для повышения устойчивости моделей в реальных условиях. Этот обзор предоставляет структурированный взгляд на исследования в области NLP, применяемые в финансах, и предлагает практические идеи для исследователей и практиков, работающих на стыке этих дисциплин..
1 Введение
Языковое моделирование стало ключевым инструментом в обработке естественного языка (NLP) для анализа неструктурированных текстов, включая отчеты, новостные статьи и публикации в социальных сетях. Эти методы все чаще применяются для решения финансовых задач, таких как анализ тональности (Balakrishnan et al. 2022), извлечение информации (Huang et al. 2023), суммаризация (Khanna et al. 2022), прогнозирование акций (Jain & Agrawal 2024) и прогнозирование волатильности (Niu et al. 2023). Учитывая растущее число научных работ по NLP, посвященных финансовым проблемам, существует необходимость в систематическом изучении того, какой вклад данная область вносит в финансовые приложения. Хотя в предыдущих обзорах рассматривалось это пересечение (Таблица 1), многие из них используют качественный подход (Chen et al. 2022b; Gao et al. 2021b; Xiao et al. 2024a), фокусируясь на общих методах NLP (Jagdale & Deshmukh 2025; Man et al. 2019; Liu 2024), глубоком обучении (Ozbayoglu et al. 2020) и LLMs (Nie et al. 2024; Li et al. 2023c) или на конкретных задачах, таких как анализ тональности (Mishev et al. 2020). Однако этим исследованиям часто не хватает систематической оценки.
В этом исследовании мы фокусируемся конкретно на исследованиях в области NLP, применяемых в финансах. Наша область охватывает статьи, опубликованные на площадках NLP, где методы разрабатываются, проходят бенчмаркинг или адаптируются для финансовых задач. Мы анализируем 374 статьи, опубликованные с 2017 по 2024 год на 38 конференциях и семинарах по NLP. После дополнительной фильтрации (раздел 2) мы отобрали 221 статью, которые напрямую касаются задач, связанных с финансами. Они оцениваются по 11 качественным и количественным параметрам, включая задачи, методологии, наборы данных, метрики оценки и доступность..
Наш анализ выявляет несколько закономерностей в текущем ландшафте исследований. К числу часто решаемых задач относятся анализ тональности, извлечение информации и QA, в то время как такие области, как объяснимость и методы сохранения конфиденциальности, исследуются реже (раздел 3). Стандартные метрики машинного обучения широко используются для оценки, хотя они не всегда могут отражать приоритеты, специфичные для предметной области (раздел 7.1). Большинство исследований сосредоточены на стабильных рыночных условиях, уделяя меньше внимания периодам с высокой волатильностью (раздел 7.2), а также опираясь на устаревшие источники или игнорируя такие проблемы, как ошибка выжившего (раздел 7.3). Наконец, мы наблюдаем тенденцию к использованию LLM общего назначения вместо специализированных архитектур (раздел 4). Хотя это отражает быструю интеграцию последних достижений в области NLP, дальнейшее изучение стратегий, специфичных для предметной области, может предложить дополнительную ценность для задач, связанных с финансами..
| Paper | Review Years | Papers Reviewed | Features | Area surveyed | Systematic Collection | Domain trends | Quantitative Analysis | Temporal Analysis |
|---|---|---|---|---|---|---|---|---|
| (Gao et al. 2021a) | 1959 (A)-2020 | 87 | 5 | General Overview | × | × | × | × |
| (Liu 2024) | 2022-2024 | 49 | 11 | General Overview | × | × | × | × |
| (Millo et al. 2024) | 2018-2023 | 30 | 1 | Methodologies | × | × | ✓ | × |
| (Chen et al. 2020b) | 2016-2019 | 62 | 3 | Financial Technology | × | × | × | × |
| (Chen et al. 2022a) | 2018-2022 | 38 | 2 | Financial Technology | × | ✓ | × | × |
| (Xing et al. 2017) | 1998 (A)-2016 | 127 | 4 | Financial Forecasting | × | ✓ | × | × |
| (Zhao et al. 2024a) | 2004 (A)-2024 | 146 | 1 | Large Language Models | × | × | ✓ | × |
| (Li et al. 2024) | 2020-2023 | 68 | 1 | Large Language Models | × | × | × | × |
| (Dong et al. 2024) | 2023-2024 | 206 | 2 | Large Language Models | × | × | ✓ | ✓ |
| (Nie et al. 2024) | 2019-2024 | 318 | 1 | Large Language Models | × | × | × | ✓ |
| (Lee et al. 2025) | 2018-2023 | 51 | 3 | Large Language Models | × | × | × | × |
| (Man et al. 2019) | 2004-2019 | 89 | 1 | Machine Learning | × | × | × | × |
| (Ozbayoglu et al. 2020) | 1998 (A)-2020 | 151 | 6 | Deep Learning | × | × | ✓ | ✓ |
| (Mishev et al. 2020) | 2003 (A)-2020 | 89 | 1 | Sentiment Analysis | × | ✓ | × | ✓ |
| Language Modeling for the Future of Finance | 2017-2024 | 374 | 11 | Tasks, Methodologies, Data, Metrics, Code, Authorship, Funding | ✓ | ✓ | ✓ | ✓ |
2 Процесс извлечения данных из статей
Чтобы изучить, как NLP применялось в финансах, мы отобрали статьи из 38 площадок NLP, включая CoLM, ACL, NAACL, EMNLP, LREC, COLING и такие семинары, как FinNLP и Workshop on Economics and Natural Language Processing. Полный список площадок представлен в Таблице 9 (Приложение E). Как показано на Рисунке 1, мы начали с фильтрации статей, в аннотациях которых упоминались «finance» или «financial». Из всех таких статей, опубликованных с 1975 года по настоящее время, более 94% были опубликованы начиная с 2017 года. Этот рост совпадает с появлением моделей на основе transformers (Vaswani et al. 2017), которые значительно расширили сферу применения NLP. Соответственно, мы используем 2017 год в качестве порогового года для нашего анализа..
| Category | Description |
|---|---|
| Financial Forecast (Category I) | Targets predicting financial events, including stock movements, volatility, bankruptcy, and currency exchange rates. |
| Financial Resources (Category II) | Covers tasks addressing finance-specific issues beyond prediction, such as constructing financial datasets, detecting fraud in finance-related documents, and extracting financial events. |
| Financial Applications (Category III) | Focuses on general ML/NLP tasks like sentiment analysis and information/relation extraction for financial datasets. |
| Finance Related (Category IV) | Covers tasks not applied to financial data or targeting financial problems, but potentially useful in finance, such privacy-preserving and explainable AI. |
Эта первичная фильтрация позволила отобрать 374 статьи. Среди них 88 были связаны с общими задачами (например, SemEval-2017 (Kar et al. 2017), FinCausal-2022 (Mondal et al. 2022)), а 65 использовали термин «финансовый» в ином контексте — например, при упоминании финансовых ресурсов (Sekeres et al. 2024; Ding & Riloff 2018) — без какого-либо реального финансового применения. После их удаления мы оставили 221 статью для нашего анализа..
В отличие от предыдущих обзоров, которые часто делают упор на качественные наблюдения, наше исследование объединяет как качественные, так и количественные методы, чтобы обеспечить более широкий взгляд на данную область. Мы классифицировали отобранные статьи по их основной направленности, выделив четыре категории, основанные на задачах (Рисунок 2). Эта классификация помогает нам изучить тенденции использования методов NLP для решения финансовых задач и способствует проведению более детальных сравнений между различными типами задач..
3 Распределение задач в NLP для финансовых приложений
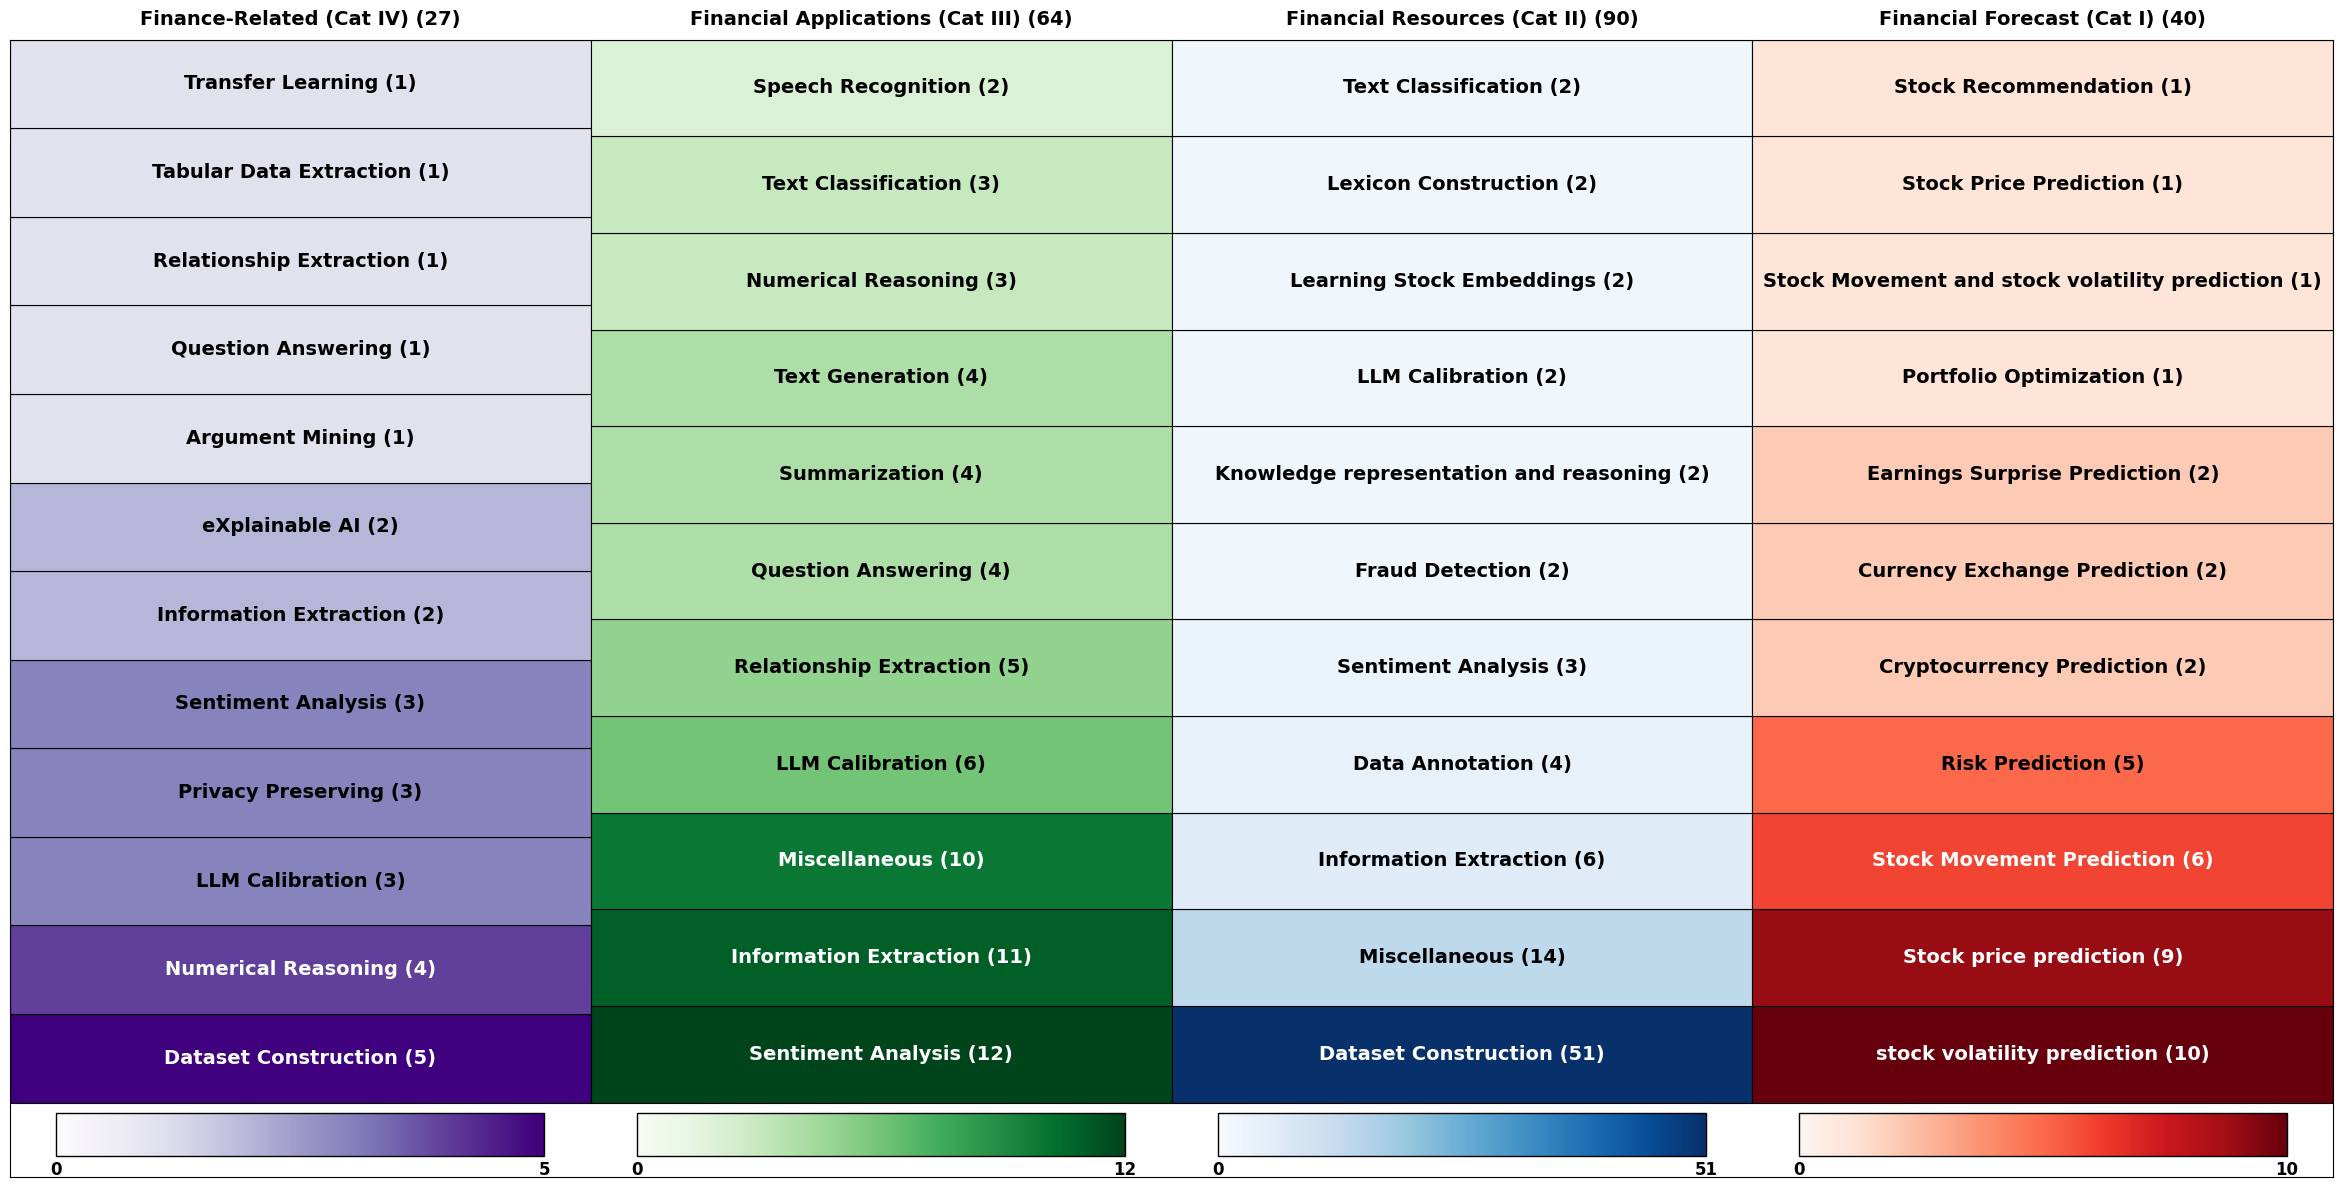
Чтобы понять, как NLP использовался в финансовых контекстах, мы разделили статьи на четыре группы (показаны в таблице 2) на основе их основных задач (рисунок 2). Эта классификация помогает определить, как применяются методы языкового моделирования и насколько непосредственно каждая статья связана с финансами, при этом категория I представляет собой наиболее прямые финансовые варианты использования. Подробные описания каждой категории приведены в приложении D⟧.
Статьи по финансовому прогнозированию (Категория I) охватывают такие прогностические задачи, как прогнозирование цен на акции и волатильности. Хотя эти области хорошо изучены, другие, такие как экономическое прогнозирование (Arno et al. 2023), оценка рисков (Zhou et al. 2020) и прогнозирование криптовалют (Seroyizhko et al. 2022), получают меньше внимания. Эти области открывают возможности для расширения сферы применения прогностических моделей, а также повышения их устойчивости и сопоставимости (Раздел 7).
Статьи о финансовых ресурсах (Категория II) часто фокусируются на создании наборов данных (Раздел 4, Рисунок 3). Эти наборы данных – от аннотированных отчетов о доходах до новостей и выступлений – поддерживают такие задачи, как извлечение финансовых событий (Huang et al. 2024; Ju et al. 2023), обнаружение мошенничества (Erben & Waldis 2024; Wang et al. 2019) и аннотирование (Aguda et al. 2024; Khatuya et al. 2024). Хотя эти задачи способствуют улучшению обработки финансовых данных, другие задачи остаются относительно недостаточно представленными..
В группе Финансовых приложений (Категория III) анализ тональности (Rodriguez Inserte et al. 2023), извлечение информации (Lior et al. 2024) и QA (Kosireddy et al. 2024) являются доминирующими задачами. Эти методы широко используются для анализа отчетов о прибылях, докладов и рыночных комментариев, где настроения инвесторов и извлечение фактических данных являются ключевыми входными параметрами для принятия решений. Недавние усилия были направлены на улучшение моделей QA для обработки финансовых текстов (Theuma & Shareghi 2024; Liu et al. 2024; Mavi et al. 2023).
Наконец, среди работ, связанных с финансами (Категория IV), наиболее изученными областями являются создание наборов данных и численные рассуждения. Хотя эти наборы данных не являются узкоспециализированными для финансов, они имеют потенциальное применение в финансовой сфере. Например, наборы данных для обнаружения фальшивых новостей (Vargas et al. 2021) могут помочь уменьшить количество дезинформации на рынках. Численные рассуждения (Akhtar et al. 2023), важные для понимания финансовой отчетности и оценки рисков, получают все больше внимания. Однако другие области, такие как объяснимый ИИ (XAI) (Klein & Walther 2024) и методы сохранения конфиденциальности (Abbe et al. 2012), остаются редко исследованными, несмотря на их актуальность для безопасного и интерпретируемого принятия решений (Basu et al. 2021)⟧.
4 Внедрение языковых моделей и наборы данных
Ускорение внедрения моделей
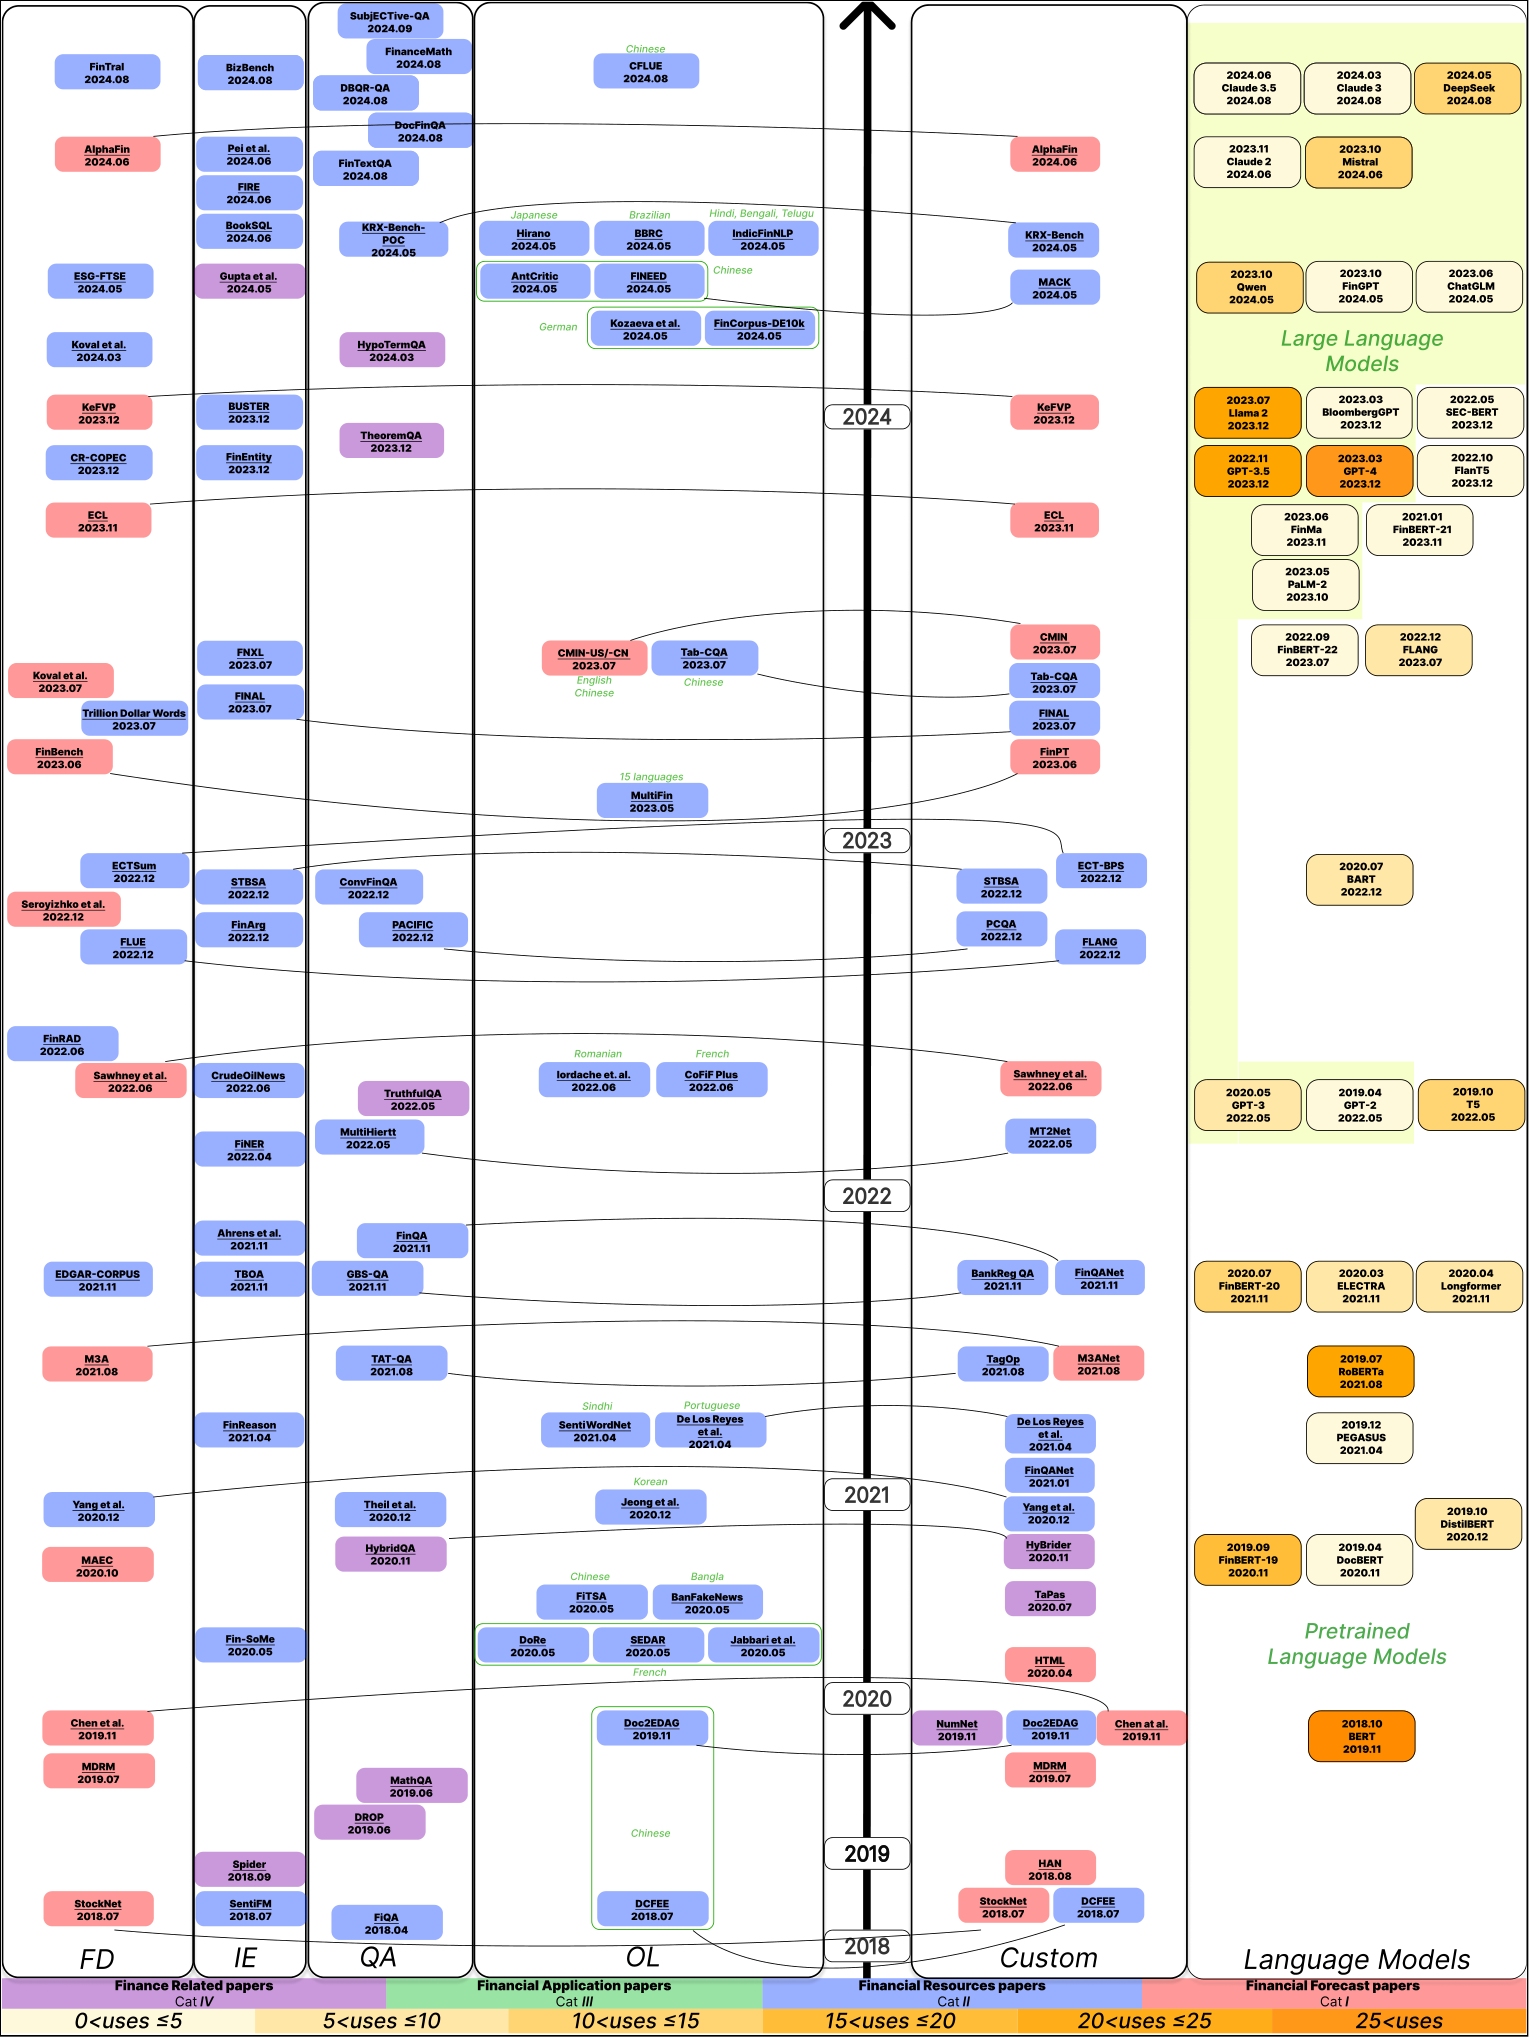
Рисунок 3 (Языковые модели) показывает, как быстро языковые модели внедряются в задачи NLP, связанные с финансами. В то время как ранним моделям, таким как BERT (Devlin et al. 2019), потребовалось 13 месяцев для появления в этих приложениях, недавние модели – GPT-3.5, GPT-4 (Achiam et al. 2023) и Mistral (Jiang et al. 2023) – были внедрены в течение 6–12 месяцев. LLaMA-2 (Touvron et al. 2023)) была интегрирована всего за 5 месяцев, что отражает растущую скорость сообщества в применении достижений в области общего NLP к финансовым задачам.
Доминирование моделей общего назначения
Как показано на Рисунке 3 (Языковые модели), модели общего назначения – LLMs, такие как GPT-4 и LLaMA-2, и предварительно обученные языковые модели (PLMs), такие как BERT и RoBERTa (Liu et al. 2019)) – используются гораздо чаще, чем адаптированные к предметной области. BERT встречается более чем в 70 статьях, в то время как специализированные для финансов модели, такие как FinBERT (Araci 2019; Yang et al. 2020b; Liu et al. 2020; Huang et al. 2022), FinMA (Xie et al. 2024a) и FinGPT (Yang et al. 2023), встречаются реже. Примечательно, что более ранние версии FinBERT используются шире, чем более поздние, что позволяет предположить, что улучшения в моделях общего назначения часто перевешивают преимущества адаптации к конкретной предметной области..
Упадок специализированных архитектур
Специализированные модели были распространены до 2022 года, особенно для таких задач, как QA на основе таблиц (например, TagOp для TAT-QA (Zhu et al. 2021), HyBrider для HybridQA (Chen et al. 2020c)). Некоторые модели, такие как MDRM (Qin & Yang 2019), HTML (Yang et al. 2020a) и HAN (Hu et al. 2021), до сих пор используются в качестве базовых, особенно в прогнозировании волатильности (Niu et al. 2023; Mathur et al. 2022). Однако появление общих LLM привело к резкому сокращению использования специализированных архитектур. В результате ускоренной разработки и внедрения этих моделей общего назначения исследователи все чаще полагаются на адаптацию предобученных моделей вместо создания предметно-ориентированных с нуля..
Языковой охват в наборах данных
Разделы OL и FD на рисунке 3 подчеркивают нехватку неанглоязычных наборов данных для задач прогнозирования, таких как предсказание доходности или волатильности. Одним из исключений является CMIN (Luo et al. 2023), который включает финансовые данные на английском и китайском языках. Большинство наборов данных используют только англоязычные источники, такие как отчеты EDGAR (Maheshwari et al. 2022) и финансовые новости (Xie et al. 2024b), что может ограничивать производительность моделей на неанглоязычных рынках. Создание многоязычных наборов данных для прогнозирования способствовало бы более широкой применимости и снижению языковой предвзятости, что также отмечается в Jørgensen et al. 2023⟧.
С 2017 года исследования по применению NLP в финансах сместились от специализированных моделей к архитектурам общего назначения с предварительным обучением. Новые модели внедряются быстрее, чем раньше, а общие PLM в значительной степени заменили финансово-ориентированные. Это предпочтение также влияет на использование наборов данных: большинство наборов данных для прогнозирования представлены только на английском языке, что ограничивает возможность обобщения на глобальные рынки..
5 Методы, используемые в NLP для финансов
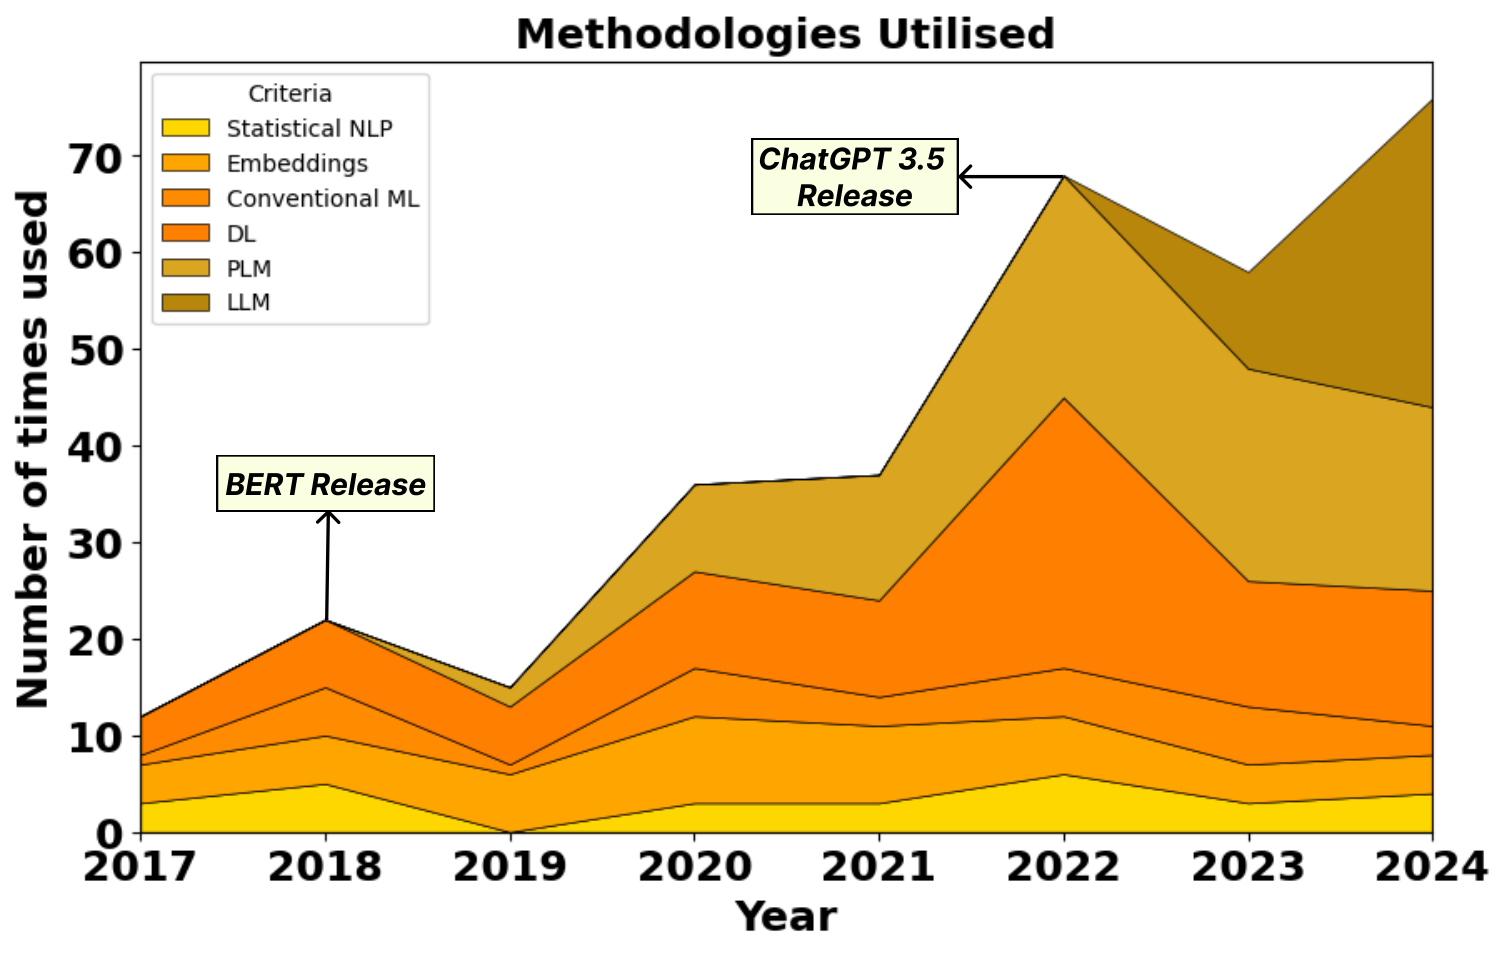
Чтобы понять методологический ландшафт, мы сгруппировали подходы, используемые в исследованных статьях, по девяти категориям (Приложение C, Таблица 6). Хотя общее количество статей выросло, такие методы, как статистический NLP, традиционное машинное обучение и эмбеддинги, остались практически на прежнем уровне. Напротив, наблюдается резкий рост использования глубокого обучения, PLMs и LLMs, что отражает сдвиг в области в сторону предобученных архитектур..
Сдвиг в сторону PLM и LLM
Как показано на Рисунке 4, первые три категории — статистический NLP, эмбеддинги и традиционное ML — сохранились, но их использование сократилось, поскольку PLM и LLM вышли на первый план. Подъем начался с таких моделей, как BERT в 2019 году, которые значительно улучшили обработку контекста в финансовых текстах (Li et al. 2017; Chen et al. 2019; Ein-Dor et al. 2019). PLM в настоящее время широко используются для таких задач, как суммаризация и распознавание сущностей. С 2023 года LLM, такие как ChatGPT-3.5, получили быстрое распространение (Tang et al. 2023; Li et al. 2023a; Ni et al. 2023), особенно для генерации текста (Guo et al. 2023b) и финансового QA (Uluoglakci & Temizel 2024). Этот переход также привел к появлению более сложных архитектур deep learning, используемых для многошагового рассуждения и решения специфических для предметной области задач (Ma et al. 2024; Zhao et al. 2024b; Su et al. 2024)⟧.
Малоизученные методы
Несмотря на доминирование предобученных моделей, некоторые методы остаются недостаточно используемыми, несмотря на их перспективность. Статистическое моделирование, графовые подходы и графы знаний могли бы повысить устойчивость и интерпретируемость моделей, особенно для таких задач, как обнаружение причинно-следственных связей (Tabari et al. 2018) или динамика рынка (Menzio et al. 2024). Новые методы, такие как GraphRAG (Edge et al. 2024), подчеркивают потенциал подобных подходов, однако они встречаются лишь в малой части работ. Их ограниченное присутствие указывает на возможности для расширения методологического разнообразия в будущих исследованиях..
6 Доступность кода и данных
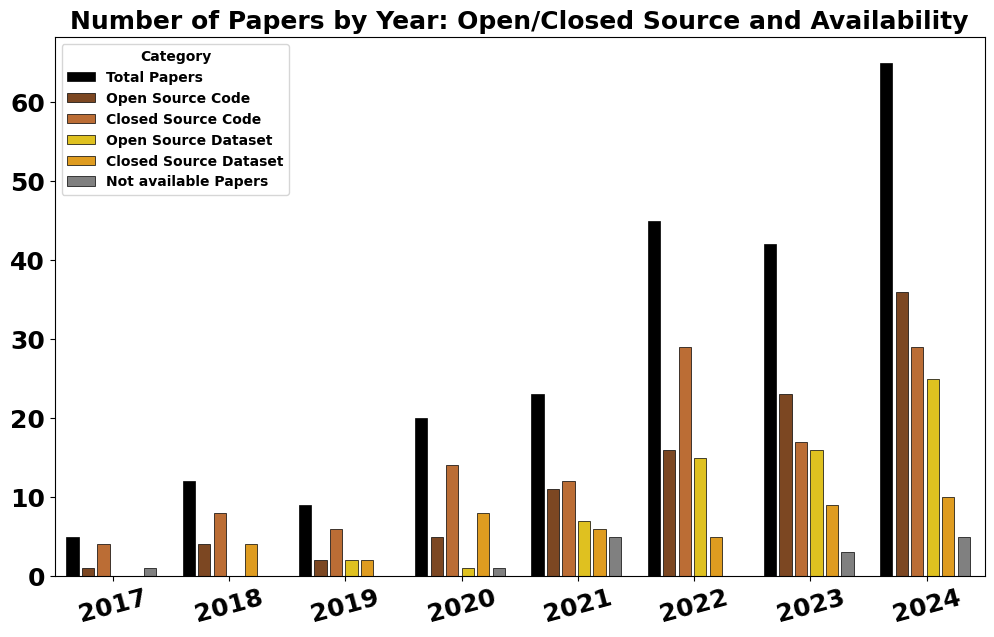
По мере ускорения внедрения языковых моделей вопрос открытой доступности в исследованиях NLP, особенно в сфере финансов, становится все более актуальным. Как показано на Рисунке 5, практика использования открытого исходного кода в последние годы стала более распространенной. До 2021 года преобладал закрытый исходный код, но тенденция сместилась в сторону обмена кодом и наборами данных. Этот шаг повышает прозрачность, воспроизводимость и совместный прогресс в исследованиях NLP, применяемых в финансах (Whited 2023). Несмотря на это, некоторые статьи все еще содержат неактивные ссылки или пустые репозитории, что ограничивает воспроизводимость. В то же время доступность наборов данных неуклонно растет с 2017 года, что указывает на растущую осведомленность об открытых данных. Поддержание функциональных и актуальных репозиториев остается необходимым для обеспечения значимого бенчмаркинга и разработки моделей..
7 Потенциал в финансовом прогнозировании
Статьи категории I выявляют несколько областей, в которых модели прогнозирования могут быть улучшены. Большинство исследований используют общие метрики ML, упуская из виду специфические для финансов показатели, которые лучше отражают практическую полезность. Кризисные периоды рассматриваются редко, что ограничивает понимание того, как модели ведут себя в стрессовых ситуациях. Наконец, наблюдается сильный уклон в сторону США и английского языка в данных, при ограниченном использовании глобальных финансовых наборов данных. Расширение этих областей исследования могло бы укрепить устойчивость моделей и поддержать их более широкое практическое применение..
7.1 Потенциал в финансовых метриках
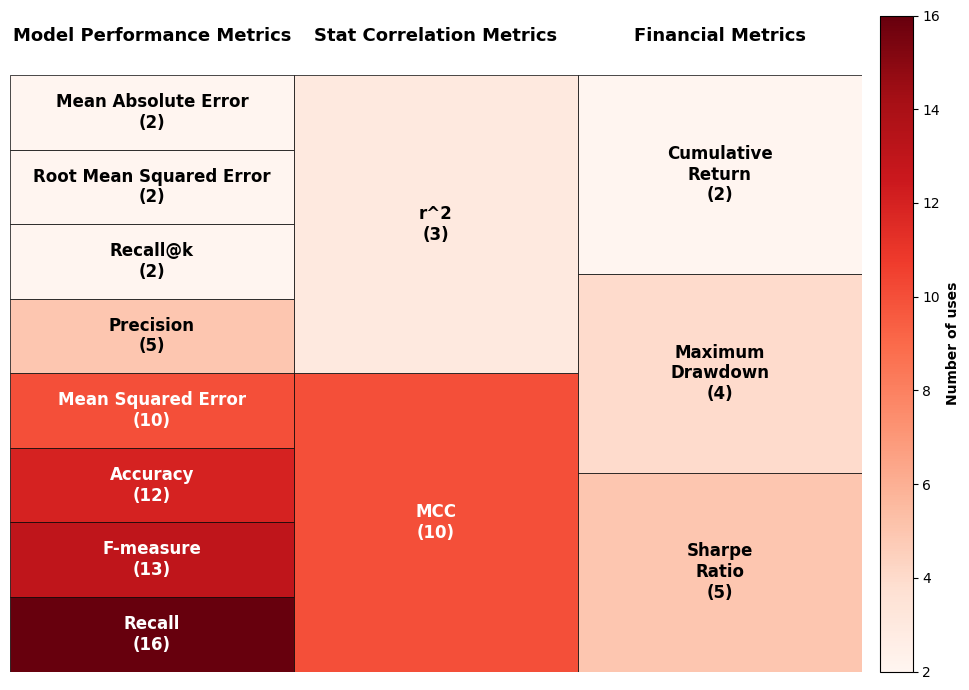
Как показано на Рисунке 6, статьи Категории I в основном опираются на ML метрики, такие как accuracy, F1 или MSE (Sawhney et al. 2020b; Wu 2020; Yangjia et al. 2022). Несмотря на свою полезность, они не в полной мере отражают финансовые показатели. Только три финансовых показателя встречаются более одного раза – Sharpe Ratio, Maximum Drawdown и Cumulative Return (определены в Приложении G).⟧).
Специфические для финансов метрики предлагают основанные на оценке риска выводы, которые упускают из виду меры ML. Коэффициент Шарпа, например, оценивает доходность относительно риска (Zou et al. 2022). Внедрение таких метрик улучшило бы сопоставимость между моделями и привело бы результаты исследований в соответствие с практическими потребностями (Zhang et al. 2024; Zou et al. 2022; Sawhney et al. 2021b).
7.2 Кризисные годы для стресс-тестирования
На рисунке 7 показано, что использование данных начинает расти после 1993 года, когда электронная отчетность стала общедоступной, с еще одним увеличением в 2005 году после введения обязательного формата HTML для подачи отчетности (U.S. Securities and Exchange Commission). Однако использование снижается примерно в 2009 и 2020 годах — в годы, связанные с мировым финансовым кризисом и пандемией COVID-19. Эти периоды важны для оценки устойчивости моделей, однако они остаются недостаточно используемыми, вероятно, из-за проблем с доступностью данных до 2015 года (Bloomberg L.P. 2015).
Несмотря на эти ограничения, периоды кризисов предоставляют ценные площадки для тестирования. Большинство моделей обучаются в стабильных условиях, что может не отражать их поведение во время волатильности. Включение данных из кризисных периодов позволяет проводить стресс-тестирование (Investopedia Staff 2025b) и помогает создавать модели прогнозирования, которые остаются надежными в условиях нестабильности..
7.3 Источники данных
Часто используемые и упускаемые из виду источники данных
Большинство моделей прогнозирования используют общие финансовые источники: цены на акции, документы SEC, финансовые новости, отчеты о прибылях и убытках (например, MDRM (Qin & Yang 2019), StockNet (Xu & Cohen 2018)). Однако многие ценные наборы данных либо редко используются (например, отчеты Федеральной резервной системы (Menzio et al. 2024)), либо полностью отсутствуют в исследованиях NLP. Публичные ресурсы, такие как FRED (Federal Reserve Bank of St. Louis 2024) и Fama-French (Fama & French 2024), предлагают богатые макроэкономические показатели, которые остаются неизученными. Включение этих наборов данных может помочь уловить макроэкономические тенденции и динамику рынка, повышая надежность моделей..
Доступность и поддержка данных
Ограничения доступа также вызывают беспокойство. Устаревшие наборы данных, такие как MDRM, потеряли актуальность, а программные интерфейсы, например Yahoo Finance, были закрыты. Другие, такие как CRSP, требуют платного доступа. Это ограничивает воспроизводимость и доступ к надежным, актуальным данным. Существует явная потребность в открытых, регулярно обновляемых наборах данных, применимых для финансового прогнозирования..
8 Обсуждение и заключение
В данной статье представлен систематический количественный анализ исследований в области NLP, применимых к финансам. Из первоначального массива в 374 статьи, опубликованных на основных площадках по NLP (Приложение E), после фильтрации мы отобрали итоговый набор из 221 статьи. Мы классифицировали их по основной задаче (Раздел 3) и оценили каждую по 11 качественным и количественным параметрам (Таблица 5). В Таблице 3 обобщены ключевые тенденции и определены возможности, в рамках которых исследования по языковому моделированию могут внести дополнительный вклад в решение задач, связанных с финансами..
| Criteria | Trends and Observations | Potential Opportunities and Recommendations |
|---|---|---|
| NLP Tasks in Finance | Sentiment analysis, information extraction, and question answering are the most frequently addressed tasks. Forecasting is mostly centered around stock and volatility prediction. | Underexplored areas such as explainability, privacy-preserving methods, and tasks like bankruptcy or cryptocurrency prediction present valuable directions for future work (Section 3). |
| PLM/LLM Adoption | General-purpose PLMs and LLMs have largely replaced finance-specific and custom architectures. At the same time, the use of statistical NLP and conventional ML continues to decline (Section 4). | Revisiting finance-specific models and exploring alternative methods such as graph-based learning or hybrid statistical models could offer improvements for financial tasks (Section 5). |
| Evaluation Metrics | Most studies rely on ML metrics such as accuracy and MSE, which do not reflect financial performance. | Incorporating financial metrics like Sharpe Ratio or Maximum Drawdown would improve the practical relevance and comparability of predictive models (Section 7.1). |
| Crisis Periods | Few studies include data from financial crises such as 2008–2009 or 2020–2021, focusing instead on stable periods. | Including data from volatile periods can support stress-testing and help build models more resilient to real-world fluctuations (Section 7.2). |
| Data Selection and Bias | Most studies use English-language datasets and U.S.-based financial sources. While there is growing diversity in the types of data used (e.g., news, filings, social media), much of it is static, with limited updates or adaptation to changing financial contexts. | Developing multilingual and globally representative datasets, along with maintaining and updating existing ones, would support better generalization and long-term applicability of models across financial domains (Section 7.3). |
| Open Accessibility | Code and dataset sharing has become more common, especially after 2021, enhancing transparency and reproducibility. | Open access should be a standard in NLP-for-finance research when legally feasible. Maintaining functional and up-to-date repositories is key for long-term reproducibility (Section 5). |
Последствия для исследователей NLP и LM
Исследования в области NLP, применяемые в финансах, в значительной степени сосредоточены на нескольких ключевых задачах — анализе тональности, извлечении информации и QA, — в то время как другие направления, такие как интерпретируемость и методы сохранения конфиденциальности, изучены недостаточно (Раздел 3). Быстрое внедрение PLM и LLM упростило применение языковых моделей, но также привело к снижению методологического разнообразия (Раздел 4). Графовые модели, статистические методы и другие альтернативы остаются недостаточно используемыми, несмотря на свой потенциал (Раздел 5). Хотя практика использования открытого исходного кода стала более распространенной, исследователям следует более тщательно подходить к поддержке функциональных и актуальных репозиториев для обеспечения долгосрочной воспроизводимости и значимого бенчмаркинга (Раздел 5). Кроме того, принятие метрик финансовой предметной области может сделать оценки более значимыми и соответствующими практическим целям (Раздел 7.1). Включение периодов кризиса в наборы данных (Раздел 7.2) и улучшение практики отбора данных (Раздел 7.3) могут помочь обеспечить устойчивость и согласованность. Также необходимы более разнообразные наборы данных, особенно за пределами английского языка и рынков США, для расширения применимости (Раздел 7.3⟧).
Соображения для финансовых специалистов
Хотя методы NLP все чаще используются в финансовых контекстах, остается ряд проблем. Многие модели обучаются на статических или неполных наборах данных, что приводит к предвзятости, которая может повлиять на прогнозы (Раздел 7.3). Оценки часто не учитывают реальные факторы, такие как волатильность рынка и финансовые риски (Разделы 7.2, 7.1). Внедрение финансовых бенчмарков и тестирование моделей в стрессовых условиях могли бы повысить их практическую ценность. Дальнейший прогресс в этом направлении позволит лучше согласовать результаты исследований с потребностями в принятии решений в финансовых условиях..
Заявление об этике
Данное исследование не оценивает достоинства или качество отдельных работ. Мы не утверждаем, что какая-либо категория или метод по своей сути лучше других. Наша цель — отобразить объем и распределение исследований, применяющих методы NLP в финансах, и предложить основу для дальнейшего изучения, не вынося суждений о ценности конкретных подходов..
Благодарности
Мы не получали какого-либо специального финансирования для этой работы. Мы благодарим Arnav Hiray и Michael Galarnyk за их комментарии.
Список литературы
- ⟦Abbe et al. (2012) Эммануэль А. Аббе, Амир Э. Хандани и Эндрю У. Ло. Методы сохранения конфиденциальности при обмене данными о подверженности финансовым рискам. American Economic Review, 102(3):65–70, май 2012 г. doi: 10.1257/aer.102.3.65. URL https://www.aeaweb.org/articles?id=10.1257/aer.102.3.65.
- ⟦Achiam et al. (2023) Джош Ачиам, Стивен Адлер, Сандхини Агарвал, Лама Ахмад, Ильге Аккая, Флоренсия Леони Алеман, Диого Алмейда, Янко Альтеншмидт, Сэм Альтман, Шьямал Анадкат и др. Технический отчет GPT-4. arXiv preprint arXiv:2303.08774, 2023.
- ⟦Addlesee (2024) Ангус Аддлси. Привязка LLM к инструкциям внутри промпта: снижение галлюцинаций, вызванных статическими знаниями предварительного обучения. В Танви Динкар, Джузеппе Аттанасио, Аманда Серкас Карри, Иоаннис Констас, Дирк Хови и Верена Ризер (ред.), Труды Safety4ConvAI: Третий семинар по безопасности для разговорного AI на LREC-COLING 2024, стр. 1–7, Турин, Италия, май 2024 г. ELRA и ICCL. URL https://aclanthology.org/2024.safety4convai-1.1.
- ⟦Aguda et al. (2024) Тойин Д. Агуда, Сучета Сиддагангаппа, Елена Кочкина, Симерджот Каур, Донгшенг Ванг и Чариз Смайли. Large language models as financial data annotators: A study on effectiveness and efficiency. В Николетта Кальцолари, Мин-Йен Кан, Вероник Хосте, Алессандро Ленчи, Сакриани Сакти и Нианвен Сюэ (ред.), Труды совместной международной конференции 2024 года по вычислительной лингвистике, языковым ресурсам и оценке (LREC-COLING 2024), стр. 10124–10145, Турин, Италия, май 2024 г. ELRA и ICCL. URL https://aclanthology.org/2024.lrec-main.885.
- ⟦Ahbali et al. (2022) Нуджуд Ахбали, Синьюань Лю, Альберт Нанда, Джейми Старк, Ашит Талукдер и Рупиндер Пол Ханпур. Выявление настроений корпоративного кредитного риска на основе финансовых новостей. В Анастасии Лукиной, Рашми Гангадхарае и Бонан Мине (ред.), Труды конференции 2022 года Североамериканского отделения Ассоциации компьютерной лингвистики: Человеческие языковые технологии: Отраслевой трек, стр. 362–370, Гибридный формат: Сиэтл, Вашингтон + Онлайн, июль 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.naacl-industry.40. URL https://aclanthology.org/2022.naacl-industry.40.
- ⟦Akhtar et al. (2023) Мубашара Ахтар, Абхилаш Шанкарампета, Вивек Гупта, Арпит Патил, Оана Кокараску и Елена Симперл. Исследование способностей языковых моделей к численным рассуждениям: всесторонний анализ табличных данных. В сборнике: Худа Буамор, Хуан Пино и Калика Бали (ред.), Результаты Ассоциации компьютерной лингвистики: EMNLP 2023, стр. 15391–15405, Сингапур, декабрь 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.findings-emnlp.1028. URL https://aclanthology.org/2023.findings-emnlp.1028⟧.
- ⟦Araci (2019) Догу Арачи. Finbeunknownrt: Анализ финансовых настроений с помощью предварительно обученных языковых моделей, 2019. URL https://arxiv.org/abs/1908.10063.
- ⟦Arno et al. (2023) Анри Арно, Клаас Мюлье, Йоке Бек и Томас Деместер. От чисел к словам: мультимодальное прогнозирование банкротства с использованием набора данных ECL. В сборнике: Чун-Чи Чен, Хен-Хсен Хуанг, Хироя Такамура, Хсин-Хси Чен, Хироки Сакаджи и Киёши Изуми (ред.), Труды шестого семинара по финансовым технологиям и Natural Language Processing, стр. 11–21, Бали, Индонезия, ноябрь 2023 г. Ассоциация вычислительной лингвистики. doi: 10.18653/v1/2023.finnlp-2.2. URL https://aclanthology.org/2023.finnlp-2.2.
- ⟦Balakrishnan et al. (2022) Судхандар Балакришнан, Ихао Фанг и Сяодань Чжу. Исследование устойчивости prefix tuning в зашумленных данных: тематическое исследование в области финансового анализа тональности. В Чун-Чи Чен, Хен-Хсен Хуанг, Хироя Такамура и Хсин-Хсен Чен (ред.), Труды четвертого семинара по финансовым технологиям и Natural Language Processing (FinNLP), стр. 78–88, Абу-Даби, Объединенные Арабские Эмираты (гибридный формат), декабрь 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.finnlp-1.9. URL https://aclanthology.org/2022.finnlp-1.9.
- ⟦Basu et al. (2021) Приям Басу, Тиаса Сингха Рой, Ракшит Найду и Зумрут Муфтуоглу. Классификация финансовых текстов с обеспечением конфиденциальности с использованием дифференциальной приватности и федеративного обучения. В сборнике: Удо Хан, Вероник Хост и Аманда Стент (ред.), Труды третьего семинара по экономике и Natural Language Processing, стр. 50–55, Пунта-Кана, Доминиканская Республика, ноябрь 2021 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2021.econlp-1.7. URL https://aclanthology.org/2021.econlp-1.7.
- ⟦Bloomberg L.P. (2015) Bloomberg L.P. Обмен данными во благо 2015: Наука о данных и ее влияние на общество, 2015. URL https://www.bloomberg.com/company/press/2015-data-for-good-exchange-data-science-and-its-impact-on-society/. Дата обращения: 2025-03-05.
- ⟦Burger et al. (2023) Кристофер Бургер, Лингвей Чен и Тай Ле. «надежны ли ваши объяснения?» исследование стабильности LIME при объяснении текстовых классификаторов путем объединения XAI и состязательных атак. В сборнике: Худа Буамор, Хуан Пино и Калика Бали (ред.), Труды конференции 2023 года по эмпирическим методам в Natural Language Processing, стр. 12831–12844, Сингапур, декабрь 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.emnlp-main.792. URL https://aclanthology.org/2023.emnlp-main.792.
- ⟦Chen et al. (2020a) Чун-Чи Чен, Хен-Хсен Хуанг и Хсин-Хси Чен. Проблемы и перспективы 10 000 аннотированных данных финансовых социальных сетей. В Николетта Кальцолари, Фредерик Беше, Филипп Блаш, Халид Шукри, Кристофер Сьери, Тьерри Деклерк, Сара Гогги, Хитоши Исахара, Бенте Маегаард, Джозеф Мариани, Элен Мазо, Асунсьон Морено, Ян Одейк и Стелиос Пиперидис (ред.), Труды Двенадцатой конференции по языковым ресурсам и оценке, стр. 6106–6110, Марсель, Франция, май 2020a. Европейская ассоциация языковых ресурсов. ISBN 979-10-95546-34-4. URL https://aclanthology.org/2020.lrec-1.749.
- ⟦Chen et al. (2020b) Чун-Чи Чен, Хен-Хсен Хуанг и Хсин-Хси Чен. NLP в приложениях fintech: прошлое, настоящее и будущее, 2020b. URL https://arxiv.org/abs/2005.01320.
- ⟦Chen et al. (2022a) Чун-Чи Чен, Хен-Сен Хуан, Хироя Такамура и Син-Си Чен. Обзор инноваций в области финансовых технологий. В сборнике материалов веб-конференции 2022 года, WWW ’22, стр. 572–575, Нью-Йорк, штат Нью-Йорк, США, 2022a. Ассоциация вычислительной техники. ISBN 9781450391306. doi: 10.1145/3487553.3524868. URL https://doi.org/10.1145/3487553.3524868.
- ⟦Chen et al. (2022b) Чун-Чи Чен, Хен-Хсен Хуанг, Хироя Такамура и Син-Син Чен. Обзор инноваций в области финансовых технологий. В сборнике материалов веб-конференции 2022 года, стр. 572–575, Нью-Йорк, штат Нью-Йорк, США, 2022b. Ассоциация вычислительной техники. doi: 10.1145/3487553.3524868. URL https://doi.org/10.1145/3487553.3524868.
- ⟦Chen et al. (2019) Дели Чен, Шумин Ма, Кейко Харимото, Руйхан Бао, Ци Су и Сюй Сунь. Группировка, извлечение и агрегирование: обобщение большого объема финансовых новостей для прогнозирования движения валютных курсов. В сборнике: Удо Хан, Вероник Хост и Чжу Чжан (ред.), Труды второго семинара по экономике и Natural Language Processing, стр. 41–50, Гонконг, ноябрь 2019 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/D19-5106. URL https://aclanthology.org/D19-5106.
- ⟦Chen et al. (2020c) Вэньху Чэнь, Ханьвэнь Чжа, Чжиюй Чэнь, Вэньхань Сюн, Хун Ван и Уильям Ян Ван. HybridQA: Набор данных для многошаговых ответов на вопросы по табличным и текстовым данным. В сборнике: Тревор Кон, Юлань Хэ и Ян Лю (ред.), Результаты Ассоциации компьютерной лингвистики: EMNLP 2020, стр. 1026–1036, онлайн, ноябрь 2020 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2020.findings-emnlp.91. URL https://aclanthology.org/2020.findings-emnlp.91.
- ⟦Chen et al. (2022c) Чжиюй Чэнь, Шиян Ли, Чариз Смайли, Чжицян Ма, Самина Шах и Уильям Ян Ван. ConvFinQA: Исследование цепочки численных рассуждений в разговорных финансовых вопросно-ответных системах. В Йоав Голдберг, Зорница Козарева и Юэ Чжан (ред.), Труды конференции 2022 года по эмпирическим методам в Natural Language Processing, стр. 6279–6292, Абу-Даби, Объединенные Арабские Эмираты, декабрь 2022c. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.emnlp-main.421. URL https://aclanthology.org/2022.emnlp-main.421.
- ⟦Choe et al. (2023) Джеён Чо, Кеонун Но, Наён Ким, Сеюн Ан и Вухван Чон. Исследование влияния разнообразия корпуса на финансовые предобученные LLM. В сборнике: Худа Буамор, Хуан Пино и Калика Бали (ред.), Результаты Ассоциации компьютерной лингвистики: EMNLP 2023, стр. 2101–2112, Сингапур, декабрь 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.findings-emnlp.138. URL https://aclanthology.org/2023.findings-emnlp.138.
- ⟦Conforti et al. (2022) Костанца Конфорти, Якоб Берндт, Мохаммад Тахер Пилехвар, Хрисси Джаннисару, Флавио Токсверд и Найджел Кольер. Включение сигналов фондового рынка для определения позиции в Twitter. В Смаранда Мурешан, Преслав Наков и Алин Виллависенсио (ред.), Труды 60-го ежегодного собрания Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), стр. 4074–4091, Дублин, Ирландия, май 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.acl-long.281. URL https://aclanthology.org/2022.acl-long.281.
- ⟦Devlin et al. (2019) Джейкоб Девлин, Мин-Вэй Чанг, Кентон Ли и Кристина Тутанова. BERT: Предварительное обучение глубоких двунаправленных transformers для понимания языка. В Джилл Берштейн, Кристи Доран и Тамар Солорио (ред.), Труды конференции 2019 года Североамериканского отделения Ассоциации компьютерной лингвистики: Технологии человеческого языка, Том 1 (Длинные и короткие статьи), стр. 4171–4186, Миннеаполис, Миннесота, июнь 2019 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/N19-1423. URL https://aclanthology.org/N19-1423.
- ⟦Ding & Riloff (2018) Хайбо Дин и Эллен Рилофф. Категоризация аффективных событий на основе потребностей человека с использованием размеченных и неразмеченных данных. В Мэрилин Уокер, Хэн Цзи и Аманда Стент (ред.), Труды конференции 2018 года Североамериканского отделения Ассоциации компьютерной лингвистики: Технологии человеческого языка, Том 1 (Длинные статьи), стр. 1919–1929, Новый Орлеан, Луизиана, июнь 2018 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/N18-1174. URL https://aclanthology.org/N18-1174.
- ⟦Dong et al. (2024) Менмин Майкл Донг, Теофанис К. Стратопулос и Виктор Сяоци Ван. Обзор исследований ChatGPT в области бухгалтерского учета и финансов. International Journal of Accounting Information Systems, 55:100715, 2024. ISSN 1467-0895. doi: https://doi.org/10.1016/j.accinf.2024.100715. URL https://www.sciencedirect.com/science/article/pii/S1467089524000484.
- ⟦Duan et al. (2021) Ханью Дуань, И Ян и Кар Ян Там. Обучение работе с числами: простой, но эффективный подход к представлению чисел с использованием графа знаний. В сборнике: Мари-Франсин Моэнс, Сюаньцзин Хуан, Лусия Спесия и Скотт Вэнь-тау Йи (ред.), Результаты Ассоциации компьютерной лингвистики: EMNLP 2021, стр. 2597–2602, Пунта-Кана, Доминиканская Республика, ноябрь 2021 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2021.findings-emnlp.221. URL https://aclanthology.org/2021.findings-emnlp.221.
- ⟦Edge et al. (2024) Даррен Эдж, Ха Чинь, Ньюман Ченг, Джошуа Брэдли, Алекс Чао, Апурва Моди, Стивен Труитт и Джонатан Ларсон. От локального к глобальному: подход Graph RAG к суммаризации с фокусом на запросе, 2024. URL https://arxiv.org/abs/2404.16130.
- ⟦Ein-Dor et al. (2019) Лиат Эйн-Дор, Ариэль Гера, Орит Толедо-Ронен, Алон Халфон, Бенджамин Шнайдер, Лена Данкин, Йонатан Билу, Йоав Кац и Ноам Слоним. Извлечение финансовых событий с использованием слабого обучения на основе Википедии. В сборнике: Удо Хан, Вероник Хост и Чжу Чжан (ред.), Труды второго семинара по экономике и Natural Language Processing, стр. 10–15, Гонконг, ноябрь 2019 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/D19-5102. URL https://aclanthology.org/D19-5102.
- ⟦Erben & Waldis (2024) Стефан Эрбен и Андреас Валдис. ScamSpot: Борьба с финансовым мошенничеством в комментариях Instagram. В Николаос Алетрас и Орфе Де Клерк (ред.), Труды 18-й конференции Европейского отделения Ассоциации компьютерной лингвистики: Демонстрации систем, стр. 71–81, Сент-Джулианс, Мальта, март 2024 г. Ассоциация компьютерной лингвистики. URL https://aclanthology.org/2024.eacl-demo.9.
- ⟦Fama & French (2024) Юджин Ф. Фама и Кеннет Р. Френч. Библиотека данных Фама-Френч, 2024. URL https://mba.tuck.dartmouth.edu/pages/faculty/ken.french/data_library.html. Дата обращения: 2024-03-05.
- ⟦Federal Reserve Bank of St. Louis (2024) Федеральный резервный банк Сент-Луиса. FRED, Экономические данные Федеральной резервной системы, 2024. URL https://fred.stlouisfed.org. Дата обращения: 2024-03-05.
- ⟦Gao et al. (2021a) Руйчжо Гао, Зеци Чжан, Чжэннин Ши, Дан Сюй, Вэйцзюань Чжан и Девей Чжу. Обзор обработки естественного языка для финансовых технологий. В сборнике: Хуэйминь Лу, Шэнлинь Му и Шота Накасима (ред.), Международный симпозиум по искусственному интеллекту и робототехнике 2021, том 11884, стр. 118840U. Международное общество оптики и фотоники, SPIE, 2021a. doi: 10.1117/12.2604371. URL https://doi.org/10.1117/12.2604371.
- ⟦Gao et al. (2021b) Руйчжо Гао, Зеци Чжан, Чжэннин Ши, Дан Сюй, Вэйцзюань Чжан и Девей Чжу. Обзор обработки естественного языка для финансовых технологий. В материалах Международного симпозиума по искусственному интеллекту и робототехнике 2021, том 11884, стр. 118840U. SPIE, 2021b. doi: 10.1117/12.2604371. URL https://www.spiedigitallibrary.org/conference-proceedings-of-spie/11884/2604371/A-review-of-natural-language-processing-for-financial-technology/10.1117/12.2604371.short.
- ⟦Guo et al. (2023a) Юэ Го, Чэньси Ху и И Ян. Предсказать будущее по прошлому? О сдвиге распределения временных данных в задачах классификации финансовых настроений. В сборнике: Худа Буамор, Хуан Пино и Калика Бали (ред.), Труды конференции 2023 года по эмпирическим методам в Natural Language Processing, стр. 1029–1038, Сингапур, декабрь 2023a. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.emnlp-main.65. URL https://aclanthology.org/2023.emnlp-main.65.
- ⟦Guo et al. (2023b) Юэ Го, Зиан Сюй и И Ян. Является ли ChatGPT финансовым экспертом? Оценка языковых моделей в области финансовой обработки естественного языка. В сборнике: Худа Буамор, Хуан Пино и Калика Бали (ред.), Результаты Ассоциации компьютерной лингвистики: EMNLP 2023, стр. 815–821, Сингапур, декабрь 2023b. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.findings-emnlp.58. URL https://aclanthology.org/2023.findings-emnlp.58.
- ⟦Hu et al. (2021) Юнли Ху, Пуман Чен, Тенгфей Лю, Джунбин Гао, Янфенг Сун и Баоцай Инь. Иерархические трансформерные сети с механизмом внимания для классификации длинных документов. В материалах Международной объединенной конференции по нейронным сетям 2021 года (IJCNN), стр. 1–7, 2021. doi: 10.1109/IJCNN52387.2021.9533869.
- ⟦Huang et al. (2022) Аллен Хуанг, Хуэй Ван и И Ян. Finbert: LLM для извлечения информации из финансовых текстов†. Contemporary Accounting Research, 40, 09 2022. doi: 10.1111/1911-3846.12832.
- ⟦Huang et al. (2023) Та-вэй Хуан, Цзя-хуэй Цзюй, Юй-сян Хуан, Чэн-вэй Линь, И-сюань Цзян и Чуань-цзюй Ван. FISH: Финансовая интерактивная система для выделения сигналов. В Данило Кроче и Лука Солдаини (ред.), Труды 17-й конференции Европейского отделения Ассоциации компьютерной лингвистики: Демонстрации систем, стр. 50–56, Дубровник, Хорватия, май 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.eacl-demo.7. URL https://aclanthology.org/2023.eacl-demo.7.
- ⟦Huang et al. (2024) Юйшэн Хуан, Нин Ху, Куньпин Ли, Нань Ван и Чжоухань Ли. Извлечение финансовых событий из необработанных текстов посредством матричного сегментирования. В Николетта Кальцолари, Мин-Йен Кан, Вероник Хост, Алессандро Ленчи, Сакриани Сакти и Нианьвэнь Сюэ (ред.), Труды совместной международной конференции 2024 года по компьютерной лингвистике, языковым ресурсам и оценке (LREC-COLING 2024), стр. 7035–7044, Турин, Италия, май 2024 г. ELRA и ICCL. URL https://aclanthology.org/2024.lrec-main.617.
- ⟦Investopedia Staff (2023a) Сотрудники Investopedia. Совокупная доходность. https://www.investopedia.com/terms/c/cumulativereturn.asp, 2023a. https://www.investopedia.com/terms/c/cumulativereturn.asp.
- ⟦Investopedia Staff (2023b) Сотрудники Investopedia. Максимальная просадка (mdd). https://www.investopedia.com/terms/m/maximum-drawdown-mdd.asp, 2023b. https://www.investopedia.com/terms/m/maximum-drawdown-mdd.asp.
- ⟦Investopedia Staff (2025a) Сотрудники Investopedia. Определение коэффициента Шарпа, 2025a. URL https://www.investopedia.com/terms/s/sharperatio.asp. Дата обращения: 2025-03-05.
- ⟦Investopedia Staff (2025b) Сотрудники Investopedia. Определение стресс-тестирования, 2025b. URL https://www.investopedia.com/terms/s/stresstesting.asp. Дата обращения: 2025-03-05.
- ⟦Jagdale & Deshmukh (2025) Раджкумар Джагдале и Майур Дешмукх. Обработка естественного языка в финансах: методы, приложения и будущие направления. В книге Хаоцзюнь Чэнь (ред.), Методы машинного обучения и моделирования в науке о финансовых данных, стр. 411–434. IGI Global, 2025. doi: 10.4018/979-8-3693-8186-1.ch016. URL https://www.igi-global.com/chapter/natural-language-processing-in-finance/368553.
- ⟦Jain & Agrawal (2024) Джайнендра Кумар Джайн и Ручит Агравал. FB-GAN: Новая нейронная модель с улучшенным анализом тональности для прогнозирования цен на акции. В Чун-Чи Чен, Сяомо Лю, Удо Хан, Армине Нурбахш, Чжицян Ма, Чариз Смайли, Вероник Хосте, Санджив Ранджан Дас, Манлинг Ли, Мохаммад Гассеми, Хен-Хсен Хуан, Хироя Такамура и Син-Си Чен (ред.), Труды совместного семинара 7-го семинара по финансовым технологиям и Natural Language Processing, 5-го семинара по извлечению знаний из неструктурированных данных в финансовых услугах и 4-го семинара по экономике и Natural Language Processing, стр. 85–93, Турин, Италия, май 2024 г. Ассоциация вычислительной лингвистики. URL https://aclanthology.org/2024.finnlp-1.9.
- ⟦Jiang et al. (2023) Альберт К. Цзян, Александр Саблероль, Артур Менш, Крис Бэмфорд, Девендра Сингх Чаплот, Диего де лас Касас, Флориан Брессан, Джанна Лендьел, Гийом Лампль, Люсиль Сонье, Лелио Ренар Лаво, Мари-Анн Лашо, Пьер Сток, Тевен Ле Скао, Тибо Лавриль, Томас Ван, Тимоте Лакруа и Уильям Эль Сайед. Mistral 7b, 2023. URL https://arxiv.org/abs/2310.06825⟧.
- ⟦Jørgensen et al. (2023) Расмус Йоргенсен, Оливер Брандт, Марейке Хартманн, Сян Дай, Кристиан Игель и Десмонд Эллиотт. MultiFin: Набор данных для многоязычной финансовой NLP. В сборнике Андреаса Влахоса и Изабель Огенштейн (ред.), Результаты Ассоциации компьютерной лингвистики: EACL 2023, стр. 894–909, Дубровник, Хорватия, май 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.findings-eacl.66. URL https://aclanthology.org/2023.findings-eacl.66.
- ⟦Ju et al. (2023) Цзя-Хуэй Цзюй, Ю-Сян Хуан, Чэн-Вэй Линь, Че Линь и Чуань-Цзюй Ван. Многоэтапный конвейер сравнения и сопоставления для выявления финансовых сигналов в финансовых отчетах. В Анна Роджерс, Джордан Бойд-Грабер и Наоаки Окадзаки (ред.), Труды 61-го ежегодного собрания Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), стр. 14307–14321, Торонто, Канада, июль 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.acl-long.800. URL https://aclanthology.org/2023.acl-long.800.
- ⟦Kar et al. (2017) Судипта Кар, Сурадж Махарджан и Тамар Солорио. RiTUAL-UH в задаче 5 SemEval-2017: Анализ тональности финансовых данных с использованием нейронных сетей. В Стивен Бетард, Марин Карпуат, Марианна Апидиатаки, Саиф М. Мохаммад, Дэниел Сер и Дэвид Юргенс (ред.), Труды 11-го международного семинара по семантической оценке (SemEval-2017), стр. 877–882, Ванкувер, Канада, август 2017 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/S17-2150. URL https://aclanthology.org/S17-2150.
- ⟦Khanna et al. (2022) Урваши Ханна, Самира Годратнама, Диего Молла и Амин Бехешти. Transformer-based модели для суммаризации длинных документов в финансовой сфере. В материалах семинара по обработке финансовых нарративов (4-й: 2022), стр. 73–78. Европейская ассоциация языковых ресурсов (ELRA), 2022.
- ⟦Khatuya et al. (2024) Субхенду Хатуя, Радждип Мукерджи, Акаш Гош, Манджунат Хегде, Кустув Дасгупта, Нилой Гангули, Саптарши Гош и Паван Гоял. Параметрически эффективная настройка инструкций LLM для экстремальной финансовой числовой маркировки. В Кевин Ду, Хелена Гомес и Стивен Бетард (ред.), Труды конференции 2024 года Североамериканского отделения Ассоциации компьютерной лингвистики: Технологии человеческого языка (Том 1: Длинные статьи), стр. 7391–7403, Мехико, Мексика, июнь 2024 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.naacl-long.410. URL https://aclanthology.org/2024.naacl-long.410.
- ⟦Kim et al. (2022) Донггю Ким, Гарам Ли и Сунву О. На пути к сохранению конфиденциальности при определении сходства текстовых эмбеддингов с помощью гомоморфного шифрования. В сборнике: Чунг-Чи Чен, Хен-Хсен Хуанг, Хироя Такамура и Хсин-Хси Чен (ред.), Труды четвертого семинара по финансовым технологиям и Natural Language Processing (FinNLP), стр. 25–36, Абу-Даби, Объединенные Арабские Эмираты (гибридный формат), декабрь 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.finnlp-1.4. URL https://aclanthology.org/2022.finnlp-1.4.
- ⟦Klein & Walther (2024) Тони Кляйн и Томас Вальтер. Достижения в области объяснимого искусственного интеллекта (xai) в финансах. Finance Research Letters, 70:106358, 2024. ISSN 1544-6123. doi: https://doi.org/10.1016/j.frl.2024.106358. URL https://www.sciencedirect.com/science/article/pii/S1544612324013874.
- ⟦Kosireddy et al. (2024) Тагор Рао Косиредди, Джеффри Дэвид Уолл и Эван Лукас. Исследование готовности известных small language models к демократизации финансовой грамотности. В Сачин Кумар, Видиша Балачандран, Чан Янг Парк, Вэйцзя Ши, Ширли Анугра Хаяти, Юлия Цветкова, Ноа Смит, Ханнане Хаджиширзи, Донгеоп Кан и Дэвид Юргенс (ред.), Труды 1-го семинара по Customizable NLP: прогресс и проблемы в адаптации NLP для домена, приложения, группы или индивида (CustomNLP4U), стр. 124–149, Майами, Флорида, США, ноябрь 2024 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.customnlp4u-1.11. URL https://aclanthology.org/2024.customnlp4u-1.11/.
- ⟦Lee et al. (2025) Джин Ли, Николас Стивенс и Соён Карен Хан. Large language models in finance (finllms). Neural Computing and Applications, январь 2025 г. ISSN 1433-3058. doi: 10.1007/s00521-024-10495-6. URL http://dx.doi.org/10.1007/s00521-024-10495-6.
- ⟦Li et al. (2017) Куанчжи Ли, Самина Шах, Армине Нурбахш, Руй Фан и Сяомо Лю. funSentiment в задаче 5 SemEval-2017: Гранулярный анализ тональности финансовых микроблогов с использованием векторных представлений слов, построенных на основе StockTwits и Twitter. В Стивен Бетард, Марин Карпуат, Марианна Апидиатаки, Саиф М. Мохаммад, Дэниел Сер и Дэвид Юргенс (ред.), Труды 11-го международного семинара по семантической оценке (SemEval-2017), стр. 852–856, Ванкувер, Канада, август 2017 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/S17-2145. URL https://aclanthology.org/S17-2145.
- ⟦Li et al. (2023a) Сяньчжи Ли, Сэмюэл Чан, Сяодань Чжу, Юйлун Пэй, Чжицян Ма, Сяомо Лю и Самина Шах. Являются ли ChatGPT и GPT-4 универсальными решателями для финансового текстового анализа? исследование нескольких типичных задач. В сборнике: Минсюань Ван и Имед Зитуни (ред.), Труды конференции 2023 года по эмпирическим методам в Natural Language Processing: отраслевое направление, стр. 408–422, Сингапур, декабрь 2023a. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.emnlp-industry.39. URL https://aclanthology.org/2023.emnlp-industry.39.
- ⟦Li et al. (2023b) Сюруй Ли, Юэ Цинь, Жуй Чжу, Тяньцяньцзинь Линь, Юнмин Фань, Янъян Кан, Кайсун Сун, Фубан Чжао, Чанлун Сунь, Хайсюй Тан и Сяочжун Лю. STINMatch: Полуконтролируемая семантико-топологическая итерационная сеть для выявления финансовых рисков посредством диффузии меток новостей. В сборнике: Хоуда Буамор, Хуан Пино и Калика Бали (ред.), Труды конференции 2023 года по эмпирическим методам в Natural Language Processing, стр. 9304–9315, Сингапур, декабрь 2023b. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.emnlp-main.578. URL https://aclanthology.org/2023.emnlp-main.578.
- ⟦Li et al. (2023c) Иньхэн Ли, Шаофэй Ван, Хань Дин и Хан Чэнь. Большие языковые модели в финансах: обзор. В материалах Четвертой международной конференции Ассоциации вычислительной техники по искусственному интеллекту в финансах, ICAIF ’23, стр. 374–382, Нью-Йорк, штат Нью-Йорк, США, 2023c. Ассоциация вычислительной техники. ISBN 9798400702402. doi: 10.1145/3604237.3626869. URL https://doi.org/10.1145/3604237.3626869.
- ⟦Li et al. (2024) Иньхэн Ли, Шаофэй Ван, Хань Дин и Хан Чэнь. Large language models in finance: A survey, 2024. URL https://arxiv.org/abs/2311.10723⟧.
- ⟦Lior et al. (2024) Гили Лиор, Йоав Голдберг и Габриэль Становски. Использование сходств в рамках всей коллекции для обучения без учителя извлечению структуры документа. В сборнике: Лун-Вэй Ку, Андре Мартинс и Вивек Срикумар (ред.), Результаты Ассоциации по компьютерной лингвистике ACL 2024, стр. 9538–9550, Бангкок, Таиланд и виртуальная встреча, август 2024 г. Ассоциация по компьютерной лингвистике. doi: 10.18653/v1/2024.findings-acl.568. URL https://aclanthology.org/2024.findings-acl.568.
- ⟦Liou et al. (2021) И-Тин Лиу, Чун-Чи Чен, Хен-Хсен Хуанг и Хсин-Хси Чен. Динамический graph transformer для распознавания неявных тегов. В Паола Мерло, Йорг Тидеманн и Реут Царфати (ред.), Труды 16-й конференции Европейского отделения Ассоциации компьютерной лингвистики: Основной том, стр. 1426–1431, онлайн, апрель 2021 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2021.eacl-main.122. URL https://aclanthology.org/2021.eacl-main.122.
- ⟦Liu et al. (2023) Чуан Лю, Джунчжо Ли и Деи Сюн. Tab-CQA: набор данных для табличных вопросно-ответных диалоговых систем по финансовой отчетности. В Сунаяна Ситарам, Беата Бейгман Клебанов и Джейсон Д. Уильямс (ред.), Труды 61-го ежегодного собрания Ассоциации компьютерной лингвистики (Том 5: Отраслевой трек), стр. 196–207, Торонто, Канада, июль 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.acl-industry.20. URL https://aclanthology.org/2023.acl-industry.20.
- ⟦Liu et al. (2024) Цзясинь Лю, И Ян и Кар Ян Там. За пределами поверхностного сходства: обнаружение тонких семантических сдвигов в финансовых нарративах. В сборнике: Кевин Ду, Хелена Гомес и Стивен Бетард (ред.), Результаты Ассоциации компьютерной лингвистики: NAACL 2024, стр. 2641–2652, Мехико, Мексика, июнь 2024 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.findings-naacl.168. URL https://aclanthology.org/2024.findings-naacl.168.
- ⟦Liu (2024) Джунхуа Лю. Обзор финансового искусственного интеллекта: архитектуры, достижения и открытые проблемы, 2024. URL https://arxiv.org/abs/2411.12747.
- ⟦Liu et al. (2019) Yinhan Liu, Myle Ott, Naman Goyal, Jingfei Du, Mandar Joshi, Danqi Chen, Omer Levy, Mike Lewis, Luke Zettlemoyer, and Veselin Stoyanov. Roberta: надежно оптимизированный подход к предварительному обучению bert, 2019. URL https://arxiv.org/abs/1907.11692.
- ⟦Liu et al. (2020) Чжуан Лю, Деген Хуан, Кайюй Хуан, Чжуан Ли и Цзюнь Чжао. Finbert: предварительно обученная модель представления финансового языка для интеллектуального анализа финансовых текстов. В сборнике: Кристиан Бессьер (ред.), Труды двадцать девятой Международной объединенной конференции по искусственному интеллекту, IJCAI-20, стр. 4513–4519. Организация международных объединенных конференций по искусственному интеллекту, 7 2020. doi: 10.24963/ijcai.2020/622. URL https://doi.org/10.24963/ijcai.2020/622. Специальное направление по ИИ в FinTech.
- ⟦Luo et al. (2023) Ди Луо, Вэйхэн Ляо, Шуци Ли, Синь Чэн и Руй Янь. Сеть многоуровневого взаимодействия с памятью на основе причинно-следственных связей для прогнозирования движения цен на акции по нескольким переменным. В сборнике: Анна Роджерс, Джордан Бойд-Грабер и Наоаки Окадзаки (ред.), Труды 61-го ежегодного собрания Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), стр. 12164–12176, Торонто, Канада, июль 2023 г. Ассоциация вычислительной лингвистики. doi: 10.18653/v1/2023.acl-long.679. URL https://aclanthology.org/2023.acl-long.679.
- ⟦Ma et al. (2024) Вэйчэн Ма, Чуньюань Дэн, Арам Мооссави, Лили Ван, Соруш Восуги и Дийи Ян. Имитационная восприимчивость к дезинформации (SMISTS): расширение исследований дезинформации с помощью симуляций на базе LLM. В сборнике: Лун-Вэй Ку, Андре Мартинс и Вивек Срикумар (ред.), Результаты Ассоциации компьютерной лингвистики ACL 2024, стр. 2774–2788, Бангкок, Таиланд и виртуальная встреча, август 2024 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.findings-acl.162. URL https://aclanthology.org/2024.findings-acl.162.
- ⟦Maheshwari et al. (2022) Химаншу Махешвари, Нетра Сивакумар, Шелли Джейн, Танви Карандикар, Винай Аггарвал, Навита Гоял и Сумит Шекхар. DynamicTOC: Персонализированное оглавление для работы с длинными документами. В сборнике: Марин Карпуат, Мари-Катрин де Марнефф и Иван Владимир Меза Руис (ред.), Труды конференции 2022 года Североамериканского отделения Ассоциации компьютерной лингвистики: Технологии обработки естественного языка, стр. 5133–5143, Сиэтл, Соединенные Штаты, июль 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.naacl-main.378. URL https://aclanthology.org/2022.naacl-main.378.
- ⟦Man et al. (2019) Силиу Ман, Тонг Луо и Цзяньу Линь. Анализ финансовых настроений (FSA): Обзор. В материалах Международной конференции IEEE по промышленным киберфизическим системам (ICPS) 2019 года, стр. 617–622, 2019. doi: 10.1109/ICPHYS.2019.8780312.
- ⟦Mathur et al. (2022) Пунит Матур, Михир Гоял, Рамит Сони, Ритик Матур, Йохан Лейднер, Франк Дернонкур и Динеш Маноча. DocFin: Мультимодальное финансовое прогнозирование и снижение предвзятости с использованием полуструктурированных документов. В сборнике: Йоав Голдберг, Зорница Козарева и Юэ Чжан (ред.), Результаты Ассоциации компьютерной лингвистики: EMNLP 2022, стр. 1933–1940, Абу-Даби, Объединенные Арабские Эмираты, декабрь 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.findings-emnlp.139. URL https://aclanthology.org/2022.findings-emnlp.139.
- ⟦Mavi et al. (2023)
Вайбхав Мави, Абулхаир Сапаров и Чен Чжао.
Retrieval-augmented chain-of-thought в полуструктурированных доменах.
В Дэниел Прео
iuc-Пьетро, Каталина Гоанта, Илиас Чалкидис, Лесли Барретт, Герасимос Спанакис и Николаос Алетрас (ред.), Труды семинара по обработке естественного юридического языка 2023, стр. 178–191, Сингапур, декабрь 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.nllp-1.18. URL https://aclanthology.org/2023.nllp-1.18.t , - ⟦Menzio et al. (2024) Мартина Менцио, Давиде Пари и Элизабетта Ферсини. Раскрытие динамики валютного рынка: использование коммуникаций Федеральной резервной системы для получения стратегических инвестиционных выводов. В Чун-Чи Чен, Сяомо Лю, Удо Хан, Армине Нурбахш, Чжицян Ма, Чариз Смайли, Вероник Хост, Санджив Ранджан Дас, Манлинг Ли, Мохаммад Гассеми, Хен-Хсен Хуанг, Хироя Такамура и Син-Си Чен (ред.), Труды совместного семинара 7-го семинара по финансовым технологиям и Natural Language Processing, 5-го семинара по извлечению знаний из неструктурированных данных в финансовых услугах и 4-го семинара по экономике и Natural Language Processing, стр. 94–102, Турин, Италия, май 2024 г. Ассоциация компьютерной лингвистики. URL https://aclanthology.org/2024.finnlp-1.10.
- ⟦Millo et al. (2024) Дениса Милло, Блерина Вика и Невила Бачи. Интеграция методов обработки естественного языка для интеллектуального анализа текстов в финансовую систему: Применения и ограничения, 2024. URL https://arxiv.org/abs/2412.20438.
- ⟦Mishev et al. (2020) Костадин Мишев, Ана Гьоргьевич, Ирена Воденска, Любомир Т. Читкушев и Димитар Траянов. Оценка анализа тональности в финансах: от словарей до transformers. IEEE Access, 8:131662–131682, 2020. doi: 10.1109/ACCESS.2020.3009626.
- ⟦Mondal et al. (2022) Джойдеб Мондал, Нагарадж Бхат, Прамир Саркар и Шахид Реза. ExpertNeurons в задаче 2 FinCausal 2022: извлечение причинно-следственных связей для финансовых документов. В Махмуд Эль-Хадж, Пол Рейсон и Надем Змандар (ред.), Труды 4-го семинара по обработке финансовых нарративов @LREC2022, стр. 128–130, Марсель, Франция, июнь 2022 г. Европейская ассоциация языковых ресурсов. URL https://aclanthology.org/2022.fnp-1.22.
- ⟦Ni et al. (2023) Цзинвэй Ни, Чжицзин Цзинь, Цянь Ван, Мринмая Сачан и Маркус Лейппольд. Когда работает агрегирование нескольких навыков с помощью многозадачного обучения? тематическое исследование в области финансового NLP. В Анна Роджерс, Джордан Бойд-Грабер и Наоаки Окадзаки (ред.), Труды 61-й ежегодной конференции Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), стр. 7465–7488, Торонто, Канада, июль 2023 г. Ассоциация вычислительной лингвистики. doi: 10.18653/v1/2023.acl-long.412. URL https://aclanthology.org/2023.acl-long.412.
- ⟦Nie et al. (2024) Юйци Не, Ясюань Кун, Сяовэнь Дун, Джон М. Малви, Х. Винсент Пур, Цинсун Вэнь и Стефан Зорен. Обзор LLM для финансовых приложений: прогресс, перспективы и проблемы, 2024. URL https://arxiv.org/abs/2406.11903.
- ⟦Niu et al. (2023) Хао Ню, Юнь Сюн, Сяосу Ван, Вэньцзин Юй, Яо Чжан и Вэйцзу Ян. KeFVP: Прогнозирование финансовой волатильности с расширением знаний. В сборнике: Худа Буамор, Хуан Пино и Калика Бали (ред.), Результаты Ассоциации компьютерной лингвистики: EMNLP 2023, стр. 11499–11513, Сингапур, декабрь 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.findings-emnlp.770. URL https://aclanthology.org/2023.findings-emnlp.770.
- ⟦Ozbayoglu et al. (2020) Ахмет Мурат Озбайоглу, Мехмет Угур Гуделек и Омер Берат Сезер. Глубокое обучение для финансовых приложений: Обзор. Applied Soft Computing, 93:106384, 2020. ISSN 1568-4946. doi: https://doi.org/10.1016/j.asoc.2020.106384. URL https://www.sciencedirect.com/science/article/pii/S1568494620303240.
- ⟦Pardawala et al. (2025) Хузайфа Пардававала, Сиддхант Сукхани, Агам Шах, Вир Кеджривал, Абхишек Пиллаи, Рохан Бхасин, Эндрю ДиБиазио, Тарун Мандапати, Дхрув Адха и Судхир Чава. Subjective-qa: Измерение субъективности в QA транскриптов отчетов о доходах посредством шестимерного анализа признаков, 2025. URL https://arxiv.org/abs/2410.20651.
- ⟦Qin & Yang (2019) Ю Цинь и И Ян. Важно то, что вы говорите и как вы это говорите: прогнозирование волатильности акций с использованием вербальных и вокальных сигналов. В сборнике: Анна Корхонен, Дэвид Траум и Льюис Маркес (ред.), Труды 57-го ежегодного собрания Ассоциации компьютерной лингвистики, стр. 390–401, Флоренция, Италия, июль 2019 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/P19-1038. URL https://aclanthology.org/P19-1038.
- ⟦Rodriguez Inserte et al. (2023) Пау Родригес Инсерте, Мариам Нахле, Рахиль Кадер, Гаэтан Кайо и Цзиншу Лю. Адаптация LLM для финансового анализа тональности. В Чун-Чи Чен, Хен-Хсен Хуан, Хироя Такамура, Хсин-Хси Чен, Хироки Сакадзи и Киёси Идзуми (ред.), Труды шестого семинара по финансовым технологиям и Natural Language Processing, стр. 1–10, Бали, Индонезия, ноябрь 2023 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2023.finnlp-2.1. URL https://aclanthology.org/2023.finnlp-2.1.
- ⟦Roy & Roth (2018) Субхро Рой и Дэн Рот. Отображение в декларативные знания для решения текстовых задач. Транзакции Ассоциации по компьютерной лингвистике, 6:159–172, 2018. doi: 10.1162/tacl_a_00012. URL https://aclanthology.org/Q18-1012.
- ⟦Sang & Bao (2022) Юньсинь Сан и Ян Бао. DialogueGAT: Графовая сеть внимания для прогнозирования финансовых рисков путем моделирования диалогов в ходе конференц-звонков по доходам. В Йоав Голдберг, Зорница Козарева и Юэ Чжан (ред.), Результаты Ассоциации по компьютерной лингвистике: EMNLP 2022, стр. 1623–1633, Абу-Даби, Объединенные Арабские Эмираты, декабрь 2022 г. Ассоциация по компьютерной лингвистике. doi: 10.18653/v1/2022.findings-emnlp.117. URL https://aclanthology.org/2022.findings-emnlp.117.
- ⟦Sawhney et al. (2020a) Рамит Сони, Шивам Агарвал, Арнав Вадхва и Раджив Рат Шах. Глубокое обучение с механизмом внимания для прогнозирования движения акций на основе текстов из социальных сетей и корреляций между компаниями. В сборнике: Бонни Веббер, Тревор Кон, Юлан Хэ и Ян Лю (ред.), Труды конференции 2020 года по эмпирическим методам в NLP (EMNLP), стр. 8415–8426, онлайн, ноябрь 2020a. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2020.emnlp-main.676. URL https://aclanthology.org/2020.emnlp-main.676.
- ⟦Sawhney et al. (2020b) Рамит Сони, Пиюш Ханна, Аршия Аггарвал, Тару Джайн, Пунит Матур и Раджив Рат Шах. VolTAGE: Прогнозирование волатильности посредством слияния текста и аудио с использованием графовых сверточных сетей для отчетов о доходах. В Бонни Уэббер, Тревор Кон, Юлан Хэ и Ян Лю (ред.), Труды конференции 2020 года по эмпирическим методам в Natural Language Processing (EMNLP), стр. 8001–8013, онлайн, ноябрь 2020b. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2020.emnlp-main.643. URL https://aclanthology.org/2020.emnlp-main.643.
- ⟦Sawhney et al. (2021a) Рамит Сони, Арнав Вадхва, Шивам Агарвал и Раджив Ратн Шах. FAST: Сеть с учетом временных факторов на основе финансовых новостей и твитов для биржевой торговли. В Паола Мерло, Йорг Тидеманн и Реут Царфати (ред.), Труды 16-й конференции Европейского отделения Ассоциации компьютерной лингвистики: Основной том, стр. 2164–2175, онлайн, апрель 2021a. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2021.eacl-main.185. URL https://aclanthology.org/2021.eacl-main.185.
- ⟦Sawhney et al. (2021b) Рамит Сони, Арнав Вадва, Шивам Агарвал и Раджив Ратн Шах. Количественная внутридневная торговля на основе естественного языка с использованием обучения с подкреплением. В сборнике: Кристина Тутанова, Анна Румшиски, Люк Зеттлмойер, Дилек Хаккани-Тур, Из Белтаги, Стивен Бетард, Райан Коттерелл, Танмой Чакраборти и Ичао Чжоу (ред.), Труды конференции 2021 года Североамериканского отделения Ассоциации компьютерной лингвистики: технологии человеческого языка, стр. 4018–4030, онлайн, июнь 2021b. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2021.naacl-main.316. URL https://aclanthology.org/2021.naacl-main.316.
- ⟦Sekeres et al. (2024) Хедвиг Г. Секерес, Вильберт Херинга, Витсе де Врис, Оскар Иде Звагерс, Мартейн Вилинг и Гоффе Т. Йенсма. Разработка инфраструктуры для создания корпусов малоресурсных языков. В сборнике: Майте Мелеро, Сакриани Сакти и Клаудия Сориа (ред.), Труды 3-го ежегодного собрания Специальной группы по малоресурсным языкам в рамках LREC-COLING 2024, стр. 72–78, Турин, Италия, май 2024 г. ELRA и ICCL. URL https://aclanthology.org/2024.sigul-1.10.
- ⟦Seroyizhko et al. (2022) Павло Серойжко, Жанель Жекенова, Мухаммад Зохаиб Шафик, Фабио Мерицци, Андреа Галасси и Федерико Руджери. Набор данных с аннотациями тональности и эмоций для прогнозирования цены биткоина на основе публикаций в Reddit. В сборнике: Чун-Чи Чен, Хен-Хсен Хуанг, Хироя Такамура и Хсин-Хси Чен (ред.), Труды четвертого семинара по финансовым технологиям и Natural Language Processing (FinNLP), стр. 203–210, Абу-Даби, Объединенные Арабские Эмираты (гибридный формат), декабрь 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.finnlp-1.27. URL https://aclanthology.org/2022.finnlp-1.27.
- ⟦Shah et al. (2023) Агам Шах, Суван Патури и Судхир Чава. Слова на триллион долларов: новый финансовый набор данных, задача и анализ рынка. В сборнике: Анна Роджерс, Джордан Бойд-Грабер и Наоаки Окадзаки (ред.), Труды 61-го ежегодного собрания Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), стр. 6664–6679, Торонто, Канада, июль 2023 г. Ассоциация вычислительной лингвистики. doi: 10.18653/v1/2023.acl-long.368. URL https://aclanthology.org/2023.acl-long.368.
- ⟦Shah et al. (2022) Радж Шах, Кунал Чавла, Дирадж Эиднани, Агам Шах, Венди Ду, Судхир Чава, Натрадж Раман, Чариз Смайли, Цзяао Чен и Дийи Ян. Когда FLUE встречает FLANG: Бенчмарки и большая предобученная языковая модель для финансовой сферы. В Йоав Голдберг, Зорница Козарева и Юэ Чжан (ред.), Труды конференции 2022 года по эмпирическим методам в Natural Language Processing, стр. 2322–2335, Абу-Даби, Объединенные Арабские Эмираты, декабрь 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.emnlp-main.148. URL https://aclanthology.org/2022.emnlp-main.148.
- ⟦Sinha et al. (2021) Санчит Синха, Ханджи Чен, Аршдип Сехон, Янфэн Цзи и Яньцзюнь Ци. Возмущение входных данных для хрупких интерпретаций в глубоком NLP. В сборнике: Ясмейн Бастингс, Йонатан Белинков, Эммануэль Дюпу, Марио Джулианелли, Дьюке Хупкес, Юваль Пинтер и Хассан Саджад (ред.), Труды четвертого семинара BlackboxNLP по анализу и интерпретации нейронных сетей для NLP, стр. 420–434, Пунта-Кана, Доминиканская Республика, ноябрь 2021 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2021.blackboxnlp-1.33. URL https://aclanthology.org/2021.blackboxnlp-1.33.
- ⟦Su et al. (2024) И Су, Юньпэн Тай, Исинь Цзи, Цзюньтао Ли, Янь Бовэнь и Минь Чжан. Увеличение демонстраций для zero-shot in-context learning. В Лунь-Вэй Ку, Андре Мартинс и Вивек Срикумар (ред.), Материалы Ассоциации компьютерной лингвистики ACL 2024, стр. 14232–14244, Бангкок, Таиланд и виртуальная встреча, август 2024 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.findings-acl.846. URL https://aclanthology.org/2024.findings-acl.846.
- ⟦Tabari et al. (2018) Наргес Табари, Пиюша Бисвас, Бхану Пранит, Армин Сейедитабари, Мирсад Хадзикадич и Влодек Задрозны. Анализ причинно-следственной связи между настроениями в Twitter и доходностью фондового рынка. В сборнике: Удо Хан, Вероник Хост и Мин-Фэн Цай (ред.), Труды первого семинара по экономике и Natural Language Processing, стр. 11–19, Мельбурн, Австралия, июль 2018 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/W18-3102. URL https://aclanthology.org/W18-3102.
- ⟦Tang et al. (2023) Исюань Тан, И Ян, Аллен Хуан, Энди Тэм и Джастин Тан. FinEntity: Классификация тональности на уровне сущностей для финансовых текстов. В сборнике: Худа Буамор, Хуан Пино и Калика Бали (ред.), Труды конференции 2023 года по эмпирическим методам в Natural Language Processing, стр. 15465–15471, Сингапур, декабрь 2023 г. Ассоциация вычислительной лингвистики. doi: 10.18653/v1/2023.emnlp-main.956. URL https://aclanthology.org/2023.emnlp-main.956.
- ⟦Theuma & Shareghi (2024) Эдриан Теума и Эхсан Шареги. Оснащение языковых моделей возможностью использования инструментов для анализа табличных данных в сфере финансов. В сборнике: Иветт Грэм и Мэтью Пурвер (ред.), Труды 18-й конференции Европейского отделения Ассоциации компьютерной лингвистики (Том 2: Краткие статьи), стр. 90–103, Сент-Джулианс, Мальта, март 2024 г. Ассоциация компьютерной лингвистики. URL https://aclanthology.org/2024.eacl-short.10⟧.
- ⟦Touvron et al. (2023) Хьюго Туврон, Луи Мартен, Кевин Стоун, Питер Альберт, Амджад Алмахайри, Ясмин Бабаеи, Николай Башлыков, Соумья Батра, Праджвал Бхаргава, Шрути Бхосале и др. Llama 2: Открытые базовые и дообученные чат-модели. arXiv preprint arXiv:2307.09288, 2023.
- ⟦Uluoglakci & Temizel (2024) Джем Улуоглакчи и Тугба Темизель. HypoTermQA: набор данных гипотетических терминов для бенчмаркинга склонности LLM к галлюцинациям. В Ниле Фальк, Сара Папи и Майк Чжан (ред.), Труды 18-й конференции Европейского отделения Ассоциации компьютерной лингвистики: Семинар для студентов-исследователей, стр. 95–136, Сент-Джулианс, Мальта, март 2024 г. Ассоциация компьютерной лингвистики. URL https://aclanthology.org/2024.eacl-srw.9.
- ⟦(101) Комиссия по ценным бумагам и биржам США. Sec edgar: Обзор системы. URL https://www.sec.gov/info/edgar/regoverview.htm. Дата обращения: 2025-03-05.
- ⟦Vargas et al. (2021) Франсиэль Варгас, Фабрисио Беневенуто и Тьяго Пардо. На пути к дискурсивно-ориентированным моделям для многоязычного обнаружения фейковых новостей. В Сухила Джабри, Динара Гимади, Цветомила Михайлова и Ивелина Николова-Колева (ред.), Труды студенческого исследовательского семинара, связанного с RANLP 2021, стр. 210–218, онлайн, сентябрь 2021 г. INCOMA Ltd. URL https://aclanthology.org/2021.ranlp-srw.29.
- ⟦Vaswani et al. (2017) Ашиш Васвани, Ноам Шазир, Ники Пармар, Якоб Ушкорайт, Лион Джонс, Эйдан Н. Гомес, Лукаш Кайзер и Илья Полосухин. Attention is all you need, 2017. URL https://arxiv.org/abs/1706.03762.
- ⟦Wang et al. (2024) Шенкун Ван, Таоран Цзи, Цзяньфэн Хэ, Мариам Аль-Мутаири, Дан Ван, Линьхань Ван, Минь Чжан и Чан-Тьен Лу. AMA-LSTM: Пионерский подход к надежному и справедливому финансовому аудиоанализу для прогнозирования волатильности акций. В И Ян, Аида Давани, Ави Сил и Ануп Кумар (ред.), Труды конференции 2024 года Североамериканского отделения Ассоциации компьютерной лингвистики: Технологии обработки естественного языка (Том 6: Отраслевой трек), стр. 379–386, Мехико, Мексика, июнь 2024 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.naacl-industry.32. URL https://aclanthology.org/2024.naacl-industry.32.
- ⟦Wang et al. (2019) Вейкан Ван, Цзяцзюнь Чжан, Цянь Ли, Чэнцин Цзун и Чжифэй Ли. Вы настоящие? обнаружение мошенничества с личными данными посредством диалоговых взаимодействий. В Кентаро Инуи, Цзин Цзян, Винсент Нг и Сяоцзюнь Ван (ред.), Труды конференции 2019 года по эмпирическим методам в обработке естественного языка и 9-й Международной объединенной конференции по обработке естественного языка (EMNLP-IJCNLP), стр. 1762–1771, Гонконг, Китай, ноябрь 2019 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/D19-1185. URL https://aclanthology.org/D19-1185.
- ⟦Whited (2023) Тони Уайтэд. Издержки и выгоды воспроизводимости в финансах и экономике. Harvard Data Science Review, 5(3), 27 июля 2023 г. https://hdsr.mitpress.mit.edu/pub/mnhzk8gq.
- ⟦Wu (2020) Сяньчао У. Обучение систематическому поведению на фондовых рынках на основе событий. В Тревор Кон, Юлань Хэ и Ян Лю (ред.), Результаты Ассоциации компьютерной лингвистики: EMNLP 2020, стр. 2434–2444, онлайн, ноябрь 2020 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2020.findings-emnlp.220. URL https://aclanthology.org/2020.findings-emnlp.220.
- ⟦Xiao et al. (2024a) Цзюэ Сяо, Цзяншань Ван, Вэньцин Бао, Тинтин Дэн и Шуочень Би. Применение технологий natural language processing в финансовых исследованиях. Financial Engineering and Risk Management, 7(3):155–161, 2024a. doi: 10.23977/ferm.2024.070320. URL https://www.clausiuspress.com/article/12576.html.
- ⟦Xiao et al. (2024b) Ян Сяо, Яочу Цзинь и Куанжун Хао. Федеративное извлечение биомедицинских отношений на уровне документа с использованием локализованного контекстного контраста. В Николетта Кальцолари, Мин-Йен Кан, Вероник Хост, Алессандро Ленчи, Сакриани Сакти и Нианвен Сюэ (ред.), Труды совместной международной конференции 2024 года по вычислительной лингвистике, языковым ресурсам и оценке (LREC-COLING 2024), стр. 7163–7173, Турин, Италия, май 2024b. ELRA и ICCL. URL https://aclanthology.org/2024.lrec-main.629.
- ⟦Xie et al. (2024a) Цяньцянь Се, Вэйгуан Хань, Сяо Чжан, Яньчжао Лай, Минь Пэн, Алехандро Лопес-Лира и Цзиминь Хуан. Pixiu: LLM, данные для обучения с инструкциями и эталонный тест для оценки в сфере финансов. В материалах 37-й Международной конференции по системам нейронной обработки информации, NIPS ’23, Ред-Хук, штат Нью-Йорк, США, 2024a. Curran Associates Inc.
- ⟦Xie et al. (2024b) Йонг Се, Каран Аггарвал и Айтзаз Ахмад. Эффективное непрерывное предварительное обучение для создания специализированных LLM. В сборнике: Лун-Вэй Ку, Андре Мартинс и Вивек Срикумар (ред.), Результаты Ассоциации компьютерной лингвистики ACL 2024, стр. 10184–10201, Бангкок, Таиланд и виртуальная встреча, август 2024b. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.findings-acl.606. URL https://aclanthology.org/2024.findings-acl.606.
- ⟦Xing et al. (2017) Фрэнк З. Синг, Эрик Камбрия и Рой Э. Уэлш. Финансовое прогнозирование на основе естественного языка: обзор. Artificial Intelligence Review, 50(1):49–73, 2017.
- ⟦Xu & Cohen (2018) Юмо Сюй и Шэй Б. Коэн. Прогнозирование движения акций на основе твитов и исторических цен. В Ирине Гуревич и Юсуке Мияо (ред.), Труды 56-го ежегодного собрания Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), стр. 1970–1979, Мельбурн, Австралия, июль 2018 г. Ассоциация вычислительной лингвистики. doi: 10.18653/v1/P18-1183. URL https://aclanthology.org/P18-1183.
- ⟦Yang et al. (2023) Хунъян Ян, Сяо-Ян Лю и Кристина Дан Ван. FinGPT: финансовые LLM с открытым исходным кодом, 2023. URL https://arxiv.org/abs/2306.06031.
- ⟦Yang et al. (2020a) Линьи Ян, Тин Лок Джеймс Нг, Барри Смит и Жуйхай Дун. Html: Иерархическое многозадачное обучение на основе transformers для прогнозирования волатильности. В материалах конференции The Web Conference 2020, WWW ’20, стр. 441–451, Нью-Йорк, штат Нью-Йорк, США, 2020a. Ассоциация вычислительной техники. ISBN 9781450370233. doi: 10.1145/3366423.3380128. URL https://doi.org/10.1145/3366423.3380128.
- ⟦Yang et al. (2020b) И Ян, Марк УИ и Аллен Хуанг. Finbert: предобученная языковая модель для финансовых коммуникаций, 06 2020b.
- ⟦Yangjia et al. (2022) Чжэн Янцзя, Ли Ся, Ма Цзюньтэн и Чэнь Юань. Нейронная сеть на основе фундаментального анализа для прогнозирования движения акций. В сборнике: Маосун Сунь, Ян Лю, Ваньсян Че, Ян Фэн, Сипэн Цю, Гаоци Рао и Юбо Чэнь (ред.), Труды 21-й Китайской национальной конференции по компьютерной лингвистике, стр. 973–984, Наньчан, Китай, октябрь 2022 г. Китайское общество по обработке информации. URL https://aclanthology.org/2022.ccl-1.86.
- ⟦Zhang et al. (2024) Чжилу Чжан, Прочета Сен, Зиму Ван, Жоюй Сунь, Чжэнъюн Цзян и Цзюнлун Су. FinBPM: фреймворк для модели восприятия поведения финансовых инвесторов на основе управления портфелем. В Иветт Грэм и Мэтью Пурвер (ред.), Труды 18-й конференции Европейского отделения Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), стр. 246–257, Сент-Джулианс, Мальта, март 2024 г. Ассоциация компьютерной лингвистики. URL https://aclanthology.org/2024.eacl-long.15.
- ⟦Zhao et al. (2024a) Хуацинь Чжао, Чжэнлян Лю, Цзыхао У, Ивэй Ли, Тяньцзэ Ян, Пэн Шу, Шаочэнь Сюй, Хайсин Дай, Линь Чжао, Ханьци Цзян, И Пань, Цзюньхао Чэнь, Ифань Чжоу, Гэнчэнь Май, Нинхао Лю и Тяньмин Лю. Революция в финансах с помощью LLM: обзор приложений и идей, 2024a. URL https://arxiv.org/abs/2401.11641.
- ⟦Zhao et al. (2024b) Илунь Чжао, Хунцзюнь Лю, Итао Лун, Жуй Чжан, Чэнь Чжао и Арман Кохан. KnowledgeFMath: Набор данных для математических рассуждений, требующих глубоких знаний, в финансовой сфере. В сборнике: Лун-Вэй Ку, Андре Мартинс и Вивек Срикумар (ред.), Труды 62-й ежегодной конференции Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), стр. 12841–12858, Бангкок, Таиланд, август 2024b. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.acl-long.693. URL https://aclanthology.org/2024.acl-long.693.
- ⟦Zhao et al. (2024c) Ииюн Чжао, Пратик Сингх, Ханоз Батена, Бернардо Рамос, Авирал Джоши, Сваруп Гадиярам и Сакет Шарма. Оптимизация конвейеров генерации с дополнением выборкой на основе LLM в финансовой сфере. В сб.: И Ян, Аида Давани, Ави Сил и Ануп Кумар (ред.), Труды конференции 2024 года Североамериканского отделения Ассоциации компьютерной лингвистики: Технологии человеческого языка (Том 6: Отраслевой трек), стр. 279–294, Мехико, Мексика, июнь 2024 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2024.naacl-industry.23. URL https://aclanthology.org/2024.naacl-industry.23.
- ⟦Zhao et al. (2024d) Зишуо Чжао, Зиян Ма, Чжэнчжоу Линь, Цзинъю Се, Инхуэй Ли и Ин Шэнь. Адаптация домена без исходных данных для анализа тональности на основе аспектов. В Николетта Кальцолари, Мин-Йен Кан, Вероник Хост, Алессандро Ленчи, Сакриани Сакти и Нианвен Сюэ (ред.), Труды совместной международной конференции 2024 года по вычислительной лингвистике, языковым ресурсам и оценке (LREC-COLING 2024), стр. 15076–15086, Турин, Италия, май 2024 г. ELRA и ICCL. URL https://aclanthology.org/2024.lrec-main.1310.
- ⟦Zheng et al. (2019) Шунь Чжэн, Вэй Цао, Вэй Сюй и Цзян Бянь. Doc2EDAG: Сквозная структура на уровне документа для извлечения финансовых событий на китайском языке. В сборнике: Кентаро Инуи, Цзин Цзян, Винсент Нг и Сяоцзюнь Ван (ред.), Труды конференции 2019 года по эмпирическим методам в области обработки естественного языка и 9-й Международной объединенной конференции по обработке естественного языка (EMNLP-IJCNLP), стр. 337–346, Гонконг, Китай, ноябрь 2019 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/D19-1032. URL https://aclanthology.org/D19-1032.
- ⟦Zhou et al. (2020) Фань Чжоу, Шэнмин Чжан и И Ян. Интерпретируемая классификация операционных рисков с помощью полуавтоматического вариационного автокодировщика. В сборнике: Дэн Джурафски, Джойс Чай, Натали Шлютер и Джоэл Тетро (ред.), Труды 58-го ежегодного собрания Ассоциации компьютерной лингвистики, стр. 846–852, онлайн, июль 2020 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2020.acl-main.78. URL https://aclanthology.org/2020.acl-main.78.
- ⟦Zhu et al. (2021) Фэнбинь Чжу, Вэньцян Лэй, Ючэн Хуан, Чао Ван, Шо Чжан, Цзяньчэн Люй, Фули Фэн и Тат-Сен Чуа. TAT-QA: Бенчмарк для QA по гибридному табличному и текстовому контенту в сфере финансов. В Чэнцин Цзун, Фэй Ся, Вэньцзе Ли и Роберто Навильи (ред.), Труды 59-го ежегодного собрания Ассоциации вычислительной лингвистики и 11-й Международной объединенной конференции по Natural Language Processing (Том 1: Длинные статьи), стр. 3277–3287, онлайн, август 2021 г. Ассоциация вычислительной лингвистики. doi: 10.18653/v1/2021.acl-long.254. URL https://aclanthology.org/2021.acl-long.254.
- ⟦Zmandar et al. (2022) Надхем Змандар, Тобиас Даудерт, Сина Ахмади, Махмуд Эль-Хадж и Пол Рейсон. CoFiF plus: Корпус для суммаризации финансовых нарративов на французском языке. В Николетта Кальцолари, Фредерик Беше, Филипп Блаш, Халид Шукри, Кристофер Сьери, Тьерри Деклерк, Сара Годжи, Хитоши Исахара, Бенте Маегаард, Джозеф Мариани, Элен Мазо, Ян Одейк и Стелиос Пиперидис (ред.), Труды тринадцатой конференции по языковым ресурсам и оценке, стр. 1622–1639, Марсель, Франция, июнь 2022 г. Европейская ассоциация языковых ресурсов. URL https://aclanthology.org/2022.lrec-1.174.
- ⟦Zou et al. (2022) Цзиньань Цзоу, Хайяо Цао, Линцяо Лю, Юйхао Линь, Эхсан Аббаснеджад и Джавен Цинфэн Ши. Astock: Новый набор данных и автоматизированная биржевая торговля на основе модели анализа новостей, специфичных для акций. В сборнике: Чун-Чи Чен, Хен-Хсен Хуан, Хироя Такамура и Син-Си Чен (ред.), Труды четвертого семинара по финансовым технологиям и Natural Language Processing (FinNLP), стр. 178–186, Абу-Даби, Объединенные Арабские Эмираты (гибридный формат), декабрь 2022 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/2022.finnlp-1.24. URL https://aclanthology.org/2022.finnlp-1.24.
Appendix A Авторство и финансирование
На основе проведенного нами анализа мы также выполнили бинарную классификацию следующих категорий:
- ⟦• Авторы, связанные с академическими кругами
- ⟦• Авторы, аффилированные с индустрией
- ⟦• Финансирование со стороны индустрии
- ⟦• Финансирование из государственных источников
- ⟦• Финансирование из академических источников
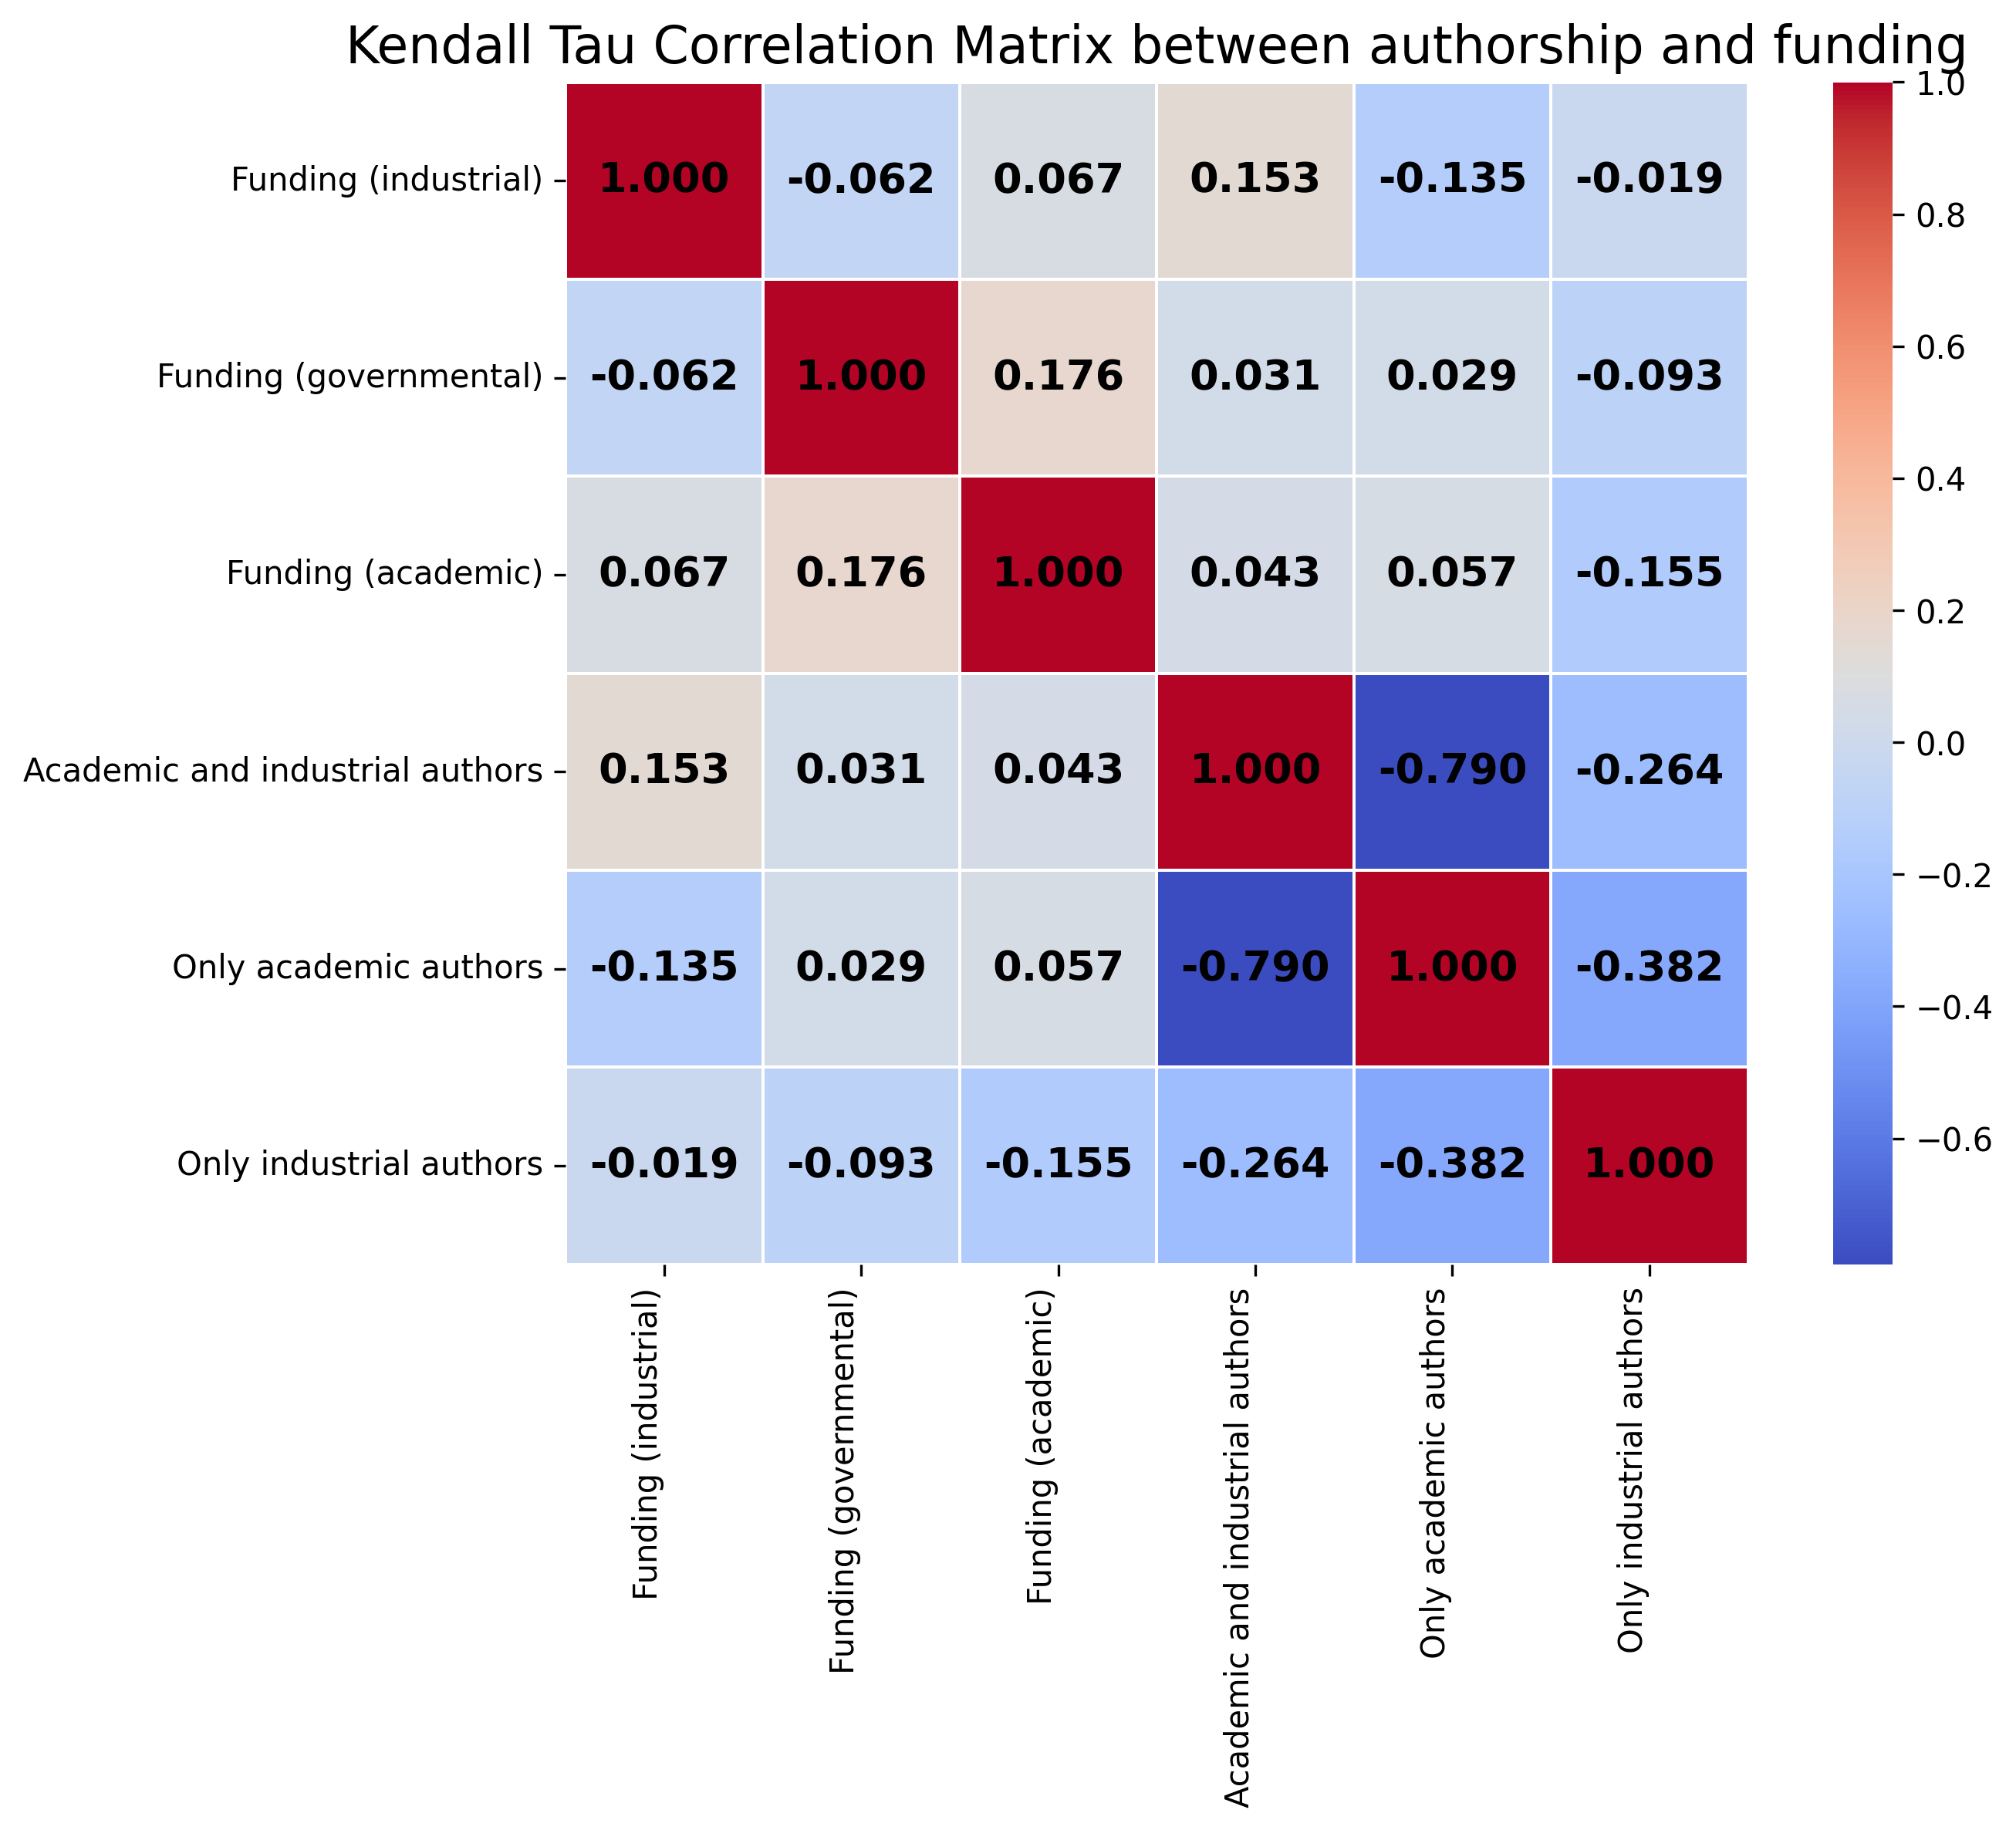
Как показано на рисунке 8, мы видим, что между финансированием и авторством нет существенной корреляции. Таким образом, это не означает, что если в списке авторов присутствует представитель индустрии или академических кругов, то обязательно будет финансирование со стороны индустрии, академических кругов или правительства..
| Category | Count |
|---|---|
| Papers with Academic and Industrial authors | 78 |
| Papers with only Academic authors | 118 |
| Papers with only Industrial authors | 25 |
| Papers with Industrial Funding | 49 |
| Papers with Governmental Funding | 61 |
| Papers with Academic Funding | 35 |
Appendix B Исследованы различные аспекты ⟦K0⟧
| Exploration dimension | Description |
|---|---|
| Primary task | The main task addressed in the paper, such as volatility prediction (Wang et al. 2024). |
| Sub-Tasks | Additional tasks that support the primary objective, like using sentiment analysis to enhance stock price predictions (Jain & Agrawal 2024). |
| Methodology | Techniques applied, ranging from traditional machine learning to deep learning and large language models. See Section 5. |
| Code and data availability | Whether the paper provides open-source code or data, and whether those artifacts are accessible (e.g., active links). |
| Contribution | What type of contribution the paper has such as a dataset, framework, model, evaluation, and so on. |
| Comparison/baselines | The baselines the paper compares their work to. |
| Data source | The types of data used, including financial reports, social media, news articles, or other financial documents. |
| Metrics | Evaluation criteria, including standard ML metrics (accuracy, precision) and finance-specific metrics (Sharpe ratio). |
| Data years | The time periods covered by the data, such as crisis years or more stable financial periods. |
| Authorship | Indicates what affiliation the authors of the paper have (academic, industrial). |
| Funding source | The origin of the research funding (academic, industrial, or governmental) if any. |
Appendix C Общие методы ⟦K0⟧
| Methodology | Description |
|---|---|
| Statistical NLP | Methods like TF-IDF, Bag-of-Words, and n-grams focused on extracting statistical patterns from financial text. |
| Embeddings | Techniques such as Word2Vec, GloVe, and custom embeddings designed to map financial terms into vector spaces, improving downstream tasks. |
| Conventional ML | Algorithms like Logistic Regression, Support Vector Machines (SVM), and Decision Trees, often used for classification and risk prediction. |
| Deep Learning (DL) | Custom neural network architectures tailored for specific financial tasks such as stock price forecasting. |
| PLMs | Encoder-only models (e.g., BERT) and Encoder-Decoder models (e.g., T5) are used for tasks like document summarization and information extraction. |
| LLMs | Models like GPT-3.5 and LLaMA-2 focus on text generation and understanding complex financial language. |
| Statistical Modeling | Involves correlation analysis, Granger causality, etc., to understand relationships in financial data. |
| Graphs | Uses graph structures to model interactions in financial systems. |
| Knowledge Graphs | Integrating structured knowledge within financial tasks to enhance model performance and reliability. |
Appendix D Описание задачи
| Primary Task | Examples & Insights |
| Finance-Related (Categories IV) | |
| Explainable AI (XAI) refers to methods that make machine learning outputs more interpretable and less of a "black box." | These papers show how small input changes can drastically affect model explanations (Sinha et al. 2021) and highlight the instability of tools like LIME in sensitive applications (Burger et al. 2023). In finance, where decisions must be traceable and justifiable, clear and reliable explanation methods are essential for building trust in tasks like fraud detection and risk assessment. |
| Privacy-preserving methods protect sensitive data while still allowing model training and analysis. | Examples include homomorphic encryption for text similarity (Kim et al. 2022), federated learning for distributed training without raw data exchange (Zhao et al. 2024d), and domain adaptation that shares only model parameters (Xiao et al. 2024b). These methods are especially important in finance, where institutions must work with private data while staying compliant and avoiding breaches. |
| Numerical reasoning involves working with numbers and structured data to solve problems or develop algorithms. | This includes solving math word problems using declarative knowledge (Roy & Roth 2018), learning numeracy through number embeddings (Duan et al. 2021), and pretraining models for verifying tabular claims (Akhtar et al. 2023). In finance, good numerical reasoning supports tasks like market prediction and risk evaluation by improving how models interpret and reason about numbers. |
| Financial Applications (Category III) | |
| Sentiment analysis helps assess market mood and forecast financial movements using sources like news, social media, and reports. | Studies analyze opinions in reports and news (Rodriguez Inserte et al. 2023), investor sentiment on social media (Guo et al. 2023a), and tone in financial texts (Choe et al. 2023). As markets become more influenced by public opinion, sentiment analysis plays a growing role in trading and analysis. |
| Information extraction (IE) and relation extraction focus on identifying entities and linking them to events or other entities. | Examples include extracting financial events from documents (Zheng et al. 2019), signals in reports (Huang et al. 2023), and patterns in social media (Conforti et al. 2022). These tools help connect companies, individuals, and financial instruments to real-world developments (Liou et al. 2021), supporting real-time analysis and prediction. |
| Question Answering (QA) enables systems to find specific information in financial documents, reports, and databases. | QA models support quick access to relevant facts (Mavi et al. 2023), and recent work focuses on calibrating large language models (LLMs) for finance-specific tasks (Zhao et al. 2024c; Theuma & Shareghi 2024; Addlesee 2024). This area emphasizes not only building QA tools but also improving their accuracy for use in high-stakes financial contexts. |
| Primary Task | Examples & Insights |
| Financial Resources (Category II) | |
| Dataset and Resource Construction involves building structured, labeled financial datasets for model development and evaluation. | These papers focus on creating large-scale annotated resources (Chen et al. 2020a), including datasets like Tab-CQA (Liu et al. 2023) and ConvFinQA (Chen et al. 2022c) designed for reasoning over tables and multi-step numerical queries. Other works assemble corpora from Earnings calls (Pardawala et al. 2025), financial reports (Shah et al. 2022), company filings (Zmandar et al. 2022), news (Tang et al. 2023), and government documents (Shah et al. 2023), enabling downstream tasks like entity linking, numerical reasoning, or forecasting. |
| Fraud detection leverages domain-specific data and models to identify deceptive financial behavior across platforms. | Erben & Waldis 2024 identifies financial scams on Instagram using a fine-tuned BERT model deployed via browser extension and REST API. Another approach detects identity fraud through interactive dialogue, employing knowledge graphs and reinforcement learning to expose inconsistencies in claimed personal data (Wang et al. 2019). These systems highlight how NLP architectures can protect users from financial manipulation. |
| Financial Forecast (Category I) | |
| Stock Price and Volatility Prediction aims to forecast stock movements or market instability using text data. | These models use historical data (Sawhney et al. 2021a), news (Ahbali et al. 2022), and event-driven signals (Sawhney et al. 2020a; Wu 2020) to predict stock trends. Volatility prediction further explores market sensitivity by analyzing unstructured text like press releases or financial articles (Qin & Yang 2019), helping traders anticipate fluctuations. |
| Risk Prediction involves identifying the likelihood and impact of adverse financial events, such as defaults or market disruptions. | These models analyze unstructured data like earnings call transcripts (Sang & Bao 2022), regulatory filings, and legal documents to detect early signals of financial risk (Li et al. 2023b). Applications include credit risk estimation, fraud detection, and systemic risk monitoring (Zhang et al. 2024). |
Appendix E Материалы конференции
| Category | Conferences and Workshops |
|---|---|
| Financial Forecast (Category I) | ACL, Australasian Language Technology Association Workshop, CCL, EACL, EcoNLP Workshop, EMNLP, EMNLP (Industry), Financial Technology and Natural Language Processing (FinNLP) Workshop, ICCL, LREC-COLING, NAACL, NAACL (Industry), SRW |
| Financial Resources (Category II) | ACL, ACL (Industry), CoNLL, EACL, EcoNLP Workshop, EMNLP, EMNLP-IJCNLP, e-Commerce and NLP Workshop, Financial Narrative Processing and MultiLing Financial Summarisation Workshop, Financial Technology and Natural Language Processing (FinNLP) Workshop, GWC, ICON, ICCL, LREC, LREC-COLING, NAACL, NAACL (Industry), NLP4PI Workshop, Pattern-based Approaches to NLP in the Age of Deep Learning Workshop, SIGHUM Workshop |
| Financial Applications (Category III) | ACL, ATALA, Bridging Human–Computer Interaction and Natural Language Processing Workshop, CCL, CoLM, Computational Approaches to Subjectivity, Sentiment and Social Media Analysis Workshop, DeeLIO Workshop, EACL, EcoNLP Workshop, EMNLP, EMNLP (Industry), EMNLP-IJCNLP, Financial Narrative Processing and MultiLing Financial Summarisation Workshop, Financial Technology and Natural Language Processing (FinNLP) Workshop, ICON, ICCL, INLG, LREC, LREC-COLING, NAACL, NAACL (Industry), Natural Legal Language Processing Workshop, News Media Content Analysis and Automated Report Generation Workshop, Pattern-based Approaches to NLP in the Age of Deep Learning Workshop, Safety4ConvAI Workshop, Structured Prediction for Natural Language Processing Workshop, TextGraphs |
| Finance Related (Category IV) | ACL, ACL-IJCNLP, BlackboxNLP Workshop, EMNLP, Financial Technology and Natural Language Processing (FinNLP) Workshop, LREC-COLING, SRW, TrustNLP Workshop |
Appendix F Количество статей в год
| Year | 2024 | 2023 | 2022 | 2021 | 2020 | 2019 | 2018 | 2017 | 2016 | 2015 | 2014 | 2012 | 2010 | 2008 | 2006 | 2002 | 2001 | 1976 | 1975 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Number of Papers | 127 | 53 | 90 | 32 | 57 | 15 | 14 | 21 | 6 | 1 | 5 | 1 | 3 | 3 | 1 | 1 | 1 | 1 | 1 |
Appendix G Глоссарий
| Metric | Definition |
|---|---|
| Sharpe Ratio | Measures how much return an investment gives for each unit of risk, compared to a risk-free asset (Investopedia Staff 2025a). |
| Maximum Drawdown | The biggest drop from a peak to a low point in a portfolio’s value before it recovers (Investopedia Staff 2023b). |
| Cumulative Return | The total profit or loss from an investment over time (Investopedia Staff 2023a). |