Эффект бабочки: траектории обучения нейронных сетей являются
Высокая чувствительность к начальным условиям
Аннотация
Обучение нейронных сетей по своей природе чувствительно к инициализации и случайности, вызванной стохастическим градиентным спуском. Однако остается неясным, в какой степени такие эффекты приводят к значимо различным сетям, как с точки зрения весов моделей, так и с точки зрения изученных ими базовых функций. В этой работе мы показываем, что во время начальной «хаотической» фазы обучения даже чрезвычайно малые возмущения надежно вызывают расхождение идентичных в остальном траекторий обучения — эффект, который быстро уменьшается с течением времени обучения. Мы количественно оцениваем это расхождение с помощью (i) расстояния между параметрами, (ii) барьера функции потерь при интерполяции между сетями, (iii) и барьера между параметрами после выравнивания перестановок, и (iv) репрезентативного сходства между промежуточными активациями; раскрывая, как возмущения при различных гиперпараметрах или настройках fine-tuning направляют траектории обучения к различным минимумам функции потерь. Наши результаты дают представление о стабильности обучения нейронных сетей с практическими последствиями для fine-tuning, объединения моделей и разнообразия ансамблей моделей. 11 1 Наш код доступен по адресу https://github.com/gsaltintas/lmc
Ключевые слова: обучение нейронных сетей, стабильность обучения, ландшафт функции потерь, динамика оптимизации, дообучение, ансамблирование моделей, эффект бабочки:
Машинное обучение, ICML
1 Введение
Обучение нейронных сетей известно своей нестабильностью в том смысле, что шум может нарушить сходимость к конкретному минимуму (Frankle et al. 2020a; Wu et al. 2018). Это верно даже при рассмотрении решений, которые работают одинаково хорошо, поскольку симметрии и связанные минимумы в ландшафте функции потерь порождают множество различных способов параметризации идентичных или схожих функций нейронной сетью..
Хотя нестабильность обучения в целом влияет на сходимость (Iyer et al. 2023; Jastrzebski et al. 2020), она также препятствует тому, чтобы различные запуски одной и той же нейронной сети стабильно приходили к одному конкретному решению, что имеет практические последствия для объединения моделей (Singh & Jaggi 2020; Ainsworth et al. 2023) и ансамблирования. Предыдущие работы классифицировали обучение на хаотическую (раннюю) и стабильную (позднюю) фазы (Fort et al. 2020; Frankle et al. 2020a), однако неясно, является ли нестабильность скорее продуктом шума (например, шума пакетов, аугментации данных, недетерминированности GPU), текущего состояния сети (например, случайного или предобученного) или самой процедуры обучения (например, выбора оптимизатора и гиперпараметров). Глубокое понимание нестабильности должно позволить разделить эти факторы, поскольку их влияние может варьироваться в зависимости от времени обучения и различных условий. Более того, в зависимости от задачи не всеми этими факторами можно управлять — например, при SFT предобученной модели можно варьировать гиперпараметры, но не начальные веса, в то время как при предобучении той же модели ситуация может быть обратной..
Эти ограничения побуждают нас изучать стабильность обучения в отсутствие влияния шума. Опираясь на перспективу динамических систем, мы рассматриваем, насколько сильно детерминированное отображение обучения отклоняется при внесении контролируемого возмущения в его начальные условия (то есть начальные веса нейронной сети). Выбирая начальные веса из моделей, обученных или прошедших SFT в течение различного времени, мы формируем представление о том, в каких областях ландшафта функции потерь траектории обучения склонны к расхождению и насколько чувствительны траектории к возмущениям в этих областях. Критически важно, что наш подход позволяет количественно оценить стабильность более точно и для более широкого спектра моделей — от случайно инициализированных до предобученных — чем это было возможно в предыдущих работах, в которых измерялась только нестабильность по отношению к шуму при обучении. Наш вклад заключается в следующем:
- ⟦1. Мы показываем, что крошечное возмущение даже одного веса на раннем этапе обучения приводит к тому, что две идентично инициализированные и обученные нейронные сети начинают расходиться — эффект бабочки (Figure 2⟧).
- ⟦2. Напротив, даже сети, устойчивые к шуму при обучении, расходятся при более сильных возмущениях. Это указывает на возможность использования возмущений в процессе обучения или fine-tuning для повышения разнообразия моделей и эффективности ensembling Figure 3).
- ⟦3. Мы обнаружили, что стабильность улучшается при использовании таких настроек, как более широкие/менее глубокие сети и увеличенный период прогрева скорости обучения (среди прочих), и эти настройки можно комбинировать для дальнейшего снижения, но не устранения, нестабильности вблизи инициализации (Figure 4).
- ⟦4. Хотя предварительно обученные нейронные сети на порядки стабильнее сетей со случайной инициализацией, стабильность сильно варьируется в зависимости от задач, и, что примечательно, более интенсивное предварительное обучение LLM в некоторых случаях может фактически снижать стабильность (Figure 5⟧).
- ⟦5. Вопреки взгляду с позиции динамических систем, и барьеры (Frankle & Carbin 2019) не растут экспоненциально в процессе обучения (Figure 6), и хотя и барьеры в некоторых случаях сильно коррелируют, это не является верным в общем случае (Figure 7).
2 Связанные работы
Стабильность и оптимизация. Многие работы исследуют стабильность оптимизации, задаваясь вопросом, сходятся ли нейронные сети к минимумам с хорошей обобщающей способностью (Cohen et al. 2021; Jastrzebski et al. 2020; Wu et al. 2018) или сходятся ли они вообще (Iyer et al. 2023; Jacot et al. 2018; Sohl-Dickstein 2024). Однако эти работы не рассматривают стабильность относительно какой-либо конкретной траектории обучения..
Мы фокусируемся на вопросе о том, стремится ли обучение из начальной точки следовать по одной и той же траектории к конкретному «бассейну функции потерь», то есть к линейно связной области ландшафта функции потерь с низким значением потерь. Хотя этот вопрос более узкий по охвату, он крайне актуален для практических контекстов, таких как использование предобученных моделей или проведение fine-tuning. Для объединения или ансамблирования моделей в этих контекстах может потребоваться не просто найти хорошее решение, а, например, стремиться к сходимости к определенному уже существующему решению или, наоборот, в сторону от него, чтобы улучшить возможность слияния или разнообразие моделей соответственно..
Устойчивость динамических систем. Обучение нейронных сетей изучалось как стохастический процесс (Smith & Le 2018; Teh et al. 2016; Redman et al. 2024) и как динамическая система (Wu et al. 2018; Jastrzebski et al. 2020; Cohen et al. 2021). Мы придерживаемся последнего взгляда и анализируем, как малые возмущения начальных весов сети развиваются в процессе обучения. Это дает два преимущества: во-первых, мы можем различать нестабильность, вызванную шумом, и нестабильность, присущую самому обучению (подобно тому, как детерминированные динамические системы демонстрируют хаос); во-вторых, мы можем моделировать более простые и масштабные (экспоненциальные) нестабильности, которые, если они присутствуют, должны преобладать над стохастическими эффектами и делать стохастическую перспективу излишней (Wu et al. 2018).
Предыдущие работы (Wu et al. 2018; Jastrzebski et al. 2020; Cohen et al. 2021) рассматривали устойчивость динамических систем с точки зрения того, будет ли расстояние между весами нейронной сети и фиксированным минимумом увеличиваться с течением времени. Наша работа отличается тем, что мы оцениваем устойчивость относительно движущейся траектории, а также хотим знать, расходятся ли сети по функционалу (а не только по весам). Для измерения функциональной дивергенции мы используем барьеры (Frankle et al. 2020a), барьеры, учитывающие перестановочные симметрии нейронных сетей (Entezari et al. 2022; Ainsworth et al. 2023), и репрезентативное сходство через Angular CKA (Williams et al. 2021). Хотя эти величины не поддаются аппроксимации линейными динамическими системами, они лучше отражают практические различия между сетями.
Линейная связность мод. Барьеры (Frankle et al. 2020a; Neyshabur et al. 2020) представляют собой максимальное увеличение функции потерь на линейном пути между двумя нейронными сетями. Считается, что сети с барьерами ниже определенного порога шума демонстрируют линейную связность мод (LMC), что, помимо прочих полезных свойств, является необходимым условием для локальной выпуклости ландшафта функции потерь (Neyshabur et al. 2020, Definition 3.1). Таким образом, ненулевые барьеры указывают на то, что две нейронные сети принадлежат к разным выпуклым бассейнам функции потерь (Goodfellow et al. 2015; Huang et al. 2017; Yunis et al. 2022).22 2 Следуя Entezari et al. 2022; Neyshabur et al. 2020, мы вводим дополнительные предположения, необходимые для принятия обратного утверждения, а именно: сети с нулевым барьером находятся в одном и том же бассейне функции потерь..
Заметим, что мы не рассматриваем более общее понятие (нелинейной) связности мод по нескольким причинам. Во-первых, несмотря на невыпуклость, обучение нейронных сетей часто рассматривается с точки зрения выпуклой оптимизации. Однако в выпуклых областях ландшафта функции потерь выпуклая оптимизация ведет себя именно так, как ожидается. Аналогично, подход с точки зрения динамических систем часто использует линейную или квадратичную аппроксимацию ландшафта функции потерь, что опять же справедливо именно в выпуклых областях. На практике объединение моделей путем усреднения весов требует линейно связных сетей, что гарантируется, если сети принадлежат одной и той же выпуклой области. Наконец, как теоретические Simsek et al. 2021; Lin et al. 2024, так и эмпирические (Draxler et al. 2018; Garipov et al. 2018; Sonthalia et al. 2024) работы предполагают, что большинство или все минимумы могут быть тривиально связаны нелинейными путями..
Запуск экспериментов. Frankle et al. 2020a; Frankle et al. 2020b и Fort et al. 2020 рассматривают, является ли обучение устойчивым к случайному порядку пакетов и аугментациям данных (шуму при обучении), запуская пары сетей из одного родителя и измеряя барьеры между ними после обучения. Они обнаруживают, что обучение становится устойчивым к шуму после начального периода нестабильности. Altıntaş et al. 2023 показывает, что снижение изменчивости на ранних этапах обучения за счет уменьшения скорости обучения, увеличения размеров пакетов и добавления прогрева скорости обучения дополнительно повышает устойчивость к шуму, а Singh et al. 2024 связывает устойчивость барьеров с геометрией ландшафта функции потерь. Эти результаты согласуются с наблюдениями о том, что после начальной хаотической фазы траектории обучения SGD могут быть аппроксимированы линейным ядром (Fort et al. 2020).
Мы используем те же эксперименты по порождению «родитель-потомок» (Frankle et al. 2020a; Frankle et al. 2020b; Fort et al. 2020), но устраняем весь шум при обучении, чтобы изолировать эффекты возмущения в конкретные моменты времени обучения. Это не только позволяет нам точно определить, когда и в какой степени возмущение вызывает нестабильность, но и дает возможность сделать это как для случайно инициализированных (хаотических), так и для предварительно обученных (стабильных) сетей..
Усреднение моделей. Усреднение весов позволяет объединять сети с нулевым барьером из одной траектории обучения (Izmailov et al. 2018), разных запусков (Utans 1996; Wortsman et al. 2021) или разных задач (Mirzadeh et al. 2021) для повышения скорости вывода и даже производительности. Усреднение весов является основой для более сложных стратегий слияния моделей (Ilharco et al. 2023), включая те, что используют перестановки для выравнивания расходящихся (Wang et al. 2020) или не связанных между собой (Singh & Jaggi 2020) моделей. Наша работа указывает на условия, при которых модели устойчивы по отношению к барьерам и, следовательно, поддаются усреднению весов..
Перестановочные симметрии. Недавние работы показали, что независимо инициализированные сети могут сходиться к линейно связанным бассейнам после учета перестановочных симметрий или различных способов упорядочивания нейронов в сети (Entezari et al. 2022; Ainsworth et al. 2023; Benzing et al. 2022). Перестановки, выравнивающие две сети, наиболее нестабильны на ранних этапах обучения (Sharma et al. 2024), что предполагает связь с нестабильностью обучения. Хотя в нашей работе сравниваются идентичные, а не случайно инициализированные сети, мы применяем алгоритмы сопоставления весов и активаций таким же образом, как в Ainsworth et al. 2023, чтобы определить: (1) вызывает ли нестабильность обучения перестановки между сетями, и (2) возвращает ли устранение этих перестановок расходящиеся траектории в тот же бассейн функции потерь..
Репрезентативное сходство. Репрезентативное сходство сравнивает промежуточные (скрытые) выходы двух сетей и позволяет обнаружить функциональные различия, даже когда две сети имеют идентичную производительность. Хотя существует множество методов, мы используем Angular CKA (Williams et al. 2021), который подробно объясняем и обосновываем в Section B.2. В целом, методы репрезентативного сходства инвариантны к симметриям выходов сети, но не к симметриям её весов. Таким образом, несхожие представления указывают на большее разнообразие между сетями (что может улучшить производительность ensembling), однако схожие представления не гарантируют, что две сети находятся в одном и том же loss basin (из-за симметрий весов), и поэтому этого недостаточно для успешного усреднения весов..
Стабильность дообучения. Предварительно обученные модели, как правило, устойчивы к шуму при обучении и сходятся к одному и тому же бассейну в процессе дообучения (Neyshabur et al. 2020). Однако более поздние работы показали, что это не всегда так, поскольку Juneja et al. 2023 обнаружили, что шум при обучении заставляет дообучение LLM сходиться к различным бассейнам. Хотя это вредит объединению моделей, такой вид нестабильности может повысить разнообразие моделей и, следовательно, производительность ансамбля (Lubana et al. 2023; Sadrtdinov et al. 2023), даже если отдельный бассейн обладает эквивалентным разнообразием (Lion et al. 2024).
Наш метод позволяет найти порог между стабильностью и нестабильностью для любой настройки SFT — даже для тех, которые устойчивы к шуму при обучении, — поскольку мы можем увеличивать наши возмущения до любого масштаба, необходимого для вызова нестабильности в заданной сети. Используя наш метод, мы выявляем различия в стабильности между языковыми и визуальными моделями, в частности, изучая динамику SFT для ResNets (He et al. 2016), ViT (Dosovitskiy et al. 2021), BERT (Devlin et al. 2019) и OLMo (Groeneveld et al. 2024)⟧.
3 Методы
В этом разделе мы определяем наше понятие стабильности обучения, описываем постановку наших экспериментов с возмущениями и, наконец, определяем оценки функционального различия и другие величины, которые мы оцениваем (барьеры, барьеры по модулю перестановки и дивергенцию во времени обучения).
3.1 Нестабильность обучения
Рассматривайте обучение как итеративное применение стохастического обучающего отображения к начальным параметрам нейронной сети, так что параметры сети после обучения становятся
| (1) |
где учитывает все стохастические факторы, влияющие на обучение, такие как выборка пакетов, аугментация данных и недетерминизм, вызванный аппаратным обеспечением. Если не указано иное, мы рассматриваем как векторную конкатенацию параметров сети, а при записи мы опускаем обучающие или тестовые данные, если их можно вывести из контекста.
Нас интересует степень стабильности обучения в том смысле, что небольшое возмущение начальных весов нейронной сети не приводит к значительным изменениям сети после завершения обучения. Чтобы описать стабильность в континууме, мы оцениваем, насколько и разошлись после обучения в соответствии с различными понятиями сходства (Section 3.4). Мы выбираем таким образом, чтобы сети сходились к схожему уровню производительности на обучающей и тестовой выборках (подробности см. в Appendix A).
Если мы зафиксируем конкретный , описывает динамическую систему, результат которой зависит только от начальных параметров . Эта перспектива имеет многочисленные преимущества. Во-первых, мы можем разделить эффекты шума при обучении и изолировать нестабильность до воздействия . Поскольку динамические системы могут расходиться с экспоненциальной скоростью, доминируя над стохастическими эффектами (Wu et al. 2018), наши детерминированные эксперименты также устанавливают нижнюю границу нестабильности обычного стохастического обучения — то есть.
для независимо выбранного шума и и меры сходства .
3.2 Эксперимент «порождение и возмущение»
Наш эксперимент адаптирует эксперимент по порождению родитель-потомок, представленный в Frankle et al. 2020a, к понятию стабильности, введенному выше. Процедура выглядит следующим образом:
- ⟦1. Выберите начальное состояние для нейронной сети.
- ⟦2. Обучайте нейронную сеть до момента возмущения , получая .
- ⟦3. Создайте две копии нейронной сети и внесите возмущение в одну из них, добавив шум с амплитудой , чтобы получить .33 3 Для интерпретируемости нормализуется в соответствии с ожидаемым масштабом сети при инициализации — подробности см. в Section B.3.
- ⟦4. Обучайте как исходные (), так и возмущенные () копии с идентичным шумом обучения, чтобы получить и ⟧.
- ⟦5. Измерьте результирующую нестабильность с помощью , где представляет собой показатель различия.
Контролируя и , мы можем исследовать устойчивость различных точек в ландшафте функции потерь. Более конкретно, мы выбираем между различными траекториями путем случайной инициализации или установки его в значение предварительно обученной контрольной точки из другой задачи. Затем мы варьируем время возмущения , чтобы изучить, как устойчивость развивается в процессе обучения. Изменение (путем выбора различных архитектур моделей, оптимизаторов, гиперпараметров или задач обучения) позволяет проводить сравнения между различными ландшафтами функций потерь..
Для количественной оценки нестабильности мы фиксируем скорость, с которой показатель различия возрастает относительно величины возмущения . Путем выборки возмущений различных размеров и направлений мы можем оценить размер и форму локальной области вокруг , где не приводит к расходимости с точки зрения ⟧.
Наш эксперимент отличается от Frankle et al. 2020a и Fort et al. 2020 тем, что они используют независимый шум обучения, начиная с , вместо единичного возмущения для вызова нестабильности. Хотя это отражает стабильность обычного обучения, наши эксперименты имеют два ключевых преимущества: мы можем изолировать наш анализ нестабильности для конкретных частей траектории обучения от до , а также можем применять гораздо меньшие или большие возмущения, чем шум обучения, чтобы количественно оценить нестабильность в более широком масштабе. В Figure 10 мы подтверждаем, что нестабильность в нашем методе — то есть к единичным возмущениям — подразумевает нестабильность в методах Frankle et al. 2020a; Fort et al. 2020 — то есть к шуму обучения..
3.3 Возмущения
Стабильность динамической системы вокруг заданной точки зависит от направления. Мы учитываем это, выполняя выборку возмущений с использованием двух различных методов, которые обеспечивают либо узкое, либо широкое распределение направлений. Как описано в Section B.3, все выборки шума также нормализуются до фиксированного относительно масштаба инициализации сети..
Возмущение пакета.
Пакетные возмущения (Eq. 2) измеряют стабильность вдоль направлений, которые с наибольшей вероятностью будут исследованы в процессе обучения, путем имитации одного независимо выбранного шага оптимизации:
| (2) |
где — это градиент функции потерь весов сети, а — это примеры, выбранные из мини-пакета обучающего набора данных . Если не учитывать такие факторы, как момент, это эквивалентно выполнению дополнительного шага обучения в момент времени , который масштабируется величиной возмущения вместо скорости обучения.
Гауссово возмущение.
Для измерения стабильности во всех направлениях в целом мы используем гауссовы возмущения (Eq. 3), которые представляют собой масштабированные версии распределения сети при случайной инициализации. Для сетей, инициализированных с помощью нормального распределения Kaiming/He (He et al. 2015), гауссовы возмущения выбираются как
| (3) |
где — это возмущение для -го веса слоя , — количество входных сигналов от предыдущего слоя (обычно называемое fan-in), а — нормальное распределение со средним значением 0 и стандартным отклонением ⟧.
Хотя это не является строго равномерным во всех направлениях (при рассмотрении всех весов сети как единого вектора), мы решили согласовать масштаб инициализации сети, чтобы гарантировать, что возмущения не влияют на одни слои непропорционально сильнее, чем на другие. Поскольку смещения и веса нормализации имеют постоянную инициализацию, мы не подвергаем их возмущениям в наших основных экспериментах.44 4 Figure 9 демонстрирует результаты возмущения смещений и весов нормализации.
3.4 Оценка функционального сходства
Мы используем четыре метода для оценки функционального сходства сетей в нашем эксперименте по порождению и возмущению: (1) расстояние в пространстве весов , (2) барьер функции потерь в Equation 4, (3) барьер функции потерь после учета перестановочных симметрий с использованием алгоритма сопоставления весов из (Ainsworth et al. 2023), и (4) репрезентативное сходство промежуточных слоев, измеренное с помощью Angular CKA (Williams et al. 2021).
дивергенция.
В линейной динамической системе дивергенция может экспоненциально расходиться со временем со скоростью , где зависит от кривизны (см. Section B.4 для вывода). Чтобы определить, справедливо ли это линейное приближение для обучения нейронных сетей, мы измеряем расстояние между векторами параметров в процессе обучения, чтобы выявить экспоненциальный рост и определить, пропорциональны ли дивергенции величине возмущения .
Барьеры.
Барьеры измеряют максимальное увеличение функции потерь или ошибки вдоль линейного пути между весами (Frankle et al. 2020a; Neyshabur et al. 2020). Мы измеряем барьер функции потерь при обучении как
| (4) |
где выполняет интерполяцию между сетями, а является функцией потерь для обучающих данных. Поскольку наша работа посвящена форме ландшафта функции потерь, в которой происходит обучение, в основном тексте мы приводим барьер функции потерь кросс-энтропии для обучающих данных () и после учета перестановок (). Section B.1 более подробно описывает, как мы вычисляем барьеры..
Барьеры по модулю перестановки.
Чтобы рассмотреть, вызывает ли нестабильность обучения сходимость сетей к различным переставленным версиям одного и того же бассейна функции потерь, мы применяем алгоритмы сопоставления весов и активаций из Ainsworth et al. 2023, чтобы найти перестановку нейронов , которая приблизительно минимизирует расстояние между весами или промежуточными активациями двух сетей соответственно. Чтобы измерить степень, в которой и были переставлены относительно друг друга, мы фиксируем как барьер между и , так и долю тождественных элементов (непереставленных нейронов) в .
Поскольку два алгоритма сопоставления не обязательно находят перестановку, которая наилучшим образом минимизирует барьеры (то есть барьер по модулю перестановки), мы следуем Sharma et al. 2024, рассматривая барьер между и как верхнюю границу. В результате, если барьер после перестановки с помощью значительно снижается, можно утверждать, что нестабильность обучения в основном вызывает перестановки, которые существенно не меняют функцию нейронной сети. Однако, если не снижает барьер между и , это может означать либо то, что нестабильность обучения заставляет сети изучать различные функции, либо то, что нам просто не удалось найти перестановку, которая действительно снижает барьеры..
Репрезентативное сходство.
Мы также рассматриваем, различаются ли сети в наших экспериментах по своим предпоследним представлениям, используя угловую версию Centered Kernel Alignment (CKA), тип метрики сходства представлений. CKA измеряет взаимную корреляцию между двумя произвольными представлениями одних и тех же данных (Kornblith et al. 2019). Как определено в Equation 5, мы используем Angular CKA с линейным ядром (Williams et al. 2021) для измерения расстояния между выходами последнего остаточного или блока внимания. Поскольку полученное расстояние является углом, указывает на то, что две сети имеют идеально схожие представления, а указывает на то, что две сети имеют несхожие представления. Section B.2 содержит полные подробности.
4 Эксперименты
Полные сведения об обучении, включая гиперпараметры и показатели производительности на обучающей и тестовой выборках, приведены в Appendix A.
4.1 Ранняя и поздняя нестабильность обучения
Сначала мы обучаем остаточные сети (He et al. 2015) на CIFAR-10 (Krizhevsky 2009) с помощью SGD, используя стандартные методы аугментации данных и настройки гиперпараметров, включая период прогрева в 2%, за которым следует линейно убывающая скорость обучения.
Ранние возмущения надежно вызывают значительные барьеры.
⟦Figure 2 показывает, что обучение нейронных сетей со случайной инициализацией крайне чувствительно к начальным условиям, поскольку возмущения пакета, составляющие всего 0,01% от весов сети, создают значительные барьеры. Мы дополнительно уменьшаем величину возмущения, изменяя лишь часть весов, и обнаруживаем, что одного возмущенного веса достаточно для возникновения нестабильности (Figure 11).
Хотя в предыдущих работах было показано, что шум при обучении вблизи инициализации вызывает барьеры (Fort et al. 2020; Frankle et al. 2020a), мы впервые демонстрируем, что барьеры могут возникать при крайне малых возмущениях, сосредоточенных на первых нескольких шагах, поскольку применение тех же возмущений уже на 0,5% пути обучения приводит к значительному уменьшению барьеров. Мы называем эту начальную нестабильность «эффектом бабочки» в хаотических динамических системах..
Стабильность возрастает в течение первых 0,5% времени обучения, что полностью укладывается в используемый нами 2% период прогрева, и только очень значительные возмущения (10% от инициализации) приводят к ненулевому барьеру после 50% времени обучения. В то время как в предыдущих работах установлено, что модели становятся устойчивыми к шуму обучения после первых нескольких эпох обучения (Fort et al. 2020; Frankle et al. 2020a), мы количественно оцениваем масштаб возмущения, необходимого для создания барьеров за пределами этой критической точки, показывая, что стабильность продолжает расти на протяжении всего процесса обучения..
Ранняя нестабильность не зависит от направления.
Сравнивая пакетные и гауссовские возмущения (Figure 2), мы обнаруживаем, что, хотя сети более устойчивы к последним (которые равномерно распределены по направлению), сети, подвергнутые возмущению при инициализации, имеют высокие барьеры для обоих типов. Это показывает, что ранняя нестабильность в основном обусловлена состоянием сети, а не направлением или величиной возмущения. Однако более поздняя нестабильность действительно варьируется в зависимости от направления возмущения, что позволяет предположить, что результаты, полученные с использованием шума при обучении ((Fort et al. 2020; Frankle et al. 2020a)), могут быть неприменимы к другим видам возмущений..
Расхождение процесса обучения вряд ли вызвано перестановками.
Сравнивая барьеры с выравниванием перестановок и без него (Figure 2), мы обнаруживаем, что применение перестановок для минимизации расстояния между сетями не уменьшает барьеры.55 5 Мы опускаем расстояние между сетями после выравнивания, так как оно, как правило, не сильно уменьшается при сопоставлении весов (Ito et al. 2025). Хотя мы не можем исключить возможность того, что более совершенные (и более затратные) методы выравнивания могут уменьшить барьеры, мы утверждаем, что это маловероятно. В предыдущих работах по выравниванию сетей с разной инициализацией было обнаружено, что сопоставление весов может в некоторой степени уменьшить барьеры, даже если оно уступает другим методам (Peña et al. 2023; Navon et al. 2024; Ainsworth et al. 2023), тогда как в нашем случае, при идентичной инициализации сетей, сопоставление весов вообще не способно уменьшить барьеры. Это говорит о том, что нестабильность обучения порождает реальные функциональные различия между сетями, а не просто перестановку весов, которые в остальном эквивалентны..
4.2 Функциональное разнообразие
Сравнивая сходство промежуточных представлений в Figures 3 и 23, мы обнаруживаем, что Angular CKA (уравнение 5) коррелирует с более ранними и значительными возмущениями (слева), а также с барьерами после обучения (посередине). Это вновь указывает на функциональные различия, выходящие за рамки симметрии весов.66 6 Заметим, что сети с нулевым барьером все еще имеют ненулевое значение Angular CKA, вероятно, потому что линейно связанные сети могут по-разному работать на отдельных примерах (Yunis et al. 2022).
Поскольку ансамблирование моделей выигрывает от разнообразия, мы также рассматриваем, может ли намеренное внесение возмущений в нейронные сети улучшить производительность ансамбля. Этот эффект наиболее полезен для fine-tuned сетей, которые неизбежно обладают сниженным разнообразием из-за обучения из одного и того же начального состояния, далекого от случайной инициализации. Figure 3 (справа) и Figure 15 показывают, что при ансамблировании исходных и возмущенных сетей производительность ансамбля действительно масштабируется вместе с Angular CKA несходством. Однако fine-tuning ViT моделей на CIFAR-100 не демонстрирует этой тенденции (Figure 21). Это противоречие может быть объяснено наблюдениями схожей производительности между ансамблированием и усреднением в Utans 1996⟧.
4.3 Влияние настроек гиперпараметров
Далее мы сравниваем стабильность различных схем обучения для ResNets, обученных на CIFAR-10: отсутствие затухания весов, десятикратный прогрев скорости обучения, четырехкратный размер пакета, Adam, неглубокая широкая архитектура с сопоставимым количеством параметров (точные детали в Table 1⟧).
⟦Figures 4 и 12 показывают, что в соответствии с предыдущими работами (Altıntaş et al. 2023; Vlaar & Frankle 2022), снижение скорости обучения (за счет увеличения периода прогрева) и увеличение размера пакета повышают стабильность. Adam и затухание весов снижают стабильность, что, как мы предполагаем, может быть связано с их влиянием на резкость ландшафта функции потерь, которая, как известно, влияет на стабильность SGD (Wu et al. 2018). Мелко-широкая архитектура является наиболее стабильной из этих конфигураций, что, как мы предполагаем, связано с тем, что ее динамика обучения более тесно согласуется с режимом бесконечной ширины и линеаризованного ядра (Lee et al. 2019; Fort et al. 2019).
Далее мы рассматриваем, может ли комбинация гиперпараметров, повышающих стабильность, снизить барьеры до 0 для сетей, возмущенных при инициализации. Мы обнаружили, что обучение неглубокой широкой архитектуры в сочетании с 10-кратным прогревом скорости обучения улучшает стабильность по сравнению с каждой отдельной настройкой (Figure 4 справа), но не устраняет барьеры при инициализации..
4.4 Дообучение
Исследовав стабильность ландшафта функции потерь вдоль траекторий, начинающихся со случайной инициализации, мы далее рассматриваем стабильность на траекториях обучения с переносом знаний. Fine-tuning, как известно, обладает большей стабильностью, поскольку начинается с предобученных сетей, имеющих неслучайные паттерны весов (Neyshabur et al. 2020), однако относительная сложность задачи предобучения и переноса знаний может как повышать, так и понижать стабильность к шуму при обучении (Vlaar & Frankle 2022).
Мы снова выходим за рамки влияния шума при обучении, чтобы количественно определить точные моменты и масштабы возмущений, при которых transfer learning становится нестабильным. Мы рассматриваем комбинации задач как из области компьютерного зрения, так и из области обработки естественного языка, поскольку известно, что fine-tuning последних нестабилен к шуму при обучении (Juneja et al. 2023).
Стабильность предварительного обучения зависит от вовлеченных задач.
Начиная с CIFAR-10 и CIFAR-100 (Krizhevsky 2009), мы проводим предварительное обучение двух сетей ResNet-50 с нормализацией слоев для каждой из задач, а затем выполняем их fine-tuning на противоположной задаче, начиная как с ранних (0,24% от предварительного обучения), так и с поздних (100% от предварительного обучения) контрольных точек..
⟦Figure 5 (слева, по центру) и Figures 17 и 18 показывают, что fine-tuning в целом более стабилен по сравнению с ResNet-20 (Figure 2) или обучением тех же моделей с нуля (Figure 19). Это особенно верно для более поздних checkpoints () и больших возмущений (, эквивалентных 10% от инициализации), тогда как fine-tuning из более ранних checkpoints по барьерам больше похож на обычное обучение (Figure 5). Это показывает, что, как и при обычном обучении, нестабильность в основном является функцией времени предварительного обучения.
Стабильность зависит от задачи, поскольку перенос с CIFAR-100 на CIFAR-10 более стабилен, чем в обратном направлении. Это согласуется с Vlaar & Frankle 2022, которые обнаружили, что предварительное обучение на связанных данных по сравнению со случайными данными улучшает или ухудшает (соответственно) барьеры между двумя точками вдоль траектории обучения.77 7 Наша работа отличается тем, что мы рассматриваем две расходящиеся траектории.
Vision Transformers (ViTs). Для изучения другой архитектуры в области компьютерного зрения мы вносим возмущения в траектории дообучения ViTs (Dosovitskiy et al. 2021) различных размеров на наборе данных CIFAR-100 (Section A.2). Хотя мы смогли рассмотреть только контрольные точки в конце предварительного обучения, Section D.2 показывает, что, в соответствии с нашими предыдущими результатами, более значительные и ранние возмущения во время дообучения приводят к более высоким барьерам.
Предварительное обучение не всегда повышает стабильность дообучения.
Установив, что более длительное предварительное обучение повышает стабильность для маломасштабных моделей компьютерного зрения, мы далее исследуем глубоко предварительно обученные языковые модели. Этот сценарий представляет особый интерес, поскольку недавняя работа Juneja et al. 2023 демонстрирует, что, в отличие от моделей компьютерного зрения (Neyshabur et al. 2020), шум при обучении может приводить к тому, что LLM после SFT сходятся к различным бассейнам притяжения..
Для исследования этого вопроса мы анализируем стабильность Multi-BERT (Sellam et al. 2022), которая предоставляет промежуточные контрольные точки каждые 20 000 шагов в процессе предварительного обучения. Мы берем контрольные точки на 20к, 200к и 2000к (100%) шагах времени предварительного обучения в качестве отправных точек и выполняем fine-tuning на различных задачах GLUE (Wang et al. 2019): логический вывод на естественном языке (QNLI, RTE), оценка перефразирования и сходства (MRPC), классификация тональности (SST-2) и лингвистическая приемлемость (CoLA).).
⟦Figures 5 и 22 показывают, что BERT более чувствителен к размеру возмущений по сравнению с нашими экспериментами со зрением (Figure 5 слева, в центре). Для всех контрольных точек предварительного обучения более ранние возмущения во время fine-tuning неизменно приводят к большим барьерам. Однако, в отличие от наших настроек зрения, стабильность не всегда улучшается с увеличением времени предварительного обучения. Примечательно, что для QNLI и RTE (Figure 22) финальная контрольная точка предварительного обучения (2000k) имеет самые большие барьеры. При оценке предварительно обученной сети на этих задачах (Table 3) мы наблюдаем, что контрольная точка 2000k имеет худшую точность на тестовой выборке, несмотря на более низкую кросс-энтропию по сравнению с контрольными точками 200k и 20k. Мы предполагаем, что это может быть связано с переобучением на распределении предварительного обучения,88 8 MultiBERT был предварительно обучен в течение примерно 100 эпох, что может привести к тому, что модель станет хрупкой к возмущениям во время fine-tuning — явление, названное «катастрофическим переобучением» в Springer et al. 2025⟧.
Модели типа decoder-only. Billion-parameter модели типа decoder-only широко используются в SFT и объединении моделей, однако динамика их обучения остается крайне малоизученной. Чтобы восполнить этот пробел, мы проводим SFT промежуточных чекпоинтов OLMo (Groeneveld et al. 2024) на наборе данных математических задач GSM8K (Cobbe et al. 2021a). Figure 24 показывает, что более длительное предварительное обучение может снова снизить стабильность к SFT, что подтверждает наши выводы по MultiBERT. Более того, мы наблюдаем те же тенденции — когда более ранние и значительные возмущения приводят к более высоким барьерам — как и в предыдущих условиях..
5 Дивергенция и барьеры
Барьеры и расходимости не развиваются в соответствии с линеаризованной динамической системой.
⟦Figure 6 показывает скорости, с которыми увеличиваются барьеры и дивергенция по мере прогресса обучения.99 9 Поскольку барьеры и пренебрежимо малы во время возмущения и растут на протяжении всего обучения, это указывает на то, что наши результаты обусловлены нестабильностью, а не просто начальным возмущением. Вопреки линеаризованной динамике, выведенной в Section B.4, ни барьер, ни не увеличиваются экспоненциально в процессе обучения. Требуется дополнительная работа для изучения других механизмов, которые могли бы определять эти наблюдаемые скорости дивергенции.
Барьеры масштабируются экспоненциально дивергенция в настройках зрения.
Хотя сети могут расходиться в пространстве весов без увеличения барьеров (Frankle et al. 2020a; Vlaar & Frankle 2022), в наших экспериментах мы обнаруживаем, что барьеры и расхождение после обучения демонстрируют сильную логарифмически линейную зависимость (Figure 7 слева). Этот результат отличается от Vlaar & Frankle 2022 тем, что они рассматривают расстояние, пройденное от инициализации, тогда как мы рассматриваем расстояние между траекториями обучения, которые начались из одной и той же точки. Мы обнаружили, что доля тождественных элементов в согласующих перестановках также связана с барьерами, хотя и в меньшей степени (Figure 16). Поскольку минимизирует расстояние между и , это, вероятно, связано с корреляцией между барьерами и расхождением..
Интересно, однако, что дообученные языковые модели демонстрируют слабую корреляцию или её отсутствие между дивергенцией и барьерами (Figure 7 верно, Figure 26). Это предполагает, что взаимосвязь между и барьером может проявляться только в моделях меньшего масштаба, что подчеркивает необходимость проведения крупномасштабных и мультимодальных экспериментов (Juneja et al. 2023).
6 Обсуждение и заключение
Мы представляем метод измерения того, является ли обучение нейронных сетей стабильным (надежно сходящимся к одному и тому же бассейну притяжения) для распределения возмущений, применяемых в любое время обучения, к любым начальным весам сети и для любой процедуры обучения. Этот метод позволяет нам оценивать стабильность в большем количестве условий и с более высокой точностью, чем это было возможно в предыдущих работах, в которых рассматривались только эффекты шума при обучении (Vlaar & Frankle 2022; Fort et al. 2020; Frankle et al. 2020a). Наши эксперименты показывают, что, хотя случайно инициализированные сети крайне нестабильны, стабильность быстро возрастает по мере обучения, становясь устойчивой к возмущениям, значительно превышающим шум при обучении..
Наша работа согласуется с выводом в Sarnthein et al. 2023 о том, что студенческая сеть, инициализированная очень близко к случайному учителю, тем не менее значительно отклоняется после обучения. Необходимы дальнейшие исследования, чтобы понять, почему, в отличие от наших условий, студент в Sarnthein et al. 2023 остается в том же линейно связанном бассейне, что и случайный учитель..
Хотя нестабильность вблизи инициализации является универсальной, многие тенденции непоследовательны и зависят от задачи или модели. Мы обнаружили, что (1) скорость, с которой стабильность возрастает вдоль траекторий обучения, сильно варьируется, (2) более длительное предварительное обучение не всегда улучшает стабильность во время SFT, (3) дивергенция в одних случаях сильно коррелирует с барьерами, а в других — нет, и (4) скорости, с которыми и барьеры расходятся, не соответствуют таковым для простой динамической системы. Хотя конкретные контрпримеры, которые мы выявили, являются достаточным доказательством для этих результатов, детальное исследование их глубинных причин и обстоятельств, в которых они справедливы (например, при изоляции эффектов задачи по сравнению с архитектурой), оставлено для будущей работы. Также необходимы дальнейшие исследования, чтобы определить (1) могут ли определенные настройки гиперпараметров полностью устранить нестабильность при инициализации, и (2) какие возмущения, если таковые имеются, можно использовать для надежного улучшения производительности ансамбля..
Благодарности
Особая благодарность Гаураву Айеру, Дэвиду Микишу, Эканшу Шарме, Сидаку Палу Сингху и Жюльену Буссару за дискуссии и комментарии. Данное исследование было поддержано грантом NSERC Discovery, программой Canada CIFAR AI Chairs и Фондом исследований Квебека — Природа и технологии (стипендия FRQNT для докторантов №352816). Вычислительные ресурсы были предоставлены Квебекским институтом искусственного интеллекта Mila и корпорацией NVIDIA..
Заявление о влиянии
В данной статье представлена работа, целью которой является развитие области Machine Learning. Существует множество потенциальных социальных последствий нашей работы, ни одно из которых, по нашему мнению, не требует особого выделения здесь..
Список литературы
- ⟦Adilova et al. (2024) Адилова, Л., Андрющенко, М., Камп, М., Фишер, А., и Джагги, М. Послойная линейная модовая связность. В материалах Международной конференции по обучению представлениям, 2024. URL https://openreview.net/forum?id=LfmZh91tDI.
- ⟦Ainsworth et al. (2023) Эйнсворт, С., Хаясе, Дж. и Сриниваса, С. Git re-basin: Объединение моделей по модулю перестановочных симметрий. В материалах Международной конференции по представлениям обучения, 2023. URL https://openreview.net/forum?id=CQsmMYmlP5T.
- ⟦Altıntaş et al. (2023) Алтынташ, Г. С., Бахманн, Г., Ночи, Л., и Хофманн, Т. Разделение линейной связности мод. В UniReps: первый семинар по унификации представлений в нейронных моделях, 2023. URL https://openreview.net/forum?id=PbvPwiySXz⟧.
- ⟦Ba et al. (2016) Ba, J. L., Kiros, J. R., and Hinton, G. E. Layer normalization, 2016. URL https://arxiv.org/abs/1607.06450.
- ⟦Benzing et al. (2022) Бенцинг, Ф., Шуг, С., Майер, Р., Освальд, Дж. В., Акрам, Я., Зуккет, Н., Эйтчисон, Л., и Стегер, А. Случайные инициализации, работающие лучше случайного угадывания, и способы их поиска. В OPT 2022: Оптимизация для машинного обучения (Семинар NeurIPS 2022), 2022. URL https://openreview.net/forum?id=HS5zuN_qFI.
- ⟦Bradley et al. (2022) Брэдли, А. В., Гомес-Урибе, К. А., и Вуйюру, М. Р. Сдвиг кривизны, SGD и обобщающая способность, июль 2022 г. URL http://arxiv.org/abs/2108.09507. arXiv:2108.09507 [stat].
- ⟦Cobbe et al. (2021a) Коббе, К., Косараджу, В., Бавариан, М., Чен, М., Джун, Х., Кайзер, Л., Плапперт, М., Творек, Дж., Хилтон, Дж., Накано, Р., Хессе, К., и Шульман, Дж. Обучение верификаторов для решения текстовых математических задач, 2021a. URL https://arxiv.org/abs/2110.14168.
- ⟦Cobbe et al. (2021b) Cobbe, K., Kosaraju, V., Bavarian, M., Chen, M., Jun, H., Kaiser, L., Plappert, M., Tworek, J., Hilton, J., Nakano, R., Hesse, C., and Schulman, J. Обучение верификаторов для решения текстовых математических задач. CoRR, abs/2110.14168, 2021b. URL https://arxiv.org/abs/2110.14168.
- ⟦Cohen et al. (2021) Cohen, J. M., Kaur, S., Li, Y., Kolter, J. Z., and Talwalkar, A. Градиентный спуск в нейронных сетях обычно происходит на грани устойчивости, 2021. URL http://arxiv.org/abs/2103.00065.
- ⟦D’Angelo et al. (2024) Д’Анджело, Ф., Андрющенко, М., Варре, А., и Фламмарион, Н. Почему нам нужен weight decay в современном глубоком обучении?, 2024. URL http://arxiv.org/abs/2310.04415. arXiv:2310.04415 [cs] версия: 2.
- ⟦Devlin et al. (2019) Девлин, Дж., Чанг, М.-У., Ли, К., и Тутанова, К. BERT: Предварительное обучение глубоких двунаправленных transformers для понимания языка. В материалах конференции 2019 года Североамериканского отделения Ассоциации компьютерной лингвистики: Технологии человеческого языка, Том 1 (Длинные и короткие статьи), стр. 4171–4186, Миннеаполис, Миннесота, июнь 2019 г. Ассоциация компьютерной лингвистики. doi: 10.18653/v1/N19-1423. URL https://aclanthology.org/N19-1423/.
- ⟦Dosovitskiy et al. (2021) Досовицкий, А., Бейер, Л., Колесников, А., Вайссенборн, Д., Чжай, С., Унтертинер, Т., Дехгани, М., Миндерер, М., Хейгольд, Г., Гелли, С., Ушкорайт, Дж., и Хоулсби, Н. Изображение стоит 16x16 слов: Transformers для распознавания изображений в масштабе. В сборнике Международной конференции по представлениям обучения, 2021. URL https://openreview.net/forum?id=YicbFdNTTy.
- ⟦Draxler et al. (2018) Дракслер, Ф., Вешгини, К., Сальмхофер, М., и Хампрехт, Ф. По сути, отсутствие барьеров в энергетическом ландшафте нейронных сетей. В материалах 35-й Международной конференции по машинному обучению, стр. 1309–1318. PMLR, июль 2018 г. URL https://proceedings.mlr.press/v80/draxler18a.html. ISSN: 2640-3498.
- ⟦Entezari et al. (2022) Энтезари, Р., Седги, Х., Саух, О. и Нейшабур, Б. Роль перестановочной инвариантности в линейной связности мод нейронных сетей. В материалах Международной конференции по обучению представлений, 2022. URL https://openreview.net/forum?id=dNigytemkL.
- ⟦Fort et al. (2019) Форт, С., Ху, Х., и Лакшминараянан, Б. Глубокие ансамбли: взгляд с точки зрения ландшафта функции потерь, 2019.
- ⟦Fort et al. (2020) Форт, С., Дзюгайте, Г. К., Пол, М., Харагани, С., Рой, Д. М. и Гангули, С. Глубинное обучение против ядерного обучения: эмпирическое исследование геометрии ландшафта функции потерь и временной эволюции нейронного касательного ядра. Advances in Neural Information Processing Systems, 33:5850–5861, 2020. URL https://proceedings.neurips.cc/paper/2020/hash/405075699f065e43581f27d67bb68478-Abstract.html.
- ⟦Frankle & Carbin (2019) Фрэнкл, Дж. и Карбин, М. Гипотеза лотерейного билета: поиск разреженных, обучаемых нейронных сетей. В материалах Международной конференции по обучению представлений, 2019. URL https://openreview.net/forum?id=rJl-b3RcF7.
- ⟦Frankle et al. (2020a) Frankle, J., Dziugaite, G. K., Roy, D., and Carbin, M. Линейная связность мод и гипотеза лотерейного билета. В материалах 37-й Международной конференции по машинному обучению, том 119, стр. 3259–3269. PMLR, 2020a. URL https://proceedings.mlr.press/v119/frankle20a.html.
- ⟦Frankle et al. (2020b) Frankle, J., Schwab, D. J., and Morcos, A. S. Ранняя фаза обучения нейронных сетей. В материалах Международной конференции по обучению представлениям, 2020b. URL https://openreview.net/forum?id=Hkl1iRNFwS.
- ⟦Garipov et al. (2018) Гарипов, Т., Измайлов, П., Подоприхин, Д., Ветров, Д. П., и Уилсон, Э. Г. Поверхности функции потерь, связность мод и быстрое ансамблирование DNN. В сборнике Advances in Neural Information Processing Systems, том 31. Curran Associates, Inc., 2018. URL https://proceedings.neurips.cc/paper/2018/hash/be3087e74e9100d4bc4c6268cdbe8456-Abstract.html.
- ⟦Goodfellow et al. (2015) Goodfellow, I. J., Vinyals, O., and Saxe, A. M. Качественная характеристика задач оптимизации нейронных сетей, 2015. URL https://arxiv.org/abs/1412.6544.
- ⟦Groeneveld et al. (2024) Груневельд, Д., Белтаги, И., Уолш, П., Бхагиа, А., Кинни, Р., Тафьорд, О., Джа, А. Х., Ивисон, Х., Магнуссон, И., Ван, И., Арора, С., Аткинсон, Д., Артур, Р., Чанду, К. Р., Коэн, А., Дюма, Ж., Элазар, Я., Гу, И., Хессель, Дж., Хот, Т., Меррилл, У., Моррисон, Дж., Мюннигхофф, Н., Наик, А., Нам, К., Питерс, М. Э., Пяткин, В., Равичандер, А., Швенк, Д., Шах, С., Смит, У., Струбелл, Э., Субрамани, Н., Вортсман, М., Дасиги, П., Ламберт, Н., Ричардсон, К., Зеттльмойер, Л., Додж, Дж., Ло, К., Солдаини, Л., Смит, Н. А., и Хаджиширзи, Х. OLMo: Ускорение науки о языковых моделях, июнь 2024 г. URL http://arxiv.org/abs/2402.00838. arXiv:2402.00838 [cs].
- ⟦He et al. (2015) Хе, К., Чжан, С., Рен, С. и Сан, Дж. Глубокое погружение в выпрямители: Превосходя уровень человеческих способностей в классификации изображений на наборе данных imagenet. В материалах Международной конференции IEEE по компьютерному зрению (ICCV), декабрь 2015 г. URL https://openaccess.thecvf.com/content_iccv_2015/html/He_Delving_Deep_into_ICCV_2015_paper.html.
- ⟦He et al. (2016) Хе, К., Чжан, С., Рен, С. и Сун, Дж. Глубокое остаточное обучение для распознавания изображений. В материалах конференции IEEE по компьютерному зрению и распознаванию образов (CVPR), июнь 2016 г..
- ⟦Huang et al. (2017) Хуанг, Г., Ли, Й., Плейсс, Г., Лю, З., Хопкрофт, Дж. Э. и Вайнбергер, К. К. Snapshot ensembles: Train 1, get M for free. В сборнике Международной конференции по представлениям в обучении, 2017. URL https://openreview.net/forum?id=BJYwwY9ll⟧.
- ⟦Ilharco et al. (2023) Илхарку, Г., Рибейру, М. Т., Вортсман, М., Шмидт, Л., Хаджиширзи, Х., и Фархади, А. Редактирование моделей с помощью арифметики задач. В Международной конференции по обучению представлений, 2023. URL https://openreview.net/forum?id=6t0Kwf8-jrj.
- ⟦Ito et al. (2025) Ито, А., Ямада, М. и Кумагаи, А. Анализ линейной связности мод посредством сопоставления весов на основе перестановок. В материалах Международной конференции по обучению представлениям, 2025. URL https://openreview.net/forum?id=lYRkGZZi9D.
- ⟦Iyer et al. (2023) Айер, Г., Ханин, Б. и Рольник, Д. Максимальные начальные скорости обучения в глубоких ReLU сетях. В Краузе, А., Бранскилл, Э., Чо, К., Энгельгардт, Б., Сабато, С. и Скарлетт, Дж. (ред.), Труды 40-й Международной конференции по машинному обучению, том 202 Трудов по машинному обучению, стр. 14500–14530. PMLR, 23–29 июля 2023 г. URL https://proceedings.mlr.press/v202/iyer23a.html.
- ⟦Izmailov et al. (2018) Измайлов, П., Подоприхин, Д., Гарипов, Т., Ветров, Д., и Уилсон, Э. Усреднение весов приводит к более широким оптимумам и лучшей обобщающей способности. В материалах 34-й конференции по неопределенности в искусственном интеллекте 2018, UAI 2018, стр. 876–885, 2018.
- ⟦Jacot et al. (2018) Jacot, A., Gabriel, F., and Hongler, C. Нейронное касательное ядро: сходимость и обобщение в нейронных сетях. В сборнике Advances in Neural Information Processing Systems, том 31, 2018. URL https://proceedings.neurips.cc/paper_files/paper/2018/file/5a4be1fa34e62bb8a6ec6b91d2462f5a-Paper.pdf.
- ⟦Jastrzebski et al. (2020) Jastrzebski, S., Szymczak, M., Fort, S., Arpit, D., Tabor, J., Cho*, K., and Geras*, K. Точка безубыточности на траекториях оптимизации глубоких нейронных сетей. В материалах Международной конференции по представлениям обучения, 2020. URL https://openreview.net/forum?id=r1g87C4KwB.
- ⟦Jordan et al. (2023) Джордан, К., Седги, Х., Саух, О., Энтезари, Р. и Нейшабур, Б. REPAIR: Перенормировка перестановочных активаций для исправления интерполяции. В материалах Международной конференции по представлениям обучения, 2023. URL https://openreview.net/forum?id=gU5sJ6ZggcX.
- ⟦Juneja et al. (2023) Джунеджа, Дж., Бансал, Р., Чо, К., Седок, Дж., и Сафра, Н. Линейная связность раскрывает стратегии обобщения. В материалах Международной конференции по представлениям обучения, 2023. URL https://openreview.net/forum?id=hY6M0JHl3uL.
- ⟦Keskar et al. (2017) Кескар, Н. С., Мудигере, Д., Носедал, Дж., Смелянский, М., и Танг, П. Т. П. Об обучении на больших пакетах для глубокого обучения: разрыв в обобщающей способности и острые минимумы. В материалах Международной конференции по представлениям в обучении, 2017. URL https://openreview.net/forum?id=H1oyRlYgg.
- ⟦Kornblith et al. (2019) Корнблит, С., Норузи, М., Ли, Х. и Хинтон, Дж. Пересмотр сходства представлений нейронных сетей. В материалах 36-й Международной конференции по машинному обучению, том 97, стр. 3519–3529. PMLR, 09–15 июня 2019 г. URL https://proceedings.mlr.press/v97/kornblith19a.html.
- ⟦Krizhevsky (2009) Крижевский, А. Обучение многослойным признакам на миниатюрных изображениях, 2009. URL https://www.cs.toronto.edu/~kriz/learning-features-2009-TR.pdf.
- ⟦Lange et al. (2023) Ланге, Р. Д., Квок, Д., Мательски, Дж. К., Ван, С., Рольник, Д. и Кординг, К. Глубокие сети как пути на многообразии нейронных представлений. В материалах 2-го ежегодного семинара по топологии, алгебре и геометрии в машинном обучении (TAG-ML), том 221, стр. 102–133. PMLR, 28 июля 2023 г. URL https://proceedings.mlr.press/v221/lange23a.html.
- ⟦Lee et al. (2019) Ли, Дж., Сяо, Л., Шёнхольц, С., Бахри, Я., Новак, Р., Соль-Дикштейн, Дж., и Пеннингтон, Дж. Широкие нейронные сети любой глубины развиваются как линейные модели при градиентном спуске. В сборнике «Достижения в системах обработки нейронной информации», том 32, 2019. URL https://proceedings.neurips.cc/paper_files/paper/2019/file/0d1a9651497a38d8b1c3871c84528bd4-Paper.pdf.
- ⟦Lin et al. (2024) Лин, З., Ли, П., и Ву, Л. Исследование ландшафтов нейронных сетей: звездообразная и геодезическая связность. arXiv preprint arXiv:2404.06391, 2024.
- ⟦Lion et al. (2024) Лайон, К., Ночи, Л., Хофманн, Т., и Бахманн, Г. Насколько хорош отдельный бассейн притяжения? В материалах 27-й Международной конференции по искусственному интеллекту и статистике, том 238, стр. 4015–4023. PMLR, 02–04 мая 2024 г. URL https://proceedings.mlr.press/v238/lion24a.html.
- ⟦Loshchilov & Hutter (2017) Лощилов, И. и Хаттер, Ф. Исправление регуляризации весового затухания в adam. CoRR, abs/1711.05101, 2017. URL http://arxiv.org/abs/1711.05101.
- ⟦Lubana et al. (2023) Лубана, Э. С., Бигелоу, Э. Дж., Дик, Р. П., Крюгер, Д. и Танака, Х. Механистическая связность мод. В материалах 40-й Международной конференции по машинному обучению, том 202, стр. 22965–23004. PMLR, 23–29 июля 2023 г. URL https://proceedings.mlr.press/v202/lubana23a.html.
- ⟦Mirzadeh et al. (2021) Mirzadeh, S. I., Farajtabar, M., Gorur, D., Pascanu, R., and Ghasemzadeh, H. Линейная связность мод в многозадачном и непрерывном обучении, 2021. URL https://openreview.net/forum?id=Fmg_fQYUejf.
- ⟦Navon et al. (2024) Навон, А., Шамсиан, А., Фетая, Э., Чечик, Г., Дим, Н., и Марон, Х. Эквивариантное выравнивание пространства весов глубоких нейронных сетей. В материалах 41-й Международной конференции по машинному обучению, том 235, стр. 37376–37395. PMLR, 21–27 июля 2024 г. URL https://proceedings.mlr.press/v235/navon24a.html.
- ⟦Neyshabur et al. (2020) Neyshabur, B., Sedghi, H., and Zhang, C. Что именно переносится при трансферном обучении? В сборнике «Достижения в системах обработки нейронной информации», том 33, стр. 512–523, 2020. URL https://proceedings.neurips.cc/paper_files/paper/2020/file/0607f4c705595b911a4f3e7a127b44e0-Paper.pdf.
- ⟦Nguyen et al. (2021) Нгуен, Т., Рагу, М., и Корнблит, С. Изучают ли широкие и глубокие сети одно и то же? Раскрытие того, как представления нейронных сетей варьируются в зависимости от ширины и глубины. Международная конференция по обучению представлений, 2021. URL https://openreview.net/forum?id=KJNcAkY8tY4.
- ⟦Peña et al. (2023) Пенья, Ф. А. Г., Медейрос, Х. Р., Дюбей, Т., Аминбейдохти, М., Грейнджер, Э., и Педерсоли, М. Повторное нахождение бассейна посредством неявного дифференцирования Синхорна. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 20237–20246, июнь 2023 г. URL https://openaccess.thecvf.com/content/CVPR2023/html/Pena_Re-Basin_via_Implicit_Sinkhorn_Differentiation_CVPR_2023_paper.html.
- ⟦Raghu et al. (2017) Raghu, M., Gilmer, J., Yosinski, J., and Sohl-Dickstein, J. SVCCA: Сингулярный векторный канонический корреляционный анализ для динамики и интерпретируемости глубокого обучения. В сборнике Advances in Neural Information Processing Systems, том 30, стр. 6076–6085, 2017. URL https://proceedings.neurips.cc/paper_files/paper/2017/hash/dc6a7e655d7e5840e66733e9ee67cc69-Abstract.html.
- ⟦Redman et al. (2024) Redman, W. T., Bello-Rivas, J. M., Fonoberova, M., Mohr, R., Kevrekidis, Y., and Mezic, I. Идентификация эквивалентной динамики обучения. В материалах Тридцать восьмой ежегодной конференции по нейронным системам обработки информации, 2024. URL https://openreview.net/forum?id=bOYVESX7PK.
- ⟦Russakovsky et al. (2015) Руссаковский, О., Денг, Дж., Су, Х., Краузе, Дж., Сатиш, С., Ма, С., Хуанг, З., Карпатый, А., Хосла, А., Бернштейн, М., Берг, А. К., и Фей-Фей, Л. Конкурс по крупномасштабному распознаванию визуальных образов ImageNet. Международный журнал компьютерного зрения, 115(3):211–252, декабрь 2015 г. ISSN 0920-5691, 1573-1405. doi: 10.1007/s11263-015-0816-y. URL http://link.springer.com/10.1007/s11263-015-0816-y.
- ⟦Sadrtdinov et al. (2023) Сартдинов, И., Поздеев, Д., Ветров, Д. П. и Лобачева, Е. Оставаться или не оставаться в бассейне предварительного обучения: инсайты об ансамблировании в трансферном обучении. В Advances in Neural Information Processing Systems, том 36, стр. 15936–15964, 2023. URL https://proceedings.neurips.cc/paper_files/paper/2023/file/336572db3e99930814d6b328d4220cb6-Paper-Conference.pdf.
- ⟦Sarnthein et al. (2023) Сарнтхайн, Ф., Бахманн, Г., Анагностидис, С. и Хофманн, Т. Случайные учителя — хорошие учителя. В материалах 40-й Международной конференции по машинному обучению, том 202, стр. 30022–30041. PMLR, 23–29 июля 2023 г. URL https://proceedings.mlr.press/v202/sarnthein23a.html.
- ⟦Sellam et al. (2022) Селлам, Т., Ядловски, С., Тенни, И., Вэй, Дж., Сафра, Н., Д’Амур, А., Линзен, Т., Бастингс, Дж., Турк, И., Эйзенштейн, Дж., Дас, Д., и Павлик, Э. The MultiBERTs: репродукции BERT для анализа устойчивости. В материалах Международной конференции по обучению представлений, 2022.
- ⟦Sharma et al. (2024) Шарма, Э., Квок, Д., Дентон, Т., Рой, Д. М., Рольник, Д. и Дзюгайте, Г. К. Одновременная линейная связность нейронных сетей по модулю перестановки. В Бифет, А., Дэвис, Дж., Крилавичюс, Т., Кулл, М., Нтуци, Э. и Жлобайте, И. (ред.), Машинное обучение и обнаружение знаний в базах данных. Исследовательское направление, стр. 262–279, Шам, 2024. Шпрингер Нейчер Швейцария. ISBN 978-3-031-70368-3.
- ⟦Simsek et al. (2021) Simsek, B., Ged, F., Jacot, A., Spadaro, F., Hongler, C., Gerstner, W., and Brea, J. Геометрия ландшафта функции потерь в перепараметризованных нейронных сетях: симметрии и инвариантности. В материалах 38-й Международной конференции по машинному обучению, том 139, стр. 9722–9732. PMLR, 2021. URL https://proceedings.mlr.press/v139/simsek21a.html.
- ⟦Singh & Jaggi (2020) Сингх, С. П. и Джагги, М. Объединение моделей посредством оптимальной транспортировки. В сборнике «Достижения в системах обработки нейронной информации», том 33, стр. 22045–22055, 2020. URL https://proceedings.neurips.cc/paper/2020/hash/fb2697869f56484404c8ceee2985b01d-Abstract.html.
- ⟦Singh et al. (2024) Сингх, С. П., Адилова, Л., Камп, М., Фишер, А., Шёлькопф, Б., Тюбинген, М.-И., Хофманн, Т., и Ч, Э. Ландшафтирование линейной связности мод. В сборнике: Динамика обучения в пространствах высокой размерности 2024: Возникновение структуры и рассуждений, 2024.
- ⟦Smith (2018) Смит, Л. Н. Дисциплинированный подход к гиперпараметрам нейронных сетей: Часть 1 – скорость обучения, размер пакета, момент и затухание весов, апрель 2018 г. URL http://arxiv.org/abs/1803.09820. arXiv:1803.09820 [cs].
- ⟦Smith & Le (2018) Смит, С. Л. и Ле, К. В. Байесовская перспектива обобщения и стохастического градиентного спуска. В материалах Международной конференции по обучению представлениям, 2018. URL https://openreview.net/forum?id=BJij4yg0Z.
- ⟦Sohl-Dickstein (2024) Sohl-Dickstein, J. Граница обучаемости нейронных сетей является фрактальной, 2024. URL https://arxiv.org/abs/2402.06184⟧.
- ⟦Sonthalia et al. (2024) Сонталия, А., Рубинштейн, А., Аббаснеджад, Э., и О, С. Дж. Формируют ли решения глубоких нейронных сетей звездную область?, 2024. URL https://arxiv.org/abs/2403.07968⟧.
- ⟦Springer et al. (2025) Шпрингер, Дж. М., Гоял, С., Вен, К., Кумар, Т., Юэ, Х., Маллади, С., Нойбиг, Г. и Рагунатан, А. Переобученные языковые модели сложнее подвергаются дообучению, 2025. URL https://arxiv.org/abs/2503.19206⟧.
- ⟦Strogatz (2019) Строгац, С. Нелинейная динамика и хаос: с приложениями к физике, биологии, химии и инженерии. Книга издательства Chapman & Hall. CRC Press, Бока-Ратон, Лондон, Нью-Йорк, второе издание, впервые выпущено в твердом переплете, 2019. ISBN 978-0-8133-4910-7 978-0-367-09206-1.
- ⟦Teh et al. (2016) Те, И. У., Тьери, А. Х. и Воллмер, С. Дж. Согласованность и флуктуации для стохастической градиентной динамики Ланжевена. J. Mach. Learn. Res., 17(1):193–225, январь 2016. ISSN 1532-4435.
- ⟦Utans (1996) Ютанс, Дж. Усреднение весов для нейронных сетей и схемы локальной перевыборки. В сб. трудов семинара AAAI-96 по интеграции множественных обученных моделей. Издательство AAAI, стр. 133–138, 1996.
- ⟦Vlaar & Frankle (2022) Влаар, Т. Дж. и Франкл, Дж. Что может рассказать нам линейная интерполяция ландшафтов функции потерь нейронных сетей? В материалах 39-й Международной конференции по машинному обучению, том 162, стр. 22325–22341. PMLR, 2022. URL https://proceedings.mlr.press/v162/vlaar22a.html.
- ⟦Wang et al. (2019) Ван, А., Сингх, А., Майкл, Дж., Хилл, Ф., Леви, О. и Боумен, С. Р. GLUE: многозадачный бенчмарк и платформа для анализа понимания естественного языка. В материалах Международной конференции по обучению представлений, 2019. URL https://openreview.net/forum?id=rJ4km2R5t7.
- ⟦Wang et al. (2020) Ван, Х., Юрочкин, М., Сун, Ю., Папаилиопулос, Д. и Хазаени, Й. Федеративное обучение с согласованным усреднением. В материалах Международной конференции по представлениям обучения, 2020. URL https://openreview.net/forum?id=BkluqlSFDS.
- ⟦Williams et al. (2021) Уильямс, А. Х., Кунц, Э., Корнблит, С. и Линдерман, С. Обобщенные метрики формы нейронных представлений. В сборнике «Достижения в системах обработки нейронной информации», том 34, стр. 4738–4750, 2021. URL https://proceedings.neurips.cc/paper_files/paper/2021/file/252a3dbaeb32e7690242ad3b556e626b-Paper.pdf.
- ⟦Wortsman et al. (2021) Вортсман, М., Хортон, М. К., Гестрин, К., Фархади, А., и Растегари, М. Обучение подпространств нейронных сетей. В материалах 38-й Международной конференции по машинному обучению, том 139, стр. 11217–11227. PMLR, 2021. URL https://proceedings.mlr.press/v139/wortsman21a.html.
- ⟦Wu et al. (2018) Ву, Л., Ма, К. и Э, В. Как SGD выбирает глобальные минимумы в перепараметризованном обучении: взгляд с точки зрения динамической устойчивости. В сборнике «Достижения в системах обработки нейронной информации», том 31, 2018. URL https://proceedings.neurips.cc/paper_files/paper/2018/file/6651526b6fb8f29a00507de6a49ce30f-Paper.pdf.
- ⟦Yunis et al. (2022) Юнис, Д., Патель, К. К., Саварезе, П. Х. П., Варди, Г., Франкл, Дж., Уолтер, М., Ливеску, К., и Мэр, М. О выпуклости и линейной связности мод в нейронных сетях. В OPT 2022: Оптимизация для машинного обучения (Семинар NeurIPS 2022), 2022. URL https://openreview.net/forum?id=TZQ3PKL3fPr.
- ⟦Zhou et al. (2023) Чжоу, З., Ян, Ю., Ян, Х., Ян, Дж. и Ху, В. Выход за пределы линейной связности мод: послойная линейная связность признаков. В сборнике «Достижения в системах обработки нейронной информации», том 36, стр. 60853–60877, 2023. URL https://proceedings.neurips.cc/paper_files/paper/2023/file/bf3ee5a5422b0e2a88b0c9c6ed3b6144-Paper-Conference.pdf.
Appendix A Детали обучения
В этом разделе мы приводим подробную информацию о нашей методологии обучения. Если не указано иное, мы проводили все эксперименты с ResNet на отдельных графических процессорах NVIDIA RTX 8000 с 4 ядрами центрального процессора. Эксперименты с ViT и языковыми моделями проводились на графических процессорах NVIDIA L40S..
A.1 Эксперименты с гиперпараметрами CIFAR-10
Мы обучаем остаточные сверточные модели (He et al. 2015) на наборе данных CIFAR-10 (Krizhevsky 2009), используя настройки гиперпараметров из Table 1. Время обучения выбрано таким образом, чтобы перекрестная энтропия потерь на обучающих данных для возмущенной модели в среднем была ниже после завершения обучения. Все модели имеют точность на тестовой выборке в пределах 2 процентных пунктов (88-90%). Для удобства интерпретации время обучения округлено в большую сторону до ближайших 5000 шагов. Хотя модели в наших экспериментах не полностью сошлись и сохраняются некоторые различия между разными настройками гиперпараметров, мы не обнаружили, что наши результаты коррелируют с разным временем обучения или конечной производительностью сети на обучающей или тестовой выборке (Figure 8).
| Setting | Model | Optimizer | LR | W-up | WD | BS | Steps | ||
|---|---|---|---|---|---|---|---|---|---|
| Standard | ResNet20-32 | SGD | 0.100 | 0.020 | – | 128 | 25000 | 0.89 ± 0.00 | 0.13 ± 0.01 |
| 10x Warm-up | ResNet20-32 | SGD | 0.100 | 0.200 | – | 128 | 25000 | 0.89 ± 0.01 | 0.12 ± 0.01 |
| AdamW (no Weight Decay) | ResNet20-32 | AdamW | 0.003 | 0.020 | – | 128 | 20000 | 0.89 ± 0.00 | 0.13 ± 0.01 |
| Batch Size = 512 | ResNet20-32 | SGD | 0.100 | 0.020 | – | 512 | 10000 | 0.88 ± 0.00 | 0.15 ± 0.02 |
| Perturb Norm Weights | ResNet20-32 | SGD | 0.100 | 0.020 | ✓ | 128 | 20000 | 0.90 ± 0.00 | 0.15 ± 0.00 |
| ResNet-8 | ResNet8-64 | SGD | 0.100 | 0.020 | – | 128 | 25000 | 0.89 ± 0.00 | 0.14 ± 0.01 |
| ResNet-8, 10x Warm-up | ResNet8-64 | SGD | 0.100 | 0.200 | – | 128 | 25000 | 0.89 ± 0.00 | 0.13 ± 0.01 |
| SGD w. Weight Decay | ResNet20-32 | SGD | 0.100 | 0.020 | ✓ | 128 | 20000 | 0.89 ± 0.01 | 0.15 ± 0.01 |
Для упрощения сопоставления весов и активаций мы используем layer normalization (Ba et al. 2016) вместо batch normalization, что приводит к незначительному снижению производительности. При оценке барьеров после выравнивания перестановок это позволяет избежать выполнения дополнительных проходов вывода для корректировки статистики batch normalization на каждом шаге интерполяции (Jordan et al. 2023).
A.2 Эксперименты по дообучению
Предварительное обучение на CIFAR
Мы провели предварительное обучение двух моделей ResNet-50 с различными инициализациями как на наборах данных CIFAR-10, так и на CIFAR-100 с использованием нормализации слоев. Каждая модель обучалась в течение 75 000 шагов (приблизительно 200 эпох) с использованием SGD с моментом 0,9 и графиком косинусного отжига. Мы использовали пиковую скорость обучения 0,1 с прогревом 2,5%, коэффициентом затухания весов и размером пакета 128. Модель обучалась с использованием горизонтальных отражений, случайных поворотов до 10 градусов, случайных смещений до 4 пикселей и аугментации cutout с 2 пикселями..
Дообучение на CIFAR
Начиная с наших предварительно обученных контрольных точек ResNet-50, мы выполнили SFT каждой модели на CIFAR-10 (или CIFAR-100), используя стохастический градиентный спуск с моментом 0,9 в течение 20 000 шагов.
Эксперименты по дообучению BERT
Мы провели эксперименты на бенчмарке GLUE (Wang et al. 2019) с использованием модели MultiBERT (Sellam et al. 2022), в частности, применяя чекпоинты из google/multiberts-seed_0 и google/multiberts-seed_1, доступные на HuggingFace.1010 10 https://huggingface.co/google/multiberts-seed_0-step_0k и https://huggingface.co/google/multiberts-seed_1-step_0k. Все задачи используют одинаковые базовые гиперпараметры AdamW (Loshchilov & Hutter 2017) со скоростью обучения и коэффициентом затухания весов 0.01, в то время как размер батча и длительность обучения масштабировались в соответствии с размером набора данных, как подробно описано в Table 2.
Из-за вычислительных ограничений мы выбрали QNLI из числа более крупных наборов данных, содержащих более 100 тысяч примеров (QNLI, QQP, MNLI), и следовали Devlin et al. 2019, выполняя fine-tuning в течение трех эпох. Для набора данных среднего размера SST-2 мы проводили обучение в течение 2500 шагов. Небольшие наборы данных (RTE, MRPC) с 2,5–3,7 тысячами примеров обучались в течение 500 шагов с использованием размера пакета 32, в то время как набор данных среднего-малого размера CoLA (5,7–8,5 тысяч примеров) обучался в течение 1500 шагов с тем же размером пакета. Эти настройки гарантируют, что все модели достигли значения функции потерь кросс-энтропии при обучении ниже 0,2, хотя наши нейронные сети, по-видимому, в некоторых случаях переобучились на задаче fine-tuning (Table 3).
| Dataset | Examples | Batch Size | Training Schedule |
|---|---|---|---|
| QNLI | 105k | 128 | 3 epochs |
| SST-2 | 67k | 128 | 2500 steps |
| CoLA | 8.5k | 32 | 1500 steps |
| MRPC | 3.7k | 32 | 500 steps |
| RTE | 2.5k | 32 | 500 steps |
| Before Training | End of Fine-tuning | ||||
|---|---|---|---|---|---|
| Dataset | Starting Checkpoint | Acc | CE | Acc | CE |
| COLA | 2000k | 0.61 | 0.68 | 0.84 | 0.58 |
| 200k | 0.38 | 0.75 | 0.77 | 0.79 | |
| 20k | 0.57 | 0.68 | 0.72 | 0.87 | |
| MRPC | 2000k | 0.69 | 0.68 | 0.85 | 0.43 |
| 200k | 0.32 | 0.87 | 0.83 | 0.45 | |
| 20k | 0.32 | 0.77 | 0.77 | 0.82 | |
| QNLI | 2000k | 0.44 | 0.70 | 0.91 | 0.26 |
| 200k | 0.52 | 0.75 | 0.89 | 0.32 | |
| 20k | 0.54 | 0.70 | 0.84 | 0.38 | |
| RTE | 2000k | 0.47 | 0.70 | 0.66 | 0.86 |
| 200k | 0.53 | 0.74 | 0.64 | 1.06 | |
| 20k | 0.53 | 0.70 | 0.64 | 1.13 | |
| SST2 | 2000k | 0.49 | 0.70 | 0.92 | 0.30 |
| 200k | 0.48 | 0.72 | 0.91 | 0.34 | |
| 20k | 0.51 | 0.70 | 0.88 | 0.48 | |
Дообучение ViT
Мы выполняем дообучение на CIFAR-100, начиная с четырех Vision Transformers (ViTs) (Dosovitskiy et al. 2021) на HuggingFace: google/vit-base-patch16-224 (86M параметров),1111 11 https://huggingface.co/google/vit-base-patch16-224 google/vit-base-patch16-224-in21k (86M параметров),1212 12 https://huggingface.co/google/vit-base-patch16-224-in21k google/vit-large-patch16-224-in21k (304M параметров),1313 13 https://huggingface.co/google/vit-large-patch16-224-in21k и google/vit-huge-patch14-224-in21k (632M параметров).1414 14 https://huggingface.co/google/vit-huge-patch14-224-in21k Все модели были предварительно обучены на ImageNet-21k, при этом vit-base-patch16-224 дополнительно дообучена на ImageNet-1k (Russakovsky et al. 2015).
Мы используем одинаковые гиперпараметры для всех размеров моделей: оптимизатор AdamW (Loshchilov & Hutter 2017) со скоростью обучения , коэффициентом затухания весов , размером пакета 32 и графиком косинусного отжига с 10% прогревом в течение 5 эпох. Аугментация данных состояла из горизонтальных отражений, случайного поворота (), случайного смещения ( пикселей) и вырезания фрагментов (). Изображения масштабируются до , чтобы соответствовать входному разрешению, ожидаемому моделями..
Дообучение OLMo
Мы выполняем SFT модели OLMo-1B1515 15 https://huggingface.co/allenai/OLMo-1B-hf на наборе данных GSM8K (Cobbe et al. 2021b), начиная с различных контрольных точек, полученных на протяжении всех шагов предварительного обучения (3 триллиона токенов). Для нашей настройки мы выбираем три контрольные точки из разных фаз обучения: (1) первая доступная контрольная точка (4 млрд токенов), (2) середина предварительного обучения (1,5 трлн токенов) и (3) финальная контрольная точка (3 трлн токенов). Мы выполнили SFT каждой контрольной точки в течение 5000 шагов, используя AdamW со скоростью обучения и косинусным отжигом с прогревом..
Appendix B Методологические подробности
Во всех наших экспериментах мы обучаем две сети одновременно с включенными детерминированными вычислениями, используя идентичные случайные начальные числа для случайной инициализации (если применимо), порядка пакетов и аугментации данных. Мы подтверждаем, что обучение без возмущений приводит к получению в точности идентичных сетей, как и ожидалось..
Все оценки моделей, обученных с инициализации, усреднены по трем запускам, в то время как все оценки для fine-tuned моделей, перечисленных в Section A.2, усреднены по двум запускам..
B.1 Вычислительные барьеры
Для вычисления барьеров мы оцениваем 11 равноудаленных значений вдоль линейного пути между и ⟧.
В нашем определении барьеров (Equation 4) мы интерполируем между значениями функции потерь в конечных точках согласно (Sharma et al. 2024), вместо того чтобы брать их среднее значение, как в Frankle et al. 2020a. Это связано с тем, что первый вариант вытекает из определения выпуклости и более уместен для описания выпуклого бассейна функции потерь. На практике, поскольку и имеют практически идентичные значения функции потерь в наших экспериментах, данные определения являются взаимозаменяемыми..
Мы также измеряем барьеры ошибки на тестовой выборке, заменяя на 0-1 функцию потерь на тестовых данных. На практике тестовые барьеры немного меньше барьеров на обучающей выборке, поскольку сеть достигает почти нулевой функции потерь на обучающих данных, но не на тестовых, что допускает бо́льшие барьеры в первом случае. Однако, поскольку барьеры тестовой ошибки следуют тем же тенденциям, что и барьеры кросс-энтропии при обучении, мы опускаем их в тексте..
B.2 Вычисление углового CKA
Существует множество различных методов оценки репрезентативного сходства, и их сравнение выходит за рамки данной работы. Мы используем CKA по ряду причин: он инвариантен к линейным преобразованиям (за исключением аффинных), что хорошо согласуется с емкостью слоев нейронных сетей (Kornblith et al. 2019; Lange et al. 2023), он использовался для сравнения нейронных сетей в других контекстах (Nguyen et al. 2021), менее зависим от весовых коэффициентов главных компонент, чем SVCCA (Raghu et al. 2017), и может применяться к сетям с количеством промежуточных выходов , превышающим количество тестовых входных данных (Kornblith et al. 2019). Мы приводим Angular CKA по той простой причине, что он дает расстояние, которое увеличивается по мере роста различий, что согласуется с другими нашими измерениями. Заметим, что Angular CKA и CKA различаются только применением арккосинуса..
Мы вычисляем угловую CKA между финальным скрытым представлением следующим образом:
| (5) | ||||
где — это количество остаточных или блоков внимания, — выход последнего блока на фиксированном наборе входных данных , а — критерий независимости Гильберта-Шмидта, который измеряет взаимную корреляцию между центрированными матрицами сходства.
Мы используем реализацию Lange et al. 2023, которая включает определенные модификации для ускорения вычислений. А именно, мы выбираем примеров, так как Lange et al. 2023 показывает, что CKA можно надежно оценить с использованием относительно небольшого количества примеров, и мы используем их оценщик с уменьшенным смещением для :
где — количество тестовых входных данных, извлекает нижнюю треугольную часть матрицы, — центрирующая матрица, которая вычитает среднее значение, а — норма Фробениуса. Фактически, данный оценщик игнорирует диагональ матрицы сходства .
B.3 Масштаб возмущения
Для обеспечения корректного сравнения между различными методами возмущения и архитектурами нейронных сетей мы нормализуем все возмущения до достижения ими согласованной величины , которая для удобства интерпретации задается относительно размера сети при инициализации (уравнение 6). Формально мы гарантируем, что квадрат нормы соответствует общей дисперсии при инициализации возмущенных весов, так что
| (6) |
где — это пакет или образец гауссова возмущения, — это 0-1 маска весов для возмущения, — это поэлементное произведение, — это ожидаемая дисперсия (не выборочная дисперсия), а — это начальные веса нейронной сети. Таким образом, например, возмущение величиной составляет приблизительно 1% от размера ⟧.
Наконец, чтобы сохранить распределение активаций после каждого слоя нормализации, мы не подвергаем возмущениям смещения или веса нормализации в наших экспериментах. Хотя в предыдущих работах было обнаружено, что линейная связность мод может варьироваться между различными слоями (Vlaar & Frankle 2022; Zhou et al. 2023; Adilova et al. 2024), мы не обнаружили, что наши результаты существенно меняются в зависимости от того, какие слои подвергались возмущениям. Figure 9 показывает результаты, когда возмущениям подвергаются только смещения и веса нормализации. В этом случае мы используем тот же масштаб возмущений, который мы обычно назначаем весам в слое, следующем за смещениями или весами нормализации..
B.4 Линеаризованная аппроксимация для Дивергенция
Классический результат теории динамических систем гласит, что линеаризованная система, подверженная малым возмущениям, может экспоненциально расходиться во времени со скоростью, зависящей от наибольшего собственного числа (то есть старшего показателя Ляпунова) градиента обучающего отображения (Strogatz 2019):
| (7) |
где — это градиент карты обучения по отношению к весам, а — это максимальное собственное число среди всех градиентов на каждом шаге .
Подставляя определение SGD, мы обнаруживаем, что дивергенция между исходной и возмущенной моделями после обучения зависит от кривизны ландшафта функции потерь:
| (8) |
где — это скорость обучения, — это гессиан весов, а — это наибольшее собственное значение по всем . Расходимость возникает либо из-за высокой положительной кривизны, как в Wu et al. 2018, но дополнительно, если в направлении возмущения присутствует любая отрицательная кривизна, то подразумевает возможность экспоненциального роста расходимости в процессе обучения.
Appendix C Дальнейшие эксперименты
C.1 Базовые модели
Стабильность не зависит от типа слоя. В основном тексте (Figure 2) мы исключили веса нормализации и смещения из возмущений. Однако в Figure 9 мы показываем, что возмущение только слоев нормализации приводит к аналогичным тенденциям. Это говорит о том, что на стабильность fine-tuning больше влияет общая динамика сети, а не конкретные типы слоев. Хотя отдельные параметры или слои могут иметь разную важность, как отмечалось в предыдущих работах (Adilova et al. 2024), пакетные возмущения уже в некоторой степени учитывают этот эффект. Увеличенные барьеры для наименьших возмущений при инициализации являются артефактом численной нестабильности — в наших регулярных экспериментах мы избегаем этой проблемы, уменьшая долю возмущенных весов вместо уменьшения масштаба возмущения за пределами .
Как наши возмущения соотносятся с шумом SGD? Чтобы установить относительную величину наших возмущений по сравнению с шумом SGD, мы воспроизводим эксперимент по порождению родительских и дочерних моделей из Frankle et al. 2020a. Figure 10 показывает, что наши пакетные возмущения являются нижней границей барьеров базовой линии Frankle, что означает, что нестабильность, возникающая в результате независимого обучения в течение нескольких шагов, должна быть как минимум не меньше нестабильности, возникающей в результате одного независимого шага обучения..
Заметьте, что для этого сравнения мы масштабируем возмущения пакета до ожидаемой величины шума SGD во время возмущения . Это делает возмущение пакета эквивалентным выполнению только одного шага во время с другим шумом SGD, в отличие от использования разного шума SGD начиная с в базовом методе Frankle..
C.2 Возмущение только части весов.
Мы дополнительно уменьшаем масштаб наших возмущений с Figure 2, подвергая возмущению лишь часть весов с нашим наименьшим масштабом возмущения . Поразительно, но мы обнаружили, что возмущения даже одного веса, что происходит, когда доля возмущенных весов составляет , достаточно для создания барьеров при инициализации (Figure 11, справа). Масштаб этого возмущения (Figure 11, слева) значительно ниже масштаба шума, вызванного аппаратной неопределенностью..
C.3 Дополнительные настройки гиперпараметров
В этом разделе мы представляем результаты обучения ResNet-20 на CIFAR-10 для всех комбинаций гиперпараметров, перечисленных в Table 1.
Хорошо известно, что обучение нейронных сетей крайне чувствительно к гиперпараметрам оптимизации (Smith 2018). Наши эксперименты подтверждают наличие сложных взаимозависимостей между ключевыми гиперпараметрами оптимизации, что указывает на необходимость дальнейших теоретических исследований. Мы специально фокусируемся на влиянии выбора оптимизатора, размера пакета и затухания весов..
SGD повышает стабильность обучения. Выбор оптимизатора существенно влияет на стабильность карты обучения. Кроме того, сети, обученные с помощью Adam, также демонстрируют более высокие расстояния (Figure 7). Мы утверждаем, что это явление связано с неявным смещением SGD. В частности, Bradley et al. 2022 подчеркивают, что присущий SGD шум помогает ему избегать областей с высокой кривизной, которые часто связаны с плохой обобщающей способностью и, в наших условиях, вероятно, могут содержать линейно связанные минимумы..
В наших экспериментах мы наблюдали, что большие размеры пакетов приводят к более высоким барьерам функции потерь, что указывает на компромисс между размером пакета и стабильностью. Это явление согласуется с результатами Keskar et al. 2017, которые показывают, что большие размеры пакетов могут приводить к более острым минимумам, что может увеличить барьеры функции потерь и потенциально ухудшить обобщающую способность..
Регуляризация весов обеспечивает несколько большую стабильность, особенно сразу после инициализации. D’Angelo et al. 2024 подчеркивают, что регуляризация весов изменяет динамику оптимизации, усиливая неявную регуляризацию SGD посредством механизмов стабилизации функции потерь. Они также отмечают роль отсечения градиентов, которое стабилизирует обучение, особенно на границе стабильности..
C.4 Функциональное разнообразие для дополнительных настроек гиперпараметров
Мы воспроизводим Section 4.2 на двух наших дополнительных настройках гиперпараметров: с затуханием весов и с десятикратным прогревом. Результаты в Figures 13, 14 и 15 тесно согласуются с нашими выводами в Figure 3⟧.
C.5 Неподвижные точки выравнивания перестановок
Хотя сопоставление весов не способно уменьшить барьеры в нашем случае идентично инициализированных сетей, мы исследуем, остается ли актуальным для наших наблюдений фундаментальный механизм, предложенный (Entezari et al. 2022), согласно которому барьеры возникают из-за перестановок в сети. Мы рассматриваем, коррелируют ли наблюдаемые барьеры и расстояния между исходной и возмущенной сетями с количеством неподвижных точек в перестановках, найденных с помощью выравнивания весов (Ainsworth et al. 2023). Здесь под неподвижными точками понимаются непереставленные элементы в выравнивающих перестановках. Поскольку мы ожидаем, что две сети с идентичными весами будут выровнены перестановками, состоящими только из неподвижных точек, доля неподвижных точек может быть использована для указания степени, в которой две расходящиеся сети были переставлены относительно друг друга..
⟦Figure 16 указывает на слабую корреляцию, при которой количество неподвижных точек обратно пропорционально как высоте барьеров, так и расстоянию между сетями до выравнивания в конфигурациях ResNet. К сожалению, это наблюдение не распространяется на наши конфигурации ViT или BERT, поскольку сопоставление весов не позволяет выявить нетривиальные перестановки (то есть перестановки, отличные от тождественных) для данных архитектур transformers..
Appendix D Результаты дальнейшего SFT
D.1 Дообучение ResNet
Расширенное предварительное обучение приводит к почти нулевым барьерам дообучения в конфигурациях ResNet-50/CIFAR. Figure 5 показывает, что дообучение с более поздних контрольных точек значительно улучшает стабильность в экспериментах с ResNet-50. Для улучшения читаемости мы увеличиваем масштаб возмущений с помощью на Figures 18, 5 и 4, что показывает, что перенос с CIFAR-100 на CIFAR-10 и наоборот приводит к почти нулевым барьерам. Направление от CIFAR-100 к CIFAR-10 демонстрирует большую стабильность, что может указывать на то, что предварительное обучение на CIFAR-100 лучше подходит для оптимизации на CIFAR-10, чем наоборот..
Случайные инициализации менее стабильны, чем предобученные инициализации. В Figure 18 мы продемонстрировали, что предобучение улучшает стабильность SFT, в то время как Figure 17 предположили, что более ранние чекпоинты более чувствительны к возмущениям. В качестве базовой линии мы обучаем ResNet-50 со случайной инициализацией на CIFAR-10 и обнаруживаем, что она демонстрирует еще большие барьеры (Figure 19), сопоставимые по величине с обучением с нуля..
| Starting Checkpoint | Relative Perturb Step (%) | Distance | Train | |
|---|---|---|---|---|
| 191ep319st | 0.005 | 0.00001 | 39.41 ± 0.23 | 0.00 ± 0.00 |
| 191ep319st | 0.005 | 0.00100 | 39.46 ± 0.18 | 0.00 ± 0.00 |
| 191ep319st | 0.005 | 0.01000 | 40.41 ± 0.82 | 0.00 ± 0.00 |
| 191ep319st | 0.5 | 0.00001 | 39.49 ± 0.23 | 0.00 ± 0.00 |
| 191ep319st | 0.5 | 0.00100 | 39.42 ± 0.19 | 0.00 ± 0.00 |
| 191ep319st | 0.5 | 0.01000 | 40.03 ± 0.62 | 0.00 ± 0.00 |
| 191ep319st | 10 | 0.00001 | 38.02 ± 0.18 | 0.00 ± 0.00 |
| 191ep319st | 10 | 0.00100 | 38.04 ± 0.21 | 0.00 ± 0.00 |
| 191ep319st | 10 | 0.01000 | 38.19 ± 0.13 | 0.00 ± 0.00 |
| 57ep213st | 0.005 | 0.00001 | 40.81 ± 0.14 | 0.00 ± 0.00 |
| 57ep213st | 0.005 | 0.00100 | 40.93 ± 0.15 | 0.00 ± 0.00 |
| 57ep213st | 0.005 | 0.01000 | 41.49 ± 0.44 | 0.00 ± 0.00 |
| 57ep213st | 0.5 | 0.00001 | 40.90 ± 0.06 | 0.00 ± 0.00 |
| 57ep213st | 0.5 | 0.00100 | 40.82 ± 0.17 | 0.00 ± 0.00 |
| 57ep213st | 0.5 | 0.01000 | 41.26 ± 0.29 | 0.00 ± 0.00 |
| 57ep213st | 10 | 0.00001 | 39.50 ± 0.14 | 0.00 ± 0.00 |
| 57ep213st | 10 | 0.00100 | 39.50 ± 0.13 | 0.00 ± 0.00 |
| 57ep213st | 10 | 0.01000 | 39.63 ± 0.10 | 0.00 ± 0.00 |
| Starting Checkpoint | Relative Perturb Step (%) | Distance | Train | |
|---|---|---|---|---|
| 191ep319st | 0.005 | 0.00001 | 67.98 ± 0.00 | 0.00 ± 0.00 |
| 191ep319st | 0.005 | 0.00100 | 68.05 ± 0.00 | 0.00 ± 0.00 |
| 191ep319st | 0.005 | 0.00500 | 68.92 ± 0.00 | 0.01 ± 0.00 |
| 191ep319st | 0.005 | 0.01000 | 70.73 ± 2.25 | 0.01 ± 0.00 |
| 191ep319st | 0.5 | 0.00001 | 67.89 ± 0.00 | 0.00 ± 0.00 |
| 191ep319st | 0.5 | 0.00100 | 67.96 ± 0.00 | 0.01 ± 0.00 |
| 191ep319st | 0.5 | 0.00500 | 68.18 ± 0.00 | 0.01 ± 0.00 |
| 191ep319st | 0.5 | 0.01000 | 68.34 ± 0.25 | 0.01 ± 0.00 |
| 191ep319st | 10 | 0.00001 | 64.05 ± 0.00 | 0.00 ± 0.00 |
| 191ep319st | 10 | 0.00100 | 64.11 ± 0.00 | 0.00 ± 0.00 |
| 191ep319st | 10 | 0.00500 | 64.47 ± 0.00 | 0.00 ± 0.00 |
| 191ep319st | 10 | 0.01000 | 65.54 ± 0.94 | 0.00 ± 0.00 |
| 57ep213st | 0.005 | 0.00001 | 62.34 ± 0.00 | 0.01 ± 0.00 |
| 57ep213st | 0.005 | 0.00100 | 62.68 ± 0.00 | 0.01 ± 0.00 |
| 57ep213st | 0.005 | 0.00500 | 63.31 ± 0.00 | 0.01 ± 0.00 |
| 57ep213st | 0.005 | 0.01000 | 65.23 ± 2.39 | 0.01 ± 0.00 |
| 57ep213st | 0.5 | 0.00001 | 62.32 ± 0.00 | 0.01 ± 0.00 |
| 57ep213st | 0.5 | 0.00100 | 62.34 ± 0.00 | 0.01 ± 0.00 |
| 57ep213st | 0.5 | 0.00500 | 62.70 ± 0.00 | 0.01 ± 0.00 |
| 57ep213st | 0.5 | 0.01000 | 63.21 ± 0.72 | 0.01 ± 0.00 |
| 57ep213st | 10 | 0.00001 | 59.47 ± 0.00 | 0.00 ± 0.00 |
| 57ep213st | 10 | 0.00100 | 59.43 ± 0.00 | 0.00 ± 0.00 |
| 57ep213st | 10 | 0.00500 | 59.50 ± 0.00 | 0.00 ± 0.00 |
| 57ep213st | 10 | 0.01000 | 59.70 ± 0.29 | 0.00 ± 0.00 |
D.2 Дообучение ViT
Первоначальные эксперименты по стабильности дообучения на ResNets и MultiBERTs показали противоположные тенденции между задачами компьютерного зрения с использованием сверточных архитектур и языковыми задачами с использованием архитектур transformers. Чтобы разобраться, обусловлено ли это различие природой задачи или архитектурой, мы применили нашу экспериментальную процедуру к Vision Transformers (ViTs), которые являются репрезентативными для архитектуры transformer и представляют собой модели большего масштаба, чем ResNet-50. Источники для предобученных ViTs и процедура дообучения, которую мы используем, указаны в Section A.2.
Хотя у нас не было доступа к промежуточным контрольным точкам обучения для моделей ViT, мы вместо этого сравниваем четыре ViT разных размеров, которые были предварительно обучены на вариантах ImageNet: google/vit-base-patch16-224 (86M параметров), google/vit-base-patch16-224-in21k (86M параметров), google/vit-large-patch16-224-in21k (304M параметров) и google/vit-huge-patch14-224-in21k (632M параметров). Размер каждого набора данных для предварительного обучения служит косвенным показателем продолжительности предварительного обучения.
Расширяя наши выводы на ViTs, дообученные на CIFAR-100. В соответствии с нашими результатами для меньших сверточных сетей, в Figure 20 мы наблюдаем, что более ранние и значительные возмущения вызывают более выраженные барьеры. Интересно, что вариант google/vit-base-patch16-224, который прошел дополнительное дообучение на ImageNet-1K после первоначального предварительного обучения на ImageNet-21K, фактически представляет собой более длительный процесс обучения. Хотя точное расписание скорости обучения неизвестно, эта настройка напоминает расширенное предварительное обучение, наблюдаемое в более поздних контрольных точках BERT. Модели, дообученные из этого варианта (Figure 20, вверху слева), демонстрируют самые большие барьеры среди всех настроек, причем барьеры на порядок больше, чем у google/vit-base-patch16-224-in21k (Figure 20, вверху справа). Это дает дополнительные доказательства того, что расширенное предварительное обучение снижает стабильность дообучения. Будущие исследования могли бы изучить стабильность промежуточных контрольных точек ViT..
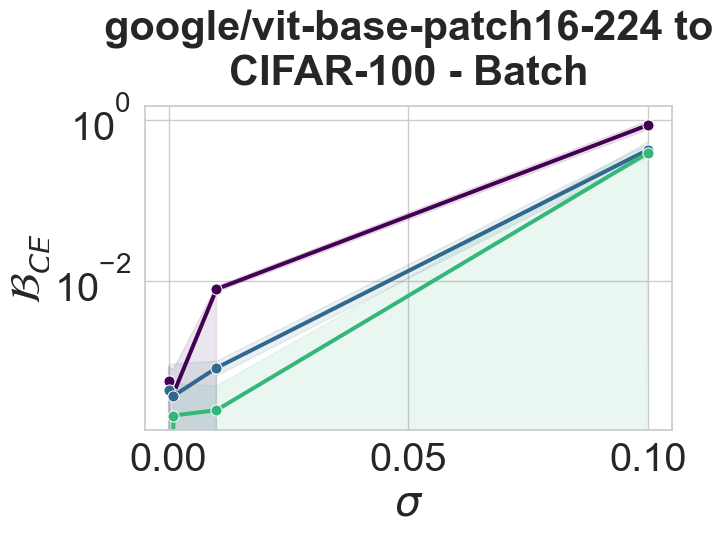
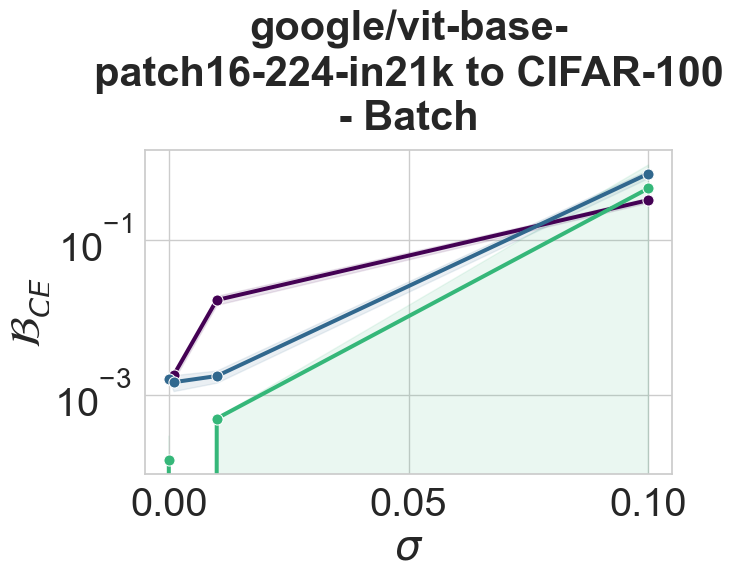
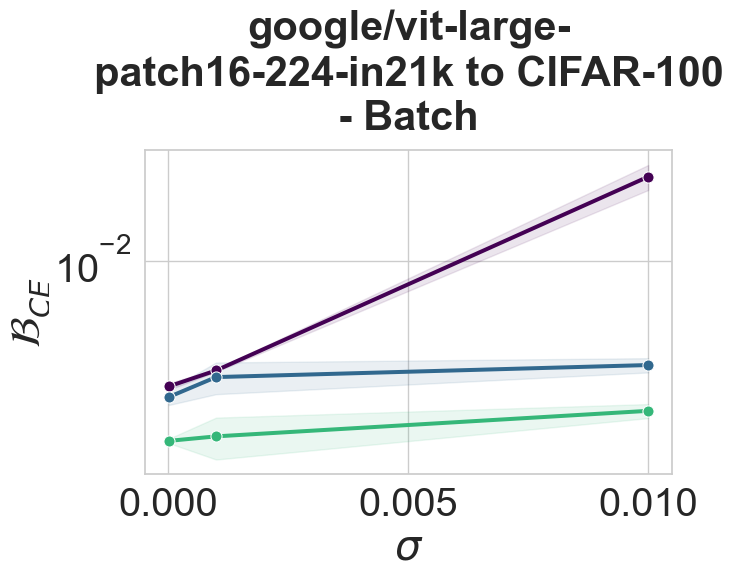
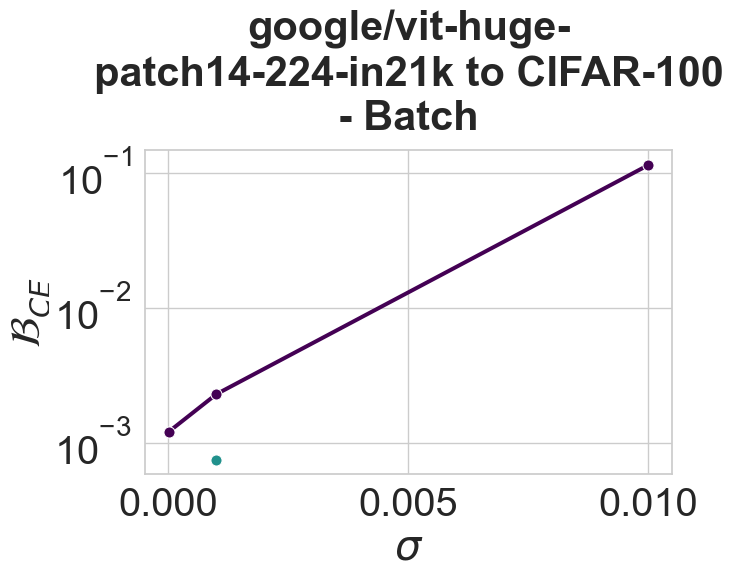
D.3 Дообучение BERT
⟦Figure 22 отображает дополнительные задачи дообучения, как описано в Section A.2⟧.
Репрезентативное сходство для моделей BERT. Мы также приводим графики Angular CKA для BERT на наборах данных MRPC и QNLI в Figure 23. Figure 23 показывает, что барьеры коррелируют с Angular CKA, что указывает на реальные функциональные различия между сетями. Это согласуется с нашими результатами для моделей компьютерного зрения (Figures 3, 14 и 21 справа), в отличие от корреляции между барьерами и дивергенцией (Figure 26), которая не является устойчивой при сравнении моделей компьютерного зрения и языковых моделей..
D.4 Дообучение OLMo
⟦Figure 24 демонстрирует, что тенденции, которые мы наблюдаем в отношении времени и величины возмущения, распространяются на decoder-only LLM. В соответствии с нашими результатами MultiBERT, мы обнаружили, что более длительное pre-training не обязательно приводит к повышению стабильности fine-tuning..
D.5 Дивергенция и барьеры
Здесь мы более подробно рассматриваем взаимосвязь между барьерами и дивергенцией между моделями в конце обучения. Figure 25 (слева, в центре) показывает, что SFT на задачах компьютерного зрения, таких как перенос с CIFAR-100 на CIFAR-10 и наоборот, следует тенденциям, представленным в Figure 7 (слева). Мы видим, что эта прямая зависимость слабая или отсутствует при переносе ViTs с ImageNet на CIFAR-100 (Figure 25 справа), а также для бенчмарка GLUE в нашем исследовании (Figure 26), где QNLI и COLA практически не демонстрируют корреляции. Интересно, что OLMo, дообученная на GSM8K (Figure 24, справа), показывает более четкую корреляцию между барьерами и дивергенцией, что больше напоминает наши результаты для ResNet-20 (Figure 7, слева), чем для BERT..
Appendix E Дополнительные графики в логарифмическом масштабе
Эти графики являются копиями графиков с основного рисунка с логарифмическими осями ординат и включены для демонстрации более четкого разделения между меньшими барьерами.