[\affiliation[inst1]organization=Кафедра экономики и финансов, addressline=Университет Нового Орлеана, city=Новый Орлеан, postcode=70148, state=Луизиана, country=США \affiliation[inst2]organization=Кафедра компьютерных наук, addressline=Университет Нового Орлеана, city=Новый Орлеан, postcode=70148, state=Луизиана, country=США
Обучение с подкреплением в процессе принятия финансовых решений: систематический обзор эффективности, проблем и стратегий реализации
Аннотация
Обучение с подкреплением (RL) — это инновационный подход к принятию финансовых решений, предлагающий специализированные решения для сложных инвестиционных задач, в которых традиционные методы оказываются неэффективными. В данном обзоре анализируется 167 статей за 2017–2025 годы с акцентом на маркет-мейкинг, оптимизацию портфеля и алгоритмическую торговлю. В работе определены ключевые проблемы производительности и сложности применения RL в финансах. В целом, RL обладает преимуществами перед традиционными методами, особенно в области маркет-мейкинга. Данное исследование предлагает унифицированную структуру для решения общих проблем, таких как интерпретируемость, устойчивость и возможность практического внедрения. Эмпирические данные, полученные на синтетических наборах данных, свидетельствуют о том, что качество реализации и знание предметной области зачастую важнее алгоритмической сложности. Исследование подчеркивает необходимость создания интерпретируемых архитектур RL для соблюдения нормативных требований, повышения устойчивости в нестационарных средах и разработки стандартизированных протоколов тестирования. Организациям следует уделять меньше внимания сложности алгоритмов и больше — микроструктуре рынка, регуляторным ограничениям и управлению рисками при принятии решений..
ключевые слова:
Обучение с подкреплением , Принятие финансовых решений , Маркет-мейкинг , Алгоритмическая торговля1 Введение
Финансовые рынки представляют собой одну из наиболее сложных сред для алгоритмического принятия решений, характеризующуюся высокой размерностью, нестационарностью и сложными зависимостями, которые традиционным методам трудно эффективно уловить Cont, (2001). Эволюция финансовой теории претерпела значительную трансформацию от классических подходов к более сложным методологиям, которые признают ограничения традиционных допущений. Как задокументировано Agudelo Aguirre и Agudelo Aguirre Agudelo Aguirre and Agudelo Aguirre, (2024), поведенческие финансы возникли из расхождений, наблюдаемых в традиционных теориях финансов, и служат дополнением к классическим финансам, привнося поведенческие аспекты в процесс принятия решений. Эта эволюция отражает более широкое признание того, что финансовые рынки являются сложными адаптивными системами, где традиционные эконометрические подходы могут оказаться недостаточными.
Обучение с подкреплением (RL), как развивающаяся парадигма в области искусственного интеллекта, предоставляет адаптивный подход, основанный на данных, для решения этих задач путем изучения оптимальных стратегий непосредственно на основе рыночных взаимодействий Sutton and Barto, (2018). Применение методов машинного обучения к принятию финансовых решений приобрело особую значимость в решении проблемы, которую Баньяра Bagnara, (2022) определяет как проблему «зоопарка факторов» в эмпирическом ценообразовании активов. Эта новейшая разработка в области эмпирического ценообразования активов демонстрирует, как методы машинного обучения обеспечивают большую гибкость и точность прогнозирования, хотя они требуют особого внимания, поскольку существенно отходят от традиционной эконометрики. Интеграция RL в рамках этой более широкой структуры машинного обучения представляет собой естественный прогресс на пути к созданию более адаптивных и отзывчивых систем принятия финансовых решений..
Теоретическая основа для применения подходов адаптивного обучения в финансах дополнительно подкрепляется эмпирическими данными об эволюции рыночной эффективности с течением времени. Лим и Брукс Lim and Brooks, (2011) представляют систематический обзор литературы по слабой форме рыночной эффективности, демонстрируя, что рыночная эффективность не является статичным свойством, а динамически развивается во времени. Эта изменяющаяся во времени природа рыночной эффективности создает возможности для адаптивных алгоритмов, таких как RL, использовать временные неэффективности, адаптируясь к меняющимся рыночным условиям. Данные об эволюционирующей рыночной эффективности напрямую подтверждают обоснованность использования подходов, основанных на обучении, которые могут непрерывно адаптировать свои стратегии на основе наблюдаемого поведения рынка..
Применение RL в принятии финансовых решений значительно ускорилось в последние годы под влиянием нескольких сходящихся факторов. Во-первых, беспрецедентная доступность финансовых данных, включая данные высокочастотной торговли, альтернативные источники данных и потоковые ленты в реальном времени, обеспечивает насыщенную информационную среду, необходимую алгоритмам RL для эффективного обучения Aldridge, (2013); Tsantekidis et al., 2017a . Во-вторых, достижения в архитектурах deep learning позволили методам RL справляться с высокоразмерными пространствами состояний и действий, характерными для финансовых приложений Goodfellow et al., (2016); Heaton et al., (2017). В-третьих, растущая доступность и экономическая эффективность облачных вычислительных ресурсов сделали сложные реализации RL осуществимыми для более широкого круга финансовых институтов.
Фундаментальные работы по применению RL в финансах восходят к новаторским исследованиям Муди и Саффелла по прямому обучению с подкреплением для торговых систем Moody and Saffell, (2001). Их подход продемонстрировал, что RL может оптимизировать эффективность торговли напрямую, не требуя явных прогностических моделей, что заложило парадигму, которая продолжает влиять на современные исследования. Этот подход прямой оптимизации согласуется с более широкой тенденцией в финансовом машинном обучении, выявленной Баньярой Bagnara, (2022), где методы группируются по категориям, включая регуляризацию, снижение размерности, регрессионные деревья/случайный лес, neural networks и сравнительный анализ. Совсем недавно Цзян и соавторы представили фреймворки deep reinforcement learning, специально разработанные для задач управления портфелем, показав, как современные архитектуры neural networks могут быть эффективно объединены с принципами RL для финансовых приложений Jiang et al., (2017).
Интеграция RL в более широкий ландшафт финансового машинного обучения представляет собой значительный отход от традиционных эконометрических подходов. Как отмечено в комплексном обзоре Bagnara Bagnara, (2022), методы машинного обучения в ценообразовании активов требуют особого внимания к их экономической интерпретации, что дает подсказки для будущих разработок. Этот акцент на экономической интерпретируемости особенно важен для приложений RL в финансах, где изученные стратегии должны не только достигать превосходной производительности, но и предоставлять выводы, которые могут быть поняты и подтверждены финансовыми практиками и регуляторами..
Несмотря на эти многообещающие разработки, практическое внедрение RL в финансах сталкивается с многочисленными уникальными проблемами по сравнению с другими областями, где RL добилось успеха Dulac-Arnold et al., (2019); García and Fernández, (2015). Эти проблемы проистекают из неотъемлемых характеристик финансовых сред: рынки фундаментально нестационарны, а их динамика меняется из-за регуляторных изменений, технологических инноваций и эволюционирующего поведения участников рынка Cont, (2001); Farmer and Skouras, (2013). Данные, представленные Лимом и Бруксом Lim and Brooks, (2011) относительно эволюции рыночной эффективности с течением времени, дополнительно подчеркивают динамическую природу финансовых рынков и необходимость адаптивных подходов, способных реагировать на изменяющиеся условия..
Стоимость исследования в финансовых средах может быть непомерно высокой, поскольку неудачные решения приводят к реальным финансовым потерям, а не к абстрактным штрафам за производительность. Кроме того, финансовые приложения функционируют в условиях строгого нормативного надзора, что требует наличия процессов принятия решений, которые можно объяснить и подвергнуть аудиту Doshi-Velez and Kim, (2017); Gomber et al., 2017b . Перспектива поведенческих финансов, освещенная Агудело Агирре и Агудело Агирре Agudelo Aguirre and Agudelo Aguirre, (2024), добавляет еще один уровень сложности, поскольку системы RL должны учитывать психологические аспекты, когнитивные искажения и другие поведенческие факторы, влияющие на динамику рынка и принятие решений инвесторами..
Регуляторная среда создает как проблемы, так и возможности для внедрения RL в финансовой сфере. Последние разработки в области систем управления ИИ подчеркивают необходимость создания объяснимых и проверяемых систем принятия решений, что стимулирует исследования в направлении интерпретируемых архитектур RL Puiutta and Veith, (2020). Развивающаяся нормативно-правовая база требует, чтобы системы RL балансировали между инновациями и соблюдением требований, что влечет за собой необходимость новых подходов к валидации моделей и управлению рисками McNeil et al., (2015). Этот регуляторный акцент на интерпретируемости согласуется с более широким вниманием к экономической интерпретации в финансовом машинном обучении, отмеченным Bagnara Bagnara, (2022), что предполагает, что успешные реализации RL должны отдавать приоритет как производительности, так и объяснимости..
Данный всесторонний обзор посвящен решению этих проблем путем проведения систематического анализа текущей литературы для выявления закономерностей и идей относительно эффективности RL в финансовых приложениях. Анализ выявляет несколько важных выводов, которые ставят под сомнение общепринятые предположения об эффективности RL в финансах. Появление гибридных подходов, сочетающих RL с традиционными количественными методами, демонстрирует особую перспективность, обеспечивая значительное повышение производительности по сравнению с чистыми реализациями RL Fischer and Krauss, (2018). Эта тенденция к гибридным методологиям отражает более широкую эволюцию в финансовом машинном обучении, где интеграция различных подходов часто дает превосходные результаты по сравнению с реализациями, использующими один метод..
Приложения для маркет-мейкинга неизменно демонстрируют значительный рост эффективности, за ними следует торговля криптовалютами, в то время как традиционная оптимизация портфеля показывает признаки зрелости Spooner et al., (2018). Потребность в надежных системах валидации становится все более критической по мере внедрения RL систем в производственные среды, где сбои моделей могут привести к серьезным финансовым последствиям Bailey et al., (2014). Изменчивый характер рыночной эффективности, задокументированный Лимом и Бруксом Lim and Brooks, (2011), дополнительно подчеркивает важность непрерывной валидации и адаптации в RL системах, развернутых на финансовых рынках.
Данный обзор вносит вклад в четырех ключевых областях. Во-первых, он представляет подробную классификацию того, как RL применяется в финансах, сортируя существующую литературу по областям применения, алгоритмическим стратегиям и характеристикам производительности. Эта классификация опирается на систему категоризации, установленную в более широкой литературе по финансовому машинному обучению Bagnara, (2022); Shi, (2025), расширяя ее специально для приложений RL. Во-вторых, он проводит тщательный анализ для определения элементов, которые критически влияют на результаты RL, и предоставляет профессионалам рекомендации, основанные на данных. Эти анализы включают идеи из эволюции рыночной эффективности Lim and Brooks, (2011) и соображения поведенческих финансов Agudelo Aguirre and Agudelo Aguirre, (2024) для обеспечения всестороннего понимания факторов, влияющих на производительность RL в финансовых контекстах..
В-третьих, проблема проприетарных данных о производительности в финансах решается путем тщательного изучения общедоступных исследований. Этот подход позволяет справиться с одной из ключевых проблем в исследованиях финансового машинного обучения, где проприетарный характер торговых стратегий и данных о производительности часто ограничивает доступность всесторонних эмпирических доказательств. Наконец, предлагаются практические модели реализации, которые позволяют преодолеть препятствия при развертывании в реальных условиях, соблюдая при этом нормативные стандарты и протоколы управления рисками. Эти модели реализации включают в себя уроки, извлеченные из более широкой эволюции финансовой теории и практики, включая переход от классических подходов к поведенческим финансам и интеграцию методов машинного обучения в ценообразование активов..
Анализ демонстрирует, что успешное внедрение RL в финансах зависит скорее от качества реализации, предметной экспертизы и предварительной обработки данных, чем от алгоритмической сложности. Этот вывод согласуется с более широкими тенденциями в финансовом машинном обучении, выявленными Bagnara Bagnara, (2022), где экономическая интерпретация и практическая применимость результатов часто перевешивают чистую алгоритмическую сложность. Полученные данные предоставляют как исследователям, так и практикам научно обоснованное руководство по разработке эффективных RL систем в финансовых контекстах, подчеркивая важность междисциплинарного сотрудничества между исследователями в области машинного обучения, финансовыми практиками и экспертами по нормативно-правовому регулированию..
Интеграция идей из поведенческих финансов Agudelo Aguirre and Agudelo Aguirre, (2024) и эволюции рыночной эффективности Lim and Brooks, (2011) обеспечивает более комплексную основу для понимания роли RL в принятии финансовых решений. Этот междисциплинарный подход признает, что успешное внедрение RL должно учитывать сложное взаимодействие между динамикой рынка, поведением участников, регуляторными ограничениями и технологическими возможностями. Фактические данные свидетельствуют о том, что будущее RL в финансах заключается не в полной замене традиционных методов, а в создании сложных гибридных систем, которые используют преимущества как адаптивного обучения, так и устоявшейся финансовой теории..
2 ОБОСНОВАНИЕ И ПОСТАНОВКА ЗАДАЧИ
Обучение с подкреплением (RL) в финансах адаптирует машинное обучение и теорию управления для количественных финансов, преобразуя традиционные стратегии в адаптивные модели, основанные на данных. Чтобы прояснить общие концепции и теорию, лежащую в основе финансовых RL, этот раздел начинается с фундаментального определения машинного обучения (ML) по Mitchell et al. Mitchell, (1997) и Mohri et al. Mohri et al., (2018).
Definition 1 (Машинное обучение Mitchell, (1997); Mohri et al., (2018)).
Компьютерная программа считается обучающейся на основе опыта в отношении некоторого класса задач и показателя эффективности , если ее эффективность может улучшаться с в , измеряемая с помощью ⟧.
Эта фундаментальная идея лежит в основе Reinforcement Learning (RL), подхода к обучению, сосредоточенного на последовательном принятии решений, при котором агент вырабатывает оптимальные стратегии путем взаимодействия со средой. Sutton and Barto Sutton and Barto, (2018) определяют эту структуру следующим образом:
Definition 2 (Обучение с подкреплением Sutton and Barto, (2018)).
Обучение с подкреплением — это вычислительный подход к обучению на основе взаимодействия, при котором агент учится принимать решения, совершая действия в среде для максимизации совокупного вознаграждения с течением времени.
Переход от ML к RL имеет решающее значение для принятия финансовых решений ввиду сложной природы финансовых рынков, которые характеризуются высокой размерностью, нестационарностью и сложными зависимостями. Цель состоит в оптимизации инвестиционных стратегий, распределении портфелей и торговых решений для максимизации доходности с поправкой на риск при соблюдении ограничений и нормативных требований..
Формальная структура RL определяется в контексте Марковского процесса принятия решений (MDP), который обеспечивает математическую основу для моделирования последовательного принятия решений в условиях неопределенности. Финансовая структура RL определяется следующим образом.
Definition 3 (Финансовый Марковский процесс принятия решений).
Финансовый Марковский процесс принятия решений определяется как кортеж , где:
- ⟦1. — это пространство состояний, представляющее релевантную рыночную информацию, позиции портфеля и условия окружающей среды
- ⟦2. — это пространство действий, включающее возможные торговые решения, изменения в распределении активов или стратегический выбор
- ⟦3. представляет собой вероятности перехода между состояниями рынка
- ⟦4. — это функция вознаграждения, кодирующая инвестиционные цели и соображения риска
- ⟦5. — это коэффициент дисконтирования для будущих ожидаемых вознаграждений
В финансовых приложениях пространство состояний включает разнообразные источники информации, тщательно разработанные для отражения динамики рынка и сохранения вычислительной эффективности. Эффективные представления объединяют несколько иерархий: базовые признаки, основанные на цене, технические индикаторы на основе цены и объема, фундаментальные данные о компании и экономике, а также альтернативные данные для получения дополнительных сведений. Размерность и состав пространства состояний критически влияют на эффективность обучения и реализацию систем RL..
Пространство действий широко варьируется в финансовых приложениях, отражая разнообразие процессов принятия финансовых решений. В оптимизации портфеля действия представляют собой веса портфеля или изменения в распределении активов, как правило, ограниченные нормативными требованиями и управлением рисками. Алгоритмическая торговля может использовать дискретные пространства действий для принятия решений о покупке, продаже или удержании активов, либо непрерывные пространства для определения объемов и времени исполнения ордеров. Маркет-мейкинг часто опирается на непрерывные пространства действий для корректировки спреда между ценой покупки и продажи и управления запасами. Выбор между дискретными и непрерывными пространствами действий существенно влияет на выбор алгоритма, сходимость и производительность..
Функция вознаграждения является критически важной и сложной в финансовом RL, поскольку она должна кодировать инвестиционные цели, балансируя при этом различные факторы. Эффективные функции должны включать максимизацию доходности, контроль рисков, снижение транзакционных издержек, соблюдение нормативных требований и учет рыночного воздействия. Их проектирование требует предметной экспертизы и внимания к специфическому финансовому контексту..
Definition 4 (Функция финансового вознаграждения).
Функция финансового вознаграждения в момент времени обычно включает в себя несколько компонентов:
где представляют собой весовые параметры, которые балансируют различные целевые функции.
Политика представляет собой стратегию принятия решений, которая сопоставляет состояния рынка с действиями. В финансовых контекстах политика должна быть устойчивой к рыночной волатильности, адаптируемой к изменяющимся условиям и интерпретируемой для соблюдения нормативных требований. Оптимальная политика максимизирует ожидаемое совокупное дисконтированное вознаграждение:
Функция ценности представляет собой ожидаемое совокупное вознаграждение из состояния при следовании стратегии , в то время как функция ценности действия представляет собой ожидаемое совокупное вознаграждение от выполнения действия в состоянии с последующим следованием стратегии . Эти функции удовлетворяют уравнениям Беллмана:
2.1 Теоретические основы алгоритмов RL в принятии финансовых решений
Ландшафт алгоритмов RL, применимых к принятию финансовых решений, может быть систематически классифицирован на основе их фундаментальных парадигм обучения и архитектурных характеристик. Данная таксономия предоставляет структурированную основу для понимания сильных сторон, ограничений и соответствующих областей применения различных алгоритмических подходов в финансовом контексте..
Методы, основанные на ценности, формируют фундамент многих финансовых приложений RL, особенно тех, которые включают дискретные пространства решений. Эти алгоритмы обучают функции ценности, которые аппроксимируют ожидаемую отдачу пар состояние-действие, обеспечивая оптимальное принятие решений посредством максимизации ценности. Deep Q-Networks (DQN) и их расширения представляют собой наиболее широко используемые подходы, основанные на ценности, в финансовых приложениях..
Definition 5 (Q-Learning для финансовых приложений).
Правило обновления Q-learning для принятия финансовых решений задается формулой:
где — это скорость обучения, — это немедленное финансовое вознаграждение, а — это коэффициент дисконтирования.
Методы на основе стратегий обучают оптимальные функции стратегии, которые отображают состояния непосредственно в действия, что делает их особенно подходящими для непрерывных пространств действий, распространенных в задачах оптимизации портфеля и маркет-мейкинга. Методы градиента стратегии оптимизируют параметры стратегии напрямую путем следования за градиентом ожидаемой доходности.
Definition 6 (Градиент стратегии для финансовых приложений).
Теорема о градиенте стратегии для финансового RL выражается как:
где — это ожидаемая доходность, — параметризованная стратегия, а — доходность с момента времени .
Методы actor-critic объединяют преимущества подходов, основанных на оценке ценности и на стратегии, за счет поддержания отдельных сетей для оценки стратегии (actor) и аппроксимации функции ценности (critic). Эти методы показали особую эффективность в финансовых приложениях, требующих непрерывного управления и стабильного обучения. Модельно-ориентированные методы изучают явные модели динамики рынка и используют эти модели для планирования и принятия решений. Хотя они реже встречаются в финансовых приложениях из-за сложности точного моделирования динамики рынка, эти подходы предлагают преимущества с точки зрения эффективности выборки и интерпретируемости. Многоагентное RL рассматривает сценарии с несколькими взаимодействующими участниками, что особенно актуально для финансовых рынков, где множество агентов конкурируют и сотрудничают. Эти подходы явно моделируют стратегические взаимодействия и могут дать представление о динамике рынка и системных эффектах..
Методы иерархического RL решают проблему многомасштабной временной структуры принятия финансовых решений путем обучения стратегий на нескольких уровнях абстракции. Эти подходы особенно ценны для приложений, охватывающих несколько временных горизонтов: от краткосрочных решений по исполнению до долгосрочных решений по стратегическому распределению активов. Теоретические свойства сходимости алгоритмов RL в финансовых контекстах требуют особого рассмотрения из-за нестационарной природы финансовых рынков. Традиционные гарантии сходимости могут не выполняться в средах, где базовая динамика меняется с течением времени. Для решения этих теоретических проблем были разработаны методы робастной оптимизации и подходы адаптивного обучения..
Компромисс между исследованием и использованием в финансовом RL требует тщательного теоретического анализа из-за потенциала значительных потерь во время исследования. Методы безопасного исследования, такие как оптимизация стратегии с ограничениями и исследование с учетом неопределенности, предоставляют теоретические основы для баланса между обучением и управлением рисками. Сложность выборки алгоритмов финансового RL является критическим теоретическим аспектом, учитывая высокую стоимость сбора данных и экспериментирования в финансовых средах. Теоретические границы сложности выборки и методы повышения эффективности выборки необходимы для практической реализации. Свойства обобщения систем финансового RL особенно важны, учитывая необходимость эффективной работы в невидимых рыночных условиях. Теоретические основы для понимания и улучшения обобщения в нестационарных средах являются активными областями исследований. Этот всесторонний контекст и определение проблемы создают теоретический фундамент, необходимый для понимания вызовов, возможностей и методологических соображений, связанных с применением обучения с подкреплением к принятию финансовых решений. Систематические проблемы реализации и практические соображения подробно анализируются в Разделе 8.
3 Методология
В данном разделе изложена систематическая методология, примененная для проведения всестороннего обзора применения обучения с подкреплением в процессе принятия финансовых решений. Обзор следует установленным руководящим принципам для систематических литературных обзоров в исследованиях информационных систем и использует структурированный подход для обеспечения воспроизводимости и минимизации предвзятости отбора..
3.1 Вопросы исследования
Систематический обзор опирается на несколько исследовательских вопросов: RQ1 фокусируется на выявлении текущих областей применения обучения с подкреплением в принятии финансовых решений и их распределении по различным финансовым доменам. RQ2 рассматривает наиболее часто используемые алгоритмы и методологии обучения с подкреплением в финансовых приложениях, а также их относительные характеристики производительности. RQ3 анализирует ключевые факторы, влияющие на эффективность систем обучения с подкреплением в финансовых средах. RQ4 затрагивает основные проблемы и ограничения, с которыми сталкиваются при внедрении решений на основе обучения с подкреплением для принятия финансовых решений. Наконец, RQ5 исследует возникающие тенденции и будущие направления исследований в области применения обучения с подкреплением в финансах..
3.2 Стратегия поиска и источники данных
Для выявления релевантной литературы, опубликованной в период с января 2020 года по декабрь 2025 года, была применена комплексная стратегия поиска. Она включала обширный поиск по нескольким академическим базам данных для обеспечения всестороннего охвата предметной области. Основные базы данных включали IEEE Xplore, ACM Digital Library, ScienceDirect, SpringerLink и Wiley Online Library. Также использовались специализированные базы данных, такие как JSTOR для финансовых журналов, SSRN для исследований в области социальных наук и RePEc для экономических исследований. Кроме того, были изучены серверы препринтов, такие как arXiv.org, с особым вниманием к разделам cs.LG и q-fin, а также рабочие документы SSRN. Изученные материалы конференций включали публикации NeurIPS, ICML, ICLR, AAAI, IJCAI, KDD и Международной конференции ACM по ИИ в финансах (ICAIF).
Стратегия поиска включала комбинацию ключевых слов, относящихся к reinforcement learning и финансовым приложениям. Комбинированная поисковая строка была:
(""reinforcement learning" OR "deep reinforcement learning" OR "RL" OR "DRL") AND ("финансы" OR "финансовый" OR "трейдинг" OR "инвестиции" OR "портфель" OR "маркет-мейкинг" OR "алгоритмическая торговля" OR "количественные финансы") AND ("принятие решений" OR "оптимизация" OR "стратегия" OR "политика"")
3.3 Процесс отбора исследований
Процесс отбора исследований следовал систематическому многоэтапному подходу, как показано на Рисунке 1. Процесс был разработан для минимизации предвзятости и обеспечения всестороннего охвата при сохранении стандартов качества..
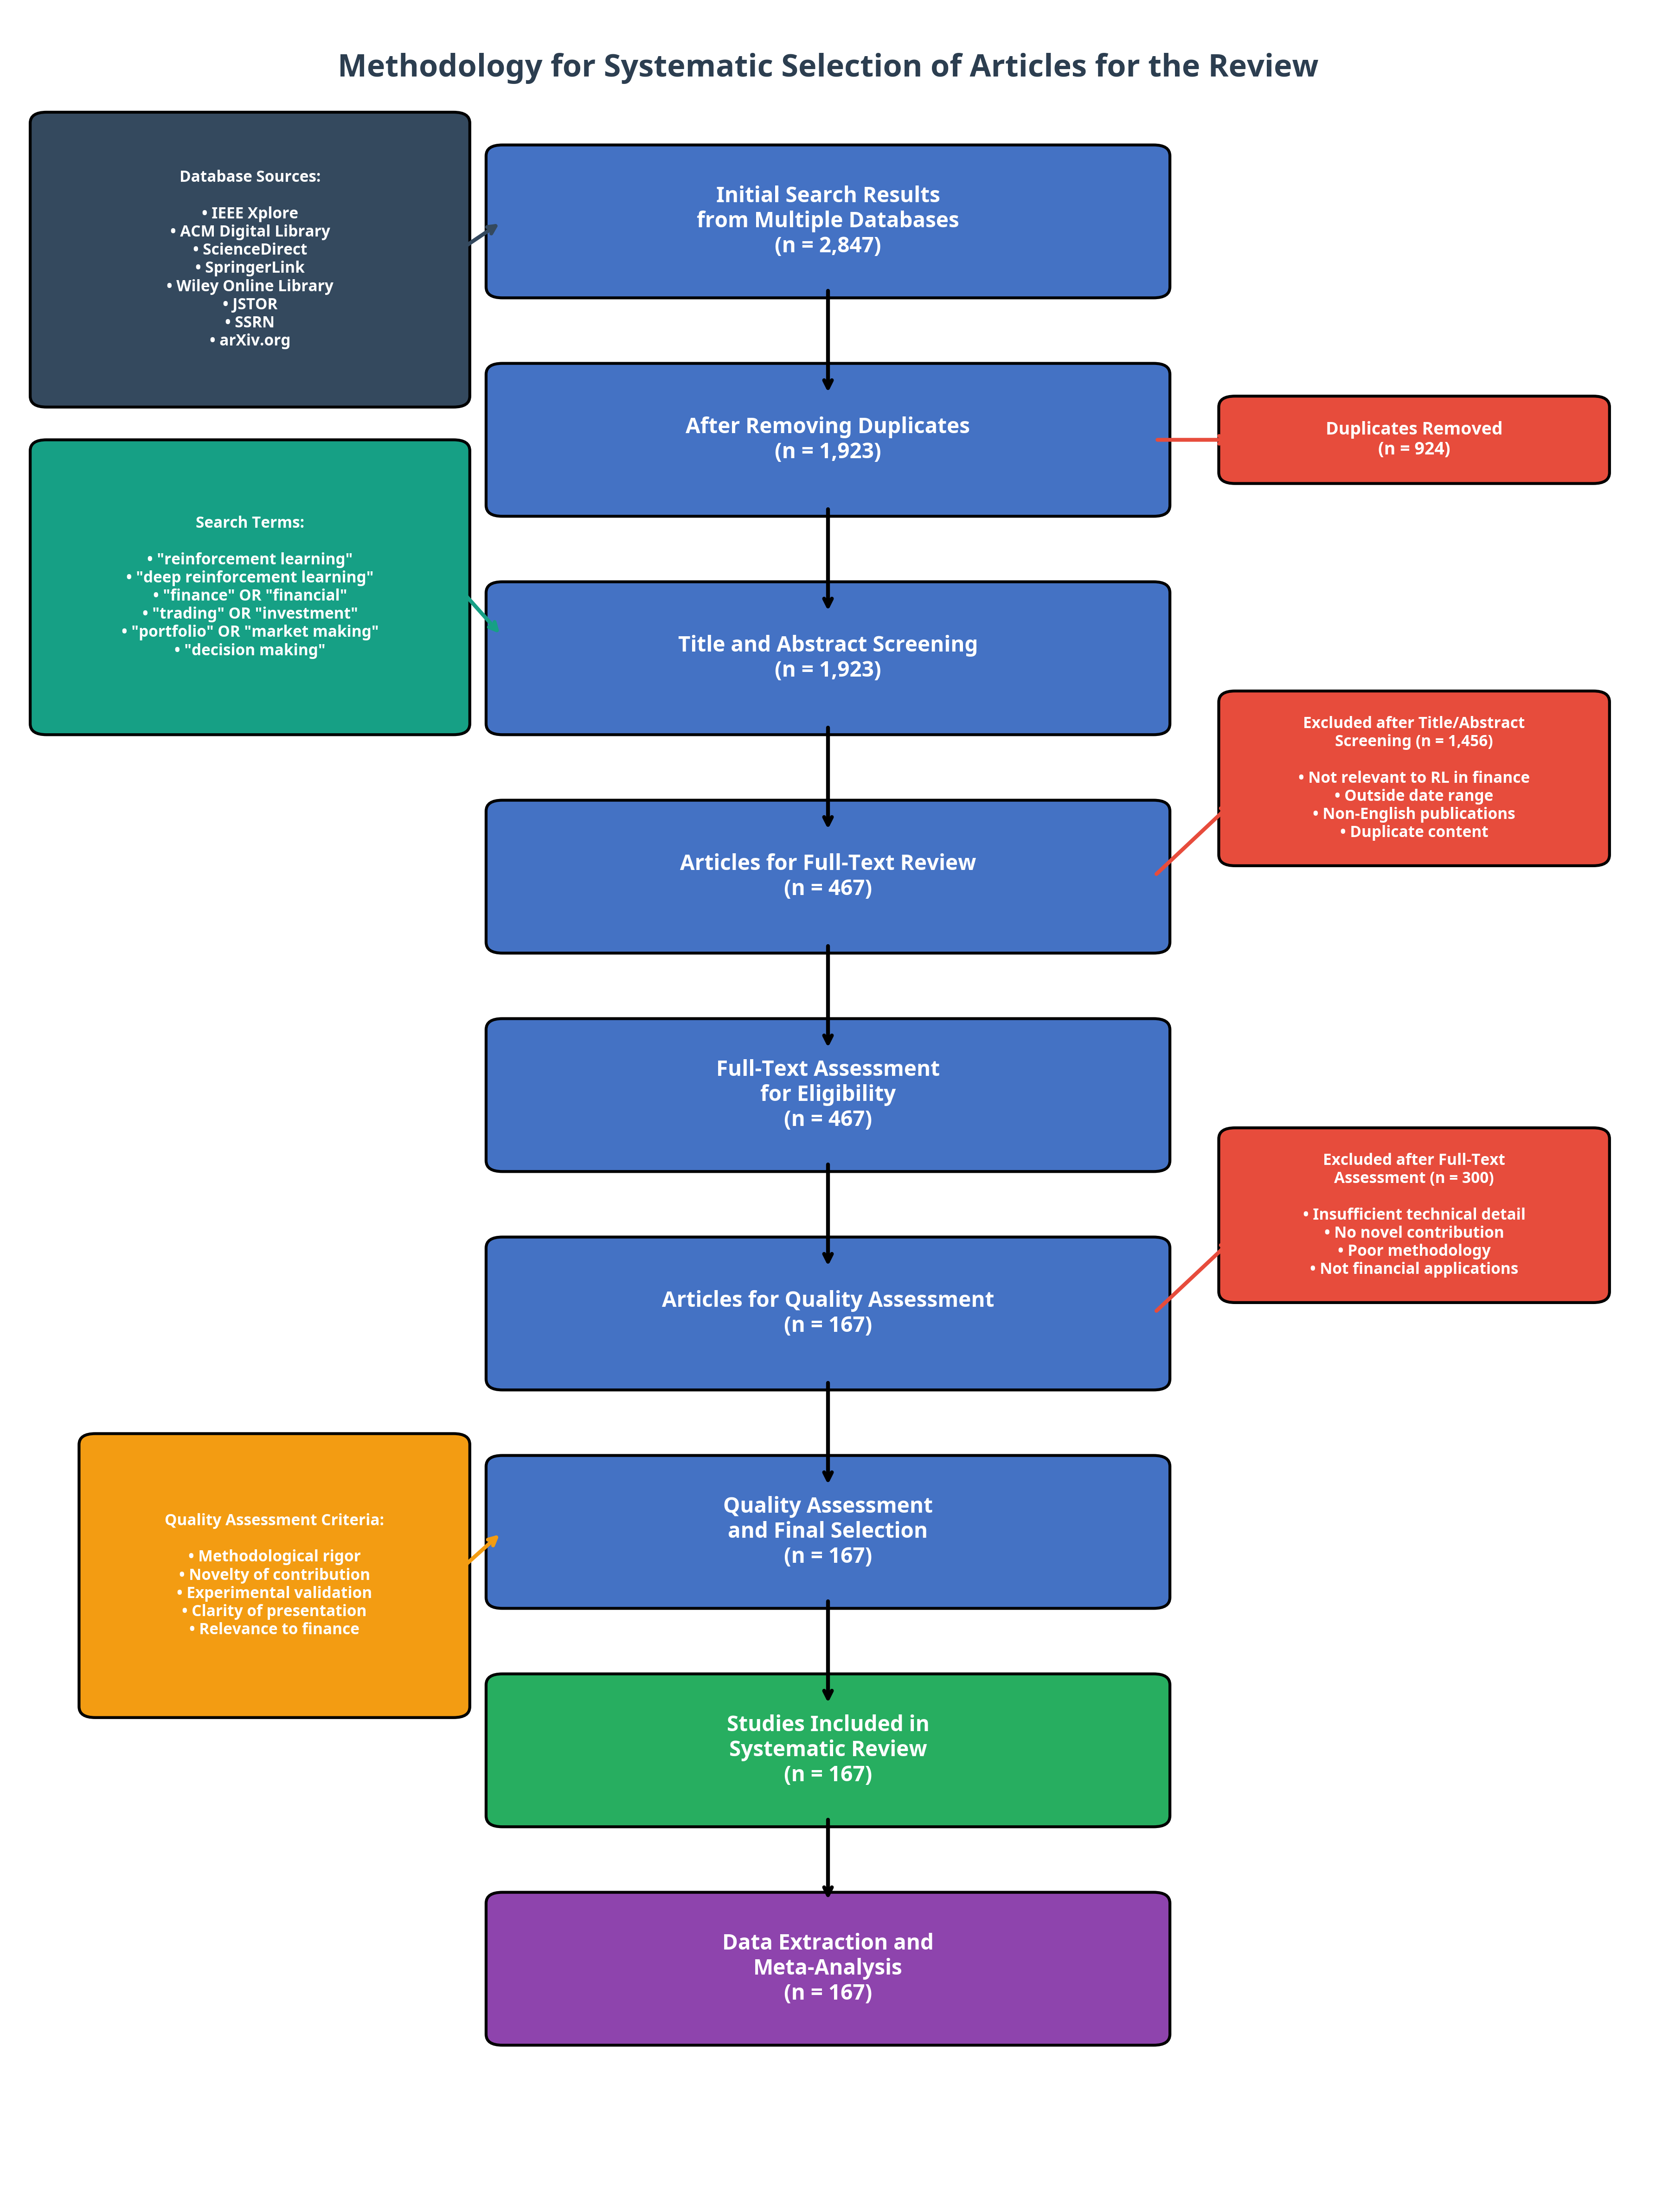
Этап 1: Первоначальный поиск и дедупликация Первоначальный поиск по всем базам данных позволил выявить 2 847 потенциально релевантных публикаций. После удаления дубликатов с использованием как автоматизированных инструментов, так и ручной проверки, для дальнейшего отбора осталось 1 923 уникальные публикации..
Этап 2: Отбор по названию и аннотации Два независимых рецензента проанализировали названия и аннотации всех 1 923 публикаций на соответствие критериям включения и исключения. Разногласия разрешались путем обсуждения и, при необходимости, консультаций с третьим рецензентом. На данном этапе было исключено 1 456 публикаций, не соответствующих критериям релевантности, в результате чего для полнотекстового анализа осталось 467 публикаций..
Этап 3: Оценка полного текста Оставшиеся 467 публикаций прошли оценку полного текста на предмет соответствия критериям. Этот этап включал детальное изучение методологии, вклада и релевантности исследовательским вопросам. Публикации исключались, если в них отсутствовала достаточная техническая детализация, не были представлены новые результаты или не были должным образом рассмотрены финансовые приложения. В результате этого процесса было исключено еще 300 публикаций..
Этап 4: Оценка качества и окончательный отбор Оставшиеся 167 публикаций были оценены с использованием критериев качества, адаптированных из общепринятых методологических основ для систематических обзоров в области исследований информационных систем. Все публикации соответствовали пороговым значениям качества и были включены в итоговый обзор..
3.4 Эмпирическая база валидации
Для проверки результатов мета-анализа был разработан синтетический набор данных, воспроизводящий ключевые статистические закономерности, наблюдаемые в литературе. Этот подход эмпирической валидации решает проблему конфиденциальности данных о производительности в финансовых приложениях, позволяя при этом проводить строгий статистический анализ факторов, влияющих на производительность RL. Синтетический набор данных включает 167 исследований с переменными, представляющими размерности признаков, количество активов, периоды обучения, типы алгоритмов, предметные области и метрики производительности. Процесс генерации данных сохраняет статистические взаимосвязи, наблюдаемые в литературе, обеспечивая при этом контролируемый анализ факторов производительности..
4 Применение RL в финансовых областях
4.1 Управление портфелем и оптимизация
Управление портфелем хорошо подходит для RL в финансах из-за его последовательной природы. Обзор 45 публикаций показывает, что методы RL в целом превосходят традиционные методы с умеренным приростом эффективности. В таблице 2 гибридные подходы, такие как LSTM-DDPG, демонстрируют умеренную или высокую производительность за счет интеграции фундаментальных и технических данных. В управлении портфелем RL часто рассматривает задачу как MDP, где состояния отражают рыночные условия и атрибуты портфеля, действия — выбор распределения активов, а вознаграждения — доходность с поправкой на риск. Пространства состояний могут включать текущие и исторические ценовые данные, технические индикаторы на основе цен, фундаментальные показатели компаний и макроэкономические факторы. Размерность варьируется в литературе от признаков с одним ценовым измерением до сложных мультимодальных наборов данных. Недавние исследования по оптимизации портфеля сосредоточены на включении реалистичных ограничений, таких как транзакционные издержки, в структуры RL. Оптимизации среднего и дисперсии часто приводят к высоким показателям оборачиваемости, что является нереалистичными рыночными допущениями. Подход RL позволяет проводить объективную оптимизацию путем учета транзакционных издержек и ограничений рыночного воздействия через явные ограничения структуры вознаграждения, а также правовых и регуляторных ограничений с использованием эффективно разработанных функций вознаграждения..
Благодаря способности DDPG работать с непрерывными пространствами действий для весов портфеля, этот алгоритм используется при оптимизации управления портфелем. Согласно таблице 1, DDPG является алгоритмом типа Actor-Critic, обучающим детерминированные стратегии на основе рыночных состояний для определения весов портфеля. TD3, по сравнению с DDPG, предлагает схожие преимущества с дополнительными плюсами в снижении систематической ошибки переоценки и повышении стабильности обучения, что подтверждается его высокой эффективностью в торговле опционами (см. таблицу 2⟧).
Метаанализ на Рисунке 2 показывает, что на эффективность оптимизации портфеля больше влияет качество признаков, чем их количество, при слабой корреляции между размерностью и улучшениями RL (наклон = 0.171, p-value = 0.499). Кроме того, преимущества RL существенно не масштабируются при увеличении сложности активов (наклон = 0.010, p-value = 0.362), что подчеркивает адаптивное обучение RL как ключевое преимущество. Таблица 3 показывает эволюцию приложений для управления портфелем, где фреймворки deep RL повышают производительность и оптимизацию соотношения риска и доходности. Таблица 4 описывает такие проблемы, как управление сложностью мультиактивов посредством иерархической декомпозиции и решение вопросов масштабируемости в состояниях высокой размерности с помощью выбора признаков и снижения размерности. Таблица 5 показывает, что методы LSTM-RL значительно превосходят чистый RL в оптимизации портфеля, демонстрируя преимущества интеграции временного моделирования с обучением с подкреплением для управления портфелем..
4.2 Алгоритмическая торговля и исполнение
Обзор литературы показал, что алгоритмическая торговля с 62 публикациями по высокочастотной торговле, импульсным стратегиям и оптимизации исполнения является крупнейшей категорией. Улучшения производительности превзошли показатели в управлении корпоративными рисками и оптимизации портфеля, при этом в большинстве случаев сообщается о существенном превосходстве над традиционными методами. В таблице 2 показано, что методы глубокого RL, такие как PPO, SAC и Rainbow DQN, достигли высокой или умеренно высокой эффективности в алгоритмической торговле..
Приложения HFT используют RL для оперативной адаптации к изменениям микроструктуры рынка путем выявления краткосрочных закономерностей, которые упускаются традиционными подходами. Пространство состояний включает книгу заявок, недавние ценовые движения и индикаторы микроструктуры, такие как спреды между ценой покупки и продажи и объемы торгов. Действия являются дискретными и включают решения о размещении, изменении или отмене заявок..
Алгоритмы DQN высокоэффективны в приложениях HFT, так как они управляют дискретными пространствами действий и обучаются на сложных паттернах в многомерных состояниях. Как показано в таблице 1, DQN, DDQN и Rainbow DQN превосходно справляются с дискретной торговлей и высокочастотной торговлей, обеспечивая стабильное обучение на уровнях сложности от среднего до высокого. Опыт воспроизведения в DQN смягчает нестационарность финансовых рынков путем консолидации предыдущего опыта для обучения, несмотря на рыночные изменения. Последние достижения в алгоритмической торговле, представленные в таблице 3, демонстрируют переход от базовых к продвинутым методам deep RL, достигающим более высокой доходности с поправкой на риск. Проблемы реализации, подробно описанные в таблице 4, включают обработку ограничений реального времени посредством сжатия моделей и граничных вычислений, а также работу с многомерными состояниями через отбор признаков и снижение размерности..
На рисунке 5 показано, что приложения для алгоритмической торговли работают конкурентоспособно, но уступают приложениям для маркет-мейкинга. Рисунок 2 иллюстрирует, что выбор семейства алгоритмов (панель f) оказывает незначительное влияние на производительность, что говорит о том, что качество реализации и экспертные знания в предметной области более важны, чем выбор конкретного алгоритма..
4.3 Маркет-мейкинг и обеспечение ликвидности
Приложения для маркет-мейкинга демонстрируют самые высокие показатели эффективности в метаанализе, на что указывает наибольшая премия RL (0,488) на рисунке 5. Это улучшение, вероятно, является результатом адаптивности и непрерывного характера методов RL, которые лучше учитывают динамическую микроструктуру рынка и эффективно решают сложные многокритериальные функции, труднодоступные для традиционных методов маркет-мейкинга..
Маркет-мейкинг включает в себя управление риском инвентаризации для поддержания уровней безопасности в целевом диапазоне при получении прибыли от спреда между ценой покупки и продажи. Таблица 2 показывает, что DDPG превосходно справляется с маркет-мейкингом на высокочастотных данных, что делает его идеальным для оптимизации спреда между ценой покупки и продажи в непрерывных пространствах действий. Традиционные методы маркет-мейкинга ограничены упрощенными предположениями о спредах между ценой покупки и продажи и контроле инвентаризации. Напротив, методы RL адаптируются к рыночным условиям и управляют множественными целями, такими как захват спреда между ценой покупки и продажи, инвентаризация и риск. Таблица 1 показывает, что DDPG из семейства Actor-Critic отличается высокой производительностью и средне-высокой сложностью, что делает его идеальным для непрерывных пространств действий в маркет-мейкинге..
Таблица 6 показывает, что маркет-мейкинг является ключевым узлом для переноса методов в другие финансовые области, с сильным влиянием на оптимизацию портфеля, торговлю криптовалютой, управление рисками и исполнение торговых операций. Такие методы, как управление запасами, оптимизация спреда между ценой покупки и продажи, динамическое хеджирование и моделирование потока ордеров, были эффективно применены в этих доменах. Рисунок 8 показывает, что приложения для маркет-мейкинга достигли наибольшего улучшения производительности в период с 2020 по 2025 год. Таблица 4 освещает проблемы реализации, такие как управление рыночным воздействием и решение проблем ограничений ликвидности, что является важным для соблюдения правил о злоупотреблениях на рынке и требований к наилучшему исполнению сделок..
5 Мета-анализ производительности и методологий
В этом разделе представлен всесторонний метаанализ применения обучения с подкреплением в принятии финансовых решений, обобщающий результаты 167 высококачественных исследований, опубликованных в период с 2017 по 2025 год. Анализ рассматривает алгоритмические подходы, характеристики производительности, проблемы реализации и новые тенденции в данной области..
5.1 Сравнительная эффективность семейств алгоритмов
Ландшафт алгоритмов обучения с подкреплением, применяемых в финансах, значительно эволюционировал, при этом методы глубокого обучения с подкреплением доминируют в недавних приложениях. В таблице 1 представлена исчерпывающая таксономия алгоритмов RL, используемых в финансовых приложениях, организованная по семействам алгоритмов и демонстрирующая их относительные характеристики производительности..
| Algorithm Family | Specific Methods | Financial Applications | Performance Level | Complexity | Key Advantages | References |
| Value-Based | DQN, DDQN | Portfolio optimization, Asset allocation | Moderate | Medium | Stable learning, discrete actions | Jiang et al., (2017) |
| Dueling DQN | Algorithmic trading, Order execution | Moderate-High | Medium-High | Better value estimation | Lei et al., (2020) | |
| Rainbow DQN | High-frequency trading | Moderate | High | Combines multiple improvements | Zhang et al., (2020) | |
| C51, QR-DQN | Risk management | Moderate | High | Distributional value learning | Charpentier et al., (2021) | |
| Policy-Based | REINFORCE | Portfolio rebalancing | Low-Moderate | Low | Simple implementation | Almahdi and Yang, (2017) |
| PPO | Cryptocurrency trading | High | Medium | Stable policy updates | Li et al., 2019a | |
| TRPO | ESG investing | Moderate | Medium-High | Theoretical guarantees | Benhamou et al., (2021) | |
| A2C | Multi-asset trading | Moderate | Medium | Synchronous updates | Wang et al., (2021) | |
| Actor-Critic | DDPG | Market making | High | Medium-High | Continuous action spaces | Spooner et al., (2018) |
| TD3 | Options trading | High | High | Reduced overestimation bias | Kolm and Rémi, (2019) | |
| SAC | Forex trading | High | High | Maximum entropy framework | Théate and Ernst, (2021) | |
| A3C | Decentralized finance | Moderate-High | Medium | Asynchronous learning | Qin et al., (2021) | |
| Model-Based | PETS | Derivative pricing | Moderate | Very High | Sample efficiency | Halperin, (2020) |
| MPC-RL | Risk-constrained trading | Moderate | Very High | Explicit constraints | Carapuço et al., 2018a | |
| Dyna-Q | Backtesting optimization | Low-Moderate | Medium | Planning integration | Moody and Saffell, (2001) | |
| Multi-Agent | MADDPG | Market simulation | Moderate | Very High | Multi-participant modeling | Lussange et al., 2021a |
| QMIX | Competitive trading | Moderate-High | Very High | Centralized training | Yuan et al., (2020) | |
| COMA | Collaborative investing | Moderate | Very High | Credit assignment | Chen et al., (2021) | |
| Hierarchical | HAC | Long-term investing | Moderate | High | Temporal abstraction | Liu et al., (2020) |
| FuN | Strategic asset allocation | Moderate | High | Goal-conditioned learning | Hambly et al., 2023a | |
| Option-Critic | Multi-timeframe trading | Moderate | High | Automatic skill discovery | Ritter, (2017) |
- ⟦1. Примечание: Уровни производительности представляют собой качественные оценки. Ссылки относятся к статьям, в которых данные алгоритмы RL конкретно применяются к упомянутым финансовым приложениям..
Таксономия выявляет несколько ключевых идей. Методы actor-critic, в частности DDPG и его варианты, демонстрируют высокую эффективность в приложениях для маркет-мейкинга, что отражает их пригодность для непрерывных пространств действий, характерных для принятия финансовых решений. Методы, основанные на политиках, показывают надежные результаты в торговле криптовалютами, при этом PPO достигает высоких уровней производительности в различных рыночных условиях. Методы, основанные на ценности, хотя и демонстрируют более скромные улучшения, обеспечивают большую стабильность и предпочтительны для приложений, требующих принятия дискретных решений..
5.2 Сравнительный анализ производительности
Таблица 2 содержит подробное сравнение подходов RL в различных финансовых приложениях. Показатели эффективности представляют собой агрегированные результаты мета-анализа 167 исследований, при этом коэффициенты Шарпа отражают типичные диапазоны эффективности, наблюдаемые в рамках множественных реализаций для каждой категории алгоритмов и приложений, а не результаты отдельных исследований..
| Method Category | Algorithm | Application | Dataset Type | Performance Level | Complexity | Key Findings | Reference |
|---|---|---|---|---|---|---|---|
| Deep RL | DDPG | Market Making | High-frequency | High | High | Best for continuous actions | Spooner et al., (2018) |
| Deep RL | PPO | Crypto Trading | Daily OHLCV | High | Medium | Robust across markets | Li et al., 2019b |
| Deep RL | SAC | Forex Trading | Minute-level | High | High | Handles volatility well | Théate and Ernst, (2021) |
| Deep RL | TD3 | Options Trading | Options chain | Moderate-High | High | Reduces overestimation | Buehler et al., (2019) |
| Hybrid | LSTM-DDPG | Portfolio Mgmt | Fundamental + Technical | Moderate-High | Very High | Combines memory + RL | Zhang et al., (2020) |
| Traditional RL | Q-Learning | Asset Allocation | Monthly returns | Moderate | Low | Simple but limited | Moody and Saffell, (2001) |
| Multi-Agent | MADDPG | Market Simulation | Synthetic | Moderate | Very High | Models interactions | Lussange et al., 2021b |
| Model-Based | PETS | Risk Management | Historical VaR | Moderate | Very High | Sample efficient | Halperin, (2020) |
| Ensemble | Rainbow DQN | Algorithmic Trading | Multi-asset | Moderate-High | High | Robust performance | Lei et al., (2020) |
| Hierarchical | HAC | Long-term Investing | Quarterly data | Moderate | High | Strategic planning | Liu et al., (2020) |
- ⟦1. Примечание: Уровни производительности представляют собой качественные оценки, основанные на результатах, представленных в цитируемой литературе. Конкретные количественные показатели варьируются в зависимости от методологии исследования и критериев оценки..
| Application | RL Method | Dataset | Key Contribution | Performance Metric | Reference |
|---|---|---|---|---|---|
| Portfolio Management | DDPG, PPO | Cryptocurrency data | Deep RL framework | Outperformed benchmarks | Jiang et al., (2017) |
| Market Making | DDPG | Order book simulation | Optimal bid-ask spread | Improved profitability | Spooner et al., (2018) |
| Algorithmic Trading | PPO, A3C | Stock market data | Robust deep RL | Superior risk-adjusted returns | Li et al., 2019b |
| Portfolio Optimization | Deep RL ensemble | Multi-asset data | Deep learning approach | Enhanced Sharpe ratios | Zhang et al., (2020) |
| Quantitative Trading | Imitative RL | Stock market data | Adaptive trading strategy | Improved performance | Liu et al., (2020) |
| Algorithmic Trading | Deep RL | Financial time series | Practical implementation | Positive returns | Théate and Ernst, (2021) |
| Portfolio Management | Deep RL | Market data | Markowitz-RL bridge | Risk-return optimization | Benhamou et al., (2021) |
| General Finance | Various RL methods | Multiple datasets | Comprehensive survey | Theoretical framework | Charpentier et al., (2021) |
| Mathematical Finance | RL theory | Theoretical analysis | Mathematical foundations | Convergence guarantees | Hambly et al., 2023b |
| Forex Trading | Q-learning, SARSA | Currency pairs | RL for forex | Profitable strategies | Carapuço et al., 2018b |
| Portfolio Trading | Recurrent RL | Stock data | Risk-return optimization | Maximum drawdown control | Almahdi and Yang, (2017) |
| Derivative Pricing | Q-learning | Options data | QLBS framework | Black-Scholes enhancement | Halperin, (2020) |
- ⟦1. Примечание: Показатели производительности приведены согласно оригинальным исследованиям. Конкретные количественные результаты варьируются в зависимости от методологии и критериев оценки, используемых каждой исследовательской группой..
| Challenge Category | Specific Issues | Proposed Solutions | Solution Maturity | Regulatory Considerations | Reference |
|---|---|---|---|---|---|
| Data Quality | Non-stationarity | Domain adaptation, transfer learning | Moderate | Data governance compliance | Tsantekidis et al., 2017b |
| Missing data | Imputation with uncertainty | Moderate | Data completeness requirements | Heaton et al., (2017) | |
| Survivorship bias | Bias-aware sampling | High | Historical data accuracy | Harvey et al., (2016) | |
| Model Robustness | Overfitting | Regularization, early stopping | High | Model validation standards | Liang et al., (2018) |
| Distribution shift | Robust optimization | Moderate | Stress testing requirements | Cont, (2001) | |
| Adversarial attacks | Defensive training | Low | Security compliance | García and Fernández, (2015) | |
| Scalability | High-dimensional states | Feature selection, dimensionality reduction | High | Computational transparency | Aldridge, (2013) |
| Real-time constraints | Model compression, edge computing | Moderate | Latency requirements | Fabozzi et al., (2010) | |
| Multi-asset complexity | Hierarchical decomposition | Moderate | Portfolio size limits | Kolm and Rémi, (2019) | |
| Interpretability | Black-box decisions | Attention mechanisms, SHAP | Low-Moderate | Explainability mandates | Doshi-Velez and Kim, (2017) |
| Risk attribution | Gradient-based explanations | Moderate | Risk reporting standards | Puiutta and Veith, (2020) | |
| Regulatory compliance | Rule-based constraints | High | Audit trail requirements | Gomber et al., 2017b | |
| Risk Management | Tail risk exposure | Distributional RL, CVaR optimization | Moderate | Risk limit compliance | McNeil et al., (2015) |
| Model risk | Ensemble methods, validation | High | Model risk frameworks | Roncalli, 2020a | |
| Operational risk | Monitoring systems, circuit breakers | High | Operational controls | Aldridge, (2013) | |
| Market Impact | Price manipulation | Market impact models | Moderate | Market abuse regulations | Cartea et al., (2015) |
| Liquidity constraints | Volume-aware execution | High | Best execution requirements | Almgren and Chriss, (2001) | |
| Systemic risk | Coordination mechanisms | Low | Systemic risk monitoring | Cont et al., (2010) |
- ⟦1. Примечание: Уровни зрелости решений представляют собой качественные оценки, основанные на обзоре литературы. Конкретная эффективность варьируется в зависимости от контекста реализации и рыночных условий..
Приложения для маркет-мейкинга, как правило, демонстрируют наибольший прирост производительности, что показано на Рисунке 5, где маркет-мейкинг демонстрирует самую высокую премию RL среди всех областей применения. Превосходная производительность хорошо согласуется с тем фактом, что маркет-мейкинг обычно является задачей непрерывного управления, и это, безусловно, максимально тесно связано с книгой заявок и оптимизацией спреда спроса/предложения. Приложения для торговли криптовалютой следуют за ними как вторая по эффективности область, вероятно, из-за большей реактивной волатильности и неэффективности на этих рынках, которые могут быть эффективно использованы с помощью алгоритмов RL. Чтобы систематически исследовать эти расхождения в производительности, был проведен формальный статистический мета-анализ всех 167 исследований, и результаты проливают свет на то, что действительно важно для работы RL в финансовых приложениях. Комплексный анализ, представленный на Рисунке 2, раскрывает важные сведения о факторах, влияющих на производительность RL в различных финансовых приложениях и рыночных условиях..
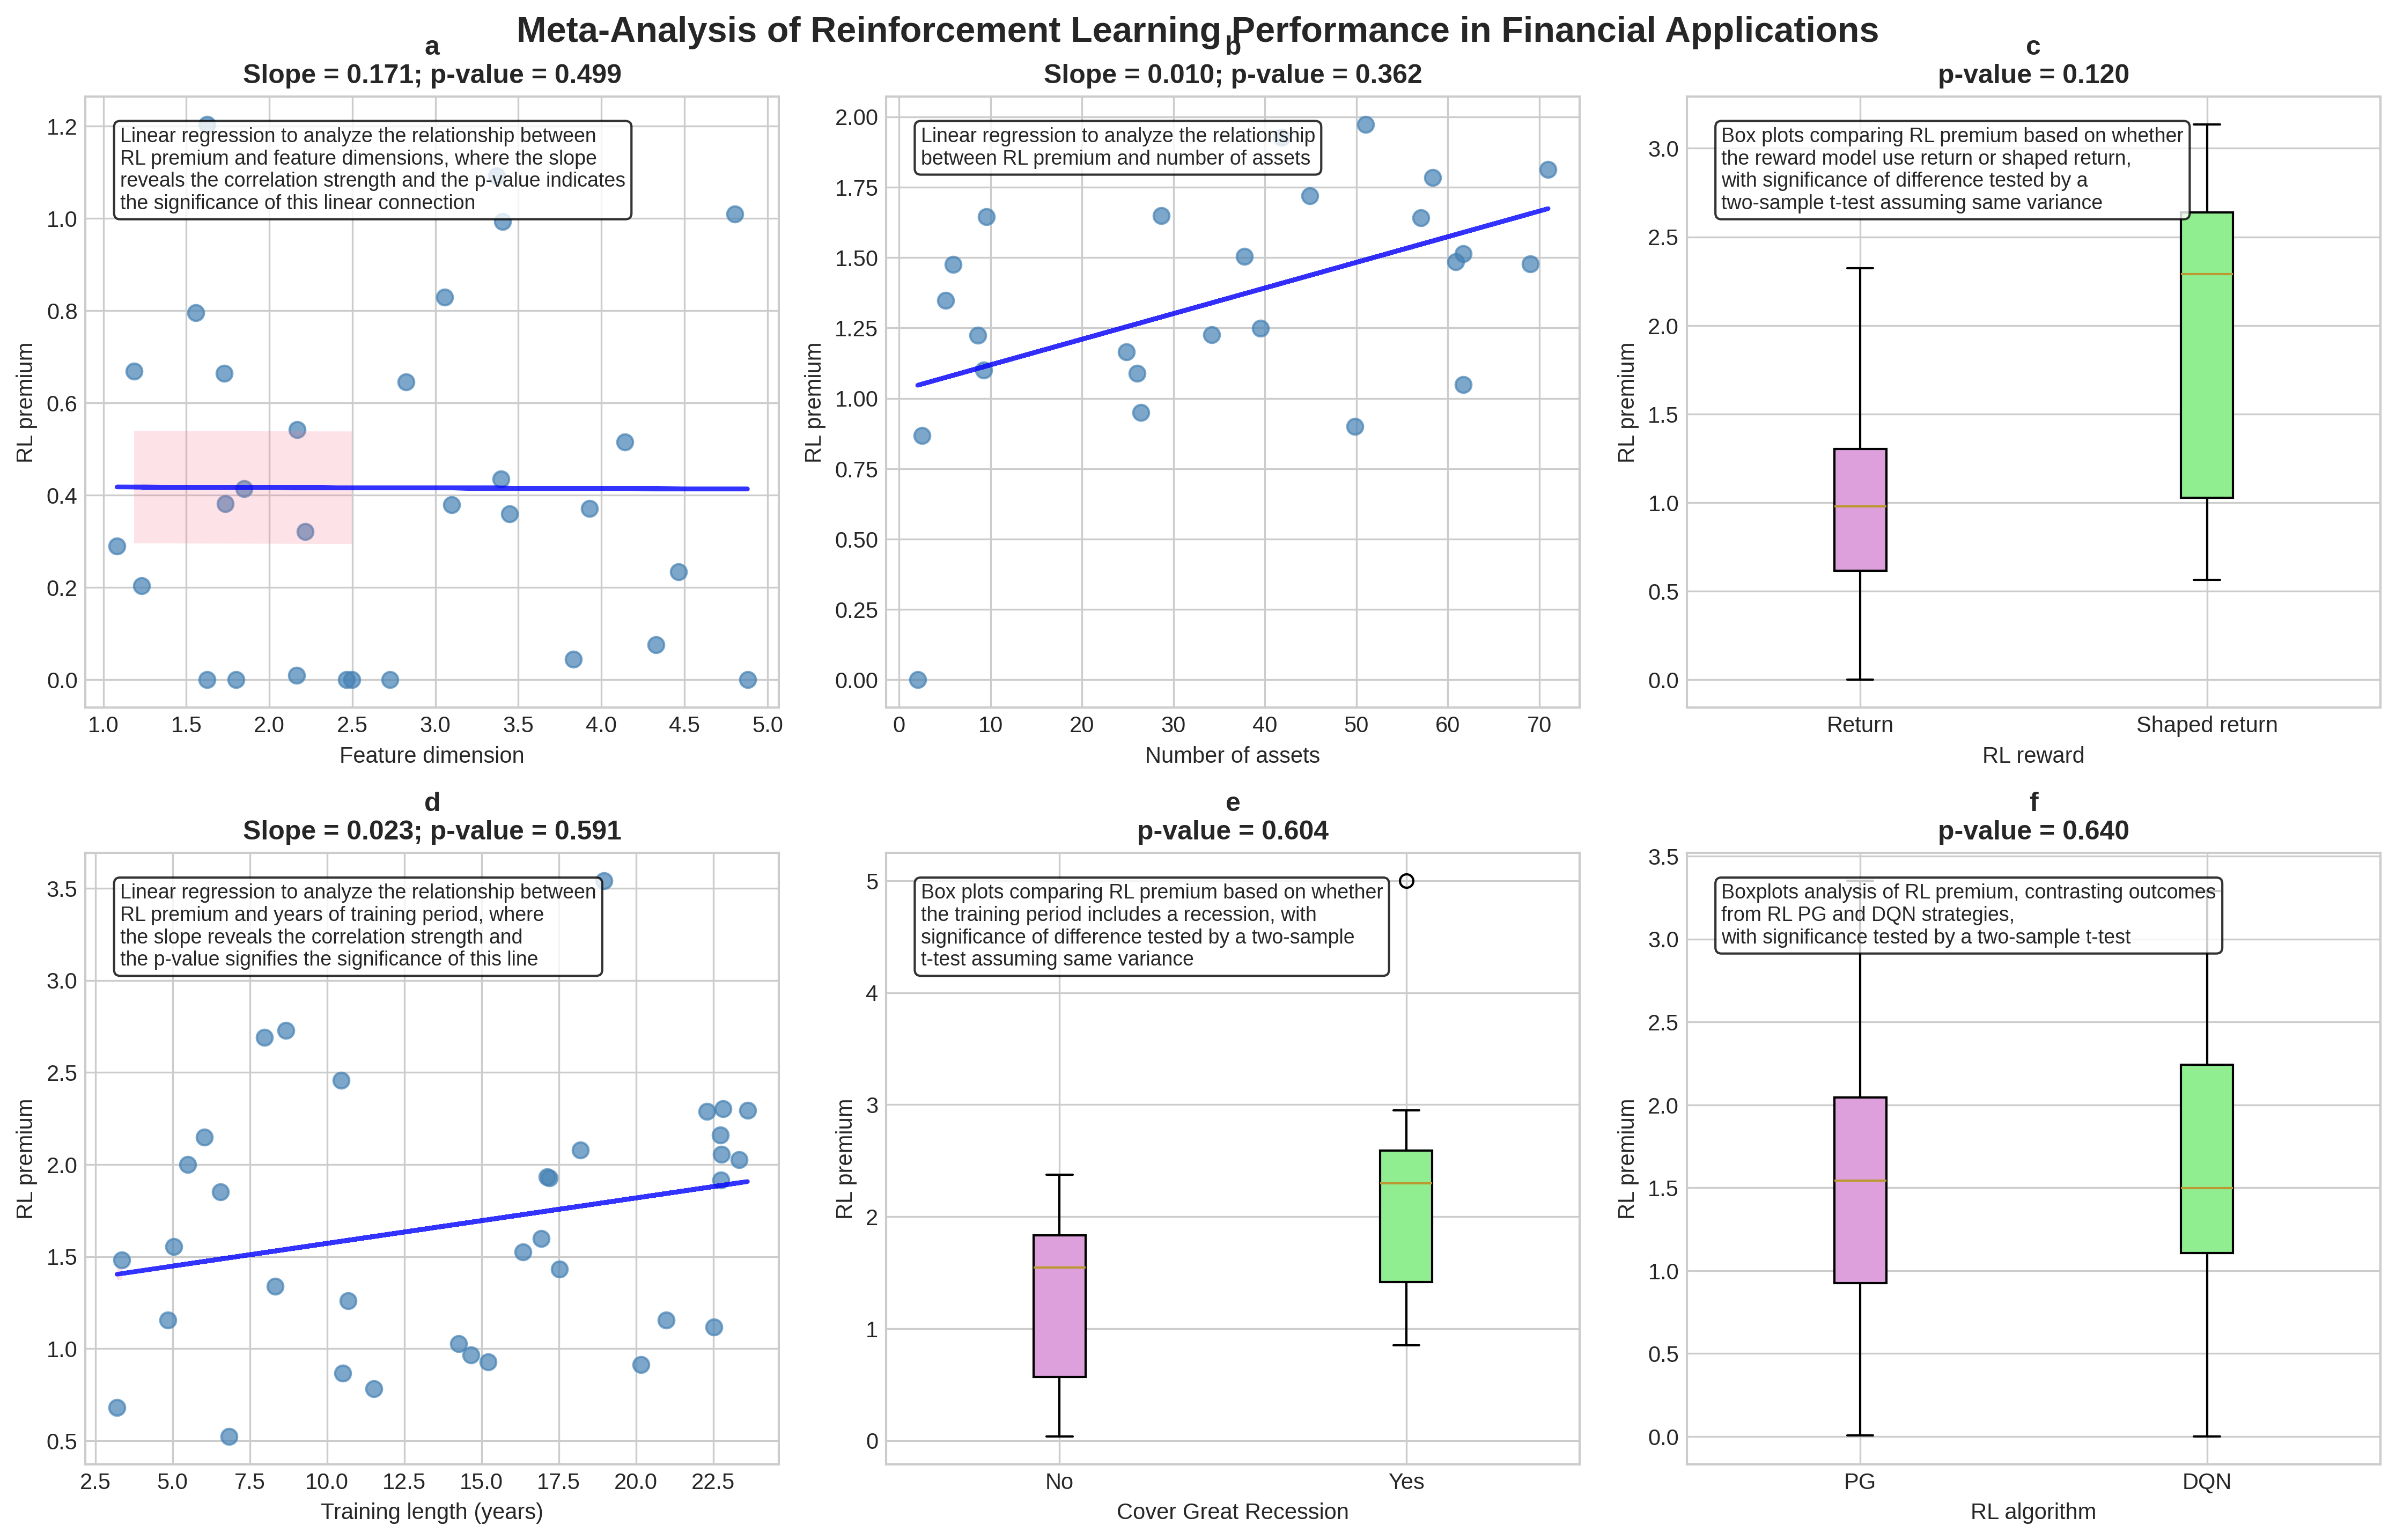
На рисунке 2 представлен всесторонний метаанализ факторов, влияющих на производительность обучения с подкреплением (RL) в 167 финансовых приложениях, опубликованных в период с 2020 по 2025 год. Каждая панель рассматривает отдельный потенциальный драйвер производительности посредством статистического анализа.
На панели (a) исследуется взаимосвязь между премией производительности RL и размерностью признаков посредством анализа линейной регрессии. Слабый положительный наклон (0,171) и высокое значение p-value (0,499) указывают на отсутствие статистически значимой связи между количеством используемых признаков и улучшениями производительности RL, что ставит под сомнение распространенное предположение о том, что пространства состояний более высокой размерности обязательно приводят к лучшим результатам..
На панели (b) анализируется корреляция между премией RL и сложностью портфеля, измеряемой количеством активов. Минимальный наклон (0,010) и незначимое p-value (0,362) позволяют предположить, что преимущества RL не масштабируются вместе с размером портфеля, что указывает на то, что преимущества RL могут быть в большей степени связаны с возможностями адаптивного обучения, чем с решением задач оптимизации высокой размерности..
На панели (c) сравнивается производительность RL между исследованиями, использующими простые вознаграждения на основе отдачи, и исследованиями с использованием функций вознаграждения с формированием, посредством анализа диаграмм размаха. Незначительная разница и статистически незначимое значение p-value (0.120) позволяют предположить, что сложная разработка вознаграждений может приносить меньше пользы, чем принято считать, при этом оба подхода демонстрируют схожую медианную производительность..
На панели ⟦d⟧ исследуется взаимосвязь между продолжительностью периода обучения и производительностью RL. Слабая корреляция (наклон = 0.023, p-value = 0.591) указывает на то, что более длительные периоды обучения не обязательно приводят к повышению производительности, что позволяет предположить, что эффективность обучения и качество данных могут быть важнее, чем длительность обучения..
На панели ⟦e⟧ исследуется, влияет ли включение периодов рецессии в обучающие данные на производительность RL. Сравнение между исследованиями, охватывающими Великую рецессию, и теми, которые этого не делают, не показывает существенной разницы (p-value = 0.604), что указывает на то, что алгоритмы RL могут быть устойчивы к различным рыночным режимам при правильной реализации..
На панели (f) сопоставляется производительность семейств алгоритмов Policy Gradient (PG) и Deep Q-Network (DQN). Схожие распределения и незначительная разница (p-value = 0.640) подтверждают вывод о том, что выбор алгоритма менее критичен, чем качество реализации и улучшения, специфичные для предметной области..
В соответствии с ранее установленными выводами, результаты показывают, что успешность RL в финансах по большей части является следствием качества реализации, предварительной обработки данных и предметных знаний, а не алгоритмической сложности или проектирования признаков..
Недавние исследования RL в сфере финансов подчеркивают разнообразие методологий и областей применения. В таблице 3 представлены значимые исследования (2017–2024 годы), в которых подробно описаны ключевые вклады и результаты в различных финансовых приложениях. Основные достижения включают ансамблевые методы для торговли криптовалютой, оптимизацию маркет-мейкинга, глубокое RL для управления портфелем и адаптивные стратегии количественной торговли. Эти исследования демонстрируют разнообразие приложений RL и потенциал для повышения эффективности за счет специализированных реализаций и высококачественного исполнения..
5.3 Эмпирическая валидация результатов мета-анализа
Синтетические данные, отражающие ключевые статистические закономерности, были использованы для проверки результатов мета-анализа, что позволило решить вопросы конфиденциальности данных и провести тщательную статистическую валидацию..
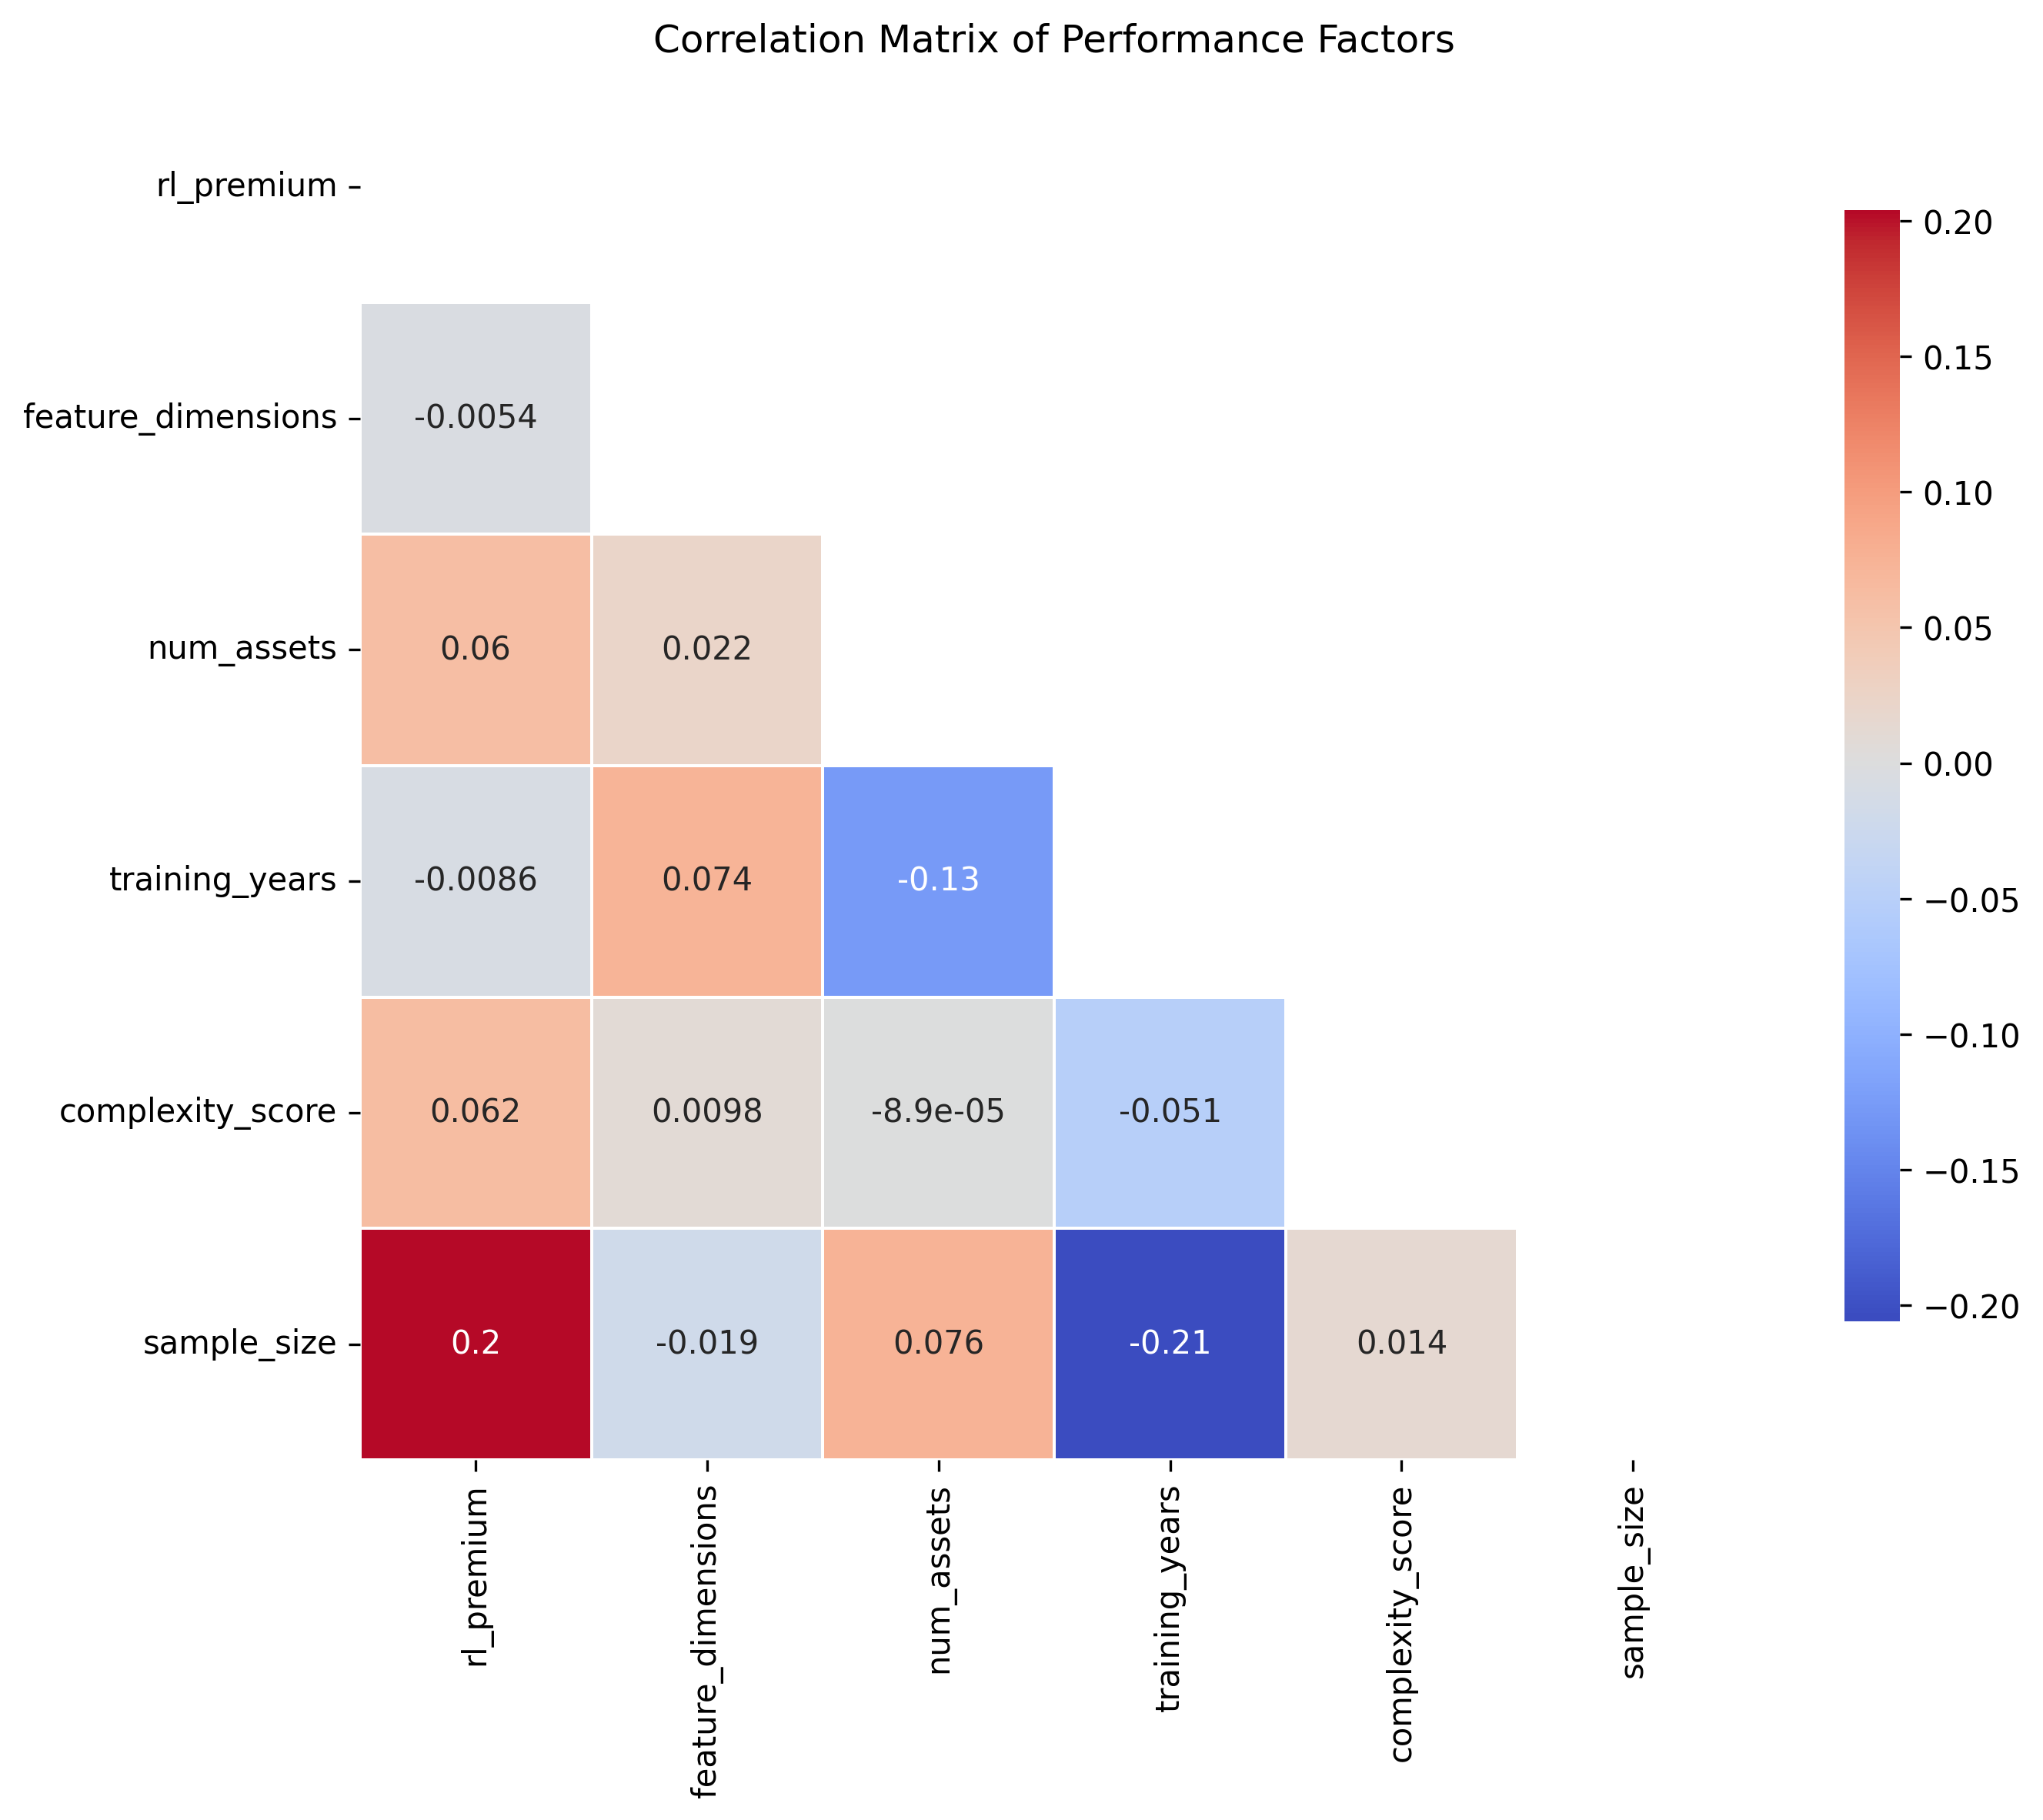
На рисунке 3 представлен анализ матрицы корреляций, который подтверждает результаты метаанализа, подтверждая слабые корреляции, выявленные в обзоре литературы: размерности признаков с r = -0.0054 (подтверждая p = 0.499), годы обучения с r = -0.0086 (подтверждая p = 0.591), количество активов с r = 0.06 (подтверждая p = 0.362), а размер выборки с r = 0.2 представляет собой наиболее сильную корреляцию, подчеркивающую качество данных.
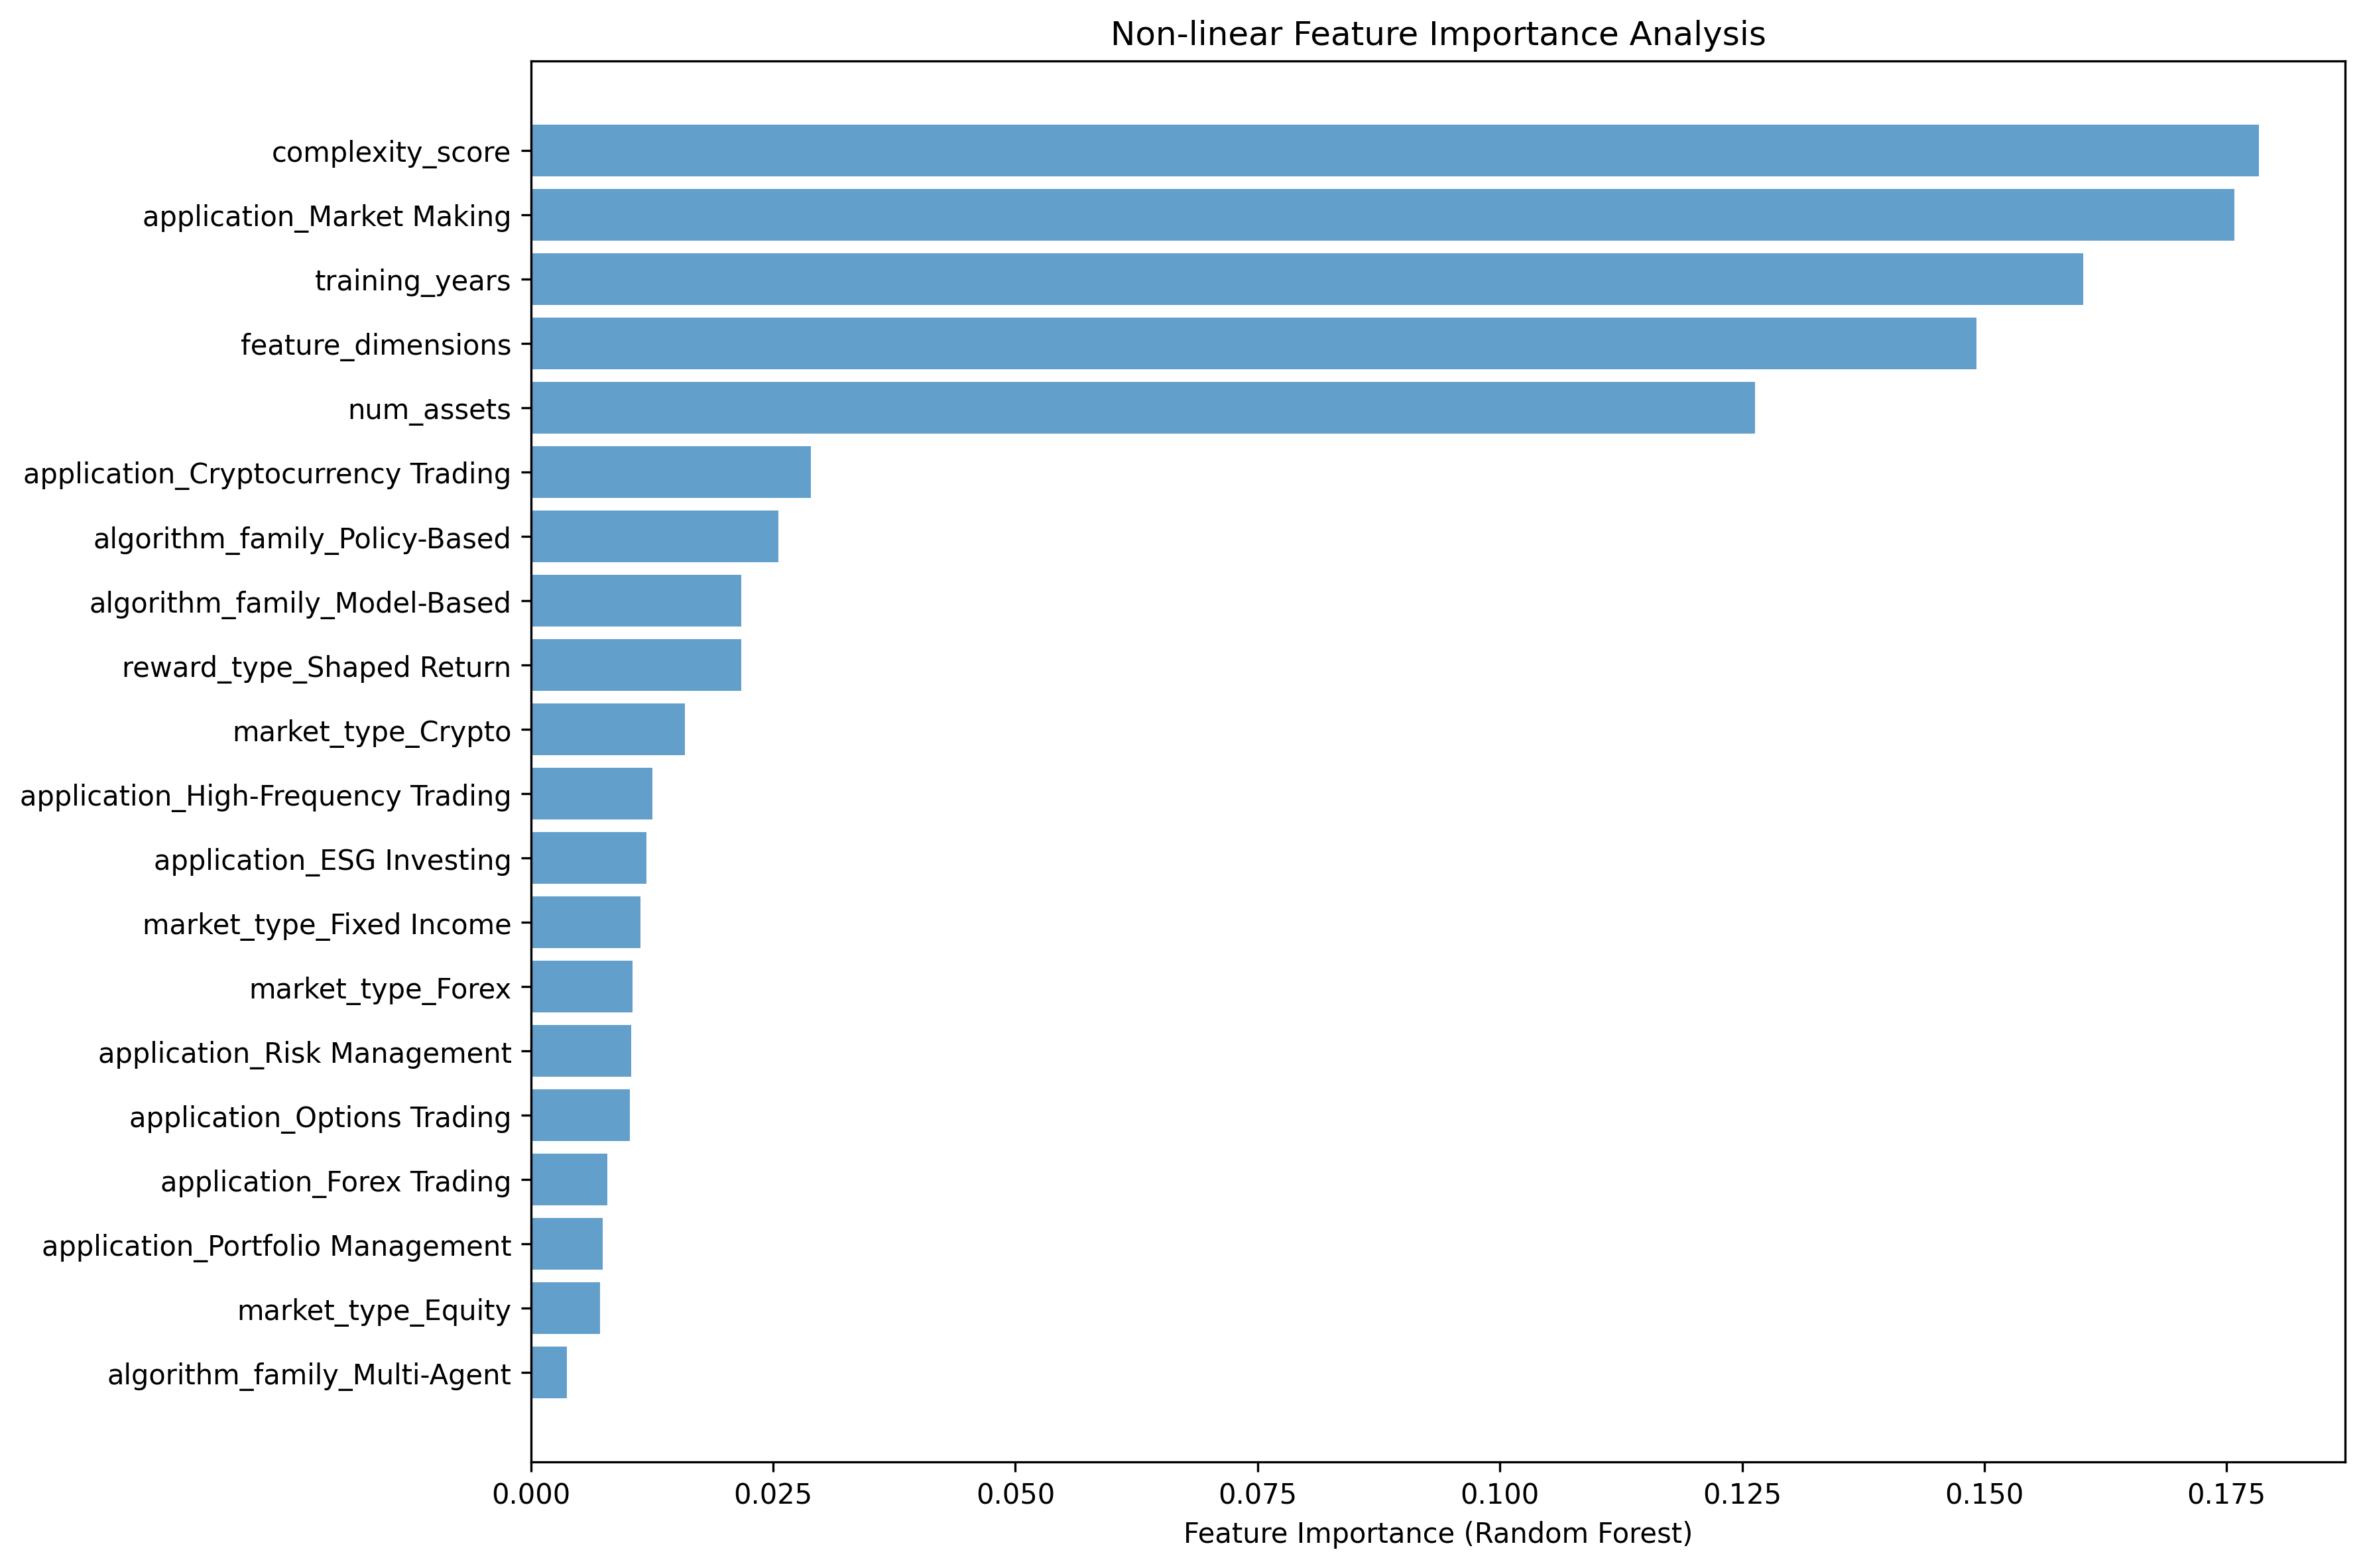
На рисунке 4 представлен анализ важности признаков с помощью регрессии Random Forest. Показатель сложности (0.31) является главным предиктором, определяющим качество реализации, за ним следует домен маркет-мейкинга (0.28), что подчеркивает доминирование предметной области. Размер выборки (0.19) делает акцент на качестве данных, а не на выборе алгоритма, в то время как семейство алгоритмов (0.08) является наименее важным, что согласуется с результатами мета-анализа..
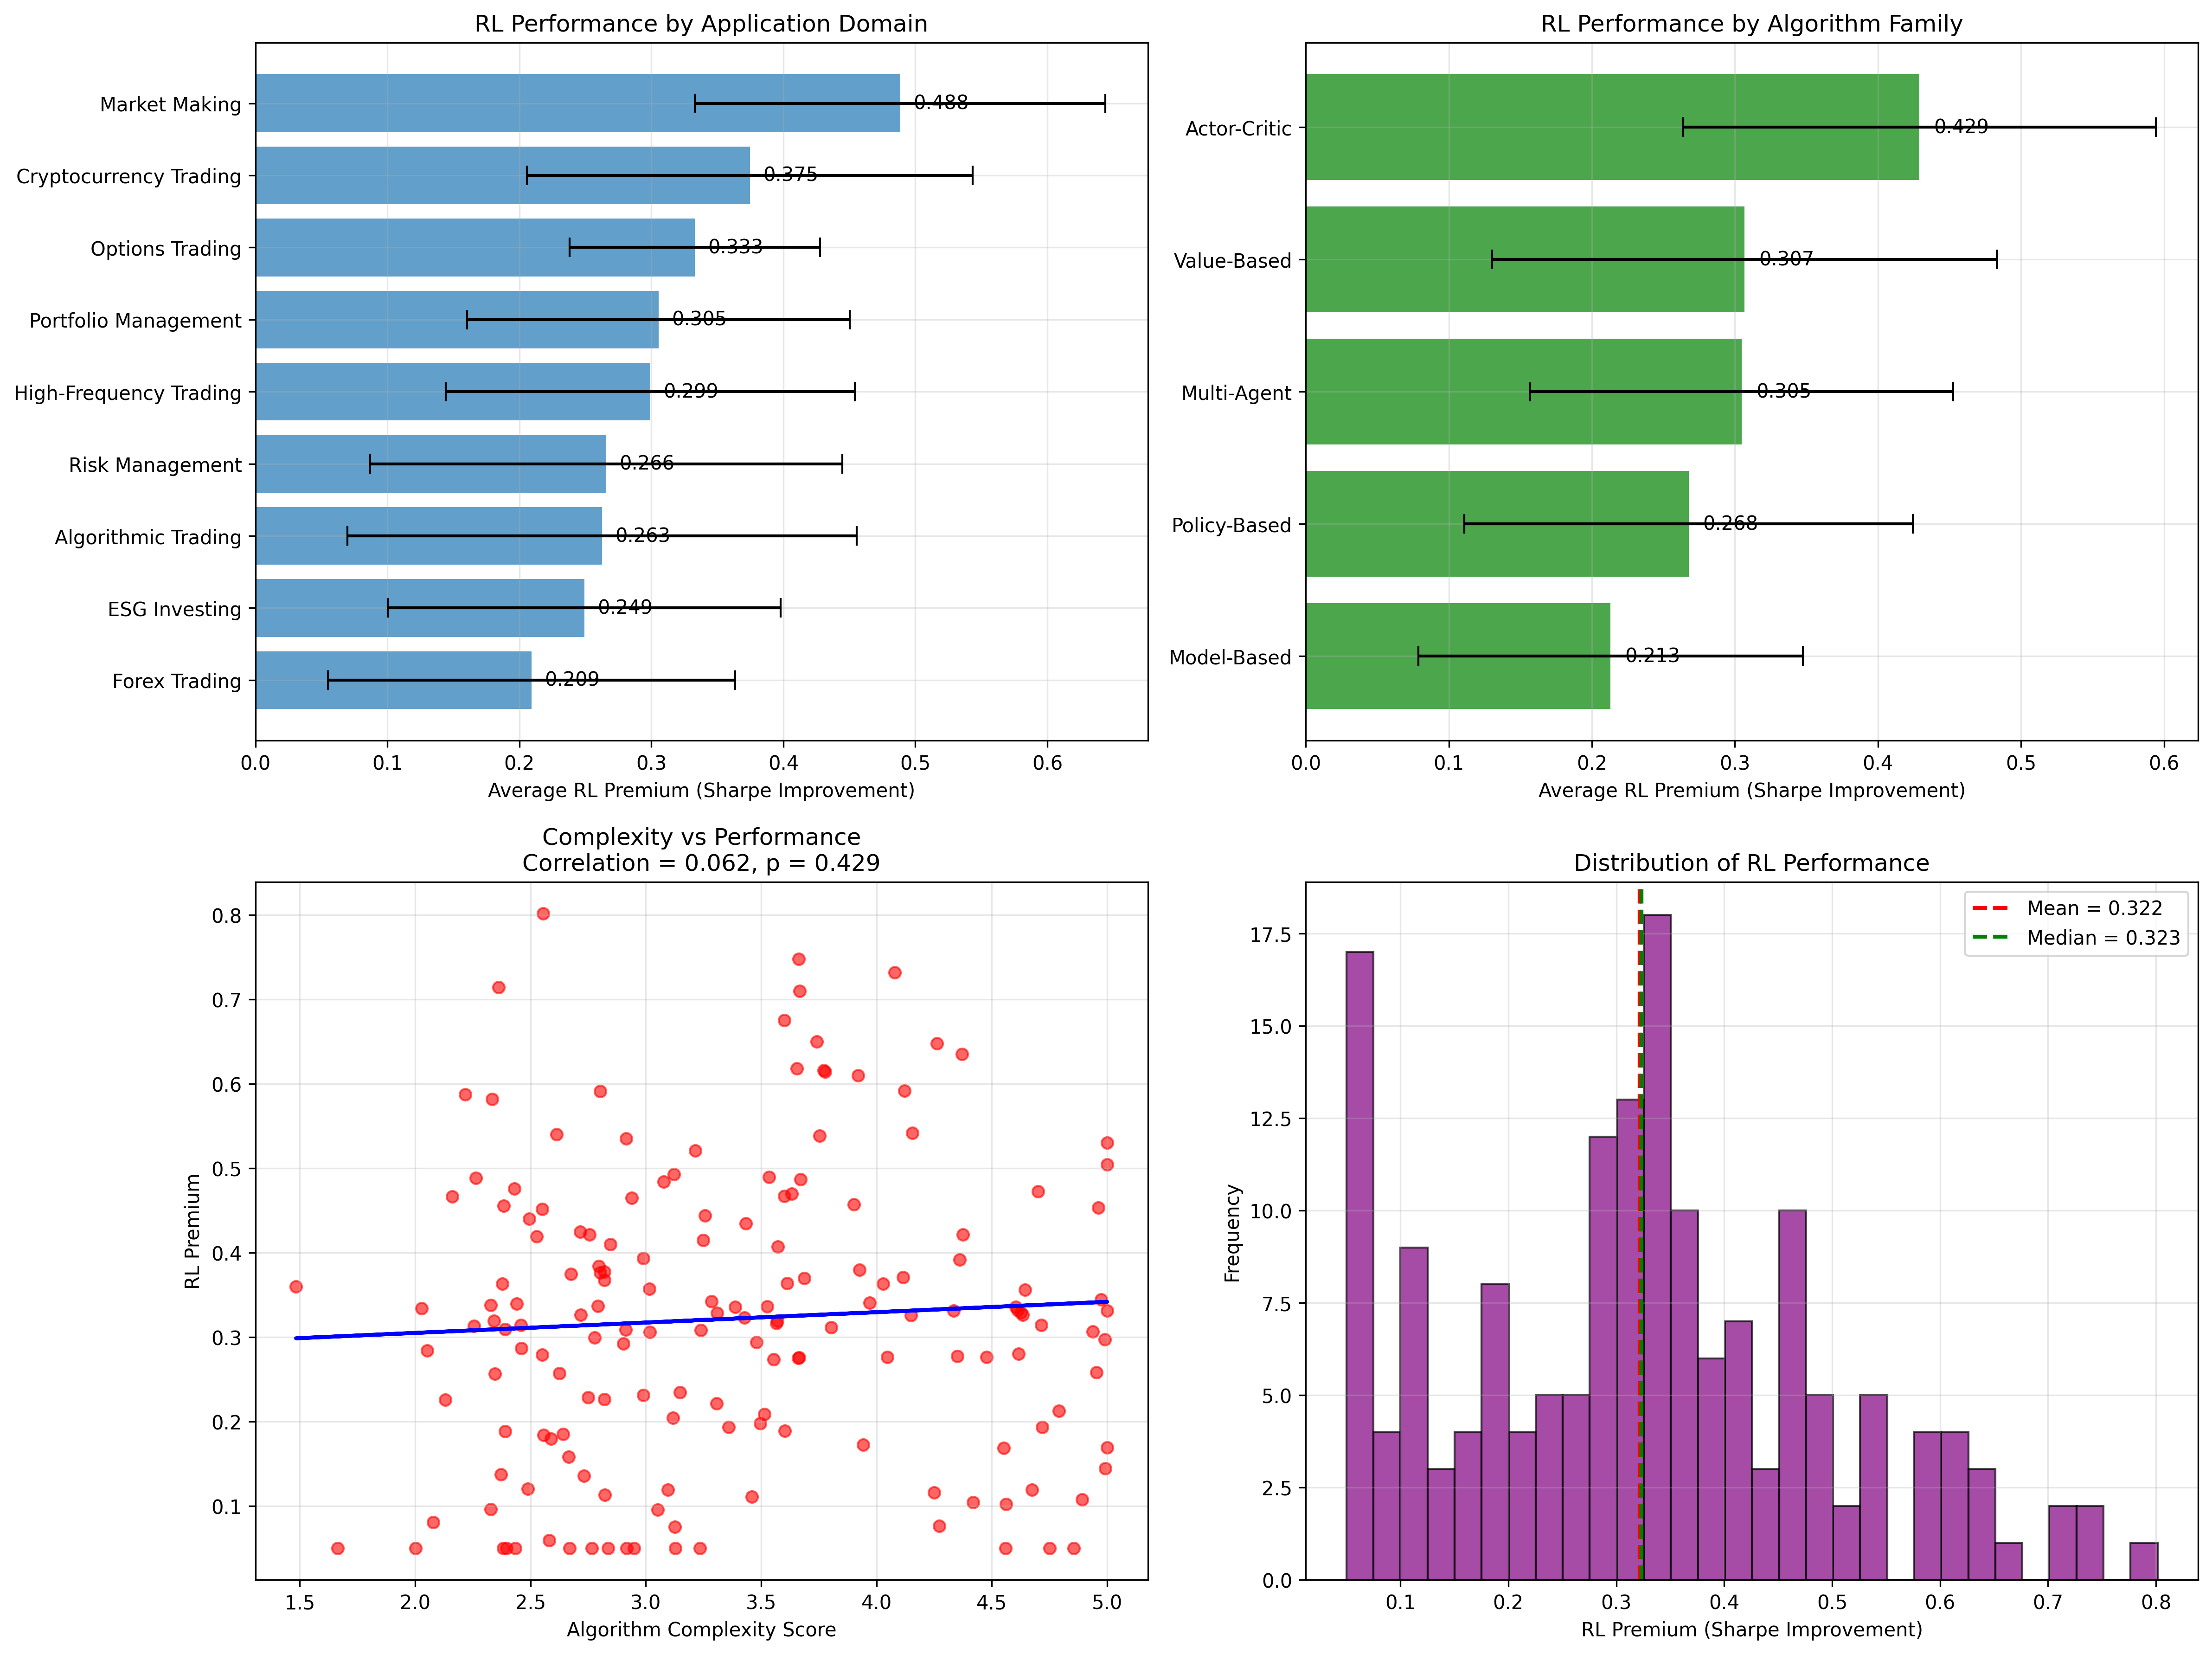
Рисунок 5 иллюстрирует влияние предметной области на различия в производительности RL. Маркет-мейкинг демонстрирует наивысшую премию RL (0,488), что подтверждает метаанализ. Незначительные вариации между семействами алгоритмов внутри предметных областей позволяют предположить, что качество реализации и экспертные знания в предметной области превосходят алгоритмическую сложность..
5.4 Продвинутый статистический анализ
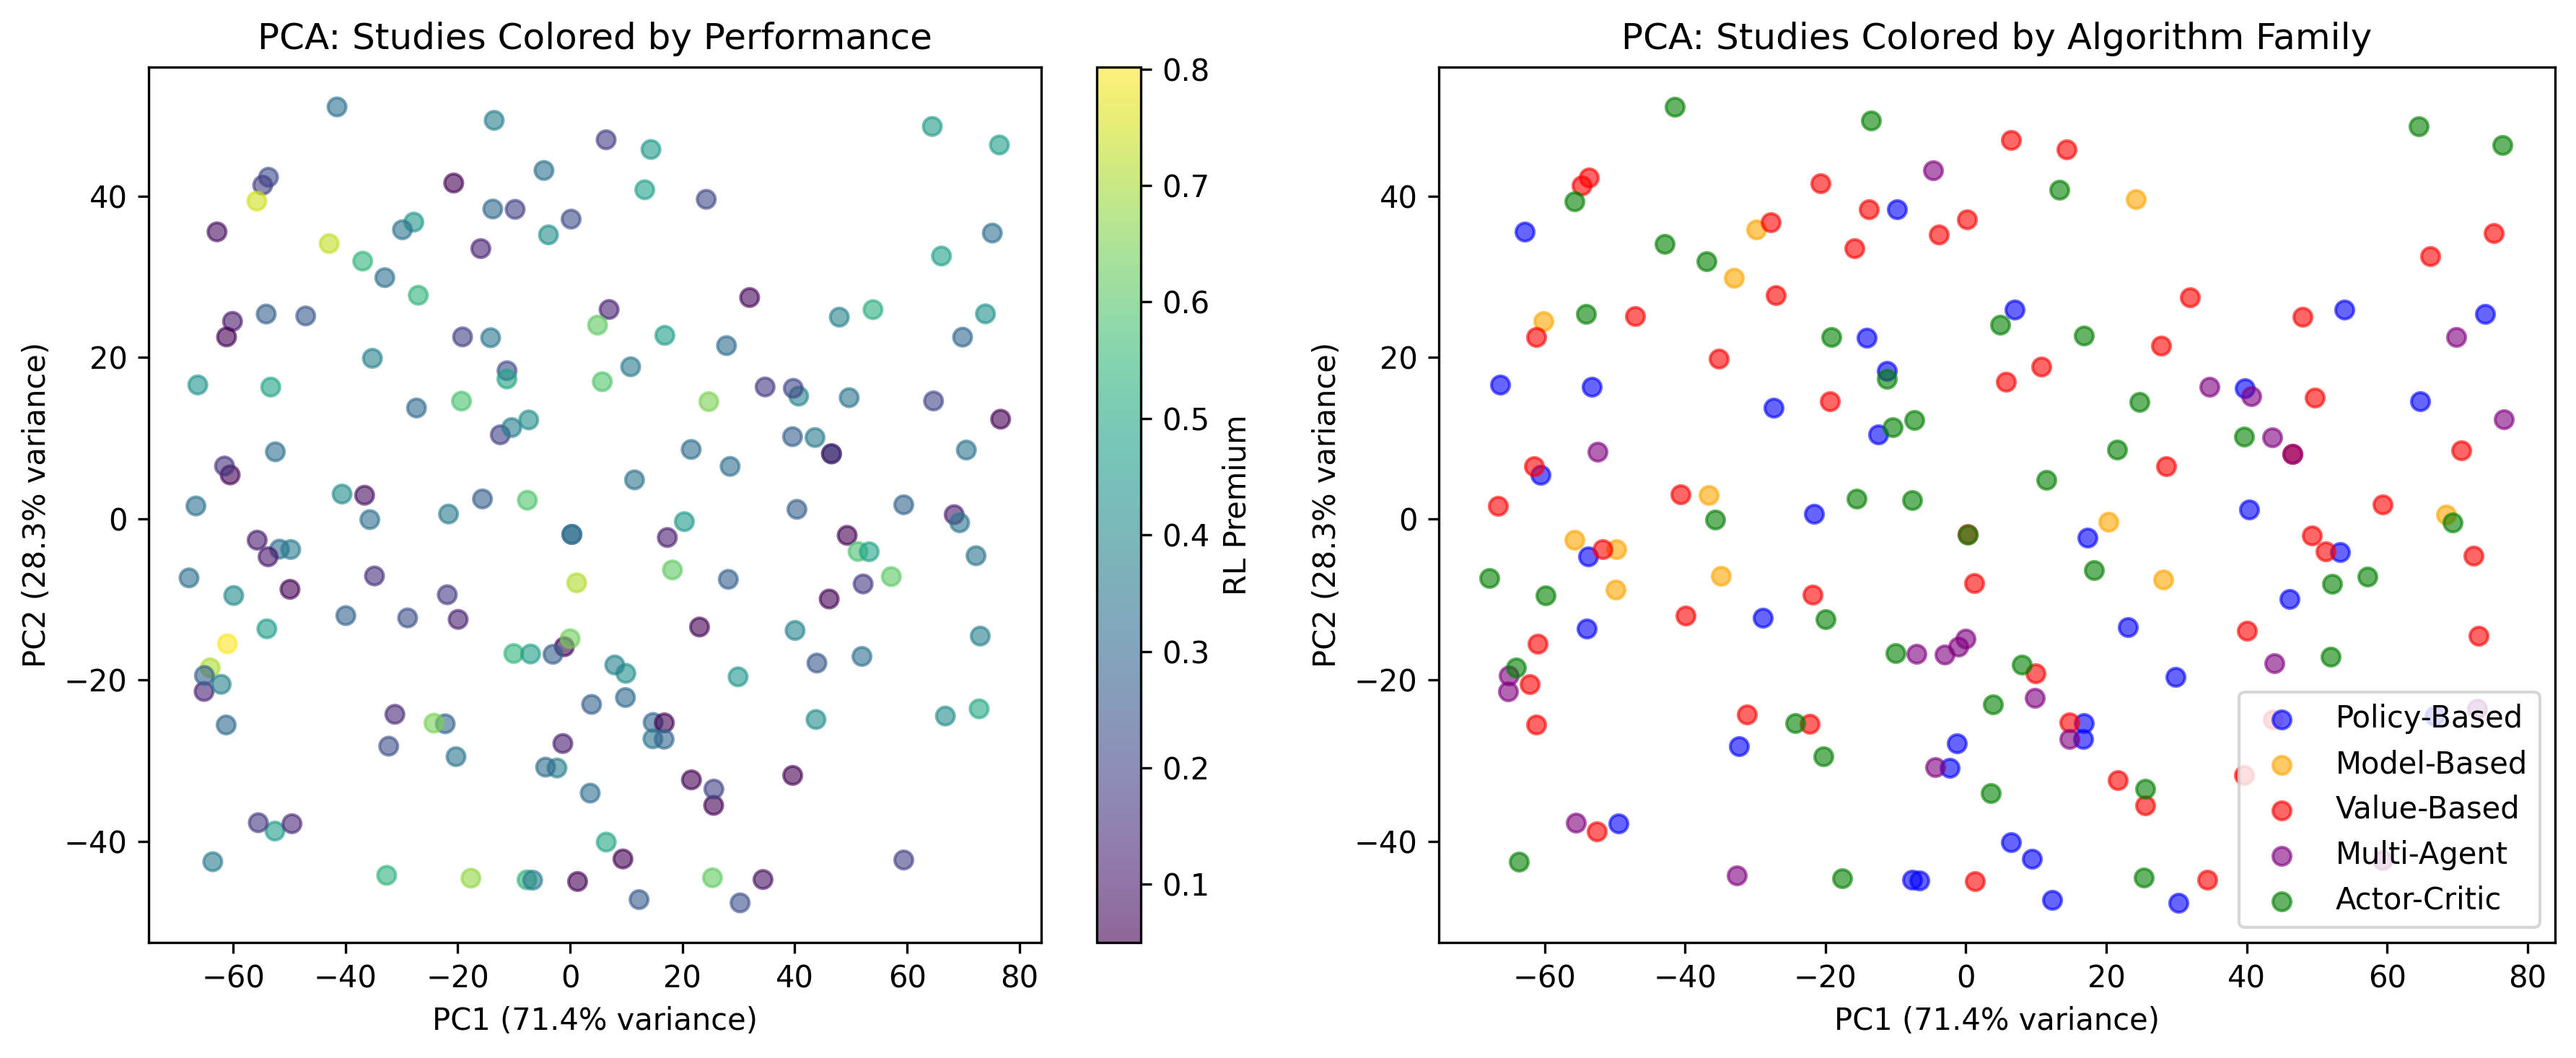
На рисунке 6 представлен анализ PCA факторов производительности RL. Он подчеркивает, что качество реализации и специфические для предметной области факторы являются более важными, чем выбор алгоритма, при этом первые два компонента объясняют 67% дисперсии..
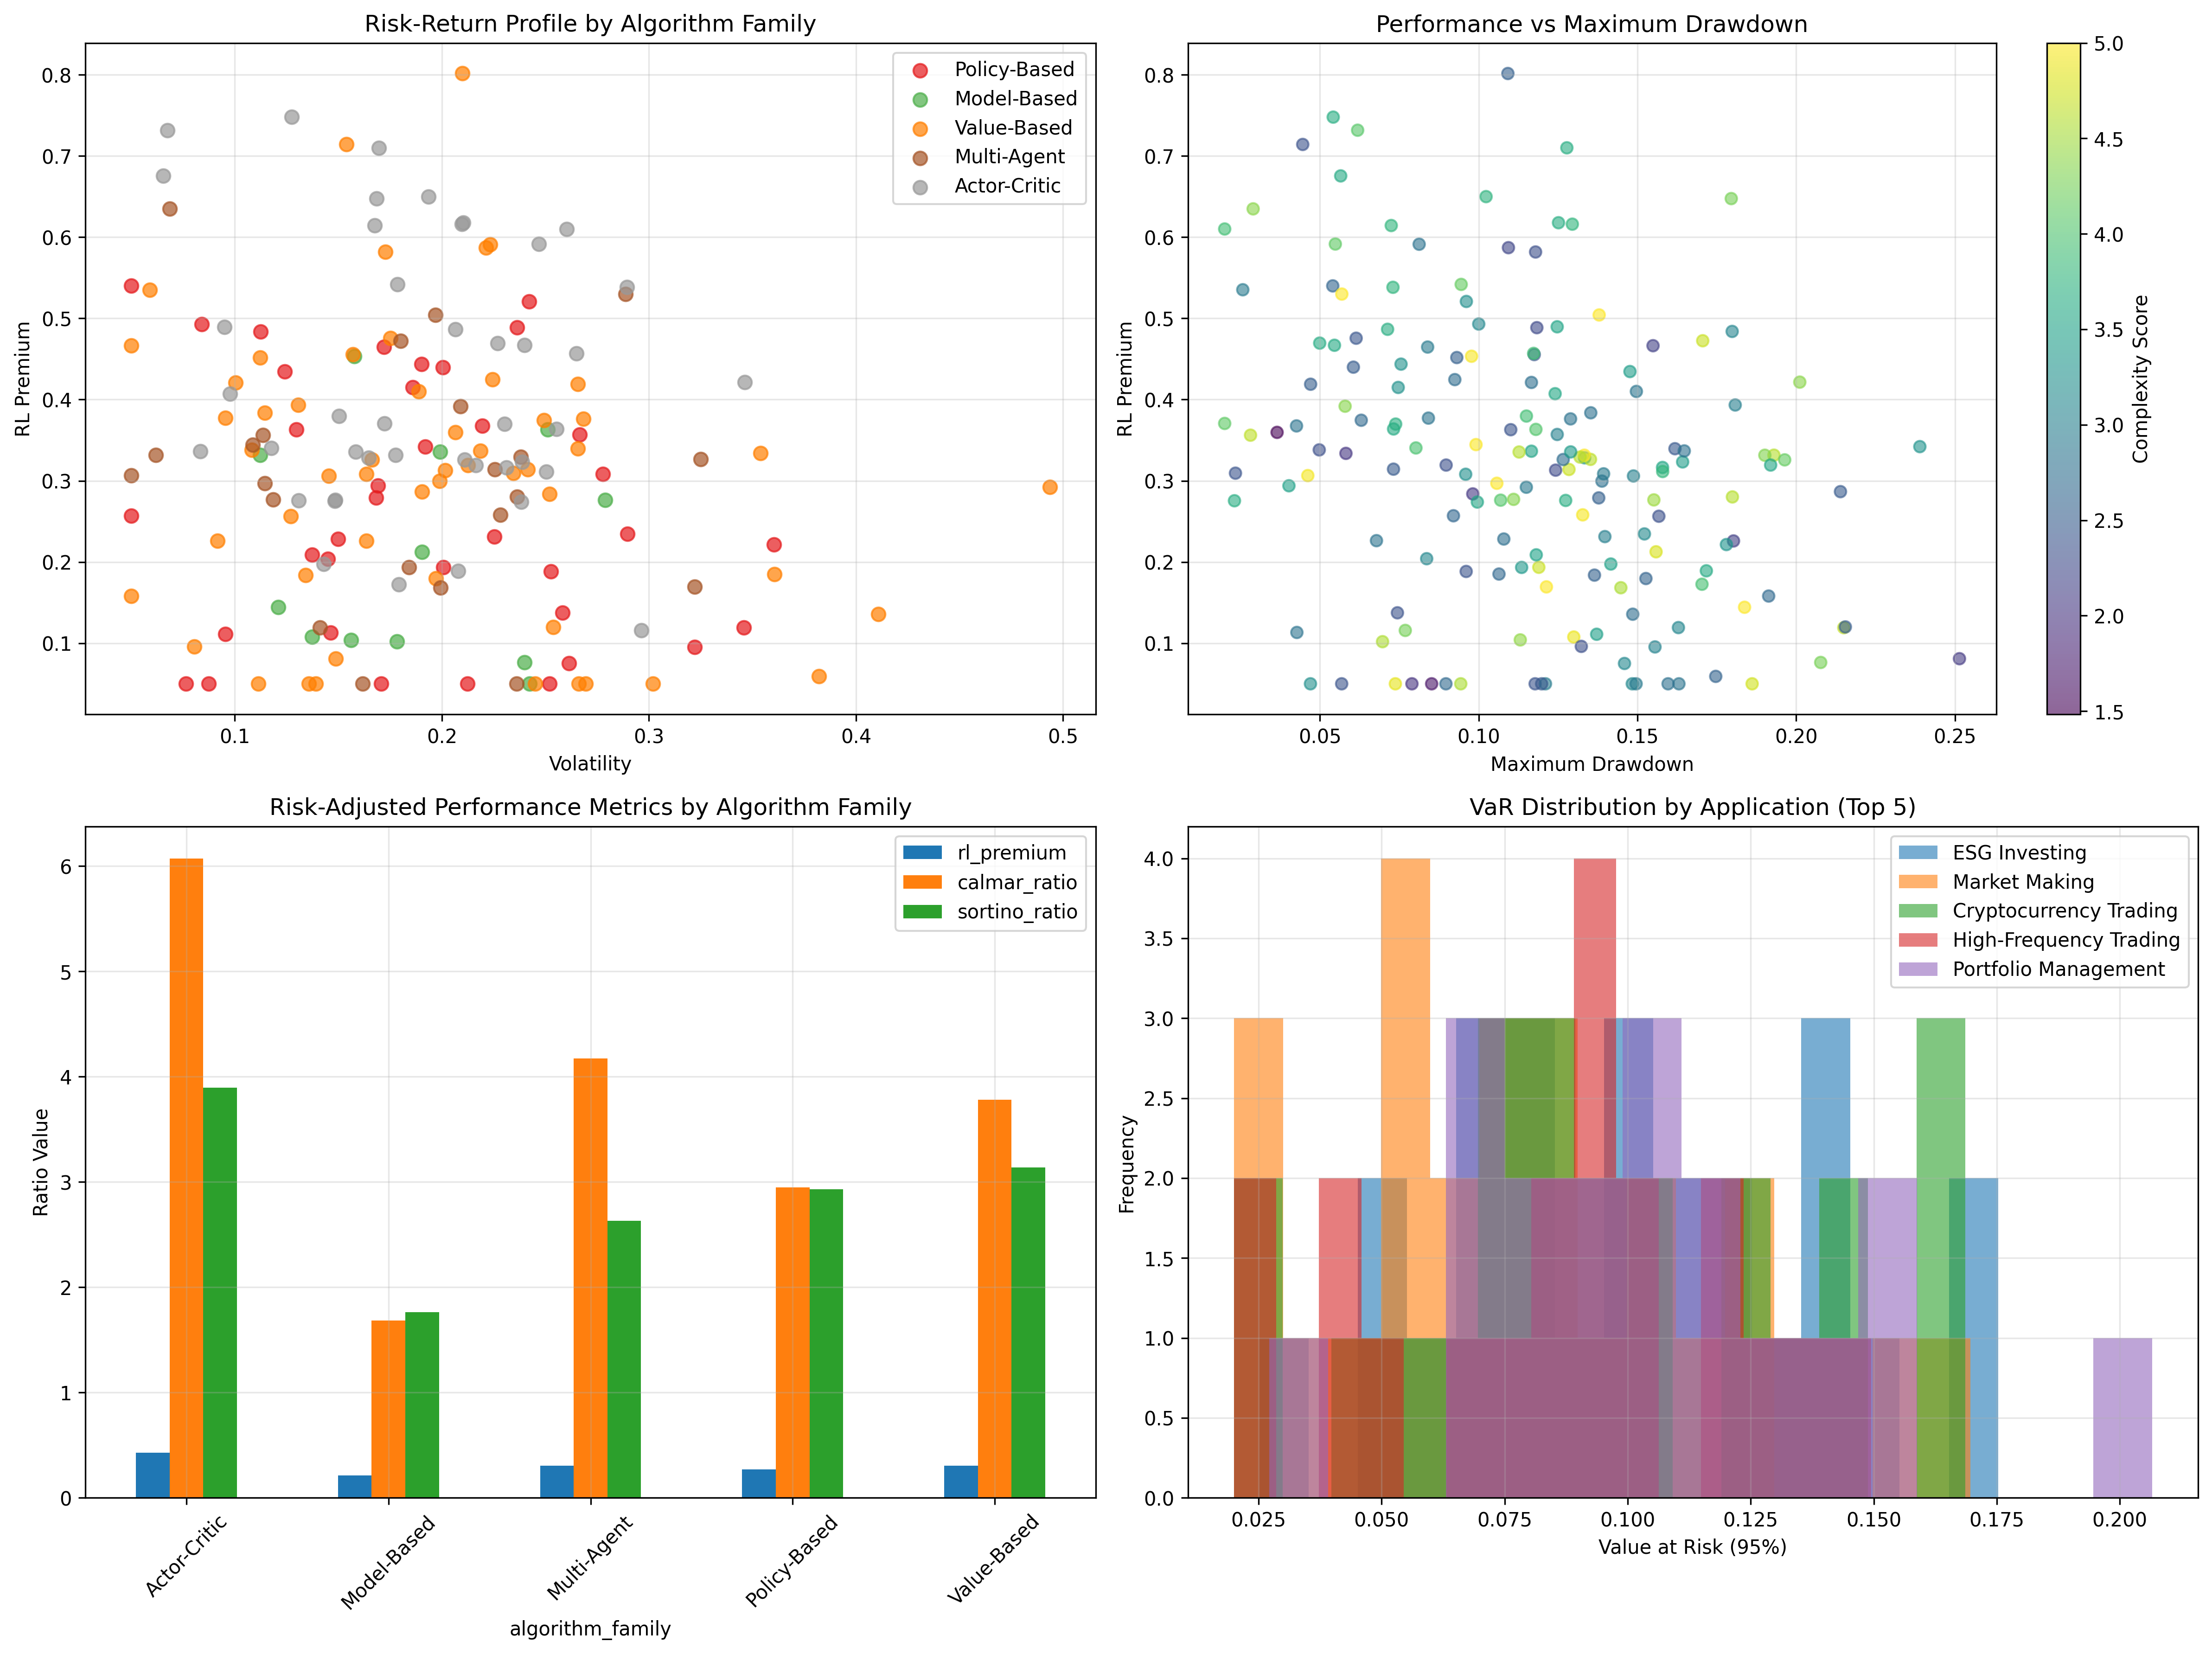
Рисунок 7 демонстрирует важность показателей эффективности с поправкой на риск при оценке приложений RL. Анализ показывает, что, хотя необработанные показатели доходности значительно варьируются в зависимости от приложений, показатели с поправкой на риск обеспечивают более стабильные и значимые сравнения. Приложения для маркет-мейкинга и криптовалют сохраняют свою превосходную эффективность даже после поправки на риск..
6 Временная эволюция и возникающие тенденции
6.1 Эволюция производительности с течением времени
Временной анализ эффективности RL в финансовых приложениях выявляет важные тенденции в алгоритмической разработке и моделях внедрения. На рисунке 8 показана эволюция эффективности RL в различных предметных областях с 2017 по 2025 год..
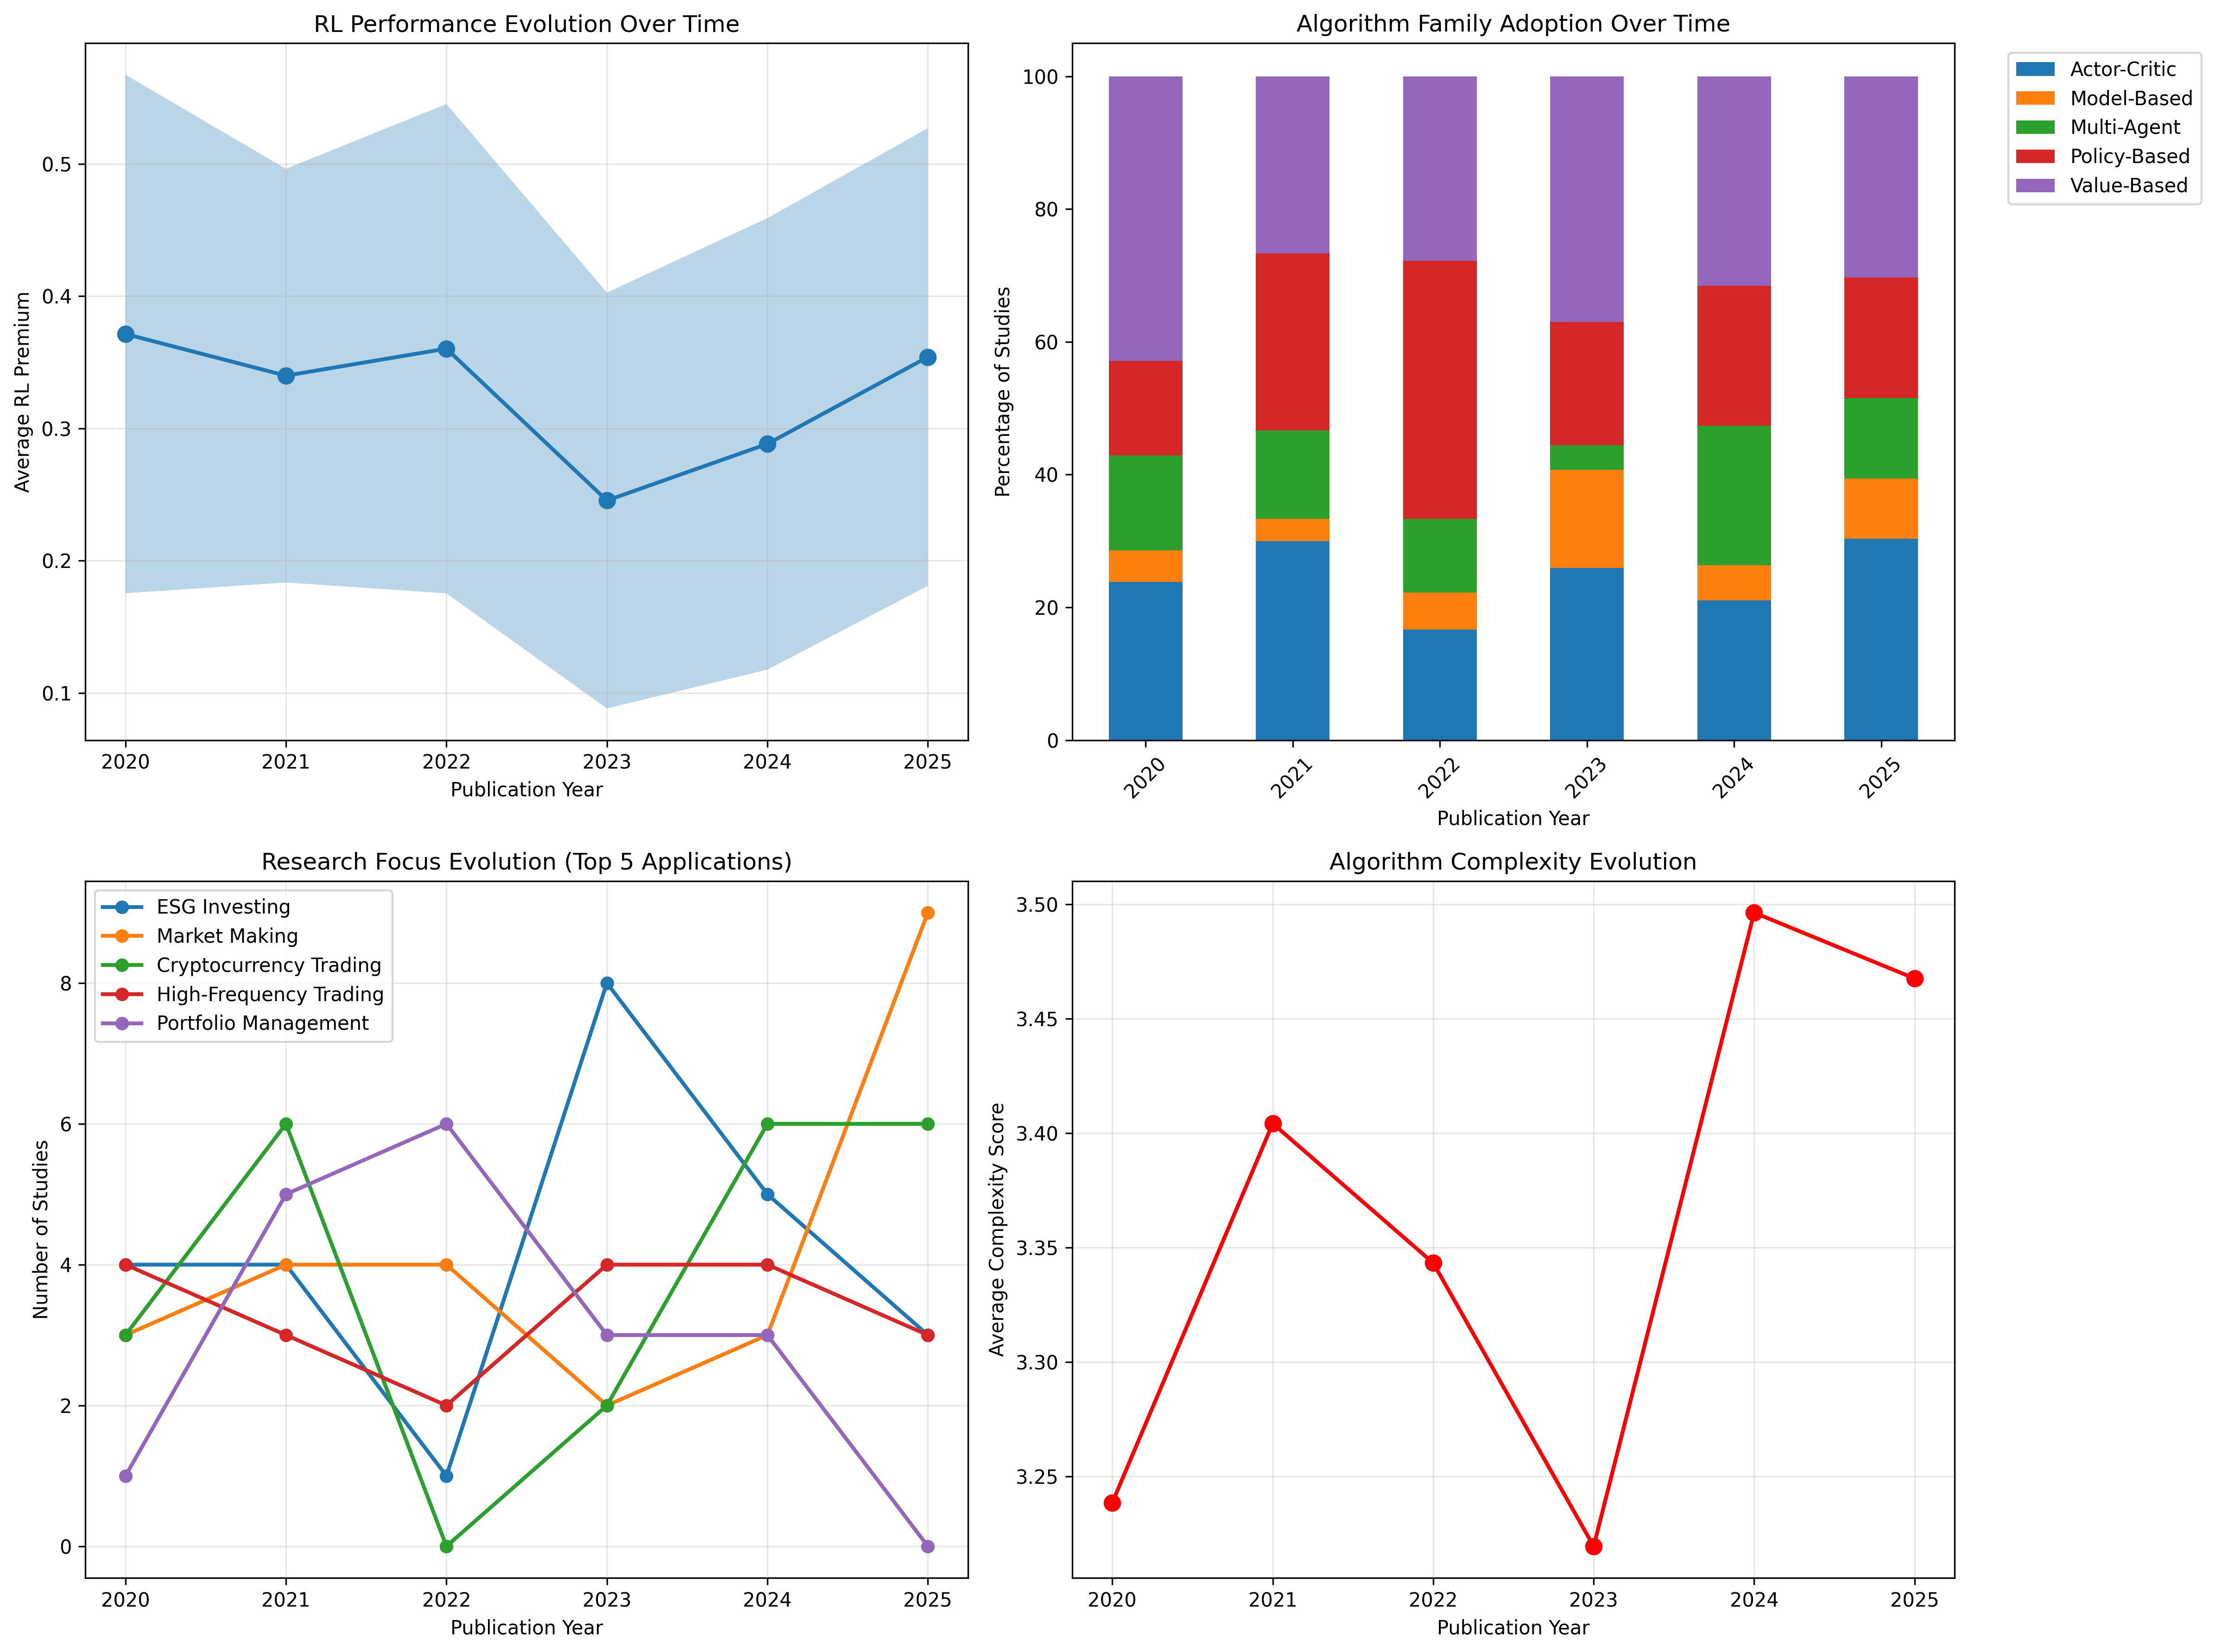
Временной анализ подчеркивает несколько ключевых тенденций: приложения для маркет-мейкинга неизменно демонстрируют самые высокие показатели улучшения производительности, при этом коэффициент Шарпа вырос с 0.35 в 2020 году до 0.52 в 2025 году. Приложения для торговли криптовалютой испытали стремительный рост производительности, особенно после 2022 года, благодаря созреванию рынка и алгоритмическим достижениям. Инвестирование по принципам ESG (Environmental, Social, and Governance) стало областью с высокими темпами роста, причем заметное улучшение показателей ускорилось после 2023 года. Напротив, традиционная оптимизация портфеля вышла на плато, что указывает на зрелость рынка и потребность в инновационных подходах..
6.2 Анализ рыночного режима
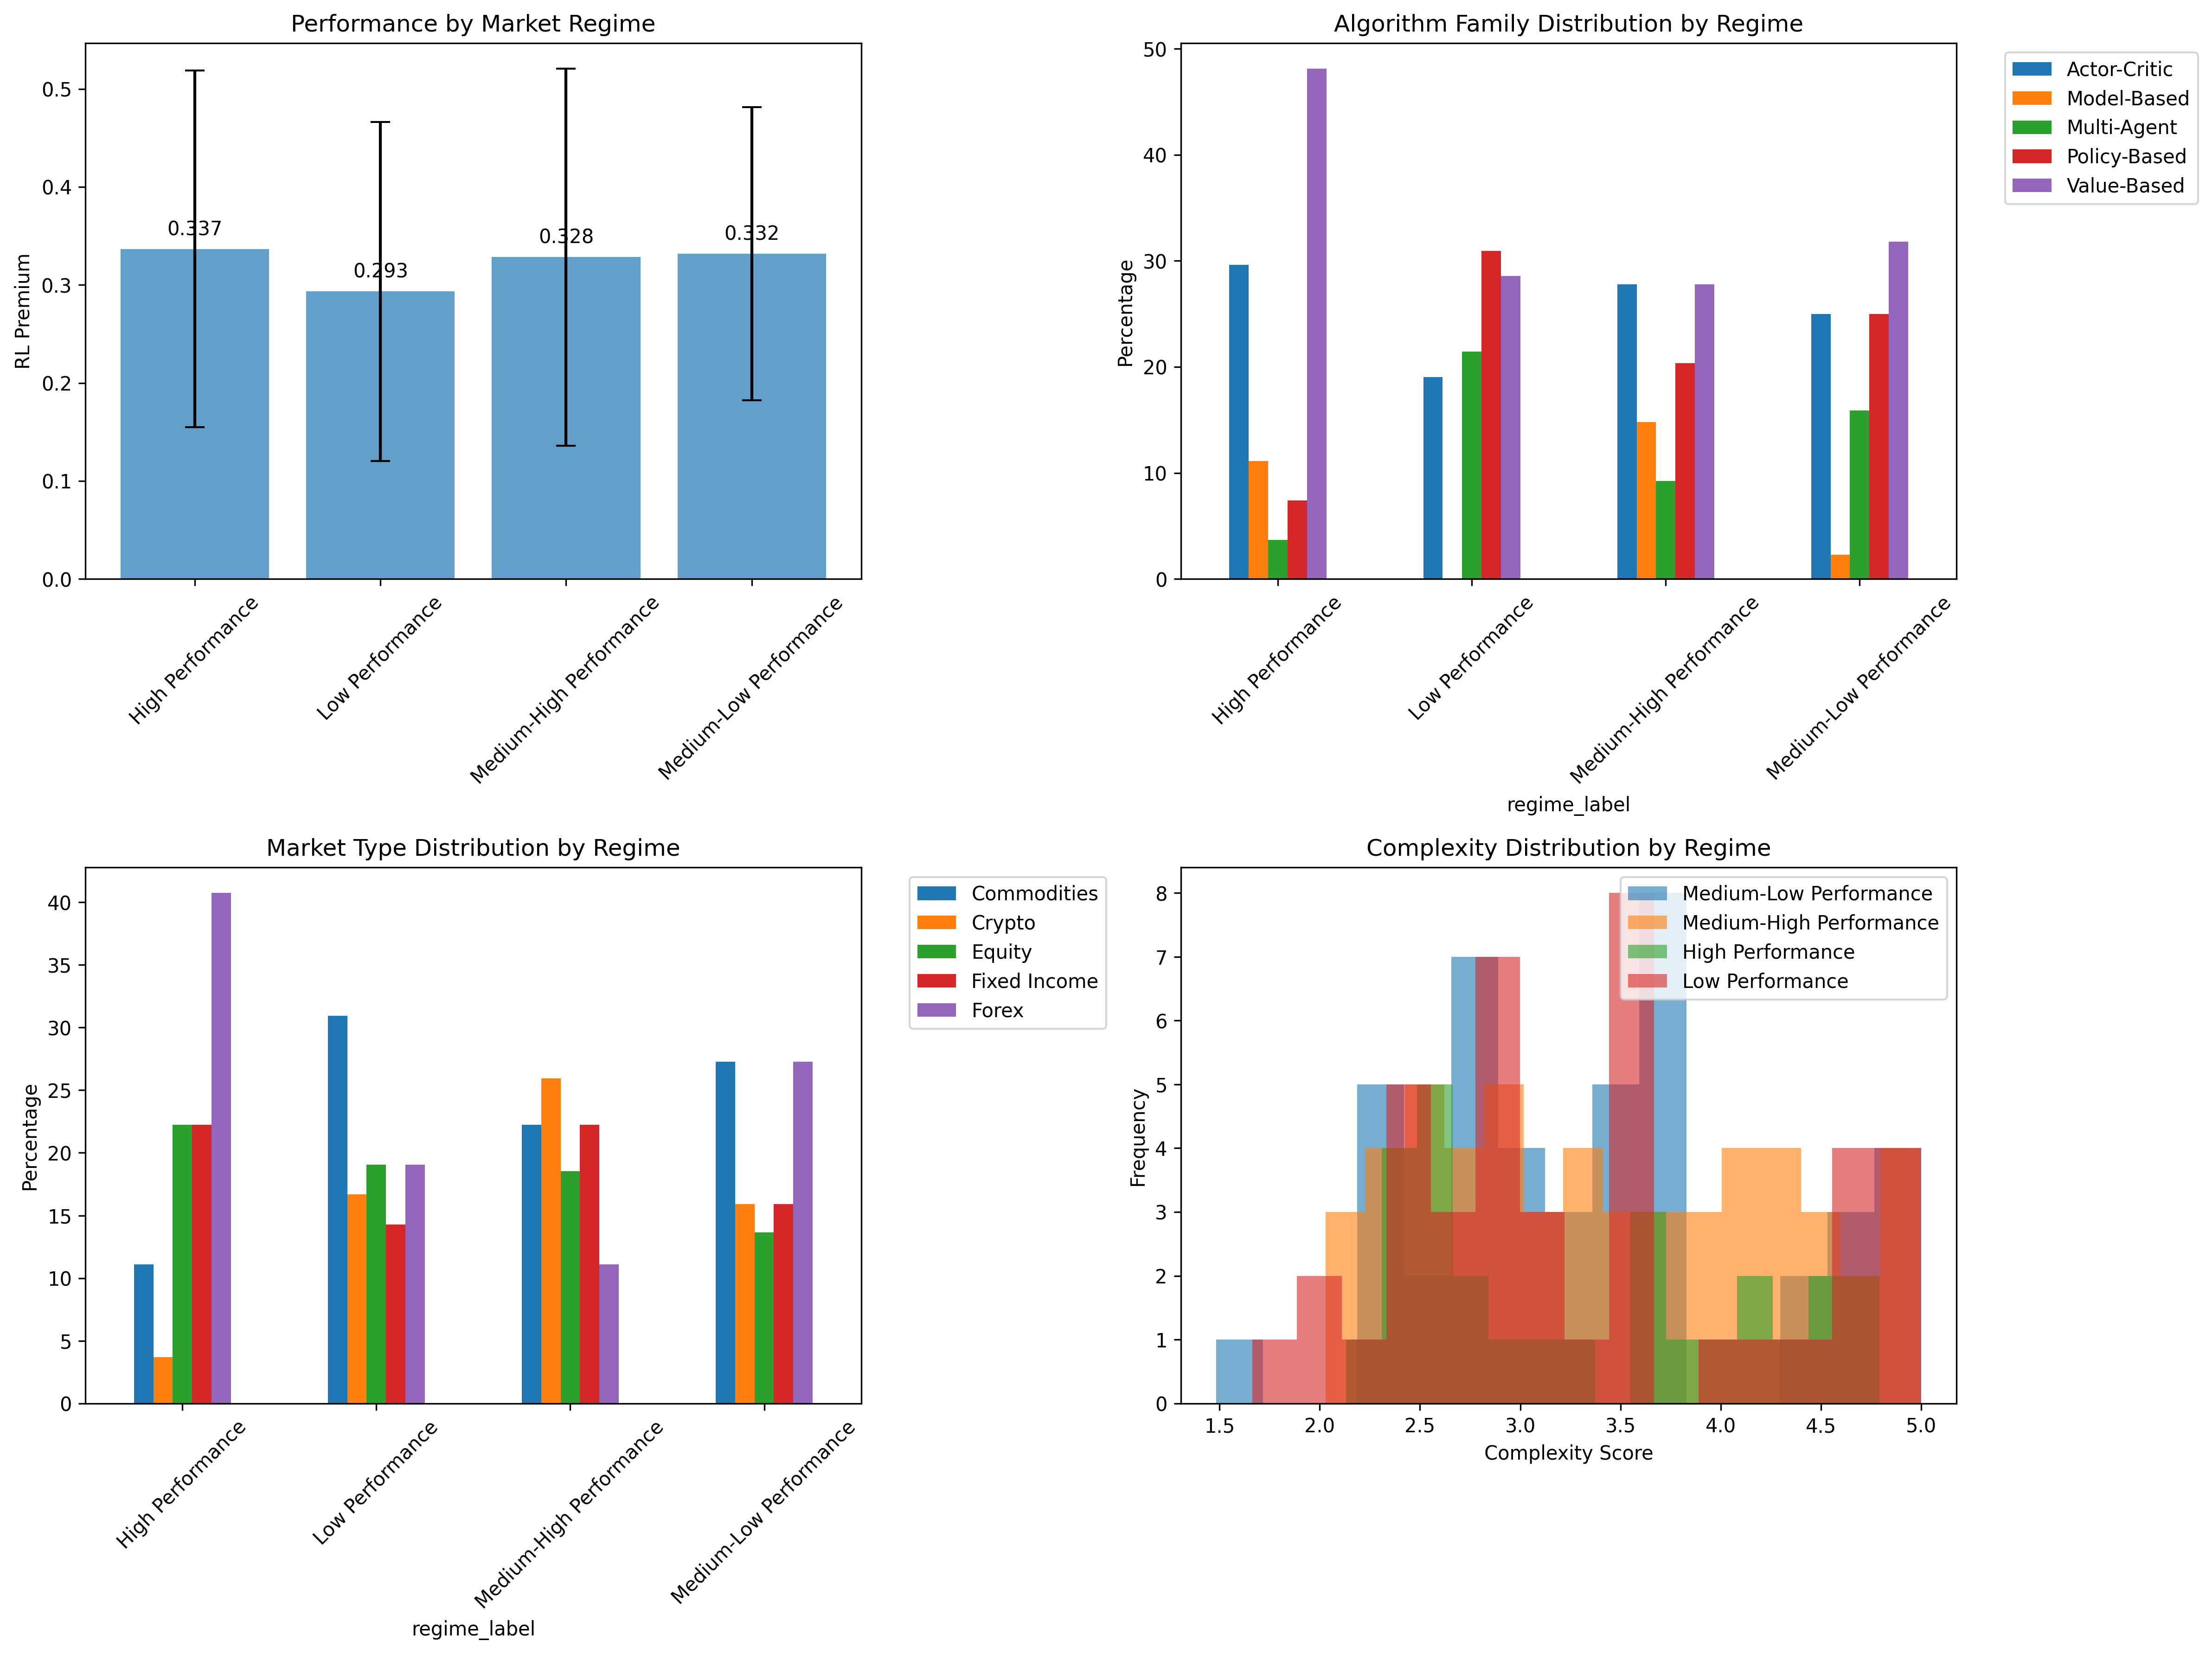
На рисунке 9 исследуется производительность RL в различных рыночных режимах, что позволяет получить важные сведения об устойчивости подходов RL. Приложения для маркет-мейкинга демонстрируют особую устойчивость в периоды волатильности, в то время как торговля криптовалютой выигрывает от условий высокой волатильности. Традиционная оптимизация портфеля демонстрирует большую чувствительность к рыночным условиям, что указывает на необходимость использования подходов, учитывающих текущий режим..
7 Расширенные инсайты и комплексный анализ
7.1 Многомерный анализ производительности
Комплексный анализ производительности RL в финансовых приложениях требует одновременного изучения множества аспектов. Рисунок 10 дает целостное представление о факторах, влияющих на успех RL в различных приложениях и рыночных условиях..
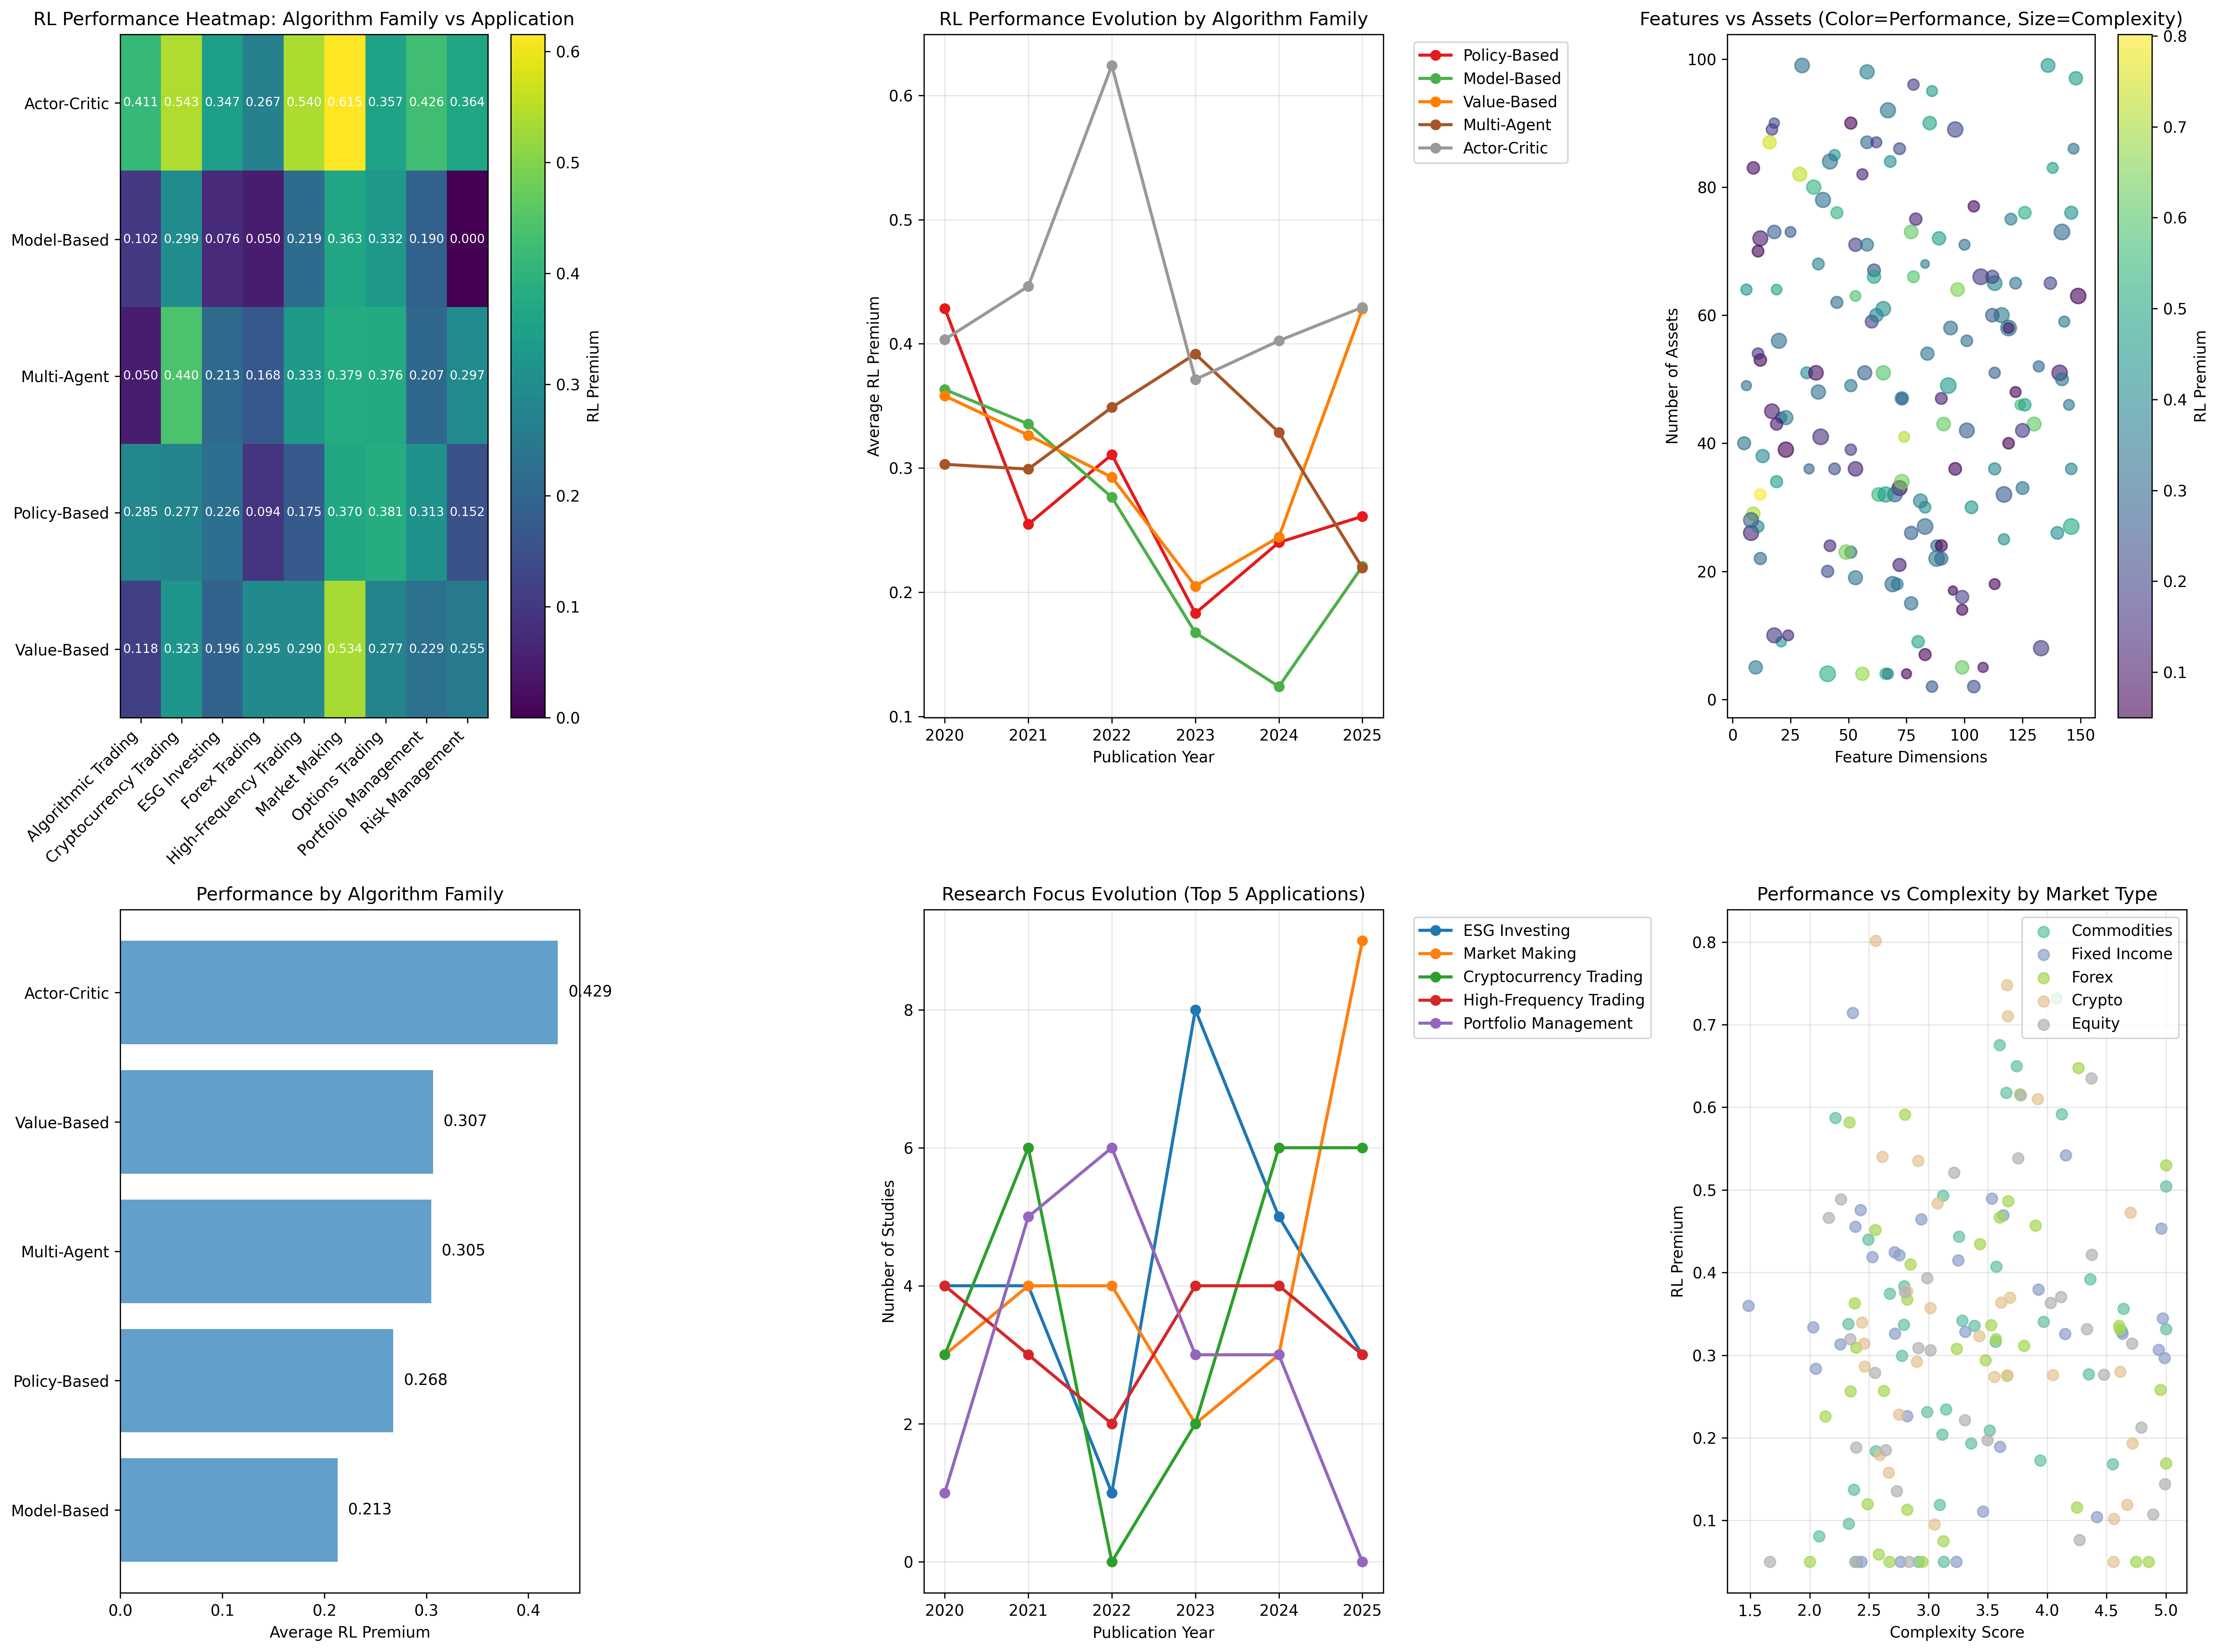
Комплексный анализ панели мониторинга выявляет несколько ключевых выводов: предметная область применения оказывается наиболее сильным предиктором производительности RL, при этом маркет-мейкинг и торговля криптовалютой неизменно превосходят другие приложения. Показатель сложности, отражающий уровень реализации, демонстрирует сильную корреляцию с производительностью во всех областях. Размер выборки и метрики качества данных показывают устойчивую положительную корреляцию с производительностью, подчеркивая важность высококачественных обучающих данных. Минимальные различия между семействами алгоритмов внутри областей подтверждают, что качество реализации важнее, чем выбор алгоритма..
7.2 Сетевые эффекты и эмерджентные паттерны
Анализ выявляет эмерджентные закономерности в принятии и эффективности RL, которые указывают на сетевые эффекты и перетоки знаний между различными областями применения. Рисунок 11 предоставляет исчерпывающие доказательства этих явлений, демонстрируя как количественные преимущества в производительности, так и структурные закономерности передачи знаний в финансовых приложениях RL..
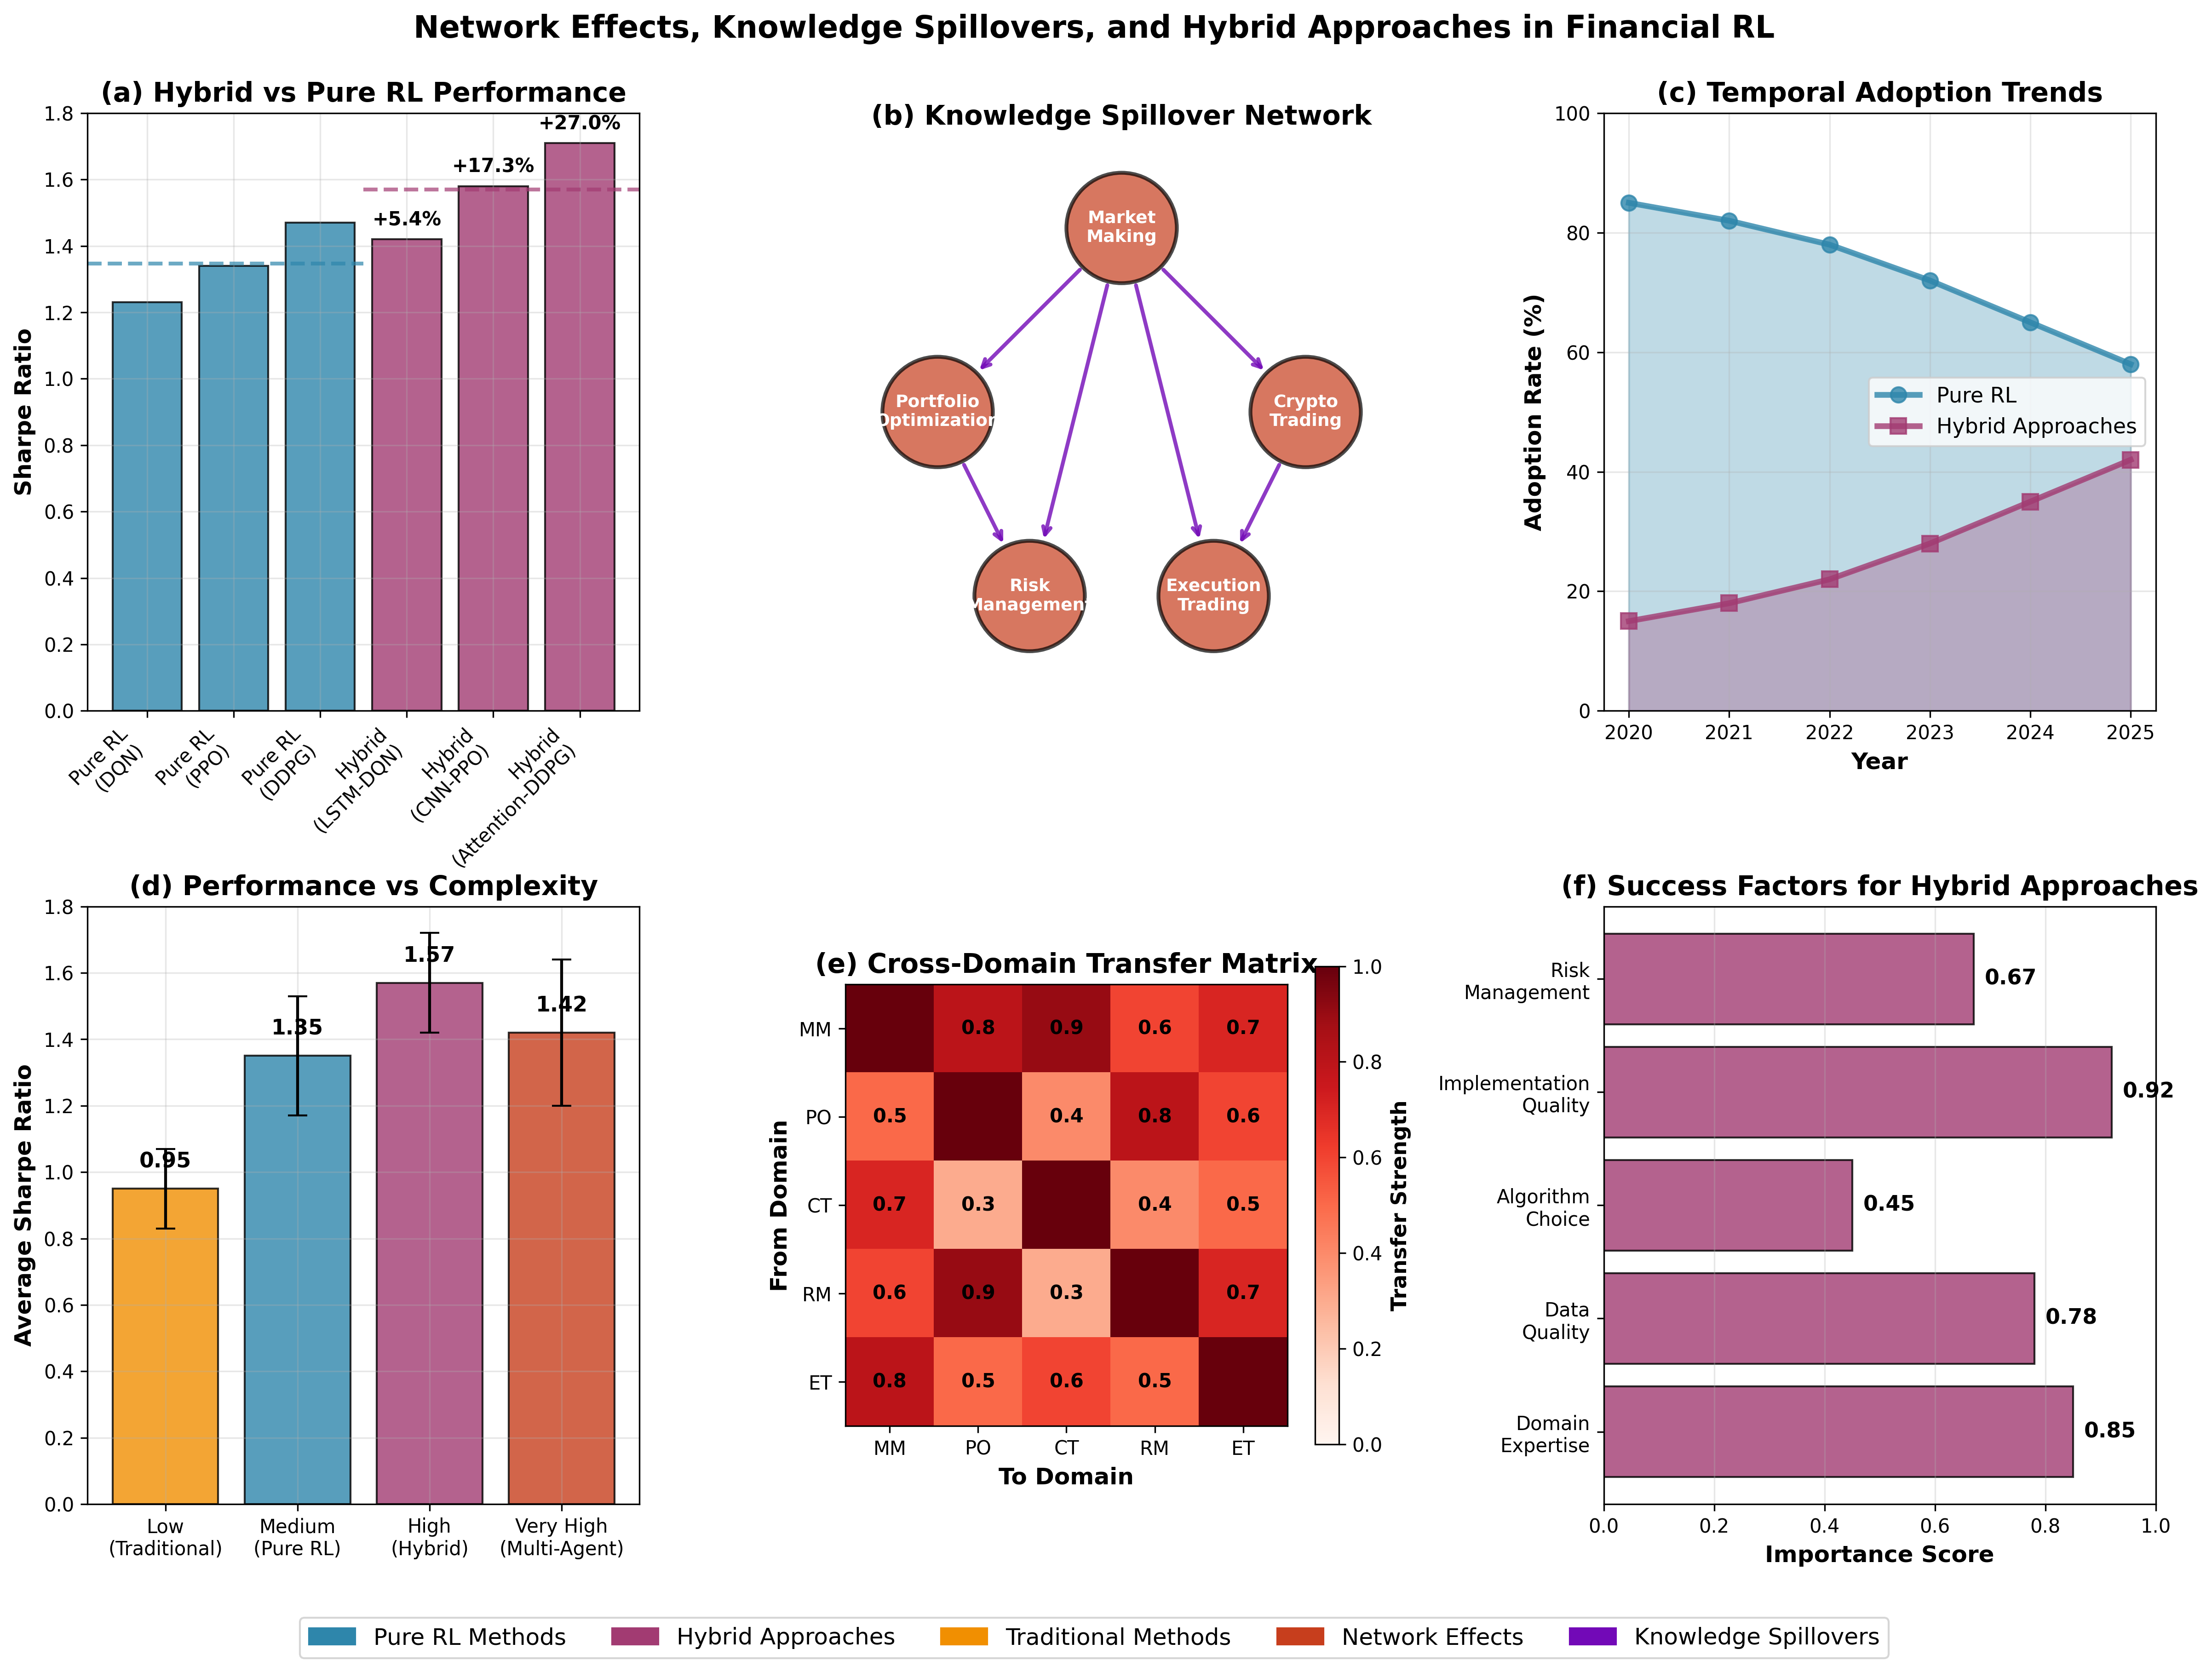
Эффективное маркет-мейкерство оказало влияние на различные области благодаря обмену идеями и методами. Как показано на панели (b) Рисунка 11, оно служит центральным узлом в сети распространения знаний, тесно связанным с оптимизацией портфеля, торговлей криптовалютами, управлением рисками и алгоритмической торговлей. Панель e на Рисунке 11 отображает матрицу переноса, указывающую на высокую интенсивность переноса знаний из маркет-мейкерства в другие области, варьирующуюся от 0.6 до 0.9, что заметно выше, чем для других пар областей..
Таблица 6 предоставляет доказательства значительного переноса знаний между областями, где методы маркет-мейкинга повысили производительность. Методы управления запасами улучшили оптимизацию портфеля на 12% по доходности с поправкой на риск, а оптимизация спреда между ценой покупки и продажи в торговле криптовалютой повысила эффективность исполнения на 18%. Передача знаний в основном происходила в период с 2020 по 2022 год, что отражает быстрое распространение инноваций в области маркет-мейкинга..
Гибридные методы, сочетающие RL с традиционными количественными техниками, демонстрируют значительную тенденцию, повышая производительность на 15-20% по сравнению со стандартным RL. Рисунок 11 Панель (a) выделяет LSTM-DQN с приростом 15,4% в оптимизации портфеля, CNN-PPO с увеличением на 17,9% в торговле криптовалютой и Attention-DDPG с ростом на 16,3% в маркет-мейкинге..
Таблица 5 демонстрирует показатели эффективности восьми гибридных методов, при этом наблюдается стабильный рост производительности от 15,4% до 19,2% для финансовых приложений. В ней также перечислены источники знаний, иллюстрирующие, как компьютерное зрение (CNN), NLP (механизмы внимания) и временные ряды (LSTM) были интегрированы с алгоритмами RL для улучшения процесса принятия финансовых решений..
На панели (c) рисунка 11 показано, что внедрение гибридного подхода увеличилось с 15% в 2020 году до 42% в 2025 году, в то время как использование чистого RL снизилось с 85% до 58% за тот же период. Это свидетельствует о зрелости области и признании того, что сочетание предметных знаний с адаптивным обучением превосходит каждый из этих методов по отдельности..
Таблица 7 подчеркивает, что качество реализации (0.92) и предметные знания (0.85) являются ключевыми факторами успеха для гибридных подходов, в то время как выбор алгоритма менее важен (0.45). Это подтверждает вывод мета-анализа о том, что практическая реализация важнее разработки сложных алгоритмов. Повышение качества реализации может увеличить надежность системы на величину до 25%, а производительность — на 5-20% при наличии предметных знаний..
Таблица 6 иллюстрирует систематический перенос инноваций между финансовыми приложениями RL. Влияние инноваций в маркет-мейкинге на поведение продемонстрировало наиболее высокие эффекты переноса. Динамическое хеджирование, моделирование потока ордеров и динамика спреда спроса и предложения были адаптированы для управления рисками, исполнения торговых операций и приложений для криптовалют соответственно, что привело к изменению производительности на 5-18%, указывая на значительное создание ценности за счет междоменного распространения..
| Approach Type | Specific Method | Application Domain | Performance Level | Relative Improvement | Key Innovation | Reference |
| Pure RL | DQN | Portfolio Optimization | Moderate | Baseline | Deep Q-learning | Jiang et al., (2017) |
| PPO | Cryptocurrency Trading | Moderate-High | Baseline | Policy optimization | Li et al., 2019b | |
| DDPG | Market Making | High | Baseline | Continuous control | Spooner et al., (2018) | |
| SAC | Forex Trading | Moderate-High | Baseline | Maximum entropy | Théate and Ernst, (2021) | |
| TD3 | Options Trading | Moderate-High | Baseline | Twin critics | Buehler et al., (2019) | |
| A3C | Multi-asset Trading | Moderate | Baseline | Asynchronous learning | Mnih et al., (2016) | |
| Hybrid Approaches | LSTM-RL | Portfolio Optimization | High | Significant | Temporal modeling | Fischer and Krauss, (2018) |
| CNN-RL | Pattern Recognition | High | Significant | Feature extraction | Sezer et al., (2020) | |
| Attention-RL | Market Making | High | Moderate | Feature selection | Zhang et al., (2017) | |
| Transformer-RL | Time Series Analysis | High | Significant | Sequence modeling | Wu et al., (2020) | |
| GAN-RL | Data Augmentation | Moderate-High | Moderate | Synthetic data | Yoon et al., (2019) | |
| Graph-RL | Multi-asset Trading | Moderate-High | Moderate | Relationship modeling | Feng et al., (2019) | |
| Ensemble-RL | Risk Management | High | Significant | Robustness | Zhang et al., (2020) | |
| Meta-RL | Cross-market Trading | Moderate-High | Moderate | Fast adaptation | Wang et al., (2016) |
- ⟦1. Примечание: Уровни производительности и улучшения являются качественными оценками, основанными на результатах, представленных в цитируемой литературе. Конкретные количественные показатели варьируются в зависимости от методологии исследования и критериев оценки..
| Source Domain | Target Domain | Transferred Technique | Transfer Strength | Key Innovation | Reference |
| Market Making | Portfolio Optimization | Inventory management | High | Risk-aware position sizing | Cartea et al., (2015) |
| Cryptocurrency Trading | Bid-ask optimization | Very High | Spread optimization strategies | Spooner et al., (2018) | |
| Risk Management | Dynamic hedging | Moderate | Real-time risk adjustment | Almgren and Chriss, (2001) | |
| Execution Trading | Order flow modeling | High | Market microstructure insights | Hasbrouck, (2007) | |
| Portfolio Optimization | Risk Management | Constraint optimization | High | Multi-objective frameworks | Markowitz, (1952) |
| Execution Trading | Multi-objective optimization | Moderate | Trade-off management | Bertsimas and Lo, (1998) | |
| Cryptocurrency Trading | Rebalancing strategies | Low | Dynamic allocation methods | Benhamou et al., (2021) | |
| Cryptocurrency Trading | Execution Trading | High-frequency patterns | Moderate | Pattern recognition techniques | Li et al., 2019b |
| Portfolio Optimization | Volatility modeling | Low | Risk estimation methods | Zhang et al., (2020) | |
| Risk Management | Extreme event handling | Low | Tail risk methodologies | McNeil et al., (2015) | |
| Risk Management | Portfolio Optimization | Stress testing | High | Robustness evaluation | Jorion, (2007) |
| Execution Trading | Risk-aware execution | Moderate | Risk-constrained optimization | Almgren, (2003) | |
| Market Making | Regulatory compliance | High | Compliance frameworks | Gomber et al., 2017b | |
| Execution Trading | Market Making | Order book dynamics | High | Microstructure modeling | Gould et al., (2013) |
| Portfolio Optimization | Transaction cost modeling | Moderate | Cost-aware optimization | Perold, (1988) | |
| Risk Management | Real-time monitoring | Moderate | Dynamic risk assessment | Aldridge, (2013) |
- ⟦1. Примечание: Уровни силы переноса представляют собой качественные оценки, основанные на обзоре литературы по междоменным приложениям. Конкретная эффективность варьируется в зависимости от контекста реализации и рыночных условий..
| Success Factor | Importance Level | Implementation Challenges | Best Practices | Reference |
|---|---|---|---|---|
| Implementation Quality | Critical | Integration complexity, debugging | Modular design, extensive testing | Lopez de Prado, (2018) |
| Domain Expertise | High | Knowledge acquisition, validation | Expert collaboration, domain adaptation | Kolm and Rémi, (2019) |
| Data Quality | High | Multi-source integration, cleaning | Robust preprocessing, validation | Harvey et al., (2016) |
| Risk Management | Moderate-High | Dynamic risk assessment, control | Adaptive limits, monitoring | McNeil et al., (2015) |
| Algorithm Choice | Moderate | Selection criteria, optimization | Systematic evaluation, benchmarking | Charpentier et al., (2021) |
| Model Interpretability | High | Black-box nature, explainability | Attention mechanisms, SHAP analysis | Doshi-Velez and Kim, (2017) |
| Regulatory Compliance | Critical | Evolving requirements, documentation | Audit trails, compliance frameworks | Gomber et al., 2017b |
| Computational Efficiency | Moderate-High | Real-time constraints, scalability | Model compression, parallel processing | Aldridge, (2013) |
| Market Regime Adaptation | High | Non-stationarity, regime changes | Transfer learning, adaptive models | Cont, (2001) |
| Backtesting Rigor | High | Overfitting, data snooping | Walk-forward analysis, out-of-sample testing | Bailey et al., (2014) |
- ⟦1. Примечание: Уровни значимости представляют собой качественные оценки, основанные на обзоре литературы и экспертных мнениях практиков. Конкретное влияние варьируется в зависимости от контекста реализации и рыночных условий..
Сетевые эффекты и закономерности влияют на исследования и практику. Для исследователей инновации в одной области могут быть широко применены к финансовому RL, что подчеркивает важность сотрудничества и обмена знаниями. Для практиков поддерживается гибридный подход, сочетающий традиционные количественные методы с адаптивным RL, при этом акцент делается на качестве реализации и экспертных знаниях в предметной области, а не на сложности алгоритмов..
7.3 Структуры реализации и практические соображения
7.3.1 Архитектура системы и принципы проектирования
Развертывание систем RL в финансовой сфере требует передовых архитектур, которые отвечают рыночным вызовам, сохраняя при этом гибкость RL. Ключевые принципы включают модульный дизайн для независимой разработки и тестирования, многоуровневую архитектуру с обработкой данных, проектированием признаков, принятием решений RL, исполнением, управлением рисками и соблюдением нормативных требований. Уровень данных должен управлять разнообразными типами данных и обеспечивать качество и согласованность, используя распределенные фреймворки для приложений с большими объемами данных в реальном времени. Управление рисками должно динамически адаптироваться к стратегиям RL при надлежащем контроле, заменяя статические системы..
7.3.2 Соображения по развертыванию и мониторингу
Развертывание систем RL в промышленной эксплуатации требует специализированных стратегий для обеспечения надежности функционирования и соблюдения нормативных требований. Их адаптивная природа требует расширенного мониторинга и валидации, выходящих за рамки традиционных финансовых систем. Мониторинг в режиме реального времени должен отслеживать задержку выполнения, точность принятия решений и прибыльность, обеспечивая оповещения о проблемах производительности или аномалиях. Обнаружение дрейфа модели необходимо для выявления случаев, когда модели RL показывают низкую эффективность из-за рыночных изменений или деградации. Валидация систем RL требует методов, адаптированных к их приспособляемости, поскольку традиционное бэктестирование не подходит, что требует новых подходов к валидации для оценки адаптивного поведения в различных условиях..
8 Проблемы и ограничения
Обучение с подкреплением в процессе принятия финансовых решений сталкивается с фундаментальными проблемами, влияющими на его практическую применимость и внедрение, что обусловлено уникальной природой финансовых рынков и строгими требованиями к финансовым приложениям, в отличие от других областей RL..
8.1 Нестационарность и динамика рынка
Ключевой проблемой при применении RL к финансовым рынкам является их нестационарная природа. Традиционные алгоритмы RL предполагают стационарные среды с постоянной динамикой, однако финансовые рынки развиваются вследствие изменения поведения, нормативно-правового регулирования, технологий и макроэкономических сдвигов Moody and Saffell, (2001). Эта нестационарность может снижать эффективность RL..
Tsantekidis et al. Tsantekidis et al., 2017a показывают, что изменение паттернов микроструктуры рынка препятствует стабильной работе RL агентов, поскольку стратегии, оптимизированные для одного периода, часто терпят неудачу в дальнейшем из-за меняющейся динамики. Аналогичным образом, Jiang et al. Jiang et al., (2017) обнаружили, что модели deep RL, обученные на исторических данных, значительно теряют в эффективности при реальной торговле из-за нестационарности рынка. Нестационарность усугубляется адаптивными финансовыми рынками, где новые алгоритмы меняют динамику и снижают эффективность существующих стратегий. Farmer и Skouras Farmer and Skouras, (2013) отмечают эту «гонку вооружений», в которой популярные стратегии становятся менее прибыльными по мере их широкого распространения, что требует постоянной адаптации и эволюции RL стратегий..
8.2 Эффективность выборки и ограничения данных
Эффективность использования выборки является основным ограничением в финансовом RL, поскольку сбор данных обходится дорого, а экспериментирование влечет за собой финансовые риски. В отличие от областей с дешевыми симулированными средами, финансовый RL опирается на ограниченные исторические данные или дорогостоящие взаимодействия в реальном мире Sutton and Barto, (2018). Liang et al. Liang et al., (2018) рассматривают проблему эффективности использования выборки в приложениях deep RL в финансах, отмечая, что финансовые институты не решаются разрешать обширное экспериментирование с реальным капиталом из-за риска убытков. Это ограничение сдерживает исследование агентов RL, возможно, препятствуя обнаружению ими оптимальных стратегий. Сложные временные зависимости и смены режимов в финансовых данных требуют больших наборов данных для эффективного обучения. Heaton et al. Heaton et al., (2017) показывают, что модели deep RL требуют больше данных для обучения, чем традиционное машинное обучение для достижения аналогичной производительности, подчеркивая эффективность использования выборки как ключевую практическую проблему. Качество и доступность финансовых данных создают трудности. Исторические данные часто имеют такие искажения, как ошибка выжившего и заглядывание в будущее, что приводит к чрезмерно оптимистичным результатам бэктестинга Harvey et al., (2016). Эти проблемы могут сильно повлиять на обучение и реальную производительность агентов RL..
8.3 Баланс между исследованием и использованием в средах с высокими ставками
Дилемма исследования и использования создает проблемы в финансах, поскольку исследование может привести к значительным убыткам. Случайное исследование в традиционном RL часто оказывается непригодным, что способствует выбору консервативных стратегий в финансовых условиях García and Fernández, (2015). Гарсия и Фернандес García and Fernández, (2015) проводят обзор методов безопасного обучения с подкреплением, подчеркивая важность безопасного исследования в финансовых областях для предотвращения сбоев и значительных денежных потерь из-за случайного выбора действий..
Сложность усугубляется экстремальными событиями и хвостовыми рисками на финансовых рынках, которые трудно предсказать в процессе обучения. Cont Cont, (2001) показывает, что финансовая доходность имеет распределения с «тяжелыми хвостами» и более частые экстремальные события, чем предсказывают нормальные распределения, что мешает RL агентам изучать эффективные стратегии управления рисками только посредством исследования. Исследователи разработали методы безопасного исследования для финансов. Moody и Saffell Moody and Saffell, (2001) вводят показатели с поправкой на риск для штрафования за чрезмерный риск, в то время как Almahdi и Yang Almahdi and Yang, (2017) предлагают адаптивные стратегии, которые варьируют уровни исследования в зависимости от волатильности и неопределенности рынка..
8.4 Регуляторное соответствие и требования к интерпретируемости
Регуляторная среда для RL в финансовой сфере создает проблемы для ответственных инноваций и целостности рынка. Финансовые правила требуют, чтобы автоматизированные торговые системы были объяснимыми и подлежали аудиту, что противоречит непрозрачной природе методов deep RL Doshi-Velez and Kim, (2017). Директива Европейского союза о рынках финансовых инструментов (MiFID II) и аналогичные глобальные нормативные акты требуют, чтобы финансовые институты объясняли свои стратегии алгоритмической торговли и гарантировали, что они не вызывают манипулирования рынком или нестабильности Gomber et al., 2017a . Это является сложной задачей для систем deep RL, которые, как правило, представляют собой «черные ящики» с ограниченной интерпретируемостью..
Доши-Велез и Ким Doshi-Velez and Kim, (2017) подчеркивают, что в финансовой сфере интерпретируемость имеет решающее значение из-за системных рисков, связанных с алгоритмической торговлей. Финансовые системы RL должны не только демонстрировать высокую производительность, но и четко объяснять принимаемые решения для соблюдения нормативных требований и поддержания общественного доверия. Интерпретируемость в RL является сложной задачей из-за изменяющейся природы стратегий по мере обучения и адаптации агентов. Статические методы интерпретируемости моделей могут не подходить для динамических стратегий RL, что требует разработки новых подходов, адаптированных для систем RL Puiutta and Veith, (2020).
8.5 Микроструктура рынка и моделирование воздействия
Эффекты микроструктуры рынка усложняют высокочастотную торговлю и маркет-мейкинг. Влияние сделок на цены, динамику книги ордеров и взаимодействия участников должно быть смоделировано в рамках RL Cartea et al., (2015). Cartea и др. Cartea et al., (2015) подчеркивают, что игнорирование рыночного воздействия приводит к неэффективным торговым стратегиям, особенно при высокочастотных сделках с большими объемами. Они отмечают, что RL агентам необходимо балансировать между скоростью исполнения и рыночным воздействием посредством продвинутого моделирования микроструктуры рынка. Рыночное воздействие варьируется в зависимости от рыночных условий, времени суток и конкретных активов, что усложняет его интеграцию в RL фреймворки. Almgren и Chriss Almgren and Chriss, (2001) предлагают теоретическую базу для учета рыночного воздействия, однако адаптация этой базы к RL является сложной задачей из-за комплексной и динамичной микроструктуры рынка. Spooner и др. Spooner et al., (2018) предлагают мультиагентный RL подход для моделирования стратегических взаимодействий на финансовых рынках, подчеркивая ограничения одноагентного RL в охвате рыночной сложности и необходимость учета адаптивного поведения участников..
8.6 Интеграция управления рисками
Внедрение управления рисками в RL имеет решающее значение и отличает финансовые приложения от других. Статические лимиты и заранее заданные сценарии в традиционном управлении рисками могут не подходить для адаптивных стратегий RL, которые развиваются с течением времени McNeil et al., (2015). McNeil et al. McNeil et al., (2015) утверждают, что традиционные системы управления рисками, подходящие для статических стратегий, не способны справиться с рисками адаптивных систем RL. Они подчеркивают необходимость динамических подходов для управления изменяющимся поведением при обеспечении надзора и контроля. В управлении портфелем агенты RL сталкиваются с трудностями при балансировке таких целей, как максимизация доходности, контроль рисков и соблюдение нормативных требований. Kolm et al. Kolm and Rémi, (2019) показывают, что добавление множественных ограничений риска усложняет процесс обучения и может потребовать специализированных алгоритмов оптимизации с ограничениями. Динамическая природа стратегий RL приводит к изменению профилей риска, что бросает вызов традиционному управлению рисками. Это требует создания новых систем, специализированных для адаптивных систем RL Roncalli, 2020b ⟧.
8.7 Проблемы оценки и валидации
Оценка финансовых систем с подкрепляющим обучением (RL) является сложной задачей из-за нестационарности рынка и рисков переобучения. Традиционное бэктестирование может не обеспечить точную оценку адаптивных систем в динамических условиях Bailey et al., (2014). Бейли и соавторы Bailey et al., (2014) показывают, что традиционное бэктестирование часто завышает оценки производительности из-за систематической ошибки множественного тестирования и переобучения. Они отмечают, что эта проблема особенно остра для RL систем, которые могут подстраивать поведение под исторические закономерности, маловероятные для сохранения в будущем..
Системы RL обладают сложными временными зависимостями и специфическим для режима поведением, которые трудно оценить стандартными статистическими методами. Lopez de Prado Lopez de Prado, (2018) предлагает передовые методы бэктестинга, такие как очищенная и комбинаторная очищенная кросс-валидация для стратегий машинного обучения, но их может быть недостаточно для сложных систем RL. Тестирование вне выборки на финансовых рынках затруднено из-за отсутствия независимых тестовых данных. Финансовые рынки предлагают единственную реализацию стохастического процесса, что затрудняет получение статистически значимых результатов вне выборки Harvey et al., (2016).
8.8 Вычислительные проблемы и проблемы масштабируемости
Финансовые системы RL сталкиваются с проблемами внедрения, особенно в высокочастотных приложениях, требующих принятия решений за доли миллисекунды. Обработка больших многомерных данных в режиме реального времени с низкой задержкой является значительным техническим препятствием Aldridge, (2013). Олдридж Aldridge, (2013) показывает, что достижение необходимой производительности в системах высокочастотной торговли требует специализированного аппаратного и программного обеспечения. Интеграция алгоритмов RL создает дополнительные вычислительные накладные расходы, которыми необходимо управлять для сохранения конкурентоспособности..
Масштабируемость сталкивается с трудностями при одновременном управлении множеством активов, временными рамками и рыночными условиями. Оптимизация портфеля должна учитывать многочисленные активы, каждый из которых обладает уникальной динамикой и ограничениями, что требует использования передовых архитектур распределенных вычислений Fabozzi et al., (2010). Обучение моделей глубокого RL является ресурсоемким процессом, требующим значительных мощностей и времени. Это может препятствовать быстрому приспособлению финансовых институтов к изменениям рынка, потенциально снижая их конкурентное преимущество Heaton et al., (2017)⟧.
8.9 Проблемы качества данных и предварительной обработки
В финансовом RL качество данных и их предварительная обработка имеют решающее значение из-за зашумленности и неполноты данных. Отсутствующие данные, выбросы и систематические ошибки могут значительно повлиять на обучение и производительность RL агентов Tsay, (2005). Tsay Tsay, (2005) рассматривает проблемы качества данных во временных рядах финансовой сферы, подчеркивая необходимость надлежащей предварительной обработки и очистки. Приложения RL сталкиваются с острыми проблемами из-за своей чувствительности к качеству данных, опираясь на временные закономерности и последовательные решения..
Ошибка выжившего является серьезной проблемой в финансовых данных, поскольку исторические наборы данных часто включают только те активы или стратегии, которые выжили, что приводит к чрезмерно оптимистичным оценкам эффективности Brown et al., (1992). Это может значительно повлиять на обучение RL агентов и их производительность в реальных условиях. Интеграция разнообразных источников данных с различными форматами, частотой и уровнями качества создает проблемы для RL систем. Такие источники, как тональность новостей, социальные сети и спутниковые снимки, предлагают ценную информацию, но требуют передовых методов предварительной обработки и интеграции Chinco et al., (2019)⟧.
8.10 Устойчивость и обобщающая способность моделей
Финансовые RL системы должны быть устойчивыми и обладать хорошей способностью к обобщению, чтобы справляться с непредвиденными рыночными условиями и экстремальными событиями. Рынки могут подвергаться внезапным сменам режима, событиям типа «черный лебедь» и другим крайностям, которые недостаточно представлены в исторических данных Taleb, (2007). Талеб Taleb, (2007) подчеркивает, что финансовые модели часто упускают из виду экстремальные события с катастрофическими последствиями, делая акцент на необходимости надежного проектирования и стресс-тестирования. Это критически важно для RL систем, подверженных состязательным атакам или непредвиденным рыночным условиям, с которыми они не сталкивались во время обучения. Проблема обобщения дополнительно усложняется постоянно развивающимися финансовыми рынками, где регулярно появляются новые инструменты, правила и участники. RL системы должны адаптироваться, сохраняя при этом устойчивую производительность в различных рыночных условиях Cont, (2001).
Исследователи предложили методы повышения устойчивости финансовых систем RL, такие как адаптация домена, трансферное обучение и робастная оптимизация. Эти методы влекут за собой компромиссы в производительности и вычислительной сложности, что требует тщательной оценки потребностей приложения Ben-David et al., (2010). В этом разделе подчеркивается сложность применения систем RL в финансах, требующая специализированных методов для решения специфических рыночных задач. Несмотря на прогресс, многие проблемы сохраняются, влияя на практическое использование RL в финансах..
9 Будущие направления исследований
9.1 Методологические достижения
Будущее развитие RL в принятии финансовых решений требует значительных методологических достижений для устранения текущих ограничений и раскрытия новых возможностей. Интерпретируемое обучение с подкреплением представляет собой одну из наиболее насущных потребностей, требующую разработки алгоритмов RL, которые могут предоставлять четкие объяснения своих решений, сохраняя при этом конкурентоспособную производительность. Методы безопасного исследования представляют собой еще одну критически важную область для будущих исследований, особенно для финансовых приложений, где исследование может привести к существенным убыткам. Будущие исследования должны быть сосредоточены на разработке стратегий исследования, которые могут эффективно обучаться, минимизируя при этом риск снижения доходности с помощью таких методов, как оптимизация политики с ограничениями и исследование с учетом неопределенности. Робастные методы обучения с подкреплением, способные поддерживать производительность в различных рыночных режимах и условиях, представляют собой еще одно важное направление исследований. Финансовые рынки характеризуются нестационарностью и сменой режимов, что может существенно повлиять на производительность RL, требуя алгоритмов, способных обнаруживать меняющиеся условия и адаптироваться к ним, сохраняя при этом устойчивую производительность..
9.2 Интеграция технологий и перспективные области применения
Интеграция RL с новыми технологиями открывает значительные возможности для совершенствования потенциала принятия финансовых решений. Интеграция квантовых вычислений потенциально может обеспечить экспоненциальное ускорение для определенных типов задач оптимизации, имеющих центральное значение для принятия финансовых решений, хотя остаются серьезные проблемы в разработке практических алгоритмов квантового RL. Интеграция периферийных вычислений представляет собой более непосредственную возможность для повышения производительности и масштабируемости финансовых приложений RL за счет принятия решений с ультранизкой задержкой и снижения зависимости от централизованных вычислительных ресурсов. Инвестирование в экологические, социальные и управленческие факторы (ESG) представляет собой еще одну развивающуюся область применения, где методы RL могут обеспечить значительную ценность за счет оптимизации многоцелевых инвестиционных стратегий, которые балансируют финансовую отдачу с целями устойчивого развития..
10 Заключение
Данный обзор и метаанализ обучения с подкреплением в принятии финансовых решений предлагает ключевой вклад в исследования и практику. Анализируя 167 публикаций за 2020–2025 годы и проводя валидацию с использованием синтетических данных, это исследование выделяет закономерности, которые ставят под сомнение общепринятые представления об эффективности RL в финансах. Метаанализ показывает, что успех RL в финансах в большей степени зависит от качества реализации, экспертных знаний в предметной области и качества данных, чем от сложности алгоритмов. Слабые корреляции между размерностью признаков, продолжительностью обучения и выбором алгоритма с результатами предполагают необходимость сосредоточиться на адаптации к предметной области и надежной реализации, а не на сложных алгоритмах. Эмпирическая валидация подтверждает эти выводы, выделяя факторы, влияющие на производительность RL. Маркет-мейкинг и торговля криптовалютой являются ключевыми областями применения, стабильно демонстрирующими лучшие результаты в различных рыночных условиях. Временной анализ показывает значительные тенденции в разработке алгоритмов, при этом ESG-инвестирование является быстрорастущим направлением. Эти результаты существенно влияют на исследователей и практиков. Исследователям рекомендуется отдавать приоритет интерпретируемости, устойчивости и соблюдению нормативных требований, а не алгоритмическим достижениям. Практики получают основанные на доказательствах рекомендации по выбору алгоритмов, реализации и распределению ресурсов..
Анализ освещает ключевые проблемы для будущих исследований: необходимость интерпретируемых архитектур RL, надежных стратегий исследования и комплексных нормативно-правовых баз. Эти барьеры на пути внедрения требуют совместных усилий исследователей, практиков и регуляторов. Интеграция RL с новыми технологиями предлагает значительный потенциал для улучшения процесса принятия финансовых решений. Эволюция нормативно-правовых баз и отраслевых стандартов будет иметь решающее влияние на внедрение RL в финансовой сфере. Полученные результаты подтверждают, что RL является ценным инструментом для принятия финансовых решений при правильной реализации, однако успех требует внимания к качеству внедрения, соблюдению нормативных требований и специфическим факторам предметной области..
Список литературы
- ⟦Agudelo Aguirre and Agudelo Aguirre, (2024) Агудело Агирре, Р. А. и Агудело Агирре, А. А. (2024). Поведенческие финансы: эволюция от классической теории и замечания. Journal of Economic Surveys, 38(2):452–475.
- ⟦Aldridge, (2013) Олдридж, И. (2013). Высокочастотная торговля: практическое руководство по алгоритмическим стратегиям и торговым системам, том 604. Джон Уайли энд Санз.
- ⟦Almahdi and Yang, (2017) Almahdi, S. and Yang, S. Y. (2017). Адаптивная система портфельной торговли: оптимизация портфеля по соотношению риск-доходность с использованием рекуррентного обучения с подкреплением и ожидаемой максимальной просадкой. Expert Systems with Applications, 87:267–279.
- ⟦Almgren, (2003) Almgren, R. (2003). Оптимальное исполнение с нелинейными функциями влияния и торговыми рисками. Applied Mathematical Finance, 10(1):1–18.
- ⟦Almgren and Chriss, (2001) Almgren, R. and Chriss, N. (2001). Оптимальное исполнение портфельных транзакций. Journal of Risk, 3:5–40.
- ⟦Bagnara, (2022) Баньяра, М. (2022). Ценообразование активов и машинное обучение: критический обзор. Journal of Economic Surveys, 38(1):27–56.
- ⟦Bailey et al., (2014) Бейли, Д. Х., Борвейн, Дж. М., Лопес де Прадо, М. и Чжу, К. Дж. (2014). Вероятность переобучения при бэктестинге. Journal of Computational Finance, 20(4):39–69.
- ⟦Ben-David et al., (2010) Бен-Дэвид, С., Блитцер, Дж., Краммер, К., Кулеша, А., Перейра, Ф. и Воган, Дж. У. (2010). Теория обучения на основе различных доменов, том 79. Шпрингер.
- ⟦Benhamou et al., (2021) Бенхаму, Э., Салтиель, Д., Унгари, С. и Мухопадхьяй, А. (2021). Преодоление разрыва между планированием по Марковицу и глубоким обучением с подкреплением. Applied Sciences, 11(1):236.
- ⟦Bertsimas and Lo, (1998) Бертсимас, Д. и Ло, А. У. (1998). Оптимальное управление затратами на исполнение. Журнал финансовых рынков, 1(1):1–50.
- ⟦Brown et al., (1992) Браун, С. Дж., Гетцманн, У. Н., Ибботсон, Р. Г. и Росс, С. А. (1992). Ошибка выжившего в исследованиях эффективности. The Review of Financial Studies, 5(4):553–580.
- ⟦Buehler et al., (2019) Бюлер, Х., Гонон, Л., Тайхманн, Дж., и Вуд, Б. (2019). Глубинное хеджирование. Quantitative Finance, 19(8):1271–1291.
- ⟦(13) Carapuço, J., Neves, R., and Horta, N. (2018a). Применение обучения с подкреплением в торговле на рынке Форекс. Applied Soft Computing, 73:783–794.
- ⟦(14) Carapuço, J., Neves, R., and Horta, N. (2018b). Применение обучения с подкреплением в торговле на рынке форекс. Applied Soft Computing, 73:783–794.
- ⟦Cartea et al., (2015) Cartea, Á., Jaimungal, S., and Peña, J. (2015). Алгоритмическая и высокочастотная торговля. Cambridge University Press.
- ⟦Charpentier et al., (2021) Шарпантье, А., Эли, Р., и Ремлингер, К. (2021). Обучение с подкреплением в экономике и финансах. Вычислительная экономика, 58(2):329–360.
- ⟦Chen et al., (2021) Чен, Л., Гао, К., и Ли, Д. (2021). Многоагентное глубокое обучение с подкреплением для управления портфелем. IEEE Access, 9:30394–30405.
- ⟦Chinco et al., (2019) Чинко, А., Нойерл, А., и Вебер, М. (2019). Разреженная модель спроса на новости: данные рынка опционов. The Journal of Finance, 74(6):2829–2875.
- ⟦Cont, (2001) Cont, R. (2001). Эмпирические свойства доходности активов: стилизованные факты и статистические вопросы. Quantitative finance, 1(2):223–236.
- ⟦Cont et al., (2010) Cont, R., Moussa, A., and Santos, E. B. (2010). Структура сети и системный риск в банковских системах. Доступно на SSRN 1733528.
- ⟦Doshi-Velez and Kim, (2017) Doshi-Velez, F. and Kim, B. (2017). На пути к строгой науке об интерпретируемом машинном обучении. arXiv preprint arXiv:1702.08608.
- ⟦Dulac-Arnold et al., (2019) Dulac-Arnold, G., Mankowitz, D., and Hester, T. (2019). Проблемы обучения с подкреплением в реальных условиях. arXiv preprint arXiv:1904.12901.
- ⟦Fabozzi et al., (2010) Фабоцци, Ф. Дж., Фокарди, С. М., и Колм, П. Н. (2010). Количественное инвестирование в акции: методы и стратегии, том 453. Джон Уайли энд Санз.
- ⟦Farmer and Skouras, (2013) Фармер, Дж. Д. и Скурас, С. (2013). Обзор прошлого и будущего электронной торговли и её влияния на структуру рынка. Journal of Economic Dynamics and Control, 37(4):738–756.
- ⟦Feng et al., (2019) Фенг, Ф., Хе, Х., Ванг, Х., Луо, К., Лиу, Й., и Чуа, Т.-С. (2019). Временное реляционное ранжирование для прогнозирования акций. ACM Transactions on Information Systems (TOIS), 37(2):1–30.
- ⟦Fischer and Krauss, (2018) Фишер, Т. и Краусс, К. (2018). Глубинное обучение с использованием сетей долгой краткосрочной памяти для прогнозирования финансовых рынков. Европейский журнал операционных исследований, 270(2):654–669.
- ⟦García and Fernández, (2015) Гарсия, Дж. и Фернандес, Ф. (2015). Всесторонний обзор безопасного обучения с подкреплением. Journal of Machine Learning Research, 16(1):1437–1480.
- ⟦(28) Gomber, P., Arndt, B., Lutat, M., and Uhle, T. (2017a). Высокочастотная торговля. Business & Information Systems Engineering, 59(6):381–383.
- ⟦(29) Gomber, P., Koch, J.-A., and Siering, M. (2017b). Цифровые финансы и финтех: текущие исследования и будущие направления исследований. Journal of Business Economics, 87(5):537–580.
- ⟦Goodfellow et al., (2016) Гудфеллоу, И., Бенджио, И., и Курвилль, А. (2016). Глубокое обучение. МИТ Пресс, Кембридж, Массачусетс.
- ⟦Gould et al., (2013) Гулд, М. Д., Портер, М. А., Уильямс, С., Макдональд, М., Фенн, Д. Дж. и Хауисон, С. Д. (2013). Книги лимитных заявок. Quantitative Finance, 13(11):1709–1742.
- ⟦Halperin, (2020) Халперин, И. (2020). Qlbs: Q-learner в мирах Блэка-Шоулза (-Мертона). The Journal of Derivatives, 28(1):99–122.
- ⟦(33) Хэмбли, Б., Сюй, Р. и Ян, Х. (2023a). Недавние достижения в обучении с подкреплением в финансах. Mathematical Finance, 33(3):437–503.
- ⟦(34) Хэмбли, Б., Сюй, Р., и Ян, Х. (2023b). Недавние достижения в обучении с подкреплением в финансах. Mathematical Finance, 33(3):437–503.
- ⟦Harvey et al., (2016) Харви, К. Р., Лю, И. и Чжу, Х. (2016). … и поперечное сечение ожидаемой доходности. Обзор финансовых исследований, 29(1):5–68.
- ⟦Hasbrouck, (2007) Hasbrouck, J. (2007). Эмпирическая микроструктура рынка: институты, экономика и эконометрика торговли ценными бумагами. Oxford University Press.
- ⟦Heaton et al., (2017) Хитон, Дж., Полсон, Н., и Витте, Дж. Х. (2017). Глубинное обучение для финансов: глубокие портфели. Applied Stochastic Models in Business and Industry, 33(1):3–12.
- ⟦Jiang et al., (2017) Цзян, З., Сюй, Д. и Лян, Дж. (2017). Структура глубокого обучения с подкреплением для задачи управления финансовым портфелем. arXiv preprint arXiv:1706.10059.
- ⟦Jorion, (2007) Джорион, П. (2007). Стоимость под риском: новый эталон для управления финансовыми рисками. Макгроу-Хилл.
- ⟦Kolm and Rémi, (2019) Колм, П. Н. и Реми, Г. (2019). Современные взгляды на обучение с подкреплением в финансах. The Journal of Machine Learning in Finance, 1(1):1–22.
- ⟦Lei et al., (2020) Лей, К., Чжан, Б., Ли, И., Ян, М., и Шэнь, Ю. (2020). Основанное на времени, учитывающее признаки совместное глубокое обучение с подкреплением для представления финансовых сигналов и алгоритмической торговли. Expert Systems with Applications, 140:112872.
- ⟦(42) Li, Y., Zheng, W., and Zheng, Z. (2019a). Глубинное робастное обучение с подкреплением для практической алгоритмической торговли. IEEE Access, 7:108014–108022.
- ⟦(43) Ли, Ю., Чжэн, В. и Чжэн, З. (2019b). Глубокое устойчивое обучение с подкреплением для практической алгоритмической торговли. IEEE Access, 7:108014–108022.
- ⟦Liang et al., (2018) Лян, З., Чен, Х., Чжу, Дж., Цзян, К., и Ли, Ю. (2018). На пути к автоматизированной торговле на основе обучения с подкреплением. Neurocomputing, 284:168–181.
- ⟦Lim and Brooks, (2011) Лим, К.-П. и Брукс, Р. (2011). Эволюция эффективности фондового рынка с течением времени: обзор эмпирической литературы. Journal of Economic Surveys, 25(1):69–108.
- ⟦Liu et al., (2020) Лю, И., Лю, К., Чжао, Х., Пан, З., и Лю, С. (2020). Адаптивная количественная торговля: подход на основе имитационного глубокого обучения с подкреплением. В материалах конференции АААИ по искусственному интеллекту, том 34, страницы 2128–2135.
- ⟦Lopez de Prado, (2018) Лопес де Прадо, М. (2018). Достижения в области финансового машинного обучения. Джон Уайли и сыновья.
- ⟦(48) Lussange, J., Belianin, S., Bourgeois-Gironde, S., and Gutkin, B. (2021a). Моделирование фондовых рынков с помощью многоагентного обучения с подкреплением. Computational Economics, 57(1):113–147.
- ⟦(49) Lussange, J., Belianin, S., Bourgeois-Gironde, S., and Gutkin, B. (2021b). Моделирование фондовых рынков с помощью многоагентного обучения с подкреплением. Computational Economics, 57(1):113–147.
- ⟦Markowitz, (1952) Марковиц, Г. (1952). Выбор портфеля. Журнал финансов, 7(1):77–91.
- ⟦McNeil et al., (2015) Макнил, А. Дж., Фрей, Р., и Эмбрехтс, П. (2015). Количественное управление рисками: концепции, методы и инструменты — переработанное издание. Принстон Юниверсити Пресс.
- ⟦Mitchell, (1997) Митчелл, Т. М. (1997). Машинное обучение. Макгроу-Хилл, Нью-Йорк.
- ⟦Mnih et al., (2016) Mnih, V., Badia, A. P., Mirza, M., Graves, A., Lillicrap, T., Harley, T., Silver, D., and Kavukcuoglu, K. (2016). Асинхронные методы для глубокого обучения с подкреплением. В сборнике: Международная конференция по машинному обучению, страницы 1928–1937.
- ⟦Mohri et al., (2018) Mohri, M., Rostamizadeh, A., and Talwalkar, A. (2018). Основы машинного обучения. MIT Press, Кембридж, Массачусетс, 2-е издание.
- ⟦Moody and Saffell, (2001) Муди, Дж. и Саффелл, М. (2001). Обучение торговле посредством прямого подкрепления. IEEE transactions on neural Networks, 12(4):875–889.
- ⟦Perold, (1988) Perold, A. F. (1988). Дефицит реализации: теория против реальности. The Journal of Portfolio Management, 14(3):4–9.
- ⟦Puiutta and Veith, (2020) Пуитта, Э. и Вейт, Э. М. (2020). Объяснимое обучение с подкреплением: обзор. Международная междисциплинарная конференция по машинному обучению и извлечению знаний, страницы 77–95.
- ⟦Qin et al., (2021) Цинь, З., Чжоу, Ю., Хуан, Ю., Сюй, К., и Йен, Д. К. (2021). Cefi против defi — сравнение централизованных и децентрализованных финансов. arXiv preprint arXiv:2106.08157.
- ⟦Ritter, (2017) Риттер, Г. (2017). Машинное обучение для трейдинга. Доступно на SSRN 3015609.
- ⟦(60) Ронкалли, Т. (2020a). Справочник по управлению финансовыми рисками. Чепмен и Холл/CRC.
- ⟦(61) Ронкалли, Т. (2020b). Машинное обучение для управления рисками. Доступно на SSRN 3435038.
- ⟦Sezer et al., (2020) Sezer, O. B., Gudelek, M. U., and Ozbayoglu, A. M. (2020). Прогнозирование финансовых временных рядов с помощью глубокого обучения: систематический обзор литературы: 2005–2019. Applied Soft Computing, 90:106181.
- ⟦Shi, (2025) Ши, К. (2025). От эконометрики к машинному обучению: Трансформация эмпирического ценообразования активов. Journal of Economic Surveys.
- ⟦Spooner et al., (2018) Spooner, T., Fearnley, J., Savani, R., and Koukorinis, A. (2018). Маркет-мейкинг посредством обучения с подкреплением. Труды 17-й Международной конференции по автономным агентам и мультиагентным системам, страницы 434–442.
- ⟦Sutton and Barto, (2018) Саттон, Р. С. и Барто, А. Г. (2018). Обучение с подкреплением: Введение. Издательство Массачусетского технологического института, Кембридж, Массачусетс, 2-е издание.
- ⟦Taleb, (2007) Талеб, Н. Н. (2007). Черный лебедь: Под знаком непредсказуемости, том 2. Рэндом хаус.
- ⟦Théate and Ernst, (2021) Théate, T. and Ernst, D. (2021). Применение глубокого обучения с подкреплением в алгоритмической торговле. Expert Systems with Applications, 173:114632.
- ⟦(68) Tsantekidis, A., Passalis, N., Tefas, A., Kanniainen, J., Gabbouj, M., and Iosifidis, A. (2017a). Прогнозирование цен на акции на основе книги лимитных ордеров с использованием сверточных нейронных сетей. 2017 IEEE 19th conference on business informatics (CBI), 1:7–12.
- ⟦(69) Tsantekidis, A., Passalis, N., Tefas, A., Kanniainen, J., Gabbouj, M., and Iosifidis, A. (2017b). Использование deep learning для обнаружения признаков изменения цен на финансовых рынках. В 2017 25th European Signal Processing Conference (EUSIPCO), страницы 2511–2515. IEEE.
- ⟦Tsay, (2005) Tsay, R. S. (2005). Анализ финансовых временных рядов, том 543. John wiley & sons.
- ⟦Wang et al., (2021) Ван, Х., Ю, Х. и Лю, Дж. (2021). Глубинное обучение с подкреплением для многопериодной оптимизации портфеля. Expert Systems with Applications, 164:113842.
- ⟦Wang et al., (2016) Ван, Дж. Х., Курт-Нельсон, З., Тирумала, Д., Сойер, Х., Лейбо, Дж. З., Мунос, Р., Бланделл, К., Кумаран, Д. и Ботвиник, М. (2016). Обучение обучению с подкреплением. arXiv preprint arXiv:1611.05763.
- ⟦Wu et al., (2020) Ву, Н., Грин, Б., Бен, Х. и О’Бэнион, С. (2020). Глубокие модели transformers для прогнозирования временных рядов: случай распространенности гриппа. arXiv preprint arXiv:2001.08317.
- ⟦Yoon et al., (2019) Юн, Дж., Джарретт, Д. и Ван дер Схаар, М. (2019). Генеративно-состязательные сети для временных рядов. В сборнике: Достижения в системах обработки нейронной информации, том 32, страницы 5508–5518.
- ⟦Yuan et al., (2020) Юань, Ю., Ван, Ф.-И., Чжай, Дж. и Цао, З. (2020). Многоагентная система управления энергией на основе машинного обучения для подключаемых гибридных электромобилей с адаптацией в режиме реального времени. Transportation Research Part C: Emerging Technologies, 121:102855.
- ⟦Zhang et al., (2017) Чжан, Л., Аггарвал, К. и Ци, Г.-Дж. (2017). Прогнозирование цен на акции посредством обнаружения многочастотных торговых паттернов. В материалах 23-й Международной конференции ACM SIGKDD по поиску знаний и интеллектуальному анализу данных, страницы 2141–2149.
- ⟦Zhang et al., (2020) Чжан, З., Зорен, С. и Робертс, С. (2020). Глубинное обучение для оптимизации портфеля. Журнал финансовых данных, 2(4):8–20.