marginparsep был изменён. topmargin был изменён. marginparwidth был изменён. marginparpush был изменён. Разметка страницы нарушает стиль ICML. Пожалуйста, не изменяйте разметку страницы и не подключайте пакеты вроде geometry, savetrees или fullpage, которые меняют её за вас. Мы не можем надёжно отменить произвольные изменения стиля. Пожалуйста, удалите проблемный(е) пакет(ы) или команды, изменяющие разметку, и повторите попытку..
BLASST: динамическое блочное разрежение механизма внимания с использованием порогового отсечения Softmax
Авторы без указания1
Аннотация
Растущий спрос на возможности долгосрочного контекстного вывода в больших языковых моделях (LLMs) усугубил проблемы с производительностью и памятью, присущие стандартному механизму внимания. Для решения этой задачи мы представляем BLASST — метод разреженного внимания по принципу «вставь и работай», который динамически обрезает матрицу внимания без каких-либо предварительных вычислений или оценок-прокси. Наша методика использует фиксированный порог и имеющуюся информацию из online softmax для выявления пренебрежимо малых оценок внимания, пропуская вычисление softmax, загрузку Value block и последующее матричное умножение. Это естественным образом встраивается в существующие конструкции ядер FlashAttention с пренебрежимо малым накладным временем. Подход применим как на стадиях prefill, так и decode для всех вариантов внимания (MHA, GQA, MQA и MLA), обеспечивая единое решение для ускорения вывода с длинным контекстом. Мы разрабатываем автоматизированную процедуру калибровки, которая выявляет простую обратную зависимость между оптимальным порогом и длиной контекста, позволяя надежно разворачивать метод в разнообразных сценариях. Сохраняя высокую точность, мы демонстрируем ускорение 1.62 для prefill при разреженности 74.7% и ускорение 1.48 для decode при разреженности 73.2% на современных GPU. Кроме того, мы изучаем обучение с учетом разреженности как естественное продолжение, показывая, что модели можно обучать так, чтобы они изначально были более устойчивыми к разреженным паттернам внимания, продвигая границу «точность—разреженность» еще дальше.
Предварительная работа. На рассмотрении в конференции Machine Learning and Systems (MLSys). Не распространять.
1 Введение
Большие языковые модели (LLMs) произвели революцию в обработке естественного языка, продемонстрировав выдающуюся производительность на разнообразных задачах. Однако при их практическом развертывании возникает критическое узкое место: квадратичная вычислительная сложность механизма внимания. По мере того как приложения все чаще требуют более длинных окон контекста — от обработки целых баз кода roziere2023code до анализа объемных документов zeng2025glm и поддержания продолжительных разговоров achiam2023gpt — это узкое место становится все более серьезным. Недавние модели, такие как Deepseek-R1 guo2025deepseek и Qwen3 yang2025qwen3, поддерживают длины контекста до 128K токенов, а некоторые модели продвигаются до 1M токенов comanici2025gemini. Тем не менее обработка таких длинных последовательностей по‑прежнему оказывается вычислительно неприемлемой, поскольку вычисления внимания доминируют как по задержке, так и по потреблению памяти. Для последовательности длины механизм внимания требует операций и обращений к памяти, что делает реальное развертывание длинноконтекстных
моделей сложным даже при использовании современного оборудования. Хотя FlashAttention dao2022flashattention и его последователи оптимизировали использование пропускной способности памяти за счет разбиения на блоки и слияния ядер, они по-прежнему вычисляют полную матрицу внимания, оставляя фундаментальную квадратичную сложность без решения.
Методы разреженного внимания стали многообещающим решением благодаря тому, что вычисляют только подмножество полной матрицы внимания. Однако существующие подходы страдают от фундаментальных ограничений. Во‑первых, они требуют нетривиальных операций для определения шаблонов разреженности: методы вроде MInference jiang2024minference и XAttention xu2025xattention выполняют дорогие предварительные проходы для выявления важных блоков, что часто сводит теоретическое ускорение к минимуму; в то время как статические шаблоны разреженности xiao2023efficient позволяют избежать предварительных вычислений, но являются негибкими и часто неоптимальными для разнообразных распределений внимания в разных задачах и для разных длины контекста. Во‑вторых, эти методы опираются на косвенные оценки важности, такие как накопленные веса внимания или сходство запрос–ключ, которые могут быть неточными и упускать критические взаимодействия токенов. В‑третьих, большинство существующих методов разреженного внимания ориентированы исключительно либо на фазу prefill, либо на фазу decode, упуская возможности для сквозной оптимизации..
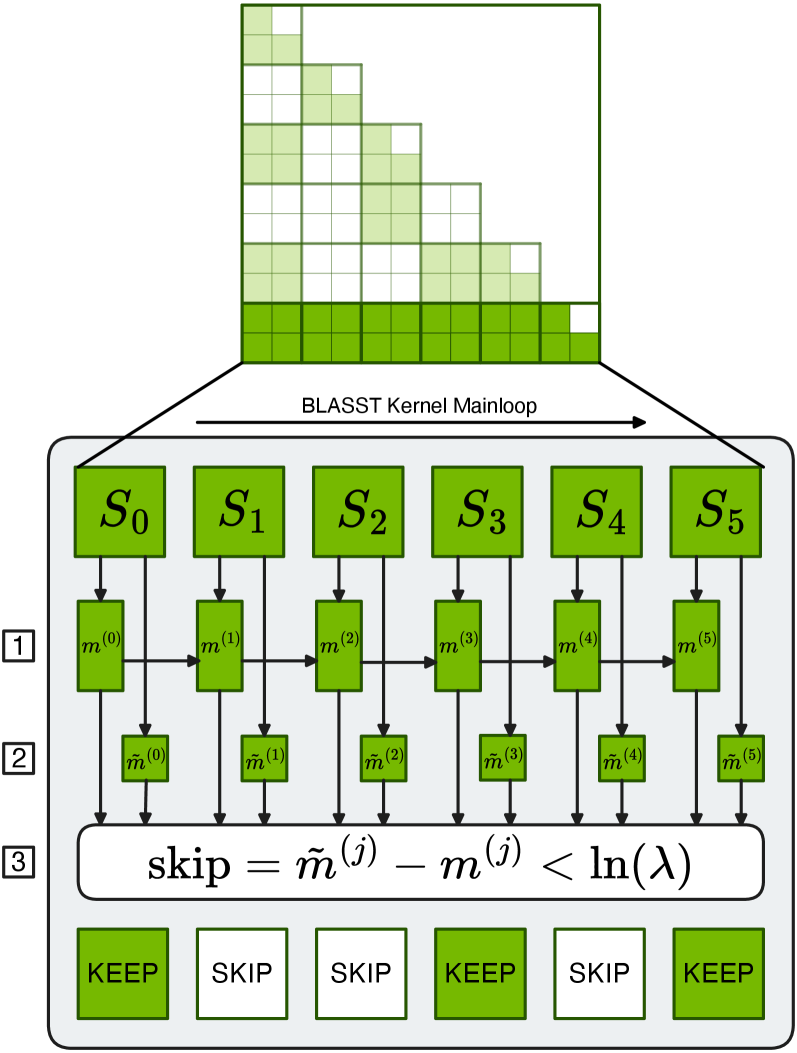
В данной статье мы представляем BLASST (BLocked Attention Sparsity via Softmax Thresholding), простoй, но при этом эффективный метод разреженного внимания, который динамически отсекает незначимые блоки внимания без какого-либо дополнительного накладного вычислительного расхода на предварительное вычисление. Наш ключевой вывод заключается в том, что в ходе блочной онлайн-реализации softmax в FlashAttention мы можем определять и пропускать блоки, вклад которых в итоговый выход будет пренебрежимо малым, опираясь только на уже вычисленную информацию. В частности, при последовательной обработке блоков мы поддерживаем текущее максимальное значение оценок внимания. Как показано на Рисунке 1, если локальная максимальная оценка блока существенно меньше текущего максимума (на величину порога ), то его значения после softmax будут близки к нулю после нормализации. Поэтому для таких блоков мы можем пропустить три дорогостоящие операции: (1) вычисление экспоненты для softmax, (2) загрузку соответствующего блока значений из HBM и (3) выполнение матричного умножения с этими значениями. Это простое правило отсечения требует лишь одного сравнения на блок и без труда встраивается в существующие реализации FlashAttention.
Чтобы максимизировать практическое влияние BLASST, мы разрабатываем высоко оптимизированные CUDA-ядра, реализующие наш алгоритм разреженного внимания. Наши ядра ориентированы на две ключевые цели: (1) обеспечить минимальные накладные расходы для логики принятия решения о пропуске блоков за счет повторного использования уже вычисленных статистик и (2) стратегически воздействовать на узкие места ресурсов на каждом этапе — снижать использование CUDA core и tensor core при вычислительно-насыщенном prefill и снижать потребление пропускной способности памяти при память-ограниченном decode. Мы реализуем специализированные ядра как для этапа prefill, так и для decode, с оптимизациями, соответствующими их различным вычислительным шаблонам. На современных GPU (H200, B200) наши ядра достигают до 1.62 ускорения для prefill при 74.7% разреженности и 1.48 ускорения для decode при 73.2% разреженности по сравнению с базовыми вариантами FlashAttention shah2024flashattention, при этом сохраняя численную устойчивость и поддерживая различные варианты внимания, включая grouped-query attention и sliding window attention.
Помимо базового алгоритма и реализации ядра, мы разрабатываем две ключевые техники для улучшения развертывания и производительности BLASST. Во-первых, мы предлагаем автоматизированную процедуру калибровки, которая определяет оптимальные пороги для любого целевого уровня разреженности. Наша калибровка выявляет устойчивую обратную зависимость между порогом и длиной контекста , обеспечивая надежное развертывание в различных сценариях без ручной настройки. Во-вторых, мы исследуем обучение с учетом разреженности как естественное продолжение, показывая, что модели можно обучать так, чтобы они были изначально более устойчивыми к разреженным шаблонам внимания. Такой подход к обучению дополнительно продвигает границу точность-разреженность, позволяя достигать еще более высоких уровней разреженности при минимальной потере точности.
Наши вклад(ы) включают:
- ⟦1. Метод «подставь и работай» без накладных расходов на предварительные вычисления и без прокси-оценок, обеспечивающий минимальную потерю точности.
- ⟦2. Автоматический подбор гиперпараметров и обучение с учетом разреженности для надежного, гибкого и расширяемого развертывания.
- 3. Оптимизированные CUDA-ядра на базе FlashAttention для как префилла, так и декодирования, с высокой производительностью.
2 Смежные работы
Эффективное использование свойства разреженного внимания требует либо уменьшения вычислений для неважных взаимодействий, либо уменьшения занимаемой памяти (например, KV cache - Key (К) и Value (V) для каждого уже обработанного токена) без дорогостоящих накладных расходов на выбор или переобучение. По сравнению со следующими связанными работами BLASST одновременно решает оба этих аспекта, в режиме без обучения.
2.1 Сжатие с разреженностью, оптимизированной для вычислений
Несколько подходов снижают вычисления внимания за счет выбора важных взаимодействий. Статические методы по шаблонам, такие как Sparse Transformer child2019generating, LongFormer beltagy2020longformer и BigBird zaheer2020big, уменьшают сложность за счет локального или блочного внимания. Методы на основе retrieval-головок wu2024retrieval; xiao2024duoattention ускоряют декодирование модели, сосредоточивая вычисления на ключевых retrieval-головках. Динамические методы разреженности, такие как MInference jiang2024minference, используют предварительно вычисленные оценки важности, XAttention xu2025xattention ранжирует антидиагональные блоки, а FlexPrefill lai2025flexprefill предлагает поддерживаемые компилятором гибкие блочные шаблоны; при этом эффективные для prefill, их предварительные вычисления и накладные расходы планирования могут ограничивать достигнутые ускорения. Разреженность, обусловленная обучением, такая как SeerAttention gao2025seerattention, индуцирует высокую разреженность через (пред)обучающие затворы, улучшая эффективность, но добавляя стоимость обучения и демонстрируя смешанную эффективность на последующих задачах.
SpargeAttention zhang2025spargeattn имеет самое близкое по замыслу к BLASST. Мы отличаемся в трех ключевых аспектах: (1) BLASST оптимизирует и prefill, и decode с помощью специализированных ядер, тогда как SpargeAttention нацелена только на prefill; (2) мы принимаем решения о пропуске напрямую, используя уже вычисленную статистику, без нулевых накладных расходов, в то время как SpargeAttention использует отдельный шаг предсказания; (3) наше decode-ядро пропускает загрузку Value из HBM, устраняя проблемные места, ограниченные памятью, поверх экономии на вычислениях. Кроме того, мы предоставляем автоматическую калибровку и обучение с учетом разреженности.
2.2 Память-оптимизированная разреженность
Сконцентрированность токенов/сведений KV на разрежении направлена на сокращение объёма памяти и издержек по времени декодирования. H2O zhang2023h2o, TOVA oren2024transformers и InfLLM xiao2024infllm отбрасывают токены на основе шаблонов запросов. StreamingLLM xiao2023efficient сохраняет исходные и последние токены для согласованной задержки и использования памяти. Quest tang2024quest производит отсечение токенов, обусловленное текущим запросом; Rectified Sparse Attention sun2025rectified адаптивно выбирает токены, чтобы поддерживать точность при высокой разреженности; RocketKV behnam2025rocketkv сжимает кэш KV с избирательным вытеснением, а недавнее сжатие KV для гипермасштабирования lancucki2025inference дополнительно расширяет эффективный контекст; TidalDecode yang2024tidaldecode стабилизирует эффективность декодирования с помощью устойчивых к позиции шаблонов. Эти подходы в первую очередь нацелены на память посредством отсечения/сжатия KV на фазе декодирования, тогда как BLASST напрямую снижает вычисления и на стадии prefill, и на стадии декодирования, оставаясь без обучения.
2.3 Новые варианты внимания
Помимо упомянутых методов, альтернативные механизмы включают Sliding Window Attention beltagy2020longformer, Linear or Gated Attention qiu2025gated и State-Space Models (SSM) gu2023mamba. Native Sparse Attention (NSA) yuan2025native и DeepSeek Sparse Attention (DSA) deepseekai2024deepseekv32, хотя и эффективны в некоторых режимах, часто требуют архитектурных изменений или переобучения. В отличие от этого, BLASST — это метод после обучения, который ускоряет как prefill, так и decode без прокси-оценок или сложных предварительных вычислений, при этом он бесшовно интегрируется с реализациями FlashAttention.
3 Методология
3.1 Сокращение внимания с помощью текущих максимумов
Ключевая идея BLASST заключается в том, что при вычислении оценок внимания в FlashAttention многие блоки вносят пренебрежимо малый вклад в итоговый результат после нормализации softmax. Наша методика динамически находит и пропускает эти блоки во время прямого прохода, не требуя предварительного вычисления или вычисления прокси-оценок.
3.1.1 Ключевая идея
В стандартном механизме внимания операция softmax вычисляет:
| (1) |
Во время блочно-ориентированных вычислений FlashAttention мы поддерживаем текущий максимум по блокам. Если локальный максимум блока существенно меньше текущего текущего максимума, то есть для некоторого порога , тогда после возведения в степень:
| (2) |
Поскольку максимальное значение ограничено , вклад блока в итоговый выход внимания будет пренебрежимо малым, что позволяет нам полностью пропустить его вычисление.
Интуитивно, это критерий следует трехшаговому приближению. Во-первых, идеальная значимость каждого балла — это его значение относительно (неизвестного) глобального максимума. Во-вторых, вычисление истинного максимума на лету слишком дорого, поэтому мы используем текущий максимум как удобный заменитель и сравниваем с ним. В-третьих, чтобы обеспечить эффективное блочно-уровневое принятие решения внутри ядра, мы заменяем токен-уровневое на блочно-локальный максимум, получая недорогое условие .
3.1.2 Дизайн алгоритмов
Алгоритм 1 представляет наш модифицированный прямой проход FlashAttention. Ключевое изменение заключается во введении динамического условия отсечения, которое экономит как вычисления, так и полосу пропускания памяти. Где мы экономим: Когда (строка 7), мы пропускаем:
- 1. Вычислительные сбережения (CUDA cores): Дорогие операции для вычисления требуют нескольких инструкций на элемент: MUFU.EX2 (экспоненциальная), FMUL (умножение) и FADD (сложение). Мы также пропускаем операции редукции rowsum (инструкции FADD) для нормализации весов внимания. Для типичного блока это экономит тысячи инструкций CUDA core.
- ⟦2. Вычислительная экономия (Tensor cores) при умножении матриц . На фазе prefill, когда вычисления ограничены производительностью, обход этих операций MMA обеспечивает существенное ускорение.
- ⟦Экономия пропускной способности памяти: загрузка блока Value из HBM в SRAM. Это особенно критично на фазе декодирования, где внимание ограничено памятью.
Наш подход напрямую снижает общее количество вычислений за счет динамического выявления и пропуска пренебрежимо малозначимых блоков внимания во время прямого прохода. Это простое, но эффективное изменение требует минимальных доработок существующей реализации FlashAttention и при этом обеспечивает существенную экономию вычислений.
3.2 Калибровка для оптимальной разреженности
Критической задачей при развертывании BLASST является выбор подходящего порога , который обеспечивает баланс между разреженностью и точностью. Чтобы понять эту взаимосвязь, мы провели эксперименты на Llama-3.1-8B на сложных подмножествах бенчмарка RULER (NIAH_MULTI, VT, FWE) с длинами контекста от 8K до 64K токенов.
Сходимость разреженности определяет точность. Рисунок 2 (слева) показывает относительное ухудшение точности в зависимости от коэффициента разреженности. Мы нормализуем каждую кривую по результату полного внимания для корректного сравнения. Примечательно, что все кривые демонстрируют согласованные закономерности ухудшения: производительность остается стабильной вплоть до разреженности 60-70%, после чего точность резко падает. Эта согласованность для различных задач и длин последовательностей показывает, что ухудшение точности в первую очередь определяется самим коэффициентом разреженности, а не типом набора данных или длиной последовательности.
Калибровка порога необходима. Для достижения согласованной производительности следует поддерживать фиксированное соотношение разреженности, а не фиксированный порог. Однако рисунок 2 (справа) показывает, что для достижения 75% разреженности требуется для контекстов 8K, но только для контекстов 64K. Это требует адаптивной калибровки. Важно, что при нацеливании на фиксированную разреженность посредством калибровки пользователи могут управлять и предвидеть ускорение вычислений, поскольку выигрыш в производительности масштабируется предсказуемо в зависимости от достигнутого уровня разреженности.
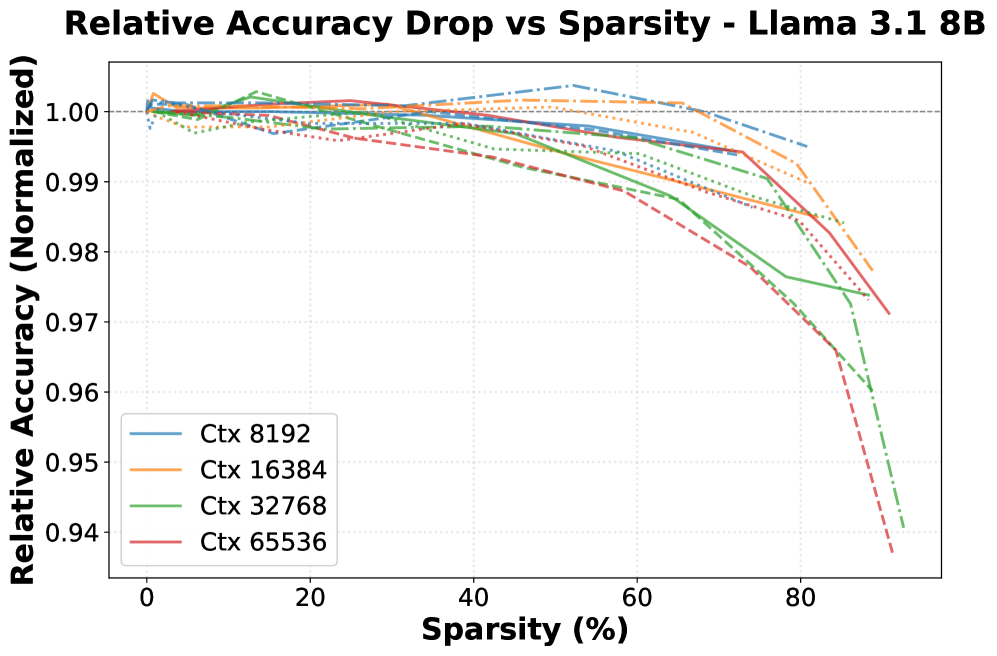
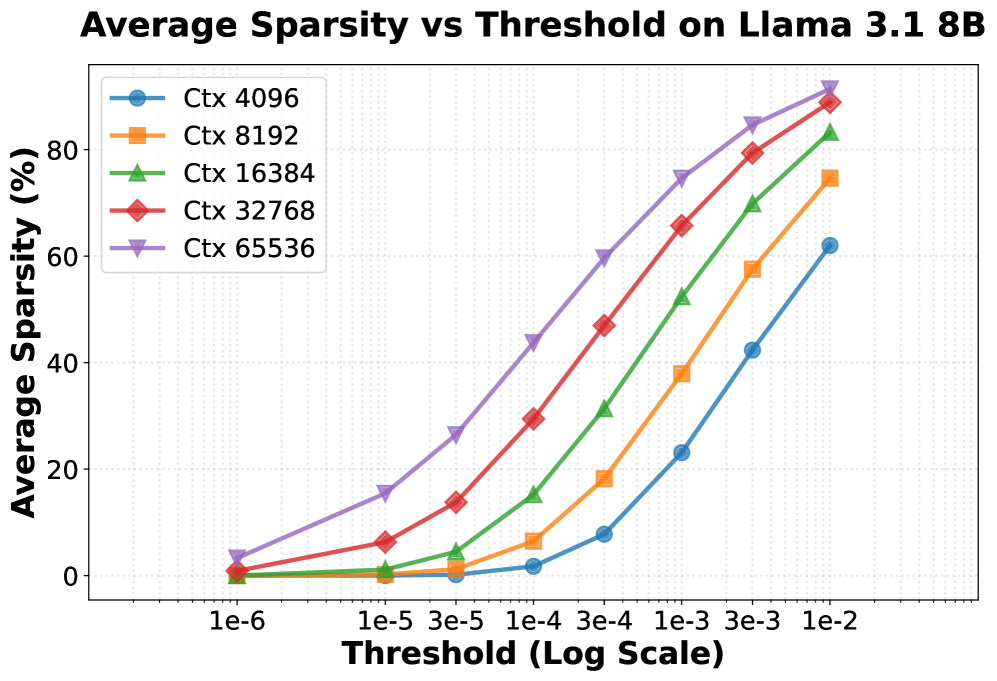
Путем эмпирического анализа мы обнаруживаем, что оптимальный порог следует обратно пропорциональной зависимости от длины контекста ⟧:
| (3) |
где — это константа, зависящая от модели. Эта обратная зависимость имеет теоретическое обоснование: поскольку оценки внимания нормируются по строкам так, что их сумма равна 1, для более длинных последовательностей характерны более низкие средние оценки на токен, что требует пропорционально меньших порогов. Без калибровки фиксированные пороги приводили бы к существенно различающимся уровням разреженности между последовательностями разной длины.
Чтобы найти оптимальное значение для заданной целевой разреженности , мы предлагаем процедуру калибровки, подробно описанную в алгоритме 2. Процесс включает эмпирический поиск наилучшего порога для нескольких длин контекста , который обеспечивает заданную целевую разреженность (в пределах допуска ). Затем мы выполняем линейную регрессию по преобразованным точкам данных , чтобы найти наклон , который задает нашу функцию калибровки .
Более того, нацеливаясь на фиксированные уровни разреженности, наша калибровка обеспечивает предсказуемое ускорение вычислений на различных длинах контекста. Это важное свойство для производственного развертывания, где требуется стабильная производительность.
3.3 Обучение с учетом разреженности
Хотя BLASST в первую очередь предназначен для оптимизации инференса после обучения, мы рассматриваем обучение с учетом разреженности как простое расширение, позволяющее далее улучшить компромисс между точностью и разреженностью. Мотивация понятна: если модели в процессе обучения учатся концентрировать важную информацию в блоках внимания с высокими оценками, то они должны сохранять более высокую точность, когда эти блоки будут обрезаны во время инференса.
Наш метод прост: при дообучении мы применяем BLASST в прямом проходе, чтобы пропускать незначимые блоки внимания на основе порогового критерия. В обратном проходе пропущенные блоки естественным образом не получают градиентов, поскольку они не вычислялись в прямом проходе. Это побуждает модель адаптировать свои шаблоны внимания к большей совместимости с разреженностью, концентрируя важную информацию в блоках, которые проходят пороговый тест. Этот подход не требует изменений архитектуры или дополнительных потерь — это просто обучение с той же разреженной схемой внимания, которая будет использоваться во время вывода.
4 Дизайн ядра
Ядра BLASST были разработаны с двумя основными целями: (1) минимальные изменения существующих интерфейсов ядра FlashAttention и структуры реализации и (2) минимальные накладные расходы для логики принятия решений о пропуске блоков. Наш ключевой вывод заключается в повторном использовании статистик, уже вычисляемых в стандартном алгоритме FlashAttention — в частности, локального максимума и текущих значений максимума, которые существуют в каждом потоке при выполнении онлайн softmax.
Пропуск реализации решения. Процесс принятия решения (строка 7 в алгоритме 1) требует лишь нескольких дополнительных инструкций на блок: (1) установка предиката для каждого потока на основе сравнения с порогом, (2) выдача инструкции VOTE для определения, согласны ли все потоки внутри warp на пропуск, и (3) одна инструкция ATOMIC в общую память, выдаваемая одним потоком на warp, чтобы координировать решение уровня блока между softmax warpgroup. Мы тщательно проектируем ядро так, чтобы инструкции принятия решений были скрыты за существующими операциями, добавляя пренебрежимо малое увеличение задержки.
Поскольку фаза предзаполнения и фаза декодирования имеют принципиально разные характеристики производительности, мы реализуем специализированные оптимизации для каждой.


4.1 Префилл ядро: оптимизация, ограниченная вычислениями
Предзаполнение ядер обычно является вычислительно ограниченным, упирающимся в пропускную способность вычислительных блоков CUDA core (softmax) и tensor core (умножение матриц), а не в пропускную способность памяти. Поэтому наше предзаполнение ядра предназначено для пропуска как вычисления softmax, так и операций MMA (умножение внимание-значение) для обрезанных блоков.
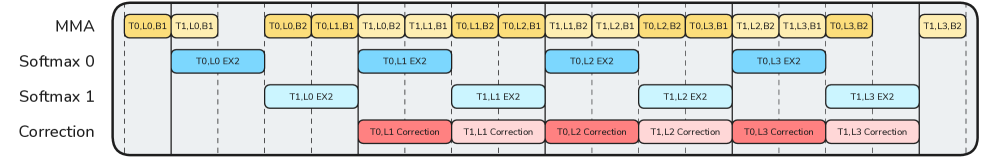
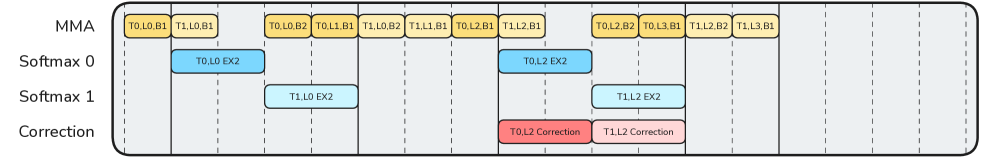
Рисунок 3 иллюстрирует наши изменения в расписании конвейера для префилл-ядра BLASST, оптимизированного для сценариев с вычислительной насыщенностью за счет перекрытия различных вычислительных задач. Конвейерные расписания распределяют операции между Tensor Cores (математический warp/умножение матриц) и CUDA cores (логика softmax и коррекции). Рисунок 3(b) показывает, что даже когда выполняются все (BMM1) операции, ядро динамически пропускает вычислительно затратные операции softmax и умножение attention-value (BMM2) для блоков, определенных как незначимые (например, loop 1 и loop 3 на рисунке 3(b)). Пропуская эти вычислительные операции, ядро освобождает вычислительные модули, что позволяет последующим операциям планироваться раньше. Это сжимает общее расписание, уменьшая общее время выполнения с 18 временных единиц на рисунке 3(a) до 14 единиц на рисунке 3(b).
Блоки Value остаются загруженными из HBM в ядре prefill потому что: (1) пропускная способность памяти не является узким местом, (2) конвейер предварительной выборки выигрывает от предсказуемых шаблонов доступа к памяти, и (3) задержка условной загрузки Value превысит получаемую экономию. Сосредоточившись на устранении вычислительных операций, мы добиваемся ускорений, которые масштабируются почти линейно с разреженностью в вычислительно-ограниченном режиме. Наша текущая конструкция отдает приоритет типичному случаю, когда prefill на современных GPU является вычислительно-ограниченным; однако загрузку Value можно пропустить в prefill, если будущие рабочие нагрузки или архитектуры оборудования сместят узкое место в область ограничений пропускной способности памяти.
| Model | Sparsity | Prefill Phase | Decode Phase | Prefill + Decode Phase | ||||
|---|---|---|---|---|---|---|---|---|
| RULER-32K | LongBench | MATH500 | AIME2024 | GPQA | RULER-32K | LongBench | ||
| Llama-3.1-8B | Dense | 92.33 | 31.40 | 73.40 | 46.66 | 46.71 | 92.33 | 31.40 |
| 50% | 91.81 | 31.80 | 73.71 | 46.15 | 46.31 | 91.79 | 32.40 | |
| 75% | 91.67 | 31.80 | 73.89 | 46.01 | 45.95 | 91.67 | 31.80 | |
| Qwen3-8B | Dense | 91.90 | 33.60 | 95.87 | 75.00 | 61.21 | 91.90 | 33.60 |
| 50% | 92.08 | 35.10 | 96.23 | 76.50 | 61.56 | 92.07 | 33.30 | |
| 75% | 92.11 | 34.40 | 96.07 | 75.33 | 61.51 | 91.74 | 33.10 | |
4.2 Декодирование ядра: оптимизация, ограниченная памятью
Декодирующие ядра обычно являются ограниченными по памяти, упираясь в узкое место пропускной способности HBM, необходимой для выборки KV-кэша, а не в вычисления, поскольку внимание предполагает только один запрос Query ко всем ключам Keys. Поэтому наше ядро сосредоточено на пропуске ресурсоемкой загрузки матрицы значений Value для обрезанных блоков, напрямую устраняя это узкое место по HBM. Эта оптимизация уменьшает объем трафика памяти пропорционально уровню разреженности, при этом накладывая пороговые и операции с Key на оставшиеся загрузки Value, чтобы обеспечить существенное ускорение, отражающее различающиеся характеристики производительности при декодировании по сравнению с prefill.
Рисунок 4 иллюстрирует наши изменения в расписании конвейера для декодирующего ядра BLASST. Длительные времена загрузки плиток и показывают, как ведет себя ядро в этой памяти-ограниченной ситуации. Пропуская загрузку плитки и BMM2 для циклов 1, 2 и 4, графический процессор может завершить ожидающие загрузки из других стадий конвейера TMA быстрее. В результате Рисунок 4(a) занимает 30 единиц времени, чтобы завершить все V-загрузки, тогда как Рисунок 4(b) занимает 23 единицы.
Для механизмов внимания вроде Multi-head Latent Attention (MLA) liu2024deepseek, которые даже при декодировании являются более вычислительно ограниченными, мы дополнительно пропускаем операции softmax для вырезанных блоков, обеспечивая дополнительное ускорение помимо одних только сбережений памяти.
5 Эксперименты
5.1 Экспериментальная установка
Модели. Мы оцениваем BLASST на современнейших языковых моделях, чтобы продемонстрировать его эффективность на различных архитектурах. Наша оценка сосредоточена на двух моделях с 8B параметров: Llama-3.1-8B-Instruct и Qwen3-8B-Instruct, обе поддерживают контекстные длины до 128K токенов. Для задач длительного генеративного рассуждения мы используем Llama-3.1-8B-Instruct, дистиллированную из DeepSeek-R1 guo2025deepseek, которая обеспечивает улучшенные способности к рассуждению при сохранении совместимости с нашим подходом к разреженному вниманию.
Базовые методы. Мы сравниваем BLASST с плотным вниманием и современными методами разреженного внимания. Для оптимизации префилла мы сравниваем с MInference jiang2024minference, FlexPrefill lai2025flexprefill и XAttention xu2025xattention. Для оптимизации декодирования мы оцениваем в сравнении с Quest tang2024quest и RocketKV behnam2025rocketkv. Для каждого базового метода мы используем его наилучшую по результатам конфигурацию, указанную в соответствующей статье, чтобы обеспечить справедливое сравнение.
Наборы данных. Мы оцениваем на двух категориях наборов тестов: (1) Задачи с длинным контекстом: RULER hsieh2024ruler (синтетическое извлечение и рассуждение по 4K-128K токенам) и LongBench v2 bai2024longbench (прикладные задачи QA, суммаризация и дополнение кода). (2) Задачи на рассуждение: MATH500 (решение математических задач), AIME 2024 (продвинутая математика), GPQA (научные дисциплины на уровне аспирантуры) и LiveCodeBench (генерация кода). Эти проверочные наборы на рассуждение тестируют, сохраняет ли разреженное внимание сложные многошаговые рассуждательные способности. Мы используем фреймворк NVIDIA NeMo-Skills framework111https://github.com/NVIDIA-NeMo/Skills для стандартизированной оценки задач на рассуждение.
Сведения по реализации. Мы реализуем BLASST как оптимизированные CUDA-ядра, интегрированные с фреймворком flashinfer ye2025flashinfer. Для калибровки (Алгоритм 2) мы отбираем приблизительно 1000 последовательностей из набора данных RULER для разных длин контекста (4K, 8K, 16K, 32K, 64K), чтобы определить оптимальную зависимость порога для заданных уровней разреженности. Для обучения с учетом разреженности мы используем подход к обучению по учебному плану из ProLong gao2024train, применяя BLASST на этапе дообучения с фиксированным порогом разреженности.
Для оценки мы используем различные стратегии выборки в зависимости от типа задачи. Для тестов с длинным контекстом (RULER и LongBench) мы используем жадекодирование с температурой и выполняем один запуск на каждый пример, чтобы обеспечить детерминированные и воспроизводимые результаты. Для задач рассуждения, которым полезно разнообразие выборок, мы используем температуру и top-p . А именно, мы генерируем 10 образцов на задачу для MATH500, GPQA и LiveCodeBench, и 20 образцов на задачу для AIME 2024 из-за его большей сложности. Для этих задач рассуждения мы сообщаем наилучшее из N (best-of-N) по тому, как окончательный ответ выбирается с помощью мажоритарного голосования или самосогласованности.
| Method | RULER | LongBench | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 4K | 8K | 16K | 32K | 64K | Average | Easy | Hard | Short | Medium | Long | Overall | |
| Dense Attention | 96.16 | 95.07 | 94.80 | 92.33 | 87.69 | 93.21 | 29.7 | 32.5 | 38.3 | 28.8 | 25.0 | 31.4 |
| FlexPrefill | 95.99 | 93.67 | 92.73 | 88.14 | 81.14 | 87.72 | 28.8 | 23.8 | 24.4 | 26.5 | 26.2 | 25.7 |
| MInference | 96.54 | 94.06 | 91.37 | 85.79 | 83.03 | 84.15 | 28.6 | 32.8 | 36.7 | 30.2 | 24.1 | 31.2 |
| XAttention | 96.37 | 94.47 | 94.48 | 91.91 | 85.01 | 92.44 | 29.2 | 31.5 | 38.3 | 26.0 | 26.9 | 30.6 |
| BLASST (50%) | 96.17 | 94.70 | 94.61 | 91.81 | 87.06 | 92.87 | 30.7 | 32.5 | 38.3 | 29.8 | 25.0 | 31.8 |
| Method | RULER-32K | LongBench | MATH500 | AIME 2024 | LiveCodeBench | GPQA | Average |
|---|---|---|---|---|---|---|---|
| Dense Attention | 91.90 | 33.60 | 95.87 | 75.00 | 53.83 | 61.21 | 68.57 |
| Quest | 56.23 | 30.30 | 94.18 | 71.50 | 52.17 | 60.12 | 60.75 |
| RocketKV | 87.89 | 30.60 | 95.88 | 73.54 | 53.10 | 60.50 | 66.91 |
| BLASST 50% | 91.55 | 33.90 | 96.23 | 76.50 | 54.15 | 61.51 | 68.97 |
5.2 Основные результаты
Итоговая производительность. Таблица 1 демонстрирует производительность BLASST при уровнях разреженности 50% и 75% для Llama-3.1-8B и Qwen3-8B на различных наборах тестов. Примечательно, что BLASST не только сохраняет точность с минимальным ухудшением, но иногда превосходит плотную базовую модель. Например, для Qwen3-8B наблюдаются улучшения на MATH500 (96.23 против 95.87) и AIME 2024 (76.50 против 75.00) при разреженности 50%. Этот контринтуитивный результат можно объяснить двумя факторами. Во-первых, в задачах с длинным контекстом, где информация по своей природе разреженная, отсечение блоков с низкой значимостью внимания заставляет модель концентрировать плотность вероятности на наиболее релевантных токенах, фактически выступая как неявное подавление шума. Во-вторых, для задач рассуждений с длинной генерацией некоторые промежуточные шаги рассуждений или токены могут быть избыточными или даже вредными sui2025stop; пропуская блоки с пренебрежимо малыми значениями внимания, мы отсеиваем такие отвлекающие факторы, позволяя модели сосредоточиться на ключевых цепочках рассуждений. Эти результаты показывают, что BLASST обеспечивает не только вычислительную эффективность, но и улучшает качество вывода в некоторых сценариях.
Сравнение фазы предварительного заполнения. Таблица 2 сравнивает BLASST с современными методами разреженного внимания, оптимизированными для предварительного заполнения, на Llama-3.1-8B. На протяжении RULER (длины контекста 4K-64K) и LongBench BLASST обеспечивает наилучшую общую производительность (92.87 RULER в среднем, 31.8 LongBench) среди всех разреженных методов, почти совпадая с плотным вниманием (93.21, 31.4), при этом не требуя предварительных вычислений. Примечательно, что BLASST существенно превосходит MInference (84.15 RULER) и FlexPrefill (87.72 RULER), демонстрируя эффективность нашего порогового отсечения по сравнению с оцениванием важности на основе прокси.
Сравнение фаз декодирования. Таблица 3 оценивает BLASST на Qwen3-8B на задачах, требующих интенсивного рассуждения. При и 50% разреженности BLASST соответствует или превосходит по показателям производительности плотную базовую модель на всех наборах данных, при этом сохраняя возможности работы с длинным контекстом. Мы отмечаем, что все существующие методы используют разные стратегии оптимизации и ориентируются на разные сценарии развертывания, что делает прямое сравнение затруднительным. Мы включаем Quest и RocketKV в качестве точек отсчета, чтобы контекстуализировать производительность BLASST. Например, RocketKV демонстрирует 87.89 RULER и 30.60 точность LongBench, что иллюстрирует компромиссы, связанные с агрессивным сжатием кэша KV, по сравнению с подходом BLASST, сохраняющим критические паттерны внимания.
| Blackwell Prefill | Blackwell Decode | ||
|---|---|---|---|
| Sparsity | Speedup | Sparsity | Speedup |
| 0.00% | 0.99 | 0.00% | 0.98 |
| 23.24% | 1.07 | 36.91% | 1.18 |
| 32.78% | 1.13 | 46.68% | 1.25 |
| 42.26% | 1.18 | 61.23% | 1.34 |
| 50.67% | 1.24 | 73.15% | 1.48 |
| 63.96% | 1.34 | 82.62% | 1.64 |
| 73.47% | 1.41 | 87.01% | 1.71 |
| 80.35% | 1.49 | 91.99% | 1.79 |
5.3 Производительность GPU-ядра
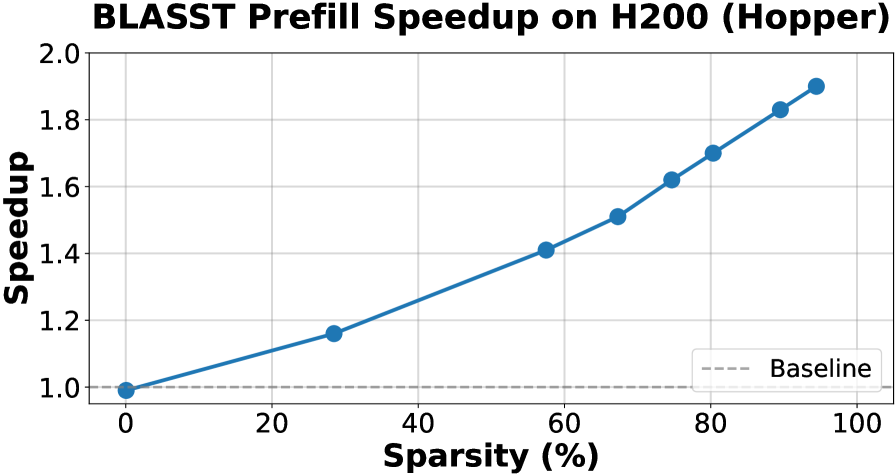
Мы реализуем и проводим бенчмаркинг высоко оптимизированных ядер для архитектур GPU Blackwell (B200) и Hopper (H200), демонстрируя, что BLASST обеспечивает существенные ускорения в реальных условиях. Таблица 4 и рисунок 5 показывают масштабирование производительности при росте уровней разреженности для обеих фаз: prefill и decode. Все ускорения измеряются по сравнению с базовыми вариантами FlashAttention-3 BF16.
Ключевые результаты. При близкой к безошибочной точности (50% разреженности) мы достигаем приблизительно 1.24 ускорения для prefill и 1.23 ускорения для decode на Blackwell. При более высокой разреженности (70%) ускорение prefill и decode увеличивается до 1.40. На Hopper prefill обеспечивает до 1.62 ускорения при 74.7% разреженности. Эти ускорения предсказуемо масштабируются с разреженностью: более высокая разреженность дает большие приросты производительности, позволяя пользователям выбирать предпочитаемый компромисс точность—эффективность.
Важно, что мы не наблюдаем значимого ухудшения производительности при 0% разреженности (0.99-1.03 базовый уровень), что гарантирует, что BLASST добавляет минимальные накладные расходы при низкой разреженности.
5.4 Результаты калибровки
Ключевая мотивация нашего подхода к калибровке заключается в том, что фиксированные пороги дают несогласованную разреженность при разных длинах контекста, что делает развертывание ненадежным. Таблица 5 демонстрирует эффективность нашего метода калибровки при изменяющихся длинах последовательностей. Для целевой разреженности 50% подход с фиксированным порогом приводит к крайне нестабильной разреженности от 23% при 4K до 75% при 64K, что делает его непригодным для производственного развертывания. В отличие от этого наш откалиброванный подход поддерживает разреженность в узком диапазоне со средним отклонением всего 1,2% от целевого значения. Аналогичные улучшения наблюдаются при целевой разреженности 70%. Эти результаты подтверждают, что наша калибровка обеспечивает надежное, предсказуемое управление разреженностью при различных длинах последовательностей без ручной настройки.
| Method | 4K | 8K | 16K | 32K | 64K |
|---|---|---|---|---|---|
| Target Sparsity: 50% | |||||
| Fixed | 23.09 | 37.92 | 52.38 | 65.72 | 74.63 |
| (-26.91) | (-12.08) | (+2.38) | (+15.72) | (+24.63) | |
| Calibrated | 54.20 | 49.70 | 52.20 | 46.96 | 48.75 |
| (+4.20) | (-0.30) | (+2.20) | (-3.04) | (-1.25) | |
| Target Sparsity: 70% | |||||
| Fixed | 42.35 | 57.54 | 69.83 | 79.36 | 84.63 |
| (-27.65) | (-12.46) | (-0.17) | (+9.36) | (+14.63) | |
| Calibrated | 67.99 | 74.65 | 73.64 | 72.54 | 74.63 |
| (-2.01) | (+4.65) | (+3.64) | (+2.54) | (+4.63) | |
5.5 Результаты обучения с учетом разреженности
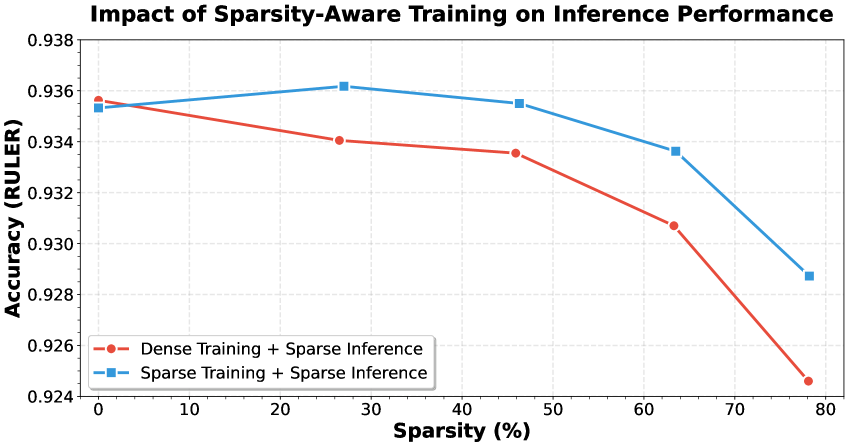
Рисунок 6 демонстрирует, что обучение с учетом разреженности улучшает компромисс «точность—разреженность» на бенчмарках RULER. На низких уровнях разреженности модели, обученные с разреженностью, даже немного превосходят базовую плотную модель, что указывает на то, что модель усваивает более устойчивые паттерны внимания. В целевом диапазоне разреженности 50%-75% модели, обученные с разреженностью, достигают существенно более высокой точности по сравнению с применением разреженности после обучения, снижая деградацию точности на величину до 1.7. Эти результаты подтверждают, что модели можно обучать так, чтобы концентрировать информацию в блоках внимания с высокими оценками, делая их по своей сути более совместимыми с разреженными паттернами внимания и продвигая границу Парето эффективного внимания.
5.6 Абляционные исследования
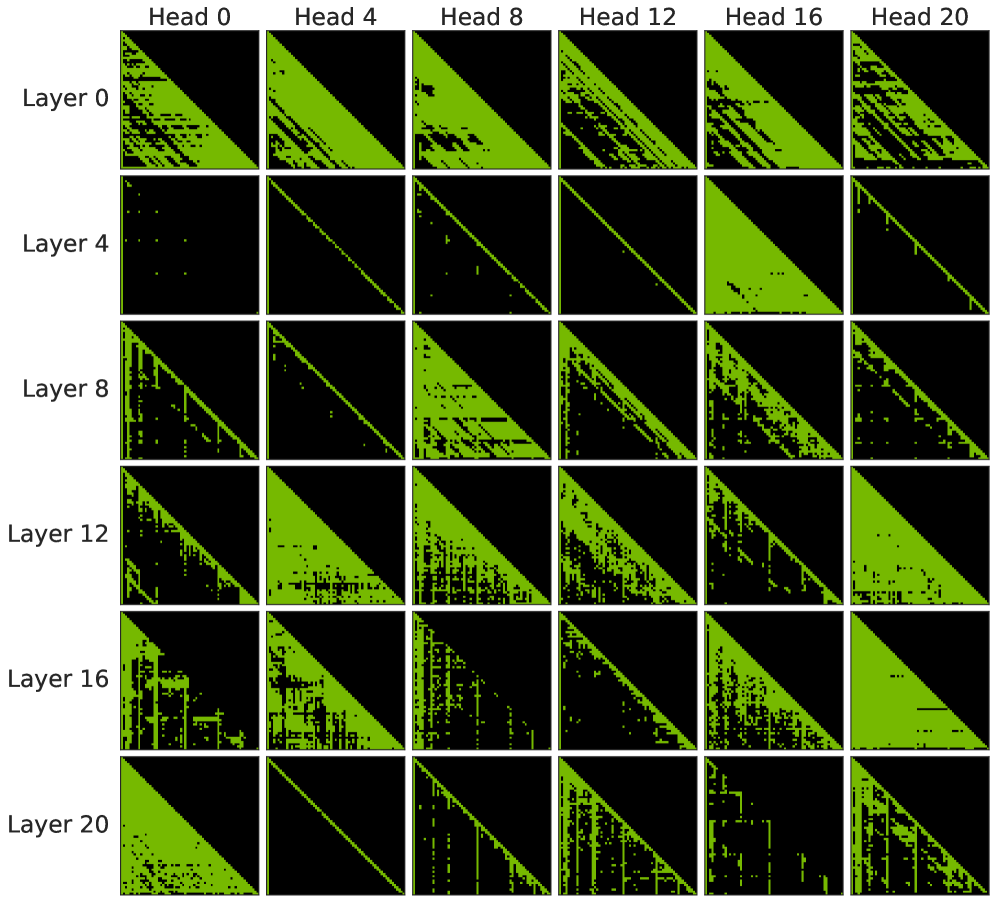
Анализ распределения разреженности. Рисунок 7 иллюстрирует, как разреженность меняется между слоями и внимательными головками, раскрывая естественное распределение важности внимания и закономерности в модели. Мы наблюдаем существенную неоднородность: разные слои демонстрируют различные уровни разреженности, а отдельные головки внутри каждого слоя также показывают заметную вариативность. Ключевым образом BLASST естественным образом включает эту неоднородность без необходимости явных механизмов вроде выбора top-k или отсечения головок — применяя один и тот же порог ко всем слоям и головкам, наш метод автоматически адаптируется к естественному распределению внимания для каждого слоя и каждой головки, удаляя более агрессивно там, где внимание естественным образом более сосредоточено, и сохраняя больше блоков там, где внимание более рассеяно.
Комбинация с другими методами разреженности. В таблице 6 рассматривается сочетание BLASST с другими методами разрежения внимания. Мы обнаружили, что BLASST может быть эффективно объединена как с методами, оптимизированными для prefill (XAttention), так и с методами сжатия KV cache (RocketKV). При объединении XAttention (prefill) с BLASST (decode) ухудшение точности остается минимальным, что демонстрирует, что методы в значительной степени ортогональны. Аналогично, при объединении BLASST (prefill) с RocketKV сохраняется высокая производительность. Эти результаты показывают, что BLASST является гибким строительным блоком для сквозной оптимизации в существующих конвейерах разреженного внимания.
| Prefill Method | Decode Method | RULER-16K | LongBench-16K |
|---|---|---|---|
| Dense Attention | Dense Attention | 93.22 | 29.4 |
| XAttention | Dense Attention | 92.99 (-0.23) | 29.1 (-0.3) |
| XAttention | BLASST | 92.89 (-0.33) | 28.8 (-0.6) |
| Dense Attention | RocketKV | 92.72 (-0.50) | 30.0 (+0.6) |
| BLASST | RocketKV | 92.60 (-0.62) | 29.4 (-0.0) |
| Context | Attention Mode | Sparsity (P) | Sparsity (D) | Accuracy |
|---|---|---|---|---|
| Qwen3-Coder-30B-A3B-Instruct, 16K Context | ||||
| 16K | Full (Dense) | 0% | 0% | 0.897 |
| 16K | BLASST Prefill | 64.1% | 0% | 0.904 |
| 16K | BLASST Prefill+Decode | 64.1% | 48.4% | 0.882 |
| Qwen3-Coder-30B-A3B-Instruct, 200K Context | ||||
| 200K | Full (Dense) | 0% | 0% | 0.850 |
| 200K | BLASST Prefill | 57.5% | 0% | 0.841 |
| 200K | BLASST Prefill+Decode | 57.5% | 40.8% | 0.838 |
Очень длинные длины последовательностей. Мы оцениваем BLASST на чрезвычайно длинных последовательностях с использованием бенчмарка RepoQA liu2024repoqa. Таблица 7 представляет результаты для Qwen3-Coder-30B при длинах контекста 16K и 200K. При 200K токенах BLASST достигает высокой разреженности префила (58%) при минимальном снижении точности, а применение разреженности как к фазе префила, так и к фазе декодирования обеспечивает дополнительные вычислительные сбережения при пренебрежимо малых дополнительных затратах. Примечательно, что для более длинных контекстов характерна более высокая естественная разреженность, что делает наш метод все более эффективным для сценариев с экстремальной длиной, где плотное внимание становится непрактичным.
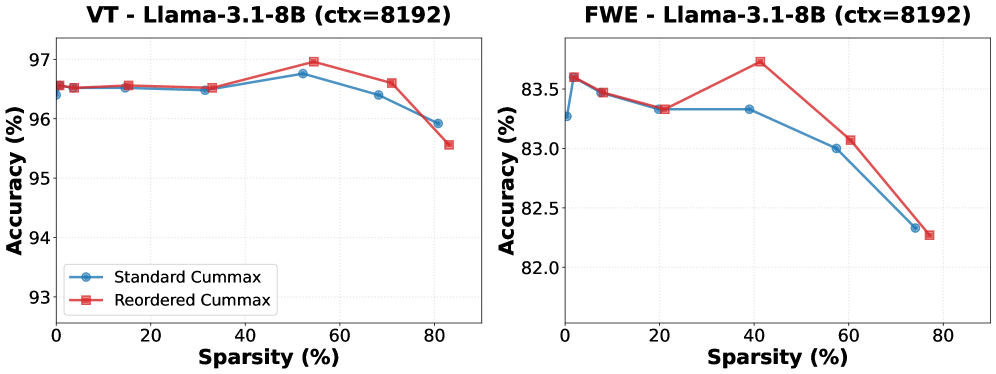
Перестановка порядка строк плитки. Мы исследовали, может ли перестановка порядка обработки строк плитки повысить точность отсечения. Мотивация исходит из локального феномена окна, наблюдаемого в StreamingLLM xiao2023efficient, где последние токены (локальное окно) часто получают высокие оценки внимания наряду с токенами sink внимания в начале. Обрабатывая плитки, содержащие локальное окно, в первую очередь, текущий максимум можно быстро заполнить этими токенами с высокими оценками, тем самым раньше в вычислении сформировав более удачную аппроксимацию глобального максимума. Это позволило бы принимать более точные решения об пропуске для последующих блоков. Важно, что BLASST поддерживает такую гибкость перестановок на уровне планирования ядер с пренебрежимо малым накладным расходом.
Рисунок 8 сравнивает стандартную последовательную обработку с переставленной обработкой в задачах VT и FWE. Результаты показывают поведение, зависящее от набора данных: перестановка обеспечивает сопоставительную производительность на VT, но дает заметные улучшения на FWE. Это указывает на то, что эффективность перестановки в значительной степени зависит от конкретных шаблонов внимания в каждом наборе данных. Тем не менее, это демонстрирует ценное свойство BLASST: алгоритм устойчив к различным порядкам обработки и может адаптироваться к различным стратегиям оптимизации. Гибкость для поддержки перестановки плит (tile reordering) показывает потенциал оптимизаций, специфичных для набора данных, без необходимости в фундаментальных изменениях алгоритма.
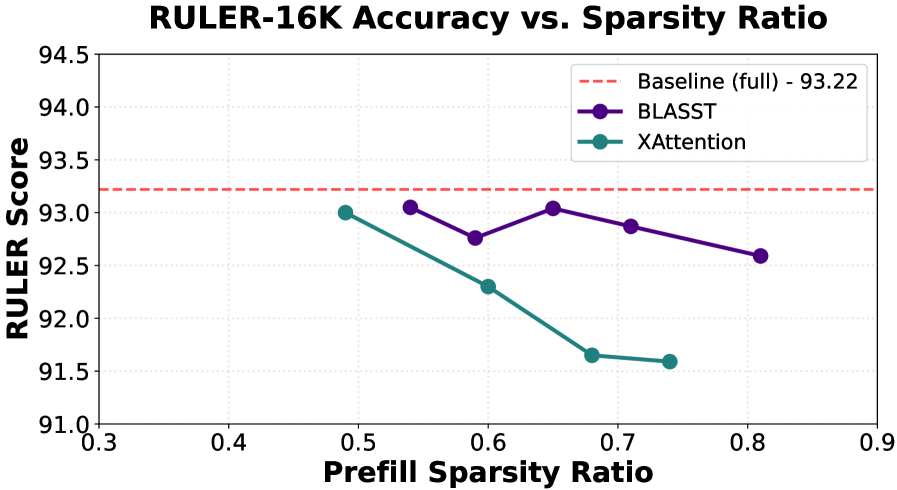
Анализ экстремальной разреженности. Рисунок 9 показывает поведение BLASST на RULER-бенчмарках при более высоких уровнях разреженности (70–90%). По сравнению с XAttention, BLASST демонстрирует более стабильное снижение точности при увеличении уровней разреженности. Хотя XAttention показывает более резкие падения точности при высокой разреженности, пороговое отсечение в BLASST с использованием фактической статистики softmax (а не оценок-заменителей) обеспечивает более плавную деградацию. Эта устойчивость делает BLASST более подходящим для агрессивных режимов разреженности, где критически важна вычислительная эффективность.
6 Заключение
Мы представили BLASST — простую, но эффективную методику разреженного внимания, которая динамически исключает вычисления внимания, повторно используя онлайн-статистики softmax, и не требует предварительных вычислений или прокси-оценок. Достигая более 50% разреженности при минимальном снижении точности и обеспечивая до 1.6 ускорения на современных GPU, BLASST делает вывод для длинного контекста заметно более практичным. Автоматическая калибровка и обучение с учетом разреженности дополнительно повышают ее надежность и гибкость, закладывая практическую основу для эффективных transformers с длинным контекстом.
В дальнейшем мы считаем, что сочетание аппаратно-зависимых разреженных шаблонов, обучаемой разреженности в процессе обучения и адаптивных гибридных методов станет ключом к раскрытию полного потенциала будущих агентных систем ИИ.