\ул
 Finch: Бенчмаркинг финансов и бухгалтерии в корпоративных рабочих процессах, основанных на таблицах
Аннотация
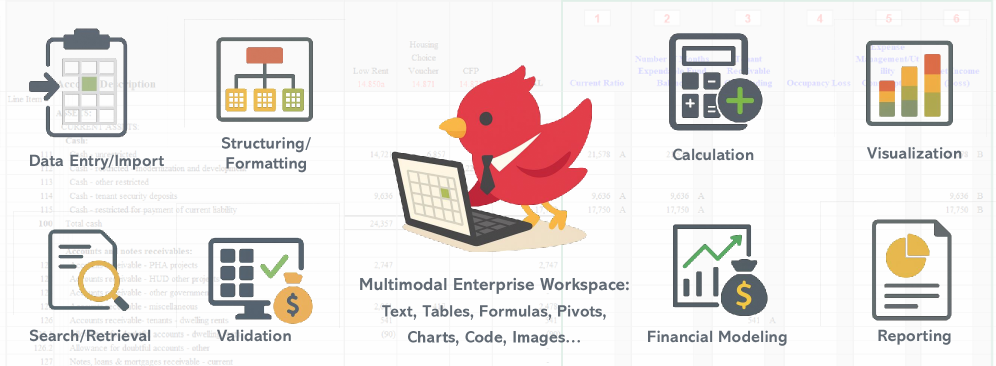
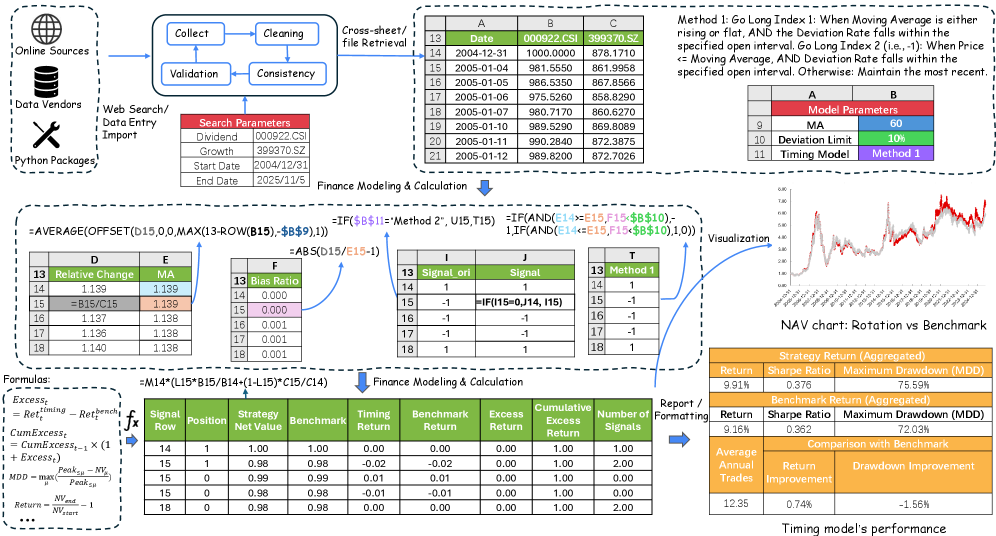
Мы представляем эталонный тест по финансам и бухгалтерии (Finch) для оценки ИИ-агентов на реальных, корпоративного уровня профессиональных рабочих процессах — включающих ввод данных, структурирование, форматирование, веб-поиск, поиск по файлам, вычисления, моделирование, валидацию, перевод, визуализацию и составление отчетов. Finch основан на подлинных корпоративных рабочих пространствах Enron (15 000 таблиц и 500 000 писем от 150 сотрудников) и других финансовых учреждениях, сохраняя естественный беспорядок в мультимодальных артефактах (текст, таблицы, формулы, диаграммы, код и изображения) и охватывая различные области, такие как бюджетирование, торговля и управление активами..
Мы предлагаем процесс построения рабочих процессов, который сочетает в себе обнаружение с помощью LLM и экспертную аннотацию: (1) вывод рабочих процессов с помощью LLM, проверенный экспертами, на основе реальных цепочек электронных писем и истории версий файлов электронных таблиц, и (2) тщательная экспертная аннотация рабочих процессов, требующая более 700 часов работы специалистов в области. В результате получено 172 составных рабочих процесса с 384 задачами, включающими 1 710 электронных таблиц с 27 миллионами ячеек, а также PDF и другие артефакты, отражающие по своей сути хаотичный, долгосрочный, насыщенный знаниями и коллективный характер реальной корпоративной работы..
Мы проводим как ручную, так и автоматизированную оценку передовых систем искусственного интеллекта, включая GPT 5.1, Claude Sonnet 4.5, Gemini 3 Pro, Grok 4 и Qwen 3 Max. GPT 5.1 Pro в общей сложности тратит 48 часов, но справляется только с 38,4 % рабочих процессов, а Claude Sonnet 4.5 — с 25,0 %. Комплексные тематические исследования дополнительно выявляют проблемы, которые реальные корпоративные рабочие процессы создают для ИИ-агентов..
1 Введение
Передовые системы ИИ всё активнее трансформируют профессиональные рабочие пространства. Инструменты с поддержкой ИИ, такие как ChatGPT [openai_agent], Claude [claude_excel], Gemini [gemini_workspace] и Copilot [microsoft_copilot], теперь встроены в повседневные корпоративные рабочие процессы — помогая специалистам составлять документы, исследовать данные, работать с электронными таблицами и создавать отчёты. Эти инструменты особенно эффективны в финансах и бухгалтерии (F&A), области с высокими ставками, требующей глубоких знаний и значительных трудозатрат, критически важной для каждой организации..
Однако реальная работа в области F&A по своей природе хаотична и обладает значительной контекстуальной сложностью: артефакты взаимосвязаны между гетерогенными электронными таблицами, PDF и другими форматами, эволюционируя через несколько версий с совместными правками [klimt2004enron]; электронные таблицы содержат большие, сложные структуры [spreadsheetllm2024] с перекрестными ссылками между листами, запутанными макетами, несогласованным форматированием, непонятными терминами, ошибочными формулами и мультимодальными артефактами, такими как диаграммы, изображения и код. Это также долгосрочный процесс [gdpval2025]: рабочие процессы требуют многоэтапного рассуждения, охватывающего ввод данных, редактирование, извлечение, вычисления, моделирование, валидацию, отчетность и многое другое..
Это поднимает ключевой вопрос: могут ли современные передовые ИИ-агенты действительно справляться с запутанными, долгосрочными и насыщенными знаниями рабочими процессами, с которыми ежедневно сталкиваются профессионалы?
Чтобы ответить на это, мы представляем Finch, корпоративный эталон F&A, полученный из аутентичных корпоративных сред. Finch отражает внутреннюю сложность профессиональной работы через:
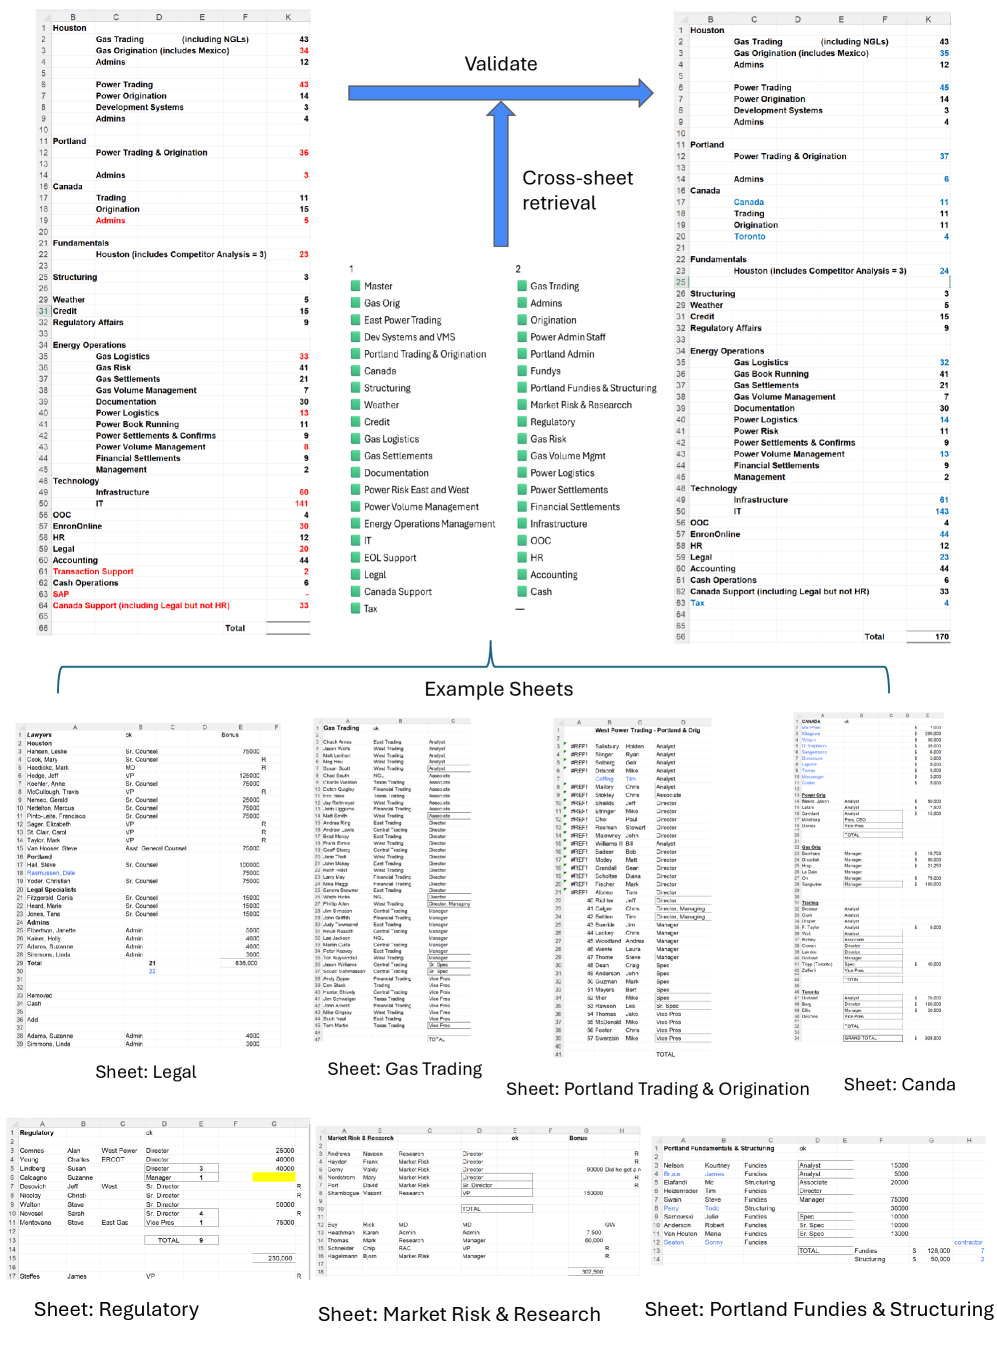
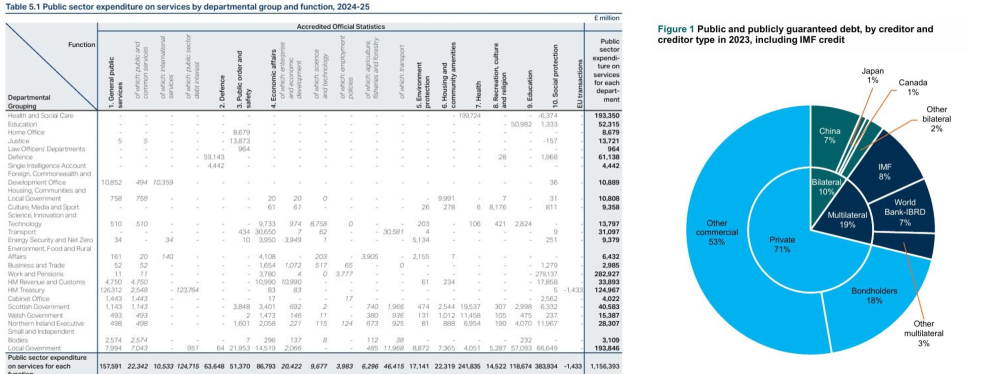
- • Реальные корпоративные источники: Finch построен на основе подлинных корпоративных электронных таблиц, писем и PDF-файлов из реальных корпоративных рабочих пространств — в первую очередь Enron [enrondata_pst] (около 15 000 файлов электронных таблиц и 500 000 писем от 150 руководителей и сотрудников) и EUSES [fisher2005euses] (около 450 финансовых электронных таблиц из различных источников), а также компаний по управлению ценными бумагами и активами, глобальных организаций, таких как Всемирный банк [worldbank_idr_2024], и правительств Канады и Великобритании [financecanada_fiscalref_2025, hmt_pesa_2023]. Документы большие, с перекрестными ссылками и неструктурированные — содержат богатые мультимодальные артефакты, такие как таблицы, формулы, диаграммы, сводные таблицы и изображения.
- ⟦Тщательный процесс построения: Мы предлагаем новый конвейер построения рабочих процессов, основанный на реальном совместном контексте электронных писем и версионированных артефактов. Мы выводим рабочие процессы из корпоративных цепочек электронных писем и вложений, где участники естественным образом описывают, обсуждают и отслеживают рабочие процессы как часть своей повседневной работы. И мы предлагаем метод, поддерживаемый LLM и проверенный экспертами, для вывода рабочих процессов путем анализа изменений в версионированных электронных таблицах, выявляя основные цели, которые движут работой профессионалов. Аннотаторам необходимо рассуждать над большими многостраничными рабочими книгами и тонкими дельтами версий, чтобы понять, чего изначально пытался достичь аналитик, что делает процесс аннотирования значительно сложнее, чем составление пар QA над изолированными таблицами..
Мы составили 172 тщательно аннотированных, корпоративного уровня рабочих процессов, построенных на 1,710 электронных таблицах, а также PDF и других артефактах, которые в совокупности отражают композиционный, хаотичный, насыщенный знаниями и коллективный характер реальной работы. Каждый рабочий процесс охватывает одну или несколько взаимозависимых задач — ввод данных, редактирование, извлечение, вычисление, моделирование, валидацию, перевод, визуализацию и отчетность — что отражает, как профессионалы на самом деле работают с манипуляцией и созданием артефактов..
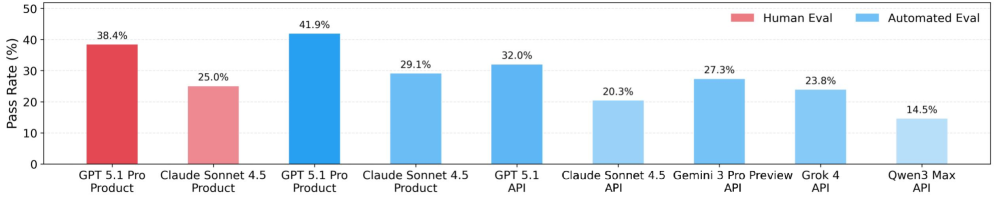
Мы оцениваем спектр передовых систем ИИ — включая Claude Sonnet 4.5, GPT 5.1, Gemini 3, Grok 4 и Qwen 3 — используя как экспертную оценку, так и новую автоматизированную систему оценки, которая тесно согласуется с экспертными суждениями. Наши эксперименты показывают, что даже передовые агенты проходят менее 40% рабочих процессов (GPT 5.1 Pro в среднем тратит 16.8 минут на один рабочий процесс), что подчеркивает значительные сложности, которые Finch представляет для ИИ-агентов. Комплексный анализ кейсов дополнительно выявляет конкретные вызовы, которые реальные корпоративные рабочие процессы ставят перед ИИ-агентами..
2 Fяnch: Реальный эталонный тест рабочего процесса в финансах и бухгалтерии
2.1 Построение набора данных
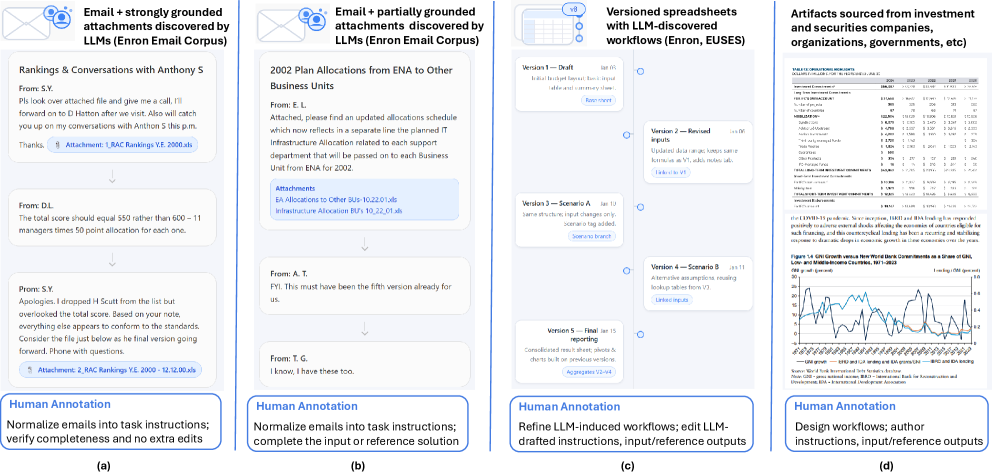
Мы предлагаем новую конвейерную систему построения рабочих процессов, основанную на реальном совместном контексте электронных писем и версионированных артефактов, как показано на рисунке 4 (a–c). Во-первых, мы извлекаем рабочие процессы из корпоративных цепочек электронных писем и версионированных документов, где участники естественным образом описывают, обсуждают и отслеживают работу в рамках своих повседневных задач. Во-вторых, мы выводим рабочие процессы, анализируя изменения в версионированных таблицах, выявляя фактические преобразования данных и этапы анализа, которые выполняли специалисты. В-третьих, мы используем высококачественные таблицы и отчёты: мы проектируем рабочие процессы, создаём инструкции по задачам и редактируем эти таблицы и отчёты так, чтобы они служили входными файлами и эталонными решениями..
Все аннотированные рабочие процессы из этих различных каналов объединены в единую схему с согласованными полями (NL инструкция, входные файлы, эталонные выходные данные), и каждый рабочий процесс помечен типами задач (например, ввод/импорт данных, структурирование, валидация) и типами бизнеса (например, планирование и бюджетирование, ценообразование и оценка, операции, управление активами). Обратите внимание, что эталонные выходные данные включают как эталонные ответы на основе файлов (для большинства случаев генерации/редактирования), так и текстовые эталонные ответы (для небольшого числа случаев QA и суммирования/визуализации).).
2.1.1 Рабочий процесс из корпоративных цепочек электронной почты
Сначала мы анализируем корпоративные цепочки электронных писем для выявления рабочих процессов. Начиная с корпуса электронных писем Enron, мы используем GPT-5 для определения совместных сообщений, которые (i) явно указывают бизнес-цель (например, «обновить рейтинги RAC» или «пересмотреть распределения 2002 года») и (ii) ссылаются на одну или несколько прикрепленных таблиц. Для каждой выбранной цепочки модель суммирует коммуникативное намерение и формулирует описание рабочего процесса..
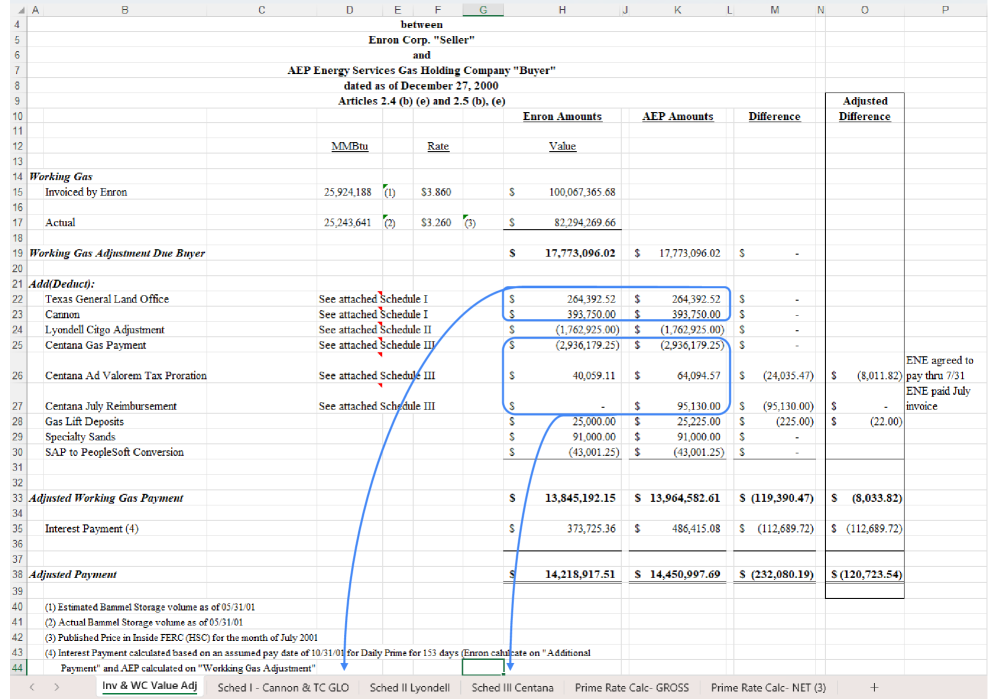
Мы различаем два случая. В случае с сильной привязкой, иллюстрированном на рисунке 4 (a), как входные данные, так и конечные эталонные артефакты для рабочего процесса уже присутствуют в виде вложений в переписке (например, исходный файл ранжирования и исправленная версия). Случаи с сильной привязкой хорошо мотивировали этот бенчмарк, но они относительно редки. В случае с частичной привязкой, иллюстрированном на рисунке 4 (b), в письме указана чёткая цель, но прикреплены только некоторые из необходимых артефактов (например, только обновлённое расписание или промежуточный отчёт). В обоих случаях люди - эксперты нормализуют текст разговорной электронной почты в инструкции к задаче и абстрагируются от индивидуальных деталей, сохраняя при этом бизнес-замысел. Для потоков с сильной привязкой аннотаторы в основном проверяют, что прикреплённые файлы точно реализуют запрошенное изменение без дополнительных правок. Для потоков с частичной привязкой они либо выявляют отсутствующие артефакты из версионированных таблиц и корректируют их в соответствии с описанным рабочим процессом — тщательно избегая внесения новых изменений, — либо создают отсутствующие артефакты самостоятельно, что обычно требует гораздо больших усилий..
2.1.2 Вывод рабочего процесса из версионированных электронных таблиц
Помимо явных сообщений в цепочках электронной почты, мы предлагаем выявлять рабочие процессы, которые неявно зафиксированы в историях версий электронных таблиц, как показано на рисунке 4(c). Мы собираем семейства версионированных рабочих книг из репозиториев Enron и EUSES и применяем процедуру дифференцирования на основе LLM, которая распознаёт последовательные версии и выводит базовый рабочий процесс..
Для каждой распознанной пары (или цепочки) версий мы предлагаем GPT-5 (i) один или несколько типов рабочих процессов (например, «версионирование с отметкой даты, обновления предположений и исправление ошибок», «ввод данных, структурирование и визуализация») и (ii) подробное описание на естественном языке всех изменений. Человеческие эксперты затем проверяют и уточняют эти кандидаты на рабочие процессы, сгенерированные LLM. Они сначала определяют, являются ли предложенные различия последовательным и значимым рабочим процессом, а не случайными изменениями. Для принятых случаев они (i) переписывают черновое описание в точную инструкцию задачи, описывающую трансформацию, и (ii) редактируют соответствующие версии рабочих книг так, чтобы назначенные входные и эталонные файлы чётко реализовывали описанный рабочий процесс без внесения изменений, выходящих за рамки инструкции. Соответствующие входные и эталонные файлы таким образом основаны на фактических версиях, использованных в различиях, что даёт экземпляры рабочих процессов, не зависящие от контекста электронной почты, а закреплённые в реальной эволюции корпоративных электронных таблиц..
2.1.3 Рабочий процесс, основанный на высококачественных артефактах
Наконец, мы отбираем рабочие процессы из высококачественных электронных таблиц и отчетов, взятых из корпусов Enron и EUSES, различных инвестиционных и ценных компаний, международных организаций и национальных правительств (например, Всемирного банка и правительств Канады и Великобритании). Эксперты в предметной области разлагают эти окончательные финансовые артефакты на промежуточные артефакты, которые служат входными данными, при этом рассматривая оригинальные документы как эталонные выходные данные, а затем создают реалистичные инструкции для рабочих процессов. Например, модель оценки из инвестиционной фирмы может быть преобразована в задачу финансового моделирования; отчет Всемирного банка может быть использован для определения задачи суммирования и визуализации на основе данных; а двуязычные отчеты правительства Канады могут быть использованы для построения задач перевода и проверки согласованности. Кроме того, мы используем размеченные образцы из существующих наборов данных: мы адаптируем 10 финансовых кейсов из WideSearch [wong2025widesearch] в рабочие процессы, ориентированные на веб-поиск, и расширяем их в многошаговые конвейеры вычислений и визуализации, а также используем 3 примера из DABStep [egg2025dabstep] для построения рабочих процессов многоканального ответа на вопросы..
2.1.4 Контроль качества
Учитывая высокую сложность каждого рабочего процесса, необходим строгий контроль качества. Мы проводим межаннотационную валидацию всех рабочих процессов и используем продуктовые агенты ChatGPT 5.1 Pro и Claude-Sonnet-4.5 в качестве вторичных проверяющих: при наличии инструкции, входных и эталонных файлов модель запрашивается оценить, соответствует ли эталонный результат инструкции и отсутствуют ли какие-либо очевидные шаги. Оценки на основе LLM используются для выявления потенциальных дефектов для последующего человеческого рассмотрения. В совокупности эти процедуры контроля качества обеспечивают коллекцию рабочих процессов, в которых NL инструкции, входные файлы и эталонные результаты хорошо согласованы..
2.2 Характеристики набора данных
Finch включает 172 тщательно аннотированных, корпоративного уровня рабочих процессов, которые в совокупности отражают композиционный, хаотичный, мультимодальный и совместный характер реальной работы в области финансов и бухгалтерии. В этих рабочих процессах корпус содержит 1,710 электронных таблиц вместе с 13 PDF, 7 изображениями, 3 документами Word и дополнительными файлами, такими как JSON, CSV и Markdown. Эта смесь отражает то, как реальные аналитики координируют работу с гетерогенными артефактами, а не с чистыми, однотабличными входными данными..
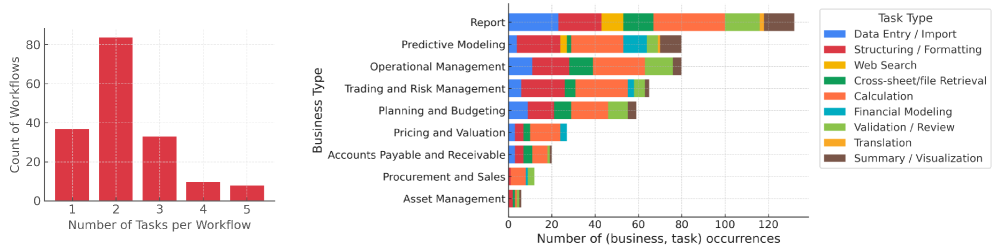
Рисунок 5 суммирует охват типов задач и бизнеса. С точки зрения задач, категории являются:
- • Вычисления (119 рабочих процессов): заполнение формул или вычисление показателей (например, чистая стоимость).
- ⟦Структурирование / Форматирование (86): реорганизация таблиц (например, корректировка иерархий), форматирование содержимого (например, размер шрифта и заливка ячеек), а также вставка/удаление строк или столбцов.
- ⟦Ввод данных / Импорт (44): транскрибирование или импорт данных из таблиц, PDF, изображений или внешних источников в таблицы.
- ⟦Проверка / Рецензирование (37): проверка согласованности и согласование расчетов внутри листа или между листами/файлами.
- ⟦Перекрестный поиск по листам/файлам (36): извлечение значений из нескольких листов или файлов в целевую рабочую книгу.
- • Резюме / Визуализация (33): создание резюме или диаграмм, которые выявляют ключевые финансовые инсайты.
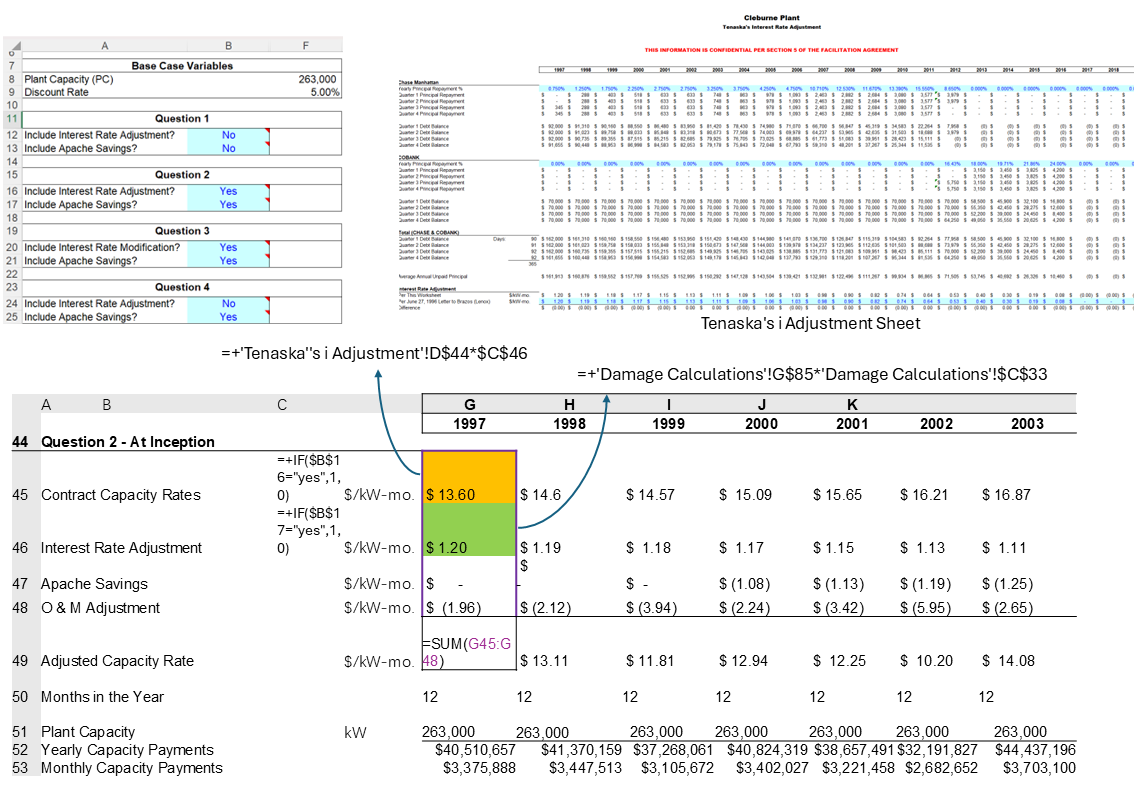
- ⟦Финансовое моделирование (15): расширение или калибровка моделей оценки и временных моделей, часто с помощью сценарного и чувствительного анализа.
- ⟦Веб-поиск (11): сбор финансовых данных из интернета и интеграция их в электронные таблицы.
- ⟦перевод электронных таблиц или отчетов с сохранением структуры, форматирования и расположения элементов.
С бизнес-стороны рабочие процессы охватывают отчетность (48 рабочих процессов), торговлю и управление рисками (35), предиктивное моделирование (33), операционное управление (36), планирование и бюджетирование (26), ценообразование и оценку (15), счета к оплате/получению (10), а также закупки и продажи (7) и управление активами (3); некоторые рабочие процессы помечены несколькими типами бизнеса. В целом, распределение указывает на то, что Finch ориентируется на основные вертикали финансов и бухгалтерии, а не на отобранные учебные задачи..
2.2.1 Композиционность задач
Finch явно разработан вокруг составных рабочих процессов, а не изолированных задач. Как показано на рисунке 5, только 37 рабочих процессов (21,5%) являются однозадачными; оставшиеся 135 (78,5%) включают несколько задач. Важно, что каждая «задача» сама по себе обычно требует значительного многошагового рассуждения: например, веб-поиск часто включает множество раундов вызовов LLM для обнаружения, фильтрации и проверки доказательств; кросс-листовой поиск требует повторных вызовов для чтения и нахождения ключевой информации в нескольких листах; а вычисления обычно охватывают множество формул, распределённых по разным строкам и столбцам..
Эти задачи не являются независимыми подзадачами, а переплетаются вокруг общих электронных таблиц и файлов. Типичный рабочий процесс может начинаться с структурирования или импорта необработанных данных, переходить к поиску по разным листам или файлам, а затем завершаться вычислениями, моделированием или составлением отчетов. Распределение на рисунке 5 показывает, что большинство рабочих процессов включает несколько задач.
2.2.2 Беспорядок
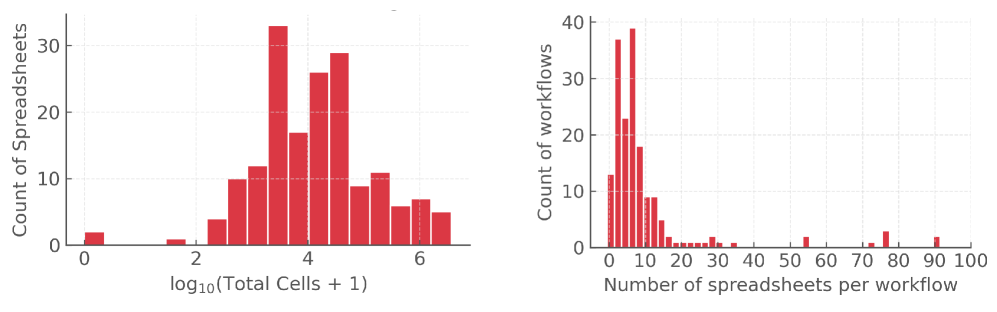
Исходные файлы в Finch намеренно большие, многостраничные и структурно сложные. На уровне файла 86,6% рабочих процессов включают более одного файла при учёте как входных, так и эталонных артефактов, и некоторые рабочие процессы затрагивают до 14 различных файлов. На уровне таблиц 92,4% рабочих процессов включают несколько листов, в среднем 8 листов, с длинным хвостом, достигающим 91 листа. В результате системы должны учитывать зависимости между листами, скрытую логику и разбросанные промежуточные вычисления, а не работать с одним «анализируемым» листом. Более того, большинство таблиц имеют сложные макеты, которые чередуют текст, таблицы, формулы и диаграммы, а также сложные структуры таблиц с объединёнными ячейками, вложенными заголовками, иерархическими данными, пустыми строками и столбцами и другими нерегулярностями..
Статистика на уровне ячеек дополнительно подчеркивает масштаб данных. Медианный рабочий процесс охватывает 15 тыс. ячеек (в среднем 157 тыс. для всех рабочих процессов), при этом самая большая рабочая книга масштабируется до 3,7 миллиона ячеек. Плотность формул также распределена с перекосом: в рабочих процессах содержится в среднем 21,5 тыс. формул (медиана — 212), при этом самые сложные из них имеют сотни тысяч формул, что отражает глубоко вложенные вычисления и длинные цепочки зависимостей. В совокупности эти свойства создают сложный режим, в котором модели должны рассуждать о больших, шумных и сильно нерегулярных макетах электронных таблиц, а не о чистых, прямоугольных таблицах..
2.2.3 Мультимодальность
Хотя Finch ориентирован на электронные таблицы, рабочие процессы по своей природе являются мультимодальными. Около 10,5% рабочих процессов связывают электронные таблицы с дополнительными артефактами, не являющимися таблицами, такими как PDF, документы Word и изображения, а 7,6% явно требуют рассуждений над PDF или изображениями. В самих электронных таблицах 20,3% рабочих процессов включают диаграммы, а 2,3% содержат сводные таблицы, поэтому модели должны понимать не только исходные значения ячеек, но и производные визуальные сводки и явные структуры агрегации (и большинство рабочих процессов включает неявные структуры агрегации). Эта мультимодальная, кросс-артефактная структура контрастирует с предыдущими бенчмарками, которые работают исключительно с изолированными таблицами, и лучше отражает среды, в которых фактически выполняются задачи корпоративных финансов и бухгалтерии..
2.3 Метод оценки
2.3.1 Человеческая оценка
Мы проводим оценку человеком всех рабочих процессов для прямой оценки производительности модели. Для каждого рабочего процесса аннотаторы читают NL-инструкцию, просматривают входные данные, эталонные и выходные файлы модели рядом (обычно выравнивая таблицы или документы в соседних вкладках) и определяют, выполнила ли модель запрошенную задачу добросовестно. Рабочий процесс считается успешным только в том случае, если модель генерирует или изменяет содержимое и структуру в соответствии с инструкцией и не вносит критических ошибок, упущений или нежелательных изменений; в противном случае он помечается как неудача. Важно, что оценка основана на том, была ли инструкция удовлетворительно выполнена, а не на чисто механическом сравнении выходных данных модели и эталона, поскольку может существовать несколько приемлемых решений для суммирования, визуализации, форматирования, формул и связанных аспектов. Чтобы уменьшить субъективность и неоднозначность, аннотаторы в конечном итоге присваивают бинарную метку прохождения/непрохождения для каждого рабочего процесса. Эти человеческие суждения служат золотым стандартом для измерения производительности модели и для проверки надежности нашего метода автоматической оценки..
2.3.2 Оценка LLM в роли судьи
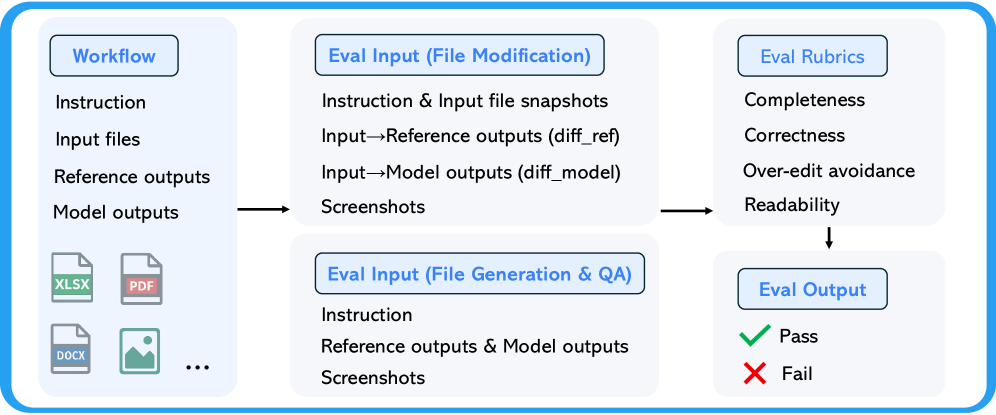
Для масштабирования оценки мы используем фреймворк LLM-as-judge, который поддерживает три основных типа задач в Finch: modify (редактирование входных артефактов), generate (создание новых файлов, таких как рабочие книги и документы) и QA (ответы на вопросы на основе одного или нескольких артефактов). Фреймворк принимает гетерогенные входные данные — включая .xlsx, .txt, .docx, .md, .pdf и изображения — и нормализует их в последовательность текстовых входных данных и скриншотов для модели судьи..
Для задач модификации, особенно в электронных таблицах, фреймворк вычисляет структурированные различия между входными данными и эталонным выводом (diff_ref) и между входными данными и выводом модели (diff_model), а затем строит компактный «снимок входных данных» (snapshot), который для каждого изменённого листа сохраняет только первые и последние десять строк и первые пять столбцов (которые обычно содержат заголовки таблиц и макет) вместе со строками и столбцами, содержащими отредактированные ячейки. Это сохраняет важный контекст для diff_ref и diff_model, одновременно значительно сокращая длину токенов. Параллельно фреймворк создаёт скриншоты (screenshot) листов с изменениями из входных данных, эталонного и модельного вывода, чтобы судья мог воспринимать объединённые ячейки, условное форматирование, диаграммы и другие свойства макета, которые трудно закодировать только текстом..
Для задач генерации, связанных с электронными таблицами, фреймворк извлекает все значения ячеек и формулы как из эталонного, так и из выходного результата модели, а также делает скриншоты каждого листа, поскольку необходимо проверить весь сгенерированный артефакт, а не только локализованные правки. Для задач QA он подаёт последовательность из текста и изображений, сформированную из эталонного ответа и ответа модели, при необходимости дополненную соответствующими входными файлами, когда вопрос требует опоры на внешние артефакты..
Мы разрабатываем три специализированных подсказки для судьи для задач modify, generate и QA соответственно, но они используют общую рубрику оценки. Во всех случаях судье поручено сосредоточиться на (i) полноте в отношении NL инструкции, (ii) числовой и логической корректности полученных значений и формул, (iii) избегании излишних правок, штрафуя за ненужные и неожиданные изменения рабочей книги помимо инструкции, и (iv) читаемости форматирования и структуры. Точное пословное совпадение с эталоном не требуется, когда допустимо несколько решений (например, альтернативные макеты, эквивалентные формулы или разные, но семантически эквивалентные сводки); вместо этого судья решает, удовлетворительно ли модель выполнила инструкцию. Для снижения субъективности судья выдает бинарный балл (пройдено/не пройдено) вместе с кратким NL обоснованием. В некоторых задачах веб-поиска рубрика допускает небольшие допуски при сравнении значений, позволяя расхождения в данных из разных источников..
Эта рамочная модель LLM в роли судьи не только автоматизирует масштабную оценку, но и выявляет тонкие ошибки в электронных таблицах (такие как формулы, незаметно заменённые на статические значения), которые трудно обнаружить только с помощью визуального интерфейса и человеческой проверки. В разделе 3.2 мы приводим данные о согласованности между человеческой и автоматизированной оценками и показываем, что оценки LLM в роли судьи тесно соответствуют человеческим суждениям..
3 Эксперименты
3.1 Агенты и Модели
3.1.1 Агенты со стороны продукта
Мы оцениваем двух передовых агентов с продуктовой стороны: (i) ChatGPT, использующий модель GPT 5.1 в режиме Pro, и (ii) Claude, использующий модель Sonnet 4.5 в режиме мышления. Мы сосредотачиваемся на этих двух системах, а не на альтернативах, таких как Gemini или Grok, потому что они изначально поддерживают возврат загружаемых файлов (например, электронных таблиц) в качестве выходных данных, а не выводят код или таблицы в формате markdown, которые не интуитивно понятны для человеческой оценки. Для обоих агентов мы включаем их внешний веб-браузинг, но отключаем использование исторических чатов, чтобы каждый рабочий процесс оценивался независимо и без утечки между запусками. Поскольку обновления моделей происходят часто, а ручная оценка очень трудоемка, мы использовали последнюю модель из нашего финального раунда экспериментов и не учитывали последующие обновления..
3.1.2 Модели на основе API
Мы оцениваем пять передовых больших языковых моделей (LLMs), представленных в Таблице 1, через API интерфейсы. Наша оценочная система основана на открытом исходном коде фреймворка SpreadsheetBench [ma2024spreadsheetbench]. Подробности парадигмы выполнения и стратегий подсказок приведены в Приложении B.1. В то время как SpreadsheetBench предоставляет только базовую реализацию, мы вводим несколько практических улучшений для повышения его применимости к задачам реального мира..
| Model | Provider | Context | Max Output | Vision | Native PDF |
|---|---|---|---|---|---|
| GPT 5.1 [gpt5openai] | OpenAI | 400K | 128K | ✓ | ✓ |
| Claude Sonnet 4.5 [claudesonnet45] | Anthropic | 1M† | 64K | ✓ | ✓ |
| Grok 4 [grok4] | xAI | 256K | 256K | ✓ | — |
| Qwen 3 Max [qwen3technicalreport] | Alibaba | 256K | 32.8K | — | — |
| Gemini 3 Pro Preview [gemini3pro] | 1.05M | 65.5K | ✓ | ✓ |
Кодирование электронных таблиц.
SpreadsheetBench производит только простые текстовые таблицы без сохранения адресов ячеек, типов данных или формул. Однако эти детали необходимы для задач в Finch. Мы расширяем кодирование SpreadsheetLLM [spreadsheetllm2024] и вводим семантически насыщенное кодирование кортежей, которое сохраняет полную структурную и семантическую точность. Каждый лист начинается с его названия и соответствующей ограничивающей области данных (например, ## Sheet: [name] (A1:Z100)). Затем мы сериализуем ограниченную область, используя формат на основе Markdown. Каждая ячейка кодируется как кортеж (Address, Value, Type, Formula), где Address обозначает ссылку на ячейку (например, A3), Type указывает тип данных (T = Текст, I = Целое число, F = Число с плавающей точкой, D = Дата, B = Логический), а Formula содержит формулу ячейки (например, =SUM(A1:A10)->100).).
Обработка мультимодального ввода.
Мы расширяем рамки для поддержки мультимодальных входных данных, включающих изображения и PDF. Для моделей с возможностями зрения (GPT 5.1, Claude Sonnet 4.5, Grok 4 и Gemini 3 Pro) мы используем официальный мультимодальный API каждого провайдера для передачи визуальных входных данных вместе с текстовыми подсказками. Для PDF-документов мы применяем многоуровневую стратегию. Модели с нативной поддержкой PDF — GPT 5.1, Claude Sonnet 4.5 и Gemini 3 Pro Preview — напрямую обрабатывают PDF-файлы через интерфейсы загрузки файлов, что позволяет анализировать как текстовые, так и визуальные элементы без предварительного извлечения. Для Grok 4, который не поддерживает PDF нативно, мы извлекаем текст с помощью PyMuPDF и включаем его в поле pdf_content. Для Qwen 3 Max, который полностью не поддерживает мультимодальность, и содержимое изображений, и PDF преобразуются в текстовые описания. Хотя такой резерв сохраняет семантические подсказки, он теряет информацию о расположении и визуальном контексте..
Управление контекстом.
Для обработки больших электронных таблиц, которые могут превышать ограничения контекста модели, мы реализуем автоматическое усечение. Мы резервируем 32K токенов для вывода модели — этого достаточно для комплексной генерации кода и анализа, при этом оставаясь в пределах лимитов вывода всех оцененных моделей. Усечение запускается, когда ввод превышает оставшуюся емкость, удаляя содержимое с конца данных электронной таблицы с явным уведомлением, добавленным для информирования модели о потере данных..
3.2 Экспериментальные результаты
Веб-агенты (ChatGPT 5.1 Pro против Claude Sonnet 4.5).
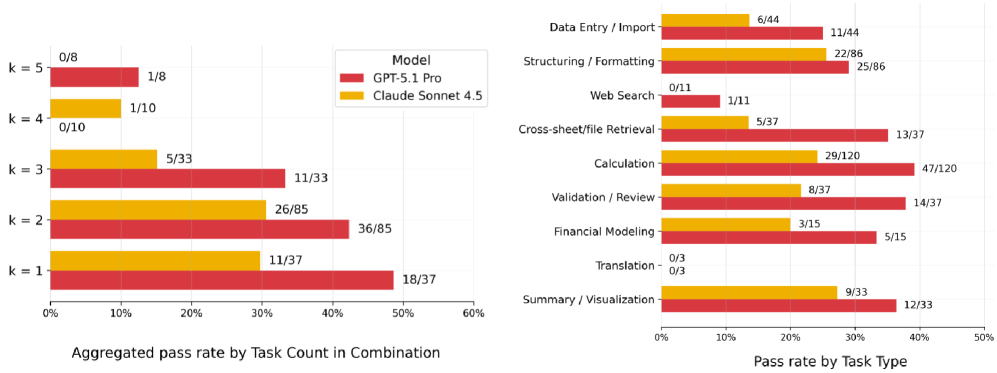
Как показано на рисунке 2 и в таблице 3, ChatGPT 5.1 Pro достигает лучших общих показателей успешного прохождения на Finch. Их преимущество в значительной степени обусловлено богатыми интерактивными возможностями: они могут итеративно проверять электронные таблицы, корректировать промежуточные состояния и восстанавливаться после частичных ошибок в ходе множества вызовов инструментов. Однако он решает менее 40% рабочих процессов Finch, что свидетельствует о том, что реальная финансовая и бухгалтерская работа остается далеко не «решенной» даже для передовых агентов. Подробный анализ на рисунке 8 дополнительно подчеркивает, что составление с длинным горизонтом является ключевым узким местом: когда рабочий процесс содержит более двух задач, уровень успешного прохождения резко падает — GPT 5.1 Pro снижается с 44.3% (рабочие процессы с задачами) до 23.5% (рабочие процессы с задачами), а Claude Sonnet 4.5 снижается с 30.3% до 11.8%. Это указывает на то, что накопление ошибок на этапах и отсутствие промежуточных возможностей непропорционально сильно влияют на выполнение многошаговых процессов..
Процент успешного выполнения также существенно варьируется в зависимости от типа задачи (Рисунок 8). Ввод данных / Импорт и структурирование / Форматирование постоянно входят в число самых сложных категорий, что соответствует тому, что таблицы Finch имеют неаккуратные макеты, нерегулярные таблицы и нетривиальные структурные ограничения. Кроме того, рабочие процессы Ввода данных / Импорта часто переплетаются с веб-поиском или разбором PDF, вводя мультимодальные зависимости, которые усиливают режимы сбоев. Примечательно, что Перевод — задача, в которой современные LLM обычно показывают отличные результаты в стандартных NLP условиях — в Finch работает удивительно плохо. В таблицах с финансовой направленностью перевод может легко исказить или пропустить критические структурные и макетные подсказки (например, иерархии заголовков, выравнивание строк/столбцов), а большие сетки увеличивают вероятность пропусков, что приводит к систематическим ошибкам. Подробный анализ ошибок можно найти в разделе 3.3⟧.
| # Tasks per workflow | # Workflows | Pass Rate (%) | Avg. time (min) |
|---|---|---|---|
| 1 | 37 | 48.6 | 13.1 |
| 2 | 84 | 42.4 | 17.4 |
| 3 | 33 | 33.3 | 18.7 |
| 4 | 10 | 0 | 21.3 |
| 5 | 8 | 12.5 | 13.6 |
Мы дополнительно анализируем, как время завершения веб-запроса GPT 5.1 масштабируется с количеством задач в рабочем процессе (Таблица 2). Самый длительный отдельный запуск рабочего процесса занимает примерно 60 минут — но завершается с ошибкой, что подчеркивает, насколько сложными могут быть рабочие процессы для текущих агентов. В среднем, рабочие процессы с одной задачей занимают 13.1 минуты, тогда как рабочие процессы с двумя, тремя и четырьмя задачами требуют соответственно 17.4, 18.7 и 21.3 минуты, что отражает возросшую композиционную сложность многозадачных настроек. Интересно, что рабочие процессы с пятью задачами показывают меньшее среднее время (13.6 минут), большинство из которых связаны с веб-поиском и почти все завершаются неудачей..
На основе API.
Рисунок 2 дополнительно показывает, что наш метод на основе API остается конкурентоспособным, несмотря на использование всего одного вызова LLM. В автоматической оценке, например, GPT 5.1 Pro достигает 41.9%, в то время как GPT 5.1 с нашим агентом на основе API достигает 32.0% — относительно небольшой разрыв, учитывая значительно более ограниченный бюджет взаимодействия. Наш дизайн агента сокращает разрыв за счет предоставления более эффективных представлений таблиц и инструментальных выходных данных, соответствующих задаче, в рамках бюджета одного вызова, тем самым уменьшая хрупкое рассуждение над сложными макетами и снижая каскадные ошибки..
3.2.1 Согласованность между человеческой и автоматизированной оценкой
Мы используем легковесную мультимодальную модель GPT-5-mini в качестве судьи для проверки эффективности нашей автоматизированной системы оценки. Как показано в таблице 3, автоматизированная оценка в значительной степени совпадает с человеческими суждениями: для GPT 5.1 Pro и Claude Sonnet 4.5 судья согласен с человеческими метками в 82.1% и 90.2% рабочих процессов соответственно. Судья также достигает высокой полноты (83.3% и 88.4%), что означает, что он восстанавливает большинство помеченных человеком успешных случаев, и достаточно высокой точности (73.6% и 76.0%), указывающей на то, что большинство автоматически предсказанных успешных случаев также принимаются человеческими оценщиками. В целом, это говорит о том, что автоматизированная оценка может несколько переоценивать точность на несколько процентных пунктов..
| Model (Product) | Automated Eval | Human Eval | Agreement w/ Human Eval | ||||
|---|---|---|---|---|---|---|---|
| Pass | Pass Rate (%) | Pass | Pass Rate (%) | Acc (%) | Recall (%) | Precision (%) | |
| GPT 5.1 Pro | 72/172 | 41.9 | 66/172 | 38.4 | 82.1 | 83.3 | 73.6 |
| Claude Sonnet 4.5 | 50/172 | 29.1 | 43/172 | 25.0 | 90.2 | 88.4 | 76.0 |
С точки зрения модели, LLM-судья иногда может упускать нюансы в рубрике — либо не замечать тонкие визуальные или числовые ошибки в больших таблицах, либо, наоборот, слишком буквально воспринимать определённые инструкции (например, штрафовать за безвредные преобразования формул в константы). Однако мы также наблюдаем случаи, когда LLM-судья прав, а человеческие оценщики ошибаются — например, когда формулы тихо заменяются на статические значения, которые трудно обнаружить только при осмотре через GUI. С точки зрения системы, ограничения наших инструментов для работы с таблицами и конвейера данных (например, неполная поддержка повреждённых, но читаемых человеком рабочих книг или редких форматов файлов) могут приводить к тому, что корректные результаты отмечаются как ошибки. В совокупности эти факторы означают, что наши автоматизированные оценки следует воспринимать как приблизительные, а не точные, и что человеческий контроль остаётся важным для пограничных или критически важных рабочих процессов..
3.3 Анализ ошибок
Чтобы понять источники сбоев на Finch, мы провели качественный анализ ошибок GPT 5.1 Pro и Claude Sonnet 4.5 в их веб-агентских и API конфигурациях. Для всех неудачных рабочих процессов в нашей оценке мы вручную проанализировали траектории и аннотировали основную причину сбоя..
С точки зрения ориентированного на рабочий процесс подхода, мы выделяем пять доминирующих категорий ошибок.111Для данного исследования, как только мы выявляем первую явную ошибку в неудачном рабочем процессе, мы прекращаем дальнейший анализ этого рабочего процесса. В качестве примера возьмём веб-агента Claude Sonnet 4.5. Среди всех рассмотренных сбоев 10% связаны с неправильным пониманием задачи: корпоративные задачи часто опираются на неявный контекст в корпоративных артефактах (например, электронных таблицах), который модели часто игнорируют, что приводит к неправильной интерпретации того, что требуется и какой результат должен быть получен. 25% составляют ошибки извлечения данных, включая выбор неправильного диапазона строк/столбцов между листами, таблицами или внутри таблицы. 35% возникают из-за ошибок в рассуждениях с формулами, таких как неспособность восстановить скрытую бизнес-логику, закодированную в формулах, или вывод неправильных новых формул. 25% связаны с ошибками генерации кода, когда сгенерированные скрипты (например, Python с API для электронных таблиц) синтаксически неверны или не соответствуют структуре электронной таблицы. Оставшиеся 5% относятся к ошибкам отображения данных, включая неправильное форматирование, некорректно настроенные диаграммы или ошибочные итоговые отчёты, которые отклоняются от запрошенного макета или повествования — например, создание совершенно новой электронной таблицы вместо изменения исходной, как было запрошено. Мы также сравниваем шаблоны ошибок между веб-агентами и настройками на основе API, подробности приведены в Приложении C.⟧.
Примечательно, что все эти типы ошибок соответствуют общим возможностям, которыми современные LLM уже, по-видимому, владеют во многих существующих бенчмарках. Вопрос тогда в том, почему эти, казалось бы, сильные базовые способности так резко ухудшаются на Finch. Наш анализ указывает на пять взаимосвязанных свойств реальных корпоративных рабочих процессов в области финансов и бухгалтерии, которые делают сбои более вероятными и более катастрофичными. Во-первых, рабочие процессы Finch регулярно включают большие, фрагментированные экосистемы электронных таблиц: десятки взаимосвязанных рабочих книг и тысячи строк, распределённых по множеству листов. Точное выполнение этих рабочих процессов требует дальнодействующей навигации между листами и точного указания ссылок, что существенно увеличивает вероятность мелких ошибок извлечения. Во-вторых, содержимое плотное и семантически однородное: многие ячейки содержат специфические для домена финансовые концепции, которые тонко различаются, но лексически схожи (например, варианты статей доходов/расходов, скорректированные и нескорректированные метрики), что делает дизамбигуацию сущностей и привязку ячеек необычно сложной. В-третьих, макеты и структуры таблиц сложны и часто нерегулярны, включая многоуровневые заголовки, объединённые ячейки, вложенные промежуточные итоги и индивидуальные макеты, которые заставляют модель выводить структуру из шумного содержимого и произвольного форматирования. Например, на уровне кода даже крошечные неправильные интерпретации этих макетов (например, ошибки сдвига на один при указании диапазонов) могут затем распространяться в глобально неверные результаты, особенно когда логика применяется пакетно к множеству таких листов. В-четвёртых, формулы кодируют скрытую структуру и логику. В датасете Finch каждый лист содержит большое количество формул, которые кодируют скрытую бизнес-логику, временные предположения и тонкозернистые зависимости, невидимые только по отображаемым значениям; однако модели обычно придают приоритет значениям ячеек и недостаточно используют формулы, что приводит к систематическим неправильным интерпретациям. Например, в листе с ценами с заголовком столбца IF NGPL MidContinent index (@ Baker) очевидная семантика только по заголовку предполагает метрику ежедневного риска. Однако при изучении связанной формулы (25 * V21 + C41 * C22) становится ясно, что столбец фактически кодирует 55-дневный срок платежа. Модели, игнорирующие или недостаточно использующие формулы, систематически неправильно интерпретируют роль таких столбцов в последующих вычислениях, и эта неправильная интерпретация затем распространяется на последующие шаги. Наконец, многие рабочие процессы включают мультимодальные артефакты и задачи, ориентированные на чат, такие как объединение электронных таблиц с PDF, диаграммами и скриншотами, требуя от агента совместного рассуждения по гетерогенным форматам. Например, таблицы, встроенные в PDF, часто ссылаются только частично, при этом ключевые записи отсутствуют или усечены..
Многие из этих факторов были изучены в предыдущих работах (например, многотабличные настройки, сложные структуры таблиц, рассуждения с формулами и многошаговые рабочие процессы), и современные модели могут достаточно хорошо справляться с эталонами, которые акцентируют внимание на ограниченном подмножестве этих факторов. Однако в Finch эти факторы сосуществуют в одном и том же рабочем процессе в реальных корпоративных данных, и наши результаты показывают, что именно такое сочетание вызывает резкое падение производительности. Finch не требует принципиально новых способностей; скорее, он проверяет эти способности в корпоративном «экстремальном» режиме высокой сложности, шума и долгосрочных зависимостей — что тесно отражает реальную работу в области финансов и бухгалтерии. Поэтому прогресс в композиционных возможностях требует обучения и оценки на длительных, вычислительно и логически интенсивных рабочих процессах с использованием больших, неструктурированных мультимодальных корпоративных артефактов..
4 Связанные работы
Интеграция LLMs в инструменты корпоративной продуктивности резко ускорилась в последнее время. Недавно запущенный ChatGPT Agent [openai_agent] расширяет эти возможности до автономного выполнения задач, обеспечивая многоэтапные рабочие процессы, охватывающие веб-браузинг, выполнение кода и манипуляции с электронными таблицами. Microsoft Copilot [microsoft_copilot] внедряет возможности ИИ во весь пакет Microsoft 365, позволяя пользователям создавать документы, анализировать электронные таблицы и автоматизировать рабочие процессы через взаимодействие на естественном языке. Аналогично, Google интегрировала Gemini [gemini_workspace] в Google Workspace, предоставляя функции с поддержкой ИИ в Docs, Sheets и Gmail. Claude Excel от Anthropic также вошёл в корпоративный сектор с возможностями автоматизации электронных таблиц [claude_excel], в то время как такие выдающиеся инструменты, как Shortcut AI [shortcut_spreadsheet], сосредоточены специально на управлении электронными таблицами с помощью ИИ..
Появление агентных ИИ-систем знаменует значительный сдвиг от понимания и QA к автономному выполнению задач [li2023sheetcopilot, chen2024sheetagent, ma2024spreadsheetbench]. Однако существуют давние проблемы, такие как неструктурированные входные данные и мультимодальная обработка. SpreadsheetLLM [spreadsheetllm2024] вводит новые методы кодирования и сжатия, чтобы помочь LLM понимать большие и неструктурированные структуры таблиц, а также дополнительно решает эту проблему через постобучение на таблицах. Помимо структурного понимания, мультимодальная обработка остается сложной задачей для ИИ-систем, работающих с таблицами. В области форматирования ранние работы исследовали нейронные подходы к форматированию таблиц [dong2020neural]. Недавние достижения в генерации формул продвинулись от предобучения с числовым рассуждением [cheng2022fortap] к синтезу формул, управляемому естественным языком [zhao2024nl2formula], рекомендациям на основе контрастивного обучения [chen2024auto] и интерактивному предсказанию формул через иерархическое расширение [he2023hermes].⟧.
В последние годы наблюдается значительный прогресс в бенчмарках для финансового рассуждения [chen2021finqa, islam2023financebench, finance_agent_benchmark, finben2024, findabench2025, finagentbench2025, finauditing2025, li2025investorbench, visfineval2025, gdpval2025, finsearchcomp2025, xfinbench2025], рассуждения с электронными таблицами [li2023sheetcopilot, chen2024sheetagent, ma2024spreadsheetbench, sodbench2025, li2023auto, dong2019tablesense, sheetmind2025, spreadsheetllm2024, wu2025realhitbench, li2025mimotable, dong2025machinelearninglm, dong2025reasoning, li2024tapilot, zhao2024nl2formula, odysseybench2025, officebench2024], а также мультимодального документального [mathew2021docvqa], табличного [li2020tablebank, zheng2024multimodal], графического [wang2024charxiv], таблично-графического [dong2024ttc] и табличного [xia2024vision, dong2019tablesense] рассуждения, что стимулирует развитие агентов на базе LLM для корпоративных задач. Однако Finch предлагает новый бенчмарк для хаотичных артефактов и долгосрочных рабочих процессов в реальных условиях F&A предприятий..
5 Заключение
Мы представили Finch, новый эталон для рабочих процессов F&A в реальных корпоративных условиях. Finch объединяет рабочие процессы, извлечённые из корпоративных email-переписок, истории версий электронных таблиц и высококачественных финансовых артефактов с тщательной экспертной аннотацией и откалиброванной системой LLM-as-judge, что позволяет систематически оценивать агентов на разнообразных рабочих процессах, работающих с большими, неструктурированными и мультимодальными корпоративными артефактами и требующих долгосрочного, ориентированного на электронные таблицы, рассуждения. Наши эксперименты показывают, что даже самые продвинутые системы проходят менее 40% рабочих процессов после 48 часов работы с эталоном, что выявляет значительный разрыв между текущими возможностями ИИ и требованиями реальной корпоративной практики. Мы надеемся, что Finch станет основой для разработки агентов, способных справляться с реальной, неструктурированной и долгосрочной профессиональной работой..
Appendix A Список авторов
- ⟦Haoyu Dong* (Университет Китайской академии наук) donghaoyu82@gmail.com
- ⟦Pengkun Zhang (Южно-Китайский технологический университет) sezhangpengkun@mail.scut.edu.cn
- ⟦Yan Gao (Академия Чжунгуаньцунь) gaoyan@zgci.ac.cn
- ⟦Xuanyu Dong (Harvest Fund) qianmuxuanyu@126.com
- ⟦Yilin Cheng (Университет Фудань, Академия Чжунгуаньцунь) ylcheng23@m.fudan.edu.cn
- • Минчже Лу (Университет Китайской академии наук) lumingzhe23@mails.ucas.edu.cn
- • Адина Якефу (Hugging Face) adina@huggingface.co
- ⟦Shuxin Zheng (Академия Чжунгуаньцунь) sz@bjzgca.edu.cn
*Автор для корреспонденции.
Appendix B Детали эксперимента
B.1 Модели на основе API
Парадигма выполнения.
Мы рассматриваем оценку API как задачу генерации кода. Моделям даются инструкции решать задачи манипуляции и генерации электронных таблиц путём создания исполняемых скриптов на Python, которые затем выполняются в изолированной среде для получения выходных артефактов. Эта парадигма соответствует философии SpreadsheetBench, рассматривающей код, написанный моделью, как основное пространство действий, но здесь адаптирована для учёта долгосрочных, мультимодальных корпоративных задач..
- ⟦Action Space: Модели генерируют Python код с использованием стандартных библиотек, включая openpyxl (для работы с Excel), pandas (для обработки данных), matplotlib (для визуализации) и scikit-learn (для статистического анализа)).
- • ... ‘‘‘).
- • Изолированное выполнение: сгенерированный код извлекается с помощью регулярных выражений и выполняется в изолированных контейнерах Docker, работающих с Jupyter Kernel Gateway. Каждый контейнер монтирует том с набором данных по пути /mnt/data/ с тайм-аутом сессии в 10 минут.
- ⟦Single-shot Protocol: Мы используем строгий протокол однократной генерации без итеративного уточнения — каждая модель создает ровно одно решение для каждого рабочего процесса. Если сгенерированный код не выполняется (например, из-за синтаксических ошибок или исключений во время выполнения), рабочий процесс считается неудачным без повторной попытки. Эта строгая настройка предназначена для оценки способности модели к генерации исходного кода в условиях реального развертывания..
Это унифицированное представление кода как действия гарантирует, что измеренная производительность отражает врожденную компетентность модели в сложных рабочих процессах, а не преимущества, полученные за счет интерактивной отладки..
Стратегия подсказок.
Мы используем режим zero-shot с структурированным системным запросом, состоящим из:
- 1. Определение роли: «Вы эксперт, который может управлять электронными таблицами с помощью кода на Python».”
- 2. Подробное описание компактного формата кодирования электронных таблиц с иллюстративными примерами.
- ⟦Инструкция к задаче и явные пути к входным/выходным файлам.
- 4. Специфические для библиотеки лучшие практики (например, шаблоны создания диаграмм в openpyxl) для снижения распространённых ошибок в коде.
- 5. Явная директива для генерации кода на Python в качестве конечного результата.
Эта структурированная разработка явно направляет модели на генерацию корректного, контекстно-согласованного Python кода, минимизируя неоднозначность в интерпретации задачи. Однако для моделей, поддерживающих следы рассуждений (GPT 5.1, Gemini 3 Pro), мы запрашиваем явные рассуждения через параметр include_reasoning API, что позволяет нам фиксировать внутренний процесс размышлений модели для последующего качественного анализа ошибок. Температура установлена на уровне 0.7 для всех моделей.
Appendix C Подробный анализ
Веб-агенты (ChatGPT 5.1 Pro против Claude Sonnet 4.5).
ChatGPT 5.1 Pro склонен разлагать рабочие процессы на большее количество более мелких шагов с явным рассуждением, вызовами инструментов, выполнением и самопроверкой на каждом этапе. Это приводит к более длинным трассировкам и заметно большей задержке, но также предоставляет больше возможностей для промежуточной валидации (например, проверки здравого смысла частичных результатов). Однако сгенерированный им код часто скрыт за абстракциями инструментов, поэтому наша атрибуция ошибок ограничивается наблюдаемым поведением и рассуждениями на естественном языке, а не точными деталями реализации. Claude Sonnet 4.5 обычно использует меньше шагов и выдает более прямые решения. В рабочих процессах с интенсивной визуализацией его сгенерированные графики часто бывают как более точными, так и более эстетично оформленными, чем те, что создает ChatGPT 5.1 Pro, что приводит к относительно меньшему количеству сбоев в подзадачах визуализации данных..
Агенты ChatGPT 5.1 Pro и Claude Sonnet 4.5 могут исследовать файлы Excel через множество вызовов API в рамках одного рабочего процесса, но их методы кодирования не очень подходят для таблиц с сложными макетами и структурами. Благодаря эффективному кодированию и правильному использованию инструментов, следующий метод на основе одного вызова API достигает процента успешных результатов, который гораздо ближе к показателям агентов со стороны продукта..
На основе API
Наши запуски на основе API являются однократными вызовами: они используют базовые способности моделей к рассуждению, но лишены двух ключевых возможностей, которые используют веб-агенты. (i) чередующееся выполнение кода с обратной связью, и (ii) явное размышление на основе промежуточных результатов инструментов. В результате агенты API должны сгенерировать весь план, код и результаты в рамках одного вызова LLM. Когда их первоначальные структурные предположения о таблице немного ошибочны, у них нет механизма для обнаружения или исправления ошибки, что приводит к значительно более высокой частоте ошибок, особенно в категориях, связанных с пониманием схемы и манипуляцией таблицами. В будущем желательно исследовать агентные методы с несколькими раундами вызовов API..
Appendix D Заявление об этике
Бенчмарк Finch полностью построен на основе существующих, общедоступных источников данных. Конкретно, наши рабочие процессы получены из (1) корпусов электронной почты Enron, включая разобранный набор данных электронной почты Enron на Kaggle (выпущен под лицензией CC0 Public Domain) и набор данных электронной почты Enron с EnronData.org (лицензирован под CC BY 3.0 US); (2) корпуса электронных таблиц EUSES и его модифицированных вариантов (CC BY 4.0); и (3) разнообразной коллекции артефактов, похожих на корпоративные, включая документы инвестиционных и ценных компаний, Всемирного банка (CC BY 3.0), веб-сайты канадского и британского правительств (Open Government License), а также публичные корпуса, такие как WideSearch (лицензия MIT) и DABStep (CC BY 4.0). Мы уважаем оригинальные лицензии всех исходных ресурсов и распространяем контент только в рамках разрешённых ими условий..
Помимо этих источников, мы применяем дополнительную фильтрацию, нормализацию и экспертную аннотацию для организации таблиц и связанных документов в согласованные рабочие процессы с инструкциями по задачам, входными файлами и эталонными результатами. Мы не вводим никакой новой персонально идентифицируемой информации. В процессе курирования мы удаляем явно чувствительные поля, когда они не необходимы для задачи (например, личные контактные данные или подписи) и избегаем аннотирования рабочих процессов, успешное выполнение которых зависело бы от чувствительных личных атрибутов, а не от бизнес-логики. Полученный набор данных Finch выпускается под лицензией Creative Commons Attribution 3.0 United States (CC BY 3.0 US), которая разрешает широкое повторное использование при условии соответствующего указания авторства..
Язык в Finch преимущественно английский, что отражает доминирующий язык исходных корпусов Enron и EUSES, а также многих публичных институциональных источников. Поскольку некоторые артефакты происходят из фондовых и ценных бумаг институтов и материалов канадского правительства, небольшая часть рабочих процессов включает китайский или французский контент..
Appendix E Примеры
E.1 Пример 1
E.2 Пример 2
E.3 Пример 3
E.4 Пример 4
E.5 Пример 5
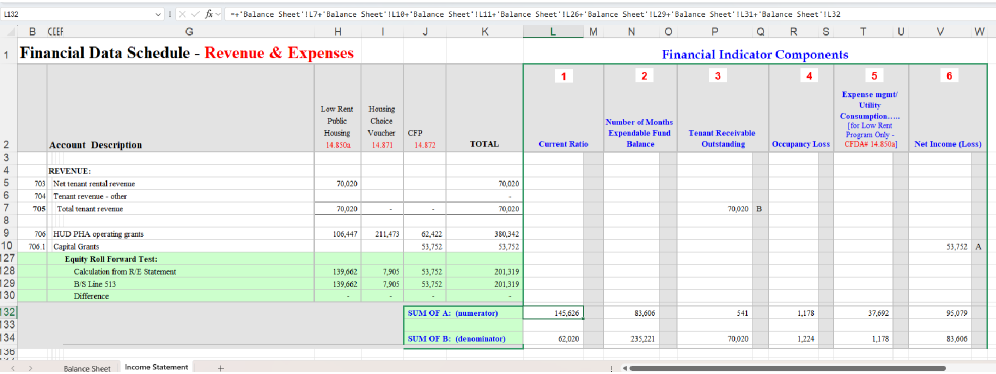
E.6 Пример 6
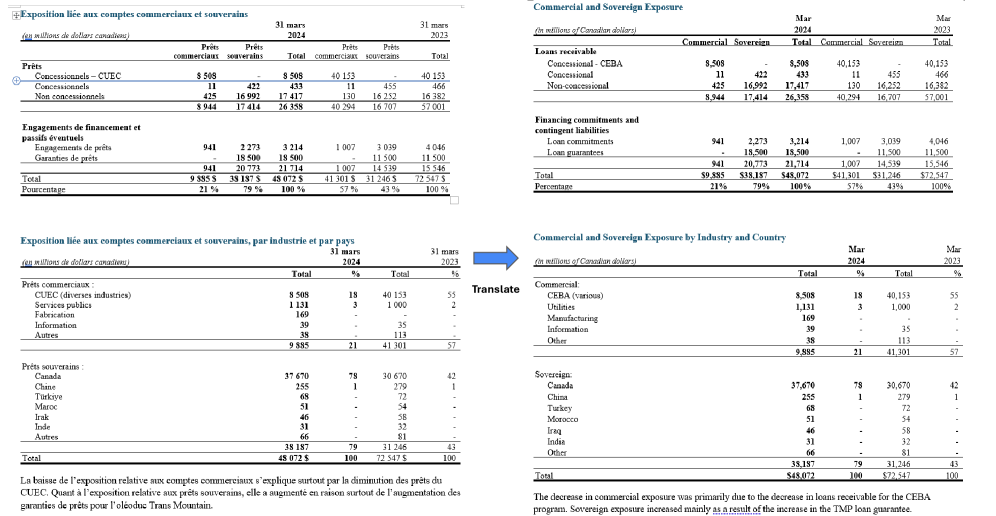
E.7 Пример 7
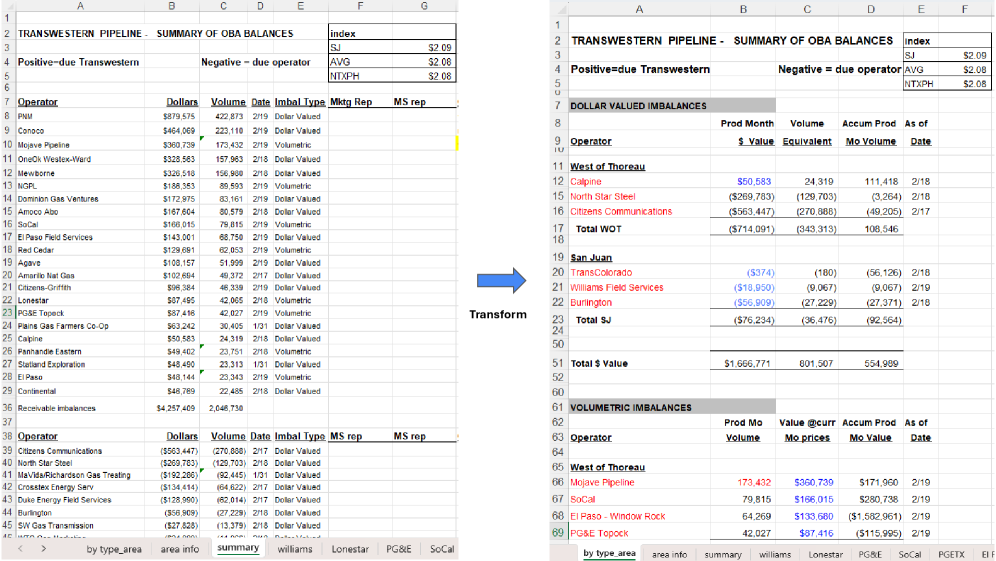
E.8 Пример 8
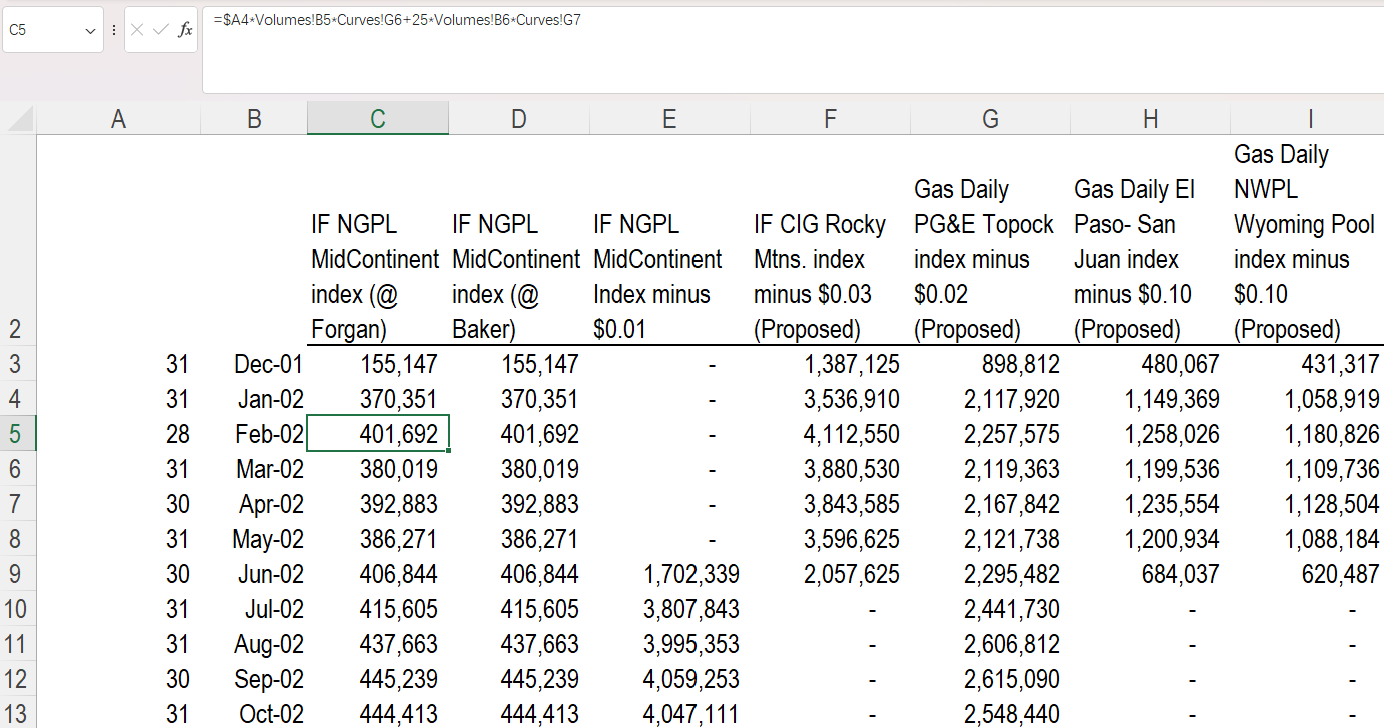
E.9 Пример 9
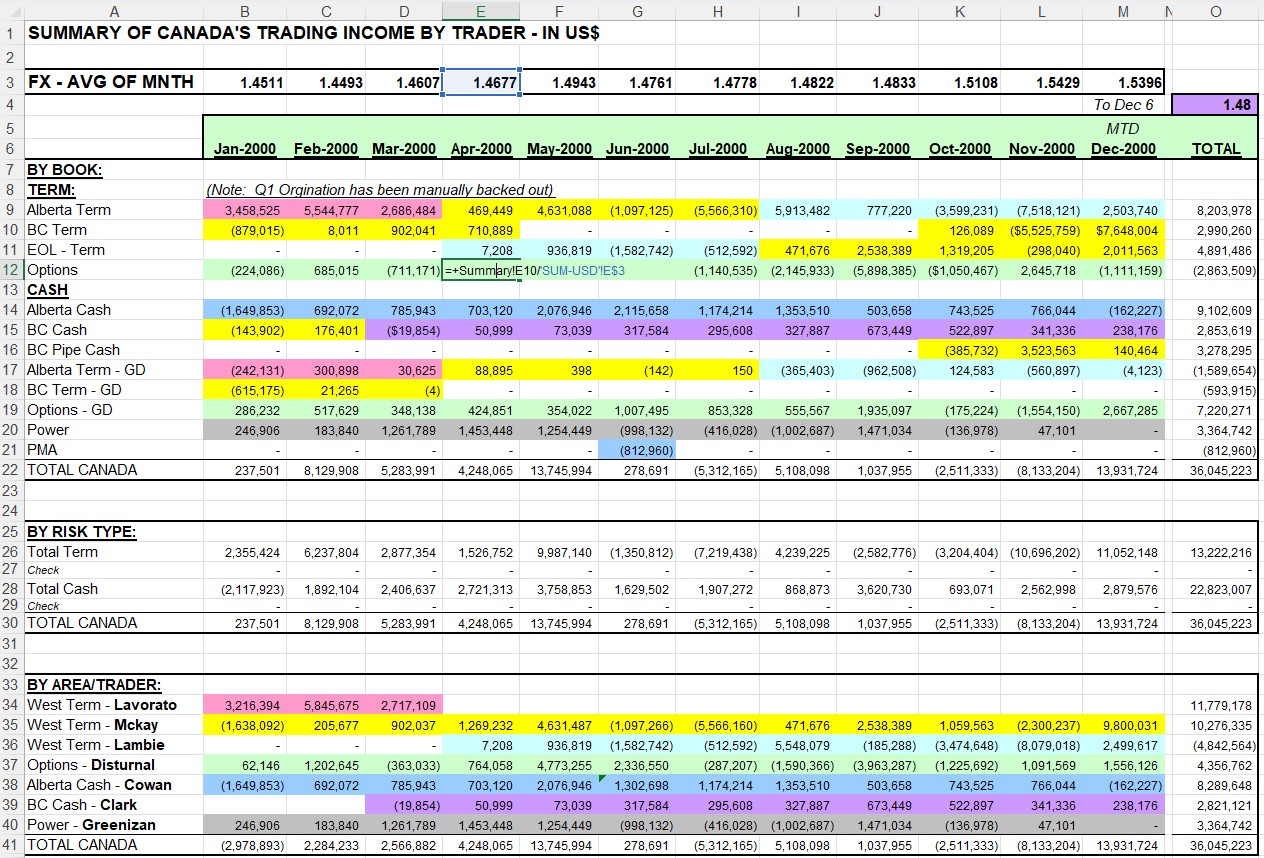
E.10 Пример 10
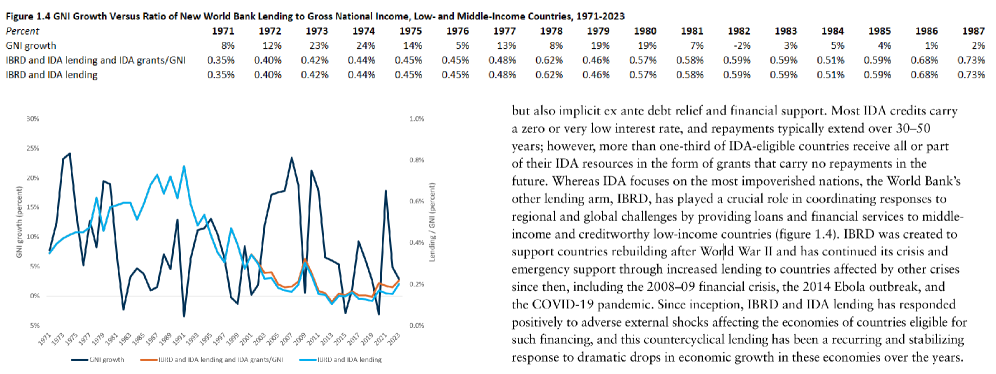
E.11 Пример 11