] Команда WorldBench Равный вклад Руководитель проекта Авторы для корреспонденции
Модели зрения-языка-действия для автономного вождения: прошлое, настоящее и будущее
 Сяолу Лю
Сун Ван
Ияо Чжу
Ао Лян
Линдун Кун
 Цзывэй Лю
 Джунвэй Лян
Аннотация
Автономное вождение долгое время опиралось на модульные конвейеры «Восприятие-Решение-Действие», где созданные вручную интерфейсы и компоненты на основе правил часто дают сбой в сложных или редких сценариях. Их каскадная архитектура способствует распространению ошибок восприятия, ухудшая последующее планирование и управление. Модели Vision-Action (VA) устраняют некоторые ограничения, изучая прямые отображения визуальных входных данных в действия, но они остаются непрозрачными, чувствительными к сдвигам распределения и лишенными структурированного рассуждения или возможностей следования инструкциям. Недавний прогресс в LLM и мультимодальном обучении способствовал появлению фреймворков Vision-Language-Action (VLA), которые интегрируют восприятие с принятием решений на основе языка. Объединяя визуальное понимание, лингвистическое рассуждение и исполнимые выходные данные, VLA предлагают более интерпретируемую, обобщаемую и согласованную с человеком парадигму для стратегий вождения. Данная работа представляет структурированную характеристику развивающегося ландшафта VLA для автономного вождения. Мы прослеживаем эволюцию от ранних подходов VA до современных фреймворков VLA и организуем существующие методы в две основные парадигмы: End-to-End VLA, которая интегрирует восприятие, рассуждение и планирование в рамках одной модели, и Dual-System VLA, которая отделяет медленное обдумывание (посредством VLM) от быстрого, критически важного для безопасности исполнения (посредством планировщиков). В рамках этих парадигм мы дополнительно выделяем подклассы, такие как текстовые и численные генераторы действий, а также механизмы явного и неявного руководства. Мы также обобщаем репрезентативные наборы данных и бенчмарки для оценки систем вождения на основе VLA и выделяем ключевые проблемы и открытые направления, включая надежность, интерпретируемость и точность следования инструкциям. В целом, эта работа направлена на создание последовательной основы для развития совместимых с человеком систем автономного вождения..
[ Страница проекта]https://worldbench.github.io/vla4ad \metadata[ Репозиторий GitHub]https://github.com/worldbench/awesome-vla-for-ad \metadata[ Таблица лидеров HuggingFace]https://huggingface.co/spaces/worldbench/vla4ad⟧
1 Введение
Стремление к полностью автономному вождению (AD) долгое время было центральной целью в области ИИ и робототехники [73, 38, 124]. Традиционные системы AD обычно используют модульный конвейер «Восприятие-Решение-Действие», в котором картографирование [82, 83], обнаружение объектов [150, 199, 123, 153], прогнозирование движения [307, 117, 55] и планирование траектории [151, 308] разрабатываются и оптимизируются как отдельные компоненты. Хотя такая архитектура позволила достичь высоких показателей в структурированных средах, ее зависимость от созданных вручную интерфейсов и правил ограничивает адаптивность в сложных [84, 85, 220], динамических [274, 275, 122] и редких сценариях [197, 74, 302]. Более того, последовательный каскад подвержен распространению ошибок между этапами, при котором шум восприятия усиливается последующими процессами рассуждения и управления, что ставит под угрозу стабильность и безопасность..
Для смягчения этих проблем исследования все чаще смещаются в сторону сквозного автономного вождения, где модели Vision-Action (VA) напрямую отображают необработанные сенсорные входные данные в команды управления или путевые точки траектории с использованием imitation [43, 198, 204] и reinforcement learning [151, 281, 68]. Ранние системы, такие как ALVINN [203] и ChauffeurNet [10], продемонстрировали жизнеспособность behavior cloning в широком масштабе. Последующие достижения представили более выразительные архитектуры: TransFuser [40] использовал transformer-based мультимодальную интеграцию, UniAD [93] объединил восприятие и планирование, VAD [108] задействовал векторизованные представления сцены, DriveTransformer [104] исследовал масштабируемые transformer бэкенды, а DiffusionDrive [156] применил генеративное моделирование для мультимодального прогнозирования траектории. В совокупности эти VA модели показывают, что сложные стратегии вождения могут быть изучены непосредственно на основе данных, закладывая фундамент для современных сквозных AD систем.
Несмотря на эти успехи, VA модели демонстрируют фундаментальные ограничения. Они по большей части ведут себя как «черные ящики», предлагая ограниченную интерпретируемость в критически важных для безопасности условиях [28, 113, 189, 309, 126, 125]. Их обобщающая способность остается хрупкой в редких или долгохвостых сценариях, которые недостаточно представлены в обучающей выборке [28, 110, 3, 309, 69, 146]. Прямо отображая восприятие в низкоуровневые действия, они лишены CoT рассуждений и контекстуального обдумывания [110, 28, 70, 286], что ограничивает их способность разрешать неоднозначные или многоэтапные взаимодействия. Более того, их фокусировка на визуальных входных данных препятствует включению высокоуровневых планов или инструкций человека на естественном языке, оставляя пробел во взаимодействии человека и транспортного средства [110, 197, 320, 222]⟧.
Появление LLM и LMM послужило катализатором новой парадигмы: моделей Vision-Language-Action (VLA) [2, 217, 336]. Модели VLA объединяют основу VLM с блоком прогнозирования действий, обеспечивая прямое отображение мультимодальных входных данных (зрение + язык) в исполняемые команды вождения. Совместно моделируя восприятие, понимание языка и принятие решений, фреймворки VLA стремятся обеспечить человекоподобное рассуждение, интерпретируемость и следование инструкциям [340, 67, 72]. Первоначальные исследования, такие как DriveMLM [264] и GPT-Driver [184], внедрили языковые модули в конвейеры вождения для понимания решений высокого уровня, проложив путь к более интегрированным проектам. Позднее системы продвинулись в сторону замкнутых и ориентированных на рассуждения моделей VLA: LMDrive [222] реализовала вождение в замкнутом цикле с языковым управлением, DriveLM [225] обеспечила структурированное рассуждение посредством QA, а DriveGPT4 [287] предоставила обоснования решений на естественном языке. Недавние работы дополнительно исследуют тесно связанные рассуждения и управление, включая AutoVLA [340] с быстрым/медленным мышлением и оптимизацией на основе GRPO [224], а также SimLingo [213], в которой явно изучается согласование языка и действий..
Модели VLA, работающие по принципу end-to-end, должны одновременно рассуждать и действовать в режиме реального времени, что создает проблемы для задержки и безопасности. Это привело к созданию архитектур Dual-System VLA, в которых высокоуровневое принятие решений отделено от низкоуровневого выполнения траектории. DriveVLM [249] генерирует текстовые обоснования или решения с помощью VLM, полагаясь на классический планировщик для построения траекторий. VLP [197] токенизирует путевые точки и карты значений для создания латентных действий с учетом планирования, а Diff-VLA [106] синтезирует управляемые языком траектории, уточняемые с помощью контроллеров, основанных на правилах или оптимизации. InsightDrive [227] интегрирует причинно-следственные языковые рассуждения с MPC, делегируя вопрос «почему» модели VLM, а вопрос «как» — планировщику..
В совокупности эти разработки знаменуют собой смену парадигмы от конвейеров, основанных на восприятии, к системам, которые совместно рассуждают, понимают и действуют. Учитывая стремительную эволюцию этой области, существует необходимость в консолидации ее концептуальных основ, прояснении архитектурных тенденций и предоставлении структурированного анализа возникающих направлений..
Вклад. Данная работа представляет собой всестороннюю характеристику VLA моделей для автономного вождения. В частности:
- ⟦• Мы прослеживаем эволюцию от предшествующих VA моделей (раздел 3) до современных VLA фреймворков (раздел 4), предоставляя исторический контекст и разъясняя мотивацию, стоящую за этим сдвигом парадигмы..
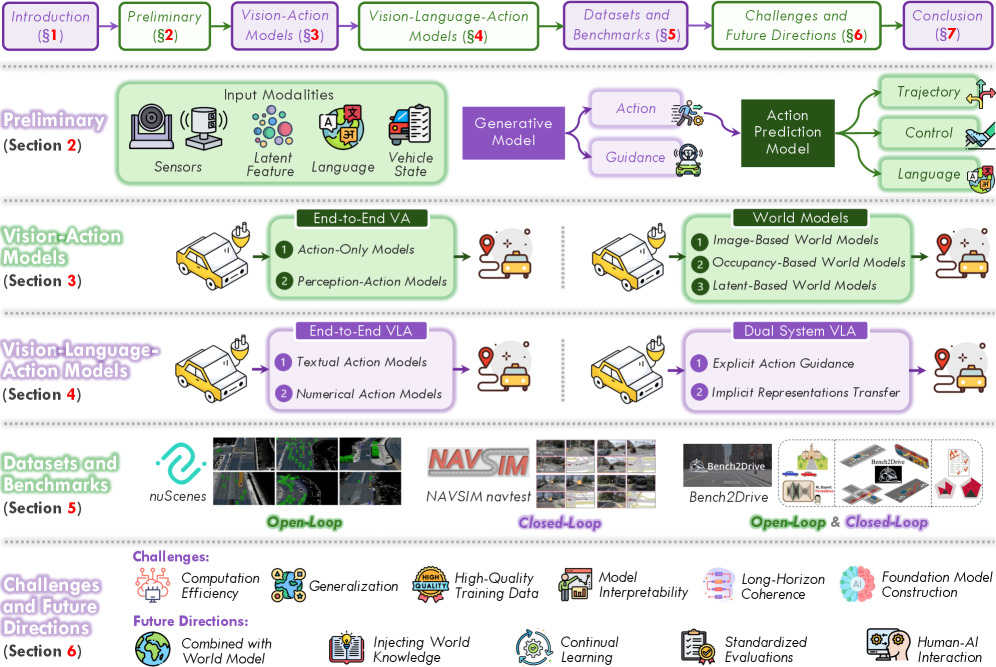
- ⟦• Мы предлагаем таксономию, которая классифицирует архитектуры VLA на сквозные (раздел 4.1) и двухсистемные (раздел 4.2) проекты, а также сравниваем их принципы, преимущества и ограничения.
- ⟦• Мы представляем систематизированный обзор наборов данных и оценочных бенчмарков, относящихся к VLA-ориентированному вождению (раздел 5), что способствует проведению последовательных и значимых сравнений.
- ⟦• Мы определяем ключевые проблемы при развертывании VLA в реальных условиях и намечаем будущие направления исследований (раздел 6) для обеспечения прогресса в создании более безопасных и надежных автономных систем.
Область применения. Данная работа отличается от предыдущих исследований моделей VLA [2, 217, 336, 110] своей узкоспециализированной направленностью, историческим контекстом и глубиной архитектурного анализа. 1Узкоспециализированная направленность. В отличие от более широких аналитических обзоров, охватывающих робототехнику или embodied AI [180, 223], наша работа сосредоточена исключительно на автономном вождении, что позволяет провести детальный анализ специфических для вождения проблем, характеристик наборов данных и требований безопасности. 2Историческая и концептуальная преемственность. Мы используем повествование в формате «Прошлое-Настоящее-Будущее», которое прослеживает путь от ранних моделей VA до современных фреймворков VLA, подчеркивая мотивацию и техническую преемственность, лежащую в основе интеграции языкового обоснования в процессы восприятия и управления. 3Детализированная архитектурная таксономия. В отличие от предыдущих высокоуровневых обзоров [338, 299, 45, 110], мы предлагаем иерархическую таксономию, которая разграничивает End-to-End и Dual-System модели VLA и анализирует то, как они организуют восприятие, рассуждение и управление..
Благодаря такому сочетанию предметной специфики, исторической глубины и структурированного архитектурного анализа мы стремимся предоставить исчерпывающий и содержательный справочный материал для исследований VLA в области автономного вождения.
Структура. Остальная часть данной статьи организована следующим образом. В разделе 2 представлены предварительные основы VLA-фреймворков. В разделе 3 описана эволюция VA-моделей. В разделе 4 представлена наша таксономия и анализ VLA-архитектур. В разделе 5 обобщены наборы данных и бенчмарки. В разделе 6 обсуждаются остающиеся проблемы и будущие направления исследований. В разделе 7 подведены итоги данной работы..
2 Предварительные основы
Фреймворки Vision-Language-Action (VLA) [180, 340, 3, 339] используют большие Vision-Language Models (VLMs) [258, 130, 35, 41] для интерпретации сложных дорожных сцен и формирования исполняемых действий. Типовая формулировка может быть представлена как:
| (1) |
где обозначает мультимодальные входные данные на временной отметке , — это VLM backbone, параметризованный , а — это head генерации действий. В этом разделе представлены данные три компонента: входные модальности (), VLM backbone () и head прогнозирования действий (⟧).
2.1 Входные модальности
Входные данные агрегируют гетерогенные сигналы, которые описывают внешнюю среду и состояние транспортного средства [17, 233, 270]. Эти входные данные можно разделить на четыре категории: сенсорные наблюдения, латентные представления сцены, языковые инструкции и проприоцептивные состояния..
2.1.1 Входные данные датчиков
Входные данные датчиков включают необработанные или предварительно обработанные данные, полученные непосредственно с установленных на транспортном средстве датчиков [25, 24, 141].
- ⟦• Визуальные изображения. RGB-изображения кругового обзора, предоставляющие плотную семантическую информацию: , где — количество камер (например, от до ), а , — высота и ширина каждого изображения.
- ⟦• Облака точек LiDAR. Разреженное или плотное множество трехмерных точек, представляющих геометрию окружающей среды: , где — количество точек, а включает такие размерности, как , скорость и интенсивность.
2.1.2 Латентные представления
Многочисленные VLA системы работают на основе промежуточных пространственных представлений, которые объединяют мультимодальные сенсорные входные данные.
- ⟦• Признаки вида сверху (BEV). Представление вида сверху, часто генерируемое путем объединения данных с камер или LiDAR [150, 155, 168]: , где — количество каналов признаков, а — пространственные размеры сетки BEV.
- ⟦• Сетки заполненности. Трехмерное объемное представление, предсказывающее заполненность и семантику для каждой пространственной локации [260, 268, 284, 167]: , где — пространственное разрешение трехмерной сетки, а обозначает количество каналов признаков заполненности (например, заполненность, поток и семантика).
2.1.3 Языковые входные данные
Для обеспечения возможностей VLA модель также получает высокоуровневые текстовые инструкции или описания задач [66, 287, 76]. Она состоит из последовательности токенов, представляющих задачу или цель вождения (например, «поверните налево на следующем перекрестке»): или , где — это длина последовательности, а — размерность эмбеддинга (если используются эмбеддинги токенов)).
2.1.4 Информация о состоянии транспортного средства
2.2 Магистральная модель VLM ()
VLM backbone является основным механизмом рассуждения системы. Обычно это большая vision language model [160, 258, 6, 35, 343, 9]. Ее основная роль заключается в объединении различных входных модальностей в единое мощное латентное представление. Она состоит из vision encoder (например, Vision Transformer, ViT) [210] для обработки визуальных входных данных и LLM decoder, который обуславливает свою генерацию визуальными признаками. Bridge network [160, 35] или унифицированный механизм multimodal token modelling [258, 6] используются для выравнивания визуальных признаков с языковыми эмбеддингами. VLM может напрямую генерировать действия или предоставлять рекомендации другому эксперту по действиям для получения более надежных результатов..
2.2.1 VLM для прямой генерации действий (односистемный ⟦K0⟧)
В этой парадигме VLM напрямую выдает действия через свою языковую голову [264, 184, 225, 98] или небольшую присоединенную голову [288, 222, 213]. Такая полностью end-to-end архитектура использует способности VLM к рассуждению для отображения визуальных/языковых входных данных в исполняемые элементы управления.
2.2.2 VLM для генерации руководств (двухсистемная ⟦K0⟧)
В качестве альтернативы, VLM функционирует как модуль высокоуровневого рассуждения, который создает промежуточные рекомендации — текстовые обоснования [249, 80, 207] или структурированные латентные намерения [197, 146], которые последующий планировщик преобразует в низкоуровневые действия [257]. Эта архитектура «медленное мышление + быстрое исполнение» улучшает интерпретируемость и позволяет планировщикам обеспечивать физическую реализуемость и ограничения безопасности..
2.3 Голова прогнозирования действий ()
Голова преобразует латентное представление VLM в выходные данные действий. В соответствии с таксономией, используемой в существующей литературе, мы классифицируем головы действий на четыре типа в зависимости от их формулировки вывода и механизма генерации: Language Head (LH), Regression (REG), Trajectory Selection (SEL) и Trajectory Generation (GEN).).
- ⟦• Языковая голова (LH). Данная архитектура напрямую использует присущие VLM возможности генерации текста для создания действий в языковом пространстве. Эта голова, как правило, представляет собой голову языкового моделирования VLM, обученную выводить либо текстовые команды в свободной форме (например, «повернуть налево») [287], либо последовательность дискретизированных токенов действий [340]. Модель авторегрессионно предсказывает эти токены, которые впоследствии преобразуются в исполняемые сигналы. Этот подход широко применяется в текстовых генераторах действий, таких как DriveMLM [264] и DriveGPT4 [287].⟧.
- ⟦• Регрессия (REG). Данная формулировка использует структуру декодера, за которой следует регрессор (как правило, многослойный перцептрон), для прямого прогнозирования непрерывных значений. В отличие от языковых «голов», она позволяет избежать дискретизации путем отображения латентных признаков, агрегированных с помощью transformers или GRU, в конкретные числовые выходные данные, такие как углы поворота рулевого колеса, значения газа/тормоза или путевые точки траектории. Репрезентативные методы, использующие этот детерминированный подход, включают LMDrive [222] и DriveGPT4-V2 [288]⟧.
- ⟦• Выбор траектории (SEL). Вместо прямой регрессии единственного пути, этот блок оценивает набор траекторий-кандидатов и выбирает оптимальную на основе обученной функции стоимости или механизма оценки. Модель обычно генерирует или выбирает разнообразный набор динамически допустимых траекторий и использует латентное представление для прогнозирования стоимости или вероятности для каждого кандидата. Этот подход, используемый такими методами, как WoTE [145] и SeerDrive [315], гарантирует, что итоговый результат соответствует кинематическим ограничениям за счет выбора из заранее определенных кандидатов.
- ⟦• Генерация траекторий (GEN). Данная генеративная формулировка синтезирует действия посредством вероятностного моделирования, наиболее примечательно с использованием диффузионных моделей или вариационных автокодировщиков [156, 333, 106]. Начиная с шума, «голова» итеративно уточняет выборку траектории, обусловленную латентным состоянием VLM и, опционально, языковыми инструкциями. Это позволяет модели учитывать мультимодальность и неопределенность будущих распределений. Яркими примерами являются ORION [67] и DiffVLA [106]⟧.
2.4 Действие в вождении
В контексте автономного вождения, особенно для таких моделей, как VLA, пространство действий определяет набор возможных выходных данных, которые модель может генерировать для управления транспортным средством. Выбор представления действий является фундаментальным проектным решением, которое определяет, как рассуждения модели преобразуются в физическое движение. Ниже мы описываем три основные парадигмы представления пространства действий..
2.4.1 Дискретные представления траекторий
Данная парадигма представляет предполагаемую будущую траекторию транспортного средства как конечную последовательность пространственных путевых точек [168]. Каждая путевая точка — это пространственная координата, которую транспортное средство должно достичь в определенный будущий момент времени. Такое представление позволяет осуществлять явное геометрическое планирование пути и оптимизацию траектории. Действие , сформулированное в текущий момент времени , представляет собой набор из будущих путевых точек.:
| (2) |
Здесь — это горизонт прогнозирования (общее количество будущих шагов), а каждое — это координата на двумерной декартовой плоскости, представляющая целевое положение на шаге .⟧.
2.4.2 Непрерывные представления траекторий
Вместо дискретных точек данный подход параметризует движение транспортного средства как непрерывную функцию на будущем временном горизонте [166]. Траектория обычно определяется функциями, которые управляют продольным и поперечным движением транспортного средства, такими как скорость и радиус поворота. Действие, , определяется этими непрерывными функциями на временном интервале ⟧:
| (3) |
В данной формулировке представляет профиль скорости транспортного средства, а представляет его профиль кривизны на будущем временном горизонте . Это по своей сути отражает непрерывный характер динамики транспортного средства..
2.4.3 Представления прямого управления
Данная парадигма предполагает непосредственный вывод низкоуровневых команд управления транспортным средством, которые немедленно передаются на исполнительные механизмы автомобиля [288]. Эти выходные данные обычно состоят из непрерывных сигналов для управления рулевым механизмом, ускорением и торможением. Значения часто нормализуются и ограничиваются таким образом, чтобы они находились в пределах физических эксплуатационных диапазонов транспортного средства. Вектор действий, , представляет собой управляющие сигналы для конкретного временного шага :
| (4) |
где — угол поворота рулевого колеса, — входной сигнал дроссельной заслонки, а — входной сигнал тормозной системы на временном шаге . Каждый компонент ограничен аппаратными пределами транспортного средства, например, .
2.4.4 Языковые представления
Данная парадигма использует возможности естественного языка VLMs для выражения действий вождения посредством текстовых описаний [19]. Действие представлено как последовательность дискретных токенов из предопределенного словаря:
| (5) |
Здесь представляет словарь модели, — это длина последовательности, а каждый токен соответствует элементу в словаре. Действие, основанное на языке, может варьироваться от команд высокого уровня (например, «поверните налево на перекрестке») до конкретных числовых представлений траектории, закодированных в виде текстовых токенов.
3 Модели зрения-действия
Модели Vision-Action (VA) представляют собой одно из самых ранних и влиятельных направлений исследований в области автономного вождения. Их основная идея заключается в прямом отображении сенсорных наблюдений — как правило, данных с камер — в действия по управлению автомобилем, что позволяет избежать явной модульной декомпозиции на восприятие, прогнозирование и планирование. Благодаря глубоким нейронным сетям модели VA были исследованы в рамках двух основных парадигм обучения: 1imitation learning, которая извлекает стратегии из экспертных демонстраций, и 2reinforcement learning, которая оптимизирует поведение посредством взаимодействия методом проб и ошибок. В последнее время world models расширили эту парадигму, позволив агентам моделировать динамику сцены и рассуждать о последствиях действий, что повышает надежность и масштабируемость. В таблице 1 представлен обзор репрезентативных работ..
С архитектурной точки зрения методологии VA для автономного вождения можно в широком смысле разделить на:
- ⟦• Сквозные модели, которые напрямую предсказывают команды управления или запланированные траектории на основе сенсорных входных данных.
- ⟦• World Models, которые явно моделируют будущую динамику с учетом действий для поддержки обучения стратегий и принятия решений.
3.1 Сквозные модели для автономного вождения
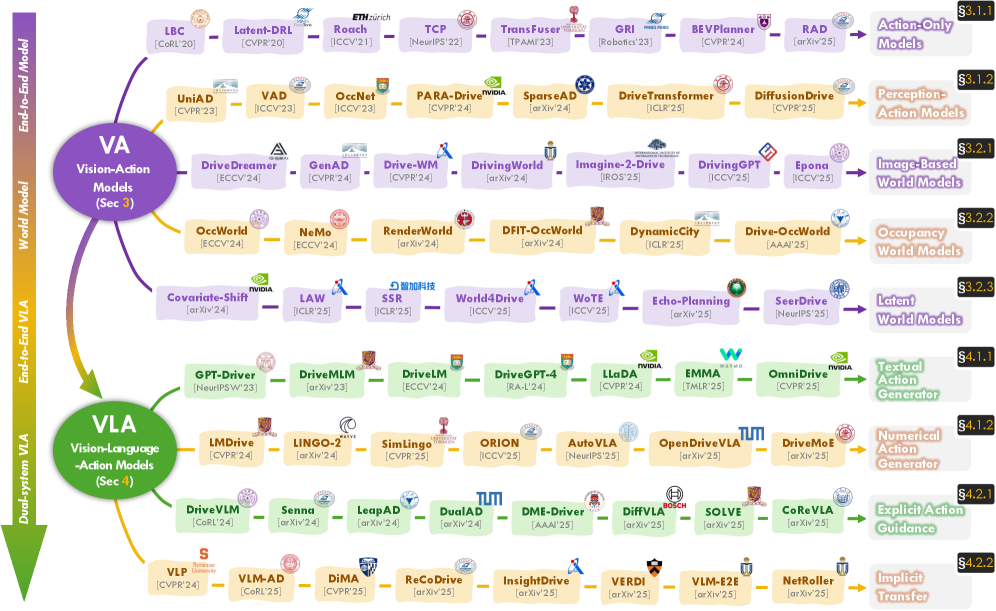
End-to-end (E2E) модели обучают единую нейронную сеть, которая отображает необработанные или промежуточные данные сенсоров в действия или запланированные траектории [28, 38, 145, 16]. В отличие от модульных стеков, которые изолируют восприятие, прогнозирование и планирование, E2E подходы неявно связывают эти задачи в рамках унифицированного представления [235, 109, 91]. В зависимости от того, используется ли контроль восприятия, существующие методы делятся на две основные категории: модели только для действий и модели восприятия-действия, как показано на Рисунке 3.
3.1.1 Модель, основанная только на действиях
Модели, основанные только на действиях, используют упрощенную одноэтапную формулировку: сенсорные входные данные подаются непосредственно в нейронную сеть, которая выдает низкоуровневые действия. Эти методы в основном различаются тем, обучаются ли стратегии на основе демонстраций или посредством исследования..
Imitation Learning (IL), особенно behavior cloning [7], изучает стратегию путем сопоставления действий эксперта, как показано в ветке IL на рисунке 3. Ранние работы [203, 16, 198, 43] продемонстрировали, что действия можно предсказывать непосредственно на основе монокулярных или многоракурсных входных данных, а последующие разработки усовершенствовали архитектуры backbone [205, 24, 40]. NEAT [39] выделяет поведенчески значимые области изображения с помощью промежуточных карт внимания, в то время как TCP [273] объединяет ветку траектории и ветку управления для дополнительного контроля. Чтобы лучше использовать геометрию сцены, BEV-Planner [149] предсказывает траектории на основе BEV признаков, дополненных состояниями ego. Urban-Driver [218] выходит за рамки оценки с разомкнутым контуром, обучая стратегии в дифференцируемом симуляторе, основанном на данных..
Методы на основе IL просты, эффективны и не требуют проектирования функций вознаграждения; однако они остаются чувствительными к сдвигу распределения [215, 56, 206] и причинной путанице [190, 49, 200], что может снизить надежность в сценариях с длинным хвостом или редкими событиями..
| # | Model | Venue | Input | Dataset | Vision | Action | Output |
| Sec. 3.1.1 Action-only Models | |||||||
| 1 | LBC [25] | CoRL’20 |  |
C N |
ResNet [87] | RL | Ctrl.+Traj. |
| 2 | Latent-DRL [251] | CVPR’20 | |
C |
ResNet [87] | RL | Ctrl. |
| 3 | NEAT [39] | ICCV’21 | |
C |
ResNet [87] | REG | Traj. |
| 4 | Roach [326] | ICCV’21 | |
C |
ResNet [87] | RL | Ctrl. |
| 5 | WoR [26] | ICCV’21 | |
C N P |
ResNet [87] | REG | Ctrl. |
| 6 | TCP [273] | NeurIPS’22 | |
C |
ResNet [87] | REG | Ctrl.+Traj. |
| 7 | Urban-Driver [218] | CoRL’22 | |
L |
ResNet [87] | REG | Traj. |
| 8 | LAV [24] | CVPR’22 |
|
C |
ResNet [87] | REG | Ctrl.+Traj. |
| 9 | TransFuser [40] | TPAMI’23 |
|
C |
ResNet [87] | REG | Traj. |
| 10 | GRI [23] | Robotics’23 | |
C |
EfficientNet [238] | RL | Ctrl. |
| 11 | BEVPlanner [149] | CVPR’24 | |
N |
ResNet [87] | REG | Traj. |
| 12 | Raw2Drive [301] | NeurIPS’25 | |
C |
ResNet [87] | RL | Ctrl. |
| 13 | RAD [68] | NeurIPS’25 | |
P |
ResNet [87] | RL | Traj. |
| 14 | TrajDiff [75] | arXiv’25 |
|
N |
ResNet [87] | GEN | Traj. |
| Sec. 3.1.2 Perception-Action Models | |||||||
| 15 | ST-P3 [91] | ECCV’22 | |
N C |
EfficientNet [238] | SEL | Traj. |
| 16 | UniAD [93] | CVPR’23 | |
N |
ResNet [87] | REG | Traj. |
| 17 | VAD [108] | ICCV’23 | |
N |
ResNet [87] | REG | Traj. |
| 18 | OccNet [250] | ICCV’23 | |
N |
ResNet [87] | SEL | Traj. |
| 19 | GenAD [333] | ECCV’24 | |
N |
ResNet [87] | GEN | Traj. |
| 20 | PARA-Drive [269] | CVPR’24 | |
N |
ResNet [87] | REG | Traj. |
| 21 | Hydra-MDP [148] | CVPRW’24 |
|
N |
ResNet [87] | SEL | Traj. |
| 22 | SparseAD [317] | arXiv’24 | |
N |
ResNet [87] | REG | Traj. |
| 23 | GaussianAD [332] | arXiv’24 | |
N |
ResNet [87] | REG | Traj. |
| 24 | DiFSD [231] | arXiv’24 | |
N |
ResNet [87] | GEN | Traj. |
| 25 | DriveTransformer [104] | ICLR’25 | |
N B |
ResNet [87] | REG | Traj. |
| 26 | SparseDrive [235] | ICRA’25 | |
N |
ResNet [87] | REG | Traj. |
| 27 | DiffusionDrive [156] | CVPR’25 |
|
N N |
ResNet [87] | GEN | Traj. |
| 28 | GoalFlow [279] | CVPR’25 |
|
N |
VoVNet [129] | GEN | Traj. |
| 29 | GuideFlow [162] | arXiv’25 | |
N N B |
ResNet [87] | GEN | Traj. |
| 30 | ETA [78] | arXiv’25 | |
B |
CLIP-ViT [210] | REG | Traj. |
| 31 | Geo [105] | arXiv’25 | |
N |
ResNet [87] | REG | Traj. |
| 32 | DiffusionDriveV2 [345] | arXiv’25 |
|
N |
ResNet [87] | GEN | Traj. |
| 33 | NaviHydra [272] | arXiv’25 |
|
N |
ResNet [87] | SEL | Traj. |
| 34 | Mimir [280] | arXiv’25 |
|
N |
ResNet [87] | GEN | Traj. |
| Sec. 3.2.1 Image-Based World Models | |||||||
| 35 | DriveDreamer [265] | ECCV’24 |
|
N |
SD [214] | REG | Traj. |
| 36 | GenAD [296] | CVPR’24 | |
O |
SDXL [202] | REG | Traj. |
| 37 | Drive-WM [267] | CVPR’24 |
|
N |
ConvNeXt [173] | SEL | Traj. |
| 38 | DrivingWorld [92] | arXiv’24 |
|
N |
VQ-VAE [254] | REG | Traj. |
| 39 | Imagine-2-Drive [71] | IROS’25 | |
C |
SVD [15] | SEL | Traj. |
| 40 | DrivingGPT [34] | ICCV’25 |
|
N |
VQ-VAE [254] | REG | Traj. |
| 41 | Epona [321] | ICCV’25 |
|
N N N |
DC-AE [27] | REG | Traj. |
| 42 | VaViM [11] | arXiv’25 | |
O |
LLaMAGen [234] | GEN | Traj. |
| Sec. 3.2.2 Occupancy-Based World Models | |||||||
| 43 | OccWorld [334] | ECCV’24 |
|
N O |
ResNet [87] | REG | Traj. |
| 44 | NeMo [96] | ECCV’24 | |
N |
ResNet [87] | REG | Traj. |
| 45 | OccVAR [112] | - |
|
N O |
ResNet [87] | REG | Traj. |
| 46 | RenderWorld [292] | arXiv’24 | |
N |
Swin-T [172] | REG | Traj. |
| 47 | DFIT-OccWorld [318] | arXiv’24 |
|
N O |
ResNet [87] | REG | Traj. |
| 48 | Drive-OccWorld [297] | AAAI’25 | |
N |
ResNet [87] | REG | Traj. |
| 49 | Former [282] | arXiv’25 |
|
N O |
ResNet [87] | REG | Traj. |
| 50 | AD-R1 [289] | arXiv’25 |
|
N |
- | RL | Traj. |
| Sec. 3.2.3 Latent-Based World Models | |||||||
| 51 | Covariate-Shift [204] | arXiv’24 |
|
C |
DINOv2 [196] | REG | Traj. |
| 52 | World4Drive [335] | ICCV’25 | |
N |
ResNet [87] | REG | Traj. |
| 53 | WoTE [145] | ICCV’25 |
|
N B |
ResNet [87] | SEL | Traj. |
| 54 | LAW [143] | ICLR’25 | |
N |
Swin-T [172] | REG | Traj. |
| 55 | SSR [134] | ICLR’25 | |
N C |
ResNet [87] | REG | Traj. |
| 56 | Echo-Planning [232] | arXiv’25 | |
N |
ResNet [87] | REG | Traj. |
| 57 | SeerDrive [315] | NeurIPS’25 |
|
N N |
VoVNet [129] | SEL | Traj. |
Обучение с подкреплением (RL) оптимизирует действия посредством взаимодействия, предлагая большую гибкость, чем подходы, основанные на имитации [237, 119]. Ряд работ решает проблему неэффективности выборки в RL путем объединения его с контролируемым предварительным обучением: Latent-DRL [251] и Gri [23] предварительно обучают визуальные энкодеры с использованием семантической сегментации, в то время как LSD [194] инициализирует политики через IL перед выполнением RL дообучения. Дистилляция привилегированной информации также доказала свою эффективность: LBC [25], WoR [26] и Roach [326] используют состояния, доступные только в симуляторе, для управления агентами, работающими на основе сенсоров.
В сочетании с моделью мира Think2Drive [137] обучает агента с помощью метода Model-Based RL (MBRL) в паре с компактной латентной моделью мира, изучающей переходы среды. Raw2Drive [301] представляет собой двухпоточный подход MBRL, в котором модель мира на основе необработанных сенсорных данных согласовывается с привилегированной моделью мира для прогнозирования действий на основе камер. В отличие от исследований в нефотореалистичной CARLA [56], недавние усилия сместились в сторону фотореалистичного моделирования мира. RAD [68] устанавливает парадигму обучения с подкреплением в замкнутом цикле на основе 3DGS [116], регулируемую с помощью IL в реалистичной среде 3DGS. Ключевые проблемы в моделях на основе RL включают неэффективность выборки [151], проектирование функции вознаграждения [120] и перенос из симуляции в реальность [38]⟧.
3.1.2 Модель восприятия-действия
Модели восприятия-действия следуют двухэтапной парадигме, в которой задачи восприятия (например, картографирование, отслеживание) контролируют и ограничивают прогнозирование траектории. Эти методы обычно используют либо плотные представления на основе BEV, либо разреженные представления на основе запросов, как показано на рисунке 3.
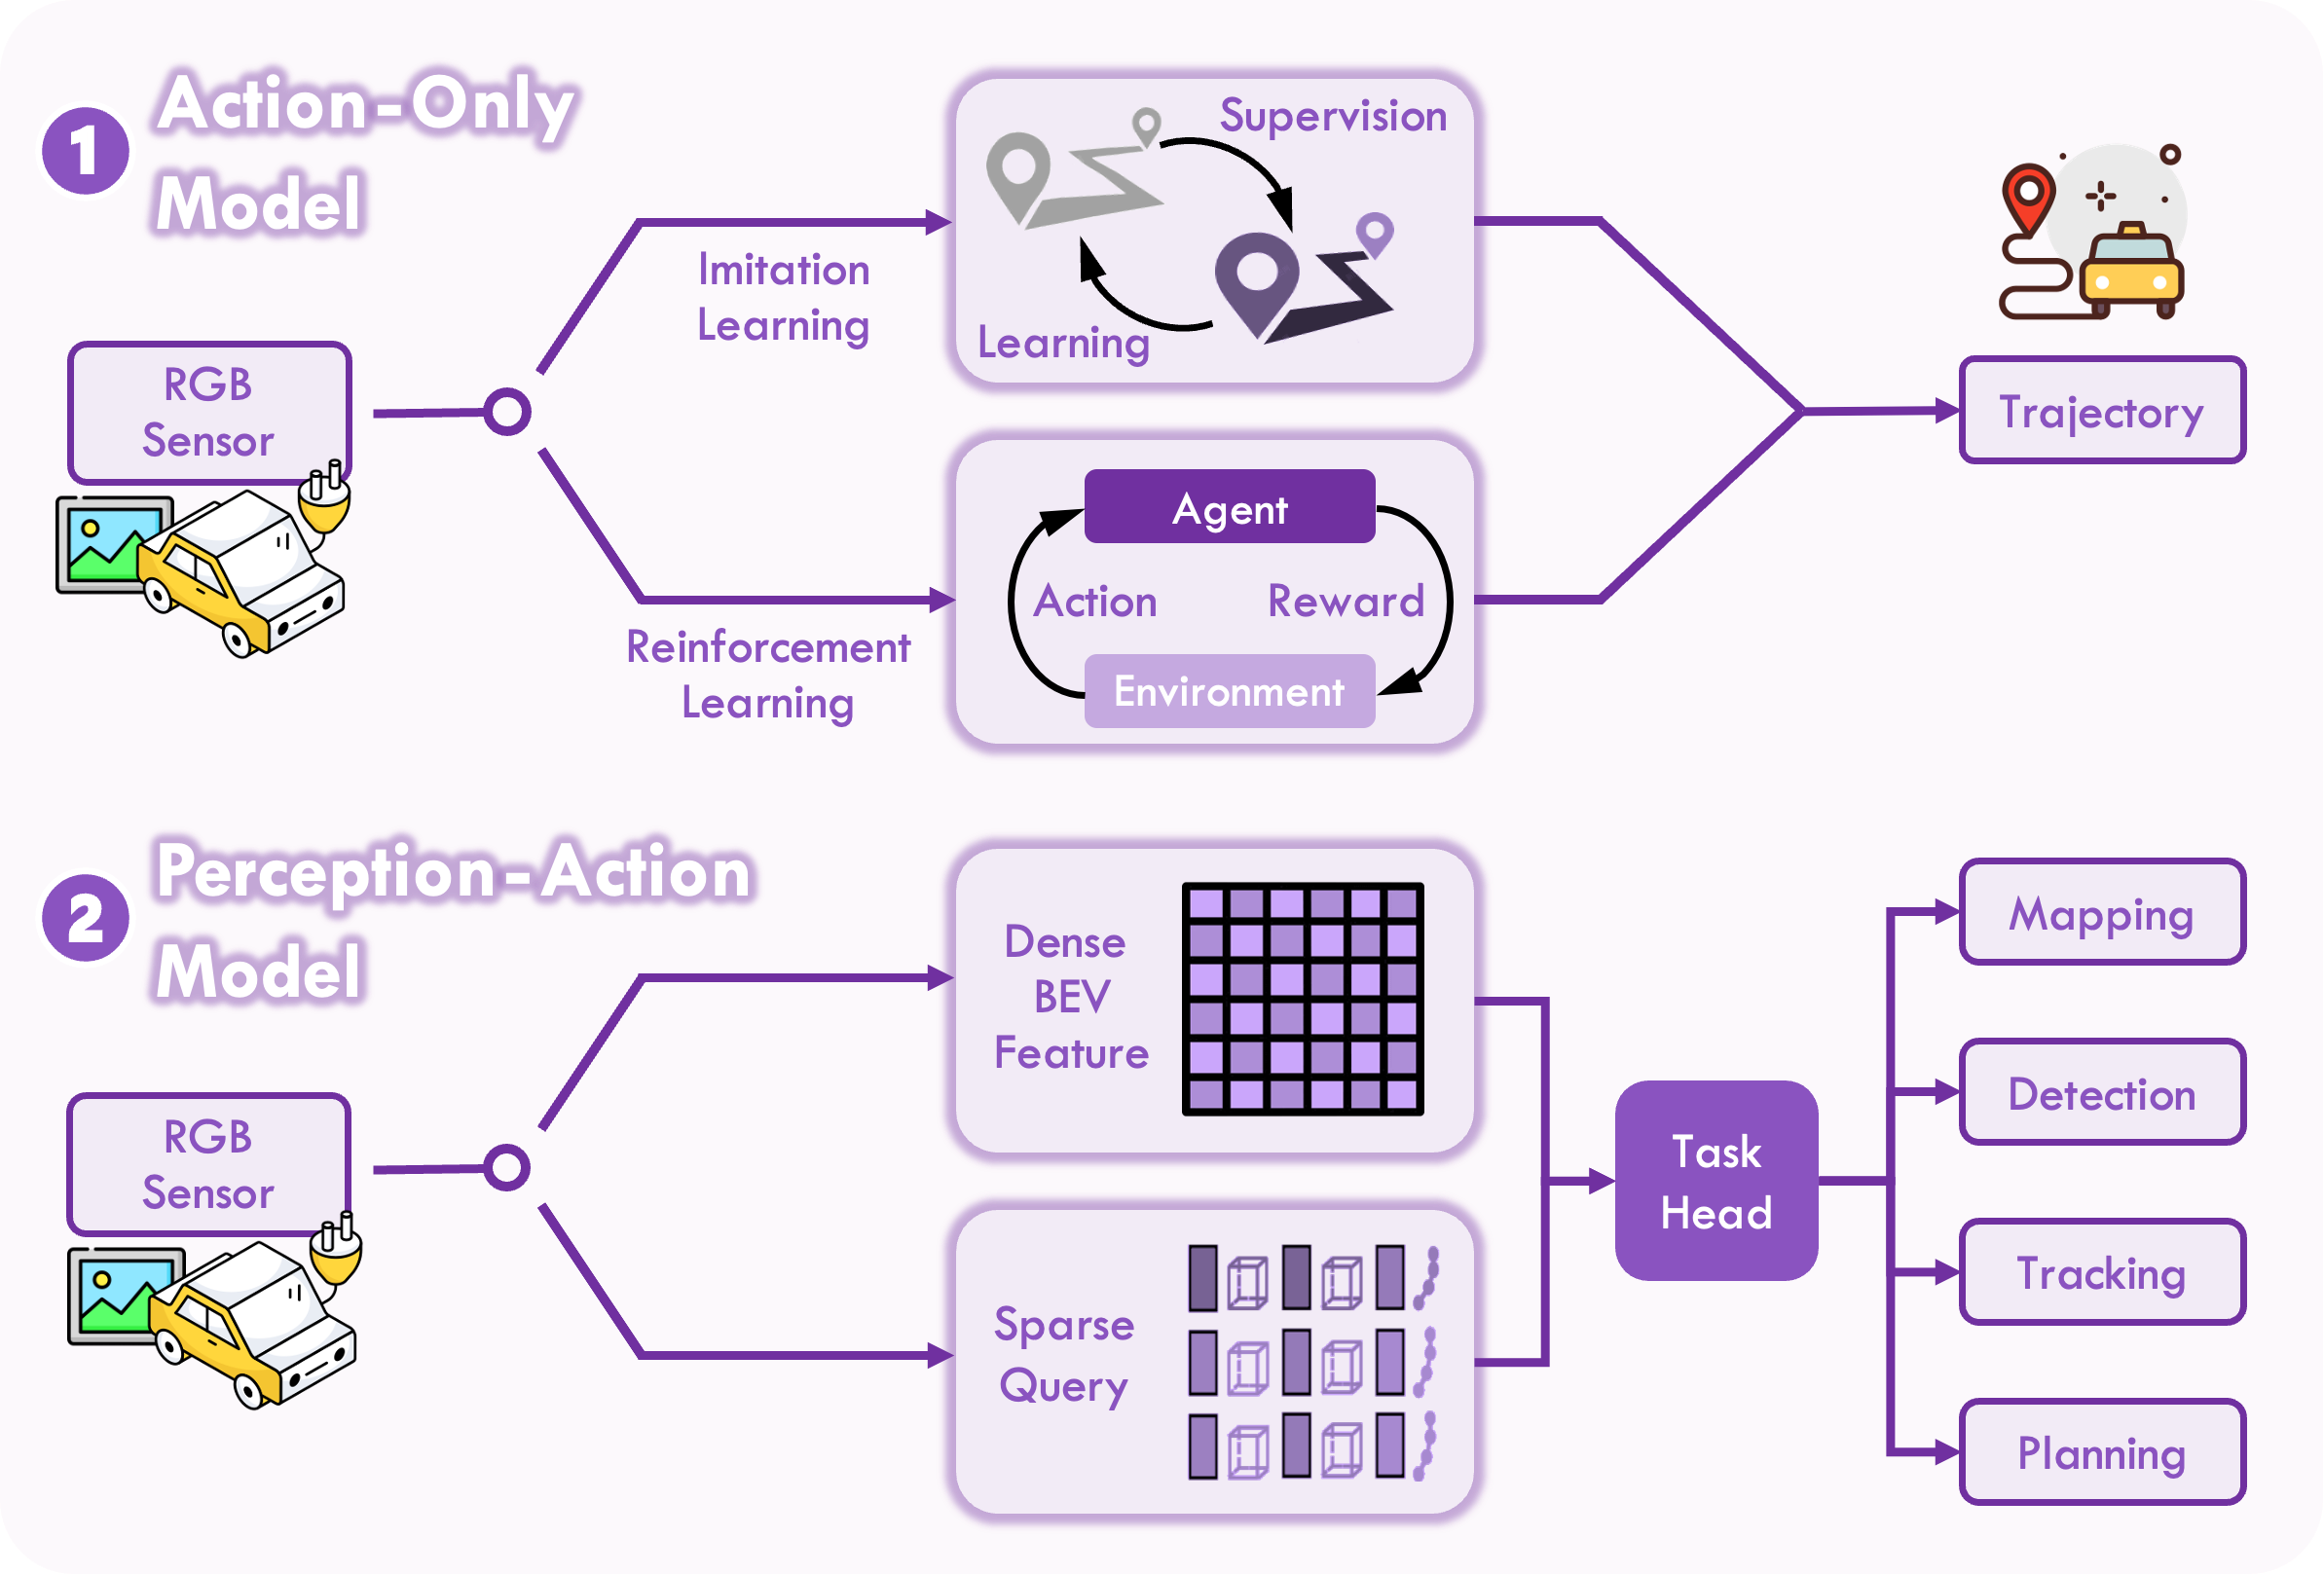
Плотные модели на основе BEV формируют унифицированные признаки вида сверху на основе данных с камер с разных ракурсов. ST-P3 [91] совместно обучается пространственно-временным признакам для восприятия и планирования; UniAD [93] интегрирует последовательные зависимости задач для поддержки целенаправленного планирования. VAD [108] использует векторизованное представление сцены для повышения безопасности и эффективности планирования. OccNet [250] включает эмбеддинги заполненности для захвата трехмерной геометрии сцены. Para-Drive [269] предлагает полностью параллельную E2E архитектуру для развертывания в реальном времени..
Недавно появились генеративные и основанные на выборке подходы: GenAD [333] формулирует планирование как выборку из изученных распределений; DiffusionDrive [156] представляет усеченную диффузионную политику, управляемую мультимодальными якорями; GuideFlow [162] включает явные физические ограничения в процесс генерации. Хотя BEV представления естественным образом согласуются с 2D планированием траектории, они требуют значительных вычислений из-за своей плотной пространственной структуры.
Модели на основе разреженных запросов избегают явных сеток BEV, используя латентные запросы для агрегирования признаков изображения. SparseAD [317] и SparseDrive [235] представляют всю сцену с помощью разреженных запросов восприятия и параллельного планировщика, достигая эффективного баланса между точностью и производительностью. DiFSD [231] внедряет эгоцентрическую разреженную формулировку и моделирует неопределенность посредством шумоподавления траектории. DriveTransformer [104] включает параллелизм задач, разреженное внимание и потоковые обновления для повышения стабильности. GaussianAD [332] использует 3D семантические гауссианы для детализированного, но компактного представления сцены..
Методы разреженных запросов значительно сокращают задержку вывода, однако отсутствие плотного представления будущего состояния мира может ограничить рассуждения на длинном горизонте и безопасность планирования..
3.2 Мировые модели для автономного вождения
Мировые модели нацелены на прогнозирование того, как дорожные сцены развиваются при различных действиях эго-автомобиля [77, 291, 121]. Совместно моделируя динамику сцены и движение эго-автомобиля, они предоставляют мощный механизм для обучения безопасным стратегиям вождения на длинном горизонте планирования [53]. Их применение охватывает иммерсивное моделирование [90, 175, 212, 290, 13, 342], end-to-end планирование [265, 69, 267, 92] и обучение признаков для последующих задач [188, 298, 319, 170, 29, 30, 138]. Здесь мы фокусируемся на мировых моделях, предназначенных для планирования траекторий, и классифицируем их по модальности прогнозирования и гранулярности представления на три группы: модели на основе изображений, модели на основе занятости пространства и модели на основе латентных представлений (Рисунок 4).
3.2.1 Модель мира на основе изображений
Модели мира на основе изображений генерируют будущие кадры с учетом действий агента, позволяя агентам «мечтать» о развитии сцены и оценивать последствия различных траекторий. Эти методы используют современные генеративные модели для синтеза реалистичных, временно согласованных видео и обычно классифицируются на архитектуры, основанные на диффузии, и авторегрессионные архитектуры..
Диффузионные модели мира используют латентную видеодиффузию [214, 14] для создания многошаговых разверток. Для прогнозирования вида спереди GenAD [296] и Vista [69] включают модули временных рассуждений для обработки сложных паттернов движения. Imagine-2-Drive [71] интегрирует диффузионную генерацию в структуру обучения с подкреплением, обучая агента стратегии внутри модели мира. Для поддержки прогнозов с нескольких ракурсов DriveDreamer [265] использует двухэтапный конвейер для синтеза видео и обучения стратегии. Drive-WM [267] факторизует ракурсы внутри пространственно-временной модели и генерирует несколько вероятных вариантов будущего, выбирая траектории с использованием наград на основе изображений..
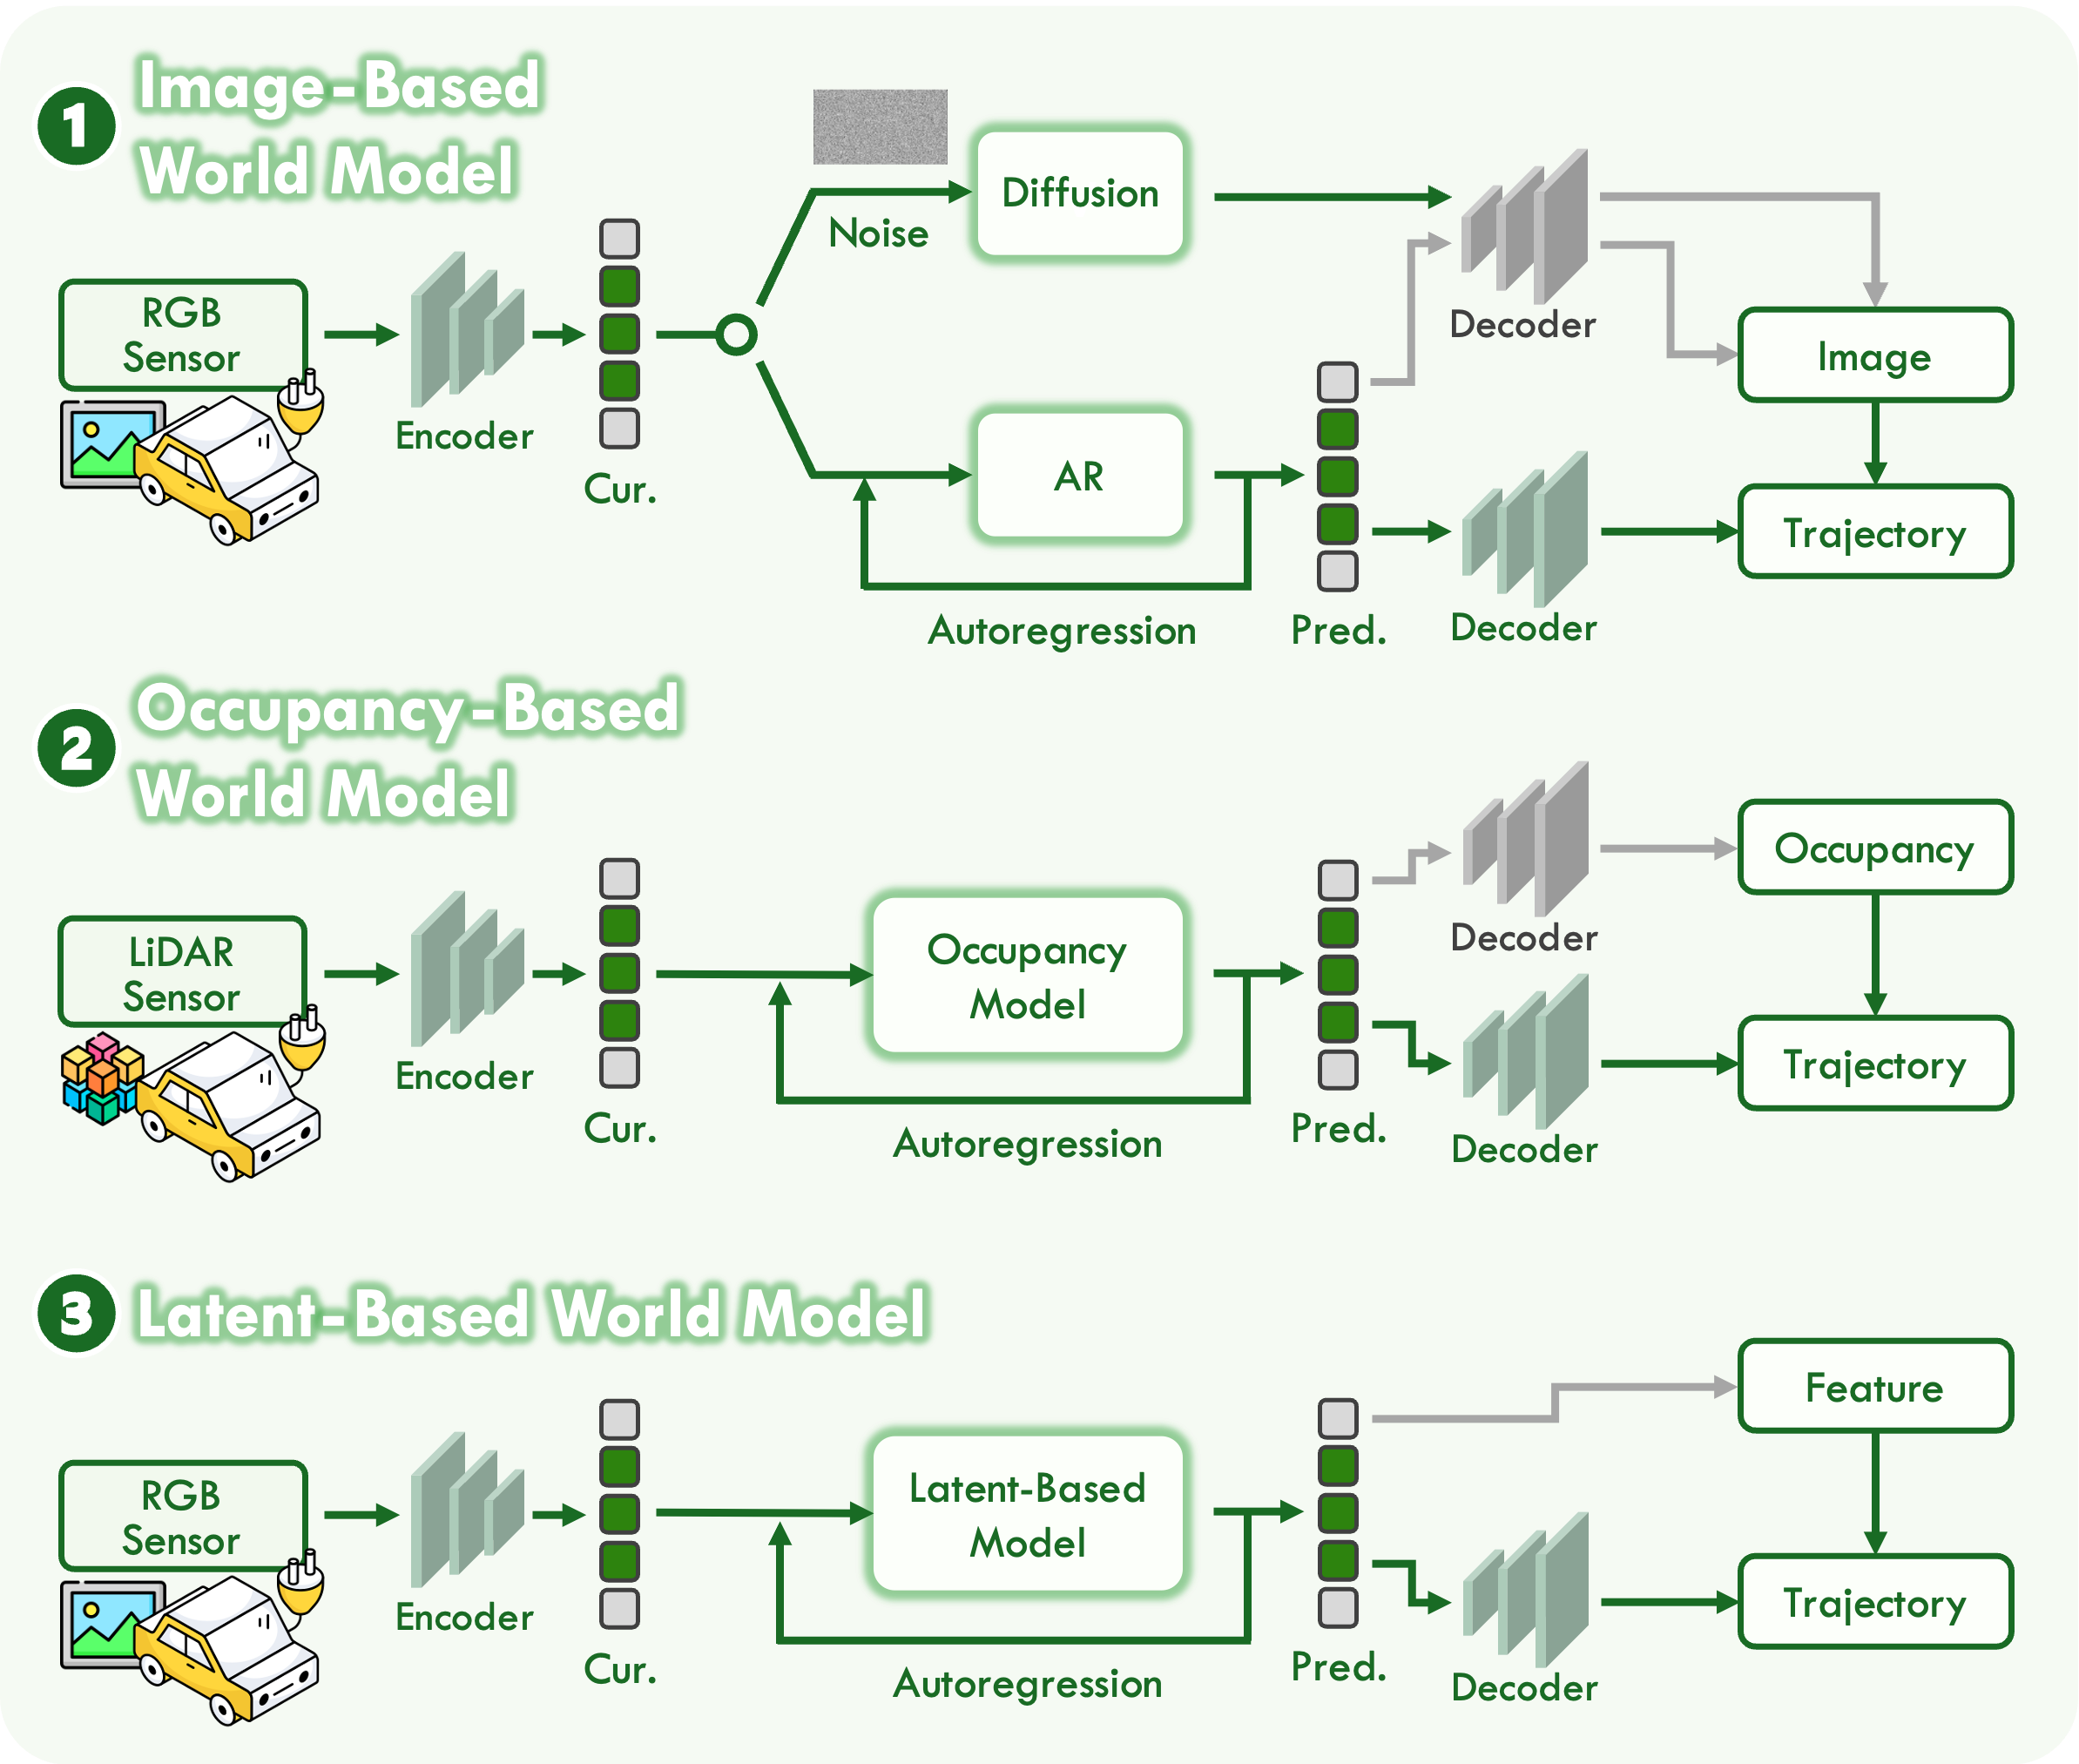
Авторегрессионные (AR) модели токенизируют изображения с использованием VQ-VAE [254] и моделируют развитие сцены посредством предсказания следующего токена [59, 128, 305]. DrivingWorld [92] выстраивает архитектуру в стиле GPT для высокоточной генерации видео с длинным горизонтом планирования. DrivingGPT [34] чередует токены изображений и действий, объединяя симуляцию и планирование траектории. Epona [321] сочетает AR-моделирование с диффузией для создания высокоразрешенных и длительных сценариев развертывания..
Модели мира на основе изображений обеспечивают фотореалистичное моделирование, имеющее решающее значение для обучения и оценки. Однако их зависимость от двумерного представления ограничивает явное трехмерное рассуждение, что может препятствовать долгосрочному планированию в критически важных для безопасности задачах..
3.2.2 Модели мира на основе заполненности пространства
Модели мира на основе заполненности представляют сцену вождения в виде пространственно-временных сеток заполненности и прогнозируют их эволюцию при различных действиях. Вместо синтеза необработанных пикселей эти модели фокусируются на геометрии и семантике свободного пространства, препятствий и агентов [154, 171, 342]. Как показано в середине Figure 4, AR prediction обычно используется в моделях мира на основе заполненности.
OccWorld [334] впервые представляет прогнозирование заполненности для планирования, используя токенизатор сцены для дискретизации 3D заполненности перед применением GPT-style transformer для синтеза будущих сцен и траекторий эго-транспорта. RenderWorld [292] создает 3D заполненность с помощью самообучающегося гауссова модуля, в то время как OccVAR [112] выполняет прогнозирование 4D заполненности от грубого к точному. Former [282] кодирует заполненность, используя компактные триплоскости, и предсказывает будущие обновления триплоскостей на основе многомасштабной истории.
Альтернативное направление использует одноэтапное прямое прогнозирование. Drive-OccWorld [297] использует предсказанные будущие BEV признаки для 3D-прогнозирования с учетом действий. DFIT-OccWorld [318] внедряет стратегию разделенного динамического потока для поддержки эффективного неавторегрессионного прогнозирования. NeMo [96] улучшает прогнозирование заполненности на основе зрения путем объединения его с сигналами самообучающейся реконструкции изображений..
Модели, основанные на представлении занятости, обеспечивают высокую геометрическую точность и явное рассуждение о свободном пространстве, но зависят от дорогостоящих 3D-аннотаций, что может ограничивать масштабируемость в различных средах..
3.2.3 Латентные модели мира
Модели мира на основе латентных представлений обходят явное прогнозирование изображений или занятости и вместо этого предсказывают будущую динамику непосредственно в сжатом латентном пространстве. Работая с высокоуровневыми признаками, эти модели улавливают поведенческие паттерны и долгосрочные зависимости, избегая при этом вычислительных затрат, связанных с генерацией на уровне пикселей. Что касается стратегии прогнозирования, латентная модель мира использует однокадровое или AR предсказание, представленное в нижней части рисунка 4⟧.
Ранние латентные модели [337, 8] изучают динамику на уровне признаков для планирования без генерации визуальных кадров. LAW [143] использует самообучение для прогнозирования будущих признаков сцены на основе текущих признаков и запланированных траекторий движения, обеспечивая сквозное вождение без меток восприятия. World4Drive [335] применяет базовые модели компьютерного зрения для создания латентных представлений, на основе которых могут быть сгенерированы и оценены различные траектории планирования. Echo-Planning [232] внедряет двунаправленный цикл Current→Future→Current (CFC) для обеспечения временной согласованности в латентных признаках BEV. Для повышения устойчивости в обучении с подражанием Covariate-Shift [204] решает проблему несоответствия распределений с помощью латентных разверток. Путем внедрения прогнозируемых признаков BEV, SeerDrive [315] уточняет как латентное прогнозирование, так и генерацию траектории в замкнутом цикле..
Латентные мировые модели обеспечивают эффективное и семантически обоснованное прогнозирование. Однако для достижения высококачественного планирования по-прежнему требуется вспомогательный контроль на основе 2D/3D аннотаций, таких как ограничивающие рамки или HD карты..
3.3 Ограничения VA по сравнению с VLA
Хотя модели VA по-прежнему широко используются, они сталкиваются со структурными ограничениями, которые препятствуют повышению производительности в сложных, неоднозначных или редко встречающихся сценариях: областях, в которых модели VLA превосходят их..
- ⟦• Ограниченная интерпретируемость. Модели VA предоставляют мало информации о процессе принятия ими решений. В отличие от них, модели VLA могут формулировать этапы рассуждения или объяснения с помощью языка.
- ⟦• Слабая обобщающая способность. Политики VA лишены обширных знаний о мире и часто требуют переобучения для конкретных сред. Модели VLA используют крупномасштабное предварительное обучение для лучшей генерализации в условиях сдвига распределения и редких событий..
- ⟦• Отсутствие пошагового рассуждения. Модели VA напрямую преобразуют пиксели в действия, что затрудняет выполнение явных рассуждений или контекстуального анализа. VLA изначально поддерживают пошаговое рассуждение.
- ⟦• Отсутствие понимания языка. Системы VA не могут учитывать инструкции человека или высокоуровневые цели, выраженные на естественном языке. Модели VLA естественным образом интегрируют такие входные данные для управления планированием и принятием решений..
4 Модели зрения-языка-действия
Модели Vision-Language-Action (VLA) расширяют парадигму Vision-Action, объединяя визуальное восприятие с возможностями мультимодального рассуждения больших vision-language моделей. Благодаря выводу в стиле chain-of-thought и обширным знаниям о мире, эти модели особенно перспективны для редких, неоднозначных и долгохвостых сценариев вождения. В таблице 2 обобщены типичные стратегии промптинга, а в таблице 3 представлен обзор репрезентативных подходов на основе VLA..
С архитектурной точки зрения современные методологии VLA для автономного вождения можно разделить на две основные категории:
- ⟦• End-to-End VLA: единая модель, которая напрямую преобразует мультимодальные сенсорные входные данные и язык в действия.
- ⟦• Двухсистемная VLA: VLM обеспечивает высокоуровневое рассуждение или руководство, в то время как специализированный модуль вождения выполняет быстрые низкоуровневые действия.
| Prompt Type | Explanations |
 System Prompt |
Text templates or query formulations designed to interact with large language models, guiding them to perform specific driving-related reasoning or trajectory prediction tasks. System prompts often define the task structure, provide role definitions, and shape the model’s reasoning behavior. |
 Instructions |
Commands or instructions provided by humans or systems, typically describing the driving goal or required maneuver (e.g., “turn left at the next intersection”). |
 Scene Description |
Textual descriptions of surroundings, including perceived objects, road layout, and contextual factors (e.g., “a pedestrian is crossing on the right”, or “a vehicle is 5 meters ahead on the left”). |
 Traffic Rules |
Prompts encoding regulatory constraints or domain knowledge, such as traffic laws, traffic light status, right-of-way rules, or safety guidelines. |
|
Ego Status
|
Information about the ego vehicle’s internal state, including speed, position, heading, or navigation intent. |
 Context Information |
Demonstrations presented as paired examples of driving scenarios and corresponding actions, used to guide the model via in-context learning. |
| # | Model | Venue | Input Modality | Dataset | Vision | Language | Action | Output |
| Sec. 4.1.1: Textural Action Generator | ||||||||
| 1 | DriveMLM [264] | arXiv’23 |
|
C |
EVA-CLIP [62] |
 LLaMA [252] |
LH | Desc.+Meta. |
| 2 | RAG-Driver [309] | RSS’24 |
|
B |
CLIP [210] | Vicuna-1.5 [37] | LH | Desc.+Ctrl. |
| 3 | RDA-Driver [97] | ECCV’24 |
|
D N |
BEVFusion [155] |
LLaMA [252]
|
LH | Desc.+Traj. |
| 4 | DriveLM [225] | ECCV’24 |
|
D |
BLIP-2 [133] |
LLaMA [252]
|
LH | Meta.+Traj. |
| 5 | DriveGPT4 [287] | RA-L’24 |
|
B |
CLIP [210] |
LLaMA-2 [252]
|
LH | Desc.+Ctrl. |
| 6 | DriVLMe [95] | IROS’24 |
|
B |
CLIP [210] | Vicuna [37] | LH | Desc.+Ctrl. |
| 7 | LLaDA [131] | CVPR’24 |
|
N N |
- |
 GPT-4 [1] |
LH | Ctrl.+Traj. |
| 8 | VLAAD [201] | WACVW’24 |
|
V |
BLIP-2 [133] |
LLaMA-2 [252]
|
LH | Ctrl. |
| 9 | OccLLaMA [268] | arXiv’24 |
|
N |
Swin-T [172], PointPillar [127] |
LLaMA-3 [58]
|
LH | Ctrl.+Traj. |
| 10 | Doe-1 [331] | arXiv’24 |
|
N |
Lumina-mGPT [158] | BPE tokenizer [241] | LH | Ctrl.+Traj. |
| 11 | LINGO-2 [245] | - |
|
P |
Wayve Vision Model [246] | Wayve VLA Model [246] | LH | Desc.+Traj. |
| 12 | SafeAuto [320] | ICML’25 |
|
B |
LanguageBind [341] |
 Video-LLaVA [157] |
LH | Desc.+Ctrl. |
| 13 | OpenEMMA [278] | WACV’25 |
|
N |
 Qwen2-VL [258] |
Qwen2-VL [258]
|
LH | Desc.+Traj. |
| 14 | ReasonPlan [169] | CoRL’25 |
|
B |
SigLIP [314] |
Qwen [5]
|
LH | Desc.+Traj.+Meta. |
| 15 | FutureSightDrive [312] | NeurIPS’25 |
|
N D |
ViT [57] |
Qwen2-VL [258]
|
LH | Desc.+Traj. |
| 16 | ImpromptuVLA [36] | NeurIPS’25 |
|
I |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
LH | Traj. |
| 17 | WKER [313] | AAAI’25 |
|
N |
EVA-02 [63] |
LLaMA3 [58]
|
LH | Desc.+Traj. |
| 18 | OmniDrive [259] | CVPR’25 |
|
N |
EVA-02 [63] |
LLaMA2 [252]
|
LH | Desc.+Traj |
| 19 | S4-Driver [276] | CVPR’25 |
|
W N |
PaLI3 [32] | PaLI3 [32] | LH | Meta.+Traj. |
| 20 | EMMA [98] | TMLR’25 |
|
W |
 Gemini-VLM [243] |
Gemini [242]
|
LH | Desc.+Traj. |
| 21 | Occ-LLM [284] | ICRA’25 |
|
N |
- |
LLaMA2 [252]
|
LH | Traj. |
| 22 | Sce2DriveX [327] | RA-L’25 |
|
N |
OpenCLIP [99] | Vicuna-1.5 [37] | LH | Ctrl.+Traj. |
| 23 | DriveAgent-R1 [330] | arXiv’25 |
|
N P |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
LH | Desc.+Meta. |
| 24 | Drive-R1 [147] | arXiv’25 |
|
N |
 InternVL2 [263] |
InternVL2 [263]
|
LH | Desc.+Traj.+Meta. |
| 25 | FastDriveVLA [19] | arXiv’25 |
|
N |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
LH | Desc.+Traj. |
| 26 | WiseAD [323] | arXiv’25 |
|
B C D | CLIP [210] | MobileVLM [41] | LH | Traj.+Ctrl. |
| 27 | AutoDrive-R² [310] | arXiv’25 |
|
N W |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
LH | Traj. |
| 28 | OmniReason [164] | arXiv’25 |
|
N |
EVA-02 [63] |
LLaVA-1.5 [161]
|
LH | Meta.+Traj. |
| 29 | OpenREAD [324] | arXiv’25 |
|
N |
Qwen3 [294]
|
Qwen3 [294]
|
LH | Desc.+Meta.+Traj. |
| 30 | dVLM-AD [179] | arxiv’25 |
|
W |
SigLIP2 [253] | LLaDA-V [303] | LH | Desc.+Traj. |
| 31 | PLA [325] | arXiv’25 |
|
N |
Sensor Encoder |
GPT-4.1 [1]
|
LH | Desc.+Traj. |
| 32 | AlphaDrive [107] | arXiv’25 |
|
M |
Qwen2-VL [258]
|
Qwen2-VL [258]
|
LH | Desc.+Meta. |
| 33 | CoReVLA [61] | arXiv’25 |
|
B |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
LH | Ctrl.+Traj. |
| Sec. 4.1.2: Numerical Action Generator | ||||||||
| 34 | LMDrive [222] | CVPR’24 |
|
C |
ResNet [87] |
LLaMA [252] Vicuna [37]
|
REG | Ctrl. |
| 35 | BEVDriver [271] | IROS’25 |
|
C |
InterFuser [221] |
LLaMA-3.1 [58]
|
REG | Ctrl.+Traj. |
| 36 | CoVLA-Agent [3] | WACV’25 |
|
C |
CLIP [210] |
LLaMA2 [252]
|
REG | Desc.+Traj. |
| 37 | ORION [67] | ICCV’25 |
|
N B |
EVA-02 [63] | Vicuna-1.5 [37] | GEN | Desc.+Traj. |
| 38 | SimLingo [213] | CVPR’25 |
|
C |
InternViT [35]
|
Qwen2 [258]
|
REG | Ctrl.+Traj. |
| 39 | DriveGPT4-V2 [288] | CVPR’25 |
|
C |
CLIP [210] SigLIP [314] |
Qwen [5] Tinyllama [322]
|
REG | Ctrl.+Traj. |
| 40 | AutoVLA [340] | NeurIPS’25 |
|
N |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
LH | Traj. |
| 41 | DriveMoE [300] | arXiv’25 |
|
B |
PaliGemma [12] | PaliGemma [12] | GEN | Ctrl. |
| 42 | DSDrive [168] | arXiv’25 |
|
C |
ResNet [87] |
LLaMA [252]
|
REG | Desc.+Traj. |
| 43 | OccVLA [167] | arXiv’25 |
|
N |
VQ-VAE [254] | PaliGemma-2 [230] | REG | Traj. |
| 44 | VDRive [76] | arXiv’25 |
|
N |
Qwen2.5-VL [6], CVQ [329]
|
InternVL3 [343]
|
GEN | Desc.+Traj. |
| 45 | ReflectDrive [136] | arXiv’25 |
|
N |
LLaDA-V [303] | LLaDA-V [303] | GEN | Traj. |
| 46 | E3AD [240] | arXiv’25 |
|
T |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
REG | Traj. |
| 47 | LCDrive [239] | arXiv’25 |
|
P |
DINOv2 [196] | Qwen3 [294] | LH | Traj. |
| 48 | Alpamayo-R1 [266] | arXiv’25 |
|
P |
 Cosmos-Reason1 [4] |
Cosmos-Reason1 [4]
|
REG | Desc.+Ctrl.+Traj. |
| 49 | UniUGP [174] | arXiv’25 |
|
W N N |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
GEN | Desc.+Traj. |
| 50 | MindDrive [236] | arXiv’25 |
|
N |
ResNet-34 [87] |
LLaVA-1B [130]
|
GEN | Traj. |
| 51 | AdaThinkDrive [177] | arXiv’25 |
|
N |
InternVL3 [343]
|
InternVL3 [343]
|
REG | Desc.+Traj.+Meta. |
| 52 | Percept-WAM [79] | arXiv’25 |
|
N N |
InternViT [35]
|
InternVL2 [263]
|
REG | Traj. |
| 53 | Reasoning-VLA [316] | arXiv’25 |
|
N N W A |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
REG | Traj. |
| 54 | SpaceDrive [135] | arXiv’25 |
|
N |
Qwen2.5-VL [6]
|
Qwen2.5-VL [6]
|
REG | Desc.+Traj. |
| 55 | OpenDriveVLA [339] | AAAI’26 |
|
N |
BEVFormer [150] |
Qwen2.5 [293]
|
LH | Ctrl.+Traj. |
| Sec. 4.2.1: Dual-System: Explicit Action Guidance | ||||||||
| 56 | DriveVLM [249] | CoRL’24 |
|
N |
- |
QwenVL [5]
|
REG | Desc.+Traj. |
| 57 | LeapAD [187] | NeurIPS’24 |
|
C |
QwenVL [5]
|
GPT-4 [1], Qwen1.5 [244]
|
LH | Ctrl.+Traj. |
| 58 | FasionAD [207] | arXiv’24 |
|
N |
GenAD [333] | CLIP [210], QwenVL [5] |
GEN | Ctrl.+Traj. |
| 59 | Senna [109] | arXiv’24 |
|
N |
VADv2 [31], ViT [57] | Vicuna [37] | REG | Desc.+Traj. |
| 61 | DME-Driver [80] | AAAI’25 |
|
H |
UniAD [93] |
LLaVA [160]
|
REG | Desc.+Traj. |
| 62 | SOLVE [33] | CVPR’25 |
|
N |
EVA-02 [63] |
LLaVA-1.5 [161]
|
REG | Ctrl.+Traj. |
| 63 | ReAL-AD [176] | ICCV’25 |
|
N B |
UniAD [93], VAD [108] | MiniCPM-2.5 [306] | REG | Ctrl.+Traj. |
| 64 | LeapVAD [181] | TNNLS’25 |
|
D |
QwenVL [5] InternVL2 [263]
|
GPT-4o [195]
|
LH | Ctrl.+Traj. |
| 65 | DiffVLA [106] | arXiv’25 |
|
N |
CLIP [210] | Vicuna-1.5 [37] | GEN | Traj. |
| 66 | FasionAD++ [208] | arXiv’25 |
|
N |
BEVFormer [150] | Vicuna-1.5 [37], QwenVL [5] |
GEN | Ctrl.+Traj. |
| Sec. 4.2.2: Dual-System: Implicit Representations Transfer | ||||||||
| 67 | VLP [197] | CVPR’24 |
|
N |
UniAD [93], VAD [108] | CLIP [210] | REG | Traj. |
| 68 | VLM-AD [286] | CoRL’25 |
|
N |
UniAD [93], VAD [108] | CLIP [210] | REG | Traj. |
| 69 | DiMA [88] | CVPR’25 |
|
N |
UniAD [93], VAD [108] |
LLaVA-1.5 [161]
|
REG | Ctrl.+Traj. |
| 70 | ALN-P3 [182] | arXiv’25 |
|
N |
VAD [108] |
LLaMA-2 [252]
|
REG | Desc.+Traj. |
| 71 | VERDI [64] | arXiv’25 |
|
N |
VAD [108] |
Qwen2.5-VL [6]
|
REG | Ctrl.+Traj. |
| 72 | VLM-E2E [166] | arXiv’25 |
|
N |
EfficientNet [238] | CLIP [210] | REG | Traj. |
| 73 | ReCogDrive [146] | arXiv’25 |
|
N |
InternViT [35]
|
Qwen2.5 [293]
|
GEN | Desc.+Traj. |
| 74 | InsightDrive [227] | arXiv’25 |
|
N |
ResNet [87] | BERT [52] | REG | Traj. |
| 75 | NetRoller [277] | arXiv’25 |
|
N D |
CLIP [210] |
LLaMA-2 [252]
|
REG | Traj. |
| 76 | ViLaD [46] | arXiv’25 |
|
N |
SigLIP-2 [253] | LLaDA-V [303] | GEN | Ctrl.+Traj. |
| 77 | OmniScene [165] | arXiv’25 |
|
N |
ResNet [87] |
Qwen2.5-VL [6]
|
REG | Traj. |
| 78 | LMAD [226] | arXiv’25 |
|
N |
VAD [108] |
LLaVA-1.5 [161]
|
LH | Desc.+Meta. |
4.1 Сквозные VLA для автономного вождения
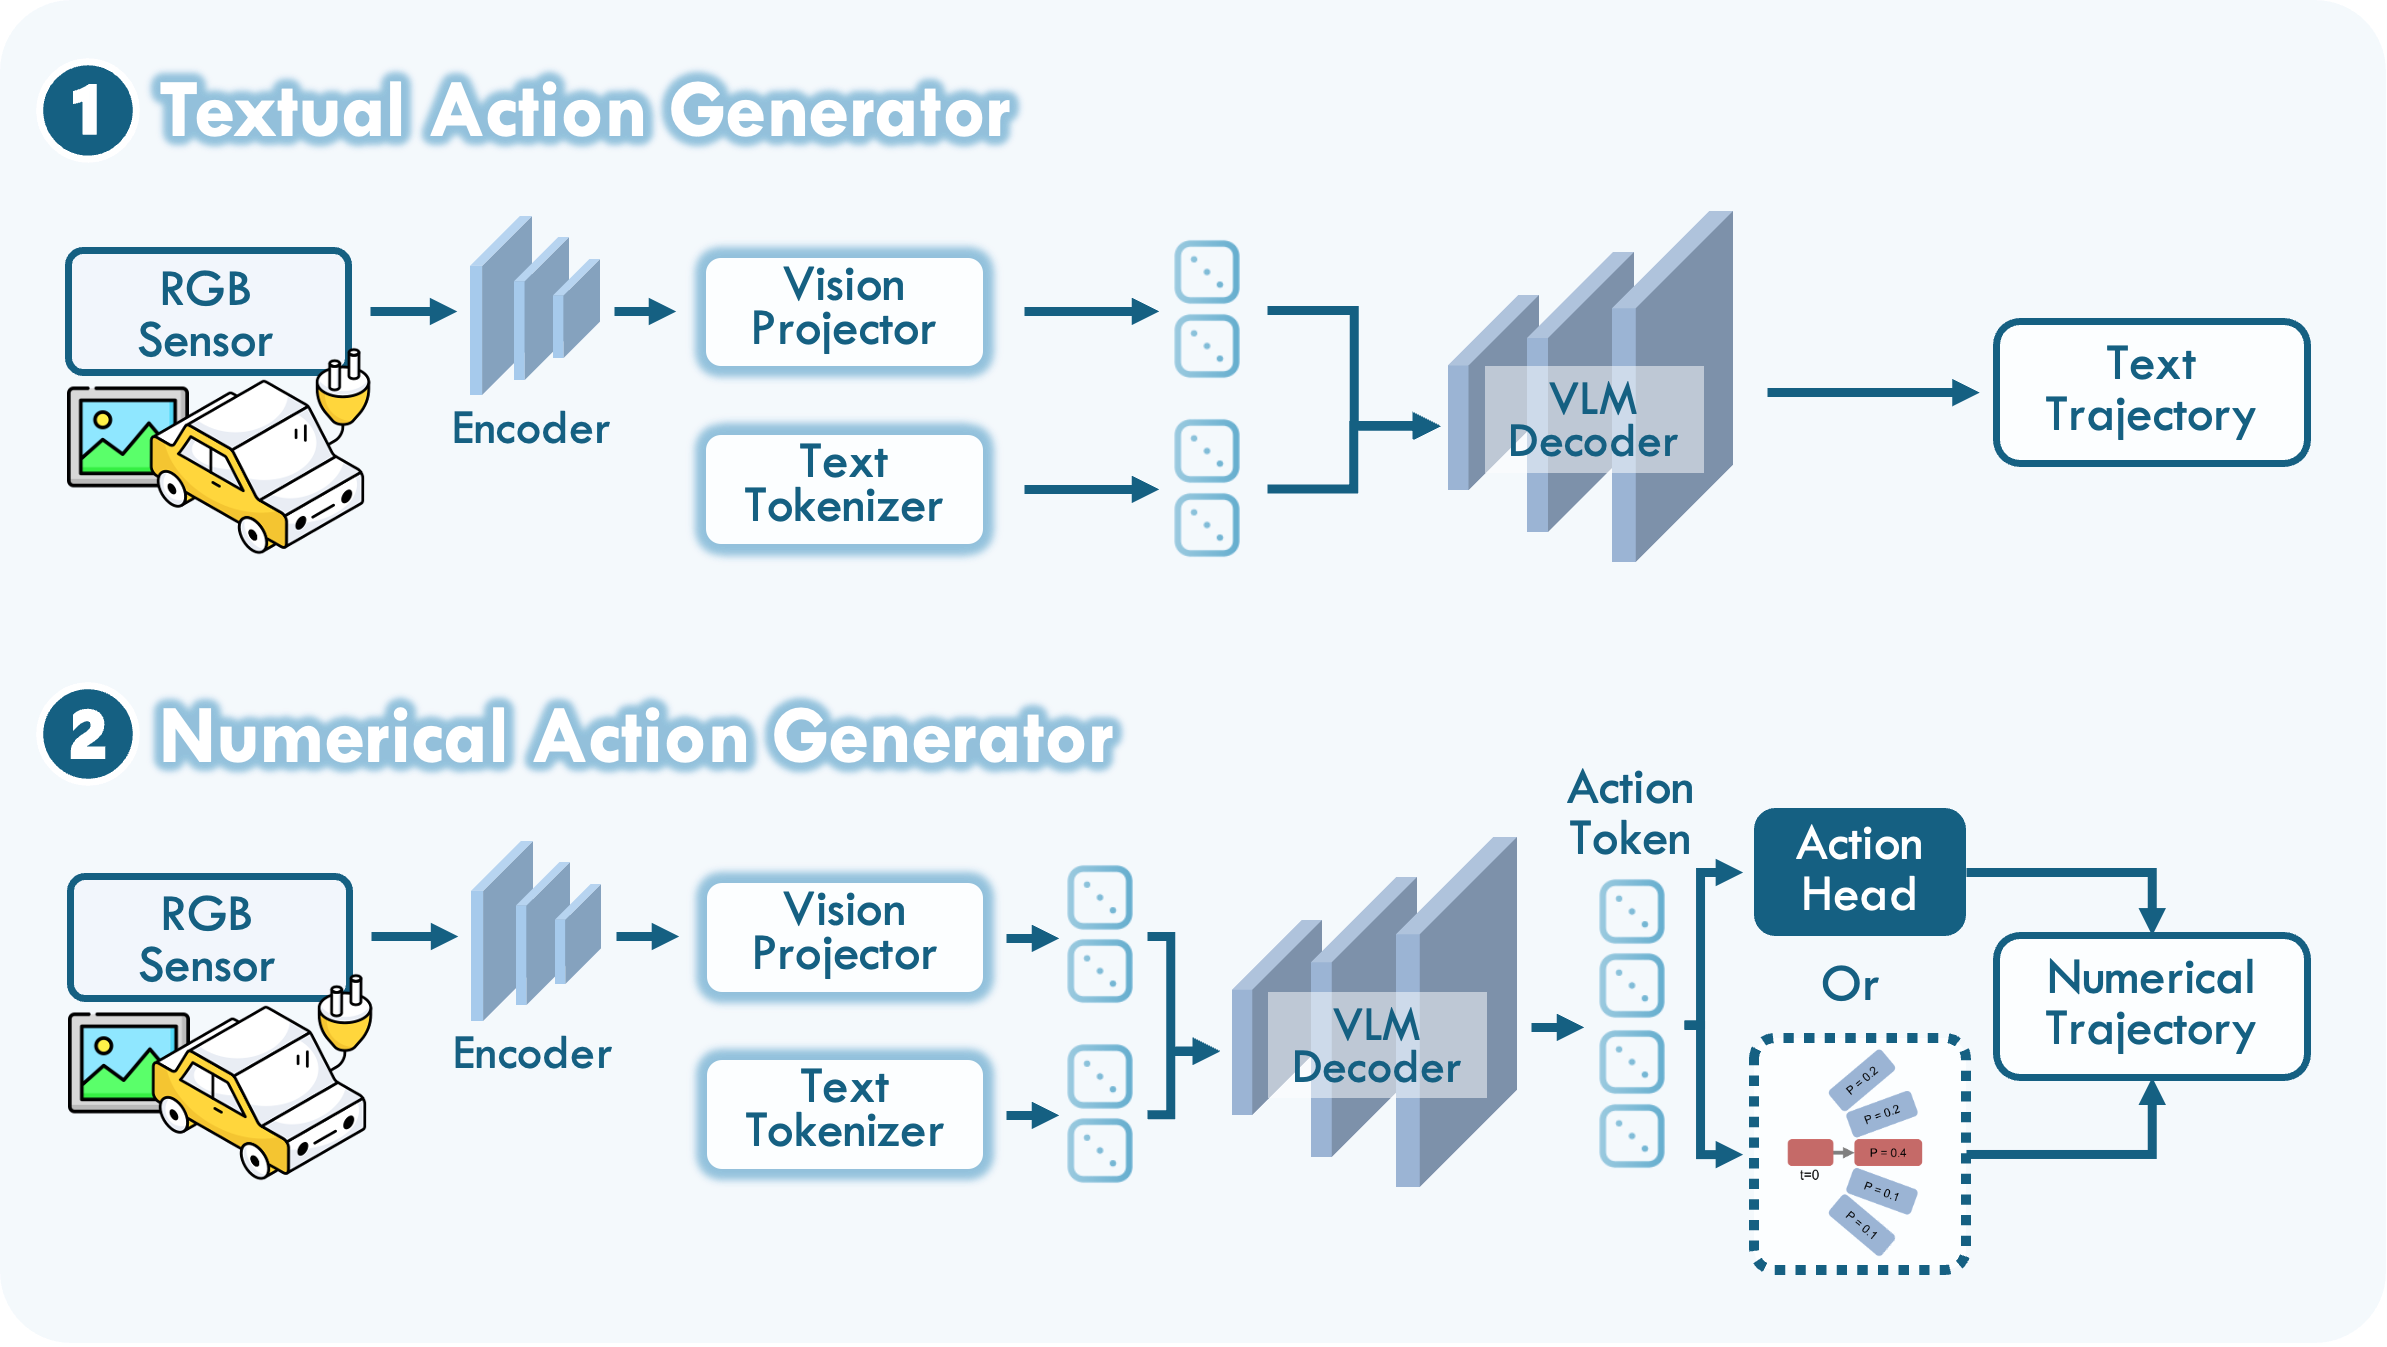
Сквозные VLA-фреймворки нацелены на объединение восприятия, рассуждения и планирования в рамках единой архитектуры. Используя способность к обобщению мультимодальных LLM (MLLMs), они напрямую преобразуют мультимодальные наблюдения в действия, снижая зависимость от созданных вручную модулей и эвристик, специфичных для конкретных задач. В соответствии с формой их выходных данных существующие подходы можно в широком смысле разделить на два семейства, как показано на рисунке 5: генераторы текстовых действий, которые работают преимущественно в языковом пространстве, и генераторы числовых действий, которые предсказывают траектории или управления в непрерывном или дискретизированном числовом пространстве..
4.1.1 Генератор текстовых действий
Текстовые генераторы действий формулируют вождение как задачу рассуждения в языковом пространстве. Модель создает понятные человеку символьные решения, позволяя ей «думать» и обосновывать свои выходные данные словами. В зависимости от уровня абстракции этих выходных данных, существующие методы можно разделить на мета-действия и путевые точки траектории..
Мета-действия — это дискретные семантические решения по вождению, такие как «ускориться», «остановиться» или «сменить полосу». Они формируют интерпретируемый интерфейс между высокоуровневыми рассуждениями в VLM и последующими контроллерами. Ранние работы в основном использовали языковые модели для вывода текста в свободной форме или концептуальных описаний, которые не являются непосредственно исполняемыми. DriveMLM [264] сокращает этот разрыв путем согласования выходных данных LLM с состояниями поведенческого планирования в модульном стеке, позволяя языковым моделям выступать в качестве промежуточных планировщиков, чьи символьные решения могут быть преобразованы в команды управления..
Последующие методы повышают устойчивость и согласованность планирования рассуждений с помощью обучения с подкреплением и контроля цепочки мыслей [107, 224, 147]. AlphaDrive [107] внедряет GRPO [224] для уточнения мета-действий с использованием вознаграждений, которые совместно учитывают качество траектории, правильность принятия решений и согласованность формата. DriveAgent-R1 [330] сначала выполняет SFT на специально подобранном наборе данных CoT для стимулирования пошагового визуального рассуждения, а затем применяет RL с вознаграждениями на основе траектории и мета-действий, чтобы сместить пути рассуждений в сторону решений, практически полезных для вождения. Признавая, что входные данные с фронтальной камеры в виде отдельных кадров ограничивают временное и пространственное понимание, Sce2DriveX [327] дополнительно включает многоракурсные видеопотоки и представления BEV, обеспечивая контекстно-зависимые мета-решения, которые согласуются с топологией дороги и пространственно-временной динамикой.
Текстовые генераторы на основе путевых точек траектории формулируют планирование движения как предсказание будущих координат, выраженных на естественном языке, тем самым объединяя рассуждения и прогнозирование траектории в рамках единой лингвистической последовательности. DriveLM [225] является ранним представителем этой парадигмы, моделирующим автономное вождение как визуальные ответы на вопросы с графовой структурой и генерирующим текстовые путевые точки траектории, обусловленные многоэтапным восприятием, прогнозированием и планированием. Развивая эту идею, последующие работы используют end-to-end мультимодальные формулировки. EMMA [98] интегрирует наблюдения с камер и навигационные команды в единый конвейер, управляемый языком, для совместного восприятия, понимания дорожного графа и прогнозирования траектории. Для повышения надежности в сложных сценариях ImpromptuVLA [36] представляет набор данных из 80 тысяч клипов с граничными случаями, демонстрируя, что предварительное обучение на разнообразных критических ситуациях значительно улучшает точность траектории и стабильность в замкнутом контуре. LightEMMA [209] дополнительно проводит сравнительный анализ 12 vision–language models, выявляя четкие компромиссы между интерпретируемостью и численной точностью..
Дополнительное направление исследований сосредоточено на улучшении согласования рассуждений с принятием решений. RDA-Driver [97] обеспечивает согласованность между объяснениями в виде цепочки рассуждений и выходными траекториями посредством специализированных ограничений, в то время как Drive-R1 [147] использует reinforcement learning для улучшения согласования между текстовыми рассуждениями и прогнозированием путевых точек. Помимо согласования, эффективность и интеграция знаний исследуются в FastDriveVLA [19] посредством сокращения токенов, в WiseAD [323] через явные априорные знания о вождении и в OmniDrive [259] с использованием контрфактических рассуждений. WKER [313] дополнительно повышает устойчивость в условиях окклюзии за счет объединения выбора токенов на основе инструкций с внешними источниками знаний..
В целом, текстовые генераторы действий обеспечивают высокую интерпретируемость и глубокое логическое обоснование, однако они должны преодолеть фундаментальный разрыв между дискретными языковыми токенами и непрерывными пространствами управления. Это несоответствие может привести к ограничениям точности, а в крайних случаях — к нестабильным или разрушенным траекториям..
4.1.2 Генератор числовых действий
Генераторы числовых действий дополняют магистральные архитектуры VLM механизмами, которые создают непосредственно пригодные для использования числовые выходные данные. Модель по-прежнему использует внутренние рассуждения на основе языка, но ее итоговые предсказания выражаются в виде траекторий, путевых точек или значений управления, которые могут быть использованы классическими планировщиками или низкоуровневыми контроллерами. Существуют две основные реализации: дополнительные головки действий, присоединенные к магистральной архитектуре, и дополнительные токены действий, которые дискретизируют непрерывные действия в пространство токенов..
Дополнительная головка для действий. Распространенная стратегия заключается в присоединении специализированных головок предсказания к vision-language моделям. BEVDriver [271] связывает мультимодальный энкодер с головкой на основе GRU поверх BEV признаков, объединяя рассуждения на основе языка с предсказанием пространственных путевых точек. CoVLA-Agent [3] использует легковесную MLP головку, обученную на наборе данных CoVLA, демонстрируя, что совместное обучение на траекториях и описаниях может одновременно улучшить интерпретируемость и числовую точность. DriveGPT4-V2 [288] дополняет планирование на основе токенов с помощью MLP, которая отображает мультимодальные эмбеддинги в непрерывные траектории, повышая эффективность выборки при сохранении рассуждений в стиле GPT..
Для специализации поведения DriveMoE [300] использует архитектуру Mixture-of-Experts, в которой головной модуль управления действиями динамически активирует экспертов для выполнения таких навыков, как следование по полосе или обгон. DSDrive [168] предлагает модуль координации с двумя головными блоками, один из которых прогнозирует путевые точки, а другой генерирует логические выводы; дистилляция из более крупных VLM позволяет сохранить модель компактной и интерпретируемой. LMDrive [222] объединяет мультимодальные энкодеры с MLP, который напрямую выдает сигналы управления в замкнутом контуре, что делает ее одной из первых систем с поддержкой инструкций и языковым управлением, работающей по принципу end-to-end..
Помимо простых MLP, ORION [67] заменяет детерминированные головы на предикторы на основе диффузии, моделируя мультимодальные распределения траекторий в условиях неопределенности. SimLingo [213] отделяет временные путевые точки скорости от геометрических путевых точек пути с помощью разделенной головы MLP, обеспечивая более точное управление..
Дополнительные токены действий. Вместо явных «голов» некоторые работы повторно используют пространство языковых токенов для представления действий. AutoVLA [340] дискретизирует непрерывные траектории в кодовую книгу токенов действий, которые генерируются авторегрессионно наряду с токенами рассуждения, тем самым объединяя семантическое рассуждение и планирование в рамках одной последовательности. Reinforcement fine-tuning штрафует избыточные рассуждения и повышает эффективность токенов. OpenDriveVLA [339] следует аналогичной парадигме на основе токенов, но основывает генерацию токенов на иерархическом выравнивании между 2D/3D восприятием и LLM. Структурированные признаки встраиваются в единое семантическое пространство, а токены взаимодействия для эго-транспортного средства, окружающей среды и других агентов авторегрессионно декодируются в действия по вождению..
Численные генераторы действий хорошо подходят для последующего управления, так как их выходные данные изначально совместимы с планировщиками и исполнительными механизмами. Однако они обычно жертвуют некоторой интерпретируемостью и часто требуют значительного объема данных SFT для стабильного обучения. При использовании дискретизированных токенов действий артефакты квантования могут дополнительно ограничивать точность управления с высокой детализацией..
4.2 Двухсистемная VLA
Двухсистемные VLA-фреймворки черпают вдохновение из теории двойного процесса, популяризированной в книге «Думай медленно... решай быстро» [114]. В этой парадигме VLM выступает в роли медленной, рассудительной системы, которая выполняет высокоуровневые рассуждения, ситуационную оценку и лингвистические выводы, в то время как специализированный модуль автономного вождения действует как быстрая система, отвечающая за генерацию траектории и управление в режиме реального времени с низкой задержкой. Объединяя эти взаимодополняющие сильные стороны, двухсистемные фреймворки стремятся достичь как интерпретируемости, так и критически важной для безопасности реактивности..
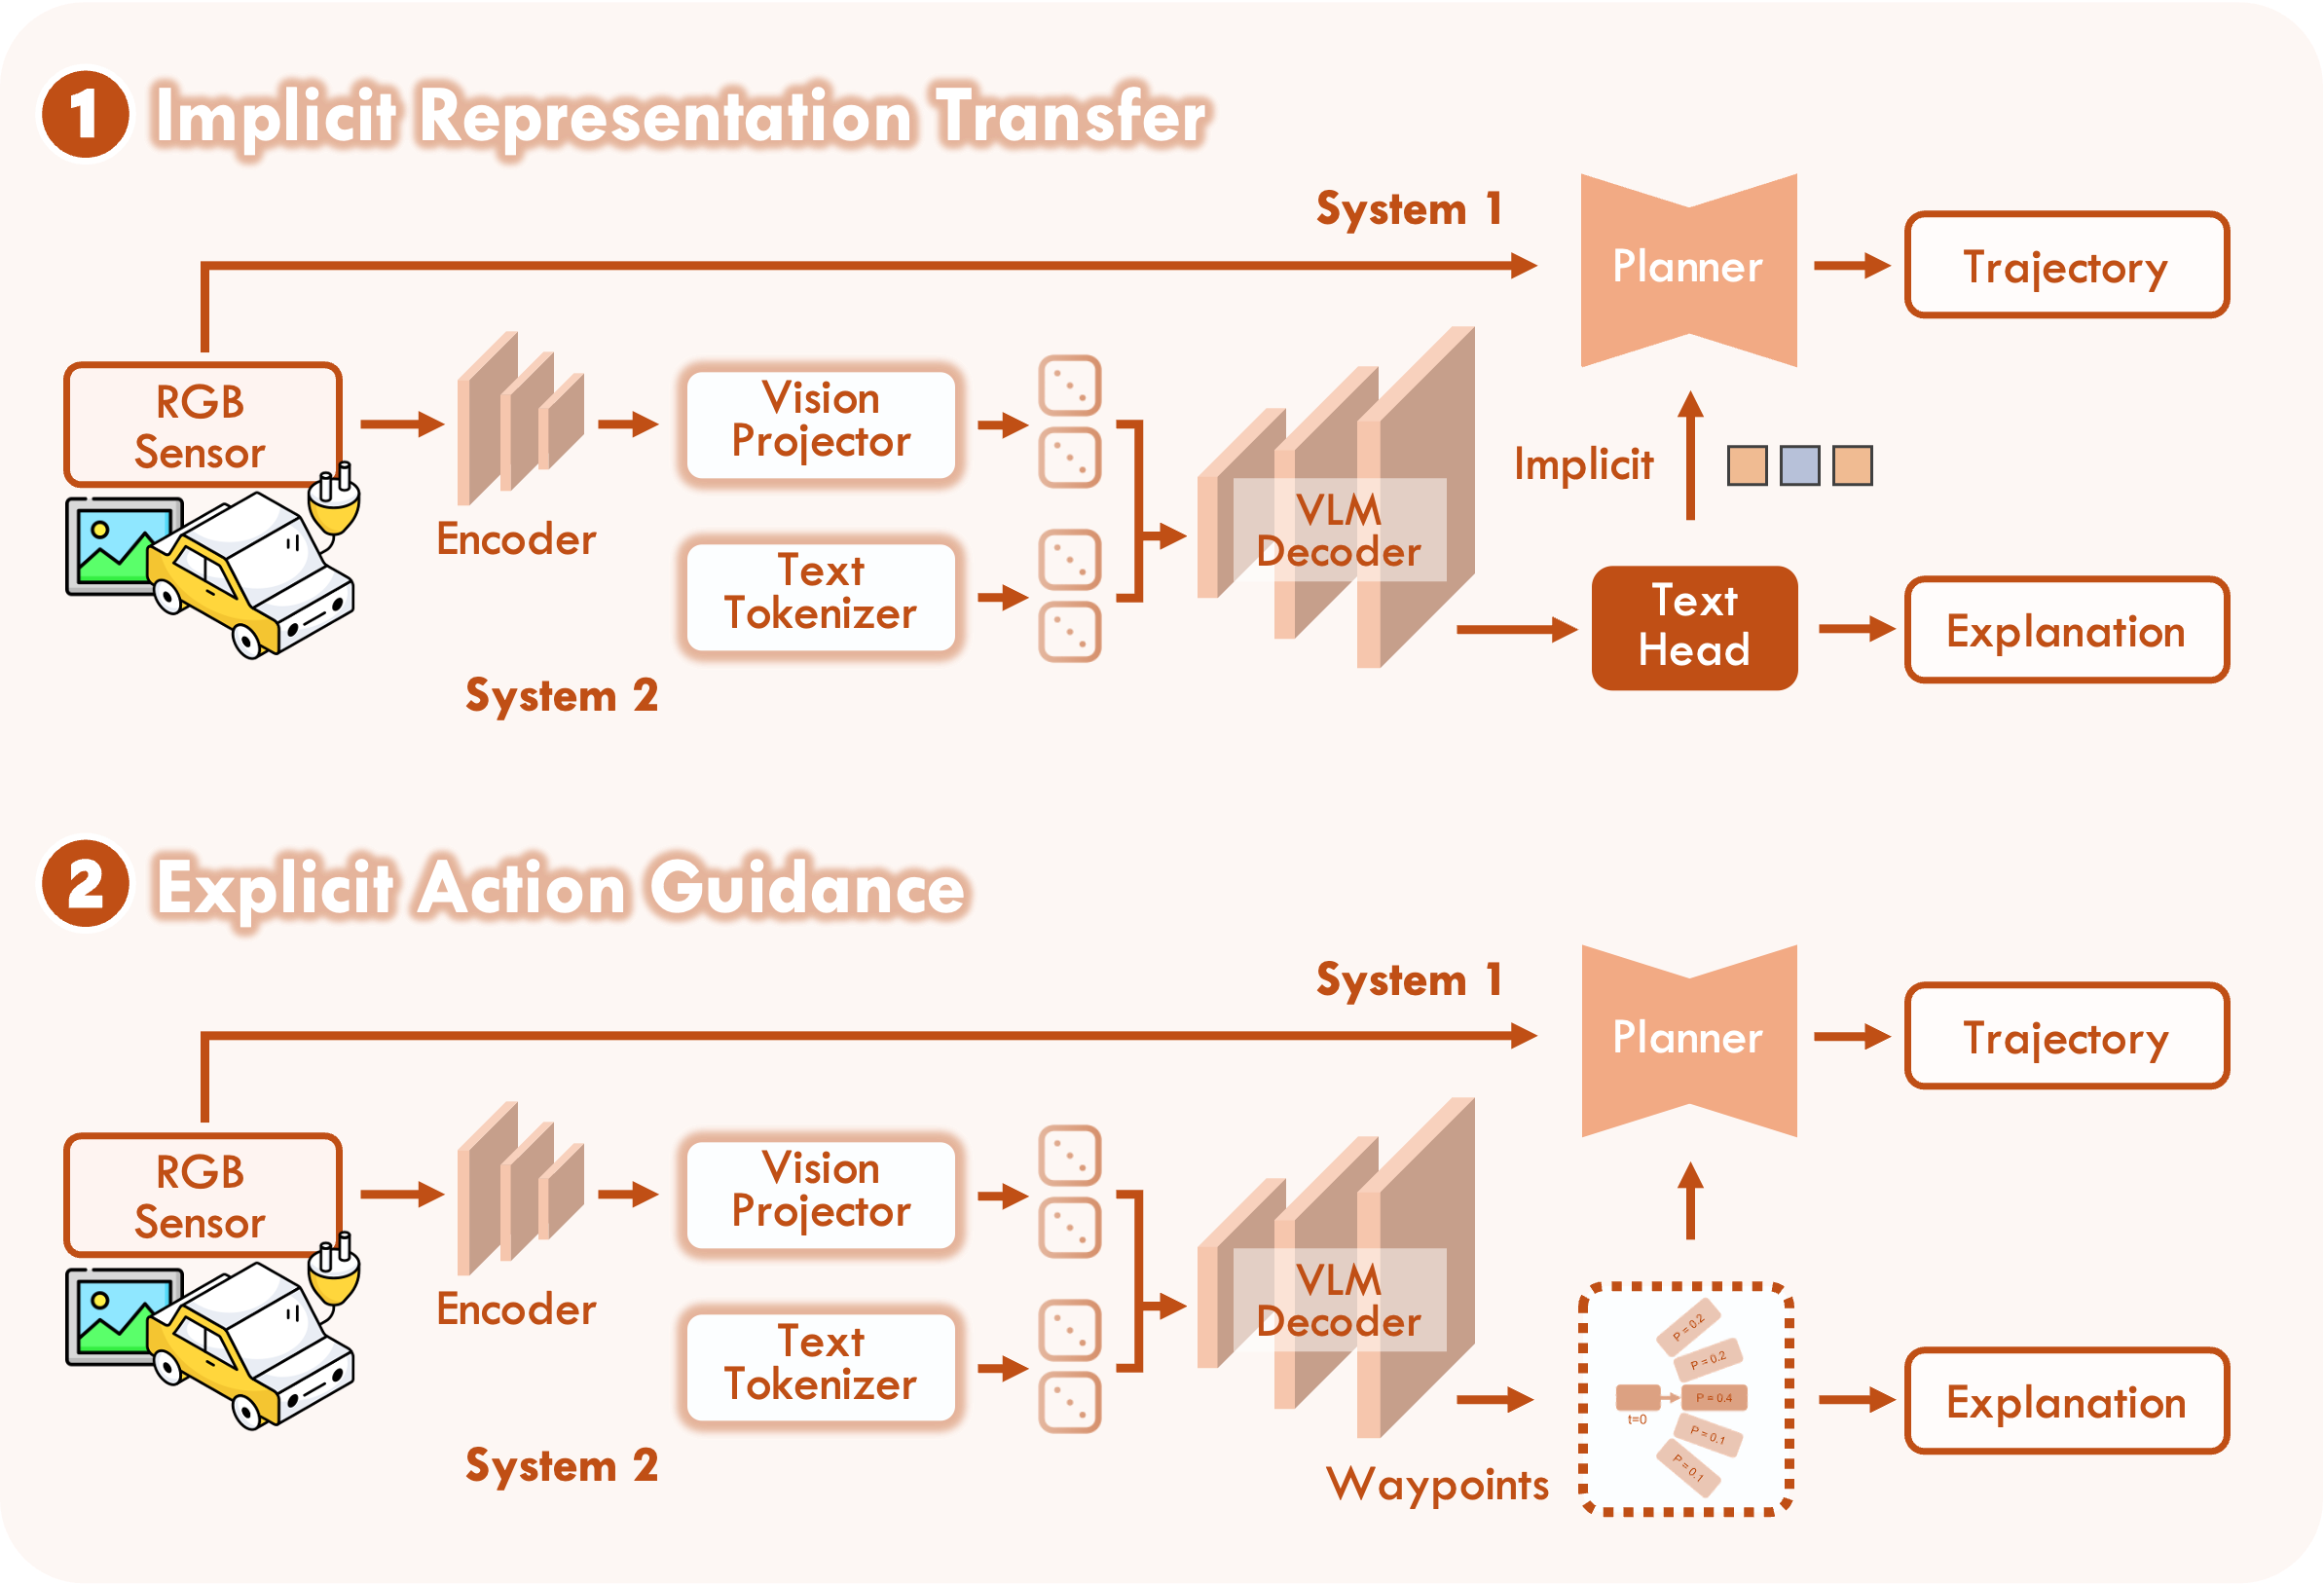
В зависимости от того, как выходные данные VLM взаимодействуют со специализированным планировщиком, существующие методы можно разделить на два семейства: явное руководство действиями и неявная передача представлений, как показано на Рисунке 6.
4.2.1 Явное руководство по действиям
Структуры явного управления действиями используют VLM в качестве генераторов структурированных действий, чьи высокоуровневые выходные данные впоследствии преобразуются или уточняются модулем быстрого вождения. Эти подходы различаются по уровню абстракции и в основном группируются в управление мета-действиями и контроль по контрольным точкам..
Руководство мета-действиями опирается на VLM для вывода символьных намерений вождения, таких как «замедлиться», «сменить полосу» или «повернуть налево», которые выступают в качестве семантических априорных данных для последующих планировщиков. Такая архитектура использует интерпретируемость лингвистических действий, избегая при этом проблем с точностью, возникающих при непосредственной генерации непрерывных траекторий. Ранние работы, такие как FasionAD [207], воплощают концепцию двухпроцессного проектирования, объединяя быстрый планировщик на основе данных с медленной VLM, которая выдает мета-действия; обученный механизм переключения выбирает подходящий путь на основе уверенности и контекста сцены. LeapVAD [181] совершенствует эту структуру, объединяя аналитическую ветвь, формирующую банк памяти, с эвристической ветвью, которая извлекает предыдущие мета-действия для знакомых ситуаций..
Более современные системы более тесно интегрируют высокоуровневые рассуждения с планированием. Senna [109] связывает VLM, обладающую здравым смыслом, с end-to-end планировщиком: Senna-VLM генерирует решения на естественном языке, которые Senna-E2E преобразует в исполняемые траектории. DiffVLA [106] внедряет сгенерированные VLM поперечные и продольные решения в качестве one-hot априорных данных в планировщик на основе диффузии, направляя мультимодальное шумоподавление траектории..
Иерархические структуры, такие как DME-Driver [80], дополнительно разделяют принятие решений и исполнение: VLM-ориентированный модуль принятия решений предоставляет мета-решения или априорные данные о визуальном внимании, а специализированный исполнительный модуль преобразует их в детальное управление. ReAL-AD [176] расширяет этот подход до полноценной трехуровневой иерархии: стратегия, решение и операция, где полученные с помощью VLM ситуационные инсайты формируют постепенно уточняемые команды планирования..
Контроль по путевым точкам — это явное руководство, которое использует VLM для генерации грубых путевых точек траектории, которые модуль быстрого планирования уточняет до плотных, исполняемых траекторий. DriveVLM [249] использует иерархический конвейер рассуждения-к-планированию: VLM создает мета-действия и грубые путевые точки посредством рассуждения по цепочке мыслей, а традиционные планировщики преобразуют их в детализированные траектории.
SOLVE [33] усиливает координацию между VLM и планировщиком посредством общего визуального энкодера и модуля Trajectory Chain-of-Thought, который итеративно уточняет варианты контрольных точек перед их окончательным выбором E2E планировщиком. Эти решения обеспечивают более тесный численный интерфейс между рассуждением и управлением, позволяя VLM влиять на планирование при сохранении стабильности за счет классического уточнения..
В целом, подходы с явным управлением сохраняют высокую интерпретируемость и предоставляют LLM непосредственную роль в принятии решений. Однако они остаются чувствительными к точности и согласованности выходных данных LLM; несогласованные или неоднозначные команды могут распространяться на последующие этапы и снижать безопасность планирования..
4.2.2 Перенос неявных представлений
Неявное ограничение признаков относится к методам, при которых VLM выступает в качестве учителя или вспомогательного модуля во время обучения, передавая способности к рассуждению или когнитивные априорные знания в виде латентных признаков компактной E2E сети. Эти подходы делятся на две основные группы: дистилляция знаний и мультимодальное слияние признаков..
Подходы, основанные на дистилляции знаний, переносят сгенерированные VLM объяснения, цепочки рассуждений или структурированную семантику действий в латентное пространство E2E модели вождения. VLP [197] выравнивает BEV признаки и запросы планирования с предобученными языковыми эмбеддингами, используя контрастивные и контролируемые целевые функции, что позволяет планировщикам наследовать здравое понимание сцены. VLM-AD [286] генерирует текстовые обоснования в свободной форме и структурированные метки поведения с использованием VLM, дистиллируя их в планировщик через блок выравнивания и блок классификации действий. Такая архитектура с двойным контролем помогает E2E модулю приобретать более богатые семантические представления, оставаясь при этом вычислительно легким во время развертывания..
Более комплексное выравнивание наблюдается в VERDI [64], которое согласовывает результаты восприятия, прогнозирования и планирования с цепочками рассуждений, сгенерированными VLM, внедряя структурированное логическое обоснование на всех этапах конвейера. ALN-P3 [182] расширяет этот принцип с помощью полностековой совместной дистилляции: токены восприятия, прогнозируемые движения и запланированные траектории совместно выравниваются с рассуждениями VLM для объединения когнитивных процессов и исполнения..
Подходы, основанные на слиянии мультимодальных признаков, напрямую интегрируют признаки, полученные с помощью VLM, в быстрый планировщик. InsightDrive [227] внедряет языковые представления сцены, где описания, сгенерированные VLM, выделяют критические области и модулируют BEV признаки посредством cross-attention. VLM-E2E [166] явно моделирует внимание водителя путем слияния текстовых сигналов внимания с BEV признаками через обучаемый механизм gating. Помимо сигналов внимания, NetRoller [277] извлекает латентные переменные рассуждения из VLM и адаптирует их в компактные признаки, подходящие для планировщиков реального времени. ReCogDrive [146] согласовывает лингвистические априорные знания с диффузионным планировщиком, уточняя траектории посредством reinforcement learning для обеспечения безопасности и поведения, подобного человеческому. ETA [78] фокусируется на эффективности: рассуждения VLM вычисляются асинхронно в предыдущих кадрах и объединяются с текущими признаками с использованием механизма action-mask, обеспечивая управление без высоких затрат в реальном времени..
Методы неявного переноса снижают затраты на вычисления при выводе и позволяют избежать зависимости от крупных VLM во время выполнения, однако они могут приводить к потере интерпретируемости, а чрезмерная дистилляция способна излишне упростить сигналы рассуждения. Их эффективность также сильно зависит от того, насколько хорошо дистиллированные или объединенные признаки согласуются с возможностями быстрого модуля вождения..
| Dataset | Year |
Vision 
|
Language 
|
Action  |
Other Tasks | |||||
| Sensor | Type | Scale | Category | Label | Scale | Type | Metric | |||
| Vision-Action Datasets | ||||||||||
| B BDD100K [304] | 2020 | |
Real | 120M | - | - | - | Traj. | - | Percept. |
| N nuScenes [17] | 2020 |
|
Real | 1.4M | - | - | - | Traj. | Open | Percept. |
| W Waymo[233] | 2020 |
|
Real | 200M | - | - | - | Traj. | Open | Percept., Forecast. |
| N nuPlan [18] | 2021 |
|
Real | 4.6M | - | - | - | Ctrl, Traj. | CL | Forecast. |
| A Argoverse 2 [270] | 2021 |
|
Real | 300K | - | - | - | Traj. | Open | Percept., Forecast. |
| B Bench2Drive [103] | 2024 |
|
Sim | 2M | - | - | - | Traj. | CL | - |
| R RoboBEV [274] | 2025 |
|
Real | 866K | - | - | - | Traj. | Open | Percept. |
| W WOD-E2E [283] | 2025 | |
Real | 800K | - | - | - | Traj. | Open | - |
| Vision-Language-Action Datasets | ||||||||||
| B BDD-X [118] | 2018 | |
Real | 8.4M | Caption | M | 26K | Ctrl | Open | Reason. |
| T Talk2Car [51] | 2022 |
|
Real | 400K | Caption | M | 12K | Ctrl, Traj. | Open | Ground. |
| S SDN [183] | 2022 | |
Sim | - | Instruction, QA | A+M | 8.4K | Ctrl, Traj. | CL | QA |
| D DriveMLM [264] | 2023 |
|
Sim | - | Reason., Deci. | A+M | - | Ctrl, Traj. | CL, Lang. | Reason., QA |
| L LMDrive [222] | 2024 |
|
Sim | 3M | Instruction | A+M | 64K | Traj. | CL | - |
| B DriveLM-N [225] | 2024 |
|
Real | 4.8K | QA | M | 445K | Ctrl, Traj. | Open | Reason., QA |
| B DriveLM-C [225] | 2024 |
|
Sim | 64K | QA | A | 3.76M | Ctrl, Traj. | Open | Reason., QA |
| H HBD [80] | 2024 | |
Real,Sim | - | Deci., Descrip., QA | A+M | - | Traj. | Open | Descrip., QA |
| V VLAAD [201] | 2024 | |
Real | - | Reason., QA | A+M | 64K | Ctrl. | Lang. | Caption, QA |
| S SUP-AD [249] | 2024 | |
Real | - | Action, Reason., QA | A+M | - | Ctrl, Traj. | Open, Lang. | Reason, QA |
| N NuInstruct [54] | 2024 |
|
Real | 11.8K | Instruction | A | 91K | Ctrl | Lang. | Reason. |
| W WOMD-Reason [142] | 2024 | |
Real | 63K | QA | A | 2940K | Plan. | Lang. | Reason., QA |
| D DriveCoT [262] | 2024 |
|
Sim | - | CoT, Deci. | A | 36K | Ctrl | Open | Reason. |
| R Reason2Drive [192] | 2024 |
|
Real | - | Reason., QA | A | 632K | Ctrl, Traj. | Open | Reason., QA |
| D DriveBench [275] | 2025 |
|
Real | 19.2K | QA | A+M | 20.5K | Ctrl | Lang. | QA |
| M MetaAD [107] | 2025 | |
Real | 120K | Reason., Plan, QA | - | 30K | Ctrl | Lang. | Reason. |
| O OmniDrive [259] | 2025 |
|
Real | - | Reason., QA | A | - | Ctrl, Traj. | Open | Reason. |
| N NuInteract [328] | 2025 |
|
Real | 34K | Caption, QA | A | 1.5M | Ctrl | Lang. | Percept., Ground. |
| D DriveAction [86] | 2025 | |
Real | 2.6K | QA | A | 16.18K | Ctrl | Lang. | - |
| I ImpromptuVLA [36] | 2025 | |
Real,Sim | 2M | Instruction, QA | A+M | 80K | Ctrl, Traj. | Open, CL | QA |
| C CoVLA [3] | 2025 | |
Real | 6M | Caption | A | 6M | Traj. | Open | - |
| O OmniReason-N [164] | 2025 |
|
Real | - | QA | A | - | Ctrl, Traj. | Open | Reason., QA |
| O OmniReason-B2D [164] | 2025 | |
Sim | - | QA | A | - | Ctrl, Traj. | Open | Reason., QA |
5 Наборы данных и эталонные тесты
Стандартизированные наборы данных и бенчмарки формируют эмпирическую основу исследований VLA, поддерживая разработку, обучение и оценку моделей. Поскольку системы вождения VLA объединяют восприятие, язык и действия, наборы данных VLA демонстрируют существенное разнообразие в составе модальностей, гранулярности аннотаций и определениях задач. Соответственно, протоколы оценки существенно различаются, охватывая традиционные метрики на основе траекторий, оценки, ориентированные на язык, и интерактивные оценки с замкнутым контуром..
5.1 Наборы данных для VLA в автономном вождении
Традиционно наборы данных VA предоставляют богатые сенсорные наблюдения (камеры, LiDAR, RADAR) в сочетании с управляющими воздействиями, обеспечивая сквозное отображение от изображений к траекториям [17, 18, 304]. Эти наборы данных лежат в основе разработки ранних VA моделей, основанных на IL/RL..
По мере того как язык становится все более важной модальностью для рассуждений, выполнения инструкций и интерпретируемости, появились VLA наборы данных [264, 225, 249, 262]. Эти наборы данных расширяют традиционные журналы вождения текстовыми инструкциями, парами вопрос-ответ или обоснованиями, согласованными с визуальными наблюдениями и действиями экспертов [36, 3]. В целом, набор данных считается совместимым с VLA, когда он предоставляет временно или семантически согласованные языковые аннотации, которые связывают визуальные наблюдения с действиями или траекториями, обеспечивая тримодальное обучение. Обобщенные коллекции представлены в Таблице 4.
5.1.1 Наборы данных для визуального действия
Изначально BDD100K [304] предоставляет 100 тысяч разнообразных видеозаписей вождения со всей территории Соединенных Штатов, охватывающих широкий спектр погодных условий, освещения и дорожной обстановки, что делает его фундаментальным набором данных для behavioral cloning и end-to-end вождения. Позднее nuScenes [17] предложил 1000 мультисенсорных сцен вождения с синхронизированными обзорами с 6 камер, данными LiDAR, радарами, 3D-рамками и траекториями движения, поддерживая как задачи восприятия, так и прогнозирование движения нескольких агентов. Более масштабные наборы данных, такие как Waymo Open Dataset [60] и Argoverse 2 [270], дополнительно расширяют эту парадигму за счет датчиков с более высоким разрешением, более длинных траекторий и детализированных HD-карт, обеспечивая надежное обучение конвейеров perception-to-prediction в разнообразных городских условиях. Дополняя эти усилия, nuPlan [18] включает в себя траектории ego с длинным горизонтом планирования, плотный контекст карт и интерфейсы симуляции для closed-loop тестирования, обеспечивая всесторонний контроль для оценки принятия решений и планирования в сложных реальных условиях..
Несмотря на отсутствие явного языкового контроля, эти VA наборы данных создают визуально-действенную основу для разработки VLA путем предоставления структурированного контроля, который связывает визуальное восприятие, временную динамику и экспертное принятие решений.
5.1.2 Наборы данных для моделей зрения-языка-действия
Основываясь на фундаменте визуально-действенных данных, заложенном наборами данных VA, наборы данных VLA обогащают журналы вождения структурированным или свободно сформулированным естественным языком для поддержки совместного обучения восприятию, языку и действиям..
| Model | Year | Input | Vision |
Language |
Action |
L2 | CR | ||||||
| 1s | 2s | 3s | Avg. | 1s | 2s | 3s | Avg. | ||||||
| Vision-Action Models | |||||||||||||
| ST-P3 [91] | 2022 | |
EfficientNet | - | REG | 1.33 | 2.11 | 2.90 | 2.11 | 0.23 | 0.62 | 1.27 | 0.71 |
| UniAD [93] | 2022 | |
ResNet | - | REG | 0.44 | 0.67 | 0.96 | 0.69 | 0.04 | 0.08 | 0.23 | 0.12 |
| VAD [108] | 2023 | |
ResNet | - | REG | 0.17 | 0.34 | 0.60 | 0.37 | 0.07 | 0.10 | 0.24 | 0.14 |
| OccNet [250] | 2023 | |
ResNet | - | SEL | 1.29 | 2.13 | 2.99 | 2.14 | 0.21 | 0.59 | 1.37 | 0.72 |
| BEV-Planner [149] | 2024 | |
ResNet | - | REG | 0.30 | 0.52 | 0.83 | 0.55 | 0.10 | 0.37 | 1.30 | 0.59 |
| Drive-WM [267] | 2024 |
|
ConvNeXt | - | SEL | 0.43 | 0.77 | 1.20 | 0.80 | 0.10 | 0.21 | 0.48 | 0.26 |
| GenAD [333] | 2024 | |
ResNet | - | GEN | 0.36 | 0.83 | 1.55 | 0.91 | 0.06 | 0.23 | 1.00 | 0.43 |
| OccWorld [334] | 2024 | |
ResNet | - | REG | 0.43 | 1.08 | 1.99 | 1.17 | 0.07 | 0.38 | 1.35 | 0.60 |
| DriveDreamer [265] | 2024 |
|
SD | - | REG | - | - | - | 0.29 | - | - | - | 0.15 |
| SparseAD [317] | 2024 | |
ResNet | - | REG | 0.15 | 0.31 | 0.56 | 0.34 | 0.00 | 0.04 | 0.15 | 0.06 |
| GaussianAD [332] | 2024 | |
ResNet | - | REG | 0.40 | 0.64 | 0.88 | 0.64 | 0.09 | 0.38 | 0.81 | 0.42 |
| LAW [143] | 2024 | |
Swin-T | - | REG | 0.24 | 0.46 | 0.76 | 0.49 | 0.08 | 0.10 | 0.39 | 0.19 |
| SSR [134] | 2024 | |
ResNet | - | REG | 0.18 | 0.36 | 0.63 | 0.39 | 0.01 | 0.04 | 0.12 | 0.06 |
| Drive-OccWorld [297] | 2025 | |
ResNet | - | REG | 0.25 | 0.44 | 0.72 | 0.47 | 0.03 | 0.08 | 0.22 | 0.11 |
| DriveTransformer [104] | 2025 | |
ResNet | - | REG | 0.19 | 0.34 | 0.66 | 0.40 | 0.03 | 0.10 | 0.21 | 0.11 |
| DiffusionDrive [156] | 2025 |
|
ResNet | - | GEN | 0.27 | 0.54 | 0.90 | 0.57 | 0.03 | 0.05 | 0.16 | 0.08 |
| World4Drive [335] | 2025 | |
ResNet | - | REG | 0.23 | 0.47 | 0.81 | 0.50 | 0.02 | 0.12 | 0.33 | 0.16 |
| Epona [321] | 2025 |
|
DC-AE | - | REG | 0.61 | 1.17 | 1.98 | 1.25 | 0.01 | 0.22 | 0.85 | 0.36 |
| SeerDrive [315] | 2025 |
|
ResNet | - | SEL | 0.20 | 0.39 | 0.69 | 0.43 | 0.00 | 0.05 | 0.14 | 0.06 |
| GuideFlow [162] | 2025 | |
ResNet | - | GEN | - | - | - | - | 0.00 | 0.02 | 0.18 | 0.07 |
| Vision-Language-Action Models | |||||||||||||
| Agent-Driver [185] | 2023 |
|
- |
GPT-3.5
|
LH | 0.16 | 0.34 | 0.61 | 0.37 | 0.02 | 0.07 | 0.18 | 0.09 |
| DriveVLM [249] | 2024 |
|
ViT |
QwenVL
|
GEN | 0.18 | 0.34 | 0.68 | 0.40 | 0.10 | 0.22 | 0.45 | 0.27 |
| DriveVLM-Dual [249] | 2024 |
|
ViT |
QwenVL
|
REG | 0.15 | 0.29 | 0.48 | 0.31 | 0.05 | 0.08 | 0.17 | 0.10 |
| RAG-Driver [309] | 2024 |
|
CLIP | Vicuna-1.5 | LH | 0.34 | 0.37 | 0.69 | 0.40 | 0.01 | 0.05 | 0.26 | 0.10 |
| Senna [109] | 2024 |
|
ViT | Vicuna-1.5 | REG | 0.37 | 0.54 | 0.86 | 0.59 | 0.09 | 0.12 | 0.33 | 0.18 |
| Doe-1 [331] | 2024 |
|
Lumina-mGPT | BPE Tokenizer | LH | 0.37 | 0.67 | 1.07 | 0.70 | 0.02 | 0.14 | 0.47 | 0.21 |
| VLP [197] | 2024 |
|
UniAD, VAD | CLIP | REG | 0.30 | 0.53 | 0.84 | 0.55 | 0.01 | 0.07 | 0.38 | 0.15 |
| VLM-AD [286] | 2024 |
|
UniAD, VAD | CLIP-ViT | REG | 0.24 | 0.46 | 0.75 | 0.48 | 0.12 | 0.17 | 0.41 | 0.23 |
| OpenDriveVLA [339] | 2025 |
|
ResNet |
Qwen2.5-VL
|
LH | 0.14 | 0.30 | 0.55 | 0.33 | 0.02 | 0.07 | 0.22 | 0.10 |
| OmniDrive [259] | 2025 |
|
EVA-02 |
LLaMA2
|
LH | 0.40 | 0.80 | 1.32 | 0.84 | 0.04 | 0.46 | 2.32 | 0.94 |
| ORION [67] | 2025 |
|
EVA-02 | Vicuna-1.5 | GEN | 0.17 | 0.31 | 0.55 | 0.34 | 0.05 | 0.25 | 0.80 | 0.37 |
| EMMA [98] | 2025 |
|
Gemini-VLM
|
Gemini
|
LH | 0.14 | 0.29 | 0.54 | 0.32 | - | - | - | - |
| WKER [313] | 2025 |
|
EVA-02 |
LLaMA3
|
LH | 0.14 | 0.30 | 0.55 | 0.33 | 0.07 | 0.14 | 0.32 | 0.18 |
| Drive-R1 [147] | 2025 |
|
InternVL2
|
InternVL2
|
LH | 0.14 | 0.28 | 0.50 | 0.31 | 0.02 | 0.06 | 0.19 | 0.09 |
| ReAL-AD [176] | 2025 |
|
ResNet | MiniCPM | REG | 0.30 | 0.48 | 0.67 | 0.48 | 0.07 | 0.10 | 0.28 | 0.15 |
| ReAL-AD [176] | 2025 |
|
ResNet |
QwenVL
|
REG | 0.35 | 0.53 | 0.71 | 0.53 | 0.09 | 0.12 | 0.31 | 0.17 |
| DiMA [88] | 2025 |
|
VAD |
LLaVA-1.5
|
REG | 0.18 | 0.50 | 1.03 | 0.57 | 0.00 | 0.05 | 0.16 | 0.08 |
| FasionAD [207] | 2025 |
|
BEVFormer | VLM+Thinking | GEN | 0.19 | 0.62 | 1.25 | 0.69 | 0.02 | 0.09 | 0.44 | 0.18 |
| InsightDrive [227] | 2025 |
|
ResNet | VLMs | REG | 0.23 | 0.41 | 0.68 | 0.44 | 0.09 | 0.10 | 0.27 | 0.15 |
| S4-Driver [276] | 2025 |
|
ViT-G | PaLI3 | LH | 0.13 | 0.28 | 0.51 | 0.31 | - | - | - | - |
| SOLVE [33] | 2025 |
|
EVA-02 |
LLaVA-1.5
|
REG | 0.13 | 0.25 | 0.47 | 0.28 | 0.00 | 0.16 | 0.43 | 0.20 |
| VERDI [64] | 2025 |
|
VAD |
Qwen2.5-VL
|
REG | 0.36 | 0.62 | 0.96 | 0.65 | - | - | - | - |
| OmniReason [164] | 2025 |
|
EVA-02 |
LLaVA-1.5
|
LH | 0.15 | 0.31 | 0.57 | 0.34 | 0.04 | 0.18 | 0.98 | 0.40 |
| FutureSightDrive [312] | 2025 |
|
ViT |
Qwen2-VL
|
LH | 0.14 | 0.25 | 0.46 | 0.28 | 0.03 | 0.06 | 0.21 | 0.10 |
| Occ-LLM [284] | 2025 |
|
- |
LLaMA2
|
LH | 0.12 | 0.24 | 0.49 | 0.28 | - | - | - | - |
| FastDriveVLA [19] | 2025 |
|
Qwen2.5-VL
|
Qwen2.5-VL
|
LH | 0.14 | 0.29 | 0.54 | 0.33 | 0.00 | 0.18 | 0.70 | 0.29 |
| AutoDrive-R² [310] | 2025 |
|
Qwen2.5-VL
|
Qwen2.5-VL
|
LH | 0.13 | 0.19 | 0.25 | 0.19 | - | - | - | - |
| VDrive [76] | 2025 |
|
Qwen2.5-VL, CVQ
|
InternVL3
|
GEN | 0.12 | 0.26 | 0.50 | 0.29 | 0.03 | 0.16 | 0.36 | 0.18 |
| OccVLA [167] | 2025 |
|
VQ-VAE | PaliGemma-2 | REG | 0.18 | 0.26 | 0.40 | 0.28 | - | - | - | - |
| FasionAD++ [207] | 2024 |
|
GenAD |
CLIP, QwenVL
|
GEN | 0.13 | 0.26 | 0.45 | 0.28 | 0.05 | 0.08 | 0.15 | 0.09 |
| ALN-P3 [182] | 2025 |
|
VAD | CLIP, LLaMA-2 |
REG | - | - | - | - | 0.05 | 0.09 | 0.35 | 0.16 |
| VLM-E2E [166] | 2025 |
|
EfficientNet | CLIP | REG | 0.28 | 0.50 | 0.80 | 0.53 | 0.01 | 0.06 | 0.20 | 0.09 |
| NetRoller[277] | 2025 |
|
CLIP |
LLaMA-2
|
REG | 0.38 | 0.66 | 1.01 | 0.68 | 0.06 | 0.13 | 0.30 | 0.16 |
| OmniScene [165] | 2025 |
|
ResNet |
Qwen2.5-VL
|
REG | 0.28 | 0.53 | 0.91 | 0.57 | 0.00 | 0.04 | 0.19 | 0.08 |
| Sce2DriveX [327] | 2025 |
|
OpenCLIP | Vicuna-1.5 | LH | 0.15 | 0.33 | 0.59 | 0.36 | - | - | - | - |
| dVLM-AD [179] | 2025 |
|
SigLIP2 | LLaDA-V | LH | 0.15 | 0.40 | 0.68 | 0.41 | - | - | - | - |
| Percept-WAM [79] | 2025 |
|
InternViT
|
InternVL2
|
REG | 0.16 | 0.33 | 0.60 | 0.36 | - | - | - | - |
| Reasoning-VLA [316] | 2025 |
|
Qwen2.5-VL
|
Qwen2.5-VL
|
REG | 0.05 | 0.19 | 0.41 | 0.22 | 0.02 | 0.06 | 0.13 | 0.07 |
Репрезентативные примеры включают BDD-X [118], который расширяет BDD100K временными обоснованиями от человека, где аннотаторы описывают, почему водитель совершил конкретное действие. Этот набор данных обеспечивает раннее обоснование для объяснений на основе языка. DriveLM [225] формирует пары вопрос-ответ в виде графовых структур на основе сценариев nuScenes и CARLA. Эти QA пары нацелены на условное рассуждение, позволяя моделям выводить высокоуровневые намерения, пространственные отношения и решения по вождению. Impromptu VLA [36] агрегирует данные из восьми публичных наборов данных по вождению и дополняет их описаниями, инструкциями и QA парами, согласованными с траекториями экспертов. Основное внимание уделяется граничным случаям и событиям с длинным хвостом. Другие наборы данных, такие как LingoQA [186] и CoVLA [3], собирают видео реального вождения в сочетании с QA на естественном языке или описаниями поведения, делая акцент на пространственно-временных рассуждениях и понятных человеку мотивах вождения..
Примечательно, что аннотации в стиле QA стали доминирующей парадигмой для расширения наборов данных по вождению, служа общей основой для обучения и оценки способностей к рассуждению и планированию [225, 86]. Однако объем и допущения, заложенные в таких аннотациях, естественным образом влияют на поведение модели, что стимулирует дальнейшее изучение более разнообразных перспектив, горизонтов планирования и протоколов оценки для внедрения в реальных условиях..
5.2 Метрики оценки
Метрики оценки различаются в зависимости от модальности вывода модели: метрики на основе траекторий для прогнозирования непрерывных действий и текстовые метрики для моделей, генерирующих лингвистические команды или обоснования..
5.2.1 Оценка действий на основе траекторий
Выходные данные на основе траекторий обычно оцениваются в условиях разомкнутого и замкнутого контуров.
Оценка с разомкнутым контуром. Предсказанная траектория напрямую сравнивается с экспертными траекториями без выполнения в симуляторе. Широко используются такие метрики, как L2 error и collision rate [91], наряду с индикаторами на основе траекторий, включая Average Displacement Error (ADE), Final Displacement Error (FDE) и Miss Rate (MR) [93]. Эти метрики рассматривают демонстрации вождения человеком как ground truth и формулируют планирование по сути как задачу imitation learning. Измеряя отклонение между предсказанными и экспертными траекториями, они предоставляют простой способ оценки точности прогнозирования движения..
Оценка в замкнутом контуре. Вместо этого она измеряет производительность модели при взаимодействии с симуляционной средой (например, CARLA [56]). Репрезентативные метрики включают завершение маршрута (RC), балл вождения (DS) и дистанцию до нарушения (ID). Bench2Drive [103] дополнительно учитывает коэффициент успеха, эффективность и комфорт. NAVSIM [47], построенный на базе nuPlan [18], вводит оценку прогностической модели водителя (PDMS), которая агрегирует промежуточные баллы для прогресса собственного транспортного средства (EP), времени до столкновения (TTC) и комфорта (C), одновременно применяя штрафы за столкновения (NC) и допустимость вождения (DAC). Эти метрики обеспечивают целостное представление о безопасности, осуществимости и возможности развертывания действий планирования..
5.2.2 Оценка действий на основе текста
Для низкоуровневого управления транспортным средством, выраженного на естественном языке, оценка охватывает как лингвистическое качество, так и эффективность управления. Стандартные текстовые метрики, такие как BLEU, ROUGE и CIDEr, обычно используются для оценки качества сгенерированного языка [328, 225], что измеряет n-граммное совпадение с размеченными человеком эталонными командами. Помимо точности команд, качество рассуждений оценивается посредством согласованности обоснований [192] и оценок предпочтений людей в отношении языковых объяснений, особенно в наборах данных, следующих формату BDD-X [118]. Для оценки приложений вождения вводятся метрики на основе исполнения для оценки поведения. SimLingo [213] представляет бенчмарк action-dreaming. Соответствующие действия отображаются из входной инструкции, которая оценивается в режиме разомкнутого цикла с использованием коэффициента успешности.
Независимо от модальности вывода, данные бенчмарки подчеркивают ключевые аспекты качества действий, включая точность, исполнимость, безопасность и соответствие намерениям..
| Model | Year | Input | Vision |
Language |
Action |
RFS(Overall)() | RFS(Spotlight)() | ADE 5s() | ADE 3s() |
| Vision-Action Models | |||||||||
| Waymo Baseline | 2025 | |
- | - | - | 7.53 | 6.60 | 3.02 | 1.32 |
| Swin-Trajectory [283] | 2025 | |
SwinT | - | REG | 7.54 | 6.68 | 2.81 | 1.21 |
| DiffusionDrive [156] | 2025 | |
ResNet | - | GEN | 7.69 | 6.65 | 2.99 | 1.31 |
| RAP-DINO [65] | 2025 | |
DINO | - | REG | 8.04 | 7.20 | 2.65 | 1.17 |
| Vision-Language-Action Models | |||||||||
| OpenEMMA [278] | 2025 |
|
Qwen2-VL |
Qwen2-VL |
LH | 5.16 | 4.71 | 12.74 | 6.68 |
| HMVLM [256] | 2025 |
|
ViT |
Qwen2.5-VL
|
LH | 7.74 | 6.73 | 3.07 | 1.33 |
| AutoVLA [340] | 2025 |
|
Qwen2.5-VL |
Qwen2.5-VL |
LH | 7.56 | 6.94 | 2.96 | 1.35 |
| Poutine [216] | 2025 |
|
ViT |
Qwen2.5-VL
|
LH | 7.99 | 6.89 | 2.74 | 1.21 |
| LightEMMA [209] | 2025 |
|
Qwen2.5-VL |
Qwen2.5-VL |
LH | 6.52 | 5.71 | 3.73 | 1.71 |
| dVLM-AD [179] | 2025 |
|
SigLIP2 | LLaDA-V | LH | 7.63 | - | 3.02 | 1.29 |
| Model | Year | Input | Vision |
Language |
Action |
NC() | DAC() | TTC() | Comf() | EP() | PDMS() |
| Vision-Action Models | |||||||||||
| TransFuser [40] | 2022 |
|
ResNet | - | REG | 97.7 | 92.8 | 92.8 | 100 | 79.2 | 84.0 |
| UniAD [93] | 2023 | |
ResNet | - | REG | 97.8 | 91.9 | 92.9 | 100 | 78.8 | 83.4 |
| VADv2 [31] | 2024 | |
ResNet | - | REG | 97.2 | 89.1 | 91.6 | 100 | 76.0 | 80.9 |
| PARA-Drive [269] | 2024 | |
ResNet | - | REG | 97.9 | 92.4 | 93.0 | 99.8 | 79.3 | 84.0 |
| LAW [143] | 2024 | |
Swin-T | - | REG | 96.4 | 95.4 | 88.7 | 99.9 | 81.7 | 84.6 |
| DRAMA [308] | 2024 |
|
ResNet | - | REG | 98.0 | 93.1 | 94.8 | 100 | 80.1 | 85.5 |
| DiffusionDrive [156] | 2024 |
|
ResNet | - | GEN | 98.2 | 96.2 | 94.7 | 100 | 82.2 | 88.1 |
| WoTE [145] | 2025 |
|
ResNet | - | SEL | 98.5 | 96.8 | 94.9 | 99.9 | 81.9 | 88.3 |
| World4Drive [335] | 2025 | |
ResNet | - | REG | 97.4 | 94.3 | 92.8 | 100 | 79.9 | 85.1 |
| DrivingGPT [34] | 2025 | |
VQ-VAE | - | REG | 98.9 | 90.7 | 94.9 | 95.6 | 79.7 | 82.4 |
| AD-R1 [289] | 2025 |
|
- | - | RL | 98.7 | 97.8 | 94.8 | 100 | 87.5 | 91.9 |
| SeerDrive [315] | 2025 |
|
VoVNet | - | SEL | 98.8 | 98.6 | 95.8 | 100 | 84.2 | 90.7 |
| Epona [321] | 2025 |
|
DC-AE | - | REG | 97.9 | 95.1 | 93.8 | 99.9 | 80.4 | 86.2 |
| GoalFlow [279] | 2025 |
|
VoVNet | - | GEN | 98.4 | 98.3 | 94.6 | 100 | 85.0 | 90.3 |
| TrajDiff [75] | 2025 |
|
ResNet | - | GEN | 98.1 | 97.0 | 94.3 | 100.0 | 82.7 | 88.5 |
| DiffusionDriveV2 [345] | 2025 |
|
ResNet | - | GEN | 98.3 | 97.9 | 94.8 | 99.9 | 87.5 | 91.2 |
| NaviHydra [272] | 2025 |
|
ResNet | - | SEL | 98.7 | 98.6 | 88.7 | 96.2 | 100.0 | 92.7 |
| Mimir [280] | 2025 |
|
ResNet | - | GEN | 98.2 | 97.5 | 94.6 | 100 | 83.6 | 89.3 |
| Vision-Language-Action Models | |||||||||||
| ReCogDrive [146] | 2025 |
|
InternViT |
Qwen2.5-VL |
GEN | 98.2 | 97.8 | 95.2 | 99.8 | 83.5 | 89.6 |
| AutoVLA [340] | 2025 |
|
Qwen2.5-VL
|
Qwen2.5-VL
|
LH | 99.1 | 97.1 | 97.1 | 99.9 | 87.6 | 92.1 |
| ReflectDrive [136] | 2025 |
|
LLaDA-V | LLaDA-V | GEN | 99.7 | 99.5 | 99.1 | 99.9 | 88.9 | 94.7 |
| AdaThinkDrive [177] | 2025 |
|
InternVL3
|
InternVL3
|
REG | 99.1 | 98.8 | 97.2 | 100.0 | 87.9 | 93.0 |
| Percept-WAM [79] | 2025 |
|
InternViT
|
InternVL2 |
REG | 98.8 | 98.6 | 94.4 | 99.5 | 84.8 | 90.2 |
| Reasoning-VLA [316] | 2025 |
|
Qwen2.5-VL
|
Qwen2.5-VL
|
REG | 97.8 | 93.2 | 98.1 | 99.8 | 80.7 | 91.7 |
| Method | Year | Input | Vision |
Language |
Action |
Closed-Loop | Open-Loop | |||
| DS | SR(%) | Efficiency | Comfort | Avg. L2 | ||||||
| Vision-Action Models | ||||||||||
| TCP [273] | 2022 | |
ResNet | - | REG | 40.70 | 15.00 | 54.26 | 47.80 | 1.70 |
| ThinkTwice [102] | 2023 | |
ResNet | - | REG | 62.44 | 31.23 | 69.33 | 16.22 | 0.95 |
| DriveAdapter [101] | 2023 |
|
ResNet | - | REG | 64.22 | 33.08 | 70.22 | 16.01 | 1.01 |
| UniAD-Base [93] | 2023 | |
ResNet | - | REG | 45.81 | 16.36 | 129.21 | 43.58 | 0.73 |
| VAD [108] | 2023 | |
ResNet | - | REG | 42.35 | 15.00 | 157.94 | 46.01 | 0.91 |
| GenAD [333] | 2024 | |
ResNet | - | GEN | 44.81 | 15.90 | - | - | - |
| DriveTransformer [104] | 2025 | |
ResNet | - | REG | 63.46 | 35.01 | 100.64 | 20.78 | 0.62 |
| ETA [78] | 2025 | |
CLIP | - | REG | 69.53 | 38.64 | 184.51 | 28.43 | - |
| WoTE [145] | 2025 |
|
ResNet | - | SEL | 61.71 | 31.36 | - | - | - |
| GuideFlow [162] | 2025 | |
ResNet | - | GEN | 75.21 | 51.36 | - | - | - |
| Raw2Drive [301] | 2025 | |
ResNet | - | RL | 71.36 | 50.24 | 214.17 | 22.42 | - |
| Vision-Language-Action Models | ||||||||||
| ORION [67] | 2025 |
|
EVA-02 | Vicuna-1.5 | GEN | 77.74 | 54.62 | 151.48 | 17.38 | 0.68 |
| AutoVLA [340] | 2025 |
|
SigLIP |
Qwen2.5-VL
|
LH | 78.84 | 57.73 | 146.93 | 39.33 | - |
| SimLingo-Base [213] | 2025 |
|
InternViT |
Qwen2 |
REG | 85.94 | 66.82 | 244.18 | 25.49 | - |
| SimLingo [213] | 2025 |
|
InternViT
|
Qwen2
|
REG | 85.07 | 67.27 | 259.23 | 33.67 | - |
| ReAL-AD [176] | 2025 |
|
ResNet |
QwenVL |
REG | 40.76 | 10.93 | - | - | 0.87 |
| ReasonPlan [169] | 2025 |
|
SigLIP |
Qwen
|
LH | 64.01 | 34.55 | 180.64 | 25.63 | 0.61 |
| DriveMoE [300] | 2025 |
|
BEV Encoder |
LLaMA |
REG | 74.22 | 48.64 | 175.96 | 15.31 | 0.31 |
| VDRive[76] | 2025 |
|
Qwen2.5-VL, CVQ
|
InternVL3
|
GEN | 66.15 | 50.51 | 110.23 | 22.90 | 0.55 |
| CoReVLA [61] | 2025 |
|
Qwen2.5-VL |
Qwen2.5-VL |
LH | 72.18 | 50.00 | 145.41 | 34.35 | - |
5.3 Количественные эксперименты и анализы
В этом разделе рассматриваются количественные бенчмарки для оценки VLA моделей в задачах прогнозирования действий, точности планирования и эффективности вождения в замкнутом контуре. Среди них наиболее широко используются nuScenes [17], NAVSIM [47] и Bench2Drive [103]. Совсем недавно в WOD-E2E [283] были представлены редкие, критически важные для безопасности сцены с аннотациями предпочтений человека, что позволяет проводить более надежную оценку современных E2E и VLA систем..
5.3.1 Эталонный тест nuScenes
Открытый бенчмарк nuScenes оценивает качество планирования с использованием метрик на основе траекторий, включая ошибку смещения L2 и частоту столкновений, как обобщено в Таблице 5. В основном, vision-action модели, такие как UniAD [93], показывают 0.69 м L2 и 0.12 частоту столкновений. Включение языка обычно улучшает производительность за счет предоставления семантических подсказок для более безопасного планирования. Например, Drive-R1 [147] сочетает SFT CoT выравнивание с RL дообучением для достижения 0.31 м L2 и 0.09 частоты столкновений..
Помимо точности, недавние исследования изучают роль языка в обработке сложных и редких сценариев вождения. Хотя улучшения наиболее заметны в типичных случаях, редкие и крайне сложные ситуации остаются активной областью исследований, что стимулирует интеграцию более богатых сигналов рассуждения и источников данных..
С системной точки зрения вычислительная эффективность является важным фактором для практического развертывания. Облегченные и ориентированные на эффективность разработки, такие как InsightDrive [227] (16.3 FPS) и архитектуры с прореживанием токенов, подобные FastDriveVLA [19], иллюстрируют текущие усилия по достижению баланса между мощностью модели и возможностью работы в режиме реального времени. Для кросс-доменной оценки nuScenes выделяет обобщение на ранее не виденные города и сдвиги распределения в качестве ключевого эталонного измерения. Работы, такие как VLP [197] и DiMA [88], исследуют этот сценарий и обосновывают дополнительные стратегии, включая адаптацию домена, дистилляцию и аугментацию данных..
5.3.2 WOD-E2E Benchmark
Waymo Open Dataset for End-to-End Driving (WOD-E2E) [283] — это крупномасштабный бенчмарк, предназначенный для оценки систем сквозного вождения в редких, критически важных для безопасности сценариях, которые редко встречаются в обычных наборах данных. Он содержит 4K сегментов с высокоуровневыми командами маршрутизации, сигналами состояния ego-автомобиля и видами с нескольких камер, что позволяет проводить строгую оценку взаимодействия восприятия и планирования. Ключевым вкладом WOD-E2E является Rater Feedback Score (RFS), который измеряет качество траектории на основе соответствия аннотациям человеческих предпочтений, а не записанным траекториям экспертов. Как показано в таблице 6, RFS (Overall и Spotlight) дополняет традиционные метрики ADE, обеспечивая более согласованную с человеком оценку поведения при вождении..
Общие результаты показывают, что, хотя vision–action модели достигают стабильной точности смещения, VLA модели демонстрируют более разнообразную производительность. Подходы, такие как Poutine [216] и dVLM-AD [179], достигают сбалансированных показателей RFS и ADE, подчеркивая важность эффективного согласования языкового рассуждения с генерацией траектории. На рисунке 7 представлена визуализированная производительность AutoVLA [340] в наборе данных WOD-E2E..
5.3.3 Тест NAVSIM
NAVSIM [47] построена на базе OpenScene (перераспределение nuPlan [18]) и предоставляет среду симуляции с замкнутым контуром, предназначенную для оценки качества планирования в реалистичных городских условиях вождения. В ней используется метрика PDMS, которая объединяет несколько аспектов вождения, включая отсутствие столкновений (NC), допустимость вождения (DAC), время до столкновения (TTC), прогресс эго-транспортного средства (EP) и комфорт (C), обеспечивая комплексную оценку безопасности, эффективности и плавности вождения. Как показано в таблице 7, большинство методов демонстрируют высокие показатели по метрикам, связанным с безопасностью, таким как NC и DAC, в то время как TTC и EP служат более дифференцирующими индикаторами дальновидности планирования и качества принятия решений на долгосрочную перспективу. Эти метрики подчеркивают различия в том, как модели балансируют между безопасностью и прогрессом при взаимодействии с динамическими средами..
Репрезентативные подходы «зрение-действие», такие как WoTE [145], достигают 88.3 PDMS путем интеграции world model на основе BEV с выбором траектории, управляемым вознаграждением, что демонстрирует эффективность структурированного моделирования мира для планирования с обратной связью. Опираясь на этот фундамент, методы с языковой обусловленностью дополнительно улучшают процесс принятия решений. Например, AutoVLA [340] повышает производительность до 99.1 NC и 87.6 EP за счет использования языковых априорных решений и стратегии оценки Best-of-N oracle, иллюстрируя, как языковой контроль может направлять выбор траектории и улучшать поведение при долгосрочном планировании..
5.3.4 Тест Bench2Drive ⟦K0⟧
Bench2Drive [103] предоставляет протокол оценки с замкнутым контуром, построенный на базе CARLA V2, фокусирующийся на показателе успешности и комплексных оценках вождения для анализа целенаправленного поведения при вождении в интерактивных условиях. В отличие от бенчмарков с разомкнутым контуром, Bench2Drive явным образом оценивает способность агента выполнять долгосрочные задачи и реагировать на динамическую обратную связь от окружающей среды..
Недавние подходы VLA демонстрируют явные преимущества использования языкового обоснования в данном бенчмарке. Например, SimLingo [213] внедряет механизм «мечтания» о действиях, который согласовывает инструкции на естественном языке с последовательностями управления, достигая лидирующего показателя вождения 85.94, как указано в Таблице 8. Эти результаты показывают, что рассуждения с языковым сопровождением могут эффективно влиять на принятие решений в замкнутом цикле и улучшать качество планирования в интерактивных сценариях вождения..
В совокупности с бенчмарками с разомкнутым контуром, Bench2Drive подчеркивает растущую важность согласования языка и действий в VLA системах, особенно для интерпретации высокоуровневых целей, управления поведением на длинных горизонтах планирования и адаптации действий в соответствии со сложными, ориентированными на человека инструкциями..
6 Проблемы и будущие направления
Модели VLA знаменуют собой переход от модульных стеков к целостным, управляемым рассуждениями агентам вождения. Используя крупные мультимодальные основы, они обещают более глубокое понимание окружающей среды, более сильную обобщающую способность и более интерпретируемое принятие решений. Тем не менее, реализация их полного потенциала в критически важных для безопасности системах автономного вождения требует решения ряда фундаментальных проблем. Параллельно с этим, новые направления исследований указывают на системы следующего поколения, которые являются более эффективными, надежными и способными к долгосрочному рассуждению..
6.1 Текущие проблемы
6.1.1 Архитектура модели и эффективность системы
Обработка в реальном времени и задержка. Модели VLA наследуют значительные вычислительные затраты современных визуально-языковых архитектур. Входные данные с камер высокого разрешения и высокой частоты кадров генерируют длинные последовательности визуальных токенов, а объединение данных с нескольких ракурсов увеличивает требования к памяти и задержки. Поэтому соблюдение строгих ограничений реального времени для автономных транспортных средств остается сложной задачей [111, 269]. Недавние достижения в области потокового сжатия токенов и адаптивных визуальных энкодеров [139, 19] предлагают перспективные направления, однако достижение времени вывода менее 50 мс остается невыполненным требованием для развертывания систем, критически важных для безопасности..
Отсутствие специализированных базовых моделей. Универсальные VLM [6, 35, 343] обеспечивают сильные априорные знания, но не оптимизированы для задач восприятия, физики или мультисенсорной интеграции, специфичных для вождения. Автономное вождение требует точного пространственного мышления, соблюдения правил дорожного движения и понимания редких, критически важных граничных случаев — способностей, которые не в полной мере охвачены универсальными моделями. Как подчеркивается в разделе 3, специализированные базовые модели для вождения [152] остаются недостающим краеугольным камнем для масштабируемых и надежных VLA систем..
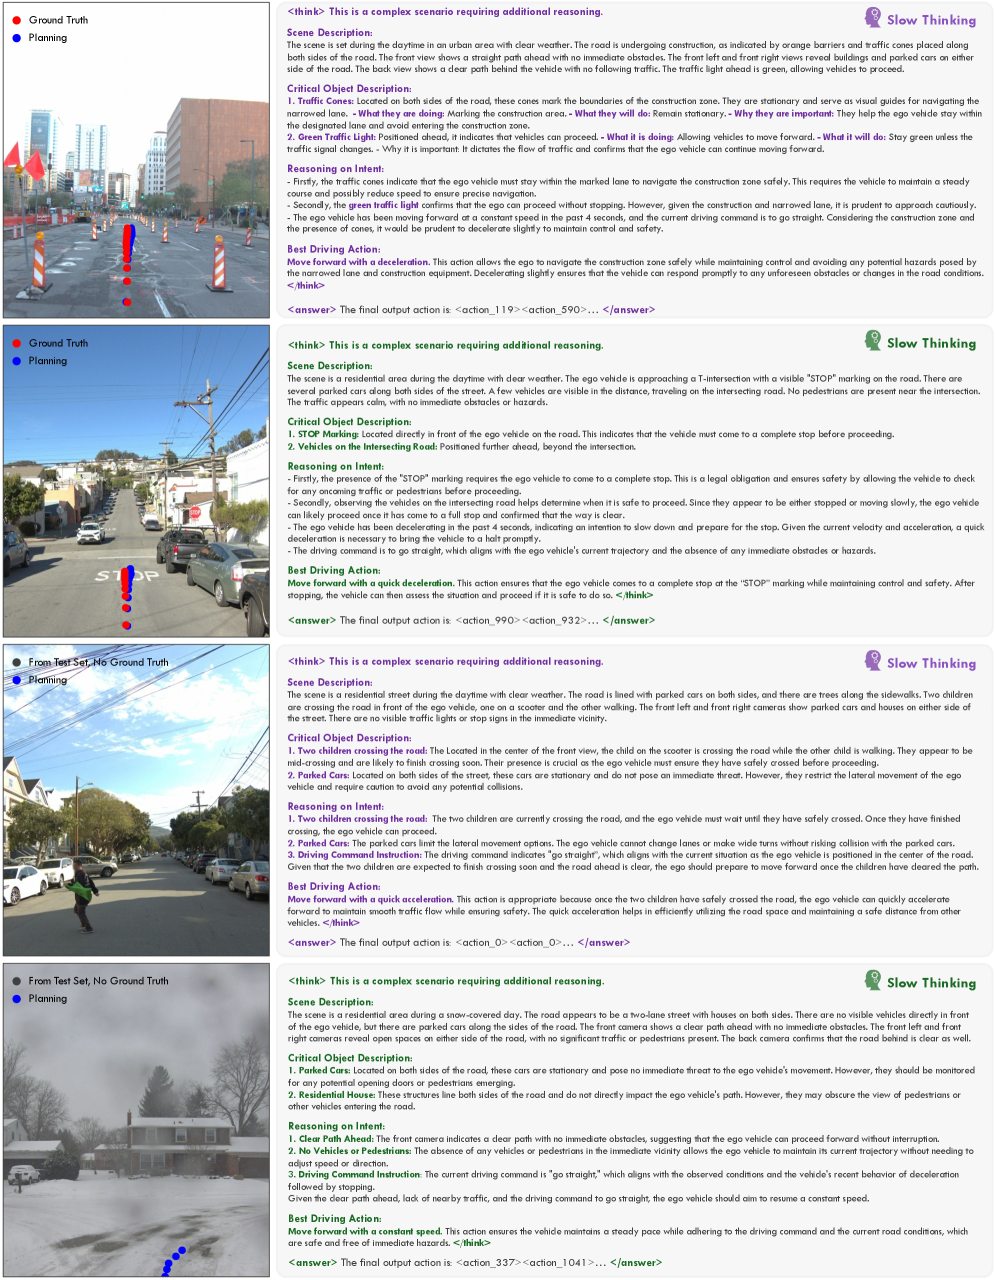
6.1.2 Данные и обобщение
Обобщение на редкие и новые сценарии. Одной из мотиваций для VLA является их способность использовать сильные визуально-языковые априорные знания для интерпретации сложных сцен. Однако, хотя компоненты VLM могут хорошо обобщать перцептивную информацию, согласование этого понимания с пространством действий порождает новые неопределенности. Как отмечено в разделе 4, представления, богатые логическими выводами, не автоматически транслируются в надежную генерацию действий. Сценарии с «длинным хвостом» — некорректное поведение участников дорожного движения, необычная дорожная разметка, непредсказуемая погода — остаются точками отказа [74, 302, 311, 247, 48].
Стоимость высококачественных данных. VLA опираются на разнообразные высококачественные мультимодальные наборы данных [163, 132], однако сбор парных триплетов «зрение-действие-язык» в больших масштабах обходится дорого. Синтетические среды [228, 22, 191] помогают, но сталкиваются со значительными разрывами между симуляцией и реальностью, с расхождениями в характеристиках шума, освещении и поведении других агентов [123, 274]. Повышение эффективности данных и смягчение сдвигов распределения остаются давними проблемами..
6.1.3 Основные возможности и надежность
Интерпретируемость и галлюцинации. Хотя VLA модели генерируют обоснования на естественном языке посредством chain-of-thought prompting [67, 340, 261], эти объяснения являются искусственно созданными артефактами, а не достоверным отражением лежащих в основе причинно-следственных связей. Языковые галлюцинации [211, 159, 94] создают новые риски: модель может обосновать неверное решение уверенным, но ложным повествованием. Обеспечение согласованной привязки между восприятием, действиями и объяснениями остается открытой проблемой..
Временная согласованность на больших горизонтах. Вождение зависит от прогнозирования многоэтапных взаимодействий и поддержания ситуационной осведомленности на протяжении длительных временных горизонтов [199, 229, 285]. Современные VLA архитектуры на базе transformers остаются ограниченными из-за малых контекстных окон и краткосрочного обусловливания, унаследованных от стандартных VLM дизайнов. Временная фрагментация приводит к противоречивым решениям, особенно в многоагентных или высокодинамичных дорожных сценах..
6.2 Будущие направления
6.2.1 Парадигмы моделей следующего поколения
Унифицированные модели зрения-языка-мира. Многообещающая эволюция объединяет VLA с предиктивными моделями мира [9, 21, 144, 143], расширяя VA-модели, описанные в разделе 3.2. Вместо того чтобы реагировать кадр за кадром, такие системы моделируют будущее развитие сцены с учетом возможных действий, что обеспечивает проактивное планирование и более надежное поведение в условиях неопределенности. Создание унифицированных, сквозных моделей мира, которые совместно рассуждают о восприятии, языке и динамике, может стать основой для автономных агентов следующего поколения..
Более богатое мультимодальное слияние. По мере диверсификации наборов датчиков будущие архитектуры будут включать раннее и тесное слияние данных LiDAR, радаров, событийных камер и карт высокого разрешения [123, 274, 222]. Язык улучшает семантическое обоснование, но надежная трехмерная геометрия необходима для принятия безопасных решений [167, 248]. Целостное мультимодальное слияние позволяет объединить интерпретируемость VLM с пространственной точностью геометрических датчиков.
6.2.2 Совершенствование интеллекта и адаптации
Социально ориентированное вождение, основанное на знаниях. VLA модели должны приобретать более глубокие навыки здравого смысла — понимание намерений, условностей и причинно-следственных связей, выходящих за рамки явных аннотаций [140, 313]. Будущие усилия будут опираться на крупномасштабные видео-языковые корпуса, используя внешние базы знаний и модули структурированного рассуждения для поддержки социально приемлемого и упреждающего вождения..
Непрерывное и бортовое обучение. Статические модели, обученные в автономном режиме, не способны учитывать изменяющуюся дорожную инфраструктуру или региональные особенности вождения [255, 344, 20]. Обеспечение безопасного, инкрементального обучения в процессе повседневного вождения при предотвращении катастрофического забывания и соблюдении гарантий безопасности имеет решающее значение для долгосрочного развертывания. Это тесно связано с устранением пробелов в обобщении редких сценариев..
| Abbr. | - | Full Name | Description | Ref. |
| Action-Planning Open-Loop Evaluation | ||||
| L2 | L2 Error | L2 distance error between the planned trajectory and the human driving trajectory in 3 seconds. | [91] | |
| CR | Collision Rate | How often the self-driving vehicle would collide with other agents on the road. | [91] | |
| ADE | Average Displacement Error | Mean displacement error between predicted trajectories and expert waypoints across the horizon, reflecting overall trajectory accuracy. | [93] | |
| FDE | Final Displacement Error | Displacement error at the final predicted waypoint compared with expert trajectories, emphasizing long-term accuracy. | [93] | |
| MR | Miss Rate | Fraction of prediction time steps where displacement error exceeds horizon-specific thresholds, reflecting failure in trajectory coverage. | [93] | |
| AHE | Average Heading Error | Mean absolute angular deviation between predicted and expert heading over the trajectory horizon, measuring orientation accuracy. | [115] | |
| FHE | Final Heading Error | Absolute angular deviation of predicted heading from expert at the final timestep, reflecting terminal orientation accuracy. | [115] | |
| SLE | Speed L1 Error | Mean absolute error of predicted speed control signals. | [100] | |
| SALE | Steer Angle L1 Error | Mean absolute error of predicted steering angle control signals. | [100] | |
| RFS | Rater Feedback Score | Measure how well the predicted trajectory aligns with human driving preferences by checking whether it falls within trust regions. | [283] | |
| Trajectory-Based Closed-Loop Evaluation | ||||
| RC | Route Completion | The percentage of route distance completed. | [205] | |
| DS | Driving Score | RC weighted by a penalty factor that accounts for collisions with pedestrians, vehicles, etc. | [205] | |
| NC | No Collision | Fraction of scenarios without ego-fault collisions, focusing exclusively on responsibility-aware collision evaluation. | [47] | |
| DAC | Driving Admissibility Check | Boolean evaluation that checks whether the ego vehicle remains inside drivable polygons throughout the rollout. | [47] | |
| TTC | Time To Collision | Boolean verification that the time-to-collision value exceeds safety thresholds, preventing imminent crashes. | [47] | |
| C | Driving Comfort | The comfort of driving. | [47] | |
| EP | Ego Progress | Penalization of excessive jerk, acceleration, or yaw-rate, reflecting ride quality and passenger comfort. | [47] | |
| PDMS | Predictive Driver Model Score | A flexible weighted evaluation score in autonomous driving that aggregates multiple safety, progress, and comfort subscores into a single metric. | [47] | |
| SR | Success Rate | Percentage of navigation episodes that successfully reach the goal within a fixed time budget, indicating overall task completion. | [56] | |
| ID | Infraction Distance | Average driving distance between two infractions, with longer distances reflecting safer and more reliable policy behavior. | [56] | |
| Text-Based Action Evaluation | ||||
| CIDEr | Consensus-based Image Description Evaluation | Measures similarity of generated captions to multiple human references using TF-IDF weighted n-grams. | [182] | |
| BLEU | Bilingual Evaluation Understudy | Precision-based metric that compares n-grams of the generated text against reference texts. | [182] | |
| METEOR | Metric for Evaluation of Translation with Explicit Ordering | Considers unigram precision and recall with stemming, synonym matching, and fragmentation penalty. | [182] | |
| Rouge | Recall-Oriented Understudy for Gisting Evaluation | Recall-focused metric using overlapping n-grams, word sequences, or word pairs between generated and reference texts. | [182] | |
| Top-1 Acc | Visual Question Answering Top-1 Accuracy | Percentage of predictions where the most confident output matches the ground truth label. | [182] | |
6.2.3 Экосистема для безопасного развертывания
Стандартизированная оценка и гарантии безопасности. Метрики оценки из текущих бенчмарков, например, NAVSIM [47] и Bench2Drive [103], оценивают безопасность и комфорт, но не учитывают ключевые риски, специфичные для VLA, такие как ошибки рассуждений, ошибки следования инструкциям или кросс-модальные несоответствия [159, 211]. Будущие бенчмарки должны оценивать выполнение многошаговых инструкций, устойчивость к неоднозначному языку и сопротивляемость галлюцинациям. Помимо эмпирического тестирования, необходимы инструменты формальной верификации для обеспечения теоретических гарантий безопасности критически важных моделей поведения..
Взаимодействие и персонализация с ориентацией на человека. VLA системы открывают возможности для более глубокого взаимодействия внутри автомобиля [295, 219]. Естественный язык позволяет водителям задавать цели, ограничения и предпочтения («веди машину осторожно», «избегай незащищенных левых поворотов»). Модули персонализации [81] могут адаптировать стили вождения под разных пользователей, повышая комфорт и доверие. Сложность заключается в поиске баланса между персонализацией и строгими требованиями безопасности и нормативными актами..
7 Заключение
Модели Vision-Language-Action меняют сферу автономного вождения, объединяя восприятие с высокоуровневым рассуждением и пониманием естественного языка. В данной работе формализуется постановка задачи VLA, описывается переход от традиционных конвейеров VA и существующие методы систематизируются в логические архитектурные семейства вместе с наборами данных и бенчмарками, которые поддерживают их развитие. Системы VLA предлагают явные преимущества в интерпретируемости, обобщающей способности и взаимодействии с человеком, однако остаются ключевые проблемы: согласование символьных рассуждений с непрерывным управлением, обеспечение устойчивости в редких сценариях и создание протоколов оценки, которые достоверно измеряют следование инструкциям и безопасность. Прогресс будет зависеть от достижений в области эффективных архитектур, более глубокого мультимодального слияния, планирования на основе world models и более строгого тестирования, ориентированного на человека. В целом, VLA представляет собой перспективное направление для создания автономных агентов, которые являются не только компетентными водителями, но и коммуникабельными, прозрачными и отзывчивыми к намерениям человека..
Список литературы
- ⟦Achiam et al. [2023] Джош Ачиам и др. Технический отчет GPT-4. arXiv preprint arXiv:2303.08774, 2023.
- ⟦Adilkhanov et al. [2025] Адильжан Адильханов и др. Обзор моделей зрения-языка-действия. arXiv preprint arXiv:2502.06851, 2025.
- ⟦Arai et al. [2025] Хидехиса Араи и др. CoVLA: Комплексный набор данных «зрение-язык-действие» для автономного вождения. В IEEE/CVF Winter Conf. Appl. Comput. Vis., страницы 1933–1943, 2025.
- ⟦Azzolini et al. [2025] Алиссон Аццолини и др. Cosmos-Reason1: От физического здравого смысла к воплощенному рассуждению. arXiv preprint arXiv:2503.15558, 2025.
- ⟦Bai et al. [2023] Цзиньцзэ Бай и др. Технический отчет Qwen. arXiv preprint arXiv:2309.16609, 2023.
- ⟦Bai et al. [2025] Шуай Бай и др. Технический отчет Qwen2.5-VL. arXiv preprint arXiv:2502.13923, 2025.
- ⟦Bain and Sammut [1995] Майкл Бэйн и Клод Саммут. Структура для поведенческого клонирования. В Mach. intell., том 15, страницы 103–129, 1995.
- ⟦Baldassarre et al. [2025] Федерико Бальдассарре и др. Назад к признакам: DINO как основа для видео world models. arXiv preprint arXiv:2507.19468, 2025.
- ⟦Ball et al. [2025] Филип Дж. Болл и др. Genie 3: Новый рубеж для моделей мира. https://deepmind.google/discover/blog/genie-3-a-new-frontier-for-world-models/, 2025.
- ⟦Bansal et al. [2018] Маянк Бансал, Алекс Крижевский и Абхиджит Огале. ChauffeurNet: Обучение вождению путем имитации лучших и синтеза худших примеров. arXiv preprint arXiv:1812.03079, 2018.
- ⟦Bartoccioni et al. [2025] Барточчони и др. VaViM и VaVAM: Автономное вождение посредством генеративного моделирования видео. arXiv preprint arXiv:2502.15672, 2025.
- ⟦Beyer et al. [2024] Лукас Бейер и др. PaliGemma: Универсальная 3B VLM для трансфера. arXiv preprint arXiv:2407.07726, 2024.
- ⟦Bian et al. [2025] Хэнвэй Бянь и др. DynamicCity: генерация крупномасштабной 4D-занятости на основе динамических сцен. В сб.: Int. Conf. Learn. Represent., 2025.
- ⟦Blattmann et al. [2023a] Андреас Блаттманн и др. Согласование латентных представлений: высококачественный синтез видео с помощью латентных диффузионных моделей. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 22563–22575, 2023a.
- ⟦Blattmann et al. [2023b] Андреас Блаттманн и др. Стабильная диффузия видео: масштабирование латентных диффузионных моделей видео до больших наборов данных. arXiv preprint arXiv:2311.15127, 2023b.
- ⟦Bojarski et al. [2016] Мариуш Боярски и др. Сквозное обучение для беспилотных автомобилей. arXiv preprint arXiv:1604.07316, 2016.
- ⟦Caesar et al. [2020] Холгер Цезарь и др. nuScenes: Мультимодальный набор данных для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 11621–11631, 2020.
- ⟦Caesar et al. [2021] Холгер Цезарь и др. nuPlan: Эталонный тест планирования на основе ML с замкнутым контуром для автономных транспортных средств. arXiv preprint arXiv:2106.11810, 2021.
- ⟦Cao et al. [2025] Цзяцзюнь Цао и др. FastDriveVLA: Эффективное сквозное вождение посредством подключаемого прореживания токенов на основе реконструкции. arXiv preprint arXiv:2507.23318, 2025.
- ⟦Cao et al. [2022] Чжун Цао и др. Непрерывное обучение стратегии автономного вождения с использованием единичного случая вмешательства водителя. IEEE Trans. Intell. Veh., 8(2):1380–1391, 2022.
- ⟦Cen et al. [2025] Джун Цен и др. WorldVLA: На пути к авторегрессионной модели мира действий. arXiv preprint arXiv:2506.21539, 2025.
- ⟦Chao et al. [2020] Цяньвэнь Чао и др. Обзор визуального моделирования дорожного движения: модели, оценки и приложения в автономном вождении. В Computer Graphics Forum, том 39, страницы 287–308. Wiley Online Library, 2020.
- ⟦Chekroun et al. [2023] Рафаэль Шекрун, Марин Тороманов, Саша Хорнауэр и Фабьен Мутард. GRI: General reinforced imitation и ее применение в автономном вождении на основе компьютерного зрения. Robotics, 12(5):127, 2023.
- ⟦Chen and Krähenbühl [2022] Диан Чен и Филипп Крэхенбюль. Обучение на всех транспортных средствах. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 17222–17231, 2022.
- ⟦Chen et al. [2020] Диан Чен и др. Обучение через жульничество. В сб. Conf. Robot Learn., страницы 66–75. PMLR, 2020.
- ⟦Chen et al. [2021] Диань Чен и др. Обучение вождению на основе мира, ограниченного рельсами. В IEEE/CVF Int. Conf. Comput. Vis., страницы 15590–15599, 2021.
- ⟦Chen et al. [2025a] Джунью Чен и др. DC-AE 1.5: Ускорение сходимости диффузионных моделей с помощью структурированного латентного пространства. arXiv preprint arXiv:2508.00413, 2025a.
- ⟦Chen et al. [2024a] Ли Чэнь и др. Сквозное автономное вождение: вызовы и рубежи. IEEE Trans. Pattern Anal. Mach. Intell., 46(12):10164–10183, 2024a.
- ⟦Chen et al. [2023a] Руннан Чен и др. CLIP2Scene: На пути к эффективному с точки зрения разметки пониманию 3D-сцен с помощью CLIP. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 7020–7030, 2023a.
- ⟦Chen et al. [2023b] Руннан Чен и др. На пути к пониманию сцен без разметки с помощью базовых моделей компьютерного зрения. В сб. Adv. Neural Inf. Process. Syst., том 36, страницы 75896–75910, 2023b.
- ⟦Chen et al. [2024b] Шаоюй Чэнь и др. VADv2: Сквозное векторное автономное вождение посредством вероятностного планирования. arXiv preprint arXiv:2402.13243, 2024b.
- ⟦Chen et al. [2023c] Си Чэнь и др. Зрительно-языковые модели PaLI-3: меньше, быстрее, сильнее. arXiv preprint arXiv:2310.09199, 2023c.
- ⟦Chen et al. [2025b] Сюэсун Чэнь и др. SOLVE: Синергия языково-визуальных и сквозных сетей для автономного вождения. В материалах IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 12068–12077, 2025b.
- ⟦Chen et al. [2024c] Юньтао Чен и др. DrivingGPT: Унификация моделирования мира вождения и планирования с помощью мультимодальных авторегрессионных transformers. arXiv preprint arXiv:2412.18607, 2024c.
- ⟦Chen et al. [2024d] Чжэ Чэнь и др. InternVL: Масштабирование базовых моделей компьютерного зрения и их адаптация для общих визуально-лингвистических задач. В материалах IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 24185–24198, 2024d.
- ⟦Chi et al. [2025] Хаохань Чи и др. Impromptu VLA: открытые веса и открытые данные для моделей зрения-языка-действия в вождении. arXiv preprint arXiv:2505.23757, 2025.
- ⟦Chiang et al. [2023] Вэй-Линь Цзян и др. Vicuna: чат-бот с открытым исходным кодом, достигающий 90%* качества ChatGPT и впечатляющий GPT-4. https://vicuna. lmsys. org (дата обращения: 14 апреля 2023 г.), 2023.
- ⟦Chib and Singh [2023] Пранав Сингх Чиб и Правендра Сингх. Недавние достижения в области сквозного автономного вождения с использованием глубокого обучения: обзор. IEEE Trans. Intell. Veh., 9(1):103–118, 2023.
- ⟦Chitta et al. [2021] Кашьяп Читта, Адитья Пракаш и Андреас Гейгер. NEAT: Нейронные поля внимания для сквозного автономного вождения. В материалах IEEE/CVF Int. Conf. Comput. Vis., страницы 15793–15803, 2021.
- ⟦Chitta et al. [2022] Кашьяп Читта и др. TransFuser: Имитационное обучение с использованием слияния сенсорных данных на основе transformers для автономного вождения. IEEE Trans. Pattern Anal. Mach. Intell., 45(11):12878–12895, 2022.
- ⟦Chu et al. [2024] Сянсян Чу и др. MobileVLM v2: Более быстрая и мощная базовая модель для vision language model. arXiv preprint arXiv:2402.03766, 2024.
- ⟦Cobbe et al. [2020] Karl Cobbe, Chris Hesse, Jacob Hilton, and John Schulman. Использование процедурной генерации для бенчмаркинга reinforcement learning. В Int. Conf. Mach. Learn., страницы 2048–2056. PMLR, 2020.
- ⟦Codevilla et al. [2018] Фелипе Кодевилла и др. Сквозное вождение посредством условного имитационного обучения. В материалах IEEE Int. Conf. Robot. Autom., страницы 4693–4700, 2018.
- ⟦Codevilla et al. [2019] Фелипе Кодевилья и др. Исследование ограничений поведенческого клонирования для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 9329–9338, 2019.
- ⟦Cui et al. [2024] Кан Цуй и др. Обзор мультимодальных LLM для автономного вождения. В IEEE/CVF Winter Conf. Appl. Comput. Vis., страницы 958–979, 2024.
- ⟦Cui et al. [2025] Кан Цуй и др. ViLaD: Большая диффузионная модель зрения и языка для сквозного автономного вождения. arXiv preprint arXiv:2508.12603, 2025.
- ⟦Dauner et al. [2024] Даниэль Даунер и др. NAVSIM: Симуляция и бенчмаркинг автономных транспортных средств на основе данных без учета реактивности. В сб.: Adv. Neural Inf. Process. Syst., том 37, страницы 28706–28719, 2024.
- ⟦Davidson et al. [2025] Кейнан Дэвидсон, Дева Раманан и Нихар Пери. RefAV: На пути к сценарному майнингу, ориентированному на планирование. arXiv preprint arXiv:2505.20981, 2025.
- ⟦De Haan et al. [2019] Пим Де Хаан, Динеш Джаяраман и Сергей Левин. Причинно-следственная путаница в обучении по демонстрациям. В сб.: Adv. Neural Inf. Process. Syst., том 32, страницы 11698–11709, 2019.
- ⟦Deruyttere et al. [2019] Тьерри Деруиттер и др. Talk2Car: Берем управление беспилотным автомобилем на себя. В сб. Конф. по эмпирическим методам в обработке естественного языка, страницы 2088–2098, 2019.
- ⟦Deruyttere et al. [2022] Тьерри Деруиттер и др. Talk2Car: Прогнозирование физических траекторий для команд на естественном языке. IEEE Access, 10:123809–123834, 2022.
- ⟦Devlin et al. [2018] Джейкоб Девлин, Мин-Вэй Чанг, Кентон Ли и Кристина Тутанова. BERT: Предварительное обучение глубоких двунаправленных transformers для понимания языка. arXiv preprint arXiv:1810.04805, 2018.
- ⟦Ding et al. [2024a] Цзинтао Дин и др. Понимание мира или прогнозирование будущего? всесторонний обзор world models. ACM Comput. Surveys, 2024a.
- ⟦Ding et al. [2024b] Синьпэн Дин и др. Целостное понимание автономного вождения с помощью мультимодальных больших моделей с внедрением вида сверху. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 13668–13677, 2024b.
- ⟦Djuric et al. [2020] Неманья Джурич и др. Прогнозирование краткосрочного движения участников дорожного движения с учетом неопределенности для автономного вождения. В IEEE/CVF Winter Conf. Appl. Comput. Vis., страницы 2095–2104, 2020.
- ⟦Dosovitskiy et al. [2017] Алексей Досовицкий и др. CARLA: Открытый симулятор городского вождения. В сб. Conf. Robot Learn., страницы 1–16. PMLR, 2017.
- ⟦Dosovitskiy et al. [2021] Алексей Досовицкий и др. Изображение стоит 16x16 слов: transformers для распознавания изображений в масштабе. В сб.: Int. Conf. Learn. Represent., 2021.
- ⟦Dubey et al. [2024] Абхиманью Дубей и др. Семейство моделей LlaMA 3. Препринт arXiv:2407.21783, 2024.
- ⟦Esser et al. [2021] Патрик Эссер, Робин Ромбах и Бьорн Оммер. Taming transformers для синтеза изображений высокого разрешения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 12873–12883, 2021.
- ⟦Ettinger et al. [2021] Скотт Эттингер и др. Масштабное интерактивное прогнозирование движения для автономного вождения: набор данных Waymo Open Motion. В IEEE/CVF Int. Conf. Comput. Vis., страницы 9710–9719, 2021.
- ⟦Fang et al. [2025] Шию Фан и др. CoReVLA: двухэтапная сквозная система автономного вождения для сценариев с длинным хвостом посредством сбора и уточнения. arXiv preprint arXiv:2509.15968, 2025.
- ⟦Fang et al. [2023] Юйсинь Фан и др. EVA: Исследование пределов обучения маскированных визуальных представлений в масштабе. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 19358–19369, 2023.
- ⟦Fang et al. [2024] Юйсинь Фан и др. EVA-02: Визуальное представление для неогенезиса. Image and Vision Computing, 149:105171, 2024.
- ⟦Feng et al. [2025a] Боуэн Фэн и др. VERDI: VLM-embedded reasoning для автономного вождения. arXiv preprint arXiv:2505.15925, 2025a.
- ⟦Feng et al. [2025b] Лань Фэн и др. RAP: сквозное планирование с дополнением 3D-растеризацией. arXiv preprint arXiv:2510.04333, 2025b.
- ⟦Fu et al. [2024] Даочэн Фу и др. Водить как человек: переосмысление автономного вождения с помощью LLM. В материалах зимней конференции IEEE/CVF по прикладному компьютерному зрению, страницы 910–919, 2024.
- ⟦Fu et al. [2025] Хаоюй Фу и др. ORION: целостная сквозная система автономного вождения на основе генерации действий, управляемой зрением и языком. arXiv preprint arXiv:2503.19755, 2025.
- ⟦Gao et al. [2025a] Хао Гао и др. RAD: Обучение сквозной стратегии вождения посредством обучения с подкреплением на основе крупномасштабных 3DGS. arXiv preprint arXiv:2502.13144, 2025a.
- ⟦Gao et al. [2024] Шэньюань Гао и др. Vista: обобщаемая модель мира вождения с высокой точностью и универсальной управляемостью. Adv. Neural Inf. Process. Syst., 37:91560–91596, 2024.
- ⟦Gao et al. [2025b] Сянбо Гао и др. LangCoop: Совместное вождение с использованием языка. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 4226–4237, 2025b.
- ⟦Garg and Madhava Krishna [2024] Ананта Гарг и К. Мадхава Кришна. Imagine-2-Drive: Использование высокоточных моделей мира посредством мультимодальных диффузионных политик. arXiv preprint arXiv:2411.10171, 2024.
- ⟦Ge et al. [2025] Маонин Ге и др. VLA-MP: фреймворк vision-language-action для мультимодального восприятия и генерации действий с учетом физических ограничений в автономном вождении. Sensors, 25(19):6163, 2025.
- ⟦Geiger et al. [2012] Андреас Гайгер, Филип Ленц и Ракель Уртасун. Готовы ли мы к автономному вождению? набор тестов компьютерного зрения KITTI. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 3354–3361, 2012.
- ⟦Ghosh et al. [2024] Анураг Гош и др. Набор данных ROADWork: обучение распознаванию, наблюдению, анализу и вождению в зонах дорожных работ. arXiv preprint arXiv:2406.07661, 2024.
- ⟦Gui et al. [2025] Синтай Гуй и др. TrajDiff: Сквозное автономное вождение без аннотирования восприятия. arXiv preprint arXiv:2512.00723, 2025.
- ⟦Guo and Zhang [2025] Зианг Гуо и Зуфенг Жанг. VDRive: Использование усиленных VLA и диффузионной политики для сквозного автономного вождения. arXiv preprint arXiv:2510.15446, 2025.
- ⟦Ha and Schmidhuber [2018] Дэвид Ха и Юрген Шмидхубер. Мировые модели. arXiv preprint arXiv:1803.10122, 2018.
- ⟦Hamdan et al. [2025] Шади Хамдан и др. ETA: Эффективность через опережающее мышление, двойной подход к беспилотному вождению с использованием больших моделей. arXiv preprint arXiv:2506.07725, 2025.
- ⟦Han et al. [2025a] Цзяньхуа Хань и др. Percept-WAM: Модель восприятия, дополненная осознанием мира и действиями, для надежного сквозного автономного вождения. arXiv preprint arXiv:2511.19221, 2025a.
- ⟦Han et al. [2025b] Вэньчэн Хань и др. DME-Driver: Интеграция логики принятия решений человеком и восприятия 3D-сцены в автономном вождении. В сб.: AAAI Conf. Artifi. Intell., том 39, страницы 3347–3355, 2025b.
- ⟦Hao et al. [2025a] Руйян Хао и др. StyleDrive: На пути к бенчмаркингу сквозного автономного вождения с учетом стиля вождения. arXiv preprint arXiv:2506.23982, 2025a.
- ⟦Hao et al. [2024] Сяошуай Хао и др. Надежен ли ваш конструктор HD-карт в условиях повреждения данных с датчиков? Adv. Neural Inf. Process. Syst., 37:22441–22482, 2024.
- ⟦Hao et al. [2025b] Сяошуай Хао и др. MapFusion: Новая сеть слияния признаков BEV для построения мультимодальных карт. Information Fusion, 119:103018, 2025b.
- ⟦Hao et al. [2025c] Сяошуай Хао и др. MSC-Bench: Тестирование и анализ искажений мультисенсорных данных для систем восприятия беспилотного транспорта. arXiv preprint arXiv:2501.01037, 2025c.
- ⟦Hao et al. [2025d] Сяошуай Хао и др. SafeMap: Надежное построение HD-карт на основе неполных наблюдений. В сб.: Int. Conf. Mach. Learn., стр. 22091–22102. PMLR, 2025d.
- ⟦Hao et al. [2025e] Юхань Хао и др. DriveAction: эталонный тест для исследования человекоподобных решений при вождении в моделях VLA. arXiv preprint arXiv:2506.05667, 2025e.
- ⟦He et al. [2016] Каймин Хэ и др. Глубокое остаточное обучение для распознавания изображений. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 770–778, 2016.
- ⟦Hegde et al. [2025] Дипти Хегде и др. Дистилляция мультимодальных LLM для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 27575–27585, 2025.
- ⟦Houston et al. [2021] Джон Хьюстон и др. Тысяча один час: набор данных для прогнозирования движения беспилотных автомобилей. В сб. Conf. Robot Learn., стр. 409–418. PMLR, 2021.
- ⟦Hu et al. [2023a] Энтони Ху и др. GAIA-1: Генеративная модель мира для автономного вождения. arXiv preprint arXiv:2309.17080, 2023a.
- ⟦Hu et al. [2022] Шэнчао Ху и др. ST-P3: Сквозное автономное вождение на основе зрения посредством пространственно-временного обучения признаков. В сб.: Eur. Conf. Comput. Vis., страницы 533–549. Springer, 2022.
- ⟦Hu et al. [2024] Сяотао Ху и др. DrivingWorld: Построение мировой модели для автономного вождения с помощью видео GPT. arXiv preprint arXiv:2412.19505, 2024.
- ⟦Hu et al. [2023b] Ихан Ху и др. Планирование в автономном вождении. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 17853–17862, 2023b.
- ⟦Huang et al. [2025] Лэй Хуан и др. Обзор галлюцинаций в LLM: принципы, таксономия, проблемы и открытые вопросы. ACM Trans. Info. Syst., 43(2):1–55, 2025.
- ⟦Huang et al. [2024a] Идун Хуан и др. DriVLMe: Улучшение LLM-агентов для автономного вождения с помощью воплощенного и социального опыта. В IEEE/RSJ Int. Conf. Intell. Robots Syst., страницы 3153–3160, 2024a.
- ⟦Huang et al. [2024b] Занминг Хуанг, Джимуянг Чжан и Эшед Он-Бар. Нейронные объемные модели мира для автономного вождения. В сб.: Eur. Conf. Comput. Vis., стр. 195–213. Springer, 2024b.
- ⟦Huang et al. [2024c] Чжицзянь Хуан и др. Улучшение планирования больших языковых моделей посредством согласования рассуждений и принятия решений. В сб.: Европейская конференция по компьютерному зрению, стр. 73–90. Springer, 2024c.
- ⟦Hwang et al. [2024] Джи-Цзин Хван и др. EMMA: Сквозная мультимодальная модель для автономного вождения. arXiv preprint arXiv:2410.23262, 2024.
- ⟦Ilharco et al. [2021] Габриэль Иларко и др. OpenCLIP. Zenodo, 2021.
- ⟦Jia et al. [2023a] Фань Цзя и др. ADriver-I: Универсальная модель мира для автономного вождения. arXiv preprint arXiv:2311.13549, 2023a.
- ⟦Jia et al. [2023b] Сяосун Цзя и др. DriveAdapter: Преодоление барьера сопряжения восприятия и планирования в сквозном автономном вождении. В материалах IEEE/CVF Int. Conf. Comput. Vis., страницы 7953–7963, 2023b.
- ⟦Jia et al. [2023c] Сяосун Цзя и др. Дважды подумай перед вождением: на пути к масштабируемым декодерам для сквозного автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., 2023c.
- ⟦Jia et al. [2024] Сяосун Цзя и др. Bench2Drive: На пути к многофункциональному бенчмаркингу для замкнутых систем сквозного автономного вождения. В сб.: Adv. Neural Inf. Process. Syst., том 37, страницы 819–844, 2024.
- ⟦Jia et al. [2025a] Сяосун Цзя и др. DriveTransformer: Унифицированный transformer для масштабируемого сквозного автономного вождения. В сб.: Int. Conf. Learn. Represent., 2025a.
- ⟦Jia et al. [2025b] Сяосун Цзя и др. Пространственно-ориентированная дополненная генерация для автономного вождения. arXiv preprint arXiv:2512.06865, 2025b.
- ⟦Jiang et al. [2025a] Аньцин Цзян и др. DiffVLA: Диффузионное планирование с визуально-языковым управлением для автономного вождения. arXiv preprint arXiv:2505.19381, 2025a.
- ⟦Jiang et al. [2025b] Бо Цзян, Шаоюй Чэнь, Цянь Чжан, Вэньюй Лю и Синган Ван. Alphadrive: Раскрытие потенциала VLM в автономном вождении посредством обучения с подкреплением и рассуждений. arXiv preprint arXiv:2503.07608, 2025b.
- ⟦Jiang et al. [2023] Бо Цзян и др. VAD: Векторизованное представление сцены для эффективного автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 8340–8350, 2023.
- ⟦Jiang et al. [2024] Бо Цзян и др. Senna: Соединение больших визуально-языковых моделей и сквозного автономного вождения. arXiv preprint arXiv:2410.22313, 2024.
- ⟦Jiang et al. [2025c] Сицун Цзян и др. Обзор моделей зрения-языка-действия для автономного вождения. arXiv preprint arXiv:2506.24044, 2025c.
- ⟦Jihong et al. [2024] Се Цзихун и др. Периферийные вычисления для принятия решений в режиме реального времени в автономном вождении: обзор проблем, решений и будущих тенденций. Int. J. Adv. Comput. Sci. & Appl., 15(7), 2024.
- ⟦Jin et al. [2025] Бу Цзинь, Сяотао Ху, Сонген Гу, Юпэн Чжэн, Сяоян Го и др. OccVAR: Масштабируемое прогнозирование 4D-занятости посредством прогнозирования следующего масштаба. https://openreview.net/forum?id=X2HnTFsFm8, 2025.
- ⟦Jing et al. [2022] Таотао Цзин и др. Inaction: Интерпретируемое принятие решений о действиях для автономного вождения. В Европейской конференции по компьютерному зрению, страницы 370–387. Springer, 2022.
- ⟦Kahneman [2011] Даниэль Канеман. Думай медленно... решай быстро. Фаррар, Страус и Жиру, 2011.
- ⟦Karnchanachari et al. [2024] Напат Карнчаначари и др. На пути к планированию на основе обучения: бенчмарк nuPlan для автономного вождения в реальных условиях. В сб.: IEEE Int. Conf. Robot. Autom., стр. 629–636, 2024.
- ⟦Kerbl et al. [2023] Бернхард Кербл и др. 3D gaussian splatting для рендеринга полей излучения в реальном времени. ACM Trans. Graph., 42(4):139–1, 2023.
- ⟦Khandelwal et al. [2020] Сиддеш Ханделвал и др. Прогнозирование движения по принципу «что, если» для автономного вождения. arXiv preprint arXiv:2008.10587, 2020.
- ⟦Kim et al. [2018] Джинкю Ким и др. Текстовые пояснения для беспилотных транспортных средств. В сб.: Eur. Conf. Comput. Vis., стр. 563–578. Springer, 2018.
- ⟦Kiran et al. [2021] Б. Рави Киран и др. Глубинное обучение с подкреплением для автономного вождения: обзор. IEEE Int. Conf. Intell. Transport. Syst., 23(6):4909–4926, 2021.
- ⟦Knox et al. [2023] У. Брэдли Нокс и др. Неправильное проектирование вознаграждения для автономного вождения. Artifi. Intell., 316:103829, 2023.
- ⟦Kong et al. [2025a] Лингдонг Конг, Уэсли Янг, Цзяньбяо Мэй, Юцюань Лю, Ао Лян, Декай Чжу, Дунюэ Лу, Вэй Инь, Сяотао Ху, Минкай Цзя, Цзюньюань Дэн, Кайвэнь Чжан, Ян У, Тяньи Янь, Шэньюань Гао, Сун Ван, Линьфэн Ли, Лян Пань, Юн Лю, Цзянькэ Чжу, Вэй Цанг Оой, Стивен К. Х. Хой и Цзывэй Лю. 3D и 4D моделирование мира: обзор. arXiv preprint arXiv:2509.07996, 2025a.
- ⟦Kong et al. [2023a] Лингдонг Конг и др. Переосмысление представления диапазона обзора для сегментации LiDAR. В IEEE/CVF Int. Conf. Comput. Vis., страницы 228–240, 2023a.
- ⟦Kong et al. [2023b] Лингдонг Конг и др. Robo3D: На пути к устойчивому и надежному 3D-восприятию в условиях искажений. В IEEE/CVF Int. Conf. Comput. Vis., страницы 19994–20006, 2023b.
- ⟦Kong et al. [2024] Лингдонг Конг и др. Соревнование RoboDrive: вождение в любое время, в любом месте и в любых условиях. arXiv preprint arXiv:2405.08816, 2024.
- ⟦Kong et al. [2025b] Лингдонг Конг и др. LargeAD: Крупномасштабное предварительное обучение на кросс-сенсорных данных для автономного вождения. IEEE Trans. Pattern Anal. Mach. Intell., 2025b.
- ⟦Kong et al. [2025c] Лингдонг Конг и др. Мультимодальное 3D-понимание сцен с эффективным использованием данных для автономного вождения. IEEE Trans. Pattern Anal. Mach. Intell., 47(5):3748–3765, 2025c.
- ⟦Lang et al. [2019] Алекс Х. Лэнг и др. PointPillars: Быстрые энкодеры для обнаружения объектов по облакам точек. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 12697–12705, 2019.
- ⟦Lee et al. [2022] Доюп Ли и др. Авторегрессионная генерация изображений с использованием остаточного квантования. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 11523–11532, 2022.
- ⟦Lee et al. [2019] Янгван Ли и др. Энергоэффективная и оптимизированная для GPU-вычислений магистральная нейронная сеть для обнаружения объектов в реальном времени. В материалах IEEE/CVF Conf. Comput. Vis. Pattern Recog. Worksh., страницы 1–9, 2019.
- ⟦Li et al. [2024a] Бо Ли и др. LlaVA-OneVision: Легкий перенос визуальных задач. arXiv preprint arXiv:2408.03326, 2024a.
- ⟦Li et al. [2024b] Бойи Ли и др. Вождение повсюду с адаптацией стратегии на основе LLM. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 14948–14957, 2024b.
- ⟦Li et al. [2023a] Хунъян Ли и др. Экосистема открытых данных в автономном вождении: настоящее и будущее. arXiv preprint arXiv:2312.03408, 2023a.
- ⟦Li et al. [2023b] Джуннан Ли, Донгсю Ли, Сильвио Саварезе и Стивен Хой. BLIP-2: Начальное обучение языково-визуальных моделей с использованием замороженных визуальных энкодеров и LLM. В сб.: Междунар. конф. по машинному обучению, стр. 19730–19742. PMLR, 2023b.
- ⟦Li and Cui [2024] Пейдун Ли и Дисяо Цуй. Разреженное представление сцены с навигационным сопровождением для сквозного автономного вождения. arXiv preprint arXiv:2409.18341, 2024.
- ⟦Li et al. [2025a] Пейчжэн Ли и др. SpaceDrive: Внедрение пространственного восприятия в VLM-ориентированное автономное вождение. arXiv preprint arXiv:2512.10719, 2025a.
- ⟦Li et al. [2025b] Пэнсян Ли и др. Дискретная диффузия для рефлексивных vision-language-action models в автономном вождении. arXiv preprint arXiv:2509.20109, 2025b.
- ⟦Li et al. [2024c] Цифэн Ли и др. Think2Drive: Эффективное обучение с подкреплением посредством мышления с использованием латентной модели мира для автономного вождения (в CARLA-V2). В сб.: Eur. Conf. Comput. Vis., стр. 142–158. Springer, 2024c.
- ⟦Li et al. [2025c] Ронг Ли и др. 3EED: Обоснование всего везде в 3D. В сб.: Adv. Neural Inf. Process. Syst., том 38, 2025c.
- ⟦Li et al. [2025d] Вентонг Ли и др. TokenPacker: Эффективный визуальный проектор для мультимодальных LLM. Int. J. Comput. Vis., 133:6794–6812, 2025d.
- ⟦Li et al. [2023c] Синь Ли и др. На пути к автономному вождению, управляемому знаниями. arXiv preprint arXiv:2312.04316, 2023c.
- ⟦Li et al. [2024d] Йе Ли и др. Оптимизировано ли ваше размещение LiDAR для понимания трехмерных сцен? В Adv. Neural Inf. Process. Syst., том 37, страницы 34980–35017, 2024d.
- ⟦Li et al. [2024e] Ихэн Ли и др. WOMD-Reasoning: Крупномасштабный набор данных для рассуждения о взаимодействиях при вождении. arXiv preprint arXiv:2407.04281, 2024e.
- ⟦Li et al. [2024f] Инъян Ли и др. Улучшение сквозного автономного вождения с помощью латентной модели мира. arXiv preprint arXiv:2406.08481, 2024f.
- ⟦Li et al. [2025e] Инъян Ли и др. DriveVLA-W0: Мировые модели усиливают закон масштабирования данных в автономном вождении. arXiv preprint arXiv:2510.12796, 2025e.
- ⟦Li et al. [2025f] Инъян Ли и др. Сквозное вождение с онлайн-оценкой траектории посредством world model на основе bev. arXiv preprint arXiv:2504.01941, 2025f.
- ⟦Li et al. [2025g] Йонгкан Ли и др. ReCogDrive: Усиленная когнитивная структура для сквозного автономного вождения. arXiv preprint arXiv:2506.08052, 2025г.
- ⟦Li et al. [2025h] Юэ Ли и др. Drive-R1: Соединение рассуждения и планирования в VLM для автономного вождения с помощью обучения с подкреплением. arXiv preprint arXiv:2506.18234, 2025h.
- ⟦Li et al. [2024g] Чжэньсинь Ли и др. Hydra-MDP: Сквозное мультимодальное планирование с использованием многоцелевой гидра-дистилляции. arXiv preprint arXiv:2406.06978, 2024г.
- ⟦Li et al. [2024h] Чжици Ли, Чжидин Юй, Шии Лань, Цзяхань Ли, Ян Каутц, Тун Лу и Хосе М. Альварес. Достаточно ли статуса эго-автомобиля для сквозного автономного вождения с разомкнутым контуром? В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 14864–14873, 2024h.
- ⟦Li et al. [2024i] Чжици Ли и др. BEVFormer: обучение представлению «вид с высоты птичьего полета» на основе данных LiDAR и камер с помощью пространственно-временных transformers. IEEE Trans. Pattern Anal. Mach. Intell., 47(3):2020–2036, 2024i.
- ⟦Li et al. [2025i] Чжожэнь Ли и др. Обзор планирования движения на основе обучения с подкреплением для автономного вождения: извлеченные уроки с точки зрения задач вождения. arXiv preprint arXiv:2503.23650, 2025i.
- ⟦Li Auto Inc. [2025] Li Auto Inc. MindVLA. https://ir.lixiang.com/news-releases/news-release-details/li-auto-inc-march-2025-delivery-update, 2025.
- ⟦Liang et al. [2025] Ао Лян и др. Инвариантное к ракурсу 3D-детектирование объектов. В материалах IEEE/CVF Int. Conf. Comput. Vis., страницы 27725–27738, 2025.
- ⟦Liang et al. [2026] Ао Лян и др. LiDARCrafter: Динамическое 4D-моделирование мира на основе последовательностей LiDAR. В сб.: AAAI Conf. Artifi. Intell., том 40, 2026.
- ⟦Liang et al. [2022] Тинтин Лян и др. BEVFusion: Простая и надежная структура слияния данных лидара и камеры. Adv. Neural Inf. Process. Syst., 35:10421–10434, 2022.
- ⟦Liao et al. [2025] Бэнчэн Ляо и др. DiffusionDrive: Усеченная диффузионная модель для сквозного автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 12037–12047, 2025.
- ⟦Lin et al. [2023] Бин Линь и др. Video-LLaVA: Обучение объединенному визуальному представлению путем выравнивания перед проекцией. arXiv preprint arXiv:2311.10122, 2023.
- ⟦Liu et al. [2024a] Дунъян Лю и др. Lumina-MGPT: Освещение гибкой фотореалистичной генерации изображений по тексту с помощью мультимодального генеративного предварительного обучения. arXiv preprint arXiv:2408.02657, 2024a.
- ⟦Liu et al. [2024b] Ханьчао Лю и др. Обзор галлюцинаций в больших визуально-языковых моделях. arXiv preprint arXiv:2402.00253, 2024b.
- ⟦Liu et al. [2023a] Хаотянь Лю и др. Настройка визуальных инструкций. В сб.: Adv. Neural Inf. Process. Syst., том 36, страницы 34892–34916, 2023a.
- ⟦Liu et al. [2024c] Хаотянь Лю и др. Улучшенные базовые модели с помощью настройки визуальных инструкций. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 26296–26306, 2024c.
- ⟦Liu et al. [2025a] Лин Лю и др. GuideFlow: Constraint-guided flow matching для планирования в сквозном автономном вождении. arXiv preprint arXiv:2511.18729, 2025a.
- ⟦Liu et al. [2024d] Минъюй Лю и др. Обзор наборов данных для автономного вождения: статистика, качество аннотирования и взгляд в будущее. IEEE Trans. Intell. Veh., 9(11):7138–7164, 2024d.
- ⟦Liu et al. [2025b] Пей Лю и др. OmniReason: фреймворк с временным управлением для зрения, языка и действий в автономном вождении. arXiv preprint arXiv:2509.00789, 2025b.
- ⟦Liu et al. [2025c] Пей Лю и др. OmniScene: Мультимодальное 4D-понимание сцены с расширенным вниманием для автономного вождения. arXiv preprint arXiv:2509.19973, 2025c.
- ⟦Liu et al. [2025d] Пей Лю и др. VLM-E2E: Улучшение сквозного автономного вождения с помощью мультимодального слияния внимания водителя. arXiv preprint arXiv:2502.18042, 2025d.
- ⟦Liu et al. [2025e] Руйшунь Лю и др. OccVLA: Модель зрения-языка-действия с неявным 3D-наблюдением за заполненностью пространства. arXiv preprint arXiv:2509.05578, 2025e.
- ⟦Liu et al. [2025f] Вэньру Лю, Пэй Лю и Цзюнь Ма. DSDrive: Дистилляция LLM для облегченного сквозного автономного вождения с унифицированным рассуждением и планированием. arXiv preprint arXiv:2505.05360, 2025f.
- ⟦Liu et al. [2025g] Сюэи Лю и др. ReasonPlan: Унифицированное предсказание сцены и логическое обоснование решений для автономного вождения с замкнутым контуром. arXiv preprint arXiv:2505.20024, 2025г.
- ⟦Liu et al. [2023b] Юцюань Лю и др. Сегментация любых последовательностей облаков точек путем дистилляции фундаментальных моделей компьютерного зрения. В сб.: Adv. Neural Inf. Process. Syst., том 36, страницы 37193–37229, 2023b.
- ⟦Liu et al. [2026] Юцюань Лю и др. La La LiDAR: Генерация крупномасштабных планировок на основе данных LiDAR. В сб.: AAAI Conf. Artifi. Intell., том 40, 2026.
- ⟦Liu et al. [2021] Зе Лю и др. Swin transformer: Иерархический vision transformer с использованием сдвигающихся окон. В IEEE/CVF Int. Conf. Comput. Vis., страницы 10012–10022, 2021.
- ⟦Liu et al. [2022] Чжуан Лю и др. ConvNet для 2020-х годов. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 11976–11986, 2022.
- ⟦Lu et al. [2025a] Хао Лу и др. UniUGP: Унификация понимания, генерации и планирования для сквозного автономного вождения. arXiv preprint arXiv:2512.09864, 2025a.
- ⟦Lu et al. [2024] Цзячэнь Лу и др. WoVoGen: Диффузия с учетом объема мира для управляемой генерации сцен вождения с нескольких камер. В сб.: Eur. Conf. Comput. Vis., стр. 329–345. Springer, 2024.
- ⟦Lu et al. [2025b] Юхан Лу и др. ReAL-AD: На пути к человекоподобному рассуждению в сквозном автономном вождении. arXiv preprint arXiv:2507.12499, 2025b.
- ⟦Luo et al. [2025] Юэчэнь Ло и др. AdaThinkDrive: Адаптивное мышление посредством обучения с подкреплением для автономного вождения. arXiv preprint arXiv:2509.13769, 2025.
- ⟦Ma et al. [2024a] Джуни Ма и др. Cam4DOcc: эталонный тест для прогнозирования 4D-занятости только по данным камер в приложениях для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 21486–21495, 2024a.
- ⟦Ma et al. [2025a] Инцзы Ма и др. dVLM-AD: Улучшение диффузионной vision-language-model для вождения посредством контролируемого рассуждения. arXiv preprint arXiv:2512.04459, 2025a.
- ⟦Ma et al. [2024b] Юэнь Ма и др. Обзор моделей зрения-языка-действия для воплощенного ИИ. arXiv preprint arXiv:2405.14093, 2024b.
- ⟦Ma et al. [2025b] Юкай Ма и др. LeapVAD: скачок в автономном вождении посредством когнитивного восприятия и двухпроцессного мышления. arXiv preprint arXiv:2501.08168, 2025b.
- ⟦Ma et al. [2025c] Юньшэн Ма и др. ALN-P3: Унифицированное языковое выравнивание для восприятия, прогнозирования и планирования в автономном вождении. arXiv preprint arXiv:2505.15158, 2025c.
- ⟦Ma et al. [2022] Зицяо Ма и др. Дороти: Разговорная речь для обработки непредвиденных ситуаций в интерактивных агентах автономного вождения. arXiv preprint arXiv:2210.12511, 2022.
- ⟦Mao et al. [2023] Цзягэн Мао и др. GPT-Driver: Обучение вождению с помощью GPT. arXiv preprint arXiv:2310.01415, 2023.
- ⟦Mao et al. [2025] Цзягэн Мао и др. Языковой агент для автономного вождения. В сб. Conf. Lang. Model., 2025.
- ⟦Marcu et al. [2024] Ана-Мария Марку и др. LingoQA: Визуальные ответы на вопросы для автономного вождения. В сб.: Eur. Conf. Comput. Vis., стр. 252–269. Springer, 2024.
- ⟦Mei et al. [2024] Цзяньбяо Мэй и др. Непрерывное обучение, адаптация и совершенствование: двухпроцессный подход к автономному вождению. В Adv. Neural Inf. Process. Syst., том 37, страницы 123261–123290, 2024.
- ⟦Min et al. [2024] Чэнь Минь и др. DriveWorld: 4D предобученное понимание сцены посредством world models для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 15522–15533, 2024.
- ⟦Mirzaie and Rosenhahn [2025] Мона Мирзаи и Бодо Розенхан. Интерпретируемое принятие решений для end-to-end автономного вождения. arXiv preprint arXiv:2508.18898, 2025.
- ⟦Muller et al. [2005] Урс Мюллер и др. Обход препятствий на бездорожье посредством end-to-end learning. В Adv. Neural Inf. Process. Syst., том 18, страницы 739–746, 2005.
- ⟦Mütsch et al. [2023] Фердинанд Мютш и др. От моделирования на основе моделей к симуляции на основе данных: проблемы и тенденции в автономном вождении. arXiv preprint arXiv:2305.13960, 2023.
- ⟦Nie et al. [2024] Мин Не и др. Reason2Drive: На пути к интерпретируемым и цепочечным рассуждениям для автономного вождения. В сб.: Eur. Conf. Comput. Vis., стр. 292–308. Springer, 2024.
- ⟦NVIDIA [2025] NVIDIA. Набор данных для физического ИИ автономных транспортных средств. https://huggingface.co/datasets/nvidia/PhysicalAI-Autonomous-Vehicles, октябрь 2025 г. URL https://huggingface.co/datasets/nvidia/PhysicalAI-Autonomous-Vehicles.
- ⟦Ohn-Bar et al. [2020] Эшед Он-Бар и др. Обучение ситуативному вождению. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 11296–11305, 2020.
- ⟦OpenAI [2024] OpenAI. Привет GPT4-o. https://openai.com/index/hello-gpt-4o, 2024.
- ⟦Oquab et al. [2023] Максим Окуаб и др. DINOv2: Обучение устойчивым визуальным признакам без учителя. arXiv preprint arXiv:2304.07193, 2023.
- ⟦Pan et al. [2024] Чэньбинь Пань и др. VLP: Планирование на основе визуально-языковых моделей для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 14760–14769, 2024.
- ⟦Pan et al. [2018] Юньпэн Пань и др. Маневренное автономное вождение с использованием сквозного глубокого имитационного обучения. В Robot. Sci. Syst., 2018.
- ⟦Park et al. [2023] Джинхён Пак и др. Время покажет: новые перспективы и базовый метод для временного многоракурсного 3D-детектирования объектов. В сб.: Int. Conf. Learn. Represent., 2023.
- ⟦Park et al. [2021] Джонджин Пак и др. Объектно-ориентированная регуляризация для устранения причинно-следственной путаницы в обучении с подражанием. В Adv. Neural Inf. Process. Syst., том 34, страницы 3029–3042, 2021.
- ⟦Park et al. [2024] Сун Ён Пак и др. VLAAD: Визуально-языковой ассистент для автономного вождения. В сб.: Зимняя конференция IEEE/CVF по прикладному компьютерному зрению, стр. 980–987, 2024.
- ⟦Podell et al. [2023] Дастин Поделл и др. SDXL: Улучшение латентных диффузионных моделей для синтеза изображений высокого разрешения. В сб.: Int. Conf. Learn. Represent., 2023.
- ⟦Pomerleau [1988] Дин А. Померло. ALVINN: Автономное наземное транспортное средство в нейронной сети. В Adv. Neural Inf. Process. Syst., том 1, страницы 305–313, 1988.
- ⟦Popov et al. [2024] Александр Попов и др. Смягчение ковариационного сдвига в обучении с подражанием для автономных транспортных средств с использованием генеративных моделей мира в латентном пространстве. arXiv preprint arXiv:2409.16663, 2024.
- ⟦Prakash et al. [2021] Адитья Пракаш, Кашьяп Читта и Андреас Гейгер. Мультимодальный fusion transformer для сквозного автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 7077–7087, 2021.
- ⟦Prakash et al. [2020] Адитья Пракаш и др. Исследование агрегации данных при обучении стратегий для городского автономного вождения на основе компьютерного зрения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 11763–11773, 2020.
- ⟦Qian et al. [2024] Канган Цянь и др. FasionAD: Системы быстрого и медленного синтетического мышления для человекоподобного автономного вождения с адаптивной обратной связью. arXiv preprint arXiv:2411.18013, 2024.
- ⟦Qian et al. [2025] Канган Цянь и др. FasionAD++: Интеграция высокоуровневых инструкций и информационного узкого места в толсто-медленных системах слияния для повышения безопасности в автономном вождении с адаптивной обратной связью. arXiv preprint arXiv:2503.08162, 2025.
- ⟦Qiao et al. [2025] Чжицзе Цяо и др. LightEMMA: Легковесная сквозная мультимодальная модель для автономного вождения. arXiv preprint arXiv:2505.00284, 2025.
- ⟦Radford et al. [2021] Алек Рэдфорд и др. Обучение переносимым визуальным моделям на основе контроля естественным языком. В сб.: Междунар. конф. по машинному обучению, стр. 8748–8763. PMLR, 2021.
- ⟦Rawte et al. [2023] Випула Равте, Амит Шет и Амитава Дас. Обзор галлюцинаций в больших фундаментальных моделях. arXiv preprint arXiv:2309.05922, 2023.
- ⟦Ren et al. [2025] Сюаньчи Жэнь и др. Cosmos-Drive-Dreams: Масштабируемая генерация синтетических данных для вождения с помощью мировых фундаментальных моделей. arXiv preprint arXiv:2506.09042, 2025.
- ⟦Renz et al. [2025] Катрин Ренц и др. SimLingo: Автономное вождение с использованием только визуальных данных в замкнутом контуре с выравниванием языка и действий. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 11993–12003, 2025.
- ⟦Rombach et al. [2022] Робин Ромбах и др. Синтез изображений высокого разрешения с помощью латентных диффузионных моделей. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 10684–10695, 2022.
- ⟦Ross et al. [2011] Стефан Росс и др. Сведение обучения с подражанием и структурного прогнозирования к онлайн-обучению без сожалений. В сб.: Междунар. конф. по искусственному интеллекту и статистике, стр. 627–635, 2011.
- ⟦Rowe et al. [2025] Люк Роу и др. Poutine: предварительное обучение на основе зрения, языка и траекторий, а также пост-обучение с подкреплением обеспечивают надежное сквозное автономное вождение. arXiv preprint arXiv:2506.11234, 2025.
- ⟦Sapkota et al. [2025] Ранджан Сапкота и др. Модели зрения-языка-действия: концепции, прогресс, приложения и вызовы. arXiv preprint arXiv:2505.04769, 2025.
- ⟦Scheel et al. [2022] Оливер Шил и др. Городской водитель: обучение вождению на основе демонстраций из реального мира с использованием градиентов стратегии. В сб. Conf. Robot Learn., страницы 718–728. PMLR, 2022.
- ⟦Schrum et al. [2024] Марайя Л. Шрам, Эмили Самнер, Мэтью К. Гомболей и Эндрю Бест. Maveric: подход на основе данных к персонализированному автономному вождению. IEEE Trans. Robot., 40:1952–1965, 2024.
- ⟦Shan et al. [2025] Хао Шань и др. Стабильность под пристальным вниманием: сравнительный анализ парадигм представления для онлайн-картографирования высокой четкости. arXiv preprint arXiv:2510.10660, 2025.
- ⟦Shao et al. [2023] Хао Шао и др. Повышение безопасности автономного вождения с использованием интерпретируемого transformers для слияния сенсорных данных. В материалах Conference on Robot Learning, страницы 726–737. PMLR, 2023.
- ⟦Shao et al. [2024a] Хао Шао и др. LMDrive: Сквозное вождение с замкнутым контуром с использованием больших языковых моделей. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 15120–15130, 2024a.
- ⟦Shao et al. [2025] Руй Шао и др. Крупные VLM-ориентированные модели «зрение-язык-действие» для роботизированных манипуляций: обзор. arXiv preprint arXiv:2508.13073, 2025.
- ⟦Shao et al. [2024b] Чжихун Шао и др. DeepSeekMath: Расширение границ математических рассуждений в открытых языковых моделях. arXiv preprint arXiv:2402.03300, 2024b.
- ⟦Sima et al. [2024] Чонгхао Сима и др. DriveLM: Вождение с помощью визуально-вопросно-ответного графа. В сб.: Европейская конференция по компьютерному зрению, стр. 256–274. Springer, 2024.
- ⟦Song et al. [2025a] Нан Сонг и др. LMAD: Интегрированная сквозная vision-language модель для объяснимого автономного вождения. arXiv preprint arXiv:2508.12404, 2025a.
- ⟦Song et al. [2025b] Руйци Сун и др. InsightDrive: представление сцены с глубоким пониманием для сквозного автономного вождения. arXiv preprint arXiv:2503.13047, 2025b.
- ⟦Song et al. [2023] Чжихан Сун и др. Синтетические наборы данных для автономного вождения: обзор. IEEE Trans. Intell. Veh., 9(1):1847–1864, 2023.
- ⟦Song et al. [2025c] Зиин Сун и др. Не крутите руль: планирование с учетом инерции в сквозном автономном вождении. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 22432–22441, 2025c.
- ⟦Steiner et al. [2024] Андреас Штайнер и др. PaliGemma 2: Семейство универсальных VLM для переноса обучения. arXiv preprint arXiv:2412.03555, 2024.
- ⟦Su et al. [2024] Хайшэн Су и др. DiFSD: Эгоцентрическая полностью разреженная парадигма с шумоподавлением неопределенности и итеративным уточнением для эффективного сквозного автономного вождения. arXiv preprint arXiv:2409.09777, 2024.
- ⟦Sun et al. [2025a] Цзиньтао Сунь и др. Эхо-планирование для автономного вождения: от текущих наблюдений к будущим траекториям и обратно. arXiv preprint arXiv:2505.18945, 2025a.
- ⟦Sun et al. [2020] Пей Сун и др. Масштабируемость восприятия для автономного вождения: открытый набор данных Waymo. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 2446–2454, 2020.
- ⟦Sun et al. [2024] Пейзе Сунь и др. Авторегрессионная модель превосходит диффузионную: Llama для масштабируемой генерации изображений. arXiv preprint arXiv:2406.06525, 2024.
- ⟦Sun et al. [2025b] Вэньчао Сунь и др. SparseDrive: Сквозное автономное вождение посредством разреженного представления сцены. В IEEE Int. Conf. Robot. Autom., страницы 8795–8801, 2025b.
- ⟦Suna et al. [2025] Бин Сун и др. MindDrive: Универсальная архитектура, объединяющая мировые модели и vision-language model для сквозного автономного вождения. arXiv preprint arXiv:2512.04441, 2025.
- ⟦Sutton et al. [1998] Ричард С. Саттон, Эндрю Г. Барто и др. Обучение с подкреплением: введение, том 1. Издательство Массачусетского технологического института, Кембридж, 1998.
- ⟦Tan and Le [2019] Мингсин Тан и Куок Ле. EfficientNet: Переосмысление масштабирования моделей для сверточных нейронных сетей. В сб.: Int. Conf. Mach. Learn., стр. 6105–6114. PMLR, 2019.
- ⟦Tan et al. [2025] Шухань Тан и др. Моделирование мира на основе латентных цепочек рассуждений для сквозного вождения. arXiv preprint arXiv:2512.10226, 2025.
- ⟦Tang et al. [2025] Ихун Тан и др. E3AD: Эмоционально-ориентированная vision-language-action модель для человекоцентричного сквозного автономного вождения. arXiv preprint arXiv:2512.04733, 2025.
- ⟦Team [2024a] Команда Chameleon. Chameleon: Фундаментальные модели с ранним слиянием смешанных модальностей. arXiv preprint arXiv:2405.09818, 2024a.
- ⟦Team et al. [2023] Команда Gemini и др. Gemini: Семейство высокоэффективных мультимодальных моделей. arXiv preprint arXiv:2312.11805, 2023.
- ⟦Team et al. [2025] Gemini Robotics Team и др. Gemini robotics: Привнося AI в физический мир. arXiv preprint arXiv:2503.20020, 2025.
- ⟦Team [2024b] Команда Qwen. Представляем Qwen1.5, февраль 2024 года. URL https://qwenlm.github.io/blog/qwen1.5/.
- ⟦Team [2024c] Команда Wayve. LINGO-2: Вождение с использованием естественного языка. https://wayve.ai/thinking/lingo-2-driving-with-language/, 2024c.
- ⟦Team et al. [2024] Исследовательская группа Waywe и др. LINGO-2: Вождение с использованием естественного языка, 2024.
- ⟦Tian et al. [2025a] Ран Тянь и др. Токенизация мира в знания на уровне объектов для решения проблем редких событий в автономном вождении. В сб. Conf. Robot Learn., страницы 3656–3673. PMLR, 2025a.
- ⟦Tian et al. [2023] Сяоюй Тянь и др. Occ3D: Крупномасштабный эталонный тест трехмерного прогнозирования заполненности для автономного вождения. В Adv. Neural Inf. Process. Syst., том 36, страницы 64318–64330, 2023.
- ⟦Tian et al. [2025b] Сяоюй Тянь и др. DriveVLM: Конвергенция автономного вождения и больших визуально-языковых моделей. В сб. Conf. Robot Learn., страницы 4698–4726. PMLR, 2025b.
- ⟦Tong et al. [2023] Вэньвэнь Тун и др. Сцена как заполненность. В IEEE/CVF Int. Conf. Comput. Vis., страницы 8406–8415, 2023.
- ⟦Toromanoff et al. [2020] Марин Тороманов и др. Сквозное обучение с подкреплением без использования моделей для городского вождения с применением неявных аффордансов. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 7153–7162, 2020.
- ⟦Touvron et al. [2023] Хьюго Туврон и др. LlaMA 2: Открытые базовые и дообученные чат-модели. arXiv preprint arXiv:2307.09288, 2023.
- ⟦Tschannen et al. [2025] Майкл Чаннен и др. SigLIP 2: Многоязычные визуально-языковые энкодеры с улучшенным семантическим пониманием, локализацией и плотными признаками. arXiv preprint arXiv:2502.14786, 2025.
- ⟦Van Den Oord et al. [2017] Аарон Ван Ден Оорд, Ориол Виньялс и др. Нейронное дискретное обучение представлений. В сб.: Adv. Neural Inf. Process. Syst., том 30, страницы 6309–6318, 2017.
- ⟦Verwimp et al. [2023] Эли Вервимп и др. CLAD: Реалистичный эталон непрерывного обучения для автономного вождения. Neural Net., 161:659–669, 2023.
- ⟦Wang et al. [2025a] Дамин Ван и др. HMVLM: Мультистадийная модель зрения-языка с улучшенным рассуждением для сценариев вождения с длинным хвостом. arXiv preprint arXiv:2506.05883, 2025a.
- ⟦Wang et al. [2025b] Динжуй Ван и др. DualAD: Двухуровневое планирование для рассуждений в автономном вождении. В IEEE/RSJ Int. Conf. Intell. Robots Syst., 2025b.
- ⟦Wang et al. [2024a] Пэн Ван и др. Qwen2-VL: Улучшение восприятия мира мультимодальными моделями при любом разрешении. arXiv preprint arXiv:2409.12191, 2024a.
- ⟦Wang et al. [2025c] Шихао Ван и др. OmniDrive: Целостный набор данных на основе зрения и языка для автономного вождения с контрфактическим рассуждением. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 22442–22452, 2025c.
- ⟦Wang et al. [2024b] Сонг Ван и др. Не все воксели равны: семантическое заполнение сцены с учетом сложности на основе самодистилляции. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 14792–14801, 2024b.
- ⟦Wang et al. [2025d] Сонг Ван и др. PixelThink: На пути к эффективному попиксельному цепочечному рассуждению. arXiv preprint arXiv:2505.23727, 2025d.
- ⟦Wang et al. [2024c] Тяньци Ван и др. DriveCoT: Интеграция рассуждений по цепочке мыслей с комплексным вождением. arXiv preprint arXiv:2403.16996, 2024c.
- ⟦Wang et al. [2024d] Вэйюнь Ван и др. Повышение способности к рассуждению мультимодальных LLM посредством оптимизации смешанных предпочтений. arXiv preprint arXiv:2411.10442, 2024d.
- ⟦Wang et al. [2023] Вэньхай Ван и др. DriveMLM: Согласование мультимодальных LLM с состояниями поведенческого планирования для автономного вождения. arXiv preprint arXiv:2312.09245, 2023.
- ⟦Wang et al. [2024e] Сяофэн Ван и др. DriveDreamer: На пути к созданию моделей мира для реальных условий вождения в автономном транспорте. В сб.: Eur. Conf. Comput. Vis., стр. 55–72. Springer, 2024e.
- ⟦Wang et al. [2025e] Ян Ван и др. Alpamayo-R1: Соединение рассуждений и прогнозирования действий для обобщаемого автономного вождения в условиях длинного хвоста. arXiv preprint arXiv:2511.00088, 2025e.
- ⟦Wang et al. [2024f] Юйци Ван и др. Движение в будущее: многоракурсное визуальное прогнозирование и планирование с использованием мировой модели для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 14749–14759, 2024f.
- ⟦Wei et al. [2024] Джулун Вэй, Шаньшуай Юань, Пэнфэй Ли и др. OccLLaMA: Генеративная модель мира на основе оккупационных сеток, языка и действий для автономного вождения. arXiv preprint arXiv:2409.03272, 2024.
- ⟦Weng et al. [2024] Синшо Вен и др. PARA-Drive: Параллелизованная архитектура для автономного вождения в реальном времени. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 15449–15458, 2024.
- ⟦Wilson et al. [2023] Бенджамин Уилсон и др. Argoverse 2: Наборы данных следующего поколения для восприятия и прогнозирования в беспилотном вождении. arXiv preprint arXiv:2301.00493, 2023.
- ⟦Winter et al. [2025] Катарина Винтер и др. BEVDriver: Использование BEV карт в LLM для надежного вождения с обратной связью. arXiv preprint arXiv:2503.03074, 2025.
- ⟦Wu et al. [2025] Ханьфэн У и др. NaviHydra: Управляемое навигационно-ориентированное сквозное автономное вождение с использованием гидра-дистилляции. arXiv preprint arXiv:2512.10660, 2025.
- ⟦Wu et al. [2022] Пэнхао У и др. Прогнозирование управления на основе траектории для сквозного автономного вождения: простой, но надежный базовый метод. В сб.: Adv. Neural Inf. Process. Syst., том 35, страницы 6119–6132, 2022.
- ⟦Xie et al. [2025a] Шаоюань Се и др. Бенчмаркинг и повышение устойчивости восприятия в виде сверху в автономном вождении. IEEE Trans. Pattern Anal. Mach. Intell., 47(5):3878–3894, 2025a.
- ⟦Xie et al. [2025b] Шаоюань Се и др. Готовы ли VLMs к автономному вождению? эмпирическое исследование с точки зрения надежности, данных и метрик. В IEEE/CVF Int. Conf. Comput. Vis., страницы 6585–6597, 2025b.
- ⟦Xie et al. [2025c] Ичен Се и др. S4-Driver: Масштабируемая самообучающаяся мультимодальная большая языковая модель для вождения с пространственно-временным визуальным представлением. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 1622–1632, 2025c.
- ⟦Xin et al. [2025] Рен Синь и др. NetRoller: сопряжение общих и специализированных моделей для сквозного автономного вождения. arXiv preprint arXiv:2506.14589, 2025.
- ⟦Xing et al. [2025a] Шуо Син и др. OpenEMMA: Мультимодальная модель с открытым исходным кодом для сквозного автономного вождения. В IEEE/CVF Winter Conf. Appl. Comput. Vis., страницы 1001–1009, 2025a.
- ⟦Xing et al. [2025b] Зебинь Син и др. GoalFlow: Потоковое сопоставление на основе целей для генерации мультимодальных траекторий в сквозном автономном вождении. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 1602–1611, 2025b.
- ⟦Xing et al. [2025c] Зебин Син и др. Mimir: Иерархическая диффузия на основе целей с распространением неопределенности для сквозного автономного вождения. arXiv preprint arXiv:2512.07130, 2025c.
- ⟦Xu et al. [2025a] Чэнкай Сюй и др. На пути к автономному вождению, ориентированному на человека: быстро-медленная архитектура, объединяющая руководство LLM с обучением с подкреплением. arXiv preprint arXiv:2505.06875, 2025a.
- ⟦Xu et al. [2025b] Хаоран Сюй и др. Временные трипланарные transformers как модели мира заполненности. arXiv preprint arXiv:2503.07338, 2025b.
- ⟦Xu et al. [2025c] Руншэн Сюй и др. WOD-E2E: Открытый набор данных Waymo для сквозного вождения в сложных сценариях с длинным хвостом. arXiv preprint arXiv:2510.26125, 2025c.
- ⟦Xu et al. [2025d] Тяньшо Сюй, Хао Лу, Сюй Янь и др. Occ-LLM: Совершенствование автономного вождения с помощью больших языковых моделей на основе занятости пространства. В материалах IEEE Int. Conf. Robot. Autom., 2025d.
- ⟦Xu et al. [2025e] Сян Сюй и др. За пределами одного кадра, за пределами одного ракурса: дистилляция на основе перекрестных видов и долгосрочного планирования для улучшения представлений LiDAR. В материалах IEEE/CVF Int. Conf. Comput. Vis., страницы 25506–25518, 2025e.
- ⟦Xu et al. [2024a] И Сюй и др. VLM-AD: Сквозное автономное вождение посредством контроля со стороны vision-language model. arXiv preprint arXiv:2412.14446, 2024a.
- ⟦Xu et al. [2024b] Чжэньхуа Сюй и др. DriveGPT4: Интерпретируемое сквозное автономное вождение с помощью LLM. IEEE Robot. Autom. Lett., 9(10):8186–8193, 2024b.
- ⟦Xu et al. [2025f] Чжэньхуа Сюй и др. DriveGPT4-V2: Использование возможностей LLM для улучшенного автономного вождения с замкнутым контуром. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 17261–17270, 2025f.
- ⟦Yan et al. [2025a] Тяньи Янь и др. AD-R1: Обучение с подкреплением в замкнутом контуре для сквозного автономного вождения с беспристрастными моделями мира. arXiv preprint arXiv:2511.20325, 2025a.
- ⟦Yan et al. [2025b] Тяньи Янь и др. DrivingSphere: создание высокоточной четырехмерной среды для моделирования с замкнутым контуром. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 27531–27541, 2025b.
- ⟦Yan et al. [2024] Сюй Янь и др. Создание фундаментальных моделей компьютерного зрения для автономного вождения: проблемы, методологии и возможности. arXiv preprint arXiv:2401.08045, 2024.
- ⟦Yan et al. [2025c] Зиян Ян и др. RenderWorld: Мировая модель с самообучающейся трехмерной разметкой. В IEEE Int. Conf. Robot. Autom., страницы 6063–6070, 2025c.
- ⟦Yang et al. [2024a] Ан Ян и др. Технический отчет Qwen2.5. arXiv preprint arXiv:2412.15115, 2024a.
- ⟦Yang et al. [2025a] Ан Ян и др. Технический отчет Qwen3. arXiv preprint arXiv:2505.09388, 2025a.
- ⟦Yang et al. [2025b] Хаохань Ян и др. Непрерывное обучение под руководством человека для персонализированного принятия решений в автономном вождении. IEEE Int. Conf. Intell. Transport. Syst., 26(4):5435–5447, 2025b.
- ⟦Yang et al. [2024b] Цзячжи Ян и др. Обобщенная прогностическая модель для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 14662–14672, 2024b.
- ⟦Yang et al. [2025c] Юй Ян и др. Вождение в мире заполненности: 4D-прогнозирование заполненности на основе зрения и планирование с помощью world models для автономного вождения. В AAAI Conf. Artifi. Intell., том 39, страницы 9327–9335, 2025c.
- ⟦Yang et al. [2024c] Зетон Ян и др. Прогнозирование визуальных облаков точек обеспечивает масштабируемое автономное вождение. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 14673–14684, 2024c.
- ⟦Yang et al. [2024d] Чжэньцзе Ян и др. LLM4Drive: Обзор больших языковых моделей для автономного вождения. В сб. Adv. Neural Inf. Process. Syst. Worksh., 2024d.
- ⟦Yang et al. [2025d] Чжэньцзе Ян и др. DriveMoE: Смесь экспертов для моделей зрения-языка-действия в сквозном автономном вождении. arXiv preprint arXiv:2505.16278, 2025d.
- ⟦Yang et al. [2025e] Чжэньцзе Ян и др. Raw2Drive: Обучение с подкреплением с использованием согласованных моделей мира для сквозного автономного вождения (в CARLA-V2). arXiv preprint arXiv:2505.16394, 2025e.
- ⟦Yao et al. [2025] Хуайюань Яо и др. LiloDriver: фреймворк непрерывного обучения для замкнутого цикла планирования движения в сценариях автономного вождения с длинным хвостом. arXiv preprint arXiv:2505.17209, 2025.
- ⟦You et al. [2025] Зебин Ю и др. LlaDA-V: Большие языковые диффузионные модели с визуальной настройкой инструкций. arXiv preprint arXiv:2505.16933, 2025.
- ⟦Yu et al. [2020] Фишер Ю и др. BDD100K: Разнообразный набор данных вождения для гетерогенного многозадачного обучения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 2636–2645, 2020.
- ⟦Yu et al. [2023] Лицзюнь Юй и др. Языковая модель превосходит диффузионный токенизатор — ключ к визуальной генерации. arXiv preprint arXiv:2310.05737, 2023.
- ⟦Yu et al. [2024] Тяньюй Юй и др. RLAIF-V: Открытая обратная связь от AI обеспечивает надежность, превосходящую GPT-4V. arXiv preprint arXiv:2405.17220, 2024.
- ⟦Yu et al. [2025] Зе Ю и др. Объединение слияния данных камер и LiDAR и планирования движения с использованием представления «вид с высоты птичьего полета» для сквозного автономного вождения. Drones, 9(4):281, 2025.
- ⟦Yuan et al. [2024a] Чэньжань Юань и др. DRAMA: Эффективный сквозной планировщик движения для автономного вождения на основе mamba. arXiv preprint arXiv:2408.03601, 2024a.
- ⟦Yuan et al. [2024b] Цзяньхао Юань и др. RAG-Driver: Обобщаемые объяснения вождения с помощью обучения в контексте с дополненной генерацией в мультимодальных LLM. arXiv preprint arXiv:2402.10828, 2024b.
- ⟦Yuan et al. [2025] Чжэнлун Юань и др. AutoDrive-R2: Стимулирование способностей к рассуждению и саморефлексии для VLA моделей в автономном вождении. arXiv preprint arXiv:2509.01944, 2025.
- ⟦Yurt et al. [2025] Махмут Юрт и др. LTDA-Drive: генеративные модели на основе LLM для аугментации данных с длинным хвостом в автономном вождении. arXiv preprint arXiv:2505.18198, 2025.
- ⟦Zeng et al. [2025] Шуан Цзэн и др. FutureSightDrive: Визуальное мышление с использованием пространственно-временного CoT для автономного вождения. arXiv preprint arXiv:2505.17685, 2025.
- ⟦Zhai et al. [2025] Минлян Чжай и др. Рассуждения с использованием мировых знаний через интерактор, управляемый инструкциями, в автономном вождении. В AAAI Conf. Artifi. Intell., том 39, страницы 9842–9850, 2025.
- ⟦Zhai et al. [2023] Сяохуа Чжай и др. Sigmoid loss для предварительного обучения языковых моделей по изображениям. В материалах IEEE/CVF Int. Conf. Comput. Vis., страницы 11975–11986, 2023.
- ⟦Zhang et al. [2025a] Бочжоу Чжан и др. Сквозное вождение с учетом будущего: двунаправленное моделирование планирования траектории и эволюции сцены. arXiv preprint arXiv:2510.11092, 2025a.
- ⟦Zhang et al. [2025b] Дапэн Чжан и др. Reasoning-VLA: Быстрая и универсальная модель рассуждений на основе зрения, языка и действий для автономного вождения. arXiv preprint arXiv:2511.19912, 2025b.
- ⟦Zhang et al. [2024a] Дианкун Чжан и др. SparseAD: Разреженная парадигма с ориентацией на запросы для эффективного сквозного автономного вождения. arXiv preprint arXiv:2404.06892, 2024a.
- ⟦Zhang et al. [2024b] Хаймин Чжан и др. Эффективная модель мира на основе занятости посредством разделенного динамического потока и обучения с поддержкой изображений. arXiv preprint arXiv:2412.13772, 2024b.
- ⟦Zhang et al. [2025c] Хаймин Чжан и др. VisionPAD: парадигма предварительного обучения с ориентацией на визуальные данные для автономного вождения. В IEEE/CVF Conf. Comput. Vis. Pattern Recog., страницы 17165–17175, 2025c.
- ⟦Zhang et al. [2025d] Цзявэй Чжан и др. SafeAuto: Безопасное автономное вождение с расширенными знаниями на основе мультимодальных фундаментальных моделей. arXiv preprint arXiv:2503.00211, 2025d.
- ⟦Zhang et al. [2025e] Кайвэнь Чжан и др. Epona: Авторегрессионная диффузионная модель мира для автономного вождения. arXiv preprint arXiv:2506.24113, 2025e.
- ⟦Zhang et al. [2024c] Пейюань Чжан и др. TinyLLaMA: языковая модель с открытым исходным кодом малого размера. arXiv preprint arXiv:2401.02385, 2024c.
- ⟦Zhang et al. [2024d] Сунъянь Чжан и др. WiseAD: Сквозное автономное вождение с расширенными знаниями на основе визуально-языковой модели. arXiv preprint arXiv:2412.09951, 2024d.
- ⟦Zhang et al. [2025f] Сонгян Чжан и др. OpenREAD: Обучение с подкреплением для открытых рассуждений в сквозном автономном вождении с использованием LLM-as-Critic. arXiv preprint arXiv:2512.01830, 2025f.
- ⟦Zhang et al. [2025g] И Чжан и др. Единая структура восприятия, языка и действий для адаптивного автономного вождения. arXiv preprint arXiv:2507.23540, 2025g.
- ⟦Zhang et al. [2021] Чжэцзюнь Чжан и др. Сквозное городское вождение путем имитации тренера с обучением с подкреплением. В IEEE/CVF Int. Conf. Comput. Vis., страницы 15222–15232, 2021.
- ⟦Zhao et al. [2025a] Руи Чжао и др. Sce2DriveX: Обобщенная MLLM-структура для обучения от сцены к вождению. IEEE Robot. Autom. Lett., 2025a.
- ⟦Zhao et al. [2025b] Цзунчуан Чжао и др. Расширение больших визуально-языковых моделей для разнообразных интерактивных задач в автономном вождении. arXiv preprint arXiv:2505.08725, 2025b.
- ⟦Zheng and Vedaldi [2023] Чуанься Чжэн и Андреа Ведальди. Онлайн-кластеризованная кодовая книга. В материалах IEEE/CVF Int. Conf. Comput. Vis., страницы 22798–22807, 2023.
- ⟦Zheng et al. [2025a] Вэйчэн Чжэн и др. DriveAgent-R1: Продвижение автономного вождения на основе VLM с использованием гибридного мышления и активного восприятия. arXiv preprint arXiv:2507.20879, 2025a.
- ⟦Zheng et al. [2024a] Вэньчжао Чжэн и др. Doe-1: Автономное вождение с замкнутым контуром управления на основе большой модели мира. arXiv preprint arXiv:2412.09627, 2024a.
- ⟦Zheng et al. [2024b] Вэньчжао Чжэн и др. GaussianAD: сквозное автономное вождение на основе гауссианов. arXiv preprint arXiv:2412.10371, 2024b.
- ⟦Zheng et al. [2024c] Вэньчжао Чжэн и др. GenAD: Генеративное сквозное автономное вождение. В сб.: Eur. Conf. Comput. Vis., стр. 87–104. Springer, 2024c.
- ⟦Zheng et al. [2024d] Вэньчжао Чжэн и др. OccWorld: Обучение 3D-модели мира заполненности для автономного вождения. В Eur. Conf. Comput. Vis., страницы 55–72. Springer, 2024d.
- ⟦Zheng et al. [2025b] Юпэн Чжэн и др. World4Drive: Сквозное автономное вождение посредством физической латентной модели мира с учетом намерений. arXiv preprint arXiv:2507.00603, 2025b.
- ⟦Zhong et al. [2025] Ифань Чжун и др. Обзор моделей зрения-языка-действия: перспектива токенизации действий. arXiv preprint arXiv:2507.01925, 2025.
- ⟦Zhou et al. [2025a] Гаоюэ Чжоу и др. DINO-WM: Мировые модели на основе предобученных визуальных признаков обеспечивают планирование с нулевым выстрелом. В сб.: Междунар. конф. по машинному обучению. PMLR, 2025a.
- ⟦Zhou et al. [2024] Синчэн Чжоу и др. Визуально-языковые модели в автономном вождении: обзор и перспективы. IEEE Trans. Intell. Veh., страницы 1–20, 2024.
- ⟦Zhou et al. [2025b] Синчэн Чжоу и др. OpenDriveVLA: На пути к сквозному автономному вождению с использованием большой модели зрения, языка и действий. arXiv preprint arXiv:2503.23463, 2025b.
- ⟦Zhou et al. [2025c] Зевей Чжоу и др. AutoVLA: Модель «зрение-язык-действие» для сквозного автономного вождения с адаптивным рассуждением и дообучением с подкреплением. arXiv preprint arXiv:2506.13757, 2025c.
- ⟦Zhu et al. [2024] Бин Чжу и др. LanguageBind: Расширение видео-языкового предварительного обучения до N-модальности посредством семантического выравнивания на основе языка. В сб.: Int. Conf. Learn. Represent., 2024.
- ⟦Zhu et al. [2025a] Декай Чжу и др. SPIRAL: Семантически-ориентированная прогрессивная генерация и понимание сцен LiDAR. В Adv. Neural Inf. Process. Syst., том 38, 2025a.
- ⟦Zhu et al. [2025b] Цзинго Чжу и др. InternVL3: Исследование передовых методов обучения и тестирования для мультимодальных моделей с открытым исходным кодом. arXiv preprint arXiv:2504.10479, 2025b.
- ⟦Zhuang et al. [2024] Хуйпин Чжуан и др. Онлайн-аналитическое непрерывное обучение без примеров с использованием больших моделей для несбалансированных задач автономного вождения. IEEE Trans. Veh. Tech., 74(2):1949–1958, 2024.
- ⟦Zou et al. [2025] Цзяльв Цзоу и др. DiffusionDriveV2: Моделирование усеченной диффузии с ограничениями обучения с подкреплением в сквозном автономном вождении. arXiv preprint arXiv:2512.07745, 2025.