DriveLaW: Унификация планирования и генерации видео в латентном мире вождения
Аннотация
Мировые модели стали критически важными для автономного вождения, поскольку они изучают, как сценарии развиваются с течением времени, чтобы решать проблемы редких событий в реальном мире. Однако текущие подходы отводят мировым моделям ограниченные роли: они функционируют в рамках якобы унифицированных архитектур, которые по-прежнему сохраняют прогнозирование мира и планирование движения как раздельные процессы. Чтобы преодолеть этот разрыв, мы предлагаем DriveLaW, новую парадигму, которая объединяет генерацию видео и планирование движения. Путем прямой передачи латентного представления из своего генератора видео в планировщик, DriveLaW обеспечивает внутреннюю согласованность между высокоточной генерацией будущего и надежным планированием траектории. В частности, DriveLaW состоит из двух основных компонентов: DriveLaW-Video, нашей мощной мировой модели, которая генерирует высокоточные прогнозы с выразительными латентными представлениями, и DriveLaW-Act, диффузионного планировщика, который генерирует согласованные и надежные траектории на основе латентного представления DriveLaW-Video, при этом оба компонента оптимизированы с помощью трехэтапной стратегии прогрессивного обучения. Мощность нашей унифицированной парадигмы демонстрируется новыми результатами state-of-the-art в обеих задачах. DriveLaW не только значительно продвигает прогнозирование видео, превосходя лучшие существующие работы на 33.3% по FID и 1.8% по FVD, но и устанавливает новый рекорд в бенчмарке планирования NAVSIM..
1 Введение
Автономное вождение стремительно развивалось в последние годы благодаря значительному прогрессу в области восприятия [45, 75, 47, 32] и планирования [31, 34, 48, 44]. Тем не менее, существующие системы остаются недостаточно устойчивыми в редких и нетипичных сценариях, что снижает эффективность работы в замкнутом контуре. В недавних работах были представлены world models, которые прогнозируют будущее развитие дорожных сцен на основе прошлых наблюдений с нескольких камер и состояния транспортного средства для решения проблемы недостаточной устойчивости в редких сценариях. Они позволяют синтезировать данные для последующих задач [20, 29, 18, 68, 40] в редких сценариях, обеспечивая обучение стратегий в симуляции [17, 77, 39], а также предоставляют вспомогательный контроль будущего [42, 41, 82, 54, 69], что способствует улучшению обобщающей способности и надежности при изменении распределения..
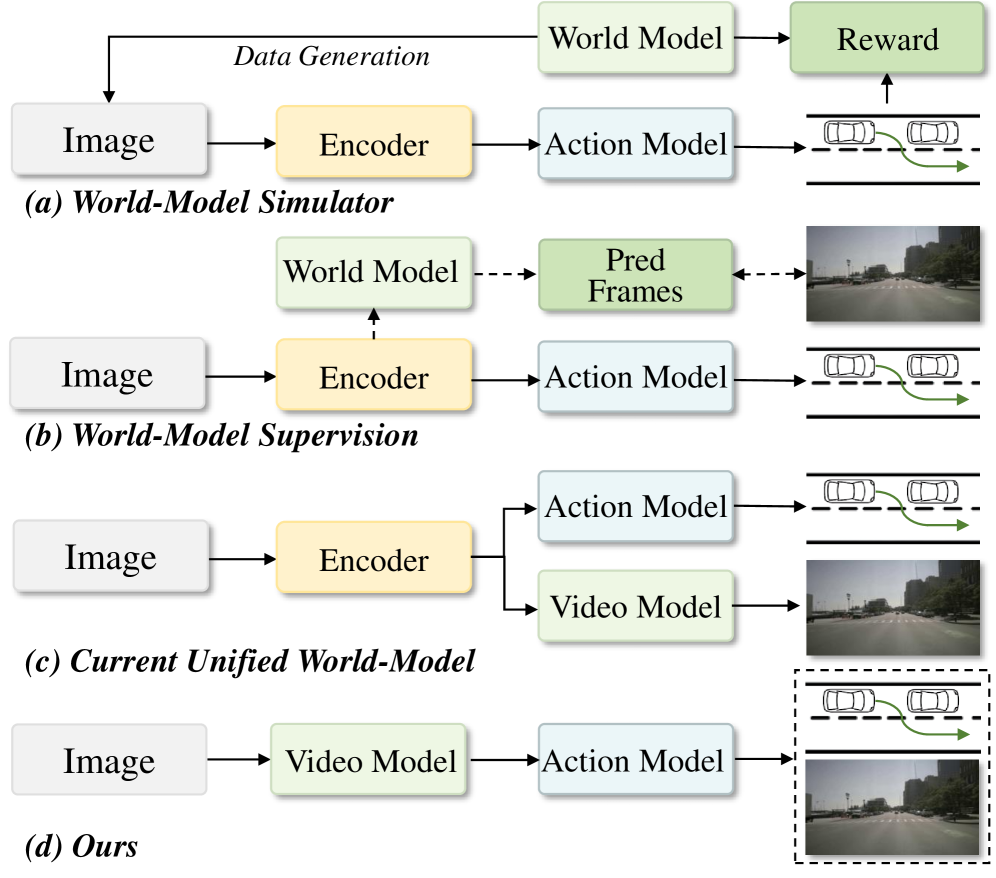
Несмотря на преимущества в обобщении, достигаемые за счет изучения физических закономерностей посредством крупномасштабной генерации видео, вклад современных world models в планирование автономного вождения остается либо косвенным, либо параллельным по отношению к планировщику, а не тесно связанным с принятием решений. В частности, с точки зрения их роли в планировании, существующие подходы на основе world models делятся на три категории, как показано на рис. 1. Во-первых, симуляторы на основе world models (рис. 1 (a)) синтезируют последующие данные или служат средами с замкнутым контуром для управления обучением стратегии, что является косвенным и не передает физическое понимание модели в состояние планировщика. Во-вторых, контроль на основе world models (рис. 1 (b)) прогнозирует будущие визуальные или аффорданс-сигналы для контроля будущих кадров, занятости или траекторий, улучшая предвидение, но оставляя планирование внешне заданным. В-третьих, унифицированные world models (рис. 1 (c)) совместно генерируют видео и траектории, обеспечивая более тесную связь между восприятием и управлением, а также улучшенную временную согласованность. Однако текущие реализации этой парадигмы все еще не позволяют полностью реализовать задуманную тесную связь. Такие методы, как Epona [80] и DriveVLA-W0 [42], разделяют генерацию и планирование, обучая генератор видео и policy head как отдельные модули. Несмотря на доказательства того, что генераторы видео кодируют глубокое понимание мира и априорные знания о восприятии, эти подходы не используют внутренние latents генератора в качестве состояния планирования, оставляя разрыв между визуальным воображением и выбором действия..
В данной статье мы предлагаем DriveLaW, латентную модель мира, которая объединяет генерацию и планирование посредством общего представления в латентном пространстве. Вместо того чтобы рассматривать генерацию и планирование как два параллельных модуля, мы объединяем их в цепочку, вдохновляясь [49], как показано на рис. 2 (d), используя мощные представления вождения, изученные видеогенератором на основе крупномасштабной генерации видео, для выполнения планирования траектории. Латентные признаки из видеогенератора, изученные на крупномасштабных видеозаписях вождения, инкапсулируют семантику сцены, динамику агентов и физические закономерности в компактном представлении. Action DiT (Diffusion Transformer [56]), обусловленный этими латентными признаками, генерирует временно устойчивые к распределению траектории и повышает стабильность замкнутого контура. По сравнению с этим, наш каскадный дизайн предлагает три преимущества перед параллельными базовыми моделями: (1) он полностью использует представления, изученные в ходе крупномасштабного предварительного обучения на видео, объединяя генерацию и планирование в общем латентном пространстве; (2) его режим обучения позволяет избежать интерференции градиентов между видеогенератором и планировщиком; (3) каскадирование обеспечивает согласованность между сгенерированными визуальными деталями и запланированными траекториями. Однако высококачественный синтез видео и стабильное планирование в реальном времени по своей сути находятся в противоречии. Чтобы решить эту проблему, мы разрабатываем DriveLaW-Video с пространственно-временным VAE и эффективным Video DiT, а также внедряем механизм повторного впрыска шума для баланса между агрессивным сжатием и визуальной точностью. Со стороны управления DriveLaW-Act использует стандартный DiT, обученный с целевой функцией flow-matching для создания плавных и надежных траекторий. Для гармонизации оптимизации между генерацией и планированием мы применяем трехэтапную прогрессивную учебную программу, которая сначала изучает движение на длинном горизонте, затем уточняет пространственные детали и, наконец, объединяет видеолатентные признаки в планировщик для стабильного обучения..
Мы всесторонне оцениваем DriveLaW на nuScenes [9] для генерации видео и на NAVSIM [16] для планирования траекторий. На nuScenes DriveLaW достигает state-of-the-art качества генерации, превосходя как чистые видеогенераторы, так и унифицированные baselines для генерации и планирования. На NAVSIM наш планировщик достигает высоких показателей в замкнутом цикле без какого-либо post-training (например, RL) или post-processing (например, scorers), что подчеркивает эффективность использования представлений видеогенератора для управления. Абляции и исследования масштабируемости дополнительно подтверждают наш дизайн. Основные вклады данной работы заключаются в следующем:
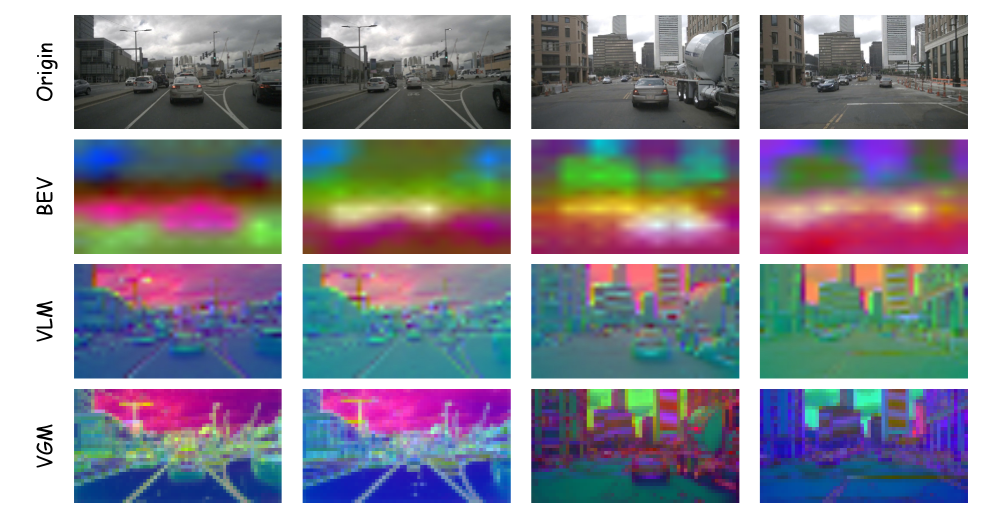
- ⟦• Мы предлагаем DriveLaW, унифицированную модель мира, которая переходит от параллельной к цепочечной генерации и планированию. Мы демонстрируем, что латентные представления, полученные в результате крупномасштабной генерации видео, обладают превосходной семантической связностью и пространственной структурой по сравнению с традиционными признаками Bird’s Eye View (BEV) или Vision-Language Models (VLM). Внедряя эти богатые генеративные априорные знания в планировщик, мы эффективно преодолеваем разрыв между визуальным прогнозированием и принятием решений о действиях..
- ⟦• Мы проектируем специализированную архитектуру, включающую DriveLaW-Video и DriveLaW-Act. Первая включает в себя новый механизм повторного внедрения шума для устранения структурных несоответствий и размытости в сценариях с высокой скоростью, в то время как вторая использует диффузионный планировщик, напрямую обусловленный латентными представлениями видео. Представлена трехэтапная стратегия прогрессивного обучения для разрешения противоречий оптимизации между высококачественным синтезом видео и надежной генерацией траектории..
- ⟦• Мы проводим валидацию DriveLaW на стандартных бенчмарках для автономного вождения. Модель достигает state-of-the-art показателей FID и FVD при генерации видео с одного ракурса на наборе данных nuScenes и устанавливает новый рекорд по метрикам планирования с замкнутым контуром (PDMS) на бенчмарке NAVSIM, превосходя предыдущие подходы на основе world models и подтверждая эффективность нашей унифицированной парадигмы без использования post-training или вспомогательных scorers..
2 Связанные работы
2.1 Мировые модели для автономного вождения
World models [7, 8, 3] нацелены на интериоризацию физической структуры и динамики реального мира в предиктивное латентное представление для воображения, управления и планирования. Недавние исследования внедряют world models в автономное вождение для генерации сцен [68, 81, 20, 26, 18, 29, 65, 19, 22, 21, 53], оценки симуляций [55, 39, 77, 74, 85] и принятия решений [80, 69, 42, 41, 43]. Ранние работы [29, 18, 20] рассматривают эту задачу как условную генерацию многоракурсного видео, отдавая приоритет геометрической согласованности нескольких камер. Чтобы более фундаментально охватить трехмерную пространственно-временную структуру, OccWorld [83] и OccSora [67] вводят представление, ориентированное на занятость пространства. UniScenes [38] и Genesis [22] дополнительно достигают совместной генерации мультимодальных сигналов (RGB, LiDAR, occupancy), в первую очередь выступая в качестве дата-центричных генераторов для обучения последующих задач. Тем временем, некоторые работы [77, 85, 74, 39, 17] интегрируют world models в качестве движков симуляции непосредственно в автономное вождение, фокусируясь на замкнутой оценке и реконструкции сцен. Например, HUGSIM [85], ReconDreamer-R [55] и RAD [17] внедряют 3D Gaussian Splatting для реконструкции сцен в целях симуляции с замкнутым контуром. ReSim [77] и OmniNWM [39] фокусируются на поведенческой симуляции, синтезируют видео, обусловленные траекториями-кандидатами, и предоставляют сигналы вознаграждения для управления фильтрацией траекторий и reinforcement learning..
Однако эти подходы обеспечивают лишь косвенное руководство для модуля планирования посредством генерации данных и симуляции, в то время как недавние исследования направлены на интеграцию генеративного моделирования и принятия решений в рамках единой модели мира. DrivingGPT [13] использует авторегрессионную стратегию в стиле GPT для генерации будущих видео и траекторий. Epona [80] использует схему авторегрессионной диффузии для параллельного создания видео и траекторий. VaViM/VaVAM [4] и DriveVLA-W0 [42] применяют архитектуру mixture-of-transformers типа 0 [5] [46], которая авторегрессионно генерирует обе модальности в рамках одной модели. Хотя эта парадигма представляет собой значительный шаг вперед, она обычно рассматривает генерацию видео и траекторий как два независимых потока вывода. Такая конструкция может привести к разрыву в представлении, поскольку траектория планирования не имеет прямой опоры на внутренние признаки, управляющие синтезом видео. Напротив, мы утверждаем, что богатые, пространственно-временные обоснованные признаки, изученные генераторами видео, представляют собой мощный, но недостаточно изученный ресурс для планирования. Чтобы преодолеть этот разрыв, DriveLaW впервые использует латентные представления среднего уровня из генератора видео в качестве представлений для планирования, что обеспечивает более стабильное вождение в замкнутом цикле..
2.2 Генерация видео
Генерация видео стала ключевым компонентом автономного вождения [52, 68, 69, 76], лежащим в основе world models, ориентированных на визуальное восприятие [29, 30]. Помимо прогнозирования статических сцен, она фиксирует временную непрерывность и сложную динамику [64, 51, 6, 25, 28], позволяя моделям изучать, как агенты и окружающая среда развиваются с течением времени. GAIA-1 [29] инновационно использует авторегрессионную структуру, которая выводит дискретные токены изображений для генерации видео сцен автономного вождения. DriveDreamer [81], Panacea [70], DrivingDiffusion [40] и MagicDrive [18] используют diffusion models, обусловленные геометрическими признаками, такими как карты Bird’s Eye View (BEV) и 3D-боксы, для синтеза управляемых сцен вождения. MagicDrive-V2 [19], MiLA [65] и GAIA-2 [60] генерируют высококачественные видео вождения с длинным горизонтом планирования посредством latent diffusion со структурированным геометрическим и поведенческим обусловливанием. TeraSim-World [66] и Cosmos-Drive [59] создают крупномасштабные конвейеры синтетических данных для автономного вождения, производя разнообразные и управляемые видеообразцы для последующего обучения и оценки восприятия. В итоге, хотя существующие методы продвинули современное состояние технологий в области визуального синтеза, они преимущественно рассматривают генератор видео как средство рендеринга. Мы полагаем, что внутренние активации этих мощных генераторов кодируют богатое, временно согласованное понимание динамики и геометрии сцены. DriveLaW перепрофилирует генератор видео в экстрактор признаков и объединяет его с diffusion planner для обеспечения end-to-end вождения..
2.3 Диффузионные политики для автономного вождения
Недавние работы привносят diffusion policies [14] в автономное вождение, используя их сильные стороны в моделировании временных действий. DiffusionDrive [48] внедряет усеченную диффузию и шум с инициализацией по опорным точкам для достижения мультимодального планирования траекторий в реальном времени. Diffusion Planner [84] совместно генерирует траектории для эго-транспортного средства и окружающих агентов посредством диффузии для моделирования интерактивных сцен вождения. ReCogDrive [44] объединяет VLM с диффузионным планировщиком, внедряя априорные знания о когнитивных аспектах вождения в процесс диффузии для обеспечения эффективной генерации непрерывных действий. GoalFlow [73] использует flow matching для генерации целевых точек, обеспечивая безопасное и стабильное вождение. Мы инновационно объединяем Video DiT с диффузионным планировщиком, дистиллируем априорные знания о вождении из крупномасштабных видеозаписей вождения и внедряем их в диффузионный планировщик для обеспечения стабильного вождения в замкнутом контуре..
3 Метод
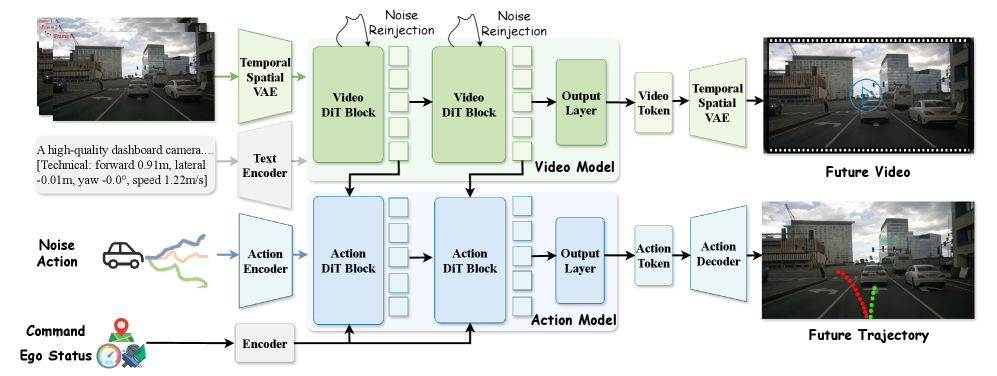
В этом разделе мы сначала исследуем обучение обобщаемым представлениям вождения на основе генератора видео. Затем мы представляем DriveLaW, world model, которая объединяет генерацию и планирование посредством общего представления в латентном пространстве. Впоследствии мы описываем DriveLaW-Video, пространственно-временной генератор видео, и DriveLaW-Act, планировщик на основе diffusion. Наконец, мы представляем трехэтапную структуру обучения, которая позволяет создавать высококачественные видео и стабильные траектории..
3.1 Изучение обобщаемых представлений вождения на основе генераторов видео
Мировые модели, такие как Genie [8] и Cosmos [2], изучают структуру реального мира путем обучения на генерации видео в больших масштабах, и многие исследования [72, 23] указывают на то, что видеогенераторы усваивают физические закономерности и выступают в качестве эффективных zero-shot learners. В автономном вождении реальные сцены предоставляют практически неограниченный объем видео, в то время как плотная аннотация является дорогостоящей, поэтому мы предлагаем изучать представления вождения на основе генерации крупномасштабных видео вождения, подобно тому, как люди приобретают навыки вождения. Конкретно, пусть — это видеоэнкодер, а — латентное представление клипа с . Обобщенный денойзер создает латентную траекторию шумоподавления при условии посредством одношагового обновления
| (1) |
где обозначает обученный оператор шумоподавления, а индексирует график вывода. Мы извлекаем признаки промежуточного шумоподавления
| (2) |
и выбирают один или небольшое множество временных шагов для формирования латентного представления восприятия . Это латентное представление кодирует априорные знания о процессе вождения, полученные путем дистилляции из генерации, и подается в модуль планирования для обеспечения стабильного вождения в замкнутом контуре.
3.2 DriveLaW
Как показано на рис. 2, DriveLaW представляет собой унифицированную структуру, состоящую из DriveLaW-Video и DriveLaW-Act. Видеомодель, например LTX-Video [24], сначала кодирует прошлые кадры вождения с помощью пространственно-временного VAE и кодирует текстовые подсказки с помощью текстового энкодера. Затем стек блоков Video DiT выполняет шумоподавление в латентном пространстве, а VAE декодер реконструирует видео. Одновременно с этим шум действий, статус эго-автомобиля и высокоуровневые команды кодируются и подаются в модель действий. Латентные представления видео из Video DiT служат сигналами обусловливания, направляя Action DiT для вывода итоговой траектории. Video DiT и Action DiT объединены в цепочку и обучены изучать представления вождения на основе крупномасштабной генерации видео, обеспечивая общую основу для планирования..
3.3 DriveLaW-Video: Пространственно-временной генератор мира
Пространственно-временной VAE.
Мы используем пространственно-временной VAE с высокой степенью сжатия [24] для эффективного моделирования сценариев вождения с длинным горизонтом планирования. VAE кодирует каждый видеоклип в причинно-следственное латентное пространство с пространственно-временным разрешением и 128 каналами, достигая коэффициента сжатия (отношение пикселей к токенам ). Это значительно компактнее, чем типичные сжатия [58, 37] или [36, 78], что позволяет увеличить горизонты прогнозирования при том же вычислительном бюджете, что критически важно для моделирования долгосрочных зависимостей, таких как изменение сигналов светофора и динамика транспортных средств. Энкодер использует 3D причинно-следственные свертки, чтобы гарантировать, что каждый временной шаг зависит только от прошлых и текущих кадров, предотвращая утечку временной информации..
В отличие от традиционных конвейеров, которые завершают все этапы обратной диффузии в латентном пространстве перед единственным проходом декодирования, мы применяем гибридный подход. Мы выполняем декодирование на позднем этапе графика rectified-flow () и проводим финальную доработку в пиксельном пространстве.:
| (3) |
где
| (4) |
Здесь обозначает декодер шумоподавления с временным условием, обученный с использованием функций потерь в пиксельном пространстве. Поскольку отображает латентные представления в пиксели, он используется только на финальном этапе. Выполнение последнего шага в пиксельном пространстве позволяет восстановить высокочастотные детали, например, блики, динамические тени, мелкие текстуры дорожного покрытия, без использования дополнительного модуля сверхразрешения и добавляет минимальные накладные расходы..
Архитектура видео transformers.
После сжатия в многомерное латентное пространство сериализованные пространственно-временные токены обрабатываются трехмерным Transformer, адаптированным из PixArt- [11] для полноценного пространственно-временного моделирования. Каждый блок использует self-attention [63] для глобального пространственно-временного моделирования и cross-attention для интеграции условий, специфичных для задачи (команды навигации, визуальные подсказки). Мы применяем RMSNorm [79] к запросам и ключам для стабильности внимания и используем Rotary Positional Embedding [61] с нормализованными координатами для повышения согласованности между разрешениями и частотой кадров..
Для обусловливания движения мы преобразуем кинематику эго-транспортного средства в текстовые подсказки на естественном языке, вместо использования специализированного кодировщика движения. Такой подход позволяет напрямую задействовать предобученные архитектуры text-to-video, обеспечивает интерпретируемое управление, унифицирует статическое и динамическое обусловливание, а также улучшает обобщающую способность между наборами данных за счет отказа от числового кодирования, привязанного к специфическим для данных масштабам..
Повторное введение шума.
При генерации видео высокоскоростного вождения долгосрочное движение и большие смещения часто вызывают деградацию восприятия: границы становятся чрезмерно сглаженными, мелкие текстуры исчезают, а размытие и двоение накапливаются, подрывая структурную целостность транспортных средств, дорожной разметки и удаленных фонов. Чтобы смягчить это, мы адаптируем принцип итеративного уточнения, встречающийся в таких работах, как DiffuseSlide [33]. В отличие от методов, которые применяют шум глобально, мы внедряем более целенаправленную стратегию. Наш подход выборочно повторно вводит шум в высокочастотные области перед каждым основным шагом шумоподавления, заставляя модель активно восстанавливать детали, а не сглаживать их..
На каждом шаге шумоподавления с текущим латентным представлением мы сначала определяем области, которые, вероятно, содержат высокочастотные детали. Чтобы сделать это стабильно, мы выполняем начальное предсказание чистого латентного представления . Важно отметить, что затем мы декодируем это латентное представление во временное изображение в пространстве пикселей с помощью VAE decoder, , и преобразуем каждый кадр в его полутоновое представление, . Весь этот процесс вычисления высокочастотной маски происходит в домене пикселей для достижения максимальной точности. Затем мы применяем дискретное ядро Лапласа для получения карты отклика , вычисляем адаптивный порог и определяем высокочастотную маску:
| (5) |
Чтобы применить эту маску обратно в латентном пространстве, мы выполняем понижающую дискретизацию из разрешения изображения () до латентного разрешения (), используя интерполяцию методом ближайшего соседа, что приводит к получению итоговой маски латентного пространства . Далее мы создаем выборочно возмущенный латент путем внесения небольшого количества контролируемого шума только в замаскированные области:
| (6) |
где — это вручную настроенная интенсивность шума для этапа повторного внедрения, а — это высокочастотная маска.
Наконец, это возмущенное латентное представление используется в качестве входных данных для полноценного оператора шумоподавления на основе transformers для вычисления латентного представления для следующего шага, . Это заставляет модель использовать свой мощный генеративный априорный опыт для «заполнения» зашумленных областей правдоподобными высокочастотными деталями, согласующимися с остальной частью сцены. Такой целенаправленный подход восстанавливает резкость и текстуру динамических объектов и дорожной разметки, сохраняя при этом естественную гладкость таких областей, как небо, что позволяет достичь лучшего баланса между восстановлением деталей и подавлением артефактов..
3.4 DriveLaW-Act: Планировщик на основе диффузионных моделей
Вдохновленные [84, 48, 44], мы используем планировщик на основе диффузии, который генерирует непрерывные, временно плавные траектории. Конкретно, мы кодируем зашумленное действие , статус эго-автомобиля и высокоуровневую команду , используя соответственно кодировщик действий и кодировщик контекста.:
| (7) |
где и . В то же время, во время первого шага шумоподавления Video DiT, латентные признаки из каждого блока transformers кэшируются как . Для каждого шага в процессе flow-matching, Action DiT (обозначаемый как ) принимает закодированное зашумленное действие и непрерывное время в качестве входных данных, обусловленных как контекстным эмбеддингом , так и кэшированными видеопризнаками .⟧:
| (8) |
где обозначает непрерывный временной шаг.
Мы обучаем планировщик, используя целевую функцию flow-matching [50], которая согласует предсказанный моделью выход с целевым потоком:
| (9) |
Это способствует генерации плавной и стабильной траектории, соответствующей изученной динамике вождения.
3.5 Трехэтапное прогрессивное обучение
Для создания высококачественных, стабильных видео процесса вождения при одновременном обеспечении планировщика надежными представлениями, мы применяем трехэтапную прогрессивную схему обучения.
На первом этапе мы фокусируемся на изучении устойчивых паттернов движения путем обучения на более длинных клипах с уменьшенным пространственным разрешением, (ширина высота кадров). Эта конфигурация отдает приоритет временному охвату перед пространственной детализацией, позволяя модели изучать плавные, непрерывные модели поведения при вождении, такие как удержание полосы, повороты и изменения скорости. Поскольку объем памяти в video diffusion масштабируется как с пространственными, так и с временными параметрами, снижение разрешения позволяет обрабатывать большее количество кадров, что критически важно для моделирования сценариев с длинным горизонтом планирования..
Впоследствии мы переключаемся на более высокое пространственное разрешение, но более короткие клипы, , чтобы дополнительно улучшить визуальное качество и детализацию, такие как дорожная разметка, окружающие транспортные средства и текстуры окружающей среды. На этом этапе большие пространственные размеры при меньшем количестве кадров выделяют ресурсы для пространственной точности, сохраняя при этом временную согласованность, установленную на первом этапе..
Наконец, опираясь на этот мощный генератор видео, который изучает физически обоснованную динамику вождения, мы обуславливаем DriveLaW-Act на латентных признаках из DriveLaW-Video и обучаем его для планирования траектории. Этот третий этап связывает генерацию и планирование путем использования латентных представлений видео в качестве компактного восприятия для планировщика. Трехэтапная учебная программа оснащает DriveLaW высококачественным синтезом видео и надежным, стабильным планированием траектории..
4 Эксперимент
| Method | Ref | Image | Lidar | NC | DAC | TTC | Comf. | EP | PDMS |
| Constant Velocity | - | 68.0 | 57.8 | 50.0 | 100 | 19.4 | \cellcolorgray!30 20.6 | ||
| Ego Status MLP | arXiv’23 | 93.0 | 77.3 | 83.6 | 100 | 62.8 | \cellcolorgray!30 65.6 | ||
| Traditional End-to-End Methods | |||||||||
| VADv2- [12] | arXiv’24 | ✓ | 97.2 | 89.1 | 91.6 | 100 | 76.0 | \cellcolorgray!30 80.9 | |
| UniAD [31] | CVPR’23 | ✓ | 97.8 | 91.9 | 92.9 | 100 | 78.8 | \cellcolorgray!30 83.4 | |
| TransFuser [15] | TPAMI’23 | ✓ | ✓ | 97.7 | 92.8 | 92.8 | 100 | 79.2 | \cellcolorgray!30 84.0 |
| PARA-Drive [71] | CVPR’24 | ✓ | 97.9 | 92.4 | 93.0 | 99.8 | 79.3 | \cellcolorgray!30 84.0 | |
| ReCogDrive-IL [44] | arXiv’25 | ✓ | 98.1 | 94.7 | 94.2 | 100 | 80.9 | \cellcolorgray!30 86.5 | |
| DiffusionDrive [48] | CVPR’25 | ✓ | ✓ | 98.2 | 96.2 | 94.7 | 100 | 82.2 | \cellcolorgray!30 88.1 |
| World Model Methods | |||||||||
| DrivingGPT [13] | arXiv’24 | ✓ | 98.9 | 90.7 | 94.9 | 95.6 | 79.7 | \cellcolorgray!30 82.4 | |
| LAW [41] | ICLR’25 | ✓ | 96.4 | 95.4 | 88.7 | 99.9 | 81.7 | \cellcolorgray!30 84.6 | |
| Epona [80] | ICCV’25 | ✓ | 97.9 | 95.1 | 93.8 | 99.9 | 80.4 | \cellcolorgray!30 86.2 | |
| Resim [77] | NeurIPS’25 | ✓ | – | – | – | – | – | \cellcolorgray!30 86.6 | |
| WoTE [43] | ICCV’25 | ✓ | ✓ | 98.5 | 96.8 | 94.9 | 99.9 | 81.9 | \cellcolorgray!30 88.3 |
| DriveVLA-W0† [42] | arXiv’25 | ✓ | 98.4 | 95.3 | 95.2 | 100 | 80.9 | \cellcolorgray!30 87.2 | |
| PWM [82] | NeurIPS’25 | ✓ | 98.6 | 95.9 | 95.4 | 100 | 81.8 | \cellcolorgray!30 88.1 | |
| DriveLaW(Ours) | - | ✓ | 99.0 | 97.1 | 96.7 | 100 | 81.3 | \cellcolorgray!30 89.1 | |
4.1 Экспериментальная установка
Детали реализации.
Наша модель DriveLaW состоит из 2B видео DiT, инициализированного из предварительно обученных весов LTX-Video [24], и 133M диффузионного планировщика для планирования траектории. Мы обеспечиваем DriveLaW возможностями генерации видео и планирования посредством трехэтапного конвейера обучения, состоящего из предварительного обучения на видео с последующей донастройкой действий. На этапе предварительного обучения видео мы обучаем Video DiT [56] на кадрах из nuScenes [9] и NuPlan [10] с использованием двухэтапной учебной программы. Сначала мы устанавливаем временную согласованность путем обучения на низкоразрешающих клипах большой длительности ( кадров). Затем мы донастраиваем модель на высокоразрешающих клипах меньшей длительности ( кадров). Первые два этапа обучаются в течение 30 тысяч итераций с размером пакета 4, скоростью обучения и весовым коэффициентом затухания . Мы используем flow matching [50] с потокенным равномерным , поэтому каждый латентный токен интерполируется независимо между данными и шумом. На этапе донастройки траектории мы подаем четыре предыдущих кадра с камер и контролируем точек траектории на следующие 4 секунды, обновляя как Video DiT, так и Planning DiT. Мы используем размер пакета 192 в течение 44 тысяч шагов с фиксированной скоростью обучения и весовым коэффициентом затухания . При выводе мы используем 30 шагов выборки для генерации видео и 5 шагов для планирования траектории..
Набор данных и метрики.
Следуя предыдущему экспериментальному протоколу автономного вождения [80, 42, 82], мы обучаем нашу модель на nuPlan и nuScenes, а затем оцениваем ее на nuScenes для генерации видео и на NAVSIM [16] для планирования траектории. Набор данных nuScenes включает 1 000 сцен вождения, собранных в Бостоне и Сингапуре, содержащих мультисенсорные данные с камер и LiDAR, при этом 850 сцен используются для обучения и валидации, а оставшиеся 150 зарезервированы для тестирования. NuPlan, первый крупномасштабный набор данных планирования для автономного вождения, предоставляет 1 200 часов данных вождения человеком из четырех городов. NAVSIM [16] дополнительно базируется на OpenScene [57], перераспределении nuPlan, предлагая ориентированный на планирование бенчмарк для прогнозирования траектории. Он разделен на два подмножества: Navtrain, содержащий 103 тыс. примеров, и Navtest, содержащий 12 тыс. примеров. Мы используем видео с камер вождения с частотой 8 Гц из nuScenes и NuPlan для обучения видео, а также данные с камер с частотой 2 Гц из NAVSIM для прогнозирования траектории..
Для оценки качества генерации видео на валидационном наборе nuScenes мы используем FVD [62] и FID [27]. Для оценки планирования на NAVSIM [16] мы используем Predictive Driver Model Score (PDMS), который объединяет штрафы за столкновения не по вине водителя (NC) и соблюдение правил движения по проезжей части (DAC) с взвешенными показателями прогресса эго-автомобиля (EP), времени до столкновения (TTC) и комфорта (Comf.) для оценки общей безопасности, соблюдения правил и эффективности..
4.2 Основные результаты
Количественные эксперименты по генерации видео.
Табл. 1 содержит количественные результаты генеративной оценки на наборе данных nuScenes. По обоим показателям DriveLaW превосходит все предыдущие одноракурсные подходы, демонстрируя передовую производительность с показателями 4.6 FID и 81.3 FVD. Результаты подтверждают эффективность нашего метода для генерации высококачественного видео вождения..
Количественные эксперименты по планированию движения.
В табл. 2 представлены результаты NAVSIM. DriveLaW достигает показателя PDMS 89,1, устанавливая новый уровень современного состояния техники без какого-либо пост-обучения, такого как reinforcement learning, или постобработки, такой как learned scorers. Он превосходит традиционные end-to-end planners, включая DiffusionDrive [48], который объединяет данные камер и LiDAR, и ReCogDrive [44], который опирается на Vision-Language Models. По сравнению с методами world-model, DriveLaW превосходит Epona на 2,9 PDMS, где Epona [80] использует архитектуру параллельной генерации и планирования, а также превосходит DriveVLA-W0 [42] и PWM [82] на 1,9 и 1,0 PDMS соответственно, которые используют VLM и контроль со стороны world-model, что демонстрирует эффективность объединения генерации с планированием..
Качественные результаты.
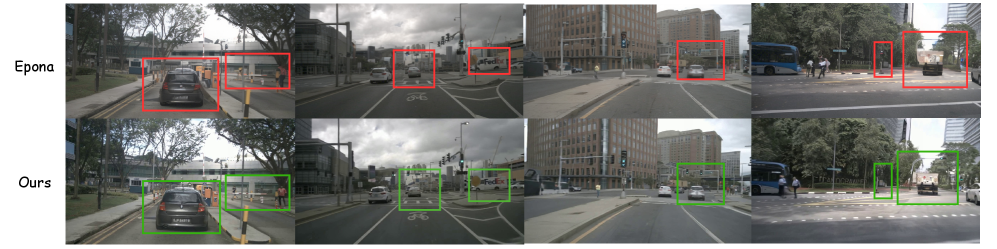
На рис. 4 представлены качественные сравнения между нашей моделью DriveLaW и текущей передовой моделью мира для автономного вождения с открытым исходным кодом Epona [80]. Как показано на самой левой паре изображений, транспортные средства на видео, сгенерированных Epona, демонстрируют заметные визуальные артефакты, в то время как DriveLaW выдает результаты с более четкими деталями транспортных средств и более стабильной структурной целостностью. В результатах Epona фигуры пешеходов почти деградируют до состояния неузнаваемости, тогда как DriveLaW сохраняет полные формы, которые остаются легко идентифицируемыми. Кроме того, в случае с визуально незаметным желтым фургоном в сцене, Epona ошибочно классифицирует его как другой объект, тогда как DriveLaW правильно распознает и сохраняет его внешний вид и пространственное положение. Эти результаты демонстрируют, что DriveLaW превосходит аналоги по визуальному качеству, сохранению объектов и семантическому пониманию мира..
4.3 Абляционное исследование
Преимущества планирования за счет масштабирования предварительного обучения генераторов видео.
Как показано в табл. 3, увеличение количества образцов предварительного обучения для генератора видео стабильно повышает производительность DriveLaW в замкнутом контуре на NAVSIM. Полностью предварительно обученный генератор обеспечивает улучшение PDMS на +3.2 по сравнению с генератором без предварительного обучения в домене вождения, что указывает на то, что более крупные корпуса данных углубляют понимание моделью физики вождения и трансформируются в более эффективное планирование, демонстрируя четкий закон масштабирования..
| Video P.T. Size | NC | DAC | TTC | Comf. | EP | PDMS |
| 0 (scratch) | 98.2 | 93.8 | 94.1 | 99.9 | 80.8 | \cellcolorgray!3085.9 |
| 76k | 98.7 | 94.7 | 95.3 | 99.9 | 80.8 | \cellcolorgray!3087.0 |
| 3.8M | 98.6 | 95.8 | 94.8 | 100 | 82.2 | \cellcolorgray!3087.8 |
| 7.6M | 99.0 | 97.1 | 96.7 | 100 | 81.3 | \cellcolorgray!30 89.1 |
Качественный анализ латентных представлений.
Чтобы продемонстрировать, что латентные признаки VGM (Video Generation Model) могут служить более эффективными и информативными условиями для обучения действиям, мы проводим систематический анализ. Как показано на рис. 5, мы визуализируем и сравниваем три типа латентных представлений. Мы применяем PCA (Principal Component Analysis) [1] для проецирования каждого представления на 3 главных компонента, отображенных в каналы RGB, с апсемплингом до 1280×704. Визуализация ясно показывает, что признаки BEV и VLM являются диффузными, нестабильными и демонстрируют нерегулярные паттерны фокусировки. Напротив, признаки VGM более четкие, менее зашумленные и демонстрируют превосходную семантическую связность с сильным осознанием пространственной структуры, даже в сложных дорожных условиях. Это предполагает, что признаки VGM обеспечивают более подходящее представление для обучения действиям в автономном вождении..
Сравнение представлений вождения в NAVSIM Navtest.
В табл. 4 представлены результаты с использованием различных представлений вождения. При использовании одного и того же планировщика на основе diffusion, латентные признаки генератора видео улучшают PDMS на 5,0 по сравнению с признаками BEV и на 2,6 по сравнению со скрытыми состояниями VLM, что демонстрирует эффективность данного представления..
| Representation | NC | DAC | TTC | Comf. | EP | PDMS |
| BEV Features | 97.6 | 93.0 | 92.9 | 100 | 79.1 | \cellcolorgray!3084.1 |
| VLM Hidden State | 98.1 | 94.7 | 94.2 | 100 | 80.9 | \cellcolorgray!3086.5 |
| Video Latents | 99.0 | 97.1 | 96.7 | 100 | 81.3 | \cellcolorgray!30 89.1 |
Абляция этапа шумоподавления видео для обусловливания Action DiT.
Как показано в Tab. 5, мы проводим абляционное исследование того, какой шаг шумоподавления видео обеспечивает латентное условие для Action DiT. Обусловливание на латентных представлениях с ранних шагов шумоподавления обеспечивает более эффективное планирование, в то время как латентные представления с более поздних шагов показывают худшие результаты. Это происходит потому, что видео в формате необработанных пикселей часто содержат избыточную, несущественную информацию, которая может препятствовать эффективности принятия решений..
| Video Denoise Step | NC | DAC | TTC | Comf. | EP | PDMS |
| 99.0 | 97.1 | 96.7 | 100 | 81.3 | \cellcolorgray!30 89.1 | |
| 99.2 | 93.7 | 95.6 | 100 | 81.8 | \cellcolorgray!3086.9 | |
| 81.7 | 63.4 | 67.6 | 0 | 15.4 | \cellcolorgray!3023.2 |
Влияние стратегии обучения.
Табл. 6 представляет результаты абляционного исследования различных стратегий обучения. Удаление первого этапа приводит к сопоставимым значениям FID, но значительно более высоким значениям FVD, что указывает на заметную потерю временной согласованности из-за отсутствия моделирования движения на больших горизонтах планирования. Пропуск второго этапа сохраняет временную стабильность, но незначительно ухудшает пространственную детализацию, что отражается в умеренном увевлении FVD. Полная многоэтапная стратегия обучения обеспечивает наилучший баланс, позволяя достичь минимальных значений FID и FVD, что подтверждает, что каждый этап играет взаимодополняющую роль в обеспечении высокого качества и временной согласованности генерации видео вождения..
| Methods | FID | FVD |
| w/o First Stage Training | 5.0 | 109.3 |
| w/o Second Stage Training | 5.0 | 93.2 |
| Ours | 4.6 | 81.3 |
5 Заключение
В данной работе мы предлагаем DriveLaW, унифицированную латентную модель мира, которая устраняет давний разрыв между генерацией видео и планированием движения в автономном вождении. Мы сначала представили DriveLaW-Video, пространственно-временной генеративный модуль, дополненный механизмом Noise Reinjection для обеспечения высококачественного и временно согласованного синтеза видео. Основываясь на этом фундаменте, мы разработали DriveLaW-Act, планировщик на основе диффузии, который использует латентные представления видео для генерации плавных и надежных траекторий. Для дальнейшей гармонизации оптимизации между генерацией и планированием мы применили трехэтапную стратегию прогрессивного обучения. Обширные эксперименты на бенчмарках nuScenes и NAVSIM демонстрируют, что DriveLaW достигает state-of-the-art производительности, подтверждая эффективность объединения генерации мира вождения и принятия решений посредством общего латентного представления для end-to-end автономных систем вождения следующего поколения..
Список литературы
- ⟦Abdi and Williams [2010] Эрве Абди и Линн Дж. Уильямс. Метод главных компонент. Wiley interdisciplinary reviews: computational statistics, 2(4):433–459, 2010.
- ⟦Ali et al. [2025] Арслан Али, Джунджи Бай, Мацей Бала, Йогеш Баладжи, Аарон Блейкман, Тиффани Цай, Цзясинь Цао, Тяньши Цао, Элизабет Ча, Ю-Вэй Чао и др. Моделирование мира с помощью видео foundation models для физического AI. arXiv preprint arXiv:2511.00062, 2025.
- ⟦Assran et al. [2025] Мидо Ассран, Адриен Бардес, Дэвид Фан, Квентин Гарридо, Рассел Хаус, Мэтью Макли, Аммар Ризви, Клэр Робертс, Кустув Синха, Артем Жолус и др. V-jepa 2: Самообучающиеся видеомодели обеспечивают понимание, прогнозирование и планирование. arXiv preprint arXiv:2506.09985, 2025.
- ⟦Bartoccioni et al. [2025] Флоран Барточчони, Элиас Рамзи, Виктор Бенье, Шашанка Венкатарамана, Туан-Хунг Ву, Ихун Сюй, Лоик Шамбон, Спирос Гидарис, Серкан Одабаш, Дэвид Хурич и др. Vavim and vavam: Автономное вождение посредством генеративного видеомоделирования. arXiv preprint arXiv:2502.15672, 2025.
- ⟦[5] Кевин Блэк, Ноа Браун, Дэнни Дрисс, Аднан Эсмаил, Майкл Экви, Челси Финн, Никколо Фусаи, Лачи Грум, Карол Хаусман, Брайан Ихтер и др. 0: Модель потока «зрение-язык-действие» для общего управления роботами. corr, abs/2410.24164, 2024. doi: 10.48550. arXiv preprint ARXIV.2410.24164.
- ⟦Blattmann et al. [2023] Андреас Блаттманн, Тим Докхорн, Сумит Кулал, Дэниел Менделевич, Мацей Килиан, Доминик Лоренц, Ям Леви, Зайон Инглиш, Викрам Волети, Адам Леттс и др. Stable video diffusion: Масштабирование латентных диффузионных моделей видео на большие наборы данных. arXiv preprint arXiv:2311.15127, 2023.
- ⟦Brooks et al. [2024] Тим Брукс, Билл Пиблс, Коннор Холмс, Уилл ДеПью, Юфэй Го, Ли Цзин, Дэвид Шнурр, Джо Тейлор, Трой Луман, Эрик Луман и др. Модели генерации видео как симуляторы мира. Блог OpenAI, 1(8):1, 2024.
- ⟦Bruce et al. [2024] Джейк Брюс, Майкл Д. Деннис, Эшли Эдвардс, Джек Паркер-Холдер, Юге Ши, Эдвард Хьюз, Мэттью Лай, Адити Маваланкар, Ричи Стайгервальд, Крис Аппс и др. Genie: Генеративные интерактивные среды. В материалах сорок первой Международной конференции по машинному обучению, 2024.
- ⟦Caesar et al. [2020] Холгер Цезарь, Варун Банкити, Алекс Х. Ланг, Соурабх Вора, Венеция Эрин Лионг, Цян Сюй, Ануш Кришнан, Ю Пан, Джанкарло Балдан и Оскар Бейбом. nuscenes: Мультимодальный набор данных для автономного вождения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 11621–11631, 2020.
- ⟦Caesar et al. [2021] Холгер Цезарь, Юрай Кабзан, Кок Сеанг Тан, Уай Кит Фонг, Эрик Вольф, Алекс Лэнг, Люк Флетчер, Оскар Бейбом и Сэмми Омари. nuplan: Эталонный тест для планирования на основе ML с замкнутым контуром для автономных транспортных средств. arXiv preprint arXiv:2106.11810, 2021.
- ⟦Chen et al. [2023] Джунсон Чен, Джинчен Ю, Чонгджан Ге, Левей Яо, Энзе Се, Юэ Ву, Жонгдао Ван, Джеймс Квок, Пинг Луо, Хучуан Лу и др. Pixart-: Быстрое обучение diffusion transformers для фотореалистичного синтеза текста в изображение. arXiv preprint arXiv:2310.00426, 2023.
- ⟦Chen et al. [2024] Шаоюй Чэнь, Бо Цзян, Хао Гао, Бэнчэн Ляо, Цин Сюй, Цянь Чжан, Чан Хуан, Вэньюй Лю и Синган Ван. Vadv2: Сквозное векторное автономное вождение посредством вероятностного планирования. arXiv preprint arXiv:2402.13243, 2024.
- ⟦Chen et al. [2025] Юньтао Чен, Юйци Ван и Чжаосян Чжан. DrivingGPT: Унификация моделирования мира вождения и планирования с помощью мультимодальных авторегрессионных transformers. В материалах Международной конференции IEEE/CVF по компьютерному зрению, страницы 26890–26900, 2025.
- ⟦Chi et al. [2025] Чэн Чи, Чжэньцзя Сюй, Сыюань Фэн, Эрик Кузино, Илунь Ду, Бенджамин Берчфил, Расс Тедрейк и Шуран Сун. Diffusion policy: Обучение визуомоторной стратегии посредством диффузии действий. The International Journal of Robotics Research, 44(10-11):1684–1704, 2025.
- ⟦Chitta et al. [2022] Кашьяп Читта, Адитья Пракаш, Бернхард Йегер, Зехао Ю, Катрин Ренц и Андреас Гейгер. Transfuser: Имитационное обучение с использованием transformers-based сенсорной интеграции для автономного вождения. IEEE transactions on pattern analysis and machine intelligence, 45(11):12878–12895, 2022.
- ⟦Dauner et al. [2024] Даниэль Даунер, Марсель Халлгартен, Тяньюй Ли, Синьшо Вэн, Чжиюй Хуан, Зетон Ян, Хунъян Ли, Игорь Гилищенски, Борис Иванович, Марко Павоне и др. Navsim: Data-driven non-reactive autonomous vehicle simulation and benchmarking. Advances in Neural Information Processing Systems, 37:28706–28719, 2024.
- ⟦Gao et al. [2025a] Хао Гао, Шаоюй Чэнь, Бо Цзян, Бэнчэн Ляо, Иян Ши, Сяоян Го, Юэчуань Пу, Хаожань Инь, Сянъюй Ли, Синьбан Чжан и др. Rad: Обучение сквозной стратегии вождения посредством обучения с подкреплением на основе крупномасштабных 3dgs. arXiv preprint arXiv:2502.13144, 2025a.
- ⟦Gao et al. [2023] Руйюань Гао, Кай Чэнь, Эньцзэ Се, Ланьцин Хун, Чжэньго Ли, Дит-Ян Ён и Цян Сюй. Magicdrive: Генерация вида улицы с разнообразным контролем 3D-геометрии. arXiv preprint arXiv:2310.02601, 2023.
- ⟦Gao et al. [2025b] Руйюань Гао, Кай Чэнь, Бо Сяо, Ланьцин Хун, Чжэньго Ли и Цян Сюй. Magicdrive-v2: Генерация видео высокого разрешения большой длительности для автономного вождения с адаптивным управлением. В материалах международной конференции IEEE/CVF по компьютерному зрению, страницы 28135–28144, 2025b.
- ⟦Gao et al. [2024] Шеньюань Гао, Цзячжи Ян, Ли Чэнь, Кашьяп Читта, Ихан Цю, Андреас Гейгер, Цзюнь Чжан и Хунъян Ли. Vista: Обобщаемая модель мира вождения с высокой точностью и универсальной управляемостью. Advances in Neural Information Processing Systems, 37:91560–91596, 2024.
- ⟦Guo et al. [2025a] Цзячжэ Го, Икан Дин, Сиу Чэнь, Шо Чэнь, Бохань Ли, Иншуан Цзоу, Сяоян Лю, Фэйян Тань, Сяоцзюань Ци, Чжихэн Ли и др. Dist-4d: Разделенная пространственно-временная диффузия с метрической глубиной для генерации 4d-сцен вождения. arXiv preprint arXiv:2503.15208, 2025a.
- ⟦Guo et al. [2025b] Сянъюй Го, Чжаньцянь У, Кайсинь Сюн, Цзыян Сюй, Лицзюнь Чжоу, Ганвэй Сюй, Шаоцин Сюй, Хайян Сунь, Бин Ван, Гуан Чэнь и др. Genesis: Мультимодальная генерация сцен вождения с пространственно-временной и кросс-модальной согласованностью. arXiv preprint arXiv:2506.07497, 2025b.
- ⟦Guo et al. [2025c] Цзыюй Го, Синьянь Чэнь, Жэньжуй Чжан, Жуйчуань Ань, Юй Ци, Дунчжи Цзян, Сянтай Ли, Маньюань Чжан, Хуншэн Ли и Фэн-Энь Хэн. Готовы ли видеомодели к роли zero-shot рассуждателей? эмпирическое исследование с использованием бенчмарка mme-cof. arXiv preprint arXiv:2510.26802, 2025c.
- ⟦HaCohen et al. [2024] Йоав ХаКоэн, Нисан Чипрут, Бенни Бразовски, Даниэль Шалем, Дуду Моше, Эйтан Ричардсон, Эран Левин, Гай Ширан, Нир Забари, Ори Гордон и др. Ltx-video: Диффузия латентных представлений видео в реальном времени. arXiv preprint arXiv:2501.00103, 2024.
- ⟦Harvey et al. [2022] Уильям Харви, Саид Надерипаризи, Ваден Масрани, Кристиан Вейлбах и Фрэнк Вуд. Гибкое диффузионное моделирование длинных видео. Достижения в системах нейронной обработки информации, 35:27953–27965, 2022.
- ⟦Hassan et al. [2025] Мариам Хассан, Себастьян Стапф, Ахмад Рахими, Педро Резенде, Ясаман Хагиги, Дэвид Брюггеманн, Исинсу Катирджиоглу, Лин Чжан, Сяоран Чен, Суман Саха и др. Gem: Обобщаемая мультимодальная модель мира с эго-видением для управления эго-движением, динамикой объектов и композицией сцены с высокой детализацией. В материалах конференции по компьютерному зрению и распознаванию образов, страницы 22404–22415, 2025.
- ⟦Heusel et al. [2017] Мартин Хойзель, Хуберт Рамзауэр, Томас Унтертинер, Бернхард Несслер и Зепп Хохрайтер. Gans, обученные по правилу обновления с двумя временными шкалами, сходятся к локальному равновесию Нэша. Достижения в системах нейронной обработки информации, 30, 2017.
- ⟦Ho et al. [2022] Джонатан Хо, Уильям Чан, Читван Сахария, Джей Ванг, Руйци Гао, Алексей Гриценко, Дидерик П. Кингма, Бен Пул, Мохаммад Норузи, Дэвид Дж. Флит и др. Imagen video: Генерация видео высокого разрешения с помощью diffusion models. arXiv preprint arXiv:2210.02303, 2022.
- ⟦Hu et al. [2023a] Энтони Хью, Ллойд Рассел, Хадсон Йео, Зак Мурез, Джордж Федосеев, Алекс Кендалл, Джейми Шоттон и Джанлука Коррадо. Gaia-1: Генеративная модель мира для автономного вождения. arXiv preprint arXiv:2309.17080, 2023a.
- ⟦Hu et al. [2024] Сяотао Ху, Вэй Инь, Минкай Цзя, Цзюньюань Дэн, Сяоян Го, Цянь Чжан, Сяосяо Лун и Пин Тань. Drivingworld: Построение мировой модели для автономного вождения с помощью video gpt. arXiv preprint arXiv:2412.19505, 2024.
- ⟦Hu et al. [2023b] Ихан Ху, Цзячжи Ян, Ли Чэнь, Кэюй Ли, Чунхао Сима, Сичжоу Чжу, Сыци Чай, Сэньяо Ду, Тяньвэй Линь, Вэньхай Ван и др. Автономное вождение, ориентированное на планирование. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 17853–17862, 2023b.
- ⟦Huang et al. [2021] Джунджи Хуан, Гуань Хуан, Чжэн Чжу, Юнь Е и Далун Ду. Bevdet: Высокопроизводительное трехмерное обнаружение объектов с нескольких камер в представлении «вид с высоты птичьего полета». arXiv preprint arXiv:2112.11790, 2021.
- ⟦Hwang et al. [2025] Гынмин Хван, Хён Гю Ко, Ёнхён Ким, Сынрён Ли и Ынбён Пак. Diffuseslide: Генерация видео с высокой частотой кадров без обучения на основе диффузии, 2025.
- ⟦Jiang et al. [2023] Бо Цзян, Шаоюй Чэнь, Цин Сюй, Бэнчэн Ляо, Цзяцзе Чэнь, Хэлун Чжоу, Цянь Чжан, Вэньюй Лю, Чан Хуан и Синган Ван. Vad: Векторизованное представление сцены для эффективного автономного вождения. В материалах Международной конференции IEEE/CVF по компьютерному зрению, страницы 8340–8350, 2023.
- ⟦Kim et al. [2021] Сын Вук Ким, Джона Филион, Антонио Торральба и Санья Фидлер. Drivegan: На пути к управляемой высококачественной нейронной симуляции. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 5820–5829, 2021.
- ⟦Kong et al. [2024] Вэйцзе Кун, Ци Тянь, Цзыцзянь Чжан, Рокс Мин, Цзочжо Дай, Цзинь Чжоу, Цзянфэн Сюн, Синь Ли, Бо У, Цзяньвэй Чжан и др. Hunyuanvideo: Систематическая структура для больших генеративных моделей видео. arXiv preprint arXiv:2412.03603, 2024.
- ⟦Lei et al. [2023] Цзяруй Лэй, Сяобо Ху, Юэ Ван и Дун Лю. Pyramidflow: Высокоразрешающая контрастная локализация дефектов с использованием пирамидального нормализующего потока. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 14143–14152, 2023.
- ⟦Li et al. [2025a] Бохан Ли, Цзячжэ Го, Хунси Лю, Иншуан Цзоу, Икан Дин, Сиу Чэнь, Ху Чжу, Фэйян Тань, Чи Чжан, Тяньцай Ван и др. Uniscene: Унифицированная генерация сцен вождения с ориентацией на заполненность пространства. В материалах конференции по компьютерному зрению и распознаванию образов, страницы 11971–11981, 2025a.
- ⟦Li et al. [2025b] Бохан Ли, Чжуан Ма, Далун Ду, Баоруй Пэн, Чжуцзинь Лян, Чжэньцян Лю, Чао Ма, Юэмин Цзинь, Хао Чжао, Вэньцзюнь Цзэн и др. Omninwm: Всеведущие мировые модели навигации для автономного вождения. arXiv preprint arXiv:2510.18313, 2025b.
- ⟦Li et al. [2024a] Сяофань Ли, Ифу Чжан и Сяоцин Е. Drivingdiffusion: генерация видео дорожных сценариев с нескольких ракурсов на основе планировки с использованием latent diffusion model. В European Conference on Computer Vision, страницы 469–485. Springer, 2024a.
- ⟦Li et al. [2024b] Инъян Ли, Лю Фань, Цзявэй Хэ, Юйци Ван, Юньтао Чэнь, Чжаосян Чжан и Тениу Тань. Улучшение end-to-end автономного вождения с помощью латентной world model. arXiv preprint arXiv:2406.08481, 2024b.
- ⟦Li et al. [2025c] Инъянь Ли, Шуяо Шан, Вэйсун Лю, Бин Чжан, Хаочэнь Ван, Юйци Ван, Юньтао Чэнь, Сяомань Ван, Ясун Ань, Чуфэн Тан и др. Drivevla-w0: World models усиливают закон масштабирования данных в автономном вождении. arXiv preprint arXiv:2510.12796, 2025c.
- ⟦Li et al. [2025d] Инъян Ли, Юйци Ван, Ян Лю, Цзявэй Хэ, Лю Фань и Чжаосян Чжан. Сквозное вождение с онлайн-оценкой траектории посредством world model в представлении bev. arXiv preprint arXiv:2504.01941, 2025d.
- ⟦Li et al. [2025e] Юнкан Ли, Кайсинь Сюн, Сянъюй Го, Фан Ли, Сисюй Янь, Ганвэй Сюй, Лицзюнь Чжоу, Лун Чэнь, Хайян Сунь, Бин Ван и др. Recogdrive: Усиленная когнитивная структура для сквозного автономного вождения. arXiv preprint arXiv:2506.08052, 2025e.
- ⟦Li et al. [2024c] Чжици Ли, Вэньхай Ван, Хунъян Ли, Эньцзэ Се, Чунхао Сима, Тун Лу, Цяо Юй и Цзифэн Дай. Bevformer: обучение представлению вида сверху на основе данных лидара и камеры с помощью spatiotemporal transformers. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2024c.
- ⟦Liang et al. [2024] Вейсинь Лян, Лили Ю, Лян Ло, Сринивасан Айер, Нин Дун, Чуньтин Чжоу, Гарги Гош, Майк Льюис, Вэнь-тау Йи, Люк Зеттльмойер и др. Mixture-of-transformers: Разреженная и масштабируемая архитектура для мультимодальных фундаментальных моделей. arXiv preprint arXiv:2411.04996, 2024.
- ⟦Liao et al. [2022] Бэнчэн Ляо, Шаоюй Чэнь, Синган Ван, Тяньхэн Чэн, Цянь Чжан, Вэньюй Лю и Чан Хуан. Maptr: Структурное моделирование и обучение для онлайн-построения векторизованных hd-карт. arXiv preprint arXiv:2208.14437, 2022.
- ⟦Liao et al. [2025a] Бэнчэн Ляо, Шаоюй Чэнь, Хаожань Инь, Бо Цзян, Чэн Ван, Сисюй Янь, Синьбан Чжан, Сянъюй Ли, Ин Чжан, Цянь Чжан и др. Diffusiondrive: Усеченная диффузионная модель для сквозного автономного вождения. В материалах Конференции по компьютерному зрению и распознаванию образов, страницы 12037–12047, 2025a.
- ⟦Liao et al. [2025b] Юэ Ляо, Пэнфэй Чжоу, Сыюань Хуан, Дунлинь Ян, Шэнцун Чэнь, Юйсинь Цзян, Юэ Ху, Цзинбинь Цай, Сы Лю, Цзяньлань Ло и др. Genie envisioner: Единая базовая мировая платформа для роботизированных манипуляций. arXiv preprint arXiv:2508.05635, 2025b.
- ⟦Lipman et al. [2022] Ярон Липман, Рики ТК Чен, Хели Бен-Хаму, Максимилиан Никель и Мэтт Ле. Flow matching для генеративного моделирования. arXiv preprint arXiv:2210.02747, 2022.
- ⟦Lotter et al. [2016] Уильям Лоттер, Габриэль Крейман и Дэвид Кокс. Глубокие сети предиктивного кодирования для прогнозирования видео и обучения без учителя. arXiv preprint arXiv:1605.08104, 2016.
- ⟦Lu et al. [2024] Цзячэнь Лу, Цзэ Хуан, Цзэюй Ян, Цзяхуэй Чжан и Ли Чжан. Wovogen: Диффузия с учетом мирового объема для управляемой генерации сцен вождения с нескольких камер. В материалах Европейской конференции по компьютерному зрению, страницы 329–345. Springer, 2024.
- ⟦Ma et al. [2024] Энхуй Ма, Лицзюнь Чжоу, Тао Тан, Чжан Чжан, Дун Хань, Цзюньпэн Цзян, Кунь Чжань, Пэн Цзя, Сяньпэн Лан, Хайян Сунь и др. Раскрытие потенциала обобщения end-to-end автономного вождения с помощью управляемой генерации длинных видео. arXiv preprint arXiv:2406.01349, 2024.
- ⟦Min et al. [2024] Чэнь Минь, Давэй Чжао, Лян Сяо, Цзянь Чжао, Синьли Сюй, Чжэн Чжу, Лэй Цзинь, Цзяньшу Ли, Юйлань Го, Цзюньлян Син и др. Driveworld: 4d предварительно обученное понимание сцены с помощью world models для автономного вождения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 15522–15533, 2024.
- ⟦Ni et al. [2025] Чаоцзюнь Ни, Гошэн Чжао, Сяофэн Ван, Чжэн Чжу, Вэнькан Цинь, Синьцзэ Чэнь, Гуанхун Цзя, Гуань Хуан и Вэньцзюнь Мэй. Recondreamer-rl: Улучшение reinforcement learning посредством реконструкции сцены на основе diffusion. arXiv preprint arXiv:2508.08170, 2025.
- ⟦Peebles and Xie [2023] Уильям Пиблс и Сайнинг Се. Масштабируемые diffusion models с использованием transformers. В материалах международной конференции IEEE/CVF по компьютерному зрению, страницы 4195–4205, 2023.
- ⟦Peng et al. [2023] Сунъюй Пэн, Кайл Дженова, Чиюй Цзян, Андреа Тальясакки, Марк Поллефейс, Томас Фанкхаузер и др. Openscene: понимание трехмерных сцен с открытыми словарями. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 815–824, 2023.
- ⟦Polyak et al. [2024] Адам Поляк, Амит Зохар, Эндрю Браун, Андрос Тьяндра, Анимеш Синха, Энн Ли, Апурв Вьяс, Боуэн Ши, Чи-Яо Ма, Чинг-Яо Чуанг и др. Movie gen: A cast of media foundation models. arXiv preprint arXiv:2410.13720, 2024.
- ⟦Ren et al. [2025] Сюаньчи Жэнь, Ифань Лу, Тяньши Цао, Жуйюань Гао, Шэнъюй Хуан, Амирмоджтаба Сабур, Тяньчан Шэнь, Тобиас Пфафф, Джей Чжанцзе У, Жуньцзянь Чэнь и др. Cosmos-drive-dreams: Масштабируемая генерация синтетических данных вождения с помощью мировых фундаментальных моделей. arXiv preprint arXiv:2506.09042, 2025.
- ⟦Russell et al. [2025] Ллойд Рассел, Энтони Хью, Лоренцо Бертони, Джордж Федосеев, Джейми Шоттон, Элахе Арани и Джанлука Коррадо. Gaia-2: Управляемая многоракурсная генеративная модель мира для автономного вождения. arXiv preprint arXiv:2503.20523, 2025.
- ⟦Su et al. [2024] Цзяньлинь Су, Муртада Ахмед, Юй Лу, Шэнфэн Пань, Вэнь Бо и Юньфэн Лю. Roformer: Enhanced transformer with rotary position embedding. Neurocomputing, 568:127063, 2024.
- ⟦Unterthiner et al. [2018] Томас Унтертинер, Сьорд Ван Стинкисте, Кароль Курач, Рафаэль Маринье, Марцин Михальски и Сильвен Желли. На пути к точным генеративным моделям видео: новая метрика и вызовы. arXiv preprint arXiv:1812.01717, 2018.
- ⟦Vaswani et al. [2017] Ашиш Васвани, Ноам Шазир, Ники Пармар, Якоб Ушкорейт, Лион Джонс, Эйдан Н. Гомес, Лукаш Кайзер и Илья Полосухин. Attention is all you need. Advances in neural information processing systems, 30, 2017.
- ⟦Villegas et al. [2017] Рубен Вильегас, Джимей Янг, Сынхун Хонг, Сюньюй Линь и Хонглак Ли. Декомпозиция движения и содержания для прогнозирования естественных видеопоследовательностей. arXiv preprint arXiv:1706.08033, 2017.
- ⟦Wang et al. [2025a] Хайгуан Ван, Даци Лю, Хунвэй Се, Хайсун Лю, Энхуэй Ма, Кайчэн Юй, Лиминь Ван и Бин Ван. Mila: мультиракурсная высокоточная долгосрочная модель мира для генерации видео в задачах автономного вождения. arXiv preprint arXiv:2503.15875, 2025a.
- ⟦Wang et al. [2025b] Цзявэй Ван, Хаовэй Сунь, Синьтао Янь, Шо Фэн, Цзюнь Гао и Генри Х. Лю. Terasim-world: Синтез критически важных для безопасности данных по всему миру для end-to-end автономного вождения. arXiv preprint arXiv:2509.13164, 2025b.
- ⟦Wang et al. [2024a] Ленинг Ван, Венжао Чжэн, Илун Жэнь, Хань Цзян, Чжиюн Цуй, Хайян Юй и Цзивэнь Лу. Occsora: модели генерации 4d-занятости как мировые симуляторы для автономного вождения. arXiv preprint arXiv:2405.20337, 2024a.
- ⟦Wang et al. [2024b] Сяофэн Ван, Чжэн Чжу, Гуань Хуан, Синьцзэ Чэнь, Цзяган Чжу и Цзивэнь Лу. Drivedreamer: На пути к созданию моделей мира для автономного вождения в реальных условиях. В материалах Европейской конференции по компьютерному зрению, страницы 55–72. Springer, 2024b.
- ⟦Wang et al. [2024c] Юйци Ван, Цзявэй Хэ, Лю Фань, Хунсинь Ли, Юньтао Чэнь и Чжаосян Чжан. Движение в будущее: многоракурсное визуальное прогнозирование и планирование с использованием world model для автономного вождения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 14749–14759, 2024c.
- ⟦Wen et al. [2024] Юйцин Вэнь, Юйчэн Чжао, Инфэй Лю, Фань Цзя, Яньхуэй Ван, Чун Ло, Чи Чжан, Тяньцай Ван, Сяоянь Сунь и Сянъюй Чжан. Panacea: Панорамная и управляемая генерация видео для автономного вождения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 6902–6912, 2024.
- ⟦Weng et al. [2024] Синшо Венг, Борис Иванович, Ян Ван, Юэ Ван и Марко Павоне. Para-drive: Параллелизованная архитектура для автономного вождения в реальном времени. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 15449–15458, 2024.
- ⟦Wiedemer et al. [2025] Таддеус Видемер, Юсюань Ли, Пол Викол, Шисян Шейн Гу, Ник Матарезе, Кевин Сверски, Бин Ким, Приянк Джайни и Роберт Гейрхос. Видеомодели являются zero-shot обучающимися и рассуждающими системами. arXiv preprint arXiv:2509.20328, 2025.
- ⟦Xing et al. [2025] Зебин Син, Синъюй Чжан, Ян Ху, Бо Цзян, Тун Хэ, Цянь Чжан, Сяосяо Лун и Вэй Инь. Goalflow: Потоковое сопоставление на основе целей для генерации мультимодальных траекторий в сквозном автономном вождении. В материалах Конференции по компьютерному зрению и распознаванию образов, страницы 1602–1611, 2025.
- ⟦Yan et al. [2024] Юньчжи Янь, Хаотун Линь, Чэньсюй Чжоу, Вэйцзе Ван, Хайян Сунь, Кунь Чжань, Сяньпэн Лан, Сяовэй Чжоу и Сида Пэн. Street gaussians: Моделирование динамических городских сцен с помощью gaussian splatting. В материалах European Conference on Computer Vision, страницы 156–173. Springer, 2024.
- ⟦Yang et al. [2023] Чэньюй Ян, Юньтао Чэнь, Хао Тянь, Чэньсинь Тао, Сичжоу Чжу, Чжаосян Чжан, Гао Хуан, Хунъян Ли, Юй Цяо, Левей Лу и др. Bevformer v2: Адаптация современных графических бэкендов для распознавания с высоты птичьего полета посредством перспективного контроля. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 17830–17839, 2023.
- ⟦Yang et al. [2024a] Цзячжи Ян, Шэньюань Гао, Ихан Цю, Ли Чэнь, Тяньюй Ли, Бо Дай, Кашьяп Читта, Пэнхао У, Цзя Цзэн, Пин Ло и др. Обобщенная предиктивная модель для автономного вождения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, страницы 14662–14672, 2024a.
- ⟦Yang et al. [2025] Цзячжи Ян, Кашьяп Читта, Шэньюань Гао, Лун Чэнь, Юйцянь Шао, Сяосун Цзя, Хунъян Ли, Андреас Гейгер, Сянъюй Юэ и Ли Чэнь. Resim: Надежное моделирование мира для автономного вождения. arXiv preprint arXiv:2506.09981, 2025.
- ⟦Yang et al. [2024b] Чжои Ян, Цзяянь Тэн, Вэньди Чжэн, Мин Дин, Шиюй Хуан, Цзячжэн Сюй, Юаньмин Ян, Вэньи Хун, Сяохань Чжан, Гуаньюй Фэн и др. Cogvideox: Диффузионные модели преобразования текста в видео с экспертным transformers. arXiv preprint arXiv:2408.06072, 2024b.
- ⟦Zhang and Sennrich [2019] Бяо Чжан и Рико Сеннрич. Нормализация слоя по среднеквадратичному значению. Достижения в системах нейронной обработки информации, 32, 2019.
- ⟦Zhang et al. [2025] Кайвэнь Чжан, Чжэньюй Тан, Сяотао Ху, Синган Пань, Сяоян Го, Юань Лю, Цзинвэй Хуан, Ли Юань, Цянь Чжан, Сяо-Сяо Лун и др. Epona: Авторегрессионная диффузионная модель мира для автономного вождения. arXiv preprint arXiv:2506.24113, 2025.
- ⟦Zhao et al. [2025a] Гошэн Чжао, Сяофэн Ван, Чжэн Чжу, Синьцзэ Чэнь, Гуань Хуан, Сяои Бао и Синган Ван. Drivedreamer-2: LLM-enhanced world models for diverse driving video generation. В материалах конференции AAAI по искусственному интеллекту, страницы 10412–10420, 2025a.
- ⟦Zhao et al. [2025b] Чжида Чжао, Талас Фу, Ифань Ван, Лицзюнь Ван и Хучуань Лу. От прогнозирования к планированию: world model политики для совместного предсказания состояний и действий. arXiv preprint arXiv:2510.19654, 2025b.
- ⟦Zheng et al. [2024] Вэньчжао Чжэн, Вэйлян Чэнь, Юаньхуэй Хуан, Божуй Чжан, Юэци Дуань и Цзивэнь Лу. Occworld: Обучение 3d occupancy world model для автономного вождения. В материалах Европейской конференции по компьютерному зрению, страницы 55–72. Springer, 2024.
- ⟦Zheng et al. [2025] Инань Чжэн, Жуймин Лян, Кэсинь Чжэн, Цзиньлян Чжэн, Лиюань Мао, Цзяньсюн Ли, Вэйхао Гу, Жуй Ай, Шэнбо Эбен Ли, Сяньюань Чжань и др. Диффузионное планирование для автономного вождения с гибким управлением. arXiv preprint arXiv:2501.15564, 2025.
- ⟦Zhou et al. [2024] Хунъюй Чжоу, Лунчжун Линь, Цзябао Ван, Ичун Лу, Дунфэн Бай, Бинбин Лю, Юэ Ван, Андреас Гайгер и Ии Ляо. Hugsim: симулятор реального времени с фотореалистичной графикой и замкнутым циклом для автономного вождения. arXiv preprint arXiv:2412.01718, 2024.
Appendix A Дополнительные детали реализации
В этом разделе мы приводим дополнительные технические подробности реализации основных компонентов DriveLaW, включая основу для генерации видео (DriveLaW-Video), модуль планирования траектории (DriveLaW-Act) и механизм промптинга с учетом движения.
A.1 DriveLaW-Video: магистральная модель генерации видео
DriveLaW-Video использует архитектуру на основе диффузии, оптимизированную для высокоэффективного пространственно-временного кодирования и последовательной генерации совместно с последующим планировщиком. Данная конструкция обеспечивает баланс между вычислительной эффективностью и качеством генерации, позволяя осуществлять синтез сценариев вождения на длительном горизонте в условиях практических аппаратных ограничений..
Пространственно-временной VAE и оптимизация сжатия.
Video-VAE служит основным модулем пространственно-временного сжатия, применяя пространственно-временную понижающую дискретизацию со 128 выходными каналами. Данная конфигурация обеспечивает общий коэффициент сжатия 1:192 (отношение пикселей к токенам 1:8192), что примерно в два раза превышает степень сжатия стандартных конвейеров преобразования текста в видео. Чтобы обеспечить столь агрессивное сжатие без ущерба для точности генерации, мы вводим следующие архитектурные и тренировочные модификации:
- ⟦• Причинно-следственный трехмерный кодировщик: гарантирует, что каждый временной шаг зависит только от текущего и предыдущих кадров, сохраняя авторегрессионную согласованность, критически важную для задач прогнозирования вождения.
- ⟦• Гибридная стратегия декодирования: Вместо выполнения всех шагов шумоподавления в латентном пространстве, финальный шаг rectified-flow () выполняется декодером VAE непосредственно в пиксельном пространстве. Такая архитектура позволяет восстановить высокочастотные детали (например, текстуру дороги, отражения, дорожные знаки) без необходимости использования отдельного этапа суперразрешения..
- ⟦• Реконструктивный GAN: дискриминатор получает пары реальных и реконструированных образцов и фокусируется на различиях в деталях с высокой точностью. Это повышает стабильность обучения и перцептивное качество при высокой степени сжатия.
- ⟦• Многослойное внедрение шума: вводит обучаемую стохастичность для каждого канала в декодере, повышая разнообразие синтезируемых текстур.
- ⟦• Равномерная логарифмическая дисперсия по каналам: обеспечивает сбалансированную KL-регуляризацию и позволяет избежать недоиспользования латентных размерностей, повышая эффективность латентного пространства.
- ⟦• Функция потерь Video-DWT: дополняет MSE и перцептивные потери путем явного штрафования высокочастотных ошибок по восьми 3D вейвлет-поддиапазонам, усиливая сохранение структурных деталей.
Видео-трансформерная магистральная архитектура.
Диффузионная магистральная сеть использует архитектуру 3D Transformer, адаптированную из PixArt-, с блоками self–cross attention, скрытым размером , коэффициентом расширения полносвязных слоев и нормализацией RMSNorm вместо LayerNorm для обеспечения лучшей стабильности.
Для поддержания пространственно-временной согласованности при различных разрешениях и длительности мы используем нормализованные дробные Rotary Positional Embeddings (RoPE), вычисляемые с экспоненциальным интервалом частот. В отличие от архитектур на основе patchifier (например, размер патча), токены сериализуются непосредственно из VAE latents с гранулярностью , что исключает избыточные операции разбиения на патчи и сохраняет геометрическую согласованность..
A.2 DriveLaW-Act: Модуль планирования траектории
DriveLaW-Act реализован как легковесный диффузионный планировщик (133M параметров), который тесно интегрирован с магистральной архитектурой DriveLaW-Video. Его ключевые конструктивные особенности заключаются в следующем:
Входное обусловливание.
Планировщик напрямую обусловлен кэшированными латентными представлениями Video-DiT с первого шага шумоподавления. Эти латентные представления кодируют богатую информацию о сцене, включая текущую геометрию и динамику агентов, и служат ключами в механизме кросс-внимания планировщика в сочетании с входным шумом траектории. Кроме того, планировщик получает структурированные контекстные эмбеддинги, включающие: кинематику транспортного средства и команды навигации..
Обучение и инференс.
Планировщик обучается с использованием целевой функции согласования потоков для генерации плавных, физически непротиворечивых траекторий. Он прогнозирует непрерывные позиции с частотой дискретизации 2 Гц на горизонте планирования 4 с. Во время вывода планировщик работает исключительно в латентном пространстве, не требуя декодирования видео, что значительно снижает вычислительные затраты. Примечательно, что градиентная изоляция между модулями генерации видео и планирования сохраняется во время обучения, обеспечивая стабильную оптимизацию каждого компонента..
A.3 Механизм промптинга, обусловленный движением
Чтобы согласовать генерацию видео с реалистичной динамикой вождения, мы разрабатываем структурированный механизм подсказок, обусловленный движением, который объединяет динамическую информацию о состоянии транспортного средства и контекст статической сцены в интерпретируемое текстовое руководство для Video-DiT.
Логика построения промптов.
Численные переменные состояния эго-транспортного средства (скорость, угол поворота рулевого колеса, смещение) сначала дискретизируются в семантические корзины (например, «низкая скорость», «равномерное движение», «поворот налево/направо»). Эти семантические метки интегрируются в фиксированный шаблон промпта, который также включает техническое численное обоснование для обеспечения точного управления. Шаблон определяется следующим образом:
Высококачественное фотореалистичное изображение с видеорегистратора автономного транспортного средства. Основываясь на прошедших секундах, предскажите и сгенерируйте следующие секунд реалистичного продолжения движения, перемещаясь со скоростью [speed bin] и с [motion descriptor], плавно продолжая движение в течение следующих секунд. Сохраняйте временную согласованность, стабильную перспективу камеры, естественный поток движения без дрожания или артефактов, четкие детали и реалистичную физику. [Technical: вперед м, вбок м, рыскание , скорость м/с]
Текстовая подсказка кодируется замороженным энкодером T5-XXL, а полученные эмбеддинги внедряются через кросс-аттеншн во все слои Video-DiT. Это позволяет семантическим сигналам движения модулировать процесс генерации, обеспечивая согласованность между синтезированным видео и динамическими ограничениями транспортного средства..
Appendix B Дополнительные экспериментальные результаты
B.1 Анализ скорости вывода
Для оценки эффективности нашего этапа генерации видео мы сравниваем скорость обработки одного кадра в DriveLaW с унифицированным базовым world-model решением Epona при идентичных экспериментальных настройках: один графический процессор NVIDIA 4090, 30 шагов сэмплирования DiT и соответствующие разрешения, указанные в таблице 7⟧.
| Method | Resolution | Params | Times |
| Epona | B | 0.88 s | |
| DriveLaW (Ours) | 0.12 s | ||
| B | 0.18 s | ||
| 0.39 s |
Как показано в таблице 7, DriveLaW достигает существенно более быстрой генерации при более низких разрешениях. Для DriveLaW требует всего 0,12 с на кадр, в то время как при скорость остается умеренной — 0,18 с, несмотря на то, что размер модели немного больше, чем у Epona. При самом высоком разрешении () DriveLaW достигает 0,39 с на кадр, что более чем в два раза быстрее результата Epona в 0,88 с, даже несмотря на то, что наше выходное разрешение значительно выше..
Эти результаты указывают на то, что предложенные архитектурные оптимизации, включающие более высокий коэффициент сжатия и гибридное декодирование, сохраняют эффективность времени выполнения при различных разрешениях. Это позволяет DriveLaW обеспечивать конкурентоспособную скорость генерации при сохранении высокой точности видео..
B.2 Абляция по использованию повторного введения шума
Мы проводим абляционное исследование для оценки влияния включения или отключения предложенного механизма повторного впрыска шума на качество генерации видео. Эксперименты проводятся на валидационном наборе данных nuScenes с использованием FID и FVD в качестве метрик оценки..
| Setting | FID | FVD |
| w/o Noise Reinjection | 6.1 | 102.1 |
| w/ Noise Reinjection (Ours) | 4.6 | 81.3 |
Как показано в таблице 8, удаление повторного введения шума приводит к заметному ухудшению временной согласованности и незначительному снижению пространственной точности. Путем выборочного возмущения высокочастотных областей перед каждым шагом шумоподавления наш метод заставляет генератор активно восстанавливать мелкие детали, тем самым улучшая как резкость, так и временную стабильность, одновременно уменьшая артефакты.
Appendix C Дополнительные качественные результаты
В этом разделе мы представляем дополнительные качественные примеры для дальнейшей иллюстрации возможностей DriveLaW в разнообразных сценариях вождения и задачах планирования.
C.1 Генерация видео на nuScenes
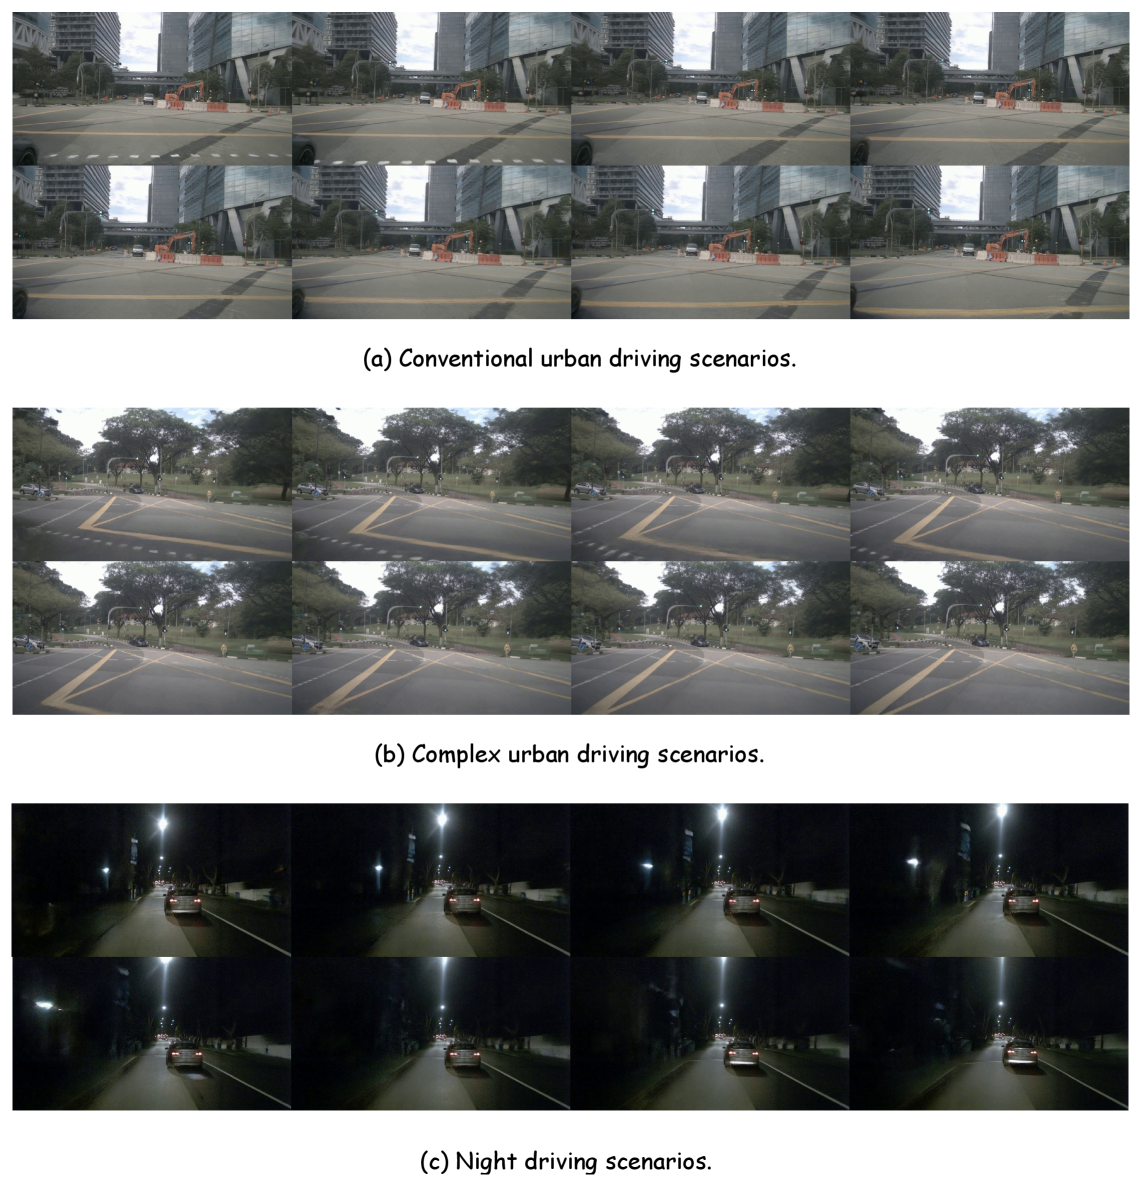
Мы оцениваем DriveLaW на валидационном наборе данных nuScenes в широком спектре реальных сценариев вождения. Как показано на рис. 6, наши результаты демонстрируют, что модель сохраняет временную согласованность, высокую пространственную детализацию и надежную производительность в разнообразных визуальных условиях..
C.2 Визуализация результатов планирования
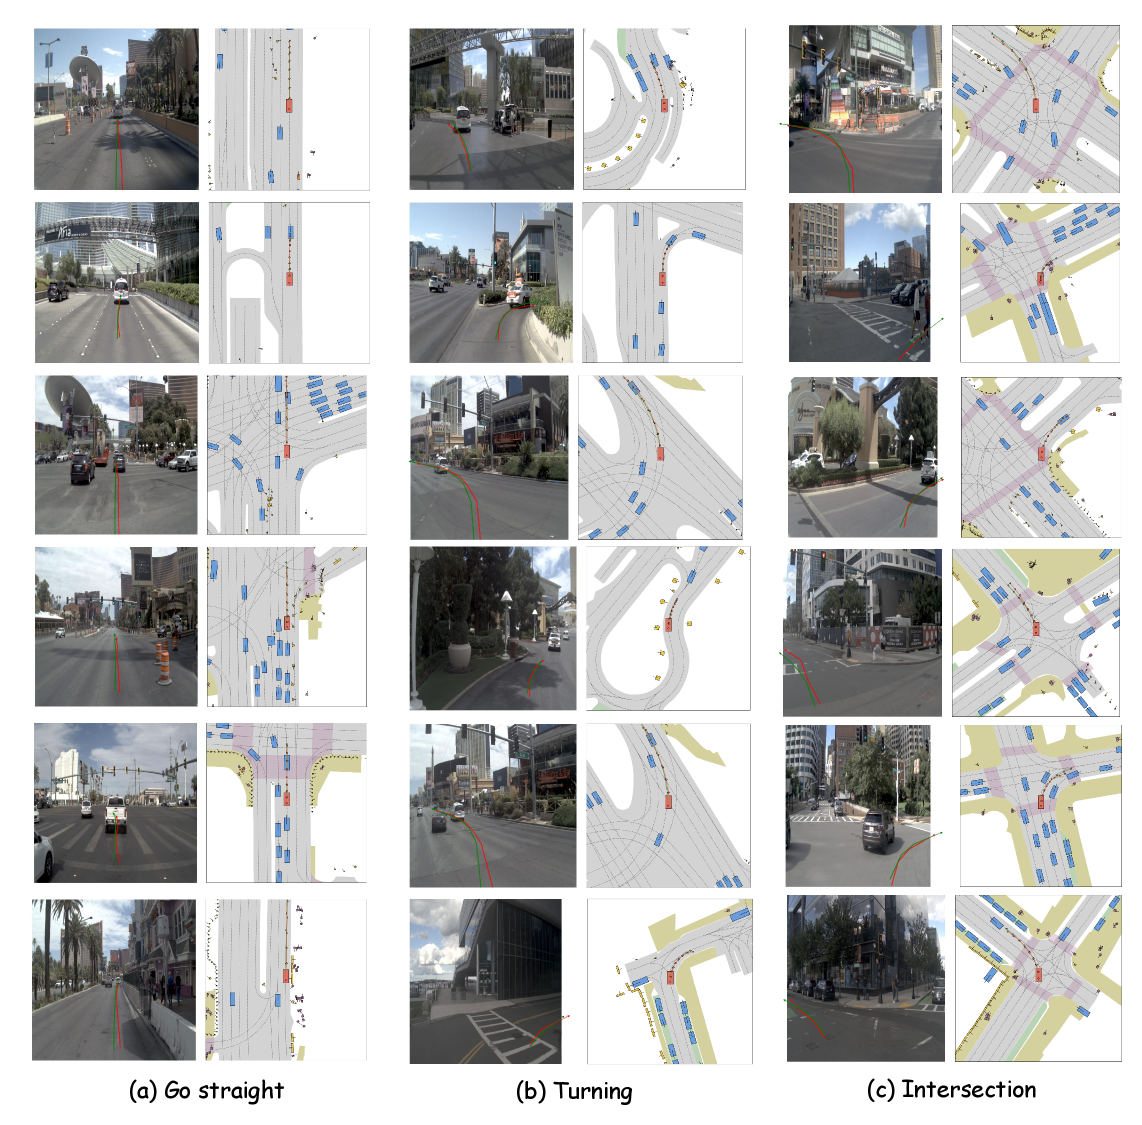
Как показано на рис. 7, мы представляем репрезентативные примеры из выборок Navtest, подчеркивающие способность DriveLaW прогнозировать будущие траектории, обеспечивая при этом безопасность и плавность движения..
C.3 Дополнительные видеодемонстрации
Для более ясного понимания мы предоставляем 6 демонстрационных видео в формате MP4 в дополнительных материалах, включая 4 сценария обычного вождения и 2 сценария в дождливую погоду. Эти примеры помогают рецензентам и читателям визуально оценить временную согласованность, пространственную детализацию и практическую полезность результатов планирования в разнообразных и сложных дорожных условиях..