Оценка способностей к бухгалтерским рассуждениям больших языковых моделей
Аннотация
Большие языковые модели трансформируют обучение, когнитивные процессы и исследования во многих областях. Эффективная интеграция их в профессиональные сферы, такие как бухгалтерский учет, является ключевой задачей цифровой трансформации предприятий. Для решения этой проблемы мы определяем вертикальное доменное бухгалтерское рассуждение и предлагаем критерии оценки, выведенные из анализа характеристик обучающих данных репрезентативных моделей GLM. Эти критерии поддерживают систематическое изучение бухгалтерского рассуждения и предоставляют ориентиры для улучшения производительности. Используя эту структуру, мы оцениваем GLM-6B, GLM-130B, GLM-4 и OpenAI GPT-4 на задачах бухгалтерского рассуждения. Результаты показывают, что дизайн промптов значительно влияет на производительность, причем GPT-4 демонстрирует наибольшую способность. Несмотря на эти достижения, текущие модели остаются недостаточными для реального корпоративного бухгалтерского учета, что указывает на необходимость дальнейшей оптимизации для раскрытия их полной практической ценности..
Оценка способностей к бухгалтерскому рассуждению больших языковых моделей
Jie Zhou, Xin Chen, Jie Zhang, Hai Li, Jie Wang, Zhe Li Школа компьютерной инженерии, Цзянсуский океанический университет jzhou23@jou.edu.cn, lizhe@jou.edu.cn
1 Введение
Благодаря стремительному развитию искусственного интеллекта, в том числе технологий больших данных, суперкомпьютеров, нейросетей и больших языковых моделей, языковые модели общего назначения вызывают большой интерес как в научных кругах, так и в промышленности. Искусственный интеллект стал центральным драйвером технологических инноваций, модернизации промышленности и национальной конкурентоспособности. В Китае такие документы, как «План развития искусственного интеллекта нового поколения» и «Временные меры по управлению сервисами генеративного искусственного интеллекта», делают упор на междисциплинарные исследования, ответственное управление и масштабное применение, создавая благоприятные условия для интеграции больших языковых моделей в такие профессиональные сферы, как бухгалтерский учет.
По мере того как большие языковые модели становятся зрелыми, их фокус развития сместился с масштаба модели на глубокую интеграцию в приложения. Эффективное внедрение этих моделей в профессиональные рабочие процессы и раскрытие предметно-ориентированной ценности стало ключевой исследовательской задачей. По сравнению с узкоспециализированными системами, языковые модели общего назначения показывают преимущества в задачах бухгалтерского учета благодаря более широкому охвату знаний, более сильному пониманию запросов и гибкому рассуждению. Эти возможности поддерживают такие приложения, как финансовый анализ, налогообложение, аудит и управленческая поддержка. Однако систематические предметно-ориентированные бухгалтерские модели все еще недостаточно развиты, и текущая практическая производительность остается ограниченной..
Большинство существующих бухгалтерских приложений используют промпт-инжиниринг для улучшения результатов моделирования. Хотя этот подход может дать краткосрочные выгоды, он обеспечивает ограниченное понимание внутренних процессов рассуждения и предлагает мало поддержки для систематической оптимизации. Бухгалтерские задачи предъявляют высокие требования к математическому рассуждению, логической последовательности и символьным вычислениям, которые не полностью решаются методами, основанными на подсказках. В этом исследовании утверждается, что способность к рассуждению является ключевым фактором, лежащим в основе производительности больших языковых моделей в бухгалтерском учете. Поэтому мы предлагаем структурированный анализ и оценку способностей к бухгалтерскому рассуждению. Интегрируя бухгалтерскую экспертизу с задачами оценки, ориентированными на рассуждение, мы создаем специализированный бенчмарк и анализируем экспериментальные результаты для выявления возможностей для улучшения..
Мы внесли четыре новых элемента. Мы вводим понятие вертикального доменного бухгалтерского учета и уточняем его взаимосвязь с математическими и логическими рассуждениями. Мы разрабатываем всеобъемлющий бенчмарк, охватывающий принципы бухгалтерского учета, финансовую отчетность, учет затрат и аудит. Мы оцениваем репрезентативные модели, включая GPT 4 и модели серии GLM, и анализируем их сильные стороны и ограничения. Наконец, мы исследуем стратегии, которые сочетают предметные знания с оптимизацией рассуждений, чтобы продвинуть интеллектуальные бухгалтерские системы и поддержать развертывание в реальном мире..
2 Связанные работы
2.1 Разработка больших языковых моделей в области бухгалтерского учета
Эффективное использование больших языковых моделей общего назначения в вертикальных областях, таких как медицина и юриспруденция, дает полезные идеи для их внедрения в бухгалтерском учете. В медицинских условиях LLM применялись для задач, включая поддержку клинических решений, интерпретацию медицинских изображений и генерацию отчетов (Yang et al., 2023). Благодаря высокой интерпретируемости медицинских изображений эти модели могут улавливать визуальные паттерны и в сочетании с генерацией естественного языка повышают прозрачность и объяснимость системы, что способствует улучшению принятия клинических решений (Guha et al., 2023).⟧.
Напротив, применения в юридической сфере обычно ограничены вспомогательными ролями, поскольку правовые системы сложны, основаны на правилах и строго регулируются. Автоматизированное рассуждение должно соответствовать правовым и этическим ограничениям, что ограничивает степень автономии модели. Бухгалтерский учет имеет аналогичную структуру, основанную на правилах, но предъявляет более высокие требования к числовой точности, количественным рассуждениям и согласованности между отчетами. В отличие от медицинских задач, ориентированных на зрение, бухгалтерский учет требует от моделей сохранения формальных стандартов, отслеживания причинно-следственных связей и выполнения многошаговых логических и числовых рассуждений. Следовательно, надежная способность к рассуждению особенно важна для случаев использования в бухгалтерском учете..
Существующие работы можно разделить на несколько направлений исследований. Одно направление стремится усилить общие навыки рассуждения, такие как математическое или логическое мышление (Huang and Chang, 2023). Эти методы часто рассматривают рассуждение как независимое от предметных знаний, что ограничивает их эффективность в задачах бухгалтерского учета, которые сильно зависят от профессиональной экспертизы (Gu et al., 2025). Специализированных исследований по бухгалтерским рассуждениям по-прежнему мало. Другое направление сосредоточено на адаптации к предметной области с помощью специализированных данных или более крупных моделей. Примеры включают BloombergGPT (Wu et al., 2023) и FinGPT (Wang et al., 2023), которые используют финансовые корпуса или увеличенные масштабы параметров. Несмотря на то, что эти модели могут повысить эффективность выполнения задач, они не всегда улучшают способность к логическому мышлению и зачастую не поддаются интерпретации, из-за чего неясно, действительно ли они способствуют развитию мышления или просто заучивают поверхностные шаблоны (Diaz and Madaio, 2024). Третье направление делает акцент на оценке на основе точности конечного ответа, например, ответы на финансовые вопросы или извлечение знаний (Srivastava et al., 2024; Xie et al., 2024; Zhang et al., 2023). В таких заданиях, ориентированных на работу с текстом, не учитывается структурированный и последовательный характер рассуждений в бухгалтерском деле, поэтому они не позволяют оценить базовые навыки логического мышления. Наконец, несколько исследовательских работ изучают потенциальную роль LLM в бухгалтерской практике (Vasarhelyi et al., 2023; Zhao and Wang, 2024). Хотя они информативны, эти усилия пока не определили систематические рамки оценки или конкретные бенчмарки для бухгалтерских рассуждений..
Подводя итог, можно сказать, что в большинстве существующих исследований большие языковые модели применяются для решения языковых задач на поверхностном уровне в сфере бухгалтерского учета. Комплексных тестов и систем оценки, которые бы напрямую определяли способность к логическому мышлению в сфере бухгалтерского учета, до сих пор не существует.
2.2 Способность LLM к рассуждению в бухгалтерском учете
В исследованиях LLM рассуждение обычно понимается как способность делать выводы из предоставленных фактов и ограничений (Huang and Chang, 2023; Mondorf and Plank, 2024). Большинство оценок рассуждения сосредоточены на правильности выходных данных в задачах, основанных на умозаключениях. С точки зрения структуры, мышление принято делить на математическое, логическое, причинно-следственное и основанное на здравом смысле (Plaat et al., 2024; Huang and Chang, 2023). Среди них математическое и логическое рассуждение наиболее актуальны для бухгалтерских приложений..
Бухгалтерские задачи часто требуют точных числовых вычислений, многошаговых рассуждений и соблюдения четко определенных правил. В результате способность к рассуждению является ключевым фактором эффективности LLM в этой области. Логическое рассуждение оценивает, может ли модель делать обоснованные выводы из посылок в рамках явных правил, что часто оценивается с помощью бенчмарков понимания естественного языка (Srivastava et al., 2023; Mondorf and Plank, 2024; Fan et al., 2024). Однако такие бенчмарки разработаны для понимания языка общего назначения и не отражают структурированную, управляемую правилами природу бухгалтерских рассуждений..
Математическое рассуждение измеряет способность модели выполнять арифметические и символьные операции. Бенчмарки, такие как GSM8K (Cobbe et al., 2021), оценивают эту способность через многошаговые текстовые математические задачи, требующие отслеживания промежуточных значений, что близко к бухгалтерским вычислениям..
На практике большинство бухгалтерских задач опираются на цепочки числовых операций, а не на высокоуровневую финансовую интерпретацию. Ошибки при распространении промежуточных результатов могут накапливаться и приводить к неверным итоговым результатам, что делает надежное многошаговое математическое рассуждение особенно важным. Кроме того, многие бухгалтерские задачи включают сущности и ограничения, зависящие от времени. Включение временных графов знаний (Xiong et al., ; Xiong et al., 2024b, a) в символьные фреймворки рассуждений на основе LLM (Yang et al., 2024) обеспечивает структурированное поддержание состояния и повышает согласованность рассуждений на каждом шаге..
Недавние исследования были направлены на изучение структурно-ориентированных подходов для усиления многошаговых рассуждений. SWAP (Xiong et al., 2025) вводит механизмы планирования, которые явно моделируют структуру рассуждений. MR-GSM8K (Zeng et al., 2023) дополнительно увеличивает сложность рассуждений, отфильтровывая задачи с короткими решениями и акцентируя более длинные вычислительные цепочки, что порождает задачи, более близкие к реальным бухгалтерским сценариям. После дополнительной фильтрации остаются 586 задач, требующих не менее трёх вычислительных шагов. Этот поднабор обеспечивает подходящую основу для оценки многошаговых числовых рассуждений в бухгалтерском контексте и называется эталоном Multi-Calculation Benchmark..
2.3 Бенчмарки оценки для китайского бухгалтерского рассуждения
Бенчмарки для оценки китайского бухгалтерского мышления в основном исходят из двух направлений. Одно направление адаптирует общие китайские бенчмарки понимания естественного языка, переведенные с английского, в то время как другое опирается на наборы данных, взятые из экзаменов по бухгалтерскому учету и тестов на профессиональную квалификацию. По сравнению с многошаговым математическим мышлением, оценка бухгалтерского мышления на китайском языке представляет дополнительные трудности из-за различий в стандартах бухгалтерского учета, лингвистической структуре и дизайне задач..
Эталонный тест Chinese Language Understanding Evaluation (CLUE) (Xu et al., 2020), часто рассматриваемый как китайский аналог GLUE (Wang et al., 2018), предоставляет широкую оценку понимания китайского языка посредством таких задач, как классификация, понимание прочитанного и логический вывод на естественном языке. Несмотря на свой охват, CLUE сосредоточен на общей языковой способности и не направлен явно на бухгалтерские рассуждения..
В рамках CLUE, CMNLI оценивает следование, противоречие и нейтральность между посылкой и гипотезой. OCNLI, разработанный на китайском языке, лучше отражает особенности использования китайского языка и рассуждений. ACMC дополнительно адаптирует CMNLI и OCNLI к сценариям, связанным с финансами и бухгалтерским учетом, но ему все еще не хватает структурированных числовых вычислений и явных цепочек бухгалтерских рассуждений..
Чтобы лучше отразить реальную бухгалтерскую практику, некоторые исследования обращаются к профессиональным экзаменационным вопросам, в том числе из экзаменов для китайских дипломированных бухгалтеров. Эти вопросы охватывают бухгалтерские проводки, финансовые расчеты, аудиторские суждения и налоговые обоснования. Однако задачи из таких экзаменов часто содержат длинные описания и значительный объем предметных знаний, что усложняет оценку. Кроме того, производительность модели сильно зависит от формулировки запроса, а ошибки могут возникать из-за неправильного толкования, а не из-за слабой способности к рассуждению..
В целом существующие бенчмарки либо делают акцент на общем рассуждении без учета бухгалтерской специфики, либо включают бухгалтерский контент без систематической оценки процессов рассуждения. Этот пробел указывает на необходимость разработки ориентированных на бухгалтерский учет тестов, которые сочетают в себе знание предметной области и структурированный численный анализ. Данная работа отвечает на эту потребность путем создания специализированных наборов данных для оценки в области бухгалтерии и анализа производительности LLM по нескольким измерениям рассуждения..
3 Эксперименты
3.1 Экспериментальная установка
В этой работе исследуются способности больших языковых моделей к бухгалтерским рассуждениям. Мы определяем бухгалтерские рассуждения как совместное использование логического вывода и численных вычислений в рамках специфических бухгалтерских правил. В соответствии с предыдущими исследованиями, бухгалтерские рассуждения рассматриваются как комбинированная способность, включающая арифметические вычисления, применение правил и последовательные многошаговые выводы. Соответственно, производительность модели оценивается с нескольких точек зрения, включая точность пошаговых вычислений, понимание бухгалтерских принципов и общее качество рассуждений в реалистичных постановках задач..
Эмпирические данные, полученные в рамках проекта Stanford Alpaca, показывают, что тщательно отобранные наборы данных, даже если их размер составляет всего 5 % от исходного, могут существенно повысить эффективность работы модели (Li et al., 2024). Таким образом, качество данных играет ключевую роль в укреплении точности и стабильности рассуждений. Следуя этому пониманию, мы сначала оцениваем базовую способность к рассуждению с помощью универсальных тестов, а затем проводим целенаправленные оценки на специфичных для бухгалтерского учета наборах данных..
Чтобы обеспечить структурированный анализ, оценка организована на трех уровнях: математическое рассуждение, рассуждение в области бухгалтерских знаний и интегрированное бухгалтерское рассуждение. Эти уровни отражают возрастающую сложность задач и практическую значимость, переходя от базовых числовых операций к сценарному бухгалтерскому анализу..
| Reasoning Task | Datasets |
|---|---|
| Mathematical and Computational Reasoning | GSM8K, SVAMP, ASDiv, AQuA-RAT, MAWPS, AddSub, MultiArith, SingleEq, SingleOp |
| Logical Reasoning | ProofWriter, EntailmentBank, RuleTaker, CLUTRR, FLD |
| Commonsense Reasoning | CommonsenseQA, StrategyQA, ARC, SayCan, BoolQ, HotpotQA, OpenBookQA, PIQA, WikiWhy, COPA |
| Abstract Reasoning | Last Letter Concatenation, Coin Flip |
| Other | SNLI, MultiNLI, HellaSwag, SQuAD, BIG-bench, SCAN, BBH |
3.2 Оценка способности к математическому рассуждению
Был предложен ряд бенчмарков для оценки способностей LLMs к математическим рассуждениям, включая наборы данных для логического вывода на естественном языке и многошаговых арифметических рассуждений (Srivastava et al., 2023; Mondorf and Plank, 2024; Fan et al., 2024). Несмотря на их популярность, большинство общих бенчмарков не отражают вычислительные характеристики учетных задач, особенно тех, которые включают условные правила и накопление промежуточных ошибок..
GSM8K (Cobbe et al., 2021) — один из наиболее часто используемых наборов данных для оценки многошаговых численных рассуждений. Тем не менее, многие задачи из GSM8K включают относительно короткие цепочки рассуждений. Чтобы сделать акцент на более длинных цепочках рассуждений, мы создали модель MR-GSM8K (Zeng et al., 2023), в которой были исключены задачи с короткими траекториями решения и оставлены только те, которые требуют длительных вычислений. В частности, экземпляры с ответами короче 300 слов исключаются, что дает набор данных, который акцентирует устойчивое рассуждение и эффекты накопления ошибок..
После дополнительной фильтрации сохраняется 586 примеров MR-GSM8K, требующих как минимум три шага вычислений. Этот поднабор служит нашим бенчмарком для оценки многошаговых вычислений, называемым Multi-Calculation Benchmark, и хорошо подходит для проверки устойчивости LLM в числовых рассуждениях в бухгалтерском стиле..
3.3 Оценка способности к рассуждениям в китайской бухгалтерии
Оценка бухгалтерского мышления на китайском языке включает дополнительную сложность, возникающую из-за языковой структуры, правил бухгалтерского учета и специализированной терминологии. Современные китайские бенчмарки для оценки мышления в основном делятся на две категории: переведенные наборы данных общего назначения и наборы данных, взятые из профессиональных экзаменов по бухгалтерскому учету..
Бенчмарк CLUE (Chinese Language Understanding Evaluation) (Xu et al., 2020) обычно используется для измерения понимания и рассуждения на китайском языке. Он включает такие задачи, как классификация, понимание прочитанного и вывод на естественном языке, и часто рассматривается как китайский аналог GLUE (Wang et al., 2018). Хотя CLUE обеспечивает широкий охват навыков рассуждения, он не предназначен для оценки специфических для бухгалтерского учета выводов..
Чтобы лучше отразить практику бухгалтерского учета, мы также рассматриваем наборы данных, полученные из профессиональных квалификационных тестов, включая экзамены на получение статуса дипломированного бухгалтера Китая (CPA). Вопросы CPA охватывают методы бухгалтерского учета, числовые вычисления, аудиторские решения и налогообложение, требуя от моделей сочетания арифметических рассуждений с нормативными знаниями. Несмотря на свою актуальность, оценки на основе CPA вызывают трудности. Вопросы часто включают длинные контексты, плотный технический язык и неявные допущения, что может приводить к ошибкам, возникающим из-за неправильного толкования, а не из-за слабых рассуждений. Кроме того, производительность чувствительна к формулировке запроса, что усложняет выделение способности к рассуждению..
3.4 Всесторонняя оценка бухгалтерских рассуждений
Для получения более надежной оценки данная работа объединяет общие бенчмарки рассуждений, задачи по вычислениям в области бухгалтерского учета и вопросы, смоделированные по образцу профессиональных экзаменов. Изучение производительности в этих условиях позволяет нам лучше охарактеризовать возможности и ограничения LLM в бухгалтерских рассуждениях..
Результаты показывают, что LLM хорошо справляются с базовыми вычислениями и поверхностными задачами рассуждения, но точность заметно снижается по мере удлинения цепочек рассуждений. Ошибки, допущенные на промежуточных этапах, имеют тенденцию накапливаться, и поддержание правильного применения правил бухгалтерского учета становится затруднительным в сценариях, включающих множество взаимозависимых ограничений..
В итоге, современные LLM демонстрируют обнадеживающие базовые навыки рассуждения, но они остаются недостаточными для практических случаев использования в бухгалтерском учете. Устранение этого разрыва потребует улучшений, выходящих за рамки инженерии подсказок, включая более качественные данные предметной области и модели, которые явно поддерживают структурированное и осведомленное о предметной области рассуждение..
3.5 Результаты оценки и анализ
Мы оцениваем производительность OpenAI GPT-4 и сравниваем ее с GLM-6B, GLM-130B и GLM-4. Во время оценки применяется подсказка цепочки рассуждений (Chain-of-Thought, CoT) для стимулирования явного создания промежуточных шагов рассуждения, что улучшает как качество рассуждений, так и интерпретируемость. Кроме того, используется обучение с несколькими примерами (Few-shot Learning) путем предоставления репрезентативных примеров решений для направления процесса рассуждения и генерации ответов..
Сначала мы исследуем поведение модели при различных стратегиях подсказок, включая Zero-shot, Few-shot, CoT и Zero-shot-CoT. Результаты показывают, что результаты Zero-shot и Zero-shot-CoT часто демонстрируют логические несоответствия. Во многих случаях модели генерируют правдоподобный окончательный ответ, в то время как промежуточные рассуждения не полностью поддерживают вывод. Это говорит о том, что оценка, основанная исключительно на окончательных ответах, может переоценивать качество рассуждений. Для решения этой проблемы мы используем подсказки Few-shot-CoT для основной оценки. По сравнению с настройками Zero-shot, подсказки Few-shot приводят к существенному повышению точности, особенно в задачах, требующих многошаговых рассуждений. Эмпирически, Few-shot-CoT повышает точность примерно на 50 процентов. В задачах, связанных с бухгалтерским учетом, эта стратегия позволяет моделям правильно обрабатывать задачи, включающие до девяти арифметических операций, что отражает заметное улучшение глубины рассуждений..
На основе этих наблюдений Few-shot-CoT принимается в качестве настройки оценки по умолчанию. Мы следуем формату Few-shot-CoT в стиле GSM8K, который явно отделяет пошаговые рассуждения от окончательного ответа. Например, при решении бухгалтерских задач, связанных с приобретением активов и амортизацией, модель сначала представляет структурированный процесс рассуждения, а затем сообщает окончательный числовой результат. Такой формат улучшает интерпретируемость и обеспечивает согласованную оценку..
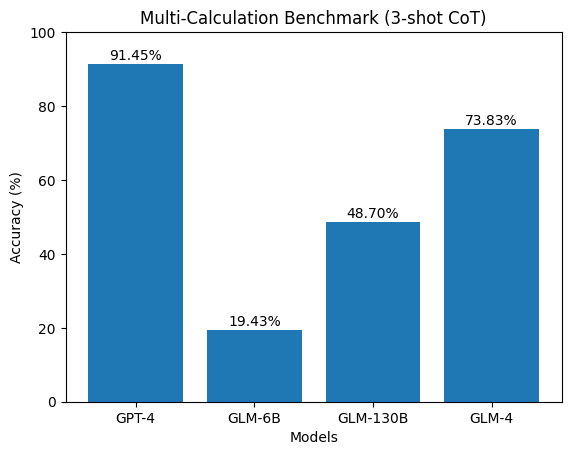
После сбора выходных данных моделей проводится количественная оценка путем сравнения предсказаний с истинными ответами. GLM-4 служит автоматическим оценщиком для ответов, сгенерированных GLM-6B, GLM-130B и GPT-4. Общая точность вычисляется по всем вопросам и сообщается для Multi-Calculation Benchmark..
GPT-4 достигает самой высокой общей точности среди оцененных моделей, устанавливая сильную точку отсчета для бухгалтерского рассуждения. Тем не менее, GPT-4 все еще не справляется с частью сложных бухгалтерских задач, что указывает на возможности для улучшения. Меньшие модели испытывают большие трудности с многошаговым арифметическим рассуждением. GLM-6B достигает точности примерно 20 процентов, в то время как GLM-130B достигает около 60 процентов, оба не дотягивают до уровня точности, обычно требуемого в профессиональной бухгалтерской практике. Хотя GLM-4 показывает конкурентоспособные результаты, его точность остается ниже желаемого порога, подчеркивая ограничения современных LLMs в точных числовых рассуждениях..
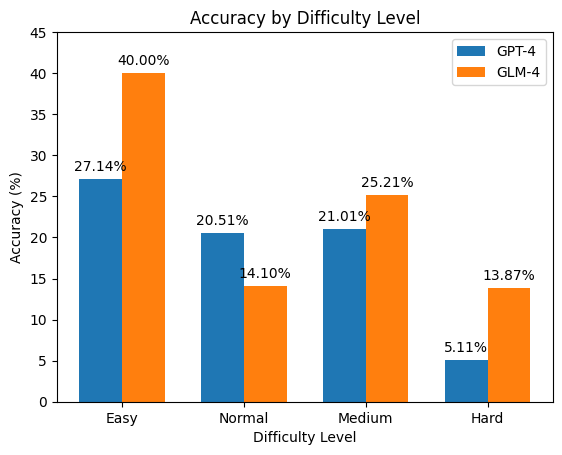
Поскольку бенчмарк делает акцент на многошаговых арифметических бухгалтерских задачах, только GPT-4 и GLM-4 дополнительно оцениваются на Accounting Reasoning Benchmark. Результаты показывают, что GPT-4 достигает точности 16.58 процента, тогда как GLM-4 достигает 21.78 процента, что указывает на небольшое преимущество GLM-4 в рассуждениях бухгалтерских знаний. По мере увеличения количества вычислительных шагов производительность обеих моделей ухудшается, и ни одна из них не демонстрирует последовательно надежных бухгалтерских рассуждений..
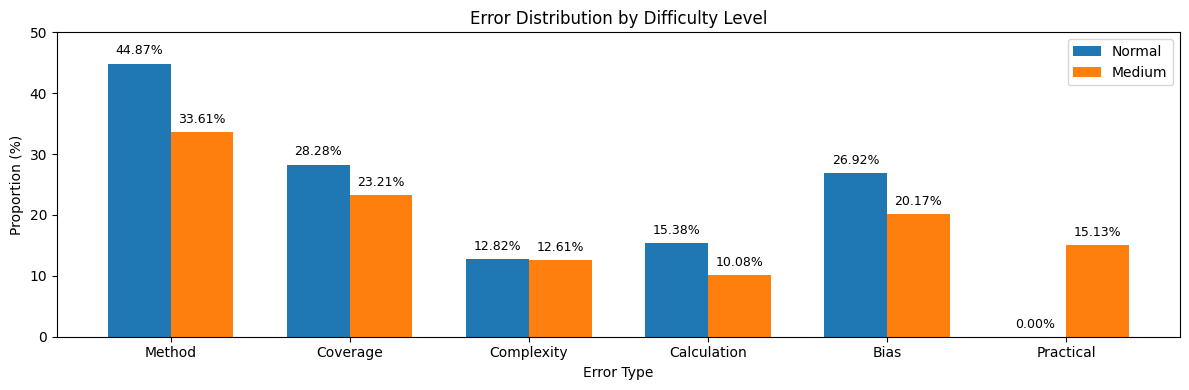
Анализ ошибок выявляет несколько повторяющихся типов сбоев. Одна из основных категорий — неверное применение логики бухгалтерского учета, например неверная интерпретация обработки активов, стандартов или налоговых правил. Другая распространенная проблема — неполное знание предметной области, когда упускаются из виду важные условия или ограничения. Модели также испытывают трудности с задачами, требующими переплетения бухгалтерских процедур, не отслеживая зависимости на нескольких этапах. Арифметические и логические несоответствия возникают, когда структуры рассуждений верны, но численные расчеты неверны. Дополнительные ошибки проистекают из расплывчатого понимания концепций или неверной интерпретации основополагающих принципов бухгалтерского учета..
Более детальный анализ показывает, что более половины всех ошибок связаны с непониманием принципов бухгалтерского учета и недостаточным концептуальным охватом. Ошибки, связанные с выполнением сложных процедур, таких как ведение бухгалтерского учета или составление финансовой отчетности, встречаются реже, но все же имеют место. Ошибки на уровне принципов особенно вредны, поскольку они часто распространяются на весь процесс рассуждения, тогда как процедурные ошибки обычно затрагивают только локальные шаги. Эта закономерность отражает акцент на концептуальном освоении в профессиональных экзаменах по бухгалтерскому учету..
В целом, результаты показывают, что современные LLM все еще не обладают надежными способностями к бухгалтерским рассуждениям. Хотя они предлагают полезную помощь для задач, связанных с бухгалтерией, необходим значительный прогресс в интеграции предметных знаний, надежности рассуждений и числовой точности, прежде чем развертывание в профессиональных бухгалтерских средах станет возможным..
4 Заключение
Данное исследование рассматривает логические рассуждения в области бухгалтерского учета в больших языковых моделях с использованием двух специализированных бенчмарков. Результаты показывают, что хотя LLMs эффективно справляются с общими многошаговыми рассуждениями, их производительность заметно снижается на задачах, связанных с бухгалтерским учетом, что выявляет существенный разрыв между широкими навыками рассуждения и компетенцией в предметной области. Дальнейший анализ ошибок демонстрирует устойчивые трудности в корректном применении принципов бухгалтерского учета в сложных сценариях. В целом, эти результаты позволяют предположить, что текущие LLMs остаются непригодными для надежного использования в профессиональных бухгалтерских средах..
Ограничения
Данная работа имеет несколько ограничений. Бенчмарк делает акцент на структурированных бухгалтерских рассуждениях и поэтому не отражает весь спектр реальной бухгалтерской практики. Кроме того, оценка охватывает лишь небольшой набор репрезентативных LLMs, поэтому результаты могут не распространяться на модели с другой архитектурой или специализированными обучающими данными. Наконец, анализ опирается на рассуждение на основе промптов, что делает результаты чувствительными к формулировке промптов. Будущие исследования должны решить эти проблемы, расширив охват бенчмарка, оценив более широкий круг моделей и изучив систематические подходы к адаптации предметной области..
Список литературы
- Обучение верификаторов для решения математических текстовых задач. arXiv preprint arXiv:2110.14168. Цитируется: §2.2, §3.2.
- Законы масштабирования не масштабируются. В материалах конференции AAAI/ACM по искусственному интеллекту, этике и обществу, Том 7, стр. 341–357. Цитируется: §2.1⟧.
- Nphardeval: динамический бенчмарк на способность к рассуждению больших языковых моделей через классы сложности. В материалах 62-го ежегодного собрания Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), стр. 4092–4114. Цитируется: §2.2, §3.2⟧.
- Об эффективности больших языковых моделей в генерации кода для конкретных предметных областей. ACM Transactions on Software Engineering and Methodology 34 (3), стр. 1–22. Цитируется: §2.1.
- Legalbench: совместно созданный бенчмарк для измерения юридического рассуждения в больших языковых моделях. Advances in neural information processing systems 36, pp. 44123–44279. Цитируется: §2.1⟧.
- К рассуждению в больших языковых моделях: обзор. В трудах ассоциации вычислительной лингвистики: ACL 2023, стр. 1049–1065. Цитируется: §2.1, §2.2.
- ⟦ От количества к качеству: повышение производительности LLM с помощью самоуправляемого выбора данных для настройки инструкций. В трудах конференции Североамериканского отделения Ассоциации вычислительной лингвистики 2024: Технологии человеческого языка (Том 1: Длинные статьи), стр. 7602–7635. Цитируется: §3.1⟧.
- Помимо точности: оценка рассудительного поведения больших языковых моделей – обзор. arXiv preprint arXiv:2404.01869. Цитируется: §2.2, §2.2, §3.2.
- Рассуждение с помощью больших языковых моделей: обзор. arXiv preprint arXiv:2407.11511. Цитируется по: §2.2.
- За пределами имитационной игры: количественная оценка и экстраполяция возможностей языковых моделей. Труды по исследованиям машинного обучения. Цитируется: §2.2, §3.2.
- Оценка математического рассуждения llms в ответах на вопросы по финансовым документам. Препринт arXiv arXiv:2402.11194. Цитируется: §2.1.
- Большие языковые модели: новая технология в бухгалтерском учете. Журнал новых технологий в бухгалтерском учете 20 (2), стр. 1–10. Цитируется: §2.1.
- GLUE: многозадачный бенчмарк и платформа анализа для понимания естественного языка. В трудах семинара BlackboxNLP конференции EMNLP 2018: Анализ и интерпретация нейронных сетей для NLP, стр. 353–355. Цитируется: §2.3, §3.3.
- Fingpt: бенчмарк для настройки инструкций для открытых больших языковых моделей на финансовых наборах данных. arXiv preprint arXiv:2310.04793. Цитируется в: §2.1.
- ⟦Bloomberggpt: большая языковая модель для финансов. arXiv preprint arXiv:2303.17564. Цитируется: §2.1.
- Finben: комплексный финансовый бенчмарк для больших языковых моделей. Advances in Neural Information Processing Systems 37, стр. 95716–95743. Цитируется: §2.1.
- Большие языковые модели могут осваивать временные рассуждения. В материалах 62-го ежегодного собрания Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), стр. 10452–10470. Цитируется: §2.2.
- Обдуманное рассуждение в языковых моделях как структурно-осознанное планирование с точной моделью мира. В трудах 63-й ежегодной встречи Ассоциации компьютерной лингвистики (Том 1: Длинные статьи), стр. 31900–31931. Цитируется: §2.2.
- [19] S. Xiong, Y. Yang, F. Fekri, и J. C. Kerce TILP: дифференцируемое обучение темпоральным логическим правилам на графах знаний. На Одиннадцатой международной конференции по представлениям обучения, Цитируется: §2.2.
- Teilp: прогнозирование времени по графам знаний с помощью логического рассуждения. В трудах конференции AAAI по искусственному интеллекту, Том 38, стр. 16112–16119. Цитируется: §2.2.
- CLUE: тест для оценки понимания китайского языка. arXiv preprint arXiv:2004.05986. Цитируется: §2.3, §3.3.
- Большие языковые модели в здравоохранении: разработка, применение и проблемы. Наука о здравоохранении 2 (4), стр. 255–263. Цитируется: §2.1.
- ⟦ Использование возможностей больших языковых моделей для перевода с естественного языка на логику первого порядка. В трудах 62-го ежегодного собрания Ассоциации вычислительной лингвистики (Том 1: Длинные статьи), стр. 6942–6959. Цитируется: §2.2⟧.
- Mr-gsm8k: мета-рассуждающий бенчмарк для оценки больших языковых моделей. arXiv preprint arXiv:2312.17080. Цитируется в: §2.2, §3.2.
- Улучшение анализа финансовых настроений с помощью дополненных поиском больших языковых моделей. В материалах четвертой международной конференции ACM по ИИ в финансах, стр. 349–356. Цитируется: §2.1.
- Раскрывая эффективность и инсайты: изучение потенциальных применений и проблем chatgpt в бухгалтерском учете. Журнал корпоративного учета и финансов 35 (1), с. 269–276. Цитируется: §2.1.