YOLO26: Анализ сквозной структуры без NMS для обнаружения объектов в реальном времени
Аннотация
Фреймворк "You Only Look Once" (YOLO) долгое время служил эталоном для обнаружения объектов в реальном времени, однако традиционные итерации (YOLOv1 – YOLO11) по-прежнему ограничены задержкой и чувствительностью к гиперпараметрам постобработки с помощью Non-Maximum Suppression (NMS). В данной статье анализируется всестороннее исследование YOLO26 — архитектуры, которая коренным образом переопределяет эту парадигму, устраняя NMS в пользу нативной сквозной стратегии обучения. Изучаются ключевые инновации, обеспечивающие этот переход, а именно: оптимизатор MuSGD для стабилизации легковесных базовых сетей, STAL для назначения с учётом малых объектов и ProgLoss для динамического контроля. В ходе систематического обзора официальных бенчмарков производительности результаты демонстрируют, что YOLO26 формирует новый фронт Парето, превосходя обширный набор предшественников и современных конкурентов (включая RTMDet и DAMO-YOLO) как по скорости инференса, так и по точности обнаружения. Анализ подтверждает, что, разделяя обучение представлениям и эвристическую постобработку, YOLOv26 успешно разрешает исторический компромисс между задержкой и точностью, знаменуя собой следующий эволюционный шаг в области компьютерного зрения на граничных устройствах..
YOLOv26, Сквозное обнаружение объектов, Без NMS, MuSGD, ProgLoss, Компьютерное зрение в реальном времени, You Only Look Once.
1 Введение
Компьютерное зрение быстро эволюционировало от базовых методов обработки изображений, таких как обнаружение краев и морфологическая фильтрация, до области, где доминирует глубокое обучение. На переднем крае этой эволюции находится Обнаружение объектов — фундаментальная задача идентификации и локализации экземпляров семантических объектов в цифровом изображении. В отличие от простой классификации, которая присваивает изображению одну метку, обнаружение объектов требует одновременного предсказания меток классов и геометрических ограничивающих рамок. Эта способность является краеугольным камнем современной автоматизации, лежа в основе критически важных приложений: от автономного вождения и роботизированной навигации до анализа медицинских изображений и видеонаблюдения в реальном времени. По мере роста спроса на анализ в реальном времени область сместилась от вычислительно тяжелых двухэтапных детекторов (таких как Faster R-CNN) к эффективным одноэтапным архитектурам, которые ставят скорость вывода выше точности..
1.1 Наследие Ultralytics
В этом ландшафте Ultralytics стала определяющей силой в обнаружении в реальном времени. Начав со стандартизации архитектуры YOLO (You Only Look Once), компания Ultralytics последовательно расширяла границы эффективности. Их итеративные релизы — наиболее заметные YOLOv5 и YOLOv8 — установили новый отраслевой стандарт, объединяя частичные магистрали Cross-Stage Partial (CSP) с удобными конвейерами развертывания. Эти модели успешно демократизировали ИИ, позволяя выполнять сложные задачи обнаружения на периферийных устройствах с ограниченными вычислительными ресурсами. Однако даже эти современные модели в значительной степени полагались на постобработку подавления немаксимумов (Non-Maximum Suppression, NMS), последовательный этап, который вносит вариабельность задержки в насыщенных сценах..
1.2 YOLOv26: Самая быстрая модель обнаружения объектов
Выпущенный в сентябре 2025 года, YOLOv26 устанавливает новый рубеж в истории обнаружения объектов в реальном времени. Чтобы оценить этот скачок, команда Ultralytics выпустила официальные эталонные тесты, сравнивающие YOLOv26 с комплексным набором предшественников (от YOLOv5 [16] до YOLO11 [18, 5]) и конкурирующими архитектурами, такими как RTMDet [34], DAMO-YOLO [49] и PP-YOLOE+ [48].
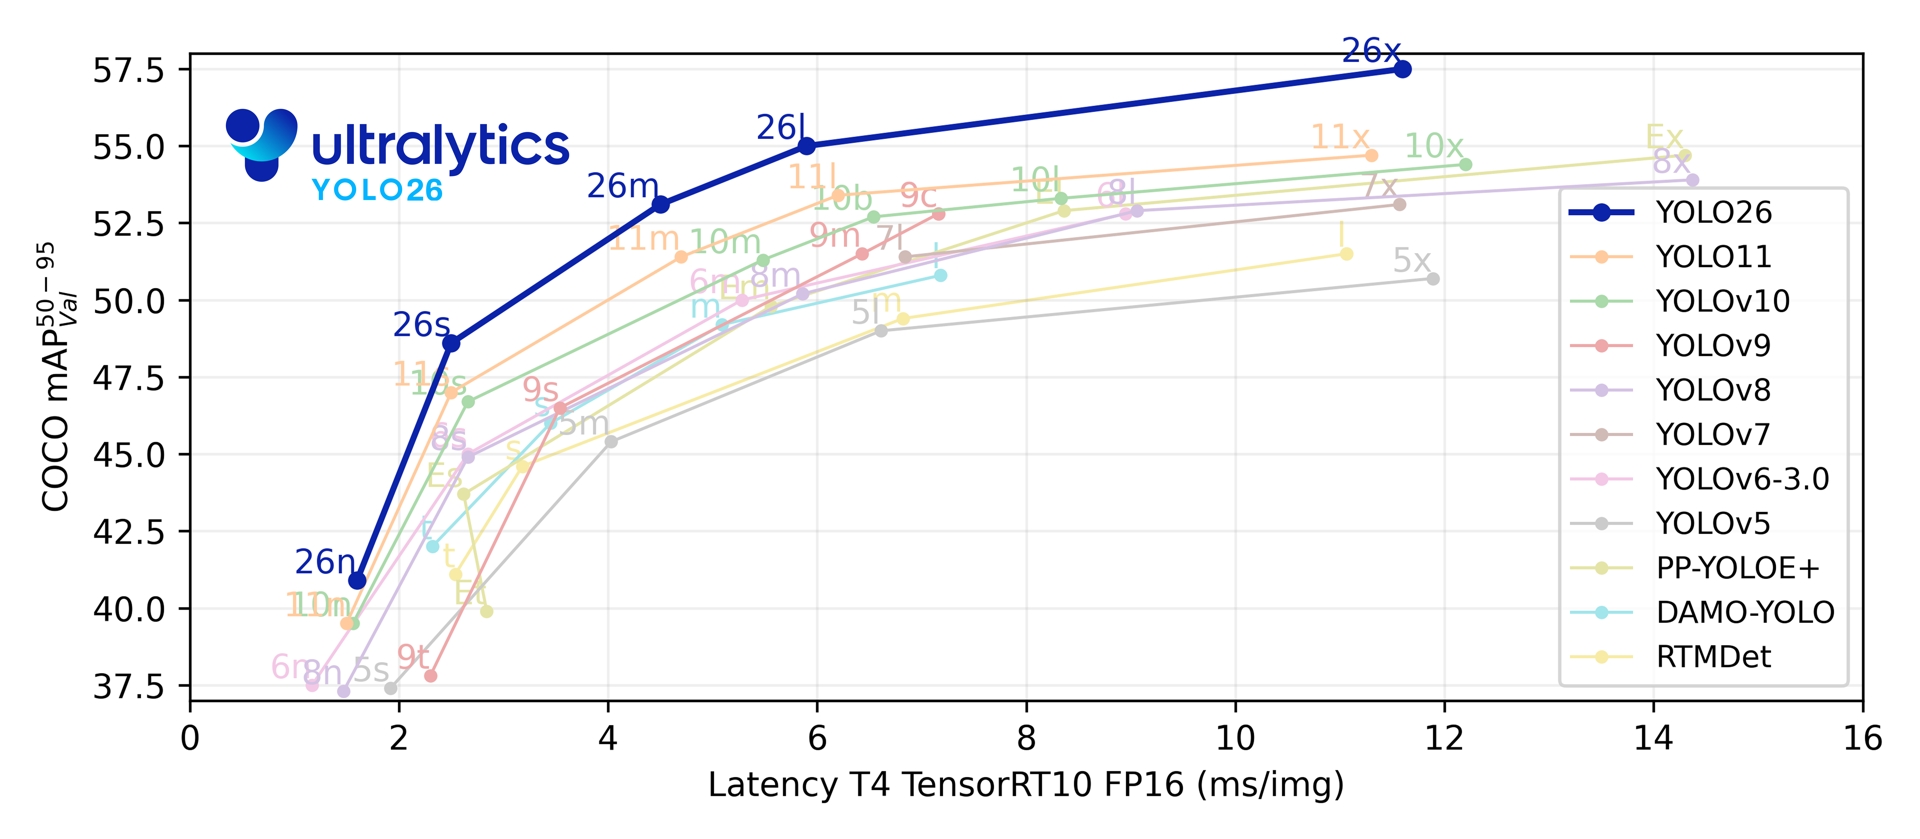
1.2.1 Анализ сообщенной производительности
Как показано в официальных данных (Рисунок 1) [19], ландшафт производительности определяется семейством YOLOv26..
- • Доминирование по Парето: Представленные метрики показывают, что кривая YOLOv26 находится строго выше и левее всех остальных моделей [18]. Это указывает на то, что для любого заданного бюджета задержки архитектура обеспечивает превосходную точность; и наоборот, для любой целевой точности она предлагает самую быструю скорость инференса..
- • Масштабирование от нано до сверхбольшого: Бенчмарки Ultralytics подчеркивают доминирование во всех масштабах моделей [18]. Показано, что нано-вариант (26n) достигает mAP при незначительной задержке в мс. На верхнем конце, сверхбольшая модель (26x) расширяет границы точности до mAP, сохраняя производительность в реальном времени ( мс), превосходя как YOLO11x [18], так и RTMDet [34].
Это эмпирическое доказательство, предоставленное разработчиками, подтверждает, что удаление NMS и внедрение сквозной архитектуры эффективно раскрыли прирост необработанной пропускной способности, закрепив статус YOLOv26 как самого быстрого детектора из задокументированных на данный момент.
1.3 Вклад данной статьи
This study provides a comprehensive analysis of the YOLOv26 architecture, evaluating its impact on the current state of real-time object detection. The primary contributions of this article are summarized as follows:
- • Архитектурная деконструкция: Эта статья представляет детальный разбор архитектуры Native End-to-End NMS-Free, объясняя математические механизмы, которые позволяют удалить недифференцируемую постобработку..
- • Анализ динамики обучения: рассматриваются новые стратегии оптимизации — в частности, MuSGD, STAL и ProgLoss — чтобы объяснить, как они обеспечивают стабильную сходимость для легковесных сквозных базовых моделей..
- • Performance Benchmarking: A comparative study of YOLOv26 against prior iterations (YOLOv1–v11) is provided, highlighting the new Pareto front formed by its speed-accuracy trade-off within the YOLO family.
- • Оценка воздействия: Обсуждаются последствия устранения «Export Gap», с анализом того, как детерминированная задержка приносит пользу критически важным для безопасности периферийным приложениям..
1.4 Структура статьи
Оставшаяся часть статьи структурирована следующим образом: Раздел 2 прослеживает историческую эволюцию линейки YOLO, задавая контекст текущего архитектурного сдвига. Раздел 3 разбирает ключевые инновации YOLOv26, включая конвейер без NMS, декомпозированную голову без DFL и динамику обучения MuSGD. Раздел 4 подробно описывает унифицированные возможности модели для выполнения нескольких задач, включая обнаружение, сегментацию и оценку позы. Раздел 5 анализирует критическую проблему «Экспортный разрыв» и то, как архитектура достигает детерминированной задержки на периферийном оборудовании. Раздел 6 предлагает будущие направления исследований, такие как внутренняя объяснимость и пространственно-временное восприятие. Наконец, Раздел 7 обобщает вклад и потенциальное влияние данной работы..
2 Эволюция YOLO
Семейство YOLO (You Only Look Once) прошло десятилетие быстрой архитектурной эволюции, перейдя от жесткого детектирования на основе сетки к гибкому многозадачному интеллекту. Этот прогресс можно разделить на три distinct эры: Фундаментальная эра (v1–v3), Эра сообщества (v4–v7) и Современная унифицированная эра (v8–v26). Каждая эра определяется сдвигом в том, как извлекаются пространственные признаки и как контролируются итоговые предсказания..
2.1 Эпоха основания (2015–2018)
Оригинальный YOLOv1 [36] революционизировал обнаружение объектов, переформулировав его как единую задачу регрессии, пожертвовав некоторой точностью локализации ради скорости в реальном времени. Последующие итерации ввели якорные боксы в YOLOv2 [37] для улучшенной полноты и многомасштабные пирамиды признаков в YOLOv3 [38] для решения «проблемы маленьких объектов», установив магистраль Darknet в качестве отраслевого стандарта. Эта эпоха характеризовалась переходом от полносвязных слоев к полностью сверточным архитектурам, заложив прецедент для рассуждения о глобальном контексте в одноэтапных детекторах..
2.2 Эра расширения сообщества (2020–2022)
В этот период произошла диверсификация линии YOLO, возглавляемая YOLOv4 [1] и YOLOv5 [16], которые представили CSP (Cross-Stage Partial) соединения и передовые методы аугментации "Bag-of-Freebies". Эта эпоха ознаменовала переход к готовым к производству фреймворкам, с вариантами, такими как YOLOv6 [25] и YOLOv7 [45], которые представили репараметризацию и архитектуры E-ELAN для максимизации использования вычислительных ресурсов, специфичных для оборудования. Интегрируя мозаичную аугментацию и оптимизацию генетических якорей, эти модели преодолели разрыв между академическими исследованиями и промышленным развертыванием на различных аппаратных платформах..
2.3 Современная унифицированная эпоха (2023–настоящее время)
Начиная с YOLOv8 [15], акцент сместился в сторону свободных от привязок разделённых головок. Эта архитектурная модульность была дополнительно усовершенствована в YOLOv9 [46] с помощью программируемой градиентной информации (PGI) и в YOLOv10 [44], который ввёл согласованное назначение двойных меток для обучения без NMS. Линия продолжилась с YOLO11 [18, 6], оптимизирующим магистраль C3k2 для многозадачной эффективности, и YOLOv12 [43], который интегрировал Area Attention () для обеспечения контекста на уровне трансформера со скоростью CNN. Совсем недавно YOLOv13 [24] использовал гиперграфовое пространственное моделирование для улучшения реляционного мышления в сложных сценах. Этот переход отражает более широкое движение в сторону устранения ручных эвристик в пользу сквозных дифференцируемых конвейеров, прокладывая путь для стратегий, оптимизированных для периферийных устройств, наблюдаемых в последних итерациях..
Критическая проблема, выявленная в эту эпоху, — это «экспортный разрыв» — падение производительности, наблюдаемое при переносе модели из среды обучения на GPU на оборудование для инференса на периферии (NPU/CPU). Сложные операторы, такие как Distribution Focal Loss (DFL), используемые в версиях с v8 по v13 [15, 44, 24], хотя и точны, часто создают задержки в узких местах на оборудовании с целочисленной арифметикой..
YOLO26 [19] представляет собой кульминацию этой линии, отходя от сложных тенденций v12 и v13 в пользу приоритета задержек на периферийных устройствах. Устранив вычислительную нагрузку DFL и внедрив собственный одно-к-одному прогностический модуль, YOLO26 достигает детерминированного времени вывода, что делает его высокоэффективным для развертывания в реальном времени на маломощных устройствах. Эти архитектурные изменения сведены в таблицу 1.
| Model | Backbone | Neck | Head | Task(s) | Anc-hors | Loss | Post-Proc. | Key Innovations & Contributions |
|
YOLOv1
(2015) |
Darknet-24 | None | Coupled | Object Detection | No | SSE (Sum) | NMS | Unified single-stage regression framework enabling real-time object detection. |
|
YOLOv2
(2016) |
Darknet-19 | Pass-thro-ugh | Coupled | Object Detection | Yes | Sum-Squared Error (SSE) | NMS | Introduced anchor boxes, batch normalization, and the passthrough layer for improved recall and small-object detection. |
|
YOLOv3
(2018) |
Darknet-53 | Multi-Scale | Coupled | Object Detection | Yes | BCE + SSE | NMS | Multi-scale feature prediction strategy for enhanced small-object localization. |
|
YOLOv4
(2020) |
CSPDarknet53 | PAN | Coupled | Object Detection | Yes | CIoU + BCE | NMS | CSP-integrated augmentation for optimal speed–accuracy trade-off. |
|
YOLOv5
(2020) |
CSPDarknet | PAN | Coupled | Object Detection | Yes | GIoU/CIoU + BCE | NMS | PyTorch-based modular design with automatic anchor optimization for easy deployment. |
|
YOLOv6
(2022) |
EfficientRep | PAN | Decoupled | Object Detection | Yes | SIoU / Varifocal | NMS | Re-parameterized convolution for high-throughput industrial inference efficiency. |
|
YOLOv7
(2022) |
E-ELAN | CSP-PAN | Lead + Auxiliary | Object Detection | Yes | CIoU + BCE | NMS | Introduced E-ELAN, deep supervision and OTA assignment for better accuracy and efficiency. |
|
YOLOv8
(2023) |
C2f | PAN | Decoupled | Obj. Det., Seg., Pose Est. | No | BCE + CIoU + DFL | NMS | Anchor-free decoupled head enabling a unified multi-task detection framework. |
|
YOLOv9
(2024) |
GELAN | PAN | Decoupled | Object Detection | No | BCE + CIoU + DFL | NMS | Programmable Gradient Information & GELAN to overcome info. bottleneck in deep networks. |
|
YOLOv10
(2024) |
GELAN | PAN | Decoupled | Object Detection | No | BCE + CIoU + DFL | NMS-Free | NMS-free inference via Dual-Label Assignment; integrates Partial Self-Attention into GELAN. |
|
YOLOv11
(2024) |
C3k2 | PAN | Decoupled | Obj. Det., Seg., Pose Est. | No | BCE + CIoU + DFL | NMS | C2PSA-based feature refinement; still uses standard NMS for post-processing. |
|
YOLOv12
(2025) |
Flash Backbone + Area Attention | PAN | Decoupled | Object Detection, Segmentation | No | BCE + CIoU + DFL | NMS | Uses Area Attention () for long-range dependency capture while keeping computation efficient; improves multi-task performance. |
|
YOLOv13
(2025) |
Hyper-Net | PAN | Decoupled | Object Detection, Segmentation, Pose Estimation | No | BCE + CIoU + DFL | NMS | Third-party release by iMoonLab; Hypergraph spatial modeling for relational reasoning and complex scene understanding. |
|
YOLOv26
(2026) |
CSP-Muon (Edge-Optimized CNN) | PAN | Decoupled (1-to-1) | Object Detection, Segmentation, Pose Estimation, OBB | No | STAL + ProgLoss | NMS-Free | Edge-optimized, DFL-free learning with one-to-one label assignment; native NMS-free head for low-latency deployment; optimized for CPU and Edge exportability. |
3 Архитектура и методология YOLOv26
Архитектурная философия YOLOv26 отходит от недавней тенденции увеличения сложности параметров (как видно в v10 и v11)[18], чтобы сосредоточиться на вычислительной плотности и детерминированной задержке. Это достигается путем реструктуризации конвейера вывода для устранения эвристических узких мест и применения стратегий оптимизации, традиционно зарезервированных для LLM, таких как MuSGD..
3.1 Нативная сквозная архитектура без подавления немаксимумов
Традиционные детекторы объектов используют немаксимальное подавление (NMS) в качестве отдельного этапа последующей обработки для фильтрации избыточных ограничивающих рамок. NMS работает путем итеративного выбора предложения с наибольшей степенью достоверности () и скрытие всех остальных перекрывающихся блоков () пересечение по объединению (IoU) с превышает заранее установленный порог (). Этот процесс можно формально определить как [2]:
| (1) |
где — это текущий бокс с максимальной уверенностью, а — обновлённая оценка. Эта эвристика по своей природе последовательна, создавая узкое место по задержке, которое варьируется в зависимости от плотности сцены (т.е. количества обнаруженных объектов).
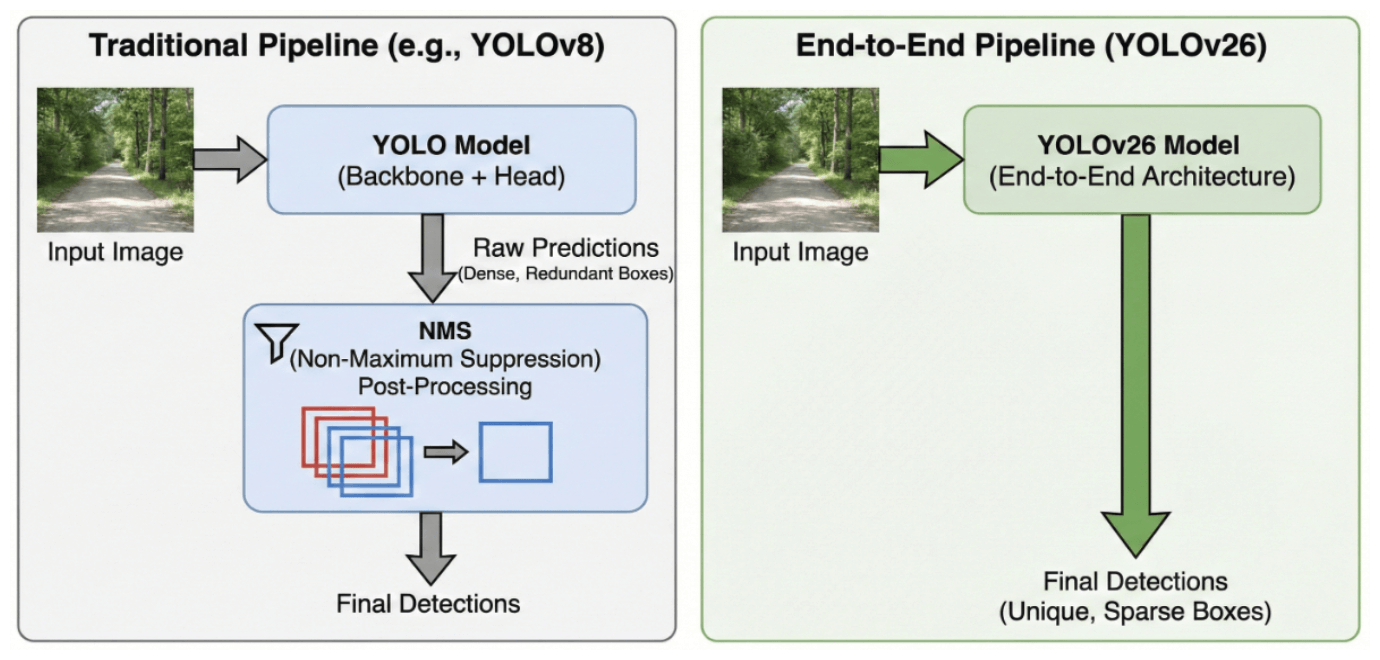
YOLOv26 принципиально изменяет этот конвейер с помощью нативной сквозной архитектуры. Перепроектируя голову предсказания для поддержки назначения меток один к одному [44], модель учится выводить один единственный окончательный бокс на каждый экземпляр объекта во время обучения. Этот архитектурный сдвиг полностью устраняет необходимость в уравнении 1, преобразуя инференс из многоэтапной операции фильтрации в прямое детерминированное отображение входа на выход (см. рис. 2). Результатом является более легкий и оптимизированный граф выполнения, который проще развертывать и который обеспечивает постоянную задержку независимо от количества объектов [34].
Влияние на производительность: Удаление оператора NMS приводит к значительному снижению задержки, особенно на оборудовании без GPU, где последовательные операции создают узкие места. Переходя к этой сквозной парадигме, Ultralytics сообщает, что YOLOv26 достигает ускорения вывода приблизительно на 43% на CPU-целях по сравнению с базовыми показателями на основе стандартного NMS [19]. Этот вывод за постоянное время критически важен для приложений, критичных к безопасности, таких как автономное вождение или медицинский мониторинг, где требуются детерминированные времена отклика независимо от сложности сцены..
3.2 Регрессионно-центрированная декаплированная голова (DFL-Free)
Последние итерации YOLO (v8–v11 [18]) перешли на использование Distribution Focal Loss (DFL) [27] для моделирования координат ограничивающих рамок в виде обобщённых распределений, а не детерминированных значений. Хотя DFL повышает точность локализации за счёт учёта неопределённости на границах объектов, он вносит существенные вычислительные накладные расходы: необходимость выполнения операций Softmax по дискретизированным бинам для каждого предсказания координат. На специализированном периферийном оборудовании (NPU и DSP) эти слои Softmax крайне сложно поддаются квантизации и часто становятся основным узким местом по задержке [11].
Количественная оценка накладных расходов Softmax: В голове на основе DFL оценка одной координаты требует интегрирования по дискретизированному распределению вероятностей (обычно 16 интервалов). Это вынуждает механизм вывода вычислять взвешенную сумму Softmax для каждого параметра ограничивающей рамки.:
| (2) |
Эта операция включает повторные экспоненциальные () вычисления и вычисления деления, которые являются вычислительно дорогими на целочисленных арифметических периферийных ускорителях [41]⟧.
[Изображение сравнения Distribution Focal Loss (DFL) и головок прямого регрессионного предсказания]
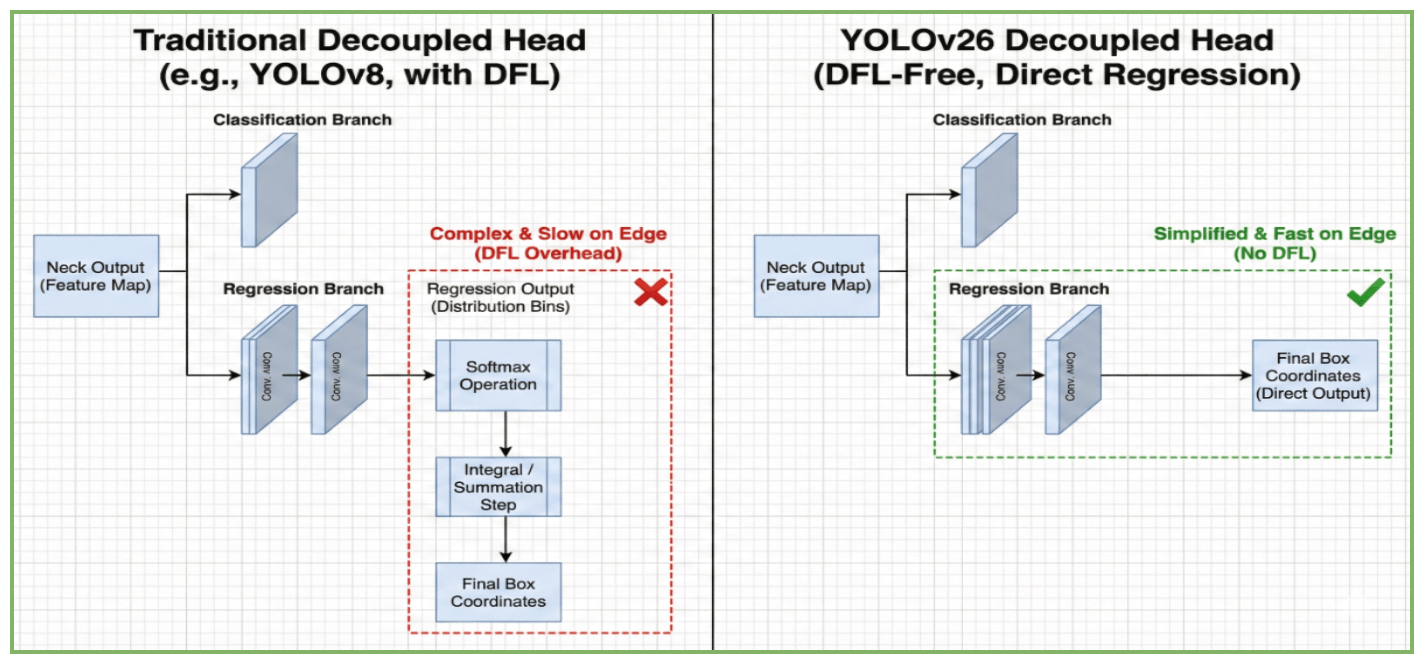
YOLOv26 возвращается к стратегии прямой регрессии, полностью удаляя этот модуль (см. рис. 3). Этот архитектурный откат мотивирован «экспортным разрывом» — несоответствием между теоретическими FLOPs и фактической скоростью вывода на развернутом оборудовании [34]. Путем устранения интегрального представления уравнения 2 этап декодирования упрощается до прямого линейного отображения.:
| (3) |
Чтобы поддерживать высокую точность без преимуществ распределения DFL, YOLOv26 использует улучшенную структуру Decoupled Head, вдохновленную YOLOX [10]. Как показано в стандартных топологиях, голова разделяет извлечение признаков на две отдельные ветви.:
| (4) |
где предсказывает вероятности классов, а напрямую предсказывает параметры регрессии боксов. Такое разделение гарантирует, что удаление DFL не ухудшает производительность классификации [10], в то время как ветвь регрессии оптимизируется с помощью новых функций STAL и ProgLoss для восстановления точности локализации, потерянной при отказе от априорного распределения..
3.3 Продвинутая динамика обучения: MuSGD, STAL и ProgLoss
Удаление модуля распределенной фокальной потери (DFL) и переход к сквозной архитектуре требуют более надежной стратегии обучения для предотвращения коллапса градиентов. YOLOv26 решает эту проблему с помощью триады инноваций в оптимизации и супервизии..
3.3.1 Оптимизатор MuSGD
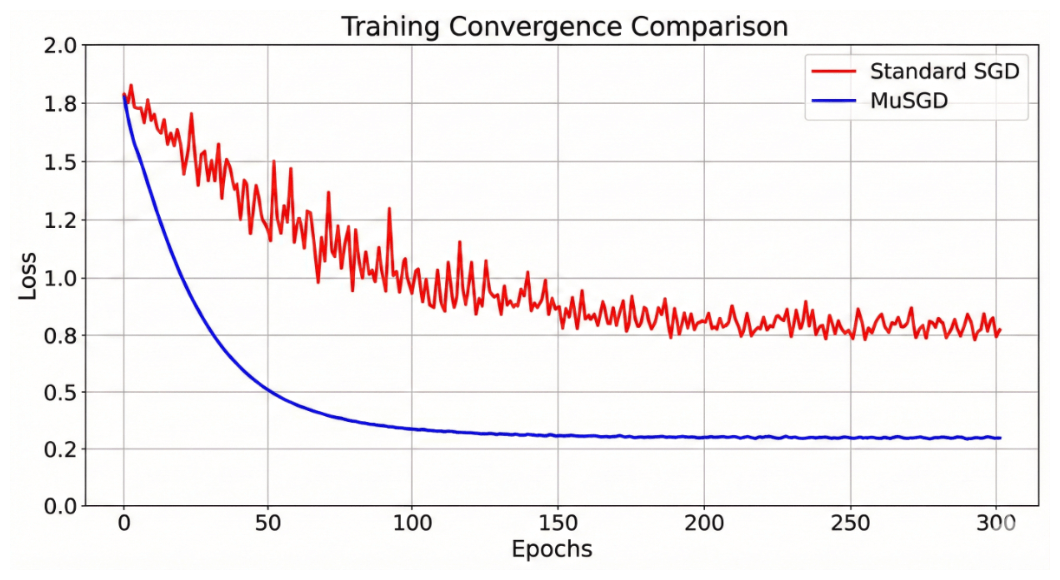
Чтобы обеспечить стабильность сходимости в новой архитектуре, Ultralytics сообщает, что YOLOv26 вводит MuSGD (Momentum-Unified Stochastic Gradient Descent), новый гибридный оптимизатор, который объединяет свойства стандартного SGD с оптимизатором Muon. Явно вдохновленный динамикой обучения большой языковой модели Kimi K2 от Moonshot AI, MuSGD представляет собой стратегический перенос передовых методов оптимизации из области NLP в компьютерное зрение [21].
Компонент Muon: Ключевое новшество MuSGD заключается в интеграции оптимизатора Muon [31]. В отличие от поэлементных оптимизаторов (например, AdamW), Muon выполняет ортогонализацию матрицы, обновляя всю матрицу весов так, чтобы она была ортогональна своему текущему состоянию. Это максимизирует эффективность обновления вдоль наиболее влиятельных направлений, сдерживая спектральную норму [20]⟧.
Математическая формулировка: MuSGD объединяет это ортогональное масштабирование с устойчивостью классического SGD. Сначала определим стандартный буфер импульса , используемый в стохастическом градиентном спуске:
| (5) |
где — градиент, а — коэффициент импульса. Затем MuSGD изменяет окончательное обновление весов, вводя ортогонализацию Ньютона-Шульца в эту траекторию.:
| (6) |
где эффективно "отбеливает" матрицу градиентов, используя итеративный процесс уточнения [13]. Этот гибридный подход снижает дисперсию чистого SGD, избегая нестабильности чистых ортогональных обновлений на ранних эпохах (см. рис. 4).
4.1 Обнаружение объектов
Основной целью YOLOv26 является идентификация и локализация отдельных экземпляров объектов с помощью выровненных по осям ограничивающих рамок, как показано на рисунке 7(a). Хотя это остается фундаментальной задачей серии YOLO, YOLOv26 оптимизирует конвейер обнаружения, используя нативную сквозную архитектуру, рассмотренную в разделе 3.1. Благодаря использованию стратегии назначения меток «один к одному», модель достигает 43% снижения задержки CPU [19], что является критическим фактором для мониторинга в реальном времени в медицине и пограничного наблюдения. Помимо высокой скорости, удаление недифференцируемого оператора NMS гарантирует, что процесс обнаружения является полностью детерминированным. Эта предсказуемость жизненно важна для достоверности методов объяснимости, обеспечивая прямой, прозрачный путь от ввода пикселей до конечного вывода рамок..
Обнаружение мельчайших признаков дополнительно поддерживается механизмом STAL, описанным в уравнении 7. В практических приложениях, таких как анализ микроаномалий в гистопатологических наборах данных, STAL предотвращает эффект "исчезающего градиента", обычно связанный с малыми объектами. Это позволяет YOLOv26 сохранять высокую полноту для объектов, занимающих менее 1% площади изображения, гарантируя, что упрощенная, свободная от DFL регрессионная головка остается точной для всех масштабов объектов..
4.2 Сегментация экземпляров
Сегментация экземпляров в YOLOv26 представляет собой критический сдвиг от локализации регионов к попиксельной классификации, как показано на рисунке 7(b). Интегрируя ветвь предсказания масок вместе с разделенной головой, модель обеспечивает точное извлечение формы для отдельных объектов. Как показано в таблице 2, выход головы для этой задачи включает как координаты ограничивающей рамки, так и попиксельную маску (), что жизненно важно для медицинской диагностики, где точная область патологии дает больше ценности, чем простая координатная рамка..
Новое усовершенствование в YOLOv26-seg заключается в использовании контролируемого обучения с учетом границ, поддерживаемого планированием ProgLoss в уравнении 8. Поскольку модель не содержит DFL, она избегает ошибок дискретизации, которые часто размывают границы объектов на периферийном оборудовании. Вместо этого акцент на регрессии на поздних стадиях в ProgLoss действует как «полировщик контуров», обеспечивая четкость масок даже для малых или перекрывающихся целей. Используя способность оптимизатора MuSGD поддерживать стабильные спектральные нормы, ветвь сегментации достигает более высокого разрешения признаков с меньшим количеством параметров, что приводит к ранее отмеченному ускорению на CPU и NPU. Это гарантирует, что высокоточная сегментация больше не ограничивается высокопроизводительными GPU, а полностью экспортируется в среды реального времени на периферийных устройствах [19]⟧.
4.3 Классификация изображений
Классификация изображений в экосистеме YOLOv26 представляет собой наиболее вычислительно эффективную задачу, поскольку она обходит необходимость пространственной регрессии или генерации масок, как показано на рисунке 7(c). Анализируя входные данные целостно, классификационная головка использует глобальное усреднение пула (GAP) для сжатия карт признаков высокого уровня из магистрали в единый вектор, который затем преобразуется в категориальные вероятности [28]. Эта архитектура отдает приоритет общим визуальным паттернам над конкретными координатными границами, как обобщено в таблице 2.
Вариант YOLOv26-cls использует упрощенную базовую сеть на основе CSP для достижения минимальной задержки вывода, что делает его идеальным для первоначальной категоризации крупномасштабных медицинских или экологических данных, где наличие патологии или объекта является основным показателем [19]. Кроме того, интеграция планирования ProgLoss (уравнение 8) гарантирует, что голова классификации достигает устойчивой сходимости на сложных многоклассовых наборах данных. Фокусируясь на семантической привязке на раннем этапе обучения, модель устанавливает надежные глобальные представления, которые менее чувствительны к пространственному шуму или загораживанию объектов по сравнению с чисто региональными детекторами [12].⟧.
4.4 Оценка позы
Оценка позы в YOLOv26 расширяет пространственное рассуждение до локализации 17 анатомических ориентиров, как показано на рисунке 7(d). Эта задача отслеживает ориентацию и движение суставов, выводя тройной формат для каждой ключевой точки. Конкретные анатомические индексы для стандартного отображения на основе COCO [30]. подробно описаны в таблице 3.
| Idx | Joint | Idx | Joint | Idx | Joint |
|---|---|---|---|---|---|
| 0 | Nose | 6 | Right Shoulder | 12 | Right Hip |
| 1 | Left Eye | 7 | Left Elbow | 13 | Left Knee |
| 2 | Right Eye | 8 | Right Elbow | 14 | Right Knee |
| 3 | Left Ear | 9 | Left Wrist | 15 | Left Ankle |
| 4 | Right Ear | 10 | Right Wrist | 16 | Right Ankle |
| 5 | Left Shoulder | 11 | Left Hip |
Точность определяется мерой сходства ключевых точек объекта (OKS), которая нормализует евклидово расстояние относительно масштаба объекта и константы спада для каждого сустава ⟦K2.⟧:
| (9) |
Для поддержания точности при отсутствии DFL, YOLOv26-pose использует Residual Log-Likelihood Estimation (RLE) [26]. Моделируя пространственную неопределенность вместо фиксированного распределения, RLE позволяет модели рассуждать о перекрытиях. В сочетании с оптимизатором MuSGD это обеспечивает высокоточную регрессию ключевых точек с детерминированной задержкой на периферийном оборудовании..
4.5 Обнаружение ориентированных объектов (OBB)
Ориентированное обнаружение объектов (OBB) в YOLOv26 вводит параметр вращения () для точного позиционирования наклонных целей, как показано на рисунке 7(e). Используя нормализованный формат xywhr, описанный в таблице 2, модель устраняет фоновый шум, типичный для прямоугольников, выровненных по осям, в аэрокосмической и промышленной областях [8]. Для устранения ошибок разрывности границ, присущих угловой регрессии, архитектура использует специализированную функцию потерь угла, которая сохраняет геометрическую согласованность даже для объектов, близких к квадрату [50].⟧.
Эта задача использует стратегию прямой регрессии и оптимизатор MuSGD для достижения высокой угловой точности без вычислительных затрат распределительной фокальной потери. При развертывании на оборудовании пограничного уровня, таком как БПЛА, головка без NMS обеспечивает детерминированную задержку в плотных средах, например, в морских портах. Эти оптимизации приводят к ускорению вывода на 43% по сравнению с традиционными эвристическими базовыми линиями вращательного NMS [19], обеспечивая работу в реальном времени на устройствах с ограниченными ресурсами..
4.6 Обнаружение и сегментация с открытым словарем (YOLOE-26)
YOLOE-26 представляет собой значительную эволюцию в линейке, интегрируя высокопроизводительную архитектуру YOLOv26 с продвинутыми возможностями открытого словаря. Согласовывая визуальные признаки с богатыми лингвистическими вложениями, эта возможность позволяет в реальном времени обнаруживать и сегментировать экземпляры произвольных классов объектов, эффективно снимая исторические ограничения обучения с фиксированными категориями [35]⟧.
Фреймворк предоставляет гибкие возможности вывода для адаптации к динамическим сценариям. Как показано концептуально на рисунке 8, YOLOE-26 поддерживает три различных режима: использование текстовых подсказок для определения целей (например, "найди красную чашку"), использование визуальных подсказок через эталонные изображения для однократного распознавания или работа в режиме без подсказок для нулевого вывода..
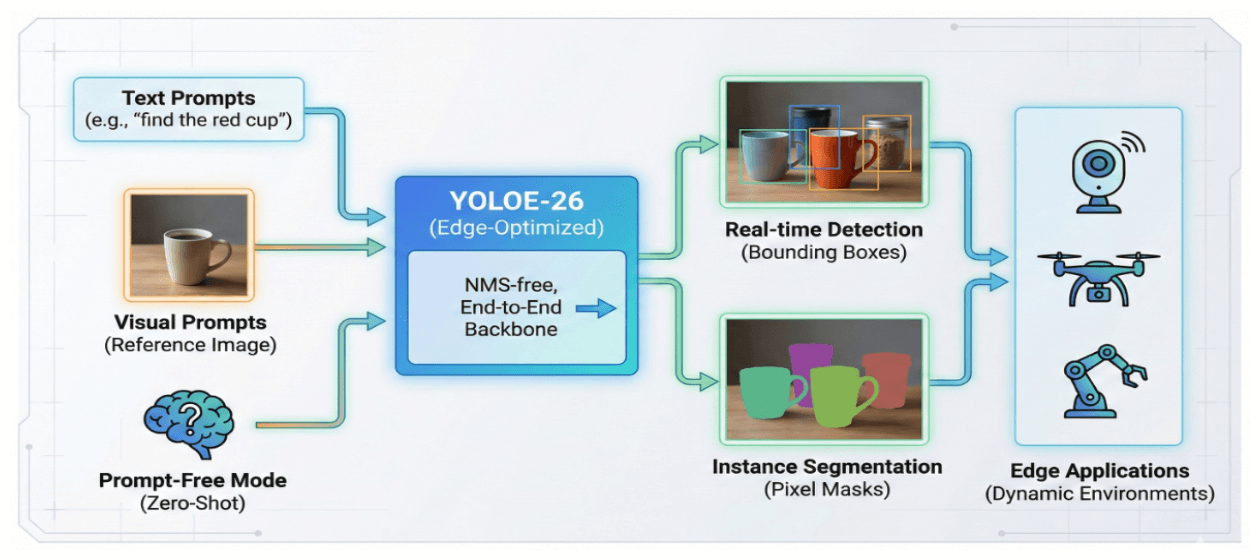
С технической точки зрения, YOLOE-26 использует родную архитектуру без NMS и сквозную конструкцию базовой основы YOLOv26. Такая конструкция устраняет необходимость в эвристических этапах постобработки, таких как подавление немаксимумов (NMS), — парадигмальный сдвиг, популяризированный детекторами на основе трансформеров [3]. Опираясь на эту упрощенную архитектуру, модель обеспечивает быстрый вывод в открытом мире с минимальной задержкой. Сочетание высокой скорости работы и семантической гибкости делает YOLOE-26 мощным решением для приложений на граничных устройствах, развернутых в средах, где объекты интереса представляют широкий и постоянно пополняющийся словарь [19].⟧.
5 Последствия для периферийного ИИ: преодоление «экспортного разрыва»"
Всепроникающая проблема в современной эпохе обнаружения объектов — это "Export Gap" — расхождение между теоретической производительностью, наблюдаемой во время обучения на GPU, и фактической задержкой, реализованной на развернутом периферийном оборудовании [34]. В этом разделе анализируется, как YOLOv26 решает это критическое узкое место с помощью своих архитектурных ограничений..
5.1 Узкое место задержки в традиционных моделях
Предшествующие передовые модели (SOTA), включая YOLOv8–YOLOv13, в значительной степени полагались на Distribution Focal Loss (DFL) для максимизации mAP [15, 44, 24]. Будучи математически точным, DFL требует сложных операций Softmax по дискретизированным бинам для вычисления итоговых координат [27]. На серверных GPU эти операции незначительны. Однако на оборудовании с целочисленной арифметикой (таком как NPU в мобильных устройствах или DSP в дронах) слои Softmax трудно квантовать, и они часто становятся основным узким местом задержки [11]. Следовательно, модель, которая выглядит эффективной в исследовательской статье, часто страдает от серьезного снижения пропускной способности при экспорте в реальные встраиваемые системы..
5.2 Детерминированный вывод через прямую регрессию
YOLOv26 разрешает этот компромисс, возвращаясь к стратегии прямой регрессии, явно устраняя вычислительную нагрузку DFL [17]. Путем разделения обучения представлениям и сложной постобработки архитектура гарантирует, что граф вывода состоит только из стандартных сверточных и линейных операций. Этот сдвиг гарантирует детерминированную задержку — время вывода остается постоянным независимо от сложности сцены или плотности объектов [17, 34]. Эта предсказуемость имеет первостепенное значение для критически важных для безопасности периферийных приложений, таких как автономное вождение и роботизированная навигация, где нарушения временных параметров могут привести к катастрофическим отказам [17]⟧.
6 Перспективные направления
Хотя YOLOv26 устанавливает новый стандарт для обнаружения в реальном времени, остается несколько направлений для исследований, чтобы полностью преодолеть разрыв между эффективностью на периферии и когнитивным интеллектом..
Внутренняя объяснимость и доверие: В настоящее время "черный ящик" глубоких детекторов решается с помощью пост-хок методов, таких как Grad-CAM [40] или SHAP [33], которые аппроксимируют процесс принятия решений моделью после вывода. Критическим будущим направлением является разработка Внутренней объяснимости [4], когда головка детекции выводит не только ограничивающий прямоугольник и класс, но также карту обоснования или текстовое объяснение (например, "Классифицировано как опухоль из-за неровной текстуры границ"). Встраивание интерпретируемости непосредственно в сквозной конвейер будет преобразующим для критически важных областей безопасности, таких как медицинская диагностика и автономная оборона, обеспечивая, чтобы высокоскоростные решения были также прозрачны и проверяемы.
Единое пространственно-временное восприятие: Безупречный, детерминированный характер YOLOv26 делает его уникально подходящим для анализа видео. Традиционные детекторы часто страдают от «мерцания» в видеопотоках, поскольку NMS произвольно выбирает разные боксы между кадрами. Будущие итерации могут расширить основу YOLOv26 для нативной обработки пространственно-временного обнаружения объектов. Рассматривая время как третье пространственное измерение, модель сможет выполнять отслеживание и распознавание действий (например, «человек бежит») в рамках одного прямого прохода, устраняя необходимость в отдельных алгоритмах отслеживания, таких как DeepSORT [47]⟧.
Адаптация во время тестирования на граничном устройстве: Наконец, статическая природа обученных моделей остается ограничением в динамических средах. Будущие исследования должны изучить Адаптацию во время тестирования (TTA) [42], позволяющую модели обновлять свои статистики пакетной нормализации или легкие слои адаптера непосредственно на граничном устройстве. Это позволит дрону или медицинскому устройству «акклиматизироваться» к новым условиям освещения или профилям шума датчиков в реальном времени, поддерживая пиковую точность без необходимости полного цикла переобучения на сервере..
7 Заключение
Данное исследование представляет всесторонний анализ YOLOv26 — архитектуры, которая переопределяет парадигму обнаружения объектов в реальном времени, устраняя подавление немаксимумов (NMS) в пользу исходной стратегии сквозного обучения. Переход к структуре без NMS, поддерживаемый новым оптимизатором MuSGD и планировщиком ProgLoss, успешно разрешает исторический компромисс между задержкой и точностью, одновременно обеспечивая значительное ускорение на стандартных CPU. Кроме того, использование головы прямого регресса (Direct Regression) эффективно закрывает "экспортный разрыв" (Export Gap), гарантируя детерминированную задержку для ресурсно-ограниченных периферийных устройств. Как демонстрирует новая граница Парето, установленная в официальных бенчмарках, YOLOv26 не только превосходит предыдущие версии и современных конкурентов, но и знаменует фундаментальный сдвиг в сторону полностью обучаемых, аппаратно-ориентированных конвейеров, необходимых для следующего поколения критически важных приложений Edge AI..
Благодарность(и)
Автор прямо заявляет об использовании инструментов искусственного интеллекта исключительно для языковой доработки и грамматической полировки; все научные концепции, данные и технические инновации, представленные здесь, являются оригинальной работой автора. Все архитектурные интерпретации и математические формулировки являются авторскими абстракциями, предназначенными для концептуальной ясности, и не представляют официальных спецификаций Ultralytics. Официальная документация доступна по адресу: https://docs.ultralytics.com/models/yolo26/.
Литература
- [1] А. Бочковский, К. Ван и Х. М. Ляо (2020) YOLOv4: оптимальная скорость и точность обнаружения объектов. arXiv preprint arXiv:2004.10934. Цитируется по: §2.2.
- [2] N. Bodla, B. Singh, R. Chellappa, and L. S. Davis (2017) Soft-NMS – улучшение обнаружения объектов одной строкой кода. В трудах IEEE International Conference on Computer Vision (ICCV), стр. 5561–5569. Внешние ссылки: Document Цитируется: §3.1.
- ⟦[3] N. Carion, F. Massa, G. Synnaeve, N. Usunier, A. Kirillov, and S. Zagoruyko (2020) Сквозное обнаружение объектов с помощью трансформеров. В трудах Европейской конференции по компьютерному зрению (ECCV), pp. 213–229. Цитируется в: §4.6⟧.
- ⟦[4] S. Chakrabarty, P. Bishwas, M. Bandyopadhyay, and J. Sublime (2025) Можем ли мы доверить ИИ свои уши? Междисциплинарный сравнительный анализ объяснимости в аудиоинтеллекте. IEEE Access 13 (), стр. 179733–179758. Внешние ссылки: Document Цитировано: §6.
- [5] S. Chakrabarty, P. Bishwas, S. Chakraborty, and O. Sarker (2025) Развитие обороны и безопасности с помощью обнаружения и отслеживания на основе глубокого обучения. В 2025 Международная конференция по интеллектуальным вычислениям и извлечению знаний (ICICKE), Vol. , pp. 1–6. Внешние ссылки: Document Цитируется: §1.2.
- ⟦[6] С. Чакрабарти, Р. Чаттерджи, С. Чакраборти, С. Рой Шуво и Р. Чоудхури (2025) Дроны в обороне: наблюдение и слежение за военными целями в реальном времени на основе видеоданных. В материалах 3-й Международной конференции по интеллектуальным системам, передовым вычислениям и коммуникациям (ISACC), 2025, Том , стр. 508–513. Внешние ссылки: Document Цитируется: §2.3⟧.
- ⟦[7] G. Chen, H. Wang, K. Chen, Z. Li, and Z. Yi (2022) К крупномасштабному обнаружению мелких объектов: обзор и бенчмарки. Препринт arXiv: 2207.14096. Цитируется: §3.3.2.
- ⟦[8] J. Ding, N. Xue, G. Xia, X. Bai, W. Yang, M. Y. Yang, S. Belongie, J. Luo, M. Datcu, M. Pelillo и др. (2019) Изучение ROI-трансформера для обнаружения ориентированных объектов на аэрофотоснимках. В трудах IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), стр. 2849–2858. Цитируется: §4.5⟧.
- [9] C. Feng, Y. Zhong, Y. Gao, G. Gui, M. Tan, J. Zhang, and K. Ma (2021) TOOD: task-aligned one-stage object detection. In Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), pp. 3490–3499. Цитируется: §3.3.2.
- [10] Z. Ge, S. Liu, F. Wang, Z. Li, и J. Sun (2021) YOLOX: превосходя серию YOLO в 2021. arXiv preprint arXiv:2107.08430. Цитировано: §3.2, §3.2.
- [11] A. Gholami, S. Kim, Z. Dong, Z. Yao, M. W. Mahoney, and K. Keutzer (2021) Обзор методов квантизации для эффективного вывода нейронных сетей. arXiv preprint arXiv:2103.13630. Цитируется: §3.2, §5.1.
- [12] K. He, X. Zhang, S. Ren, and J. Sun (2016) Глубокое остаточное обучение для распознавания изображений. В трудах IEEE конференции по компьютерному зрению и распознаванию образов (CVPR), стр. 770–778. Цитируется: §4.3.
- [13] N. J. Higham (1986) Метод Ньютона для квадратного корня из матрицы. Mathematics of Computation 46 (174), стр. 537–549. Цитируется по: §3.3.1.
- [14] S. Hossain and D. Lee (2019) Подход обучения на основе учебной программы для обнаружения объектов. arXiv preprint arXiv:1901.01890. Цитируется в: §3.3.3.
- [15] Ultralytics YOLOv8 Внешние ссылки: Link Цитируется: §2.3, §2.3, §3.3.3, §5.1.
- [16] Ultralytics/yolov5: v3.1 - исправление ошибок и улучшение производительности Внешние ссылки: Document, Link Цитируется: §1.2, §2.2.
- ⟦[17] Г. Джочер и Дж. Цю (2026) Ultralytics yolov26: нативное сквозное обнаружение объектов. Технический отчет Ultralytics. Внешние ссылки: Link Цитируется: §5.2⟧.
- [18] Ultralytics YOLO11 Внешние ссылки: Link Цитируется: 1st item, 2nd item, §1.2, §2.3, §3.2, §3.
- [19] Ultralytics yolo26 Внешние ссылки: Link Цитируется: §1.2.1, §2.3, §3.1, §4.1, §4.2, §4.3, §4.5, §4.6, §4.
- [20] К. Джордан и др. (2024) Ортогональные обновления весов для контроля спектральной нормы в глубоком обучении. Технический отчет. Цитируется: §3.3.1.
- [21] K. Jordan (2024) Muon: новый оптимизатор для быстрой сходимости в обучении LLM. Примечание: Пост в блоге GitHub Внешние ссылки: Link Цитируется: §3.3.1.
- [22] A. Kendall, Y. Gal, and R. Cipolla (2018) Многозадачное обучение с использованием неопределенности для взвешивания потерь для геометрии сцены и семантики. В трудах конференции IEEE по компьютерному зрению и распознаванию образов (CVPR), pp. 7482–7491. Цитируется: 1st item.
- ⟦[23] М. Кисалинт, З. Война, Я. Муравски, Я. Нарунец и К. Чо (2019) Аугментация для обнаружения маленьких объектов. arXiv препринт arXiv:1902.07296. Цитируется: §3.3.2.
- [24] M. Lei, S. Li, Y. Wu, H. Hu, Y. Zhou, X. Zheng, G. Ding, S. Du, Z. Wu, and Y. Gao (2025) YOLOv13: обнаружение объектов в реальном времени с адаптивным визуальным восприятием на основе гиперграфа. arXiv preprint arXiv:2506.17733. Цитируется: §2.3, §2.3, §5.1.
- ⟦[25] К. Ли, Л. Ли, Х. Цзян и др. (2022) YOLOv6: однокаскадный детектор объектов для промышленных приложений. arXiv preprint arXiv:2209.02976. Цитируется в: §2.2.
- [26] J. Li, S. Bian, Q. Xu, G. Liu, and B. Cheng (2021) Регрессия позы человека с оценкой остаточного логарифмического правдоподобия. В трудах Международной конференции по компьютерному зрению IEEE/CVF (ICCV), стр. 11039–11048. Цитируется: §4.4.
- [27] X. Li, W. Wang, L. Wu, S. Chen, X. Hu, J. Li, J. Tang, and J. Yang (2020) Обобщенные фокальные потери: обучение квалифицированным и распределенным ограничивающим рамкам для плотного обнаружения объектов. Advances in Neural Information Processing Systems (NeurIPS) 33, стр. 21002–21012. Цитируется: §3.2, §5.1.
- [28] M. Lin, Q. Chen, and S. Yan (2013) Сеть в сети. arXiv preprint arXiv:1312.4400. Цитируется: §4.3.
- [29] Т. Лин, П. Гойал, Р. Гиршик, К. Хэ и П. Доллар (2017) Фокальная потеря для плотного обнаружения объектов. В трудах международной конференции IEEE по компьютерному зрению, pp. 2980–2988. Цитируется: §3.3.3.
- [30] Т. Лин, М. Мэр, С. Белонжи, Дж. Хейс, П. Перона, Д. Раманан, П. Доллар и К. Л. Цитник (2014) Microsoft coco: обычные объекты в контексте. В трудах Европейской конференции по компьютерному зрению (ECCV), стр. 740–755. Цитировано: §4.4.
- [31] J. Liu et al. (2025) Muon масштабируем для обучения LLM. arXiv preprint arXiv:2502.16982. Цитируется: §3.3.1.
- [32] I. Loshchilov и F. Hutter (2017) SGDR: стохастический градиентный спуск с теплыми перезапусками. В International Conference on Learning Representations (ICLR), Цитировано: §3.3.3.
- [33] S. M. Lundberg и S. Lee (2017) Единый подход к интерпретации предсказаний моделей. In Advances in Neural Information Processing Systems (NeurIPS), стр. 4765–4774. Цитируется: §6.
- [34] C. Lyu, W. Zhang, H. Huang, Y. Zhou, Y. Wang, Y. Liu, S. Zhang, and K. Chen (2022) RTMDet: эмпирическое исследование проектирования детекторов объектов реального времени. arXiv preprint arXiv:2212.07784. Цитируется: 2nd item, §1.2, §3.1, §3.2, §5.2, §5.
- ⟦[35] A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, S. Agarwal, G. Sastry, A. Askell, P. Mishkin, J. Clark, et al. (2021) Обучение переносимых визуальных моделей с помощью надзора на естественном языке. In Международная конференция по машинному обучению (ICML), pp. 8748–8763. Цитируется: §4.6⟧.
- [36] Дж. Редмон, С. Диввала, Р. Гиршик и А. Фархади (2016) Вы смотрите только один раз: унифицированное обнаружение объектов в реальном времени. В трудах конференции IEEE по компьютерному зрению и распознаванию образов (CVPR), стр. 779–788. Цитируется по: §2.1.
- [37] J. Redmon и A. Farhadi (2017) YOLO9000: быстрее, лучше, сильнее. В материалах Конференции IEEE по компьютерному зрению и распознаванию образов (CVPR), стр. 7263–7271. Цитируется: §2.1.
- [38] Дж. Редмон и А. Фархади (2018) YOLOv3: инкрементальное улучшение. arXiv препринт arXiv:1804.02767. Цитируется: §2.1.
- [39] H. Rezatofighi, N. Tchapmi, Q. Shao, S. Savarese, and A. Gheissari (2019) Обобщенное пересечение над объединением: метрика и функция потерь для регрессии ограничивающих рамок. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 658–666. Цитируется: §3.3.2.
- ⟦[40] Р. Р. Сельвараджу, М. Когсвелл, А. Дас, Р. Ведантам, Д. Парих и Д. Батра (2017) Grad-CAM: визуальные объяснения из глубоких сетей с помощью локализации на основе градиента. В трудах Международной конференции IEEE по компьютерному зрению (ICCV), стр. 618–626. Цитируется в: §6.
- [41] H. Sharma, J. Park, D. Mahajan, E. Amaro, J. K. Kim, C. Shao, A. Mishra, and H. Esmaeilzadeh (2018) BitFusion: битовое конвейерное умножение и накопление для эффективного глубокого обучения. В трудах 45-й ежегодной международной симпозиума по компьютерной архитектуре (ISCA), стр. 444–455. Цитируется в: §3.2.
- [42] Y. Sun, X. Wang, Z. Liu, J. Miller, A. Efros, and M. Hardt (2020) Обучение во время тестирования с самоконтролем для обобщения при изменении распределения. В International Conference on Machine Learning (ICML), pp. 9329–9339. Цитируется: §6.
- [43] U. R. Team (2025) YOLOv12: внимание-центричное обнаружение объектов в реальном времени. arXiv preprint arXiv:2502.12588. Примечание: Препринт Цитируется: §2.3.
- [44] A. Wang, H. Chen, L. Li, K. Feng, S. Han, and G. Ding (2024) YOLOv10: обнаружение объектов в реальном времени от начала до конца. arXiv preprint arXiv:2405.14458. Цитируется: §2.3, §2.3, §3.1, §5.1.
- [45] C. Wang, A. Bochkovskiy, and H. M. Liao (2023) YOLOv7: обучаемый набор бесплатных функций устанавливает новый уровень современного состояния для детекторов объектов реального времени. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 7464–7475. Цитируется: §2.2.
- ⟦[46] C. Wang, H. M. Liao, and I. Yeh (2024) YOLOv9: изучение того, что вы хотите изучить, с помощью программируемой градиентной информации. Препринт arXiv:2402.13616. Цитируется: §2.3.
- [47] Н. Войке, А. Бьюли и Д. Паулюс (2017) Простое онлайн и в реальном времени отслеживание с глубокой метрикой ассоциации В трудах Международной конференции IEEE по обработке изображений (ICIP), стр. 3645–3649. Цитируется: §6.
- [48] С. Сюй, С. Ван, В. Лю, Ц. Чан, Ц. Цуй, К. Дэн, Г. Ван, Ц. Дан, С. Вэй, Й. Ду и др. (2022) PP-YOLOE: эволюционировавшая версия YOLO. Препринт arXiv:2203.16250. Цитируется: §1.2.
- [49] X. Xu, Y. Jiang, W. Chen, Y. Huang, Y. Zhang, and X. Sun (2022) DAMO-YOLO: отчет о разработке детекции объектов в реальном времени. Препринт arXiv:2211.15444. Цитируется в: §1.2.
- [50] X. Yang, J. Yan, Z. Feng, and T. He (2021) R3Det: уточненный одностадийный детектор с уточнением признаков для вращающихся объектов. В трудах конференции AAAI по искусственному интеллекту, Том 35, стр. 3163–3171. Цитируется: §4.5.
