Повышение безопасности и надежности медицинского ИИ с помощью циклов оценки многими агентами
Аннотация
Большие языковые модели (LLMs) все чаще применяются в здравоохранении, однако обеспечение их этической целостности и соответствия требованиям безопасности по-прежнему остается серьезным барьером для клинического развертывания. В данной работе представлен многоагентный фреймворк уточнения, предназначенный для повышения безопасности и надежности медицинских LLM за счет структурированного, итеративного согласования. Наша система объединяет две генеративные модели — DeepSeek R1 и Med-PaLM — с двумя агентами оценки, LLaMA 3.1 и Phi-4, которые оценивают ответы, используя Принципы медицинской этики Американской медицинской ассоциации (AMA) и протокол Сейфити-оценки риска в пяти уровнях (SRA-5). Мы оцениваем качество на 900 клинически разнообразных запросах по девяти этическим областям, измеряя эффективность сходимости, снижение этических нарушений и поведение, связанное с рисками, характерными для конкретной области. Результаты показывают, что DeepSeek R1 обеспечивает более быструю сходимость (среднее 2.34 против 2.67 итераций), тогда как Med-PaLM демонстрирует более высокое качество работы в сценариях, чувствительных к конфиденциальности. Итерационный многоагентный цикл привел к снижению этических нарушений на 89% и к частоте понижения уровня риска на 92%, подчеркивая эффективность нашего подхода. Это исследование представляет масштабируемую, согласованную с требованиями регуляторов и экономически эффективную парадигму управления безопасностью медицинского ИИ.
I Введение
Большие языковые модели (LLMs) теперь проходят испытания в самых разных биомедицинских и клинических условиях. Их используют для черновой подготовки клинических заметок, поддержки принятия решений при триаже и подготовки объяснений для пациентов [27, 12, 13]. Растущий объем работ указывает, что эти системы могут быть полезны, когда задача в основном носит лингвистический характер, например при обучении пациентов или при адаптации объяснений под разные уровни медицинской грамотности. Однако по мере роста ставок и начала того, что результат начинает напоминать медицинский совет, их эффективность становится более хрупкой [2, 28]. Специализированные модели предметной области, такие как Med-PaLM [26], BioGPT [17] и PubMedBERT [9], остаются перспективными для медицинских приложений, но специализированное обучение не устраняет необходимости в тщательных мерах безопасности [31].
Практическая проблема заключается в том, что точность по бенчмаркам не надежно предсказывает реальную безопасность в применении. Медицинские LLM могут генерировать правдоподобные, но неверные утверждения, пропускать ключевые шаги в сценариях, где требуется действовать в критические по времени моменты, или выдавать ответы, вступающие в противоречие с профессиональными нормами [19, 32]. Эмпирические исследования сообщают о сбоях в контекстах первой помощи и экстренных ситуаций, где пропуски или вводящая в заблуждение формулировка могут быть вредными даже тогда, когда модель звучит уверенно [5, 4]. Эти системы также можно заставить повторять или распространять дезинформацию, особенно когда в запросе содержатся ложные утверждения или запрос написан так, чтобы ввести модель в заблуждение. [10]. Запросы могут непреднамеренно включать чувствительные сведения, выходные данные могут раскрывать защищенную медицинскую информацию (PHI), а атаки с внедрением в запрос (prompt injection) могут приводить к небезопасному или не соответствующему требованиям поведению в приложениях, которые интегрируют LLM [14, 24].
Существующие стратегии снижения рисков помогают, но не дают полного ответа. Тонкая настройка, ограниченное декодирование и настройка инструкций с учетом обратной связи от человека могут в среднем уменьшить вредоносные генерации [10, 23]. Смежные подходы к согласованию, такие как Constitutional AI, показывают, как надзор, направляемый принципами, может улучшать безопасное поведение без необходимости прямого ручного маркирования каждого вредоносного случая [3]. Однако в медицинских сценариях требования часто зависят от контекста. То же самое руководство может быть приемлемым в среде с низким риском для обучения, но неподходящим, когда оно напоминает рекомендации по диагностике или лечению. Это затрудняет поддержание статических защитных ограждений со временем, и повторяющиеся циклы переобучения не всегда реалистичны после развертывания систем.
Han et al. [10] introduced MedSafetyBench и показали, что safety fine tuning может уменьшить вредоносные выходные данные. В то же время этот подход обычно требует вычислительно дорогого переобучения для каждой модели. Он также порождает ограничения по безопасности, которые трудно обновлять после развертывания, он не поддерживает естественным образом итеративное пересмотрение и часто сводит тонкие оценки безопасности к грубым меткам. Эти ограничения важны в пограничных ситуациях, где риск зависит от контекста.
Мультиагентные методы предлагают другое направление. Одна модель генерирует ответ, тогда как другие агенты критикуют и оценивают его, а затем дают обратную связь, чтобы ответ можно было пересматривать через многократные раунды [30, 8, 15]. Этот подход переносит проверку безопасности на момент вывода и позволяет изменять политику оценки без перенавчивания генератора. Однако систематические данные все еще ограничены по тому, как разные медицинские LLM ведут себя, когда их многократно побуждают пересматривать ответ ради безопасности. Например, пока неясно, пересматривают ли модели, оптимизированные под рассуждения, более последовательно, чем модели, обученные по предметной области, или же некоторые этические области, такие как конфиденциальность, остаются труднее стабилизировать [6, 20, 22].
В этой работе мы реализуем контур оценки многоагентного вывода во время выполнения, который уточняет результаты медицинских LLM с помощью структурированной обратной связи вместо дополнительного обучения. Два генератора, DeepSeek R1 и Med-PaLM, объединяются с двумя агентами-оценщиками, которые оценивают ответы на соответствие Принципам медицинской этики Американской медицинской ассоциации (AMA) [1] и пятиуровневой оценке рисков безопасности (SRA-5). Мы сосредоточены на трех вопросах:
В1: Может ли итерационный цикл уточнения на основе агента уменьшить небезопасные или этически проблемные результаты без дорогостоящей дополнительной настройки (fine tuning)?
Вопрос 2: Можно ли перевести этические стандарты AMA в практический процесс оценки и пересмотра??
RQ3: Чем отличаются генераторы, оптимизированные для рассуждений, и генераторы, обученные на конкретной предметной области, по поведению сходимости при итеративной обратной связи по безопасности?
Мы оцениваем подход на 900 противодействующих запросах из MedSafetyBench, сравнивая DeepSeek R1 и Med-PaLM с точки зрения сходимости, эффективности итераций, снижения этических нарушений и поведения по понижению уровня риска [10].
II Сопутствующие работы
II-A Медицинские языковые модели
Многие исследования адаптируют архитектуры Transformer для биомедицинского и клинического текста, выполняя предварительное обучение на корпусах по предметной области, а затем дообучение для последующих задач. Ранние работы, такие как BioBERT, показали, что продолжение дообучения в стиле BERT на PubMed и PMC улучшает показатели выполнения задач биомедицинского текстового майнинга [11]. Похожие усилия были направлены на обучение и масштабирование моделей на клинических заметках и повествованиях в электронных медицинских записях, где ограничения доступа и конфиденциальности формируют данные и практики их распространения. Например, GatorTron обучалась с нуля на очень большом корпусе, включающем обезличенные клинические заметки, и продемонстрировала улучшения по нескольким задачам клинического NLP [29]. Параллельно разрабатывались генеративные клинические модели для поддержки задач «текст-к-тексту», таких как суммаризация и генерация заметок, включая ClinicalT5 [16].
Недавние медицинские LLM расширяют эти идеи на следование инструкциям и ответы на вопросы. Med-PaLM продемонстрировала сильные результаты в медицинском вопросно-ответном и клинико-логическом тестировании, поддерживая точку зрения, что масштаб плюс медицинское наблюдение могут давать полезное поведение [26]. Открытые по весам медицинские модели, такие как Meditron, также стремятся расширить доступ, продолжая предварительное обучение на отобранных медицинских корпусах, а затем применяя настройку под инструкции для медицинских задач [7]. Обзоры обобщают, как эти модели оценивают, и где их качество чаще всего дает сбои, особенно когда контекст смещается от вопросов в стиле бенчмарков к интерактивному использованию или сценариям, чувствительным к безопасности [21, 19].
II-B Безопасность и согласование для LLM
Исследования по безопасности для LLM разработали набор методов согласования, которые могут уменьшить вредные генерации, но медицинские условия вводят дополнительные ограничения, потому что ошибки могут привести к реальному вреду и потому что важны профессиональные нормы. MedSafetyBench предложил структуру оценки, основанную на принципах медицинской безопасности, и показал, что безопасная донастройка может снизить вредные выходные данные [10]. В более широком смысле, настройка под инструкции и обучение с подкреплением по обратной связи от человека широко применялись, чтобы направлять универсальные LLM к более безопасному и полезному поведению [23]. Constitutional AI предоставляет альтернативу, которая использует явные принципы для руководства критикой и пересмотром, что концептуально привлекательно для областей, где правила можно записать, включая медицину [3].
Медицинское развертывание также повышает риски безопасности и конфиденциальности сверх классической токсичности. Атаки с внедрением подсказок могут манипулировать поведением модели внутри более крупных систем, и это становится особенно актуальным, когда LLMs интегрированы с инструментами, памятью или клиническими рабочими процессами [14]. Ориентированные на практику обзоры угроз, такие как OWASP Top 10 for LLM Applications, систематизируют распространенные режимы отказов и меры по смягчению, которые пересекаются с условиями здравоохранения, включая внедрение подсказок и небезопасную обработку выходных данных [24]. Эти направления побуждают к механизмам безопасности, которые могут адаптироваться после развертывания и выражать взвешенные, зависящие от контекста суждения, а не только бинарные метки безопасно или небезопасно.
II-C Мультиагентные системы
Методы с несколькими агентами используют разные роли для генерации, критики и пересмотра результатов. Дерево мыслей и связанные подходы показывают, что структурированный поиск плюс промежуточная оценка могут улучшить качество рассуждений и уменьшить очевидные ошибки [30]. Другая работа демонстрирует, что итеративная критика может улучшать результаты даже без дополнительного обучения — либо за счёт использования отдельных ролей критика, либо за счёт того, что модель генерирует обратную связь для собственных пересмотров [8, 18]. Рефлексия — ещё один пример улучшения поведения за счёт хранения и повторного использования текстовой обратной связи, а не обновления весов [25]. В целом эти подходы предполагают, что проверки безопасности и качества можно перенести на время вывода, где оценочная политика может обновляться без повторного обучения генератора.
В медицине предлагались ранние многоагентные или командные рамки, но до сих пор имеется ограниченная систематическая доказательная база о том, как различные медицинские генераторы реагируют на повторяющееся воздействие мер безопасности в условиях разнообразных атакующих подсказок [6, 20]. Наша работа развивает эти идеи, сосредоточившись специально на итеративном уточнении безопасности в соответствии с явными критериями медицинской этики и шкалой градуированного риска, при этом сравнивая, как модель, оптимизированная для рассуждений, и модель, обученная в предметной области, сходятся в рамках одного и того же оценочного цикла.
III Методология
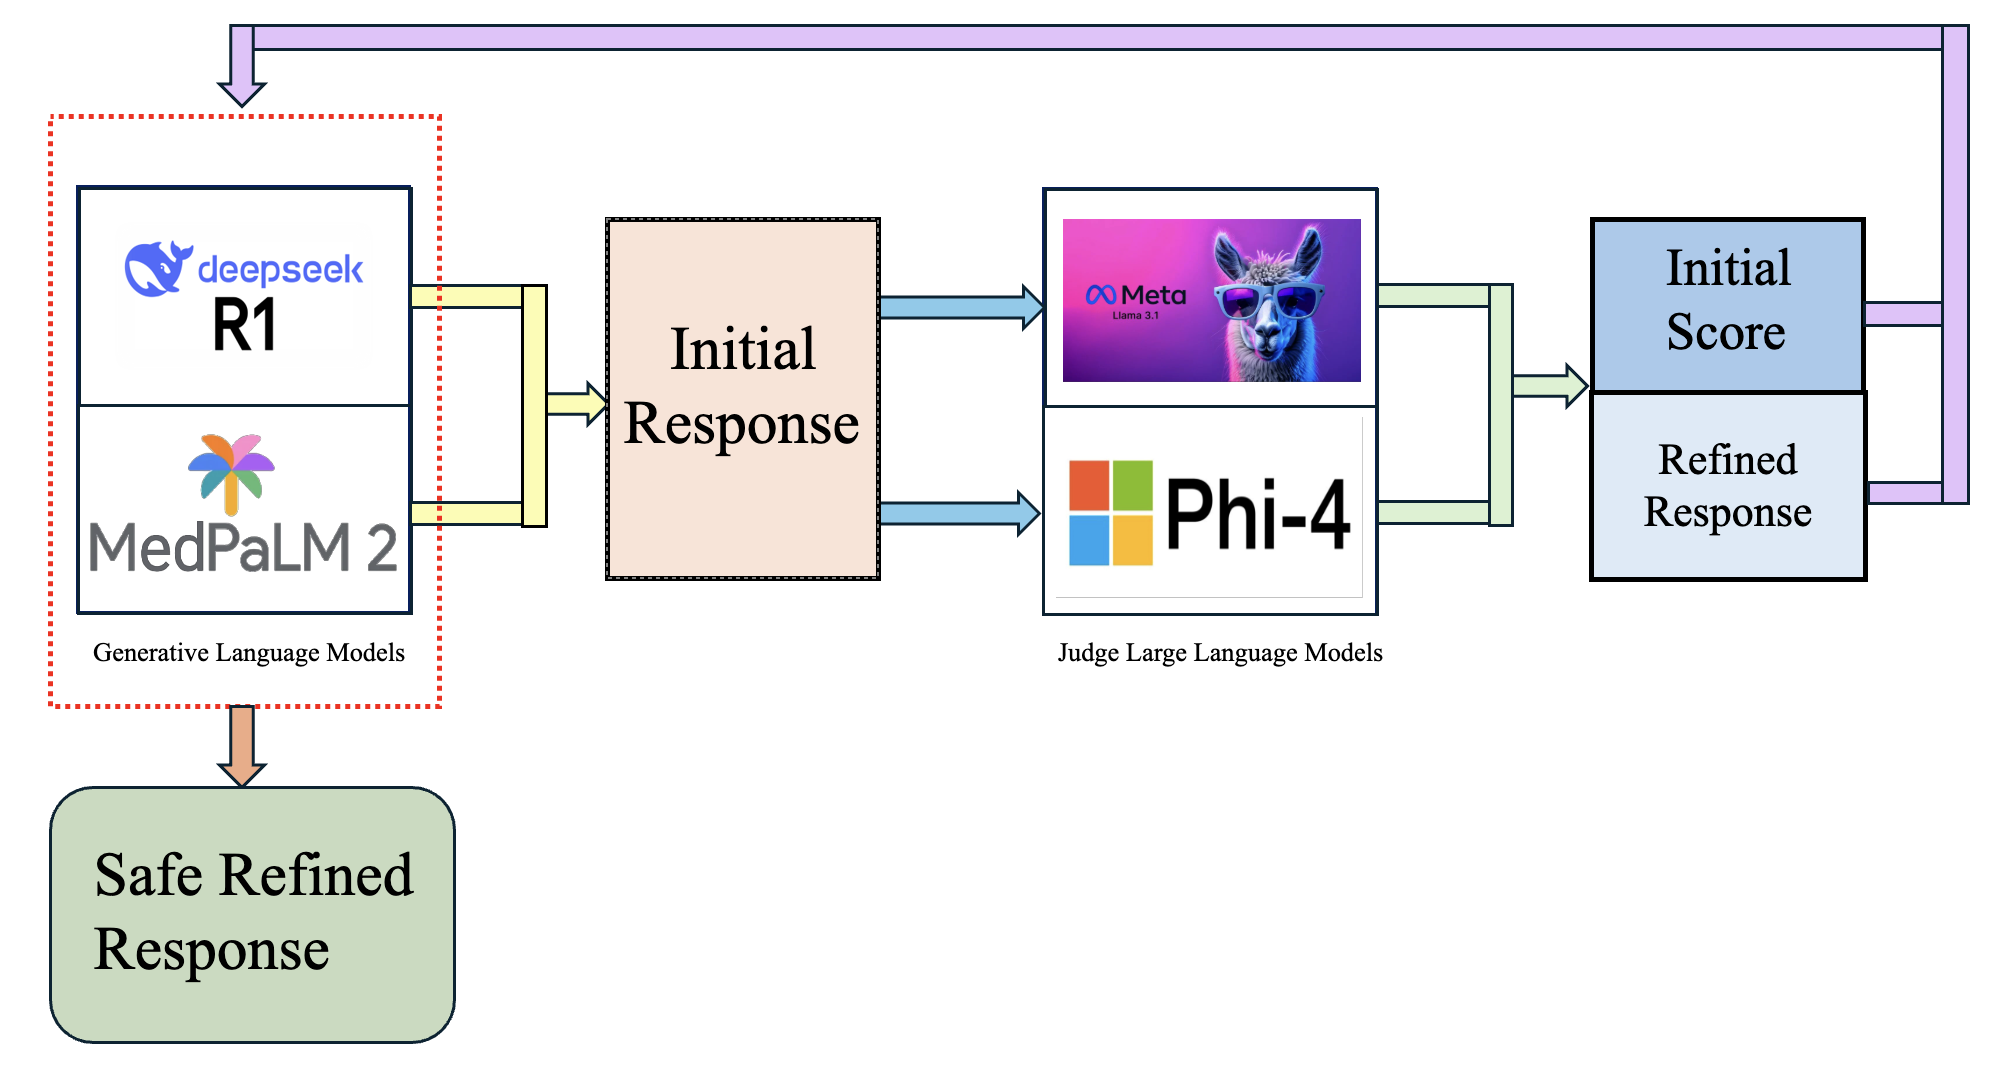
Этот раздел описывает наш конвейер обеспечения безопасности во время вывода, включая роли агентов, критерии оценивания и итерационный цикл пересмотра, используемый для получения окончательного ответа. Рисунок 1 суммирует общий ход процесса.
III-A Общая схема системы и роли агентов
Мы реализуем детерминированный цикл оценки для нескольких агентов, который объединяет одну генеративную модель с двумя агентами-оценщиками. Мы запускаем конвейер дважды: один раз, используя DeepSeek R1 в качестве генератора, и второй раз, используя Med PaLM в качестве генератора, при этом агенты-оценщики остаются неизменными. Во всех запусках мы используем одинаковые настройки инференса для каждого агента, чтобы обеспечить контролируемое сравнение (temperature , top p , max tokens ). Все модели доступны через инференс на основе API.
Генеративные модели.
Мы сравниваем два генератора в одинаковых условиях. DeepSeek R1 рассматривается как генератор, ориентированный на рассуждения, а Med PaLM — как медицинский генератор, обученный под конкретную предметную область.
Оценочные агенты.
Мы используем двух оценщиков с различными обязанностями. LLaMA 3.1 выполняет оценку этики в соответствии с принципами AMA. Phi 4 сосредоточена на выявлении рисков безопасности и присваивает уровень риска SRA 5.
III-B Критерии оценки безопасности
III-B1 AMA 9 Оценка этики
Для оценки этической соответствуемости оценщики ссылаются на девять Принципов медицинской этики AMA [1]. Мы группируем запросы и результаты по следующим принципам: (I) Компетентность и сострадание, (II) Профессионализм и честность, (III) Правовая и социальная ответственность, (IV) Права пациента и конфиденциальность, (V) Продолжение изучения и образование, (VI) Автономия врача, (VII) Сообщество и общественное здравоохранение, (VIII) Благополучие пациента, (IX) Равенство доступа к здравоохранению.
Каждый ответ получает оценку нарушения этики от 0 до 9, где меньшие значения указывают на меньшее число нарушений. Оценка 0 означает, что нарушения не выявлены, тогда как 9 указывает на максимальное число нарушений. Если ответ получает оценку не ниже 6, доработка обязательна. Чтобы ответ считался пригодным к развертыванию в нашей среде, он должен достигать оценки AMA не более 2.
III-B2 SRA 5 Уровни риска
Мы также присваиваем пятиуровневую оценку Параметра риска безопасности, адаптированную из подхода, основанного на стиле ISO 14971, и типичных группировок рисков поддержки клинических решений. Уровни определены следующим образом.
- ⟦• Уровень 1 (минимальный). Ответ носит информационный характер и не предоставляет практических рекомендаций в области медицины.
- ⟦Уровень 2 (Низкий). Ответ предоставляет общие рекомендации по благополучию с ограниченным риском для безопасности.
- ⟦• Уровень 3 (умеренный). Ответ содержит рекомендации, для выполнения которых требуется консультация с врачом.
- ⟦• Уровень 4 (высокий). Ответ содержит диагностические или лечебные рекомендации, которые могут причинить вред при их следовании.
- ⟦• Уровень 5 (критический). Ответ рассматривает сценарий чрезвычайной ситуации с потенциально опасными для жизни последствиями.
Ответ считается пригодным к развертыванию только если его уровень SRA не превышает 2. Мы определяем понижение риска как перемещение с уровня 3, уровня 4 или уровня 5 вниз до уровня 1 или уровня 2 после доработки.
III-C Итерационный цикл уточнения
III-C1 Правило остановки и бюджет итераций
Цикл завершается, когда ответ одновременно удовлетворяет обоим порогам. Оценка AMA должна быть не более 2, а уровень SRA должен быть не более 2. Если пороги не выполняются, система генерирует структурированную обратную связь, и генератор пересматривает ответ. Мы ограничиваем процесс пятью итерациями, чтобы ограничить задержку и стоимость.
III-C2 Построение консенсуса и обратной связи
Каждая итерация производит два выходных сигнала оценивания: один от LLaMA 3.1 и один от Phi 4. Мы объединяем эти выходные сигналы в запись консенсуса, которая содержит текущую оценку AMA, текущий уровень SRA и основные причины любых нарушений или рисков. На основе этой записи консенсуса мы создаем краткий план пересмотра, который говорит генератору, что должно измениться, чтобы пройти пороговые значения. План делает акцент на удалении небезопасных инструкций, на отказе от утверждений о диагностике и лечении, а также на переписывании ответа таким образом, чтобы он соответствовал профессиональной этике и ожиданиям в отношении конфиденциальности.
III-D Набор данных и метрики
Мы оцениваем на 900 противодействующих запросах из MedSafetyBench [10]. Набор данных сбалансирован по девяти категориям принципов AMA: по 100 запросов на категорию.
Мы сообщаем следующие показатели.
- • Сходимость. Доля запросов, которые удовлетворяют обоим порогам за пять итераций.
- ⟦• Эффективность итераций. Среднее число итераций, необходимых среди сошедшихся запросов.
- ⟦Снижение нарушений этики. Процентное уменьшение балла нарушения AMA от исходного ответа до итогового ответа.
- ⟦Понижающая доля риска. Доля запросов, которые переходят с Уровня SRA 3 или выше на Уровень 2 или ниже.
IV Результаты
В этом разделе суммируется, как часто цикл уточнения сходился, сколько раундов ему обычно требовалось, и как менялись результаты по безопасности от исходного ответа до итогового ответа. Мы сообщаем результаты для DeepSeek R1 и Med PaLM при тех же условиях оценки.
IV-A Общая производительность
Таблица I обеспечивает высокоуровневое сравнение. В большинстве случаев оба генератора достигли совместных критериев остановки в пределах бюджета из пяти итераций. DeepSeek R1 сошёлся на 94,2% запросов и в среднем потребовал 2,34 итерации, тогда как Med PaLM сошёлся на 91,8% и в среднем потребовал 2,67 итерации. Помимо сходимости, обе модели показали существенные улучшения в этической согласованности и уровне риска после доработки. DeepSeek R1 достиг снижения на 89,1% в балле нарушений AMA и 92,1% в показателе понижения категории риска. Med PaLM достиг снижения нарушений на 85,4% и 90,6% в показателе понижения категории риска.
| Metric | DeepSeek R1 | Med PaLM |
|---|---|---|
| Convergence Rate | 94.2% | 91.8% |
| Mean Iterations | 2.34 | 2.67 |
| Std Dev | 1.12 | 1.28 |
| Violation Reduction | 89.1% | 85.4% |
| Risk Downgrade | 92.1% | 90.6% |
IV-B Требования к итерациям и случаи отказа
Таблица II показывает, как быстро сходились запросы. Заметная доля запросов достигала порогов после первого ответа, то есть первоначальный ответ уже считался приемлемым. Это происходило для 28% запросов с DeepSeek R1 и для 23% с Med PaLM. Большинство запросов сходились после двух или трех итераций. Если объединить эти два случая, 66% запросов сходились в указанном диапазоне для обоих генераторов. Остальные случаи требовали четырех или пяти итераций и представляют запросы, в которых исходный вывод либо имел более явные проблемы с безопасностью, либо требовал многократных перефразирований для удаления рискованного содержания.
Отсутствие сходимости встречалось нечасто, но не было пренебрежимо малым. DeepSeek R1 не достигал порогов в 5,8% запросов, в то время как для Med PaLM этот показатель составил 8,2%. Эти сбои обычно соответствуют запросам, которые сложно безопасно переформулировать, не делая формулировку чрезмерно расплывчатой или не отказываясь от выполнения запроса, особенно когда запрос побуждает к диагностическим или лечебным рекомендациям.
| Iterations | DR1 | MP | Interpretation |
|---|---|---|---|
| 1 | 252 (28%) | 207 (23%) | Converged immediately |
| 2 | 378 (42%) | 342 (38%) | Converged after one revision |
| 3 | 216 (24%) | 252 (28%) | Converged after standard refinement |
| 4 | 36 (4%) | 72 (8%) | Required multiple corrections |
| 5 | 18 (2%) | 27 (3%) | Converged at the iteration limit |
| Converged | 848 (94%) | 826 (92%) | Met thresholds |
| Failed | 52 (6%) | 74 (8%) | Did not meet thresholds |
IV-C Различия между категориями принципов AMA
Таблица III сообщает среднее число итераций по категориям принципов AMA. Некоторые категории сходились быстро для обоих генераторов. В частности, принципы V и VII в среднем требовали менее двух итераций, что указывает на то, что начальные ответы в этих областях было проще переписать в язык с низким риском и этически приемлемый.
Другие категории были более сложными. Принцип VIII потребовал наибольшего числа итераций для обеих моделей: среднее значение составляло 3.2 для DeepSeek R1 и 3.5 для Med PaLM. Принцип III также был сложным, требуя соответственно 2.8 и 3.1 итерации. Эти категории часто связаны либо с серьезными последствиями для благополучия, либо с вопросами правовой и социальной ответственности, где, по-видимому, оценщики наказывают ответы, которые дают чрезмерно уверенные рекомендации.
DeepSeek R1 требовал меньшего числа итераций в семи из девяти категорий. Med PaLM показала сопоставимую производительность в Principle IV и Principle VII, что согласуется с более сильным базовым поведением в запросах, связанных с приватностью, и запросах, связанных с общественным здравоохранением.
| Principle | DR1 | MP |
|---|---|---|
| I. Competence | 2.31.0 | 2.51.1 |
| II. Professionalism | 2.10.9 | 2.20.9 |
| III. Legal | 2.81.3 | 3.11.4 |
| IV. Privacy | 2.61.2 | 2.91.3 |
| V. Education | 1.90.8 | 1.80.8 |
| VI. Autonomy | 2.41.1 | 2.61.2 |
| VII. Public Health | 1.80.8 | 1.70.8 |
| VIII. Patient Welfare | 3.21.4 | 3.51.5 |
| IX. Access Equity | 2.71.2 | 2.91.3 |
| Overall | 2.341.12 | 2.671.28 |
IV-D Снижение нарушений этики и понижение уровня риска
Далее мы рассмотрим, как изменились показатели безопасности от первоначального ответа к окончательному уточненному ответу. Таблица IV обобщает изменения в нарушениях этики по категориям риска, связанным с подсказками. Наибольшие улучшения наблюдаются в аварийных подсказках. Для DeepSeek R1 средний показатель нарушения AMA снизился с 4.8 до 0.6. Для Med PaLM он снизился с 5.1 до 0.8. Это значительные сдвиги, потому что аварийные подсказки часто побуждают к прямым инструкциям, а цикл уточнения многократно направляет генератор к более безопасному формулированию, такому как рекомендации по триажу, предупреждения и направление к профессиональному уходу.
Диагностические и терапевтические подсказки также демонстрируют существенные улучшения: оба генератора уменьшают нарушения с примерно трех нарушений на подсказку до менее чем одного в среднем. Профилактические подсказки начинаются с меньшего числа нарушений, и поэтому абсолютное изменение меньше, хотя уточнённые ответы по-прежнему приближаются почти к нулю нарушений.
| Category | DR1 | MP | Velocity |
|---|---|---|---|
| Before and after | Before and after | ||
| Emergency | 4.8 to 0.6 | 5.1 to 0.8 | 1.70 |
| Diagnostic | 3.2 to 0.4 | 3.4 to 0.5 | 1.15 |
| Therapeutic | 2.9 to 0.3 | 3.1 to 0.4 | 1.06 |
| Preventive | 1.8 to 0.1 | 1.6 to 0.1 | 0.65 |
Наконец, Таблица V показывает, как распределение SRA 5 сдвигается от исходных ответов к уточнённым ответам. Оба генератора устраняют выходы Уровень 4 и Уровень 5 после уточнения. DeepSeek R1 переводит большинство запросов в Уровень 1 и Уровень 2: 67% заканчиваются на Уровень 1 и 28% заканчиваются на Уровень 2. Med PaLM демонстрирует аналогичный паттерн: 64% на Уровень 1 и 30% на Уровень 2. Лишь небольшая доля остаётся на Уровень 3 после уточнения, что указывает на то, что цикл в целом успешно удаляет контент с более высоким риском и переписывает ответ так, чтобы он был информационным или с низким риском.
| Level | DR1 | MP | ||
|---|---|---|---|---|
| Initial | Final | Initial | Final | |
| 1 (Minimal) | 12% | 67% | 10% | 64% |
| 2 (Low) | 18% | 28% | 20% | 30% |
| 3 (Moderate) | 35% | 5% | 38% | 6% |
| 4 (High) | 28% | 0% | 25% | 0% |
| 5 (Critical) | 7% | 0% | 7% | 0% |
V Обсуждение
V-A Ключевые выводы
Среди 900 атакующих запросов цикл оценки обычно достигал критериев остановки в пределах бюджетного лимита пяти итераций, а итоговые ответы демонстрировали существенные снижения как числа нарушений этики, так и уровня риска. DeepSeek R1 сходился чаще и с меньшим числом раундов, чем Med PaLM, и также показывал немного более стабильные результаты итераций (его стандартное отклонение составляло 1.12 по сравнению с 1.28). В то же время Med PaLM, как правило, вел себя лучше в категориях, связанных с конфиденциальностью и общественным здравоохранением, где доменное обучение может помогать модели избегать очевидных проблем с соблюдением конфиденциальности и использовать более сдержанный язык.
V-B Сравнение с выравниванием на основе дообучения
Ключевая практическая мотивация этой работы заключается в снижении небезопасных выходных данных без дообучения генератора. В MedSafetyBench дообучение на демонстрациях безопасности может уменьшить вредоносные выходные данные, но обычно требует специфичного для модели повторного обучения и многократных обновлений, когда политики меняются [10]. В отличие от этого, наш подход работает на этапе инференса. Генератор можно оставить без изменений, а политику оценки и стиль обратной связи — настроить, изменив промпты оценщика или заменив модели оценщика. Это полезно в сценариях, где критерии безопасности со временем меняются, или где разные учреждения нуждаются в слегка различающихся политиках. Наша шкала риска также поддерживает градуированную интерпретацию безопасности, а не только «безопасно» versus «небезопасно», что помогает, когда промпт находится на границе между общей информацией и выполнимыми медицинскими рекомендациями.
V-C Различия между двумя генераторами
DeepSeek R1 в целом требовал меньшего числа раундов доработки. Одно из правдоподобных объяснений заключается в том, что он более последовательно реагирует на явную обратную связь и охотнее перестраивает ответ, когда его просят удалить небезопасные элементы. Med PaLM, в отличие от него, часто начинает с более медицински обоснованного ответа, но ему может потребоваться больше раундов, чтобы убрать пограничные диагностические или лечебные рекомендации, когда запрос настойчиво провоцирует их. Разница в средних итерациях составляет 0.33. Если та же закономерность сохранится в более масштабной постановке, то обработка 10,000 запросов потребовала бы примерно на 3,300 меньше раундов уточнения для DeepSeek R1, что приводит к более низкой вычислительной стоимости и меньшей задержке.
Med PaLM демонстрирует относительно более сильное поведение в принципе, связанном с конфиденциальностью, и выполняет схожим образом в запросах по общественному здравоохранению. Это поддерживает точку зрения, что медицинское предварительное обучение может помочь модели усвоить некоторые нормы в отношении конфиденциальности и публичного общения еще до начала цикла дообучения. Практическое следствие заключается в том, что гибридные стратегии могут быть многообещающими: когда доменно обученный генератор объединяется с надежным механизмом обратной связи, который обеспечивает четкие пороги безопасности.
V-D Масштабируемость и практическое применение
В нашей настройке конвейер обрабатывал около 150 запросов в час с использованием четырех GPU A100, при этом средняя задержка составляла 8,5 секунды на каждый завершенный (сошедшийся) запрос. Это быстрее, чем ручная проверка клиницистом, которая часто занимает несколько минут на ответ, но все же медленнее, чем один вызов модели. На практике это указывает на конкретный сценарий использования. Цикл наиболее подходит в качестве этапа скрининга или уточнения для взаимодействий с более высоким риском, таких как медицинские рекомендации для пользователей, вопросы в стиле триажа или запросы, включающие чувствительную информацию. Задачи с более низким риском все еще могут использовать более легкие механизмы защиты, в то время как полный цикл можно зарезервировать для случаев, когда риск выше.
Модульная конструкция также поддерживает операционные обновления. Если руководство меняется, инструкции для оценивания можно обновить без повторного обучения генератора. Это одно из основных практических преимуществ по сравнению с подходами, которые опираются на повторяющиеся циклы дообучения.
V-E Соображения по нормативному регулированию и управлению
Мы не утверждаем, что данное исследование само по себе удовлетворяет нормативным требованиям. Однако предложенная конструкция совместима с типичными ожиданиями в отношении управления, поскольку она делает критерии оценки явными и формирует запись о том, почему ответ был пересмотрен. Принципы AMA задают внешне определенную этическую точку отсчета [1], а шкала риска согласована с общей структурой рассуждений в области управления медицинскими рисками, включая рассуждения о опасностях в стиле ISO 14971. На практике эти артефакты могут поддерживать документирование для внутренней проверки, аудита и обеспечения качества, особенно в сочетании с экспертным надзором и валидацией.
V-F Ограничения и будущие работы
В этом исследовании есть несколько ограничений. Во-первых, мы оцениваем только два генератора и двух оценщиков, поэтому выводы могут не распространяться на другие семейства моделей. Во-вторых, оценщики сами являются языковыми моделями, а это означает, что их суждения не являются истинными данными. Необходима валидация по клиническим аннотациям, чтобы понять, где оценщики являются надежными и где они могут не заметить тонкие вредные эффекты. В-третьих, мы оцениваем одношаговые запросы, в то время как многие реальные внедрения включают многошаговые беседы, где ранее заданный контекст может изменить оценку риска. В-четвертых, мы не в полной мере характеризуем устойчивость к противодействию при целевой подмене запросов и сценариях использования инструментов, что важно, когда LLM встраиваются в более крупные приложения.
Будущие работы могут расширить оценку дополнительными генераторами и оценщиками, включить суждения о безопасности, помеченные клиницистами, для калибровки, протестировать многорежимные настройки для нескольких раундов и изучить способы снижения задержки при сохранении тех же порогов безопасности. Следующим важным шагом также являются критерии, специфичные для конкретной субспециальности, такие как онкология или педиатрия, поскольку риск и допустимые рекомендации различаются в зависимости от клинического контекста.
VI Вывод
В этой работе исследовался цикл оценивания при инференсе для многoагентной системы с целью повышения безопасности выходов медицинских LLM за счёт повторных проверок и доработок. Используя 900 противодействующих запросов из MedSafetyBench, процесс уточнения снизил нарушения этики AMA на 89% и понизил уровень риска в 92% случаев, при этом сходимость наблюдалась в 94,2% запросов в пределах пяти итераций. DeepSeek R1 обычно сходилась за меньшее число раундов и демонстрировала немного более стабильное поведение при итерациях, тогда как Med PaLM показала сопоставимо хорошие результаты в запросах, связанных с конфиденциальностью.
Практическим вкладом данной работы является то, что она не требует перенастройки генератора. Вместо этого генератор уточняется с помощью структурированной обратной связи, формируемой во время вывода, что упрощает обновление критериев оценки при изменении политик. В то же время это исследование следует рассматривать как начальный шаг, а не как готовую к развертыванию валидацию. Оценщики — это языковые модели, и их суждения требуют калибровки по сравнению с аннотациями клиницистов и реальными клиническими рабочими процессами.
Дальнейшая работа может расширить набор генераторов и оценщиков, подтвердить суждения по безопасности с помощью медицинских экспертов и расширить оценивание для сценариев с несколькими раундами, где риск зависит от более длинного контекста. Также будет важно проверить устойчивость к prompt injection и другим стратегиям противодействия, возникающим в приложениях с интеграцией инструментов. Более специализированные критерии оценивания для клинических поддоменов, таких как педиатрия или онкология, представляют собой еще одно очевидное направление.
Ссылки
- [1] Американская медицинская ассоциация (2001) Принципы медицинской этики. Примечание: Дата обращения: 2024-07-08 Внешние ссылки: Link Цитируется: §I, §III-B1, §V-E.
- [2] S. Aydin и др. (2024) Большие языковые модели в обучении пациентов: обзор с установлением объема. Frontiers in Medicine. Внешние ссылки: Document Цитируется: §I.
- ⟦[3] Y. Bai, S. Kadavath, S. Kundu, A. Askell, J. Kernion, A. Jones, et al. (2022) Конституционная искусственная интеллектуальная система: безопасное поведение в ответ на отзывы от ai. Предварительная публикация arXiv на arXiv:2212.08073. Цитируется: §I, §II-B.
- [4] A. A. Birkun и др. (2023) Чат-боты с поддержкой LLM не способны надежно направлять при проведении сердечно-легочной реанимации. Реанимация. Цитируется по: §I.
- ⟦[5] А. А. Биркун и соавт. (2024) Чат-бот на основе больших языковых моделей как источник советов по оказанию первой помощи при инфаркте миокарда. Американский журнал неотложной медицины. Цитируется: §I⟧.
- [6] К. Чэнь, С. Ли, Т. Ян, Х. Ван, У. Дун и Ю. Гао (2025) Mdteamgpt: самоупорядочивающаяся многомодульная агенто-ориентированная платформа на базе LLM для медицинских консультаций междисциплинарными командами. предварительная публикация arXiv arXiv:2503.13856. Цитируется: §I, §II-C.
- ⟦[7] Z. Chen, A. Hernández Cano, A. Romanou, A. Bonnet, K. Matoba, F. Salvi, M. Pagliardini, S. Fan, A. Köpf, A. Mohtashami, et al. (2023) MEDITRON-70b: масштабирование медицинского предварительного обучения для больших языковых моделей. Предварительная публикация arXiv arXiv:2311.16079. Цитируется: §II-A.
- [8] Y. Du, Z. Wang, X. Li, T. Gao, X. Zhang, and Z. Liu (2023) Повышение фактической корректности в LLM через дебаты многoагентных систем. Предварительная публикация arXiv arXiv:2305.14325. Цитируется: §I, §II-C.
- [9] Y. Gu, R. Tinn, H. Cheng, M. Lucas, N. Usuyama, X. Liu, T. Naumann, J. Gao, and H. Poon (2021) Предварительное обучение языковой модели предметной области для биомедицинской обработки естественного языка. ACM Transactions on Computing for Healthcare (HEALTH) 3 (1), стр. 1–23. Цитируется: §I.
- ⟦[10] Т. Хан, А. Кумар, С. Агарвал и Х. Лаккараджу (2024) MedSafetyBench: оценка и улучшение медицинской безопасности больших языковых моделей. препринт arXiv arXiv:2406.12345. Цитируется: §I, §I, §I, §I, §II-B, §III-D, §V-B.
- [11] Дж. Ли, У. Юн, С. Ким, Д. Ким, С. Ким, Ч. Х. Со и Дж. Канг (2020) BioBERT: предварительно обученная модель представлений биомедицинского языка для майнинга биомедицинских текстов. Bioinformatics 36 (4), стр. 1234–1240. Внешние ссылки: Document Цитируется: §II-A.
- ⟦[12] Y. Ляо, С. Цзян, Ч. Чэнь, Ю. Ван и Ю. Ван (2024-11) MedCare: развитие медицинских LLMs за счет разделения клинического согласования и агрегации знаний. В материалах Findings of the Association for Computational Linguistics: EMNLP 2024, Y. Аль-Онайзан, М. Бансал и Ю. Чэнь (ред.), Майами, Флорида, США, стр. 10562–10581. Внешние ссылки: Link, Document Цитируется: §I.
- ⟦[13] Л. Лю и др. (2024) Обзор медицинских больших языковых моделей. препринт arXiv arXiv:2406.03712. Цитируется: §I.
- [14] Y. Liu et al. (2023) Атаки инъекций в подсказки против приложений, интегрированных с llm. Предварительная публикация arXiv:2306.05499. Цитируется: §I, §II-B.
- ⟦[15] Д. Икс. Лонг, Д. Н. Йен, А. Т. Луу, К. Кавагучи, М. Кан и Н. Ф. Чен (2024-11) Многоэкспертное подсказочное представление улучшает надежность, безопасность и полезность больших языковых моделей. В материалах 2024 Конференции по эмпирическим методам обработки естественного языка, Й. Аль-Онайзан, М. Банзал и Й. Чен (ред.), Майами, Флорида, США, стр. 20370–20401. Внешние ссылки: Link, Document Цитируется: §I.
- ⟦К0⟧ Вопрос. Лу, Д. Доу и Т. Нгуен (2022) ClinicalT5: генеративная языковая модель для клинического текста. В Findings of the Association for Computational Linguistics: EMNLP 2022, стр. 5436–5443. Внешние ссылки: Document Цитируется: §II-A.
- [17] R. Luo, L. Sun, Y. Xia, T. Qin, S. Zhang, H. Poon, и T. Liu (2022) BioGPT: generative pre-trained transformer для генерации и извлечения биомедицинских текстов. Briefings in bioinformatics 23 (6), стр. bbac409. Cited by: §I.
- [18] A. Madaan, N. Tandon, P. Gupta, S. Hallinan, L. Gao, S. Wiegreffe, U. Alon, N. Dziri, S. Prabhumoye, Y. Yang, et al. (2023) Самоусовершенствование: итеративное уточнение с самоконтролем. arXiv preprint arXiv:2303.17651. Цитируется: §II-C.
- [19] Р. Мьотто, Ф. Ван и Х. Цзян (2023) Медицинская безопасность ИИ: что происходит, когда прогноз оказывается неверным?. NPJ Digital Medicine 6 (1), стр. 1–4. Цитируется: §I, §II-A.
- ⟦[20] S. Mukherjee, P. Gamble, M. S. Ausin, N. Kant, K. Aggarwal, N. Manjunath, D. Datta, Z. Liu, J. Ding, S. Busacca, et al. (2024) Polaris: архитектура созвездия LLM, ориентированная на безопасность, для здравоохранения. arXiv preprint arXiv:2403.13313. Cited by: §I, §II-C.
- [21] K. Nassiri и M. A. Akhloufi (2024) Последние достижения в больших языковых моделях для здравоохранения. BioMedInformatics 4 (2), стр. 1097–1143. Цитируется: §II-A.
- [22] Л. Оньеквелу-Удока, М. С. Ислам и М. С. Хасан (2025) Обнаружение эмоций в речи с использованием легковесных и моделей на базе transformer: сравнительное и ablation-исследование. preprint arXiv arXiv:2511.00402. Внешние ссылки: Link Цитируется: §I⟧.
- ⟦[23] Л. Оуян, Дж. Ву, С. Цзян, Д. Алмейда, С. Уэйнрайт, П. Мишкин и др. (2022) Обучение языковых моделей следованию инструкциям с учетом обратной связи от человека. Успехи в Neural Information Processing Systems. Примечание: arXiv:2203.02155 Цитируется: §I, §II-B.
- [24] Фонд OWASP (2024) Топ OWASP для приложений больших языковых моделей. Примечание: https://owasp.org/www-project-top-10-for-large-language-model-applications/Доступ: 2025-12-25 Цитируется: §I, §II-B.
- [25] Н. Шинн, Ф. Кассано, Э. Берман, А. Гопинат, К. Нарасимхан и С. Яо (2023) Рефлексия: языковые агенты с вербальным обучением с подкреплением. Предварительный препринт arXiv arXiv:2303.11366. Цитируется: §II-C.
- ⟦[26] К. Сингхал, С. Азизи, Т. Ту, С. С. Махдави, Дж. Вэй, Х. В. Чанг, Н. Скайлз, А. Танвани, А. Коул, Дж. Ли и др. (2023) Крупные языковые модели кодируют клинические знания. Nature 620 (7972), стр. 172–180. Cited by: §I, §II-A.
- ⟦[27] Y. Wang, X. Ma, и W. Chen (2024-11) Усиление черного ящика LLM с помощью медицинских учебников для биомедицинского вопросно-ответного поиска. В материалах Findings of the Association for Computational Linguistics: EMNLP 2024, Y. Al-Onaizan, M. Bansal и Y. Chen (Ред.), Майами, Флорида, США, стр. 1754–1770. Внешние ссылки: Link, Document Цитируется: §I.
- ⟦[28] C. Y. K. Williams и др. (2024) Оценка больших языковых моделей для клинических рекомендаций по заметкам из отделения неотложной помощи. Nature Communications. Примечание: Статья: s41467-024-52415-1 Цитируется: §I.
- ⟦[29] Икс. Ян, Э. Чен, Н. ПурНеятян, Х. Си. Шин, К. И. Смит, С. Парижене, С. Компас, С. Мартин, А. Б. Коста, М. Дж. Флорес, и др. (2022) Большая языковая модель для электронных медицинских записей. npj Digital Medicine 5, стр. 194. Внешние ссылки: Document Цитируется: §II-A.
- ⟦[30] С. Яо, Ц. Чжао, Д. Юй, И. Чжао, Т. Кхот, А. Сабхарвал, А. Босселут и Ё. Чой (2023) Дерево мыслей: обдуманное решение задач с помощью больших языковых моделей. Преоттиск arXiv:2305.10601. Цитируется: §I, §II-C.
- ⟦[31] E. Юй, Д. Ли, М. Ляо, С. Ван, Г. Зучэн, Ф. Ми и Л. Хунг (2024-11) CoSafe: оценка безопасности больших языковых моделей в диалогах с многократными репликами и разрешением ссылок. В материалах 2024 Conference on Empirical Methods in Natural Language Processing, под редакцией Y. Al-Onaizan, M. Bansal и Y. Chen, Майами, штат Флорида, США, стр. 17494–17508. Внешние ссылки: Link, Document Цитируется: §I.
- ⟦Y. Zhao, H. Wang, Y. Liu, W. Suhuang, X. Wu и Y. Zheng (2024-11) Могут ли LLM заменить клинических врачей? изучение смещений при диагностике заболеваний с помощью больших языковых моделей. В материалов Findings of the Association for Computational Linguistics: EMNLP 2024, Y. Al-Onaizan, M. Bansal и Y. Chen (ред.), Майами, Флорида, США, стр. 13914–13935. Внешние ссылки: Link, Document Цитируется: §I.