Учетная тождественность для алгоритмической справедливости
Аннотация
Мы выводим тождество учета для предиктивных моделей, которое связывает точность с общими критериями справедливости. Это тождество показывает, что для глобально откалиброванных моделей взвешенные суммы несоответствия калибровки внутри групп и дисбаланса ошибок между группами равны «общему бюджету несправедливости». Для бинарных исходов этот бюджет равен среднеквадратичной ошибке модели, умноженной на разность в распространенности групп между классами исходов. Тождество вкладывает стандартные результаты о невозможности как частные случаи, при этом также описывает присущие компромиссы, когда один или несколько показателей справедливости не удовлетворяются идеально. Полученные результаты предполагают, что точность и справедливость лучше рассматривать как взаимодополняющие в задачах бинарного прогнозирования: повышение точности неизбежно уменьшает общий бюджет несправедливости и наоборот. Эксперименты на эталонных данных подтверждают теорию и показывают, что многие вмешательства в справедливость в значительной степени подменяют нарушения справедливости друг другом, а когда они снижают точность, они, как правило, расширяют общий бюджет несправедливости. Результаты естественно распространяются на задачи прогнозирования с небинарными исходами, иллюстрируя, как дополнительная информация об исходах может ослаблять несовместимости справедливости, и выявляя условия, при которых бинарно-стильовая невозможность либо распространяется на регрессию, либо не распространяется на нее.
1 Введение
Поскольку предиктивные алгоритмы все чаще используются для распределения выгод и издержек в современном обществе, обширная и растущая научная литература изучает, как эти инструменты могут непреднамеренно закреплять существующие модели социального неравенства. Центральная тема этой литературы состоит в том, что существует множество правдоподобных способов формализовать «алгоритмическую справедливость» по отношению к некоторой защищаемой группе. Среди наиболее часто изучаемых критериев выделяются (i) калибровка внутри групп, (ii) баланс между группами по положительному классу и (iii) баланс между группами по отрицательному классу. Влиятельный набор результатов задает общие условия, при которых эти интуитивно привлекательные критерии оказываются несовместимыми: за исключением вырожденных случаев, ни одна предиктивная модель не может идеально удовлетворить каждое требование справедливости в заданном приложении (Chouldechova, 2017; Kleinberg et al., 2016).
Столкнувшись с этой невозможностью, естественный вопрос заключается в том, как эти аспекты справедливости взаимно ограничивают друг друга в допустимой области — то есть когда нарушается по меньшей мере одна метрика справедливости. Мы изучаем этот вопрос для глобально калиброванных предиктивных моделей. Наша главная отправная точка по сравнению с предшествующей литературой состоит в том, чтобы исследовать величину отклонений от идеальной справедливости по каждому измерению, а не рассматривать справедливость как свойство по принципу «всё или ничего». Этот сдвиг акцента обусловлен нормативными и практическими соображениями. Нормативно, те опасения, которые лежат в основе общих критериев алгоритмической справедливости, по своей природе являются непрерывными: например, если человек беспокоится о том, что алгоритм систематически концентрирует завышенные оценки риска на представителях недостаточно обеспеченной группы, то это беспокойство, как правило, более серьёзно, когда возникающий дисбаланс в частоте ошибок больше. В терминах моральной философии измерения справедливости, на которых мы сосредоточиваемся — несоответствие калибровки по группам и дисбаланс между группами, — лучше рассматривать как скалярные характеристики алгоритма, а не как бинарные суждения (Alexander, 2008). Практическая мотивация сосредоточиться на степени нарушений справедливости заключается в том, что поскольку идеальное выполнение всех критериев справедливости обычно недостижимо, для проектирования и регулирования релевантным вопросом становится то, насколько много несправедливости каждого типа порождает алгоритм.
Мы показываем, что метрики справедливости, на которых мы сосредоточены, связаны простой бухгалтерской тождественностью. Это тождество утверждает, что для глобально калиброванной модели взвешенная сумма несправедливости — то есть степень, в которой каждое критерий справедливости нарушается (в чистом виде) — равна величине, которую мы называем общим бюджетом несправедливости. Веса в этом тождестве определяются тем, где сосредоточена масса популяции и где имеется взаимное пересечение между группами относительно уровней исходов и оценок риска.
В самой общей формулировке идентичности общий бюджет несправедливости определяется связью между погрешностью предсказания модели и вариацией распространенности групп, обусловленной различиями групп по исходам. Общая несправедливость против группы больше, когда представители этой группы непропорционально сосредоточены в областях исходов, где погрешности предсказаний модели, как правило, велики. Идентичность учета показывает, что эта связь определяет, сколько общей несправедливости необходимо выделить в рамках различных форм несправедливости в любой глобально откалиброванной модели.
В случае бинарного исхода общий бюджет несправедливости принимает особенно простую форму: произведение разности распространенности групп между классами исхода и среднеквадратической ошибки модели (эквивалентно, Brier score). Это тождество приравнивает общий бюджет несправедливости к взвешенной сумме трех знакомых форм несправедливости — несогласованности калибровки по группе, дисбаланса на положительном классе и дисбаланса на отрицательном классе. Следовательно, улучшение точности предсказаний механически уменьшает общий бюджет несправедливости, который должен быть распределен между различными формами несправедливости.
Получаемое нами тождество бухгалтерского учета дает ряд полезных выводов для изучения глобально калиброванных предиктивных моделей. Начиная со случая бинарного исхода:
- ⟦• Бухгалтерская тождественность задает простую и общую связь между распространенными метриками справедливости, различиями между базовыми группами и точностью модели.
- • Идентичность усиливает и обобщает результат о невозможности Kleinberg et al. (2016), характеризуя допустимую степень нарушений справедливости вдали от граничного случая, в котором каждое условие справедливости выполнено безупречно.
- ⟦• Прямое следствие заключается в том, что вмешательства для обеспечения справедливости, сохраняющие точность модели (для глобально откалиброванных моделей), не изменяют общий бюджет несправедливости: они могут только заменять один вид несправедливости на другой. И наоборот, корректировки справедливости, которые уменьшают точность, не только перераспределяют несправедливость между разными измерениями, но и расширяют общий бюджет несправедливости, который должен быть выделен.
- ⟦• Следовательно, тождество проясняет взаимосвязь между точностью и справедливостью. Хотя возможны компромиссы между точностью и отдельными измерениями справедливости, повышение точности неизбежно снижает общий бюджет несправедливости. В этом смысле точность и справедливость являются взаимодополняющими, а не заменяющими друг друга для глобально калиброванных двоичных моделей предсказаний.
Общая версия нашего бухгалтерского тождества также дает представление о настройках, в которых исход является недвоичным:
- ⟦• Мы обеспечиваем естественные обобщения метрик справедливости, которые обычно применяются в бинарной классификации.
- ⟦• Общая бухгалтерская идентичность явно показывает, как эти метрики справедливости совместно определяются распределением принадлежности к группам и распределением ошибок предсказания по пространству исходов.
- ⟦• Идентичность подчеркивает, что результаты о несовместимости справедливости для бинарных исходов не обязаны механически распространяться на задачи регрессии. Мы приводим стилизованный контрпример, в котором и калибровка внутри групп, и баланс между группами выполняются для не-оракуловского регрессора, даже когда средние исходы различаются по группам. Затем мы указываем достаточное условие, при котором существуют такие контрпримеры, а также достаточное условие, при котором результат невозможности переносится на регрессию.
Смежные работы
Классические результаты невозможности, относящиеся к групповой калибровке и балансу, обусловлены Chouldechova (2017) (с фокусом на бинарные классификаторы) и Kleinberg et al. (2016) (с фокусом на оценках риска).111 Между этими полярными фокусами Reich and Vijaykumar (2020) показывают, что групповая калибровка оценки риска может быть совместима с равными ошибками у последующего классификатора, если обеспечить выполнение двух критериев на разных стадиях конвейера принятия решений. Большая последующая литература прояснила, что эти противоречия отражают структурную несовместимость критериев типа «достаточность» (например, предиктивное равенство / калибровка внутри групп) и критериев типа «разделение» (например, выровненные шансы / баланс частот ошибок между группами), когда группы различаются по исходной распространенности исходов. См. Hardt et al. (2016), а также обзоры Hellman (2025), Mitchell et al. (2021) и Mehrabi et al. (2021)⟧.
Тесно связана с нашей работой Pleiss et al. (2017), который характеризует компромисс между ошибками ложноположительного и ложноотрицательного срабатывания при ограничении, что идеальная калибровка внутри групп выполняется строго. Аналогично, наше тождество для учета показывает, как, когда значение риска удовлетворяет калибровке по группам, общий бюджет несправедливости должен быть распределен между дисбалансом по положительным и отрицательным классам. Мы опираемся на Pleiss et al. (2017), выводя связь между мерами несправедливости, когда калибровка внутри групп не обязана строго выполняться, и характеризуя, как общий бюджет несправедливости зависит от точности в контексте значения риска для двоичного классификатора. Bell et al. (2023) исследуют невозможность теоремы эмпирически и обнаруживают, что разрешение небольших нарушений может сделать возможным приблизительное выполнение нескольких критериев справедливости на практике, и что осуществимость, как правило, расширяется с ростом качества модели. Наше тождество для учета проливает свет на эти результаты теоретически, показывая, что более высокая предсказательная точность механически уменьшает общее количество несправедливости, которое необходимо распределить между конкурирующими формами несправедливости. В последнее время Zehlike et al. (2025) разрабатывают инструменты из optimal transport для корректировки алгоритмов в направлении заданной пользователем приоритизации калибровки по группам и баланса. Наш подход дополняющий: вместо предложения конкретной процедуры корректировки мы характеризуем реализуемые сочетания типов несправедливости, которым должна удовлетворять любая такая процедура.
Наконец, небольшая, но растущая литература изучает справедливость в условиях прогнозирования для небинарных классов (например, Berk et al. (2017); Agarwal et al. (2018)). Мы вносим вклад в эту литературу, предоставляя тождество учета, которое применимо к естественным обобщениям компонентов справедливости из бинарного случая. Мы также показываем, почему результаты о невозможности, выведенные для бинарных исходов, не обязательно переносятся на задачи регрессии, а также выявляем условия, при которых аналогичные компромиссы возникают вновь.
Оставшаяся часть статьи устроена следующим образом. Раздел 2 описывает нашу постановку и задает определения наших условий справедливости. Раздел 3 устанавливает и интерпретирует учетное тождество, с акцентом на задачи бинарного предсказания. Раздел 4 иллюстрирует и исследует результат на тестовых наборах данных. Раздел 5 фокусируется на задачах не бинарного предсказания и на применимости (или неприменимости) результата о невозможности для бинарного случая. Раздел 6 расширяет учетное тождество на классификаторы, а не на оценки риска. Раздел 7 завершает изложение обсуждением ограничений. Формальные доказательства для всех результатов приведены в Приложении A; подробности экспериментов — в Приложении B⟧.
2 Постановка задачи и определения
Этот раздел описывает нашу постановку задачи и определяет метрики справедливости, на которых мы сосредоточены.
2.1 Проблемная постановка
Людей характеризует группа, , результат, , и вектор наблюдаемых характеристик, , которые будут использоваться для прогнозирования . В зависимости от условий, может быть включен в или не включен⟧.
Оценка риска является прогнозом для на основе информации в . Например, когда бинарный, представляет собой предсказанную вероятность того, что принимает значение . В регрессионной постановке представляет собой прогноз модели для . Мы предполагаем существование конечных первых и вторых моментов для совместного распределения .
Наше основное содержательное допущение заключается в том, что глобально откалиброван:
Хотя наше внимание сосредоточено на оценках риска, мы расширяем наши результаты на классификаторы в разделе 6.
2.2 Метрики справедливости
Мы сосредоточиваемся на двух типах несправедливости в отношении производительности алгоритма между группами.
Несогласованность внутри групп
Наша первая метрика справедливости — несоответствие калибровки внутри групп по оценке риска , которую мы определяем как:
| (1) |
Если показатель риска идеально откалиброван для каждой группы, то показатель риска является достаточной статистикой для ожидаемого значения результата — информация о принадлежности к группе не должна давать дополнительной информации, то есть . Это означает , так что . В отличие от этого, будет отличным от нуля, если при фиксированном у людей в одной группе значения , как правило, выше, чем у людей в другой группе. Чем больше эти различия, тем больше по модулю .
По определению является покомпонентной мерой несоответствия калибровки алгоритма при заданном уровне риска . Также удобно определить итоговую меру несоответствия калибровки по всем уровням риска:
| (2) |
где
| (3) |
В условиях, в которых является непрерывной, мы определяем , подставляя интеграл в (2) вместо суммирования и функцию плотности для вместо в (3). Говоря словами, представляет собой взвешенную сумму разностей внутри-оценки в результате между группами, где веса отражают степень, в которой обе группы представлены при заданном значении риск-показателя. В условиях, в которых направление некалиброванности различается по значениям риск-показателя, суммирует общую степень некалиброванности, учитывая различия в распределении групп при разных значениях риск-показателя.
Большая литература рассматривает калибровку внутри групп как важный компонент справедливости (см. Corbett-Davies et al. (2023); Hedden (2021); Hellman (2025)). Часто нормативным основанием для этого утверждения является то, что если показатель неверно откалиброван по группе, то два человека с одинаковым прогнозируемым риском сталкиваются с разными истинными рисками в зависимости от принадлежности к группе, что, в свою очередь, подразумевает, что решения, основанные на алгоритме, систематически менее обоснованы для одной группы, чем для другой. Кроме того, когда алгоритм по-разному неверно откалиброван по группам, лицо, принимающее решения, заинтересованное в прогнозируемом результате, сталкивается со стимулом относиться к людям по-разному в зависимости от принадлежности к группе, когда этот признак может наблюдаться (то есть заниматься статистической дискриминацией).
Хотя несоответствие калибровки по группам обычно обсуждается как свойство «всё или ничего», алгоритмы, нарушающие это свойство, могут делать это в разной степени. Кроме того, нормативные соображения, которые питают обеспокоенность групповой несоответствующей калибровкой, как правило, тем больше, чем в большей степени алгоритм имеет несоответствие калибровки по группам. То есть если беспокоит алгоритм, который не имеет идеальной калибровки по группам, то эта обеспокоенность обычно тем сильнее, чем в большей степени алгоритм имеет несоответствие калибровки по группам. С этой точки зрения привлекательной особенностью , нашей меры несоответствия калибровки внутри групп, является то, что она не бинарная, позволяя ей отражать непрерывный характер несправедливости, возникающей, когда алгоритм имеет несоответствие калибровки внутри групп.
Наконец, хотя неправильная калибровка по группам обычно обсуждается в контексте алгоритмов, которые предсказывают бинарный результат, определение не требует, чтобы был бинарным. Таким образом, обеспечивает естественную меру неправильной калибровки внутри групп как в задачах регрессии, так и в задачах классификации.
Дисбаланс между группами
Наша вторая метрика справедливости фиксирует различия по группам в оценках риска у людей с одинаковым истинным исходом:
| (4) |
Когда оценки риска идеально сбалансированы между группами на некотором уровне исхода , не существует систематической связи между принадлежностью к группе и оценками риска, то есть . В этом случае , так что . В то время как измеряет степень, в которой принадлежность к группе предсказывает исходы после учета оценки риска, измеряет степень, в которой принадлежность к группе предсказывает оценки риска после учета исхода. Когда является двоичной, измеряет степень дисбаланса для отрицательного класса, а измеряет степень дисбаланса для положительного класса.
Как и при калибровке, полезно определить обобщенную меру дисбаланса между уровнями результата:
| (5) |
где
| (6) |
Когда является непрерывной, мы определяем , подставляя интеграл в (5) вместо суммирования и функцию плотности для вместо в (6). Проще говоря, — это взвешенное среднее дисбаланса в оценке риска между группами, причем среднее берется по уровням исхода, а веса отражают частоту уровней исхода и степень, в которой обе группы представлены на рассматриваемом уровне исхода. Например, когда является бинарной, агрегирует дисбаланс как в положительном классе , так и в отрицательном классе , взвешивая каждый с учетом доли населения в каждом классе, умноженной на распространенность перекрытия групп внутри этого класса. Когда является небинарной, интерпретация та же самая — просто усредненная по большему числу значений исхода. В условиях, когда направление дисбаланса различается на разных уровнях исхода, суммирует общую степень дисбаланса, учитывая различия в распределениях групп на разных уровнях исхода.
Как и при калибровке, существует обширная литература, рассматривающая баланс между группами как важный компонент алгоритмической справедливости. И так же, как и при калибровке, нормативные соображения, поддерживающие баланс между группами, тем сильнее затрагиваются, чем выше степень несбалансированности алгоритма. Интуитивно, баланс между группами отражает принцип горизонтального равенства: когда правило принятия решения обусловливает обращение тем, какой исход следует предсказать, людей, которые в этом соответствующем отношении схожи, следует относиться одинаково независимо от принадлежности к группе. Если одна группа систематически получает более благоприятные оценки, чем другая, среди людей с одним и тем же исходом, то решения, основанные на этих оценках, навязывают неодинаковое обращение, которое не может быть оправдано различиями в самой целевой переменной. Чем больше одна группа систематически получает более благоприятные оценки риска, чем другая группа, после учета предсказываемого исхода, тем хуже проявляется эта форма несправедливости, и тем больше по величине будет наша мера несбалансированности.
Понятие баланса, отраженное в , тесно связано с критерием справедливости, известным как separation или equalized odds (Hardt et al., 2016; Chouldechova, 2017; Kleinberg et al., 2016). Equalized odds требует, чтобы предиктор был условно независим от принадлежности к группе при заданном исходе — то есть для всех . Когда это условие выполняется точно, мы имеем для всех , и, следовательно, также. В этом смысле обеспечивает непрерывную, скалярную меру степени нарушения equalized odds, агрегируя условные несоответствия по уровням исхода.
3 Бухгалтерское тождество
В этом разделе мы выводим уравнение, связывающее несоответствие калибровки, дисбаланс, точность и различия базового уровня в распределении группы по исходу. Сначала мы выводим результаты для случая, когда является бинарным. Мы возвращаемся к случаю небинарного в Разделе 5⟧.
Наш первый шаг — установить ковариационное представление для наших обобщённых показателей несправедливости, и ⟧.
Лемма 1 позволяет нам выразить наши обобщающие меры поэлементной несогласованности калибровки и поэлементного дисбаланса как условные ковариации. Тогда тождество бухгалтерского учета следует из последовательных применений закона полной ковариации: сначала разложим вдоль скоринга , а затем разложим вдоль результата ⟧.
Proposition 1.
Предположим, что и для всех . Тогда
| (7) |
Предложение 1 раскрывает поразительно простое ограничение, которому должна удовлетворять любая глобально откалиброванная оценка риска для двоичного предсказания. Правая часть представляет собой величину, которую мы будем называть общим бюджетом несправедливости: она велика, когда (i) оценка неточна (высокое MSE) и (ii) принадлежность к группе сильно сосредоточена в одном классе исходов по сравнению с другим. Левая часть описывает, как этот бюджет распределяется по трем хорошо знакомым формам несправедливости: дисбаланс на отрицательном классе , дисбаланс на положительном классе и рассогласование по калибровке внутри групп, , причем каждая из них входит с весом, который отражает то, где фактически лежит основная плотность населения и пересечение групп.
Несколько особенностей Пропозиции 1 стоит подчеркнуть. Во-первых, если мы потребуем идеальную калибровку внутри групп и идеальный баланс для положительных и отрицательных классов — для всех и для — тогда вся левая часть ограничения в Пропозиции 1 равна нулю. Затем предложенная формулировка заставляет правую часть ограничения тоже быть равной нулю, что означает либо (то есть является оракулом), либо отсутствие базовой разницы в распространенности исхода между группами (эквивалентно, равные базовые частоты). Таким образом, невозможность, установленная Kleinberg et al. (2016), следует из Пропозиции как прямое следствие. В более общем смысле, Пропозиция 1 задаёт геометрию допустимых компромиссов по справедливости вдали от эталонного случая идеальной справедливости, который и приводит к результату о невозможности. В частности, Пропозиция показывает, как сдвиг одного компонента несправедливости обязательно перераспределяет остальные.
Во-вторых, веса проясняют, где несправедливость важна для идентичности. Дисбаланс на конкретном уровне исхода вносит наибольший вклад, когда этот уровень исхода встречается часто и когда обе группы представлены в нем в значительной степени. Аналогично, веса подчеркивают ошибочную калибровку по уровням рисков, где две группы пересекаются. В разреженных областях (мало людей) или в почти однородных областях (почти все принадлежат к одной группе) соответствующий термин несправедливости имеет небольшое значение и поэтому расходует мало бюджета. Иными словами, формы несправедливости в областях с небольшим пересечением групп вносят меньший вклад в бюджет, чем формы несправедливости в областях, где обе группы присутствуют.
Третье, предложение 1 является подписанной тождественностью: несправедливость в одном направлении может механически компенсировать несправедливость в другом. Это не нормативное утверждение о том, что такие компенсации этически приемлемы; это описательное следствие множества допустимых решений, порожденного глобальной калибровкой. В приложениях, где лицо, принимающее решения, или регулятор вместо этого заботится о (например) максимальном дисбалансе на любом уровне исходов, или о сумме абсолютных дисбалансов по уровням, эти критерии могут быть непосредственно включены в целевую функцию — оптимизируемую с учетом ограничения в предложении 1.
Наконец, предложение 1 подчеркивает тесную связь между точностью и справедливостью. Вместо того чтобы существовал общий компромисс между этими свойствами, тождество учета подчеркивает их взаимодополняющую природу: при фиксировании среды задачи механическое повышение точности сокращает общий бюджет несправедливости, который необходимо распределять между различными формами несправедливости. И наоборот, вмешательства, уменьшающие точность алгоритма, могут снизить некоторые формы несправедливости, но лишь ценой еще большего увеличения других форм несправедливости (по меньшей мере в взвешенных чистых терминах). Мы иллюстрируем эти динамики в наших экспериментах в следующем разделе.
4 Эмпирический анализ
Здесь мы приводим обзор высокого уровня нашего эмпирического подтверждения, включая набор данных COMPAS Angwin et al. (2016); мы приводим дополнительные сведения и результаты для Adult, German Credit и Bank Marketing в Приложении B). Мы используем версии наборов данных из AI Fairness 360 Bellamy et al. (2018) и исключаем защищаемый признак из обучающих признаков. Для всех величин мы используем встраиваемые оценщики. Модели перекалибруются с помощью изотонической регрессии, чтобы обеспечить глобальную калибровку. Мы оцениваем и как выборочные ковариации внутри интервалов (20 интервалов равной частоты для ).
Эксперимент 1: Гарантия корректности в конечной выборке Мы проверяем, что (7) выполняется примерно в конечных выборках с помощью абляции признаков. То есть мы обучаем модели для предсказания результата с различным числом признаков; по мере увеличения числа используемых признаков точность возрастает, уменьшая общую несправедливость. Мы используем логистическую регрессию, деревья решений, случайные леса и градиентный бустинг.
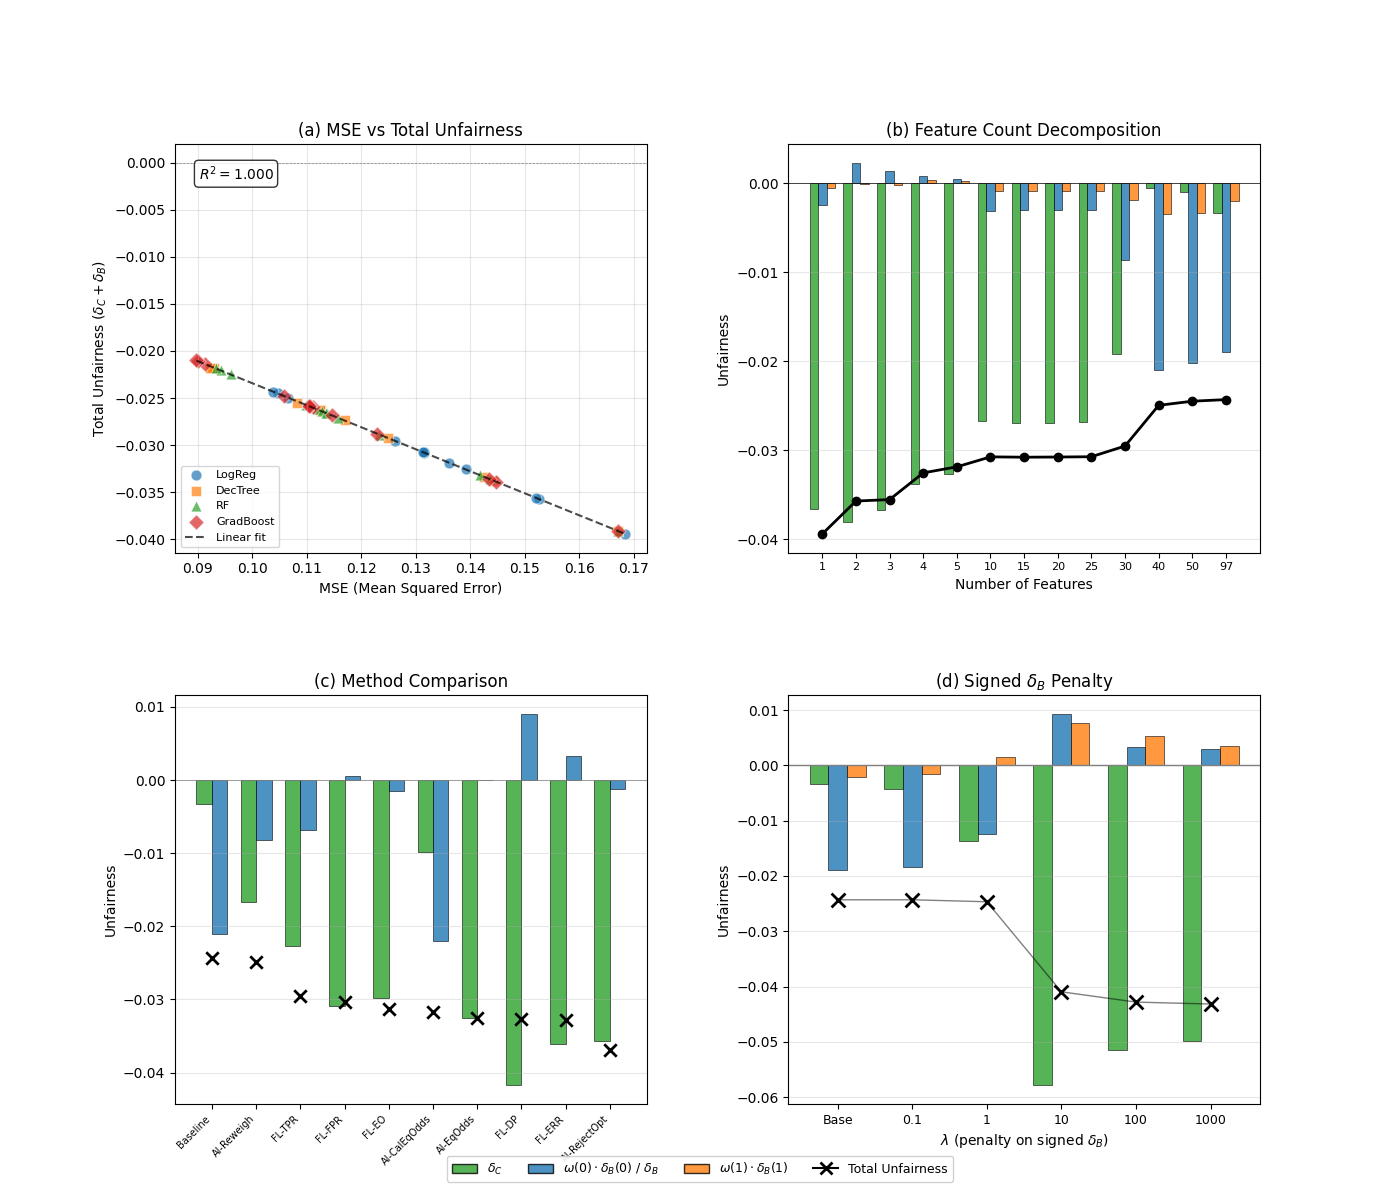
Рисунок 1(a) показывает общую несправедливость в зависимости от MSE. Экспериментальные значения близко следуют теоретическому предсказанию (пунктирная линия). Панель (b) демонстрирует трехстороннее разложение: по мере увеличения признаков общая несправедливость (черная линия) уменьшается, но распределение между , и смещается.
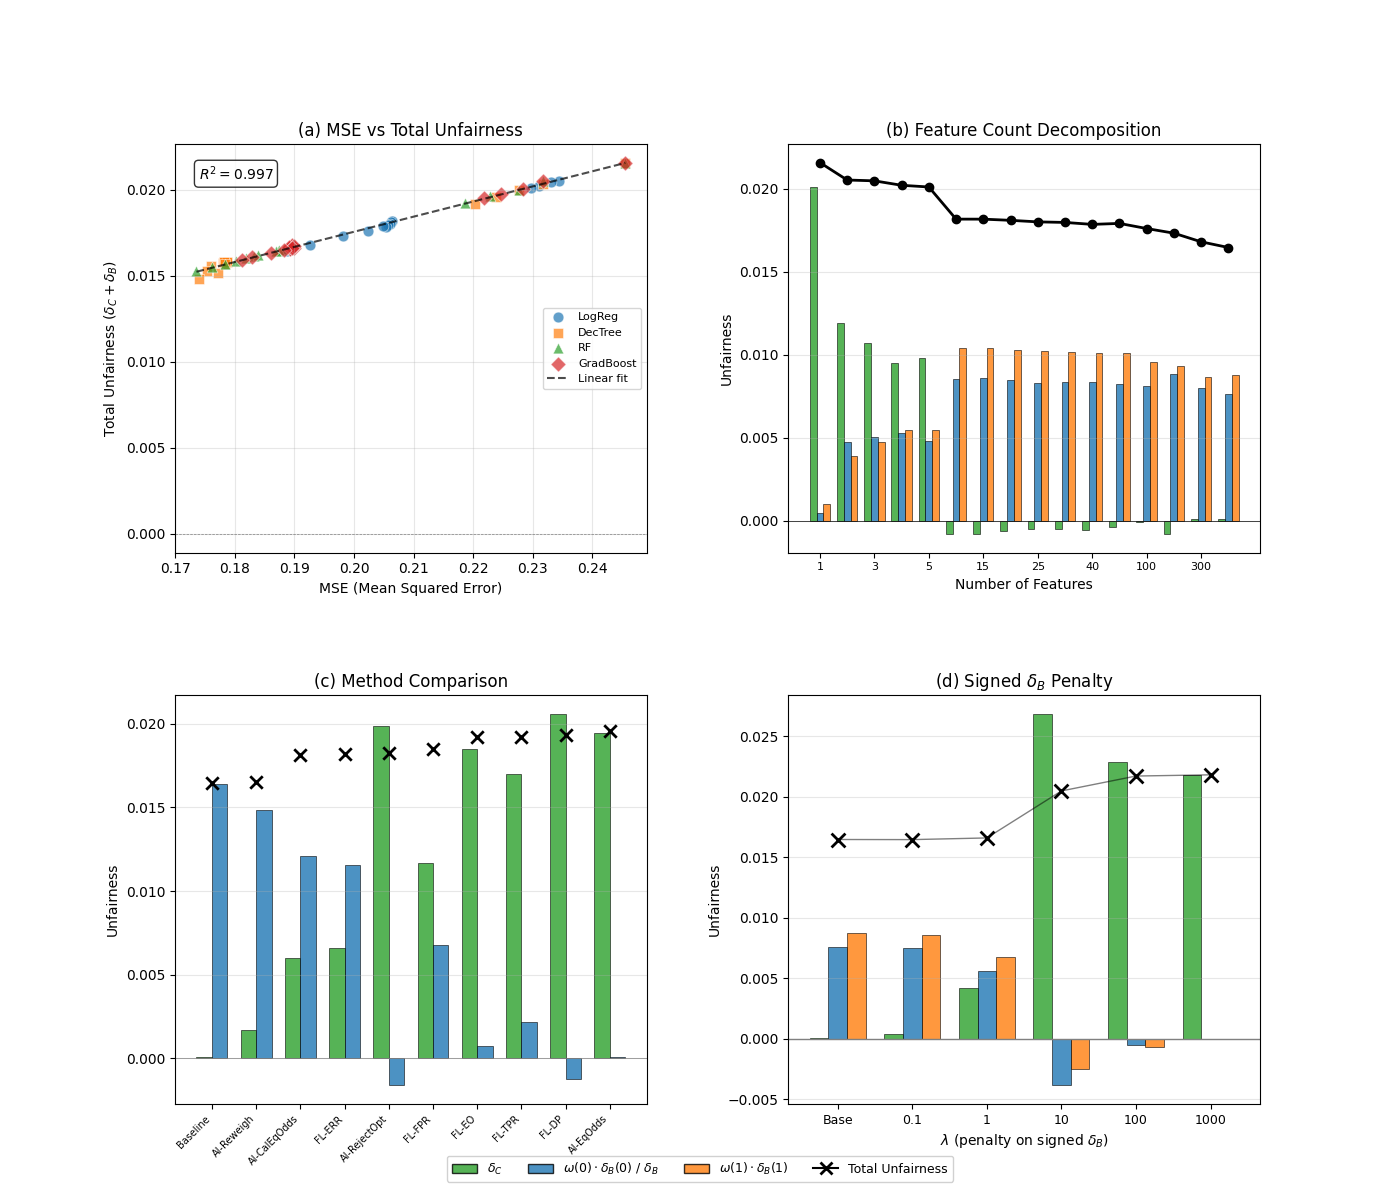
Эксперимент 2: Методы справедливости перераспределяют несправедливость Мы оцениваем методы из FairLearn Weerts et al. (2023) и AIF360 Bellamy et al. (2018), а также пенализированную логистическую регрессию, нацеленную на . На рисунке 1(c) показано, что методы, уменьшающие одну метрику справедливости, как правило, увеличивают другую, при этом увеличивая и общий бюджет несправедливости. В панели (d) изменяется штраф для : по мере роста дисбаланс уменьшается (как и ожидалось), но растет несогласованность (miscalibration), и общая несправедливость увеличивается из-за деградации точности.
5 Задачи прогнозирования с небинарными исходами
В этом разделе мы возвращаемся к случаю, когда результат является не бинарным (то есть регрессией или не бинарной классификацией). Следующий результат приводит общую форму учетного тождества.
Proposition 2.
Предположим, что для всех . Тогда
Как в Пропозиции 1, бухгалтерская тождественность в Пропозиции 2 связывает взвешенную сумму каждой покомпонентной формы несправедливости (левая часть ограничения, равная ) с общим бюджетом несправедливости (правая часть ограничения). В общем случае общий бюджет несправедливости — это ковариация между распространённостью группы при заданном уровне исхода, , и средним значением ошибки предсказания при этом уровне исхода, . Интуитивно, это измеряет связь между тем, где ошибка предсказания сосредоточена вдоль распределения исхода, и тем, где принадлежность к группе сосредоточена вдоль распределения исхода. Например, общая несправедливость против неблагополучной группы больше ровно тогда, когда эта группа непропорционально сосредоточена на уровнях исхода, где алгоритм систематически имеет большее среднее значение ошибки предсказания. Напротив, общая несправедливость будет небольшой, когда распространённость группы незначительно систематически меняется по исходу (так что почти постоянна) или когда ошибки предсказания модели имеют тенденцию быть сходными на разных уровнях исхода (в этом случае близко к тому, чтобы быть оракулом для ).
В общем виде бухгалтерского тождества ключевая особенность алгоритма, который определяет общий бюджет несправедливости, заключается не просто в величине его ошибок предсказания — как это происходит в задаче с бинарным исходом, — а в том, как эти ошибки предсказания совместно меняются с принадлежностью к группе на разных уровнях исхода. Следовательно, тесная связь между MSE алгоритма и его общим бюджетом несправедливости, которую мы наблюдали в случае бинарных исходов, не обязательно должна сохраняться в задачах регрессии.
Чтобы понять это, отметим, что мы можем разложить MSE:
| (8) |
Второй член, , отражает внутристепенной шум в оценке риска среди людей с одинаковым уровнем исхода. Прирост точности, который возникает исключительно за счет сжатия , уменьшит MSE без изменения общего бюджета, , поскольку общий бюджет зависит только от систематических предсказательных ошибок на каждом уровне исхода. В отличие от этого, вмешательство, улучшающее точность таким образом, что уменьшает разброс таких ошибок между исходами (то есть что уменьшает первый член), может как увеличить, так и уменьшить общий бюджет справедливости; направление эффекта зависит от того, в каких уровнях исхода с относительно высокой или относительно низкой распространенностью ошибок предсказания становится меньше в большей степени.
Таким образом, в отличие от бинарного случая, возможно, что повышение точности регрессионного алгоритма может увеличить общий бюджет несправедливости, и наоборот. При этом даже в небинарном случае общая несправедливость количественно ограничена точностью, что установлено в следующем Предложении
Proposition 3.
Предположим, что глобально откалиброван. Тогда:
Ослабление связи между точностью и справедливостью в условиях не бинарности потенциально ослабляет строгие результаты невозможности, которые характеризуют задачи бинарного прогнозирования; эту возможность мы исследуем в следующем разделе.
5.1 Примеры возможности для не бинарных
Теперь мы приводим достаточные условия, при которых глобально откалиброванный регрессор может полностью удовлетворять калибровке в группах и балансу по уровню ошибок поэлементно, при этом не являясь ни оракулом, ни независимым от принадлежности к группе.
Proposition 4 (Достаточные условия для точностной справедливости).
Пусть обозначает подмножество доступных признаков. Определите оценку . Предположим, что выполнены следующие условия:
- (A1) .
- (A2) .
- (A3) .
- (A4) .
Тогда: глобально откалиброван; ; не является оракулом; и для всех и всех , .
В Предложении 4 глобальная калибровка следует из построения . A1 гарантирует, что не является оракулом. Условия A2 и A3 ограничивают рассмотрение тех случаев, в которых связь между принадлежностью к группе и исходами действует через тот же канал, что и связь между принадлежностью к группе и признаками, используемыми алгоритмом. В таких условиях условие либо устраняет остаточную информацию о группе, гарантируя калибровку и баланс по группам. Наконец, A1 задаёт, что систематически изменяется вместе с ; в сочетании с A2 и A3 это подразумевает .
Теперь мы приводим стилизованный пример, чтобы проиллюстрировать, что условия в Предложении 4 не являются взаимно несовместимыми. Пусть . Пусть будет грубой наблюдаемой характеристикой, порожденной . Определим оценку риска как байесовский регрессор: , так что если и если . По построению, для каждого , следовательно, глобальная калибровка выполняется. Поскольку принимает только два значения, тогда как является недвоичным, не является оракулом.
Предположим, что принадлежность к группе зависит только от признака : и , с . Поскольку возрастает по , и поскольку детерминированно (слабо) возрастает по , мы знаем, что и положительно коррелируют.
Чтобы установить калибровку внутри групп, отметим, что является детерминированной функцией от . Следовательно, тот факт, что влечёт , который влечёт . Поэтому .
Чтобы обеспечить баланс между группами, отметим, что поскольку является детерминированной функцией от , а является детерминированной функцией от , то является детерминированной функцией от . Следовательно, . Поэтому .
Поскольку групповая калибровка и баланс соответственно выполняются для каждого и , оценка риска в точности удовлетворяет покоординатной калибровке внутри групп и балансу между группами. Это верно, несмотря на то, что не является оракулом и существуют базовые различия в по , что показывает: результаты о невозможности не распространяются напрямую на неконечную (небинарную) постановку.
5.2 Достаточное условие невозможности
Теперь мы приводим достаточное условие для восстановления теоремы о невозможности в стиле двоичной классификации для исходов не в двоичном формате. Ключевое препятствие в регрессионной постановке состоит в том, что когда является не двоичным, правая часть Пропозиции 2 принимает вид ковариации между нетривиальными функциями . В отличие от двоичного случая, эта ковариация может обращаться в нуль из-за взаимной компенсации в разных областях распределения исходов, даже когда функции внутри ковариации не являются константами на . Мы показываем, что естественное структурное ограничение — монотонные различия в исходах в сочетании со свойством предсказания «возврат к среднему» — исключает такую компенсацию и восстанавливает результат в стиле невозможности для широкого класса алгоритмов.
Proposition 5.
Определите и определите . Предположим, что: (1) глобально откалибрована; (2) слабо монотонна (не убывает или не возрастает) на опоре ; и (3) 1-Липшицева, то есть.:
Предположим, что точечные меры справедливости для всех и для всех . Тогда либо , либо (то есть является оракулом).
Предложение 5 предоставляет аналог задачи регрессии для результата о невозможности в бинарном случае при наличии дополнительной структуры. Первое новое предположение — что распространённость групп меняется монотонно по уровням исхода — определяется постановкой задачи и отражает характер систематических различий по исходам между группами. В противоположность этому, второе новое предположение — что обратная функция регрессии является 1-Lipschitz — является ограничением на поведение самой правила предсказания. Интуитивно, это требует, чтобы предсказания демонстрировали свойство возврата к среднему, не позволяя усиливать вариативность в . Будет ли это условие выполняться на практике, зависит от сделанных в моделировании выборов, например от степени регуляризации, налагаемой алгоритмом обучения.
6 Применение к классификаторам
Этот раздел дополняет наши основные результаты для оценок риска для настроек, в которых бинарный классификатор берется как базовый, вместе с бинарными и . Показатели ложноположительных и истинноположительных результатов по группам задаются и . Положительная предсказательная ценность и доли ложноотсутствующих по группам задаются и ⟧.
Определим как оценку риска, полученную классификатором. Поскольку является бинарной, принимает только два значения, которые мы называем и . Следовательно, соответствует (общей) PPV классификатора, а — его (общей) FOR. В силу построения является глобально откалиброванной.
Поскольку является детерминированной функцией , условие на эквивалентно условию на , и аналогично для и . Следовательно, мы можем выразить нашу меру внутри групповой калибровки как
| (9) | |||
| (10) |
где и . Используя определение , мы можем аналогичным образом выразить баланс между группами как
| (11) | |||
| (12) |
где и ⟧.
Применение Пропозиции 1 вместе с этими тождествами дает следующий результат.
Proposition 6.
Определите и . Затем для любого бинарного классификатора :
где .
Термин в Предложении 6 отражает точность классификатора: насколько различается истинный класс между предсказанными положительными и предсказанными отрицательными. Если является неинформативным, то и баланс между группами (то есть разрывы TPR и FPR) не расходуют много от общего бюджета на справедливость. Предложение также подчеркивает, что соответствующая мера точности, используемая для определения общего бюджета на несправедливость классификатора, — это MSE полученной оценки риска, которая может расходиться с более распространенными показателями качества работы классификатора (например, общей точностью или F1).
7 Ограничения
Наш анализ имеет несколько важных ограничений. Во-первых, наши результаты получены при сохранённом предположении о глобальной калибровке, которая часто задаётся посредством постобработки и может не выполняться равномерно для различных подгрупп или при сдвиге распределения. Во-вторых, существует множество правдоподобных метрик справедливости помимо тех, которые мы изучаем; они задавались бы другими ограничениями и могли бы иметь иное соотношение с точностью. Непосредственно связано с этим то, что измерения справедливости, на которых мы сосредоточиваемся, могут упускать источники несправедливости, возникающие из-за неверного измерения признаков или меток либо из-за взаимодействий между алгоритмом и другими общественными институтами, которые функционируют с предвзятостью. В-третьих, мы рассматриваем одну единственную бинарную защищённую характеристику; расширение рамок на несколько групп или на пересекающиеся характеристики является важным направлением будущих работ. В-четвёртых, наша учётная тождественность носит описательный, а не нормативный характер: она характеризует механические связи между статистическими метриками справедливости, точностью и исходными различиями, но сама по себе не определяет, какое распределение несправедливости этически уместно в заданной предметной области.
Список источников
- ⟦ Подход к справедливой классификации на основе сокращений. На международной конференции по машинному обучению, стр. 60–69. Цитируется: §B.3, §1.
- Скалярные свойства, бинарные суждения. Журнал прикладной философии 25 (2), стр. 85–104. Цитируется: §1.
- Систематическая предвзятость: по всей стране используется программное обеспечение, чтобы прогнозировать будущих преступников. И оно предвзято против чернокожих. ProPublica. Внешние ссылки: Link Цитируется: Appendix B, §4.
- ⟦ Возможность справедливости: пересмотр теоремы о невозможности на практике. В материалах конференции ACM 2023 года по справедливости, подотчетности и прозрачности, стр. 400–422. Цитируется в: §1.
- ⟦ AI fairness 360: расширяемый набор инструментов для обнаружения, понимания и смягчения нежелательной алгоритмической предвзятости. CoRR abs/1810.01943. Внешние ссылки: Link, 1810.01943 Цитируется: §B.3, Appendix B, §4, §4.
- ⟦ Выпуклая рамочная модель для справедливой регрессии. Предварительная публикация arXiv arXiv:1706.02409. Цитируется: §1.
- ⟦ Справедливое прогнозирование с несоразмерным влиянием: исследование смещений в инструментах прогнозирования рецидивов. Big data 5 (2), стр. 153–163. Цитируется: §1, §1, §2.2.
- ⟦ Измерение и неверное измерение справедливости. Журнал машинного обучения Research 24 (312), стр. 1–117. Цитируется: §2.2.
- ⟦ репозиторий машинного обучения UCI. Внешние ссылки: Link Цитируется: Appendix B⟧.
- Равенство возможностей в обучении с учителем. Достижения в нейронной обработке информации 29. Цитируется: §1, §2.2.
- ⟦ О статистических критериях алгоритмической справедливости. Филос. и обществ. дела 49, стр. 209. Цитировано: §2.2.
- ⟦ Алгоритмическая справедливость. В The Stanford Encyclopedia of Philosophy, E. N. Zalta и U. Nodelman (ред.), Примечание: https://plato.stanford.edu/archives/fall2025/entries/algorithmic-fairness/ Цитируется: §1, §2.2.
- Встроенные компромиссы при справедливом определении оценок риска. препринт arXiv arXiv:1609.05807. Цитируется: 2nd item, §1, §1, §2.2, §3.
- ⟦ Увеличение точности наивных байесовских классификаторов: гибрид дерева решений. В материалах Второй Международной конференции по интеллектуальному анализу знаний и добыче данных, Внешние ссылки: Link Цитируется: Appendix B.
- Обзор смещений и справедливости в машинном обучении. ACM computing surveys (CSUR) 54 (6), стр. 1–35. Цитируется: §1.
- ⟦ Алгоритмическая справедливость: выборы, допущения и определения. Ежегодный обзор статистики и его применение 8 (1), стр. 141–163. Процитировано: §1.
- ⟦ Основанный на данных подход для прогнозирования успеха телефонного маркетинга банков. Системы поддержки принятия решений 62, стр. 22–31. Внешние ссылки: Link Цитируется: Appendix B.
- ⟦ О справедливости и калибровке. Прогресс в нейронной обработке информации, том 30. Цитируется: §1.
- ⟦ Возможность в алгоритмической справедливости: можно ли согласовать калибровку и равные значения частоты ошибок?. Архивная препринт-запись arXiv:2002.07676. Цитируется: footnote 1.
- SciPy 1.0: Основные алгоритмы для научных вычислений на Python. Nature Methods 17, стр. 261–272. Внешние ссылки: Document Цитируется: §B.3.
- ⟦ Fairlearn: оценка и улучшение справедливости ИИ-систем. Примечание: https://arxiv.org/abs/2303.16626 Внешние ссылки: 2303.16626 Цитируется: §B.3, §4.
- Beyond incompatibility: trade-offs between mutually exclusive fairness criteria in machine learning and law. Искусственный интеллект 340, стр. 104280. Цитируется: §1.
Appendix A Доказательства
Доказательство.
Доказательство леммы 1.
Применяя определения , и , мы можем записать
где второе равенство следует из того, что является бинарным, а третье — из определения математического ожидания. Результат для следует аналогично. ∎
∎
Доказательство предложения 2.
Сначала разложим относительно :
| (13) | ||||
Затем мы снова применяем закон полной ковариации, чтобы разложить относительно ⟧:
| (14) | ||||
Затем мы разложим относительно :
| (16) | ||||
Окончательное применение закона полной ковариации к в отношении дает
| (18) |
Lemma 2.
Предположим, что является бинарным и . Определите . Тогда:
Доказательство.
Расширение MSE дает:
по закону итеративных ожиданий. Но поскольку является бинарным, ; благодаря этому и глобальной калибровке, мы можем записать
По закону полной дисперсии и калибровке:
перестановка и подстановка дают требуемое равенство.
∎
Доказательство предложения 1.
Напомним, что общий бюджет несправедливости в Предложении 2 равен . Поскольку этот член является ковариацией двух функций бинарной случайной величины, мы можем записать его как:
| (20) |
где . При двоичном мы также можем записать
где второе равенство следует из глобальной калибровки и применения закона полной ковариации к относительно ⟧.
Определите среднеквадратичную ошибку для как .
Используя лемму 2, мы можем записать:
| (21) |
Деление обеих частей (21) на дает:
| (22) |
| (23) |
Применение определений и для случая дает тождество учета для случая двоичного ⟧.
∎
Доказательство предложения 3.
Доказательство предложения 4.
Мы доказываем каждое утверждение по очереди.
(i) Глобальная калибровка.
По закону об итеративных ожиданиях:
так глобально откалибрована.
(ii) Точечная калибровка внутри групп: для всех .
Достаточно показать, что . Поскольку является функцией от , мы можем использовать повторяющиеся ожидания, чтобы записать
Поскольку (A2), . Следовательно
Поэтому для каждого из области определения и для каждого ,
и таким образом
(iii) Точечный баланс между группами: для всех .
Напишите , где . Затем
Кем (A3),
Таким образом
что подразумевает, что для каждого в носителе ,
и поэтому
(iv) не является оракулом.
По закону полной дисперсии и глобальной калибровки,
Предположение (A1) утверждает , следовательно , что подразумевает . Таким образом, не является оракулом.
(v) .
Во-первых, отметим, что (A2) подразумевает (при условии , не содержит дополнительной информации о ). Аналогично, (A3) подразумевает (при условии , не содержит дополнительной информации о ). Объединение этих результатов дает
Принимая во внимание дисперсии с обеих сторон, получаем
По (A4), , следовательно , то есть не является постоянной. Поэтому не независима от (поскольку подразумевало бы ). ∎
Lemma 3 (Монотонные функции имеют знакопеременную ковариацию).
Пусть — невырожденная, а и — функции, интегрируемые с квадратом от . Если и монотонны в одном направлении, то , причём строгое неравенство, если обе функции не постоянны. Если и монотонны в противоположных направлениях, то , причём строгое неравенство, если обе функции не постоянны.
Доказательство.
Пусть является независимой копией . Тогда
Если и монотонны в одном направлении, произведение почти наверное неотрицательно; если в противоположных направлениях, произведение почти наверное неположительно. Строгость следует из невырожденности и неконстантности. ∎
Доказательство предложения 5.
Точечная справедливость означает, что левая часть уравнения (14) равна нулю, следовательно, согласно тождеству учета:
| (24) |
где и ⟧.
При допущении, является 1-липшицевской; тогда должна быть монотонной (неубывающей) по . Чтобы увидеть это, предположим и применим определение липшицевости:
Кроме того, монотонна по предположению. Следовательно, согласно лемме 3, должна иметь фиксированный знак и быть строго ненулевой, если обе функции не являются константами. Таким образом, (24) означает, что либо является константой почти наверное (следовательно, ), либо является константой почти наверное.
Если почти наверное является постоянной, то (поскольку глобальная калибровка влечет ), значит, эта постоянная должна быть , и поэтому почти наверное. Поэтому
| (25) |
Вместе с глобальной калибровкой мы теперь показываем, что почти наверняка. Сначала,
где первое равенство использует , а второе использует (25). Следовательно , и таким образом
Поэтому почти наверное, то есть , то есть . ∎
Доказательство предложения 6.
Основной результат следует непосредственно из применения уравнений (9)-(12) к Предложению 1. Выражение для можно вывести следующим образом.
Сначала мы показываем, что среднеквадратичная ошибка равна ожидаемой условной дисперсии при заданном :
Далее вычислите , обусловив двумя значениями . Поскольку является Бернуллиевской в условии на , мы имеем
Поэтому,
Наконец, перепишите каждый термин, используя совместные вероятности ложноположительных и ложноотрицательных срабатываний. Обратите внимание на то, что
и
Подстановка этих тождеств приводит
Сочетание с доказывает утверждение. ∎
Appendix B Подробный обзор экспериментальных результатов
Для проверки нашей теоретической модели мы проводим два набора экспериментов на четырех хорошо изученных наборах данных для оценки справедливости. Эти эксперименты показывают, что (1) тождество учета выполняется на конечных выборках, (2) повышение точности уменьшает общую несправедливость, а не увеличивает ее, и (3) существующие меры по обеспечению справедливости перераспределяют общую несправедливость между метриками, а не дают Парето-улучшения. Используемые нами наборы данных: COMPAS, Adult, German Credit и Bank Marketing. Для воспроизводимости мы используем версии набора данных, предоставленные пакетом AI Fairness 360 Bellamy et al. (2018), который включает стандартизированные шаги предобработки (например, one-hot encoding категориальных признаков и удаление строк с любыми значениями null) и формирование защищенных/незащищенных меток в соответствии с общепринятым в литературе подходом. Во всех случаях мы исключаем переменную группы интереса из признаков, рассматриваемых при обучении модели.
COMPAS. Набор данных COMPAS Angwin et al. (2016), первоначально собранный и опубликованный ProPublica, предоставляет данные об обвиняемых в округе Брауард, Флорида, за годы 2013–2014. Мы обозначаем двухлетний прогноз рецидивизма как наш целевой показатель, а расу (с для афроамериканцев и для кавказцев) — как нашу переменную группы. Дополнительные признаки включают демографические характеристики обвиняемых, такие как возраст, описание предъявленного обвинения, а также число и тяжесть предыдущих эпизодов, среди прочего.
Доход взрослых. Набор данных Adult Income Kohavi (1996) содержит данные индивидуального уровня из переписи населения США. Мы обозначаем доход, превышающий $50,000, как наш целевой показатель, а пол (с для женщин и для мужчин) — как переменную группы. Дополнительные признаки включают возраст, образование, профессию, вид работы и др..
Немецкий кредит. Набор данных German Credit Dheeru and Karra Taniskidou (2017) состоит из записей отдельных лиц, подающих заявки на кредиты. Мы задаем статус кредитного риска как наш выходной показатель и бинаризованный возраст (с для диапазона вне 25–60 лет и в остальных случаях) как нашу переменную группы. Дополнительные признаки включают возраст, уровень профессиональных навыков, жилищный статус, цель кредита и др..
Маркетинг в банковской сфере. Набор данных Bank Marketing Moro et al. (2014) состоит из записей португальского банка, связанные с маркетингом нового счета для клиентов. Мы обозначаем открытие счета как исход, представляющий интерес (), и возраст ( для старше 25, в противном случае) как нашу переменную группы. Дополнительные признаки включают образование, семейное положение, существующие кредиты и работу, среди прочего.
B.1 Оценка объемов выборки
. Для оценки выборочных аналогов наших теоретических величин мы используем оцениватели по принципу подстановки. Для средних значений результата по группам мы определяем:
| (26) |
Для заданной модели мы вычисляем прогнозируемые вероятности и применяем изотоническую регрессию, чтобы обеспечить глобальную калибровку. Затем мы оцениваем условные ковариации как:
где обозначает бункер предсказанных вероятностей, центрированный в , а — число наблюдений в этом бункере. Мы используем 20 бункеров равной частоты для непрерывных предсказаний. Затем агрегированная несоответствующая калибровка равна .
Точно так же, для дисбаланса:
Для бинарных исходов мы вычисляем это отдельно для и и агрегируем как .
B.2 Эксперимент 1: Достоверность при конечной выборке посредством абляции признаков
Цель. Наш первый эксперимент устанавливает, что бухгалтерское тождество, выведенное в Уравнении 7, приблизительно выполняется на конечных выборках, типичных для реальных прикладных задач. Мы используем исключение признаков, чтобы зафиксировать эффект повышения точности: мы изменяем число признаков от одного до всех и обучаем каждую модель с доступом к этим признакам.
Настройка. Мы обучаем четыре стандартных алгоритма классификации на каждом наборе данных: логистическую регрессию, деревья решений, случайные леса и градиентный бустинг. Для каждой модели мы обучаем новый экземпляр с учетом каждого дополнительного признака (где мы рассматриваем каждую one-hot закодированную переменную как новый признак). Для удобства расшифровки рисунков мы включаем модели, обученные на первых нескольких признаках, а затем на количествах признаков, кратных 10. Признаки добавляются в порядке, в котором они перечислены в наборе данных, за исключением того, что мы исключаем чувствительный признак. Все модели перенастраиваются с использованием изотонической регрессии, чтобы гарантировать, что сохраняется глобальная калибровка..
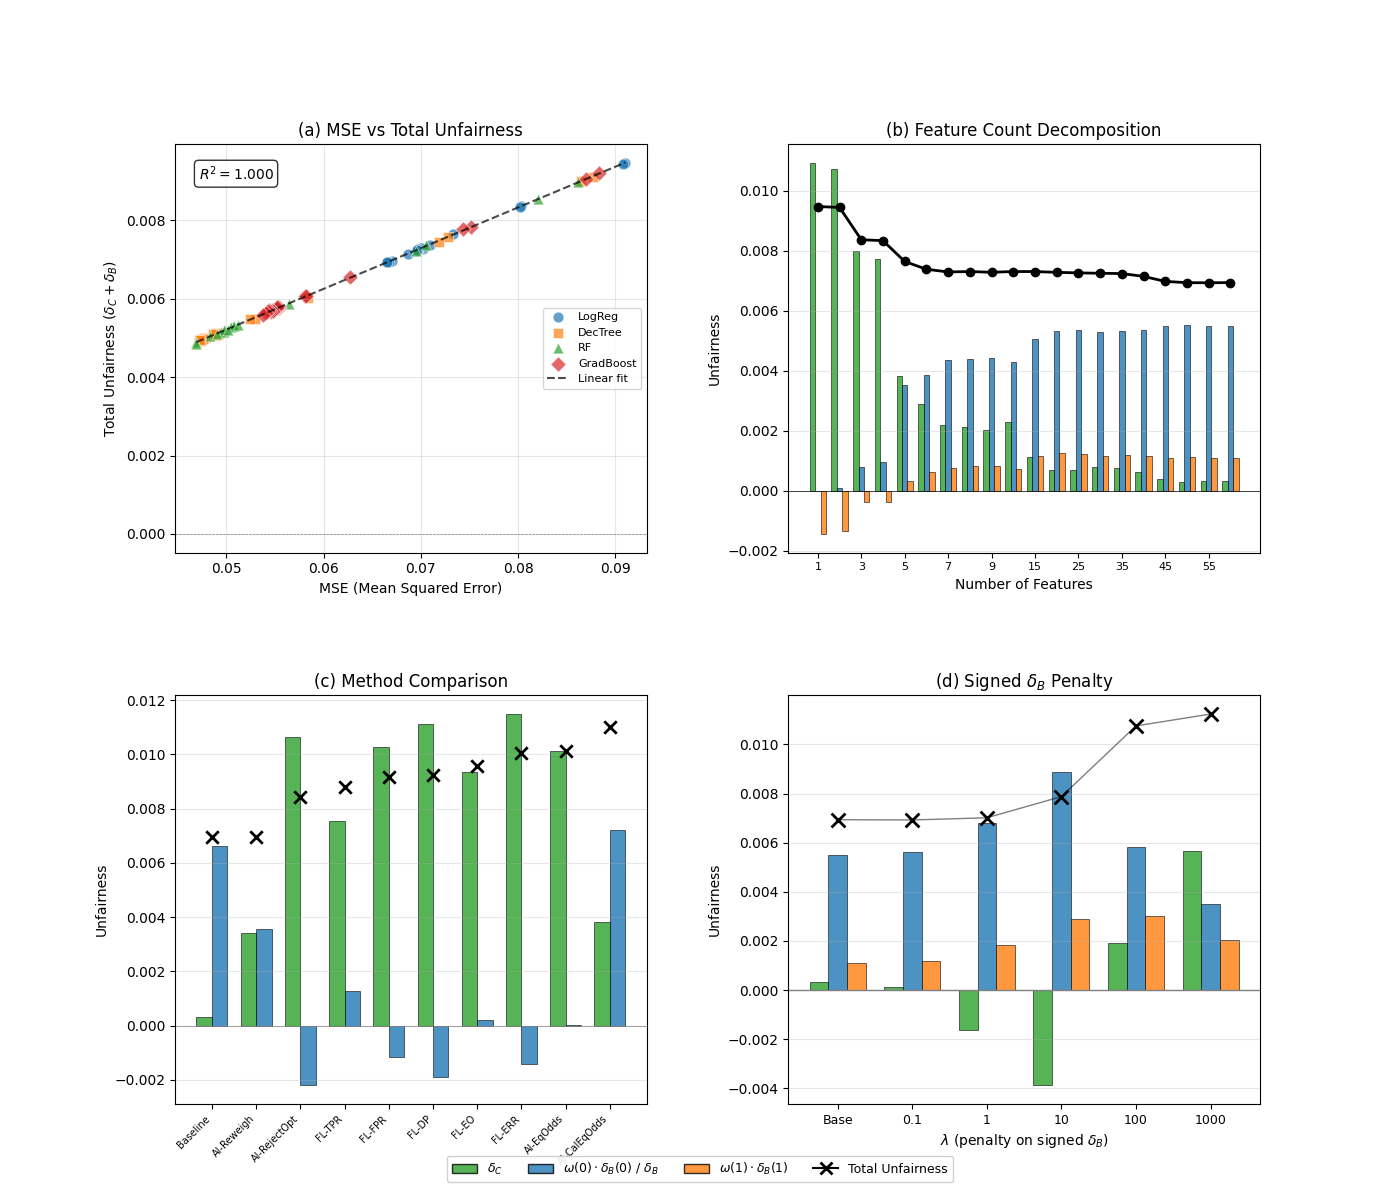
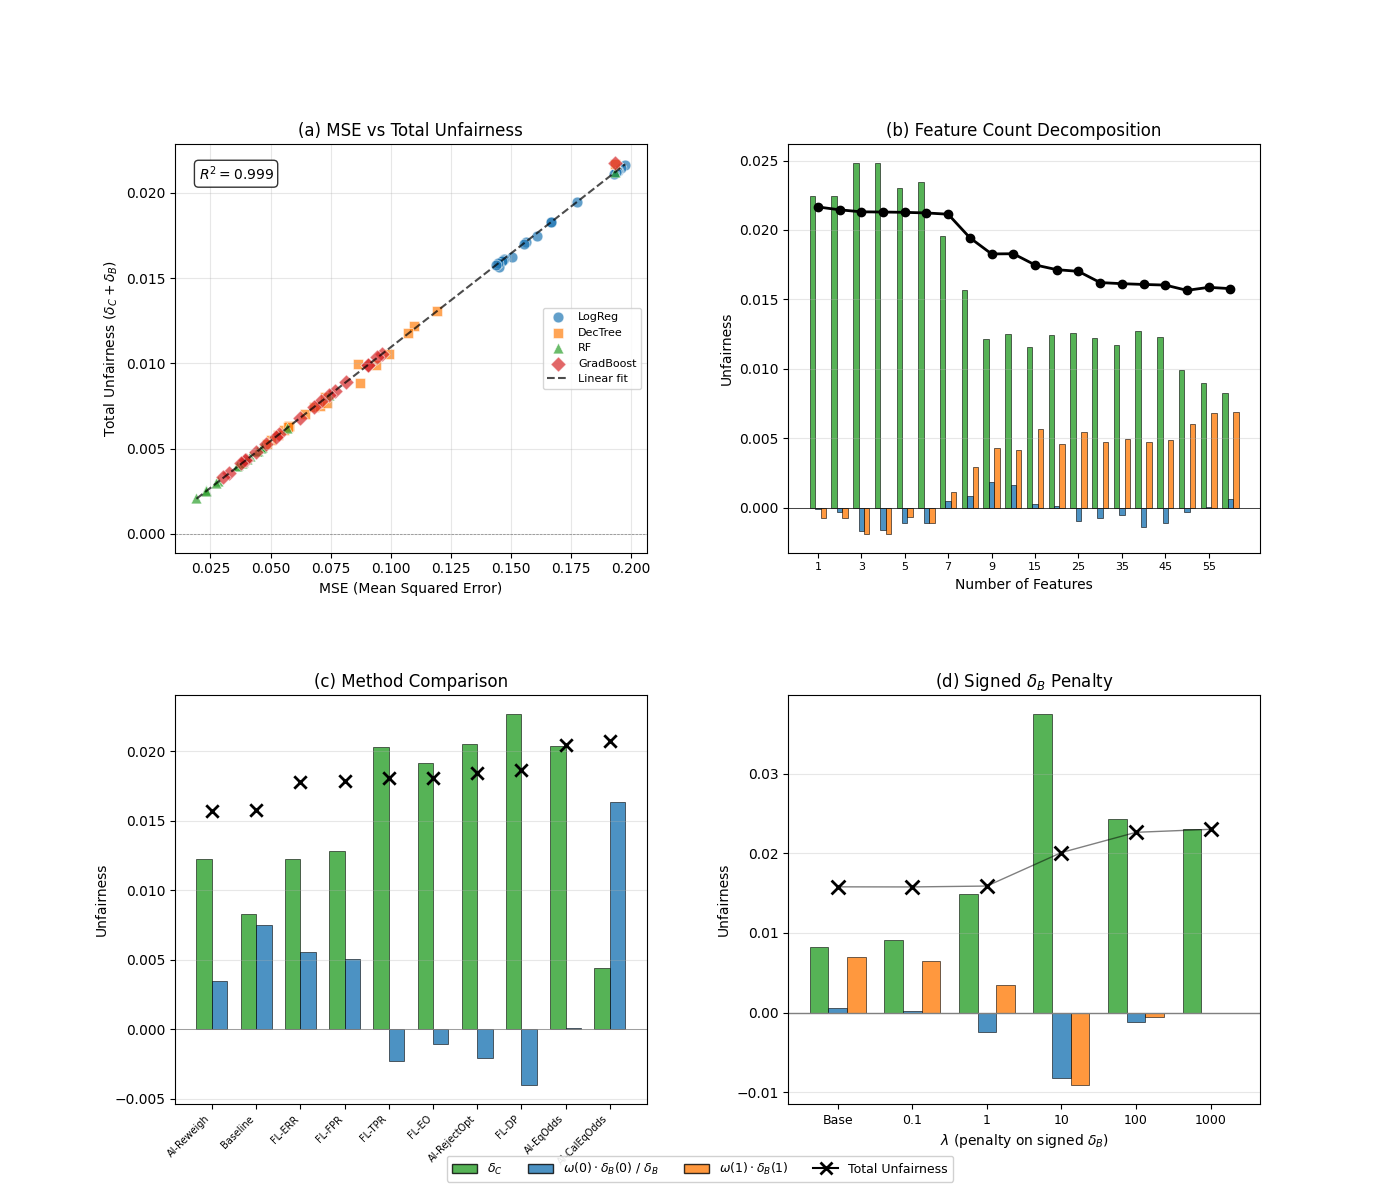
Результаты. Панель (1) на каждом из рисунков 1-4 показывает, для каждого соответствующего набора данных, модели и числа признаков, оцененную суммарную несправедливость относительно средней квадратической ошибки модели. Пунктирная черная линия показывает теоретическое предсказание из уравнения 7. Во всех четырех наборах данных и для всех типов моделей эмпирические значения практически точно следуют теоретическому предсказанию. В частности, по мере того как MSE уменьшается, суммарная несправедливость стремится к 0 на каждой диаграмме. Панель (2) на каждом из рисунков 1-4 показывает, как меняется структура несправедливости при увеличении числа признаков. Поскольку моделям разрешают использовать все большее число признаков, суммарная несправедливость уменьшается примерно монотонно, но относительные доли и сдвигаются, а также иногда меняют знаки, сдвигаются.
B.3 Эксперимент 2: Методы обеспечения справедливости перераспределяют несправедливость
Цель. Во втором эксперименте мы исследуем, как существующие методы обеспечения справедливости влияют на декомпозицию несправедливости. Мы оцениваем методы из популярных библиотек Weerts et al. (2023) и Bellamy et al. (2018). FairLearn началась как реализация Agarwal et al. (2018), и библиотека реализует описанные (среди прочего) методы для получения справедливых классификаторов посредством сведения к определенным задачам классификации с учетом чувствительных затрат. В частности, мы используем алгоритм с экспоненциальным градиентом для улучшения метрик справедливости. AI360 реализует и другие подходы, включая предварительную обработку и последующую обработку. Мы также реализуем прямой подход, включая штраф на в штрафной логистической регрессии.
Настройка. Для FairLearn мы сосредотачиваемся на методах на этапе обработки и используем экспоненциально-градиентный алгоритм для подбора справедливых классификаторов в отношении демографического паритета (FL-DP), равных возможностей (FL-EO), истинно-положительной скорости (FL-TPR), ложно-положительной скорости (FL-FPR) и паритета по уровню ошибок (FL-ERR). Для AIF360 мы используем подход с переназначением весов на этапе предварительной обработки (AI-Reweighing) и подходы на этапе постобработки, которые изменяют вероятности (AI-EqOdds, AI-CalEqOdds), или предоставляют благоприятное отношение к наблюдениям меньшинства с высокой неопределенностью (AI-reject opt).
Мы также реализуем штрафную логистическую регрессию, которая напрямую нацелена на :
| (27) |
и дополнительно
| (28) |
оптимизировано с использованием библиотеки SciPy Virtanen et al. (2020) с квазиньютоновским (L-GBFS-B) методом.
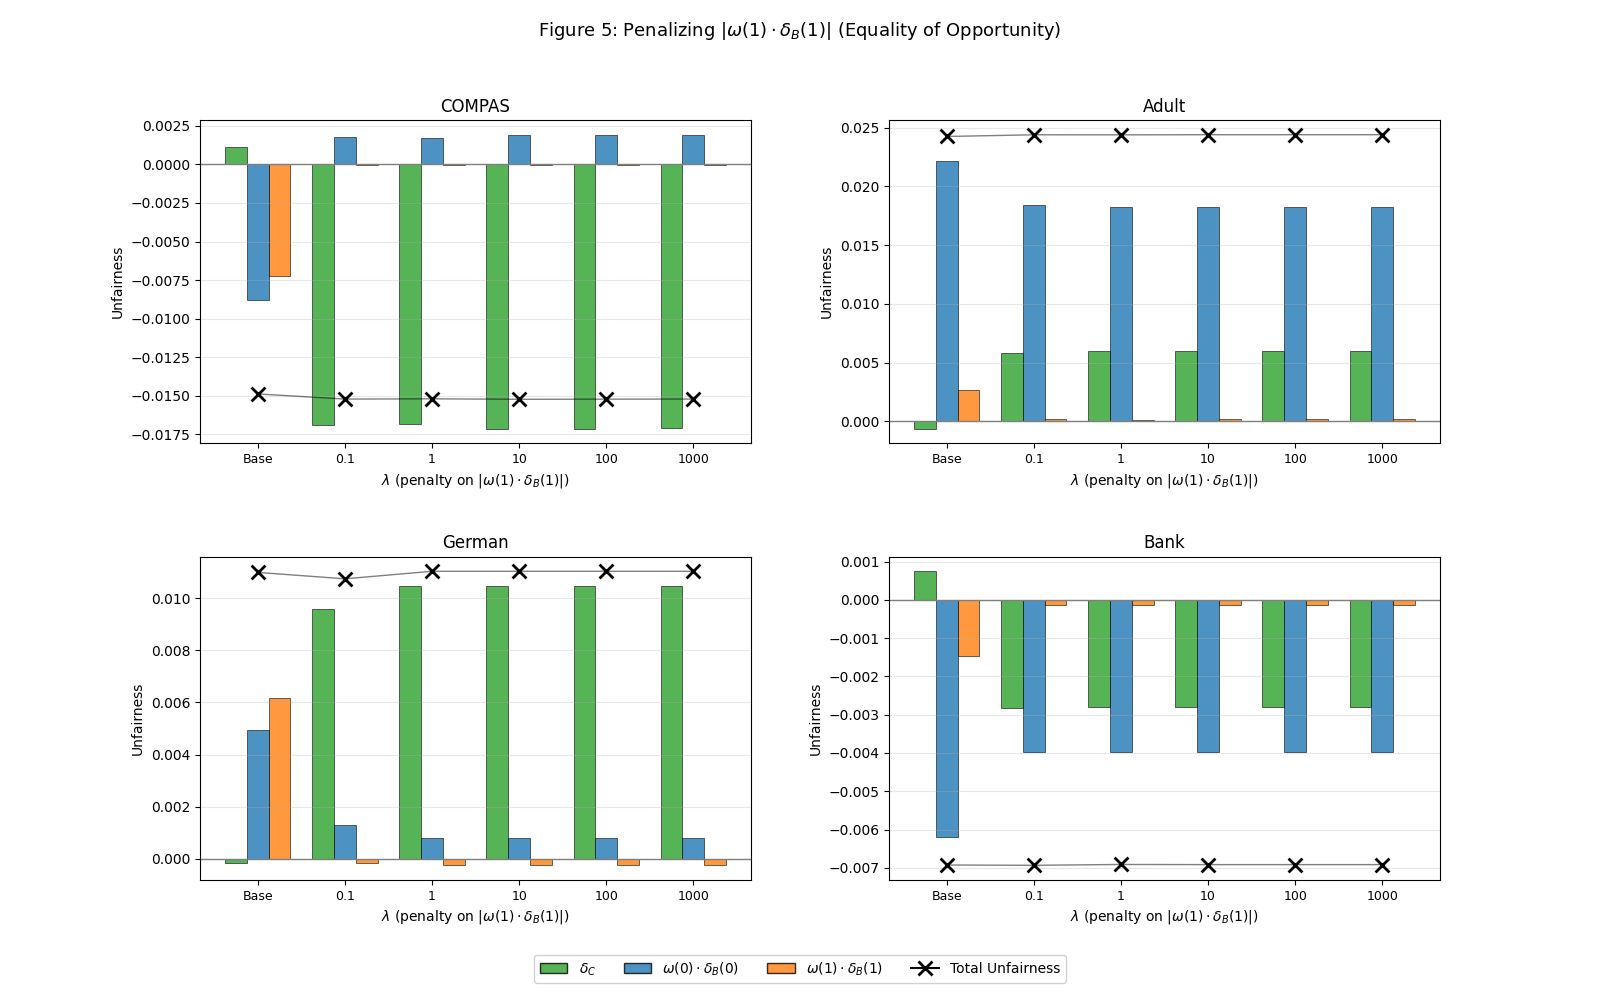
Результаты. Панель (3) на рисунках 1-4 сравнивает результаты разложения несправедливости по различным методам обеспечения справедливости. Методы, которые успешно уменьшают одну метрику справедливости, как правило, увеличивают другую. Также они, как правило, снижают точность, что увеличивает общий бюджет несправедливости. Панель (4) каждого рисунка посвящена прямому подходу с логистической регрессией с прямым штрафом и показывает, как разложение изменяется при увеличении штрафа по . По мере увеличения дисбаланс уменьшается, но растет несоответствие калибровки, и общий бюджет увеличивается, поскольку точность ухудшается. Рисунок 5 аналогичен панели (4) каждого рисунка, но с наложением штрафа только на , что соответствует фокусу на равенстве возможностей. Примечательно, что в некоторых наборах данных улучшение , по-видимому, улучшает совместно, но в других (в частности, для COMPAS) улучшение увеличивает настолько, что меняется его знак.