Масштабирование верификации медицинских рассуждений с помощью инструментально-интегрированного обучения с подкреплением
Аннотация
Большие языковые модели достигли сильных результатов на наборах тестов для медицинского рассуждения, однако их внедрение в клинических условиях требует строгой верификации, чтобы обеспечить фактическую точность. Хотя модели вознаграждения обеспечивают масштабируемый подход для верификации рассуждений по следам, существующие методы сталкиваются с двумя ограничениями: они выдают только скалярные значения вознаграждения без явного обоснования и опираются на однопроходное извлечение, что исключает адаптивный доступ к знаниям по мере развертывания верификации. Мы представляем Med-TIV — агентную структуру, которая устраняет эти ограничения за счет обучения верификаторов медицинского рассуждения итеративно запрашивать внешние медицинские корпуса во время оценки. Наш подход сочетает верификацию с инструментами, дополненными проверкой, и итеративную парадигму обучения с подкреплением, которая требует только надзор на уровне следов, а также адаптивный механизм учебной программы, который динамически изменяет распределение обучающих данных. На четырех наборах тестов для медицинского рассуждения Med-TIV достигает существенных улучшений по сравнению с существующими методами, повышая точность MedQA на 23,5% и MedXpertQA на 32,0% относительно базового генератора в частности. Критически важно, что Med-TIV демонстрирует снижение требований к бюджету выборки по сравнению с предшествующими базовыми моделями вознаграждения. Эти результаты показывают, что привязка верификации к динамически извлекаемым свидетельствам дает обоснованный путь к созданию более надежных систем медицинского рассуждения.
1 Введение
Большие языковые модели (LLMs) продемонстрировали выдающиеся возможности в медицинском рассуждении, достигнув конкурентоспособных результатов на задачах клинического вопросно-ответного поиска, диагностического вывода и бенчмарках медицинских знаний (Ji et al., 2025a; Xiao et al., 2026). Хотя эти достижения имеют значительный потенциал для усиления клинического принятия решений и расширения доступности медицинского экспертного опыта, внедрение LLMs в клинические среды с высокими ставками требует строгих механизмов верификации, чтобы гарантировать, что сгенерированное рассуждение является как фактически точным, так и логически обоснованным (Zhang et al., 2025; Wang et al., 2025).
Поскольку судьи на основе вознаграждения, таким образом, возникли как масштабируемое решение для оценивания выходных данных модели, поддерживающее как уточнение после обучения посредством reinforcement learning from human feedback (RLHF), так и масштабирование на этапе вывода посредством tree search (Snell et al., 2024). Эти судьи можно в целом классифицировать по степени детальности их надзора. Outcome Reward Models (ORMs) обеспечивают разреженное, на уровне следов, наблюдение, которое количественно оценивает качество всего вывода, тогда как Process Reward Models (PRMs) предоставляют плотную по шагам обратную связь, которая оценивает каждый промежуточный шаг рассуждения, позволяя выполнять точное приписывание кредитов и точно локализовать ошибки в многократном рассуждении. Недавние работы адаптировали обе эти парадигмы к медицинской области для оценивания сложных клинических следов рассуждения. Параллельно достижения в генерирующем моделировании вознаграждения расширили возможности моделей-судей за пределы скалярного оценивания, позволяя им формировать критические замечания на естественном языке, которые явно обосновывают их решения (Liu et al., 2025c; Xiong et al., 2025).
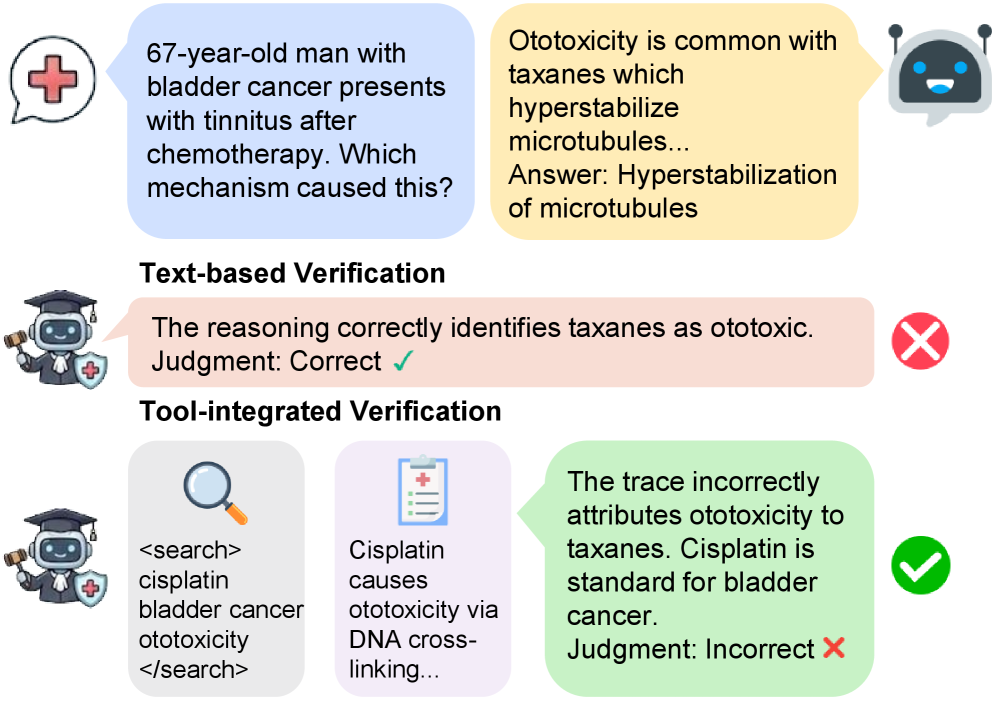
Несмотря на свою эффективность, судьи, основанные на вознаграждении, демонстрируют фундаментальные ограничения при применении к задачам клинического рассуждения (Yun et al., 2025). Главная проблема заключается в распространенности галлюцинаций в трассировках критики, где модели судей генерируют правдоподобные, но фактически неверные оценки (Рисунок 1). Эта проблема особенно заметна в медицинской области, где надежная верификация требует опоры на авторитетные клинические свидетельства и общепризнанные медицинские знания. Непроверенные суждения могут привести к распространению неверных рекомендаций по диагностике или лечению. Существующие медицинские верификаторы рассуждений обычно предоставляют только скалярные сигналы вознаграждения, предлагая мало или вообще не предоставляя обоснования своих суждений, тем самым ограничивая интерпретируемость (Jiang et al., 2025b). Кроме того, эти методы часто опираются на статический конвейер Retrieval-Augmented Generation (RAG), в котором фиксированный набор извлеченных документов добавляется в начало контекста и остается неизменным в течение оценки (Yun et al., 2025). Такая статическая конструкция не позволяет осуществлять адаптивный, многошаговый сбор свидетельств и заставляет верификатор использовать фиксированный бюджет извлечения, тем самым ограничивая масштабируемость.
Для решения этих проблем мы предлагаем Med-TIV (проверяющий рассуждения с интеграцией медицинских инструментов), агентную рамку обучения с подкреплением (RL), которая обучает LLM использовать внешние базы знаний для вынесения суждений по следам медицинских рассуждений111Код доступен по адресу https://github.com/PittNAIL/med-tiv. Med-TIV содержит три ключевых принципа проектирования: (1) парадигму верификации с расширением инструментами, которая позволяет выполнять динамический, итеративный поиск знаний в ходе процесса оценки; (2) итеративный подход RL, который постепенно улучшает возможности верификации без необходимости пошаговых экспертных аннотаций; и (3) адаптивную стратегию формулирования учебной программы, которая корректирует распределение данных в ответ на развивающиеся способности модели. Оснащая модели судьи возможностями использования инструментов, Med-TIV обосновывает решения оценки внешними свидетельствами, а не полагается исключительно на параметрические знания, тем самым уменьшая галлюцинации, повышая интерпретируемость и преодолевая ограничения статического RAG (Ji et al., 2025b; Xia et al., 2025).
Для проверки эффективности Med-TIV мы проводим обширные эксперименты на распространенных наборах оценивания задач медицинного рассуждения. Наши результаты демонстрируют, что Med-TIV обучает сильные медицинские верификаторы: при управлении поиском во время вывода для модели генератора с 7B обученный верификатор обеспечивает относительные улучшения на 23.5% для MedQA и на 32.0% для MedXpertQA по сравнению только с моделью генератора. Кроме того, Med-TIV последовательно превосходит существующие базовые модели медицинских reward-моделей и превосходит по эффективности модели, которые по масштабу больше примерно на . Примечательно, что Med-TIV также демонстрирует выигрыш в эффективности семплирования по сравнению с предшествующими подходами, основанными на reward, достигая эквивалентной точности при существенно меньшем числе семплированных трасс рассуждений во время поиска во время тестирования.
Наши основные вклады обобщены следующим образом::
- ⟦• Мы предлагаем Med-TIV, новую инструментально-интегрированную систему верификации, которая позволяет выполнять динамический, итеративный поиск знаний при оценке медицинских рассуждений, обеспечивая как интерпретируемые, детальные обоснования, так и улучшенную фактическую обоснованность.
- ⟦• Мы представляем итеративную парадигму обучения с подкреплением, основанную на постепенной адаптации сложности по принципу учебной программы, которая последовательно улучшает возможности верификации посредством самоподкрепления, требуя лишь супервизии уровня трассировки, а не плотных посшаговых экспертных аннотаций.
- ⟦• Med-TIV достигает уровня наилучших результатов по четырем бенчмаркам медицинского рассуждения, с исчерпывающими исследованиями абляции, которые подтверждают вклад каждого компонента.
2 Предварительные сведения
2.1 Постановка задачи
Мы определяем верификацию медицинских рассуждений как задачу оценки корректности многошагового следа рассуждений, сгенерированного в ответ на медицинский вопрос. Формально, при наличии медицинского вопроса и многошагового следа рассуждений от модели-генератора, модель-верификатор определяет, содержит ли какие-либо ошибки. Мы формулируем эту задачу как бинарную классификацию, в которой верификатор выдает суждение где указывает на отсутствие ошибок в следе рассуждений, а указывает на наличие одной или более ошибок. В отличие от скалярных моделей вознаграждения, которые выводят непрерывные оценки, мы применяем парадигму порождающего жюри, в которой верификатор выдает дискретное суждение, сопровождаемое подробным следом критики, обеспечивающим структурированное обоснование решения.
2.2 Проверка рассуждений с инструментами
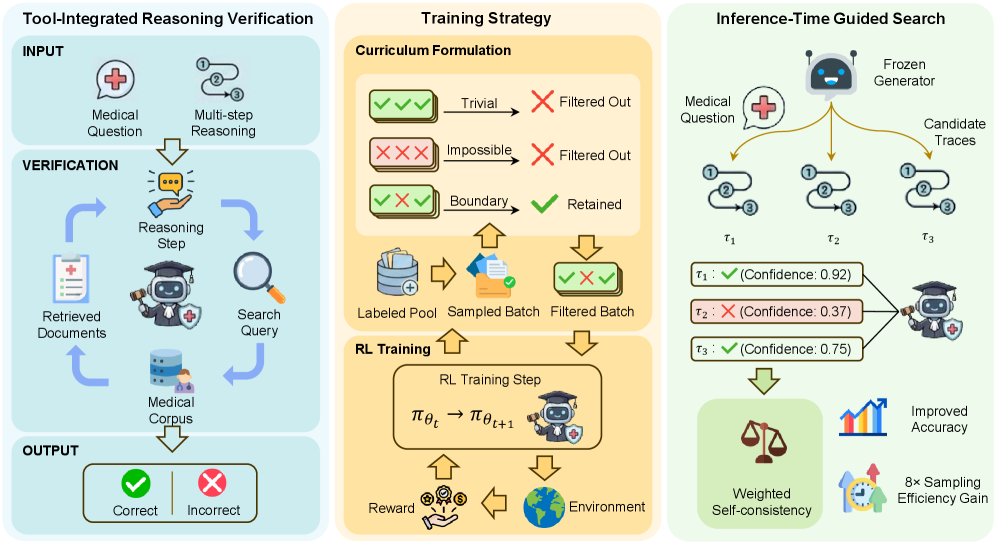
Следуя предшествующим работам (Jin et al., 2025), мы расширяем верификатор доступом к внешней поисковой системе , которая извлекает верхние документы из отобранного медицинского корпуса (см. Приложение B.2 для подробностей). Извлеченные документы дословно добавляются в контекст верификатора. Для заданного верификационного экземпляра верификатор строит итерационную траекторию верификации. На шаге траектория представлена как:
где обозначает шаг рассуждения на естественном языке, анализирующий медицинское содержание, является поисковым запросом, сформулированным для извлечения релевантных медицинских знаний, а представляет извлеченные документы. Итерационный процесс проверки определяется как:
где обозначает конкатенацию последовательностей. Этот процесс продолжается до тех пор, пока в завершающем шаге верификатор не вынесет окончательное суждение . Разрешая многократные выполнения инструментов, верификатор динамически извлекает медицинские знания по мере необходимости для проверки конкретных утверждений в трассе рассуждений. Таблица 5 в Приложении показывает явную инструкцию, использованную в наших экспериментах.
2.3 Поиск во время тестирования
Стратегии поиска при тестировании улучшают показатели рассуждений, используя модели вознаграждения для оценки и выбора среди нескольких кандидатов-решений (Shi et al., 2024). Учитывая замороженную модель генератора и вопрос , мы сначала выполняем выборку независимых траекторий рассуждений:
Обученный верификатор затем оценивает каждый кандидатский трейс, и итоговый результат выбирается на основе этих оценок. К распространенным стратегиям выбора относится Best-of- sampling, при котором выбирается трейс с наивысшим баллом:
и голосование большинством на основе проверки, при котором траектории кандидатов сначала фильтруются проверяющим, а окончательный ответ определяется консенсусом среди проверенных траекторий. Med-TIV обучает такой модуль-проверяющий, который предоставляет оценки, основанные на использовании инструментов, и их можно применять для усиления принятия решений для любой замороженной модели генератора во время вывода.
3 Инструментально интегрированный верификатор медицинских рассуждений
Med-TIV — это агентная система верификации, которая обучает модели использовать внешние базы знаний для проверки того, содержит ли заданный фрагмент медицинских рассуждений ошибки. Мы применяем итеративный подход к обучению на основе динамического учебного плана, который не требует точного пошагового экспертного надзора и обучает только за счет нескольких раундов обучения с подкреплением (Рисунок 2). Далее мы подробно опишем процедуру обучения Med-TIV.
3.1 Инструментально-интегрированное обучение с подкреплением с проверяемыми вознаграждениями
Построение данных.
Вся тренировочная выборка по всем итерациям получена из открытого набора данных Med-PRM. Каждый исходный экземпляр состоит из кортежа , где — это медицинский вопрос, — это трасса многошагового рассуждения, — это метки на уровне шагов, а — это метка корректности на уровне трассы222Набор данных доступен по адресу https://huggingface.co/datasets/dmis-lab/llama-3.1-medprm-reward-training-set.
На каждой итерации обучения мы используем только тройку с разметкой следов на уровне трассировки, выполненной человеком. Метки на уровне шагов намеренно исключены, поскольку Med-TIV предназначен для повышения качества верификации без опоры на детальный надзор. Для каждой итерации обучения мы фиксируем бюджет обучающих данных равным 20K экземплярам и обеспечиваем сбалансированное распределение меток между корректными () и некорректными () трассами рассуждений.
Алгоритм.
Мы используем Dr. GRPO (Liu et al., 2025b) как алгоритм обучения с подкреплением для обучения верификатора. При заданном верификационном экземпляре мы отбираем группу из верификационных траекторий из текущей политики . Каждая траектория состоит из токенов рассуждений, поисковых запросов, извлечённых документов и итогового суждения. Цель состоит в:
| (1) |
где , обозначают входной промпт, содержащий вопрос и след рассуждений, представляет ранее сгенерированные токены, а и являются параметрами отсечения. Термин преимущества определяется как:
Дизайны вознаграждения.
Для обеспечения многотурового обучения с подкреплением с выполнением инструментов мы разрабатываем структурированную функцию вознаграждения, охватывающую две взаимодополняющие цели, следуя предшествующим практикам (Jin et al., 2025):
(i) Награда за корректность (): Этот компонент измеряет, совпадает ли оценка проверяющего с истинной меткой. Пусть обозначает запрос на верификацию, а — истинную метку. Мы определяем:
где — индикаторная функция, а анализирует окончательное решение из тегов <answer> в сгенерированной траектории . Интуитивно, если решение проверяющего верное, и в противном случае.
(ii) Формат вознаграждения (): Чтобы обеспечить надежное использование инструментов и структурированные выходные данные, проверяющему требуется придерживаться заранее заданного формата. В частности, шаги рассуждений должны быть заключены в теги <think>, поисковые запросы — в теги <search>, а итоговое суждение — в теги <answer>. Чтобы препятствовать вырожденным выходным данным, мы дополнительно штрафуем за чрезмерное использование тегов. В частности, если выходной результат удовлетворяет всем ограничениям форматирования и содержит не более 10 пар тегов <answer>; если выходной результат корректен, но наблюдается переполнение тегов; и в остальных случаях.
Окончательное вознаграждение определяется как произведение двух компонентов:
3.2 Стратегии обучения
Адаптивное формирование учебной программы.
Центральная задача в RL для верификации — обеспечить, чтобы обучающие данные оставались надлежащим образом откалиброванными относительно развивающейся способности модели. Случаи, которые либо тривиально просты, либо практически невыполнимы, дают минимальный сигнал обучения, поскольку в результате градиенты политики стремятся к нулю. Для решения этой проблемы мы применяем механизм формулирования учебного плана с учетом модели, который динамически адаптирует распределение задач на каждой итерации обучения.
Конкретно, перед каждой итерацией мы выполняем онлайн-фильтрацию по сэмплированной выборке , чтобы сформировать эффективный обучающий набор :
Здесь для каждого кандидата экземпляра мы выбираем траектории проверки из текущей политики . Затем мы вычисляем соответствующие вознаграждения . Наконец, мы сохраняем только экземпляры, если любые два вознаграждения различаются, то есть дисперсия вознаграждения не равна нулю (Khatri et al., 2025).
Этот критерий исключает запросы, при которых модель либо последовательно успешно справляется, либо последовательно терпит неудачу на всех выборочных траекториях. Отфильтровывая эти случаи с нулевым градиентом, оптимизация сосредотачивается на ситуациях у границы решений, где проверяющий демонстрирует неопределенность.
Чтобы поддерживать фиксированный бюджет обучения на итерацию, мы итеративно повторно отбираем дополнительные экземпляры из размеченного пула и применяем то же критерий фильтрации, пока не достигнем . Этот динамический учебный план естественным образом развивается по мере улучшения верификатора, устраняя необходимость в вручную разработанных графиках сложности.
Итеративное обучение посредством самозапускающих процедур.
Мы применяем итеративный подход к обучению, который поэтапно улучшает возможности верификации за счет нескольких раундов RL. В отличие от предыдущих работ, которые чередуют между собой выборку с отказом (rejection sampling), дообучение с учителем (supervised fine-tuning, SFT) и RL (Xu et al., 2025), наш подход работает полностью за счет итеративного RL, следуя парадигме RL-Zero, где модель усиливает свои возможности верификации без необходимости в плотных покадровых демонстрациях экспертов для холодного старта.
Начиная с базовой модели , мы выполняем итераций. Каждая итерация состоит из трех этапов:
Каждая итерация извлекает свежую выборку из аннотированного пула с метками на уровне следов, обеспечивая сбалансированное распределение правильных и неправильных следов рассуждений. Затем учебная фильтрация формирует обучающий набор , как описано выше, и оптимизация RL обновляет политику на основе структурированной награды.
Ключевая идея, лежащая в основе этого итеративного подхода, заключается в совместной эволюции способности модели и распределения обучения. По мере того как улучшается верификатор, механизм фильтрации автоматически удаляет экземпляры, которые стали слишком простыми, а свежая выборка вводит новые сложные случаи. Это создает самозапускающийся цикл: более сильные модели сталкиваются с более трудными задачами верификации, что в свою очередь приводит к дальнейшим улучшениям. Поскольку вознаграждение за корректность на уровне трассы является детерминированным и однозначным, этот процесс самозапуска сходится надежно без нестабильностей, которые могут возникать из-за шумных синтетических разметок на уровне шагов. Мы кратко описываем общую процедуру обучения в Алгоритме 1.
4 Эксперименты
4.1 Экспериментальная установка
Оценочные бенчмарки.
Мы оценили Med-TIV на четырех открытых медицинских задачах вопрос-ответ: MedQA (Jin et al., 2020), MedMCQA (Pal et al., 2022), MMLU-Med (Hendrycks et al., 2021) и MedXpertQA (Zuo et al., 2025), используя точность в качестве метрики оценки. Эти наборы данных в совокупности оценивают способность проверяющего отличать корректные рассуждения от ошибочных при различном уровне сложности и в разных медицинских предметных областях. Подробные описания наборов данных приведены в Приложении C.1⟧.
Детали реализации.
Мы обучили верификаторы с использованием двух легковесных базовых моделей: Llama3.1-8B и Qwen2.5-7B, при этом Llama3.1-8B использовалась по умолчанию для представления результатов. Все обучение проводилось с использованием фреймворка VeRL-Tool (Jiang et al., 2025a). Подробные гиперпараметры приведены в Приложении B.1. Все эксперименты проводились на 4 графических процессорах NVIDIA H100 с объемом памяти 80 ГБ. В связи с вычислительными ограничениями мы ограничили максимальное число итераций RL значением , а также задали размер группы для формирования учебной программы (Раздел 3.2) равным ⟧.
Для вывода мы использовали стандартные параметры гиперпараметров выборки для всех моделей. В экспериментах по поиску с управлением поощрением, если не указано иное, мы использовали Qwen2.5-7B в качестве замороженного генератора и отбирали до 32 кандидатных цепочек рассуждений на вопрос. Мы применили Hard-Weighted Self-Consistency в качестве стратегии поиска по умолчанию на этапе тестирования.
Базовые уровни.
Мы сравнили Med-TIV с двумя группами базовых моделей. 1): Готовые LLM: GPT-4o-mini (OpenAI and others, 2024), Gemini-2.0-Flash, серии DeepSeek-R1 (Guo and others, 2025), серии Qwen2.5 (Yang and others, 2025), Llama3.1 (Grattafiori and others, 2024), AlphaMed (Liu et al., 2025a), UltraMedical (Zhang et al., 2024) и HuatuoGPT-o1 (Chen et al., 2024). 2): Медицинские предметно-специализированные Reward Models: MedS3 (Jiang et al., 2025b) и Med-PRM (Yun et al., 2025). Подробные описания каждой базовой модели Reward Model приведены в Приложении B.3.
| Baselines | Train | Size | MedQA | MedMCQA | MMLU-Med | MedXpertQA | Avg. | |
| Proprietary Models | ||||||||
| GPT-4o-mini | - | - | - | 79.03 | 68.20 | 87.79 | 17.84 | 63.22 |
| Gemini-2.0-Flash | - | - | - | 87.51 | 72.60 | 92.01 | 20.57 | 68.17 |
| General Reasoning Models | ||||||||
| DeepSeek-R1 | - | - | 671B | 90.34 | 78.80 | 94.40 | 37.76 | 75.33 |
| R1-Distill-Qwen | - | - | 7B | 24.82 | 36.40 | 47.47 | 7.43 | 29.03 |
| R1-Distill-Llama | - | - | 8B | 34.96 | 43.60 | 64.19 | 5.35 | 37.03 |
| General Non-reasoning Models | ||||||||
| Qwen2.5 | - | - | 32B | 73.21 | 64.83 | 84.94 | 13.87 | 59.21 |
| Qwen2.5 | - | - | 7B | 60.96 | 56.56 | 76.96 | 12.15 | 51.66 |
| Llama3.1 | - | - | 8B | 70.93 | 61.60 | 78.97 | 13.02 | 56.13 |
| Medical Reasoning Models | ||||||||
| AlphaMed | - | - | 7B | 71.01 | 61.46 | 81.16 | 19.16 | 58.20 |
| UltraMedical | - | - | 8B | 72.66 | 62.60 | 79.61 | 15.25 | 57.53 |
| HuatuoGPT-o1 | - | - | 8B | 72.19 | 63.60 | 75.30 | 16.84 | 56.98 |
| Medical Reward Models | ||||||||
| MedS3 | ✗ | 225k | 7B | 64.89 | 58.91 | 80.53 | 12.90 | 54.31 |
| Med-PRM | ✓ | 111k | 7B | 69.99 | 62.36 | 80.99 | 13.51 | 56.71 |
| Med-TIV (Ours) | ✓ | 20k | 7B | 75.26 | 64.70 | 85.58 | 16.04 | 60.40 |
Стратегии поиска на этапе тестирования.
Мы оценили три стратегии поиска во время тестирования, которые используют Med-TIV для повышения качества рассуждений замороженных генераторов. Учитывая след рассуждений с шагами, наш верификатор присваивает оценку уверенности для всего следа, определяемую как вероятность softmax для 1 токена по логитам как токенов 1, так и 0 токенов.
-
⟦Лучшее из N. Для заданного вопроса мы отобрали кандидатов трасс из генератора и выбрали трассу с наивысшим значением оценочной уверенности верификатора:
-
⟦Hard-Weighted Self-Consistency. Мы сначала отфильтровали трассы по бинарному решению верификатора, оставив только те, которые помечены как правильные (). Среди отфильтрованных трасс мы применили голосование большинством для определения окончательного ответа:
- ⟦Мягко-взвешенная само-согласованность. Вместо двоичной фильтрации мы взвешивали голос каждого следа (trace) по оценке уверенности верификатора:⟧
4.2 Основные результаты
Таблица 1 представляет основные результаты на четырех медицинских бенчмарках рассуждений. Модели, обученные с Med-TIV, последовательно превосходят существующие базовые уровни на всех бенчмарках. В частности, при guided-search с верификатором, обученным на Med-TIV, Qwen2.5-7B достигает точностей 75.26% на MedQA, 64.70% на MedMCQA, 85.58% на MMLU-Med и 16.04% на MedXpertQA, обеспечивая среднюю точность 60.40%. Примечательно, что Med-TIV позволяет этому генератору масштаба 7B соперничать с существенно более крупными моделями, даже превосходя базовую производительность Qwen2.5-32B, несмотря на использование генератора, который примерно на меньше. По сравнению с доменно-специализированными моделями медицинских рассуждений сопоставимого масштаба Med-TIV превосходит HuatuoGPT-o1-8B и UltraMedical-8B на 3.07% и 2.60% на MedQA соответственно, демонстрируя эффективность нашей верификации, интегрированной с инструментами. Анализ случаев в Приложении D дополнительно иллюстрирует, как Med-TIV выявляет тонкие ошибки рассуждений.
4.3 Анализ
Мы провели серию абляционных анализов, чтобы исследовать шесть ключевых исследовательских вопросов, касающихся предлагаемой нами структуры.
| Models | MedQA |
|---|---|
| Qwen2.5-7B | 60.96 |
| + Self-Consistency | 66.38 (+5.42) |
| + Best-of-N (Med-TIV) | 72.35 (+11.39) |
| + Soft Weighted SC (Med-TIV) | 75.02 (+14.06) |
| + Hard Weighted SC (Med-TIV) | 75.26 (+14.30) |
| AlphaMed-7B | 71.01 |
| + Self-Consistency | 74.23 (+3.22) |
| + Best-of-N (Med-TIV) | 75.02 (+4.01) |
| + Soft Weighted SC (Med-TIV) | 75.33 (+4.32) |
| + Hard Weighted SC (Med-TIV) | 75.65 (+4.64) |
| Qwen2.5-32B | 73.21 |
| + Self-Consistency | 75.26 (+2.05) |
| + Best-of-N (Med-TIV) | 75.57 (+2.36) |
| + Soft Weighted SC (Med-TIV) | 75.96 (+2.75) |
| + Hard Weighted SC (Med-TIV) | 75.96 (+2.75) |
Q1: Снижает ли Med-TIV обобщать по различным моделям генераторов?
Для оценки обобщающей способности обученного верификатора мы применили Med-TIV для наведения поиска в режиме тестирования по моделям генераторов разных размеров и возможностей. Как показано в таблице 2, при использовании Qwen2.5-7B в качестве генератора Hard-Weighted Self-Consistency обеспечивает относительное улучшение на 23,5% по сравнению с точностью базовой модели при одном сэмпле, что существенно превосходит выигрыш 12,2%, полученный при стандартном Self-Consistency. Примечательно, что доменно-специализированная модель AlphaMed-7B также получает пользу от наведения со стороны верификатора: относительное улучшение составляет 6,5%, что указывает на то, что наш верификатор предоставляет дополнительные возможности верификации сверх доменно-специфической донастройки. Улучшения распространяются и на более крупные модели: Qwen2.5-32B достигает относительного выигрыша 3,8% в ходе поиска в режиме тестирования, демонстрируя, что легковесный верификатор на 8B способен эффективно направлять модели, которые значительно больше его самого. Это обобщение между масштабами указывает на то, что Med-TIV усваивает переносимые паттерны верификации, а не переобучается на специфические характеристики генератора.
Q2: Как различные стратегии поиска на этапе тестирования сравниваются в условиях Med-TIV?
Затем мы систематически сравниваем различные стратегии поиска во время тестирования под руководством верификатора, чтобы определить наиболее эффективный подход к использованию сигналов верификации. Как показано в Таблице 2, Hard-Weighted Self-Consistency стабильно обеспечивает наивысшую точность во всех генераторах, за ней следуют Soft-Weighted Self-Consistency и выбор Best-of-. Для Qwen2.5-7B Hard-Weighted Self-Consistency превосходит Best-of- на 3% абсолютной точности, что указывает на то, что мажоритарное голосование среди верифицированных трасс обеспечивает более надежный выбор ответа, чем просто выбор отдельной трассы с наивысшей уверенностью.
Q3: Можете Med-TIV снизить объем выборочного бюджета, необходимый для достижения уровня современного уровня производительности по сравнению с существующими базовыми методами?
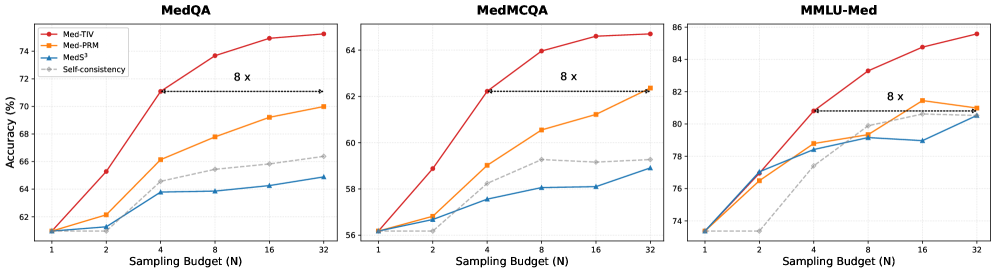
Далее мы исследовали, как качество верификации масштабируется в зависимости от бюджета семплирования, что является критически важным фактором для развертывания при различных вычислительных ограничениях. Как показано на рисунке 3, Med-TIV достигает существенного преимущества в эффективности по сравнению с существующими моделями медицинских вознаграждений на всех трех наборах тестов. В частности, Med-TIV соответствует качеству базовых моделей, используя только 4 семпла, тогда как базовые модели требуют 32 семпла, что соответствует снижению бюджета семплирования. На MedQA Med-TIV достигает точности 72,1% при , тогда как Med-PRM требует полного бюджета, чтобы достичь точности 70,0%. Поскольку стоимость инференса масштабируется приблизительно линейно с числом семплированных трасс, это означает эквивалентное качество при одном восьмом стоимости инференса генератора в практических условиях развертывания.
Q4: Существуют ли Med-TIV обобщать на различные базовые модели?
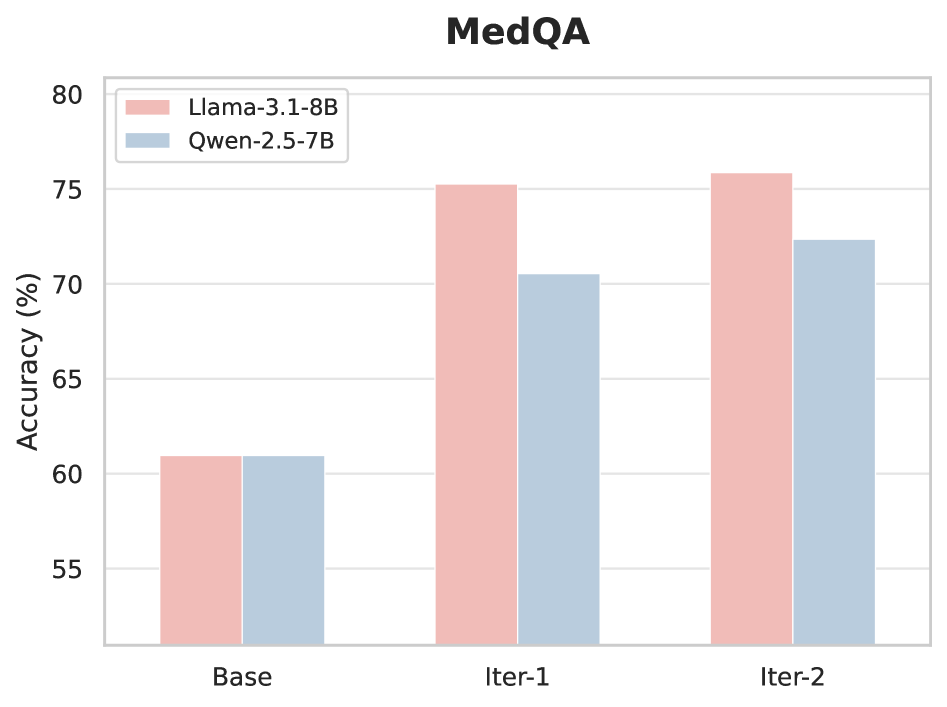
Для оценки обобщающей способности предложенной нами схемы мы сравнили результаты верификации, используя два различных варианта основы верификатора: Llama3.1-8B и Qwen2.5-7B. Как показано на рисунке 4, оба варианта основы демонстрируют высокую производительность после двух итераций обучения. Llama3.1-8B стабильно превосходит Qwen2.5-7B примерно на 3,5% абсолютной точности на MedQA, достигая 75,86% против 72,35% после 2 итераций обучения. Параллельный рост производительности, наблюдаемый у обеих моделей, указывает на то, что Med-TIV не зависит от архитектуры основы.
В5: Каково влияние итеративного обучения?
Рисунок 4 представляет результаты абляции, изучающие влияние итеративного обучения с адаптивным формированием учебной программы. Llama3.1-8B улучшает показатель с 60.96% до 75.26% после первой итерации, с небольшими приростами до 75.86% на второй итерации. Qwen2.5-7B демонстрирует аналогичную тенденцию, достигая 72.35% после двух итераций. Быстрая сходимость предполагает, что основная часть проверочной способности приобретается в первом раунде, а последующие итерации уточняют пограничные случаи.
| Models | MedQA |
|---|---|
| Qwen2.5-7B | 60.96 |
| + Med-TIV (RL) | 69.60 |
| + Med-TIV (RL + Tool) | 70.54 |
| AlphaMed-7B | 71.01 |
| + Med-TIV (RL) | 76.12 |
| + Med-TIV (RL + Tool) | 77.14 |
В6: Как обучение с подкреплением и интеграция инструментов влияют на эффективность верификации?
Таблица 3 демонстрирует двойные преимущества нашей схемы на двух генераторах. Обучение с подкреплением обеспечивает основной выигрыш, повышая точность MedQA для Qwen2.5-7B на 8,64%, подтверждая, что верификатор эффективно усваивает шаблоны рассуждений. Интеграция инструментов дает критический дополнительный прирост, еще больше повышая точность до 70,54%. Аналогичная кумулятивная тенденция наблюдается для AlphaMed-7B. Это показывает, что хотя обучение с подкреплением закрепляет логическую верификацию, динамическое извлечение необходимо для разрешения пограничных случаев, насыщенных знаниями, выходящих за пределы параметрической памяти модели.
5 Смежные работы
Модели медицинского рассуждения.
Применение больших языковых моделей для медицинского рассуждения привлекло значительное внимание. Ранние усилия были сосредоточены на предметно-адаптивном предварительном обучении и донастройке инструкций на медицинских корпусах (Wu et al., 2023; Singhal et al., 2025; Chen et al., 2023). Более поздние работы изучали медицинские модели, усиленные рассуждениями. HuatuoGPT-o1 (Chen et al., 2024) включает рассуждение с цепочкой мыслей и механизмы проверки, а UltraMedical (Zhang et al., 2024) сочетает высококачественные данные инструкций с оптимизацией предпочтений. AlphaMed (Liu et al., 2025a) использует RL для улучшения возможностей медицинского рассуждения. Несмотря на эти достижения, большинство существующих подходов ориентировано на улучшение самой модели-генератора, тогда как наша работа решает дополнительную задачу обучения подключаемого проверяющего модуля plug-and-play, который может улучшать любой замороженный генератор посредством поискового вывода.
Инструментально поддерживаемые модели вознаграждения и модели судьи.
Стандартные решающие LLM обычно работают как пассивные оценщики, ограниченные параметрическими знаниями. В недавних работах это решается за счет агентного моделирования вознаграждения, снабжая проверяющих исполнимыми инструментами. Themis (Li et al., 2024) заложила базовую основу, обеспечив доступ к калькуляторам, поисковым системам и базам знаний через структурированные трассы вызовов инструментов. TIR-Judge (Xu et al., 2025) продвинула эту парадигму в общей предметной области, интегрировав выполнение кода для оценки парных ответов. TIM-PRM (Kuang et al., 2025) ввела независимые запросы к инструментам для многомодальной проверки, чтобы устранить предвзятость подтверждения. Понятие получило дальнейшее развитие в парадигме Agent-as-a-Judge (You et al., 2026), где используются динамическое планирование, дополнение инструментами и координация многоагентных систем для декомпозиции сложных задач оценивания. Наша работа реализует эту агентную парадигму в медицинской области, выходя за рамки статического извлечения к итеративной клинической верификации, опирающейся на доказательства.
6 Заключение
Мы представили Med-TIV, агентную основу для обучения с подкреплением верификации медицинских рассуждений. Наш подход устраняет ключевые ограничения существующих медицинских моделей вознаграждения, предлагая явные трассы критики и обеспечивая динамическое извлечение знаний в ходе верификации. Эмпирические оценки на четырех медицинских бенчмарках для рассуждений демонстрируют, что Med-TIV существенно превосходит предшествующие подходы. В более широком смысле Med-TIV вводит общую парадигму для обучения верификаторов, усиленных инструментами, которую можно расширять на другие области с высокой степенью ответственности, требующие проверки, основанной на доказательствах.
Заявление о вкладе
Данная статья представляет исследование, направленное на повышение надежности больших языковых моделей для задач медицинского рассуждения. Мы полагаем, что наша работа вносит позитивный вклад в развитие заслуживающих доверия медицинских систем ИИ, предоставляя механизмы для проверки корректности рассуждений перед клиническим развертыванием. Med-TIV имеет потенциал повышать безопасность поддержки клинических решений с помощью LLM, снижая ошибочные выходные данные рассуждений за счет систематической верификации. Обосновывая суждения извлеченными медицинскими доказательствами, наш подход обеспечивает улучшенную прозрачность по сравнению с непрозрачными скалярными моделями вознаграждения, позволяя практикующим специалистам лучше понимать и проверять решения о верификации. Продемонстрированные эффекты повышения эффективности Med-TIV могут сделать доступ к надежной верификации медицинских рассуждений более демократичным, обеспечивая возможность надежной верификации даже в условиях ограниченных ресурсов.
Благодарности
Это исследование поддержано грантами Национальных институтов здравоохранения UL1TR001857, U24TR004111, R01LM014588 и R01LM014306. Спонсоры не имели роли в разработке дизайна исследования, сборе данных, анализе, интерпретации, написании отчета или решении о подаче статьи к публикации.
Список литературы
- ⟦HuatuoGPT-o1, к направлению в медицинские сложные рассуждения с llms. Внешние ссылки: 2412.18925, Link Цитируется: 3rd item, §4.1, §5.
- MEDITRON-70b: масштабирование медицинского дообучения для больших языковых моделей. Внешние ссылки: 2311.16079, Link Цитируется: §5.
- ⟦ Стадо моделей Llama 3. Внешние ссылки: 2407.21783, Link Цитируется: 2nd item, §4.1⟧.
- DeepSeek-r1 стимулирует рассуждения в llms посредством обучения с подкреплением. Nature 645 (8081). Внешние ссылки: Document Цитируется: 1st item, §4.1.
- ⟦ Измерение масштабного понимания языка для множества задач. Внешние ссылки: 2009.03300, Link Цитируется: 3rd item, §4.1.
- ⟦ Смягчение риска неравенства в сфере здравоохранения, усугубляемого большими языковыми моделями. npj Digital Medicine 8, pp. 246. Внешние ссылки: Document Цитируется: §1.
- ⟦Оценка смещения и его снижение в системах медицинского вопрос-ответа с поисковым дополнением. Внешние ссылки: 2503.15454, Link Цитируется: §1.
- VerlTool: к целостному агентному обучению с подкреплением с использованием инструментов. Внешние ссылки: 2509.01055, Link Цитируется: §4.1.
- ⟦ MedS3: к медицинскому медленному мышлению с самосформированным процессом двустороннего мягкого надзора. Внешние ссылки: 2501.12051, Link Цитируется: 1st item, §1, §4.1.
- Search-r1: обучение LLM рассуждать и использовать поисковые системы с помощью обучения с подкреплением. Внешние ссылки: 2503.09516, Link Цитируется: §2.2, §3.1.
- ⟦ Какое заболевание есть у этого пациента? крупномасштабный набор данных для вопросно-ответной задачи открытого домена по результатам медицинских обследований. Внешние ссылки: 2009.13081, Link Цитируется: 1st item, §4.1.
- MedCPT: контрастивные предварительно обученные transformers с крупномасштабными журналами поиска PubMed для извлечения биомедицинской информации в режиме zero-shot. Bioinformatics 39 (11). Внешние ссылки: ISSN 1367-4811, Link, Document Цитируется: §B.2.
- ⟦ Искусство масштабирования вычислений для обучения с подкреплением для LLM. Внешние ссылки: 2510.13786, Link Цитируется: §3.2.
- ⟦ TIM-prm: проверка мультимодального рассуждения с помощью prm, интегрированного с инструментами. Внешние ссылки: 2511.22998, Link Цитируется: §5⟧.
- Создание научных статей по машинному обучению. В материалах 17-й Международной конференции по машинному обучению (ICML 2000), P. Langley (ред.), Stanford, CA, стр. 1207–1216. Цитируется: Appendix D.
- ⟦ Моделирование награды с использованием инструментов. Внешние ссылки: 2310.01045, Link Цитируется: §5.
- ⟦ Помимо дистилляции: расширение пределов рассуждений медицинских LLM с минималистичными правилами на основе rl. Внешние ссылки: 2505.17952, Link Цитируется: 1st item, §4.1, §5.
- ⟦ Понимание обучения, похожего на r1-zero: критическая перспектива. Внешние ссылки: 2503.20783, Link Цитируется: §3.1.
- ⟦ Масштабирование на этапе вывода для обобщенного моделирования вознаграждения. Внешние ссылки: 2504.02495, Link Цитируется: §1.
- GPT-4o system card. Внешние ссылки: 2410.21276, Link Цитируется: 1st item, §4.1.
- ⟦MedMCQA : набор данных большого масштаба для медицинской области вопросного ответа, включающий множество предметов и вариантов ответов. Внешние ссылки: 2203.14371, Link Цитируется: 2nd item, §4.1⟧.
- MedAdapter: эффективная адаптация больших языковых моделей к медицинскому рассуждению во время тестирования. Внешние ссылки: 2405.03000, Link Цитируется: §2.3.
- ⟦ К экспертному уровню медицинских ответов на вопросы с помощью больших языковых моделей. Nature Medicine 31, стр. 943–950. Внешние ссылки: Document Цитируется: §5.
- ⟦ Масштабирование llm тестового вычисления оптимальным образом может быть более эффективным, чем масштабирование параметров модели. Внешние ссылки: 2408.03314, Link Цитируется: §1.
- ⟦Цифровые голоса выживания: от раскрытий в социальных сетях до мер поддержки для пострадавших от домашнего насилия. препринт arXiv arXiv:2509.12288. Цитируется: §1.
- PMC-llama: towards building open-source language models for medicine. Внешние ссылки: 2304.14454, Link Цитируется: §5.
- ⟦ Параллелизм сочетается с адаптивностью: масштабируемое понимание документов в многоагентных системах LLM. Внешние ссылки: 2507.17061, Link Цитируется: §1.
- ⟦Newton downhill optimizer с применением к задачам инженерной оптимизации и выбору признаков при раке молочной железы. Biomedical Signal Processing and Control 117, стр. 109184. Внешние ссылки: ISSN 1746-8094, Document, Link Цитируется: §1.
- ⟦ StepWiser: пошаговые генеративные оценщики для более разумного рассуждения. Внешние ссылки: 2508.19229, Link Цитируется: §1.
- ⟦ Стимулирование агентного рассуждения в LLM-судьях посредством обучения с подкреплением, интегрированного с инструментами. Внешние ссылки: 2510.23038, Link Цитируется: §3.2, §5.
- Отчет по техническим вопросам Qwen2.5. Внешние ссылки: 2412.15115 Цитируется: 1st item, §4.1.
- ⟦ Агент в роли судьи. Внешние ссылки: 2601.05111, Link Цитируется: §5.
- Med-prm: модели медицинского рассуждения с поэтапными, проверяемыми по руководствам процессами и вознаграждениями. Внешние ссылки: 2506.11474, Link Цитируется: 2nd item, §1, §4.1.
- ⟦ К безопасным ИИ-клиницистам: всестороннее исследование взломов больших языковых моделей в здравоохранении. Внешние ссылки: 2501.18632, Link Цитируется: §1.
- ⟦ UltraMedical: создание специализированных универсалов в биомедицине. Ссылки: 2406.03949, Link Цитируется: 2nd item, §4.1, §5.
- ⟦ MedRAG: повышение качества генерации с дополнением извлечением с опорой на рассуждения, извлеченные из графа знаний, для медицинского помощника. Внешние ссылки: 2502.04413, Link Цитируется: §B.2.
- MedXpertQA: тестирование эталонных навыков медицинского рассуждения и понимания. Внешние ссылки: 2501.18362, Link Цитируется: 4th item, §4.1.
Appendix A Ограничение
Хотя Med-TIV демонстрирует существенные улучшения по сравнению с существующими подходами к проверке медицинских рассуждений, некоторые ограничения требуют обсуждения и указывают направления для будущих исследований.
Процессный контроль.
Нынешняя парадигма обучения опирается исключительно на вознаграждения на уровне исходов трассировки, не обеспечивая надзора за промежуточными моделируемыми действиями проверки, такими как когда выполнять поиск, какие запросы формулировать или как интегрировать извлеченные свидетельства. Хотя такая конструкция устраняет необходимость в дорогостоящих аннотациях шагового уровня, она может приводить к неоптимальным шаблонам поиска или избыточным операциям извлечения. В будущих работах можно исследовать надзор именно для задачи проверки или использовать такие техники, как search behavior cloning из более сильных моделей, чтобы обеспечить более плотные сигналы оптимизации.
Покрытие корпуса поиска.
Точность верификации Med-TIV по своей природе ограничена полнотой и качеством исходного медицинского корпуса. Наша система поиска индексирует документы из аннотаций PubMed и медицинских учебников, что обеспечивает широкое покрытие общепринятых медицинских знаний, но может не включать самые новые результаты, сведения о редких заболеваниях или клинические рекомендации, специфичные для конкретных регионов. Верификация цепочек рассуждений, связанных с передовыми методами лечения или узкоспециализированными подспециальностями, может быть ограничена пробелами в корпусе.
Язык и область применения.
Все обучение и оценка проводятся на медицинских бенчмарках рассуждений на английском языке. Общая способность Med-TIV к обобщению на многоязычный медицинский контент или на немедицинские традиции, относящиеся к незападным медицинским практикам, остается неизученной. Кроме того, хотя наши бенчмарки охватывают несколько медицинских поддоменов, некоторые специализированные области, такие как геномика, интерпретация радиологии и планирование хирургических вмешательств, могут требовать специализированных корпусов извлечения, адаптированных под домен, для оптимальной проверочной производительности.
Appendix B Дополнительные детали реализации
B.1 Настройки гиперпараметров
Таблица 4 предоставляет всесторонние конфигурации гиперпараметров для обучения Med-TIV в обеих итерациях. Мы сохраняем в основном согласованные настройки между итерациями, чтобы изолировать влияние итерационного обучения от настройки гиперпараметров.
| Hyperparameters | Iteration 1 | Iteration 2 |
|---|---|---|
| RL Algorithm | Dr.GRPO | Dr.GRPO |
| Clip ratio (low / high) | 0.2 / 0.3 | 0.2 / 0.3 |
| Learning rate | 1e-6 | 1e-6 |
| Warmup steps | 10 | 10 |
| Training epochs | 5 | 5 |
| Global batch size | 256 | 256 |
| Mini-batch size | 256 | 256 |
| Group size () | 5 | 8 |
| Rollout sampling temperature | 1.0 | 1.0 |
| Rollout top-p | 0.95 | 0.95 |
| Curriculum filtering | Enabled | Enabled |
B.2 Настройка извлечения
Мы строим нашу инфраструктуру поиска на базе плотной поисковой архитектуры, оптимизированной для медицинских запросов. Корпус получен из коллекции MedRAG (Zhao et al., 2025), в частности путем объединения подкорпусов PubMed и Textbooks в единый индекс. Подмножество PubMed содержит приблизительно 23,9 миллиона биомедицинских рефератов, охватывающих публикации по исследованиям, тогда как подмножество Textbooks включает содержимое стандартных медицинских учебников, охватывающих клиническую медицину, фармакологию, патологию и связанные дисциплины. После дедупликации и фильтрации по качеству объединенный корпус содержит приблизительно 24 миллиона фрагментов.
Мы используем MedCPT (Jin et al., 2023) в качестве нашего плотного кодировщика для извлечения, в частности вариант кодировщика запросов для кодирования поисковых запросов и вариант кодировщика статей для кодирования фрагментов корпуса. Встраивания документов предварительно вычисляются и сохраняются в индексе FAISS с использованием конфигурации Flat для максимальной точности извлечения, при этом распределяются по нескольким GPU с использованием возможности распределения (шардирования) GPU в FAISS, чтобы обеспечить параллельный поиск по сходству. Для каждого поискового запроса мы извлекаем по три наиболее релевантных документа как для обучения, так и для инференса.
B.3 Базовая настройка
Мы описываем конфигурацию базовых моделей оценки вознаграждения, используемых в наших экспериментах. Для Med-PRM, в которой применяется статическая генерация с дополнением извлечением, мы оснащаем ее тем же корпусом для извлечения, энкодером и настройкой top-k, что и наша методика, чтобы обеспечить контролируемое сравнение. MedS3 не поддерживает вызов внешних инструментов, и поэтому оценивается без дополнения извлечением. Для извлечения оценок уверенности и задания гиперпараметров вывода мы следуем конфигурациям, указанным в исходной публикации каждого из базовых вариантов.
B.4 Шаблон запроса
Мы разрабатываем структурированный шаблон подсказки, который направляет верификатор к систематическому рассуждению с явным синтаксисом вызова инструментов. Полный текст подсказки показан в Таблице 5.
Appendix C Бенчмарки и базовые подходы
C.1 Бенчмарки
Мы оцениваем Med-TIV на четырех установленных бенчмарках медицинского рассуждения, которые в совокупности оценивают способность к верификации на уровнях сложности и в медицинских поддоменах..
- ⟦• MedQA (Jin et al., 2020): набор данных с вопросами с выбором одного варианта ответа, полученными из United States Medical Licensing Examination (USMLE), разработанный для оценки клинического мышления и интеграции медицинских знаний в различных специальностях.
- • MedMCQA (Pal et al., 2022): Крупномасштабный многопредметный эталон, полученный из индийских вступительных экзаменов по медицине (AIIMS и NEET-PG), охватывающий 21 медицинскую дисциплину с акцентом на фактические знания и клиническое применение.
- ⟦MMLU-Med (Hendrycks et al., 2021): Агрегация подмножеств, связанных с медициной, из бенчмарка Massive Multitask Language Understanding, включающая анатомию, клинические знания, college biology, college medicine, medical genetics и профессиональную медицину.
- ⟦MedXpertQA (Zuo et al., 2025): Бенчмарк экспертного уровня с трудными вопросами, которые требуют многошагового клинического рассуждения, дифференциальной диагностики и планирования лечения на уровне, ожидаемом от практикующих врачей.
C.2 Базовые подходы
Мы сравниваем Med-TIV с полными базовыми методами, охватывающими проприетарные системы, модели общего назначения и подходы, специализированные для конкретной области.
Собственные модели.
- • GPT-4o-mini (OpenAI and others, 2024): Компактный вариант GPT-4o от OpenAI, оптимизированный для эффективности при сохранении сильных способностей к рассуждению в рамках разнообразных задач.
- ⟦• Gemini-2.0-Flash: эффективная мультимодальная модель Google, предназначенная для быстрого вывода с конкурентоспособной производительностью на задачах, ориентированных на знания, в сравнительных тестах.
Обобщающие модели рассуждений.
- ⟦DeepSeek-R1 (Guo and others, 2025): модель рассуждений с 671B параметрами, обученная с помощью RL, представляющая текущий уровень передовых возможностей открыто-весового рассуждения.
- ⟦• R1-Distill-Qwen / R1-Distill-Llama: дистиллированные варианты DeepSeek-R1 в масштабах 7B и 8B соответственно, предназначенные для переноса способностей рассуждения на более компактные архитектуры.
Общие фундаментальные модели.
- ⟦Qwen2.5 (Yang and others, 2025): семейство открытых по весам языковых моделей с сильными многолингвальными и рассуждательными возможностями, оценённое на масштабах 7B и 32B параметров.
- ⟦Llama3.1 (Grattafiori and others, 2024): базовая модель с открытым исходным кодом Meta, демонстрирующая конкурентоспособную производительность на разнообразных наборах показателей, оцененная в масштабе 8B.
Медицинские доменные модели.
- ⟦AlphaMed (Liu et al., 2025a): Модель медицинского рассуждения, которая использует RL с вознаграждениями на основе правил для улучшения клинического рассуждения без опоры на дистилляцию от более крупных моделей.
- ⟦• UltraMedical (Zhang et al., 2024): специализированная медицинская модель, объединяющая высококачественную настройку по инструкциям на подобранных биомедицинских корпусах с оптимизацией предпочтений для повышения клинической точности.
- ⟦• HuatuoGPT-o1 (Chen et al., 2024): Модель медицинских рассуждений, включающая рассуждения в стиле chain-of-thought с механизмами внутренней верификации для повышения точности диагностики.
Медицинские модели вознаграждения.
- • MedS3 (Jiang et al., 2025b): Самоэволюционируемая структура надзора за обучением с мягким двойным двусторонним процессом для медицинского рассуждения, которая генерирует обучающие сигналы посредством итеративного самоулучшения без внешних аннотаций.
- ⟦Med-PRM (Yun et al., 2025): Модель вознаграждения процесса для проверки медицинских рассуждений, обеспечивающая пошаговый контроль на уровне этапов с использованием статической генерации с извлечением, дополненной руководящими проверками.
Appendix D Разбор кейса
Таблица 6 представляет полный пример верификации, иллюстрирующий, как обученный Med-TIV верификатор выявляет ошибки рассуждений посредством динамического извлечения доказательств. Случай касается пациента с раком мочевого пузыря, у которого после химиотерапии развивается ототоксичность. Трассировка рассуждений генератора ошибочно приписывает симптомы таксанам на основании их известной связи с ототоксичностью, завершаясь ответом (B). Однако модель извлекает доказательства, устанавливающие, что цисплатин — стандартная неоадъювантная терапия при переходноклеточном раке — является причинным агентом, и его механизм связан со сшивками ДНК, а не с гиперстабилизацией микротрубочек. Посредством итеративного поиска и рассуждений верификатор корректно выявляет ошибку, демонстрируя ценность расширения инструментами для обнаружения тонких медицинских ошибок в логике.