Получено 10 декабря 2025 года, принято 31 декабря 2025 года, дата публикации 5 января 2026 года, дата текущей версии 9 января 2026 года. 10.1109/ACCESS.2026.3651218
Соответствующий автор: Aditi Singh (e-mail: a.singh22@csuohio.edu).
Агентный ИИ в здравоохранении и медицине: семимерное таксономическое описание для эмпирической оценки агентов на основе LLM
Аннотация
Агенты на базе Больших языковых моделей (LLM), которые планируют, используют инструменты и действуют, начали формировать здравоохранение и медицину. Сообщаемые исследования демонстрируют компетентность в различных задачах: от анализа EHR и дифференциальной диагностики до планирования лечения и исследовательских рабочих процессов. Тем не менее литература в значительной степени состоит из обзоров, которые либо являются широкими обзорами, либо узкими погружениями в одну-единственную способность (например, память, планирование, рассуждение), оставляя работу в здравоохранении без общего каркаса. Мы устраняем этот пробел, рассматривая 49 исследований с помощью семи-мерной таксономии: Когнитивные возможности, Управление знаниями, Шаблоны взаимодействия, Адаптация и обучение, Безопасность и этика, Типология фреймворка и Основные задачи и подзадачи с 29 операционными субизмерениями. Используя явные критерии включения и исключения и рубрику маркировки (Полностью реализовано ✓, Частично реализовано , Не реализовано ✗), мы сопоставляем каждое исследование с таксономией и приводим количественные сводки распространенности возможностей и паттернов совместной встречаемости. Наша эмпирическая аналитика выявляет четкие асимметрии. Например, субизмерение Интеграция внешних знаний в рамках Управления знаниями обычно реализуется (76% ✓), тогда как Событийно-инициируемая активация в рамках Шаблонов взаимодействия в основном отсутствует (92% ✗), а субизмерение Обнаружение дрейфа и смягчение в рамках Адаптации и обучения встречается редко (98% ✗). Архитектурно субизмерение Мультиагентный дизайн в рамках Типологии фреймворка является доминирующим паттерном (82% ✓), в то время как слои оркестрации остаются в основном частичными. В рамках Основных задач и подзадач лидируют информационно-ориентированные возможности, например Медицинский вопрос-ответ и поддержка принятия решений, а также Бенчмаркинг и симуляция, тогда как области, ориентированные на действия и открытие, такие как Планирование лечения и Назначение, по-прежнему демонстрируют существенные пробелы (59% ✗). В совокупности эти результаты обеспечивают эмпирическую базовую оценку, указывающую, что текущие агенты преуспевают в консультировании, опирающемся на извлеченные данные, но им требуются более сильные платформы адаптации и соответствия требованиям, чтобы перейти от систем раннего этапа к надежным системам.
Ключевые слова:
Агентный ИИ, здравоохранение, медицина, проектирование запросов, большая языковая модель, многoагентные системы, таксономия, обзор, эмпирический анализ, клиническое исследование, взаимодействие с пациентом, диагностическое рассуждение=-15pt
I Введение
Появление LLM существенно ускорило достижения в нескольких областях, продемонстрировав преобразующий потенциал далеко за пределами традиционных применений. Эти модели, включая GPT-4 [achiam2023gpt] и PaLM [chowdhery2023palm], обучаются на обширных наборах данных, включающих миллиарды или даже триллионы параметров, что позволяет выполнять широкую обобщаемость и демонстрирует сложное понимание. Эмпирические исследования показали, что увеличение масштаба модели напрямую связано с повышением производительности в задачах сложного рассуждения, многошагового принятия решений и интерактивного планирования [wei2022chain]. Усиленные когнитивные возможности современных LLM быстро привели к их внедрению в критически важные сферы, такие как здравоохранение [yang2023large], медицина [thirunavukarasu2023large], финансы [li2023large] для оценки рисков и инвестиционных стратегий, а также образование [yan2024practical] для персонализированного обучения и учебной поддержки. Недавние исследования дополнительно развили этот подход, сделав акцент на prompt engineering, технике, включающей точную манипуляцию входными данными на естественном языке, чтобы извлекать и усиливать целенаправленные рассуждения LLM [schulhoff2024prompt, gu2023systematic, sahoo2024systematic, vatsal2024survey, vatsal2025multilingual]. Этот сдвиг подчеркивает критически важное развитие в исследованиях LLM, отражающее переход от предиктивного моделирования к сложным контекстно-зависимым когнитивным взаимодействиям. Кроме того, появление агентов на основе LLM ознаменовало еще одну значимую веху, обеспечив автономное принятие решений и интерактивное выполнение задач в различных областях применения [xi2025rise].
В здравоохранении и медицине LLM демонстрируют значительный потенциал в оптимизации клинических рабочих процессов, повышении точности диагностики и поддержке клинических исследований. Например, в недавних исследованиях использовались LLM для автоматизации клинической документации, что существенно снижало нагрузку на врачей и повышало качество клинических записей [leong2024efficient, baker2024chatgpt]. Аналогично, основанные на LLM системы поддержки принятия решений применялись для медицинского вопросно-ответного поиска, достигая экспертного уровня при интерпретации сложной медицинской литературы и клинических руководств [singhal2023large]. Дополняя эти достижения, LLM демонстрируют результаты на уровне современных достижений в задачах биомедицинского машинного чтения для понимания текста [vatsal2024can] и показывают измеримые улучшения в вопросно-ответных задачах по предварительному согласованию, основанных на руководствах, на зашумленных реальных записях [vatsal2024canprior]. Интеграция многомодальных возможностей в LLM, позволяющая интерпретировать радиологические снимки и клинические изображения, дополнительно повысила диагностическую эффективность, как это видно в таких фреймворках, как ChatCAD [wang2024interactive]. Помимо диагностики, LLM изучались для улучшения планирования лечения и поддержки медицины, основанной на доказательствах, путем синтеза огромных массивов медицинских исследований и клинических руководств [nori2023capabilities]. В разработке лекарств LLM ускоряют выявление новых кандидатов в лекарственные препараты и упрощают проектирование клинических испытаний, что существенно помогло сократить и время, и затраты [chakraborty2023artificial]. Взаимодействие с пациентами и клиническая коммуникация также получили пользу от LLM-ориентированных диалоговых агентов, тем самым улучшая соблюдение планов лечения, облегчая телемедицину и позволяя удаленный мониторинг состояния пациентов [subramanian2024enhancing]. Хотя эти достижения демонстрируют существенное влияние, они также подчеркивают необходимость непрерывной оценки LLM в здравоохранении, чтобы поддерживать высокие стандарты надежности и интерпретируемости.
Недавно разработка агентов на основе LLM, которые часто описывают под более широким зонтичным термином Agentic AI, представляет собой возникающую парадигму, использующую расширенные когнитивные возможности LLM. Эти агенты объединяют несколько когнитивных модулей, включая рассуждение, планирование и управление памятью, что позволяет им выполнять сложное решение задач и контекстно-зависимые взаимодействия в различных областях. Недавние исследования, такие как подсказки Chain-of-Thought [wei2022chain] и рассуждения Tree-of-Thoughts [yao2023tree], подчеркнули важность модульных когнитивных архитектур, которые помогают в эффективном выполнении сложных многошаговых задач рассуждения в пространстве проектирования Agentic AI. Кроме того, архитектуры с усиленной памятью, включающие эпизодическую и семантическую системы памяти, еще больше расширили возможности агентов поддерживать непрерывность между взаимодействиями, повышая как точность выполнения задач, так и надежность. Адаптивные механизмы обучения, включая обучение с подкреплением на основе обратной связи от человека (RLHF), позволяют этим агентам итеративно уточнять свое поведение, интегрируя ввод пользователя и сигналы среды, что приводит к динамической адаптации и согласованию с изменяющимися целями пользователей. По мере развития ландшафта агентов на основе LLM их влияние на принятие решений становится очевидным в здравоохранении, финансах, праве и образовании. Эта эволюция меняет практики отраслей, позволяя более интеллектуальные, адаптивные, контекстно-зависимые системы, которые переопределяют то, как задачи автоматизируются и как принимаются решения.
Опираясь на эти фундаментальные достижения, агентные системы на базе LLM стали ключевой инновацией в здравоохранении и медицине. Эти агенты объединяют расширенные механизмы рассуждений и планирования, которые помогают в выполнении сложных задач, таких как дифференциальная диагностика и мониторинг состояния пациентов в реальном времени. Исследования показали их полезность в автоматизации критически важных рабочих процессов, включая сортировку пациентов [lu2024triageagent], интерпретацию лабораторных результатов и управление EHR [wang2025colacare]. Как агентные системы, основанные на LLM, такие агенты демонстрируют перспективы в усилении клинического принятия решений посредством интерактивных диалогов, которые способствуют сотрудничеству между медицинскими специалистами и системами ИИ. Эти агенты также облегчают непрерывное медицинское образование, обеспечивая доступ в реальном времени к обновленным клиническим знаниям, лучшим практикам и рекомендациям на основе доказательств. В специализированных областях, таких как онкология, кардиология и хирургия, агентные системы на базе LLM применяются для поддержки сложных оценок риска и оптимизации лечения [zhou2024zodiac, li2024potential]. По мере углубления их интеграции в здравоохранении агентные системы на базе LLM, управляемые ИИ, могут помочь не только в оптимизации поддержки принятия решений, но и в обеспечении более целостных маршрутов ведения пациентов.
I-A Фокус нашего обзора
Растущий интерес к агентам на базе LLM побудил изучение потенциальных применений в здравоохранении и медицине. Однако в данной области отсутствует структурированная основа для оценки их многогранных возможностей и дизайнов систем. Существующие исследования часто рассматривают отдельные приложения или архитектуры агентов по отдельности, что ограничивает всестороннее понимание их операционного охвата и измерений производительности. В этом обзоре мы устраняем этот пробел, проводя масштабную оценку 49 научных работ об агентах на базе LLM, развернутых в здравоохранении и медицине. Мы предлагаем интегрированную таксономию, охватывающую 7 ключевых измерений и 29 подизмерений, систематически характеризуя этих агентов по Cognitive Capabilities, Knowledge Management, Interaction Patterns, Adaptation & Learning, Safety & Ethics, Framework Typology и Core Tasks & Subtasks. Наш обзор не только определяет и контекстуализирует каждое измерение, но и сопоставляет выбранные исследования с этой таксономией, что позволяет выполнять крупномасштабный количественный анализ преобладающих методологий. Для содействия синтезу мы включаем диаграмму таксономии, визуализирующую, как 49 исследований распределяются по 7 измерениям и 29 подизмерениям. Мы также извлекаем более широкие выводы, которые проясняют, как различные измерения и подизмерения проявляются на практике. Эти выводы помогают нам делать акцент на разнообразных возможностях агентов, предметно-ориентированных методологиях и различающихся подходах к реализации в здравоохранении и медицине. Этот масштабный анализ предоставляет структурированную основу для разработки надежных, корректных и этичных Agentic AI-driven LLM агентов в здравоохранении.
Поскольку несколько существующих обзоров [guo2024large, ferrag2025llm, dong2024survey, li2024survey, plaat2025agentic, zhao2023depth] предлагают общие обзоры агентов на базе LLM, они, как правило, подчеркивают универсальные возможности, не углубляясь в приложения, специфичные для здравоохранения и медицины. [wang2025survey] вводит релевантные обсуждения об агентах на базе LLM в медицине, но обеспечивает ограниченное изучение, охватывая примерно 25 работ. В отличие от этого, наш обзор существенно расширяет охват, анализируя 49 исследований, чтобы зафиксировать более широкий спектр тенденций и достижений в области здравоохранения и медицины. Аналогичным образом, обзоры, такие как [yu2025survey, zhang2404survey, li2025review, huang2024understanding, yehudai2025survey], рассматривают отдельные возможности, например память, планирование и рассуждение, в изоляции. Однако эти фрагментарные перспективы не позволяют сформировать единый многомерный подход. Наша работа восполняет этот пробел, выполняя комплексную оценку по 7 ключевым измерениям и 29 подизмерениям. Эта оценка обеспечивает согласованное понимание, которое соответствует уникальным задачам здравоохранения и медицины.
На протяжении этого обзора мы сосредоточиваемся на определенном фрагменте агентного ИИ: системах, построенных вокруг LLM, который управляет планированием и принятием решений агента, и которые могут использовать инструменты, поддерживать память или выполнять действия. Мы не рассматриваем агентов, которые полагаются исключительно на символьное рассуждение, вручную созданные правила или архитектуры, где LLM не является основным контролирующим компонентом. Гибридные или мультимодальные схемы включаются только тогда, когда LLM явно является компонентом, координирующим поведение агента.
I-B Процесс поиска литературы
Мы применили структурированный трехэтапный процесс фильтрации, чтобы отобрать исследовательские статьи, рассмотренные в этом обзоре.
Шаг 1: Мы использовали несколько источников, таких как Google Scholar, PubMed, DBLP, Scopus и ArXiv, чтобы провести всесторонний поиск. Некоторые из поисковых запросов, которые мы использовали, включали LLM-based Agents in Healthcare, LLM-based Agents in Medicine, Using LLM-based Agents for Healthcare Tasks, LLM-based Agents for Electronic Health Record Management, LLM-based Agents for Drug Discovery, LLM-based Agents for Clinical Documentation, Using LLM-based Agents for Clinical Summarization and LLM-based Agents in the Medical Domain. Это помогло нам собрать первоначальный пул исследовательских статей, посвященных LLM-based agents в здравоохранении и медицине. Первоначальный поиск дал 137 статей после предварительной ручной фильтрации для исключения нерелевантных работ. Предварительный ручной отбор исключил работы по причинам, таким как: (i) дублирующие публикации одной и той же работы в ArXiv и материалах конференций (ii) короткие материалы докладов семинаров или расширенные аннотации, не содержащие реализованной системы (iii) статьи, чьи вклады были сосредоточены исключительно на создании датасетов, а не на поведении агента (iv) неполные рукописи, включая постеры, страницы проектов или ранние стадии preprints без технических деталей. Группа из 3 рецензентов независимо отобрала первоначальный пул статей. Каждая статья была рассмотрена как минимум 2 рецензентами, а разногласия были разрешены на совместных встречах путем консенсуса. Этот процесс помог сохранить согласованность и минимизировать индивидуальный рецензентский уклон при решениях о включении/исключении.
Шаг 2: Мы применили два строгих критерия отбора, чтобы дополнительно сузить корпус. Во-первых, мы включали только те исследования, в которых LLM является ключевым компонентом дизайна агента, согласующимся с нашим фокусом на LLM-агентах. Во-вторых, мы сохраняли статьи, которые явно рассматривают задачи в здравоохранении или медицине, при этом исключая исследования, в основе которых преимущественно лежат другие области. Поскольку здравоохранение и медицина иногда пересекаются с близкородственными областями, такими как biomedicine, мы оценивали такие пересечения в каждом конкретном случае. Если основной вклад статьи был в основном согласован со здравоохранением или медициной даже при наличии междисциплинарных элементов, мы включали её в наш обзор.
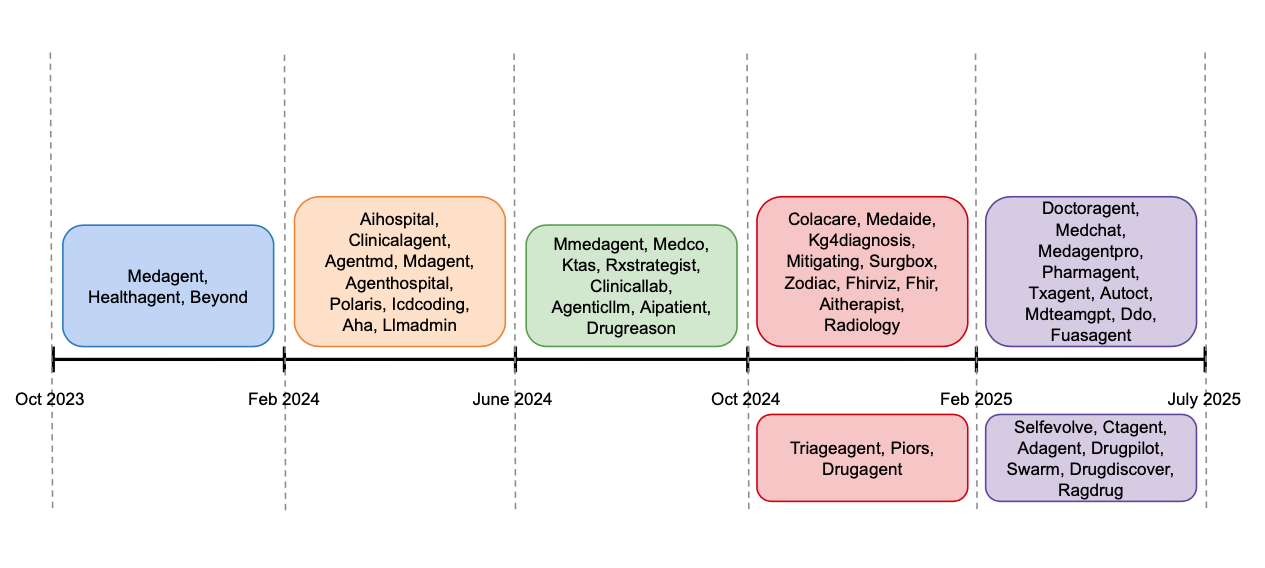
Шаг 3: затем мы ограничили корпус статьями, опубликованными в период с октября 2023 по июнь 2025 года. На рисунке 1 показана временная шкала всех включенных работ. Комбинация шагов 2 и 3 дала нам отобранный набор из 49 научных статей, которые лежат в основе нашей оценочной структуры.
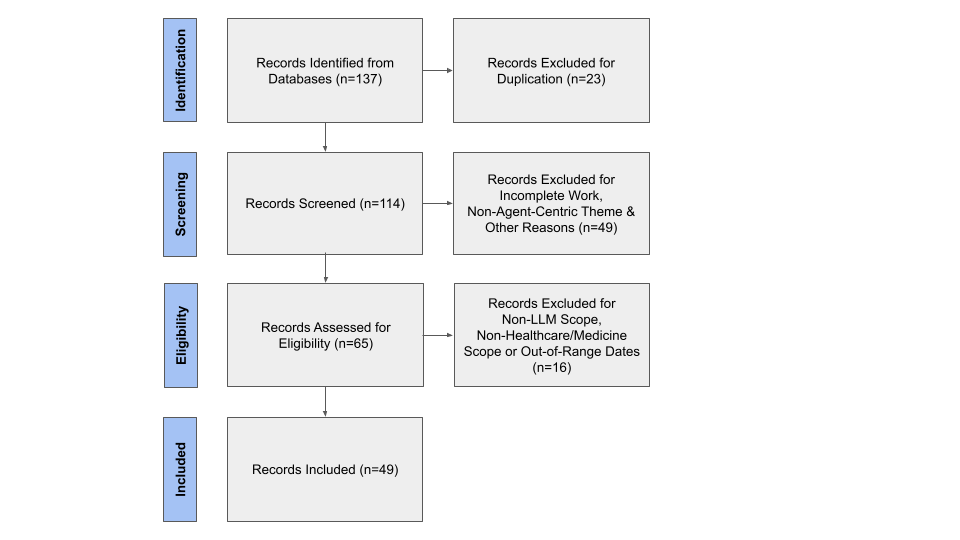
Чтобы кратко обобщить всю цепочку, мы также включаем диаграмму в стиле PRISMA на рисунке 2, в которой показаны идентификация, скрининг, оценка соответствия критериям и окончательное включение 49 исследований в этот обзор.
I-C План
Оставшаяся часть статьи структурирована следующим образом. Раздел 2 представляет 7 ключевых измерений и 29 подизмерений, которые составляют основу нашей оценочной системы, приводя подробные определения и мотивации для каждого. В Разделе 3 мы представляем ключевые выводы, полученные в ходе анализа, включая такие закономерности, как наиболее часто используемые подизмерения в здравоохранении и медицине, методологические тенденции и доминирующие архитектурные решения. Наконец, Раздел 4 завершает статью, суммируя наши вклад.
II Измерения оценки
В этом разделе представлены 7 измерений оценивания и 29 подизмерений, которые структурируют наш анализ 49 исследований. Эти измерения получены с помощью смешанной методологии, сочетающей индуктивное извлечение, структурированный синтез и сопоставление с предшествующими frameworks. Мы начали с выполнения открытого кодирования всех 49 работ, выявив повторяющиеся механизмы, связанные с планированием, памятью, взаимодействием, обучением, безопасностью и структурой системы. Затем эти коды итеративно группируются в более высокоуровневые конструкты посредством постоянного сравнения, пока не появятся устойчивые темы. Параллельно мы обращались к существующим обзорам по LLM-based agents, агентным архитектурам и оцениванию healthcare-AI, чтобы обеспечить концептуальную преемственность, избегая при этом прямого копирования. Измерения сохраняются только когда: (i) они встречаются в нескольких независимых работах (ii) они описывают операционные модели поведения, которые можно последовательно оценивать (iii) они не охвачены более широкой конструкцией. Подизмерения определяются заранее только тогда, когда в литературе уже использован хорошо установленный термин (например, planning, knowledge integration). Все оставшиеся подизмерения индуктивно извлекаются из эмпирических паттернов реализации в корпусе из 49 работ. Этот комбинированный процесс гарантирует, что таксономия одновременно опирается на литературу и допускает эмпирическую воспроизводимость.
Мы подчеркиваем, что эти определения практичны и предназначены для согласованного оценивания в разных статьях. Они не предназначены быть исчерпывающими. Медицинские агенты на базе LLM быстро развиваются, и поэтому исследователи могут по-разному проводить эти границы. Наша цель — операциональная ясность и сопоставимость между исследованиями, а не полнота. Каждое измерение допускает несколько корректных прочтений, и некоторые возможности могут относиться более чем к одному разделу в зависимости от проектирования системы и представленных доказательств. По той же причине категориальные метки, которые мы применяем: Fully Implemented ✓, Partially Implemented и Not Implemented ✗, следует рассматривать как средства принятия решений, а не как жесткие пороги. Они не являются строго взаимоисключающими. Системы часто пересекают границы, и обоснованное наложение может возникать между ✓ и или между и ✗ в зависимости от контекста развертывания и гранулярности доказательств. Чтобы последовательно обрабатывать эти «серые зоны», мы предпочитаем консервативное присвоение, основанное на поддающихся проверке описаниях. Мы по умолчанию присваиваем там, где утверждения являются неявными, то есть основаны только на абляциях или продемонстрированы исключительно в симуляции. Мы используем ✗, когда утверждается наличие механизма без конкретной процедуры или оценивания. Мы присваиваем ✓, когда возможность реализована «от начала до конца» с явными процедурами и демонстрациями. Несмотря на присущую интерпретационную вариативность, наша цель — сопоставимость. Поэтому мы стандартизируем терминологию в разных статьях, применяем общие правила принятия решений в рамках каждого подизмерения и фиксируем краткие обоснования, объясняющие, как доказательства соответствуют меткам. Это обеспечивает единообразное прочтение разнородных конструкций, охватывающих клинические задачи и различные типы данных, оставляя при этом место для нюансов и эволюции. Таксономия и метки в этом исследовании должны рассматриваться как прозрачная базовая основа для обобщения между исследованиями, а не как предписывающие суждения. Последующие разделы описывают рубрики, которые мы использовали, чтобы другие могли воспроизводить, уточнять или оспаривать конкретные присвоения по мере созревания области.
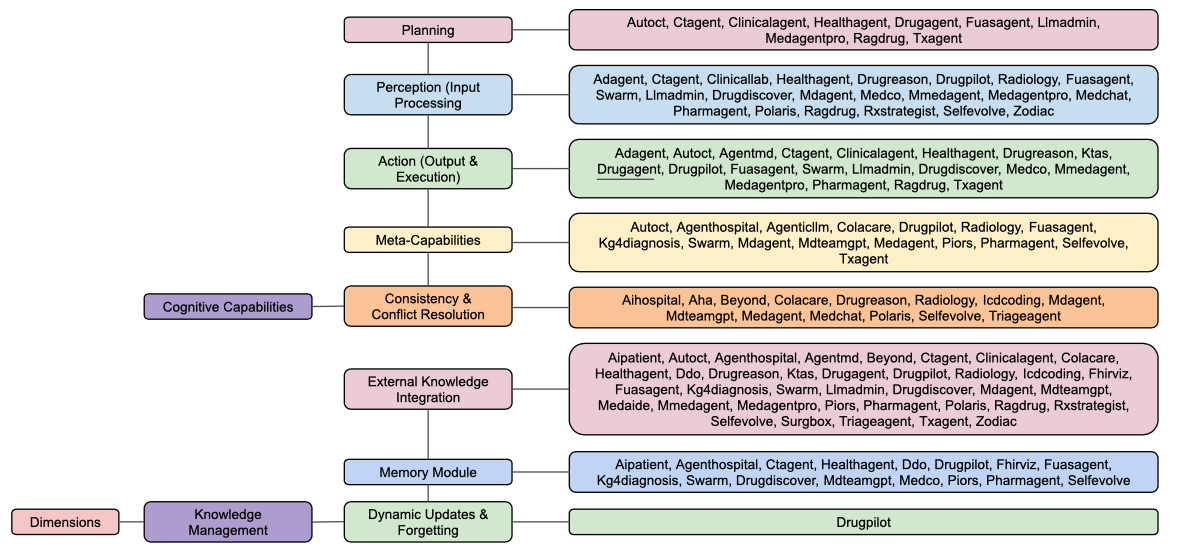
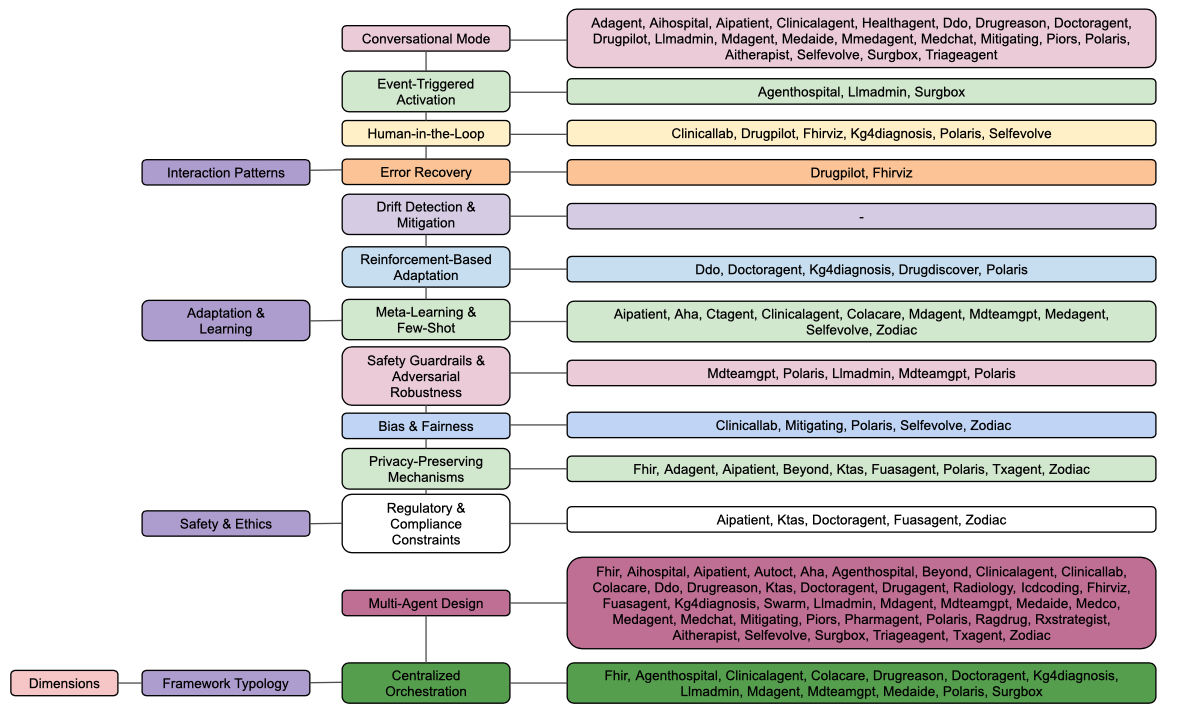
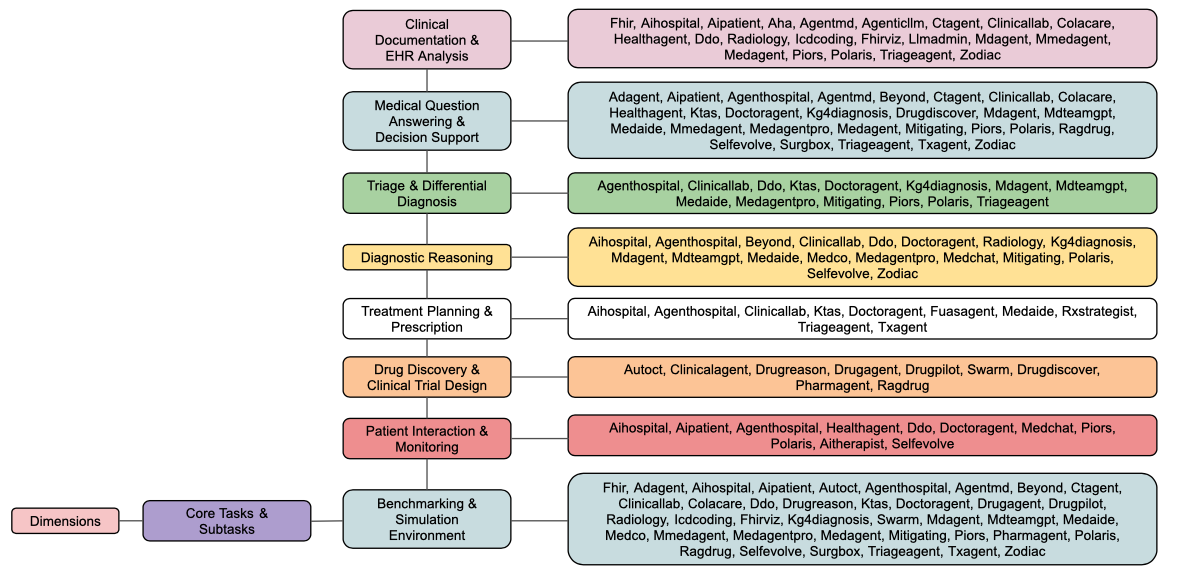
Диаграмма таксономии на рисунке 3 и 4 визуализирует структуру нашего обзора. На этой диаграмме 7 измерений оценки сгруппированы со своими 29 под-измерениями. Для каждого под-измерения мы перечисляем каждое исследование, оцененное как Fully Implemented ✓ согласно нашей рубрике. Этот обзор служит навигационным указателем. Он подчеркивает кластеры зрелости (под-измерения с большим числом ✓ публикаций), обращает наше внимание на разреженные области, где реализации встречаются редко, и выявляет исследования с многофункциональными конструкциями. Эта диаграмма проясняет пересечения между соседними конструктами и дополняет табличные обобщения.
II-A Когнитивные возможности
Агенты должны сначала преобразовать клинические цели в реализуемые курсы действий, разбивая долгосрочные целевые установки на вехи и точки принятия решений. Современные стратегии подсказок, такие как Tree-of-Thoughts [yao2023tree] и Plan-and-Solve [wang2023plan], формализуют это разложение и поиск. В здравоохранении такая структурированная предвосхищающая проработка поддерживает составление маршрутов лечения, маршрутизацию триажа и проверки предварительного согласования в условиях реальных ограничений. Эти планы зависят от семантического ввода из разнородных источников, включая заметки, анализы, изображения, потоковые данные с устройств и руководства. Мультимодальное предварительное обучение демонстрирует, как межмодальное согласование обеспечивает надежную привязку [alayrac2022flamingo], тогда как модели языка, настроенные под предметную область, такие как Med-PaLM 2 [singhal2025toward], улавливают медицинскую номенклатуру и дискурс. Преобразуя сырые сигналы EHR и визуализации в клинически значимые представления, агенты могут привязывать планы к контексту конкретного пациента, а не к поверхностным строкам. Агенты чередуют рассуждения с вызовами инструментов, как показано в ReAct [yao2023react], и учатся, когда и как вызывать API, как продемонстрировано в Toolformer [schick2023toolformer]. Поскольку клинические ставки требуют бдительности, агентам полезен самоконтроль, который критикует промежуточные результаты. Рефлексивные контурные циклы сохраняют эпизодические следы для улучшения будущих итераций [shinn2023reflexion], а декодирование с учетом разнообразия объединяет несколько рационалей, чтобы стабилизировать выводы [wang2022self]. Эти механизмы выявляют условия отсрочки, направляют эскалацию к людям и способствуют консервативному поведению, когда доказательств недостаточно. Наконец, надежные клинические решения требуют сходимости между конкурирующими гипотезами и источниками. Рамочные решения для рассуждений с участием нескольких агентов координируют обсуждение и посредничество на пути к консенсусу [wu2024autogen], тогда как проверка расхождений через сэмплирование выявляет расхождение фактов, указывающее на галлюцинации [manakul2023selfcheckgpt]. Такие протоколы согласуют рекомендации руководств с данными уровня пациента, уменьшают противоречивые назначения и обосновывают предложения поддающимся отслеживанию согласием. В совокупности эти возможности составляют Cognitive Capabilities of LLM-based agents. Таблица I приводит оценки по 5 подизмерениям Cognitive Capabilities:
II-A1 Планирование
Планирование — это способность агента синтезировать, поддерживать и пересматривать исполняемые структуры задач, которые связывают цели с действиями. Оно включает обоснованную декомпозицию задач, временно согласованное упорядочивание и иерархическую организацию, которые отличают стратегический замысел от тактических шагов. Надёжные планирующие агенты также перечисляют альтернативные стратегии, выбирают среди них и выполняют циклы критика — уточнение, чтобы исправлять упущения или тупиковые ситуации. В рамках этого обзора мы оцениваем Планирование ✓, когда имеется чёткое свидетельство динамического построения плана с многошаговой декомпозицией, явного сравнения альтернатив или циклов уточнения и корректного выбора инструментов. Мы оцениваем это , когда есть разбиение задач или динамическое назначение ролей, но нет содержательной генерации стратегий, их сравнения или итеративного пересмотра. Это ✗, когда рабочие процессы фиксированы или ограничены простым условным ветвлением. В клинических контекстах реализованная форма поддерживает адаптивную диагностическую проработку, многошаговые обзоры предварительного согласования и итеративное планирование лечения, согласованное с развивающимися данными пациента.
II-A2 Восприятие (обработка входных данных)
Восприятие — это преобразование разнородных входных данных в надежные, пригодные для модели представления посредством нормализации, подавления шума и кросс-модального слияния. Помимо токенизации, оно включает и другие вещи, такие как ASR для речи, временное согласование для форм сигналов, индукцию структуры для полей EHR и т.д. Далее строятся встраивания, чувствительные к происхождению, пригодные для последующих рассуждений и действий. Для оценки ✓ обозначает надежные конвейеры, которые объединяют несколько модальностей через специализированные энкодеры и кросс-модальное слияние, предоставляя калиброванные представления планирующим и компонентам действия агента. описывает системы, которые выполняют компетентный разбор текста или кодирование по каждой модальности с минимальным слиянием и ограниченной предварительной обработкой. ✗ применяется, когда входные данные передаются как исходные строки без нормализации или обработки мультимодальности.
II-A3 Действие (вывод и выполнение)
Действие (вывод и выполнение) — это исполнительный уровень агента, который преобразует внутренние решения во внешне проверяемые результаты. Он включает контролируемую генерацию текста, а также вызовы инструментов и API. Зрелые исполнители валидируют предусловия и постусловия, управляют побочными эффектами и направляют наблюдения обратно контроллеру для работы в замкнутом контуре. Мы помечаем эту под размерность ✓, когда система демонстрирует фактическое использование инструментов и внешнее выполнение помимо генерации текста. Это , когда действия ограничиваются базовыми вызовами API или поиском в базе данных без более богатой оркестрации инструментов или манипуляций со средой. Это ✗, когда выходные данные — только текст. В медицинских учреждениях уровень ✓ позволяет безопасно выполнять сверку лекарственных назначений, проверку заказов и проверки предварительного разрешения с поддающимися аудиту следами.
II-A4 Мета-возможности
Мета-способности включают рефлексивный контроль над рассуждениями и действиями агента. Он включает в себя генерацию критических замечаний к промежуточным шагам, калибровку уверенности, выявление пробелов в знаниях и принятие решения, когда воздержаться или запросить доказательства. В клинических контекстах этот уровень позволяет агентам выявлять неопределенность в дифференциальных диагнозах, запускать поиск литературы или получать второе мнение и уступать клиницистам, когда доказательств недостаточно. Для оценки ✓ указывает на явные циклы критики и пересмотра, откалиброванные оценки неопределенности, связанные с воздержанием, и зарегистрированную эскалацию. отражает произвольный самоконтроль, такой как обратная связь по памяти или эвристические самопроверки. ✗ указывает на отсутствие самокритики, сигналов уверенности или поведения воздержания.
II-A5 Согласованность и разрешение конфликтов
Согласованность и разрешение конфликтов в агентах относится к систематическому выявлению и согласованию противоречивой информации, возникающей из параметрического извлечения, внешнего поиска или выходов нескольких агентов. Эффективные реализации используют многоуровневые стратегии, включая обнаружение противоречий с помощью моделей вывода по естественному языку и протоколов согласия ансамблей. В сложных областях, таких как здравоохранение, такие механизмы жизненно важны для обеспечения того, что рекомендации остаются связными, основанными на доказательствах и согласованными с установленными клиническими стандартами. Степень реализации может различаться: (a) Полностью реализованные ✓ системы включают автоматизированное обнаружение конфликтов с конвейерами структурированного разрешения с использованием ансамблирования по большинству и адаптивного переразвешивания выходов специалистов (b) Частично реализованные системы могут опираться на ограниченную валидацию или подменять ее неформальным контролем со стороны человека без всеобъемлющего согласования (c) Не реализованные ✗ вовсе исключают явные механизмы, повышая риск небезопасных выходов.
| Papers | Plan | Perception | Action | Meta Capabilities | Consistency & Conflict Resolution |
| Colacare [wang2025colacare] | ✗ | ✗ | ✓ | ✓ | |
| Medagent [tang2023medagents] | ✗ | ✗ | ✓ | ✓ | |
| Medaide [yang2024medaide] | ✗ | ✗ | ✗ | ||
| Doctoragent [feng2025doctoragent] | ✗ | ✗ | ✗ | ||
| Aihospital [fan2024ai] | ✗ | ✗ | ✗ | ✓ | |
| Mmedagent[li2024mmedagent] | ✓ | ✓ | ✗ | ✗ | |
| Medchat [liu2025medchat] | ✓ | ✗ | ✗ | ✓ | |
| Medco [wei2024medco] | ✗ | ✓ | ✓ | ✗ | |
| Medagentpro[wang2025medagent] | ✓ | ✓ | ✓ | ✗ | |
| Clinicalagent[yue2024clinicalagent] | ✓ | ✓ | ✗ | ✗ | |
| Ktas [han2024development] | ✗ | ✓ | ✗ | ✗ | |
| Agentmd [jin2024agentmd] | ✗ | ✓ | ✗ | ✗ | |
| Mdagent [kim2024mdagents] | ✓ | ✗ | ✓ | ✓ | |
| Agenthospital[li2024agent] | ✗ | ✗ | ✓ | ✗ | |
| Pharmagent [gao2025pharmagents] | ✗ | ✓ | ✓ | ✓ | ✗ |
| Txagent [gao2025txagent] | ✓ | ✓ | ✓ | ✗ | |
| Autoct [liu2025autoct] | ✓ | ✓ | ✓ | ✗ | |
| Kg4diagnosis[zuo2025kg4diagnosis] | ✗ | ✓ | ✗ | ||
| Mdteamgpt [chen2025mdteamgpt] | ✗ | ✓ | ✓ | ||
| Mitigating [ke2024mitigating] | ✗ | ✗ | |||
| Polaris [mukherjee2024polaris] | ✓ | ✗ | ✓ | ||
| Rxstrategist [van2024rx] | ✗ | ✓ | ✗ | ✗ | ✗ |
| Clinicallab [yan2024clinicallab] | ✓ | ✗ | ✗ | ✗ | |
| Agenticllm [sudarshan2024agentic] | ✗ | ✗ | ✓ | ✗ | |
| Surgbox [wu2024surgbox] | ✗ | ✗ | |||
| Aipatient [yu2024simulated] | ✗ | ✗ | |||
| Healthagent [abbasian2023conversational] | ✓ | ✓ | ✓ | ✗ | ✗ |
| Icdcoding [li2024exploring] | ✗ | ✗ | ✗ | ✓ | |
| Aha [pandey2024advancing] | ✗ | ✗ | ✗ | ✓ | |
| Ddo [jia2025ddo] | ✗ | ✗ | ✗ | ||
| Beyond [wang2024beyond] | ✗ | ✗ | ✗ | ✓ | |
| Zodiac [zhou2024zodiac] | ✗ | ✓ | ✗ | ||
| Fhirviz [almutairi2024fhirviz] | ✗ | ✗ | ✗ | ||
| Fhir [de2024multi] | ✗ | ✗ | |||
| Fuasagent [zhao2025autonomous] | ✓ | ✓ | ✓ | ✓ | ✗ |
| Aitherapist [wasenmuller2024script] | ✗ | ✗ | ✗ | ||
| Radiology [zeng2024enhancing] | ✗ | ✓ | ✗ | ✓ | ✓ |
| Triageagent [lu2024triageagent] | ✗ | ✗ | ✗ | ✓ | |
| Piors [bao2024piors] | ✓ | ✗ | |||
| Selfevolve [almansoori2025self] | ✗ | ✓ | ✗ | ✓ | ✓ |
| Drugagent [liu2024drugagent] | ✓ | ✓ | ✗ | ✗ | |
| Ctagent [mao2025ct] | ✓ | ✓ | ✓ | ✗ | ✗ |
| Adagent [hou2025adagent] | ✓ | ✓ | ✗ | ||
| Drugpilot [li2025drugpilot] | ✓ | ✓ | ✓ | ✗ | |
| Llmadmin [gebreab2024llm] | ✓ | ✓ | ✓ | ✗ | ✗ |
| Swarm [song2025llm] | ✗ | ✓ | ✓ | ✓ | ✗ |
| Drugdiscover[ock2025large] | ✗ | ✓ | ✓ | ✗ | |
| Ragdrug [lee2025rag] | ✓ | ✓ | ✓ | ✗ | |
| Drugreason[inoue2025drugagent] | ✓ | ✓ | ✗ | ✓ |
II-B Управление знаниями
Управление знаниями в LLM-агентах сосредоточено на том, как параметрические знания дополняются и направляются через внешние ресурсы, когда внутреннего воспроизведения модели недостаточно. Агенты согласуют между весами и внешним миром, вызывая генерацию с поисковым усилением (RAG) [lewis2020retrieval], поиск во время дообучения, такой как REALM [guu2020retrieval], а также интерполируя с непараметрическими запоминаниями, как в kNN-LM [khandelwal2019generalization]. В клинических условиях эта комбинация помогает извлекать актуальные руководства и данные клинических испытаний с цитированиями для проверки клиницистом. Не менее важно — внутренняя архитектура памяти агента. Краткосрочные буферы поддерживают состояние дискурса и использования инструментов. С другой стороны, долгосрочные эпизодические и семантические хранилища сжимают предыдущие взаимодействия и доменные онтологии под управлением обученных контроллеров, которые загружают информацию внутрь и выводят ее из контекста, как в MemGPT [packer2023memgpt]. Эти механизмы уменьшают узкие места по длине контекста, стабилизируют многошаговые планы и дают возможность строить стратегии извлечения, чувствительные к истории пациента. В здравоохранении такая память поддерживает продольное обобщение, сверку лекарств (medication reconciliation) и преемственность между случаями, когда устойчивый контекст улучшает качество ухода. Наконец, знания должны развиваться, и соответствующим образом агентам нужно непрерывно индексировать новые документы, отдавать приоритет свежим источникам и снижать значимость устаревших записей. Саморефлексивные фреймворки извлечения, которые критикуют и повторно запрашивают [asai2024self], могут улучшать фактичность и надежность цитирования, тогда как направленные параметрические правки могут исправлять укоренившиеся факты в больших масштабах [meng2022mass]. В клинических внедрениях такие механизмы обновления и забывания жизненно важны для согласования выходных данных агента с развивающимися руководствами и новыми опубликованными исследованиями. Таблица II суммирует результаты по ее 3 подизмерениям:
II-B1 Интеграция внешних знаний
Интеграция внешних знаний относится к способности агента дополнять его собственные параметрические знания, закодированные в весах модели, непараметрической информацией. Такая непараметрическая информация извлекается из внешних, часто предметно ориентированных репозиториев во время вывода. Эти репозитории могут включать структурированные клинические базы данных, медицинские графы знаний, репозитории нормативных руководств или неструктурированные корпуса, размещённые в индексах векторного поиска. Процесс интеграции требует не только извлечения релевантного содержимого, но и механизмов арбитража между знаниями, хранящимися внутри, и знаниями, получаемыми извне, чтобы обеспечивать, что результаты являются одновременно актуальными по времени и контекстно точными. В здравоохранении и системах поддержки клинических решений это позволяет LLM-based агенту обосновывать свои рассуждения авторитетными источниками, такими как базы данных лекарственных взаимодействий, руководства по лечению или актуальные результаты клинических исследований. Степень, в которой агент воплощает эту под-измеримость, может различаться: (a) полностью реализованные реализации ✓ включают структурированные RAG-пайплайны с откалиброванным арбитражем между внутренним извлечением и внешними свидетельствами (b) частичные реализации опираются на ограниченный, статичный или вручную отобранный внешний контент (c) отсутствующие реализации ✗ работают исключительно из параметрической памяти.
| Papers | External Knowledge Integration | Memory Module | Dynamic Updates & Forgetting |
| Colacare [wang2025colacare] | ✓ | ✗ | |
| Medagent [tang2023medagents] | ✗ | ✗ | ✗ |
| Medaide [yang2024medaide] | ✓ | ✗ | |
| Doctoragent [feng2025doctoragent] | ✗ | ✗ | |
| Aihospital [fan2024ai] | ✗ | ✗ | ✗ |
| Mmedagent [li2024mmedagent] | ✓ | ✗ | |
| Medchat [liu2025medchat] | ✗ | ✗ | ✗ |
| Medco [wei2024medco] | ✗ | ✓ | |
| Medagentpro [wang2025medagent] | ✓ | ✗ | |
| Clinicalagent [yue2024clinicalagent] | ✓ | ✗ | |
| Ktas [han2024development] | ✓ | ✗ | |
| Agentmd [jin2024agentmd] | ✓ | ✗ | |
| Mdagent [kim2024mdagents] | ✓ | ✗ | |
| Agenthospital [li2024agent] | ✓ | ✓ | |
| Pharmagent [gao2025pharmagents] | ✓ | ✓ | |
| Txagent [gao2025txagent] | ✓ | ✗ | |
| Autoct [liu2025autoct] | ✓ | ✗ | |
| Kg4diagnosis [zuo2025kg4diagnosis] | ✓ | ✓ | |
| Mdteamgpt [chen2025mdteamgpt] | ✓ | ✓ | |
| Mitigating [ke2024mitigating] | ✗ | ✗ | ✗ |
| Polaris [mukherjee2024polaris] | ✓ | ✗ | |
| Rxstrategist [van2024rx] | ✓ | ✗ | |
| Clinicallab [yan2024clinicallab] | ✗ | ✗ | ✗ |
| Agenticllm [sudarshan2024agentic] | ✗ | ✗ | ✗ |
| Surgbox [wu2024surgbox] | ✓ | ✗ | |
| Aipatient [yu2024simulated] | ✓ | ✓ | |
| Healthagent [abbasian2023conversational] | ✓ | ✓ | |
| Icdcoding [li2024exploring] | ✓ | ✗ | |
| Aha [pandey2024advancing] | ✗ | ✗ | ✗ |
| Ddo [jia2025ddo] | ✓ | ✓ | |
| Beyond [wang2024beyond] | ✓ | ✗ | |
| Zodiac [zhou2024zodiac] | ✓ | ✗ | |
| Fhirviz [almutairi2024fhirviz] | ✓ | ✓ | |
| Fhir [de2024multi] | ✗ | ||
| Fuasagent [zhao2025autonomous] | ✓ | ✓ | |
| Aitherapist [wasenmuller2024script] | ✗ | ✗ | ✗ |
| Radiology [zeng2024enhancing] | ✓ | ✗ | |
| Triageagent [lu2024triageagent] | ✓ | ✗ | |
| Piors [bao2024piors] | ✓ | ✓ | |
| Selfevolve [almansoori2025self] | ✓ | ✓ | |
| Drugagent [liu2024drugagent] | ✓ | ✗ | |
| Ctagent [mao2025ct] | ✓ | ✓ | |
| Adagent [hou2025adagent] | ✗ | ✗ | ✗ |
| Drugpilot [li2025drugpilot] | ✓ | ✓ | ✓ |
| Llmadmin [gebreab2024llm] | ✓ | ✗ | |
| Swarm [song2025llm] | ✓ | ✓ | |
| Drugdiscover [ock2025large] | ✓ | ✓ | |
| Ragdrug [lee2025rag] | ✓ | ✗ | |
| Drugreason [inoue2025drugagent] | ✓ | ✗ |
II-B2 Модуль памяти
Модуль памяти в ИИ-агентах на основе LLM предоставляет структурированные механизмы для хранения и извлечения информации за пределами кратковременного контекстного окна, обеспечивая непрерывность и долгосрочные рассуждения. Механизмы кратковременной памяти поддерживают только непосредственную историю беседы. Однако долгосрочные хранилища фиксируют эпизодические повествования, такие как прошлые консультации, и семантические абстракции, такие как графы знаний. Эти модули часто опосредуются обучаемыми или основанными на правилах контроллерами, которые определяют, какая информация должна быть сохранена в долговременном хранилище, и когда исторические записи следует извлекать для принятия решений. В медицинских приложениях такие архитектуры обеспечивают более богатое взаимодействие с пациентами, позволяя агентам ссылаться на ранее полученные результаты лабораторных исследований, заметки последующих наблюдений или развивающиеся планы ведения без повторного ввода пользователем. Системы могут полностью реализовать ✓ эту под-область с помощью усовершенствованной, сохраняющей состояние многослойной памяти с динамическим управлением чтением/записью. Системы могут частично реализовать ее через ограниченное извлечение в рамках сеанса с кратковременным контекстом или базовые буферы извлечения. Системы могут не реализовать ✗ ее вообще, полагаясь исключительно на используемое по умолчанию контекстное окно модели.
II-B3 Динамические обновления и забывание
Динамические обновления и забывание отражают способность агента сохранять знания актуальными и гигиеничными, а не просто накапливаемыми. Помимо простого извлечения, система должна: (i) получать новые данные через непрерывное индексирование (ii) переоценивать хранимые элементы с помощью временного затухания (iii) удалять устаревшие или отозванные факты посредством явных правил отсечения. В клинических контекстах эти механизмы согласуют выводы с развивающимися руководствами, отзывами лекарств и вновь опубликованными или отозванными исследованиями, тем самым снижая риск устаревших рекомендаций. Мы считаем это ✓, когда присутствуют обе стороны поддержания знаний: активное добавление (непрерывные обновления/запись обратно) и явное забывание (пороговые значения временного затухания и политики деактивации). Это , когда обновления происходят, но формальное затухание не определено, что приводит к статическому накоплению со временем. Это ✗, когда система статична и нет непрерывных обновлений, затухания или отсечения сверх того, что заложено по умолчанию в контексте модели.
II-C Паттерны взаимодействия
Паттерны взаимодействия задают, как агент вызывается, поддерживает контекст и договаривается о чередовании ходов во время мультимодальных обменов, чтобы состояние оставалось согласованным во время прерывистых сессий. Общение с агентами на базе LLM — это не просто передача хода, а дисциплинированное управление контекстом во времени. Надежные практики диалога, такие как приветствия, подтверждения, уточнения и обобщение, стабилизируют смысл и поддерживают согласованность состояния [shaikh2023grounding]). Эмпирические исследования голосовых помощников на базе LLM также показывают более богатое, более адаптивное чередование ходов, которое снижает сбои за счет упреждающих уточнений [mahmood2023llm]. В клинических условиях и в общении с пациентами такая дисциплинированная манера поведения уменьшает риск неправильного понимания, улучшает фиксацию данных и поддерживает более безопасные передачи между эпизодами оказания помощи. Помимо прямого чата, поведение агента также должно управляться внешними сигналами, такими как входящие результаты лабораторных анализов, потоки данных с устройств или события рабочих процессов. В операциях здравоохранения событийно-ориентированная активация обеспечивает своевременную сортировку, проверку назначений и эскалацию мониторинга без необходимости постоянного надзора со стороны пользователя. Поскольку клинические решения имеют последствия, взаимодействие должно явно распределять роли для надзора. Работа по совместной работе человека и ИИ в медицине показывает, что экспертные инструменты с возможностью управления повышают доверие и полезность, не снижая точность [cai2019human]. Наконец, взаимодействия должны предвосхищать сбои и восстанавливаться корректно. Обобщенные меры защиты включают жадное декодирование, такое как self-consistency, чтобы выявлять расходящиеся пути рассуждений [wang2022self], процедуры Chain-of-Verification, которые планируют и отвечают на вопросы для проверки фактов до выдачи окончательного ответа [dhuliawala2023chain], а также рефлексивное перепланирование, которое переписывает цели или последовательности инструментов после неудачных попыток [shinn2023reflexion]. На уровне эксплуатации устойчивые агенты используют транзакционные откаты, ограниченные повторные попытки, схемы circuit breakers и деградированные безопасные режимы. В клинических средах модально-независимые модели поведения помогают предотвратить распространение ошибок, таких как остановка последующего размещения назначений после неудачной проверки формуляра, подавление дублирующей документации после тайм-аутов API и т.п. Как указано в Таблице III, паттерны взаимодействия оцениваются по:
II-C1 Разговорный режим
Разговорный режим характеризует способность агента к синхронным обменам с пошаговым, поочерёдным взаимодействием, которые сохраняют состояние дискурса между репликами и сессиями. Ключевые признаки включают сохранение состояния диалога и память, ограниченную рамками сессии, для фиксации намерений пользователя и поддержки уточняющих продолжений, а не одноразовых ответов. Системы могут предоставлять чат-интерфейс, но они отличаются непрерывностью и возможностью продолжения после перерывов. Мы ставим ✓, когда агент предоставляет пошаговый диалоговый интерфейс, сохраняющий контекст между репликами и поддерживающий возобновление. применяется, когда существует многораундовое взаимодействие, но оно в основном представляет собой структурированный рабочий процесс или последовательный обмен подсказками с хрупким удержанием контекста. ✗ описывает обработку одиночного запроса без доказательств пошагового диалога, непрерывности сессии или поддержания разговорного контекста. В здравоохранении виртуальный опрос, последующие уточнения симптомов и обучение при выписке, реализованные в системах, уменьшают повторный ввод информации и обеспечивают более эффективное взаимодействие клинициста и пациента.
II-C2 Активация с событийнo-управляемым запуском
Событийно-запускаемая активация обозначает способность агента автономно отслеживать внешние сигналы через webhooks или message buses и запускать рабочие процессы при выполнении заданных условий без явного запроса пользователя. Зрелые конструкции подписываются на потоки, применяют временные окна, обогащают события контекстом и вызывают идемпотентные обработчики с учетом ограничений по частоте. Мы ставим ✓, когда триггеры в реальном времени и автоматические триггеры из внешних источников активируют агентов с непрерывным мониторингом и упреждающим выполнением. засчитывается, когда существует базовый механизм запуска (API-обратные вызовы или периодический опрос по расписанию), но активация в основном инициируется пользователем или отсутствует долговременная интеграция с потоками. ✗ помечается, когда работа опирается исключительно на подсказанные пользователем взаимодействия или внутренние пороговые значения без автономного мониторинга внешних потоков. Для медицинских учреждений надежная активация обеспечивает своевременные вмешательства, такие как ненормальные показатели жизненно важных функций, подавление заказов с учетом формуляра и тому подобное.
II-C3 Человек в контуре
Человек-в-контуре фиксирует явную вставку человеком контроля во время выполнения агентом, а не только на этапе ввода или после вывода. Это достигается с помощью контуров подтверждения, пауз при возникновении неопределенности и средств отката. Затем собранная обратная связь сохраняется в поддающемся аудиту виде, чтобы уточнять память или политики на последующих этапах. Мы ставим ✓, когда пользователи могут подтвердить, одобрить или перенаправить агента в ходе выполнения. применяется, когда имитируется лишь базовая проверка или одобрение, либо когда подтверждения являются необязательными без устойчивого включения обратной связи. ✗ описывает конвейеры без контроля в процессе. В рабочих процессах вроде предварительного разрешения и чувствительных обновлений медицинских карт надежный человек-в-контуре ограничивает бесконтрольную автономность, повышает подотчетность и поддерживает клиническое управление.
II-C4 Восстановление после ошибок
Восстановление после ошибок обозначает способность агента обнаруживать, сдерживать и исправлять сбои при анализе, планировании, использовании инструментов и интеграции системы. В этой под-области агент отмечает аномалии, проводит структурированную диагностику наиболее вероятных причин и затем применяет корректирующие шаги, которые могут включать выдачу подсказок для устранения неоднозначности, переключение на альтернативные инструменты или восстановление параметров. Все эти корректирующие меры принимаются с обеспечением транзакционной безопасности. Зрелые конструкции включают явные узлы восстановления, которые фиксируют исключения и возвращают управление обратно к исполнителю для повторного выполнения. Мы оцениваем это ✓ когда надежное обнаружение, повторы и процедуры резервного плана встроены как протоколы первого класса с продемонстрированными путями повторного выполнения. применяется, когда присутствуют только базовое обнаружение или ограниченные резервные планы и повторы. ✗ описывает конвейеры, в которых отсутствует явная обработка ошибок времени выполнения или стратегии восстановления. Надежное восстановление предотвращает каскады ошибок в клиническом обслуживании. Оно останавливает запись некорректных заказов, подавляет дублирование документации, когда API завершаются по тайм-ауту, и приостанавливает обновления записей в карте до тех пор, пока проверка не будет успешно выполнена.
| Papers | Conver-sational Mode | Event-Triggered Activation | Human-in-the Loop | Error Recovery |
| Colacare [wang2025colacare] | ✗ | ✗ | ✗ | |
| Medagent [tang2023medagents] | ✗ | ✗ | ||
| Medaide [yang2024medaide] | ✓ | ✗ | ✗ | ✗ |
| Doctoragent [feng2025doctoragent] | ✓ | ✗ | ✗ | ✗ |
| Aihospital [fan2024ai] | ✓ | ✗ | ✗ | ✗ |
| Mmedagent [li2024mmedagent] | ✓ | ✗ | ✗ | ✗ |
| Medchat [liu2025medchat] | ✓ | ✗ | ✗ | ✗ |
| Medco [wei2024medco] | ✗ | ✗ | ✗ | |
| Medagentpro [wang2025medagent] | ✗ | ✗ | ✗ | |
| Clinicalagent [yue2024clinicalagent] | ✓ | ✗ | ✗ | ✗ |
| Ktas [han2024development] | ✗ | ✗ | ✗ | ✗ |
| Agentmd [jin2024agentmd] | ✗ | ✗ | ✗ | |
| Mdagent [kim2024mdagents] | ✓ | ✗ | ✗ | |
| Agenthospital [li2024agent] | ✗ | ✓ | ✗ | |
| Pharmagent [gao2025pharmagents] | ✗ | ✗ | ✗ | |
| Txagent [gao2025txagent] | ✗ | ✗ | ✗ | |
| Autoct [liu2025autoct] | ✗ | ✗ | ✗ | |
| Kg4diagnosis [zuo2025kg4diagnosis] | ✗ | ✗ | ✓ | ✗ |
| Mdteamgpt [chen2025mdteamgpt] | ✗ | ✗ | ||
| Mitigating [ke2024mitigating] | ✓ | ✗ | ✗ | ✗ |
| Polaris [mukherjee2024polaris] | ✓ | ✗ | ✓ | |
| Rxstrategist [van2024rx] | ✗ | ✗ | ✗ | ✗ |
| Clinicallab [yan2024clinicallab] | ✗ | ✗ | ✓ | ✗ |
| Agenticllm [sudarshan2024agentic] | ✗ | ✗ | ✗ | ✗ |
| Surgbox [wu2024surgbox] | ✓ | ✓ | ✗ | ✗ |
| Aipatient [yu2024simulated] | ✓ | ✗ | ✗ | |
| Healthagent [abbasian2023conversational] | ✓ | ✗ | ✗ | ✗ |
| Icdcoding [li2024exploring] | ✗ | ✗ | ✗ | |
| Aha [pandey2024advancing] | ✗ | ✗ | ✗ | ✗ |
| Ddo [jia2025ddo] | ✓ | ✗ | ✗ | ✗ |
| Beyond [wang2024beyond] | ✗ | ✗ | ✗ | ✗ |
| Zodiac [zhou2024zodiac] | ✗ | ✗ | ✗ | |
| Fhirviz [almutairi2024fhirviz] | ✗ | ✗ | ✓ | ✓ |
| Fhir [de2024multi] | ✗ | ✗ | ✗ | ✗ |
| Fuasagent [zhao2025autonomous] | ✗ | ✗ | ✗ | ✗ |
| Aitherapist [wasenmuller2024script] | ✓ | ✗ | ✗ | ✗ |
| Radiology [zeng2024enhancing] | ✗ | ✗ | ✗ | |
| Triageagent [lu2024triageagent] | ✓ | ✗ | ✗ | ✗ |
| Piors [bao2024piors] | ✓ | ✗ | ✗ | ✗ |
| Selfevolve [almansoori2025self] | ✓ | ✗ | ✓ | |
| Drugagent [liu2024drugagent] | ✗ | ✗ | ✗ | ✗ |
| Ctagent [mao2025ct] | ✗ | ✗ | ✗ | ✗ |
| Adagent [hou2025adagent] | ✓ | ✗ | ✗ | ✗ |
| Drugpilot [li2025drugpilot] | ✓ | ✗ | ✓ | ✓ |
| Llmadmin [gebreab2024llm] | ✓ | ✓ | ✗ | |
| Swarm [song2025llm] | ✗ | ✗ | ✗ | |
| Drugdiscover [ock2025large] | ✗ | ✗ | ✗ | ✗ |
| Ragdrug [lee2025rag] | ✗ | ✗ | ✗ | ✗ |
| Drugreason [inoue2025drugagent] | ✓ | ✗ | ✗ |
II-D Адаптация и обучение
Адаптация и обучение — это дисциплина поддержания развернутых агентов откалиброванными к меняющемуся миру. Она начинается с непрерывного сенсинга для выявления сдвигов в распределениях и поведении, затем применения целевых мер снижения последствий до того, как ухудшится клиническая эффективность. Дрейф можно обнаружить, отслеживая изменения в распределениях встраиваний текста [gupta2023measuring], с помощью зондов приращения активаций [abdelnabi2025get] и с помощью статистических тестов «черного ящика», которые проверяют изменения поведения во времени [richter2024auditing]. Меры снижения последствий включают точечные исправления подсказок, адаптацию к домену и запланированное дообучение. Их необходимость подтверждается временными сдвигами в наборах данных, которые ухудшают модели прогнозирования для ICU в EHR [guo2022evaluation]. На практике развертывания в здравоохранении сочетают эти мониторы с эскалацией и откатом назад, чтобы сохранить безопасность пациентов и обеспечить регуляторную прослеживаемость. Помимо обнаружения, агенты должны учиться у оценщиков. Адаптация на основе обучения с подкреплением формализует обратную связь как награды. Исследования показывают, что конституциональная само-супервизия заменяет награды ИИ обратной связью вместо человеческих меток, чтобы снизить вредоносность [bai2022constitutional], а вербальные агентЫ с наградами хранят рефлексивные критические замечания как эпизодическую память, чтобы направлять последующие решения без обновлений весов [shinn2023reflexion]. В клинических условиях эти пути позволяют формировать награды с участием клинициста (clinician-in-the-loop) и обеспечивать согласование после развертывания. Например, системы медицинского вопросного ответа, уточненные с помощью предметно-ориентированной супервизии и протоколов оценки, достигают прорывной надежности на вопросах в стиле USMLE [singhal2025toward]. Наконец, быстрая специализация при нехватке данных опирается на мета-обучение и умение в формате few-shot. Градиентные мета-обучатели инициализируют модели для быстрой адаптации по нескольким случаям [finn2017model], тогда как LLM демонстрируют обучение в контексте, которое позволяет осваивать новые задачи по нескольким демонстрациям на этапе вывода [brown2020language]. В сочетании с извлечением (retrieval) и разреженным маркированием эти методы позволяют агентам обобщать на новую больницу, устройство визуализации или редкое заболевание при минимальной нагрузке на аннотацию. Это особенно важно там, где перспективный сбор данных идет медленно и дорого. Таблица IV описывает результаты «Адаптация и обучение» по ее 3 под-измерениям:
| Papers | Drift Detection & Mitigation | Reinforce-ment Based Adaptation | Meta-Learning & Few-Shot |
| Colacare [wang2025colacare] | ✗ | ✗ | ✓ |
| Medagent [tang2023medagents] | ✗ | ✗ | ✓ |
| Medaide [yang2024medaide] | ✗ | ✗ | ✗ |
| Doctoragent [feng2025doctoragent] | ✗ | ✓ | ✗ |
| Aihospital [fan2024ai] | ✗ | ✗ | ✗ |
| Mmedagent [li2024mmedagent] | ✗ | ✗ | ✗ |
| Medchat [liu2025medchat] | ✗ | ✗ | ✗ |
| Medco [wei2024medco] | ✗ | ✗ | ✗ |
| Medagentpro [wang2025medagent] | ✗ | ✗ | ✗ |
| Clinicalagent [yue2024clinicalagent] | ✗ | ✗ | ✓ |
| Ktas [han2024development] | ✗ | ✗ | ✗ |
| Agentmd [jin2024agentmd] | ✗ | ✗ | ✗ |
| Mdagent [kim2024mdagents] | ✗ | ✗ | ✓ |
| Agenthospital [li2024agent] | ✗ | ✗ | ✗ |
| Pharmagent [gao2025pharmagents] | ✗ | ✗ | ✗ |
| Txagent [gao2025txagent] | ✗ | ✗ | ✗ |
| Autoct [liu2025autoct] | ✗ | ✗ | |
| Kg4diagnosis [zuo2025kg4diagnosis] | ✗ | ✓ | ✗ |
| Mdteamgpt [chen2025mdteamgpt] | ✗ | ✗ | ✓ |
| Mitigating [ke2024mitigating] | ✗ | ✗ | ✗ |
| Polaris [mukherjee2024polaris] | ✓ | ✗ | |
| Rxstrategist [van2024rx] | ✗ | ✗ | ✗ |
| Clinicallab [yan2024clinicallab] | ✗ | ✗ | ✗ |
| Agenticllm [sudarshan2024agentic] | ✗ | ✗ | |
| Surgbox [wu2024surgbox] | ✗ | ✗ | ✗ |
| Aipatient [yu2024simulated] | ✗ | ✗ | ✓ |
| Healthagent [abbasian2023conversational] | ✗ | ✗ | ✗ |
| Icdcoding [li2024exploring] | ✗ | ✗ | ✗ |
| Aha [pandey2024advancing] | ✗ | ✗ | ✓ |
| Ddo [jia2025ddo] | ✗ | ✓ | ✗ |
| Beyond [wang2024beyond] | ✗ | ✗ | ✗ |
| Zodiac [zhou2024zodiac] | ✗ | ✗ | ✓ |
| Fhirviz [almutairi2024fhirviz] | ✗ | ✗ | ✗ |
| Fhir [de2024multi] | ✗ | ✗ | ✗ |
| Fuasagent [zhao2025autonomous] | ✗ | ✗ | |
| Aitherapist [wasenmuller2024script] | ✗ | ✗ | ✗ |
| Radiology [zeng2024enhancing] | ✗ | ✗ | ✗ |
| Triageagent [lu2024triageagent] | ✗ | ✗ | ✗ |
| Piors [bao2024piors] | ✗ | ✗ | ✗ |
| Selfevolve [almansoori2025self] | ✗ | ✗ | ✓ |
| Drugagent [liu2024drugagent] | ✗ | ✗ | ✗ |
| Ctagent [mao2025ct] | ✗ | ✗ | ✓ |
| Adagent [hou2025adagent] | ✗ | ✗ | ✗ |
| Drugpilot [li2025drugpilot] | ✗ | ✗ | ✗ |
| Llmadmin [gebreab2024llm] | ✗ | ✗ | ✗ |
| Swarm [song2025llm] | ✗ | ✗ | ✗ |
| Drugdiscover [ock2025large] | ✗ | ✓ | ✗ |
| Ragdrug [lee2025rag] | ✗ | ✗ | |
| Drugreason [inoue2025drugagent] | ✗ | ✗ | ✗ |
II-D1 Обнаружение и снижение дрейфа
Эта под-область касается способности агентов на основе LLM сохранять надежность при изменяющихся распределениях данных, определениях задач или контекстах использования. Дрейф проявляется, когда статистический профиль входных данных расходится с режимом обучения, либо когда требования к задачам незаметно меняются, что приводит к ухудшению производительности. В хорошо реализованных системах тесты на статистическое расхождение для входящих потоков данных, сравнения в пространстве встраиваний или классификаторы дрейфа уровней активации дают ранние предупреждения. Далее следует надежное смягчение за счет дообучения, адаптации подсказок или развертывания обновленных моделей, формирующих состояние ✓. В более ограниченных случаях агенты могут демонстрировать лишь частичные меры защиты, например, воздействие на разнообразные выборки во время итеративного обучения, что снижает, но не осуществляет напрямую мониторинг дрейфа, отражая состояние . Напротив, системы без явного статистического мониторинга или каких-либо корректирующих механизмов остаются уязвимыми к скрытому ухудшению, соответствующему состоянию ✗. В здравоохранении, где сдвиги распределений возникают из‑за демографических различий или меняющихся клинических руководств, обнаружение и смягчение дрейфа имеют решающее значение для сохранения безопасности пациентов и минимизации диагностической ошибки.
II-D2 Адаптация на основе обучения с подкреплением
Эта подпространство отражает, как агенты на основе LLM уточняют свое поведение, переводя оценочную обратную связь в структурированные сигналы вознаграждения, которые формируют будущие решения. В полноценных реализациях применяются явные механизмы обучения с подкреплением, такие как RLHF. В этих механизмах используются предпочтения экспертов для оптимизации политик, которые кодируют вербальную обратную связь в память для итеративного улучшения и формируют метку ✓. Такие системы демонстрируют непрерывную адаптацию, где циклы, движимые вознаграждением, уточняют политики принятия решений и интегрируют проверку экспертами. Напротив, в частичных реализациях могут использоваться упрощенные формы обратной связи, например двоичные сигналы успеха или неудачи, эвристическая оптимизация, вербальное подкрепление в запросах и т.д. Эти подходы дают направляющее руководство, но не имеют систематических механизмов подкрепления, тем самым передавая метку . Наконец, системы, которые не включают явное моделирование вознаграждения, обучение с подкреплением или обновления, основанные на предпочтениях, относятся к категории ✗. В контекстах здравоохранения безопасная адаптация требует, чтобы агенты интегрировали обратную связь клиницистов, нормативные требования и предпочтения конкретного пациента.
II-D3 Метаобучение и обучение на малых выборках
Мета-обучение и few-shot относится к способности агентов на основе LLM быстро адаптироваться к новым задачам или областям с минимальным надзором. Методы мета-обучения, такие как градиентные алгоритмы, которые обучают модели эффективно обновляться всего по нескольким примерам, позволяют выполнять быструю перенастройку между задачами без необходимости обширного дообучения. В дополнение к этому, контекстное few-shot подсказывание использует предварительно обученные представления для обобщения во время вывода, когда несколько демонстраций внутри подсказки могут направлять точное рассуждение. Системы, которые сочетают эти подходы, используя либо мета-обученную инициализацию, либо сложные протоколы few-shot подсказывания, считаются ✓. Более ограниченные подходы, такие как опора исключительно на zero-shot обобщение или извлечение эталонных случаев без систематической адаптации, относятся к . Между тем, фреймворки, которые не упоминают few-shot адаптацию, протоколы мета-обучения или быстрое специализирование под задачи, классифицируются как ✗. Возможности этой под-мерности особенно важны в медицине, где модели должны быстро адаптироваться к изменениям в клинической практике, редким фенотипам пациентов и развивающимся базам доказательств в динамических условиях ухода.
II-E Безопасность и этика
Агенты на базе LLM в здравоохранении должны проактивно предотвращать небезопасное поведение посредством многоуровневого согласования, систематического red teaming и атакоустойчивой оркестрации, учитывающей атаки. Эмпирические работы показывают, что jailbreaks могут автоматически генерироваться даже когда модель является «черным ящиком» [chao2025jailbreaking]. Недавние исследования описывают автоматические атаки prompt injection [liu2024automatic] и систематизируют защиты в четкие таксономии [yi2024jailbreak], тогда как фреймворки вроде Constitutional AI [bai2022constitutional] и end-to-end методы red-teaming [purpura2025building] задают процедурные ограждения. Справедливость требует выявления и смягчения систематических ошибок между группами пациентов, при этом оценка и устранение последствий должны опираться на обзоры смещений LLM [gallegos2024bias, li2023survey]. В здравоохранении в частности, данные, такие как анализ [obermeyer2019dissecting] широко используемого алгоритма оценки риска, демонстрируют, как прокси-цели могут приводить к расовым различиям, что мотивирует стратифицированную отчетность и стресс-тесты на смещения. Приватность пациентов зависит от минимизации идентифицируемости и противодействия утечкам на уровне модели. Эмпирические атаки извлекают дословные данные обучения из моделей [mireshghallah2022quantifying], подчеркивая необходимость обучения с сохранением приватности. В здравоохранении federated learning позволяет совместную работу между учреждениями без централизации PHI [rieke2020future], дополняемую надежной деидентификацией клинического текста. Эти практики дают возможность разработки моделей, их оценки и мониторинга при соблюдении ограничений конфиденциальности в месте оказания помощи. Наконец, заслуживающее доверия внедрение требует проверяемого соответствия и аудируемости. Научные анализы подробно описывают, как EU AI Act изменяет классификацию рисков и обязательства для health AI [van2024eu]. В США обзоры надзора за устройствами подчеркивают пробелы в прозрачности и репрезентации для AI-инструментов [muralidharan2024scoping]. Эти фреймворки лежат в основе протоколирования происхождения данных, отслеживания обоснований и post market surveillance, необходимых для клинической подотчетности. Таблица V представляет оценки Safety & Ethics по четырем ее субизмерениям:
| Papers | Safety Guardrails & Adversarial Robustness | Bias & Fairness | Privacy Preserving Mechanism | Regulatory & Compliance Constraints |
| Colacare [wang2025colacare] | ✗ | ✗ | ||
| Medagent [tang2023medagents] | ✗ | ✗ | ✗ | ✗ |
| Medaide [yang2024medaide] | ✗ | |||
| Doctoragent [feng2025doctoragent] | ✗ | ✗ | ✓ | |
| Aihospital [fan2024ai] | ✗ | ✗ | ||
| Mmedagent [li2024mmedagent] | ✗ | ✗ | ✗ | ✗ |
| Medchat [liu2025medchat] | ✗ | ✗ | ✗ | ✗ |
| Medco [wei2024medco] | ✗ | ✗ | ✗ | |
| Medagentpro [wang2025medagent] | ✗ | ✗ | ✗ | ✗ |
| Clinicalagent [yue2024clinicalagent] | ✗ | ✗ | ✗ | ✗ |
| Ktas [han2024development] | ✗ | ✗ | ✓ | ✓ |
| Agentmd [jin2024agentmd] | ✗ | ✗ | ||
| Mdagent [kim2024mdagents] | ✗ | ✗ | ✗ | |
| Agenthospital [li2024agent] | ✗ | ✗ | ✗ | |
| Pharmagent [gao2025pharmagents] | ✗ | ✗ | ✗ | ✗ |
| Txagent [gao2025txagent] | ✓ | ✗ | ||
| Autoct [liu2025autoct] | ✗ | ✗ | ✗ | ✗ |
| Kg4diagnosis [zuo2025kg4diagnosis] | ✗ | ✗ | ✗ | |
| Mdteamgpt [chen2025mdteamgpt] | ✓ | ✗ | ✗ | |
| Mitigating [ke2024mitigating] | ✗ | ✓ | ✗ | ✗ |
| Polaris [mukherjee2024polaris] | ✓ | ✓ | ✓ | ✗ |
| Rxstrategist [van2024rx] | ✗ | ✗ | ✗ | |
| Clinicallab [yan2024clinicallab] | ✓ | |||
| Agenticllm [sudarshan2024agentic] | ✗ | ✗ | ✗ | |
| Surgbox [wu2024surgbox] | ✗ | |||
| Aipatient [yu2024simulated] | ✓ | ✓ | ||
| Healthagent [abbasian2023conversational] | ✗ | ✗ | ||
| Icdcoding [li2024exploring] | ✗ | ✗ | ✗ | |
| Aha [pandey2024advancing] | ✗ | ✗ | ||
| Ddo [jia2025ddo] | ✗ | ✗ | ✗ | ✗ |
| Beyond [wang2024beyond] | ✗ | ✗ | ✓ | ✗ |
| Zodiac [zhou2024zodiac] | ✓ | ✓ | ✓ | |
| Fhirviz [almutairi2024fhirviz] | ✗ | ✗ | ✗ | |
| Fhir [de2024multi] | ✗ | ✗ | ✓ | ✗ |
| Fuasagent [zhao2025autonomous] | ✓ | ✓ | ||
| Aitherapist [wasenmuller2024script] | ✗ | ✗ | ✗ | ✗ |
| Radiology [zeng2024enhancing] | ✗ | ✗ | ✗ | |
| Triageagent [lu2024triageagent] | ✗ | ✗ | ✗ | |
| Piors [bao2024piors] | ✗ | ✗ | ||
| Selfevolve [almansoori2025self] | ✗ | ✓ | ✗ | ✗ |
| Drugagent [liu2024drugagent] | ✗ | ✗ | ✗ | ✗ |
| Ctagent [mao2025ct] | ✗ | ✗ | ✗ | ✗ |
| Adagent [hou2025adagent] | ✗ | ✗ | ✓ | ✗ |
| Drugpilot [li2025drugpilot] | ✗ | ✗ | ✗ | |
| Llmadmin [gebreab2024llm] | ✓ | ✗ | ✗ | |
| Swarm [song2025llm] | ✗ | ✗ | ✗ | ✗ |
| Drugdiscover [ock2025large] | ✗ | ✗ | ✗ | ✗ |
| Ragdrug [lee2025rag] | ✗ | ✗ | ✗ | ✗ |
| Drugreason [inoue2025drugagent] | ✗ | ✗ | ✗ | ✗ |
II-E1 Ограждения безопасности и противодействие противникам
Ограничители безопасности и противодействие противникам (adversarial robustness) задают защитные меры, которые предотвращают, обнаруживают и сдерживают вредное поведение, когда агенты намеренно или случайно направляют в сторону от предполагаемого клинического применения. Это включает упрочнение входных данных, чтобы исключить, например, prompt injection, устойчивое планирование и управление выходными данными с непрерывным стресс-тестированием. В рамках этой под-измерения ✓ обозначает зрелые многостадийные меры защиты с автоматизированными детекторами, противоборческой оценкой и быстрыми маршрутами устранения. указывает на изолированные фильтры или разрозненную проверку человеком без систематического тестирования. ✗ отражает отсутствие явных механизмов или доказательств эффективности. В оказании медицинской помощи различие между этими метками является практичным. Надежные системы блокируют небезопасные назначения, противостоят манипулированию инструментами, связанными с EHR, выявляют аномалии дозирования и предотвращают эскалацию сбоев в рамках многошаговых рабочих процессов.
II-E2 Смещение и справедливость
Вопросы смещения и справедливости заключаются в том, сохраняется ли поведение агента справедливым во всех клинически значимых популяциях и контекстах. Это требует: (i) репрезентативных данных с верифицированными метками (ii) выбора моделирования, ограничивающего несоразмерные ошибки (iii) политик развертывания, минимизирующих неравенство. В рамках этого подпоказателя ✓ обозначает сбалансированную представленность по клинически значимым когортам, таким как возраст и пол. Он также включает анализ смещения в подгруппах с сообщенными различиями и примененными мерами по смягчению. применяется, когда используются только шаги по защите данных, такие как деидентификация/анонимизация, или когда опасения по смещению просто признаются. Но отсутствуют демографический аудит, метрики справедливости, а также реализованные механизмы обнаружения смещения или смягчения. ✗ описывает полное отсутствие оценки смещения и механизмов справедливости. В здравоохранении смещение и справедливость необходимы, чтобы предотвращать недодиагностику или неравный доступ, особенно на пересечениях расы, возраста, пола, языка, инвалидности и социально-экономического статуса.
II-E3 Механизм, сохраняющий конфиденциальность
Эта под-область задаёт архитектурные и процедурные механизмы контроля, которые ограничивают, кто и что может получать доступ к данным пациентов на протяжении всего жизненного цикла агента. Эта под-область в широком смысле охватывает механизмы, включая вывод на границе (edge inference), доверенное исполнение (trusted execution), шифрование при передаче, частичное извлечение с ограниченными контекстными окнами, деидентификацию/псевдонимизацию и дифференциальную приватность для обучения, а также аналитику. Программы также должны явным образом проверять приватность посредством моделирования угроз, аудитов утечек и проверки корректности редактирования. ✓ указывает механизмы приватности на уровне агента, выходящие за рамки предварительной обработки данных набора, включая обработку чувствительных входных данных на устройстве, встроенную деидентификацию или анонимизацию, надёжное шифрование и одобрение IRB/этики при участии человеческих или клинических данных. Многие реализации также используют двухуровневую конструкцию, которая сохраняет чувствительную обработку локальной. применяется, когда приватность ограничивается деидентификацией данных набора или общими заявлениями о соответствии (например, HIPAA compliant). Это не включает механизм деидентификации/анонимизации со стороны агента и технические средства, такие как шифрование, дифференциальная приватность и безопасные вычисления. ✗ описывает системы без технических механизмов приватности, определённых выше. В клинических развёртываниях эти механизмы предотвращают эксфильтрацию PHI из EHR-связанных инструментов, уменьшают воздействие со стороны инсайдеров и позволяют обеспечивать соответствующее требованиям совместное использование без централизации чувствительных данных.
II-E4 Регуляторные и комплаенс-ограничения
Ограничения регулирования и соответствия определяют, как дизайн агента, обработка данных и рабочие процедуры удовлетворяют обязательным законам в рамках сбора, обучения, вывода и мониторинга после развертывания. Ключевые элементы включают: (i) документированные согласия и законные основания (ii) доступ с ограничением по ролям и графики хранения (iii) элементы контроля трансграничной передачи (iv) формальные оценки рисков, связывающие политики с техническими защитными мерами. Соответствие должно быть подтверждено доказательствами, а не просто заявлено через политики, журналы испытаний и контрольные точки выпуска. В здравоохранении эти меры определяют, будут ли функции рекомендаций агента рассматриваться как регулируемое программное обеспечение, соответствует ли обработка PHI требованиям HIPAA или GDPR и выдерживают ли развертывания клиническую юридическую проверку. ✓ указывает на явное соответствие применимым законам вроде HIPAA или GDPR, операционным механизмам согласия и контролям хранения. Это также охватывает утверждение IRB или этическое одобрение, когда задействованы люди-участники или клинические данные, а также процедуры реагирования на инциденты, включающие документированные тренировки. применяется, когда доказательства ограничены изолированными подтверждениями вроде HIPAA compliant cloud и сертификаций третьих лиц. Это не охватывает документированные сценарии получения согласия или оценку рисков с формулировками в виде политик, которые не содержат операционных доказательств, и опору на заверения поставщика. ✗ описывает системы без явного сопоставления с законами или стандартами.
II-F Иерархия типологий
Типология фреймворков определяет структурные и операционные планы, лежащие в основе систем агентами на базе LLM. Она описывает, как несколько единиц рассуждений объединяются и как осуществляется контроль над их совместным поведением. Во многих современных системах наблюдается подход, при котором когнитивная работа распределяется между несколькими специализированными ролями агентов, которые взаимодействуют посредством раундов обсуждения для достижения консенсуса. Например, [tang2023medagents] использует многораундовое обсуждение между агентами LLM, имитирующими специалистов в предметной области, объединяя их индивидуальные анализы в сводку перед тем, как принять решение. Аналогично, фреймворк Multi-Agent Conversation (MAC) [chen2025enhancing] моделирует обсуждения междисциплинарной команды при диагностике редких заболеваний. Он включает нескольких агентов-врачей и агента-наставника, которые обсуждают клинические признаки и различные диагностические гипотезы. Системы такого типа дают преимущества в медицинском вопросно-ответном поиске, клинической поддержке принятия решений и диагностике, поскольку они отражают междисциплинарные рабочие процессы. Они контрастируют с монолитными конструкциями, где один LLM отвечает за все этапы рассуждений, что может быть проще, но при этом возрастает риск доменной неточности знаний в медицинских условиях. Дополняя компоновку ролей агентов, существует механизм, с помощью которого со временем управляются контроль, состояние, обратная связь и адаптация. Это включает то, как задачи оркестрируются, и имеется ли центральный контроллер, который назначает подзадачи, отслеживает выходы агентов и обеспечивает выполнение проверок. Например, [zhang2025agentorchestra] реализует центрального агента планирования, который разлагает сложные цели на части и делегирует их подагентам, а затем объединяет и синтезирует их результаты. Такая централизованная оркестрация особенно важна в клинических средах, чтобы обеспечивать соблюдение требований, управлять задержками и интегрировать вмешательства человека в критические моменты. С другой стороны, некоторые фреймворки исследуют децентрализованную или адаптивную оркестрацию. В этом направлении [yang2025agentnet] позволяет агентам самоспециализироваться, развивать свои связи в структуре DAG и маршрутизировать задачи без единого центрального контроллера. Таблица VI предоставляет оценки Типологии фреймворков по:
II-F1 Многоагентный дизайн
Мультиагентный дизайн отражает, как обязанности в системе на базе LLM распределяются между одним или несколькими агентами и как эти агенты взаимодействуют для выполнения задач. На одном крайнем полюсе однoагентные дизайны объединяют рассуждение, планирование и выполнение в рамках единого процесса, что дает нам простоту, но ограничивает специализацию. Более продвинутые системы декомпозируют функциональность на отдельные агенты, такие как планировщики, извлекатели или верификаторы. Затем эти отдельные агенты обмениваются сообщениями или совместно размышляют, тем самым обеспечивая модульность, избыточность и более четкое согласование с предметной специализацией. В здравоохранении такие распределенные структуры могут имитировать междисциплинарное сотрудничество. Например, наличие отдельных агентов для анализа результатов визуализации, валидации клинических рекомендаций и подготовки сводок, ориентированных на пациента, по смыслу напоминает такое междисциплинарное сотрудничество. Оценка этой под-измеримости требует различать, демонстрирует ли система подлинную мультиагентную архитектуру, лишь частичные следы такой координации или вообще не реализует подобное. Таким образом, ✓ применяется, когда специализированные роли явно реализованы, отражает неоднозначную или поверхностную координацию, а ✗ обозначает монолитные или использующие инструменты однoагентные системы.
II-F2 Централизованная оркестрация
Централизованная оркестрация относится к тому, как осуществляется контроль над потоком задач, данных и решений в системах агентов на базе LLM. В своей наиболее сильной форме центральный контроллер управляет последовательностью работы агентов, отслеживает их выходные результаты и интегрирует их в целостное согласованное решение. Хотя централизация может вносить единую точку отказа и узкие места по задержкам, она обеспечивает глобальную согласованность, позволяет осуществлять надзор и предоставляет четкие точки для вмешательства. Другие фреймворки опираются на более свободную координацию, такую как иерархическое делегирование или взаимодействие по принципу peer-to-peer, где агенты сотрудничают без единого координирующего органа. Эти подходы дают гибкость, но могут снижать надежность в условиях, критичных к безопасности. Некоторые системы работают только с последовательным выполнением задач и минимальным надзором, больше напоминая простые конвейеры, чем настоящую оркестрацию. В здравоохранении эти различия имеют существенное значение. Надежный оркестратор может гарантировать, что несколько источников доказательств будут согласованы до того, как будут предложены клинические решения, и инициировать эскалацию к экспертам-людям, когда неопределенность высока. Без такой оркестрации системы рискуют фрагментированным рассуждением, пропуском противоречий и ограниченной ответственностью. На практике оркестрация часто реализуется через workflow engines и планировщики, основанные на политике, которые внедряют тайм-ауты, повторы и circuit breakers. Оценка этой под-меры опирается на степень развитости координации. ✓ применяется, когда центральный оркестратор явно определен и виден двунаправленный контроль. отражает более свободные структуры, такие как peer-to-peer или иерархическое делегирование. ✗ описывает последовательные или односистемные дизайны.
| Papers | Multi-Agent Design | Centralized Orchestration |
|---|---|---|
| Colacare [wang2025colacare] | ✓ | ✓ |
| Medagent [tang2023medagents] | ✓ | |
| Medaide [yang2024medaide] | ✓ | ✓ |
| Doctoragent [feng2025doctoragent] | ✓ | ✓ |
| Aihospital [fan2024ai] | ✓ | |
| Mmedagent [li2024mmedagent] | ✗ | ✗ |
| Medchat [liu2025medchat] | ✓ | |
| Medco [wei2024medco] | ✓ | |
| Medagentpro [wang2025medagent] | ✗ | |
| Clinicalagent [yue2024clinicalagent] | ✓ | ✓ |
| Ktas [han2024development] | ✓ | |
| Agentmd [jin2024agentmd] | ✗ | ✗ |
| Mdagent [kim2024mdagents] | ✓ | ✓ |
| Agenthospital [li2024agent] | ✓ | ✓ |
| Pharmagent [gao2025pharmagents] | ✓ | |
| Txagent [gao2025txagent] | ✓ | |
| Autoct [liu2025autoct] | ✓ | |
| Kg4diagnosis [zuo2025kg4diagnosis] | ✓ | ✓ |
| Mdteamgpt [chen2025mdteamgpt] | ✓ | ✓ |
| Mitigating [ke2024mitigating] | ✓ | |
| Polaris [mukherjee2024polaris] | ✓ | ✓ |
| Rxstrategist [van2024rx] | ✓ | |
| Clinicallab [yan2024clinicallab] | ✓ | |
| Agenticllm [sudarshan2024agentic] | ✗ | |
| Surgbox [wu2024surgbox] | ✓ | ✓ |
| Aipatient [yu2024simulated] | ✓ | |
| Healthagent [abbasian2023conversational] | ✗ | ✗ |
| Icdcoding [li2024exploring] | ✓ | |
| Aha [pandey2024advancing] | ✓ | |
| Ddo [jia2025ddo] | ✓ | |
| Beyond [wang2024beyond] | ✓ | |
| Zodiac [zhou2024zodiac] | ✓ | |
| Fhirviz [almutairi2024fhirviz] | ✓ | |
| Fhir [de2024multi] | ✓ | ✓ |
| Fuasagent [zhao2025autonomous] | ✓ | |
| Aitherapist [wasenmuller2024script] | ✓ | |
| Radiology [zeng2024enhancing] | ✓ | |
| Triageagent [lu2024triageagent] | ✓ | |
| Piors [bao2024piors] | ✓ | |
| Selfevolve [almansoori2025self] | ✓ | |
| Drugagent [liu2024drugagent] | ✓ | |
| Ctagent [mao2025ct] | ✗ | ✗ |
| Adagent [hou2025adagent] | ✗ | ✗ |
| Drugpilot [li2025drugpilot] | ✗ | ✗ |
| Llmadmin [gebreab2024llm] | ✓ | ✓ |
| Swarm [song2025llm] | ✓ | |
| Drugdiscover [ock2025large] | ✗ | ✗ |
| Ragdrug [lee2025rag] | ✓ | |
| Drugreason [inoue2025drugagent] | ✓ | ✓ |
II-G Базовые задачи и подзадачи
Основные задачи и подзадачи определяют, что именно делает агент на основе LLM в здравоохранении. Они задают операционную ответственность агента и поддающиеся проверке результаты, которые он должен обеспечивать. Начиная с сырых клинических данных, эти задачи продвигаются к клиническим рекомендациям и оценке на уровне системы. Поэтому это измерение закрепляет проектирование агента в конкретных рабочих процессах и поддающихся измерению конечных точках. В начале агенты могут преобразовывать неструктурированные записи в вычислимые артефакты. Они могут суммировать проблемы, извлекать сущности и связывать их с кодами. Они могут рассуждать по многотабличным EHR, чтобы отвечать на запросы на уровне записи, как показано в EHRAgent [shi2024ehragent]. Многoагентные конвейеры могут также отражать роли ведения документации. Например, ColaCare [wang2025colacare] координирует DoctorAgents с надзорным MetaAgent для интеграции структурированных данных EHR и текстовых рассуждений. [pandey2024advancing] оформляет извлечение доказательств для предварительного согласования как задачу многoагентной классификации и поиска. Эти проектные решения напрямую связываются с повседневным ведением карт, кодированием и управлением использованием. Далее агенты могут отвечать на клинические вопросы и обеспечивать поддержку на основе руководств. MDAgents [kim2024mdagents] адаптирует роли агента модератор, извлекатель, верификатор под сложность задачи и демонстрирует улучшения по медицинским решенческим бенчмаркам. Для вопросов, опирающихся на EHR, агенты планируют использование инструментов и вычисляют доказательства внутри карты, как в EHRAgent [shi2024ehragent]. Этот шаблон связывает ответы с происхождением информации, которое требуется клиницистам для подотчетной поддержки принятия решений. Кроме того, агенты могут проводить сортировку и закладывать дифференциалы в условиях неопределенности. Ролевые специализированные команды имитируют работу врачей неотложной помощи, фармацевтов и координаторов. [han2024development] показывает, как многoагентная клиническая система поддержки принятия решений, согласованная с Korean Triage and Acuity Scale, реализует сортировку, планирование лечения и маршрутизацию в отделении неотложной помощи. Моделирование в больнице позволяет агентам отрабатывать прием, запросы и ранжирование дифференциалов end-to-end, как в [li2024agent]. Эти подходы отражают типичные для передовой помощи факторы: дефицит времени, неполноту данных и проверки на смещения. Далее агенты могут выполнять диагностическое рассуждение через планы, вызовы инструментов и явные обновления гипотез. Иерархические команды разделяют общий прием у универсала и проверку у узкого специалиста, при этом закрепляя шаги в графах знаний, как обсуждается в [zuo2025kg4diagnosis]. MedAgent-Pro [wang2025medagent] демонстрирует многомодальный агент рассуждений для диагностики. Модульные конструкции ориентируются на интерактивную дифференциальную диагностику с оркестратором и ролевыми агентами как авторами MEDDxAgent, как показано в [rose2025meddxagent]. Это повторяет консультационные маршруты, где отслеживание неопределенности и эскалация являются обязательными. Продолжая, агенты могут планировать лечения и верифицировать назначения. Фреймворки, сосредоточенные на терапевтике, рассматривают использование инструментов как операцию первого класса. TxAgent [gao2025txagent] выбирает из ToolUniverse, чтобы проверить противопоказания и персонализировать варианты. Верификация назначений может быть организована по стадиям: проверка показания, дозы и взаимодействий с использованием агентского конвейера, как задокументировано в Rx Strategist [van2024rx]. Разговорные агенты примирения вовлекают пациента в контур и согласуют списки до подписания назначений [deo2025conversational]. Эти шаги согласуются с набором назначений, фармацевтической верификацией и политиками попечительства на практике. Агенты также могут ускорять открытие и клинические испытания. В сфере открытий химические агенты планируют синтезы и рассуждают по лабораторным инструментам, как показано ChemCrow [m2024augmenting]. В испытаниях многoагентные системы поддерживают прогнозирование исходов и аналитику исследований [yue2024clinicalagent]. Подбор пациентов для испытаний выигрывает от агентного обогащения знаний [shi2024enhancing] и дополняющих подходов извлечения + LLM, таких как TrialGPT [jin2024matching]. Эти функции сокращают отбор кандидатов и повышают справедливый доступ к исследованиям. Наконец, агенты могут поддерживать взаимодействие с пациентом и мониторинг между визитами. Носимые системы вычисляют персонализированные инсайты посредством агентного выполнения кода и извлечения, как показывают эксперименты в [merrill2024transforming]. Клинические внедрения исследуют агенты под надзором врача для примирения медикаментозных назначений и безопасного общения [deo2025conversational]. Эти конструкции отражают линию сортировки медсестры, программы дистанционного мониторинга и цифровые траектории хронической помощи. В конце, агенты могут быть оценены и подвергнуты стресс-тестированию в интерактивных средах, насыщенных инструментами. Моделирующие тестовые стенды оценивают end-to-end решения, диалог и использование инструментов на реалистичных артефактах. AgentClinic [schmidgall2024agentclinic] измеряет поведение агента в многомодальных клинических взаимодействиях по специальностям и языкам. MedAgentBench [jiang2025medagentbench] встраивает агентов в виртуальный EHR, совместимый с FHIR, с сотнями задач, написанных врачами. Такие платформы связывают поведение агента с безопасностью, внешней валидностью и влиянием на рабочие процессы так, как системы здравоохранения оценивают новые инструменты. Таблицы VII и Table VIII представляют оценки Core Tasks & Subtasks across:
II-G1 Клиническая документация и анализ EHR
Эта под-измерение оценивает способность агента преобразовывать разнородную клиническую документацию и артефакты EHR в вычислимые и удобные для клиницистов результаты. Характеристики этого под-измерения охватывают сводку в виде графиков, извлечение клинически значимых сущностей, сопоставление с кодами вроде ICD, прогнозирование риска по долгосрочным сигналам и составление черновиков отчетов, например радиологических заключений. Агент получает ✓, когда он демонстрирует четкую обработку медицинских записей и структурированное извлечение информации на реальных клинических данных, а не только в демонстрациях. Это может включать поддержку базового анализа EHR, клинические задачи прогнозирования, чтение из FHIR и запись в FHIR, а также обработку специализированных отчетов. указывает на базовую генерацию записей или узкую обработку документов, например только рецепты, и/или опору на смоделированную, а не реальную документацию. ✗ применяется, когда отсутствует анализ EHR.
II-G2 Медицинский вопросно-ответный поиск и поддержка принятия решений
Медицинский вопрос-ответ и поддержка принятия решений определяет, может ли агент отвечать на клинические вопросы и обеспечивать поддержку решений, основанную на клинических руководствах, в разных модальностях и рабочих процессах. Возможности включают: (i) ответ на фактоидные и синтезирующие вопросы по авторитетным медицинским источникам (ii) рекомендации с извлечением, дополненным контекстом (retrieval-augmented) (iii) многотуровые диагностические вопросы (iv) специализированную поддержку для конкретных задач, такую как классификация триажа, оценка в кардиологии, советы по планированию хирургического вмешательства и визуальный вопрос-ответ. ✓ применяется, когда либо возможность медицинского вопрос-ответа, либо поддержки принятия решений явно реализована. Это может включать предметно-ориентированный научный вопрос-ответ с валидацией по бенчмаркам, ответы на основе доказательств, привязанные к цитированию, структурированные диагностические процессы, рекомендации в реальном времени, визуальный вопрос-ответ для областей радиологии и систематические трассировки рассуждений. отражает узкий или ограниченный охват, особенно когда демонстрации основаны только на симуляциях. Проверки медицинской необходимости, требующей предварительного разрешения, вопросы по верификации назначения и диалог без надежного извлечения из клинических руководств являются хорошими примерами для . ✗ означает отсутствие медицинского вопрос-ответа или поддержки принятия решений.
II-G3 Триаж и дифференциальная диагностика
Эта подзадача исследует способность агента преобразовывать первичную контактную информацию в два результата: решение о степени неотложности и обоснованный список альтернатив. Агент выясняет главную жалобу и историю. Он синтезирует показатели жизненно важных функций вместе с контекстом и задает целевые уточняющие вопросы. Он соотносится с установленными шкалами триажа, такими как ESI, KTAS, и рекомендует принимающую службу или отделение с кратким обоснованием. Параллельно он формирует дифференциальный диагноз, перечисляет ключевые различающие признаки и предлагает последующие тесты. ✓ применяется, когда триаж и дифференциальный диагноз явно реализованы. Это включает обработку симптомов с учетом неотложности на основе ESI/KTAS, рекомендации по отделениям с обоснованием, формирование ранжированных альтернатив и безопасную маршрутизацию с помощью агентов ролей. отражает узкий диагностический подход без явного приоритизирования, единичные классификаторы состояний, списки вероятностей без неотложности или только симуляционные рабочие процессы. ✗ обозначает отсутствие этих функций. В клинической помощи эти возможности напрямую определяют решение о направлении, время до начала лечения и эскалацию.
II-G4 Диагностическое рассуждение
Диагностическое рассуждение проверяет способность агента планировать и выполнять многошаговый клинический вывод, связывая целевое извлечение доказательств с обоснованным окончательным диагнозом. К ключевым моделям поведения относятся: (i) получение и структурирование новых данных (ii) выбор и упорядочивание диагностических тестов (iii) интерпретация результатов из структурированных и неструктурированных источников (iv) поддержание и пересмотр гипотез (v) объединение входных данных от специализированных агентов (vi) согласование выводов с руководящими принципами (vii) обход графов знаний (viii) калибровка уверенности с помощью явных дискриминаторов. Агент заслуживает ✓, когда демонстрирует структурированный рабочий процесс рассуждений, выполняет активное получение данных, объединяет мнения специалистов посредством принципиального слияния решений и выводит ранжированные дифференциалы с обоснованием. отражает поверхностную или одношаговую классификацию, ограниченную агрегацию или эвристики, специфичные для региона. ✗ обозначает отсутствие диагностического вывода сверх извлечения.
| Papers | Clinical Documentation & EHR Analysis | Medical Question Answering & Decision Support | Triage & Differential Diagnosis | Diagnostic Reasoning |
| Colacare [wang2025colacare] | ✓ | ✓ | ||
| Medagent [tang2023medagents] | ✓ | ✓ | ||
| Medaide [yang2024medaide] | ✓ | ✓ | ✓ | |
| Doctoragent [feng2025doctoragent] | ✗ | ✓ | ✓ | ✓ |
| Aihospital [fan2024ai] | ✓ | ✓ | ||
| Mmedagent [li2024mmedagent] | ✓ | ✓ | ✗ | |
| Medchat [liu2025medchat] | ✓ | |||
| Medco [wei2024medco] | ✓ | |||
| Medagentpro [wang2025medagent] | ✗ | ✓ | ✓ | ✓ |
| Clinicalagent [yue2024clinicalagent] | ✗ | ✗ | ✗ | ✗ |
| Ktas [han2024development] | ✗ | ✓ | ✓ | |
| Agentmd [jin2024agentmd] | ✓ | ✓ | ||
| Mdagent [kim2024mdagents] | ✓ | ✓ | ✓ | ✓ |
| Agenthospital [li2024agent] | ✓ | ✓ | ✓ | |
| Pharmagent [gao2025pharmagents] | ✗ | ✗ | ✗ | ✗ |
| Txagent [gao2025txagent] | ✗ | ✓ | ✗ | ✗ |
| Autoct [liu2025autoct] | ✗ | ✗ | ✗ | ✗ |
| Kg4diagnosis [zuo2025kg4diagnosis] | ✓ | ✓ | ✓ | |
| Mdteamgpt [chen2025mdteamgpt] | ✗ | ✓ | ✓ | ✓ |
| Mitigating [ke2024mitigating] | ✓ | ✓ | ✓ | |
| Polaris [mukherjee2024polaris] | ✓ | ✓ | ✓ | ✓ |
| Rxstrategist [van2024rx] | ✗ | |||
| Clinicallab [yan2024clinicallab] | ✓ | ✓ | ✓ | ✓ |
| Agenticllm [sudarshan2024agentic] | ✓ | ✗ | ✗ | ✗ |
| Surgbox [wu2024surgbox] | ✓ | ✗ | ✗ | |
| Aipatient [yu2024simulated] | ✓ | ✓ | ✗ | ✗ |
| Healthagent [abbasian2023conversational] | ✓ | ✓ | ✗ | ✗ |
| Icdcoding [li2024exploring] | ✓ | ✗ | ✗ | |
| Aha [pandey2024advancing] | ✓ | ✗ | ||
| Ddo [jia2025ddo] | ✓ | ✓ | ✓ | |
| Beyond [wang2024beyond] | ✗ | ✓ | ✓ | |
| Zodiac [zhou2024zodiac] | ✓ | ✓ | ✓ | |
| Fhirviz [almutairi2024fhirviz] | ✓ | ✗ | ✗ | ✗ |
| Fhir [de2024multi] | ✓ | ✗ | ✗ | ✗ |
| Fuasagent [zhao2025autonomous] | ✗ | |||
| Aitherapist [wasenmuller2024script] | ✗ | ✗ | ✗ | |
| Radiology [zeng2024enhancing] | ✓ | ✗ | ✗ | ✓ |
| Triageagent [lu2024triageagent] | ✓ | ✓ | ✓ | |
| Piors [bao2024piors] | ✓ | ✓ | ✓ | |
| Selfevolve [almansoori2025self] | ✓ | ✓ | ||
| Drugagent [liu2024drugagent] | ✗ | ✗ | ✗ | ✗ |
| Ctagent [mao2025ct] | ✓ | ✓ | ||
| Adagent [hou2025adagent] | ✓ | |||
| Drugpilot [li2025drugpilot] | ✗ | ✗ | ✗ | ✗ |
| Llmadmin [gebreab2024llm] | ✓ | ✗ | ✗ | ✗ |
| Swarm [song2025llm] | ✗ | ✗ | ✗ | ✗ |
| Drugdiscover [ock2025large] | ✗ | ✓ | ✗ | ✗ |
| Ragdrug [lee2025rag] | ✓ | ✗ | ✗ | |
| Drugreason [inoue2025drugagent] | ✗ | ✗ | ✗ | ✗ |
II-G5 Планирование лечения и назначение препаратов
Планирование лечения и назначение описывает способность агента переводить диагностический контекст в индивидуализированный план лечения и исполнимые назначения. Функциональности включают выбор фармакологических и неф arмакологических вариантов, персонализацию дозы, проверку противопоказаний, согласование активных назначений и формирование пациентских рекомендаций с критериями остановки. Надёжные системы также учитывают аллергию, функцию почек, сопутствующие заболевания и формуляры. Они могут также предоставлять подсказки для совместного принятия решений, фиксировать происхождение данных и передавать информацию фармацевту или назначающему врачу для верификации. ✓ подтверждается, когда либо планирование лечения, либо назначение явно реализованы. Под этой меткой система предоставляет явные рекомендации, проверки взаимодействий, обзор агента-фармацевта или основанные на инструментах проверки безопасности и обоснования, привязанные к факторам пациента. означает базовый выбор вариантов или шаблонные предложения без оптимизации дозы, проверки взаимодействий или персонализации. Демонстрации также могут быть ограничены симуляцией или обучением с обязательной интерпретацией человеком. ✗ присваивается в случаях, когда отсутствуют рекомендации по лечению или управление назначением.
| Papers | Treatment Planning & Prescription | Drug Discovery & Clinical Trial Design | Patient Interaction & Monitoring | Bench-marking & Simulation Environment |
| Colacare [wang2025colacare] | ✗ | ✗ | ✗ | ✓ |
| Medagent [tang2023medagents] | ✗ | ✗ | ✗ | ✓ |
| Medaide [yang2024medaide] | ✓ | ✗ | ✓ | |
| Doctoragent [feng2025doctoragent] | ✓ | ✗ | ✓ | ✓ |
| Aihospital [fan2024ai] | ✓ | ✗ | ✓ | ✓ |
| Mmedagent [li2024mmedagent] | ✗ | ✗ | ✗ | ✓ |
| Medchat [liu2025medchat] | ✗ | ✓ | ✗ | |
| Medco [wei2024medco] | ✗ | ✓ | ||
| Medagentpro [wang2025medagent] | ✗ | ✗ | ✗ | ✓ |
| Clinicalagent [yue2024clinicalagent] | ✗ | ✓ | ✗ | |
| Ktas [han2024development] | ✓ | ✗ | ✗ | ✓ |
| Agentmd [jin2024agentmd] | ✗ | ✗ | ✗ | ✓ |
| Mdagent [kim2024mdagents] | ✗ | ✗ | ✗ | ✓ |
| Agenthospital [li2024agent] | ✓ | ✗ | ✓ | ✓ |
| Pharmagent [gao2025pharmagents] | ✗ | ✓ | ✗ | ✓ |
| Txagent [gao2025txagent] | ✓ | ✗ | ✓ | |
| Autoct [liu2025autoct] | ✗ | ✓ | ✗ | ✓ |
| Kg4diagnosis [zuo2025kg4diagnosis] | ✗ | ✗ | ✓ | |
| Mdteamgpt [chen2025mdteamgpt] | ✗ | ✗ | ✓ | |
| Mitigating [ke2024mitigating] | ✗ | ✗ | ✗ | ✓ |
| Polaris [mukherjee2024polaris] | ✗ | ✓ | ✓ | |
| Rxstrategist [van2024rx] | ✓ | ✗ | ✗ | |
| Clinicallab [yan2024clinicallab] | ✓ | ✗ | ✓ | |
| Agenticllm [sudarshan2024agentic] | ✗ | ✗ | ✗ | |
| Surgbox [wu2024surgbox] | ✗ | ✓ | ||
| Aipatient [yu2024simulated] | ✗ | ✗ | ✓ | ✓ |
| Healthagent [abbasian2023conversational] | ✗ | ✗ | ✓ | |
| Icdcoding [li2024exploring] | ✗ | ✗ | ✓ | |
| Aha [pandey2024advancing] | ✗ | ✗ | ✗ | |
| Ddo [jia2025ddo] | ✗ | ✗ | ✓ | ✓ |
| Beyond [wang2024beyond] | ✗ | ✗ | ✗ | ✓ |
| Zodiac [zhou2024zodiac] | ✗ | ✗ | ✗ | ✓ |
| Fhirviz [almutairi2024fhirviz] | ✗ | ✗ | ✗ | ✓ |
| Fhir [de2024multi] | ✗ | ✗ | ✗ | ✓ |
| Fuasagent [zhao2025autonomous] | ✓ | ✗ | ✗ | |
| Aitherapist [wasenmuller2024script] | ✗ | ✓ | ||
| Radiology [zeng2024enhancing] | ✗ | ✗ | ✗ | ✓ |
| Triageagent [lu2024triageagent] | ✓ | ✗ | ✗ | ✓ |
| Piors [bao2024piors] | ✗ | ✗ | ✓ | ✓ |
| Selfevolve [almansoori2025self] | ✗ | ✗ | ✓ | ✓ |
| Drugagent [liu2024drugagent] | ✗ | ✓ | ✗ | ✓ |
| Ctagent [mao2025ct] | ✗ | ✗ | ✗ | ✓ |
| Adagent [hou2025adagent] | ✗ | ✗ | ✗ | ✓ |
| Drugpilot [li2025drugpilot] | ✓ | ✗ | ✓ | |
| Llmadmin [gebreab2024llm] | ✗ | ✗ | ||
| Swarm [song2025llm] | ✗ | ✓ | ✗ | ✓ |
| Drugdiscover [ock2025large] | ✗ | ✓ | ✗ | |
| Ragdrug [lee2025rag] | ✓ | ✗ | ✓ | |
| Drugreason [inoue2025drugagent] | ✗ | ✓ | ✗ | ✓ |
II-G6 Открытие лекарств и проектирование клинических испытаний
Оценка открытия лекарств и проектирования клинических испытаний измеряет способность агента ускорять трансляционные конвейеры от формулирования целевой идеи до выполнения исследования. Возможности включают предсказание взаимодействий лекарство-мишень, скрининг токсичности, генерацию гипотез и оптимизацию лидов. Функции испытаний включают авторинг протокола, извлечение критериев приемлемости, сопоставление пациентов с испытаниями, автоматизированную инженерную обработку признаков и предсказание исходов. ✓ гарантируется, когда реализованы либо открытие лекарств, либо проектирование клинических испытаний. Система должна проводить эксперименты вокруг специализированных для задач контрольных показателей, рабочих процессов, интегрированных с инструментами, и многослойной валидации. используется, когда функциональность узкая или ограничена только верхним уровнем, например поиск в базе данных, молекулярное аннотирование или базовая аналитика. Она не включает любую форму сквозной оптимизации, взаимодействие с экспериментальными ограничениями или поддержку испытаний сверх шаблонных критериев. ✗ зарезервировано для систем без возможностей открытия или проведения испытаний.
II-G7 Взаимодействие и мониторинг пациентов
Взаимодействие с пациентом и мониторинг характеризуют пациент-ориентированную функциональность агента в части коммуникации, мониторинга и логистики. Возможности включают двусторонний обмен сообщениями и обучение. Также это охватывает проверку симптомов с целевыми последующими действиями, контроль соблюдения режима с напоминаниями, планирование встреч, интеграцию устройств для физиологических сигналов и персонализированное управление беседой. ✓ присваивается, когда реализован хотя бы один из следующих элементов: взаимодействие, вовлеченность, управление встречами, напоминания или мониторинг. Доказательства могут включать реалистичное поведение в диалоге, отслеживание симптомов со сбором обратной связи, поддержку подразделения, мониторинг в реальном времени или оценку стресса. Динамическая симуляция симптомов и безопасные передачи также соответствуют этому критерию. относится к ограниченной функциональности, такой как базовый сбор анамнеза, обмен репликами по сценарию или только вводные подсказки без персонализированного мониторинга. ✗ означает отсутствие пациент-ориентированных взаимодействий, напоминаний, планирования или мониторинга.
II-G8 Бенчмаркинг и среда моделирования
Проверка и среда моделирования подтверждают, что агент тестируется в строгих и воспроизводимых условиях, отражающих клиническую работу. Область включает стандартизированные наборы испытаний с четкими протоколами и показателями. Также она включает симуляции, которые моделируют роли, артефакты (заметки, изображения, показатели жизнедеятельности) и многошаговые рабочие процессы. Надежные исследования сообщают о сравнениях с сильными базовыми вариантами, абляциях, анализе ошибок и, когда это уместно, экспертной проверке людьми. Соответственно, ✓ используется для оценки на существенном наборе испытаний или в клинически реалистичной симуляции с прозрачной настройкой, сравнениями с базовыми вариантами и исследованиями абляции. используется для узких демонстраций или синтетических микродисследований с небольшим числом примеров и ограниченными показателями. ✗ присваивается, когда не представлено содержательное бенчмаркирование или моделирование.
III Эмпирические результаты и обсуждение
В этом разделе мы обсуждаем сквозные тенденции по всем 7 измерениям оценки, представленным ранее. В следующих подразделах кратко показано, где кластеризуются LLM-агенты для здравоохранения. Например, анализ выявляет сильную интеграцию внешних знаний, но слабые динамические обновления и забывание в рамках управления знаниями, относительно распространённый разговорный режим, но редкое восстановление после ошибок в моделях взаимодействия и в целом низкое внедрение адаптации и обучения. Далее мы объясняем, почему эти закономерности важны для клинической надёжности и операционной готовности. Затем этот раздел сходится к критическим слабым местам и возможным практическим направлениям, подчёркивая, где методологические инвестиции наиболее срочно необходимы.
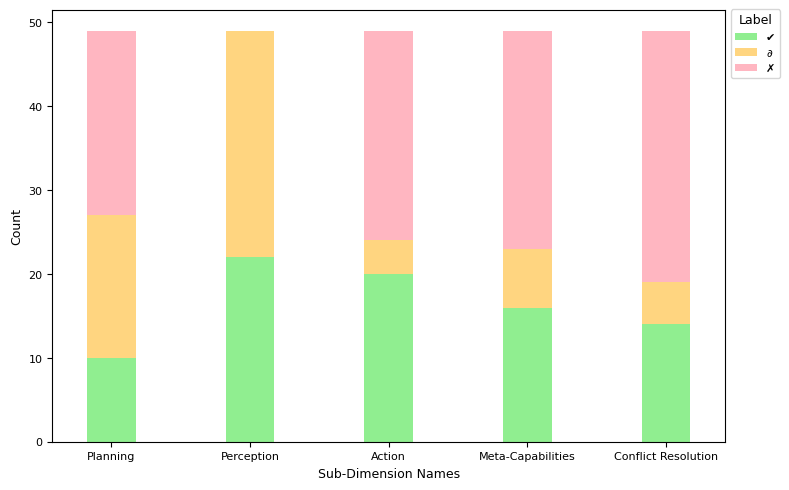
III-A Какие когнитивные подизмерения остаются недостаточно развитыми в агентах здравоохранения?
Рисунок 5 подчеркивает отмеченные асимметрии в распространенности реализации среди Когнитивных Способностей у опрошенных LLM-агентов. ✗ доминирует в трех подизмерениях: Планирование отсутствует в 45% опрошенных статей, Мета-Способности в 53% и Согласованность и разрешение конфликтов в 61%. Это указывает на то, что многие системы по-прежнему не имеют надежных механизмов для разложения задач на длительный горизонт, самоконтроля и систематического согласования противоречивых свидетельств. Напротив, ✓ встречается чаще в Восприятии (46%) и Действии (41%), где прогресс был обусловлен обучением представлениям для мультимодальных данных и конвейерами выполнения через API или инструменты. занимает промежуточное положение, что сигнализирует о частичной зрелости, а не о стабильности. Например, Восприятие демонстрирует 55%, тогда как Действие имеет только 8%, подчеркивая, что прототипы действительно показывают потенциал, но не дотягивают до надежной сквозной интеграции. Этот паттерн может быть следствием того, что когнитивные компетенции образуют основу доверенных клинических агентов. Без компетенции планирования агенты рискуют фрагментированными траекториями ухода и упущенными непредвиденными обстоятельствами при сортировке или предварительном согласовании. Слабый метаконтроль приводит к плохой калибровке неопределенности и отсутствию триггеров эскалации. Скудные конвейеры разрешения конфликтов провоцируют противоречивые обновления диаграмм или небезопасные рекомендации. Успехи во Восприятии и исполнении, хотя и необходимы, затрагивают лишь поверхностные уровни. Агенты, которые добросовестно потребляют данные EHR и генерируют структурированные выходы, все равно терпят неудачу, если не могут разрешать противоречия или адаптировать планы к развивающимся свидетельствам. Эти пробелы указывают на перспективные направления исследований: начать с формализации протоколов планирования, согласованных с клиническими рабочими процессами, продолжить встраиванием контуров метаконтроля, учитывающих неопределенность, и в завершение разработать конвейеры обнаружения противоречий.
III-B Равномерно ли реализованы возможности управления знаниями во всех LLM-агентах в сфере здравоохранения?
Рисунок 6 показывает стратифицированный шаблон реализации по трем подизмерениям, включая интеграцию внешних знаний, модуль памяти и динамические обновления и забывание. Интеграция внешних знаний является самой частой: ✓ на 37/49 (76%), на 1/49 (2%) и ✗ на 11/49 (22%). Эти значения подчеркивают широкое сочетание параметрического извлечения с авторитетными внешними источниками во время вывода. Модуль памяти смещается к (49%) при меньшем числе систем с ✓ (33%), а остальные отмечены ✗ (18%). Многие агенты сохраняют историю сеанса или простые буферы. Однако гораздо меньше систем реализуют управляемую контроллером, устойчивую, многослойную память с обоснованным чтением/записью. Наиболее заметная слабость — динамические обновления и забывание: здесь отмечено лишь 1/49 (2%) ✓, но 33/49 (67%) ✗. Очень немногие системы ориентированы одновременно на обе стороны сопровождения знаний: непрерывные добавления и явное забывание посредством правил затухания и отмены. Это распределение имеет высокую значимость, поскольку актуальность знаний, согласованность и гигиена лежат в основе безопасного клинического применения. Агенты должны согласовывать вывод с развивающимися руководствами, отзывами лекарств и изменениями в формуляре, подавляя устаревшие или противоречивые факты, чтобы предотвратить дрейф. Этот анализ также проливает свет на необходимость повышения уровня памяти — от буферов к устойчивым носителям, связывания извлечения с многослойной памятью и внедрения защитных шлюзов обнаружения отмены.
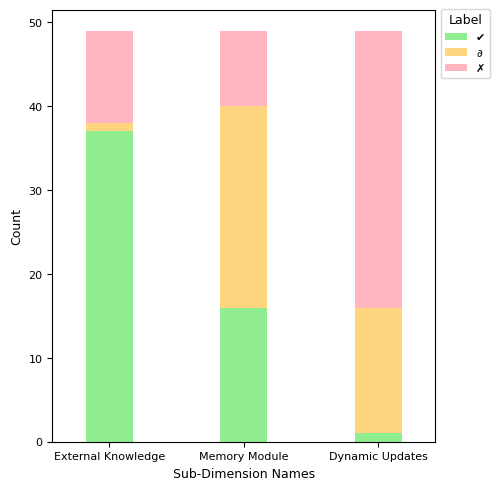
III-C Существующие ИИ-агенты достаточно хорошо обеспечивают баланс между беседой, триггерами событий, участием человека в контуре и восстановлением?
Рисунок 7 отображает распределение реализаций по четырем подизмерениям Паттернов взаимодействия: Разговорный режим, Активация по событию, Человек-в-контуре и Восстановление после ошибок. Распределение неоднородно, но перекошено в ключевых областях. Разговорный режим встречается относительно часто: ✓ на 43% работ и на 6% из них. Это указывает, что многие системы поддерживают многоходовый обмен и сохранение состояния, хотя почти половина все же не дотягивает. Активация по событию резко недопредставлена. Она составляет лишь 3/49 (6%) ✓ и 1/49 (2%) по сравнению с 45/49 (92%) ✗, что наводит на мысль о сильной зависимости от ручных подсказок вместо внешних сигналов, таких как телеметрия устройства или события EHR. Человек-в-контуре фиксирует 12% ✓, 2% , но 86% ✗, отражая конвейеры, которые не имеют контрольных точек в середине выполнения и документированных путей эскалации. Восстановление после ошибок также слабо выражено: лишь 4% ✓. Лишь несколько работ демонстрируют идемпотентное использование инструментов, откаты или деградацию в безопасном режиме. Для клинических операций мы намечаем потенциальные меры проектирования. Во-первых, привяжите активацию к регулируемым потокам событий с учетом происхождения и подавлением дребезга. Далее, определите контрольные точки Человек-в-контуре как явные шлюзы с очередями на утверждение и порогами неопределенности. Наконец, рассматривайте восстановление как подсистему первого класса с ограниченным числом повторных попыток и предохранителями. Эти меры могут превратить взаимодействия в поддающиеся проверке рабочие процессы, которые в свою очередь помогут обеспечить клиническое управление и снизить операционные риски.
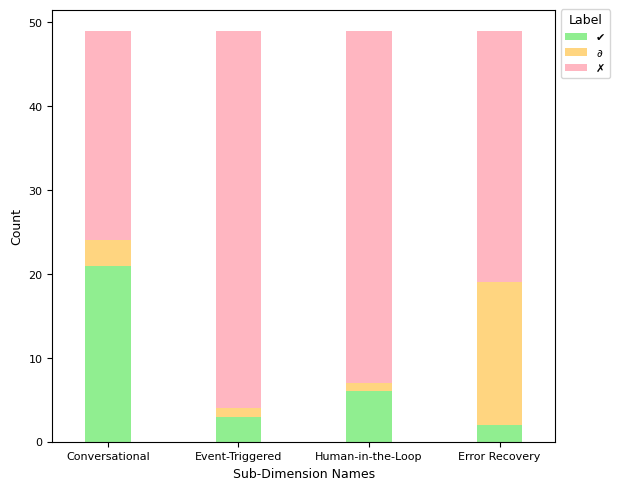
III-D Насколько хорошо агенты на базе LLM для здравоохранения адаптируются?
Рисунок 8 показывает единообразно низкое внедрение в разделе «Адаптация и обучение». ✗ или «Не реализовано» является преобладающей меткой во всех трех подизмерениях, при этом лишь тонкие хвосты и редкие случаи ✓. Обнаружение и смягчение дрейфа по сути отсутствуют: 0% ✓, 2% (1/49) и 98% (48/49) ✗. Это по сути означает, что большинство агентов не заметило бы и тем более не исправило бы сдвиги в кодах, шаблонах или составе пациентов. Адаптация на основе подкрепления проявляется только эпизодически: лишь 5 (10%) исследований имеют ✓ и 3 (6%) имеют против 41 (84%) с ✗, что указывает на то, что обновления, связанные с исходом (награды, ограничения, предпочтения клинициста), редко приводятся в рабочий режим. Мета-обучение и few-shot демонстрируют наилучшую опору, но все еще далеки от рутины: 20% ✓ и 2% при 78% ✗. Эти цифры показывают, что большинство систем по-прежнему опираются на статические подсказки, а не на легковесную адаптацию «на лету». Рассматривая эти исследования, можно выделить три отсутствующих элемента, которые повторяются: (i) ограниченная инструментализация жизненного цикла (немногие конвейеры сообщают частоты сигналов тревоги дрейфа или метрики отката) (ii) недостаточное использование обучения предпочтениям и вознаграждений, связанных с исходом, за пределами разрозненной обратной связи (iii) редкие сквозные конструкции, которые объединяют few-shot компетентность с непрерывным мониторингом. Здравоохранение по умолчанию нестационарно, и без обнаружения и контролируемого реагирования производительность незаметно деградирует там, где безопасность и аудируемость важнее всего. В заключение: сегодняшние показатели в диапазоне 0–20% ✓ по подизмерениям указывают на «островки» адаптационных возможностей. Возможный путь вперед — соединить эти «островки» в мониторируемый, обратимый контур адаптации, который сможет идти в ногу с развивающейся практикой.
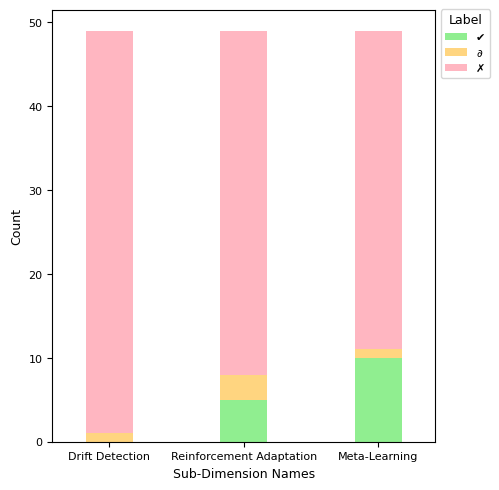
III-E Уровень зрелости внедрения безопасности и этики остается ограниченным среди опрошенных агентов
Рисунок 9 профилирует четыре подизмерения по безопасности и этике: защитные ограждения для предотвращения рисков и противодействие противоборствующим воздействиям, смещение и справедливость, механизмы сохранения приватности и ограничения, связанные с регулированием и соответствием требованиям. Для защитных ограждений, предотвращающих риски, и противодействия противоборствующим воздействиям только 3 из 49 работ (6%) получают ✓, 14 (29%) и 32 (65%) ✗. Это показывает, что у большинства агентных систем по-прежнему отсутствуют многоуровневые, поддающиеся проверке средства защиты от атак с использованием подсказок или небезопасного применения инструментов. Смещение и справедливость выглядят похоже: 5 исследований (10%) отмечены ✓, 12 с (25%) и остальные 32 (65%) имеют ✗, что указывает на то, что оценка и смягчение последствий с учетом стратификации по группам является скорее исключением, чем нормой. Механизмы сохранения приватности демонстрируют наилучшие результаты, но все еще далеки от универсальности. Их показатели включают 18% ✓, 28% и 53% ✗. Многие работы ссылаются на средства контроля на стороне размещения, однако меньшее число демонстрирует защиту на стороне агента с измеряемыми тестами на утечки данных. Ограничения, связанные с регулированием и соответствием требованиям, являются наиболее слабо реализованными: 10% ✓, только 4% и 86% ✗, что отражает то, что процедурные заверения редко представляются как верифицируемые защитные механизмы во время выполнения. Результаты на Рисунке 9, таким образом, делают больше, чем просто описывают, кто что внедрил. Они показывают разрыв между разработкой концепции и сквозными гарантиями, необходимыми для клинического внедрения, при 53–86% ✗ по подизмерениям. Возможное направление для исправления может быть таким: (i) превратить фильтры в многоуровневые защитные ограждения с наборами противоборствующих тестов и проверками опасностей на отложенных выборках (ii) заменить усреднения по макроуровню показателями, стратифицированными по группам (iii) повысить уровень приватности до деидентификации плюс отслеживаемый доступ (iv) превратить соответствие требованиям из текста политики в исполняемые контрольные механизмы, встроенные в рабочий процесс агента. Закрытие этих разрывов может перевести область от намерений к гарантиям и сделать безопасность, справедливость и поддаваемость аудиту измеримыми. Вкратце, статистика распространенности на Рисунке 9 подчеркивает градиент: сильная концептуальная нацеленность, частичная техническая реализация и ограниченные сквозные гарантии. Преодоление этого градиента может помочь обеспечить безопасные, справедливые и поддающиеся аудиту LLM-агенты, работающие в реальных клинических рабочих процессах.
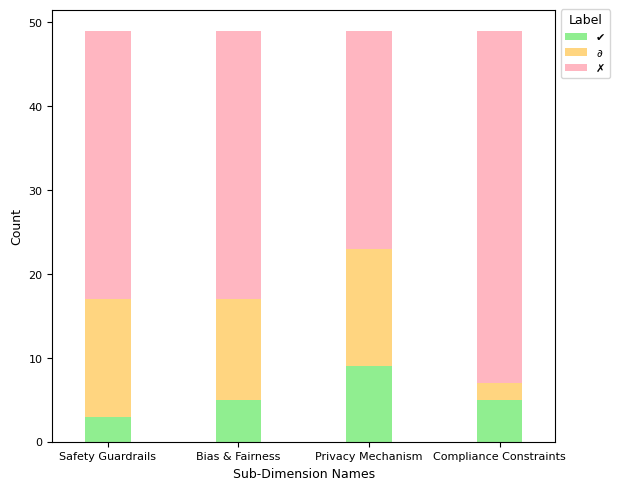
III-F Типология основ: тенденции для ИИ-агентов в здравоохранении на базе LLM
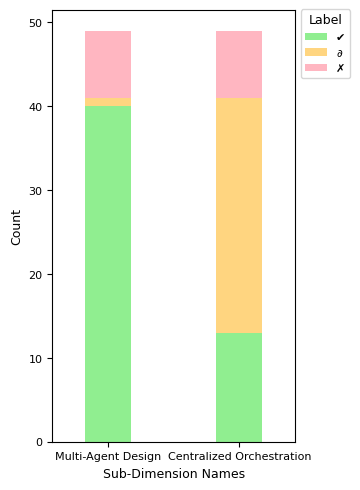
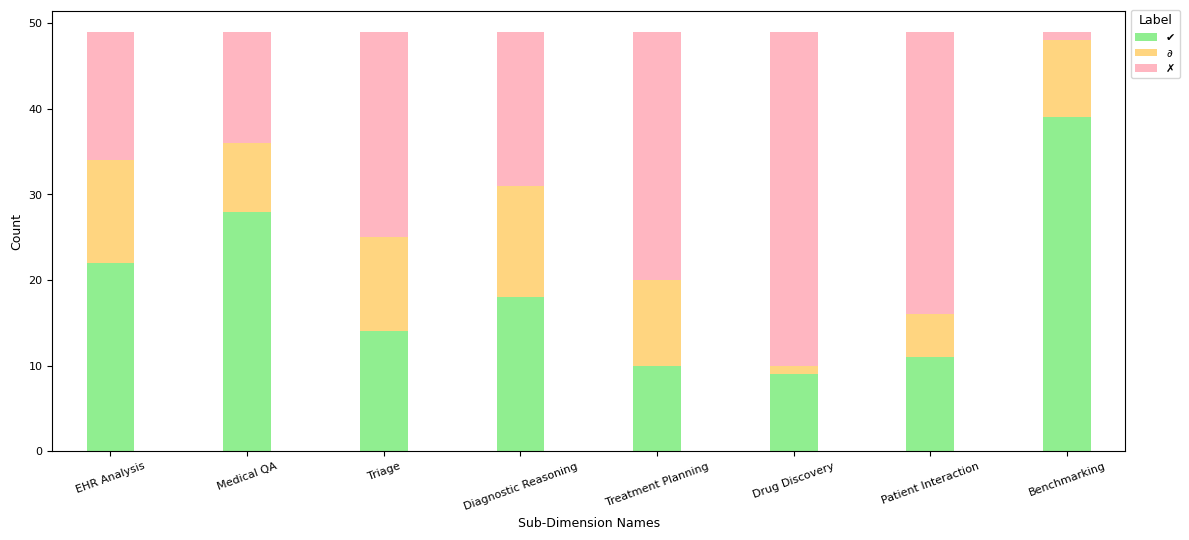
Рисунок 10 диаграммы отображает архитектурные решения в рамках типологии Framework, подсчитывая ✓, и ✗ по двум подизмерениям: Multi-Agent Design и Centralized Orchestration. Данные демонстрируют явную асимметрию. Multi-Agent Design в целом уже зрелый: 82% ✓ при лишь 16% ✗, что указывает на то, что ролевые композиции наподобие planner, retriever, verifier, explainer теперь являются шаблоном по умолчанию. Между тем Centralized Orchestration группируется в части пространства с 57% . Это предполагает, что хотя слои координации существуют, многие развертывания не доходят до полностью реализованных контроллеров с глобальным состоянием, принудительным выполнением политики и воспроизводимой последовательностью с возможностью аудита. Это не вердикт о том, какие архитектуры должны быть, а снимок того, куда в инженерном плане была направлена основная работа. Команды отдали приоритет модульной специализации, позволяющей легче распараллеливать работу и заменять компоненты, прежде чем укреплять оркестрацию ради сквозного обеспечения. На практике выборы типологии формируют поведение при нагрузке, эволюцию со временем и видимость контроля. Мультиагентные композиции могут отражать междисциплинарную заботу, распределяя отдельные агенты для соответствия руководящим принципам, синтеза доказательств и коммуникации с пациентом. Затем центральный оркестратор может согласовать эти шаги с институциональной политикой, выявлять неопределенность, направлять пограничные случаи клиницистам и примирять результаты перед оформлением назначения. Ни один из этих подходов не является универсально превосходным. Эффективные системы часто объединяют их или выбирают более легкую «хореографию», когда ограничения по задержке, стоимости или интеграции делают тяжеловесный контроллер нецелесообразным. Рассматриваемое в этом ключе, Figure 10 указывает на область, которая быстро перешла к модульному, ролевому дизайну (высокий ✓ в Multi-Agent Design), при этом постепенно наращивая механизмы координации (доминирующий в Centralized Orchestration) по мере того, как развертывания становятся более зрелыми.
III-G Какие основные задачи могут выполнять агенты здравоохранения?
Рисунок 11 показывает, как часто для каждого основного задания и подзадания его под-измерение оценивается как Полностью реализовано ✓, Частично реализовано или Не реализовано ✗. Распределение подчеркивает, где медицинские LLM-агенты уже дают надежную ценность, а где они остаются недостаточно зрелыми. Клиническая документация и анализ EHR — надежный исполнитель: 22/49 (45%) ✓, 12/49 (24%) и 15/49 (31%) ✗, что отражает достижимые улучшения в суммаризации и извлечении. Медицинский вопросный ответ и поддержка принятия решений сильнее на 28/49 (57%) ✓, показывая, что основанные на поиске рекомендации являются ведущим вариантом использования. И наоборот, Триаж и дифференциальная диагностика, а также Диагностическое рассуждение группируются вокруг частичного внедрения. Их статистика содержит 14/49 (29%) и 18/49 (37%) ✓ наряду с 11/49 (22%) и 13/49 (27%) соответственно. Это подтверждает их согласованность с более высокими требованиями к управлению структурированными гипотезами и калиброванной неопределенностью. Сферы, ориентированные на действия, остаются недостаточно развитыми. Например, Планирование лечения и назначение — лишь 10/49 (20%) ✓, а Взаимодействие с пациентом и мониторинг — 11/49 (22%) ✓, причем обе сильно смещены в сторону ✗ из-за проблем интеграции и безопасности. Открытие лекарств и проектирование клинических исследований фиксируют лишь 9/49 (18%) ✓ против 39/49 (80%) ✗, демонстрируя длительные горизонты оценки и регуляторную нагрузку. Сравнение и симуляционная среда выделяются: 39/49 (80%) ✓ и только 1/49 (2%) ✗, что указывает на широкое внедрение стандартизированных наборов данных и все более реалистичные симуляторы, которые повышают сопоставимость и скорость итераций. В целом, если интерпретировать числа на Рисунке 11, то информационно-ориентированные задачи вроде документирования, поддержки принятия решений и бенчмаркинга лидируют по зрелости. С другой стороны, задачи, сосредоточенные на принятии решений и действиях, остаются Частично реализованными, тогда как задачи по поиску отстают дальше всего. Этот паттерн напрямую соответствует клиническим рабочим процессам. Суммаризация медицинских записей и вопросный ответ готовы к применению на переднем крае, но безопасная автоматизация суждений и долгосрочное взаимодействие все еще требуют существенных усовершенствований в управлении.
IV Заключение
Агенты на основе LLM демонстрируют ранние успехи в автоматизации, поддержке принятия решений и исследованиях, но более широкое внедрение в клиническую практику остается ограниченным, пока адаптация, безопасность и соответствие требованиям не станут более надежными. В этом обзоре мы систематически рассматриваем 49 научных статей и предлагаем интегрированную таксономию для эмпирической оценки этих агентов. Наша таксономия обеспечивает структурированный подход для анализа когнитивных, интерактивных, адаптивных и этических аспектов Agentic AI-подкрепленных LLM-ориентированных агентов, а также их базовых задач и архитектур фреймворков. Благодаря этому многомерному анализу мы выявляем разнообразные распространенные паттерны, демонстрирующие методологические предпочтения, распределения возможностей и возникающие стратегии проектирования в здравоохранении и медицине. Хотя область сделала значительные шаги вперед, сохраняется несколько проблем. Эти проблемы в первую очередь связаны с обеспечением надежности, интерпретируемости и этического согласования в сложных условиях здравоохранения. Объединяя текущие методологии и выделяя ключевые тенденции, наш обзор предоставляет базовый ресурс для исследователей, стремящихся продвинуть разработку надежных, эффективных и этически ответственных LLM-ориентированных агентов. Будущие исследования могут развивать эту основу, чтобы изучать недостаточно представленные измерения, уточнять возможности агентов и учитывать потребности, специфичные для конкретных доменов. В конечном итоге это будет способствовать более надежному, безопасному и эффективному применению LLM-ориентированных агентов в здравоохранении и медицине. Наконец, хотя масштабирование агентных систем от исследовательских прототипов до промышленной эксплуатации включает оркестрацию, интеграцию, задержки/стоимость и проблемы надежности, инженерные аспекты такого развертывания выходят за рамки данной работы. Мы обозначаем масштабируемость как открытый вызов и важную ось для будущих исследований, однако наши доказательства и анализ намеренно ограничены рецензируемыми/архивными научными статьями, а не промышленными системами.
Ссылки
 |
Shubham Vatsal received the M.S. degree in Computer Science from New York University, New York, USA, in 2023. He is currently a Research Data Scientist in the healthcare domain based in New York, where he applies Machine Learning and Natural Language Processing (NLP) to real-world clinical and operational problems. From 2017 to 2021, he was with Samsung Research, focusing on Natural Language Processing (NLP) and Machine Learning. He subsequently worked at IBM Research on Multimodal learning. He has also contributed to a couple of startups, helping build data-driven products using Machine learning and Deep learning. His research interests include Large Language Models (LLMs), Agentic AI, applications of LLMs in healthcare and NLP, Deep Learning and Machine Learning. |
 |
Harsh Dubey received the M.S. degree in computer science from New York University, Courant Institute of Mathematical Sciences, New York, USA, in 2023. He is currently based in New York, where he focuses on agentic plat- forms, multi-agent frameworks, context memory management, and large-scale workflow execution. His work centers on AI agents, large language models (LLMs), retrieval and memory systems, and the design of scalable, distributed systems for enterprise applications. From 2018 to 2020, he held engineering positions at Octro and IndusOS, where he worked on backend systems, personalization, and data-driven product development. His professional experience spans machine learning, distributed infrastructure, and applied artificial intelligence. His research interests include agentic AI, large language models, retrieval-augmented generation, computational cognitive modeling, machine learning, and distributed systems |
 |
Aditi Singh received the M.S. degree in Computer Science from Kent State University, Kent, OH, USA, in 2017, and the Ph.D. degree in Computer Science from Kent State University in 2023. She is an Assistant College Lecturer with the Department of Computer Science, Cleveland State University, Cleveland, OH, USA. Previously, she served as a Graduate Assistant at Kent State University (2017–2023). Her research interests include artificial intelligence and large language models, with emphasis on agentic systems, retrieval and memory for LLMs, text-to-SQL, the Model Context Protocol (MCP), and computer vision for human–robot interaction. She has authored over 30 publications (with several in press) and has received multiple recognitions, including Best Presenter Awards at IEEE CCWC (2023–2025), a Best Paper Award (CCWC 2025), and selection as a Finalist for the Women in AI (Research) Award in 2025. She serves on program committees for venues such as AIET, AIED, EDM, and ICR and reviews for international conferences and journals, including NeurIPS and ACM Computing Surveys. She is a Senior Member of the IEEE and chairs the Cleveland ACM-W professional chapter. |