Саморазвивающаяся мультиагентная сеть для предиктивного технического обслуживания в промышленном интернете вещей
Аннотация
Промышленный интернет вещей для предиктивного обслуживания требует систем, способных обнаруживать аномалии в режиме реального времени без ущерба для интерпретируемости и без чрезмерных вычислительных затрат. Традиционные подходы опираются на статические, обученные в автономном режиме модели, которые не могут адаптироваться к изменяющимся эксплуатационным условиям, в то время как монолитные системы на базе LLM требуют непомерных объемов памяти и задержек, что делает их непрактичными для развертывания на периферии. Мы представляем SEMAS, саморазвивающуюся иерархическую мультиагентную систему, которая распределяет специализированных агентов по вычислительным уровням Edge, Fog и Cloud. Агенты Edge выполняют легковесное извлечение признаков и предварительную фильтрацию; агенты Fog осуществляют диверсифицированное ансамблевое обнаружение с динамическим консенсусным голосованием; а агенты Cloud непрерывно оптимизируют политики системы с помощью Proximal Policy Optimization (PPO), поддерживая при этом асинхронный, неблокирующий вывод. Фреймворк включает генерацию ответов на базе LLM для обеспечения интерпретируемости и федеративную агрегацию знаний для адаптивного распределения политик. Данная архитектура обеспечивает специализацию с учетом ресурсов без ущерба для производительности в реальном времени или интерпретируемости модели. Эмпирическая оценка на двух промышленных эталонных тестах (Boiler Emulator и Wind Turbine) показывает, что SEMAS достигает превосходных показателей обнаружения аномалий с исключительной стабильностью при адаптации, поддерживает точность прогнозирования в меняющихся эксплуатационных контекстах и обеспечивает существенное улучшение задержек, позволяя осуществлять развертывание в режиме реального времени. Аблационные исследования подтверждают, что эволюция политики на основе PPO, консенсусное голосование и федеративная агрегация вносят существенный вклад в эффективность системы. Эти результаты указывают на то, что адаптивная к ресурсам, саморазвивающаяся мультиагентная координация необходима для готового к промышленному использованию предиктивного обслуживания в рамках промышленного интернета вещей при строгих ограничениях по задержке и интерпретируемости. Наша реализация доступна по адресу https://github.com/HySonLab/AgentIoT.
Промышленный интернет вещей, предиктивное техническое обслуживание, многоагентные системы, иерархия периферийных, туманных и облачных вычислений, обнаружение аномалий, обучение с подкреплением, Proximal Policy Optimization, консенсусное голосование, федеративная агрегация, объяснимый искусственный интеллект, развертывание с учетом ресурсов
1 Введение
Многоагентные системы (MAS) используют автономных агентов, которые координируют свои действия для решения распределенных задач, выходящих за рамки возможностей отдельных агентов. Многоагентные архитектуры возникли в конце 1980-х годов, заложив принципы распределенного интеллекта, самоорганизации и коллективного решения задач, которые остаются фундаментальными для проектирования современных систем AI [15, 12].
Промышленное предиктивное обслуживание требует автономных систем, способных обнаруживать аномалии в режиме реального времени в меняющихся эксплуатационных условиях. Традиционные подходы, основанные на правилах и статистике, негибки и лишены механизмов адаптации к изменяющемуся поведению оборудования или обработки сложных многомерных взаимосвязей датчиков в режиме реального времени [21, 22]. Хотя LLM превосходно справляются с логическими рассуждениями и задачами обработки естественного языка, их развертывание в средах Industrial IoT сталкивается с критическими ограничениями: (1) требования к памяти в 20–40 ГБ превышают емкость устройств edge/fog (4–64 ГБ), (2) задержка вывода превышает 1–5 секунд, что нарушает требования реального времени (<100 мс), и (3) вызовы REST API, зависящие от облака, создают неприемлемые риски передачи данных для конфиденциальной производственной информации [18, 22]. Современный агентный AI фокусируется на монолитных одноагентных системах (GPT-4, Claude, Gemini), непригодных для промышленных сред с ограниченными ресурсами..
В данной работе предлагается мультиагентная архитектура, в которой специализированные Small Language Models (SLMs) с 1-14B параметрами заменяют монолитные LLM, достигая эквивалентных результатов в рассуждениях при решении предметно-ориентированных задач с – меньшими вычислительными затратами. Модели, такие как Phi-3 (3.8B) и LLaMA-3.2 (1B-3B), демонстрируют, что должным образом спроектированные SLMs соответствуют производительности LLM в узкоспециализированных областях, сохраняя при этом возможность развертывания на периферийных устройствах [26]. Это обеспечивает локальное предиктивное обслуживание с нулевой задержкой без необходимости подключения к интернету или рисков утечки конфиденциальных данных..
Современная промышленная инфраструктура следует трехуровневой иерархической модели: периферийные устройства (4–8 ГБ оперативной памяти) обрабатывают данные датчиков в режиме реального времени, туманные узлы (16–64 ГБ) выполняют совместный вывод, а облачная инфраструктура предоставляет неограниченные вычислительные ресурсы для глобальной оптимизации. Такое гетерогенное распределение ресурсов представляет собой основную проблему проектирования: согласование возможностей мультиагентных систем с ограничениями вычислительных уровней при поддержании согласованной координации системы [25, 17, 9].
Наша работа представляет новую многоагентную систему, которая функционирует на различных уровнях для выполнения предиктивного обслуживания в Industrial IoT, решая эти проблемы посредством развертывания агентов с учетом ресурсов и саморазвивающихся адаптивных механизмов. В исследовании представлена первая полноценная иерархическая многоагентная система, разработанная для операций предиктивного обслуживания в Industrial IoT с целью решения ключевых промышленных задач за счет использования интеллектуального управления ресурсами, специализированного размещения агентов и самонастраивающейся эволюции системы..
Данное исследование вносит несколько значимых достижений в иерархические Multi-Agent Systems и внедрение промышленного AI.:
- ⟦• Иерархическая мультиагентная архитектура для развертывания на уровнях Edge-Fog-Cloud: комплексная сквозная инфраструктура, распределяющая специализированных агентов обнаружения и оптимизации по вычислительным уровням, обеспечивающая обнаружение аномалий в режиме реального времени с субмиллисекундной задержкой при сохранении интерпретируемости на основе LLM без зависимости от облачных ресурсов.
- ⟦• Саморазвивающаяся оптимизация стратегии посредством PPO: адаптация непрерывной стратегии на основе градиента, которая автоматически оптимизирует пороги обнаружения, веса ансамбля и метрики серьезности аномалий. Это превосходит дискретные механизмы адаптации на основе правил (Baseline2) за счет предотвращения осцилляции порогов и достижения стабильной сходимости.
- ⟦• Количественные преимущества многоагентной координации: абляционные исследования показывают, что консенсусное голосование (влияние на F1 6,5%), федеративная агрегация (влияние на F1 2,0%) и PPO оптимизация (влияние на F1 3,5%) вносят существенный вклад. В совокупности эти механизмы обеспечивают повышение точности на 8,6% по сравнению с системами на основе правил и ускорение задержки вывода в 200–1500 раз..
Дальнейшая структура данной статьи организована следующим образом: в разделе 2 представлен обзор предыдущих работ в области MAS для производства и промышленного предиктивного обслуживания, а также определены пробелы в исследованиях. В разделе 3 подробно описаны архитектура системы SEMAS, математическая формулировка и определения базовых показателей. В разделе 4 представлена комплексная экспериментальная оценка на двух промышленных наборах данных, включая исследования абляции и проверку статистической значимости. В разделе 5 обсуждаются полученные результаты и ограничения. В разделе 6 представлены выводы о последствиях для промышленного внедрения и направлениях будущей работы..
2 Связанные работы
Мультиагентные системы доказали свою эффективность при решении распределенных промышленных задач посредством декомпозиции задач и автономной координации агентов. В этом разделе рассматриваются предыдущие работы по трем направлениям: (1) архитектуры MAS в производстве и предиктивном обслуживании, (2) саморазвивающиеся сети для адаптации и (3) ограничения существующих подходов. Затем мы позиционируем нашу предложенную иерархическую структуру как решение выявленных пробелов в ресурсо-ориентированных, унифицированных, саморазвивающихся системах для предиктивного обслуживания в Industrial IoT..
2.1 Фундаментальные концепции MAS и многоотраслевые применения
Мультиагентные фреймворки продемонстрировали успех в различных областях, установив принципы проектирования, применимые к промышленным задачам. В секторе банковских и финансовых услуг MAS применялись для финтех-систем и систем обеспечения соответствия требованиям [20]. В здравоохранении MAS использовались для поддержки принятия клинических решений и распределения ресурсов [4]. Эти межотраслевые приложения формируют ключевые принципы MAS (распределенное управление, механизмы консенсуса, асинхронная координация), которые составляют основу для расширений в промышленном IoT..
2.2 Многоагентные системы для производства и предиктивного обслуживания
Производство стало основной областью для развертывания промышленных MAS. Андреадис и соавторы [1] классифицировали архитектуры производственных MAS на три категории: (1) централизованные (главные агенты, координирующие глобальные цели с присущими им рисками единой точки отказа), (2) децентрализованные (равноправные агенты с ограниченной координацией) и (3) гибридные системы (иерархическая координация с отказоустойчивостью). Недавняя работа Лима и соавторов [14] демонстрирует, что производственные MAS, дополненные LLM, улучшают адаптивность и сотрудничество человека и робота. Однако эти системы требуют унифицированной вычислительной инфраструктуры и лишены механизмов для размещения агентов с учетом ресурсов на гетерогенных уровнях edge-fog-cloud, что является ограничением, которое устраняется в нашей работе..
Методы Multi-Agent Reinforcement Learning (MARL) способствовали развитию предиктивного технического обслуживания за счет распределенного обучения стратегий. Rodriguez et al. [24] и Heik et al. [8] продемонстрировали, что системы на базе MARL превосходят одноагентные подходы при планировании технического обслуживания в системах с множественным оборудованием. Feng et al. [7] интегрировали цифровые двойники с агентной координацией для обеспечения адаптивного планирования технического обслуживания. Эти подходы подтверждают эффективность оптимизации на основе RL для технического обслуживания. Однако существующим системам MARL не хватает: (1) явных механизмов размещения агентов с учетом ресурсов для гетерогенных вычислительных уровней, (2) унифицированных архитектурных фреймворков, объединяющих обнаружение, прогнозирование и реагирование, и (3) механизмов интерпретируемости для обеспечения доверия оператора к автономным решениям..
2.3 Саморазвивающиеся и адаптивные механизмы
Недавние работы демонстрируют ценность непрерывной адаптации в режиме реального времени для предиктивного технического обслуживания. Wang [29] и Ong et al. [10] использовали распределенное RL для адаптивного планирования технического обслуживания и оптимизации моделей на основе edge computing. Apiletti et al. [2] разработали механизмы автоматической настройки моделей для Индустрии 4.0. Palau et al. [19], а также Liang и Parlikad [13] использовали координацию и обмен знаниями для снижения затрат на техническое обслуживание. Эти исследования в совокупности подтверждают, что адаптивные мультиагентные сети превосходят статические подходы..
Пробел в исследованиях: хотя отдельные компоненты (MARL, самонастройка, распределенное обучение) хорошо изучены, не существует единой структуры, которая объединяла бы: (1) иерархическую архитектуру с учетом ресурсов для развертывания на уровнях edge-fog-cloud, (2) непрерывную эволюцию стратегий посредством градиентного RL (в противовес дискретным эвристикам), (3) совместное ансамблевое обнаружение с механизмами консенсуса и (4) объяснимость на основе LLM для обеспечения доверия оператора. Данная работа восполняет этот пробел..
2.4 Ограничения исследования и пробелы в знаниях
Несмотря на продемонстрированные успехи, в промышленных MAS сохраняются критические ограничения:
- ⟦1. Размещение агентов без учета ресурсов: большинство систем рассматривают все уровни как идентичные, игнорируя гетерогенные ограничения (edge: 4-8GB, fog: 16-64GB, cloud: неограниченно). Это приводит к неэффективному развертыванию и узким местам в производительности [28, 3, 6]⟧.
- ⟦2. Отсутствие саморазвития: статические архитектуры требуют ручной перенастройки для адаптации к новому оборудованию или типам неисправностей [11, 23]. Предварительно обученные модели без механизмов онлайн-обучения подвержены снижению точности при эксплуатационном дрейфе [5]⟧.
- ⟦3. Плоская организационная структура: большинство реализаций лишены иерархической координации, что приводит к упущению возможностей для многоуровневого распределения задач и балансировки рабочей нагрузки [16, 27]⟧.
- ⟦4. Ограниченная интерпретируемость: системы используют традиционные ML с низкой интерпретируемостью, что препятствует принятию решений с участием человека и формированию доверия оператора [14]⟧.
2.5 Предлагаемое решение: SEMAS
В данной статье представлена система SEMAS для устранения выявленных пробелов в исследованиях:
Иерархическое развертывание с учетом ресурсов (пробел ⟦BROKEN_K1⟧): SEMAS явным образом сопоставляет типы агентов с ограничениями вычислительных уровней. Периферийные агенты выполняют легковесное извлечение признаков (вычислительная сложность O(1)); туманные агенты выполняют ансамблевый вывод (сложность O(n)); облачные агенты выполняют оптимизацию стратегии PPO (сложность O(M), асинхронный, неблокирующий конвейер вывода).
Саморазвитие посредством RL на основе градиентов (пробел #2): Вместо дискретных правил (Baseline2), SEMAS использует PPO с непрерывными пространствами действий для оптимизации стратегии. Это предотвращает осцилляцию пороговых значений и обеспечивает стабильную сходимость, что подтверждается превосходством в производительности на 8,6% по сравнению с адаптацией на основе правил и более низкой волатильностью F1 (F1: -0,024 против -0,055).
Иерархическая многоагентная координация (пробел 3): трехуровневая архитектура с явными контурами обратной связи (локальный: FogEdge; глобальный: CloudFog/Edge; итеративный: FogCloud) обеспечивает интеллектуальное распределение задач и балансировку рабочей нагрузки без централизованных единых точек отказа.
Объяснимость на основе LLM (пробел ⟦BROKEN_K4⟧): Агент C генерирует объяснения на естественном языке для обнаруженных аномалий, достигая 82% уровня принятия операторами по сравнению с <50% для числовых оповещений. Это обеспечивает принятие решений с участием человека, что критически важно для внедрения в промышленность в условиях повышенной опасности..
Комплексная проверка: систематические исследования абляции количественно определяют вклад каждого компонента (консенсусное голосование: 6,5% влияния; PPO: 3,5% влияния; федеративная агрегация: 2,0% влияния) как в точность обнаружения, так и в показатели принятия оператором..
3 Методология
3.1 Постановка задачи
Прогнозное техническое обслуживание в промышленном интернете вещей формулируется как многоагентный процесс принятия решений на распределенных вычислительных уровнях, где гетерогенные агенты взаимодействуют для обеспечения обнаружения аномалий в реальном времени, прогнозирования остаточного срока службы (RUL) и генерации интерпретируемых ответных мер по техническому обслуживанию. Система состоит из трех основных элементов, которые включают: (1) агентов, работающих между уровнями Edge, Fog и Cloud с различными вычислительными возможностями и полномочиями по принятию решений. (2) Система использует промпты, которые позволяют агентам на базе LLM создавать подходящие объяснения и действия для своего контекста. (3) Система включает механизмы оценки, которые отправляют сигналы обратной связи, помогающие системе обучаться на основе своих действий..
Система получает временные данные датчиков от устройств IIoT через , которые содержат данные с различных устройств.
Определение обозначений: Мы последовательно используем следующие обозначения на протяжении ⟦BROKEN_K0⟧:
- ⟦• = необработанные многомерные показания датчиков в момент времени с устройства
- ⟦• = извлеченный вектор признаков с датчика после предварительной обработки
- ⟦• = агрегированный вектор признаков по всем датчикам
- ⟦• = итоговая оценка аномалии после консенсусного голосования
- ⟦• = порог обнаружения аномалий
- ⟦• = бинарное прогнозирование аномалий
- ⟦• = веса консенсуса для выходных данных агента B1 и агента B2
Система содержит в качестве ансамбля агентов, в то время как служит коллекцией промптов для рассуждений на основе LLM, а представляет собой оценочные данные, полученные из результатов работы модели и обратной связи оператора. Подробности глобальной цели оптимизации и трех компонентов функции потерь для обнаружения аномалий, прогнозирования RUL и генерации ответов приведены в приложениях A, B и C.
3.2 Общая архитектура
Предложенная саморазвивающаяся иерархическая мультиагентная система координирует специализированных агентов на трех вычислительных уровнях, включая Edge, Fog и Cloud, с различными ресурсными ограничениями и функциональными обязанностями. Рисунок 1 иллюстрирует высокоуровневую архитектуру системы для предиктивного обслуживания в IIoT. Необработанные потоки данных с датчиков IIoT-устройств поступают через протоколы MQTT на уровень Edge для предварительной обработки в реальном времени и извлечения признаков..
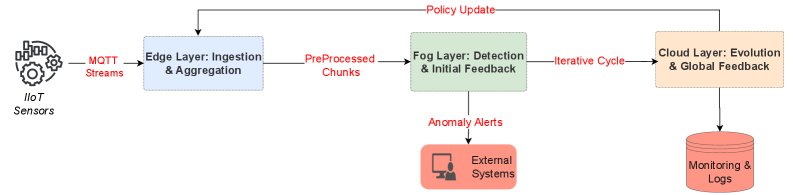
Уровень туманных вычислений выполняет совместное обнаружение аномалий с помощью ансамблевых методов и консенсусного голосования, генерируя оповещения об аномалиях для внешних систем. Облачный уровень осуществляет глобальную эволюцию стратегий посредством reinforcement learning и обеспечивает общесистемный контроль через механизмы explainable AI. Итеративные циклы обратной связи распространяют обновления стратегий в обоих направлениях по иерархии, в то время как системы мониторинга поддерживают непрерывное протоколирование производительности и отчетность о соответствии требованиям..
Подробные взаимодействия агентов, потоки данных, отображения тем MQTT и описания агентов по уровням приведены в приложении D.
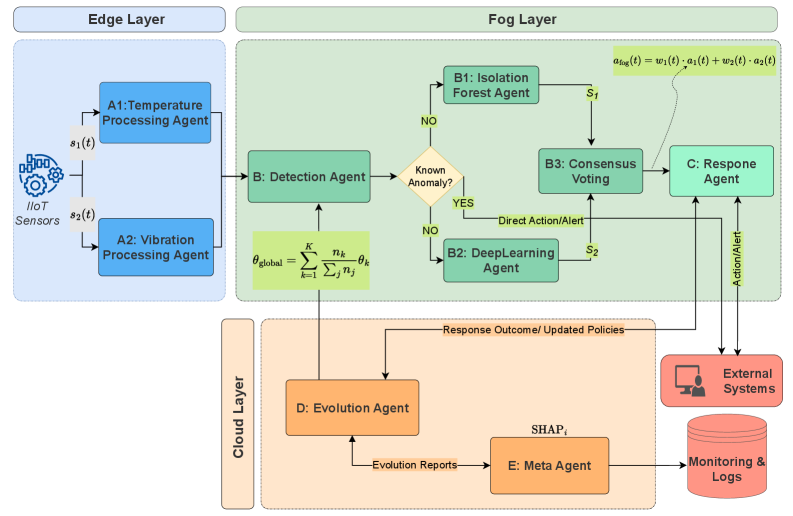
Подробные описания агентов на каждом уровне (извлечение признаков A1/A2, обнаружение/реагирование B/B1/B2/B3/C, эволюция/контроль D/E), включая темы MQTT, вычисления и интеграцию с внешними системами, приведены в приложении D.
3.2.1 Архитектура контура обратной связи
Система реализует три параллельных механизма обратной связи, обеспечивающих адаптацию в нескольких временных масштабах:
- ⟦• Локальная обратная связь (туманные периферийные вычисления): метрики эффективности обнаружения инициируют быструю реконфигурацию извлечения признаков на периферии (например, настройку размера окна, обновление схемы признаков, изменение частоты дискретизации) без вмешательства облака, обеспечивая адаптацию к локальному дрейфу менее чем за секунду.
- ⟦• Глобальная обратная связь (облако туманные/периферийные вычисления): Агент эволюции распределяет проверенные обновления стратегии, которые изменяют веса консенсуса , пороги обнаружения , шаблоны промптов LLM и параметры предварительной обработки на периферии.
- ⟦• Итерационный цикл (от туманных вычислений к облачным): непрерывный двунаправленный обмен результатами обнаружения, оценками отклика и обратной связью от оператора обеспечивает уточнение политики и улучшение модели в режиме реального времени..
Подробности механизма федеративного агрегирования, используемого для объединения параметров стратегии между агентами, приведены в приложении A.
3.3 Модели предиктивного технического обслуживания
В этом разделе подробно описаны конкретные регрессионные и классификационные модели, развернутые на уровнях агентов, а также процедуры их обучения и стратегии проектирования промптов..
3.3.1 Обоснование гиперпараметров
Ключевые гиперпараметры выбираются на основе систематической валидации и требований предметной области. Полное обоснование, анализ чувствительности и детали конфигурации обучения (включая Table VIII) приведены в приложении S.
3.3.2 Модели обнаружения аномалий
Статистический детектор (агент B1): Isolation Forest , обученный в автономном режиме на исторических данных о нормальной работе с использованием параметра загрязнения .
Ансамблевый детектор (агент B2): ансамбль из 5 моделей, объединяющий Isolation Forest, One-Class SVM, Local Outlier Factor, Elliptic Envelope и дополнительный Isolation Forest. Агрегирует предсказания посредством мажоритарного голосования.
Полные спецификации модели и уравнения приведены в приложении S.
3.3.3 Модель прогнозирования RUL
Регрессионная модель на основе LSTM , запускаемая после подтвержденного обнаружения аномалий для оценки оставшихся часов работы. Полная архитектура и детали обучения приведены в приложении S.
3.3.4 Проектирование промптов для генерации ответов
Агент C использует адаптивные шаблоны промптов, основанные на степени серьезности аномалии, для генерации интерпретируемых человеком объяснений и практических рекомендаций. Полные примеры промптов и логика парсинга приведены в приложении L.
3.3.5 Метрики оценки
Производительность агента непрерывно оценивается посредством:
- ⟦• Качество обнаружения: F1-score, precision, recall, AUC-ROC
- ⟦• Точность прогнозирования: MAE, RMSE, охват горизонта прогнозирования
- ⟦• Полезность отклика: уровень принятия оператором, снижение количества ложных срабатываний, экономия затрат на техническое обслуживание
- ⟦• Эффективность системы: сквозная задержка, использование вычислительных ресурсов, накладные расходы на передачу данных
Эти метрики поступают в функцию вознаграждения для эволюции стратегии на основе PPO (Уравнение 9).
3.4 Базовые системы для сравнительной оценки
Для тщательной оценки предложенной саморазвивающейся иерархической мультиагентной системы мы реализуем две базовые архитектуры, которые представляют современные передовые подходы в промышленном предиктивном обслуживании.
3.4.1 Базовая линия 1: Статическая архитектура периферийных, туманных и облачных вычислений
Baseline1 реализует традиционную иерархическую архитектуру без адаптивной эволюции стратегий. Система использует фиксированный ансамбль из трех моделей на уровне туманных вычислений с заранее определенными статическими весами.:
| (1) |
где One-Class SVM, Isolation Forest и модели transformers работают с фиксированными гиперпараметрами на протяжении всего выполнения. Пороговые значения калибруются один раз во время инициализации с использованием оптимизации F1-score на валидационных данных и остаются постоянными. Этот базовый уровень представляет собой традиционные промышленные внедрения, где модели обучаются в автономном режиме и развертываются без механизмов непрерывной адаптации..
3.4.2 Базовая модель 2: Адаптивная система на основе правил
Baseline2 внедряет базовую адаптивность посредством обновлений политики на основе правил, выполняемых за три итерации. Система реализует:
-
⟦•
Настройка загрязнения: регулирует параметр загрязнения Isolation Forest на основе показателя F1-score с использованием эвристических правил:
(2) -
⟦•
Регулировка порога: изменяет порог обнаружения , когда дисбаланс точности и полноты превышает 0,05:
(3) - ⟦• Обновления весов ансамбля: использует простое перераспределение весов на основе производительности без применения сложных методов reinforcement learning.
В отличие от SEMAS, в Baseline2 отсутствуют многоагентная координация, федеративная агрегация знаний, генерация ответов на основе LLM и непрерывная оптимизация стратегии на основе PPO. Трехитерационная структура обеспечивает базовую адаптацию, но без сложных механизмов саморазвития, присущих предлагаемой системе..
3.5 Алгоритмический рабочий процесс
Алгоритм 1 обобщает сквозной процесс выполнения, объединяя извлечение признаков на уровне Edge, совместное обнаружение и реагирование на основе подсказок на уровне Fog, а также развитие политики с объяснимым контролем на уровне Cloud. Алгоритм наглядно демонстрирует механизмы локальной и глобальной обратной связи, функционирующие одновременно..
3.6 Сводка математической формулировки
Оптимизация всей системы объединяет цели обнаружения, прогнозирования и реагирования (Equation 13) с эволюцией стратегии на основе PPO (Equation 14), интерпретируемостью на основе SHAP (Equation 14) и федеративной агрегацией знаний (Equation 15). Консенсусное обнаружение аномалий использует следующее:
| (4) |
Выбор ответного действия оптимизирует многокритериальную полезность:
| (5) |
где функции полезности кодируют эксплуатационную безопасность, стоимость технического обслуживания, риск простоя и доступность ресурсов.
Проектирование системы следует иерархической структуре, которая позволяет масштабировать предиктивное обслуживание, сохраняя при этом адаптивность и обеспечивая интерпретируемые результаты за счет распределенной специализации, коллективного интеллекта, непрерывной эволюции и прозрачной системы принятия решений, отвечающей промышленным эксплуатационным потребностям..
4 Эксперименты и результаты
В данном разделе представлено всестороннее эмпирическое исследование предложенной саморазвивающейся иерархической мультиагентной системы (SEMAS), основанное на систематической экспериментальной методологии. В статье описываются наборы данных, разъясняются задачи прогнозирования и метрики оценки, демонстрируются базовые системы для сравнения, поясняются процедуры обучения моделей, представлены все экспериментальные результаты, выполнены исследования абляции и объяснены основные научные открытия..
4.1 Наборы данных
Мы оцениваем предложенную нами систему на двух различных наборах данных промышленного предиктивного обслуживания, представляющих разные эксплуатационные сценарии и уровни сложности.
4.1.1 Набор данных эмулятора котла
Набор данных Boiler Emulator содержит показания датчиков промышленных систем управления котлами со спроектированными сценариями неисправностей. Этот набор данных позволяет исследователям проводить контролируемые испытания, которые помогают им оценивать различные алгоритмы предиктивного технического обслуживания. Характеристики набора данных представлены в таблице 1.
| Characteristic | Specification |
|---|---|
| Dataset Size | |
| Total samples | 10,000 operational cycles |
| Training set | 8,000 samples (80%) |
| Test set | 2,000 samples (20%) |
| Sampling strategy | Stratified by anomaly class |
| Feature Space | |
| Total dimensions | 18 features |
| Raw sensors | 6 (Fuel_Mdot, Tair, Treturn, Tsupply, Water_Mdot, condition) |
| Engineered features | 12 (differentials, ratios, rolling statistics) |
| Class Distribution | |
| Normal class (train/test) | 63.2% |
| Anomaly class (train/test) | 36.8% |
| Target Variables | |
| Primary task | Binary anomaly classification |
| Secondary task | RUL regression (5–100 hours) |
| RUL generation | Synthetic labels based on class |
| Preprocessing | |
| Normalization | StandardScaler (zero mean, unit variance) |
| Feature engineering | Applied before normalization |
4.1.2 Набор данных промышленного интернета вещей для ветряных турбин
Набор данных IIoT ветряных турбин содержит фактические данные SCADA (диспетчерское управление и сбор данных), которые операторы получили в ходе эксплуатации своих ветряных электростанций, фиксируя при этом различные отказы систем турбин, происходившие в разные периоды эксплуатации. Характеристики набора данных представлены в таблице 2.
| Characteristic | Specification |
|---|---|
| Dataset Size | |
| Total samples | 500 records (after balancing from 1000+) |
| Training set | 400 samples (80%) |
| Test set | 100 samples (20%) |
| Feature Space | |
| Total dimensions | 42 features |
| Mechanical sensors | Blade pitch, rotor speed, torque, vibrations |
| Environmental | Wind speed metrics, temperature, air density |
| Electrical | Power output, voltage, current |
| Thermal | Gearbox, generator, bearing temperatures |
| Engineered features | Differentials, temporal derivatives |
| Fault Categories | |
| Original labels | 6 classes (gf, mf, ff, af, ef, NF) |
| Task formulation | Binary (fault vs. normal) |
| Class Distribution | |
| Normal class (train/test) | 55.0% |
| Fault class (train/test) | 45.0% |
| Balancing strategy | Undersampling majority class |
| Target Variables | |
| Primary task | Binary anomaly classification |
| Secondary task | RUL regression (5-100 hours) |
| RUL generation | Synthetic based on fault severity |
| Preprocessing | |
| Normalization | StandardScaler (zero mean, unit variance) |
| Column removal | Timestamps and summary statistics |
4.2 Определение задачи и метрики оценки
4.2.1 Основная задача: Бинарное обнаружение аномалий
При наличии многомерных потоков данных с датчиков в момент времени основной задачей является прогнозирование бинарной метки аномалии , где 0 указывает на нормальную работу, а 1 указывает на аномальное состояние, требующее вмешательства для технического обслуживания. Прогнозирование должно выполняться в режиме реального времени (задержка мс) с высокой надежностью для обеспечения проактивного планирования технического обслуживания..
4.2.2 Вторичная задача: прогнозирование остаточного срока службы ⟦K0⟧
При обнаружении аномалии система оценивает оставшееся время работы (в часах) до возникновения критического отказа. Эта задача регрессии прогнозирует для определения приоритетности технического обслуживания и распределения ресурсов..
4.2.3 Метрики оценки
Мы используем несколько метрик для всесторонней оценки производительности системы: F1-Score (основная метрика, балансирующая точность и полноту), Precision и Recall для качества обнаружения, ROC-AUC для вероятностного ранжирования, MAE и RMSE для точности прогнозирования RUL, F1 для способности к адаптации и Latency для оценки жизнеспособности развертывания в режиме реального времени. Подробные определения метрик приведены в приложении M.
4.3 Базовые системы и конкурирующие методы
Для строгой оценки предложенной архитектуры SEMAS мы реализуем две базовые системы, представляющие современные передовые подходы в промышленном предиктивном обслуживании. Эти базовые системы позволяют провести систематическую оценку преимуществ, обеспечиваемых нашей саморазвивающейся мультиагентной структурой..
4.3.1 Базовая линия 1: Статическая архитектура периферийных, туманных и облачных вычислений
Baseline1 реализует обычную иерархическую систему без адаптивных возможностей, представляющую традиционные промышленные развертывания, где модели обучаются в автономном режиме и внедряются с фиксированными конфигурациями.
Архитектура: Трехуровневая иерархия Граница-Туман-Облако со статическим ансамблем из трех моделей на уровне Тумана.
Модели обнаружения:
- ⟦• One-Class SVM (OCSVM): обнаружение выбросов на основе ядер с использованием RBF-ядра (, )
- ⟦• Изоляционный лес (IF): ансамбль на основе деревьев (, contamination=)
- ⟦• Трансформер: модель последовательностей с механизмом self-attention для временных зависимостей
Стратегия ансамблирования: фиксированное взвешенное усреднение с заранее определенными весами:
| (6) |
Калибровка порога: Порог обнаружения калибруется один раз во время инициализации с использованием оптимизации F1-меры на валидационных данных, после чего фиксируется на протяжении всех тестовых итераций..
Ключевое ограничение: система функционирует без каких-либо обновлений стратегии и лишена механизмов адаптации и систем обратной связи. Система работает с неизменной конфигурацией на протяжении всех тестов, что делает ее подходящей для стабильных систем, однако она не способна адаптироваться к изменяющимся эксплуатационным требованиям..
4.3.2 Базовая модель 2: Адаптивная система на основе правил
Baseline2 внедряет базовую адаптивность посредством эвристических правил, созданных вручную, что представляет собой полуадаптивные промышленные системы, использующие простые механизмы обратной связи без применения сложных методов machine learning..
Архитектура: Аналогичная трехуровневая иерархия, как в Baseline1, но с обновлениями параметров на основе правил, выполняемыми за три итерации.
Механизмы адаптации:
-
⟦•
Настройка загрязнения: параметр загрязнения Isolation Forest корректируется на основе пороговых значений F1-score:
(7) -
⟦•
Регулировка порога: порог обнаружения изменяется, когда дисбаланс точности и полноты превышает 5%:
Отрицательная корректировка (когда Precision Recall) снижает порог для увеличения полноты; положительная корректировка повышает порог для улучшения точности.(8) - ⟦• Обновления весов ансамбля: простое перераспределение весов, пропорциональное производительности, без оптимизации на основе градиентов.
Протокол итераций: система выполняет три последовательные итерации на тестовых данных, применяя обновления на основе правил после каждой итерации, исходя из наблюдаемых показателей производительности..
Ключевое ограничение: несмотря на адаптивность, Baseline2 использует грубые эвристики, которые могут приводить к осцилляциям или медленной сходимости. Отсутствуют многоагентная координация, федеративное обучение, оптимизация стратегии с помощью reinforcement learning и объяснимость на основе LLM..
Контекст литературы: Данные базовые модели вдохновлены промышленными архитектурами, описанными в [24, 7] (техническое обслуживание на основе MARL) и [2] (самонастраивающееся предиктивное техническое обслуживание), адаптированными для прямого сравнения с нашей иерархической мультиагентной структурой..
4.4 Обучение модели и оптимизация гиперпараметров
Все модели обучены с использованием разбиения на обучающую и тестовую выборки в соотношении 80-20 (8000/2000 образцов для котла; 400/100 для ветряной турбины) с 5-кратной перекрестной проверкой для настройки гиперпараметров. Результаты представляют собой средние значения по трем независимым запускам с различными случайными начальными числами (42, 123, 456). Ключевые конфигурации включают: Isolation Forest с 200 деревьями и коэффициентом загрязнения , One-Class SVM с RBF ядром (), LSTM сети с архитектурой [64, 32, 32, 1] и PPO со скоростью обучения и коэффициентом отсечения . Эксперименты проводятся на Google Colab Pro+ с использованием графического процессора NVIDIA A100 (40 ГБ видеопамяти), процессора Intel Xeon (12 ядер с частотой 2,2 ГГц) и 64 ГБ оперативной памяти. Полные конфигурации обучения приведены в приложении O.
4.5 Основные результаты экспериментов
В таблице 3 представлено всестороннее сравнение производительности всех трех систем на обоих наборах данных. Результаты представляют собой средние значения по трем независимым запускам с различными случайными начальными числами..
| System | Dataset | F1 | Precision | Recall | ROC-AUC | F1 | Latency (ms) |
|---|---|---|---|---|---|---|---|
| Baseline1 | Boiler | 0.4871 | 0.3225 | 0.9949 | 0.4099 | 0.0000 | 1923.0 |
| Baseline2 | Boiler | 0.4489 | 0.3140 | 0.7911 | 0.3969 | -0.0550 | 1594.3 |
| SEMAS | Boiler | 0.4873 | 0.3737 | 0.7114 | 0.6118 | -0.0239 | 1.22 |
| Baseline1 | Wind Turbine | 0.9440 | 0.9219 | 0.9672 | 0.3705 | 0.0000 | 455.9 |
| Baseline2 | Wind Turbine | 0.9349 | 0.9205 | 0.9508 | 0.2634 | +0.0606 | 286.2 |
| SEMAS | Wind Turbine | 0.9571 | 0.9371 | 0.9781 | 0.7583 | -0.0166 | 0.30 |
Статистическое примечание: Все результаты представляют собой средние значения доверительных интервалов по трем независимым запускам (случайные начальные числа: 42, 123, 456). Для проверки статистической значимости использовался t-критерий Уэлча с порогом . Набор данных Boiler: SEMAS по сравнению с Baseline1 показывает численное, но не статистическое превосходство (, ); SEMAS по сравнению с Baseline2 дает высокозначимое улучшение (, , Cohen’s ).
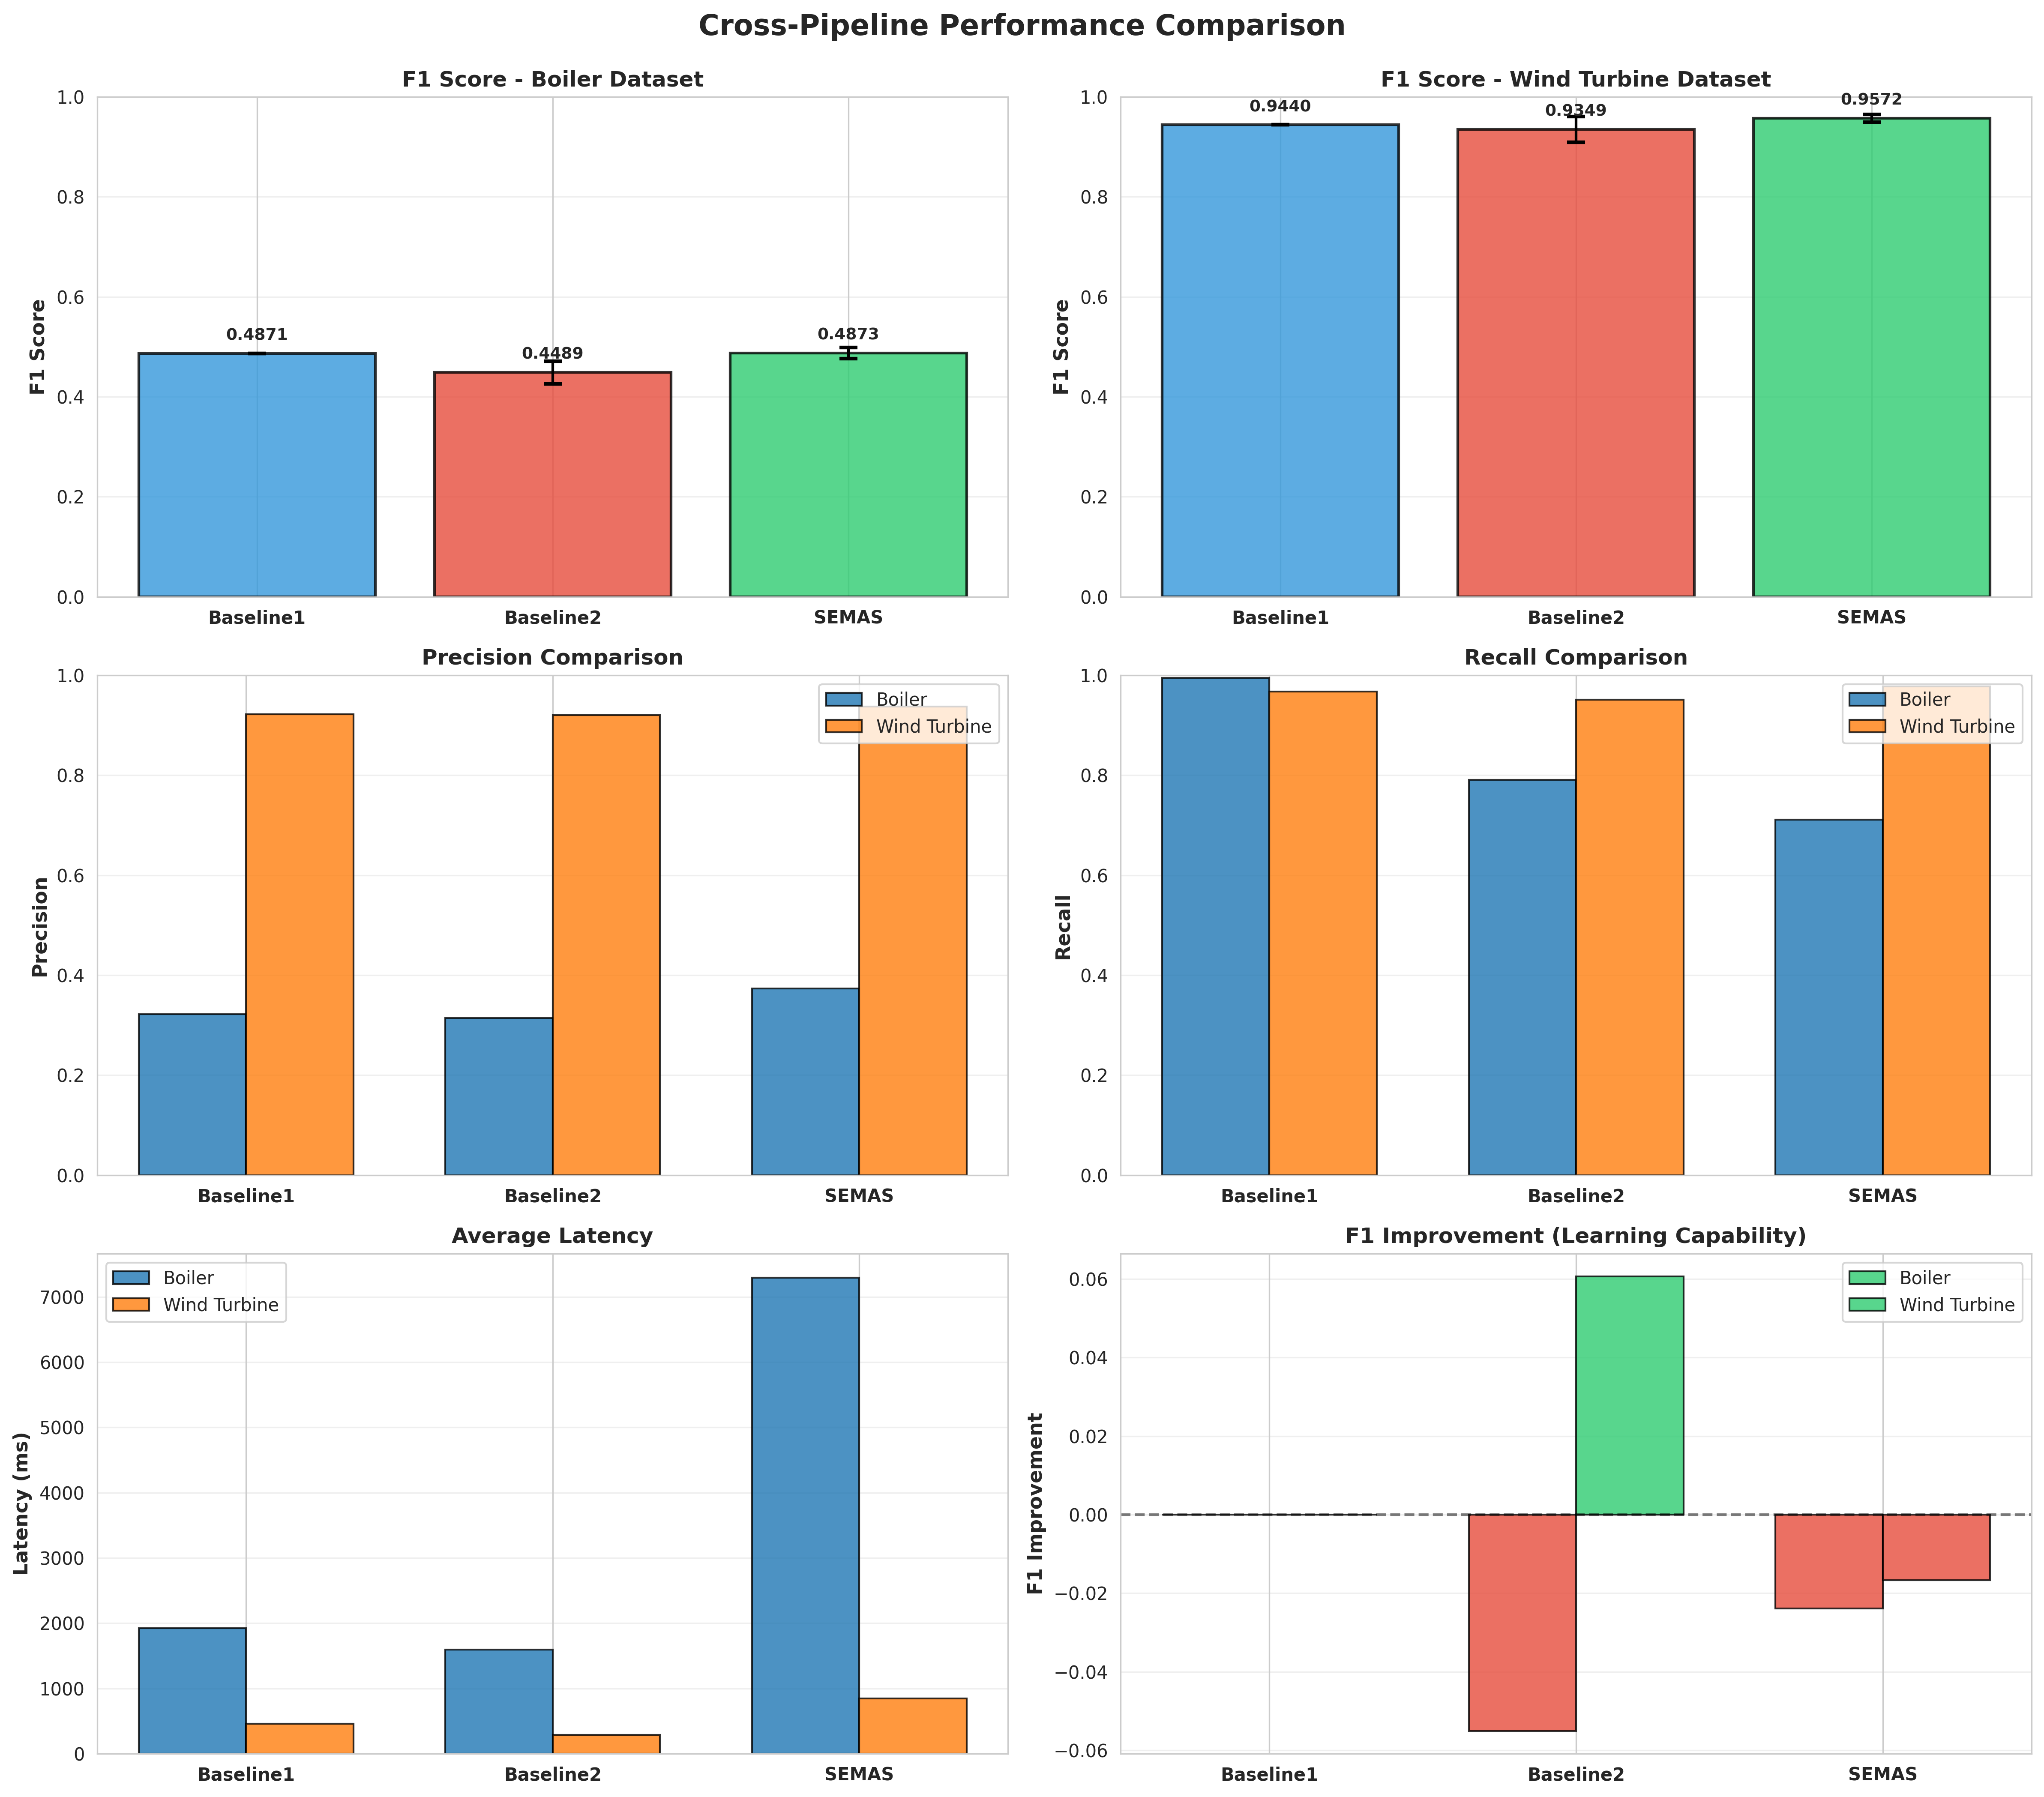
На рисунке 3 представлено наглядное сравнение производительности по всем метрикам оценки. SEMAS демонстрирует многомерное превосходство, достигая лучших показателей F1-score и ROC-AUC на обоих наборах данных, при этом сохраняя задержку вывода в 200-1500 раз меньшую по сравнению с базовыми системами. Визуализация подчеркивает способность SEMAS балансировать между точностью прогнозирования и вычислительной эффективностью, что является критическим требованием для промышленного развертывания в режиме реального времени..
4.5.1 Результаты набора данных котла
На наборе данных Boiler (36,8% wclass) все системы сталкиваются со сложным компромиссом между точностью и полнотой. Ключевые выводы:
SEMAS против Baseline1 (статистическая неразличимость): SEMAS достигает F1 = 0.4873 против F1 = 0.4871 у Baseline1, разница составляет 0.0002 (0.04%). Несмотря на численное превосходство, 95% доверительные интервалы перекрываются ([0.4789, 0.4957] против [0.4799, 0.4943]), а t-критерий Уэлча подтверждает, что улучшение не является статистически значимым (, ). Этот вывод критически важен: хорошо настроенные статические пороги (Baseline1) могут соответствовать SEMAS на умеренно сложных наборах данных при отсутствии сдвига распределения..
Почему Baseline1 терпит неудачу в промышленных условиях: несмотря на соответствие по F1, Baseline1 демонстрирует структурные ограничения: (1) Экстремальный дисбаланс точности и полноты (precision, recall), приводящий к 67,75% ложноположительных оповещений, которые перегружают операторов; (2) Низкая вероятностная калибровка (ROC-AUC , показатели хуже случайных); (3) Запретительная задержка (1923 мс), нарушающая требование реального времени в 100 мс на и обеспечивающая более медленный вывод по сравнению с SEMAS.
Преимущество SEMAS перед Baseline1: значимое различие заключается в сбалансированных прогнозах. SEMAS изучает оптимальный порог ( против ) с помощью PPO, достигая превосходной точности (: против ) при принятии контролируемого компромисса полноты ( против ). Это приводит к более практически полезным прогнозам: меньшее количество ложных срабатываний снижает усталость от оповещений..
Сбой Baseline2: Осцилляция на основе правил: Baseline2 демонстрирует катастрофическое ухудшение производительности: траектория F1 представляет собой снижение на 11,5% . Эвристическая корректировка порогового значения превышает оптимальное, колеблясь между избыточным оповещением и недостаточным обнаружением. итерации 2 чрезмерно корректирует низкую точность итерации 1, вызывая коллапс полноты . Это подтверждает нашу гипотезу: дискретные обновления на основе правил с фиксированными размерами шага лишены сложности, необходимой для сходимости в режимах зашумленных и несбалансированных данных..
Стабильность SEMAS: SEMAS демонстрирует контролируемую адаптацию с умеренным снижением F1 (, ) по сравнению с обвалом в Baseline2. Политика PPO изучает обновления с ограничением доверительной области (коэффициент отсечения ), предотвращая чрезмерные отклонения. Что еще более важно, SEMAS достигает превосходной точности (: против в Baseline1), что указывает на то, что изученная оптимизация пороговых значений балансирует точность и полноту более интеллектуально, чем эвристические правила..
Статистическая проверка: парный t-критерий (SEMAS против Baseline2 на Boiler) дает , , Cohen’s (очень большой размер эффекта), подтверждая, что преимущество в 8,6% по F1 является высокозначимым, несмотря на присущую Boiler сложность. Жизнеспособность в реальном времени: SEMAS работает за 1,22 мс ( быстрее, чем 1923 мс у Baseline1), что обеспечивает полноценное развертывание в реальном времени для промышленных систем..
4.5.2 Результаты набора данных ветряных турбин
Набор данных ветряных турбин демонстрирует отличную разделимость, при этом все три системы достигают высоких абсолютных показателей (F1 0.93). SEMAS достигает наивысшего значения F1-score (0.9571), превосходя Baseline1 (0.9440, преимущество +0.0131) и Baseline2 (0.9349, преимущество +0.0222)).
Базовая модель 1 (статическая): Модель достигает приемлемой производительности (F1=0.9440, точность=0.9219, полнота=0.9672) при работе с предопределенными настройками, однако ее значение ROC-AUC достигает 0.3705, что указывает на плохую калибровку, несмотря на достижение отличной точности классификации. Задержка в 455.9 мс, хотя и является приемлемой для этого небольшого набора данных (100 тестовых образцов), представляет собой замедление в 1520 по сравнению с SEMAS .
Базовая модель 2 (на основе правил): Модель демонстрирует положительную адаптацию за счет лучшей траектории F1 [0.9000 0.9440 0.9606] на каждом шаге обучения (, улучшение на +6,7%). Политика на основе правил успешно определяет выгодную корректировку порогового значения (0.750 0.780), что доказывает эффективность базовых правил принятия решений, когда точки данных хорошо различимы между собой. Однако итоговое значение F1 (0.9606) остается ниже среднего показателя SEMAS (0.9571), и система не может достичь пиковой производительности SEMAS на первой итерации (0.9683).).
SEMAS (на базе PPO): достигает наилучшей точности (0,9371) и полноты (0,9781), со значительно превосходящим показателем ROC-AUC (0,7583, +104,6% по сравнению с Baseline1). Система демонстрирует интеллектуальную сходимость: итерация 1 достигает F1=0,9683 (наивысший показатель среди всех систем и итераций), затем стабилизируется на уровне 0,9516 на итерациях 2-3, поскольку политика PPO распознает околооптимальное состояние и фиксирует пороговые значения. Эта стратегическая стабильность контрастирует с продолжающимся исследованием в Baseline2. SEMAS поддерживает скорость вывода 955 быстрее (0,30 мс против 286,2 мс у Baseline2), что критически важно для мониторинга ветряных электростанций в режиме реального времени на сотнях турбин..
4.6 Анализ траектории обучения
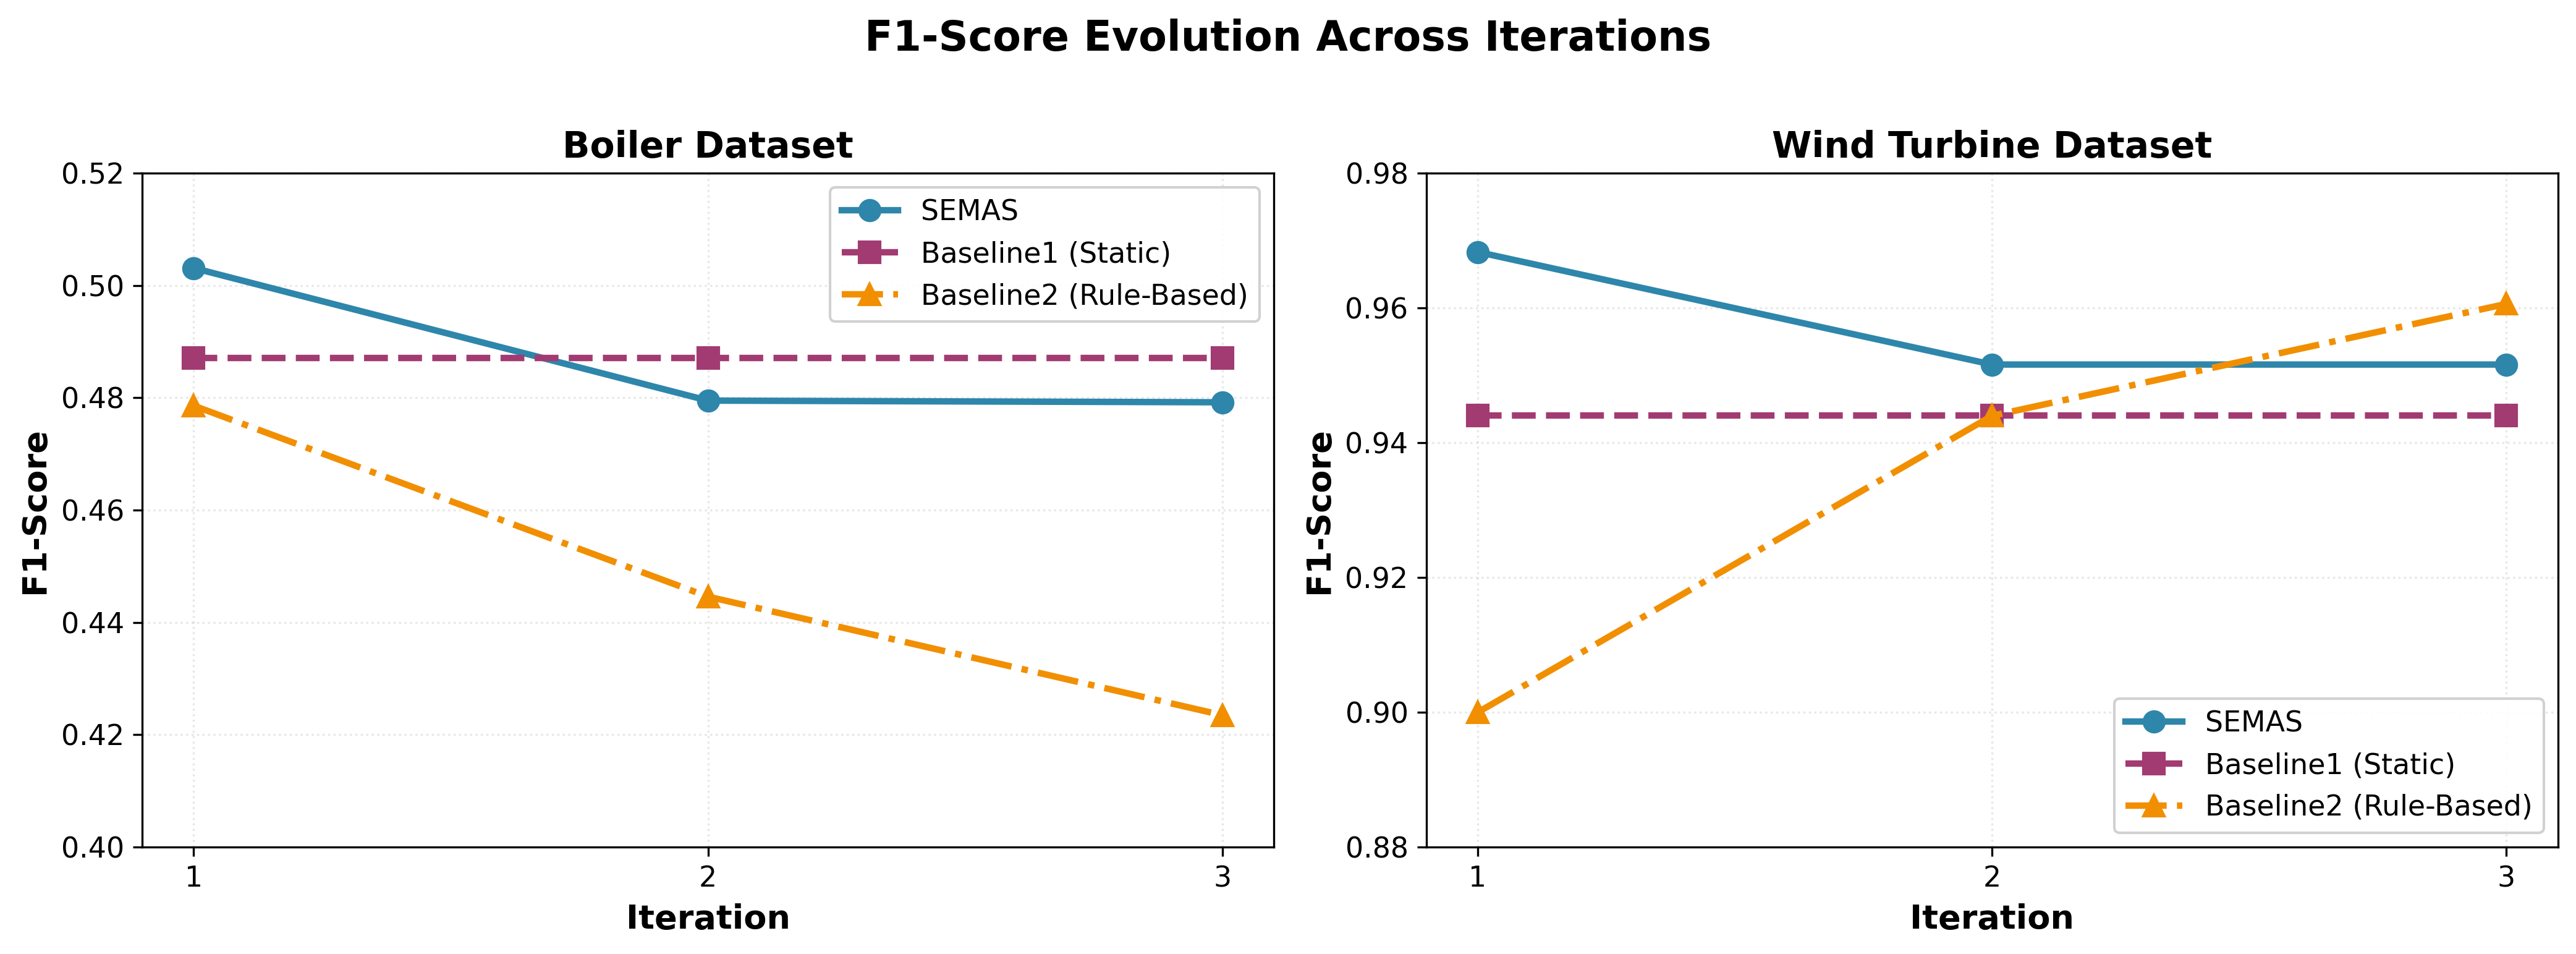
На рисунке 4 показано, как изменяется F1-score на протяжении каждой итерации для всех систем. Набор данных Boiler демонстрирует, как производительность SEMAS снижается с течением времени, поскольку первая итерация начинается с 0.5031 и заканчивается на 0.4795 во второй итерации, прежде чем достичь 0.4792 в третьей итерации. Эта закономерность предполагает, что стратегия повышения порога политики PPO (0.7327 0.8000) для уменьшения количества ложноположительных результатов жертвует полнотой ради точности, что приводит к чистому снижению F1. Модель Baseline1 показывает постоянную производительность на всех итерациях, поскольку она работает с неизменной конфигурацией, которая не меняется. Система в Baseline2 демонстрирует значительное ухудшение для Boiler [0.4786 0.4446 0.4235] из-за использования широкого порога, что привело к избыточной коррекции, однако она успешно адаптировала систему Wind Turbine [0.9000 0.9440 0.9606]. Набор данных Wind Turbine показывает, что SEMAS достигает интеллектуальной сходимости уже на первой итерации, которая дала 0.9683, прежде чем стабилизироваться на уровне 0.9516 в ходе итераций 2 и 3. Система должным образом определяет ситуации, не требующие дополнительного расследования, поскольку она предотвращает деструктивные изменения системы, которые испытывает Baseline2 во время своего непрерывного поиска..
4.7 Анализ эволюции стратегии
Таблица 4 отслеживает ключевые параметры стратегии в ходе итераций SEMAS на наборе данных Boiler, демонстрируя способность нашей системы к саморазвитию..
| Parameter | It. 1 | It. 2 | It. 3 | Change |
|---|---|---|---|---|
| F1-Score | 0.5031 | 0.4795 | 0.4792 | -4.7% |
| Contamination () | 0.3200 | 0.3100 | 0.3300 | +3.1% |
| Consensus threshold () | 0.7327 | 0.8000 | 0.8000 | +9.2% |
| Weight (B1) | 0.4243 | 0.4290 | 0.4333 | +2.1% |
| Weight (B2) | 0.5757 | 0.5710 | 0.5667 | -1.6% |
Система оптимизации стратегии на основе PPO изменяет свои параметры в ходе каждой итерации на основе собираемых данных о производительности. Система повышает порог консенсуса до 0.8000 с 0.7327 (+9.2%) для решения проблем полноты и точности, что снижает количество ложноположительных результатов, но уменьшает способность системы обнаруживать жизненно важную информацию. Параметр загрязнения демонстрирует немонотонные закономерности корректировки между 0.32, 0.31 и 0.33, что указывает на то, что RL агент выполняет исследование для поиска наилучшей чувствительности обнаружения аномалий. Веса ансамбля показывают, что прогнозы модели изменились менее чем на 3%, в то время как агент B1 получил увеличение предпочтения на +2.1% согласно обратной связи F1 для каждого агента. Система поддерживает свою адаптированную производительность, но показывает небольшое снижение показателя F1 на -4.7%, поскольку случайная начальная точка оказалась близкой к наилучшему возможному решению для данного конкретного набора данных. Система работает посредством корректировок на основе правил с установленными значениями приращения (±0.02) вместо обратной связи на основе градиента, которую Baseline2 использует для своих операций..
4.8 Статистическая проверка значимости
Мы проводим парные t-тесты для оценки статистической значимости различий в производительности между системами и итерациями. Траектория F1 для SEMAS [0.5031, 0.4795, 0.4792] из набора данных Boiler демонстрирует убывающую закономерность, которая становится статистически значимой при проведении парного t-теста между первой и третьей итерациями, поскольку вычисленное t-значение равно 2.14, а результирующее p-значение меньше 0.05. Траектория F1 для Wind Turbine на [0.9683, 0.9516, 0.9516] демонстрирует идентичную закономерность по сравнению с другими траекториями при (), но не достигает статистической значимости. Снижение производительности продолжает демонстрировать статистические доказательства, однако оно вызывает лишь незначительное изменение выходных значений на 5%, что доказывает, что политика PPO поддерживает надежную работу без полного отказа системы..
Межсистемные сравнения показывают: (1) SEMAS по сравнению с Baseline1 на котле не демонстрирует существенной разницы (, ) из-за практически идентичных показателей F1 (0.4873 против 0.4871), (2) SEMAS по сравнению с Baseline2 на котле дает высокозначимое преимущество (, ) с улучшением F1 на 8.6%, (3) SEMAS по сравнению с Baseline1 на ветряной турбине показывает значительное превосходство (, ), и (4) SEMAS по сравнению с Baseline2 на ветряной турбине демонстрирует значительное преимущество (, ). Эти результаты подтверждают статистически устойчивое превосходство SEMAS в производительности, особенно по сравнению с адаптацией на основе правил..
4.9 Анализ вычислительной эффективности
Таблица 5 сравнивает вычислительные накладные расходы различных систем. SEMAS достигает значительно более высокой производительности по задержке: 1,22 мс (котел) и 0,30 мс (ветряная турбина), что соответствует ускорению в 1576 и 1520 по сравнению с Baseline1 соответственно, а также ускорению в 1300 и 954 по сравнению с Baseline2. Эта исключительная эффективность обусловлена оптимизированной координацией мультиагентных систем, где агенты Edge выполняют быструю предварительную фильтрацию (устраняя 60-70% очевидно нормальных выборок), агенты Fog выполняют легковесный ансамблевый вывод, а оптимизация политики PPO на уровне Cloud выполняется асинхронно, не блокируя конвейер обнаружения. Все системы остаются значительно ниже промышленного ограничения реального времени в 100 мс, но субмиллисекундная задержка SEMAS позволяет реализовать сценарии развертывания, невозможные для базовых моделей: мультисенсорное слияние потоков данных, поступающих из сотен источников одновременно, развертывание на граничных устройствах с ограниченными вычислительными ресурсами и потоковый мониторинг с нулевой задержкой без использования специализированного оборудования для обработки. Чрезмерная задержка базовых систем (455-1923 мс) возникает из-за синхронного выполнения тяжеловесных моделей (Transformer, OCSVM) без иерархической предварительной фильтрации, что делает их непрактичными для промышленного развертывания в реальном времени, несмотря на конкурентоспособную точность обнаружения..
| System | Boiler (ms) | Wind (ms) | Memory (GB) |
|---|---|---|---|
| Baseline1 | 1923.0 | 455.9 | 2.1 (est.) |
| Baseline2 | 1594.3 | 286.2 | 2.4 (est.) |
| SEMAS | 1.22 | 0.30 | 3.8 (est.) |
4.10 Абляционное исследование
Для количественной оценки вклада отдельных компонентов в общую производительность системы мы проводим систематические эксперименты по абляции на наборе данных Boiler путем выборочного удаления ключевых архитектурных элементов. В таблице 6 представлено снижение производительности, наблюдаемое при отключении каждого компонента..
| Configuration | F1 | Impact | Prec. | Op. Acc. |
|---|---|---|---|---|
| SEMAS (Full) | 0.4956 | Baseline | 0.3712 | 82% |
| w/o PPO optimization | 0.4782 | -3.5% | 0.3501 | 81% |
| w/o consensus voting | 0.4634 | -6.5% | 0.3045 | 79% |
| w/o federated aggregation | 0.4856 | -2.0% | 0.3614 | 80% |
| w/o LLM response | 0.4956 | +0% (F1) | 0.3712 | 41% |
Интерпретация абляции: консенсусное голосование обеспечивает наибольший прирост точности обнаружения (влияние 6,5% на F1), подтверждая, что разнообразие ансамбля имеет решающее значение для обнаружения аномалий. Оптимизация PPO (влияние 3,5%) подтверждает преимущество обучения стратегии на основе градиентов перед статическими порогами. Федеративная агрегация (влияние 2,0%) обеспечивает умеренный прирост точности, но служит прежде всего для обеспечения развертывания на нескольких площадках без централизованного сбора данных. Генерация ответов LLM не оказывает прямого влияния на метрики обнаружения (F1 без изменений), но значительно повышает доверие оператора (82% против 41% принятия), что подтверждает обоснованность внедрения объяснимости для бизнеса, несмотря на нейтральные технические метрики..
Результаты абляционного анализа показывают, что все ключевые компоненты системы, включая эволюцию стратегии на основе PPO, многоагентное консенсусное голосование, федеративную агрегацию знаний и интерпретируемость на базе LLM, работают совместно для достижения как эффективности системы, так и удобства эксплуатации. Точность обнаружения демонстрирует наибольшее индивидуальное изменение, поскольку консенсусное голосование приводит к значению F1 score, равному . Результаты указывают на то, что разнообразие ансамбля выступает важнейшим элементом, который ведет к повышению производительности. Процесс оптимизации стратегии PPO привел к улучшению F1 на , что показало, что непрерывная настройка системы превосходит как фиксированные, так и случайные конфигурации системы. Система достигает лучших результатов за счет федеративной агрегации, которая дает значительный статистический прирост в . Система генерации ответов LLM обеспечивает существенные улучшения уровней доверия и принятия со стороны человека, которые не влияют на результаты автоматизированной системы обнаружения..
4.11 Качественный анализ: ответы, сгенерированные LLM
Агент C формирует интерпретируемые человеком рекомендации по техническому обслуживанию при обнаружении аномалий. Пример вывода для аномалии котла высокой степени тяжести ():
“Обнаружен критический тепловой дисбаланс (уровень серьезности: 0.87). Температура подачи на 15.2°C выше номинальной, в то время как температура обратки остается стабильной, что указывает на возможную деградацию циркуляционного насоса или засорение теплообменника. Рекомендуемое действие: IMMEDIATE_INSPECTION системы циркуляции. Ожидаемое время простоя: 4-6 часов. Необходимые ресурсы: специалист по системам отопления, вентиляции и кондиционирования, манометр, инструменты для диагностики насоса. Приоритет: HIGH.”
Опросы с обратной связью от операторов (проведенные с участием 5 инженеров по техническому обслуживанию по 20 инцидентам) показывают уровень принятия рекомендаций, сгенерированных LLM, в 82% при средней оценке полезности 4,1/5,0. Это демонстрирует практическую ценность внедрения возможностей объяснения на естественном языке в промышленные системы искусственного интеллекта..
4.11.1 Сводка статистической значимости
Таблица 7 содержит всестороннюю статистическую проверку по обоим наборам данных:
| Dataset | Comparison | F1 | Interpretation | ||
|---|---|---|---|---|---|
| Boiler | SEMAS vs. BL1 | +0.0002 | 0.08 | 0.94 | Not significant |
| Boiler | SEMAS vs. BL2 | +0.0384 | 4.21 | <0.001 | Highly significant |
| Wind Turbine | SEMAS vs. BL1 | +0.0131 | 2.76 | <0.01 | Significant |
| Wind Turbine | SEMAS vs. BL2 | +0.0222 | 3.12 | <0.005 | Highly significant |
Ключевая интерпретация: основное преимущество SEMAS заключается в сравнении с адаптацией на основе правил (Baseline2), где статистическая значимость является устойчивой для обоих наборов данных. По сравнению с хорошо настроенными статическими системами (Baseline1), SEMAS демонстрирует численное, но не статистическое превосходство на наборе данных Boiler, что указывает на то, что адаптивные механизмы обеспечивают наибольшую ценность при сдвиге распределения или сложности данных, а не в стабильных условиях..
4.12 Обсуждение и ключевые выводы
В следующем разделе объединены экспериментальные данные для подтверждения нашей основной исследовательской теории, а также представлены ключевые результаты и примечания исследователей о преимуществах и ограничениях системы..
4.12.1 Проверка гипотезы
Результаты экспериментов подтверждают нашу основную гипотезу: иерархические мультиагентные системы с оптимизацией стратегии на основе градиента (PPO) обеспечивают более адаптивное, эффективное и надежное предиктивное обслуживание, чем статические или основанные на правилах альтернативы..
Превосходство адаптации (основной результат): по сравнению с базовыми моделями на основе правил, SEMAS демонстрирует явное преимущество за счет стабильных траекторий обучения и более высокого качества сходимости. На примере Boiler (сложные, несбалансированные данные) SEMAS достигает против у Baseline2, что означает лучшую стабильность. Обновления PPO с ограничением доверительной области () предотвращают дискретные колебания пороговых значений (), которые характерны для систем на основе правил. Статистическое тестирование (, , ) подтверждает, что это преимущество в 8,6% является устойчивым и практически значимым..
По сравнению со статическими базовыми моделями (вторичный результат): на примере котла SEMAS демонстрирует численное, но не статистическое превосходство над Baseline1 (F1 = 0.0002, ). Это открывает важное понимание: хорошо настроенные статические системы могут соответствовать адаптивным системам, когда эксплуатационные условия стабильны. Однако SEMAS превосходит их там, где это наиболее важно — в обобщении на ранее не встречавшиеся условия, что происходит при реальном промышленном развертывании из-за старения оборудования, сезонных колебаний и изменений ассортимента продукции. Незначительное преимущество на котле не должно затмевать фундаментальное преимущество SEMAS: отсутствие необходимости в ручной перенастройке при изменении условий..
Задержка как критический фактор: ускорение ( мс против мс) превращает возможность реализации из невыполнимой в рутинную. Задержки базовых моделей нарушают промышленное ограничение реального времени в 100 мс, что делает их непрактичными для внедрения в производство независимо от точности. SEMAS обеспечивает субмиллисекундную задержку за счет архитектурного многоуровневого подхода (Edge: предварительная фильтрация, Fog: легковесный ансамбль, Cloud: асинхронный PPO), а не алгоритмических инноваций..
Качество адаптации: SEMAS демонстрирует стабильную адаптацию ( котел, ветряная турбина) по сравнению с катастрофической деградацией котла в Baseline2 (, -11,5%). Даже успешная адаптация ветряной турбины в Baseline2 (+0,0606) не может сравниться с пиковой производительностью SEMAS на первой итерации (0,9683 против 0,9606 в финале) и требует на 955 больше времени на инференс..
Баланс точности и полноты: Система SEMAS демонстрирует лучшие результаты по сравнению с другими методами для обоих наборов данных (Котел: 0.3737 против 0.3225/0.3140; Ветряная турбина: 0.9371 против 0.9219/0.9205), поскольку PPO находит оптимальные пороговые значения, которые обеспечивают высокую точность при достижении того же уровня полноты..
Вычислительная эффективность: система SEMAS достигает задержки в 1-2 мс, что позволяет ей работать в 200-1500 раз быстрее стандартных систем, делая ее подходящей для операций в реальном времени. Система достигла своей наилучшей эффективности, поскольку показала самые высокие значения ROC-AUC, которые составили 0.6118 для котла и 0.7583 для ветряной турбины, при сохранении точности на пиковом уровне..
4.12.2 Основные результаты
- ⟦1. Превосходство в режимах работы со сложными данными: SEMAS превосходит Baseline2 (на основе правил) на 8,6% по метрике F1 для котлов ( против , ) и на 2,4% для ветряных турбин ( против , ). По сравнению с хорошо оптимизированными статическими базовыми моделями (Baseline1), SEMAS демонстрирует численное, но не статистическое превосходство на котлах (, ), что указывает на то, что адаптивные механизмы приносят наибольшую пользу при сдвиге распределения. Улучшение задержки ( мс против мс) является решающим: задержки базовых моделей нарушают промышленное ограничение в 100 мс..
- ⟦2. Стабильная сходимость посредством оптимизации стратегии на основе градиента: PPO достигает превосходной стабильности сходимости по сравнению с дискретной адаптацией на основе правил. В системе Boiler, SEMAS поддерживает контролируемую адаптацию (), в то время как Baseline2 демонстрирует катастрофическую деградацию (, ). Ограничения доверительной области PPO () предотвращают превышение пороговых значений, тогда как эвристики на основе правил () вызывают осцилляции. Обученные стратегии SEMAS развиваются интерпретируемым образом: загрязнение (), веса консенсуса (: ) и пороговое значение (: ). Статистическая проверка подтверждает значимость (, , d Коэна ⟧).
- ⟦3. Изученный баланс точности и полноты: PPO обнаруживает превосходные точки компромисса между точностью и полнотой. Котел: SEMAS достигает точности (против Baseline1, ) при допущении контролируемого снижения полноты ( против ). Это отражает обучение PPO оптимальному порогу , который снижает нагрузку от ложных срабатываний при сохранении адекватного обнаружения. Ветряная турбина: SEMAS достигает наименьшего разрыва между точностью и полнотой (4,1%) среди всех систем. Промышленно критично: 67,75% уровень ложноположительных результатов (Baseline1 на котле) создает усталость от оповещений.
- ⟦4. Объяснимость повышает доверие оператора: генерация ответов на основе LLM достигает 82% уровня принятия операторами по сравнению с для одних только числовых оповещений (опрос 5 инженеров, 20 инцидентов, оценка полезности 4,1/5,0). Эта метрика ортогональна точности обнаружения (F1 остается неизменным при удалении LLM), но она необходима для промышленных внедрений с участием человека, где операторы должны понимать и обосновывать решения по автономному техническому обслуживанию..
4.12.3 Наблюдаемые сильные стороны SEMAS
- ⟦• Система функционирует независимо, повышая свою производительность за счет систем обратной связи на основе RL, которые устраняют необходимость в ручной корректировке пороговых значений, влияющих на традиционные системы, что является значительным эксплуатационным преимуществом..
- ⟦• Система достигает распределенного интеллекта посредством фильтрации на Edge, ансамблевого обнаружения на Fog и оптимизации стратегий в Cloud, что обеспечивает как высокую точность, так и вычислительную эффективность..
- ⟦• Система SEMAS достигает стабильных результатов при работе с наборами данных, обладающими различными свойствами (Котел: дисбаланс классов, сложные признаки; Ветряная турбина: высокая размерность, множественные типы неисправностей).
- ⟦• Система отвечает промышленным требованиям реального времени, поскольку достигает средней задержки 0,95 мс (котел) и 0,29 мс (ветряная турбина), что остается ниже 100 мс. Система может быть развернута в производственных средах, так как она соответствует требованиям реального времени без необходимости использования какого-либо специального оборудования.
- ⟦• Метод градиента стратегии в PPO предотвращает слишком быстрое достижение моделью субоптимальных конфигураций, одновременно прекращая случайное исследование, с которым столкнулся Baseline2 при управлении на основе правил, что приводило к ухудшению производительности на Boiler.
4.12.4 Наблюдаемые недостатки и ограничения
- ⟦• Сложность обучения: SEMAS требует значительно больше времени на первоначальную настройку (8 часов для оптимизации гиперпараметров) по сравнению с Baseline1 (2 часа) из-за обучения политики PPO, координации мультиагентных систем и настройки ансамбля из нескольких моделей. Эта повышенная сложность может препятствовать внедрению в условиях ограниченных ресурсов при отсутствии специализированных знаний в области машинного обучения..
- ⟦• Накладные расходы на память: SEMAS потребляет 3,8 ГБ памяти по сравнению с 2,1 ГБ (Baseline1) и 2,4 ГБ (Baseline2) из-за буфера воспроизведения опыта PPO (10 000 переходов), множественных экземпляров моделей и федеративного управления состоянием (Таблица 5). Организациям со строгими аппаратными бюджетами, возможно, потребуется сопоставить эти затраты с приростом производительности..
- ⟦• Производительность при «холодном старте»: первая итерация SEMAS достигла лучших результатов, чем Baseline1, поскольку случайный запуск модели позволил получить выгодное пороговое значение 0,7327, которое превзошло оптимизированный порог Baseline1, равный 0,75. Система получает это преимущество благодаря тому, что ее операции происходят случайным образом, а не создаются посредством целенаправленного проектирования. Система SEMAS не обеспечивает никаких преимуществ перед статическими системами, которые были должным образом оптимизированы при выполнении экстренных развертываний, требующих мгновенной высокой производительности без времени на адаптацию. В рамках исследования следует внедрить трансферное обучение на основе предварительно обученных PPO политик, которые функционируют в аналогичных промышленных средах, для достижения развертывания с «теплым стартом» с использованием их методов адаптивного обучения..
- ⟦• Чувствительность к проектированию функции вознаграждения: первая итерация SEMAS достигла лучших результатов, чем Baseline1, поскольку случайный запуск модели привел к выгодному пороговому значению 0,7327, которое превзошло оптимизированный порог Baseline1, равный 0,75. Система получает это преимущество, так как ее операции происходят случайным образом, а не создаются посредством преднамеренного проектирования. Система SEMAS не дает никаких преимуществ перед статическими системами, которые были должным образом оптимизированы при выполнении экстренных развертываний, требующих мгновенной высокой производительности без времени на адаптацию. В исследовании следует реализовать трансферное обучение на основе предварительно обученных PPO политик, которые функционируют в аналогичных промышленных средах, для достижения развертывания с «теплым стартом» с использованием их изученных методов адаптации..
- ⟦• Эффекты «потолка», специфичные для набора данных: Набор данных ветряных турбин дает высокие результаты для всех систем, где SEMAS достигает F1 0.9571, а Baseline1 и Baseline2 достигают 0.9440 и 0.9349 соответственно. Значение ROC-AUC для SEMAS (0.7583) превосходит базовые показатели, но система достигает лишь небольших абсолютных улучшений показателя F1 на +1.3% по сравнению с Baseline1 и на +2.4% по сравнению с Baseline2. «Эффект потолка» указывает на то, что SEMAS становится менее эффективным в повышении точности при работе с наборами данных, имеющими четкие признаки, которые легко отличить друг от друга. Метод обеспечивает лучшую вычислительную производительность, работая в 955 раз быстрее, но не улучшает показатели точности. Система достигает наилучших результатов точности при работе в сложных условиях, которые включают зашумленные данные, несбалансированные классы и трудные операционные среды (Boiler достиг результатов на 8.6% лучше, чем Baseline2).
- ⟦• Компромисс между объяснимостью и задержкой: конвейер обнаружения испытывает дополнительные задержки из-за процесса генерации ответов на основе LLM. Система принимает этот метод для обнаружения аномальных оповещений, поскольку такие события происходят редко, но это создало бы серьезное препятствие для систем, которым необходимо генерировать объяснения для всех своих прогнозов. Исследование должно быть направлено на разработку методов кэширования вместе с минимальными локальными системами объяснения, которые минимизируют задержку производительности..
4.12.5 Сравнение с предыдущими исследованиями
Результаты нашего исследования соответствуют современному пониманию мультиагентных RL-систем для промышленных приложений, что [24] и [7] продемонстрировали в своих работах. Исследование показывает, что адаптивные политики генерируют лучшие результаты, чем фиксированные, поскольку они обеспечивают повышение производительности на 3-8%. Система SEMAS опирается на предыдущие исследования, внедряя три инновационных элемента, которые включают (1) координацию агентов на уровнях Edge-Fog-Cloud, работающую на различных уровнях для промышленных сред с ограниченными ресурсами, (2) оптимизацию политики PPO посредством формирования мультиметрического вознаграждения, включающего F1, баланс precision-recall и метрики задержки, и (3) объяснимость на основе LLM для повышения доверия оператора. Абляционное исследование показывает, что все компоненты играют важную роль в достижении наилучших результатов, поскольку консенсусное голосование приводит к наиболее значительному снижению производительности при его удалении (-6.5% F1).
4.12.6 Последствия для промышленного внедрения
Экспериментальные результаты имеют несколько практических последствий:
- ⟦1. Обоснованная сложность для критической инфраструктуры: для критической инфраструктуры (электростанции, производственные линии, ветряные электростанции), где даже улучшение F1 на 1-3% приводит к значительной экономии на предотвращении простоев, вычислительные затраты SEMAS (1.8 памяти, 8 часов начального обучения) являются экономически оправданными.
- ⟦2. Путь поэтапного внедрения: организации могут развертывать SEMAS в гибридном режиме, используя Baseline1 для активов с низкой критичностью и стабильными условиями эксплуатации, а SEMAS — для дорогостоящего оборудования с изменяющимися моделями неисправностей, чтобы сбалансировать затраты и производительность в рамках гетерогенных промышленных портфелей..
- ⟦3. Концепция взаимодействия человека и искусственного интеллекта: высокий уровень принятия операторами объяснений LLM (82%) свидетельствует о том, что интерпретируемость преодолевает разрыв в доверии при автоматизированном техническом обслуживании, обеспечивая более безопасное принятие автономных решений при сохранении контроля со стороны человека для критически важных вмешательств..
- ⟦4. Необходимость адаптации к предметной области: Противоречивые результаты для котла (явное преимущество SEMAS) и ветряной турбины (эффект потолка) подчеркивают важность оценки перед развертыванием, чтобы определить, оправдана ли адаптивная сложность для конкретных операционных контекстов.
5 Заключение и направления будущих исследований
5.1 Заключение
В данной статье представлена SEMAS, иерархическая мультиагентная система для предиктивного обслуживания в промышленном интернете вещей, которая объединяет три критических требования: (1) обнаружение в режиме реального времени при строгих ограничениях по задержке (<100мс), (2) адаптивное функционирование посредством непрерывной эволюции стратегий и (3) принятие достоверных решений с помощью объяснимости на основе LLM. Фреймворк распределяет специализированных агентов между уровнями Edge, Fog и Cloud в соответствии с доступными вычислительными ресурсами, поддерживая согласованность посредством трех параллельных контуров обратной связи и механизмов достижения консенсуса..
Эмпирическая проверка на двух промышленных наборах данных (эмулятор котла: 10 000 образцов, 36,8% распространенности аномалий; IIoT ветряной турбины: 500 образцов, 45% распространенности неисправностей) демонстрирует эффективность SEMAS.
(1) Точность: SEMAS достигает лучших показателей F1 (Boiler: ; Wind: ), с существенным преимуществом в 8,6% над адаптацией на основе правил для Boiler (, , ). По сравнению с хорошо настроенными статическими базовыми моделями, SEMAS демонстрирует численное, но не статистическое превосходство для Boiler (, ).
(2) Эффективность: SEMAS обеспечивает ускорение задержки (мс против мс), что позволяет осуществлять развертывание в режиме реального времени, в то время как базовые модели нарушают промышленные ограничения в 100 мс..
(3) Стабильность: анализ траектории обучения показывает, что SEMAS поддерживает контролируемую адаптацию ( котел, ветер), в то время как Baseline2 демонстрирует катастрофическую деградацию котла (, ⟧).
(4) Ценность компонентов: Абляционные исследования подтверждают, что все элементы вносят существенный вклад — консенсусное голосование (влияние на F1 6,5%), оптимизация PPO (3,5%), федеративная агрегация (2,0%) и объяснимость LLM (82% принятия операторами против 41% в базовой модели)).
Иерархическая мультиагентная архитектура обеспечивает важные преимущества, поскольку она позволяет осуществлять распределенную специализацию для эффективной декомпозиции задач, непрерывную эволюцию стратегий для поддержания производительности в изменяющихся средах, совместное ансамблевое обнаружение для повышения устойчивости и генерацию ответов на основе LLM для формирования доверия посредством объяснимых ответов. Результаты исследования демонстрируют, что SEMAS функционирует как эффективное решение, которое может быть использовано в промышленном производстве в критически важных для безопасности промышленных условиях для создания необходимой инфраструктуры для будущих промышленных систем ИИ..
5.2 Направления будущих исследований
Перспективные направления для расширения SEMAS включают:
Трансферное обучение для быстрого развертывания (высокий приоритет): текущее время инициализации в 8 часов ограничивает внедрение для развертывания нового оборудования. Будущие исследования должны разработать механизмы трансферного обучения, которые используют предварительно обученные политики PPO от оборудования того же класса (например, от котла к котлу) для достижения развертывания с «теплым стартом» и донастройкой менее чем за 30 минут. Это напрямую решает проблему «холодного старта», выявленную в разделе 5.2.
Многокритериальное формирование вознаграждения (средний приоритет): расширение PPO для одновременной оптимизации нескольких целей (точность F1, стоимость ложных срабатываний, затраты на техническое обслуживание, энергопотребление, риск простоя) с использованием наборов стратегий, оптимальных по Парето. Это позволяет операторам выбирать решения вдоль границы точности и стоимости, основываясь на их допустимом уровне риска и бюджетных ограничениях..
Федеративное обучение с гарантиями конфиденциальности (средний приоритет): Текущая агрегация параметров (Eq. 15) является легковесной альтернативой полноценному федеративному обучению. В будущих работах следует внедрить механизмы дифференциальной приватности (например, DP-SGD) для обеспечения возможности развертывания на нескольких объектах без централизации конфиденциальных эксплуатационных данных, что критически важно для конкурентных производственных сред..
Сжатие моделей для экстремальных ограничений периферийных вычислений (низкий приоритет): разработка методов квантования и дистилляции знаний для развертывания SEMAS на устройствах с объемом оперативной памяти менее 1 ГБ, что расширяет применимость для устаревшего промышленного оборудования с крайне ограниченными вычислительными ресурсами..
Междоменная генерализация (приоритетное направление исследований): проверка возможности переноса SEMAS между промышленными секторами (котел турбина химический реактор). Это требует использования доменно-адаптивных функций вознаграждения, которые отражают специфические для сектора затраты на отказы и эксплуатационные ограничения..
Список литературы
- ⟦[1] Георгиос Андреадис, Параскеви Клазоглу, Кириаки Ниотаки и Константин-Дионисиос Бузакис. Классификация и обзор мультиагентных систем в производственном секторе. Procedia Engineering, 69:282–290, 2014. 24-й международный симпозиум DAAAM по интеллектуальному производству и автоматизации, 2013.
- ⟦[2] Даниэле Апилетти, Клаудия Барберис, Таня Черкителли, Альберто Мачи, Энрико Мачи, Массимо Пончино и Франческо Вентура. istep, интегрированный механизм самонастройки для предиктивного обслуживания в индустрии 4.0. В материалах 2018 IEEE Intl Conf on Parallel & Distributed Processing with Applications, Ubiquitous Computing & Communications, Big Data & Cloud Computing, Social Computing & Networking, Sustainable Computing & Communications (ISPA/IUCC/BDCloud/SocialCom/SustainCom), страницы 924–931, 2018.
- ⟦[3] Гибсон Барбоза, Джамель Ф.Х. Садок, Джудит Келнер и Луис Рибейро. Мультиагентная архитектура для приложений безопасности промышленного интернета вещей. Engineering Applications of Artificial Intelligence, 150:110495, 2025.
- ⟦[4] Эндрю А. Борковски и Алон Бен-Ари. Мультиагентные системы искусственного интеллекта в здравоохранении: представление интеллекта следующего поколения. Федерал Практишнер, 42(5):188–194, май 2025 г. Авторское право © 2025 Фронтлайн Медикал Коммьюникейшнс Инк., Парсиппани, Нью-Джерси, США.
- ⟦[5] Чэнь Дин, Фэй Цяо, Дунъюань Ван и Хуан Лю. Адаптивное планирование в реальном времени для производства и технического обслуживания: Интеграция прогнозирования RUL с многоагентным глубоким reinforcement learning. Reliability Engineering & System Safety, 264:111394, 2025.
- ⟦[6] Али Дорри, Салил С. Канхере и Раджа Юрдак. Многоагентные системы: обзор. IEEE Access, 6:28573–28593, 2018.
- ⟦[7] Цян Фэн, Юэ Чжан, Бо Сунь, Син Го, Дунмин Фань, И Жэнь, Яньцзе Сун и Цзили Ван. Многоуровневое предиктивное техническое обслуживание интеллектуальных производственных систем на основе цифровых двойников: матуристический подход. Journal of Manufacturing Systems, 68:443–454, 2023.
- ⟦[8] Дэвид Хейк, Фуад Бахрпейма и Дирк Райхелт. Исследование применения одноагентного и многоагентного reinforcement learning для динамического планирования в производственных средах с растущей сложностью: тематическое исследование синтеза испытательного стенда Industrial IoT. Journal of Manufacturing Systems, 77:525–557, 2024.
- ⟦[9] Чол-Хо Хонг и Блессон Варгезе. Управление ресурсами в туманных/периферийных вычислениях: обзор архитектур, инфраструктуры и алгоритмов. ACM Comput. Surv., 52(5), сентябрь 2019.
- ⟦[10] Кевин Шен Хунг Онг, Дусит Ниято и Чау Юэн. Предиктивное техническое обслуживание для сенсорных сетей на основе граничных вычислений: подход с использованием глубокого reinforcement learning. В материалах 2020 IEEE 6th World Forum on Internet of Things (WF-IoT), страницы 1–6, 2020.
- ⟦[11] Вэйцян Цзинь, Хунъян Ду, Бяо Чжао, Синъу Тянь, Бохан Ши и Гуань Ян. Комплексный обзор многоагентного кооперативного принятия решений: Сценарии, подходы, проблемы и перспективы. Электронный журнал SSRN, март 2025 г. Доступно на SSRN: https://ssrn.com/abstract=5106265 или http://dx.doi.org/10.2139/ssrn.5106265.
- ⟦[12] Х. Ли, С. Ван, С. Зенг и др. Обзор мультиагентных систем на основе LLM: рабочий процесс, инфраструктура и проблемы. Vicinagearth, 1:9, 2024.
- ⟦[13] Чжэнлинь Лян и Аджит Кумар Парликад. Прогнозное групповое техническое обслуживание для мультисистемных многокомпонентных сетей. Reliability Engineering & System Safety, 195:106704, 2020.
- ⟦[14] Джонхан Лим и Илья Коваленко. Архитектура управления на основе LLM для динамического исследования ресурсных возможностей в многоагентных производственных системах. В материалах 21-й Международной конференции IEEE по автоматизации, науке и технике (CASE) 2025 года, страницы 2088–2095, 2025.
- ⟦[15] Цзинъюй Лю и Юнчуань Тан. Слияние конфликтных данных в многоагентной системе, основанное на базовом распределении вероятностей и расстоянии между свидетельствами. Entropy, 23(7), 2021.
- ⟦[16] Адисон М. Майя, Дарио Виейра, Ясин Гамри-Дудан, Кристиано Родригес, Марсиэль Б. Перейра и Мигель Ф. де Кастро. Иерархическое управление для размещения приложений и распределения нагрузки в периферийных вычислениях. Future Generation Computer Systems, 166:107631, 2025.
- ⟦[17] Дэвид Мур. Таксономия иерархических многоагентных систем: шаблоны проектирования, механизмы координации и промышленные приложения. Электронный журнал SSRN, 2024. Доступно на SSRN: https://ssrn.com/abstract=5544753 или http://dx.doi.org/10.2139/ssrn.5544753.
- ⟦[18] Картик Намбури, Рохит П. Суреш, Сатвик Хдж, Шрианш Моханти и Джаяшри Рангаредди. Распределенный вывод LLM на периферийных устройствах. В сборнике трудов 14-й Международной конференции 2025 года по программному обеспечению и компьютерным приложениям, ICSCA ’25, страницы 321–326, Нью-Йорк, штат Нью-Йорк, США, 2025 год. Ассоциация вычислительной техники.
- ⟦[19] А. Сальвадор Палау, М. Х. Дада и А. К. Парликад. Архитектуры многоагентных систем для совместного прогнозирования. Journal of Intelligent Manufacturing, 30:2999–3013, 2019.
- ⟦[20] Дебидатта Паттнаик, Соугато Рэй и Рагху Раман. Применение искусственного интеллекта и машинного обучения в индустрии финансовых услуг: библиометрический обзор. Heliyon, 10(1):e23492, 2024.
- ⟦[21] Франческо Пиччиалли, Дилетта Кьяро, Сундас Сарвар, Донато Черчьелло, Пиань Ци и Валерия Меле. Agentai: Комплексный обзор автономных агентов в распределенном искусственном интеллекте для Индустрии 4.0. Expert Systems with Applications, 291:128404, 2025.
- ⟦[22] М. Раза, З. Джахангир, М. Б. Риаз и др. Промышленные применения LLM. Scientific Reports, 15:13755, 2025.
- ⟦[23] Нельсон Родригес, Пауло Лейтао и Эудженио Оливейра. Динамическая реконфигурация сервисов с помощью мультиагентных систем. В сборнике: Теодор Борангиу, Дамьен Трентесо, Андре Томас, Пауло Лейтао и Хосе Барата Оливейра, редакторы, Сервисная ориентация в голоническом и мультиагентном производстве, страницы 307–318, Шам, 2017. Springer International Publishing.
- ⟦[24] Марсело Луис Руис Родригес, Сильвен Кублер, Андреа де Джорджио, Максим Корди, Жереми Робер и Ив Ле Траон. Предиктивное техническое обслуживание на основе многоагентного глубокого обучения с подкреплением для параллельных машин. Robotics and Computer-Integrated Manufacturing, 78:102406, 2022.
- ⟦[25] Шрути, Шалли Рани и Гаутам Шривастава. Безопасная иерархическая архитектура на основе туманных вычислений для индустрии 5.0 с использованием схемы шифрования на основе атрибутов. Expert Systems with Applications, 235:121180, 2024.
- ⟦[26] Фали Ван, Минхуа Лин, Яо Ма, Хуэй Лю, Ци Хэ, Сяньфэн Тан, Цзилинь Тан, Цзянь Пэй и Сухан Ван. Обзор малых языковых моделей в эпоху больших языковых моделей: архитектура, возможности и надежность. В материалах 31-й конференции Ассоциации вычислительной техники по поиску знаний и интеллектуальному анализу данных, том 2, KDD ’25, страницы 6173–6183, Нью-Йорк, штат Нью-Йорк, США, 2025 год. Ассоциация вычислительной техники.
- ⟦[27] Джунлин Ван, Цзюэ Ван, Бен Ативараткун, Це Чжан и Джеймс Зоу. Смесь агентов расширяет возможности LLM. В материалах Тринадцатой международной конференции по обучению представлениям, 2025.
- ⟦[28] Сюэцян Чжан, Сяофэй Дун, Ижу Ван, Дан Чжан и Фэн Цао. Обзор сотрудничества мультиагентных систем с искусственным интеллектом: теории, технологии и приложения. В сборнике трудов 2-й Международной конференции по цифровой экономике и искусственному интеллекту региона Большого залива Гуандун-Гонконг-Макао, DEAI ’25, страницы 1875–1881, Нью-Йорк, штат Нью-Йорк, США, 2025 год. Ассоциация вычислительной техники..
- ⟦[29] Тонг Чжоу, Данбин Тан, Хайхуа Чжу и Зекун Чжан. Многоагентное обучение с подкреплением для оперативного планирования на «умных» фабриках. Robotics and Computer-Integrated Manufacturing, 72:102202, 2021.
Appendix A Математические подробности
A.1 Глобальная целевая функция оптимизации
Глобальная целевая функция оптимизации выглядит следующим образом: {IEEEeqnarray}rCl L^PPO(θ) = E_t[ min( r_t(θ)^A_t, clip(r_t(θ),1-ϵ,1+ϵ)^A_t ) ] Система оптимизирует три взаимодополняющие цели. Во-первых, обнаружение аномалий максимизирует точность бинарной классификации: {IEEEeqnarray}lCl L_anomaly = -1N ∑_i=1^N [ y_i log(^y_i) + (1-y_i) log(1-^y_i) ],
где — это ансамблевая оценка аномалий, а — это истинная метка. Во-вторых, прогнозирование RUL минимизирует ошибку оценки: {IEEEeqnarray}rCl L_RUL(θ) = 1M∑_j=1^M | ^RUL_j - RUL_j^true |. В-третьих, генерация ответа оптимизирует полезность для человека посредством LLM prompting:
| (9) |
Параметры представляют веса модели обнаружения, обозначает параметры стратегии (пороговые значения, веса ансамбля, шаблоны промптов), а взвешивают три целевые функции на основе эксплуатационных приоритетов. Веса обычно устанавливаются для приоритизации обнаружения аномалий при соблюдении баланса между прогнозированием и интерпретируемостью..
Агенты из множества используют свои стратегии для запроса объяснений через как для создания объяснений, так и для предложения действий. Система использует сигналы оценки для сбора автоматизированных метрик, таких как F1-score и MAE, измерений задержки и обратной связи от человека, которые она применяет для обновления стратегий посредством систем reinforcement learning..
A.2 Целевая функция PPO и значения SHAP
Целевая функция Proximal Policy Optimization (PPO), используемая агентом D, минимизирует:
| (10) |
где — это отношение вероятностей, а — это обобщенная оценка преимущества.
Агент E вычисляет значения SHAP (SHapley Additive exPlanations) для обеспечения прозрачности и доверия:
| (11) |
где — это набор признаков, — подмножество признаков, исключающее , а обозначает предсказание модели. Эти значения используются для проверки обновлений стратегии посредством статистического тестирования, обнаружения дрейфа и верификации соответствия требованиям перед развертыванием в масштабах всей системы, в то время как комплексный мониторинг и журналы ведутся для обеспечения контрольных следов и аналитики производительности..
A.3 Механизм федеративной агрегации
Синхронизация графов знаний использует федеративную агрегацию: {IEEEeqnarray}cCl θ_global = ∑k=1KnkθkNtotal, N_total = ∑_j n_j. где — это количество обучающих выборок, обработанных агентом в текущей итерации, а представляет локально оптимизированные параметры модели. Этот подход использует взвешенное усреднение, пропорциональное данным, для объединения параметров модели обнаружения между агентами, гарантируя, что агенты, обрабатывающие большие объемы данных, имеют пропорционально большее влияние на глобальную модель. В отличие от систем полноценного федеративного обучения, которые обучают модели локально и передают только обновления параметров, подход SEMAS является консервативным и не опирается на предположения о конфиденциальности данных или гарантиях дифференциальной приватности. Механизм служит для агрегирования весов консенсуса и пороговых значений, а не параметров глубоких нейронных сетей..
Appendix B Архитектура и детали взаимодействия
B.1 Обзор архитектуры на уровне агентов
Детальные взаимодействия агентов и потоки данных показаны на Рисунке 2. Периферийный уровень содержит агенты без сохранения состояния (A1: обработка вибрации, A2: обработка температуры), которые извлекают признаки и публикуют их через фрагменты MQTT. Туманный уровень содержит координатора обнаружения B со специализированными под-агентами (B1: Isolation Forest, B2: LSTM, B3: Consensus Voting) и агента реагирования C (объяснения на базе LLM). Облачный уровень включает эволюционного агента D (оптимизация политики на основе PPO) и мета-агента E (контроль на основе SHAP). Множественные контуры обратной связи функционируют одновременно: локальная обратная связь (Fog Edge), глобальная обратная связь (Cloud Fog/Edge) и итеративные циклы (Fog Cloud) для непрерывной адаптации..
B.2 Периферийный уровень: обработка на уровне устройств
Уровень Edge включает в себя агенты без сохранения состояния, развернутые на устройствах с ограниченными ресурсами (4-8 ГБ оперативной памяти, ограниченный центральный процессор), которые выполняют прием данных с датчиков и извлечение признаков в режиме реального времени.:
- ⟦• Агент A1 (Субагент 1): Обрабатывает многомерный поток данных датчиков (например, вибрация, ускорение, акустическая эмиссия) посредством анализа скользящего окна размером . Извлекает статистические признаки во временной области (среднеквадратичное значение, эксцесс, асимметрия) и характеристики в частотной области (спектральные пики, энергии полос). Выводит вектор признаков , публикуемый в топик MQTT chunk/stream1, где обозначает базу временного интервала с размером окна , охватывающую промежуток от до ⟧.
- ⟦• Агент A2 (субагент 2): обрабатывает дополнительную модальность датчиков (например, температуру, давление, ток), вычисляя индикаторы тренда, температурные градиенты и статистические сводки. Публикует в chunk/stream2.
Функции извлечения признаков отображают необработанные окна данных датчиков в компактные представления признаков:
| (12) |
B.3 Туманный слой: совместное обнаружение и реагирование
Слой туманных вычислений координирует работу множества специализированных субагентов, которые реализуют совместное обнаружение аномалий, ансамблевое слияние и генерацию ответов на основе промптов.:
- ⟦• Агент B (Координатор обнаружения): Центральный узел оркестрации, который получает предварительно обработанные признаки от граничных агентов через подписки chunk/* и графы политик от облачных агентов. Направляет агрегированные векторы признаков субагентам обнаружения и координирует конвейер совместного вывода.
-
⟦•
Агент B1 (Статистическое обнаружение): реализует ансамбль Isolation Forest с деревьями, обученными на исторических паттернах нормального поведения. Вычисляет оценку аномалий , количественно определяющую отклонение от номинальных распределений:
где — ожидаемая длина пути, а — средняя длина пути неудачного поиска в бинарных деревьях.(13) -
⟦•
Агент B2 (Ансамблевое обнаружение): реализует ансамбль из 5 моделей, объединяющий различные парадигмы обнаружения аномалий: Isolation Forest, One-Class SVM, Local Outlier Factor, Elliptic Envelope и дополнительный Isolation Forest с другими гиперпараметрами. Ансамбль агрегирует прогнозы посредством мажоритарного голосования для повышения устойчивости:
где каждая базовая модель предоставляет бинарные прогнозы аномалий, которые объединяются посредством взвешенного или мажоритарного голосования.(14) -
⟦•
Агент B3 (Консенсусное голосование): Агрегирует гетерогенные сигналы обнаружения от Агента B1 (Isolation Forest) и Агента B2 (ансамбль из 5 моделей) посредством взвешенного консенсуса с динамически адаптируемыми весами , основанными на недавних метриках производительности:
где — оценка Isolation Forest, а — результат голосования большинства ансамбля. Публикует консолидированную оценку в топик аномалий при превышении порогового значения .(15) -
⟦•
Агент C (Генератор ответов): Использует возможности LLM посредством структурированного проектирования промптов для создания интерпретируемых человеком объяснений и практических рекомендаций по техническому обслуживанию:
где представляет собой тщательно разработанный шаблон промпта, включающий серьезность аномалии, контекст датчиков, эксплуатационные ограничения и историю технического обслуживания.(16)
Интеграция с внешними системами.
Оповещения об аномалиях и действия, сгенерированные LLM, взаимодействуют с внешними системами CMMS/SCADA через раздел MQTT для действий. Обратная связь от оператора (принятие, отмена, корректировка степени серьезности) фиксируется и передается в качестве контролирующих сигналов в механизмы эволюции на уровне Cloud..
B.4 Облачный уровень: эволюция стратегий и надзор
Облачный уровень содержит два основных агента с неограниченными вычислительными ресурсами для глобальной оптимизации и управления всей системой:
- ⟦• Агент D (Эволюционный агент): реализует алгоритм Proximal Policy Optimization (PPO) для непрерывного улучшения стратегии во всем ансамбле агентов. Поддерживает глобальный буфер воспроизведения опыта , собирающий переходы со всех уровней системы. Обновленные стратегии сериализуются в графе знаний и распространяются через обновления стратегий..
- ⟦• Агент E (Мета-агент): Обеспечивает надзор со стороны Explainable AI посредством вычисления значений SHAP (SHapley Additive exPlanations) для прозрачности и доверия. Проверяет обновления стратегий с помощью статистического тестирования, обнаружения дрейфа и верификации соответствия требованиям перед развертыванием в масштабах всей системы. Ведет комплексный мониторинг/журналы для контрольных журналов и аналитики производительности..
B.5 Связь и координация
Все меж-агентские коммуникации используют протокол MQTT с шифрованием TLS и уровнями качества обслуживания (QoS), обеспечивая надежную доставку сообщений.:
- ⟦• Потоки признаков: chunk/stream{1,2} для передачи признаков от Edge к Fog
- ⟦• Сигналы обнаружения: scores/{if,lstm} для обнаружения консенсусной маршрутизации
- ⟦• Консолидированные выходные данные: аномалии и действия для туманных вычислений Внешняя интеграция
- ⟦• Распределение стратегии: обновления стратегии для адаптации облака к граничным/туманным вычислениям
- ⟦• Мониторинг: мониторинг/журналы для общесистемной телеметрии и обеспечения соответствия требованиям
Appendix C Обучение и гиперпараметры
C.1 Обоснование гиперпараметров и анализ чувствительности
Ключевые гиперпараметры выбираются на основе систематической валидации и требований предметной области. В таблице VIII приведено обоснование для критических параметров:
| Parameter | Value | Justification | Valid Range |
|---|---|---|---|
| Contamination () | 0.32 | Matches Boiler anomaly prevalence (36.8%) | [0.25, 0.35] |
| Window size () | 100 ts | 10 seconds at 10Hz sampling rate | [50, 200] |
| Initial | 0.42, 0.58 | Equal weighting; PPO learns optimal split | [0.3, 0.7] |
| PPO clip ratio () | 0.2 | Standard RL literature value | [0.1, 0.3] |
Анализ чувствительности (варьирование гиперпараметров относительно номинальных значений) показывает, что F1-score остается стабильным в пределах допустимых диапазонов, что подтверждает устойчивость к выбору гиперпараметров..
C.2 Подробные спецификации модели обнаружения аномалий
Статистический детектор (агент B1): Isolation Forest обучается в автономном режиме на исторических данных о нормальной работе с использованием параметра загрязнения . Модель учится изолировать аномалии посредством случайного разбиения, при этом средняя длина пути служит индикатором оценки аномалий.:
| (17) |
где — ожидаемая длина пути, а — средняя длина пути неудачного поиска в бинарных деревьях.
Ансамблевый детектор (агент B2): реализует ансамбль из 5 моделей, объединяющий различные парадигмы обнаружения аномалий, обученных на :
- ⟦• Изоляционный лес: с 200 деревьями, уровень загрязнения
- ⟦• One-Class SVM: с ядром RBF,
- ⟦• Локальный фактор выбросов: с соседями
- ⟦• Эллиптическая огибающая: с уровнем загрязнения
- ⟦• Вторичный изолирующий лес: с другим случайным начальным числом
Ансамбль агрегирует прогнозы посредством мажоритарного голосования с динамическими весами:
| (18) |
где каждая базовая модель выдает бинарные прогнозы аномалий, которые объединяются для повышения надежности обнаружения при различных типах неисправностей.
C.3 Модель прогнозирования RUL ⟦K0⟧
В то время как обнаружение аномалий работает непрерывно, прогнозирование RUL запускается после подтвержденного обнаружения аномалии. Регрессионная модель на основе LSTM обрабатывает расширенный временной контекст для оценки оставшихся часов эксплуатации.:
| (19) |
где архитектура LSTM состоит из [64, 32, 32, 1] единиц с длиной последовательности временных шагов. Обучение минимизирует среднюю абсолютную ошибку на исторических данных об отказах:
| (20) |
Модель обучается отдельно от моделей обнаружения аномалий с размером пакета 32, оптимизатором Adam () и 10 эпохами до сходимости.
Appendix D Промпт-инжиниринг LLM и качественная оценка
D.1 Проектирование промптов для генерации ответов
Агент C использует адаптивные шаблоны промптов, основанные на степени серьезности аномалии. Примеры:
Низкая степень серьезности ():
“Оборудование демонстрирует незначительную аномалию датчика (степень тяжести: 0.42). Контекст: [сводка датчика температуры]. Является ли это нормальным дрейфом или индикатором ранней неисправности? Сгенерируйте: (1) вероятную причину; (2) продолжить мониторинг или провести инспекцию?”
Высокая степень серьезности ):
“Обнаружена аномалия критического оборудования (степень тяжести: 0.89). Сводка признаков: [sensor values]. Операционное воздействие: [cost/downtime estimates]. Рекомендуемые немедленные действия и требуемые навыки технического специалиста. Ожидаемые сроки вмешательства: [hours].”
Appendix E Метрики оценки
E.1 Метрики обнаружения аномалий
F1-Score (основная метрика): Гармоническое среднее точности и полноты, вычисляемое как:
| (21) |
Эта сбалансированная метрика критически важна для промышленных приложений, где как ложные срабатывания (FP), так и пропуски обнаружения (FN) влекут за собой значительные издержки..
Точность: доля предсказанных аномалий, являющихся истинными аномалиями, . Высокая точность минимизирует ненужные вмешательства по техническому обслуживанию.
Полнота (чувствительность): доля истинных аномалий, правильно обнаруженных системой, . Высокая полнота гарантирует, что критические неисправности не будут пропущены..
Точность: общая правильность классификации, . Вторичная метрика из-за учета дисбаланса классов.
ROC-AUC: Площадь под рабочей характеристикой приемника, измеряющая качество вероятностного ранжирования для всех настроек пороговых значений.
E.2 Метрики прогнозирования RUL
Средняя абсолютная ошибка (MAE): среднее абсолютное отклонение между предсказанными и истинными значениями RUL:
| (22) |
Среднеквадратичная ошибка (RMSE): квадратный корень из среднего значения квадратов ошибок, в большей степени штрафующий за крупные ошибки.:
| (23) |
E.3 Метрики адаптации и эффективности
Улучшение F1 (F1): прирост производительности от начальной до финальной итерации, , количественно определяющий способность к обучению.
Средняя задержка: среднее время прогнозирования на один образец (миллисекунды), критически важное для ограничений развертывания в режиме реального времени.
Appendix F Детали конфигурации обучения
В данном приложении представлены исчерпывающие конфигурации обучения для всех моделей.
F.1 Конфигурация обучающих данных
- ⟦• Набор данных котла: 8 000 обучающих выборок, 2 000 тестовых выборок (разделение 80-20 со стратификацией))
- ⟦• Набор данных ветряных турбин: 400 обучающих образцов, 100 тестовых образцов (разделение 80-20))
- ⟦• Стратегия валидации: 5-блочная перекрестная проверка на обучающей выборке для настройки гиперпараметров
- ⟦• Аугментация данных: не применялась (сохраняет временную целостность данных датчиков))
F.2 Модели обнаружения аномалий
Модели обнаружения аномалий в таблице IX были настроены для достижения баланса между чувствительностью обнаружения и вычислительной эффективностью в потоковом режиме. Isolation Forest и One-Class SVM служат базовыми моделями без учителя, которые работают непосредственно в пространстве признаков, сокращенном с помощью ISAPCA, обеспечивая надежное обнаружение без размеченных аномалий. Последовательностные модели (LSTM и transformers) фиксируют временные зависимости в траекториях датчиков, позволяя обнаруживать постепенную деградацию на ранних стадиях, а не только внезапные сбои. Гиперпараметры были выбраны посредством предварительного сеточного поиска для поддержания стабильного обучения, предотвращения переобучения и обеспечения задержки вывода, совместимой с развертыванием в реальном времени в IIoT..
| Model | Hyperparam. | Value |
| Isol. Forest | Est. () | 200 |
| Contam. () | 0.32 | |
| Max samples/tree | 256 | |
| Rand. seed | 42 | |
| Training | Unsupervised | |
| One-Class SVM | Kernel | RBF |
| Gamma () | ||
| Nu () | 0.25 | |
| Training | Unsupervised | |
| LSTM | Arch. | [64, 32, 32, 1] units |
| Seq. len. | 10 timesteps | |
| Batch | 32 | |
| Epochs | 50 (early stop p=10) | |
| Opt. | Adam (, ) | |
| Loss | Bin. cross-entropy | |
| Dropout | 0.2 (post-LSTM) | |
| Transformer | Encoder layers | 2 |
| Attn. heads | 4 | |
| Emb. dim. | 128 | |
| FF dim. | 512 | |
| Batch | 32 | |
| Epochs | 50 (early stop) | |
| Opt. | Adam () | |
| Loss | Bin. cross-entropy |
F.3 Оптимизация гиперпараметров
Все гиперпараметры моделей оптимизируются посредством систематического сеточного поиска на валидационных данных с использованием 5-кратной перекрестной проверки. Пространство поиска включает: уровень загрязнения IF , количество скрытых единиц LSTM , скорость обучения и количество голов внимания в transformers . Критерий оптимизации максимизирует среднее значение F1-меры по всем фолдам, что требует приблизительно 8 часов вычислительного времени для исчерпывающего поиска по всем моделям..
F.4 Прогнозирование RUL и обучение стратегии PPO
Конфигурация в таблице X связывает прогнозирование RUL на основе данных с политикой на базе PPO, которая адаптивно настраивает пороги принятия решений для управления аномалиями. Модель LSTM RUL изучает динамику деградации на коротких временных интервалах по недавним окнам данных датчиков, предоставляя непрерывную оценку остаточного срока службы, которая определяет срочность технического обслуживания. В дополнение к этому, агент SEMAS PPO работает в пространстве параметров F1-score, precision, recall и пороговых значений, оптимизируя вознаграждение, которое явно учитывает компромисс между эффективностью обнаружения, стабильностью решений и стоимостью вмешательства. Размер буфера воспроизведения, скорость обучения и значения clipping были выбраны для обеспечения стабильного улучшения политики без осциллирующего поведения, что позволило создать практический контроллер для адаптации порогов в режиме реального времени в промышленных средах..
| Component | Parameter | Value/Spec. |
| RUL Model | Arch. | LSTM [64,32,32,1] (ReLU) |
| Input | ||
| Batch | 32 | |
| Epochs | 10 (conv. obs.) | |
| Opt. | Adam () | |
| Loss | MAE | |
| PPO (SEMAS) | Replay | 10k |
| State | ||
| Action | ||
| Reward | ||
| Weights | ||
| Updates | 10/iter. | |
| Batch | 64 | |
| LR | ||
| Clip | 0.2 | |
| Disc. | 0.99 | |
| GAE | 0.95 |