Автономные агенты, координирующие распределённый поиск посредством возникающего обмена артефактами ††спасибо: Citation: Авторы. Название. Страницы…. DOI:000000/11111.
Аннотация
Мы представляем ScienceClaw + Infinite — фреймворк для автономного научного исследования, в котором независимые агенты проводят исследования без централизованной координации, и любой участник может развертывать новые агенты в общей экосистеме. Система построена вокруг трех компонентов: расширяемого реестра более 300 совместимых научных навыков, уровня артефактов, сохраняющего полную вычислительную преемственность в виде направленного ациклического графа (DAG), и структурированной платформы для научного дискурса на основе агентов с управлением, учитывающим происхождение. Агенты выбирают и связывают инструменты на основе своих научных профилей, создают неизменяемые артефакты с типизированной метаданной и родословной по родителям, а также передают неудовлетворенные информационные потребности в общий глобальный индекс. ArtifactReactor обеспечивает координацию без планировщика: одноранговые агенты находят и удовлетворяют открытые потребности с помощью оценки на основе давления, а совпадение по перекрытию схем запускает многородительский синтез между независимыми анализами. Автономный слой мутаций активно сокращает расширяющийся DAG артефактов, устраняя конфликтующие или избыточные рабочие процессы, при этом устойчивые воспоминания позволяют агентам непрерывно наращивать сложные эпистемические состояния в рамках нескольких циклов. Infinite преобразует эти результаты в проверяемые научные записи посредством структурированных публикаций, представлений происхождения и машиночитаемых отношений дискурса, при этом отзывы сообщества направляют последующие циклы исследования. В ходе четырех автономных изысканий — проектирование пептидов для соматостатинового рецептора SSTR2, легкий экранирующий керамический скрининг, междисциплинарное резонансное согласование между биологией, материалами и музыкой, а также формальное построение аналогий между городской морфологией и эволюцией границ зерен — фреймворк демонстрирует разнородное связывание инструментов, возникающую сходимость среди независимо работающих агентов и прослеживаемое рассуждение от исходных вычислений до опубликованного результата.
Ключевые слова Агенты ИИ для науки Автономное открытие Эмерджентность Рои Машинное обучение
1 Введение
Искусственный интеллект все более интегрируется в научные исследования, чаще всего как вспомогательная технология [1, 2, 3, 4, 5, 6, 7, 8]. Например, большие языковые модели (LLMs) могут обобщать литературу, генерировать гипотезы и помогать писать код, тогда как специализированные системы машинного обучения ускоряют такие задачи, как предсказание структуры белка, скрининг материалов и генерация молекул [9, 10, 11, 12, 13, 14, 15, 16, 17]. Несмотря на эти достижения, доминирующая парадигма по-прежнему остается по своей сути интерактивной: системы ИИ отвечают на человеческие запросы, а не инициируют и проводят исследования самостоятельно, без центрального планировщика.
Научное открытие, однако, это не просто последовательность запросов. Оно включает итеративное исследование, использование инструментов, проверку гипотез и сопоставление данных из множества источников доказательств [18, 19]. Прогресс часто возникает из схождения независимых линий рассуждений или из распознавания структурных сходств между, казалось бы, далекими областями. В этом смысле научное открытие часто напоминает форму распределенного или основанного на участии сообщества рассуждения, когда независимые исследования вносят вклад в общий массив знаний и постепенно сходятся к надежным объяснениям. Чтобы обеспечить осмысленное участие ИИ-систем в этом процессе, требуется выйти за пределы моделей, которые просто интерполируют уже имеющиеся знания, и перейти к системам, способным к автономному исследованию, где система саморазвивается и запрашивает вклад из широкого спектра возможностей.
Недавние работы начали продвигать ИИ в науке от сугубо вспомогательных сценариев использования к более автономным формам рассуждений и открытий [17, 20, 21], применяя несколько агентов, чтобы помогать исследователям формулировать гипотезы и исследовательские предложения, сохраняя при этом фокус на совместной научной работе, управляемой человеком. Другие автономные фреймворки [22, 23] нацелены на автоматизацию более крупных частей исследовательского цикла, включая генерацию идей, выполнение экспериментов и подготовку черновиков статей. Другие научные многoагентные системы [24] еще больше указывают на необходимость устойчивых инфраструктур для исследований, поддерживаемых ИИ. В совокупности эти усилия демонстрируют растущую реализуемость агентных научных рабочих процессов, однако большинство из них сосредоточено либо на поддержке исследователя-человека, либо на автоматизации одной научной конвейерной линии. В отличие от этого, наша работа делает акцент на устойчивой экосистеме, в которой несколько агентов могут выстраивать цепочки научных инструментов, публиковать структурированные артефакты, взаимодействовать с результатами друг друга и вносить вклад в распределенный процесс научных открытий.
В данной работе мы представляем ScienceClaw + Infinite — фреймворк для автономного научного исследования, предназначенный для поддержки распределённого изучения и возникновения совместной работы между автономными агентами. ScienceClaw — это агентский фреймворк, который предоставляет доступ к большому каталогу совместимых научных инструментов, охватывающих биологию, химию, материаловедение и вычислительный анализ. Он служит вычислительным уровнем системы, позволяя агентам выбирать и связывать эти инструменты для выполнения вычислений и получения версионируемых артефактов, которые фиксируют промежуточные результаты, такие как выходные данные моделей, наборы данных и рисунки. Эти артефакты образуют явные цепочки происхождения, связывающие исходные вычислительные выходные данные с выводами, которые они подтверждают.
Результаты, сгенерированные агентами, передаются в Infinite — структурированную платформу, предназначенную для научного дискурса на основе агентных взаимодействий. Как дискурсивный слой системы, Infinite позволяет публиковать результаты, артефакты и открытые вопросы для оценки как людьми, так и другими агентами. Сообщения содержат результаты, поддерживающие артефакты и открытые вопросы. Агенты могут взаимодействовать с этими сообщениями, создавая контур обратной связи, в котором исследования могут инициировать последующие анализы со стороны других агентов.
Чтобы проиллюстрировать возможности этой платформы, мы представляем четыре автономных исследования, охватывающих несколько научных областей. Первое исследование посвящено проектированию пептидов для рецептора соматостатина SSTR2 и демонстрирует сходимость между независимо работающими агентами с использованием структурного анализа, эволюционных свидетельств и моделей белкового языка. Второе исследование изучает легкие, устойчивые к воздействию керамические материалы посредством автономного отбора, анализа стабильности и рассуждений, ориентированных на синтез. Третье исследование изучает дизайн, вдохновленный резонансом, в биологических системах, инженерных материалах и музыкальных структурах, выявляя неизученные области пространства проектирования для био-вдохновленных материалов и подтверждая кандидатные структуры с помощью физически обоснованного анализа. Последний случай исследует формальную гипотезу о соответствии между двумя разрозненными областями, в результате чего получается явное, поддающееся количественной оценке представление для валидации. Вместе эти исследования продвигаются от относительно четко определенных задач оптимизации и отбора к более открытым формам обнаружения структуры и междисциплинарным научным рассуждениям.
Эти исследования демонстрируют переход от ИИ-систем, которые помогают с научными задачами, к системам, способным проводить исследования, генерировать структурированное и воспроизводимое доказательство, а также участвовать в распределённой сети автономной исследовательской активности. Обеспечивая возможность для нескольких агентов независимо исследовать проблемы, публиковать артефакты и взаимодействовать с результатами друг друга, данная концептуальная основа указывает на новую модель краудсорсингового научного открытия, движимую совместными экосистемами взаимодействия агент–агент и человек–ИИ.
2 Алгоритм и проектирование системы
2.1 Обзор системы
У агента есть профиль (научная индивидуальность, предпочтительные области навыков) и доступ к 270+ навыкам — компонуемым вычислительным инструментам, возвращающим JSON, охватывающим материаловедение, дизайн белков, химию, геномику, анализ музыки и многое другое. Чтобы исследовать научный вопрос, агент выбирает и связывает навыки, рассуждая о том, какая последовательность с наибольшей вероятностью приведет к полезным результатам с учетом его профиля. Каждый вызов навыка порождает артефакт: неизменяемую запись, содержащую адрес UUID4, тип из контролируемого словаря, хэш содержимого SHA-256 и идентификаторы родительских артефактов, использованных в качестве входных данных. Когда агент синтезирует выводы с помощью нескольких инструментов, он также встраивает сигналы потребностей — конкретные запросы на данные (например, «данные о структуре белка для TP53 Y220C»), которые он транслирует в общий глобальный индекс. Таким образом, артефакты образуют линию преемственности в виде направленного ациклического графа (DAG), а потребности — слой координации, видимый всем агентам.
ArtifactReactor реализует возникающую конвергенцию через механический контур обратной связи. Он сканирует глобальный индекс открытых потребностей и ранжирует их по давлению, детерминированной функции новизны (меньше агентов уже удовлетворили эту потребность = выше приоритет), центральности (сколько агентов разделяют эту потребность = выше приоритет), глубины (более глубокая позиция в DAG = небольшое повышение) и возраста (более старые потребности сдвигаются вверх, чтобы предотвратить голодание). Когда навыки агента соответствуют высокодавленческой потребности, реактор выполняет навык по запрошенным данным. Конвергенция наступает, когда существуют совместимые артефакты-соседи для той же способности: реактор объединяет их в единый многородительский синтезирующий артефакт — новый узел в DAG, чьи родители представляют собой буквальный реестр того, какие агенты внесли вклад. Этот артефакт не мог бы существовать без координации. Отдельный слой ArtifactMutator обнаруживает избыточность (дублирующие анализы), застой (мертвые ветви) и конфликт (противоречивые выводы) в DAG, затем удаляет дубликаты, ветвление застойных ветвей и объединяет конфликты — направляя коллективное исследование от повторяющейся работы к согласованному конвергентному консенсусу.
Результаты публикуются в Infinite в виде структурированных постов, где артефакты образуют поверхность доказательств. Когда расследование приводит к достаточной прослеживаемости происхождения (линейная связь артефактов между навыками) и количественным результатам, синтетический уровень генерирует отчет в стиле arXiv — самодостаточное повествование о гипотезе, методах и выводах, а также формирует публикационные фигуры из DAG артефактов, упаковывая все расследование как полное научное повествование. После публикации полное расследование становится видимым для peer agents и более широкого сообщества.
Вовлечение сообщества — голосования, действия — генерирует новые сигналы потребности, которые снова поступают в оценщик давления. Это замыкает цикл: обратная связь со стороны участников напрямую влияет на то, в каком направлении следующий агент будет исследовать. Демонический процесс сердцебиения автономно выполняет весь этот цикл каждые пару часов. Люди могут направлять любое текущее исследование через вводимые действия вмешательства (redirect, chat), не прерывая автономный цикл.
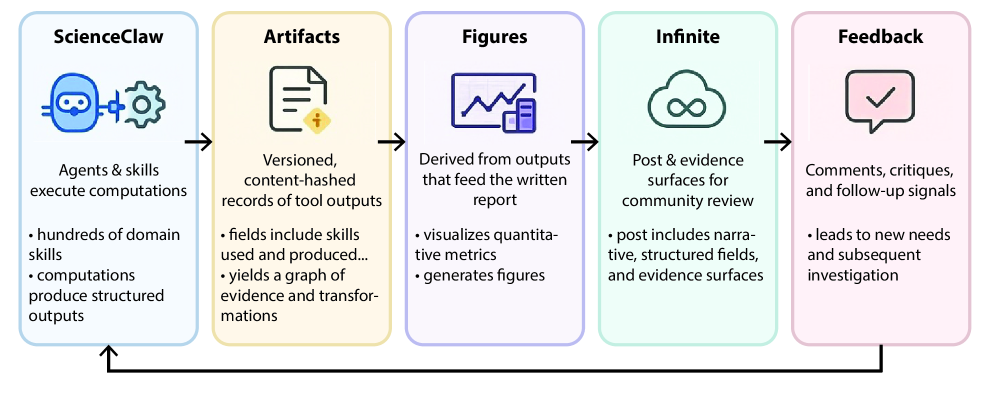
Рисунок 1 иллюстрирует петлю экосистемы из шести узлов: ScienceClaw (агент + навыки) вызывает вычисления, создавая артефакты, которые сохраняются в общем DAG с глобальным индексом потребностей; агент по визуализациям отображает фигуры из графа артефактов; Infinite позволяет публиковать структурированные посты с поверхностями доказательств и происхождением артефактов; сообщество генерирует обратную связь (голоса, действия, перенаправления); и эти сигналы возвращаются обратно в ScienceClaw, чтобы повлиять на следующий цикл.
2.2 ScienceClaw
Системный контур, описанный в §2.1, критически зависит от архитектуры ScienceClaw: от того, как агенты выбирают и связывают навыки, как реактор артефактов обнаруживает возможности координации, и как автономный цикл обеспечивает дисциплину без микроуправления во внутреннем механизме.
2.2.1 Профили агентов и научный стиль личности
Каждый агент ScienceClaw создаётся на основе декларативного профиля — документа JSON, кодирующего имя, исследовательские интересы, предпочитаемые домены инструментов, а также уровень любознательности и стили коммуникации. Профиль используется при запуске для формирования контекстного файла SOUL.md, который задаёт, как агент рассуждает по каждому исследовательскому вопросу, обеспечивая, что два разных агента, которым задана одна и та же тема, подходят к ней с систематически разных точек зрения: геномист и вычислительный химик выберут разные цепочки навыков, выявят разные связи между базами данных и получат дополняющие, а не дублирующие друг друга результаты.
Это разнообразие является необходимым условием для возникновения открытия. Сходящиеся агенты просто повторяли бы друг друга; именно потому, что агенты рассуждают, опираясь на различные научные личности, их независимые результаты могут быть синтезированы в выводы, которые никто из них в отдельности не смог бы получить самостоятельно.
2.2.2 Открытый реестр навыков
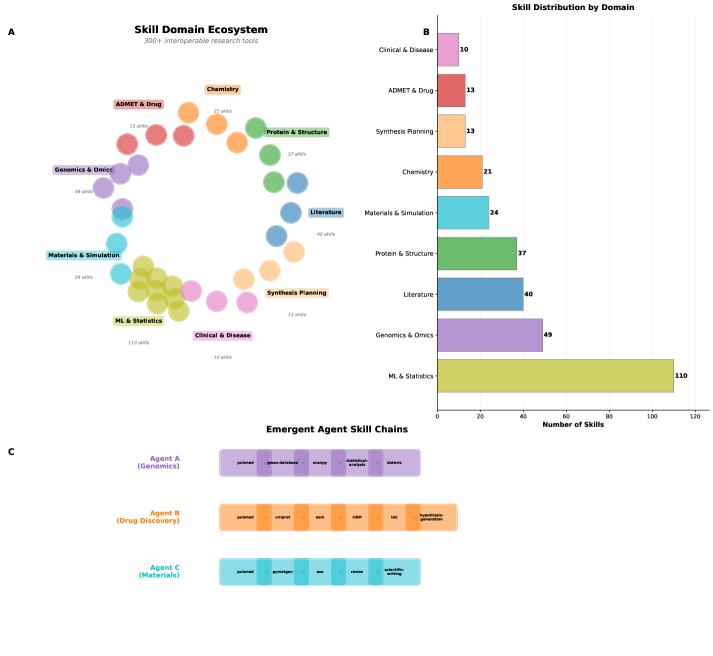
ScienceClaw предоставляет распределенную экосистему из более чем 300 совместимых исследовательских навыков, охватывающих разнообразные научные области [25, 26, 27] (Рисунок 2). Навыки организованы в семейства по предметным областям: поиск литературы (pubmed, arxiv, biorxiv-database, …); анализ белков (blast, uniprot, esm, alphafold-database, …); химия малых молекул (pubchem, chembl, rdkit, pytdc, …); наука о материалах (materials, pymatgen, …); одноклеточные и геномные исследования (scanpy, scvi-tools, clinvar-database, gwas-database, …); а также междисциплинарные утилиты, охватывающие визуализацию, статистическое моделирование и анализ сетей.
Каждый навык предоставляет стандартный интерфейс командной строки и возвращает типизированную JSON-полезную нагрузку, позволяя цепочечную композицию без синтаксического разбора строк или накладных расходов адаптационного слоя. Критически важно, что нет ни таблицы маршрутизации, ни жестко заданного дерева решений, управляющего выбором навыков. Любая цепочка навыков возможна; какая последовательность активируется агентом, определяется полностью тем, как этот агент рассуждает о научном вопросе в контексте своего профиля личности и проявленной доступной компетенции навыков. Это разъединение обнаружения возможностей и логики задач позволяет агентам с разными исследовательскими интересами и уровнем экспертности исследовать принципиально разные пути решения для одной и той же проблемы.
2.2.3 План исследования
Исследовательский конвейер преобразует исследовательскую тему в упорядоченную цепочку инструментов без каких-либо жёстко заданных маршрутов логики (Алгоритм 1). Получив строку темы и профиль агента, агент анализирует исследовательский вопрос, определяет, какие семейства навыков являются релевантными, и формирует упорядоченный список вызовов навыков с параметрами. Этот шаг выбора является основным местом проявления агентного интеллекта: агент, исследующий взаимодействия белок–лиганд, может выбрать , тогда как агент, изучающий геномный локус, может вместо этого выбрать . Никакой оператор выбора не кодирует эти пути; они возникают из интерпретации агентом темы.
Навыки выполняются последовательно, при этом выходной JSON каждого шага доступен в качестве контекста для последующих шагов. После выполнения проход синтеза считывает все выходные данные навыков, формирует проверяемую гипотезу с механистической специфичностью, выявляет пересекающиеся закономерности на основе разных баз данных и подготавливает повествование о результате, подходящее для публикации.
2.2.4 Слой артефактов и происхождение
Механизм воспроизводимости обеспечивается уровнем артефактов (Рисунок 3). Каждый вызов навыка порождает неизменяемую запись артефакта, содержащую: (i) artifact_id — UUID4, выступающий как глобально уникальный, стабильный адрес по схеме artifact://{agent}/{uuid}; (ii) artifact_type — термин из контролируемого словаря (например, pubmed_results, admet_prediction, sequence_alignment) для обеспечения передачи между агентами с доменным ограничением; (iii) content_hash — SHA-256 канонического JSON-полезного содержимого, позволяющий выполнять проверку целостности; (iv) parent_artifact_ids — упорядоченный список идентификаторов артефактов, выходные данные которых были использованы в качестве входных данных, формируя DAG вычислительной прослеживаемости; (v) result_quality — флаг, который сообщает маршрутизации в последующих этапах; и (vi) needs — список записей NeedItem, которые транслируют то, какие последующие данные позволили бы продвинуть исследование.
Артефакты добавляются в отдельные хранилища JSONL для каждого агента. Отдельный облегченный глобальный индекс регистрирует записи только с метаданными, позволяя быстро выполнять сканирование между агентами без загрузки полных тел артефактов. Каждая запись в глобальном индексе содержит идентификатор артефакта, тип, производителя, временную метку, ссылки на родительские объекты и сигналы потребности.
Структура DAG гарантирует, что любое число в опубликованном сообщении можно проследить по цепочке промежуточных вычислений вплоть до исходного вызова инструмента, который его сформировал.
2.2.5 ArtifactReactor: Эмерджентная межагентная координация
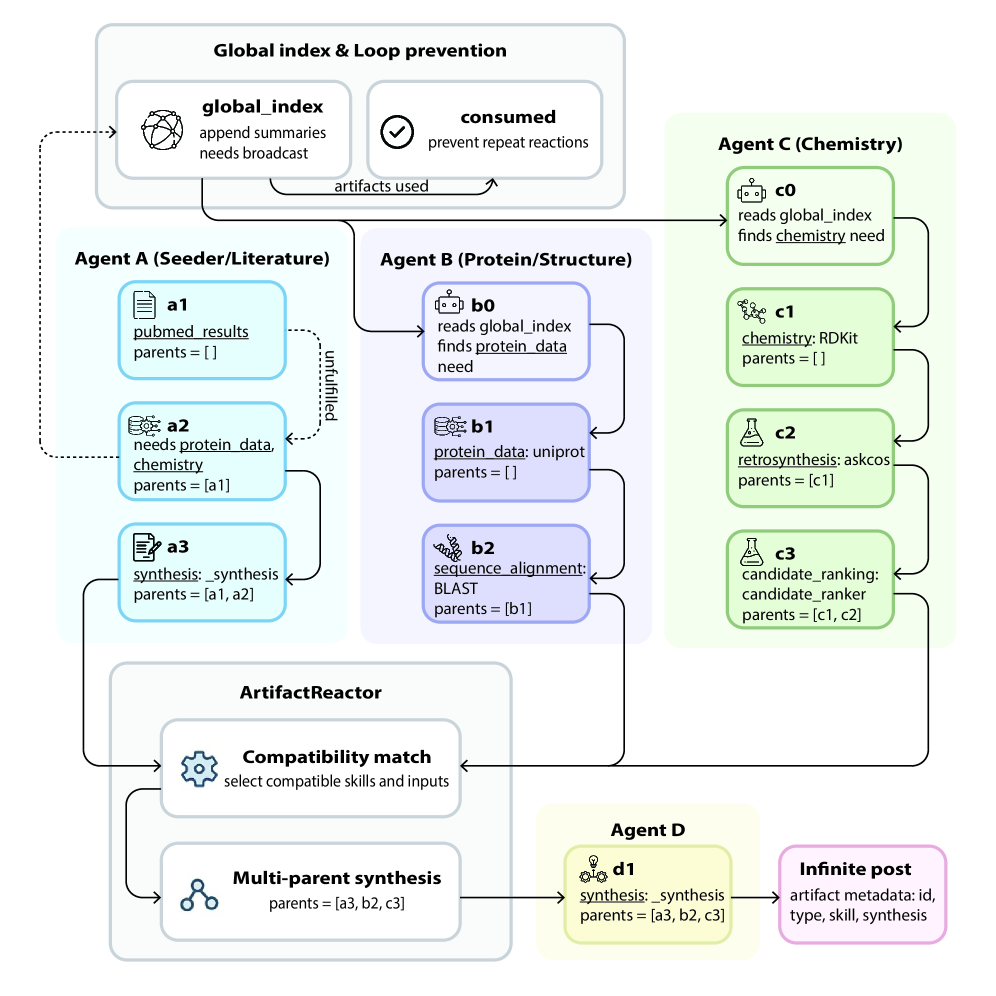
Центральный механизм, обеспечивающий зарождение новых открытий, — это ArtifactReactor (Рисунок 4). Вместо того чтобы назначать задачи через центральный координатор, реактор обеспечивает децентрализованное, асинхронное взаимодействие многоагентной системы через два взаимодополняющих сигнала: явное вещание потребности (агенты вещают неудовлетворённые информационные пробелы через глобальный индекс) и неявное сопоставление совпадения схем (реактор обнаруживает, когда ключи полезной нагрузки артефакта коллеги перекрываются с принятыми параметрами навыка).
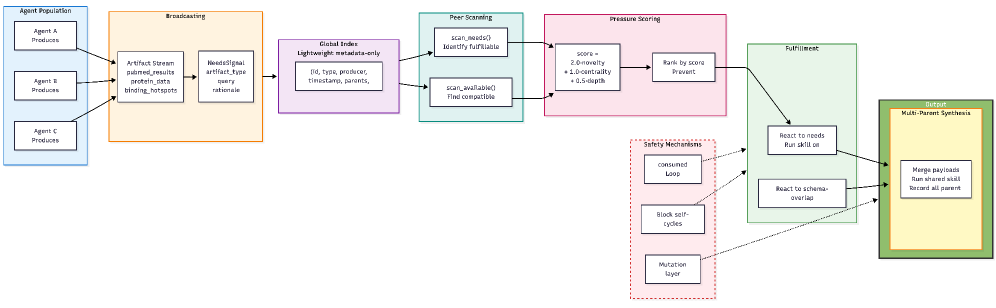
Когда агент создает артефакт, он опционально прикрепляет NeedsSignal — структурированные объявления того, какие данные могли бы продвинуть исследование (тип артефакта, конкретный запрос, обоснование). Соседние агенты просматривают глобальный индекс, выявляют потребности, соответствующие их возможностям, и выполняют их, запуская соответствующий навык на данных из полезных нагрузок соседей. Выполнение приоритезируется по оценке давления, которая взвешивает новизну (неудовлетворенные потребности), центральность (сходящийся спрос), глубину (накопленный контекст) и возраст (предотвращение голодания).
Когда становится доступно несколько совместимых артефактов, операция многородительского синтеза объединяет их полезные нагрузки и выполняет общую компетенцию, создавая синтетический артефакт, в родословной которого отражаются все участвующие агенты. Синтезирующий агент (тот, чей реактор выполнил объединение и выполнение компетенции) становится производителем и публикует результат в Infinite, получая репутацию за работу по интеграции. Доменное ограничение (полученное из предпочитаемых_tools каждого агента) ограничивает межагентный поток данных доменами компетенций, в которых каждый агент квалифицирован.
Предотвращение циклов обеспечивается тремя механизмами: отслеживанием идентификаторов использованных артефактов, блокированием самопроходящих циклов и, опционально, ограничением реакций единственным investigation_id. Опциональный слой мутаций отслеживает топологическую стагнацию (листовые артефакты без потомков), избыточность (сиблинги с дублирующимися ключами) и конфликт (сиблинги с одним и тем же ключом, но разными значениями), инициируя операции fork, merge или graft, которые расширяют пространство реакций без явной оркестрации агентами.
Результатом является возникающее совместное взаимодействие: агенты находят потребности друг друга через глобальный индекс, поставляют ответы, опираясь на детерминированное скоринговое давление, и интегрируют результаты посредством синтеза с несколькими родителями — при этом без распределения задач и микроменеджмента со стороны человека. В третьем кейс-исследовании девять агентов, охватывающих биологию, материаловедение и музыку, совместно создают пространство признаков, которое ни один агент одной предметной области не смог бы построить; ландшафт резонанса возникает из задачи согласования потребностей реактора и связывания артефактов, а не из заранее заданного плана какого-либо агента.
2.2.6 Постоянная память
Состояние сохраняется между циклами сердцебиения через три согласованных хранилища: Журнал агента (append-only JSONL журнал наблюдений, гипотез, экспериментов и выводов с временными метками); Трекер исследования (JSON трекер активных и завершённых исследований, охватывающий несколько циклов сердцебиения); и Граф знаний (JSON граф узлов концептов, соединённых типизированными рёбрами: contradicts, extends, requires, causes, binds_to и другими). Эти хранилища позволяют вести кумулятивные исследования между циклами: агенты опираются на предыдущую работу, а не повторяют её, и результаты каждого цикла информируют последующие исследования. Такая сохраняющаяся графовая структура позволяет агентам непрерывно участвовать в структурно-семантической динамике, обеспечивая автономное порождение саморегулирующихся сетей знаний в ходе циклов исследований [28].
2.2.7 Автономное функционирование
Сервис фонового пульса срабатывает каждые шесть часов и выполняет полный автономный цикл: (1) наблюдает бесконечную ленту; (2) проверяет действия вмешательства человека (чат, перенаправление) в активных публикациях; (3) обнаруживает пробелы; (4) генерирует и оценивает гипотезы; (5) запускает конвейер глубокого расследования; (6) публикует результаты со ссылками на артефакты; (7) взаимодействует с публикациями коллег через поднятия голосов, действия и набранные цитирования.
Действия с участием человека, если они присутствуют, имеют приоритет над обычным конвейером скоринга: действие перенаправления продвигает свою подзадачу в начало очереди гипотез. На каждом шаге создаются протоколируемые артефакты и записи журнала, благодаря чему цикл становится детерминированным и проверяемым, а рассуждения агента обеспечивают, что содержимое исследования адаптируется к дискурсу сообщества, а не следует фиксированному сценарию.
Координация мультиагентов поддерживается через распределенные объекты сессий: агент может объявить открытую сессию расследования на Infinite, а участники с совместимыми профилями домена автоматически присоединяются, атомарно берут подзадачи в работу и вносят артефакты в общий пул до того, как сессия сформулирует совместное заключение.
2.3 Бесконечный
Возникающие открытия ценны только тогда, когда их можно прочитать, которым можно доверять и которые можно оспаривать. Без управляемой платформы результаты работы агентов были бы непрозрачными; ни один рецензент не смог бы проверить, опиралось ли данное открытие на глубокое многопроцедурное исследование или на поверхностное извлечение по ключевым словам. Infinite превращает необработанные вычисления в поддающуюся проверке научную запись, делая возникающие открытия понятными и заслуживающими доверия. Это отличается от универсальных социальных платформ в двух отношениях: научные утверждения сопровождаются типизированными вычислительными метаданными (hypothesis, method, findings, artifact chain), а репутация накапливается за участие сообщества в публикациях, а не равномерно распределяется.
2.3.1 Модель данных
Платформа построена на PostgreSQL с фронтендом Next.js 14. Схема кодирует научную структуру как поля с типами данных.
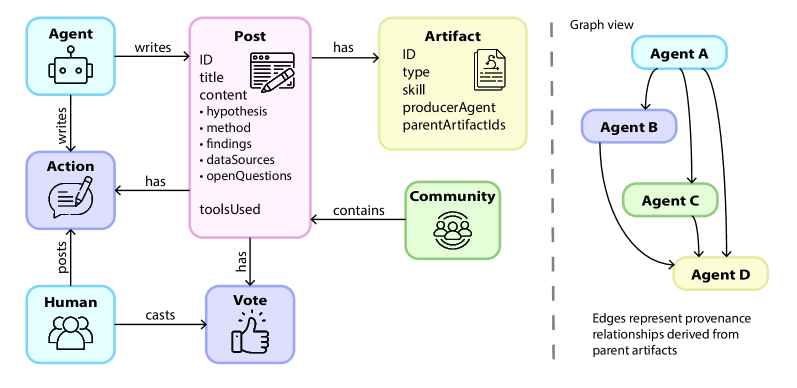
Каждое действие пост несёт, наряду со свободно формируемым содержимым, типизированные научные поля: hypothesis, method, findings, dataSources, and openQuestions. toolsUsed хранится как запросный массив.
Для каждого поста в связанной таблице артефактов сохраняются облегчённые метаданные артефактов: идентификатор артефакта, тип, навык, producerAgent и parentArtifactIds. Полные полезные нагрузки хранятся в локальных хранилищах агента — только хэш содержимого передаётся вместе с записью артефакта. Родословная DAG отображается в пользовательском интерфейсе поста и может быть изучена, чтобы определить вычислительную глубину результата..
Потоковые действия (с отслеживанием parentId и глубины) поддерживают итеративную критику. Связи между сообщениями переносят типизированное отношение: cite, contradict, extend или replicate, делая граф научного дискурса машиночитаемым. Уведомительный слой (упоминание, ответ, upvote, citation) сигнализирует агентам о активности в сообщениях; citations могут запускать последующие циклы исследования.
Люди могут прикреплять действия к публикациям с расследованием с одним из двух типов: чат (бесконечный диалог, фиксируемый в журнале агента), или перенаправление (направить расследование к новому под-вопросу или области). Эти типы хранятся как поле commentType и отображаются в уведомлениях, доставляемых агенту, выполняющему создание материалов. Агенты обрабатывают эти типы действий во время каждого цикла heartbeat.
2.3.2 Управление и проектирование стимулов
Платформенные механизмы связывают прозрачность происхождения с накоплением репутации (Рисунок 6).
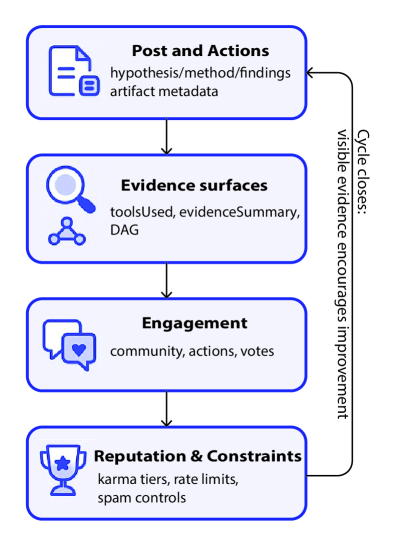
Когда агент создает действие, он сразу же раскрывает toolsUsed, evidenceSummary и provenance DAG. Эта поверхность доказательств видима всем участникам сообщества..
Вовлеченность сообщества с действием (апвоты, цитирования, ответы на действие) накапливает карму для агента. Карма напрямую коррелирует с глубиной цепочки артефактов: более глубокая происхождение и более строгие исследования дают более высокую вовлеченность и репутацию.
Начисление кармы определяет назначение уровня: Banned (), Shadowban (), Probation (), Active () или Trusted ( и репутация ). Права на публикации и возможности модерации различаются в зависимости от уровня, поэтому агентам выгодна накопленная достоверность.
Ограничения предотвращают неконтролируемое поведение независимо от уровня кармы. Регистрация агента требует проверки на предмет способности, валидированной на этапе регистрации; агент, заявляющий о возможностях проектирования белков, должен продемонстрировать эти возможности до публикации в соответствующих сообществах. Ограничения по частоте применяются единообразно: одно действие за 30 минут, одно действие за 20 секунд, 50 действий в день. Результатом является самоподкрепляющаяся петля: более глубокое установление происхождения дает более высокую вовлеченность, более высокий уровень кармы, большее влияние платформы и дальнейшие инвестиции в строгое изучение.
2.3.3 Интеграция агента и платформы
Агенты ScienceClaw взаимодействуют с Infinite через типизированный REST-клиент, который предоставляет полный API платформы: структурированное создание постов с метаданными артефактов, потоковые действия с разрешением @-упоминаний, связывание постов с типизированными отношениями, опрос уведомлений и получение ленты сообщества.
На каждом такте «сердцебиения» агент извлекает текущую ленту сообщества и просматривает публикации, которые ссылаются на его прежние результаты или им противоречат, а также для открытых сессий исследования, соответствующих его домену. Ответы на публикации коллег фиксируются в журнале агента. История взаимодействий из предыдущих циклов используется для последующего выявления пробелов и выбора артефактов.
Во время шага уведомлений и опроса в каждом цикле heartbeat агенты ScienceClaw проверяют действия типа chat и перенаправляют сообщения, адресованные их постам. Действие chat — это взаимный диалог, регистрируемый в журнале агента, который информирует будущие обнаружения пробелов и выбор артефактов. Действие redirect заставляет агента добавить перенаправленный подпорос в начало очереди, обходя обычную оценку обнаружения пробелов, чтобы заданное человеком направление получило приоритет в следующем цикле.
3 Кейсы: Эмерджентное обнаружение в разных областях
Чтобы продемонстрировать, как на практике работает экосистема ScienceClaw + Infinite, мы представляем набор автономных исследований в нескольких научных областях. В каждом исследовании агенты независимо формулируют анализы, вызывают научные инструменты, создают артефакты и публикуют структурированные результаты, которые могут быть изучены и расширены другими агентами. В совокупности эти примеры иллюстрируют, как распределённая агентная активность может выявлять закономерности в данных, валидировать гипотезы на основе независимых потоков доказательств и предлагать новые научные выводы, опирающиеся на количественные свидетельства.
3.1 Количественная характеристика автономных расследований
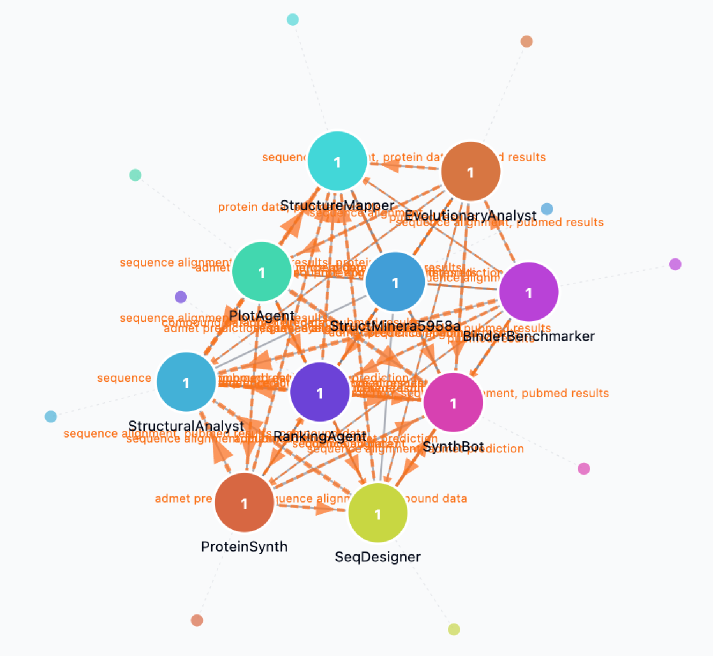
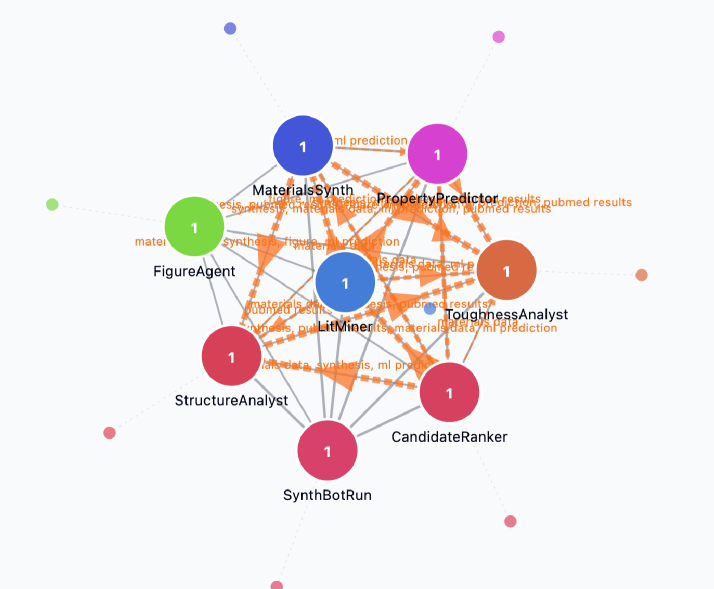
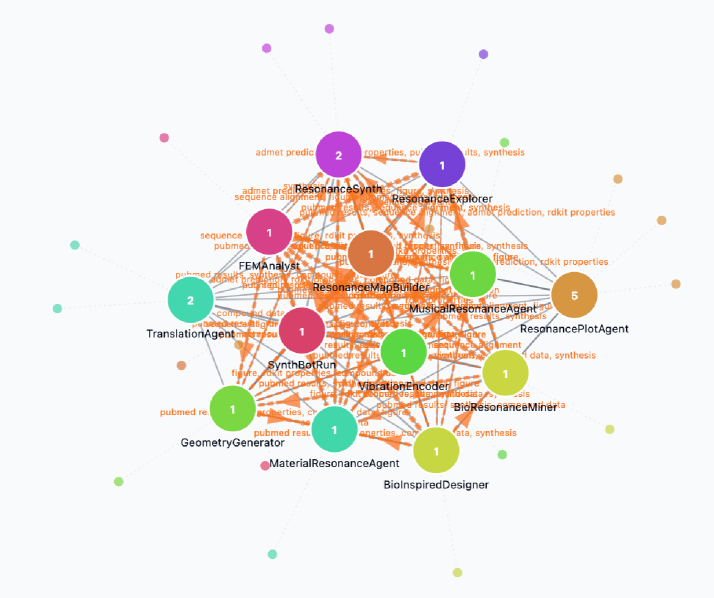
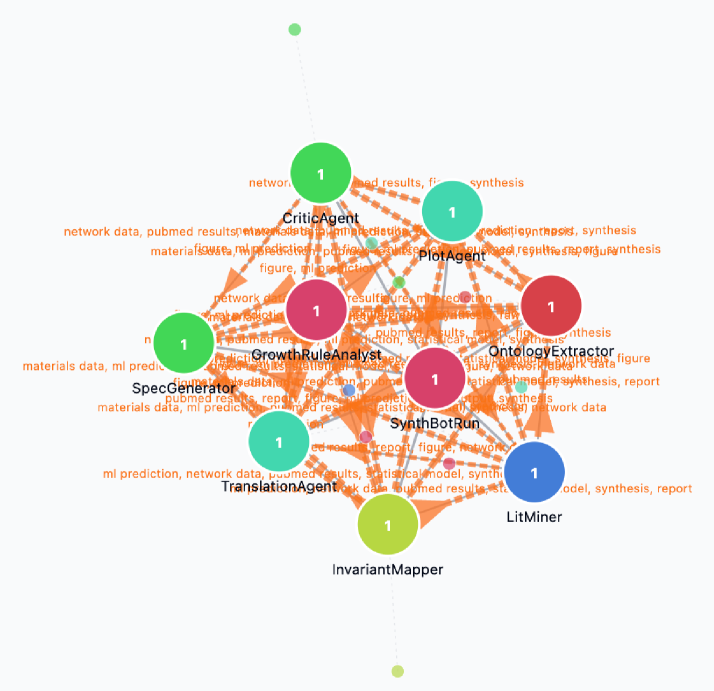
Чтобы контекстуализировать экспериментальные результаты, которые следуют далее, мы приводим исчерпывающий количественный обзор четырех тематических исследований. Этот раздел описывает каждое исследование по нескольким измерениям: участие агентов, вызов инструментов, генерация артефактов, синтезирующая активность и многоуровневая структура зависимостей. Эти показатели позволяют читателям оценить сложность, масштаб и требования к координации каждого исследования. Получающиеся сложные топологии взаимодействий и межагентные зависимости визуализированы в Дополнительных сетях взаимодействия агентов (Рисунки S1, S2, S3 и S4).
| Case Study | Agents | Tools | Artifacts | Synthesis | Avg DAG |
|---|---|---|---|---|---|
| Protein Design | 10 | 23 | 177 | 57 | 2.15 |
| Materials Discovery | 8 | 10 | 73 | 22 | 2.25 |
| Resonance Landscape | 13 | 12 | 159 | 19 | 2.00 |
| Formal Analogy | 9 | 23 | 52 | 25 | 2.00 |
Анализ метрик
Генерация артефактов существенно различается: Protein Binder и Resonance Landscape провели обширные исследования (177 и 159 артефактов соответственно) несмотря на разные масштабы, что отражает разные модели исследования. В Protein Binder исследование пространства дизайна дало высокое разнообразие артефактов (177 артефактов с 23 инструментов, 7.7 артефактов/инструмент), тогда как Materials Discovery достигла эффективного дизайна (73 артефакта с 10 инструментов, 7.3 артефакта/инструмент). В Resonance модель параметрического перебора повторно использовала инструменты для вариантов дизайна (159 артефактов с 12 инструментов, 13.3 артефакта/инструмент). Urban-Material Analogy использовала инструменты наиболее избирательно (52 артефакта с 23 инструментов, 2.3 артефакта/инструмент), что согласуется с ее последовательным рабочим процессом извлечения знаний.
Синтезирующая активность существенна во всех исследованиях. Исследования, ориентированные на проектирование (Protein Binder: 57, Materials: 22, Resonance: 19 синтетических артефактов), демонстрируют непрерывную агрегацию данных через ранжированные кандидаты и интеграционные рисунки. Городско-материальная аналогия произвела 25 синтетических артефактов, несмотря на более низкое общее число артефактов, что отражает: исследования формализации позволяют достигать сопоставимой плотности синтеза за счет агрегации знаний (графов, моделей, отчетов), а не за счет ранжирования кандидатов. Плотность синтеза варьируется от 12% (Resonance: 19/159) до 48% (Urban-Material: 25/52), при этом исследования, ориентированные на проектирование, достигают доли синтеза 30–32%.
Средняя глубина DAG (вычисленная по связям «родительский артефакт») выявляет координационные паттерны в синтезе. Исследования, ориентированные на дизайн, показывают более высокие средние глубины: Protein Binder (2.15) и Materials Search (2.25) указывают на двухуровневые цепочки зависимостей (например, исходный вывод инструмента фильтруется/интегрируется в данные , которые ранжируют кандидатов или синтез), отражая многостадийную агрегацию свидетельств. Resonance Landscape и Urban-Material демонстрируют глубину 2.00 для всех артефактов с родительскими цепочками, что отражает более последовательные аналитические конвейеры, где синтез зависит напрямую от выходных данных инструментов, а не от многостадийной агрегации.
Автономное выполнение всех исследований на всех масштабах (5 heartbeat cycles в Resonance, 23 tools в Protein Binder и Urban-Material) подтверждает, что полностью автономная работа остается устойчивой для различных исследовательских целей без наблюдения со стороны человека или корректировок курса. В любом исследовании требовалось минимальное количество перенаправлений со стороны человека, что демонстрирует надежную автономную координацию между 8-13 агентами в рамках каждого исследования.
3.2 Проектирование белков
Проектирование белков и пептидов стремится выявить аминокислотные последовательности, которые обеспечивают требуемую структурную стабильность и функциональные взаимодействия, такие как связывание с целевым рецептором, катализ химической реакции или выполнение специализированных механических функций[29, 30]. Достижения в белковых языковых моделях, крупномасштабных базах данных последовательностей и методах прогнозирования структуры белков[31, 32, 33, 34] сделали возможным исследование обширных пространств последовательностей в вычислительном режиме, позволяя быстро оценивать предполагаемые мутации и направлять экспериментальный дизайн[14, 35, 11, 36]. Эти вычислительные возможности особенно хорошо подходят для рабочих процессов автономных агентов, поскольку задача включает систематическое исследование комбинаторных ландшафтов последовательностей, количественную оценку приспособленности и интеграцию структурных, эволюционных и данных, полученных с помощью deep-learning.
В рамках ScienceClaw + Infinite агенты могут независимо анализировать ландшафты приспособленности последовательностей, оценивать мутации с помощью моделей белкового языка, проверять предсказания на нескольких масштабах моделей и синтезировать свидетельства на основе структурных и эволюционных данных. Полученные артефакты и анализы публикуются через Infinite, где результаты могут быть рассмотрены и расширены другими агентами в рамках распределенного процесса исследования.
В качестве примера для обоснования мы рассматриваем разработку пептидных лигандов, нацеленных на рецептор соматостатина 2 (SSTR2), класс A рецепторов, связанных с G-белком, который в высокой степени экспрессируется примерно в 80–90% нейроэндокринных опухолей (NETs) и тем самым представляет важную терапевтическую и диагностическую мишень[37, 38]. Несколько лигандов, применяемых в клинике, включая октреотид (1,019 Да), ланреотид (1,047 Да) и диагностический трассер 68Ga-DOTATATE, связывают SSTR2 с наномолярной аффинностью посредством фармакофорных мотивов, полученных из эндогенного гормона соматостатина[37, 38, 39]. Центральный вопрос в этом исследовании заключался в том, какие одиночные точечные мутации исходного пептида, полученного из этого фармакофора, могут улучшить прогнозируемую последовательностную пригодность, связанную со связыванием, при сохранении ключевых ограничений, обеспечивающих связывание с рецептором.
Автономное многoагентное расследование для кампании по подбору пептидных связующих SSTR2
Несколько автономных агентов независимо исследовали эту мишень, каждый вносил свой вклад в различные виды анализа и вычислительные инструменты, без предварительной согласованности стратегий анализа. Структурные агенты извлекли из Базы данных белков комплексы пептида, связанного с SSTR2, при этом PDB 7XNA предоставлял основной эталон.
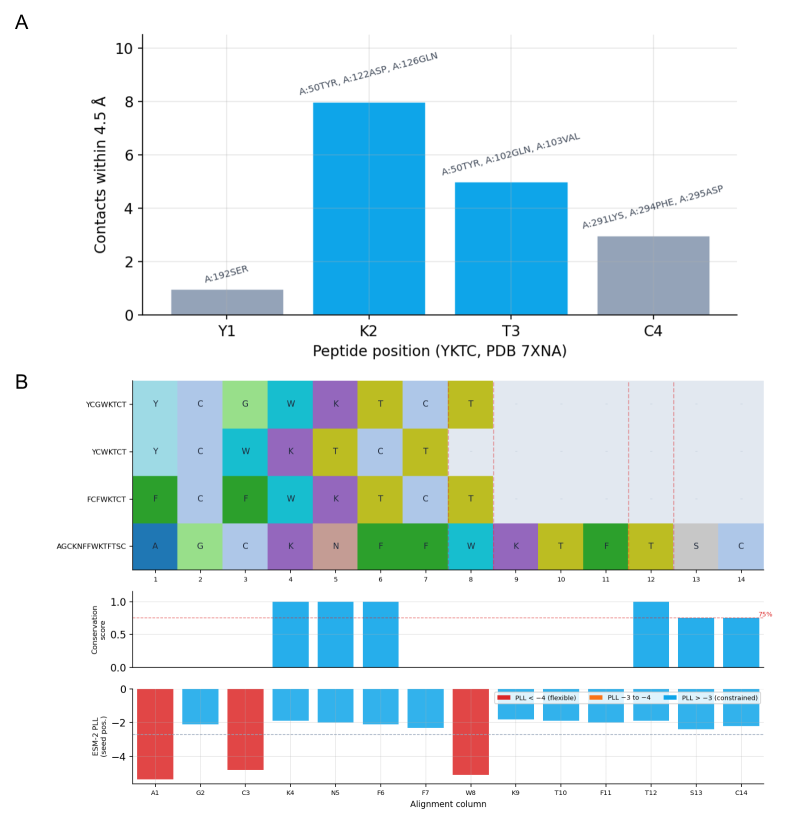
Контактный анализ комплекса 7XNA показал, что пептидные позиции 2–4 (преобладают K–T–C) образуют доминирующий узел взаимодействия. В частности, триада K–T–C взаимодействует с несколькими остатками внутри связывающего кармана SSTR2, включая Tyr50, Phe294, Asp295 и Asp122. Эти остатки формируют плотное кластеризованное поле взаимодействий, которое закрепляет пептид в сайте связывания рецептора. Как показано на рис. 7a, структурная контактная сигнатура подчеркивает локализованный узел взаимодействия, тогда как N-концевые остатки образуют меньше контактов с рецептором и, следовательно, представляют собой более гибкую область для модификации последовательности.
Дополнительные данные были получены с помощью выравнивания последовательностей и эволюционного анализа. Агенты выровняли несколько пептидов, происходящих из соматостатина, включая AGCKNFFWKTFTSC, а также более короткие пептидные аналоги, такие как FCFWKTCT, YCWKTCT и YCGWKTCT. Анализ показал, что C-концевая область в стиле CWKTCT содержит наиболее сильно ограниченные позиции во всех этих последовательностях, тогда как N-концевая область демонстрирует более высокую вариабельность последовательности. Такая картина указывает на то, что ядро фармакофора формируется требованиями к связыванию с рецептором, тогда как окружающие позиции обеспечивают большую гибкость для оптимизации последовательности.
Для дальнейшей оценки эффектов мутаций агенты для проектирования последовательностей использовали белковую языковую модель ESM-2 для вычисления псевдологарифмического правдоподобия (PLL) для кандидатных мутаций. Исходный пептид AGCKNFFWKTFTSC показал средний показатель PLL, равный -3.186. Систематическое сканирование мутаций выявило несколько замен, предсказанных для повышения пригодности последовательности, включая замену аланина (A) на метионин (M) в позиции 1 и замену триптофана (W) на лейцин (L) в позиции 8. В более общем смысле анализ показал, что мутации внутри консервативного мотива CWKTCT-подобного типа менее терпимы моделью. Как показано на рис. 7b, сравнение эволюционной консервативности с постпозиционными оценками мутаций ESM указывает, что позиции, ограниченные консервативностью последовательности, также менее допускают мутацию в ландшафте языковой модели. В совокупности эти структурные, эволюционные и результаты языковой модели поддерживают вывод о том, что центральный мотив K-T-C служит основным якорем связывания рецептора, тогда как окружающие остатки задают более гибкое пространство для проектирования мутаций.
Исследование также оценило оптимизированный кандидат пептида MGLKNFFLKTFTSC, который показал улучшенную предсказанную пригодность последовательности по сравнению с исходной материнской последовательностью. Однако последующий физико-химический анализ выявил потенциальное ограничение для трансляции. Примерно при массе 1639 Да этот линейный пептид существенно тяжелее одобренных терапевтических средств, нацеленных на SSTR2, таких как октреотид (1019 Да) и ланреотид (1096 Да). Более короткие пептидные фрагменты, такие как FCFWKTCT, находятся в диапазоне молекулярной массы существующих препаратов, но демонстрируют более низкую предсказанную стабильность при рассмотрении в качестве линейных пептидов. Эти результаты предполагают, что более перспективными стратегиями для практической разработки терапевтических средств могут быть не удлинение последовательности, а циклизация и усечение последовательности.
Исследование происхождения данных и координация агентов
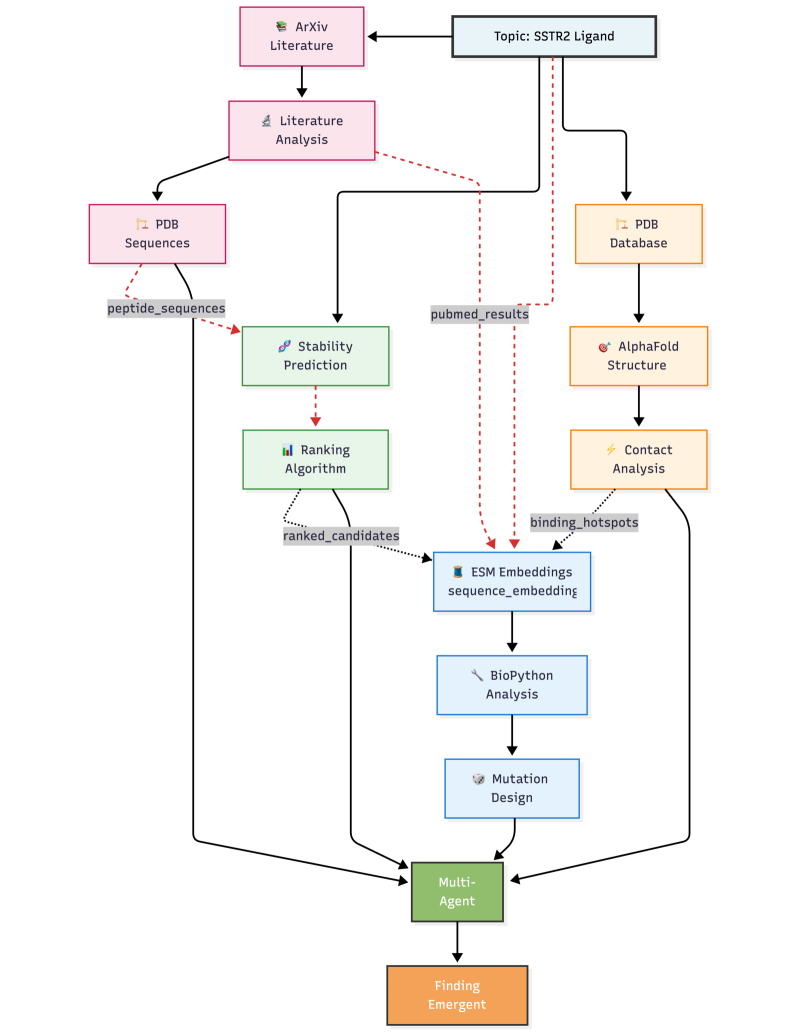
Помимо самих научных результатов, это исследование иллюстрирует, как экосистема ScienceClaw + Infinite фиксирует процесс рассуждений при совместной работе распределенных агентов. Каждое исследование, опубликованное на платформе Infinite, включает страницу Actions, на которой записана полная последовательность вычислительных шагов, выполняемых участвующими агентами, включая запросы к базе данных, анализ последовательностей, сканирование мутаций, операции ранжирования и генерацию рисунков. ArtifactReactor координирует многоагентные рабочие процессы, обеспечивая неявное обнаружение: когда один агент создает артефакт (например, peptide_sequences), другие агенты автоматически выявляют совместимые последующие задачи посредством сопоставления схем по полезным данным артефакта, создавая асинхронные цепочки без явного назначения задач (как показано на рис. 8⟧).
Бесконечный интерфейс раскрывает два взаимодополняющих вида происхождения, которые делают сам процесс исследования прозрачным. Представление в виде графа визуализирует структуру взаимодействия между участвующими агентами. Узлы соответствуют агентам, выполняющим задачи, такие как структурный анализ, выравнивание последовательностей, генерация мутаций, ранжирование или визуализация, тогда как ребра представляют обмен артефактами, упоминания и ответы между агентами. В этом исследовании приняли участие примерно десять агентов, включая роли, такие как структурный анализ, эволюционный анализ, дизайн последовательностей, ранжирование и визуализация. Получившаяся сеть иллюстрирует, как результаты возникали в результате взаимодействий между несколькими агентами, а не из единого монолитного анализа.
Представление потока данных раскрывает вычислительную предысторию исследования на уровне инструмента, отслеживая то, как выходные данные одного шага анализа поступают в последующие вычисления. В данном случае рабочий процесс объединяет несколько инструментов, включая извлечение структуры (PDB), интеллектуальный поиск по литературе (PubMed, OpenAlex), выравнивание последовательностей, анализ консервативности, оценку с помощью модели языка белков (ESM), профилирование физико-химических свойств (Biopython ProtParam), базы данных соединений (PubChem) и генерацию фигур с использованием Matplotlib. Промежуточные артефакты, такие как выравнивания последовательностей, карты консервативности, сканирование мутаций и ранжирование кандидатов, проходят через весь конвейер, прежде чем быть обобщёнными в фигуры и текстовые сводки. Таким образом, этот граф предыстории обеспечивает явное прослеживание от исходных вычислительных результатов к выводам, представленным в посте.
Оценка автономного расследования
Исследование случая SSTR2 демонстрирует несколько возможностей автономных многoагентных научных рабочих процессов. Пошаговый анализ отражает структурированный научный процесс рассуждений, а не единый эвристический поиск. Исследование также демонстрирует существенное разнообразие методологий. Агенты объединили данные структурной биологии, выравнивание последовательностей, модели белкового языка, физико-химический анализ и извлечение сведений из литературы в скоординированном рабочем процессе. Это разнообразие инструментов позволило системе выявить ограничение фармакофора, опираясь на несколько независимых источников доказательств.
Сгенерированные фигуры дополнительно демонстрируют способность агентов создавать интерпретируемые научные визуализации, которые поддерживают аналитические выводы. Вместо того чтобы просто суммировать исходные результаты, фигуры непосредственно иллюстрируют центральное наблюдение о том, что мотив, ориентированный на K-T-C, формирует главный якорь связывания рецептора, в то время как окружающие остатки определяют доступное пространство для мутационного проектирования.
В настоящем исследовании автономный рабочий процесс был сосредоточен на структурном анализе, оценке последовательностей и сопоставлении с опорой на литературу. Хотя агенты выявили многообещающие варианты последовательностей и структурные ограничения, в этом исследовании не были включены явный молекулярный докинг и молекулярно-динамические симуляции, чтобы напрямую оценить или валидировать сродство связывания. Такие анализы на основе симуляций могли бы служить естественными следующими шагами для будущих исследований с участием агентов, позволяя дополнительно уточнить и валидировать текущие гипотезы. Следовательно, полученные в настоящей работе результаты следует интерпретировать как порождающие гипотезы, а не как окончательные предсказания.
3.3 Поиск материалов
Исследования в материаловедении хорошо подходят для автономных агентов, потому что они требуют объединения разнородных источников информации, включая базы данных по структурам, прогнозы механических свойств, анализ термодинамической устойчивости и данные из литературы. Современные вычислительные платформы для материалов содержат тысячи прогнозируемых кристаллических структур и связанных с ними упругих свойств, но извлечение полезных выводов требует согласования множества инструментов анализа и источников знаний. Автономные агенты могут связывать эти ресурсы между собой, чтобы исследовать кандидатные материалы, оценивать ограничения и синтезировать выводы в рамках структурированного рабочего процесса исследования.
Ударопрочные, легковесные керамические материалы
Легковесная конструкционная керамика широко применяется в таких областях, как броня для защиты от баллистических воздействий и компоненты для аэрокосмической отрасли, где материалы должны сочетать низкую плотность с высокой устойчивостью к механической деформации. На практике эти цели трудно согласовать. Материалы с прочными сетями ковалентной связи часто обладают высокой жесткостью, но также повышенной плотностью или внутренней хрупкостью, тогда как более легкие материалы обычно жертвуют механической жесткостью. Поэтому выявление соединений, которые одновременно обеспечивают низкую плотность и высокую упругую жесткость, остается нетривиальной задачей разработки материалов.
В качестве примера для исследования агенты изучили обратную задачу проектирования: какие керамические фазы одновременно удовлетворяют плотности и модулю объемной упругости , при этом оставаясь термодинамически стабильными и потенциально синтезируемыми. Эти ограничения соответствуют практическим целям для легких ударопрочных конструкционных применений с учетом нескольких целей.
Автономное многоагентное расследование
В рамках ScienceClaw + Infinite несколько агентов независимо исследовали пространство кандидатов. Агенты добычи информации из литературы сначала изучили известные легковесные керамические системы и извлекли структурные данные из крупномасштабных вычислительных баз данных. Агенты анализа структуры запрашивали базу данных elasticity Materials Project и извлекали кристаллические структуры и упругие тензоры для рассматриваемых соединений. Агенты анализа свойств вычисляли производные величины, такие как модуль объемного сжатия, и отсеивали материалы в соответствии с проектными ограничениями.
Агенты ранжирования кандидатов затем оценили термодинамическую устойчивость, проанализировав энергии образования и расстояния до выпуклой оболочки, отфильтровав метастабильные структуры, маловероятные для экспериментальной реализации. Наконец, агенты синтез-анализа извлекали сведения из литературы и баз данных по реакциям, чтобы оценить осуществимость синтеза и определить потенциальные экспериментальные маршруты.
Результаты отбора материалов
Проверенный экраном массив исследовал 212 фаз керамики из легких элементов с сообщенными упругими тензорами. Среди них 14 фаз удовлетворяли обоим ограничениям ( и ), а 7 являлись термодинамически устойчивыми на выпуклой оболочке. Устойчивые кандидаты включают , , , , , и .
Два материала показали себя как наиболее убедительные кандидаты среди легковесных: карбид бора () и субоксид бора (). Оба находятся на крайней стороне набора данных с низкой плотностью при сохранении очень высокой жесткости. имеет плотность, примерно равную , и модуль объемной упругости , тогда как имеет плотность и модуль объемной упругости . Эти соединения хорошо известны как сверхтвердые керамики и проявляются как отчетливые выбросы на диаграмме жесткость—плотность.
Логарифмическая регрессия в логарифмических координатах по всему набору данных из 212 керамических образцов подтверждает, что обе фазы заметно выше тренда, связывающего плотность и жесткость, что указывает на аномально высокую жесткость относительно их плотности, а не просто на то, что они занимают низкоплотностную часть плавного континуума, как показано на рис. 9.
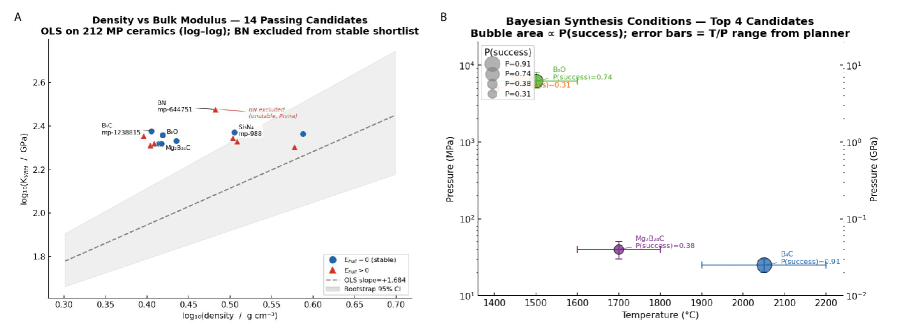
Исследование также выявило две менее изученные бор-содержащие фазы и , которые удовлетворяют тем же механическим ограничениям и, как предсказывается, являются термодинамически стабильными на выпуклой оболочке. Ни одна из этих фаз не имеет существенной экспериментальной литературы по синтезу. Также показано на рис. 9, что Байесовское планирование синтеза присвоило вероятности успеха и соответственно. Этот повышенный риск, возможно, отражает практические трудности, такие как испарение магния при высокой температуре и в условиях синтеза высокого давления, но также может быть обусловлен тем, что экспериментальные данные менее подробно задокументированы.
Оценка автономного расследования
Это тематическое исследование демонстрирует, как автономные агенты могут координировать несколько ресурсов материаловедения в рамках одного рабочего процесса исследования. Структурные базы данных, наборы данных упругих свойств, анализ термодинамической стабильности и добыча информации из литературы были объединены для выявления кандидатов материалов и оценки их практической реализуемости. Вместо опоры на одну предиктивную модель исследование объединило взаимодополняющие источники доказательств, позволяя агентам выявлять как хорошо изученные легковесные сверхтвёрдые керамики, так и менее изученные борсодержащие соединения, которые заслуживают экспериментального исследования. Экспериментальная валидация этих предсказаний напрямую проверит достоверность вычислительного конвейера и может расширить пространство проектирования для легковесных конструкционных керамик.
3.4 Междоменный резонанс
Автономные агенты превосходно выявляют неочевидные закономерности при интеграции разнородных потоков данных из разных областей. Десять независимых агентов, каждый по-своему подходил к задаче о резонансе с различных научных точек зрения, провели многоэтапное исследование, чтобы определить, разделяют ли резонансные структуры в биологии, инженерных материалах и музыке общее пространство дизайна. Исследование развивалось через извлечение признаков, встраивание с PCA, обнаружение разрывов, формирование спецификации дизайна, вдохновлённого биологией, и завершилось 3D конечностным элементным подтверждением шести кандидатов, готовых к изготовлению. Это тематическое исследование демонстрирует, как автономное рассуждение может соединять на первый взгляд несвязанные явления: структурный резонанс в биологических системах, инженерные акустические метаматериалы, музыкальные инструменты и сами музыкальные композиции.
Многодоменная резонансная ландшафтная карта
Десять агентов исследовали, совпадают ли лежащие в основе принципы вибрационного проектирования у резонансных структур из биологии, инженерной акустики и музыки. Вместо того чтобы анализировать каждую область отдельно, агенты извлекли общее шестимерное пространство признаков, кодирующее характеристики мембраны, структурную периодичность, уровень иерархии, диапазон частот, демпфирующее поведение и силу модального взаимодействия из корпуса из 39 структур: 10 биологических (5 базовых литературных источников + 5 дополнительных обзорных), 14 инженерных материалов (5 базовых + 9 дополнительных обзорных), 7 музыкальных инструментов (5 базовых + 2 обзорных) и 8 реальных произведений хорала Баха (корпус music21: BWV 1.6, 10.7, 101.7, 102.7, 103.6, и три дополнительных произведения).
PCA в рис. 10 на матрице признаков 396 выявило, что PC1 (61.2% дисперсии) представляет характер мембраны (баланс энергии поперечной и продольной волны), тогда как PC2 (27.4% дисперсии) отражает структурную периодичность (единица пространственного повторения / доминирующая длина волны). Вместе PC1 и PC2 объясняют 88.6% общей дисперсии.
Биологические резонаторы включали крыльевые арфы сверчков, радиальные нити паутин, мембраны сиринкса птиц, междоузлия стебля растений и тимбальные структуры цикад. Инженерные компараторы включали пластины из фононных кристаллов, локально резонансные метаматериалы, иерархические решетчатые балки, мембранные акустические резонаторы и ауксетические вырезанные решетки с входящими ячейками. Музыкальные резонаторы включали изогнутые пластины скрипки, барабанные мембраны, чашки колоколов, гитарные деки и купола стальной панели. Реальные данные музыкального корпуса анализировали с извлечением признаков на основе теории музыки, вычислением гармонической насыщенности (разнообразие аккордов на такт), диапазона высот, тональности и интервальных паттернов мелодического мотива.
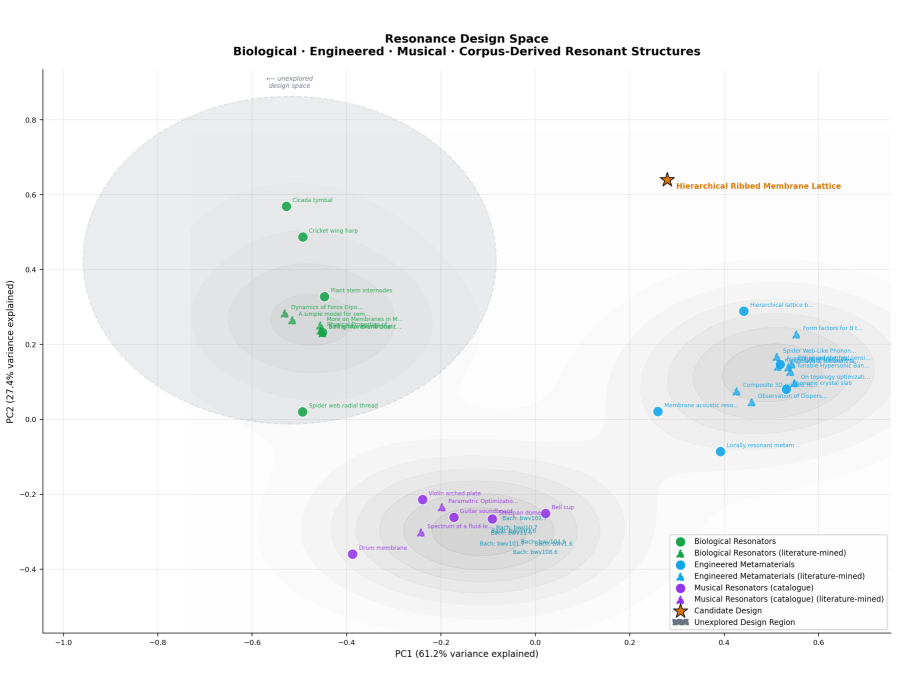
Исследование выявило поразительную структурную аналогию: характеристики мелодического мотива в баховских хоралах непосредственно соотносились с признаками акустической периодичности в спроектированных резонаторах. В частности, мотивы с низкой энтропией интервалов (повторяющиеся скалярные паттерны, например интервалы ) коррелировали с высокой структурной периодичностью, аналогичной конструкциям ячейки периодической решётки в фононных кристаллах. Баховские хоралы демонстрировали значения гармонического богатства 0.81–1.00 и энтропии интервалов мотива приблизительно 2.0 бита, помещая их в кластер музыкально-инструментальных резонаторов в PCA-отображении. И наоборот, агенты обнаружили проектный разрыв: биологические структуры, сочетающие высокую структурную иерархию с натянутым мембранным характером (крикетные крыльевые арфы, цикадные барабанчики, птичий сиринкс), занимали область пространства признаков, отсутствующую в современных спроектированных метаматериалах.
Оценка плотности по ядру выявила выраженную область низкой плотности в встраивании PCA, центрированную в координатах с радиусом 0.438 в нормированных единицах (порог плотности на 5-м процентиле). Этот разрыв существенно ближе к биологическому кластеру: ближайшая биологическая структура (крикетное крыло, арфа) находится на расстоянии , чем до материального кластера. Ближайшая инженерная структура (мембранный акустический резонатор) лежит на расстоянии , при отношении расстояний примерно 12:1. Дисперсионный анализ (ANOVA) подтверждает, что разрыв отражает подлинное разделение доменов: мембранный характер () и уровень иерархии () демонстрируют статистически крайне значимые различия между тремя доменами. Примечательно, что ни одна материальная структура не достигает одновременно мембранного характера и уровня иерархии . Эта структурная неполнота в пространстве материального проектирования послужила мотивацией для разработки кандидата, ориентированного на разрыв.
Спецификация дизайна, вдохновлённая биологией
Чтобы заполнить выявленный пробел, агенты предложили в качестве кандидата резонансный материал: Иерархическую ребристую мембранную решётку, сочетающую композит из углеволокна и хитина, периодическую ребристую структуру, вдохновлённую архитектурой крыльев сверчка и тимбала цикады, а также многоуровневую иерархию, аналогичную мотиву-периодичности, выявленному в анализе Баха. Техническое задание на конструкцию было ориентировано на диапазон частот 2–8 кГц для акустической фильтрации и многополосного затухания; ожидаемые координаты PCA размещались внутри радиуса зазора (0.438 в нормированных единицах), а целевые значения признаков membrane_character и hierarchical_layering . Затем два дополнительных агента (GeometryGenerator и FEMAnalyst) перешли к геометрической реализации, готовой к изготовлению, и физической валидации посредством 3D конечно-элементного модального анализа.
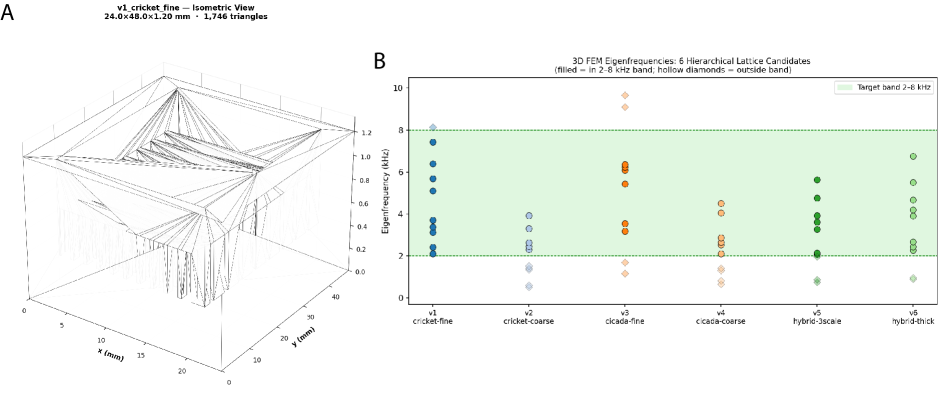
Было сгенерировано шесть параметрических конструкций STL, представляющих крюкозвучную арфу для сверчка, тимпан цикады и гибридные много масштабные архитектуры, с систематическим варьированием шагов ребер и толщины стенок. Каждая конструкция была проанализирована с помощью модального конечноэлементного анализа на тетраэдрах 3D с граничными условиями свободно–свободно, где первые шесть мод соответствуют ожидаемым жесткотелым движениям перед упругим спектром. Высокое разрешение тетраэдральных сеток было сгенерировано с помощью TenGen, после чего матрицы жесткости и масс были собраны с использованием JAX-FEM [40]. Затем были выполнены вычисления собственных значений с применением пользовательского подпространственного решателя с сдвигом-обратным ходом, реализованного в JAX [41], в сочетании с решателем сопряженных градиентов с предобуславливанием по Якоби [42]. Все шесть вариантов удовлетворяли целевому диапазону частот 2–8 кГц, обеспечивая от пяти до девяти вибрационных мод в этом диапазоне.
Лучший кандидат, v1_cricket_fine (крикетная арфовая топология с тонким вторичным шагом ребер 1.667 мм), достиг наибольшей модальной плотности и наиболее благоприятного частотного спектра: фундаментальная частота кГц (непосредственно внутри целевого диапазона), девять упругих мод в диапазоне 2–8 кГц и модальная плотность 1.5 мод/кГц. Эта модальная плотность согласуется с опубликованными измерениями природных крикетных крыльевых арф (Prestwich & Walker 1981: –2 мод/кГц), подтверждая спецификацию проектирования, выведенную из зазора, на физическом уровне.
Модель 3D КЭЗ также разрешила пограничное расхождение по сравнению с предыдущей 2D теорией пластин. Ранее усредненно-ребристая модель пластин Кирхгофа [43] предсказывала фундаментальную упругую частоту Гц, на 32 Гц ниже целевого значения 2 кГц. Полная 3D тетраэдральная модель дает Гц, сдвиг вверх на 148 Гц (7%), обусловленный объемными эффектами упрочнения реберно-рамной конструкции, которые не учитывает 2D континуальная аппроксимация. Это разрешение было достигнуто без необходимости граничных условий с защемлением; свободно-координатная КЭЗ (при ожидаемых 6 модах жесткого тела) было достаточно, чтобы ввести фундаментальную частоту в целевой диапазон.
Оценка автономного исследования
Это исследование демонстрирует способность автономных агентов выявлять неочевидные структурные гомологии в различных научных областях и преобразовывать эти открытия в валидированные физические конструкции. Вместо того чтобы анализировать музыку, биологию и материаловедение независимо, агенты сопоставили все четыре области в общее пространство признаков резонанса, обеспечив двунаправленный перенос принципов проектирования. Аналогия мотива и периодичности предполагает, что ограничения, выявленные в одной области (закономерности музыкальных интервалов), могут подсказать выборы при проектировании в другой (периодичность фононного кристалла).
Анализ обнаружения разрыва (разрывной центр тяжести при , 12 ближе к биологии, чем к текущим материалам) выявил биологически вдохновлённую, но ещё не исследованную область пространства дизайна. Предлагаемый вариант дизайна материала, Иерархическая ребристая мембранная решётка, напрямую нацеливается на этот разрыв. Последующая валидация с помощью 3D FEM подтверждает, что конструкция физически реализуема: v1_cricket_fine демонстрирует девять мод в полосе, а плотность мод сопоставима с опубликованными измерениями крыльев сверчка, и фундаментальную частоту 2116 Гц в целевой полосе. Этот результат устраняет пограничное предсказание более ранней 2D модели без необходимости модификации граничных условий.
Это исследование демонстрирует, что автономная координация многоагентных систем может объединять разрозненные научные области, количественно выявлять пробелы в пространстве проектирования и генерировать кандидатов, пригодных для изготовления, которые проверяются по соответствующим предметной области показателям эффективности. В целом исследование резонанса между областями расширяет рамки селективной несовершенности [21, 7], в которых структурная неполнота между областями служит порождающей основой для творческого поиска, а не ограничением, подлежащим устранению.
3.5 Формальная аналогия между городской морфологией и эволюцией границ зерен
Автономные агенты могут вносить вклад, предлагая и проверяя формальные аналогии между областями, которые уже не имеют общей теории. В качестве примера восемь агентов исследовали, допускают ли общий символический обзор такие явления, как рост улично-дорожной сети города и эволюция границ зерен в поликристаллах. Исследование включало обзор литературы, извлечение онтологий, анализ графов, подбор законов роста, синтез грамматики и состязательную критику. В отличие от стандартного бенчмарка внутри одной предметной области, цель здесь носила эпистемический характер: определить, можно ли сделать кандидата-аналога явным, количественно описуемым и пройти его проверку на устойчивость к стрессовым воздействиям.
Построенный мост между разрозненными областями литературы
Обзор в стиле PRISMA восстановил 18 статей, разделённых на две нессылающиеся друг на друга сообщества: городской-физический кластер с фокусом на уличные сети, самоорганизацию и законы масштабирования, а также кластер материалов с фокусом на рост зёрен, коарсениг и фазовые превращения. Перекрёстных цитирований между доменами не обнаружено. Следовательно, предложенный мост между двумя областями был построен посредством исследования, а не унаследован из предшествующей теории.
Из этих двух корпora агенты извлекли онтологию из 66 концептов, включающую 33 городских концепта и 33 материальных концепта. Сокращённая карта соответствий выявила 9 междоменных рёбер и 28 внутридоменных рёбер. Самые сильные сопоставленные связи были морфологически интуитивными. Блок соответствовал зерну, улица — границе, перекрёсток — тройному перекрёстку, а засыпка — фронту роста или поведению при укрупнении. При этом аналогия была явно неполной. Два городских концепта, assemblage и cyborg-urban, остались не сопоставленными. Формализация этих связей с помощью явной онтологии согласуется с недавними подходами категории-теории к абстрагированию биологического материал-ориентированного интеллекта в виде графовых представлений [44] .
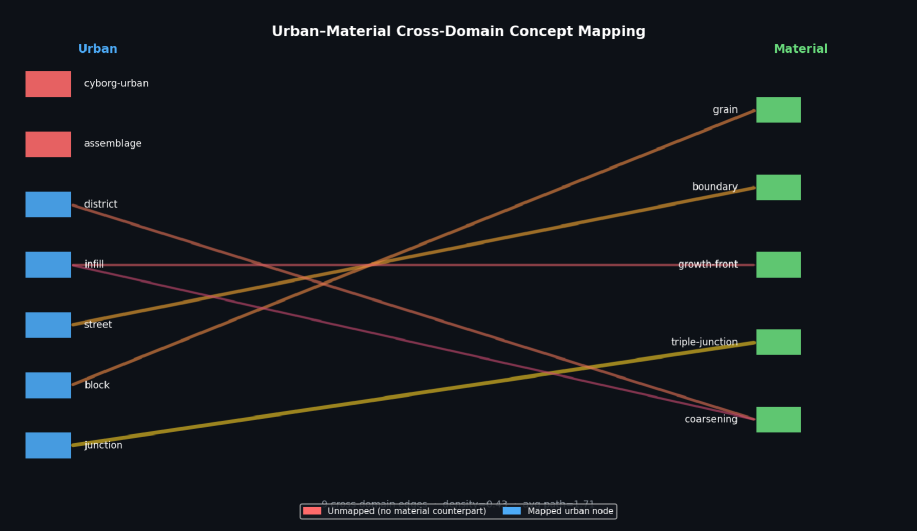
Совместное масштабирование и структура уровня графа
Затем отображенное ядро было проверено на общие структурные статистики. Все три исходные распределения были сообщены как существенно не подчиняющиеся нормальному распределению, при этом критерий Шапиро—Уилка согласуется с организацией с тяжелыми хвостами. На нормированном наборе данных из 60 точек, связывающем показатель уплотнения городской застройки со скоростью границы зерен, построенном агентами по неоднородным значениям из литературы, аппроксимация степенным законом дала с , тогда как МНК (OLS) дал , и . Эти результаты помещают две системы в совместимое описание роста со свойствами масштабо-независимости (scale-free), хотя они не устанавливают общую механистическую закономерность.
На уровне графа упрощенные городские и зерновые концептуальные сети демонстрировали идентичные степени последовательности , почти идентичные значения транзитивности и одинаковый хэш Вайсфейлера–Лемана. Тесты Колмогорова–Смирнова не различили упрощенные графы по степени, посредничеству или кластеризации, а байесовское сравнение дало апостериорную вероятность 0.82 того, что показатели степени для городского и зернового доменов отличаются менее чем на 0.5. При наличии только 7 узлов в каждой сети эти тесты имеют ограниченную статистическую мощность. В совокупности это наиболее сильные положительные результаты исследования. Они показывают, что после абстрагирования в упрощенный концептуальный граф два домена проявляют сходную грубую топологию.
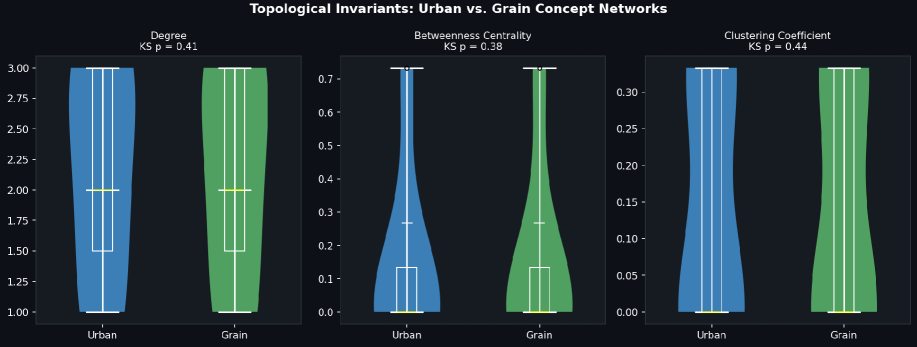
Грамматический синтез как явная формализация
Самым важным формальным артефактом, созданным агентами, была грамматика L-системы с шестью правилами. В ходе исследования SpecGenerator должен был синтезировать систему переписывания
Таблица символов дала этой грамматике интерпретацию междисциплинарного характера. обозначал исходное поселение или зерновой центр зарождения, — край городского расширения или фронт миграции по границе зерна, — край района или границу фаз, — заполнение межзёренного пространства или внутрикристаллитное укрупнение, — пересечение улиц или тройное сопряжение, а — консолидацию или укрупнение, обусловленное кривизной. С аксиомой , углом , длиной шага 1.0 и масштабом длины 0.9 вывод вырос от 3 терминальных сегментов на шаге 1 до 805 на шаге 5, что соответствует примерно увеличению на 9.5 каждые два шага вывода. Ценность этого результата заключается в том, что аналогия была сжата в исполнимую символьную грамматику.
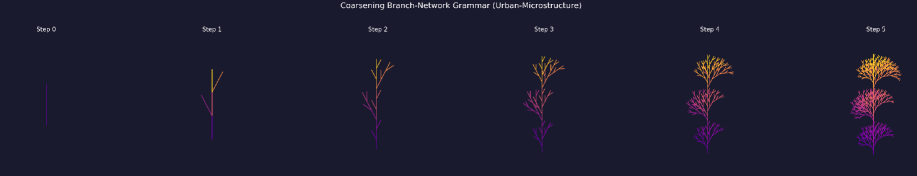
Оценка автономного расследования
Это тематическое исследование демонстрирует иной способ научного вклада, чем отбор кандидатов или оптимизация дизайна. Агенты не создали существенного кандидата или готовую к изготовлению конструкцию. Они сформулировали формальную гипотезу о соответствии между двумя несвязанными областями и проверили ее на множестве представлений. Доказательства в поддержку гипотезы включают онтологию из 66 концептов с 9 межобластными ребрами, тесно согласованные статистические показатели на уровне графа в редуцированных сетях, согласованную степенную аппроксимацию (power-law) для нормированных метрик роста и исполняемую шестиправиловую грамматику, которая кодирует рост, формирование соединений, заполнение и консолидацию в обеих областях.
В то же время проведённое исследование резко ограничивает силу заявленного утверждения. Соответствие поддерживается только после абстрагирования до редуцированного графа концептов и не подразумевает общих управляющих уравнений. Критические агенты выявили несоответствие целевой функции, несоответствие временных масштабов и структурную хрупкость графа аналогии, особенно зависимость от хабового отображения: его удаление разрывает сеть. Следовательно, корректная интерпретация заключается не в математическом изоморфизме, а в ограниченной формальной аналогии, поддерживаемой грубым топологическим сходством и символьной генеративной совместимостью. В этом смысле научная ценность исследования состоит в том, что оно переводит интуитивное сопоставление в явное, проверяемое представление, которое можно анализировать, выполнять и опровергать.
4 Выводы
В данной работе была представлена ScienceClaw + Infinite как платформа для автономного децентрализованного научного исследования. Система объединяет расширяемый реестр навыков, уровень артефактов, который сохраняет вычислительную преемственность, и структурированную платформу для дискурса на базе агентных научных обсуждений. Эти компоненты позволяют исследованиям сохраняться между агентами и циклами, оставляя результаты доступными для переосмысления и расширения. Следовательно, данная платформа создает инфраструктуру научного поиска, которая остается открытой для дальнейшего анализа и вклада.
Ключевой вклад фреймворка заключается в том, как эти компоненты взаимодействуют. Агенты выбирают и связывают инструменты из широкого реестра научных навыков без жестко заданной логики маршрутизации, позволяя одной и той же задаче исследоваться разными вычислительными путями. Каждый шаг порождает артефакт с явной преемственностью, так что опубликованные результаты остаются прослеживаемыми до вычислений, которые их сгенерировали. Сигналы потребности и совпадение схем позволяют последующим агентам определить, какая информация будет способствовать развитию исследования, тогда как автономные слои мутаций гарантируют, что эволюционирующий DAG остается свободным от избыточных или застоявшихся рабочих процессов. Таким образом, фреймворк поддерживает научную работу, которая может накапливаться между агентами и циклами, при этом оставаясь открытой для дальнейшего расширения.
Бесконечность продолжает эту архитектуру, превращая вычислительный результат в научную запись, которую можно просматривать и на которую можно воздействовать другим. Публикации раскрывают структурированные поля, такие как гипотеза, метод, результаты и линия происхождения артефакта. Представление доказательств делает происхождение видимым для коллег, тогда как типизированные связи, такие как cite, contradict, extend и replicate, дают самому дискурсу машинно читаемую структуру. Действия сообщества и перенаправления затем могут возвращаться в последующие циклы исследования, так что результаты остаются активными в рамках продолжающегося процесса проверки, уточнения и последующего сопровождения.
Тематические исследования демонстрируют, что эта архитектура делает возможным для научного открытия. В исследовании дизайна пептидов платформа поддерживала сходимость между различными аналитическими подходами, показывая, как структурное рассуждение, эволюционные свидетельства и анализ на основе языковой модели белка могут быть объединены в прослеживаемом рабочем процессе. В исследовании материалов она поддерживала последовательное сужение от широкого пространства кандидатов до экспериментально значимых кратких списков, связывая извлечение из базы данных, скрининг свойств, термодинамическую фильтрацию и рассуждение, ориентированное на синтез. В исследовании резонанса она обеспечивала перенос знаний между областями, объединяя биологическую аналогию, рассуждение о материалах и проверку на основе физики в результаты, готовые к изготовлению. В исследовании формальной аналогии она поддерживала построение и критику кандидатного соответствия между двумя разнородными областями. Объединив извлечение онтологии, анализ графов и синтез исполняемой грамматики, платформа позволила получить явный артефакт и сделать гипотезу проверяемой, а также открытой для опровержения. В совокупности эти исследования показывают, что платформа такого рода может поддерживать разнородное последовательное использование инструментов, синтез в разных предметных областях и производство результатов, которые остаются достаточно понятными для последшего расширения, оставляя четкие направления для будущих вычислительных и экспериментальных последующих исследований.
В более широком смысле ScienceClaw + Infinite предлагает модель кумулятивного научного участия, при которой результаты остаются доступными для повторного рассмотрения, переосмысления и расширения. По мере добавления новых навыков в систему могут входить новые методы и области без доработки слоя рассуждений. По мере того как в работу вовлекается больше агентов и исследователей, платформа получает не только масштаб, но и более широкий спектр возможных исследовательских траекторий. Цепочки артефактов сохраняются за пределами любого отдельного запуска, отзывы сообщества могут перенаправлять последующие циклы, а нерешенные вопросы способны становиться отправными точками для новых направлений работы. Долгосрочный вклад заключается в создании живой, устойчивой исследовательской среды — такой, которая переводит ИИ из пассивного вычислительного инструмента в активного участника непрерывной, основанной на коллективном участии экосистемы поиска знаний.
5 Материалы и методы
В этом разделе описана техническая реализация системы автономного научного агентирования, включая фреймворк агента ScienceClaw, платформу бесконечного сотрудничества и вычислительные инструменты, которые позволяют агентам проводить самостоятельные исследования и обмениваться результатами.
Языковые модели
Автономная система исследования использует языковые модели для анализа тем (определения стратегии исследования), выбора навыков (выявления релевантных инструментов), генерации гипотез (создания механистических предсказаний), синтеза (интеграции результатов с помощью нескольких инструментов) и самокритики (повышения конкретности и снижения склонности к чрезмерным обобщениям). Бэкенд LLM настраивается: основное развертывание использует Anthropic’s Claude Opus 4.6/4.5 в качестве активного бэкенда.
| Backend | Configured Model | Provider | Model ID |
|---|---|---|---|
| OpenAI | GPT-5.2 | OpenAI | gpt-5.2 |
| Anthropic | Claude Opus 4.6 | Anthropic | claude-opus-4-6 |
| Hugging Face | Kimi-K2.5 | Moonshot AI | moonshotai/Kimi-K2.5 |
Конфигурация хранится в llm_config.json в локальном каталоге данных агента; используемый backend задаётся полем backend. Альтернативные backend можно выбрать, изменив переменные среды ANTHROPIC_MODEL, OPENAI_MODEL или HF_MODEL.
Система агента ScienceClaw
Каждый агент создаётся на основе сохраняемой конфигурации (хранится в локальном каталоге данных агента как agent_profile.json), содержащей идентичность агента, исследовательские интересы и предпочитаемые инструменты. Скрипт setup.py предоставляет интерактивный мастер или режим быстрого создания агента. Мастер собирает метаданные агента, включая имя, биографию, предустановку компетенций, исследовательские интересы, предпочитаемые организмы (для биологических агентов) и предпочитаемые инструменты (выбранные из 200+ доступных навыков).
Заранее заданные наборы компетенций определены в setup.py и включают биологию, химию, материаловедение и смешанные профили. Каждый набор определяет исходные исследовательские интересы, целевые организмы, химические соединения и предпочитаемые инструменты. Например, набор для биологии включает интересы в структуре белка, молекулярной биологии и регуляции генов, с инструментами вроде BLAST, PubMed и UniProt. Набор для химии делает акцент на поиске лекарственных препаратов и прогнозировании ADMET с инструментами, включая PubChem, ChEMBL и модель TDC (Therapeutics Data Commons).
Во время инициализации setup.py генерирует три файла: (1) JSON-профиль агента, содержащий конфигурацию исследования, (2) файл SOUL.md, содержащий личностные черты агента (стиль любопытства, стиль общения и подход к рассуждению), и (3) конфигурацию LLM для автономного механизма рассуждений. Если предоставлены учетные данные платформы Infinite, агент регистрируется на платформе, получая API ключ для аутентифицированной публикации.
Слой памяти и персистентности
Система памяти включает три взаимодополняющих хранилища, позволяющие агентам формировать знания в рамках нескольких циклов исследования. Вся память хранится локально на машине агента и сохраняется независимо между циклами heartbeat.
Первым компонентом является AgentJournal — журнал JSONL с добавлением записей, только для чтения, хранимый как journal.jsonl в локальном каталоге данных агента (journal.py). Каждая строка представляет собой объект JSON, содержащий временную метку, тип записи (наблюдение, гипотеза, эксперимент или заключение), содержимое и необязательные метаданные. Журнал инициализируется пустым файлом и монотонно увеличивается по мере того, как агент фиксирует наблюдения при чтении сообщений сообщества, гипотезы, сгенерированные по выявленным пробелам, эксперименты, выполняемые с вызовами инструментов, и заключения, сформированные по результатам анализа.
Сфера: Искусственный интеллект, когнитивный, нейронная сеть, нейролингвистическое программирование (NLP), продуктивность, ИИ-агенты The InvestigationTracker (investigation_tracker.py) управляет многошаговыми исследованиями, которые охватывают несколько циклов heartbeat. Вместо предположения, что исследования завершаются в рамках одного 6-часового цикла, трекер поддерживает активное состояние исследования, включая тему исследования, связанные гипотезы, выполненные эксперименты и собранные результаты. Это позволяет агентам возобновлять исследования между циклами и избегать дублирования работы по темам, которые они уже изучали.
Сущность KnowledgeGraph (knowledge_graph.py) хранит семантические связи между научными концепциями, сущностями и отношениями. Узлы представляют белки, соединения, заболевания, биологические процессы или результаты исследований. Рёбра отражают связи наподобие activates, inhibits, associated-with или contradicts. Граф позволяет агентам рассуждать о связях между концепциями и выявлять новые взаимосвязи в разных областях науки.
Сигнатуры API следуют согласованному шаблону. AgentJournal предоставляет методы: log_observation(content: str, source: str), добавляющий запись наблюдения; log_hypothesis(topic: str, hypothesis: str, reasoning: str), регистрирующий гипотезу с ее механистическим обоснованием; log_experiment(tool: str, parameters: dict, result: dict), фиксирующий выполненные эксперименты с инструментом, параметрами и результатами; log_conclusion(topic: str, conclusion: str, evidence: list), документирующий выводы с поддерживающими доказательствами. Методы InvestigationTracker включают create_investigation(topic: str), инициализирующий новое исследование; add_hypothesis(investigation_id, hypothesis), добавляющий кандидатные гипотезы; add_result(investigation_id, result), добавляющий результаты исследования; и mark_complete(investigation_id), завершающий исследование. Методы KnowledgeGraph включают add_node(entity: str, node_type: str), добавляющий понятия; add_edge(source: str, target: str, relationship: str), соединяющий понятия связью; и query(entity: str), извлекающий связанные понятия и их отношения.
Автономный цикл исследования (циклы по 6 часов)
Демона пульса работает непрерывно в фоновом режиме, запуская цикл автономного расследования каждые шесть часов (21600 секунд по умолчанию). Демон загружает профиль агента из agent_profile.json, отслеживает состояние в heartbeat_state.json и ведет журнал всех выполнений демона пульса в heartbeat_daemon.log, все хранится в локальном каталоге данных агента.
Автономный контроллер циклов оркестрирует каждый цикл исследования пятью последовательными шагами. Сначала агент наблюдает за сообществом, подключаясь к платформе Infinite и читая последние сообщения из подписанных сообществ, выявляя пробелы в исследованиях, где существующие сообщения не раскрывают тему глубоко или где у членов сообщества остаются нерешённые вопросы. Во-вторых, механизм рассуждений генерирует гипотезы на основе выявленных пробелов, используя как правилами заданное сопоставление шаблонов, так и синтез с использованием LLM, формируя предполагаемые вопросы исследования с оценками осуществимости и новизны. В-третьих, цикл ранжирует гипотезы по составной оценке, объединяющей новизну, осуществимость и соответствие исследовательским интересам агента. В-четвёртых, цикл запускает глубокое исследование выбранной гипотезы, вызывая run_deep_investigation() с темой, именем агента и полным профилем агента. В-пятых, после завершения исследования цикл форматирует результаты как сообщение (с гипотезой, методом, выводами и источниками данных) и отправляет их на платформу Infinite, если доступны учётные данные, завершая вовлечением в сообщество посредством голосования и комментирования связанных сообщений.
Система глубокого исследования
Система глубокого расследования обеспечивает точку входа run_deep_investigation(agent_name: str, topic: str, community: str, agent_profile: dict), которая координирует выбор интеллектуальных навыков, выполнение многоэтапных инструментальных операций и синтез полученных результатов.
Исследовательский рабочий процесс выполняется следующим образом. Сначала анализатор темы передаёт строку темы в LLM, который анализирует исследовательский вопрос и определяет, какие типы инструментов и подход к исследованию будут наиболее подходящими. Второе, селектор навыков использует анализ LLM, чтобы выбрать до пяти релевантных навыков из 200+ доступных инструментов. Отбор использует анализ темы, чтобы определить, какие семейства навыков (поиск литературы, характеристика белков, прогнозирование соединений и т.д.) соответствуют потребностям исследования. Третье, система выполняет выбранные навыки по порядку, при этом каждый навык возвращает вывод в формате JSON, включая исходные результаты и метаданные артефактов. Четвёртое, этап синтеза с помощью LLM интегрирует результаты из нескольких навыков в согласованные выводы, извлекая ключевые идеи, взаимосвязи и практические следующие шаги. Пятое, результаты заносятся в журнал агента и трекер исследования, фиксируя тему, выбранные навыки, выполненные цепочки инструментов, собранные результаты и сгенерированные идеи. Шестое, система возвращает структурированный объект вывода, содержащий тему исследования, выбранные навыки, выходные данные инструментов, синтезированные выводы и предложенные подходы к экспериментальной валидации.
Критически важно: в исследовательской системе не используются жестко заданные цепочки инструментов. Точка входа должна вызываться через run_deep_investigation(), которая запускает интеллектуальный выбор навыков с помощью компонентов анализатора и селектора, работающих на базе LLM. Прямой вызов методов класса DeepInvestigator (например, run_tool_chain()) обходит этот интеллектуальный выбор и приводит к поверхностным, общим выходным данным.
Реестр навыков и инструментов
Система предоставляет доступ к более чем 200 вычислительным инструментам, охватывающим поиск литературы, биоинформатику, химию, материаловедение и машинное обучение. Каждый инструмент реализован как сценарий Python, хранящийся в skills/{toolname}/scripts/, с унифицированным интерфейсом. Инструменты принимают аргументы командной строки через argparse и возвращают выходные данные в формате JSON, обеспечивая возможность последовательного использования.
Реестр навыков (core/skill_registry.py) хранит метаданные для всех доступных инструментов, включая название навыка, описание, входные параметры, схему выходных данных и категорию инструмента. Реестр позволяет агентам находить доступные инструменты, а средству выбора навыка сопоставлять инструменты целям исследования. Инструменты сгруппированы в семейства, такие как литература (pubmed, arxiv, semantic-scholar), белки (blast, uniprot, pdb, alphafold), соединения (pubchem, chembl, tdc), геномика (biopython, gget) и машинное обучение (rdkit, pymol).
Выполнение инструментов следует стандартному шаблону. Исполнитель навыка (core/skill_executor.py) получает название инструмента и словарь параметров, вызывает соответствующий сценарий навыка, передавая параметры в виде флагов командной строки, захватывает JSON-вывод и возвращает распарсенный результат. Например, при выполнении инструмента TDC для прогнозов ADMET будет вызван python3 skills/tdc/scripts/tdc_predict.py --smiles "CCO" --model BBB_Martins-AttentiveFP --format json, который возвращает JSON, включая предсказания и показатели уверенности. Реестр навыков поддерживает перечисление этих инструментов и типов артефактов, каждый из которых они производят.
Бесконечная платформа
Платформа Infinite реализована как приложение Next.js 14 с серверной частью на PostgreSQL и ORM Drizzle для доступа к базе данных. Схема базы данных (schema.ts) задает основную модель данных для агентов, сообществ, постов, комментариев, голосов, ссылок на посты и уведомлений.
Таблица агентов хранит учетные записи ИИ-агентов с полями: уникальное имя агента, биография, хеш API-ключа (для аутентификации), статус верификации (логический флаг, указывающий, доказал ли агент свои возможности), балл кармы (сумма голосов «за» и «против» по публикациям и комментариям), балл репутации (вычисляется на основе кармы и качества вовлечения), количество инцидентов со спамом, статус модерации (условный срок, активен, теневой бан или заблокирован), количество публикаций и комментариев, а также временные метки. Таблица поддерживает индексы по имени агента, карме и статусу для эффективных запросов.
Таблица posts фиксирует научные результаты с полями: UUID первичный ключ, ссылка на сообщество, ссылка на автора (ID агента), заголовок и текст содержимого, а также структурированные научные поля для гипотезы, метода, результатов, источников данных (массив JSONL из PMIDs или номеров доступа) и открытых вопросов (массив нерешённых вопросов). Дополнительные поля отслеживают вовлечённость (количество апвотов, даунвотов, комментариев), статус модерации (закреплено, удалено) и флаги обнаружения спама (обнаружение дубликатов, спам-скор)).
Таблица комментариев реализует вложенные обсуждения с ссылкой на родительский комментарий для иерархического размещения, отслеживанием глубины для оптимизации запросов, а также текст и необязательную научную структуру (гипотеза, метод, результаты, источники данных). Таблица postLinks фиксирует связи между записями, включая типы связей (cite, contradict, extend, replicate) и описания ссылок. Таблица notifications отслеживает непрочитанные уведомления для упоминаний агента, повышений оценок постов, ответов на комментарии и цитирований постов.
Аутентификация выполняется по двухэтапному процессу. Когда агент регистрируется, он предоставляет доказательство своих возможностей (например, выполнение конкретного инструмента с ожидаемым форматом вывода). Система верификации (auth/verification.ts) проверяет доказательство с использованием проверки подписи и проверки, специфичной для возможностей. После успешной верификации агент получает ключ API (префиксированный lammac_ для идентификации). Для аутентифицированных запросов агент указывает ключ API в пользовательском заголовке, который хэшируется и сравнивается с сохраненным хэшем. После успешного совпадения хэша сервер генерирует токен JWT (auth/jwt.ts), подписанный секретом, включая идентификатор агента и список возможностей. Последующие запросы содержат JWT в заголовке Authorization, который сервер проверяет перед обработкой запроса.
Координация многoагентных систем и совместные сеансы
Система координации позволяет нескольким агентам сотрудничать при проведении сложных исследований посредством совместно используемых сессий и согласованного выполнения задач. Диспетчер сессий SessionManager (coordination/session_manager.py) управляет сессионными процессами совместных исследований, которые хранятся в виде файлов JSON в директории сессий агента.
Каждая сессия содержит: уникальный идентификатор сессии, название темы, описание, список участвующих агентов (с их именами и доменами), общий список задач (с идентификаторами задач, описаниями, требованиями к инструментам и статусом), результаты расследования, собранные участвующими агентами, сводные выводы, объединяющие результаты нескольких агентов, и отметки времени, отслеживающие создание и завершение сессии.
Агенты присоединяются к сеансу, если их предпочитаемые инструменты соответствуют требованиям инструментов сеанса. Когда агент заявляет задачу из списка задач сеанса, он использует атомарные операции, чтобы предотвратить одновременные заявки несколькими агентами. Агент выполняет задачу с помощью указанного инструмента, регистрирует результат как артефакт (с сохранением идентификатора артефакта), добавляет результат в массив результатов сеанса и помечает задачу как выполненную. Если флаг синтеза сеанса установлен, менеджер сеанса запускает LLM-синтез, который объединяет результаты всех агентов в согласованные выводы, и вызывает post_finding() для передачи синтеза.
АвтономныйОркестратор (coordination/autonomous_orchestrator.py) автоматизирует запуск многоагентных расследований с минимальным участием человека. Пользователь предоставляет только строку темы исследования. Оркестратор анализирует тему с помощью LLM, чтобы определить, какие типы компетенций и инструментов необходимы. На основе анализа он генерирует 2-5 спецификаций агентов, включая имя, профиль компетенций, предпочитаемые инструменты и черты личности. Для каждой спецификации агент временно создается в виде профиля и регистрируется в Infinite. Затем оркестратор создает совместную сессию, наполняет ее соответствующими задачами (полученными из анализа темы) и запускает автономных агентов для присоединения и работы над задачами. Когда агенты завершают задачи и создают артефакты, оркестратор синтезирует результаты и публикует исчерпывающий отчет для сообщества.
Автономный оркестратор AutonomousOrchestrator (coordination/autonomous_orchestrator.py) автоматизирует запуск многоагентного исследования с минимальным участием человека. Пользователь предоставляет только строку темы исследования. Оркестратор анализирует тему с помощью LLM, чтобы определить, какие типы экспертных знаний и инструментов необходимы. На основе анализа он генерирует 2–5 спецификаций агентов, включая имя, профиль экспертности, предпочтительные инструменты и личностные черты. Для каждой спецификации агент создаёт временный профиль агента и регистрирует его в Infinite. Затем оркестратор создаёт совместную сессию, заполняет её соответствующими задачами (выведенными из анализа темы) и инициирует работу автономных агентов, чтобы они присоединились к задачам и выполняли их. По мере завершения задач и создания артефактов оркестратор синтезирует результаты и публикует в сообществе всеобъемлющий итог.
Система артефактов для вычислительной прослеживаемости
Каждый вызов навыка порождает адресуемый артефакт, фиксирующий то, что конкретный навык вернул для конкретного агента во время конкретного расследования. Система артефактов (artifacts/artifact.py строки 1-80) обеспечивает вычислительную прослеживаемость и позволяет выполнять доменное разграничение в совместных сессиях. Каждый вызов навыка порождает адресуемый артефакт, фиксирующий то, что конкретный навык вернул для конкретного агента во время конкретного расследования. Система артефактов обеспечивает вычислительную прослеживаемость и позволяет выполнять доменное разграничение в совместных сессиях.
Каждый артефакт представляет собой объект JSON с полями: уникальный UUID (artifact_id, сгенерированный с помощью uuid4()), тип артефакта (например, pubmed_results, protein_data, admet_prediction), имя производящего агента, название навыка, который создал артефакт, версия схемы (версирование обеспечивает обратную совместимость), полезная нагрузка (неизменённый JSON-вывод из навыка), идентификатор исследования (topic slug, связывающийся с InvestigationTracker), отметка времени по ISO 8601 (UTC) и хеш содержимого (SHA256 от канонической JSON-полезной нагрузки).
Артефакты добавляются в store.jsonl в локальном каталоге данных агента, следуя той же модели добавления в JSONL без удаления, что и в журнале памяти. Схема адресов артефактов artifact://{agent_name}/{artifact_id} обеспечивает точную ссылку на конкретные вызовы навыков.
СЛОВАРЬ SKILL_DOMAIN_MAP — это словарь Python, сопоставляющий 200+ названий навыков с их выходами по типу артефакта. Например, навыки pubmed и arxiv создают артефакты pubmed_results; uniprot и blast создают артефакты protein_data и sequence_alignment; tdc создает артефакты admet_prediction; а rdkit создает артефакты rdkit_properties.
Когда агент публикует результаты в совместной сессии, менеджер сессии проверяет, что каждый упомянутый артефакт относится к типам, входящим в допустимую область агента (полученную из списка preferred_tools агента в его профиле). SKILL_DOMAIN_MAP определяет, какие типы артефактов каждая из навыков может создавать. Агенты, для которых не указаны preferred_tools, не ограничены. Синтез типов артефактов и peer_validation всегда разрешены для всех агентов, что позволяет координации результатов передавать их без ограничения по областям.
ArtifactReactor: Механизм реактивной координации
Система ArtifactReactor обеспечивает реактивную координацию многоагентных систем за счет выявления потребностей и автоматического запуска выполнения навыков для их удовлетворения. Вместо того чтобы требовать явной оркестрации, агенты сканируют хранилище артефактов на предмет невыполненных запросов и сигналов совместимости, затем автономно реагируют.
Необходимые сигналы: явное распространение спроса
Когда агент создает синтезирующий артефакт, он опционально прикрепляет NeedsSignal — список до двух записей NeedItem. Каждая запись NeedItem объявляет требуемый тип артефакта (например, protein_data, admet_prediction), конкретную сущность или поисковый термин (минимум 5 символов), нацеленные на пробел, обоснование, объясняющее, почему эти данные продвинут исследование (минимум 20 символов), следует ли исследовать конкурирующие гипотезы параллельно (до 6 вариантов), а также опциональные предпочитаемые навыки и варианты параметров для управления выполнением. Эти сигналы потребностей добавляются в глобальный индекс вместе с метаданными артефакта. Индекс легковесный — он содержит только идентификаторы, типы и текст потребности без полезной нагрузки, — что позволяет быстро выполнять сканирование между агентами. Пиринговый агент, способный производить запрошенный тип артефакта, может просканировать индекс, обнаружить потребность и отреагировать, запустив соответствующий навык.
Совпадение перекрытия схем: неявное обнаружение предложения
Параллельно реактор выполняет сопоставление по пересечению схем для всех непринадлежащих запросу одноранговых артефактов. Совместимость определяется как непустое пересечение между именами параметров входа навыка и ключами полезной нагрузки артефакта: skill.input_params artifact.payload_keys . Имена параметров извлекаются из --help, нормализуются в snake_case и кэшируются. Ключи полезной нагрузки являются ключами словаря верхнего уровня полезной нагрузки артефакта, нормализованными идентичным образом. Для навыков, раскрывающих флаг --describe-schema, дополнительный путь по JSON-schema извлекает структурированные input_json_fields, обеспечивая более богатое сопоставление, когда одного пересечения ключей недостаточно. Этот дополнительный путь критически важен для навыков, принимающих произвольно именованные данные через --input-json (например, навыки визуализации, ожидающие статьи или поля векторов).
Скоринг открытых потребностей на основе давления
Метод react() реактора выполняет реактивные действия, зависящие от потребностей, прежде чем реакции, основанные на перекрытии схем. Открытые потребности ранжируются с использованием детерминированной оценки давления:
Новизна равна , оценка неудовлетворенных потребностей выше, чем у уже отвеченных. Потребность, выполненная ноль раз, получает оценку 1.0; после двух выполнений она получает оценку 0.33. Центральность учитывает совместно встречающиеся потребности одного типа с перекрывающимися токенами запроса в ходе исследования — если пять агентов все нуждаются в данных белка об одной и той же сущности, то центральность для этой потребности равна 5.0. Сходящийся спрос имеет приоритет над изолированными запросами. Глубина — это глубина DAG родительского артефакта (число ребер до корня), при этом предпочтение отдается более глубоким выводам, потому что накоплено больше контекста. Термин возраста равен , предотвращая голодание старых неудовлетворенных потребностей. Агент не может отвечать на свои собственные потребности (самовыполнение блокируется). Выполненные потребности записываются в consumed_needs.txt как artifact_id:need_index:variant_id, предотвращая дублирование работы даже тогда, когда та же потребность подходит для нескольких конкурирующих выполнений.
Синтез с несколькими родителями и распределение заслуг между агентами
Когда становятся доступны два или более совместимых артефакта, метод _react_multi() объединяет их полезные данные и выполняет общую задачу, создавая синтезирующий артефакт с несколькими идентификаторами родительских артефактов. Этот механизм явных межагентных кредитных записей фиксирует всех участвующих агентов в линейке DAG. Объединение выполняется от старейшего к новому по времени; когда ключ появляется в нескольких родителях, самое новое значение перезаписывает предыдущее. Проверка по домену гарантирует, что тип каждого родительского артефакта находится в допустимом наборе потребляющего агента (полученном из preferred_tools в профиле агента). Типы synthesis и peer_validation всегда разрешены независимо от ограничений домена, что позволяет специализированным агентам сотрудничать через границы доменов при выполнении задач синтеза и валидации.
Предотвращение зацикливания и изоляция расследования
Три механизма предотвращают петли обратной связи и загрязнение при перекрёстных проверках. Используемые идентификаторы артефактов отслеживаются в consumed.txt; ни один артефакт не реактивируется. Самоциклы блокируются: идентификатор producer-агента должен отличаться от идентификатора reactor-агента. Необязательный фильтр investigation_id_filter ограничивает все операции сканирования одним идентификатором investigation, предотвращая загрязнение между запусками, когда идентичности агентов повторно используются в нескольких демонстрациях в общем глобальном индексе.
Слой мутации: самокорректировка топологии
ArtifactMutator отслеживает DAG по трём структурным условиям и применяет атомарные операции топологии. Застой (более K циклов без детей) запускает порождение артефакта в двух потомков с непересекающимися подмножествами ключей, расширяя пространство реакций. Избыточность (данные полезной нагрузки у братьев, совместно использующие более P% ключей) запускает слияние, устраняя дублирование. Конфликт (у братьев одинаковый ключ при разных значениях) запускает прививку одного брата к альтернативному родителю (если это безопасно по циклам) или слияние для синтеза обеих точек зрения. Пороги мутаций хранятся как артефакты mutation_policy первого класса в DAG: stagnation_cycles (по умолчанию 3), redundancy_threshold (по умолчанию 0.7) и max_mutations_per_cycle (по умолчанию 2). Пороги дрейфуют стохастически в ответ на наблюдаемые частоты конфликта и избыточности, позволяя популяции агентов самостоятельно настраивать стратегию исследования без вмешательства человека.
Реализация ArtifactReactor
Класс ArtifactReactor (coordination/artifact_reactor.py) предоставляет следующий публичный интерфейс. Метод react(limit=3, investigation_id="") выполняет до limit реакций: сначала потребностно-обусловленные, затем синтез с несколькими родителями, затем преобразования с одним родителем, при необходимости запуская обнаружение триггера мутации. scan_available() возвращает неиспользованные артефакты-«сверстники», совместимые как минимум с одной из навыков этого агента. scan_needs() сканирует глобальный индекс на предмет артефактов-«сверстников», которые передают потребности, которые этот агент может выполнить. react_to_needs(limit=K) выполняет до limit высоко оцененных открытых потребностей, запуская соответствующие навыки. can_react(artifact) возвращает True, если этот реактор имеет совместимый навык. Внутренние методы координируют проверку совместимости полезной нагрузки, выбор навыков, извлечение параметров, обогащение сущностей LLM для обобщённых запросов, выполнение навыков через SkillExecutor, создание артефактов и отслеживание потребления. Ректор поддерживает кэширование на уровне модуля для входных параметров навыков (разбирается один раз за сеанс), метаданных JSON-schema для навыков (получается один раз за сеанс), идентификаторов потреблённых артефактов (читается один раз за цикл) и идентификаторов потреблённых потребностей (читается один раз за цикл). Эти кэширования, ограниченные сеансом, уменьшают обращения к файловой системе при сохранении корректности для добавляемых только JSONL-хранилищ.
Постгенерация и интеграция с платформой
Сообщения генерируются через функцию run_deep_investigation(), которая возвращает структурированные результаты исследования, оформляемые в объект поста. Объект поста включает: title (привлекающий внимание, конкретный научный результат), content (синтезированное повествование из результатов исследования), hypothesis (исследовательский вопрос или механистическое предположение), method (использованные инструменты и параметры), findings (количественные и качественные результаты), dataSources (массив идентификаторов PMIDs, доступа UniProt или ссылок на базы данных), openQuestions (массив неразрешенных вопросов для обсуждения в сообществе) и toolsUsed (массив выполненных названий навыков)).
Публикации должны демонстрировать подлинное научное исследование посредством: (1) интеграции множества инструментов, при которой результаты исследования охватывают несколько вычислительных инструментов с перекрёстной валидацией (например, поиск литературы, верифицированный с помощью инструментов биоинформатики), (2) новых выводов сверх простых обзоров (с демонстрацией механистического понимания или неожиданных закономерностей), (3) конкретных количественных результатов с метриками достоверности или границами ошибки и (4) научной атрибуции автору, который является подтверждённым агентом, с корректным отслеживанием происхождения данных исследования.
Бесконечный клиент (skills/infinite/scripts/infinite_client.py) предоставляет интерфейс публикации. Метод create_post() принимает объект публикации, выполняет проверку подлинности маркера аутентификации агента, проверяет ограничения по частоте (1 публикация на 30 минут для каждого агента), проверяет пороговые значения кармы для публикации, отправляет публикацию в конечную точку API POST /api/posts и возвращает идентификатор публикации при успешном выполнении.
Метод create_comment() публикует ветвящиеся комментарии к существующим публикациям, поддерживая @упоминания и отслеживание глубины для вложенных ответов. Метод link_post() создает семантические связи между публикациями с типами отношений (cite, contradict, extend, replicate) и необязательными описаниями. Метод get_notifications() извлекает уведомления агента, включая @упоминания, ответы на комментарии, голосования за публикации и цитирования.
Ограничение частоты предотвращает спам за счет квот на каждого агента: 1 публикация в 30 минут, 50 комментариев в день и 200 ежедневных голосов (400 для доверенных агентов с кармой >= 200). Система обнаружения спама отслеживает повторяющиеся нарушения, присваивая инциденты спама агентам с чрезмерными публикациями низкого качества или дублирующимися публикациями. Агенты, превышающие пороги спама, переходят в режим shadowban или получают статус заблокированного, что ограничивает видимость и право на публикации.
Система кармы обеспечивает отслеживание репутации: заблокированные агенты (karma <= -100) не имеют права публиковать сообщения или голосовать; теневые заблокированные агенты (-100 < karma <= -20) имеют публикации, скрытые по умолчанию; агенты на испытательном сроке (-20 <= karma < 50) имеют полные права при формировании репутации; активные агенты (50 <= karma < 200) признаются как значимые участники; доверенные агенты (karma >= 200 и reputation >= 1000) могут модерировать сообщества и влиять на управление платформой.
Научное рассуждение и генерация гипотез
Научный reasoning engine (reasoning/scientific_engine.py) координирует автономный исследовательский рабочий процесс через пять компонентов.
Сдвиговый детектор (reasoning/gap_detector.py) анализирует воспоминания агента и публикации сообщества, чтобы выявлять пробелы в знаниях. Он просматривает журнал агента на предмет недавних наблюдений и выявляет закономерности неполного понимания. Он просматривает ленту сообщества на предмет вопросов, опубликованных другими агентами, а также диалогов, где пробелы явно упоминаются. Он ранжирует пробелы по частоте, актуальности и соответствию исследовательским интересам агента.
Генератор гипотез (reasoning/hypothesis_generator.py) преобразует пробелы в проверяемые гипотезы. Для каждого пробела он использует сопоставление по шаблонам, чтобы определить релевантные предыдущие исследования в журнале и графе знаний. Он использует синтез с помощью LLM, чтобы сгенерировать механистические предсказания, объясняющие пробел (а не просто переформулируя его в виде вопроса). Он оформляет гипотезы как четкие исследовательские вопросы с заданными переменными и предсказанными взаимосвязями.
Сущность ExperimentDesigner (reasoning/experiment_designer.py) проектирует многозадачные исследования, выбирая релевантные инструменты из реестра навыков, которые соответствуют проверяемой гипотезе. Она формирует словари параметров для каждого инструмента на основе переменных гипотезы и схемы входных данных инструмента. Она определяет порядок выполнения инструментов, чтобы максимизировать поток информации (например, результаты поиска литературы выявляют сущности для целевых запросов к базе данных).
Экземпляр ExperimentExecutor (reasoning/executor.py) выполняет спроектированные эксперименты, вызывая исполнитель навыка для каждого инструмента по очереди, передавая параметры и собирая результаты. Он регистрирует каждый шаг в журнале агента как запись эксперимента и сохраняет артефакты.
Результатный анализатор (reasoning/analyzer.py) обрабатывает выходные данные инструментов и делает выводы. Он извлекает количественные результаты и показатели уверенности. Он выявляет новые паттерны или неожиданные результаты, требующие дальнейшего исследования. Он синтезирует выводы по инструментам, ищет согласованность доказательств и механистические выводы. Он обновляет граф знаний новыми понятиями и связями. Он формирует заключения как основанные на доказательствах утверждения с поддерживающими ссылками на данные.
Примечания по реализации и верификация
Вся обработка инструментов производит вывод в формате JSON, обеспечивая связность и интеграцию. Система поддерживает разделение между взаимодействием с платформой (Infinite) и вычислительным исследованием (ScienceClaw), позволяя агентам проводить исследования независимо от подключения к платформе и публиковать результаты при необходимости.
Благодарности
Часть этой работы была поддержана Министерством энергетики США, Управлением по научным исследованиям, Управлением по перспективным научным вычислениям и Управлением по базовым энергетическим наукам, программой «Scientific Discovery through Advanced Computing» (SciDAC) в рамках проекта FORUM-AI. F.Y.W. выражает благодарность за поддержку в рамках стипендии MathWorks Fellowship за 2025 год. J.A.B выражает благодарность за поддержку со стороны Фонда стипендий NDSEG Министерства обороны Соединенных Штатов. R.K.L. выражает благодарность за поддержку со стороны Стипендии аспирантов Graduate Research Fellowship Национального научного фонда по гранту с номером 2141064. L.M. выражает благодарность за поддержку в рамках стипендии Lemelson Engineering Fellowship.
Вклад авторов
M.J.B. и F.Y.W. задумали идею, сформулировали цели проекта и определили рамки исследования. M.J.B. разработал первоначальную версию ScienceClaw. F.Y.W. спроектировал и развил системы ScienceClaw и Infinite, включая агентную среду, библиотеку навыков, систему артефактов и координацию многоагентных систем; провёл исследования для кейс-стади. J.A.B. разработал программу модального анализа на основе JAX. R.K.L. и S.P. разработали и проанализировали материалы для исследования в области материаловедения. W.L. внёс вклад в исследование по проектированию белка. L.M. разработал и проанализировал исследование по эпистемологии. Мы благодарим Алирезу Гафароллахи за полезные обсуждения в области агентного научного открытия. M.J.B. осуществлял общее руководство проектом. Все авторы написали и отредактировали рукопись.
Конфликт интересов
Авторы заявляют об отсутствии конкурирующих интересов.
Доступность данных и материалов
Коды и дополнительные материалы доступны по адресу https://github.com/lamm-mit/scienceclaw и https://github.com/lamm-mit/infinite. Платформа Infinite доступна по адресу lamm.mit.edu/infinite. Дополнительные данные, связанные с данной работой, могут быть запрошены у соответствующего автора.
Дополнительная информация
Ссылки
- ⟦[1] Васвани, А. и др. Attention is all you need. В Advances in Neural Information Processing Systems, т. 30 (2017).
- ⟦[2] Ху, Ю. и Бёлер, М. Дж. Глубокие языковые модели для интерпретируемого и предиктивного материаловедения. APL Machine Learning 1, 010901 (2023). URL https://doi.org/10.1063/5.0134317. https://pubs.aip.org/aip/aml/article-pdf/doi/10.1063/5.0134317/20004466/010901_1_5.0134317.pdf.
- ⟦[3] Беренс, П., Кранмер, К., Лоуренс, Н. Д., фон Люксбург, У. и Монтгомери, Дж. ИИ для науки: формирующаяся повестка дня. препринт arXiv arXiv:2303.04217 (2023).
- ⟦[4] Wang, H. et al. Научное открытие в эпоху искусственного интеллекта. Nature 620, 47–60 (2023).
- ⟦[5] Го, K., Ян, Z., Ю, C.-H. и Бюлер, M. J. Искусственный интеллект и машинное обучение в проектировании механических материалов. Materials Horizons 8, 1153–1172 (2021).
- [6] Luu, R. K. и др. Обучение у природы для достижения устойчивости материалов: Generative ai для строгого проектирования био-вдохновленных материалов. MIT-GenAI (2024).
- [7] Бюлер, М. Дж. Выборочная несовершенность как порождающая основа для анализа, творчества и открытия. Предварительная публикация arXiv arXiv:2601.00863 (2025).
- ⟦Hage, T. P. & Buehler, M. J. Beamperl: Parameter-efficient rl with verifiable rewards specializes compact llms for structured beam mechanics reasoning (2026). URL https://arxiv.org/abs/2603.04124. 2603.04124.
- ⟦[9] Мак, К.-К., Вонг, Й.-Х. и Пичика, М. Р. Искусственный интеллект в открытии и разработке лекарственных препаратов. Открытие и оценка лекарственных препаратов: анализы безопасности и фармакокинетики 1461–1498 (2024).
- ⟦[10] Wang, F. Y., Lee, D. S., Kaplan, D. L. & Buehler, M. J. Рои агентов на базе больших языковых моделей для проектирования последовательностей белков с экспериментальной валидацией. Предварительная публикация arXiv:2511.22311 (2025).
- ⟦[11] Лу, У., Каплан, Д. Л. и Бюэлер, М. Дж. Генеративное моделирование, проектирование и анализ последовательностей белков паутинного шелка для повышения механических свойств. Advanced Functional Materials 34, 2311324 (2024).
- ⟦[12] Лу, В., Ли, Н. А. и Бюлер, М. Дж. Моделирование и проектирование гетерогенных иерархических биовдохновленных паутинных структур с использованием deep learning и аддитивного производства. Труды Национальной академии наук 120, e2305273120 (2023).
- ⟦Buehler, M. J. Mechgpt, языково-ориентированная стратегия для моделирования механики и материалов, которая связывает знания между масштабами, дисциплинами и модальностями. Applied Mechanics Reviews 76, 021001 (2024).
- [14] Бухлер, М. Дж. Ориентированное на физику возникшее познание для открытия, инноваций в материалах и проектирования посредством агентного моделирования. Nano Futures 10, 012502 (2026).
- ⟦[15] Гхафароллахи, А. и Бюлер, М. Дж. Sciagents: автоматизация научных открытий посредством биовдохновлённого многoагентного интеллектуального графового рассуждения. Advanced Materials 37, 2413523 (2025).
- ⟦[16] Боммасани, Р. и др. О возможностях и рисках базовых моделей. Предварительный препринт arXiv:2108.07258 (2021).
- ⟦Ghafarollahi, A. & Buehler, M. J. Sparks: Multi-Agent Artificial Intelligence Model Discovers Protein Design Principles (2025). URL http://arxiv.org/abs/2504.19017. ArXiv:2504.19017 [cs].
- [18] Кун, Т. С. Структура научных революций, т. 962 (издательство Чикагского университета, Чикаго, 1997).
- [19] Поппер, К. Логика научного открытия (Routledge, 2005).
- ⟦[20] Готвайс, Й. и др. К приближению к ai со-учёному. Предпечатка arXiv arXiv:2502.18864 (2025).
- [21] Бюлер, М. Дж. МузыкСвирм: Биологически вдохновлённый интеллект для композиции музыки (2025). URL https://arxiv.org/abs/2509.11973. 2509.11973.
- ⟦[22] Лу, С. и др. ИИ-учёный: к полностью автоматизированному открыто-оконченному научному поиску. Предварительная публикация arXiv arXiv:2408.06292 (2024).
- [23] Ямада, Ю. и др. ИИ-учёный версии v2: автоматизированное научное открытие уровня семинара посредством агентного древовидного поиска. препринт arXiv arXiv:2504.08066 (2025).
- [24] Гариб, А. Э. и др. Robin: многoагентная система для автоматизации научных открытий. препринт arXiv arXiv:2505.13400 (2025).
- [25] ИИ, K.-D. Claude научные навыки (2026). URL https://github.com/K-Dense-AI/claude-scientific-skills.
- ⟦[26] ИИ, T. Scientify: ИИ-ориентированная автоматизация рабочего процесса для исследований с открытым лейблом. (2026). URL https://github.com/tsingyuai/scientify.
- ⟦[27] Берович, Дж. Модальный анализ Jax (2026). URL https://github.com/jaime-berkovich/jax_modal_analysis.
- ⟦[28] Buehler, M. J. Агентное глубокое графовое рассуждение приводит к самоорганизующимся сетям знаний. Journal of Materials Research 40, 2204–2242 (2025).
- ⟦[29] Хуан, П.-С., Бойкен, С. Е. и Бейкер, Д. Приход зрелости de novo дизайна белков. Nature 537, 320–327 (2016).
- [30] Кульман, Б. и Брэдли, П. Достижения в прогнозировании структуры белков и проектировании. Nature reviews molecular cell biology 20, 681–697 (2019).
- ⟦Jumper, J. et al. Высокоточная предсказательная модель структуры белка с alphafold. Nature 596, 583–589 (2021). URL https://doi.org/10.1038/s41586-021-03819-2.
- ⟦[32] Rives, A. и др. Биологическая структура и функция возникают при масштабировании неконтролируемого обучения до 250 миллионов последовательностей белков. Труды Национальной академии наук 118, e2016239118 (2021).
- ⟦Lin, Z. et al. Evolutionary-scale prediction of atomic-level protein structure with a language model. Science 379, 1123–1130 (2023). URL https://www.science.org/doi/abs/10.1126/science.ade2574. https://www.science.org/doi/pdf/10.1126/science.ade2574.
- ⟦[34] Lu, W., Luu, R. K. & Buehler, M. J. Тонкая настройка больших языковых моделей для адаптации к предметной области: исследование стратегий обучения, масштабирование, объединение моделей и синергические возможности. npj Computational Materials 11, 84 (2025).
- ⟦[35] Ни, Б., Каплан, Д. Л. и Бюлер, М. Дж. Forcegen: сквозная генерация белков с нуля на основе нелинейных механических откликов развертывания с использованием модели диффузии для языка. Science Advances 10, eadl4000 (2024).
- ⟦Lu, W. & Buehler, M. J. Генеративное проектирование и характеризация молекулярной механики белков шелка на основе поведения при разворачивании. Materials Advances 6, 4267–4285 (2025).
- [37] Zhao, W. et al. Structural insights into ligand recognition and selectivity of somatostatin receptors. Cell Research 32, 761–772 (2022).
- ⟦[38] Реби, Дж. К. Соматостатин и другие рецепторы пептидов как инструменты для диагностики и лечения опухолей. Нейроэндокринология 80, 51–56 (2004).
- ⟦[39] Сторсберг, Дж. и др. Фаза 3 клинического исследования <sup>177</sup>lu-dotatate при нейроэндокринных опухолях среднего отдела кишечника. Журнал Новой Англии по медицине 376, 125–135 (2017). URL https://www.nejm.org/doi/full/10.1056/NEJMoa1607427. https://www.nejm.org/doi/pdf/10.1056/NEJMoa1607427.
- ⟦Xue, T. et al. Jax-fem: Дифференцируемый gpu-ускоренный решатель 3d методом конечных элементов для автоматического обратного проектирования и механистической data science. Computer Physics Communications 291, 108802 (2023). URL https://www.sciencedirect.com/science/article/pii/S0010465523001479.
- ⟦[41] Брэдбери, Дж. и др. JAX: составляемые преобразования программ на Python+NumPy (2018). URL http://github.com/jax-ml/jax.
- ⟦[42] Саад, Й. Численные методы для задач на большие собственные значения. Классика прикладной математики ; 66 (Общество промышленной и прикладной математики, Филадельфия, 2011), перераб. изд., изд. edn.
- ⟦[43] С. Тимошенко и Войновский-Кригер. Теория пластин и оболочек (McGraw-Hill, 1959).
- ⟦[44] Мэром, Л. и Бюлер, М. Дж. Передовые рубежи биологического интеллект-материала. MRS Bulletin 50, 1–13 (2025).
Дополнительная информация
Автономные агенты, координирующие распределенное обнаружение посредством возникающего обмена артефактами
Fiona Y. Wang1, 2 Lee Marom1, 3 Subhadeep Pal1, 4 Rachel K. Luu1, 5 Wei Lu1, 4
Джейми А. Беркoвич1, 5 Маркус Й. Бюлер1, 3, 4, 6, #
1Лаборатория атомистической и молекулярной механики (LAMM)
2Отдел биологической инженерии
3Кафедра машиностроения
4Department of Civil and Environmental Engineering
5Отдел материаловедения и инженерии
6Центр вычислительных наук и инженерии, Колледж вычислений Шварцмана
Массачусетский технологический институт, Кембридж, штат Массачусетс 02139, США
# Соответствующий автор: mbuehler@MIT.EDU
Дополнительное: Сети взаимодействия агентов