Хэшэн Ван, Школа автоматизации и интеллектуального зондирования, Шанхайский Цзяотунский университет и Шанхайская ключевая лаборатория навигации и услуг, основанных на местоположении, Шанхай 200240, Китай.
К парадигме «Зрение–Звук–Язык–Действие»: фреймворк HEAR для манипулирования, ориентированного на звук
Аннотация
Люди и животные опираются на бесперебойную интеграцию непрерывных визуальных и аудиальных потоков, чтобы взаимодействовать с физическим миром. Хотя в последнее время модели Vision-Language-Action (VLA) начали включать аудио, обычно они рассматривают звук как статические подсказки перед выполнением или фокусируются исключительно на человеческой речи. Это оставляет заметный пробел в управлении, ориентированном на звук, в реальном времени, где мимолётная акустика окружающей среды (например, писк микроволновой печи или щелчок столкновения) обеспечивает критическую проверку состояния во время фактического выполнения задачи. Основная сложность при использовании непрерывного аудио заключается во временном характере. В отличие от визуальных сцен, которые обычно меняются постепенно и остаются наблюдаемыми на протяжении шагов управления, акустические сигналы мимолётны. Из-за этой кратковременности ключевые звуки легко пропустить из‑за обновлений политики с низкой частотой или задержки системы. Эта проблема усугубляется разбиением действий на фрагменты при выполнении в открытом контуре, что создает Blind Execution Interval, в течение которого важные акустические события теряются между дискретными окнами наблюдения аудио. Признавая необходимость непрерывной аудиальной осведомлённости, мы формализуем Vision-Sound-Language-Action (VSLA) как новую парадигму непрерывного управления, обусловленную зрением, потоковым аудио, языковыми инструкциями и проприоцепцией в условиях контуров принятия решений с задержкой. В качестве конкретной реализации мы представляем HEAR, фреймворк VSLA, который объединяет четыре компонента: (i) Historizer потокового типа, предназначенный для поддержания компактного причинного аудиоконтекста во время разрывов выполнения; (ii) Envisioner, адаптированный из omni foundation models, для рассуждений по интегрированным многомодальным входам; (iii) Advancer, сформулированный как аудиомодель мира, чтобы изучать временную динамику, предсказывая коды аудио на ближайшее будущее; и (iv) политику Realizer, согласованную по потоку (flow-matching), построенную для генерации плавных фрагментов действий. Чтобы справиться с нехваткой данных для предварительного обучения и стандартизированных оценок для VSLA, мы создаём OpenX-Sound для предварительного обучения, а также HEAR-Bench — первый ориентированный на звук бенчмарк манипулирования с строгими правилами причинной временной привязки. Обширные эксперименты на HEAR-Bench показывают, что HEAR достигает среднего успеха 81% в моделировании, существенно превосходя рендеринг по волновой форме (61%) и базовый уровень на основе ASR (35%). Кроме того, HEAR демонстрирует перспективную производительность в реальных развертываниях, достигая 54% успеха на четырёх задачах, ориентированных на звук, на физическом роботе Franka Panda. Наши результаты указывают на то, что надёжное управление, ориентированное на звук, требует причинного сохранения контекста и явного временного обучения. Мы считаем, что этот фреймворк обеспечивает практический шаг к многомодальным foundation-моделям для воплощённых агентов, позволяя роботам более полно воспринимать и взаимодействовать с динамическими средами. Код и видео доступны по адресу https://hear.irmv.top.
ключевые слова:
Зрение-язык-действие (VLA), обучение роботов, манипулирование, ориентированное на звук, аудиальная обработка, мультимодальное обучение, разбиение действий на фрагменты1 Введение
В естественной эволюции слуховое восприятие возникло не только ради общения. Оно развилось как первичный механизм, позволяющий организмам отслеживать и преобразовывать физическое окружение (Stein and Meredith, 1993). Хотя зрение улавливает точную пространственную геометрию и в значительной степени моделируется с помощью продвинутых 3D-представлений и визуальных фундаментальных моделей (Deng et al., 2025, 2024), звук предоставляет непрерывный, всенаправленный поток темпоральных событий. Фоновая акустика и шумы контакта раскрывают критические физические состояния, которые камеры просто не могут увидеть: от едва заметного потрескивания кипящей жидкости до резкого щелчка сталкивающихся объектов. Текущие модели Vision-Language-Action (VLA), такие как Octo (Team et al., 2024), OpenVLA (Kim et al., 2024), и (Intelligence et al., 2025), показали высокую эффективность при отображении визуальных снимков и текстовых инструкций непосредственно в непрерывное управление. Однако эти фундаментальные системы функционируют в принципиально беззвучном мире. Осознавая это ограничение, недавние пионерские работы стремились ввести звук в роботизированные манипуляции. Некоторые практические подходы включают звук, транскрибируя человеческую речь в текстовые запросы с помощью automatic speech recognition (Radford et al., 2023) или представляя короткие аудиоволновые фрагменты в виде статических 2D-изображений (Gong et al., 2021). Совсем недавно продвинутые мультимодальные модели, такие как OmniVLA (Guo et al., 2025) и Audio-VLA (Wei et al., 2025), начали проецировать аудио в общие пространства представлений, чтобы усилить понимание инструкций и вывод намерений.
Несмотря на эти значительные успехи, сохраняется структурное ограничение: большинство существующих подходов обрабатывают аудио в сильно эпизодическом или статическом режиме. Они в первую очередь предназначены для прослушивания до действий — с использованием звука для установления контекста, различения объектов или получения вербальных команд до начала перемещения. Хотя эти методы весьма эффективны для рассуждений высокого уровня, им трудно использовать звук как непрерывный сигнал обратной связи в реальном времени во время физического взаимодействия. Поскольку их архитектуры не рассматривают аудио как непрерывный сенсорный поток, они остаются нечувствительными к богатой, невербальной акустической динамике (например, внезапный щелчок при столкновении или мимолётный писк машины), которая проявляется нерегулярно в ходе выполнения задачи. Чтобы добиться устойчивого физического интеллекта, роботы должны быть наделены не только возможностью слышать инструкции до начала движения, но и активно слушать во время выполнения действий.
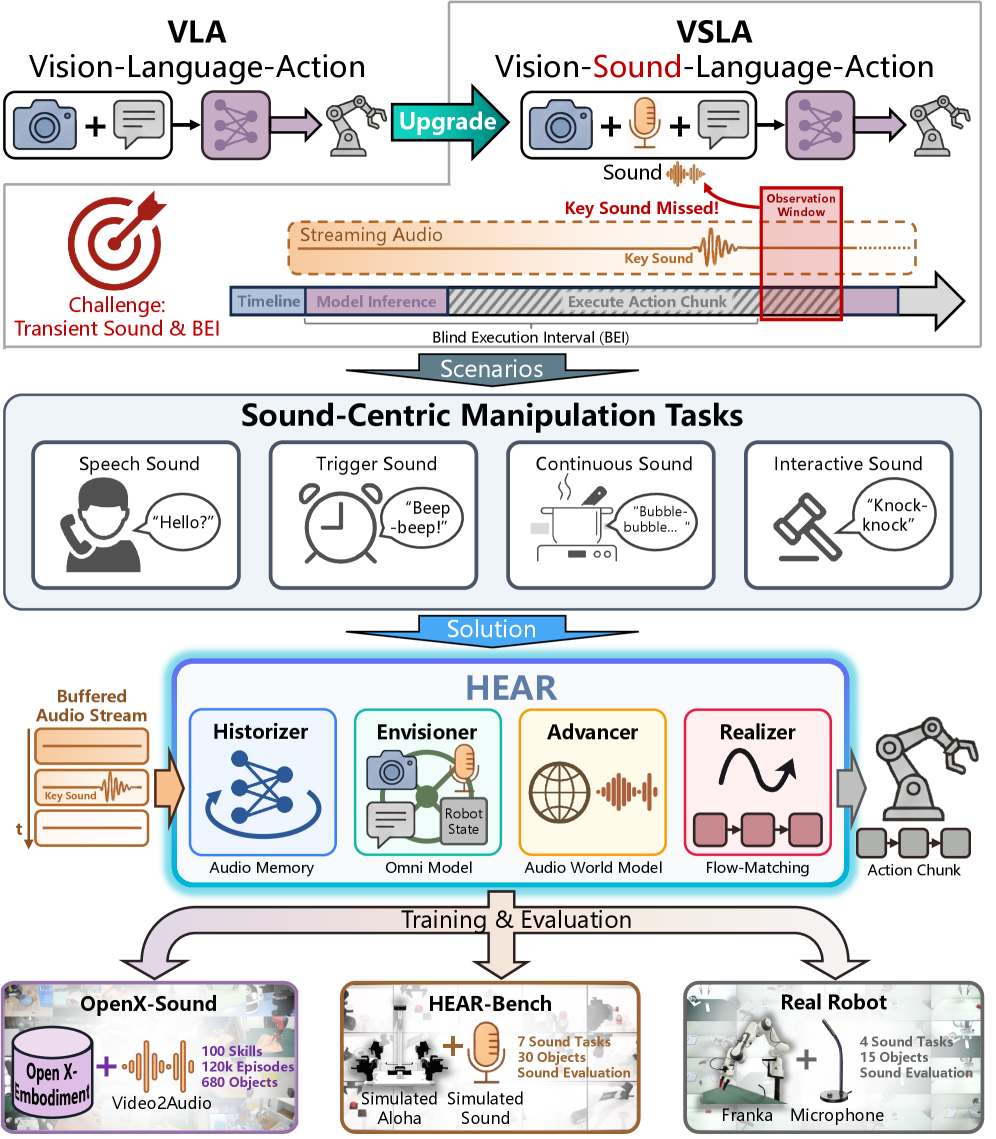
Чтобы систематически использовать эту акустическую среду при роботизированном манипулировании, мы классифицируем повседневные аудиальные сигналы на четыре основных типа: речевой звук, звук, инициируемый событиями, звук непрерывного процесса и обратная связь физического взаимодействия. В то время как речь главным образом предоставляет высокоуровневые указания, последние три дают критически важную информацию о состоянии на низком уровне. Наиболее примечательно, что обратная связь физического взаимодействия, например различимая акустика столкновений, может служить повсеместным и малозатратным суррогатом дорогостоящих тактильных сенсоров (Sinapov et al., 2009; Huang et al., 2025). Однако извлечение пользы из этих богатых акустических сигналов представляет собой серьезную задачу для управления в реальных условиях из-за их принципиально кратковременного характера. В отличие от визуальных состояний, которые обычно сохраняются в поле зрения камеры, звукоориентированные задачи обычно зависят от кратких, невоспроизводимых событий, таких как «динь» микроволновой печи или «хлопок» удара. Из-за присущих вычислительных и механических задержек реальные робототехнические системы не могут непрерывно обрабатывать сенсорные входные данные. Вместо этого они вынуждены получать данные дискретными интервалами, создавая структурные слепые зоны, в которых мимолетные сигналы среды легко пропускаются. Эта чрезмерная ставка на устойчивое зрение часто приводит к тому, что робот нарушает фундаментальную причинно-следственную логику задачи. Например, политика может преждевременно выполнить действие, которое должно строго происходить только после определенного аудиального триггера.
Хотя устранение этой временной слепой зоны необходимо для надежного управления, интегрирование потокового аудио в современные конвейеры VLA остается структурно сложной задачей. Большинство существующих подходов пытаются обойти эту проблему с помощью жестких оконных адаптеров. Например, модули автоматического распознавания речи (Automatic Speech Recognition, ASR) транскрибируют аудио и дописывают текст к языковому запросу (Baevski et al., 2020; Radford et al., 2023), тогда как методы визуальных адаптеров строят короткую аудиоволновую форму в виде 2D-изображения, рассматривая ее как дополнительный «ракурс камеры» (Gong et al., 2021). Эти адаптеры могут работать успешно, когда подсказки длятся долго и хорошо согласованы с окном наблюдения. Однако они по своей сути не имеют временной устойчивости и не могут отразить событие, которое кратковременно произошло непосредственно перед текущим окном. Кроме того, эти представления ухудшают исходный сигнал. ASR отбрасывает важные несвязанные с речью сигналы и просодию. Преобразование волновой формы в изображение фиксирует изменения амплитуды, но полностью скрывает богатые спектральные детали и контуры частот. В конечном счете эти адаптеры испытывают трудности, потому что заставляют динамические аудиопотоки превращаться в статичные, похожие на зрение снимки.
Главное различие между этими модальностями заключается в том, как их информация распределяется во времени. Мы признаем, что в сильно динамических задачах, таких как ловля летящих объектов (Kim et al., 2014), визуальные состояния также могут быть весьма кратковременными. Однако в контексте повседневных манипуляций визуальная сцена обычно изменяется постепенно, поскольку физические объекты и роботизированные манипуляторы движутся с ограниченными скоростями. Даже когда робот неподвижен, камера обеспечивает стабильное, насыщенное информацией наблюдение окружающей среды. Поскольку объекты в целом остаются в поле зрения камеры, визуальное восприятие весьма терпимо к незначительным задержкам системы.
Аудио демонстрирует совершенно противоположный паттерн. В периоды устойчивости акустическая среда в основном состоит из фонового шума с низкой информативностью. Критически важная физическая информация в значительной степени сосредоточена в кратких, мимолётных моментах, таких как внезапный щелчок при столкновении или короткий звуковой сигнал микроволновой печи. Акустический сигнал длительностью всего лишь 50–200 миллисекунд необратимо теряется, если полиси в этот самый момент не выполняет активное слушание. Поэтому, в то время как краткая задержка системы делает визуальное наблюдение лишь немного устаревшим, та же задержка может привести к полному пропуску роботом критически важного звука, что в итоге вызывает катастрофические отказы выполнения задач.
Современные политики для больших моделей усиливают эту уязвимость. Поскольку их вычислительная нагрузка не позволяет им работать с высокой частотой управления робота, многие системы VLA полагаются на разбиение действий на фрагменты (Zhao et al., 2023), чтобы сохранять плавное непрерывное движение. В этой парадигме политика предсказывает короткую последовательность действий и выполняет ее в режиме разомкнутого цикла. Это создает жесткий разрыв выполнения, который мы называем Blind Execution Interval (BEI). В течение этого интервала робот фактически не реагирует на новые наблюдения, из-за чего ему легко упустить кратковременные акустические сигналы. Интуитивным решением этой проблемы могло бы быть повышение частоты перепланирования или раннее прерывание разомкнутого выполнения. Однако такие наивные прерывания не только приводят к прерывистому, рывковому движению, но и довольно часто загоняют робота в локальные, повторяющиеся циклы действий, существенно ухудшая качество выполнения. Кроме того, даже если частоту перепланирования довести до предела, присущая сквозному (end-to-end) системная задержка гарантирует, что мимолетные акустические события все равно окажутся за пределами жесткого окна наблюдений. Поэтому фундаментальное узкое место заключается не просто в запаздывающей физической реакции, а в необратимой потере критически важной сенсорной информации. Мы определяем эту структурную потерю данных как первую крупную проблему в аудио-ориентированном управлении.
Вторая задача связана с временным восприятием и генерацией действий. Помимо успешного улавливания кратковременного звука, политика также должна преобразовать этот сигнал в соответствующую физическую реакцию. Звуко-ориентированные задачи обычно требуют, чтобы робот удерживал устойчивое положение и слушал, а затем выполнял немедленную реакцию на акустический триггер. Поскольку современные модели VLA часто опираются на наблюдения одного кадра без явного представления времени, им трудно моделировать такое поведение. При работе на больших горизонтах такие политики нередко сталкиваются с Temporal Motion Collapse (Zhao et al., 2023), когда значимые движения концентрируются в начале блока действий, а последующие шаги деградируют. Без надлежащей временной привязки робот склонен дрейфовать или замирать, вместо того чтобы сохранять стабильную позу для слушания, что препятствует немедленной реакции, необходимой для задач, управляемых аудио.
Чтобы систематически устранить эти структурные узкие места, мы формализуем Vision–Sound–Language–Action (VSLA) как новую парадигму непрерывного управления. Эта парадигма обусловлена многовидовым зрением, потоковым аудио, языковыми инструкциями и проприоцепцией робота, и работает в условиях реалистичных ограничений с задержками, низкой частотой и асинхронными обновлениями политики. Хотя VSLA задаёт общую теоретическую цель непрерывной аудиторной осведомлённости, перенесение её в реальное управление требует конкретных архитектурных инноваций. Для реализации этой парадигмы мы предлагаем HEAR — сквозную (end-to-end) платформу, предназначенную для фундаментального развязывания высокочастотной сенсорной памяти и низкочастотного принятия решений, как показано на Рисунке 1. HEAR включает четыре глубоко интегрированных компонента: Во-первых, чтобы устранить интервал слепого выполнения (Challenge 1), потоковый Historizer поддерживает компактный причинный аудиоконтекст через промежутки исполнения, гарантируя, что мимолётные звуки будут зафиксированы независимо от частоты запросов к политике. Во-вторых, Envisioner — адаптированная omni foundation-модель — рассуждает над этим вновь интегрированным сенсорным контекстом, чтобы извлечь практически полезные представления. В-третьих, чтобы решить Temporal Motion Collapse (Challenge 2), мы вводим Advancer — аудиомодель мира, которая явно предсказывает аудиокоды ближайшего будущего, обучая временной динамике и закрепляя политику в непрерывном потоке времени. Наконец, policy Realizer, сопоставляющая потоки (flow-matching), преобразует эти представления в плавные, непрерывные фрагменты действий для сочленений.
Помимо алгоритмического проектирования, более широкая область аудио-управляемой робототехники упирается в острую нехватку синхронизированных данных и строгих платформ для оценки. Чтобы открыть доступ к крупномасштабному предварительному обучению для манипуляций, ориентированных на звук, мы представляем OpenX-Sound. Этот набор данных преобразует существующие эпизоды Open X-Embodiment, дополняя их синхронизированными аудиотреками, которые генерируются с помощью современных моделей генерации видео в аудио (Luo et al., 2023; Liu et al., 2024a). Более того, чтобы обеспечить справедливую и стандартизированную оценку парадигмы VSLA, мы разрабатываем новый движок совместного моделирования звука и физики в реальном времени. Опираясь на этот движок, мы создаём HEAR-Bench. В отличие от стандартных визуальных симуляторов, которые остаются полностью бесшумными, HEAR-Bench явно оценивает истинную аудио-реактивность. Он задаёт причинно-строгие правила успеха, которые активно отклоняют визуально правдоподобные, но преждевременные действия. В частности, если робот полагается только на визуальные подсказки, чтобы инициировать или завершить задачу до момента, когда происходит требуемый аудиосигнал, выполнение строго классифицируется как неудача. Такая строгая конструкция гарантирует, что политики оцениваются по реальной акустической отзывчивости, а не по визуальному запоминанию или случайным корреляциям.
Мы тщательно валидируем наш подход на этом новом бенчмарке и на нескольких физических робототехнических установках. В обоих режимах — в смоделированной среде и в реальных условиях — HEAR существенно превосходит традиционные базовые модели ASR и waveform-adapter. Улучшения производительности особенно заметны в задачах, которые опираются на краткие несвязные акустические триггеры и мониторинг процессов на большой временной протяженности. Именно в таких условиях жесткие оконные интерфейсы становятся хрупкими и дают сбой. В конечном итоге наши результаты подчеркивают фундаментальный системный вывод: надежная звук-ориентированная манипуляция не может быть достигнута простым добавлением аудиопотока к существующим моделям. Напротив, это требует непрерывной каузальной устойчивости и явной временной привязки. Вводя парадигму VSLA совместно с OpenX-Sound и HEAR-Bench, это исследование предоставляет необходимые инструменты для перехода от традиционных политик, опирающихся только на зрение, тем самым продвигая разработку многосенсорных воплощенных агентов.
Наши основные вклады суммированы следующим образом:
- ⟦• Парадигма VSLA и структурные узкие места: мы формализуем парадигму Vision–Sound–Language–Action (VSLA), чтобы расширить текущие политики VLA за счет непрерывной аудиальной осведомленности. В ходе этой работы мы выявляем фундаментальное препятствие: Blind Execution Interval (BEI), структурную уязвимость, при которой задержка системы и разбиение на фрагменты в режиме разомкнутого контура делают кратковременное аудио невосстанавливаемым для стандартных систем без памяти.
- ⟦• Фреймворк HEAR: Чтобы преодолеть это узкое место и на практике реализовать VSLA, мы предлагаем HEAR — новую сквозную архитектуру непрерывного управления. Она обеспечивает причинную устойчивость и временную привязку за счет четырех интегрированных компонентов: потоковую причинно-следственную аудиопамять (Historizer), мультимодальное рассуждение (Envisioner), прогнозируемую динамику аудио (Advancer) и плавную генерацию действий с согласованием потока (Realizer).
- ⟦• Наборы данных, эталонные испытания и эксперименты: Мы представляем OpenX-Sound для крупномасштабного предварительного обучения. Кроме того, чтобы обеспечить строгое и стандартизированное оценивание, мы разрабатываем движок совместного моделирования аудио-физики в реальном времени для создания HEAR-Bench — первого эталонного набора, явно предназначенного для манипулирования причинно-следственными связями в звуке. Обширные развертывания с моделируемыми и реальными сценариями демонстрируют, что HEAR существенно превосходит базовые подходы в подлинной акустической реактивности.
2 Смежные работы
2.1 Политики «зрение–язык–действие»
Недавние достижения в обучении роботов продемонстрировали эффективность политик VLA. Ранние системы часто использовали большие языковые модели для планирования шагов высокого уровня, оставляя низкоуровневое управление отдельным модулям (Ahn et al., 2023; Huang et al., 2023). Текущая тенденция сместилась в сторону сквозных моделей, которые преобразуют языковые инструкции и изображения с камеры непосредственно в непрерывные действия робота (Brohan et al., 2023; Zitkovich et al., 2023; Driess et al., 2023; Nie et al., 2025). Поддерживаемые большими наборами данных, такими как Open X-Embodiment (O’Neill et al., 2024), модели вроде Octo (Team et al., 2024) и OpenVLA (Kim et al., 2024) достигли сильных результатов на разных платформах роботов. Критически важно, что вся архитектура современных VLA адаптирована под визуальные данные. Поскольку визуальные сцены обычно изменяются плавно, а объекты остаются в поле зрения камеры в течение времени, эти модели могут безопасно полагаться на дискретные снимки изображений, сделанные с относительно низкой частотой.
Для управления высокой вычислительной нагрузкой этих больших моделей и обеспечения плавного движения робота большинство систем VLA включают разбиение действий на фрагменты (Zhao et al., 2023). Вместо предсказания одного шага за раз политика генерирует короткую последовательность действий и выполняет ее без ожидания новых обновлений сенсоров. Такой подход широко применяется и улучшается с помощью генеративных моделей, таких как Diffusion Policy (Chi et al., 2025), и методов согласования потоков, таких как (Intelligence et al., 2025; Lipman et al., 2023). Хотя такое выполнение в разомкнутом контуре эффективно скрывает задержку вычислений, оно создает временный разрыв в восприятии, который мы называем интервалом слепого выполнения (BEI).
Для чисто визуальных задач BEI обычно является управляемым, поскольку визуальное состояние сохраняется в течение разрыва выполнения. Однако эта архитектурная конструкция становится существенным узким местом, когда исследователи пытаются включить высоко преходящие сигналы, такие как аудио. Кратковременный акустический сигнал, например щелчок, может легко возникнуть и завершиться, пока робот выполняет фрагмент действия. Когда затем наконец открывается следующее окно наблюдения, звук уже исчез. Поэтому расширение текущих VLA-моделей для задач, ориентированных на звук, требует новых механизмов для поддержания непрерывной сенсорной памяти в этих разрывах выполнения. Наша работа опирается на возможности непрерывного управления существующих flow-matching моделей, но специально устраняет это рассогласование по времени, чтобы мимолетные звуки не терялись.
2.2 Аудио в робототехнике
Аудио исторически выполняло разнообразные роли в робототехнике — от высокоуровневого взаимодействия с человеком до низкоуровневой физической обратной связи. Для высокоуровневых задач аудио традиционно рассматривалось как канал коммуникации. Многие системы используют модули автоматического распознавания речи (ASR) (Baevski et al., 2020; Radford et al., 2023), чтобы преобразовывать произнесённые команды в текстовые подсказки. Недавние достижения стремились более напрямую интегрировать речь в модели VLA. Например, фреймворки вроде SVA и VLAS явно обрабатывают речевые инструкции, чтобы сохранять идентичность говорящего и просодию, которые в противном случае теряются при чистой текстовой транскрибации (Li et al., 2025; Zhao et al., 2025). Хотя эти методы высокоэффективны для взаимодействия «человек — робот», они в первую очередь сосредоточены на явных вербальных командах, а не на фоновой акустической физике, возникающей в процессе манипулирования. В области навигации агенты часто используют звук для локализации источников или для вывода событий, происходящих вне поля зрения (Chen et al., 2020). Однако навигационные агенты обычно могут со временем перемещать свою базу, чтобы улучшать геометрию слушания, тогда как манипулирование требует реагировать на кратковременные события ровно в тот момент, когда робот создаёт значительный механический эго-шум.
Помимо прямых команд, последние работы исследовали аудио для более широкого понимания инструкций и упреждающего вывода намерений. Например, аудио-визуальные модели могут использовать звук, чтобы различать визуально идентичные объекты, когда языковые команды в противном случае неясны (Guo et al., 2023). В частности, исследования RoboOmni (Wang et al., 2025b) изучают упреждающее манипулирование в контексте omni-modal, где робот выводит человеческое намерение, объединяя диалог с окружающими звуками. Хотя эти подходы представляют собой значимый шаг к много сенсорному интеллекту, они главным образом используют аудио для установления контекста или вывода намерения до, либо вокруг, выполнения действия. В целом они не рассматривают аудио как сигнал физической обратной связи на низком уровне в реальном времени во время контакта, и также не решают проблему временного рассогласования между мимолетными акустическими событиями и фрагментированным, разомкнутым циклом выполнением современных политик VLA.
На уровне физического взаимодействия значительный объем работ использует звук как непосредственный механизм обратной связи. Ранние исследования интерактивного восприятия показали, что роботы могут оценивать свойства материалов по акустическим откликам (Sinapov et al., 2009, 2014). Опираясь на это, в недавних усилиях звук применяли для оценки устойчивости и мягкости роботизированных захватов (Nakahara and Calandra, 2025). Чтобы масштабировать эти возможности, сообщество быстро переходит к многомодальным базовым моделям. Работы, подобные Audio-VLA, явно добавляют восприятие контактного аудио в крупные политики, тогда как фреймворки вроде OmniVLA и MLA объединяют различные модальности (включая зрение, язык, прикосновение и аудио) в общие пространства представлений (Wei et al., 2025; Guo et al., 2025; Liu et al., 2025). Другие исследования успешно объединяли контактные микрофоны со зрением, демонстрируя, что аудио может служить масштабируемым прокси для тактильного сенсинга (Li et al., 2022; Mejia et al., 2024). В дополнение к пассивному прослушиванию активное акустическое зондирование вводит известные сигналы, чтобы по акустическому отклику восстанавливать состояния контакта (Lu and Culbertson, 2023; Wall et al., 2023), или использует активное возбуждение через захватное устройство для задач с длительным горизонтом (Zhang et al., 2025). Для обработки этих сенсорных данных существующие методы часто преобразуют короткие аудиофрагменты в двухмерные изображения формы волны, фактически рассматривая звук как дополнительное статическое изображение, либо опираются на окна наблюдений фиксированной длины, строго согласованные с частотой кадров камеры.
Хотя эти модели представляют собой огромный шаг вперёд в обучении многомодальному представлению, при развертывании в непрерывных, работающих в реальном времени контурах управления они сталкиваются с структурными трудностями. Обработка статических аудиофрагментов или текстовых расшифровок хорошо подходит для выявления громких событий или получения начальных инструкций. Однако это естественным образом не поддерживает непрерывное слушание в процессе выполнения. Эта структурная проблема усугубляется и самим современным парадигмом управления. Поскольку большие роботизированные политики часто выполняют действия открыто-цикличными фрагментами для поддержания плавного движения, они создают временные разрывы в восприятии. Если возникает краткое акустическое событие, например звуковой сигнал микроволновой печи, и оно заканчивается вне заранее заданного окна наблюдения или во время разрыва в выполнении, статическое представление не может это зафиксировать.
Масштабирование аудиовоспринимающих возможностей часто связано с использованием крупномасштабных предварительно обученных аудиопредставлений, таких как CLAP (Elizalde et al., 2023), ImageBind (Girdhar et al., 2023) и BEATs (Chen et al., 2023), которые успешно дообучались в рамках универсальных роботных политик, таких как FuSe (Jones et al., 2025). Однако эти базовые модели обычно предназначены для обработки аудиофрагментов фиксированной длины в автономном режиме и независимо. При развертывании в реальной робототехнической системе они работают без состояния. Это означает, что они по своей сути не поддерживают временной контекст от одного фрагмента к следующему. Адаптация мощных семантических базовых моделей для причинного (каузального) функционирования на протяжении этих дискретных шагов управления остается сложной задачей. Вместо попыток обрабатывать буквальный непрерывный аналоговый поток, основной мотив нашей работы состоит в построении общей парадигмы, которая сохраняет временной контекст от одного фрагмента к следующему. За счет установления причинной памяти между дискретными аудиоокнами мы гарантируем, что мимолетные акустические сигналы, возникающие между запросами политики, сохраняются и систематически синхронизируются с контуром управления робота.
2.3 Наборы данных и бенчмарки
Недавний масштабируемый успех политик VLA в значительной степени обусловлен массивными стандартизированными наборами данных. Совместные усилия, такие как набор данных Open X-Embodiment (O’Neill et al., 2024), предоставили миллионы траекторий «визуальная-кинетика», позволяя моделям осваивать устойчивые универсальные поведенческие стратегии. Однако подавляющее большинство этих крупномасштабных ресурсов полностью исключают аудиомодальность при сборе данных. Хотя несколько пионерских работ уже признали эту проблему и предложили наборы данных манипулирования, насыщенные аудио, они обычно опираются на пользовательские аппаратные конфигурации. Например, проекты вроде Play it by Ear (Du et al., 2022) и Hearing Touch (Mejia et al., 2024) собирают синхронизированные аудио-визуальные демонстрации с использованием специализированных микрофонов «ухо-в-руке» или контактных датчиков при дистанционном управлении людьми. Хотя эти наборы данных крайне ценны для демонстрации полезности акустической обратной связи, масштабирование их до уровня, требуемого для foundation models, представляет собой существенную логистическую задачу. Сбор чистого, синхронизированного аудио в реальном мире крайне чувствителен к фоновому шуму и вариативности аппаратуры, что затрудняет агрегирование данных между различными лабораториями. Чтобы преодолеть этот разрыв масштабирования без необходимости тысяч часов новой физической работы по сбору данных, мы представляем OpenX-Sound. Вместо записи нового реального аудио наш подход использует достижения моделей генерации «видео-в-аудио» (Luo et al., 2023; Liu et al., 2024a), чтобы ретроспективно синтезировать синхронизированные по времени акустические треки для существующих эпизодов манипулирования крупного масштаба. Эта стратегия согласуется с недавними результатами, указывающими, что генеративное аудио может эффективно поддерживать обучение мультимодальных sim-to-real роботных политик (Wang et al., 2025a), обеспечивая масштабируемый путь для предварительного обучения аудио-реактивным моделям поведения.
Помимо обучающих данных, область сталкивается с фундаментальным узким местом в инфраструктуре оценивания. Большинство стандартных наборов эталонных испытаний для роботизированных манипуляций, таких как RLBench (James et al., 2020) и ManiSkill (Gu et al., 2023), тщательно разработаны для проверки пространственного рассуждения и визуального управления в беззвучных средах. Платформы моделирования, которые действительно включают акустику, такие как SoundSpaces (Chen et al., 2020), в первую очередь ориентированы на мобильную навигацию к непрерывным источникам звука, а не на реагирующие манипуляции. Чтобы восполнить критический разрыв в инфраструктуре, мы разработали платформу совместного моделирования аудио-физики в реальном времени, чтобы создать HEAR-Bench. В отличие от стандартных визуальных наборов, HEAR-Bench нативно передает потоки звуков окружающей среды и взаимодействий во время физического моделирования. Кроме того, она задает причинно-строгие правила успеха, которые активно отклоняют преждевременные действия. Это гарантирует, что политики оцениваются по их реальной способности слушать и реагировать на кратковременные звуки в режиме реального времени.
3 Парадигма VSLA
Мы формализуем парадигму «Видение-Звук-Язык-Действие» (VSLA). Стандартные реализации «Видение-Язык-Действие» (VLA) в основном опираются на визуальные и проприоцептивные наблюдения, чтобы выводить состояния среды. В отличие от этого, парадигма VSLA ориентирована на задачи манипулирования, центрированные на звуке, где критические физические состояния или моменты событий активно передаются через акустические сигналы. В таких сценариях интеграция непрерывного аудио необходима, поскольку звук обеспечивает низкоуровневую физическую обратную связь и точную верификацию успешности, которую одни только камеры и совместные энкодеры не могут обеспечить.
Ключевая теоретическая задача в VSLA заключается в преодолении фундаментального временного несоответствия между непрерывной, высокочастотной природой акустических событий и запаздывающими, дискретными циклами обновления современных робототехнических политик. Чтобы систематически решить эту задачу, в следующих подразделах определяется интерфейс наблюдений VSLA, моделируются структурные слепые зоны, возникающие из-за пакетного выполнения, и формализуются зависящие от времени критерии успеха, необходимые для оценки.
3.1 Наблюдение и пространство действий в VSLA
3.1.1 Окружение и сигналы
Рассматривается динамическая система, развивающаяся во непрерывном физическом времени . Робот выполняет контроллер нижнего уровня с частотой Гц, что приводит к дискретным циклам управления, индексируемым . Физическое время, соответствующее циклу , равно .
На каждом цикле управления робот может получать наблюдения из нескольких модальностей:
- • Видение с многовидовыми RGB-изображениями .
- ⟦• Проприоцепция. Кинематическое состояние робота , состоящее из положений суставов и степени(ей) свободы захватного механизма.
- ⟦• Инструкция по естественно-языковому описанию , фиксированная в пределах эпизода.
- ⟦• Потоковое аудио: микрофон производит выборку непрерывной формы волны с частотой Гц. Пусть обозначает -ю аудиовыборку.
Чтобы связать аудио в непрерывном времени с дискретными циклами управления, определите самый последний доступный индекс аудиовыборки на физическом времени как . На цикле управления самый последний доступный индекс выборки равен
| (1) |
Обозначим аудиойсторию вплоть до цикла как ⟦K1⟈⟧.
3.1.2 Наблюдательный интерфейс
Политика запрашивается только на подмножестве циклов управления, обозначенных моментами принятия решений . Реальные системы также имеют ненулевую сквозную задержку. Мы моделируем эту задержку как задержку наблюдения на циклов управления, то есть на момент принятия решений самые свежие данные датчиков соответствуют отложенному индексу
| (2) |
Мы рассматриваем как целое число циклов управления. Если , мы ограничиваем до 0.
Для аудио интерфейс предоставляет короткий причинно-следственный фрагмент, а не всю прошлую форму волны. Интуитивно, в момент принятия решения политика получает последние секунд аудио, которые поступили к задержанному времени . Пусть . Окно определяется как последние отсчётов до индекса , дополняемых нулями при старте эпизода:
| (3) |
Затем наблюдение VSLA по каждому решению является
| (4) |
Этот интерфейс делает явным цикл отложенного принятия решений, сохраняя причинность аудиопотока.
3.1.3 Пространство действий
Роботом управляет вектор команд , где является размерностью координат суставов, специфичной для воплощения, включая степень(и) свободы захвата. Контроллер нижнего уровня отслеживает эти команды, чтобы приводить в действие физическую систему.
3.2 Временное несоответствие и слепой интервал выполнения
3.2.1 Несоответствие устойчивости между зрением и звуком
Фундаментальное различие между зрением и звуком в типичных задачах манипулирования заключается в их поведении при временной задержке. Зрительные наблюдения в первую очередь кодируют пространственную геометрию. Поскольку физические объекты обладают инерцией, а роботы работают в рамках кинематических ограничений, зрительные состояния изменяются непрерывно и сохраняют информативность в течение нескольких циклов управления. Если камера пропускает кадр, состояние объекта во многих случаях можно надежно интерполировать.
В отличие от этого, критически важные для принятия решений акустические сигналы по сути представляют собой дискретные физические события. Они соответствуют резким выбросам энергии, таким как ударный щелчок или электронный звуковой сигнал, что делает их крайне кратковременными и невоспроизводимыми. Установившийся звук между этими событиями обычно содержит низкоинформативный фоновый шум. Когда цикл принятия решений задерживается или работает с низкой частотой, эти высокоплотные переходные сигналы могут легко попасть между окнами наблюдения. В отличие от визуальных состояний, пропуск акустического импульса означает, что основное свидетельство перехода состояния безвозвратно утрачивается политикой.
3.2.2 Ритм принятия решений и задержка
Пусть обозначает циклы управления, в которых осуществляется опрос политики. Определим интервал принятия решения и эффективный разрыв восприятие-действие, измеряемые в циклах управления, как
| (5) |
Здесь фиксирует частоту обновления политики, а агрегирует задержки восприятия, предварительной обработки, коммуникации, вывода и приведения в действие. Количество обобщает, сколько времени может потребоваться существование переходного события, чтобы повлиять на следующее решение, когда доступны только наблюдения в пределах окна.
3.2.3 Разбиение на фрагменты действий и интервал слепого выполнения
Поскольку крупные «основы» часто запрашиваются с частотой ниже, чем у низкоуровневого контроллера, современные системы часто используют разбиение действий на фрагменты. Пусть обозначает цикл управления, при котором запускается -е выведение. Мы обозначаем фрагмент действия длины через
| (6) |
На каждом решении политика предсказывает фрагмент , который выполняется в разомкнутом контуре (Zhao et al., 2023). Мы обозначаем выполненный горизонт как циклов управления, так что следующий запрос происходит на , что подразумевает . В типичном случае , и выполняется весь фрагмент.
В течение интервала новые наблюдения не могут влиять на команды, которые в настоящее время выполняются. Мы называем этот промежуток выполнения Blind Execution Interval (BEI)).
3.2.4 Устойчивое причинно-следственное обоснование и исчезновение доказательств
Временный звук в сочетании с ненулевой задержкой и отложенными или низкочастотными обновлениями создает важное ограничение в манипулировании, ориентированном на звук. Краткий сигнал может возникнуть и завершиться, пока система выполняет фрагмент с разомкнутым контуром. Если следующее решение получает только конечное окно недавних выборок, сигнал может больше не появляться во входных данных политики.
Чтобы сделать это конкретным, рассмотрим индексы аудиопримеров, используемые для формирования следующего наблюдения. Пусть критическое событие занимает непрерывный интервал выборок в потоке микрофона, где — это индекс начальной выборки, а — длительность в выборках. В момент принятия решения политика формирует свое аудиовходное представление из последних доступных выборок в отложенное время . Это окно охватывает интервал индексов .
Если событие заканчивается до того, как начинается это окно, то ни один из образцов события не появляется в следующем входном окне:
| (7) |
Иными словами, акустическое событие строго завершается до начала нового окна наблюдения. В этом случае интерфейс, ограниченный только окном, не дает прямых доказательств того, что событие произошло. Это подчеркивает необходимость поддерживать состояние причинной памяти, сохраняющееся между разрывами решений, чтобы краткие акустические сигналы, возникающие во время , оставались доступными на следующем этапе принятия решения.
Конкретно, нам требуется функция причинного обновления состояния и политика фрагментов , такая что:
| (8) | ||||
Это требование отражает необходимость в манипуляциях, ориентированных на звук, при отложенном, блочном выполнении. Временные подсказки, возникающие в промежутке между выполнениями, должны быть суммированы в , чтобы они могли повлиять на следующее решение.
3.3 Временное сопоставление и коллапс движения
Захват преходящего сигнала является необходимым, но недостаточным. Звук-ориентированные задачи часто включают длительные фазы наблюдения, в которых робот должен сохранять устойчивую позу и ждать, а затем быстро реагировать, как только возникает акустический триггер. В течение таких фаз визуальная сцена может быть квази-статичной и давать слабую информацию о временном развитии. В этих условиях последовательные наблюдения для многих решений могут быть почти неотличимыми, хотя требуемое поведенческое управление со временем меняется.
Это создает временное наложение (aliasing), что характерно для частично наблюдаемых условий (Heess et al., 2015). Возможно, существуют два индекса решений такие, что доступные наблюдения сходны, в то время как фрагменты действий эксперта различаются:
| (9) |
В интуитивном смысле робот переживает «дилемму ожидания»: он видит одну и ту же статичную сцену кадр за кадром, из-за чего сложно сохранять устойчивую позу без внутреннего ощущения течения времени. На практике это несоответствие может приводить к нестабильному поведению ожидания при по частям выполняемом управлении, включая дрейф или зависание. Это тесно связано с феноменом Temporal Motion Collapse, о котором сообщалось для долгогоризонтных по частям выполняемых политик (Zhao et al., 2023)⟧.
Практичный способ смягчить эту проблему — поощрить то, чтобы представление политики кодировало ход времени даже тогда, когда изменения в изображении невелики. Аудио хорошо подходит для этой роли, потому что оно развивается непрерывно и часто отражает текущие физические процессы. В нашей постановке это побуждает к вспомогательным предиктивным целям, которые используют аудио ближнего будущего в качестве разметки, чтобы латентное представление училось предвосхищать то, как будет изменяться звуковая сцена. Это обеспечивает временную привязку без введения дополнительных критериев оценивания и согласуется с ограничениями потокового, причинного развертывания (Jaderberg et al., 2017; Arandjelovic and Zisserman, 2017).
3.4 Цель обучения и причинная оценка
3.4.1 Пороговые критерии своевременного успеха
Звукоцентрическая манипуляция чувствительна ко времени. Достижение геометрической цели до соответствующего акустического сигнала следует считать неудачей, даже если конечное состояние выглядит визуально корректным.
Пусть будет предикатом, зависящим от задачи, который становится истинным, когда выполняется условие подсказки, например когда начинается звуковой сигнал. Определим . Пусть обозначает состояние среды, используемое для оценки завершения задачи, например привилегированное симуляторное состояние в настройках для бенчмарков. Пусть обозначает максимальную дискретную длину эпизода. Определим при соглашении . Мы оцениваем траекторию с помощью индикатора успешности, чувствительного ко времени
| (10) |
Это правило обеспечивает корректную причинность при оценке, отклоняя ранние действия, которые достигают цели до поступления сигнала, и рассматривая траектории без события сигнала как неудачу.
3.4.2 Цель обучения
Мы применяем обучение с имитацией по демонстрациям экспертов. В каждый момент принятия решения эксперт выполняет фрагмент действия длиной ,
| (11) |
и обучающийся прогнозирует фрагмент , обусловленный доступным наблюдением и причинной памятью .
На уровне формулировки мы рассматриваем обучаемого как модель условных действий-чанков, обученную сопоставлять поведение эксперта в рамках интерфейса VSLA и его причинных ограничений. Конкретная реализация может представлять собой детерминированный регрессор или условную генеративную модель, и она может включать вспомогательные целевые функции для поощрения причинной устойчивости и временной привязки. Конкретные функции потерь обучения, используемые в нашем подходе, описаны в Разделе 4.
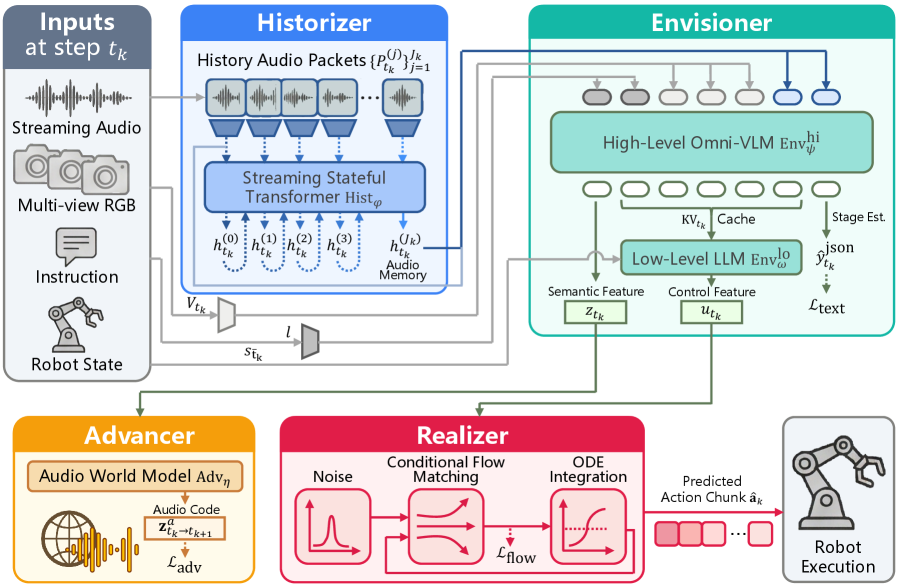
4 Фреймворк HEAR
Парадигма VSLA задает теоретические ограничения для управления, ориентированного на звук, однако ее реализация на физическом оборудовании требует определенной архитектуры. Мы представляем HEAR — сквозную (end-to-end) структуру, которая реализует парадигму VSLA в условиях задержанных, слабоинтенсивных и асинхронных циклов принятия решений. Как формализовано в разделе 3, манипулирование, ориентированное на звук, подчеркивает две трудности, связанные со временем. Во-первых, кратковременные акустические подсказки могут возникать в пределах эффективного промежутка восприятие-действие и могут исчезнуть из фиксированного аудиоокна до следующего решения, не оставляя никаких свидетельств в интерфейсе, ограниченном только окном (Eq.(7)). Эта проблема особенно заметна при разбиении действий на фрагменты в режиме open-loop, где Blind Execution Interval подавляет обновления восприятия во время выполнения. Во-вторых, многие задачи, ориентированные на звук, включают длительные фазы мониторинга с квазистационарным зрением. На таких фазах снимковые наблюдения могут быть почти неотличимы между решениями (Eq.(9)), и фрагментированное управление может стать неустойчивым на протяженных горизонтах, согласующихся с Temporal Motion Collapse (Zhao et al., 2023).
HEAR следует простой системной модели, чтобы устранить эти узкие места. Поскольку крупные базовые модели нельзя запрашивать с частотами сенсоров в реальных роботах, мы отделяем высокочастотное аудиосенсорное восприятие от низкочастотного рассуждения и генерации действий. Поддерживается легковесный аудиобуфер, чтобы непрерывно записывать кратковременные акустические события между запросами к политике. Основная политика затем работает на более медленной частоте управления, формируя свои решения в зависимости от содержимого этого буфера. Кроме того, мы вводим сигнал предиктивного обучения на динамику аудио в ближайшем будущем, который побуждает разделяемое представление кодировать течение времени даже тогда, когда изменения в видении невелики.
HEAR включает четыре модуля в следующем порядке. Historizer поддерживает причинную аудиопамять, которая связывает разрывы выполнения (раздел 4.2). Envisioner объединяет многомодальные входные данные в компактные представления для управления (раздел 4.3). Advancer предсказывает аудиокоды ближайшего будущего по скрытому представлению Envisioner, чтобы обеспечить временную привязку во время обучения (раздел 4.4). Затем Realizer генерирует плавные фрагменты действий для непрерывного управления (раздел 4.5). Рисунок 2 иллюстрирует общий поток данных.
4.1 Архитектурный обзор
Мы следуем наблюдательному интерфейсу VSLA в уравнении (4). На момент принятия решения самые свежие данные датчиков соответствуют задержанному индексу (уравнение (2)), а наблюдение на каждое решение равно . Аудиоокно содержит только самые последние секунд доступной формы сигнала по (уравнение (3)). Когда сигнал краткий и следующее решение задержано, сигнал может выйти за пределы этого окна и стать недоступным при следующем запросе (уравнение (7)).
HEAR усиливает этот интерфейс устойчивой аудиопамятью , вычисляемой по потоковому аудио, поступающему между отложенными границами и . Historizer обновляет эту память независимо от частоты запросов политики. Затем Envisioner сопоставляет наблюдение вместе с в семантическое скрытое представление и низкоразмерное управляющее встраивание . В ходе обучения Advancer предсказывает коды аудио на ближайшее будущее из , что побуждает общее представление отражать временное развитие при квазистатическом зрении. Наконец, Realizer генерирует фрагмент действия на шагов из , который выполняется в разомкнутом контуре.
Мы суммируем вычисления во время принятия решения как:
| (12) | ||||
Здесь обозначает обновление потокового аудио, обозначает кодировщик Envisioner, обозначает параметр сети Advancer, задаваемый , а обозначает генератор чанков действий. Предсказанный чанк выполняется в разомкнутом цикле для циклов управления (раздел 3.2.3). Ветвь Advancer предоставляет сигнал предиктивного обучения, который формирует скрытое представление . При развертывании HEAR не нужно явно генерировать будущие коды аудио , однако временная структура, навязанная этой целевой функцией, остается в скрытом представлении и приносит пользу управлению.
4.2 ИстоРИзатор
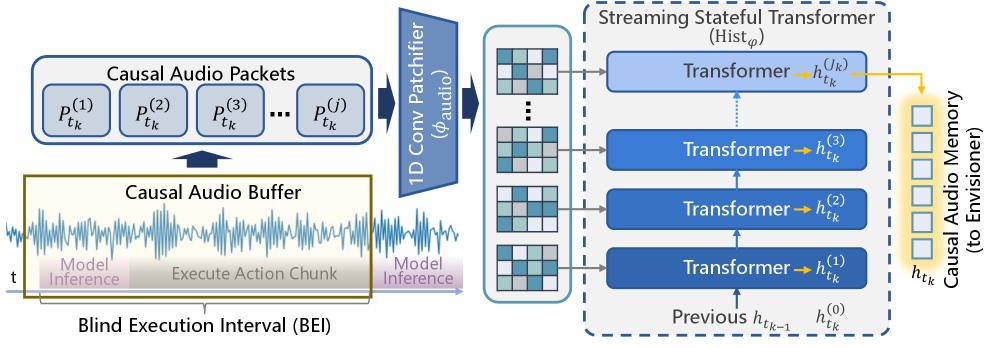
Как показано на рисунке 3, Historizer обеспечивает причинную устойчивость для кратковременных акустических признаков. При манипулировании, ориентированном на звук, может возникать краткое событие в то время, когда робот выполняет фрагмент действия в разомкнутом контуре, однако оно может не появиться в следующем фиксированном окне аудио . Чтобы сохранить такие свидетельства доступными для следующего решения, Historizer поддерживает компактное состояние памяти, которое обновляется из потокового аудио независимо от частоты запросов политики.
4.2.1 Потоковое состояние-ориентированное суммирование
Мы отличаем фиксированное окно на решение (уравнение (3)) от потоковых пакетов, используемых Historizer. Во время принятия решения из-за сквозной задержки по времени самое свежее доступное системе аудио соответствует запоздалой границе (уравнение (2)). Поэтому мы обновляем память, используя вновь поступившие выборки между последовательными запоздалыми границами . Мы разбиваем этот поток на коротких причинных пакетов , упорядоченных от старых к новым, где каждый пакет содержит выборок. На практике эти пакеты можно накапливать в небольшом кольцевом буфере и обрабатывать онлайн по мере их поступления, при этом мы просто считываем текущую память во времена принятия решения.
Мы реализуем Historizer как потоковый состоянийный трансформер, который переносит компактную память между пакетами. Лёгкий каузальный аудио-фронтенд отображает каждый пакет в признаки токенов, используя небольшой каузальный 1D сверточный пачи-фикатор. Обновление памяти —
| (13) | ||||
где обозначает основной блок transformers, параметризованный , а является окончательной причинной аудиопамятью, предоставляемой Envisioner во время принятия решения . В начале эпизода () начальная память задается как нулевой вектор. Этот потоковый процесс реализует общую функцию обновления , определенную в Уравнении (12). Это обновление причинно, потому что оно зависит только от аудио, которое поступило к .
4.2.2 Преодоление разрывов в выполнении
Поскольку охватывает аудио, которое поступает между границами задержанных решений, кратковременные сигналы, возникающие во время выполнения в режиме разомкнутого контура, все еще могут быть включены в . Это снижает вероятность исчезновения свидетельств (Eq. (7)), гарантируя, что следующее решение может опираться на сохраняющееся обобщение того, что происходило акустически, начиная с предыдущего запроса.
Практическое требование заключается в том, что у Historizer должен быть достаточный эффективный горизонт охвата , чтобы важные свидетельства оставались представимыми в вплоть до следующего решения, в котором они необходимы. Полезная целевая настройка дизайна заключается в том, что
| (14) |
так, чтобы преходящий сигнал, возникающий в пределах эффективного разрыва «восприятие-действие», мог все же повлиять на следующее решение.
Наконец, поддержание состояния памяти позволяет нам сохранять фиксированное окно входных данных относительно небольшим. По нашему опыту, опора только на очень длинное окно может смешивать различные фазы взаимодействия и делать производительность более чувствительной к точной длине окна. Комбинируя короткое причинное окно с устойчивым обобщением , HEAR может сохранять релевантную историю, оставаясь согласованной с потоковой передачей и отложенным развертыванием.
4.3 Воображатель
Как показано на Рисунке 4, Обозреватель служит ядром восприятия и рассуждений HEAR. Он использует грубо-к-точную иерархическую архитектуру, реализуя энкодер в Уравнении (12). На каждом моменте принятия решения он объединяет наблюдение VSLA с памятью Historizer . Его конструкция разделяет медленные рассуждения на основе многомодальных данных от быстого декодирования управления. В частности, модуль верхнего уровня, охватывающий все модальности, Qwen3-Omni (Xu et al., 2025) обобщает многомодальный контекст и формирует три выхода: (i) семантическое скрытое представление для обучения во времени в Advancer, (ii) кэш ключ–значение для эффективного повторного использования легковесным модулем нижнего уровня Qwen3-0.6B (Yang et al., 2025) и (iii) структурированное описание этапа , генерируемое текстовой головой модели верхнего уровня. Затем модуль нижнего уровня, обусловливаясь вместе с текущим состоянием робота, формирует низкоразмерный признак управления для Realizer.
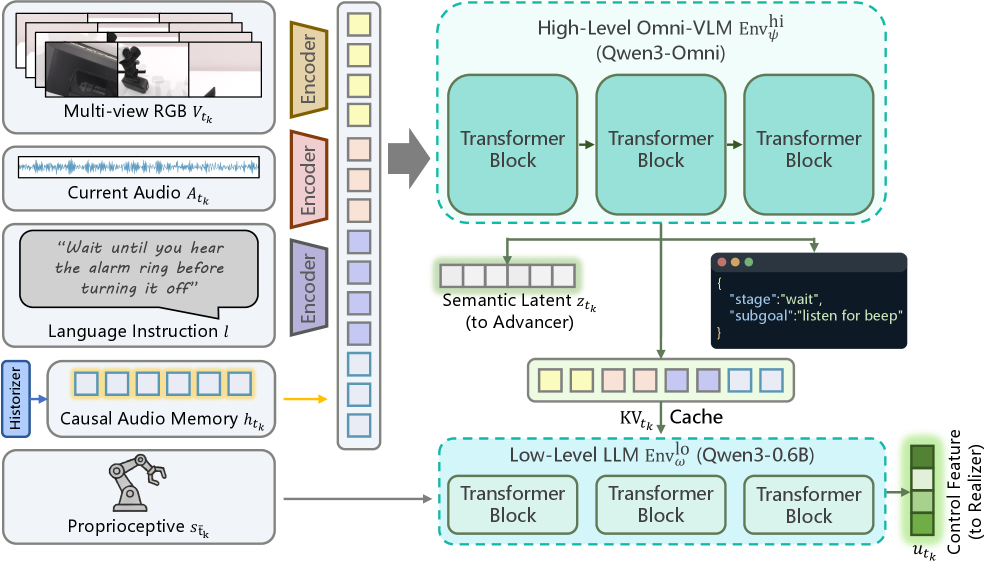
4.3.1 Высокоуровневая Omni-LLM
Мы обозначаем модуль верхнего уровня как . Его входные данные следуют интерфейсу VSLA:
- • Многовидовые RGB-изображения .
- • языковая инструкция .
- ⟦• Собственное проприоцептивное состояние .
- ⟦• Текущие аудиоокно (уравн. (3)).
- ⟦К0⟧ каузальная аудиопамять из Historizer.
Модуль формирует семантическое скрытое представление и кэш KV для повторного использования:
| (15) |
Кроме того, используя заложенную в нем возможность генерации текста, он одновременно выводит структурированную запись этапа .
4.3.2 Декомпозиция этапов
Звук-центричные задачи часто содержат визуально похожие фазы с разным намерением, например замирать, чтобы вести наблюдение, или действовать после сигнала-триггера. Чтобы сделать этот прогресс явным, верхнеуровневый модуль генерирует короткое структурированное описание стадии , например {"stage":"wait","subgoal":"listen for beep"}. Мы обучаем этот вывод, минимизируя посимвольную отрицательную логарифмическую правдоподобность по строке JSON. Мы обозначаем эту вспомогательную цель как . Эта функция потерь побуждает семантическое скрытое представление отслеживать прогресс и разделять фазы, которые могут быть визуально квази-статичными, но акустически различимыми.
4.3.3 Низкоуровневая LLM
Низкоуровневый модуль формирует вектор управляющих признаков , повторно используя кэшированный контекст вместе с состоянием робота:
| (16) |
Этот дизайн повторно использует контекст многомодальных данных высокого уровня, сохраняя при этом путь управления легковесным. Получившийся служит сигналом обусловливания для Realizer, который генерирует фрагмент действия, выполняемый после момента времени .
4.4 Advancer
Захват преходящего сигнала необходим, но длительное мониторирование также требует устойчивого представления о времени. Когда зрение квази-статично, политика, которая видит только снимковые наблюдения, может получать почти одинаковые входные данные при многих решениях, даже если требуемое поведение меняется с течением времени (Eq. (9)). Advancer решает эту задачу, обучаясь динамике аудио через предсказание на ближайшее будущее, как показано на рисунке 5. Такое предиктивное обучение побуждает общий скрытый отражать временное развитие, что может повысить стабильность во время продолжительных фаз прослушивания и усилить реактивность, как только появляется сигнал.
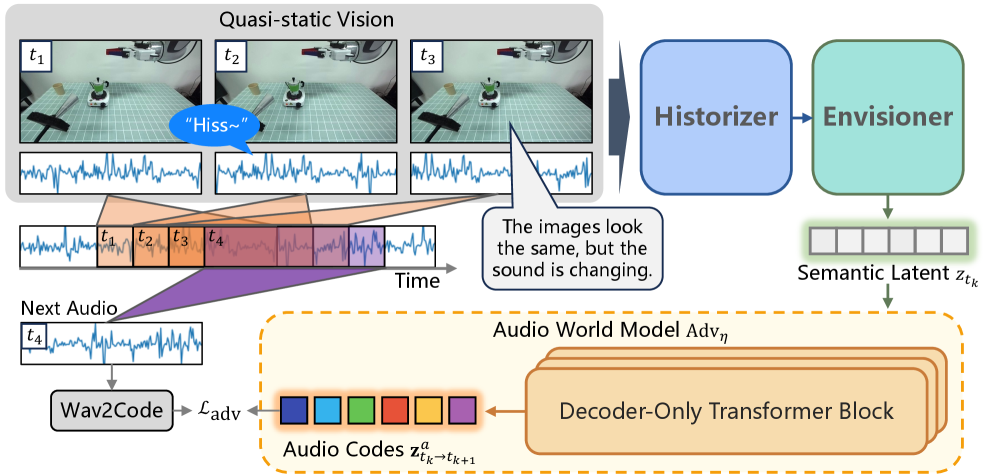
4.4.1 Ближнесрочные аудиокоды
Вместо прогнозирования исходных звуковых волн мы прогнозируем дискретные аудиокоды, полученные с помощью нейронного аудиокодировщика. Пусть отображает сегмент звуковой волны в последовательность дискретных индексов кодов. Мы используем причинный потоковый токенизатор, так что коды для сегмента зависят только от отсчетов внутри этого сегмента, что соответствует ограничениям развертывания в режиме потоковой передачи (Défossez et al., 2024).
Мы определяем целевую переменную предсказания как последовательность кода для аудио, которое поступает после задержанной границы и до следующей задержанной границы ⟧:
| (17) |
Это определение явно указывает, что целевая величина соответствует временному интервалу, а не одному моменту времени. Обратите внимание, что хотя мы для простоты обозначаем цель индексом интервала решения , фактический интервал предсказания строго согласован с отложенными границами и , чтобы соблюсти причинность. Поскольку Tok является причинным, коды для этого интервала зависят только от выборок внутри интервала, что согласуется с ограничениями потоковой обработки.
4.4.2 Латентное прогнозирование
Адвансер, обозначаемый как , реализован как декодер-только предиктор, параметризованный , который принимает в качестве входных данных и выдает распределение по будущей последовательности кода:
| (18) |
Мы обучаем его с помощью перекрёстной энтропии по индексам кодовой книги:
| (19) |
где обозначает обучающий набор данных. При развертывании HEAR не требуется явно генерировать . Роль Advancer заключается в том, чтобы внедрить конкретный временной сигнал обучения в общее скрытое пространство, чтобы лучше отслеживала состояния процесса, изменяющиеся во времени, когда изменения в визуальных данных невелики.
4.5 Реализатор
Реализатор отображает низкоуровневую управляющую характеристику в -шаговый фрагмент действия для совместного положения . Затем робот выполняет этот фрагмент в разомкнутом контуре в течение циклов управления, как описано в разделе 3.2.3. Мы моделируем Реализатор как условный генератор,
| (20) |
При манипулировании, ориентированном на звук, плавные фрагменты полезны для повышения точности отслеживания, а также они могут сделать слушание более надежным. Внезапное движение может вносить механический «эго-шум» и кратковременную вибрацию, которые маскируют слабые акустические сигналы, особенно в фазах мониторинга (Liu et al., 2024b)⟧.
Мы реализуем с помощью условного сопоставления потоков (CFM) (Lipman et al., 2023; Liu et al., 2023). CFM обучает непрерывное векторное поле, которое переносит выборки от простого гауссова априорного распределения к распределению фрагментов действия вдоль прямолинейного пути. Такая структура удобна для реальных роботов, потому что она позволяет генерировать фрагменты с небольшим фиксированным числом шагов интегрирования. По сравнению с генераторами действий в стиле диффузии (Chi et al., 2025), это может снизить вычислительные издержки при выводе в циклах принятия решений с низкой частотой.
4.5.1 Кондиционирование
Мы задаем сети потока условие , используя адаптивную нормализацию. В частности, небольшая MLP отображает в параметры масштаба и сдвига для каждого блока, и эти параметры модулируют нормализованные активации (Perez et al., 2018). Это обеспечивает легкий способ адаптировать распределение сгенерированных действий к выведенному контексту задачи (Lipman et al., 2023).
4.5.2 Регрессия по векторному полю
Пусть — экспертный фрагмент действий длины во время принятия решения (уравнение (11)). Мы сворачиваем этот фрагмент в вектор и выборочно добавляем гауссов шум . Для времени потока мы определяем линейный путь переноса ⟧.
Реализатор изучает условное векторное поле и регрессирует его к целевому направлению ⟧:
| (21) |
где производится низкоуровневым Envisioner из (уравнение (16)).
4.5.3 Вывод с помощью интегрирования по Эйлеру
На этапе тестирования мы отбираем и численно интегрируем ОДУ, заданное обученным векторным полем:
| (22) |
с до . Чтобы удовлетворить ограничениям реального времени, мы используем интегрирование Эйлера с фиксированным числом шагов. Решение на дает , которое мы преобразуем в предсказанный фрагмент действия и выполняем в разомкнутом контуре для циклов.
4.6 Цели обучения
Мы обучаем HEAR с помощью имитационного обучения на фрагментах действий эксперта. Каждый обучающий пример содержит наблюдение на каждое решение (Eq. (4)), фрагмент действия эксперта (Eq. (11)) и метку этапа . Мы обозначаем набор данных извлеченных обучающих примеров как , который явно включает непрерывные аудиофрагменты, необходимые для обновления памяти Historizer и целевой сигнал Advancer.
Общая цель представляет собой взвешенную сумму:
| (23) |
где обучает Реализатор для генерации фрагментов действий (уравнение (21)), обучает Адвансер для прогнозирования аудиокода на ближайшее будущее (уравнение (19)), а осуществляет надзор за структурированным описанием этапа, генерируемым высокоуровневым Энвиженером (раздел 4.3.2).
На практике мы постепенно увеличиваем и в ходе раннего обучения. Это позволяет модели сначала освоить базовое подражание действиям, а затем уделять больше внимания временной привязке и отслеживанию прогресса.
5 Данные и набор для оценки
Хотя крупномасштабные наборы данных VLA и бенчмарки способствовали значительному прогрессу в обучении роботов, по своей сути они недостаточны для исследований в области VSLA. Они редко обеспечивают синхронизированные аудиопотоки для обучения и не накладывают требования, учитывающие временные параметры, а также звуко-причинно-ориентированные правила для оценки. Чтобы преодолеть эти практические ограничения, мы представляем два поддерживающих ресурса. Первый — OpenX-Sound, аудио-дополненный набор данных, полученный из Open X-Embodiment, чтобы поддерживать масштабируемое предварительное обучение с потоковым аудио. Второй — HEAR-Bench, симуляционный бенчмарк, ориентированный на звук, который стандартизирует донастройку и оценку при строгих критериях успеха, согласованных со звуком и причинностью (как определено в разделе 3.4.1). Вместе эти инструменты формируют необходимую основу для обучения и оценки политик, которым нужно слушать, ждать и реагировать в реальном времени.
5.1 OpenX-Sound: Звукодополненное Open X-воплощение
Набор данных исходного Open X-Embodiment (OpenX) (O’Neill et al., 2024) обеспечивает исключительное покрытие задач и разнообразие воплощений, однако полностью лишен записей микрофона. Поскольку сбор синхронизированного, высококачественного аудио в таком масштабе логистически неприемлем и трудно стандартизировать в разных лабораториях, мы создаем OpenX-Sound ретроспективно. Мы выбираем подмножество эпизодов OpenX, подходящих для манипуляций, ориентированных на звук, и дополняем каждую траекторию временно согласованной формой волны. Эти волны синтезируются непосредственно из исходных видеотреков с использованием современных моделей генерации видео в аудио (Luo et al., 2023; Liu et al., 2024a). Мы подчеркиваем, что OpenX-Sound предназначен исключительно для масштабируемого предварительного обучения, позволяя модели запустить обучение представлений для потокового аудио и многомодальную привязку до дообучения на реальных физических данных.
Масштабирование и разнообразие.
Для каждого выбранного эпизода OpenX мы сохраняем все исходные сигналы, включая многовидовое RGB, языковые инструкции, проприоцепцию и действия эксперта, одновременно прикрепляя вновь синтезированную аудиодорожку. Как суммировано в Таблице 1, OpenX-Sound наследует широкое разнообразие исходного материала. Модели взаимодействия также столь же разнообразны, включая простые действия по захвату и размещению, сложное использование инструментов, манипулирование артикулируемым объектом.
| Statistic | Value |
|---|---|
| Episodes | 120k |
| Skills | 100 |
| Robot mass range | 7–120 kg |
| Modalities | RGB, language, qpos, actions, audio |
| Audio format | waveform, =16 kHz |
Синтез аудио и согласование.
В ходе построения набора данных современные модели видео-в-аудио создают акустические треки, которые звучат правдоподобно на слух и включают как фоновый окружающий шум, так и явные звуки взаимодействия (например, гул машины, ударные щелчки). Это обеспечивает богатый источник акустического разнообразия. Во время обучения OpenX-Sound строго придерживается интерфейса потоковой передачи, заданного в нашей формализации. В любой момент принятия решения политика получает каузальное аудио-окно (Eq. (3)). Это гарантирует, что фаза предварительного обучения сохраняет структурную согласованность с отложенным, оконным развертыванием на физическом оборудовании.
Проверка набора данных.
Поскольку последующие задачи VSLA крайне чувствительны к времени, мы провели ручной аудит, чтобы проверить, что сгенерированное аудио как синхронизировано по времени с видео, так и семантически соответствует физическим манипуляциям. Мы случайным образом отобрали 500 эпизодов и назначили двум аннотаторам каждый. Аудит показал точность синхронизации 98,7% в пределах допуска 100 мс. Эти результаты указывают на то, что OpenX-Sound обеспечивает надежную временную и семантическую привязку для целей предварительного обучения.
Учитывая разрыв предметной области между синтезированной и физической акустикой (например, неучтённые импульсные отклики помещения, вариативные размещения микрофонов, механический эго-шум), OpenX-Sound используется строго для предварительного обучения. Если не указано иное, все симуляции и оценки на реальных роботах в Разделе 6 дообучают контрольную точку OpenX-Sound на задачно-ориентированных демонстрациях реального аудио.
5.2 HEAR-Bench: Звукоцентричный симуляционный бенчмарк
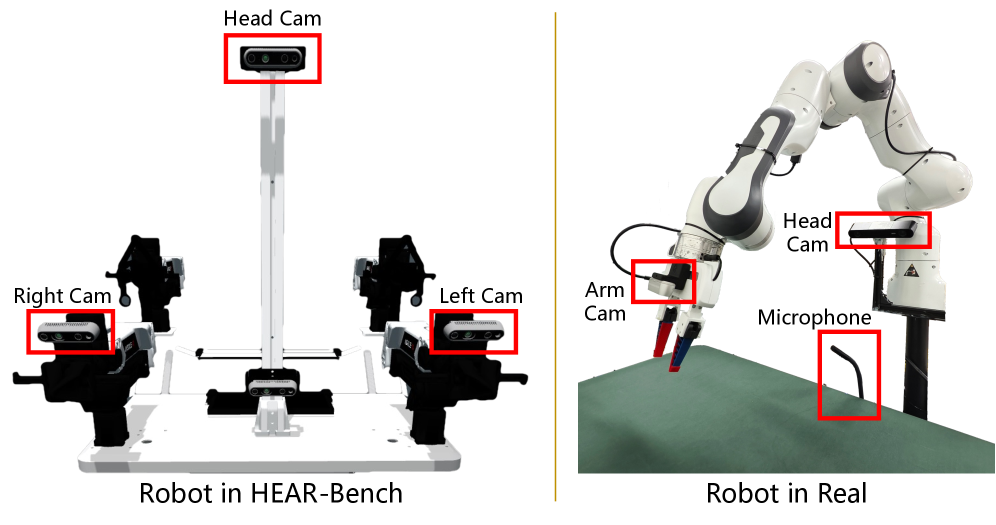
Хотя большие наборы данных облегчают обучение представлениям, стандартные манипуляционные тесты (например, RLBench (James et al., 2020), ManiSkill (Gu et al., 2023)) обычно работают в беззвучных средах и не могут оценивать слуховую реактивность. Чтобы решить эту проблему, мы вводим HEAR-Bench — тестовый набор для манипуляций с поддержкой звука, построенный на платформе RoboTwin2 (Chen et al., 2025) (показано на Рисунке 6(a)). HEAR-Bench включает канал потокового микрофона и задаёт строгие правила успеха, зависящие от причинно-следственных связей со звуком.
Акустическая платформа и аудиоконвейер. Чтобы симулятор был слышимым и поддерживал онлайн-запись, мы реализовали выделенный аудиопоток, который работает асинхронно параллельно с физическим движком. По умолчанию этот поток воспроизводит фоновый шум окружающей среды. Когда выполняются заданные задачей условия срабатывания, такие как рандомизированная тревога или событие физического контакта, симулятор внедряет соответствующий аудиофрагмент в фоновый поток, чтобы смоделировать воспроизведение внутри среды. На каждом цикле управления среда считывает последние доступные образцы из этого потока, чтобы сформировать каузальное окно . Мы согласуем момент начала внедряемого фрагмента с аудиопотоком в точном индексе образца, вычисленном в Eq. 1, гарантируя, что синхронизация между шагами физики и буфером волновой формы остается детерминированной.
Таксономия манипулятивных звуков.
Для систематической оценки слуховой осведомлённости мы организуем критически важные для принятия решений акустические сигналы в HEAR-Bench по четырём основным категориям, выведенным из повседневного человеческого опыта: человеческая речь, сигналы тревоги, запускаемые событиями, непрерывные звуки процессов и обратная связь от физических взаимодействий. Мы реализуем эти категории в рамках семи различных задач, как подробно указано в Таблице 2.
| Task | Primary cue |
|---|---|
| Event-triggered alarms | |
| Alarm Clock | alarm ringing |
| Microwave | completion beep |
| Human speech | |
| Check Yes | prosody-driven speech |
| Interrupt | spoken interruption |
| Continuous process sounds | |
| Pour Water | pouring sound evolution |
| Boil Water | boiling sound evolution |
| Physical interaction feedback | |
| Check Materials | contact acoustics |
- ⟦• Будильник и микроволновая печь требуют реагировать на срабатывающие по событиям сигналы тревоги. Эти задачи проверяют, может ли политика ждать, а затем действовать после подсказки.
- ⟦• Проверьте «Да» и «Прервать», чтобы требовалось понимание речи сверх содержимого на уровне расшифровки, включая просодию и тайминг.
- ⟦• Для воды и кипячения воды требуется непрерывный мониторинг процесса, при котором звук развивается, тогда как зрение может быть слабым или квази-статическим.
- ⟦• Проверка материалов требует использования физической обратной связи от взаимодействия, чтобы по визуально неоднозначным условиям определять свойства материалов.
Воплощение и выбор руки.
Поскольку RoboTwin2 является двухруким (Рисунок 6(a)), HEAR-Bench предоставляет управление совместным положением для обеих рук. Для задач с единственной целевой точкой взаимодействия политика также должна определить, какая рука должна действовать. В частности, в задачах «Будильник» и «Прерывание» модель должна выбрать, какая из рук — левая или правая — выполняет нажатие или поведение сброса, при этом сохраняя устойчивость другой руки.
Протокол оценки причинно-следственных связей.
Характерной особенностью HEAR-Bench является оценка, чувствительная ко времени. На всех задачах успех строго определяется формулой (10). Если робот достигает геометрической цели до того, как произойдет соответствующий акустический сигнал, попытка фиксируется как неудача. Мы рандомизируем начальные визуальные состояния и моменты появления сигналов, чтобы помешать политикам запоминать визуальные последовательности или использовать случайные корреляции. Сочетая кратковременные сигналы и длительные фазы ожидания, HEAR-Bench может напрямую проверить, способна ли политика успешно преодолевать разрывы между сенсорным восприятием и выполнением в реальном времени.
6 Эксперименты
Мы оцениваем HEAR в двух различных условиях, чтобы продемонстрировать универсальность парадигмы VSLA для разных архитектур роботов и акустических сред. Первое условие — звуково-ориентированная симуляция на HEAR-Bench (Раздел 5.2) с использованием платформы с двумя манипуляторами RoboTwin2 (Рисунок 6a). Второе — развертывание в реальном мире на одноруком Franka Panda (Рисунок 6b). В обеих средах акустические подсказки критически важны для принятия решений. Важно, что испытание считается успешным только в том случае, если робот выполняет физическую цель строго после выполнения соответствующего звукового условия, соблюдая критерии причинного успеха, определенные в Разделе 3.4.1. Мы сообщаем эту долю успешных испытаний как наш основной показатель оценки.
Наша экспериментальная схема структурирована для ответа на три ключевых исследовательских вопроса. Во‑первых, может ли политика надежно использовать разнообразные акустические признаки — от кратковременных ударных воздействий до непрерывных звуков процесса и тонких характеристик просодии речи — для манипулирования в режиме замкнутого контура? Во‑вторых, может ли система корректно справляться с пропусками признаков при задержанных или низкочастотных циклах принятия решений? Это особенно сложно, когда мимолетные акустические свидетельства выходят за пределы короткого окна наблюдения или возникают во время разрыва выполнения в разомкнутом контуре. Наконец, каким образом отдельные архитектурные компоненты HEAR способствуют снижению вероятности сбоев, ориентированных на конкретные акустические сценарии?
Чтобы строго ответить на эти вопросы, мы специально разработали наши задачи так, чтобы изолировать необходимость акустической информации. В этих сценариях политика, опирающаяся только на зрение, может порождать движения, которые выглядят правильными, но в конечном итоге потерпит неудачу согласно нашим основанным на звуке критериям успеха в уравнении Eq. (10). Мы обеспечиваем такую опору посредством длительных фаз ожидания, визуально неоднозначных состояний и непрерывных процессов, где критическая переменная прогресса кодируется исключительно во временной эволюции звука.
6.1 Экспериментальная установка
6.1.1 Интерфейс наблюдений и пространство действий
Все оцененные методы работают строго в рамках формального интерфейса наблюдения VSLA, заданного в уравнении Eq. 4. На момент принятия решения политика получает многовидовые изображения RGB , причинное аудио окно , инструкцию на естественном языке и проприоцепцию . Аудиовход стабильно предоставляется в виде векторного одномерного необработанного аудиосигнала, дискретизированного с одного микрофона, что обеспечивает однородность внешнего интерфейса даже тогда, когда некоторые базовые методы вычисляют спектрограммы внутри себя. Проприоцепция состоит из состояния положения суставов робота (qpos), включая все управляемые суставы и степени свободы захватного механизма. На каждом шаге инференса политика генерирует фрагмент действия из целевых значений положений суставов . Чтобы обеспечить контролируемое сравнение, мы сохраняем согласованный горизонт фрагмента для всех методов, если явно не указано иное.
Следуя минималистичному дизайну современных сквозных систем (Intelligence et al., 2025), наша управляющая последовательность сильно упрощена. Предсказанные фрагменты действий кодируют целевые положения суставов и захвата, которые разворачиваются и выполняются в разомкнутом цикле с частотой 30 Гц ( Гц). Эти цели напрямую отслеживаются простым низкоуровневым ПД-контроллером, без опоры на дополнительное планирование траектории, решатели обратной кинематики или обнаружение столкновений.
Мы оцениваем две различные конфигурации роботов (Рисунок 6). В симуляции HEAR-Bench мы используем платформу RoboTwin2 с двумя манипуляторами, оснащенную тремя видами камер RGB (голова, слева и справа). Для реальных развертываний мы используем однорукий Franka Panda, оснащенный камерой RGB, установленной на голове, камерой RGB, установленной на манипуляторе, и стандартным микрофоном рабочего пространства.
6.1.2 Протокол обучения и детали реализации
Все политики обучаются с помощью офлайн-имитационного обучения по двухстадийной схеме: сначала проводится предварительное обучение на наборе данных OpenX-Sound (Раздел 5.1), чтобы сформировать базовые многосенсорные представления, затем выполняется специализированная точная настройка под конкретные задачи либо на HEAR-Bench, либо на демонстрациях реального робота. Мы оцениваем каждую задачу в 100 независимых испытаниях, рандомизируя начальные визуальные сцены и моменты подачи подсказок, чтобы не допустить заучивания политиками фиксированных временных графиков.
Историзатор использует потоковый Состоящий преобразователь (Transformer) с сохранением состояния, который обрабатывает аудио-пакеты последовательно ( отсчетов, или 40 мс на пакет), поддерживая компактную память из 16 токенов с помощью 4 слоев transformer (скрытая ширина 256, 4 головы внимания). Энвизионер использует иерархический LLM: Qwen3-Omni в качестве высокоуровневого мультимодального каркаса и Qwen3-0.6B в качестве низкоуровневого управляющего каркаса. Адвансер — легковесный декодер-только transformer (4 слоя, ширина 512, 8 голов), который предсказывает коды следующего шага аудио Mimi из семантического латентного представления . Наконец, реалайзер генерирует фрагменты действий qpos с помощью action-головы, согласованной с потоком, с шагами интегрирования Euler .
Ключевые обучающие гиперпараметры стандартизируются следующим образом:
- ⟦Обработка аудио: частота дискретизации кГц; длина причинного окна с (64,000 образцов). Для повышения устойчивости к шуму окружающей среды и механическому эго-шуму мы дополняем обучающие аудиоданные аддитивным шумом (SNR равномерно выбирается в дБ) и случайным усилением ( дБ).
- ⟦Оптимизация: оптимизатор AdamW с коэффициентом обучения 1e-4, затуханием весов 0.05 и косинусным графиком затухания с линейным прогревом на 5%. Градиенты обрезаются по максимальной норме 1.0.
- ⟦• Обучающий горизонт: 200k шагов для предварительного обучения OpenX-Sound, 50k шагов на задачу для дообучения HEAR-Bench и 30k шагов на задачу для дообучения реального робота, с использованием глобального размера пакета 256 последовательностей.
- • Коэффициенты потерь: и , с линейным прогревом в первые 20% от дообучения.
Все модели обучаются и оцениваются на рабочей станции под управлением Ubuntu 22.04, оснащенной двумя графическими ускорителями NVIDIA RTX 5090, с использованием PyTorch с CUDA. Для экспериментов с реальным роботом сквозная задержка эмпирически оценивается по логам, содержащим временные метки сенсорных данных и команд, тогда как в симуляции мы по умолчанию используем , чтобы явно выделить интервалы выполнения, обусловленные разбиением на чанки действий.
6.1.3 Базовые модели
Чтобы систематически оценить эффективность парадигмы VSLA, мы сопоставляем HEAR с широко применяемыми моделями VLA и специализированными аудио-ориентированными политиками. Для строгого сравнения все базовые подходы следуют идентичному двухэтапному протоколу обучения, получают одни и те же визуальные наблюдения и причинно-обусловленные аудио-фрагменты и выдают идентичные блоки действий qpos.
Базовые модели VLA и аудиоподсистемы-приспособители.
Мы выбираем OpenVLA (Kim et al., 2024) и (Intelligence et al., 2025) в качестве представительных опорных VLA-моделей. По умолчанию эти модели являются только зрительными, полагаясь исключительно на , и . Чтобы наделить их слуховыми возможностями, мы реализуем два стандартных адаптера. Вариант -Waveform преобразует причинное 1D-аудиоокно в изображение в виде 2D-линейного графика, рассматривая его как дополнительный вид камеры. Хотя этот подход и передает огибающие амплитуды и внезапные акустические начала, он по своей сути сворачивает временную динамику в статическое пространственное представление и отбрасывает детальные спектральные частоты. Напротив, вариант -ASR обрабатывает аудио через модуль Automatic Speech Recognition, дописывая полученную расшифровку в языковой запрос. Этот подход эффективно извлекает явные вербальные команды, но отбрасывает критически важные внесловесные акустические признаки и просодию.
Компактные аудио-ориентированные политики.
Мы также сравниваем с Play it by Ear (Du et al., 2022) и ManiWAV (Liu et al., 2024b), двумя пионерскими политиками, специально разработанными для аудио-визуальной манипуляции. Эти модели непосредственно принимают на вход необработанный звук и выигрывают от быстрых показателей вывода, что теоретически позволяет использовать более короткие интервалы принятия решений. Однако их относительно компактный масштаб параметров ограничивает их способность к долгосрочному, композиционному рассуждению. Включение этих базовых вариантов позволяет нам показать, что обработка звука в собственном виде необходима, но недостаточна; для надежной звук-центрированной манипуляции также требуется архитектурная возможность поддерживать причинную память и выполнять сложное мультимодальное рассуждение в рамках протяженных горизонтов задач.
6.2 Моделирование на HEAR-Bench
Мы строго оцениваем наш подход в моделировании с использованием HEAR-Bench (раздел 5.2), построенного на платформе RoboTwin2 с двумя манипуляторами (рисунок 6a). HEAR-Bench обеспечивает потоковый сигнал микрофона и строго соблюдает правила успешности, связанные со звуком и причинностью, заданные в уравнении Eq. (10). Основная сложность этого бенчмарка заключается в том, чтобы преодолевать разрывы выполнения, не пропуская кратковременные акустические события, поддерживать стабильное управление во время продолжительных, визуально квази-статичных фаз ожидания и понимать звуки физического контакта.
6.2.1 Комплект задач и обоснование проектных решений
Мы систематически разрабатываем семь задач в HEAR-Bench, чтобы охватить взаимодополняющую таксономию задач, связанных со звуком (Таблица 2). Рисунки 7–13 предоставляют репрезентативные качественные ключевые кадры по результатам выполнения в HEAR в симуляции.
- ⟦• Удерживаемый триггер, Будильник. Тесты бесконечного ожидания и подавления визуально правдоподобных ранних действий до тех пор, пока не будет выполнено слуховое предусловие.
- • Импульсный триггер, СВЧ. Тесты, фиксирующие событие, длящееся крайне недолго и способное возникнуть внутри интервала выполнения (особенно «Промежутка слепого выполнения» при разомкнутом цикле разбиения на блоки), затем срабатывание после исчезновения сигнала-подсказки.
- ⟦Просодика, Проверь Да. Использует идентичный текст, но с другой интонацией, чтобы заставить рассуждение выходить за пределы выводов ASR.
- ⟦• Контакт и материалы, проверьте материалы. Использует визуально похожие объекты, так что тембр времени отклика служит недорогим приближением для распознавания физических свойств.
- ⟦Непрерывный мониторинг, Налейте воду и поставьте воду на кипячение. Требует отслеживания постепенной акустической эволюции на больших горизонтах, когда зрение слабое или статичное.
- ⟦• Случайное переопределение, прерывание. Размещает произнесённое прерывание в случайные моменты, чтобы препятствовать игнорированию аудио и проверить переключение в безопасный режим во время движения.
| Method | VLA | Alarm Clock | Check Yes | Check Materials | Pour Water | Boil Water | Microwave | Interrupt | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| OpenVLA (Kim et al., 2024) | Y | 0.00 | 0.33 | 0.31 | 0.00 | 0.00 | 0.00 | 0.03 | 0.10 |
| OpenVLA-Waveform (Kim et al., 2024) | Y | 0.71 | 0.60 | 0.63 | 0.26 | 0.37 | 0.45 | 0.69 | 0.53 |
| OpenVLA-ASR (Kim et al., 2024) | Y | 0.16 | 0.59 | 0.10 | 0.06 | 0.03 | 0.41 | 0.65 | 0.29 |
| (Intelligence et al., 2025) | Y | 0.00 | 0.48 | 0.43 | 0.00 | 0.00 | 0.00 | 0.09 | 0.14 |
| -Waveform (Intelligence et al., 2025) | Y | 0.80 | 0.73 | 0.71 | 0.31 | 0.43 | 0.52 | 0.75 | 0.61 |
| -ASR (Intelligence et al., 2025) | Y | 0.21 | 0.70 | 0.15 | 0.09 | 0.04 | 0.52 | 0.74 | 0.35 |
| Play it by Ear (Du et al., 2022) | N | 0.45 | 0.38 | 0.39 | 0.15 | 0.10 | 0.12 | 0.38 | 0.28 |
| ManiWAV (Liu et al., 2024b) | N | 0.40 | 0.31 | 0.41 | 0.12 | 0.17 | 0.08 | 0.32 | 0.26 |
| HEAR | Y | 0.91 | 0.89 | 0.83 | 0.51 | 0.81 | 0.85 | 0.88 | 0.81 |
6.2.2 Основные результаты
Таблица 3 сообщает о показателях успешности по 100 испытаниям на задачу. HEAR обеспечивает наивысшую общую производительность, демонстрируя средний показатель успешности 81%. Среди базовых моделей VLA представление волновой формы в виде изображения дает умеренное улучшение для задач с отчетливыми всплесками объема, тогда как адаптер ASR в первую очередь приносит пользу задачам с явными речевыми командами.
Заметно, что компактные аудио-ориентированные политики, Play it by Ear и ManiWAV, превосходят визуальные только «спинные мозги», но в целом уступают адаптированным моделям VLA и HEAR. Поскольку эти легковесные модели работают с более высокими скоростями инференса, разрыв в качестве не является в первую очередь проблемой времени выполнения; скорее, ограниченная архитектурная емкость делает долгосрочные, многостадийные поведения хрупкими и ограничивает надежную обобщаемость. Как и ожидалось, политики, использующие только зрение, заметно хуже справляются на всем наборе, подтверждая, что одних визуальных эвристик недостаточно для этих задач, управляемых звуковыми сигналами. Кроме того, при идентичном протоколе обучения OpenVLA и его варианты последовательно показывают более низкие результаты, чем и его варианты, подчеркивая, что звук-центричная замкнутая контурная манипуляция остается весьма чувствительной к выбору емкости «спинного мозга» и моделирования действий.
6.2.3 Запуск задач
Будильник.
Для задачи «Будильник» робот расположен перед часами, у которых кнопка остановки остается видимой на протяжении всего эпизода, как показано на рисунке 7. Тревога начинает звонить в случайное время. Робот должен сохранять неподвижное положение обеих рук до начала звонка и нажать кнопку только после его начала, предоставляя выбор рук политике. Нажатие до звонка нарушает причинно-следственную связь по звуку и засчитывается как ошибка в соответствии с уравнением Eq. (10).
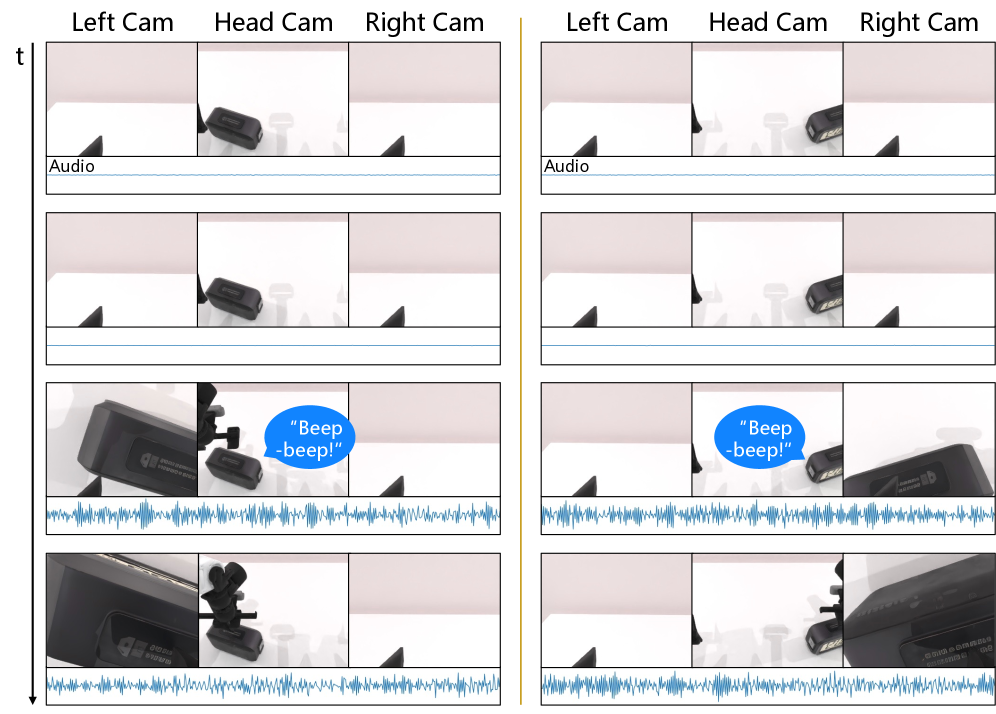
Эта настройка намеренно разработана как заманчивый обходной путь. Политика, основанная только на зрении, всегда может видеть кнопку и может попытаться нажать ее сразу, что будет выглядеть разумно в рамках стандартных метрик достижения целей. Рандомизация времени начала предотвращает эвристики с фиксированной задержкой и подчеркивает асинхронный характер акустических свидетельств. Поскольку момент начала может приходиться на промежуток между циклами вывода и быть пропущенным одноразовым интерфейсом с оконной обработкой аудио, успех требует устойчивости к временному рассогласованию.
Как показано в Таблице 3, HEAR достигает 0,91 частоты успешных действий. Лучшей базовой моделью является -Waveform с 0,80, за ней следует OpenVLA-Waveform с 0,71. Варианты на основе ASR работают плохо, поскольку сигнал не является речевым. Кроме того, как и ожидалось, политики только с визуальным восприятием испытывают трудности при выполнении этих задач, что подтверждает: одних визуальных эвристик недостаточно, когда критические переходы состояния ограничены по акустическому признаку. Когда базовые модели не справляются, преобладающей ошибкой становится слишком раннее нажатие, обусловленное визуальными возможностями. Визуализация Waveform помогает после полного появления звонка, потому что всплеск амплитуды становится визуально очевидным, но она часто переобучается на хрупкие пороговые правила и остается чувствительной к тому, где начало находится внутри отображаемого окна. HEAR избегает этих артефактов, кодируя исходную одномерную последовательность и интегрируя свидетельства о начале в причинную память, позволяя политике устойчиво ожидать и принимать решение только после сигнала.
Микроволновая печь.
Сценарий «Микроволновая печь» требует, чтобы робот стоял на месте до тех пор, пока устройство не издаст краткий звуковой сигнал «динь» в случайный момент времени, как показано на рисунке 8. Правильное поведение состоит в том, чтобы открыть дверь только после того, как произойдет этот кратковременный сигнал.
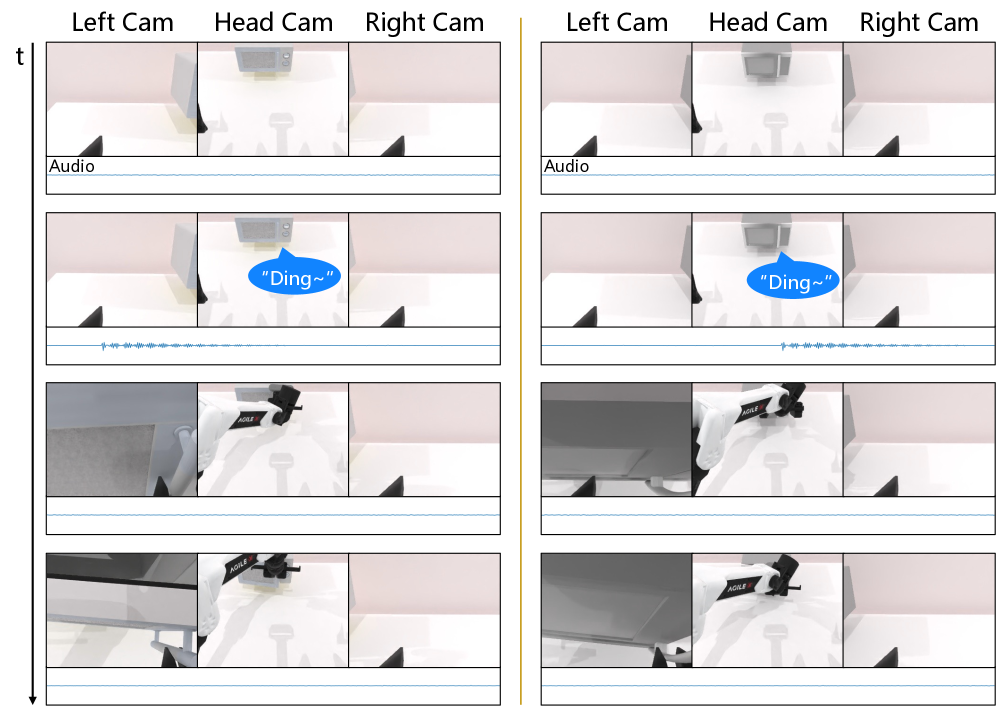
Эта задача разработана так, чтобы напрямую подвергать стрессу выпадение подсказки во время разрывов при выполнении. Акустическая подсказка может быть короче эффективного разрыва восприятие-действие (Eq. (5)) и может возникать, когда стратегия не запрашивается, например внутри интервала слепого выполнения при разбиении на чанки в разомкнутом контуре (раздел 3.2.3). К следующему моменту принятия решения подсказка уже могла исчезнуть из последнего окна , что делает ее недоступной для стратегий без памяти (Eq. (7)).
HEAR поддерживает 0.85 коэффициент успешности. Самые сильные базовые модели — -Waveform и -ASR, обе достигают 0.52. Аудио-ориентированные базовые модели тоже испытывают трудности: Play it by Ear достигает 0.12, а ManiWAV — 0.08. Это указывает на то, что простое принятие аудио в качестве входных данных не автоматически устраняет выпадение подсказок при запаздывающих обновлениях. Визуализация по изображениям Waveform в первую очередь терпит неудачу из-за пропуска кратковременного всплеска амплитуды, когда он попадает между визуальными кадрами, из-за чего робот ждёт бесконечно. HEAR работает хорошо, потому что модуль Historizer сжимает кратковременные свидетельства в устойчивое причинно-следственное состояние памяти (Eq. (8)), позволяя выполнять корректные действия даже после того, как звук прекратился.
6.2.4 Произнесённые команды и просодия
Проверьте Да.
Чтобы оценить понимание просодии, Check Yes подает роботу две одинаковые бутылки и требует определить правильную, как показано на рисунке 9. Эпизод устроен так, что робот сначала поднимает первую бутылку, а затем получает устную обратную связь, которая лексически идентична, но просодически различается. «Yes!» означает подтверждение, то есть робот выбрал правильную бутылку. «Yes?» означает сомнение, то есть ему нужно переключиться на другую бутылку.
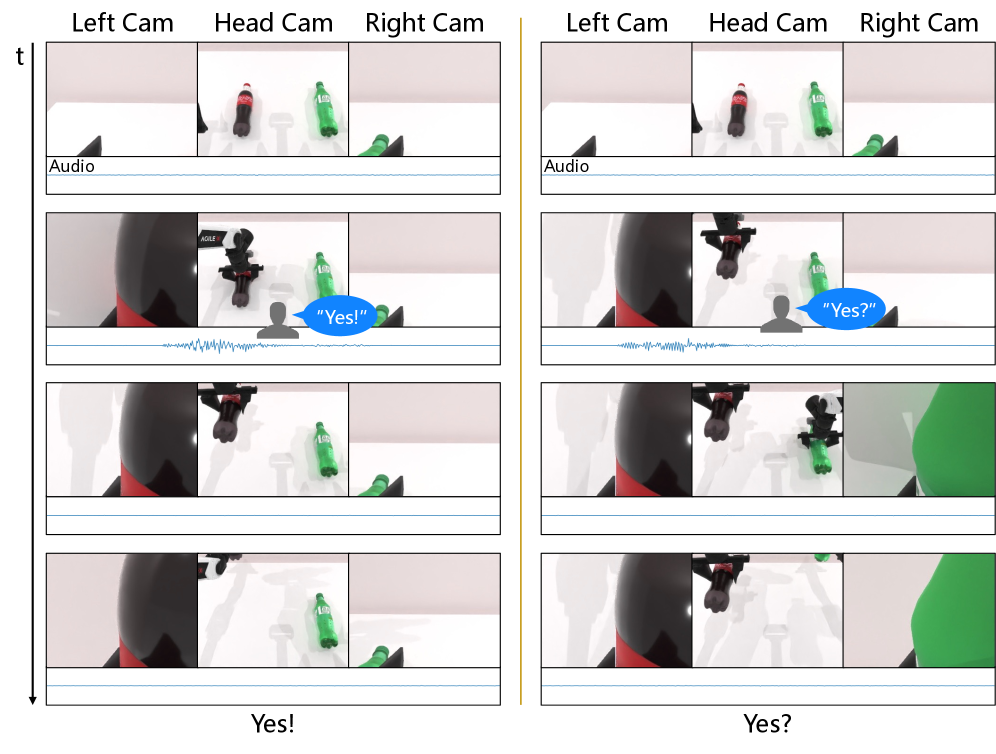
Эта задача требует понимания речи сверх простых расшифровок. Чистый интерфейс ASR-в-текст сводит оба результата к почти одинаковым последовательностям токенов, отбрасывая прагматический замысел. Поэтому надежный успех требует моделирования интонации непосредственно по сигналу с волны — возможности, критически важной для реального взаимодействия человек—робот, где просодия может менять смысл.
HEAR достигает коэффициента успешности 0.89. В то время как ASR извлекает лексическое содержание, он сжимает интонацию в текст, размывая различие между подтверждением и сомнением (-ASR достигает 0.70). Сопоставление «волновой формы с изображением» не срабатывает, потому что вариации высоты тона и просодии в значительной степени невидимы на стандартном графике огибающей амплитуды. HEAR превосходит эти базовые подходы, обучая специализированный одномерный кодировщик волновой формы, который сохраняет просодию, и объединяя эти признаки непосредственно со зрением, языком и проприоцепцией.
Прерывание.
Помимо понимания намерения, роботы должны также динамически реагировать на речь в процессе выполнения. Во время оценки прерывания, как показано на Рисунке 10, робот запускает стандартную манипуляционную процедуру, автономно выбирая, какую руку использовать (Рисунок 10). В случайный момент в середине движения подается произнесенная команда «reset». Правильный ответ — немедленно прервать текущую траекторию и вернуться в исходную позу.
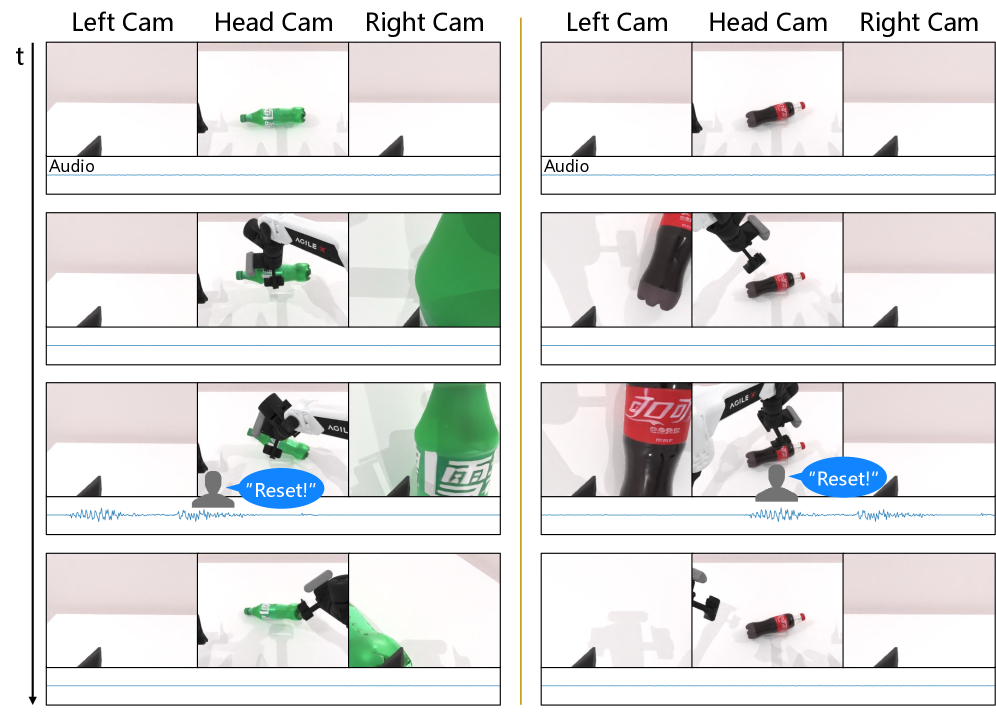
Поскольку время срабатывания прерывания рандомизировано, чисто визуальная политика, которая просто выполняет рутинную последовательность, не пройдет по метрикам звуковой причинности. Кроме того, эта задача усиливает связывание действий, поскольку одно и то же ключевое слово должно вызывать разные выходы низкоуровневого управления в зависимости от текущих суставных позиций робота.
HEAR обеспечивает 0,88 успешности. Базовые модели волновой формы и ASR работают достаточно хорошо (0,75 и 0,74 для соответственно), потому что сигнал выражен явной речью. Однако безопасное реагирование при разбиении управления на части сильно зависит от того, как команда объединяется с текущим состоянием движения. HEAR повышает устойчивость, интегрируя речевые свидетельства в то же представление, которое используется для генерации частей действия, создавая более плавные траектории совместных позиций, которые минимизируют превышение при резких коррекциях курса.
6.2.5 Контакт и материалы
Проверьте материалы.
Как показано на рисунке 11, настройка Check Materials включает две визуально идентичные пластины, размещенные в рабочей области. Одна пластина — целевой материал, а другая — отвлекающий. Робот должен поднять куб, уронить его на первую пластину, чтобы получить звук удара, и по аудио определить, приземлился ли он на целевой материал. Если ответ неверный, он должен переместить куб на вторую пластину.
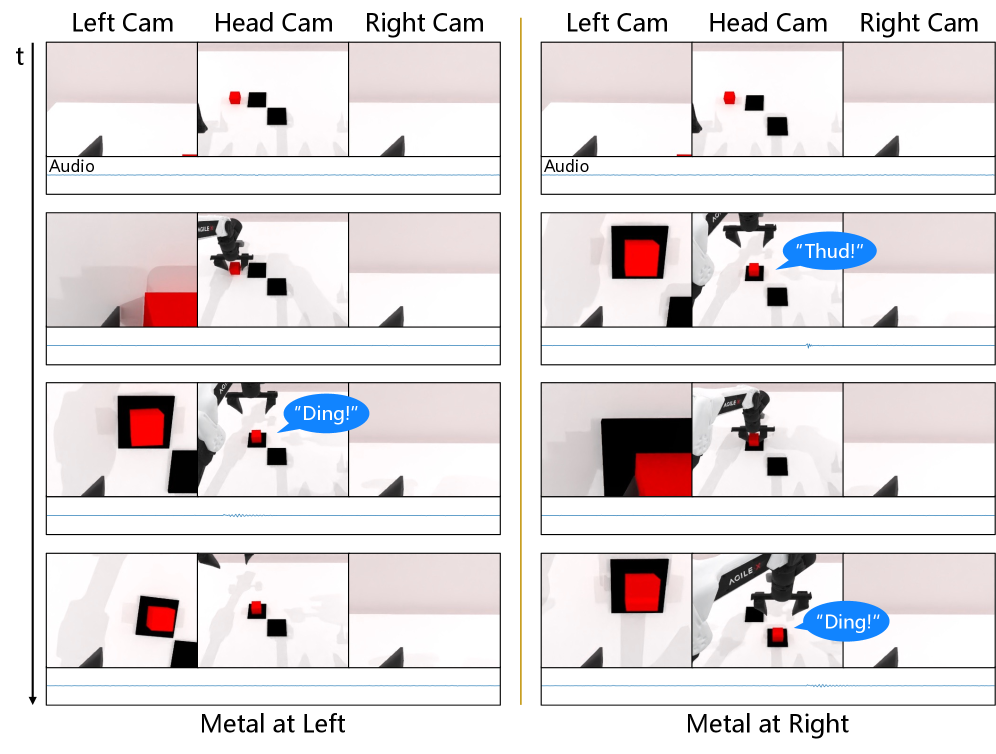
Эта задача служит контролируемым примером использования слуха как недорогого физического сенсора. Свойства материалов часто требуют тактильной обратной связи, чтобы однозначно определить, когда визуальные данные неоднозначны (Clarke et al., 2018). Здесь мы намеренно делаем зрение недостаточно информативным, чтобы заставить опираться на тембр контакта. В отличие от Alarm Clock, робот должен активно генерировать информативное аудио, а затем намеренно оставаться неподвижным, чтобы слушать, а также тесно связывать качество восприятия с устойчивостью управления.
HEAR достигает 0.83 уровня успешности. Варианты ASR терпят драматические неудачи (0.15 для -ASR), поскольку не могут преобразовать ударные акустические характеристики в полезный текст. Мы наблюдаем две доминирующие проблемы в базовых провалах. Во‑первых, безпамятные политики чувствительны к точному расположению краткого ударного воздействия в окне наблюдения. Во‑вторых, изображения волновых форм испытывают трудности с передачей тонких различий частот (тембра) между материалами, из‑за чего визуальная диаграмма оказывается крайне неоднозначной. HEAR выигрывает от работы с исходным аудиопотоком и сохранения причинной памяти для кратковременного воздействия, а также от более плавной генерации фрагментов через модуль Realizer, что помогает роботу намеренно делать паузы и повышает эффективное отношение сигнал/шум.
6.2.6 Мониторинг процессов
Pour Water.
При выполнении задачи «Налейте воду» робот дозирует жидкость в непрозрачный контейнер и должен остановиться точно на целевом уровне, заданном языковой инструкцией, процесс показан на Рисунке 12. Поскольку уровень заполнения визуально скрыт, сигнал принятия решения определяется непрерывной эволюцией звука при наливании.
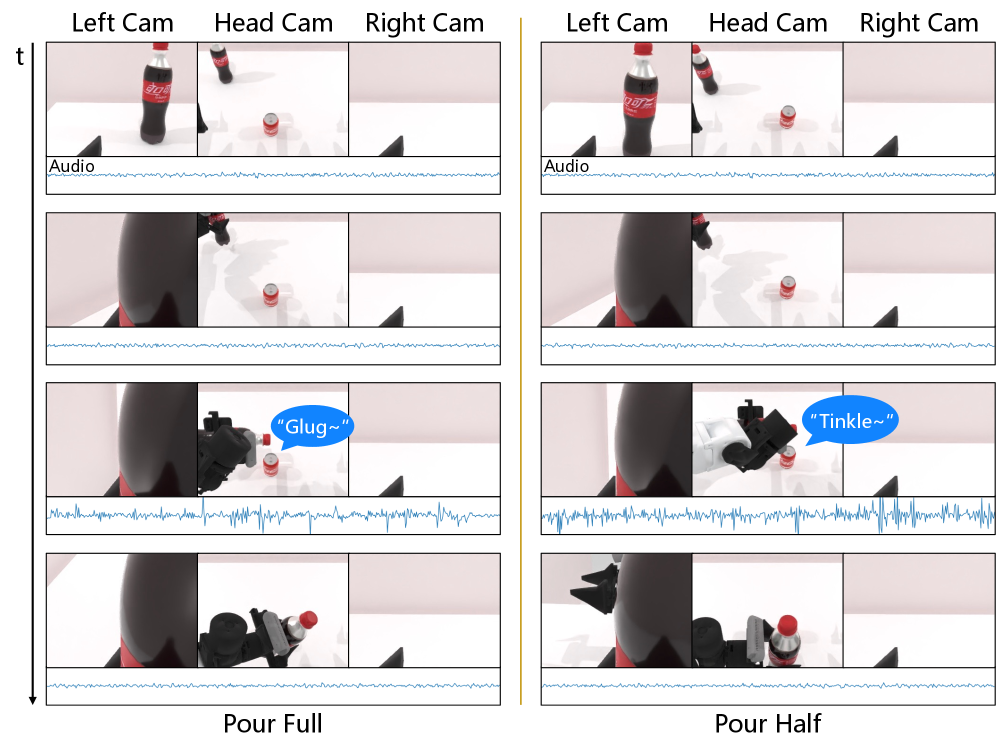
Мы включаем эту задачу для оценки непрерывного временного потока. Соответствующая информация является не изолированным акустическим событием, а скоростью и направлением изменения звука во времени. Это усложняет аудиоинтерфейсы в стиле «снимок», поскольку соседние окна наблюдения могут звучать удивительно похоже, даже если корректное управляющее решение по мере развития изменяется.
HEAR достигает 0.51 вероятности успеха, значительно превосходя -волновую форму (0.31). Визуальный график наливного шума часто выглядит как плотный статичный блок линий, из-за чего трудно заставить опорную модель для зрения отслеживать постепенную эволюцию акустики. В HEAR историзатор агрегирует свидетельства во времени, но непрерывные процессы также требуют чувствительности к прогрессированию. Модуль Advancer обеспечивает надзор за предиктивной динамикой, предсказывая токены акустики на ближайшее будущее (уравнение (18) и (19)). Этот механизм заставляет слитое представление кодировать локальные временные градиенты, эффективно обучаясь тому, как меняется звук со временем, а не просто распознавая, каким является звук в один-единственный момент.
Кипятить воду.
Рисунок 13 демонстрирует среду «Кипячение воды», в которой робот должен отслеживать кастрюлю и вмешиваться строго один раз, когда акустический профиль указывает на кипение с бурным парообразованием. Время до закипания рандомизируется, чтобы предотвратить зависимость от фиксированных расписаний ожидания.
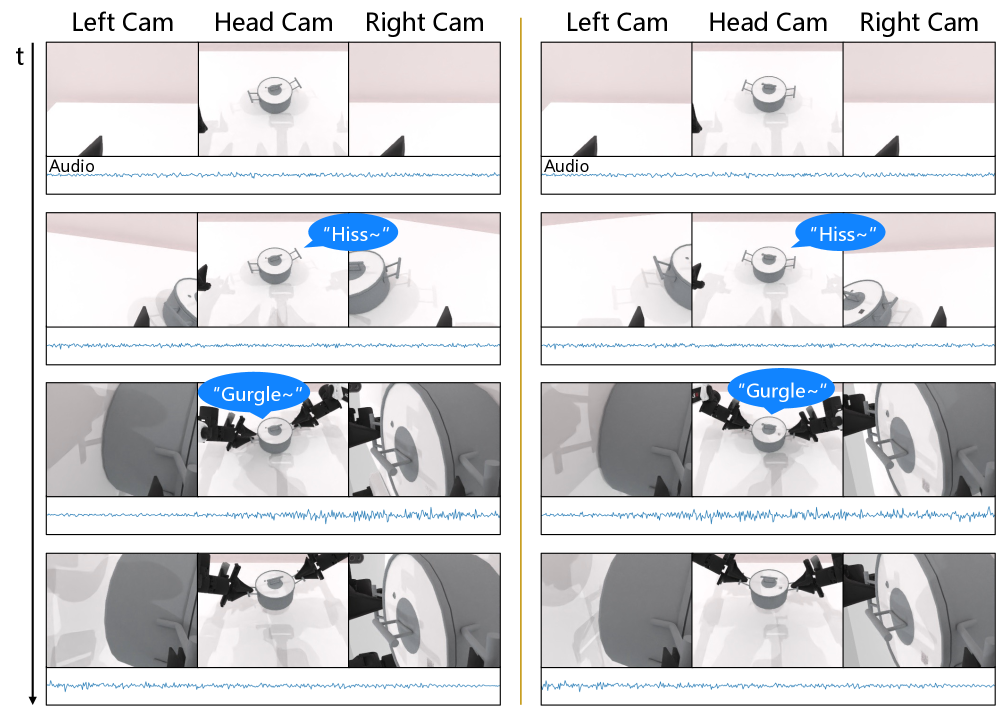
Задача выделяет длительные периоды ожидания, характеризующиеся незначительными акустическими переходами. Визуальная сцена остается статичной, в то время как звук постепенно меняется от тишины до легкого кипения и наконец до устойчивого кипения. Успех требует, чтобы политика сохраняла неподвижность в течение произвольной длительности и обнаруживала устойчивый акустический паттерн, а не кратковременный всплеск.
HEAR достигает 0.81 доли успешных исходов по сравнению с 0.43 для Waveform . Базовые неудачи обычно связаны с ранними действиями, запускаемыми визуально правдоподобными эвристиками, или чрезмерными реакциями на кратковременные шумовые всплески. HEAR снижает эти ошибки, сглаживая краткосрочные колебания за счет причинной памяти и отслеживая постепенное акустическое развитие посредством надзора за предиктивной динамикой в Advancer.
6.2.7 Сводка
В целом HEAR демонстрирует устойчивые улучшения по различным категориям звуков в HEAR-Bench. В то время как визуализация сигналов служит сильной базовой опорой, она остаётся чувствительной к размещению окон и не имеет обоснованного механизма для причинной истории. ASR эффективен, когда подсказки можно корректно токенизировать в явную речь, но по своей природе отбрасывает не-речевые детали и просодию. HEAR успешно работает как для дискретных триггеров, так и для непрерывных процессов, поскольку рассматривает исходный сигнал как полноценную модальность наблюдения. За счёт сохранения значимых свидетельств причинно-следственно через Historizer и обучения представлений, чувствительных к прогрессу обучения, с помощью Advancer, предложенная архитектура обеспечивает надёжную основу для аудио-реактивного роботизированного управления.
6.3 Эксперименты с Real-Robot
6.3.1 Платформенные и акустические проблемы
Мы развертываем обученные политики на однорычажном Franka Panda с двумя видами RGB (камеры головы и руки) и одним стандартным микрофоном, размещенным рядом с рабочим местом (Рисунок 6(b)). Политика наблюдает идентичный интерфейс , определенный в Уравнении (4). Мы намеренно избегаем специализированных акустических датчиков, таких как контактные микрофоны или наборы «ухо-в-руке», требующих, чтобы система обрабатывала исходные, окружающие акустические сигналы.
Реальное аудио создает структурные трудности, отсутствующие при моделировании, включая реверберацию помещения, нестационарный фоновый шум и различия в акустике, связанные с конкретными устройствами. Кроме того, собственные физические движения робота порождают механический эго-шум. Эти факторы делают устойчивое ожидание и осознанные, воспроизводимые контактные действия значительно более критичными, чем в безупречных смоделированных условиях. Все задачи оцениваются по 100 независимым прогонам, используя определения успеха, обусловленного звуком, изложенные в Разделе 3.4.1.
| Method | VLA | Moka Coffee | Answer Phone | Shake Bottle | Real Alarm Clock | Avg. |
|---|---|---|---|---|---|---|
| OpenVLA (Kim et al., 2024) | Y | 0.00 | 0.00 | 0.22 | 0.01 | 0.06 |
| OpenVLA-Waveform (Kim et al., 2024) | Y | 0.04 | 0.05 | 0.41 | 0.77 | 0.32 |
| OpenVLA-ASR (Kim et al., 2024) | Y | 0.01 | 0.01 | 0.19 | 0.63 | 0.21 |
| (Intelligence et al., 2025) | Y | 0.00 | 0.01 | 0.48 | 0.04 | 0.13 |
| -Waveform (Intelligence et al., 2025) | Y | 0.05 | 0.06 | 0.54 | 0.90 | 0.39 |
| -ASR (Intelligence et al., 2025) | Y | 0.01 | 0.02 | 0.21 | 0.78 | 0.26 |
| Play it by Ear (Du et al., 2022) | N | 0.04 | 0.06 | 0.42 | 0.85 | 0.34 |
| ManiWAV (Liu et al., 2024b) | N | 0.05 | 0.05 | 0.45 | 0.81 | 0.34 |
| HEAR | Y | 0.18 | 0.15 | 0.88 | 0.96 | 0.54 |
6.3.2 Комплект заданий и обоснование проектирования
Мы оцениваем четыре реальные задачи, которые отражают требования моделирования, при этом явно вводим сложности физической акустики. Фигуры 14–17 представляют репрезентативные качественные ключевые кадры.
- ⟦Moka Coffee (Long-horizon process monitoring). Требуется ожидать и реагировать на едва заметные изменения акустической фазы при минимальном визуальном прогрессе. В то время как предыдущие демонстрации роботизированного приготовления кофе обычно включали управление автоматизированными машинами с помощью дискретных действий (например, нажатие кнопки для выдачи) (Fu et al., 2024), в этой задаче робот должен отслеживать непрерывный, физический процесс заваривания на плите и принимать решения, опираясь исключительно на аудиальную обратную связь.
- ⟦• Ответ на звонок (многоэтапная речь и события). Требуется отвечать на кратковременный звонок, понимать речь во время разговора и использовать аудио, чтобы определить момент окончания взаимодействия в условиях сильного визуального наложения (повторяющихся визуальных состояний).
- ⟦Shake Bottle (Self-generated cue). Требует активного движения, чтобы извлечь звук для классификации скрытого состояния, подчеркивая связь между преднамеренной проприоцепцией и акустическим восприятием.
- ⟦• Настоящие настольные часы с будильником (устойчивый триггер). Проверка надежного ожидания и точности реакции при изменениях акустической обстановки, включая реверберацию и фоновый шум.
6.3.3 Результаты
Таблица 4 сообщает о показателях успешности при физических развертываниях. HEAR достигает среднего показателя успешности 0.54 по четырем задачам. Хотя переход от моделирования к реальному миру вносит существенные акустические сложности, HEAR стабильно превосходит все базовые подходы. Визуализация волнового сигнала в виде изображения остается самым сильным базовым вариантом VLA (в среднем 0.39 для ), в то время как адаптер ASR дает преимущества в первую очередь при явной речи или при длительных триггерах.
Аудионаблюдательные непеременные политики без VLA, Play it by Ear и ManiWAV, заметно затрудняются в этих сложных реальных сценариях, в среднем показывая лишь 0.34. Хотя эти компактные политики теоретически могут выполнять задачи на более высоких частотах, их меньший масштаб параметров делает их крайне хрупкими к реальной акустической изменчивости и протяжённым горизонтам задач. В согласии с результатами моделирования, OpenVLA и его варианты уступают и его вариантам при том же протоколе обучения.
6.3.4 Разбиение задачи
Moka Coffee.
Для оценки Moka Coffee физический робот установлен рядом с кофейником Moka и сервировочной чашкой, как показано на Рисунке 14. Процесс заваривания продолжается в течение длительного периода, при этом визуальная сцена остается в основном статичной. Поскольку традиционный кофейник Moka не имеет электронных датчиков или дискретных визуальных индикаторов завершения, робот не может полагаться на цифровую цифровую обратную связь или простые визуальные эвристики. Вместо этого роботу необходимо оставаться неподвижным и отслеживать меняющееся звучание кипящей воды и пара. Ему нужно захватить кофейник и налить кофе строго после того, как акустический профиль перейдет в характерную фазу потрескивания, которая указывает на то, что экстракция завершена. Раннее наливание засчитывается как ошибка.
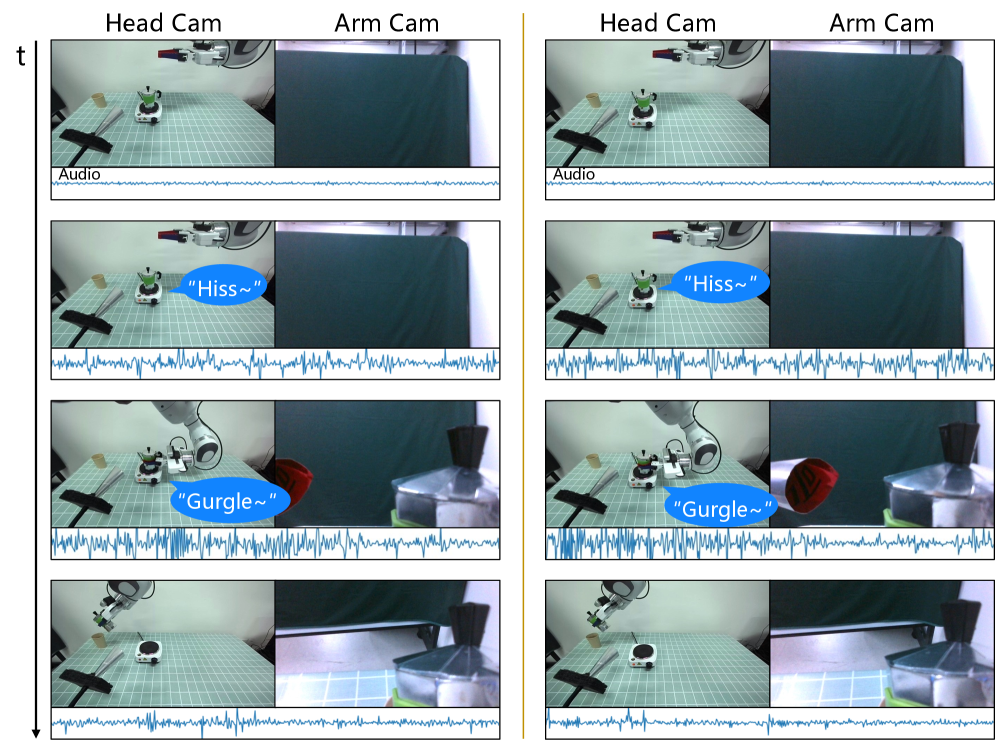
Поскольку традиционная турка мока не имеет электронных датчиков или дискретных визуальных индикаторов завершения, робот не может полагаться на цифровую обратную связь или простые визуальные эвристики. Вместо этого наиболее надежным сигналом прогресса является акустический признак. Успех в этой ситуации требует, чтобы робот выносил суждение о продолжающемся физическом процессе на основе звука, подобно тому как это сделал бы человек.
Несмотря на присущую этой задаче сложность, HEAR достигает 0.18 доли успешных исходов. Хотя эта абсолютная результативность подчеркивает крайнюю сложность долгоперспективного акустического мониторинга в неконтролируемых реальных условиях, HEAR все же обеспечивает существенное улучшение по сравнению с базовыми уровнями. Самый сильный базовый подход -Waveform падает до доли успешных исходов 0.05, а аудио-ориентированные политики вроде ManiWAV и Play it by Ear также схлопываются до 0.05 и 0.04 соответственно. Мы наблюдаем, что реальный механический эго-шум и фоновый звук существенно нарушают работу методов без памяти. Визуализация волновой формы часто подталкивает к хрупким эвристикам на основе порогов амплитуды, из-за чего модели слишком рано срабатывают на всплески фонового шума или полностью пропускают едва заметную фазу перехода. HEAR лучше справляется с этой сложной средой, используя причинную аудио-память и надзор за предиктивной динамикой для отслеживания непрерывного временного потока, однако обработка неконтролируемой реальной кухонной акустики остается открытой задачей для будущих исследований.
Ответить на звонок.
Как показано на рисунке 15, последовательность Answer Phone начинается с того, что робот ожидает случайный телефонный звонок, после чего он должен достать трубку из коробки и передать её человеку. Во время звонка он слушает речь. Когда звонок заканчивается, что обозначается звуком отбоя или речью о завершении звонка, он должен вернуть телефон в коробку.
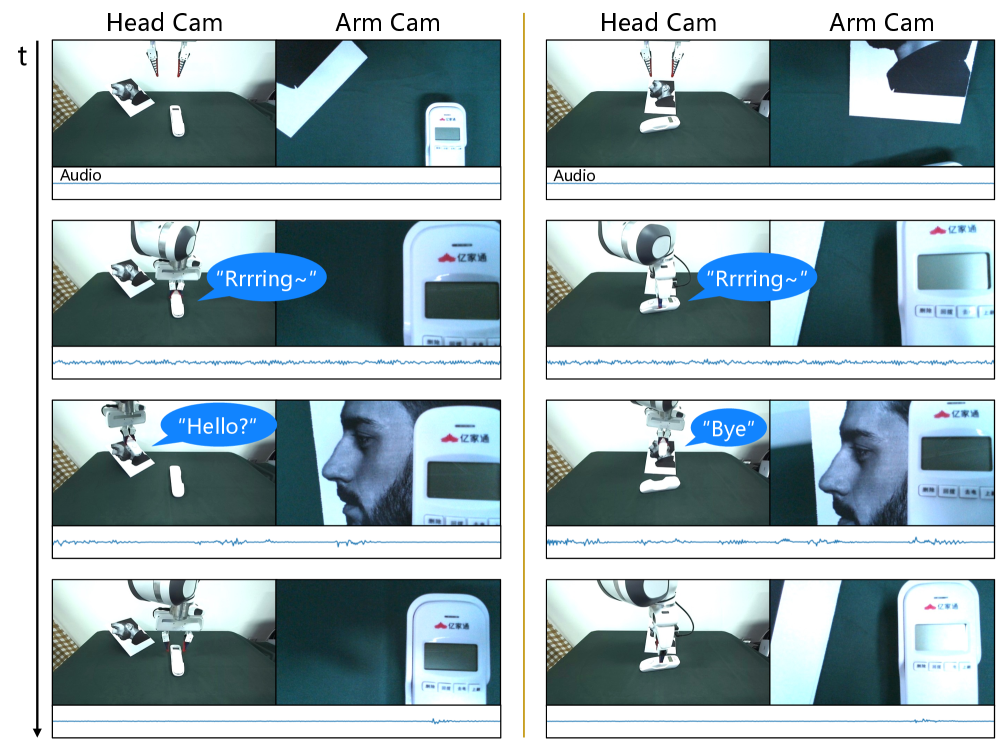
Эта долгосрочная задача объединяет несколько звуковых категорий и выявляет серьезное визуальное наложение (алиасинг). Из одного кадра RGB робот рядом с коробкой для телефона выглядит почти одинаково, когда он должен поднять звонящий телефон, и когда он должен вернуть телефон после звонка. Следовательно, корректное поведение полностью зависит от отслеживания прогресса и причинно-следственной истории, а не от распознавания визуального состояния по одиночному снимку.
HEAR достигает 0.15 уровня успешности, значительно превосходя -Waveform (0.06) и ManiWAV (0.05). Эта задача оказалась исключительна сложной из-за сочетания сильного визуального алиасинга и сложного перекрытия реальных аудиосцен. Когда базовые подходы терпят неудачу, они почти повсеместно продвигаются преждевременно. Например, они пытаются вернуть телефон до окончания звонка или парализуются повторяющимися визуальными кадрами. HEAR утроивает уровень успешности лучшего базового подхода, задействуя прогрессовое представление Envisioner и причинную аудиопамять. Этот механизм помогает сохранять краткие акустические сигналы в конце звонка, которые в противном случае маскируются речью, демонстрируя необходимость временной памяти даже тогда, когда в целом сохраняется трудность достижения успешного результата в задаче.
Тряскающая бутылка.
Для проверки активного акустического зондирования Shake Bottle побуждает робота захватить непрозрачную бутылку и выполнить энергичное трясящее движение, чтобы вызвать звук. На основе полученного дребезга робот классифицирует бутылку как занятую или пустую, как показано на рисунке 16. Затем он помещает бутылку в соответствующую область.
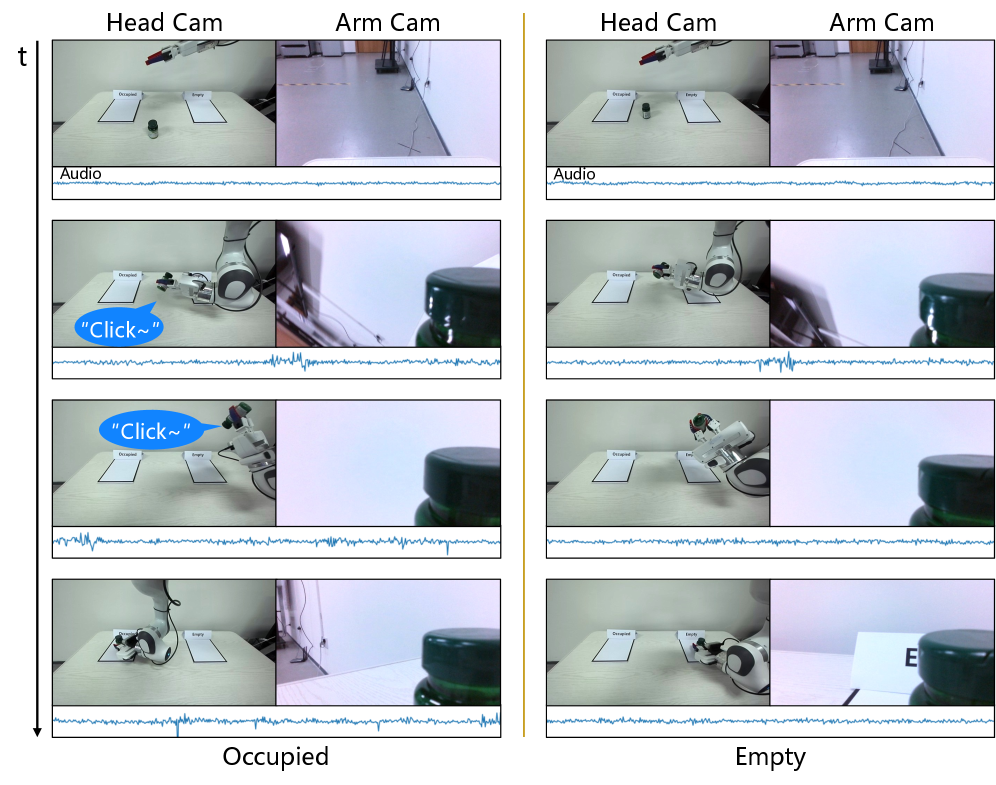
В отличие от пассивного слушания, эта схема представляет собой классический пример интерактивного восприятия. Акустические свидетельства зависят целиком от собственного движения робота. Та же самая бутылка может звучать тихо, если встряхивание слишком слабое. Успех требует согласования аудиоприема с проприоцепцией и формирования воспроизводимых примитивов движения.
HEAR достигает 0.88 вероятности успешного исхода. Рендеринг формы сигнала остается самым сильным базовым вариантом (-Waveform с 0.54), тогда как варианты только для зрения демонстрируют слабые результаты (от 0.22 до 0.48). HEAR достигает этого результата, непосредственно объединяя аудио с совместными позициями (qpos) и формируя более плавные, высоко воспроизводимые траектории дрожания с помощью Realizer, что гарантирует согласованность извлеченных акустических свидетельств между испытаниями.
Реальный будильник.
Разворачивая сценарий тревоги в физическом мире, Real Alarm Clock оснащает устройство, которое производит длительный звон в непредсказуемый момент. Рисунок 17 демонстрирует, как эта компоновка требует от робота подавлять ранние действия и нажимать кнопку только после начала акустического сигнала.
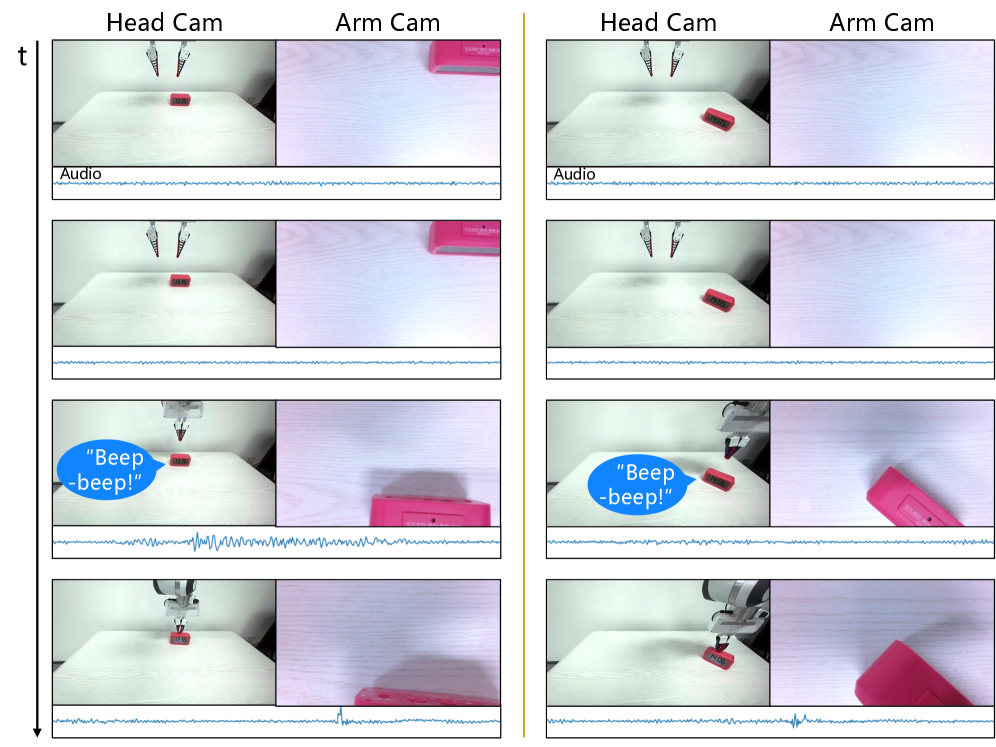
Этот сценарий проверяет, остаются ли политики состоятельными с причинно-следственной точки зрения при физических доменных сдвигах, включая реверберацию в помещении и фоновый шум, а также могут ли они подавлять визуально соблазнительный ранний обходной путь с нажатием кнопки.
HEAR достигает 0.96 доли успешных результатов. Визуализация формы сигнала работает надежно (-Waveform достигает 0.90), а варианты ASR конкурентоспособны на этом длительном сигнале (-ASR при 0.78). Базовые модели только по зрению часто дают сбои (от 0.01 до 0.04). В испытаниях с неудачными базовыми моделями изображения формы сигнала иногда становятся нестабильными из‑за реверберации помещения, которая изменяет визуальный контур, приводя к артефактам порога. Текстовый интерфейс ASR по своей природе сжимает временную детализацию, из‑за чего точность реакции ниже. HEAR остается высоконадежной, поскольку работает непосредственно по встраиваниям, полученным из формы сигнала, и непрерывно интегрирует свидетельства, эффективно устраняя преждевременные нажатия и пропущенные начала даже в шумной физической среде.
6.4 Системный анализ и абляции
Мы проводим обширные абляции в среде симуляции HEAR-Bench, чтобы выделить механизмы, определяющие производительность, и понять лежащие в основе трудности звук-ориентированного манипулирования. Чтобы обеспечить корректное сравнение, каждая абляция использует одни и те же демонстрации, интерфейс наблюдения и представление действия, изменяя только целевой компонент. Если не указано иное, мы сообщаем среднюю долю успешных задач по семи симуляционным задачам на основе 100 испытаний для каждой задачи.
| Variant | Avg. success |
|---|---|
| HEAR full (OpenX-Sound pretrained) | 0.81 |
| No OpenX-Sound pretraining | 0.69 |
| No Historizer | 0.57 |
| Historizer: causal GRU memory | 0.67 |
| Historizer: EMA/pooling memory | 0.62 |
| No Advancer | 0.73 |
| No stage text | 0.77 |
| No low-level controller | 0.75 |
| Realizer regression | 0.70 |
6.4.1 Компонентные абляции
Таблица 5 выделяет вклад отдельных архитектурных решений. Во‑первых, удаление фазы предварительного обучения OpenX-Sound приводит к существенному снижению среднего успеха (с 0.81 до 0.69). Это указывает на то, что крупномасштабное аудиовизуальное предварительное обучение важно для стабилизации обучения представлений перед выполнением усовершенствования, ориентированного на конкретную задачу, даже когда оценка в дальнейшем проводится в симуляции.
Удаление модуля Historizer приводит к наиболее существенному снижению производительности (падение до 0.57). Это подтверждает нашу ключевую предпосылку о том, что причинно-следственный механизм памяти необходим для сохранения кратковременных акустических свидетельств через дискретные границы принятия решений. Мы также проверили более лёгкие альтернативы памяти, такие как причинно-следственный GRU (0.67) и усреднение с экспоненциальным скользящим средним (EMA) по аудиопризнакам (0.62). Хотя они улучшают безмеморийную конструкцию, они заметно уступают нашей Streaming Stateful Transformer (SST). Это указывает на то, что дополнительная ёмкость и потоковое внимание, предоставляемые SST, напрямую обеспечивают более надёжное управление, обусловленное связью «звук—причинность».
| Variant | Low-motion ratio |
|---|---|
| HEAR full (OpenX-Sound pretrained) | 0.15 |
| No OpenX-Sound pretraining | 0.18 |
| No Historizer | 0.29 |
| Historizer: causal GRU memory | 0.20 |
| Historizer: EMA/pooling memory | 0.22 |
| No Advancer | 0.33 |
| No stage text | 0.20 |
| No low-level controller | 0.24 |
| Realizer regression | 0.38 |
Удаление Advancer за счёт отказа от вспомогательной задачи предсказания акустических токенов (Eq. 19) снижает средний показатель успешности до 0.73. Снижение наиболее заметно в задачах с непрерывным временным потоком, где отслеживание прогрессии и скорости изменения более критично, чем обнаружение одного дискретного события. Аналогично, удаление надзора за текстом этапов или низкоуровневого контроллера заметно ухудшает выполнение задач, требующих быстрых поведенческих сдвигов. Наконец, замена улавливающей (flow-matching) головки Realizer на прямую регрессию снижает средний показатель до 0.70. Дёрганое движение, генерируемое простой регрессией, вводит механический самошум в сигнал с микрофона, маскируя кратковременные подсказки и ухудшая как качество управления, так и аудиторное восприятие.
6.4.2 Временное коллапсирование движения и непрерывность действия
Фрагментированные политики, работающие на протяжённых горизонтах, могут страдать от Temporal Motion Collapse — явления, при котором осмысленное движение концентрируется в начале фрагмента, тогда как последующие шаги вырождаются в почти идентичные действия (Intelligence et al., 2025; Zhao et al., 2023). Чтобы количественно оценить этот эффект, мы вычисляем диагностическую величину декартового смещения для конечного эффектора: , где — это положение, подразумеваемое заданными углами в шарнирах во время . Мы классифицируем шаг как «низкодвижимый», если , и сообщаем долю таких шагов среди всех выполненных последовательностей в Таблице 6⟧.
Полная модель HEAR демонстрирует наименьшую долю вырожденных шагов (0.15). Удаление Advancer или замена Realizer на регрессию увеличивает это соотношение до 0.33 и 0.38 соответственно. Этот диагностический результат предполагает, что предиктивное временное закрепление из Advancer, объединенное с плавным формированием векторного поля Realizer, помогает смягчить коллапс движения. В результате робот сохраняет стабильное и непрерывное поведение даже во время продолжительных фаз прослушивания.
6.4.3 Влияние частоты перепланирования
Мы исследуем, можно ли устранить сбои по времени, замыкая контур управления чаще. Для этого во время инференса мы оцениваем обученную политику HEAR под тремя обёртками выполнения: (i) стандартное разомкнутое выполнение предсказанного фрагмента, (ii) выполнение первого действия фрагмента и удержание его на оставшихся шагах, и (iii) выполнение половины фрагмента ( действий) перед повторным запросом к политике.
Как показано в таблице 7, усечение фрагментов приводит к потере реактивности в обмен на стабильность. Выполнение половины фрагмента перед повторным запросом дает лишь незначительное изменение по сравнению с исходным вариантом выполнения в разомкнутом контуре. Однако выполнение и удержание только одного действия радикально меняет поведение и снижает успешность до 0.71. Более частые повторные запросы не устраняют фундаментальную сквозную задержку системы. В наших запусках агрессивное перепланирование обычно приводит к разрывам между фрагментами. Такое поведение «старт—стоп» генерирует эго-шум, который может скрывать тонкие сигналы ровно в тот момент, когда робот пытается прислушиваться. Этот анализ подчеркивает, что простое ускорение перепланирования не является бесплатной заменой причинной памяти.
| Execution strategy | Avg. success |
|---|---|
| Execute only the first action | 0.71 |
| Execute only the first half of each chunk () | 0.80 |
| Open-loop chunk execution (default) | 0.81 |
6.4.4 Чувствительность к длине окна и разрывам выполнения
Оконные аудиоинтерфейсы вводят деликатный гиперпараметр в виде длительности окна . Как показано на рисунке 18, безпамятные адаптеры, такие как waveforms и ASR, демонстрируют немонотонную тенденцию. Если окно слишком короткое, краткие сигналы упускаются. Если оно слишком длинное, различные фазы взаимодействия размываются, что побуждает политику учиться хрупким эвристикам тайминга. В отличие от них, HEAR улучшается и затем выходит на плато по мере роста окна, поскольку его причинная память интегрирует историю сверх единого снимка.
Кроме того, мы проводим стресс-тест устойчивости системы к разрывам выполнения, варьируя горизонт чанков во время инференса, сохраняя обученные веса неизменными (Рисунок 19). По мере роста увеличивается интервал решений в разомкнутом контуре. Без памяти блочные базовые варианты испытывают существенное выпадение подсказок, что согласуется с условием исчезновения свидетельств, формализованным в уравнении Eq. (7). HEAR остается заметно более стабильным при больших разрывах выполнения. Это позволяет выделить выигрыш от разделения высокочастотной частоты аудиального зондирования от частоты принятия решений на более низкой частоте.
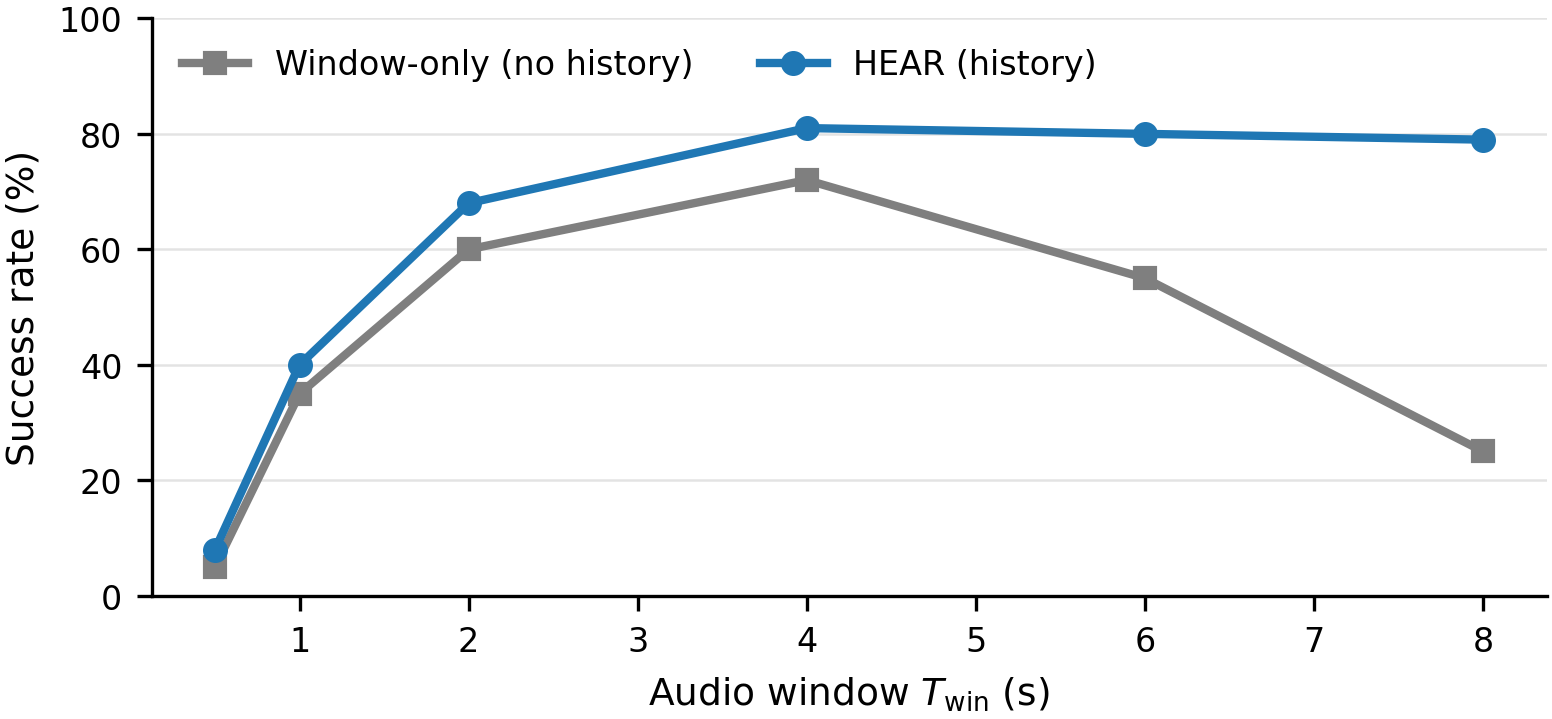
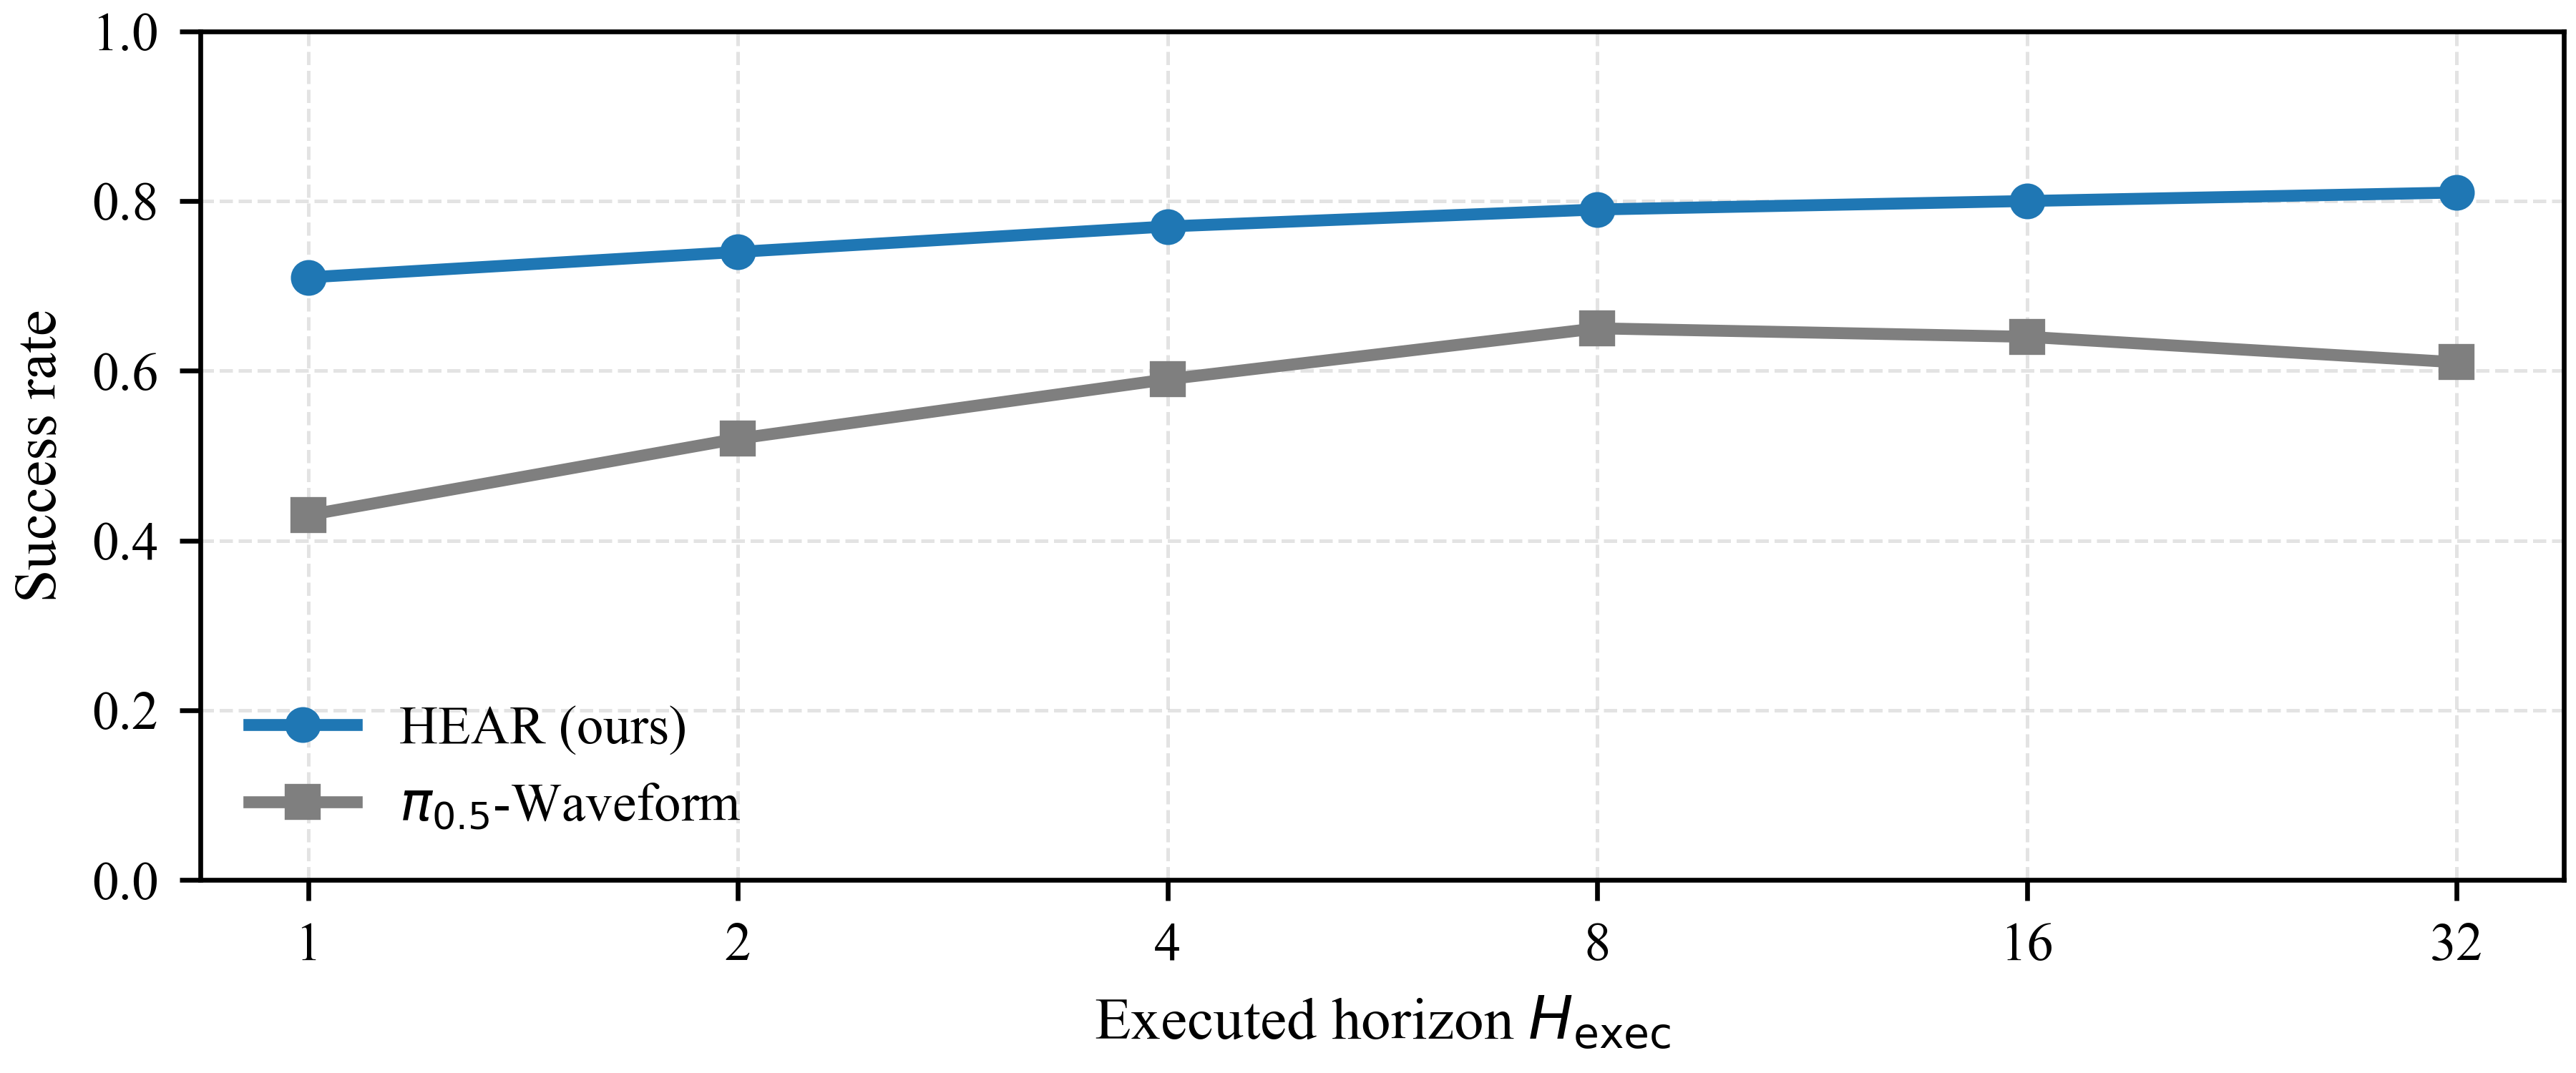
6.4.5 Режимы отказов и сигнатуры ошибок
В ходе оценок память-без-базовой модели чаще всего проявляются два различных режима отказа. Первый — действие раньше времени, когда робот выбирает правдоподобное действие, опираясь только на данные зрения, нарушая корректную причинно-следственную связь. Второй — уязвимость к разрывам выполнения, при которой краткий сигнал возникает между решениями и становится не наблюдаемым в следующем запросе.
| Method | Avg. FT | Avg. MD |
|---|---|---|
| OpenVLA (Kim et al., 2024) | 0.91 | 0.57 |
| OpenVLA-Waveform (Kim et al., 2024) | 0.15 | 0.18 |
| OpenVLA-ASR (Kim et al., 2024) | 0.46 | 0.21 |
| (Intelligence et al., 2025) | 0.89 | 0.52 |
| -Waveform (Intelligence et al., 2025) | 0.12 | 0.11 |
| -ASR (Intelligence et al., 2025) | 0.41 | 0.17 |
| Play it by Ear (Du et al., 2022) | 0.38 | 0.10 |
| ManiWAV (Liu et al., 2024b) | 0.31 | 0.09 |
| HEAR | 0.02 | 0.04 |
Чтобы сделать эти ошибки измеримыми, мы определяем частоту ложных срабатываний (действие до требуемого звукового сигнала) и частоту пропусков (неспособность действовать после сигнала). Используя временные метки из формулы Eq. (10), испытание является ложным срабатыванием, если , и пропуском, если . Таблица 8 показывает, что модели, использующие только зрение, почти исключительно терпят неудачу из-за ложных срабатываний (например, 0.91 для OpenVLA). Адаптеры для волновых форм уменьшают число ложных срабатываний, но все же демонстрируют заметные частоты пропусков, когда сигналы рассогласуются с окном наблюдения. HEAR эффективно смягчает оба режима ошибок.
Наконец, абляции выявляют различные сигнатуры ошибок, подчеркивающие связь восприятия и управления. Без Historizer сбои на задачах с триггерами обычно проявляются как «пропуск, затем ожидание»; робот не совершает действие, потому что подсказка исчезает во время интервала выполнения. Без Advancer задачи с непрерывным потоком чаще дают сбой поздно: робот продолжает лить или ждать после того, как звук уже продвинулся. Замена Realizer на регрессию увеличивает небольшие колебания, что повышает самошум и вызывает ложные реакции. Вместе эти паттерны подтверждают ключевой принцип ориентированного на звук манипулирования: политика, которая слушает во время движения, должна также двигаться так, чтобы слушание было возможным.
7 Обсуждение и будущие работы
Введение парадигмы Vision-Sound-Language-Action (VSLA) дает полезную перспективу для обучения роботами с использованием многосенсорного подхода. Хотя современные модели vision-language-action достигли замечательных результатов, опираясь на устойчивые визуальные состояния, наши результаты показывают, что надежное физическое взаимодействие часто требует, чтобы роботы обрабатывали кратковременные сигналы среды в режиме реального времени. В этом разделе мы рассматриваем более широкие последствия нашей структуры, признаем текущие ограничения систем и намечаем потенциальные направления для робототехники, управляемой аудио.
7.1 Более широкие последствия для мультисенсорного контроля
Базовая структурная проблема, на которую ориентирован HEAR, выходит за рамки простого обработки аудио. Она отражает универсальное противоречие в современных робототехнических системах между высокочастотными, кратковременными сенсорными событиями и низкочастотными, запаздывающими обновлениями политики. В типичных средах манипулирования визуальные состояния деградируют при задержках системы постепенно, потому что объекты, как правило, остаются в поле зрения камеры. Однако акустические события крайне мимолётны. Кратковременный звук удара или сигнал завершения могут легко возникнуть и исчезнуть в пределах одного фрагмента действия с разомкнутой петлёй, делая это полностью ненаблюдаемым для политик управления без памяти.
Наша работа показывает, что простое добавление новых сенсорных модальностей к существующим архитектурам VLA недостаточно. При работе с преходящими сигналами в условиях неизбежной сквозной системной задержки надежное замкнутое контурное управление требует продуманного архитектурного проектирования. В частности, это требует разделения высокочастотной частоты сенсорного измерения и низкочастотной частоты принятия решений. Используя непрерывную причинную память для преодоления разрывов в выполнении и вводя предиктивную динамику, чтобы привязать политику к течению времени, HEAR предотвращает критическую потерю информации. Мы полагаем, что эта системная концепция будет становиться все более актуальной не только для слухового восприятия, но и для интеграции других высокочастотных физических модальностей в крупномасштабные модели foundation. Например, недавние попытки раскрыть физическое знание с помощью тактильного сенсинга сталкиваются с похожими трудностями, связанными с преходящим характером контактных сил (Huang et al., 2025). Проектирование архитектур, сохраняющих причинную устойчивость через разрывы выполнения, будет иметь важное значение для полного раскрытия потенциала этих разнообразных сенсорных входов.
7.2 Проблема «узкого места» в данных для робототехники с управлением по аудиосигналам
Масштабирование парадигмы VSLA естественным образом сталкивается с острой нехваткой синхронизированных данных реального аудио в существующих наборах данных для обучения роботов. Хотя наш набор данных OpenX-Sound предоставляет масштабируемое обходное решение, синтезируя темпорально согласованное аудио на основе видео, мы должны явно признать доменную разницу, которую это вводит. Продвинутые модели генерации «видео-аудио» могут создавать воспринимаемо правдоподобные звуковые сцены, но они не идеально передают истинную физическую акустику. Сгенерированное аудио иногда может упускать тонкие сигналы контакта, искажать точные моменты событий или галлюцинировать звуки, не имеющие истинного физического источника.
Поскольку задачи, ориентированные на звук, чрезвычайно чувствительны к причинности и синхронизации по времени, эти синтетические артефакты ограничивают верхний предел исключительно автономного предварительного обучения. Следовательно, OpenX-Sound в первую очередь служит механизмом начальной подстройки для обучения представлениям, а не полной заменой физическим данным. В дальнейшем сообществу робототехники принесло бы пользу формирование собственных наборов данных, включающих синхронизированные записи с микрофонов вместе со стандартной разметкой, такой как расположение микрофона и акустические свойства помещения. До того как такие наборы данных станут широко доступными, дообучение на реальных демонстрациях, ориентированных на конкретную задачу, остается необходимым шагом для надежного физического внедрения.
7.3 Ограничения и дальнейшие направления
Хотя наш подход обеспечивает конкретный шаг к манипулированию, ориентированному на звук, текущая система имеет несколько ограничений, которые открывают захватывающие возможности для дальнейшей работы.
Во-первых, наша аппаратная настройка опирается на один рабочий микрофон. Такая конфигурация по своей сути ограничивает способность робота локализовать источники звука или надежно разделять перекрывающиеся акустические события в шумной среде, что представляет собой задачу, функционально сходную с классической проблемой «коктейльного вечеринки» (Cherry, 1953). Будущие системы могли бы выиграть от пространственного слуха, интегрировав многомикрофонные массивы, например, сочетая базовый микрофон с микрофоном на оконечнике исполнительного механизма. Это обеспечило бы пространственные акустические подсказки и улучшило бы отношения сигнал-шум за счет активного формирования луча.
Во-вторых, наши политики обучаются целиком посредством офлайн-обучения с имитацией. Следовательно, устойчивость робота строго ограничена разнообразием акустического шума и вариаций по времени, присутствующих в демонстрационных данных. При развертывании в реальных условиях возникают непредсказуемый механический эго-шум и не учтённые отражения в помещении, которые могут легко ухудшить восприятие. Исследование онлайн-дополнительного обучения или методов обучения с подкреплением, позволяющих роботу адаптироваться к своей конкретной акустической среде на аппаратном обеспечении, существенно повысит надёжность развертывания (Lu et al., 2025).
Наконец, наш текущий интерфейс наблюдения обрабатывает звук и зрение как отдельные потоки, прежде чем объединять их на уровне представлений. Однако в человеческом восприятии тонкие зрительные микродвижения часто глубоко синхронизированы с генерацией звука. Будущие архитектуры могут исследовать нативные аудио-визуальные видеокодеры, которые обрабатывают синхронизированные мультимодальные клипы напрямую (Kim et al., 2026). Такая интеграция может помочь роботам лучше связывать конкретные акустические тембры с событиями физического контакта, еще больше уменьшая визуальное алиасирование и прокладывая путь к более целостному физическому интеллекту.
8 Вывод
В данной работе формализована парадигма Vision-Sound-Language-Action (VSLA) для преодоления фундаментальных ограничений роботовых политик, ориентированных на зрение, в средах, зависящих от звука. Мы выявили, что основным узким местом в аудио-управляемых манипуляциях является временное несоответствие между кратковременными акустическими сигналами и запаздывающими, фрагментированными циклами выполнения современных систем VLA. Для устранения этой проблемы мы предложили HEAR — архитектуру, которая разделяет высокочастотное аудиовосприятие и низкочастотное принятие решений. Интегрируя потоковую причинно-следственную память и предиктивную временную привязку, HEAR эффективно устраняет слепые зоны выполнения, чтобы обеспечить надежные замкнутые физические реакции в контуре управления.
Для поддержки обучения политик и строгой оценки мы представили набор данных для предварительного обучения OpenX-Sound наряду с HEAR-Bench, применяя строгие критерии успеха «звук-причина». Широкие эксперименты продемонстрировали эффективность нашего подхода: HEAR достиг 81% средней доли успешных исходов в симуляции и 54% в различных развертываниях в реальном мире на физическом роботе. В конечном счете наши результаты показывают, что включение аудио в foundation-модели требует не просто добавления входного потока; это требует устойчивой причинно-следственной памяти и явного временного выравнивания. Мы надеемся, что парадигма VSLA и наши сопутствующие инструменты с открытым исходным кодом обеспечат надежную основу для развития полностью воплощенного, многосенсорного интеллекта.
Ссылки
- Поступай так, как я могу, а не так, как я говорю: согласование языка с возможностями робототехники. В материалах 6-й конференции по обучению роботам, Материалы по машинному обучению, том 205, стр. 287–318. Цитируется: §2.1.
- Смотри, слушай и учись. В материалах IEEE Международной конференции по компьютерному зрению, стр. 609–617. Цитируется: §3.3.
- wav2vec 2.0: Фреймворк для самоконтролируемого обучения представлений речи. In Advances in Neural Information Processing Systems, Vol. 33, pp. 12449–12460. Cited by: §1, §2.2.
- ⟦ RT-1: Робототехнический трансформер для управления в реальном мире в масштабе. В материалах конференции Robotics: Science and Systems, Цитируется: §2.1.
- ⟦ Звуковые пространства: аудиовизуальная навигация в трехмерных средах. В материалах Европейской конференции по компьютерному зрению, стр. 17–36. Цитируется: §2.2, §2.3.
- ⟦ BEATs: аудиопредобучение с акустическими токенизаторами. В материалах 40-й Международной конференции по машинному обучению, Proceedings of Machine Learning Research, Vol. 202, стр. 5178–5193. Цитируется: §2.2.
- ⟦ RobotWin 2.0: Масштабируемый генератор данных и набор тестов с сильной доменной рандомизацией для надежного бимануального роботизированного манипулирования. Публикация на arXiv:2506.18088. Цитируется: §5.2.
- ⟦ Некоторые эксперименты по распознаванию речи: с одним ухом и с двумя ушами. Журнал Акустического общества Америки 25, стр. 975–979. Цитируется: §7.3.
- ⟦ Политика диффузии: обучение политики висуомоторного управления посредством диффузии действий. Международный журнал робототехнических исследований 44 (10-11), стр. 1684–1704. Цитируется: §2.1, §4.5.
- Обучение аудиальной обратной связи для оценки количества и расхода гранулированного материала. В материалах 2-й конференции по обучению роботам, Материалы по машинному обучению, том 87, стр. 529–550. Цитируется: §6.2.5.
- Моши: Основополагающая модель преобразования речи в текст для диалога в реальном времени. Предварительная публикация arXiv arXiv:2410.00037. Цитируется: §4.4.1.
- ⟦ Компактное трехмерное гауссово сплаттинг-отображение для плотного визуального SLAM. Преинт публикации arXiv:2403.11247. Цитируется: §1.
- ⟦К0⟧ Что является наилучшим представлением трехмерной сцены для робототехники? от геометрических подходов к базовым моделям. препринт arXiv arXiv:2512.03422. Цитируется: §1.
- ⟦ PaLM-E: воплощенная мультимодальная языковая модель. В материалах 40-й Международной конференции по машинному обучению, Proceedings of Machine Learning Research, Том 202, стр. 8469–8488. Цитируется: §2.1.
- ⟦ Играйте на слух: обучение навыкам при наличии скрывающих помех посредством обучения имитации аудио-визуальных данных. В материалах конференции Robotics: Science and Systems, Цитируется: §2.3, §6.1.3, Table 3, Table 4, Table 8.
- ⟦ CLAP: Обучение аудиоконцепциям из естественноязыкового надзора. На Международной конференции IEEE по акустике, речи и обработке сигналов (ICASSP) 2023–2023. стр. 1–5. Цитируется: §2.2.
- Мобильное алаха: обучение бимануальной мобильной манипуляции с низкозатратной телоперацией всего тела. Предварительная публикация arXiv arXiv:2401.02117. Цитируется: 1st item.
- ⟦ ImageBind: Одно пространство встраиваний, чтобы связать их всех. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 15180–15190. Цитируется: §2.2.
- AST: Audio Spectrogram Transformer. В Interspeech, стр. 571–575. Цитируется: §1, §1.
- ManiSkill2: единый эталон для обобщаемых навыков манипулирования. На Международной конференции по обучающим представлениям, Цитируется: §2.3, §5.2.
- Понимание инструкций аудио-визуального языка для роботизированной сортировки. Робототехника и автономные системы 159, стр. 104271. Цитируется: §2.2.
- OmniVLA: Физически обоснованная мультимодальная VLA с единой многодатчиковой перцепцией для роботизированного манипулирования. Предварительная публикация arXiv по адресу arXiv:2511.01210. Цитируется: §1, §2.2.
- ⟦ Управление на основе памяти с рекуррентными нейронными сетями. препринт arXiv arXiv:1512.04455. Цитируется: §3.3.
- ⟦ Тактильная VLA: раскрытие физического знания у модели видение-язык-действие для тактильного обобщения. Публикация в виде препринта arXiv:2507.09160. Цитируется: §1, §7.1.
- ⟦ VoxPoser: компонуемые трехмерные карты значений для роботизированного манипулирования с языковыми моделями. В материалах 7-й конференции по роботному обучению, Proceedings of Machine Learning Research, Vol. 229, pp. 540–562. Цитируется: §2.1.
- ⟦ : Модель видение-язык-действие с обобщением на открытый мир. В препринте arXiv arXiv:2504.16054, Цитируется: §1, §2.1, §6.1.1, §6.1.3, §6.4.2, Table 3, Table 3, Table 3, Table 4, Table 4, Table 4, Table 8, Table 8, Table 8.
- Обучение с подкреплением с использованием неконтролируемых вспомогательных задач. На Международной конференции по изучению представлений, Цитируется: §3.3.
- RLBench: Бенчмарк обучения роботов и обучающая среда. IEEE Robotics and Automation Letters 5 (2), стр. 3019–3026. Цитируется: §2.3, §5.2.
- ⟦ За пределами зрения: дообучение универсальных роботовых политик с разнородными датчиками посредством языкового закрепления. На 2025 IEEE Международной конференции по робототехнике и автоматизации (ICRA), стр. 5961–5968. Цитируется: §2.2.
- ⟦ Политика Cosmos: дообучение видеомоделей для управления движениями и планирования. Предварительная публикация arXiv:2601.16163. Цитируется: §7.3.
- ⟦OpenVLA: модель действий «зрение-язык» с открытым исходным кодом. В материалах 8-й конференции по обучению робототехнике, Proceedings of Machine Learning Research, том 270, стр. 2679–2713. Цитируется: §1, §2.1, §6.1.3, Table 3, Table 3, Table 3, Table 4, Table 4, Table 4, Table 8, Table 8, Table 8.
- ⟦ Ловля объектов в полёте. IEEE Transactions on Robotics 30 (5), стр. 1049–1065. Цитируется: §1.
- ⟦ Смотри, Слушай и Чувствуй: Умное сенсорное слияние для роботизированного манипулирования. В материалах 6-й конференции по обучению робототехники, Proceedings of Machine Learning Research, Vol. 205, pp. 1368–1378. Цитируется: §2.2.
- SVA: К направлению модели зрения-языка-действия, поддерживающей речь. Распознавание образов, с. 112915. Цитируется: §2.2.
- ⟦ Сопоставление потоков для порождающего моделирования. На Международной конференции по представлениям в обучении, Цитируется: §2.1, §4.5.1, §4.5.
- Прямой и быстрый поток: обучение генерации и переносу данных с выправленным потоком. На Международной конференции по обучению представлениям, Процитировано: §4.5.
- ⟦ Расскажи, что ты слышишь, исходя из того, что ты видишь — генерация аудио из видео с использованием текста. В Advances in Neural Information Processing Systems, Том 37, стр. 101337–101366. Цитируется: §1, §2.3, §5.1.
- ⟦ ManiWAV: обучение робота манипулированию по аудио-визуальным данным из реальной среды. В материалах 8-й конференции по обучению роботов, Proceedings of Machine Learning Research, Vol. 270, стр. 947–962. Цитируется: §4.5, §6.1.3, Table 3, Table 4, Table 8.
- ⟦ МЛА: Мультимодальная языково-действующая модель с использованием нескольких сенсорных модальностей для понимания и прогнозирования в роботизированном манипулировании. Предварительная публикация на arXiv arXiv:2509.26642. Цитируется: §2.2.
- ⟦ VLA-RL: К мастерскому и универсальному манипулированию роботами с масштабируемым обучением с подкреплением. Пре-препринт arXiv arXiv:2505.18719. Цитируется: §7.3.
- Активное акустическое зондирование для манипулирования роботом. В 2023 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS), стр. 3161–3168. Цитируется: §2.2.
- ⟦ Diff-Foley: Синхронизированный синтез видео в аудио с помощью моделей латентной диффузии. In Advances in Neural Information Processing Systems, Vol. 36, pp. 48855–48876. Cited by: §1, §2.3, §5.1.
- ⟦ Слуховое прикосновение: аудиовизуальное предварительное обучение для манипулирования с богатым контактом. На 2024 IEEE Международной конференции по робототехнике и автоматизации (ICRA), стр. 6912–6919. Цитируется: §2.2, §2.3.
- Обучение мягкому захватыванию с использованием зрения, звука и осязания. На 2025 IEEE/RSJ Международной конференции по интеллектуальным роботам и системам (IROS), стр. 7607–7614. Цитируется по: §2.2.
- Ermv: редактирование 4d роботизированных многовидовых изображений для усиления воплощённых агентов. Предварительная публикация arXiv arXiv:2507.17462. Цитируется: §2.1.
- Открытое X- воплощение: робототехнические наборы данных для обучения и модели RT-X. В 2024 году на Международной конференции IEEE по робототехнике и автоматизации (ICRA), стр. 6892–6903. Внешние ссылки: Document Цитируется: §2.1, §2.3, §5.1.
- ⟦FiLM: Визуальное рассуждение с обобщённым кондиционирующим слоем. В материалах конференции AAAI по искусственному интеллекту, Том 32. Цитируется: §4.5.1.
- ⟦Robust Speech Recognition via Large-Scale Weak Supervision. В материалах 40-й Международной конференции по машинному обучению, Proceedings of Machine Learning Research, Vol. 202, pp. 28492–28518. Цитируется: §1, §1, §2.2.
- ⟦ Установление семантических категорий на основе поведенческих взаимодействий: эксперименты со 100 объектами. Робототехника и автономные системы 62 (5), стр. 632–645. Цитируется по: §2.2.
- Интерактивное обучение акустическим свойствам бытовых объектов. В 2009 IEEE Международной конференции по робототехнике и автоматизации, стр. 2518–2524. Цитируется: §1, §2.2.
- ⟦ Слияние смыслов. MIT press. Цитируется: §1.
- Octo: Политика универсального робота с открытым исходным кодом. В материалах конференции по робототехнике: наука и системы, Нидерланды, Делфт. Цитируется: §1, §2.1.
- Пассивное и активное акустическое зондирование для мягких пневматических приводов. Международный журнал робототехнических исследований 42 (3), стр. 108–122. Цитируется: §2.2.
- ⟦Звук симуляции: обучение многомодальных стратегий робототехники для sim-to-real с использованием генерируемого аудио. Предварительная публикация arXiv arXiv:2507.02864. Цитируется: §2.3.
- RoboOmni: Упреждающее роботизированное манипулирование в контекстах с многомодальными данными. Предварительная публикация arXiv arXiv:2510.23763. Цитируется: §2.2.
- Аудио-VLA: добавление восприятия контактного звука к модели видение-язык-действие для роботизированного манипулирования. предварительная публикация arXiv arXiv:2511.09958. Цитируется: §1, §2.2.
- ⟦ Технический отчет Qwen3-Omni. Публикация на arXiv:2509.17765. Цитируется: §4.3.
- Технический отчет Qwen3. Предварительная публикация arXiv arXiv:2505.09388. Цитируется: §4.3.
- Проверка настроения: использование активного акустического тактильного сенсинга для манипулирования, богатого контактами. Предварительный препринт arXiv arXiv:2504.15535. Цитируется: §2.2.
- Обучение точным двухручным манипуляциям с недорогим аппаратным обеспечением. В материалах конференции Robotics: Science and Systems, Цитировано: §1, §1, §2.1, §3.2.3, §3.3, §4, §6.4.2.
- ⟦VLAS: Vision-Language-Action Model with Speech Instructions for Customized Robot Manipulation. Предварительная публикация arXiv:2502.13508. Цитируется: §2.2.
- ⟦RT-2: Модели зрения-язык-действие передают веб-знания для робототехнического управления. В материалах 7-й конференции по робототехническому обучению, Материалы по машинному обучению и исследовательские работы, том 229, стр. 2165–2183. Цитируется: §2.1.