Обучение саморазвитию
Аннотация
Мы представляем Learning to Self-Evolve (LSE) — фреймворк обучения с подкреплением, который тренирует LLM улучшать собственные контексты во время тестирования. Мы рассматриваем LSE в контексте самоэволюции во время тестирования, где модель итеративно уточняет свой контекст на основе обратной связи по уже увиденным задачам для более эффективного выполнения новых. Существующие подходы полностью полагаются на внутренние способности модели к рассуждению и никогда не обучают её этой задаче явным образом. LSE сводит проблему многошаговой эволюции к одношаговой целевой функции RL, где каждое изменение контекста поощряется улучшением производительности в последующих задачах. Мы сочетаем эту целевую функцию с циклом эволюции, управляемым деревом. В задачах генерации Text-to-SQL (BIRD) и общего QA (MMLU-Redux) модель с 4B-параметрами, обученная с помощью LSE, превосходит политики самоэволюции на базе GPT-5 и Claude Sonnet 4.5, а также методы оптимизации промптов, включая GEPA и TextGrad, и переносится для управления другими моделями без дополнительного обучения. Наши результаты подчеркивают эффективность рассмотрения самоэволюции как обучаемого навыка.111Код доступен по адресу https://github.com/chenyn66/learning-to-self-evolve.
1 Введение
Способность адаптироваться и развиваться в ответ на обратную связь от окружающей среды долгое время считалась центральным элементом человеческого интеллекта (Piaget, 1952; Sternberg, 2019). Шахматист совершенствуется, анализируя прошлые партии; инженер-программист становится более опытным в работе с кодовой базой благодаря месяцам ежедневной практики. В обоих случаях опыт накапливается, и человек соответствующим образом корректирует свой подход. Текущие конвейеры обучения LLM демонстрируют схожую динамику, особенно на этапе пост-обучения, где reinforcement learning (RL) уточняет поведение модели на основе её собственных сгенерированных данных (Lightman et al., 2023; OpenAI, ; DeepSeek-AI, 2025). Однако это обучение прекращается, как только завершается процесс тренировки. При развертывании LLM применяет одну и ту же стратегию независимо от того, сколько задач она решила в данной предметной области, и отбрасывает весь накопленный опыт, как только контекст сбрасывается. Этот разрыв между статическим развертыванием и динамической адаптацией стимулирует изучение саморазвивающихся систем на этапе тестирования: систем, которые непрерывно обновляют себя в ответ на новые наблюдения во время тестирования..
Самоэволюция во время тестирования может быть охарактеризована как минимум по двум измерениям: как обновляется стратегия и когда это происходит. На одном конце первого измерения градиентные методы напрямую модифицируют параметры модели; на другом — методы на основе промптов переписывают контекст модели, сохраняя параметры неизменными. Вдоль второго измерения внутриэпизодическая эволюция обновляет стратегию в рамках одного эпизода: модель пересматривает свои собственные попытки и уточняет ответ на конкретную задачу, обменивая дополнительные вычислительные ресурсы на прирост производительности для конкретного экземпляра (Shinn et al., 2023; Kumar et al., 2025; Yuksekgonul et al., 2026). Межэпизодическая эволюция обновляет стратегию после одного или нескольких завершенных эпизодов и применяет результат к новым задачам, извлекая переносимые знания, которые обобщаются на различные задачи (Yin et al., 2024; Hu et al., 2025; Zhang et al., 2025b)⟧.
Мы фокусируемся на межэпизодной, основанной на промптах самоэволюции: LLM анализирует свою производительность на пакете задач и переписывает собственный контекст для улучшения результатов на следующем пакете. В ряде недавних работ это направление исследуется через автоматическую оптимизацию промптов (Khattab et al., 2024; Agrawal et al., 2025; Yuksekgonul et al., 2024), самореферентные обновления (Fernando et al., 2024; Zhao et al., 2024; Zhang et al., 2025b; Hu et al., 2025; Zhang et al., 2025c) и агентные системы памяти (Zhang et al., 2025a; c; Chhikara et al., 2025). Однако эти методы полностью полагаются на внутреннюю способность LLM анализировать обратную связь и предлагать более качественный контекст. Модель никогда не обучается этой задаче самосовершенствования явным образом..
Мы утверждаем, что самоэволюция представляет собой задачу рассуждения, отличную от других областей рассуждений. Этот процесс, по сути, разделяет структуру проблемы RL. Оптимизатор RL полагается на специализированные алгоритмы для распределения кредита, оценки градиентов и баланса между исследованием и эксплуатацией. В самоэволюции модель должна выполнять все три действия неявно, используя только рассуждения на естественном языке. Она должна оценивать, какие части текущего контекста помогают, а какие вредят, предвидеть, как пересмотр изменит последующее поведение, и решать, стоит ли уточнять то, что работает, или пробовать что-то новое. Эти требования обосновывают явную оптимизацию для самоэволюции.
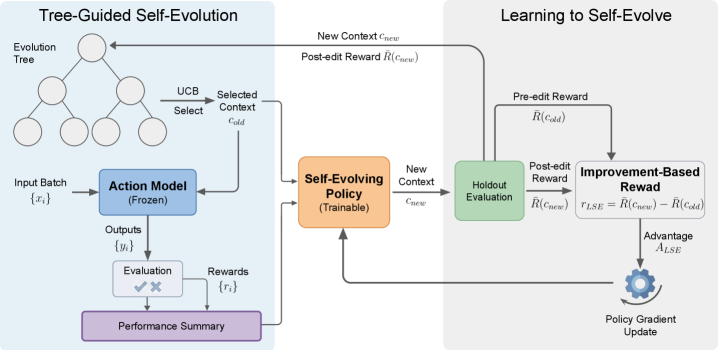
Мы предлагаем Learning to Self-Evolve (LSE) — фреймворк RL, который целенаправленно обучает LLM быть эффективной саморазвивающейся стратегией. Вместо оптимизации всей многошаговой траектории эволюции, LSE упрощает обучение до одного шага: модель получает текущий контекст и сводку производительности, а затем создает улучшенный контекст. Каждое изменение вознаграждается за счет повышения производительности в последующих задачах, а не за счет абсолютной оценки после редактирования. На этапе тестирования мы используем цикл эволюции с древовидным поиском, который позволяет системе исследовать возможные контексты и возвращаться к предыдущим состояниям..
Мы оцениваем LSE в задачах генерации Text-to-SQL и общем QA. Несмотря на использование модели всего с 4B параметрами, стратегия, обученная с помощью LSE, превосходит саморазвивающиеся стратегии, работающие на базе передовых моделей, таких как GPT-5 и Claude Sonnet 4.5, а также методы оптимизации промптов, такие как GEPA и TextGrad. Наши основные результаты заключаются в следующем:
- ⟦• Мы формализуем самоэволюцию между эпизодами во время тестирования и реализуем её посредством обновлений на основе промптов с поиском, управляемым деревом (§3.1, §3.2⟧).
- ⟦• Мы предлагаем LSE, структуру RL, которая явным образом обучает саморазвивающуюся стратегию с помощью вознаграждения, основанного на улучшении (§3.3).
- ⟦• Мы показываем, что модель с 4 миллиардами параметров, обученная с использованием LSE, превосходит более крупные необученные модели и методы оптимизации промптов, а также переносится для управления другими моделями без дополнительного обучения (§4).
2 Связанные работы
Термин self-evolution использовался для обозначения множества различных концепций в недавних исследованиях LLM. Мы классифицируем этот ландшафт на две широкие категории. Training-time self-evolution фокусируется на использовании LLM для генерации собственных обучающих данных и сигналов обучения в процессе тренировки. Test-time self-evolution позволяет стратегии продолжать самообновление после завершения обучения, динамически адаптируясь на основе опыта, накопленного во время развертывания..
Самообучение во время тренировки.
Растущий объем исследований использует LLM для генерации собственных данных и сигналов обучения в процессе тренировки. Пост-тренировка на основе RL заставляет модель создавать цепочки рассуждений и оптимизирует их с учетом проверяемых вознаграждений (Lightman et al., 2023; OpenAI, ; DeepSeek-AI, 2025). Методы бутстрэппинга, такие как STaR (Zelikman et al., 2022), итеративно генерируют варианты обоснований и проводят SFT на основе правильных. Подходы с самовознаграждением (Yuan et al., 2024; Zhao et al., 2025b) расширяют это, используя саму модель в качестве сигнала вознаграждения. Absolute Zero (Zhao et al., 2025a) доводит это до крайности: одна модель одновременно предлагает и решает задачи без внешних данных, используя исполнитель кода в качестве единственного источника проверяемого вознаграждения. Хотя эти методы позволяют создавать более мощные модели, итоговая политика остается статической после завершения обучения. Наша работа решает дополнительную задачу: обеспечение возможности для политики продолжать улучшаться во время тестирования..
Самоэволюция во время тестирования.
Статическая политика не способна адаптироваться к сдвигам распределения, возникающим во время тестирования. Саморазвитие на этапе тестирования решает эту проблему, позволяя модели самостоятельно обновляться на основе собственного опыта после развертывания. Эта возможность охватывает два временных масштаба. Методы внутри эпизода улучшают решение отдельной задачи за счет выделения дополнительных вычислительных ресурсов. Reflexion (Shinn et al., 2023) побуждает модель анализировать неудачные попытки и повторять их, SCoRe (Kumar et al., 2025) обучает самокоррекции с помощью RL, а TTRL (Zuo et al., 2025) применяет RL непосредственно во время тестирования, используя мажоритарное голосование в качестве прокси-награды. TTT-Discover (Yuksekgonul et al., 2026) продолжает обучение модели на этапе тестирования с помощью RL для поиска наилучшего решения одной открытой задачи. Эти методы обменивают вычислительные ресурсы на точность в отдельных случаях, но не переносят знания между задачами..
Методы межэпизодного обучения накапливают опыт на основе завершенных эпизодов и применяют его к новым. Одним из активных направлений является автоматическая оптимизация промптов. GEPA (Agrawal et al., 2025) и TextGrad (Yuksekgonul et al., 2024) используют обратную связь на естественном языке, полученную в ходе выполнения задач, для итеративного изменения и переписывания промптов. Второе направление развивает самореферентные агенты, которые модифицируют собственный код или инструкции. ExpeL (Zhao et al., 2024) извлекает переносимые уроки из успешных и неудачных траекторий. PromptBreeder (Fernando et al., 2024) эволюционирует промпты с помощью операторов мутации и кроссовера. Более современные системы, такие как ADAS (Hu et al., 2025) и Darwin Gödel Machine (Zhang et al., 2025b), расширяют этот подход путем рекурсивной переработки самой самоэволюционирующей политики (Yin et al., 2024). Третье направление создает агентные системы памяти: Voyager (Wang et al., 2023) накапливает библиотеку повторно используемых навыков на основе опыта в Minecraft, в то время как системы, такие как MemGen (Zhang et al., 2025a) и Mem0 (Chhikara et al., 2025), поддерживают развивающиеся хранилища памяти, сохраняющиеся между эпизодами (Zhang et al., 2025c). Все эти методы опираются на присущую LLM способность к рассуждению для анализа обратной связи и предложения улучшений. Наша работа относится к этой категории, но использует иной подход: вместо того чтобы полагаться на эмерджентные способности, мы явно обучаем самоэволюционирующую политику с помощью RL..
3 Метод
Теперь мы представляем нашу предлагаемую структуру и метод. Сначала мы формализуем саморазвитие между эпизодами во время тестирования (§3.1). Затем мы описываем, как мы реализуем это на практике с помощью обновлений на основе промптов и поиска, управляемого деревом (§3.2). Наконец, мы представляем Learning to Self-Evolve (LSE) — RL структуру, которая обучает политику саморазвития (§3.3⟧).
3.1 Эволюция между эпизодами во время тестирования
Рассмотрим задачу , включающую пространство входных данных , пространство выходных данных и функцию вознаграждения . Стратегия отображает входные данные в выходные данные . Саморазвивающаяся стратегия представляет собой функцию , которая обновляет текущую стратегию на основе опыта, накопленного в ходе взаимодействия. Для заданной задачи система выполняет раундов эволюции. На каждом раунде текущая стратегия применяется к пакету задач, выбранных из , создавая кортежи опыта . Затем саморазвивающаяся стратегия вычисляет обновленную стратегию:
| (1) |
Это создает последовательность стратегий . Цель заключается в максимизации совокупного вознаграждения за раундов эволюции:
| (2) |
В контексте языковых моделей стратегия определяется её параметрами и контекстом , включающим системные промпты, инструкции, библиотеки навыков и любые другие текстовые входные данные, формирующие поведение. Такая декомпозиция допускает две естественные реализации :
- ⟦• Основанный на градиентах: изменяет напрямую (например, посредством RL или SFT на основе недавнего опыта);
- ⟦• На основе промптов: модифицирует , сохраняя замороженными.
Мы фокусируемся на инстанцировании на основе промптов, где сама по себе является LLM, которая генерирует обновленные контексты на основе прошлого опыта. Этот выбор не требует вычисления градиентов во время тестирования, тем самым позволяя избежать проблемы катастрофического забывания при непрерывном обучении, и представляет задачу эволюции как задачу рассуждения на естественном языке, которая сама по себе может быть улучшена посредством обучения..
3.2 Эволюция на основе промптов с использованием древовидного поиска
LLM с замороженными параметрами определяет условную стратегию , где — это экземпляр задачи, а — контекст, представленный в §3.1. В нашей реализации мы выделяем специальное поле инструкций внутри для редактирования саморазвивающейся стратегией, оставляя все остальные компоненты (например, описание задачи, спецификацию формата) неизменными..
На каждом этапе саморазвивающаяся стратегия сопоставляет текущий контекст и сводку производительности с обновленным контекстом:
| (3) |
где представляет собой структурированную сводку производительности, содержащую задачи, выходные данные action LLM, эталонные ответы и сигналы правильности для каждой задачи из раунда ⟧.
Заметьте, что содержит только задачи, где обычно невелик, и на каждом раунде извлекается разный пакет. Таким образом, производительность внутри пакета дает лишь зашумленную оценку качества контекста. Чтобы получить согласованную меру по всем раундам, мы фиксируем отдельный отложенный набор и определяем вознаграждение контекста как
| (4) |
Древовидно-направленная эволюция.
Линейная цепочка эволюции жадно расширяет самый последний контекст, что создает риск необратимого выбора субоптимального пути эволюции. Чтобы обеспечить более широкое исследование пространства контекстов, мы поддерживаем дерево эволюции , в котором каждый узел хранит кортеж из контекста, сводки производительности, среднего вознаграждения на отложенной выборке и количества посещений. На каждом раунде, вместо того чтобы всегда расширять последний узел, мы выбираем узел, который максимизирует оценку Upper Confidence Bound (UCB) (Auer, 2002):
| (5) |
где — это количество завершенных раундов, а управляет балансом между исследованием и эксплуатацией. Контекст и резюме используются в качестве входных данных для следующего этапа эволюции, а полученный дочерний узел добавляется к . Это позволяет системе возвращаться к перспективным контекстам, обнаруженным ранее, и создавать от них ответвления, вместо того чтобы следовать единственному пути эволюции. Полная процедура обобщена в алгоритме 1.
3.3 Обучение саморазвитию ⟦K0⟧)
Хотя готовые LLM уже демонстрируют некоторую способность к итеративному уточнению собственных промптов (Yin et al., 2024; Agrawal et al., 2025; Zhang et al., 2025b), эта способность полностью возникает в результате предварительного обучения и стандартного пост-тренинга, а модель никогда не оптимизируется явным образом для самосовершенствования. Мы предлагаем Learning to Self-Evolve (LSE) — RL-фреймворк, который явно обучает быть эффективной саморазвивающейся стратегией..
Вспомните из уравнения (2), что целью саморазвивающейся стратегии является максимизация совокупного вознаграждения за раунды эволюции. Естественной целью обучения для является:
| (6) |
Прямая оптимизация этой -шаговой целевой функции является затратной: каждый прогон требует последовательных раундов оценки и генерации контекста, а вознаграждение на уровне траектории создает проблему распределения кредита на длинном горизонте. Поэтому мы упрощаем задачу до одношаговой настройки (), где создает одно обновление контекста и получает вознаграждение немедленно. Это сводит проблему к контекстному бандиту и позволяет избежать трудностей с распределением кредита на длинном горизонте, при этом сохраняя основную задачу обучения улучшению инструкций на основе обратной связи.
Даже в одношаговой постановке выбор функции вознаграждения имеет существенное значение. Естественным кандидатом является вознаграждение после редактирования , то есть эффективность стратегии действий в обновленном контексте. Однако это вознаграждение смещено в сторону контекстов, которые уже являются эффективными. Рассмотрим два сценария: (1) исходный контекст достигает точности 80%, а после редактирования она падает до 70%, что дает ; (2) исходный контекст достигает точности 30%, а после улучшения доходит до 60%, что дает лишь . Вознаграждение после редактирования оценивает первый сценарий выше, несмотря на снижение эффективности, поскольку оно смешивает качество отправной точки с качеством самого редактирования. Это смещение побуждает стратегию сохранять уже эффективные контексты, вместо того чтобы по-настоящему учиться их улучшать. Вместо этого мы определяем вознаграждение как улучшение вознаграждения:
| (7) |
что напрямую стимулирует создавать правки, повышающие производительность относительно исходной точки, независимо от начального уровня производительности.
Примечательно, что если используется в качестве вознаграждения в стандартном алгоритме градиента стратегии, таком как PPO или GRPO, базовый оценщик поглощает член . Чтобы убедиться в этом, пусть обозначает состояние, наблюдаемое до редактирования. Базовая линия , оцененная при , удовлетворяет , где — это базовая линия при вознаграждении после редактирования. Тогда преимущество сводится к:
| (8) |
что идентично преимуществу при использовании только награды за пост-редактирование. То есть дельта-награда и награда за пост-редактирование дают одинаковые оценки градиента всякий раз, когда используется обученная базовая линия. Вместо использования модели оценки или групповой нормализации в качестве базовой линии, мы можем полностью обойти оценку базовой линии: награда за пре-редактирование известна до того, как начинает действовать, и равна награде за нулевое редактирование, которое возвращает без изменений, поэтому она может служить непосредственно в качестве базовой линии. Это дает преимущество LSE:
| (9) |
и соответствующая оценка градиента стратегии:
| (10) |
Поскольку не зависит от действия, использование его в качестве базовой линии не изменяет ожидаемый градиент. Однако это контрольная переменная, которая нивелирует смещения, специфичные для конкретного промпта. На практике шум при оценке и различия в сложности между промптами, вероятно, преобладают над показателями точности в чистом виде. В этих условиях преимущество, основанное на улучшении, обеспечивает более четкий сигнал обучения и более стабильные обновления градиента стратегии. Это также снижает стоимость обучения, поскольку не требует ни множественных прогонов для каждого промпта для групповой нормализации, ни отдельной сети оценки..
Градиент в Eq. (10) зависит от распределения начальных состояний . Если всегда является исходным контекстом, возникает несоответствие: во время тестирования policy выполняется в течение нескольких раундов (Algorithm 1) и должна улучшать контексты, созданные ее собственными предыдущими правками. Поэтому мы наполняем дерево несколькими раундами эволюции для формирования обучающего набора данных, а затем случайным образом выбираем узлы из в качестве начальных контекстов на каждом шаге RL. Это подвергает воздействию распределения контекстов, аналогичного тому, которое она увидит во время многошаговой эволюции.
4 Эксперименты
Мы оцениваем LSE в двух предметных областях: генерации Text-to-SQL и общих вопросно-ответных системах, проводя сравнение как с более мощными моделями, так и с альтернативными методами оптимизации промптов (§4.1–4.2). Затем мы проводим абляционное исследование дизайна вознаграждения и стратегии поиска в §4.3.
4.1 Экспериментальная установка
| Method | Financial | Toxicology | Codebase | Formula 1 | Card Games | Avg. |
|---|---|---|---|---|---|---|
| Seed prompt | 51.0 | 60.3 | 63.7 | 54.5 | 56.5 | 57.2 |
| Qwen3-4B-Instruct | 63.7 | 60.3 | 70.2 | 56.0 | 61.0 | 62.2 |
| Claude Sonnet 4.5 | 70.8 | 63.8 | 67.8 | 57.3 | 63.0 | 64.5 |
| GPT-5 | 70.8 | 65.8 | 72.0 | 54.3 | 63.3 | 65.2 |
| GEPA | 64.0 | 62.0 | 72.0 | 54.0 | 62.0 | 62.8 |
| TextGrad | 60.3 | 66.0 | 71.5 | 56.5 | 61.3 | 63.1 |
| LSE (ours) | 72.0 | 68.5 | 72.0 | 59.8 | 64.0 | 67.3 |
Модели.
Мы используем Qwen3-4B-Instruct как в качестве политики действий , так и в качестве саморазвивающейся политики , если не указано иное. Подробности обучения и гиперпараметры можно найти в Приложении A.
Задачи и наборы данных.
Мы проводим оценку на задачах из двух областей: генерация Text-to-SQL, где политика создает исполняемые SQL-запросы, извлекающие данные, указанные в вопросе пользователя, и общее вопросно-ответное взаимодействие (QA), где политика отвечает на вопросы с множественным выбором по различным академическим дисциплинам. Промпты для каждой задачи находятся в Приложении B.
Для Text-to-SQL мы используем BIRD (Li et al., 2024), который сопоставляет вопросы на естественном языке с SQL-запросами в различных предметных областях баз данных. Каждая база данных представляет собой отдельную предметную область задачи: проблемы выбираются из одной и той же области как для раундов эволюции, так и для отложенной оценки. Мы проводим обучение на обучающей выборке BIRD и выполняем оценку на пяти случайно выбранных базах данных из выборки BIRD-SQL Mini-Dev..
Для общих QA мы используем SuperGPQA (Team et al., 2025) и MMLU-Redux (Gema et al., 2024). Мы преобразуем вопросы SuperGPQA в формат с четырьмя вариантами ответа, чтобы они соответствовали MMLU-Redux, и рассматриваем каждый предмет как отдельную область задач. Как и в случае с Text-to-SQL, каждый цикл эволюции работает в рамках одной предметной области. Мы проводим обучение на SuperGPQA и оценку по десяти предметам из MMLU-Redux.
Базовые модели.
Сначала мы оцениваем более мощные модели в качестве саморазвивающейся стратегии , сохраняя при этом Qwen3-4B-Instruct в качестве стратегии действий . Мы рассматриваем две передовые модели с закрытым исходным кодом, GPT-5 (OpenAI, 2025) и Claude Sonnet 4.5 (Anthropic, 2025)
Мы также проводим сравнение с двумя альтернативными проектами саморазвивающейся стратегии. Для обоих методов мы используем Qwen3-4B-Instruct в качестве генератора промптов и оптимизатора..
- ⟦• GEPA (Agrawal et al., 2025) — это рефлексивный оптимизатор промптов, который объединяет текстовую рефлексию с многокритериальным эволюционным поиском. GEPA мутирует промпты на основе обратной связи на естественном языке от новых развертываний и поддерживает фронт Парето по производительности для каждого экземпляра, чтобы избежать жадных локальных оптимумов. Каждый шаг оптимизации GEPA соответствует одному раунду эволюции: выбранный пакет задач является обучающими данными для рефлексии, а отложенный набор — это в GEPA.
- ⟦• TextGrad (Yuksekgonul et al., 2024) декомпозирует каждое обновление промпта на два вызова LLM: обратный вызов, который критикует текущую инструкцию с учетом сбоев в пакете и создает «градиенты» на естественном языке (обратную связь о том, как следует изменить инструкцию), за которым следует вызов Textual Gradient Descent (TGD), переписывающий инструкцию с учетом этой обратной связи. Мы следуем примеру, представленному в официальном репозитории222https://github.com/zou-group/textgrad/blob/main/evaluation/prompt_optimization.py, и рассматриваем каждый шаг backward–TGD как один раунд эволюции.
Протокол оценки.
Для всех методов мы производим выборку задач и представляем их стратегии действий в фиксированном порядке для всех запусков. Отложенная выборка также остается неизменной для всех оценочных запусков в рамках каждой предметной области. Мы приводим лучшие показатели, достигнутые за раундов эволюции. Дополнительные сведения можно найти в Приложении A⟧.
4.2 Основные результаты
| Method | Bus. Eth. | Phil. | Prof. Acc. | Econ. | Anat. | Security | Virol. | Moral Sc. | Glob. Facts | Prof. Law | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Seed prompt | 70.5 | 76.0 | 67.7 | 76.2 | 76.0 | 68.2 | 72.5 | 59.7 | 55.5 | 54.0 | 67.6 |
| Qwen3-4B-Instruct | 75.5 | 79.2 | 73.0 | 83.0 | 82.3 | 68.8 | 77.0 | 59.7 | 56.0 | 57.3 | 71.2 |
| Claude Sonnet 4.5 | 75.3 | 79.0 | 75.5 | 81.0 | 79.8 | 69.3 | 77.5 | 67.3 | 57.0 | 58.5 | 72.0 |
| GPT-5 | 77.5 | 80.0 | 73.0 | 83.5 | 81.0 | 70.0 | 82.0 | 64.8 | 55.5 | 58.0 | 72.5 |
| GEPA | 76.0 | 80.0 | 78.0 | 84.0 | 82.0 | 70.0 | 78.0 | 62.0 | 56.0 | 64.0 | 73.0 |
| TextGrad | 74.0 | 79.0 | 67.8 | 73.3 | 80.0 | 67.8 | 77.3 | 62.5 | 51.3 | 58.3 | 69.1 |
| LSE (ours) | 75.0 | 82.0 | 73.0 | 85.0 | 84.5 | 70.5 | 79.0 | 64.5 | 57.0 | 62.0 | 73.3 |
В таблицах 1 и 2 представлены результаты по Text-to-SQL и QA. Даже без специального обучения для самосовершенствования, готовые LLM могут улучшать свои собственные промпты при получении обратной связи во время тестирования. Базовая модель Qwen3-4B-Instruct без дополнительного обучения превосходит исходный промпт на 5% в BIRD и на 3,6% в MMLU-Redux. Это подтверждает, что LLM уже способны учиться на собственном опыте в рамках эволюционного цикла алгоритма 1.
Обучение с подкреплением с использованием LSE существенно улучшает эту способность. Несмотря на использование модели всего с 4 миллиардами параметров, LSE превосходит обе передовые модели в BIRD, опережая GPT-5 на 2,1% (67,3% против 65,2%) и Claude Sonnet 4.5 на 2,8%. В MMLU-Redux LSE сравнивается с GPT-5 (73,3% против 72,5%) и превосходит Claude Sonnet 4.5. Эти результаты показывают, что явное обучение с подкреплением для самоэволюции эффективно, позволяя небольшой модели сравниться с передовыми моделями или превзойти их..
LSE также превосходит оба метода оптимизации промптов. На BIRD LSE опережает GEPA на 4,5% (67,3% против 62,8%) и TextGrad на 4,2% (67,3% против 63,1%). На MMLU-Redux LSE показывает результаты, сопоставимые с GEPA (73,3% против 73,0%), и превосходит TextGrad на 4,2%. В совокупности эти результаты показывают, что, хотя готовые LLM обладают определенной способностью к уточнению промптов, явное обучение саморазвитию соответствует или превосходит нетренированные базовые модели, более крупные модели и специализированные методы оптимизации..
Наконец, как улучшение за счет самоэволюции на основе исходного промпта, так и дополнительное преимущество LSE на MMLU-Redux меньше, чем на BIRD. Одно из возможных объяснений заключается в структуре этих двух задач. В BIRD все запросы внутри домена нацелены на одну и ту же базу данных, поэтому существует четкое общее знание между задачами: понимание схемы, общих шаблонов объединения или семантики столбцов из одного запроса напрямую помогает при работе с другими. В MMLU-Redux задачи в рамках одного предмета намеренно дедуплицированы и разработаны для охвата широких тем. Решение одного вопроса по эконометрике не гарантирует полезных знаний для следующего. Это ограничивает возможности любой самоэволюционирующей стратегии по улучшению контекста стратегии действий на основе опыта в рамках одного домена..
4.3 Анализ
Влияние проектирования вознаграждения.
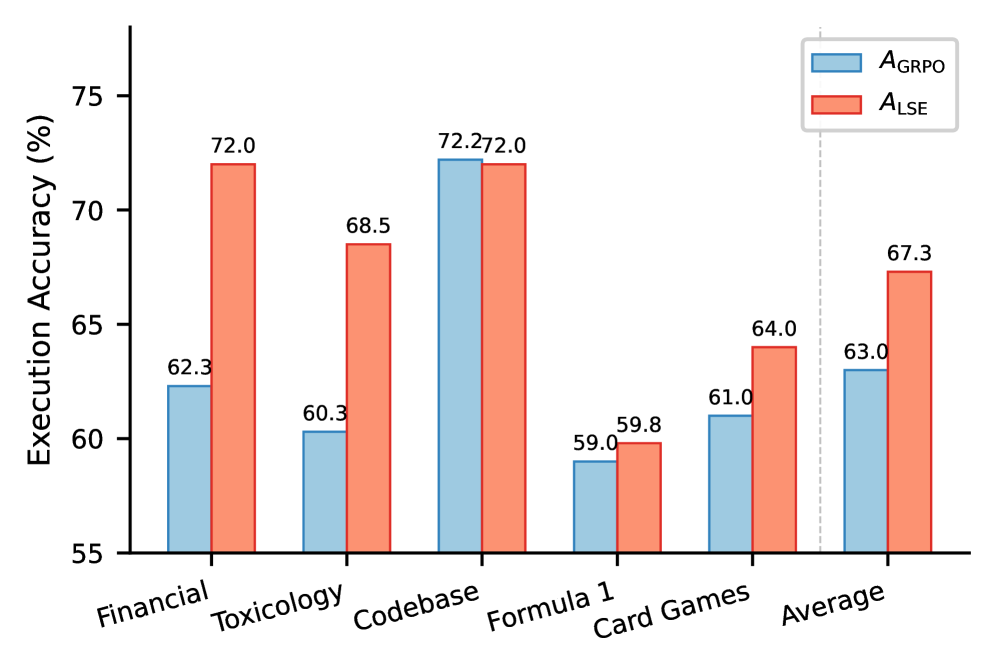
В §3.3 мы обосновали как более чистый сигнал обучения, чем стандартное преимущество GRPO , которое сводится к оптимизации точности после редактирования. Мы обучаем вариант с , сохраняя все остальные настройки идентичными. На BIRD превосходит на 4,3% (67,3% против 63,0%; Рисунок 2(a)). Эти результаты предоставляют эмпирические доказательства того, что целевая функция, основанная на улучшении, более эффективна для обучения саморазвивающихся стратегий..
Влияние стратегии поиска.
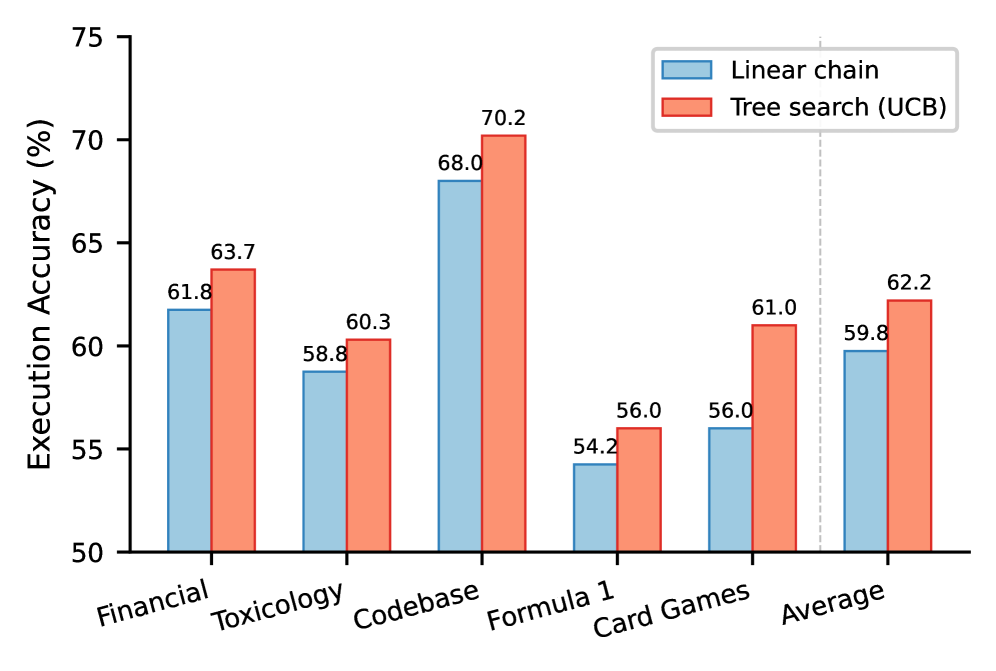
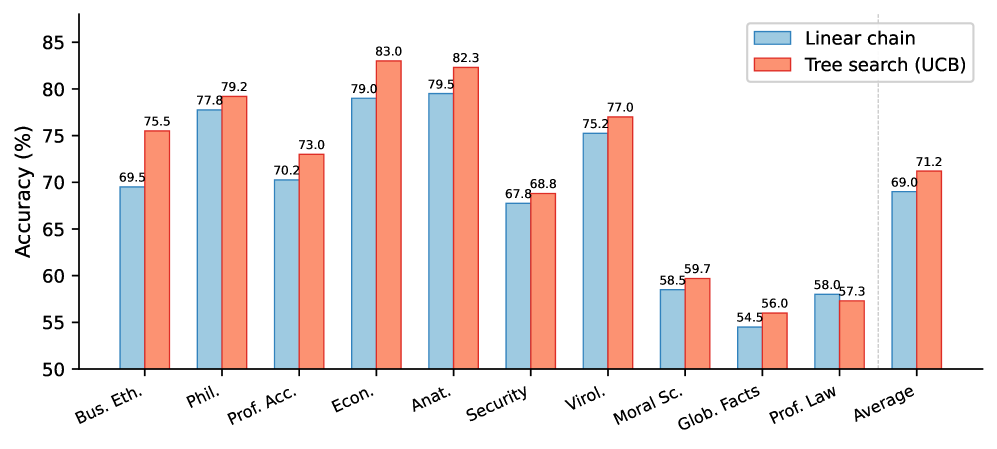
Мы сравниваем древовидный поиск UCB с базовой моделью линейной цепи, которая всегда расширяет самый последний узел. Оба метода используют необученную Qwen3-4B-Instruct в качестве . Рисунок 2(b) показывает, что древовидный поиск улучшает средний показатель на 2,4% в BIRD (62,2% против 59,8%) и на 2,2% в MMLU-Redux (71,2% против 69,0%; Рисунок 4).
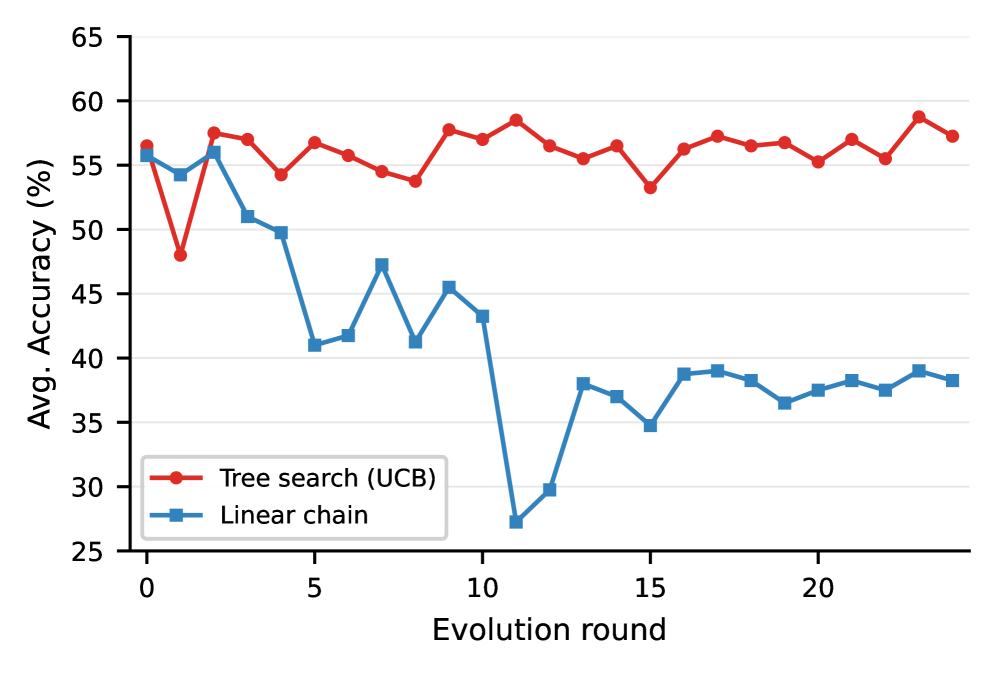
Ключевое преимущество заключается в том, что древовидный поиск не фиксирует ошибочную правку безвозвратно. На рисунке 3 показан конкретный пример на наборе данных BIRD Card Games. Средняя точность линейной цепочки падает с 56% до менее чем 30% после последовательности ошибочных правок и никогда не восстанавливается, поскольку каждый раунд опирается на предыдущий контекст. При использовании древовидного поиска ошибочная правка на раннем этапе не приводит к каскадным последствиям: выбор UCB переключается обратно на предка с более высоким баллом, что позволяет траектории избежать плохих локальных оптимумов..
Самоэволюция во время тестирования для специализированных моделей.
Современная разработка LLM часто включает обучение специализированных моделей для определенной области задач. Может ли саморазвитие во время тестирования дополнительно улучшить такие модели? Мы проверяем это, заменяя на Arctic-Text2SQL-R1-7B (Yao et al., 2025), модель преобразования текста в SQL, дообученную с помощью RL на обучающем наборе BIRD, и применяя ту же (Qwen3-4B-Instruct), обученную методом LSE, без дополнительного обучения..
Таблица 3 показывает, что эволюция LSE улучшает Arctic в среднем на 6,7% (с 57,7% до 64,4%). Это указывает на то, что оптимизация на уровне параметров и на уровне промптов дополняют друг друга: обучение RL кодирует общие шаблоны SQL в веса модели, в то время как эволюция промптов адаптирует контекст к каждой базе данных во время тестирования. Результат также демонстрирует, что стратегия, обученная с помощью LSE, переносится между моделями действий: хотя обучалась исключительно с использованием Qwen3-4B-Instruct, стратегия эволюции обобщается для управления другой моделью.
| Variant | Financial | Toxicology | Codebase | Formula 1 | Card Games | Avg. |
|---|---|---|---|---|---|---|
| Seed prompt | 56.8 | 54.5 | 65.3 | 52.3 | 59.5 | 57.7 |
| + LSE evolution | 68.3 | 62.3 | 71.5 | 57.0 | 63.0 | 64.4 |
5 Заключение
Данная работа демонстрирует, что самоэволюция во время тестирования является обучаемым навыком, который можно напрямую оптимизировать посредством fine-tuning. Ключевым проектным решением в LSE является одношаговая целевая функция RL, которая вознаграждает улучшение, достигаемое каждой правкой, что позволяет избежать многошаговой оптимизации траектории, сохраняя при этом основную задачу обучения на основе обратной связи. Поиск с направляющим деревом затем объединяет эти правки в многораундовую эволюцию во время тестирования. Наши результаты показывают, что прямая оптимизация самоэволюции эффективна, позволяя модели с 4B-параметрами сравниться с передовыми моделями и оптимизаторами промптов или превзойти их. В совокупности эти выводы подчеркивают преимущество выделения самоэволюции в качестве отдельного навыка и разработки алгоритмов обучения для него..
Ограничения.
Наша работа имеет несколько ограничений. Во-первых, мы сводим задачу многошаговой эволюции к одношаговой цели обучения, полностью делегируя исследование алгоритму древовидного поиска на этапе тестирования. Совместная оптимизация по многошаговым траекториям могла бы дать более сильные стратегии, но создала бы дополнительные трудности в распределении кредита и вычислительных затратах. Во-вторых, мы обучаем отдельную саморазвивающуюся стратегию для каждой предметной области. Обучение единой стратегии, которая обобщается на различные задачи, является естественным расширением, хотя, вероятно, требует масштабного обучения во многих областях. В-третьих, мы ограничиваем эволюцию полем инструкций в контексте; другие компоненты, такие как инструменты, библиотеки навыков и внешняя память, не исследуются. В более широком смысле, фреймворк LSE может быть объединен с обновлениями в латентном пространстве или пространстве параметров (Sun et al., 2020; Tandon et al., 2025). Наконец, наши среды обучения и оценки относительно невелики по масштабу. Подбор эффективных сред для самоэволюции во время тестирования затруднителен, так как требует не только достаточного количества задач с обратной связью, но и задач, которые имеют достаточно общую структуру для того, чтобы эволюция была значимой. Разработка более принципиальных и масштабируемых подходов к подбору сред и оценке остается важной открытой проблемой..
Список литературы
- ⟦ GEPA: рефлексивная эволюция промптов может превосходить обучение с подкреплением. arXiv preprint arXiv:2507.19457. Цитируется в: §1, §2, §3.3, 1st item.
- ⟦ Системная карта: claude opus 4.5. Внешние ссылки: Link Цитируется в: §4.1⟧.
- ⟦ Использование доверительных границ для компромисса между эксплуатацией и исследованием. Journal of machine learning research 3 (нояб.), стр. 397–422. Цитируется в: §3.2.
- ⟦ Mem0: создание готовых к промышленному внедрению ИИ-агентов с масштабируемой долговременной памятью. В материалах ECAI 2025 — 28-й Европейской конференции по искусственному интеллекту, 25–30 октября 2025 г., Болонья, Италия — включая 14-ю конференцию по престижным приложениям интеллектуальных систем (PAIS 2025), под редакцией И. Линс, Н. Мурано, М. Валлати, С. Виллата, Ф. Чезани, М. Милано, А. Омичини и М. Дастани, Frontiers in Artificial Intelligence and Applications, том 413, стр. 2993–3000. Внешние ссылки: Link, Document Цитируется в: §1, §2⟧.
- ⟦ DeepSeek-R1: стимулирование способности к рассуждению в LLM посредством обучения с подкреплением. arXiv preprint arXiv:2501.12948. Цитируется в: §1, §2.
- ⟦ Promptbreeder: самореферентное самосовершенствование посредством эволюции промптов. В материалах 41-й Международной конференции по машинному обучению, Цитируется: §1, §2.
- ⟦ Покончили ли мы с mmlu?. Внешние ссылки: 2406.04127 Цитируется в: §4.1⟧.
- ⟦ Автоматизированное проектирование агентных систем. В Международной конференции по обучению представлениям, Цитируется: §1, §1, §2.
- ⟦ DSPy: компиляция декларативных вызовов языковых моделей в современные конвейеры. В Международной конференции по обучению представлений, Цитируется: §1.
- ⟦ Обучение языковых моделей самокоррекции посредством обучения с подкреплением. В Международной конференции по обучению представлениям, Цитируется: §1, §2.
- ⟦ Могут ли LLM уже служить интерфейсом для баз данных? Большой стенд для крупномасштабных text-to-sql, основанных на базах данных. Достижения в системах нейронной обработки информации 36. Цитируется: §4.1.
- ⟦ Давайте проверим шаг за шагом. На Двенадцатой международной конференции по обучению представлениям, Цитируется: §1, §2.
- ⟦[13] OpenAI Обучение рассуждению с помощью LLMs. Примечание: https://openai.com/index/learning-to-reason-with-llms/Дата обращения: 2025-03-21 Цитируется: §1, §2.
- ⟦ Системная карта OpenAI gpt-5. Препринт arXiv: 2601.03267. Цитируется в: §4.1⟧.
- ⟦ Истоки интеллекта у детей. W. W. Norton & Company. Примечание: Пер. М. Кук Внешние ссылки: Document Цитируется: §1.
- ⟦ HybridFlow: гибкая и эффективная структура RLHF. Препринт arXiv: 2409.19256. Цитируется в: Appendix A.
- ⟦ Reflexion: языковые агенты с вербальным обучением с подкреплением. В сборнике Advances in Neural Information Processing Systems, Том 36. Цитируется: §1, §2.
- ⟦ Теория адаптивного интеллекта и ее связь с общим интеллектом. Journal of Intelligence 7 (4). Внешние ссылки: Link, ISSN 2079-3200, Document Цитируется: §1.
- ⟦ Обучение во время тестирования с самообучением для обеспечения обобщающей способности при сдвигах распределения. В ICML, Цитируется: §5.
- ⟦ Сквозное обучение во время тестирования для длинного контекста. arXiv препринт arXiv: 2512.23675. Цитируется в: §5.
- ⟦ SuperGPQA: масштабирование оценки LLM по 285 дисциплинам уровня магистратуры. Внешние ссылки: 2502.14739, Link Цитируется: §4.1.
- ⟦ Voyager: агент с открытым финалом, воплощенный в среде, на базе LLM. В сборнике Advances in Neural Information Processing Systems, Том 36. Цитируется в: §2.
- ⟦ Arctic-text2sql-r1: простые вознаграждения, сильное рассуждение в задачах преобразования текста в SQL. arXiv preprint arXiv:2505.20315. Цитируется в: §4.3, Table 3.
- ⟦ Агент Гёделя: фреймворк самореферентного агента для рекурсивного самосовершенствования. Препринт arXiv: 2410.04444. Цитируется в: §1, §2, §3.3.
- ⟦ Самообучающиеся языковые модели. В материалах 41-й Международной конференции по машинному обучению, Цитируется по: §2.
- ⟦ TextGrad: автоматическое «дифференцирование» посредством текста. arXiv preprint arXiv: 2406.07496. Цитируется в: §1, §2, 2nd item.
- ⟦ Обучение открытию во время тестирования. arXiv preprint arXiv: 2601.16175. Цитируется в: §1, §2.
- ⟦ STaR: самообучение рассуждениям через рассуждения. В сборнике Достижения в системах обработки нейронной информации, Том 35. Цитируется в: §2.
- ⟦ MemGen: плетение генеративной латентной памяти для саморазвивающихся агентов. arXiv preprint arXiv: 2509.24704. Цитируется в: §1, §2.
- ⟦ Машина Дарвина-Гёделя: бесконечная эволюция самосовершенствующихся агентов. arXiv preprint arXiv:2505.22954. Цитируется в: §1, §1, §2, §3.3.
- ⟦ Агентная контекстная инженерия: развитие контекстов для самообучающихся языковых моделей. Препринт arXiv: 2510.04618. Цитируется в: §1, §2.
- ⟦ ExpeL: LLM агенты являются эмпирическими обучающимися. В материалах конференции AAAI по искусственному интеллекту, Том 38. Цитируется: §1, §2.
- ⟦ Абсолютный ноль: усиленное рассуждение через самообучение без использования данных. arXiv препринт arXiv:2505.03335. Цитируется в: §2.
- ⟦ Обучение рассуждению без внешних вознаграждений. Препринт arXiv: 2505.19590. Цитируется в: §2⟧.
- ⟦ TTRL: обучение с подкреплением во время тестирования. arXiv preprint arXiv:2504.16084. Цитируется в: §2.
Appendix A Детали обучения и оценки
Генерация данных.
Мы обучаем отдельную саморазвивающуюся стратегию для каждой предметной области (Text-to-SQL и QA), используя траектории эволюции, сгенерированные на основе соответствующего обучающего набора данных. Для каждой области мы выполняем 200 запусков генерации данных, каждый из которых содержит 20 раундов эволюции, что дает приблизительно 4000 узлов дерева для выборки во время RL обучения..
Обучение с подкреплением.
Мы реализуем наш RL фреймворк, используя verl (Sheng et al., 2024). Мы обнаружили, что случайная выборка узлов из деревьев эволюции создает слабый обучающий сигнал на ранних этапах обучения. Вместо этого мы выстраиваем простую учебную программу, отдавая предпочтение выборке узлов с наибольшим потенциалом улучшения, который определяется как разница между производительностью узла и максимальной производительностью в его собственном дереве. Мы используем скорость обучения , выбираем 32 узла на пакет и генерируем 4 развертывания на узел. Мы проводим on-policy обучение и не применяем KL регуляризацию. Мы обучаем модель в течение 4 эпох и выбираем лучшую контрольную точку на основе отдельного набора для разработки..
Протокол оценки.
Для каждой предметной области мы фиксируем отложенную выборку в размере 50 задач. Эффективность на отложенной выборке рассчитывается как среднее значение по восьми генерациям. Мы проводим 25 раундов эволюции и фиксируем наилучший показатель эффективности на отложенной выборке, достигнутый каждым методом самоэволюции в процессе эволюции. В каждом раунде пакет из 10 задач выбирается с возвращением и передается модели действий. Случайное зерно фиксируется таким образом, чтобы все методы наблюдали одну и ту же последовательность пакетов задач..
Размеры наборов данных.
В таблице 4 приведено количество задач для оценки по каждой предметной области.
| Task | Domain | # Problems |
|---|---|---|
| BIRD | Financial | 106 |
| Toxicology | 145 | |
| Card Games | 191 | |
| Formula 1 | 174 | |
| Codebase | 186 | |
| MMLU-Redux | Business Ethics | 100 |
| Philosophy | 100 | |
| Professional Accounting | 95 | |
| Econometrics | 100 | |
| Anatomy | 100 | |
| Security Studies | 100 | |
| Virology | 96 | |
| Moral Scenarios | 100 | |
| Global Facts | 96 | |
| Professional Law | 100 |
Appendix B Промпты
Каждая задача использует три шаблона промптов: (1) системный промпт, который предоставляет модели действий контекст задачи и текущие инструкции, (2) сообщение пользователя, которое представляет каждый экземпляр проблемы, и (3) промпт самоэволюции, который получает саморазвивающаяся политика для создания пересмотренной инструкции. Поле инструкции внутри системного промпта — это компонент, который редактирует на каждом раунде эволюции. Ниже мы воспроизводим шаблоны для обеих задач.
B.1 Текст-в-SQL
Системный промпт модели действий.
Task Overview:
You are a data science expert. Below, you are provided with a
database schema and a natural language question. Your task is to
understand the schema and generate a valid SQL query to answer the
question.

Database Engine:
SQLite

Database Schema:
{schema}
This schema describes the database’s structure, including tables,
columns, primary keys, foreign keys, and any relevant relationships
or constraints.

**Instructions**
{instructions}
Исходная инструкция: Верните только один корректный SQL-запрос SQLite в <answer>...</answer>>.
Сообщение пользователя модели действий.
Question:
{question}

**Instructions**
{instructions}

Follow the instructions and show your work. When you are ready,
return the query output list in tags: <answer> ... </answer>
Саморазвивающаяся стратегия промпта.
You are an expert at designing text-to-SQL agents. The agent is
running on a fixed database schema. Below is the current agent
prompt and a summary of recent performance. Rewrite ONLY the
instructions to improve execution accuracy while maintaining
strict output format.

Current prompt:
{old_prompt}

Evaluation summary over {n_problems} problems and the agent’s
full thinking process:
{summary}

**How to write Instructions**
- The agent will continue receive different user queries so don’t
  make the instructions too specific to a single question.
  Referring to the questions in the current summary with only the
  question number is not helpful.
- Keep it concise and practical.
- You may include rules, heuristics, knowledge about the database,
  low-level instructions/examples, high-level ideas/strategies,
  pitfalls and any information that you think can make the agent
  better.
- Organize however you like (bullets, headings, checklists).
- Be creative and think about the agent’s behavior across
  iterations. Don’t be confined by what I told you.
- Don’t change the output format, the agent should still return
  the final SQL query in tags: <answer> ... </answer>.

Think step by step and show your work. Reason about the history
of the model’s behavior across iterations.

When you are ready, put your revised Instructions within
<prompt>[your new instructions]</prompt> tags.
B.2 Ответы на вопросы
Системный промпт модели действий.
Task Overview:
You are an expert taking a test. Below, you are provided with a
question and a list of choices. Your task is to select the correct
answer from the choices.

**Instructions**
{instructions}
Исходная инструкция: Верните только букву правильного варианта (A, B, C или D) в <answer>...</answer>>.
Сообщение пользователя модели действий.
Question:
{question}

Choices:
{choices}

Follow the instructions and show your work. When you are ready,
return the answer letter in tags: <answer> ... </answer>
Саморазвивающаяся стратегия промпта.
You are an expert at designing agents for solving multiple-choice
questions that involve both factual knowledge and reasoning.
Below is the current agent prompt and a summary of recent
performance on a set of problems. Rewrite ONLY the instructions
to improve accuracy while maintaining strict output format.

Current prompt:
{old_prompt}

Evaluation summary over {n_problems} problems and the agent’s
full thinking process:
{summary}

**How to write Instructions**
- The agent will continue to receive different questions from the
  same subjects. Don’t make the instructions too specific to a
  single question.
- Keep it concise and practical.
- You may include rules, heuristics, strategies for multiple
  choice questions (e.g., elimination, careful reading), knowledge
  about the subjects (e.g., common misconceptions, important
  facts, etc.), and any information that you think can make the
  agent better.
- Organize however you like (bullets, headings, checklists).
- Be creative and think about the agent’s behavior across
  iterations. Don’t be confined by what I told you.
- Don’t change the output format, the agent should still return
  the final answer letter in tags: <answer> ... </answer>.

Think step by step and show your work. Reason about the history
of the model’s behavior across iterations.

When you are ready, put your revised Instructions within
<prompt>[your new instructions]</prompt> tags.
B.3 Примеры инструкций, найденные с помощью ⟦K0⟧
Ниже мы воспроизводим лучшие инструкции, обнаруженные саморазвивающейся стратегией, обученной на LSE, по одной для каждого домена задач. Эти инструкции заменяют исходную инструкцию в промпте модели действий после нескольких раундов эволюции, управляемой деревом..
Text-to-SQL: база данных кодовой базы BIRD.
1. Always return exactly one valid SQLite query in the format:
   <answer>YOUR_SQL_QUERY_HERE</answer>

2. Carefully analyze the natural language question to identify:
   - The target attribute (e.g., name, count, date, status)
   - The relevant tables and their columns
   - Any joins required to connect tables via foreign keys
   - Any filters (e.g., equality, date ranges, null checks)

3. Use only the provided schema. Do not assume columns or
   tables that are not defined.

4. When joining tables:
   - Match foreign key references precisely
     (e.g., posts.OwnerUserId -> users.Id)
   - Use explicit column aliases only if needed for clarity
   - Ensure join conditions match the schema

5. For date filtering:
   - Use strftime(’%Y’, column) to extract year
   - Never use YEAR() -- SQLite does not support it
   - Match date format exactly (e.g., ’2014-04-23 20:29:39.0’)

6. For conditional outputs (e.g., "well-finished"):
   - Use CASE WHEN or IIF to map NULL / non-NULL values
   - Match the definition in the question
     (e.g., "not well-finished" = ClosedDate IS NULL)

7. Common pitfalls to avoid:
   - Misidentifying OwnerUserId vs. LastEditorUserId
   - Incorrectly joining on UserId instead of Id
   - Misspelling column names (e.g., CreaionDate)
   - Forgetting required joins for user attributes
   - Confusing UserDisplayName in comments with post ownership

8. Always use subqueries for exact values (MIN, MAX):
   - e.g., WHERE Age = (SELECT MIN(Age) FROM users)
     instead of ORDER BY Age LIMIT 1

9. For percentages or ratios, compute numerator and
   denominator separately using subqueries. Use
   CAST(... AS REAL) for floating-point division.

10. Avoid redundant joins -- if a query can be answered
    from a single table, do not introduce unnecessary joins.
Ответы на вопросы: Анатомия в MMLU-Redux.
- Return only the letter of the correct choice (A, B, C,
  or D) in <answer>...</answer>.
- Carefully analyze the question and all answer options
  before selecting.
- Use elimination to rule out clearly incorrect choices
  based on factual knowledge or logical inconsistency.
- For biological and anatomical questions, recall key
  structures and their functions (e.g., fertilization
  occurs in the fallopian tube, not the ovary or uterus;
  the pituitary is the "master gland").
- In neurology: upper motor neuron lesions cause spastic
  paralysis; lower motor neuron lesions cause flaccid
  paralysis; sympathetic pathways use noradrenaline.
- In embryology, palatine shelf elevation is due to turgor
  pressure from hydrophilic molecules, not directly from
  tongue descent or brain flexure.
- For spinal cord injuries, breathing is controlled by the
  brainstem (medulla), not the cervical spinal cord.
- Fracture types: closed = skin intact; greenstick = bent
  but not displaced; open = skin broken; spiral = twisting.
- In autonomic responses, sympathetic chain damage leads to
  pupillary constriction and vasodilation (loss of
  vasoconstriction), not increased sweating.
- In Horner’s syndrome: miosis, facial vasodilation,
  decreased lacrimation, and anhydrosis.
- In cerebrovascular accidents, internal capsule lesions
  cause contralateral spastic paralysis.
- Prioritize accuracy over common assumptions -- especially
  regarding directionality (contralateral vs ipsilateral),
  timing (diastole vs systole), and structural relationships.
- Be vigilant for common misconceptions used as distractors.
- Do not over-rely on common associations; base decisions
  on precise anatomical, physiological, or pathological facts.