Latent-WAM: моделирование скрытых состояний мира для сквозного автономного вождения
Аннотация
Мы представляем Latent-WAM, эффективную сквозную систему автономного вождения, которая обеспечивает качественное планирование траектории за счет использования пространственно-ориентированных и динамически-информированных латентных мировых представлений. Существующие планировщики на основе мировых моделей страдают от недостаточно сжатых представлений, ограниченного пространственного понимания и неполного использования временной динамики, что приводит к субоптимальному планированию в условиях ограниченных данных и вычислительных ресурсов. Latent-WAM решает эти проблемы с помощью двух основных модулей: пространственно-ориентированного компрессионного мирового энкодера (SCWE), который извлекает геометрические знания из базовой модели и сжимает изображения с нескольких камер в компактные токены сцены посредством обучаемых запросов, и динамической латентной мировой модели (DLWM), которая использует причинно-следственный Transformer для авторегрессионного прогнозирования будущего состояния мира на основе исторических визуальных и двигательных представлений. Обширные эксперименты на NAVSIM v2 и HUGSIM демонстрируют новые передовые результаты: 89.3 EPDMS на NAVSIM v2 и 28.9 HD-Score на HUGSIM, что превосходит лучший из предыдущих методов без восприятия на 3.2 EPDMS при значительно меньшем объеме обучающих данных и компактной модели со 104 миллионами параметров..
1 Введение
Сквозное автономное вождение привлекло значительное внимание благодаря своей природе, основанной на данных, и масштабируемости. Предыдущие методы объединяют восприятие и прогнозирование в единую дифференцируемую сеть, извлекая представления, релевантные для планирования, для сквозного прогнозирования траектории [hu2023uniad, jiang2023vad]. Однако эти методы, как правило, опираются на сложные конструкции вспомогательных задач и аннотации восприятия, что ограничивает дальнейшее масштабирование алгоритмов сквозного вождения..
В последнее время подходы, основанные на моделях мира, изучают представления сцены посредством временного самообучения, обеспечивая плотное обучение при одновременном снижении зависимости от меток восприятия. Эти методы можно в широком смысле разделить на две группы. Первая группа [zhang2025epona, li2025drivevla-w0] изучает планирование вождения посредством явной генерации видео. Однако генерация видео влечет за собой значительные вычислительные затраты, а изученные промежуточные представления, как правило, фокусируются на визуальных деталях, не имеющих отношения к планированию. Вторая группа изучает представления, релевантные планированию, посредством неявного прогнозирования будущих латентных состояний [li2024law, zheng2025world4drive]. Хотя латентные представления относительно легковесны и фиксируют динамическую информацию посредством временного самообучения, они все еще страдают от недостаточного качества представления. В частности: (1) латентные представления остаются недостаточно сжатыми; (2) им не хватает пространственного понимания, либо они полагаются на внешние модели оценки глубины во время вывода, что вносит дополнительные задержки; и (3) историческая и динамическая информация используются недостаточно эффективно, поскольку эти методы просто прогнозируют представление из кадра . Как показано на Fig.˜1, эти ограничения приводят к субоптимальной эффективности планирования..
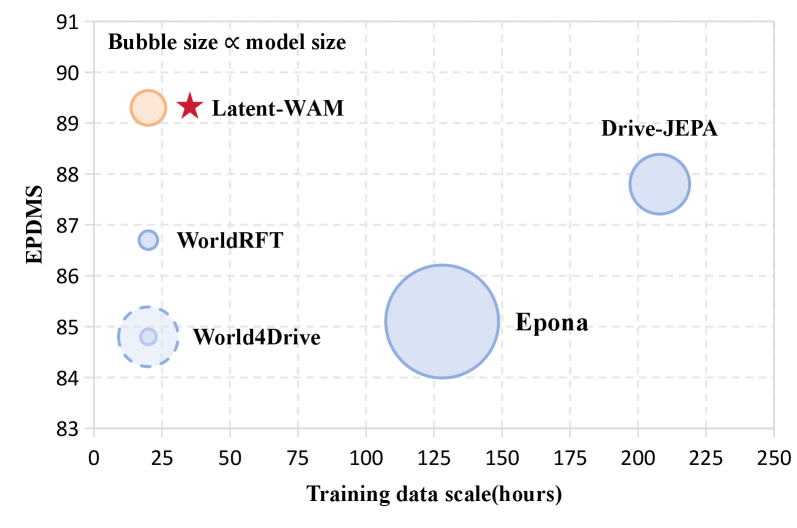
Для решения этих проблем мы предлагаем Latent-WAM, который включает в себя пространственно-ориентированный сжимающий мировой энкодер (SCWE) и динамическую латентную мировую модель (DLWM), нацеленные на две наиболее важные для планирования задачи понимания — пространственное и динамическое понимание — для достижения высокосжатых представлений мира вождения с улучшенной производительностью планирования. В частности, SCWE дистиллирует знания из геометрической фундаментальной модели в визуальный бэкбоун и использует обучаемые запросы для извлечения пространственно-информированных токенов из обогащенных признаков, достигая высокого сжатия информации о сцене. DLWM использует причинно-следственный Transformer для моделирования мира, предсказывая будущее состояние мира в зависимости от исторического состояния мира эго-транспортного средства, включая сжатые визуальные и двигательные представления. Благодаря самообучающемуся визуальному предсказанию и предсказанию движения с учителем, представления состояния мира приобретают возможности динамического понимания, важные для планирования. Наконец, облегченный декодер траекторий генерирует запланированную траекторию на основе представлений состояния мира..
Мы всесторонне оцениваем Latent-WAM на NAVSIM v2 [cao2025navsimv2] и HUGSIM [zhou2024hugsim]. Latent-WAM достигает 89.3 EPDMS на NAVSIM v2, 45.9 RC и 28.9 HD-score на HUGSIM, устанавливая новые передовые результаты. В условиях отсутствия восприятия наш метод превосходит предыдущие подходы на 3.2 EPDMS. Примечательно, что визуализация карт внимания показывает, что наши представления о мире в значительной степени сфокусированы на пространственных структурах и намерениях вождения, демонстрируя эффективность нашего подхода для обучения представлений, ориентированных на планирование. Наши вклады суммированы следующим образом:
- ⟦• Мы предлагаем Spatial-Aware Compressive World Encoder, новый метод сжатия сцен, который дистиллирует геометрические знания в визуальную основу для извлечения высокосжатых, пространственно-ориентированных визуальных представлений.
- ⟦• Мы предлагаем динамическую латентную модель мира — новый подход к моделированию мира, который использует причинно-следственный Transformer для совместного обучения визуальной динамике и динамике движения, формируя представления с пониманием динамических сцен.
- ⟦• Наш метод достигает новых передовых результатов как на NAVSIM v2, так и на HUGSIM, превосходя предыдущий метод без восприятия [li2025drivevla-w0] на 3,2 EPDMS.
2 Родственные работы
2.1 Представление сцены в сквозном автономном вождении
Сквозное автономное вождение напрямую оптимизирует планирование траектории, что делает промежуточное представление сцены критически важным для общей производительности. Ранние работы [hu2023uniad, transfuser] используют плотные BEV-макеты, контролируемые семантическими картами и метками заполненности. Последующие методы [jiang2023vad, chen2024vadv2, sun2024sparsedrive, jia2025drivetransformer] переходят к облегченным векторизованным или разреженным представлениям для повышения эффективности. Недавние разработки используют VLM [tian2024token, pan2024vlp, Hegde2025DistillingML] для получения более богатой семантической информации или применяют латентные world models [li2024law, zheng2025world4drive] и генерацию видео [xia2025drivelaw] для представления сцены. Однако эти методы часто демонстрируют слабое понимание трехмерного пространства и полагаются на громоздкие представления. Мы решаем эти проблемы путем дистилляции геометрических знаний в vision backbone для более глубокого пространственного понимания, одновременно сжимая информацию о сцене в компактный набор токенов с помощью обучаемых запросов..
2.2 Мировые модели для автономного вождения
Мировые модели получили широкое распространение в автономном вождении для представления окружающей среды и прогнозирования будущих состояний. Одно из направлений работы применяет модели генерации видео [Hu2023GAIA1AG, wang2023drivedreamer, zhao2024drivedreamer-2, chen2024driveworld, wang2023driving-wm, gao2024vista, guo2024dist4d] для построения представлений мира вождения на уровне пикселей, в то время как 3D мировые модели, основанные на занятости и облаках точек [zheng2023occworld, zhang2024copilotd, zyrianov2025lidardm, dang2025sparseworld], накладывают геометрические ограничения в 3D пространстве, а последующие работы [li2024uniscene, li2025scaling] объединяют 2D и 3D моделирование. Опираясь на эти возможности, некоторые подходы [yang2024drivearena, li2025omninwm] используют мировые модели в качестве симуляторов с замкнутым контуром, в то время как другие [zhang2025epona, li2025drivevla-w0, xia2025drivelaw, li2024law, zheng2025world4drive] напрямую используют их для планирования. Чтобы снизить вычислительные затраты, LAW [li2024law], World4Drive [zheng2025world4drive] и Drive-JEPA [wang2026drivejepa] выполняют планирование траектории в латентном пространстве. Наш метод аналогичным образом использует латентную мировую модель, но дополнительно включает статус эго-автомобиля для управления будущими прогнозами и 3D-RoPE для улучшения пространственно-временного отслеживания..
3 Метод
3.1 В целом
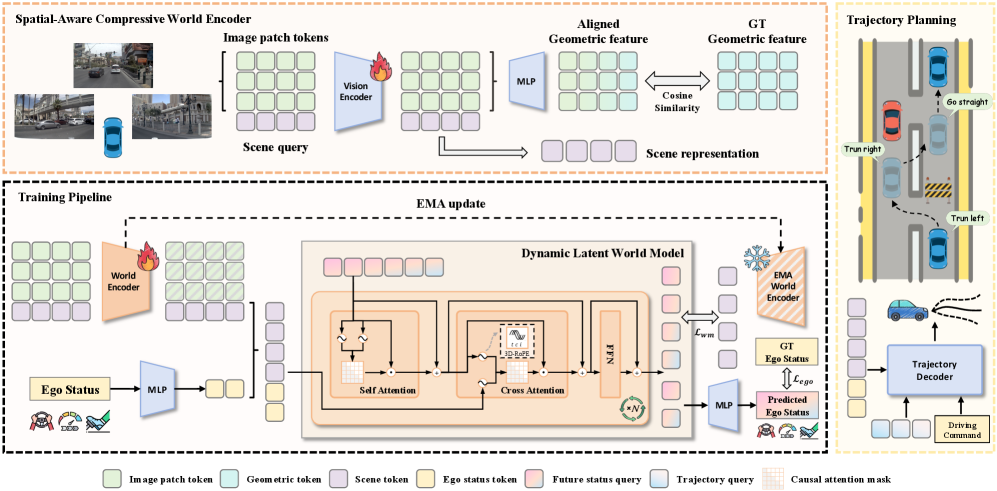
Общая архитектура Latent-WAM проиллюстрирована на Fig.˜2 и состоит из трех основных модулей: 1) Пространственно-ориентированный сжимающий мировой энкодер (Sec.˜3.2), который использует обучаемые запросы и визуальный энкодер для сжатия изображений в компактные токены сцены, а геометрическая фундаментальная модель используется для дистилляции способности геометрического восприятия в энкодер для улучшения пространственного понимания, 2) Динамическая латентная мировая модель (Sec.˜3.3), причинно-следственный transformers декодер, который моделирует динамику переходов мира путем авторегрессионного прогнозирования будущего состояния мира, обусловленного историческими представлениями сцены и состоянием эго-автомобиля, и 3) Декодер траекторий (Sec.˜3.4), который прогнозирует траектории на 4-секундном горизонте на основе представлений состояния мира. SCWE и DLWM совместно оптимизируют визуальный бэкбон. Геометрическая дистилляция улучшает пространственное понимание, в то время как самообучение улучшает моделирование временной динамики. Такая конструкция обеспечивает высокую производительность планирования во время вывода без дополнительных вычислительных затрат со стороны вспомогательных модулей..
3.2 Пространственно-ориентированный сжимающий кодировщик моделей мира
Для моделирования переходов состояний мира на больших горизонтах планирования представления статуса мира должны быть достаточно легковесными, при этом сжимая богатую информацию о сцене. В отличие от предыдущих методов, опирающихся на обширную визуальную информацию, мы используем лишь небольшой набор обучаемых запросов, которые полностью взаимодействуют с токенами фрагментов изображения из входных данных, сжимая богатую информацию о восприятии мира в латентное пространство. Кроме того, для улучшения пространственного понимания визуального бэкбона мы используем геометрическую фундаментальную модель WorldMirror [liu2025worldmirror] для внедрения геометрической осведомленности в бэкбон посредством дистилляции..
3.2.1 Сжатие сцены.
Мы используем набор компактных токенов сцены для сжатия тяжелых визуальных токенов из изображений с нескольких ракурсов, формируя фундаментальный компонент представлений состояния мира.
Получая на вход последовательные изображения с нескольких камер , мы сначала преобразуем их в токены фрагментов изображения , где обозначают временной горизонт, количество камер и количество фрагментов изображения соответственно. Набор запросов сцены инициализируется случайным образом и конкатенируется с . Объединенные признаки подаются в энкодер DINO , содержащий MLP, который проецирует их в латентное пространство размерности , формируя покадровые и специфичные для каждого ракурса представления сцены и токены изображения :
| (1) |
где — количество токенов запроса сцены, — размерность энкодера, а — размерность латентного пространства.
Благодаря интеграции запросов сцены с необработанными токенами изображений обширная визуальная информация из множества токенов фрагментов изображений эффективно сжимается в компактный набор токенов, что значительно снижает вычислительные затраты для последующего обучения world models с долгосрочной перспективой и trajectory planning..
3.2.2 Геометрическое выравнивание.
Для дистилляции способностей пространственного понимания геометрических фундаментальных моделей в энкодер DINO мы используем токенизированные фрагменты изображения, полученные с помощью SCWE, в качестве носителей для получения плотной пространственно-семантической информации из геометрических признаков.
Изображения с нескольких ракурсов в последовательных кадрах дополнительно подаются в геометрическую фундаментальную модель , создавая геометрические признаки на уровне патчей . Выходные данные магистральной сети DINO впоследствии проецируются через геометрический проектор , формируя . И , и сначала нормализуются с использованием LayerNorm, после чего мы вычисляем их функцию потерь косинусного сходства:
| (2) |
где обозначает косинусное сходство, а обозначает LayerNorm.
Примечательно, что, поскольку остается замороженным на протяжении всего обучения, геометрические признаки могут быть предварительно вычислены и кэшированы в автономном режиме, что позволяет осуществлять прямую загрузку во время обучения без возникновения повторных затрат на инференс или избыточного использования памяти графического процессора. Такая конструкция существенно сокращает время обучения и вычислительные расходы..
3.3 Динамическая латентная модель мира
В этом разделе мы предлагаем динамическую латентную модель мира (DLWM). Путем причинного прогнозирования представлений будущего состояния мира в латентном пространстве, магистральная сеть обретает возможности моделирования временной динамики посредством парадигмы самообучения в условиях отсутствия восприятия..
3.3.1 Агрегация латентных состояний мира.
Токены сцены для каждой камеры фиксируют лишь изолированную информацию, специфичную для конкретного вида, чего недостаточно для целостного моделирования мира. Чтобы обеспечить эффективное прогнозирование будущего и планирование траектории, мы агрегируем эти токены и объединяем их со статусом эго-автомобиля для построения унифицированных представлений состояния мира для каждого кадра. Статус эго-автомобиля в последовательных кадрах, включающий команды управления, скорость и ускорение, кодируется энкодером статуса эго-автомобиля (однослойный MLP) в эмбеддинги статуса эго-автомобиля . Токены сцены из SCWE и эмбеддинги статуса эго-автомобиля в совокупности формируют латентное состояние мира для каждого кадра.
В частности, токенизированные данные сцены с различных камер агрегируются для формирования целостного представления восприятия окружающей среды, которое впоследствии объединяется с , кодирующим состояние собственного транспортного средства, что дает унифицированное представление состояния мира и собственного транспортного средства . Это представление служит основой для последующего прогнозирования будущего состояния мира в рамках world model и trajectory planning..
3.3.2 Прогнозирование причинно-следственной модели мира.
Мы формулируем моделирование динамики перехода состояний мира как задачу авторегрессионного прогнозирования, где все прогнозы состояния мира для будущих кадров обусловлены представлениями о состоянии мира в прошлом, охватывающими целостные представления сцены и статус эго-автомобиля. Эта унифицированная авторегрессионная структура обеспечивает естественную стратегию обучения: рассмотрение чередующейся последовательности токенов состояния мира Сцена-Эго как покадровых блоков и применение стандартного прогнозирования следующего токена для обучения модели мира..
Подробно, мы случайным образом инициализируем набор обучаемых запросов состояния будущего мира , где формируют кэш ключ-значение . DLWM использует стандартный Transformer decoder, включающий Rotary Position Embedding, создавая прогнозы состояния будущего мира . Формально,
| (3) |
Эталон генерируется целевым энкодером, который представляет собой замороженную копию SCWE, обновляемую посредством экспоненциального скользящего среднего (EMA) для обеспечения стабильных сигналов обучения..
3.3.3 Маска внимания при обучении с учителем.
Получив чередующуюся последовательность токенов сцены и эго-состояния ⟦BROKEN_K0⟧, модель мира предсказывает каждый будущий токен, учитывая все исторические токены. Мы используем метод teacher forcing во время обучения: токены из ground truth служат контекстом для предсказания последующих токенов, что предотвращает накопление ошибок на разных временных шагах ⟦BROKEN_K1⟧.
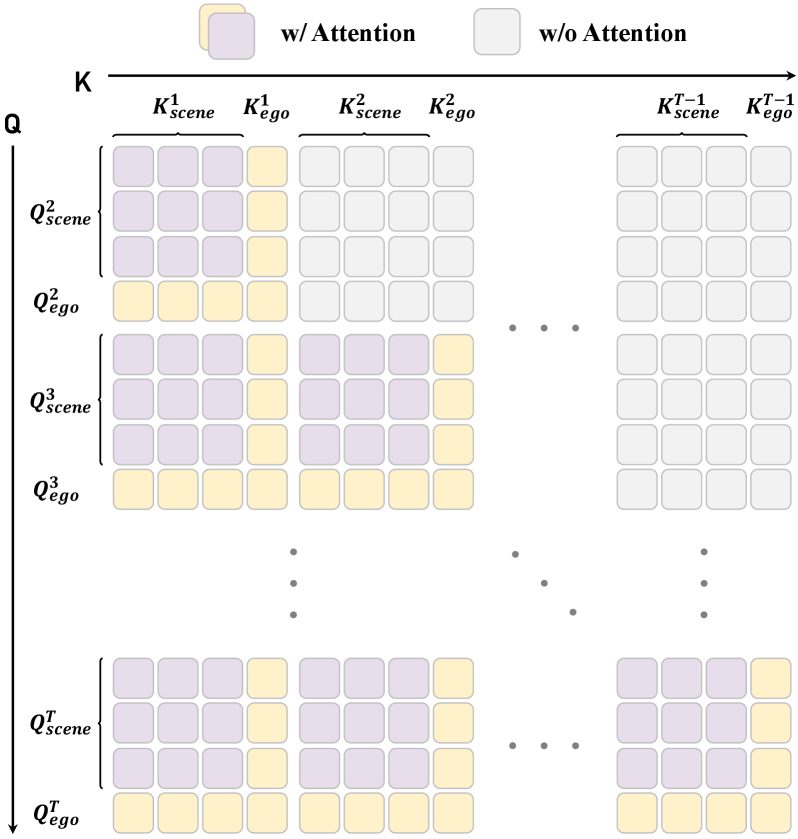
Причинно-следственное прогнозирование реализуется посредством покадровых масок внимания, как показано в Fig.˜3. Внутри каждого блока кадров токены учитывают друг друга двунаправленно. Между кадрами каждый токен может учитывать только те токены, которые появляются ранее в последовательности, что обеспечивает временную причинно-следственную связь. Такая конструкция покадрового внимания позволяет параллельно прогнозировать все будущие состояния мира при сохранении причинно-следственной согласованности, что значительно повышает скорость и эффективность обучения..
3.3.4 3D-RoPE.
Хотя содержит представления состояния мира для нескольких временных меток и ракурсов камер, векторы запросов и контекстные признаки не несут явной информации о временном или пространственном положении. Чтобы позволить модели различать временные и пространственные взаимосвязи между токенами, мы внедряем пространственно-временную позиционную информацию в механизм multi-head attention с помощью 3D-RoPE, что позволяет дифференцировать токены по временным шагам, ракурсам камер и позициям внутри длинных последовательностей..
На практике мы разделяем размерность головы на три части для кодирования временной координаты , индекса камеры и индекса токена в и . Мы используем абсолютные индексы позиций для кодирования всех трех координат: временной размерности с частотой 50, индекса камеры с частотой 10 и индекса токена с частотой 100..
3.3.5 Контроль состояния эго-автомобиля.
Представление состояния мира содержит как токены сцены, так и эмбеддинги статуса эго-автомобиля. В процессе прогнозирования мировой модели статус эго-автомобиля направляет эволюцию представлений сцены, а также самого себя. Таким образом, точное прогнозирование статуса эго-автомобиля имеет решающее значение для моделирования динамики мира. Чтобы обеспечить точное руководство для перехода состояния мира, мы вводим контроль статуса эго-автомобиля, основанный на самообучающемся прогнозировании будущего статуса..
Мы извлекаем эмбеддинги статуса эго-автомобиля из предсказанного будущего состояния мира , где . Затем эти эмбеддинги подаются в три отдельных MLP: декодер команд вождения , декодер скорости и декодер ускорения , формируя прогнозы , и соответственно. Формально:
| (4) |
3.4 Планирование траектории
Мы используем декодер траекторий для планирования, который генерирует траектории, соответствующие различным намерениям вождения на основе команд управления. Набор случайно инициализированных обучаемых запросов траекторий подается в декодер траекторий вместе с текущим представлением состояния мира сценария вождения. После обработки токены траектории декодируются с помощью легковесного MLP в траекторий-кандидатов. Наконец, с учетом команды вождения на текущем временном шаге , соответствующая траектория-кандидат выбирается в качестве итоговой траектории . Формально,
| (5) |
Каждая декодированная кандидатная траектория представляет собой последовательность из поз, охватывающую период от текущего временного шага до будущего момента времени , где обозначает общий горизонт прогнозирования. Каждая поза представлена как , что дает полные траектории в , где и соответствуют продольному и поперечному смещениям соответственно, а обозначает угол курса. Все величины отнесены к локальной системе координат эго-транспортного средства на временном шаге . Предполагается, что временной интервал между последовательными прогнозируемыми позами является равномерным..
3.5 Обучение и логический вывод
Цель обучения. Следуя предыдущим работам, мы используем функцию потерь для оптимизации сгенерированных многовариантных траекторий путем имитации экспертных траекторий. Геометрическое выравнивание вычисляет функцию потерь косинусного сходства на нормализованных признаках, максимизируя косинусное сходство для дистилляции способности к пространственному пониманию. Для модели мира мы используем MSE функцию потерь для оптимизации прогнозирования будущего состояния мира. Будущий статус эго-автомобиля требует контроля над командой вождения, скоростью и ускорением, включая , и . Общая функция потерь для статуса эго-автомобиля составляет . Итоговая функция потерь для сквозного обучения —:
| (6) |
где , и ⟧.
3.5.1 Вывод.
Во время вывода требуются только пространственно-ориентированный сжимающий кодировщик и декодер траекторий, без каких-либо дополнительных модулей, которые могли бы увеличить задержку вывода..
4 Эксперимент
4.1 Детали реализации
4.1.1 Архитектура.
Мы используем DINOv2-Base [oquab2023dinov2] в качестве нашего визуального энкодера (86,6 млн параметров), который составляет основу пространственно-ориентированного сжимающего мирового энкодера (SCWE) и генерирует патч-токены размерности . Мы применяем обучаемых запросов сцены размерности , проецируемых в латентное пространство посредством MLP. Мы устанавливаем временной горизонт на кадров и используем три вида с камер — левый, передний и правый. Каждый вид изменяется до размера перед подачей в мировой энкодер. Примечательно, что геометрическая фундаментальная модель, которую мы используем, — это WorldMirror [liu2025worldmirror], модель прямого распространения, построенная на базе VGGT [wang2025vggt]. Размерность карты геометрических признаков для эталонных данных составляет .
Для DLWM мы проектируем причинно-следственный декодер transformers с 3D-RoPE для позиционного эмбеддинга. Декодер траекторий следует стандартной архитектуре transformers. Как DLWM, так и декодер траекторий состоят из 4 слоев с 8 головами внимания, скрытой размерностью 256 и размерностью FFN 1024. Чтобы обеспечить представления состояния мира в качестве ground truth для обучения с самоконтролем, мы дополнительно вводим замороженный SCWE, обновляемый посредством экспоненциального скользящего среднего (EMA), поддерживая полную архитектурную симметрию с онлайн-энкодером..
Модель содержит 104M параметров во время вывода. В процессе обучения вводится дополнительный EMA encoder для самообучения, доводя общее число до 191M, из которых только 104M являются обучаемыми..
4.1.2 Конфигурация обучения.
Latent-WMA обучается на 32 графических процессорах A100 в течение 100 эпох с общим размером пакета 512, что занимает примерно два дня. Мы используем оптимизатор AdamW [loshchilov2019adamw] со скоростью обучения и коэффициентом затухания весов 0,05. График обучения включает линейный прогрев в течение первых 10% шагов с последующим использованием косинусного отжига до после достижения пика. Для уменьшения объема используемой памяти применяется обучение со смешанной точностью BF16..
4.2 Бенчмарки и основные результаты
4.2.1 NAVSIM.
NAVSIM [im2024navsim] — это набор данных для автономного вождения в реальных условиях, построенный на базе OpenScene [openscene2023] и nuPlan [nuplan], включающий 103 тысячи сценариев для обучения и 12 тысяч для оценки. NAVSIM v1 оценивает планирование с замкнутым контуром с использованием показателя Predictive Driver Model Score (PDMS), который объединяет отсутствие столкновений по вине системы (NC), соблюдение границ проезжей части (DAC), время до столкновения (TTC), прогресс эго-транспортного средства (EP) и комфорт (C). NAVSIM v2 [cao2025navsimv2] расширяет PDMS до EPDMS, добавляя метрики соблюдения правил — соблюдение направления движения (DDC), соблюдение сигналов светофора (TLC), удержание полосы движения (LK) — и уточняет комфорт, разделяя его на комфорт на основе истории (HC) и расширенный комфорт (EC).).
Результаты на NAVSIM v2 представлены в Tab.˜1. Latent-WMA достигает наивысшего показателя EPDMS среди всех методов, включая те, что опираются на аннотации восприятия. Наш метод демонстрирует строгое соблюдение правил, при этом DDC, TLC и LK входят в число лучших. По сравнению с Drive-JEPA [wang2026drivejepa], который дополнительно полагается на аннотации восприятия, наш подход без использования восприятия немного отстает по показателям безопасности, но достигает существенно лучших результатов по EC. Наш EP (87.7) немного ниже, чем у Epona (88.6), вероятно, потому что наше планирование с учетом безопасности отдает предпочтение поддержанию более безопасных дистанций, а не агрессивному продвижению эго-автомобиля..
| Method | NC | DAC | DDC | TLC | EP | TTC | LK | HC | EC | EPDMS |
| Perception-based Methods | ||||||||||
| TransFuser [transfuser] | 96.9 | 89.9 | 97.8 | 99.7 | 87.1 | 95.4 | 92.7 | 98.3 | 87.2 | 76.7 |
| DriveSuprim [yao2025drivesuprim] | 97.5 | 96.5 | 99.4 | 99.6 | 88.4 | 96.6 | 95.5 | 98.3 | 77.0 | 83.1 |
| ReCogDrive [li2025recogdrive] | 98.3 | 95.2 | 99.5 | 99.8 | 87.1 | 97.5 | 96.6 | 98.3 | 86.5 | 83.6 |
| DiffusionDrive [diffdrive] | 98.2 | 95.9 | 99.4 | 99.8 | 87.5 | 97.3 | 96.8 | 98.3 | 87.7 | 84.5 |
| WorldRFT[yang2025worldrft] | 97.8 | 96.5 | 99.5 | 99.8 | 88.5 | 97.0 | 97.4 | 98.1 | 69.1 | 86.7 |
| Drive-JEPA† [wang2026drivejepa] | 98.4 | 98.6 | 99.1 | 99.8 | 88.4 | 97.8 | 97.6 | 97.9 | 84.8 | 87.8 |
| Perception-free Methods | ||||||||||
| World4Drive [zheng2025world4drive] | 97.8 | 96.3 | 99.4 | 99.8 | 88.3 | 97.1 | 97.7 | 98.0 | 53.9 | 84.8 |
| Epona [zhang2025epona] | 97.1 | 95.7 | 99.3 | 99.7 | 88.6 | 96.3 | 97.0 | 98.0 | 67.8 | 85.1 |
| DriveVLA-W0 [li2025drivevla-w0] | 98.5 | 99.1 | 98.0 | 99.7 | 86.4 | 98.1 | 93.2 | 97.9 | 58.9 | 86.1 |
| Ours | 98.1 | 97.3 | 99.6 | 99.8 | 87.7 | 97.3 | 97.6 | 98.1 | 87.3 | 89.3 |
4.2.2 HUGSIM.
Для оценки в замкнутом цикле мы используем HUGSIM [zhou2024hugsim], эталонный тест со сценариями из KITTI-360 [kitti360], nuScenes [nuscenes], PandaSet [pandaset] и Waymo [waymo]. Эти сценарии реконструируются как фотореалистичные трехмерные среды, в которых планировщик управляет автономным транспортным средством с помощью камер RGB с динамически настраиваемыми точками обзора..
| Method | RC | HD-Score | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| E | M | H | X | Avg. | E | M | H | X | Avg. | ||
| UniAD | [hu2023uniad] | 58.6 | 41.2 | 40.4 | 26.0 | 40.6 | 48.7 | 29.5 | 27.3 | 14.3 | 28.9 |
| VAD | [jiang2023vad] | 38.7 | 27.0 | 25.5 | 23.0 | 27.9 | 24.3 | 9.9 | 10.4 | 8.2 | 12.3 |
| LTF | [chitta2022transfuser] | 68.4 | 40.7 | 36.9 | 25.5 | 41.4 | 52.8 | 24.6 | 19.8 | 8.1 | 24.8 |
| GTRS-Dense | [li2025gtrs] | 64.2 | 50.0 | 20.7 | 22.3 | 38.0 | 55.5 | 39.0 | 11.7 | 14.3 | 28.6 |
| Ours | 84.2 | 42.5 | 30.6 | 35.5 | 45.9 | 72.5 | 24.0 | 12.2 | 18.1 | 28.9 | |
| E: Easy, M: Medium, H: Hard, X: Extreme | |||||||||||
⟦Tab.˜2 представляет результаты на тестовом наборе HUGSIM до начала соревнования, который содержит 436 сценариев четырех уровней сложности. Следуя протоколу zero-shot, мы проводим оценку с использованием Road Completion (RC) и HUGSIM Driving Score (HD-Score) — последний объединяет RC со средними значениями NC, DAC, TTC и метриками комфорта. Мы оцениваем Latent-WMA в условиях zero-shot на HUGSIM: модель обучается исключительно на NAVSIM без какой-либо донастройки, однако достигает 45.9 RC и 28.9 HD-Score, занимая первое место по RC и соответствуя лучшему показателю HD-Score среди всех базовых моделей..
4.3 Анализ абляции
| Scene Representation | Dynamic World Modeling | EPDMS | ||
|---|---|---|---|---|
| Compression | Geometry | World Model | Ego Status | |
| ✗ | ✗ | ✗ | ✗ | 87.9 |
| ✓ | ✗ | ✗ | ✗ | 87.7 |
| ✓ | ✗ | ✓ | ✗ | 88.0 |
| ✓ | ✗ | ✓ | ✓ | 88.3 |
| ✓ | ✓ | ✗ | ✗ | 88.6 |
| ✓ | ✓ | ✓ | ✗ | 89.0 |
| ✓ | ✓ | ✓ | ✓ | 89.3 |
4.3.1 Эффективность каждого компонента.
Мы проводим прогрессивные абляционные эксперименты, постепенно добавляя модули к базовой модели, как показано в Tab.˜3.
Представление сцены. Базовая модель напрямую подает токены фрагментов изображения в декодер траекторий, достигая 87,9 EPDMS. Чтобы обеспечить прогнозирование на длительный горизонт в модели мира, мы сжимаем фрагменты изображения в компактные токены сцены, что приводит лишь к незначительному снижению производительности (). Внедрение геометрической информации повышает производительность до 88,6, демонстрируя, что геометрическое восприятие имеет решающее значение для точного планирования траектории..
Динамическое моделирование мира. Основываясь на сжатых токенах сцены, DLWM улучшает производительность с 87.7 до 88.0 за счет учета будущей динамики. Добавление статуса эго-автомобиля дополнительно повышает оценку до 88.3, что указывает на то, что осведомленность о собственном состоянии полезна для планирования. С использованием геометрической информации модель мира достигает 89.0. Полная модель, объединяющая все компоненты, достигает 89.3, показывая, что все модули вносят синергетический вклад..
4.3.2 Влияние геометрической информации.
Мы сравниваем различные подходы к внедрению геометрической информации, как показано в Tab.˜5.
Без геометрической информации полная модель (с учетом сжатия, world model и статуса ego) достигает 88.3 EPDMS. Прямое объединение замороженных геометрических признаков в качестве входных данных типа ключ-значение, как ни странно, снижает производительность до 88.0, вероятно, из-за несоответствия между замороженными признаками и задачей планирования, что приводит к возникновению противоречивых сигналов..
Напротив, дистилляция геометрических знаний в визуальный каркас повышает производительность до 89.3. Сквозная донастройка позволяет модели изучать пространственно-ориентированные представления, внутренне согласованные с последующим планированием, что приводит к существенным преимуществам по сравнению с обеими альтернативами..
4.3.3 Визуальный каркас для геометрической дистилляции.
Мы сравниваем различные масштабы магистральных сетей и стратегии дообучения для геометрической дистилляции, как показано в Tab.˜5.
| Geometric Information | EPDMS |
|---|---|
| w/o Geometric feature | 88.3 |
| Concatenation | 88.0 |
| Distillation | 89.3 |
| DINO Backbone | EPDMS |
|---|---|
| Small | 86.3 |
| Base | 89.3 |
| Small-LoRA | 84.7 |
| Base-LoRA | 68.5 |
Масштаб магистральной сети. DINO-Small достигает 86.3 EPDMS, но остается субоптимальной из-за недостаточной емкости параметров для высокоразмерных геометрических признаков. DINO-Base с полной донастройкой достигает наилучшей производительности (89.3), что указывает на то, что достаточная емкость магистральной сети необходима для эффективной дистилляции..
Стратегия обучения. Эффективная по параметрам донастройка через LoRA приводит к серьезной деградации и нестабильности обучения как для DINO-Small-LoRA (84.7), так и для DINO-Base-LoRA (68.5). Низкоранговые ограничения LoRA недостаточны для дистилляции высокоразмерных геометрических признаков, которые требуют полного обновления параметров. Примечательно, что DINO-Base-LoRA деградирует сильнее, чем DINO-Small-LoRA, поскольку в более крупной модели при использовании LoRA замораживается больше параметров, что усиливает несоответствие между низкоранговым подпространством обновления и высокоразмерной целью дистилляции..
Подводя итог, эффективная геометрическая дистилляция требует как достаточной емкости модели, так и полной гибкости fine-tuning..
4.3.4 Прогнозирование временного шага мировой модели.
Мы исследуем влияние временного шага прогнозирования в DLWM, как показано в Tab.˜6.
Прогнозирование только финального кадра () позволяет достичь 88.4 EPDMS. Включение исторических кадров и промежуточных будущих прогнозов с шагом 4 () повышает производительность до 89.3, поскольку многошаговое прогнозирование обеспечивает более богатое обучение с учителем для обучения представлений..
Дальнейшее увеличение плотности до шага 2 () дает 89.1, не обеспечивая улучшения по сравнению с шагом 4. Поскольку все конфигурации прогнозируют до одного и того же горизонта (8 кадров), более плотная дискретизация не расширяет диапазон временных рассуждений. В то же время соседние кадры в сценах вождения демонстрируют высокое сходство, предоставляя ограниченный дополнительный обучающий сигнал. Более того, оптимизация большего количества целей прогнозирования может быть менее эффективной в условиях плотного контроля. Дополнительно, более плотное прогнозирование влечет за собой более высокие вычислительные затраты и более длительное время обучения..
Мы пришли к выводу, что умеренная плотность прогнозирования обеспечивает баланс между эффективностью обучения с учителем и эффективностью оптимизации.
| Prediction Temporal Stride | EPDMS |
|---|---|
| 88.4 | |
| 89.3 | |
| 89.1 |
4.3.5 Качественный анализ.
В этом разделе мы проводим качественную оценку Latent-WMA на NAVSIM, анализируя как эффективность планирования траектории, так и возможности пространственного понимания World Encoder после геометрической дистилляции.
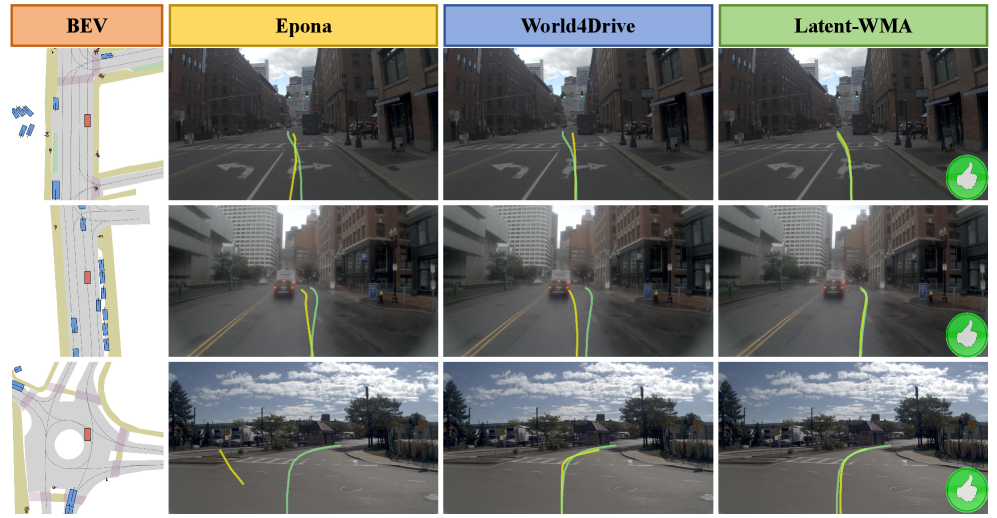
Сравнение траекторий. Как показано в Fig.˜4, мы сравниваем предсказанные траектории различных методов, основанных на world models (зеленый: траектории человека, желтый: предсказание). Наш метод лучше согласуется с траекториями человека и поддерживает более безопасные дистанции от других транспортных средств. Напротив, Epona [zhang2025epona] создает относительно менее качественные траектории, а World4Drive [zheng2025world4drive] выдает приемлемые, но не оптимальные пути..
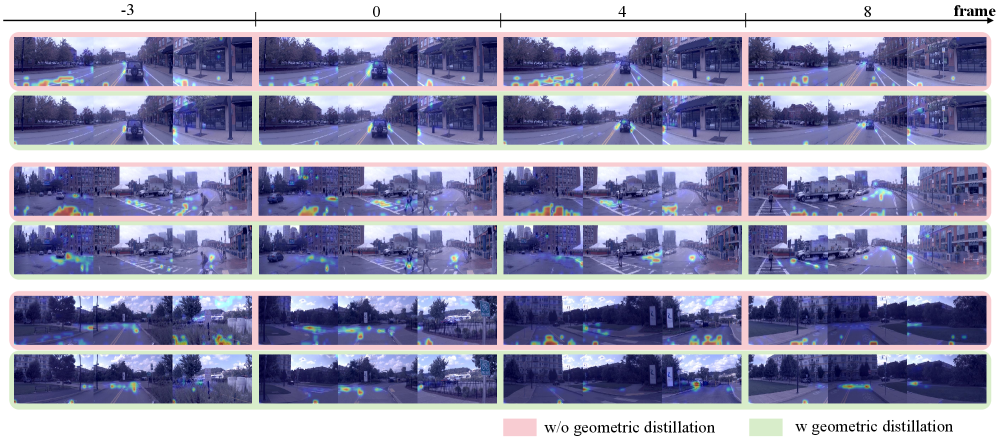
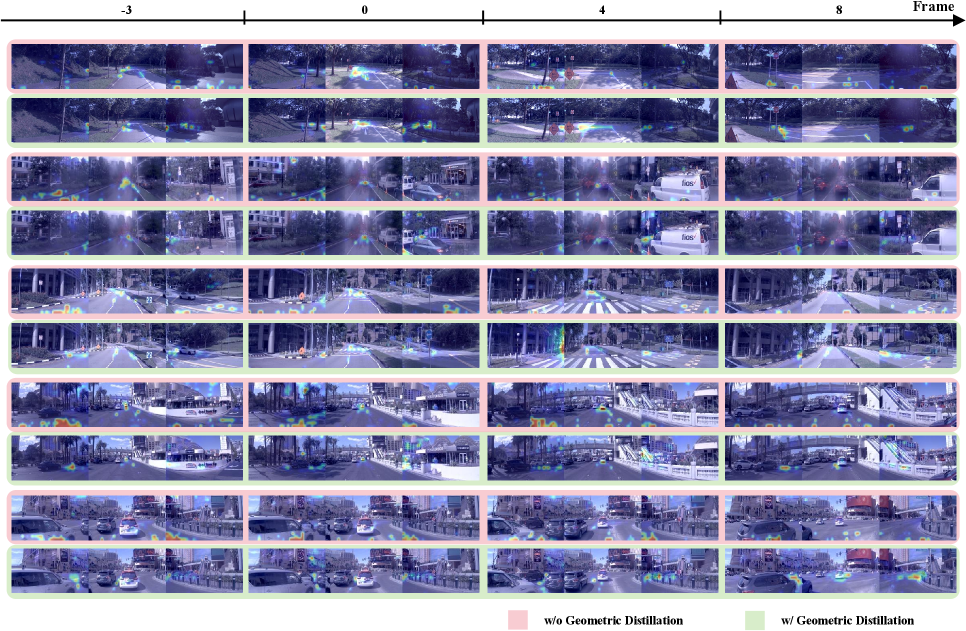
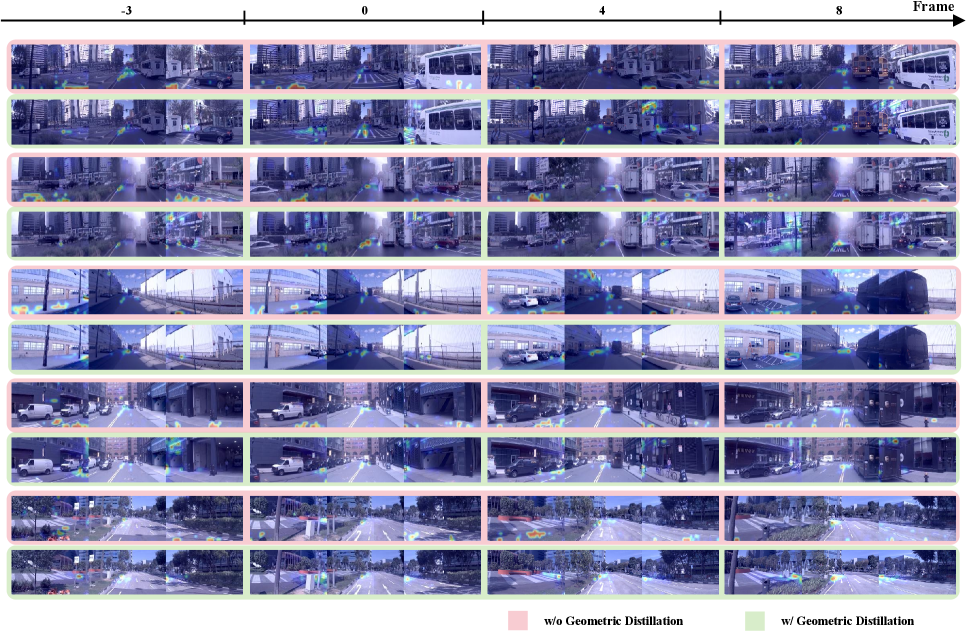
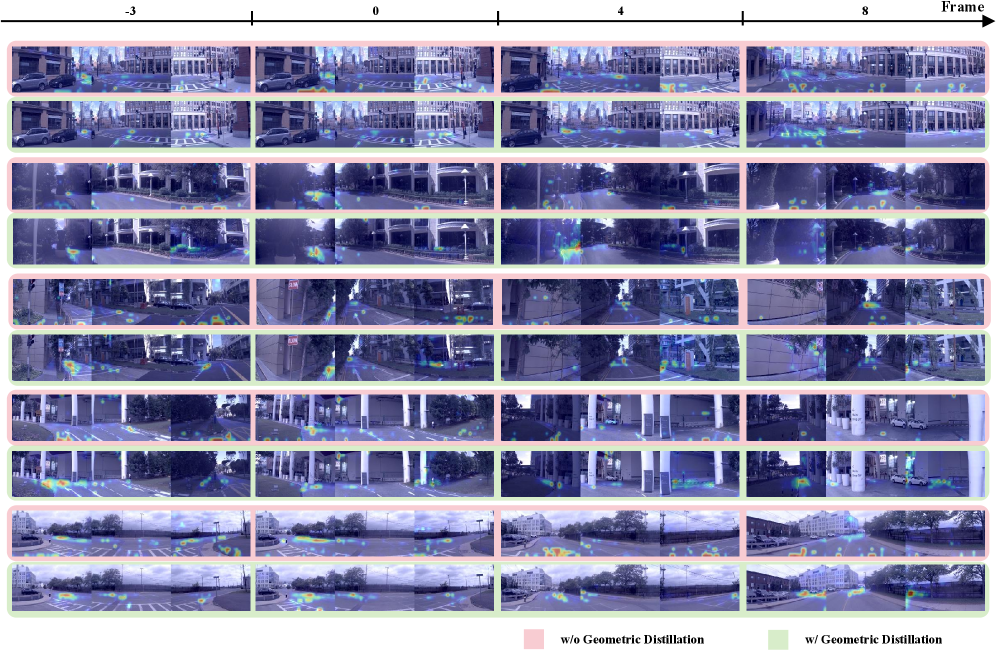
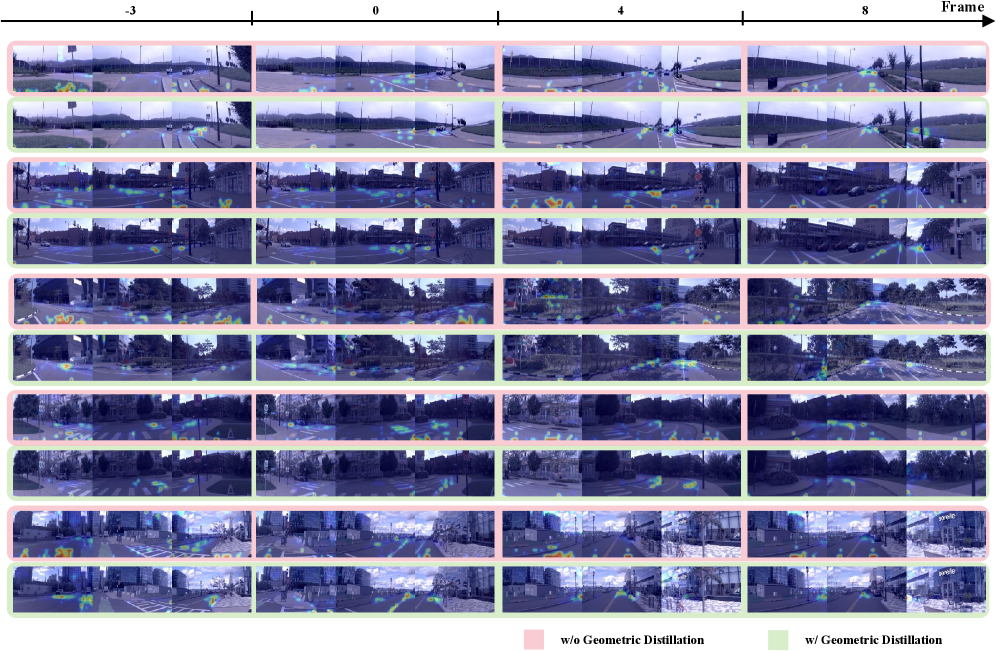
Пространственное понимание. Чтобы исследовать, как геометрическая дистилляция улучшает пространственное понимание, мы визуализируем карты перекрестного внимания между токенами сцены и фрагментами изображения в Fig.˜5.
По сравнению с базовым методом, который лишь сжимает изображения в токенизированные представления сцены без геометрической дистилляции, наша модель демонстрирует значительно более сфокусированные паттерны внимания, концентрируясь на дорожной разметке, структуре сцены и областях, пригодных для движения, которые критически важны для планирования траектории. Базовый метод, напротив, создает рассеянное внимание, распределяя значительные веса на нерелевантные фоновые области (например, небо, отдаленные здания), что свидетельствует о том, что без геометрического контроля сжатые токены сцены склонны кодировать зашумленную информацию, которая мешает последующему планированию..
Более того, наши карты внимания демонстрируют более сильное соответствие с лежащей в основе геометрической структурой. В то время как базовый метод показывает размытые и рассредоточенные области внимания, наш World Encoder создает компактные паттерны, которые плотно следуют геометрическим границам — таким как дорожная разметка и свободные пространства, прилегающие к препятствиям..
Мы также визуализируем карты внимания при различных намерениях вождения, включая движение прямо, поворот направо и поворот налево. Распределение внимания сильно коррелирует с намерением вождения: модель преимущественно фокусируется на областях вдоль намеченного направления, в то время как зоны, отклоняющиеся от запланированной траектории, получают минимальное внимание. Такое поведение, учитывающее намерения, демонстрирует, что наш World Encoder учится избирательно фокусироваться на пространственной информации, релевантной задаче, в зависимости от контекста вождения..
5 Заключение
Мы представили Latent-WAM, end-to-end фреймворк для автономного вождения, который создает компактные, значимые для планирования представления мира посредством пространственно-ориентированного сжатия и динамического латентного моделирования. Spatial-Aware Compressive World Encoder дистиллирует геометрические знания из foundation model в vision backbone, сжимая изображения с нескольких камер в небольшой набор пространственно-информированных токенов сцены. Dynamic Latent World Model использует причинно-следственный Transformer с 3D-RoPE для авторегрессионного прогнозирования будущего состояния мира, приобретая динамическое понимание посредством самообучающегося визуального и контролируемого прогнозирования движения. Latent-WAM достигает новых state-of-the-art результатов как на NAVSIM v2 (89.3 EPDMS), так и на HUGSIM (45.9 RC и 28.9 HD-Score) при значительно меньшем объеме обучающих данных и меньшем количестве параметров по сравнению с конкурирующими методами..
Список литературы
Дополнительные материалы
А. Метрики
А.1. NAVSIM
NAVSIM v2 [cao2025navsimv2] расширяет метрику PDMS из NAVSIM v1 [im2024navsim] до расширенной метрики PDMS (EPDMS):
| (7) |
где NC, DAC, DDC, TLC, EP, TTC, LK, HC и EC обозначают отсутствие вины в столкновении, соблюдение границ проезжей части, соблюдение направления движения, соблюдение сигналов светофора, прогресс автономного транспортного средства, время до столкновения, удержание полосы движения, комфорт при движении по истории и расширенный комфорт соответственно. Среди них DDC, TLC, LK, HC и EC являются новыми показателями, представленными в NAVSIM v2.
А.2. HUGSIM
Оценка вождения HUGSIM [zhou2024hugsim] (HD-Score) в момент времени вычисляется как произведение показателей стратегии вождения и средневзвешенного значения вкладов отдельных элементов.:
| (8) |
где NC, DAC, TTC и COM обозначают отсутствие столкновений по вине агента, соблюдение границ проезжей части, время до столкновения и комфорт эго-автомобиля соответственно. Данные метрики следуют тем же определениям, что используются в NAVSIM v1.
Итоговые значения HD-Score представляют собой усредненные по всем временным меткам покадровые оценки, масштабированные с учетом показателя завершенности маршрута :
| (9) |
Примечательно, что NC и TTC учитывают столкновения со статичными фоновыми объектами (например, зданиями, ограждениями, растительностью) с использованием семантической сегментации.
B. Конвейер обработки данных
Б.1. Предварительная обработка изображений
Мы используем три вида с камер (левый, передний, правый) в качестве входных данных. Каждое изображение проходит двухэтапный конвейер предварительной обработки: изменение размера с последующей центральной обрезкой. В частности, исходные изображения сначала масштабируются до , а затем подвергаются центральной обрезке до итогового разрешения , что дает соотношение сторон 2:1..
B.2. Корректировка внутренних параметров камеры
При применении геометрического извлечения признаков к изображениям матрица внутренних параметров камеры должна быть соответствующим образом скорректирована для поддержания геометрической согласованности. Учитывая исходную матрицу внутренних параметров :
| (10) |
где и обозначают фокусные расстояния вдоль осей и , а представляет главную точку. После изменения размера с на коэффициенты масштабирования вычисляются как:
| (11) |
Для центральной обрезки до смещения обрезки составляют:
| (12) |
Скорректированные внутренние параметры затем:
| (13) |
получая скорректированную внутреннюю матрицу :
| (14) |
B.3. Преобразование внешних параметров камеры
Матрица внешних параметров камеры представляет собой преобразование из координат камеры в мировые координаты (LiDAR). Мы конструируем матрицу перехода от камеры к миру как:
| (15) |
где — матрица поворота, а — вектор переноса. Матрица перехода из мировых координат в камерные , используемая для 3D-в-2D проекции, получается путем инверсии матрицы:
| (16) |
B.4. Извлечение геометрических признаков
Следуя формулировке геометрического выравнивания в разделе Методология, мы извлекаем геометрические признаки на уровне патчей из изображений с нескольких ракурсов, используя замороженную геометрическую фундаментальную модель WorldMirror [liu2025worldmirror] в качестве , где обозначает количество временных кадров, обозначает количество ракурсов камер, обозначает количество токенов патчей на ракурс, а обозначает размерность геометрических признаков.
Извлечение априорных данных камер. При наличии изображений с нескольких ракурсов , а также их внутренних и внешних параметров камер, геометрическая фундаментальная модель сначала кодирует эти входные данные в пространственно-геометрические априорные представления , которые инкапсулируют положения камер, оценки глубины и внутренние параметры.:
| (17) |
Геометрическое кодирование признаков. Затем визуальный геометрический transformers обрабатывает изображения с учетом этих априорных данных. Следуя условной архитектуре модели, мы используем информацию о положении камеры и ее внутренних параметрах (обозначенных флагами условий для положения камеры, глубины и внутренних параметров соответственно), исключая при этом контроль глубины.:
| (18) |
Поскольку остается замороженной на протяжении всего обучения, мы предварительно вычисляем и кэшируем в автономном режиме для всех обучающих выборок, что позволяет осуществлять прямую загрузку во время обучения без затрат на повторный вывод. Такая архитектура существенно сокращает время обучения и потребление памяти графического процессора..
C. Задержка вывода
Мы измерили задержку вывода для каждого модуля Latent-WMA на одном графическом процессоре A100 для одного пакета данных. Задержка вывода каждого модуля показана в Tab.˜7. Задержка оценивалась после трех итераций прогрева, при этом итоговое число было усреднено по 10 проходам вперед..
| Module | Parameters | Memory Usage | Latency | ||
|---|---|---|---|---|---|
| World Encoder | 86.6M | — | 100ms | ||
| Trajectory Decoder | 8.4M | — | 6ms | ||
| All modules | 104M | 1.1GB | 107ms |
D. Дополнительная визуализация
D.1. Планирование траектории
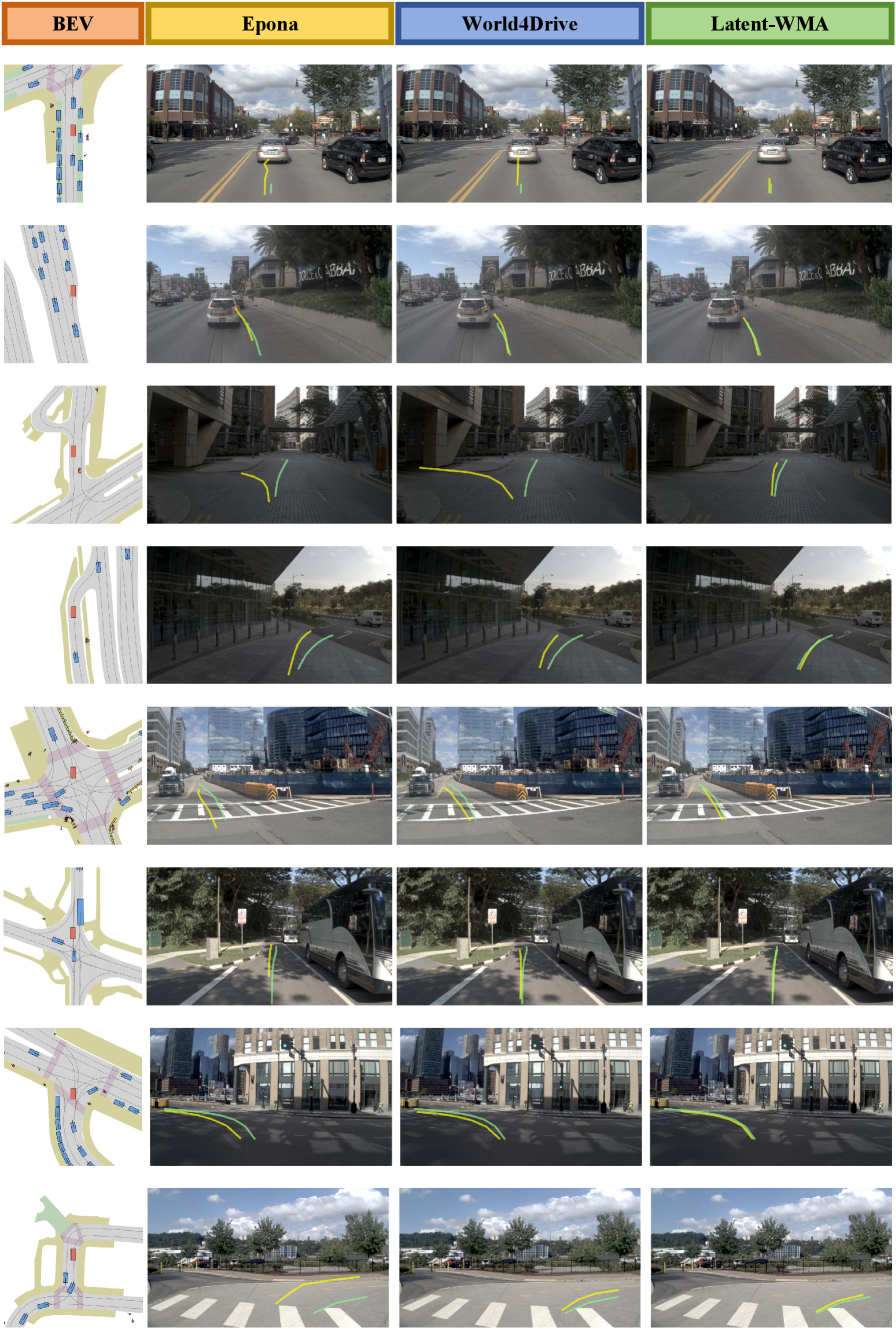
D.2. Карта внимания
0..0.1 С.3. HUGSIM