Агентное использование инструментов в больших языковых моделях
Аннотация.
Крупные языковые модели все чаще используются в качестве автономных агентов, однако их эффективность в реальном мире зависит от надежных инструментов для поиска информации, вычислений и внешних действий. Существующие исследования остаются фрагментированными по задачам, типам инструментов и условиям обучения, не имея единого взгляда на то, как методы использования инструментов различаются и развиваются. В данной статье литература организована в три парадигмы: prompting как plug-and-play, supervised tool learning и reward-driven tool policy learning, анализируются их методы, сильные стороны и режимы сбоев, рассматривается ландшафт оценки и выделяются ключевые вызовы, с целью преодоления этой фрагментации и предоставления более структурированного эволюционного взгляда на агентное использование инструментов..
Ключевые слова:
Большие языковые модели, Агентное использование инструментов, Проектирование подсказок, Настройка инструкций, Обучение с подкреплением1. Введение
Искусственный интеллект (ИИ) эволюционировал от ранних экспертных систем на основе правил к современному машинному обучению, основанному на данных (Bishop2006PRML). Архитектура Transformer (Vaswani2017Attention) стала катализатором этого перехода и позволила появиться крупным языковым моделям (LLM). Фундаментальные модели, такие как BERT (Devlin2019BERT) и T5 (Raffel2020T5), заложили прочные парадигмы для понимания и генерации естественного языка. Последующие модели, включая Llama 2 (Touvron2023Llama2), Qwen (Qwen2025Qwen25), Mixtral (Jiang2024Mixtral) и GPT-4 (OpenAI2023GPT4), продемонстрировали беспрецедентные возможности. Предварительно обученные на огромных корпусах (Gao2020Pile), эти модели проявляют возникающие сильные стороны (Wei2022EmergentAbilities) в контекстном понимании, сложном рассуждении (Kojima2022ZeroShotReasoners) и генерации контента..
Однако стандартные LLM по-прежнему остаются по своей природе статичными. Их знания ограничены обучающими данными, что может приводить к фактическим ошибкам или «галлюцинациям» (Lewis2020RAG). Они также испытывают трудности с доступом к информации в реальном времени, выполнением точных вычислений или надежным взаимодействием с внешними системами (Ji2023HallucinationSurvey). Эти ограничения, вместе с рисками безопасности и предвзятости, унаследованными от данных масштаба веба (Bender2021StochasticParrots), ограничивают применение в динамичных реальных условиях..
Для преодоления этих ограничений агентный ИИ стал центральной парадигмой (Zhao2023LLMAIAgentsSurvey; Wang2024LLMAutonomousAgents; Mialon2023AugmentedLMs). В этой парадигме LLM служит ядром рассуждения, но дополняется возможностями планирования, памяти и действия. Использование инструментов является ключевым механизмом, который реализует действие (Schick2023Toolformer; Shen2023HuggingGPT). Вызывая внешние инструменты (например, API, базы данных и интерпретаторы кода), агент LLM может получать доступ к актуальным знаниям через поиск (Nakano2021WebGPT), повышать вычислительную точность через программное выполнение (Gao2023PAL) и выполнять операции в реальном мире через внешние системы (Shen2023HuggingGPT).⟧.
Растущая значимость использования инструментов стимулировала значительную исследовательскую активность, включая несколько обзоров, которые пытаются структурировать эту область. Существующие обзоры охватывают дополнительные перспективы: одни акцентируют внимание на архитектуре агента (планирование, память и действие) (Zhao2023LLMAIAgentsSurvey); другие рассматривают расширенные языковые модели и механизмы внешней памяти/инструментов (Mialon2023AugmentedLMs; Zhang2025MemoryAgents); а третьи сосредоточены на таксономиях инструментов и конвейерах построения данных (Qu2025ToolLearningLLM). Несмотря на их ценность, многие из этих рамок предоставляют в основном статичный снимок. Что остается недостаточно проработанным — это методологическая эволюция от prompting как plug-and-play к контролируемому обучению инструментам и обучению политике, основанной на вознаграждении. Этот отсутствующий эволюционный взгляд может затушевывать как преемственность, так и компромиссы между парадигмами. Таблица 1 сравнивает представительные обзоры по шести измерениям: хронологическая эволюция, таксономия парадигм, охват инструментов, обучающие данные, ландшафт оценки и открытые вызовы..
| Survey Paper | Chronological evolution | Paradigm taxonomy | Tool coverage | Training data | Evaluation landscape | Open challenges |
|---|---|---|---|---|---|---|
| Zhao et al. (Zhao2023LLMAIAgentsSurvey) | ✓ | ✗ | ✗ | ✗ | ✓ | ✓ |
| Wang et al. (Wang2024LLMAutonomousAgents) | ✓ | ✗ | ✗ | ✗ | ✓ | ✓ |
| Mialon et al. (Mialon2023AugmentedLMs) | ✓ | ✗ | ✗ | ✗ | ✓ | ✓ |
| Qu et al. (Qu2025ToolLearningLLM) | ✗ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Shen (Shen2024LLMWithToolsSurvey) | ✗ | ✓ | ✓ | ✓ | ✗ | ✓ |
| Chen et al. (Chen2025ToolLearningComprehensiveSurvey) | ✗ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Ours | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
В этой статье мы вносим несколько ключевых вкладов в область использования агентных инструментов на основе LLM:
- • Мы предлагаем эволюционный синтез агентного использования инструментов, прослеживая, как область развивается от управления на основе подсказок к контролируемому обучению инструментам и обучению политике, основанному на вознаграждении..
- • Мы предлагаем единую таксономию с тремя парадигмами с явными методологическими границами, уточняя роль сигналов оптимизации (контекстное управление, контролируемые сигналы и обратная связь по вознаграждению).
- ⟦Мы систематизируем ландшафт оценки как сквозное измерение, связывающее семейства методов с уровнями бенчмарков от корректности вызова функций до комплексного интерактивного успеха, безопасности и устойчивости..
- ⟦Мы выявляем нерешённые задачи и практические направления исследований, включая распределение кредитов на длинных горизонтах, масштабируемую генерализацию инструментов и развертывание с учётом выравнивания..
В этом обзоре мы синтезируем агентное использование инструментов с явно эволюционной точки зрения. Мы организуем предыдущие работы в три методологических парадигмы: (I) Подсказка как Plug-and-Play, где замороженная модель направляется на использование инструментов через подсказки и взаимодействие в контексте вместо обновления весов (Xie2022ICLBayes); (II) Обучение инструментам с учителем, которое использует размеченное или синтетическое обучение для внутреннего усвоения устойчивого поведения при использовании инструментов (Shen2023HuggingGPT); и (III) Обучение политике использования инструментов на основе вознаграждения, которое оптимизирует долгосрочное взаимодействие через подкрепление и обратную связь по вознаграждению (Shinn2023Reflexion). Мы дополнительно анализируем оценку как сквозное измерение и отслеживаем её эволюцию от корректности вызова функции (Li2023APIBank) до успешного выполнения задачи в интерактивных условиях (Liu2024AgentBench). Через эту призму мы стремимся предоставить согласованную карту области, прояснить компромиссы в дизайне, связывающие парадигмы, и соединить фундаментальные методы с новыми системами автономных агентов. Рисунок 1 суммирует эту структуру..
- ⟦Prompting как Plug-and-Play. Этот первоначальный подход использует замороженные параметры LLM и опирается на обучение в контексте и проектирование подсказок. Он не требует обучения модели. Эта категория исследует управляющие потоки, такие как чередующиеся циклы рассуждений и действий, которые смешивают мышление и действие, а также раздельное планирование и выполнение, которое отделяет планирование от действия. Хотя метод очень гибкий, он часто страдает от высокой задержки и затрат на токены, а его надежность может быть хрупкой для сложных многошаговых задач..
- ⟦Supervised Tool Learning. Этот подход переходит от проектирования подсказок к инженерии данных, чтобы преодолеть ограничения масштабируемости и надежности методов без настройки. Основная идея заключается в использовании контролируемой донастройки (SFT) для обучения моделей синтаксису и логике использования инструментов, внутренне интегрируя этот навык в параметры модели. Основная задача — создание масштабных, высококачественных наборов данных. Ключевые стратегии включают самообучаемую генерацию данных и синтез инструкций под руководством учителя для сложных многошаговых траекторий использования инструментов..
- ⟦Reward-Driven Tool Policy Learning. Эта парадигма смещается от статичного подражания к динамической оптимизации, рассматривая использование инструментов как задачу последовательного принятия решений. Используется обучение с подкреплением (RL) для тренировки агента с целью обнаружения эффективной политики в динамических средах, а не имитации фиксированных траекторий. Исследование направлено на стратегическое принятие решений, включая выбор момента вызова инструмента по сравнению с опорой на знания модели, а также распределение кредитов между несколькими инструментами в длинных цепочках вызовов инструментов..
- ⟦Оценка. Эта категория обобщает оценку агентов, использующих инструменты, и развивалась вместе с методологическими парадигмами. Бенчмарки продвинулись от проверки корректности вызова функций (валидный синтаксис и аргументы) к успешному выполнению задач от начала до конца в интерактивных средах. Недавние бенчмарки дополнительно оценивают, соблюдают ли агенты правила безопасности и операционные инструкции при выполнении задач..
Примечательно, что в этом обзоре подчеркивается взаимодополняющий характер трех парадигм и утверждается, что производственные системы, вероятно, будут сочетать все из них. Мы также обобщаем нерешенные задачи и перспективные направления исследований, включая распределение кредитов между несколькими инструментами в задачах с длинным горизонтом, автономное создание инструментов и саморасширение, а также интеграцию безопасности, выравнивания и соответствия в развернутые агентные системы. Организация остальной части этого обзора следующая. Мы начинаем с фона этого обзора в section 2, представляя хронологию развития использования инструментов LLM. Затем мы обсуждаем три методологических парадигмы: prompting как plug-and-play (section 3), supervised tool learning (section 4) и reward-driven tool policy learning (section 5). Мы рассматриваем оценку как сквозное измерение и обобщаем науку и бенчмарки оценки в section 6. В конце мы завершаем эту статью резюме трех взаимодополняющих парадигм и обсуждением наших будущих перспектив в section 7.⟧.
2. Предпосылки использования инструментов агентами
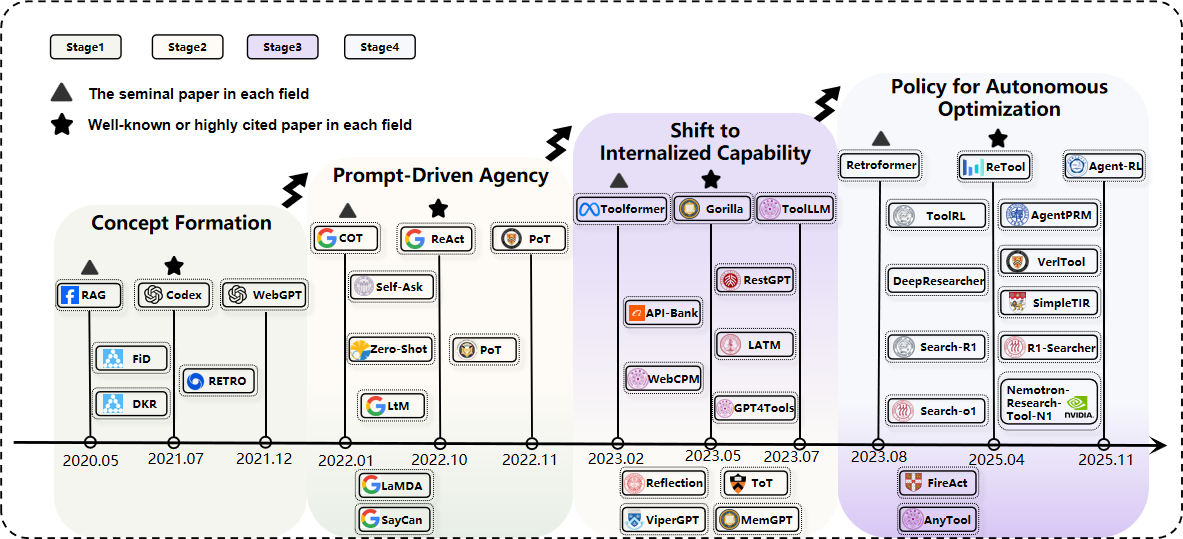
В этом разделе мы очерчиваем траекторию развития агентного использования инструментов, прослеживая эволюцию от элементарных нейросимволических концепций до современных сложных, самооптимизирующихся агентов. Этот прогресс охватывает первоначальные теоретические проекты, появление основанных на подсказках рамок рассуждений и переход к основанной на данных интернализации и обучению с подкреплением. Ключевые вехи, определяющие эту временную шкалу, иллюстрированы на рисунке 2⟧.
2.1. Раннее исследование и формирование концепции
Концептуальные основы агентного использования инструментов возникли до появления современных LLM с настройкой по инструкциям. По мере того как исследователи осознавали, что чисто параметрические модели ограничены в обновлении фактов, точных вычислениях и взаимодействии с внешними средами, ранние работы начали дополнять языковые модели внешними ресурсами, а не полагаться только на масштабирование. Важным шагом стало Retrieval-Augmented Generation (RAG) (Lewis2020RAG), которое показало, что сочетание генератора с непараметрической памятью может улучшить доступ к знаниям и снизить количество галлюцинаций. Эта линия мышления была далее обобщена MRKL (Karpas2022MRKL), которая рассматривала языковую модель как центральный маршрутизатор, способный направлять подзадачи специализированным модулям и символическим системам..
В то же время несколько работ вышли за рамки статического дополнения и перешли к явному взаимодействию. WebGPT (Nakano2021WebGPT) продемонстрировал, что модель может просматривать веб для сбора доказательств при ответах на вопросы в длинной форме, в то время как LaMDA (Thoppilan2022LaMDA) включил такие инструменты, как калькулятор и переводчик, в генерацию диалогов, показывая ценность обоснования ответов внешними утилитами. Помимо доступа к информации, TALM (Parisi2022TALM) исследовал, как меньшие модели могут быть обучены генерировать вызовы инструментов и использовать возвращаемые результаты через контролируемое обучение, предоставляя ранний пример использования инструментов, ориентированных на API..
Понятие инструментов также расширилось за пределы традиционных API. Codex (Chen2021Codex) предположил, что языковые модели могут решать задачи, генерируя исполняемый код, фактически рассматривая выполнение программ как внешний вычислительный интерфейс. Параллельно SayCan (Ahn2022DoAsICan) расширил эту парадигму на воплощённые среды, сочетая априорные знания языковых моделей с возможностями роботов, позволяя LLM направлять выбор физических действий. Эти ранние исследования ещё не представляли собой универсальных агентов, но заложили ключевые компоненты последующих систем: доступ к внешним знаниям, модульную маршрутизацию, исполняемые действия и основанное на реальности взаимодействие с цифровой или физической средой..
2.2. Появление агентства, управляемого подсказками (2022-2023))
Опираясь на эти ранние исследования, учёные начали замечать, что большие языковые модели могут демонстрировать эффективное поведение при использовании инструментов без изменения своих параметров. Этот этап характеризовался инженерией подсказок и обучением в контексте, что позволяло вызывать поведение, похожее на поведение агента, у замороженных моделей через соответствующие рассуждения и структуры взаимодействия. Chain-of-Thought prompting (Wei2022ChainOfThought) заложил основу, показав, что LLM могут решать сложные задачи через явное промежуточное рассуждение. Опираясь на эту идею, ReAct (Yao2023ReAct) связал рассуждение с внешним действием через цикл Thought-Action-Observation, позволяя моделям решать, когда вызывать инструменты, и обновлять последующие шаги на основе возвращённых наблюдений. Self-Ask (Press2023CompositionalityGap) дополнительно подчеркнул ценность разбиения сложных вопросов на более простые подзадачи, особенно в вопросно-ответных системах с поддержкой инструментов. По мере усложнения задач Reflexion (Shinn2023Reflexion) ввёл саморефлексивную вербальную обратную связь, чтобы помочь агентам учиться на прошлых ошибках, в то время как Tree of Thoughts (Yao2023TreeOfThoughts) расширил линейное рассуждение в поиск по нескольким кандидатным траекториям, улучшая гибкость планирования..
Параллельно другая линия исследований улучшила надежность, перенаправляя части рассуждений к исполняемым промежуточным элементам. Program-Aided Language Models (Gao2023PAL) и Program of Thoughts (Chen2023ProgramOfThoughts) использовали генерацию кода для внешнего выполнения вычислений, повышая точность в арифметических и символических задачах. Эта идея была расширена до мультимодальных и нейросимволических настроек с помощью ViperGPT (Suris2023ViperGPT) и Binder (Cheng2023BindingSymbolic), где код служил структурированным интерфейсом для координации внешних инструментов. По мере роста экосистем инструментов исследователи также изучали более модульные формы оркестрации. ART (Paranjape2023ART) выбирал из шаблонов рассуждений с поддержкой инструментов, Chameleon (Lu2023Chameleon) рассматривал инструменты как компонуемые модули, ReWOO (Xu2023ReWOO) разделял планирование и выполнение для снижения накладных расходов на взаимодействие, а HuggingGPT (Shen2023HuggingGPT) представлял LLM в качестве центрального контроллера над разнообразными экспертными моделями..
Агентство, управляемое подсказками, также начало выходить за рамки решения задач за один ход в сторону устойчивого и открытого поведения. Generative Agents (Park2023GenerativeAgents) продемонстрировали роль памяти в продолжительном поведении агента, MemGPT (Packer2023MemGPT) представил механизм управления памятью для работы с взаимодействиями в длинном контексте, а Voyager (Wang2023Voyager) показал, что агенты, основанные на подсказках, могут непрерывно приобретать и совершенствовать навыки в воплощённых средах. Эти работы обозначили отдельную фазу, в которой использование инструментов, планирование и память могли быть вызваны преимущественно через подсказки, создавая практическую основу для последующих систем агентов, основанных на обучении и управляемых политиками..
2.3. Переход к контролируемому обучению инструментам (2023-2024))
По мере того как использование инструментов на основе подсказок становилось все более эффективным, его ограничения также становились более очевидными. Повторное использование подсказок вводило значительную задержку и избыточное количество токенов, в то время как длинные траектории рассуждений и действий часто оставались хрупкими в сложных задачах. Эти проблемы стимулировали переход от вызова использования инструментов в контексте к их внутреннему усвоению через обучение, что позволяло моделям вызывать инструменты более эффективно и надежно. Ранние усилия были направлены на контролируемое имитирование поведения с использованием инструментов. WebCPM (Qin2023WebCPM) показал, что языковые модели можно дообучать на траекториях веб-серфинга человека для целенаправленного взаимодействия, а Toolformer (Schick2023Toolformer) дополнительно продемонстрировал, что модели могут самостоятельно обучаться, когда и как вызывать API, вставляя аннотации использования инструментов в собственные обучающие данные. Это направление было расширено в настройках с инструкциями с помощью ToolAlpaca (Tang2023ToolAlpaca), который использовал синтетический надзор от более сильных моделей, и ToolLLM (Qin2023ToolLLM), который масштабировал обучение до тысяч реальных API..
По мере увеличения количества и разнообразия инструментов, внутреннее использование инструментов также требовало лучших механизмов для выбора, адаптации и оценки. API-Bank (Li2023APIBank) предоставил ранний эталон для планирования, вызова инструментов и генерации ответов в взаимодействии на основе API. Для улучшения масштабируемости при больших библиотеках инструментов AnyTool (Du2024AnyTool) ввёл иерархический поиск для сужения пространства кандидатов перед вызовом. Динамическая природа внешних интерфейсов представляла ещё одну проблему, поскольку API со временем эволюционируют, и новые инструменты появляются постоянно. Gorilla (Patil2024Gorilla) решил эту проблему, сочетая поиск с API-ориентированной донастройкой, что позволило моделям использовать актуальную документацию во время вывода. Связанные усилия, такие как RestGPT (Song2023RESTGPT) и GPT4Tools (Yang2023GPT4Tools), далее исследовали структурированное взаимодействие с RESTful API и генерацию специализированных данных для использования инструментов..
Последующие работы все больше сосредотачивались на устойчивости, переносе и балансе между агентным поведением и общей способностью. FireAct (Chen2023FireAct) показал, что дообучение на перемежающихся траекториях рассуждений и действий может существенно улучшить производительность меньших открытых моделей. Обобщение на невидимые инструменты было дополнительно изучено NexusRaven (Srinivasan2023NexusRaven), который акцентировал внимание на точном вызове функций из описаний инструментов, в то время как APIGen (Liu2024APIGen) улучшил качество данных за счет проверяемой синтетической генерации вызовов API. В то же время исследователи начали изучать, как специализация инструментов может быть интегрирована с более широкой компетенцией модели. Lemur (Xu2024Lemur) предложил унифицированную структуру, которая балансировала вызов функций, планирование инструментов и общее понимание языка, а AgentTuning (Zeng2024AgentTuning) дополнительно подчеркнул важность сохранения способности к универсальному рассуждению при оптимизации агентного поведения. Эти исследования ознаменовали переход от обучения использованию инструментов через подсказки к обучению этому в весах модели, установив supervised fine-tuning и синтетическую генерацию данных как практические пути к более эффективным, масштабируемым и устойчивым агентам, использующим инструменты..
2.4. Рост политики для автономной оптимизации (2024-настоящее время))
Несмотря на эффективность контролируемой донастройки, оставалось важное ограничение: статические обучающие сигналы часто были недостаточны для исследования, восстановления после ошибок и адаптации на длительном горизонте в динамических средах. В результате, недавние исследования все чаще обращаются к обучению с подкреплением, рассматривая многошаговое использование инструментов как задачу последовательного принятия решений, оптимизируемую через обратную связь от среды, а не только через имитацию. Этот этап можно понять как переход от обучения вызову инструментов к обучению оптимизации взаимодействия с ними..
Ранние усилия в этом направлении были сосредоточены на улучшении качества решений по использованию инструментов на основе обратной связи. ReTool (Feng2025ReTool) применял обучение с подкреплением, чтобы помочь агентам различать случаи, требующие внешних инструментов, и те, которые можно решить с помощью внутреннего знания, тем самым снижая количество ненужных вызовов инструментов. Другой важной задачей было обучение на ошибочных выполнениях. Retroformer (Yao2024Retroformer) решал эту проблему посредством ретроспективного обучения на основе прошлых траекторий использования инструментов, позволяя агентам корректировать политики на основе результатов взаимодействия с окружением. В том же духе TRICE (Qiao2024TRICE) занимался распределением заслуг в длинных цепочках инструментов, усиливая шаги, способствующие правильным итоговым ответам, и подавляя шумные или бесполезные действия..
Более недавние работы направлены на совместную оптимизацию стратегий рассуждения и использования инструментов в масштабе. Search-R1 (Jin2025SearchR1) показал, что обучение с подкреплением на основе взаимодействия между рассуждением и поиском может вызывать более эффективное поведение при поиске, чем методы, основанные только на имитации. SimpleTIR (Xue2025SimpleTIR) дополнительно объединил рассуждение и выполнение инструментов в едином сквозном цикле обучения, уменьшая несоответствия, часто возникающие при конвейерных подходах. В то же время RLFactory (Chai2025RLFactory) и VerlTool (Jiang2025VerlTool) способствовали систематизации этой новой парадигмы, предоставляя инфраструктуру для моделирования вознаграждения на уровне траекторий и более широких рабочих процессов агентного обучения с подкреплением. Эти исследования указывают на новый этап, в котором агенты, использующие инструменты, оптимизируются не только для вызова внешних ресурсов, но и для совершенствования своих стратегий взаимодействия через обратную связь и метод проб и ошибок..
3. Подсказки как plug-and-play
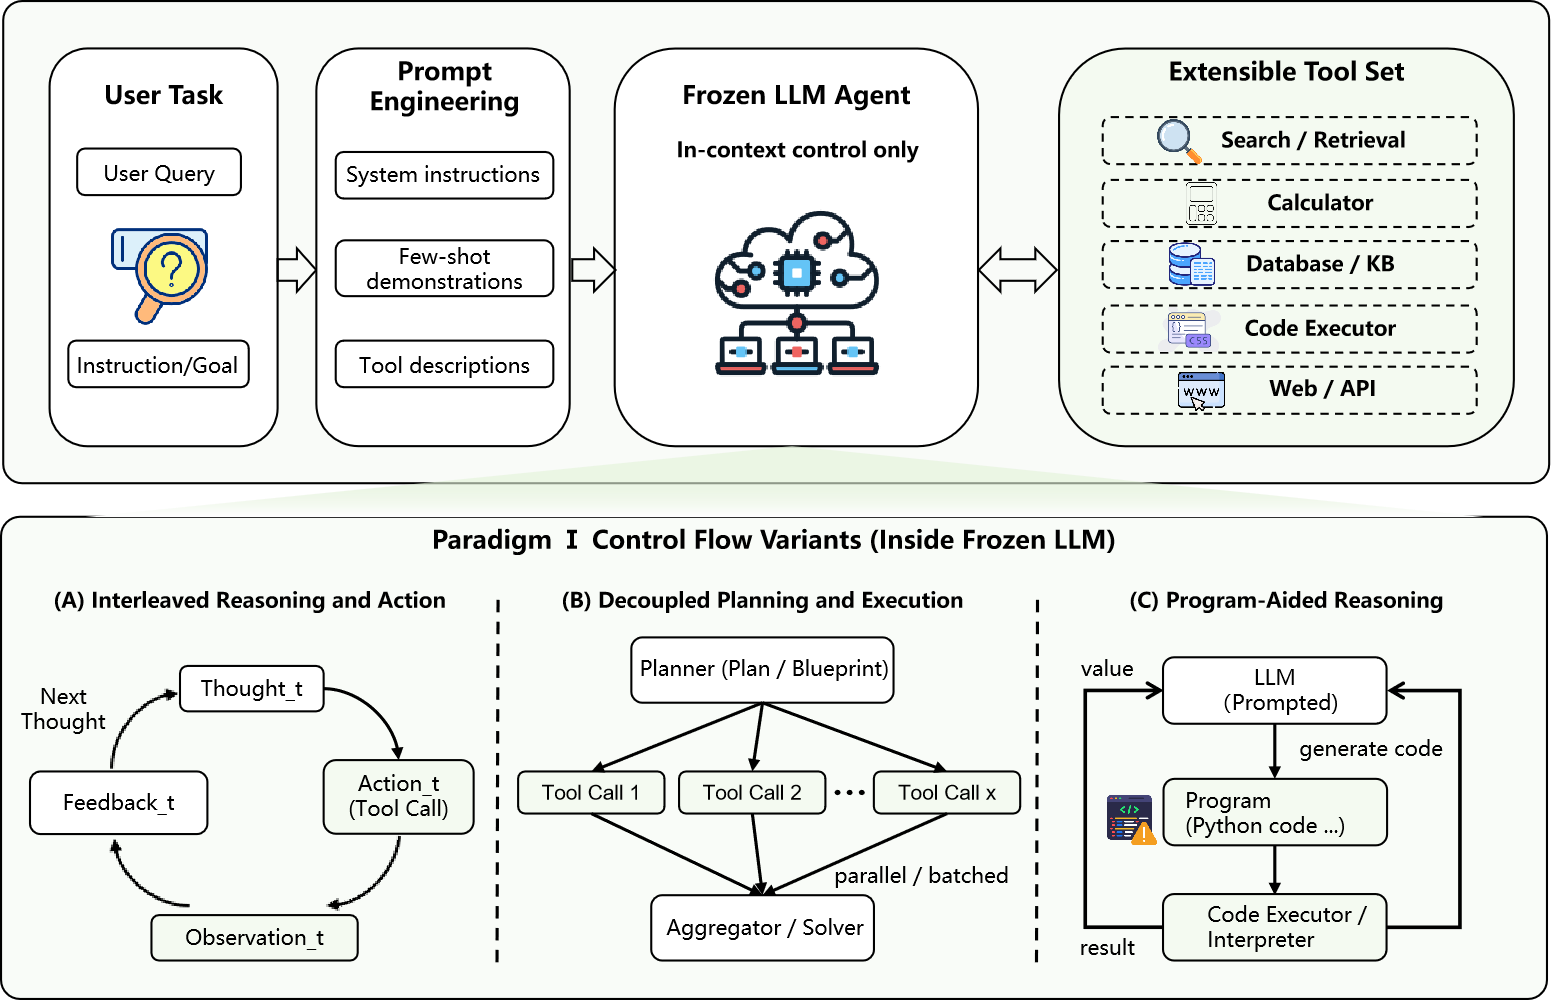
Подход prompting как plug-and-play относится к методам использования инструментов, которые опираются на prompting и взаимодействие в контексте, а не на обновление параметров. В этой парадигме языковая модель остаётся замороженной и служит центральным модулем рассуждения и координации, в то время как поведение по использованию инструментов вызывается через инструкции, демонстрации и обратную связь из внешних сред. Такая конструкция предлагает несколько практических преимуществ, включая гибкость, интерпретируемость и низкую стоимость развертывания, что делает её особенно подходящей для быстрого прототипирования и адаптации к недавно введённым инструментам. В то же время, поскольку модель не интернализирует поведение использования инструментов в своих параметрах, эти методы часто страдают от большей задержки и менее стабильной производительности в сложных или долгосрочных задачах. Для лучшей организации этой парадигмы мы группируем существующие методы в три представительные структуры в зависимости от того, как координируются рассуждение, планирование и выполнение: чередующееся рассуждение и действие, раздельное планирование и выполнение, а также рассуждение с помощью программ. Как показано на рисунке 3, эти три категории охватывают основные потоки управления, через которые замороженные LLM взаимодействуют с внешними инструментами..
3.1. Чередующееся рассуждение и действие
Представительной структурой в рамках Парадигмы I является чередование рассуждений и действий, которое рассматривает решение задач как многошаговое взаимодействие между агентом и его окружением. Вместо того чтобы завершать все рассуждения до начала действий, модель чередует промежуточные размышления и внешние операции, используя наблюдения из окружения для руководства последующими решениями. Представительной отправной точкой в этом направлении является ReAct (Yao2023ReAct), который чередует следы рассуждений с задачеспецифическими действиями, так что модель может явно решать, что делать дальше на основе недавно полученной информации. Этот подход помогает смягчить разрыв между абстрактным рассуждением и внешним выполнением и стал канонической управляющей петлей для использования инструментов на основе prompting..
Последующая работа расширила этот чередующийся цикл в нескольких направлениях. Одно направление сосредоточилось на улучшении устойчивости через самокоррекцию и итеративное уточнение. Reflexion (Shinn2023Reflexion) дополняет стандартный цикл взаимодействия вербальной саморефлексией, позволяя агенту критиковать неудачные траектории и использовать эти размышления в последующих попытках, в то время как Self-Refine (Madaan2023SelfRefine) показывает, что модель может итеративно улучшать собственное промежуточное рассуждение или конечные результаты через самогенерируемую обратную связь. Другое направление ввело явные механизмы верификации. Chain-of-Verification (Dhuliawala2024ChainOfVerification) побуждает модель генерировать вопросы для проверки собственных утверждений перед тем, как выдать пересмотренный ответ, а CRITIC (Gou2024Critic) дополнительно основывает этот процесс на внешних инструментах, проверяя промежуточные или конечные результаты с помощью поисковых систем и других утилит. Для лучшей обработки задач, требующих предвидения и исследования, LATS (Zhou2023LATS) сочетает цикл взаимодействия ReAct с деревом поиска, позволяя более осознанно исследовать альтернативные траектории рассуждений и действий..
Связанные техники подсказок могут дополнительно укрепить эту парадигму, хотя они сами по себе не являются фреймворками для чередующегося использования инструментов. Self-Consistency (Wang2023SelfConsistency) повышает устойчивость за счёт агрегации нескольких выборочных путей рассуждений, Least-to-Most Prompting (Zhou2023LeastToMost) поощряет разложение на более простые подзадачи, а Take a Step Back (Zheng2023TakeAStepBack) способствует абстрагированию перед выбором низкоуровневого действия. Эти методы демонстрируют, как только подсказки могут поддерживать тесно связанный цикл рассуждения, действия, наблюдения и корректировки, делая чередующийся контроль одной из самых влиятельных архитектур в использовании инструментов агентами на основе подсказок..
3.2. Разделённое планирование и выполнение
Вторая представительная структура в рамках Парадигмы I — это раздельное планирование и выполнение, которое отделяет высокоуровневое рассуждение от вызова инструментов на последующих этапах. По сравнению с чередующимися циклами рассуждений и действий, такой подход снижает повторные размышления на каждом шаге и может повысить эффективность при выполнении задач, требующих длинных цепочек инструментов или нескольких зависимых операций. Вместо того чтобы чередовать размышления и действия после каждого наблюдения, модель сначала создает структурированный план, а затем выполняет его с помощью внешних инструментов, что позволяет более явно управлять планированием и выполнением..
Представительной отправной точкой в этом направлении является ReWOO (Xu2023ReWOO), который разделяет рассуждение и наблюдение, вводя архитектуру планировщик-исполнитель. Планировщик сначала генерирует последовательность исполняемых подзадач с назначениями переменных, а исполнитель затем выполняет их без необходимости повторного планирования модели после каждого промежуточного наблюдения. Такая конструкция снижает накладные расходы на взаимодействие и делает использование инструментов более эффективным. Последующие работы расширили эту идею, направленную на более богатое планирование и более адаптивное управление. LLMCompiler (Kim2024LLMCompiler) организует вызовы инструментов в виде графа вычислений с учетом зависимостей и позволяет параллельное выполнение, когда подзадачи независимы, в то время как AdaPlanner (Sun2023AdaPlanner) демонстрирует, что разделенное планирование может оставаться адаптивным за счет пересмотра планов в ответ на обратную связь из окружающей среды.
Связанные методы исследовали соседние формы управления с приоритетом планирования. Plan-and-Solve Prompting (Wang2023PlanAndSolve) подчеркивает ценность генерации явного плана перед решением задачи, а Skeleton-of-Thought (Ning2023SkeletonofThought) аналогично повышает эффективность за счет создания грубого конспекта перед детализацией. В более структурированных условиях PEARL (Sun2024PEARL) применяет стратегию планирования и выполнения к длинным документам, позволяя модели разлагать задачи, основанные на документах, на управляемые действия. Другие системы расширили раздельное управление на более широкую оркестрацию инструментов. ART (Paranjape2023ART) извлекает подходящие программы рассуждений и действий из внешней библиотеки задач, Chameleon (Lu2023Chameleon) композирует инструменты через модульные конвейеры исполнения, а системы такие как HuggingGPT (Shen2023HuggingGPT) и TaskMatrix.AI (Liang2024TaskMatrixAI) дополнительно демонстрируют, как LLM может выступать в роли центрального планировщика для различных экспертных моделей и API. Эти методы показывают, что разделение планирования и выполнения предлагает практическую альтернативу тесно переплетенному управлению, особенно когда использование инструментов требует структурированного разложения, снижения задержек или координации между несколькими модулями..
3.3. Программно-поддерживаемое рассуждение
Третий суб-парадигма решает склонность LLM к арифметическим и логическим ошибкам при рассуждениях исключительно на естественном языке путем перехода промежуточного представления от текста к исполняемому коду. В этом контексте внешний исполнитель программ является не просто вспомогательным инструментом, а становится частью самого процесса рассуждения. PAL (Gao2023PAL) и PoT (Chen2023ProgramOfThoughts) являются представительными отправными точками в этом направлении, побуждая модель генерировать Python-программы, которые выносят вычисления наружу и разделяют рассуждение и выполнение. Для дальнейшего усиления логической строгости Logic-LM (Pan2023LogicLM) переводит задачи на естественном языке в символьные формулировки, которые могут быть решены внешними логическими решателями, улучшая детерминизм в задачах дедуктивного рассуждения..
Этот ориентированный на программы подход впоследствии был расширен на более широкие среды выполнения. Chain of Code (Li2024ChainOfCode) расширяет рассуждения на основе кода за пределы чисто исполняемых вычислений, позволяя модели смешивать исполняемый код с гибким псевдокодом, так что семантические подзадачи всё ещё могут обрабатываться через эмулятор кода, дополненный языковой моделью. ViperGPT (Suris2023ViperGPT) применяет аналогичную философию к визуальному рассуждению, где модель генерирует Python-код для вызова API зрения и композиции мультимодальных операций. В воплощённых условиях Code as Policies (Liang2022CodeAsPolicies) дополнительно демонстрирует, что инструкции на естественном языке могут быть скомпилированы в код политики робота через предопределённые API управления, расширяя рассуждения с помощью программ до генерации действий..
Та же идея также мотивирует более продвинутые формы создания и повторного использования инструментов. MathPrompter (Imani2023MathPrompter) повышает надежность за счет генерации нескольких кандидатных Python-функций и проверки согласованности их результатов выполнения. LATM (Cai2024LLMToolMakers) идет еще дальше, позволяя агентам создавать повторно используемые Python-инструменты для невиданных задач, в то время как CREATOR (Qian2023CREATOR) дополнительно формализует этот процесс, разделяя создание инструментов и выполнение последующих решений. Эти методы показывают, что prompt-инг может использовать код не только как исполнительную основу, но и как структурированное средство для рассуждений, управления и даже самого изобретения инструментов..
4. Обучение инструментам с учителем
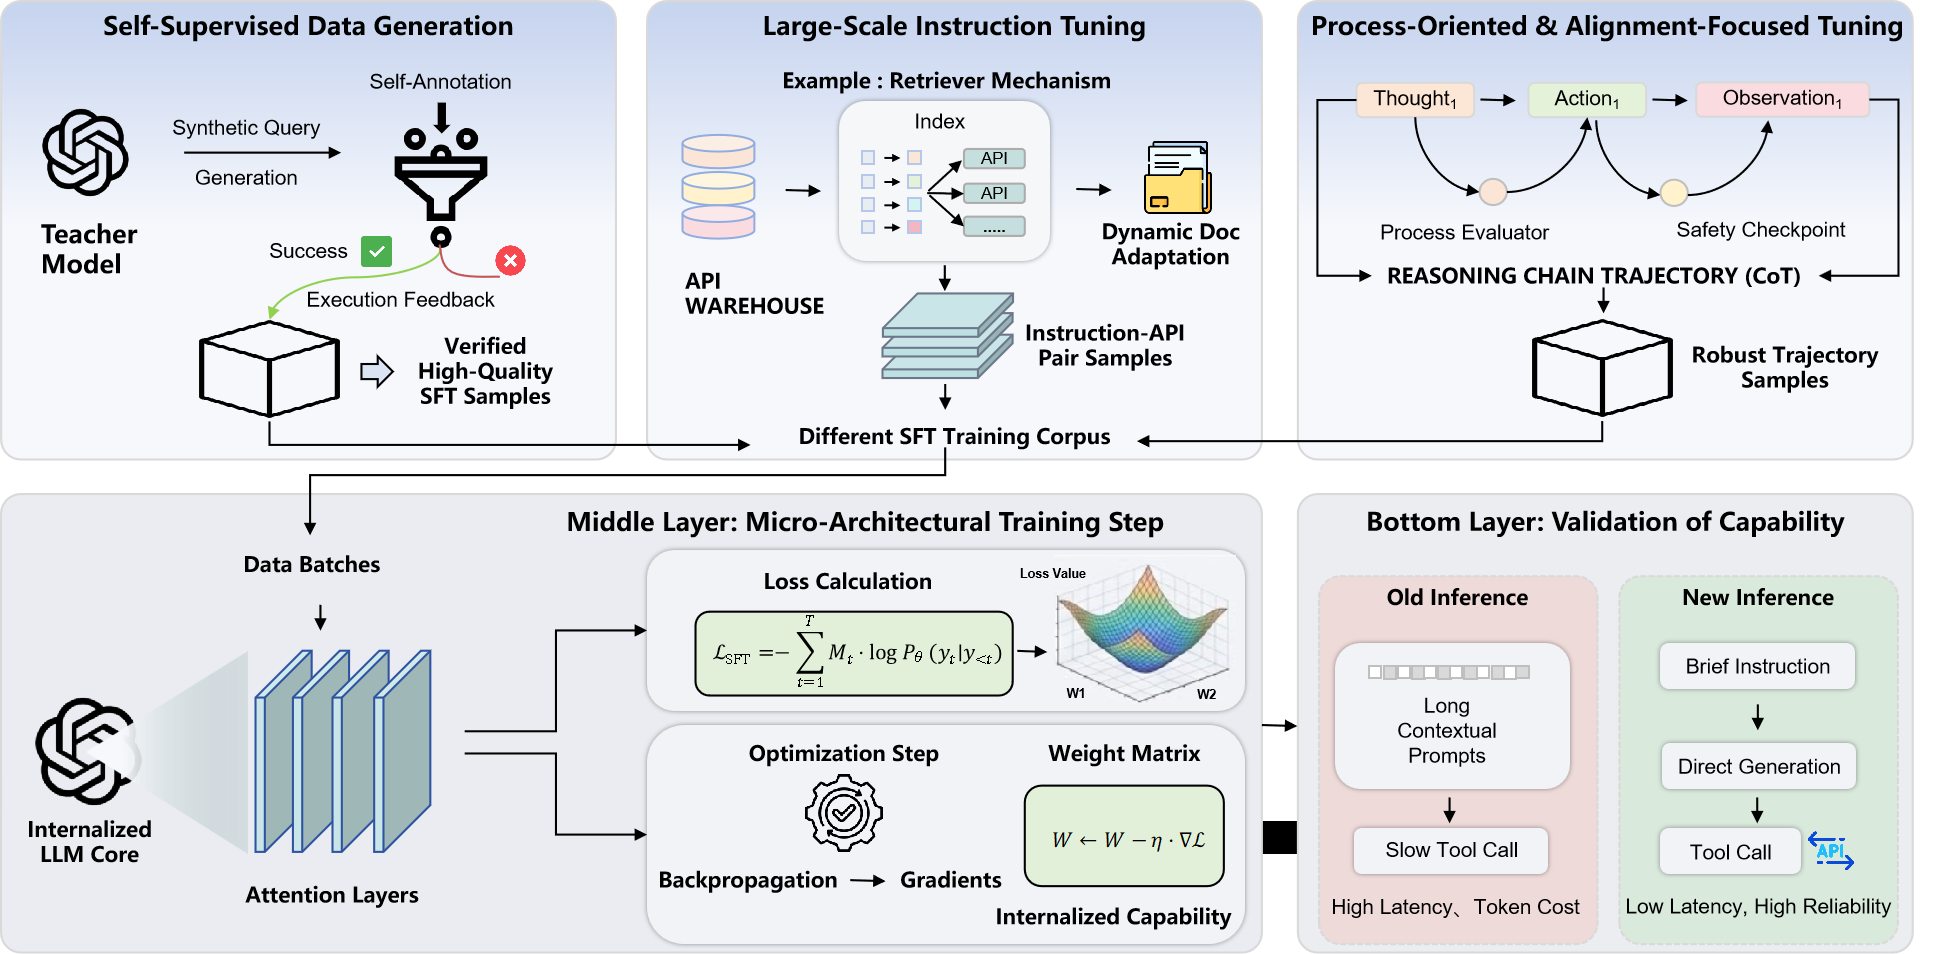
По сравнению с подходами, основанными только на подсказках, эта парадигма смещает акцент с внешнего вызова поведения использования инструментов во время вывода на его внутреннее усвоение через обучение. Вместо того чтобы полагаться только на подсказки для поддержки рассуждений и вызова инструментов, Supervised Tool Learning использует размеченное или синтетическое обучение для прямого кодирования шаблонов использования инструментов в параметры модели. Этот переход улучшает эффективность, стабильность и масштабируемость, а также позволяет моделям более надежно обобщать знания на различные инструменты и задачи. В этом контексте центральной задачей является не только получение обучающих данных в большом объеме, но и разработка сигналов обучения, которые учитывают синтаксис инструментов, семантику вызова, структуру планирования и требования к согласованию. Как показано на рисунке 4, эти категории вместе демонстрируют, как различные формы обучения позволяют моделям приобретать и усваивать способность использования инструментов..
4.1. Самостоятельно контролируемая генерация данных
Естественной отправной точкой для Парадигмы II является снижение зависимости от дорогостоящей человеческой аннотации за счёт автоматического создания супервизии использования инструментов. Ранние попытки исследовали самообучаемую генерацию данных, где модели изучают паттерны использования инструментов, маркируя или симулируя собственные следы взаимодействия, а не полностью полагаясь на вручную подготовленные демонстрации. Представительной отправной точкой в этом направлении является Toolformer (Schick2023Toolformer), который показал, что языковая модель может аннотировать собственный тренировочный корпус вызовами API и соответствующими результатами, таким образом обучаясь, когда и как следует вызывать внешние инструменты при минимальном человеческом контроле. Более конкретно, ключевая идея заключается в сохранении кандидата на вызов инструмента только тогда, когда возвращённый результат улучшает предсказание следующего токена в рамках базовой задачи языкового моделирования. Это можно записать как уменьшение ошибки предсказания после вставки ответа инструмента:
| (1) |
где обозначает исходный контекст, обозначает ответ инструмента, а обозначает следующий токен, который нужно предсказать. Этот критерий отражает основную идею самообучающейся аннотации инструментов: вызов инструмента полезен не просто потому, что он синтаксически корректен, а потому, что он заметно улучшает предсказание модели о том, что будет дальше..
Последующая работа расширила эту идею от локальной самоаннотации к более богатому синтетическому генерации траекторий. ToolAlpaca (Tang2023ToolAlpaca) использовал синтетические демонстрации использования инструментов, сгенерированные более мощными моделями, для обучения меньших открытых LLM, показывая, что поведение использования инструментов, настроенное по инструкциям, можно эффективно передавать через сгенерированные корпуса. AutoAct (Qiao2023AutoAct) дополнительно сократил зависимость от вручную созданных демонстраций, автоматически синтезируя планирующие траектории для агентов с поддержкой инструментов, что сделало возможным запуск агентного поведения с ограниченным первоначальным контролем..
По мере смещения фокуса с генерации траекторий на качество вызова функций, последующие работы всё больше акцентировали внимание на проверяемости и контроле качества данных. APIGen (Liu2024APIGen) представил многоэтапный конвейер для генерации и валидации обучающих данных вызовов API, улучшая надёжность синтетического надзора через исполняемую верификацию. ToolACE (Liu2024ToolACE) далее развил это направление с помощью саморазвивающейся системы, которая сочетает расширение API, синтез диалогов и иерархическую валидацию для получения данных о использовании инструментов более высокого качества. Confucius (Gao2024Confucius) дополняет эти усилия, включая интроспективную обратную связь и куррикулум-стиль доработки, подчёркивая, что генерация синтетических данных может улучшаться не только за счёт масштаба, но и за счёт прогрессивно структурированного надзора. Эти методы показывают, что самообучение и генерация синтетических данных обеспечивают практическую основу для обучения моделей, использующих инструменты, в масштабе, особенно когда ручной сбор высококачественных траекторий дорог или невозможен..
4.2. Масштабная настройка инструкций
Как только синтетическое и самоконтролируемое обучение стало возможным, фокус Парадигмы II сместился с построения данных на масштаб и обобщение. Целью больше не было обучение агентов для небольшого набора предопределённых инструментов, а создание моделей, способных работать с тысячами разнообразных реальных API с более сильным обобщением по доменам и интерфейсам. Представительным поворотным моментом в этом направлении является ToolLLM (Qin2023ToolLLM), который представил ToolBench, крупномасштабный набор данных, охватывающий более 16 000 реальных RESTful API, и показал, что настройка инструкций на широких корпусах API может существенно расширить возможности использования инструментов..
По мере того как библиотеки инструментов становились больше и динамичнее, масштабная настройка также требовала лучшей поддержки для поиска, адаптации и выбора инструментов. Gorilla (Patil2024Gorilla) решала проблему эволюции API через обучение с учётом поиска, позволяя моделям основывать использование инструментов на найденной документации, а не полагаться исключительно на статическую параметрическую память. API-Bank (Li2023APIBank) дополнил эту линию, акцентируя внимание на планировании и способностях поиска, необходимых для выбора подходящих инструментов из больших пулов кандидатов. Для дальнейшего улучшения масштабируемости AnyTool (Du2024AnyTool) внедрил иерархический поиск по большим наборам инструментов, в то время как EasyTool (Yuan2025EasyTool) сократил нагрузку на контекст, преобразуя длинную документацию в более токен-эффективные представления..
Недавние работы все больше сосредоточены на улучшении эффективности вызова и обобщения в практических условиях вызова функций. Octopus v2 (Chen2024OctopusV2) оптимизировал задержку с помощью легковесной стратегии отображения аргументов функций, а ToolkenGPT (Hao2023ToolkenGPT) представил инструменты в виде параметрических токен-эмбеддингов для поддержки больших коллекций инструментов без чрезмерного расширения словаря. Для более специализированного высокопроизводительного вызова функций xLAM (Zhang2025xLAM) нацелен на большие пространства действий, в то время как Granite-Function-Calling (Abdelaziz2024GraniteFunctionCalling) улучшил предсказание параметров через многозадачное обучение. Functionary (MeetKai2024Functionary) дополнительно подчеркнул тесную интеграцию разговорного взаимодействия и вызова функций, а NexusRaven (Srinivasan2023NexusRaven) выделил надежное обобщение в режиме zero-shot к невиданным определениям инструментов. Эти методы демонстрируют, как масштабное инструкционное обучение выходит за рамки изолированных демонстраций использования инструментов к универсальным моделям, которые могут извлекать, интерпретировать и вызывать широкие экосистемы инструментов с растущей эффективностью и надежностью..
4.3. Настройка, ориентированная на процесс и фокусированная на согласовании
Третий суб-парадигма выходит за рамки простой корректности вызовов функций, чтобы оптимизировать процесс рассуждения, который приводит к использованию инструментов, и согласовать этот процесс с человеческими предпочтениями и требованиями безопасности. Выполнение инструмента недостаточно, если базовая логика ошибочна, хрупка или не соответствует предполагаемой цели. Представительным ранним примером в этом направлении является FireAct (Chen2023FireAct), который показал, что дообучение на траекториях рассуждений может лучше усваивать структуру решения задач, чем только прямая супервизия вход-выход. ToRA (Gou2024ToRA) далее усиливает эту линию, обучаясь на чередующихся траекториях рассуждений и действий с явными обоснованиями перед каждым вызовом инструмента, что помогает преодолеть семантический разрыв между языковыми рассуждениями и исполняемыми действиями. Synapse (Zheng2024Synapse) расширяет эту идею, дистиллируя траектории агента в примеры, которые могут направлять последующее принятие решений..
Другой направленностью работы является повышение устойчивости и дискриминации этих процессов рассуждения. Masked Thought (Chen2024MaskedThought) вводит тренировочную цель, которая маскирует части цепочки рассуждений и просит модель восстановить отсутствующую логику, тем самым препятствуя поверхностному сопоставлению шаблонов. Agent-FLAN (Chen2024AgentFLAN) разлагает возможности агента на следование формату и рассуждение, и использует негативные примеры для уменьшения галлюцинаций действий. В условиях, зависящих от поиска, RAFT (Zhang2024RAFT) дополнительно повышает устойчивость, обучая модели различать релевантные и нерелевантные извлечённые документы, что особенно полезно, когда использование инструментов зависит от внешних источников информации..
Выравнивание и безопасность становятся все более важными после развертывания моделей, использующих инструменты, в реальных условиях. ToolAlign (Chen2024ToolAlign) вводит принцип H2A, балансируя полезность, безвредность и автономию в контроле использования инструментов. ToolSword (Ye2024ToolSword) более напрямую нацелен на выравнивание безопасности, создавая адвесариальные сценарии, такие как атаки с внедрением подсказок, для устойчивого обучения использованию инструментов, в то время как RoT (Ye2024RoTBench) улучшает стабильность в условиях шума, подвергая модели воздействию несовершенной документации инструментов во время обучения. MetaTool (Huang2024MetaTool) дополняет эти усилия, обучая модели оценивать, действительно ли необходим инструмент, прежде чем пытаться его вызвать. Наконец, несколько работ подчеркивают, что специализация на инструментах не должна происходить за счет более широкой компетентности. Lemur (Xu2024Lemur) балансирует вызов функций, планирование и общее понимание языка в единой структуре, а AgentTuning (Zeng2024AgentTuning) сохраняет универсальные способности, смешивая агентно-ориентированное обучение с обычными разговорными данными. Эти методы показывают, что настройка для использования инструментов должна оптимизировать не только способность модели вызывать инструменты, но и то, как она рассуждает, когда действует и сохраняется ли ее поведение выровненным, устойчивым и широко способным..
5. Обучение политике использования инструментов, основанное на вознаграждении
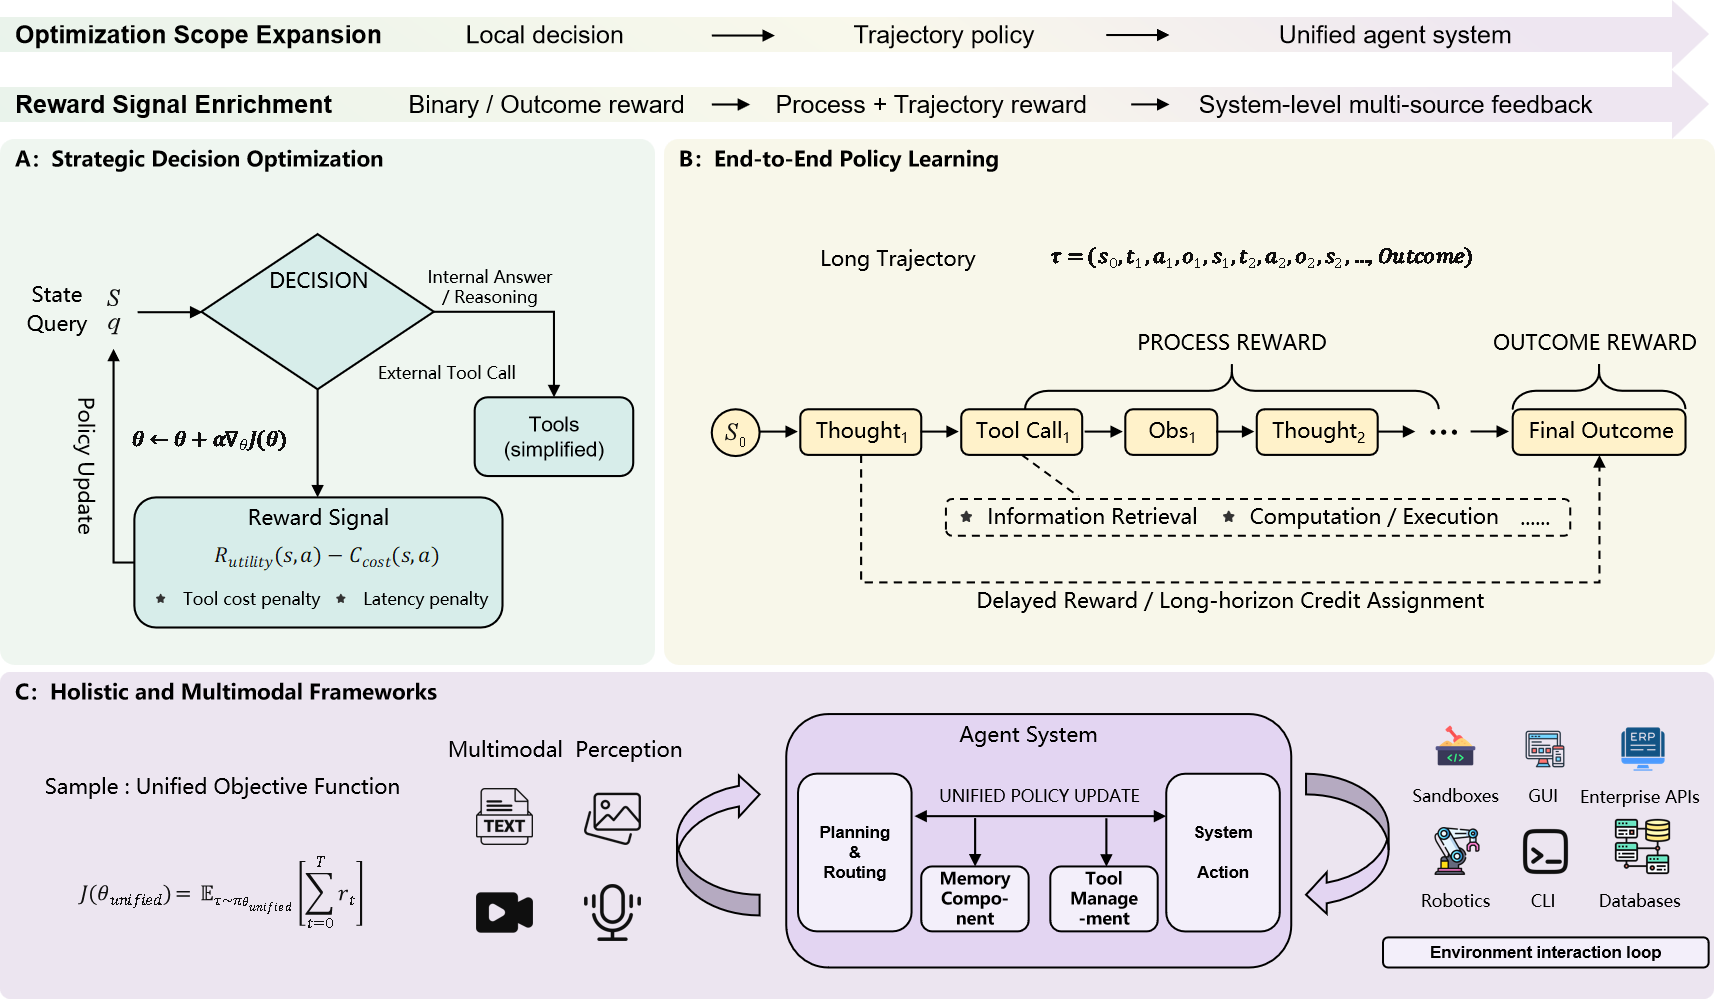
По сравнению с предыдущей парадигмой, которая в основном внутренне усваивала поведение использования инструментов через статическое наблюдение, эта парадигма сосредоточена на оптимизации взаимодействия с инструментами через обратную связь от окружающей среды. Центральной задачей теперь является не только то, может ли модель правильно вызвать инструмент, но и когда ей следует действовать, как она должна восстанавливаться после сбоев и как она может улучшить свою стратегию в ходе многошаговых взаимодействий. По этой причине последние исследования все чаще обращаются к обучению с подкреплением, рассматривая использование инструментов как задачу последовательного принятия решений, а не чисто имитативную. Для организации этой парадигмы мы группируем существующие методы в три категории в зависимости от доминирующей области оптимизации политики: Оптимизация стратегических решений, Сквозное обучение политики для многошагового рассуждения и Целостные и мультимодальные агентные фреймворки. Как показано на рисунке 5, эти категории отражают прогрессию от оптимизации отдельных решений по использованию инструментов к обучению более общих политик для долгосрочного и мультимодального поведения агентов..
5.1. Стратегическая оптимизация принятия решений
Самое раннее применение обучения с подкреплением в этой парадигме было сосредоточено на высокоуровневых стратегических решениях о использовании инструментов. Вместо оптимизации всей траектории рассуждений и действий, эта линия работы задает более базовый, но важный вопрос: когда агент должен вызвать внешний инструмент, а когда ему следует полагаться на свои внутренние знания? Цель заключается не только в улучшении точности, но и в балансировке эффективности инструмента с вычислительными затратами и задержкой. На практике такие стратегические политики использования инструментов часто оптимизируются с помощью целей обучения с подкреплением в стиле policy-gradient. Широко используемым методом является PPO clipped surrogate objective:
| (2) |
где
| (3) |
Здесь обозначает оценённое преимущество действия с использованием инструмента, а операция обрезки стабилизирует обновления политики, предотвращая чрезмерно большие отклонения от предыдущей политики. В контексте оптимизации стратегических решений это отражает, как агент может постепенно научиться, полезно ли вызывать инструмент в данном состоянии на основе обратной связи по вознаграждению..
Представительной отправной точкой в этом направлении является ReTool (Feng2025ReTool), который формулирует вызов инструментов как задачу обучения с подкреплением и сосредотачивается на изучении того, когда во время рассуждений следует использовать внешние инструменты. Вместо предположения, что большее использование инструментов всегда полезно, он оптимизирует сигнал вознаграждения, который поощряет правильные результаты и одновременно препятствует ненужным вызовам, тем самым улучшая избирательность и эффективность рассуждений с помощью инструментов. ToolRL (Qian2025ToolRL) дополнительно упрощает эту задачу, показывая, что аккуратно масштабированные вознаграждения, основанные на результатах, уже могут обеспечить эффективный сигнал для оптимизации поведения при использовании инструментов, снижая необходимость в более сложной разработке вознаграждений..
Последующая работа расширила стратегическую оптимизацию в направлении расширения возможностей и самоусовершенствования. ToolExpander (Chen2025ToolExpander) вводит динамическую многораундовую стратегию жесткой выборки, которая выявляет устойчивые случаи неудач и заменяет их более сильными демонстрациями в процессе обучения с подкреплением, эффективно выступая в роли учебной программы для более слабых моделей. Agent0 (Xia2025Agent0) продвигается дальше в этом направлении, позволяя агенту выступать как дизайнером учебной программы, так и исполнителем, используя Ambiguity Dynamic Policy Optimization (ADPO) для генерации задач на грани его текущих возможностей и улучшения без внешних данных. В более специализированных условиях Arcee (Wang2025LargeActionModels) расширяет эту идею на доменно-специфические рабочие процессы через Large Action Model, обученную с помощью обучения с подкреплением, показывая, что стратегическая оптимизация политики также может поддерживать структурированные пространства действий в предприятиях. Эти методы меньше сосредоточены на полной автономии от начала до конца и больше на улучшении высокоуровневых решений о том, следует ли, когда и как агентам действовать..
5.2. Обучение политики от начала до конца для многошагового рассуждения
По сравнению с оптимизацией стратегических решений, данное направление работы непосредственно оптимизирует политику полного рассуждения и действий в многократных взаимодействиях. Ключевая проблема теперь заключается не только в том, должен ли агент вызвать инструмент, но и в том, как распределить заслуги по длинным траекториям, где ранняя ошибка может распространиться на последующие шаги рассуждения и выполнения. SearchR1 (Jin2025SearchR1) является представительным примером в этом направлении, показывая, что масштабное обучение с подкреплением может обучать агентов разрабатывать ориентированные на поиск стратегии рассуждения, такие как реформулирование запросов и синтез информации, основываясь только на разреженных наградах за результат. SimpleTIR (Xue2025SimpleTIR) далее продвигает эту установку к сквозной оптимизации, совместно обучая рассуждение и выполнение инструментов в единой петле обучения с подкреплением, уменьшая несоответствие, вызванное конвейерными дизайнами. Ранние усилия, такие как Retroformer (Yao2024Retroformer) и TRICE (Qiao2024TRICE), обеспечивают важные основы для этого направления, позволяя агентам учиться на ретроспективной обратной связи по выполнению и улучшая распределение заслуг в длинных цепочках использования инструментов..
Второе направление исследований стремится сделать эту оптимизацию более стабильной за счёт введения более плотных или более структурированных сигналов обучения. AgentPRM (Xi2025AgentPRM) адаптирует моделирование вознаграждения процесса к агентным задачам, оценивая промежуточные шаги как с точки зрения их перспективы, так и их прогресса к цели. LeTS (Zhang2025LeTS) аналогично сочетает вознаграждения на уровне процесса и на уровне результата для управления совместным развитием рассуждений и поведения при извлечении. RAGEN (Wang2025RAGEN) расширяет эту перспективу на саморазвивающихся агентов, генерируя данные для рефлексивного пересмотра из предыдущих траекторий и используя их для усиления поведения по исправлению ошибок в ходе многошагового обучения с подкреплением..
Более недавние работы исследуют более сложные механизмы координации в рамках сквозного обучения политике. MATPO (Mo2025MATPO) вводит оптимизацию с учётом ролей для координации планировщика и исполнителя, распределяя вознаграждения между различными функциями внутри одной и той же архитектуры агента, что позволяет одновременно улучшать делегирование и выполнение. Agent-R (Yuan2025AgentR) дополнительно рассматривает рефлексию как явное действие внутри цикла обучения с подкреплением, позволяя агенту критически оценивать прошлое поведение и включать эти оценки в будущие обновления политики. В этом контексте обучение с подкреплением используется не просто для уточнения отдельных решений инструментов, а для формирования того, как агенты ищут, восстанавливаются, координируются и пересматривают своё поведение в течение длительных горизонтов взаимодействия..
5.3. Целостные и мультимодальные агентные рамки
Граница Парадигмы III расширяется за пределы текстовых API, охватывая мультимодальные взаимодействия и комплексную оптимизацию системы. По мере того как агенты внедряются в насыщенные визуальные среды, определение использования инструментов развивается и включает визуальное восприятие, управление графическим интерфейсом и управление долговременной памятью..
VerlTool (Jiang2025VerlTool) предлагает целостную структуру для агентного обучения с подкреплением, утверждая, что оптимизация вызовов инструментов по отдельности недостаточна. Он рассматривает всю систему агента, включая модуль памяти и селектор инструментов, как единую политику и обновляет все компоненты совместно. DeepAgent (Li2025DeepAgent) дополняет эту перспективу, вводя автономный механизм сворачивания памяти, который сжимает прошлые взаимодействия в структурированную эпизодическую память для поддержания когерентности на длительных горизонтах. AgentRL (Zhang2025AgentRL) расширяет это направление в сторону масштабируемого многошагового и многозадачного обучения через асинхронный конвейер генерации и обучения, унифицированный API-интерфейс на основе вызовов функций и централизованный контроллер среды, подчеркивая растущую важность инфраструктуры на уровне системы в агентном обучении с подкреплением. RLFactory (Chai2025RLFactory) дополнительно поддерживает эту тенденцию, предоставляя инфраструктуру plug-and-play для моделирования сред инструментов и вычисления наград на уровне траекторий, облегчая разработку саморазвивающихся агентов..
В области визуальных и воплощённых агентов, Agent Q (Putta2024AgentQ) сочетает направленный Монте-Карло поиск по дереву (MCTS) с механизмом самокритики, позволяя агентам учиться как на успешных, так и на неудачных траекториях в интерактивных веб-средах через самоигру. SEAgent (Sun2025SEAgent) ориентирован на агентов для использования компьютера, которые учатся на опыте, применяя механизм самоэволюции, при котором агент автономно исследует ОС и формирует собственные данные для настройки инструкций. DigiRL (Bai2024DigiRL) решает задачу обучения агентов управления устройствами в реальных условиях, вводя масштабируемую офлайн-в-онлайн схему обучения с подкреплением, которая позволяет агентам совершенствовать свои политики взаимодействия с GUI через автономное исследование на устройствах Android..
Продвинутые фреймворки также включают структурные априоры и мультимодальное заземление. GEPO (Yuan2025GraphEnhancedPolicyOpt) динамически строит граф переходов состояний на основе опыта агента и использует центральность графа для направления исследования к состояниям с высоким воздействием в открытых средах. MGPO (Huang2025MGPO) специально ориентирован на визуальное рассуждение, позволяя агентам уточнять фокус на ключевых областях изображения через последовательное принятие решений. OS-Copilot (Wu2024OSCopilot) представляет фреймворк для создания универсальных компьютерных агентов, которые оптимизируют удовлетворение намерений пользователя в различных приложениях. Cradle (Tan2025Cradle) расширяет эту идею до общего управления компьютером, позволяя агентам управлять программным обеспечением через наблюдение за экраном и эмуляцию клавиатуры и мыши. ToolRM (Agarwal2025ToolRM) дополняет эти фреймворки, вводя специализированные модели вознаграждения за результат для оценки эффективности и корректности траекторий использования инструментов, обеспечивая более сильные сигналы обучения для сложного агентного обучения с подкреплением..
6. Оценка агентного использования инструментов: эталоны и метрики
Оценка агентного использования инструментов развивалась вместе с основными методологическими парадигмами. Ранние бенчмарки сосредотачивались на том, могут ли модели генерировать корректные и соответствующие схеме вызовы инструментов, фиксируя правильность вызова инструмента на уровне функций. По мере того как использование инструментов становилось более тесно интегрированным с рассуждениями и планированием, оценка расширилась до оценки успешного выполнения задач от начала до конца на статических наборах данных. Более современные бенчмарки движутся в сторону интерактивных и высокоточных сред, где агенты должны адаптироваться к изменяющимся состояниям, восстанавливаться после ошибок выполнения и соблюдать ограничения безопасности. Следуя этой эволюции, мы организуем существующие бенчмарки оценки по трем уровням: правильность использования инструментов, выполнение задач и взаимодействие, управляемое инструментами..
6.1. Корректность использования инструмента
Эта категория формирует диагностическую основу оценки агентного использования инструментов. Она проверяет, может ли модель понимать спецификации инструмента, определять необходимость использования инструмента, выбирать соответствующую функцию из пула кандидатов и создавать структурно корректные вызовы с правильно обоснованными аргументами. В отличие от более поздних уровней оценки, бенчмарки на этом уровне в первую очередь оценивают локальную компетентность в вызове инструментов, а не успех выполнения задачи от начала до конца. Представительные бенчмарки на этом уровне суммированы в Таблице 2⟧.
| Year | Benchmark | Primary Focus | Executable | Compositional | Tool Source |
| Category I: Function-Call Validity | |||||
| 2025 | BFCL (Patil2025BFCL) | Function-call validity | ✗ | ✗ | Curated functions |
| 2025 | ToolEyes (Ye2025ToolEyes) | Fine-grained error diagnosis | ✗ | ✗ | Curated functions |
| 2024 | T-Eval (Chen2024TEval) | Step-wise invocation correctness | ✗ | ✓ | Curated functions |
| Category II: Tool Retrieval and Selection | |||||
| 2023 | API-Bank (Li2023APIBank) | API retrieval and selection | ✓ | ✓ | Simulated tools |
| 2024 | StableToolBench (Guo2024StableToolBench) | Large-scale tool selection | ✓ | ✓ | Real-world APIs |
| 2024 | Gorilla (Patil2024Gorilla) | Retrieval over evolving APIs | ✓ | ✗ | Evolving API docs |
| Category III: Tool-Use Decisions | |||||
| 2025 | When2Call (Ross2025When2Call) | Tool-use necessity | ✗ | ✗ | Curated functions |
| 2024 | WTU-Eval (Ning2024WTUEval) | Whether-or-not tool usage | ✗ | ✗ | Curated functions |
| Category IV: Compositional Invocation | |||||
| 2023 | NexusRaven (Srinivasan2023NexusRaven) | Complex function calling | ✗ | ✓ | Curated functions |
| 2025 | NESTFUL (Basu2024NESTFUL) | Nested API calls | ✓ | ✓ | Curated APIs |
(1) Корректность вызова функции. Первое направление исследований оценивает, может ли модель создавать структурно правильные вызовы инструментов, когда соответствующая функция доступна. Berkeley Function Calling Leaderboard (BFCL) (Patil2025BFCL) стал широко используемой точкой отсчёта для этой задачи, акцентируя внимание на выборе функции, заполнении аргументов и генерации с ограничениями схемы в различных форматах вызова. Однако агрегированные оценки «пройдено» или «не пройдено» часто скрывают, где именно произошла ошибка. Поэтому ToolEyes (Ye2025ToolEyes) вводит более детализированную диагностическую систему, которая разделяет ошибки в понимании намерения, согласовании формата и выборе инструмента. T-Eval (Chen2024TEval) продвигает диагностику дальше, разлагая использование инструмента на промежуточные шаги, что позволяет оценивать решения по рассуждению и выполнению на протяжении всего процесса, а не только при окончательном вызове..
(2) Поиск и выбор инструмента. По мере увеличения количества доступных инструментов правильность уже не ограничивается соответствием схеме, но также зависит от того, может ли модель найти и выбрать правильный инструмент из большого набора кандидатов. API-Bank (Li2023APIBank) предоставляет ранний эталон для этого более широкого конвейера, охватывая поиск API, планирование и генерацию ответов в смоделированных сценариях использования инструментов. StableToolBench (Guo2024StableToolBench) расширяет эту линию в сторону более надежного масштабного бенчмаркинга, улучшая воспроизводимость оценки по реальным API. Gorilla (Patil2024Gorilla) дополняет эти бенчмарки, акцентируя внимание на адаптации к изменяющейся документации, тем самым проверяя, могут ли модели поддерживать правильное использование инструментов при изменении спецификаций API со временем..
(3) Решения о использовании инструментов. Не менее важным аспектом корректности является решение о том, уместно ли вообще использование инструмента. Многие ранние бенчмарки подразумевают, что инструмент должен быть вызван, но реалистичные агенты также должны решать, когда отвечать напрямую, когда запрашивать уточнение, а когда воздерживаться. When2Call (Ross2025When2Call) напрямую нацеливается на эту границу решения, оценивая, могут ли модели выбирать между вызовом инструмента, последующим вопросом и неиспользованием. WTU-Eval (Ning2024WTUEval) аналогично изучает вопрос использования инструмента или его отсутствия как в условиях, требующих инструмент, так и в условиях, где он опционален, подчеркивая, что ненужный вызов может ухудшать общую производительность, даже если доступен соответствующий инструмент..
(4) Композиционный вызов. Наконец, некоторые бенчмарки сосредоточены на корректности при композиционных структурах вызовов, где качество вызова зависит от обработки более сложных сигнатур или передачи выходных данных между вызовами. NexusRaven (Srinivasan2023NexusRaven) подчеркивает zero-shot обобщение на основе описаний инструментов и остается представительным для оценки сложного поведения вызова функций без интенсивной настройки под конкретные задачи. NESTFUL (Basu2024NESTFUL) усложняет эту задачу, оценивая вложенные последовательности вызовов API, где выход одного вызова становится входом для последующего. Эти настройки все еще локальны в том смысле, что они пока не измеряют полное сквозное выполнение задачи, но лучше отражают композиционные требования, с которыми все чаще сталкиваются современные агентные системы..
В совокупности, бенчмарки на этом уровне показывают, что корректность использования инструментов является многогранным понятием. Она включает не только синтаксическую правильность, но и выбор инструмента в масштабе, откалиброванные решения о необходимости использования инструмента, а также композиционную точность в более сложных схемах вызова. Эти диагностические бенчмарки, таким образом, обеспечивают основу для оценки более высокого уровня, где акцент смещается с качества локального вызова на полное выполнение задачи и устойчивое взаимодействие..
6.2. Завершение задачи
Эта категория оценивает, может ли агент успешно выполнить сквозную задачу, когда инструменты используются в качестве функциональных компонентов конвейера решения, а не просто для создания синтаксически корректного вызова. В отличие от диагностических тестов на корректность, оценки выполнения задач акцентируют внимание на успешности конечной задачи при реалистичных входных данных, ограничениях домена и обратной связи по выполнению, тем самым отражая как качество рассуждений, так и эффективность, обеспечиваемую инструментами. Представительные тесты на этом уровне суммированы в таблице 3⟧.
| Year | Benchmark | Task Type | Tool Role | Executable | Open-Ended |
| Category I: Mathematical and Knowledge-Centric Reasoning Tasks | |||||
| 2025 | AIME 25 (MAA_AIME) | Competition math | Compute | ✗ | ✗ |
| 2023 | TabMWP (Lu2023TabMWP) | Table math reasoning | Compute | ✗ | ✗ |
| 2023 | FreshQA (Vu2024FreshLLMs) | Knowledge QA | Retrieve | ✗ | ✗ |
| 2023 | ToolQA (Zhuang2023ToolQA) | Tool-augmented QA | Retrieve + compute | ✓ | ✗ |
| 2021 | MATH / GSM8K (Hendrycks2021MATH; Cobbe2021GSM8K) | Foundation math | Compute | ✗ | ✗ |
| 2018 | HotpotQA (Yang2018HotpotQA) | Multi-hop QA | Retrieve | ✗ | ✗ |
| Category II: Programming and Data-Centric Task Execution | |||||
| 2025 | BigCodeBench (Zhuo2024BigCodeBench) | Code generation | Execute | ✓ | ✓ |
| 2024 | SWE-bench (Jimenez2024SWEbench) | Software engineering | Execute + debug | ✓ | ✓ |
| 2024 | BIRD / Spider 2.0 (Li2023BIRD; Lei2024Spider2) | Text-to-SQL | Query | ✓ | ✓ |
| 2024 | DSBench (Jing2024DSBench) | Data science | Execute | ✓ | ✓ |
| 2024 | InterCode (Yang2023InterCode) | Interactive coding | Execute + debug | ✓ | ✓ |
| 2024 | SheetBench (Ma2024SpreadsheetBench) | Spreadsheet tasks | Execute | ✓ | ✓ |
| 2021 | HumanEval / MBPP (Chen2021Codex; Austin2021ProgramSynthesisLLM) | Python coding | Execute | ✓ | ✓ |
| Category III: Scientific and Professional Domain Benchmarks | |||||
| 2024 | SciBench (Wang2024SciBench) | Scientific reasoning | Compute | ✗ | ✗ |
| 2024 | SciCode (Tian2024SciCode) | Scientific coding | Execute | ✓ | ✓ |
| 2024 | BioPlanner (ODonoghue2023BioPlanner) | Biological protocols | Plan + retrieve | ✗ | ✓ |
| 2024 | MedAgent-Bench (Jiang2025MedAgentBench) | Clinical tasks | Plan + retrieve | ✗ | ✓ |
| 2023 | ChemCrow (Bran2024ChemCrow) | Chemistry workflows | Plan + execute | ✓ | ✓ |
(1) Математические и ориентированные на знания задачи рассуждения. Основное направление исследований по оценке выполнения задач заключается в проверке того, могут ли агенты решать задачи рассуждения более надежно, когда они оснащены калькуляторами, интерпретаторами кода, поисковыми системами или другими внешними инструментами. MATH (Hendrycks2021MATH) и GSM8K (Cobbe2021GSM8K) широко используются в качестве базовых тестовых площадок для измерения того, улучшает ли использование инструментов многошаговое числовое рассуждение, в то время как AIME (MAA_AIME) и MATH-500 (Lightman2024LetsVerify) дополнительно повышают сложность до уровня соревновательной математики. TabMWP (Lu2023TabMWP) расширяет эту задачу до математического рассуждения на основе таблиц, где для решения задачи часто требуется разбор структурированных входных данных и выполнение вычислений на основе формул. С точки зрения знаний, HotpotQA (Yang2018HotpotQA) остается представительным эталоном для многопереходного поиска и составления ответов, а ToolQA (Zhuang2023ToolQA) более прямо оценивает сквозное ответ на вопросы с использованием внешних инструментов в качестве функциональных компонентов процесса решения. FreshQA (Vu2024FreshLLMs) дополняет эти эталоны, сосредотачиваясь на быстро меняющихся знаниях о мире, тем самым проверяя, могут ли агенты выполнять задачи поиска информации, которые не поддерживаются только статическими параметрическими знаниями. Более общие эталоны QA, такие как 2WikiMultihopQA (Ho2020TwoWikiMultihopQA), Natural Questions (Kwiatkowski2019NaturalQuestions), TriviaQA (Joshi2017TriviaQA), MMLU (Hendrycks2021MMLU) и StrategyQA (Geva2021StrategyQA), также часто используются для изучения того, улучшает ли поиск или дополнение инструментами качество конечного ответа..
(2) Программирование и выполнение задач, ориентированных на данные. Вторая линия оценки сосредоточена на том, могут ли агенты выполнять задачи программирования, работы с базами данных и анализа данных с обратной связью в виде исполняемого кода. HumanEval (Chen2021Codex) и MBPP (Austin2021ProgramSynthesisLLM) предоставляют классическую отправную точку для генерации кода на основе выполнения, в то время как BigCodeBench (Zhuo2024BigCodeBench) значительно повышает реализм, требуя генерации кода с интенсивным использованием библиотек по большому набору API. Помимо синтеза на уровне функций, SWE-bench (Jimenez2024SWEbench) оценивает программную инженерию на уровне репозиториев, предлагая агентам решать реальные проблемы GitHub в существующих кодовых базах, что особенно актуально для сквозного агентного кодирования. BIRD (Li2023BIRD) и Spider 2.0 (Lei2024Spider2) расширяют выполнение задач до корпоративных сценариев преобразования текста в SQL, где успех зависит от понимания схемы, планирования и генерации исполняемых запросов. DSBench (Jing2024DSBench) и DS-1000 (Lai2023DS1000) дополнительно расширяют эту область до реалистичных рабочих процессов в области науки о данных — от очистки данных до разработки моделей. В более специализированных условиях FinQA (Chen2021FinQA) нацелена на числовое рассуждение по финансовым документам, SheetBench (Ma2024SpreadsheetBench) решает задачи манипуляции электронными таблицами, а InterCode (Yang2023InterCode) стандартизирует интерактивное кодирование с обратной связью выполнения, позволяя агентам отлаживать и совершенствовать скрипты в процессе решения задач..
(3) Научные и профессиональные доменные бенчмарки. Оценка выполнения задач также расширилась на научные и профессиональные области, где использование инструментов требуется для удовлетворения специфических доменных ограничений, а не только для улучшения общего рассуждения. SciBench (Wang2024SciBench) проверяет, могут ли агенты решать задачи по физике и химии, которые часто требуют работы с уравнениями, рассуждений с учётом единиц измерения и вычислений на основе кода. SciCode (Tian2024SciCode) движется в сторону решения научных задач с помощью кода в таких областях, как физика и материаловедение. BioPlanner (ODonoghue2023BioPlanner) оценивает генерацию биологических протоколов, акцентируя внимание на структурированном процедурном планировании и точном извлечении функций. ChemCrow (Bran2024ChemCrow) и MedAgent-Bench (Jiang2025MedAgentBench) дополнительно демонстрируют, что бенчмарки по выполнению задач теперь охватывают критически важные рабочие процессы, такие как органический синтез и клиническая диагностика, где агент должен сочетать рассуждения, специализированные инструменты и доменные знания для создания применимых решений..
6.3. Взаимодействие, управляемое инструментами
Эта категория оценивает агентов в динамичных и состоящих из состояний средах, где использование инструментов напрямую влияет на внешний мир. В отличие от статических QA или офлайн-бенчмарков выполнения, эти условия требуют от агентов обновлять планы по мере изменения среды, восстанавливаться после промежуточных ошибок и удовлетворять цели пользователя в рамках реалистичных ограничений. Таким образом, акцент смещается с того, является ли вызов инструмента корректным в изоляции, на то, может ли последовательность действий надежно достичь цели в интерактивной среде. Таблица 4 суммирует представительные бенчмарки на этом уровне..
| Year | Benchmark | Trajectory | Target | Challenge | Signal |
| Web Environments | |||||
| 2024 | WebArena (Zhou2024WebArena) | ✓ | Web | Navigation | Task success |
| 2024 | VisualWebArena (Koh2024VisualWebArena) | ✓ | Web | Multimodal grounding | Task success |
| 2024 | WebVoyager (He2024WebVoyager) | ✓ | Web | Open-ended tasks | Task success |
| 2024 | GAIA (Mialon2024GAIA) | ✓ | General assistant | Multi-step tool use | Task success |
| 2024 | TravelPlanner (Xie2024TravelPlanner) | ✓ | Planning | Constraint satisfaction | Task success |
| 2023 | WorldSense (Benchekroun2023WorldSense) | ✓ | 3D environment | World-model reasoning | Task success |
| 2023 | Mind2Web (Deng2023Mind2Web) | ✗ | Web trajectories | Offline generalization | Trajectory match |
| Computer Environments | |||||
| 2024 | OSWorld (Xie2024OSWorld) | ✓ | Desktop / OS | Long-horizon control | Task success |
| 2024 | OS-Copilot (Wu2024OSCopilot) | ✓ | Desktop / OS | Console and GUI control | Task success |
| 2024 | OmniACT (Kapoor2024OmniACT) | ✓ | Cross-app workflows | Scripted interaction | Task success |
| 2025 | AndroidWorld (Rawles2025AndroidWorld) | ✓ | Mobile / Android | App interaction | Task success |
| 2025 | AppWorld / AppAgent (Trivedi2024AppWorld; Zhang2025AppAgent) | ✓ | Mobile apps | App control | Task success |
| 2024 | ScreenAgent (Niu2024ScreenAgent) | ✓ | GUI | Visual UI automation | Task success |
| 2024 | GUI-World (Chen2024GUIWorld) | ✓ | GUI | Multimodal grounding | Task success |
| 2024 | OfficeBench (Wang2024OfficeBench) | ✓ | Office software | Procedural workflows | Task success |
| 2024 | WorkArena (Drouin2024WorkArena) | ✓ | Enterprise platform | Workflow completion | Task success |
| 2024 | -bench (Yao2024TauBench) | ✓ | User + tools | Policy compliance | State outcome |
| 2024 | TheAgentCompany (Xu2024TheAgentCompany) | ✓ | Workplace simulation | Consequential tasks | Task success |
| 2024 | CodeAct (Wang2024CodeAct) | ✓ | Interactive environments | Code as action | Task success |
| Safety and Reliability | |||||
| 2024 | ToolSword (Ye2024ToolSword) | ✗ | Tool outputs | Prompt-injection defense | Attack resistance |
| 2024 | InjEcT-Agent (Zhan2024InjecAgent) | ✗ | Tool outputs | Indirect prompt injection | Attack resistance |
| 2024 | ToolEmu (Ruan2024ToolEmu) | ✓ | Tool sandbox | Risk-aware interaction | Failure analysis |
| 2024 | SafetyBench (Zhang2024SafetyBench) | ✗ | Safety scenarios | Risk refusal | Safety judgment |
| 2024 | R-Judge (Yuan2024RJudge) | ✗ | Risk evaluation | Risk awareness | Risk judgment |
| 2024 | PsySafe (Zhang2024PsySafe) | ✗ | Psychological safety | Manipulation resistance | Safety judgment |
(1) Веб-среды. WebArena (Zhou2024WebArena) и VisualWebArena (Koh2024VisualWebArena) устанавливают основную эталонную линию для интерактивных веб-агентов, предоставляя высокоточные среды, в которых агенты должны перемещаться по функциональным веб-сайтам через текстовые и визуальные наблюдения. WebVoyager (He2024WebVoyager) расширяет эту настройку до открытых веб-задач на реальных сайтах, требующих более надежного планирования и мультимодального обоснования. Mind2Web (Deng2023Mind2Web) дополняет эти эталоны офлайн-траекториями по разнообразным структурам DOM, что делает его полезным для оценки обобщения перед полной онлайн-разверткой. Помимо навигации в браузере, GAIA (Mialon2024GAIA) оценивает общие задачи ассистентского стиля, требующие использования инструментов, доступа к вебу и многошагового решения проблем, в то время как TravelPlanner (Xie2024TravelPlanner) сосредоточен на ограниченном планировании с внешними поисковыми инструментами. WorldSense (Benchekroun2023WorldSense) дополнительно расширяет оценку взаимодействия до обоснованных 3D-сред, где агент должен поддерживать согласованную модель мира во время действий..
(2) Компьютерные среды. Вторая линия исследований оценивает агентов, взаимодействующих с операционными системами, приложениями и программным обеспечением для рабочего места. OS-Copilot (Wu2024OSCopilot) и OSWorld (Xie2024OSWorld) проводят бенчмарки агентов по управлению рабочим столом через терминальные команды, действия в графическом интерфейсе и мультимодальное восприятие в рамках реалистичных компьютерных задач. OmniACT (Kapoor2024OmniACT), ScreenAgent (Niu2024ScreenAgent) и GUI-World (Chen2024GUIWorld) дополнительно акцентируют внимание на основанном на реальности взаимодействии с графическими интерфейсами, в то время как AndroidWorld (Rawles2025AndroidWorld), AppWorld (Trivedi2024AppWorld) и AppAgent (Zhang2025AppAgent) расширяют эту линию на мобильные среды. В рабочих условиях OfficeBench (Wang2024OfficeBench) и WorkArena (Drouin2024WorkArena) оценивают взаимодействие с корпоративными платформами и офисным программным обеспечением, где успех выполнения задач зависит от долгосрочного отслеживания состояния и процедурной корректности. Недавние бенчмарки движутся дальше в сторону реалистичной цифровой работы. -bench (Yao2024TauBench) оценивает взаимодействие инструмент-агент-пользователь с учётом доменных политик и ограничений состояния базы данных, в то время как TheAgentCompany (Xu2024TheAgentCompany) проводит бенчмарки агентов по значимым рабочим задачам, которые объединяют веб-сёрфинг, выполнение кода и сотрудничество в смоделированной корпоративной среде. CodeAct (Wang2024CodeAct) предоставляет дополнительную перспективу, рассматривая исполняемый код как единое пространство действий для интерактивных сред..
(3) Безопасность и Надежность. По мере того как агенты становятся более способными действовать во внешних средах, оценка должна также проверять, остаются ли они надежными и безопасными в условиях противодействия или высокого риска. ToolSword (Ye2024ToolSword) и InjEcT-Agent (Zhan2024InjecAgent) сосредоточены на косвенной инъекции подсказок, проверяя, могут ли вредоносные инструкции, встроенные в выводы инструментов, захватить последующее поведение агента. ToolEmu (Ruan2024ToolEmu) решает эту проблему с дополнительной точки зрения, используя LLM-симулированную песочницу для эмуляции выполнения инструментов с высоким риском и выявления опасных режимов сбоев без причинения реального вреда. R-Judge (Yuan2024RJudge) и SafetyBench (Zhang2024SafetyBench) оценивают, могут ли агенты выявлять и отказываться от рискованных действий, в то время как PsySafe (Zhang2024PsySafe) расширяет эту линию на психологическую безопасность и устойчивость к манипуляциям. Вместе эти бенчмарки показывают, что оценка на уровне взаимодействия касается не только выполнения задач, но и поддержания надежности, соблюдения политики и безопасного поведения, когда действия имеют реальные последствия..
7. Будущие направления
По мере того как парадигма агентного использования инструментов развивается от экспериментальных прототипов к системам производственного уровня, мы ожидаем несколько ключевых направлений, которые определят следующее поколение автономных агентов. Эти направления выходят за рамки простого улучшения точности вызовов API, стремясь вместо этого изменить фундаментальную архитектуру, интерактивность и социальную интеграцию ИИ-агентов..
- ⟦Стандартизация и революция MCP Текущая экосистема агентов, использующих инструменты, фрагментирована, требуя индивидуальных интеграций для каждого нового инструмента и фреймворка. Чтобы преодолеть это узкое место масштабируемости, область движется в сторону универсальных протоколов взаимодействия, наиболее заметно Model Context Protocol (MCP) (Hou2025MCP). MCP служит стандартизированным интерфейсом, который отделяет агента от конкретной реализации инструментов, позволяя разработчикам создавать инструмент один раз и сразу использовать его любым совместимым агентом. Эта стандартизация преобразует проблему интеграции из квадратичной сложности в линейную. Помимо протоколов, мы наблюдаем сдвиг в сторону стандартизированных паттернов оркестрации. OpenAI Swarm (Rahman2025LLMSwarms) вводит эргономичные паттерны для многоагентной оркестрации, исследуя легковесные передачи между специализированными агентами, в то время как AgentKit (Wu2024AgentKit) предоставляет единый фреймворк для «усиленного тонкого настройки» агентных рабочих процессов. Мы предвидим будущее, в котором библиотеки инструментов не будут статичными списками, а динамическими рынками, соответствующими протоколам, к которым агенты смогут обращаться и подписываться в реальном времени..
- ⟦Мультимодальные и воплощённые фундаментальные модели Будущие агенты превзойдут ограничения текстовых API, чтобы взаимодействовать с миром через богатые мультимодальные интерфейсы. Вместо того чтобы полагаться исключительно на структурированные вызовы функций, агенты развиваются, чтобы воспринимать и манипулировать графическими пользовательскими интерфейсами (GUI) напрямую. Ключевым сдвигом в 2025 году станет появление «Agentic Foundation Models», специально предобученных для действий. Magma (Yang2025Magma) представляет собой новое поколение мультимодальной модели, способной интерпретировать и основывать вводы как в цифровой, так и в физической средах, эффективно преодолевая разрыв между навигацией по UI и роботизированной манипуляцией. В дополнение к этому ShowUI (Lin2025ShowUI) вводит выбор визуальных токенов, управляемый UI, для эффективной работы с экранами высокого разрешения, в то время как OmniParser (Lu2024OmniParser) предоставляет модуль парсинга экрана, основанный исключительно на зрении, который извлекает структурированные элементы из скриншотов, значительно улучшая возможности предсказания действий универсальных моделей. Более того, Agent-S (Agashe2025AgentS) устанавливает открытую агентскую платформу, которая использует компьютеры как человек, обучаясь на опыте для выполнения сложных межприложенческих задач. Эти достижения сигнализируют о переходе от дополнения LLM визуальными энкодерами к созданию родных моделей «Vision-Language-Action»..
- ⟦Агентская самосогласованность и непрерывная эволюция Для достижения истинной автономии агенты должны выйти за рамки реактивного однократного выполнения и перейти к рассуждениям системы 2 и обучению на протяжении всей жизни. Это предполагает использование методов масштабирования во время тестирования, когда агенты выполняют глубокие поиски с прогнозированием или проверки самосогласованности перед выполнением критических вызовов инструментов. Такие фреймворки, как SearchR1 (Jin2025SearchR1), продемонстрировали силу внутреннего выполнения шагов рассуждения, но будущие агенты пойдут дальше, активно управляя своей памятью. Titans (Behrouz2025TitansMemorize) вводит нейронный модуль долговременной памяти, который учится запоминать исторический контекст во время тестирования, позволяя агентам справляться с задачами поиска «иголки в стоге сена» в огромных историях взаимодействий без дополнительного обучения. System 2 Attention (Weston2023System2Attention) позволяет агентам динамически восстанавливать собственный контекст, чтобы сосредоточиться на релевантной информации, в то время как Trove (Wang2024TroVE) способствует непрерывной эволюции библиотеки инструментов агента. Вместо сброса после каждой сессии будущие агенты будут курировать собственные внутренние библиотеки синтезированных инструментов и шаблонов использования, достигая формы самосогласованности, при которой их действия становятся все более эффективными и согласованными с их историческим опытом. Помимо повышения эффективности использования инструментов, обучение с подкреплением может также оптимизировать свойства поведения, специфичные для агентов. Character-R1 предполагает, что оптимизация будущих агентов может распространяться на осознанное в отношении ролей рассуждение и согласованность персонажей в специализированных условиях (Tang2026CharacterR1).⟧.
- ⟦Повышенные стандарты безопасности и надежности Поскольку агентам предоставляется возможность выполнять значимые действия, такие как изменение баз данных или управление финансовыми транзакциями, безопасность должна быть поднята с второстепенного показателя до основного ограничения при проектировании. Будущие исследования будут сосредоточены на установлении протоколов безопасности банковского уровня, выходящих за рамки простой настройки выравнивания. Это включает разработку надежных защит от косвенных инъекций подсказок, которые могут захватить выполнение инструментов, как это показано в InjEcT-Agent (Zhan2024InjecAgent). Промышленные решения, такие как NeMo Guardrails (Rebedea2023NeMoGuardrails), начинают предоставлять программируемые слои безопасности, которые обеспечивают поведенческие границы, в то время как PromptArmor (Shi2025PromptArmor) предлагает механизмы обнаружения враждебных вводов. Крайне важно решить проблему обманчивого выравнивания, гарантируя, что агенты не научатся обходить системы вознаграждения, скрывая ошибки или искажая использование своих инструментов — явление, исследованное в Sleeper Agents (Hubinger2024SleeperAgents). Надежность будет опираться на проверяемые аудиторские следы и изолированные среды выполнения, которые гарантируют контроль человека даже при увеличении автономии агентов..
- ⟦Человеко-Агентный Симбиоз и Перестройка Рабочих Процессов Последним направлением является человеко-агентный симбиоз и перестройка рабочих процессов. Как показывают системы такие как MetaGPT (Hong2023MetaGPT), AutoGen (Wu2023AutoGen) и OpenDevin (Wang2024OpenHands), будущее использования инструментов может заключаться не столько в полностью автономных монолитных агентах, сколько в совместных рабочих процессах, которые объединяют человеческий контроль с специализированными автоматизированными компонентами. В связи с этим, недавние исследования систем на основе LLM с несколькими агентами предполагают, что будущие агентные рабочие процессы будут все больше опираться на координацию на уровне системы, распределение ролей и оркестровку между несколькими специализированными агентами, а не на одного монолитного агента (Zhou2026ArchitectingMAS). В таком контексте навыки могут стать более практичной абстракцией, чем автономия от начала до конца: вместо того чтобы требовать от одного агента решения каждой задачи от начала до конца, системы могут предоставлять повторно используемые возможности, такие как поиск, программирование, редактирование таблиц, проверка или анализ в конкретной области, и гибко комбинировать их под контролем человека. Такой ориентированный на навыки подход также помогает объяснить, почему более простые и структурированные системы могут оставаться высококонкурентными. Например, Agentless (Xia2025Agentless) показывает, что тщательно спроектированные конвейеры могут превосходить более сложных агентов с долгосрочным горизонтом, когда структура задачи ясна. В совокупности эти тенденции указывают на будущее, в котором использование агентных инструментов формируется за счет калиброванного делегирования, повторно используемых навыков и сотрудничества, учитывающего рабочие процессы, между людьми и агентами..
8. Заключение
В этом обзоре мы систематически рассмотрели технологический ландшафт агентного использования инструментов, исследуя переход от подсказок к динамической автономной оптимизации. Мы разделили эту область на три различных парадигмы: Парадигма I использует подсказки и стратегии на основе контекста для обеспечения использования инструментов в режиме plug-and-play; Парадигма II применяет обучение с учителем для внутренней реализации надежных возможностей использования инструментов; а Парадигма III использует обучение политики на основе вознаграждения, чтобы позволить агентам адаптироваться, самостоятельно исправляться и восстанавливаться после сложных ошибок выполнения. Наряду с этими парадигмами мы рассматривали оценку как сквозное измерение и проанализировали развивающуюся экосистему бенчмарков, которая эволюционировала от оценки корректности отдельных вызовов функций к измерению комплексного успеха задач и безопасности в реалистичных симуляциях. Мы надеемся, что этот обзор предоставит последовательную дорожную карту для исследователей и практиков, а также поможет ускорить развитие агентов, использующих инструменты, в направлении более способных, надежных и стандартизированных автономных агентов..
Appendix A Обзор связанных работ
Таблица 5 обобщает основные методологические статьи, рассмотренные в этом обзоре.
| Paper | Year | Training Signal | Tool Scope | Multi-turn | Multi-tool | Setting | Affiliation |
|---|---|---|---|---|---|---|---|
| ReAct (Yao2023ReAct) | 2023 | Prompting / ICL | External actions | ✓ | ✓ | Reason–act loop | Princeton |
| Reflexion (Shinn2023Reflexion) | 2023 | Prompting + verbal feedback | External actions | ✓ | ✓ | Self-reflective interaction | Princeton |
| CRITIC (Gou2024Critic) | 2024 | Prompting + interactive critique | Verification tools | ✓ | ✓ | Verification and correction | Tsinghua |
| LATS (Zhou2023LATS) | 2023 | Prompting + search | Search | ✓ | ✓ | Trajectory tree search | UIUC |
| ReWOO (Xu2023ReWOO) | 2023 | Prompting / planning | General external tools | ✓ | ✓ | Decoupled planning | MSU |
| HuggingGPT (Shen2023HuggingGPT) | 2023 | Prompting / orchestration | Expert models | ✓ | ✓ | LLM tool orchestration | ZJU |
| LLM-Compiler (Kim2024LLMCompiler) | 2024 | Prompting / planning | Function calls | ✓ | ✓ | Parallel decomposition | UC Berkeley |
| PAL (Gao2023PAL) | 2023 | Prompting / code generation | Code execution | ✗ | ✗ | Program-aided reasoning | CMU |
| PoT (Chen2023ProgramOfThoughts) | 2023 | Prompting / code generation | Code execution | ✗ | ✗ | Program-of-thought | Waterloo |
| ViperGPT (Suris2023ViperGPT) | 2023 | Prompting / code generation | Vision APIs | ✗ | ✓ | Visual reasoning | Columbia |
| Code as Policies (Liang2022CodeAsPolicies) | 2022 | Prompting / code generation | Control APIs | ✗ | ✓ | Embodied control | |
| LATM (Cai2024LLMToolMakers) | 2024 | Prompting / tool creation | Python tools | ✓ | ✓ | Tool creation and reuse | Stanford |
| Toolformer (Schick2023Toolformer) | 2023 | Self-supervised API annotation | APIs | ✗ | ✓ | API self-annotation | Meta AI |
| AutoAct (Qiao2023AutoAct) | 2024 | Synthetic planning trajectories | Tool-augmented agents | ✓ | ✓ | Trajectory synthesis | ZJU |
| ToolACE (Liu2024ToolACE) | 2025 | Self-evolving synthetic data | Function calls | ✓ | ✓ | API/dialogue synthesis | SJTU |
| APIGen (Liu2024APIGen) | 2024 | Verifiable synthetic data | Function calls | ✗ | ✓ | API-call generation | Salesforce AI Research |
| ToolLLM (Qin2023ToolLLM) | 2023 | Instruction tuning | RESTful APIs | ✓ | ✓ | Large-scale API use | Tsinghua |
| API-Bank (Li2023APIBank) | 2023 | Benchmark-driven supervision | APIs | ✓ | ✓ | Planning and API use | Alibaba DAMO |
| GPT4Tools (Yang2023GPT4Tools) | 2023 | Synthetic data + instruction | Tool collections | ✗ | ✓ | Tool-use tuning | Tsinghua SIGS |
| Functionary (MeetKai2024Functionary) | 2024 | Instruction tuning | Function calls | ✓ | ✓ | Function calling | MeetKai |
| FireAct (Chen2023FireAct) | 2023 | SFT on reasoning trajectories | General external tools | ✓ | ✓ | Reason–act tuning | System2 |
| Agent-FLAN (Chen2024AgentFLAN) | 2024 | SFT with negative samples | Agent actions | ✓ | ✓ | Agent tuning | USTC |
| ToolAlign (Chen2024ToolAlign) | 2024 | Alignment-oriented tuning | Tool-use environments | ✓ | ✓ | HHA alignment | RUC |
| ToRA (Gou2024ToRA) | 2024 | Rationale-augmented training | Mathematical tools | ✓ | ✓ | Tool-augmented math | Tsinghua |
| MetaTool (Huang2024MetaTool) | 2024 | Supervised tuning | Tool selection | ✗ | ✓ | Tool selection | XJTU |
| ReTool (Feng2025ReTool) | 2025 | Reinforcement learning | General external tools | ✗ | ✓ | Strategic tool use | ByteDance Seed |
| ToolExpander (Chen2025ToolExpander) | 2025 | RL + hard-sampling curriculum | General external tools | ✓ | ✓ | Capability expansion | OPPO |
| ToolRL (Qian2025ToolRL) | 2025 | Outcome-reward RL | General external tools | ✗ | ✓ | Tool-use optimization | UIUC |
| Agent0 (Xia2025Agent0) | 2025 | RL + self-generated curriculum | General external tools | ✓ | ✓ | Self-evolving tool use | UNC |
| Search-R1 (Jin2025SearchR1) | 2025 | Reinforcement learning | Search / retrieval tools | ✓ | ✗ | Search-oriented reasoning | UIUC |
| DeepResearcher (Zheng2025DeepResearcher) | 2025 | Reinforcement learning | Web research tools | ✓ | ✓ | Deep web research | SJTU |
| AgentPRM (Xi2025AgentPRM) | 2025 | Process reward modeling | General external tools | ✓ | ✓ | Stepwise agent evaluation | FDU |
| SimpleTIR (Xue2025SimpleTIR) | 2025 | End-to-end RL | General external tools | ✓ | ✓ | Joint reason–tool execution | NTU |
| VerlTool (Jiang2025VerlTool) | 2025 | Agentic RL | Tool selector + memory | ✓ | ✓ | Holistic optimization | UWaterloo |
| DeepAgent (Li2025DeepAgent) | 2025 | Agentic RL framework | Scalable toolsets | ✓ | ✓ | General tool agent | RUC |
| ToolRM (Agarwal2025ToolRM) | 2025 | Reward modeling | Tool-use trajectories | ✓ | ✓ | Tool-call reward modeling | IBM Research |
| Agent Q (Putta2024AgentQ) | 2024 | Guided MCTS + self-critique | Web environment | ✓ | ✓ | Interactive web agents | MultiOn |
| DigiRL (Bai2024DigiRL) | 2024 | Offline-to-online RL | GUI / device control | ✓ | ✓ | Android interaction | UC Berkeley |