Аннотация
Retrieval-Augmented Generation (RAG) широко используется для привязки LLM к внешним источникам знаний. Однако при применении к гетерогенным корпусам и многошаговым запросам конвейеры Naive RAG часто теряют в качестве из-за плоских представлений знаний и отсутствия явных рабочих процессов. В данной работе мы представляем DCD (Domain–Collection–Document) — предметно-ориентированный дизайн для структурирования знаний и управления обработкой запросов в RAG системах без модификации базовой языковой модели. Предложенный подход опирается на иерархическую декомпозицию информационного пространства и многоэтапную маршрутизацию на основе структурированных выходных данных модели, что позволяет постепенно ограничивать области поиска и генерации. Архитектура дополнена интеллектуальной нарезкой на фрагменты, гибридным поиском, а также интегрированными механизмами проверки и защитными барьерами генерации. Мы описываем архитектуру и рабочий процесс DCD, а также обсуждаем результаты оценки на синтетическом наборе данных, подчеркивая их влияние на устойчивость, фактическую точность и релевантность ответов в прикладных RAG сценариях..
DCD: Предметно-ориентированное проектирование для контролируемой генерации с дополнением поиском
Валерий Ковальский, Никита Белов, Никита Митейко, Игорь Решетников, Макс Максимов
red_mad_robot
1 Введение
RAG получил широкое распространение как практический подход для интеграции языковых моделей с внешними источниками знаний Lewis et al., 2020]. Даже базовые реализации Naive RAG могут эффективно решать широкий спектр прикладных задач, от обработки запросов в службе поддержки клиентов до анализа корпоративной документации Izacard et al., 2021⟧].
Однако по мере роста объемов данных и усложнения пользовательских запросов ограничения стандартных конвейеров RAG становятся все более очевидными. В частности, линейная архитектура Naive RAG демонстрирует снижение производительности при выполнении многошаговых запросов, требующих последовательной интерпретации, поиска по нескольким фрагментам знаний и агрегирования результатов Wei et al., 2023]. Еще одной критической проблемой является чувствительность систем RAG к параметрам сегментации документов. Эти факторы ограничивают применимость Naive RAG в сценариях, требующих высокой точности и предсказуемого поведения..
В данной работе мы рассматриваем архитектурный подход к организации знаний и рабочих процессов вокруг языковой модели, направленный на повышение точности и безопасности RAG систем без модификации самих моделей. Мы предлагаем DCD (Domain–Collection–Document), предметно-ориентированный дизайн, который вводит явную иерархию знаний и контролируемый рабочий процесс обработки запросов. Предложенный подход демонстрирует существенное улучшение качества ответов для многошаговых запросов, обеспечивая при этом воспроизводимость и управляемость в прикладных условиях..
2 Предварительные сведения
2.1 Генерация с дополнением поиском
Мы фокусируемся на повышении точности и устойчивости RAG систем в сценариях, включающих многошаговые запросы и гетерогенные корпуса знаний. В частности, мы рассматриваем архитектурные подходы, которые позволяют:
- ⟦• ограничение пространства поиска релевантными подмножествами знаний,
- ⟦• явный контроль над рабочими процессами обработки запросов,
- ⟦• воспроизводимость и обеспечение качества генерируемых результатов.
На протяжении всей этой работы Naive RAG относится к линейному конвейеру без явного структурирования знаний, декомпозиции запросов или многоэтапного контроля генерации. Мы намеренно фокусируемся не на модификации самой языковой модели, а на организации знаний и рабочих процессов вокруг нее..
Во многих практических реализациях RAG поиск выполняется один раз в начале конвейера и остается неизменным на протяжении всего процесса генерации. Такая архитектура предполагает, что одного этапа поиска достаточно для получения всей информации, необходимой для ответа на запрос. Однако, когда корпус знаний содержит документы из нескольких семантических областей, поиск на основе сходства может возвращать фрагменты, которые являются локально релевантными, но принадлежат к разным контекстам знаний. В результате извлеченный контекст может содержать частично совместимые данные, вынуждая LLM согласовывать противоречивую информацию во время генерации Li et al., 2025].
Мы концептуализируем систему RAG как композицию следующих этапов:
- ⟦• интерпретация запроса пользователя,
- ⟦• выбор релевантного подмножества знаний,
- ⟦• поиск и агрегация контекстной информации,
- ⟦• генерация ответа языковой моделью,
- ⟦• валидация и контроль качества выходных данных Guu et al., 2020⟧].
В стандартных реализациях эти этапы часто являются неявными или объединенными в один шаг. Напротив, наш подход рассматривает каждый этап как явный компонент рабочего процесса, обеспечивая детальный контроль и дополнительную проверку..
2.2 Разбиение на фрагменты
Качество системы RAG в значительной степени зависит от стратегий сегментации документов. Распространенные подходы к разбиению на части включают сегментацию на основе абзацев, фрагменты фиксированной длины и методы скользящего окна Gao et al., 2021]. В нашей реализации мы применяем стратегию сегментации со скользящим окном с перекрытием в диапазоне 5–10% от размера фрагмента. Перекрытие в 5% обычно достаточно для сохранения контекстуальной непрерывности между соседними фрагментами. Для документов, содержащих семантически схожие или повторяющиеся разделы, перекрытие увеличивается до 10% для более точного учета контекстуальных зависимостей..
2.3 Защитные механизмы
Классические реализации RAG обычно полагаются на встроенные механизмы безопасности языковых моделей и лишены явных архитектурных процедур для проверки сгенерированных результатов Ji et al., 2023]. В частности, они не предоставляют систематических средств для проверки соответствия между сгенерированными ответами и извлеченным контекстом или для отказа от генерации вне функциональной области системы [Lin et al., 2022]. Наша система включает механизм защитных барьеров в сочетании с модулем предотвращения галлюцинаций. Этот механизм состоит из двух взаимосвязанных компонентов. Первый компонент анализирует запросы пользователей на наличие запрещенных тем, используя составной словарь, который включает как базовый набор стоп-слов, так и пользовательские элементы, определенные владельцем системы. Второй компонент анализирует сгенерированные результаты, обеспечивая отсутствие запрещенного контента и обнаруживая галлюцинации. Это достигается путем сравнения исходного запроса, извлеченного контекста и сгенерированного ответа, что позволяет заблаговременно выявлять отклонения в процессе генерации..
3 Метод
3.1 Ключевое допущение
Центральное методологическое допущение данной работы заключается в том, что качество ответов значительно улучшается, когда поиск и генерация ограничены семантически однородными областями знаний — подмножеством корпуса, документы которого имеют общую тематическую направленность, терминологию и ожидаемое намерение пользователя, оставаясь при этом четко отличимыми от документов, принадлежащих другим областям Yao et al., 2023]. Внутри такой области документы затрагивают тесно связанные предметные сферы и поэтому при поиске конкурируют преимущественно с семантически релевантными источниками..
Данное ограничение позволяет процессу поиска функционировать в рамках ограниченного семантического пространства, уменьшая помехи от нерелевантных документов и улучшая согласованность между извлеченными данными и информационной структурой запроса. Вместо работы с монолитным хранилищем документов мы предполагаем предварительную декомпозицию корпуса на независимые подпространства, внутри которых документы конкурируют только с семантически схожими источниками Khot et al., 2023].
Эта проблема тесно связана с организацией самого пространства знаний. Когда поиск осуществляется по гетерогенному корпусу без явных семантических границ, документы из различных областей знаний конкурируют в рамках одного и того же поискового пространства. В таких условиях одной лишь близости эмбеддингов может быть недостаточно для отражения структурных зависимостей между фрагментами информации, необходимыми для ответа на запрос. В результате извлеченные данные могут быть релевантны по отдельности, но в совокупности недостаточны для последовательного логического вывода Li et al., 2025].
Исследования по поиску доказательств для длинных документов показывают, что стратегии поиска от общего к частному могут улучшить идентификацию релевантных доказательств по сравнению с плоским поиском на уровне фрагментов. В таких подходах сначала определяются структурные сегменты более высокого уровня, которые затем используются для управления детализированным выбором отрывков. Сужая пространство поиска до семантически связных областей документа, поисковые системы сохраняют глобальные контекстуальные связи и повышают надежность последующего QA Nair et al., 2023].
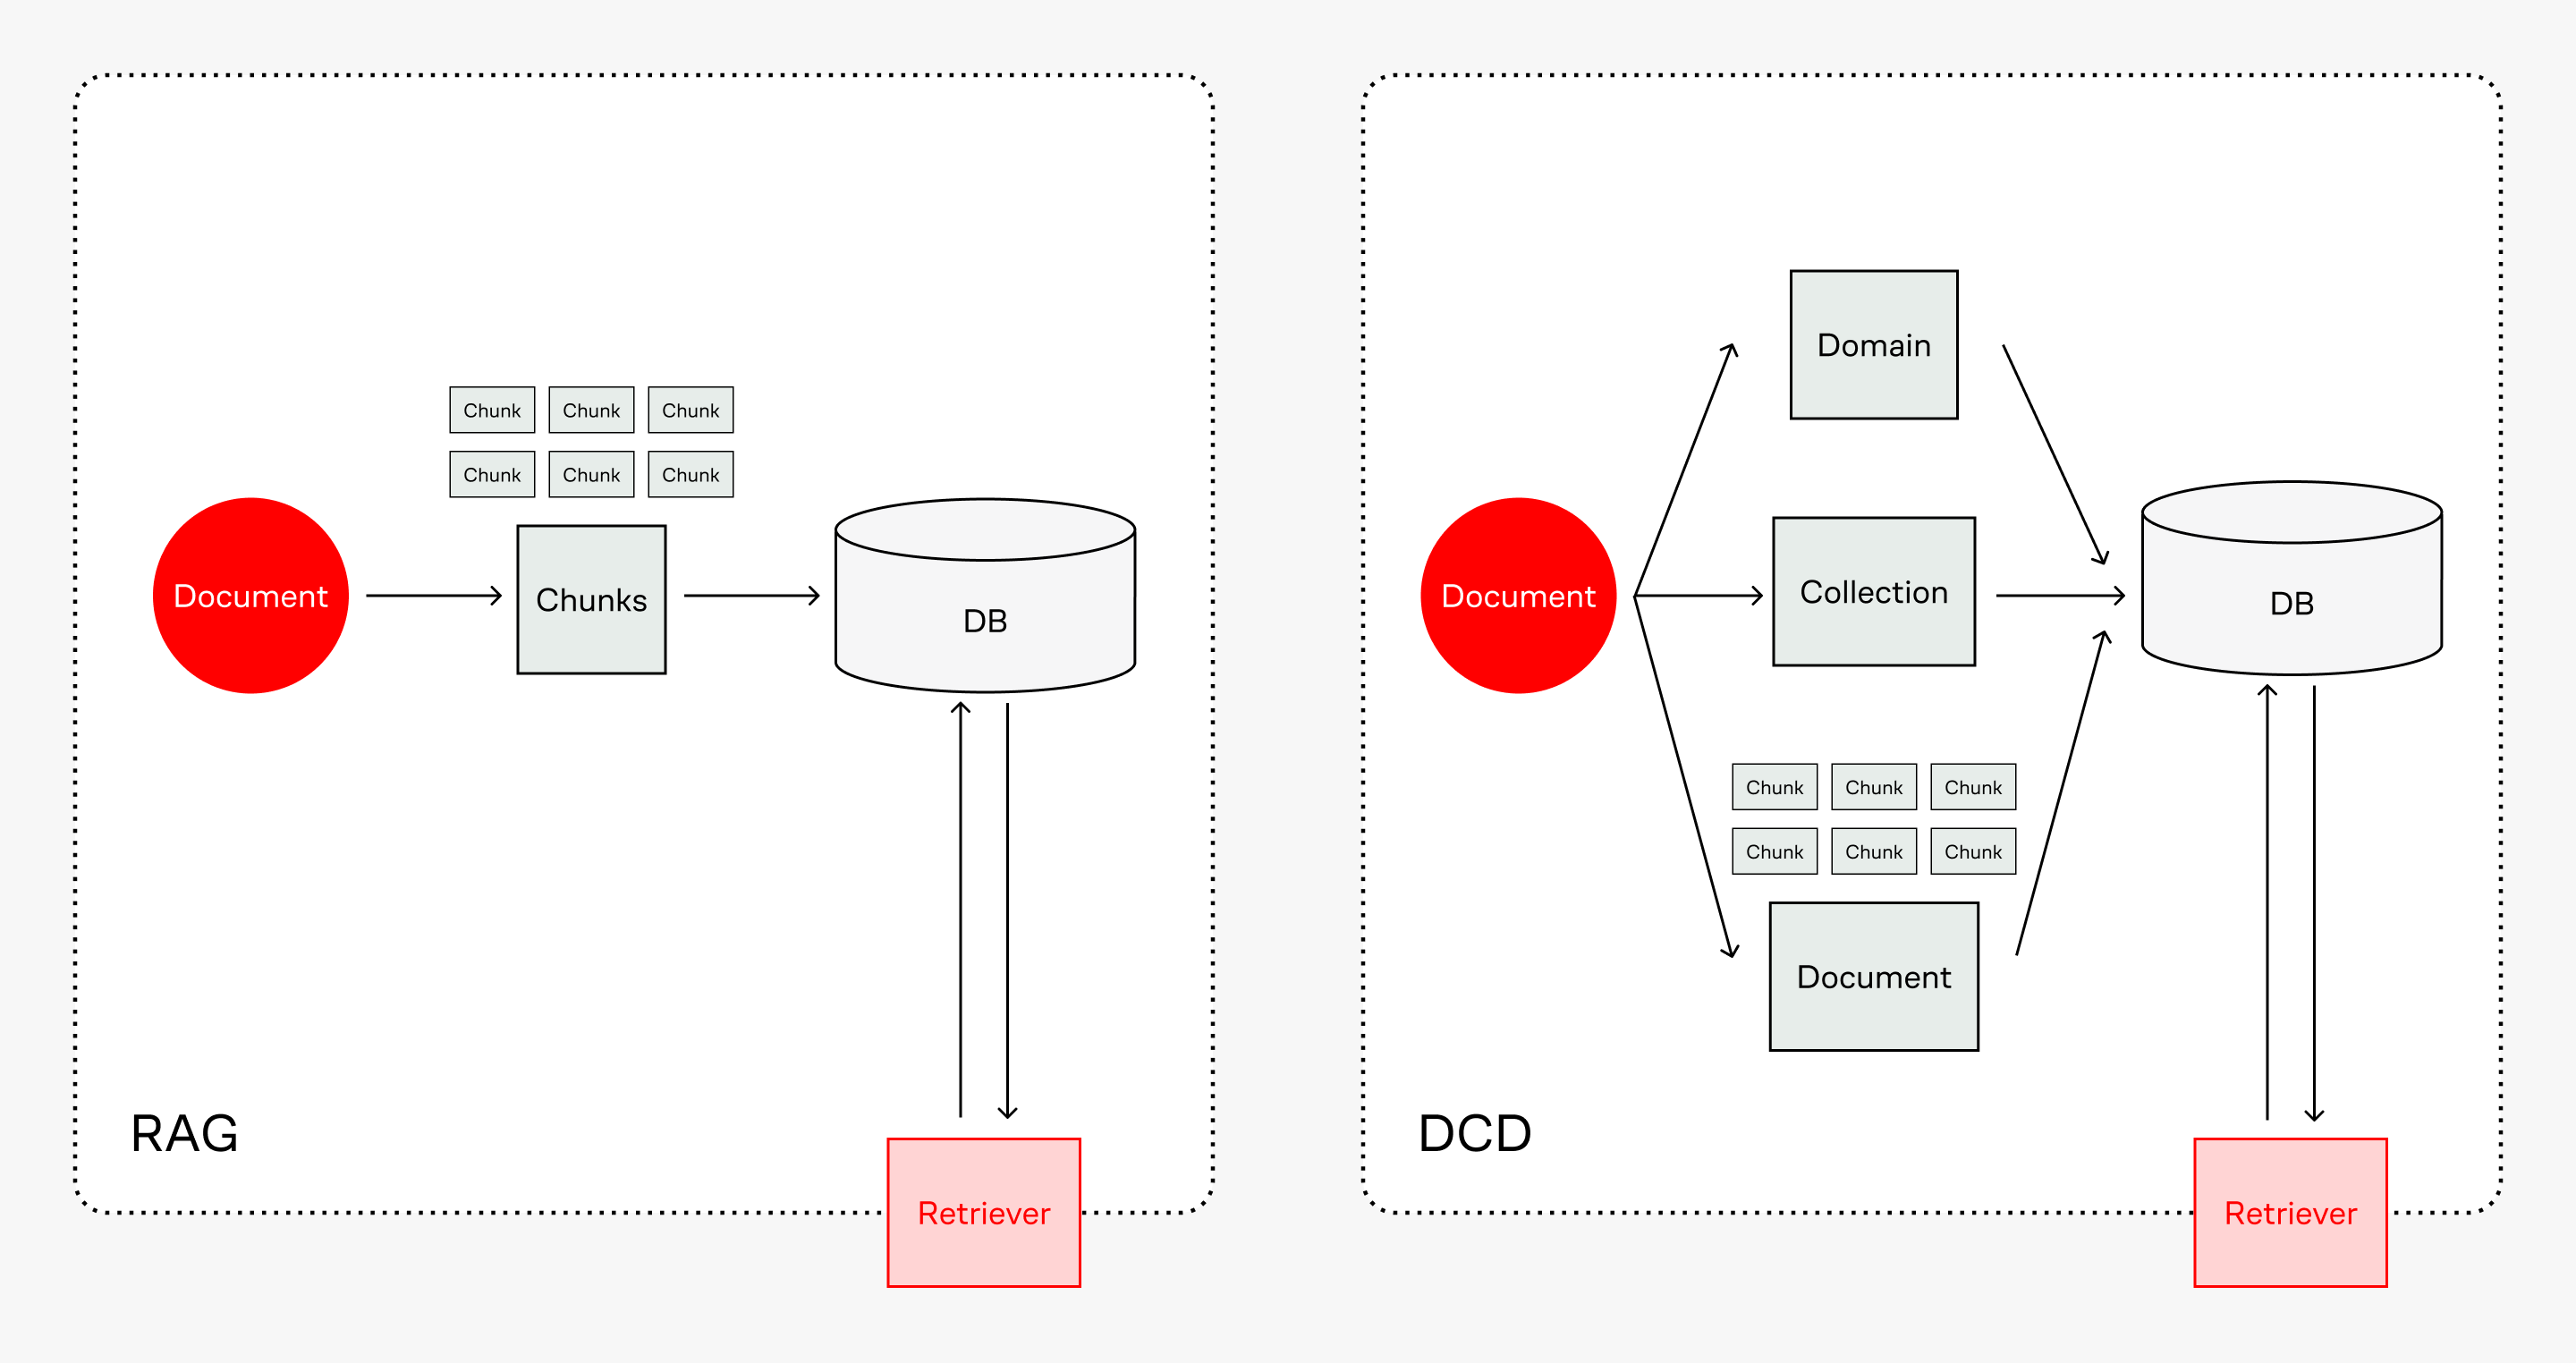
Предложенная архитектура DCD устраняет это ограничение посредством явной декомпозиции пространства знаний до этапа поиска. Ограничивая поиск семантически однородными областями, система снижает междоменные помехи и улучшает согласованность между извлеченным контекстом и структурой рассуждения запроса..
3.2 Экспериментальная проверка предположения
Для проверки этого предположения мы провели эксперименты на синтетическом наборе данных, созданном для аппроксимации реальных сценариев RAG. Корпуса состоят из гетерогенных документов с различной структурой и семантической гранулярностью — условий, при которых конвейеры чаще всего деградируют из-за плоской организации знаний и нестабильного поиска..
Все наборы данных были анонимизированы в целях конфиденциальности: идентификаторы клиентов и конфиденциальные метаданные были удалены. В статье описаны процедуры и наблюдаемые эффекты без раскрытия содержания документов. Помимо показателей качества, мы зафиксировали операционные характеристики конвейера, включая общее время оценки, среднее время отклика от начала до конца и время до получения первого токена, что позволило проанализировать компромисс между точностью и задержкой при повышенной сложности рабочего процесса..
4 DCD: Домен–Коллекция–Документ
Дизайн DCD (Domain–Collection–Document) — это подход к организации знаний в системах RAG посредством явной иерархической сегментации информационного пространства. Его основная цель заключается в минимизации перекрытия между областями знаний и предотвращении передачи нерелевантного контекста в языковую модель Makin, 2024].
DCD структурирует данные на трех уровнях:
- ⟦• Домен — предметная область высокого уровня,
- ⟦• Коллекция — тематически однородное подмножество внутри домена,
- ⟦• Документ — атомарная единица знаний с метаданными.
4.1 Иерархические уровни
Домен определяет границы поиска верхнего уровня и создается для минимизации семантического перекрытия с другими доменами. Коллекция представляет собой более узкий тематический срез внутри домена и дополнительно ограничивает пространство поиска. Примеры включают юридические документы, справочные материалы или пользовательские QA внутри одного домена. Документ является базовой единицей, используемой в процессе RAG. Документы дополняются метаданными и могут быть дополнительно сегментированы на фрагменты для извлечения контекста. Информационный поиск следует принципу «сверху вниз»: от домена к коллекции и к документу..
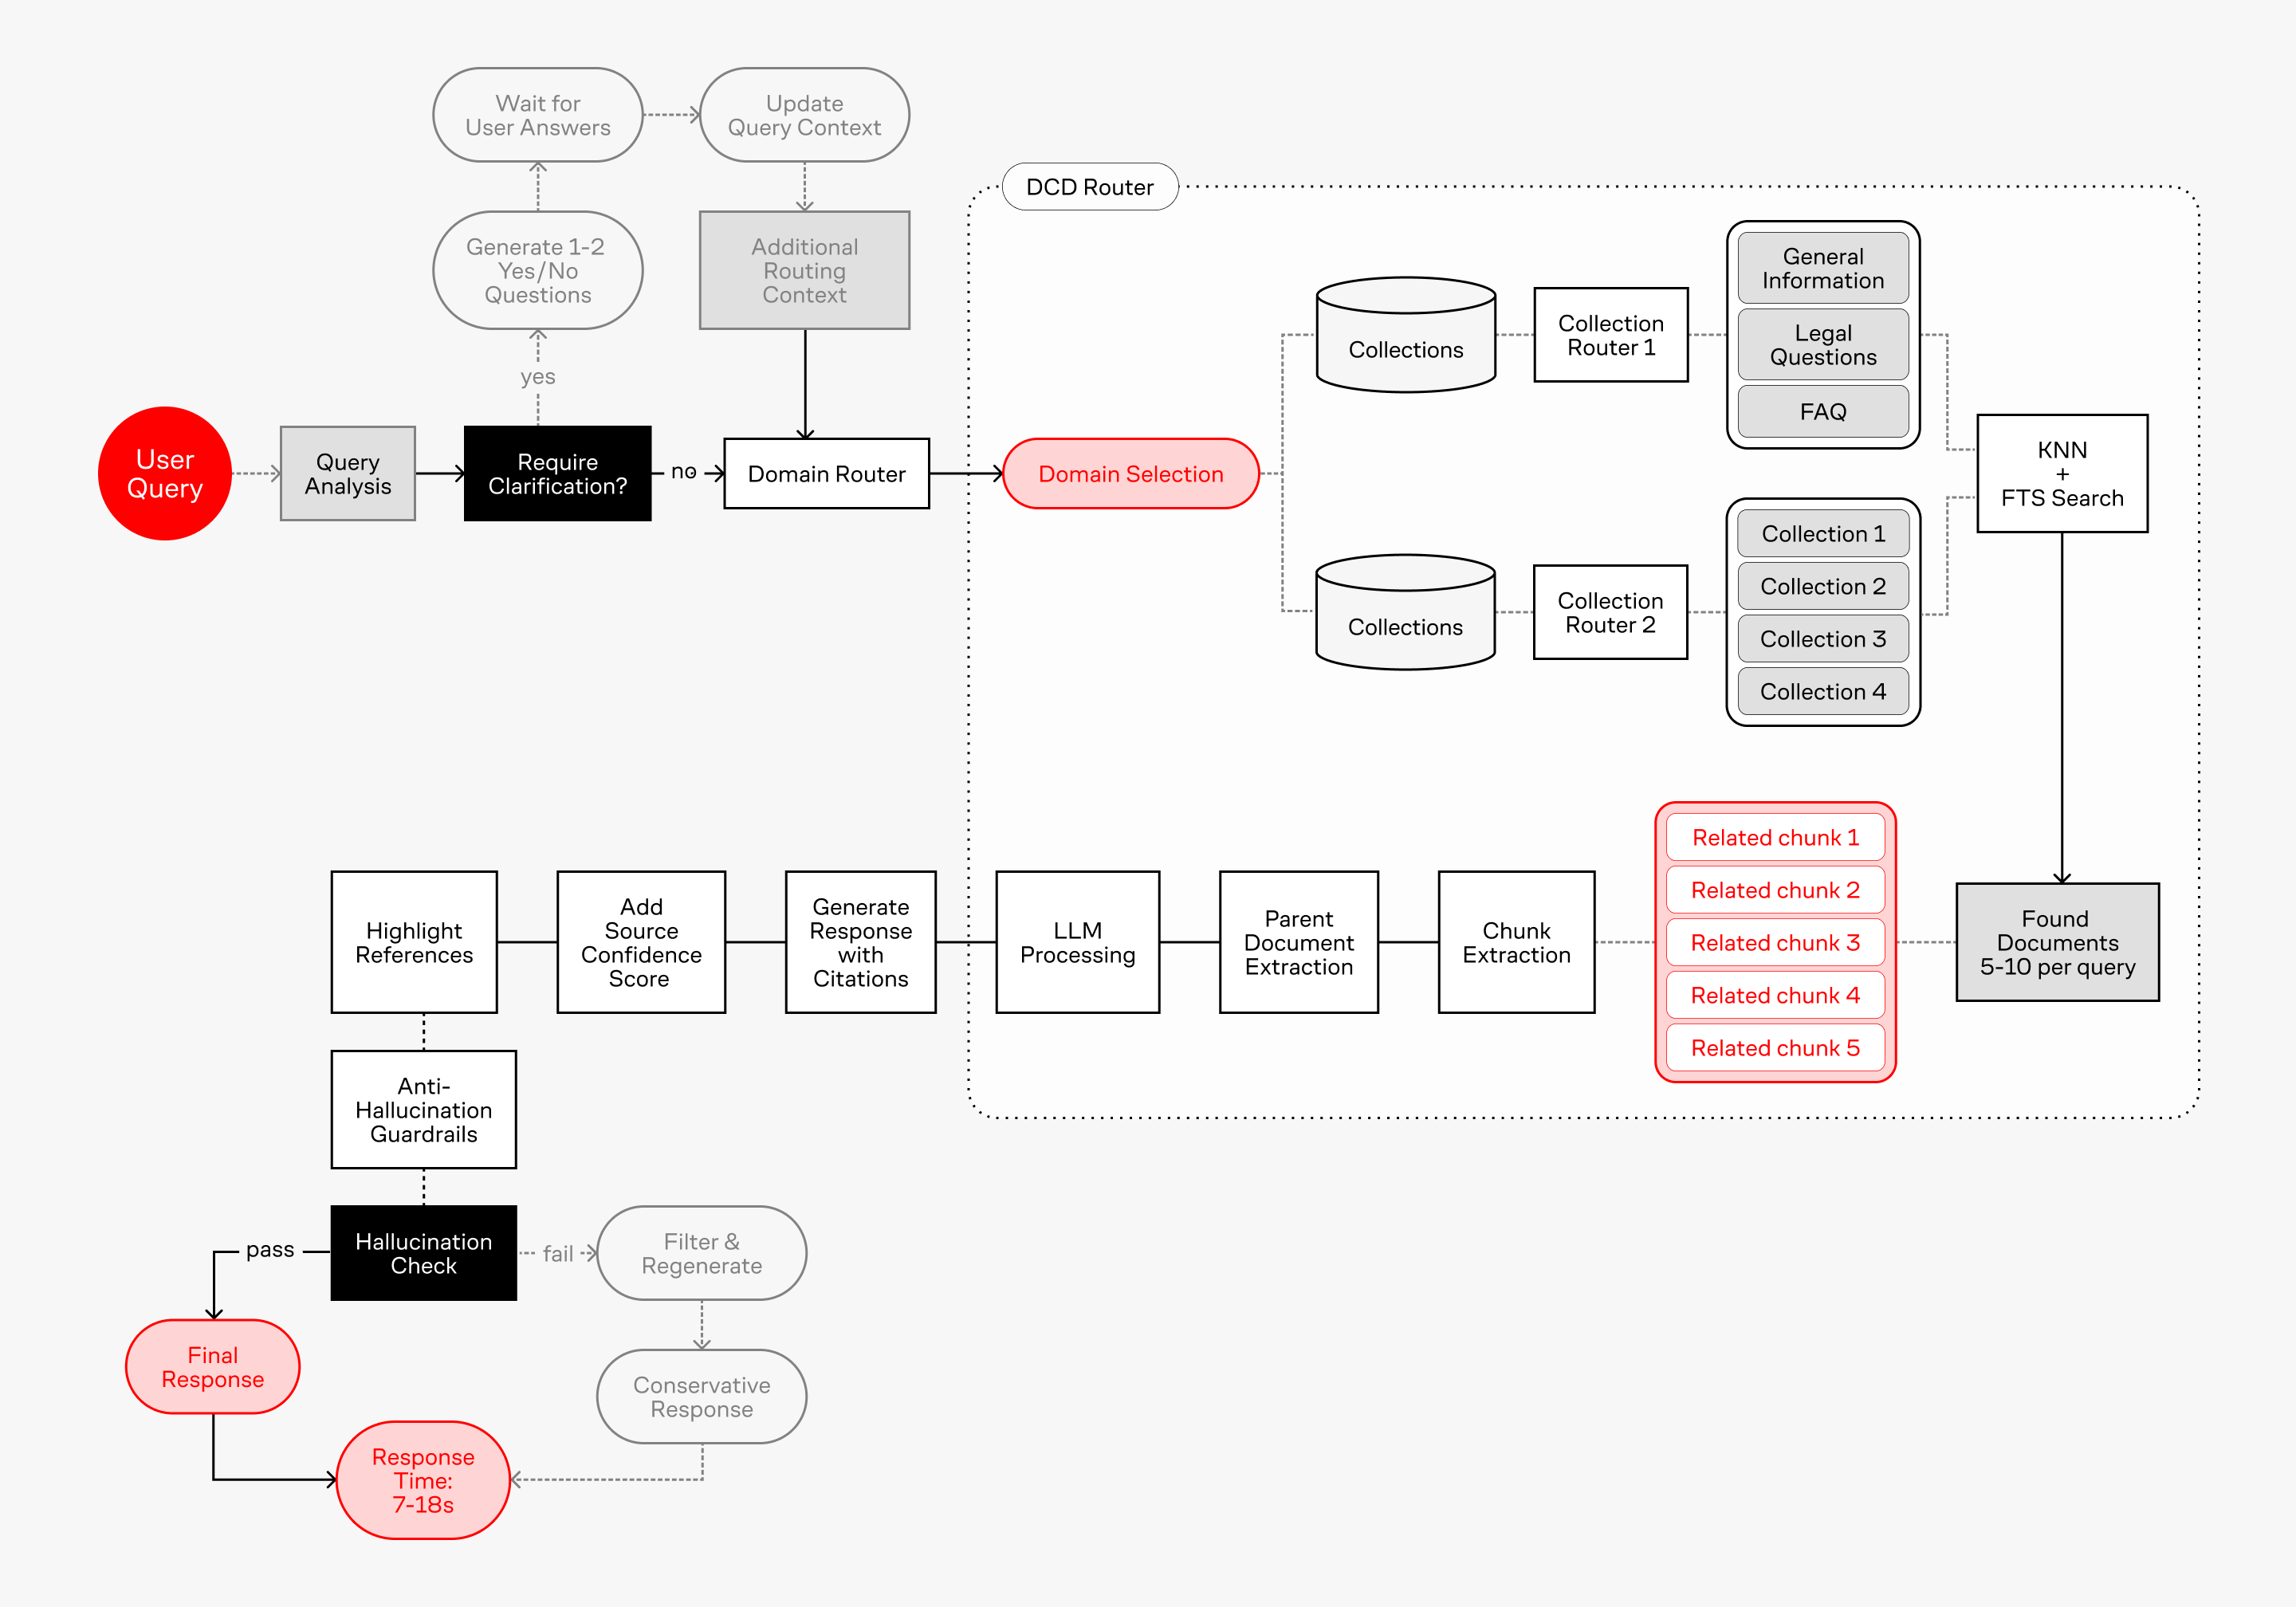
Навигация по иерархии осуществляется с помощью DCD Router, который последовательно выбирает наиболее релевантный домен, коллекцию и документ для заданного запроса. На каждом уровне маршрутизация формулируется как задача выбора из ограниченного набора кандидатов Shazeer et al., 2017]. Решения маршрутизатора формируются с использованием структурированных выводов LLM, что обеспечивает прозрачность, воспроизводимость и кэширование промежуточных результатов. Для повышения устойчивости на каждом уровне определены резервные элементы (основной домен, основная коллекция, основной документ)..
4.2 Маршрутизатор DCD
Функциональным ядром сегментации доменов является DCD Router, специализированный модуль, отвечающий за определение целевого сегмента знаний для извлечения. Как и большинство системных компонентов, он опирается на структурированные выходные данные языковой модели (JSON), что обеспечивает высокоточную обработку и прозрачность принятия решений OpenAI, 2024].
Первоначальная конфигурация включает определение структур доменов и коллекций, а также соответствующее распределение информационных активов. Документы сохраняют свои исходные заголовки, в то время как домены и коллекции получают идентификаторы, заданные вручную. При получении запроса пользователя система передает его вместе с реестром доступных доменов в LLM для определения наиболее релевантного домена. Эта процедура иерархически повторяется для коллекций и документов. Если LLM выдает некорректные результаты, резервные элементы на каждом уровне обеспечивают устойчивость системы и гарантируют получение ответа даже после нескольких неудачных попыток маршрутизации..
Более высокие уровни иерархии описываются с помощью более богатых метаданных для уменьшения ошибок маршрутизации, поскольку ошибки на верхних уровнях могут распространяться вниз по потоку и ограничивать пространство поиска неверной семантической областью базы знаний. Предоставление более четких семантических описаний для доменов и коллекций повышает надежность первоначальных решений по маршрутизации и помогает поддерживать стабильную навигацию по иерархии.
В настоящем исследовании точность маршрутизации на отдельных уровнях иерархии не оценивалась как отдельная метрика классификации. Вместо этого механизм маршрутизации рассматривается как часть общего конвейера поиска, а его эффективность отражается в поведении системы на последующих этапах, включая релевантность ответов, фактическую точность и полноту поиска..
4.3 Интеграция с конвейером RAG
После выбора документа система извлекает релевантные фрагменты с помощью семантического и полнотекстового поиска, за которыми следуют дедупликация и переранжирование. Полученный контекст передается в LLM для генерации ответа..
Ограничивая пространство поиска на начальном этапе, DCD снижает вероятность включения нерелевантного контекста и повышает устойчивость генерации при выполнении многошаговых запросов. В то время как Naive RAG использует линейный конвейер обработки — разбиение на фрагменты, эмбеддинг, поиск и генерацию, — DCD сохраняет аналогичный пользовательский интерфейс, но внедряет принципиально иную внутреннюю организацию, основанную на многоуровневой обработке..
4.4 Умное сегментирование
Интеллектуальное сегментирование является неотъемлемым компонентом архитектуры DCD. Хотя DCD может функционировать с использованием классических методов сегментирования, выбранная стратегия обеспечила наиболее стабильное поведение в рамках предложенной архитектуры, поскольку она лучше сохраняет структурные свойства базовой базы знаний..
В этом подходе документы сегментируются с использованием механизма скользящего окна с частичным перекрытием между соседними фрагментами. Такая стратегия сегментации сохраняет локальную семантическую непрерывность и снижает вероятность потери релевантной контекстной информации на границах фрагментов. В результате логически связанные утверждения, охватывающие несколько предложений или абзацев, остаются доступными при поиске, что особенно важно для запросов, требующих композиционного рассуждения..
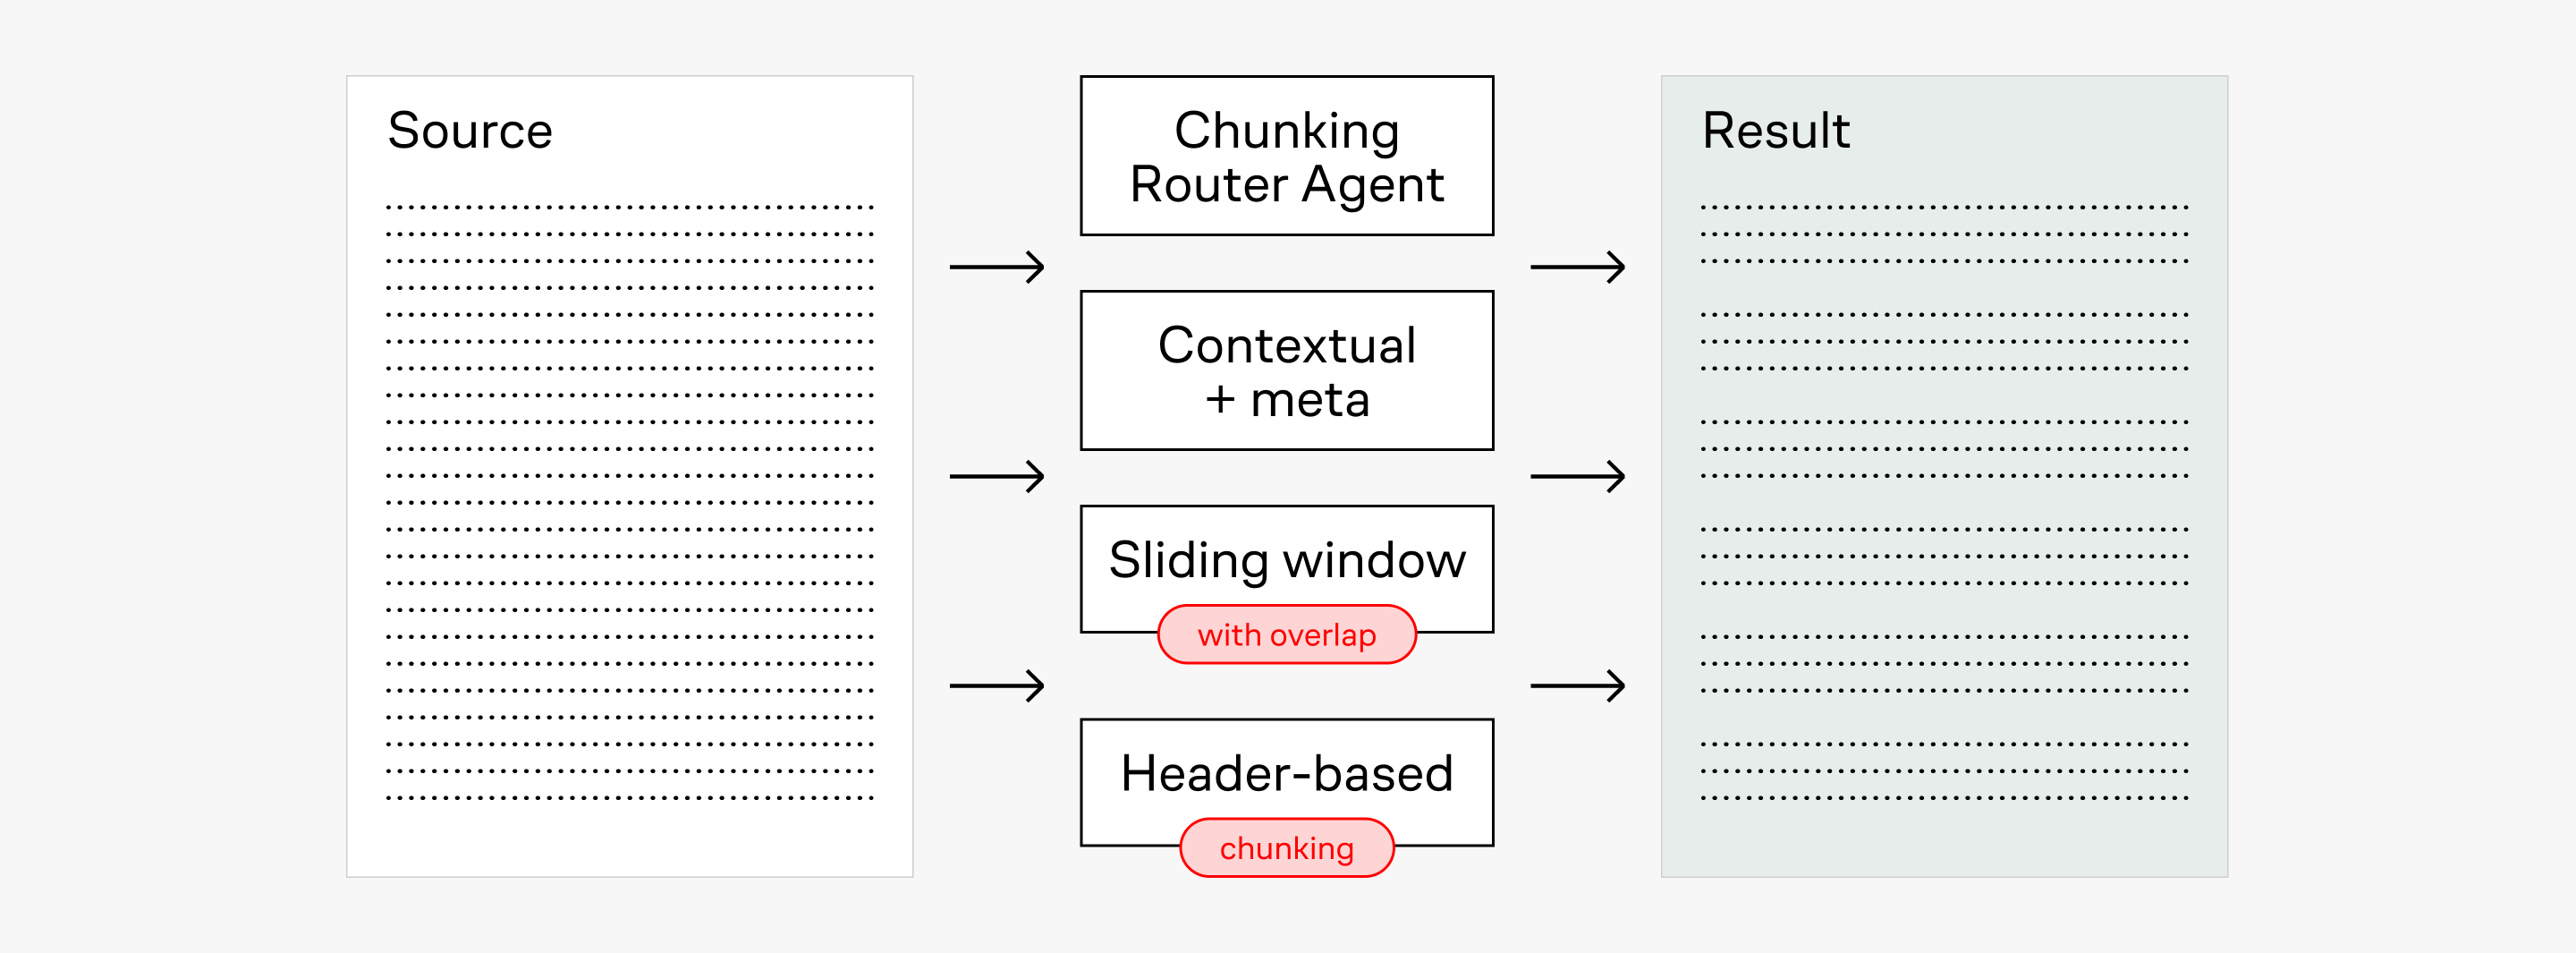
Каждый фрагмент дополнительно обогащается метаданными на уровне чанков, полученными из структуры документа. Эти метаданные описывают положение фрагмента в иерархии документа и поддерживают ссылки на соответствующую сущность уровня документа. Такие структурные аннотации позволяют этапу поиска опираться не только на семантическое сходство, но и на контекстные взаимосвязи между фрагментами, происходящими из одного и того же документа или коллекции..
Сочетание перекрывающейся сегментации и структурированных метаданных повышает согласованность извлечения фрагментов и снижает вероятность формирования ответов из семантически несвязанных контекстов. Такая архитектура позволяет конвейеру извлечения лучше соотносить выбранные доказательства с концептуальной структурой запроса и способствует более стабильной генерации ответов в рабочих процессах с использованием retrieval-augmented, что отражено в экспериментальной оценке, представленной далее в статье..
4.5 Быстрые защитные барьеры
В дополнение к основному конвейеру поиска и генерации, система внедряет механизм быстрых защитных барьеров для предварительной проверки ответа. Система включает в себя механизм защитных барьеров в сочетании с предотвращением галлюцинаций и функцию быстрой предварительной проверки, которая оценивает ответы до завершения полной генерации Manakul et al., 2023].
Рабочий процесс ограничителей выглядит следующим образом:
- ⟦• запрос пользователя проходит проверку на стоп-слова,
- ⟦• соответствующие запросы передаются в конвейер DCD RAG,
- ⟦• во время потоковой передачи ответа анализируются первые 150 токенов,
- ⟦• на основе запроса, контекста и частичного вывода система принимает решение о том, отобразить или заблокировать ответ.
Этот механизм фильтрует неподдерживаемые запросы и проверяет сгенерированный контент параллельно с генерацией, избегая дополнительных задержек.
4.6 Сводка полноты системы
Архитектура DCD демонстрирует значительные преимущества в адаптивности при обработке гетерогенных данных и структурно сложных запросов. Ее гибкость обеспечивает существенное повышение точности в многоуровневых сценариях работы со знаниями, интегрируя при этом критически важные этапы валидации и контроля, отсутствующие в системах Naive RAG. Хотя первоначальная конфигурация требует дополнительных усилий по настройке, эти затраты компенсируются превосходной производительностью и быстрой окупаемостью за счет повышения операционной эффективности..
5 Метрики
Для всесторонней оценки предложенного подхода DCD мы используем набор метрик, выходящий за рамки стандартных оценок. Оценка опирается на структурированную оценку качества генерации с использованием LLM в качестве эксперта Liu et al., 2023].
5.1 Строгая бинарная релевантность и полнота ответа
⟦ — это строгая бинарная метрика, оценивающая, является ли ответ одновременно релевантным и полным по отношению к вопросу.
| (1) |
⟦ — вопрос и ответ соответственно,
⟦ — бинарный вердикт вывода,
⟦ — критерий прямого ответа,
⟦ — критерий полноты,
⟦ — критерий специфичности,
⟦ — критерий неопределенности,
| (2) |
⟦ — общее количество пар (вопрос, ответ) в наборе данных для оценки.
5.2 Строгий бинарный контекстный отзыв
⟦ оценивает, используется ли вся релевантная контекстная информация в ответе.
| (3) |
⟦ — контекст и ответ соответственно,
⟦ — бинарный выходной вердикт,
⟦ — множество всех релевантных фактов, присутствующих в контексте,
⟦ — набор фактов из контекста, которые используются в ответе,
| (4) |
⟦ — общее количество пар (вопрос, ответ) в наборе данных для оценки.
5.3 Строгая бинарная фактическая точность
⟦ оценивает фактическую точность и отсутствие галлюцинаций.
| (5) |
⟦ — контекст и ответ соответственно,
⟦ — бинарный вердикт вывода,
⟦ — все утверждения в ответе явно присутствуют в контексте или прямо вытекают из него,
⟦ — ответ не противоречит информации, содержащейся в контексте,
⟦ — ответ не содержит информации, отсутствующей в контексте,
| (6) |
⟦ — общее количество пар (вопрос, ответ) в наборе данных для оценки.
5.4 Оценка охвата поиска ⟦K0⟧)
⟦ измеряет, насколько полно извлеченный контекст воспроизводит исходный (эталонный) контекст, и, следовательно, характеризует качество поискового механизма.
Пусть — исходный контекст, а — контекст, извлеченный поисковым механизмом. Функция оценки определяется следующим образом:
| (7) |
Здесь — это либо экспертная оценка, либо результат работы оценщика на базе LLM, который сравнивает два текста.
⟦ — извлеченный контекст не содержит информации из исходного контекста ,
⟦ — извлеченный контекст содержит часть информации из , но не всю ее,
⟦ — вся информация из исходного контекста присутствует в извлеченном контексте .
Итоговое значение для набора данных вычисляется как среднее арифметическое:
| (8) |
Где — это общее количество запросов в оценочном наборе данных.
6 Эксперимент
Целью эксперимента была оценка эффективности подхода DCD по сравнению с базовым конвейером Naive RAG. Исследовательский процесс состоял из пяти последовательных этапов:
- ⟦1. Генерация текстового набора данных
- ⟦2. Генерация оценочных данных (вопрос–ответ–контекст),
- ⟦3. Создание векторной базы данных,
- ⟦4. Вывод с использованием конвейеров DCD и Naive RAG,
- ⟦5. Вычисление метрик.
На первом этапе был сгенерирован набор синтетических текстовых данных. Используя языковую модель gpt-oss-120b и набор предопределенных шаблонов, мы синтезировали тексты, описывающие различные домены. В качестве доменов использовались десять жилых комплексов. Внутри каждого домена было создано несколько коллекций документов, соответствующих различным разделам, таким как инфраструктура, безопасность и описание комплекса. Вариативность набора данных была достигнута за счет генерации на основе шаблонов семантически согласованных экземпляров промптов, где численные параметры и переменные систематически варьировались при сохранении одной и той же базовой модели рассуждений. Такой подход позволил нам сформировать корпус документов с контролируемой семантической структурой..
На втором этапе для полученного корпуса документов были сгенерированы пары вопрос-ответ. С использованием языковой модели gpt-oss-120b для каждого документа были синтезированы релевантные вопросы, ответы и подтверждающий контекст. Полученный набор данных вопрос-ответ-контекст послужил эталонным множеством для оценки конвейеров поиска и генерации..
Третий этап включал создание векторной базы данных. В качестве решения для хранения использовалась ChromaDB. Документы были разделены с помощью оконного разделителя с фиксированным размером окна 300 токенов и перекрытием 20%. Эмбеддинги фрагментов были сгенерированы с использованием модели эмбеддингов bge-m3..
На четвертом этапе оба подхода были оценены. Для каждого запроса из оценочного набора данных система извлекала релевантный контекст и генерировала ответ с использованием LLM. Эмбеддинги запросов вычислялись с помощью bge-m3, в то время как генерация ответов выполнялась моделью qwen2.5-7b-instruct. Эта процедура выполнялась отдельно для конвейера DCD и конвейера Naive RAG..
Наконец, мы вычислили метрики, описанные в разделе 5.
| Metrics | DCD | Naive |
|---|---|---|
| Strict Binary Answer Relevance | 0.86 | 0.87 |
| Strict Binary Context Recall | 0.95 | 0.59 |
| Strict Binary Factual Accuracy | 0.89 | 0.40 |
| Retrieval Coverage Score | 1.76 | 1.28 |
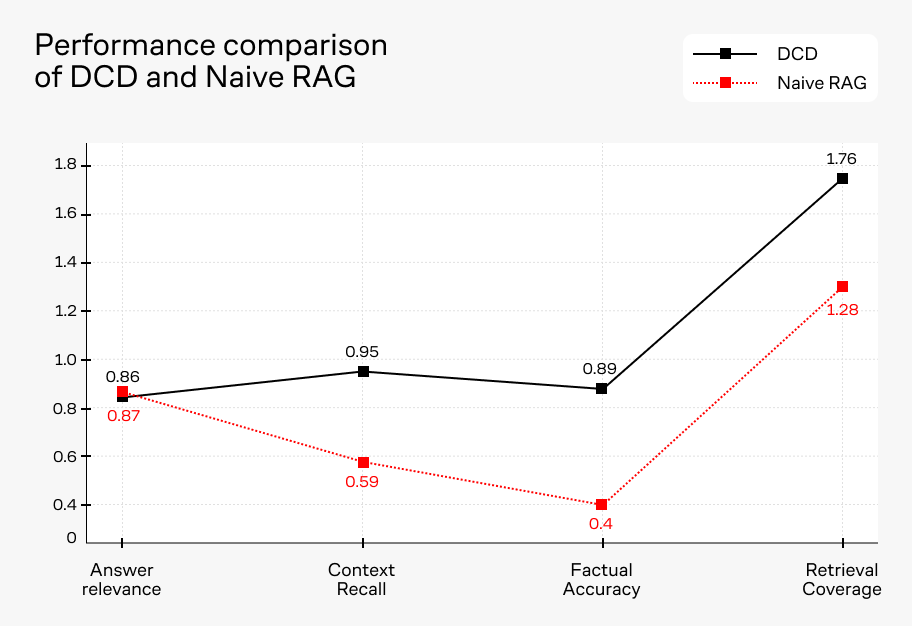
Что касается качества генерации ответов, оба подхода продемонстрировали сопоставимые результаты. В то же время оценка retriever показывает явное преимущество DCD: предложенный подход обеспечивает более точное извлечение релевантного контекста. На наборе данных со структурой документов на основе шаблонов DCD значительно превосходит Naive RAG в извлечении релевантной информации..
7 Ограничения
7.1 Сложность конфигурации
Предложенный подход DCD вносит дополнительную сложность конфигурации по мере увеличения размера и гетерогенности базы знаний. Трудность поддержания корректной сегментации домена растет пропорционально количеству семантически несвязанных областей знаний Yao et al., 2023] — компромисс, часто наблюдаемый в системах, опирающихся на явную структуру рассуждений и контролируемые пространства поиска..
7.2 Полностью неструктурированные данные
DCD предполагает наличие по меньшей мере минимальной семантической организации внутри корпуса знаний. При применении к полностью неструктурированным данным эффективность механизмов структурированного поиска и маршрутизации снижается, зачастую приближаясь к поведению продвинутых наивных RAG конвейеров Gao et al., 2021].
7.3 Вычислительные накладные расходы
Важно учитывать специфику сгенерированного набора данных: все документы имеют шаблонную структуру, в которой тексты внутри каждого домена практически идентичны и различаются только конкретными значениями, такими как имена и числовые характеристики, при сохранении той же общей синтаксической и семантической структуры. Shazeer et al., 2017].
Для данного типа данных, характеризующегося высокой степенью контекстуального перекрытия, DCD предсказуемо демонстрирует более высокое качество поиска по сравнению с наивным подходом RAG..
7.4 Методология оценки
Качество ответов в данном исследовании оценивалось с использованием подхода LLM-as-a-Judge с применением модели gpt-oss-120b. Судья оценивал сгенерированные ответы в соответствии с метриками оценки, определенными в Разделе 5, получая на вход запрос пользователя, извлеченный контекст и сгенерированный ответ. Промпты для оценки предписывали модели оценивать ответы согласно определениям метрик и формировать структурированное обоснование перед вынесением окончательного решения. Температура для этих оценок была установлена на 0 для обеспечения детерминированного выставления баллов..
Качество поиска оценивалось отдельно с использованием Retrieval Coverage Score. В этих условиях судья сравнивал извлеченный контекст с эталонным контекстом и присваивал оценку по трехбалльной шкале от 0 до 2, отражающую, отсутствовала ли извлеченная информация, была ли она частично достаточной или полностью соответствовала эталонному контексту. Для этой оценки температура была установлена на уровне 0.1, чтобы допустить ограниченную вариативность в пояснительных рассуждениях..
8 Заключение
Мы представили DCD, архитектуру RAG, ориентированную на предметную область, основанную на явных иерархиях знаний и контролируемых многоэтапных рабочих процессах. Эксперименты на производственных данных демонстрируют устойчивое повышение качества для гетерогенных корпусов и многошаговых запросов при предсказуемых вычислительных затратах. Дальнейшая работа включает замену LLM общего назначения в задачах маршрутизации на специализированные легковесные модели и интеграцию механизмов обратной навигации с проверкой контекстной релевантности..
9 Ресурсы
Набор данных: Huggin Face
Репозиторий кода: GitHub
Оба ресурса поддерживаются командой исследований и разработок в области искусственного интеллекта в red_mad_robot.
10 Список литературы
Льюис, П., Перез, Э., Пиктус, А. и др. Генерация с дополнением поиском для NLP-задач, требующих интенсивного использования знаний. Достижения в системах обработки нейронной информации (NeurIPS), 2020.
Guu, K., Lee, K., Tung, Z., Pasupat, P., Chang, M.-W. REALM: Retrieval-Augmented Language Model Pre-Training. Международная конференция по машинному обучению (ICML), 2020.
Izacard, G., Grave, E. Использование поиска фрагментов текста с генеративными моделями для ответов на вопросы в открытых доменах. Европейское отделение ACL (EACL), 2021.
Хот, Т. Хот, Т., Сабхарвал, А., Кларк, П. Декомпозированное промптирование: модульный подход для решения сложных задач. Международная конференция по обучению представлениям (ICLR), 2023.
Вэй, Дж., Ван, С., Схурманс, Д. и др. Промпт-инжиниринг с цепочкой рассуждений вызывает способность к логическому выводу у LLM. NeurIPS, 2022.
Яо, С., Чжао, Дж., Ю, Д. и др. Древо мыслей: осознанное решение задач с помощью LLM. arXiv preprint arXiv:2305.10601, 2023.
Шейзер, Н., Мирхосейни, А., Мазярз, К. и др. Невероятно большие нейронные сети: разреженно-активируемый слой смеси экспертов. ICLR, 2017.
Структурированные выводы OpenAI в языковых моделях. Технический отчет / документация, 2024.
Гао, Л., Ма, С., Лин, Дж., Каллан, Дж. Точный Zero-Shot плотный поиск без меток релевантности. ACL, 2021.
Чжэн, Л., Цзян, В.-Л., Шэн, И. и др. Оценка LLM-as-a-Judge с помощью MT-Bench и Chatbot Arena. NeurIPS, 2023.
Джи, З., Ли, Н., Фриске, Р. и др. Обзор галлюцинаций в генерации естественного языка. ACM Computing Surveys, 2023.
Ли, Ю., Вэйчжи Чжан, Юйяо Ян и др. На пути к агентному RAG с глубоким рассуждением: обзор систем RAG-рассуждения в LLM. Препринт arXiv, 2025.
Лю, И. Итер, Д. и др. G-Eval: Оценка NLG с использованием GPT-4 с улучшенным человеческим выравниванием. Препринт arXiv arXiv:2303.16634, 2023.
Лю, И. Лин, С., Хилтон, Дж., Эванс, О. TruthfulQA: Измерение того, как модели имитируют человеческие заблуждения. ACL, 2022.
Manakul, P., Liusie, A., Gales, M. Manakul, P.. EMNLP, 2023.
Макин, А. Системы управления знаниями на основе онтологий, дополненные LLM. Препринт ResearchGate, 2024.
Наир, И. Сомасундарам, С., Саксена, А., Госвами, К. Углубленный анализ дискурсивной структуры с помощью LLM для ответов на вопросы по длинным документам. Препринт arXiv, 2023.