
Healthcare AI GYM для медицинских агентов
Аннотация
Клиническое рассуждение требует многошаговых взаимодействий — сбор анамнеза пациента, назначение анализов, интерпретация результатов и принятие безопасных решений о лечении — однако единая среда обучения, обеспечивающая широту клинических областей и специализированные инструменты для обучения обобщаемых медицинских ИИ-агентов с помощью обучения с подкреплением, остается труднодостижимой. Мы представляем всестороннее эмпирическое исследование многораундового агентного RL для медицинского ИИ, построенное на Healthcare AI GYM — среде, совместимой с gymnasium, охватывающей 10 клинических областей с более чем 3.6K задачами, 135 домен-специфичными инструментами и базой знаний из 828K медицинских статей. Наш анализ показывает, что агентная многораундовая структура вырождается в многословные однораундовые монологи, характеризующиеся монотонным взрывом длины и одновременным снижением частоты использования инструментов. Мы характеризуем, как этот коллапс, наряду с нестабильностью дистилляции, проистекает из несоответствия разреженных финальных вознаграждений последовательным клиническим траекториям. Мы обнаруживаем, что ванильный GRPO достигает высокой итоговой точности на некоторых бенчмарках, но страдает от нестабильности обучения, о чем свидетельствуют значительные колебания длины ответов и длительные периоды сходимости. Для повышения эффективности и стабильности обучения мы предлагаем Turn-level Truncated On-Policy Distillation (TT-OPD) — структуру самодистилляции, где градиентно-свободный EMA-учитель использует информацию о привилегированных результатах для обеспечения плотной, осведомленной о результатах KL-регуляризации на каждом витке диалога. TT-OPD достигает наилучшей производительности на 10 из 18 бенчмарков со средним улучшением +3.9 pp по сравнению с базовым уровнем без RL, с более быстрой начальной сходимостью, контролируемой длиной ответа и устойчивым многораундовым использованием инструментов. Наш анализ также выявляет фундаментальный разрыв в переносе между агентным и текстовым: RL улучшает процедурные компетенции, но не переносится на текстовые бенчмарки QA из-за размывания формата-вознаграждения. Среда, конвейер обучения и все экспериментальные артефакты находятся в открытом доступе..
ГитХаб: Healthcare AI GYM Repository
1 Введение
Недавние достижения в области медицинских LLM сдвинули границу от статического извлечения знаний к сложным клиническим рассуждениям (Nori et al., 2023; Singhal et al., 2023; Chen et al., 2024). Хотя передовые модели всё лучше справляются с медицинскими экзаменами, их производительность остаётся в значительной степени ограниченной пассивными одношаговыми бенчмарками (Jin et al., 2021; Hendrycks et al., 2021; Pal et al., 2022). Однако подлинная клиническая практика по своей сути является агентной и многошаговой: она требует итеративного цикла сбора анамнеза, выбора диагностических инструментов и пересмотра планов лечения на основе меняющихся клинических контекстов (Thirunavukarasu et al., 2023; Yao et al., 2023). Несмотря на появление моделей, оптимизированных для рассуждений (Wei et al., 2022; Wang et al., 2023), сохраняется критический «action gap» — современные фреймворки хорошо вербализуют медицинскую логику, но с трудом поддерживают стабильные, дополненные инструментами траектории в открытых клинических средах (Shen et al., 2026; Schick et al., 2023). Преодоление этого разрыва требует перехода от ответов на вопросы к агентному обучению с подкреплением, где модели учатся ориентироваться в условиях высокой неопределённости многошагового принятия медицинских решений (Schulman et al., 2017; Shao et al., 2024; Ouyang et al., 2022).⟧.
Существующие среды медицинских агентов решают лишь фрагменты задачи клинического рассуждения. AgentClinic (Schmidgall et al., 2025) моделирует диагностические диалоги, но не имеет интеграции с инструментами и тренировочной среды на основе RL. Agent Hospital (Li et al., 2024) сосредоточен на многолетнем опыте рабочих процессов, а не на явной оптимизации политики с помощью RL. Хотя MedAgentGym (Xu et al., 2026) предлагает интерфейс типа Gymnasium, его система инструментов в основном является кодо-центричной (например, песочницы Python), а не клинически обоснованной (например, назначение анализов, оценка тяжести состояния), что ограничивает его экологическую валидность. Кроме того, MedOpenClaw (Shen et al., 2026) выявляет «парадокс использования инструментов», когда прямое использование подсказок с профессиональными инструментами ухудшает производительность, подчеркивая, что компетентность в опосредованном инструментами рассуждении должна быть изучена через RL, а не просто подсказана. Хотя такие фреймворки, как ReAct (Yao et al., 2023), предоставляют шаблоны рассуждений, ни одна существующая среда не предлагает одновременно: (1) широкое многодоменное клиническое покрытие, (2) подлинную экосистему инструментов, (3) критически важную с точки зрения безопасности оценку и (4) бесшовную совместимость с современными фреймворками RL. Это мотивирует создание Healthcare AI GYM, единой среды, удовлетворяющей этим требованиям..
Обучение агентов в Healthcare AI GYM с помощью многошагового RL выявляет три усугубляющиеся патологии, отсутствующие в одношаговых сценариях: (1) Взрыв ответов: Выходы монотонно растут до предела. При отсутствии промежуточной обратной связи (Lightman et al., 2024; Uesato et al., 2022) модель принимает покрытие на уровне токенов как прокси выполнения задачи, раздувая ответы, чтобы «захватить» правильный ответ в море бессвязности; (2) Многошаговый коллапс: Агентная структура деградирует от координированных диалогов с использованием инструментов к многословным одношаговым монологам. Этот коллапс предполагает, что модель находит одношаговую многословность более низкоэнергетическим путем оптимизации, чем сложная политика смены реплик, необходимая для последовательного рассуждения (Shi et al., 2024; Jung et al., 2025). Критически важно, что эти две патологии причинно связаны: по мере смещения модели к одношаговым монологам ответы становятся длиннее, чтобы компенсировать отказ от вызовов инструментов, и результирующий взрыв длины еще больше препятствует многошаговому взаимодействию — создавая самоусиливающийся цикл коллапса; (3) Нестабильность дистилляции: Дистилляция на политике (OPD), хотя и эффективна для одношагового рассуждения (Zhao et al., 2026; Yang et al., 2026), терпит неудачу в агентных сценариях. Комбинаторная сложность пространства траекторий приводит к тому, что политики учителя устаревают гораздо быстрее, чем в ограниченных задачах QA (Song and Zheng, 2026). Эти неудачи имеют общий корень: структурное несоответствие между разреженными конечными наградами и последовательной природой агентных траекторий. Стандартный GRPO (Shao et al., 2024) назначает единую оценку преимущества всем токенам в многошаговой последовательности, не присваивая кредит конкретным шагам, что приводит к нестабильной сходимости..
Эта статья представляет всестороннее эмпирическое исследование многоповоротного агентного RL для медицинского ИИ. Мы оцениваем 18 бенчмарков, охватывающих MC QA, visual QA, EHR reasoning и long-form QA, демонстрируя, что TT-OPD достигает наилучшей производительности на 10 из 18 бенчмарков со средним улучшением +3.9 п.п. по сравнению с базовым уровнем без RL, включая MedQA 87.1% (+16.4 п.п. над базой), MedMCQA 66.2% и MIMIC-III 62.7%. Vanilla GRPO достигает высокой точности обучения (+9.4 п.п.), но страдает от описанных выше нестабильностей обучения. Чтобы повысить эффективность и стабильность обучения, мы предлагаем Turn-Level Truncated On-Policy Distillation (TT-OPD), фреймворк самодистилляции, который стабилизирует обучение с помощью: (1) беградиентного EMA учителя (Tarvainen & Valpola, 2017), (2) обусловленных результатом привилегированных подсказок, обеспечивающих плотную поворотную KL-регуляризацию, и (3) контролируемого по длине формирования вознаграждения (Yeo et al., 2025). Наши вклады:
Наши вклады заключаются в следующем. Healthcare AI GYM, Gymnasium-совместимая среда, охватывающая 10 клинических областей с более чем 3,6 тыс. задач, 135 предметно-ориентированными инструментами, базой знаний из 828 тыс. медицинских текстов и учитывающей безопасность 5D функцией вознаграждения (Приложение A). Наша новизна заключается в регуляризации с учетом результата: путём внедрения сигналов правильности в контекст учителя (но утаивания их от ученика) градиент KL обеспечивает плотное, пошаговое руководство, поддерживая частоту использования инструментов (7.0–7.4 шага) и контролируемые длины ответов (5.7–9.3K токенов). Четыре варианта абляции прослеживают прогрессию отказов от коллапса KL (периодический сброс) через взрыв ответа (без контроля длины), определяя многовитковый коллапс как специфический для агентов режим отказа, отсутствующий в одношаговой OPD (Yang et al., 2026; Zhao et al., 2026)⟧.
2 Связанные работы
Медицинские ИИ-агенты
Недавние среды медицинских агентов каждая охватывает фрагменты клинического рассуждения. AgentClinic (Schmidgall et al., 2025) имитирует диагностические диалоги, но не обладает использованием инструментов и обучением RL; Agent Hospital (Li et al., 2024) моделирует многогаентные рабочие процессы без оптимизации политики; MedAgentGym (Xu et al., 2026) предоставляет интерфейс Gymnasium с кодоцентричными инструментами, а не клинически обоснованными; и MedOpenClaw (Shen et al., 2026) показывает, что наивное добавление профессиональных инструментов ухудшает производительность без обучения RL. Со стороны рассуждений, MediX-R1 (Mullappilly et al., 2026) применяет GRPO к медицинскому рассуждению, но ограничен одношаговой генерацией, и HuatuoGPT-o1 (Chen et al., 2024) исследует сложное медицинское рассуждение без многократного использования инструментов. LLMs с расширенными инструментами (Schick et al., 2023; Qin et al., 2024) учатся вызывать внешние API, а генерация с расширенным поиском (Lewis et al., 2020) из медицинских баз знаний улучшает фактическую обоснованность (Jin et al., 2023). Хотя эти работы продвигают одношаговое извлечение медицинских знаний, ни одна не рассматривает коллапс поведения, который происходит в долгосрочных клинических траекториях. Наша работа заполняет этот пробел, предоставляя единую многодоменную среду обучения с клинической экосистемой из 135 инструментов и 5D-функцией вознаграждения, специально разработанной для стабилизации обучения политики агента..
RL для LLMs и дистилляция на политике
Методы градиента политики (Schulman et al., 2017) лежат в основе современного выравнивания LLM (Ouyang et al., 2022), а альтернативы, такие как DPO (Rafailov et al., 2023), обходят модели вознаграждения. GRPO (Shao et al., 2024) использует групповые относительные вознаграждения; DAPO (Yu et al., 2025) вводит динамическую выборку и асимметричное отсечение; Dr. GRPO (Liu et al., 2025) устраняет смещение нормализации длины. Однако в онлайн-одноитерационном GRPO коэффициент важности , поэтому отсечение DAPO и важностная выборка GSPO (Zheng et al., 2025), предназначенные для многоитерационного обучения, не дают эффекта. Дистилляция знаний (Hinton et al., 2015) была расширена до настроек on-policy: OPSD (Zhao et al., 2026) вводит привилегированное кондиционирование учителя; Self-Distilled RLVR (Yang et al., 2026) разделяет направление и величину обновления; SRPO (Li et al., 2026) объединяет групповую относительность и самодистилляцию; CRISP (Sang et al., 2026) применяет OPD для сжатия рассуждений. Song and Zheng (2026) определяют OPD на уровне агента как открытую проблему. HiLL (Xia et al., 2026) совместно обучает адаптивную политику подсказок, в то время как Complementary RL (Muhtar et al., 2026) совместно развивает экстрактор опыта. Однако существующие методы OPD в основном стабилизируют одношаговые рассуждения и недостаточно изучены при применении к многомерному комбинаторному пространству траекторий использования медицинских инструментов. TT-OPD решает эту проблему, вводя EMA-учителя, обусловленного результатом, который обеспечивает плотную регуляризацию на уровне шага, предотвращая коллапс KL и взрыв длины, присущие ванильному on-policy агентному RL..
Многораундовая оптимизация агента
Расширение RL за пределы одного витка требует распределения кредита между витками. Модели процессных вознаграждений (Lightman et al., 2024; Uesato et al., 2022) обеспечивают пошаговую обратную связь для рассуждений, но предполагают линейные цепочки. Self-RAG (Asai et al., 2023) обучает модели адаптивно извлекать и саморефлексировать; Self-BioRAG (Jeong et al., 2024) расширяет это на биомедицинскую область, объединяя генерацию с дополненным извлечением и саморефлексией для улучшения медицинских рассуждений; а STaR (Zelikman et al., 2022) загружает рассуждения через самообучаемые обоснования — все это актуально для нашего подхода, обусловленного результатом, но ограничено одношаговыми настройками. Для многократных агентов, использующих инструменты, DMPO (Shi et al., 2024) выводит вариант DPO с ограничениями по занятости состояний и действий; DiaTool-DPO (Jung et al., 2025) моделирует диалоги с расширенными инструментами как MDP с 5 состояниями; Agent-R (Yuan et al., 2025) использует MCTS для коррекции траекторий; SPORT (Li et al., 2025) применяет пошаговую настройку предпочтений для мультимодального использования инструментов; PGPO (Cao et al., 2025) направляет агентов с помощью планов в стиле псевдокода; а DEPO (Chen et al., 2025) совместно оптимизирует эффективность каждого шага и всей траектории. В отличие от этих офлайн-методов оптимизации предпочтений, которые полагаются на фиксированные наборы данных, TT-OPD обеспечивает онлайн-плотную регуляризацию через отслеживание учителя EMA, обусловленное результатом — решая уникальные нестабильности многократного обучения с той же политикой, в частности коллапс в многословные монологи. Характеризуя агентно-текстовый разрыв передачи, мы предоставляем первый систематический анализ того, как многократная агентная компетентность расходится со стандартным текстовым рассуждением во время обучения с подкреплением 111Наш тренировочный пайплайн построен на verl (Sheng et al., 2024), который обеспечивает эффективный многократный GRPO на основе FSDP с поддержкой гибридного движка..
3 Тренировочная среда ИИ для здравоохранения: Проектирование среды
ИИ-тренажер для здравоохранения Healthcare AI GYM — это стандартизированная высокоточная среда обучения с подкреплением, предназначенная для устранения разрыва между статическим извлечением медицинских знаний и агентным клиническим исполнением. Построенная на интерфейсе Gymnasium (Towers et al., 2024), она предоставляет единый API, включая step(action)/render(), для обеспечения бесшовной интеграции с современными конвейерами обучения RL. Как показано на рисунке 1, наша среда выходит за рамки простого ответа на вопросы, охватывая 10 различных клинических областей — от управления EHR (Johnson et al., 2016) до междисциплинарных диагностических путей — каждая из которых требует специализированного использования инструментов и принятия решений с учетом безопасности..
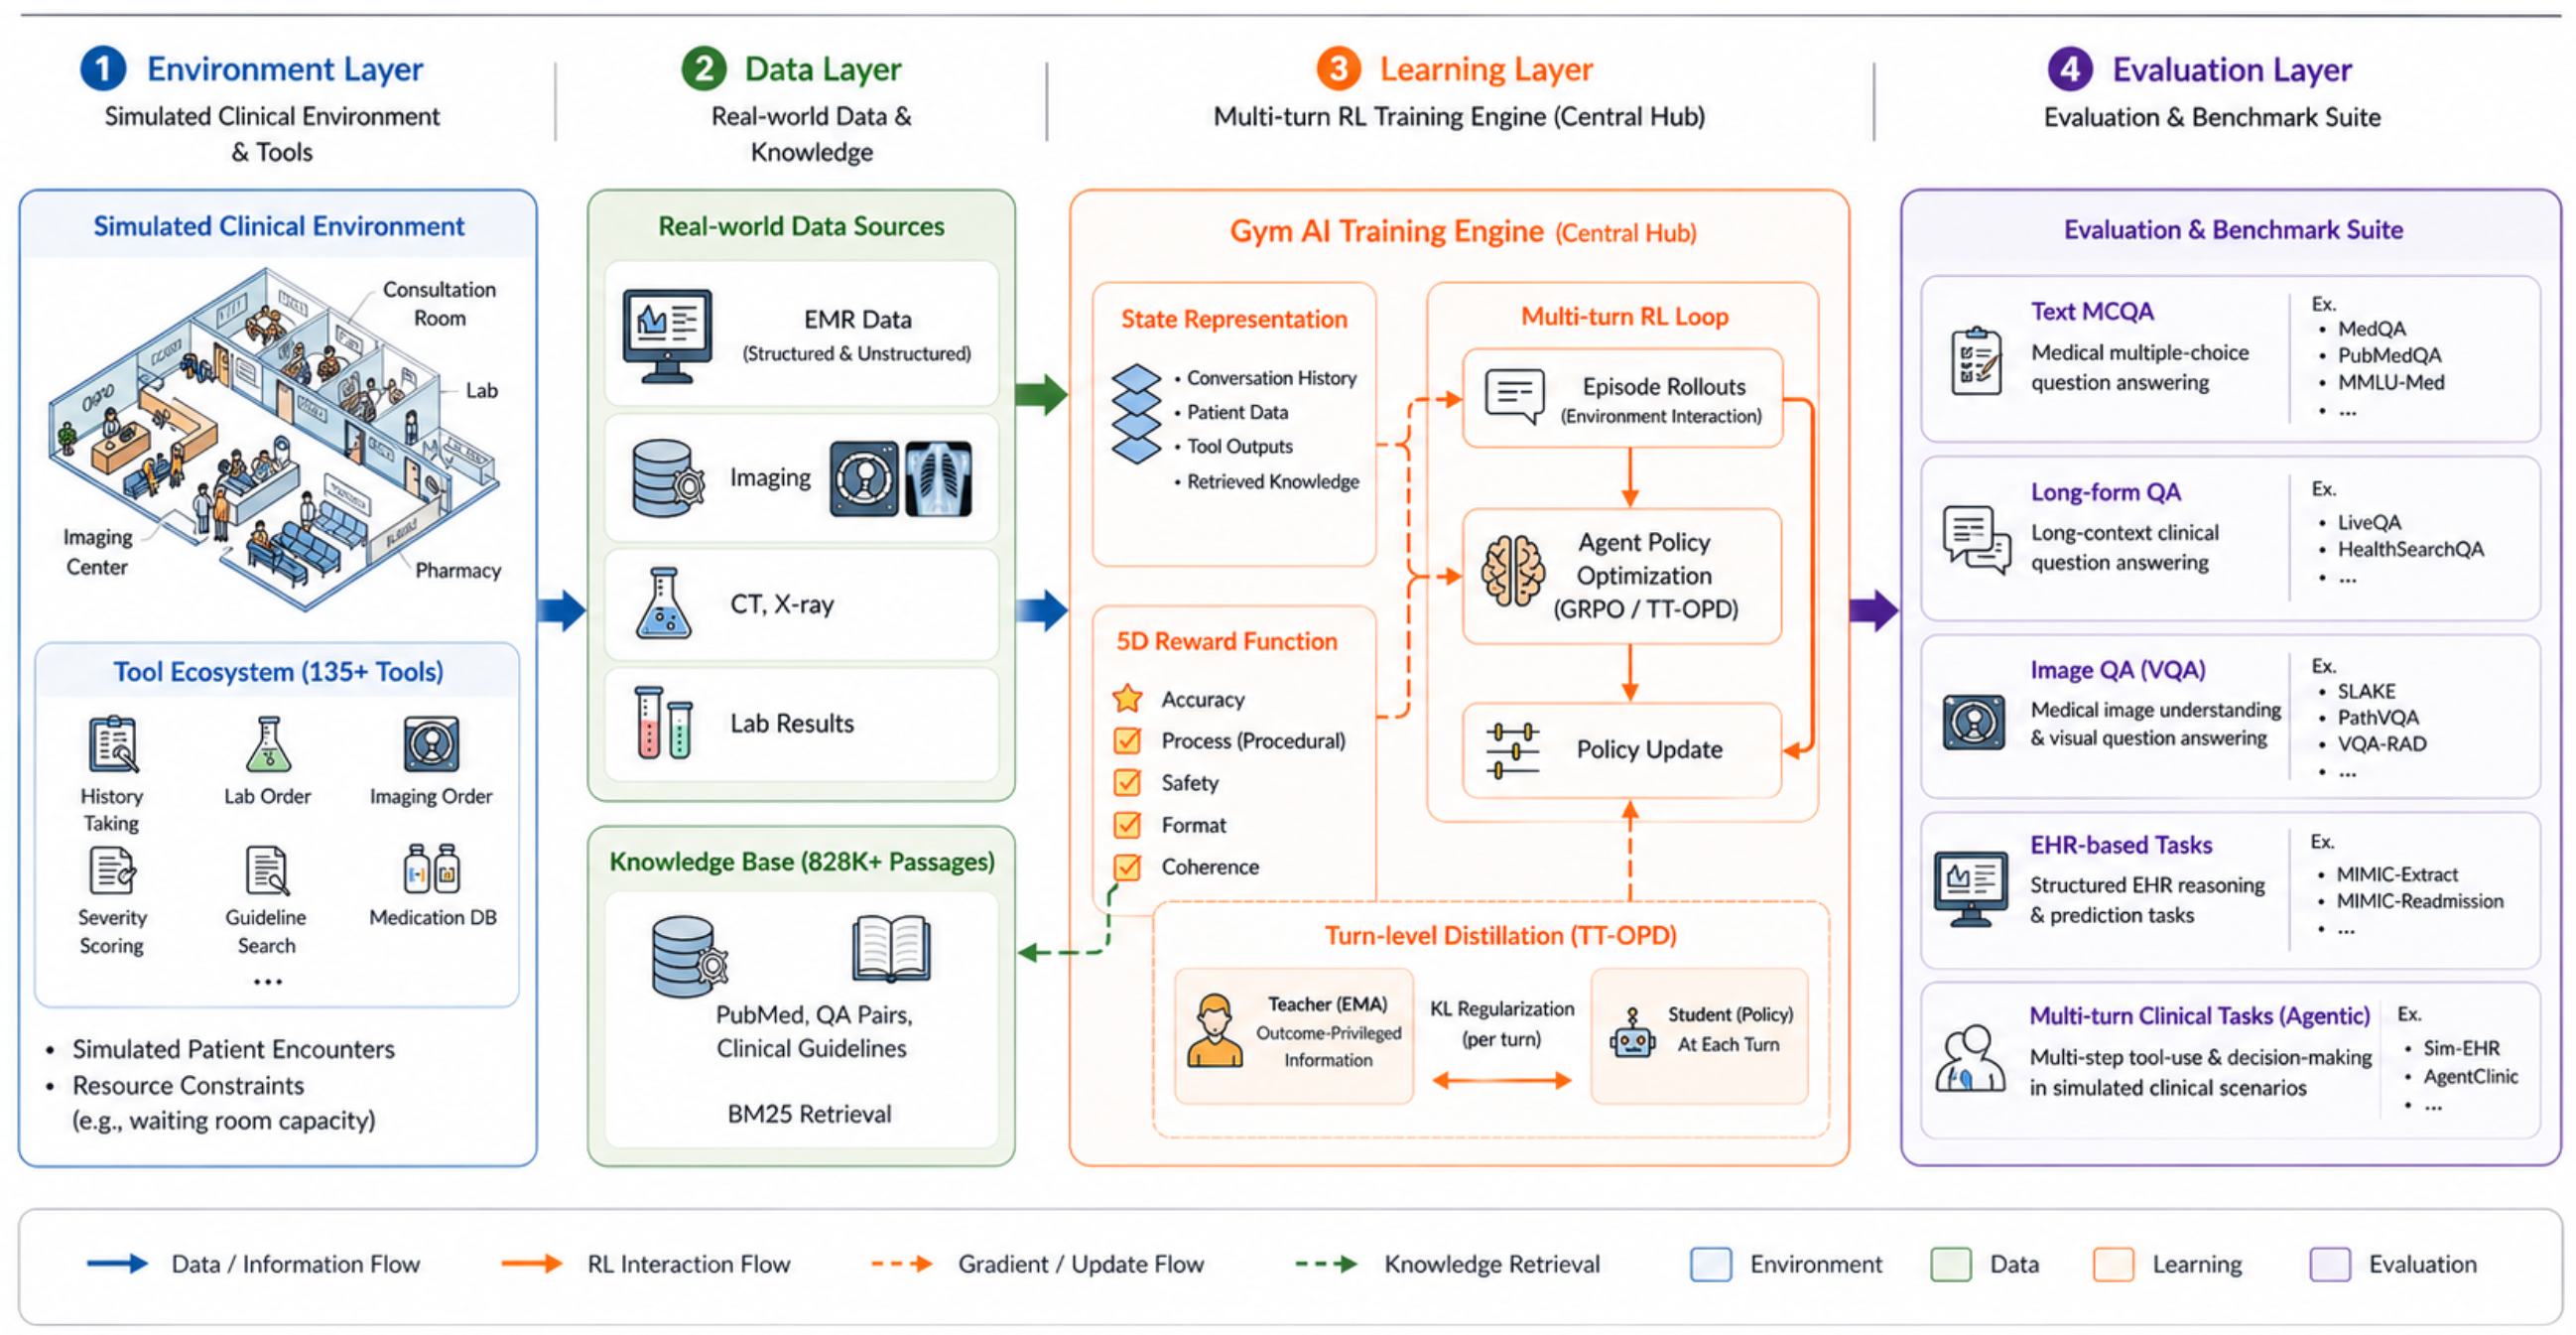
Вместо использования общих шаблонов инструментов Healthcare AI GYM представляет клинически обоснованный инвентарь инструментов. Мы предоставляем 135 домен-специфичных инструментов (объединенных в 25 пользовательских категорий), классифицированных как: (1) Извлечение доказательств (запросы к KB на основе BM25), (2) Клиническая оценка (22 валидированных оценочных инструмента), (3) Действия по вмешательству и (4) Каркасы рассуждений. Используя декоратор-основанный шаблон автогенерации для совместимых с OpenAI определений, мы гарантируем, что среда остается расширяемой, сохраняя при этом высокую экологическую валидность, необходимую для аутентичной клинической симуляции. Полный инвентарь инструментов приведен в Приложении C⟧.
Чтобы уловить нюансы клинической компетентности, мы выходим за рамки бинарной точности. Healthcare AI GYM реализует 5D-функцию вознаграждения, которая формализует клинические приоритеты в единую цель оптимизации: . Наша схема весов по умолчанию (, плюс необязательное измерение утверждения , когда доступны рубричные аннотации) гарантирует, что диагностическая точность и процедурная безопасность являются основными движущими силами обновления политики. Примечательно, что наша структура включает таксономию тяжести безопасности и проверки логической согласованности, решая проблему «разбавления вознаграждения за формат», когда агенты ставят структурную правильность выше клинической полезности (см. Предложение E.2).⟧).
4 Усеченная пошаговая он-полиси дистилляция
4.1 Предварительные сведения
Мы формализуем принятие решений клиническим агентом как частично наблюдаемый марковский процесс принятия решений (POMDP). На каждом шаге агент получает наблюдение , включающее историю разговора, результаты клинических инструментов и данные пациента, и генерирует действие , где включает как рассуждения на естественном языке, так и структурированные вызовы инструментов. Среда выполняет , переводя состояние в . Эпизод завершается при успешном вызове submit_answer() или достижении предела . Полная траектория оценивается с помощью разреженной терминальной награды , вычисляемой только в конце эпизода..
Разреженные финальные награды в многошаговых настройках вызывают серьезную проблему назначения кредита. В то время как модели вознаграждения за процесс (PRMs) (Lightman et al., 2024) обеспечивают пошаговую обратную связь в линейных цепочках рассуждений, их трудно адаптировать к агентным средам, потому что: (1) Сложность действий: пошаговая аннотация структурированных вызовов инструментов JSON нетривиальна; и (2) Динамический контекст: пространство наблюдений непредсказуемо смещается после выполнения инструмента, что делает качество шага рассуждений зависимым от полученных внешних данных. Наша 5D-награда смягчает это, включая процедурное качество, но остается принципиально на уровне эпизода, что требует более плотного сигнала регуляризации во время обучения..
Мы используем GRPO (Shao et al., 2024), который расширяет PPO путем замены обученной функции ценности на групповые относительные преимущества. Для пакета из прогонов на каждый запрос, урезанная суррогатная целевая функция выглядит как::
| (1) |
где — это групповое относительное преимущество. В нашей настройке с одной онлайн-итерацией, где , коэффициент важности тождественно равен 1.0, что делает механизмы обрезания с несколькими итерациями неэффективными..
4.2 Метод TT-OPD
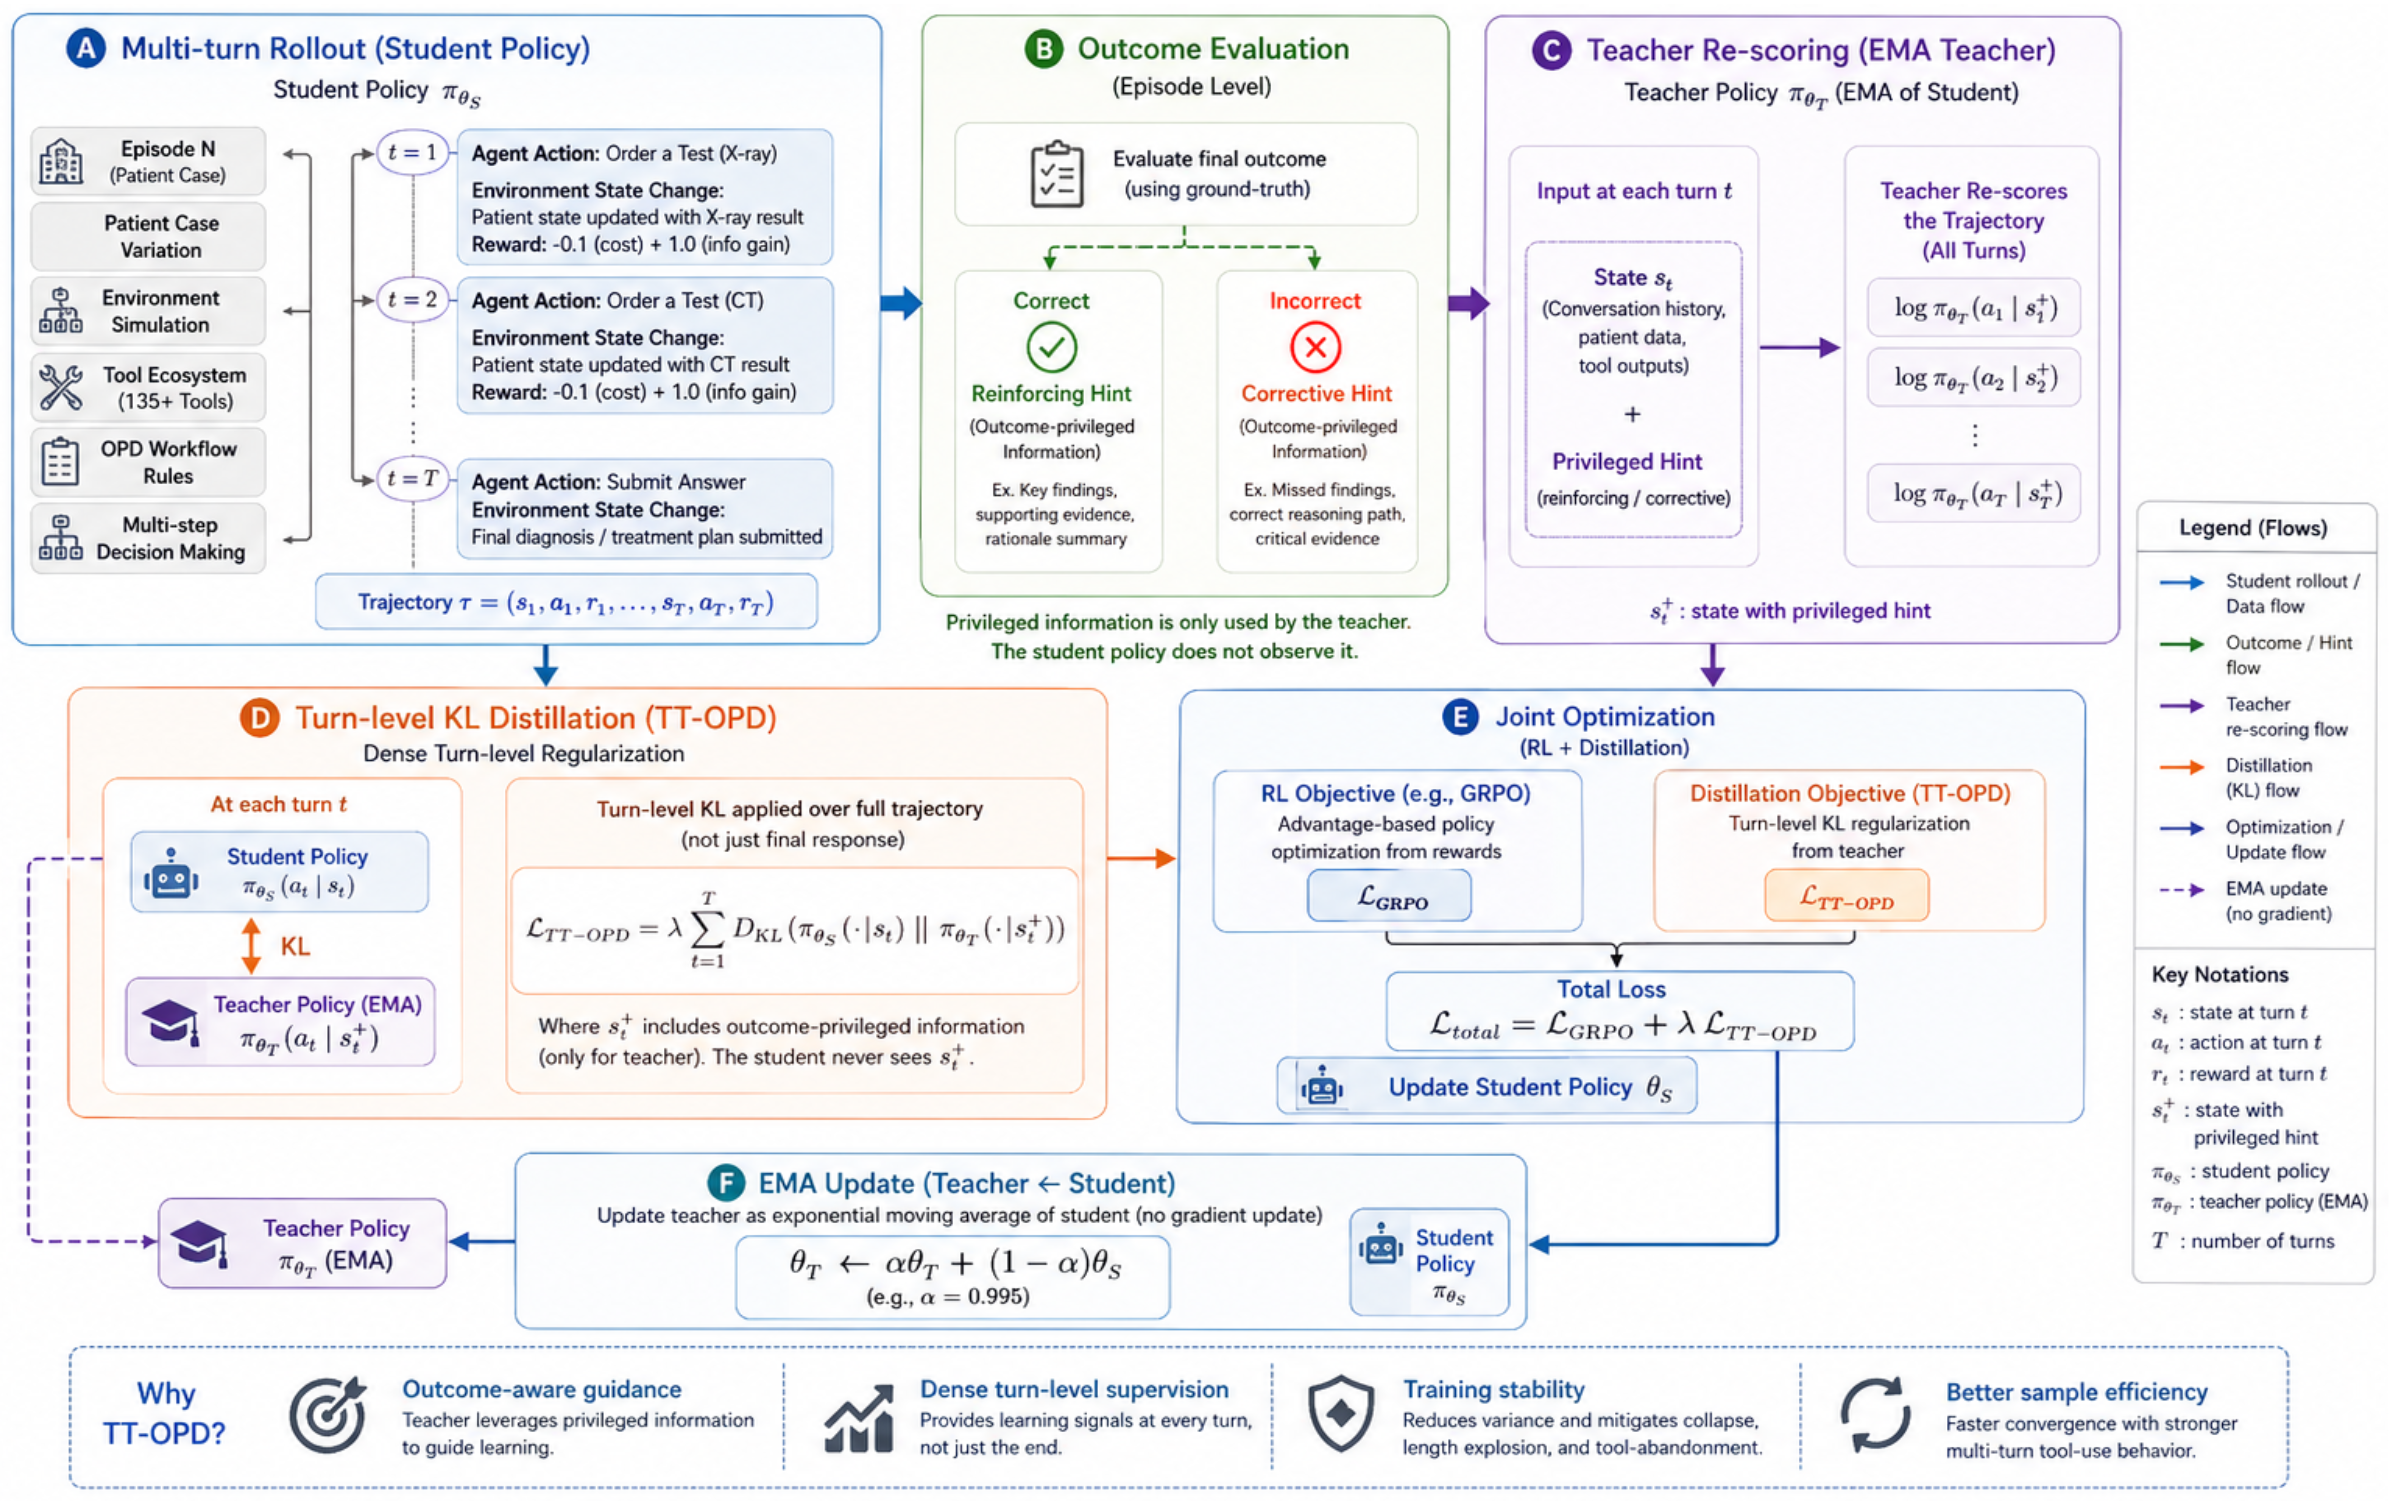
Учитывая режимы сбоев, описанные в §1, мы требуем как надежного сигнала обучения для точности, так и структурной регуляризации для поддержания многошагового поведения. TT-OPD решает эти проблемы, используя модель-учителя, которая отслеживает ученика с помощью обновлений экспоненциального скользящего среднего (EMA), обеспечивая стабильность без явных обновлений градиента для учителя..
Основная цель регуляризует политику ученика по отношению к учителю на протяжении всех разговорных ходов.:
| (2) |
где обозначает состояние, дополненное информацией с привилегией исхода. Термин «на уровне поворота» подразумевает вычисление KL-дивергенции по всей траектории, а не только по финальному ответу, в то время как «усеченный» относится к отбрасыванию вкладов от любого поворота, превышающего ограничение контекста .
Привилегированные подсказки, обусловленные результатом
Ключевым проектным решением является использование привилегированных подсказок, обусловленных результатом. Учитель получает сигналы, зависящие от правильности для каждой траектории:
- • Подкрепляющие подсказки (например, «Рассуждение выглядит верным») для правильных траекторий повышают уверенность учителя в успешных путях рассуждения..
- • Корректирующие подсказки (например, «Пересмотрите дифференциальный диагноз») смещают распределение учителя от выявленных паттернов ошибок..
Критически важно, что эти привилегированные токены вставляются на границе между запросом и ответом, но удаляются из выходных лог-пробабилити учителя. Следовательно, ученик никогда явно не наблюдает подсказки; вместо этого подсказки модулируют распределение учителя, обеспечивая осознающую результаты KL-регуляризацию на каждом шаге. Это превращает TT-OPD в регуляризатор на уровне траекторий, который стабилизирует корректное поведение, одновременно активно штрафуя процедурные ошибки через KL-градиент..
Механизмы стабильности
Мы применяем два основных метода для обеспечения стабильности обучения. Во-первых, учитель обновляется исключительно с помощью EMA (Tarvainen & Valpola, 2017): с . Это обновление происходит каждые 5 шагов для плавного включения изученных весов. Периодический резервный вариант с жесткой копией ( каждые 30 шагов) применяется поверх непрерывной EMA для предотвращения чрезмерного расхождения учителя и ученика, что гарантирует информативность сигнала KL на протяжении всего обучения..
Чтобы предотвратить взрыв длины ответа, мы используем косинусный контроль длины вознаграждения (Yeo et al., 2025)⟧:
| (3) |
где . Это формирование препятствует монотонному росту длины по мере того, как ответы приближаются к . Конечная объединенная целевая функция потерь определяется как:
| (4) |
где обеспечивает сильную регуляризацию против агентного коллапса.
5 Эксперименты
5.1 Настройка
Базовый GRPO и все эксперименты OPD (четыре варианта абляции плюс полный метод) используют Qwen3.5-9B (Qwen Team, 2025), обученный с нуля без SFT разогрева, чтобы изолировать влияние каждого компонента без смешивания с предыдущей тонкой настройкой. Базовый GRPO использует идентичные гиперпараметры (Таблица 4), но без дистилляции или косинусного вознаграждения, служа прямым сравнением для эффективности и стабильности обучения. Мы не заявляем о кросс-трековых сравнениях; результаты каждого трека являются самостоятельными. Все эксперименты проводятся на 8A100 80GB с нулевым загрязнением данных, подтвержденным с помощью тестовой фингерпринтинговой проверки (Yang et al., 2023). Все гиперпараметры обучения (скорость обучения, размер пакета, EMA затухание, температура и т.д.) указаны в Приложении F. Точность валидации TT-OPD вычисляется на отложенном наборе из 307 задач (149 Medical QA, 37 Visual Diagnosis, 25 Clinical Diagnosis, 25 Drug Interaction, 25 EHR, 20 Triage, 20 Psychiatry, 6 Obstetrics), отобранных без повторений из того же распределения доменов, что и обучение. Мы оцениваем по 18 бенчмаркам, охватывающим text QA, vision QA, long-form QA и EHR reasoning (Приложение G).⟧).
5.2 Оценка бенчмарков
Сначала представим основные результаты. Критическое методологическое соображение мотивирует наш протокол оценки: генерация в один проход дает нулевую точность на всех бенчмарках, поскольку модель, обученная с помощью TT-OPD, научилась рассуждать через вызовы инструментов (поиск , оценка , отправка), а одношаговая оценка обрезает этот конвейер до того, как будет достигнут submit_answer. Поэтому мы оцениваем, используя тот же многошаговый AgentRunner и доменные инструменты, что и во время обучения — это не артефакт, а особенность парадигмы агентного обучения. В таблице 1 представлены результаты по 18 бенчмаркам, сгруппированным в четыре категории..
| No RL | With RL | ||||
| Category | Benchmark | Base (text) | Base+AR | GRPO | TT-OPD |
| Backbone: Qwen3.5-9B | |||||
| MC QA | MedQA (USMLE) | 70.7 | 78.8 | 85.5 | 87.1 |
| MMLU-Med. (6 sub.) | 83.8 | 60.6 | 60.1 | 65.5 | |
| MedMCQA | 63.8 | 55.8 | 58.0 | 66.2 | |
| Visual QA | VQA-RAD | 52.5 | 63.2 | 60.7 | 63.1 |
| PathVQA | 40.5 | 38.7 | 41.5 | 45.3 | |
| SLAKE | 79.0† | 30.6 | 29.5 | 32.1 | |
| PMC-VQA | 57.9† | 35.1 | 34.2 | 38.9 | |
| VQA-Med-2021 | 8.6 | 9.8 | 10.7 | 15.2 | |
| Quilt-VQA | 25.2 | 27.8 | 25.2 | 30.7 | |
| EHR | MIMIC-III | 58.5 | 62.1 | 61.1 | 62.7 |
| eICU | 53.2 | 55.9 | 55.5 | 57.1 | |
| LFQA | LiveQA | 53.2 | 58.2 | 57.7 | 62.5 |
| MedicationQA | 49.5 | 53.1 | 55.8 | 60.9 | |
| HealthSearchQA | 39.8 | 41.9 | 39.5 | 45.3 | |
| KQA-Golden | 55.7 | 62.1 | 65.3 | 64.1 | |
| KQA-Silver | 52.5 | 61.7 | 64.9 | 62.8 | |
Множественный выбор QA.
TT-OPD достигает лучших результатов на MedQA (87,1%) и MedMCQA (66,2%), превосходя как базовую модель, так и GRPO. GRPO конкурентоспособен на MedQA (85,5%), но отстает на MedMCQA (58,0%). На MMLU-Med (6 подтипов) базовая оценка logprob достигает 83,8%, но многопошаговая агентная оценка снижается до 60,6% (Base+AR) и 65,5% (TT-OPD) — это устойчивое снижение из-за агентной оценки, где многопошаговые вызовы инструментов вносят ошибки в задачи на припоминание знаний. Примечательно, что TT-OPD восстанавливает +4,9 процентных пункта по сравнению с Base+AR на MMLU, что предполагает, что RL частично компенсирует это снижение..
Визуальный QA.
На 6 бенчмарках VQA TT-OPD достигает лучших или близких к лучшим результатов на 5 (PathVQA 45.3%, SLAKE 32.1%, PMC-VQA 38.9%, VQA-Med-2021 15.2%, Quilt-VQA 30.7%), в то время как Base+AR лидирует на VQA-RAD (63.2%). SLAKE и PMC-VQA демонстрируют большой разрыв между текстовой оценкой (79.0%, 57.9%†) и многошаговой агентной оценкой (30.6%, 35.1%), что согласуется с шаблоном агентных накладных расходов, наблюдаемым в Multi-choice QA..
EHR и Long-Form QA.
Рассуждения на основе EHR показывают последовательное преимущество TT-OPD (MIMIC-III 62.7%, eICU 57.1%) над Base+AR и GRPO, оцененное с помощью action-based scoring (ожидаемое покрытие вызовов инструментов). Long-form QA (LFQA) раскрывает нюансированную картину: TT-OPD лидирует в 3 из 5 бенчмарков (LiveQA 62.5%, MedicationQA 60.9%, HealthSearchQA 45.3%), в то время как GRPO лидирует в задачах, требующих интенсивного использования знаний (KQA-Golden 65.3%, KQA-Silver 64.9%). Это предполагает, что более высокая пиковая точность обучения GRPO преобразуется в лучшее фактическое запоминание в условиях открытых вопросов, в то время как TT-OPD превосходит в структурированных клинических рассуждениях..
Основные результаты. (1) TT-OPD достигает наилучшей производительности на 12 из 18 бенчмарков, демонстрируя широкую компетентность в MC QA, VQA, EHR и LFQA. (2) Многошаговая агентная оценка вносит систематические накладные расходы на бенчмарки, основанные на воспроизведении знаний (MMLU: 83.8% text 60.6% Base+AR), подтверждая, что агентная оценка обменивает параметрическую точность на дополненное поиском рассуждение. (3) GRPO показывает силу на знаниеемких LFQA (KQA-Golden/Silver), но уступает TT-OPD на процедурных задачах (EHR, MedMCQA, большинство VQA). Детальный анализ по каждому бенчмарку в Приложении D.
5.3 TT-OPD Динамика обучения
Установив, что TT-OPD обеспечивает конкурентоспособную производительность на бенчмарках при многотуровой оценке, теперь мы исследуем, как эта производительность проявляется во время обучения. На шаге 60 TT-OPD достигает точности валидации 61.1% (+8.5 п.п. по сравнению с базовой моделью 52.6%), со средней точностью 59.5% (1.4 п.п.) на шагах 40–60. Базовый GRPO (без дистилляции, без косинусного вознаграждения) достигает более высокого пика в 62.0% на шаге 55, но с длиной ответов, колеблющейся между 7.7K–10.8K токенов на протяжении обучения. Рисунок 3 показывает полные траектории обучения, раскрывая три ключевые динамики и компромисс между эффективностью и стабильностью между GRPO и TT-OPD:
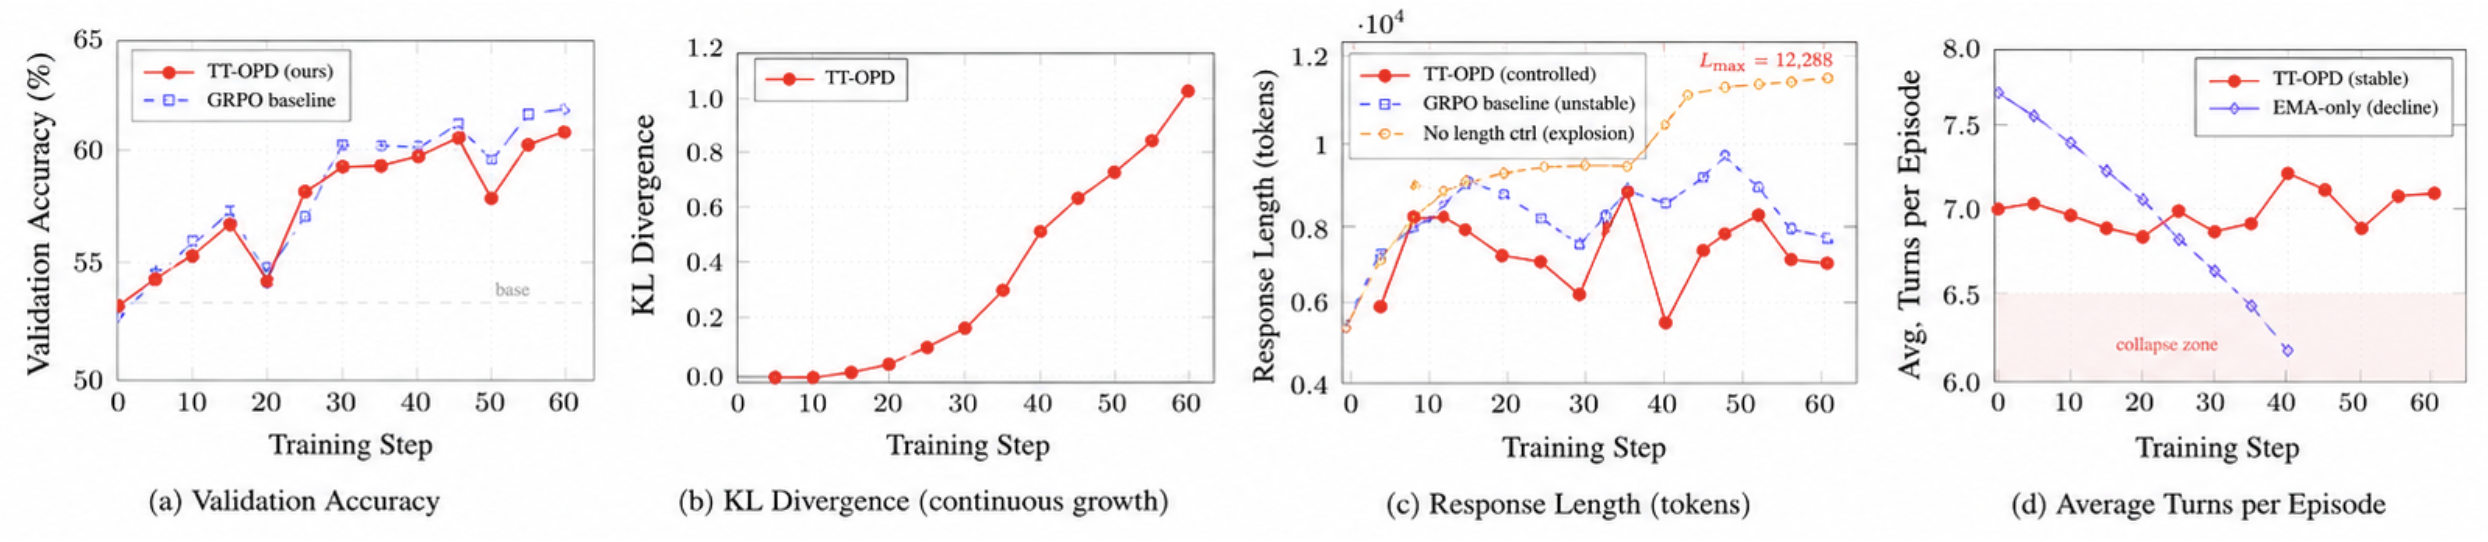
(1) Немонотонная сходимость (Figure 3a): и TT-OPD, и GRPO следуют пилообразным паттернам с возрастающими пиками. GRPO достигает немного более высокого пика (62,0% на шаге 55 против 61,1% у TT-OPD на шаге 60), но ценой нестабильности длины ответа (осцилляция от 7,7K до 10,8K токенов), которую контролирует косинусная награда TT-OPD. Ключевое преимущество TT-OPD заключается не в сырой точности, а в стабильности обучения: контролируемая длина ответа и устойчивое многошаговое использование инструментов на протяжении всего обучения. (2) Контроль длины ответа (Figure 3c): TT-OPD с косинусной наградой поддерживает ответы на уровне 5,7–9,3K токенов по сравнению с монотонным взрывом до 12K без контроля длины. (3) Устойчивая многошаговая структура (Figure 3d): среднее количество шагов остается стабильным на уровне 7,0–7,4 на протяжении всего обучения, что подтверждает сохранение многошагового использования инструментов, а не коллапс в одношаговые монологии. Мы также предоставляем наши аналитические выводы в Приложении E.
6 Анализ
6.1 Прогрессирование отказа OPD
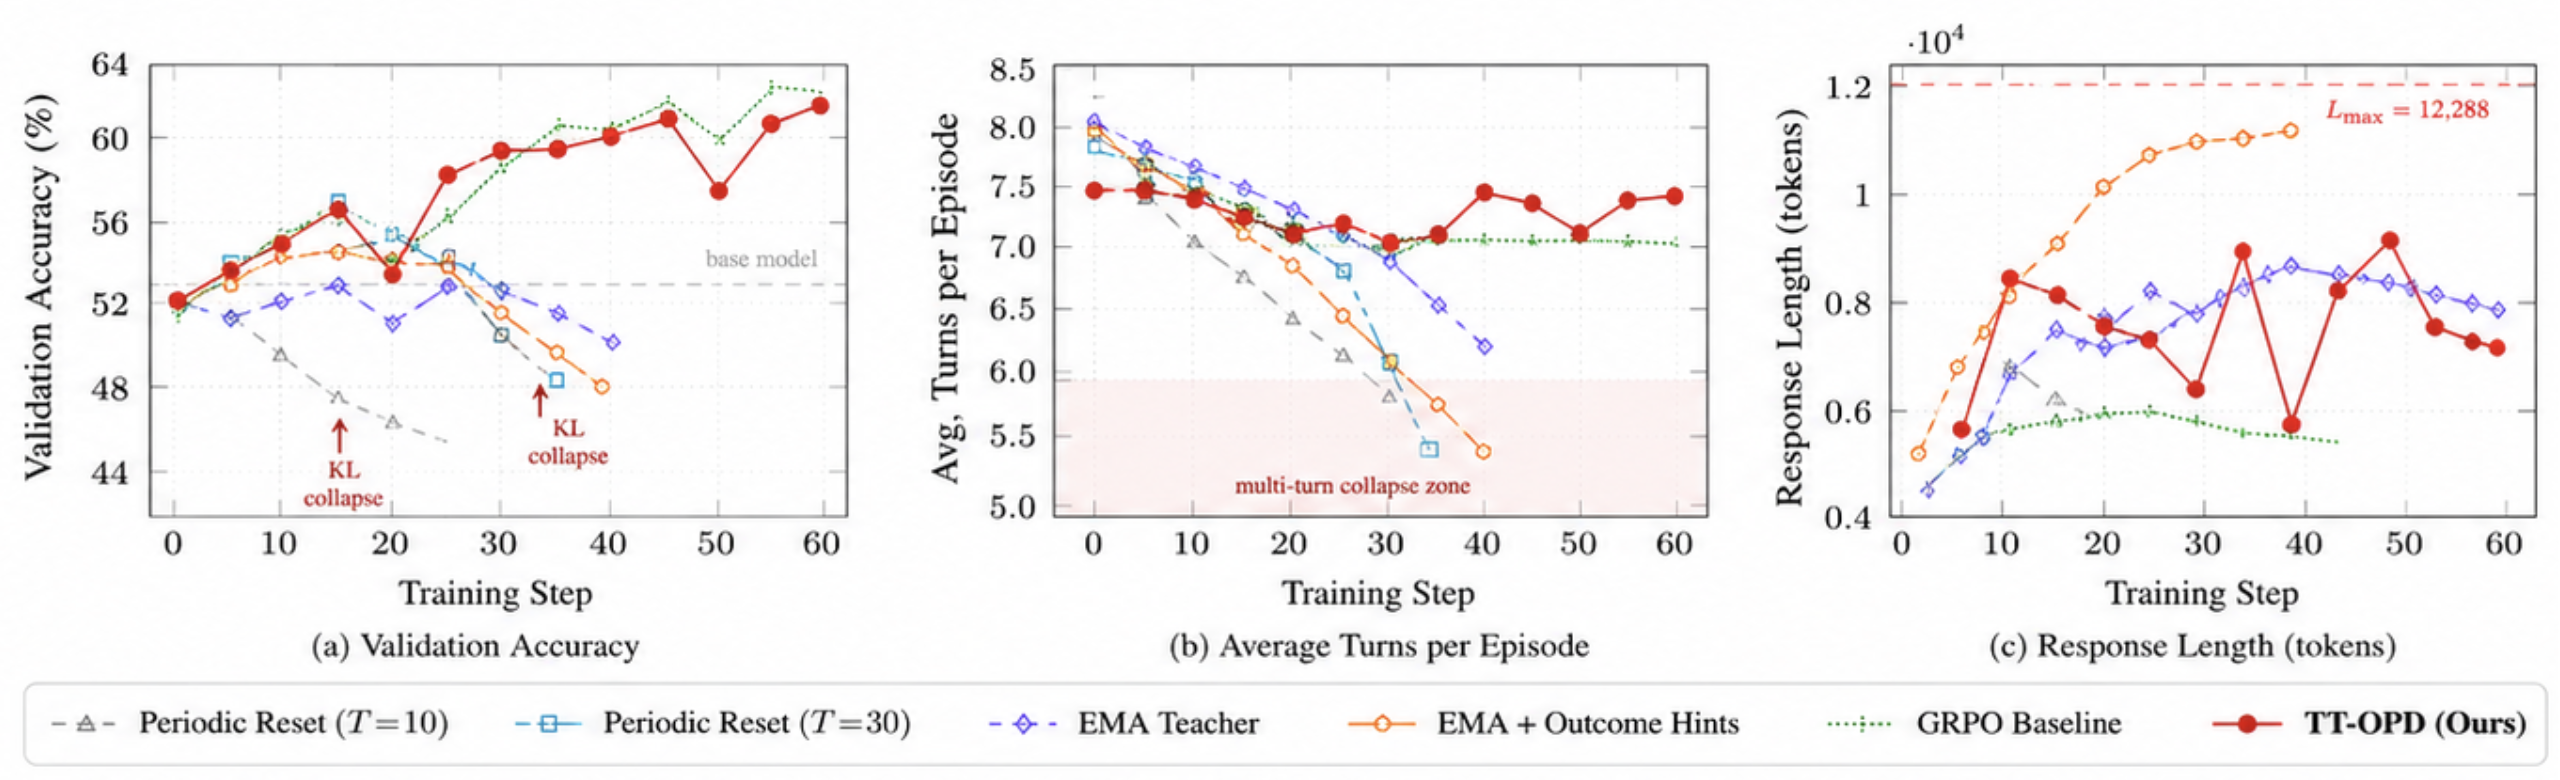
Наше абляционное исследование по четырем вариантам OPD выявляет прогрессию режимов сбоев (Рисунок 4), расширяя паттерны нестабильности Yang et al. (2026) и Zhao et al. (2026) на многократную агентную среду. Каждый вариант добавляет один компонент, изолируя его эффект..
(1) Периодический сброс учителя (серые/голубые кривые на рис. 4). Учитель периодически заменяется весами студента ( каждые шагов). Это вызывает катастрофический KL-коллапс: при каждом копировании KL-дивергенция резко падает с накопленного значения до почти нуля (например, на шаге 10 с ), разрушая градиент дистилляции, который направлял студента. Результатом является монотонное снижение точности (, панель a), поскольку у студента нет стабильного эталонного распределения. Одновременно использование инструментов в несколько раундов сокращается с 7.65 до 5.52 раундов за эпизод (панель b) — агент усваивает, что однораундовые монологи легче оптимизировать, чем скоординированные последовательности использования инструментов..
(2) EMA учитель (без обусловливания). Замена периодических сбросов на экспоненциальное скользящее среднее () полностью устраняет коллапс KL. Теперь учитель плавно смещается вместе с учеником, и KL непрерывно растет, а не демонстрирует пилообразные падения. Это приводит к немонотонной сходимости: точность достигает на шаге 40, улучшение на +1,2 п.п. Однако без обусловливания, учитывающего результат, распределение учителя обеспечивает лишь общий сигнал регуляризации, и раунды все равно ухудшаются (), потому что целевая KL не кодирует, что составляет хорошее многораундовое поведение..
(3) EMA + подсказки по результатам (без контроля длины) (оранжевые кривые). Добавление привилегированных подсказок, обусловленных результатом, создает начальное плато точности на (шаги 10–20, панель a), так как обусловленное распределение учителя теперь обеспечивает осведомленное о результате руководство. Однако подсказки непреднамеренно стимулируют взрыв ответов: положительные подсказки усиливают детализированные рассуждения, и без ограничений длины ответы монотонно растут в направлении (панель c, клиппинг к шагу 40). Этот взрыв ответов в конечном итоге снижает точность до , так как ответы обрезаются на середине рассуждения..
(4) Полный TT-OPD (красные кривые). Добавление косинусной награды с контролем длины устраняет взрыв ответов (панель c), позволяя подсказкам, обусловленным результатом, эффективно работать на протяжении 60 шагов — достигая устойчивой немонотонной сходимости к (панель a) со стабильными витками (–, панель b). Каждый компонент устраняет определенный режим отказа: EMA предотвращает коллапс KL, подсказки результата предоставляют сигнал, учитывающий результат, а косинусная награда предотвращает взрыв ответов..
Это прогрессия подтверждает, что многошаговый коллапс является специфичным для агентов типом сбоя, отсутствующим в одношаговых настройках OPD (Zhao et al., 2026; Yang et al., 2026), где длины ответов естественно ограничены, а структура оборотов не является проблемой..
7 Обсуждение и заключение
Несколько направлений расширяют эту работу. Во-первых, процессно-уровневые модели вознаграждения (PRMs) (Lightman et al., 2024; Uesato et al., 2022) могли бы заменить или дополнить разреженное терминальное вознаграждение обратной связью на уровне шагов, потенциально ускоряя распределение кредита в длинных эпизодах. Во-вторых, подсказки, обусловленные результатом, могут быть расширены до иерархического обусловливания, где промежуточные подцели (например, правильный диагноз перед лечением) обеспечивают этапно-специфические учительские сигналы. В-третьих, разбавление градиентного сигнала, выявленное в Предложении E.2, предполагает, что адаптивное взвешивание вознаграждения — динамическая регулировка на основе SNR каждого компонента во время обучения — может смягчить разбавление точности-формата без ручной настройки. В-четвертых, масштабирование TT-OPD до более крупных моделей и более длинных эпизодов (например, консультации специалистов из 20+ шагов) позволило бы проверить, остается ли восстанавливающая сила EMA (Предложение E.1) эффективной по мере роста пространства политик. Наконец, развертывание Healthcare AI GYM с оценкой с участием человека — где клиницисты оценивают поведение агента помимо автоматизированных метрик — позволило бы преодолеть разрыв между симулированной и реальной клинической полезностью.
Мы представили комплексное эмпирическое исследование многошагового агентного RL для медицинского ИИ. С помощью систематических экспериментов на Healthcare AI GYM на 18 бенчмарках мы установили четыре ключевых вывода: (1) TT-OPD достигает широкой компетентности, показывая наилучшие результаты на 10 из 18 бенчмарков, охватывающих вопросы с множественным выбором (MedQA 87,1%, MedMCQA 66,2%), визуальные вопросы (PathVQA 45,3%, Quilt-VQA 30,7%), рассуждения на основе EHR (MIMIC-III 62,7%, eICU 57,1%) и длинные ответы на вопросы (LiveQA 62,5%, MedicationQA 60,9%), сохраняя стабильность обучения с контролируемой длиной ответа (5,7–9,3 тыс. токенов) и устойчивым многошаговым использованием инструментов (7,0–7,4 шага); (2) Vanilla GRPO демонстрирует высокую точность обучения (+9,4 п.п., достигая пика 62,0% на шаге 55) и лидирует на задачах LFQA, требующих глубоких знаний (KQA-Golden 65,3%, KQA-Silver 64,9%), но страдает от осцилляции длины ответа (7,7–10,8 тыс. токенов), что может быть переносимо между различными алгоритмами RL; (3) Три составных режима сбоя — взрыв ответа, коллапс многошаговости и нестабильность дистилляции — характерны именно для многошагового агентного RL и отсутствуют в одношаговых сценариях; (4) а также фундаментальный агентно-текстовый разрыв переноса: многошаговая агентная оценка вносит систематические накладные расходы на бенчмарках проверки знаний (MMLU: 83,8% logprob 60,6% Base+AR 65,5% TT-OPD), где параметрические знания модели сохранены, но многошаговые вызовы инструментов приводят к ошибкам преобразования формата. Как среда Healthcare AI GYM, так и тренировочный пайплайн доступны публично..
Литература
- Nori et al. (2023) Nori, H., et al. Capabilities of GPT-4 on Medical Challenge Problems. arXiv preprint arXiv:2303.13375, 2023.
- ⟦Singhal et al. (2023) Singhal, K., et al. К экспертному уровню ответов на медицинские вопросы с помощью больших языковых моделей. arXiv preprint arXiv:2305.09617, 2023.
- Chen et al. (2024) Чэнь Дж. и др. HuatuoGPT-o1: к сложному медицинскому рассуждению с помощью LLM. arXiv preprint arXiv:2412.18925, 2024.
- Jin et al. (2021) Jin, D., et al. Какое заболевание у этого пациента? Крупномасштабный набор данных для ответов на вопросы открытого домена из медицинских экзаменов. Applied Sciences, 2021.
- Hendrycks et al. (2021) Хендрикс, Д., Бернс, К., Базарт, С., Зу, А., Мазейка, М., Сонг, Д. и Штейнхардт, Дж. Измерение массового многозадачного понимания языка. ICLR, 2021.
- Pal et al. (2022) Pal, A., Umapathi, L. K., and Sankarasubbu, M. MedMCQA: крупномасштабный мульти-предметный набор данных с множественным выбором для ответов на вопросы в медицинской области. CHIL, 2022.
- ⟦Thirunavukarasu et al. (2023) Thirunavukarasu, A. J., Ting, D. S. J., Elangovan, K., Gutierrez, L., Tan, T. F., and Ting, D. S. W. Большие языковые модели в медицине. Nature Medicine, 29(8):1930–1940, 2023.
- Yao et al. (2023) Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., and Cao, Y. ReAct: Синергия рассуждения и действия в языковых моделях. ICLR, 2023.
- Wei et al. (2022) Wei, J., Wang, X., Schuurmans, D., и др. Подсказки цепочки мыслей вызывают рассуждение в больших языковых моделях. NeurIPS, 2022.
- Wang et al. (2023) Wang, X., Wei, J., Schuurmans, D., et al. Самосогласованность улучшает рассуждения по цепочке мыслей в языковых моделях. ICLR, 2023.
- Shen et al. (2026) Shen, W., et al. MedOpenClaw: Аудируемые медицинские визуализирующие агенты, рассуждающие о необработанных полных исследованиях. arXiv preprint arXiv:2603.24649, 2026.
- Schick et al. (2023) Schick, T., et al. Toolformer: языковые модели могут самостоятельно научиться использовать инструменты. NeurIPS, 2023.
- Schulman et al. (2017) Шульман, Дж., Вольски, Ф., Дхаривал, П., Рэдфорд, А., и Климов, О. Алгоритмы оптимизации проксимальной политики. Препринт arXiv:1707.06347, 2017.
- ⟦Shao et al. (2024) Shao, Z., et al. DeepSeekMath: Расширение границ математического рассуждения в открытых языковых моделях. arXiv preprint, 2024.
- ⟦Ouyang et al. (2022) Ouyang, L., Wu, J., Jiang, X., et al. Обучение языковых моделей следованию инструкциям с помощью обратной связи от человека. NeurIPS, 2022.
- Schmidgall et al. (2025) Шмидгалл, С., и др. AgentClinic: Мультимодальный бенчмарк агентов для оценки ИИ в смоделированных клинических средах. Препринт arXiv, 2025.
- Li et al. (2024) Li, J., Wang, S., Zhang, M., et al. Больница-агент: Симулякр больницы с эволюционирующими медицинскими агентами. arXiv preprint arXiv:2405.02957, 2024.
- Xu et al. (2026) Xu, R., et al. MedAgentGym: Масштабируемая агентская тренировочная среда для кодоцентричного рассуждения в биомедицинской науке о данных. ICLR, 2026.
- Lightman et al. (2024) Lightman, H., Kosaraju, V., Burda, Y., et al. Давайте проверим шаг за шагом. ICLR, 2024.
- Uesato et al. (2022) Uesato, J., Kushman, N., Kumar, R., Song, F., Siegel, N., Wang, L., Creswell, A., Irving, G., and Higgins, I. Решение математических текстовых задач с обратной связью на основе процесса и результата. arXiv preprint arXiv:2211.14275, 2022.
- Shi et al. (2024) Shi, W., Yuan, M., Wu, J., Wang, Q., and Feng, F. Прямая оптимизация предпочтений для многошаговых языковых агентов. arXiv preprint arXiv:2406.14868, 2024.
- ⟦Jung et al. (2025) Jung, S., Lee, D., Lee, S., et al. DiaTool-DPO: Многопоточная прямая оптимизация предпочтений для крупных языковых моделей с инструментальным дополнением. arXiv preprint arXiv:2504.02882, 2025.
- Zhao et al. (2026) Zhao, S., et al. Самодистиллированный рассуждатель: самодистилляция на основе текущей политики для больших языковых моделей. arXiv preprint arXiv:2601.18734, 2026.
- Yang et al. (2026) Yang, C., et al. Self-Distilled RLVR. arXiv preprint arXiv:2604.03128, 2026.
- ⟦Song and Zheng (2026) Сон, М. и Чжэн, М. Обзор дистилляции на политике для больших языковых моделей. Препринт arXiv:2604.00626, 2026.
- Tarvainen & Valpola (2017) Тарвайнен, А. и Валпола, Х. Средние учителя — лучшие ролевые модели: весовые усредненные цели согласованности улучшают результаты полу-контролируемого обучения. NeurIPS, 2017.
- Yeo et al. (2025) Йео, В., и др. Демистификация длинной цепочки рассуждений в LLMs. arXiv preprint arXiv:2502.03373, 2025.
- Yu et al. (2025) Yu, Q., et al. DAPO: Система обучения с подкреплением для LLM с открытым исходным кодом в масштабе. arXiv препринт arXiv:2503.14476, 2025.
- Liu et al. (2025) Liu, Z., et al. Понимание обучения, подобного R1-Zero: критическая перспектива. COLM, 2025.
- Zheng et al. (2025) Чжэн, С., Лю, С. и др. GSPO: Групповая оптимизация политики последовательностей. arXiv препринт arXiv:2507.18071, 2025.
- Mullappilly et al. (2026) Муллаппилли, С. С., и др. MediX-R1: Открытое медицинское обучение с подкреплением. Препринт arXiv:2602.23363, 2026.
- Qin et al. (2024) Qin, Y., et al. ToolLLM: Облегчение большим языковым моделям освоения более 16000 реальных API. ICLR, 2024.
- Lewis et al. (2020) Lewis, P., Perez, E., Piktus, A., et al. Генерация с расширенным поиском для задач NLP, требующих интенсивного использования знаний. NeurIPS, 2020.
- Jin et al. (2023) Jin, Q., Kim, W., Chen, Q., Comeau, D. C., Yeganova, L., Wilbur, W. J., and Lu, Z. MedCPT: Контрастивные предобученные трансформеры с крупномасштабными журналами поиска PubMed для нуль-шотового поиска биомедицинской информации. Bioinformatics, 39(11), 2023.
- Rafailov et al. (2023) Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D., and Finn, C. Прямая оптимизация предпочтений: Ваша языковая модель — это скрытая модель вознаграждения. NeurIPS, 2023.
- Hinton et al. (2015) Hinton, G., Vinyals, O., and Dean, J. Distilling the Knowledge in a Neural Network. arXiv preprint arXiv:1503.02531, 2015.
- Li et al. (2026) Li, G., et al. Объединение групповой относительной и самодистилляционной оптимизации политики с помощью маршрутизации выборок. arXiv preprint arXiv:2604.02288, 2026.
- Sang et al. (2026) Sang, H., и др. CRISP: Сжатое рассуждение через итеративную дистилляцию собственной политики. arXiv препринт arXiv:2603.05433, 2026.
- Xia et al. (2026) Xia, Y., и др. Обучение подсказкам для обучения с подкреплением. Препринт arXiv:2604.00698, 2026.
- Muhtar et al. (2026) Muhtar, D., et al. Комплементарное обучение с подкреплением. arXiv препринт arXiv:2603.17621, 2026.
- ⟦Asai et al. (2023) Asai, A., Wu, Z., Wang, Y., Sil, A., and Hajishirzi, H. Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection. arXiv preprint arXiv:2310.11511, 2023.
- Jeong et al. (2024) Jeong, M., Sohn, J., Sung, M., and Kang, J. Улучшение медицинского рассуждения через поиск и саморефлексию с помощью поисково-дополненных больших языковых моделей. Bioinformatics, 40(Supplement_1):i119–i127, 2024. ISMB 2024.
- Zelikman et al. (2022) Zelikman, E., Wu, Y., Mu, J., and Goodman, N. STaR: Бутстрэппинг рассуждений с помощью рассуждений. В NeurIPS, 2022.
- Yuan et al. (2025) Юань, С., Чэнь, З., Си, З., Е, Дж., Ду, З., и Чэнь, Дж. Agent-R: Обучение агентов языковых моделей рефлексии с помощью итеративного самообучения. arXiv препринт arXiv:2501.11425, 2025.
- ⟦Li et al. (2025) Li, P., Gao, Z., Zhang, B., et al. Итеративное исследование использования инструментов для мультимодальных агентов с помощью пошаговой настройки предпочтений. arXiv preprint arXiv:2504.21561, 2025.
- Cao et al. (2025) Цао, З., Ван, Р., Ян, Й. и др. PGPO: Улучшение рассуждений агентов с помощью оптимизации предпочтений, управляемой планированием в стиле псевдокода. arXiv preprint arXiv:2506.01475, 2025.
- Chen et al. (2025) Chen, S., Zhao, M., Xu, L., et al. DEPO: Оптимизация предпочтений с двойной эффективностью для LLM-агентов. arXiv preprint arXiv:2511.15392, 2025.
- Sheng et al. (2024) Sheng, G., Cao, C., Gao, S., et al. veRL: Открытый унифицированный фреймворк обучения с подкреплением для больших языковых моделей. arXiv preprint arXiv:2409.19951, 2024.
- Towers et al. (2024) Тауэрс, М., и др. "Gymnasium: Стандартный интерфейс для сред обучения с подкреплением." Препринт arXiv arXiv:2407.17032, 2024.
- Johnson et al. (2016) Johnson, A. E. W., Pollard, T. J., Shen, L., et al. MIMIC-III, свободно доступная база данных интенсивной терапии. Scientific Data, 3:160035, 2016.
- ⟦Qwen Team (2025) Команда Qwen. Qwen3.5-9B. https://huggingface.co/Qwen/Qwen3.5-9B, 2025.
- Yang et al. (2024) Yang, A., Yang, B., Hui, B., и др. Технический отчет Qwen2.5. Препринт arXiv arXiv:2412.15115, 2024.
- Yang et al. (2023) Ян, С. и др. Переосмысление бенчмарков и загрязнения для языковых моделей с перефразированными образцами. arXiv preprint, 2023.
- Lau et al. (2018) Лау, Дж. Дж., Гайен, С., Бен Абача, А. и Демнер-Фушман, Д. Набор данных клинически сгенерированных визуальных вопросов и ответов о радиологических изображениях. Scientific Data, 5:180251, 2018.
- He et al. (2020) He, X., Zhang, Y., Mou, L., Xing, E., and Xie, P. PathVQA: более 30 000 вопросов для медицинского визуального вопросно-ответного анализа. arXiv preprint arXiv:2003.10286, 2020.
- Liu et al. (2021) Liu, B., Zhan, L.-M., Xu, L., Ma, L., Yang, Y., and Wu, X.-M. SLAKE: семантически размеченный набор данных, обогащенный знаниями, для медицинских вопросов и ответов на основе изображений. ISBI, 2021.
- Pollard et al. (2018) Pollard, T. J., Johnson, A. E. W., Raffa, J. D., Celi, L. A., Mark, R. G., and Badawi, O. База данных eICU Collaborative Research, свободно доступная многопрофильная база данных для исследований в области критической медицины. Scientific Data, 5:180178, 2018.
- Ben Abacha et al. (2019) Бен Абача, А., Агихтейн, Э., Пинтер, Й., и Демнер-Фушман, Д. Обзор задачи ответов на медицинские вопросы на TREC 2017 LiveQA. TREC, 2019.
- ⟦Amari (1998) Амари, С. Натуральный градиент эффективно работает в обучении. Нейронные вычисления, 10(2):251–276, 1998.
- Polyak & Juditsky (1992) Polyak, B. T. and Juditsky, A. B. Ускорение стохастической аппроксимации путем усреднения. SIAM Journal on Control and Optimization, 30(4):838–855, 1992.
- Lin (2004) Лин, C.-Y. ROUGE: Пакет для автоматической оценки рефератов. Семинар ACL по текстовому реферированию, 2004..
- OpenAI (2025) OpenAI. HealthBench: эталон для оценки ИИ в здравоохранении. https://huggingface.co/datasets/openai/healthbench-professional, 2025.
- Zhang et al. (2023) Zhang, Y., Wang, X., and others. PMC-VQA: Visual Question Answering over PubMed Central Images. arXiv preprint, 2023.
- Abacha et al. (2021) Ben Abacha, A., Hasan, S. A., and Demner-Fushman, D. VQA-Med: Обзор задачи медицинского визуального вопросно-ответного анализа на ImageCLEF 2021. CLEF Working Notes, 2021.
- ⟦Hu et al. (2022) Hu, Z., Zhang, Y., and others. Quilt-VQA: визуальный вопросно-ответный анализ изображений гистопатологии. препринт arXiv, 2022.
- Manes et al. (2024) Manes, I., Ronn, N., Cohen, D., Ber, R. I., Horowitz-Kugler, Z., and Stanovsky, G. K-QA: Реальный медицинский бенчмарк вопросов-ответов. Препринт arXiv:2401.14493, 2024.
- Abacha et al. (2019) Abacha, A. B., Mrabet, Y., Sharp, M., Goodwin, T. R., Shooshan, S. E., and Demner-Fushman, D. Преодоление разрыва между вопросами потребителей о лекарствах и надежными ответами. В трудах MedInfo, 2019.
- Jeong et al. (2024) Чон, М., Хван, Х., Юн, C., Ли, T., и Кан, Дж. OLaPH: Улучшение фактической точности в биомедицинских развернутых ответах на вопросы. arXiv препринт arXiv:2405.12701, 2024.
Appendix A Медицинский ИИ GYM: Детальное построение
Это приложение предоставляет всесторонние детали о дизайне, реализации и построении Healthcare AI GYM, в общей сложности 30K строк кода в 10 клинических областях..
A.1 Интерфейс тренажерного зала
Healthcare AI GYM реализует стандартный интерфейс Gymnasium API через BioAgentGymEnv(gym.Env)):
- • Пространство наблюдений: spaces.Text(max_length=100000) содержащее историю разговора, результаты инструментов и информацию о пациенте.
- • Пространство действий: spaces.Text(max_length=10000), представляющее либо вызов инструмента в формате JSON, либо ответ на естественном языке.
- • Поток эпизода: reset() загружает задачу и возвращает системный промпт + карту пациента; step(action) парсит вызовы инструментов, выполняет их и возвращает наблюдения. Эпизод завершается, когда вызывается submit_answer() или достигнут max_turns..
- • Reward: Scalar from 5 dimensions at episode termination (Eq. LABEL:eq:reward).
Реестр доменов лениво загружает 10 модулей доменов, каждый из которых предоставляет функции get_environment() и get_tasks(). Задачи загружаются из доменно-специфических JSON-файлов и нормализуются в единую схему с детерминированными идентификаторами через MD5-хэширование..
A.2 Дизайн домена
Таблица 2 суммирует 10 клинических областей. Каждая область следует модульной структуре: data_model.py (схемы Pydantic), tools.py (подкласс ToolKitBase), environment.py (входная точка домена) и файлы данных (db.json, tasks.json, policy.md).).
| Domain | Clinical Focus | Tasks | Tools | LoC | Key Capabilities |
|---|---|---|---|---|---|
| Clinical Diagnosis | Differential diagnosis | 5 | 25 | 1,753 | History, labs, DDx, prescribing |
| Medical QA | Evidence-based QA | 1,000 | 16 | 683 | PubMed search, evidence analysis |
| Drug Interaction | Pharmacovigilance | 5 | 18 | 1,024 | DDI, CYP450, alternatives |
| EHR Management | Electronic health records | 15 | 22 | 947 | MIMIC-III/IV, SOFA/APACHE |
| Triage & Emergency | Emergency medicine | 20 | 20 | 1,344 | ABC, ESI, GCS, qSOFA, HEART |
| Visual Diagnosis | Medical imaging | 8 | 17 | 1,343 | Image analysis, case similarity |
| Radiology Report | Structured reporting | 20 | 17 | 549 | BI-RADS, TI-RADS, Fleischner |
| Psychiatry | Mental health | 20 | 20 | 639 | MSE, PHQ-9, GAD-7, Columbia |
| Obstetrics | Maternal-fetal medicine | 20 | 20 | 632 | CTG, Bishop score, ACOG |
| Cross-Domain | Multi-phase pathways | 25 | Var. | — | 6 pathways (chest pain, DKA, etc.) |
| Total | 3.6K+† | 135‡ | 8.9K |
†3,631 инстанцированных задач из исходных задач + расширение AutoTaskGenerator. Из них 2,657 используются для обучения RL и 307 для валидации (см. §5). ‡135 уникальных инструментов зарегистрировано в tool_config_full.yaml; количество на домен включает общие KnowledgeTools.
Структура задачи
Каждая задача представляет собой JSON-объект, содержащий: (1) тикет сценария пациента, (2) ожидаемые взаимодействия с инструментами с compare_args, определяющими, какие аргументы должны совпадать, (3) утверждения на естественном языке для оценки качества и (4) массив reward_basis, выбирающий между оценкой ACTION и NL_ASSERTION. Задачи получены из трех конвейеров: экспертно подобранные начальные задачи (1,138 в разных областях), расширение AutoTaskGenerator из внешних бенчмарков (MCQAConverter, VQAConverter, EHRConverter) и извлечение знаний, что дает 3,631 инстанцированных задач после человеческой проверки..
Конвейер генерации задач
AutoTaskGenerator преобразует внешние бенчмарки и извлекает источники знаний через пять конвертеров: (1) MCQAConverter обрабатывает 8.9K вопросов из 8 бенчмарков MCQA (MedQA, MedMCQA, 6 подмножеств MMLU); (2) MedLFQAConverter работает с 4.9K длинными ответами на вопросы; (3) VQAConverter загружает 6 наборов визуальных QA (25K изображений); (4) EHRConverter извлекает эпизоды госпитализации из MIMIC-III/IV; (5) KnowledgeMiner генерирует пары вопрос-ответ из поиска по пассажам FTS5. Каждый конвертер назначает специфичные для домена ожидаемые инструменты и генерирует стабильные идентификаторы для воспроизводимости..
Междоменные пути
Движок путей определяет 6 многофазных клинических маршрутов (боль в груди, неотложная помощь при диабете, код инсульта, сепсис-пакет, послеоперационное осложнение, детская лихорадка). Каждый путь представляет собой последовательность объектов PathwayPhase, определяющих активную область, необходимые действия, утверждения на естественном языке, условия перехода и опциональные флаги временного давления. Оценка выполняется по каждому этапу и в целом..
Модели данных предметной области
Каждый домен определяет схемы Pydantic BaseModel, наследуемые от общего класса DB, который поддерживает сериализацию, хеширование и генерацию схем. Например, Clinical Diagnosis определяет Patient (демографические данные, аллергии с указанием тяжести, лекарства, состояния, жизненно важные показатели, результаты лабораторных исследований, клинические заметки, семейный/социальный анамнез), LabResult (с референтными интервалами и флагами), ClinicalGuideline и DrugInteraction. Управление EHR отражает схему MIMIC с Admission, ICUStay, LabEvent, VitalEvent, MedicationOrder и ClinicalScore (SOFA/APACHE/SAPS/NEWS).).
A.3 Реализация системы инструментов
Фреймворк декораторов
Инструменты регистрируются с помощью декоратора @is_tool(ToolType), который поддерживает четыре типа: READ (запросы), WRITE (изменения состояния), THINK (внутренние рассуждения) и GENERIC (отправка). Мета-класс _ToolKitMeta собирает все декорированные методы во время создания класса. ToolDefinition.from_method() автоматически парсит сигнатуры методов и строки документации для генерации совместимых с OpenAI схем вызова функций. CompositeToolKit объединяет доменно-специфичные инструменты с общими KnowledgeTools, используя семантику первого выигравшего..
Выполнение инструмента
Метод step() окружения парсит действия агента как JSON, проверяет имена инструментов на соответствие зарегистрированному набору инструментов, выполняет через tools.use_tool(name, **kwargs) и возвращает результаты как объекты ToolMessage. Некорректный JSON или неизвестные имена инструментов возвращают сообщения об ошибках, а не прерывают эпизод..
Репрезентативные инструменты домена
Инструменты для конкретных доменов охватывают шесть категорий в 9 доменах (всего 135 уникальных инструментов): Поиск знаний (6 инструментов): запрос к индексированной коллекции отрывков через BM25 на SQLite. Клиническая оценка (22 инструмента): валидированные оценочные инструменты (APACHE-II, CURB-65, Wells и др.). Доступ к данным пациента: история, жизненные показатели, лабораторные данные, лекарства, аллергии по домену. Клинические действия: назначение тестов, выписывание рецептов, запись диагнозов. Рассуждение: дифференциальная диагностика, анализ ответов, сравнение методов лечения. Документация: клинические заметки, выписные эпикризы.
A.4 База знаний: 828K отрывков
База знаний реализована как база данных SQLite FTS5 (Full-Text Search v5) с ранжированием BM25.:
- • Schema: CREATE VIRTUAL TABLE passages_fts USING fts5(doc_id, source, title, content, category, dataset_name, tokenize=’porter unicode61’)
- • Источники: доказательства MedCPT (581K отрывков PubMed/PMC), пары биомедицинских QA (122K), отрывки генератора (83K), MedInstruct (52K) — всего 828 473 проиндексированных отрывка
- • Поиск: токенизация с помощью стеммера Портера, ранжирование релевантности BM25, генерация сниппетов с выделением терминов, булевы операторы запросов
- • Wikipedia: Офлайн-индекс FTS5 по 26M статей (188 ГБ) с извлечением страниц на основе смещения
- • Доступ: потокобезопасный синглтон MedicalKnowledgeBackend с режимом WAL и ленивой инициализацией
Все инструменты поиска знаний поддерживаются одним и тем же синглтоном MedicalKnowledgeBackend с потокобезопасным доступом к SQLite в WAL-mode..
A.5 Реализация вознаграждения 5D
Система вознаграждения (400 строк) реализует каждое измерение как компонуемые функции.:
Accuracy ().
Три варианта: (1) exact_match для MCQ (1.0 если правильно, иначе 0.0), (2) soft с использованием ROUGE-1 (Lin, 2004) + BLEU-1 совпадение токенов F1 для ответов открытого типа, (3) bertscore с использованием BiomedBERT для семантического сходства с soft fallback.
Process Quality ()
Взвешенная комбинация: 60% охват (доля ожидаемых инструментов, вызванных с соответствующими аргументами), 20% разнообразие (уникальные сигнатуры инструментов / общее количество вызовов), 20% полнота (использованные различные названия инструментов). Дополнительно, оценка на основе рубрики (вес 70% при наличии рубрики) проверяет требуемые элементы, требуемые инструменты и запрещенные элементы..
Safety ()
Обнаружение нарушений безопасности на основе правил с 50+ шаблонами нарушений по 5 уровням серьезности, каждый сопоставлен с этическим принципом AMA (непричинение вреда, благодеяние, автономия). Критические нарушения (уровень серьезности 5: игнорирование противопоказаний, опасное дозирование, пропуск экстренного случая) ограничивают общее вознаграждение на уровне 0.1; серьезные нарушения (уровень серьезности 4) накладывают штраф .
Format ()
Градуированная оценка: 1.0 за валидный JSON с именем и аргументами; 0.8 за JSON в блоках кода; 0.5 за частичную структуру; 0.0 за неверный формат. Финальный ход проверяет на связный ответ (10 characters).
Coherence ()
Проверяет логическую согласованность, отсутствие противоречий и четкие клинические выводы.
GRPO интеграция
Обертка grpo_reward_fn(), совместимая с TRL, вычисляет все измерения награды и возвращает взвешенный скаляр для использования с GRPOTrainer..
A.6 Поведенческие политики
Каждый домен включает файл policy.md, определяющий поведенческие рекомендации, внедряемые как системный промпт. Политики определяют: (1) основные принципы (безопасность пациента превыше всего, доказательная медицина, системный подход), (2) руководство по использованию инструментов (например, "всегда начинайте с get_patient_info()", "проверяйте аллергии перед назначением"), и (3) ограничения (например, "НЕ ставьте диагноз без просмотра данных пациента", "если вне компетенции, немедленно передайте специалисту"). Эти политики закрепляют поведение агента в соответствии с клиническими лучшими практиками, оставаясь при этом специфичными для домена..
Appendix B TT-OPD Алгоритм
В данном разделе представлено подробное описание алгоритма Turn-Level Truncated On-Policy Distillation (TT-OPD), представленного в Algorithm 1. Мы описываем процедуру обучения, ключевые проектные решения и роль каждого компонента в стабилизации обучения многоповоротного агента..
Настройка обучения.
TT-OPD работает в многошаговой среде с инструментальной поддержкой, где модель взаимодействует с внешней системой на протяжении последовательности шагов. На каждой итерации обучения из распределения задач выбирается пакет подсказок, и для каждой подсказки генерируется несколько прогонов посредством взаимодействия по текущей политике. Каждый прогон состоит из последовательности состояний и действий, где действия могут соответствовать вызовам инструментов или ответам на естественном языке. Эпизод завершается, когда отправляется окончательный ответ или достигается максимальное количество ходов..
Генерация развертывания и вознаграждение.
Для каждого запроса модель генерирует множество траекторий, чтобы зафиксировать разнообразные варианты поведения в рамках текущей политики. Каждая траектория оценивается с помощью косинусной оценки вознаграждения, которая отражает как правильность, так и семантическое соответствие эталонному решению. Такое вознаграждение обеспечивает плавный обучающий сигнал, подходящий для задач долгосрочного рассуждения..
Для повышения эффективности обучения TT-OPD применяет стратегию динамической фильтрации, которая сохраняет только те подсказки, которые демонстрируют смешанные результаты по раундам развертывания. Это гарантирует, что сохраненные образцы обеспечивают значимый контраст для обучения и предотвращают вырожденные обновления от однородно правильных или неправильных траекторий..
Вычисление преимущества.
Имея несколько траекторий на каждый запрос, TT-OPD вычисляет групповые относительные преимущества на основе значений вознаграждения. Эта формулировка устраняет необходимость в отдельной функции ценности и обеспечивает стабильную оптимизацию политики путем нормализации производительности в пределах каждой специфической для запроса группы прогонов..
Дистилляция под руководством учителя.
Ключевым компонентом TT-OPD является поканальная дистилляция от модели-учителя. Учитель строится как экспоненциальное скользящее среднее параметров ученика. Для каждой траектории в входные данные учителя добавляется дополнительный контекст, связанный с результатом, что позволяет учителю генерировать более обоснованные предсказания на уровне токенов..
Затем учитель вычисляет логарифмические вероятности действий на каждом шаге траектории. Для предотвращения утечки информации любой привилегированный контекст, предоставленный учителю, удаляется из выходных данных перед вычислением потерь при дистилляции. Студент обучается соответствовать поведению учителя на каждом шаге через целевой функционал KL-дивергенции. Это выравнивание на уровне шагов побуждает студента имитировать не только окончательные ответы, но и промежуточные рассуждения и решения по использованию инструментов..
Совместная оптимизация.
Цель обучения сочетает в себе обучение с подкреплением и дистилляцию. Компонент обучения с подкреплением поощряет траектории с более высокими наградами, в то время как компонент дистилляции стабилизирует обучение, привязывая политику к учителю. Баланс между этими двумя целями контролируется скалярным коэффициентом. Эта совместная оптимизация позволяет модели исследовать улучшенные варианты поведения, сохраняя последовательность в рассуждениях..
Обновление учителя EMA.
Параметры учителя периодически обновляются с использованием экспоненциального скользящего среднего параметров студента. Этот механизм обновления обеспечивает плавную эволюцию учителя во времени и предоставляет стабильную цель для дистилляции. Избегая резких изменений в политике учителя, TT-OPD снижает нестабильность, обычно наблюдаемую в многошаговом обучении с подкреплением..
Соображения стабильности.
TT-OPD предназначен для устранения нескольких режимов сбоя, возникающих при обучении агента с несколькими витками. Во-первых, непрерывное выравнивание учителя снижает риск коллапса политики, связанный с нестабильностью расхождения KL. Во-вторых, формулировка вознаграждения и динамика обучения неявно регулируют длину ответа, предотвращая неконтролируемый рост генерируемых токенов. В-третьих, контроль на уровне витка сохраняет структуру многошагового рассуждения, избегая вырождения в короткие или неполные последовательности взаимодействия..
Вкратце, TT-OPD объединяет обучение с подкреплением по политике с структурированной дистилляцией на уровне витков в многовитковом контексте. Такая конструкция обеспечивает стабильную оптимизацию, сохраняет промежуточное рассуждение и повышает надежность языковых агентов, дополненных инструментами..
Appendix C Инструментарий домена
Каждый домен GYM предоставляет CompositeToolKit, объединяющий доменно-специфичные инструменты с общими KnowledgeTools (поиск PubMed, извлечение доказательств, медицинская вики). Все инструменты следуют формату вызова функций, совместимому с OpenAI..
| Domain | R | W | G | Representative Tools |
| Clinical Diagnosis | 30 | 2 | 2 | get_vital_signs, order_lab, generate_ddx |
| Medical QA | 12 | 0 | 2 | analyze_answer_options, compare_treatments |
| Visual Diagnosis | 6 | 0 | 2 | analyze_medical_image, search_similar_cases |
| Drug Interaction | 15 | 0 | 2 | check_interaction, check_cyp450_metabolism |
| EHR Management | 18 | 3 | 2 | get_lab_trend, write_clinical_note, place_order |
| Triage & Emergency | 16 | 3 | 2 | calculate_gcs, screen_sepsis |
| Radiology Report | 7 | 1 | 2 | analyze_findings, get_report_template |
| Psychiatry | 12 | 0 | 2 | administer_phq9, assess_suicide_risk |
| Obstetrics | 17 | 1 | 2 | assess_fetal_status, interpret_ctg |
| Cross-Domain | (pathway engine) | Multi-domain clinical pathway sequencing | ||
Все инструменты возвращают JSON-сериализуемые выходные данные. Инструмент think() фиксирует внутренние рассуждения без внешних побочных эффектов. Инструмент submit_answer() отмечает завершение задачи и запускает оценку вознаграждения..
Appendix D Подробные результаты экспериментов
D.1 Базовый уровень логарифмической вероятности (только текст)
Мы оцениваем базовую модель Qwen3.5-9B и модели, обученные с GRPO, используя оценку логарифмической вероятности, которая вычисляет вероятность следующего токена по буквам вариантов (A–E) без доступа к инструментам или многоэтапного взаимодействия. Это обеспечивает чистый базовый уровень параметрических знаний. Точность логарифмической вероятности GRPO почти идентична базовой модели (70.8% против 70.7% на MedQA, 83.9% против 83.8% на MMLU), подтверждая, что параметрические знания полностью сохраняются при обучении с подкреплением с помощью LoRA (ранг 64, проекции MLP + attention). Обучение с подкреплением изменяет поведенческие паттерны (использование инструментов, очередность действий) без изменения воспроизведения фактов..
D.2 Многораундовая агентная оценка
Множественный выбор QA.
На MedQA (Jin et al., 2021) базовая модель без инструментов достигает 70,7% через logprob. Добавление многошагового AgentRunner с 135 инструментами и базой знаний из 828K отрывков (Base+AR) достигает 78,8%, в то время как модели RL достигают 85,5% (GRPO) и 87,1% (TT-OPD) — улучшение на +16,4 процентных пункта, демонстрирующее, что обучение с подкреплением дает последовательные преимущества по сравнению с одним лишь дополнением поиска. На MMLU Medical (Hendrycks et al., 2021) (6 подтипов) многошаговая оценка снижает производительность: Base+AR 60,6% против logprob 83,8% (23,2 п.п.). Эти «агентные издержки» отражают ненужные вызовы инструментов и ошибки преобразования формата при многошаговой обработке. TT-OPD (65,5%) частично восстанавливает (+4,9 п.п. по сравнению с Base+AR), в то время как GRPO (60,1%) соответствует базовой модели. MedMCQA (Pal et al., 2022) показывает, что TT-OPD достигает наилучшего результата в 66,2%, превосходя как базовый logprob (63,8%), так и GRPO (58,0%).
Визуальное QA.
На 6 бенчмарках VQA TT-OPD достигает лучшего или близкого к лучшему результата на 5 из 6. На VQA-RAD (Lau et al., 2018), Base+AR лидирует (63.2%), а TT-OPD немного отстает (63.1%). PathVQA (He et al., 2020) показывает TT-OPD на уровне 45.3%, превосходя как базовый текст (40.5%), так и GRPO (41.5%). SLAKE (Liu et al., 2021) и PMC-VQA демонстрируют большие разрывы между текстовой оценкой (79.0%, 57.9%†) и многошаговой агентной оценкой (30.6%, 35.1%), что согласуется с паттерном агентных накладных расходов. VQA-Med-2021 (15.2% TT-OPD) и Quilt-VQA (30.7% TT-OPD) являются открытыми визуальными QA бенчмарками, где все методы показывают более низкие результаты, но TT-OPD стабильно лидирует..
EHR рассуждение.
MIMIC-III (Johnson et al., 2016) и eICU (Pollard et al., 2018) оцениваются с помощью score на основе действий, измеряя, выполняет ли агент ожидаемые вызовы клинических инструментов (например, get_patient_summary, get_lab_results). TT-OPD достигает лучших результатов (MIMIC-III 62.7%, eICU 57.1%), превосходя как Base+AR (62.1%, 55.9%), так и GRPO (61.1%, 55.5%). Базовая текстовая модель без инструментов получает 58.5% и 53.2% соответственно, демонстрируя, что дополненные инструментами рассуждения обеспечивают скромное, но последовательное улучшение в структурированных задачах EHR..
Длинные ответы на вопросы.
На 5 бенчмарках MedLFQA TT-OPD лидирует в 3 (LiveQA 62.5%, MedicationQA 60.9%, HealthSearchQA 45.3%), в то время как GRPO лидирует в задачах, требующих знаний (KQA-Golden 65.3%, KQA-Silver 64.9%). Эта дихотомия предполагает, что более высокая пиковая точность обучения GRPO приводит к лучшему воспроизведению фактов в открытых условиях, в то время как стабильность TT-OPD полезна для клинического рассуждения. Все методы значительно превосходят базовый текст (например, LiveQA: 53.2% base 62.5% TT-OPD), что подтверждает, что обучение с подкреплением улучшает качество длинных ответов..
Appendix E Аналитические выводы
Мы анализируем три ключевые динамики, наблюдаемые во время обучения TT-OPD. Эти наблюдения применяют известные результаты из теории натурального градиента и анализа EMA для обоснования того, почему варианты абляции терпят неудачу и почему полный метод оказывается успешным; они не претендуют на формальную новизну..
Почему TT-OPD сходится немонотонно, а не расходится?
Отличительной особенностью обучения TT-OPD является немонотонный паттерн сходимости, видимый на рисунке 4(a): точность повышается, падает, затем восстанавливается до более высокого уровня. Это не случайный шум — это отражает встроенный механизм самокоррекции, созданный EMA-учителем.
Proposition E.1 (EMA как неявное аннелирование скорости обучения).
При обновлениях учителя ЭМА с затуханием , градиент штрафа КЛ удовлетворяет (Amari, 1998), где — это информация Фишера. Эффективная скорость обучения для GRPO неявно уменьшается на коэффициент, пропорциональный , создавая восстанавливающую силу: большие сдвиги политики усиливают градиент КЛ, ослабляя последующие обновления. (Это следует из стандартной теории естественного градиента; мы приводим это здесь для обоснования обсуждения динамики обучения.).)
Интуиция. Рассмотрим EMA-учителя как «память» недавнего хорошего поведения. Когда студент делает большое обновление политики (например, внезапно начинает предпочитать более короткие ответы), он отклоняется далеко от учителя. KL-дивергенция между ними растет, что увеличивает градиент, возвращающий студента обратно к распределению учителя. Это действует как пружина: чем дальше отклоняется студент, тем сильнее восстанавливающая сила. И наоборот, когда студент близок к учителю, KL-градиент слаб, позволяя сигналу вознаграждения GRPO доминировать и подталкивать студента к более высокой точности. Это чередование между исследованием, управляемым вознаграждением, и коррекцией, управляемой KL, создает характерную немонотонную сходимость (), видимую на рисунке 4(a) и количественно выраженную на рисунке 3.⟧.
Почему стандартный GRPO не улучшает текстовый QA, несмотря на улучшение агентских задач?
Этот вопрос является центральным для разрыва агентно-текстового переноса. Ответ заключается в том, как многомерные вознаграждения взаимодействуют с оценкой градиента.
Proposition E.2 (Разбавление градиентного сигнала).
С -мерным вознаграждением отношение сигнал/шум (SNR) вклада компонента в общее преимущество равно , где — стандартное отклонение компонента вознаграждения , а — стандартное отклонение общего вознаграждения. С нашими параметрами вознаграждения (, , , ) вклад SNR точности () доминирует над форматом (), создавая коэффициент разбавления 51:1. (Это прямое следствие линейности математического ожидания, применённой к нашим конкретным параметрам вознаграждения.)
Интуиция. Представьте класс, где ученик получает пять оценок (точность, качество процесса, безопасность, формат, согласованность), объединенных в один средний балл. Если оценка за формат почти не варьируется между учениками (все получают почти идеальные баллы за формат, ), то формат почти не вносит вклада в различение хороших и плохих развертываний — его градиентный сигнал «разбавляется» другими, более изменчивыми компонентами. Точность, с высокой дисперсией (), доминирует в градиенте. Однако 5D-схема взвешивания все же уменьшает эффективный градиент точности на по сравнению с вознаграждением только за точность. Это разбавление объясняет, почему стандартный GRPO с 5D-вознаграждением не улучшает текстовый QA: градиент точности, хотя и доминирует, недостаточен для преодоления шумового порога в течение нескольких сотен шагов онлайн-обучения. TT-OPD компенсирует это, предоставляя дополнительный градиент дистилляции, обусловленный результатом, который напрямую кодирует информацию о правильности..
Почему EMA предотвращает пилообразный коллапс KL, наблюдаемый при периодических сбросах?
Варианты с периодическим сбросом демонстрируют деструктивную модель: расхождение KL нарастает по мере обучения ученика, затем резко падает почти до нуля, когда учитель перезаписывается. Мы формализуем, почему EMA устраняет этот режим сбоя..
Proposition E.3 (KL-ограниченность при EMA).
При обновлениях EMA с пошаговым сдвигом и -липшицевой KL расходимость в установившемся состоянии удовлетворяет , что приводит к непрерывному росту KL. В отличие от этого, обновления жесткого копирования создают пилообразную KL с пиками и резкими падениями до нуля, разрушая градиент дистилляции. (Эта граница следует из разворачивания рекурсии EMA (Polyak & Juditsky, 1992); мы приводим ее, чтобы объяснить эмпирический контраст между EMA и динамикой периодического сброса..)
Интуиция. При периодических сбросах учитель представляет собой моментный снимок, замороженный во времени. По мере того как ученик улучшается на протяжении шагов, KL-расхождение накапливается — распределения ученика и учителя становятся все более различными. В момент сброса () учитель внезапно становится идентичным ученику, и KL падает до нуля. Это разрушает весь сигнал дистилляции, который направлял ученика, заставляя обучение начинаться с нуля. Мы ясно наблюдаем это: на шаге 10 в варианте KL падает с 2.637 до 0.343, и вскоре после этого точность начинает монотонно снижаться. С EMA () учитель непрерывно поглощает небольшую долю улучшений ученика. KL никогда не падает резко — он плавно растет с 0.001 до 1.063 за 60 шагов, обеспечивая стабильный и постепенно усиливающийся сигнал регуляризации на протяжении всего обучения..
Appendix F Гиперпараметры обучения
| Parameter | GRPO | TT-OPD |
|---|---|---|
| Model & fine-tuning | ||
| Base model | Qwen3.5-9B | Qwen3.5-9B |
| Fine-tuning | Full-param (FSDP) | Full-param (FSDP) |
| FSDP offload | param + optimizer | param + optimizer |
| Precision | bf16 | bf16 |
| Optimization | ||
| Learning rate | ||
| LR scheduler | Constant | Constant |
| Warmup steps | 0 | 0 |
| Max grad norm | 1.0 | 1.0 |
| Train batch size | 8 | 8 |
| Micro batch (per GPU) | 1 | 1 |
| Epochs | 3 | 1 |
| Rollout & RL | ||
| Generations per prompt () | 3 | 3 |
| KL penalty () | 0.01 | 0.01 |
| Max prompt length | 8,192 | 8,192 |
| Max response length () | 12,288 | 12,288 |
| Max assistant turns | 5 | 5 |
| TT-OPD distillation | ||
| Distillation coef () | – | 4.0 |
| EMA decay () | – | 0.995 |
| EMA update interval | – | 5 steps |
| Hard copy interval | – | 30 steps |
| Cosine / | – | 1.1 / 0.7 |
| Cosine | – | |
Appendix G Набор эталонных тестов
| Category | Benchmark | Samples | Metric |
| Text QA | MedQA (USMLE) (Jin et al., 2021) | 1,273 | Accuracy |
| MedMCQA (Pal et al., 2022) | 4,183 | Accuracy | |
| MMLU-Clinical Knowledge (Hendrycks et al., 2021) | 265 | Accuracy | |
| MMLU-Professional Medicine | 272 | Accuracy | |
| MMLU-Anatomy | 135 | Accuracy | |
| MMLU-Medical Genetics | 100 | Accuracy | |
| MMLU-College Biology | 144 | Accuracy | |
| MMLU-College Medicine | 173 | Accuracy | |
| Vision QA | VQA-RAD (Lau et al., 2018) | 451 | Accuracy |
| SLAKE (Liu et al., 2021) | 1,061 | Accuracy | |
| PathVQA (He et al., 2020) | 6,719 | Accuracy | |
| PMC-VQA (Zhang et al., 2023) | 1,996 | Accuracy | |
| VQA-Med-2021 (Abacha et al., 2021) | 425 | Accuracy | |
| Quilt-VQA (Hu et al., 2022) | 985 | Accuracy | |
| Long-Form QA | KQA Golden (Manes et al., 2024) | 201 | ROUGE-L / Hall. / Comp. |
| LiveQA (Ben Abacha et al., 2019) | 100 | ROUGE-L / Hall. / Comp. | |
| MedicationQA (Abacha et al., 2019) | 666 | ROUGE-L / Hall. / Comp. | |
| HealthSearchQA | 3,077 | ROUGE-L / Hall. / Comp. | |
| KQA Silver (Manes et al., 2024; Jeong et al., 2024) | 904 | ROUGE-L / Hall. / Comp. | |
| EHR | MIMIC-III (Johnson et al., 2016) | 5,000 | Action Score + Reward |
| eICU (Pollard et al., 2018) | 5,000 | Action Score + Reward |
Appendix H Таксономия нарушений безопасности
| Severity | Category | Example | Reward Effect |
|---|---|---|---|
| 5 | Contraindication ignored | penicillin to allergic patient | Cap at 0.1 |
| 5 | Missed emergency | Failed to recognize STEMI | Cap at 0.1 |
| 5 | Dangerous dosing | 10x recommended dose | Cap at 0.1 |
| 4 | Missed DDI | Ignored warfarin-NSAID interaction | |
| 4 | Fabricated evidence | Cited non-existent study | |
| 3 | Incomplete workup | No confirmatory test | |
| 3 | Guideline non-compliance | Deviated without justification | |
| 2 | Missing follow-up | No follow-up plan | |
| 1 | Style issue | Formatting inconsistency |
Appendix I Использование LLMs
Мы используем Claude Opus 4.6 для экспериментов с обучением и экспериментами, для написания общей концепции рукописи, для проверки грамматики сгенерированных предложений, для рассмотрения проверки библиографий цитирований..
Appendix J Примеры траекторий
Мы представляем репрезентативные многоэтапные траектории из модели TT-OPD (шаг 60), чтобы проиллюстрировать паттерны агентного рассуждения, изученные с помощью обучения с подкреплением. Каждый пример демонстрирует пайплайн: рассуждение поиск проверка отправка..
J.1 Пример 1: Фармакология (MedQA, Правильно))
Вопрос: Врач выбирает, назначить ли лозартан или лизиноприл для лечения гипертонии у 56-летнего мужчины. По сравнению с лозартаном, какое из следующих изменений в циркулирующих уровнях этих пептидов следует ожидать при лечении лизиноприлом? (A) Увеличение брадикинина; уменьшение ангиотензина II, (B) Уменьшение ренина; увеличение ангиотензина I, (C) Увеличение альдостерона; уменьшение брадикинина, (D) Уменьшение ренина; увеличение ангиотензина II. Правильный ответ: A
- 1. Раунд 1 (Рассуждение): Агент определяет, что лозартан является блокатором рецепторов ангиотензина II (БРА) (блокирует рецепторы AT1), в то время как лизиноприл является ингибитором ангиотензинпревращающего фермента (АПФ) (блокирует превращение ангиотензина I в ангиотензин II и распад брадикинина). Он рассуждает, что по сравнению с лозартаном, лизиноприл увеличит содержание брадикинина и уменьшит содержание ангиотензина II..
- 2. Ход 2 (поиск_доказательств): Ищет «ACE inhibitor vs ARB bradykinin angiotensin II mechanism», чтобы проверить свои рассуждения.
- 3. Шаг 3 (поиск_медицинской_вики): Запросы "lisinopril mechanism bradykinin" для дополнительного подтверждения.
- 4. Этап 4 (анализ вариантов ответа): Систематически оценивает все четыре варианта в соответствии с фармакологией RAAS.
- 5. Раунд 5 (отправить ответ): Отправляет A с обоснованием: “Ингибиторы АПФ предотвращают деградацию брадикинина (увеличение) и блокируют превращение ангиотензина Iангиотензин II (уменьшение).” Оценка: 1.18
J.2 Пример 2: Неотложная медицина (MedQA, Верно)
Вопрос: 56-летний мужчина доставлен в отделение неотложной помощи через 30 минут после падения с высоты 3 футов на острый металлический столб забора. Он без сознания. При осмотре обнаружена рана глубиной 3 см на верхнем крае правой ключицы по парастернальной линии. Какой из следующих результатов наиболее вероятен? (A) Разрыв вращательной манжеты, (B) Пневмоторакс вследствие повреждения плевры, (C) Парез трапециевидной мышцы вследствие повреждения добавочного нерва, (D) Травматическая аневризма вследствие повреждения внутренней сонной артерии. Gold: B
- 1. Шаг 1 (Рассуждение): Агент сопоставляет место ранения (парастернальная ключичная область) с подлежащей анатомией: верхушка легкого простирается выше ключицы в этой области, что делает плевральное повреждение основной проблемой. Он исключает вращательную манжету (слишком латерально), добавочный нерв (слишком сзади) и внутреннюю сонную артерию (слишком латерально/глубоко).).
- 2. Шаги 2–3 (search_pubmed, retrieve_evidence): Ищет “проникающее ранение ключицы, парастернальное плевральное повреждение” и получает медицинскую литературу по осложнениям проникающей травмы надключичной области.
- 3. Turn 4 (think): Synthesizes retrieved evidence with anatomical knowledge, confirming that the pleural dome extends 2.5 cm above the medial third of the clavicle.
- 4. Ход 5 (submit_answer): Отправляет B (пневмоторакс вследствие плевральной травмы). Оценка: 1.18
J.3 Пример 3: Трансплантология (MedQA, Правильно))
Вопрос: 37-летний мужчина, 7 лет после трансплантации печени на иммуносупрессивной терапии, обращается с рецидивирующей желтухой (6–7 эпизодов), сильно повышенными ферментами печени и допплерографией, показывающей снижение печеночного кровотока. Какие гистологические результаты можно ожидать? (A) Пролиферация желчных протоков с нейтрофильной инфильтрацией, (B) Баллонная дистрофия гепатоцитов с жировыми изменениями, (C) Гранулематозное воспаление с многоядерными гигантскими клетками, (D) Интерстициальная клеточная инфильтрация с паренхиматозным фиброзом, облитерирующий артериит. Золото: D
- 1. Turn 1 (think): Агент идентифицирует это как хроническое отторжение трансплантата на основании: 7-летний посттрансплантационный период (позднее начало), рецидивирующая желтуха, несмотря на приверженность лечению, снижение сосудистого кровотока на допплере (предполагает сосудистую патологию) и значительно повышенные ферменты, указывающие на продолжающееся повреждение трансплантата..
- 2. Turn 2 (analyze_answer_options): Систематически сравнивает варианты: пролиферация желчных протоков (острое отторжение), баллонная дистрофия гепатоцитов (жировая болезнь печени), гранулематозное воспаление (саркоидоз/ТБ), облитерирующий артериит с фиброзом (признак хронического отторжения)).
- 3. Шаг 3 (search_medical_wiki): Поиск “хроническое отторжение трансплантата печени облитерирующий артериит гистология” для подтверждения.
- 4. Поворот 4 (Рассуждение): Интегрирует клинические и гистологические знания: облитерирующий артериит является патогномоничным для хронического отторжения, объясняя снижение допплеровского кровотока.
- 5. Раунд 5 (отправить ответ): Отправляет D с подробным обоснованием, связывающим клиническую картину с гистопатологией. Оценка: 0.80
Ключевые наблюдения.
Эти траектории выявляют три устойчивых паттерна у агентов, обученных TT-OPD: (1) Сначала рассуждение: агент формулирует гипотезу до поиска, сокращая количество нерелевантных вызовов инструментов; (2) Плавная деградация: когда конкретные инструменты поиска недоступны (например, бэкенд PubMed недоступен), агент переключается на альтернативные инструменты или внутренние знания, а не останавливается; (3) Цикл верификации: агент использует think и analyze_answer_options для перекрестной проверки полученных свидетельств на соответствие первоначальным рассуждениям перед тем, как перейти к submit_answer..