Баланс устойчивости и пластичности при последовательном обучении
Раннее прекращение нейронных сетей
Аннотация
Ранний выход в нейронных сетях позволяет выполнять адаптивное логирование за счет того, что входные данные могут выходить через промежуточные классификаторы, уменьшая вычисления для простых примеров при сохранении высокой точности. На практике выходы можно обучать последовательно, постепенно добавляя их к общей основе; однако такое последовательное обучение может приводить к тому, что вновь введенные выходы будут мешать ранее освоенным, ухудшая качество работы более ранних классификаторов. Мы решаем эту проблему, сохраняя знания, встроенные в существующие выходы, при одновременном разрешении новым выходам специализироваться. Мы предлагаем два альтернативных подхода, работающих на разных уровнях модели. Первый ограничивает обучение, защищая параметры, которые важны для ранее обученных выходов, а второй сохраняет распределения выходов более ранних выходов по мере адаптации сети. Эти альтернативы напрямую отражают компромисс стабильность—пластичность, изучаемый в непрерывном обучении. Соответственно, мы используем Elastic Weight Consolidation для ограничения критических весов и Learning without Forgetting для сохранения распределений выходов. Эксперименты на стандартных наборах тестов показывают, что наши подходы последовательно улучшают качество работы при раннем выходе, обеспечивая более высокую точность по сравнению с существующими методами последовательного обучения, а также значительные ускорения производительности при низких вычислительных бюджетах.
Ключевые слова — Раннее прекращение работы нейронных сетей, Последовательное обучение, Катастрофическое забывание, Непрерывное обучение
1 Введение
Повышающееся внедрение моделей глубокого обучения в условиях строгих ограничений по задержке, энергии и памяти побудило к разработке ресурсоэффективных динамических архитектур. Вместо выполнения фиксированного вычислительного графа для всех входных данных такие архитектуры адаптируют вычислительную стоимость к сложности входа, обеспечивая эффективный вывод при сохранении высокой точности [5]. Раннервые нейронные сети с преждевременным выходом (EENNs) представляют собой показательный пример этой парадигмы. EENNs дополняют базовую сеть несколькими внутренними классификаторами (ICs), размещёнными на возрастающих глубинах, позволяя завершать вывод заранее, как только достигнута достаточная уверенность. Лёгкие примеры могут быть классифицированы с использованием неглубоких представлений, тогда как более сложные входные данные распространяются глубже по сети. Такая адаптивность, основанная на выходе, существенно снижает среднюю вычислительную стоимость вывода и делает EENNs хорошо подходящими для приложений с ограниченными ресурсами [2].
Для реализации этих преимуществ на практике критически важным является дизайнерское решение о том, как обучать несколько выходов в EENN. Большинство предшествующих работ сосредоточивались на стратегиях совместного обучения, которые оптимизируют остов вместе со всеми выходами одновременно в сквозном end-to-end режиме. Совместное обучение показало сильные эмпирические результаты и поэтому стало преобладающим подходом [17, 4, 3, 11]. В отличие от этого, последовательное обучение выполняет обучение инкрементально по мере добавления выходов к существующему остову. Последовательное обучение естественным образом согласуется с предварительно обученными остовами, позволяя более быстрое проектирование и эффективный анализ того, где внутри сети возникают осмысленные предсказания — полезное свойство для больших моделей, где вычислительная стоимость полного совместного обучения может быть чрезмерной или даже нежелательной [24, 22].
Последовательные подходы к обучению для EENNs группируются на три основные группы в зависимости от конкретной методологии обучения, применяемой для каждого последующего выхода [11]. Дизъюнктное обучение (также называемое двухэтапным обучением) сначала независимо обучает базовую часть, а затем замораживает ее при обучении ICs [20, 23]. Этот подход особенно эффективен для дооснащения предварительно обученных моделей ранними выходами ценой ограниченной адаптируемости; новые выходы не могут уточнять более ранние представления, чтобы лучше поддерживать их конкретные цели. Обучение по ветвям вводит выходы последовательно, при этом размораживается только сегмент базовой части, связанный с текущим выходом, обеспечивая умеренную гибкость и помогая смягчать исчезающие или взрывные градиенты в глубоких архитектурах [7]. Однако этот подход с опережающим учетом последствий страдает от преждевременного замораживания: как только выход обучен и процесс обучения углубляется, параметры этого выхода становятся зафиксированными, не позволяя дальнейшего уточнения даже тогда, когда последующие выходы выявляют полезные структуры представлений. Раздельное обучение дополнительно ослабляет эти ограничения за счет размораживания всей сети [11]. Выходы также вводятся последовательно, однако обучение каждого выхода выполняется совместно с предыдущими выходами, позволяя каждой ветви извлекать признаки на разных уровнях абстракции за счет потенциально различных целей. Хотя этот подход обеспечивает большую гибкость, он применяет единообразные обновления ко всем параметрам базовой части на каждой итерации, не выявляя, какие параметры необходимы для более ранних выходов, а какие можно изменять для новых.
Ключевая проблема объединяет эти методы: введение новых выходов нарушает ранее выученные представления за счет интерференции градиентов, причем деградация усиливается по мере добавления большего числа выходов [14]. Это возникает потому, что современные подходы игнорируют неоднородную важность параметров, особенно тех, которые уже были настроены для более ранних выходов. Действительно, некоторые веса кодируют критически важные признаки, от которых зависят более ранние выходы, тогда как другие менее значимы и могут быть свободно адаптированы. Поэтому различение этих типов параметров необходимо, поскольку оно позволяет избирательно защищать критически важные знания, сохраняя при этом пластичность, нужную для того, чтобы новые выходы могли эффективно специализироваться. Важно отметить, что эта проблема не является уникальной для сетей с ранним выходом. В непрерывном обучении (CL) модели сталкиваются с аналогичной дилеммой при обучении последовательных задач: им нужно приобретать новые возможности (пластичность) при сохранении ранее выученных знаний (устойчивость), чтобы снизить катастрофическое забывание [19]. Таким образом, мы признаем, что последовательное обучение с ранним выходом демонстрирует ту же дилемму устойчивость-пластичность. Это концептуальное согласование указывает на то, что методы CL могут быть адаптированы для защиты значимых признаков более ранних выходов от забывания во время последовательного обучения. Стоит отметить, что цель здесь не в том, чтобы реализовать CL на EENN (например, Szatkowski et al. [16]), а в том, чтобы использовать некоторые регуляризационные техники CL для смягчения деградации представлений при последовательном обучении EENN.
Опираясь на эту перспективу, мы предлагаем новый двухэтапный последовательный подход к обучению. На первом этапе мы предварительно обучаем основу, используя только конечный выход, чтобы глубокие слои могли сформировать богатые абстрактные представления до введения ранних выходов [21, 13]. На втором этапе мы выполняем последовательное обучение, явно сохраняя знания, приобретенные более ранними выходами, по мере введения новых выходов. В согласии с точкой зрения CL наша цель — противодействовать забыванию, вызванному интерференцией градиентов. Без механизмов защиты оптимизация нового выхода неизбежно перезаписывает представления, от которых зависят предыдущие выходы, приводя к прогрессирующей деградации. Поэтому мы стремимся регуляризовать последовательное обучение с двух альтернативных позиций, а именно на уровне параметров и на уровне распределения выходов, каждое из которых решает проблему забывания с различных аспектов. На уровне параметров забывание возникает потому, что обновления оптимизации рассматривают все веса одинаково, хотя некоторые из них критически важны для работы существующих выходов. Определяя, какие параметры являются существенными, мы можем избирательно защищать их, позволяя сети адаптироваться безопасно, сохраняя при этом знания, на которые опираются более ранние выходы. Это мотивирует использование Elastic Weight Consolidation (EWC) [9, 15], которая оценивает важность параметров через информацию Фишера и ограничивает обновления по критически важным весам, тем самым взвешивая процесс обучения для баланса стабильности и пластичности. На уровне распределения выходов, однако, в конечном счете важно, чтобы предсказательное поведение более ранних выходов оставалось стабильным при обучении новых выходов. Для этого мы применяем Learning without Forgetting (LwF) [12], которая регуляризует выходы более ранних выходов, согласуя их с исходными предсказаниями и поддерживая функциональную согласованность при обучении новых выходов. И EWC, и LwF управляются настраиваемыми гиперпараметрами, обеспечивая явный контроль компромисса между сохранением производительности ранних выходов и обеспечением адаптации для новых выходов.
Основной вклад этой работы носит тройственный характер:
- ⟦• Мы предлагаем новый метод для смягчения деградации ранее изученных представлений, чтобы решить компромисс между стабильностью и пластичностью, с которым сталкивается последовательное обучение EENN.
- ⟦Мы применяем две стратегии регуляризации для CL: EWC для защиты на уровне параметров и LwF для согласованности на уровне распределения выходных данных, чтобы обеспечить обоснованное последовательное обучение, которое согласует специализацию при выходе с сохранением знаний.
- ⟦• Мы демонстрируем устойчивые улучшения по сравнению с существующими последовательными методами обучения на наборах эталонных архитектур, подтверждая эффективность подхода CL для EENNs.
2 Предлагаемая методология
Рассматривается EENN, состоящая из IC, где каждая подсеть «основной» сети параметризована и формирует вектор вероятностей классов (см. Figure 1), причем (для ) является вероятностью, связанной с классом . Мы формулируем последовательное обучение IC как последовательность обучающих задач, индексируемых , где задача соответствует обучению IC при сохранении прогностических возможностей всех ранее обученных IC . Параметры общей «основной» сети должны соответствовать целям всех обученных IC, уравновешивая пластичность (то есть способность уточнять представления для текущей задачи) и устойчивость (то есть сохранение качества работы на более ранних задачах).
Чтобы решить дилемму устойчивость–пластичность, мы дополняем стандартную функцию классификационной потери регуляризационным членом, который защищает ранее приобретённые знания. Функция потерь для обучения выхода принимает общий вид:
| (1) |
где обозначает функцию потерь кросс-энтропии для выхода , которая зависит от и параметров IC ; и являются терминами регуляризации, которые смягчают деградацию более ранних выходов, соответствуя EWC (уровень параметров) и LwF (уровень распределения выходов) соответственно. Их относительная сила задается гиперпараметрами и . Двоичная переменная указывает, какая стратегия регуляризации активна.
Чтобы проиллюстрировать процедуру обучения, Figure 1 показывает состояние каждой подсети при выходе из обучения 3. На этом этапе первые два блока (параметризованные и ) и соответствующие им классификаторы (формирующие предсказания и ) уже были обучены. Теперь мы добавляем IC 3 и поэтому нам нужно обучить всю сеть до выхода 3. Мы минимизируем потери перекрестной энтропии , дополненные регуляризацией , применяемой к ранее обученным блокам: либо ограничивая их параметры (EWC), либо сохраняя их предсказания (LwF). Финальный блок () и соответствующий ему классификатор остаются замороженными на протяжении этого этапа.
2.1 Регуляризация на уровне параметров
Первый подход использует регуляризацию на уровне параметров через EWC, которая защищает параметры, критичные для ранее обученных выходов, посредством штрафования изменений важных весов. Оценка важности вычисляется с помощью Информации Фишера [1]. Параметры с большими значениями Информации Фишера соответствуют направлениям в пространстве параметров, в которых небольшие возмущения сильно увеличивают значение функции потерь кросс-энтропии на предыдущих выходах, и поэтому им уделяется приоритет при защите.
Следуя онлайн-инфраструктуре EWC [15], регуляризация на уровне параметров определяется как
| (2) |
Здесь обозначает значение параметра после обучения до выхода . Термин представляет собой информацию Фишера, измеряющую важность параметра для выхода . На практике мы используем эмпирическую информацию Фишера [18], которая вычисляется как:
| (3) |
где обозначает обучающий набор данных, — общее число обучающих образцов, а — вероятность, связанная с истинной меткой для входных данных на выходе ⟧.
2.2 Вывод распределения-уровня Регуляризация
Второй предлагаемый подход использует принципиально иную перспективу, работая на уровне выходного распределения. Вместо защиты отдельных параметров LwF сохраняет знания, обеспечивая, что текущая модель сохраняет отображения «вход—выход», изученные ранее обученными exits. В отличие от EWC, LwF накладывает функциональное ограничение, не зависящее от конкретных значений параметров, и вместо этого фокусируется на сохранении границ решений. В рамках LwF параметры могут существенно изменяться, пока выходные распределения ранее обученных exits минимально смещаются в процессе обучения этого нового exit, что позволяет сети адаптировать внутренние представления при сохранении стабильного поведения. Важно, что функция потерь LwF обеспечивает поток градиента как через общую backbone, так и через classifier heads более ранних exits; эта дополнительная гибкость позволяет более ранним классификаторам компенсировать умеренный дрейф backbone, потенциально снижая деградацию качества. Следовательно, регуляризация на уровне выходного распределения задаётся как:
| (4) |
где обозначает распределение выхода IC при завершении обучения , обозначает распределение выхода, полученное при обучении IC , а представляет собой дивергенцию Кульбака — Лейблера.
3 Эксперименты
Мы оцениваем наш подход на стандартных тестах раннего выхода, следуя экспериментальной схеме, предложенной в [11]. Наша оценка сосредоточена на сравнении предложенных стратегий регуляризации EWC и LwF с существующими методами последовательного обучения для различных архитектур и вычислительных бюджетов.
| Model | Method | ||||
|---|---|---|---|---|---|
| ResNet34 | Disjoint | ||||
| Branch-wise | |||||
| Separate | |||||
| Joint | 74.32 | 74.17 | |||
| EWC | 74.07 | ||||
| LwF | 70.71 | ||||
| MSDNet | Disjoint | ||||
| Branch-wise | |||||
| Separate | |||||
| Joint | 74.73 | 75.86 | |||
| EWC | |||||
| LwF | 66.50 | 73.04 |
3.1 Экспериментальная установка
Набор данных. Мы проводим эксперименты на CIFAR-100 [10], широко используемом наборе данных для классификации изображений, состоящем из 60,000 изображений размером 32×32 с тремя каналами RGB по 100 детально размеченным классам. Набор данных разбит на 50,000 тренировочных изображений и 10,000 тестовых изображений. Архитектуры. Мы используем те же архитектуры, что и в [11]. Мы оцениваем две взаимодополняющие архитектуры: ResNet-34 [6] и MSDNet [7]. Для ResNet-34 мы расширяем стандартную архитектуру 8 внутренними классификаторами, размещёнными на слоях , где каждый выход состоит из пуллинга типа SDN [8], за исключением последнего классификатора, который использует адаптивный усредняющий пуллинг, с последующим линейным классификатором. Для MSDNet мы применяем вариант для CIFAR с 7 блоками. Базовые методы: все значения точности для базовых методов взяты из [11]. В первую очередь мы сравниваем наш метод с тремя базовыми подходами последовательного обучения: disjoint, branch-wise и separate training, и включаем joint training для полноты. Для предлагаемого нами подхода мы задаём и для ResNet34, а также и для MSDNet, если не указано иное. Детали обучения. Сначала мы предварительно обучаем каждую магистральную сеть, используя только финальный выход, с применением стандартного контролируемого обучения. Затем, следуя [11], для ResNet-34 мы используем размер батча 128, learning rate и не применяем weight decay. Для MSDNet мы используем размер батча 512 и learning rate без weight decay. Обе модели используют стратегии аугментации CutMix и Mixup, а также раннюю остановку с терпением 50 эпох. После предварительного обучения магистралей мы добавляем IC последовательно — от неглубоких к глубоким, применяя предложенную нами регуляризацию на каждом этапе.
3.2 Результаты и обсуждение
Таблица 1 показывает точность top-1 на выходах, соответствующих различным вычислительным бюджетам (, , и FLOPs) для наших двух моделей EENN на CIFAR-100. Предложенный нами метод последовательно превосходит все базовые подходы последовательного обучения. По сравнению с самым сильным базовым последовательным вариантом (раздельное обучение) как EWC, так и LwF обеспечивают существенные улучшения, особенно при низких бюджетах: и при бюджете соответственно. Это демонстрирует, что наш подход эффективно сочетает специализацию ранних выходов с глубоким обучением представлений.
Сравнение по архитектурам подчеркивает взаимодействие между типом регуляризации и топологией базовой сети. В ResNet34 и EWC, и LwF улучшают показатели раннего выхода: при этом EWC немного превосходит LwF на самом глубоком выходе, что указывает на достаточность стабилизации параметров на последовательных остаточных блоках. Пропускные соединения облегчают повторное использование признаков, поэтому закрепление параметров сохраняет показатели раннего выхода, не сковывая более глубокие слои. Напротив, у MSDNet плотносвязная, многомасштабная структура связывает многие слои с несколькими выходами. Здесь LwF стабильно превосходит EWC как на ранних, так и на поздних выходах, что указывает на то, что регуляризация распределения выходов лучше учитывает функциональные зависимости между выходами. Ограничивая предсказания, а не параметры, LwF поддерживает точность раннего выхода, позволяя базовой сети гибко адаптироваться для последующих классификаторов, тем самым эффективно балансируя стабильность и пластичность в сильно переплетенной многовыходной архитектуре.
Кроме того, мы последовательно наблюдаем улучшения по сравнению с совместным обучением на более ранних выходах, при этом сохраняя сопоставимую производительность на более поздних выходах. Это различие обусловлено различной оптимизационной динамикой двух подходов. Совместное обучение направляет все выходы к единому компромиссному решению, тогда как наш метод постепенно увеличивает регуляризацию по мере добавления новых выходов, ограничивая способность более глубоких слоёв изменять ранее сформированные представления. Хотя это может несколько сдерживать последующую адаптацию на поздних выходах, оно обеспечивает существенно более сильные ранние выходы, согласуясь с основной целью EENNs. Дальнейшие улучшения могут быть возможны за счёт динамического планирования силы регуляризации для более точного балансирования ранних и поздних выходов.
| Reg. | W.U | ||||||
|---|---|---|---|---|---|---|---|
| EWC | – | True | |||||
| – | True | ||||||
| – | True | ||||||
| – | False | ||||||
| LwF | – | True | |||||
| – | True | ||||||
| – | True | ||||||
| – | False |
Чтобы лучше понять влияние наших проектных решений, мы проводим исследование посредством абляции для MSDNet (см. Table 2). Абляция исследует две основные размерности: (i) силы регуляризации, а именно и , и (ii) влияние начальной фазы предварительного обучения, или разогрева, когда полная модель обучается при оптимизации только финального классификатора. В обоих подходах сила регуляризации играет центральную роль в управлении компромиссом устойчивость–пластичность: более сильная регуляризация защищает ранние выходы, но снижает гибкость магистрали для более глубоких слоев, тогда как более слабая регуляризация позволяет адаптацию ценой ухудшения работы ранних выходов. Ключевое различие заключается в том, как применяется это ограничение. EWC жестко фиксирует параметры, важные для более ранних выходов, стабилизируя низкоуровневые признаки, но ограничивая способность магистрали перестраивать представления для более глубоких классификаторов. Это объясняет, почему производительность ранних выходов улучшается последовательно при увеличении , тогда как выходы с большим бюджетом слегка сдерживаются. В противоположность этому, LwF ограничивает выходы более ранних выходов, а не сами параметры, позволяя внутренним представлениям изменяться, пока сохраняется распределение выходов. Умеренное обеспечивает баланс: сохраняется точность ранних выходов, при этом выходы с глубоким бюджетом могут извлечь выгоду из гибкой адаптации признаков, тогда как высокое чрезмерно акцентирует мелкие классификаторы и снижает производительность для выходов с большим бюджетом. Кроме того, разогрев магистрали взаимодействует с обоими методами, обеспечивая начальное согласование признаков между слоями до применения регуляризации. Без разогрева оба метода испытывают трудности: EWC может зафиксировать неоптимальные параметры, а LwF может чрезмерно ограничить признаки, которые еще не структурированы осмысленным образом, что приводит к более низкой точности на всех выходах. В целом данное исследование методом абляции подтверждает эффективность предложенной нами двухэтапной стратегии: предварительное обучение финального выхода формирует богатые иерархические признаки, а выборочная регуляризация позволяет каждому выходу эффективно адаптироваться, не ставя под угрозу полную способность сети к формированию представлений.
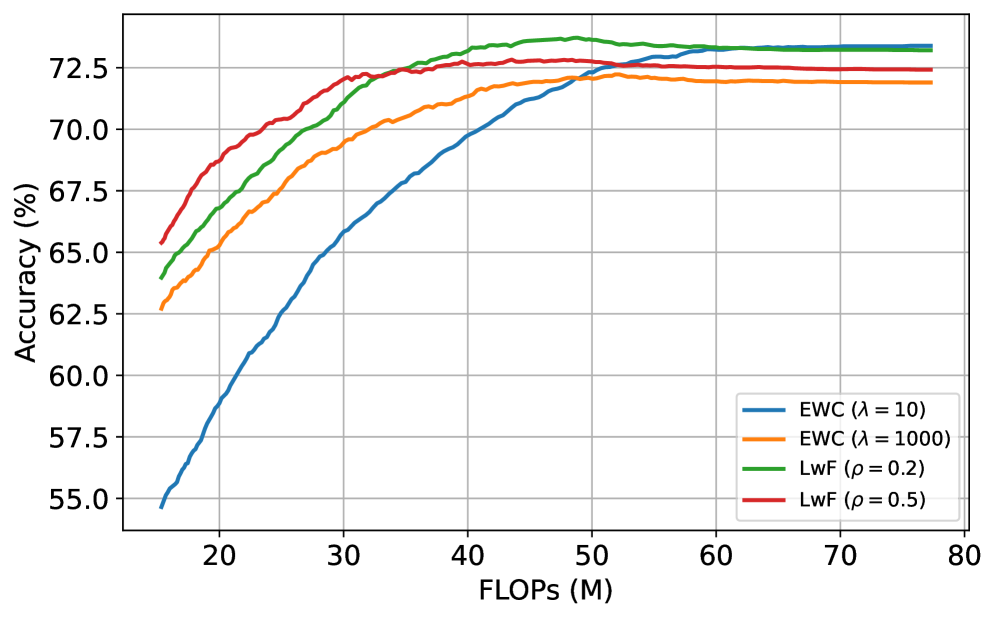
Рисунок 2 следует бюджетируемому подходу к классификации (например, [3, 11]), оценивая top-1 точность подмножества конфигураций на MSDNet в рамках заданного вычислительного бюджета. EWC с (синяя кривая) демонстрирует замедленный рост точности: она начинается лишь с и требует приблизительно 40M FLOPs, чтобы достичь точности , что почти вдвое превышает вычисления, необходимые хорошо регуляризованным методам. Это указывает на то, что слабая регуляризация не защищает представления ранних слоёв и вынуждает полагаться на более глубокие слои, что приводит к более высокой вычислительной нагрузке. В противоположность этому, более сильная регуляризация обеспечивает существенно более быстрое схождение: варианты LwF и хорошо настроенные конфигурации EWC достигают точности примерно при 20-25M FLOPs, обеспечивая около 2-кратного ускорения вычислений.
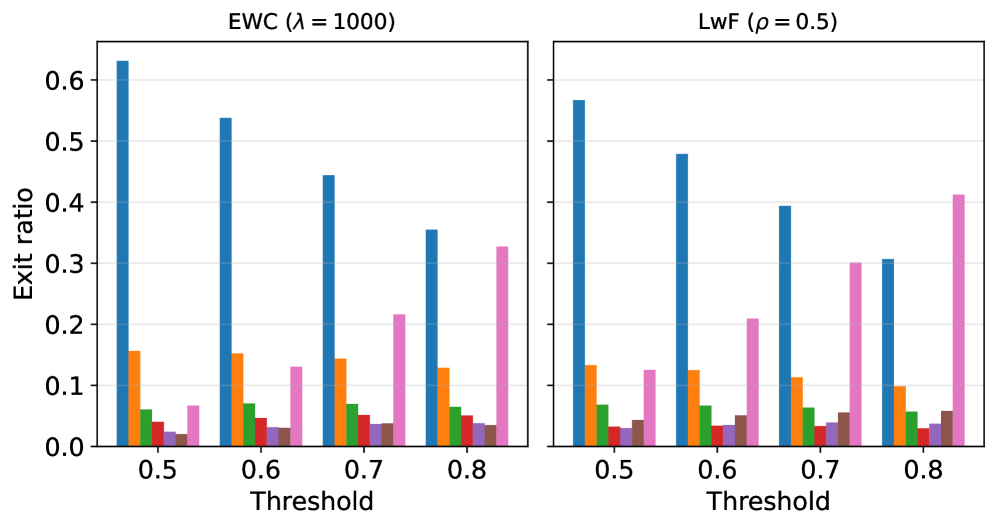
Наконец, Рисунок 3 дополнительно анализирует, как пороги уверенности управляют динамическим поведением MSDNet, сообщая доли выходов для всех промежуточных классификаторов. По мере увеличения порога предсказания все более смещаются к более глубоким выходам, что указывает на то, что более сложные образцы направляются к более поздним классификаторам с более богатыми представлениями. Сравнение EWC () и LwF () выявляет систематическое различие: при одинаковых порогах LwF выходит из меньшего числа образцов на ранних классификаторах, тогда как EWC делает это раньше. Если истолковать это вместе с Figure 2, где LwF достигает более высокой точности при существенно меньших FLOPs, то это показывает, что LwF обеспечивает более высокое эффективное ускорение, несмотря на то, что в среднем выходит позже. Такое поведение предполагает, что LwF обучает более точные, но менее уверенные ранние классификаторы, чаще откладывая решения, тогда как EWC приводит к более ранним, но менее точным выходам.
4 Вывод
В данной работе мы предлагаем новую стратегию обучения EENNs для смягчения деградации ранее изученных представлений, вызванной поэтапным добавлением выходов. За счет включения защиты на уровне параметров посредством EWC и согласованности распределения выходов через LwF мы устанавливаем обоснованную последовательную обучающую схему, которая уравновешивает специализацию выходов и сохранение знаний. Наше экспериментальное исследование показывает, что предложенный подход последовательно превосходит существующие методы последовательного обучения и обеспечивает более высокую точность раннего выхода по сравнению с совместным обучением. В дальнейшем работа будет посвящена исследованию адаптивного планирования регуляризации и более структурированных механизмов защиты, например на уровне свёрточных ядер или головок attention.
Ссылки
- [1] S. Amari (1998) Естественный градиент работает эффективно при обучении. Нейронные вычисления 10 (2), стр. 251–276. Внешние ссылки: Document Цитируется: §2.1.
- ⟦[2] R. Dong, Y. Mao и J. Zhang (2022) Ресурсно-ограниченный периферийный ИИ с прогнозированием раннего выхода. Журнал коммуникаций и информационных сетей 7 (2), стр. 122–134. Внешние ссылки: Document Цитируется: §1⟧.
- [3] C. Gong, Y. Chen, Q. Luo, Y. Lu, T. Li, Y. Zhang, Y. Sun, and L. Zhang (2025) Глубинная реконфигурация признаков: к точным и эффективным сетям с несколькими выходами. В Computer Vision – ECCV 2024, Cham, pp. 435–451. Внешние ссылки: ISBN 978-3-031-72967-6 Цитируется: §1, §3.2.
- ⟦D. Han, J. Park, S. Ham, N. Lee, and J. Moon (2024) Улучшение предсказаний с низкой задержкой в многоузловых нейронных сетях с несколькими выходами с помощью потерь, зависящих от блоков. IEEE Transactions on Neural Networks and Learning Systems 35 (11), стр. 16927–16935. Внешние ссылки: Document Цитировано: §1.
- [5] Й. Хань, Г. Хуан, С. Сонг, Л. Ян, Х. Ван и Й. Ван (2022-11) Динамические нейронные сети: обзор. IEEE Transactions on Pattern Analysis & Machine Intelligence 44 (11), стр. 7436–7456. Внешние ссылки: ISSN 1939-3539, Document, Link Цитируется: §1.
- [6] K. He, X. Zhang, S. Ren, and J. Sun (2016) Глубокое остаточное обучение для распознавания изображений. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), pp. 770–778. Cited by: §3.1.
- [7] Г. Хуанг, Д. Чэнь, Т. Ли, Ф. У, Л. ван дер Маатен и К. Q. Вайнбергер (2018) Многомасштабные плотные сети для классификации изображений с эффективным использованием ресурсов. В материалах конференции IEEE по компьютерному зрению и распознаванию образов (CVPR), с. 284–293. Цитируется: §1, §3.1.
- [8] Y. Kaya, S. Hong, и T. Dumitras (2019-09–15 Jun) Неглубокие-глубокие сети: понимание и снижение сетевого переосмысления. В материалах 36-й Международной конференции по машинному обучению, Proceedings of Machine Learning Research, Vol. 97, pp. 3301–3310. Внешние ссылки: Link Цитируется: §3.1.
- [9] Дж. Киркпатрик, Р. Паскану, Н. Рабиновиц, Дж. Венесс, Г. Дежарден, А. А. Русу, К. Милан, Дж. Куан, Т. Рамалью, А. Грабска-Барвиньска, Д. Хассабис, К. Клопат, Д. Кумаран и Р. Хадселл (2017) Преодоление катастрофического забывания в нейронных сетях. Труды Национальной академии наук 114 (13), стр. 3521–3526. Внешние ссылки: Document, Link, https://www.pnas.org/doi/pdf/10.1073/pnas.1611835114 Цитируется: §1.
- [10] А. Кризhevsky (2009) Обучение извлечению признаков на нескольких уровнях из небольших изображений. Технический отчет Университет Торонто. Цитируется: §3.1.
- [11] П. Кубати, Б. Вуйцик, Б. Т. Кшепковски, М. Михалюк, Т. Тшцински, Дж. Помпони и К. Адамчевский (2025) Как обучать вашу модель с несколькими выходами? анализ влияния стратегий обучения. На Сорок второй Международной конференции по машинному обучению, Внешние ссылки: Link Цитируется: §1, §1, §3.1, §3.2, §3.
- [12] З. Ли и Д. Хойем (2018-12) Обучение без забывания. IEEE Trans. Pattern Anal. Mach. Intell. 40 (12), стр. 2935–2947. Внешние ссылки: ISSN 0162-8828, Link, Document Цитируется: §1.
- ⟦[13] W. Liu, P. Zhou, Z. Wang, Z. Zhao, H. Deng и Q. Ju (2020-07) FastBERT: самодистиллирующий BERT с адаптивным временем вывода. В материалах 58-й ежегодной конференции Ассоциации по вычислительной лингвистике, Онлайн, стр. 6035–6044. Внешние ссылки: Link, Document Цитируется: §1.
- [14] H. Rahmath P, V. Srivastava, K. Chaurasia, R. G. Pacheco, and R. S. Couto (2024-11) Раннее прерывание глубокой нейронной сети — всесторонний обзор. ACM Comput. Surv. 57 (3). Внешние ссылки: ISSN 0360-0300, Link, Document Цитируется: §1.
- ⟦[15] J. Schwarz, W. Czarnecki, J. Luketina, A. Grabska-Barwinska, Y. W. Teh, R. Pascanu и R. Hadsell (2018-10–15 Jul) Прогресс и сжатие: масштабируемая структура для непрерывного обучения. В материалах 35-й Международной конференции по машинному обучению, Proceedings of Machine Learning Research, Vol. 80, стр. 4528–4537. Внешние ссылки: Link Цитировано: §1, §2.1.
- [16] Ф. Шаткoвский, Ф. Ян, Б. Твардовский, Т. Тшцинский и Й. ван де Вейер (2024-06) Ускоренный вывод и сниженное забывание: двойная выгода раннего выхода в нейронных сетях для непрерывного обучения. На 5-м семинаре по непрерывному обучению в компьютерном зрении, CVPR, Сиэтл, США. Примечание: Внешние ссылки: Link Цитируется: §1.
- [17] S. Teerapittayanon, B. McDanel, and H.T. Kung (2016) BranchyNet: fast inference via early exiting from deep neural networks. In 2016 23rd International Conference on Pattern Recognition (ICPR), Vol. , pp. 2464–2469. External Links: Document Cited by: §1.
- [18] Г. М. в. д. Вен (28 апреля 2025) О вычислении Фишеровской информации при непрерывном обучении. В ICLR Blogposts 2025, Примечание: https://iclr-blogposts.github.io/2025/blog/fisher/ Внешние ссылки: Link Цитировано: §2.1⟧.
- ⟦[19] Л. Ван, С. Чжан, Х. Су и Дж. Чжу (2024) Всесторонний обзор непрерывного обучения: теория, методы и применение. IEEE Transactions on Pattern Analysis and Machine Intelligence 46 (8), стр. 5362–5383. Внешние ссылки: Document Цитируется: §1.
- [20] B. Wojcik, M. Przewiezlikowski, F. Szatkowski, M. Wolczyk, K. Balazy, B. Krzepkowski, I. Podolak, J. Tabor, M. Smieja, and T. Trzcinski (2023) Потеря нулевого времени в предварительно обученных нейронных сетях с ранним выходом. Нейронные сети 168, стр. 580–601. Внешние ссылки: ISSN 0893-6080, Document, Link Цитируется: §1.
- [21] Дж. Син, Р. Тан, Дж. Ли, Ю. Ю, и Дж. Лин (2020-07) DeeBERT: динамическое раннее завершение для ускорения вывода BERT. В материалах 58-й Ежегодной конференции Ассоциации по компьютерной лингвистике, Онлайн, стр. 2246–2251. Внешние ссылки: Link, Document Цитируется: §1.
- [22] Дж. Син, Р. Тан, Ю. Ю и Дж. Лин (2021-04) BERxiT: раннее прекращение для BERT с более качественным дообучением и расширением для регрессии. В материалах 16-й конференции Европейского отделения Ассоциации по компьютерной лингвистике: основной том, Онлайн, стр. 91–104. Внешние ссылки: Link, Document Цитируется: §1.
- ⟦[23] G. Xu, J. Hao, L. Shen, H. Hu, Y. Luo, H. Lin, и J. Shen (2023) LGViT: динамическое раннее прерывание для ускорения vision transformer. In Proceedings of the 31st ACM International Conference on Multimedia, MM ’23, New York, NY, USA, pp. 9103–9114. External Links: ISBN 9798400701085, Link, Document Cited by: §1.
- ⟦[24] В. Чжу, С. Ван, И. Ни и Г. Се (2021-11) GAML-BERT: улучшение раннего выхода BERT посредством взаимного обучения, согласованного по градиентам. В материалах 2021 Конференции по эмпирическим методам обработки естественного языка, Онлайн и Пунта-Кана, Доминиканская Республика, стр. 3033–3044. Внешние ссылки: Link, Document Цитируется: §1.