inkscapelatex=false\pdftraileridredacted
Универсальный ИИ-агент для диагностики редких заболеваний и приоритизации генов риска
Аннотация
Точная и своевременная диагностика необходима для эффективного лечения, особенно в контексте редких заболеваний. Однако текущие диагностические процессы часто приводят к длительным периодам оценки и низкой точности. Чтобы устранить эти ограничения, мы представляем Hygieia — многомодальную систему ИИ-агентов, предназначенную для поддержки точной диагностики заболеваний путем интеграции разнообразных источников данных, включая фенотипические признаки, генетические профили и клинические записи. Hygieia имеет маршрутизируемую и обогащенную знаниями архитектуру, которая уменьшает галлюцинации и адаптирует диагностические стратегии к различным категориям заболеваний. Примечательно, что она уделяет приоритетное внимание связанным с риском геномным факторам для редких заболеваний и предоставляет показатели уверенности для поддержки клинических решений. Мы провели всестороннюю оценку, показавшую, что Hygieia достигает передовых результатов по нескольким диагностическим критериям. В сотрудничестве с клиническими экспертами из Йельской школы медицины и Медицинской школы Дьюк-НУС мы дополнительно подтвердили практическую ценность этого метода, продемонстрировав (1) более высокую точность диагностики с помощью Hygieia по сравнению с врачами: точность диагностики выросла с 12% до 60%. и (2) ее эффективность в помощи клиницистам с медицинскими записями при работе с реальными случаями. Наши результаты показывают, что Hygieia не только повышает точность и интерпретируемость диагностики, но и значительно снижает нагрузку на врачей, что подчеркивает ее потенциал как ценного инструмента в системах поддержки клинических решений..
ключевые слова:
ИИ-агент, Диагностика заболеваний, Редкие заболевания, Приоритизация генов риска, Клиническая система1 Введение
Редкие заболевания определяются как состояния, затрагивающие менее 1 из 2000 человек, поражающие более 300 миллионов пациентов по всему миру [valdez2016public, nguengang2020estimating, paul2013hope, jonker2024access, zhao2025agentic]. Кроме того, диагностика и рекомендации по тестированию редких заболеваний являются весьма сложными. Диагностика редких заболеваний на основе традиционных медицинских методов обычно занимает от 4 до 5 лет [ghosh2025artificial], что известно как «диагностическая одиссея». Одна из причин заключается в том, что фенотипы редких заболеваний иногда трудно напрямую отличить от распространенных заболеваний. Это также увеличивает вероятность ошибочного диагноза и неправильного лечения врачами [dong2020misdiagnosis].
Чтобы преодолеть вышеупомянутые проблемы, исследователи начали собирать генотипы, фенотипы и планы диагностики редких заболеваний, чтобы углубить наше понимание этих болезней и разработать более эффективные методы диагностики и лечения. Эти мультимодальные наборы данных предоставляют ценный исследовательский материал для диагностики заболеваний. Кроме того, значительное внимание в последнее время привлекли подходы, основанные на данных, такие как методы диагностики заболеваний на основе интеллектуального анализа данных, глубокого обучения и передового искусственного интеллекта (ИИ) [lee2022deep]. Эксперты могут обучить модель на упомянутых диагностических данных, чтобы прогнозировать заболевания или ранжировать гены риска, тем самым повышая точность диагностики. Однако такие модели часто сталкиваются с недостатками в плане обобщения и развертывания [rossi2025meta]. Чтобы сделать модель более универсальной и доступной для врачей, были разработаны инструменты для диагностики редких заболеваний на основе базовых моделей (таких как большие языковые модели (LLM) [thirunavukarasu2023large] и визуально-языковые модели (VLM) [liu2025visual]). LLM предварительно обучаются на крупномасштабном текстовом корпусе и могут обобщаться на различные задачи обработки естественного языка (NLP) с помощью методов пост-тренировки. LLM могут обрабатывать электронные медицинские карты (EHR) пациентов и ставить диагнозы на их основе [sarker2024natural, liu2024geneverse], а несколько LLM с разными ролями могут также совместно работать как система агентов [tran2025multi, du2025accelerating]. Такой ИИ-агент может ставить диагнозы, моделируя реальные сценарии, используя предварительные знания и предоставляя рекомендации и предложения врачам в качестве медицинских ИИ-ассистентов [liu2025spemo, liu2025teampath].⟧.
Несколько инструментов на основе ИИ были разработаны для диагностики редких заболеваний. Например, общий базовый уровень для диагностики редких заболеваний будет заключаться в подсказке LLM, обсуждаемой в RareBench [chen2024rarebench], и RareArena [chen2026rarearena]. Исследователи также рассматривают возможность разработки ИИ-агентов для медицинского использования на основе таких методов, как поиск с расширенными знаниями [wang2025visualrag], а также мультиагентная коммуникация [dhatterwal2023multi, chen2025enhancing]. Хотя эти модели интересны по замыслу и имеют некоторое клиническое значение, их недостатки все еще довольно очевидны. Во-первых, даже продвинутые модели на основе ИИ, используемые для диагностики редких заболеваний, не могут отличить распространенные заболевания от редких, что является основным шагом для предотвращения ошибочного диагноза (Supplementary Figure 1 (a)). Это открытие сильно ограничивает применимость моделей диагностики редких заболеваний. Во-вторых, из-за случайности, существующей в обучении и выводе моделей, эти модели могут не давать согласованных результатов на основе одних и тех же входных данных с разными случайными начальными значениями, что также вредно для доверия к выходным данным (Supplementary Figure 1 (b)). В-третьих, текущие методы ИИ сосредоточены только на диагностике, но не имеют необходимых шагов и возможностей для интерпретации результатов и выявления важных причинных генов редких заболеваний. Наконец, текущие исследования [lee2022deep, zhao2025agentic, liu2026vc] напрямую не рассматривают, как эти модели ИИ могут быть применены в диагностических сценариях и сотрудничать с врачами. Более того, недавние исследования показали, что более 80% редких заболеваний обусловлены генетическими факторами и могут передаваться следующему поколению [zhao2025agentic], но то, как эти генетические факторы включаются в диагностику и как выявлять связанные с заболеванием гены на основе клинической картины, недостаточно изучено в методах на основе ИИ. Поэтому существует критическая необходимость в разработке модели ИИ, которая может одновременно диагностировать различные типы заболеваний и давать объяснения принятому решению..
В этой рукописи мы представляем Hygieia, который является AI-агентом для диагностики и интерпретации заболеваний. Наша модель разбивает диагностический процесс на несколько этапов: сначала определяет тип заболевания, затем разрабатывает отдельные диагностические подходы для распространенных и редких заболеваний. Диагностика распространенных заболеваний основана на использовании подсказок LLMs. В то же время, из-за сложности диагностики редких заболеваний, наш агент использует несколько инструментов (таких как поиск в интернете и извлечение данных пациентов) для использования предварительных знаний и принятия решения. У нас есть два нововведения в дизайне этого агента. Во-первых, для устранения несогласованности наш агент имеет верификатор, который отслеживает выходы основной части Hygieia и обеспечивает сходимость результатов. Во-вторых, чтобы улучшить прозрачность использования AI-агентов для принятия клинических решений, мы внедряем структуру с траекторией рассуждений и оценкой уверенности, чтобы помочь пользователям понять и доверять этому рабочему процессу. Hygieia может принимать несколько модальностей или типов данных в качестве входных данных, такие как фенотипическая информация, генная информация, история болезни и другие сведения. Мы также предоставили таблицу в Приложении A, чтобы отличить Hygieia от других AI-агентов, ориентированных на диагностику (редких) заболеваний, и уникальные компоненты (маршрутизатор случаев, оценка уверенности и многозадачность) Hygieia дополнительно повышают его новизну..
В целом, Hygieia может интерпретировать результаты диагностики с отслеживаемыми цепочками рассуждений и расставлять приоритеты для генов риска, ассоциированных с заболеваниями, предоставляя более информативную обратную связь в качестве справочных материалов, помогающих врачам принимать решения и давать рекомендации. Hygieia также может быть интегрирована как навык для улучшения использования передовых AI-агентов в диагностике редких заболеваний. Мы приглашаем врачей-генетиков с верификацией от Yale School of Medicine и DUKE-NUS Medical School для оценки вклада Hygieia как эффективного медицинского AI-ассистента и изучения новых направлений диагностики редких заболеваний в эпоху ИИ и цифрового здравоохранения..
2 Результаты
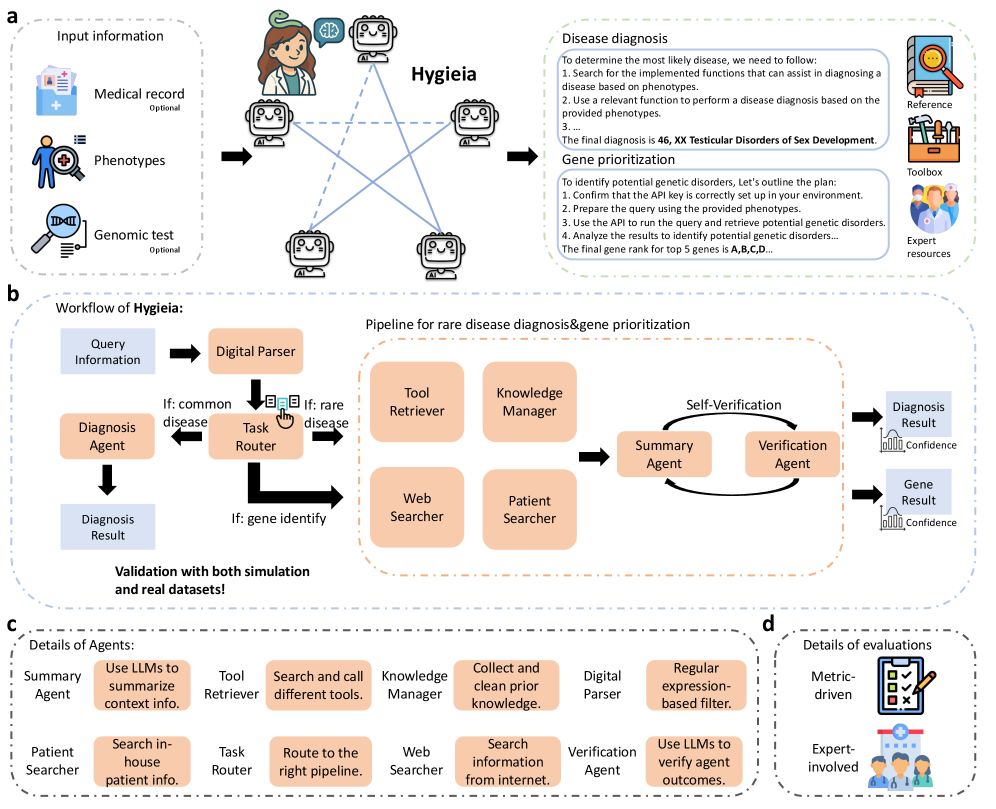
Обзор метода. Для каждого пациента мы собираем аннотации по фенотипам, медицинским записям и результатам генетических тестов в качестве входных данных для Hygieia, а затем принимаем решение на основе предварительных знаний из медицинских исследований, полученных из интернета и баз данных. Чтобы инициировать рабочий процесс, Hygieia сначала вычисляет вероятность типа заболевания на основе роутера, а затем определяет наиболее подходящий конвейер для диагностики как распространенных, так и редких заболеваний. Конвейер, используемый для диагностики редких заболеваний, более сложен и включает несколько агентов, таких как агент поиска знаний, агент извлечения информации, агент обобщения и агент верификации. Hygieia также определяет ген риска на основе фенотипов пациента или медицинских записей в качестве дополнительной функции для медицинских генетиков. Наконец, мы предоставляем уровень уверенности выходных данных модели с помощью подхода голосования большинством. Типы входных данных, рабочий процесс и сценарии применения Hygieia представлены на рисунке 1. Наши наборы данных для бенчмаркинга включают MyGene2 [rodrigues2022variant], четыре разделения от RareBench [chen2024rarebench] (RAMEDIS, MME, HMS и LIRICCAL), RareArena [chen2026rarearena] и внутренние данные Медицинской школы Йельского университета (YSM) и Больниц Йельского Нью-Хейвена (YNHH), использованные для сравнения между экспертами-людьми и Hygieia..
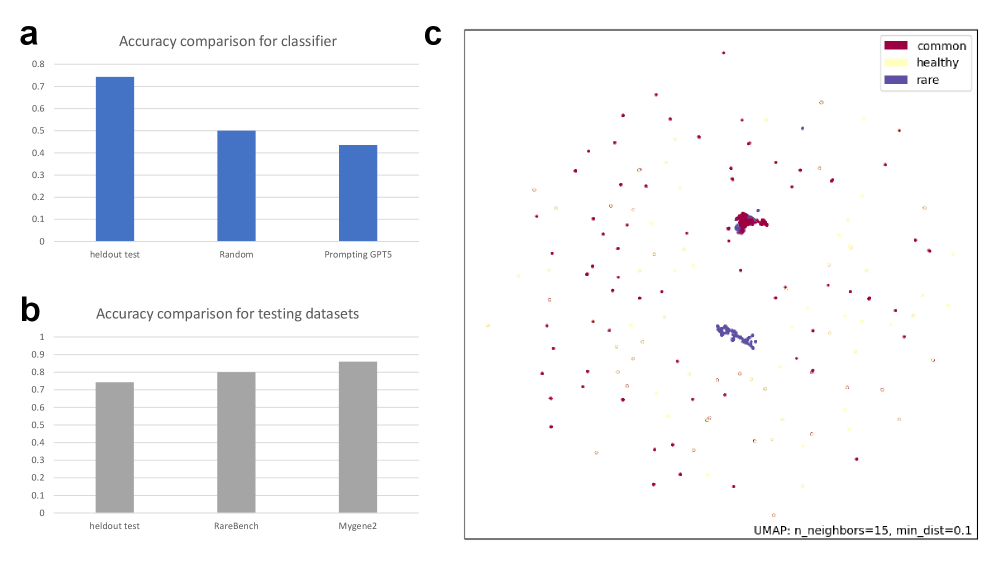
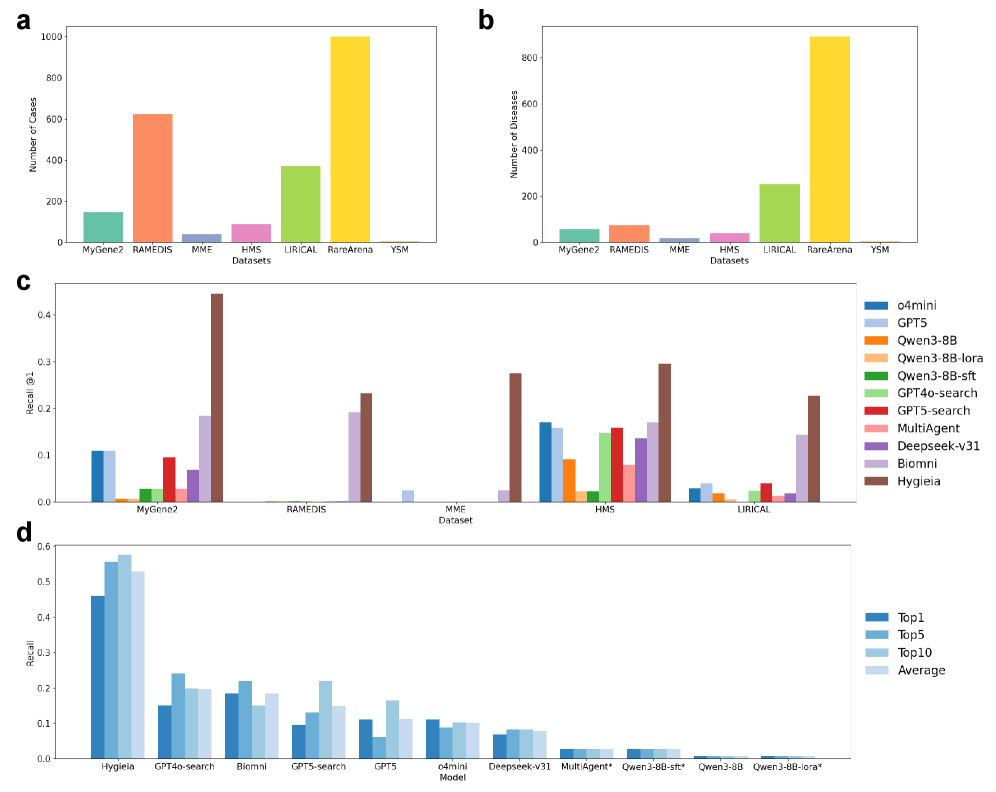
Hygieia служит сильным медицинским агентом для диагностики заболеваний. Сначала мы демонстрируем высокую способность Hygieia выступать в роли виртуального врача, что подтверждается валидациями, проведёнными на различных клинических наборах данных из разных источников. Точность классификации заболеваний значительно выше, чем при случайном угадывании или использовании подсказок LLM (Дополнительный рисунок 2 (a)), что показывает преимущества наличия маршрутизатора для создания более простого конвейера диагностики распространённых заболеваний. Наш классификатор также точно предсказывает правильные типы заболеваний не только на нашем отложенном тестовом разбиении, но и на внешних валидационных наборах данных (MyGene2 и RareBench), как показано в Дополнительном рисунке 2 (b). Мы также визуализируем распределение эмбеддингов с помощью Uniform Manifold Approximation and Projection (UMAP) [mcinnes2018umap] в Дополнительном рисунке 2 (c), окрашенных по типам заболеваний, где видно чёткое различие между образцами с редкими заболеваниями и образцами с распространёнными заболеваниями, что служит объяснением нашего вклада. Диагностика редких заболеваний сложнее, и мы собрали семь наборов данных в нашем конвейере оценки. Рисунок 2 (a) показывает распределение количества случаев по всем наборам данных, а Рисунок 2 (b) показывает уникальное количество заболеваний в разных наборах данных. Эти рисунки показывают, что выбранные нами наборы данных имеют очевидные различия в распределении данных, что помогает смоделировать клиническое использование в реальных условиях. Среди этих наборов данных RAMEDIS, MME, HMS и LIRICAL извлечены из RareBench, который является общедоступной эталонной платформой для оценки производительности моделей диагностики редких заболеваний. MyGene2 содержит информацию на уровне семей для пациентов с редкими заболеваниями и также доступен публично. RareArena — это недавно собранный набор данных для оценки производительности LLM в диагностике редких заболеваний. Набор данных YSM содержит пять внутренних образцов как часть Undiagnosed Diseases Network (UDN) [ramoni2017undiagnosed], которая охватывает заболевания, которые трудно диагностировать. Этот набор данных недоступен напрямую исследователям из соображений защиты личной информации..
Что касается базовых методов, мы также рассматриваем группу с сильным разнообразием. Наши базовые методы включают LLM с/без способностей к рассуждению и поиску, агенты для биомедицинских исследований и LLM, дообученные на смоделированных данных на уровне пациентов из [alsentzer2025few] с открытой моделью Qwen3 [yang2025qwen3]. Подробности о наших базовых методах можно найти в разделе Методы..
Во время оценки мы проверяем показатель полноты, сравнивая наблюдаемые заболевания с предсказанными заболеваниями от различных методов. Рисунок 2 (c) показывает, что Hygieia превосходит различные базовые методы на наборах данных из разных источников. Тонкая настройка LLM для диагностики заболеваний также не обладает сильной способностью к обобщению и поэтому не может превзойти большинство решений на основе агентов. Более того, поскольку некоторые редкие заболевания имеют схожие фенотипы или могут лечиться одинаково [griggs2009clinical], мы также проверяем, может ли увеличение размера предсказанных целей (например, топ-5 и топ-10 заболеваний) улучшить показатель полноты. Рисунок 2 (d) показывает наши результаты на наборе данных MyGene2, где Hygieia имела более высокий показатель полноты при увеличении размера тестирования. Мы сообщаем результаты бенчмаркинга на основе случайно выбранного подмножества из RareArena на дополнительном рисунке 3, где Hygieia все еще демонстрирует лидирующую производительность даже в условиях оценки с продвинутым набором данных. В то же время не все методы демонстрируют это явление, что противоречит интуиции. Это может указывать на то, что подход некоторых моделей к клиническому принятию решений все еще может быть основан в первую очередь на догадках, при этом рассуждение играет второстепенную роль. Однако, интегрируя предварительные знания и вводя дизайн саморефлексии, Hygieia достигает лучшего результата в диагностике редких заболеваний..
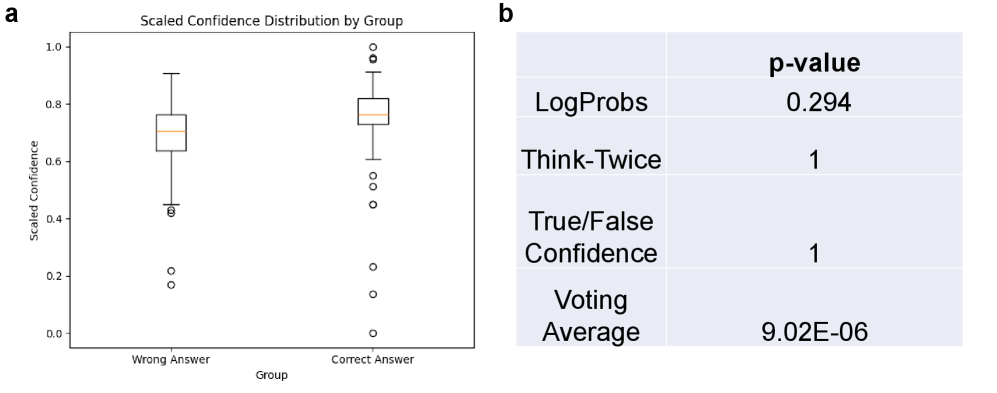
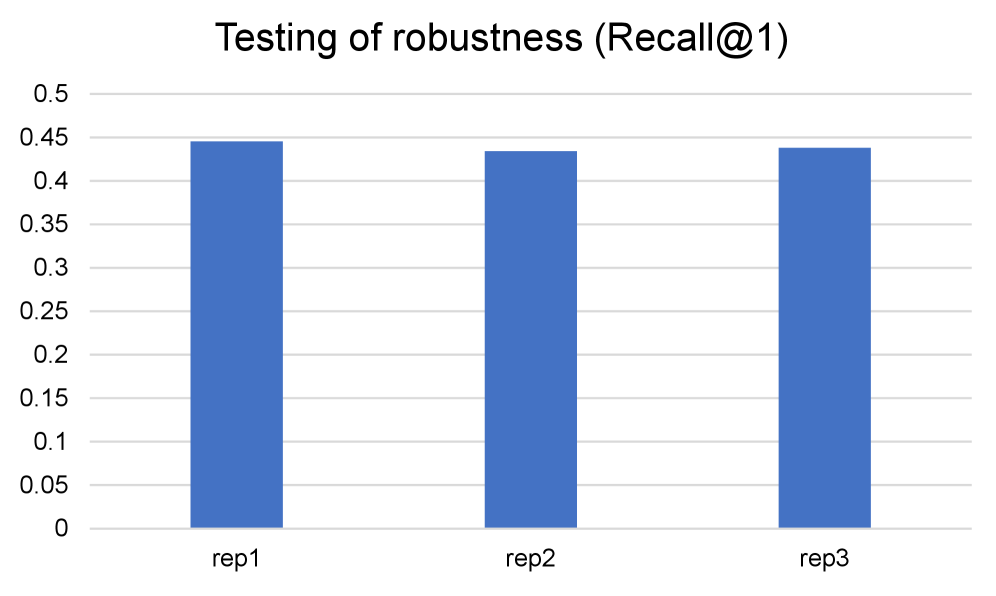
Мы также проверяем надежность оцененной уверенности, показанной на дополнительном рисунке 4 (a). Наше ожидание состоит в том, что Hygieia имеет более высокую уверенность для вопросов с правильными ответами. Наши результаты показывают, что 1. уверенность, предлагаемая Hygieia, надежна, так как группа ответов с более высокой уверенностью также имеет более высокий показатель полноты, и 2. другие методы оценки уверенности хуже текущей конструкции, что показано на дополнительном рисунке 4 (b) — остальные три метода не могут создать значимых различий между этими двумя группами. Мы также проверяем робастность Hygieia, используя три разных случайных зерна для запросов, и на основе дополнительного рисунка 5 не наблюдаем больших различий между результатами трех разных запусков..
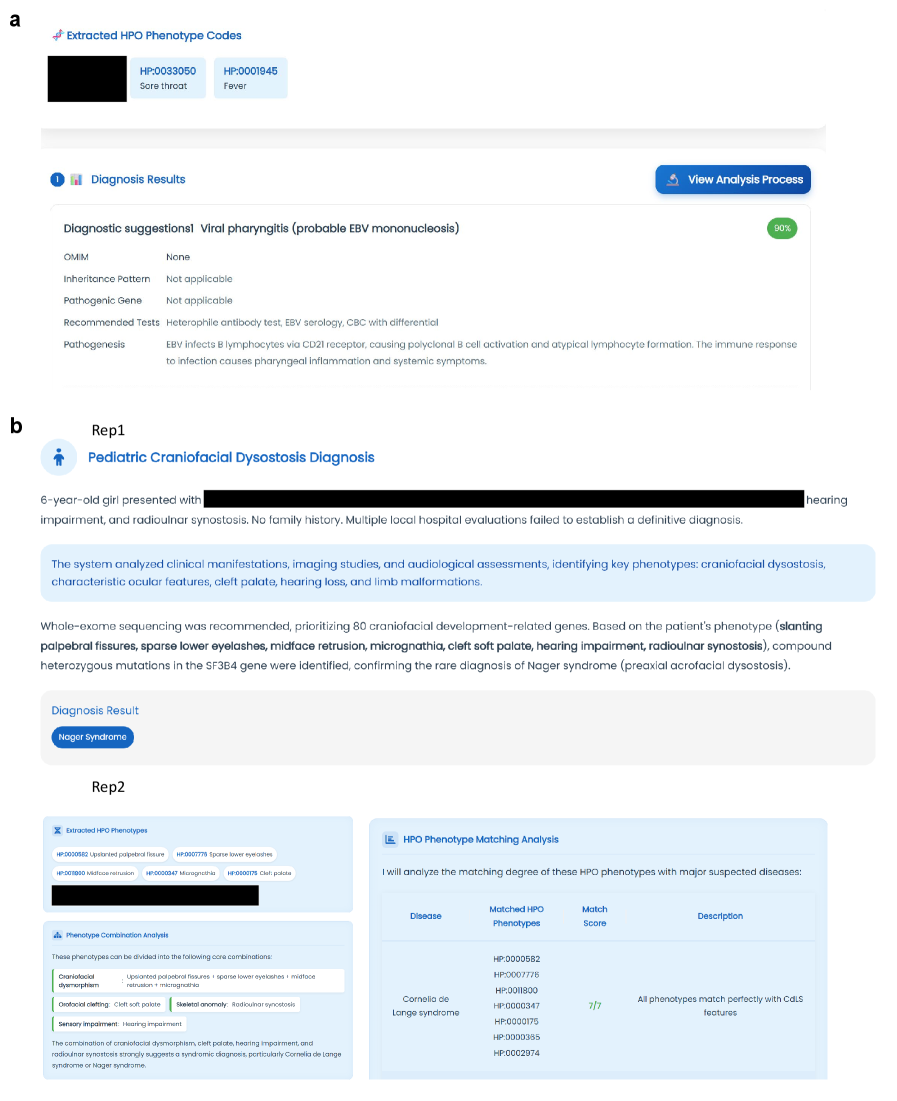
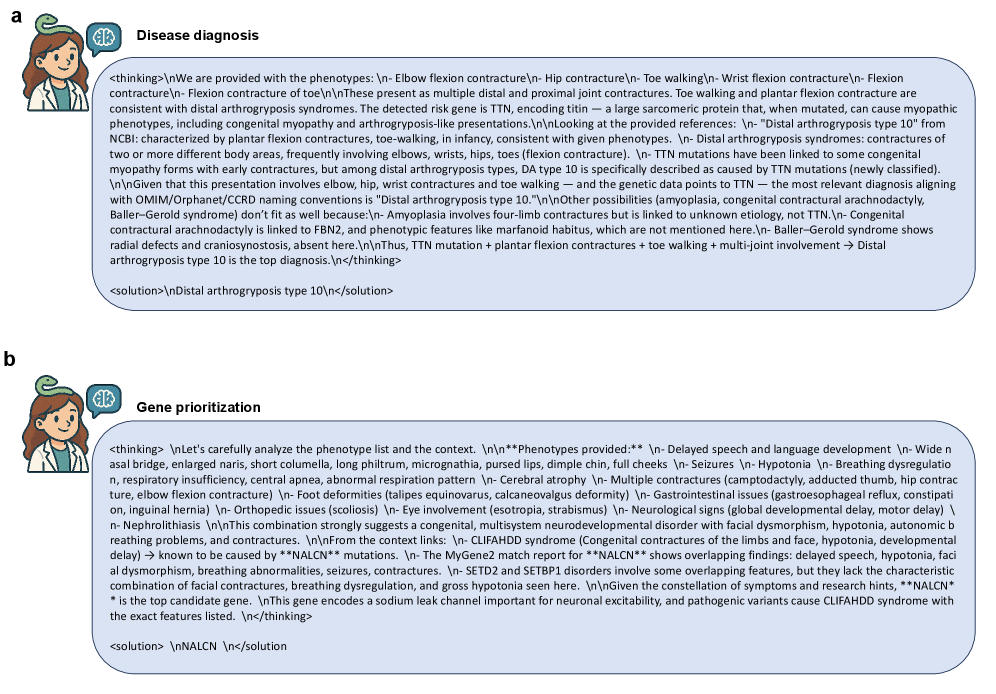
Пример использования Hygieia для диагностики заболеваний показывает его уникальный и информативный процесс принятия решений. Чтобы понять процесс принятия решений Hygieia и провести углубленное сравнение с другими базовыми методами, мы предоставляем пример использования с MyGene2. В этом примере мы предоставляем фенотипы и обнаруженные гены в качестве входных данных; диагноз — дистальный артрогрипоз, тип 10. Полный путь рассуждений Hygieia можно найти в дополнительном рисунке 6 (a).
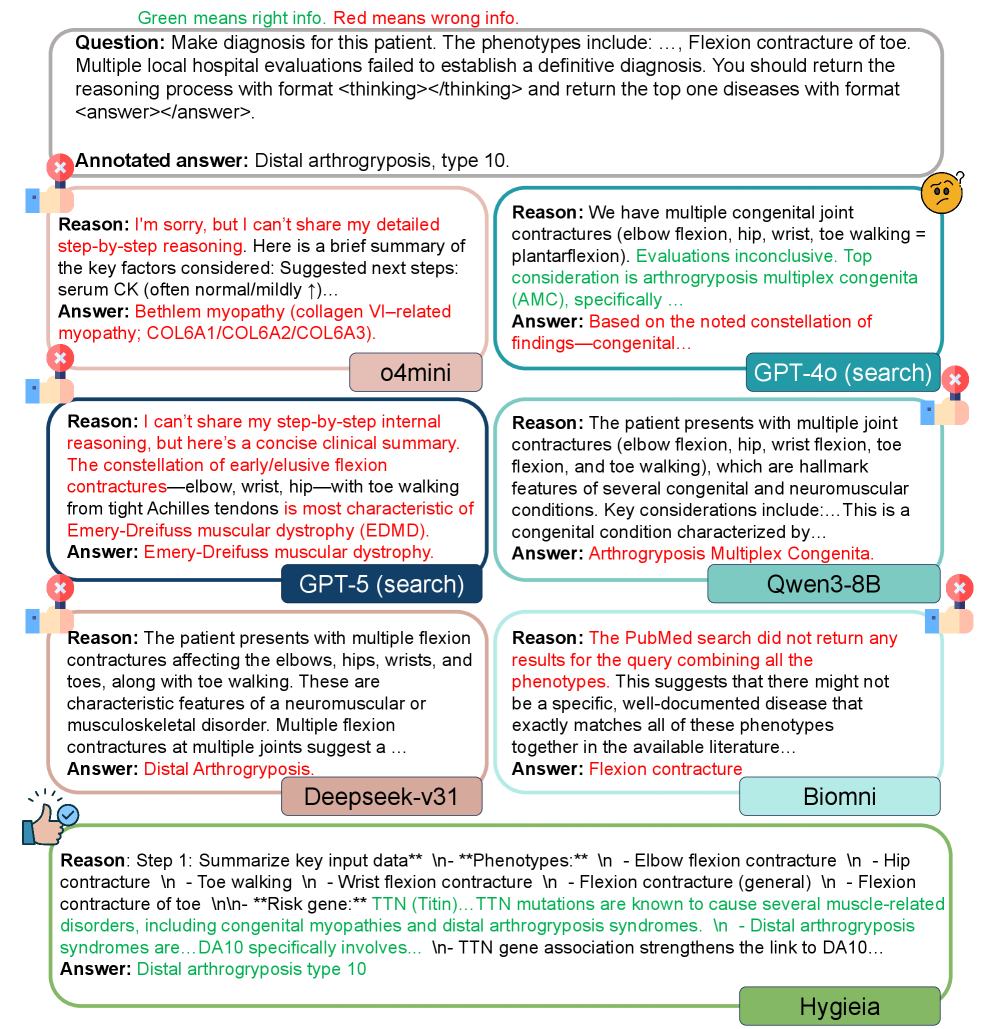
Основываясь на рисунке 3 и среди всех оцененных методов, Hygieia является единственной моделью, которая правильно поставила окончательный диагноз Дистальный артрогрипоз, тип 10, полностью совпадающий как с аннотированным ответом, так и с генетической этиологией (мутация TTN). В отличие от этого, альтернативные базовые модели либо дают неверные диагнозы (например, миопатия Бетлема, мышечная дистрофия Эмери–Дрейфуса, сгибательная контрактура, множественный врожденный артрогрипоз), либо делают чрезмерно широкие, неспецифические выводы. Это демонстрирует, что Hygieia не только находит правильную категорию заболевания, но и способна к детальному разрешению подтипов, что является важным требованием в прецизионной медицине..
В отличие от других моделей, Hygieia использует многоэтапный процесс рассуждения, который интегрирует фенотипические паттерны, ассоциации с генами риска и специфичность синдромов. Это демонстрирует более высокий уровень биомедицинской причинной интерпретируемости. В то время как некоторые базовые модели отказываются показывать внутренние рассуждения или по умолчанию дают расплывчатые клинические резюме, Hygieia демонстрирует прозрачную причинно-следственную связь между фенотипом, генотипом и нозологией, воспроизводя когнитивно достоверную схему диагностической аргументации.
Этот конкретный случай намеренно включает множественные фенотипы, призванные сбить с толку системы, основанные на правилах или сопоставлении с образцом. Модели, такие как o4-mini, GPT-4o и Qwen3-8B, не могут интегрировать совокупность результатов, вместо этого переобучаясь на одном клиническом признаке (например, ходьба на носках, контрактура запястья) и выдавая несвязанные диагнозы. Однако Hygieia успешно распознает, что картина множественных врожденных контрактур суставов представляет собой диагностический признак дистального артрогрипоза, демонстрируя устойчивость к избыточности признаков и фенотипическому шуму..
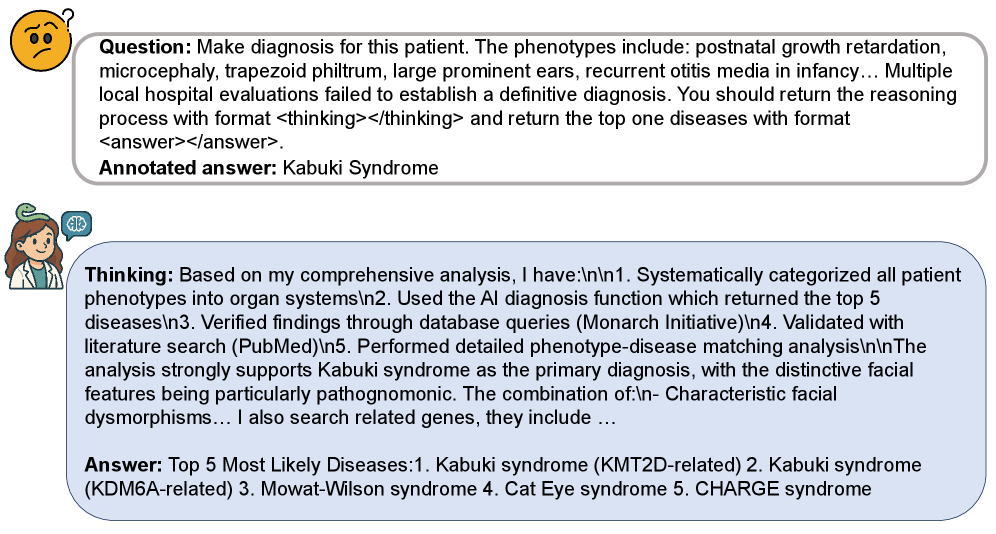
Мы также выбрали сложный пример из YNHH, чтобы продемонстрировать потенциал Hygieia в решении комплексных проблем. Согласно дополнительному рисунку 7, Hygieia успешно ставит диагноз синдрома Кабуки, включая подтипы, связанные с генами, на основе итерационных шагов. Исходя из распространенности, только 1 из 32 000 новорожденных имеет синдром Кабуки [bogershausen2013unmasking], что делает этот случай очень редким и сложным, и демонстрирует потенциал Hygieia для обработки трудных образцов и очень редких случаев..
Там, где конкурирующие модели либо не предлагают никаких следующих шагов, либо предлагают неспецифические исследования, Hygieia напрямую связывает диагноз с известным молекулярным драйвером и связанным с ним спектром заболеваний. Это усиливает трансляционную ценность её выходных данных, позволяя проводить последующие этапы, такие как подтверждающее генетическое тестирование, семейное консультирование и стратификацию прогноза. Результат — это не просто ярлык, а клинически применимое знание, превосходящее диагностическую пассивность базовых систем. В совокупности данные свидетельствуют о том, что Hygieia демонстрирует значительно более высокий стандарт диагностической точности, глубины биомедицинских рассуждений и клинической применимости по сравнению как с традиционными базовыми LLM, так и с системами, дополненными поиском. Её способность объединять фенотипическую сложность с молекулярными знаниями иллюстрирует следующее поколение систем поддержки принятия медицинских решений на основе ИИ, тем самым позиционируя Hygieia как наиболее надежную и клинически согласованную модель в данной оценке..
Hygieia успешно определяет приоритетность генов с более высокими рисками заболеваний на основе данных индивидуального уровня. Чтобы улучшить интерпретируемость диагностики и уверенность в ней, а также предоставить дополнительные терапевтические идеи, современная медицина часто стремится выявить причинные факторы [sanchez2022causal]. При диагностике редких заболеваний некоторые врачи могут рекомендовать секвенирование экзома или целого генома или таргетное секвенирование генов для выявления мутаций, вызывающих заболевания, что позволяет делать более надежные выводы [boycott2013rare]. Поэтому определение того, как предоставить пациентам список потенциальных генов для секвенирования, является критической задачей в диагностике редких заболеваний. Однако немногие фреймворки AI-агентов учитывали эту задачу. Наш анализ показывает, что диагностика заболеваний имеет сходство с определением приоритетности факторов риска, что позволяет решать эту задачу с помощью единого фреймворка. Здесь наши входные данные по-прежнему представляют собой фенотипы или данные EHR, а выходными данными будет ген или список генов. Выбранные нами базовые линии аналогичны кандидатам, используемым для оценки функций диагностики заболеваний. Подробности можно найти в разделе «Методы»..
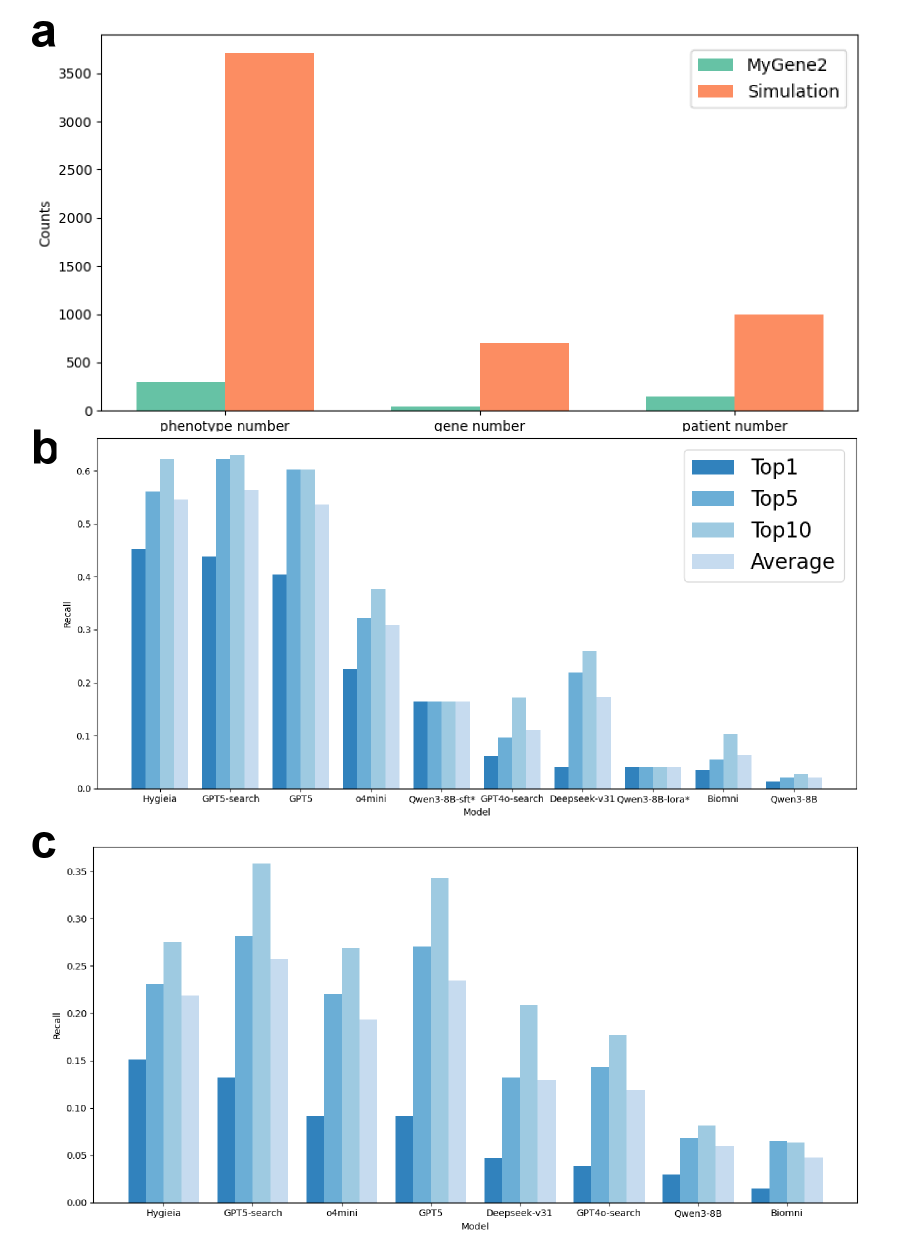
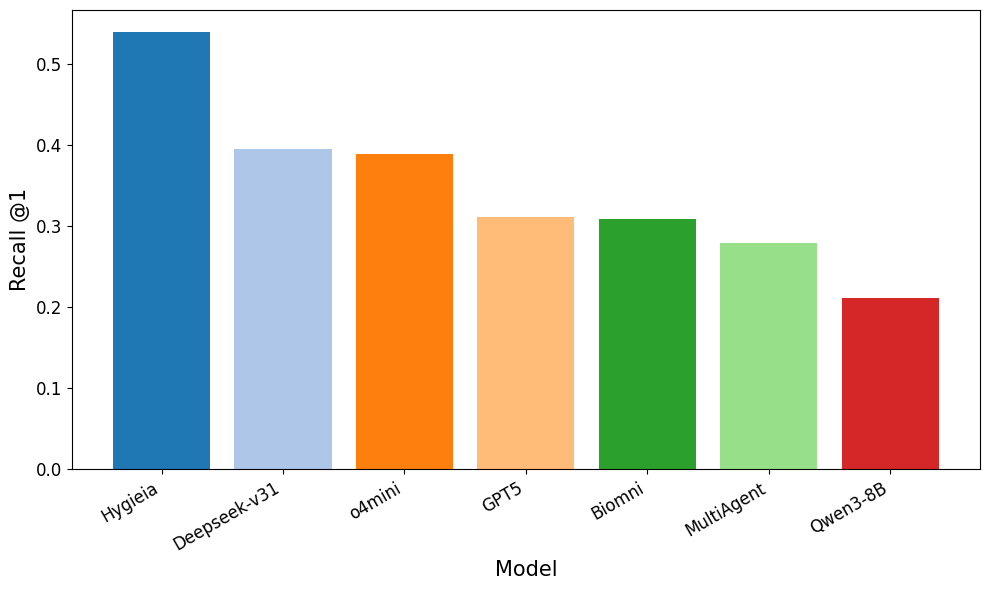
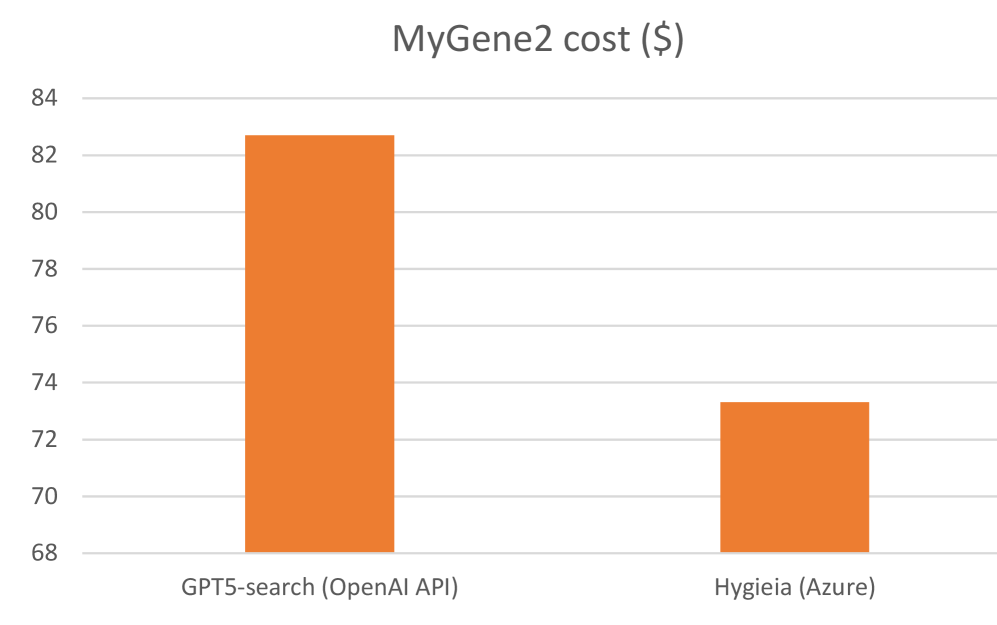
Из-за нехватки наборов данных, содержащих как фенотипы, так и истинные болезнетворные гены, в данном разделе используются MyGene2 и данные симуляции, предоставленные SHEPHERD [alsentzer2025few], для оценки модели. Статистика выбранных наборов данных обобщена на рисунке 4 (a). Масштаб данных симуляции больше, чем у MyGene2, и поэтому наша оценка также учитывала различные сценарии. Мы также вычислили показатель Recall на основе списков генов разного размера и наблюдаемых меток генов. Рисунки 4 (b) и (c) показывают, что Hygieia имеет высокий показатель Recall, особенно в настройке top 1 по сравнению с другими базовыми линиями. Однако по мере увеличения пула кандидатов преимущество Hygieia снижается. При сравнении показателя Recall этой задачи с диагностикой заболеваний мы замечаем, что приоритизация генов является относительно более простой задачей. Следовательно, по мере расширения пула кандидатов выгоды от использования агентов (например, дополнительных верификаторов) пропорционально уменьшаются. Учитывая, что чем больше генов необходимо протестировать, тем выше стоимость для пациентов, наш подход уравновешивает точность и расходы. Мы также сравнили затраты Hygieia и GPT-5-search, выявив, что Hygieia имеет преимущество и в потреблении токенов, как показано на дополнительном рисунке 8. На рисунке 4 (c), поскольку мы можем создать обучающий набор данных из больших данных симуляции, мы также можем создать оракульную модель (Qwen3-8B-sft, показатель 0,724). Однако производительность этой модели для рекомендаций на основе MyGene2 низкая, что указывает на то, что AI Agents обладают лучшей способностью к обобщению, чем традиционные подходы SFT..
Пример использования Hygieia для ранжирования генов показывает его уникальный и информативный процесс принятия решений. Чтобы понять процесс принятия решений Hygieia и провести углубленное сравнение с другими базовыми методами, мы предоставили пример с одним образцом из MyGene2, но для приоритизации генов риска. В этом образце мы предоставили фенотипы в качестве входных данных; наблюдаемый ген риска — NALCN. Полный путь рассуждений Hygieia можно найти в дополнительном рисунке 6 (б).
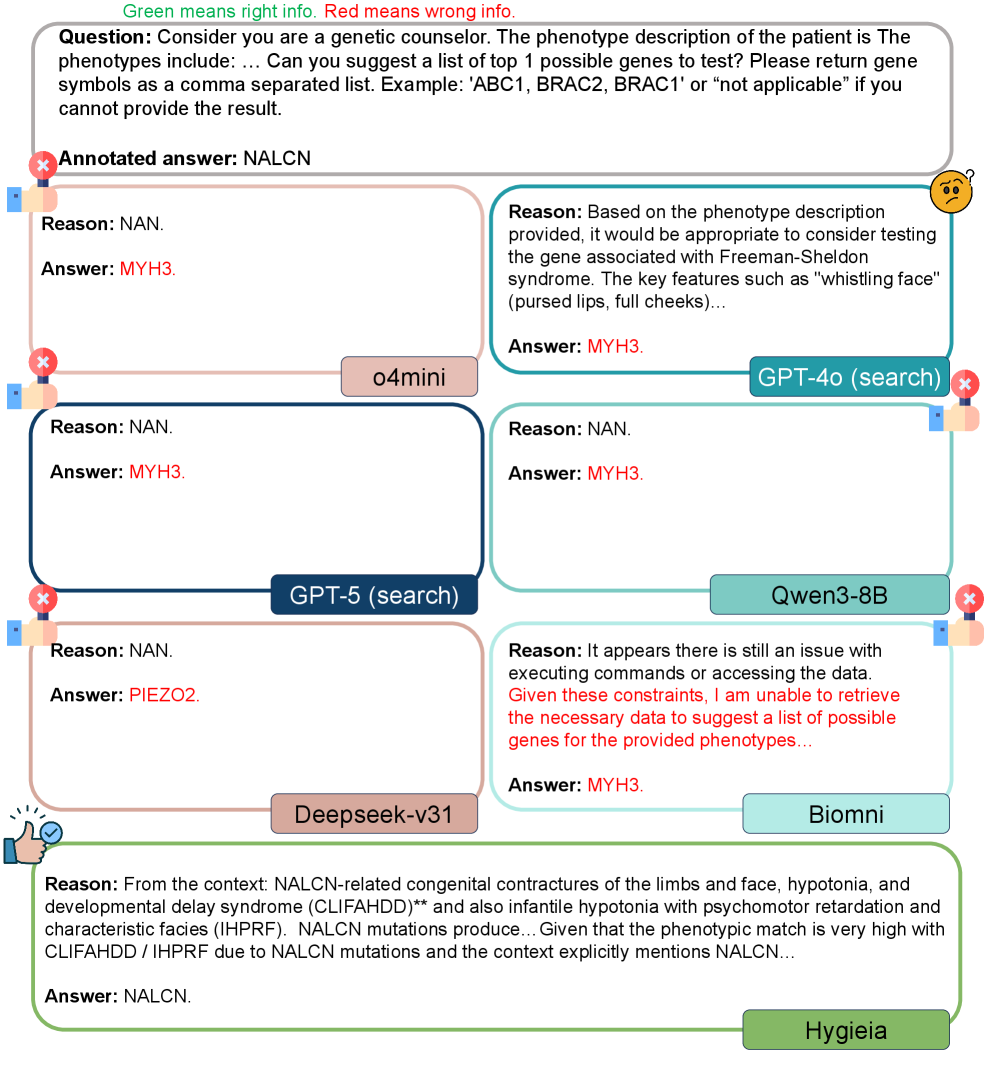
Согласно рисунку 5, в этой оценке Hygieia — единственная система, которая успешно идентифицирует NALCN, правильный ген, связанный с фенотипическим профилем пациента, полностью совпадающий с аннотированной эталонной истиной. Все остальные базовые модели, включая o4mini, GPT-4o (search), GPT-5 (search), Qwen3-8B и DeepSeek-v31, либо возвращали неверные кандидаты, такие как MYH3 или PIEZO2, либо вообще не давали пригодного ответа. Этот пример демонстрирует, что Hygieia стабильно превосходит как универсальные LLMs, так и инструменты с расширенным поиском в задачах биомедицинского вывода с высокой ответственностью, требующих точного сопоставления генов и фенотипов..
В отличие от конкурирующих моделей, которые по умолчанию определяют MYH3 на основе поверхностного сходства с синдромом Фримена–Шелдона, Hygieia различает клинически перекрывающиеся, но генетически различные нарушения путем интеграции фенотипических, молекулярных и нозологических данных. Модель явно связывает наблюдаемые признаки — включая врожденные контрактуры, гипотонию, задержку нервно-психического развития и характерные черты лица, которые являются синдромами CLIFAHDD/IHPRF, ассоциированными с NALCN. Это указывает на то, что Hygieia не полагается исключительно на сопоставление фенотипических паттернов, а вместо этого выполняет многоуровневые биомедицинские рассуждения, соответствующие практике генетического консультирования..
Несколько базовых линий не работают из-за невозможности извлечь или интерпретировать данные, создавая непригодные для использования выходные данные (“NAN", “unable to retrieve data"). Hygieia остается полностью функциональной даже при неполном сигнале, что отражает устойчивость к реальным клиническим ограничениям, где фенотипы пациентов могут быть редко задокументированы, зашумлены или частично перекрываться. Эта устойчивость необходима для развертывания в поддержке клинических решений, где диагностическая полнота редко гарантируется..
Hygieia не только выводит правильный целевой ген, но и помещает его в контекст клинически значимой диагностической категории. Это резко контрастирует с конкурирующими моделями, которые предоставляют необоснованные названия генов без объяснения, что было бы неприемлемо в рабочем процессе клинической генетики, где решения о генетическом тестировании имеют финансовые, этические и прогностические последствия. Интерпретируемость и биологическая обоснованность Hygieia, следовательно, делают ее более надежным кандидатом для интеграции в конвейеры точной медицины..
Сравнение ясно показывает, что Hygieia превосходит существующие базовые модели на основе LLM и поисково-улучшенные базовые модели по точности, валидности рассуждений и клинической значимости. Ее способность различать фенотипически схожие синдромы развития и выдавать ген с прямой трансляционной ценностью подчеркивает ее потенциал как системы ИИ следующего поколения для приоритизации генетических факторов..
Использование Hygieia в качестве медицинского ассистента для врачей при решении сложных случаев. Одной из главных целей разработки и внедрения Hygieia является создание виртуального ассистента (Copilot) для врачей и клиницистов, работающих над диагностикой редких заболеваний и разработкой методов лечения, и поэтому согласование требований пользователей с функциональностью Hygieia является критически важным шагом. Предыдущие разработки медицинских ИИ-агентов не исследовали эту область в достаточной мере, что ограничивало их возможности конкретного развертывания. В этой работе мы сотрудничали с врачами из Duke-NUS, YSM и YNHH, чтобы определить ключевых заинтересованных сторон в диагностике заболеваний/приоритизации генов и составить план человеко-ИИ сотрудничества, тем самым обеспечив руководящую основу для конкретной реализации Hygieia..
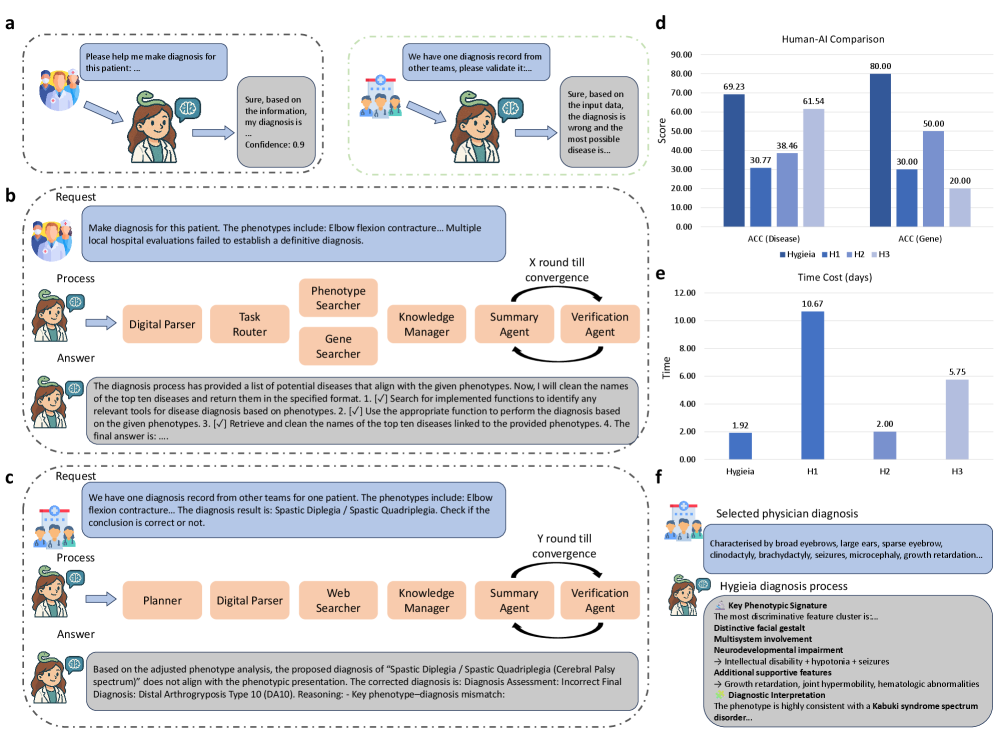
Рисунок 6 (a) показывает две ожидаемые функции Hygieia для врачей по повышению эффективности и снижению усилий, включая прямую диагностику на основе ввода врача, а также проверку и уточнение суждений врача. Общность между этими двумя задачами заключается в том, что обе требуют взаимодействия между врачом и агентом ИИ, где врач излагает потребности персонажа, а агент их выполняет. Мы также приводим несколько примеров, чтобы продемонстрировать, как можно использовать Hygieia для выполнения этих задач. На рисунке 6 (b) мы иллюстрируем, что Hygieia может принимать инструкции врачей с информацией о фенотипе пациента (в формате свободного текста) и другой соответствующей информацией в качестве входных данных, и интегрировать свои различные компоненты для создания конвейера, вызывать различные инструменты и взаимодействовать с различными агентами ИИ для получения результата диагностики. На рисунке 6 (c) мы демонстрируем, как Hygieia может принимать результаты диагностики врачей, а также информацию о фенотипе в качестве входных данных, и, используя альтернативный наилучший конвейер, сначала определить истинность/ложность первоначального диагноза, а затем выполнить рассуждение и коррекцию, чтобы сообщить новый ответ диагноза..
Мы также пригласили трех сертифицированных врачей-генетиков в качестве экспертов в области педиатрии и диагностики редких заболеваний, чтобы они соревновались с Hygieia на основе двух выбранных задач, обсуждаемых в этой рукописи. Их образование и опыт кратко описаны в Дополнительном файле 1, чтобы подтвердить их высокую квалификацию. Мы назначили одинаковые наборы вопросов для экспертов-людей и Hygieia, предоставив им доступ к одним и тем же ресурсам (но экспертам-людям не разрешалось использовать LLM в качестве помощников), и провели прямое сравнение их способностей к решению задач. Согласно рисунку 6 (d), Hygieia показывает лучшие результаты, чем все выбранные эксперты-люди, как в диагностике редких заболеваний, так и в приоритизации генов, причем улучшение по сравнению со вторым лучшим экспертом составляет 12,49% и 60% соответственно. Эксперты-люди также отметили, что приоритизация генов сложнее, чем диагностика заболеваний, что подтверждается разницей в улучшении. Что касается эффективности, Hygieia тратит менее двух часов на решение всех выбранных вопросов, в то время как экспертам-людям требуется от двух до десяти часов, чтобы ответить на все вопросы, как показано на рисунке 6 (e). Таким образом, медицинские ассистенты на основе ИИ способны предоставлять обратную связь быстрее; эта способность может быть очень ценной, особенно в случаях, требующих своевременных решений. Наконец, мы представляем пример изучения ранее упомянутого сложного случая — синдрома Кабуки, и анализируем причины, по которым эксперты-люди и Hygieia ставят диагноз. Согласно рисунку 6 (f), эксперты-люди предпочитают давать краткие объяснения и выбирать наиболее релевантные фенотипы для постановки диагноза. Однако Hygieia предпочитает генерировать более структурированный путь рассуждения с иерархией и выделением важной информации жирным шрифтом. Таким образом, Hygieia может облегчить рассуждения при диагностике заболеваний, предлагая более простой для понимания и анализа подход, особенно для начинающих врачей и студентов-медиков, изучающих процесс диагностики..
Надёжная производительность Hygieia, отражающаяся как в её процессе рассуждения, так и в диагностических результатах, а также её преимущество перед экспертами-людьми в сравнительных оценках демонстрируют её потенциал для преобразования в ощутимую медицинскую ценность для медицинских команд, дополнительно подчёркивая её двойной вклад как на алгоритмическом, так и на прикладном уровнях. В будущем мы привлечём врачей в качестве людей-оценщиков для прямого сравнения Hygieia с врачами в таких задачах, как диагностика заболеваний и идентификация ключевых генов, тем самым дополнительно расширяя Hygieia..
3 Обсуждение
Точная и своевременная диагностика остается фундаментальной проблемой современной медицины, особенно для редких и генетически гетерогенных заболеваний, где фенотипическое перекрытие, неполные записи и ограниченный клинический опыт часто приводят к длительным диагностическим одиссеям и неправильным диагнозам. Хотя недавние достижения в LLM и биомедицинском ИИ продемонстрировали многообещающие результаты в клинических рассуждениях, большинство существующих подходов сосредоточены узко либо на предсказании заболеваний на основе паттернов, либо на поисково-дополненном ответе на вопросы, не затрагивая полный диагностический процесс, интерпретируемость или ограничения клинического внедрения. В этой работе мы представляем Hygieia, универсальную мультимодальную агентную систему, предназначенную для совместного решения задач диагностики заболеваний и приоритизации генов риска путем интеграции фенотипической, геномной и контекстной клинической информации в единой структуре на основе ИИ..
В целом, Hygieia представляет несколько концептуальных и технических достижений, которые в совокупности решают вышеуказанные проблемы. Во-первых, она формализует диагностику как многоэтапный агентный рабочий процесс, начиная с разбора задачи и маршрутизации по типу заболевания, с последующими специализированными конвейерами для распространенных и редких заболеваний. Явно разделяя эти пути, Hygieia избегает сверхобобщенных рассуждений и снижает как вычислительные затраты, так и диагностические ошибки для распространенных состояний, выделяя при этом более сложные ресурсы рассуждений для случаев редких заболеваний. Во-вторых, система включает механизм самопроверки, который итеративно оценивает и корректирует промежуточные диагностические результаты до сходимости. Эта конструкция верификатор-корректор существенно улучшает согласованность и надежность, смягчая хорошо задокументированную случайность выводов на основе LLM. Эмпирически эта конструкция приводит к более стабильным прогнозам, и мы также предоставляем лучше откалиброванные оценки уверенности с множественными запросами. В-третьих, Hygieia выходит за рамки диагностики к приоритизации генов риска, рассматривая это как тесно связанную задачу вывода, которая выигрывает от тех же фенотипических и контекстных рассуждений. Объединяя эти задачи в единую структуру, мы получаем клинически применимые результаты, которые могут напрямую обеспечивать несколько связанных задач. В-четвертых, Hygieia также подчеркивает интерпретируемость и клиническое соответствие. Вместо создания непрозрачных прогнозов или общих сводок, наша система явно связывает фенотипы, заболевания и доказательства на уровне генов через многошаговые траектории рассуждений..
Более того, Hygieia оценивается не только с помощью всесторонних тестов на разнообразных наборах данных с несбалансированными и зашумленными данными в качестве входных, но и в исследованиях с участием практикующих врачей (human-in-the-loop), демонстрируя свою полезность в качестве диагностического помощника и верификатора суждений клиницистов. Мы не только сравниваем производительность Hygieia и экспертов-людей в выбранных задачах, но и представляем несколько тематических исследований, чтобы показать вклад взаимодействия человека и ИИ. Такая двойная стратегия оценки усиливает трансляционную значимость предложенной системы..
Несмотря на свою высокую производительность, Hygieia имеет несколько ограничений, заслуживающих обсуждения. Во-первых, она в значительной степени опирается на возможности базовых LLM, многие из которых являются закрытыми и подвержены изменениям в поведении, структуре затрат и ограничениям доступа. Во-вторых, хотя Hygieia демонстрирует сильную обобщающую способность на разных наборах данных, ее оценка по-прежнему ограничена доступностью и качеством размеченных данных по редким заболеваниям, особенно на уровне генов (ground truth). Симиуляционных наборов данных недостаточно для прямой проверки их реального применения в более сложных сценариях. В будущем мы сосредоточимся на расширении Hygieia за счет более гибкого выбора моделей, а также на создании дополнительных наборов данных для обучения и валидации агентной системы..
4 Методы
Постановка задачи. Здесь мы намерены разработать специальную агентную систему для анализа, связанного с заболеваниями, включая диагностику заболеваний и ранжирование факторов риска (таких как гены). Наша агентная система может принимать следующую информацию в качестве входных данных, включая промпты для конкретных задач , фенотипы , функциональную и/или генетическую информацию о генах риска и информацию из медицинских записей . Для задачи диагностики заболеваний эта система делает вывод с помощью для пациента , и результатом будет диагноз. Аналогично, для ранжирования генов риска мы заменяем промпт для конкретной задачи на , и результатом будет ранжированный ген. Выход модели содержит не только ожидаемые заболевания или гены (в виде строки), но и уверенность в принятии такого решения в диапазоне от 0 до 100.
Рабочий процесс Hygieia. Наш рабочий процесс содержит четыре основных этапа, включая планирование конкретных задач, поиск и интеграцию информации, проверку на основе саморефлексии и оценку уверенности. По умолчанию большинство агентов реализованы с использованием GPT-5 [openai2025gpt5] в качестве их базовой модели после рассмотрения компромисса между производительностью модели, стоимостью и защитой конфиденциальности пациентов. Мы используем Claude-Sonnet-4.5 [anthropic2025claudesonnet45] в качестве базовой модели нашего агента верификации для уменьшения смещения модели. Мы обсудили абляционные исследования в разделе Методы, чтобы обосновать наши настройки..
Относительно планирования для конкретной задачи мы можем интегрировать информацию, предложенную известными биомедицинскими базами данных, и разделить основную задачу на несколько шагов на основе Biomni [huang2025biomni]. Агент сначала проанализирует входную информацию и выполнит поиск в текущей базе инструментов, разработанной на основе как инструментов Biomni, так и недавно реализованных функций поиска. Затем он определит правильный инструмент для решения данной задачи. Мы не сопоставляем фенотипы с терминами HPO [robinson2010human], поскольку предполагаем, что наш агент (на основе продвинутых LLM) уже знает соответствующую информацию. Относительно различий в диагностике распространенных и редких заболеваний мы обучаем маршрутизатор на основе классификатора для более точной диагностики и снижения затрат на основе классификатора KNN [pedregosa2011scikit]. Этот этап выполняется компонентом анализатора и маршрутизатора..
Что касается поиска и интеграции информации, мы осуществляем поиск по связанным данным о фенотипах, возможных названиях генов и функциях генов с помощью инструментов веб-поиска, используя такие источники данных, как Google, Google Scholar и PubMed [white2020pubmed]. Конкретные варианты генов человека и связанная с ними информация не включены в текущую версию по соображениям защиты конфиденциальности. Мы также разрешаем использование расширенных инструментов поиска в LLM, таких как инструменты веб-поиска в GPT-4o [hurst2024gpt] и GPT-5 [openai2025gpt5]. Здесь мы рассматриваем поиск наиболее релевантных пациентов из известных баз данных с информацией о диагнозах в качестве ссылок. После сбора необходимой информации мы интегрируем предварительные знания в качестве входных данных для следующего компонента этой системы. Эта задача выполняется компонентами управления знаниями, веб-поиска и поиска пациентов..
Что касается валидации на основе саморефлексии, мы предоставляем диагностическое решение, а также методы валидации. Агент-сумматор в нашей системе будет использовать информацию из предыдущих двух этапов и генерировать клиническое решение. После принятия решения на основе агента-сумматора мы вводим нашего агента верификации, который принимает предыдущие знания и выходные данные агента-сумматора в качестве входных данных и проверяет, является ли результат правильным или неправильным [yao2022react]. Если результат неверен, подсказка, используемая для агента-сумматора, будет обновлена, и агент-сумматор примет решение снова, пока агент верификации не согласится с решением или не будет достигнут лимит попыток. Алгоритм этой системы показан в Algorithm 1 на примере задачи диагностики заболеваний. Эта задача выполняется компонентами агента-сумматора и агента верификации..
Что касается оценки уверенности, мы ссылаемся на метод, представленный [junxianhecanllm], и просим агента суммаризации раз, чтобы получить ответов, а также парных списков уверенности . Мы усредняем уровни уверенности и используем результат мажоритарного голосования из этих ответов как окончательное решение. Таким образом, итоговая уверенность равна . Мы опробовали другие методы, включая суммирование logprobs, самооценку [kadavath2022language] и двукратное обдумывание перед ответом [li2024think], но их результаты недостаточно хороши для представления уверенности. Поскольку большинство продвинутых LLM являются закрытыми и моделями типа «черный ящик», другие подходы, используемые для открытых LLM, неприменимы. Мы провели статистические тесты, чтобы продемонстрировать, что наши текущие настройки помогают калибровать выходные данные модели..
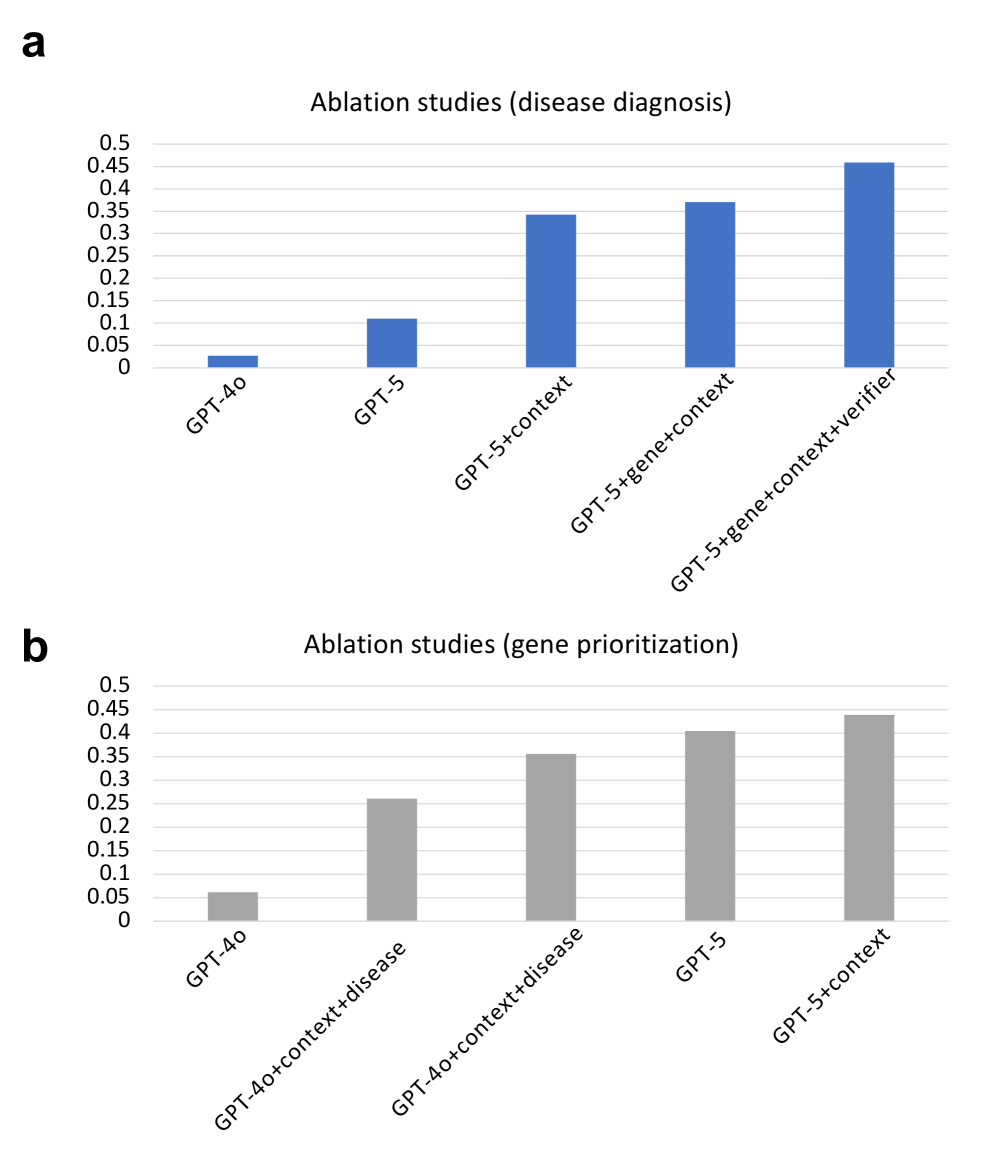
Абляционные исследования. На дополнительных рисунках 9 (a) и (b) мы показываем вклад настройки базовых моделей и входной информации для этих задач. В обоих случаях замена базовых моделей с GPT-4o на GPT-5 дает заметное улучшение, а добавление большего контекста, например подробных описаний фенотипов, а также наличие верификатора, помогает Hygieia определять заболевания и наборы генов. Мы также обнаруживаем, что предоставление информации о заболевании помогает Hygieia ранжировать гены; однако, поскольку в реальных клинических случаях врачи должны сначала узнать результаты генетических тестов, а затем поставить диагноз, мы не используем эту информацию как входные данные для приоритизации генов риска..
Дизайн с участием человека в цикле. Мы также рассматриваем сравнение и сотрудничество между врачами и моделями ИИ при принятии решений. Мы пригласили четырех врачей-генетиков из YSM, YNHH и Медицинской школы Duke-NUS и рассматриваем два сценария..
В нашем первом экспериментальном сценарии мы назначаем 23 вопроса (13 для диагностики заболеваний, включая 2 сложных вопроса, связанных с крайне редкими заболеваниями, и 10 для приоритизации генов) для X врачей и Hygieia, и оцениваем результаты на основе точности..
Во втором экспериментальном сценарии мы позволяем Hygieia получать доступ к результатам, предоставленным врачами, и используем Hygieia для проверки решений врачей. Если проверка даст отрицательные результаты, мы запустим конвейер коррекции, описанный в нашем разделе «Методы и результаты»..
Исследование примера. Чтобы лучше продемонстрировать преимущества Hygieia, мы приводим несколько примеров из разных базовых методов и включаем шаги рассуждений Hygieia. В этих вопросах только Hygieia принимает правильное решение, в то время как остальные методы не дают нам ни правильных путей рассуждений, ни правильных ответов..
Пояснения к базовым методам. Для проприетарных моделей мы рассматриваем LLM с возможностями рассуждения, включая o4-mini [o3o4mini-systemcard-2025], GPT-5 [openai2025gpt5] и GPT-5 (search) [openai2025gpt5], продвинутые LLM, включая GPT-4o [hurst2024gpt] и GPT-4o (search) [hurst2024gpt]. Для моделей с открытым исходным кодом мы рассматриваем Qwen3-8B [yang2025qwen3] и Deepseek-v3.1 [liu2024deepseek]. Для доменно-экспертных моделей мы рассматриваем мультиагентную диагностическую систему (базовая модель GPT-4o в качестве рекомендуемой настройки), а также DeepRare [zhao2025agentic]. Однако API-версия DeepRare содержит ошибки, связанные с обработкой данных, и мы не можем найти их опубликованные тестовые наборы данных, что затрудняет получение формата данных. Для биомедицинских агентов мы рассматриваем Biomni (базовая модель GPT-4o в качестве рекомендуемой настройки. Для Qwen3-8B мы также рассматриваем дообучение базовой модели как с Low-rank adaptation (LoRA), так и с полными параметрами (Full) [zheng2024llamafactory] на основе предоставленных симуляционных данных. Промпты, используемые для запроса LRM и LLM, задокументированы в Приложении B. Для других моделей подробности можно найти в нашей кодовой базе..
Метрики. Мы следуем настройкам, обсуждаемым в [chen2024rarebench, zhao2025agentic], где ПолнотаK является основной метрикой, используемой при оценке сгенерированного диагноза заболевания и результатов ранжирования генов. Мы рассматриваем первые 1, 5, 10 кандидатов и вычисляем Полноту1, Полноту5, Полноту10 соответственно. Мы выполняем вычисление метрик после нормализации названий заболеваний/генов..
5 Доступность кода и данных
Мы используем авторизованные API OpenAI, Claude API и Gemini API для разработки нашего метода и выполнения бенчмарковых исследований. Для дообучения открытых LLM мы используем кластер Misha из Института Ву Цай в Йеле с одним GPU NVIDIA H100 и 80 ГБ памяти. Коды Hygieia можно найти в https://github.com/HelloWorldLTY/hygieia под лицензией MIT..
Все данные доступны онлайн или по запросу. Мы собрали ссылки для скачивания каждого набора данных в Дополнительном файле 2..
6 Одобрение институционального наблюдательного совета (IRB)
Этот проект получил одобрение от Йельского IRB, номер проекта 2000039055..
7 Благодарность
Мы выражаем благодарность за поддержку Сети недиагностированных заболеваний. T.L. выражает благодарность за поддержку от Программы исследовательского доступа OpenAI..
8 Вклад авторов
T.L. разработал это исследование совместно с W.Z. и H.Z. T.L. разработал метод. T.L. провел эксперименты. B.K.G.K., H.Z. и J.L. провели человеческую оценку. Все авторы участвовали в написании и рецензировании рукописи. H.Z. руководил этим проектом..
Литература
Appendix A Сравнение Hygieia с другими AI-агентами
| System | Distinguish | Human | Confidence | Risk Gene | Flexible Input | Open Source | Evaluation Setting | Domain |
|---|---|---|---|---|---|---|---|---|
| MCA [chen2025enhancing] | ✗ | ✗ | ✗ | ✗ | ✓ | ✓ | Benchmark | Rare |
| MDAgent [kim2024mdagents] | ✓ | ✗ | ✗ | ✗ | ✓ | ✓ | Benchmark | General |
| DeepRare [zhao2025agentic] | ✗ | ✗ | ✗ | ✗ | ✗ | ✓ | Benchmark | Rare |
| Biomni [huang2025biomni] | ✓ | ✗ | ✗ | ✓ | ✓ | ✓ | Benchmark & Human Eval | General |
| RDguru [yang2025rdguru] | ✗ | ✗ | ✗ | ✗ | ✗ | ✗ | Benchmark | Rare |
| RareAgent [chen2024rareagents] | ✗ | ✗ | ✗ | ✗ | ✗ | ✗ | Benchmark | Rare |
| Hygieia (Ours) | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | Benchmark & Human Eval | Rare |
В дополнительной таблице 1 мы демонстрируем уникальный вклад Hygieia, сравнивая его с другими агентами диагностики заболеваний по нескольким измерениям..
Appendix B Промпты
Подсказки, используемые для диагностики заболеваний: «Поставьте диагноз этому пациенту. Известные фенотипы включают: {phenotype_list}. Множественные оценки в местных больницах не позволили установить окончательный диагноз»."
Подсказки, используемые для приоритизации генов: «Представьте, что вы генетический консультант. Описание фенотипа пациента: {phenotype_list}. Можете ли вы предложить список из 1 наиболее вероятного гена для тестирования»?"
Подсказки, используемые для обнаружения и исправления ошибок:
Вы сертифицированный клинический генетик и невролог, специализирующийся на редких нервно-мышечных и врожденных заболеваниях. Вы рассуждаете пошагово, используя установленные диагностические критерии, корреляции генотип-фенотип и логику дифференциальной диагностики..
Ниже представлен клинический фенотип пациента и предполагаемый диагноз..
Ваша задача — определить, правилен ли предложенный диагноз.
Инструкции: 1. Тщательно оцените, соответствует ли фенотип предложенному диагнозу. 2. Если диагноз верен, явно укажите, что он верен, и объясните почему. 3. Если диагноз неверен или неполон, четко укажите, что он неверен, и: - Укажите наиболее вероятный исправленный диагноз - Кратко обоснуйте исправление, используя ключевые соответствия фенотипа и заболевания 4. Не предоставляйте несколько диагнозов — укажите только один лучший диагноз. 5. Будьте кратки, клинически точны и избегайте предположений, выходящих за пределы данного фенотипа..
Фенотип пациента: {PHENOTYPE_LIST}}
Предложенный диагноз: {PROPOSED_DIAGNOSIS}}
Формат вывода (строгий)):
Оценка диагноза: Правильно / Неправильно
Окончательный диагноз: <single diagnosis name>>
Рассуждение: - Ключевое соответствие фенотипа и диагноза (или несоответствие) - Критические признаки, подтверждающие окончательный диагноз
Appendix C Дополнительные рисунки