Прогнозирование кривой доходности с использованием машинного обучения и эконометрики: сравнительный анализ
Аннотация
Хотя машинное обучение произвело революцию во многих областях, таких как обработка естественного языка (NLP) и компьютерное зрение, его влияние на прогнозирование временных рядов по-прежнему широко оспаривается, особенно в финансовой сфере. В данной работе сравнивается качество прогнозирования данных по кривой доходности U.S. Treasury между подходами эконометрики/анализа временных рядов, классического машинного обучения и методов глубокого обучения с использованием ежедневных данных за 47 лет. Кривая доходности Treasury важна, потому что она широко используется каждым участником рынков облигаций, которые больше рынков акций. Мы рассматриваем разнообразные методы, которые не были протестированы на прогнозировании кривой доходности, особенно алгоритмы глубокого обучения. Алгоритмы включают модель Autoregressive Integrated Moving Average (ARIMA) и ее расширения, простые эталонные модели, методы ансамблей, рекуррентные нейронные сети (RNNs) и несколько моделей transformers, созданных для прогнозирования. В целом ARIMA и наивные эконометрические модели превосходят другие модели, за исключением одного временного блока. Среди методов машинного обучения наилучшие результаты показывают TimeGPT, LGBM и RNNs. Кроме того, в статье рассматривается вопрос о том, какие данные — стационарные или нестационарные — более подходят в качестве входных данных для моделей глубокого обучения.
Ключевые слова: временные ряды, кривая доходности, облигации, прогнозирование, transformers, ARIMA, RNNs, machine learning, deep learning
Ключевые слова:
кривая доходности, облигации, прогнозирование, временные ряды, transformers, ARIMA, RNNs, машинное обучение, глубокое обучение1 Введение
1.1 Мотивация
Машинное обучение, особенно глубокое обучение, произвело революцию в таких областях, как обработка естественного языка (NLP), компьютерное зрение и генеративное моделирование. RNNs/LSTMs доминировали в NLP вплоть до того, как были изобретены Transformers в (Vaswani et al., 2017). В конце концов Transformers были масштабированы и обучены на огромных массивах текстовых данных в самоконтролируемом режиме, что привело к созданию больших языковых моделей (LLMs). Сверточные нейронные сети (CNNs) доминируют в приложениях компьютерного зрения уже более десяти лет. Для задач генеративного зрения вначале доминировали Variational Autoencoders (VAEs) и Generative Adversarial Networks (GANs) (Singh and Ogunfunmi, 2022; Goodfellow et al., 2014; Kingma and Welling, 2014), пока не были созданы модели диффузии.
LLM и модели диффузии являются примерами базовых моделей. «Базовая модель» — это очень крупная модель машинного обучения «которая обучается на широких данных (обычно с использованием самоконтроля в масштабе), которая может быть адаптирована (например, дообучена) для широкого спектра задач последующего назначения» (Bommasani and others, 2021). В контексте прогнозирования временных рядов машинное обучение и глубокое обучение не были столь доминирующими; ведутся споры о том, являются ли они более эффективными, чем традиционные методы или даже наивные методы.
Соревнования Макридикиса — это серия соревнований по прогнозированию временных рядов, цель которых заключается в сравнении точности различных алгоритмов прогнозирования; они также известны как соревнования серии M. В соревнованиях M4 2018–2019 использовался обширный набор данных, включающий 100 000 временных рядов, чтобы определить наиболее точные методы прогнозирования, адаптированные для различных категорий предсказаний (Makridakis et al., 2020). Что показали M4, так это то, что чистые модели машинного обучения/нейронных сетей демонстрировали слабые результаты, а комбинации прогнозов выиграли 12 из 17 лучших моделей. Однако победителем стали Exponential Smoothing-Recurrent Neural Networks (ES-RNN) — гибрид статистического и глубокого обучения (Smyl, 2020). На втором месте оказалась комбинация прогнозов из семи статистических методов и одного подхода машинного обучения. Взвешивание для усреднения определялось алгоритмом машинного обучения. С момента выхода ES-RNN на данных M4 были выполнены бенчмарки нескольких моделей глубокого обучения, таких как NBEATS, NHITS и DeepAR, и они превзошли ES-RNN.
Созданы многочисленные модели на основе transformers для решения задач прогнозирования, такие как Temporal Fusion Transformer (TFT) (Lim et al., 2021), Fedformer (Zhou et al., 2022), Autoformer (Wu et al., 2021), Informer (Zhou and others, 2021), PatchTST (Nie et al., 2023), Pyraformer (Liu et al., 2022) и iTransformer (Liu et al., 2024). Методы transformers сопоставимы с традиционными подходами временных рядов в эконометрике для прогнозирования процентных ставок, что является предметом данной статьи.
В Zeng et al. (2023) FEDformer, Autoformer, Informer и Pyraformer тестируются на наборах данных для прогнозирования, и обнаруживается, что в целом они работают хуже, чем простая линейная модель DLinear, по метрикам MSE и MAE. Предполагается, что поскольку механизм self-attention является перестановочно-инвариантным, происходит потеря временной информации. Simhayev et al. (2023) предлагает ответ с несколькими экспериментами, в которых результаты оцениваются с помощью метрики MASE. В первом эксперименте сравнивается Autoformer (одномерный) и DLinear на трех наборах данных; при этом выясняется, что Autoformer справляется лучше. Во втором эксперименте сравниваются Vanilla Transformer (одномерный), Vanilla Transformer (многомерный), Informer (одномерный), Informer (многомерный), Autoformer (одномерный) и DLinear; при этом выясняется, что Vanilla Transformer справляется лучше. С момента выхода статьи были выпущены и другие transformers, такие как PatchTST и Temporal Fusion Transformers. Для transformers, похоже, нет согласия относительно наилучшей производительности.
В 2023 году Nixtla111https://www.nixtla.io выпустила основанную на transformer базовую модель для прогнозирования под названием TimeGPT (Garza et al., 2024), которая демонстрирует хорошие результаты по сравнению с другими основными методами на 300,000 наборах временных рядов из нескольких предметных областей. С тех пор были выпущены и другие базовые модели для прогнозирования, такие как TimeFM (Sen and Zhou, 2024), Chronos (Ansari et al., 2024), Time-LLM (Jin et al., 2024) и MOIRAI (Woo et al., 2024).
Гибридные методы и методы глубокого обучения могут демонстрировать перспективность в прогнозировании, хотя это не означает хороших результатов для каждой задачи прогнозирования. В данной статье мы сосредоточимся на финансовой отрасли, которая обычно выполняет прогнозирование волатильности, цены, доходности или направления финансовых активов, в основном в сфере акций. Меньшее внимание уделялось ML-прогнозированию для кривых доходности с постоянным сроком погашения Казначейства, особенно с использованием методов глубокого обучения. Кривые доходности важны, потому что они необходимы для торговли облигациями и могут предсказывать рецессии.
Другой областью интереса является то, насколько хорошо алгоритмы глубокого обучения справляются с нестационарными данными. Зачастую алгоритмы прогнозирования требуют разностного преобразования входных данных, чтобы сделать их стационарными, или требуют предварительного приведения входных данных к стационарному виду перед использованием. Высказывается гипотеза, что алгоритмы глубокого обучения могут непосредственно работать с нестационарными данными. См. Приложение A.1 для более подробной информации о стационарности. Мы рассматриваем оба типа входных данных: с обработкой нестационарности и без нее..
Перед тем как подытожить вклад, который вносит данная статья, мы рассмотрим существующую литературу.
1.2 Обзор литературы
Большая часть литературы по прогнозированию кривой доходности сосредоточена на прогнозировании кривой доходности в разрезе месяцев. Мы используем дневные данные.
Традиционные модели временных рядов/эконометрики для прогнозирования помесячной кривой доходности включают авторегрессионные модели (AR-модели), векторные авторегрессионные (VAR) модели, байесовские VAR-модели и модели VAR с факторным дополнением (Caldeira et al., 2013; Moench, 2006). В Caldeira et al. (2013) авторы использовали комбинации прогнозов. В Swanson and Xiong (2018) авторы сравнивают динамическую модель Nelson-Siegel (Nelson and Siegel, 1987) с AR, VAR и моделями главных компонент (PCA). Сравнения используют модели для больших данных по сравнению с моделями для малых данных на данных кривой доходности на конец месяца.
Машинное обучение использовалось для прогнозирования помесячной кривой доходности для прогнозирования на один шаг вперед. В Sambasivan and Das (2017), для US Treasury Constant Maturities, подход Dynamic Gaussian Process был сопоставлен с моделью Nelson-Siegel и VAR; авторы не использовали никаких других признаков. Они обнаружили, что Dynamic Gaussian Process и VAR показывают лучшие результаты, чем модель N-S. В краткосрочном диапазоне кривой доходности VAR работает лучше, чем Dynamic Gaussian Process, но Dynamic Gaussian Process обеспечивает лучшее качество для среднесрочных и долгосрочных сроков погашения. В Reinicke (2019), авторы сопоставили Functional PCA Regression с Dynamic Nelson-Siegel (с AR/VAR) и Dynamic Gaussian Process на кривых доходности США и Германии. Они применили подход с расширяющимся окном, оцениваемый с помощью метрики RMSE. Они также исследовали, как размер обучающего окна влияет на качество прогнозирования.
В Zhang et al. (2022) авторы пытаются объединить факторные модели машинного обучения с теорией ценообразования без арбитража, чтобы прогнозировать движения на кривых доходностей казначейских инструментов, обращающихся через биржи в Китае. В Rahimi (2020) авторы сравнивают Random Forests, Functional Non-parametric и Dynamic Nelson-Siegel модели. Они обнаруживают, что модель Random Forest превосходит по прогнозированию короткого конца кривой доходности, а Dynamic Nelson-Siegel модель превосходит по предсказанию доходностей облигаций с долгим сроком до погашения; они также обнаруживают, что использование макроэкономических переменных является важным. Oosterlaken (2020) направлен на воссоздание и расширение работы Swanson and Xiong (2018). Они сравнивают традиционные методы (AR модели, VAR модели, Dynamic Nelson-Siegel модели и Principal Component Analysis) с машинным обучением (Regression Trees, Random Forests, Gradient Boosted Trees и Gaussian Process Regression). Они использовали помесячные данные, несколько горизонтов прогнозирования и обнаружили, что модели машинного обучения не показывают лучшего результата, чем AR(1).
⟦Bianchi et al. (2020) использовать машинное обучение для прогнозирования избыточной доходности казначейских облигаций. Они применяли PCR, PLS, штрафные регрессии, деревья регрессии, нейронные сети (только доходности) и нейронные сети (доходности+макроэкономические переменные). Они стремились выяснить, привели ли улучшения предсказательной точности к повышению инвестиционной результативности по сравнению со сценарием без предсказуемости. Они обнаруживают, что «нелинейные модели», такие как деревья и нейронные сети, выявляют существенные, статистически значимые колебания в доходности облигаций. Прогнозы, полученные с помощью этих методов, обеспечивают существенные экономические выгоды на тестовом наборе. Они также обнаруживают, что в случае нейронных сетей добавление макроэкономических переменных дает более высокую доходность, чем использование только данных по доходности.
В (Hoogteijling, 2020) авторы опираются на (Bianchi et al., 2020), но указывают на два недостатка. Первый заключается в том, что они использовали нестационарные входные данные вместо стационарных. Второе: часто макроэкономические переменные за апрель публикуются лишь спустя 2 месяца; они не учли этого и использовали переменные, которые не будут доступны на момент прогнозирования.
В Mun and Soong (2021) авторы сравнили доходности по выпускам Казначейства США с постоянным сроком погашения (на месячной основе) за период с января 2017 года по апрель 2021 года. Они использовали AdaBoost, k-NN, линейную регрессию, MLP, Random Forest, SVM, модели AR и модели VAR. Также они использовали набор экономических признаков в качестве экзогенных переменных. SVM показала лучшие результаты по прогнозированию доходности 20 Year и 30 Year облигаций, тогда как ARIMA превзошла другие модели на более коротких участках кривой доходности, но качество ARIMA существенно снижалось при увеличении числа шагов прогноза. В целом подход машинного обучения обычно предпочтительнее благодаря более высокой точности для долгосрочного прогнозирования доходности.
1.3 Вклад
Хотя эти исследования предоставили ценные сведения о применении различных моделей для прогнозирования кривой доходности, данная статья также стремится затронуть несколько дополнительных аспектов, которые ранее были неизучены/изучены недостаточно. В частности, основные цели заключаются в том, чтобы: (1) Оценить эффективность машинного обучения (классического машинного обучения и глубокого обучения) по сравнению с традиционными методами эконометрики/временных рядов. (2) Проверить эффективность на нескольких горизонтах прогнозирования и на протяжении различных временных периодов. (3) Исследовать, что работает лучше: обучение/оценивание с расширяющимся окном или со скользящим окном. (4) Сравнить стационарные и нестационарные входные данные для алгоритмов глубокого обучения. Эта статья более всеобъемлющая по числу охваченных методов, включая модели глубокого обучения, такие как small transformers и foundation models, которые не тестировались на прогнозировании кривой доходности. Мы используем соответствующие бенчмарки для сравнения методов. Недавние работы также обычно используют месячные данные; мы используем дневные данные. Имеется ограниченная литература о стационарных и нестационарных входных данных для глубокого обучения, и мы дополняем этот пробел в данном исследовании. Основные результаты таковы: ARIMA и Naive Method превосходят все остальные модели в целом, за исключением одного временного блока. Среди методов машинного обучения наилучшие результаты показывают TimeGPT, LGBM и RNNs.
2 Методология
В этом подразделе мы описываем данные, используемые в работе, методологию и экспериментальную схему.
2.1 Данные
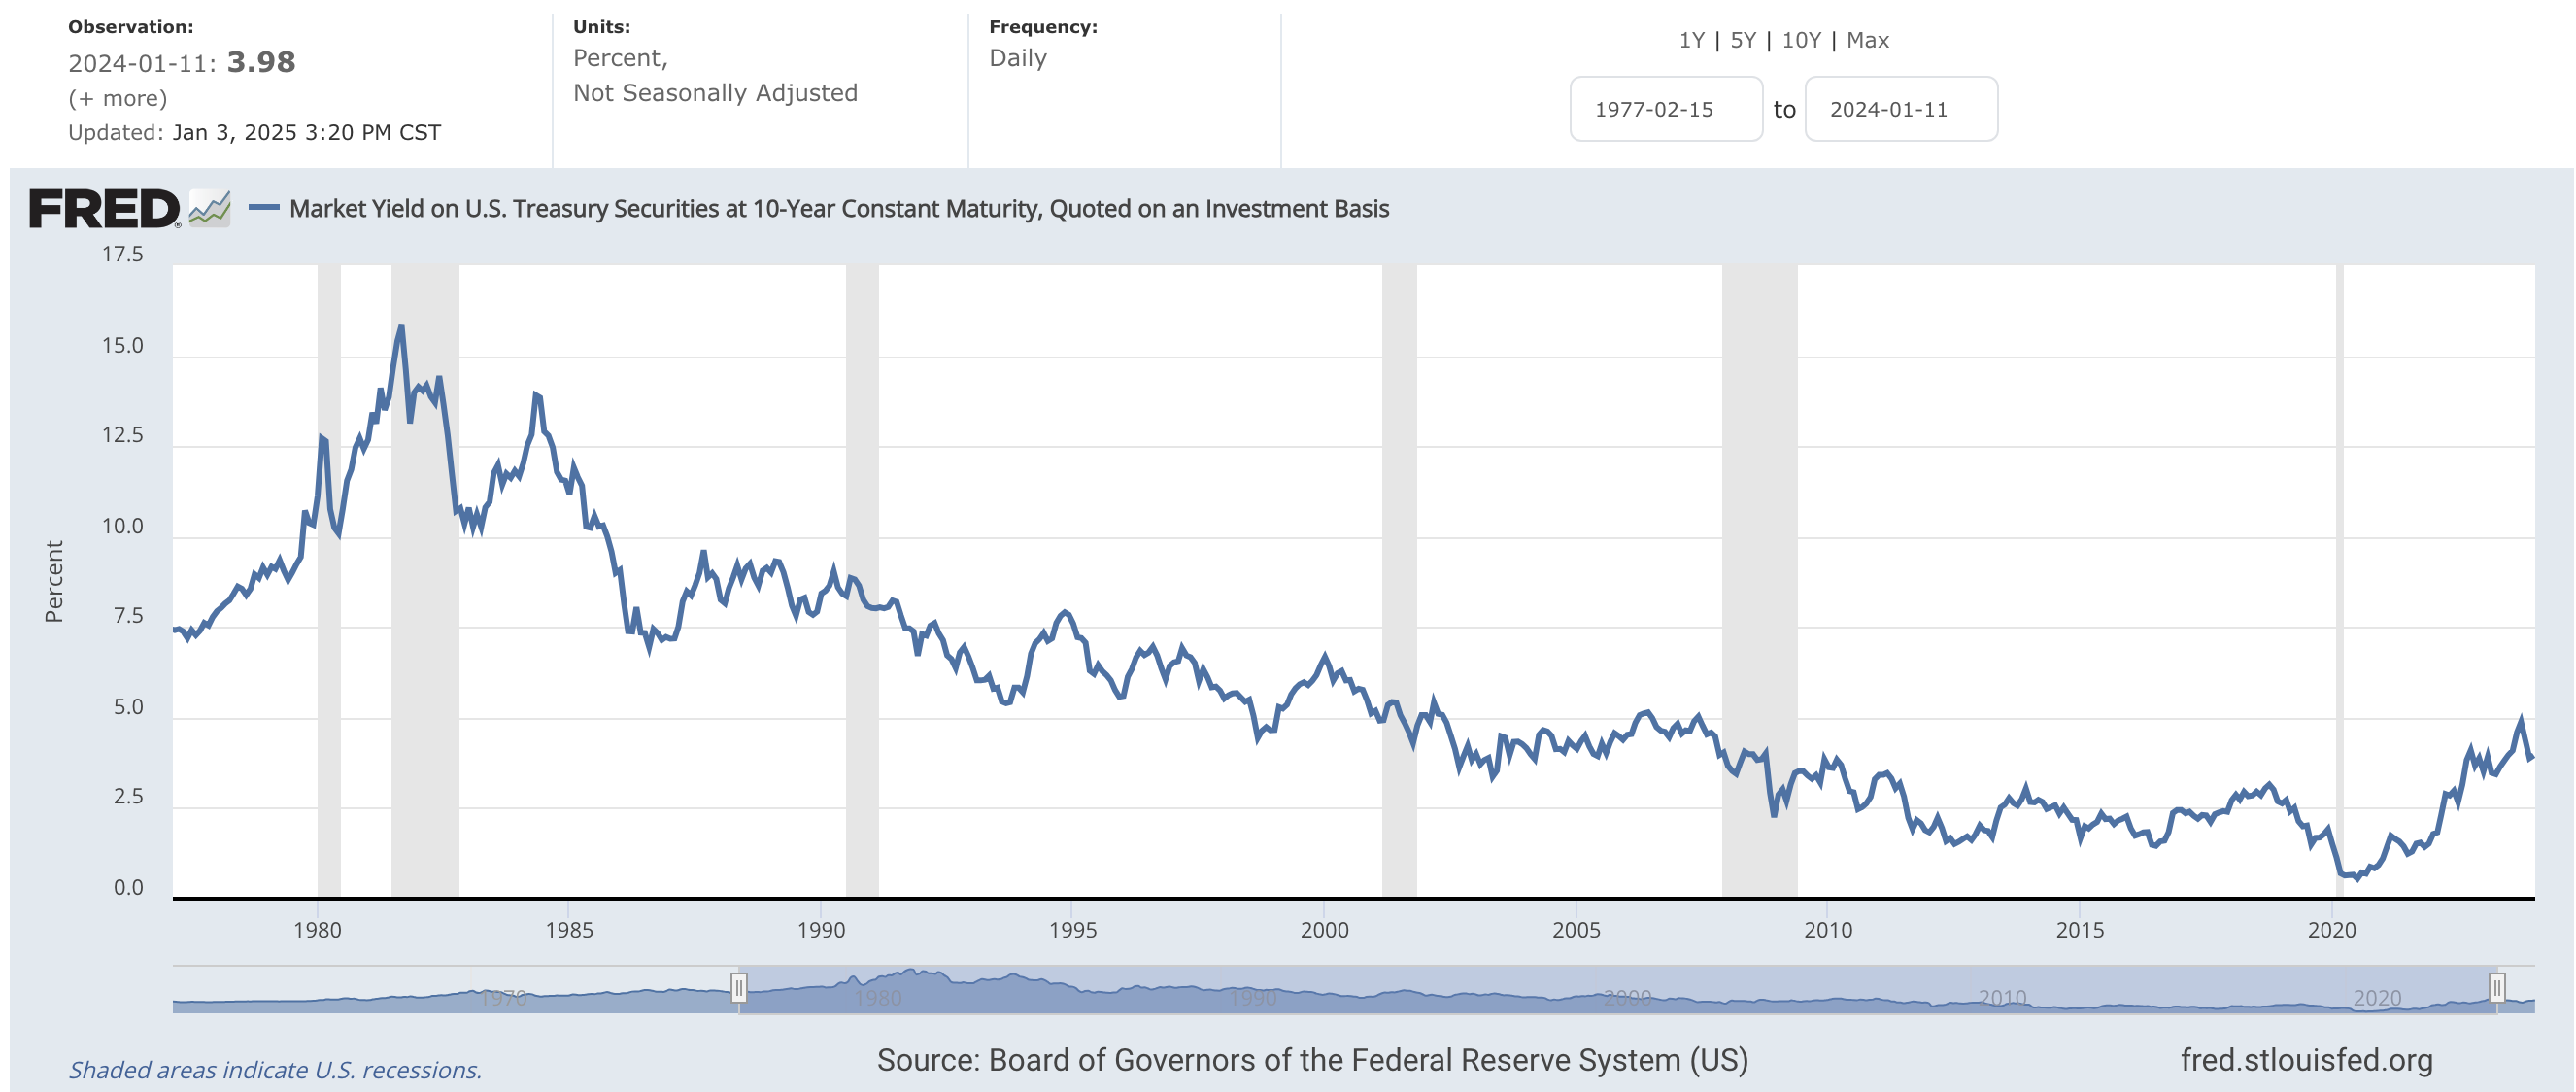
Мы используем доходности с постоянной зрелостью для шести сроков 1, 2, 5, 7, 10 и 30 лет из базы данных FRED.222https://fred.stlouisfed.org Это данные высокого качества Федеральной резервной системы. Соответствующие тикеры DGS1, DGS2, DGS5, DGS7, DGS10 и DGS30 формируют кривые доходности с 1977-02-15 по 2024-01-11, то есть многомерный временной ряд, охватывающий ежедневные данные за 47 лет, включая шесть рецессий.
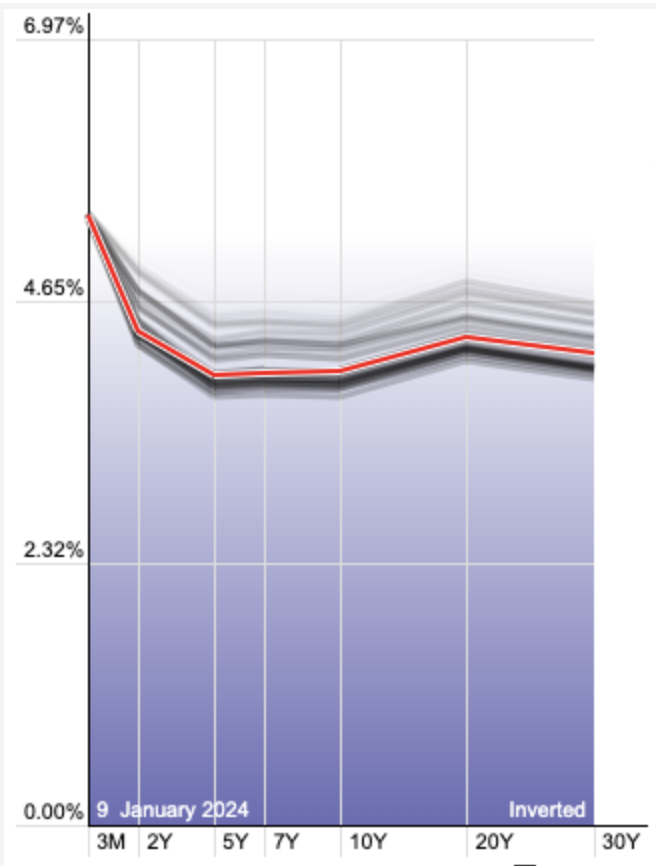
Доходность по облигации со сроком погашения лет — это годовая норма доходности, если облигация покупается и удерживается до погашения (это также называется доходностью к погашению облигации или YTM). В любой конкретный день кривая, соединяющая YTM облигаций с различными сроками погашения, называется кривой доходности. Например, временной ряд для доходности текущей облигации со сроком погашения 10 лет (DGS10) и кривая доходности (для всех облигаций) в один и тот же день показаны на рисунке 1. Мы выбрали шесть точек на кривой доходности для прогнозирования — они в целом отражают структурные изменения кривой доходности с течением времени для полного спектра сроков погашения. Казначейство США обычно использует вариант интерполяции кубическими сплайнами, чтобы построить гладкую кривую, проходящую через значения доходности, и тем самым изобразить кривую доходности для каждого дня.333https://home.treasury.gov/policy-issues/financing-the-government/interest-rate-statistics/treasury-yield-curve-methodology Этот метод был обновлен в середине 2021 года.444https://home.treasury.gov/quasi-cubic-hermite-spline -treasury-yield-curve-methodology
Казначейские векселя (краткий срок погашения) и облигации (средний и долгий сроки погашения) торгуются непрерывно, и их цены поддаются наблюдению. Они предоставляют денежные потоки в виде платежей по процентной ставке каждые шесть месяцев. YTM — это единственная норма доходности, при которой будущие денежные потоки дисконтируются так, что сумма этих дисконтированных денежных потоков равняется текущей цене облигации, котируемой на торгах. Таким образом, доходности математически неявно выводятся из цен облигаций и их процентных платежей. Поскольку казначейские доходности используются не только для ценообразования казначейских ценных бумаг, но и для всех облигаций на рынке, прогнозирование доходностей — критически важная деятельность по генерации информации для всех участников рынка облигаций, независимо от типа облигаций, которыми они торгуют. Оценка существующих методов прогнозирования кривой доходности и современных ML/DL-методов для улучшений представляет врожденный интерес для трейдеров рынка облигаций, специалистов по управлению рисками, регуляторов и даже участников рынков акций и сырьевых товаров, поскольку доходности входят в модели на всех этих рынках. Стоимость рынка облигаций США в 2022 году составила $51 TN555https://www.weforum.org/stories/2023/04/ranked-the-largest-bond-markets-in-the-world/, что больше, чем стоимость рынков акций США ($40 TN).666https://www.ceicdata.com/en/indicator/united-states/market-capitalization Фирмы Уолл-стрит имеют специальных сотрудников, известных как «Fed-watchers». Прогнозируя кривые доходности, Fed watchers стремятся предвосхитить изменения в денежно-кредитной политике, экономических условиях и потенциальных движениях рынка, предоставляя ценную информацию участникам рынка облигаций и инвесторам по различным классам активов.
2.2 Модели и настройка
Мы сравниваем производительность методов машинного обучения с традиционными методами временных рядов/эконометрики. Традиционные методы временных рядов/эконометрики включают ARIMA, DHR-ARIMA, VAR и VECM (Shumway and Stoffer, 2006; Chen, 2022). В машинном обучении выделяются две группы — группа глубокого обучения и группа классического машинного обучения. Первая группа включает RNN, Vanilla Transformer, Informer, PatchTST, TFT, TimeGPT, DeepAR, NHITS и NBEATS (Salinas et al., 2020; Challu and others, 2023; Oreshkin et al., 2019). Vanilla Transformer и RNN взяты специально из реализации Nixtla. Вторая группа включает Random Forests, XGBoost и LGBM. Все методы сравниваются с 3 простыми (наивными) бенчмарками: Mean Forecast, Naive Forecast и Naive Seasonal Forecast.
Наивный прогноз использует последнее значение из обучающего окна и повторяет это значение на всем протяжении прогнозного горизонта. Также это называется базовым уровнем случайного блуждания. Наивный сезонный прогноз использует значения из последнего сезона и повторяет их для прогнозов. Средний прогноз использует среднее значение обучающего окна и использует его на всем протяжении прогнозного горизонта.
Модели прогнозирования на основе Transformer, такие как TimeGPT, адаптируют механизм внимания для улавливания временных зависимостей на больших горизонтах. В отличие от моделей ARIMA или VAR, которые опираются на явно заданные лаги и допущения стационарности, трансформеры учатся устанавливать связи во временных рядах и масштабируются без предварительного задания. Самовнимание позволяет модели гибко определять, какие части исторического временного ряда наиболее важны для прогнозирования будущих значений. Хотя все трансформерные модели в этой статье разделяют базовую архитектуру механизмов внимания, TimeGPT существенно отличается от более компактных трансформерных моделей прогнозирования, таких как Informer, PatchTST и Vanilla Transformer. TimeGPT — это предварительно обученная базовая модель, обученная на сотнях тысяч временных рядов из различных предметных областей с использованием самоконтроля. Она предназначена для обобщения между доменами при минимальной или нулевой донастройке. Напротив, более компактные трансформеры, такие как Informer и PatchTST, являются моделями, ориентированными на конкретную задачу, и обучаются с нуля на целевом наборе данных (в данном случае — кривые доходности Казначейства). Они не извлекают выгоды из предварительного обучения, а их качество в значительной степени зависит от структуры локального набора данных и от режима обучения. В результате TimeGPT стремится использовать переносное обучение и масштабирование, тогда как малые трансформеры опираются исключительно на обучение с нуля, что делает их более гибкими в теории, но часто менее надежными на практике, когда данные ограничены или зашумлены.
Для ARIMA мы используем autoarima для выбора гиперпараметров, который использует AIC в качестве критерия выбора. Для VAR и VECM мы также используем выбор порядка на основе информационных критериев. Для моделей глубокого обучения мы выбираем гиперпараметры с помощью перекрёстной валидации (CV).
Мы используем следующие метрики: RMSE (среднеквадратическая ошибка) и MAPE (средняя абсолютная процентная ошибка). Поскольку RMSE не нормируется по уровню процентной ставки и, следовательно, по размеру ошибки прогноза, MAPE нормируется; таким образом, последняя поддерживает сравнение точности прогнозов во времени.
Для обучения и оценки производительности алгоритмов мы используем две схемы: скользящее окно CV и расширяющееся окно CV; более подробную информацию об этих подходах перечислено в Приложении A.2. Эти схемы предотвращают любой просмотр будущих данных, что исключает утечку данных. Кроме того, единственной предварительно обученной моделью, которую мы использовали, является TimeGPT, обученная на многих временных рядах, поэтому возможно, что она уже видела доходности ранее. Однако мы не передаем модели даты временных рядов, тем самым усложняя использование ею своей памяти для прогнозирования. Мы также не выполняли никакой донастройки и использовали модель в режиме zero-shot, что дополнительно снижает вероятность утечки. Учитывая, что она не превосходит эконометрические модели, можно заключить, что утечка информации не является проблемой.
При использовании скользящего окна CV размер окна составляет 1044 рабочих дня, что примерно равно 4 годам. Это окно используется для обучения алгоритма прогнозирования, который затем выдает прогноз на следующие 15 рабочих дней, и он будет оцениваться метриками.
Окно затем будет сдвигаться на 5 рабочих дней. Это новое окно данных будет использовано для повторной оценки параметров модели, а затем будет выдан прогноз, который будет оценен. Затем мы переходим к следующему окну и повторяем процесс, пока у нас больше не будет достаточно данных для тестового окна продолжительностью 15 дней.
С расширяющимся окном CV, начальное окно составляет 1044 дня, и оно расширяется на 5 рабочих дней в каждом окне вместо скольжения.
В установках с скользящим окном CV и с расширяющимся окном CV мы также разбиваем данные на то, что будем называть блоками времени гиперпараметров, чтобы учитывать структурные сдвиги в экономике со временем. Таблица 1 показывает эти блоки для оценки с расширяющимся окном и для оценки со скользящим окном. Их можно рассматривать как набор смежных окон обучения, которые используют одни и те же гиперпараметры. В качестве примера, Блок 0 начинается с окна, содержащего данные за период с 1977-02-15 по 1981-02-13; мы обучаем модель, выполняем прогноз и оцениваем по метрикам. Затем мы переходим к следующему окну и повторяем процесс. Когда окно обучения становится окном, содержащим данные за период с 1982-02-16 по 1986-02-14, это будет последнее окно блока времени гиперпараметров 0. После его завершения модель затем переключится на другой временной блок с новым набором гиперпараметров.
| Sliding Windows | Expanding Windows | |||
|---|---|---|---|---|
| Block | Start Window | End Window | Start Window | End Window |
| 0 | 1977-02-15: 1981-02-13 | 1982-02-16 : 1986-02-14 | 1977-02-15 : 1981-02-13 | 1977-02-15 : 1986-02-14 |
| 1 | 1982-02-23 : 1986-02-21 | 1987-02-24 : 1991-02-22 | 1977-02-15 : 1986-02-21 | 1977-02-15 : 1991-02-22 |
| 2 | 1987-03-03 : 1991-03-01 | 1992-03-03 : 1996-03-01 | 1977-02-15 : 1991-03-01 | 1977-02-15 : 1996-03-01 |
| 3 | 1992-03-10 : 1996-03-08 | 1997-03-11 : 2001-03-09 | 1977-02-15 : 1996-03-08 | 1977-02-15 : 2001-03-09 |
| 4 | 1997-03-18 : 2001-03-16 | 2002-03-12 : 2006-03-10 | 1977-02-15 : 2001-03-16 | 1977-02-15 : 2006-03-10 |
| 5 | 2002-03-19 : 2006-03-17 | 2007-03-20 : 2011-03-18 | 1977-02-15 : 2006-03-17 | 1977-02-15 : 2011-03-18 |
| 6 | 2007-03-27 : 2011-03-25 | 2012-03-27 : 2016-03-25 | 1977-02-15 : 2011-03-25 | 1977-02-15 : 2016-03-25 |
| 7 | 2012-04-03 : 2016-04-01 | 2017-04-04 : 2021-04-02 | 1977-02-15 : 2016-04-01 | 1977-02-15 : 2021-04-02 |
| 8 | 2017-04-11 : 2021-04-09 | 2019-12-17 : 2023-12-15 | 1977-02-15 : 2021-04-09 | 1977-02-15 : 2023-12-15 |
Выбор гиперпараметров выполняется с использованием первого тренировочного окна в каждом блоке времени гиперпараметров, а затем используется для всех окон в этом блоке времени. Для каждого блока времени гиперпараметров мы повторяем процесс выбора гиперпараметров, обучения, тестирования и скользящего/расширяющего окно. После завершения последнего блока времени мы усредняем значения оценки RMSE и MAPE из каждого окна, чтобы получить общие значения MAPE и RMSE. Весь эксперимент также повторяется с горизонтами прогнозирования 20 и 60 рабочих дней в дополнение к 15-дневному горизонту прогнозирования. Результаты устойчивы на различных горизонтах прогнозирования.
3 Результаты
Сначала мы рассмотрим методы глубокого обучения, изучив, как каждый метод проявил себя для скользящих стационарных, скользящих нестационарных, расширяющихся стационарных и расширяющихся нестационарных конфигураций (стационарные входные данные — это данные, которые были обработаны для устранения нестационарности). Затем мы перейдем к традиционной статистике/эконометрике и классическим методам машинного обучения с конфигурациями на основе скользящего окна и расширяющегося окна. Лучшие конфигурации для каждой модели представлены в том, что мы назовем таблицей итоговой производительности модели.
3.1 Анализ методов глубокого обучения
Таблица 2 показывает результаты оценки ошибок для методов глубокого обучения. Таблица 6 в Приложении A.3 показывает стандартное отклонение этих результатов. И есть запаздывание Из всех методов глубокого обучения для общего среднего лучшие показатели по обеим метрикам, RMSE и MAPE, у TimeGPT. Если исключить TimeGPT, наилучшие результаты по обеим метрикам показывает RNN sliding stationary. Остальные семь методов глубокого обучения уступают двум лидерам. Однако TimeGPT является базовой моделью, и неудивительно, что она хорошо справляется и способна работать с нестационарностью.
В методах глубокого обучения не наблюдается закономерности в том, является ли прогнозная ошибка лучше в стационарном или нестационарном случае, хотя такая закономерность есть внутри каждого метода. Поэтому, вероятно, лучше заранее выполнить обратное тестирование всех четырех конфигураций для любой модели, прежде чем применять ее на практике. Интересно отметить, что MAPE снижается по мере роста зрелости процентной ставки (см. последовательность прогнозных ошибок для TimeGPT). Вероятно, это связано с тем, что кривая доходности более стабильна для более длинных сроков погашения.
| DGS1 | DGS2 | DGS5 | DGS7 | DGS10 | DGS30 | |||||||
| RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | |
| RNN (sliding stationary) | 0.146486 | 5.691793 | 0.166394 | 5.716609 | 0.176017 | 4.465607 | 0.177391 | 3.926334 | 0.170646 | 3.410476 | 0.152589 | 2.581476 |
| RNN (sliding nonstationary) | 0.195552 | 9.748064 | 0.208004 | 8.089539 | 0.212033 | 5.506938 | 0.209340 | 4.693390 | 0.203377 | 4.139175 | 0.189386 | 3.366322 |
| RNN (expanding stationary) | 0.154095 | 5.712689 | 0.168214 | 5.490106 | 0.182967 | 4.455710 | 0.181488 | 3.894526 | 0.176783 | 3.447804 | 0.161176 | 2.670425 |
| RNN (expanding nonstationary) | 0.174211 | 7.175032 | 0.186559 | 6.950657 | 0.186624 | 4.725463 | 0.183169 | 3.983092 | 0.173481 | 3.400692 | 0.162370 | 2.693776 |
| NBEATS (sliding stationary) | 0.169360 | 6.735220 | 0.193535 | 6.775572 | 0.212114 | 5.300780 | 0.212962 | 4.618561 | 0.204240 | 4.054331 | 0.183500 | 3.080803 |
| NBEATS (sliding nonstationary) | 0.155120 | 5.972669 | 0.172803 | 5.821611 | 0.183478 | 4.592024 | 0.182792 | 4.0196230 | 0.178032 | 3.586611 | 0.161656 | 2.748928 |
| NBEATS (expanding stationary) | 0.173883 | 6.486442 | 0.193031 | 6.541242 | 0.208101 | 5.094602 | 0.208493 | 4.438186 | 0.200222 | 3.901296 | 0.184558 | 3.030955 |
| NBEATS (expanding nonstationary) | 0.151298 | 5.916051 | 0.172361 | 5.843841 | 0.186442 | 4.712045 | 0.186479 | 4.144330 | 0.177689 | 3.599258 | 0.160228 | 2.739180 |
| NHITS (sliding stationary) | 0.196427 | 8.606049 | 0.218681 | 8.168106 | 0.239196 | 6.457983 | 0.236885 | 5.695617 | 0.229014 | 4.949347 | 0.211299 | 3.878304 |
| NHITS (sliding nonstationary) | 0.156482 | 5.983679 | 0.173916 | 5.860408 | 0.185598 | 4.677531 | 0.185756 | 4.086771 | 0.179829 | 3.594320 | 0.160569 | 2.717352 |
| NHITS (expanding stationary) | 0.176017 | 7.021676 | 0.197292 | 6.960992 | 0.209467 | 5.361165 | 0.210712 | 4.730384 | 0.205131 | 4.170214 | 0.183448 | 3.091368 |
| NHITS (expanding nonstationary) | 0.163171 | 6.252572 | 0.184494 | 6.245819 | 0.198605 | 4.935274 | 0.196601 | 4.267738 | 0.189513 | 3.726338 | 0.169368 | 2.83406 |
| DeepAR (sliding stationary) | 0.192119 | 7.581507 | 0.213584 | 7.294004 | 0.233002 | 5.806743 | 0.236858 | 5.025318 | 0.228642 | 4.319988 | 0.213584 | 3.468202 |
| DeepAR (sliding nonstationary) | 0.219236 | 8.408970 | 0.240060 | 7.754574 | 0.247739 | 6.125960 | 0.242207 | 5.230717 | 0.235767 | 4.593314 | 0.209073 | 3.445667 |
| DeepAR (expanding stationary) | 0.172453 | 7.350338 | 0.194703 | 6.805798 | 0.208526 | 5.551862 | 0.206971 | 4.728295 | 0.201522 | 4.175998 | 0.181019 | 3.149804 |
| DeepAR (expanding nonstationary) | 0.212721 | 9.348876 | 0.236940 | 8.509383 | 0.252568 | 6.849793 | 0.247249 | 5.874684 | 0.239420 | 5.136509 | 0.215373 | 3.853309 |
| Vanilla Transformer (sliding stationary) | 0.168031 | 6.658371 | 0.189859 | 6.590129 | 0.201136 | 5.139067 | 0.199215 | 4.424766 | 0.190739 | 3.862510 | 0.173157 | 2.951177 |
| Vanilla Transformer (sliding nonstationary) | 0.198712 | 7.292155 | 0.220846 | 7.033475 | 0.233620 | 5.697577 | 0.231314 | 4.953559 | 0.223127 | 4.418951 | 0.199697 | 3.378204 |
| Vanilla Transformer (expanding stationary) | 0.158572 | 7.036351 | 0.179798 | 6.671527 | 0.196566 | 5.304733 | 0.197786 | 4.651128 | 0.191146 | 4.115878 | 0.172766 | 3.083212 |
| Vanilla Transformer (expanding nonstationary) | 0.169460 | 6.423364 | 0.189774 | 6.118753 | 0.199669 | 4.842441 | 0.202535 | 4.297821 | 0.195714 | 3.790389 | 0.172761 | 2.851225 |
| Informer (sliding stationary) | 0.161757 | 6.567544 | 0.182682 | 6.604669 | 0.201996 | 5.211218 | 0.202185 | 4.535645 | 0.196770 | 4.010102 | 0.177369 | 3.045935 |
| Informer (sliding nonstationary) | 0.165135 | 6.411187 | 0.188657 | 6.160168 | 0.196469 | 4.841849 | 0.195355 | 4.253372 | 0.189050 | 3.739071 | 0.171406 | 2.913314 |
| Informer (expanding stationary) | 0.160592 | 6.140962 | 0.181482 | 6.056592 | 0.195449 | 4.919052 | 0.195497 | 4.337823 | 0.188660 | 3.817651 | 0.172038 | 2.930998 |
| Informer (expanding nonstationary) | 0.164961 | 6.191474 | 0.182133 | 5.907332 | 0.195373 | 4.705156 | 0.192961 | 4.132589 | 0.187783 | 3.684220 | 0.170620 | 2.833431 |
| PatchTST (sliding stationary) | 0.160592 | 6.947785 | 0.195449 | 6.622958 | 0.195449 | 5.154602 | 0.195497 | 4.484637 | 0.188660 | 3.857123 | 0.172038 | 2.962577 |
| PatchTST (sliding nonstationary) | 0.154030 | 5.955978 | 0.172140 | 5.813934 | 0.185133 | 4.668095 | 0.182121 | 4.025542 | 0.176372 | 3.556664 | 0.158867 | 2.707418 |
| PatchTST (expanding stationary) | 0.168842 | 6.690186 | 0.187639 | 6.477896 | 0.205637 | 5.135185 | 0.204779 | 4.446965 | 0.196693 | 3.886160 | 0.176897 | 2.933590 |
| PatchTST (expanding nonstationary) | 0.152471 | 5.731149 | 0.170355 | 5.556025 | 0.183704 | 4.537304 | 0.183254 | 3.961829 | 0.175795 | 3.452532 | 0.158956 | 2.653176 |
| TFT (sliding stationary) | 0.157429 | 5.874464 | 0.178096 | 5.962244 | 0.195562 | 4.815003 | 0.193904 | 4.213565 | 0.190366 | 3.762933 | 0.171455 | 2.875232 |
| TFT (sliding nonstationary) | 0.179963 | 6.779674 | 0.198092 | 6.366203 | 0.205914 | 5.093868 | 0.204881 | 4.537172 | 0.198841 | 3.952223 | 0.176219 | 2.992915 |
| TFT (expanding stationary) | 0.159421 | 6.709400 | 0.181031 | 6.476538 | 0.199413 | 5.20641 | 0.202069 | 4.61318 | 0.19785 | 4.094073 | 0.174754 | 3.058329 |
| TFT (expanding nonstationary) | 0.160591 | 6.947784 | 0.1814820 | 6.622957 | 0.195449 | 5.154601 | 0.195496 | 4.484636 | 0.188660 | 3.857123 | 0.172038 | 2.962577 |
| TimeGPT (sliding nonstationary) | 0.142020 | 5.289395 | 0.159870 | 5.192356 | 0.171269 | 4.261029 | 0.170635 | 3.740923 | 0.164447 | 3.292777 | 0.147716 | 2.519419 |
3.2 Анализ классического машинного обучения и эконометрики
Таблица 3 показывает результаты для традиционных методов, классических методов машинного обучения и наивных бенчмарков. Таблица 7 в Приложении A.3 показывает стандартное отклонение этих результатов. Среди традиционных методов ARIMA sliding, ARIMA expanding и Naive Forecast демонстрируют наилучшие показатели в общей средней величине как по RMSE, так и по MAPE. Для ARIMA, если рассматривать точные значения, expanding ARIMA модель лучше для некоторых облигаций, а sliding ARIMA модель лучше в некоторых областях. Но различия по MAPE все меньше 0.1, и многие из них даже меньше 0.01. Таким образом, в общей средней величине нет явного победителя, и они фактически равны. Мы можем графически посмотреть временные блоки для ARIMA на рисунке 3 в Приложении. Рассматривая RMSE, графически не похоже, что есть заметная разница между sliding и expanding; точки, представляющие значение RMSE на i-м блоке времени для гиперпараметра, почти полностью перекрываются. Модели DHR-ARIMA также близки по производительности к моделям ARIMA. Модель DHR-ARIMA — это модель, которая объединяет модель ARIMA с терминами Фурье.
Для всех ансамблевых методов машинного обучения (Random Forests, LGBM и XGBoost) конфигурации с расширяющимся окном обгоняют конфигурации со скользящим окном как по RMSE, так и по MAPE. Однако для Random Forests различия по MAPE меньше 0.1. Для LGBM и XGBoost различия по MAPE во всех случаях больше 0.1%; для LGBM они находятся в диапазоне от 0.28% до 1.7%, а для XGBoost — от 0.2% до 1.6%. Таким образом, для этих методов, очевидно, больше данных означает более высокую эффективность. В целом методы ML не способны превзойти традиционные эконометрические методы.
| DGS1 | DGS2 | DGS5 | DGS7 | DGS10 | DGS30 | |||||||
| RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | MAPE | RMSE | MAPE | RMSE | |
| Naive | 0.135770 | 5.055572 | 0.152728 | 4.993154 | 0.163252 | 4.049806 | 0.162623 | 3.547320 | 0.156592 | 3.117768 | 0.141502 | 2.395196 |
| Naive Mean(sliding) | 1.533966 | 148.892752 | 1.406859 | 89.746779 | 1.128839 | 40.778551 | 1.014991 | 29.009124 | 0.911509 | 0.224073 | 0.750931 | 14.436432 |
| Naive Mean (expanding) | 3.503505 | 793.977015 | 3.504329 | 415.631810 | 3.380958 | 173.709844 | 3.301792 | 128.761174 | 3.214526 | 106.0753242 | 2.952753 | 74.544802 |
| Seasonal Naive | 0.157473 | 5.864617 | 0.177100 | 5.838530 | 0.190007 | 4.734742 | 0.188553 | 4.128603 | 0.181263 | 3.627423 | 0.162442 | 2.757525 |
| Random Forests (sliding) | 0.150790 | 6.196810 | 0.171023 | 5.894464 | 0.180937 | 4.599250 | 0.177776 | 3.944089 | 0.172608 | 3.492104 | 0.154956 | 2.653543 |
| Random Forests (expanding) | 0.146412 | 5.74374 | 0.165113 | 5.739487 | 0.176855 | 4.517249 | 0.176312 | 3.935435 | 0.168709 | 3.397517 | 0.153621 | 2.617225 |
| XGBoost (sliding) | 0.165700 | 7.250983 | 0.187430 | 6.488116 | 0.201199 | 5.154135 | 0.194842 | 4.376742 | 0.190484 | 3.822953 | 0.173862 | 2.967910 |
| XGBoost (expanding) | 0.152398 | 5.616206 | 0.175870 | 5.809686 | 0.186491 | 4.635582 | 0.184002 | 4.008400 | 0.178698 | 3.521038 | 0.160632 | 2.714995 |
| LGBM (sliding) | 0.161913 | 7.026354 | 0.177675 | 6.176718 | 0.189634 | 4.799284 | 0.185725 | 4.097728 | 0.181207 | 3.652131 | 0.164472 | 2.793609 |
| LGBM (expanding) | 0.142607 | 5.256113 | 0.160504 | 5.260603 | 0.172458 | 4.264067 | 0.171610 | 3.743909 | 0.165295 | 3.257688 | 0.148907 | 2.504541 |
| ARIMA (sliding) | 0.135890 | 5.055572 | 0.152612 | 5.005200 | 0.163123 | 4.059200 | 0.162586 | 3.555000 | 0.156626 | 3.120700 | 0.141562 | 2.397700 |
| ARIMA (expanding) | 0.135159 | 5.1487 | 0.152409 | 5.0561 | 0.163337 | 4.0585 | 0.162833 | 3.5543 | 0.156754 | 3.1232 | 0.141746 | 2.4018 |
| DHR-ARIMA (sliding) | 0.138657 | 6.2857 | 0.156686 | 5.1705 | 0.166255 | 4.1621 | 0.165264 | 3.6306 | 0.158840 | 3.1763 | 0.143420 | 2.4417 |
| DHR-ARIMA (expanding) | 0.137952 | 5.929800 | 0.154671 | 5.227900 | 0.166255 | 4.1621 | 0.165264 | 3.6306 | 0.158840 | 3.1763 | 0.143420 | 2.4417 |
| diff+VAR (sliding) | 0.138799 | 5.670032 | 0.153870 | 5.101855 | 0.163995 | 4.071155 | 0.163209 | 3.565666 | 0.157270 | 3.134817 | 0.142127 | 2.407170 |
| diff+VAR (expanding) | 0.1368373 | 5.198148 | 0.153148 | 5.034782 | 0.163663 | 4.053175 | 0.162886 | 3.547698 | 0.157007 | 3.122647 | 0.141831 | 2.400855 |
| VECM (sliding) | 0.1533478 | 6.446511 | 0.16965499 | 5.908182 | 0.18156569 | 4.576077 | 0.18084767 | 3.984029 | 0.17377951 | 3.508151 | 0.15539558 | 2.666769 |
| VECM (expanding) | 0.15623516 | 7.701282 | 0.17347999 | 6.220672 | 0.1798443 | 4.633831 | 0.17667 | 3.937529 | 0.16877586 | 3.410169 | 0.15207266 | 2.6136 |
3.3 Анализ таблицы итоговой производительности модели
Таблица 4 — это итоговая таблица производительности модели, которая сравнивает результаты лучших конфигураций. Таблица 8 в приложении A.3 показывает среднеквадратичное отклонение этих результатов. В среднем по всем показателям лучше всего справляются ARIMA с раздвигающимся окном, ARIMA с скользящим окном или Naive forecasts, что указывает на то, что для прогнозирования кривой доходности по-прежнему предпочтительным методом остаются традиционные эконометрические подходы. Для DGS1 и DGS2 лучше всего работает ARIMA с раздвигающимся окном, но Naive Forecast лучше всего на остальном. Ни один другой метод не обогнал Naive Forecast. Интуицию этого можно понять, поскольку на дневной частоте значение доходности обычно остается стабильным день за днем с очень незначительными колебаниями, за исключением случаев, когда происходит какое-то изменение политики или экономический фактор, вызывающий резкий скачок. Поэтому рассматриваемый процесс близок к martingale.
Из классических методов машинного обучения расширяющийся LGBM показывает наилучшие результаты. Среди методов глубокого обучения лучше всего показывает себя TimeGPT, а скользящая стационарная RNN занимает второе место. Три лучших алгоритма машинного обучения — это TimeGPT, расширяющийся LGBM и скользящая стационарная RNN.
| DGS1 | DGS2 | DGS5 | DGS7 | DGS10 | DGS30 | |||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | |
| Naive | 0.13577 | 5.055572 | 0.152728 | 4.993154 | 0.163252 | 4.049806 | 0.162623 | 3.547320 | 0.156592 | 3.117768 | 0.141502 | 2.395196 |
| Naive Mean (sliding) | 1.533966 | 148.892752 | 1.406859 | 89.746779 | 1.128839 | 40.778551 | 1.014991 | 29.009124 | 0.911509 | 0.224073 | 0.750931 | 14.436432 |
| Seasonal Naive | 0.157473 | 5.864617 | 0.177100 | 5.838530 | 0.190007 | 4.734742 | 0.188553 | 4.128603 | 0.181263 | 3.627423 | 0.162442 | 2.757525 |
| ARIMA (sliding) | 0.135890 | 5.055572 | 0.152612 | 5.005200 | 0.163123 | 4.059200 | 0.162586 | 3.555000 | 0.156626 | 3.120700 | 0.141562 | 2.397700 |
| ARIMA (expanding) | 0.135159 | 5.1487 | 0.152409 | 5.0561 | 0.163337 | 4.0585 | 0.162833 | 3.5543 | 0.156754 | 3.1232 | 0.141746 | 2.4018 |
| DHR-ARIMA (sliding) | 0.138657 | 6.2857 | 0.156686 | 5.1705 | 0.166255 | 4.1621 | 0.165264 | 3.6306 | 0.158840 | 3.1763 | 0.143420 | 2.4417 |
| DHR-ARIMA (expanding) | 0.137952 | 5.929800 | 0.154671 | 5.227900 | 0.166255 | 4.162100 | 0.165264 | 3.630600 | 0.158840 | 3.176300 | 0.143420 | 2.441700 |
| diff+VAR (expanding) | 0.1368373 | 5.198148 | 0.153148 | 5.034782 | 0.163663 | 4.053175 | 0.162886 | 3.547698 | 0.157007 | 3.122647 | 0.141831 | 2.400855 |
| VECM (sliding) | 0.1533478 | 6.446511 | 0.16965499 | 5.908182 | 0.18156569 | 4.576077 | 0.18084767 | 3.984029 | 0.17377951 | 3.508151 | 0.15539558 | 2.666769 |
| VECM (expanding) | 0.15623516 | 7.701282 | 0.17347999 | 6.220672 | 0.1798443 | 4.633831 | 0.17667 | 3.937529 | 0.16877586 | 3.410169 | 0.15207266 | 2.6136 |
| Random Forests (expanding) | 0.146412 | 5.74374 | 0.165113 | 5.739487 | 0.176855 | 4.517249 | 0.176312 | 3.935435 | 0.168709 | 3.397517 | 0.153621 | 2.617225 |
| XGBoost (expanding) | 0.152398 | 5.616206 | 0.175870 | 5.809686 | 0.186491 | 4.635582 | 0.184002 | 4.008400 | 0.178698 | 3.521038 | 0.160632 | 2.714995 |
| LGBM (expanding) | 0.142607 | 5.256113 | 0.160504 | 5.260603 | 0.172458 | 4.264067 | 0.171610 | 3.743909 | 0.165295 | 3.257688 | 0.148907 | 2.504541 |
| RNN (sliding stationary) | 0.146486 | 5.691793 | 0.166394 | 5.716609 | 0.176017 | 4.465607 | 0.177391 | 3.926334 | 0.170646 | 3.410476 | 0.152589 | 2.581476 |
| RNN (expanding stationary) | 0.154095 | 5.712689 | 0.168214 | 5.490106 | 0.182967 | 4.455710 | 0.181488 | 3.894526 | 0.176783 | 3.447804 | 0.161176 | 2.670425 |
| RNN (expanding nonstationary) | 0.174211 | 7.175032 | 0.186559 | 6.950657 | 0.186624 | 4.725463 | 0.183169 | 3.983092 | 0.173481 | 3.400692 | 0.162370 | 2.693776 |
| NBEATS (sliding nonstationary) | 0.155120 | 5.972669 | 0.172803 | 5.821611 | 0.183478 | 4.592024 | 0.182792 | 4.0196230 | 0.178032 | 3.586611 | 0.161656 | 2.748928 |
| NBEATS (expanding nonstationary) | 0.151298 | 5.916051 | 0.172361 | 5.843841 | 0.186442 | 4.712045 | 0.186479 | 4.144330 | 0.177689 | 3.599258 | 0.160228 | 2.739180 |
| NHITS (sliding nonstationary) | 0.156482 | 5.983679 | 0.173916 | 5.860408 | 0.185598 | 4.677531 | 0.185756 | 4.086771 | 0.179829 | 3.594320 | 0.160569 | 2.717352 |
| DeepAR (expanding stationary) | 0.172453 | 7.350338 | 0.194703 | 6.805798 | 0.208526 | 5.551862 | 0.206971 | 4.728295 | 0.201522 | 4.175998 | 0.181019 | 3.149804 |
| Vanilla Transformer (sliding nonstationary) | 0.198712 | 7.292155 | 0.220846 | 7.033475 | 0.233620 | 5.697577 | 0.231314 | 4.953559 | 0.223127 | 4.418951 | 0.199697 | 3.378204 |
| Vanilla Transformer(expanding stationary) | 0.158572 | 7.036351 | 0.179798 | 6.671527 | 0.196566 | 5.304733 | 0.197786 | 4.651128 | 0.191146 | 4.115878 | 0.172766 | 3.083212 |
| Informer(expanding stationary) | 0.160592 | 6.140962 | 0.181482 | 6.056592 | 0.195449 | 4.919052 | 0.195497 | 4.337823 | 0.188660 | 3.817651 | 0.172038 | 2.930998 |
| Informer (expanding nonstationary) | 0.164961 | 6.191474 | 0.182133 | 5.907332 | 0.195373 | 4.705156 | 0.192961 | 4.132589 | 0.187783 | 3.684220 | 0.170620 | 2.833431 |
| PatchTST (sliding nonstationary) | 0.154030 | 5.955978 | 0.172140 | 5.813934 | 0.185133 | 4.668095 | 0.182121 | 4.025542 | 0.176372 | 3.556664 | 0.158867 | 2.707418 |
| PatchTST (expanding nonstationary) | 0.152471 | 5.731149 | 0.170355 | 5.556025 | 0.183704 | 4.537304 | 0.183254 | 3.961829 | 0.175795 | 3.452532 | 0.158956 | 2.653176 |
| TFT (sliding stationary) | 0.157429 | 5.874464 | 0.178096 | 5.962244 | 0.195562 | 4.815003 | 0.193904 | 4.213565 | 0.190366 | 3.762933 | 0.171455 | 2.875232 |
| TFT (expanding nonstationary) | 0.160591 | 6.947784 | 0.1814820 | 6.622957 | 0.195449 | 5.154601 | 0.195496 | 4.484636 | 0.188660 | 3.857123 | 0.172038 | 2.962577 |
| TimeGPT (sliding nonstationary) | 0.142020 | 5.289395 | 0.159870 | 5.192356 | 0.171269 | 4.261029 | 0.170635 | 3.740923 | 0.164447 | 3.292777 | 0.147716 | 2.519419 |
| DGS1 | DGS2 | DGS5 | DGS7 | DGS10 | DGS30 | |||||||
| RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | |
| Naive | 0.125155 | 8.080886 | 0.157298 | 7.236926 | 0.16938 | 5.734847 | 0.164981 | 5.147716 | 0.15713 | 4.787099 | 0.140188 | 3.833706 |
| ARIMA (sliding) | 0.120157 | 8.48615 | 0.16938 | 5.734847 | 0.164981 | 5.147716 | 0.157465 | 4.801335 | 0.140546 | 3.848617 | ||
| ARIMA (expanding) | 0.154068 | 7.270121 | 0.168742 | 5.728651 | 0.164294 | 5.13737 | 0.15666 | 4.786389 | 0.140324 | 3.842605 | ||
| PatchTST (expanding nonstationary) | 0.123822 | 8.056854 | 0.155287 | 7.251545 | ||||||||
| TFT (expanding nonstationary) | 0.120108 | 8.017696 | 0.155279 | 7.282278 | 0.169733 | 5.784258 | 0.165366 | 5.183267 | 0.157947 | 4.832981 | 0.140756 | 3.846431 |
Однако, если мы наблюдаем различные блоки времени для гиперпараметров, замечаем, что в некоторых случаях PatchTST и TFT могут справляться лучше, особенно с нестационарными расширяющимися данными. Таблица 5 показывает TFT и PatchTST (оба с расширяющимися нестационарными данными) по сравнению с Naive Forecast и ARIMA на блоке времени 8. Для DGS1 нестационарный расширяющийся TFT обходит Naive Forecast и скользящий ARIMA, но не расширяющийся ARIMA. Однако эти показатели очень близки. В блоке времени 8 для DGS5, DG7, DGS10 и DGS30 нестационарный расширяющийся PatchTST превосходит другие методы; однако это совсем небольшие различия, например 0,03% или 0,05%. Это может быть связано с большим объемом данных или с блоком времени. Поэтому мы можем наблюдать его работу во времени, чтобы увидеть, улучшается ли она со временем относительно Naive Forecast и ARIMA; и можем сравнить ее со скользящими методами с окном (см. рисунок 4 для графика). Скользящее окно PatchTST также хорошо работает на этом блоке времени, но хуже, чем расширяющийся нестационарный. Таким образом, некоторые эффекты могут быть обусловлены как типом случайного процесса, который соответствует последнему блоку времени, так и наличием большего объема данных, возникающего при конфигурации с расширяющимся окном.
Рисунок 3 показывает эффективность модели ARIMA со временем. Рисунки 4, 5 и 6 в Приложении A.4 сравнивают эффективность лучших конфигураций со временем некоторых моделей глубокого обучения по сравнению с ARIMA и Naive Forecast. Верхняя половина рисунков показывает эволюцию RMSE со временем, а нижняя половина — эволюцию MAPE со временем. RMSE снижается со временем, а MAPE, по-видимому, растет со временем. Это просто потому, что процентные ставки в периоде выборки в среднем снизились до более низких уровней, как видно на Рисунке 1. Следовательно, уровни ошибки снижаются, но процентная ошибка увеличивается.
Мы также провели аналогичные анализы по общим средним значениям для горизонтов прогнозирования в 20 и 60 рабочих дней. В целом оказалось, что Naive Forecast обычно превосходит все остальные методы, а ARIMA идет сразу за ним. Это подтверждает, что традиционные эконометри ческие методы по-прежнему являются наилучшими для этой задачи. Предобученные модели, такие как TimeGPT, использовались только в режиме zero-shot без дообучения и могут быть менее конкурентоспособными по сравнению с эконометри ческими моделями, такими как ARIMA, которые каждый раз подгоняются при выполнении прогноза. Глубокие модели, которые мы пробовали, могут демонстрировать худшие результаты из-за переобучения данных, что приводит к слабой вневыборочной производительности.
4 Заключение
Статья рассматривает важный артефакт в финансах — кривая доходности, которая лежит в основе всей торговли облигациями. Рынки облигаций гораздо больше рынков акций, как отмечено в разделе 2.1, и потому анализы в данной статье будут адресованы широкой аудитории участников финансовых рынков. Угол наклона кривой доходности эмпирически известен как предвестник рецессий: то есть когда кривая доходности понижается, это предсказывает рецессию примерно за 18-24 месяца, с сопутствующими финансовыми и экономическими последствиями для всех граждан. Для этого в методологии предусмотрена возможность прогнозировать наклон на основе индивидуальных прогнозов доходности. Подходящий выбор прогнозов также представляет интерес для регуляторов, особенно для Федеральной резервной системы и Министерства финансов, которые управляют доходностями и испытывают влияние со стороны процентных ставок.
В этой статье мы поставили четыре основные цели: (1) Сравнить производительность методов машинного обучения (классического ML и глубокого обучения) и традиционных методов эконометрики/временных рядов на временных рядах доходностей казначейских облигаций. Мы использовали RMSE и MAPE для оценки производительности. (2) Проверить производительность моделей на нескольких горизонтах прогнозирования и на различных скользящих временных интервалах. (3) Определить, что работает лучше: обучение с расширяющимся окном или с скользящим окном. (4) Сравнить стационарные и нестационарные входные данные специально для алгоритмов глубокого обучения на этом наборе данных.
В разделе 3 мы выполнили эксперименты для сравнительной оценки этих целей на ежедневном временном ряду длиной 47 лет. Наши анализы показывают, что традиционный эконометрический алгоритм (ARIMA) и наивная модель-эталон в среднем показали наилучшие результаты. Поэтому подходы глубокого обучения не смогли превзойти традиционные (и, по меньшей мере, более простые) эконометрические методы. Методы глубокого обучения превосходили другие методы только в последнем временном блоке, где PatchTST лучше работал с расширяющимися окнами обучения, хотя и с небольшим отрывом. Классические модели машинного обучения также не смогли обойти традиционные модели. В случаях, когда мы выполняли прогноз на 20 и 60 дней вперед, эти общие выводы не изменились.
Для нашей цели изучить, показывает ли модель глубокого обучения более высокую производительность при стационарности по сравнению с нестационарностью данных, модель RNN показала лучшую работу при стационарной скользящей конфигурации; PatchTST и TFT показали лучшую работу при нестационарной конфигурации.
4.1 Расширения и направления для улучшения
Существует множество способов, с помощью которых анализы в этой статье могут быть расширены. Во-первых, мы можем использовать больше экзогенных переменных в качестве признаков. Например, для содействия прогнозированию кривой доходности при предсказании рецессии может применяться анализ настроений в социальных сетях и новостях. Кроме того, включение экзогенных переменных, таких как макроэкономические показатели, рыночные настроения и другие релевантные финансовые метрики, может дать больше контекста и повысить точность прогнозов. Во-вторых, могут быть применены вероятностные методы прогнозирования, такие как conformal prediction (Manokhin, 2023), чтобы количественно оценить неопределенность в наших прогнозах. Поскольку мы сравниваем несколько методов, мы используем точечное прогнозирование вместо использования интервалов прогнозирования/вероятностного прогнозирования, потому что все методы не поддерживают простое формирование интервалов ошибок прогноза. В-третьих, возможно использование проверки значимости нулевой гипотезы для сравнения результатов. Это вносит потенциальное осложнение, связанное с необходимостью иметь дело с множественными сравнениями. В-четвертых, дальнейшая работа также может исследовать применение методов комбинирования прогнозов, которые объединяют сильные стороны различных моделей для достижения более высокой производительности. В-пятых, мы можем использовать более современные foundation models для прогнозирования, которые сейчас проходят апробацию. Для TimeGPT мы не изучали различия между стационарными и нестационарными входными данными; также можно исследовать, как fine tuning может изменить результаты. В-шестых, мы можем использовать разные частоты данных, в частности недельные данные. Это может улучшить прогнозы, если дневные данные более зашумлены, чем недельные.
Еще одно расширение, которое мы рассмотрим, — использование многомерного оценивания. Проверялись VAR и VECM, и это корректные многомерные модели. Однако обычный ARIMA необходимо применять в одномерном режиме, а многие модели глубокого обучения, использованные в исследовании, были реализованы компанией Nixtla как «глобальные одномерные модели», где одна модель обучается на всех временных рядах. Тем не менее, для обеспечения справедливого сравнения всех моделей мы не объединяли все временные ряды в многомерном анализе. Поэтому можно ожидать некоторого улучшения, когда это дополнение будет выполнено. Дополнительные результаты, не включенные в данную статью, доступны в Singh (2024). Еще один многофакторный подход, который демонстрирует хорошие результаты, — это работа Ang and Piazzesi (2003).
В заключение, данная статья сравнила модели машинного обучения с традиционными моделями эконометрики и наивными бенчмарками. Анализ показывает, что в лидерах оказываются ARIMA и Naive. Среди моделей машинного обучения наилучшие результаты продемонстрировали TimeGPT и расширяющийся LGBM. Мы также сравнили подход со скользящим окном и подход с расширяющимся окном, а также нестационарный ввод и стационарные входные данные для deep learning; результаты при этом различаются в зависимости от модели. В целом, кривая доходности, по-видимому, по-прежнему лучше всего прогнозируется с использованием традиционных методов эконометрики, которые просты и недороги в применении.
Ссылки
- Безарбитражная векторная авторегрессия динамики временной структуры с макроэкономическими и скрытыми переменными. Journal of Monetary Economics 50 (4), pp. 745–787. Внешние ссылки: ISSN 0304-3932, Link, Document Цитируется: §4.1.
- Хронос: изучение языка временных рядов. Примечание: https://arxiv.org/abs/2403.07815 Внешние ссылки: 2403.07815 Цитируется: §1.1.
- ⟦ Премии за риск облигаций с использованием машинного обучения. The Review of Financial Studies 34 (2), pp. 1046–1089. Внешние ссылки: Document Цитируется: §1.2, §1.2.
- ⟦ О возможностях и рисках базовых моделей. Примечание: https://arxiv.org/abs/2108.07258 Доступ осуществлён: 24 мая 2024 г. Цитируется: §1.1.
- ⟦ Прогнозирование кривой доходности с использованием комбинаций прогнозов. Примечание: https://dx.doi.org/10.2139/ssrn.2311733 Внешние ссылки: Document Цитируется: §1.2.
- NHITS: neural hierarchical interpolation for time series forecasting. Том 37. Примечание: https://doi.org/10.1609/aaai.v37i6.25854 Внешние ссылки: Document Цитируется: §2.2.
- ⟦ Модели коррекции ошибок вектора с стационарными и нестационарными переменными. Примечание: https://ssrn.com/abstract=4218834Доступно на SSRN: http://dx.doi.org/10.2139/ssrn.4218834 Цитируется: §2.2.
- TimeGPT-1. Примечание: https://arxiv.org/abs/2310.03589 Внешние ссылки: 2310.03589 Цитируется: §1.1.
- Генеративные состязательные сети. В материалах Ежегодной конференции по нейронной обработке информационных данных (NIPS), Монреаль, Квебек, Канада, стр. 2672–2680. Цитируется: §1.1.
- Оценка прогнозов для специалистов по анализу данных: типичные ошибки и лучшие практики. Data Mining and Knowledge Discovery 37 (2), pp. 788–832. Внешние ссылки: Link Цитируется: §A.1.2.
- Прогнозирование премий риска облигаций с помощью машинного обучения. Аттестационная работа магистра, Университет Эразма, Роттердам, Нидерланды; https://thesis.eur.nl/pub/55747/Final_version_thesis.pdf. Внешние ссылки: Link Цитируется: §1.2.
- Вероятностное распределение по схеме Шаума, случайные величины и случайные процессы. McGraw-Hill Education, Нью-Йорк. Цитируется: §A.1.1.
- Прогнозирование: принципы и практика. Otexts, Lexington, KY. Внешние ссылки: Link Цитируется: item 1, §A.1.2.
- ⟦ Time-llm: прогнозирование временных рядов с перепрограммированием больших языковых моделей. Примечание: https://arxiv.org/abs/2310.01728 Внешние ссылки: 2310.01728 Цитируется: §1.1.
- ⟦ Автокодирование с вариационным байесовским выводом. arXiv. Внешние ссылки: 1312.6114 Цитировано: §1.1.
- Temporal fusion transformers для интерпретируемого многогоризонтного прогнозирования временных рядов. International Journal of Forecasting 37 (4), стр. 1748–1764. Внешние ссылки: Link Цитируется: §1.1.
- ⟦Pyraformer: low-complexity pyramidal attention for long-range time-series modeling and forecasting. In Proceedings of the International Conference on Learning Representations, External Links: Link Cited by: §1.1.
- ITransformer: инвертированные transformer являются эффективными для прогнозирования временных рядов. препринт arXiv. внешние ссылки: 2310.06625, Link цитируется: §1.1.
- Достижения в машинном обучении для финансов. Wiley. Внешние ссылки: ISBN 978-1119482086, Link Цитируется: §A.2.
- Соревнование m4: 100 000 временных рядов и 61 метод прогнозирования. International Journal of Forecasting 36 (1), стр. 54–74. Внешние ссылки: Link Цитируется: §1.1.
- ⟦ Конформное предсказание для временных рядов и прогнозирования. In Practical Guide to Applied Conformal Prediction in Python, Cited by: §4.1.
- ⟦ Стационарность тренда против процессов разностной стационарности. Примечание: Доступ осуществлён: 11 янв. 2024 г. Внешние ссылки: Link Цитируется: §A.1.2.
- ⟦К0⟧ Невозвратность стационарности корня единицы. Примечание: Доступ осуществлён: 11 янв. 2024 Внешние ссылки: Link Цитируется: §A.1.2.
- ⟦ Прогнозирование кривой доходности в среде с богатым данными: подход var с добавлением факторов без арбитража. SSRN Electronic Journal. Внешние ссылки: Document, Link Цитируется: §1.2.
- ⟦ Прогнозирование кривой доходности с моделями, управляемыми макроэкономическими факторами: сравнение подходов машинного обучения и традиционных статистических методов. RPubs. Внешние ссылки: Link Процитировано: §1.2.
- ⟦ Скудное моделирование кривых доходности. Журнал бизнеса 60 (4), стр. 473. Внешние ссылки: Document Цитируется: §1.2.
- ⟦ Временной ряд стоит 64 слова: долгосрочное прогнозирование с помощью transformers. На одиннадцатой Международной конференции по Learning Representations, Внешние ссылки: Link Цитируется: §1.1.
- Прогнозирование доходностей казначейских облигаций США с использованием методов машинного обучения. Магистерская работа, Университет Эразма Роттердамского, Школа экономики Эразма. Цитируется: §1.2.
- N-beats: neural basis expansion analysis for interpretable time series forecasting. arXiv:1905.10437 [cs.LG]. External Links: Link Cited by: §2.2.
- ⟦ Сравнение прогнозов финансовых моделей. Докторская диссертация, Университет Суррея. Цитируется: §1.2.
- ⟦ Моделирование и прогнозирование кривых доходности: сравнение опубликованных методов. Магистерская работа, Людвиг-Максимилианс-Университет Мюнхена, Мюнхен, Германия. Цитируется: §1.2.
- DeepAR: вероятностное прогнозирование с авторегрессионными рекуррентными сетями. International Journal of Forecasting 36 (3), стр. 1181–1191. Внешние ссылки: Document, Link Цитируется: §2.2.
- Статистический подход машинного обучения для прогнозирования кривой доходности. На 2017 International Conference on Computational Intelligence in Data Science (ICCIDS), Внешние ссылки: Document Цитируется: §1.2.
- ⟦ Модель в виде «только декодера» фундаментального типа для прогнозирования временных рядов. Блог Google Research. Внешние ссылки: Link Цитируется: §1.1.
- Анализ временных рядов и его применения. Springer, New York, NY. Цитируется: §2.2.
- ⟦ Да, transformers эффективны для прогнозирования временных рядов (+ autoformer). Блог Hugging Face. Внешние ссылки: Link Цитируется: §1.1.
- ⟦ Обзор вариационных автоэнкодеров для разделения источников, финансовых приложений и задач обработки биосигналов. Entropy 24 (1), стр. 55. Внешние ссылки: Link Цитируется: §1.1.
- ⟦ Рекурсивное многошаговое прогнозирование кривых доходности казначейских облигаций США с использованием машинного обучения и эконометрики. Магистерская диссертация, Университет Санта-Клары, Санта-Клара, США. Цитируется: §4.1.
- ⟦A hybrid method of exponential smoothing and recurrent neural networks for time-series forecasting. International Journal of Forecasting 36 (1), pp. 75–85. Ссылки на внешние ресурсы: Link Цитируется: §1.1.
- Глава 6 - случайные процессы. EE 385, Университет Алабамы в Хантингтоне. Примечание: Дата обращения: 17 марта 2023 г. Альтернативная ссылка: https://drive.google.com/file/d/1X-2hRmXtF9D-hXuBf1hHs73AmLbNjaj7/view?usp=sharing Внешние ссылки: Link Цитируется: §A.1.2⟧.
- ⟦ Введение в регрессию временных рядов и прогнозирование. В Introduction to Econometrics, стр. 568–621. Цитируется: item 2, §A.1.2.
- Аналитика больших данных в экономике: что мы узнали на данный момент и куда нам следует двигаться дальше?. Canadian Journal of Economics/Revue canadienne d’économique 51 (3), pp. 695–746. Цитируется: §1.2, §1.2.
- Анализ финансовых временных рядов. Wiley, Hoboken, NJ. Цитируется: §A.1.1.
- ⟦ Внимание — это всё, что нужно. arXiv 1706.03762. Внешние ссылки: Link Цитируется: §1.1⟧.
- ⟦ Moirai: модель фундаментального типа для временных рядов, предназначенная для универсального прогнозирования. Блог Salesforce AI Research. Внешние ссылки: Link Цитируется: §1.1.
- ⟦Autoformer: decomposition transformers with auto-correlation for long-term series forecasting. In Advances in Neural Information Processing Systems 34 (NeurIPS 2021), Cited by: §1.1.
- ⟦Are transformers effective for time-series forecasting?. In Proceedings of the Thirty-Seventh AAAI Conference on Artificial Intelligence (AAAI-23), pp. 26317. External Links: ISBN 978-1-57735-880-0, Document Cited by: §1.1.
- Прогнозирование цены казначейского облигационного займа и кривой доходности с использованием аргументов отсутствия арбитража и машинного обучения. Примечание: https://ssrn.com/abstract=4024209 Внешние ссылки: Document Цитируется: §1.2⟧.
- ⟦ Informer: beyond efficient transformer for long sequence time-series forecasting. Proceedings of the AAAI Conference on Artificial Intelligence 35 (12), pp. 11106–11115. External Links: Document Cited by: §1.1.
- ⟦ FEDformer: frequency enhanced decomposed transformer for long-term series forecasting. В материалах 39-й Международной конференции по машинному обучению (ICML 2022), Том 162, стр. 27268–27286. Цитируется: §1.1.
Appendix A Приложение
A.1 Стационарность
A.1.1 Слабая стационарность
Случайный процесс является слабо стационарным, если он удовлетворяет следующим условиям [Hsu, 2014, Tsay, 2010]:
- ⟦1. (constant mean)
- ⟦2. (автоковариация зависит только от разности во времени)
- 3. Конечная дисперсия
Свойство указывает, что автоковариация между случайным процессом во времена и зависит только от разности по времени .
Свойство 2 подразумевает, что дисперсия постоянна. Мы будем просто называть слабую стационарность стационарностью.
A.1.2 Причины нестационарности
Есть несколько причин нестационарности [MathWorks, 2024b, a, Hewamalage et al., 2022, Hyndman and Athanasopoulos, 2021, Stensby, 2014, Stock and Watson, 2015].
- ⟦1. Тенденции: «долгосрочное увеличение или уменьшение в данных» [Hyndman and Athanasopoulos, 2021]. a) Детерминированные тенденции: тенденция является детерминированной. Шоки будут иметь временные эффекты. b) Стохастические тенденции: тенденция является стохастической. Шоки имеют постоянные эффекты. Также известны как unit roots.
- 2. Структурные разрывы: Внезапные или постепенные изменения в коэффициентах регрессии для населения [Stock and Watson, 2015].
- ⟦Гетероскедастичность: дисперсия ряда меняется.
- ⟦4. Сезонность: это периодические колебания.
Для стохастических трендов используется операция дифференцирования, чтобы преобразовать данные в стационарные. Для детерминированных трендов тренд можно моделировать с помощью регрессионной модели и вычитать из временного ряда. Для сезонности применяют сезонное дифференцирование или используют сезонные компоненты. В этой статье мы использовали операцию дифференцирования, чтобы получить стационарность в наших данных.
A.2 Разбиение данных
Один из способов оценить алгоритм прогнозирования называется методом фиксированного начала. Данные разделяются на обучающую и тестовую выборки; после обучения алгоритм прогнозирует следующие шагов по тестовой выборке; мы измеряем ошибку на каждом прогнозе с помощью выбранной метрики.
Однако это может быть не строгой оценкой; лучше использовать несколько окон, где момент начала прогноза смещается; это известно как метод скользящего начала или метод пошагового прогнозирования. Скользящая оконная CV и расширяющая оконная CV являются частными случаями метода пошагового прогнозирования.
(a) (b)
В расширяющемся окне для CV мы начинаем с исходного окна данных размером . Модель обучается на этом окне, а затем прогнозирует точек, которые можно оценить. Затем окно расширяется, чтобы включить шаг размера , с + точками. Поэтому если конечные положения исходного окна были [0,], то новое окно будет [0,]. Затем модель обучается на этих точках и снова прогнозирует точек. Это повторяется до тех пор, пока горизонт прогноза не достигнет конца набора данных. См. рисунок 2.
В скользящем окне для CV мы начинаем с начального окна данных размера , но в этом случае размер не меняется. Модель обучается на этом окне, а затем прогнозирует точек, которые можно оценить. Затем окно сдвигается вперед на шагов; так что если начальные положения конца окна были [0,], то новое окно будет ,]. Затем она обучается на этих точках и снова прогнозирует h точек. Это повторяется до тех пор, пока горизонт прогноза не достигнет конца набора данных.
Метод скользящего пошагового просмотра можно определить как «историческое моделирование того, как наш алгоритм работал в прошлом» [López de Prado, 2018]. Преимущества метода скользящего пошагового просмотра следующие:
- ⟦1. Существует историческая интерпретация.
- ⟦2. Устраняет утечку данных.
Два основных недостатка:
- ⟦1. Возвращаясь к идее случайного процесса, исторический путь является лишь одним осуществлением этого процесса. Поскольку исторический путь — это всего лишь один сценарий, тестирование, опирающееся только на один прошлый сценарий, рискует привести к переобучению.
- ⟦2. Производительность на историческом пути методом скользящего обхода вперед может не отражать будущую производительность вашего алгоритма; алгоритм может переобучиться к конкретному порядку последовательности на траектории в выборке.
A.3 Среднеквадратическое отклонение метрик ошибки прогноза
В этом подразделе мы представляем стандартное отклонение показателей RMSE и MAPE прогнозов. Таблица 6 содержит стандартное отклонение оценок ошибок прогноза из Таблицы 2, которые были анализом методов глубокого обучения. Можно видеть, что у TimeGPT самое низкое стандартное отклонение. В рамках каждой модели наилучшее среднее значение оценок в большинстве случаев согласуется с наилучшими стандартными отклонениями, но не во всех случаях.
| DGS1 | DGS2 | DGS5 | DGS7 | DGS10 | DGS30 | |||||||
| RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | |
| RNN (sliding stationary) | 0.194001 | 9.371014 | 0.162663 | 7.487174 | 0.138588 | 4.900849 | 0.137446 | 3.878843 | 0.128832 | 3.270737 | 0.110987 | 2.214017 |
| RNN (sliding nonstationary) | 0.210150 | 23.148221 | 0.197456 | 14.242268 | 0.189039 | 6.998076 | 0.184905 | 5.731761 | 0.182635 | 4.861462 | 0.177668 | 4.364616 |
| RNN (expanding stationary) | 0.199035 | 8.926611 | 0.165057 | 6.676691 | 0.147118 | 4.587371 | 0.140713 | 3.669374 | 0.139866 | 3.306758 | 0.126082 | 2.295027 |
| RNN (expanding nonstationary) | 0.213879 | 11.242475 | 0.184713 | 24.053279 | 0.165088 | 10.626178 | 0.156569 | 5.745948 | 0.144809 | 3.461721 | 0.152542 | 3.001306 |
| NBEATS (sliding stationary) | 0.220370 | 11.640842 | 0.198353 | 9.696634 | 0.181917 | 5.927290 | 0.179617 | 4.674210 | 0.170585 | 4.023178 | 0.147968 | 2.731574 |
| NBEATS (sliding nonstationary) | 0.205605 | 11.160539 | 0.176561 | 7.864686 | 0.149617 | 5.199758 | 0.143902 | 4.310816 | 0.139380 | 3.995326 | 0.126600 | 2.567527 |
| NBEATS (expanding stationary) | 0.267078 | 11.395466 | 0.224555 | 8.908530 | 0.204546 | 5.789594 | 0.192343 | 4.446875 | 0.187227 | 3.995224 | 0.178735 | 2.855251 |
| NBEATS (expanding nonstationary) | 0.192890 | 9.541708 | 0.171958 | 7.133679 | 0.150931 | 5.198079 | 0.144840 | 4.249010 | 0.138660 | 3.618320 | 0.121443 | 2.419592 |
| NHITS (sliding stationary) | 0.295382 | 20.647861 | 0.264905 | 13.653818 | 0.237426 | 9.195409 | 0.219601 | 7.606641 | 0.216036 | 6.629158 | 0.192707 | 5.025899 |
| NHITS (sliding nonstationary) | 0.212958 | 10.205821 | 0.183349 | 8.264613 | 0.154622 | 5.371029 | 0.149619 | 4.187724 | 0.144124 | 3.493338 | 0.126850 | 2.366968 |
| NHITS (expanding stationary) | 0.242094 | 12.362057 | 0.230782 | 9.875113 | 0.174944 | 6.328451 | 0.170008 | 5.259927 | 0.169041 | 4.524931 | 0.152423 | 2.919252 |
| NHITS (expanding nonstationary) | 0.223415 | 10.884414 | 0.195813 | 8.550162 | 0.169195 | 5.517250 | 0.161844 | 4.382561 | 0.157555 | 3.549090 | 0.140878 | 2.511572 |
| DeepAR (sliding stationary) | 0.370247 | 16.225342 | 0.344032 | 13.691147 | 0.325369 | 7.690113 | 0.437514 | 6.574858 | 0.442863 | 5.773779 | 0.440790 | 5.242536 |
| DeepAR (sliding nonstationary) | 0.289207 | 20.071034 | 0.258349 | 13.979573 | 0.216005 | 8.157852 | 0.201986 | 5.918027 | 0.197893 | 4.647609 | 0.173889 | 2.895238 |
| DeepAR (expanding stationary) | 0.236524 | 14.612460 | 0.204433 | 10.436315 | 0.176311 | 7.739720 | 0.169411 | 5.517188 | 0.161797 | 5.115320 | 0.150860 | 3.585523 |
| DeepAR (expanding nonstationary) | 0.274395 | 23.638295 | 0.247546 | 16.050064 | 0.224100 | 10.881948 | 0.215877 | 8.924385 | 0.208023 | 7.082444 | 0.188662 | 4.627351 |
| Vanilla Transformer (sliding stationary) | 0.246883 | 10.738816 | 0.219728 | 8.794384 | 0.177163 | 5.628856 | 0.167761 | 4.457940 | 0.162165 | 4.010988 | 0.144691 | 2.681127 |
| Vanilla Transformer (sliding nonstationary) | 0.282478 | 16.684708 | 0.257638 | 10.242921 | 0.229150 | 6.796254 | 0.226525 | 5.371173 | 0.217671 | 4.708711 | 0.203272 | 3.355001 |
| Vanilla Transformer (expanding stationary) | 0.209274 | 15.833094 | 0.179388 | 10.396997 | 0.160312 | 6.371660 | 0.157623 | 5.302686 | 0.153099 | 5.184526 | 0.139460 | 3.222339 |
| Vanilla Transformer (expanding nonstationary) | 0.229673 | 10.819989 | 0.197327 | 7.307497 | 0.168772 | 5.026107 | 0.166882 | 3.994161 | 0.158347 | 3.447255 | 0.137912 | 2.335996 |
| Informer (sliding stationary) | 0.193975 | 12.408978 | 0.172880 | 9.540640 | 0.158191 | 6.047171 | 0.152022 | 4.740823 | 0.147216 | 4.043175 | 0.130097 | 2.732288 |
| Informer (sliding nonstationary) | 0.215522 | 10.267083 | 0.193711 | 7.066434 | 0.167023 | 5.118081 | 0.161740 | 4.234935 | 0.156405 | 3.713271 | 0.140469 | 2.892915 |
| Informer(expanding stationary) | 0.214680 | 10.453842 | 0.193129 | 7.971823 | 0.168308 | 5.151635 | 0.170636 | 4.111550 | 0.165369 | 3.610841 | 0.152312 | 2.592824 |
| Informer (expanding nonstationary) | 0.230936 | 11.904753 | 0.204508 | 7.820154 | 0.179234 | 4.822743 | 0.162614 | 3.879693 | 0.159271 | 3.411392 | 0.145086 | 2.415426 |
| PatchTST (sliding stationary) | 0.236839 | 17.681349 | 0.205936 | 11.336896 | 0.178746 | 6.394113 | 0.175206 | 4.806855 | 0.167399 | 3.997774 | 0.148863 | 2.740026 |
| PatchTST (sliding nonstationary) | 0.205970 | 10.751123 | 0.178671 | 7.816217 | 0.154022 | 5.285043 | 0.145980 | 4.297380 | 0.140401 | 3.699716 | 0.122231 | 2.406886 |
| PatchTST (expanding stationary) | 0.238233 | 13.221792 | 0.208217 | 9.549650 | 0.188198 | 6.220946 | 0.178926 | 4.727653 | 0.171295 | 4.095948 | 0.158887 | 2.702615 |
| PatchTST (expanding nonstationary) | 0.206674 | 9.505235 | 0.180923 | 6.572556 | 0.154196 | 4.806834 | 0.149170 | 3.891382 | 0.143946 | 3.326227 | 0.127001 | 2.336191 |
| TFT (sliding stationary) | 0.187052 | 9.023897 | 0.169054 | 7.582436 | 0.151602 | 4.861313 | 0.14586689 | 3.985152 | 0.147138 | 3.744146 | 0.130086 | 2.539736 |
| TFT (sliding nonstationary) | 0.24939805 | 11.914427 | 0.211641 | 8.224129 | 0.172777 | 5.806524 | 0.165844 | 5.208768 | 0.156989 | 3.928065 | 0.138504 | 2.675744 |
| TFT (expanding stationary) | 0.198127 | 15.236749 | 0.172650 | 8.335560 | 0.157108 | 6.473974 | 0.154537 | 5.366698 | 0.15127 | 4.30497 | 0.13077044 | 2.83763286 |
| TFT (expanding nonstationary) | 0.194463 | 15.672102 | 0.172193 | 10.281637 | 0.14923727 | 6.52532487 | 0.144136 | 5.036954 | 0.13860627 | 3.884175 | 0.124012 | 2.687823 |
| TimeGPT (sliding nonstationary) | 0.185213 | 8.673029 | 0.160217 | 6.202305 | 0.134315 | 4.494245 | 0.127829 | 3.752648 | 0.122387 | 3.236531 | 0.109011 | 2.213337 |
| DGS1 | DGS2 | DGS5 | DGS7 | DGS10 | DGS30 | |||||||
| RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | MAPE | RMSE | MAPE | RMSE | |
| Naive | 0.176857 | 8.361122 | 0.152006 | 5.974901 | 0.127638 | 4.284059 | 0.122221 | 3.500764 | 0.117291 | 2.994061 | 0.104616 | 2.0475081 |
| Naive Mean (sliding) | 1.134344 | 327.476781 | 1.053095 | 176.308774 | 0.941467 | 71.960916 | 0.908777 | 43.731603 | 0.879130 | 31.322088 | 0.815037 | 16.037434 |
| Naive Mean (expanding) | 1.698148 | 1543.402788 | 1.676391 | 757.577714 | 1.428569 | 275.145696 | 1.332582 | 169.538344 | 1.234872 | 123.875560 | 1.083507 | 65.867542 |
| Seasonal Naive | 0.195756 | 9.977126 | 0.166908 | 6.975633 | 0.139491 | 4.818090 | 0.133196 | 3.897796 | 0.128109 | 3.363182 | 0.113856 | 2.245416 |
| Random Forests (sliding) | 0.200185 | 10.203589 | 0.174595 | 7.347237 | 0.146761 | 5.366249 | 0.140711 | 4.440794 | 0.136712 | 4.060309 | 0.119932 | 2.484318 |
| Random Forests (expanding) | 0.198143 | 8.809668 | 0.169089 | 6.889892 | 0.143366 | 5.151816 | 0.137224 | 4.117087 | 0.133940 | 3.421853 | 0.120949 | 2.379350 |
| XGBoost (sliding) | 0.206805 | 8.197967 | 0.187669 | 6.358201 | 0.169268 | 5.325441 | 0.155966 | 4.221225 | 0.153512 | 2.767437 | 0.139364 | 2.767437 |
| XGBoost (expanding) | 0.206852 | 8.595066 | 0.190732 | 7.118983 | 0.164261 | 5.430950 | 0.150865 | 4.104016 | 0.150212 | 3.440415 | 0.127500 | 2.439450 |
| LGBM (sliding) | 0.209923 | 11.994326 | 0.180402 | 7.925223 | 0.150094 | 5.189844 | 0.144166 | 4.096100 | 0.140838 | 3.744107 | 0.127421 | 2.508858 |
| LGBM (expanding) | 0.200158 | 8.133562 | 0.175234 | 6.306747 | 0.143970 | 4.633200 | 0.138330 | 3.892541 | 0.134607 | 3.224729 | 0.119278 | 2.257060 |
| ARIMA (sliding) | 0.178056 | 8.4470 | 0.151584 | 5.9788 | 0.127203 | 4.3132 | 0.122192 | 3.5289 | 0.117364 | 2.9945 | 0.104733 | 2.0471 |
| ARIMA (expanding) | 0.178253 | 7.8837 | 0.152189 | 5.8641 | 0.127280 | 4.2859 | 0.122359 | 3.4999 | 0.117487 | 2.9849 | 0.104760 | 2.0495 |
| DHR-ARIMA (sliding) | 0.177390 | 19.2421 | 0.154861 | 6.1686 | 0.129988 | 4.4301 | 0.123386 | 3.6433 | 0.118064 | 3.1094 | 0.106099 | 2.1604 |
| DHR-ARIMA (expanding) | 0.176259 | 9.6016 | 0.151950 | 6.2879 | 0.129006 | 4.3682 | 0.122032 | 3.5432 | 0.117069 | 3.0202 | 0.104409 | 2.0554 |
| diff+VAR (sliding) | 0.176812 | 8.850917 | 0.1524477 | 6.052817 | 0.12985984 | 4.270754 | 0.12449062 | 3.496821 | 0.11968569 | 2.99846958 | 0.10584956 | 2.05373023 |
| diff+VAR (expanding) | 0.177444 | 8.243917 | 0.152393 | 5.922836 | 0.129550 | 4.251956 | 0.12405484 | 3.473514 | 0.119452 | 2.979156 | 0.105826 | 2.045680 |
| VECM (sliding) | 0.208336 | 10.906442 | 0.1771358 | 7.563252 | 0.148699 | 4.943110 | 0.14134967 | 3.929636 | 0.13512554 | 3.414322 | 0.11882189 | 2.33132972 |
| VECM (expanding) | 0.192521 | 13.046624 | 0.165482 | 7.887848 | 0.141066 | 5.10768405 | 0.134406 | 3.98585103 | 0.129452 | 3.351312 | 0.114338 | 2.294795 |
Мы видим, что только традиционные методы (скользящее ARIMA, расширяющееся ARIMA, расширяющееся DHR-ARIMA и расширяющееся VAR) имеют наименьшее стандартное отклонение. Наивный прогноз не имеет наименьшего стандартного отклонения ни для одной оценки, хотя в некоторых случаях он фактически связан с другими. Среди классических методов машинного обучения расширяющийся LGBM имеет наименьшее стандартное отклонение, тогда как TimeGPT имеет наименьшее из всех методов машинного обучения.
| DGS1 | DGS2 | DGS5 | DGS7 | DGS10 | DGS30 | |||||||
| RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | RMSE | MAPE | |
| Naive | 0.176857 | 8.361122 | 0.152006 | 5.974901 | 0.127638 | 4.284059 | 0.122221 | 3.500764 | 0.117291 | 2.994061 | 0.104616 | 2.0475081 |
| Naive Mean (sliding) | 1.134344 | 327.476781 | 1.053095 | 176.308774 | 0.941467 | 71.960916 | 0.908777 | 43.731603 | 0.879130 | 31.322088 | 0.815037 | 16.037434 |
| Seasonal Naive | 0.195756 | 9.977126 | 0.166908 | 6.975633 | 0.139491 | 4.818090 | 0.133196 | 3.897796 | 0.128109 | 3.363182 | 0.113856 | 2.245416 |
| ARIMA (sliding) | 0.178056 | 8.4470 | 0.151584 | 5.9788 | 0.127203 | 4.3132 | 0.122192 | 3.5289 | 0.117364 | 2.9945 | 0.104733 | 2.0471 |
| ARIMA (expanding) | 0.178253 | 7.8837 | 0.152189 | 5.8641 | 0.127280 | 4.2859 | 0.122359 | 3.4999 | 0.117487 | 2.9849 | 0.104760 | 2.0495 |
| DHR-ARIMA (sliding) | 0.177390 | 19.2421 | 0.154861 | 6.1686 | 0.129988 | 4.4301 | 0.123386 | 3.6433 | 0.118064 | 3.1094 | 0.106099 | 2.1604 |
| DHR-ARIMA (expanding) | 0.176259 | 9.6016 | 0.151950 | 6.2879 | 0.129006 | 4.3682 | 0.122032 | 3.5432 | 0.117069 | 3.0202 | 0.104409 | 2.0554 |
| diff+VAR (expanding) | 0.177444 | 8.243917 | 0.152393 | 5.922836 | 0.129550 | 4.251956 | 0.124054 | 3.473514 | 0.119452 | 2.979156 | 0.105826 | 2.045680 |
| VECM (sliding) | 0.208336 | 10.906442 | 0.177135 | 7.563252 | 0.148699 | 4.943110 | 0.141349 | 3.929636 | 0.135125 | 3.414322 | 0.118821 | 2.331329 |
| VECM (expanding) | 0.192521 | 13.04662 | 0.165482 | 7.887848 | 0.141066 | 5.107684 | 0.134406 | 3.985851 | 0.129452 | 3.351312 | 0.114338 | 2.294795 |
| XGBoost (expanding) | 0.206852 | 8.595066 | 0.190732 | 7.118983 | 0.164261 | 5.430950 | 0.150865 | 4.104016 | 0.150212 | 3.440415 | 0.127500 | 2.439450 |
| LGBM (expanding) | 0.200158 | 8.133562 | 0.175234 | 6.306747 | 0.143970 | 4.633200 | 0.138330 | 3.892541 | 0.134607 | 3.224729 | 0.119278 | 2.257060 |
| RNN (sliding stationary) | 0.194001 | 9.371014 | 0.162662 | 7.487174 | 0.138587 | 4.900849 | 0.137446 | 3.878842 | 0.128832 | 3.270737 | 0.110987 | 2.214016 |
| RNN (expanding stationary) | 0.199035 | 8.926611 | 0.165056 | 6.676690 | 0.147118 | 4.587371 | 0.140712 | 3.669374 | 0.139865 | 3.306757 | 0.126081 | 2.295027 |
| RNN (expanding nonstationary) | 0.213878 | 11.242474 | 0.184713 | 24.053278 | 0.165087 | 10.626177 | 0.156568 | 5.745947 | 0.144808 | 3.461720 | 0.152542 | 3.001306 |
| NBEATS (sliding nonstationary) | 0.205605 | 11.160538 | 0.176561 | 7.864685 | 0.149616 | 5.199757 | 0.143901 | 4.310816 | 0.139380 | 3.995325 | 0.126599 | 2.567526 |
| NBEATS (expanding nonstationary) | 0.192890 | 9.541707 | 0.171957 | 7.133678 | 0.150931 | 5.198078 | 0.144840 | 4.249009 | 0.138660 | 3.618319 | 0.121443 | 2.419592 |
| NHITS (sliding nonstationary) | 0.21295811 | 10.205821 | 0.1833486 | 8.264612 | 0.154622 | 5.371029 | 0.149619 | 4.187724 | 0.144124 | 3.493338 | 0.126850 | 2.366968 |
| DeepAR (expanding stationary) | 0.236523 | 14.612460 | 0.204432 | 10.436314 | 0.176311 | 7.739719 | 0.169411 | 5.517187 | 0.161796 | 5.115320 | 0.150859 | 3.585523 |
| Vanilla Transformer (sliding nonstationary) | 0.282478 | 16.684707 | 0.257637 | 10.242920 | 0.229149 | 6.796253 | 0.226524 | 5.371173 | 0.217671 | 4.708710 | 0.203271 | 3.355000 |
| Vanilla Transformer (expanding stationary) | 0.209273 | 15.833093 | 0.179387 | 10.396997 | 0.160312 | 6.371659 | 0.157623 | 5.302686 | 0.153099 | 5.184526 | 0.139459 | 3.222339 |
| Informer(expanding stationary) | 0.214680 | 10.453842 | 0.193128 | 7.971822 | 0.168308 | 5.151635 | 0.170636 | 4.111549 | 0.165369 | 3.610840 | 0.152311 | 2.592824 |
| Informer (expanding nonstationary) | 0.230935 | 11.904752 | 0.204508 | 7.820154 | 0.179233 | 4.822743 | 0.162614 | 3.879693 | 0.159271 | 3.411391 | 0.145086 | 2.415425 |
| PatchTST (sliding nonstationary) | 0.205969 | 10.751122 | 0.178671 | 7.816217 | 0.154022 | 5.285042 | 0.145979 | 4.297380 | 0.140400 | 3.699716 | 0.122231 | 2.406886 |
| PatchTST (expanding nonstationary) | 0.206674 | 9.505235 | 0.180923 | 6.572556 | 0.154196 | 4.806834 | 0.149170 | 3.891382 | 0.143946 | 3.326227 | 0.127001 | 2.336191 |
| TFT (sliding stationary) | 0.187052 | 9.023897 | 0.169054 | 7.582436 | 0.151602 | 4.861313 | 0.145866 | 3.985152 | 0.147138 | 3.744146 | 0.130086 | 2.539736 |
| TFT (expanding nonstationary) | 0.194463 | 15.672102 | 0.172193 | 10.281637 | 0.149237 | 6.525324 | 0.144136 | 5.036954 | 0.138606 | 3.884175 | 0.124012 | 2.687823 |
| TimeGPT (sliding nonstationary) | 0.185213 | 8.673029 | 0.160217 | 6.202305 | 0.134315 | 4.494245 | 0.127829 | 3.752648 | 0.122387 | 3.236531 | 0.109011 | 2.213337 |
A.4 Анализ на основе блоков времени
В этом подразделе мы представляем некоторые результаты раздела 3 графически; в частности, выполняем декомпозицию метрик ошибок по блокам времени гиперпараметров. Рисунок 3 выполняет декомпозицию скользящего оконного ARIMA и расширяющегося оконного ARIMA по блокам времени. Рисунок 4 сравнивает эффективность лучших конфигураций PatchTST с ARIMA и Наивным прогнозом, с декомпозицией по блокам времени гиперпараметров.
В Рисунке 5 видно, что нестационарная расширяющаяся конфигурация TFT также имеет некоторые заметные показатели (например, для DGS1 в Блоке времени 2). Ее показатель MAPE составляет 2.452953%, что выше, чем показатель Naive 2.463761%, и чем показатель ARIMA для расширения 2.461910%; но эти значения по сути равны. Здесь TFT не лучше, чем ARIMA со скользящим окном, которое имеет среднюю ошибку 2.418810%. В Рисунке 6 видно, что у RNN также есть некоторые показатели в Блоке времени 3, которые превосходят ARIMA, но не метод Naive. Однако она обходит и ARIMA, и Naive в Блоке времени 6 для большинства связей.
(a) (b)
(a) (b)
(a) (a)
| (a) |
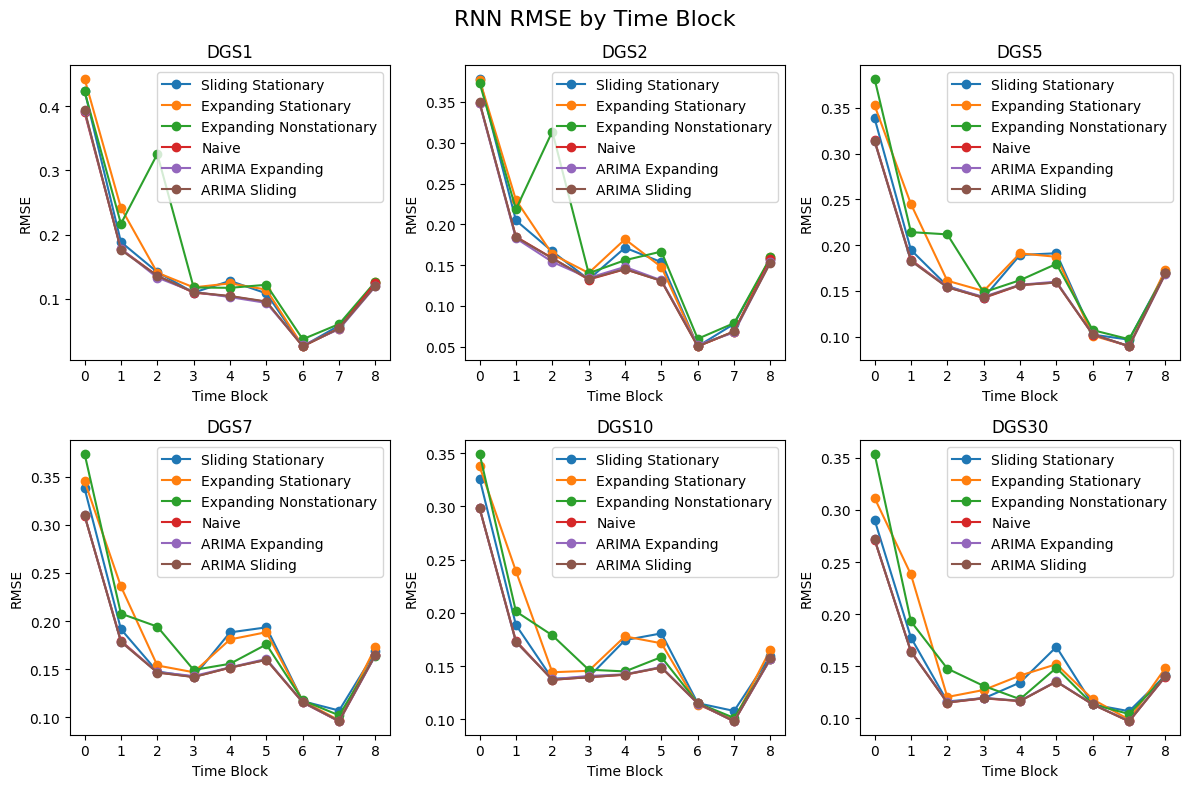 |
| (b) |
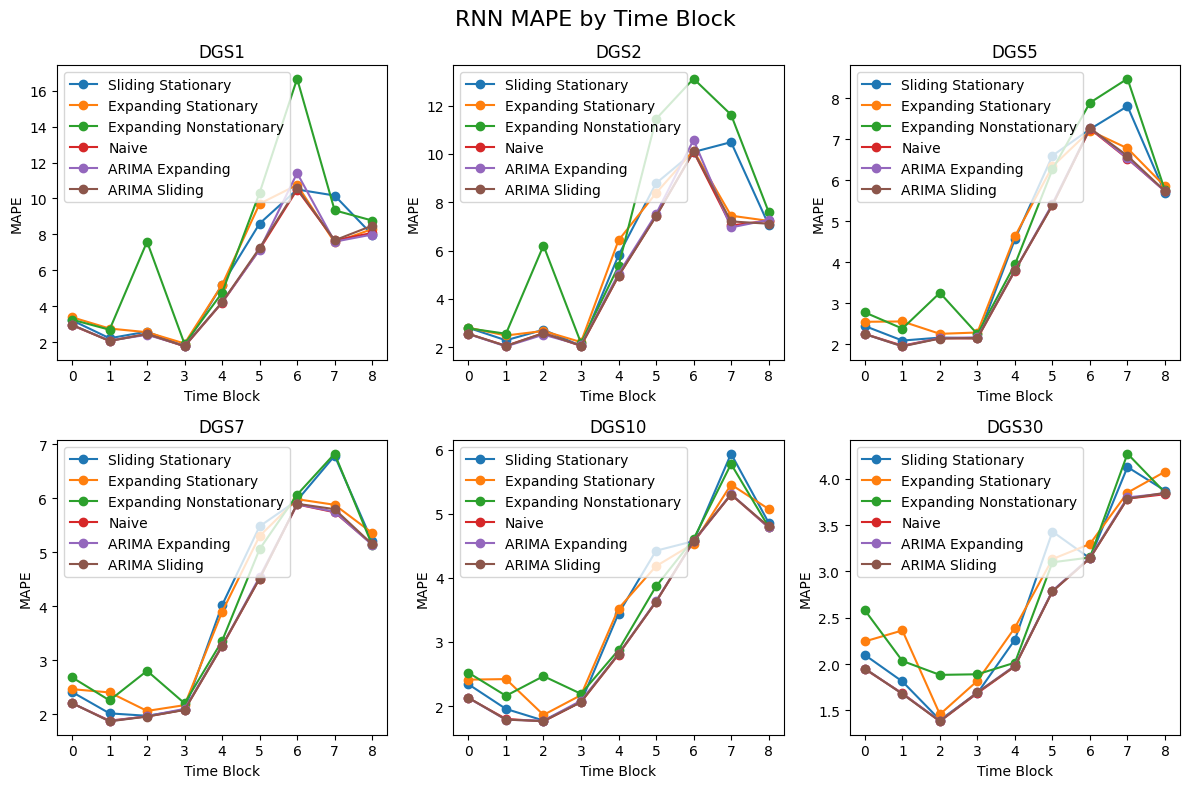 |