Сравнительное исследование машинного обучения и глубокого обучения для обнаружения выхода данных за пределы распределения
Аннотация
Обнаружение распределений вне обучения (OOD) необходимо для построения надежных систем искусственного интеллекта, поскольку модели, которые выдают выходные данные для недопустимых входных данных, нельзя считать надежными. Хотя в глубоком обучении (DL) часто предполагают превосходство над традиционным машинным обучением (ML), данные медицинской визуализации обычно получают по стандартизированным протоколам, что приводит к относительно ограниченной вариативности изображений в задачах обнаружения OOD. Это мотивирует провести прямое сравнение подходов ML и DL в данном контексте. Оба подхода оцениваются на открытых наборах данных, включающих более 60 000 изображений глазного дна и не глазного дна в нескольких разрешениях. Оба подхода достигли значения AUROC 1.000 и точностей в диапазоне от 0.999 до 1.000 на внутренних и внешних наборах валидации, демонстрируя сопоставимую эффективность обнаружения. Однако подход ML показал существенно более низкую сквозную задержку при сохранении эквивалентной точности, что указывает на более высокую вычислительную эффективность. Эти результаты предполагают, что для задач обнаружения OOD с ограниченной визуальной сложностью облегченные подходы ML могут обеспечивать производительность на уровне DL при существенно меньших вычислительных затратах, поддерживая практическое развертывание в реальных условиях.
Индексные термины— обнаружение распределений вне области применимости, фундус-изображения, машинное обучение, глубокое обучение, задержка
1 Введение
Практические системы компьютерного обнаружения (CADe) и диагностики (CADx) часто подвергаются воздействию внераспределительных (OOD) входных данных, не относящихся к их целевым задачам. Обнаружение OOD снижает этот риск, фильтруя такие входные данные перед последующим выводом. Например, в офтальмологии не-фундусные изображения — например, фотографии внешнего глаза, виды с щелевой лампы или даже рентгенограммы грудной клетки — могут непреднамеренно попадать в рабочие процессы фундусной визуализации. Без надлежащего скрининга обычные системы CADe/CADx все еще могут выдавать результаты для этих недопустимых входных данных, формируя ложные вероятности и потенциально нарушая клинические рабочие процессы. Такое поведение подрывает надежность системы и подчеркивает необходимость явного обнаружения OOD в критически важных для безопасности приложениях медицинского искусственного интеллекта (ИИ). Хотя академические бенчмарки обычно предполагают фиксированные наборы данных внутрираспределения, реальное внедрение требует устойчивости к непредвиденным входным данным за счет интегрированных механизмов обнаружения OOD.
Исследовательское сообщество изучило широкий спектр стратегий обнаружения OOD, включая пороги уверенности, оценки энергии, метрики расстояния в латентном пространстве, ошибки генеративной реконструкции и оценки неопределенности на основе ансамблей [15, 14]. Хотя эти методы продвинули область, большинство из них опираются на высокомощные глубокие энкодеры и существенные вычислительные ресурсы для достижения приемлемой производительности. Следовательно, значительная часть литературы по OOD неявно предполагает, что сама задача по своей природе является сложной и требует мощности представлений уровня deep learning (DL) [24].
Однако в медицинской визуализации данные обычно получают в стандартизированных условиях с использованием специализированных устройств визуализации, что приводит к ограниченному разнообразию точки зрения, освещения и анатомического контекста. В результате обнаружение OOD между изображениями глазного дна и не-глазного дна в этой предметной области может быть относительно простым. В таких условиях классический подход машинного обучения (ML) может быть как достаточным, так и предпочтительным, обеспечивая сопоставимую точность при существенно более высокой вычислительной эффективности и интерпретируемости.
На основе этих допущений данное исследование изучает, оправдана ли сложность DL для обнаружения OOD в медицинской визуализации. Используя разнообразные открытые наборы данных, охватывающие несколько модальностей медицинской визуализации и разрешений, мы оцениваем точность, вычислительную эффективность и устойчивость с целью определить компромиссы между сложностью модели и практическим развертыванием.
2 Методы
2.1 Наборы данных
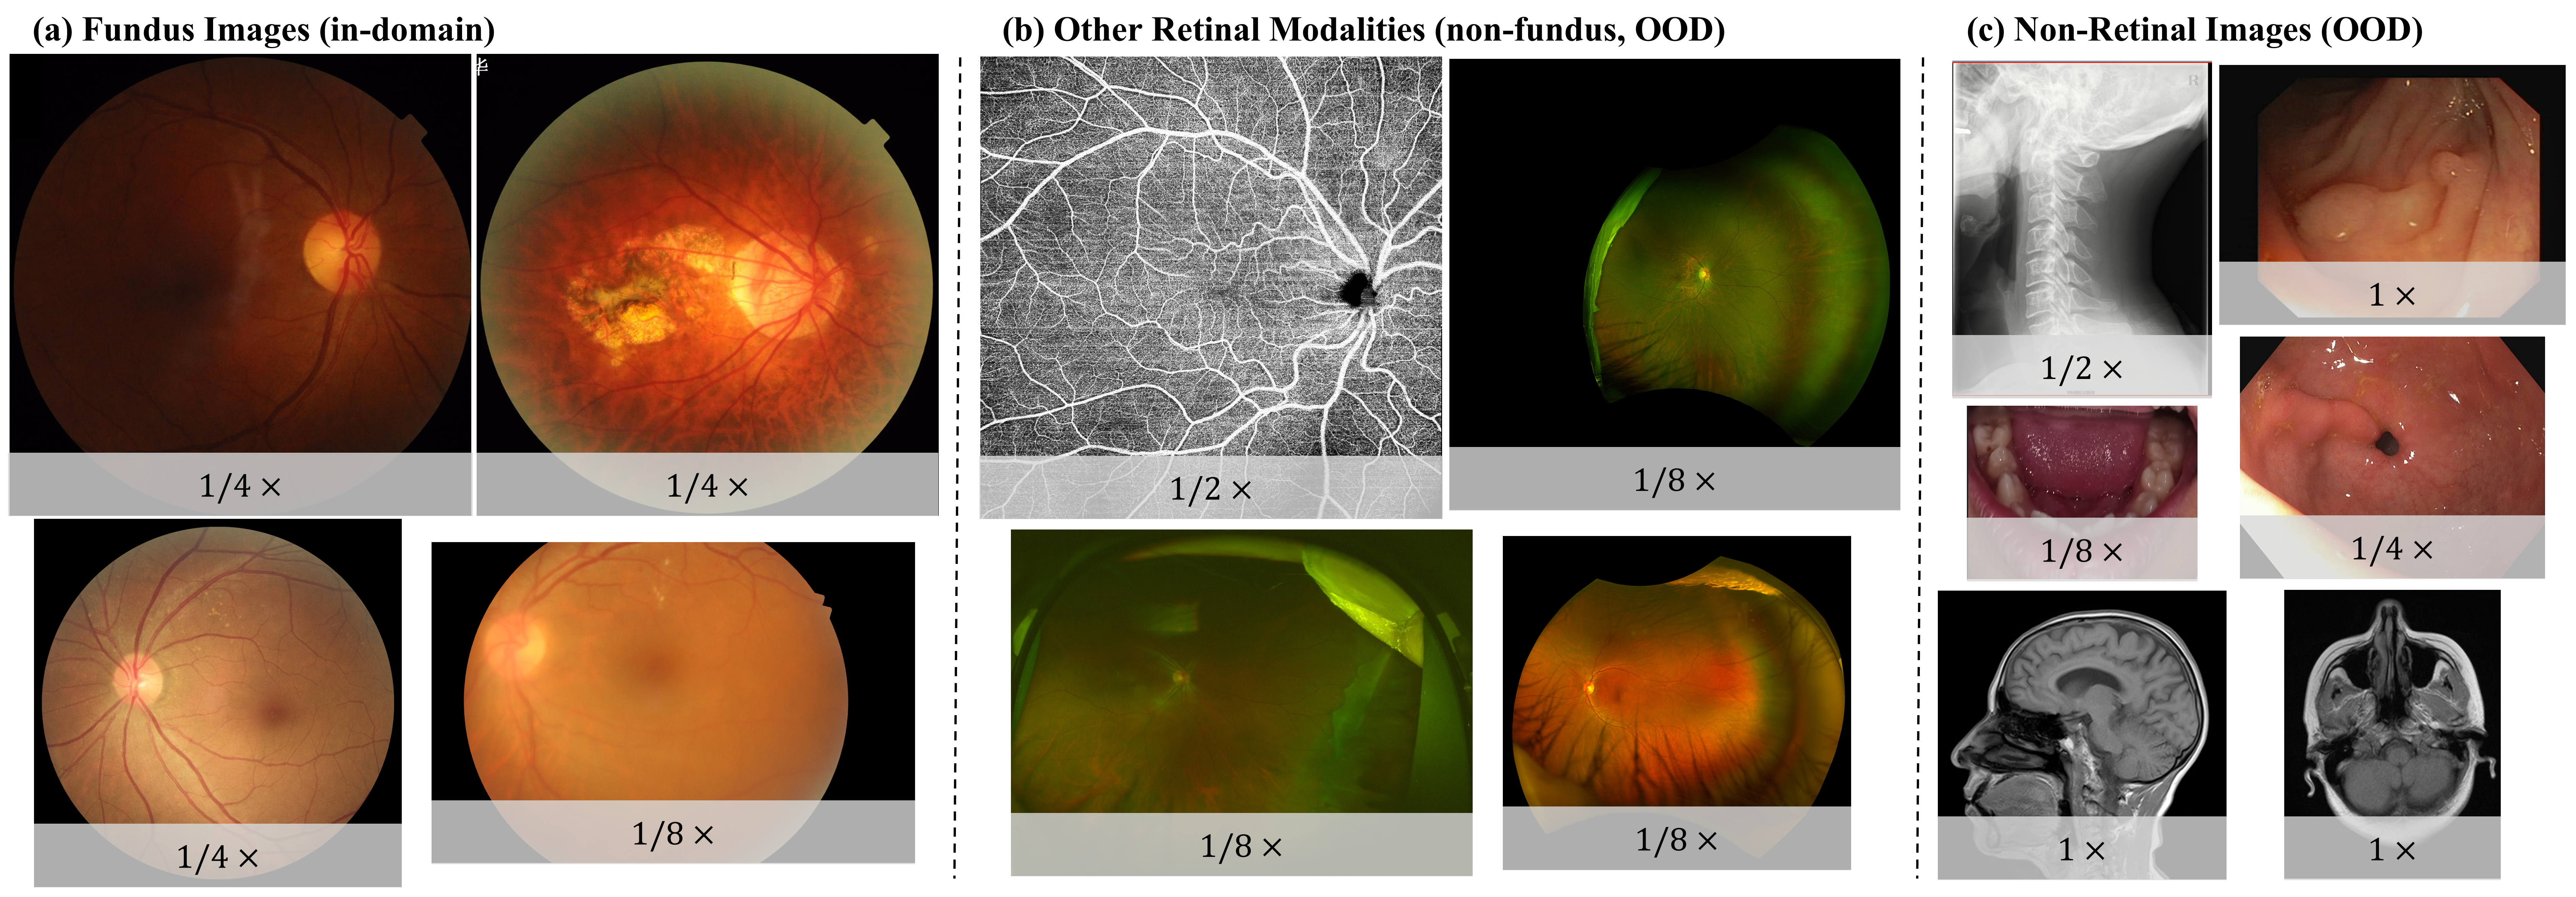
В качестве репрезентативной задачи в этом исследовании выполнялась классификация каждого изображения как либо глазного дна, либо не глазного дна. Для обучения и оценки модели было использовано в общей сложности 61 143 изображения из общедоступных наборов данных, распределённых на две группы: внутренняя валидационная выборка (IV) и внешняя валидационная выборка (EV). Набор IV относится ко всем наборам данных, использованным для обучения модели и внутренней оценки, тогда как набор EV был строго удержан для тестовой оценки только.
В набор IV были включены семь публично доступных наборов данных цветной фундусной фотографии (CFP), а именно ADAM [10], FIVES [12], G1020 [2], MESSIDOR [1], PAPILA [13], REFUGE [9] и RFMiD [19]. Помимо этих фундусных наборов данных, набор IV также включал нефундусные и ретинальные модальности OOD, такие как флуоресцентная ангиография (FA) и изображения фундуса с сверхшироким полем зрения (UWF) из набора данных DRAC [21, 23], МРТ головного мозга [5], шейного отдела позвоночника [22], рентгенографию грудной клетки [18], изображения зубов и полости рта [7], фотографии кожных поражений [17], а также эндоскопические наборы данных, такие как CVC-Clinic [3] и Hyper-Kvasir [4]⟧.
Набор EV использовался исключительно для независимого тестирования с целью оценки обобщающей способности модели на неиспользованных данных. В частности, набор EV включал TOP [8], IDRiD [20], фотографии кожных поражений [17] и CVC-Clinic [3], охватывая как фундус, так и нефундусные модальности. Эти наборы данных не применялись во время обучения модели и служили только как источники для тестирования.
Для разработки и оценки модели множество IV, включающее в общей сложности 45,909 изображений, было разделено на обучающую, валидационную и тестовую подвыборки в соотношении 3:1:1. Множество EV состояло из 15,234 изображений. Множество IV включало 9,108 изображений с глазным дном и 36,801 изображений без глазного дна, тогда как множество EV содержало 597 изображений с глазным дном и 14,637 изображений без глазного дна.
2.2 Предобработка
Для моделей машинного обучения использовались исходные изображения без центрированного обрезания. Вместо этого изображения анализировались на нескольких относительных разрешениях (, , и ), чтобы оценить масштабно-зависимое поведение признаков. Градации серого () и представления в HSV генерировались по необходимости для извлечения признаков. Признаки Local Binary Pattern (LBP) вычислялись на с с использованием униформного отображения. Для моделей глубокого обучения все входные изображения подвергались центрированному обрезанию до максимальной квадратной области и изменению размера до нескольких разрешений (, , и ), чтобы оценить производительность, зависящую от разрешения. Значения RGB нормализовались до , обеспечивая согласованное масштабирование входных данных для обработки сверточными слоями.
| Resolution | ML-CPU (ms) | DL-CPU (ms) | DL-GPU (ms) | ML (accuracy) | DL (accuracy) | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ML | DL | L | F | C | Overall | L | P | F | Overall | L | P | F | Overall | IV | EV | IV | EV |
| 1 | 15 | 378 | 3 | 396 | 177 | 8 | 44 | 229 | 198 | 9 | 7 | 214 | 1.000 | 0.988 | 1.000 | 1.000 | |
| 1/2 | 15 | 101 | 3 | 119 | 175 | 6 | 16 | 197 | 187 | 5 | 4 | 196 | 1.000 | 0.985 | 1.000 | 1.000 | |
| 1/4 | 15 | 32 | 3 | 50 | 173 | 5 | 10 | 188 | 188 | 4 | 4 | 196 | 1.000 | 0.995 | 1.000 | 0.995 | |
| 1/8 | 15 | 13 | 3 | 31 | 173 | 4 | 6 | 183 | 191 | 3 | 3 | 197 | 1.000 | 0.999 | 1.000 | 0.997 | |
2.3 Конвейер машинного обучения и ручные признаки
Мы извлекли 39 вручную разработанных признаков, организованных в пять категорий: статистики интенсивности и фона, цвет и текстура, пространственное распределение, форма и морфология, а также глобальные структурные показатели. Эти признаки были разработаны для отражения предметно-специфических характеристик CFP, включая круговую поле зрения, темный периферический фон и распределение оттенков красновато-оранжевого цвета. Они дают прозрачные и клинически интерпретируемые подсказки для различения изображений глазного дна и изображений не глазного дна, включая как ретинальные, так и неретинальные модальности.
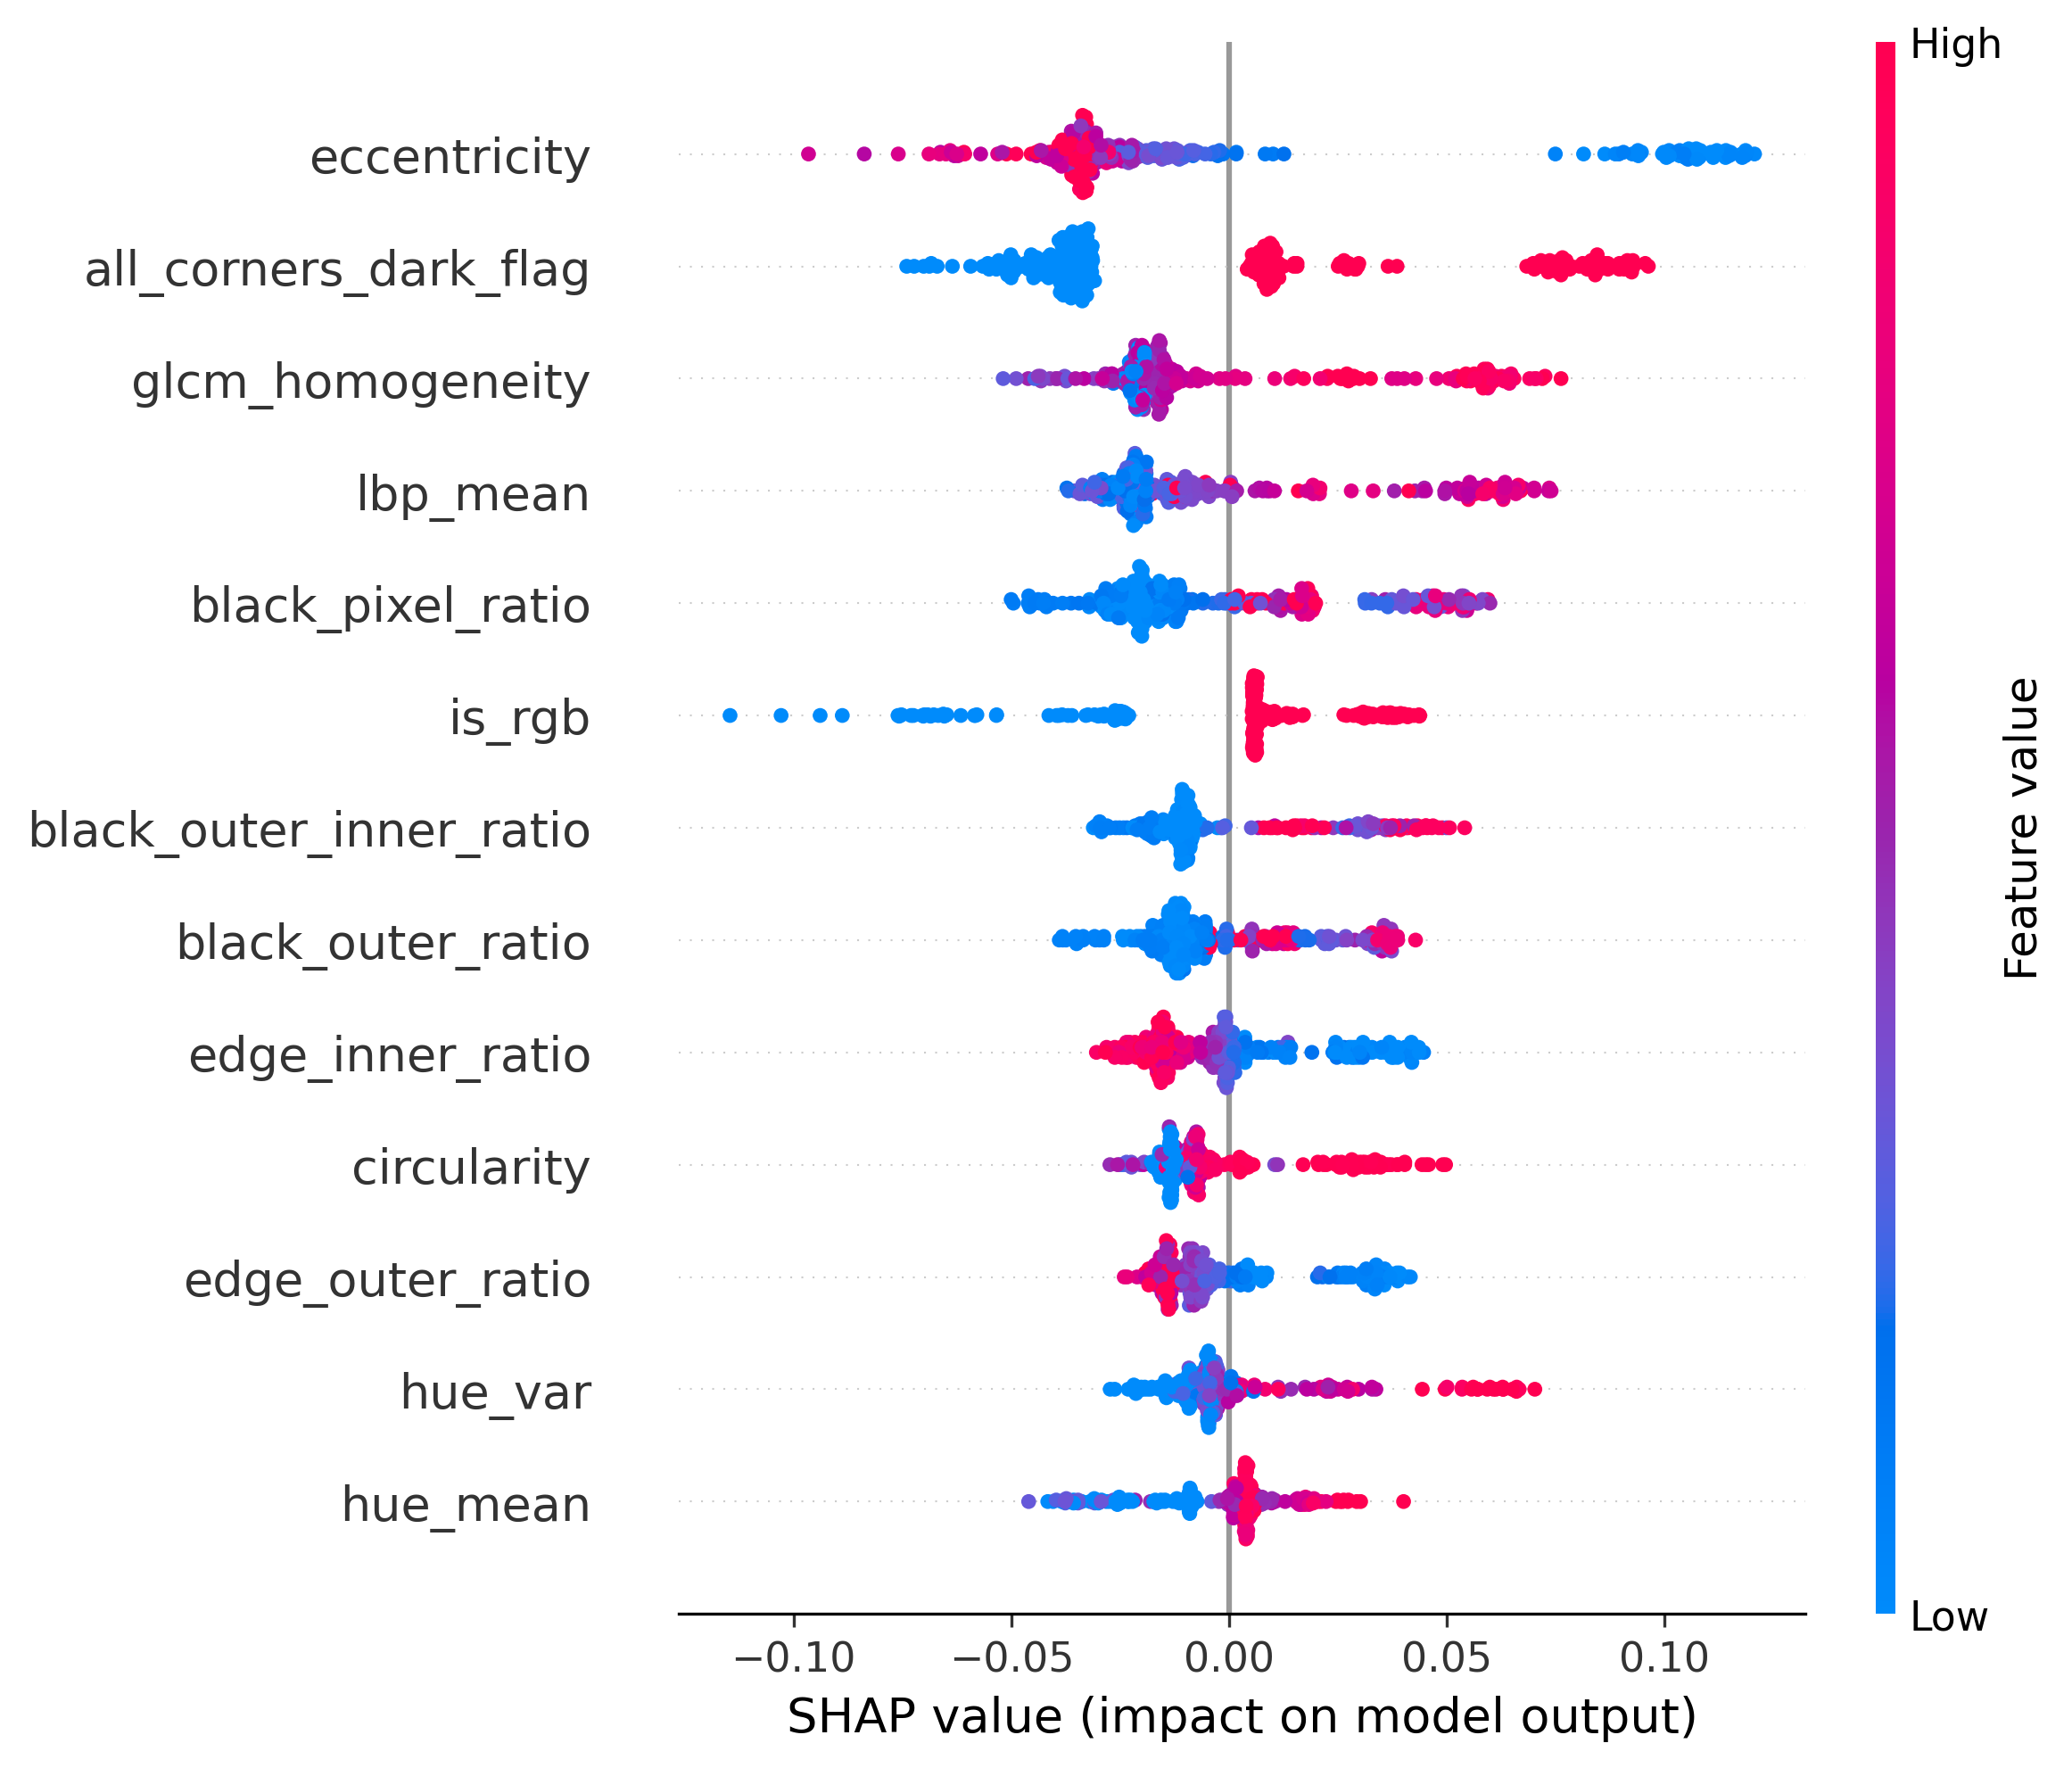
Категории признаков обобщены следующим образом: (1) Интенсивность и фоновые статистики: измеряют глобальную яркость, контраст и периферическую затемненность (например, min, max, mean, variance, background flag); (2) Цвет и текстура: фиксируют хроматическую согласованность и мелкозернистую текстуру с помощью статистик hue/saturation и локальных дескрипторов, таких как LBP и GLCM (например, hue mean, sat var, glcm contrast, lbp mean); (3) Пространственное распределение: представляют градиенты интенсивности «центр–периферия» и асимметрии яркости между полушариями (например, radial slope mean, center minus outer, hemisphere asymmetry); (4) Форма и морфология: отражают геометрические характеристики ретинальной маски, которые соответствуют круговой форме изображений глазного дна, включая меры круговости, эксцентриситета, солидности и нерегулярности границы (например, circularity, solidity, circle residual mean, eccentricity). Большинство этих признаков предназначены для количественной оценки того, насколько наблюдаемая область сетчатки соответствует типичной круглой структуре CFP, тем самым выступая в качестве сильных индикаторов для различения внутридоменных образцов глазного дна от OOD или неретинальных изображений; и (5) Глобальные структурные индикаторы: обобщают общую композицию изображения, включая тип цвета и долю темных областей (например, is rgb, black pixel ratio).
Классификатор ExtraTrees [11] с крайне случайными деревьями был обучен с использованием 100 оценщиков, максимальной глубины 10 и стратегии подмножества признаков на основе квадратного корня. Чтобы сбалансировать обобщение и простоту модели, для каждого внутреннего разбиения требовалось минимум 10 образцов, а листовые узлы содержали минимум два образца. Вывод выполнялся в одном потоке CPU, чтобы обеспечить точное измерение задержки холодного старта для каждого изображения. Модель была реализована с использованием библиотеки scikit-learn. Для интерпретируемости были вычислены значения SHapley Additive exPlanations (SHAP) [16], чтобы количественно оценить вклад каждого признака для каждого изображения.
2.4 Конвейер глубокого обучения
Основа ResNet-18, предварительно обученная на ImageNet, была использована как базовая модель глубокого обучения. Сеть была дообучена с использованием оптимизатора AdamW при скорости обучения , коэффициенте затухания весов , размере батча 128 и обучалась в течение 3 эпох. Лучший контрольная точка была выбрана в соответствии с минимальной величиной потерь на валидации, и в качестве целевой функции оптимизации была использована функция потерь кросс-энтропии.
Все изображения были центр-обрезаны в соответствии с меньшей стороной по ширине или высоте, затем изменены по размеру до целевого разрешения обучения. Каждое изображение было стандартизировано с использованием среднего значения и стандартного отклонения ImageNet. Чтобы повысить устойчивость модели и обобщающую способность, были применены вероятностные преобразования данных, включая горизонтальные () и вертикальные () отражения, повороты до , а также фотометрические вариации, такие как корректировки яркости/контраста и гамма-коррекция в пределах .
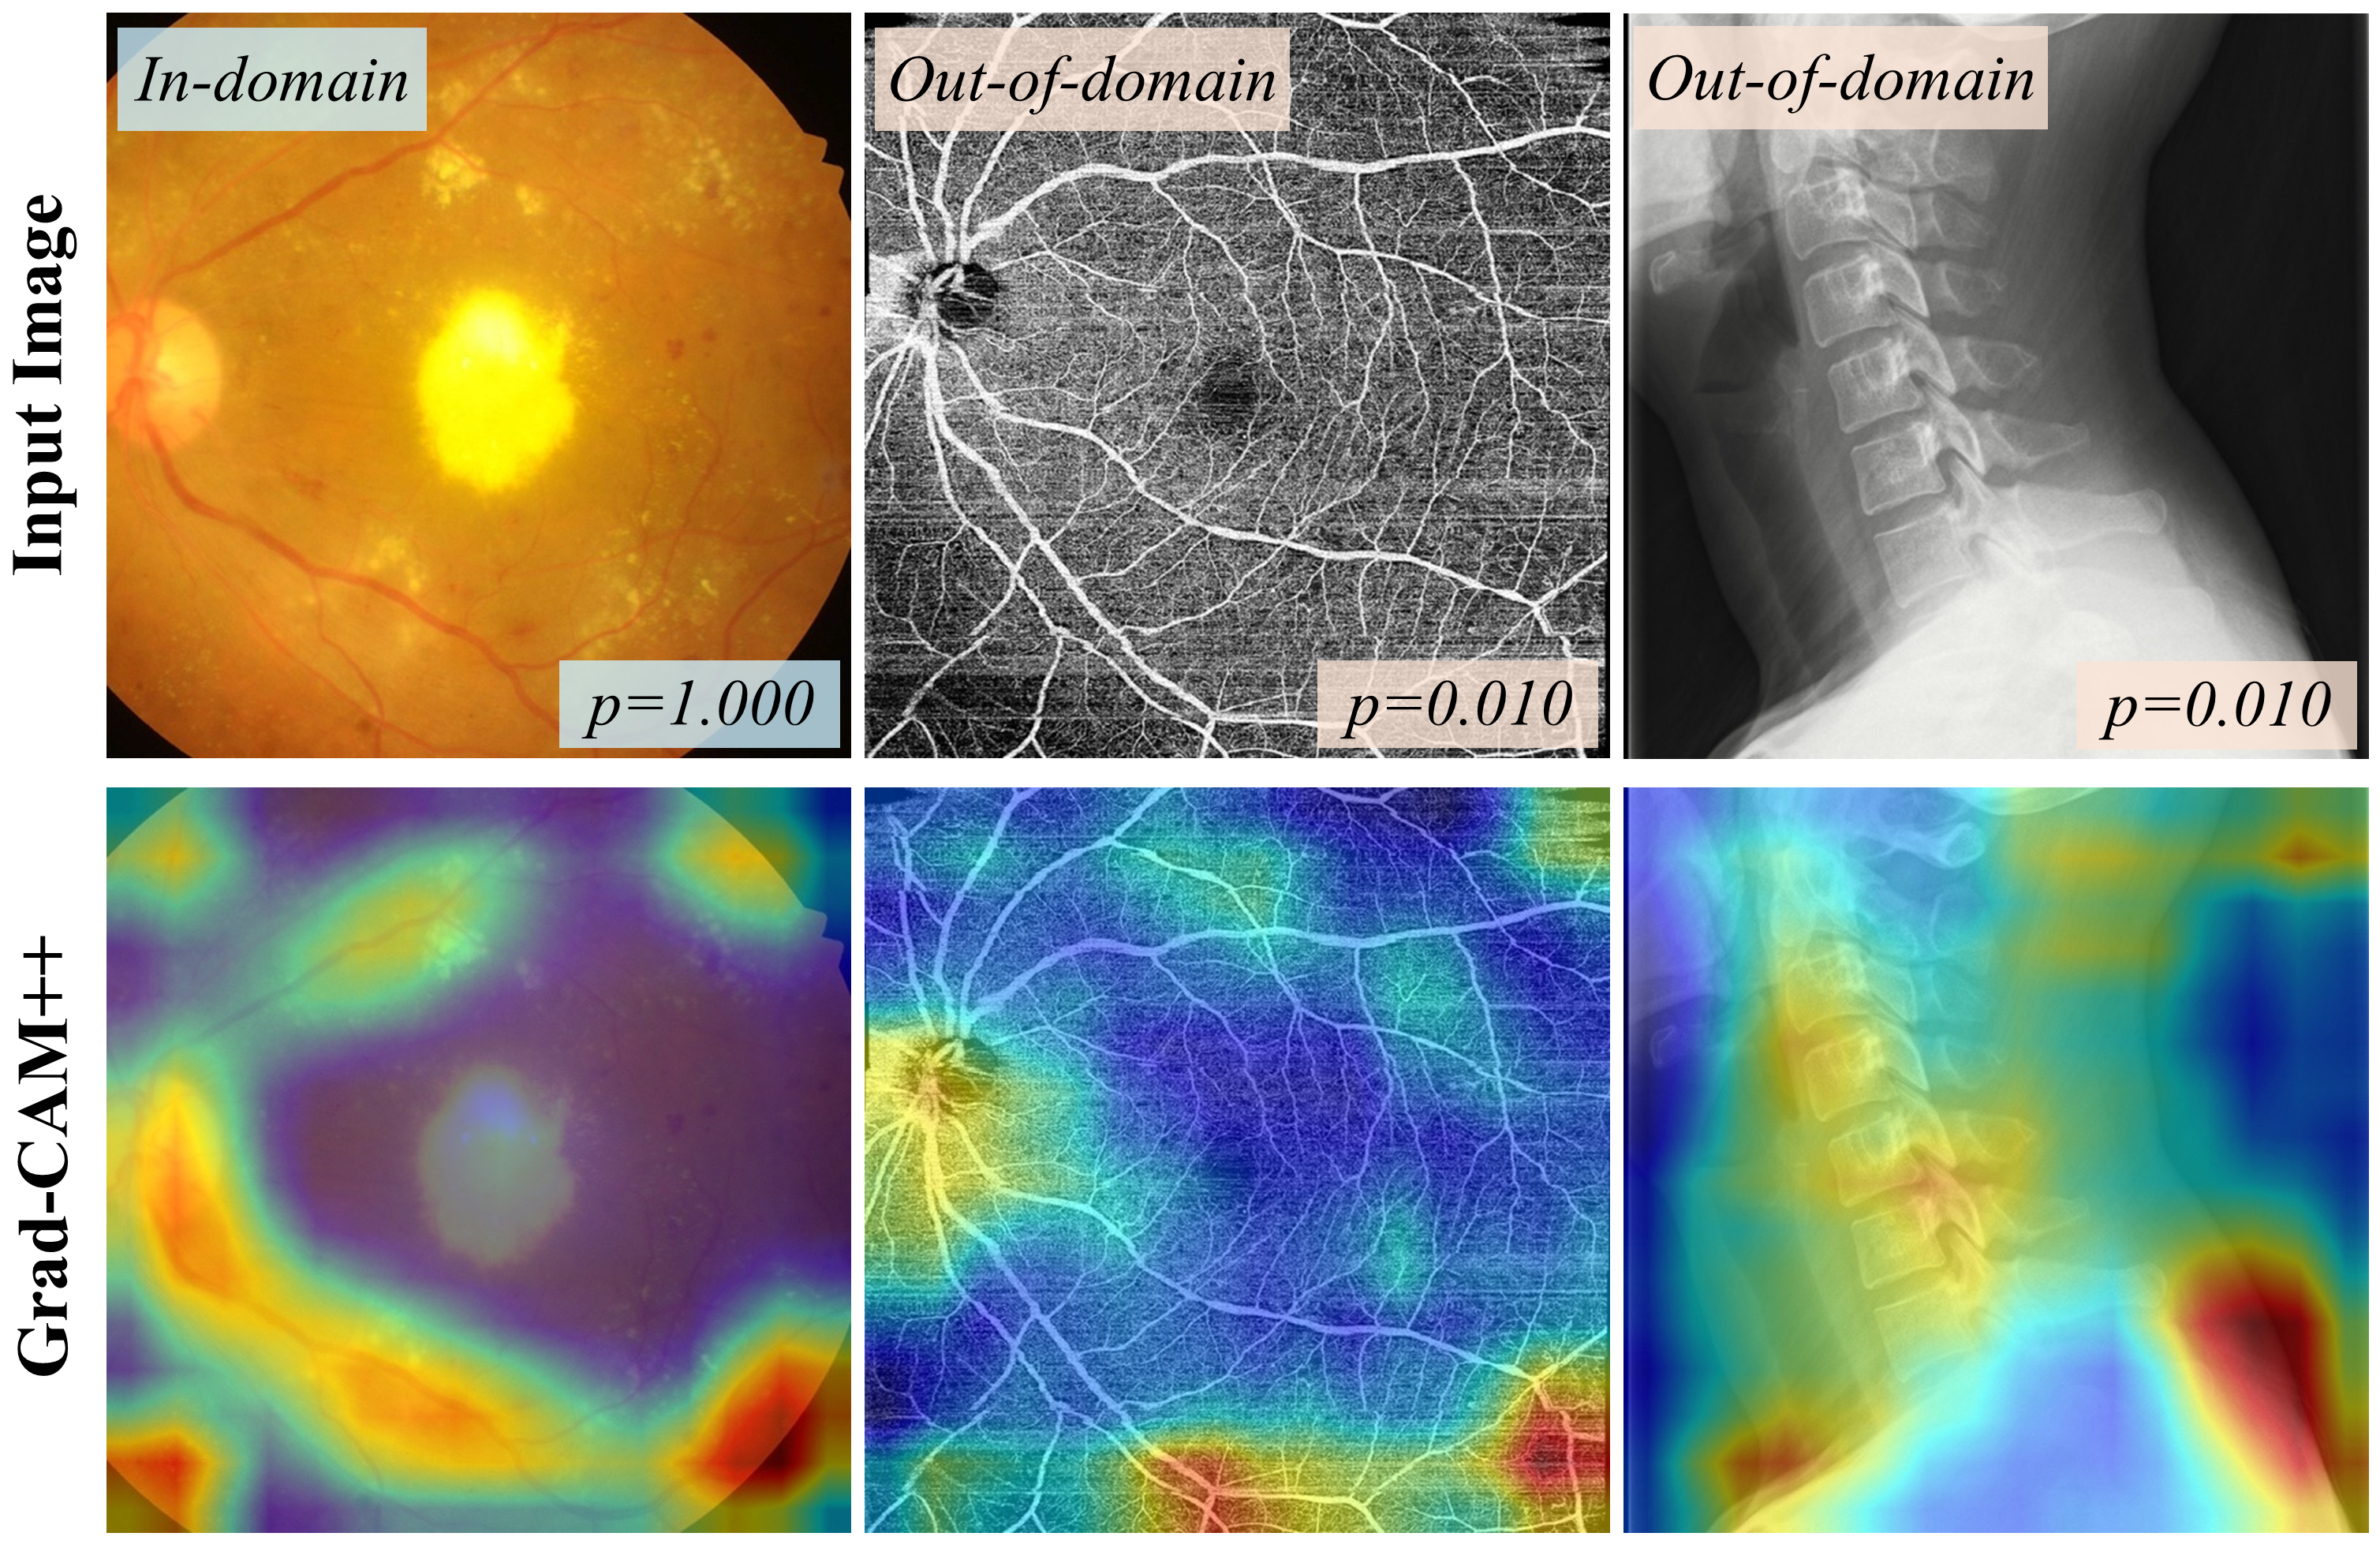
Grad-CAM++ [6] использовался для визуализации информативных областей изображения, которые в наибольшей степени способствовали решению модели. Карты активации извлекались из последнего сверточного блока основы ResNet-18 и вычислялись относительно истинной метки для каждого изображения. Полученные тепловые карты смешивались с соответствующими входными изображениями, чтобы качественно оценить пространственное соответствие между вниманием модели и клинически значимыми областями.
2.5 Метрики оценки и измерение задержки
Была проведена пятикратная перекрёстная проверка для внутренней валидации с использованием стратифицированной выборки для сохранения баланса классов между фолдами. В каждом фолде модель обучалась на четырёх подмножествах и оценивалась на оставшемся тестовом подмножестве. После пофолдового тестирования предсказания со всех пяти тестовых подмножеств были объединены путём конкатенации для вычисления общей метрики внутренней валидации. Для внешней валидации пять моделей, полученных в ходе перекрёстной проверки, независимо применялись к невидимому внешнему набору данных, а предсказанные вероятности для каждого изображения усреднялись по моделям для получения единого консенсусного предсказания. Фиксированный порог принятия решения применялся единообразно во всех экспериментах для получения бинарных предсказаний. Эффективность модели оценивалась по площади под кривой рабочей характеристики приёмника (AUROC) и точности.
Для оценки вычислительной эффективности систематически измерялась задержка инференса как для ML, так и для DL конвейеров. Для ML конвейера задержка была разложена на загрузку модели, извлечение признаков и классификацию. Для DL базового варианта задержка измерялась отдельно на CPU и GPU и включала загрузку модели, предварительную обработку и прямое распространение через энкодер. Конец-в-конец задержка определялась как общее затраченное время от загрузки модели до генерации итогового выхода вероятностей. Измерения задержки проводились на 1,000 случайно выбранных тестовых изображениях при размере батча равном одному. ML конвейер испытывался при нескольких коэффициентах даунсемплинга (, , и ), тогда как DL модель оценивалась на соответствующих входных разрешениях (, , и ). Все эксперименты выполнялись на рабочей станции, оснащенной двумя процессорами Intel Xeon Gold 5218R (80 ядер, 2.10 GHz), 504 GB ОЗУ и графическим процессором NVIDIA Tesla V100 (32 GB VRAM).
3 Результаты
3.1 Сквозная проверка и внешняя оценка производительности
Таблица 1 суммирует количественные результаты по различным разрешениям изображений. Обе модели машинного обучения (ExtraTrees) и глубокого обучения (ResNet-18) достигли значений AUROC равных 1.000 при всех условиях. Различия в точности между двумя подходами были незначительными на внутренних (IV) и внешних (EV) наборах валидации. Для конвейера ML точность варьировалась от 0.985 до 1.000 в зависимости от разрешения, тогда как для модели DL — от 0.995 до 1.000. При самом низком разрешении (, ) модель ML достигла 1.000 на внутреннем наборе и 0.999 на внешнем наборе, фактически совпав с базовой моделью DL, несмотря на её компактный дизайн. Интересно, что конвейер ML сохранял надёжную производительность даже при более низких разрешениях, тогда как у модели DL точность снижалась по мере уменьшения разрешения изображений.
3.2 Анализ разрешения и задержки
Как показано в Таблице 1, конвейеры ML и DL демонстрировали различное поведение масштабирования в зависимости от разрешения изображения. Для ML-модели задержка при наивысшей конфигурации () достигала 396 мс на CPU, главным образом из-за извлечения признаков (378 мс). По мере снижения разрешения задержка ML резко уменьшалась — с 396 мс при до 31 мс при — при сохранении сопоставимой точности (0,999 на EV). В отличие от этого, для DL-модели наблюдалась стабильно высокая задержка в диапазоне разрешений (183–229 мс) вследствие фиксированной сложности архитектуры и большого числа параметров; при этом время выполнения было обусловлено загрузкой модели, выделением памяти и накладными расходами на I/O, а не вычислениями, зависящими от входных данных.
Эти результаты демонстрируют, что конвейер машинного обучения эффективно масштабируется с размером изображения и обеспечивает существенные приросты скорости без потери точности, демонстрируя практически отсутствие компромисса между точностью и задержкой. В сравнении с этим задержка модели глубокого обучения в значительной степени не зависит от разрешения из-за фиксированной инициализации и затрат на передачу памяти. В целом конвейер машинного обучения обеспечивает эквивалентную дискриминацию при снижении задержки до шестикратного, что подчеркивает его пригодность для легковесного, работы в реальном времени обнаружения OOD в клинических условиях при ограниченных вычислительных ресурсах.
3.3 Интерпретируемость: SHAP для ML по сравнению с CAM для DL
Сводный график SHAP (Рисунок 2) показывает, что эксцентриситет, all_corners_dark_flag и glcm_homogeneity являются тремя наиболее влиятельными признаками при различении изображений глазного дна и не-глазного дна. Низкое значение эксцентриситета, соответствующее близкой к круговой форме, в значительной степени способствует прогнозу «глазное дно», что согласуется с круговой геометрией, характерной для изображений сетчатки. Аналогично, высокое значение all_corners_dark_flag положительно влияет на класс «глазное дно», отражая наличие темной периферической каймы, типичной для фотографий глазного дна. Кроме того, высокие значения glcm_homogeneity связаны с гладкими и однородными текстурами, что дополнительно усиливает классификацию «глазное дно». В совокупности эти результаты указывают на то, что ML-модель в первую очередь опирается на интерпретируемые глобальные признаки — круговость, периферическое затемнение и однородность текстуры — чтобы идентифицировать изображения глазного дна.
Хотя конвейер ML обеспечивает интерпретируемость на уровне признаков с помощью SHAP, модель глубокого обучения опирается на основанную на градиентах визуализацию значимости, такую как Grad-CAM++. Однако при двоичном обнаружении OOD эти визуализации дают мало информации о реальном процессе принятия решения. Рисунок 3 показывает результаты Grad-CAM++ для базовой модели ResNet-18 на представительных примерах из предметной области (in-domain) и OOD. Первые два изображения имеют одинаковое происхождение из области сетчатки — фундус и флюоресцентная ангиография — однако карты активации демонстрируют почти идентичные паттерны, с сосредоточением вокруг зрительного диска и крупных сосудов. Такие области визуально различимы, но не связаны непосредственно с классификацией OOD, что указывает на то, что модель уделяет внимание общим структурам с высокой контрастностью, а не признакам, характерным для предметной области. Для нетретинального рентгеновского изображения активации пространственно размыты и не несут согласованного анатомического смысла. В целом градиентные методы объяснимости, которые эффективны в задачах локализации поражений или аномалий, дают ограниченную интерпретируемую ценность для обнаружения OOD.
4 Обсуждение
Обнаружение вне-распределительных данных (OOD) является критически важным предварительным условием для надежного развертывания систем ИИ в клинической практике. В ретинальной визуализации проверка корректности входных данных перед диагностическим выводом имеет важное значение, поскольку предсказания по нефундусным изображениям могут снижать точность и подрывать доверие пользователей. Эффективная фильтрация OOD (то есть скрининг фундусных и нефундусных изображений) гарантирует, что последующие диагностические модели работают только с валидными данными, тем самым повышая безопасность, прослеживаемость и общую целостность системы.
Экспериментальные результаты указывают, что в рассматриваемых условиях различение изображений глазного дна и не-глазного дна формирует хорошо определенную задачу классификации при обучении на достаточно разнообразных наборах данных. Обе модели ML и DL достигли почти насыщенной производительности (AUROC = 1.000, ACC 0.999) как на внутренних, так и на внешних наборах валидации. В таких условиях дополнительная архитектурная сложность не дает измеримого выигрыша в производительности в данной постановке задачи, а практические факторы развертывания — время вычислений, требования к памяти и интерпретируемость — становятся доминирующими критериями выбора модели.
Предложенный ML-конвейер на основе ExtraTrees, построенный на компактном наборе ручных и учитывающих глазное дно дескрипторов, обеспечил сквозную задержку меньше чем на аппаратном обеспечении только с CPU при сохранении точности обнаружения, сопоставимой с DL-основанием. Анализ SHAP выявил стабильные и согласованные с доменом атрибуции признаков — подчеркнув опору модели на периферическую темноту, плавное распределение цветов и круговую геометрию изображения — тем самым обеспечив прозрачную и воспроизводимую интерпретацию ее процесса принятия решений. Эти характеристики делают ML-конвейер особенно подходящим для обработки в реальном времени при фильтрации OOD в клинических системах, где детерминированное поведение и ограниченные вычислительные ресурсы являются критическими ограничениями.
В отличие от этого, базовая модель ResNet-18 требовала существенно больших вычислительных и оперативно-экранных ресурсов. При наименьшем разрешении () ее сквозная задержка инференса составляла приблизительно 183 мс на CPU и 197 мс на GPU, тогда как для пайплайна ML при идентичных условиях — 31 мс, то есть примерно шестикратное увеличение. Например, коммерческое программное обеспечение, такое как VUNO Med–Fundus AI, которое выполняет полное обнаружение поражений и количественную оценку по двенадцати категориям, работает менее чем за 2 секунды на оборудовании только с CPU. Учитывая, что детектирование OOD включает лишь бинарную фильтрацию, а не полный диагностический инференс, задержка почти 200 мс на изображение представляет собой существенную дополнительную нагрузку. Кроме того, все измерения задержек в данном исследовании были выполнены на высокопроизводительной рабочей станции. В типичных клинических условиях при использовании стандартного настольного оборудования разрыв по времени выполнения между подходами ML и DL, вероятно, был бы еще более выраженным. Несмотря на более высокую вычислительную стоимость, модель DL не показала измеримого улучшения точности или AUROC по сравнению с подходом ML во всех вариантах оценивания. Эти результаты демонстрируют, что компактная модель ML обеспечивает эквивалентную способность к различению, сохраняя при этом существенно более высокую вычислительную эффективность и предсказуемую задержку.
У этого исследования есть несколько ограничений. Во-первых, хотя наборы данных охватывают различные типы изображений, они могут не отражать редкие сценарии получения данных, такие как получение изображений глазного дна с помощью ручных устройств или смартфонов, или сильные искажения на периферии. Во-вторых, сообщаемые значения задержки могут отличаться в зависимости от систем из-за аппаратных и программных конфигураций, поэтому их следует интерпретировать как ориентировочные, а не как абсолютные. Наконец, текущий набор признаков оптимизирован для изображений глазного дна и потребовал бы предметно-ориентированной адаптации для других задач медицинской визуализации.
В заключение, легковесная и интерпретируемая модель машинного обучения может обеспечивать показатели обнаружения выхода за пределы распределения (OOD), эквивалентные модели глубокого обучения, дообученной (fine-tuned), при этом достигая значительно более высокой вычислительной эффективности. Эти результаты поддерживают практическую архитектуру развертывания, в которой ML-основанная фильтрация OOD выполняется на этапе поступления данных, обеспечивая корректность входных данных и резервируя вычисления DL для последующего диагностического анализа.
5 СОБЛЮДЕНИЕ ЭТИЧЕСКИХ СТАНДАРТОВ
Это исследование было проведено ретроспективно с использованием данных субъектов, полученных от людей, предоставленных в открытом доступе. Этическое одобрение не требовалось, что было подтверждено лицензией, прикрепленной к данным открытого доступа.
6 Конфликт интересов
Авторы являются сотрудниками VUNO Inc., но заявляют, что не имеют конкурирующих финансовых или нефинансовых интересов, связанных с данной работой.
Ссылки
- ⟦[1] A. A. Ardakani, A. Mohammadi, M. Mirza-Aghazadeh-Attari, and U. R. Acharya (2023) Открытая база данных изображений ультразвука поражений молочной железы, применимая в исследованиях по искусственному интеллекту. Computers in Biology and Medicine 152, pp. 106438. Cited by: §2.1.
- [2] M. N. Bajwa, G. A. P. Singh, W. Neumeier, M. I. Malik, A. Dengel и S. Ahmed (2020) G1020: набор эталонных изображений глазного дна для автоматизированного обнаружения глаукомы. На 2020 International Joint Conference on Neural Networks (IJCNN), стр. 1–7. Цитируется: §2.1.
- [3] Дж. Бернал, Ф. Дж. Санчес, Дж. Фернандес-Эспаррач, Д. Гил, С. Родригес и Ф. Виларино (2015) WM-dova-карты для точного выделения полипов при колоноскопии: валидация в сравнении с картами значимости, полученными от врачей. Компьютерная медицинская визуализация и машинная графика 43, стр. 99–111. Цитируется: §2.1, §2.1.
- [4] Г. Боргли, В. Тхамбавита, П. Х. Смедсруд, С. Хикс, Д. Джа, С. Л. Эскеланд, К. Р. Рандел, К. Погорелов, М. Люкс, Д. Т. Д. Нгуен, Д. Йохансен, К. Гриводз, Х. К. Стенсланд, Э. Гарсия-Сеха, П. Т. Шмидт, Х. Л. Хаммер, М. А. Риглер, П. Халворсен и Т. де Ланге (2020) HyperKvasir, комплексный многоклассовый набор данных изображений и видео для эндоскопии желудочно-кишечного тракта. Scientific Data 7 (1), стр. 283. Внешние ссылки: Document, ISSN 2052-4463, Link Цитируется: §2.1.
- ⟦[5] Y. Brima, M. H. K. Tushar, U. Kabir и T. Islam (2021) Набор данных Brain mri. figshare. Примечание: Набор данных Внешние ссылки: Document, Link Цитируется: §2.1.
- [6] A. Чаттопадхай, А. Саркар, П. Хоулейдер и В. Н. Баласубраманиан (2018) Grad-cam++: обобщенные градиентные визуальные объяснения для глубоких сверточных сетей. На зимней конференции IEEE по прикладной компьютерной видимости (WACV) в 2018 году, стр. 839–847. Цитируется: §2.4.
- ⟦[7] С. Д. Чаудхари, П. Пайгуде и П. Шах (2024) Набор данных изображений зубов или стоматологических изображений. Mendeley Data. Внешние ссылки: Document, Link Цитируется: §2.1⟧.
- [8] Дж. Энгельманн, А. Д. МакТрастис, И. Дж. МакКормик, Э. Пиад, А. Сторки и М. О. Бернабеу (2022) Обнаружение нескольких заболеваний сетчатки на изображениях глазного дна сверхширокого поля с использованием глубокого обучения: данные, полученные для выявления релевантных областей. препринт arXiv arXiv:2203.06113. Цитируется: §2.1.
- ⟦H. Fu, F. Li, J. I. Orlando, H. Bogunović, X. Sun, J. Liao, Y. Xu, S. Zhang, и X. Zhang (2019) REFUGE: задача по глаукоме по снимкам глазного дна. IEEE Dataport. Внешние ссылки: Document, Link Цитируется: §2.1.
- [10] Г. Фу, Ф. Ли, Дж. И. Орландо, Х. Богунович, С. Сан, Дж. Ляо, Ю. Сюй, С. Чжан и С. Чжан (2020) ADAM: задача автоматического выявления возрастной макулярной дегенерации. IEEE Dataport. Внешние ссылки: Document, Link Цитируется: §2.1.
- ⟦[11] P. Geurts, D. Ernst и L. Wehenkel (2006) Чрезвычайно рандомизированные деревья. Машинное обучение 63 (1), стр. 3–42. Цитируется: §2.3.
- [12] K. Jin, X. Huang, J. Zhou, Y. Li, Y. Yan, Y. Sun, Q. Zhang, Y. Wang, and J. Ye (2022) Fives: набор данных изображений глазного дна для искусственного интеллекта на основе сегментации сосудов. Scientific data 9 (1), стр. 475. Цитировано: §2.1.
- ⟦[13] О. Ковалик, Х. Моралес-Санчэс, Р. Верду-Монедеро, И. Сельес-Наварро, А. Паласон-Кабанес и Х. Санчо-Гомес (2022) PAPILA: набор данных с изображениями глазного дна и клиническими данными обоих глаз одного и того же пациента для оценки глаукомы. Scientific Data 9 (1), стр. 291. Цитировано: §2.1.
- ⟦[14] К. Ли, К. Ли, Х. Ли и Дж. Шин (2018) Простая унифицированная структура для обнаружения выборок вне распределения и атак с использованием противодействия. Труды по достижениям в нейронной обработке информации 31. Цитируется по: §1.
- [15] W. Liu, X. Wang, J. Owens, and Y. Li (2020) Обнаружение выбросов вне распределения на основе энергетических моделей. Сборник трудов по достижениям в обработке нейронной информации 33, стр. 21464–21475. Цитируется: §1.
- [16] S. M. Lundberg и S. Lee (2017) Единый подход к интерпретации предсказаний модели. Труды по нейронной обработке информации, 30. Цитируется: §2.3.
- [17] М. М. Х. Матин, Мд. А. Хасру, Мд. Г. Моаззам и М. С. Уддин (2023) Набор данных для распознавания кожных заболеваний и рака кожи. Mendeley Data. Внешние ссылки: Document, Link Цитируется: §2.1, §2.1.
- ⟦H. Q. Nguyen, K. Lam, L. T. Le, H. H. Pham, D. Q. Tran, D. B. Nguyen, D. D. Le, C. M. Pham, H. T. Tong, D. H. Dinh, et al. (2022) VinDr-cxr: открытый набор данных рентгенограмм грудной клетки с аннотациями радиолога. Scientific Data 9 (1), стр. 429. Cited by: §2.1.
- [19] С. Пачаде, П. Порвал, Д. Тулкар, М. Кокаре, Г. Дешмукх, В. Сахасрабуддхе, Л. Джанкарда, Г. Квеллек и Ф. Мериядо (2021) Набор данных многоуровневых изображений глазного дна при множественных заболеваниях (rfmid): набор данных для исследований обнаружения множественных заболеваний. Данные 6 (2). Внешние ссылки: Link, ISSN 2306-5729, Document Цитируется: §2.1.
- [20] П. Порвал, С. Пачейд, Р. Камбле, М. Кокаре, Г. Дешмукх, В. Сахасрабуддхе и Ф. Мериоде (2018) Индийский набор изображений для диабетической ретинопатии (idrid). IEEE Dataport. Внешние ссылки: Document, Link Цитируется: §2.1.
- ⟦[21] B. Qian, H. Chen, X. Wang, Z. Guan, T. Li, Y. Jin, Y. Wu, Y. Wen, H. Che, G. Kwon, et al. (2024) DRAC 2022: публичный набор для оценки (benchmark) анализа диабетической ретинопатии по изображениям ультраширокой оптической когерентной томографии ангиографии. Patterns 5 (3). Cited by: §2.1.
- ⟦[22] Y. Ran, W. Qin, C. Qin, X. Li, Y. Liu, L. Xu, X. Mu, L. Yan, B. Wang, Y. Dai, et al. (2024) Набор данных высокого качества с классифицированными и аннотированными атласами рентгенограмм шейного отдела позвоночника. Scientific Data 11 (1), стр. 625. Цитируется: §2.1.
- [23] Дж. Сан, С. Чжао, С. Чэнь, Ю. Чжан, Х. Жэнь, Ю. Сан и Г. Чжан (2025) Набор данных изображений глазного дна сверхширокого поля для интеллектуальной диагностики внутриглазных опухолей. Scientific Data 12 (1), стр. 1521. Цитируется: §2.1.
- [24] Дж. Ян, К. Чжоу, Ю. Ли и Ц. Лю (2024) Обнаружение обобщённого выхода за пределы распределения: обзор. Международный журнал компьютерного зрения 132 (12), стр. 5635–5662. Цитируется: §1.