Динамическое управление жизненным циклом навыков для
Агентное обучение с подкреплением
Аннотация
Агенты на основе больших языковых моделей все чаще опираются на внешние навыки для решения сложных задач, где навыки выступают как модульные единицы, расширяющие их возможности сверх того, что поддерживается только параметрической памятью. Существующие методы предполагают, что внешние навыки либо накапливаются как устойчивое направляющее воздействие, либо встраиваются во внутреннюю политику, в итоге приводя к выводу без навыков. Мы утверждаем, что это предположение является чрезмерно ограничительным, поскольку при ограниченной параметрической емкости и неодинаковом предельном вкладе между навыками оптимальный набор активно используемых навыков является немонотонным, зависящим от задачи и стадии. В данной работе мы предлагаем SLIM — рамочную модель динамического управления жизненным циклом навыков для агентного обучения с подкреплением (RL), которая рассматривает активный внешний набор навыков как переменную динамической оптимизации, совместно обновляемую вместе с обучением политики. А именно, SLIM оценивает предельный внешний вклад каждого активно используемого навыка с помощью проверки при исключении одного навыка (leave-one-skill-out validation), затем применяет три операции жизненного цикла: сохранение навыков с высокой ценностью, вывод из эксплуатации навыков, вклад которых становится пренебрежимо малым после достаточного воздействия, и расширение банка навыков, когда устойчивые сбои выявляют недостающее покрытие возможностей. Эксперименты показывают, что SLIM превосходит лучшие базовые подходы в среднем на 7.1 процентных пункта в ALFWorld и SearchQA. Дополнительно результаты указывают, что обучение политики и сохранение внешних навыков не являются взаимоисключающими: некоторые навыки поглощаются политикой, тогда как другие продолжают обеспечивать внешнюю ценность, поддерживая SLIM как более общий парадигмальный подход для навык-ориентированного агентного RL. Код доступен по адресу https://github.com/ejhshen/SLIM.
1 Введение
Агенты большой языковой модели (LLM) [34, 53] все чаще используются для решения сложных задач, требующих многошагового рассуждения [41], планирования на длительном горизонте [22] и надежного использования инструментов [48]. Набирающий рост способ улучшения этих агентов заключается в оснащении их внешними навыками [8, 75, 37], где каждый навык представляет собой модульный процедурный артефакт, вставляемый во время инференса для предоставления повторно используемых рекомендаций по решению задач. [77]. Путем обусловливания агента такой внешней процедурной осведомленностью агентные системы, основанные на навыках, могут расширять возможности сверх того, что базовая модель может надежно выражать только из своих параметров [17, 54, 67].
Несмотря на этот прогресс, существующие методы агентного обучения с подкреплением, основанные на навыках, в основном следуют двум монотонным парадигмам. Одна парадигма рассматривает навыки как устойчивое дополнение и непрерывно расширяет внешний банк навыков, чтобы поддерживать исследование и принятие решений [59]. Другая рассматривает навыки как временные строительные леса и постепенно удаляет их до нулевого вывода навыков, стремясь перенести их преимущества в параметры модели [33]. Хотя в соответствующих условиях оба подхода оказываются эффективными, неявно предполагается, что активный внешний набор навыков либо должен продолжать расти, либо в конечном итоге исчезнуть. Это предположение упускает более общий вопрос: по мере того как агент обучается, как должен изменяться его активный внешний набор навыков при ограниченной параметрической емкости и неравномерном предельном вкладе между навыками?
Этот вопрос особенно важен, поскольку параметрическое хранение в языковых моделях конечно и ограничено размером модели, бюджетом обучения и компромиссом между запоминанием и обобщением [3, 4, 5]. В результате не следует принуждать каждую полезную возможность встраивать в параметры модели. Внешние навыки особенно подходят для сохранения узких, низкочастотных или принадлежащих длинному хвосту процедур, которые могут быть дорогостоящими или нецелесообразными для параметрического кодирования [70]. При этом удержание слишком большого числа навыков не является бесплатным, поскольку большие банки навыков могут вносить шум маршрутизации, а длительные внедряемые контексты могут снижать надежность использования навыков [76, 32]. Поэтому центральная проблема заключается не в том, следует ли накапливать навыки или исключать их, а в том, как определить внешнюю границу обучающегося агента. Навык следует сохранять, когда он по-прежнему дает дополнительную внешнюю ценность, выводить из эксплуатации, когда его вклад становится пренебрежимо малым, и расширять, когда устойчивые сбои выявляют недостаточное покрытие требуемых возможностей.
Для решения этой задачи мы предлагаем SLIM — фреймворк для динамического управления жизненным циклом умений (Skill LIfecycle Management) в агентном обучении с подкреплением (RL). SLIM рассматривает само активное внешнее множество навыков как динамическую переменную оптимизации во время обучения. В частности, SLIM поддерживает задачно-обусловленное активное множество навыков в ходе RL, извлекает иерархические умения из текущего активного пула, оценивает предельный внешний вклад каждого активного умения с помощью валидации leave-one-skill-out и связывает эти сигналы с оптимизацией политики на основе RL, чтобы на протяжении обучения сохранять, прекращать или расширять активное множество навыков. Это создает практический механизм управления между параметрами модели и внешними модульными навыками: повторно используемые способности могут быть усвоены политикой, когда внешняя поддержка становится больше не нужна, в то время как узкие или редкие по распределению (long-tail) способности могут оставаться внешними, пока они продолжают приносить ценность. Как показано на рисунке 1, SLIM приводит к немонотонной траектории внешних возможностей, а не заставляет либо полное накопление, либо вывод без навыков.
Мы оцениваем SLIM на двух репрезентативных агентных RL-бенчмарках со ставкой на навыки: ALFWorld и SearchQA, и сравниваем его со стандартным методом GRPO [12], а также с репрезентативными методами усиления навыков и внутренализации навыков, включая SkillRL [59] и Skill0 [33]. Обширные эксперименты показывают, что SLIM демонстрирует наилучшие в целом результаты, обгоняя лучшие базовые подходы в среднем на 7,1 п.п. по ALFWorld и SearchQA. Динамика обучения и анализ жизненного цикла также выявляют качественно иной конечный результат по сравнению с предшествующими методами, при котором наилучшая производительность в целом не сходится ни к устойчивому полному усилению, ни к инференсу с нулевыми навыками.
Наши вклад состоит из трех частей. (i) Мы формулируем агентное обучение с подкреплением на основе навыков как задачу динамического управления жизненным циклом навыков, при которой активный внешний набор навыков не предполагается монотонно растущим или исчезающим, а рассматривается как поддающаяся обучению внешняя граница способности. (ii) Мы предлагаем SLIM, который оценивает предельный внешний вклад с помощью проверки leave-one-skill-out и использует эту оценку для сохранения, вывода из использования или расширения навыков во время обучения с подкреплением. (iii) Эксперименты на двух широко используемых тестовых наборах показывают, что SLIM улучшает качество выполнения задач, одновременно сходясь к компактному непустому активному набору навыков, демонстрируя выученную границу между внутренне освоенными возможностями и внешними навыками.
2 Сопутствующие работы
Агенты больших языковых моделей. Агенты на основе большой языковой модели (LLM) превращают автогенеративные модели в последовательных лиц, принимающих решения, которые планируют, действуют и взаимодействуют с внешними средами через инструменты, API и воплощённые интерфейсы [65, 60, 44]. Прогресс в использовании инструментов [40, 43, 18], навигации по вебу [19, 39, 16], использовании компьютера [38, 6] и завершении задач на большой временной протяжённости [73, 9, 23] показывает, что структурированные пространства действий и внешние опоры критически важны для надёжного поведения агента. Внешняя память [62, 10] и поддержка навыков [8, 37, 54, 75] дополнительно повышают устойчивость и композиционность. Наша работа следует этому направлению, но фокусируется на том, как активный внешний набор навыков должен развиваться во время обучения с подкреплением.
Агентное обучение с подкреплением. Обучение с подкреплением стало ключевой парадигмой для постобучения LLM-агентов [61, 29], особенно когда требуется взаимодействие, исследование и отложенное назначение кредитов [56, 15, 74]. Недавние методы объединяют оптимизацию политики со структурированными наградами, сигналами предпочтений или целями, относительными группе, чтобы улучшить качество рассуждений и действий [12, 47, 45, 14, 68]. Эти достижения обеспечивают сильную основу для оптимизации, но они не определяют, как следует сохранять, удалять или расширять внешние навыки во время обучения. SLIM сохраняет фиксированным оптимизатор RL и изучает эту задачу управления внешними возможностями.
Агенты, основанные на навыках. Навык является давним механизмом организации многократно используемого поведения агента [77, 70]. Недавние работы по агентам на базе LLM реализуют эту идею через внешние хранилища навыков [52, 55, 75, 54, 59], многоразовые модули подсказок [13, 30, 28, 66] и дистиллированные процедурные указания [37, 8, 36]. Похожие методы либо сохраняют навыки как устойчивое дополнение [59], устраняют их до нулевого навыкового вывода [33], либо совместно развивают агента принятия решений и агента из банка навыков на основе прогонов [58]. SLIM дополняет эти направления, то есть рассматривает активный внешний набор навыков во время RL как динамическую переменную и определяет, когда навыки следует сохранять, прекращать или расширять при конечной вычислительной мощности модели.
3 Предварительные сведения
Агент LLM. Мы моделируем агента LLM как политику , которая взаимодействует со средой при последовательных решениях. Дано конкретное задание , агент формирует траекторию , где и — это наблюдение и действие на шаге , а — это горизонт. Политика , параметризованная , учитывает историю . В средах, содержащих только текст, и , и являются последовательностями токенов, и — это каузальная языковая модель, которая автoreгрессивно генерирует следующее действие из .
Групповая относительная оптимизация политики. Мы используем Group Relative Policy Optimization (GRPO) [12] в качестве оптимизатора для обучения с подкреплением. Для каждой задачи GRPO сэмплирует траекторий из поведенческой политики и назначает каждой из них скалярное вознаграждение . Пусть . Групповая относительная нормированная оценка преимущества равна . Поскольку вознаграждения уровня исхода, одно и то же используется для всех шагов генерации действий в . Пусть — число шагов действий, а — отношение политик на каждом шаге. Целевая функция GRPO равна
|
|
(1) |
где и являются гиперпараметрами, а — опорной политикой.
Банк навыков и постановка проблемы. Следуя SkillRL [59], мы предполагаем иерархическую внешнюю библиотеку навыков, включающую общие навыки и навыки, специфичные для задач. Пусть обозначает глобальный банк навыков, с пулом общих навыков и пулом навыков, специфичных для задач, для типа задач . На шаге аудита агент обращается только к активному подмножеству и действует по политике, обусловленной навыком , где обозначает выбранный внешний навык. Мы используем следующую формализацию для описания задачи распределения, которая мотивирует SLIM. Пусть , и обозначают соответственно активное внешнее множество, латентное внутренне усвоенное множество и неактивное внешнее множество. Пусть будет эффективной параметрической стоимостью памяти для внутреннего усвоения навыка , и пусть обозначает конечную емкость знаний модели [5]. Стоимость внешней поддержки моделируется как концептуальная черно-ящичная монотонная функция множеств , где добавление любого неактивного навыка влечет положительную предельную стоимость, то есть для . Эта формализация мотивирует обучение как следующую задачу распределения с ограничением по емкости:
| (2) |
Монотонность отражает тот факт, что дополнительные активные навыки увеличивают контекст или накладные расходы маршрутизации, тогда как ограничение конечной емкости не позволяет считать, что все навыки могут быть поглощены параметрами. Навыки, удаленные из , могут перейти в , если они усвоены, или в , если они шумные или устаревшие..
4 Метод: SLIM
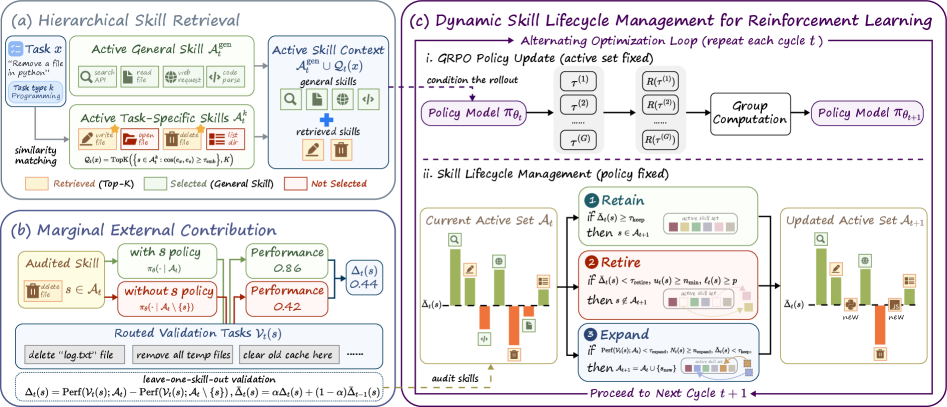
Обзор SLIM показан на рисунке 2. Уравнение (2) мотивирует взгляд на распределение с ограниченной пропускной способностью по политике и активному внешнему набору навыков, но точная онлайн-оптимизация в этом смешанном пространстве недостижима. Поэтому SLIM использует три приближения, допускающих вычисление. Сначала (раздел 4.1) он ограничивает поиск активного набора задач-обусловленным множеством видимых навыков. Затем (раздел 4.2) он оценивает локальную ценность каждого проверяемого навыка посредством валидации leave-one-skill-out. Наконец (раздел 4.3), он объединяет эти сигналы с оптимизацией политики на основе GRPO, позволяя сохранять, прекращать или расширять активный набор навыков по мере продолжения обучения. Таким образом, SLIM учится, какие возможности должны оставаться активными, а какие должны быть удалены из активной внешней поддержки.
4.1 Иерархическое извлечение навыков
Первый компонент SLIM сокращает пространство поиска активного множества в уравнении 2. Непосредственный выбор из полного банка навыков является комбинаторной задачей, поэтому SLIM использует иерархическую структуру в разделе 3, чтобы преобразовать глобальный выбор навыков в выбор кандидатов, обусловленный задачей.
Формально, пусть обозначает в настоящее время активный пул общих навыков на шаге аудита , а пусть обозначает активный пул, относящийся к конкретной задаче, для типа задачи . Для экземпляра задачи типа SLIM выбирает активные общие навыки вместе с извлечённым подмножеством навыков, относящихся к задаче, из . Пусть обозначает встраивание текущего описания задачи, а пусть обозначает встраивание навыка . Извлечённый набор навыков, относящихся к задаче,
| (3) |
где — порог извлечения, а — максимальное число предметно-ориентированных навыков, загружаемых в подсказку. Тогда итоговая навыко-обусловленная политика для задачи представляет собой объединение активных общих навыков и извлечённого множества предметно-ориентированных навыков, то есть . Поскольку извлечение ограничено текущим активным набором, решения по жизненному циклу напрямую влияют на внешнюю возможность, раскрываемую для последующих развёртываний.
Интуитивно, внешние навыки должны быть релевантны, прежде чем они смогут быть полезными. При этом только релевантность извлечения не подсказывает нам, стоит ли по-прежнему сохранять навык внешним. Разные активные навыки могут выбираться для одного и того же типа задач, принося при этом существенно разный объем внешней ценности. Это подталкивает к явной оценке предельного внешнего вклада каждого активного навыка.
4.2 Оценка предельного внешнего вклада
Учитывая заданный набор навыков с маршрутизацией из Раздела 4.1, следующая задача — определить, все ли активные навыки по-прежнему заслуживают внешней поддержки. Даже после ограничения множества кандидатов перечисление комбинаций навыков для оценки предельного внешнего вклада (MEC) каждого активного навыка остается непрактичным. Поэтому SLIM использует валидацию leave-one-skill-out как осуществимое локальное приближение.
Для прошедшего аудит навыка пусть обозначает подмножество задач валидации, развертывания которых используют навык при текущем активном наборе, то есть задачи , для которых . Пусть обозначает эффективность валидации на подмножестве , когда активный набор равен . МЕС для на шаге аудита определяется посредством валидации leave-one-skill-out:
| (4) |
Чтобы снизить аудиторский шум, SLIM сглаживает оценки текущего раунда с помощью экспоненциального скользящего среднего, . Для управления жизненным циклом мы используем , а не . Положительное значение означает, что текущая политика по-прежнему получает выгоду от сохранения этой способности внешней, тогда как близкое к нулю или отрицательное значение означает, что способность могла быть поглощена, стать избыточной или вредной в качестве внешней помощи. Это локальная оценка, обусловленная текущей политикой, активным набором и поведением маршрутизации, а не глобальная атрибуция по всем возможным подмножествам навыков. Она надежна, когда валидационные задачи, маршрутизируемые в , отражают то же локальное поведение, наблюдаемое во время развертывания; в этом случае удаление в этих задачах является прямым тестом того, нужна ли политике по-прежнему ее внешняя поддержка. Лемма A.6 в приложении A дополнительно объясняет этот локальный суррогат.
4.3 Динамическое управление жизненным циклом навыков для обучения с подкреплением
Теперь мы связываем обновления жизненного цикла навыков с оптимизацией политики посредством чередующейся оптимизации. Уравнение 2 содержит непрерывную переменную политики и дискретную переменную активного множества ; первая может быть обновлена методами RL на основе градиентов, тогда как для второй требуются недифференцируемые операции с множествами при черном ящике-стоимости . Поэтому SLIM разлагает каждый цикл аудита на обновление политики GRPO с зафиксированным активным множеством, а затем на управление жизненным циклом навыков с зафиксированной политикой. Для анализа мы записываем уравнение 2 как , при соблюдении его скрытого ограничения по пропускной способности.
На этапе GRPO зафиксирован, поэтому является постоянной и обновление должно только улучшить политику при текущей внешней поддержке. При локальном согласовании суррогатов в предположении A.3 выступает в качестве локального суррогата для улучшения термина, связанного с производительностью, для . Этот шаг может уменьшить зависимость политики от некоторых внешних навыков, но исчезла ли такая зависимость на самом деле, измеряется величиной MEC, а не предполагается.
На этапе управления жизненным циклом навыков фиксирована. Любая операция над активным набором желательна, пока обновлённый активный набор делает положительным. Согласно уравнению (4), разницу в производительности, вызванную удалением активного навыка, можно оценить по его MEC. Трудность заключается в члене стоимости , который представляет собой неизвестную строго монотонную функцию множества, и глобальный поиск по всем конфигурациям активного набора невозможен. Поэтому мы ограничиваем управление жизненным циклом одно-навыковыми переходами. Для таких переходов абсолютная разница в стоимости ограничена в рамках рабочего режима в лемме A.7. С учётом этого SLIM задаёт правила переходов состояния вокруг , так что каждый принятый переход является локальным обновлением с ограниченным риском.
Retain сохраняет подтверждённый навык активным, когда его сглаженная MEC явно положительна. Здесь указывает, что значение, создаваемое , достаточно больше, чем его внешняя стоимость поддержки, поэтому навык должен продолжать кондиционировать политику в последующих прогонах.
| (5) |
Retire удаляет прошедший аудит навык , когда его предельный вклад становится пренебрежимо малым, и этот сигнал остается стабильным после достаточного воздействия. Здесь — это кумулятивное число воздействий, а — серия последовательных периодов низкого вклада. Эти два условия защищают навыки с низкой частотой от удаления до того, как будет наблюдено достаточно маршрутизированных свидетельств. Порог действует как консервативная нижняя суррогатная оценка внешней стоимости, возмещаемой за счет удаления. В частности, удаление может привести к потере в производительности, но при этом оно сохраняет неизвестную внешнюю стоимость удержания в активном состоянии. Списание означает лишь то, что при текущей политике он больше не обеспечивает достаточно предельной ценности; возможно, он был усвоен, стал избыточным, либо превратился в шумный или устаревший. Когда , SLIM не выполняет немедленный переход жизненного цикла для и сохраняет его активным до тех пор, пока более поздние аудиты не предоставят более убедительные доказательства.
| (6) |
Расширение добавляет новое умение , когда текущее активное умение устойчиво не покрывает область назначенной ему задачи. Здесь — это накопленное число неудач задач, перенаправленных на . Порог указывает, что текущая производительность с этим умением достаточно низка, чтобы оставить пространство для значительных улучшений, поэтому ожидается, что новое внешнее умение обеспечит достаточно выигрыша, чтобы покрыть разумное однократное увеличение стоимости.
| (7) |
Лемма A.8 задаёт локальные достаточные условия, при которых эти эвристические правила являются консервативными или улучшают , а лемма A.10 формализует, что в настоящее время проверяемое извне необходимое умение защищено, пока его MEC остаётся выше порога выхода. Интуитивно, если политика по-прежнему зависит от необходимого умения, его удаление ухудшает качество валидации, остаётся высоким, и выход блокируется; если остаётся близким к нулю, активное удержание не требуется, потому что умение могло быть усвоено или стало избыточным. Кроме того, SLIM включает в себя предшествующие методы как граничные случаи. Если выход отключён, то есть для всех , это сводится к режиму устойчивого наращивания, похожему на SkillRL. При монотонности внешняя стоимость поддержки не может уменьшаться и со временем может ухудшать производительность. Если расширение отключено и выход принудительно выполняется вплоть до , это сводится к режиму с нулевыми умениями, похожему на Skill0. Поскольку тогда необходимые внешние возможности должны быть поглощены в , это может нарушить ограничение конечной ёмкости в уравнении Eq. (2), тем самым вытесняя другие полезные возможности.
5 Реализация
Алгоритм. Алгоритм 1 суммирует практический цикл обучения SLIM. Реализация следует трем компонентам в Разделе 4.1–4.3, то есть каждый шаг GRPO извлекает активные навыки, выполняет развёртывания, обусловленные навыком, и обновляет политику; на каждом интервале аудита SLIM оценивает предельный внешний вклад и применяет операции retain, retire или expand. Чтобы аудит был доступным по стоимости, SLIM не оценивает каждый активный навык. Аудиты жизненного цикла выполняются каждые шагов GRPO, и каждый аудит рассматривает не более навыков с наибольшим недавним маршрутизированным использованием среди навыков, которые появлялись в top- извлечении.
Настройки обучения и вывода. Для обучения задача-специфическое извлечение использует Qwen3-Embedding-0.6B [71] совместно с и . Мы оптимизируем политику с помощью GRPO, используя вознаграждения на уровне исхода. В частности, каждое завершенное развертывание получает награду за успех в среде, при этом во время сбора траектории применяются штрафы за недопустимые действия. В основных запусках SLIM мы отключаем как потерю KL со стороны политики, так и регуляризацию KL-в-вознаграждении. Решения «сохранять» и «отзывать» реализуются, как описано выше. Расширение использует маршрутизируемые корзины неудач и создает автономные артефакты SKILL.md, соответствующие задаче, с рабочим процессом создателя навыков в стиле Anthropic [7]. Во время финального вывода агент может запускаться с навыками, извлекая активные навыки перед каждым развертыванием; в запросе содержатся активные общие навыки и извлеченный набор задачно-специфичных навыков , при этом обновление жизненного цикла не выполняется. Шаблоны запросов, пороги жизненного цикла, полные настройки обучения и детали вывода приведены в Приложении B.1.
6 Эксперимент
6.1 Оценочная схема
Базовые модели для проверки. Мы проводим все основные эксперименты с Qwen3-4B [63] на ALFWorld [50] и SearchQA [23]. ALFWorld охватывает бытовые задачи Pick, Look, Clean, Heat, Cool и Pick2, тогда как SearchQA охватывает NQ [25], TriviaQA [24], PopQA [35], HotpotQA [64], 2Wiki [20], MuSiQue [51] и Bamboogle [42]. Мы сравниваем с базовыми подходами на основе подсказок, агентом/памятью и основанными на RL, включая ReAct [65], Reflexion [49], Mem0 [10], ExpeL [72], GRPO [46], EvolveR [57], SkillRL [59] и Skill0 [33]. Полные сведения о базовых моделях приведены в Приложении B.2⟧.
Оценка. Мы сообщаем долю успешных попыток на обоих бенчмарках. Попытка считается успешной, если агент выполняет цель ALFWorld или возвращает корректный заключительный ответ SearchQA в рамках общего оценщика бенчмарка. Все методы используют один и тот же протокол train/validation/test: обучение использует разбиение train, аудит жизненного цикла и подбор гиперпараметров используют validation, а итоговая отчетность использует test. Все RL-ориентированные методы обучаются без cold-start SFT или прогрева. Приложение D дополнительно сообщает о переносе между задачами, передаче из skill-bank, устойчивости SLIM к изменениям в производительности, чувствительности к инициализации, расширенных сравнениях с базовыми моделями и накладных расходах на аудит. Подробные разбиения и меры обеспечения справедливости приведены в Приложении C⟧.
6.2 Основные результаты
Метод ALFWorld SearchQA Выбор Смотреть Очистить Нагреть Охладить Выбор2 В среднем. NQ TriviaQA PopQA HotpotQA 2Wiki MuSiQue Bamboogle В среднем. Методы, основанные на подсказках Нулевой выстрел 82.9 0.0 31.2 23.1 21.7 30.0 41.4 28.5 49.6 32.7 23.5 27.7 5.3 35.2 32.3 Похожий выстрел 80.0 40.0 37.5 7.7 17.4 15.0 39.1 32.9 55.6 34.9 28.0 28.5 7.2 37.6 35.5 Нулевой выстрел† 94.3 40.0 81.2 38.5 17.4 55.0 63.3 26.6 48.2 31.8 22.7 27.9 5.3 33.6 31.5 Похожий выстрел† 94.3 60.0 84.4 38.5 34.8 30.0 64.1 32.3 54.6 34.6 28.1 27.2 7.4 38.4 34.8 Методы на основе агента или памяти ReAct 100.0 33.3 25.0 53.8 23.8 26.7 50.5 33.2 54.5 36.5 28.8 30.8 7.7 33.6 36.4 Reflexion 93.9 30.0 52.0 20.0 47.8 68.2 59.4 22.3 45.7 25.8 22.6 28.3 4.9 31.2 29.1 Mem0 93.9 30.0 32.0 26.7 17.4 18.2 42.2 29.3 50.6 33.3 24.6 28.2 6.5 30.4 33.1 ExpeL 97.1 62.5 38.5 13.3 21.7 61.9 53.5 23.5 47.0 29.6 22.8 30.0 6.5 28.0 31.0 Методы на основе RL GRPO 85.4 100.0 49.8 64.6 53.1 54.2 67.2 35.9 57.8 36.5 30.8 30.1 9.2 30.4 37.5 GRPO† 84.6 62.5 48.9 68.8 61.0 80.8 68.8 36.4 58.2 37.0 31.2 30.4 9.6 31.2 37.9 EvolveR 67.6 37.5 49.3 15.6 36.0 36.5 39.8 36.0 57.5 36.8 30.6 30.0 9.5 29.6 37.4 SkillRL† 90.6 75.0 54.6 76.2 67.7 87.5 75.0 36.8 59.8 36.9 31.5 29.7 10.3 31.2 38.1 Skill0 93.6 87.5 59.8 66.7 57.6 78.4 74.2 37.9 59.5 38.6 32.7 31.9 10.3 32.8 39.3 SLIM 91.4 80.0 46.9 61.5 73.9 85.0 72.7 38.6 62.2 40.0 37.2 31.7 12.8 37.6 41.0 SLIM† 92.9 100.0 91.4 78.3 88.5 81.2 87.5 38.4 62.1 40.4 36.9 31.5 12.7 36.0 41.0
Общее сравнение. Таблица 1 приводит основное сравнение. На ALFWorld SLIM† достигает 87,5, опережая самый сильный не основанный на SLIM базовый подход SkillRL† на 12,5 пункта. Также она существенно улучшает показатели по сравнению с GRPO, GRPO† и Skill0, демонстрируя, что выигрыш не обусловлен обычным RL, наивной инъекцией навыков, устойчивым накоплением или принудительным выводом с нулевыми навыками. Разрыв между SLIM и SLIM† также велик (72,7 против 87,5), что указывает на то, что в ALFWorld присутствуют процедурные поведения с длинными горизонтами, где некоторые возможности лучше сохранять снаружи. SearchQA демонстрирует иной режим. И SLIM, и SLIM† достигают 41,0, улучшая самый сильный не основанный на SLIM базовый подход Skill0 на 1,7 пункта. Здесь разрыв во время вывода между SLIM и SLIM† почти исчезает, что предполагает, что преимущество в основном отражено в обученной политике, а не в сильной конечной внешней зависимости. В совокупности результаты поддерживают наш центральный тезис о том, что конечная точка skill-based agentic RL зависит от задачи, то есть некоторые предметные области требуют сохранения внешних процедурных навыков, тогда как в других можно усвоить или отбросить большую часть внешней поддержки после обучения.
Подробный анализ. ALFWorld получает концентрацию на задачах процедурного преобразования состояний. SLIM† достигает 91,4 на Clean и 88,5 на Cool, что значительно выше SkillRL† и Skill0. Это согласуется с пробой на протяжении жизненного цикла на рисунке 5, то есть навык cle_003, специфичный для Clean, сохраняет внешнюю ценность, тогда как несколько навыков для охлаждения прекращают использоваться, что указывает: выигрыш получается за счет фильтрации процедурной поддержки, а не за счет сохранения каждого навыка, специфичного для задач. Heat показывает меньший, но стабильный прирост, что указывает на то, что управление жизненным циклом наиболее полезно тогда, когда процедуры являются композиционными и неравномерно покрыты. Преимущество распределено неодинаково по всем типам задач. Более простые задачи получения объектов, такие как Pick, оставляют ограниченный резерв для управления жизненным циклом, тогда как SLIM† достигает полного успеха на Look, сохраняя навыки, которые покрывают этот тип задач. Более того, GRPO† улучшает Pick2 и Cool, но ухудшает или не улучшает Look и Pick, демонстрируя, что простая вставка навыков не дает равномерной пользы. Это подтверждает наш контроль жизненного цикла, при котором навыки остаются активными только тогда, когда их предельный эффект является положительным при текущей политике. На SearchQA улучшение меньше, но в целом распределено шире: SLIM или SLIM† является лучшим или близким к лучшему на большинстве подмножеств. Простая вставка навыков может даже навредить, поскольку Zero-Shot† и Few-Shot† опускаются ниже своих вариантов без навыков. Таким образом, SearchQA отражает режим с меньшей зависимостью, где обучение с учетом жизненного цикла улучшает политику больше, чем вставка навыков во время вывода, дополняя ALFWorld, где сохраненные процедурные навыки остаются полезными.
6.3 Динамика обучения
| Method | ALFWorld Avg. |
| SLIM | 87.5 |
| w/o Retirement | 73.4 |
| w/o Expansion | 78.9 |
| Random Audit | 68.8 |
| Fixed Active Set Size | 75.6 |
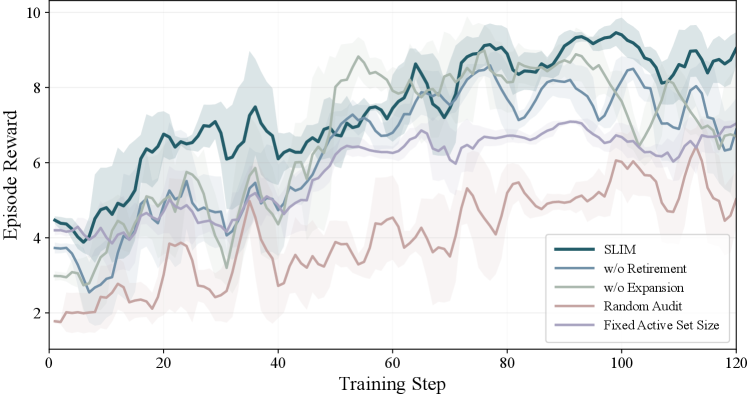
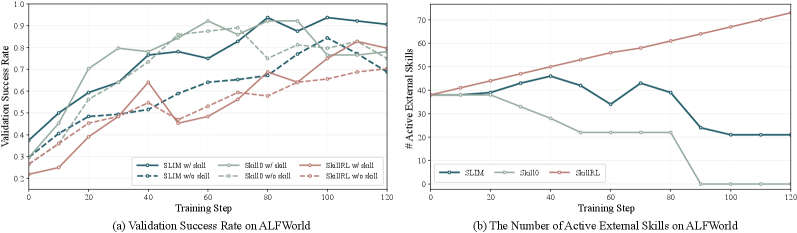
Рисунок 3 сравнивает динамику обучения на ALFWorld. SkillRL следует устойчивому накоплению, при котором число активных навыков увеличивается с 38 до 73 в ходе обучения. Хотя обе кривые валидации с навыком и без навыка улучшаются, итоговая производительность остается ниже SLIM. Это показывает, что сохранение большего числа внешних навыков не обязательно приводит к лучшей итоговой производительности, что согласуется с нашей мотивацией: большие банки навыков могут порождать накладные расходы на маршрутизацию и контекст. Skill0 демонстрирует противоположную картину. Его активный набор уменьшается с 38 до 0. Его производительность без навыка становится сильной на более поздней стадии, что указывает на то, что политика действительно учится на обучении, обусловленном навыком. Однако, как только активный набор навыков достигает нуля примерно к эпохе 90, валидация снижается с 92.2% до 76.6% в следующем интервале аудита. Это подтверждает наше утверждение о том, что выход на пенсию не эквивалентен успешной внутренней интернализации, поскольку принудительный вывод без навыка может удалить полезную внешнюю поддержку, особенно для нестабильных, редко встречающихся или высокоразреженных возможностей из хвоста распределения.
SLIM обучается немонотонной траектории. Ее активное множество сначала расширяется с 38 до 46, колеблется по мере чередования расширения и выхода, и в конечном итоге стабилизируется на компактном непустом множестве из 21 навыка. Тем временем результат без навыков повышается с 29,7% до 84,4%, показывая, что сама политика обучается, тогда как результат с навыками достигает пика на 93,8% и остается 90,6% в конце. Таким образом, SLIM не жертвует обучением политики ради внешней зависимости. Она улучшает политику, сохраняя набор внешних навыков, которые по-прежнему дают предельный вклад.
6.4 Исследование посредством исключения (ablation)
Компоненты жизненного цикла. Таблица 2 изолирует операции жизненного цикла. Удаление этапа выхода на пенсию снижает успешность ALFWorld с 87,5 до 73,4, показывая, что расширение без удаления вырождается в накопление, похожее на SkillRL, где больше активных навыков не означает более высокую производительность. Удаление этапа расширения достигает 78,9, что выше, чем без выхода на пенсию, но всё же на 8,6 пункта ниже SLIM, показывая, что само по себе прореживание не может исправить регионы задач с недостаточным покрытием. Поскольку без расширения всё же лучше, чем несколько базовых уровней, полный выигрыш нельзя объяснить только опорной частью skill-creator; расширение важно, потому что оно заполняет отсутствующее покрытие, специфичное для задач. Рисунок 4 демонстрирует ту же закономерность: улучшения локального вознаграждения могут быть временными, но конечная точка остаётся хуже без полного жизненного цикла.
Эффективность внешнего предельного вклада. «Случайная аудиторская проверка» сохраняет то же пространство операций, но заменяет решения, учитывающие вклад, на стохастические: выбор retain/delete осуществляется с вероятностями 0.8/0.2, а расширение запускается независимо с вероятностью 0.1. Она получает лишь 68.8 — самое большое снижение, а кривая награды остается ниже, чем у остальных вариантов, в течение большей части обучения. Таким образом, выигрыш SLIM не объясняется случайными возмущениями набора навыков; решения на уровне жизненного цикла должны отслеживать, продолжает ли навык по-прежнему обеспечивать предельную внешнюю ценность в рамках текущей политики.
За пределами контроля бюджета промптов. «Фиксированный размер активного набора» управляет числом активных навыков на начальном размере 38, используя удаление по LRU после расширения и расширение после выхода из режима, чтобы бюджет оставался фиксированным. Он достигает 75,6, оставаясь при этом на 11,9 пункта ниже SLIM. Это исключает чистое объяснение через бюджет промптов: ключевым является не только то, сколько навыков остаётся активными, но и какие навыки сохраняются, удаляются и расширяются.
6.5 Тематическое исследование: Анализ управления жизненным циклом навыков
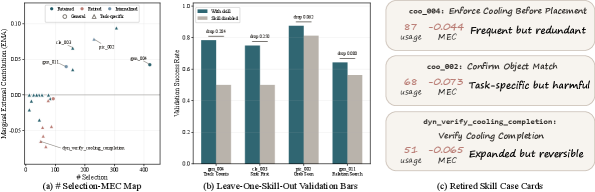
Мы используем зонд жизненного цикла, предназначенный только для диагностики, чтобы объяснить операции SLIM. Зонд регистрирует для каждой проверяемой компетенции число выбранных раз, маргинальный внешний вклад (MEC), результативность соответствующей компетенции, результативность отключенной компетенции и исход жизненного цикла. Мы помечаем компетенцию как внутренне усвоенную только для анализа, если она часто выбирается, но имеет почти нулевой MEC, и если ее отключение приводит лишь к небольшому падению валидации при текущей политике. Эта метка не используется как сигнал обучения, и все операции по-прежнему следуют Разделу 4.3. Хотя на Рисунке 3 показано, что активное множество сначала расширяется, затем сужается и в итоге остается непустым, на Рисунке 5 объясняется, почему это происходит. Итоговое активное множество — это не просто остаток неполного внутреннего усвоения, а результат отборочной фильтрации с учетом вклада.
Жизненный цикл следует MEC. Панели (a) и (b) показывают, что решения о жизненном цикле определяются MEC, а не только частотой выбора. Широкие и часто выбираемые навыки, такие как pic_002 и gen_011, становятся близкими к внутренней закрепленности, поскольку их отключение приводит лишь к падениям 0.062 и 0.080; однако высокая частота сама по себе не достаточна для выхода на пенсию, поскольку gen_004 также является широким и частым, но при этом сохраняет внешнюю ценность со значительно большим падением 0.284. И наоборот, низкая частота не означает низкую ценность: cle_003 выбирается реже, но имеет высокое MEC, и его отключение вызывает падение 0.250, делая его глобально редким, но локально незаменимым. Панель (c) дополнительно показывает, что частые, привязанные к задачам или вновь расширенные навыки могут быть выведены из эксплуатации, как только их предельная внешняя ценность становится отрицательной. Таким образом, SLIM выводит навык из эксплуатации только тогда, когда его внешняя предельная ценность исчезает при текущей политике, сохраняя навыки длинного хвоста, которые остаются полезными на конкретных маршрутизированных подмножествах.
Эмпирическая поддержка локальных сигналов жизненного цикла. Тематическое исследование также связывает локальную теорию с наблюдаемым поведением. Зонд MEC показывает, что уход «leave-one-skill-out» снижает соответствие результатам retain и retire, при этом Рисунок 3 демонстрирует, что эти локальные решения приводят к немонотонному активному набору, а не к монотонному накоплению или исключению. Абляции дополнительно подтверждают этот механизм: без Retirement показатель падает до 73.4, Random Audit до 68.8, а Fixed Active Set Size до 75.6, что указывает на то, что эффективность зависит от зависящих от вклада решений о жизненном цикле, а не от бесконтрольного роста навыков, случайной мутации или простого контроля бюджета подсказок.
7 Заключение и дальнейшие работы
Мы представляем SLIM — фреймворк для динамического управления жизненным циклом навыков в агентном RL. Ключевая идея SLIM состоит в том, что внешние навыки не следует предполагать накапливающимися бесконечно, но и не нужно принуждать их исчезать до нулевого уровня при выводе. Вместо этого активный набор внешних навыков следует рассматривать как динамическую переменную оптимизации и обновлять его с помощью обучения политике, что позволяет выученной конечной точке избегать как устойчивого полного накопления, так и принудительного вывода с нулевыми навыками. На ALFWorld и SearchQA SLIM улучшает стандартный RL и предшествующие методы на основе навыков, одновременно обучаясь качественно иному конечному состоянию. Динамика обучения, абляции и исследования частных случаев жизненного цикла показывают, что активный набор развивается не монотонно, и что решения, учитывающие вклад, имеют принципиальное значение. Эти результаты указывают на разделение труда между параметрами модели и внешней процедурной памятью: повторно используемые поведенческие паттерны могут становиться менее внешне необходимыми, тогда как узкие или локально значимые навыки остаются полезными в качестве внешних модулей. В будущих работах эту перспективу можно распространить на более богатые мультимодальные среды, более детализированные единицы жизненного цикла и более масштабируемые методы аудита.
Ссылки
- Ahmadian et al. [2024] Араш Ахмадиан, Крис Кремер, Маттиас Галле, Марзие Фадаи, Юлия Кройцер, Оливье Пьеткин, Ахмет Устюн и Сара Хукер. К базовым принципам: повторное рассмотрение оптимизации в стиле REINFORCE для обучения по обратной связи от человека в LLMs. препринт arXiv arXiv:2402.14740, 2024.
- Ahn et al. [2024] Дженис Ан, Ришу Верма, Ренце Лоу, Ди Лью, Жуй Чжан и Венпэн Ин. Большие языковые модели для математического рассуждения: прогресс и проблемы. препринт arXiv arXiv:2402.00157, 2024.
- ⟦Zeyuan Allen-Zhu и Yuanzhi Li. Физика языковых моделей: Часть 3.1, хранение знаний и извлечение. В материалах 41-й Международной конференции по машинному обучению, страницы 1067–1077, Вена, Австрия, 2024.
- ⟦Allen-Zhu and Li [2025a] Зейуан Аллен-Чжу и Юаньчжи Ли. Физика языковых моделей: Часть 3.2, манипулирование знаниями. В материалах 13-й Международной конференции по машинному обучению представлениям, Сингапур, Сингапур, 2025a.
- ⟦Zeyuan Allen-Zhu and Yuanzhi Li. Physics of language models: Part 3.3, knowledge capacity scaling laws. In Proceedings of the 13th International Conference on Learning Representations, Singapore, Singapore, 2025b.
- Anthropic [2024] Anthropic. Представляем компьютерное использование, новый claude 3.5 sonnet и claude 3.5 haiku. https://www.anthropic.com/news/3-5-models-and-computer-use, 2024.
- Anthropic [2025] Антропик. Навыки агента. https://docs.claude.com/en/docs/agents-and-tools/agent-skills, 2025.
- Chen et al. [2026] Ле Чэнь, Эрху Фэн, Юбин Ся и Хайбо Чэнь. Skvm: Пересмотр языковой vm для навыков на разных heterogenous llms и в различных harnesses. arXiv preprint arXiv:2604.03088, 2026.
- ⟦Chen et al. [2025] Синьи Чэнь, Иилун Чэнь, Янвэй Фу, Нин Гао, Цзяя Цзя, Вэйян Цзинь, Хао Ли, Яо Му, Цзянмяо Пэн, Ю Цяо, Ян Тянь, Бин Ван, Бо Лун Ван, Фанцзин Ван, Ханьцин Ван, Тай Ван, Цзыцин Ван, Сюэюань Вэй, Чао У, Шуай Ян, Цзинхуй Йе, Цзюнцю Юй, Цзя Зэн, Цзинцзин Чжан, Цзинью Чжан, Ши Чжан, Фэн Чжэн, Боуэн Чжоу и Янкун Чжу. Internvla-m1: Пространственно направляемая схема видение-язык-действие для универсальной робототехнической политики. arXiv preprint arXiv:2510.13778, 2025.
- Chhikara et al. [2025] Пратиик Чхикара, Дев Хант, Сакет Арайан, Таранджит Сингх и Дешрадж Ядав. Mem0: Разработка готовых к производственному применению ИИ-агентов с масштабируемой долговременной памятью. arXiv препринт arXiv:2504.19413, 2025.
- ⟦Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Yunxuan Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, Albert Webson, Shixiang Shane Gu, Zhuyun Dai, Mirac Suzgun, Xinyun Chen, Aakanksha Chowdhery, Alex Castro-Ros, Marie Pellat, Kevin Robinson, Dasha Valter, Sharan Narang, Gaurav Mishra, Adams Yu, Vincent Zhao, Yanping Huang, Andrew Dai, Hongkun Yu, Slav Petrov, Ed H. Chi, Jeff Dean, Jacob Devlin, Adam Roberts, Denny Zhou, Quoc V. Le, and Jason Wei. Масштабирование инструкции-визированных моделей языка, донастроенных. Журнал машинного обучения, 25(70):1–53, 2024.
- ⟦DeepSeek-AI et al. [2025] DeepSeek-AI, Дая Го, Дэян Ян, Хаовэй Чжан, Цзюньсяо Сун, Пэйи Ван, Цихao Чжу, Жусинь Сюй, Руою Чжан, Широнг Ма, Сяо Би, Сяокан Чжан, Синкай Юй, Юй У, Z. Ф. У, Чжибин Гоу, Чжихун Шао, Чжошу Ли, Цзыи Гао, Айсин Лю, Бин Сюэ, Бинсюань Ван, Боачao У, Бэй Фэн, Чэнда Лу, Чэнган Чжао, Чэнци Ден, Чэнь Юй Чжан, Чун Жань, Дамай Дай, Делi Чэнь, Донгцзе Цзи, Эрхан Ли, Фанъюнь Линь, Фуконг Дай, Фули Ло, Гуанбо Хао, Гантин Чэнь, Говэй Ли, Х. Чжан, Хань Бао, Ханьвэй Сюй, Хаочэн Ван, Хунхуэй Дин, Хуайцзян Синь, Хуачзо Гао, Хуэй Цюй, Хуэй Ли, Цзяньчжун Го, Цзяши Ли, Цзявэй Ван, Цзиньчан Чэнь, Цзинъян Юань, Цзюньцзе Цю, Цзюньлун Ли, Цз. Л. Кай, Цзяци Ни, Лян Лян, Цзинь Чэнь, Кай Дун, Кай Ху, Кайгэ Гао, Кан Гуань, Кэксин Хуан, Куай Юй, Лин Ван, Лэconг Чжан, Лян Чжао, Литун Ван, Лиюэ Чжан, Лэй Сюй, Лэйи Ся, Минчувань Чжан, Минхуа Чжан, Минхуэй Тан, Мэн Ли, Мяо Цзюнь Ван, Мингмин Ли, Нин Тянь, Панпан Хуан, Пэн Чжан, Цяньчэн Ван, Цинъю Чэнь, Циуши Ду, Жуйци Ге, Руисонг Чжан, Жуйчэ Пан, Жунцзи Ван, Р. Дж. Чэнь, Р. Л. Цзинь, Жуйи Чэнь, Шанхао Лу, Шанъян Чжоу, Шаньхуан Чэнь, Шэнфэн Е, Шию Ван, Шуйпин Юй, Шуньфэн Чжоу, Шутин Пан, С. С. Ли, Шуан Чжоу, Шаоцин У, Тао Юнь, Тянь Пэй, Тяньюй Сун, Т. Ван, Ванъдин Цзэн, Ваньцзя Чжао, Вэнь Лю, Венфэн Лян, Венцзюнь Гао, Венцин Юй, Вэнтао Чжан, В. Л. Сяо, Вэй Ань, Сяодун Лю, Сяохань Ван, Сяокан Чэнь, Сяотao Ни, Син Чэн, Синь Лю, Синь Се, Синьчао Лю, Синьюй Ян, Синъюань Ли, Сюэчэн Су, Сюхэн Линь, Х. Ц. Ли, Сянъюэ Цзинь, Сяоцзинь Шэнь, Сяоша Чэнь, Сяовэнь Сунь, Сяосян Ван, Синнан Сун, Синьи Чжоу, Сяньцзу Ван, Синься Шань, Й. К. Ли, Й. Ц. Ван, Й. Х. Вэй, Ян Чжан, Яньхун Сюй, Яо Ли, Яо Чжао, Яофэн Сун, Яохуэй Ван, Йи Юй, Ичао Чжан, Ифань Ши, Илян Сюн, Ин Хэ, Иши Пяо, Исонг Ван, Исюань Тан, Иян Ма, Июань Лю, Юнциан Го, Юань Ао, Юдуань Ван, Юэ Гун, Юхэн Цзоу, Юйцзя Хэ, Юньфан Сюн, Юсян Луо, Юсян Ю, Юсюань Лю, Юян Чжоу, Й. Х. Чжу, Яньпин Хуан, Яохуэй Ли, Йи Чжэн, Юйчэнь Чжу, Юньсянь Ма, Ин Тан, Юкун Чжа, Ютин Ян, Z. Z. Рен, Цзэхуи Рен, Чжанли Ша, Чжэ Фу, Чжэан Сюй, Чжэнда Се, Чжэнъян Чжан, Чжэвэнь Хао, Чжичэн Ма, Чжиганг Ян, Чжию У, Цзихуй Гу, Цзицзя Чжу, Цзицзюнь Лю, Цзилинь Ли, Цивэй Се, Цзыян Сун, Цзицзэн Пан, Чжэнь Хуан, Чжипэн Сюй, Чжунъюй Чжан, и Чжэнь Чжан. Deepseek-r1 поощряет рассуждение в llms посредством обучения с подкреплением. Nature, 645(8081):633–638, 2025.
- Fu et al. [2024] Яо Фу, Дон-Ки Ким, Джекиом Ким, Сангриул Сон, Ладжанюген Логесваран, Кюнхон Бэ и Хонглак Ли. Autoguide: Автоматизированная генерация и отбор контекстно-зависимых руководств для агентов больших языковых моделей. предварительная публикация arXiv arXiv:2403.08978, 2024.
- Fujimoto et al. [2019] Скотт Фудзимото, Дэвид Мегер и Доину Прекьюп. Без поискового исследования оф-политики глубокого обучения с подкреплением. В материалах 36-й Международной конференции по машинному обучению, страницы 2052–2062, Лонг-Бич, Калифорния, 2019.
- Goldie et al. [2025] Анна Голди, Азалия Мирхосейни, Хао Чжоу, Айрин Кай и Кристофер Д. Мэннинг. Генерация синтетических данных и многократное пошаговое rl для рассуждений и использования инструментов. Препринт arXiv arXiv:2504.04736, 2025.
- Google [2025] Google. Gemini Deep Research — ваш персональный исследовательский помощник. https://gemini.google/overview/deep-research/, 2025.
- ⟦Guo et al. [2025] Йиджие Го, Бингцзе Тан, Иретайо Акиндола, Дитер Фокс, Абхишек Гупта и Яшрадж Наранг. SRSA: извлечение навыков и адаптация для задач роботизированной сборки. В материалах 13-й Международной конференции по представлениям в обучении, Сингапур, Сингапур, 2025. OpenReview.net.
- ⟦Hao et al. [2023] Шибо Хао, Тянъян Лю, Чжэнь Ван и Чжитин Ху. Toolkengpt: Увеличение замороженных языковых моделей с помощью массивных инструментов через tool embeddings. В Advances in Neural Information Processing Systems 36, Новый Орлеан, ЛА, 2023.
- ⟦He et al. [2024] Хунлян Хэ, Вэньлинь Яо, Кайсинь Ма, Вэньхао Юй, Юн Дай, Хунмин Чжан, Чжэньчжун Лань и Дон Юй. Webvoyager: Построение сквозного веб-агента с большими мультимодальными моделями. В Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics, pages 6864–6890, Bangkok, Thailand, 2024.
- Ho et al. [2020] Кхан Хо, Ан-Кхоа Зыонг Нгуен, Саку Сугавары и Акико Айзава. Построение набора данных для многосвязного qa для всесторонней оценки шагов рассуждения. В материалах 28-й Международной конференции по компьютерной лингвистике, страницы 6609–6625, Барселона, Испания, 2020.
- Hoeffding [1963] Василий Хёффдинг. Неравенства вероятностей для сумм ограниченных случайных величин. Журнал Американской статистической ассоциации, 58(301):13–30, 1963.
- ⟦Huang et al. [2024] Сюй Хуан, Вэйвэнь Лю, Сяолун Чэнь, Синмэй Ван, Хао Ван, Дэфу Лян, Яшэн Ван, Руимин Тан и Эньхонг Чэнь. Понимание планирования LLM-агентов: обзор. arXiv preprint arXiv:2402.02716, 2024.
- ⟦Jin et al. [2025] Bowen Jin, Hansi Zeng, Zhenrui Yue, Jinsung Yoon, Sercan O Arik, Dong Wang, Hamed Zamani и Jiawei Han. Search-r1: Обучение LLM рассуждать и использовать поисковые системы с помощью обучения с подкреплением. В материалах 2-й конференции по моделированию языка, Монреаль, Канада, 2025.
- ⟦Joshi et al. [2017] Мандар Джоши, Ынсол Чой, Дэниел С. Уэлд и Люк Зеттлемойер. Triviaqa: крупномасштабный набор данных для решения задач на понимание прочитанного, с дистанционным присвоением разметки. В материалах 55-й ежегодной конференции Ассоциации по компьютерной лингвистике, страницы 1601–1611, Ванкувер, Канада, 2017.
- ⟦Kwiatkowski et al. [2019] Том Квятковски, Дженнимария Паломаки, Оливия Редфилд, Майкл Коллинз, Анкур Парих, Крис Альберти, Даниэль Эпштейн, Иллия Полосухин, Джейкоб Девлин, Кентон Ли, Кристина Тутоанова, Ллион Джонс, Мэтью Келси, Мин-Вэй Чанг, Эндрю М. Дай, Якоб Узскореит, Квок Ле и Слав Петров. Natural questions: A benchmark for question answering research. Transactions of the Association for Computational Linguistics, 7:453–466, 2019.
- ⟦Lewis et al. [2020] Патрик Льюис, Итан Перес, Александра Пиктус, Фабио Петрóни, Владимир Карпухин, Наман Гойал, Хайнрих Кюттлер, Майк Льюис, Вен-тау Ии, Тим Роктэшхель, Себастьян Ридель и Дауэ Кийла. Генерация с подкреплением извлечением для задач НЛП, требующих знаний. Труды Advances in Neural Information Processing Systems 33, страницы 9459–9474, 2020.
- Li et al. [2025a] Сяосі Ли, Гантин Дун, Цзяцзе Цзин, Юяо Чжан, Юйцзя Чжоу, Ютао Чжу, Пэйтян Чжан и Чжичэн Доу. Search-o1: Агентный поиск, усиленный моделями крупного рассуждения. arXiv preprint arXiv:2501.05366, 2025a.
- ⟦Li et al. [2025b] Чжигэн Ли, Цзянсян Пэн, Яньмэн Ван, Юн Цао, Тяньхао Шэнь, Минхуэй Чжан, Линси Су, Шан У, Ихан Ву, Юциан Ван, Е Ван, Вэй Ху, Цзянфэн Ли, Шаоцзюнь Ван, Цзин Сяо и Дэйи Сюн. Chatsop: Диспетчеризируемая sop-подсказками mcts-планировочная структура для управляемых llm-диалоговых агентов. В материалах 63-го ежегодного собрания Ассоциации по вычислительной лингвистике (том 1: длинные статьи), страницы 17637–17659, Вена, Австрия, 2025b.
- ⟦Lin et al. [2025] Минхуа Лин, Цзунъюй У, Чжичао Сюй, Хуэй Лю, Сяньфэн Тан, Ци Хэ, Чару Аггарвал, Хуэй Лю, Сян Чжан и Суханг Ван. Всеобъемлющий обзор агентного поиска на основе обучения с подкреплением: основания, роли, оптимизации, оценки и применения. arXiv preprint arXiv:2510.16724, 2025.
- ⟦Liu et al. [2024a] Энтони Жэ Лю, Чонгвук Чой, Сонгрюл Сон, Яо Фу, Джекиом Ким, Дон-Ки Ким, Синхэ Ван, Джэвон Ю и Хонглак Ли. Skillact: Использование абстракций навыков улучшает LLM-агентов. На семинаре ICML 2024 по LLM и когниции, Вена, Австрия, 2024a.
- Liu et al. [2026] Цзяци Лю, Яофэн Су, Пэн Ся, Сивэй Хань, Цэю Чжэн, Цихан Се, Минъюй Дин и Хуасю Яо. Simplemem: Эффективная долговременная память для агентов LLM. Предварительный отчет arXiv arXiv:2601.02553, 2026.
- ⟦Liu et al. [2024b] Нельсон Ф. Лю, Кевин Лин, Джон Хьюитт, Ашвин Паранджапе, Микеле Бевилаква, Фабио Петрони и Перси Лианг. Потерянные посередине: как языковые модели используют длинные контексты. Труды Ассоциации по компьютерной лингвистике, 12:157–173, 2024b.
- ⟦Lu et al. [2026] Чжэнси Лу, Чжиюань Яо, Цзиньян У, Чэнчэн Хань, Ци Гу, Сюньлянь Цай, Вэймин Лу, Цзюнь Сяо, Юэтин Чжуан и Юнлян Шэнь. Навык0: Контекстное агентное обучение с подкреплением для внутренней интеграции навыков. препринт arXiv:2604.02268, 2026.
- ⟦Luo et al. [2025] Джунъю Лу, Вэйчжи Чжан, Е Юань, Юшэн Чжао, Цзюньвэй Ян, Иян Гу, Боан Ву, Бинци Чэнь, Цзыюэ Цяо, Цинцин Лун, Жунчэн Ту, Сяо Луо, Вэй Цзю, Чипин Сяо, Ифань Ван, Мэн Сяо, Чэньу Лю, Цзинъян Юань, Шичан Чжан, Ицяо Цзинь, Фань Чжан, Сянь У, Ханьцин Чжао, Дачэн Тао, Филип С. Ю, и Мин Чжан. Агент на основе большой языковой модели: обзор методологий, применений и задач. arXiv препринт arXiv:2503.21460, 2025.
- ⟦Mallen et al. [2023] Алекс Маллен, Акири Асаи, Виктор Чжон, Раджарши Дас, Даниэль Хашабин и Ханнанех Хаджиширзи. Когда не следует доверять языковым моделям: исследование эффективности параметрической и непараметрической памяти. В материалах 61-го ежегодного собрания Ассоциации лингвистической вычислительной техники, страницы 9802–9822, Торонто, Канада, 2023.
- ⟦Mi et al. [2026] Цируй Ми, Чжицзян Ма, Мэнъюэ Ян, Хаосюань Ли, Ийсэн Ван, Хайфэн Чжан и Цзюнь Ван. Skill-pro: Обучение повторно используемым навыкам на основе опыта с помощью непараметрического ppo для llm-агентов. препринт arXiv arXiv:2602.01869, 2026.
- Ni et al. [2026] Цзинвэй Ни, Ихао Лю, Синпэн Лю, Ютао Сун, Мэнъюй Чжоу, Пэнъюй Чэн, Дэсинь Ван, Эраочао Чжао, Сяосий Цзян и Гуаньцзюнь Цзян. Trace2skill: Извлекать локальные знания траектории, чтобы формировать переносимые навыки агента. arXiv preprint arXiv:2603.25158, 2026.
- ⟦OpenAI [2025a] OpenAI. агент, использующий компьютер. https://openai.com/index/computer-using-agent/, 2025a.
- ⟦OpenAI [2025b] OpenAI. карточка системы глубокого исследования. https://openai.com/index/deep-research-system-card, 2025b.
- ⟦К0⟧ Шишир Г. Патил, Тяньцзюнь Чжан, Синь Ван и Джозеф Е. Гонсалес. Gorilla: Большая языковая модель, подключенная к масштабным apis. В Advances in Neural Information Processing Systems 37, Ванкувер, Канада, 2024.
- ⟦Plaat et al. [2026] Кеcке Плаат, Энни Вонг, Сюзан Верберне, Йост Брукенс, Ники ван Стейн и Томас Бэк. Многошаговое рассуждение с большими языковыми моделями, обзор. ACM Computing Surveys, 58(6):160:1–160:35, 2026.
- ⟦Press et al. [2023] Офир Пресс, Муру Чжан, Севон Мин, Людвиг Шмидт, Ноа А. Смит и Майк Льюис. Измерение и сужение разрыва в композициональности в языковых моделях. В материалах Findings of the Association for Computational Linguistics: EMNLP 2023, страницы 5687–5711, Сингапур, 2023.
- ⟦Yujia Qin, Shihao Liang, Yining Ye, Kunlun Zhu, Lan Yan, Yaxi Lu, Yankai Lin, Xin Cong, Xiangru Tang, Bill Qian, Sihan Zhao, Lauren Hong, Runchu Tian, Ruobing Xie, Jie Zhou, Mark Gerstein, Dahai Li, Zhiyuan Liu, and Maosong Sun. Toolllm: facilitating large language models to master 16000+ real-world apis. In Proceedings of the 12th International Conference on Learning Representations, Vienna, Austria, 2024.
- Schick et al. [2023] Тимо Шик, Джейн Двиведи-Ю, Роберто Десси, Роберта Райлеану, Мария Ломели, Эрик Хамбро, Льюк Зеттлемойер, Никола Канседда и Томас Сциалом. Toolformer: языковые модели могут обучаться самостоятельно использовать инструменты. В Advances in Neural Information Processing Systems 36, Новый Орлеан, Лос-Анджелес, 2023.
- ⟦Schulman et al. [2017] Джон Шульман, Филип Вольски, Прафулла Дхариуал, Алек Радфорд и Олег Климов. Алгоритмы проксимальной оптимизации политики. arXiv препринт arXiv:1707.06347, 2017.
- ⟦Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Xiao Bi, Haowei Zhang, Mingchuan Zhang, Y. K. Li, Y. Wu, and Daya Guo. Deepseekmath: Push the limits of mathematical reasoning in open language models. arXiv preprint arXiv:2402.03300, 2024.
- ⟦Junhao Shen, Haiteng Zhao, Yuzhe Gu, Songyang Gao, Kuikun Liu, Haian Huang, Jianfei Gao, Dahua Lin, Wenwei Zhang, and Kai Chen. Полу-оффполиcное обучение с подкреплением для медленного рассуждения в задачах видение-язык. В Advances in Neural Information Processing Systems 38, Сан-Диего, Калифорния, 2025.
- Shen [2024] Чжуочэн Шэнь. Llm с инструментами: обзор. Предварительная публикация arXiv arXiv:2409.18807, 2024.
- Shinn et al. [2023] Ноа Шинн, Федерико Кассано, Эдвард Бэрман, Ашвин Гопинатх, Картик Нарасимхан и Шунью Яо. Рефлексия: языковые агенты с вербальным обучением с подкреплением. В Advances in Neural Information Processing Systems 36, Новый Орлеан, штат Луизиана, США, 2023.
- Shridhar et al. [2021] Мохит Шридхар, Синджи Юань, Марк-Александр Коте, Йонатан Биск, Адам Тришлер и Мэтью Хаускенхт. Alfworld: Согласование текста и воплощённых сред для интерактивного обучения. В материалах 9-й Международной конференции по Learning Representations, Виртуальная конференция, 2021.
- Trivedi et al. [2022] Харш Триведи, Ниранджан Баласубраманиан, Тушар Хот и Ашиш Сабхарвал. Музыка: многократные вопросы через композицию вопросов с одним переходом. Труды Ассоциации по компьютерной лингвистике, 10:539–554, 2022.
- ⟦Wang et al. [2023] Гуанчжи Ван, Юйци Се, Юньфань Цзян, Аджай Манделкар, Чаовэй Сяо, Юке Чжу, Линьси Фань и Анима Анандкумар. Voyager: открытый агент, воплощенный в среде, с большими языковыми моделями. arXiv preprint arXiv:2305.16291, 2023.
- ⟦Wang et al. [2024a] Лэй Ван, Чэнь Ма, Сюэян Фэн, Цзэйюй Чжан, Хао Ян, Цзиньсэн Чжан, Чжиъюань Чэнь, Цзякай Тан, Сюй Чэнь, Янкай Лин, Уэйн Синь Чжао, Чжэвэй Вэй и Цзи-Ронг Вэнь. Обзор автономных агентов на основе больших языковых моделей. Frontiers of Computer Science, 18(6):186345, 2024a.
- Wang et al. [2026] Чжаоян Ван, Цяньхуэй У, Сючao Чжан, Чаоюнь Чжан, Венлин Яо, Фазле Элахи Файсал, Баолин Пэн, Си Цин, Суман Нате, Цинвэй Лин, Четан Бансал, Дунмэй Чжан, Сараван Раджмохан, Цзяньфэн Гао и Хуасю Яо. Webxskill: Обучение навыкам для автономных веб-агентов. arXiv preprint arXiv:2604.13318, 2026.
- ⟦Wang et al. [2024b] Zora Zhiruo Wang, Jiayuan Mao, Daniel Fried, and Graham Neubig. Память рабочего процесса агента. Предварительная публикация arXiv arXiv:2409.07429, 2024b.
- ⟦Quan Wei, Siliang Zeng, Chenliang Li, William Brown, Oana Frunza, Wei Deng, Anderson Schneider, Yuriy Nevmyvaka, Yang Katie Zhao, Alfredo Garcia, and Mingyi Hong. Усиление многократного контекстного рассуждения в агентах LLM за счет поэтапного дизайна вознаграждения. Предварительная публикация arXiv arXiv:2505.11821, 2025.
- ⟦Rong Wu, Xiaoman Wang, Jianbiao Mei, Pinlong Cai, Daocheng Fu, Cheng Yang, Licheng Wen, Xuemeng Yang, Yufan Shen, Yuxin Wang, and Botian Shi. Evolver: Самоэволюционирующие llm-агенты через ориентированный на опыт жизненный цикл. arXiv препринт arXiv:2510.16079, 2025.
- Wu et al. [2026] Сяньян У, Цзунся Ли, Гуанъяо Ши, Александр Даффи, Тайлер Маркес, Мэттью Лайл Олсон, Тяньи Чжоу и Динеш Маноача. Совместно развивающиеся агенты для принятия решений на базе llm и банка навыков для задач с большой протяжённостью по времени. препринт arXiv arXiv:2604.20987, 2026.
- ⟦Xia et al. [2026] Пэн Ся, Цзяньвэнь Чэнь, Ханьян Ван, Цзяци Лю, Кайде Цзэн, Ю Ван, Сивэй Хань, Иян Чжоу, Сюйцзян Чжао, Хайфэн Чэнь, Цэю Чжэн, Цихан Се и Хуасю Яо. Skillrl: Развивающиеся агенты посредством рекурсивного усиленного навыками обучения с подкреплением. Предварительная публикация arXiv:2602.08234, 2026.
- ⟦Xie et al. [2024] Тяньбао Се, Фань Чжоу, Чэн Чжоуцзюнь, Пен Ши, Лосянь Вэн, Итао Лю, Тоэ Джинг Хуа, Цзюньин Чжао, Цянь Лю, Чэ Лю, Лео З. Лю, Ихэн Сюй, Хунцзин Су, Дончхан Шин, Цаймин Сюн и Тао Юй. Openagents: открытая платформа для языковых агентов в реальных условиях. В материалах 1-й конференции по моделированию языка, Филадельфия, Пенсильвания, 2024.
- Xu et al. [2025a] Фэнли Сюй, Цяньюэ Хао, Цэфан Цзун, Цзинвэй Ван, Юнько Чжан, Цзиньи Ван, Сяочун Лань, Цзяхуэй Гун, Тяньцзян Оуян, Фаньцзин Мэн, Чэньян Шао, Ювэй Ян, Цинлун Ян, Ивэнь Сун, Сицзян Жэнь, Синьюань Ху, Юй Ли, Цзе Фэн, Чэнь Гао и Юн Ли. К большим моделям рассуждений: обзор усиленного рассуждения с большими языковыми моделями. arXiv препринт arXiv:2501.09686, 2025a.
- Xu et al. [2025b] Вуцзян Сюй, Цзуйцзе Лян, Кай Мэй, Хан Гао, Цзунтао Тан и Юнфэн Чжан. A-mem: агентская память для llm-агентов. препринт arXiv arXiv:2502.12110, 2025b.
- ⟦Yang et al. [2025] Ань Ян, Аньфэн Ли, Баосун Ян, Бэйчэн Чжан, Биньюань Хуи, Бо Чжэн, Боуюй Юй, Чан Гао, Чэнгэ Хуан, Чэньсюй Лю, Чуцзе Чжэн, Дайихэн Лю, Фань Чжоу, Фэй Хуан, Фэн Ху, Хао Гэ, Хаоран Вэй, Хуань Линь, Цзялонг Тан, Цзянь Ян, Цзяньхун Ту, Цзяньвэй Чжан, Цзянисинь Ян, Цзяси Ян, Цзинь Чжоу, Цзиньжэнь Чжоу, Цзюньян Линь, Кай Данг, Кэцин Бао, Кексин Ян, Ле Юй, Лянхао Дэн, Мэй Ли, Минфэн Сюэ, Минцзе Ли, Пэй Чжан, Пэн Ван, Цинь Чжу, Жуй Мэн, Жуйцзе Гао, Шисюань Лю, Шуан Луо, Тяньхао Ли, Тяни Тан, Вэньбяо Инь, Синчжан Жэнь, Синъюй Ван, Синъюй Чжан, Сюанчэн Жэнь, Ян Фань, Ян Су, Ичан Чжан, Инъэр Чжан, Юй Ван, Юйцюнь Лю, Цзекун Ван, Цзэю Цуй, Чжэньжу Чжан, Чжипэн Чжоу, и Цзихань Цю. Технический отчет Qwen3. arXiv preprint arXiv:2505.09388, 2025.
- ⟦Yang et al. [2018] Жилин Ян, Пэн Ци, Сайчжэн Чжан, Йошуа Бенджио, Уильям Коэн, Руслан Салахутдинов и Кристофер Д. Мэннинг. Hotpotqa: набор данных для разнообразного, объяснимого многослойного ответа на вопросы. В материалах 2018 Conference on Empirical Methods in Natural Language Processing, страницы 2369–2380, Брюссель, Бельгия, 2018.
- ⟦Yao et al. [2023] Шунью Яо, Джеффри Чжао, Диан Юй, Нань Ду, Ицхак Шафран, Картик Нарасимхан и Юань Цао. ReAct: Сочетание рассуждения и действий в языковых моделях. В материалах 11-й Международной конференции по обучению представлениям (ICLR), Кигали, Руанда, 2023.
- Ye et al. [2025] Anbang Ye, Qianran Ma, Jia Chen, Muqi Li, Tong Li, Fujiao Liu, Siqi Mai, Meichen Lu, Haitao Bao, and Yang You. Sop-agent: Расширьте возможности универсального ИИ-агента с помощью предметно-ориентированных sops. arXiv preprint arXiv:2501.09316, 2025.
- ⟦Yim et al. [2026] Тик Ю Йим, Вентинг Тан, Сум Йи Чан, Так-Вах Лам и Сиу Мин Йий. Asda: Автоматизированная дистилляция навыков и адаптация для финансового рассуждения. препринт arXiv arXiv:2603.16112, 2026.
- Yu et al. [2025] Циюн Юй, Чжэн Чжан, Рофэй Чжу, Юфэн Юань, Сяочэнь Цзо, Ю Юэ, Вэйнань Дай, Тяньтянь Фань, Гаохун Лю, Линьцзюнь Лю, Синь Лю, Хайбин Линь, Чжици Линь, Бо Ли Ма, Гуанмин Шэн, Юсюань Тун, Чи Чжан, Мофань Чжан, Ван Чжан, Хан Чжу, Цзиньхуа Чжу, Цзяцзе Чэнь, Цзянцзе Чэнь, Чэнъи Ван, Хунли Юй, Юсюань Сун, Сянпэн Вэй, Хао Чжоу, Цзинцзин Лю, Вэйин Мa, Я-Цинь Чжан, Линь Ян, Му Цяо, Юнхуэй У, и Минсюань Ван. Dapo: Система reinforcement learning для LLM с открытым исходным кодом в масштабе. arXiv preprint arXiv:2503.14476, 2025.
- Zhang et al. [2026a] Шэнтао Чжан, Цзяцян Ван, Жуйвэнь Чжоу, Цзюньвэй Ляо, Юйчэнь Фэн, Чжо Ли, Юцзе Чжэн, Вэйнан Чжан, Инь Вэнь, Чжи Ю Ли, Фэйюй Ксионг, Ютао Ци, Бо Танг и Мунин Вэнь. Memrl: Самоэволюционирующие агенты посредством обучения с подкреплением во время выполнения на эпизодической памяти. Предварительный препринт arXiv:2601.03192, 2026a.
- Zhang et al. [2026b] Синь Чжан, Гуанхуэй Ван, Янвэй Цуй, Вэй Цю, Цзыюань Ли, Бинь Чжу и Пэйян Хэ. Спектр сжатия опыта: объединение памяти, навыков и правил в llm-агентах. препринт arXiv arXiv:2604.15877, 2026b.
- Zhang et al. [2025] Янжао Чжан, Минсин Ли, Динкун Лонг, Синь Чжан, Хуань Линь, Баосонг Ян, Пэнцзюнь Се, Ан Янг, Дайхэн Лю, Цзюньян Линь, Фэй Хуан и Цзиньжэнь Чжоу. Qwen3 embedding: Продвижение текстового встраивания и переупорядочивания с помощью базовых моделей. арXiv препринт arXiv:2506.05176, 2025.
- Zhao et al. [2024] Эндрю Чжао, Дэниел Хуан, Квентин Сюй, Маттьё Лин, Юн-Джин Лю и Гао Хуан. Изгнать: Llm agents являются эмпирическими обучающимися. В материалах 38-й конференции AAAI по искусственному интеллекту, страницы 19632–19642, Ванкувер, Канада, 2024.
- Zhao et al. [2026] Хайтэн Чжао, Цзюньхао Шэнь, Иимин Чжан, Суньян Гао, Куйкун Лю, Тянью Ма, Фань Чжэн, Дахуа Линь, Вэньвэй Чжан и Кай Чэнь. Достижение геометрической модели агента уровня олимпиады с помощью крупномасштабного языкового агента через усиление сложности в обучении с подкреплением. В материалах 14-й Международной конференции по представлениям обучения, Рио-де-Жанейро, Бразилия, 2026.
- ⟦Qingfei Zhao, Ruobing Wang, Dingling Xu, Daren Zha, and Limin Liu. R-search: Empowering llm reasoning with search via multi-reward reinforcement learning. arXiv preprint arXiv:2506.04185, 2025.
- ⟦Zheng et al. [2025] Боянь Юй Чжэн, Майкл Й. Фатеми, Сяолунь Цзин, Зора Жируо Ван, Апурва Ганди, Юэци Сун, Юй Гу, Джаянтх Сриниваса, Гаовэнь Лю, Грэм Нойбиг и Юй Су. Skillweaver: веб-агенты могут самоулучшаться, обнаруживая и оттачивая навыки. arXiv preprint arXiv:2504.07079, 2025.
- ⟦Zheng et al. [2026] Ян Чжао Чжэн, Чжэнь Тао Чжан, Чжао Ма, Юань Цян Юй, Цзи Хуай Чжу, Юн У, Тянь Цзэ Сюй, Бао Хуа Дун, Ханчэн Чжу, Жуохуй Хуан и Ган Юй. Skillrouter: маршрутизация навыков для llm-агентов в масштабе. предварительная публикация arXiv arXiv:2603.22455, 2026.
- ⟦Zhou et al. [2026] Чэнь Юйчжоу, Хуакань Чай, Вэнтэн Чэнь, Цыхань Го, Жун Шань, Юаньъи Сун, Тяньи Сюй, Инсюань Ян, Аофань Юй, Вэймин Чжан, Цунмин Чжэн, Цзячэнь Чжу, Цэюй Чжэн, Чжошэн Чжан, Синъюй Лоу, Чанвант Чжан, Чжихуэй Фу, Цзюнь Ван, Вэйвэнь Лю, Цзянхао Линь и Вэйнань Чжан. Внешнее представление в агентах llm: единый обзор памяти, навыков, протоколов и инженерии обвязки. препринт arXiv arXiv:2604.08224, 2026.
Приложение организовано следующим образом: Приложение A представляет локальный теоретический анализ, дополняющий SLIM. Приложение B описывает подробные настройки SLIM и базовые методы. Приложение C описывает подробную экспериментальную постановку, включая конфигурацию обучения, параметры извлечения и детали аудита жизненного цикла. Приложение D приводит дополнительные экспериментальные результаты, включая дополнительные таблицы, кривые и анализ устойчивости. Приложение E вводит все подсказки, используемые при обучении, оценке и расширении навыков. Приложение F суммирует исходный и расширенный набор навыков, используемые SLIM. Приложение G обсуждает ограничения SLIM. Приложение H обсуждает более широкий эффект этого исследования.
Appendix A Теоретический анализ
Этот раздел содержит теоретический анализ, дополняющий Раздел 4.1, Раздел 4.2 и Раздел 4.3. Мы сохраняем анализ локальным, поскольку в Eq. (2) присутствует непрерывная переменная политики, дискретное активное множество, концептуальная функция стоимости “черного ящика” и скрытое ограничение пропускной способности. Цель не состоит в доказательстве глобальной оптимальности Eq. (2); вместо этого леммы дают локальные достаточные условия, объясняющие, почему эвристики жизненного цикла могут быть консервативными при сделанных допущениях об условиях эксплуатации. На протяжении всего анализа навыки вне активного внешнего множества могут относиться либо к скрытому внутренне усвоенному множеству , либо к неактивному внешнему множеству , поэтому деактивация не идентифицируется с внутренней усвоенностью.
Пусть обозначает ожидаемый член показателя качества выполнения задачи в уравнении 2, и пусть обозначает его целевую функцию, связанную со стоимостью показателя качества.
Assumption A.1.
Для задачи типа иерархический ретривер в уравнении 3 сохраняет локально полезные активные навыки, специфичные для задачи, с ограниченной вероятностью ошибки. В частности, если активный навык, специфичный для задачи , имеет условно-обусловленное по задаче предельное приращение не меньше , то
| (A1) |
Это стандартное требование к полноте при извлечении, когда извлечение используется как шаг сокращения множества кандидатов, и оно согласуется с иерархическими библиотеками навыков и системами маршрутизации навыков [59, 76].
Lemma A.2.
При допущении A.1 для любой фиксированной локально полезной активной задачи-специфического навыка извлечение с учетом задачи не находит с вероятностью не более . Следовательно, вероятность пропустить хотя бы один навык в не превышает по оценке объединением (union bound).
Доказательство. Пусть обозначает локально полезные активные предметно-ориентированные навыки для задачи . Для любого предположение A.1 дает
| (A2) |
Это доказывает утверждение о фиксированном навыке. Для события на уровне множества,
| (A3) |
где первое неравенство соответствует верхней границе объединения. Этим завершается доказательство. ∎
Assumption A.3.
Для фиксированного активного множества целевая функция GRPO локально согласована с членом, связанным с производительностью. Если одно обновление GRPO отображает в , то
| (A4) |
где и фиксируют локальное несоответствие суррогата. Это стандартное локально-улучшающее представление, используемое в оптимизации политики в стиле PPO/GRPO [45, 12, 68].
Assumption A.4.
Для проверяемого навыка сглаженная оценка leave-one-skill-out концентрируется вокруг предельного внешнего вклада в популяции согласно обновленной политике . Пусть
| (A5) |
После сглаживания методом EMA и при достаточной экспозиции оценка аудита удовлетворяет
| (A6) |
с вероятностью не менее . В ходе раундов аудита, при условии текущей политики и активного множества, ошибки валидации условно независимы или удовлетворяют эквивалентному условию перемешивания. Это конечное условие концентрации для валидации для контрафактического абляционного подхода: ограниченные метрики валидации допускают концентрацию вокруг своего ожидания при достаточном числе образцов [21], тогда как условия терпения и минимального воздействия в уравнении Eq. (6) предотвращают принятие решений, основанных на одном шумном аудите.
Assumption A.5.
Контроллер жизненного цикла работает в рамках фиксированного физического бюджета. Из-за строгих ограничений на максимальное контекстное окно , слоты маршрутизации top-, ограниченную длину артефакта навыка и конечный бюджет аудита, предельные вычислительные, маршрутизирующие и контекстные накладные расходы добавления или удаления одного навыка строго ограничены. Поэтому для любого одиночного перемещения навыка с на существует такая что
| (A7) |
Это утверждение связано с рабочим режимом системы, а не с глобальной моделью или оценивателем ; оно согласуется с исследованиями по маршрутизации навыков и по длинному контексту, показывающими, что затраты на маршрутизацию и контекст являются конкретными величинами на уровне системы [76, 32]. В экспериментах мы сообщаем о реализованных операционных издержках, таких как число активных навыков, вызовы аудита, время по настенным часам и сложность извлечения, а не оцениваем абсолютное значение .
Lemma A.6.
При допущении A.4 сглаженная оценка исключения одной специальности является прокси -точности для истинного предельного внешнего вклада с вероятностью по меньшей мере .
Доказательство. Из предположения A.4 событие
| (A8) |
удовлетворяет . По ,
| (A9) |
что эквивалентно
| (A10) |
Таким образом, является -точным приближением для с вероятностью не менее . Это завершает доказательство. ∎
Lemma A.7.
При допущении A.5 для любого перехода с одного навыка из в , где или , абсолютная разность затрат удовлетворяет
| (A11) |
Доказательство. Это в точности верхняя граница затрат режима работы в предположении A.5. Для полноты рассмотрим два однонавыкового перехода. Если , то
| (A12) |
где равенство использует монотонность , а неравенство использует допущение A.5. Если , то
| (A13) |
Это завершает доказательство. ∎
Lemma A.8.
Пусть выполняются предположение A.4 и предположение A.5. Мы анализируем одно принятую операцию жизненного цикла, при этом в Разделе B.1 применяется строго ограниченное число операций на цикл аудита как локальное приближение, аналогичное пакетным обновлениям политики. В событие в Лемме A.6, которое выполняется с вероятностью не менее для каждого проверяемого навыка, правила жизненного цикла в Ур. (5)–Ур. (7) являются консервативными решениями для одной операции при следующих достаточных запасах. Если , Ур. (5) блокирует удаление, которое не может улучшить . Если срабатывает Ур. (6) и сохраненная стоимость удовлетворяет , уход в отставку улучшает . Если Ур. (7) выбирает , ожидаемый выигрыш в производительности которого по меньшей мере равен , добавление не уменьшает . Для аудита, который оценивает не более навыков, выводы о сохранении/уходе в отставку, зависящие от валидации, выполняются совместно с вероятностью не менее по оценке объединением.
Доказательство. Для сохранения локальная целевая функция изменения при удалении
| (A14) |
где . Если Eq. (5) срабатывает, то . Сочетание с леммой A.6 дает
| (A15) |
По лемме A.7, . Следовательно,
| (A16) | ||||
Таким образом, сохранение блоков обеспечивает удаление, которое не может улучшить .
Для вычитания, уравнение (6) дает . По лемме A.6,
| (A17) |
Если , то
| (A18) | ||||
Таким образом, принятый уходящий ход улучшает в анализе одного хода в рамках заданного порога экономии затрат. Поскольку не наблюдается алгоритмом напрямую, уравнение 6 следует интерпретировать как консервативную эвристику, гарантия улучшения для которой выполняется только тогда, когда восстановленная внешняя стоимость поддержки превышает этот достаточный запас.
Для расширения, пусть
| (A19) |
обозначим ожидаемый прирост производительности от добавления нового навыка. Локальное изменение целевой функции
| (A20) | ||||
где неравенство следует из Леммы A.7. Если , то расширяющий переход не уменьшает . Заявление о вероятности следует из Леммы A.6; применение оценки объединения по не более чем проверенным навыкам дает совместную вероятность по меньшей мере для выводов о сохранении/отказе, зависящих от валидации. Это завершает доказательство. ∎
Lemma A.9.
Предположим, что допущение A.4 выполняется на протяжении раундов аудита. Если активный навык имеет истинный предельный внешний вклад для в течение последовательных раундов аудита , тогда существует эффективная константа концентрации , зависящая от размера валидационной выборки, сглаживания EMA и временного смешивания, такая что вероятность того, что будет ошибочно снят с эксплуатации условием терпения в Eq. (6), не превышает .
Доказательство. Для одного раунда аудита ложное доказательство низкого вклада требует . Начиная с , это событие подразумевает
| (A21) |
Хотя EMA вносит временную корреляцию в , каждый раунд аудита включает новые валидационные выборки. При условии смешивания в предположении A.4 получаемая сглаженная оценка по-прежнему удовлетворяет эффективной оценке концентрированности. Поэтому, согласно концентрации типа Hoeffding для ограниченных метрик валидации с эффективным размером выборки и поправкой на смешивание [21], существует такая что
| (A22) |
Условие терпения требует, чтобы это событие с ложным низким вкладом происходило для последовательных раундов аудита. При условии условной независимости или эквивалентном условии перемешивания в Допущении A.4 новые выборки для валидации в разных раундах аудита дают эффективную усиленную оценку концентрации:
| (A23) |
Таким образом, терпение экспоненциально снижает вероятность ошибочного прекращения навыка, если его истинный предельный вклад остается выше порога прекращения. Это завершает доказательство. ∎
Lemma A.10.
Доказательство. Поскольку внешне необходимо и удовлетворяет , удаление его внешней поддержки уменьшает ожидаемую производительность как минимум на эту величину. По лемме A.6 с вероятностью по меньшей мере ,
| (A24) |
Если , то
| (A25) | ||||
Таким образом, первое условие в формуле (6), а именно , ложно. Следовательно, нельзя вывести из соотношения (6). Ограниченная емкость модели объясняет, почему такие внешне необходимые навыки могут сохраняться, но сама лемма использует лишь наблюдаемый предельный внешний вклад. Она защищает в настоящее время проходящие аудит активные навыки и не утверждает, что ранее выведенные из употребления неактивные навыки защищены от последующего забывания. Этим завершается доказательство. ∎
Appendix B Детали реализации
B.1 Настройка SLIM
Опорная модель и протокол данных. Все основные эксперименты SLIM используют Qwen3-4B [63] в качестве модели политики. Для обновлений GRPO мы используем разбиение train, для аудита жизненного цикла и мониторинга во время обучения — разбиение validation, а разбиение test используем только для итоговой отчетности. Для ALFWorld мы используем 16 обучающих задач на каждое обновление, 32 проверочные задачи на каждый проход проверки, максимальную длину запроса 4096, максимальную длину ответа 512, правое усечение и не применяем фильтрацию запросов избыточной длины. Для SearchQA мы используем 64 обучающие задачи на каждое обновление, 512 проверочных задач на каждый проход проверки, максимальную длину запроса 5000, максимальную длину ответа 700, левое усечение и фильтрацию запросов избыточной длины. ALFWorld выполняется в течение 120 шагов GRPO, а SearchQA — в течение 180 шагов GRPO, и в обоих случаях проверка выполняется каждые 10 шагов. Проверка и итоговая оценка используют выборочную генерацию с температурой 0.4.
Обучение. SLIM использует целевую функцию GRPO, определяемую уравнением Eq. 1, и не использует отдельный этап warmup или cold-start. ALFWorld использует rollouts на запрос, максимум 50 шагов среды и 50 шагов истории взаимодействия. SearchQA использует rollouts на запрос, максимум 4 шага среды, 4 шага истории и общий поисковый backend, используемый всеми методами SearchQA. Оптимизатор использует learning rate в обоих бенчмарках. Размеры PPO mini-batch и per-device micro-batch равны 32 и 2 для ALFWorld и 512 и 8 для SearchQA. Награды представляют собой награды на уровне исхода от среды: завершённые успешные траектории получают награду за успех бенчмарка, а неуспешные траектории получают нулевую награду, при этом штрафы за недопустимые действия применяются во время сбора траектории. Коэффициент штрафа за недопустимые действия равен 0.1 для ALFWorld и 0.01 для SearchQA. Для основных прогонов SLIM отключены и loss по KL на стороне актёра, и регуляризация KL-in-reward.
Извлечение. SLIM использует иерархический банк навыков в стиле SkillRL, описанный в Разделе 3. Навыки, специфичные для задачи, извлекаются только из активного пула обнаруженного типа задачи. Запрос на извлечение представляет собой текущее описание задачи, тогда как каждый ключ навыка — это маршрутизирующий текст, объединяющий название навыка, описание или принцип, поле when_to_apply, body, tags и тип задачи. Мы встраиваем и запрос, и ключи с помощью Qwen3-Embedding-0.6B [71] и ранжируем кандидатов по навыкам по косинусному сходству. Мы устанавливаем верхний предел извлечения, специфичного для задачи, равным , а порог встраивания — равным , поэтому извлечение может вставлять меньше трех навыков, специфичных для задачи, когда ни один активный навык не является достаточно релевантным.
Жизненный цикл навыка. Периодически после валидации GRPO выполняются циклы аудита жизненного цикла. Каждый аудит фиксирует маршрутизированные навыки, результаты валидации и маршрутизированные отказы в рамках текущего активного набора. В ALFWorld каждый аудит рассматривает ограниченное множество недавно маршрутизированных навыков, включая не более четырех навыков, специфичных для задач, выбранных среди навыков, появившихся в извлеченном наборе top-. В SearchQA применяется та же логика при более крупном бюджете аудита — не более 12 активных навыков, поскольку пакеты валидации больше, а эпизоды короче. Пропущенные кандидаты не заменяются дополнительными кандидатами за пределами бюджета аудита. Этот бюджет ограничивает стоимость аудита, а условия ниже по экспозиции и терпению предотвращают вывод из эксплуатации редко маршрутизируемых навыков только из‑за того, что они недостаточно часто подвергались аудиту. Для каждого аудируемого навыка SLIM вычисляет маргинальный внешнесистемный вклад leave-one-skill-out и обновляет сглаженную оценку с коэффициентом EMA 0.9. Вывод из эксплуатации использует и терпение в обоих бенчмарках. Минимальный порог экспозиции — для ALFWorld и для SearchQA. Решения о сохранении используют для ALFWorld и для SearchQA. Таким образом, навык выводится из эксплуатации только после того, как его достаточно часто маршрутизировали, и его сглаженный вклад остается пренебрежимо малым в течение нескольких аудитов. Расширение является строго специфичным для задач и выполняется во время аудитов обучения, никогда во время финальной оценки на тестах. ALFWorld использует , и создает не более двух новых навыков на каждый аудит. SearchQA использует , и создает не более трех новых навыков на каждый аудит. Формируется «корзина отказов» из отказов валидации, маршрутизированных в один и тот же активный навык и тип задачи. Новый навык наследует тип задачи из этой корзины, поэтому расширение добавляет поддержку только в соответствующий пул навыков, специфичных для задач. Новые навыки являются самостоятельными артефактами SKILL.md, генерируемыми бэкбоном skill-creator, совместимым с OpenAI, на основе конвейера создания навыков в стиле Anthropic [7]. Подсказка расширения, показанная на Рисунке A11, включает репрезентативные отказавшие задачи, сводные трассы отказов и недостаточное число активных навыков. Мы устраняем дубликаты по существующим навыкам по названию, описанию триггера и сходству встраивания маршрутизирующего текста. Мы отклоняем сгенерированные навыки, если они общие, дублируют существующий навык, слишком короткие для определения полезного рабочего процесса или пытаются создать новые общие либо базовые навыки.
Затраты на аудит. Оставление одного навыка для аудита добавляет накладные расходы на время валидации, однако это ограничено графиком аудита и бюджетом кандидатов. Аудиты выполняются каждые 10 шагов GRPO и используют ограниченные подмножества для валидации. В ALFWorld каждый аудит оценивает не более одной группы навыков общего назначения и навыков, специфичных для задачи; в SearchQA больший валидационный пакет и более короткие эпизоды позволяют аудитировать максимум 12 активных навыков. Таким образом, SLIM не выполняет повторную валидацию для полного банка навыков. В наших запусках ALFWorld завершается примерно за 20 часов, а SearchQA — примерно за 25 часов, что сопоставимо по порядку величин с Skill0 и SkillRL в рамках общей обучающей схемы. Таблица A7 в Приложении D.6 содержит подробное сравнение накладных расходов.
Вывод. Для итогового вывода с обусловливанием навыками SLIM использует заключительное активное множество после обучения. Перед каждым разворачиванием агент вставляет активные общие навыки и извлекает навыки, специфичные для задачи, используя то же извлечение с встраиванием с учетом типа задачи, что и во время обучения. Итоговая оценка не выполняет операций retain, retire или expand. Подсказки среды показаны на рисунках A2 и A4, а формат вставки навыков показан на рисунке A5⟧.
Вычислительные ресурсы. По зарегистрированным подсчётам токенов и времени шагов полный прогон SLIM для ALFWorld имеет порядок операций с плавающей запятой. SearchQA использует более короткие эпизоды, но больший объём валидационной выборки и более длительный горизонт обучения, что в сумме даёт бюджет вычислений порядка – операций с плавающей запятой. Эти оценки включают генерацию развёрток, вычисление лог-вероятностей, обновления политики, валидацию и повторные запуски аудита жизненного цикла, но исключают разовую предварительную обработку данных.
B.2 Настройка базовых моделей
Нулевое и малошотовое побуждение. Базовые модели только с подсказкой оценивают базовую модель без обновлений при обучении с подкреплением. Нулевое побуждение напрямую использует эталонный взаимодействующий запрос на Рисунке A1 или на Рисунке A3. Малошотовое побуждение дополняет начало решенными примерами в соответствии с Рисунком A6. Варианты с навыком используют тот же протокол запроса, но дополнительно вставляют извлеченные внешние навыки в соответствии с Рисунком A5. Базовые модели с побуждением оцениваются с тем же анализатором среды, метрикой успешности и заключительным разбиением теста, что и методы обучения с подкреплением, используя размер батча 16 для ALFWorld и 32 для SearchQA.
ReAct. ReAct реализован как адаптер «рассуждение-и-действие» в соответствии с средой, поверх общей оценочной платформы. Он использует инструкцию на рисунке A7, сохраняет те же теги действий и парсер, что и основная среда, и не использует долговременную память. Это адаптация идеи ReAct на уровне подсказки, а не верхнеуровневое точное выполнение с отдельным интерфейсом инструментов.
Рефлексия. Рефлексия сохраняет краткие размышления о неудачных траекториях и извлекает релевантные размышления перед последующими действиями. Подсказки для выполнения и генерации размышлений показаны на рисунке A8. Мы извлекаем максимум три размышления и поддерживаем ограниченную память из 200 элементов. Генерация использует детерминированное сервисное декодирование с максимальными 768 токенами, температурой 0 и top-. Наша реализация сохраняет механизм повторного использования размышлений о неудаче в рамках протокола совместной среды, но не воспроизводит исходный многопробный конвейер обучения в точности.
ExpeL. ExpeL реализован как базовая модель «опыт—урок». После каждого эпизода метод извлекает из траектории компактный многоразовый урок и затем для будущих решений извлекает не более трех релевантных уроков, при этом сохраняются тот же предел памяти в 200 элементов и детерминированное сервисное декодирование, как у Reflexion. На рисунке A9 приведены подсказки для действий и для дистилляции уроков. Этот адаптер сохраняет ключевую идею дистилляции опыта в уроки, одновременно используя тот же разборщик действий, метрику успеха и протокол обучения/валидации/тестирования, что и у остальных базовых моделей.
Mem0. Mem0 реализован как легкая базовая модель долговременной памяти. Он извлекает до трех кратких атомарных воспоминаний после каждой эпизода, сохраняет их в том же ограниченном банке памяти из 200 элементов и извлекает не более трех релевантных воспоминаний перед генерацией действий, следуя Рисунок A10. Эта адаптация измеряет ценность компактной извлеченной памяти в рамках общего оценочного стека, а не различия во внешней инфраструктуре памяти.
GRPO и GRPO со навыками. Базовая модель GRPO использует тот же RL-оптимизатор, стек среды и определение вознаграждения, что и SLIM, но не получает внешнего контекста навыков или памяти и не использует этап прогрева. ALFWorld использует размер обучающего пакета 16, размер пакета валидации 32, количество запусков 8, максимальную длину эпизода 50, learning rate , размер PPO mini-batch 32, micro-batch размер 2, 120 обучающих шагов и валидацию каждые 10 шагов. SearchQA использует размер обучающего пакета 64, размер пакета валидации 512, количество запусков 4, максимальную длину эпизода 4, learning rate , размер PPO mini-batch 512, micro-batch размер 8, 180 обучающих шагов и валидацию каждые 10 шагов. В обоих настройках отключаются KL-убыток на стороне актёра и регуляризация KL-in-reward, а коэффициенты штрафа за недопустимое действие равны 0.1 для ALFWorld и 0.01 для SearchQA. GRPO со навыками сохраняет тот же оптимизатор и настройки развертывания, но вставляет извлечённые внешние навыки, используя формат skill-conditioned prompt на рисунке A5; при этом не выполняются операции retain, retire или expand.
EvolveR. EvolveR оценивается как базовый уровень поиска по жизненному циклу опыта. Он извлекает прошлые траектории в виде повторно используемых принципов, извлекает релевантный опыт до развертывания и обновляет хранилище опыта во время обучения. Мы адаптируем EvolveR к тем же средам ALFWorld и SearchQA, показателю успешности и протоколу обучения/валидации/тестирования. Там, где дистилляция опыта или обновление требует сервисной модели, мы используем то же семейство сервисов, совместимое с OpenAI, что и в других методах-ориентирах. Адаптер извлекает три лучших принципа опыта перед каждым развертыванием. Таким образом, сравнение сохраняет идею, основанную на жизненном цикле опыта, при этом поддерживая согласованными разбор действий, вычисление вознаграждения, протокол валидации и доступ к сервисной модели с остальными методами. EvolveR не оценивает маргинальный внешний вклад в режиме leave-one-skill-out и не поддерживает состояния жизненного цикла retain/retire/expand по артефактам навыков.
Skill0. Skill0 адаптирован как базовый уровень с запланированным «выводом» навыков и не использует отдельную стадию прогрева в нашем сравнении. Во время обучения политика подвергается воздействию внешних навыков, а видимый набор навыков постепенно сокращается в соответствии с расписанием учебной программы. ALFWorld использует расписание с размером обучающего пакета 16, размером пакета для валидации 32, количеством прогонов 8, максимальной длиной эпизода 50, коэффициентом обучения , размером мини-пакета PPO 32, размером микро-пакета 2, 120 шагами обучения и валидацией каждые 10 шагов. SearchQA использует расписание с размером обучающего пакета 64, размером пакета для валидации 512, количеством прогонов 4, максимальной длиной эпизода 4, коэффициентом обучения , размером мини-пакета PPO 512, размером микро-пакета 8 и 180 шагами обучения. Оба варианта отключают KL-потери со стороны актёра и регуляризацию KL-в-награде, и используют те же коэффициенты штрафа за недопустимое действие, что и SLIM. Исходная кодовая база Skill0 включает компоненты, связанные с текстовым рендерингом и OCR, но наши настройки ALFWorld и SearchQA являются ориентированными на текст. Поэтому мы отключаем OCR/текстовый рендеринг, чтобы избежать внесения визуально-рендерингового смешивающего фактора; исходное сравнение Skill0 сообщает о приросте менее чем в три балла от текстового рендеринга, так что эта адаптация не влияет на основное сравнение жизненного цикла навыков. Skill0 предназначен для приближения к инференсу «нулевого навыка».
SkillRL. SkillRL адаптируется как устойчивый базовый уровень обучения с усилением навыками и не использует отдельный этап прогрева в нашем сравнении. Политика извлекает внешние навыки во время обучения и инференса с тем же путем извлечения в стиле SkillRL, который используется для инициализации нашего банка навыков, применяя формат подсказки, обусловленной навыками, на Рисунке A5. ALFWorld использует извлечение верхних 6 навыков, динамическое обновление банка навыков с порогом 0.4, не более трех новых навыков на обновление, размер обучающего пакета 16, размер пакета для валидации 32, количество разверток 8, максимальную длину эпизода 50, learning rate , размер мини-пакета для PPO 32, micro-batch size 2, 120 шагов обучения и валидацию каждые 10 шагов. Ее автор/обновляющий навыки использует сопоставимую базовую архитектуру o3, совместимую с OpenAI, которая анализирует неудачные траектории и выдает новые записи навыков в формате JSON, соответствующие формату банка навыков в стиле SkillRL, а не генерирует артефакты SKILL.md. SearchQA использует тот же протокол извлечения верхних 6 навыков и динамического обновления банка навыков, с размером обучающего пакета 64, размером пакета для валидации 512, количеством разверток 4, максимальной длиной эпизода 4, learning rate , размером мини-пакета для PPO 512, micro-batch size 8 и 180 шагов обучения. В отличие от GRPO, SkillRL сохраняет потерь KL для опорной политики, используя коэффициенты KL 0.01 для ALFWorld и 0.001 для SearchQA, при этом KL-in-reward остается отключенным. Исходная реализация SkillRL не определяет тот же явный протокол этапа валидации, который используется в наших экспериментах, поэтому мы добавляем валидацию на выделенном валидационном разбиении и резервируем тестовое разбиение для итоговой отчетности. Это приспособление сохраняет основную идентичность SkillRL как устойчивого усиления внешними навыками.
B.3 Дополнительная настройка базовых моделей
GPT-4o и Gemini-2.5-Pro в ALFWorld. Для сравнения ALFWorld с закрытым исходным кодом мы сообщаем результаты GPT-4o и Gemini-2.5-Pro из SkillRL [59]. Эти результаты используются только в расширенной таблице ALFWorld в Приложении D.5, чтобы контекстуализировать масштаб производительности агента в условиях сильных проприетарных моделей. Они не используются для выбора гиперпараметров, аудита жизненного цикла или любых сравнений во время обучения.
SimpleMem в ALFWorld. SimpleMem оценивается как базовый подход к долговременной памяти после его семантического сжатия и извлечения памяти по конструкции [31]. Каждый завершенный эпизод ALFWorld преобразуется в компактную текстовую запись памяти, содержащую описание задачи, ключевые наблюдения, действия, исход и краткий урок. Память индексируется с помощью Qwen3-Embedding-0.6B, чтобы соответствовать встраивающей основе, используемой в других наших экспериментах. Следуя исходному стилю настройки SimpleMem, мы включаем планирование и рефлексию при извлечении, используем семантическое извлечение как основной путь, и допускаем ключевые слова и структурированные фильтры как вспомогательные пути. Извлекатель памяти рассматривает до 25 семантических кандидатов, 5 кандидатов по ключевым словам и 5 структурированных кандидатов, затем вставляет не более трех компактных записей памяти в подсказку действий, чтобы сохранить бюджет подсказки сопоставимым с другими базовыми подходами памяти. Модель политики — Qwen3-4B, а парсер среды, метрика успеха, разбиение train/validation/test и итоговый протокол оценивания такие же, как у других базовых подходов.
RLOO на ALFWorld. RLOO оценивается как базовая модель-оптимизатор в режиме RL, используя тот же набор сред ALFWorld, что и GRPO. Единственное изменение на уровне оптимизатора — оценщик преимущества: для каждого запроса мы выполняем прогонов и вычисляем преимущество leave-one-out , следуя формулировке leave-one-out REINFORCE [1]. Все остальные настройки согласованы с базовой моделью ALFWorld GRPO, включая размер обучающего пакета 16, размер пакета валидации 32, максимальную длину эпизода 50, learning rate , 120 обучающих шагов, валидацию каждые 10 шагов и отсутствие cold-start SFT. RLOO не получает внешние навыки, контекст памяти или обновления по жизненному циклу.
MemRL в ALFWorld. MemRL оценивается как базовый подход с усилением оперативной памяти, который обновляет эпизодическую память без обновления параметров модели [69]. Мы сохраняем исходную структуру метода, используя процедуризацию для построения памяти, извлечение по запросу и обновления памяти на основе корректировок. Чтобы сравнение было корректным, модель политики — Qwen3-4B, а модель встраиваний — Qwen3-Embedding-0.6B, при этом анализатор ALFWorld, примеры для обучения с малым числом примеров, разбиение задач и метрика успеха разделяются с остальной частью нашей оценки. Извлекатель памяти использует , максимум 8 извлеченных ключевых слов, порог добавочного сходства 0.90, порог новизны 0.85, порог обнаружения неизвестных 0.62 и множество кандидатов с учетом значения размером 3. Обновление значения следует исходной настройке с одним шагом: с коэффициентом обучения , дисконтированием , наградой за успех 1.0, наградой за неудачу и равными весами 0.5/0.5 для сходства и ценности памяти в объединенной оценке извлечения.
RAG в SearchQA. RAG оценивается как базовый уровень one-shot retrieval-augmented generation на SearchQA [26]. Следуя настройке Search-R1 [23], каждое заданное вопрос используется в качестве поискового запроса, общий поисковый корпус запрашивается перед генерацией, а в подсказку вставляются три наиболее релевантных извлеченных фрагмента. Затем модель генерирует окончательный ответ без итеративных поисковых вызовов, RL-обновлений, извлечения навыков или контроля жизненного цикла. Этот базовый уровень использует ту же базовую архитектуру Qwen3-4B, правило сопоставления ответов и тот же тестовый разбиение, что и другие методы SearchQA.
Поиск-o1 по SearchQA. Search-o1 оценивается как агентная базовая линия поиска во время вывода [27]. Модель побуждают рассуждать, при необходимости формировать поисковые запросы, читать извлечённые свидетельства и продолжать рассуждения перед тем, как выдать окончательный ответ. Мы используем тот же поисковый интерфейс, по три извлечённых фрагмента на каждый вызов поиска, максимальный бюджет действий 4 раунда поиска и оцениватель ответа в качестве среды SearchQA. Search-o1 не обновляет параметры модели и не использует внешние навыки; он отличается от RAG главным образом тем, что позволяет выполнять итеративный поиск и рассуждения во время вывода.
Поиск-R1 в SearchQA. Поиск-R1 оценивается как базовый вариант на основе RL с поиском в соответствии с протоколом обучения Search-R1 [23]. Во время развертывания политика чередует токены рассуждений, сгенерированные моделью, и вызовы поиска, а извлеченные токены маскируются от потерь градиента политики, чтобы оптимизация применялась только к токенам, сгенерированным моделью. Мы используем общий интерфейс поиска SearchQA с верхними-3 извлеченными фрагментами, максимальным бюджетом действий 4, вознаграждением за точное совпадение исхода, learning rate и тем же разделением обучающих/валидационных/тестовых данных, что и в SLIM. Этот базовый вариант не использует внешние навыки или операции жизненного цикла, поэтому он выделяет эффект обучения взаимодействию с поиском отдельно от эффекта управления банком навыков.
SFT для SearchQA. SFT оценивается как базовая модель контролируемой донастройки для SearchQA [11]. Примеры обучения формируются только из обучающего раздела с использованием того же формата ответа, что и в среде с включенным поиском. Модель оптимизируется для имитации целевой траектории рассуждений и ответа, при этом валидация используется только для выбора контрольной точки. SFT не использует RL с вознаграждением по исходу, внешние навыки, аудит жизненного цикла или тестовые траектории во время обучения.
Отклоняющая выборка при SearchQA. Отклоняющая выборка следует базовой конструкции Search-R1 [23, 2]. Для каждого обучающего запроса мы отбираем пять траекторий-кандидатов с включенным поиском с тем же интерфейсом поиска и бюджетом действий, сохраняем траектории, чьи итоговые ответы корректны согласно точному совпадению, и дообучаем модель на выбранных траекториях. Это сохраняет формат взаимодействия LLM–поиск в несколько ходов, заменяя онлайн RL на отфильтрованное обучение с учителем. Для выбора контрольной точки используется валидация, а итоговый тестовый разбиение откладывается до момента представления результатов.
Appendix C Настройка оценки
Протокол бенчмарка. Мы оцениваем все методы на двух агентных бенчмарках, использованных в основной статье. ALFWorld [50] — это бенчмарк длительных текстовых взаимодействий, в котором агент должен выполнять бытовые задачи, выполняя допустимые текстовые действия. Мы приводим как общую долю успешных попыток, так и доли успешных попыток по типам задач для Pick, Look, Clean, Heat, Cool и Pick2, следуя категориям задач, используемым средой. Хотя ALFWorld имеет фиксированный набор типов задач, RL-наблюдение собирается по траекториям действий в несколько шагов, поэтому каждый эпизод в рамках общего протокола развертывания вносит множество решений на уровне действий. SearchQA следует постановке поисково-усиленного вопросно-ответного режима Search-R1 [23]. Агент взаимодействует с поисковым инструментом и в конечном итоге должен выдавать итоговый ответ на вопросы из NQ [25], TriviaQA [24], PopQA [35], HotpotQA [64], 2Wiki [20], MuSiQue [51] и Bamboogle [42]. Все методы используют один и тот же разборщик действий со стороны среды, поисковый интерфейс, правило завершения траектории и оцениватель успешности в рамках каждого бенчмарка.
Разбиения данных и использование данных. Мы используем явные разбиения на обучающую, разработческую и финальную проверочную (окончательную оценочную) части для обоих наборов. Для ALFWorld обучающее разбиение содержит 16 задач текстового взаимодействия, разработческое разбиение содержит 64 задачи, а финальная проверочная (окончательная оценочная) часть содержит 128 задач. Для SearchQA обучающее разбиение содержит 169,615 вопросов из HotpotQA (90,447) и NQ (79,168). Разработческое разбиение содержит 4,000 примеров и сбалансировано по типу навыка, а не по источнику: compare, direct retrieval, entity-attribute lookup и multi-hop reasoning каждое содержит 1,000 примеров. Его распределение по источникам: HotpotQA (1,246), PopQA (1,000), TriviaQA (743), 2Wiki (729), NQ (257), MuSiQue (24) и Bamboogle (1). Построение по типу навыка сопоставляет compare с 2Wiki/HotpotQA/MuSiQue/Bamboogle, direct retrieval с NQ/TriviaQA, entity-attribute lookup с PopQA, а multi-hop reasoning с HotpotQA. Финальная проверочная (окончательная оценочная) часть содержит 51,713 примеров из PopQA (14,267), 2Wiki (12,576), TriviaQA (11,313), HotpotQA (7,405), NQ (3,610), MuSiQue (2,417) и Bamboogle (125). Для SearchQA разработческое разбиение организовано как фиксированное представление валидации над распределением источников в наборе. Протокол фиксирован и общедоступен для всех методов: policy optimization использует обучающую часть, lifecycle auditing и выбор контрольной точки используют разработческое представление, а финальная отчетность использует финальная проверочная (окончательная оценочная) часть после того, как контрольная точка политики и активный набор навыков зафиксированы.
Показатели успеха. Основным показателем во всех таблицах является доля успешных попыток. В ALFWorld попытка считается успешной, если среда возвращает конечный сигнал успеха для целевой задачи для конкретного домашнего хозяйства. Мы вычисляем общую долю успешных попыток в ALFWorld, усредняя двоичные индикаторы успеха по эпизодам оценки, и вычисляем показатели успешности по типам задач, группируя эпизоды в соответствии с их типом задачи в ALFWorld. В SearchQA попытка считается успешной, если итоговый ответ, выданный агентом, совпадает с эталонным ответом по фактам под общим правилом сопоставления ответов, используемым средой SearchQA. Мы приводим доли успешных попыток для каждого источника и их среднее значение по семи перечисленным выше источникам SearchQA.
Диагностика устойчивости. Следуя распространенной практике в исследованиях LLM в RL, основные кривые обучения приводятся по результатам одного запуска при фиксированном тренировочном протоколе, поскольку полное агентное обучение с подкреплением вычислительно дорого. Чтобы снизить озабоченность, связанную с вариативностью, мы приводим результаты на уровне категорий, траектории на протяжении жизненного цикла, результаты абляционных исследований, оценку накладных расходов на аудит, а также диагностические тесты чувствительности к переносу или инициализации. Эти анализы показывают, что полученные улучшения не объясняются одной-единственной благоприятной траекторией жизненного цикла.
Итоговый протокола оценки. Для обучаемых методов итоговая оценка выполняется из выбранной контрольной точки при отключенной адаптации во время обучения. Для SLIM итоговый активный набор навыков фиксируется до оценивания теста; тестовые развертывания могут извлекать из этого замороженного активного набора, но сохранять, отстранять, расширять, проводить аудит жизненного цикла и создавать навыки запрещено. Для Skill0 состояние учебной программы фиксируется его расписанием до итоговой оценки. Для SkillRL банк навыков и конфигурация извлечения фиксируются до оценивания теста. Памятно-ориентированные и агентно- или память-ориентированные базовые варианты также оцениваются на том же итоговом тестовом разбиении; когда метод накапливает память во время оценивания, эта память создается только из более ранних эпизодов оценивания этого метода и не передается между методами.
Элементы управления справедливостью. Все основные сравнения используют Qwen3-4B [63] в качестве базовой модели. Обучаемые методы начинаются с одного и того же базового контрольного чекпойнта и используют одну и ту же среду бенчмарка, определение вознаграждения, формат действий и метрику успеха. Базовые линии на основе подсказок и базовые линии в стиле методов используют одну и ту же обслуживаемую базовую модель и одни и те же обертки среды, поэтому их сгенерированные действия разбираются и оцениваются одним и тем же парсером на стороне среды так же, как и действия методов RL. Мы согласуем ограничения по длине подсказки, ограничения по длине ответа, горизонты развертывания, частоту валидации и итоговые разбиения теста, когда класс метода это позволяет; различия, специфичные для метода, такие как запланированное отзыва навыков Skill0, постоянное извлечение навыков SkillRL и жизненный аудит SLIM, сохраняются, поскольку они определяют соответствующие алгоритмы. Справедливость особенно важна для методов с расширением навыков или обновлениями skill-bank. Когда методы включают сравнимые модули, мы создаем эти модули с одинаковыми решениями по реализации. Методы с навыком используют одну и ту же начальную семейство skill bank в стиле SkillRL, тот же формат вставки навыка, показанный на рисунке A5, и то же базовое ядро извлечения встраиваний, где требуется извлечение. Методы, которые создают или обновляют навыки, используют сравнимые backbones создателя или обновления, совместимые с OpenAI, в рамках собственных форматах вывода, специфичных для каждого метода; в частности, расширение SLIM и обновления skill-bank SkillRL оба используют OpenAI-совместимый backbone o3, тогда как EvolveR и baselines в стиле памяти используют то же семейство служебных моделей, когда для построения опыта или памяти требуется одна. Методы, которые не определяют создание навыков, не получают дополнительных сгенерированных навыков, и никакой метод не создает или не обновляет навыки на основе тестовых данных. Таким образом, сравнение меняет политику жизненного цикла, а не силу базовой инфраструктуры извлечения, подсказок, среды или генерации навыков. Независимо от того, выполняется ли метод через стек обучения RL или через обертку оценивания на основе службы, генерация обслуживается через SGLang. Если иное не указано протоколом, специфичным для метода, мы сохраняем конфигурацию вывода LLM на общем значении по умолчанию и включаем сэмплированное декодирование для оценки.
Без Cold-Start SFT. Все базовые варианты RL оцениваются в одинаковой контролируемой среде без прогрева. В частности, все RL-методы начинают с одного и того же базового контрольного чекпойнта без Cold-Start SFT или прогрева, поэтому сравнение выделяет онлайн RL и поведение на протяжении жизненного цикла, а не влияние предварительной адаптации, выполненной с учителем. Это позволяет избежать смешения эффектов жизненного цикла с политикой, которая уже была обучена следовать определённому формату навыка, стилю траектории или шаблону действий до начала RL. Мы настраиваем метод-специфические гиперпараметры только на валидационном разбиении.
Предотвращение утечек. Ключевое разделение в нашем протоколе заключается в том, что управляющие сигналы во время обучения никогда не вычисляются по итоговому тестовому разбиению. В частности, SLIM оценивает предельный внешний вклад, направляет отказавшие корзины (failure buckets), принимает решения о сохранении/выводе из использования (retain/retire) и запускает расширение только по валидационному разбиению, никогда по тестовым задачам. Запросы для расширения формируются строго из аудиторских отказов на стороне валидации; они никогда не включают финальные оценочные запросы, траектории, отказы, метки или ответы. Расширенные навыки создаются до финальной оценки, и создатель навыков никогда не получает тестовые запросы, тестовые траектории, тестовые отказы или тестовые метки. Во время финальной оценки контрольная точка политики и активный набор навыков замораживаются; тестовые прогоны могут извлекать данные из замороженного активного набора, но не могут создавать, редактировать, выводить из использования или расширять навыки. Skill0 и SkillRL оцениваются при одинаковом разделении train/validation/test: валидация может влиять на учебную программу в процессе обучения, обновления skill-bank или мониторинг, где метод этого требует, но финальные тестовые примеры исключаются до момента отчётности. Для базовых линий с онлайн-памятью любая память, накопленная во время финальной оценки, является частной для этой базовой линии и возникает только из более ранних эпизодов в том же последовательном прогоне оценивания; она не используется для выбора контрольных точек, обновления параметров модели, настройки запросов или модификации skill banks до оценивания. Это предотвращает попадание тестовых меток, тестовых траекторий и тестовых отказов в оптимизацию политики, обновления skill-bank, решения жизненного цикла или расширение навыков.
Appendix D Дополнительные экспериментальные результаты
Это приложение содержит дополнительные эксперименты, которые поддерживают основные утверждения в Разделе 6. Мы сосредоточимся на шести вопросах, которые не полностью охвачены основной таблицей: переносится ли изученный жизненный цикл между семействами задач SearchQA, полезен ли итоговый активный банк навыков за пределами обученной политики, насколько SLIM устойчив к различным исходным банкам навыков, насколько надежны заявленные выигрыши, как выбранные дополнительные базовые модели сравниваются на каждом наборе тестов отдельно и насколько дополнительное аудитное накладное время для управления жизненным циклом увеличивает.
D.1 Перенос обобщения между задачами в SearchQA
Метод Источник обучения Удержанные источники Среднее удержанное Среднее общее NQ HotpotQA Среднее. TriviaQA PopQA 2Wiki MuSiQue Bamboogle GRPO 35.9 30.8 33.4 57.8 36.5 30.1 9.2 30.4 32.8 37.5 SkillRL† 36.8 31.5 34.2 59.8 36.9 29.7 10.3 31.2 33.6 38.1 Skill0 37.9 32.7 35.3 59.5 38.6 31.9 10.3 32.8 34.6 39.3 SLIM 38.6 37.2 37.9 62.2 40.0 31.7 12.8 37.6 36.9 41.0 SLIM† 38.4 36.9 37.7 62.1 40.4 31.5 12.7 36.0 36.5 41.0
SearchQA обеспечивает естественную настройку перекрёстной обобщаемости между источниками, потому что обучение использует HotpotQA и NQ, а итоговый файл тестирования также включает TriviaQA, PopQA, 2Wiki, MuSiQue и Bamboogle. Таблица A1 переорганизует основные результаты SearchQA на подмножества обучающих источников и удерживаемых источников. SLIM достигает наилучшего среднего значения для обучающих источников и наилучшего среднего значения для удерживаемых источников, улучшая среднее значение для удерживаемых источников с 34.6 для Skill0 до 36.9. Приросты распределены широко, а не сосредоточены в одном наборе данных: SLIM наиболее силён на TriviaQA, MuSiQue и Bamboogle, тогда как SLIM† наиболее силён на PopQA. Это подтверждает, что обучение с учётом жизненного цикла изучает переиспользуемые процедуры для QA, а не только адаптируется к источникам, наблюдавшимся во время RL-обучения.
D.2 Перенос Базового Банка Активных Навыков на Финальном Этапе
Метод подсказок Источник навыка ALFWorld в среднем SearchQA в среднем Нулевой выстрел Нет 41.4 32.3 Начальный банк навыков 63.3 31.5 Финальные активные навыки SLIM 65.8 32.7 Малые примеры Нет 39.1 35.5 Начальный банк навыков 64.1 34.8 Финальные активные навыки SLIM 66.9 35.8
Таблица A2 переносит различные источники навыков на политики, которые не участвовали в жизненном цикле обучения: без внешних навыков, начальный банк навыков до RL и конечный активный набор навыков, изученный с помощью SLIM. На ALFWorld перенос является сильным: конечные навыки SLIM улучшают политики с нулевым выстрелом и малым числом примеров на 24.4 и 27.8 пункта по сравнению с подсказками без навыков, а также на 2.5 и 2.8 пункта по сравнению с начальным банком навыков. Это указывает на то, что выученный активный набор передаёт повторно используемые процедурные указания, а не только служит частной опорой для обученной политики SLIM. SearchQA демонстрирует иной характер. Конечные активные навыки улучшают подсказки с нулевым выстрелом и малым числом примеров лишь незначительно по сравнению с подсказками без навыков — на 0.4 и 0.3 пункта, но при этом стабильно превосходят начальный банк навыков на 1.2 и 1.0 пункта. Таким образом, на SearchQA конечный банк навыков в основном отфильтровывает шумные или менее полезные внешние указания, а не обеспечивает крупные прямые выигрыши от переноса. Это подтверждает более общую точку зрения о том, что переносимость навыкового банка зависит от того, приносит ли данный бенчмарк пользу от устойчивой внешней процедурной поддержки.
D.3 Чувствительность к инициализации навыков
Начальный банк навыков Среднее значение в конце Активные навыки в конце Покинутые навыки Расширенные навыки Пустой банк навыков 76.4 18 8 26 Слабый начальный банк навыков 81.2 23 15 29 Шумный начальный банк навыков 85.6 25 46 33 Исходный начальный банк навыков 87.5 21 33 16
Устойчивость к инициализации. Этот эксперимент изменяет исходный банк навыков, сохраняя неизменными протокол обучения и аудита. Таблица A3 показывает, что SLIM устойчив к несовершенным исходным банкам, поскольку расширение может восстановить отсутствующее покрытие, а уход на пенсию может отфильтровать шумные или малозначимые навыки. При этом исходный банк навыков по-прежнему дает наивысший итоговый показатель, указывая на то, что управление жизненным циклом дополняет, а не заменяет инициализацию навыков.
Расширение при слабом покрытии. Начиная с пустого банка навыков, SLIM достигает 76,4% и создаёт 26 навыков в ходе обучения. Это показывает, что SLIM — это не просто выбор из фиксированной библиотеки; он может формировать полезную внешнюю поддержку на основе устойчивых случаев неудач. Однако разрыв в 11,1 пункта с исходной настройкой указывает на то, что расширение с нуля не полностью замещает достаточно информативную начальную библиотеку. При наличии лишь 25% исходных навыков SLIM улучшает результат до 81,2% и расширяет 29 новых навыков, что предполагает, что контроллер жизненного цикла может частично восстановить недостающее покрытие задач при неполной инициализации.
Фильтрация зашумлённых навыков. Зашумлённая постановка обеспечивает наиболее убедительные доказательства устойчивости. Даже когда 30% исходных навыков искажаются и встраиваются 30% дополнительных несоответствующих навыков, SLIM достигает 85.6%, лишь на 1.9 пункта ниже исходной постановки. Контроллер прекращает использование 46 навыков и добавляет 33 новых, что указывает на то, что SLIM активно удаляет вредные внешние знания и восстанавливает недостающий охват, а не просто слепо сохраняет первоначальный банк.
Инициализация по-прежнему имеет значение. Исходный банк навыков дает наилучший результат, но SLIM все же существенно его перестраивает, выводя из использования 33 навыка и расширяя его за счет 16 новых, оставляя компактное активное множество из 21 навыка. Таким образом, выигрыш не проистекает из статического повторного использования исходных навыков. Разумный начальный банк повышает верхнюю границу, в то время как управление жизненным циклом определяет, какие навыки должны оставаться активными после RL.
D.4 Устойчивость к надежности работы SLIM
Бенчмарк Сравнение Средний разрыв 95% ДИ Пересечения 0? ALFWorld SLIM† – Skill0 +13.3 [+3.9, +22.7] Нет ALFWorld SLIM† – SkillRL† +12.6 [+3.1, +21.9] Нет SearchQA SLIM† – Skill0 +1.72 [+1.13, +2.31] Нет SearchQA SLIM† – SkillRL† +2.95 [+2.35, +3.52] Нет
Таблица A4 сообщает независимый агрегированный бутстрэп-анализ по результатам тестирования. Все доверительные интервалы остаются выше нуля. На ALFWorld интервалы шире, поскольку набор тестов содержит 128 эпизодов, но нижние границы остаются положительными по сравнению как с Skill0, так и с SkillRL†. На SearchQA абсолютные выигрыши меньше, но большой набор тестов дает узкие интервалы, показывая, что улучшение небольшое, но статистически надежное при данной проверке ресэмплирования.
D.5 Расширенные результаты
Метод Выбор Наблюдение Очистка Нагрев Охлаждение Выбор2 Среднее. GPT-4o∗ 75.3 60.8 31.2 56.7 21.6 49.8 48.0 Gemini-2.5-Pro∗ 92.8 63.3 62.1 69.0 26.6 58.7 60.3 SimpleMem 100.0 25.0 9.5 53.3 39.1 11.8 48.7 MemRL 100.0 33.3 10.0 46.2 9.5 6.7 41.3 RLOO 85.3 100.0 50.0 75.0 52.2 38.9 65.3 SLIM† 92.9 100.0 91.4 78.3 88.5 81.2 87.5
Метод NQ TriviaQA PopQA HotpotQA 2Wiki MuSiQue Bamboogle Среднее RAG 42.1 65.7 46.4 37.1 30.7 8.4 28.0 37.6 Search-o1 30.6 51.8 22.6 28.2 38.2 11.2 41.6 33.3 Search-R1 38.0 59.7 38.4 35.7 40.1 13.2 35.2 37.2 SFT 48.7 49.4 43.6 28.8 31.4 7.1 32.0 34.4 Reject Sampling 38.0 61.2 40.0 35.1 31.6 14.3 37.6 36.8 SLIM† 38.4 62.1 40.4 36.9 31.5 12.7 36.0 41.0
Дополнительные базовые модели ALFWorld. Расширенное сравнение ALFWorld добавляет закрытые, основанные на памяти и RL-ориентированные базовые модели сверх основной таблицы. SLIM сохраняет конкурентоспособность по сравнению с этими более широкими альтернативами при использовании той же среды и протокола оценки, что усиливает вывод о том, что управление жизненным циклом улучшает обучение процедурных агентов, а не только превосходит узкий набор базовых моделей..
Дополнительные базовые модели для SearchQA. Расширенное сравнение SearchQA включает базовые модели с поисковым дополнением, обучением с учителем, выборкой с отклонением и базовые модели в стиле RL. Эти результаты показывают, что SLIM выигрывает не только за счет более сильного подсказки или интерфейса поиска; его улучшения сохраняются при сравнении с альтернативными способами повышения качества работы поиска-дополненного QA поведения.
D.6 Сравнение накладных расходов при аудите
Метод Дополнительные вызовы, эквивалентные валидации Масштабирование банка навыков Узкое место Главная выгода Навык0 грубые сравнения по учебному плану Сокращение множества навыков Валидация учебного плана Эффективное отступление к выводу при нулевых навыках SkillRL обычная валидация извлечение / сопровождение по мере накопления навыков Растущий банк навыков и управление подсказками Постоянное наращивание навыков и поддержка исследований SLIM извлечение и ограниченный аудит Периодический аудит «исключи один навык» Динамическая внешняя граница через retain, retire и expand
SLIM вводит аудитные вызовы leave-one-skill-out, но бюджет аудита периодический и ограничен. Таблица A7 показывает, что SLIM дороже обычной валидации, но его затраты на жизненный цикл ограничиваются , а не полным размером банка навыков. Напротив, SkillRL выполняет более лёгкую валидацию, но может накапливать растущий банк навыков, тогда как Skill0 дешевле, но в основном моделирует прогрессивное исключение. Хотя не реализуется во время обучения, её операционные эффекты отражаются измеряемыми величинами. SLIM снижает итоговое число активных навыков с 38 исходных навыков плюс 16 расширений до 21 активного навыка, тогда как SkillRL вырастает до 73. Его бюджет аудита ограничен и не масштабируется с полным банком навыков, а время выполнения в стенах остаётся сопоставимым с SkillRL и Skill0. В сочетании с абляциями w/o Retirement и Fixed Active Set Size эти результаты указывают, что выгоды SLIM не объясняются неограниченной внешней поддержкой или простым контролем бюджетов запросов.
Appendix E Подсказки
Этот раздел содержит шаблоны запросов, используемые для взаимодействия со средой, вставки навыков, базовых адаптеров и расширения навыков. Мы сохраняем плейсхолдеры, такие как {task_description} и {retrieved_memories}, явными, чтобы шаблоны могли быть напрямую сопоставлены с протоколом обучения и оценки.
Запросы взаимодействия со средой. Фигура A2 и Фигура A4 показывают запросы для развертывания с учетом навыка, использованные для ALFWorld и SearchQA. Фигура A1 и Фигура A3 показывают соответствующие шаблоны без навыка.
Формат вставки навыков. Рисунок A5 показывает, как извлеченные общие и предметно-специализированные навыки вставляются в контекст агента.
Базовые подсказки. Рисунок A6, рисунок A7, рисунок A8, рисунок A9 и рисунок A10 содержат подсказки, используемые базовыми подходами на основе подсказок и в стиле памяти.
Промпт для создания навыков. Рисунок A11 дает расширяющий промпт, используемый SLIM для создания новых автономных артефактов SKILL.md, ориентированных на конкретные задачи, из маршрутизированных неудач.
Appendix F Детали банка навыков
Мы обобщаем представительные навыки из иерархических банков навыков, используемых SLIM. В таблицах представлены общие навыки и навыки, специфичные для задач, для ALFWorld и SearchQA, с краткими условиями срабатывания и однострочным процедурным содержимым. Динамически расширенные навыки вставляются в пул навыков, специфичных для задач, соответствующего типа задачи и становятся доступными для последующего извлечения и аудита жизненного цикла.
Appendix G Ограничения
SLIM имеет три основные ограничения. Во-первых, предельный внешний вклад представляет собой локальную оценку leave-one-out для одного навыка, обусловленную текущей политикой, поведением маршрутизации и активным набором. Это не глобальная атрибуция в стиле Shapley и не отражает взаимодействия более высокого порядка между навыками. Во-вторых, пороги жизненного цикла и бюджеты аудита требуют настройки валидации, поэтому перенос одной и той же конфигурации на существенно разные домены может потребовать дополнительной калибровки. В-третьих, аудит жизненного цикла остается практичным в нашей текущей постановке, но может стать дорогим для очень больших банков навыков, где потребуется более масштабируемый выбор кандидатов для аудита..
Appendix H Более широкое воздействие
Это исследование изучает, как внешние возможности следует распределять между параметрами модели и модульными артефактами навыков в ходе агентного обучения с подкреплением (agentic RL). Сделав распределение возможностей явным, SLIM может повысить управляемость, аудируемость и эффективность по выборкам skill-based агентного RL, а также предложить более ясное представление о том, какие модели поведения лучше внутренне усваиваются, а какие — лучше сохраняются во внешнем виде. Мы надеемся, что эта перспектива поддержит будущие исследования в области более адаптивных, интерпретируемых и практически эффективных парадигм обучения агентов.
Задача Идентификатор навыка Название навыка Триггер Содержимое Общее gen_004 Отслеживание количества и прогресса Многоэкземплярные цели, такие как размещение двух объектов. Поддерживайте счетчик оставшихся объектов цели и прекращайте только тогда, когда счетчик достигнет нуля. Общее gen_011 Эффективный поиск отношений Цели, в которых упоминаются и целевой объект, и опорный объект. Ищите один объект рядом с другим, а не рассматривайте их независимо. Общее gen_001 Систематическое исследование Количество объектов цели не выполнено, и остаются неисследованные локации. Ищите правдоподобные поверхности или контейнеры один раз, прежде чем возвращаться к проверенным локациям. Общее gen_002 Немедленное получение Первое визуальное подтверждение объекта, относящегося к цели. Берите требуемый объект, как только он становится видимым и доступным. Общее gen_003 Политика «сначала пункт назначения» Удержание объекта цели после определения его целевой локации. Прямо перейдите к емкости и разместите объект, прежде чем возобновить поиск. pick_and_place pic_001 Систематический поиск с первого прохода Перед получением требуемых объектов. Ведите контрольный список видимых и закрытых кандидатов и осматривайте каждого по одному разу. pick_and_place pic_002 Берите, когда увидели Первое обнаружение удерживаемого целевого объекта, который еще не взят. Сразу возьмите нужный видимый объект, прежде чем перемещаться в другое место. clean cle_003 Сначала раковина для очистки Целевой объект удерживается и должен быть чистым. Перейдите к ближайшей раковине или тазу и очистите объект перед размещением. clean cle_005 Проверка состояния перед опусканием После очистки и перед окончательным размещением. Проверьте, что объект чистый; снова очистите, если состояние неясно. heat hea_003 Сначала открыть, затем нагреть На микроволновой печи с удерживаемым целевым объектом. Откройте микроволновую печь, поместите объект внутрь и выполните действие нагрева. cool coo_005 Прямая доставка после охлаждения Действие охлаждения успешно. Доставьте охлажденный объект непосредственно к месту назначения без объездов. cool coo_002 Подтверждение соответствия объекта После получения объекта в задаче охлаждения. Убедитесь, что удерживаемый предмет соответствует запрошенному типу цели; в противном случае опустите его и возобновите поиск. cool coo_004 Требовать охлаждение перед размещением Удерживается корректный объект перед окончательным размещением. Не размещайте целевой объект, пока действие охлаждения в холодильнике или морозильнике не завершится успешно. cool dyn_verify _cooling _completion Проверка завершения охлаждения После размещения объекта внутри охлаждающего прибора. Подтвердите, что объект охлажден, перед извлечением, затем переходите непосредственно к доставке.
Задача Идентификатор навыка Название навыка Триггер Содержание Общее gen_001 Разложить, затем искать Сложные или многокомпонентные вопросы. Разбейте вопрос на минимальные под-вопросы и выполняйте поиск по каждому перед синтезом. Общее gen_002 Точное формулирование запроса Первичная формулировка запроса. Используйте точные имена сущностей и целевые атрибуты, избегая слов-паразитов. Общее gen_003 Итеративное уточнение запроса Первое множество результатов не содержит окончательных доказательств. Добавляйте уточнители, альтернативные названия, даты или контекст вместо повторения того же запроса. Общее gen_004 Утверждения с опорой на источники Перед тем как зафиксировать окончательный ответ. Отвечайте только после нахождения подтверждающего доказательства. Общее gen_005 Перепроверка по нескольким источникам Факты могут быть устаревшими или оспариваемыми. Проверяйте имена, даты и числа по нескольким независимым источникам. прямой_поиск_из_источника dir_001 Выделить ключевой запрос Начало прямого извлечения. Сведите вопрос к ключевой сущности и запрашиваемому факту, затем выполните поиск для этой пары. прямой_поиск_из_источника dir_002 Уточнить, если результатов нет Начальный поиск дает слабые или отсутствующие совпадения. Переформулируйте с использованием синонимов, альтернативных названий, дат или цитируемых фраз. прямой_поиск_из_источника dir_003 Закрепить с помощью цитат Отличительные фразы, тексты песен, названия или цитаты. Заключайте уникальные фразы в кавычки, чтобы получить источники точного совпадения. прямой_поиск_из_источника dyn_direct_retrieval _search_first _answer_second Сначала поиск, затем ответ Запросы о фактах или определениях. Всегда выполняйте внешний поиск, прежде чем полагаться на память. многоходовое_рассуждение mul_001 Сначала разложить вопрос Многоходовые вопросы, связывающие несколько фактов. Разбейте вопрос на явные под-вопросы перед поиском. многоходовое_рассуждение mul_003 Сначала собрать, затем сравнить Сравнительные многоходовые задачи. Извлекайте конкретные значения для всех элементов перед сравнением. поиск_атрибутов_сущностей ent_001 Прямой запрос атрибута Дано полное, однозначное имя сущности. В первом поиске укажите полное имя сущности и целевой атрибут. поиск_атрибутов_сущностей ent_003 Проверка атрибута по двум источникам Первый правдоподобный ответ появляется или атрибут остается неопределенным. Подтвердите атрибут как минимум в двух независимых источниках. сравнение com_001 Разложить и выделить Чтение вопроса типа сравнения. Разделите вопрос на сущности и единственный атрибут, который нужно сравнить. сравнение com_003 Нормализовать перед сравнением После того как вы собрали атрибут каждой сущности. Преобразуйте значения в общую сопоставимую форму перед оценкой равенства или порядка..