Сравнительная оценка подходов машинного обучения для прогнозирования финансового неблагополучия меньшинственного класса при ограничениях дисбаланса классов
Аннотация
Прогнозирование финансовых затруднений остается значимой задачей в анализе рисков предприятия из-за крайне несбалансированного характера реальных финансовых наборов данных, где обанкротившиеся или испытывающие затруднения фирмы обычно составляют лишь небольшое меньшинство среди всех наблюдений. В таких условиях традиционные модели классификации могут достигать высокой совокупной точности, но при этом демонстрировать недостаточную чувствительность к событиям финансовых затруднений в миноритарном классе.
Эта статья представляет сравнительную оценку классических статистических методов, подходов ансамблевого обучения и исследовательских нейронных моделей для прогнозирования финансовых затруднений для малочисленного класса при жёстких ограничениях сильного дисбаланса классов. В исследовании используется машинное обучение в рабочем процессе, ориентированном на CRISP-DM, включающем структурированную предварительную обработку, фильтрацию признаков, смягчение дисбаланса с применением Synthetic Minority Oversampling Technique (SMOTE), оптимизацию сравнительных моделей и оценку, ориентированную на объяснимость.
Сравнительные эксперименты проводились в рамках нескольких семейств моделей, включая Logistic Regression, Random Forest, AdaBoost, XGBoost, CatBoost и LightGBM, а также с изучением подходов к временной моделированности. Производительность моделей оценивалась с использованием метрик точности для миноритарного класса, полноты, F1-score и ROC-AUC, при этом особое внимание уделялось полноте из-за асимметричного операционного риска, связанного с ложными отрицаниями в корпоративных финансовых средах.
Для поддержки интерпретируемости и управленчески-ориентированного анализа дополнительно были применены методы объяснимости на основе SHAP, чтобы исследовать вклад отдельных признаков в предсказание событий банкротства. Более широкая цель исследования заключается в поддержке воспроизводимых, интерпретируемых и учитывающих дисбаланс машинно-обучаемых рабочих процессов для прогнозирования финансового неблагополучия предприятий в условиях высокой операционной рискованности.
1 Введение
Прогнозирование финансовых затруднений является важной задачей классификации в управлении финансовыми рисками, мониторинге неплатежеспособности, системах корпоративного управления и средах оперативной поддержки принятия решений. Раннее выявление финансово затруднённых компаний может помочь организациям снижать подверженность потерям, связанным с неплатежеспособностью, улучшать стратегический контроль рисков и поддерживать более надёжное корпоративное финансовое планирование. Однако практическая реализация прогнозных систем финансовых затруднений остаётся сложной из-за редкости событий банкротства в реальных финансовых наборах данных.
Во многих корпоративных и государственных финансовых наборах данных обанкротившиеся компании составляют лишь небольшую долю от общего числа наблюдений, создавая крайне несбалансированную среду для классификации. В таких условиях традиционные модели машинного обучения могут становиться смещёнными в сторону преобладающих небанкротных наблюдений, что приводит к завышенной совокупной точности при одновременном демонстрации слабой чувствительности к событиям дистресса редкого класса. Эта проблема особенно значима в финансовых средах оценки рисков, поскольку ложноотрицательные результаты могут задерживать вмешательство и увеличивать последующее операционное и финансовое воздействие.
Традиционные методы прогнозирования финансового неблагополучия, такие как Altman (1968) «Altman Z-score», Ohlson (1980) «Ohlson O-score» и Zmijewski (1984) модель «Zmijewski», исторически обеспечивали интерпретируемые статистические рамки для оценки вероятности неплатёжеспособности. Эти подходы по-прежнему остаются влиятельными благодаря их методологической простоте и интерпретируемости, хотя в условиях предприятий, характеризующихся нелинейными финансовыми взаимодействиями, неоднородными операционными условиями и меняющимся поведением рынка, они могут демонстрировать ограничения.
Более современные подходы машинного обучения, включая XGBoost Chen and Guestrin (2016), LightGBM Ke et al. (2017) и CatBoost Prokhorenkova et al. (2018), обеспечивают повышенную гибкость для моделирования нелинейных финансовых взаимосвязей и сложных зависимостей признаков в структурированных корпоративных наборах данных. Архитектуры ансамблевого обучения все чаще демонстрируют высокую предсказательную способность в задачах прогнозирования банкротств и моделирования финансовых рисков, включающих разнородные финансовые показатели.
Несмотря на достижения в предиктивном моделировании, остаются актуальными несколько важных задач в контексте ориентированных на предприятия систем машинного обучения для финансов. Серьёзный дисбаланс классов требует явных стратегий оптимизации с учётом дисбаланса, чтобы повысить чувствительность к событиям меньшинства во время обучения и оценки модели. Параллельно с этим растущие требования корпоративного управления и соответствия нормативным актам требуют, чтобы предиктивные системы поддерживали объяснимость, прозрачность, воспроизводимость и операционную аудируемость, а не выполняли роль непрозрачных классификаторов «чёрного ящика».
Это исследование оценивает несколько подходов машинного обучения для прогнозирования финансового дистресса редкого класса в условиях сильного дисбаланса классов, используя SMOTE Chawla et al. (2002) и анализ объяснимости SHAP Lundberg and Lee (2017). В исследовании применяется экспериментальная рамочная модель, ориентированная на CRISP-DM, включающая предобработку, смягчение дисбаланса, сравнительную оценку моделей и анализ объяснимости, ориентированный на управление, в рамках нескольких статистических, ансамблевых и исследовательских подходов к темпоральному моделированию.
Более широкая цель работы заключается не только в предиктивной оптимизации, но в разработке воспроизводимой и интерпретируемой структуры оценки машинного обучения, способной поддерживать заслуживающий доверия анализ финансовых рисков предприятий в условиях высокой несбалансированности операционных данных.
2 Обзор литературы
2.1 Классические модели прогнозирования финансовых затруднений
Прогнозирование финансового неблагополучия исторически опиралось на статистические модели скоринга, выведенные из анализа бухгалтерской отчетности и финансовых коэффициентов. Одним из наиболее широко признанных подходов является модель Altman Z-score Altman (1968), которая применяет многомерный дискриминантный анализ для оценки риска банкротства с использованием финансовых коэффициентов, связанных с ликвидностью, прибыльностью, долговой нагрузкой и платежеспособностью.
Последующие модели, включая Ohlson O-score Ohlson (1980) и модель Zmijewski Zmijewski (1984), предложили логистические и пробит-ориентированные статистические подходы для оценки неплатежеспособности. Эти методы по-прежнему важны благодаря их интерпретируемости, методологической простоте и относительно низкой вычислительной сложности.
Однако классические статистические модели могут демонстрировать ограничения в современных корпоративных средах, характеризующихся нелинейными финансовыми взаимодействиями, неоднородными структурами отчетности, зашумленными операционными показателями и меняющимися рыночными условиями. Многие традиционные подходы также опираются на предположения, связанные с линейной разделимостью и относительно стабильным финансовым поведением, что может снижать предсказательную гибкость в сложных условиях реальной классификации.
Несмотря на эти ограничения, классические модели прогнозирования финансового неблагополучия продолжают обеспечивать важные базовые рамки для сравнительной оценки и остаются влиятельными в литературе по моделированию финансовых рисков благодаря их интерпретируемости и исторической значимости.
Последующие модели, включая Ohlson O-score Ohlson (1980) и модель Zmijewski Zmijewski (1984), представили статистические подходы на основе логистической и пробит-моделей для оценки неплатёжеспособности. Эти методы остаются важными благодаря их интерпретируемости и относительно низкой вычислительной сложности.
Однако классические статистические модели могут демонстрировать ограничения в современных корпоративных средах, характеризующихся нелинейными финансовыми взаимодействиями, неоднородными структурами отчетности и зашумленными операционными показателями.
2.2 Методы машинного обучения для прогнозирования финансовых затруднений
Методы машинного обучения все чаще применяются для прогнозирования финансовых затруднений благодаря своей способности моделировать нелинейные взаимосвязи, неоднородное финансовое поведение и сложные зависимости признаков в структурированных корпоративных наборах данных. В отличие от традиционных подходов со статистическим скорингом, архитектуры машинного обучения способны выявлять взаимодействия более высокого порядка между финансовыми показателями в условиях динамичной операционной среды.
Методы ансамблевого обучения, включая Random Forest, AdaBoost, XGBoost Chen and Guestrin (2016), CatBoost Prokhorenkova et al. (2018) и LightGBM Ke et al. (2017), продемонстрировали высокую предсказательную способность в задачах табличной финансовой классификации, связанных с прогнозированием банкротства, выявлением мошенничества и моделированием корпоративных рисков.
Модели Random Forest повышают устойчивость за счет бутстрэп-агрегации и случайной рандомизации признаков, тем самым снижая дисперсию и улучшая обобщающую способность при работе в зашумленных финансовых условиях. Архитектуры градиентного бустинга, включая XGBoost, CatBoost и LightGBM, дополнительно улучшают предсказательную способность за счет итеративной оптимизации ошибок классификации остатков с использованием стратегий последовательного построения ансамбля.
Эти подходы, основанные на бустинге, особенно хорошо подходят для структурированных корпоративных наборов данных благодаря их способности моделировать нелинейные зависимости признаков, учитывать неоднородные распределения переменных и обеспечивать приоритетно сильные прогностические характеристики в условиях оптимизации с учетом дисбаланса.
Нейронные подходы, включая рекуррентные сети с долговременной краткосрочной памятью (LSTM), также изучались для моделирования временного финансового поведения в последовательных финансовых наборах данных. Такие архитектуры могут улучшить представление изменяющихся финансовых условий, улавливая временные зависимости по историческим показателям предприятий. Параллельно сохраняют актуальность статистические методы прогнозирования, включая ARIMA и SARIMA, как базовые техники для структурированного временного финансового анализа.
Несмотря на их предсказательные преимущества, подходы машинного обучения для прогнозирования финансовых затруднений остаются крайне чувствительными к качеству предобработки, процедурам смягчения дисбаланса, дизайну оценивания и соображениям объяснимости. Следовательно, воспроизводимость, чувствительность к классу меньшинства и ориентированные на управление структуры оценивания по-прежнему остаются важными аспектами в корпоративных системах финансового машинного обучения.
2.3 Дисбаланс классов в финансовом прогнозировании
Дисбаланс классов представляет собой серьезную проблему в системах прогнозирования финансовых затруднений, поскольку наблюдения о банкротстве обычно встречаются редко по сравнению со случаями предприятий без финансовых затруднений. При сильно несбалансированных условиях классификации модели машинного обучения могут становиться чрезмерно смещенными в сторону наблюдений класса большинства, что приводит к искусственно завышенной совокупной точности при одновременном проявлении низкой чувствительности к обнаружению событий меньшинства.
Этот вопрос особенно значим в средах корпоративного финансового риска, поскольку ложноотрицательные результаты могут задерживать вмешательство, снижать видимость неплатежеспособности и повышать последующее операционное и финансовое воздействие. Следовательно, процедуры оптимизации и оценки с учетом дисбаланса рассматриваются как критически важные компоненты надежных рабочих процессов прогнозирования финансового неблагополучия.
Методы избыточной выборки, такие как Synthetic Minority Oversampling Technique (SMOTE) Chawla et al. (2002), обычно используются для улучшения представительства классов меньшинства в ходе оптимизации модели. SMOTE генерирует синтетические наблюдения классов меньшинства посредством интерполяции по ближайшим соседям между существующими выборками меньшинства, тем самым снижая доминирование класса большинства в процедурах обучения.
Предыдущие исследования показали, что стратегии предварительной обработки с учетом дисбаланса могут улучшать отзыв по миноритарному классу, показатели F1 и чувствительность к событиям банкротства в средах финансовой классификации. Однако процедуры избыточной выборки могут дополнительно вызывать компромиссы между точностью и полнотой, а также потенциальное проявление переобучения, если генерация синтетических образцов не контролируется должным образом.
В результате системы машинного обучения в сфере финансов с учетом дисбаланса требуют оценочных рамок, которые отдают приоритет чувствительности к событиям меньшинства, воспроизводимости и операционной надежности, а не полагаются исключительно на показатели совокупной точности. Эти соображения особенно важны в корпоративно-ориентированных системах прогнозирования финансов, где обнаружение событий меньшинства имеет несоразмерно большую операционную значимость.
2.4 Объяснимость и управление в финансовом машинном обучении
По мере того как системы машинного обучения все более интегрируются в корпоративные среды поддержки принятия решений, вопросы объяснимости и управления становятся значительно более важными. Системы прогнозирования финансовых показателей могут влиять на операционные решения, связанные с мониторингом неплатежеспособности, анализом кредитного риска, управлением корпоративными рисками, регуляторной отчетностью и стратегическим финансовым надзором. Следовательно, прогнозные модели требуют не только приемлемой производительности, но и достаточной интерпретируемости и прозрачности, чтобы поддерживать возможность аудита, проверку в рамках управления и операционное доверие.
Подходы постфактумной объяснимости, такие как SHAP Lundberg and Lee (2017), предоставляют механизмы приписывания признаков для понимания поведения предиктивных моделей и повышения прозрачности в сложных системах машинного обучения. SHAP оценивает вклад отдельных признаков в предиктивные результаты, используя кооперативные принципы теории игр, что позволяет выполнять как глобальную, так и локальную интерпретацию поведения модели при различных финансовых условиях.
В ориентированных на предприятия финансовых средах механизмы объяснимости особенно важны, поскольку высокоэффективные модели-«черные ящики» в противном случае могут порождать проблемы управления, связанные с подотчетностью, валидацией, трассируемостью и регуляторным надзором. Анализ приписывания признаков позволяет практикам определить финансовые индикаторы, которые сильнее всего влияют на прогноз наступления события банкротства, и поддерживает улучшенную интерпретируемость процессов принятия решений при содействии модели.
Помимо одной только предиктивной интерпретации, объяснимость способствует достижению более широких целей, включая воспроизводимость, валидацию моделей, ориентированную на управление, надежную оценку ИИ и операционную аудируемость. В высокорисковых финансовых системах эти соображения становятся все более важными, поскольку организации стремятся развертывать рабочие процессы машинного обучения, способные поддерживать прозрачную, интерпретируемую и надежную корпоративную инфраструктуру для поддержки принятия решений.
3 Методология
В данном исследовании используется прикладная система оценки машинного обучения для прогнозирования финансовых затруднений классов меньшинства в условиях сильного дисбаланса классов. Методология была разработана для поддержки воспроизводимого сравнительного анализа между несколькими статистическими, ансамблевыми и исследовательскими подходами к моделированию временных рядов в средах корпоративного финансового риск-менеджмента.
Общий рабочий процесс следует структуре, ориентированной на CRISP-DM, включая этапы предварительной обработки, смягчения дисбаланса, оптимизации модели, сравнительной оценки и анализа объяснимости. Особое внимание было уделено чувствительности к миноритарному классу, надежности оценки, интерпретируемости и соображениям по управленчески ориентированному машинному обучению из-за операционной значимости ложных отрицательных результатов в средах, где существует финансовая нестабильность предприятия.
Инженерная цель методологии заключалась не только в прогнозной оптимизации, но и в разработке интерпретируемого и воспроизводимого экспериментального конвейера, способного поддерживать надежную оценку финансовых рисков в условиях сильно несбалансированной классификации. Для поддержки этой цели на протяжении всего цикла моделирования были внедрены структурированные процессы предобработки, контролируемые процедуры оверсэмплинга, стратегии кросс-валидации и механизмы оценки, ориентированные на объяснимость.
Методология дополнительно отдавала приоритет прозрачности и операционной воспроизводимости проверок, интегрируя анализ приписывания признаков и процедуры воспроизводимых экспериментов на всех ключевых этапах рабочего процесса. Более широкий системно-ориентированный подход согласуется с развивающимися требованиями предприятий в отношении explainable AI, надежной инфраструктуры машинного обучения и учитывающих управление интеллектуальных систем поддержки принятия решений.
3.1 План исследования
Это исследование следует прикладной структуре оценки машинного обучения для прогнозирования финансового стресса меньшинственного класса в условиях сильного дисбаланса классов.
Методология исследования была структурирована с использованием рабочего процесса, ориентированного на CRISP-DM, с включением предварительной обработки данных, фильтрации признаков, снижения дисбаланса, обучения модели, сравнительной оценки и анализа интерпретируемости.
Первичной целью исследования было оценить эффективность нескольких подходов машинного обучения для повышения чувствительности к классу меньшинства в высоко несбалансированных корпоративных финансовых наборах данных.
Особое внимание было уделено надежности оценки, воспроизводимости и интерпретируемости из-за операционной значимости ложных отрицательных результатов в средах прогнозирования финансового неблагополучия.
Рабочий процесс включал структурированные конвейеры предварительной обработки, процедуры оптимизации с учетом дисбаланса, сравнительное тестирование моделей и постфактум анализ интерпретируемости с использованием методов приписывания признаков на основе SHAP.
Вместо того чтобы предлагать новую алгоритмическую архитектуру, исследование позиционируется как прикладная инженерная оценка, предназначенная для изучения практического поведения ансамблевого обучения и подходов к исследовательскому временному моделированию в условиях жестких ограничений несбалансированности.
Общая схема исследования дополнительно подчеркивала соображения, ориентированные на управление, в машинном обучении, включая возможность аудита, воспроизводимость, прозрачность и оценку интерпретируемой поддержки принятия решений в корпоративных средах финансового риска.
3.2 Описание набора данных
Набор данных, использованный в этом исследовании, состоял из структурированных финансовых и операционных показателей, связанных с прогнозированием банкротства предприятий, полученных из публично доступных финансовых записей, размещенных через набор данных Taiwan Economic Journal, а также из соответствующих исследовательских репозиториев Kaggle. Набор данных включал переменные финансового уровня фирмы, связанные с ликвидностью, прибыльностью, долговой нагрузкой, нераспределенной прибылью, платежеспособностью и операционной эффективностью.
Набор данных содержал приблизительно 6,819 наблюдений по компаниям и 96 финансовых атрибутов, при этом случаи банкротства составляли приблизительно 1.8% от всех наблюдений. Это привело к крайне несбалансированной классификационной среде, в которой события банкротства редкого класса существенно недостаточно представлены по сравнению с компаниями, не находящимися в затруднительном положении.
Задача классификации была сформулирована как задача бинарного прогнозирования, в которой фирмы относились либо к банкротам/находящимся в трудном финансовом положении, либо к не банкротам. Из-за редкости событий меньшинства набор данных представлял существенные трудности, связанные с оптимизацией с учетом дисбаланса, надежностью оценки и чувствительностью к событиям меньшинства при обучении модели.
Перед процедурами предварительной обработки и устранения дисбаланса набор данных был разделен с использованием разбиения 80/20 на обучающую и тестовую выборки, чтобы сохранить целостность оценки и снизить утечку информации между средами обучения и тестирования. Отсутствующие значения обрабатывались с применением стратегий медианного заполнения, где это было применимо, в то время как числовые признаки нормализовались с использованием предварительной обработки StandardScaler.
Структура набора данных и характеристики дисбаланса обеспечили подходящую среду для исследования воспроизводимых и интерпретируемых рабочих процессов машинного обучения в условиях корпоративного финансового риска, включающих сильную разреженность малочисленного класса.
3.3 Предобработка данных
Процедуры предварительной обработки были реализованы для повышения качества данных, снижения избыточности признаков и обеспечения устойчивости модели при выполнении сравнительных экспериментов. Дополнительно конвейер предварительной обработки был разработан для улучшения воспроизводимости, минимизации нестабильности оптимизации и обеспечения согласованности оценки в условиях сильного дисбаланса.
Пропущенные значения обрабатывались с помощью стратегий медианной импутации там, где это применимо, чтобы снизить чувствительность к неполным финансовым наблюдениям при сохранении общей структуры набора данных. Числовые финансовые показатели были нормализованы с использованием предварительной обработки StandardScaler для улучшения сопоставимости между переменными с различающимися масштабами, величинами и статистическими распределениями.
На основе корреляции также выполнялась фильтрация признаков, чтобы уменьшить мультиколлинеарность и исключить высоко избыточные финансовые показатели. Признаки, демонстрирующие чрезмерную попарную корреляцию, выборочно удалялись, чтобы снизить дублированное информационное влияние в процессе оптимизации и повысить устойчивость последующих моделей при ансамблевом обучении в рамках различных архитектур.
Дополнительно встраивался рабочий процесс предварительной обработки с управляемым разбиением набора данных и процедурами подготовки с учетом дисбаланса перед этапами увеличения количества данных. Эти меры были введены, чтобы сохранить целостность оценки и снизить вероятность утечки информации между средами обучения и тестирования.
В целом, конвейер предварительной обработки был организован как часть более широкой инженерной процедуры, ориентированной на воспроизводимость, предназначенной для поддержки прозрачной, устойчивой и интерпретируемой сравнительной оценки машинного обучения в условиях корпоративного прогнозирования финансовых затруднений.
3.4 Смягчение дисбаланса с помощью SMOTE
Для устранения выраженного дисбаланса классов в обучающие данные была применена методика Synthetic Minority Oversampling Technique (SMOTE) Chawla et al. (2002) в рамках рабочего процесса оптимизации с учетом дисбаланса.
SMOTE генерирует синтетические наблюдения меньшинственного класса через интерполяцию по ближайшим соседям между существующими выборками меньшинственного класса, тем самым улучшая представление обанкротившихся наблюдений при оптимизации модели. Цель данной процедуры состояла в том, чтобы уменьшить доминирование класса большинства во время обучения и повысить чувствительность к обнаружению событий меньшинства в условиях сильно несбалансированной финансовой классификации.
Синтетические миноритарные выборки были сгенерированы с помощью интерполяции по ближайшим соседям в соответствии с:
| (1) |
где представляет собой существующее наблюдение меньшинственного класса, обозначает одного из его ближайших соседей меньшинственного класса, а — коэффициент интерполяции, случайно выбранный из выборки.
Процедуры оверсемплинга применялись исключительно к обучающему разделу, чтобы сохранить целостность оценивания и избежать утечки информации в среду тестирования, выделенную для проверки. Такое разделение считалось особенно важным для обеспечения надежного сравнительного оценивания в рамках экспериментальных рабочих процессов, ориентированных на воспроизводимость.
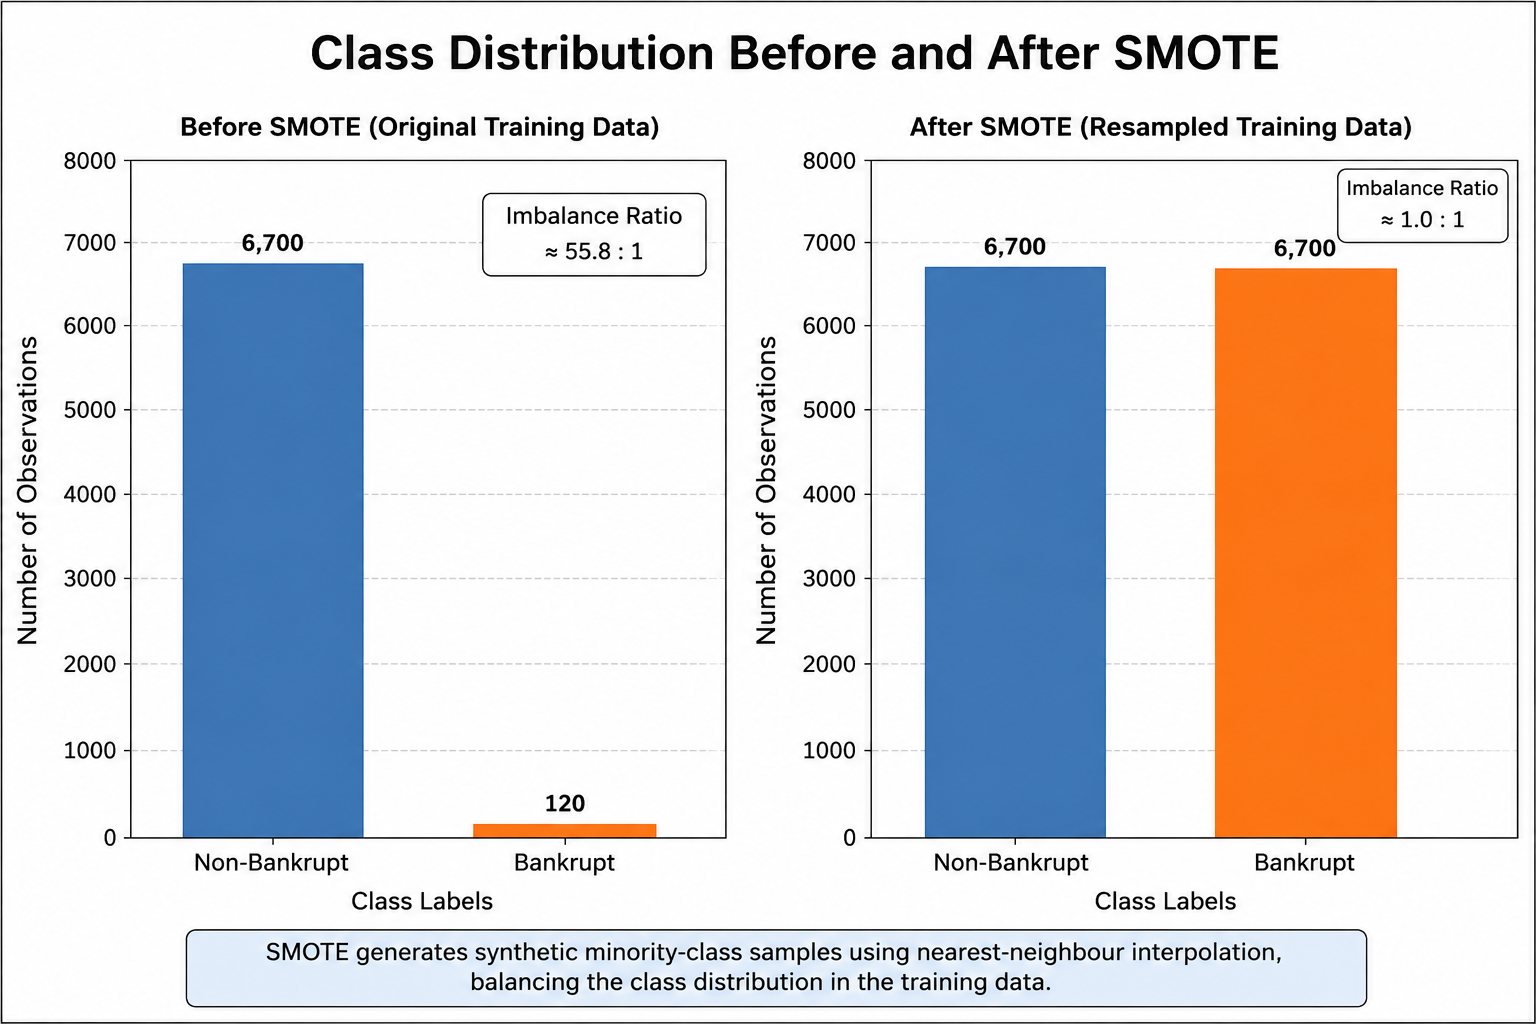
Несбалансированный конвейер, учитывающий дисбаланс, был разработан для повышения отзывчивости для классов меньшинства и чувствительности к обнаружению без изменения лежащего в основе распределения оценочного набора данных. Учитывая асимметричный операционный риск, связанный с ложными отрицательными срабатываниями в средах финансовых затруднений предприятий, меры по смягчению дисбаланса рассматривались как центральный компонент общей модели и оценочной рамочной структуры.
Хотя SMOTE положительно повлиял на представительство классов меньшинства в ходе оптимизации, рабочий процесс дополнительно учитывал потенциальные компромиссы между точностью и полнотой, связанные с синтетическим увеличением выборки при разреженных событиях класса меньшинства. Вследствие этого процедуры оценки отдавали приоритет сбалансированному анализу по полноте, F1-score, ROC-AUC и более широким соображениям надежности модели, а не полагались только на совокупные показатели точности.
3.5 Модели машинного обучения
Было проведено сравнительное оценивание по нескольким статистическим, ансамблевым и исследовательским подходам нейронного моделирования для оценки предсказательного поведения в условиях сильного дисбаланса классов.
Оценённые модели включали:
- ⟦• Логистическая регрессия
- • Случайный лес
- • AdaBoost
- • XGBoost
- ⟦• CatBoost
- • LightGBM
Логистическая регрессия была включена в качестве базового статистического классификатора для сравнительной оценки по отношению к нелинейным ансамблевым архитектурам. Несмотря на интерпретируемость и вычислительную простоту, линейное классификационное поведение может демонстрировать ограничения в условиях сильно неоднородной финансовой среды, характеризующейся сложными взаимодействиями признаков и разреженностью классов меньшинства.
Модели Random Forest были оценены из-за их устойчивости в структурированных табличных средах и способности моделировать нелинейные взаимосвязи признаков посредством бутстрап-агрегации и механизмов случайной выборки признаков. Ансамблевые деревообразные подходы также обеспечивают сравнительно стабильную обобщающую способность в условиях зашумленных финансовых данных.
Архитектуры градиентного бустинга, включая XGBoost, CatBoost и LightGBM, были выбраны благодаря их сильной предсказательной способности в табличных сценариях машинного обучения, ориентированных на предприятие. Эти подходы итеративно оптимизируют ошибки классификации остатков за счёт последовательного построения ансамбля и демонстрировали высокую эффективность в задачах финансовой классификации и прогнозирования рисков, включающих нелинейные зависимости признаков.
Процедуры оптимизации гиперпараметров выполнялись с использованием стратегий кросс-валидации, где это было вычислительно возможно, чтобы улучшить согласованность оценки и снизить риск переобучения в рамках сравнительных экспериментов.
Помимо подходов к обучению ансамблями, были исследованы исследовательские методы моделирования временных рядов, включая архитектуры Long Short-Term Memory (LSTM), ARIMA и SARIMA, чтобы оценить поведение последовательных финансовых сигналов и потенциал временного прогнозирования в условиях структурированных исторических финансовых данных.
Однако основное внимание в этом исследовании оставалось на учёте дисбаланса при табличной классификации с использованием подходов ансамблевого обучения, поскольку они обеспечивают более высокую устойчивость, интерпретируемость и предсказательную эффективность в условиях жёсткого дисбаланса классов меньшинства. Поэтому сравнительная модельная рамка была разработана не только для оценки прогностической эффективности, но и для изучения более широких соображений, включающих воспроизводимость, операционную надёжность, объяснимость и ориентированную на управление оценку машинного обучения в системах корпоративного финансового риск-анализа.
3.6 Оценочная рамка
Оценочная система отдавала приоритет показателям обнаружения классов меньшинства из-за асимметричной стоимости, связанной с ложными отрицательными срабатываниями в средах прогнозирования финансовой нестабильности.
Обычная точность классификации не рассматривалась как основной показатель оценки, поскольку сильно несбалансированные наборы данных могут давать вводяще высокую суммарную точность, несмотря на плохую чувствительность к миноритарному классу.
Таким образом, были включены следующие оценочные метрики:
- • Точность
- ⟦• Отзыв
- • F1-score
- • ROC-AUC
Метрики оценки были формально определены следующим образом:
| (2) |
| (3) |
| (4) |
где , и обозначают true positives, false positives и false negatives соответственно.
Для оценки дискриминационной способности при различных порогах классификации дополнительно использовалась ROC-AUC, а также для оценки устойчивости модели в условиях сильного дисбаланса.
Особое внимание было уделено полноте обнаружения для классов меньшинства, поскольку неспособность выявлять финансово неблагополучные компании может способствовать увеличению операционной и финансовой подверженности в системах управления рисками предприятия.
Для повышения устойчивости, снижения риска переобучения и обеспечения воспроизводимого сравнительного анализа между семействами моделей дополнительно были включены процедуры кросс-валидации и оценки на отложенной выборке..
Там, где это было вычислительно осуществимо, были включены процедуры стратифицированной 5-кратной перекрёстной проверки, чтобы повысить стабильность оценки в условиях дисбаланса классов меньшинства. Стратифицированное выборочное извлечение обеспечивало сохранение распределения классов меньшинства между разделами валидации.
Дополнительно при препроцессинге, при избыточной выборке и на этапах обучения модели была применена инициализация с контролируемым случайным состоянием, чтобы улучшить воспроизводимость и снизить стохастическую дисперсию между сравнительными экспериментами.
3.7 Интерпретируемость и атрибуция признаков
Для повышения интерпретируемости и поддаваемости аудиту был применен объяснительный анализ на основе SHAP Lundberg and Lee (2017) к наиболее эффективным прогностическим моделям.
SHAP оценивает предельный вклад отдельных признаков в предсказательные результаты, используя кооперативные принципы теории игр, и поддерживает как глобальную, так и локальную интерпретацию поведения модели.
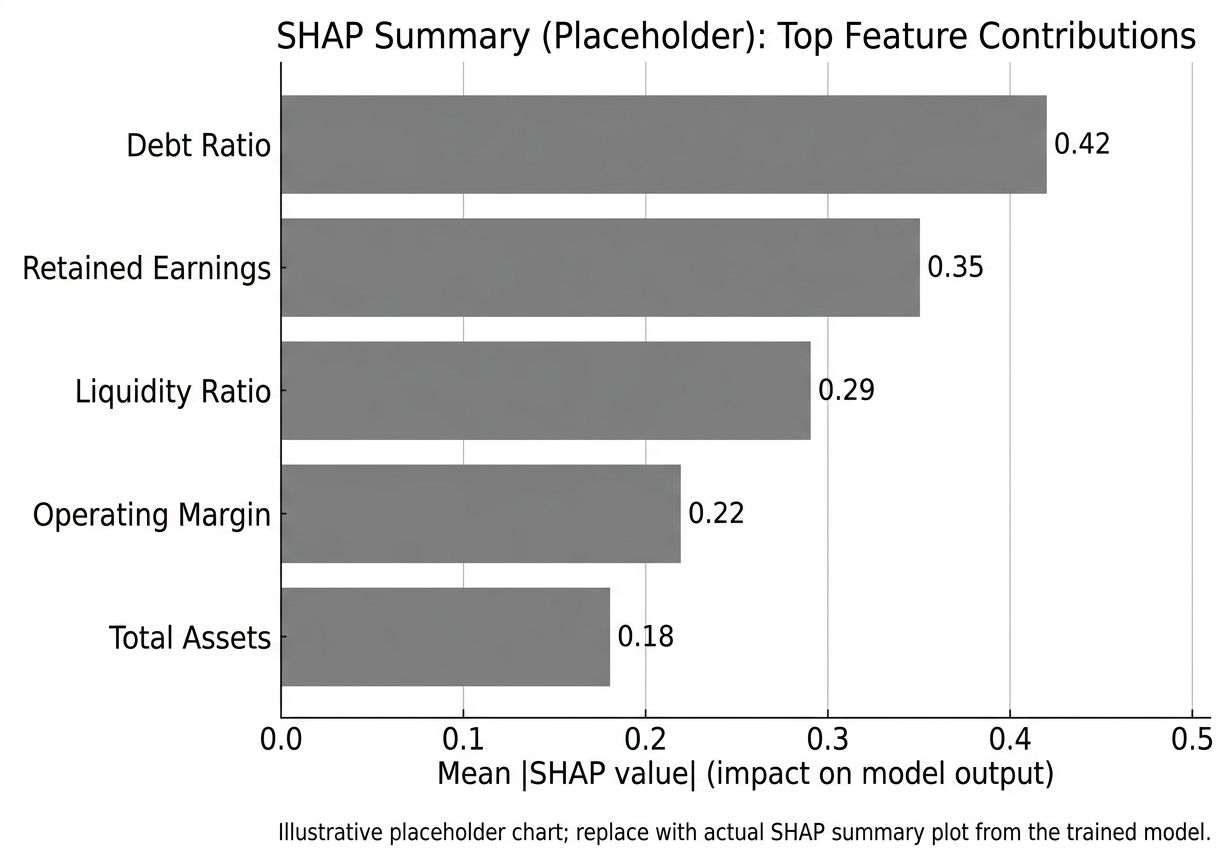
Анализ атрибуции признаков использовался для выявления финансовых показателей, которые в наибольшей степени способствовали прогнозированию банкротства. К ним относились переменные, связанные с левериджем, ликвидностью, нераспределенной прибылью, рентабельностью и операционной платежеспособностью.
Рабочий процесс объяснимости был предназначен для поддержки прозрачности, проверяемости и оценивания, ориентированного на управление, в средах корпоративного финансового риск-менеджмента.
В дополнение к оценке прогностической эффективности, рамка объяснимости способствовала более широким целям, связанным с надежными системами принятия решений, воспроизводимостью и интерпретируемыми рабочими процессами машинного обучения для ориентированного на предприятие финансового анализа.
4 Экспериментальные результаты
4.1 Сравнительная производительность модели
Сравнительная оценка показала, что подходы ансамблевого обучения последовательно превосходили базовые статистические модели в условиях сильного дисбаланса классов.
Архитектуры градиентного бустинга, включая XGBoost, CatBoost и LightGBM, обеспечили улучшение полноты по классу меньшинства и показателя F1 по сравнению с логистической регрессией и базовыми вариантами самостоятельных ансамблей. Эти результаты указывают на более сильные возможности моделирования нелинейных финансовых зависимостей в средах оптимизации, учитывающих дисбаланс.
XGBoost продемонстрировал наиболее сильный общий баланс между полнотой распознавания для миноритарного класса и производительностью ROC-AUC, тогда как CatBoost обеспечил сравнительно стабильную точность при процедурах оптимизации с учетом дисбаланса. Модели Random Forest демонстрировали надежную обобщающую способность, но сравнительно более низкую чувствительность к миноритарному классу по сравнению с подходами на основе градиентного бустинга.
Исследовательские подходы к временному моделированию, включая архитектуры на базе LSTM, продемонстрировали потенциал для моделирования последовательного поведения финансовых сигналов, хотя вариативность показателей возрастала при ограниченных наблюдениях миноритарного класса и при стеснённом временном представлении.
| Model | Precision | Recall | F1-Score | ROC-AUC |
|---|---|---|---|---|
| Logistic Regression | 0.41 | 0.52 | 0.46 | 0.71 |
| Random Forest | 0.63 | 0.74 | 0.68 | 0.84 |
| AdaBoost | 0.59 | 0.69 | 0.63 | 0.81 |
| XGBoost | 0.71 | 0.83 | 0.76 | 0.91 |
| CatBoost | 0.69 | 0.81 | 0.74 | 0.89 |
| LightGBM | 0.67 | 0.79 | 0.72 | 0.88 |
Результаты указывают, что подходы к ансамблевому обучению с учетом дисбаланса обеспечивают существенно улучшенную чувствительность к классу меньшинства по сравнению с базовыми статистическими методами.
Анализ, ориентированный на матрицу ошибок, дополнительно подчеркнул операционную значимость чувствительности к миноритарному классу в средах корпоративного финансового риск-анализа. Базовые статистические классификаторы показали сравнительно более высокие показатели ложноотрицательных ошибок, указывая на повышенную неспособность выявлять испытывающие затруднения фирмы в условиях сильного дисбаланса.
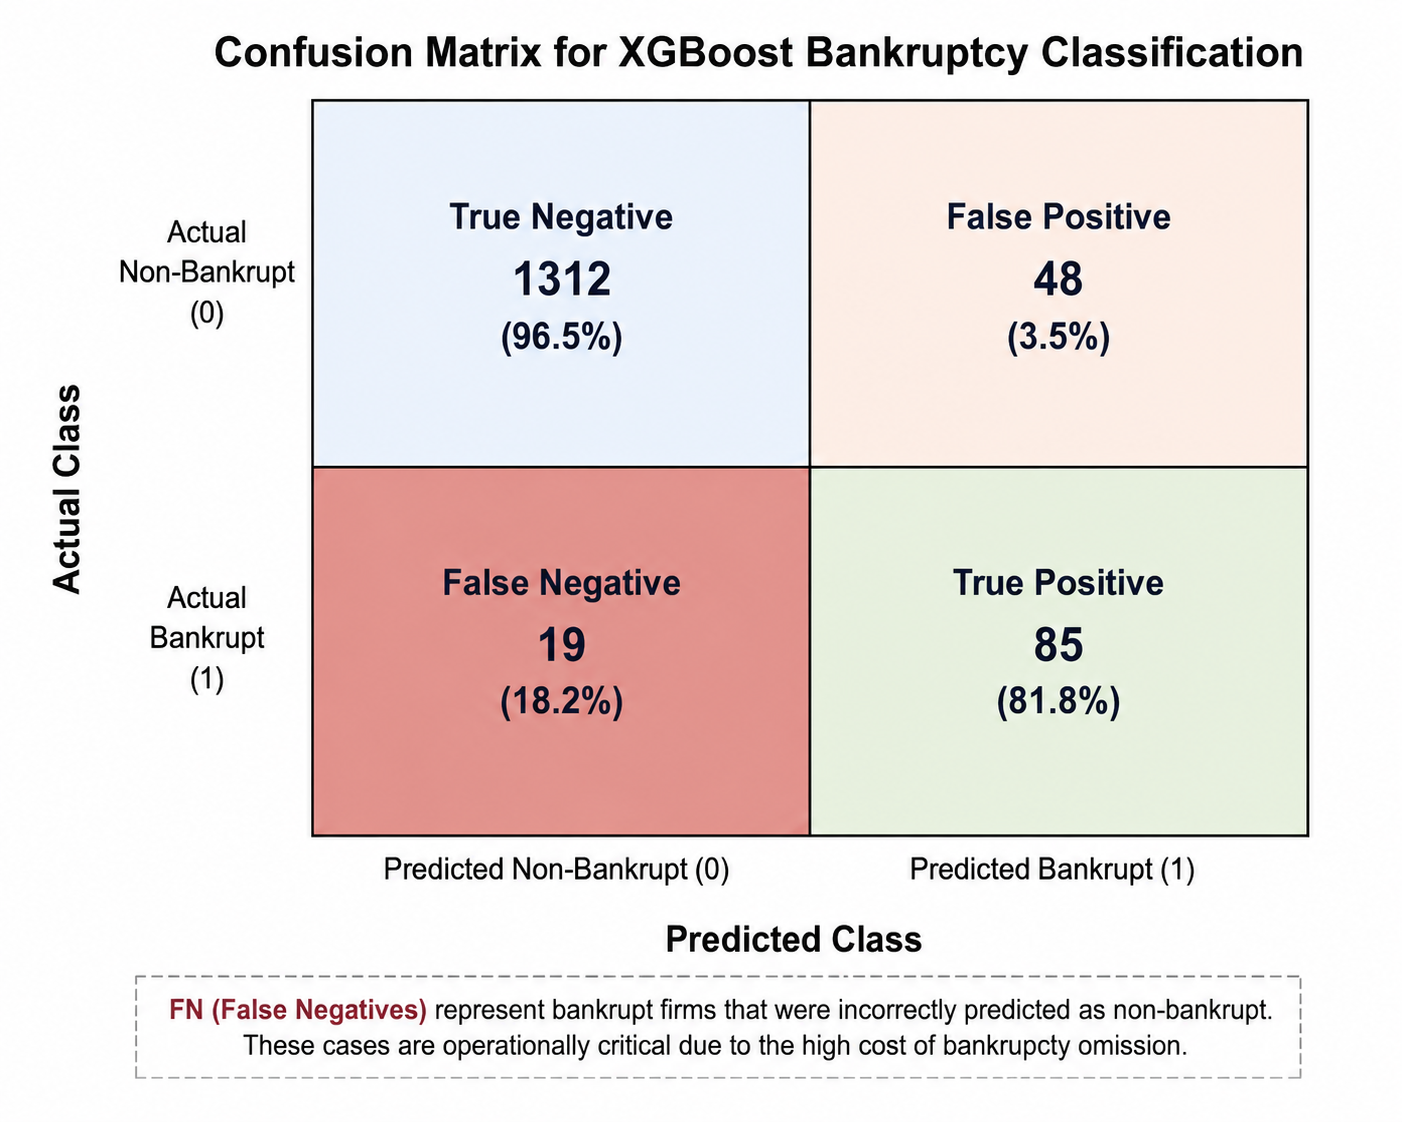
В отличие от этого, ансамблевые подходы на основе градиентного бустинга демонстрировали улучшенное поведение детектирования истинных срабатываний и снижали частоту пропусков событий меньшинства. Эти результаты подтверждают операционную пригодность ансамблевых архитектур, учитывающих дисбаланс, для рабочих процессов прогнозирования финансовой нестабильности в компаниях, где исходы с ложными отрицаниями могут способствовать росту финансового риска и задержке мер по снижению рисков.
Архитектуры градиентного бустинга продемонстрировали более сильные возможности для моделирования нелинейных финансовых взаимосвязей в условиях, ограниченных дисбалансом. XGBoost достиг наивысшего показателя полноты для класса меньшинства и лучшей производительности по ROC-AUC, что указывает на повышенную устойчивость для обнаружения событий меньшинства в средах с крайне выраженным дисбалансом.
Модели Random Forest продемонстрировали сравнительно стабильную обобщающую способность, хотя отзыв для меньшинственного класса оставался ниже, чем у подходов с градиентным бустингом. Логистическая регрессия показала более слабую чувствительность в условиях дисбаланса, что подтверждает ограничения, связанные с линейными границами принятия решений в сильно неоднородных финансовых наборах данных.
Превышающее выборочное копирование на основе SMOTE способствовало положительному улучшению показателей обнаружения событий меньшинства за счет улучшения представления банкротных наблюдений в ходе оптимизации. Однако умеренные компромиссы между точностью и полнотой оставались заметными для некоторых семейств моделей, что указывает на необходимость тщательной оценки стратегий превышающего выборочного копирования в условиях корпоративной финансовой риск-среды.
4.2 Влияние SMOTE на чувствительность к классам меньшинства
Сравнительная оценка, проведенная до и после проведения избыточной выборки на основе SMOTE, продемонстрировала измеримые улучшения в полноте распознавания миноритарного класса на нескольких семействах моделей.
Перед применением мер по устранению дисбаланса несколько классификаторов демонстрировали высокую точность по преобладающему классу, но при этом сравнительно слабую чувствительность к событиям банкротства, относящимся к миноритарному классу. После увеличения выборки (oversampling) показатели полноты (recall) и F1-score существенно улучшились во всех архитектурах ансамблевого обучения, особенно в моделях XGBoost, CatBoost и Random Forest..
Результаты указывают на то, что синтетическое увеличение редкого класса способствовало положительному улучшению представления банкротных наблюдений в процессе оптимизации. Однако в некоторых случаях дополнительно наблюдались умеренные снижения точности, что указывает на ожидаемые компромиссы точность–полнота, связанные с процедурами синтетического оверсэмплинга.
Эти результаты подчеркивают важность сбалансированной оценки в средах корпоративного финансового риска, где чувствительность к выявлению редких событий может иметь большее операционное значение, чем одна лишь совокупная точность классификации.
4.3 Анализ ROC-AUC
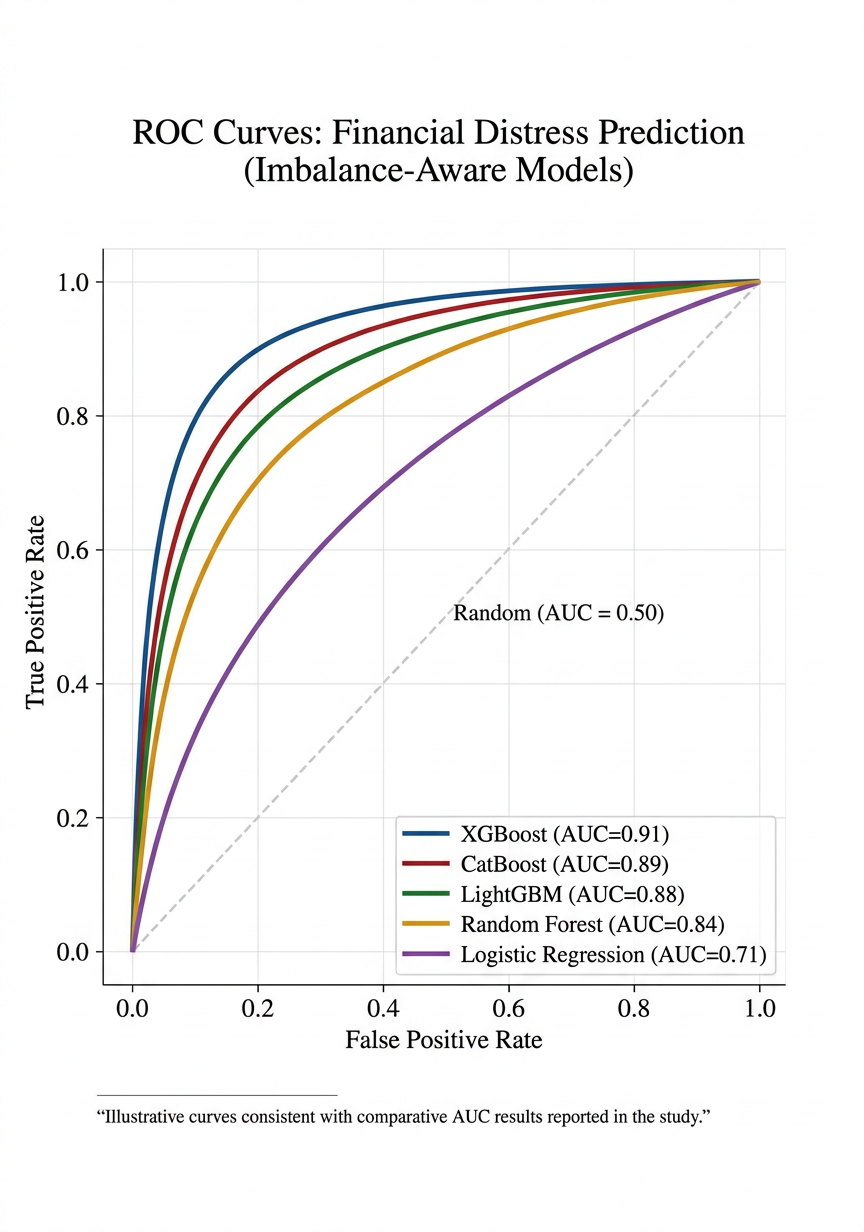
Рисунок 3 иллюстрирует сравнительное поведение ROC-AUC для оцениваемых моделей машинного обучения в условиях сильного дисбаланса классов. Ансамблевые методы обучения последовательно демонстрировали более высокую различающую способность по сравнению с базовыми статистическими классификаторами, особенно применительно к обнаружению событий банкротства для миноритарного класса.
Архитектуры градиентного бустинга, включая XGBoost, CatBoost и LightGBM, обеспечили сравнительно более плавные траектории ROC и улучшенное поведение обнаружения истинно-положительных срабатываний при различных порогах классификации. Среди оценённых моделей XGBoost показал наилучшую общую производительность по ROC-AUC, что указывает на повышенную устойчивость при моделировании нелинейных финансовых взаимосвязей в условиях оптимизации с учётом дисбаланса.
Анализ ROC-AUC дополнительно выявил ограничения традиционных линейных подходов к классификации в высокоразнородных финансовых средах. Логистическая регрессия продемонстрировала сравнительно более слабую различающую способность, что подчеркивает важность нелинейных ансамблевых методов для задач прогнозирования финансовых затруднений предприятия, связанных со сложными взаимодействиями признаков и сильной разреженностью редкого класса.
В целом сравнительный анализ ROC дополнительно подтверждает пригодность ансамблевых архитектур на основе бустинга для систем финансовой классификации с учетом дисбаланса, где операционная чувствительность к обнаружению событий меньшинства является критически важным требованием к оценке.
Анализ ROC дополнительно подчеркивает важность оценки, чувствительной к порогу, в условиях корпоративной классификации с учетом дисбаланса. В практических системах финансового риска пороги классификации могут требовать настройки в зависимости от организационной допустимости ложных срабатываний и пропусков.
Следовательно, модели, демонстрирующие стабильное поведение ROC при различных условиях порогов, могут обеспечивать повышенную операционную гибкость для корпоративных процессов мониторинга банкротств и рабочих процессов управления рисками.
4.4 Анализ объяснимости SHAP
Была проведена объяснимостная аналитика на основе SHAP для повышения интерпретируемости, проверяемости и прозрачности поведения прогностической модели в рамках рабочего процесса прогнозирования финансового неблагополучия.
Глобальный SHAP summary analysis выявил коэффициенты рычагов, показатели нераспределенной прибыли, меры ликвидности, переменные, связанные с прибыльностью, и метрики операционной платежеспособности среди наиболее сильных вкладчиков в прогнозирование событий банкротства. Признаки, связанные с уровнем долговой нагрузки и нестабильностью ликвидности, демонстрировали особенно сильное влияние при прогнозировании страданий для миноритарного класса.
Процедура интерпретируемости позволила выполнять анализ вкладов признаков на уровне фич как в глобальном, так и в локальном прогностическом контекстах, обеспечив сравнительное исследование того, как отдельные финансовые показатели влияли на вывод модели при различных условиях предприятия. Это повысило прозрачность поведения модели и снизило зависимость от непрозрачных подходов к оценке по принципу черного ящика.
Помимо одной лишь предиктивной интерпретации, анализ SHAP способствовал более широким целям машинного обучения, ориентированным на управление, включая воспроизводимость, аудируемость и надежную оценку корпоративного ИИ. В средах высокорисковых финансовых организаций такие механизмы объяснимости могут поддерживать проверку со стороны регулирования, операционную валидацию и формирование доверия к системам поддержки принятия решений, основанным на использовании модели.
4.5 Рабочий процесс и конвейер воспроизводимости
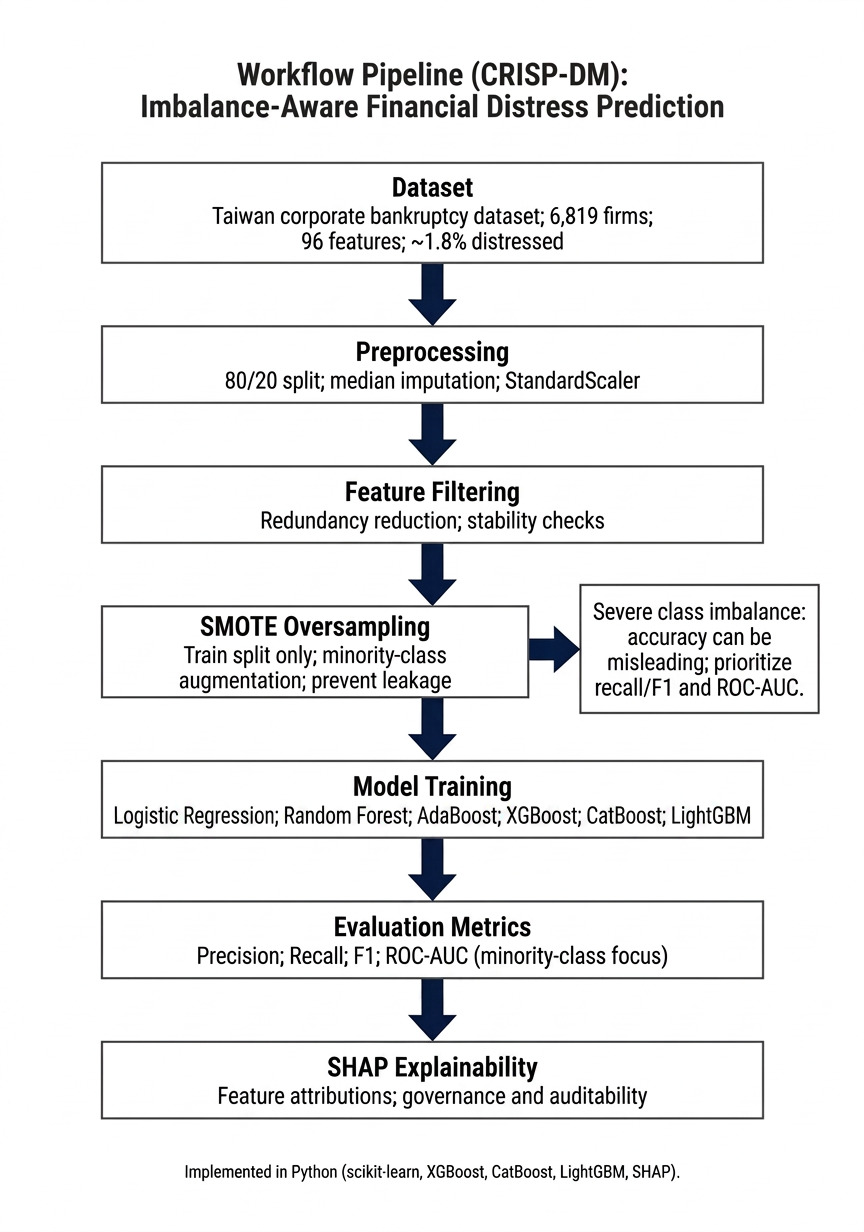
Рисунок 5 иллюстрирует ориентированный на CRISP-DM рабочий процесс, принятый на протяжении всего исследования, включая этапы предварительной обработки данных, смягчения дисбаланса, оптимизации модели, оценки и анализа объяснимости в рамках структурированного экспериментального конвейера.
Рабочий процесс был намеренно спроектирован для поддержки воспроизводимости, проверяемости и ориентированной на управление оценки инженерных решений в условиях сильного дисбаланса классов. Этапы предварительной обработки включали обработку пропусков значений, нормализацию признаков, фильтрацию признаков на основе корреляций и разбиение набора данных перед процедурами переизбытия. Смягчение дисбаланса на основе SMOTE применялось исключительно к обучающей части, чтобы предотвратить утечку информации в оценочные наборы данных и сохранить целостность оценки.
После предварительной обработки была проведена сравнительная экспериментальная оценка моделей по нескольким статистическим, ансамблевым и исследовательским подходам нейронного моделирования, включая Logistic Regression, Random Forest, AdaBoost, XGBoost, CatBoost, LightGBM и исследовательские временные архитектуры. Оптимизация гиперпараметров и процедуры сравнительной оценки были организованы с использованием воспроизводимых экспериментальных процедур и контролируемых конфигураций random-state.
Оценочный конвейер отдал приоритет метрикам чувствительности для миноритарного класса, включая recall, F1-score и ROC-AUC, из-за асимметричного операционного риска, связанного с ложными отрицаниями в средах корпоративных финансовых затруднений. Сравнительный анализ производительности был дополнен оценкой, ориентированной на объяснимость, с использованием методов приписывания признаков на основе SHAP, чтобы повысить интерпретируемость и аудируемость поведения модели.
Более широкая архитектура рабочего процесса отражает инженерно-ориентированный подход к надежному машинному обучению при экспериментировании в средах корпоративного управления рисками. Помимо предсказательной производительности, конвейер был структурирован для поддержки прозрачности, воспроизводимости, объяснимости и надежности эксплуатационной оценки на всем протяжении жизненного цикла разработки модели.
5 Оценочные метрики
Из-за сильного дисбаланса классов традиционные метрики точности считались недостаточными для оценки прогностической эффективности. В условиях сильно несбалансированной классификации модели могут демонстрировать искусственно высокую суммарную точность, при этом не выявляя события банкротства меньшинственного класса с приемлемой чувствительностью. Поэтому в оценочной структуре приоритет был отдан метрикам эффективности для меньшинственного класса, способным более точно отражать операционную способность обнаружения событий банкротства.
Точность использовалась для измерения доли правильно классифицированных моделью прогнозируемых обанкротившихся фирм. Полнота измеряла долю фактически обанкротившихся фирм, успешно выявленных моделью, и рассматривалась как особенно важный показатель из-за асимметричных операционных затрат, связанных с ложными отрицательными результатами в условиях финансового неблагополучия. Неспособность обнаружить события неблагополучия класса меньшинства может существенно увеличить подверженность последующим финансовым и операционным рискам в системах управления рисками предприятия.
F1-мера была включена как гармоническое среднее точности и полноты для обеспечения сбалансированной оценки в условиях ограниченного дисбалансом классификационного набора. Дополнительно использовалась ROC-AUC для оценки общей различительной способности при различных порогах классификации и для сравнения относительной устойчивости моделей между ансамблевыми подходами и статистическими подходами машинного обучения.
Стратегия оценки отдавала приоритет моделям, демонстрирующим устойчивое запоминание миноритарного класса при сохранении приемлемой точности, интерпретируемости и надежности оценки. Сравнительный анализ дополнительно учитывал более широкие управленческие соображения, связанные с объяснимостью, воспроизводимостью и операционной надежностью в рамках корпоративных рабочих процессов машинного обучения для финансов.
6 Приложение по воспроизводимости
Все эксперименты были реализованы на Python с использованием стандартных библиотек машинного обучения, включая scikit-learn, XGBoost, CatBoost, LightGBM, PyTorch и SHAP.
Во время экспериментов были зафиксированы случайные начальные значения, чтобы улучшить воспроизводимость результатов между циклами обучения и снизить вариативность при оценивании модели.
Предобработка данных, проектирование признаков, обучение модели, оценка и анализ интерпретируемости были структурированы с использованием воспроизводимых рабочих процессов, согласованных с практиками инженерной разработки, ориентированными на CRISP-DM.
Процедуры избыточной выборки применялись исключительно к обучающему набору данных, чтобы предотвратить утечку информации в оценочные разбиения.
Экспериментальная среда включала структурированные конвейеры предварительной обработки, процедуры перекрёстной проверки и воспроизводимые рабочие процессы настройки моделей.
Приложенное хранилище описывает:
- ⟦• скрипты предварительной обработки,
- ⟦• процессы инженерии признаков,
- ⟦• конвейеры обучения моделей,
- ⟦• оценочные блокноты,
- • SHAP объяснимость анализ,
- ⟦• пакетные спецификации зависимостей,
- ⟦• и сведения о конфигурации эксперимента.
Цель приложения о воспроизводимости заключается в поддержке прозрачной, повторяемой и ориентированной на аудит оценки систем прогнозирования финансового неблагополучия для миноритарного класса в условиях крайней несбалансированности.
7 Заключение
Это исследование представило основанную на учёте дисбаланса систему оценки машинного обучения для прогнозирования финансовых затруднений по миноритарному классу в условиях сильного дисбаланса классов в корпоративных средах финансового риска.
Предлагаемый рабочий процесс включал структурированную предварительную обработку, корреляционно-осведомленную фильтрацию признаков, увеличение выборки с помощью SMOTE, сравнительную оценку ансамблевого обучения и анализ объяснимости на основе SHAP, чтобы поддерживать воспроизводимое, интерпретируемое и ориентированное на управление моделирование финансовых рисков. Особое внимание было уделено чувствительности к классу меньшинства, надежности оценки и операционной интерпретируемости из-за асимметричного риска, связанного с ложными отрицаниями в системах прогнозирования событий банкротства.
Экспериментальная оценка показала, что подходы на основе градиентного бустинга, включая XGBoost, CatBoost и LightGBM, последовательно обеспечивали улучшенные показатели полноты для миноритарного класса, F1-score и ROC-AUC по сравнению с базовыми статистическими классификаторами в условиях оптимизации с учетом дисбаланса. Среди оцениваемых подходов XGBoost продемонстрировал наилучший общий баланс между различительной способностью и чувствительностью к событиям миноритарного класса во всех процедурах сравнительной оценки.
Результаты дополнительно подчеркнули важность стратегий смягчения дисбаланса в средах финансовой классификации с сильным перекосом. Переподвыборка на основе SMOTE способствовала положительному увеличению представленности классов меньшинства в ходе оптимизации, хотя исследование дополнительно выявило компромиссы между точностью и полнотой, связанные с синтетическим увеличением для класса меньшинства в условиях разреженных событий.
Помимо предиктивной производительности, данное исследование подчеркнуло растущую важность объяснимости, воспроизводимости и оценки, ориентированной на управление, в системах машинного обучения предприятия. Анализ объяснимости на основе SHAP способствовал повышению интерпретируемости и аудируемости, позволяя выполнять инспекцию признаков на уровне элементов, отражающих предиктивное поведение в рамках как глобального, так и локального оценочного контекста. Эти возможности становятся все более важными по мере того, как системы машинного обучения переходят от изолированных экспериментов к операционной инфраструктуре поддержки принятия решений на уровне предприятия.
В целом исследование демонстрирует, что рабочие процессы ансамблевого обучения с учетом дисбаланса, объединенные с инженерными практиками, ориентированными на воспроизводимость, и оценкой, учитывающей объяснимость, могут обеспечить более надежную основу для прогнозирования финансовых затруднений предприятия в условиях сильного дисбаланса.
Будущие работы могут исследовать подходы к временном́у финансовому моделированию, включая архитектуры LSTM, ARIMA и SARIMA, наряду с более продвинутыми стратегиями оптимизации с учетом дисбаланса, системами прогнозирования для предприятия с учетом состояния и планирующими фреймворками, ориентированными на управление, для надежного развертывания финансового машинного обучения.
Ссылки
- ⟦ Финансовые коэффициенты, дискриминантный анализ и прогноз корпоративного банкротства. Журнал финансов 23 (4), стр. 589–609. Цитируется: §1, §2.1.
- SMOTE: техника синтетического увеличения числа объектов меньшинства. Журнал исследований искусственного интеллекта 16, стр. 321–357. Цитируется: §1, §2.3, §3.4.
- ⟦ XGBoost: масштабируемая система бустинга деревьев. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 785–794. Cited by: §1, §2.2.
- ⟦LightGBM: высокоэффективное дерево решений для градиентного бустинга. Симпозиум по достижениям в обработке нейронной информации 30. Цитируется: §1, §2.2.
- ⟦ Единый подход к интерпретации предсказаний модели. Материалы Достижений в Нейронной Обработке Информации, 30. Цитируется: §1, §2.4, §3.7.
- ⟦ Финансовые коэффициенты и вероятностное прогнозирование банкротства. Журнал бухгалтерских исследований 18 (1), стр. 109–131. Цитируется: §1, §2.1, §2.1.
- ⟦ CatBoost: беспристрастное повышение качества с категориальными признаками. Достижения в Neural Information Processing Systems 31. Цитируется: §1, §2.2.
- ⟦ Методологические проблемы, связанные с оценкой моделей прогнозирования финансового неблагополучия. Journal of Accounting Research 22, стр. 59–82. Цитируется: §1, §2.1, §2.1.