Ланьсинь Сян
Кафедра статистики
Виргиния Тек
francesx@vt.edu &Лян Ши
Кафедра статистики
Транспортный институт Виргинского технологического университета
Вирджиния Тек
sliang@vt.edu &Юхуй Е
Кафедра статистики
Виргиния Тек
yye1997@vt.edu &Бою Цзян
Кафедра статистики
Вирджиния Тек
boyuj@vt.edu &Давэй Чжоу
Кафедра компьютерных наук
Виргинский технологический университет
zhoud@vt.edu &Фэн Го
Кафедра статистики
Транспортный институт Виргинского политехнического университета
Виргинский технологический институт
feng.guo@vt.eduАвтор для корреспонденции.
Аннотация
Анализ атрибуции признаков критически важен для интерпретации моделей машинного обучения и поддержки надежных решений, основанных на данных.
Однако меры атрибуции признаков часто демонстрируют стохастическую вариативность: различные разбиения на обучающую и тестовую выборки, случайное начальное число (random seed) или процедуры подгонки модели могут давать существенно различающиеся значения атрибуции и ранжирования признаков.
В данной статье предлагается фреймворк для учета стохастической природы атрибуции признаков и устойчивая метрика атрибуции RoSHAP для стабильного ранжирования признаков на основе метрики SHAP.
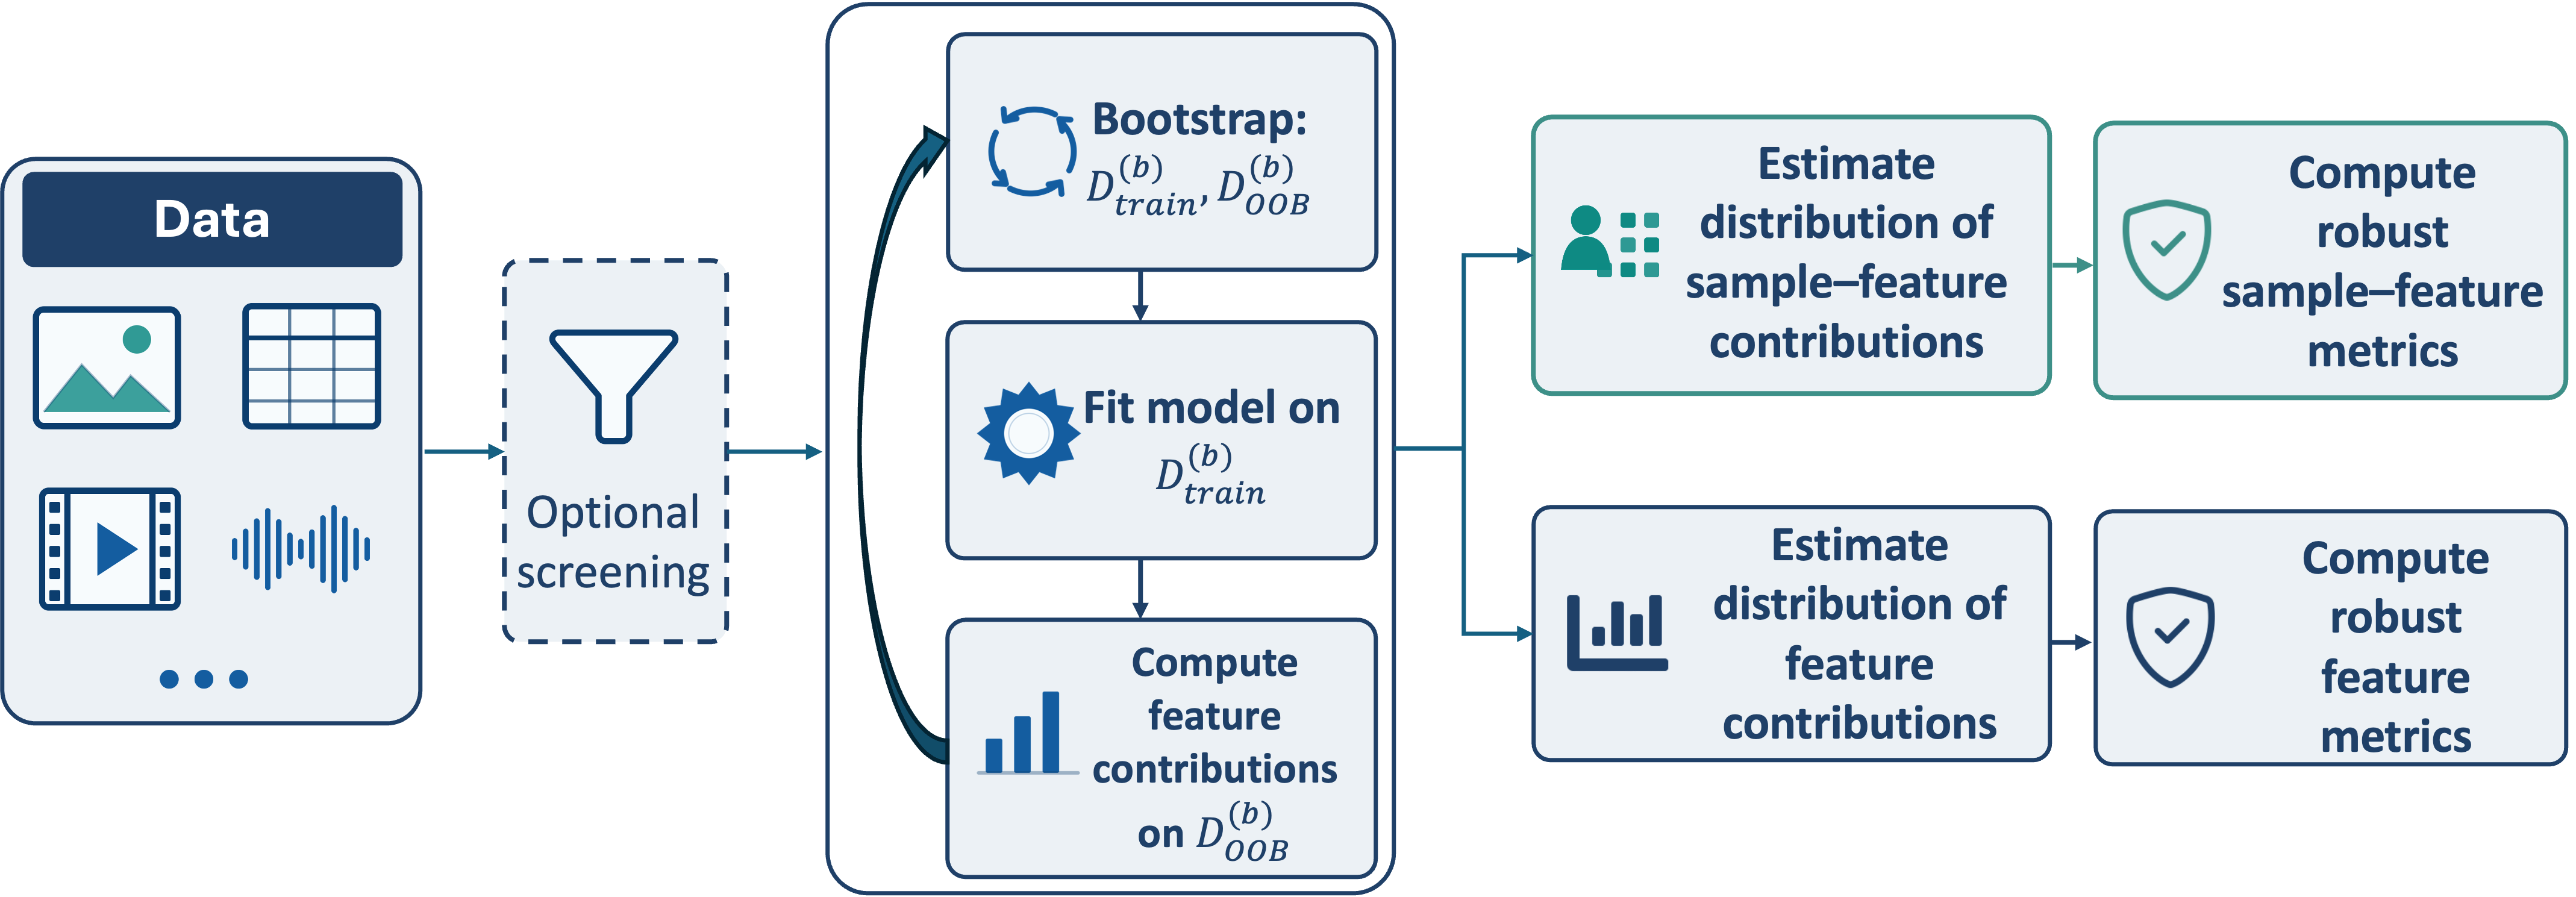
Предложенный фреймворк моделирует распределение оценок атрибуции признаков и оценивает его с помощью бутстреп-ресемплинга и оценки плотности ядра (bootstrap resampling and kernel density).
Мы показываем, что при соблюдении некоторых условий регулярности агрегированная оценка атрибуции признаков асимптотически соответствует нормальному распределению, что значительно снижает вычислительные затраты на оценку распределения.
RoSHAP обобщает распределение SHAP в устойчивый критерий ранжирования признаков, который одновременно вознаграждает признаки, которые являются активными, сильными и стабильными.
С помощью симуляций и экспериментов на реальных данных предложенный фреймворк и RoSHAP превосходят стандартные одноразовые меры атрибуции в выявлении сигнальных признаков.
Кроме того, модели, построенные с использованием признаков, отобранных с помощью RoSHAP, достигают прогностической производительности, сравнимой с моделями, использующими все признаки, при этом используя существенно меньше предикторов. Предложенный подход RoSHAP улучшает стабильность и интерпретируемость моделей машинного обучения, обеспечивая надежные и согласованные выводы для анализа..
1 Введение
Атрибуция признаков обеспечивает количественную основу для интерпретации моделей машинного обучения (ML) путем присвоения оценок вклада отдельным предикторам.
Однако для многих современных ML-моделей эти оценки не могут быть напрямую получены из структуры модели и вместо этого должны оцениваться с помощью пост-хок методов атрибуции.
Эта задача становится особенно сложной, когда данные являются многомерными, зашумленными и коррелированными, или когда связь между предиктором и откликом является сложной.
В таких условиях результаты атрибуции может быть трудно интерпретировать, и они могут не обеспечивать стабильную основу для научных или практических выводов..
В рамках большого количества исследований были разработаны методы атрибуции признаков для объяснения результатов работы моделей, в том числе SHapley Additive exPlanations (SHAP) [14], Local Interpretable Model-agnostic Explanations (LIME) [18], DeepLIFT [22] и меры на основе прироста информации. Эти метрики отражают различные аспекты вклада признаков, каждый с различными теоретическими свойствами и практическими компромиссами. SHAP, например, создает аддитивные оценки атрибуции на уровне экземпляров, основанные на кооперативной теории игр, и является единственным аддитивным методом атрибуции, удовлетворяющим локальной точности, отсутствию и согласованности [14]. Эти гарантии сделали SHAP популярным выбором в различных областях, включая медицину [1, 17, 24, 12], обработку естественного языка [16] и анализ пространственных данных [11].⟧.
Хотя существующие методы атрибуции признаков ценны, остаются проблемы с оценкой и интерпретацией значений атрибуции.
Стандартный рабочий процесс разделяет данные на обучающую и тестовую выборки, подгоняет модель и вычисляет значения атрибуции на основе обученной модели.
Каждый шаг может вносить стохастическую вариацию, включая случайное разбиение данных, случайную инициализацию и стохастическую оптимизацию.
Следовательно, значения атрибуции не являются фиксированными величинами; разные разбиения на обучающую и тестовую выборки или случайные начальные значения могут давать существенно различающиеся ранжировки признаков [6].
Эта неопределенность особенно выражена в постановках с высокой размерностью, таких как геномика, где количество признаков значительно превышает количество образцов.
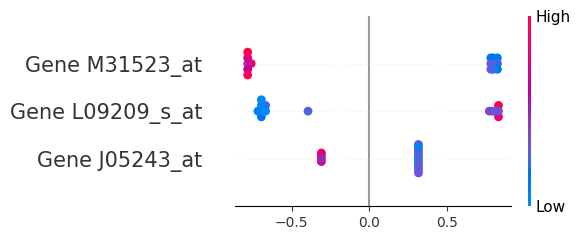
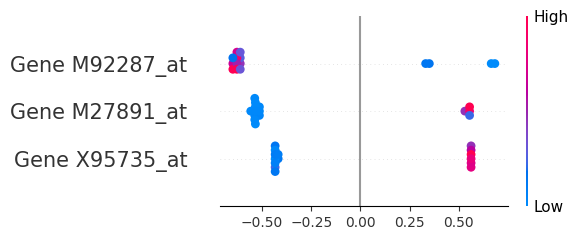
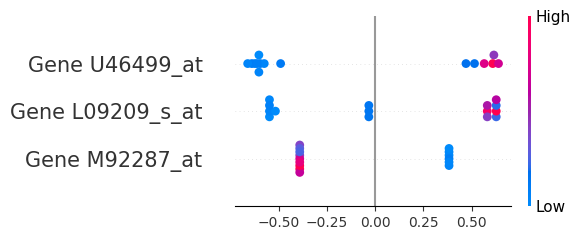
Рисунок 1 иллюстрирует эту проблему: три главных гена, ранжированных по SHAP для классификации рака, различаются в зависимости от разбиений на обучающую и тестовую выборки, а также сильно различаются величины их атрибуции. Такая случайность представляет собой ненадежную основу для дорогостоящего последующего тестирования генов..
(a)Раунд 1
(b)Раунд 2
(c)Раунд 3
Figure 1: Лучшие признаки, ранжированные по SHAP, в данных Golub на разных обучающе-тестовых наборах. Хотя все три запуска достигают идеального macro F1, выбранные лучшие признаки существенно различаются..
Мы предлагаем фреймворк на основе бутстрепа для оценки распределения показателей важности признаков. На основе этого фреймворка мы представляем RoSHAP (Robust SHAP) — устойчивую метрику атрибуции для стабильного ранжирования признаков. Фреймворк многократно перевыбирает данные и переобучает модель для учета изменчивости в оценках важности признаков. Полученные оценки атрибуции обобщаются с помощью оценки плотности ядра, что дает оценку распределения, отражающего как величину атрибуции, так и изменчивость. Кроме того, мы выводим гауссову аппроксимацию для агрегированной оценки атрибуции на уровне признаков при соблюдении небольшого условия регулярности, что существенно снижает вычислительные затраты на оценку распределения.
RoSHAP обобщает оцененное распределение атрибуции через три компонента: активность, силу и стабильность.
Активность измеряет долю ненулевых значений атрибуции, сила измеряет медианную величину ненулевых значений атрибуции, а стабильность измеряет отношение сигнал-шум распределения атрибуции.
Поощряя признаки, которые часто вносят вклад, имеют большие величины атрибуции и остаются стабильными при повторных выборках, RoSHAP обеспечивает надежную основу для ранжирования и интерпретации признаков..
Результаты как на синтетических, так и на реальных наборах данных показывают, что RoSHAP обеспечивает стабильные интерпретации в задачах регрессии и классификации, а также в различных модальностях данных. RoSHAP эффективно выявляет наиболее влиятельные признаки, и модели, обученные только на этих выбранных признаках, достигают производительности, сравнимой с моделями, обученными на полном наборе признаков..
Оставшаяся часть этой статьи организована следующим образом. В разделе 2 рассматриваются связанные работы по SHAP и другим методам вклада признаков. В разделе 4 сообщается об имитационных исследованиях в различных условиях. В разделе 5 представлены три мотивирующих примера и сравнения производительности. Раздел 6 завершается обсуждением основных результатов и будущих направлений..
2 Связанные работы
Атрибуция признаков и аддитивная атрибуция.
Атрибуция признаков широко используется для интерпретации прогностических моделей.
Для классических линейных моделей -значения, -тесты и -тесты обеспечивают вывод на уровне признаков в рамках параметрических предположений.
Для моделей машинного обучения распространенные меры важности включают показатели на основе прироста, примесей и энтропии, а также апостериорные методы, такие как SHAP [14], LIME [18] и DeepLIFT [22].
SHAP основан на кооперативной теории игр, рассматривая предикторы как игроков, а предсказание модели как выигрыш; каждому признаку присваивается его средний предельный вклад по всем коалициям.
Эта аддитивная формулировка делает SHAP широко применимым для различных классов моделей.
TreeSHAP [13] обеспечивает эффективные вычисления для ансамблей деревьев, таких как случайные леса, XGBoost [4] и LightGBM [9], в то время как KernelSHAP и DeepSHAP расширяют возможности SHAP для общих моделей «черного ящика» и глубокого обучения.
стабильность SHAP и неопределенность предсказаний.
Растущее число исследований изучает, как атрибуции признаков варьируются в зависимости от случайности данных и модели.
Shaikhina et al. [20] показали, что предсказательная неопределенность может распространяться на неопределенность объяснения, создавая нестабильные оценки атрибуции, особенно для выборок, выходящих за пределы распределения.
Другие исследования используют повторную передискретизацию или вложенную перекрестную проверку для обобщения значений SHAP по фолдам через средние значения, частоты отбора или распределения рангов [19, 8, 6].
Связанные работы объясняют предсказательную неопределенность: Watson et al. [26] расширили SHAP с помощью теоретико-информационных функций ценности для атрибуции эпистемической и алеаторной неопределенности.
Однако большинство подходов сосредоточены на средних значениях или ранжированиях, а не на полной структуре распределения оценок атрибуции..
SHAP для отбора признаков.
SHAP также используется для отбора признаков, обычно путем ранжирования переменных по средним абсолютным значениям SHAP и сохранения верхней подвыборки.
Эта стратегия была принята в различных областях применения [15, 5, 21].
Сравнительные исследования оценили отбор признаков на основе SHAP по сравнению со встроенными показателями важности модели и другими правилами отбора [25].
Хотя часто эффективны, эти подходы остаются в значительной степени основанными на величине, с ограниченным вниманием к нестабильности повторной выборки, точным нулям и корреляции предикторов..
В целом, предыдущие работы установили SHAP как полезный инструмент для интерпретации, анализа неопределенности и выбора признаков. Однако существующие подходы в основном сосредоточены на средней величине атрибуции, стабильности ранжирования или прогностической неопределенности, а не на полном эмпирическом распределении оценок атрибуции по выборкам и повторным выборкам. Этот пробел мотивирует основу, предложенную в данной статье..
3 Методология
Чтобы учесть стохастическую природу атрибуции признаков, мы принимаем дистрибутивный взгляд на атрибуцию признаков и вводим новую метрику под названием RoSHAP. Поскольку большинство аддитивных методов атрибуции являются результатом сложных вычислительных процедур, базовое распределение недоступно в замкнутой форме.
Мы предлагаем использовать бутстреп для аппроксимации этих распределений, а затем оценивать результирующее эмпирическое распределение с помощью оценки плотности ядра (KDE).
При соблюдении некоторых условий регулярности распределение атрибуции можно аппроксимировать распределением Гаусса, что снижает вычислительную нагрузку, связанную с бутстрэппингом.
RoSHAP затем количественно определяет атрибуцию признаков, совместно учитывая неактивность, сигнал и уровень шума. Общий конвейер проиллюстрирован на рисунке 2.⟧.
Figure 2: Общая структура для оценки атрибуции распределительных признаков.
Алгоритм 1. Оценка распределения SHAP на основе бутстрепа
1:Данные ; запуски бутстрапа
2:Распределения SHAP на уровне выборки и признаков
3:Предобработка ; опционально отбирать предикторы
4:дляделать
5: Рисовать из
6: Определите множество вне бэггинга
7: Обучение модели на
8: Вычислить OOB SHAP
9:конецдля
10:Суммировать от
11:Оцените распределение для и
Бутстреп-оценка атрибуций признаков.
Пусть обозначает размеченный набор данных с наблюдениями и признаками, где и является откликом.
Пусть обозначает подогнанную модель, с предсказанием для наблюдения .
Для каждого наблюдения и признака , обозначим через вклад признака в .
Мы оцениваем распределение значений атрибуции с помощью бутстрэпа.
Путем многократной перевыборки обучающих данных, переобучения модели и пересчета атрибуций мы получаем множество реализаций , которые служат выборками из базового распределения.
Алгоритм 3 обобщает процедуру оценки распределения на основе бутстрэпа.
Моделирование с избыточными нулями и гауссово приближение атрибуций на уровне признаков.
Наша структура применима к любому аддитивному методу атрибуции, и мы используем SHAP в качестве репрезентативного примера на протяжении всей работы. На практике значения SHAP часто содержат точные нули, особенно в моделях на основе деревьев, где признаки, отсутствующие в пути предсказания, не получают атрибуции [14, 13].
Чтобы учесть такое поведение, мы моделируем значение SHAP для признака-образца в виде смеси с нулевой инфляцией,
где — точечная масса в нуле, , а обозначает ненулевую компоненту .⟧.
Мы определяем атрибуцию на уровне признаков как агрегированную величину
Для асимптотического анализа удобно разложить
где указывает на , а — это ненулевая величина.
Это представление отделяет разреженность от величины, сохраняя распределение .
Мы оцениваем распределение непараметрически с помощью KDE..
При выполнении слабых условий регулярности распределение может быть хорошо аппроксимировано гауссовским распределением и, следовательно, описано своим средним и стандартным отклонением. Данная аппроксимация обосновывается аргументом, основанным на центральной предельной теореме Ляпунова..
Среднее и дисперсия задаются
Assumption.
Для фиксированного признака пары , взаимно независимы, причем для каждого . Кроме того, для некоторого выполняется условие Ляпунова.:
Это предположение гарантирует, что совокупный вклад определяется множеством малых слагаемых, а не несколькими доминирующими, что важно для гауссовского приближения..
Theorem.
При вышеуказанном предположении,
Этот результат оправдывает аппроксимацию распределения гауссианом, когда . На практике это означает, что для признаков с достаточно стабильными агрегированными вкладами неопределенность может быть эффективно обобщена с использованием только среднего и дисперсии, что существенно уменьшает количество бутстреп-ресэмплов. Доказательство приведено в Приложении A.1. Когда условия регулярности приближенно выполняются, мы обобщаем с использованием его среднего и стандартного отклонения..
Робастная метрика.
На основе оцененного распределения атрибуции на уровне признаков мы определяем несколько дополнительных метрик для оценки признаков. Для признака определяем
Робастная оценка атрибуции признаков, RoSHAP, определяется как
Здесь, измеряет бездействие, в то время как поощряет признаки, которые активны, сильны и стабильны.
4 Симуляция
Данное имитационное исследование демонстрирует, что предложенный метод обеспечивает более надежные и интерпретируемые оценки вклада признаков. С распределительной точки зрения метод помогает выявлять стабильные сигналы и отличать их от шумовых признаков, отобранных случайно.
Результаты подтверждают, что распределения вклада признаков являются приблизительно нормальными, что позволяет сократить количество бустрэп-повторений и снизить вычислительные затраты..
Настройка симуляции.
Рассматривалась задача бинарной классификации с наблюдениями и предикторами, где первые предикторов были истинными сигналами, а остальные предикторов — шумом, с . Для имитации ситуаций, в которых признак информативен на уровне популяции, но может мало способствовать для некоторых отдельных наблюдений, предикторы генерировались из распределений Гаусса с нулевым смещением..
Для каждого сигнального признака ,
где , и . Таким образом, характеристики сигналов различались между двумя классами через их ненулевые средние компоненты..
Для шумовых признаков , классно-условные распределения имели ту же нуль-инфлированную гауссову форму, но с нулевым средним в обоих классах.:
Следовательно, шумовые признаки не имели зависящего от класса сдвига среднего. При таком подходе сигнальные признаки могут быть локально неактивными, когда принимают нулевое значение, оставаясь при этом глобально информативными благодаря зависящим от класса ненулевым средним..
В этом эксперименте , и были установлены на 600, 1000 и 10 соответственно. Для сигнальных признаков — и . Для шумовых признаков — и . Силы сигналов были определены с помощью , причем равномерно распределены от 1,5 до 0,4 среди десяти сигнальных признаков. Затем был обучен классификатор XGBoost с использованием одних и тех же параметров модели во всех сравниваемых настройках..
Результаты.
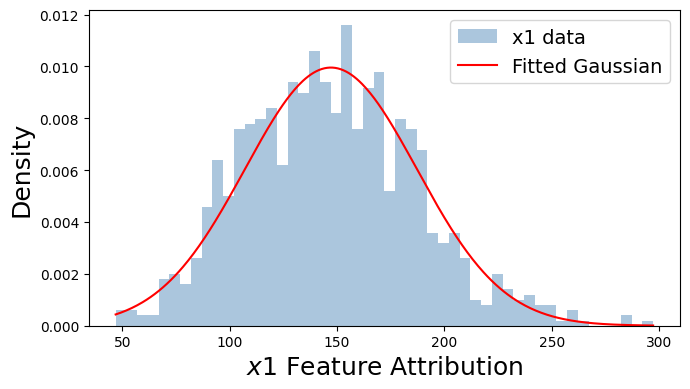
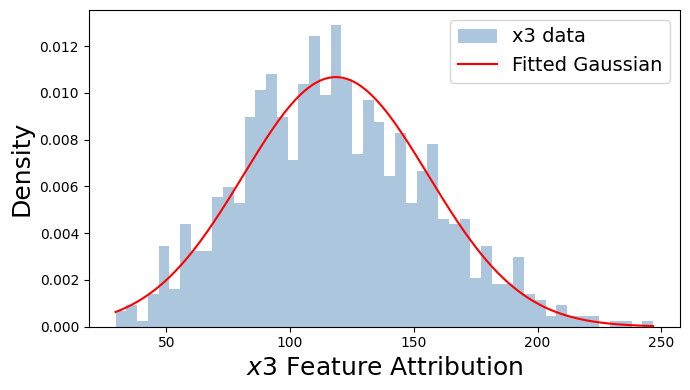
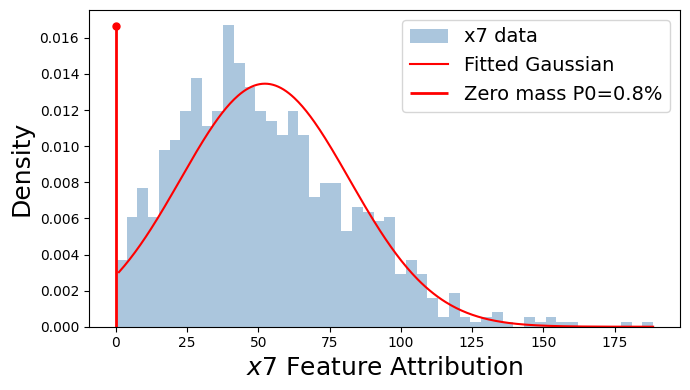
На рисунке 3 показаны эмпирические распределения оценок важности по 1000 бутстреп-прогонам. Среди выбранных предикторов распределения для и приблизительно гауссовы, тогда как распределение для слегка смещено вправо. В целом ненулевые части распределений близки к гауссовым, что подтверждает использование сводок неопределенности на основе гауссова распределения с меньшим числом повторений бутстрепа..
(a)
(b)
(c)
Figure 3: Эмпирические распределения робастных оценок важности по 1000 бутстреп-прогонов с подобранными гауссовскими распределениями для предикторов , и ⟧.
Были сравнены три настройки: бутстреп с 1000 запусков, бутстреп с 10 запусками и стандартное разделение на обучающую и тестовую выборки SHAP.
Как показано в таблице 1, бутстреп с 1000 запусков обеспечивает наиболее надежное ранжирование: восемь сигнальных признаков восстановлены в первой дюжине, а самый низкоранговый сигнальный признак занимает 85-е место среди 1000 признаков на основе устойчивой метрики важности. Бутстреп с 10 запусками также показывает хорошие результаты, восстанавливая восемь сигнальных признаков в первой дюжине, хотя самый низкоранговый сигнальный признак опускается на 317-е место среди 1000 признаков.
Процент нулевых значений дает дополнительное понимание стабильности. Сильные сигнальные признаки имеют почти нулевой , что указывает на постоянный вклад по всем бутстреп-запускам. Напротив, более слабые или менее стабильные признаки, такие как и , демонстрируют больший , что предполагает более частые нулевые вклады..
Table 1: Сравнение ранжирования признаков на основе робастной важности с бутстрепом, однораундового SHAP, информационного выигрыша, прироста XGBoost и метрик скрининга LIME.
1000 Runs
10 Runs
XGBoost SHAP
Information Gain
XGBoost Gain
LIME
Rank
ID
RoSHAP
Rank
ID
RoSHAP
Rank
ID
Score
Rank
ID
Score
Rank
ID
Score
Rank
ID
Score
1
512.66
0.00
1
779.54
0.00
1
35.24
1
0.090
5
1.826
1
0.077
2
347.21
0.00
2
767.57
0.00
2
25.86
48
0.043
6
1.782
2
0.075
3
339.45
0.00
3
433.42
0.00
3
15.38
187
0.024
10
1.696
3
0.055
4
270.75
0.00
4
430.41
0.00
4
15.14
235
0.021
13
1.450
4
0.036
5
120.99
0.20
5
271.18
0.00
12
4.12
259
0.019
26
1.069
5
0.035
6
80.65
0.40
6
104.68
0.00
31
0.14
281
0.017
41
0.887
7
0.008
9
14.73
7.20
7
60.94
0.00
333
0.00
292
0.015
74
0.686
15
0.004
12
10.65
11.00
10
25.85
0.00
387
0.00
329
0.012
131
0.555
58
0.000
53
1.92
27.60
95
2.64
30.00
669
0.00
658
0.000
159
0.494
960
0.000
85
1.08
37.00
317
0.32
40.00
670
0.00
744
0.000
707
0.063
999
0.000
Другие метрики значительно менее стабильны. Только четыре сигнальных признака восстанавливаются в топ-12, в то время как четыре сигнальных признака неактивны, включая , который по построению имеет самый сильный сигнал. Это подчеркивает, что один запуск SHAP может не выявить важные предикторы, в то время как бутстреп-основанияя робастная важность более эффективно улавливает стабильные сигнальные признаки..
Альтернативные метрики значительно менее эффективны. Однораундовый SHAP идентифицирует только четыре сигнальных признака в топ-12 и присваивает нулевую или близкую к нулю важность нескольким истинным сигналам, включая , самый сильный сигнал по построению. Информационный выигрыш и важность на основе выигрыша также показывают ненадежные ранжирования, помещая несколько истинных сигналов значительно ниже шумовых переменных. Несмотря на достаточно хорошее восстановление первых семи сигнальных признаков, LIME считает оставшиеся три сигнала неактивными. Напротив, RoSHAP идентифицирует сигнальные признаки при повторных подгонках модели более последовательно..
Вычислительное сравнение.
TreeSHAP имеет вычислительную сложность примерно , где — количество деревьев, — максимальное количество листьев на дерево, а — максимальная глубина дерева [13]. При бутстреп-повторениях общий объем вычислений составляет примерно , поэтому уменьшение с 1000 до 10 сокращает вычисления SHAP примерно в 100 раз.
Каждая бутстреп-выборка охватывает около исходных наблюдений. За прогонов вероятность того, что наблюдение будет выбрано хотя бы один раз, составляет примерно , что близко к 1, когда . Таким образом, меньшее количество бутстреп-прогонов все еще может обеспечить широкий охват данных и полезные сводки неопределенности на основе гауссовского распределения при гораздо меньшем времени выполнения..
5 Эксперименты
Четыре эксперимента демонстрируют предложенную структуру на различных типах данных. Набор данных Golub [7] представляет собой высокоразмерную классификацию с малым объемом выборки, Musk (версия 2) [3] представляет собой умеренную по размеру высокоразмерную молекулярную классификацию, UJIIndoorLoc [23] представляет собой высокоразмерную регрессию, а CIFAR-10 представляет собой классификацию изображений на 10 классов..
Для табличных данных интерпретируемость на уровне признаков оценивается на нейронных сетях, моделях на основе деревьев, включая LightGBM, XGBoost, случайный лес (RF) и CatBoost, а также логистическую регрессию (LR).
Поскольку истинные важные признаки неизвестны, предлагаемые результаты выбора признаков сравниваются с информационным выигрышем (IG), модельным выигрышем или коэффициентами LR, LIME и SHAP.
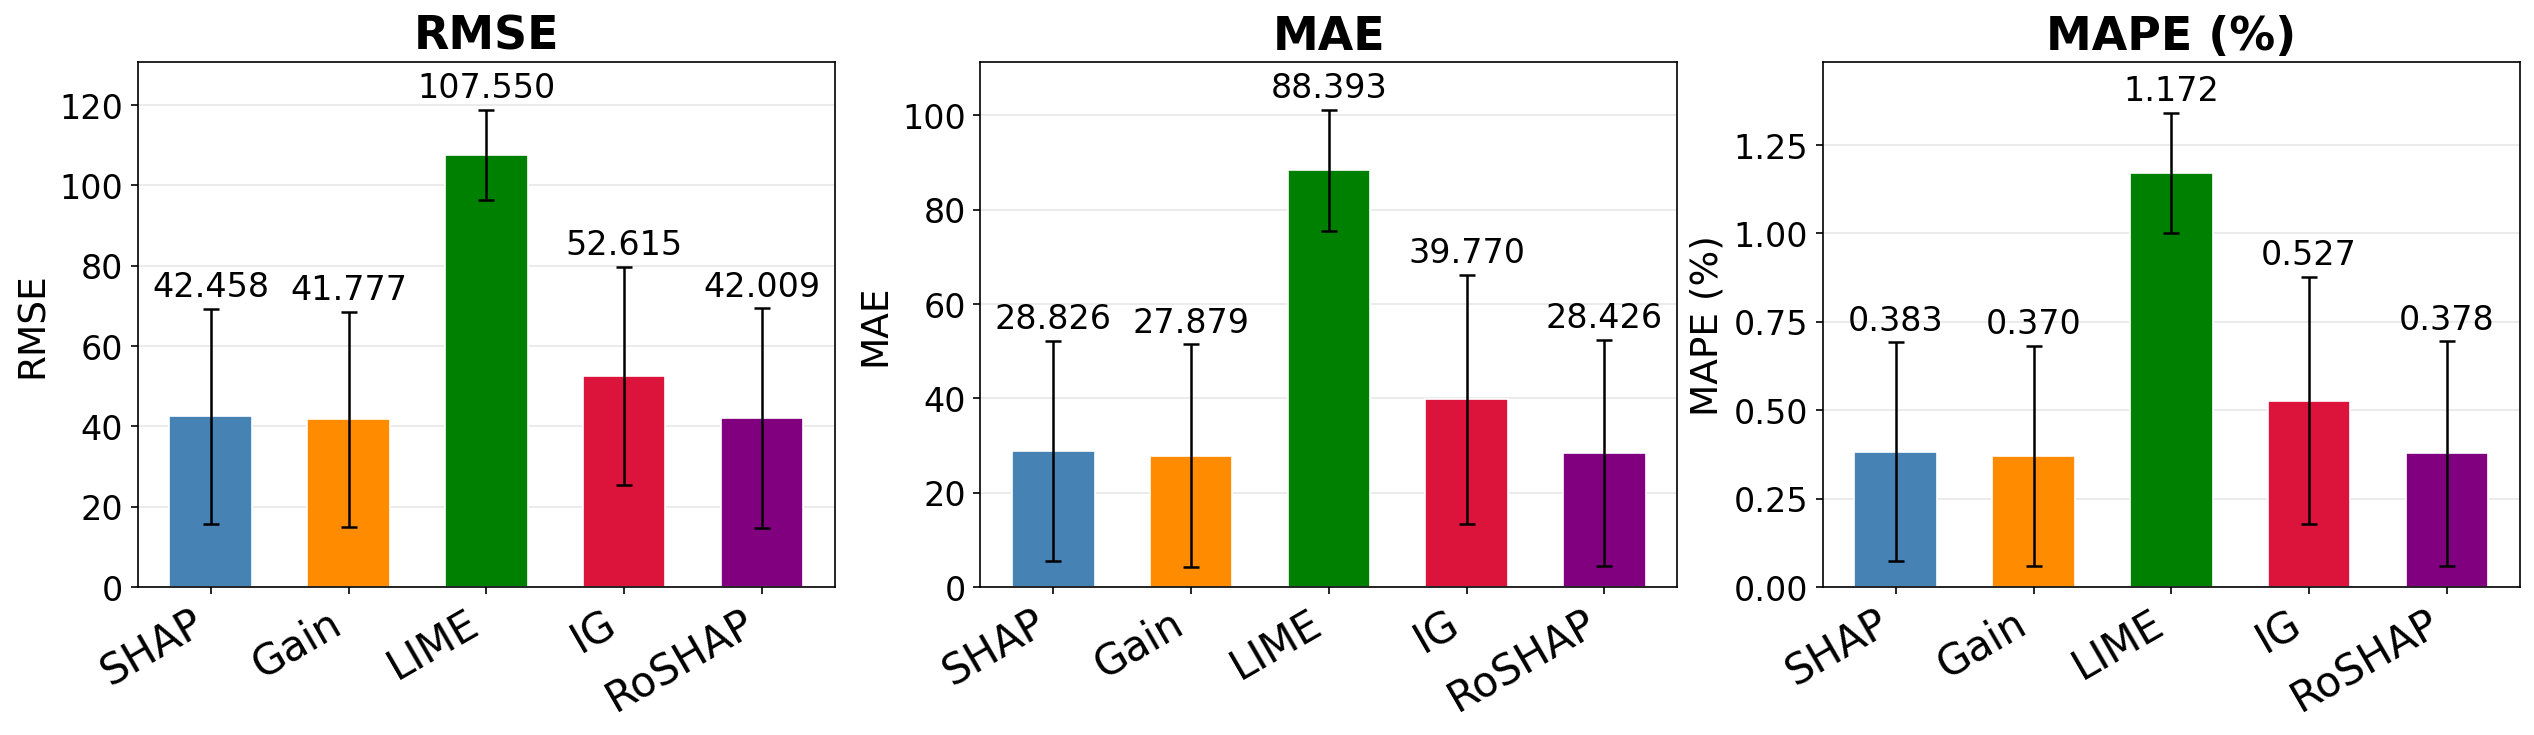
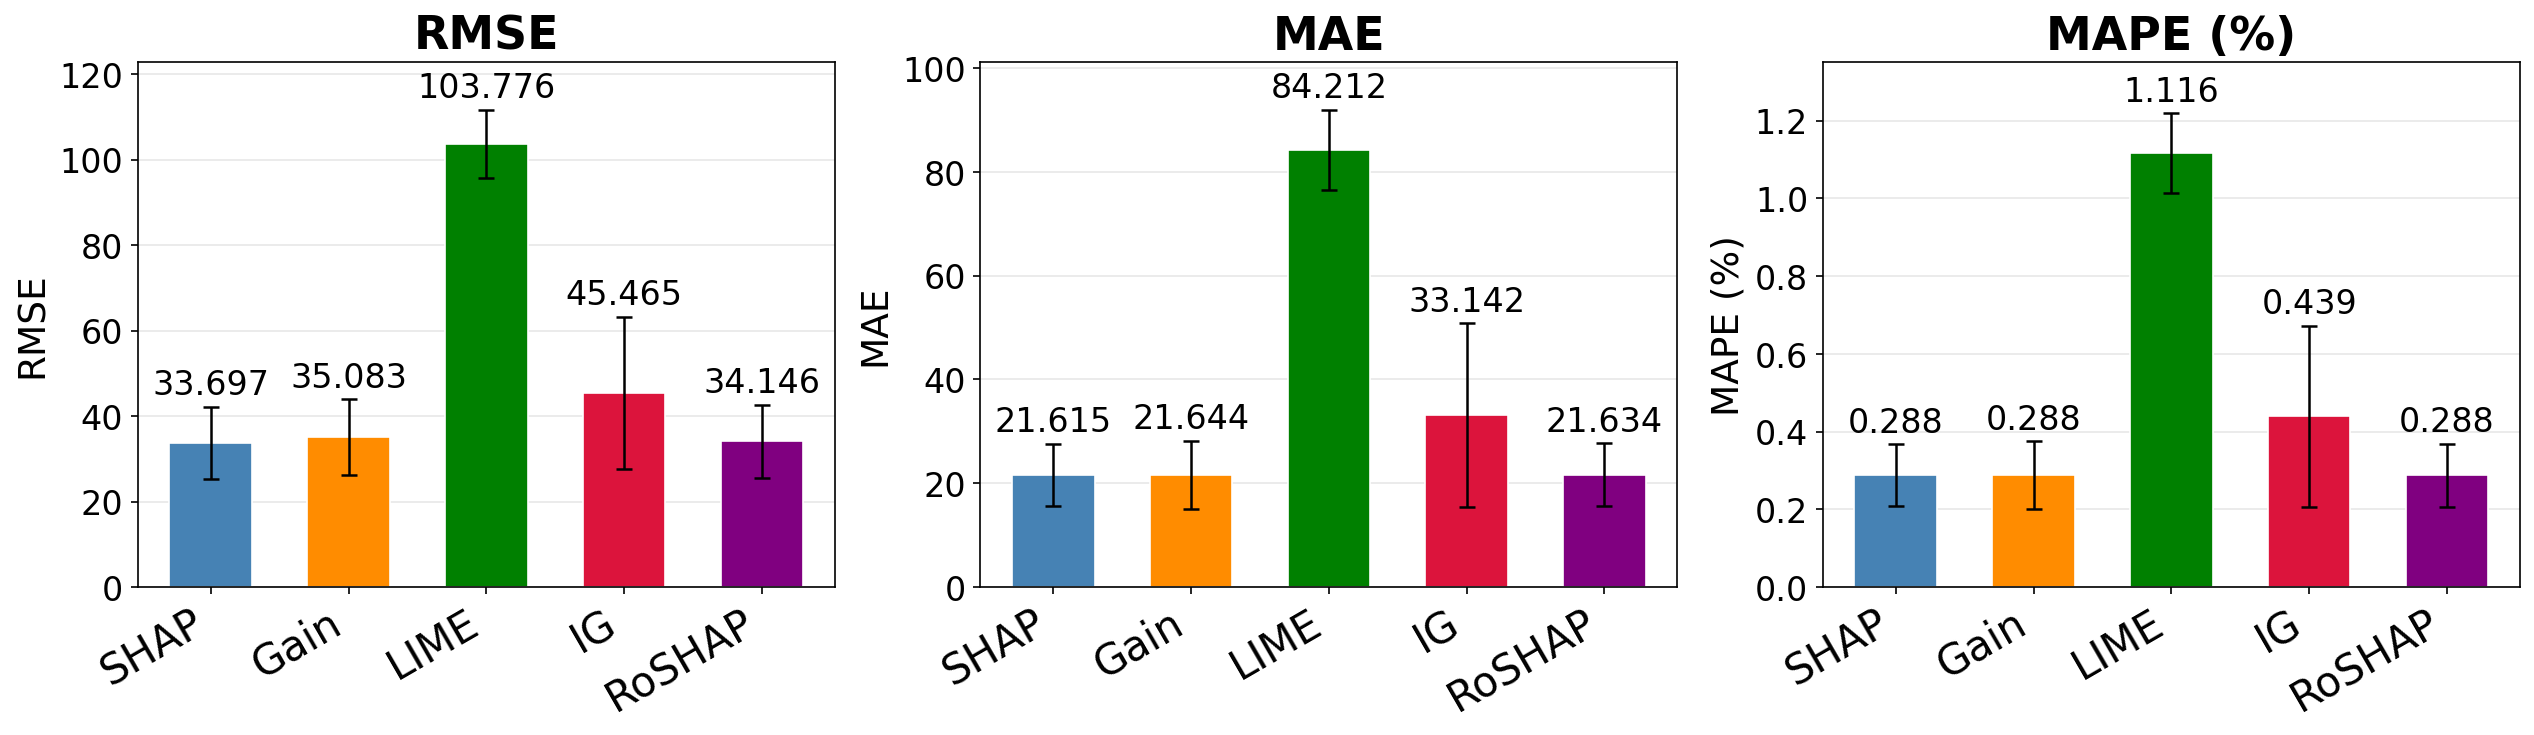
Производительность классификации оценивается по точности, F1-мере, средней точности (AP) и AUC-ROC; производительность регрессии оценивается по среднеквадратической ошибке (RMSE), средней абсолютной ошибке (MAE) и средней абсолютной процентной ошибке (MAPE).
Для каждого метода лучших отобранных признаков используются для переобучения той же прогностической модели с фиксированными параметрами.
Все сравнения используют одно и то же разбиение на обучающую и тестовую выборки, процедуру кросс-валидации и отложенные тестовые данные, поэтому различия в производительности отражают качество подмножества признаков, а не различия в модели или разбиении данных.
В основном тексте приводятся результаты одной репрезентативной модели, остальные модели приведены в приложении.
Для данных изображений фреймворк применяется на уровне образца.
В эксперименте CIFAR-10 классификатор ViT-base с атрибуцией на уровне патчей используется для определения областей изображения, вносящих наибольший вклад в предсказанный класс..
5.1 Классификация: Golub
Набор данных Golub [7] содержит образцов и зондов экспрессии генов. Интересующий отклик — подтип лейкемии: острый лимфобластный лейкоз (ALL), включая allB и allT, в сравнении с острым миелобластным лейкозом (AML). Набор данных содержит образцов ALL и образцов AML.
В данном эксперименте изучается оценка важности признаков на уровне генов с использованием классификатора XGBoost. Цель состоит в том, чтобы определить не только гены, которые вносят наибольший вклад в предсказание, но и гены, которые вносят наиболее стабильный вклад при многократном переобучении модели. Набор данных Golub представляет собой типичный пример высокой размерности при малом количестве выборок, где интерпретация затруднена, а нестабильность атрибуции является обычным явлением..
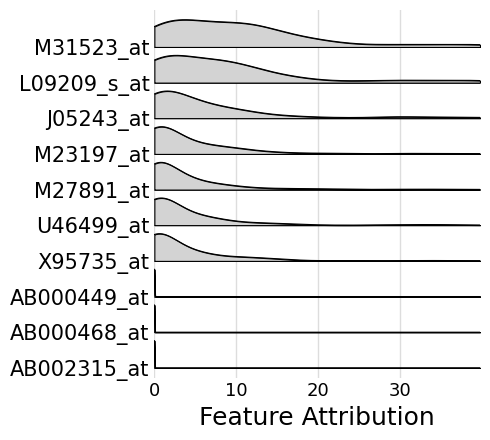
Figure 4: Распределение топ-10 оценок вклада признаков XGBoost для набора данных Golub.
Рисунок 4 показывает распределения топ-10 генов, ранжированных по метрике RoSHAP, по 500 бутстреп-запускам. После гена, занявшего восьмое место, большинство генов показывают малый или нулевой вклад в прогнозирование рака. По сравнению с результатами SHAP для конкретных начальных значений на Рисунке 1, предлагаемый метод дает более четкое резюме того, какие гены стабильно важны в рамках обученной модели XGBoost..
В этом случае небольшое количество наблюдений может доминировать над дисперсией, поэтому условие Ляпунова не выполняется. Распределения, следовательно, оцениваются непараметрически с помощью ядерной оценки плотности..
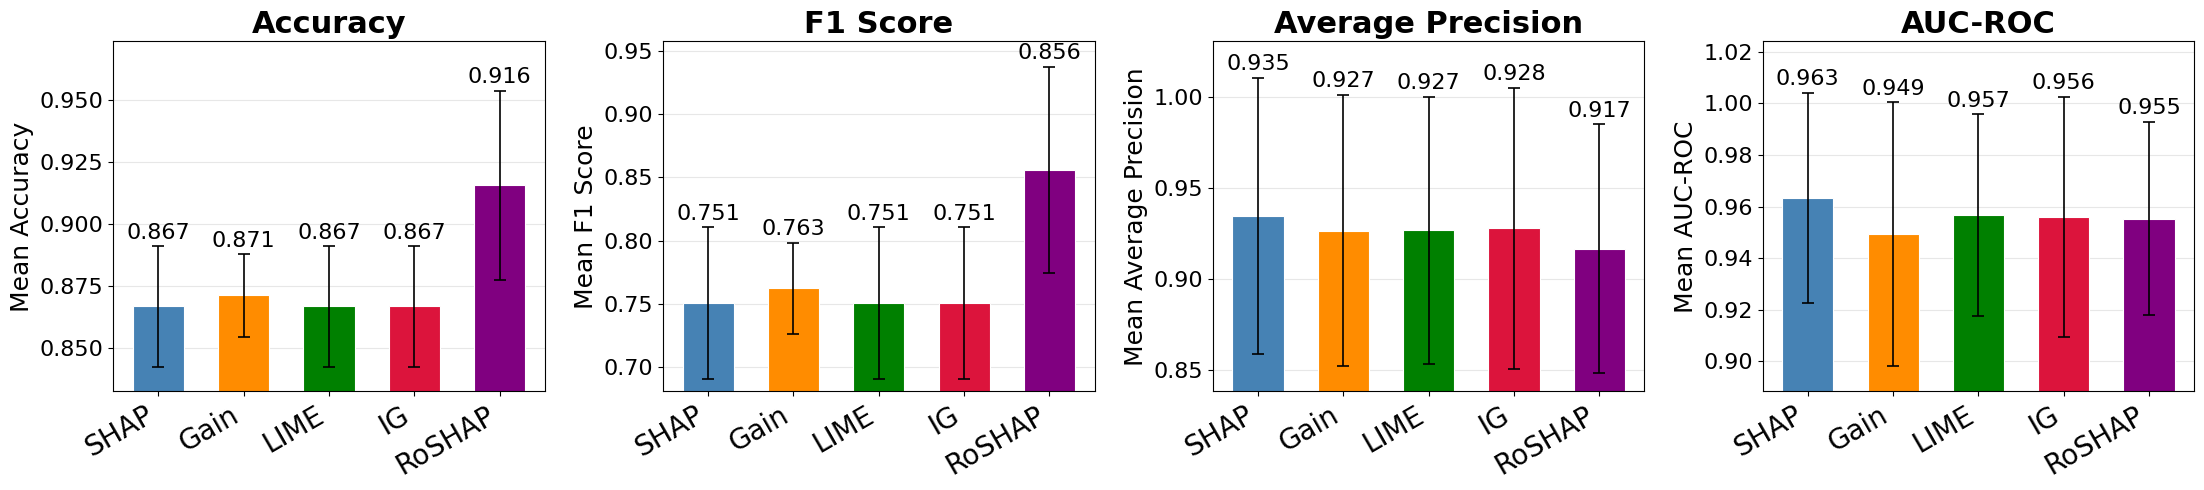
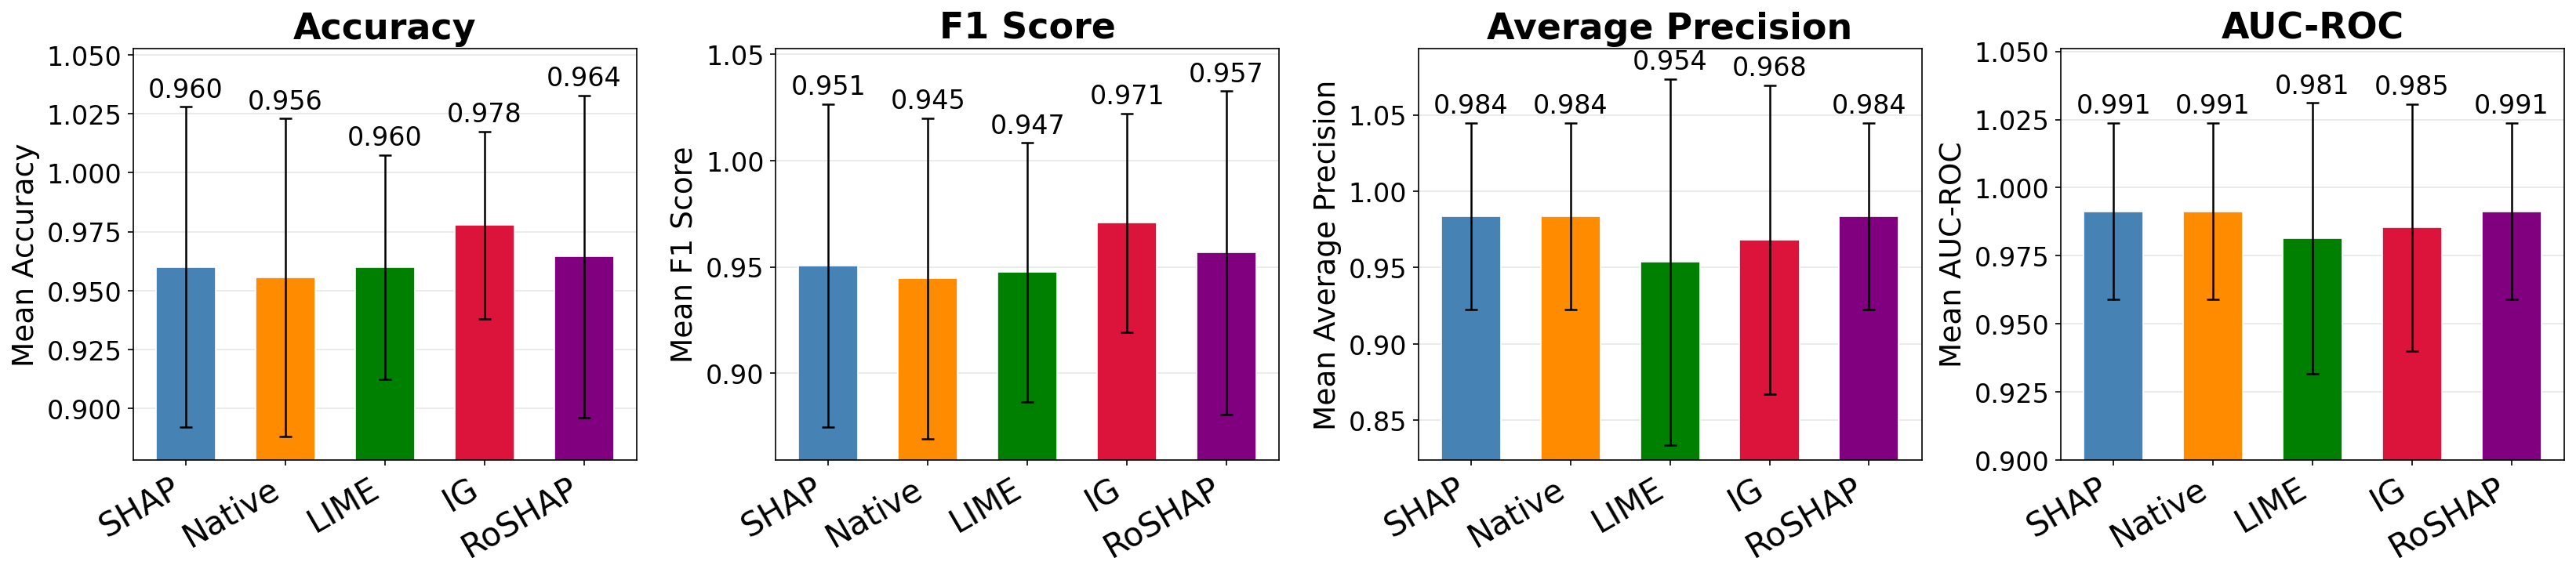
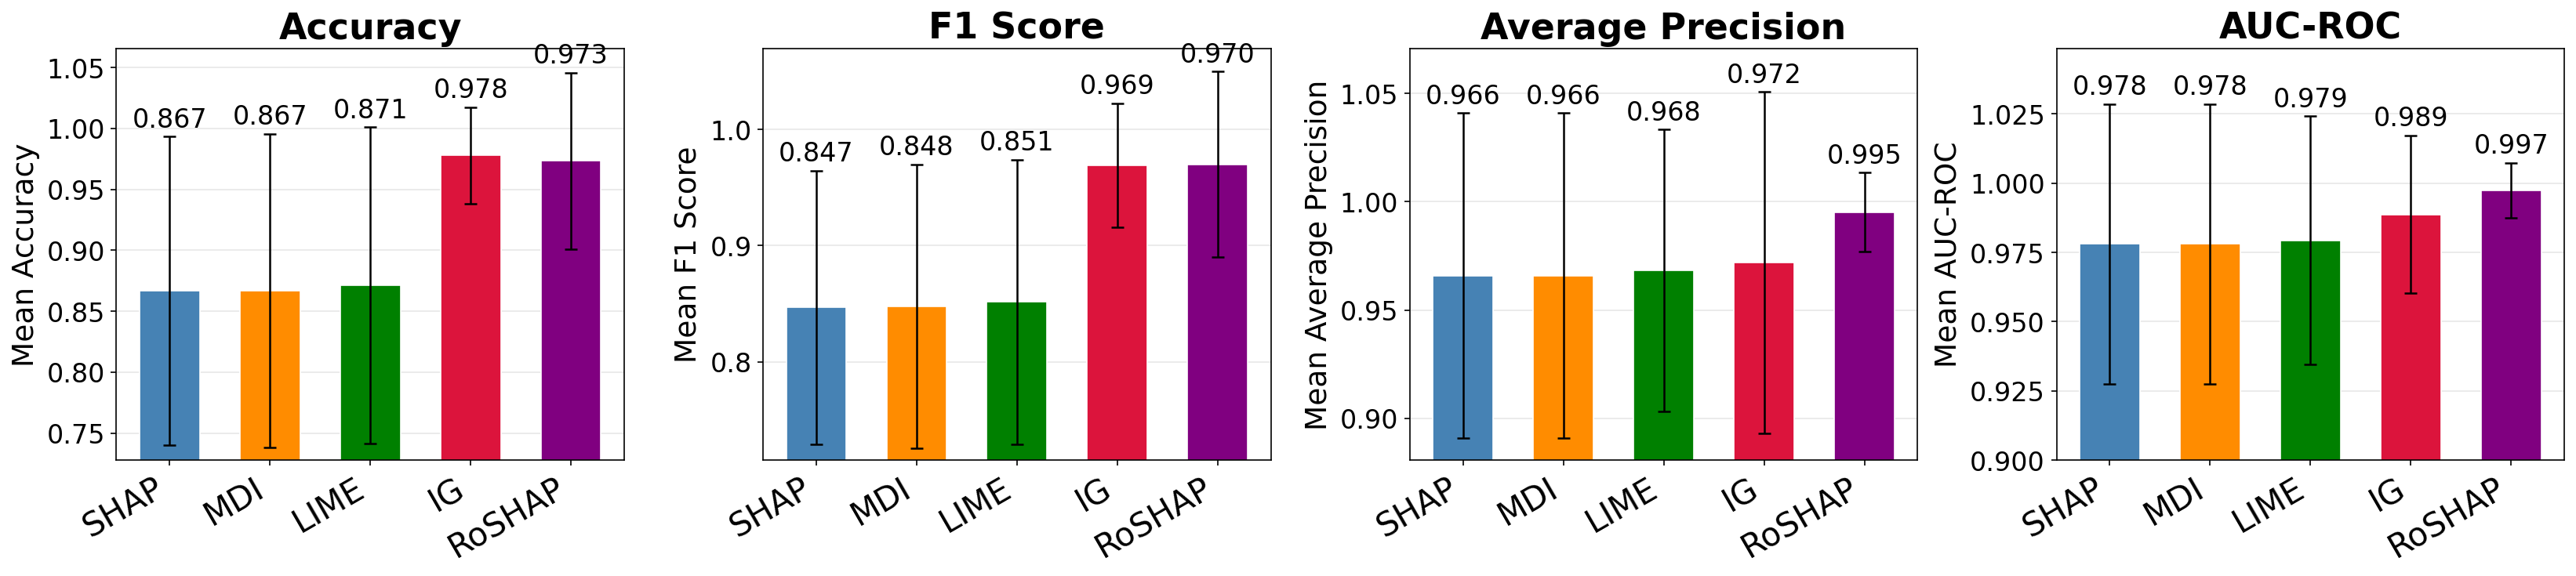
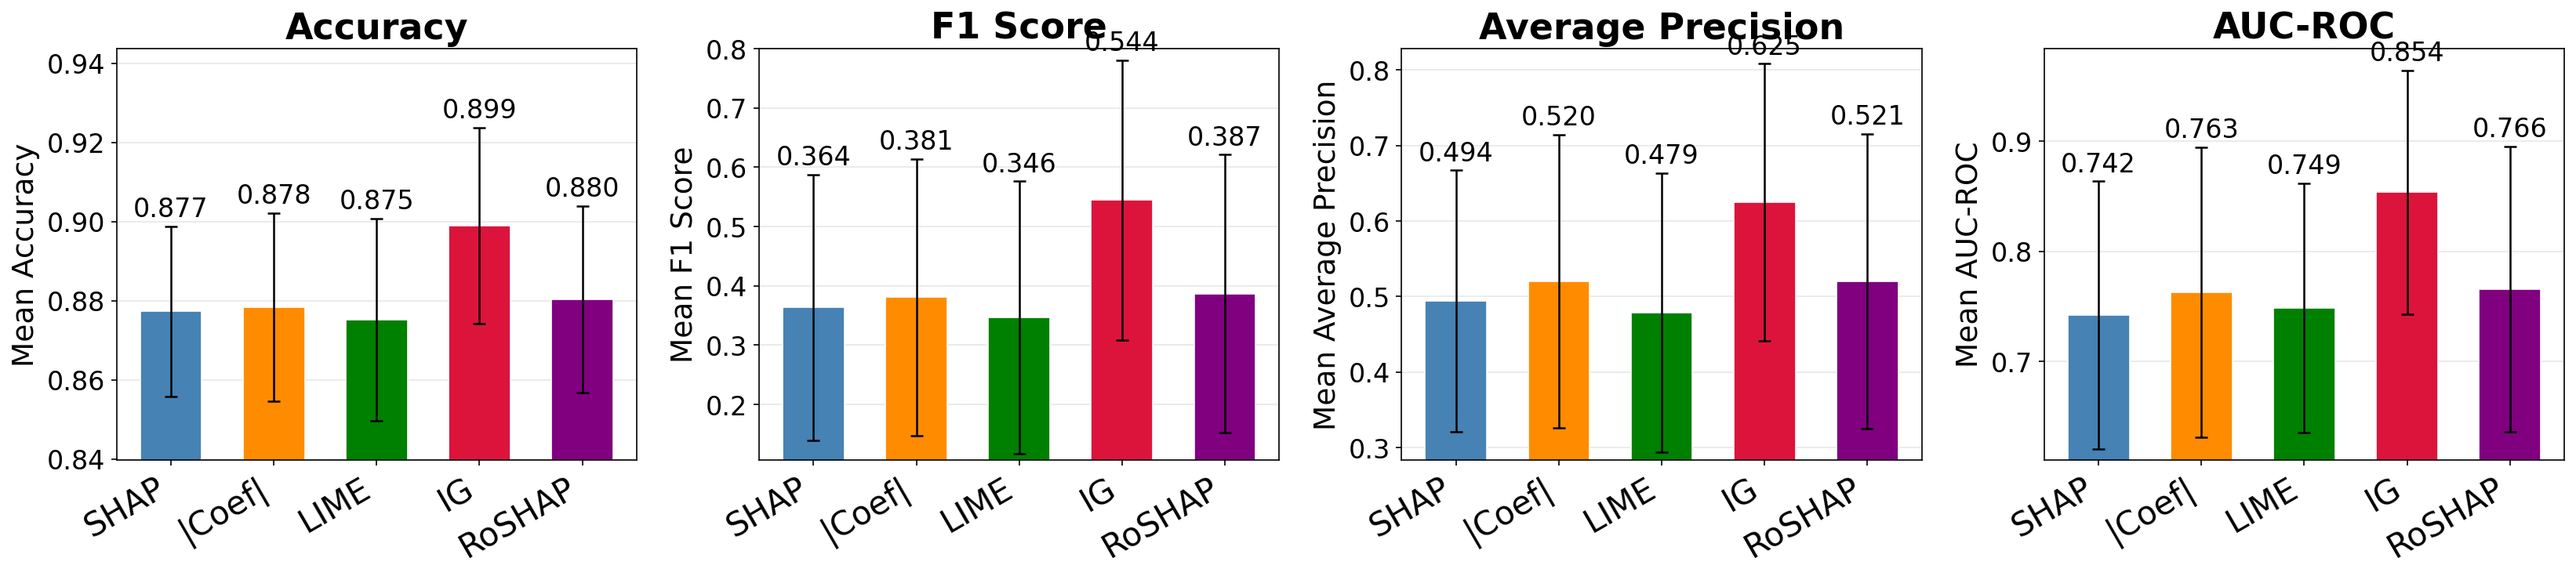
Рисунок 5 сравнивает производительность выбора признаков между методами.
Поскольку экспериментальная валидация генов-кандидатов часто дорогостояща, оценка сосредоточена на первых 1–15 выбранных признаках из каждого метода.
Для каждой метрики столбцы показывают среднюю производительность по размерам наборов признаков-кандидатов, а столбцы ошибок показывают соответствующую вариативность.
Предложенный метод, показанный фиолетовым, достигает высокой точности и F1-меры.
RoSHAP также сохраняет сопоставимые AP и AUC-ROC, что предполагает стабильный и надежный выбор признаков..
Figure 5: Производительность выбора признаков на данных Golub с использованием XGBoost. Методы: SHAP (синий), gain (оранжевый), LIME (зеленый), IG (красный) и RoSHAP (фиолетовый). Столбцы показывают среднюю производительность по размерам наборов признаков-кандидатов; планки погрешностей показывают вариацию. Выше - лучше..
5.2 Классификация: Маск (Версия 2))
Набор данных Musk (версия 2) [3] содержит 6 598 экземпляров и 166 непрерывных признаков. Задача бинарной классификации заключается в различении молекул мускуса и не-мускуса, где каждый экземпляр представляет одну молекулярную конформацию, описанную физико-химическими дескрипторами. Набор данных несбалансирован: 5 581 экземпляр не-мускуса и 1 017 экземпляров мускуса, что делает его полезным для оценки устойчивости вклада признаков в многомерной молекулярной классификации..
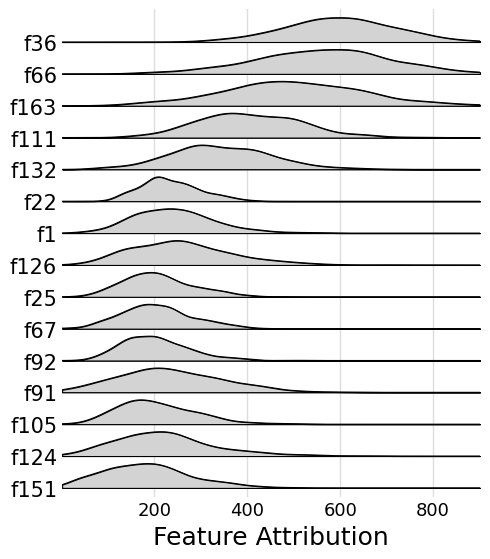
Figure 6: Распределение оценок важности признаков CatBoost для 15 наиболее значимых признаков набора данных Musk.
Эксперимент Musk изучает атрибуцию на уровне признаков с помощью классификатора CatBoost. На рисунке 6 показаны распределения оценок вклада 15 лучших признаков CatBoost для набора данных Musk. Несколько признаков имеют схожие величины вклада и изменчивость, что указывает на то, что предиктивный сигнал распределен по нескольким признакам, а не доминируется одним признаком..
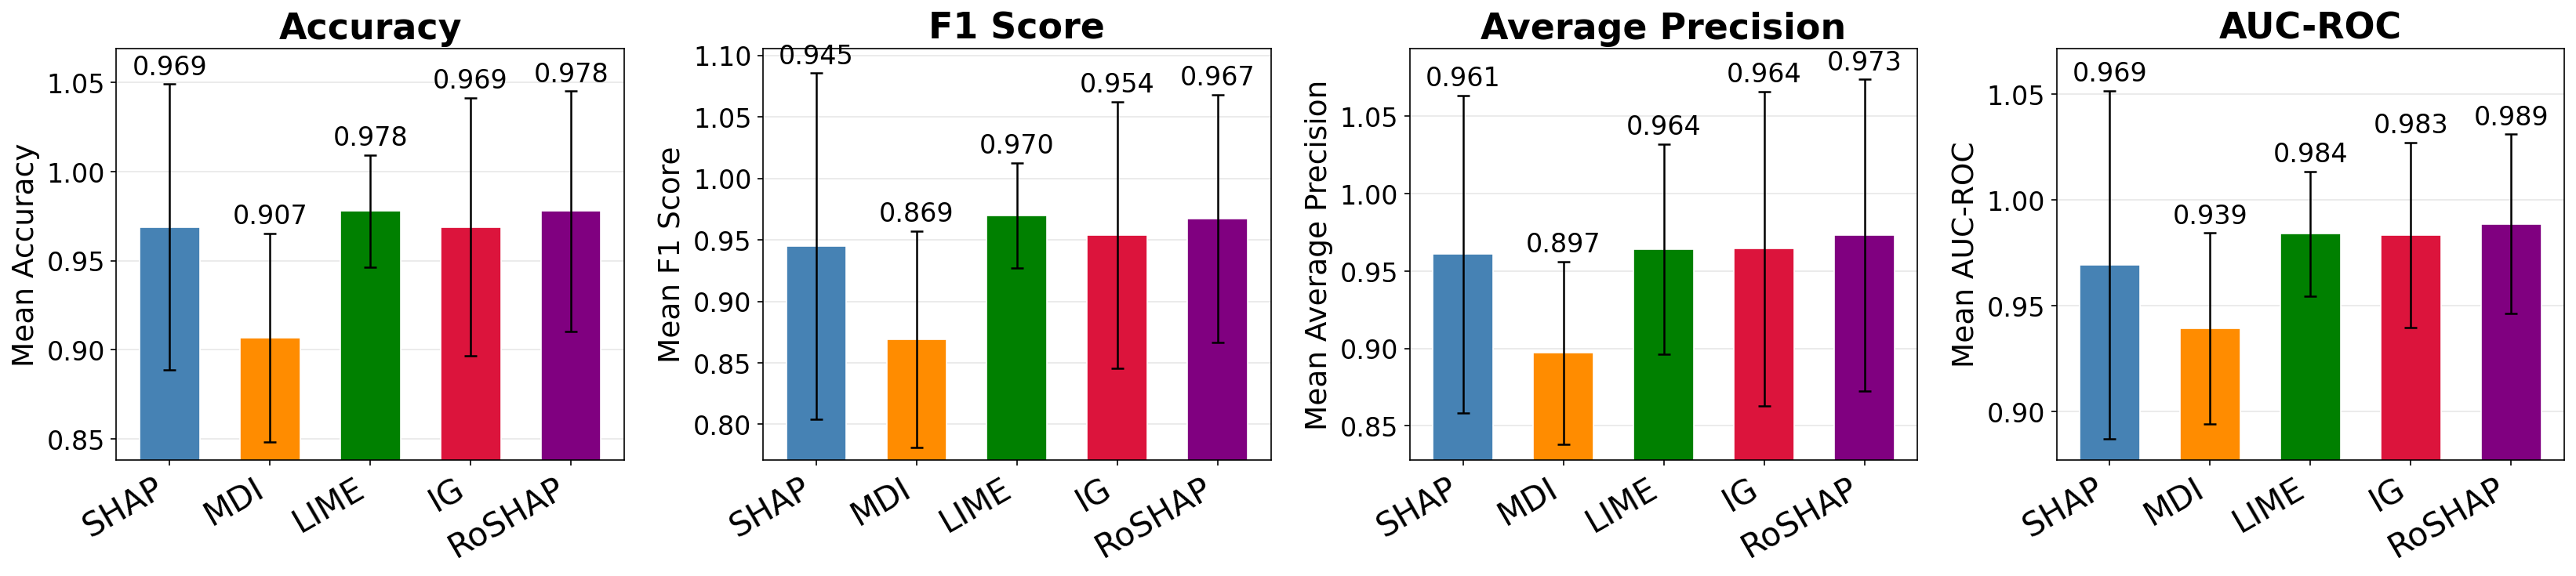
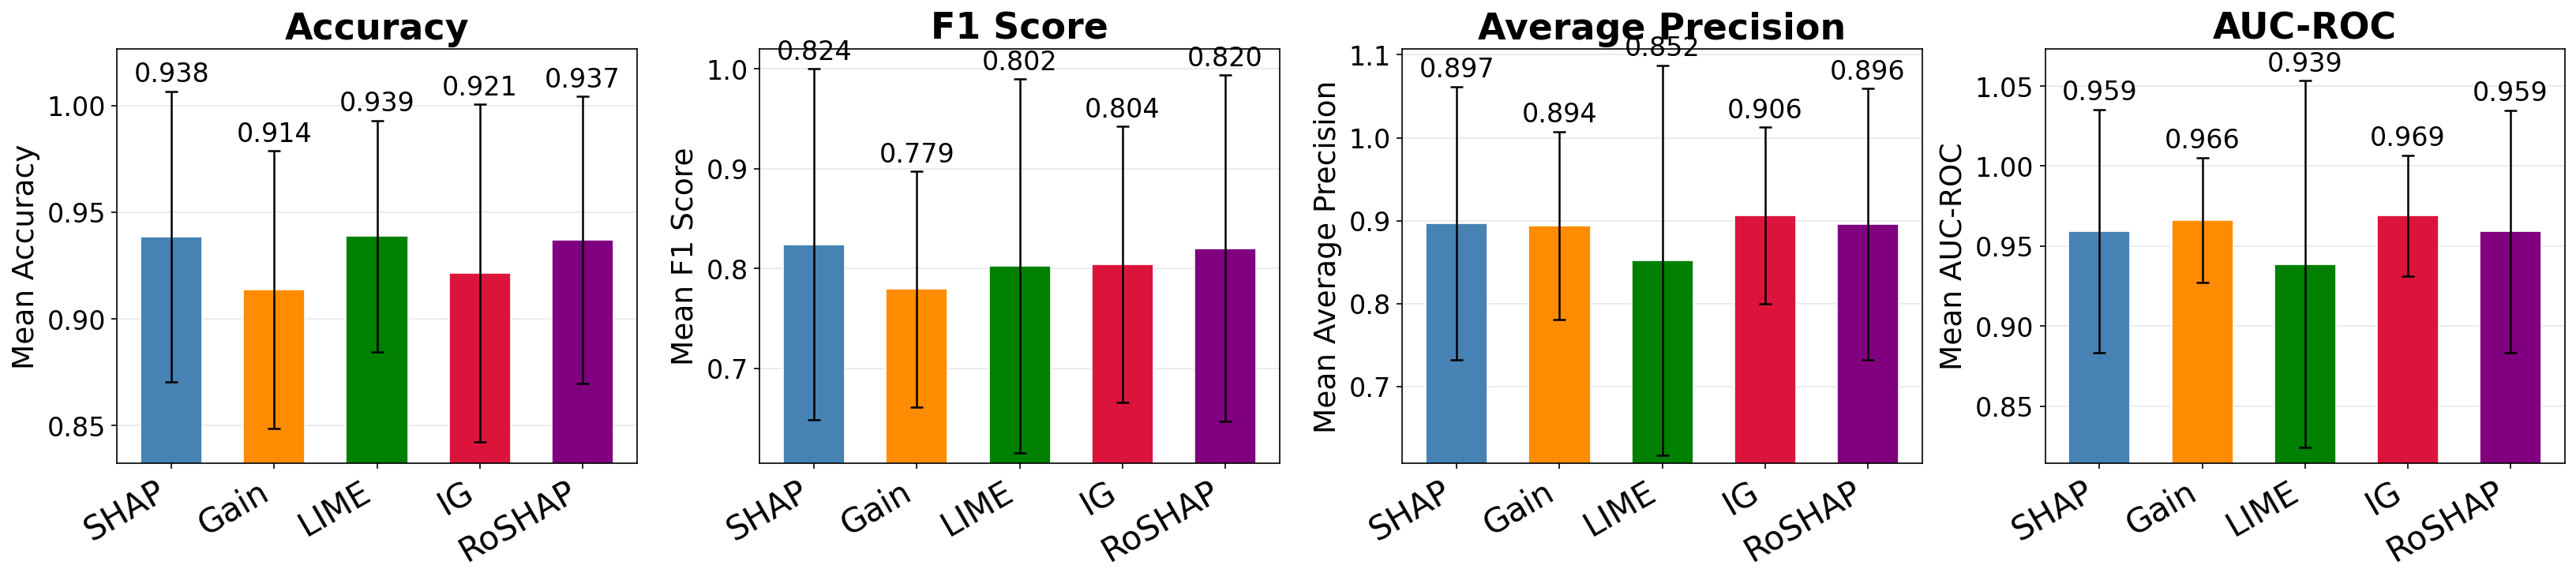
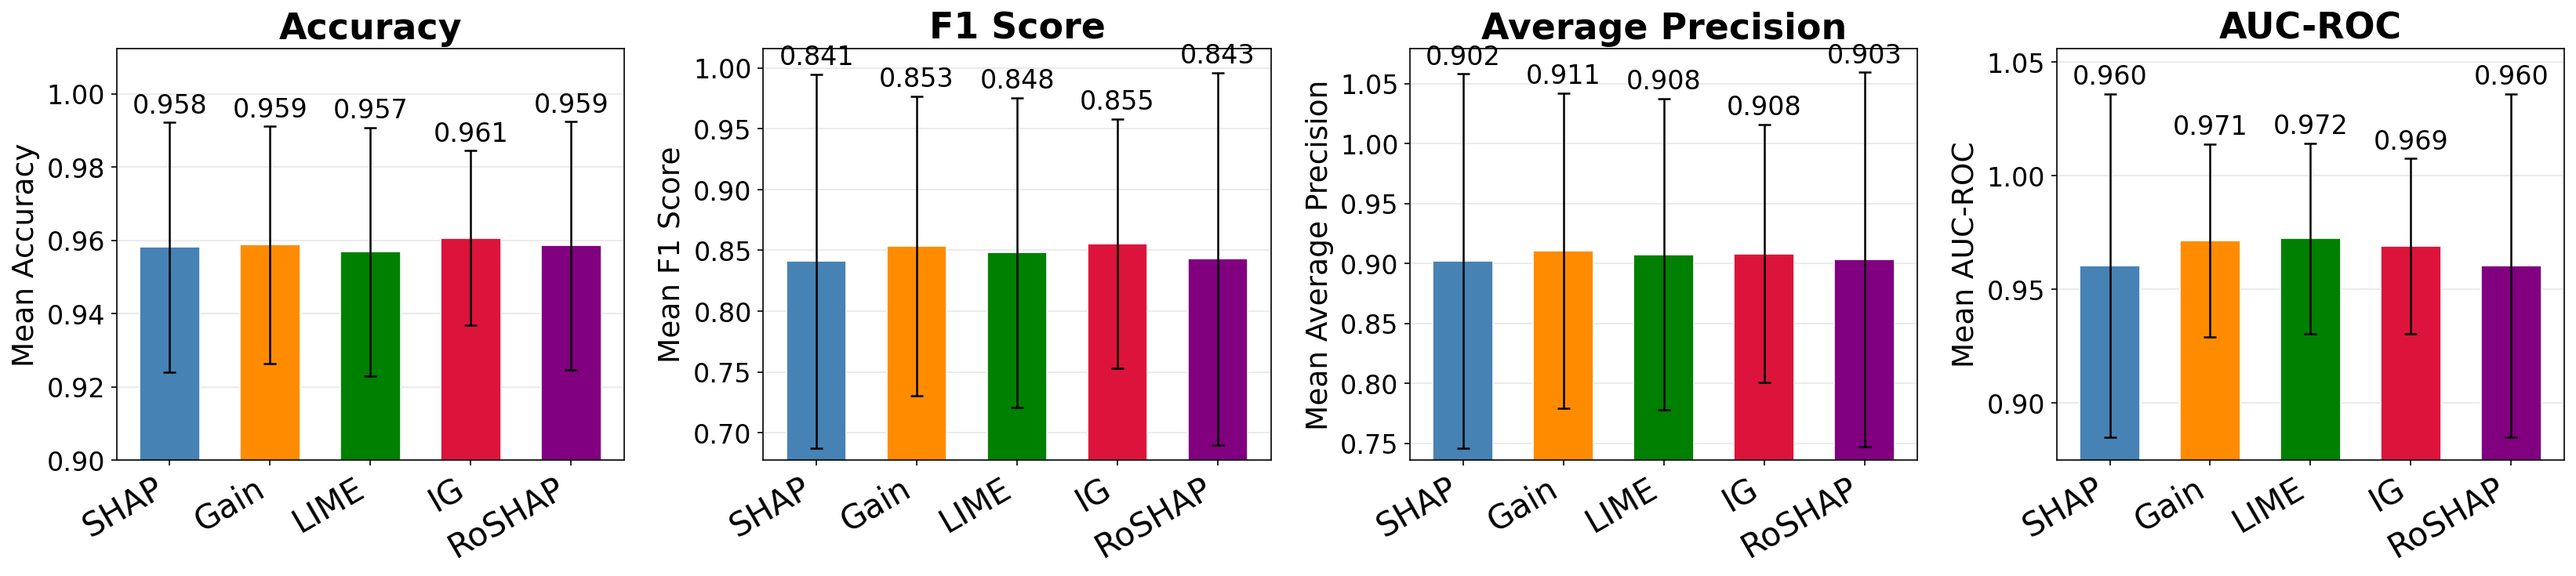
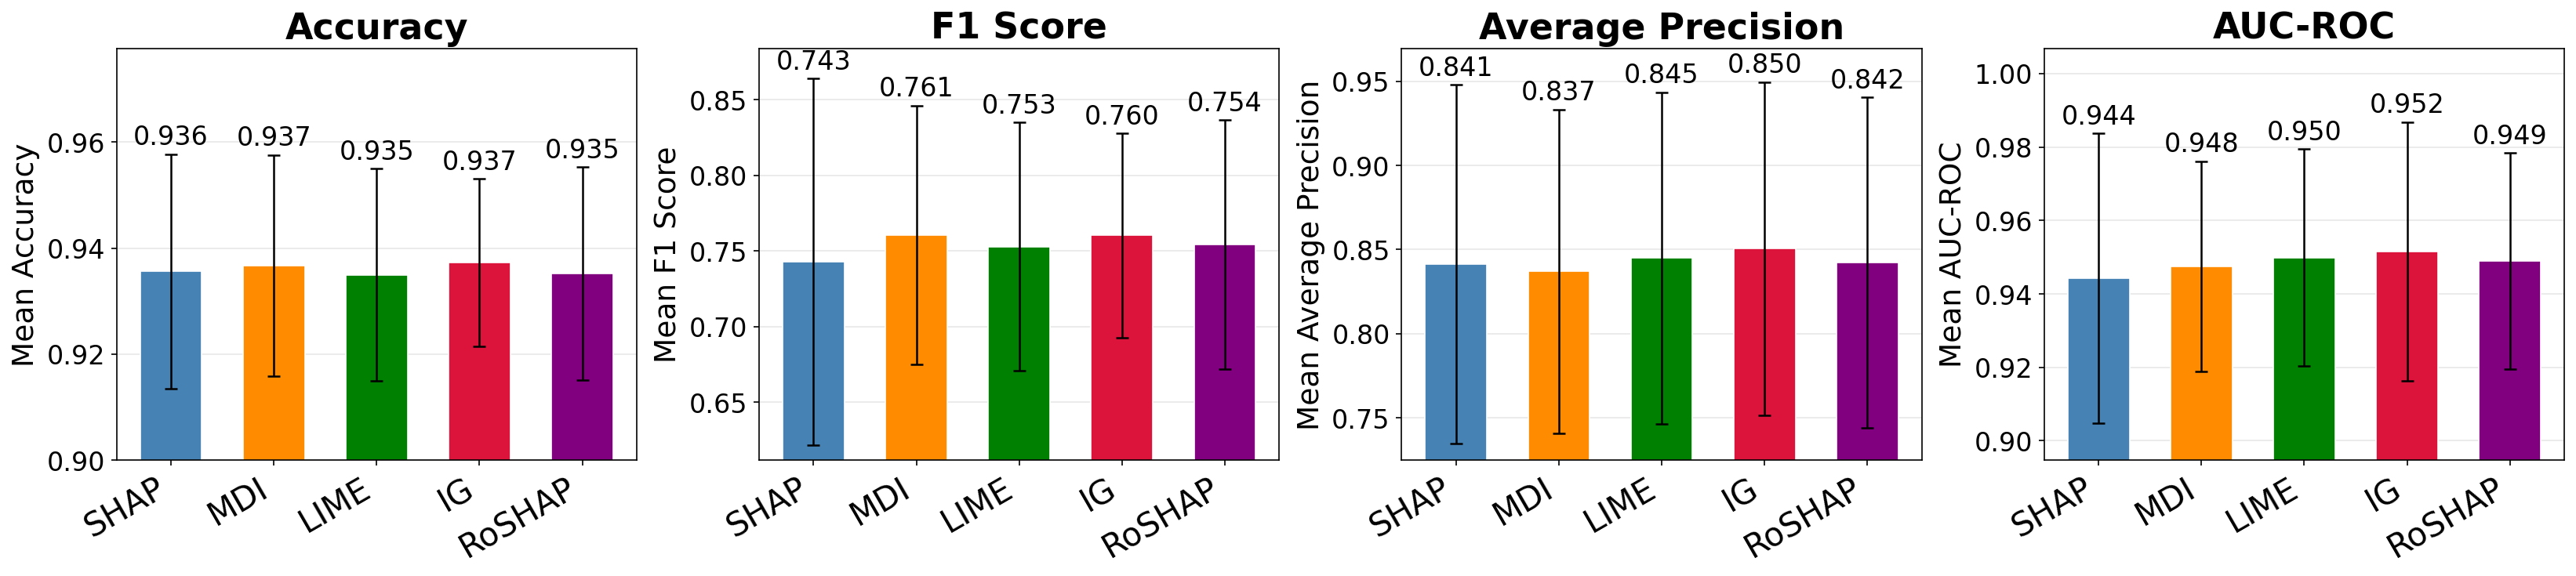
Для отбора переменных сравниваются только 30 лучших выбранных признаков для набора данных Musk, поскольку после этого момента точность прогнозирования остается высокой. На рисунке 7 показана производительность отбора признаков для набора данных Musk. Производительность по метрикам отбора в значительной степени сопоставима. Распределение вклада признаков показывает, что многие признаки имеют схожий уровень важности. В результате различия в выбранных подмножествах признаков оказывают ограниченное влияние на точность прогнозирования..
Figure 7: Производительность выбора признаков на данных Musk (Version 2) с использованием CatBoost. Методы: SHAP (синий), gain (оранжевый), LIME (зеленый), IG (красный) и RoSHAP (фиолетовый). Столбцы показывают среднюю производительность по размерам наборов признаков; планки погрешностей показывают вариацию. Чем выше, тем лучше..
5.3 Регрессия: UJIIndoorLoc
Набор данных UJIIndoorLoc используется для оценки предложенной структуры в задаче регрессии. Это общедоступный эталонный набор данных для indoor-локализации, собранный в Университете Жауме I для оценки систем позиционирования на основе отпечатков WLAN/WiFi [23]. Набор данных содержит 21 048 наблюдений, включая 19 937 обучающих/эталонных записей и 1 111 проверочных/тестовых записей. Каждое наблюдение включает измерения интенсивности принимаемого сигнала (RSSI) от 520 беспроводных точек доступа (WAP), а также переменные местоположения и метаданные..
Значения RSSI варьируются от приблизительно до dBm, при этом указывает на необнаруженную точку доступа. В этом исследовании 520 переменных силы сигнала WAP используются в качестве предикторов, а долгота используется в качестве непрерывного отклика. Значение перекодируется как для представления очень слабого или необнаруженного сигнала..
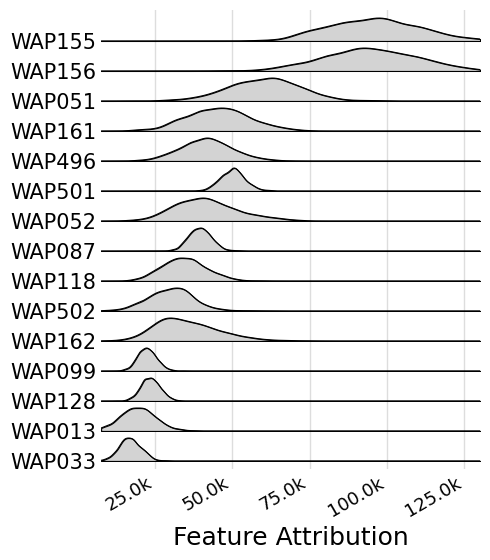
Figure 8: Распределение 15 лучших оценок атрибуции признаков LightGBM для набора данных UJIIndoorLoc.
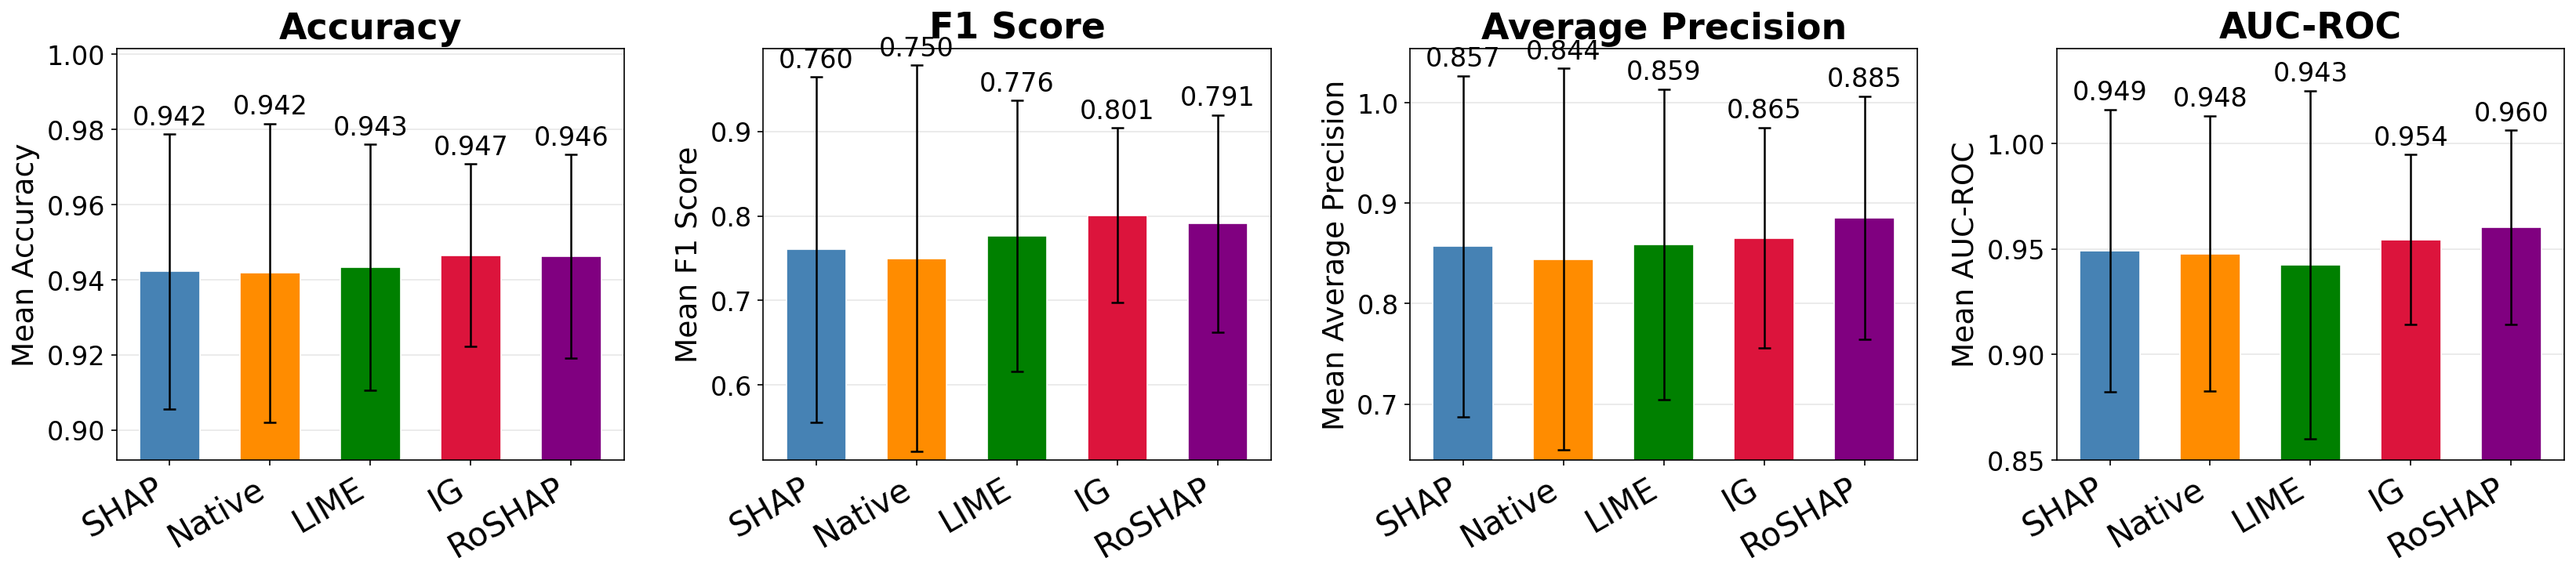
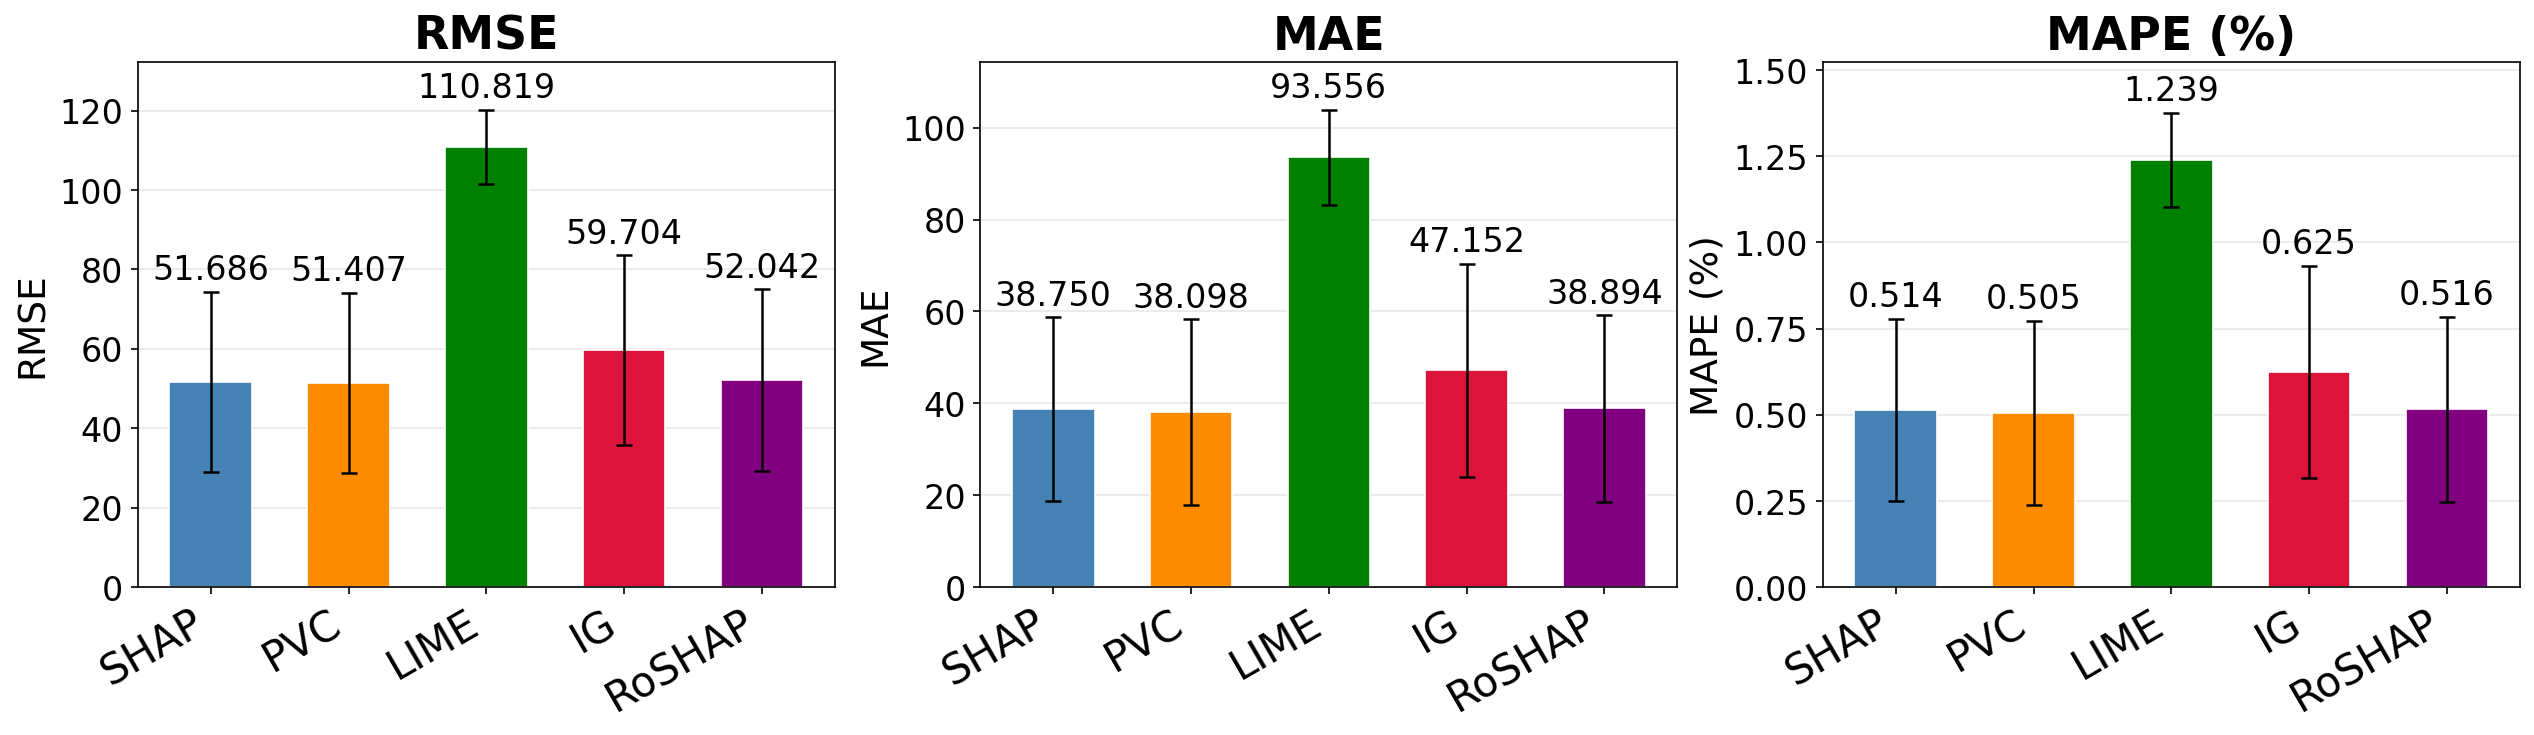
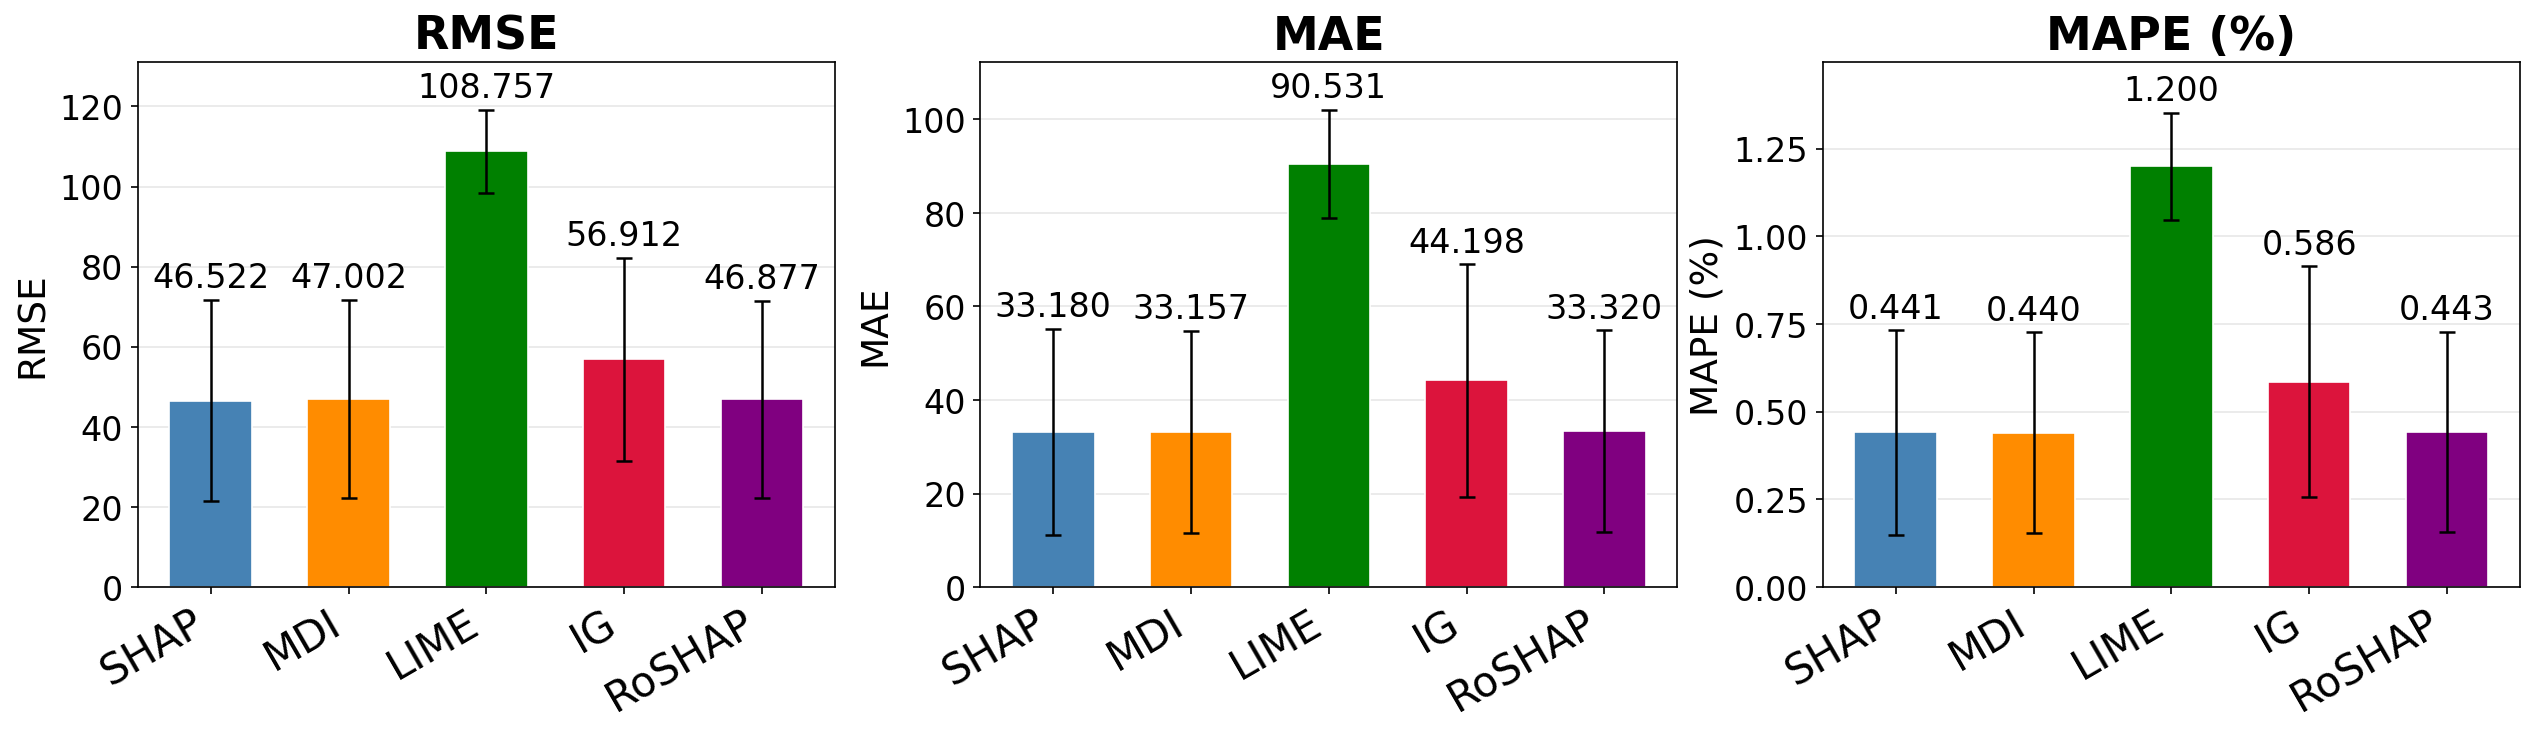
В данном эксперименте изучается атрибуция на уровне признаков с использованием регрессионной модели LightGBM. На рисунке 8 показаны распределения 15 наиболее значимых оценок атрибуции признаков LightGBM для набора данных UJIIndoorLoc. Два наиболее значимых признака имеют схожие паттерны атрибуции, в то время как остальные признаки демонстрируют различные уровни изменчивости: одни распределения более сконцентрированы, другие — более разбросаны. На рисунке 9 сравнивается производительность отбора признаков различных мер важности в задаче регрессии UJIIndoorLoc с использованием LightGBM. В целом, RoSHAP демонстрирует конкурентоспособную и стабильную производительность по всем метрикам оценки..
Figure 9: Производительность выбора признаков на данных UJIIndoorLoc с использованием LightGBM. Методы: SHAP (синий), gain (оранжевый), LIME (зеленый), IG (красный) и RoSHAP (фиолетовый). Столбцы показывают среднюю производительность по размерам набора признаков; планки ошибок показывают вариацию. Чем ниже, тем лучше..
5.4 Классификация: CIFAR-10
Этот эксперимент расширяет предложенную структуру за пределы табличных данных до интерпретации изображений на уровне выборок. Набор данных CIFAR-10 содержит 60 000 цветных изображений из 10 классов, с 50 000 обучающих и 10 000 тестовых изображений [10].
Мы проводим 50 анализов SHAP на основе бутстрепа с использованием модели ViT-base.
Для каждого тестового изображения массив SHAP имеет размерность , где — количество патчей изображения, а 10 — количество классов.
Результаты сосредоточены на распределении SHAP для предсказанного класса.
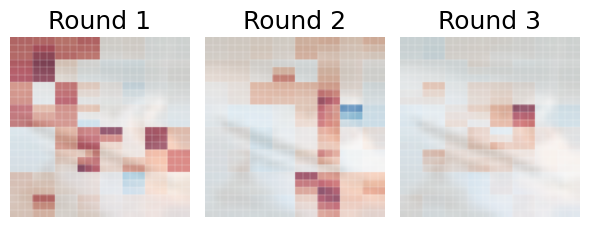
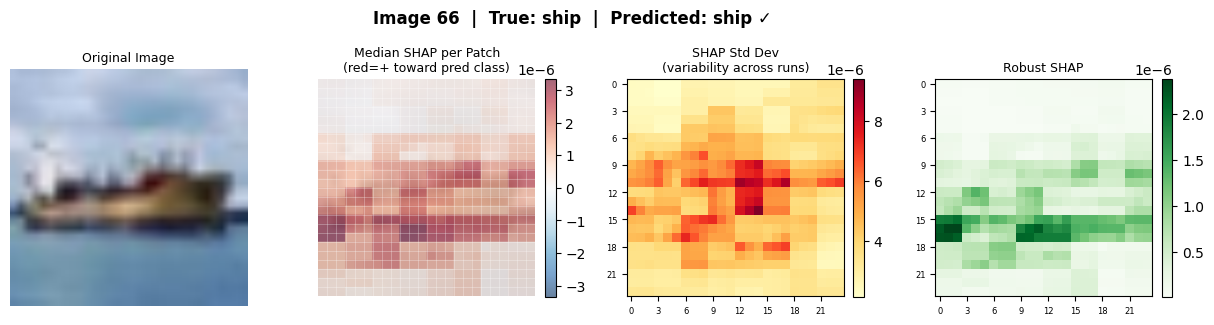
В качестве иллюстративного примера выбрано одно изображение корабля, которое было правильно предсказано большинством моделей, подогнанных с помощью бутстрепа.
На рисунке 10 показаны карты SHAP на уровне патчей для трех случайно выбранных бутстреп-прогонов, где красный цвет указывает на положительные значения SHAP, синий — на отрицательные, а белый — на значения, близкие к нулю.
Хотя предсказание точное, вклад патчей заметно различается между прогонами, что говорит о чувствительности объяснений изображений на основе одного прогона к случайности обучения.
Например, в Раунде 1 at Например, наибольшее значение SHAP появляется в области воды в Раунде 1, но смещается к корпусу корабля в Раунде 3.
После агрегации надежная карта атрибуции на рисунке 11(a) показывает, что предсказание в основном приписывается патчам на корпусе корабля..
Figure 10: Пример с изображением корабля из CIFAR-10 с использованием 3 раундов бутстрапа.
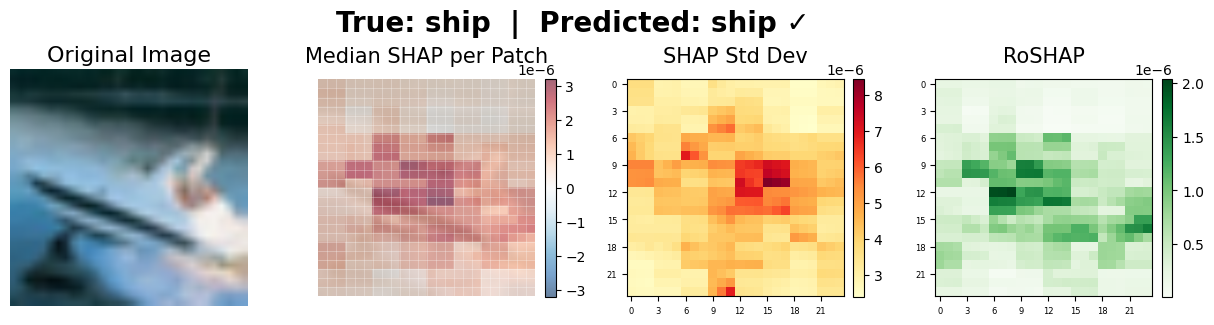
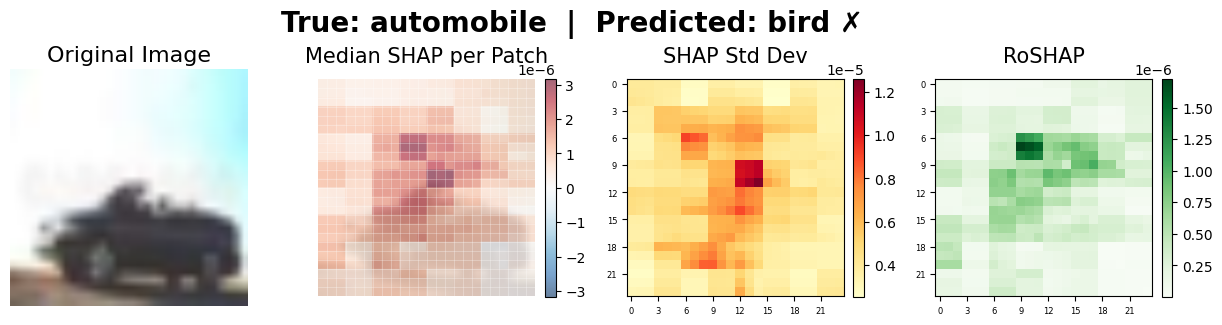
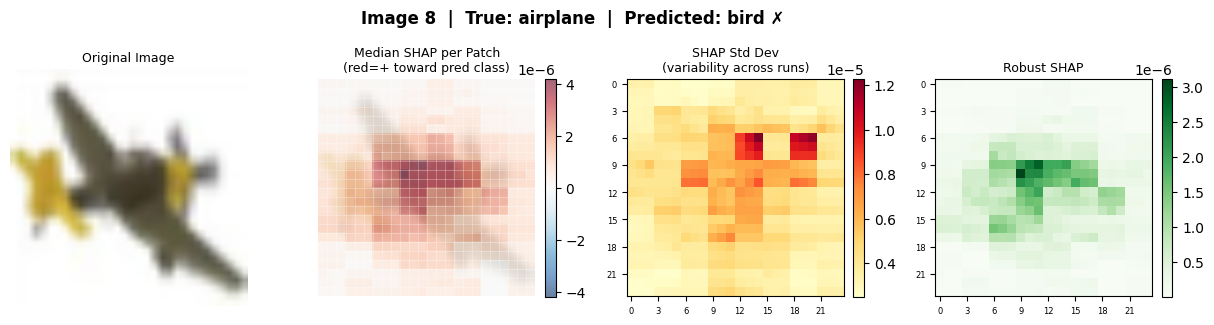
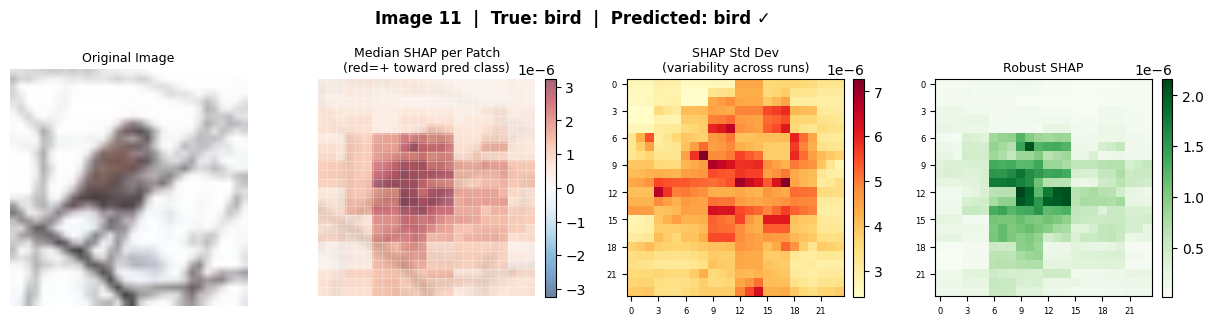
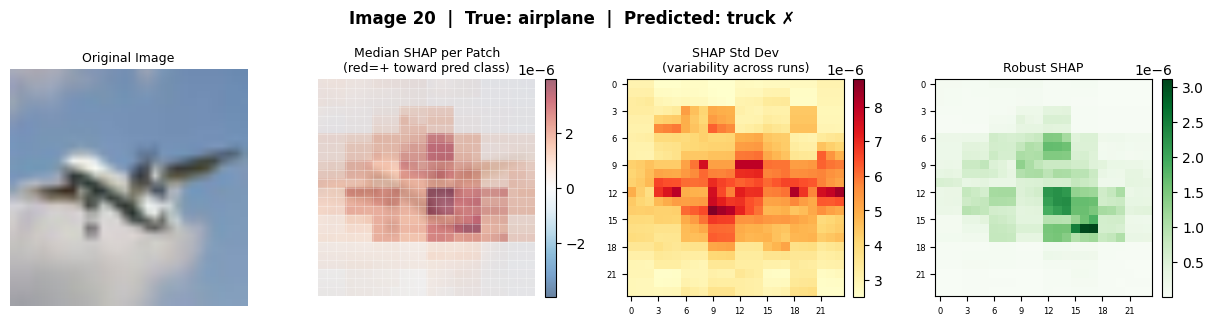
Предложенная структура обеспечивает дополнительное понимание паттернов атрибуции, лежащих в основе предсказаний изображений. Рисунок 11 иллюстрирует два характерных случая: правильное предсказание с атрибуцией, сосредоточенной на целевом объекте, и неправильное предсказание, в котором атрибуция сконцентрирована на нерелевантных областях. Слева направо каждая строка показывает исходное изображение, медианную карту SHAP для предсказанного класса, стандартное отклонение значений SHAP по бутстреп-прогонам и устойчивую карту SHAP. В медианной карте SHAP красный цвет указывает на положительный вклад, синий — на отрицательный, а белый — на вклад, близкий к нулю; на карте стандартного отклонения красный цвет указывает на большую вариацию, а белый — на малую вариацию; на устойчивой карте SHAP зеленый цвет указывает на больший вклад, а белый — на отсутствие вклада. На рисунке 11(a) модель фокусируется в основном на правильной области объекта. На рисунке 11(b), однако, модель в значительной степени фокусируется на небе, а не на автомобиле, что приводит к неправильному предсказанию птицы. Эти примеры показывают, что структура может помочь диагностировать ошибки предсказания, выявляя, обращает ли модель внимание на соответствующие области изображения..
(a)Правильное предсказание; атрибуция сосредоточена на корабле.
(b)Неверное предсказание; атрибуция не фокусируется на автомобиле.
Figure 11: Объяснения CIFAR-10 после 50 запусков бутстрапа ViT-base. Столбцы показывают исходное изображение, медианную карту SHAP, стандартное отклонение SHAP и устойчивую карту SHAP. Красный/синий обозначают положительные/отрицательные значения SHAP, красный на карте стандартного отклонения обозначает большую изменчивость, а зеленый — большую устойчивую атрибуцию..
6 Обсуждение
Это исследование рассматривает ключевое ограничение существующих методов атрибуции признаков: оценки атрибуции часто рассматриваются как фиксированные величины, несмотря на их стохастическую природу. Мы предлагаем дистрибутивный фреймворк для характеристики неопределенности атрибуции и представляем RoSHAP — надежную метрику на основе SHAP для стабильного ранжирования признаков и оценки вклада. RoSHAP отдает приоритет признакам, которые последовательно активны, сильны и стабильны при повторных анализах. Мы всесторонне тестируем нашу модель на реалистичных наборах данных и демонстрируем, что предложенная надежная метрика улучшает стабильность интерпретации, помогает отличать устойчивые сигналы от случайно выбранных признаков и может применяться к различным типам данных. Хотя процедура бутстрепа остается более затратной, чем однократная атрибуция, аппроксимация Гаусса помогает существенно снизить это бремя, когда это применимо. Будущие работы могут расширить фреймворк от случайности выборки данных до случайности на уровне модели. В целом, RoSHAP служит полезным дополнением к существующим методам атрибуции признаков, способствуя более стабильной и надежной интерпретации..
Список литературы
[1]
P. Bhattarai, D. S. Thakuri, Y. Nie, and G. B. Chand (2024)
Объяснимый ИИ на основе Deep-SHAP для отображения многомерных связей между региональными нейровизуализационными биомаркерами и когнитивными функциями.
Европейский журнал радиологии 174, стр. 111403.
Цитируется: §1.
[2]
П. Биллингсли (1995)
Вероятность и мера.
3-е издание, Wiley, Нью-Йорк.
Цитировано: Lemma 1.
[3]
Д. Чепмен и А. Джайн (1994)
Musk (Версия 2).
Примечание: UCI Machine Learning Repository
Внешние ссылки: Document
Цитируется: §5.2,
§5.
[4]
T. Chen and C. Guestrin (2016)
Xgboost: a scalable tree boosting system.
In Proceedings of the 22nd acm sigkdd international conference on knowledge discovery and data mining,
pp. 785–794.
Цитируется по: §2.
⟦[5]
Y. Gebreyesus, D. Dalton, S. Nixon, D. De Chiara, and M. Chinnici (2023)
Машинное обучение для оптимизации центров обработки данных: выбор признаков с использованием Shapley Additive Explanation (shap).
Future Internet 15 (3), стр. 88.
Цитируется по: §2⟧.
[6]
Дж. Голдвассер и Г. Хукер (2024)
Статистическая значимость рейтингов важности признаков.
Препринт arXiv:2401.15800.
Цитируется: §1,
§2.
[7]
T. R. Golub, D. K. Slonim, P. Tamayo, C. Huard, M. Gaasenbeek, J. P. Mesirov, H. Coller, M. L. Loh, J. R. Downing, M. A. Caligiuri, et al. (1999)
Молекулярная классификация рака: обнаружение классов и предсказание классов по мониторингу экспрессии генов.
Science 286 (5439), сс. 531–537.
Цитируется: §5.1,
§5.
[8]
Р. Халаби, Б. Х. Мулсант, М. Толенд, Д. М. Блумбергер, А. ДеШоу, А. Хинце, К. Гонсалес-Торрес, М. И. Хусейн, Х. К. Ким, К. О’Донован и др. (2026)
Систематическое исследование цифровых биомаркеров для выявления депрессивных эпизодов при биполярном расстройстве.
npj Mental Health Research 5 (1), стр. 13.
Цитируется в: §2⟧.
[9]
G. Ke, Q. Meng, T. Finley, T. Wang, W. Chen, W. Ma, Q. Ye, and T. Liu (2017)
Lightgbm: высокоэффективный градиентный бустинг деревьев решений.
Достижения в области нейронных систем обработки информации 30.
Цитируется: §2.
[10]
А. Крижевский, Г. Хинтон и др. (2009)
Изучение множества слоев признаков из крошечных изображений.
Цитируется: §5.4.
[11]
Z. Li (2022)
Извлечение пространственных эффектов из модели машинного обучения с использованием метода локальной интерпретации: пример shap и xgboost.
Компьютеры, окружающая среда и городские системы 96, с. 101845.
Цитируется: §1⟧.
[12]
Y. Liu, Z. Liu, X. Luo, and H. Zhao (2022)
Диагностика болезни Паркинсона на основе выбора признаков по значению SHAP.
Биокибернетика и биомедицинская инженерия 42 (3), стр. 856–869.
Цитируется в: §1.
⟦[13]
S. M. Lundberg, G. Erion, H. Chen, A. DeGrave, J. M. Prutkin, B. Nair, R. Katz, J. Himmelfarb, N. Bansal, and S. Lee (2020)
От локальных объяснений к глобальному пониманию с помощью объяснимого ИИ для деревьев.
Nature machine intelligence 2 (1), pp. 56–67.
Цитируется: §2,
§3,
§4.
[14]
S. M. Lundberg и S. Lee (2017)
Единый подход к интерпретации предсказаний моделей.
Advances in neural information processing systems 30.
Цитируется в: §1,
§2,
§3.
⟦[15]
У. Э. Марсилио и Д. М. Элер (2020)
От объяснений к отбору признаков: оценка значений SHAP как механизма отбора признаков.
В 2020 году на 33-й конференции SIBGRAPI по графике, шаблонам и изображениям (SIBGRAPI), стр. 340–347.
Цитируется: §2⟧.
[16]
E. Mosca, F. Szigeti, S. Tragianni, D. Gallagher, and G. Groh (2022)
Методы объяснения на основе SHAP: обзор для интерпретируемости NLP.
В трудах 29-й международной конференции по компьютерной лингвистике,
сс. 4593–4603.
Цитируется: §1.
[17]
A. V. Ponce-Bobadilla, V. Schmitt, C. S. Maier, S. Mensing, and S. Stodtmann (2024)
Практическое руководство по анализу SHAP: объяснение прогнозов модели машинного обучения с учителем в разработке лекарств.
Клиническая и трансляционная наука 17 (11), стр. e70056.
Цитируется: §1.
[18]
M. T. Ribeiro, S. Singh, and C. Guestrin (2016)
" Why should i trust you?" explaining the predictions of any classifier.
In Proceedings of the 22nd ACM SIGKDD international conference on knowledge discovery and data mining,
pp. 1135–1144.
Cited by: §1,
§2.
[19]
R. Scheda and S. Diciotti (2022)
Объяснения моделей машинного обучения в повторной вложенной перекрестной проверке: применение в прогнозировании возраста с использованием характеристик сложности мозга.
Applied Sciences 12 (13), стр. 6681.
Цитируется: §2.
[20]
T. Shaikhina, U. Bhatt, R. Zhang, K. Georgatzis, A. Xiang, and A. Weller (2021)
Влияние неопределенности на качество объяснений важности признаков.
В семинаре AAAI по объяснимому агенту в искусственном интеллекте,
Цитируется: §2.
[21]
А. Шен, Дж. Сан, К. Чен и К. Гао (2025)
Ориентированный на данные и интерпретируемый электроэнцефалографический фреймворк для оценки степени тяжести депрессии с использованием SHAP-анализа.
Journal of NeuroEngineering and Rehabilitation 22 (1), стр. 116.
Цитировано: §2.
[22]
А. Шрикумар, П. Гринсайд, А. Кундадже (2017)
Изучение важных признаков путем распространения различий активаций.
В Международной конференции по машинному обучению,
стр. 3145–3153.
Цитируется: §1,
§2.
[23]
J. Torres-Sospedra, R. Montoliu, A. Martínez-Usó, T. Arnau, and J. P. Avariento (2014)
UJIIndoorLoc.
Примечание: UCI Machine Learning RepositoryПолучено из UCI Machine Learning Repository
Внешние ссылки: Document
Цитируется: §5.3,
§5.
[24]
V. Vimbi, N. Shaffi, and M. Mahmud (2024)
Интерпретация моделей искусственного интеллекта: систематический обзор применения LIME и SHAP в обнаружении болезни Альцгеймера.
Brain informatics 11 (1), pp. 10.
Цитируется: §1.
[25]
H. Wang, Q. Liang, J. T. Hancock, and T. M. Khoshgoftaar (2024)
Стратегии отбора признаков: сравнительный анализ методов, основанных на SHAP-значениях и важности.
Журнал Big Data 11 (1), стр. 44.
Цитируется: §2.
[26]
Д. Уотсон, Дж. О’Хара, Н. Такс, Р. Мадд и И. Гай (2023)
Объяснение прогностической неопределенности с помощью информационно-теоретических значений Шепли.
Достижения в системах обработки нейронной информации 36, стр. 7330–7350.
Цитируется: §2.
Пусть — независимые случайные величины с , дисперсиями и . Если для некоторого ⟧,
затем
Доказательство.
Поскольку
независимость и дает
Следовательно,
Далее, по закону полной дисперсии,
При условии ,
Следовательно
Поскольку пары взаимно независимы, переменные взаимно независимы, и поэтому
Теперь определите центрированные слагаемые
По указанному условию Ляпунова с ,
Таким образом, центральная предельная теорема Ляпунова применима, давая
Поскольку и , это именно то
∎
Remark 1(Об условии Ляпунова).
Естественным выбором является , что сводит условие к
Простое достаточное условие состоит в том, что третьи моменты равномерно ограничены, , и ни один отдельный член не доминирует над дисперсией, т.е..,
При таких условиях числитель растет максимум линейно по , в то время как растет пропорционально количеству вносящих вклад членов, что дает
и, следовательно, условие Ляпунова выполняется..
A.2 Дополнительные результаты данных Голуба
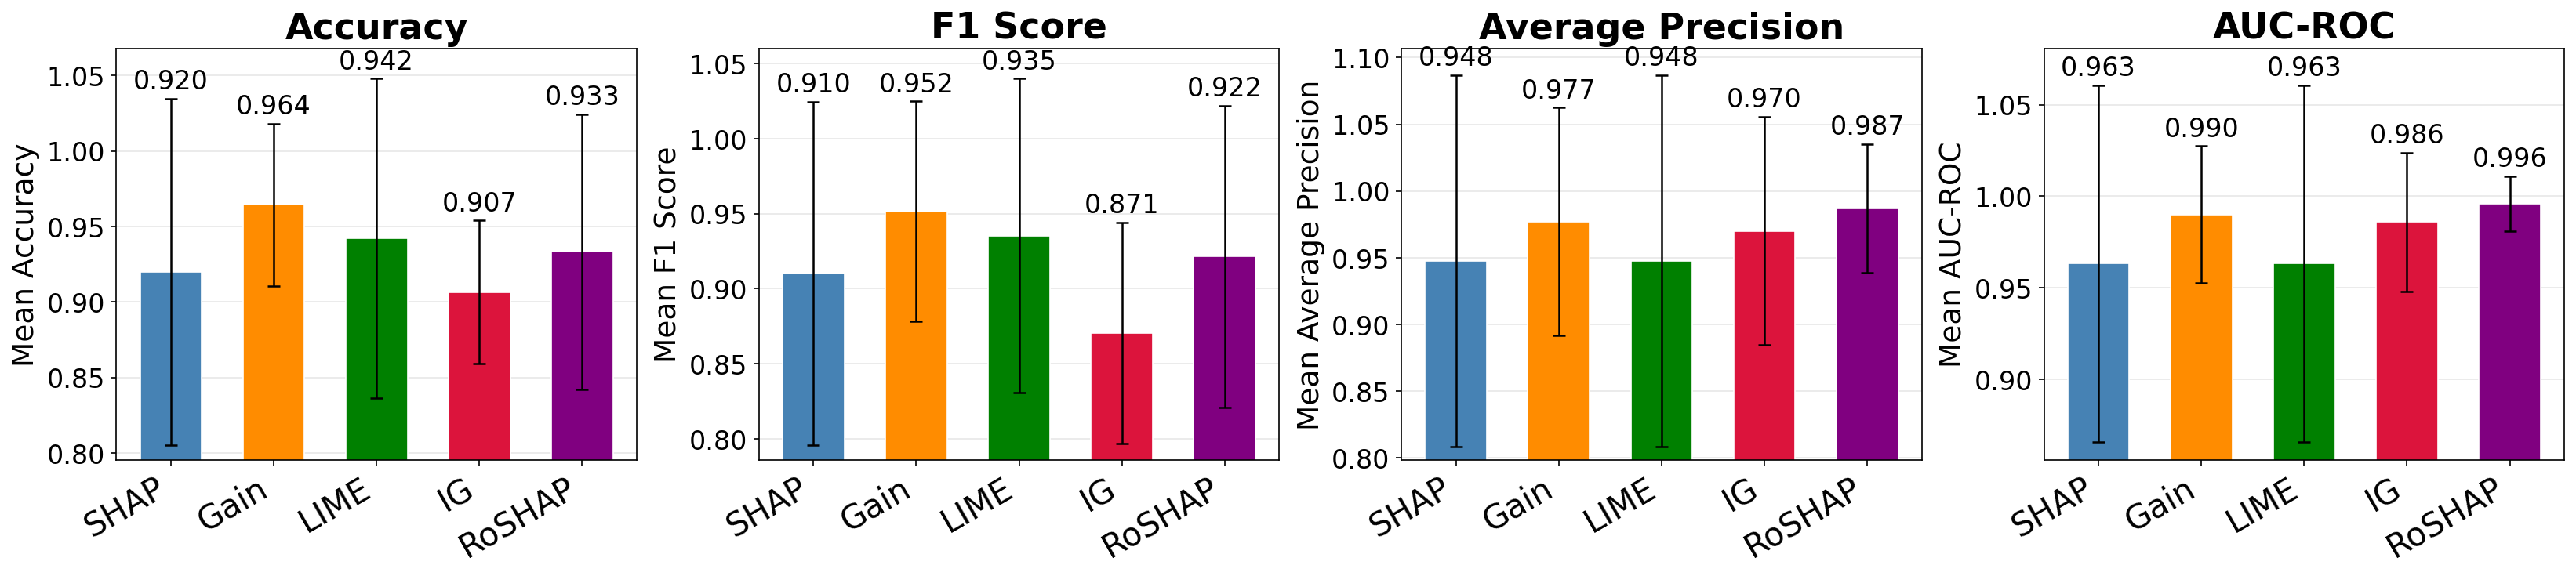
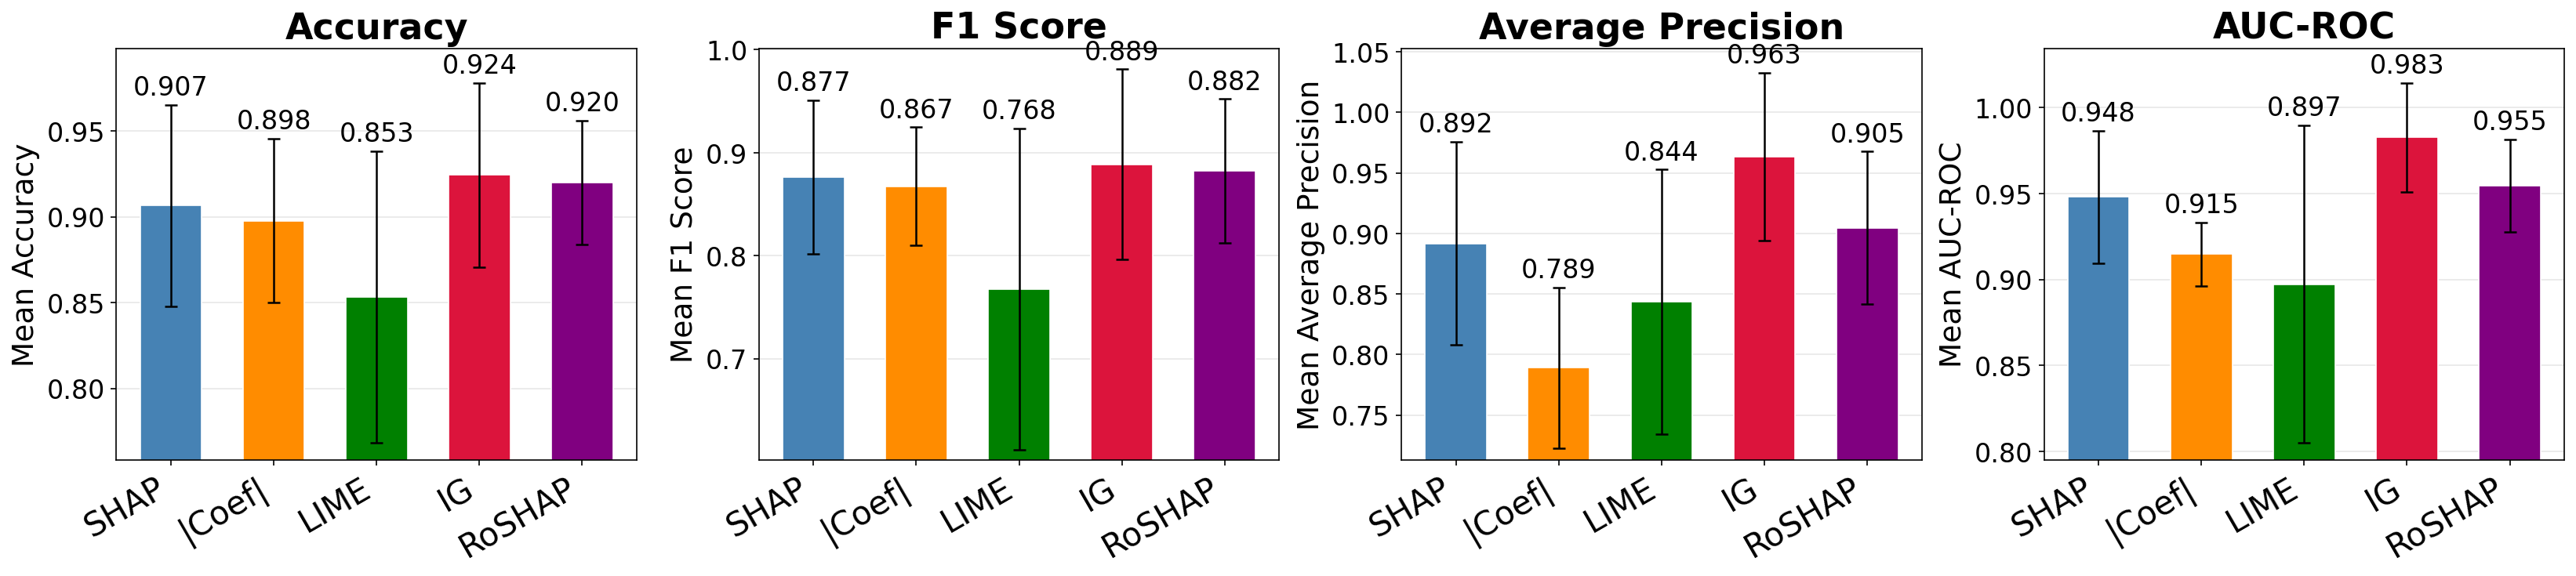
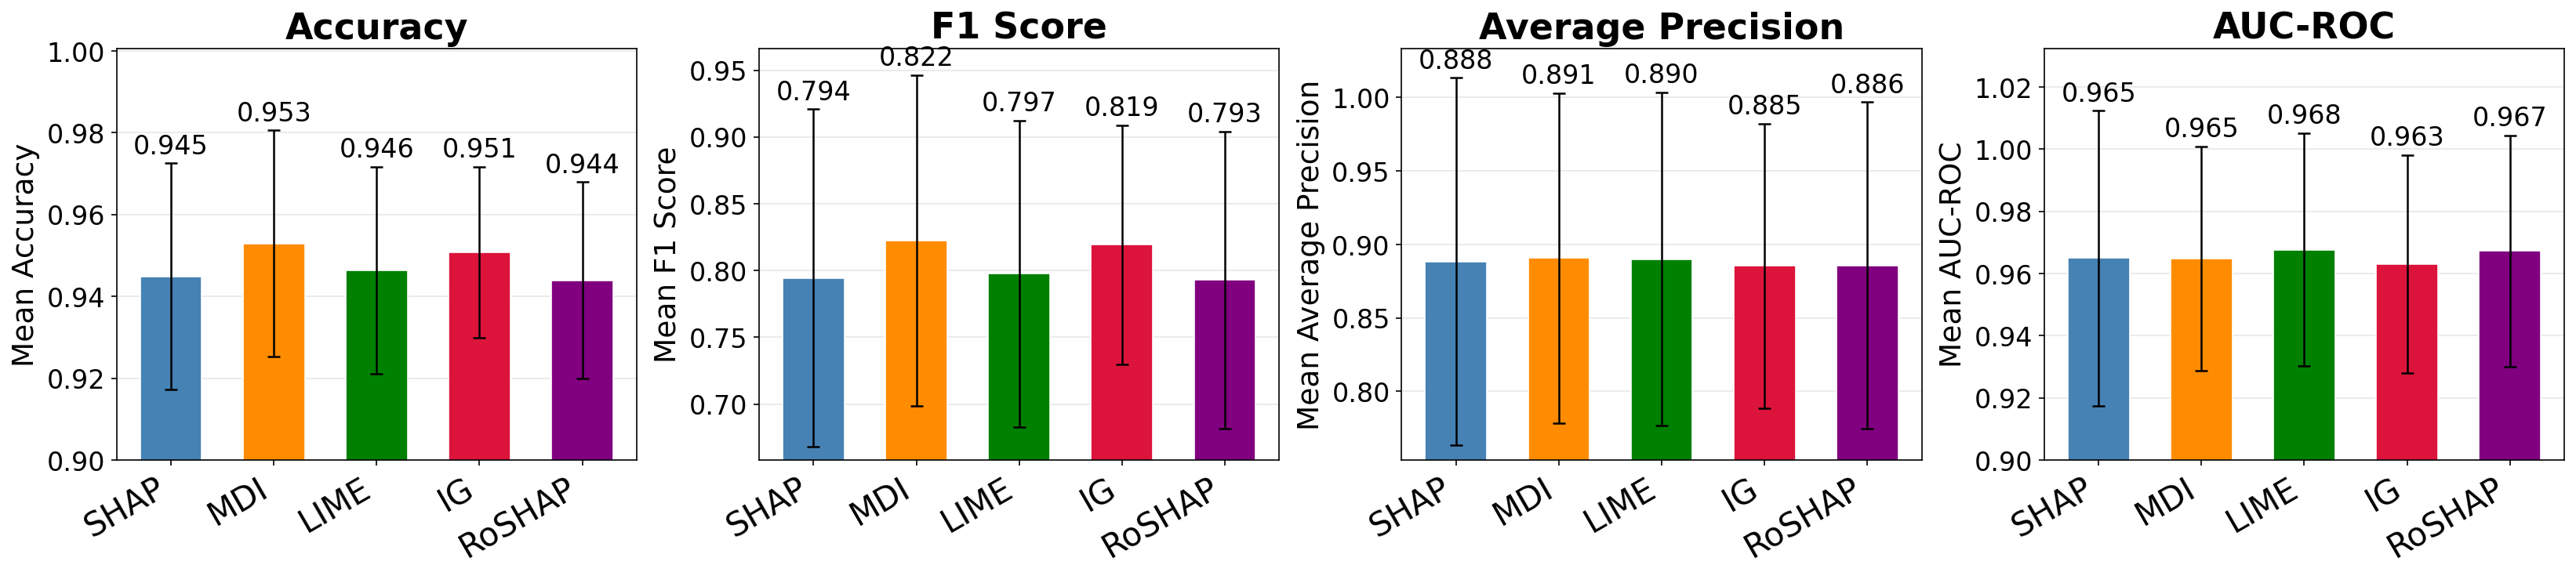
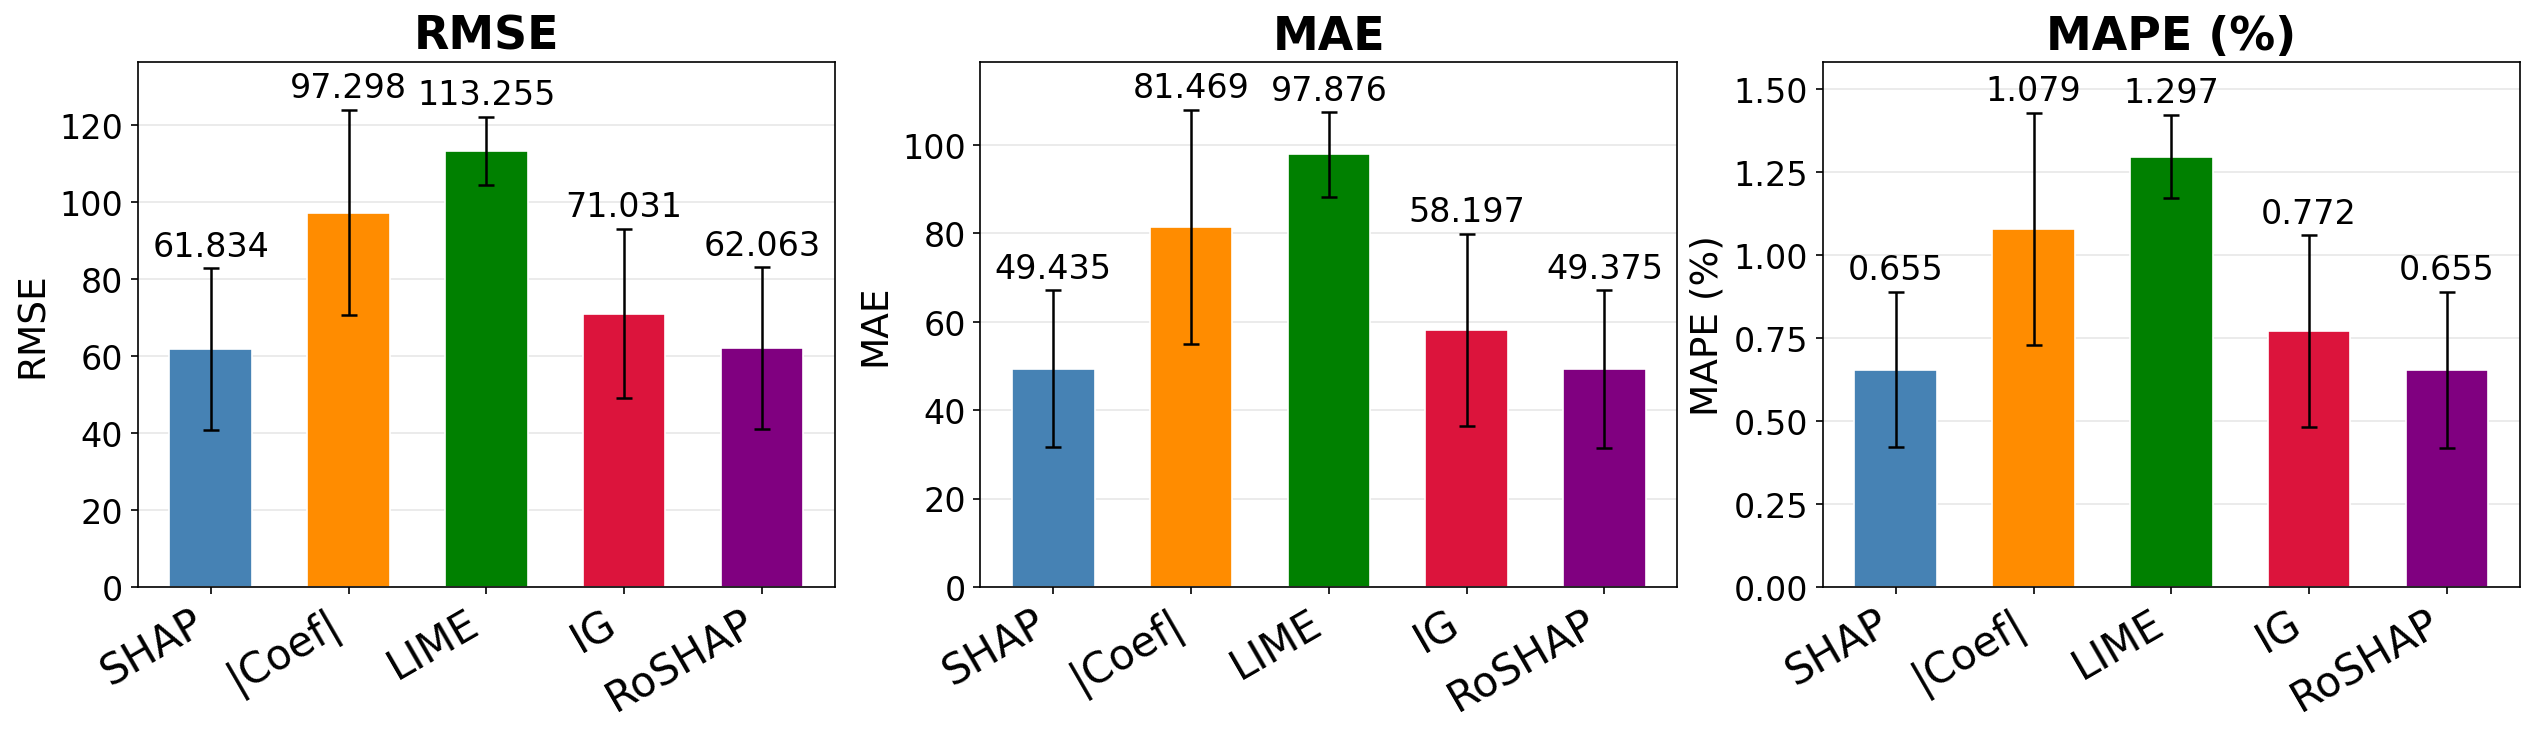
We employed the same six classifiers as in the previous experiments, with hyperparameters re-tuned to suit the characteristics of the Golub dataset. The tree-based ensemble models were configured as follows: LightGBM (binary objective, binary logloss metric, learning rate 0.1, max depth 8, 31 leaves, minimum 15 samples per leaf, 80% feature and bagging fractions with bagging frequency of 1, 150 boosting rounds); XGBoost (binary logistic objective, logloss evaluation metric, learning rate 0.1, max depth 6, 80% subsample and 60% column sampling, 100 boosting rounds); and CatBoost (logloss metric, learning rate 0.1, depth 6, default iterations); Random Forest used 100 trees with max depth 6, while Gradient Boosting used 200 trees with max depth 3 at the default learning rate. As a linear baseline, Logistic Regression was trained with a maximum of 200 iterations using default regularization. All models were initialized with a fixed random seed to ensure reproducibility, and feature contribution was extracted using tree-based explainers for the ensemble models and a linear (coefficient-based) explainer for Logistic Regression. The XGBoost results are presented in the main text, while the feature selection performance for the remaining classifiers on the Golub dataset is shown in Figures 12, 13, 14, 15, and 16.
Figure 12: Сравнение производительности выбора генов Golub с использованием CatBoost. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зелёный), information gain (IG; красный) и предложенный устойчивый метод (фиолетовый). Чем выше, тем лучше.. Figure 13: Сравнение производительности выбора генов Golub с использованием Gradient Boosting. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), информационный выигрыш (IG; красный) и предлагаемый устойчивый метод (фиолетовый). Чем выше, тем лучше.. Figure 14: Сравнение производительности выбора генов по методу Голуба с использованием LightGBM. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предложенный робастный метод (фиолетовый). Чем выше, тем лучше.. Figure 15: Сравнение эффективности выбора генов Golub с использованием логистической регрессии. Методы выбора признаков включают SHAP (синий), |coefficient| (оранжевый), LIME (зеленый), information gain (IG; красный) и предлагаемый робастный метод (фиолетовый). Чем выше, тем лучше.. Figure 16: Сравнение производительности отбора генов Golub с использованием случайного леса. Методы отбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предлагаемый устойчивый метод (фиолетовый). Чем выше, тем лучше.
A.3 Дополнительные результаты данных Musk (Версия 2)
В предыдущих экспериментах использовались те же шесть классификаторов, с перенастройкой гиперпараметров под характеристики набора данных Musk (Version 2). Ансамблевые модели на основе деревьев были настроены следующим образом: LightGBM (бинарная цель, метрика binary logloss, скорость обучения 0.1, максимальная глубина 8, 31 лист, минимум 15 образцов на лист, 80% доля признаков и доля бэггинга с частотой бэггинга 1, 150 раундов бустинга); XGBoost (бинарная логистическая цель, метрика оценки logloss, скорость обучения 0.1, максимальная глубина 6, 80% подвыборка и 60% выборка столбцов, 100 раундов бустинга); и CatBoost (метрика logloss, скорость обучения 0.1, глубина 6, итерации по умолчанию); Random Forest использовал 100 деревьев с максимальной глубиной 6, а Gradient Boosting использовал 200 деревьев с максимальной глубиной 3 при скорости обучения по умолчанию. Логистическая регрессия была обучена с максимум 200 итераций с регуляризацией по умолчанию. Все модели были инициализированы с фиксированным зерном случайности для обеспечения воспроизводимости, и вклад признаков был извлечен с помощью объяснителей на основе деревьев для ансамблевых моделей и линейного (на основе коэффициентов) объяснителя для логистической регрессии. Результаты CatBoost представлены в основном тексте, а производительность выбора признаков для остальных классификаторов на наборе данных Musk Version 2 показана на рисунках 17, 18, 19, 20 и 21.⟧.
Figure 17: Musk (Version 2) сравнение производительности выбора признаков с использованием XGBoost. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предложенный устойчивый метод (фиолетовый).).Figure 18: Сравнение производительности выбора переменных Musk (Version 2) с использованием Gradient Boosting. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предлагаемый устойчивый метод (фиолетовый)).Figure 19: Сравнение производительности выбора переменных Musk (версия 2) с использованием LightGBM. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предложенный устойчивый метод (фиолетовый)).Figure 20: Musk (Версия 2) сравнение производительности выбора переменных с использованием логистической регрессии. Методы выбора признаков включают SHAP (синий), |coefficient| (оранжевый), LIME (зеленый), информационный выигрыш (IG; красный) и предложенный робастный метод (фиолетовый)).Figure 21: Musk (Версия 2) сравнение производительности отбора переменных с использованием случайного леса. Методы отбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предложенный устойчивый метод (фиолетовый).).
A.4 Дополнительные UJIIndoorLoc Результаты
Для эксперимента с регрессией на наборе данных UJIIndoorLoc, за исключением модели случайного леса, использовались те же прогностические модели, что и в предыдущих экспериментах, с перенастройкой гиперпараметров под характеристики набора данных UJIIndoorLoc. Целевой переменной была долгота. Ансамблевые модели на основе деревьев были сконфигурированы следующим образом: LightGBM использовала регрессионную цель с метрикой RMSE, скорость обучения 0.03, максимальную глубину 7, 63 листа, минимум 30 образцов на лист, 70% долю признаков, 80% долю бэггинга с частотой бэггинга 1, регуляризацию 0.01, регуляризацию 1.0 и 300 раундов бустинга; XGBoost использовала регрессионную цель с квадратичной ошибкой и метрикой оценки RMSE, скорость обучения 0.03, максимальную глубину 6, 80% долю подвыборки, 70% выборку столбцов, минимальный вес потомка 10, регуляризацию 0.01, регуляризацию 2.0, построение деревьев на основе гистограмм и 300 раундов бустинга; CatBoost использовала функцию потерь RMSE и метрику оценки, скорость обучения 0.03, глубину 6, 300 итераций, регуляризацию листьев 5.0 и 70% случайное подпространство. Гребневая регрессия была включена в качестве линейного базового метода с параметром регуляризации . Все модели были инициализированы с фиксированным случайным зерном для обеспечения воспроизводимости, а вклад признаков был извлечен с помощью объяснителей на основе деревьев для ансамблевых моделей и линейного объяснителя для гребневой регрессии.
Результаты LightGBM представлены в основном тексте, а производительность отбора признаков для остальных моделей на наборе данных UJIIndoorLoc показана на рисунках 22, 23, 24 и 25.⟧.
Figure 22: Сравнение производительности выбора переменных UJIIndoorLoc с использованием CatBoost. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предложенный робастный метод (фиолетовый). Высота столбцов представляет среднюю метрику производительности для разных размеров наборов признаков-кандидатов, а планки погрешностей показывают соответствующую вариацию. Чем ниже, тем лучше.⟦Figure 23: Сравнение производительности выбора переменных UJIIndoorLoc с использованием градиентного бустинга. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предложенный робастный метод (фиолетовый). Высоты столбцов представляют среднюю метрику производительности по разным размерам наборов признаков-кандидатов, а планки погрешностей указывают на соответствующую вариацию. Чем ниже, тем лучше..Figure 24: Сравнение производительности выбора переменных UJIIndoorLoc с использованием XGBoost. Методы выбора признаков включают SHAP (синий), gain (оранжевый), LIME (зеленый), information gain (IG; красный) и предложенный робастный метод (фиолетовый). Высоты столбцов представляют среднюю метрику производительности для разных размеров набора кандидатных признаков, а планки погрешностей указывают соответствующую вариацию. Чем ниже, тем лучше..Figure 25: Сравнение производительности выбора переменных UJIIndoorLoc с использованием линейной регрессии (Ridge). Методы выбора признаков включают SHAP (синий), |coef| (оранжевый), LIME (зеленый), информационный выигрыш (IG; красный) и предложенный робастный метод (фиолетовый). Высота столбцов представляет среднюю метрику производительности для разных размеров наборов признаков-кандидатов, а планки погрешностей указывают на соответствующую вариацию. Меньше — лучше..
A.5 Дополнительные результаты данных CIFAR 10
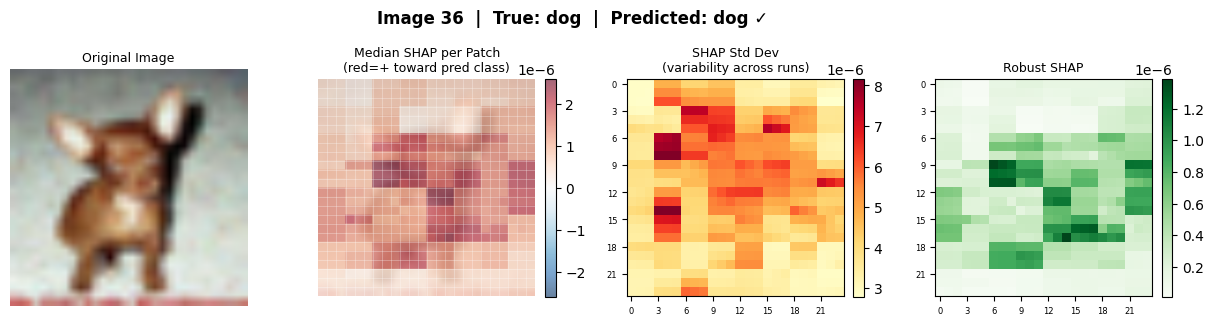
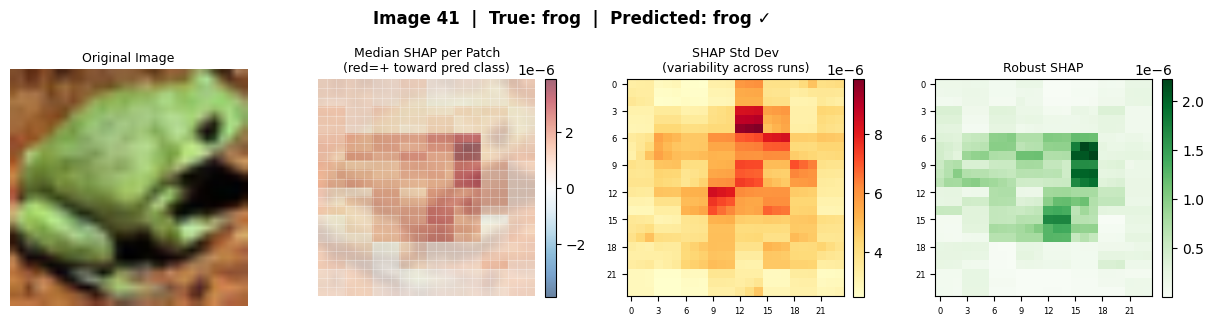
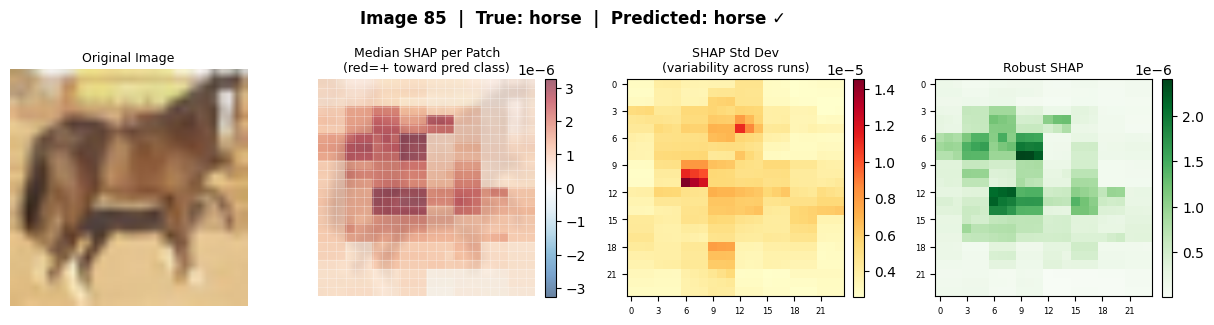
В данном эксперименте используется ViT-Base/16, предобученный на ImageNet-21k. Модель принимает входные изображения размером 384×384, разбитые на патчи 16×16 (сетка 24×24, всего 576 патчей), с 12 слоями трансформера, 12 головами внимания и скрытым измерением 768 (86M параметров). Классификационная головка заменяется линейным слоем, отображающим на 10 классов CIFAR-10, и дообучается в течение 10 эпох с использованием Adam (lr=1e-4, косинусное затухание) с размером батча 128..
Figure 26: Прогноз и результаты начальной загрузки для изображения 8. Figure 27: Предсказание и результаты бутстрепа для изображения 11. Figure 28: Прогноз и результаты бутстрепа для изображения 20. Figure 29: Прогноз и результаты бутстрэпа для изображения 36. Figure 30: Прогноз и результаты начальной загрузки для изображения 41. Figure 31: Предсказание и результаты бустрепа для изображения 66. Figure 32: Прогноз и результаты бутстрепа для изображения 85.