AnomalyAgent: Обучающие модели агентов без обучения для обнаружения аномалий в условиях нулевого/малого количества примеров
Аннотация
Благодаря обобщающей способности визуально-языковых моделей (VLM), таких как CLIP, многие подходы к обнаружению аномалий (AD) с нулевым или малым количеством примеров (zero-/few-shot) достигли впечатляющих результатов на различных наборах данных. Тем не менее, они требуют значительного обучения на больших вспомогательных наборах данных для адаптации VLM к обнаружению аномалий, а их логика вывода в значительной степени опирается на оценки аномалий, основанные на сходстве визуально-текстовых эмбеддингов, что лишает их способности к рассуждению, необходимой для выявления сложных аномалий, требующих глубокого контекстуального понимания. Чтобы устранить это ограничение, мы предлагаем AnomalyAgent — новую агентную структуру, не требующую обучения, которая использует передовые возможности рассуждения и обобщения мультимодальных больших языковых моделей (MLLM) для обнаружения аномалий. Ключевые компоненты включают: 1) комплексный инструментарий, ориентированный на аномалии, который обеспечивает адаптивное агентное рассуждение об аномалиях на основе MLLM в условиях zero-shot, и 2) специализированный модуль памяти, который обосновывает рассуждения об аномалиях с помощью few-shot примеров в контексте. Мы расширяем оценку за пределы обнаружения простых аномалий (например, поверхностных дефектов, таких как трещины, вмятины и явные повреждения) в широко используемых бенчмарках до более разнообразных типов аномалий, таких как логические/контекстуальные аномалии в логистике и производственных условиях. Обширные результаты экспериментов демонстрируют, что наш AnomalyAgent достигает значительно более высокой производительности по сравнению с методами AD на основе VLM без обучения и общими агентными методами, подчеркивая его превосходную способность к обобщению как в условиях zero-shot, так и в условиях few-shot обнаружения аномалий. Реализацию кода можно найти по адресу this address.
1 Введение
Обнаружение аномалий (AD) является одной из ключевых задач в компьютерном зрении, направленной на выявление экземпляров, которые значительно отклоняются от базового распределения данных. Это критически важно для широкого спектра реальных приложений, включая промышленную инспекцию, медицинскую диагностику, мониторинг безопасности и автономные системы Bergmann et al. (2019); Salehi et al. (2021); Bergmann et al. (2022); Höfer et al. (2025). Ключевая проблема в AD заключается в ее неотъемлемой открытой природе, то есть аномалии редки, разнообразны и зачастую непредсказуемы, что делает непрактичным исчерпывающее моделирование всех возможных отклонений во время обучения. Чтобы справиться с этой задачей, традиционные подходы Pang et al. (2021); Cao et al. (2024a); Wu et al. (2026) вместо этого фокусируются на изучении нормальных паттернов на основе больших объемов нормальных обучающих данных. Последние достижения сместили фокус с этой парадигмы обучения без учителя в сторону эффективных с точки зрения данных настроек, в частности zero-shot Xu et al. (2026); Fang et al. (2025); Cao et al. (2024b) и few-shot AD Qu et al. (2025); Zhang et al. (2025); Jeong et al. (2023), в зависимости от доступности нормальных эталонных образцов..
Благодаря мощным возможностям распознавания в режиме zero/few-shot, присущим предварительно обученным vision-language models (VLMs), возникло направление исследований по адаптации их унифицированных визуально-текстовых представлений для AD посредством parameter-efficient tuning, что позволило достичь впечатляющих результатов на множестве бенчмарков Zhou et al. (2024); Zhu et al. (2025); Ma et al. (2025). Ранние исследования, такие как WinCLIP Jeong et al. (2023), заложили основу парадигмы без обучения, используя созданные вручную текстовые промпты и многомасштабные визуальные признаки из CLIP Zheng et al. (2021) для оценки аномалий, что обеспечило надежные базовые показатели для zero- и few-shot AD..
Следуя этому направлению, методы zero-shot AD обычно улучшают визуально-текстовое выравнивание посредством обучения промптам для захвата семантики, релевантной аномалиям Zhu et al. (2025); Zhou et al. (2024); Cao et al. (2024b); Ma et al. (2025), в то время как методы few-shot AD используют нормальные эталонные образцы для характеристики ожидаемых нормальных паттернов и обнаружения аномалий посредством сравнения на основе эталонов с запрошенными образцами Zhu and Pang (2024); Chen et al. (2023); Qu et al. (2025)⟧.
Однако существующие методы на основе VLM по-прежнему требуют значительного обучения на вспомогательных наборах данных для адаптации VLM к AD. Более того, их логический вывод в значительной степени опирается на оценку аномалий на основе сходства визуально-текстовых представлений, что обеспечивает лишь поверхностное выравнивание между текстовыми подсказками и визуальными признаками, при этом аномалии идентифицируются посредством пороговой обработки полученных оценок Xu et al. (2026); Roth et al. (2022). Несмотря на эффективность для относительно простых и четко определенных паттернов аномалий, таких как поверхностные дефекты или локализованные поражения, этой парадигме не хватает явного рассуждения, что делает ее недостаточной для обработки аномалий, требующих контекстуального, реляционного или специфического для задачи понимания. Например, обнаружение логических аномалий может зависеть от расположения объектов или операционных правил Bergmann et al. (2022); Zhang et al. (2025), в то время как реальные промышленные и логистические сценарии часто демонстрируют открытые вариации внешнего вида объектов, позы и условий окружающей среды Höfer et al. (2025)⟧.
Эти проблемы выходят за рамки поверхностного сопоставления представлений и требуют более структурированного рассуждения о подобных контекстуальных и логических аномалиях. Недавние достижения в области мультимодальных LLM (MLLM) предлагают многообещающую основу для таких рассуждений и не только Bai et al. (2023); Liu et al. (2024); Li et al. (2024a). Однако их применение к задаче AD остается в значительной степени неизученным. Существующие методы AD на основе MLLM обычно используют рассуждения либо для интерпретации аномалий Jiang et al. (2025); Xu et al. (2025); Chao et al. (2025); Gu et al. (2024b), либо в качестве вспомогательного извлечения априорных данных для последующего анализа аномалий Zhang et al. (2025). В обоих случаях рассуждения MLLM не интегрированы напрямую в само решение об обнаружении, что ограничивает их полезность для zero-shot и few-shot AD. Как следствие, их эффективность в условиях zero-shot и few-shot обнаружения аномалий остается ограниченной, часто уступая сильным VLM-базовым методам без обучения или требуя настройки под конкретный набор данных для достижения конкурентоспособных результатов..
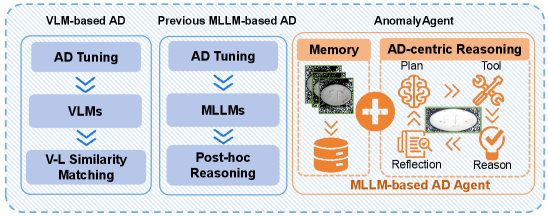
Для решения этих задач мы предлагаем AnomalyAgent, полностью не требующую обучения агентную структуру, которая напрямую использует превосходные агентные способности MLLM — планирование, использование инструментов, рассуждение и рефлексию — специально для обнаружения аномалий. Как показано на рис. 1, в отличие от существующих методов на основе VLM, которые полагаются на поверхностное сопоставление сходства с настройкой вспомогательного домена, или предыдущих подходов на основе MLLM, требующих адаптации под конкретную задачу для апостериорного рассуждения, AnomalyAgent напрямую интегрирует агентные способности, ориентированные на аномалии, в сам процесс обнаружения полностью без необходимости обучения. С этой целью в AnomalyAgent представлен набор инструментов, ориентированных на аномалии, для постепенного сбора и проверки визуальных доказательств посредством исследования на основе гипотез, контрфактической проверки и рефлексивного рассуждения, адаптированного для AD. Это позволяет ему справляться со сложными паттернами отклонений, выходящими за рамки простых визуальных различий. В сценариях, где доступны контекстные примеры, например, в настройках few-shot AD, дополнительно внедряется механизм памяти на основе самокалибровки для преобразования few-shot примеров в применимые контекстные воспоминания, чтобы обеспечить самокалибровку рассуждений относительно нормальных паттернов, специфичных для набора данных в AnomalyAgent..
В целом, наш вклад можно резюмировать следующим образом:
- ⟦• Мы представляем AnomalyAgent, новую агентную структуру без обучения, адаптированную для AD. Она переводит обнаружение аномалий от оценки аномалий на основе сходства визуально-текстовых представлений к рассуждению об аномалиях с расширенными инструментами и памятью, что позволяет принимать решения об аномалиях без пороговых значений оценки и проводить глубокий анализ сложных паттернов отклонений..
- ⟦• Мы дополнительно предлагаем инструментарий рассуждения, ориентированный на аномалии, и механизм памяти на основе самокалибровки для создания агентного конвейера планирования-рассуждения-рефлексии, ориентированного на AD. С помощью этого конвейера AnomalyAgent может активно собирать, проверять и уточнять доказательства в противовес ожидаемым нормальным паттернам на протяжении всего процесса рассуждения, а также привлекать внешние воспоминания для выполнения самокалибровки, когда такая информация доступна..
- ⟦• Мы создаем комплексный оценочный эталон, охватывающий широкий спектр типов аномалий в различных сценариях AD, включая промышленный контроль, медицинскую визуализацию и логистику. Обширные сравнения с методами на основе VLM и агентами MLLM демонстрируют высокую способность AnomalyAgent к обобщению как в условиях zero-shot, так и few-shot..
2 Связанные работы
Обнаружение аномалий на основе VLM в режиме Zero-/Few-Shot. Для улучшения обобщающей способности в отношении ранее не встречавшихся доменов появились методы обнаружения аномалий в режиме zero- и few-shot (ZSAD/FSAD), позволяющие выявлять аномалии без обучения на специфических наборах данных. Последние достижения в значительной степени обусловлены использованием vision-language models (VLM), которые обеспечивают AD посредством сопоставления визуально-текстового сходства в едином пространстве эмбеддингов. Ранние методы, такие как WinCLIP Jeong et al. (2023), формируют парадигму без обучения, используя признаки CLIP Radford et al. (2021) с помощью созданных вручную промптов как в условиях ZSAD, так и FSAD. Для ZSAD последующие подходы в основном улучшают обучение представлений, чувствительных к аномалиям, посредством адаптации на основе промптов Chen et al. (2023); Zhu et al. (2025); Zhou et al. (2024); Cao et al. (2024b); Gu et al. (2024a). Например, APRIL-GAN Chen et al. (2023) внедряет дополнительные обучаемые слои, обученные на вспомогательных данных об аномалиях, в то время как такие методы, как AnomalyCLIP Zhou et al. (2024), FAPrompt Zhu et al. (2025) и AdaCLIP Cao et al. (2024b), используют обучаемые промпты для лучшего согласования визуальных признаков с семантикой, относящейся к аномалиям. Для FSAD существующие методы используют нормальные эталонные образцы посредством сравнения на основе эталонов Li et al. (2024b); Zhu and Pang (2024); Yao et al. (2024). PromptAD Li et al. (2024b) изучает нормальные паттерны, специфичные для класса, посредством обучения промптов для одного класса, в то время как InCTRL Zhu and Pang (2024) и ResAD Yao et al. (2024) моделируют остаточные расхождения между запрошенными образцами и нормальными эталонами для обнаружения аномалий. Однако эти методы по-прежнему опираются на механизмы принятия решений, основанные на сходстве, что ограничивает их эффективность в сценариях, требующих контекстуального или реляционного понимания..
Обнаружение аномалий и рассуждения на основе MLLM. Мотивированные мощными способностями MLLM к рассуждениям, недавние исследования изучают обнаружение аномалий с точки зрения логического вывода. Такие подходы, как MMAD Jiang et al. (2025), AnomalyGPT Gu et al. (2024b), Anomaly-OV Xu et al. (2025) и AnomalyR1 Chao et al. (2025), в основном рассматривают MLLM как модули апостериорного рассуждения для анализа аномалий посредством описаний на естественном языке или многошагового вывода. Другие методы, такие как LogSAD Zhang et al. (2025), используют MLLM для моделирования структурных или логических ограничений в качестве априорных знаний для AD. Однако существующим методам по-прежнему не хватает руководства по рассуждению с учетом аномалий, которое явно интегрировало бы рассуждения в сам процесс обнаружения аномалий, что часто требует настройки под конкретный набор данных и приводит к результатам хуже, чем у сильных VLM-базовых моделей, не требующих обучения. Недавние агентные фреймворки продемонстрировали сильные способности в планировании, использовании инструментов и многошаговых рассуждениях в мультимодальных задачах Yao et al. (2023); Shinn et al. (2023); Chhikara et al. (2025). Однако прямое применение универсальных агентов к AD остается сложной задачей из-за отсутствия руководства по рассуждению, специфичного для аномалий, и откалиброванных априорных представлений о нормальности. В отличие от них, AnomalyAgent — это полностью не требующий обучения агентный AD-фреймворк, который явно интегрирует рассуждения MLLM в обнаружение аномалий с помощью набора инструментов для рассуждения, ориентированного на аномалии, и механизма памяти, основанного на самокалибровке..
3 Методология
Постановка задачи. Существующие методы ZSAD/FSAD Zhu et al. (2025); Zhou et al. (2024); Zhu and Pang (2024) обычно требуют вспомогательных наборов данных для адаптации VLM к AD. В частности, при наличии вспомогательных данных , где обозначает обучающие изображения, обозначает соответствующие бинарные метки, и каждый образец удовлетворяет , при этом и представляют нормальные и аномальные образцы соответственно, предобученная функция оценки аномалий на основе VLM дообучается с использованием , а затем напрямую применяется для получения оценки аномальности для образцов из невидимых тестовых данных . В отличие от этого, наша работа функционирует полностью без обучения, не требуя ни обучения на вспомогательных данных, ни адаптации параметров. В частности, наша цель — разработать обобщаемый агент рассуждения об аномалиях на основе MLLM , который может эффективно обобщаться на различные невидимые тестовые наборы данных как в условиях zero-shot, так и few-shot, где каждый тестовый набор данных взят из отдельной предметной области и не требует никакого обучения. В условиях zero-shot во время вывода отсутствуют эталонные образцы целевого домена. Напротив, FSAD дополнительно предоставляет небольшой набор нормальных эталонных образцов из целевого домена, обозначаемый как , где обычно является небольшим числом (например, ). Ожидается, что полученная модель будет напрямую выдавать жесткое предсказание метки, то есть «аномальный» или «нормальный», обеспечивая глобальный прогноз того, содержит ли запрашиваемое изображение какой-либо аномальный контент..
Обзор AnomalyAgent. Как показано на рис. 2, AnomalyAgent вводит изображение и название класса в инструменты шаблонов, получая общий анализ шаблона и контрфактический анализ шаблона для конкретного класса. Учитывая общий анализ шаблона и исходное изображение, планировщик выбирает и вызывает соответствующий визуальный инструмент для усиления доказательств, связанных с аномалиями. Затем дополненное изображение, исходное изображение и анализ шаблона передаются в модуль Reasoner для принятия решения. Если условие завершения не выполнено, вышеупомянутая информация, а также ход мыслей модуля Reasoner будут переданы в модуль Reflector для нового цикла исследования. Ниже мы подробно представляем эти модули..
3.1 Набор инструментов, ориентированный на аномалии, для агентного планирования, рассуждения и рефлексии, направленного на AD ⟦K0⟧
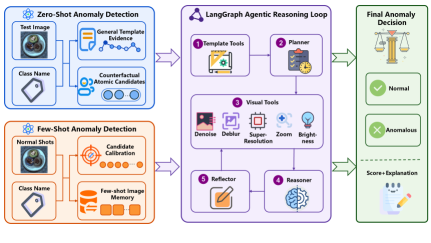
Для обеспечения обнаружения аномалий в условиях полного отсутствия обучения мы представляем zero-shot агентную структуру, которая может адаптироваться к разнообразным требованиям инспекции без доступа к обучающим выборкам или выполнения обновления параметров. В отличие от общих MLLM агентов, которые в основном полагаются на визуальные QA открытого типа, AnomalyAgent специально разработан для обнаружения аномалий с двух взаимодополняющих аспектов: инструментарий, ориентированный на аномалии, который предоставляет релевантные для задачи визуальные и семантические доказательства, и агентный конвейер, ориентированный на AD, который последовательно планирует, рассуждает и анализирует такие доказательства перед вынесением решения с жесткой меткой..
Набор инструментов, ориентированный на аномалии.
Инструменты в AnomalyAgent организованы в две категории. Первая категория состоит из общих визуальных инструментов, которые улучшают изображение запроса или фокусируются на локальных областях для предоставления более четких визуальных доказательств для проверки аномалий. Вторая категория состоит из шаблонных инструментов, которые используют как текстовые априорные знания, так и описания на уровне изображения для построения структурированных сигналов, связанных с аномалиями. Такая конструкция позволяет агенту улучшить видимость подозрительных наблюдений, основывая свои рассуждения на явных априорных знаниях, специфичных для AD..
Общие визуальные инструменты. Мы включаем пять общих визуальных инструментов: шумоподавление изображений, устранение размытости изображений, сверхразрешение, масштабирование и регулировка яркости. Эти инструменты вызываются, когда планировщик или рефлектор выявляет недостаточные или неоднозначные визуальные доказательства, такие как низкое качество изображения, небольшие подозрительные области, размытость или плохое освещение. Реализации представлены в приложении A.1.
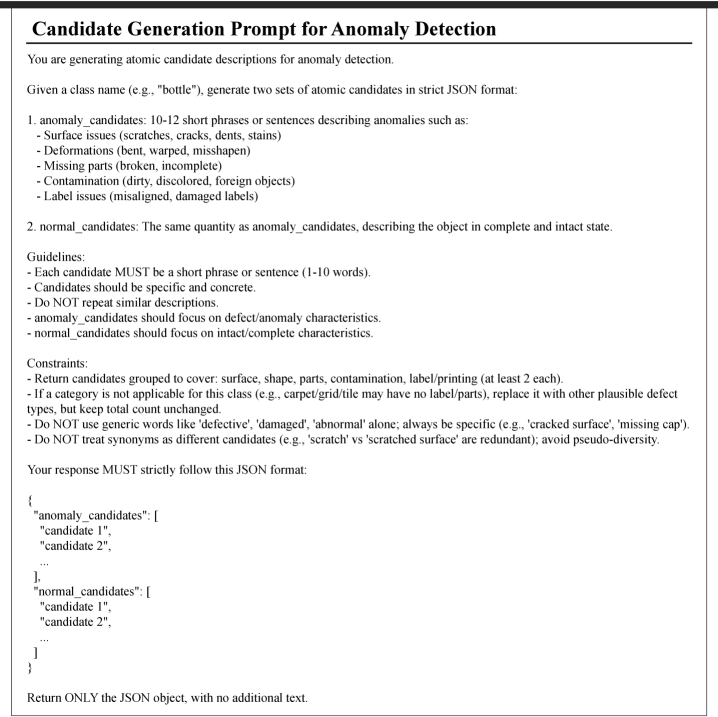
Инструменты шаблонов. Включают в себя инструмент общих шаблонов и инструмент контрфактуальных атомарных шаблонов. Инструмент общих шаблонов вдохновлен ансамблями шаблонов в WinCLIP Jeong et al. (2023), а именно: нормальными ансамблями () и ансамблями аномалий (). Однако, вместо ограничения доказательств аномалий соответствием между визуальными признаками CLIP и предопределенными текстовыми шаблонами, мы используем возможности MLLM по детализированному визуальному описанию. В частности, для генерации подробных описаний целевого изображения с дополнительных визуальных ракурсов применяется модель описания изображений на основе MLLM.:
| (1) |
где каждая подпись фокусируется на отдельном визуальном аспекте объекта, а можно найти в Приложении B.
Затем эти описания сравниваются с нормальными и аномальными шаблонами, обусловленными классами, что дает предварительный отчет о семантических доказательствах, который указывает на то, соответствует ли наблюдаемый внешний вид скорее нормальности или аномальности.:
| (2) |
где обозначает модель векторных представлений текста.
Инструмент контрфактуальных атомарных шаблонов работает аналогичным образом, будучи при этом более адаптивным и гибким. LLM используется для генерации обусловленных классом наборов аномальных и нормальных кандидатов:
| (3) |
Кандидаты на аномалии описывают конкретные нетипичные паттерны, такие как повреждение поверхности, деформация, отсутствие деталей, загрязнение или структурные дефекты, в то время как нормальные кандидаты описывают неповрежденные и правильные внешние виды. Для каждой подписи мы вычисляем ее сходство с нормальными и аномальными семантическими прототипами, получая мягкую оценку аномальности.:
где и представляют собой усредненные эмбеддинги прототипов аномальных и нормальных текстовых данных. Это позволяет сформировать интерпретируемый предварительный отчет о доказательствах, включающий оценки аномалий на уровне подписей, границы сходства и паттерны согласованности между различными перспективами. Кроме того, мы дополнительно создаем контрфактический отчет о доказательствах посредством сопоставления атомарных кандидатов. В частности, каждая подпись к изображению сравнивается с наборами сгенерированных аномальных и нормальных кандидатов:
| (4) |
где является гиперпараметром. Извлеченные кандидаты предоставляют детализированные доказательства, объясняющие, ближе ли визуальное описание к аномальным или нормальным семантическим паттернам. Мы вычисляем маржу на уровне кандидатов:
| (5) |
и обобщить наиболее подходящие аномальные и нормальные кандидаты в качестве контрфактических доказательств:
| (6) |
Этот отчет не используется напрямую в качестве жесткого правила принятия решений; вместо этого он предоставляет структурированные семантические подсказки для рассуждения агента ⟦BROKEN_K0⟧.
Агентный конвейер, ориентированный на AD. После получения и , AnomalyAgent выполняет оценку аномалий посредством конвейера планирования–рассуждения–рефлексии. Планировщик сначала получает необработанное изображение, название класса и отчеты с семантическими доказательствами, а затем преобразует их в план проверки:
| Plan | (7) | |||
Здесь потенциальные аномалии суммируют подозрительные визуальные области или аномальные паттерны, предложенные шаблонными отчетами, в то время как эвристический промпт предоставляет руководство по проверке конкретного класса для последующего рассуждения. Когда визуальных доказательств недостаточно, планировщик вызывает соответствующие общие визуальные инструменты для получения расширенных наблюдений .
Затем Reasoner объединяет необработанное изображение, расширенные наблюдения, план инспекции и отчеты о семантических доказательствах для вынесения структурированного суждения об аномалии:
| Result | (8) | |||
Прогноз выбирается из , где Reason объясняет подтверждающие визуальные наблюдения и их согласованность с семантическими априорными данными. Если получено уверенное решение о нормальном или аномальном состоянии, конвейер напрямую возвращает результат.
Когда Reasoner выдает неопределенный результат, Reflector пересматривает предыдущий план и суждение, выявляет недостающие или неоднозначные доказательства и уточняет инструкцию по проверке.:
| Reflect | (9) | |||
Затем отраженная инструкция отправляется обратно в Planner или Reasoner для целенаправленной повторной проверки. Таким образом, AnomalyAgent избегает преждевременных решений на основе неполных данных, сохраняя при этом итоговый прогноз в виде жесткого решения об аномалии..
3.2 Самокалибровка с расширенной памятью с использованием нормальных эталонных примеров
Чтобы дополнительно снизить количество ложных срабатываний, вызванных нормальными вариациями, специфичными для класса, мы внедряем механизм самокалибровки с расширенной памятью, который использует небольшой набор нормальных эталонных примеров без обновления каких-либо параметров модели. Для каждого класса , пусть
| (10) |
обозначим доступные нормальные эталонные изображения. Мы сначала запускаем тот же конвейер AnomalyAgent для каждого и записываем его промежуточные данные:
| (11) |
Поскольку все заведомо являются нормальными, эти записи предоставляют сигналы самокалибровки для идентификации нормальных визуальных паттернов, которые могут быть ошибочно приняты за аномалии.
Контрфактическая калибровка кандидатов.
Для каждого атомарного кандидата мы назначаем вес надежности , инициализированный значением . Учитывая подписи к обычному эталонному изображению, LLM оценивает отношение между эталонным описанием и каждым кандидатом как . Мы вычисляем силу соответствия подписи и кандидата
| (12) |
Затем вес обновляется в соответствии с ограничением нормального эталона:
| (13) |
где нормальные кандидаты усиливаются, когда они соответствуют нормальным эталонам, в то время как аномальные кандидаты ослабляются, когда они соответствуют нормальным эталонам. На практике, если исходное контрфактическое свидетельство ошибочно указывает на аномалию на нормальном эталонном изображении, используется больший коэффициент обновления. Затем откалиброванные веса внедряются в сопоставление атомарных кандидатов:
| (14) |
где восстанавливает исходное невзвешенное сопоставление. Калиброванная контрфактическая маржа вычисляется как
| (15) |
, который создает уточненный для последующего рассуждения агента.
Память с нормальной эталонной выборкой.
Помимо калибровки кандидатов, мы создаем банк памяти с нормальными эталонами. Каждое эталонное изображение сохраняется вместе с его CLIP image embedding, подписями, полями шаблона, итоговым решением и цепочкой рассуждений.:
| (16) |
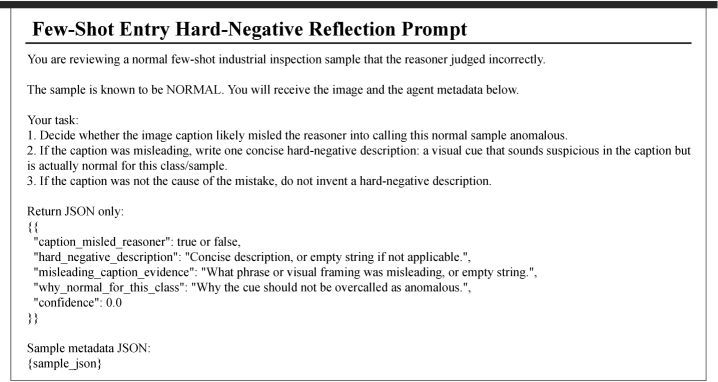
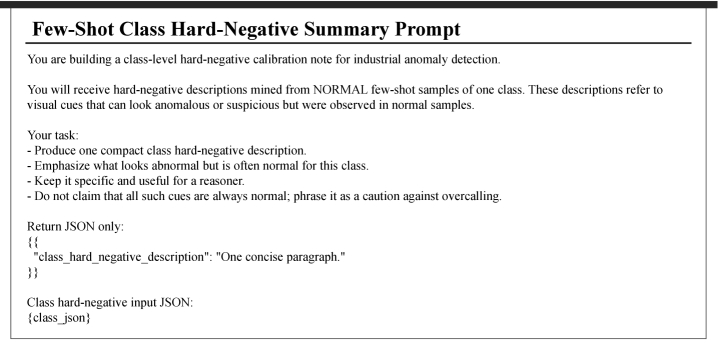
где обозначает эмбеддинг уровня изображения. Для нормальных эталонов, которые ошибочно классифицируются как аномальные, агент дополнительно анализирует случай сбоя и извлекает признаки нормальных объектов высокого уровня сложности, то есть визуальные паттерны, которые выглядят подозрительно, но являются нормальными. Эти признаки обобщаются в заметку о калибровке класса и активируются только в том случае, если проверка на нормальных эталонах повышает точность, не ухудшая при этом результаты для ранее верно классифицированных случаев.
Во время вывода, запрос изображения извлекает визуально похожие нормальные воспоминания:
| (17) |
где — пороговое значение сходства. Извлеченные записи обобщаются в отчет о памяти , включающий статистику сходства, средние значения полей шаблонов и надежность предыдущих суждений по извлеченным нормальным ссылкам.
Наконец, Reasoner получает как семантические отчеты, так и сигналы калибровки, основанные на памяти ⟦BROKEN_K0⟧:
| Result | (18) | |||
Отчет о памяти используется только в качестве исторической калибровки нормальных состояний, а не как жесткое правило принятия решений. Таким образом, итоговый прогноз остается суждением об аномалии с жесткой меткой, в то время как агент калибруется с учетом специфических для класса нормальных вариаций и трудноразличимых негативных нормальных проявлений..
4 Эксперименты
Наборы данных.
Для проверки эффективности AnomalyAgent мы проводим обширные эксперименты на пяти реальных наборах данных из различных прикладных областей, включая набор данных промышленных дефектов (MVTec Bergmann et al. (2019)), наборы данных медицинских изображений (HeadCT Salehi et al. (2021) и LAG Li et al. (2019)), набор данных логистических дефектов (Kaputt Höfer et al. (2025)) и набор данных логических аномалий (MVTec LOCO Bergmann et al. (2022)). Это тестовые наборы данных, которые используются непосредственно для оценки эффективности обнаружения в условиях zero-shot. В условиях few-shot нормальные подсказки few-shot для целевых данных случайным образом выбираются из обучающей выборки целевых наборов данных и остаются неизменными для всех моделей обнаружения для обеспечения справедливого сравнения. Мы оцениваем производительность при различном количестве наборов нормальных образцов few-shot: (Подробности о настройках наборов данных см. в Приложении).
Базовые методы и метрики оценки.
Мы сравниваем AnomalyAgent с несколькими современными (SotA) методами обнаружения аномалий как в условиях zero-shot, так и few-shot. Для ZSAD конкурирующие методы включают базовые модели, не требующие обучения, а именно: CLIP Radford et al. (2021), WinCLIP Jeong et al. (2023), MRAD Xu et al. (2026) и ReAct Agent Yao et al. (2023). Мы также включили обучаемые подходы ZSAD, включая APRIL-GAN Chen et al. (2023), AnomalyCLIP Zhou et al. (2024) и FAPrompt Zhu et al. (2025), однако они не включены в прямое сравнение производительности; их результаты используются только для проверки разрыва в эффективности между методами AD, не требующими обучения, и обучаемыми методами. Для FSAD базовые модели, не требующие обучения, включают WinCLIP+ Jeong et al. (2023), PatchCore Roth et al. (2022) и агентный метод Mem0 Chhikara et al. (2025), в то время как обучаемые базовые модели включают APRIL-GAN Chen et al. (2023) и InCTRL Zhu and Pang (2024). Обратите внимание, что ReAct не включен в эксперименты FSAD, поскольку он не может напрямую использовать few-shot референсы; аналогично, Mem0, требующий few-shot референсов, не используется в экспериментах ZSAD. Следуя предыдущим подходам AD Cao et al. (2024b); Zhang et al. (2025); Fučka et al. (2026), мы используем площадь под рабочей характеристикой приемника (AUROC) и максимально возможную F1-меру (F1-max) в качестве наших метрик оценки..
Детали реализации.
Мы используем GPT-5.1 OpenAI (2025b) с Response API в качестве MLLM по умолчанию для всех агентных методов (AnomalyAgent, ReACT и Mem0) для описания изображений, планирования, рассуждения и рефлексии в основных экспериментах. Для снижения стоимости инференса GPT-4.1-mini OpenAI (2025a) используется для вспомогательных рассуждений и операций, связанных с памятью. Для сопоставления доказательств на основе эмбеддингов мы по умолчанию применяем модель текстовых эмбеддингов на базе Qwen3-4B Yang and others (2025). Для методов без обучения все наборы данных напрямую используются для инференса без какого-либо обучения или адаптации. Для обучаемых методов мы следуем официальным экспериментальным протоколам конкурирующих подходов, где модели обучаются на соответствующих вспомогательных наборах данных и оцениваются на целевых тестовых наборах без дополнительной fine-tuning. Детали реализации для AnomalyAgent и конкурирующих методов приведены в Приложении.
4.1 Основные результаты
Zero-shot обнаружение аномалий. В таблице 1 представлены результаты ZSAD по пяти наборам данных как для методов, полностью не требующих обучения, так и для обучаемых методов. В целом, AnomalyAgent достигает наилучшей средней производительности среди всех методов, не требующих обучения, превосходя наиболее сильный базовый метод без обучения на величину до 2,7% по AUROC и 1,7% по -. По сравнению с традиционными подходами на основе VLM, полагающимися на сопоставление визуально-языкового сходства, AnomalyAgent демонстрирует особенно значительные улучшения на наборах данных, требующих контекстуального и реляционного понимания, таких как MVTec LOCO и Kaputt, и даже достигает конкурентоспособных результатов по сравнению с рядом обучаемых методов. Хотя обучаемые подходы, такие как AnomalyCLIP и FAPrompt, по-прежнему показывают несколько лучшие результаты на некоторых наборах данных благодаря оптимизации во вспомогательных доменах, AnomalyAgent остается высококонкурентным без какого-либо обучения или адаптации параметров. Эти результаты демонстрируют эффективность предложенной агентной структуры рассуждений для обработки контекстуальных, структурных и зависящих от задачи аномалий..
Что касается универсального MLLM агента ReAct, он достигает конкурентоспособной производительности по сравнению с WinCLIP, демонстрируя потенциал агентного рассуждения для AD. Однако между ReAct и AnomalyAgent все еще существует явный разрыв, что говорит о том, что универсальным MLLM агентам не хватает специфического для AD руководства по рассуждению и откалиброванных априорных представлений о нормальности для надежного понимания аномалий. В отличие от них, AnomalyAgent явно организует ориентированные на аномалии инструменты в рамках структурированного рабочего процесса рассуждения, обеспечивая более надежные решения об аномалиях в различных сценариях AD. Более того, стабильно более сильные результаты -, достигнутые методами на основе MLLM, в частности ReAct и AnomalyAgent, указывают на то, что анализ аномалий на основе рассуждений позволяет получать более дискриминативные решения об аномалиях с лучшим разделением норма/аномалия, чем традиционные методы, основанные на оценке аномалий..
| Dataset | Training-Free Methods | Trainable Methods | ||||||||||||||
| WinCLIP | MRAD-TF | ReACT | AnomalyAgent | CLIP | AprilGAN | AnomalyCLIP | FAPrompt | |||||||||
| AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | |
| MVTec | 90.4 | 92.7 | 81.2 | 89.3 | 74.3 | 86.3 | 84.5 | 90.7 | 74.0 | 74.7 | 86.1 | 83.5 | 91.6 | 89.6 | 91.8 | 89.7 |
| MVTec LOCO | 59.1 | 53.8 | 58.2 | 77.3 | 60.0 | 77.3 | 62.8 | 77.3 | 53.6 | 44.9 | 58.6 | 39.8 | 61.9 | 57.4 | 59.5 | 51.3 |
| LAG | 59.6 | 65.4 | 60.1 | 81.3 | 57.7 | 81.3 | 65.3 | 81.3 | 62.6 | 66.7 | 80.7 | 77.9 | 76.4 | 77.9 | 74.9 | 80.2 |
| HeadCT | 86.7 | 81.5 | 74.7 | 72.4 | 91.0 | 91.2 | 91.0 | 91.5 | 61.2 | 66.7 | 89.7 | 82.4 | 93.4 | 89.5 | 94.4 | 90.4 |
| Kaputt | 55.6 | 36.6 | 47.6 | 48.3 | 53.6 | 45.0 | 61.3 | 48.9 | 55.0 | 41.3 | 61.4 | 42.4 | 55.4 | 48.8 | 63.9 | 50.6 |
| Average | 70.3 | 66.0 | 64.4 | 73.7 | 67.3 | 76.2 | 73.0 | 77.9 | 61.3 | 58.9 | 75.3 | 65.2 | 75.7 | 72.6 | 76.9 | 72.4 |
| Shot | Dataset | Training-Free Methods | Trainable Methods | ||||||||||
| WinCLIP+ | PatchCore | Mem0 | AnomalyAgent | AprilGAN | InCTRL | ||||||||
| AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | AUROC | F1-max | ||
| 1-shot | MVTec | 94.1 | 92.0 | 83.8 | 87.4 | 83.0 | 89.2 | 85.0 | 91.0 | 92.2 | 89.4 | 93.0 | 91.5 |
| MVTec LOCO | 61.2 | 56.0 | 60.9 | 54.0 | 53.3 | 77.3 | 64.0 | 78.6 | 64.6 | 50.0 | 60.0 | 57.3 | |
| LAG | 55.1 | 50.5 | 40.8 | 49.3 | 60.5 | 81.3 | 66.1 | 82.0 | 77.3 | 68.8 | 47.0 | 67.0 | |
| HeadCT | 81.3 | 82.0 | 65.1 | 85.6 | 89.0 | 89.8 | 91.1 | 91.2 | 89.6 | 83.4 | 90.2 | 91.6 | |
| Kaputt | 55.9 | 55.6 | 51.0 | 63.0 | 55.6 | 46.3 | 61.9 | 49.5 | 57.4 | 56.8 | 58.0 | 57.2 | |
| Average | 69.5 | 67.2 | 60.3 | 67.9 | 68.3 | 76.8 | 73.6 | 78.5 | 76.2 | 69.7 | 69.6 | 72.9 | |
| 2-shot | MVTec | 95.0 | 92.5 | 86.8 | 88.4 | 80.6 | 89.0 | 85.6 | 91.2 | 82.8 | 88.6 | 94.3 | 92.9 |
| MVTec LOCO | 63.3 | 67.2 | 61.7 | 53.9 | 52.6 | 77.3 | 66.3 | 79.4 | 65.2 | 59.7 | 61.6 | 58.2 | |
| LAG | 59.5 | 58.5 | 59.6 | 68.1 | 59.3 | 81.3 | 67.0 | 82.3 | 77.1 | 73.0 | 58.8 | 76.9 | |
| HeadCT | 81.2 | 77.6 | 70.0 | 77.0 | 89.5 | 90.2 | 91.5 | 91.6 | 89.6 | 86.0 | 91.5 | 92.2 | |
| Kaputt | 55.7 | 55.9 | 50.1 | 52.1 | 57.4 | 48.3 | 63.0 | 51.5 | 57.1 | 56.5 | 57.7 | 56.9 | |
| Average | 70.9 | 70.3 | 65.6 | 67.9 | 67.9 | 77.2 | 74.7 | 79.2 | 74.4 | 72.8 | 72.8 | 75.4 | |
| 4-shot | MVTec | 94.9 | 93.0 | 89.7 | 89.5 | 82.4 | 89.2 | 86.4 | 91.8 | 82.7 | 88.9 | 95.3 | 93.8 |
| MVTec LOCO | 63.9 | 66.8 | 64.2 | 54.6 | 53.6 | 77.3 | 67.4 | 79.9 | 65.4 | 53.9 | 62.8 | 62.2 | |
| LAG | 65.0 | 66.9 | 67.9 | 73.0 | 60.1 | 81.3 | 68.8 | 83.2 | 77.2 | 75.8 | 72.4 | 80.8 | |
| HeadCT | 84.0 | 79.5 | 79.1 | 92.3 | 90.0 | 90.7 | 92.0 | 91.4 | 90.9 | 92.1 | 91.8 | 92.3 | |
| Kaputt | 55.6 | 58.2 | 50.2 | 52.1 | 56.8 | 47.2 | 62.7 | 51.8 | 57.4 | 57.7 | 57.3 | 57.1 | |
| Average | 72.7 | 72.9 | 70.2 | 72.3 | 68.6 | 77.1 | 75.5 | 79.6 | 74.7 | 73.7 | 75.9 | 77.2 | |
Few-shot обнаружение аномалий. В таблице 2 представлены результаты AD для 1-, 2- и 4-shot. Среди базовых моделей, не требующих обучения, AnomalyAgent достигает наилучшей производительности в большинстве конфигураций наборов данных и количества примеров, а также неизменно демонстрирует самые высокие средние показатели AUROC и - для всех значений shot, превосходя сильнейшую базовую модель без обучения на величину до 2,8% по AUROC и 2,5% по -. Схожие тенденции, что и для zero-shot конфигурации, наблюдаются как для методов на основе VLM, так и для методов на основе MLLM. По сравнению с традиционными FSAD методами на основе VLM, AnomalyAgent показывает особенно значительные улучшения на наборах данных, требующих контекстуального и реляционного понимания, в то время как общие MLLM агенты по-прежнему демонстрируют явные ограничения из-за отсутствия специфического для AD руководства по рассуждению и откалиброванных априорных представлений о нормальности. Что еще более важно, AnomalyAgent демонстрирует стабильное улучшение при увеличении количества shot, при этом производительность последовательно растет от 1-shot до 4-shot. Напротив, Mem0, оснащающий zero-shot версию AnomalyAgent общим модулем памяти, не получает надежной выгоды от дополнительных примеров. Это говорит о том, что преимущество AnomalyAgent проистекает не просто из расширения памяти, а из специфического для AD механизма памяти, который преобразует few-shot эталоны нормальности в эффективные контекстные априорные представления о нормальности для калибровки рассуждений. Хотя обучаемые методы, такие как InCTRL, по-прежнему достигают несколько более высоких показателей за счет специфической для AD оптимизации, AnomalyAgent остается весьма конкурентоспособным без какого-либо обучения или адаптации параметров, что дополнительно подтверждает эффективность агентных рассуждений с калибровкой по памяти для FSAD..
4.2 Анализ AnomalyAgent
Абляционное исследование. В этом разделе мы анализируем ключевые проектные решения в AnomalyAgent как в условиях zero-shot, так и в условиях few-shot. Если не указано иное, GPT-4.1-mini используется в качестве MLLM по умолчанию на протяжении всего этого анализа из соображений эффективности..
| Setting | Model | MVTec | MVTec LOCO | ||
| AUROC | F1-max | AUROC | F1-max | ||
| Zero-shot | Base | 65.8 | 81.7 | 53.2 | 49.1 |
| w. Ref. | 67.2 | 84.3 | 52.8 | 50.3 | |
| w. Ref. & V-Tools | 73.4 | 86.6 | 51.7 | 48.6 | |
| AnomalyAgent | 81.4 | 89.4 | 60.8 | 75.7 | |
| Few-shot | w. Hard-Normal | 79.3 | 88.1 | 58.4 | 72.9 |
| w. Calibration | 82.3 | 89.6 | 61.3 | 75.5 | |
| AnomalyAgent | 83.5 | 90.4 | 62.0 | 77.1 | |
В таблице 3 представлены результаты абляционного исследования на MVTec и MVTec LOCO. В условиях zero-shot «базовая» модель, содержащая только планировщик и модуль рассуждений, демонстрирует ограниченную производительность, особенно на сложном наборе данных MVTec LOCO, где структурная согласованность и априорные знания на уровне категорий имеют более критическое значение. Внедрение рефлексивных рассуждений («w. Ref.») приводит лишь к незначительным улучшениям, что говорит о недостаточности одних только циклов рассуждений без дополнительных доказательств, связанных с AD, или внешнего руководства. Дальнейшее включение общих визуальных инструментов (т.е. «w. Ref. & V-Tools») значительно повышает производительность на MVTec, демонстрируя важность расширенных визуальных доказательств для обнаружения простых аномалий. Однако производительность на MVTec LOCO немного снижается, что указывает на недостаточность одной лишь общей визуальной обработки для обнаружения сложных аномалий, например, логических аномалий в MVTec LOCO. В отличие от этого, AnomalyAgent (версия zero-shot) стабильно достигает наилучших результатов на обоих наборах данных в условиях zero-shot, что свидетельствует о том, что предложенный набор инструментов, ориентированный на аномалии, предоставляет ценные априорные данные об аномалиях для эффективного обнаружения как простых, так и сложных аномалий. Это также указывает на то, что такой набор инструментов должен быть явно интегрирован в рабочий процесс рассуждений, а не рассматриваться как опциональные инструменты..
Для режима few-shot все варианты построены на основе zero-shot версии AnomalyAgent. Вариант «w. Hard-Normal» внедряет информацию о «жесткой норме», извлеченную из few-shot эталонов нормы, в то время как «w. Calibration» использует few-shot примеры для калибровки кросс-модальных априорных инструментов в соответствии с паттернами нормы целевых данных. Очевидно, что использование только информации о «жесткой норме» приводит лишь к ограниченным улучшениям («w. Hard-Normal» по сравнению с zero-shot AnomalyAgent), что говорит о том, что простого предоставления дополнительных описаний нормы недостаточно для эффективного few-shot рассуждения об аномалиях. Напротив, вариант с калибровкой демонстрирует стабильно более высокую производительность, что указывает на то, что few-shot примеры более эффективны при использовании для адаптации рассуждения об аномалиях к распределению нормы целевых данных. Наконец, интеграция как информации о «жесткой норме», так и калибровки в AnomalyAgent (т.е. few-shot AnomalyAgent) обеспечивает наилучшую общую производительность, демонстрируя, что явные априорные данные о нормальности и рассуждение с калибровкой по памяти дополняют друг друга для few-shot обнаружения аномалий..
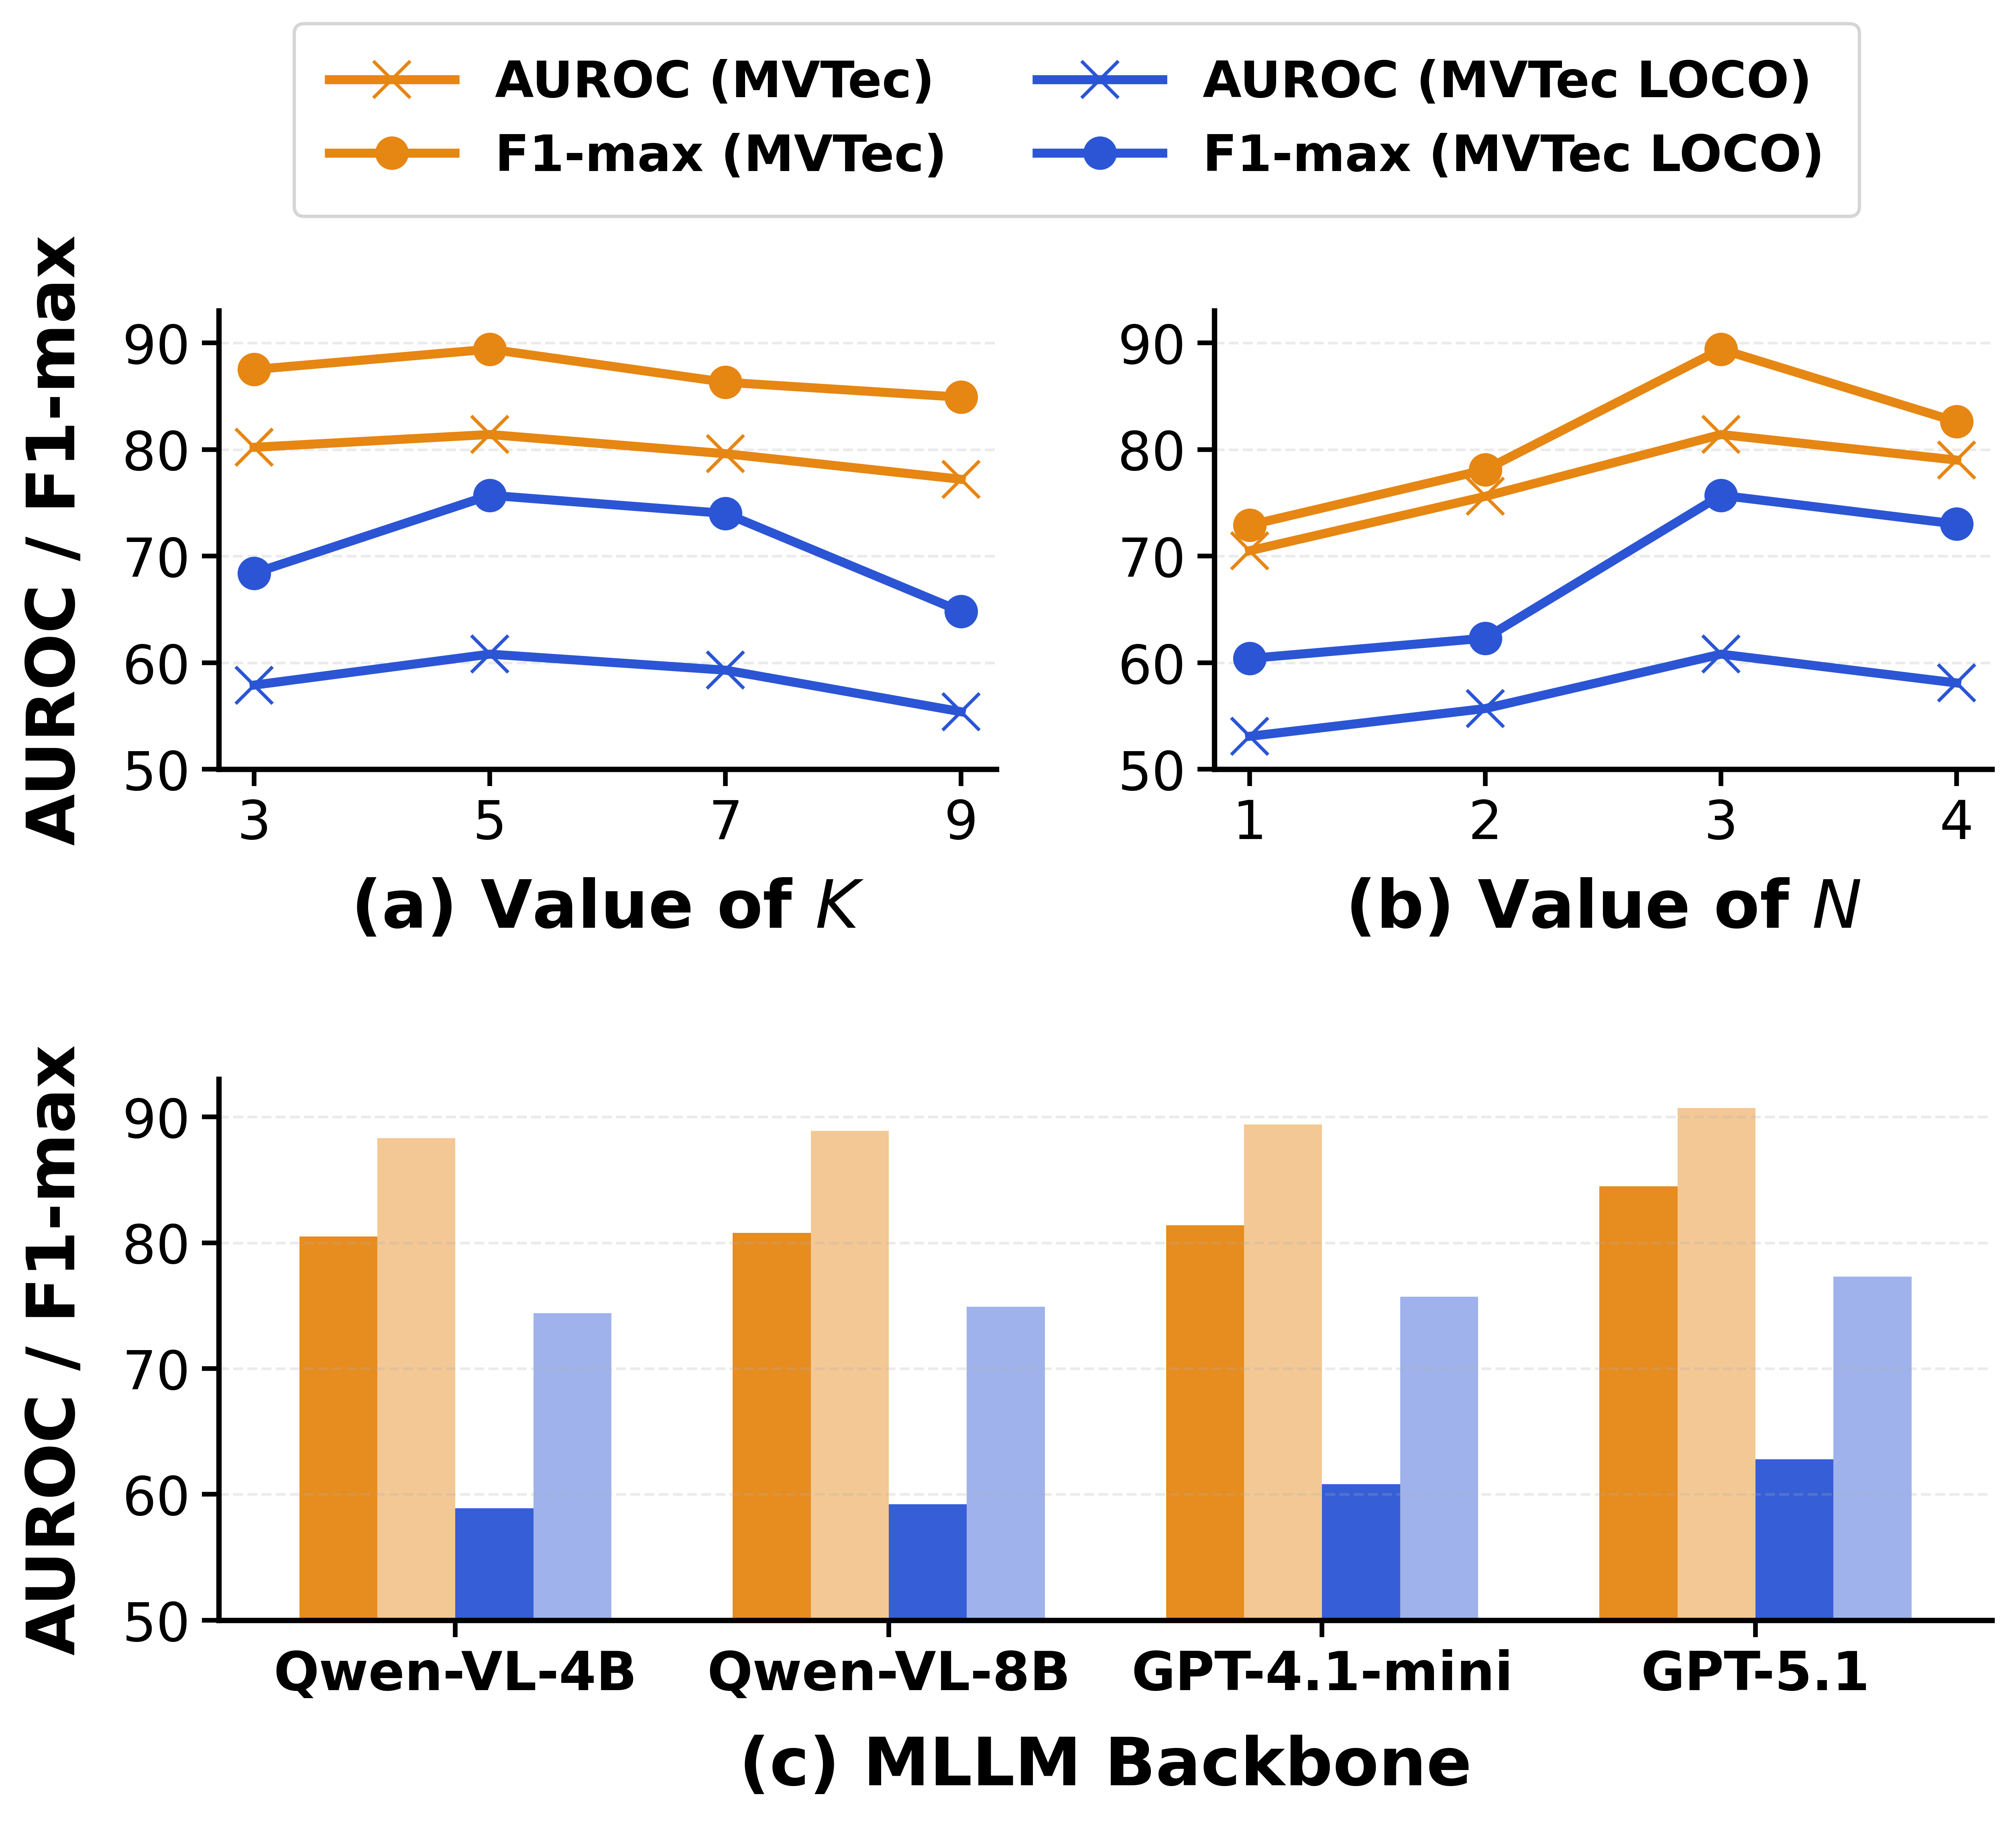
Чувствительность гиперпараметров. AnomalyAgent содержит два ключевых гиперпараметра: , который управляет количеством выбранных атомарных кандидатов при анализе контрфактических шаблонов, и , который обозначает количество последовательных суждений «Норма», требуемых для завершения работы агента. Рис. 3 представляет соответствующий анализ чувствительности гиперпараметров на MVTec и MVTec LOCO. Как показано на рис. 3(a), производительность сначала улучшается, а затем немного снижается по мере увеличения . Малое значение может предоставить недостаточно доказательств, относящихся к аномалиям, для надежного рассуждения, в то время как слишком большое значение может привести к появлению избыточных или зашумленных кандидатов, которые ослабляют различительную способность контрфактического анализа. В целом, AnomalyAgent достигает наилучшего баланса при значении около . Рис. 3(b) анализирует влияние . Увеличение с 1 до 3 стабильно улучшает производительность, что говорит о том, что требование нескольких последовательных суждений о нормальности помогает подавить преждевременные прогнозы о нормальном состоянии и приводит к более надежным решениям об аномалиях. Однако дальнейшее увеличение до 4 немного снижает производительность, возможно, из-за того, что чрезмерное подтверждение приводит к излишне консервативному поведению при рассуждении. Наконец, рис. 3(c) сравнивает различные MLLM бэкенды. Более крупные и мощные MLLM стабильно приводят к улучшению производительности обнаружения аномалий, подтверждая, что предложенная структура рассуждений может эффективно использовать преимущества более сильных возможностей мультимодального рассуждения..
5 Заключение
В данной работе представлен AnomalyAgent, предлагающий принципиальную агентную структуру, которая раскрывает превосходные способности рассуждения MLLM для обучения без использования данных в условиях zero-shot и few-shot AD. Это не является жизнеспособным для общих агентных моделей из-за отсутствия априорных знаний, ориентированных на аномалии, и нормальности. Для решения этой задачи в AnomalyAgent представлены два новых компонента, включая комплексный набор инструментов, ориентированных на аномалии, и механизм памяти на основе самокалибровки. Наши обширные эксперименты показывают, что при поддержке этих двух компонентов AnomalyAgent достигает многообещающей производительности AD в условиях zero-shot и few-shot, значительно превосходя модели AD на основе VLM без обучения и общие агенты на основе MLLM, с конкурентоспособной производительностью по сравнению с методами SotA на основе VLM, поддающимися обучению..
Список литературы
- ⟦[1] Дж. Бай, С. Бай, Ю. Чу, З. Цуй, К. Данг, Х. Денг, Ю. Фан, В. Ге, Ю. Хан, Ф. Хуанг и др. (2023) Технический отчет Qwen. arXiv preprint arXiv:2309.16609. Цитируется в: §1.
- ⟦[2] П. Бергманн, К. Бацнер, М. Фаузер, Д. Сатлеггер и К. Штегер (2022) За пределами вмятин и царапин: логические ограничения в обучении без учителя для обнаружения и локализации аномалий. Международный журнал компьютерного зрения 130 (4), стр. 947–969. Цитируется в: §1, §1, §4.
- ⟦[3] П. Бергманн, М. Фаузер, Д. Сатлеггер и К. Штегер (2019) MVTec ad–комплексный набор данных из реального мира для обучения без учителя при обнаружении аномалий. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 9592–9600. Цитируется в: §1, §4.
- ⟦[4] И. Цао, Х. Сюй, Дж. Чжан, И. Чэн, Х. Хуан, Г. Панг и В. Шен (2024) Обзор визуального обнаружения аномалий: вызовы, подходы и перспективы. arXiv препринт arXiv:2401.16402. Цитируется в: §1.
- ⟦[5] И. Цао, Дж. Чжан, Л. Фриттоли, И. Чэн, У. Шэнь и Г. Боракки (2024) Adaclip: адаптация CLIP с помощью гибридных обучаемых промптов для zero-shot обнаружения аномалий. В материалах Европейской конференции по компьютерному зрению, стр. 55–72. Цитируется в: §1, §1, §2, §4.
- ⟦[6] И. Чао, Дж. Лю, Дж. Танг и Г. Ву (2025) Anomalyr1: сквозная MLLM на основе GRPO для промышленного обнаружения аномалий. arXiv preprint arXiv:2504.11914. Цитируется в: §1, §2.
- ⟦[7] Х. Чен, Ю. Хан и Дж. Чжан (2023) April-gan: метод классификации и сегментации аномалий с нулевым/малым количеством примеров для треков 1 и 2 конкурса семинара CVPR 2023 VAND: 1-е место по zero-shot AD и 4-е место по few-shot AD. arXiv preprint arXiv:2305.17382. Цитируется в: §1, §2, §4.
- ⟦[8] П. Чикара, Д. Хант, С. Арьян, Т. Сингх и Д. Ядав (2025) Mem0: создание готовых к промышленному использованию ИИ-агентов с масштабируемой долговременной памятью. arXiv preprint arXiv:2504.19413. Цитируется в: §2, §4.
- ⟦[9] К. Фанг, В. Лв и К. Су (2025) AF-clip: zero-shot обнаружение аномалий посредством адаптации clip, сфокусированной на аномалиях. В материалах 33-й Международной конференции ACM по мультимедиа, стр. 4846–4855. Цитируется в: §1.
- ⟦[10] М. Фучка, В. Завртаник и Д. Скочай (2026) AnomalyVFM — трансформация vision foundation models в детекторы аномалий с нулевым обучением. Препринт arXiv:2601.20524. Цитируется в: §4.
- ⟦[11] З. Гу, Б. Чжу, Г. Чжу, Ю. Чэнь, Х. Ли, М. Тан и Дж. Ван (2024) Filo: zero-shot обнаружение аномалий с помощью гранулярного описания и высококачественной локализации. В материалах 32-й Международной конференции ACM по мультимедиа, стр. 2041–2049. Цитируется в: §2.
- ⟦[12] З. Гу, Б. Чжу, Г. Чжу, Ю. Чэнь, М. Тан и Дж. Ван (2024) AnomalyGPT: обнаружение промышленных аномалий с использованием больших мультимодальных моделей. Материалы конференции Ассоциации по развитию искусственного интеллекта. Цитируется в: §1, §2.
- ⟦[13] С. Хёфер, Д. Ф. Хеннинг, А. Амиранашвили, Д. Моррисон, М. Тзес, И. Познер, М. Матвиенко, А. Реннола и А. Милан (2025) Kaputt: крупномасштабный набор данных для визуального обнаружения дефектов. В материалах международной конференции IEEE/CVF по компьютерному зрению, стр. 24224–24233. Цитируется в: §1, §1, §4.
- ⟦[14] Дж. Чон, Ю. Цзоу, Т. Ким, Д. Чжан, А. Равичандран и О. Дабир (2023) Winclip: классификация и сегментация аномалий с нулевым/малым количеством примеров. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 19606–19616. Цитируется в: §1, §1, §2, §3.1, §4.
- ⟦[15] Х. Цзян, Дж. Ли, Х. Дэн, Ю. Лю, Б. Гао, Ю. Чжоу, Дж. Ли, К. Ван и Ф. Чжэн (2025) MMAD: комплексный эталонный тест для мультимодальных LLM в промышленном обнаружении аномалий. В материалах Международной конференции по обучению представлениям, Цитируется: §1, §2.
- ⟦[16] Б. Ли, Ю. Чжан, Д. Го, Р. Чжан, Ф. Ли, Х. Чжан, К. Чжан, П. Чжан, Ю. Ли, З. Лю и др. (2024) Llava-onevision: простой перенос визуальных задач. arXiv preprint arXiv:2408.03326. Цитируется в: §1.
- ⟦[17] Л. Ли, М. Сюй, С. Ван, Л. Цзян и Х. Лю (2019) Обнаружение глаукомы на основе механизмов внимания: крупномасштабная база данных и модель cnn. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 10571–10580. Цитируется в: §4.
- ⟦[18] Х. Ли, З. Чжан, Х. Тан, К. Чен, Ю. Ку, Ю. Се и Л. Ма (2024) PromptAD: обучение промптов только на нормальных выборках для few-shot обнаружения аномалий. Труды конференции IEEE/CVF по компьютерному зрению и распознаванию образов. Цитируется в: §2.
- ⟦[19] А. Лю, Б. Фэн, Б. Сюэ, Б. Ван, Б. У, К. Лу, К. Чжао, К. Дэн, К. Чжан, К. Жуань и др. (2024) Технический отчет Deepseek-v3. arXiv preprint arXiv:2412.19437. Цитируется в: §1.
- ⟦[20] У. Ма, С. Чжан, Ц. Яо, Ф. Тан, К. У, И. Ли, Р. Янь, З. Цзян и С. К. Чжоу (2025) Aa-clip: улучшение zero-shot обнаружения аномалий с помощью anomaly-aware CLIP. В материалах конференции по компьютерному зрению и распознаванию образов, стр. 4744–4754. Цитируется в: §1, §1.
- ⟦[21] OpenAI (2025) GPT-4.1 mini. Примечание: https://platform.openai.com/docs/models Цитируется в: §4.
- ⟦[22] OpenAI (2025) GPT-5.1. Примечание: https://platform.openai.com/docs/models Цитируется в: §4.
- ⟦[23] Г. Панг, К. Шен, Л. Цао и А. В. Д. Хенгель (2021) Глубинное обучение для обнаружения аномалий: обзор. ACM Computing Surveys 54 (2), стр. 1–38. Цитируется в: §1.
- ⟦[24] З. Цюй, С. Тао, С. Гун, С. Цюй, С. Чжан, С. Ван, Ф. Шэнь, З. Чжан, М. Прасад и Г. Дин (2025) Dictas: фреймворк для обобщаемой по классам few-shot сегментации аномалий посредством поиска по словарю. В материалах международной конференции IEEE/CVF по компьютерному зрению, стр. 20519–20528. Цитируется: §1, §1.
- ⟦[25] A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, S. Agarwal, G. Sastry, A. Askell, P. Mishkin, J. Clark, et al. (2021) Обучение переносимым визуальным моделям на основе контроля естественным языком. В сборнике: Международная конференция по машинному обучению, стр. 8748–8763. Цитируется в: §A.1, §2, §4.
- ⟦[26] К. Рот, Л. Пемула, Дж. Зепеда, Б. Шёлькопф, Т. Брокс и П. Гелер (2022) На пути к полному запоминанию в промышленном обнаружении аномалий. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 14318–14328. Цитируется в: §1, §4.
- ⟦[27] М. Салехи, Н. Саджади, С. Базелизаде, М. Х. Рохбан и Х. Р. Рабии (2021) Дистилляция знаний с несколькими разрешениями для обнаружения аномалий. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 14902–14912. Цитируется в: §1, §4.
- ⟦[28] Н. Шинн, Ф. Кассано, А. Гопинат, К. Нарасимхан и С. Яо (2023) Reflexion: языковые агенты с вербальным обучением с подкреплением. Достижения в системах нейронной обработки информации 36, стр. 8634–8652. Цитируется в: §2.
- ⟦[29] Х. Ван, Л. Се, К. Донг и Ю. Шан (2021) Real-esrgan: обучение слепому суперразрешению в реальных условиях с использованием чисто синтетических данных. В материалах международной конференции IEEE/CVF по компьютерному зрению, стр. 1905–1914. Цитируется в: §A.1.
- ⟦[30] П. Ву, К. Пан, Ю. Ян, Г. Панг, К. Ян, П. Ван и Ю. Чжан (2026) Глубинное обучение для обнаружения аномалий на видео: обзор. IEEE Transactions on Neural Networks and Learning Systems. Цитируется в: §1.
- ⟦[31] С. Сюй, С. Лю, Ц. Чэнь, Ф. Чжан и З. Чжан (2026) MRAD: zero-shot обнаружение аномалий с помощью поиска на основе памяти. В материалах Международной конференции по обучению представлений, Цитируется: §1, §1, §4.
- ⟦[32] Дж. Сюй, С. Ло, Б. Сафаеи, В. М. Патель и И. Двиведи (2025) На пути к обнаружению аномалий и рассуждению в режиме zero-shot с помощью мультимодальных LLM. В материалах конференции по компьютерному зрению и распознаванию образов, стр. 20370–20382. Цитируется в: §1, §2.
- ⟦[33] А. Янг и др. (2025) Технический отчет Qwen3. Препринт arXiv arXiv:2505.xxxxx. Цитируется в: §4.
- ⟦[34] С. Яо, Дж. Чжао, Д. Ю, Н. Ду, И. Шафран, К. Нарасимхан и И. Цао (2023) REACT: синергия рассуждения и действия в языковых моделях. В материалах Международной конференции по обучению представлениям, Цитируется: §2, §4.
- ⟦[35] Х. Яо, З. Чен, Г. Чао, Г. Чжай и К. Чжан (2024) ResAD: простая структура для обобщаемого обнаружения аномалий по классам. Внешние ссылки: Link Цитируется: §2⟧.
- ⟦[36] Дж. Чжан, Г. Ван, Ю. Цзинь и Д. Хуан (2025) На пути к обнаружению аномалий без обучения с использованием фундаментальных моделей зрения и языка. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 15204–15213. Цитируется в: §1, §1, §1, §2, §4⟧.
- ⟦[37] И. Чжэн, М. Цзинь, И. Лю, Л. Чи, К. Т. Фан и И. П. Чэнь (2021) Генеративное и контрастивное самообучение для обнаружения аномалий в графах. IEEE Transactions on Knowledge and Data Engineering 35 (12), стр. 12220–12233. Цитируется в: §1.
- ⟦[38] К. Чжоу, Г. Панг, Ю. Тянь, С. Хэ и Дж. Чен (2024) AnomalyCLIP: обучение промптам, не зависящее от объекта, для zero-shot обнаружения аномалий. В материалах Международной конференции по обучению представлениям, Цитируется в: §1, §1, §2, §3, §4.
- ⟦[39] Дж. Чжу, Ю. Онг, К. Шен и Г. Панг (2025) Мелкозернистое обучение промптам для обнаружения аномалий в режиме zero-shot. В материалах Международной конференции IEEE/CVF по компьютерному зрению, стр. 22241–22251. Цитируется в: §1, §1, §2, §3, §4⟧.
- ⟦[40] Дж. Чжу и Г. Панг (2024) На пути к универсальному обнаружению аномалий посредством контекстного остаточного обучения с использованием few-shot выборочных подсказок. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов, стр. 17826–17836. Цитируется в: §1, §2, §3, §4.
Appendix A Дополнительные детали реализации
A.1 Подробности использования визуальных инструментов
AnomalyAgent оснащает MLLM агента набором легковесных визуальных инструментов для поддержки сбора доказательств, ориентированных на аномалии. Эти инструменты предоставляют дополнительные наблюдения при различных визуальных условиях, и их выходные данные не используются в качестве самостоятельных прогнозов аномалий. Вместо этого обработанные наблюдения возвращаются в цикл планировщик–рассуждающий–рефлектор, где они рассматриваются вместе с исходным изображением, семантическими априорными данными, контрфактическими доказательствами и накопленной историей рассуждений. Все инструменты вызываются только во время вывода и не требуют обучения на целевом наборе данных или адаптации параметров..
Удаление шума с изображений.
Инструмент шумоподавления реализован с помощью алгоритма быстрого нелокального усреднения из библиотеки OpenCV, который подавляет цветовой и пространственный шум, сохраняя при этом локальные структуры изображения. В AnomalyAgent этот инструмент полезен в тех случаях, когда предполагаемые дефекты могут быть ошибочно приняты за шум при получении данных, артефакты сжатия или ухудшение качества из-за недостаточного освещения, что позволяет системе рассуждения проверить, остаются ли признаки аномалии видимыми после подавления шума..
Устранение размытия изображений.
Инструмент для устранения размытия реализован с помощью нерезкого маскирования, основанного на вычитании Gaussian blur. Он усиливает локальные границы и контуры без внедрения какой-либо обученной адаптации. Этот инструмент используется, когда гипотезы об аномалиях зависят от резкости границ, формы объекта или разрывов поверхности, помогая агенту отличать истинные структурные нерегулярности от неоднозначности, вызванной размытием..
Улучшение яркости.
Инструмент улучшения яркости применяет адаптивное выравнивание гистограммы с ограничением контраста (CLAHE) к L-каналу в цветовом пространстве LAB. Эта операция улучшает локальный контраст, ограничивая при этом чрезмерное усиление. В цикле рассуждений он используется для повторного анализа областей, затронутых недостаточной или избыточной экспозицией, где аномальные паттерны в противном случае могли бы быть скрыты или визуально преувеличены..
Суперразрешение изображений.
Инструмент суперразрешения использует Real-ESRGAN Wang et al. (2021) для повышения разрешения изображений и восстановления мелкозернистых текстурных деталей. Это обеспечивает дополнительные визуальные доказательства для случаев, когда решение об аномалии зависит от мелких дефектов, тонких изменений текстуры или локальных отсутствующих компонентов. Улучшенное изображение рассматривается как вспомогательное наблюдение для верификации, а не как замена исходного изображения..
Поиск изображений.
Инструмент поиска использует визуально-текстовый поиск на основе CLIP Radford et al. (2021), где косинусное сходство между эмбеддингами CLIP используется для оценки релевантности. Этот инструмент предоставляет контекстные справочные данные путем извлечения ранее наблюдавшихся примеров, относящихся к текущему запросу или предполагаемому аномальному паттерну. Извлеченные результаты используются для поддержки сравнения с нормальными или подозрительными визуальными паттернами, но окончательное решение об аномалии все равно принимается механизмом рассуждения в процессе агентного рассуждения..
Appendix B Шаблоны промптов