VideoMLA: Кэш KV скрытых признаков с низким рангом для авторегрессионной видеодиффузии с минутным масштабом
Реферат
Длительное причинное развертывание для видеодиффузии со скользящим окном фиксированного размера KV cache сошлось к этому макету; недавний прогресс внес инновации в рамках данной компоновки, изменяя, какие токены занимают окно, или то, как их позиции кодируются. Сам макет KV по головам, являющийся доминирующим вкладом в потоковую память и задержку, в основном остается без изменений. В этой статье мы представляем первое исследование Multi-Head Latent Attention (MLA) в видеодиффузии. VideoMLA заменяет по-головным ключам и значениям общую низкоранговую контент-латентную компоненту и общую разъединенную 3D-RoPE позиционную компоненту ключа, снижая память KV на токен в на каждом кэшированном слое. Мы дополнительно исследуем, почему MLA успешно работает в видеодиффузии, несмотря на то, что спектральное допущение, которое часто используют для обоснования в language models, не выполняется: предварительно обученное видео-внимание не является низкоранговым, при этом 99%-энергетический эффективный ранг намного выше любого практического размера латентного пространства. VideoMLA сохраняет качество при коэффициентах сжатия, где прямое спектральное приближение предсказывало бы большую ошибку реконструкции. Мы показываем, что узкое место MLA, а не предварительный спектр, определяет эффективный ранг: как спектральная, так и случайная инициализация занимают почти весь выделенный бюджет по рангам с момента инициализации, и обучение сохраняет этот бюджет, адаптируясь внутри него. На VBench VideoMLA соответствует базовым подходам для streaming-видеодиффузии на малых горизонтах, достигает наилучшего общего показателя на больших горизонтах среди рассмотренных методов и повышает пропускную способность на на одном B200.
1 Введение
Причинные модели диффузии для видео [9, 4, 16, 31, 25, 24, 17, 27, 22, 3, 23, 12, 30, 13] получили распространение как доминирующий подход к потоковой, генерации видео на больших горизонтах. Будучи дистиллированными из двунаправленных учителей, они генерируют кадры [31, 5, 11, 8] или фрагменты автoreгрессионно, одновременно обращаясь к непрерывно обновляемому кэшу ключ-значение (KV) прошлых кадров, создавая видеоролики длительностью до минутного уровня с интерактивными скоростями на одной GPU. По мере масштабирования моделей к более длинным разверткам наработки на один head KV-кэш все в большей степени определяют рабочую точку. В масштабе Wan-1.3B [21] каждый кэшированный токен хранит плотных KV-скаляров на слой, учитывая ключи и значения для 12 head при 128 каналах в каждом. При кэше из 21 латентного кадра, 1,560 токенов на латентный кадр и 30 трансформерных слоях плотный KV-кэш содержит 3.02B скаляров, или примерно 6.0GB в bf16/fp16. Этот объем кэша объясняет, почему в недавних потоковых системах используются кэши фиксированного размера со скользящим окном: сохранение всех прошлых KV-состояний росло бы линейно с длиной развертки. Однако фиксация окна лишь ограничивает число кэшированных токенов; она не снижает стоимость на токен, на слой для компоновки per-head KV. Поэтому уменьшение этой компоновки является прямым рычагом для более длинных горизонтов, больших батчей и более быстрой инференции.
Доминирующая линия недавних работ рассматривает кэш как окно с фиксированным размером, сдвигающееся по времени, и предлагает инновации внутри него. CausVid [27] инициировал это направление, преобразовав двунаправленную диффузию в причинную авторегрессионную генерацию посредством distillation распределительного согласования distribution matching distillation, при этом с самого начала использовался скользящий KV-кэш. Self-Forcing [9] закрыл разрыв между обучением и тестированием, обусловливая обучение самогенерируемыми кадрами в рамках того же роллинг-кэша. Последующие работы усовершенствовали этот рецепт с помощью attention-sink, выбора токенов и механизмов сжатой памяти для согласованности на больших расстояниях [16, 25, 17, 28, 12, 29], стратегий обучения для развертываний на несколько минут и переключения подсказок prompt switching [4, 22, 7, 24], улучшенных целей дистилляции [31, 17], а также позиционной пере параметризации, такой как Infinity-RoPE [24]. Однако все эти методы сохраняют исходную per-head раскладку KV, которая и заполняет окно: они перераспределяют, пере взвешивают, сжимают со временем или пере размещают закэшированные токены, не снижая per-token состояние KV.
Вторая, дополняющая линия изменений касается самой вычислительной схемы внимания. SANA-Video [3] заменяет softmax-внимание на блочно-каузальное линейное внимание, убирая традиционный KV-кэш и используя состояние накопительного типа с постоянной памятью для генерации длинных видео. SCD [2] уменьшает кэшированное состояние, направляя темпоральное рассуждение через 25-слойный каузальный кодировщик и применяя 10-слойный покадровый декодер, так что кэшируются только слои кодировщика. При той же геометрии Wan-кэша это снижает плотное хранение KV на . VideoMLA ортогонален: он сохраняет кэшированными все 30 слоев self-attention, но уменьшает кэшированное состояние для каждого токена с 3072 до 224 скаляров, в результате чего получается меньший кэш, чем у SCD, для того же окна из 21 латентного кадра. Таким образом, вместо изменения того, какие токены кэшируются, как они размещаются, или сколько слоев кэшируется, VideoMLA напрямую нацеливается на оставшийся фактор: раскладку KV на уровне токена в каждом кэшированном слое self-attention.
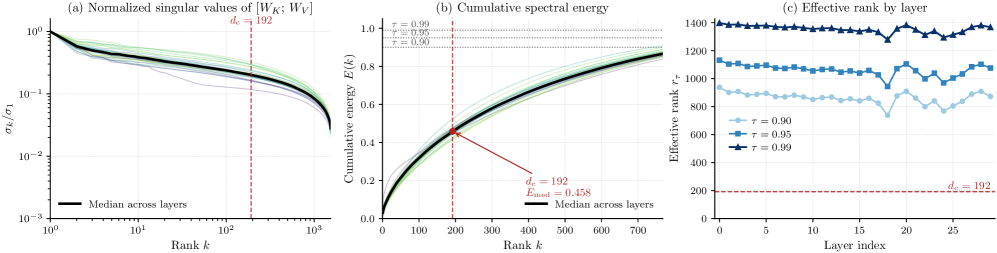
В этой статье мы воздействуем непосредственно на компоновку на уровне голов. Опираясь на Multi-Head Latent Attention (MLA) [14], мы представляем VideoMLA — первую MLA-подобную скрытую KV-кэш-память для авторегрессионной видео-диффузии. VideoMLA заменяет ключи и значения на уровне каждой головы на совместный низкоранговый скрытый латент контента и общий для голов декуплированный 3D-RoPE позиционный ключ, уменьшая память KV на каждый токен на на каждом кэшируемом слое. Это ставит задачу на размышление: MLA обычно мотивируется низкоранговой предобученной [14, 10], однако Wan-1.3B (рис. 1) имеет 99%-ную ранговую энергию, существенно превышающую практические размерности латентного пространства. Тем не менее VideoMLA сохраняет качество там, где прямое спектральное приближение привело бы к большой ошибке реконструкции (рис. 2). Мы показываем, что узкое место MLA определяется не предобученным спектром, а эффективным рангом: и SVD, и случайная инициализация почти полностью насыщают выделенный бюджет ранга, при этом обучение сохраняет его с минимальным спектральным изменением. Поэтому вопрос дизайна смещается с того, каков собственный ранг? на то, какой латентный бюджет сохраняет качество видео? Наши вклады суммированы следующим образом:
- ⟦Скрытое кэширование KV для диффузии видео. Мы вводим VideoMLA — видеодиффузионную модель в стиле MLA с авторегрессионной архитектурой, которая заменяет ключи и значения для каждой головы на общую скрытую величину содержимого и на ключ 3D-RoPE, разделяемый по головам и отделённый друг от друга, сокращая память KV на токен на на каждом кэшируемом слое.
- • Спектральная головоломка и разрешение с ранговым бюджетом. Мы показываем, что внимание к видео Wan-1.3B не является низкоранговым: эффективный ранг, дающий 99%-ную энергию, существенно превышает практические скрытые размерности. VideoMLA тем не менее сохраняет качество, тогда как и SVD, и случайная инициализация насыщают навязанный ранговый бюджет уже при инициализации и сохраняют его в ходе обучения.
- ⟦• Эффективная генерация на большой длине горизонта. Мы определяем распределение NoPE/RoPE, которое сохраняет визуальную достоверность и согласованность движения на временных горизонтах в масштабе минут. На VBench VideoMLA соответствует базовым моделям для краткосрочных горизонтов, достигает наилучшего общего показателя на длинном горизонте среди оцененных методов и повышает пропускную способность на на одном B200.
2 Смежные работы
Генерация причинных видео. Причинная видео диффузия преобразует двунаправленного учителя в потокового ученика, который генерирует кадры или фрагменты авторегрессионно с использованием запоминающегося (rolling) KV-кэша. CausVid [27] запустил это направление с дистилляцией на основе Distribution Matching Distillation (DMD) [26] для причинного переноса знаний, и Self-Forcing [9] сократил рассогласование между обучением и тестированием за счет обучения на самогенерируемых разворотах. Последующие работы повышают устойчивость на больших горизонтах за счет совместного устранения шума и sink’ов внимания [16], корректировки под руководством учителя [4], инициализации причинного ODE [31], дистилляции с весами по вознаграждению и EMA sink’ов [17], deep sink и обрезки кэша [25], KV recaching при переключении подсказок [22] и блочно-относительной временной RoPE [24]. Эти методы улучшают то, что хранится в окне, или то, как оно размещено, но сохраняют плотную компоновку per-head KV.
Эффективная генерация причинно-следственных видеопоследовательностей. В качестве дополнения другая линия перестраивает внимание, чтобы уменьшить память или вычисления. SANA-Video [3] заменяет softmax на блочно-причинное линейное внимание и использует накопительное состояние постоянного размера. SCD [2] разделяет темпоральное рассуждение и покадровый рендеринг, кэшируя только причинный энкодер. VideoSSM [28] дополняет KV с скользящим окном сжатой SSM глобальной памятью. Эти подходы уменьшают темпоральную или построчную по слоям память, но не сжимают состояние KV для каждого токена и каждой головы на каждом кэшируемом слое.
Многоголовое скрытое внимание. DeepSeek-V2 [14] представила Multi-Head Latent Attention (MLA), заменив KV для каждой головы на общее скрытое представление с низким рангом и отделенным позиционным ключом; DeepSeek-V3 [15] масштабировала эту конструкцию. MTLA [6] дополнительно сжимает по времени, в то время как MHA2MLA [10] и TransMLA [18] преобразуют предварительно обученные LLM с MHA [20] или GQA [1] в MLA. Эти работы ориентированы на развертывание языка. Мы изучаем MLA в диффузии видео, где профиль памяти и спектр предварительно обученного внимания существенно различаются.
3 Метод
Мы обозначаем входом внимания в текущем фрагменте , где фрагмент обозначает группу скрытых кадров. Пусть будет размерностью модели, — числом головок, а — размерностью на головку, так что . VideoMLA вводит общую скрытую размерность KV для кэшированного содержимого и разделяет каждую головку на подпространство NoPE для оценки содержимого и подпространство RoPE для позиционного представления, . Часть NoPE восстанавливается из общей скрытой размерности и не кодируется с ротационной позиционной привязкой; часть RoPE использует общую для головок декуплированную ключевую 3D-RoPE кодировку.
3.1 Сжатое построение кэша KV
Каждый видео-скрытый токен , произведенный базовой сетью, сначала сжимается в скрытое представление с низким рангом, которое обобщает его ключевое и ценностное содержимое для скользящего кэша:
| (1) |
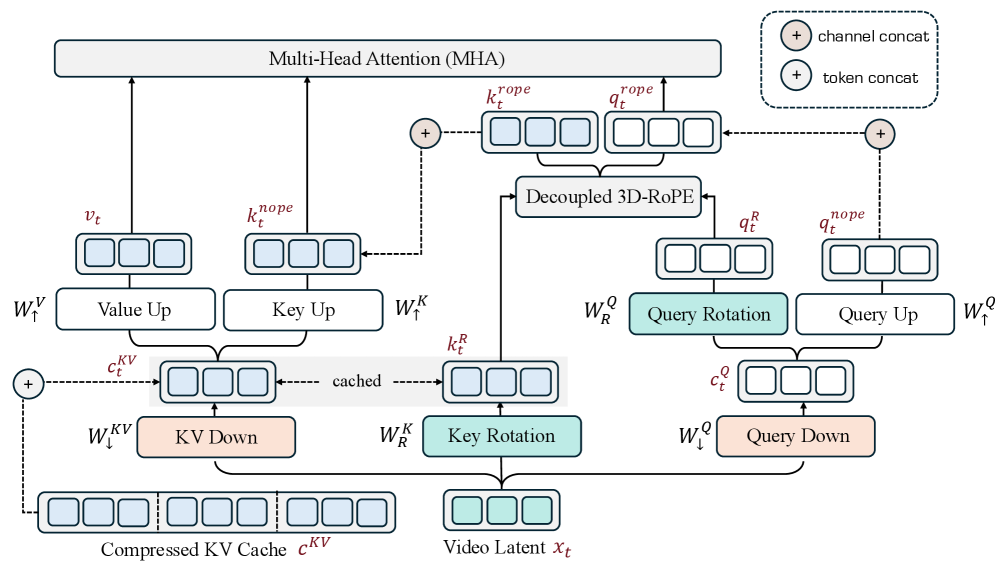
где — совместная понижающая проекция KV (рис. 3, понижение KV). Вектор — объект содержимого, записываемый в сжатый KV-кэш. Он имеет размерность , поэтому он заменяет плотные ключи и значения содержимого для каждой головы, которые иначе пришлось бы хранить для каждой головы. Пространственная информация не свертывается в это скрытое представление; она хранится отдельно через раздельный ключ , введенный в разделе 3.2. Таким образом, каждый кэшированный токен хранит пару , а не плотные состояния KV для каждой головы.
Ключи и значения на каждого отдельного элемента, необходимые для внимания, получаются из через две восходящие проекции,
| (2) |
где индексирует головы внимания, а — ключевые и ценностные восходящие проекции (Рис. 3, Key Up и Value Up). Два свойства этой конструкции важны. Во-первых, один и тот же кэшированный латентный разделяется всеми головами: одно чтение из кэша производит на ключи для каждой головы и на значения для каждой головы через уравнение 2. Во-вторых, восстановленный ключ не несет ротаторной позиционной информации. Это компонент ключа для каждой головы, ориентированный только на содержание, обозначаемый ; позиционный компонент находится в отдельном подпространстве RoPE.
Вместе с отделённым позиционным ключом, запоминание состояния на уровне токена уменьшается с скаляров плотного KV-кэша на голову до скаляров. В нашей настройке по умолчанию это скаляров на токен на слой, что даёт уменьшение.
Путь запроса является построчным и использует аналогичную структуру «снизу/сверху». Из понижающая проекция запроса формирует латентное представление запроса, а повышающая проекция содержимого восстанавливает пораздельный NoPE-запрос для каждой головы:
| (3) |
| (4) |
где является размерностью скрытого представления запроса, а — проекцией Query Up на рис. 3. Поскольку запросы пересчитываются из текущего блока на каждом шаге генерации, является внутренней частью слоя и никогда не записывается в KV cache. Совместное использование головок происходит только в разветвленной позиционной ветви: VideoMLA использует одну ключевую RoPE, общую для всех головок, тогда как NoPE-запросы, NoPE-ключи и значения остаются специфичными для головок после up-проекции.
Размерность является основным регулятором вместимости кэша основного содержимого слоя: она определяет, насколько агрессивно сжимается кэшированное содержимое, и какой объем общего подпространства модель может использовать для совместного ключ-значение содержимого. Выбор эмпирически исследуется на Рисунке 7 и в Приложении.
| Metric | Causal Full | Causal Local | Causal Linear | MLA Local |
| Memory | ||||
| Comp. (-th token) | ||||
| Comp. ( tokens) |
3.2 Раздельная 3D-RoPE
Скрытый кэш хранится без привязки к позиции, чтобы низкоранговый путь содержимого мог быть разделён между головками и повторно использоваться при сдвиговой перекодировке индексов. Вместо этого позиционная информация переносится в отдельном подпространстве RoPE. Мы разбиваем каждую головку как , где — это восстановленный ключ содержимого, а оставшиеся каналы образуют развязанный ключ 3D-RoPE. Как в Wan, разбивается по осям времени, высоты и ширины, используя соответствующие высокочастотные вращательные полосы.
Для каждого токена VideoMLA вычисляет одну общую для нескольких головок позиционную ключевую величину
| (5) |
вместо на ключи RoPE для каждого элемента. Кэш хранит не повернутое состояние ; поворот применяется только когда формируется активное окно внимания. Это сохраняет кэшированные состояния независимыми от абсолютного времени развертывания и обеспечивает размер кэша на токен .
Ветвь запроса следует той же декомпозиции. От скрытого представления запроса позиционный запрос для головы
| (6) |
Затем внимание вычисляется по конкатенированным компонентам NoPE и RoPE: каждая голова использует против , при этом значения остаются восстановленными только из содержимого латентного пространства.
3.3 Прямой проход во время обучения
Во время обучения каждый видеокодовый скрытый токен записывает свое сжатое состояние кэша , определенное в уравнениях 1 и 5, в KV-кэш как блок по мере продвижения блочного шумоподавления. Затем внимание вычисляется в стандартной многоголовочной форме: ключи и значения содержимого для каждой головы восстанавливаются по требованию из закэшированного скрытого содержания через уравнение 2, а общий позиционный ключ получается путем поворота закэшированного позиционного состояния во время использования.
Для токена запроса в позиции и кэшированного токена в позиции , головка внимания объединяет содержимое и позиционные вкладки в единую оценку
| (7) |
где и являются компонентами содержимого и повернутого позиционного запроса из уравнений 4 и 6, является ключом содержимого для каждого головного сегмента из уравнения 2, а — повернутым общим позиционным ключом, полученным из уравнения 5. Два скалярных произведения существуют в подпространствах размерностей и соответственно, поэтому совместная оценка нормируется по их суммарной размерности. softmax по активному окну внимания, за которым следует взвешенная сумма , дает выход для каждой головы, а выходы голов смешиваются через проекцию выхода .
Форма соответствует тому, что произвела бы плотная attention-слой с тем же размером на голову. В результате VideoMLA замещает модуль плотного self-attention без каких-либо изменений в окружающем обучающем конвейере: chunkwise causal block masks, sink tokens и ядра FlexAttention работают с восстановленными ключами и значениями на уровне голов точно так же, как они работали бы с плотными. Единственное структурное изменение по отношению к плотной базовой модели находится внутри attention-слоя: кэш хранит вместо per-head и , а представления на уровне голов, потребляемые attention, восстанавливаются во время использования.
4 Эксперименты
4.1 Настройка и набор данных
Подробности реализации. Мы реализуем VideoMLA поверх базовой модели Wan-2.1 T2V-1.3B [21], заменяя только слои self-attention, при этом оставляя остальную архитектуру без изменений. Модель содержит блоков transformer, скрытое измерение , голов, и размерность на головную часть . Если не указано иное, мы используем и , причем размерность на головную часть разделяется на и . Декуплированные каналы 3D-RoPE распределяются по осям временная, высота и ширина как комплексных пар, используя наиболее высокочастотные диапазоны. Это дает размер кэша на токен скаляров, что соответствует сокращению по сравнению с плотным -скалярным KV-кэшем. Обучение следует трехстадийному конвейеру Causal Forcing [31], включая Teacher Forcing, инициализацию Consistency Distillation на четырех шагах, а также DMD, при общей величине batch size . Мы используем learning rates для Teacher Forcing и для Consistency Distillation и DMD. Все эксперименты по обучению выполняются в bf16 смешанной точности на графических ускорителях 8 B200 GPU.
Набор данных. Для этапа дистилляции согласованности перед DMD мы используем 47,680 видео: 29,471 из OpenVid-1M [19] и 18,209 синтезированных фрагментов.
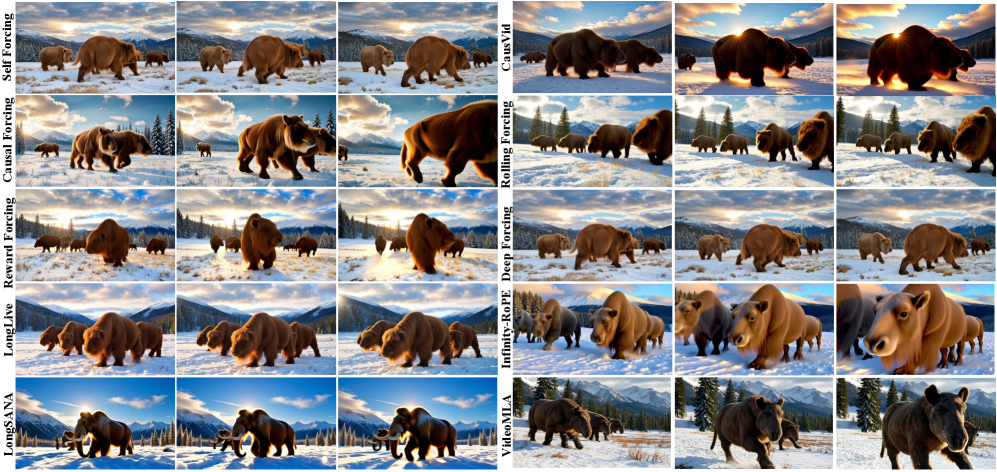
Базовые модели. Мы сравниваем VideoMLA с современными методами причинной видеодейффузии, охватывающими стандартные конвейеры потоковой обработки, переработки архитектуры внимания и переараметризации позиционирования. Базовые модели потоковой обработки включают CausVid [27], Self-Forcing [9], Rolling-Forcing [16], Causal Forcing [31], Reward Forcing [17], Deep Forcing [25] и LongLive [22], а также Infinity-RoPE[24]. Мы также сравниваем с методом повышения эффективности архитектуры LongSANA [3].
4.2 Основные результаты
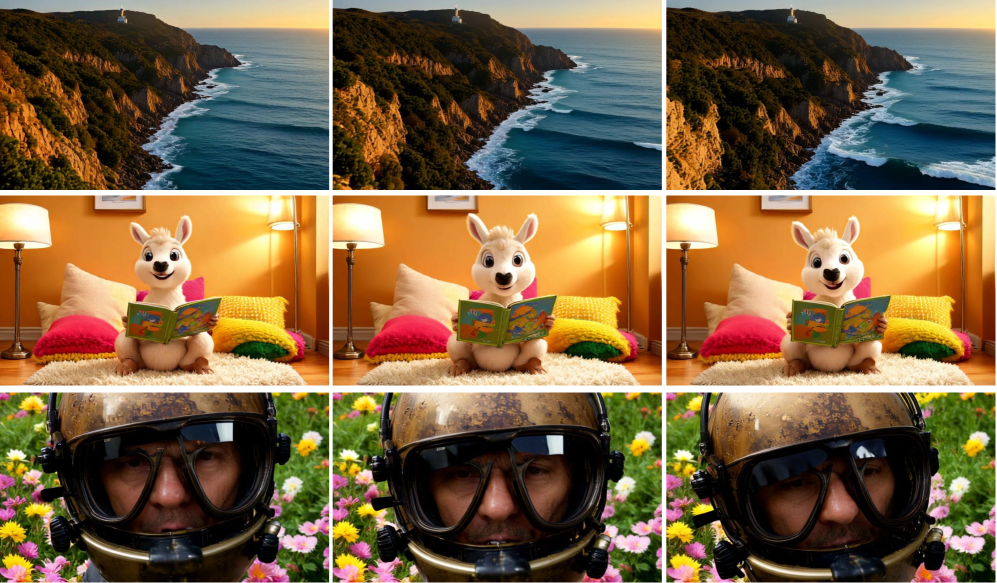
Качественные результаты. Рисунок 4 показывает, что VideoMLA сохраняет идентичность субъекта, структуру сцены и визуальную достоверность в ходе разверток длительностью 30 секунд, несмотря на замену плотного KV-кэша для каждого головы на компактный латентный кэш. Наконец, Рисунок 5 показывает, что VideoMLA генерирует результаты, сопоставимые с репрезентативными базовыми моделями потокового причинного видео, при этом обеспечивая более быстрый вывод и существенно меньшие затраты памяти. Эти качественные результаты указывают на то, что VideoMLA улучшает компромисс эффективность–память без выраженных потерь визуальной достоверности, динамичности или стабильности на длинных горизонтах, наблюдаемых в более агрессивных альтернативах, основанных на сжатии.
Количественные результаты. Таблица 2 сообщает результаты VBench на горизонте 30 с и 60 с. VideoMLA достигает наилучшей динамической степени на обоих горизонтах: 0.981 на 30 с и 0.958 на 60 с, что указывает на то, что скрытое сжатие KV не подавляет движение и не приводит к статической генерации. Также она обеспечивает наилучшее качество визуализации и плавность движения и достигает наивысшего общего балла за 60 с — 0.859, существенно превосходя предшествующие базовые подходы для потоковой передачи, такие как Reward Forcing, Infinity-RoPE, LongLive и LongSANA. На 30 с VideoMLA также конкурирует с самым сильным базовым подходом, достигая второго лучшего общего балла при использовании гораздо меньшей памяти KV-кеша.
| Model | Results on 30s | Results on 60s | User Study | |||||||||||||||
| AQ | BC | DD | IQ | MS | SC | Overall | AQ | BC | DD | IQ | MS | SC | Overall | PA | TC | DC | Overall | |
| Self-Forcing [9] | 0.541 | 0.948 | 0.624 | 0.577 | 0.952 | 0.932 | 0.762 | 0.565 | 0.958 | 0.393 | 0.650 | 0.987 | 0.974 | 0.755 | 2.79 | 2.79 | 2.70 | 2.76 |
| CausVid [27] | 0.597 | 0.921 | 0.473 | 0.663 | 0.935 | 0.913 | 0.750 | 0.497 | 0.929 | 0.723 | 0.574 | 0.948 | 0.933 | 0.767 | – | – | – | – |
| Causal Forcing [31] | 0.526 | 0.945 | 0.738 | 0.628 | 0.968 | 0.947 | 0.792 | 0.503 | 0.936 | 0.847 | 0.608 | 0.935 | 0.920 | 0.792 | 2.59 | 2.63 | 2.81 | 2.68 |
| Rolling-Forcing [16] | 0.620 | 0.953 | 0.742 | 0.688 | 0.982 | 0.960 | 0.824 | 0.580 | 0.958 | 0.380 | 0.670 | 0.988 | 0.977 | 0.759 | 2.55 | 2.68 | 2.60 | 2.61 |
| Deep Forcing [25] | 0.621 | 0.953 | 0.713 | 0.660 | 0.979 | 0.961 | 0.815 | 0.597 | 0.957 | 0.402 | 0.690 | 0.987 | 0.979 | 0.769 | 2.60 | 2.76 | 2.68 | 2.68 |
| Reward Forcing [17] | 0.644 | 0.956 | 0.954 | 0.683 | 0.981 | 0.957 | 0.863 | 0.585 | 0.952 | 0.676 | 0.673 | 0.985 | 0.974 | 0.808 | 2.91 | 2.99 | 2.83 | 2.91 |
| LongLive [22] | 0.654 | 0.959 | 0.649 | 0.678 | 0.983 | 0.967 | 0.816 | 0.606 | 0.961 | 0.433 | 0.664 | 0.991 | 0.982 | 0.773 | 2.56 | 2.70 | 2.58 | 2.61 |
| Infinity-RoPE [24] | 0.640 | 0.958 | 0.847 | 0.669 | 0.982 | 0.966 | 0.844 | 0.607 | 0.959 | 0.647 | 0.638 | 0.988 | 0.979 | 0.803 | 2.46 | 2.44 | 2.41 | 2.43 |
| LongSANA [3] | 0.573 | 0.976 | 0.149 | 0.683 | 0.974 | 0.988 | 0.723 | 0.529 | 0.976 | 0.103 | 0.702 | 0.991 | 0.986 | 0.714 | 2.48 | 2.63 | 2.56 | 2.56 |
| VideoMLA (Ours) | 0.601 | 0.942 | 0.981 | 0.697 | 0.986 | 0.952 | 0.859 | 0.569 | 0.963 | 0.958 | 0.715 | 0.993 | 0.954 | 0.859 | 3.04 | 3.24 | 3.22 | 3.17 |
| Model | #Params | Resolution | Throughput | Latency | CLIP-T | CLIP-F | HPSv3 |
| Frame-wise autoregressive models | |||||||
| NOVA [5] | 0.6B | 768480 | 2.26 | 14.63 | 0.2764 | 0.9673 | 2.95 |
| Pyramid Flow [11] | 2B | 640384 | 1.39 | 87.32 | 0.2888 | 0.9795 | 8.02 |
| Chunk-wise autoregressive models | |||||||
| Self-Forcing [9] | 1.3B | 832480 | 18.06 | 4.19 | 0.3036 | 0.9689 | 9.86 |
| LongSANA [3] | 2B | 832480 | 19.35 | 4.48 | 0.2978 | 0.9887 | 7.54 |
| VideoMLA (Ours) | 1.3B | 832480 | 23.96 | 3.38 | 0.3278 | 0.9686 | 9.74 |
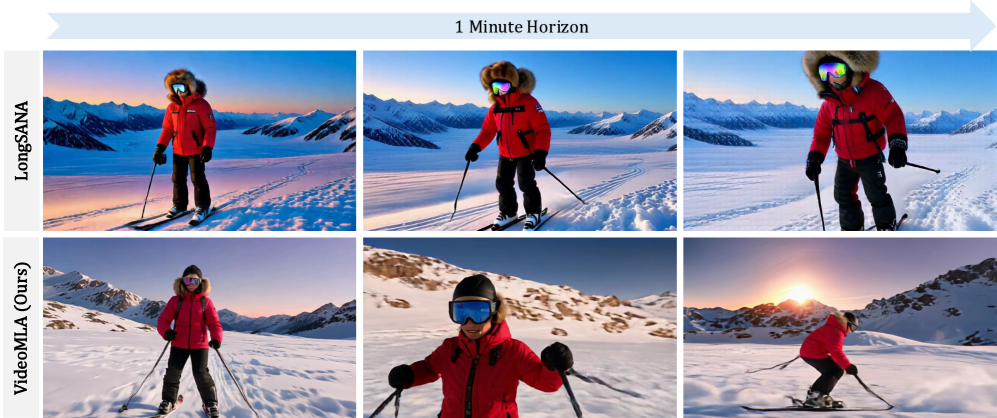
Результаты эффективности. Таблица 3 показывает, что VideoMLA достигает наибольшей пропускной способности и наименьшей задержки среди блочных (chunk-wise) авторегрессионных моделей, а также получает лучший балл CLIP-T. Хотя LongSANA имеет несколько более высокий балл CLIP-F, это отчасти связано с более статичными генерациями, которые сохраняют сходство на уровне кадров, но снижают динамику движения. Последовательно VideoMLA получает более высокий показатель HPSv3 и, как показано на рисунке 6, создает более четкие, более динамичные и более временно стабильные видеоролики при длительной развертке (long-rollout), чем LongSANA.
4.3 Анализ вклада (ablation)
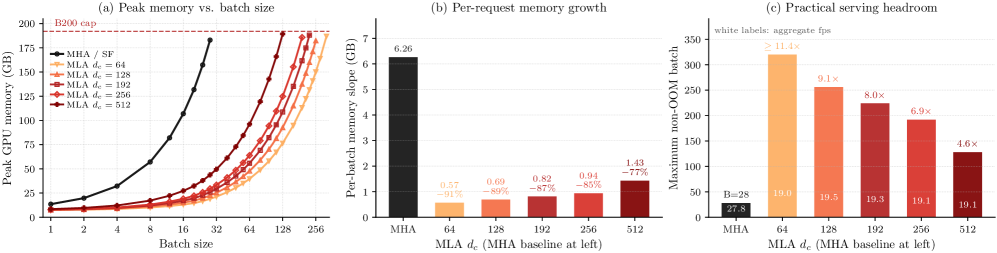
Пакетное масштабирование при фиксированной памяти. Рис. 7 показывает, что VideoMLA переводит сжатие кэша в практический запас по объёму обслуживания на одном B200. Плотная MHA достигает предела памяти на , тогда как MLA сдвигает «обрыв» OOM далеко вправо; с она остаётся в пределах бюджета даже при . Наклон по памяти на запрос снижается с ГБ/пакет для MHA до – ГБ/пакет для MLA, что даёт сокращение на – по сравнению с . Следовательно, MLA поддерживает как минимум до более крупных не приводящих к OOM пакетов при том же ограничении по памяти, при этом наш стандартный даёт запас по объёму пакета.
5 Почему MLA работает в видеодиффузии: бюджет ранга и спектральная структура
Мотивация для MLA часто опирается на предположение, что предварительно обученные отображения ключей/значений примерно имеют низкий ранг. Мы проверяем, справедливо ли это объяснение для видеодиффузии, анализируя совместный плотный оператор в Wan2.1-T2V-1.3B. На рис. 1 показано, что этот оператор не является низкоранговым: при заданном по умолчанию бюджете медианный слой сохраняет лишь спектральной энергии, а эффективный ранг по 99%-энергии превышает 1300 в каждом слое. Таким образом, прямое спектральное приближение с рангом- отбросит большую часть плотной энергии ключей/значений, даже несмотря на то, что VideoMLA сохраняет качество генерации при этом размере кэша.
Это несоответствие предполагает, что MLA не следует интерпретировать как восстановление скрытой структуры низкого ранга во предварительно обученных весах внимания. Вместо этого MLA изменяет задачу оптимизации: составной оператор ключей/значений
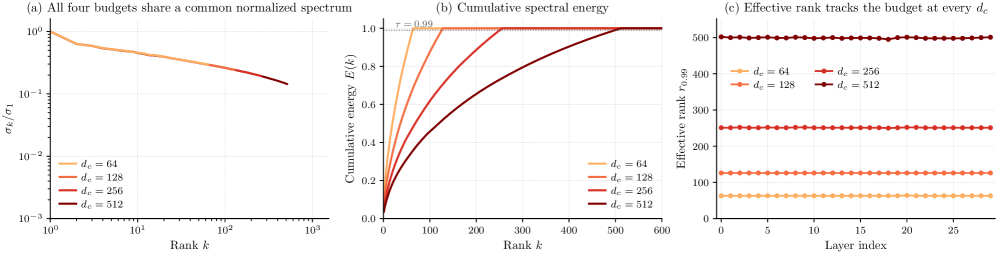
ограничена по конструкции так, чтобы иметь ранг не более . Рис. 2 подтверждает, что изученный составной оператор использует этот архитектурный бюджет почти полностью для различных размеров скрытого пространства. Для нормированные спектры имеют общую форму, обрезанную на , а ранговая оценка по 99%-энергии на уровне слоёв остается близкой к на протяжении всей сети. Следовательно, эффективный ранг задается узким местом MLA, а не спектром исходного плотного оператора.
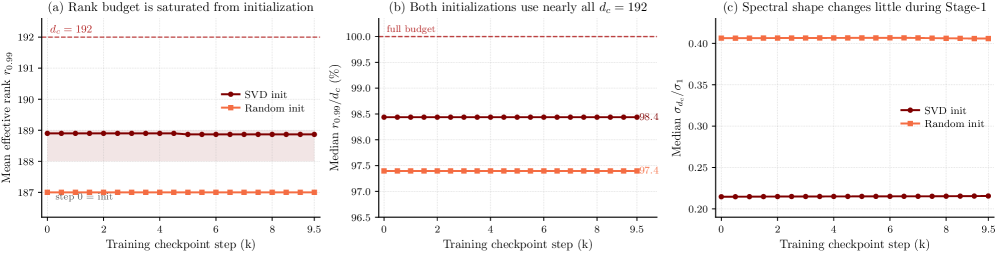
Мы дополнительно исследуем, является ли это артефактом инициализации SVD. Рис. 8 сравнивает SVD и случайную инициализацию при во время обучения. Оба почти насыщают бюджет по рангу с момента инициализации, и обучение сохраняет эффективный ранг и спектральный хвост. Таким образом, обучение не обнаруживает решение меньшего ранга и не приводит к коллапсу спектра; оно адаптируется в рамках заданного бюджета.
6 Ограничения и более широкое влияние
VideoMLA уменьшает KV-кэш на токен, но скрытый бюджет не может произвольно сокращаться. Небольшие бюджеты, такие как , улучшают запас памяти, но теряют детализированность и снижают качество, из-за чего становится компромиссом между качеством и эффективностью. Наши эксперименты сфокусированы на Wan2.1-T2V-1.3B и генерации в масштабе минут; более крупные базовые модели, более высокие разрешения, более длинные горизонты и переключение подсказок остаются задачами будущих работ. Более эффективная генерация на длинных горизонтах может снизить стоимость развертывания и расширить доступ к творческим инструментам, симуляциям, образованию и производству вспомогательных медиа.
7 Вывод
Мы представили VideoMLA — первую кэш-память скрытых KV в стиле MLA для авторегрессионной видеодиффузии. Заменяя плотные ключи и значения, характерные для каждого head, на общую низкоранговую скрытую латентность контента и на позиционный ключ 3D-RoPE с раздельной развязкой и общим head, VideoMLA снижает память кэша KV на токен на 92,7% при сохранении совместимости со стандартной chunk-causal генерацией. Наш анализ показывает, что этот успех не обусловлен intrinsically low-rank pretrained оператором «ключ-значение»; напротив, bottleneck MLA задаёт бюджет ранга, который модель использует почти полностью и адаптирует в ходе обучения. Эмпирически VideoMLA сохраняет визуальное качество и движение на больших горизонтах, достигает наилучшего общего балла за одну минуту среди оцененных методов и повышает пропускную способность при существенно меньшей памяти кэша. Эти результаты указывают на компоновку KV на токен как на эффективную и дополняющую ось для масштабирования эффективной видеодиффузии с протяжёнными горизонтами.
Благодарности
Пинар Янарада поддерживается Национальным научным фондом по гранту № 2543524.
Список источников
- [1] Дж. Айнсли, Дж. Ли-Тхорп, М. де Йонг, Й. Землянский, Ф. Леброн и С. Сангай (2023) Gqa: обучение обобщённых моделей transformer с многозапросным режимом из контрольных точек с многими головами. В материалах 2023 Conference on Empirical Methods in Natural Language Processing, стр. 4895–4901. Цитируется: §2.
- [2] X. Bai, G. He, Z. Li, E. Shechtman, X. Huang, and Z. Wu (2026) Причинность в видеодискретизаторах, разделимая с устранением зашумления. Пре́принт arXiv arXiv:2602.10095. Цитируется: §1, §2.
- ⟦[3] Дж. Чэнь, Ю. Чжао, Дж. Юй, Р. Чу, Дж. Чэнь, С. Ян, С. Ван, Ю. Пан, Д. Чжоу, Х. Лин, и др. (2025) Sana-video: эффективная генерация видео с блочно-линейным диффузионным трансформером. предварительная публикация arXiv arXiv:2509.24695. Цитируется по: §1, §1, §2, §4.1, Table 2, Table 3.
- [4] Дж. Цуй, Дж. У, М. Ли, Т. Ян, Си. Ли, Р. Ван, А. Бай, Ю. Бан и Си. Хсие (2025) Self-forcing++: к генерации видеоматериалов высокого качества с длительностью в пределах минут. Предварительная публикация arXiv по адресу arXiv:2510.02283. Цитируется: §1, §1, §2.
- [5] Г. Денг, Т. Пан, Х. Дяо, Ч. Луо, Ю. Цуй, Х. Лу, С. Шань, Ю. Ци и С. Ван (2024) Авторегрессионная генерация видео без векторного квантования. препринт arXiv arXiv:2412.14169. Цитируется: §1, Table 3.
- [6] K. Deng and P. C. Woodland (2025) Многоголовое временное латентное внимание. Предварительная публикация arXiv arXiv:2505.13544. Цитируется: §2.
- ⟦[7] Дж. Гао, Чж. Чэнь, С. Лю, Ц. Фэн, С. Си, Й. Фу, Й. Цяо и Чж. Лю (2025) Longvie: multimodal-guided controllable ultra-long video generation. Предварительная публикация arXiv arXiv:2508.03694. Цитируется: §1.
- [8] R. Henschel, L. Khachatryan, H. Poghosyan, D. Hayrapetyan, V. Tadevosyan, Z. Wang, S. Navasardyan, and H. Shi (2025) Streamingt2v: согласованное, динамическое и расширяемое порождение длинных видео по тексту. В материалах конференции по компьютерному зрению и распознаванию образов, стр. 2568–2577. Цитируется: §1.
- ⟦[9] X. Huang, Z. Li, G. He, M. Zhou, and E. Shechtman (2025) Самопринуждение: преодоление разрыва между обучением и тестированием в авторегрессионной видеодиффузии. Предварительная публикация arXiv arXiv:2506.08009. Цитируется: §1, §1, §2, §4.1, Table 2, Table 3.
- ⟦[10] Т. Цзи, Б. Го, Ю. У, Ц. Го, Л. Шэнь, Ц. Чэнь, С. Цю, Ц. Чжан и Т. Гуй (2025) К экономному выводу: внедрение многоголовочного скрытого внимания deepseek в любые llms на основе transformers. В материалах 63-го ежегодного собрания Ассоциации по компьютерной лингвистике (том 1: длинные доклады), стр. 33313–33328. Цитируется: §1, §2.
- [11] Y. Jin, Z. Sun, N. Li, K. Xu, H. Jiang, N. Zhuang, Q. Huang, Y. Song, Y. Mu, and Z. Lin (2024) Пирамидальное согласование потоков для эффективного моделирования генерации видео. Предварительная публикация arXiv arXiv:2410.05954. Цитируется: §1, Table 3.
- ⟦[12] Y. Kim, Q. Hu, C. J. Kuo, and P. A. Beerel (2026) MemRoPE: обучение без тренировки бесконечной генерации видео посредством развивающихся токенов памяти. arXiv препринт arXiv:2603.12513. Цитируется: §1, §1.
- ⟦[13] Х. Ли, С. Лю, Ц. Линь и М. Чандракер (2026) Rolling sink: bridging limited-horizon training and open-ended testing in autoregressive video diffusion. arXiv preprint arXiv:2602.07775. Cited by: §1.
- [14] А. Лю, Б. Фэн, Б. Ван, Б. Ван, Б. Лю, С. Чжао, C. Денгр, C. Руан, Д. Дай, Д. Го, и др. (2024) Deepseek-v2: мощная, экономичная и эффективная смесь экспертов языковая модель. предварительная публикация arXiv arXiv:2405.04434. Цитируется: §1, §2.
- [15] A. Liu, B. Feng, B. Xue, B. Wang, B. Wu, C. Lu, C. Zhao, C. Deng, C. Zhang, C. Ruan, et al. (2024) Deepseek-v3 technical report. arXiv preprint arXiv:2412.19437. Cited by: §2.
- [16] К. Лю, В. Ху, Ц. Сюй, Я. Шань и С. Лу (2025) Прокатное принудительное воздействие: авторегрессионная диффузия длинных видео в реальном времени. Предварительная публикация arXiv:2509.25161. Цитируется: §1, §1, §2, §4.1, Table 2.
- ⟦[17] Й. Лу, Ю. Цэн, Х. Ли, Х. Оуян, Ц. Ван, К. Л. Чэн, Дж. Чжу, Х. Цао, Ц. Чжан, Х. Чжу, и др. (2025) Принуждение к вознаграждению: эффективная генерация потокового видео с вознаграждением посредством дистилляции согласования распределений. Предварительная публикация arXiv arXiv:2512.04678. Цитируется: §1, §1, §2, §4.1, Table 2.
- [18] F. Meng, P. Tang, X. Tang, Z. Yao, X. Sun, and M. Zhang (2025) Transmla: multi-head latent attention is all you need. arXiv preprint arXiv:2502.07864. Cited by: §2.
- [19] К. Нан, Р. Се, П. Чжоу, Т. Фань, Ц. Ян, Ц. Чэнь, С. Ли, Ц. Янь и Ю. Тай (2024) Openvid-1m: крупномасштабный высококачественный набор данных для генерации текста в видео. arXiv препринт arXiv:2407.02371. Цитируется: §4.1.
- [20] А. Васвани, Н. Шазир, Н. Пармар, Дж. Узскореит, Л. Джонс, А. Н. Гомез, Ł. Кайзер и И. Полосухин (2017) Внимание — это всё, что нужно. Успехи в системах обработки нейронной информации 30. Цитируется: §2.
- [21] Т. Ван, А. Ван, Б. Ай, Б. Вэнь, С. Мао, С. Се, Д. Чэнь, Ф. Юй, Х. Чжао, Дж. Ян и др. (2025) Ван: открытые и продвинутые крупномасштабные модели генерации видео. предварительная публикация arXiv arXiv:2503.20314. Цитируется: §1, §4.1.
- [22] С. Ян, У. Хуан, Р. Чу, Ю. Сяо, Ю. Чжао, X. Ван, М. Ли, Э. Се, Ю. Чэнь, Ю. Лу, и др. (2025) Longlive: генерация длинных видео в реальном времени с интерактивным взаимодействием. препринт arXiv arXiv:2509.22622. Цитируется: §1, §1, §2, §4.1, Table 2.
- ⟦[23] Y. Yang, T. Zhang, W. Huang, J. Chen, B. Wu, X. He, D. Cai, B. Li и P. Jiang (2026) Принудительное закрепление: закрепляющая память и tri-region rope для интерактивной потоковой диффузии видео. Препринт arXiv arXiv:2603.13405. Цитируется: §1.
- [24] H. Yesiltepe, T. H. S. Meral, A. K. Akan, K. Oktay и P. Yanardag (2025) Infinity-rope: генерация бесконечного видео с управляемыми действиями возникает из авторегрессионного саморазвёртывания. препринт arXiv arXiv:2511.20649. Цитируется: §D.5, §1, §1, §2, §4.1, Table 2.
- [25] Дж. Йи, У. Джанг, П. Х. Чо, Дж. Нам, Х. Юн и С. Ким (2025) Deep forcing: обучение без дообучения для генерации длинных видео на основе deep sink и совместного сжатия. Предварительная публикация arXiv arXiv:2512.05081. Цитируется: §1, §1, §2, §4.1, Table 2.
- [26] T. Yin, M. Gharbi, T. Park, R. Zhang, E. Shechtman, F. Durand, and B. Freeman (2024) Улучшенное дистиллирование подгонки распределения для быстрого синтеза изображений. Труды Advances in neural information processing systems 37, стр. 47455–47487. Цитируется: §2.
- [27] Т. Инь, Ц. Чжан, Р. Чжан, У. Т. Фримен, Ф. Дюранд, Э. Шехтман и С. Хуан (2025) От медленной двунаправленной передачи к быстрым авторегрессионным моделям диффузии для видео. В материалах конференции Computer Vision and Pattern Recognition, стр. 22963–22974. Цитируется: §1, §1, §2, §4.1, Table 2.
- ⟦[28] Ю. Юй, С. У, С. Ху, Т. Ху, Ю. Сун, С. Люй, Б. Ван, Л. Ма, Ю. Ма, Ц. Ван и др. (2025) Videossm: авторегрессионная генерация длинных видео с гибридной памятью на основе пространственно-частотного состояния. Предварительная публикация arXiv arXiv:2512.04519. Цитируется: §1, §2.
- ⟦[29] L. Zhang и M. Agrawala (2025) Упаковка контекста входного кадра в моделях прогнозирования следующего кадра для генерации видео. arXiv e-prints, стр. arXiv–2504. Цитируется: §1.
- ⟦[30] З. Чжао, Ю. Лу, Ц. Лю, Дж. Сонг, Дж. Дэн, и И. Патрас (2026) Уберите принудительность: расслабленная kv-память для согласованного генерирования длинных видео. предварительная публикация arXiv arXiv:2603.21366. Цитируется: §1.
- ⟦[31] Г. Чжу, М. Чжао, Г. Хэ, Х. Су, К. Ли и Дж. Чжу (2026) Принудительное причинное воздействие: дистилляция автoregressive-диффузии, выполненная правильно, для высококачественной генерации реального времени интерактивного видео. препринт arXiv arXiv:2602.02214. Цитируется: §1, §1, §2, §4.1, §4.1, Table 2.
Оглавление
Appendix A Видео и веб-сайт
Для облегчения всесторонней оценки и повышения доступности результатов мы предоставляем видеорезультаты, включающие качественные примеры, исследования с исключением компонентов, сравнения и ограничения в https://videomla.github.io.
Appendix B Детали исследования пользователей
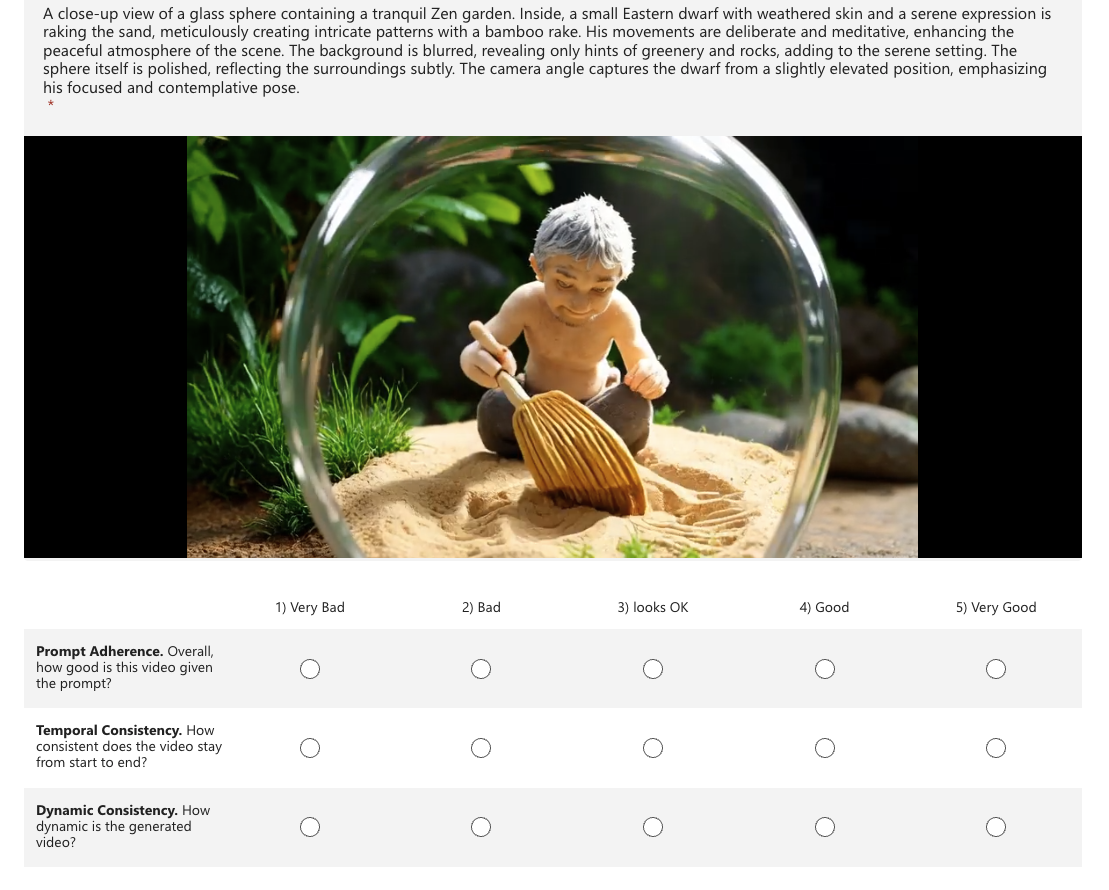
Мы проводим пользовательское исследование для оценки перцептивного качества генераций длительностью в одну минуту. Мы сравниваем девять моделей и просим 50 участников оценить каждое видео, используя интерфейс, показанный на рис. 9. Для каждого сгенерированного видео участники отвечают на три вопроса: соответствие запросу, измеряющее, насколько хорошо видео следует запросу; временная согласованность, измеряющая, сохраняется ли связность видео от начала до конца; и динамическая согласованность, измеряющая, содержит ли видео правдоподобное и устойчивое движение. Каждый вопрос оценивается по пятибалльной шкале Лайкерта, от 1) Очень плохо до 5) Очень хорошо.
Appendix C Фон
C.1 Wan2.1-T2V-1.3B базовая часть
Наши эксперименты используют Wan2.1-T2V-1.3B в качестве базового видео диффузионного остова. Wan2.1-T2V-1.3B — это латентный видео диффузионный трансформер, работающий по спатиотемпоральным латентным токенам, а не по пикселям RGB. Видео кодируется с помощью 3D VAE, которая сжимает временную размерность на и каждую пространственную размерность на , поэтому входное видео отображается в латентный тензор с временной длиной и пространственным разрешением . Модель шумоподавления следует формулировке rectified-flow, где чистый латент и гауссов шум линейно интерполируются как
а обратный процесс параметризован нейронным полем скоростей и решается с помощью интегрирования Эйлера во время вывода.
Wan2.1-T2V-1.3B использует диффузионный transformer с многошаговым (multi-head) самовниманием по токенам латентного представления видео. В нашей реализации базовая часть содержит 30 блоков transformer, скрытое измерение , attention-голов, и измерение для каждой attention-головы. В плотном базовом варианте каждый кэшированный токен хранит и ключи, и значения для всех голов, обеспечивая размер кэш-памяти KV на токен, на слой, равный
scalars. При кэше из 21 латентного кадра, 1 560 токенов на латентный кадр и 30 кэшированных слоёв transformers это соответствует 3,02B кэшированных scalars, или примерно 6,0GB в bf16/fp16. Эта плотная компоновка KV на голову является основным целевым объёмом памяти VideoMLA.
Основой служат трехмерные роторные позиционные вложения (3D-RoPE), которые кодируют временные и пространственные координаты токенов перед самовниманием. Для скрытых признаков с размерность канала разделяется по осям временной координаты, высоты и ширины, и RoPE применяется отдельно к соответствующим подпространствам координат перед их объединением. В Wan для каждой размерности RoPE задана фиксированная максимальная длина последовательности 1024; хотя RoPE остается математически определенной и за пределами этого диапазона, генерация вне позиционного режима, наблюдаемого во время обучения, может ухудшить качество внимания.
Для авторегрессионной генерации длинных видео Wan2.1-T2V-1.3B обычно используется после обучения с каузальной дистилляцией или после self-rollout. Модель генерирует фрагменты латентных кадров последовательно и обусловливает каждый фрагмент на основе скользящего KV cache предыдущих фрагментов. Этот cache обеспечивает эффективную потоковую генерацию, поскольку ранее сохраненные состояния ключей и значений повторно используются, а не пересчитываются заново. Однако в плотной разметке внимания Wan cache по-прежнему хранит полные ключи и значения для каждой головы для каждого удерживаемого токена и для каждого закешированного слоя. VideoMLA сохраняет неизменными backbone Wan и настройку каузального rollout, но заменяет это плотное состояние KV на токен на общий latent content cache и разъединенный head-shared 3D-RoPE key.
| Hyperparameter | Value |
| Backbone | Wan2.1-T2V-1.3B |
| Transformer blocks | 30 |
| Hidden dimension | 1536 |
| Number of heads | 12 |
| Per-head dimension | 128 |
| KV latent dimension | 192 |
| Query latent dimension | 768 |
| NoPE channels | 96 |
| RoPE channels | 32 |
| 3D-RoPE complex pairs | |
| Per-token cache size | 224 scalars |
| KV cache reduction | |
| Training precision | bf16 |
| Training GPUs | B200 |
| Total batch size | 128 |
| Teacher Forcing LR | |
| Consistency Distillation LR | |
| DMD LR | |
| Training pipeline | TF CD DMD |
| Inference steps | 4 |
Appendix D Детали реализации
D.1 Опорная сеть и токенизация
VideoMLA реализован поверх Wan2.1-T2V-1.3B. Основа содержит блоков transformer, скрытое измерение , attention heads и измерение на голову , так что . Скрытое измерение feed-forward равно . Мы сохраняем текстовую ветвь для conditioning в Wan и все неattention-модули неизменными, и заменяем только временные слои self-attention на блок VideoMLA, описанный в Разделе 3.
Мы обучаемся на 5-секундных фрагментах с разрешением и 16 кадров в секунду. Ван VAE кодирует каждый фрагмент в латентный тензор с 16 каналами, 21 латентным фреймом и пространственным размером . Порождающее в 3D встраивание с размером патча отображает каждый латентный фрейм в визуальных токенов. Таким образом, каждый 5-секундный фрагмент содержит токенов для self-attention. Автoregressive генерация выполняется фрагментами по 3 латентных фрейма.
D.2 Блок VideoMLA
Каждый слой временного self-attention следует обозначениям Раздела 3. Учитывая вход внимания , VideoMLA сначала формирует общий кэш латентного содержания latent
и скрытый запрос
В модели по умолчанию мы используем
с . Форма понижающего проекционного преобразования
Оба и нормализуются с помощью RMSNorm перед соответствующими проекциями вверх.
Ключ содержимого и значение для head восстанавливаются из общего кэша latent:
Агрегирование всех головок: формы проекции являются
Запрос NoPE восстанавливается аналогичным образом:
Ветвь RoPE отделена от кэширования содержимого. Для каждого токена VideoMLA вычисляет один позиционный ключ с разделяемой по головам проекцией
и запросы позиционных признаков для каждого отдельного канала
Исходная проекция выходного внимания — это исходная проекция выхода внимания
Поэтому каждый кэшированный токен хранит только
чем плотные ключи и значения на голову. При настройке по умолчанию это скаляров на токен на слой, по сравнению с скалярами для плотного MHA, что соответствует снижению кэширования.
D.3 Разделение NoPE/RoPE и трехмерный RoPE
Каждая голова разделяется как
где подпространство NoPE используется для сопоставления содержимого, а подпространство RoPE — для сопоставления с учетом позиции. Запрос и ключ на каждую голову
где
Позиционный ключ является общим для всех головок, тогда как ключи NoPE, запросы NoPE и значения остаются специфичными для каждой головки после up-projection.
Для стандартного разбиения подпространство RoPE содержит пар комплексных частот. Следуя факторизации Wan 3D-RoPE, эти пары распределяются по осям времени, высоты и ширины следующим образом
используя наиболее высокочастотные диапазоны из соответствующих групп осей.
D.4 Скользящее окно внимания с причинным вниманием к фрагментам
VideoMLA сохраняет шаблон внимания с причинностью по чанкам, используемый в авторегрессионной Wan-основе. Токены в рамках одного 3-латентно-кадрового чанка могут обращать внимание друг на друга, тогда как токены в более позднем чанке не могут быть доступны более ранним чанкам. Для генерации с длинным горизонтом внимание ограничено фиксированным кэшем, состоящим из одного sink-латентного кадра и последних шести латентных кадров. Поскольку каждый латентный кадр содержит 1560 токенов, sink занимает 1560 слотов кэшированных токенов, а локальное окно занимает слотов токенов.
Во время обучения применяется та же структура chunk-causal и скользящего окна с блочно-разреженными масками внимания. Во время инференса кэш хранит
где — это число закешированных токенов в контексте sink-plus-window. Когда кэш заполнен, токены вне sink вытесняются в порядке FIFO. Вычисление внимания считывает активный кэш, восстанавливает ключи и значения содержимого через и , применяет 3D-RoPE к активным позиционным ключам и вычисляет стандартные оценки внимания для каждого head по формуле из Eq. (7).
D.5 Перепиндексация RoPE на длинных горизонтах
Для разверток сверх 21 скрытого кадра, наблюдавшегося во время обучения на 5 секунд, заранее сохраняются позиционные ключи, которые кэшируются до применения RoPE. Когда формируется окно внимания, активные кэшированные ключи назначаются локальные временные координаты внутри текущего контекста sink-plus-window, а затем поворачиваются на в соответствии с [24]. Текущий фрагмент запроса также поворачивается в той же локальной системе координат. Таким образом, и запросы, и кэшированные ключи используют ограниченную, зависящую от окна позиционную рамку даже после вытеснения из кэша.
Эта переиндексация сохраняет фазу RoPE в режиме короткого горизонта, наблюдавшемся за магистралью во время обучения, при этом позволяя сгенерированному видео выходить за пределы исходной длины клипа в 21 скрытый фрейм. Все сообщенные развертывания для длинного видео используют один sink скрытый фрейм, локальное окно из шести скрытых фреймов и 4-шаговый сэмплер студента.
D.6 Учебный конвейер
Мы обучаем одну и ту же архитектуру VideoMLA в три этапа на 8 графических процессорах NVIDIA B200, используя FSDP полное расщепление, bf16 смешанную точность, AdamW с и , и задачу сглаживающего шумоподавления с выпрямленным потоком.
Этап 1: Учительское принуждение.
Мы инициализируем проекции MLA на основе разложения в стиле SVD предварительно обученных матриц плотного внимания Wan в целевой конфигурации
Затем модель обучают как ученика для chunk-causal flow-matching с чистым предыдущим контекстом блоков из latents, закодированных учителем. Мы используем learning rate , размер batch на GPU 1, общий размер batch 2, gradient checkpointing, 1000 training timesteps и timestep shift 5.0.
Этап 2: Дистилляция согласованности.
Начиная с контрольной точки Stage-1, мы дистиллируем модель по схеме выборки из 4 шагов
Мы используем сдвиг по таймстепам 5.0 и масштаб classifier-free guidance 3.0. Генератор learning rate равен , critic learning rate равен , а общий размер batch равен 2 при включенном gradient checkpointing enabled.
Этап 3: Дистилляция с согласованием распределений.
Наконец, мы инициализируемся из контрольной точки Stage-2 на итерации 2500 и дообучаемся с помощью distillation по соответствию распределений на том же четырехшаговом расписании. Реальная оценка предоставляется замороженным учителем, а поддельная оценка изучается онлайн. Мы выполняем пять обновлений критика на одно обновление генератора, используем веса EMA 0.99, начиная с шага 1, коэффициент обучения генератора , коэффициент обучения критика , масштаб наведения 3.0 и сдвиг по времени 5.0. Общий размер батча равен 16, получен из размера батча на GPU 8 на 8 GPU и накопления градиентов 2.
Контрольная точка Stage-3 используется для всех полученных результатов VideoMLA, включая оценки с длительным горизонтом.
Appendix E Переараметризация во время инференса
Формулировка во время обучения в разделе 3 записана так, чтобы явно установить связь со стандартным multi-head attention: каждый кэшированный токен хранит , а ключи и значения NoPE для каждой головы реконструируются через Eq. 2 перед применением обычного вычисления attention. Это удобно во время обучения, потому что позволяет VideoMLA повторно использовать те же блок-каузальные маски, логику sink-token и attention kernels, что и плотностная базовая модель. Однако при инференсе явная реконструкция и частично сводила бы на нет выигрыш от латентного кэширования, материализуя плотные тензоры для каждой головы после каждого считывания кэша. Поэтому мы используем эквивалентную пере параметризацию, которая сохраняет кэш и вычисление attention в латентной форме.
Для вычисления оценки единственный вклад реконструированного ключа NoPE осуществляется через его скалярное произведение с реконструированным запросом NoPE. Подстановка уравнений 3, 4 и 2 в член, соответствующий содержимому, уравнения 7 дает
| (8) |
где
| (9) |
Матрица зависит только от обученных параметров и не зависит от текущей последовательности, содержимого кэша, диффузионного шага по времени и позиции развертывания. Поэтому ее можно заранее вычислить один раз при загрузке модели. Во время инференса оценка содержания NoPE для головы вычисляется непосредственно из латентного представления запроса и кэшированного латентного представления содержимого , без формирования либо , либо в виде явных векторов на каждую голову.
Путь ценности допускает аналогичное поглощение. Пусть обозначает срез проекции выхода, примененный к выходу головы . Используя уравнение 2,
| (10) |
где
| (11) |
Таким образом, значение up-проекции также можно включить в выходной микшер. На практике после вычисления весов внимания для головы взвешенная сумма может быть накоплена по кэшированным латентным представлениям и затем спроецирована с помощью , вместо того чтобы сначала восстанавливать все плотные значения , а затем применять выходную проекцию.
Ветвь RoPE сохраняется отдельно от этого поглощения. Кэш хранит не повернутый, разделяемый по головам позиционный ключ из уравнения 5. Когда активное окно внимания собирается, поворачивается на с использованием текущего индекса окна, и член позиционной оценки в уравнении 7 вычисляется как
| (12) |
Это разделение важно, потому что RoPE зависит от позиции и не может быть свернут в фиксированную матричную параметризацию так же, как проекции содержимого NoPE. Хранение без поворота также сохраняет возможность переиндексирования кэшированных токенов в пределах скользящего окна, как описано в Разделе 3.2⟧.
После перенапараметризации кэш для вывода никогда не расширяется в плотные ключи и значения для каждой головы. Каждый закэшированный токен вносит только скрытое содержимое и разделяемый между головами позиционный ключ . Поэтому состояние, кэшированное для каждого токена, остается
| (13) |
вместо плотной базовой стоимости
| (14) |
Для окна внимания размера трафик кэш-памяти уменьшается с
| (15) |
до
| (16) |
При стандартной конфигурации и это соответствует кэшированным скалярным значениям на токен на слой по сравнению с скалярными значениями для плотной MHA. Поэтому параметризация сохраняет математическое вычисление внимания формулировки, используемой во время обучения, при этом гарантируя, что реализация во время вывода реализует предполагаемые сбережения по памяти и пропускной способности латентного кэша.
Appendix F Дополнительные абляции
Таблица 5 рассматривает два архитектурных выбора: скрытое размерение KV и разделение каналов NoPE/RoPE. Скрытое размерение управляет основной компромиссной связью качество–эффективность. При VideoMLA обеспечивает наибольшее сжатие кэша и запас по памяти, но бюджет оказывается слишком ограничительным: как семантические, так и показатели качества снижаются, что согласуется с потерей детализированных визуальных характеристик при чрезмерно агрессивном сжатии. Увеличение до в значительной степени восстанавливает качество при сохранении высокой степени сжатия. Дальнейшее увеличение до или даёт лишь незначительные улучшения, но существенно уменьшает преимущество по памяти. Это указывает на то, что полезный рабочий режим определяется не максимально возможным скрытым размерением, а минимальным бюджетом, который сохраняет видеопризнаки, значимые для задачи.
Разделение NoPE/RoPE также имеет четкий эффект. При наличии только каналов RoPE пространственная емкость оказывается слишком ограниченной, что приводит к слабой временной и пространственной привязке. И наоборот, «RoPE-ориентированное» разделение оставляет слишком мало емкости для кэшированного содержимого и ухудшает семантическую точность. Сбалансированная настройка улучшает ситуацию по сравнению с этими крайними вариантами, но все же остается ниже стандартной конфигурации, ориентированной на содержимое. Наилучший результат дает разделение , что указывает на то, что потоковое видео выигрывает от выделения большинства каналов под путь кэшированного содержимого при сохранении меньшего выделенного подпространства RoPE для формирования позиционной структуры.
(а) Латентное измерение
| Semantic | Quality | Total | Mem. | FPS | |
| 64 | 77.42 | 79.18 | 78.30 | 32.00 | 26.93 |
| 128 | 82.16 | 84.31 | 83.24 | 19.20 | 27.00 |
| 256 | 82.74 | 84.58 | 83.66 | 10.67 | 26.93 |
| 512 | 82.41 | 84.39 | 83.40 | 5.65 | 26.79 |
(b) Разделение NoPE/RoPE
| Semantic | Quality | Total | ||
| 112 | 16 | 74.62 | 78.31 | 76.47 |
| 64 | 64 | 79.54 | 82.12 | 80.83 |
| 32 | 96 | 75.88 | 80.74 | 78.31 |
| 96 | 32 | 83.02 | 84.76 | 83.89 |