Gmos: Сегментация движущихся объектов с привязкой к тексту
в 3D пространстве и времени
Аннотация
Сегментация движущихся объектов (MOS) направлена на обнаружение, сегментацию и отслеживание объектов, которые перемещаются независимо от камеры. Однако современные методы MOS демонстрируют два фундаментальных ограничения: они полагаются на предварительно вычисленные вспомогательные 2D-модальности, такие как оптический поток или траектории точек, в которых отсутствует 3D-геометрическая информация, и они рассматривают движение как атрибут на уровне последовательности, упуская из виду мгновенное состояние движения каждого объекта. Мы решаем обе проблемы, обосновывая MOS в 3D-пространстве и времени, и предлагаем Gmos — фреймворк, который работает непосредственно с RGB-видео для создания 3D-осведомленной, временно детализированной сегментации множества движущихся объектов, наряду с вариантом для переднего и заднего плана Gmos-S для более быстрого развертывания. Для поддержки обучения и оценки в этом режиме мы подготовили Gmos-2K, набор данных из реальных видео с временными аннотациями движения для каждого объекта, взятыми из пяти признанных бенчмарков Video Object Segmentation (VOS), и формализовали MOS-I («I» означает мгновенный) — протокол оценки с временной детализацией и тремя взаимодополняющими метриками. Gmos достигает передовых результатов в бенчмарках MOS, MOS-I и Unsupervised VOS, работая при этом значительно быстрее, чем предыдущие методы MOS для нескольких объектов, и поддерживая онлайн-вывод для потокового развертывания..
1 Введение
Сегментация движущихся объектов (MOS) направлена на обнаружение, сегментацию и отслеживание объектов, которые перемещаются независимо от камеры. Эта возможность является основополагающей для таких приложений, как автономное вождение [5, 33], обнаружение замаскированных объектов [Lamdouar20, Yang21a] и видеонаблюдение [45, 65], и становится все более важной для современных методов реконструкции 3D/4D сцен [35, 19], которым требуются маски движения для отделения динамических объектов от статической сцены..
Современные методы MOS демонстрируют два фундаментальных ограничения, как указано в Tab.˜1. Во-первых, они не учитывают 3D-структуру и остаются уязвимыми при значительном движении камеры или параллаксе глубины. Это проистекает из их сильной зависимости от предварительно вычисленных 2D вспомогательных модальностей (например, оптического потока [Yang21a, Xie22, 36] или траекторий точек [22, Karazija24b]), в которых отсутствует 3D геометрическая информация и которые требуют значительных затрат на предварительную обработку. Во-вторых, существующие бенчмарки предполагают, что объекты движутся на протяжении всего видео, что заставляет методы рассматривать движение как атрибут уровня последовательности и игнорировать мгновенное состояние движения каждого объекта. Такая грубая временная гранулярность препятствует развертыванию в режиме онлайн и реального времени..
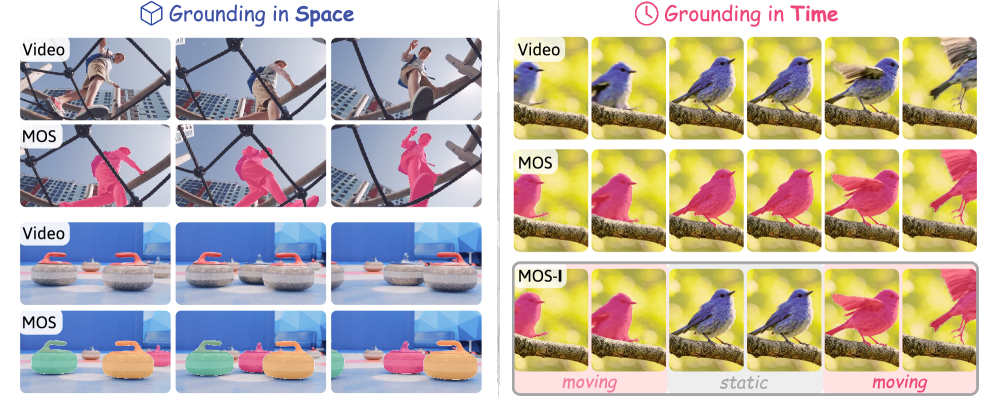
Мы устраняем оба ограничения путем привязки MOS к пространству и времени. Наш подход основан на двух наблюдениях: (i) геометрические представления, изученные современными моделями 3D реконструкции прямого распространения, уже кодируют достаточный объем информации для разделения движения камеры и объекта, и (ii) независимое движение объекта надежно идентифицируется по короткому временному окну ( с).
Опираясь на эти выводы, мы предлагаем Gmos — структуру типа «предлагающий-распространяющий», которая работает непосредственно с RGB-видео без каких-либо вспомогательных предварительно вычисленных модальностей. Покадровый предлагающий модуль объединяет геометрические признаки из encoder [64] с признаками сегментации из SAM2 encoder [55], совместно формируя предложения масок объектов и покадровые прогнозы состояния движения. Затем распространяющий модуль на базе SAM2 связывает эти предложения в согласованные треки по всем кадрам. Мы также представляем Gmos-S («S» для single), потоковый вариант для переднего и заднего плана, который прогнозирует все движущиеся объекты как единую бинарную маску и обходится без распространяющего модуля для еще более быстрого вывода..
Для поддержки MOS более геометрически обоснованным и темпорально детализированным образом мы подготовили Gmos-2K, коллекцию из видео из реального мира, взятых из пяти признанных бенчмарков VOS и аннотированных покадровыми состояниями движения для каждого объекта. Подмножества охватывают взаимодополняющие домены, включая сцены с сильным перекрытием, взаимодействия рук с объектами, а также ролики с дикой природой и участием людей. Наряду с этим набором данных мы формализуем MOS-I («I» означает мгновенный), протокол оценки MOS с темпоральной детализацией. Как показано на Fig.˜1 (справа), MOS-I оценивает маски сегментации только на кадрах, где объекты активно движутся, и штрафует за ложноположительные предсказания на статических и фоновых объектах..
Подводя итог, наши основные достижения заключаются в следующем:
- ⟦• Мы предлагаем Gmos, структуру типа «предлагающий–распространяющий», которая обеспечивает 3D-осведомленную, временно детализированную MOS исключительно на основе RGB-видео и поддерживает онлайн-вывод. Мы также представляем Gmos-S, вариант для разделения переднего и заднего плана для еще более быстрого развертывания.
- ⟦• Мы представляем целевую функцию обучения на основе доверия, которая автоматически снижает веса зашумленных аннотаций движения на уровне кадров вблизи переходов от статики к движению.
- ⟦• Мы подготовили Gmos-2K, набор данных из видео реального мира, взятых из пяти признанных эталонов VOS и аннотированных временными метками движения для каждого объекта, что обеспечивает унифицированный ресурс как для обучения, так и для оценки методов MOS с высокой временной детализацией..
- ⟦• Мы формализуем MOS-I, протокол оценки с высокой временной детализацией для MOS, вместе с тремя дополнительными метриками, которые совместно измеряют точность сегментации на активно движущихся кадрах и устойчивость к ложноположительным предсказаниям на статических и фоновых объектах.
Gmos достигает передовых результатов в бенчмарках MOS, MOS-I и Unsupervised VOS (UVOS), работая при этом примерно в три раза быстрее, чем предыдущие методы MOS (Tab.˜1⟧).
2 Метод: Gmos
Получив на вход видео в формате RGB , мы ставим своей целью предсказать для каждого кадра и каждого независимо движущегося объекта маску сегментации вместе с его состоянием движения,
| (1) |
где — это бинарная маска сегментации, — состояние движения, при котором указывает на то, что объект движется в кадре . Gmos формирует эти выходные данные совместно и, следовательно, охватывает как MOS-I (Sec.˜4.2), так и стандартные настройки MOS.
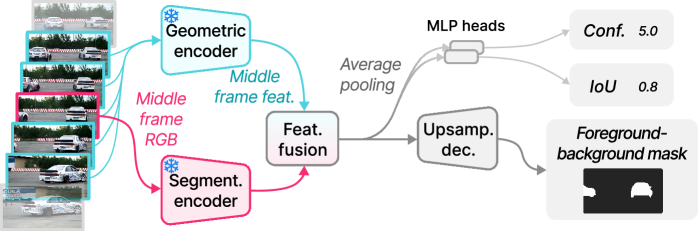
⟦Fig.˜2 (слева) представляет собой обзор Gmos, который следует архитектуре «предлагающий-распространяющий». Предлагающий модуль работает на коротком локальном окне и выводит для среднего кадра набор предложений для каждого объекта, каждое из которых включает маску движущегося объекта и предсказанное состояние движения. Распространяющий модуль затем связывает эти покадровые предложения в согласованные треки объектов по всему видео.
2.1 Gmos предлагающий
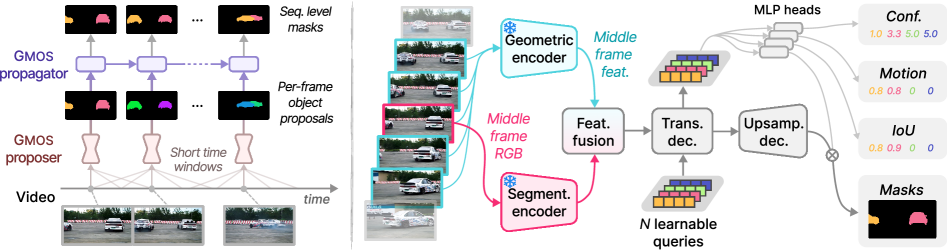
Как показано на Fig.˜2 (справа), пропоузер принимает необработанные видеокадры в качестве единственного входного сигнала и предсказывает для каждого из объектных запросов маску сегментации вместе с вспомогательными выходными данными: оценкой достоверности, состоянием движения и оценкой IoU маски..
Геометрический энкодер. Для достижения 3D-осведомленности мы извлекаем геометрические признаки, используя замороженный энкодер [64]. Вместо подачи всей последовательности мы обрабатываем короткое временное окно , центрированное относительно опорного кадра , что достаточно для различения независимого движения объекта и параллакса, вызванного движением камеры. После кодирования мы сохраняем только признак среднего кадра , так как межкадровая корреспонденция уже закодирована в нем посредством механизма cross-frame attention модели..
Энкодер сегментации. Поскольку одни лишь геометрические признаки содержат мало информации о признаках сегментации объектов, мы используем сильный априорный показатель объектности замороженного энкодера SAM2 [55]. Только опорный кадр проходит через SAM2, что дает признак «бутылочного горлышка» вместе с признаками высокого разрешения, которые впоследствии используются масочной головкой..
Слияние признаков. Геометрический признак обычно имеет более низкое пространственное разрешение, чем признак сегментации , т.е. . Поэтому мы применяем билинейную интерполяцию к , объединяем два признака по каналам и применяем линейную проекцию для получения объединенного признака . Затем к применяется легковесный transformers self-attention энкодер для обеспечения глобальной пространственной согласованности..
Декодер transformers. Следуя общепринятой практике в сегментации на основе запросов [7, 31], мы вводим обучаемых объектных запросов с и подаем их в двухсторонний декодер transformers [27] вместе с . Каждый слой чередует механизм self-attention для запросов с cross-attention между запросами и признаками, а также между признаками и запросами, создавая уточненные токены запросов и уточненные плотные признаки .
Голова маски. Уточненные плотные признаки повышаются до полного разрешения посредством транспонированных сверток, при этом высокоразрешающие признаки SAM2 добавляются в качестве пробросов. MLP отображает каждый уточненный запрос в эмбеддинг маски, а маска для каждого запроса получается путем скалярного произведения с повышенными признаками, следуя архитектуре гиперсети в [7]. Во время обучения запросы сопоставляются с эталонными данными посредством двудольного венгерского алгоритма. Заметим, что эталонная маска объекта определяется как пустая всякий раз, когда объект не движется, поэтому обучение совместно формирует маску и состояние движения..
Головы движения и IoU. Две независимые головы MLP принимают на вход уточненный запрос . Голова движения приводит к вероятности того, что объект движется в кадре , а голова IoU выдает скаляр , оценивающий качество с точки зрения ожидаемого IoU относительно эталонных данных..
Прогнозирование уверенности. Мгновенное состояние движения по своей природе неоднозначно вблизи переходов между движением и покоем, где истинная разметка внезапно переключается между полной маской с и пустой маской с . Чтобы уменьшить этот шум в метках, мы следуем [62] и вводим обучаемую уверенность для каждого запроса , предсказываемую финальным MLP head с сигмоидальным выходом. Полученная уверенность модулирует потери маски и движения (см. Eq.˜2).
Цель обучения. Общая функция потерь пропоузера выглядит следующим образом
| (2) |
Функция потерь усредняется по объектным запросам и кадрам , при этом соответствующие индексы опущены для ясности. Здесь представляет собой комбинацию фокусной функции потерь и функции потерь Дайса, — это бинарная кросс-энтропия для состояния движения, а — это MSE loss между предсказанным IoU и фактическим IoU относительно ground truth..
Потери маски и движения модулируются масштабированной уверенностью , а последний член представляет собой состязательный регуляризатор уверенности [62], который повышает на чистых, простых примерах, которые модель может решить точно. Для сложных примеров, таких как идущий пешеход, который останавливается, потери маски и движения велики из-за неоднозначности меток в области перехода. Поэтому модель понижает , чтобы ослабить мультипликативный член, выплачивая небольшой штраф взамен.
На практике уровень уверенности повышается только для статических образцов, поскольку предсказание пустой маски для статического объекта тривиально проще, чем предсказание точной маски движущегося объекта, что не позволяет устранить шум перехода. Поэтому мы разделяем регуляризацию по состоянию движения согласно ground-truth , используя различные коэффициенты и для независимой калибровки движущихся и статических образцов..
Gmos-S: вариант с разделением переднего и заднего плана. Для развертывания, критичного к эффективности, мы дополнительно создаем Gmos-S («S» означает предсказание единой бинарной маски), который предсказывает все движущиеся объекты в виде одной маски переднего плана. Gmos-S использует общие энкодеры, слияние признаков и модуль self-attention с пропозером Gmos, но (i) удаляет query-based transformer decoder, (ii) заменяет масочную голову для каждого запроса на единый сверточный декодер, который выводит одну бинарную маску переднего плана на кадр, и (iii) полностью отказывается от последующего пропагатора. Это делает Gmos-S моделью end-to-end, которая выполняет мгновенную (покадровую) сегментацию движения и достигает меньшей задержки вывода, чем Gmos. Полные архитектурные детали приведены в Приложении A.1.
2.2 Gmos пропагатор
Для каждого кадра пропоузер выдает набор из кортежей кандидатов . Роль пропагатора заключается в преобразовании этих покадровых предложений в согласованные треки объектов по всему видео, руководствуясь предсказанными вероятностями движения и оцененными IoUs . Оценки достоверности здесь не используются, так как они в основном служат регуляризаторами во время обучения пропоузера. Мы строим этот процесс на основе видеопредиктора SAM2 [55], используемого в качестве трекера с обусловленностью по маске, и определяем элементарный шаг распространения, на основе которого мы выстраиваем онлайн и офлайн процедуры.
Базовый шаг распространения. Дан начальный кадр и направление, SAM2 распространяет текущие отслеживаемые маски кадр за кадром. На каждом посещенном кадре предсказания пропоузера сначала фильтруются путем пороговой обработки вероятностей движения и оценочных IoU . Оставшиеся высококачественные пропоузалы движущихся объектов затем сопоставляются с распространяемыми масками посредством венгерского алгоритма на основе масочного IoU, и набор активных треков обновляется в соответствии с одним из двух случаев:
- ⟦• Дополнение. Если предсказание инициатора не совпадает ни с одним из существующих треков SAM2, оно создается как новый трек маски, начинающийся с кадра .
- ⟦• Подкрепление. Если предсказание пропоузера совпадает с существующим треком SAM2 при высоком значении IoU, оно внедряется в качестве дополнительного промпта для этого трека, подавляя дрейф.
Для обоих случаев выше состояние движения трека в кадре устанавливается как движущееся. И наоборот, если для существующего трека имеется распространяемая маска в кадре , но предсказание пропоузера не попадает в ту же область (например, объект двигался ранее, но стал статичным), состояние движения трека в кадре устанавливается как статичное..
Онлайн-процедура. Онлайн-процедура инициализирует трекер по первому кадру и выполняет базовые шаги распространения за один причинно-следственный прямой проход. Это обеспечивает потоковую передачу маски и состояния движения для каждого кадра сразу после его обработки, поддерживая MOS-I. Поскольку последовательность просматривается только один раз и причинно-следственным образом, маски не могут быть восстановлены для кадров, предшествующих первому наблюдаемому движению объекта, что делает онлайн-процедуру несовместимой с традиционной настройкой MOS, требующей наличия маски на каждом кадре..
Автономная процедура. Автономная процедура строится на основе результатов онлайн-обработки с использованием второго этапа распространения. Сначала выбирается опорный кадр из результатов онлайн-обработки, определяемый как кадр, чьи предложения движущихся объектов имеют наибольший совокупный прогнозируемый IoU. Затем базовый шаг распространения выполняется двунаправленно: вперед от к и назад от к , что дает плотную маску для каждого объекта на каждом кадре. Этот режим может использоваться как для MOS, так и для MOS-I. Дальнейшие алгоритмические подробности и псевдокод приведены в Приложении A.2.
3 Набор данных: Gmos-2K
Мы представляем Gmos-2K, набор данных для сегментации движущихся объектов на видео с временно детализированными метками движения. Помимо масок истинных значений для движущихся объектов, он определяет точные временные интервалы, в течение которых каждый объект находится в движении, что позволяет проводить точное обучение и оценку методов сегментации движения, чувствительных ко времени..
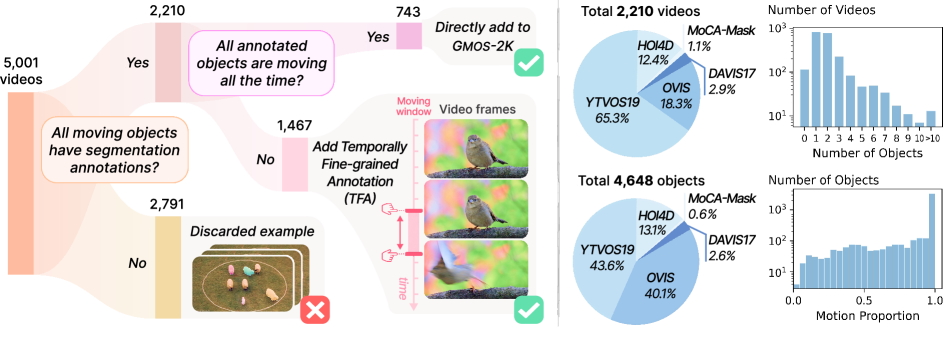
Конвейер подготовки данных. Временные метки движения получить значительно дешевле, чем плотные маски сегментации. Поэтому мы опираемся на пять существующих наборов данных для сегментации объектов на видео (DAVIS17 [53], YTVOS19 [67], OVIS [54], MoCA-Mask [11] и HOI4D [40]) и размечаем их с помощью временных меток движения для каждого объекта. Fig.˜3 (слева) иллюстрирует конвейер фильтрации и аннотирования данных. Начиная с видео-кандидатов, мы применяем два последовательных фильтра:
- ⟦(i) Имеют ли все независимо движущиеся объекты на видео сегментационные маски, соответствующие истинным данным? Если да, последовательность переходит ко второму вопросу, в противном случае она отфильтровывается. Обратите внимание, объект считается «движущимся», если он совершает движение, независимое от камеры, по крайней мере в течение одного кадра. Этот вопрос касается только масок движущихся объектов. Статические объекты без масок допустимы..
- ⟦(ii) Все ли аннотированные объекты движутся на протяжении всей последовательности? Если да, дополнительная аннотация не требуется. В противном случае видео направляется на Temporally Fine-grained Annotation (TFA)).
Временно детализированная аннотация (TFA). Учитывая видеопоследовательность, TFA нацелена на аннотирование временных интервалов на временной оси, которые определяют, когда объекты находятся в движении, при этом каждый объект аннотируется независимо. Процесс аннотирования следует методу для временного обоснования видео. Дополнительные сведения об интерфейсе аннотирования, руководствах и контроле качества представлены в Приложении D.
Статистика набора данных. Gmos-2K включает видео с аннотированными движущимися объектами, взятыми из пяти составляющих подмножеств, которые охватывают разнообразные домены: сцены с сильным перекрытием (OVIS), взаимодействия рук с объектами (HOI4D), а также клипы с дикой природой и участием людей (DAVIS17, YTVOS19, MoCA-Mask). Примеры последовательностей показаны в Fig.˜C2, где отмечены мгновенно движущиеся объекты.
Круговые диаграммы на Fig.˜3 (справа) показывают распределение видео и объектов по подмножествам. OVIS вносит непропорционально большую долю объектов, что отражает его плотные многообъектные сцены. Сопутствующие гистограммы характеризуют два взаимодополняющих аспекта набора данных. Количество объектов на видео (вверху) сосредоточено на последовательностях с – движущимися объектами, с длинным «хвостом», выходящим за пределы . Доля движения (внизу), определяемая как часть кадров, в которых объект активно движется, достигает пика на полностью движущихся объектах, при этом остальные случаи распределены примерно равномерно по более низким значениям..
Обучающая и тестовая выборки состоят из и видео соответственно. Все пять подмножеств включены в обучающую выборку, в то время как DAVIS17 и YTVOS19 дополнительно включены в тестовую выборку, предназначенную для оценки MOS-I, и переименованы в DAVIS17-IM и YTVOS19-IM («IM» означает мгновенное движение) для отличия их от обычных наборов данных MOS. Полная статистика по каждому подмножеству приведена в Tab.˜C1⟧.
4 Эксперименты
4.1 Обучающие наборы данных
Мы обучаем Gmos на составном наборе данных из видео (K аннотированных кадров), объединяющем три источника данных. (i) Синтетические данные. Kubric [20], PointOdyssey [77] и DynamicReplica [25] предоставляют видео с идеально точными попиксельными эталонными данными и метками движения. (ii) Данные с реальными движущимися объектами (Gmos-2K). Пять подмножеств для обучения Gmos-2K (Sec.˜3) содержат видео из реального мира с временно детализированными метками движения. (iii) Данные со статичными сценами. фрагментов из набора данных Mannequin Challenge [34], в которых люди остаются неподвижными, пока камера свободно перемещается, обеспечивают контроль статических сцен, что обучает модель отличать глубинный параллакс от независимого движения объектов. Подробная статистика по каждому набору данных приведена в Tab.˜C1⟧.
4.2 Тестовые наборы для оценки
Мы оцениваем Gmos в следующих задачах сегментации объектов на видео.
Сегментация движущихся объектов (MOS) прогнозирует для каждого кадра маску сегментации для каждого объекта, который перемещается в любой момент последовательности, независимо от его состояния движения в конкретном кадре. Мы проводим оценку на общепринятых бенчмарках MOS: DAVIS16-M [22] («M» означает «Moving»), DAVIS17-M [14], SegTrackv2 [32], FBMS-59 [46] и MoCA [Lamdouar20], а также на YTVOS19-M — новом бенчмарке, полученном из тестового набора Gmos-2K. Следуя стандартной практике, все бенчмарки сообщают о сходстве областей и точности контуров , за исключением MoCA, который использует коэффициент успешности обнаружения (SR) [Yang21a]⟧.
MOS-I («I» означает мгновенный) — это протокол оценки с временной детализацией для MOS, который (i) сохраняет ассоциацию идентификации объектов на уровне последовательности MOS, (ii) оценивает маски сегментации только для кадров, на которых объект активно движется, и (iii) явно штрафует ложноположительные предсказания для статических или фоновых объектов. Мы реализуем его на двух новых бенчмарках, полученных из тестового набора Gmos-2K, а именно DAVIS17-IM и YTVOS19-IM («IM» означает «мгновенное движение»), и сообщаем о производительности по трем взаимодополняющим метрикам.
- ⟦• Jaccard движущихся объектов () – точность сегментации на активно движущихся кадрах. Для каждого аннотированного объекта усредняется по кадрам, в которых он помечен как движущийся в Gmos-2K.
- ⟦• Количество ложноположительных результатов (FP count) — штрафование статических и фоновых предсказаний. Мы измеряем среднее количество статических или фоновых объектов на кадр, которые ошибочно предсказаны как движущиеся. В то время как поощряет обнаружение истинного движения, FP count штрафует за ложные утверждения о движении..
- ⟦• Среднее временное IoU (mtIoU) — совместная метрика обнаружения движущихся объектов и подавления ложноположительных результатов. Для каждой последовательности мы вычисляем временное IoU между предсказанными и истинными движущимися объектами, подсчитываемое для каждого объекта в каждом кадре. Объединение охватывает все записи (объект, кадр), помеченные как движущиеся либо предсказанием, либо истинными данными. Пересечение охватывает записи, где предсказанный и истинный движущиеся объекты сопоставлены по сходству областей с порогом . Варьирование и усреднение полученных tIoU дает итоговое mtIoU.
Неконтролируемая сегментация объектов на видео (UVOS) требует автоматической сегментации значимых объектов на видео, где цели определяются перцептивной значимостью и не обязательно должны находиться в движении. Мы представляем результаты на DAVIS16 [52] и DAVIS17 [53], используя стандартное сходство областей и точность контуров ⟧.
4.3 Детали реализации
Ниже мы подробно описываем проектные решения Gmos. Дополнительные детали реализации приведены в приложении B, наряду с исчерпывающим исследованием абляции в приложении E⟧.
Архитектура. Gmos использует предобученные [64] (DINOv2 [49] ViT-L/14) и SAM2 [55] (Hiera-L [57]) в качестве геометрического и сегментационного энкодеров, оба из которых остаются замороженными. Признаки «бутылочного горлышка» имеют пространственное разрешение и размерность каналов . Обучаемые трансформерный энкодер и декодер имеют по слоев и голов внимания. Мы используем объектных запросов и предсказываем маски с разрешением .
Настройка входных данных. Предлагающий модуль Gmos работает с кадрами, отобранными равномерно из временного окна, центрированного относительно целевого кадра. Размер окна случайным образом выбирается в диапазоне от с до с во время обучения, чтобы модель могла адаптироваться к различным скоростям движения, и фиксируется на значении с при выполнении вывода..
Настройка обучения. Мы проводим оптимизацию с помощью AdamW [41], используя скорость обучения , коэффициент затухания весов , отсечение градиентов по норме и косинусное расписание с шагами прогрева. Обучение выполняется на графических процессорах NVIDIA RTX A6000 в течение примерно дней с эффективным размером пакета . Для функции потерь пропоузера в Eq.˜2 мы устанавливаем с перемасштабированной верхней границей достоверности . Функция потерь маски объединяет фокальную (, ) и dice функции потерь в соотношении ..
| Methods | Multi-Object | Foreground–Background | |||||||||||||
| YTVOS19-M | DAVIS17-M | YTVOS19-M | DAVIS17-M | DAVIS16-M | STv2 | FBMS | MoCA | ||||||||
| SR | |||||||||||||||
| OCLR-TTA [Xie22] | - | - | - | - | |||||||||||
| ABR [Xie24] | - | - | - | - | - | ||||||||||
| FlowSAM [Xie24a] | 66.6 | 68.2 | |||||||||||||
| SegAnyMo [22] | 77.4 | 83.6 | 90.0 | 89.2 | |||||||||||
| GeoMotion [21] | - | - | - | - | |||||||||||
| Gmos | 79.9 | 82.2 | 79.7 | 86.0 | 85.1 | 84.6 | 90.0 | 90.6 | 90.3 | 82.0 | 88.3 | 91.9 | 93.0 | 0.837 | |
| Gmos-S | - | - | - | - | 81.4 | 81.8 | 90.7 | 93.1 | 90.0 | 93.2 | 78.9 | 85.9 | 83.0 | 84.9 | 0.785 |
| vs. prev. SoTA | |||||||||||||||
4.4 Количественные результаты
⟦Tab.˜2 сообщает о результатах в рамках стандартной настройки MOS, где маски движущихся объектов предсказываются на уровне последовательности. Gmos и его вариант для переднего и заднего плана Gmos-S достигают новых передовых показателей производительности по всем бенчмаркам. Прирост наиболее выражен на YTVOS19-M, чьи более плотные и разнообразные взаимодействия объектов выявляют ограничения предыдущих методов, основанных на потоках и траекториях. Gmos также сохраняет устойчивость при работе с замаскированными объектами (MoCA), где сегментация должна опираться исключительно на признаки движения..
| Methods | YTVOS19-IM | DAVIS17-IM | ||||
| mtIoU | FP count | mtIoU | FP count | |||
| OCLR-TTA [Xie22] | - | - | - | |||
| ABR [Xie24] | - | - | - | |||
| FlowSAM [Xie24a] | ||||||
| SegAnyMo [22] | ||||||
| Gmos (online) | 64.2 | 76.4 | 0.197 | 72.9 | 83.5 | 0.075 |
| Gmos | 63.4 | 76.6 | 0.238 | 72.9 | 84.2 | 0.079 |
| vs. prev. SoTA | ||||||
Как показано в Tab.˜4, разрыв в производительности еще больше увеличивается на MOS-I, что требует предсказаний с более высокой временной гранулярностью. Поскольку предыдущие методы рассматривают движение как атрибут уровня последовательности и не могут уловить мгновенные состояния движения, Gmos превосходит их со значительным отрывом по всем трем метрикам. Мы дополнительно оцениваем онлайн-вариант Gmos (Sec.˜2.2), который работает наравне с режимом офлайн по умолчанию. Это можно объяснить мгновенной природой MOS-I, где короткого причинно-следственного окна уже достаточно для получения свидетельств движения. Вторая глобальная итерация в режиме офлайн даже немного ухудшает показатели FP count и mtIoU, поскольку двунаправленный проход усиливает любые пограничные ложноположительные результаты первого прохода. Однако онлайн-режим ограничен настройкой MOS-I, так как одиночный прямой проход не позволяет восстановить маски для объектов, которые изначально статичны и начинают двигаться только позже. Таким образом, процедура офлайн остается нашей основной для всех задач, включая MOS и UVOS..
Мы также сообщаем о результатах производительности в задаче неконтролируемой сегментации видеообъектов (UVOS), которая направлена на предсказание значимых объектов независимо от их состояния движения. Хотя UVOS выходит за рамки нашего основного фокуса на сегментации только движущихся объектов, Tab.˜4 показывает, что Gmos хорошо обобщается на эту смежную задачу, достигая передовых результатов на многообъектном бенчмарке DAVIS17 и оставаясь на уровне с лучшими предыдущими показателями на однообъектном DAVIS16.
4.5 Качественные результаты
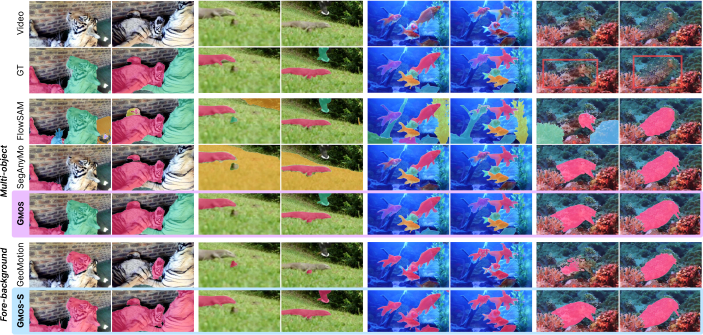
⟦Fig.˜4 сравнивает Gmos с репрезентативными базовыми моделями на последовательностях из YTVOS19, DAVIS17 и MoCA. Что касается предсказаний для нескольких объектов, FlowSAM [Xie24a] имеет тенденцию к избыточной сегментации движущихся объектов (например, принимая кораллы за движущиеся), в то время как SegAnyMo [22] пропускает движущиеся объекты или накладывает маски на фон. Напротив, Gmos присваивает каждому движущемуся объекту согласованную идентичность и границы, которые точно соответствуют эталонным данным, даже при сильном перекрытии. В рамках протокола переднего плана и фона GeoMotion [21] фиксирует заметное движение, но упускает объекты вблизи границ изображения (например, тигра справа), тогда как Gmos-S восстанавливает их надежно..
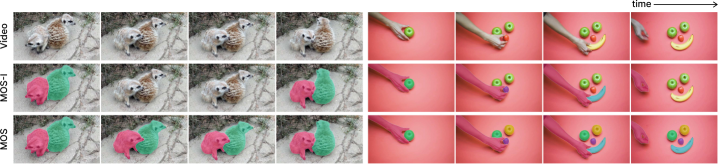
⟦Fig.˜5 демонстрирует Gmos на видео из реальных условий, сопоставляя предсказания MOS-I и MOS. В левой последовательности сурикаты становятся статичными в середине видеоряда. Наши предсказания MOS-I корректно определяют статические состояния, в то время как MOS обеспечивает согласованную сегментацию по всем кадрам. В правой последовательности рука поочередно раскладывает фрукты. Наши предсказания MOS-I корректно снимают маску с каждого объекта, как только он приходит в состояние покоя, тогда как MOS оставляет их замаскированными на протяжении всего видео..
5 Связанные работы
Неконтролируемая сегментация объектов на видео (UVOS) направлена на идентификацию значимых объектов на видео без какой-либо аннотации во время вывода, в отличие от полуконтролируемой VOS [52, 53, 67, 48, 10, 72, 8, 55], которая распространяет маски из эталонных данных первого кадра. Ранние методы используют двухпотоковые архитектуры, которые объединяют входные данные о движении и внешнем виде [23, 42, 79, 68, 56, 38, 24, 75, 51], в то время как другие полагаются преимущественно на механизмы значимости или внимания [Wang19, 71, 17, 29, 12, 73, 78, 39, 13, 30, 59]. Более современные работы масштабируют UVOS с помощью новых стратегий работы с данными и модульных конструкций конвейеров: VideoCutLER [63] масштабирует обучение посредством аугментации копированием-вставкой, перенесенной из неконтролируемой сегментации экземпляров изображений, DEVA [9] объединяет сегментатор уровня изображения с отдельным временным распространителем, а подходы на основе SAM [27, 55, 3, 76] выстраивают конвейеры UVOS вокруг предварительно обученных базовых сегментаторов. Несмотря на значительный прогресс, методы UVOS обычно нацелены на наиболее значимые объекты, которые не обязательно соответствуют объектам, которые действительно движутся..
Сегментация движения (MS) стремится отделить независимо движущиеся области от статического фона, создавая бинарную маску переднего плана и фона. Основные подходы используют оптический поток в качестве сигнала движения и группируют пиксели в соответствии с похожими паттернами движения [50, 1, 60, 61, Yang21a, Lamdouar20, 14, 69, Choudhury22, 70, 43, 44]. Однако эти подходы, основанные на потоке, по своей сути ограничены качеством предварительно вычисленного оптического потока, а также уязвимы для значительного движения камеры и вызванного им параллакса глубины. Дополнительное направление исследований агрегирует признаки движения на более длительных временных интервалах с помощью траекторий точек [2, 47, 26, 18]. Последние достижения в отслеживании точек [Karaev25, 15, 16] существенно улучшили установление соответствий на больших дистанциях, позволив обучаться сегментации непосредственно на плотных траекториях [Karazija24b, 22]. Тем не менее, такая зависимость от долгосрочного отслеживания делает эти методы нечувствительными к переходам между статическим и динамическим состояниями, что ограничивает их применимость в режиме реального времени..
Другое направление исследований использует 3D или 4D геометрические априорные данные для сегментации движения. MegaSAM [35] изучает карты вероятности движения на основе оценочных параметров камеры и глубины для разделения движущегося и статического контента, в то время как RoMo [19] объединяет оптический поток с эпиполярными ограничениями и итеративно уточняет маски движения, используя априорные данные сегментации из SAM [27]. Основываясь на методах реконструкции с прямой связью [62, Wang25], MonST3R [74] и DAS3R [66] совместно декодируют движущиеся области наряду с временно согласованными реконструкциями видео. Easi3R [6] показывает, что слои внимания таких моделей реконструкции уже кодируют относительное движение камеры и объекта. GeoMotion [21] дополнительно использует латентные 4D признаки [64] для прямого разделения движения объекта и камеры методом прямой связи..
Сегментация движущихся объектов (MOS) направлена на обнаружение, сегментацию и отслеживание отдельных движущихся объектов. Для видео, содержащих один движущийся объект, MOS вырождается в сегментацию движения переднего плана и фона. Современные работы, напротив, фокусируются на более сложной задаче с несколькими объектами, аналогичным образом опираясь на вышеупомянутые признаки движения (т.е. поток, траектории и геометрические априорные данные).
Не полагаясь на разметку, выполненную человеком, одна группа методов [58, 36, 28] использует чисто обучение без учителя посредством реконструкции потока в качестве вспомогательной целевой функции. В качестве альтернативы, OCLR [Xie22] принимает оптический поток на вход и обучает объектно-ориентированные многослойные представления на синтетических данных для обнаружения и отслеживания множества объектов в условиях окклюзии, в то время как ABR [Xie24] расширяет этот подход за счет уточнения на основе внешнего вида..
Благодаря растущей доступности аннотированных масок и мощным предобученным моделям, FlowSAM [Xie24a] внедряет оптический поток в SAM [27] либо в качестве входного канала, либо в качестве сигналов подсказок для сегментации движущихся объектов. SegAnyMo [22] объединяет сигналы долгосрочных траекторий с признаками DINO [4] и использует SAM2 [55] для уплотнения масок..
6 Заключение
Мы представили Gmos, фреймворк прямого распространения, который обосновывает сегментацию движущихся объектов в 3D-пространстве и времени, делая его устойчивым к параллаксу, вызванному камерой в пространстве, и чувствительным к изменениям состояния движения в каждом кадре. Gmos работает исключительно с RGB-видео и поддерживает как онлайн, так и офлайн-инференс. Чтобы облегчить обучение и оценку в этом режиме, мы подготовили Gmos-2K, набор данных реальных видео с временными аннотациями для каждого объекта, и формализовали MOS-I, протокол оценки с временной детализацией, включающий три взаимодополняющие метрики. Gmos достигает результатов state-of-the-art на бенчмарках MOS, MOS-I и UVOS, работая при этом примерно в три раза быстрее, чем предыдущие методы MOS..
Благодарности. Данное исследование поддерживается грантом программы EPSRC Великобритании VisualAI (EP/T028572/1), профессорской исследовательской стипендией Королевского общества RSRPR241003 и стипендией Кларендона..
Список литературы
- ⟦[1] П. Бидо и Э. Лернед-Миллер (2016) Оно движется! вероятностная модель для причинно-следственной сегментации движения на видео с движущейся камеры. В ECCV, Цитируется в: §5⟧.
- ⟦[2] Т. Брокс и Дж. Малик (2010) Сегментация объектов посредством долгосрочного анализа траекторий точек. В ECCV, Цитируется: §5⟧.
- ⟦[3] Н. Карион, Л. Густафсон, Ю. Ху, С. Дебнат, Р. Ху, Д. С. Колл-Винент, К. Ряли, К. В. Алвала, Х. Хедр, А. Хуанг, Дж. Лей, Т. Ма, Б. Го, А. Калла, М. Маркс, Дж. Грир, М. Ван, П. Сун, Р. Рэдле, Т. Афурас, Э. Мавруди, К. Сюй, Т. Ву, Ю. Чжоу, Л. Момени, Р. ХАЗРА, С. Динг, С. Вазе, Ф. Порчер, Ф. Ли, С. Ли, А. Камат, Х. К. Ченг, П. Доллар, Н. Рави, К. Саенко, П. Чжан и К. Фейхтенхофер (2026) SAM 3: сегментация чего угодно с помощью концептов. В ICLR, Цитируется: Table E3, §E.1, §5.
- ⟦[4] М. Карон, Х. Туврон, И. Мисра, Х. Жегу, Дж. Майрал, П. Бояновски и А. Жулен (2021) Возникающие свойства в самообучающихся vision transformers. В ICCV, Цитируется: §5.
- ⟦[5] Х. Чен, С. Ли, Б. Мерш, Л. Визманн, Дж. Галл, Дж. Бели и К. Стахнисс (2021) Сегментация движущихся объектов в 3D данных LiDAR: подход на основе обучения с использованием последовательных данных. В IROS, Цитируется: §1⟧.
- ⟦[6] Х. Чен, Ю. Чен, Ю. Сю, А. Гейгер и А. Чен (2025) Easi3R: оценка разделенного движения из dust3r без обучения. В ICCV, Цитируется: §5⟧.
- ⟦[7] Б. Ченг, А. Г. Швинг и А. Кириллов (2021) Попиксельной классификации недостаточно для семантической сегментации. В NeurIPS, Цитируется: §2.1, §2.1.
- ⟦[8] Х. К. Ченг, С. В. О, Б. Прайс, Дж. Ли и А. Швинг (2024) Возвращение объекта в сегментацию видеообъектов. В CVPR, Цитируется по: §5.
- ⟦[9] Х. К. Ченг, С. В. О, Б. Прайс, А. Швинг и Дж. Ли (2023) Отслеживание чего угодно с помощью раздельной сегментации видео. В ICCV, Цитируется: Table 4, §5.
- ⟦[10] Х. К. Ченг и А. Г. Швинг (2022) XMem: долгосрочная сегментация видеообъектов с моделью памяти Аткинсона-Шиффрина. В ECCV, Цитируется в: §5.
- ⟦[11] Х. Ченг, Х. Сюн, Д. Фан, Ю. Чжун, М. Харанди, Т. Драммонд и З. Ге (2022) Неявная обработка движения для обнаружения замаскированных объектов на видео. В CVPR, Цитируется: Table C1, Table D2, §3⟧.
- ⟦[12] С. Чо, М. Ли, С. Ли, К. Парк, Д. Ким и С. Ли (2023) Рассмотрение движения как опции для снижения зависимости от движения в неконтролируемой сегментации видеообъектов. В WACV, Цитируется в: §5⟧.
- ⟦[13] С. Чо, М. Ли, С. Ли, Д. Ли, Х. Чой, И. Ким и С. Ли (2024) Двойное прототипное внимание для сегментации видеообъектов без учителя. В CVPR, Цитируется: §5.
- ⟦[14] А. Дэйв, П. Токмаков и Д. Раманан (2019) На пути к сегментации всего, что движется. В ICCV, Цитируется: §4.2, §5.
- ⟦[15] К. Дёрш, А. Гупта, Л. Маркеева, А. Рекасенс, Л. Смайра, Й. Айтар, Дж. Каррейра, А. Зиссерман и Й. Янг (2022) TAP-vid: эталонный тест для отслеживания любой точки на видео. В NeurIPS, Цитируется: §5⟧.
- ⟦[16] К. Дёрш, Ю. Ян, М. Вечерик, Д. Гокай, А. Гупта, Ю. Айтар, Дж. Каррейра и А. Зиссерман (2023) TAPIR: отслеживание любой точки с покадровой инициализацией и временным уточнением. В ICCV, Цитируется: §5⟧.
- ⟦[17] Д. Фан, В. Ван, М. Чен и Дж. Шен (2019) Перенос большего внимания на обнаружение значимых объектов на видео. В CVPR, Цитируется: §5.
- ⟦[18] К. Фрагкиадаки, Г. Чжан и Дж. Ши (2012) Сегментация видео путем отслеживания разрывов во вложении траекторий. В CVPR, Цитируется: §5⟧.
- ⟦[19] Л. Голи, С. Сабур, М. Мэттьюс, Б. Маркус, Д. Лагун, А. Джейкобсон, Д. Дж. Флит, С. Саксена и А. Тальясакки (2025) RoMo: надежная сегментация движения улучшает восстановление структуры по движению. В ICCV, Цитируется: §1, §5.
- ⟦[20] К. Грефф, Ф. Беллети, Л. Бейер, К. Дёрш, Ю. Ду, Д. Дакворт, Д. Дж. Флит, Д. Гнанапрагасам, Ф. Големо, К. Херрманн, Т. Кипф, А. Кунду, Д. Лагун, И. Лараджи, Х. Лю, Х. Мейер, Ю. Мяо, Д. Ноурузезахраи, К. Озтирели, Э. Пот, Н. Радван, Д. Ребейн, С. Сабур, М. С. М. Саджади, М. Села, В. Ситцманн, А. Стоун, Д. Сун, С. Вора, З. Ван, Т. Ву, К. М. Йи, Ф. Чжун и А. Тальясакки (2022) Kubric: масштабируемый генератор наборов данных. В CVPR, Цитируется: Table C1, §4.1.
- ⟦[21] Х. Хэ, П. Линь, Ю. Цуй, Д. Го, К. Шэнь и Х. Чжан (2026) GeoMotion: переосмысление сегментации движения через скрытую 4d геометрию. В CVPR, Цитируется в: Table 1, §4.5, Table 2, Table 4, §5⟧.
- ⟦[22] Н. Хуан, В. Чжэн, К. Сюй, К. Кёйцер, С. Чжан, А. Каназава и К. Ван (2025) Сегментация любого движения на видео. В CVPR, Цитируется в: Table 1, §1, §4.2, §4.5, Table 2, Table 4, Table 4, §5, §5.
- ⟦[23] С. Д. Джейн, Б. Сюн и К. Грауман (2017) Fusionseg: обучение объединению движения и внешнего вида для полностью автоматической сегментации общих объектов на видео. В CVPR, Цитируется: §5.
- ⟦[24] Г. Джи, К. Фу, З. Ву, Д. Фан, Дж. Шен и Л. Шао (2021) Полнодуплексная стратегия для сегментации объектов на видео. В ICCV, Цитируется: §5⟧.
- ⟦[25] Н. Караев, И. Рокко, Б. Грэм, Н. Неверова, А. Ведалди и К. Руппрехт (2023) DynamicStereo: согласованная динамическая глубина по стереовидео. В CVPR, Цитируется: Table C1, §4.1.
- ⟦[26] М. Кёйпер, Б. Андрес и Т. Брокс (2015) Сегментация траекторий движения посредством мультиразрезов с минимальной стоимостью. В ICCV, Цитируется в: §5.
- ⟦[27] А. Кириллов, Э. Минтун, Н. Рави, Х. Мао, К. Ролланд, Л. Густафсон, Т. Сяо, С. Уайтхед, А. К. Берг, В. Ло, П. Доллар и Р. Гиршик (2023) Сегментируй что угодно. В ICCV, Цитируется в: §2.1, §5, §5, §5.
- ⟦[28] Д. Лао, З. Ху, Ф. Локателло, И. Янг и С. Соатто (2023) Разделенное внимание: обнаружение множественных объектов без учителя с помощью контекстно разделенных слотов. arXiv preprint arxiv:2304.01430. Цитируется в: §5⟧.
- ⟦[29] М. Ли, С. Чо, С. Ли, К. Парк и С. Ли (2023) Сегментация видеообъектов без учителя с помощью сети с прототипической памятью. В WACV, Цитируется: §5.
- ⟦[30] М. Ли, С. Чо, Д. Ли, К. Парк, Дж. Ли и С. Ли (2024) Направляемое слотовое внимание для сегментации объектов на видео без учителя. В CVPR, Цитируется: §5⟧.
- ⟦[31] Ф. Ли, Х. Чжан, Х. Сюй, С. Лю, Л. Чжан, Л. М. Ни и Х. Шум (2023) Mask dino: к единой структуре на основе transformers для обнаружения и сегментации объектов. В CVPR, Цитируется: §2.1⟧.
- ⟦[32] Ф. Ли, Т. Ким, А. Хумаюн, Д. Цай и Дж. М. Рег (2013) Сегментация видео путем отслеживания множества сегментов «фигура-фон». В ICCV, Цитируется: §4.2.
- ⟦[33] К. Ли, Ю. Чжуан, Ю. Чэнь, Дж. Хуай, М. Ли, Т. Ма, Ю. Тан и С. Лян (2023) Мультисенсорная интеграция для надежной локализации с сегментацией движущихся объектов в сложных динамических трехмерных сценах. Международный журнал прикладного наблюдения Земли и геоинформации. Цитируется в: §1.
- ⟦[34] З. Ли, Т. Декель, Ф. Коул, Р. Такер, Н. Снэвели, К. Лю и У. Т. Фримен (2019) Изучение глубины движущихся людей путем наблюдения за неподвижными людьми. В CVPR, Цитируется: Table C1, Appendix C, §4.1.
- ⟦[35] З. Ли, Р. Такер, Ф. Коул, К. Ван, Л. Джин, В. Йе, А. Каназава, А. Холински и Н. Снэвели (2025) MegaSaM: точная, быстрая и надежная структура и движение из обычных динамических видео. В CVPR, Цитируется: §1, §5.
- ⟦[36] Л. Лиан, З. Ву и С. Х. Ю (2023) Начальная загрузка объектности из видео посредством ослабленного общего движения и визуальной группировки. В CVPR, Цитируется: §1, §5.
- ⟦[37] Х. Лин, С. Чен, Дж. Х. Лью, Д. И. Чен, З. Ли, И. Чжао, С. Пенг, Х. Гуо, Х. Чжоу, Г. Ши, Дж. Фенг и Б. Канг (2026) Depth anything 3: восстановление визуального пространства из любых ракурсов. В ICLR, Цитируется: Table E3.
- ⟦[38] Д. Лю, Д. Ю, К. Ван и П. Чжоу (2021) F2Net: обучение фокусировке на переднем плане для неконтролируемой сегментации объектов на видео. В AAAI, Цитируется: §5⟧.
- ⟦[39] В. Лю, С. Шэнь, Х. Ли, С. Би, Б. Лю, К. Пун и С. Кан (2024) Обучение на этапе тестирования с учетом глубины для сегментации объектов на видео в режиме zero-shot. В CVPR, Цитируется: §5⟧.
- ⟦[40] Ю. Лю, Ю. Лю, К. Цзян, К. Лю, В. Ван, Х. Шэнь, Б. Лян, З. Фу, Х. Ван и Л. И (2022) HOI4D: 4D эгоцентрический набор данных для взаимодействия человека с объектами на уровне категорий. В CVPR, Цитируется в: Table C1, Table D2, §3⟧.
- ⟦[41] I. Loshchilov and F. Hutter (2019) Регуляризация с разделенным весовым коэффициентом затухания. В ICLR, Цитируется: §4.3.
- ⟦[42] Х. Лу, В. Ван, К. Ма, Дж. Шен, Л. Шао и Ф. Порикли (2019) Видеть больше, знать больше: неконтролируемая сегментация видеообъектов с помощью сиамских сетей с ко-вниманием. В CVPR, Цитируется: §5.
- ⟦[43] Э. Менье, А. Бадуал и П. Бутеми (2022) Обучение без учителя на основе EM для эффективной сегментации движения. IEEE TPAMI. Цитируется в: §5.
- ⟦[44] Э. Менье и П. Бутеми (2023) Неконтролируемая сегментация движения за один проход: сглаженная долгосрочная модель видеопотока. arXiv preprint arXiv:2310.01040. Цитируется в: §5.
- ⟦[45] Н. Насаруддин, К. Мухтар, А. Афдал и А. П. Дж. Двиянтаро (2020) Глубинное обнаружение аномалий посредством визуального внимания на видеозаписях систем наблюдения. Журнал больших данных. Цитируется в: §1.
- ⟦[46] П. Окс, Дж. Малик и Т. Брокс (2014) Сегментация движущихся объектов посредством анализа видео на основе долгосрочных зависимостей. IEEE TPAMI. Цитируется в: §4.2.
- ⟦[47] П. Окс и Т. Брокс (2011) Сегментация объектов на видео: иерархический вариационный подход для преобразования траекторий точек в плотные области. В ICCV, Цитируется: §5.
- ⟦[48] С. У. О, Дж. Ли, Н. Сюй и С. Дж. Ким (2019) Сегментация видеообъектов с использованием пространственно-временных сетей памяти. В ICCV, Цитируется: §5.
- ⟦[49] М. Окуаб, Т. Дарсе, Т. Мутаканни, Х. В. Во, М. Шафранец, В. Халидов, П. Фернандес, Д. Азиза, Ф. Масса, А. Эль-Нуби, М. Ассран, Н. Баллас, В. Галуба, Р. Хаус, П. Хуанг, С. Ли, И. Мисра, М. Раббат, В. Шарма, Г. Синнаев, Х. Сюй, Х. Жегу, Ж. Майраль, П. Лабату, А. Жулен и П. Божановски (2024) DINOv2: обучение устойчивым визуальным признакам без учителя. TMLR. Цитируется в: §4.3.
- ⟦[50] А. Папазоглу и В. Феррари (2013) Быстрая сегментация объектов в неструктурированном видео. В ICCV, Цитируется в: §5⟧.
- ⟦[51] Г. Пей, Ф. Шен, Ю. Яо, Г. Се, З. Танг и Дж. Танг (2022) Иерархическая сеть выравнивания признаков для неконтролируемой сегментации объектов на видео. В ECCV, Цитируется по: §5.
- ⟦[52] Ф. Перацци, Дж. Понт-Тусет, Б. МакВильямс, Л. Ван Гул, М. Гросс и А. Соркин-Хорнунг (2016) Эталонный набор данных и методология оценки для сегментации объектов на видео. В CVPR, Цитируется: §4.2, §5.
- ⟦[53] Дж. Понт-Тусет, Ф. Перацци, С. Каэльес, П. Арбелаэс, А. Соркин-Хорнунг и Л. В. Гул (2017) Конкурс DAVIS 2017 года по сегментации объектов на видео. arXiv preprint arXiv:1704.00675. Цитируется в: Table C1, Table C1, Table D2, Table D2, §3, §4.2, §5⟧.
- ⟦[54] Дж. Ци, Ю. Гао, Ю. Ху, С. Ван, С. Лю, С. Бай, С. Белонги, А. Юйль, П. Торр и С. Бай (2022) Сегментация экземпляров на видео с перекрытиями: эталонный набор данных. IJCV. Цитируется в: Table C1, Table D2, §3⟧.
- ⟦[55] Н. Рави, В. Габер, Ю. Ху, Р. Ху, К. Ряли, Т. Ма, Х. Кедр, Р. Рэдле, К. Ролланд, Л. Густафсон, Э. Минтун, Дж. Пан, К. В. Алвала, Н. Карион, К. Ву, Р. Гиршик, П. Доллар и К. Фейхтенхофер (2024) SAM 2: сегментация всего на изображениях и видео. arXiv preprint arXiv:2408.00714. Цитируется в: Table E3, Table E3, Table E3, Table E3, §1, §2.1, §2.2, §4.3, §5, §5⟧.
- ⟦[56] С. Рен, В. Лю, Ю. Лю, Х. Чен, Г. Хан и С. Хе (2021) Взаимные преобразования для сегментации видеообъектов без учителя. В CVPR, Цитируется: §5⟧.
- ⟦[57] К. Ряли, Ю. Ху, Д. Боля, К. Вэй, Х. Фан, П. Хуан, В. Аггарвал, А. Чоудхури, О. Пурсаид, Дж. Хоффман, Дж. Малик, Ю. Ли и К. Фейхтенхофер (2023) Hiera: иерархический vision transformer без лишних усложнений. В ICML, Цитируется в: §4.3.
- ⟦[58] С. Сафадуст и Ф. Гюней (2023) Обнаружение множественных объектов с помощью низкоразмерного движения объектов. В ICCV, Цитируется в: §5.
- ⟦[59] Х. Сонг, Т. Су, Ю. Чжэн, К. Чжан, Б. Лю и Д. Лю (2024) Обобщаемая аугментация Фурье для сегментации видеообъектов без учителя. В AAAI, Цитируется в: §5⟧.
- ⟦[60] П. Токмаков, К. Алахари и К. Шмид (2017) Обучение сегментации объектов на видео с использованием визуальной памяти. В ICCV, Цитируется: §5.
- ⟦[61] П. Токмаков, К. Шмид и К. Алахари (2019) Обучение сегментации движущихся объектов. IJCV. Цитируется в: §5.
- ⟦[62] С. Ван, В. Леруа, И. Кабон, Б. Чидловский и Дж. Рево (2024) DUSt3R: геометрическое 3D-зрение стало проще. В CVPR, Цитируется: §2.1, §2.1, §5⟧.
- ⟦[63] Х. Ван, И. Мисра, З. Зенг, Р. Гирдхар и Т. Даррелл (2023) VideoCutLER: удивительно простое обучение без учителя для сегментации экземпляров на видео. arXiv preprint arXiv:2308.14710. Цитируется в: §5.
- ⟦[64] И. Ван, Дж. Чжоу, Х. Чжу, В. Чанг, И. Чжоу, З. Ли, Дж. Чен, Дж. Панг, К. Шен и Т. Хе (2026) : Перестановочно-эквивариантное обучение визуальной геометрии. В ICLR, Цитируется: Table E3, Table E3, Table E3, §1, §2.1, §4.3, §5.
- ⟦[65] З. Венг, З. Джин, С. Чен, К. Шен, Х. Рен и В. Ли (2021) Сеть временного кодирования на основе механизмов внимания с маской движения, не зависящей от фона, для распознавания действий. Вычислительный интеллект и нейронауки. Цитируется в: §1.
- ⟦[66] К. Сюй, Т. Х. Э. Це, Дж. Пэн и А. Яо (2024) DAS3R: гауссовское сплэттинг-моделирование с учетом динамики для реконструкции статических сцен. arXiv preprint arxiv:2412.19584. Цитируется в: §5.
- ⟦[67] Н. Сюй, Л. Ян, Ю. Фань, Д. Юэ, Ю. Лян, Дж. Ян и Т. Хуан (2018) Youtube-vos: масштабный эталонный набор данных для сегментации объектов на видео. В ECCV, Цитируется в: Table C1, Table C1, Table D2, Table D2, §3, §5⟧.
- ⟦[68] С. Ян, Л. Чжан, Дж. Ци, Х. Лу, С. Ван и Х. Чжан (2021) Обучение совместному вниманию движения и внешнего вида для zero-shot сегментации объектов на видео. В ICCV, Цитируется: §5⟧.
- ⟦[69] И. Янг, Б. Лай и С. Соатто (2021) DyStaB: обучение без учителя для сегментации объектов посредством динамико-статического бутстрэппинга. В CVPR, Цитируется в: §5⟧.
- ⟦[70] И. Ян, А. Локерсио, Д. Скарамуцца и С. Соатто (2019) Обучение без учителя для обнаружения движущихся объектов посредством разделения контекстной информации. В CVPR, Цитируется в: §5⟧.
- ⟦[71] З. Янг, К. Ван, Л. Бертинетто, С. Бай, В. Ху и П. Х. С. Торр (2019) Диффузия опорных точек для сегментации видеообъектов без учителя. В ICCV, Цитируется в: §5.
- ⟦[72] З. Ян и Ю. Ян (2022) Разделение признаков в иерархическом распространении для сегментации объектов на видео. В NeurIPS, Цитируется: §5⟧.
- ⟦[73] Ю. Юань, Ю. Ван, Л. Ван, С. Чжао, Х. Лу, Ю. Ван, В. Су и Л. Чжан (2023) Isomer: изомерный transformer для zero-shot сегментации объектов на видео. В ICCV, Цитируется: §5⟧.
- ⟦[74] Дж. Чжан, К. Херрманн, Дж. Хур, В. Джампани, Т. Даррелл, Ф. Коул, Д. Сан и М. Янг (2025) MonST3r: простой подход к оценке геометрии при наличии движения. В ICLR, Цитируется в: §5.
- ⟦[75] К. Чжан, З. Чжао, Д. Лю, К. Лю и Б. Лю (2021) Глубокая транспортная сеть для неконтролируемой сегментации видеообъектов. В ICCV, Цитируется: §5⟧.
- ⟦[76] З. Чжан, С. Чжан, З. Вэй, З. Дай и С. Чжу (2024) UVOSAM: парадигма без использования масок для неконтролируемой сегментации объектов на видео с помощью модели segment anything model. arXiv preprint arXiv:2305.12659. Цитируется в: §5.
- ⟦[77] И. Чжэн, А. У. Харли, Б. Шен, Г. Ветцштайн и Л. Дж. Гибас (2023) PointOdyssey: крупномасштабный синтетический набор данных для долгосрочного отслеживания точек. В ICCV, Цитируется: Table C1, §4.1.
- ⟦[78] Т. Чжоу, Дж. Ли, Х. Ли и Л. Шао (2021) Обнаружение и ассоциация объектов с учетом целевых характеристик для неконтролируемой сегментации множественных объектов на видео. В CVPR, Цитируется в: §5⟧.
- ⟦[79] Т. Чжоу, С. Ван, Ю. Чжоу, Ю. Яо, Дж. Ли и Л. Шао (2020) Переход с учетом движения для zero-shot сегментации объектов на видео. В AAAI, Цитируется: §5⟧.
Приложение
Данное приложение организовано следующим образом:
- ⟦• Дополнительные сведения о методе: в приложении A описаны архитектура и целевая функция варианта Gmos-S, а также приведены полный псевдокод и пошаговое руководство по элементарным операциям для пропагатора Gmos.
- ⟦• Дополнительные детали реализации: в приложении B представлены настройки обучения Gmos-S, пороговые значения пропагатора и протокол измерения времени выполнения..
- ⟦• Подробности о наборе данных: в приложении C приведена статистика по каждому набору данных для наших источников обучения и оценки, а также примеры визуализаций из Gmos-2K.
- ⟦• Детали подготовки набора данных Gmos-2K: в приложении D подробно описаны инструкции для аннотаторов, инструмент аннотирования, а также статистика подготовки данных по каждому подмножеству вместе со стоимостью аннотирования..
- ⟦• Аблационное исследование: в приложении E представлены всесторонние абляции как для модуля предложения Gmos, так и для модуля распространения Gmos, наряду с повторными циклами обучения с использованием различных случайных начальных чисел для оценки статистической устойчивости..
- ⟦• Дополнительные качественные визуализации: в приложении F представлены дальнейшие качественные сравнения с базовыми методами, а также дополнительные результаты MOS/MOS-I для данных, полученных в естественных условиях..
- ⟦• Обсуждение: В приложении G рассматриваются текущие случаи сбоев, намечены возможные расширения и затронуто более широкое социальное воздействие.
Дополнительно мы публикуем в сопроводительных материалах: (i) видеовизуализацию, охватывающую сравнение протоколов оценки (MOS против MOS-I), примеры из набора данных и результаты работы модели, и (ii) репозиторий с кодом, содержащий конвейеры обучения и оценки, а также метки состояний движения с временной детализацией для подмножеств Gmos-2K, индексированные по набору данных, разделению и названию последовательности.
Appendix A Дополнительные сведения о методе
A.1 Gmos-S
Архитектура. Gmos-S спроектирован как потоковый вариант Gmos proposer для сегментации переднего и заднего плана. Как показано на Fig.˜A1, он использует замороженный геометрический энкодер (), замороженный энкодер сегментации (SAM2) и модуль слияния признаков совместно с Gmos proposer (Fig.˜2). Два конструктивных решения отличают его от полноценного proposer: (i) transformer декодер и обучаемые объектные запросы удалены, а объединенный признак передается напрямую через декодер с повышающей дискретизацией, который предсказывает одну бинарную маску переднего и заднего плана для каждого кадра; и (ii) поскольку движение неявно содержится в объединении движущихся объектов, модуль оценки движения исключен, а оставшиеся модули оценки уверенности и IoU работают с глобально усредненными по пулингу объединенными признаками, создавая один скаляр на кадр вместо одного на объект..
Кроме того, мы отказываемся от пропагатора, поскольку Gmos-S не создает предложений на уровне объектов. Таким образом, предсказания являются мгновенными и выполняются в режиме реального времени, что делает Gmos-S самым быстрым вариантом в нашей структуре..
Цель обучения. Gmos-S предсказывает единую маску переднего и заднего плана на уровне кадра , поэтому пообъектное венгерское сопоставление и функция потерь движения, используемые в предсказателе Gmos, больше не требуются. Таким образом, мы упрощаем Eq.˜2 до
| (A1) |
где и являются покадровыми аналогами функций потерь маски и IoU для пропоузера в Eq.˜2, а представляет собой масштабированную покадровую достоверность. Поскольку Gmos-S выполняет рассуждения на уровне кадров, а не на уровне объектов, регуляризатор разделенной достоверности пропоузера Gmos сводится к единственному члену.
A.2 Gmos пропагатор
Теперь мы подробно остановимся на элементарном шаге распространения и процедурах в режиме онлайн/офлайн, описанных в разд. 2.2, и приведем полный псевдокод в Algorithm˜1. Пропагатор поддерживает набор промптов в состоянии SAM2 и создает покадровые маски и метки движения .
PropStep. Начиная с и двигаясь в заданном направлении, для каждого кадра :
- ⟦(i) SAM2 распространяет текущие отслеживаемые маски на кадр , формируя .
- ⟦(ii) Предлагающий модуль работает на коротком локальном окне для получения предсказаний (а именно: предложений масок, вероятностей движения и оценочных IoU), которые сопоставляются с по масочному IoU с использованием венгерского алгоритма.
- ⟦(iii) Если включено обновление подсказки, набор подсказок обновляется по одному из двух правил, применяемых только к уверенным предложениям о движении (, ): (i) добавление, когда маска предложения не покрыта ни одним существующим треком (), инициирует новый трек; (ii) подкрепление, когда сопоставленная маска предложения совпадает с распространяемой маской (), внедряет в качестве дополнительной подсказки для того же трека.
- ⟦(iv) Метка движения для каждого кадра наследуется от предсказания соответствующего пропоузера, . Существующие треки, для которых на кадре не находится уверенного предсказания движущегося пропоузера (либо из-за отсутствия соответствия, либо из-за соответствия с ), таким образом помечаются как статические, что фиксирует переход «движение-затем-статика».
Онлайн-процедура. Мы инициализируем уверенными предложениями о движении из кадра (то есть первого кадра) и однократно запускаем PropStep в прямом направлении с . Процедура является причинно-следственной и потоково передает покадровые результаты по мере поступления видео, что делает ее непосредственно пригодной для развертывания MOS-I..
Автономная процедура. Мы сначала запускаем онлайн-процедуру, затем выбираем масок наивысшего качества для каждого объекта из полученных треков в качестве фиксированного набора подсказок и повторно инициализируем с его помощью. Мы выбираем опорный кадр на основе онлайн-оценок IoU для каждого объекта и запускаем PropStep вперед и назад от с . Курируемый набор подсказок и двунаправленное распространение вместе восстанавливают маски на кадрах, где при онлайн-проходе объект был пропущен или была создана маска низкого качества..
Appendix B Дополнительные детали реализации
Настройка обучения Gmos-S. Gmos-S использует тот же оптимизатор, расписание и аппаратное обеспечение, что и Gmos proposer (разд. 4.3). Для функции потерь в Eq.˜A1 мы устанавливаем , и с пересчитанной верхней границей достоверности . Потеря маски на уровне кадра объединяет focal loss (, ) и dice loss в соотношении ..
Настройки пропагатора. Для пороговых значений, используемых в Algorithm˜1, мы устанавливаем (показатель движения, выше которого объект считается движущимся), (прогноз IoU пропоузера, выше которого маске можно доверять), (IoU между маской пропоузера и пропагированной маской, выше которого маска пропоузера усиливает существующий трек) и (максимальная точность на трек, ниже которой маска пропоузера рассматривается как новый объект). Для автономного шага SelectTopK мы выбираем лучшие кадров для каждого объекта, ранжированные по прогнозу IoU пропоузера, сохраняя только те, у которых IoU выше .
Измерение времени выполнения. Время выполнения для каждого кадра в Tab.˜1 измеряется на одном графическом процессоре NVIDIA RTX A6000 по всем кадрам DAVIS17. Каждое измерение включает подготовку вспомогательных входных модальностей (оптический поток, глубина или треки точек), прямой проход модели и любую постобработку (например, уточнение SAM2), но исключает накладные расходы на загрузку данных..
Appendix C Детали набора данных
Общая статистика набора данных. Как описано в Sec.˜3, наш обучающий набор включает три синтетических набора данных (Kubric, PointOdyssey и DynamicReplica), пять подмножеств реальных видео из Gmos-2K и набор данных Mannequin Challenge [34], который не содержит движущихся объектов и служит источником негативных примеров статических сцен. Для оценки MOS с высокой временной детализацией мы используем подмножества DAVIS17 и YTVOS19 из Gmos-2K в качестве тестовых наборов. Все наборы данных находятся в открытом доступе для исследовательских целей, при этом лицензии и условия использования наборов данных строго соблюдаются..
⟦Tab.˜C1 содержит полную статистику по каждому набору данных, включая количество видео, общую длительность, аннотированные кадры, количество объектов и долю кадров, содержащих движение. Подмножества, относящиеся к Gmos-2K, отмечены звездочкой (*). В общей сложности обучающая выборка охватывает видео с аннотированными кадрами и объектами.
| Split | Dataset | Videos | Duration (hr) | Anno. frames | Anno. frames / video | Objects | Objects / video | Motion prop. /object |
| Train (Synthetic) | Kubric [20] | 10,000 | 5.56 | 240,000 | 24.0 | 29,294 | 2.93 | 60.8% |
| PointOdyssey [77] | 43 | 1.24 | 107,514 | 2500.0 | 64 | 1.49 | 57.1% | |
| DynamicReplica [25] | 483 | 1.68 | 144,900 | 300.0 | 933 | 1.93 | 60.7% | |
| Train (Real) | *DAVIS17 [53] | 44 | 0.03 | 3,101 | 70.5 | 92 | 2.09 | 94.8% |
| *MoCA-Mask [11] | 26 | 0.11 | 1,978 | 76.1 | 26 | 1.00 | 54.8% | |
| *HOI4D [40] | 273 | 0.95 | 81,900 | 300.0 | 609 | 2.23 | 69.9% | |
| *OVIS [54] | 404 | 0.24 | 25,925 | 64.2 | 1,865 | 4.62 | 92.6% | |
| *YTVOS19 [67] | 1,183 | 1.74 | 31,327 | 26.5 | 1,623 | 1.37 | 91.1% | |
| Mannequin Challenge [34] | 1,715 | 1.22 | 145,483 | 84.8 | 0 | 0.00 | 0.0% | |
| Total (Train) | 14,171 | 12.77 | 782,128 | 55.2 | 34,506 | 2.43 | 64.2% | |
| Test | *DAVIS17 [53] | 19 | 0.01 | 1,237 | 65.1 | 31 | 1.63 | 96.9% |
| *YTVOS19 [67] | 261 | 0.40 | 7,115 | 27.3 | 402 | 1.54 | 91.5% | |
| Total (Test) | 280 | 0.41 | 8,352 | 29.8 | 433 | 1.55 | 91.9% | |
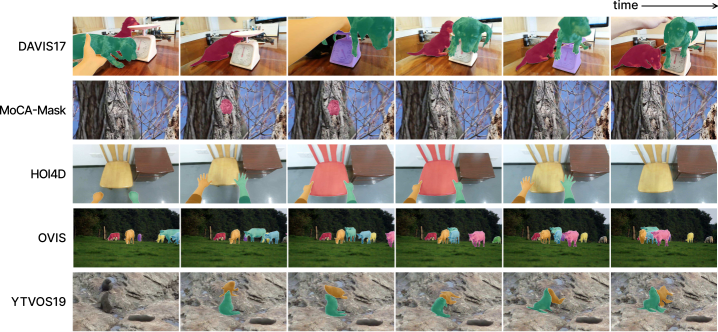
Примеры визуализаций в Gmos-2K. Fig.˜C2 представляет примеры последовательностей из каждого из пяти подмножеств Gmos-2K, иллюстрируя разнообразие сцен и паттернов движения. Объект маскируется только в тех кадрах, где он активно движется, что отражает темпорально детализированный характер аннотированных меток движения. Например, в HOI4D обе руки находятся в движении на протяжении большей части последовательности, тогда как стул маскируется только в течение короткого интервала, когда его поднимают. Аналогично, пример YTVOS19 показывает, что тюлень в нижнем правом углу никогда не маскируется, поскольку он остается неподвижным на протяжении всей последовательности..
Appendix D Gmos-Подробности курирования ⟦K0⟧
D.1 Инструкции и инструменты для аннотаторов
Фильтрация на уровне видео. Как описано в Sec.˜3, конвейер подготовки данных начинается с фильтрации видео-кандидатов посредством двух последовательных вопросов: (i) имеют ли все независимо движущиеся объекты маски сегментации ground-truth, и (ii) движутся ли все аннотированные объекты на протяжении всей последовательности. Аннотаторы просматривают каждое видео и соответствующим образом отмечают свои ответы. Подробные инструкции, предоставленные аннотаторам, приведены ниже.
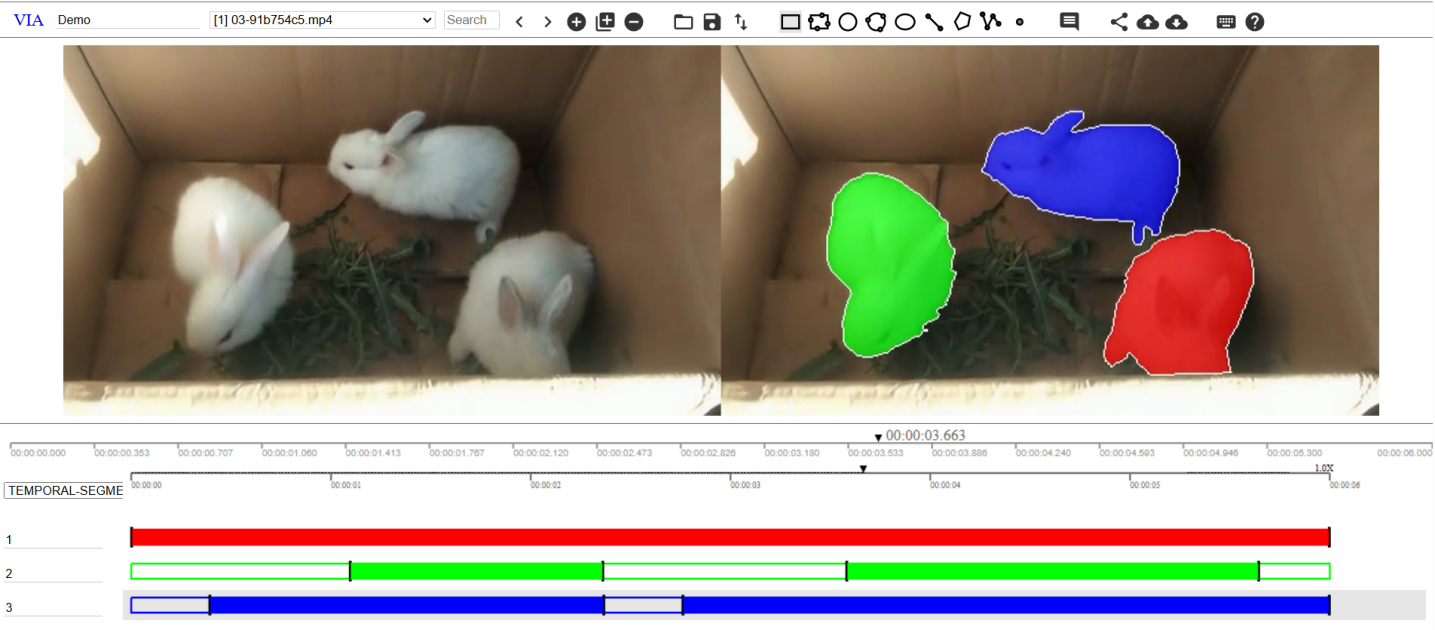
Временная детализированная аннотация (TFA). Видео, которые проходят первый фильтр, но не проходят второй, направляются на TFA, где размечаются интервалы движения каждого объекта вдоль временной оси. Мы выполняем TFA с использованием VIA [Dutta19a], инструмента аннотирования с открытым исходным кодом, обладающего встроенной функциональностью временной привязки. Как показано в Fig.˜D3, мы адаптируем стандартный интерфейс VIA с помощью двух модификаций: (i) исходное видео и его версия с наложенной маской отображаются рядом, при этом каждому объекту присваивается уникальный цвет для легкой идентификации; и (ii) временные оси имеют цветовую кодировку, соответствующую отдельным объектам. Подробный рабочий процесс аннотирования и инструкции приведены ниже..
Контроль качества. Мы применяем протоколы контроля качества на каждом из вышеперечисленных этапов.
- ⟦• Фильтрация на уровне видео. Два аннотатора независимо отвечают на два вопроса фильтрации для каждого видео-кандидата. Последовательности, по которым возникают разногласия, помечаются и совместно пересматриваются до достижения консенсуса, что гарантирует, что ни одно подходящее видео не будет отсеяно, а ни одно неподходящее видео не будет передано в TFA.
- ⟦• Временная детализированная аннотация (TFA). После аннотирования каждой последовательности второй аннотатор визуализирует полученные эталонные данные MOS-I, при этом маска каждого объекта накладывается только на кадры в пределах его размеченных интервалов движения. Рецензент проверяет наличие (i) движущихся объектов, интервалы движения которых полностью отсутствуют (объект никогда не получает маску, несмотря на движение), (ii) статических или фоновых объектов, ошибочно помеченных как движущиеся (маска появляется на кадрах, где объект находится в состоянии покоя), и (iii) неточных границ перехода между движением и покоем. Этот этап также позволяет выявить ошибки, допущенные на этапе фильтрации, удаляя любые неподходящие видео, которые ошибочно прошли предыдущий фильтр. Отмеченные случаи возвращаются исходному аннотатору для исправления и повторно проверяются рецензентом..
D.2 Статистика курирования
Статистика по подмножествам. Tab.˜D2 содержит подробную разбивку конвейера подготовки данных, описанного в Sec.˜3, с указанием количества видео, сохраненных после каждого этапа фильтрации и аннотирования для каждого подмножества Gmos-2K. Из исходных видео-кандидатов отсеиваются первым фильтром на уровне видео, а оставшиеся формируют итоговый набор данных, из которых требуют TFA.
| Split | Dataset | Initial videos | Filtered videos | Videos in Gmos-2K | ||
| w/o TFA | w/ TFA | Total | ||||
| Train | DAVIS17 [53] | 60 | 16 | 32 | 12 | 44 |
| MoCA-Mask [11] | 26 | 0 | 2 | 24 | 26 | |
| HOI4D [40] | 300 | 27 | 0 | 273 | 273 | |
| OVIS [54] | 607 | 203 | 59 | 345 | 404 | |
| YTVOS19 [67] | 3,471 | 2,288 | 526 | 657 | 1,183 | |
| Total (Train) | 4,464 | 2,534 | 619 | 1,311 | 1,930 | |
| Test | DAVIS17 [53] | 30 | 11 | 15 | 4 | 19 |
| YTVOS19 [67] | 507 | 246 | 109 | 152 | 261 | |
| Total (Test) | 537 | 257 | 124 | 156 | 280 | |
Стоимость аннотирования. Для всего процесса подготовки данных задействованы три аннотатора. Этап 1 (фильтрация на уровне видео) занимает примерно часов для проверки всех кандидатов. Этап 2 (TFA) требует около часов аннотирования для видео, нуждающихся во временных метках. Дополнительные часов затрачиваются на проверку качества и повторное аннотирование, что доводит общие трудозатраты до примерно человеко-часов. Все аннотаторы получают вознаграждение выше местного минимального размера оплаты труда..
Appendix E Абляционное исследование
E.1 Абляции на Gmos предлагающий
| Syn. | Gmos -2K | M.C. | DAVIS17-IM | ||
| mtIoU | FP count | ||||
| ✓ | ✗ | ✗ | 0.097 | ||
| ✓ | ✓ | ✗ | |||
| ✓ | ✓ | ✓ | 68.7 | 82.2 | |
| Confidence loss | DAVIS17-IM | ||
| mtIoU | FP count | ||
| ✗ | |||
| ✓ | 68.7 | 82.2 | 0.147 |
| Temporal window (s) | DAVIS17-IM | ||
| mtIoU | FP count | ||
| 0.130 | |||
| * | 68.7 | ||
| 82.7 | |||
| Frame gap | DAVIS17-IM | ||
| mtIoU | FP count | ||
| 1 1 1 1* | 0.147 | ||
| 2 1 1 2 | |||
| 3 1 1 3 | 68.9 | 83.4 | |
| Early-layer feat. | DAVIS17-IM | ||
| mtIoU | FP count | ||
| feat. | 69.0 | 82.3 | |
| attn. | 0.126 | ||
| ✗* | |||
| Mask decoder | DAVIS17-IM | ||
| mtIoU | FP count | ||
| SAM2 | |||
| Trainable* | 68.7 | 82.2 | 0.147 |
Чтобы напрямую протестировать пропоузер, мы пропускаем пропагатор и применяем покадровое венгерское сопоставление между выходными данными пропоузера и эталонными данными, сообщая о производительности на DAVIS17-IM.
Геометрические и сегментационные энкодеры. Tab.˜E3 проводит абляционное исследование выбора энкодера для Gmos proposer. Удаление геометрического энкодера разрушает способность модели к граундингу, порождая множество галлюцинированных ложноположительных результатов. Замена на VGGT или DA3 приводит к умеренному снижению показателей, что говорит о том, что предоставляет более богатые 4D априорные данные, которые лучше отделяют движение объекта от движения камеры..
С другой стороны, отказ от кодировщика сегментации снижает количество ложноположительных результатов, но существенно ухудшает качество масок, вызывая значительное падение mtIoU и . Замена SAM2 на более современный SAM3 [3] обеспечивает сопоставимое качество масок и лишь незначительный прирост . Поэтому мы сохраняем SAM2 в качестве кодировщика сегментации по умолчанию для прямого сравнения с предыдущими методами, которые также построены на его основе..
Состав обучающего набора данных. Tab.˜E4 исследует, как основные подмножества влияют на обучение. Использование только синтетических данных позволяет получить сильный пропоузер с низким количеством FP, но ограниченным mtIoU и из-за разрыва доменов между синтетическими и реальными данными. Добавление данных о движущихся объектах из Gmos-2K существенно улучшает качество сегментации, в то время как клипы со статичными сценами из Mannequin Challenge дополнительно снижают количество FP, обучая модель подавлять ложное движение, вызванное параллаксом глубины..
Функция потерь на основе уверенности. Tab.˜E5 показывает, что функция потерь на основе уверенности улучшает все три метрики за счет снижения влияния зашумленных аннотаций движения вблизи переходов от статики к движению..
Размер временного окна вывода. Tab.˜E6 варьирует временное окно, из которого равномерно выбираются пять входных кадров при выводе. Поскольку пропоузер обучен с переменной длиной окна, производительность остается относительно стабильной при различных настройках. В частности, большее окно облегчает обнаружение движущихся объектов (повышая ), но снижает временную гранулярность, что приводит к большему количеству ложноположительных результатов. Окно размером с обеспечивает наилучший баланс, достигая наивысшего mtIoU.
Интервал между входными кадрами. Tab.˜E7 заменяет равномерный интервал между кадрами (т.е. «1 1 1 1») на неравномерные интервалы, которые делают акцент на центральном кадре. Неравномерные интервалы незначительно улучшают для движущихся объектов, но стабильно увеличивают количество ложноположительных результатов, что говорит о том, что равномерная выборка обеспечивает наиболее сбалансированные признаки движения для модуля предложений..
Объединение признаков ранних слоев. По умолчанию Gmos-пропоузер принимает на вход два источника признаков: геометрические (последний слой энкодера ) и сегментационные (последний слой энкодера SAM2). Мы исследуем, улучшает ли пропоузер добавление третьего источника — сигналов ранних слоев от энкодера . Как указано в Tab.˜E9, мы рассматриваем два режима, в обоих из которых выполняется выборка сигналов ранних слоев из слоев , , и (из ). В режиме признаков активации из выбранных слоев конкатенируются и проецируются. В режиме внимания карты кросс-внимания между средним кадром и всеми остальными кадрами конкатенируются и проецируются для формирования дополнительного сигнала..
⟦Tab.˜E9 показывает, что оба варианта работают наравне со стандартным, что указывает на то, что одного лишь признака последнего слоя достаточно для анализа движения. Поэтому мы сохраняем только признак последнего слоя в качестве геометрического входного сигнала.
Декодер масок. Как подробно описано в Fig.˜2, Gmos proposer использует обучаемый гиперсетевой декодер масок, в котором карта признаков подвергается повышающей дискретизации и обрабатывается с помощью механизмов внимания на основе эмбеддингов объектов..
Альтернативный подход заключается в отказе от апсемплера и предсказании масок непосредственно в разрешении «узкого места» () с использованием готовой модели SAM2 для восстановления полноразмерной маски для каждого объекта. В частности, мы случайным образом выбираем положительных и отрицательных точек из низкоразрешенного предсказания каждого объекта в качестве промптов для SAM2..
⟦Tab.˜E9 сравнивает наш легковесный обучаемый декодер апсемплинга с этим декодированием на основе SAM2. Последний показывает более низкие результаты по всем метрикам, что говорит о том, что предсказание с низким разрешением не полностью отражает информацию о движущихся объектах..
E.2 Абляции на Gmos пропагатор
| Exp. | Prop. 1 | Prop. 2 | Online | MOS-I | MOS | DAVIS17-IM | ||
| mtIoU | FP count | |||||||
| A (online default) | forward | - | ✓ | ✓ | ✗ | |||
| B | forward | forward | ✗ | ✓ | ✓ | |||
| C | select | forward | ✗ | ✓ | ✓ | |||
| D | select | select | ✗ | ✓ | ✓ | |||
| E (offline default) | forward | select | ✗ | ✓ | ✓ | |||
⟦Tab.˜E10 исследует стратегию начального кадра для каждого этапа распространения в пропагаторе Gmos. Эксп. A соответствует нашей стандартной онлайн-настройке с однократным прямым распространением, начинающимся с кадра . Поскольку последовательность проходится только один раз в хронологическом порядке, маски не могут быть восстановлены для каждого кадра (например, если объект изначально статичен, но начинает двигаться позже). Следовательно, Gmos (онлайн) ограничен настройкой MOS-I.
Четыре оставшихся варианта (Exp. B–E) добавляют второй этап распространения, обеспечивая оценку как MOS-I, так и MOS. Среди них Exp. C и D начинают первое распространение с выбранного опорного кадра и в целом показывают себя немного лучше, но они жертвуют причинно-следственной связью на первом этапе распространения. Поэтому мы принимаем Exp. E в качестве нашего офлайн-варианта по умолчанию, поскольку его первый этап совпадает с онлайн-процедурой, а второй этап дополнительно уточняет результат с помощью подготовленного набора подсказок..
| Exp. | DAVIS17-IM (Gmos proposer) | DAVIS17-IM (Gmos propagator) | ||||
| mtIoU | FP count | mtIoU | FP count | |||
| A | ||||||
| B | ||||||
| C | ||||||
| D | ||||||
| Avg. | ||||||
E.3 Повторение экспериментов
Обучение Gmos proposer является стохастическим, в то время как шаг propagator является полностью детерминированным. Мы повторяем обучение proposer с четырьмя различными случайными начальными числами (Exp. A–D), приводим результаты, сопоставленные по венгерскому алгоритму для каждого кадра, в левой половине Tab.˜E11 и применяем детерминированный propagator поверх каждого из них для получения результатов на уровне последовательности (связанных с идентификатором объекта) в правой половине. Небольшие стандартные отклонения в обеих половинах указывают на то, что Gmos статистически стабилен при различных начальных числах, а propagator обеспечивает последовательный прирост по сравнению с одним лишь proposer в каждом запуске..
Appendix F Дополнительные качественные визуализации
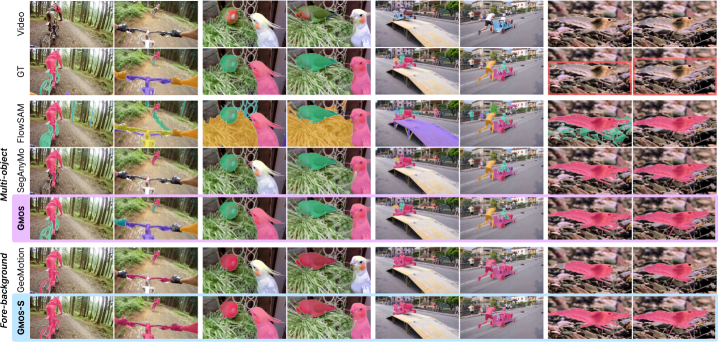
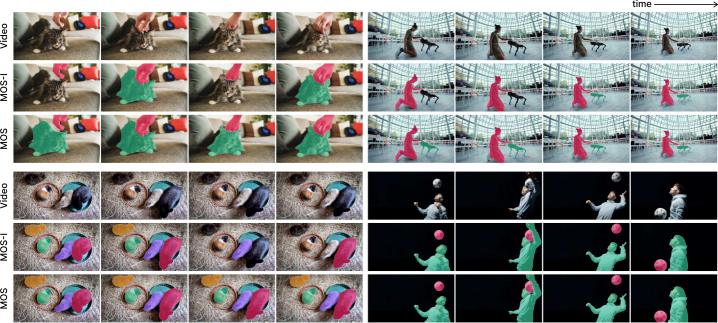
Мы предоставляем дополнительные качественные результаты в дополнение к Figs.˜4 и 5 в основной статье. Fig.˜F4 демонстрирует дальнейшие сравнения с репрезентативными базовыми методами в рамках протоколов для нескольких объектов и разделения переднего и заднего планов, а Fig.˜F5 иллюстрирует поведение Gmos на большем количестве последовательностей из реальных условий, проводя различие между прогнозами MOS-I и MOS..
Appendix G Обсуждение
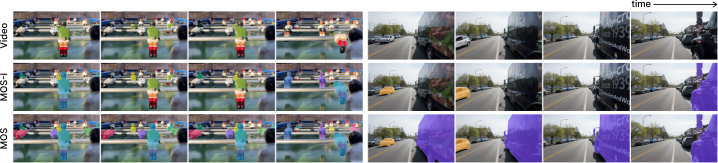
Случаи неудач. Fig.˜G6 иллюстрирует два типичных режима сбоев, оба из которых проистекают из ограниченной пространственной гранулярности геометрического бэкенда . Левый пример (настольный футбол) показывает сцену с множеством быстро движущихся объектов в условиях сильного перекрытия. Gmos пропускает несколько небольших движущихся экземпляров на заднем плане, что говорит о том, что бэкенд испытывает трудности с обнаружением мелкомасштабных движущихся объектов в загроможденных сценах. Правый пример показывает сцену вождения, в которой мимо камеры проезжает большой зеркальный грузовик. Несмотря на то, что грузовик статичен, Gmos ошибочно предсказывает его движение в определенном кадре, что обнажает ограничения бэкенда в прогнозировании состояния движения отдельных объектов в условиях отражений и экстремального параллакса глубины..
Возможные расширения. Мы намечаем два естественных направления для будущей работы. Во-первых, геометрический каркас может быть дообучен на более крупных и разнообразных наборах данных с аннотациями движения для усиления как обнаружения движущихся объектов с высокой детализацией, так и прогнозирования состояния движения. Во-вторых, предлагающий и распространяющий модули могут быть объединены в единую сквозную обучаемую структуру, что позволит сигналу временной согласованности улучшить качество масок и обеспечить более точные прогнозы состояния движения на длинных видео..
Более широкое влияние. Gmos обеспечивает идентификацию движущихся объектов в реальном времени непосредственно из RGB-видео, поддерживая критически важные для безопасности приложения, такие как автономное вождение, экологический и биомедицинский мониторинг, наблюдение за общественной безопасностью, а также динамическую реконструкцию 3D/4D-сцен для робототехники и AR/VR. Работа без предварительно вычисленных потоков или траекторий также снижает вычислительные затраты на восприятие с учетом движения. Мы выпускаем Gmos-2K и протокол MOS-I для воспроизводимых исследований. Как и любая система сегментации видео, Gmos может быть использована не по назначению в контексте наблюдения, что вызывает опасения по поводу конфиденциальности, особенно в сочетании с инструментами распознавания личности. Мы призываем конечных пользователей соблюдать правила защиты данных и получать соответствующее согласие..