Об эффективном масштабировании GNN через реализации слоев с учетом ввода и вывода
Аннотация
Графовые нейронные сети (GNN) ограничены разреженным, нерегулярным доступом к памяти. Популярные фреймворки, такие как DGL и PyTorch Geometric, поддерживают обобщённое распространение сообщений, но сложные слои часто материализуют промежуточные результаты по рёбрам, увеличивая трафик памяти и ограничивая масштабируемость на больших графах. Мы рассматриваем взгляд, ориентированный на ввод-вывод и арифметическую интенсивность, и показываем, что широко используемые слои распадаются на три семейства ядер: свёртки на основе SpMM, агрегации на основе редукций и слои на основе внимания (GATv2/Graph Transformer). Для каждого семейства мы разрабатываем GPU-ядра, которые уменьшают объём перемещаемых данных, улучшают локальность и сохраняют устойчивость на реалистичных графах. Мы также изучаем перестановку вершин графа и находим, что её влияние зависит от отображения на ядро: она приносит пользу соседне-параллельным (доминирующим по сбору) ядрам более стабильно, чем вариантам с параллелизмом по признакам. Экспериментально наши слитые ядра для внимания обеспечивают ускорение до 3.9 для Graph Transformer (медиана 1.6), а варианты с Tensor Core (block-sparse) — до 7.3 на локально плотных графах; для GATv2 мы достигаем ускорения до 8.5 (медиана 2.0) при уменьшении пикового потребления памяти до 76 (медиана 6). Наши редукционные ядра с учётом степени обеспечивают ускорение до 10 (медиана 2.6). Для слоёв на основе SpMM корректно кэшируемый cuSPARSE обеспечивает ускорение до 8 по сравнению с DGL и превосходит оценённые пользовательские базовые реализации в большинстве экспериментов. Мы публикуем наши реализации как готовые замены в нашем GitHub repository, чтобы поддерживать воспроизводимое, ориентированное на оборудование ускорение GNN.
Ключевые слова:
Машинное обучение, ICML, CUDA, GNN, ускорение, графики, графовое машинное обучение1 Введение
Графовые нейронные сети (GNNs) являются базовым инструментом обучения по реляционным и неструктурированным данным, применяемым в рекомендательных системах и выявлении мошенничества, в задачах спatiotemporal прогнозирования, а также в научном моделировании и многом другом (Lam et al., 2023; Shi et al., 2023; Pfaff et al., 2021; Fey et al., 2023; Sanchez-Gonzalez et al., 2020). Несмотря на быстрое развитие дизайна моделей, производительность обучения и вывода GNNs на современных GPU часто отстает от рабочих нагрузок плотного глубокого обучения. Ключевая причина заключается в том, что доминирующие операторы GNN являются разреженными и нерегулярными: агрегация по соседству и внимание обходят ребра графа с зависящими от данных, перестановочно-инвариантными шаблонами доступа, что приводит к низкой арифметической интенсивности и ограниченной локальности (Zhang et al., 2021; Peng et al., 2024).
Этот разрыв усиливается аппаратными тенденциями. Современные графические процессоры демонстрируют растущее расхождение между пиковои̮ вычислительнои̮ пропускнои̮ способностью и пропускнои̮ по HBM, что вталкивает большее число ядер в режим, ограниченныи̮ памятью, если только они не выполняют существенную вычислительную работу на каждыи̮т перемещенный байт. В терминах roofline точка излома (арифметическая интенсивность, требуемая, чтобы стать вычислительно-ограниченным) смещается к более высоким значениям111Для справки, A100 SXM-4 имеет 312 TFLOPs (FP16/BF16 Tensor Cores) и 2 TB/s пропускнои̮ HBM (156 FLOPs/byte); H100 SXM-5 имеет 1980 TFLOPs и 3.35 TB/s (592 FLOPs/byte).. В результате только снижение FLOPs часто не приводит к ускорениям по времени выполнения (Zhang et al., 2025). Этот разрыв хорошо задокументирован в transformer attention, где IO-aware алгоритмы, которые явно уменьшают трафик HBMSRAM, обеспечивают большие практические выигрыши (Dao et al., 2022; Dao, 2023; Shah et al., 2024; Ivanov et al., 2021). Мы утверждаем, что аналогичныи̮ отсутствующии̮ принцип препятствует масштабируемому ускорению GNN: многие реализации отдают приоритет универсальности операторов, при этом недостаточно оптимизируя перемещение данных и промежуточную материализацию, из-за чего производительность все больше начинает определяться трафиком памяти (Zhang et al., 2021).
Существующие программные наборы для GNN обычно следуют одному из двух подходов. Фреймворки, такие как Deep Graph Library (DGL) и PyTorch Geometric, предоставляют универсальный интерфейс передачи сообщений и оптимизированные разреженные примитивы (Wang et al., 2019; Fey et al., 2025), но типичные слои все же могут порождать большие промежуточные представления вдоль ребер, увеличивая как трафик памяти, так и пиковый объем активаций. С другой стороны, специализированные реализации операторов могут требовать существенной инженерной проработки на каждый слой и не всегда последовательно извлекать выгоду из новых возможностей аппаратного обеспечения на различных графах и при разных размерах признаков (Liu et al., 2024; Xiang et al., 2025).
Недавние работы решают эти проблемы с помощью адаптивных сред выполнения и планирования (Wang et al., 2021), более эффективных реализаций для отдельных слоев (Peng et al., 2024; Zhang et al., 2021) и структурированных форматов разреженности, которые отображают разреженные вычислительные нагрузки на Tensor Cores (Wang et al., 2023; Xiang et al., 2025; Li and Chandramowlishwaran, 2025). Однако эти подходы часто нацелены только на подмножество операторов, требуют нетривиальной предварительной обработки/специальных форматов и могут быть чувствительны к структуре графа и распределению степеней.
В данной работе мы рассматриваем вычисления в GNN с фокусом на ввод-вывод и арифметическую интенсивность и показываем, что широко используемые слои группируются в три семейства ядер с различным поведением на аппаратном уровне: (i) свёртки на основе умножений разреженных и плотных матриц (на основе SpMM) (например, GCN/GraphConv), (ii) агрегации на основе редукций (например, / и связанные сегментные редукции), и (iii) сложные рабочие процессы, такие как слои, основанные на внимании (например, GATv2 и Graph Transformers). Для каждого семейства мы анализируем поведение памяти в типичных реализациях и подтверждаем наши конструкции профилированием на реалистичных графах с различной плотностью и распределениями степеней.
Это дает три практических результата. Во‑первых, наши эксперименты показывают, что для сверток на основе SpMM примитивы вендоров остаются высококонкурентными: cuSPARSE часто соответствует или превосходит базовые варианты фреймворков, а кэширование предварительной обработки графа и транспонирование матрицы смежности снижает сквозную задержку для обратного прохода. Во‑вторых, эмпирически мы обнаруживаем, что для слоев, основанных на редукции, степень‑ориентированое разбиение на тайлы критично при распределениях степеней с тяжелыми хвостами, улучшая пропускную способность на узлах с высокой степенью без увеличения объема памяти, тогда как для узлов с низкой степенью достаточно простого коалесцированного размещения. В‑третьих, для слоев внимания мы вносим вклад в IO‑ориентированные ядра, вдохновленные FlashAttention, которые объединяют вычисления по соседям, избегают материализации промежуточных значений по ребрам и, при необходимости, используют Tensor Cores за счет разреженных блочных раскладок.
Мы также пересматриваем перестановку графов и показываем, что ее эффективность зависит от стратегии параллелизации ядра и распределения степеней: конструкции с параллелизацией по соседям дают больше выгоды на графах с высокой степенью, тогда как на графах с низкой степенью (то есть на дорожных сетях) влияние ограничено и производительность определяется накладными расходами на уровне узла. Наконец, мы выпускаем реализацию с открытым исходным кодом с минимальными зависимостями (CUDA, PyTorch, cuSPARSE) и интерфейсом PyTorch как прямые замены для широко используемых слоев GNN.
2 Фон
2.1 Обозначения и передача сообщений
Рассмотрим однородный граф с узлами и направленными ребрами. Признаки узлов на слое равны , при . Для хранения графа мы в основном используем формат Compressed Sparse Row (CSR). В остальной части статьи мы часто опускаем индекс слоя , когда он очевиден из контекста, поскольку анализируем производительность одного представительного слоя, и те же доводы на уровне ядер применимы ко всем слоям.
Большинство слоёв GNN можно выразить с помощью шаблона Message Passing Neural Network (MPNN):
где может быть любой функцией, инвариантной к перестановкам, такой как min/max/average и тому подобное, а и могут быть произвольными обучаемыми функциями (Gilmer et al., 2017; Kimura et al., 2024). С точки зрения аппаратного обеспечения основная стоимость обычно связана с агрегацией в окрестности по ребрам, что приводит к разреженным и нерегулярным шаблонам доступа к памяти (Peng et al., 2024; Zhang et al., 2021).
2.2 Три семейства операторов слоев GNN
Мы сосредоточены на трех семействам операторов, которые охватывают широко используемые слои GNN и выявляют различные аппаратные узкие места.
(i) Свертки на основе SpMM. Эти слои можно выразить как SpMM между разреженной (обычно нормализованной) матрицей смежности и плотной матрицей , где 222Отметим, что представляет собой обычную операцию GEMM двух плотных матриц, и потому ее вычисление не подлежит оптимизации в данной статье.:
Например, в случае Graph Convolutional Network из Kipf and Welling (2017), .
(ii) Агрегации на основе редукций. Некоторые слои (объединение, редукции “segment“) вычисляют значения для каждого ребра, а затем выполняют редукцию по окрестности333Отметим, что в этой группе мы рассматриваем операторы, которые нельзя выразить как SpMM в отличие от реберно-зависимых или , например.:
где обычно , (Hamilton et al., 2017). В отличие от операторов на основе SpMM, эти операторы часто реализуются с использованием примитивов scatter/gather и пользовательских ядер редукции. Их производительность чувствительна к (1) распределению степеней (из-за дисбаланса нагрузки), (2) стратегии редукции (линейная vs параллельная) и (3) тому, материализуются ли промежуточные тензоры по ребрам, если применимо.
(iii) Слои на основе внимания. Операторы этого семейства используют механизм внимания для взвешивания сообщений от соседей в фазе обновления (для простоты обозначений мы опускаем размерность головки из индексации):
Члены семьи в основном различаются тем, как они параметризуют логиты и вектор(ы) значений , которые агрегируются после softmax. Типичные примеры включают слои GAT, GATv2 и слои графового трансформера (veličković2018_GATv1; Brody et al., 2022; Shi et al., 2021). Для GATv2 логиты вычисляются как , а значения как , где , и являются обучаемыми параметрами. Слои Graph Transformer (Min et al., 2022; Shi et al., 2021) используют attention по скалярному произведению (Vaswani et al., 2017):
2.3 Промежуточные модули GNN и предшествующие работы по ускорению GNN
Два наиболее широко используемых фреймворка для Graph-ML в PyTorch — Deep Graph Library (DGL) и PyTorch Geometric (PyG). DGL предоставляет ориентированный на графы API и реализует слои GNN с помощью двух обобщенных разреженных примитивов: generalized SpMM (gSpMM) для агрегации по узлам и generalized sampled dense–dense matrix multiplication (gSDDMM) для вычислений по ребрам. В своей CUDA-реализации DGL обычно параллелизует gSpMM по узлам назначения и gSDDMM по ребрам (Wang et al., 2019). PyG придерживается нативного для PyTorch дизайна и обычно реализует обмен сообщениями с редукциями scatter/gather и легковесными CUDA-расширениями, предлагая гибкий интерфейс для обобщенных слоев обмена сообщениями (Matthias et al., 2025).
Хотя DGL предоставляет эффективные ядерные реализации на уровне операторов для этих примитивов (например, через dgl.ops), более сложные слои часто выражаются как композиция gSDDMM и gSpMM, что приводит к материализации промежуточных сообщений по ребрам и последующему их сокращению во время и сложных в обеих средах, увеличивая трафик памяти и пиковый объем активаций. На практике DGL частично снижает это издержки за счет оптимизированных примитивных ядер, но материализация по-прежнему распространена для составных слоев. Кроме того, слияние таких конвейеров посредством автоматической компиляции не является тривиальной задачей, поскольку вычисление чередует фазы параллельной обработки ребер и параллельной обработки узлов, что затрудняет сохранение и локальности, и баланса нагрузки по всему слою (Zhang et al., 2021).
Предыдущие работы по ускорению GNN на GPU охватывают библиотечные решения поставщиков, примитивы разреженных ядер, системы, ориентированные на слияние операций, а также преобразования графов и форматов. Со стороны поставщика NVIDIA cuSPARSE предоставляет высоко оптимизированную разреженную линейную алгебру (в частности SpMM) и служит сильной базовой линией для слоёв GNN на основе SpMM. Однако операторы редукции и внимания не охватываются универсальными примитивами SpMM, и их производительность в значительной степени зависит от выбора параллелизации, промежуточной материализации и локальности памяти. cuGraph аналогично предоставляет примитивы графов на GPU и компоненты, ориентированные на GNN, в рамках экосистемы RAPIDS.
Помимо библиотек вендоров, GE-SpMM предлагает CSR-ориентированные SpMM-подобные ядра, настроенные под использование в GNN, и вводит кэширование строк с объединением и техники на уровне warp для улучшения поведения памяти (Huang et al., 2020). Адаптивное разреженное блочное разбиение улучшает локальность для SpMM/SDDMM в CSR за счет перестановки внутри строки, чтобы обеспечить блочное разбиение и повторное использование данных (Hong et al., 2019). Классические анализы разреженных GPU-ядeр (например, CSR SpMV на кэш-ориентированных GPU) подчеркивают роль локальности, параметризованных отображений и (авто-)настройки, что остается актуальным при интерпретации эффектов кэша и перестановок графа в современных рабочих нагрузках GNN (Reguly and Giles, 2012).
Дополняющая линия нацелена на сквозные графы выполнения и слияние. FuseGNN, Fused3S и связанные конвейеры уменьшают накладные расходы на запуск ядер и промежуточные тензоры, объединяя общие последовательности операторов (например, SDDMM–softmax–SpMM для разреженного внимания) (Li and Chandramowlishwaran, 2025; Chen et al., 2020). DF-GNN адаптирует слияние и планирование потоков к структуре операций и перекосу степеней, включая супер-узлы (Liu et al., 2024). GNNAdvisor изучает вычислительные графы через согласованную призму вычислений/ввода-вывода/памяти и предлагает реорганизацию операторов, единое отображение потоков для слияния на фазах вершин/ребер и пересчёт для сокращения занимаемого объёма активаций (Wang et al., 2021). Cached Operator Reordering исследует альтернативные порядки выполнения с кэшированием, хотя общедоступные реализации доступны не всегда (Bazinska et al., 2023). MaxK-GNN представляет совместное проектирование алгоритма и системы, в котором изменяются представления, чтобы уменьшить трафик памяти и обеспечить специализированные ядра (Peng et al., 2024).
Наконец, несколько работ используют специализированные блоки GPU посредством преобразований формата и графа. TC-GNN и cuTeSpMM исследуют плотные Tensor Cores для SpMM через структурное блочное разбиение и вводят зависящие от структуры критерии того, когда ускорение с помощью Tensor-Core является выгодным (Wang et al., 2023; Xiang et al., 2025). RT-GNN нацеливается на Sparse Tensor Cores, перестраивая графы так, чтобы лучше соответствовать ограничениям структурированной разреженности; его практическое влияние зависит от стоимости перестроений, ограничений совместимости и того, насколько тесно рассматриваемые настройки совпадают с реальными сквозными конвейерами (Yan et al., 2025).
2.4 Графовая перестановка для локальности
Перестановка порядка графа применяет перестановку к индексам узлов, чтобы улучшить кэш-локальность за счет размещения чаще совместно обращаемых узлов ближе в памяти. Классические методы включают разбиение в стиле METIS и порядки с уменьшением заполнения (Karypis and Kumar, 1997). В GNN перестановка может уменьшить объем трафика памяти и улучшить сквозное время выполнения в общих фреймворках (Merkel et al., 2024). В этой статье мы показываем, что ее выгода не является универсальной: эффект зависит от шаблона доступа к памяти ядра (feature-parallel versus neighbor-parallel) и структуры графа. В частности, для узлов с низкой степенью рабочее множество на узел невелико, и потенциальное улучшение локальности ограничено.
2.5 Аппаратные характеристики и соображения по производительности
Мы сосредоточены на GPU, поскольку они являются доминирующей платформой для обучения и инференса современных GNN. Качественные соображения по производительности, обсуждаемые ниже, распространяются и на другие ускорители, ориентированные на высокую пропускную способность.
CUDA Execution model and GPU memory hierarchy. GPU programs (kernels) are executed by massive number of threads grouped into warps and thread blocks scheduled on streaming multiprocessors (SMs).
Современные GPU демонстрируют глубокую иерархию памяти, которая меняет ёмкость на пропускную способность и задержку. Ресурсы на кристалле (регистры, общая разделяемая память и кэш L1) распределяются внутри одного SM и на порядки быстрее, чем глобальная High-Bandwidth Memory (HBM), однако имеют гораздо меньшую ёмкость (NVIDIA, ). Поскольку пиковая вычислительная пропускная способность росла быстрее, чем пропускная способность HBM, многие ядра всё чаще ограничиваются трафиком памяти, а не арифметической пропускной способностью, что делает эффективное переиспользование в памяти на кристалле критически важным. Для достижения высокой производительности обычно требуется (i) согласованный доступ к глобальной памяти, (ii) достаточный параллелизм, чтобы скрывать задержку памяти, и (iii) аккуратное использование локального хранилища на кристалле для частичных редукций и переиспользования часто обращающихся переменных.
Кровельная модель и арифметическая интенсивность. Удобный способ рассуждать о производительности GPU — модель Roofline (Williams et al., 2009), которая связывает достижимую пропускную способность с арифметической интенсивностью (FLOPs на байт, перемещаемый из HBM). По мере того как вычислительная пропускная способность GPU растет быстрее, чем пропускная способность HBM, требуемая арифметическая интенсивность для перехода в режим compute-bound увеличивается, в результате чего больше разреженных и нерегулярных операторов переводятся в режим memory-bound. Операторы с высокой интенсивностью (например, плотные GEMM) могут быть compute-bound, тогда как операторы с низкой интенсивностью обычно бывают bandwidth-bound. Большинство разреженных и ориентированных на редукцию примитивов, используемых в GNN, демонстрируют низкую арифметическую интенсивность и поэтому часто относятся к memory-bound; кроме того, промежуточная материализация дополнительно увеличивает объем перемещаемых данных.
Слияние ядер и промежуточная материализация. Стандартный способ ускорить операции, ограниченные пропускной способностью, — это слияние ядер: объединение нескольких операций так, чтобы входные данные загружались один раз из HBM и затем повторно использовались в регистрах/SRAM (Wei et al., 2021; Chen et al., 2018).
| Backend | ogbn-arxiv | artnet-exp | city-roads-M | pokec-regions | tolokers-2 | city-roads-L |
|---|---|---|---|---|---|---|
| Latency speedup (), fwd/bwd | ||||||
| Ours (CSR fused) | 1.27/1.24 | 1.17/1.15 | 1.15/1.19 | 1.25/1.15 | 2.00/1.10 | 1.15/1.16 |
| DF-GNN | 1.62/1.19 | 1.19/1.21 | 1.12/1.20 | N/A | N/A | 1.13/1.18 |
| Ours (WSB/TC) | 1.56/0.77 | 1.29/0.78 | 1.16/1.07 | 1.50/0.70 | 2.69/0.71 | 1.15/1.03 |
| Peak-memory ratio (), fwd/bwd | ||||||
| Ours (CSR fused) | 1.19/1.01 | 1.22/1.02 | 1.17/1.00 | 1.27/1.04 | 1.57/1.13 | 1.16/1.00 |
| DF-GNN | 1.18/1.14 | 1.19/1.08 | 1.16/1.08 | N/A | N/A | 1.16/1.13 |
| Ours (WSB/TC) | 1.08/1.21 | 1.08/1.21 | 1.08/1.21 | 1.10/1.21 | 1.23/1.20 | 1.07/1.21 |
Проблемы с GNN. Нагрузки на GNN сочетают разреженный, нерегулярный доступ к графам с плотными вычислениями признаков на узел/на ребро, что порождает ряд специфичных для графических процессоров проблем.
Во-первых, агрегация по соседству требует сбора признаков из несмежных индексов узлов, и даже когда загрузка признаков сгруппирована вдоль размерности признаков, последовательность базовых адресов соседей может быть весьма нерегулярной, снижая эффективность кэша и увеличивая нагрузку на TLB/DRAM. Кроме того, в формулировках с передачей сообщений промежуточные сообщения по ребрам (часто размера ) могут быть материализованы до агрегации. Это дополнительно увеличивает объем трафика памяти и пиковый объем активаций, и становится ключевым узким местом для больших графов.
Во-вторых, слои GNN естественным образом требуют вычислений на уровне ребер с последующим выполнением редукций на уровне узлов. Хотя современные компиляторы глубокого обучения, такие как torch.compile, весьма мощны, эффективное слияние (fusion) сложно реализовать в этом чередующемся рабочем процессе (Zhang et al., 2021; Li et al., 2021; Dao et al., 2022; Paszke et al., 2019).
Эти характеристики мотивируют разработки ядер, учитывающих осведомленность о вводе-выводе, которые (i) уменьшают промежуточную материализацию, (ii) повышают повторное использование на кристалле за счет разбиения на блоки и слияния там, где это возможно, и (iii) явно учитывают перекос по степеням и чувствительность к расположению при отображении вычислений на потоки GPU.
| Latency speedup | ogbn-arxiv | twitch-views | artnet-exp | pokec-regions | tolokers-2 | city-roads-L |
|---|---|---|---|---|---|---|
| Ours | 2.82/0.98 | 5.32/1.30 | 5.45/2.04 | 6.68/2.02 | 5.59/1.89 | 9.70/1.71 |
| PyG | 0.95/0.95 | 0.57/0.67 | 0.39/0.51 | OOM/OOM | 0.45/0.70 | 1.54/0.62 |
| Peak-memory ratio | ogbn-arxiv | twitch-views | artnet-exp | pokec-regions | tolokers-2 | city-roads-L |
| Ours | 4.67/3.46 | 44.17/31.71 | 6.90/5.34 | 12.74/8.47 | 32.59/28.55 | 1.77/1.51 |
| PyG | 0.58/0.69 | 0.61/0.68 | 0.59/0.72 | OOM/OOM | 0.61/0.71 | 0.54/0.72 |
| GATv2 speedups for larger hidden size (heads , head dim ). Graphs with stable measurements using DGL are reported. | ||||||
| Latency speedup | ogbn-arxiv | city-reviews | artnet-exp | city-roads-M | tolokers-2 | city-roads-L |
| Ours | 3.11/1.16 | 4.96/1.48 | 4.73/1.83 | 2.19/1.38 | 9.78/2.18 | 2.01/1.34 |
| PyG | 0.46/0.54 | 0.31/0.40 | 0.36/0.47 | 0.42/0.59 | 0.35/0.44 | 0.42/0.58 |
| Peak-memory ratio | ogbn-arxiv | city-reviews | artnet-exp | city-roads-M | tolokers-2 | city-roads-L |
| Ours | 6.73/4.11 | 14.09/8.62 | 10.38/6.37 | 2.72/1.76 | 69.74/44.80 | 2.37/1.53 |
| PyG | 0.55/0.64 | 0.58/0.66 | 0.57/0.66 | 0.49/0.62 | 0.60/0.67 | 0.48/0.61 |
3 Кernels, учитывающие ввод
В этом разделе мы приводим краткий обзор предложенных методов, направленных на улучшение использования памяти ядра и снижение задержки. Полное описание и перечень доступных параметров ядер с анализом приведены в Приложении D в соответствующих разделах.
3.1 Снижение на основе учёта степени с последующей агрегирующей свёрткой
Реальные графы демонстрируют распределения степеней с тяжелыми хвостами, что приводит к дисбалансу нагрузки при равномерной обработке каждого узла (Albert and Barabási, 2002; Newman, 2003). Мы разделяем узлы на подмножества легких и тяжелых по порогу степени узла (обычно это некоторая верхняя квантиль из распределения степеней). Для легких узлов используется фиче-параллельное ядро (один блок на узел) с согласованным шаблоном доступа к памяти. Для тяжелых узлов вводится разбиение на плитки для редукции по фрагментам ребер: каждый блок потоков вычисляет локальную редукцию на своем фрагменте. Частичные результаты объединяются с помощью атомарных операций над упакованными 64-битными (значение, индекс) парами, что позволяет использовать одну атомарную операцию для обновления и значения редукции, и индекса исходного узла для обратного распространения. На этапе обратного прохода сохраняются индексы исходных узлов, и выполняется распространение градиента как sparse scatter-add.
Сохраняется памятьный шаблон загруженных байт, поскольку эти сокращения имеют очень низкую арифметическую интенсивность и по своей сути ограничены пропускной способностью. Поэтому наша конструкция нацелена на доминирующий источник неэффективности: узлы высокой степени (тяжёлые), где отображение «один блок на узел» недоиспользует GPU. Разбивая их окрестности на фрагменты (чанки), мы увеличиваем параллелизм на уровне памяти и улучшаем баланс загрузки, сохраняя при этом ту же асимптотическую I/O. Более подробное описание приведено в Приложении D.1.
3.2 Слои на основе внимания: объединённое CSR-внимание для Graph Transformers и GATv2
Слои GNN, основанные на внимании, обычно формируют по ребрам логиты или сообщения размера или соответственно, где — это число голов. Это увеличивает трафик HBM и размер активаций. Мы проектируем слитые CSR-кернелы, которые выполняют вычисление оценок, нормализацию softmax и агрегирование значений за один проход по соседям в поточном режиме, избегая явного формирования реберного тензора.
Ключевая техника — онлайн softmax: каждый warp поддерживает текущую статистику в регистрах и выполняет инкрементальное перескалирование выходного аккумулятора по мере обработки новых соседей, что позволяет корректно нормализовать без хранения по каждой связи логитов.
Для обратного прохода, следуя стратегии FlashAttention-2 (Dao, 2023), мы храним только компактные статистики softmax для каждой вершины размера , вместо того чтобы материализовать весa внимания по ребрам размера . Это уменьшает пиковую память активаций и позволяет эффективную схему пересчета, в которой мы переоцениваем только логиты и выводим весa внимания на лету. Мы предоставляем слитые ядра как для attention по скалярному произведению (Graph Transformers), так и для GATv2; детали реализации приведены в Приложении D.2⟧.
3.3 Блочно-разреженные схемы для использования Tensor Core
Хотя наши объединённые ядра CSR устраняют необходимость в материализации граничных данных, они опираются на скалярные ядра и нерегулярные операции выборки. Чтобы задействовать Tensor Cores, мы расширяем формат block-sparse из Li and Chandramowlishwaran (2025), добавляя поддержку матриц взвешенной смежности: упаковываем локальные окрестности в плитки фиксированного размера 1616, совместимые с инструкциями WMMA. Это позволяет обменять предварительную обработку и вычисления на заполненных (с добавлением) элементах на более высокую арифметическую интенсивность и лучшее использование оборудования. Мы называем этот формат Weighted Block Sparse (WSB), поскольку он поддерживает веса рёбер. Такой подход наиболее эффективен, когда оконные фрагменты строк демонстрируют достаточную локальную плотность; для очень разреженных графов доминировать могут замаскированные вычисления, и это сводит на нет выгоду для Tensor Core (Xiang et al., 2025; Li and Chandramowlishwaran, 2025). В предварительных экспериментах мы обнаружили, что задержка обратного прохода для направленных графов в формате block-sparse оказывается неэффективной, поскольку требуется формировать транспонирование в block-sparse формате и использовать atomics, что в значительной степени нивелирует ускорение вперёд. Поэтому в нашей настройке WSB мы выполняем обратный проход с помощью примитива SpMM. Подробности реализации приведены в Appendix D.3⟧.
3.4 Свертки на основе SpMM
Учитывая зрелость библиотек поставщиков, мы используем cuSPARSE SpMM в качестве основного программного интерфейса и сосредотачиваемся на минимизации дополнительного накладного расхода. Мы также кэшируем метаданные, специфичные для графа (дескрипторы cuSPARSE, предварительно вычисленные нормированные веса, буферы рабочей области), и поддерживаем автонастройку для вариантов алгоритма, усредняя издержки настройки между итерациями обучения; дополнительно мы опционально кэшируем предварительно вычисленную транспонированную матрицу смежности для обратного прохода и оцениваем, как это влияет на задержку времени выполнения и занимаемый объем памяти. Кроме того, мы предоставляем ядра Tensor Core SpMM, использующие тот же формат взвешенной блочно-разреженной матрицы, который описан в Разделе 3.3, обеспечивая ускорение с помощью Tensor Core.
4 Эксперименты
Настройка.
Мы оцениваем на Graph-Land (Bazhenov et al., 2025), наборе тестов с разнообразными структурами графов, а также на ogbn-arxiv и ogbn-products из Open Graph Benchmark (Hu et al., 2021), и на стандартных сетях цитирования (Cora, Citeseer, Pubmed) для совместимости с предшествующими работами (Yang et al., 2016). Все эксперименты используют конфигурацию full-batch на одном NVIDIA A100 80GB SXM4. Мы выполняем бенчмаркинг GCN для слоев на основе SpMM, -агрегации для слоев, основанных на редукции; для слоев на основе Attention мы фокусируемся на Graph Transformer и GATv2, которая, как показано, является более выразительной по сравнению с исходной GAT, при этом наши методы оптимизации остаются в целом применимыми и к данной архитектуре.
Для свёрток на основе SpMM и свёрток на основе редукции мы перебираем . Для GATv2 мы перебираем число голов и размер на одну головку (так что суммарный размер скрытого слоя равен ). Для Graph Transformer мы сохраняем суммарный размер скрытого слоя фиксированным и варьируем соответствующим образом пары : для общей размерности 256 мы используем , а для общей размерности 512 — . Мы оцениваем перестановку reordering с METIS при размерах разбиений по сравнению с исходным порядком. Параметры ядра автоматически настраиваются для каждой конфигурации. Мы измеряем задержку прямого/обратного проходов и их пиковый объём памяти GPU.
Базовые бэкенды. Мы используем DGL в качестве нашей основной базовой модели, и все ускорения сообщаются относительно его поведения. Для сверток на основе SpMM мы дополнительно сравниваем с cuSPARSE SpMM в формате CSR, TC-GNN444 Мы наблюдаем, что у TC-GNN некорректный обратный проход для неориентированных графов в GCN, и во время обратного прохода требуется транспонирование матрицы смежности в реальном времени; мы добавляем это исправление. FuseGNN, PyG и стандартные разреженные операции в vanilla PyTorch. Для сверток на основе редукций мы дополнительно выполняем сравнение -агрегации с cuGraph. Для слоя Graph Transformer мы сравниваем с DF-GNN, когда он доступен (Мы используем вариант DF-GNN-hyper, поскольку это единственный вариант с доступной реализацией обратного прохода). Мы также оцениваем собственные ядра для Tensor Core для SpMM и слоев Graph Transformer (мы обозначаем это как WSB/TC backend).
Не все сторонние системы могли быть оценены на каждом наборе данных из-за дополнительных допущений и инженерных ограничений. В частности, DF-GNN успешно выполнила вычисления только на 8 графах в нашей тестовой подборке. Fused3S не смогла построить требуемое блочно-разреженное представление для нескольких крупных графов веб-тем, и даже когда построение выполнялось успешно, мы наблюдали незаконный доступ к памяти, приводивший к сбоям во время выполнения. Кроме того, выпущенный код Fused3S не предоставляет обратную реализацию для обучения, поэтому мы утверждаем, что он не подходит как сквозная альтернатива для обучения. Наконец, операторы внимания cuGraph требуют двудольного графа, чтобы поддерживать слои с различными левыми/правыми признаками узлов (как в GATv2) и чтобы соответствовать интерфейсу Graph Transformer; поскольку наши тесты для внимания используют не двудольные графы, базовые варианты внимания cuGraph не приводятся. Мы приводим дополнительные эксперименты в Приложении B.
4.1 Результаты
В этом разделе мы подводим итоги основных экспериментальных результатов и выделяем наиболее показательные результаты по производительности. Полные таблицы с ускорениями по каждому набору данных и по каждой конфигурации, а также все результаты относительно переупорядочивания графа, приведены в Приложении E⟧.
CuSparse по-прежнему трудно превзойти на сверточных операциях, основанных на SpMM. Таблица 3 показывает, что cuSPARSE по-прежнему остается сильной базовой линией для слоев на основе SpMM. Например, при использовании кэшированных дескрипторов cuSPARSE достигает ускорения 2.30 на прямом проходе ogbn-arxiv и 3.24/1.51 на city-roads-L (прямой/обратный), тогда как кэширование заранее вычисленного для обратного прохода увеличивает ускорение обратного прохода до и на тех же графах (а также до на web-traffic и web-topics) за счет дополнительной памяти. Размещение WSB может быть конкурентоспособным в некоторых режимах (например, на прямом проходе для tolokers-2 и для city-roads-L), но оно зависит от структуры и влечет накладные расходы на формат, поэтому мы рассматриваем его как необязательную оптимизацию, а не как универсальную замену CSR+cuSPARSE. Несколько специализированных базовых подходов менее устойчивы на этом масштабе: TC-GNN достигает / на city-roads-L, но показывает почти нулевую пропускную способность на web-traffic и выходит из памяти на ogbn-arxiv.
Сверточные операции на основе редукции: степень-осведомительное разбиение обеспечивает значительный прирост в прямом проходе. Как показано в таблице 4, для настройки с скрытой размерностью наше разбиение с -агрегацией существенно ускоряет прямой проход по сравнению с DGL на всех графах, достигая до для веб-трафика и для веб-тем, при этом сохраняя согласованные улучшения в обратном проходе, например на ogbn-arxiv). Кроме того, наша реализация снижает пиковое потребление памяти по сравнению с базовым вариантом DGL как для прямого, так и для обратного прохода, при типичных соотношениях в диапазоне – на основных графах. Ускорение наиболее заметно для графов с высокой средней степенью, и менее выражено на разреженных графах с низкой средней степенью узлов, таких как city-roads-L, где средняя степень равна 1.96.
Слои на основе внимания: объединенные ядра CSR улучшают задержку и существенно снижают пиковую память. Как показано в Таблице 2, для GATv2 наши объединенные ядра CSR обеспечивают большие ускорения прямого прохода на всех основных графах в базовой конфигурации (например, на city-roads-L, на pokec-regions и на tolokers-2), тогда как обратный проход демонстрирует более смешанные результаты из-за накопления градиентов с высокой долей атомарных операций. Ключевым образом объединенная формулировка позволяет избежать материализации сообщений по ребрам и дает существенные сокращения пикового использования памяти (например, на tolokers-2 и на twitch-views). При большем размере скрытого представления (число головок , размер головки ) DGL не смог масштабироваться, и мы сообщаем результаты для других наборов данных. Наша реализация остается стабильной; мы наблюдаем еще большие приросты на прямом проходе (до на tolokers-2), сохраняя ускорения на обратном проходе –; экономия памяти остается существенной (например, на tolokers-2 и на city-reviews).
Для Graph Transformer (Table 1) наш объединённый CSR-ядро обеспечивает согласованные выигрыши в прямом и обратном проходах на показанной конфигурации (например, 1.27/1.24 на ogbn-arxiv и 2.00/ на tolokers-2), в то время как DF-GNN не удаётся запустить на некоторых графах в этой конфигурации из-за ошибок времени выполнения (N/A). Ядро Tensor Core WSB layout может дополнительно улучшить пропускную способность в прямом проходе на некоторых графах (например, на tolokers-2 и 1.50 на pokec-regions), но не является универсально более быстрым в обратном проходе из-за накопления scatter/atomic между тайлами (например, 0.77 на ogbn-arxiv и 0.70 на pokec-regions).
| Backend | ogbn-arxiv | web-traffic | twitch-views | pokec-regions | tolokers-2 | city-roads-L |
|---|---|---|---|---|---|---|
| Latency speedup (), fwd/bwd | ||||||
| cuSPARSE | 2.30/0.97 | 2.44/0.94 | 1.26/0.61 | 1.34/0.66 | 2.33/0.65 | 3.24/1.51 |
| cuSPARSE + | 2.27/1.64 | 2.44/1.60 | 1.26/1.18 | 1.34/1.28 | 2.46/1.32 | 3.27/1.74 |
| Ours (WSB/TC) | 1.56/1.41 | 0.87/1.35 | 1.80/1.07 | 1.99/1.20 | 2.59/0.79 | 2.35/1.55 |
| TC-GNN | 2.63/OOM | 0.01/0.01 | 0.08/0.09 | 1.76/2.05 | 0.71/0.50 | 4.99/1.94 |
| FuseGNN | 0.27/1.44 | 0.19/0.09 | 0.32/0.37 | 0.92/1.20 | 0.35/0.58 | 0.53/1.80 |
| PyG | 0.20/0.18 | OOM/OOM | 0.06/OOM | OOM/OOM | 0.11/0.07 | 0.36/0.36 |
| Peak-memory ratio (), fwd/bwd | ||||||
| cuSPARSE | 0.49/0.54 | 1.47/1.14 | 0.64/0.66 | 1.92/1.23 | 0.06/0.08 | 1.82/1.19 |
| cuSPARSE + | 0.23/0.29 | 1.42/1.12 | 0.30/0.35 | 1.50/1.09 | 0.02/0.03 | 1.80/1.18 |
| Ours (WSB/TC) | 1.49/0.99 | 1.31/1.00 | 1.20/0.96 | 1.44/0.99 | 1.24/0.98 | 1.51/1.00 |
| TC-GNN | 1.93/OOM | 1.48/1.15 | 1.36/0.84 | 1.78/1.45 | 1.92/1.17 | 2.38/1.48 |
| FuseGNN | 0.21/0.20 | 0.11/0.14 | 0.27/0.23 | 0.22/0.22 | 0.22/0.22 | 0.22/0.21 |
| PyG | 0.01/0.01 | OOM/OOM | 0.03/OOM | OOM/OOM | 0.01/0.01 | 0.12/0.12 |
| Backend | ogbn-arxiv | web-traffic | web-topics | pokec-regions | tolokers-2 | city-roads-L |
|---|---|---|---|---|---|---|
| Latency speedup (), fwd/bwd | ||||||
| Ours | 4.84/2.09 | 8.31/1.52 | 8.24/1.50 | 2.59/1.41 | 2.54/1.32 | 4.14/1.63 |
| cuGraph | 2.87/1.45 | 0.06/2.17 | 0.06/2.11 | 1.42/1.14 | 0.44/0.87 | 3.50/1.38 |
| Peak-memory ratio (), fwd/bwd | ||||||
| Ours | 1.71/1.37 | 1.43/1.28 | 1.57/1.33 | 1.77/1.40 | 1.97/1.51 | 1.66/1.35 |
| cuGraph | 1.19/1.14 | 1.19/1.13 | 1.24/1.15 | 1.27/1.16 | 1.19/1.12 | 1.28/1.17 |
Перестановка графа: выгоды зависят от схемы доступа к ядру и режима кэширования.
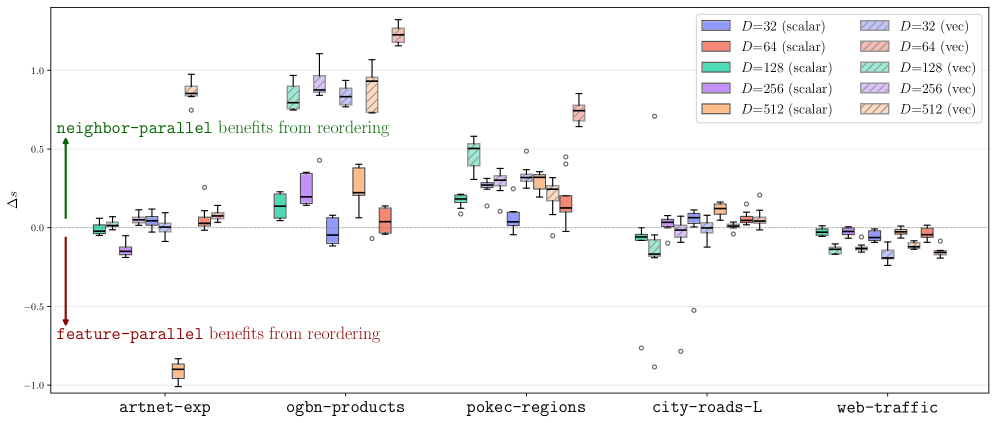
В наших сквозных (end-to-end) бенчмарках перестановка графа обеспечивает ограниченные и неуниверсальные выигрыши. Чтобы изолировать эффекты локальности, мы используем кэш-чувствительный микробенчмарк (dot-aggr) с двумя реализациями «по одному пакету потоков (warp) на узел», которые выполняют одинаковые арифметические операции, но используют разные шаблоны доступа к памяти: (i) параллелизм по признакам (соседние (coalesced) загрузки по признакам, соседи просматриваются последовательно) и (ii) параллелизм по соседям (считывания в стиле gather по соседям, при этом каждая линия (lane) обрабатывает разные соседи). Мы используем второй проход, чтобы выявить повторное использование кэша, и перебираем скрытую размерность , рассматривая два режима доступа: скалярные загрузки vs. 16B векторизованные загрузки. Мы измеряем разрыв от перестановки , где представляет собой ускорение за счет перестановки (чем выше, тем лучше). Положительное означает, что перестановка улучшает отображение neighbor-parallel, чувствительное к операциям gather, больше, чем feature-parallel..
Рисунок 1 иллюстрирует, что этот разрыв сильно зависит от набора данных и режима (скалярные vs. 16B векторизованные загрузки). На самом плотном/высокостепенном графе в этом подмножестве ogbn-products (ср. степень ), стабильно положителен, особенно с векторизованными загрузками, что указывает на то, что улучшения локальности в первую очередь приносят пользу для шаблона доступа, доминируемого gather. Для pokec-regions (ср. степень ) остается умеренно положительным при разных размерах признаков, предполагая меньшую, но все же надежную выгоду от перестановки для отображений, доминируемых gather. Напротив, в разреженной дорожной сети city-roads-L (ср. степень 2) держится близко к нулю (средне встречающиеся выбросы), что означает: рабочий набор на узел слишком мал, чтобы перестановка позволяла обеспечивать согласованное повторное использование кэша; производительность определяется фиксированными накладными расходами на узел, а не локальностью соседей. Аналогичное поведение «низкой степени» наблюдается для web-traffic (ср. степень ), где близок к нулю и слегка отрицателен во многих настройках, то есть перестановка не является универсально положительной оптимизацией и может даже благоприятствовать отображению, параллельному по признакам/согласованному. Наконец, artnet-exp (ср. степень 11) подчеркивает чувствительность к режиму выполнения: знак/величина может меняться между скалярными и векторизованными загрузками, что согласуется с идеей о том, что снижение накладных расходов на инструкции (векторизация) делает локальность памяти более заметным узким местом и тем самым изменяет, какие отображения получают наибольшую пользу от перестановки.
5 Заключение и будущая работа
Мы изучаем производительность GNN с точки зрения, ориентированной на ввод-вывод и арифметическую интенсивность, и показываем, что широко используемые слои группируются в три семейства ядер с различными узкими местами: свёртки на основе SpMM, агрегации на основе редукции и слои на основе внимания. Опираясь на эту таксономию, мы разрабатываем реализации для GPU, которые уменьшают избыточный трафик HBM, улучшают локальность и сохраняют устойчивость на реалистичных графах. В частности, наши слитые ядра внимания избегают материализации промежуточных величин по ребрам и существенно уменьшают пиковую память активаций как в прямом, так и в обратном распространении, тогда как учитывающее степень разбиение на блоки улучшает пропускную способность для операторов редукции при тяжелохвостных распределениях степеней. Для слоёв на основе SpMM мы подчёркиваем, что примитивы поставщика остаются надёжной базовой опорой: при учёте графовой структуры для кэширования и кэшированном транспонировании для обратного распространения cuSPARSE может соответствовать специализированным системам или превосходить их в наших условиях. Мы также исследуем путь для block-sparse на Tensor-Core, который может улучшить пропускную способность в прямом проходе на локально плотных графах; однако для ориентированных графов обратное распространение во время обучения может быть менее эффективным из-за рассеяния/атомарного накопления, что может доминировать получаемые выигрыши. Наконец, мы возвращаемся к переупорядочиванию графа и показываем, что его влияние не является универсальным: оно зависит от стратегии распараллеливания ядра, шаблона доступа к памяти и эффективного размера рабочего набора, причём отображения соседей, чувствительные к операциям gather, выигрывают более стабильно, чем варианты, параллелящие по признакам.
В качестве следующего шага адаптивное время выполнения/автоподстройщик, который выбирает между интерфейсами выполнения (например, cuSPARSE против пользовательских ядер, CSR-схлопнутые против путей с блочно-разреженными Tensor-Core) на основе статистики графа (смещение степени, локальная плотность, размер признаков), сделает производительность более предсказуемой и снизит объем ручной настройки. Еще одно перспективное направление — повышение эффективности обучения вариантов Tensor-Core за счет уменьшения давления от рассеяния/атомарных операций в обратном ходе, особенно для ориентированных графов. Наконец, мы выпускаем наши реализации как готовые для подстановки замены с легковесным набором зависимостей (CUDA/PyTorch и опциональный cuSPARSE), позволяя на практике воспроизводимое, учитывающее аппаратную специфику ускорение GNN.
Заявление о влиянии
Эта статья представляет работу, цель которой — продвинуть область Машинного обучения. Существует множество потенциальных социальных последствий нашей работы, ни одно из которых, по нашему мнению, не должно быть специально выделено здесь.
Благодарности
Мы благодарим Людмилу Прохоренкову и Олега Платонова за ранние обсуждения и отзывы о направлении исследования. Мы благодарим Дмитрия Еремеева за помощь с тестированием ранней версии библиотеки. Мы также благодарим Романа Гарипова, Илью Дробышевского, Илью Судакова, Тимофея Сенина и Александра Матосяна за ценные отзывы на статью и полезные обсуждения по реализации кода и будущим направлениям исследований.
Ссылки
- Статистическая механика сложных сетей. Rev. Mod. Phys. 74, pp. 47–97. Внешние ссылки: Document, Link Цитируется: §D.1, §3.1.
- ⟦ GraphLand: оценка моделей машинного обучения графов на разнообразных промышленных данных. Достижения в Neural Information Processing Systems. Цитируется: §C.1, §C.1, §D.2, §4.
- ⟦ Кэшированная перестановка операторов: единое представление для быстрой тренировки gnn. Внешние ссылки: 2308.12093, Link Цитируется: §2.3.
- ⟦Как внимательны графовые сети внимания? Внешние ссылки: 2105.14491, Link Цитируется: §2.2.
- ⟦TVM: автоматизированный конвейерный оптимизирующий компилятор для глубокого обучения. Внешние ссылки: 1802.04799, Link Цитируется: §2.5.
- FuseGNN: ускорение обучения графовой сверточной нейронной сети на gpgpu. В материалах 39-й Международной конференции по автоматизированному проектированию, ICCAD ’20, New York, NY, USA. Внешние ссылки: ISBN 9781450380263, Link, Document Цитируется: §2.3⟧.
- FlashAttention: быстрое и экономичное по памяти точное внимание с io-awareness. Внешние ссылки: 2205.14135, Link Цитируется: §1, §2.5.
- ⟦ FlashAttention-2: более быстрое внимание с лучшим параллелизмом и разбиением работы. Внешние ссылки: 2307.08691, Link Цитируется: §1, §3.2.
- ⟦Глубокое обучение по связям: обучение представлений графов по реляционным базам данных. Внешние ссылки: 2312.04615 Цитируется: §1.
- ⟦PyG 2.0: масштабируемое обучение на реальных графах. Внешние ссылки: 2507.16991, Link Цитируется: §1.
- Обмен нейронными сообщениями для квантовой химии. Внешние ссылки: 1704.01212, Link Цитируется: §2.1.
- Индуктивное обучение представлениям на больших графах. Труды по достижениям в обработке информации нейронными системами 30. Цитируется: §2.2.
- ⟦ Адаптивное разбиение на плитки для умножения разреженных матриц. стр. 300–314. Внешние ссылки: Document Цитируется: §2.3.
- Открытый бенчмарк: наборы данных для машинного обучения на графах. Внешние ссылки: 2005.00687, Link Цитируется: §C.1, §C.1, §4.
- ⟦ GE-spmm: универсальное разреженное умножение матриц на gpus для графовых нейронных сетей. Внешние ссылки: 2007.03179, Link Цитируется: §2.3.
- ⟦ Передача данных — это всё, что нужно: пример оптимизации transformers. Внешние ссылки: 2007.00072, Link Цитируется: §1.
- METIS— программный пакет для разбиения неструктурированных графов, разбиения сеток и вычисления упорядочивания для заполнения с уменьшением числа ненулевых элементов разреженных матриц. стр. . Цитируется: §2.4.
- О перестановочно-инвариантных нейронных сетях. Внешние ссылки: 2403.17410, Link Цитируется: §2.1.
- ⟦ Полуконтролируемая классификация с использованием графовых сверточных сетей. Внешние ссылки: 1609.02907, Link Цитируется в: §2.2.
- GraphCast: обучение навыку искусного среднесрочного глобального прогнозирования погоды. Внешние ссылки: 2212.12794 Цитируется: §1.
- Компилятор глубокого обучения: всеобъемлющий обзор. IEEE Transactions on Parallel and Distributed Systems 32 (3), с. 708–727. Внешние ссылки: ISSN 2161-9883, Link, Document Цитируется: §2.5.
- Fused3S: быстрая разреженная поэлементная векторизация на тензорных ядрах. Внешние ссылки: 2505.08098, Link Цитируется: §1, §2.3, §3.3.
- DF-gnn: dynamic fusion framework for attention graph neural networks on gpus. External Links: 2411.16127, Link Cited by: §1, §2.3.
- ⟦ PyG 2.0: масштабируемое обучение на реальных графах. На семинаре по Temporal Graph Learning @ KDD, Цитируется: §2.3.
- ⟦ Может ли переупорядочивание графов ускорять обучение графовых нейронных сетей? Экспериментальное исследование. Внешние ссылки: 2409.11129, Link Цитируется: §2.4.
- ⟦ Трансформер для графов: обзор с точки зрения архитектуры. Предварительная публикация arXiv arXiv:2202.08455. Цитируется: §2.2.
- ⟦ Структура и функция сложных сетей. SIAM Review 45 (2), стр. 167–256. Внешние ссылки: Document, Link, https://doi.org/10.1137/S003614450342480 Цитируется: §D.1, §3.1.
- [28] NVIDIA Руководство по программированию CUDA. Примечание: https://docs.nvidia.com/cuda/cuda-programming-guide/Дата обращения: 2026-01-22 Цитируется: §2.5.
- PyTorch: императивный стиль, библиотека высокопроизводительного глубокого обучения. Внешние ссылки: 1912.01703, Link Цитируется: §2.5.
- MaxK-gnn: сверхбыстрый дизайн графического процессорного ядра для ускорения обучения graph neural networks. In Proceedings of the 29th ACM International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS 2024), Cited by: §1, §1, §2.1, §2.3.
- ⟦ Обучение на основе матричного моделирования с графовыми сетями. Внешние ссылки: 2010.03409 Цитируется: §1.
- Эффективное разреженное умножение матрица-вектор на кэш-ориентированных gpus. стр. 1–12. Внешние ссылки: ISBN 978-1-4673-2632-2, Document Цитируется: §2.3.
- ⟦ Обучение моделированию сложной физики с помощью графовых сетей. Внешние ссылки: 2002.09405 Цитируется: §1.
- ⟦ FlashAttention-3: быстрое и точное внимание с асинхронностью и низкой точностью. Внешние ссылки: 2407.08608, Link Цитируется: §1.
- ⟦ Совместное проектирование аминокислотной последовательности и структуры белка с эквивариантным переносом. Внешние ссылки: 2210.08761 Цитируется: §1.
- Маскированное предсказание меток: объединенная модель передачи сообщений для полууправляемой классификации. Внешние ссылки: 2009.03509, Link Цитировано: §2.2.
- ⟦ Внимание — это всё, что нужно. Прогресс в нейронной обработке информации, 30. Процитировано: §2.2⟧.
- Библиотека глубоких графов: пакет, ориентированный на графы, с высокой производительностью для нейронных сетей на графах. препринт arXiv arXiv:1909.01315. Цитируется: §1, §2.3.
- ⟦ GNNAdvisor: адаптивная и эффективная система времени выполнения для ускорения GNN на GPU. На 15-м Симпозиуме USENIX по проектированию и реализации операционных систем (OSDI 21), стр. 515–531. Цитируется: §1, §2.3.
- TC-gnn: соединение разреженных вычислений gnn и плотных тензорных ядер на gpus. Внешние ссылки: 2112.02052, Link Цитируется: §1, §2.3.
- ⟦DNNFusion: ускорение выполнения глубоких нейронных сетей с помощью расширенной слияния операторов. В материалах 42-й Международной конференции ACM SIGPLAN по программированию: проектирование и реализация языков, PLDI 2021, New York, NY, USA, pp. 883–898. Внешние ссылки: ISBN 9781450383912, Link, Document Цитируется: §2.5.
- ⟦ Roofline: наглядная модель производительности для многопроцессорных архитектур. Commun. ACM 52 (4), стр. 65–76. Внешние ссылки: ISSN 0001-0782, Link, Document Цитируется: §2.5.
- CuTeSpMM: ускорение умножения разреженных и плотных матриц с использованием gpu tensor cores. Внешние ссылки: 2504.06443, Link Цитируется: §1, §1, §2.3, §3.3.
- RT-gnn: ускорение разреженных графовых нейронных сетей за счет слияния ядер tensor-cuda. ACM Trans. Archit. Code Optim. 22 (1). Внешние ссылки: ISSN 1544-3566, Link, Document Цитируется: §2.3.
- Пересмотр полууправляемого обучения с графовыми встраиваниями. На Международной конференции по машинному обучению, стр. 40–48. Цитируется: §C.1, §C.1, §4.
- ⟦ Понимание вычислительного графа gnn: скоординированная вычислительная схема, io и перспектива памяти. Внешние ссылки: 2110.09524, Link Цитируется: §1, §1, §1, §2.1, §2.3, §2.5.
- ⟦ Могут ли тензорные ядра приносить пользу для память-ограниченных ядер? (нет!). Внешние ссылки: 2502.16851, Link Цитируется: §1.
Appendix A Доступность кода и воспроизводимость результатов
Экспериментальные детали описаны в разделе 4. Мы используем 10 итераций прогрева и 30 итераций измерения, а затем усредняем полученные метрики. Мы выполняем автоподстройку ядер для каждой конфигурации и сообщаем метрики, полученные для наилучшей конфигурации, обеспечившей наилучшие результаты.
Мы публикуем исходный код в нашем репозитории: github.com/yandex-research/On-Efficient-Scaling-Of-GNNs.
Appendix B Дополнительные эксперименты
B.1 Учет степени для распределения витков в ядрах внимания
Степень-зависимое разбиение, представленное в Разделе 3.1, естественным образом применяется к ядрам внимания. Когда внутриграфовая вариативность степени высока, блоки потоков, назначенные узлам с высокой степенью, работают существенно дольше, чем для узлов с низкой степенью, что приводит к хвостовой задержке и недоиспользованию SM. Мы тестируем это расширение на наших слитых ядрах внимания: узлы-назначения разбиваются на легкие и тяжелые корзины, и каждая корзина запускается с независимо настроенным числом варпов. Таблица 5 сообщает ускорение этого варианта по сравнению с исходным степенно-независимым ядром внимания для Graph Transformer и GATv2 (размерность головы , heads). Ускорение согласуется со скошенностью степени: web-traffic (skewness 738) и ogbn-arxiv (skewness 111) дают наибольший выигрыш, тогда как дорожные сетевые графы с почти равномерным распределением степеней показывают минимальное улучшение. Обратный проход GT дает меньшую выгоду, так как atomicAdd на вносит сериализацию независимо от числа варпов.
| Dataset | Skewness | GT fwd | GT bwd | GATv2 fwd | GATv2 bwd |
|---|---|---|---|---|---|
| web-traffic | 738.1 | 5.83 | 6.34 | 5.45 | 7.34 |
| ogbn-arxiv | 110.8 | 3.72 | 1.09 | 3.91 | 2.49 |
| pokec-regions | 71.8 | 1.07 | 1.02 | 1.13 | 1.10 |
| twitch-views | 42.4 | 2.10 | 1.45 | 2.23 | 2.08 |
| city-reviews | 35.0 | 2.07 | 1.40 | 2.24 | 1.78 |
| ogbn-products | 17.5 | 1.07 | 1.02 | 1.19 | 1.11 |
| avazu-ctr | 9.4 | 2.48 | 1.37 | 2.30 | 2.04 |
| hm-categories | 7.3 | 1.79 | 1.26 | 1.62 | 1.65 |
B.2 Кернелы обратного распространения с учетом направления для неориентированных графов
Для неориентированных графов обратный проход может обходить ту же структуру CSR, что и прямой проход, устраняя операции рассеяния/атомарные операции по транспонированной матрице смежности, которые доминируют в направленном обратном проходе для WSB. Мы разрабатываем специализированные обратно-направленные ядра для обоих бэкендов CSR-fused и WSB, которые используют неориентированность, когда она доступна. Таблица 6 показывает ускорение по сравнению с направленным базовым вариантом обратного прохода (размерность head dim , heads). Обратный проход GT на основе CSR получает прирост 5–21% от этой оптимизации, поскольку устранение обхода в транспонированном виде улучшает локальность. WSB обеспечивает медианное ускорение , поскольку удаление конкуренции за scatter/atomic по окнам строк полностью восстанавливает преимущество Tensor Core в обратном проходе, которое теряется для направленных графов. Для GATv2 на неориентированных графах мы дополнительно объединяем вычисление градиента по отношению к признакам источника и назначения в один проход ядра, устраняя один полный проход по графу. Все бэкенды дают численно идентичные градиенты по сравнению с направленной реализацией.
| Dataset | Avg. deg | GT (CUDA) | GATv2 (CUDA) | GT (WSB) |
|---|---|---|---|---|
| avazu-ctr | 289 | 1.21 | 1.12 | 8.59 |
| hm-categories | 461 | 1.19 | 1.08 | 8.16 |
| tolokers-2 | 89 | 1.01 | 1.05 | 7.57 |
| twitch-views | 81 | 1.03 | 1.01 | 9.36 |
| ogbn-products | 51 | 1.11 | 1.14 | 7.03 |
| pokec-regions | 28 | 1.11 | 0.97 | 6.76 |
| ogbn-arxiv | 14 | 1.13 | 1.09 | 7.73 |
| web-traffic | 9 | 1.06 | 1.21 | 10.74 |
| city-roads-L | 4 | 1.10 | 1.01 | 2.75 |
B.3 WSB Затраты на предварительную обработку и амортизация
Формат WSB при построении требует одноразовых затрат на предварительную обработку для каждой структуры графа, которые необходимо окупить за счет распределения на множество итераций обучения. Эти затраты также можно полностью устранить, если сериализовать представление WSB на диск для повторного использования между запусками. Таблица 7 сообщает время построения WSB, задержку обучения на эпоху относительно DGL и соответствующее количество эпох, при котором достигается точка безубыточности (GT, 4 слоя, размерность головы , голов). Для локально плотных графов, таких как hm-prices (точка безубыточности: 65 эпох) и avazu-ctr (точка безубыточности: 159 эпох), WSB быстро окупается и становится предпочтительным для реалистичных запусков обучения. Однако на 9 из 16 графов более быстрым оказывается CSR-fused бэкенд на эпоху, а точка безубыточности превышает 1000 эпох, что согласуется с тем, что WSB является опциональным ускоряющим путем для локально плотных графов, а не универсальной заменой.
| Dataset | WSB cost (s) | DGL (ms/ep) | WSB (ms/ep) | Speedup | Break-even (ep.) |
|---|---|---|---|---|---|
| hm-prices | 16.1 | 731.2 | 484.4 | 1.51 | 65 |
| avazu-ctr | 14.9 | 825.5 | 731.9 | 1.13 | 159 |
| city-roads-L | 4.4 | 296.3 | 285.5 | 1.04 | 404 |
| city-roads-M | 4.3 | 145.5 | 139.4 | 1.04 | 693 |
Appendix C Наборы данных
C.1 Обзор.
Наша оценочная система объединяет (i) промышленные, насыщенные атрибутами графы из GraphLand (Bazhenov et al., 2025) и (ii) широко используемые бенчмарки по сетям цитирования (Cora/Citeseer/Pubmed) из настройки Planetoid (Yang et al., 2016), а также (iii) графы узловых свойств OGB (ogbn-arxiv, ogbn-products) (Hu et al., 2021). Таблица 8 сообщает базовые структурные статистики, вычисленные по нашим обработанным представлениям графа.
| Dataset | #nodes | #edges | density | avg. degree |
|---|---|---|---|---|
| hm-categories | ||||
| tolokers-2 | ||||
| avazu-ctr | ||||
| cora | ||||
| citeseer | ||||
| twitch-views | ||||
| pubmed | ||||
| artnet-exp | ||||
| city-reviews | ||||
| city-roads-M | ||||
| ogbn-arxiv | ||||
| ogbn-products | ||||
| city-roads-L | ||||
| pokec-regions | ||||
| web-traffic |
Наборы данных GraphLand (Bazhenov et al., 2025).
GraphLand — это набор графов из реалистичных промышленных областей. Мы используем следующие наборы данных:
веб-мошенничество, веб-темы, web-traffic.
Наборы данных представлены как большие направленные веб-графы (граф является общим): узлы — это веб-сайты, ребра представляют наблюдаемые переходы пользователей между веб-сайтами. Мы используем веб-трафик в наших экспериментах.
Задачи различаются: выявление мошенничества (двоичное, несбалансированное), классификация тем (многоклассовая) и прогнозирование трафика (регрессия).
artnet-views, artnet-exp.
Обе разделяют один и тот же (дружеский) социальный граф создателей искусства: узлы — это пользователи, ребра соединяют друзей. Задачи: предсказать просмотры пользователей (регрессия) и предсказать создателей явного контента (бинарная классификация). В наших экспериментах мы используем artnet-views.
city-roads-M, city-roads-L.
Направленные дорожные графы: вершины представляют дорожные сегменты, а ребра указывают на выполнимые переходы между сегментами в соответствии с правилами движения. Задача состоит в прогнозировании средней скорости движения для каждого сегмента в заданный момент времени (регрессия).
city-reviews.
Граф пользователя из обзорного сервиса: вершины — пользователи, ребра соединяют пользователей, которые часто оставляют отзывы об одних и тех же организациях. Задача: обнаружить мошеннических рецензентов (бинарная классификация).
avazu-ctr.
Граф, построенный по данным соревнования Avazu CTR: вершины — это устройства, ненаправленные ребра соединяют устройства, которые часто посещают одни и те же веб-сайты. Задача: предсказать CTR устройства (регрессия).
hm-категории, hm-prices.
Получено на основе общей графовой модели совместных покупок H&M: узлы представляют продукты, неориентированные ребра соединяют продукты, которые часто покупают вместе. Задачи: прогнозирование категории (многоклассовая классификация) и прогнозирование цены (регрессия). В наших экспериментах мы используем hm-categories.
pokec-regions.
Онлайн социальная сеть Pokec: вершины соответствуют пользователям, направленные ребра соответствуют отметкам «друзья». Задача: прогноз региона (экстремальная многоклассовая классификация) по признакам профиля пользователя.
twitch-views.
Социальная сеть Twitch: узлы — это пользователи, неориентированные ребра соединяют пользователей, которые взаимно подписаны друг на друга. Задача: спрогнозировать просмотры пользователя (регрессия).
tolokers-2.
Сеть работников из Toloka: узлы — это работники (tolokers), неориентированные ребра соединяют работников, которые выполняли одну и ту же задачу. Задача: обнаружение мошенничества (запрещено vs не запрещено) с расширенным набором признаков.
Наборы данных OGB (Hu et al., 2021).
ogbn-arxiv — это ориентированный граф цитирования статей arXiv с задачей предсказания свойств узлов по категориям/областям статей (классификация узлов). ogbn-products — это граф совместных покупок товаров Amazon с задачей предсказания свойств узлов по категориям товаров (классификация узлов)).
Сети цитирований (Yang et al., 2016).
cora, citeseer и pubmed — классические сети цитирования, используемые для полууправляемой классификации узлов. В настройке Planetoid узлы — это документы с признаками мешка слов, а ребра представляют связи цитирования (симметризованные), и цель — классифицировать документы по классам. Мы рассматриваем их как небольшие проверки на корректность, а не как репрезентативные тесты масштабирования.
Представления графов и накладные расходы на предварительную обработку.
| Dataset | DGL | PyG | cuGraph | cuSPARSE | cuSPARSE + | Torch sparse | Ours (CSR fused) | TC-GNN | DF-GNN | Fused3S | Ours (WSB/TC) |
|---|---|---|---|---|---|---|---|---|---|---|---|
| artnet-exp | 24.28 | 24.28 | 59.63 | 17.48 | 20.00 | 46.62 | 21.11 | 21.57 | 26.03 | 34.97 | 49.72 |
| avazu-ctr | 413.17 | 413.17 | 1681.86 | 252.57 | 336.95 | 1681.86 | 245.86 | 329.11 | 497.38 | 1343.80 | 1681.86 |
| citeseer | 47.22 | 47.22 | 47.96 | 47.09 | 47.15 | 47.30 | 47.17 | 47.15 | 47.23 | 47.09 | 47.82 |
| city-reviews | 155.40 | 155.56 | 298.91 | 127.59 | 137.62 | 189.67 | 138.18 | 144.84 | 163.16 | 143.78 | 266.75 |
| city-roads-L | 120.84 | 120.84 | 147.46 | 116.56 | 118.71 | 124.24 | 119.25 | 118.18 | 120.82 | 116.12 | 134.01 |
| city-roads-M | 18.30 | 18.30 | 29.59 | 16.35 | 17.29 | 19.46 | 17.51 | 17.15 | 8.37 | 16.12 | 23.78 |
| cora | 15.04 | 15.04 | 15.82 | 14.89 | 14.96 | 15.11 | 14.97 | 14.97 | 15.06 | 14.90 | 15.63 |
| hm-categories | 350.69 | 350.68 | 1640.98 | 246.32 | 328.55 | 1640.98 | 187.12 | 268.68 | 432.84 | 1311.87 | 1640.98 |
| ogbn-arxiv | 124.16 | 125.45 | 224.84 | 184.36 | 203.72 | 224.84 | 197.98 | 147.29 | 208.97 | 156.08 | 224.84 |
| ogbn-products | 4791.77 | 4811.92 | 13996.19 | 10582.25 | 12072.83 | 13996.19 | 11582.20 | 7599.92 | 13771.59 | 8511.87 | 13996.19 |
| pokec-regions | 858.82 | 858.38 | 2717.03 | 496.16 | 626.39 | 2461.85 | 632.62 | 723.00 | 962.47 | 1871.63 | 2461.85 |
| pubmed | 39.86 | 39.86 | 46.22 | 38.70 | 39.19 | 40.43 | 39.26 | 39.30 | 40.05 | 38.77 | 45.03 |
| tolokers-2 | 17.00 | 16.99 | 80.09 | 12.06 | 16.11 | 80.09 | 9.12 | 12.90 | 21.07 | 63.92 | 80.09 |
| twitch-views | 229.77 | 228.48 | 1053.04 | 159.14 | 212.29 | 1053.04 | 124.91 | 174.45 | 279.05 | 831.86 | 1053.04 |
| web-traffic | 13281.56 | 13281.56 | 14206.88 | 13112.91 | 13184.15 | 13363.83 | 13197.13 | 13202.41 | 13314.69 | N/A | 13860.13 |
Графовые форматы и представление: накладные расходы.
Разные варианты выполнения требуют разных способов кодирования графа и предварительной обработки, что влияет на объем памяти графического процессора (GPU) даже до учета признаков узлов и промежуточных активаций. Таблица 9 показывает память (МБ) объектов графа, которые кэшируются/предварительно обрабатываются и используются каждым вариантом выполнения. CSR-ориентированные варианты выполнения (DGL, PyG, cuSPARSE и наши CSR-слитые ядра) хранят смещения строк и индексы столбцов, опционально со значениями ребер, и поэтому размеры представления сопоставимы для большинства наборов данных. Кэширование транспонированной матрицы смежности для обратного прохода в cuSPARSE («cuSPARSE + ») увеличивает память представления, как и ожидалось, например, с МБ до МБ на ogbn-arxiv, и с МБ до МБ на pokec-regions.
Наш путь через тензорные ядра использует разреженную блочно-взвешенную (WSB) компоновку, которая обменивает дополнительную память структуры (из-за блочности/пэддинга и метаданных тайлов) на более высокую арифметическую интенсивность и более полное использование тензорных ядер. Следовательно, WSB может быть существенно более затратной, чем CSR, на плотных или локально плотных графах, например hm-prices (MB в cuSPARSE против MB в Ours (WSB/TC)) и tolokers-2 (MB против MB). На очень больших разреженных графах накладные расходы более умеренны по сравнению с уже значительным объёмом CSR, например web-traffic (MB в cuSPARSE против MB в Ours (WSB/TC)). Наконец, для некоторых наборов данных Fused3S не удаётся построить требуемое представление блочно-разрежённого формата (отмечено как N/A в Table 9), что подчёркивает: требования к формату влияют не только на память, но и на устойчивость оценочного конвейера.
Appendix D IO aware kernels (extended)
D.1 Свертки на основе агрегации с редукцией с учетом степени
На GPU этот оператор обычно ограничен пропускной способностью: основная стоимость — потоковая передача соседних признаков из HBM, тогда как вычисления на каждый элемент ограничены сравнениями и обновлениями. Существенная практическая проблема связана с тяжелохвостым распределением степеней реальных графов: небольшая доля узлов с высокой степенью (тяжелых) может доминировать по времени работы, если каждый узел обрабатывается с равномерным отображением, таким как по одному блоку (или warp) на узел-назначение (Newman, 2003; Albert and Barabási, 2002).
Адаптивное разбиение по степени.
Чтобы устранить перекос по степени и улучшить балансировку нагрузки, мы разделяем узлы назначения на легкие и тяжелые подмножества, используя порог степени, специфичный для графа ; значения и механизм разделения будут описаны позже. Легкие узлы обрабатываются с помощью стандартного feature-parallel ядра, в то время как тяжелые узлы обрабатываются по схеме 2D разбиения на плитки, которая распараллеливает вычисления по фрагментам ребер и объединяет частичные редукции.
Лёгкие узлы: редукция со схождением по признаковому параллелизму.
Для легких узлов мы используем простое и эффективное отображение, при котором каждому блоку CUDA назначается один узел назначения, а потоки выполняют итерации по размерности признаков. Конкретно, каждый поток обрабатывает разреженное подмножество признаков, и для каждого признака выполняет последовательное сканирование по списку соседей, чтобы обновить текущее минимальное значение и соответствующий индекс источника. Такое отображение сохраняет состояние на уровне каждого потока в регистрах и позволяет избежать синхронизации между потоками, что эффективно, когда степени умеренные и сканирование по соседям не доминирует во времени выполнения от начала до конца..
Тяжелые узлы: разбиение на 2D реберные плитки и параллельное сокращение.
Для тяжелых узлов поиск соседей становится узким местом, а стратегия «один блок на узел» недоиспользует GPU из-за недостаточного параллелизма и плохой хвостовой задержки. Поэтому мы вводим разложение на двумерную сетку: blockIdx.x выбирает тяжелый узел назначения, а blockIdx.y выбирает фрагмент ребер внутри его списка смежности. Каждый блок обрабатывает смежный фрагмент соседей размером EDGES_PER_BLOCK, вычисляет локальный минимум (и argmin) для каждой характеристики, а затем объединяет эти промежуточные результаты в единый выход для узла. Размер фрагмента EDGES_PER_BLOCK и число warps на блок выносятся в настраиваемые параметры, балансирующие дополнительные накладные расходы на объединение против повышения параллелизма для узлов с высокой степенью.
Объединение частичных минимумов с атомарным (value, index) приведением.
Чтобы объединить частичные результаты между фрагментами на границе без синхронизации на уровне блоков между blockIdx.y, мы используем атомарное сокращение по упакованным парам (значение, индекс). Мы отображаем значение с плавающей точкой в ключ целого числа с сохранением порядка и упаковываем его вместе с индексом аргминим в 64-битное слово, позволяя одной atomicMin обновлять одновременно минимальное значение и его исходный узел. Эта атомарная операция объединения дает тот же результат, что и полное сокращение по всем соседям, при этом позволяя независимым фрагментам ребер выполняться параллельно.
Декуплированная материализация через распаковку.
Для тяжелых узлов частичные редукции накапливаются во промежуточном упакованном буфере формы . Затем выделенное ядро распаковки преобразует упакованное представление обратно в выходной тензор признаков и тензор argmin. Хотя это добавляет дополнительное линейное по памяти преобразование, оно полностью согласовано и позволяет сохранять основное редукционное ядро простым и высокопараллельным, избегая дорогостоящей глобальной синхронизации.
Обратный проход: разреженное рассеяние с использованием сохранённых argmin.
При обратном проходе градиент от min/max-редукции отличен от нуля только вдоль выбранного источника argmin/argmax. Поэтому мы сохраняем индексы argmin во время прямого прохода и реализуем обратное распространение как разреженное scatter-add: для каждого мы добавляем в , используя атомарные операции add. Хранение argmin позволяет избежать пересчета структуры редукции во время обратного прохода и уменьшает избыточную работу, по духу аналогично кэшированию статистик нормализации в объединенных ядрах fused attention, чтобы минимизировать дополнительные операции во время backpropagation.
Ввод и вычислительные характеристики.
И исходная реализация, и наша реализация, учитывающая степень, должны считывать соседние признаки из HBM. Однако в исходном отображении наблюдается плохой баланс загрузки, поскольку сканирования соседей для нескольких узлов сериализуют выполнение. Для графа с ребрами и размерностью признаков это соответствует считыванию примерно байт из HBM в прямом проходе, независимо от схемы отображения выполнения. Разбиение с учетом степени не изменяет эту границу. Оно распараллеливает сканирования соседей узлов с высокой степенью между несколькими блоками потоков, улучшая параллелизм и снижая хвостовую задержку. Дополнительные шаги слияния и распаковки вносят дополнительные обращения к памяти, но они полностью когерентны и линейны по расположению данных в памяти, поэтому накладные расходы пренебрежимо малы по сравнению со считыванием соседних признаков.
Порог степени и параметры автотюнинга.
Назначенные конечные узлы классифицируются как тяжёлые, если их степень превышает значение, определяемое для графа как квантиль распределения степеней. В наших экспериментах мы рассматриваем huge_degree_threshold_quantile , что соответствует верхним и узлов по степени соответственно. Мы дополнительно включаем базовую настройку без разбиения, при которой все узлы помечаются как лёгкие. Параметры запуска ядра выбираются с помощью автонастройщика, который выполняет поиск по сетке в ограниченном пространстве параметров. Мы осуществляем поиск по warps_per_block и edges_per_block_heavy_nodes для тяжёлых узлов. Эти параметры согласуют параллелизм на уровне признаков, параллелизм на уровне чанков и степень сериализации на шаге объединения. Для каждого графа и размерности признаков автонастройщик выбирает конфигурацию с наименьшей измеренной задержкой.
Порядко-сохраняющее уплотнение для атомарных редукций.
Чтобы обеспечить корректное атомарное выполнение reduction atomicMin по значениям с плавающей запятой, мы преобразуем числа с плавающей запятой IEEE-754 в представление без знака с упорядочиванием. Битовый шаблон каждого значения переназначается таким образом, что стандартное сравнение без знака отражает полное упорядочение чисел с плавающей запятой: для отрицательных значений выполняется побитовая инверсия, а для неотрицательных значений устанавливается знаковый бит. Это преобразование гарантирует, что меньшее значение с плавающей запятой всегда соответствует меньшему целочисленному ключу при сравнении без знака. Полученный 32-битный ключ упаковывается вместе с индексом исходного узла в одно 64-битное слово, при этом ключ значения занимает старшие биты. Применение atomicMin к этому упакованному представлению, следовательно, выполняет лексикографическое reduction: значения сравниваются в первую очередь, а исходные индексы используются для детерминированного разрешения совпадений. Это позволяет выполнить корректное глобальное min reduction по фрагментам ребер без синхронизации между блоками.
D.2 Слои на основе внимания: слитое внимание CSR для Graph Transformers и GATv2
Для Graph Transformers наши измерения включают полный блок внимания, включающий нормализацию слоя, проекцию QKV и сам механизм внимания.
На протяжении этого раздела обозначает количество узлов, — количество ребер, — количество головок, а — размерность признаков на головку.
Слои GNN на основе внимания (графовые трансформеры и семейство GAT) особенно сложно реализовывать на графических процессорах, потому что прямолинейная реализация передачи сообщений обычно приводит к явному формированию тензоров логитов внимания по ребрам и/или сообщений размера или до того, как они будут редуцированы в узлах назначения. Это промежуточное формирование увеличивает трафик HBM и пиковый объем активаций, а также усиливает накладные расходы на запуск ядер из-за чередования фаз ребро-параллельной (похожей на SDDMM) и узло-параллельной (похожей на SpMM) обработки. Чтобы решить эту проблему, мы проектируем слитые, учитывающие ввод-вывод CUDA-ядра, которые выполняют потоковую обработку соседей в формате CSR и осуществляют вычисление скорей, нормировку softmax и агрегирование значений внутри одного ядра, избегая явного формирования тензоров ребер.
Сведённая прямая передача в CSR (Графовой трансформер).
Мы реализуем слитное ядро Graph Transformer над окрестностями CSR, параметризованное узлом и головкой . Каждому CUDA-блоку назначается одна пара (2D сетка по узлам и головкам), а внутри используется фиксированное число варпов (kWarpsPerBlock=4) для распараллеливания по списку соседей. В начале работы ядра мы совместно подготавливаем в разделяемую память вектор ключей, связанный с узлом назначения (например, k_shared), обеспечивая повторное использование для всех взаимодействий с соседями. Каждый варп выполняет итерации по непересекающемуся разреженному подмножеству соседей и вычисляет оценку внимания с использованием варп-разнесённых загрузок по размерности признаков и редукций на уровне варпа. Промежуточные результаты, полученные разными варпами, объединяются посредством редукции между варпами для получения итогового нормализованного выхода. Как и в ядрах в стиле FlashAttention, мы дополнительно сохраняем logsumexp[i,h] для эффективного обратного прохода.
Слитый прямой проход в CSR (GATv2).
Для GATv2 логит внимания вычисляется как , где — LeakyReLU, а — предварительно вычисляемые для каждой вершины признаки. Мы используем тот же IO-aware шаблон, что и в ядре Graph Transformer: каждый блок обрабатывает одну пару , этапы загружаются в общую память, и выполняется потоковая обработка соседей в порядке CSR. В цикле по соседям потоки совместно вычисляют с использованием векторизованных загрузок float4 и редукций на уровне warp, а затем агрегируют вклады от соседей за один потоковый проход. Мы сохраняем logsumexp[i,h], чтобы избежать материализации весов внимания и поддержать эффективный обратный проход.
Онлайн softmax и объединённая агрегация.
Чтобы не хранить логиты или веса внимания, ядро поддерживает для каждой варпы состояние онлайн softmax в регистрах (max_val, sum_exp) и инкрементально обновляет его для каждого обработанного соседа. Когда текущий максимум меняется, ранее накопленные величины масштабируются на коэффициент коррекции, а накопитель взвешенного значения обновляется в том же потоковом проходе. В частности, каждая варпа хранит в регистрах накопитель выходного значения (полосатые по варпе скаляры по размерности признаков) и выполняет слитное обновление вида , где реализует онлайн rescaling softmax. Такое проектное решение объединяет (i) вычисление оценки, (ii) нормализацию softmax и (iii) агрегацию значения, тем самым устраняя промежуточные логиты и сообщения по ребрам из HBM.
Сквозное объединение warp и нормализация (Graph Transformer).
В прямом ядре Graph Transformer разные warps обрабатывают непересекающиеся подмножества соседей, и каждый warp формирует частичное состояние online-softmax и частичный аккумулятор. Мы сохраняем эти частичные результаты для каждого warp в разделяемой памяти (warp_out, warp_max, warp_sum) и выполняем слияние между warps в warp 0. Слияние сначала вычисляет глобальный максимум по warps, а затем глобально нормализованный знаменатель, переоценивая локальную сумму каждого warp с помощью . Те же масштабные коэффициенты повторно используются для объединения частичных аккумуляторов выходного сигнала до применения окончательной нормализации. Ядро записывает окончательный выход и дополнительно сохраняет статистику per-node log-sum-exp logsumexp[i,h] для использования в обратном проходе. Мы также предоставляем набор специализированных ядер для типичных размерностей головы (D=32,64,128,256) посредством специализации на этапе компиляции, что позволяет выполнять статическую развертку и снижает накладные расходы на управление потоком, при необходимости выполняя откат к варианту runtime-.
Обратный проход: кэширование статистики для уменьшения избыточной работы (Graph Transformer).
В обратном проходе наивная реализация либо сохраняла бы все веса внимания для каждого ребра (чрезвычайно большой объем), либо многократно пересчитывала бы термины нормировки. Следуя тому же принципу, который используется в объединенных ядрах attention, мы кэшируем компактную статистику для каждой вершины в процессе прямого прохода, чтобы снизить накладные расходы обратного прохода. В частности, мы повторно используем сохраненное logsumexp и вычисляем дополнительный скаляр в выделенном ядре с использованием векторизованных загрузок. Основное обратное ядро выполняет итерации по транспонированному графу (CSR⊤), чтобы обрабатывать входящие ребра для каждой исходной вершины , и накапливает градиенты, пересчитывая по сохраненному logsumexp . Градиенты для и в вершине накапливаются локально, тогда как в вершине обновляется посредством атомарных добавлений вдоль входящих ребер, согласуясь с обходом CSR⊤.
Обратный проход: объединённая двухъядерная структура (GATv2).
Для GATv2 мы аналогично повторно используем сохранённый logsumexp, чтобы по требованию пересчитать . Мы выполняем обратное распространение в два слитых ядра: ядро AL, которое вычисляет градиенты по параметрам внимания и левым признакам, а также вычисляет вспомогательную скалярную статистику , и ядро R, которое обрабатывает CSR⊤ для вычисления градиентов по правым признакам. Оба ядра используют буферизацию фрагментов признаков по узлам в общей памяти (и векторизацию float4), чтобы повысить повторное использование внутри варпа при потоковой передаче по рёбрам. Наконец, поскольку градиент вектора внимания накапливается по узлу как , мы выполняем отдельную редукцию по размерности узлов, чтобы получить итоговый градиент ; эта редукция реализована как блочное ядро, которое обрабатывает чанки узлов и тайлы признаков, чтобы сбалансировать параллелизм и эффективность по памяти.
Снижение градиента вектора внимания (GATv2).
Градиент по вектору внимания , накопленный по каждому узлу в ядре AL как тензор , должен быть уменьшен по размерности узлов, чтобы получить итоговый градиент . Мы реализуем это как блочное 2D-редуцирующее ядро, где каждый блок потоков обрабатывает фрагмент узлов (управляется grad_A_reduce_row_chunk_size, обычно 512–2048) и фрагмент признаков размера 32 (один варп) для определенной головы . Потоки совместно загружают тайлы в общую память в транспонированной раскладке, выполняют редукции на уровне варпа по размерности узлов и накапливают промежуточные суммы по нескольким фрагментам узлов в регистрах. Итоговые значения записываются посредством атомарных добавлений, чтобы обрабатывать вклады от различных блоков, обрабатывающих одну и ту же пару , при этом уменьшая параллелизм редукции в обмен на уменьшение конфликтов атомарных операций.
Параметры, перебранные в экспериментах (GATv2 и Graph Transformer).
Мы оцениваем производительность по параметрам модели и ядра, которые напрямую влияют на интенсивность вычислений и поведение памяти. Со стороны модели мы просматриваем и , которые управляют шириной признаков на одну голову и общей шириной признаков, и тем самым масштабируют как арифметическую работу, так и передачу признаков. Для GATv2 мы дополнительно просматриваем размер редукционного чанка, используемого для агрегации градиента attention-vector по узлам, grad_A_reduce_row_chunk_size, что определяет компромисс между параллелизмом редукции, повторным использованием общей памяти и давлением на атомарные обновления на стадии . В этом оценивании мы сохраняем отключенную перестановку графа (graph_reordering_partition_size=), чтобы изолировать поведение на уровне ядра. Все эксперименты проводятся на нескольких реальных графах (GraphLand (Bazhenov et al., 2025) и стандартные наборы тестов), чтобы охватить разнообразные распределения степеней, которые взаимодействуют со стримингом CSR на уровне warp.
Ввод и анализ арифметической интенсивности (базовый вариант против объединённого).
Мы количественно оцениваем влияние слияния, используя IO-ориентированный взгляд, схожий по духу с анализом roofline. Пусть — число узлов, — число ребер, — число голов, а — размерность головы. Мы считаем трафик HBM (глобальные чтения+записи памяти) и используем байт на скаляр (для нашей текущей реализации fp32 ). Мы опускаем трафик индекса для row_ptr/col_idx ради ясности, так как он обычно доминируется считываниями признаков, когда умеренное или большое.
Обычные декомпозиции. Общий базовый подход разлагает внимание на отдельные фазы: (i) вычисление оценок по ребрам (похожее на SDDMM), (ii) построчный softmax по каждой окрестности назначения и (iii) взвешенную агрегацию (похожую на SpMM). Для этого нужно материализовать хотя бы веса внимания по ребрам (а часто также и логиты), что приводит к дополнительному трафику HBM сверх неизбежного чтения признаков. Игнорируя постоянные множители, объем байтов HBM для прямого прохода для такой декомпозиции масштабируется как
| (1) |
где термин учитывает запись и последующее повторное чтение граничных логитов и/или нормализованных весов. В более общей реализации передачи сообщений промежуточные сообщения для ребер размера могут быть материализованы до редукции, что дополнительно увеличивает и трафик, и занимаемый активациями объем до .
Слияная CSR-потоковая передача (наша). Наши ядра объединяют вычисление оценки, нормализацию softmax и агрегацию значений в одном проходе CSR. В прямом ходе каждый блок обрабатывает одну пару и выполняет потоковую передачу по соседям без записи тензоров ребер. Тогда основная нагрузка HBM обусловлена чтением участвующих признаков узлов и записью только итоговых выходов и компактных статистик для каждого узла:
| (2) |
где обозначает logsumexp. Ключевое отличие от Eq. (1) состоит в отсутствии членов материализации ребер или . Для GATv2 мы дополнительно считываем вектор внимания один раз на узел-получатель (пренебрежимо малое по сравнению с чтением ребер, когда графы нетривиальны).
FLOPs и арифметическая интенсивность. И обычные, и слитые варианты выполняют одну и ту же базовую математику (оценка, softmax и взвешенная сумма), поэтому ускорения в первую очередь зависят от ввода-вывода. Для Graph Transformer преобладающие прямые FLOPs на ребро состоят из скалярного произведения ( FLOPs) плюс слитое обновление выходного накопителя ( FLOPs), что дает
| (3) |
где описывает операции с постоянной стоимостью нелинейного характера (exp/max/log). Для GATv2 вычисление оценки требует оценки , что добавляет покомпонентное сложение ( ops), LeakyReLU ( ops) и скалярное произведение с ( ops), наряду со взвешенной агрегацией ( ops), получая
| (4) |
где учитывает активацию LeakyReLU. Устранение материализации граничных данных повышает эффективную арифметическую интенсивность за счет уменьшения в обоих случаях.
Назад: сохранение компактной статистики вместо весов ребер. Обычная реализация обратного прохода часто хранит покомпонентные коэффициенты внимания по ребрам (а иногда и логиты), что приводит к увеличению активационного следа и дополнительному трафику HBM. Наши обратные ядра избегают хранения тензоров ребер, кэшируя только компактную статистику для узла во время прямого прохода и пересчитывая по требованию. Для Graph Transformer мы дополнительно вычисляем и используем , чтобы сформировать градиент softmax без материализации . Для GATv2 мы аналогично кэшируем и вычисляем скаляр на узел для оценки . В результате сохраненные активации для внимания масштабируются как , а не как (или в универсальном обмене сообщениями).
| Method | Edge tensors saved | Node tensors saved | Peak saved size |
|---|---|---|---|
| Generic MP (messages) | – | ||
| Vanilla (edge weights) | (opt.) | ||
| Ours (fused, Graph Transformer) | – | ||
| Ours (fused, GATv2) | – |
D.3 Блочно-разреженные структуры для использования Tensor Core
Хотя объединённые CSR-ядра в §3.2 устраняют материализацию пограничного тензора, они всё равно работают с нерегулярными шаблонами выборки и в основном опираются на скалярные ядра. Чтобы дополнительно задействовать Tensor Cores, мы вводим взвешенное блочно-разрежённое представление, которое упаковывает локальные окрестности в небольшие фиксированного размера тайлы, совместимые с матричным умножением в стиле WMMA. Ключевая идея состоит в том, чтобы обменять предварительную обработку и (иногда) дополнительное вычисление на заполняющих элементах на существенно более высокую интенсивность арифметики и лучшее использование аппаратного обеспечения для матричного умножения.
Формат WSB и построение TCB.
Мы разбиваем узлы назначения на окна строк размера . Для каждого окна строк мы собираем все ребра , чье назначение лежит в этом окне, и строим локальный список уникальных столбцов-источников . Эти столбцы сортируются и разбиваются на Tensor Core Blocks (TCBs) ширины . Каждый TCB хранит: (i) col_idx — глобальные индексы столбцов для этого блока (дополняются нулями, если их меньше ), (ii) компактную битовую карту (два 64-битных слова), кодирующую, какие из ребер существуют, и (iii) (для SpMM) плотный фрагмент весов , хранящийся в порядке строк (веса, дополняются нулями для отсутствующих ребер). Также мы храним tcb_row_offset — массив индексов, который сопоставляет каждому окну строк его смежный диапазон TCBs. Эта предварительная обработка выполняется один раз для каждого графа и амортизируется по итерациям обучения.
Tensor Core SpMM на WSB.
Для сверточных операций на основе SpMM с взвешенной смежностью мы вычисляем с помощью ядра Tensor Core по WSB. Ядро назначает одному экземпляру программы каждое окно строк (16 строк) и накапливает плотный блок выходных данных в fp32. Чтобы сформировать тайл, совместимый с WMMA, мы объединяем две последовательные TCB (каждая ) в матрицу весов . Для каждой пары мы собираем соответствующие столбцы источника (8 из каждой TCB), загружаем блок признаков в fp16 и выполняем обновление матричного умножения Tensor Core:
Эта конструкция обеспечивает высокую плотность вычислений внутри тайла (умножение матриц), сохраняя разреженную структуру закодированной компактно с помощью col_idx и списка TCB для каждого оконного блока по строкам. Мы обнаружили, что дорогостоящая компонента остается сбором (нерегулярные индексы столбцов), но последующее обновление WMMA амортизирует эти затраты, когда достаточно велико или когда окна демонстрируют переиспользуемую структуру столбцов.
Tensor Core attention (Graph Transformer) on WSB.
Мы применяем то же упаковочное решение к Graph Transformer. Для каждого оконного блока строк и для каждого head ядро загружает блок запроса (fp16) и выполняет итерации по парам TCB. Пара TCB предоставляет до столбцов key/value, формируя . Мы вычисляем логиты с помощью Tensor Core matmul:
затем примените поэлементную маску bitmap для TCB, чтобы установить недопустимые ребра в . Мы выполняем softmax в онлайн-режиме в стиле FlashAttention по столбцам для каждой из 16 строк, поддерживая текущую статистику по каждой строке и аккумулятор значений ⟧:
Наконец, мы нормализуем по , чтобы получить , и сохраняем logsumexp для обратного прохода. По сравнению со стримингом CSR, WSB увеличивает повторное использование данных внутри тайла: каждый загруженный вектор ключа участвует в скалярных произведениях со всеми 16 запросами в окне, и каждый запрос участвует в скалярных произведениях с 16 ключами одновременно, что обеспечивает существенно более высокую арифметическую интенсивность внутри каждой пары TCB.
Обратные и практические компромиссы.
Обратное ядро WSB следует тому же принципу кэшированных статистик, что и наш CSR-сведенный обратный проход: оно повторно использует сохраненный logsumexp для восстановления , вычисляет , , , а затем , посредством matmuls на Tensor Core. Однако поскольку одни и те же исходные столбцы могут встречаться в нескольких оконных строках, обновления и требуют атомарного накопления. В нашей реализации SpMM мы наблюдали, что обратный проход на Tensor Core для часто определяется нерегулярными рассеяниями и атомиками; на практике использование высокопроизводительного библиотечного бэкенда (например, cuSPARSE SpMM с предварительно вычисленной транспонированной смежностью) может быть быстрее и надежнее.
Когда WSB помогает?
WSB наиболее эффективен, когда в оконных группах строк наблюдается достаточная локальная плотность и/или повторное использование, так что стоимость сбора исходных столбцов амортизируется за счет плотных вычислений. Если оконные группы крайне разрежены (мало истинных ребер на блок ), подход может расходовать вычисления на замаскированные элементы и увеличивать затраты на предварительную обработку и дополнение, что снижает или устраняет преимущество Tensor Core. Поэтому мы рассматриваем WSB как опциональный путь ускорения и оцениваем его чувствительность к структуре графа, перекосу степеней и порядку.
Перспектива IO/FLOPs для WSB.
В ядре CSR, объединяющем внимание, каждый ребро вносит независимое скалярное произведение между вектором назначения и вектором соседа. Это выявляет ограниченную повторную переработку между ребрами, а вычисления в значительной степени ограничены памятью из-за нерегулярных выборок. В отличие от этого, WSB упаковывает окрестности в плитки , обеспечивая матмулы Tensor Core, которые переиспользуют данные по всей плитке.
Вычисления. Для Graph Transformer одна пара тайлов WSB вычисляет при операциях умножения-суммирования на голову (плюс обновление значения), независимо от того, сколько ребер фактически присутствует (замаскированные элементы позже устанавливаются в ). Пусть обозначает среднюю плотность ребер внутри замаскированного тайла . По сравнению с CSR, который выполняет работу, пропорциональную числу истинных ребер, WSB может увеличить объем вычислений примерно в раза за счет замаскированных вычислений, при этом выигрывая от пропускной способности Tensor Core и повторного использования данных.
Трафик HBM. И CSR, и WSB в конечном итоге должны загружать участвующие признаки узлов. WSB дополнительно сохраняет компактные структурные метаданные (списки столбцов и битмапы) и, для взвешенного SpMM, плотные плитки весов. WSB уменьшает необходимость материализовывать тензоры для каждого ребра и может снизить накладные расходы по индексам для каждого потенциального ребра (битмап вместо явного списка ребер), но при этом может увеличить трафик признаков, когда загружаются заполненные столбцы. В целом WSB следует рассматривать прежде всего как оптимизацию арифметической интенсивности, а не как чистую технику снижения IO..
Затраты на хранение.
Для внимания каждый TCB хранит индексы столбцов (32 байта) и 128-битную битовую карту (16 байт), то есть 48 байт метаданных на каждый блок (охватывая 128 потенциальных ребер). Для взвешенного SpMM каждый TCB дополнительно хранит плотный весовой тайл (128 скаляров). Этот накладной расход амортизируется, когда оконные строки достаточно плотны и переиспользуются между итерациями; в противном случае заполнитель может увеличивать объем памяти по сравнению с CSR.
Ограничения и когда Tensor Cores не помогают.
Путь WSB/TCB меняет нерегулярные разреженные вычисления на плотные матмулы плиточного вида, и его преимущество критически зависит от эффективной плотности каждой плиты. Когда оконные по строкам данные оказываются очень разреженными (малое ), ядро всё равно выполняет плотные и последующие обновления матмулов по многим замаскированным элементам, увеличивая напрасные FLOPs и часто вновь делая производительность ограниченной по памяти или по накладным расходам. Также WSB вводит издержки препроцессинга и выравнивания: построение для каждого оконного блока уникальных списков столбцов, битовых карт и (для взвешенного SpMM) плотных плит весов увеличивает и время преобразования, и объём хранения; это должно быть амортизировано за счёт повторяющихся шагов обучения/вывода. Наконец, обратный проход может быть менее благоприятным, чем прямой: поскольку одни и те же исходные столбцы могут встречаться в нескольких оконных блоках по строкам, обновления / (а для SpMM — ) часто требуют атомарного накопления и нерегулярных разреженных рассылок, которые могут доминировать во времени выполнения и ограничивать достижимое ускорение, несмотря на использование матмулов Tensor Core во внутреннем цикле.
FLOPs и интенсивность арифметических вычислений.
Рассматриваем FLOPs и арифметическую интенсивность в GraphTransformer, который выполняет вычисления на графах в форматах CSR и WSB. Обозначим как число вершин в графе, как число ненулевых элементов в матрице смежности, как размерность встраивания.
CSR. Мы выполняем SpDDMM с запросом и ключом в bfloat и выполняем SpMM в разделяемой памяти. Для каждого ненулевого элемента мы вычисляем скалярное произведение ( FLOPs на ненулевой элемент), вычисляем softmax по размеру строки (2 FLOPs на ненулевой элемент) и выполняем взвешенный SpMM ( FLOPs на ненулевой элемент). Таким образом, суммарные FLOPs можно приблизительно записать как
| (5) |
Во время выполнения ядра мы загружаем каждый элемент матрицы ключей, запросов и значений один раз ( байт) и два INT32 (8 байт) индекса для каждого ненулевого элемента. Это упрощённая модель трафика памяти даёт следующее:
| (6) |
приводя к арифметической интенсивности
| (7) |
Ядра CSR обычно выполняются на скалярных CUDA-ядрах. Таким образом, пиковая производительность ограничивается производительностью CUDA-потоков, поэтому фактические FLOPs
| (8) |
где — пропускная способность памяти.
WSB. Теперь рассмотрим те же вычисления, выполняемые на графе, который хранится в нашем формате WSB. Граф разбит на блоков, и хранятся только ненулевые блоки. Обозначим как среднее число ненулевых элементов в одном блоке WSB (). Также обозначим как число блоков. Для каждого блока в SpDDMM мы выполняем операций с плавающей точкой. В онлайн softmax мы выполняем дополнительные (2 FLOPs на элемент в блоке) операций, а затем выполняем количество операций в weighted SpMM
Выполненное число операций с плавающей запятой — это
| (9) |
Следуя той же логике, как в GraphTransformer на основе CSR, мы загружаем каждый элемент проекций QKV в память один раз для каждого блока: загружаем элементов BF16 и одно слово -бит (16 байт), и один раз сохраняем выход. Поэтому результат следующий:
| (10) |
приводящее к арифметической интенсивности
| (11) |
Ядра WSB могут использовать Tensor Cores; поэтому пиковая производительность ограничена пропускной способностью Tensor Core, и достижимая производительность
| (12) |
где — пропускная способность памяти.
Отметим, что , поэтому верхняя граница производительности ядер на основе формата WSB значительно больше, чем у основанных на CSR..
Замкнутая в явном виде интенсивностная доля и предельные режимы.
Чтобы сделать преимущество по арифметической интенсивности WSB точным, мы выводим выражение в замкнутой форме для отношения . Подставляя в и используя и , мы получаем
| (13) |
С у нас есть , так что знаменатель удовлетворяет . Тогда прямое сравнение числителя и знаменателя показывает, что отношение всегда : WSB имеет арифметическую интенсивность по меньшей мере такую же высокую, как CSR, независимо от размера графа, его плотности или размерности признаков.
Два предельных случая информативны. Когда доминируют ребра (), термины признаков узла исчезают, и отношение стремится к
| (14) |
которые для (полностью плотные тайлы) и больших подходов . Когда доминируют признаки узлов (), члены с edge-index исчезают, и отношение стремится к
| (15) |
где — средняя доля заполнения плиток. Для больших это упрощается до , подтверждая, что более разреженные плитки уменьшают преимущество по интенсивности пропорционально.
Ограничения производительности Roofline.
Сочетая анализ интенсивности с верхними пределами вычислительных возможностей аппаратного обеспечения, достижимая пропускная способность для каждого формата ограничена
| (16) | ||||
| (17) |
где — это пропускная способность HBM, — пиковая скалярная пропускная способность CUDA-core, а — пиковая пропускная способность Tensor Core. Для типичных графов GNN и размеров признаков невелико, а ядро CSR ограничено памятью, поэтому . Более высокая арифметическая интенсивность WSB сдвигает ядро ближе к режиму, ограниченному вычислениями, а его более высокий верхний предел (например, против TFLOPs на A100 для BF16 против FP32 скалярных) означает, что даже частично ограниченное памятью ядро WSB может существенно обойти полностью ограниченное памятью ядро CSR. Преимущество Tensor Core окупается до тех пор, пока , что выполняется для умеренно плотных окон строк на графах со структурой, локально сгруппированной.
D.4 Свёртки на основе SpMM
Многие широко используемые слои GNN (например, агрегирования в стиле GCN и SAGE) можно выразить как умножение разреженной и плотной матриц (SpMM), где — это разреженная матрица смежности (опционально взвешенная и нормализованная), а — плотная матрица признаков. С учетом зрелости и высокой производительности разреженной линейной алгебры у вендоров мы рассматриваем NVIDIA cuSPARSE SpMM как основной бэкенд для этого семейства операторов и сосредотачиваемся на том, чтобы сделать его практичным и эффективным внутри конвейера обучения.
Интеграция cuSPARSE.
Мы представляем в CSR с 32-битными индексами и создаем дескрипторы cuSPARSE для разреженной матрицы и плотных матриц и . cuSPARSE предоставляет несколько вариантов алгоритмов SpMM для CSR (например, CUSPARSE_SPMM_CSR_ALG1/2/3), производительность которых может различаться для разных графов и размерностей признаков. Поэтому мы поддерживаем явный выбор алгоритма или выбор через легковесную процедуру автоматической настройки, которая выполняет бенчмаркинг доступных вариантов и фиксирует лучший выбор для заданного графа.
Нормализация как этап предварительной обработки.
Для поддержки распространённых нормализаций GNN мы реализуем четыре режима: none, left, right и both. Когда включена нормализация и/или предоставлены весовые коэффициенты рёбер, мы предварительно вычисляем степени узлов и строим нормализованный массив значений рёбер, выровненный с индексами CSR. Это создаёт вектор значений рёбер float32, который используется как буфер значений CSR в дескрипторе разрежённой матрицы cuSPARSE. Когда включено кэширование, оба вектора степеней и нормализованные значения рёбер сохраняются и повторно используются при последующих вызовах.
Кэш кэша структуры графа для повторяющихся шагов обучения.
При типичном обучении GNN структура графа фиксирована, тогда как SpMM вызывается многократно в течение эпохи (и между эпохами), что делает однократную предварительную обработку и создание дескрипторов окупаемыми. Мы реализуем кэш графов, индексируемый по указателям CSR (indptr, indices) вместе с режимом нормализации, наличием весов ребер и тем, используется ли разреженная матрица транспонированной. Для каждого кэшированного графа мы храним: (i) дескриптор cuSPARSE CSR матрицы (cusparseSpMatDescr_t), который ссылается на структуру CSR и (возможно) нормализованные значения, (ii) заранее вычисленные векторы степеней и нормализованные значения ребер, (iii) выбранный алгоритм cuSPARSE SpMM и (iv) буфер рабочей области cuSPARSE и его размер. Это позволяет избежать многократного создания дескрипторов и перераспределения рабочей области, а также дает возможность повторно использовать один и тот же cuSPARSE handle и граф-специфичную конфигурацию SpMM при прямых и обратных проходах.
Переработка с повторным использованием в прямом и обратном направлениях.
Для прямого прохода мы вызываем cusparseSpMM либо для , либо для (контролируется do_transpose_a) в зависимости от формулировки слоя. Для обратного прохода ту же кэшированную метадату графа можно использовать повторно: градиенты по отношению к входам соответствуют умножению на транспонированную матрицу смежности, то есть , что эффективно обрабатывается cuSPARSE с использованием той же структуры CSR и кэшированного рабочего пространства. Создавая и кэшируя дескрипторы и рабочее пространство cuSPARSE во время прямого прохода, мы уменьшаем накладные расходы при обратном проходе и обеспечиваем стабильную производительность при повторном использовании одного и того же графа на многих итерациях.
Практические соображения.
Наша реализация использует индексы CSR 32-бит и предполагает непрерывные плотные матрицы признаков. Мы предоставляем (i) выбор алгоритма SpMM (фиксированный или автоматически настроенный), (ii) режим нормализации, (iii) выполняется ли транспонирование и (iv) размер блока CUDA, используемый в ядрах предварительной обработки для степеней и нормализации. Мы также предоставляем утилиту сброса кэша для управления использованием памяти при бенчмаркинге нескольких графов.
Накладные расходы и почему кэширование важно.
На практике для умеренных размеров признаков или меньших графов сквозное время выполнения часто определяется не самим ядром SpMM, а вспомогательными накладными расходами: вычислением степеней и нормализацией весов, многократным построением дескрипторов, запросом размера рабочей области и выделением/освобождением рабочей области. Кэшируя результаты предварительной обработки, зависящие от графа (степени и нормализованные значения), вместе с дескриптором cuSPARSE CSR, выбранным алгоритмом и буфером рабочей области, мы распределяем эти затраты по множественным итерациям обучения. Это превращает вызов SpMM в почти чистый библиотечный вызов и для прямого, и для обратного проходов, делая производительность более стабильной и повышая пропускную способность в реалистичных циклах обучения.
Appendix E Расширенные результаты
В этом разделе мы приводим расширенные измерения для всех конфигураций, оцениваемых в статье.
На нескольких крупных наборах данных с графами (в основном граф веб-трафика при больших размерах модели) базовые реализации DGL не проходят обратный проход из-за ошибок переполнения памяти в плотных проекционных слоях: выходная проекция в GATv2 и проекция QKV в Graph Transformer. Эти сбои происходят до (или независимо от) пользовательских ядер внимания и не позволяют выполнять измерения сквозной задержки/памяти для базовых конфигураций в указанных настройках. Мы помечаем такие записи как OOM и исключаем их из прямых сравнений.
E.1 Перестановка графа
Рисунок 2 демонстрирует эффект перестановки для dot-aggr kernel на всех используемых наборах данных.
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 1.26 | 1.37 | 1.39 | 1.21 | 1.14 | 0.67 | 1.20 | 1.24 | 1.07 | 1.03 | 1.04 | 1.19 |
| avazu-ctr | N/A | 2.68 | 5.59 | N/A | 0.86 | 0.91 | N/A | 2.31 | 1.25 | N/A | 2.00 | 1.55 |
| citeseer | 3.02 | 4.58 | 2.56 | 2.20 | 2.57 | 1.91 | 1.04 | 1.05 | 1.03 | 1.12 | 1.01 | 1.08 |
| city-reviews | N/A | 1.48 | 2.02 | N/A | 0.92 | 0.73 | N/A | 1.23 | 1.07 | N/A | 1.05 | 1.20 |
| city-roads-L | 1.04 | 1.13 | 1.18 | 1.17 | 1.24 | 1.00 | 1.15 | 1.15 | 1.06 | 1.09 | 1.01 | 1.20 |
| city-roads-M | 1.17 | 1.22 | 1.27 | 1.23 | 1.24 | 1.04 | 1.16 | 1.17 | 1.07 | 1.01 | 1.01 | 1.21 |
| cora | 2.97 | 4.53 | 2.61 | 2.11 | 2.50 | 1.95 | 1.06 | 1.07 | 1.03 | 1.16 | 1.01 | 1.09 |
| hm-categories | N/A | 3.66 | 6.91 | N/A | 0.95 | 0.92 | N/A | 2.96 | 1.34 | N/A | 2.62 | 1.73 |
| ogbn-arxiv | 2.50 | 1.53 | 2.16 | 1.21 | 1.60 | 0.62 | 1.17 | 1.19 | 1.06 | 1.11 | 1.02 | 1.20 |
| ogbn-products | N/A | 1.51 | 2.73 | N/A | 1.35 | 0.74 | N/A | 1.43 | 1.05 | N/A | 1.16 | 1.20 |
| pokec-regions | N/A | 1.48 | 1.86 | N/A | 1.23 | 0.63 | N/A | 1.27 | 1.04 | N/A | 1.06 | 1.19 |
| pubmed | 1.80 | 1.67 | 2.07 | 0.94 | 1.32 | 1.02 | 1.09 | 1.13 | 1.04 | 1.20 | 1.01 | 1.14 |
| tolokers-2 | N/A | 2.34 | 3.01 | N/A | 1.04 | 0.62 | N/A | 1.54 | 1.09 | N/A | 1.21 | 1.18 |
| twitch-views | N/A | 2.15 | 3.29 | N/A | 0.98 | 0.55 | N/A | 1.60 | 1.00 | N/A | 1.26 | 1.16 |
| web-traffic | N/A | 1.71 | 2.49 | N/A | 0.78 | 1.73 | N/A | 1.11 | 1.04 | N/A | 1.01 | 1.15 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 1.15 | 1.16 | 1.29 | 1.17 | 1.09 | 0.62 | 1.19 | 1.20 | 1.07 | 1.08 | 1.02 | 1.20 |
| avazu-ctr | N/A | 2.16 | 4.90 | N/A | 0.73 | 0.69 | N/A | 2.14 | 1.38 | N/A | 1.43 | 1.32 |
| citeseer | 2.37 | 2.45 | 2.99 | 1.70 | 1.66 | 1.34 | 1.06 | 1.07 | 1.03 | 1.18 | 1.01 | 1.10 |
| city-reviews | N/A | 1.20 | 1.54 | N/A | 0.89 | 0.69 | N/A | 1.22 | 1.09 | N/A | 1.03 | 1.21 |
| city-roads-L | 1.13 | 1.16 | 1.15 | 1.18 | 1.15 | 1.01 | 1.16 | 1.16 | 1.07 | 1.13 | 1.00 | 1.21 |
| city-roads-M | 1.12 | 1.17 | 1.16 | 1.15 | 1.19 | 1.05 | 1.16 | 1.17 | 1.08 | 1.08 | 1.00 | 1.21 |
| cora | 2.14 | 2.51 | 2.75 | 1.65 | 1.64 | 1.23 | 1.09 | 1.09 | 1.04 | 1.21 | 1.00 | 1.11 |
| hm-categories | N/A | 2.70 | 6.13 | N/A | 0.77 | 0.67 | N/A | 2.65 | 1.46 | N/A | 1.80 | 1.47 |
| ogbn-arxiv | 1.57 | 1.15 | 1.50 | 1.18 | 1.20 | 0.61 | 1.18 | 1.19 | 1.07 | 1.14 | 1.01 | 1.21 |
| ogbn-products | N/A | 1.25 | 2.17 | N/A | 1.17 | 0.55 | N/A | 1.37 | 1.11 | N/A | 1.08 | 1.21 |
| pokec-regions | N/A | 1.20 | 1.51 | N/A | 1.10 | 0.53 | N/A | 1.24 | 1.08 | N/A | 1.03 | 1.20 |
| pubmed | 1.20 | 1.18 | 1.28 | 1.18 | 1.20 | 0.89 | 1.14 | 1.15 | 1.06 | 1.06 | 1.01 | 1.18 |
| tolokers-2 | N/A | 1.75 | 2.50 | N/A | 0.91 | 0.47 | N/A | 1.47 | 1.15 | N/A | 1.11 | 1.18 |
| twitch-views | N/A | 1.57 | 2.57 | N/A | 0.82 | 0.37 | N/A | 1.50 | 1.10 | N/A | 1.13 | 1.19 |
| web-traffic | N/A | 1.24 | 1.60 | N/A | OOM | OOM | N/A | 1.13 | 1.06 | N/A | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 1.24 | 1.23 | 1.45 | 1.23 | 1.21 | 0.77 | 1.20 | 1.26 | 1.10 | 1.03 | 1.04 | 1.20 |
| avazu-ctr | N/A | 2.76 | 5.64 | N/A | 0.92 | 1.21 | N/A | 3.49 | 1.90 | N/A | 2.64 | 2.05 |
| citeseer | 3.79 | 4.57 | 2.71 | 2.20 | 2.48 | 2.09 | 1.04 | 1.05 | 1.03 | 1.12 | 1.01 | 1.08 |
| city-reviews | N/A | 1.52 | 2.13 | N/A | 0.93 | 0.89 | N/A | 1.30 | 1.13 | N/A | 1.06 | 1.21 |
| city-roads-L | 1.05 | 1.11 | 1.29 | 1.15 | 1.22 | 0.88 | 1.16 | 1.16 | 1.07 | 1.09 | 1.01 | 1.20 |
| city-roads-M | 1.15 | 1.06 | 1.25 | 1.21 | 1.29 | 0.93 | 1.17 | 1.18 | 1.08 | 1.01 | 1.01 | 1.21 |
| cora | 3.83 | 4.60 | 2.75 | 2.27 | 2.57 | 2.08 | 1.07 | 1.07 | 1.04 | 1.16 | 1.01 | 1.09 |
| hm-categories | N/A | 3.28 | 6.36 | N/A | 1.01 | 1.18 | N/A | 4.68 | 2.11 | N/A | 3.57 | 2.35 |
| ogbn-arxiv | 2.62 | 1.62 | 2.23 | 1.21 | 1.55 | 0.79 | 1.19 | 1.22 | 1.09 | 1.11 | 1.02 | 1.20 |
| ogbn-products | N/A | 1.46 | 2.48 | N/A | 1.33 | 0.83 | N/A | 1.66 | 1.22 | N/A | 1.19 | 1.23 |
| pokec-regions | N/A | 1.34 | 1.69 | N/A | 1.18 | 0.68 | N/A | 1.36 | 1.11 | N/A | 1.07 | 1.20 |
| pubmed | 1.38 | 1.45 | 1.71 | 0.94 | 1.28 | 1.02 | 1.10 | 1.15 | 1.06 | 1.19 | 1.01 | 1.14 |
| tolokers-2 | N/A | 2.39 | 3.25 | N/A | 1.14 | 0.90 | N/A | 1.88 | 1.33 | N/A | 1.24 | 1.22 |
| twitch-views | N/A | 2.29 | 3.00 | N/A | 0.98 | 0.67 | N/A | 1.97 | 1.23 | N/A | 1.30 | 1.21 |
| web-traffic | N/A | 1.84 | 2.47 | N/A | 0.74 | 2.08 | N/A | 1.12 | 1.05 | N/A | 1.01 | 1.16 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 1.19 | 1.17 | 1.29 | 1.21 | 1.15 | 0.78 | 1.19 | 1.22 | 1.08 | 1.08 | 1.02 | 1.21 |
| avazu-ctr | N/A | 2.46 | 5.03 | N/A | 0.91 | 0.97 | N/A | 2.47 | 1.59 | N/A | 1.75 | 1.62 |
| citeseer | 2.22 | 2.41 | 2.73 | 1.84 | 1.85 | 1.52 | 1.06 | 1.07 | 1.03 | 1.18 | 1.01 | 1.10 |
| city-reviews | N/A | 1.30 | 1.61 | N/A | 1.06 | 0.85 | N/A | 1.24 | 1.10 | N/A | 1.03 | 1.21 |
| city-roads-L | 1.13 | 1.15 | 1.15 | 1.18 | 1.16 | 1.03 | 1.16 | 1.16 | 1.07 | 1.13 | 1.00 | 1.21 |
| city-roads-M | 1.12 | 1.15 | 1.16 | 1.20 | 1.19 | 1.07 | 1.16 | 1.17 | 1.08 | 1.08 | 1.00 | 1.21 |
| cora | 2.22 | 2.57 | 2.72 | 1.83 | 1.85 | 1.55 | 1.09 | 1.09 | 1.04 | 1.21 | 1.00 | 1.11 |
| hm-categories | N/A | 2.91 | 5.88 | N/A | 0.98 | 0.95 | N/A | 3.28 | 1.81 | N/A | 2.35 | 1.92 |
| ogbn-arxiv | 1.62 | 1.27 | 1.56 | 1.19 | 1.24 | 0.77 | 1.18 | 1.19 | 1.08 | 1.14 | 1.01 | 1.21 |
| ogbn-products | N/A | 1.37 | 2.16 | N/A | OOM | OOM | N/A | 1.43 | 1.16 | N/A | OOM | OOM |
| pokec-regions | N/A | 1.25 | 1.50 | N/A | 1.15 | 0.70 | N/A | 1.27 | 1.10 | N/A | 1.04 | 1.21 |
| pubmed | 1.22 | 1.22 | 1.30 | 1.14 | 1.18 | 1.00 | 1.15 | 1.15 | 1.07 | 1.06 | 1.01 | 1.18 |
| tolokers-2 | N/A | 2.00 | 2.69 | N/A | 1.10 | 0.71 | N/A | 1.57 | 1.23 | N/A | 1.13 | 1.20 |
| twitch-views | N/A | 1.87 | 2.54 | N/A | 1.02 | 0.54 | N/A | 1.60 | 1.17 | N/A | 1.15 | 1.21 |
| web-traffic | N/A | 1.35 | 1.66 | N/A | OOM | OOM | N/A | 1.14 | 1.06 | N/A | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 1.23 | 1.21 | 1.52 | 1.17 | 1.07 | 0.89 | 1.22 | 1.31 | 1.14 | 1.03 | 1.05 | 1.21 |
| avazu-ctr | N/A | 3.50 | 5.63 | N/A | 0.89 | 1.72 | N/A | 4.90 | 2.66 | N/A | 3.92 | 3.04 |
| citeseer | 3.78 | 4.48 | 2.72 | 2.25 | 2.33 | 2.20 | 1.04 | 1.05 | 1.03 | 1.12 | 1.01 | 1.08 |
| city-reviews | N/A | 1.63 | 2.24 | N/A | 0.88 | 1.08 | N/A | 1.36 | 1.19 | N/A | 1.07 | 1.23 |
| city-roads-L | 1.02 | 0.93 | 1.30 | 1.07 | 1.09 | 0.86 | 1.16 | 1.17 | 1.08 | 1.09 | 1.01 | 1.20 |
| city-roads-M | 1.10 | 0.93 | 1.32 | 1.13 | 1.11 | 0.93 | 1.17 | 1.18 | 1.09 | 1.01 | 1.01 | 1.21 |
| cora | 3.79 | 4.61 | 2.76 | 2.26 | 2.41 | 2.22 | 1.07 | 1.08 | 1.04 | 1.16 | 1.01 | 1.09 |
| hm-categories | N/A | 3.62 | 6.01 | N/A | 0.95 | 1.69 | N/A | 6.72 | 3.03 | N/A | 5.46 | 3.60 |
| ogbn-arxiv | 2.64 | 1.97 | 2.39 | 1.23 | 1.45 | 0.98 | 1.20 | 1.25 | 1.11 | 1.11 | 1.03 | 1.21 |
| ogbn-products | N/A | 1.75 | 2.51 | N/A | 1.10 | 1.05 | N/A | 1.89 | 1.39 | N/A | 1.33 | 1.38 |
| pokec-regions | N/A | 1.38 | 1.67 | N/A | 0.99 | 0.81 | N/A | 1.45 | 1.19 | N/A | 1.09 | 1.22 |
| pubmed | 1.24 | 1.17 | 1.53 | 0.89 | 1.20 | 1.05 | 1.11 | 1.16 | 1.07 | 1.19 | 1.01 | 1.14 |
| tolokers-2 | N/A | 2.99 | 3.83 | N/A | 1.15 | 1.32 | N/A | 2.31 | 1.64 | N/A | 1.40 | 1.38 |
| twitch-views | N/A | 2.92 | 2.72 | N/A | 0.88 | 0.89 | N/A | 2.42 | 1.51 | N/A | 1.73 | 1.60 |
| web-traffic | N/A | 1.88 | 2.37 | N/A | 0.70 | 2.45 | N/A | 1.13 | 1.07 | N/A | 1.02 | 1.16 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 1.21 | 1.11 | 1.27 | 1.21 | 1.11 | 0.82 | 1.20 | 1.24 | 1.11 | 1.08 | 1.03 | 1.21 |
| avazu-ctr | N/A | 2.43 | 4.77 | N/A | 0.93 | 1.23 | N/A | 3.33 | 2.15 | N/A | 2.46 | 2.28 |
| citeseer | 2.19 | 2.28 | 2.70 | 1.74 | 1.71 | 1.52 | 1.06 | 1.07 | 1.03 | 1.18 | 1.01 | 1.10 |
| city-reviews | N/A | 1.27 | 1.63 | N/A | 1.02 | 0.93 | N/A | 1.27 | 1.14 | N/A | 1.04 | 1.22 |
| city-roads-L | 1.11 | 1.07 | 1.15 | 1.15 | 1.12 | 0.91 | 1.16 | 1.17 | 1.08 | 1.13 | 1.00 | 1.21 |
| city-roads-M | 1.11 | 1.06 | 1.16 | 1.19 | 1.16 | 0.97 | 1.17 | 1.18 | 1.08 | 1.08 | 1.01 | 1.22 |
| cora | 2.24 | 2.50 | 2.76 | 1.79 | 1.76 | 1.58 | 1.09 | 1.10 | 1.04 | 1.21 | 1.01 | 1.11 |
| hm-categories | N/A | 2.66 | 5.31 | N/A | 1.03 | 1.21 | N/A | 4.58 | 2.54 | N/A | 3.45 | 2.82 |
| ogbn-arxiv | 1.70 | 1.32 | 1.62 | 1.21 | 1.21 | 0.87 | 1.19 | 1.21 | 1.10 | 1.14 | 1.02 | 1.21 |
| ogbn-products | N/A | 1.36 | 2.08 | N/A | OOM | OOM | N/A | 1.55 | 1.26 | N/A | OOM | OOM |
| pokec-regions | N/A | 1.19 | 1.43 | N/A | 1.13 | 0.75 | N/A | 1.31 | 1.14 | N/A | 1.05 | 1.22 |
| pubmed | 1.14 | 1.04 | 1.23 | 1.13 | 1.14 | 0.99 | 1.15 | 1.16 | 1.07 | 1.06 | 1.01 | 1.18 |
| tolokers-2 | N/A | 2.06 | 2.81 | N/A | 1.17 | 0.92 | N/A | 1.76 | 1.39 | N/A | 1.17 | 1.24 |
| twitch-views | N/A | 1.86 | 2.31 | N/A | 1.01 | 0.64 | N/A | 1.79 | 1.32 | N/A | 1.20 | 1.26 |
| web-traffic | N/A | 1.33 | 1.61 | N/A | OOM | OOM | N/A | 1.15 | 1.07 | N/A | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 6.61 | 0.72 | 1.81 | 0.64 | 6.27 | 0.60 | 4.73 | 0.70 |
| avazu-ctr | 4.91 | 0.68 | 1.43 | 0.85 | 50.54 | 0.61 | 53.35 | 0.68 |
| citeseer | 6.15 | 1.20 | 2.43 | 1.61 | 1.09 | 0.89 | 1.10 | 0.92 |
| city-reviews | 3.22 | 0.69 | 1.11 | 0.94 | 6.74 | 0.61 | 5.74 | 0.69 |
| city-roads-L | 3.33 | 0.60 | 1.29 | 0.59 | 1.57 | 0.58 | 1.39 | 0.71 |
| city-roads-M | 5.47 | 0.46 | 1.76 | 0.90 | 1.90 | 0.56 | 1.61 | 0.71 |
| cora | 8.52 | 1.72 | 2.26 | 1.68 | 1.22 | 0.84 | 1.30 | 0.91 |
| hm-categories | 7.43 | 0.66 | 1.79 | 0.70 | 66.40 | 0.61 | 72.70 | 0.68 |
| ogbn-arxiv | 2.69 | 1.37 | 1.01 | 1.32 | 3.96 | 0.59 | 3.18 | 0.68 |
| pokec-regions | 5.84 | 0.44 | 1.72 | 0.49 | 11.13 | 0.60 | 8.08 | 0.67 |
| pubmed | 6.03 | 1.25 | 1.81 | 1.41 | 1.80 | 0.67 | 1.84 | 0.78 |
| tolokers-2 | 4.76 | 0.60 | 1.65 | 0.91 | 21.76 | 0.61 | 21.61 | 0.70 |
| twitch-views | 4.65 | 0.77 | 1.29 | 0.93 | 34.56 | 0.61 | 27.95 | 0.68 |
| web-traffic | 2.43 | 2.36 | 0.88 | 6.57 | 1.55 | 0.72 | 1.54 | 0.77 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 5.45 | 0.39 | 2.04 | 0.51 | 6.90 | 0.59 | 5.34 | 0.72 |
| avazu-ctr | 5.87 | 0.43 | 1.47 | 0.51 | 81.35 | 0.61 | 74.38 | 0.68 |
| citeseer | 3.60 | 1.25 | 1.94 | 1.57 | 1.15 | 0.83 | 1.26 | 0.88 |
| city-reviews | 3.81 | 0.54 | 1.19 | 0.67 | 8.64 | 0.60 | 6.59 | 0.69 |
| city-roads-L | 9.70 | 1.54 | 1.71 | 0.62 | 1.77 | 0.54 | 1.51 | 0.72 |
| city-roads-M | 4.67 | 0.62 | 1.73 | 0.65 | 2.10 | 0.54 | 1.92 | 0.76 |
| cora | 6.06 | 1.24 | 2.05 | 1.66 | 1.41 | 0.76 | 1.61 | 0.84 |
| hm-categories | 8.66 | 0.41 | 1.96 | 0.44 | 110.29 | 0.61 | 105.89 | 0.68 |
| ogbn-arxiv | 2.82 | 0.95 | 0.98 | 0.95 | 4.67 | 0.58 | 3.46 | 0.69 |
| pokec-regions | 6.68 | OOM | 2.02 | OOM | 12.74 | OOM | 8.47 | OOM |
| pubmed | 5.75 | 1.01 | 1.71 | 0.87 | 2.26 | 0.62 | 2.56 | 0.79 |
| tolokers-2 | 5.59 | 0.45 | 1.89 | 0.70 | 32.59 | 0.61 | 28.55 | 0.71 |
| twitch-views | 5.32 | 0.57 | 1.30 | 0.67 | 44.17 | 0.61 | 31.71 | 0.68 |
| web-traffic | 2.44 | 1.48 | 0.83 | 3.98 | 1.92 | 0.65 | 1.79 | 0.72 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 4.37 | 0.36 | 1.89 | 0.51 | 8.00 | 0.58 | 5.40 | 0.69 |
| citeseer | 6.26 | 1.32 | 1.91 | 0.84 | 1.28 | 0.74 | 1.44 | 0.83 |
| city-reviews | 3.55 | 0.41 | 1.06 | 0.54 | 10.07 | 0.58 | 7.00 | 0.67 |
| city-roads-L | 2.07 | 0.41 | 1.44 | 0.61 | 1.89 | 0.51 | 1.47 | 0.67 |
| city-roads-M | 7.44 | 1.35 | 1.60 | 0.42 | 2.20 | 0.51 | 1.76 | 0.71 |
| cora | 11.12 | 2.26 | 2.77 | 2.70 | 1.65 | 0.67 | 1.94 | 0.81 |
| ogbn-arxiv | 2.38 | 0.65 | 0.78 | 0.69 | 5.13 | 0.56 | 3.55 | 0.67 |
| pubmed | 4.16 | 0.66 | 1.39 | 0.67 | 2.74 | 0.58 | 2.61 | 0.79 |
| tolokers-2 | 6.65 | 0.40 | 1.56 | 0.52 | 42.98 | 0.60 | 32.84 | 0.69 |
| twitch-views | 5.50 | 0.35 | 1.12 | OOM | 51.03 | 0.60 | 33.94 | OOM |
| web-traffic | 2.14 | OOM | OOM | OOM | 2.38 | OOM | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 3.23 | 0.37 | 1.63 | 0.50 | 8.42 | 0.57 | 5.49 | 0.67 |
| citeseer | 5.50 | 1.27 | 1.56 | 1.24 | 1.49 | 0.67 | 1.66 | 0.79 |
| city-reviews | 2.86 | 0.38 | 1.13 | 0.51 | 11.08 | 0.58 | 7.24 | 0.66 |
| city-roads-L | 1.61 | 0.50 | 1.24 | 0.67 | 1.98 | 0.50 | 1.45 | 0.65 |
| city-roads-M | 1.73 | 0.49 | 1.32 | 0.67 | 2.28 | 0.50 | 1.68 | 0.67 |
| cora | 5.31 | 0.92 | 1.38 | 0.73 | 2.02 | 0.62 | 2.27 | 0.78 |
| ogbn-arxiv | 1.73 | 0.54 | 0.80 | 0.63 | 5.43 | 0.56 | 3.58 | 0.66 |
| pubmed | 2.15 | 0.46 | 1.29 | 0.62 | 3.20 | 0.56 | 2.61 | 0.73 |
| tolokers-2 | 5.77 | 0.35 | 1.79 | 0.45 | 52.21 | 0.60 | 36.43 | 0.69 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 4.81 | 0.46 | 1.77 | 0.52 | 7.54 | 0.59 | 5.82 | 0.72 |
| avazu-ctr | 5.61 | 0.46 | 1.51 | 0.52 | 85.40 | 0.61 | 79.71 | 0.67 |
| citeseer | 6.15 | 1.26 | 2.69 | 1.85 | 1.16 | 0.83 | 1.27 | 0.88 |
| city-reviews | 3.81 | 0.57 | 1.20 | 0.68 | 9.38 | 0.60 | 7.18 | 0.68 |
| city-roads-L | 2.44 | 0.41 | 1.03 | 0.54 | 1.88 | 0.54 | 1.56 | 0.70 |
| city-roads-M | 3.82 | 0.64 | 1.52 | 0.59 | 2.26 | 0.53 | 2.03 | 0.74 |
| cora | 6.10 | 1.23 | 2.46 | 1.78 | 1.43 | 0.76 | 1.63 | 0.84 |
| hm-categories | 7.19 | 0.43 | 1.81 | 0.46 | 115.38 | 0.61 | 113.01 | 0.67 |
| ogbn-arxiv | 3.29 | 1.10 | 1.09 | 0.92 | 5.12 | 0.57 | 3.75 | 0.68 |
| pokec-regions | 5.59 | OOM | 1.68 | OOM | 14.17 | OOM | 9.37 | OOM |
| pubmed | 5.39 | 0.92 | 1.47 | 0.82 | 2.36 | 0.62 | 2.67 | 0.78 |
| tolokers-2 | 6.02 | 0.56 | 1.84 | 0.66 | 34.30 | 0.61 | 30.93 | 0.71 |
| twitch-views | 5.12 | 0.59 | 1.36 | 0.66 | 48.69 | 0.61 | 35.20 | 0.67 |
| web-traffic | 2.61 | 1.48 | 0.92 | 3.99 | 1.98 | 0.65 | 1.84 | 0.71 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 5.18 | 0.37 | 1.91 | 0.45 | 8.62 | 0.58 | 5.91 | 0.68 |
| avazu-ctr | 6.65 | OOM | OOM | OOM | 125.85 | OOM | OOM | OOM |
| citeseer | 6.14 | 1.16 | 2.16 | 1.61 | 1.31 | 0.74 | 1.46 | 0.82 |
| city-reviews | 4.36 | 0.44 | 1.32 | 0.52 | 11.17 | 0.59 | 7.67 | 0.67 |
| city-roads-L | 2.38 | 0.38 | 1.34 | 0.54 | 2.05 | 0.51 | 1.53 | 0.65 |
| city-roads-M | 2.91 | 0.45 | 1.48 | 0.56 | 2.42 | 0.51 | 1.86 | 0.70 |
| cora | 6.14 | 1.24 | 2.01 | 1.67 | 1.68 | 0.67 | 1.95 | 0.80 |
| hm-categories | 8.95 | OOM | OOM | OOM | 176.25 | OOM | OOM | OOM |
| ogbn-arxiv | 2.97 | 0.69 | 0.97 | 0.67 | 5.70 | 0.56 | 3.85 | 0.66 |
| pubmed | 6.25 | 0.88 | 2.01 | 0.65 | 2.93 | 0.58 | 2.77 | 0.78 |
| tolokers-2 | 7.16 | 0.45 | 2.05 | 0.52 | 47.46 | 0.60 | 35.85 | 0.69 |
| twitch-views | 6.06 | 0.38 | 1.49 | OOM | 57.04 | 0.60 | 37.71 | OOM |
| web-traffic | 2.61 | OOM | OOM | OOM | 2.51 | OOM | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 4.61 | 0.36 | 1.75 | 0.47 | 9.33 | 0.57 | 6.03 | 0.67 |
| citeseer | 6.06 | 0.70 | 1.72 | 0.42 | 1.52 | 0.66 | 1.70 | 0.78 |
| city-reviews | 4.48 | 0.37 | 1.27 | 0.49 | 12.42 | 0.58 | 7.98 | 0.66 |
| city-roads-L | 2.05 | 0.42 | 1.30 | 0.57 | 2.17 | 0.49 | 1.51 | 0.63 |
| city-roads-M | 2.17 | 0.41 | 1.39 | 0.59 | 2.51 | 0.50 | 1.76 | 0.66 |
| cora | 10.93 | 2.23 | 1.69 | 1.31 | 2.10 | 0.61 | 2.38 | 0.77 |
| ogbn-arxiv | 2.66 | 0.52 | 0.95 | 0.59 | 6.09 | 0.56 | 3.90 | 0.65 |
| pubmed | 2.93 | 0.42 | 1.39 | 0.57 | 3.47 | 0.55 | 2.77 | 0.72 |
| tolokers-2 | 8.59 | 0.37 | 1.90 | 0.47 | 57.97 | 0.60 | 40.47 | 0.69 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 3.30 | 0.38 | 1.55 | 0.49 | 9.71 | 0.57 | 6.03 | 0.66 |
| citeseer | 3.79 | 1.05 | 1.26 | 0.87 | 1.82 | 0.60 | 1.94 | 0.75 |
| city-reviews | 3.36 | 0.32 | 1.34 | 0.42 | 13.18 | 0.58 | 8.15 | 0.66 |
| city-roads-L | 1.60 | 0.49 | 1.22 | 0.68 | 2.24 | 0.49 | 1.50 | 0.62 |
| city-roads-M | 1.71 | 0.49 | 1.21 | 0.66 | 2.57 | 0.49 | 1.71 | 0.63 |
| cora | 3.80 | 0.70 | 1.15 | 0.88 | 2.57 | 0.58 | 2.70 | 0.76 |
| ogbn-arxiv | 1.99 | 0.47 | 0.99 | 0.58 | 6.30 | 0.55 | 3.92 | 0.65 |
| pubmed | 2.15 | 0.45 | 1.27 | 0.60 | 3.89 | 0.54 | 2.76 | 0.68 |
| tolokers-2 | 7.19 | 0.34 | 2.01 | 0.42 | 65.28 | 0.60 | 42.01 | 0.68 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 4.79 | 0.42 | 1.64 | 0.45 | 9.13 | 0.58 | 6.22 | 0.68 |
| avazu-ctr | 6.14 | OOM | OOM | OOM | 130.84 | OOM | OOM | OOM |
| citeseer | 6.08 | 1.25 | 2.23 | 1.69 | 1.32 | 0.74 | 1.47 | 0.82 |
| city-reviews | 4.21 | 0.47 | 1.30 | 0.54 | 11.80 | 0.59 | 8.11 | 0.66 |
| city-roads-L | 2.22 | 0.37 | 1.74 | 0.76 | 2.14 | 0.50 | 1.56 | 0.64 |
| city-roads-M | 2.70 | 0.40 | 1.24 | 0.48 | 2.55 | 0.51 | 1.92 | 0.69 |
| cora | 5.89 | 1.23 | 1.90 | 1.66 | 1.71 | 0.67 | 1.99 | 0.80 |
| hm-categories | 7.34 | OOM | OOM | OOM | 183.08 | OOM | OOM | OOM |
| ogbn-arxiv | 3.29 | 0.74 | 1.11 | 0.69 | 6.05 | 0.56 | 4.05 | 0.66 |
| pubmed | 3.88 | 0.61 | 1.47 | 0.61 | 3.03 | 0.58 | 2.86 | 0.77 |
| tolokers-2 | 6.47 | 0.48 | 1.94 | 0.54 | 49.03 | 0.60 | 38.02 | 0.69 |
| twitch-views | 5.57 | 0.41 | 1.46 | OOM | 60.66 | 0.60 | 40.19 | OOM |
| web-traffic | 2.57 | OOM | OOM | OOM | 2.58 | OOM | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 5.23 | 0.37 | 1.98 | 0.45 | 9.94 | 0.57 | 6.37 | 0.67 |
| citeseer | 6.11 | 1.25 | 1.97 | 1.47 | 1.55 | 0.66 | 1.72 | 0.78 |
| city-reviews | 5.11 | 0.40 | 1.59 | 0.47 | 13.22 | 0.58 | 8.44 | 0.66 |
| city-roads-L | 2.40 | 0.39 | 1.32 | 0.53 | 2.29 | 0.49 | 1.54 | 0.62 |
| city-roads-M | 2.54 | 0.39 | 1.42 | 0.53 | 2.66 | 0.50 | 1.81 | 0.65 |
| cora | 6.23 | 1.19 | 1.85 | 1.42 | 2.17 | 0.61 | 2.42 | 0.77 |
| ogbn-arxiv | 3.39 | 0.55 | 1.17 | 0.57 | 6.47 | 0.56 | 4.09 | 0.65 |
| pubmed | 5.38 | 0.61 | 1.68 | 0.54 | 3.64 | 0.55 | 2.89 | 0.72 |
| tolokers-2 | 8.23 | 0.40 | 2.37 | 0.48 | 61.85 | 0.60 | 43.06 | 0.69 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 4.73 | 0.36 | 1.83 | 0.47 | 10.38 | 0.57 | 6.37 | 0.66 |
| citeseer | 5.43 | 0.97 | 1.38 | 0.83 | 1.87 | 0.60 | 2.00 | 0.75 |
| city-reviews | 4.96 | 0.31 | 1.48 | 0.40 | 14.09 | 0.58 | 8.62 | 0.66 |
| city-roads-L | 2.01 | 0.42 | 1.34 | 0.58 | 2.37 | 0.48 | 1.53 | 0.61 |
| city-roads-M | 2.19 | 0.42 | 1.38 | 0.59 | 2.72 | 0.49 | 1.76 | 0.62 |
| cora | 5.62 | 1.10 | 1.38 | 0.88 | 2.67 | 0.58 | 2.80 | 0.76 |
| ogbn-arxiv | 3.11 | 0.46 | 1.16 | 0.54 | 6.73 | 0.55 | 4.11 | 0.64 |
| pubmed | 2.91 | 0.40 | 1.47 | 0.55 | 4.10 | 0.54 | 2.85 | 0.67 |
| tolokers-2 | 9.78 | 0.35 | 2.18 | 0.44 | 69.74 | 0.60 | 44.80 | 0.67 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| Ours | PyG | Ours | PyG | Ours | PyG | Ours | PyG | |
| artnet-exp | 3.37 | 0.38 | 1.63 | 0.49 | 10.62 | 0.57 | 6.37 | 0.65 |
| citeseer | 2.34 | 0.65 | 1.26 | 0.74 | 2.21 | 0.56 | 2.07 | 0.76 |
| city-reviews | 3.57 | OOM | OOM | OOM | 14.56 | OOM | OOM | OOM |
| city-roads-L | 1.59 | 0.49 | 1.25 | 0.68 | 2.41 | 0.48 | 1.52 | 0.60 |
| city-roads-M | 1.70 | 0.49 | 1.28 | 0.67 | 2.75 | 0.49 | 1.74 | 0.61 |
| cora | 2.46 | 0.63 | 1.20 | 0.70 | 3.12 | 0.55 | 2.76 | 0.77 |
| ogbn-arxiv | 2.23 | 0.37 | 1.19 | 0.50 | 6.86 | 0.55 | 4.13 | 0.64 |
| pubmed | 2.18 | 0.45 | 1.36 | 0.61 | 4.40 | 0.53 | 2.86 | 0.65 |
| tolokers-2 | 8.51 | 0.28 | 2.28 | 0.34 | 74.59 | 0.60 | 45.63 | 0.67 |
| Dataset | Fwd time | Bwd time | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 7.26 | 11.19 | 0.31 | 2.45 | 5.05 | 0.76 | 10.15 | 1.77 | 1.64 | 1.44 | 0.62 | 1.55 | 0.38 | 0.47 |
| avazu-ctr | 1.45 | 1.52 | 0.18 | 0.01 | 1.57 | 0.10 | 1.29 | 0.74 | 1.24 | 0.25 | 0.01 | 1.01 | 0.09 | 0.18 |
| citeseer | 9.95 | 12.02 | 0.55 | 12.76 | 5.42 | 1.46 | 14.89 | 1.93 | 2.04 | 2.03 | 0.84 | 1.79 | 1.98 | 0.57 |
| city-reviews | 2.61 | 2.67 | 0.25 | 0.26 | 2.35 | 0.31 | 2.42 | 1.38 | 1.36 | 0.49 | 0.19 | 0.52 | 0.22 | 0.32 |
| city-roads-L | 5.89 | 10.14 | 0.41 | 5.42 | 4.51 | 0.89 | 9.73 | 1.61 | 1.76 | 1.57 | 1.11 | 1.59 | 0.62 | 0.70 |
| city-roads-M | 8.22 | 10.73 | 0.27 | 10.14 | 4.65 | 1.26 | 11.41 | 1.74 | 2.09 | 1.97 | 0.97 | 1.63 | 0.91 | 0.64 |
| cora | 10.92 | 12.07 | 0.55 | 11.24 | 4.64 | 1.45 | 12.96 | 1.93 | 2.24 | 2.33 | 0.97 | 2.03 | 2.20 | 0.63 |
| hm-categories | 1.44 | 1.54 | 0.26 | 0.00 | 2.04 | 0.10 | 1.32 | 0.87 | 1.32 | 0.46 | 0.00 | 0.98 | 0.09 | 0.15 |
| ogbn-arxiv | 3.57 | 6.19 | 0.25 | 1.92 | 1.80 | 0.48 | 5.76 | 1.65 | 2.45 | 1.54 | OOM | 1.71 | 0.37 | 0.56 |
| ogbn-products | 1.21 | 1.17 | 0.34 | 0.34 | 2.22 | 0.11 | 1.11 | 0.73 | 1.18 | 0.89 | 0.49 | 1.07 | OOM | 0.28 |
| pokec-regions | 1.36 | 1.36 | 0.40 | 0.51 | 2.44 | 0.15 | 1.21 | 0.92 | 1.26 | 0.99 | 0.76 | 1.16 | 0.17 | 0.34 |
| pubmed | 11.78 | 14.60 | 0.41 | 7.62 | 5.75 | 1.53 | 14.68 | 2.15 | 2.13 | 3.17 | 1.09 | 2.31 | 1.80 | 0.78 |
| tolokers-2 | 6.66 | 7.92 | 0.38 | 0.93 | 1.81 | 0.54 | 6.96 | 0.99 | 1.87 | 0.99 | 0.31 | 1.31 | 0.25 | 0.31 |
| twitch-views | 1.59 | 1.62 | 0.25 | 0.02 | 1.70 | 0.16 | 1.43 | 1.13 | 1.20 | 0.34 | 0.02 | 1.09 | 0.13 | 0.23 |
| web-traffic | 2.31 | 2.52 | 0.08 | 6.55e-05 | 0.32 | 0.20 | 1.88 | 1.74 | 1.37 | 0.08 | 5.15e-04 | 1.11 | 0.55 | 0.44 |
| Dataset | Fwd time | Bwd time | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 6.05 | 6.20 | 0.28 | 1.75 | 4.72 | 0.46 | 6.29 | 1.35 | 1.69 | 1.17 | 0.62 | 1.49 | 0.23 | 0.52 |
| avazu-ctr | 1.40 | 1.41 | 0.14 | 0.01 | 1.61 | 0.05 | 1.33 | 0.50 | 1.20 | 0.16 | 0.01 | 1.02 | 0.04 | 0.21 |
| citeseer | 14.93 | 15.43 | 0.56 | 14.77 | 5.67 | 1.48 | 16.31 | 2.35 | 2.50 | 2.64 | 1.03 | 1.75 | 2.11 | 0.68 |
| city-reviews | 2.56 | 2.58 | 0.25 | 0.24 | 2.12 | 0.19 | 2.26 | 0.91 | 1.30 | 0.32 | 0.23 | 1.19 | 0.14 | 0.37 |
| city-roads-L | 5.38 | 7.96 | 0.43 | 4.20 | 4.05 | 0.62 | 7.67 | 1.32 | 1.65 | 1.41 | 1.09 | 1.48 | 0.41 | 0.76 |
| city-roads-M | 7.36 | 8.45 | 0.28 | 7.85 | 5.40 | 0.94 | 8.36 | 1.28 | 1.85 | 1.74 | 0.98 | 1.63 | 0.54 | 0.65 |
| cora | 11.37 | 14.03 | 0.58 | 12.05 | 6.21 | 1.53 | 13.72 | 1.28 | 2.32 | 2.35 | 1.04 | 1.62 | 2.06 | 0.61 |
| hm-categories | 1.33 | 1.41 | 0.22 | 0.00 | 1.91 | 0.05 | 1.37 | 0.56 | 1.26 | 0.32 | 0.00 | 0.98 | 0.04 | 0.18 |
| ogbn-arxiv | 3.56 | 3.62 | 0.21 | 1.60 | 1.68 | 0.33 | 3.24 | 1.01 | 1.53 | 1.06 | OOM | 1.46 | 0.21 | 0.40 |
| ogbn-products | 1.15 | 1.15 | 0.38 | 0.35 | 1.86 | OOM | 1.06 | 0.53 | 1.12 | 0.73 | 0.57 | 1.09 | OOM | 0.38 |
| pokec-regions | 1.39 | 1.37 | 0.46 | 0.57 | 2.00 | 0.10 | 1.27 | 0.66 | 1.29 | 0.84 | 0.83 | 1.20 | 0.11 | 0.46 |
| pubmed | 11.63 | 14.57 | 0.52 | 6.64 | 5.74 | 1.22 | 12.21 | 1.64 | 2.53 | 2.64 | 1.22 | 2.37 | 1.08 | 0.78 |
| tolokers-2 | 6.33 | 6.32 | 0.36 | 0.81 | 3.38 | 0.35 | 5.83 | 0.93 | 1.75 | 0.48 | 0.26 | 0.67 | 0.13 | 0.33 |
| twitch-views | 1.60 | 1.61 | 0.20 | 0.03 | 1.68 | 0.10 | 1.25 | 0.66 | 1.30 | 0.23 | 0.03 | 1.16 | 0.09 | 0.27 |
| web-traffic | 2.54 | 2.57 | 0.07 | 1.07e-04 | 0.43 | 0.17 | 2.04 | 1.50 | 1.45 | 0.05 | 6.38e-04 | 1.17 | 0.41 | 0.51 |
| Dataset | Fwd time | Bwd time | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 3.88 | 3.98 | 0.28 | 1.67 | 4.09 | 0.27 | 3.69 | 1.17 | 1.55 | 1.46 | 0.82 | 1.40 | 0.17 | 0.63 |
| avazu-ctr | 1.25 | 1.35 | 0.28 | 0.02 | 2.34 | 0.04 | 1.19 | 0.53 | 1.20 | 0.38 | 0.02 | 1.08 | 0.04 | 0.32 |
| citeseer | 13.68 | 16.03 | 0.40 | 14.99 | 6.32 | 1.47 | 16.07 | 2.34 | 2.59 | 2.06 | 1.06 | 2.04 | 2.13 | 0.68 |
| city-reviews | 1.98 | 1.96 | 0.37 | 0.37 | 2.10 | 0.14 | 1.69 | 0.91 | 1.39 | 0.58 | 0.40 | 0.67 | 0.13 | 0.53 |
| city-roads-L | 3.77 | 3.80 | 0.45 | 4.04 | 2.88 | 0.42 | 3.23 | 1.49 | 1.76 | 1.65 | 1.50 | 1.51 | 0.38 | 1.00 |
| city-roads-M | 6.01 | 6.30 | 0.29 | 6.99 | 5.04 | 0.65 | 5.89 | 1.47 | 1.75 | 1.68 | 1.17 | 1.54 | 0.42 | 0.75 |
| cora | 13.35 | 15.66 | 0.54 | 11.83 | 6.26 | 1.46 | 13.51 | 2.20 | 2.53 | 2.29 | 1.06 | 2.11 | 1.98 | 0.55 |
| hm-categories | 1.20 | 1.40 | 0.36 | 0.01 | 2.98 | 0.04 | 1.27 | 0.57 | 1.47 | 0.56 | 0.01 | 1.00 | 0.04 | 0.34 |
| ogbn-arxiv | 2.72 | 2.71 | 0.29 | 2.01 | 1.58 | 0.24 | 2.38 | 0.99 | 3.08 | 1.43 | OOM | 1.43 | 0.19 | 1.06 |
| ogbn-products | 1.13 | 1.14 | 0.63 | 0.68 | 1.93 | OOM | 1.08 | 0.53 | 1.12 | 1.05 | 1.04 | 1.08 | OOM | 0.56 |
| pokec-regions | 1.35 | 1.35 | 0.72 | 1.04 | 2.00 | 0.09 | 1.24 | 0.66 | 1.28 | 1.24 | 1.40 | 1.20 | OOM | 0.66 |
| pubmed | 9.06 | 9.21 | 0.51 | 5.81 | 5.74 | 0.91 | 9.44 | 1.68 | 2.03 | 1.90 | 0.90 | 1.87 | 0.50 | 0.65 |
| tolokers-2 | 3.62 | 3.64 | 0.36 | 0.75 | 2.97 | 0.19 | 3.20 | 0.75 | 1.45 | 0.69 | 0.35 | 0.88 | 0.09 | 0.41 |
| twitch-views | 1.33 | 1.36 | 0.32 | 0.05 | 1.82 | 0.07 | 1.21 | 0.66 | 1.27 | 0.43 | 0.05 | 1.18 | 0.07 | 0.46 |
| web-traffic | 2.49 | 2.49 | 0.18 | 2.08e-04 | 0.63 | 0.14 | 1.96 | 1.05 | 1.54 | 0.11 | 9.21e-04 | 1.27 | 0.26 | 0.64 |
| Dataset | Fwd time | Bwd time | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 2.76 | 2.84 | 0.29 | 1.77 | 3.28 | 0.18 | 2.47 | 1.08 | 1.48 | 1.36 | 1.12 | 1.34 | 0.15 | 0.77 |
| avazu-ctr | 1.22 | 1.22 | 0.30 | 0.03 | 3.22 | OOM | 1.09 | 0.53 | 1.16 | 0.36 | 0.03 | 1.05 | OOM | 0.48 |
| citeseer | 13.20 | 16.50 | 0.56 | 14.45 | 6.02 | 1.48 | 15.27 | 2.38 | 2.55 | 2.59 | 1.06 | 1.81 | 1.53 | 0.69 |
| city-reviews | 1.75 | 1.73 | 0.41 | 0.54 | 2.14 | 0.12 | 1.48 | 0.89 | 1.40 | 0.55 | 0.66 | 1.11 | 0.12 | 0.74 |
| city-roads-L | 3.24 | 3.27 | 0.53 | 4.99 | 2.35 | 0.36 | 2.69 | 1.51 | 1.74 | 1.80 | 1.94 | 1.55 | 0.36 | 1.19 |
| city-roads-M | 4.05 | 4.30 | 0.28 | 6.04 | 3.15 | 0.42 | 3.65 | 1.48 | 1.69 | 1.76 | 1.54 | 1.54 | 0.37 | 0.91 |
| cora | 13.84 | 15.92 | 0.55 | 11.42 | 6.39 | 1.47 | 12.83 | 2.27 | 2.55 | 2.58 | 1.08 | 2.06 | 1.50 | 0.58 |
| hm-categories | 1.19 | 1.22 | 0.39 | 0.01 | 4.24 | OOM | 1.10 | 0.56 | 1.18 | 0.50 | 0.01 | 1.05 | OOM | 0.43 |
| ogbn-arxiv | 2.30 | 2.27 | 0.27 | 2.63 | 1.56 | 0.20 | 1.95 | 0.97 | 1.64 | 1.44 | OOM | 1.41 | 0.18 | 0.86 |
| ogbn-products | 1.14 | 1.14 | 0.78 | 1.20 | 2.02 | OOM | 1.10 | 0.52 | 1.12 | 1.03 | 1.71 | 1.08 | OOM | 0.74 |
| pokec-regions | 1.34 | 1.34 | 0.92 | 1.76 | 1.99 | OOM | 1.23 | 0.66 | 1.28 | 1.20 | 2.05 | 1.20 | OOM | 0.85 |
| pubmed | 6.35 | 6.73 | 0.50 | 5.10 | 5.28 | 0.59 | 6.37 | 1.35 | 1.71 | 1.51 | 0.97 | 1.57 | 0.33 | 0.69 |
| tolokers-2 | 2.33 | 2.46 | 0.35 | 0.71 | 2.59 | 0.11 | 2.19 | 0.65 | 1.32 | 0.58 | 0.50 | 0.79 | 0.07 | 0.50 |
| twitch-views | 1.26 | 1.26 | 0.32 | 0.08 | 1.80 | 0.06 | 1.13 | 0.61 | 1.18 | 0.37 | 0.09 | 1.07 | OOM | 0.62 |
| web-traffic | 2.44 | 2.44 | 0.19 | 4.08e-04 | 0.87 | OOM | 1.92 | 0.94 | 1.60 | 0.09 | 0.00 | 1.35 | OOM | 0.83 |
| Dataset | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 2.05 | 1.95 | 0.04 | 1.97 | 1.17 | 0.03 | 1.43 | 1.41 | 1.37 | 0.05 | 1.39 | 0.97 | 0.04 | 1.06 |
| avazu-ctr | 0.57 | 0.23 | 0.31 | 3.37 | 1.29 | 0.09 | 2.20 | 0.56 | 0.23 | 0.40 | 2.54 | 1.25 | 0.09 | 0.67 |
| citeseer | 0.02 | 0.01 | 0.02 | 1.04 | 1.02 | 0.02 | 1.02 | 0.02 | 0.01 | 0.02 | 1.02 | 1.00 | 0.02 | 1.00 |
| city-reviews | 0.18 | 0.07 | 0.14 | 1.72 | 1.08 | 0.10 | 1.37 | 0.21 | 0.08 | 0.17 | 1.36 | 0.96 | 0.12 | 1.01 |
| city-roads-L | 1.40 | 1.33 | 0.11 | 1.44 | 1.24 | 0.10 | 1.20 | 1.14 | 1.10 | 0.13 | 1.16 | 1.00 | 0.12 | 1.01 |
| city-roads-M | 0.04 | 0.02 | 0.03 | 1.75 | 1.38 | 0.03 | 1.31 | 0.06 | 0.02 | 0.04 | 1.22 | 1.01 | 0.04 | 1.02 |
| cora | 0.01 | 0.00 | 0.01 | 1.11 | 1.05 | 0.01 | 1.06 | 0.01 | 0.00 | 0.01 | 1.06 | 1.00 | 0.01 | 1.01 |
| hm-categories | 0.50 | 0.19 | 0.29 | 3.86 | 1.46 | 0.08 | 2.39 | 0.49 | 0.20 | 0.37 | 2.84 | 1.42 | 0.09 | 0.65 |
| ogbn-arxiv | 0.13 | 0.05 | 0.12 | 1.70 | 1.18 | 0.10 | 1.32 | 0.16 | 0.07 | 0.15 | OOM | 0.97 | 0.12 | 1.04 |
| ogbn-products | 2.28 | 1.36 | 0.73 | 2.54 | 0.92 | 0.13 | 1.76 | 1.72 | 1.20 | 1.02 | 1.84 | 0.90 | OOM | 0.81 |
| pokec-regions | 1.82 | 0.85 | 0.65 | 2.24 | 1.08 | 0.17 | 1.57 | 1.35 | 0.81 | 0.75 | 1.52 | 0.95 | 0.20 | 0.97 |
| pubmed | 0.03 | 0.01 | 0.03 | 1.28 | 1.12 | 0.03 | 1.15 | 0.03 | 0.01 | 0.03 | 1.13 | 1.00 | 0.03 | 1.03 |
| tolokers-2 | 0.03 | 0.01 | 0.03 | 3.31 | 0.97 | 0.02 | 2.06 | 0.03 | 0.01 | 0.03 | 2.26 | 0.96 | 0.02 | 0.73 |
| twitch-views | 0.34 | 0.14 | 0.25 | 3.19 | 0.91 | 0.09 | 2.03 | 0.37 | 0.15 | 0.31 | 2.17 | 0.89 | 0.10 | 0.74 |
| web-traffic | 1.12 | 1.05 | 0.95 | 1.13 | 1.07 | 0.66 | 1.07 | 1.06 | 1.01 | 0.93 | 1.07 | 1.00 | 0.68 | 1.01 |
| Dataset | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 1.96 | 1.90 | 0.06 | 1.98 | 1.29 | 0.05 | 1.39 | 1.32 | 1.30 | 0.08 | 1.31 | 0.98 | 0.06 | 1.03 |
| avazu-ctr | 0.57 | 0.23 | 0.33 | 3.18 | 1.28 | 0.05 | 2.09 | 0.59 | 0.25 | 0.42 | 2.32 | 1.22 | 0.06 | 0.70 |
| citeseer | 0.02 | 0.01 | 0.02 | 1.07 | 1.05 | 0.02 | 1.04 | 0.02 | 0.01 | 0.02 | 1.04 | 1.00 | 0.02 | 1.00 |
| city-reviews | 0.24 | 0.10 | 0.19 | 1.79 | 1.18 | 0.10 | 1.36 | 0.29 | 0.12 | 0.23 | 1.30 | 0.97 | 0.13 | 1.04 |
| city-roads-L | 1.55 | 1.49 | 0.16 | 1.59 | 1.35 | 0.14 | 1.24 | 1.16 | 1.14 | 0.20 | 1.17 | 1.00 | 0.18 | 1.01 |
| city-roads-M | 0.07 | 0.03 | 0.06 | 1.85 | 1.47 | 0.05 | 1.32 | 0.10 | 0.04 | 0.08 | 1.21 | 1.01 | 0.07 | 1.01 |
| cora | 0.01 | 0.00 | 0.01 | 1.17 | 1.10 | 0.01 | 1.09 | 0.01 | 0.00 | 0.01 | 1.08 | 1.00 | 0.01 | 1.01 |
| hm-categories | 0.50 | 0.20 | 0.30 | 3.71 | 1.45 | 0.05 | 2.30 | 0.51 | 0.21 | 0.38 | 2.65 | 1.39 | 0.05 | 0.67 |
| ogbn-arxiv | 0.19 | 0.08 | 0.18 | 1.79 | 1.29 | 0.12 | 1.33 | 0.24 | 0.10 | 0.22 | OOM | 0.98 | 0.16 | 1.02 |
| ogbn-products | 2.02 | 1.37 | 0.88 | 2.40 | 1.01 | OOM | 1.65 | 1.55 | 1.20 | 1.06 | 1.62 | 0.92 | OOM | 0.91 |
| pokec-regions | 1.78 | 1.02 | 0.89 | 2.16 | 1.20 | 0.14 | 1.49 | 1.29 | 0.92 | 0.87 | 1.39 | 0.97 | 0.17 | 1.06 |
| pubmed | 0.03 | 0.01 | 0.03 | 1.40 | 1.22 | 0.03 | 1.19 | 0.04 | 0.02 | 0.04 | 1.15 | 1.00 | 0.04 | 1.02 |
| tolokers-2 | 0.03 | 0.01 | 0.03 | 2.97 | 1.02 | 0.02 | 1.86 | 0.04 | 0.01 | 0.04 | 1.95 | 0.98 | 0.03 | 0.82 |
| twitch-views | 0.38 | 0.16 | 0.29 | 2.88 | 0.96 | 0.06 | 1.84 | 0.43 | 0.19 | 0.37 | 1.87 | 0.92 | 0.07 | 0.83 |
| web-traffic | 1.19 | 1.13 | 1.03 | 1.21 | 1.12 | 0.57 | 1.10 | 1.09 | 1.04 | 0.97 | 1.09 | 1.00 | 0.60 | 1.01 |
| Dataset | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 1.98 | 1.94 | 0.10 | 1.99 | 1.41 | 0.07 | 1.37 | 1.26 | 1.25 | 0.13 | 1.26 | 0.99 | 0.09 | 1.02 |
| avazu-ctr | 0.60 | 0.25 | 0.35 | 2.93 | 1.28 | 0.03 | 1.93 | 0.63 | 0.28 | 0.46 | 2.07 | 1.19 | 0.03 | 0.76 |
| citeseer | 0.03 | 0.01 | 0.03 | 1.13 | 1.09 | 0.03 | 1.06 | 0.03 | 0.01 | 0.03 | 1.06 | 1.00 | 0.03 | 1.00 |
| city-reviews | 0.36 | 0.15 | 0.29 | 1.86 | 1.31 | 0.11 | 1.35 | 0.41 | 0.19 | 0.34 | 1.26 | 0.98 | 0.14 | 1.03 |
| city-roads-L | 1.70 | 1.66 | 0.25 | 1.73 | 1.44 | 0.19 | 1.28 | 1.18 | 1.16 | 0.31 | 1.19 | 1.00 | 0.25 | 1.00 |
| city-roads-M | 0.13 | 0.05 | 0.10 | 1.91 | 1.52 | 0.09 | 1.33 | 0.17 | 0.07 | 0.14 | 1.21 | 1.00 | 0.12 | 1.01 |
| cora | 0.01 | 0.00 | 0.01 | 1.28 | 1.18 | 0.01 | 1.13 | 0.01 | 0.01 | 0.01 | 1.11 | 1.00 | 0.01 | 1.00 |
| hm-categories | 0.51 | 0.21 | 0.32 | 3.42 | 1.43 | 0.03 | 2.14 | 0.54 | 0.22 | 0.41 | 2.36 | 1.33 | 0.03 | 0.71 |
| ogbn-arxiv | 0.31 | 0.13 | 0.29 | 1.87 | 1.41 | 0.15 | 1.33 | 0.36 | 0.17 | 0.35 | OOM | 0.99 | 0.20 | 1.01 |
| ogbn-products | 2.01 | 1.51 | 1.14 | 2.27 | 1.14 | OOM | 1.54 | 1.41 | 1.20 | 1.10 | 1.45 | 0.95 | OOM | 1.05 |
| pokec-regions | 1.86 | 1.26 | 1.14 | 2.09 | 1.33 | 0.12 | 1.42 | 1.25 | 1.02 | 0.98 | 1.30 | 0.98 | OOM | 1.03 |
| pubmed | 0.05 | 0.02 | 0.05 | 1.55 | 1.31 | 0.05 | 1.23 | 0.07 | 0.03 | 0.07 | 1.17 | 1.00 | 0.06 | 1.01 |
| tolokers-2 | 0.04 | 0.02 | 0.04 | 2.63 | 1.13 | 0.02 | 1.69 | 0.05 | 0.02 | 0.05 | 1.63 | 0.98 | 0.03 | 0.94 |
| twitch-views | 0.48 | 0.21 | 0.38 | 2.59 | 1.07 | 0.04 | 1.68 | 0.53 | 0.25 | 0.46 | 1.61 | 0.94 | 0.06 | 0.95 |
| web-traffic | 1.31 | 1.25 | 1.16 | 1.33 | 1.20 | 0.48 | 1.15 | 1.12 | 1.08 | 1.02 | 1.12 | 1.00 | 0.53 | 1.01 |
| Dataset | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 1.99 | 1.97 | 0.17 | 1.99 | 1.48 | 0.09 | 1.35 | 1.23 | 1.23 | 0.22 | 1.23 | 0.99 | 0.12 | 1.01 |
| avazu-ctr | 0.67 | 0.29 | 0.41 | 2.68 | 1.31 | OOM | 1.77 | 0.70 | 0.33 | 0.53 | 1.79 | 1.14 | OOM | 0.85 |
| citeseer | 0.03 | 0.01 | 0.03 | 1.23 | 1.16 | 0.03 | 1.10 | 0.04 | 0.01 | 0.04 | 1.09 | 1.00 | 0.04 | 1.00 |
| city-reviews | 0.54 | 0.24 | 0.44 | 1.92 | 1.41 | 0.11 | 1.34 | 0.58 | 0.30 | 0.50 | 1.23 | 0.99 | 0.15 | 1.01 |
| city-roads-L | 1.82 | 1.80 | 0.41 | 1.84 | 1.51 | 0.27 | 1.30 | 1.19 | 1.18 | 0.47 | 1.19 | 1.00 | 0.35 | 1.00 |
| city-roads-M | 0.23 | 0.09 | 0.18 | 1.95 | 1.56 | 0.14 | 1.33 | 0.29 | 0.12 | 0.24 | 1.20 | 1.00 | 0.20 | 1.00 |
| cora | 0.02 | 0.01 | 0.02 | 1.43 | 1.27 | 0.02 | 1.18 | 0.02 | 0.01 | 0.02 | 1.14 | 1.00 | 0.02 | 1.00 |
| hm-categories | 0.55 | 0.23 | 0.35 | 3.04 | 1.41 | OOM | 1.93 | 0.60 | 0.26 | 0.46 | 2.04 | 1.26 | OOM | 0.78 |
| ogbn-arxiv | 0.49 | 0.23 | 0.47 | 1.93 | 1.49 | 0.18 | 1.33 | 0.54 | 0.29 | 0.52 | OOM | 0.99 | 0.24 | 1.01 |
| ogbn-products | 2.01 | 1.66 | 1.43 | 2.16 | 1.27 | OOM | 1.46 | 1.32 | 1.20 | 1.14 | 1.34 | 0.97 | OOM | 1.04 |
| pokec-regions | 1.92 | 1.50 | 1.40 | 2.05 | 1.44 | OOM | 1.38 | 1.23 | 1.09 | 1.07 | 1.25 | 0.99 | OOM | 1.02 |
| pubmed | 0.08 | 0.03 | 0.08 | 1.69 | 1.40 | 0.07 | 1.26 | 0.11 | 0.04 | 0.11 | 1.18 | 1.00 | 0.09 | 1.00 |
| tolokers-2 | 0.06 | 0.02 | 0.06 | 2.39 | 1.24 | 0.02 | 1.56 | 0.08 | 0.03 | 0.08 | 1.45 | 0.98 | 0.03 | 1.07 |
| twitch-views | 0.64 | 0.30 | 0.54 | 2.36 | 1.20 | 0.03 | 1.55 | 0.66 | 0.35 | 0.60 | 1.43 | 0.96 | OOM | 1.06 |
| web-traffic | 1.47 | 1.42 | 1.33 | 1.48 | 1.31 | OOM | 1.20 | 1.14 | 1.12 | 1.08 | 1.15 | 1.00 | OOM | 1.00 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| cuGraph | Ours | cuGraph | Ours | cuGraph | Ours | cuGraph | Ours | |
| artnet-exp | 0.96 | 2.56 | 0.79 | 1.64 | 1.16 | 1.67 | 1.11 | 1.41 |
| avazu-ctr | 0.54 | 7.71 | 0.84 | 1.25 | 0.93 | 2.81 | 0.94 | 2.53 |
| citeseer | 0.07 | 4.43 | 0.91 | 1.75 | 1.02 | 1.04 | 1.02 | 1.04 |
| city-reviews | 0.56 | 5.59 | 1.17 | 1.44 | 1.11 | 1.55 | 1.08 | 1.38 |
| city-roads-L | 1.43 | 2.18 | 1.15 | 1.58 | 1.16 | 1.38 | 1.12 | 1.26 |
| city-roads-M | 1.25 | 2.96 | 0.76 | 2.26 | 1.23 | 1.58 | 1.14 | 1.34 |
| cora | 1.46 | 4.20 | 0.65 | 1.61 | 1.04 | 1.10 | 1.04 | 1.09 |
| hm-categories | 0.51 | 5.07 | 0.97 | 1.38 | 0.92 | 3.32 | 0.92 | 3.00 |
| ogbn-arxiv | 4.31 | 9.35 | 1.78 | 2.60 | 1.16 | 1.55 | 1.12 | 1.35 |
| ogbn-products | 0.67 | 2.84 | 1.11 | 1.41 | 1.04 | 2.12 | 1.03 | 1.76 |
| pokec-regions | 0.80 | 3.40 | 1.14 | 1.68 | 1.13 | 1.88 | 1.09 | 1.53 |
| pubmed | 2.00 | 4.87 | 0.59 | 2.31 | 1.11 | 1.25 | 1.07 | 1.19 |
| tolokers-2 | 0.60 | 3.67 | 0.84 | 1.70 | 0.99 | 2.71 | 0.98 | 2.10 |
| twitch-views | 0.55 | 7.00 | 1.01 | 1.39 | 1.00 | 2.62 | 1.00 | 2.07 |
| web-traffic | 0.12 | 16.85 | 2.99 | 1.26 | 1.05 | 1.12 | 1.05 | 1.11 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| cuGraph | Ours | cuGraph | Ours | cuGraph | Ours | cuGraph | Ours | |
| artnet-exp | 1.25 | 2.46 | 0.98 | 1.57 | 1.21 | 1.71 | 1.14 | 1.40 |
| avazu-ctr | 0.61 | 6.03 | 0.39 | 1.32 | 0.96 | 2.63 | 0.97 | 2.24 |
| citeseer | 1.54 | 4.37 | 0.68 | 1.89 | 1.04 | 1.07 | 1.03 | 1.07 |
| city-reviews | 0.66 | 5.06 | 1.12 | 1.46 | 1.17 | 1.61 | 1.12 | 1.38 |
| city-roads-L | 2.36 | 2.63 | 1.30 | 1.58 | 1.21 | 1.49 | 1.14 | 1.30 |
| city-roads-M | 0.23 | 2.31 | 1.00 | 1.54 | 1.26 | 1.65 | 1.16 | 1.36 |
| cora | 1.51 | 4.28 | 0.85 | 1.90 | 1.08 | 1.17 | 1.07 | 1.14 |
| hm-categories | 0.55 | 4.06 | 1.03 | 2.09 | 0.94 | 3.13 | 0.94 | 2.68 |
| ogbn-arxiv | 4.79 | 8.58 | 1.70 | 2.41 | 1.22 | 1.62 | 1.14 | 1.36 |
| ogbn-products | 1.07 | 2.70 | 1.08 | 1.41 | 1.10 | 2.00 | 1.08 | 1.61 |
| pokec-regions | 1.40 | 2.95 | 1.17 | 1.49 | 1.19 | 1.83 | 1.13 | 1.46 |
| pubmed | 1.29 | 2.86 | 0.88 | 1.69 | 1.15 | 1.35 | 1.11 | 1.24 |
| tolokers-2 | 0.75 | 3.45 | 0.66 | 1.75 | 1.06 | 2.39 | 1.04 | 1.85 |
| twitch-views | 0.68 | 5.55 | 1.09 | 1.39 | 1.06 | 2.34 | 1.05 | 1.80 |
| web-traffic | 0.13 | 12.87 | 2.54 | 1.42 | 1.09 | 1.20 | 1.07 | 1.16 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| cuGraph | Ours | cuGraph | Ours | cuGraph | Ours | cuGraph | Ours | |
| artnet-exp | 1.32 | 2.85 | 1.08 | 1.53 | 1.26 | 1.71 | 1.16 | 1.38 |
| avazu-ctr | 0.34 | 4.32 | 0.97 | 1.33 | 1.01 | 2.43 | 1.01 | 1.97 |
| citeseer | 1.48 | 4.29 | 0.88 | 2.03 | 1.07 | 1.13 | 1.06 | 1.11 |
| city-reviews | 0.41 | 4.34 | 1.20 | 1.45 | 1.22 | 1.66 | 1.14 | 1.38 |
| city-roads-L | 3.13 | 3.58 | 1.34 | 1.61 | 1.25 | 1.60 | 1.16 | 1.33 |
| city-roads-M | 2.16 | 3.04 | 1.00 | 1.60 | 1.29 | 1.70 | 1.17 | 1.37 |
| cora | 1.26 | 4.10 | 0.82 | 2.02 | 1.13 | 1.27 | 1.10 | 1.20 |
| hm-categories | 0.48 | 2.73 | 1.10 | 1.42 | 0.98 | 2.83 | 0.98 | 2.28 |
| ogbn-arxiv | 3.69 | 6.37 | 1.82 | 2.54 | 1.26 | 1.67 | 1.16 | 1.37 |
| ogbn-products | 1.07 | 2.48 | 1.09 | 1.41 | 1.17 | 1.90 | 1.11 | 1.50 |
| pokec-regions | 1.43 | 2.80 | 1.16 | 1.47 | 1.24 | 1.79 | 1.15 | 1.42 |
| pubmed | 1.12 | 2.97 | 0.93 | 1.48 | 1.20 | 1.46 | 1.14 | 1.28 |
| tolokers-2 | 0.57 | 2.57 | 0.87 | 1.75 | 1.13 | 2.10 | 1.09 | 1.62 |
| twitch-views | 0.48 | 3.62 | 1.09 | 1.38 | 1.14 | 2.10 | 1.09 | 1.61 |
| web-traffic | 0.09 | 10.93 | 2.33 | 1.35 | 1.14 | 1.31 | 1.10 | 1.22 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||
|---|---|---|---|---|---|---|---|---|
| cuGraph | Ours | cuGraph | Ours | cuGraph | Ours | cuGraph | Ours | |
| artnet-exp | 1.34 | 2.96 | 1.19 | 1.51 | 1.28 | 1.74 | 1.17 | 1.38 |
| avazu-ctr | 0.28 | 3.23 | 1.10 | 1.38 | 1.07 | 2.21 | 1.06 | 1.74 |
| citeseer | 1.17 | 3.94 | 0.98 | 1.77 | 1.12 | 1.22 | 1.09 | 1.16 |
| city-reviews | 0.43 | 3.50 | 1.18 | 1.49 | 1.26 | 1.70 | 1.16 | 1.38 |
| city-roads-L | 3.50 | 4.14 | 1.38 | 1.63 | 1.28 | 1.66 | 1.17 | 1.35 |
| city-roads-M | 2.78 | 3.73 | 1.00 | 1.63 | 1.30 | 1.72 | 1.17 | 1.37 |
| cora | 0.96 | 3.87 | 0.85 | 1.83 | 1.18 | 1.40 | 1.13 | 1.26 |
| hm-categories | 0.36 | 2.41 | 1.18 | 1.51 | 1.03 | 2.51 | 1.02 | 1.95 |
| ogbn-arxiv | 2.87 | 4.84 | 1.45 | 2.09 | 1.28 | 1.71 | 1.17 | 1.37 |
| ogbn-products | 1.05 | 2.48 | 1.09 | 1.39 | 1.23 | 1.83 | 1.14 | 1.44 |
| pokec-regions | 1.42 | 2.59 | 1.14 | 1.41 | 1.27 | 1.77 | 1.16 | 1.40 |
| pubmed | 1.19 | 2.93 | 1.07 | 1.50 | 1.24 | 1.58 | 1.15 | 1.33 |
| tolokers-2 | 0.44 | 2.54 | 0.87 | 1.32 | 1.19 | 1.97 | 1.12 | 1.51 |
| twitch-views | 0.35 | 2.69 | 1.10 | 1.32 | 1.20 | 1.95 | 1.13 | 1.50 |
| web-traffic | 0.06 | 8.31 | 2.17 | 1.52 | 1.19 | 1.43 | 1.13 | 1.28 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 2.71 | 2.15 | 2.01 | 1.98 | 5.51 | 4.62 | 4.96 | 8.30 | 404.91 | 339.57 | 328.75 | 378.50 | 767.08 | 746.43 | 741.92 | 643.47 |
| avazu-ctr | 54.92 | N/A | 22.10 | 10.62 | 78.56 | N/A | 91.98 | 86.73 | 1644.74 | N/A | 710.89 | 1311.04 | 2614.23 | N/A | 1308.05 | 1684.20 |
| citeseer | 1.22 | 0.40 | 0.27 | 0.48 | 1.31 | 0.60 | 0.51 | 0.70 | 87.75 | 84.77 | 83.69 | 85.78 | 125.10 | 112.28 | 124.19 | 116.54 |
| city-reviews | 11.38 | N/A | 7.73 | 6.10 | 19.60 | N/A | 21.55 | 26.89 | 1263.54 | N/A | 1030.37 | 1183.51 | 2303.21 | N/A | 2196.43 | 1911.58 |
| city-roads-L | 5.18 | 4.97 | 4.58 | 4.40 | 10.90 | 9.47 | 8.93 | 11.04 | 1118.33 | 974.71 | 970.44 | 1052.42 | 2095.34 | 1917.25 | 2082.58 | 1747.78 |
| city-roads-M | 2.23 | 1.92 | 1.93 | 1.85 | 4.74 | 4.10 | 4.06 | 4.85 | 429.67 | 372.99 | 369.36 | 402.45 | 822.59 | 817.73 | 815.99 | 681.88 |
| cora | 1.22 | 0.42 | 0.27 | 0.47 | 1.29 | 0.61 | 0.52 | 0.69 | 50.99 | 48.03 | 47.86 | 49.58 | 81.95 | 70.39 | 81.36 | 75.14 |
| hm-categories | 53.47 | N/A | 15.08 | 8.00 | 69.66 | N/A | 73.45 | 76.12 | 1416.12 | N/A | 477.68 | 1060.52 | 2254.51 | N/A | 861.60 | 1306.97 |
| ogbn-arxiv | 14.66 | 6.01 | 9.60 | 7.32 | 20.43 | 17.15 | 13.01 | 33.27 | 1317.56 | 1131.22 | 1109.60 | 1244.17 | 2489.21 | 2236.22 | 2435.84 | 2072.42 |
| ogbn-products | 259.88 | N/A | 210.58 | 116.01 | 491.59 | N/A | 458.58 | 839.18 | 23420.77 | N/A | 16337.11 | 22245.57 | 41127.10 | N/A | 35472.38 | 34204.84 |
| pokec-regions | 107.05 | N/A | 78.40 | 62.12 | 205.48 | N/A | 178.55 | 349.89 | 12971.79 | N/A | 10227.77 | 12479.97 | 24381.13 | N/A | 22985.20 | 20453.79 |
| pubmed | 1.29 | 0.86 | 0.82 | 0.77 | 2.32 | 2.48 | 1.85 | 2.29 | 194.21 | 177.88 | 171.55 | 185.92 | 402.54 | 336.77 | 398.31 | 353.31 |
| tolokers-2 | 3.01 | N/A | 1.33 | 1.02 | 4.93 | N/A | 5.07 | 8.44 | 146.06 | N/A | 95.11 | 133.67 | 281.98 | N/A | 235.51 | 239.63 |
| twitch-views | 51.41 | N/A | 23.94 | 15.60 | 79.14 | N/A | 81.25 | 145.35 | 1809.94 | N/A | 1128.59 | 1810.49 | 3065.38 | N/A | 2442.73 | 2632.12 |
| web-traffic | 253.29 | N/A | 164.41 | 112.52 | 831.95 | N/A | 1195.89 | 538.99 | 33450.46 | N/A | 30169.03 | 32083.52 | 53330.01 | N/A | 52750.73 | 46197.45 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 6.91 | 6.00 | 5.97 | 5.35 | 14.87 | 12.78 | 13.71 | 23.83 | 759.77 | 640.63 | 631.56 | 708.06 | 1448.28 | 1343.33 | 1422.83 | 1203.96 |
| avazu-ctr | 80.17 | N/A | 39.38 | 17.35 | 134.29 | N/A | 188.49 | 198.07 | 2483.80 | N/A | 1159.48 | 1798.18 | 3361.54 | N/A | 2354.93 | 2546.00 |
| citeseer | 1.22 | 0.57 | 0.50 | 0.45 | 1.77 | 1.08 | 1.10 | 1.37 | 112.42 | 106.08 | 105.44 | 109.15 | 190.59 | 162.58 | 190.29 | 173.66 |
| city-reviews | 24.64 | N/A | 20.71 | 16.10 | 48.64 | N/A | 55.58 | 72.28 | 2317.01 | N/A | 1902.74 | 2130.45 | 4336.73 | N/A | 4230.88 | 3586.71 |
| city-roads-L | 15.66 | 13.93 | 13.57 | 13.72 | 34.30 | 29.84 | 30.38 | 34.57 | 2099.96 | 1811.42 | 1807.59 | 1957.42 | 4046.93 | 3591.43 | 4034.44 | 3350.27 |
| city-roads-M | 6.47 | 5.77 | 5.58 | 5.59 | 14.16 | 12.47 | 12.53 | 14.26 | 827.23 | 711.24 | 707.61 | 766.99 | 1611.63 | 1495.25 | 1604.50 | 1327.35 |
| cora | 1.21 | 0.58 | 0.48 | 0.44 | 1.67 | 1.02 | 1.03 | 1.39 | 71.83 | 66.27 | 65.98 | 69.14 | 136.56 | 112.76 | 135.98 | 123.31 |
| hm-categories | 77.68 | N/A | 29.31 | 12.91 | 122.26 | N/A | 158.54 | 182.23 | 1990.48 | N/A | 751.71 | 1358.87 | 2667.72 | N/A | 1482.26 | 1816.59 |
| ogbn-arxiv | 27.76 | 17.86 | 24.37 | 18.61 | 49.63 | 42.85 | 42.01 | 83.40 | 2494.61 | 2121.96 | 2102.29 | 2322.42 | 4803.95 | 4218.45 | 4751.80 | 3979.92 |
| ogbn-products | 554.70 | N/A | 536.49 | 308.39 | 1197.22 | N/A | 1232.62 | 2622.15 | 42072.62 | N/A | 30690.47 | 37795.69 | 74618.41 | N/A | 68962.74 | 61715.95 |
| pokec-regions | 258.07 | N/A | 227.46 | 182.06 | 570.44 | N/A | 544.81 | 1134.51 | 24620.00 | N/A | 19800.56 | 22847.51 | 46717.36 | N/A | 45320.64 | 38797.58 |
| pubmed | 2.53 | 2.26 | 2.32 | 2.07 | 5.39 | 4.90 | 4.84 | 6.07 | 332.99 | 291.19 | 289.81 | 313.80 | 639.33 | 605.24 | 635.35 | 543.34 |
| tolokers-2 | 4.79 | N/A | 2.74 | 1.99 | 8.86 | N/A | 10.12 | 19.44 | 244.62 | N/A | 166.26 | 212.10 | 465.53 | N/A | 418.35 | 395.01 |
| twitch-views | 79.76 | N/A | 50.84 | 31.07 | 142.10 | N/A | 172.83 | 386.92 | 3171.29 | N/A | 2117.02 | 2881.58 | 5369.96 | N/A | 4748.28 | 4527.29 |
| web-traffic | 475.79 | N/A | 402.89 | 313.91 | OOM | N/A | OOM | OOM | 53433.19 | N/A | 47109.51 | 50432.36 | OOM | N/A | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 2.94 | 2.37 | 2.39 | 2.03 | 5.72 | 4.64 | 4.83 | 7.49 | 422.41 | 351.98 | 334.80 | 385.90 | 771.36 | 750.70 | 742.31 | 643.86 |
| avazu-ctr | 64.95 | N/A | 24.92 | 12.22 | 88.56 | N/A | 100.11 | 73.38 | 2486.44 | N/A | 711.49 | 1311.63 | 3455.62 | N/A | 1308.65 | 1684.79 |
| citeseer | 1.22 | 0.32 | 0.27 | 0.45 | 1.30 | 0.60 | 0.54 | 0.63 | 88.06 | 84.84 | 84.22 | 85.81 | 125.17 | 112.35 | 124.72 | 116.56 |
| city-reviews | 13.22 | N/A | 8.68 | 6.20 | 20.87 | N/A | 22.65 | 23.72 | 1335.81 | N/A | 1031.50 | 1185.17 | 2320.99 | N/A | 2197.57 | 1913.23 |
| city-roads-L | 5.33 | 5.09 | 4.83 | 4.15 | 11.01 | 9.67 | 9.17 | 12.55 | 1128.42 | 976.83 | 971.92 | 1053.36 | 2097.38 | 1919.38 | 2084.06 | 1748.72 |
| city-roads-M | 2.29 | 2.01 | 2.17 | 1.84 | 4.78 | 4.19 | 3.95 | 5.19 | 436.02 | 373.83 | 371.11 | 402.88 | 826.74 | 818.57 | 819.60 | 682.31 |
| cora | 1.21 | 0.32 | 0.27 | 0.45 | 1.28 | 0.59 | 0.53 | 0.63 | 51.34 | 48.11 | 47.88 | 49.60 | 82.03 | 70.47 | 81.38 | 75.16 |
| hm-categories | 61.81 | N/A | 18.82 | 9.72 | 77.68 | N/A | 76.56 | 65.83 | 2236.40 | N/A | 478.04 | 1060.88 | 3074.32 | N/A | 861.96 | 1307.33 |
| ogbn-arxiv | 16.04 | 6.16 | 9.96 | 7.22 | 21.15 | 17.84 | 13.93 | 27.21 | 1353.16 | 1140.32 | 1110.30 | 1245.85 | 2496.23 | 2245.32 | 2436.55 | 2074.10 |
| ogbn-products | 307.41 | N/A | 248.69 | 146.49 | 541.99 | N/A | 499.76 | 802.31 | 27215.25 | N/A | 16355.80 | 22264.26 | 42070.89 | N/A | 35491.07 | 34223.53 |
| pokec-regions | 119.39 | N/A | 95.09 | 75.04 | 217.43 | N/A | 195.40 | 338.89 | 13919.14 | N/A | 10240.23 | 12492.43 | 24614.76 | N/A | 22997.66 | 20466.25 |
| pubmed | 1.28 | 0.95 | 0.91 | 0.80 | 2.32 | 2.49 | 1.92 | 2.39 | 197.06 | 178.56 | 171.70 | 186.07 | 403.21 | 337.44 | 398.47 | 353.46 |
| tolokers-2 | 3.52 | N/A | 1.50 | 1.10 | 5.47 | N/A | 5.14 | 6.58 | 177.82 | N/A | 95.20 | 133.76 | 289.90 | N/A | 235.60 | 239.72 |
| twitch-views | 57.77 | N/A | 25.48 | 19.36 | 84.83 | N/A | 86.90 | 126.41 | 2227.41 | N/A | 1130.11 | 1811.72 | 3182.40 | N/A | 2444.25 | 2633.35 |
| web-traffic | 280.37 | N/A | 162.95 | 121.45 | 846.52 | N/A | 1284.58 | 458.24 | 33866.05 | N/A | 30191.08 | 32105.57 | 53428.39 | N/A | 52772.78 | 46219.50 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 7.15 | 6.03 | 6.10 | 5.55 | 15.11 | 12.60 | 13.42 | 19.67 | 768.01 | 644.91 | 631.95 | 708.44 | 1452.55 | 1347.60 | 1423.19 | 1204.34 |
| avazu-ctr | 90.45 | N/A | 38.59 | 18.86 | 146.17 | N/A | 162.22 | 152.20 | 2860.74 | N/A | 1160.06 | 1798.01 | 4129.89 | N/A | 2354.78 | 2546.55 |
| citeseer | 1.22 | 0.56 | 0.51 | 0.45 | 1.77 | 1.06 | 1.05 | 1.24 | 112.56 | 106.15 | 105.46 | 109.18 | 190.66 | 162.65 | 190.64 | 173.69 |
| city-reviews | 26.33 | N/A | 20.50 | 16.55 | 50.19 | N/A | 49.92 | 60.48 | 2352.57 | N/A | 1903.64 | 2132.08 | 4354.51 | N/A | 4232.51 | 3588.34 |
| city-roads-L | 15.80 | 14.09 | 13.82 | 13.81 | 34.43 | 29.90 | 30.35 | 34.07 | 2104.22 | 1813.55 | 1808.64 | 1958.30 | 4048.96 | 3593.56 | 4035.49 | 3351.15 |
| city-roads-M | 6.53 | 5.86 | 5.68 | 5.64 | 14.22 | 12.45 | 12.55 | 13.76 | 828.69 | 712.08 | 708.04 | 767.42 | 1612.07 | 1496.09 | 1604.93 | 1327.79 |
| cora | 1.21 | 0.55 | 0.47 | 0.45 | 1.67 | 0.97 | 0.94 | 1.15 | 71.99 | 66.35 | 66.00 | 69.04 | 136.53 | 112.84 | 136.00 | 123.17 |
| hm-categories | 85.61 | N/A | 29.48 | 14.56 | 131.14 | N/A | 133.80 | 138.19 | 2466.01 | N/A | 752.06 | 1359.23 | 3488.08 | N/A | 1482.61 | 1816.95 |
| ogbn-arxiv | 29.08 | 18.09 | 23.31 | 18.78 | 50.50 | 43.03 | 41.52 | 66.49 | 2512.41 | 2131.06 | 2103.34 | 2323.66 | 4812.84 | 4227.56 | 4752.73 | 3981.16 |
| ogbn-products | 605.63 | N/A | 526.40 | 332.24 | OOM | N/A | 1185.58 | 1944.58 | 43960.62 | N/A | 30709.16 | 37813.77 | OOM | N/A | 68981.42 | 61734.03 |
| pokec-regions | 271.27 | N/A | 229.13 | 191.23 | 584.70 | N/A | 532.38 | 874.32 | 25087.28 | N/A | 19812.88 | 22859.51 | 46951.02 | N/A | 45333.09 | 38809.58 |
| pubmed | 2.57 | 2.26 | 2.28 | 2.09 | 5.42 | 4.82 | 4.72 | 5.49 | 334.48 | 292.01 | 289.96 | 313.20 | 640.35 | 606.05 | 635.50 | 543.49 |
| tolokers-2 | 5.29 | N/A | 2.69 | 2.03 | 9.44 | N/A | 8.92 | 13.76 | 260.46 | N/A | 166.35 | 211.17 | 473.45 | N/A | 418.44 | 394.83 |
| twitch-views | 86.12 | N/A | 46.54 | 33.98 | 148.22 | N/A | 145.96 | 274.12 | 3379.29 | N/A | 2118.36 | 2882.50 | 5473.68 | N/A | 4749.63 | 4528.95 |
| web-traffic | 502.98 | N/A | 385.20 | 314.21 | OOM | N/A | OOM | OOM | 53629.95 | N/A | 47131.57 | 50454.41 | OOM | N/A | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 3.57 | 2.91 | 2.95 | 2.39 | 6.37 | 5.45 | 6.08 | 7.22 | 440.41 | 361.42 | 335.57 | 386.71 | 779.91 | 760.15 | 743.08 | 644.67 |
| avazu-ctr | 88.42 | N/A | 26.39 | 16.44 | 112.47 | N/A | 126.51 | 65.32 | 3491.66 | N/A | 712.63 | 1312.79 | 5128.84 | N/A | 1309.79 | 1685.95 |
| citeseer | 1.22 | 0.32 | 0.27 | 0.45 | 1.30 | 0.59 | 0.57 | 0.61 | 88.33 | 84.98 | 84.27 | 85.86 | 125.30 | 112.49 | 124.77 | 116.61 |
| city-reviews | 16.08 | N/A | 9.90 | 7.20 | 23.87 | N/A | 27.21 | 22.14 | 1406.94 | N/A | 1033.77 | 1186.86 | 2356.56 | N/A | 2199.84 | 1914.93 |
| city-roads-L | 5.67 | 5.59 | 6.12 | 4.38 | 11.34 | 10.63 | 10.56 | 13.26 | 1136.94 | 981.09 | 973.55 | 1055.53 | 2101.63 | 1923.63 | 2085.69 | 1750.89 |
| city-roads-M | 2.43 | 2.23 | 2.61 | 1.85 | 4.92 | 4.58 | 4.52 | 5.34 | 440.06 | 376.09 | 371.99 | 403.75 | 828.77 | 820.83 | 820.47 | 683.18 |
| cora | 1.22 | 0.32 | 0.27 | 0.45 | 1.28 | 0.59 | 0.56 | 0.58 | 51.66 | 48.27 | 47.92 | 49.64 | 82.19 | 70.64 | 81.42 | 75.20 |
| hm-categories | 82.56 | N/A | 22.82 | 13.75 | 100.13 | N/A | 104.89 | 59.36 | 3218.72 | N/A | 478.91 | 1061.75 | 4710.04 | N/A | 862.83 | 1308.20 |
| ogbn-arxiv | 19.17 | 7.28 | 9.77 | 8.03 | 23.61 | 19.40 | 16.55 | 24.47 | 1388.75 | 1158.32 | 1112.89 | 1248.02 | 2514.03 | 2263.32 | 2439.13 | 2076.27 |
| ogbn-products | 442.34 | N/A | 291.97 | 202.94 | 679.89 | N/A | 733.21 | 772.10 | 30991.46 | N/A | 16393.17 | 22301.63 | 47178.58 | N/A | 35528.44 | 34260.90 |
| pokec-regions | 152.91 | N/A | 117.54 | 97.00 | 251.40 | N/A | 269.70 | 328.94 | 14853.67 | N/A | 10265.28 | 12517.51 | 25082.02 | N/A | 23022.71 | 20491.34 |
| pubmed | 1.28 | 1.05 | 1.11 | 0.86 | 2.34 | 2.65 | 2.06 | 2.24 | 199.77 | 179.91 | 172.00 | 186.37 | 404.56 | 338.80 | 398.77 | 353.76 |
| tolokers-2 | 4.89 | N/A | 1.65 | 1.34 | 6.88 | N/A | 6.35 | 5.53 | 218.93 | N/A | 95.38 | 133.94 | 328.61 | N/A | 235.78 | 239.90 |
| twitch-views | 73.45 | N/A | 25.26 | 27.01 | 100.11 | N/A | 114.84 | 113.57 | 2737.99 | N/A | 1132.24 | 1814.29 | 4220.09 | N/A | 2446.39 | 2635.91 |
| web-traffic | 307.16 | N/A | 163.25 | 129.85 | 873.10 | N/A | 1404.93 | 398.55 | 34259.59 | N/A | 30235.18 | 32149.67 | 53625.16 | N/A | 52816.88 | 46263.60 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | DGL | DF-GNN | Ours | Ours (WSB/TC) | |
| artnet-exp | 7.58 | 6.28 | 6.85 | 5.96 | 15.59 | 12.88 | 14.03 | 19.09 | 785.43 | 654.36 | 632.76 | 709.22 | 1461.11 | 1357.05 | 1424.00 | 1205.12 |
| avazu-ctr | 108.26 | N/A | 46.41 | 23.54 | 166.21 | N/A | 179.20 | 135.22 | 3866.44 | N/A | 1161.22 | 1799.92 | 5803.13 | N/A | 2355.93 | 2547.74 |
| citeseer | 1.22 | 0.56 | 0.53 | 0.45 | 1.82 | 1.06 | 1.07 | 1.21 | 112.83 | 106.29 | 105.51 | 109.23 | 190.80 | 162.79 | 190.36 | 173.74 |
| city-reviews | 28.70 | N/A | 22.65 | 17.66 | 52.53 | N/A | 52.19 | 56.99 | 2423.70 | N/A | 1905.91 | 2133.77 | 4390.08 | N/A | 4234.05 | 3590.03 |
| city-roads-L | 16.03 | 14.50 | 15.13 | 14.02 | 34.67 | 30.40 | 31.28 | 38.28 | 2112.83 | 1817.81 | 1810.27 | 1960.67 | 4053.31 | 3597.82 | 4037.82 | 3353.52 |
| city-roads-M | 6.63 | 6.01 | 6.27 | 5.73 | 14.33 | 12.62 | 12.96 | 15.20 | 832.73 | 714.34 | 708.92 | 768.29 | 1614.10 | 1498.35 | 1605.80 | 1328.65 |
| cora | 1.22 | 0.55 | 0.49 | 0.45 | 1.67 | 0.97 | 0.98 | 1.06 | 72.43 | 66.51 | 66.04 | 69.56 | 136.81 | 113.00 | 136.04 | 123.69 |
| hm-categories | 100.31 | N/A | 37.78 | 18.90 | 148.35 | N/A | 143.95 | 123.07 | 3448.49 | N/A | 753.05 | 1359.94 | 5123.63 | N/A | 1483.60 | 1817.66 |
| ogbn-arxiv | 31.72 | 18.80 | 24.20 | 19.76 | 52.67 | 44.24 | 43.97 | 61.25 | 2548.00 | 2149.06 | 2105.50 | 2325.83 | 4830.64 | 4245.56 | 4755.24 | 3983.33 |
| ogbn-products | 701.30 | N/A | 598.61 | 391.81 | OOM | N/A | 1278.95 | 1869.35 | 47736.62 | N/A | 30746.53 | 37851.74 | OOM | N/A | 69018.79 | 61772.00 |
| pokec-regions | 294.59 | N/A | 259.24 | 215.95 | 609.00 | N/A | 565.86 | 852.05 | 26021.79 | N/A | 19837.80 | 22885.05 | 47418.26 | N/A | 45357.87 | 38835.13 |
| pubmed | 2.64 | 2.31 | 2.55 | 2.15 | 5.51 | 4.88 | 4.85 | 5.60 | 337.04 | 293.22 | 290.26 | 314.25 | 641.36 | 607.27 | 635.80 | 543.80 |
| tolokers-2 | 6.39 | N/A | 3.13 | 2.29 | 10.61 | N/A | 9.44 | 11.93 | 292.13 | N/A | 166.52 | 211.35 | 489.29 | N/A | 418.62 | 395.00 |
| twitch-views | 96.18 | N/A | 52.26 | 42.01 | 158.91 | N/A | 158.47 | 248.87 | 3793.62 | N/A | 2120.50 | 2884.63 | 5703.12 | N/A | 4751.76 | 4531.08 |
| web-traffic | 523.32 | N/A | 394.86 | 326.18 | OOM | N/A | OOM | OOM | 54023.49 | N/A | 47175.67 | 50498.51 | OOM | N/A | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 2.95 | 0.45 | 4.08 | 2.62 | 1.45 | 4.07 | 494.43 | 78.87 | 827.04 | 702.33 | 148.55 | 1005.33 |
| avazu-ctr | 77.78 | 15.83 | 115.17 | 101.34 | 71.11 | 119.33 | 17071.02 | 337.77 | 27890.18 | 23026.90 | 431.66 | 33786.08 |
| citeseer | 1.60 | 0.26 | 1.33 | 1.34 | 0.55 | 0.84 | 72.38 | 66.69 | 80.94 | 78.17 | 70.78 | 84.69 |
| city-reviews | 9.33 | 2.90 | 13.47 | 13.43 | 12.06 | 14.33 | 2025.84 | 300.48 | 3347.58 | 2768.71 | 482.15 | 4028.52 |
| city-roads-L | 1.65 | 0.50 | 2.76 | 1.85 | 1.44 | 3.16 | 434.45 | 276.44 | 746.35 | 625.13 | 451.29 | 876.25 |
| city-roads-M | 1.62 | 0.30 | 3.55 | 1.42 | 0.81 | 1.57 | 170.71 | 89.71 | 304.76 | 257.59 | 159.67 | 363.09 |
| cora | 2.24 | 0.26 | 1.30 | 1.35 | 0.60 | 0.80 | 41.48 | 33.89 | 49.42 | 48.30 | 37.22 | 53.31 |
| hm-categories | 73.45 | 9.89 | 111.49 | 83.03 | 46.30 | 118.05 | 16607.94 | 250.14 | 27148.81 | 22409.38 | 308.27 | 32898.17 |
| ogbn-arxiv | 10.68 | 3.96 | 7.77 | 10.71 | 10.56 | 8.09 | 1105.40 | 278.94 | 1884.15 | 1548.53 | 487.65 | 2260.83 |
| ogbn-products | OOM | 42.42 | OOM | OOM | 188.69 | OOM | OOM | 4358.62 | OOM | OOM | 7348.55 | OOM |
| pokec-regions | 75.96 | 13.00 | 171.16 | 89.67 | 52.26 | 184.86 | 24989.80 | 2244.59 | 41959.50 | 34234.03 | 4239.20 | 50771.96 |
| pubmed | 1.61 | 0.27 | 1.29 | 1.41 | 0.78 | 1.00 | 136.05 | 75.70 | 203.23 | 184.03 | 99.79 | 234.60 |
| tolokers-2 | 3.69 | 0.77 | 6.16 | 5.49 | 3.32 | 6.03 | 826.11 | 37.96 | 1346.89 | 1139.32 | 52.73 | 1628.36 |
| twitch-views | 53.93 | 11.59 | 70.43 | 70.45 | 54.64 | 75.66 | 10619.01 | 307.29 | 17462.54 | 14405.97 | 515.40 | 21157.31 |
| web-traffic | 207.15 | 85.42 | 87.71 | 766.44 | 866.76 | 116.61 | 24780.82 | 16038.75 | 34650.23 | 30059.66 | 19568.42 | 39218.03 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 2.62 | 0.48 | 6.68 | 3.63 | 1.78 | 7.06 | 945.54 | 137.06 | 1607.31 | 1393.44 | 260.99 | 1932.09 |
| avazu-ctr | 103.87 | 17.69 | 241.28 | 131.92 | 89.70 | 260.53 | 33541.34 | 412.32 | 54848.32 | 44696.43 | 600.90 | 66134.84 |
| citeseer | 1.62 | 0.45 | 1.29 | 1.35 | 0.70 | 0.86 | 81.31 | 70.86 | 98.21 | 99.86 | 79.07 | 113.38 |
| city-reviews | 12.94 | 3.40 | 23.81 | 18.02 | 15.17 | 26.88 | 3858.27 | 446.55 | 6462.25 | 5338.21 | 810.62 | 7766.19 |
| city-roads-L | 7.44 | 0.77 | 4.83 | 3.88 | 2.27 | 6.30 | 731.71 | 414.16 | 1349.38 | 1151.85 | 763.18 | 1599.32 |
| city-roads-M | 1.71 | 0.37 | 2.75 | 1.90 | 1.10 | 2.93 | 305.56 | 145.85 | 571.11 | 548.81 | 285.88 | 726.17 |
| cora | 1.60 | 0.26 | 1.29 | 1.34 | 0.65 | 0.81 | 51.55 | 36.60 | 67.90 | 70.93 | 44.17 | 84.39 |
| hm-categories | 96.11 | 11.10 | 236.02 | 112.45 | 57.52 | 254.35 | 32683.60 | 296.33 | 53427.59 | 43548.03 | 411.27 | 64433.57 |
| ogbn-arxiv | 13.15 | 4.66 | 13.79 | 14.50 | 14.78 | 15.21 | 2082.45 | 445.67 | 3617.28 | 2976.16 | 860.48 | 4341.43 |
| ogbn-products | OOM | 55.55 | OOM | OOM | 261.55 | OOM | OOM | 6750.79 | OOM | OOM | 12730.79 | OOM |
| pokec-regions | 119.57 | 17.89 | OOM | 153.81 | 75.99 | OOM | 48893.76 | 3837.83 | OOM | 66306.77 | 7826.46 | OOM |
| pubmed | 1.61 | 0.28 | 1.59 | 1.43 | 0.84 | 1.64 | 216.57 | 95.77 | 347.76 | 372.78 | 145.49 | 470.78 |
| tolokers-2 | 4.87 | 0.87 | 10.74 | 7.65 | 4.05 | 10.93 | 1608.21 | 49.34 | 2634.98 | 2245.41 | 78.66 | 3174.29 |
| twitch-views | 72.97 | 13.72 | 128.49 | 94.65 | 72.53 | 141.85 | 20883.22 | 472.84 | 34365.08 | 28038.00 | 884.32 | 41441.56 |
| web-traffic | 234.50 | 95.98 | 158.02 | 810.91 | 979.53 | 203.71 | 36208.68 | 18861.76 | 55685.47 | 46328.78 | 25920.80 | 64459.82 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 4.18 | 0.96 | 11.67 | 7.06 | 3.74 | 13.80 | 1821.96 | 227.66 | 3162.62 | 2614.62 | 484.61 | 3797.60 |
| avazu-ctr | OOM | 22.20 | OOM | OOM | 144.44 | OOM | OOM | 562.33 | OOM | OOM | 935.87 | OOM |
| citeseer | 1.67 | 0.27 | 1.27 | 1.30 | 0.68 | 1.54 | 98.83 | 77.29 | 132.90 | 135.05 | 93.91 | 163.52 |
| city-reviews | 18.24 | 5.13 | 44.67 | 28.37 | 26.87 | 52.81 | 7418.60 | 736.96 | 12701.76 | 10255.98 | 1465.96 | 15252.86 |
| city-roads-L | 4.01 | 1.94 | 9.76 | 7.87 | 5.45 | 12.88 | 1309.50 | 693.33 | 2553.32 | 2045.62 | 1389.02 | 3044.80 |
| city-roads-M | 6.44 | 0.86 | 4.79 | 3.86 | 2.41 | 9.09 | 567.71 | 258.13 | 1108.67 | 948.89 | 538.37 | 1327.57 |
| cora | 2.88 | 0.26 | 1.27 | 2.16 | 0.78 | 0.80 | 69.42 | 42.17 | 103.30 | 108.44 | 55.77 | 133.95 |
| hm-categories | OOM | 14.02 | OOM | OOM | 100.72 | OOM | OOM | 386.42 | OOM | OOM | 615.74 | OOM |
| ogbn-arxiv | 17.21 | 7.23 | 26.50 | 21.40 | 27.59 | 31.17 | 3978.51 | 775.38 | 7085.58 | 5701.61 | 1604.51 | 8502.87 |
| ogbn-products | OOM | 101.31 | OOM | OOM | 542.65 | OOM | OOM | 11535.16 | OOM | OOM | 23495.35 | OOM |
| pokec-regions | OOM | 36.32 | OOM | OOM | 159.81 | OOM | OOM | 7028.51 | OOM | OOM | 15003.22 | OOM |
| pubmed | 1.69 | 0.41 | 2.56 | 2.01 | 1.44 | 3.01 | 367.71 | 134.40 | 638.30 | 613.72 | 234.77 | 777.29 |
| tolokers-2 | 7.21 | 1.08 | 18.08 | 10.83 | 6.92 | 20.82 | 3128.51 | 72.79 | 5216.85 | 4322.19 | 131.61 | 6273.00 |
| twitch-views | 102.76 | 18.69 | 296.09 | 142.99 | 127.17 | OOM | 40795.53 | 799.38 | 68171.25 | 55002.73 | 1620.63 | OOM |
| web-traffic | 283.36 | 132.16 | OOM | OOM | 1449.60 | OOM | 58411.46 | 24507.98 | OOM | OOM | 38622.83 | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 8.87 | 2.75 | 24.17 | 14.36 | 8.95 | 28.46 | 3588.85 | 426.46 | 6272.14 | 5082.69 | 925.47 | 7530.85 |
| avazu-ctr | OOM | 41.79 | OOM | OOM | 234.31 | OOM | OOM | 859.11 | OOM | OOM | 1605.43 | OOM |
| citeseer | 1.63 | 0.30 | 1.30 | 1.38 | 0.89 | 1.12 | 134.82 | 90.98 | 202.92 | 206.33 | 124.97 | 263.21 |
| city-reviews | 35.98 | 12.62 | 93.96 | 56.32 | 51.48 | 110.81 | 14609.28 | 1318.24 | 25174.00 | 20086.98 | 2773.62 | 30221.57 |
| city-roads-L | 10.58 | 6.62 | 21.44 | 20.71 | 16.91 | 31.05 | 2476.18 | 1248.39 | 4955.52 | 3834.03 | 2639.43 | 5928.32 |
| city-roads-M | 4.66 | 2.73 | 9.58 | 8.86 | 6.82 | 13.47 | 1094.10 | 481.14 | 2170.76 | 1744.68 | 1040.00 | 2603.48 |
| cora | 1.63 | 0.32 | 1.84 | 1.36 | 1.02 | 1.92 | 108.08 | 53.88 | 176.48 | 184.94 | 81.82 | 238.84 |
| hm-categories | OOM | 26.72 | OOM | OOM | 177.44 | OOM | OOM | 567.96 | OOM | OOM | 1024.18 | OOM |
| ogbn-arxiv | 28.65 | 17.16 | 54.80 | 42.40 | 54.71 | 69.34 | 7808.88 | 1437.34 | 14020.28 | 11085.74 | 3093.08 | 16826.30 |
| ogbn-products | OOM | 258.53 | OOM | OOM | 936.45 | OOM | OOM | 21102.80 | OOM | OOM | 45023.20 | OOM |
| pokec-regions | OOM | 106.76 | OOM | OOM | 365.68 | OOM | OOM | 13405.87 | OOM | OOM | 29355.51 | OOM |
| pubmed | 2.34 | 1.11 | 5.21 | 4.12 | 3.27 | 6.61 | 674.80 | 210.66 | 1214.63 | 1055.90 | 404.71 | 1449.87 |
| tolokers-2 | 12.41 | 2.15 | 35.60 | 18.09 | 10.50 | 40.69 | 6198.51 | 118.73 | 10368.49 | 8563.28 | 235.06 | 12455.81 |
| twitch-views | OOM | 38.47 | OOM | OOM | 218.97 | OOM | OOM | 1455.23 | OOM | OOM | 3098.47 | OOM |
| web-traffic | OOM | 302.61 | OOM | OOM | 2352.66 | OOM | OOM | 35794.49 | OOM | OOM | 64024.34 | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 3.20 | 0.67 | 6.96 | 3.93 | 2.21 | 7.50 | 943.62 | 125.09 | 1605.78 | 1377.29 | 236.67 | 1926.04 |
| avazu-ctr | 117.14 | 20.89 | 256.48 | 144.25 | 95.72 | 276.19 | 33699.59 | 394.59 | 55007.15 | 44994.28 | 564.50 | 66769.49 |
| citeseer | 1.62 | 0.26 | 1.28 | 1.50 | 0.56 | 0.81 | 80.93 | 70.02 | 97.85 | 98.28 | 77.38 | 112.04 |
| city-reviews | 14.22 | 3.73 | 25.00 | 18.89 | 15.70 | 27.88 | 3858.61 | 411.17 | 6463.12 | 5301.40 | 738.86 | 7769.11 |
| city-roads-L | 1.99 | 0.82 | 4.87 | 3.11 | 3.03 | 5.79 | 716.93 | 381.56 | 1335.82 | 1087.05 | 696.43 | 1543.43 |
| city-roads-M | 1.61 | 0.42 | 2.51 | 1.77 | 1.16 | 3.01 | 299.17 | 132.17 | 566.43 | 523.19 | 258.15 | 703.93 |
| cora | 1.59 | 0.26 | 1.30 | 1.50 | 0.61 | 0.84 | 51.25 | 35.91 | 67.62 | 69.68 | 42.77 | 83.38 |
| hm-categories | 106.17 | 14.76 | 249.49 | 123.27 | 67.96 | 270.14 | 32841.14 | 284.64 | 53585.64 | 43853.19 | 388.03 | 65067.32 |
| ogbn-arxiv | 15.57 | 4.73 | 14.21 | 14.46 | 13.24 | 15.71 | 2070.63 | 404.23 | 3606.09 | 2911.18 | 777.00 | 4298.75 |
| ogbn-products | OOM | 83.03 | OOM | OOM | 372.46 | OOM | OOM | 6171.42 | OOM | OOM | 11553.38 | OOM |
| pokec-regions | 137.18 | 24.56 | OOM | 166.83 | 99.58 | OOM | 48928.03 | 3452.97 | OOM | 65976.67 | 7043.60 | OOM |
| pubmed | 1.61 | 0.30 | 1.75 | 1.40 | 0.95 | 1.70 | 214.78 | 91.06 | 346.45 | 363.50 | 135.92 | 465.27 |
| tolokers-2 | 6.01 | 1.00 | 10.64 | 7.89 | 4.28 | 11.90 | 1614.65 | 47.08 | 2641.51 | 2256.90 | 72.96 | 3200.36 |
| twitch-views | 80.46 | 15.72 | 136.13 | 100.63 | 74.20 | 151.46 | 20966.38 | 430.57 | 34448.56 | 28163.26 | 800.01 | 41778.44 |
| web-traffic | 245.84 | 94.28 | 165.64 | 821.84 | 890.48 | 206.15 | 35954.19 | 18177.41 | 55452.69 | 45114.16 | 24530.40 | 63529.11 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 4.44 | 0.86 | 11.84 | 6.03 | 3.16 | 13.26 | 1821.91 | 211.37 | 3154.79 | 2572.80 | 435.40 | 3765.88 |
| avazu-ctr | 162.27 | 24.38 | OOM | OOM | 126.03 | OOM | 65965.63 | 524.18 | OOM | OOM | 859.53 | OOM |
| citeseer | 1.61 | 0.26 | 1.39 | 1.37 | 0.63 | 0.85 | 98.06 | 75.00 | 132.00 | 131.06 | 89.81 | 159.57 |
| city-reviews | 20.39 | 4.67 | 46.27 | 27.41 | 20.69 | 52.43 | 7435.77 | 665.61 | 12684.33 | 10144.40 | 1321.77 | 15182.16 |
| city-roads-L | 3.48 | 1.46 | 9.26 | 6.00 | 4.47 | 11.18 | 1280.56 | 623.16 | 2520.54 | 1908.64 | 1248.66 | 2918.00 |
| city-roads-M | 1.90 | 0.65 | 4.25 | 2.86 | 1.94 | 5.11 | 558.21 | 230.38 | 1096.61 | 896.56 | 482.50 | 1277.32 |
| cora | 1.61 | 0.26 | 1.30 | 1.36 | 0.68 | 0.81 | 69.27 | 41.11 | 103.14 | 105.61 | 54.07 | 131.33 |
| hm-categories | 152.93 | 17.08 | OOM | OOM | 87.87 | OOM | 64329.83 | 364.99 | OOM | OOM | 572.02 | OOM |
| ogbn-arxiv | 17.83 | 6.01 | 25.98 | 19.88 | 20.50 | 29.69 | 3964.80 | 695.09 | 7054.90 | 5552.85 | 1442.00 | 8377.91 |
| ogbn-products | OOM | 108.13 | OOM | OOM | 515.36 | OOM | OOM | 10357.56 | OOM | OOM | 21121.66 | OOM |
| pokec-regions | OOM | 34.64 | OOM | OOM | 146.38 | OOM | OOM | 6242.38 | OOM | OOM | 13418.91 | OOM |
| pubmed | 2.24 | 0.36 | 2.55 | 2.36 | 1.17 | 3.63 | 365.87 | 124.90 | 634.12 | 594.94 | 214.71 | 761.42 |
| tolokers-2 | 8.47 | 1.18 | 18.71 | 11.13 | 5.44 | 21.42 | 3149.38 | 66.35 | 5222.20 | 4326.67 | 120.68 | 6292.79 |
| twitch-views | 115.15 | 19.01 | 303.02 | 145.82 | 98.16 | OOM | 41065.93 | 719.93 | 68235.99 | 55044.85 | 1459.86 | OOM |
| web-traffic | 291.61 | 111.57 | OOM | OOM | 1032.47 | OOM | 58021.34 | 23117.91 | OOM | OOM | 35820.92 | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 8.14 | 1.77 | 22.65 | 12.33 | 7.03 | 26.34 | 3576.45 | 383.44 | 6250.66 | 4991.04 | 827.21 | 7448.78 |
| avazu-ctr | OOM | 30.88 | OOM | OOM | 208.08 | OOM | OOM | 786.80 | OOM | OOM | 1458.72 | OOM |
| citeseer | 1.61 | 0.27 | 2.31 | 1.28 | 0.74 | 3.02 | 133.05 | 87.44 | 200.57 | 200.03 | 117.43 | 256.31 |
| city-reviews | 34.58 | 7.73 | 92.45 | 51.31 | 40.24 | 105.30 | 14591.98 | 1174.61 | 25120.47 | 19831.80 | 2483.92 | 30006.08 |
| city-roads-L | 7.73 | 3.78 | 18.37 | 14.42 | 11.09 | 25.32 | 2415.84 | 1111.34 | 4888.96 | 3561.08 | 2363.55 | 5662.83 |
| city-roads-M | 3.54 | 1.63 | 8.54 | 6.44 | 4.62 | 10.86 | 1070.20 | 425.88 | 2144.20 | 1634.45 | 929.97 | 2495.10 |
| cora | 2.86 | 0.26 | 1.28 | 1.39 | 0.83 | 1.07 | 106.27 | 50.60 | 174.30 | 179.18 | 75.15 | 231.63 |
| hm-categories | OOM | 21.73 | OOM | OOM | 158.69 | OOM | OOM | 523.15 | OOM | OOM | 933.26 | OOM |
| ogbn-arxiv | 26.76 | 10.06 | 51.05 | 36.15 | 37.97 | 60.82 | 7753.66 | 1273.03 | 13947.06 | 10771.52 | 2762.65 | 16534.83 |
| ogbn-products | OOM | 201.19 | OOM | OOM | 1068.14 | OOM | OOM | 18728.74 | OOM | OOM | 40256.57 | OOM |
| pokec-regions | OOM | 71.22 | OOM | OOM | 315.17 | OOM | OOM | 11824.94 | OOM | OOM | 26180.03 | OOM |
| pubmed | 1.98 | 0.67 | 4.68 | 3.31 | 2.37 | 5.83 | 669.71 | 192.92 | 1207.26 | 1021.95 | 368.69 | 1415.35 |
| tolokers-2 | 13.34 | 1.55 | 35.93 | 19.39 | 10.18 | 41.37 | 6217.18 | 107.26 | 10369.23 | 8555.47 | 211.42 | 12462.60 |
| twitch-views | OOM | 25.95 | OOM | OOM | 181.90 | OOM | OOM | 1293.19 | OOM | OOM | 2771.51 | OOM |
| web-traffic | OOM | 171.66 | OOM | OOM | 1645.54 | OOM | OOM | 32998.17 | OOM | OOM | 58405.40 | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 17.83 | 5.43 | 47.44 | 27.70 | 17.87 | 56.35 | 7083.12 | 729.59 | 12445.20 | 9766.47 | 1619.32 | 14814.95 |
| avazu-ctr | OOM | 58.52 | OOM | OOM | 344.10 | OOM | OOM | 1308.08 | OOM | OOM | 2652.55 | OOM |
| citeseer | 1.70 | 0.45 | 1.63 | 1.65 | 1.31 | 1.92 | 202.89 | 111.93 | 338.91 | 335.85 | 173.42 | 449.74 |
| city-reviews | 70.30 | 20.95 | 222.12 | 107.03 | 81.34 | 256.46 | 28904.31 | 2193.10 | 49985.97 | 39207.38 | 4813.51 | 59643.22 |
| city-roads-L | 20.93 | 13.19 | 42.64 | 40.74 | 33.60 | 60.69 | 4673.70 | 2084.51 | 9631.70 | 6879.97 | 4589.36 | 11161.16 |
| city-roads-M | 9.16 | 5.44 | 18.83 | 16.71 | 14.01 | 25.76 | 2098.80 | 817.49 | 4248.80 | 3120.14 | 1823.73 | 4945.10 |
| cora | 1.67 | 0.45 | 2.43 | 1.65 | 1.46 | 1.88 | 182.28 | 71.27 | 318.19 | 327.69 | 121.87 | 434.36 |
| hm-categories | OOM | 41.89 | OOM | OOM | 286.32 | OOM | OOM | 842.65 | OOM | OOM | 1664.14 | OOM |
| ogbn-arxiv | 50.26 | 25.75 | 109.58 | 78.36 | 81.08 | 136.63 | 15333.87 | 2432.88 | 27741.65 | 21210.79 | 5414.15 | 32857.93 |
| ogbn-products | OOM | 513.45 | OOM | OOM | OOM | OOM | OOM | 35472.99 | OOM | OOM | OOM | OOM |
| pokec-regions | OOM | 211.68 | OOM | OOM | 740.04 | OOM | OOM | 22986.11 | OOM | OOM | 51690.72 | OOM |
| pubmed | 4.33 | 2.05 | 9.81 | 7.53 | 5.96 | 12.65 | 1274.92 | 327.84 | 2354.64 | 1868.35 | 677.43 | 2767.32 |
| tolokers-2 | 24.14 | 3.36 | 70.59 | 33.97 | 16.96 | 81.62 | 12351.17 | 189.22 | 20674.93 | 16758.58 | 398.91 | 24815.12 |
| twitch-views | OOM | 56.79 | OOM | OOM | 322.57 | OOM | OOM | 2443.06 | OOM | OOM | 5402.26 | OOM |
| web-traffic | OOM | 435.45 | OOM | OOM | OOM | OOM | OOM | 52752.75 | OOM | OOM | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 5.11 | 1.07 | 12.26 | 6.46 | 3.95 | 14.36 | 1824.22 | 199.76 | 3157.87 | 2565.11 | 412.16 | 3778.38 |
| avazu-ctr | 189.89 | 30.91 | OOM | OOM | 141.89 | OOM | 66291.41 | 506.65 | OOM | OOM | 823.29 | OOM |
| citeseer | 1.61 | 0.26 | 1.29 | 1.35 | 0.61 | 0.80 | 97.70 | 74.15 | 131.69 | 129.53 | 88.05 | 158.52 |
| city-reviews | 23.23 | 5.51 | 49.43 | 29.53 | 22.76 | 55.06 | 7453.07 | 631.46 | 12704.07 | 10142.68 | 1251.20 | 15260.66 |
| city-roads-L | 3.47 | 1.56 | 9.43 | 8.39 | 4.82 | 10.99 | 1267.86 | 591.78 | 2510.86 | 1848.68 | 1183.08 | 2874.70 |
| city-roads-M | 1.88 | 0.70 | 4.70 | 2.68 | 2.15 | 5.53 | 553.17 | 217.09 | 1091.42 | 871.69 | 455.12 | 1259.52 |
| cora | 1.61 | 0.27 | 1.30 | 1.35 | 0.71 | 0.81 | 69.00 | 40.40 | 102.92 | 104.42 | 52.60 | 130.63 |
| hm-categories | 177.98 | 24.24 | OOM | OOM | 111.89 | OOM | 64651.07 | 353.14 | OOM | OOM | 548.58 | OOM |
| ogbn-arxiv | 20.32 | 6.17 | 27.56 | 21.13 | 19.00 | 30.51 | 3961.83 | 654.93 | 7053.85 | 5505.56 | 1359.74 | 8376.55 |
| ogbn-products | OOM | 164.66 | OOM | OOM | 743.15 | OOM | OOM | 9796.84 | OOM | OOM | 19962.84 | OOM |
| pokec-regions | OOM | 48.32 | OOM | OOM | 196.41 | OOM | OOM | 5870.11 | OOM | OOM | 12648.58 | OOM |
| pubmed | 1.62 | 0.42 | 2.67 | 1.78 | 1.21 | 2.91 | 364.35 | 120.29 | 633.27 | 587.75 | 205.20 | 758.97 |
| tolokers-2 | 9.68 | 1.50 | 20.08 | 12.38 | 6.39 | 22.85 | 3163.69 | 64.53 | 5236.69 | 4352.01 | 114.46 | 6350.94 |
| twitch-views | 131.48 | 23.58 | 321.40 | 160.16 | 109.79 | OOM | 41252.76 | 680.04 | 68424.42 | 55377.47 | 1377.87 | OOM |
| web-traffic | 292.95 | 113.95 | OOM | OOM | 970.25 | OOM | 57865.19 | 22455.56 | OOM | OOM | 34452.48 | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 8.38 | 1.60 | 22.92 | 11.70 | 5.91 | 26.14 | 3572.33 | 359.24 | 6247.31 | 4958.18 | 778.02 | 7436.10 |
| avazu-ctr | OOM | 37.30 | OOM | OOM | 188.17 | OOM | OOM | 748.83 | OOM | OOM | 1382.37 | OOM |
| citeseer | 1.61 | 0.26 | 1.29 | 1.37 | 0.69 | 0.93 | 132.00 | 84.99 | 199.57 | 195.59 | 113.49 | 252.28 |
| city-reviews | 37.38 | 7.31 | 94.37 | 49.96 | 31.38 | 105.60 | 14590.75 | 1104.07 | 25121.77 | 19756.78 | 2340.36 | 30011.20 |
| city-roads-L | 6.79 | 2.83 | 17.57 | 11.55 | 8.75 | 21.83 | 2383.60 | 1042.60 | 4860.46 | 3428.53 | 2224.43 | 5548.33 |
| city-roads-M | 3.11 | 1.23 | 8.02 | 5.19 | 3.66 | 9.79 | 1059.20 | 398.38 | 2132.72 | 1583.29 | 874.16 | 2450.13 |
| cora | 1.61 | 0.26 | 1.35 | 1.37 | 0.74 | 0.96 | 106.70 | 49.28 | 174.05 | 176.42 | 73.00 | 229.04 |
| hm-categories | OOM | 29.04 | OOM | OOM | 147.24 | OOM | OOM | 501.89 | OOM | OOM | 889.52 | OOM |
| ogbn-arxiv | 28.46 | 8.39 | 51.52 | 33.97 | 29.13 | 59.52 | 7729.55 | 1193.86 | 13926.38 | 10640.80 | 2601.08 | 16451.54 |
| ogbn-products | OOM | 214.50 | OOM | OOM | 1025.04 | OOM | OOM | 17569.64 | OOM | OOM | 37901.19 | OOM |
| pokec-regions | OOM | 68.45 | OOM | OOM | 287.38 | OOM | OOM | 11051.26 | OOM | OOM | 24607.97 | OOM |
| pubmed | 2.98 | 0.55 | 4.91 | 3.17 | 1.89 | 5.92 | 666.64 | 183.39 | 1202.98 | 1005.42 | 348.41 | 1401.66 |
| tolokers-2 | 14.81 | 1.80 | 36.74 | 20.13 | 8.50 | 41.92 | 6229.78 | 100.72 | 10382.00 | 8575.32 | 199.16 | 12514.58 |
| twitch-views | OOM | 28.60 | OOM | OOM | 144.97 | OOM | OOM | 1215.80 | OOM | OOM | 2612.61 | OOM |
| web-traffic | OOM | 142.72 | OOM | OOM | 1141.86 | OOM | OOM | 31629.96 | OOM | OOM | 55625.17 | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 16.11 | 3.40 | 45.15 | 24.80 | 13.55 | 52.84 | 7065.31 | 680.52 | 12427.64 | 9681.88 | 1519.03 | 14750.03 |
| avazu-ctr | OOM | 47.26 | OOM | OOM | 335.34 | OOM | OOM | 1235.75 | OOM | OOM | 2504.50 | OOM |
| citeseer | 1.61 | 0.30 | 1.66 | 1.37 | 0.99 | 1.65 | 201.15 | 107.74 | 335.90 | 329.31 | 164.48 | 441.93 |
| city-reviews | 66.22 | 13.35 | 216.13 | 97.07 | 65.50 | 244.66 | 28866.76 | 2049.17 | 49952.27 | 38985.92 | 4523.24 | 59501.74 |
| city-roads-L | 15.36 | 7.64 | 36.56 | 28.75 | 21.39 | 49.65 | 4609.10 | 1948.26 | 9567.71 | 6609.78 | 4313.22 | 10905.86 |
| city-roads-M | 6.90 | 3.15 | 16.24 | 12.50 | 9.03 | 21.34 | 2072.08 | 761.51 | 4221.71 | 3010.18 | 1710.76 | 4842.03 |
| cora | 1.69 | 0.30 | 1.53 | 1.44 | 1.05 | 1.64 | 181.91 | 68.11 | 315.83 | 322.89 | 115.41 | 426.62 |
| hm-categories | OOM | 36.99 | OOM | OOM | 277.49 | OOM | OOM | 797.67 | OOM | OOM | 1572.64 | OOM |
| ogbn-arxiv | 47.25 | 15.18 | 103.82 | 66.33 | 56.96 | 122.79 | 15268.71 | 2268.61 | 27677.86 | 20913.37 | 5082.98 | 32605.20 |
| ogbn-products | OOM | 400.81 | OOM | OOM | OOM | OOM | OOM | 33116.86 | OOM | OOM | OOM | OOM |
| pokec-regions | OOM | 141.55 | OOM | OOM | 629.71 | OOM | OOM | 21417.05 | OOM | OOM | 48526.37 | OOM |
| pubmed | 3.64 | 1.25 | 9.03 | 6.00 | 4.07 | 10.88 | 1267.50 | 309.51 | 2347.90 | 1830.92 | 643.01 | 2733.23 |
| tolokers-2 | 24.93 | 2.55 | 70.89 | 36.33 | 16.65 | 81.80 | 12359.77 | 177.22 | 20683.61 | 16764.29 | 374.21 | 24852.99 |
| twitch-views | OOM | 40.61 | OOM | OOM | 287.10 | OOM | OOM | 2282.16 | OOM | OOM | 5075.23 | OOM |
| web-traffic | OOM | 249.49 | OOM | OOM | OOM | OOM | OOM | 49977.74 | OOM | OOM | OOM | OOM |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | DGL | Ours | PyG | |
| artnet-exp | 35.27 | 10.50 | 93.34 | 57.13 | 35.04 | 115.55 | 14059.40 | 1324.30 | 24782.87 | 19141.43 | 3004.76 | 29372.63 |
| avazu-ctr | OOM | 91.15 | OOM | OOM | 563.65 | OOM | OOM | 2206.03 | OOM | OOM | 4744.99 | OOM |
| citeseer | 1.79 | 0.77 | 2.78 | 2.63 | 2.12 | 3.61 | 338.72 | 153.99 | 610.89 | 560.31 | 270.52 | 736.47 |
| city-reviews | 132.97 | 37.81 | OOM | OOM | 138.49 | OOM | 57420.90 | 3942.78 | OOM | OOM | 8890.42 | OOM |
| city-roads-L | 41.53 | 26.21 | 84.57 | 83.45 | 66.64 | 123.51 | 9063.55 | 3756.76 | 18984.14 | 12923.70 | 8488.57 | 21625.22 |
| city-roads-M | 17.82 | 10.62 | 36.57 | 35.36 | 27.73 | 53.06 | 4103.65 | 1490.19 | 8405.04 | 5893.14 | 3391.54 | 9632.29 |
| cora | 1.76 | 0.71 | 2.77 | 2.50 | 2.13 | 3.58 | 330.30 | 106.04 | 601.62 | 556.20 | 201.97 | 725.71 |
| hm-categories | OOM | 71.21 | OOM | OOM | 502.60 | OOM | OOM | 1392.02 | OOM | OOM | 2944.92 | OOM |
| ogbn-arxiv | 94.29 | 43.14 | 257.79 | 154.65 | 131.01 | 315.25 | 30345.66 | 4422.47 | 55168.37 | 41461.39 | 10051.20 | 64904.61 |
| ogbn-products | OOM | 1025.55 | OOM | OOM | OOM | OOM | OOM | 64212.92 | OOM | OOM | OOM | OOM |
| pokec-regions | OOM | 421.01 | OOM | OOM | OOM | OOM | OOM | 42148.86 | OOM | OOM | OOM | OOM |
| pubmed | 8.33 | 3.93 | 18.84 | 14.93 | 11.09 | 24.91 | 2472.16 | 562.21 | 4627.63 | 3493.25 | 1222.88 | 5393.89 |
| tolokers-2 | 48.21 | 5.67 | 172.27 | 66.68 | 29.48 | 196.14 | 24627.81 | 330.19 | 41292.72 | 33155.81 | 726.60 | 49539.98 |
| twitch-views | OOM | 93.15 | OOM | OOM | 526.96 | OOM | OOM | 4418.71 | OOM | OOM | 10009.07 | OOM |
| Dataset | Fwd time | Bwd time | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 1.21 | 0.17 | 0.17 | 4.00 | 0.50 | 0.24 | 1.62 | 0.19 | 0.38 | 0.23 | 0.25 | 0.29 | 0.67 | 0.27 | 1.09 | 0.87 |
| avazu-ctr | 3.26 | 2.24 | 2.23 | 18.23 | 343.32 | 2.07 | 34.19 | 2.63 | 2.73 | 3.68 | 2.27 | 10.88 | 338.45 | 2.71 | 31.81 | 16.03 |
| citeseer | 1.15 | 0.12 | 0.10 | 2.10 | 0.09 | 0.21 | 0.79 | 0.08 | 0.38 | 0.20 | 0.19 | 0.19 | 0.45 | 0.21 | 0.19 | 0.72 |
| city-reviews | 1.30 | 0.51 | 0.49 | 5.44 | 5.09 | 0.57 | 4.29 | 0.55 | 0.78 | 0.60 | 0.60 | 1.71 | 4.42 | 1.61 | 3.84 | 2.55 |
| city-roads-L | 1.17 | 0.20 | 0.19 | 2.82 | 0.22 | 0.26 | 1.31 | 0.19 | 0.46 | 0.33 | 0.30 | 0.34 | 0.47 | 0.33 | 0.85 | 0.75 |
| city-roads-M | 1.15 | 0.14 | 0.13 | 4.21 | 0.11 | 0.25 | 0.91 | 0.13 | 0.38 | 0.22 | 0.18 | 0.19 | 0.39 | 0.23 | 0.42 | 0.62 |
| cora | 1.15 | 0.11 | 0.10 | 2.08 | 0.10 | 0.25 | 0.79 | 0.09 | 0.38 | 0.23 | 0.20 | 0.19 | 0.45 | 0.21 | 0.20 | 0.75 |
| hm-categories | 3.35 | 2.35 | 2.34 | 13.07 | 843.59 | 1.66 | 34.13 | 2.72 | 2.79 | 3.21 | 2.26 | 6.04 | 838.68 | 2.85 | 31.64 | 19.59 |
| ogbn-arxiv | 1.16 | 0.36 | 0.35 | 5.20 | 0.68 | 0.72 | 2.71 | 0.38 | 0.63 | 0.50 | 0.44 | 0.53 | OOM | 0.48 | 2.21 | 2.11 |
| ogbn-products | 20.17 | 23.99 | 23.88 | 86.71 | 85.01 | 13.09 | 274.38 | 26.30 | 20.45 | 40.21 | 25.02 | 33.10 | 59.82 | 27.51 | OOM | 103.97 |
| pokec-regions | 7.95 | 6.18 | 6.17 | 21.09 | 16.40 | 3.45 | 55.66 | 6.97 | 7.75 | 9.46 | 6.85 | 8.83 | 11.51 | 7.52 | 50.28 | 25.49 |
| pubmed | 1.18 | 0.10 | 0.10 | 2.94 | 0.16 | 0.21 | 0.80 | 0.09 | 0.35 | 0.22 | 0.19 | 0.15 | 0.43 | 0.20 | 0.26 | 0.60 |
| tolokers-2 | 1.15 | 0.17 | 0.16 | 3.06 | 1.23 | 0.64 | 2.12 | 0.18 | 0.36 | 0.41 | 0.21 | 0.41 | 1.33 | 0.31 | 1.62 | 1.25 |
| twitch-views | 3.06 | 2.17 | 2.13 | 13.96 | 139.53 | 2.04 | 22.23 | 2.40 | 2.55 | 2.43 | 2.25 | 8.09 | 138.14 | 2.53 | 20.56 | 11.25 |
| web-traffic | 5.51 | 2.40 | 2.28 | 69.50 | 84477.44 | 17.04 | 28.09 | 3.06 | 7.03 | 11.08 | 13.98 | 234.44 | 37505.82 | 17.47 | 34.93 | 44.00 |
| Dataset | Fwd time | Bwd time | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 1.13 | 0.19 | 0.19 | 4.20 | 0.67 | 0.25 | 2.53 | 0.20 | 0.45 | 0.35 | 0.28 | 0.40 | 0.76 | 0.32 | 2.04 | 0.92 |
| avazu-ctr | 3.70 | 2.68 | 2.72 | 27.65 | 349.08 | 2.33 | 77.91 | 2.90 | 3.10 | 6.38 | 2.68 | 19.93 | 342.22 | 3.14 | 75.63 | 16.40 |
| citeseer | 1.15 | 0.08 | 0.08 | 2.06 | 0.08 | 0.20 | 0.78 | 0.07 | 0.38 | 0.16 | 0.16 | 0.14 | 0.37 | 0.22 | 0.18 | 0.57 |
| city-reviews | 1.38 | 0.58 | 0.57 | 5.81 | 6.16 | 0.70 | 7.98 | 0.65 | 0.95 | 1.12 | 0.74 | 3.21 | 4.51 | 0.86 | 7.51 | 2.69 |
| city-roads-L | 1.19 | 0.23 | 0.22 | 2.84 | 0.29 | 0.30 | 1.96 | 0.24 | 0.62 | 0.49 | 0.40 | 0.45 | 0.59 | 0.43 | 1.55 | 0.86 |
| city-roads-M | 1.14 | 0.15 | 0.13 | 4.00 | 0.14 | 0.21 | 1.21 | 0.14 | 0.41 | 0.32 | 0.23 | 0.23 | 0.41 | 0.25 | 0.75 | 0.64 |
| cora | 1.13 | 0.11 | 0.08 | 2.07 | 0.10 | 0.19 | 0.78 | 0.09 | 0.37 | 0.30 | 0.17 | 0.17 | 0.37 | 0.24 | 0.19 | 0.73 |
| hm-categories | 3.81 | 2.86 | 2.70 | 17.47 | 852.74 | 1.99 | 77.03 | 3.00 | 3.29 | 5.92 | 2.78 | 10.39 | 839.54 | 3.34 | 74.09 | 19.78 |
| ogbn-arxiv | 1.22 | 0.43 | 0.42 | 7.45 | 0.95 | 0.91 | 4.64 | 0.47 | 0.78 | 0.89 | 0.55 | 0.85 | OOM | 0.61 | 4.22 | 2.23 |
| ogbn-products | 24.78 | 37.48 | 37.45 | 113.76 | 121.71 | 23.21 | OOM | 40.59 | 25.94 | 84.75 | 39.62 | 61.20 | 78.57 | 41.04 | OOM | 117.39 |
| pokec-regions | 9.96 | 8.99 | 9.03 | 27.29 | 22.16 | 6.25 | 123.78 | 9.84 | 10.74 | 20.07 | 10.28 | 15.74 | 16.03 | 11.09 | 119.47 | 29.09 |
| pubmed | 1.13 | 0.10 | 0.08 | 2.23 | 0.17 | 0.20 | 0.94 | 0.09 | 0.36 | 0.28 | 0.16 | 0.18 | 0.38 | 0.20 | 0.43 | 0.59 |
| tolokers-2 | 1.12 | 0.19 | 0.19 | 3.40 | 1.50 | 0.36 | 3.50 | 0.21 | 0.38 | 0.43 | 0.23 | 0.83 | 1.54 | 0.60 | 3.06 | 1.25 |
| twitch-views | 3.49 | 2.65 | 2.64 | 20.99 | 144.38 | 2.53 | 42.17 | 2.81 | 2.90 | 5.45 | 2.77 | 15.82 | 137.86 | 3.12 | 41.02 | 11.53 |
| web-traffic | 8.85 | 3.55 | 3.52 | 125.18 | 84730.25 | 20.99 | 51.86 | 4.45 | 11.38 | 16.00 | 16.43 | 447.99 | 37535.07 | 20.55 | 58.81 | 46.60 |
| Dataset | Fwd time | Bwd time | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 1.16 | 0.30 | 0.30 | 4.20 | 0.70 | 0.29 | 4.34 | 0.33 | 0.63 | 0.58 | 0.44 | 0.46 | 0.83 | 0.48 | 4.08 | 1.10 |
| avazu-ctr | 6.09 | 5.15 | 4.94 | 23.32 | 351.03 | 2.75 | 157.89 | 5.59 | 5.76 | 11.70 | 5.10 | 16.21 | 342.29 | 5.73 | 158.46 | 19.14 |
| citeseer | 1.15 | 0.08 | 0.07 | 2.92 | 0.08 | 0.18 | 0.79 | 0.07 | 0.38 | 0.16 | 0.15 | 0.19 | 0.36 | 0.19 | 0.18 | 0.56 |
| city-reviews | 1.96 | 1.07 | 1.08 | 5.70 | 5.77 | 1.01 | 15.17 | 1.20 | 1.71 | 2.08 | 1.36 | 3.27 | 4.74 | 2.83 | 14.98 | 3.27 |
| city-roads-L | 1.34 | 0.36 | 0.36 | 3.07 | 0.34 | 0.48 | 3.31 | 0.43 | 1.11 | 0.77 | 0.67 | 0.69 | 0.76 | 0.75 | 3.00 | 1.16 |
| city-roads-M | 1.17 | 0.19 | 0.19 | 4.00 | 0.17 | 0.23 | 1.79 | 0.20 | 0.56 | 0.39 | 0.34 | 0.34 | 0.49 | 0.37 | 1.36 | 0.78 |
| cora | 1.12 | 0.09 | 0.07 | 2.11 | 0.10 | 0.18 | 0.78 | 0.09 | 0.38 | 0.17 | 0.17 | 0.17 | 0.36 | 0.18 | 0.19 | 0.73 |
| hm-categories | 6.46 | 5.39 | 5.12 | 17.90 | 854.18 | 2.17 | 155.22 | 5.66 | 6.05 | 10.66 | 5.26 | 10.72 | 841.23 | 6.05 | 155.89 | 22.45 |
| ogbn-arxiv | 1.69 | 0.77 | 0.76 | 7.20 | 1.04 | 1.32 | 8.66 | 0.87 | 1.43 | 1.61 | 0.97 | 1.11 | OOM | 1.11 | 8.48 | 2.68 |
| ogbn-products | 48.00 | 74.82 | 74.70 | 135.49 | 125.35 | 43.99 | OOM | 78.32 | 51.23 | 168.93 | 79.11 | 84.51 | 84.96 | 81.81 | OOM | 158.20 |
| pokec-regions | 19.23 | 17.90 | 17.66 | 33.58 | 23.28 | 12.10 | 267.84 | 19.55 | 21.29 | 39.54 | 20.43 | 21.22 | 18.78 | 21.86 | OOM | 39.91 |
| pubmed | 1.13 | 0.13 | 0.12 | 2.26 | 0.20 | 0.20 | 1.27 | 0.12 | 0.36 | 0.23 | 0.19 | 0.20 | 0.43 | 0.21 | 0.77 | 0.59 |
| tolokers-2 | 1.13 | 0.33 | 0.33 | 3.32 | 1.60 | 0.40 | 6.32 | 0.37 | 0.55 | 0.75 | 0.38 | 0.81 | 1.61 | 0.63 | 6.02 | 1.41 |
| twitch-views | 5.81 | 5.02 | 4.92 | 20.60 | 144.10 | 3.68 | 98.90 | 5.51 | 5.60 | 10.29 | 5.31 | 15.80 | 140.11 | 5.78 | 98.86 | 14.38 |
| web-traffic | 16.91 | 6.95 | 6.93 | 93.93 | 83131.37 | 27.56 | 121.47 | 8.82 | 22.63 | 32.88 | 22.53 | 326.42 | 37547.82 | 27.17 | 131.90 | 53.53 |
| Dataset | Fwd time | Bwd time | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 1.42 | 0.53 | 0.53 | 5.05 | 0.83 | 0.45 | 7.96 | 0.60 | 1.08 | 1.04 | 0.75 | 0.83 | 1.00 | 0.84 | 7.50 | 1.45 |
| avazu-ctr | 11.24 | 9.79 | 9.75 | 40.29 | 348.73 | 3.72 | OOM | 10.96 | 11.07 | 22.29 | 10.08 | 32.90 | 341.79 | 11.28 | OOM | 24.67 |
| citeseer | 1.15 | 0.09 | 0.07 | 2.08 | 0.08 | 0.19 | 0.78 | 0.08 | 0.38 | 0.16 | 0.15 | 0.15 | 0.36 | 0.21 | 0.25 | 0.57 |
| city-reviews | 3.30 | 2.06 | 2.07 | 8.82 | 6.63 | 1.69 | 31.29 | 2.28 | 3.30 | 4.12 | 2.51 | 6.62 | 5.59 | 3.30 | 30.12 | 4.59 |
| city-roads-L | 2.11 | 0.66 | 0.65 | 4.01 | 0.43 | 0.91 | 5.92 | 0.80 | 2.10 | 1.41 | 1.23 | 1.19 | 1.10 | 1.38 | 5.91 | 1.78 |
| city-roads-M | 1.24 | 0.31 | 0.30 | 4.42 | 0.21 | 0.39 | 2.99 | 0.35 | 0.93 | 0.66 | 0.56 | 0.55 | 0.63 | 0.63 | 2.63 | 1.03 |
| cora | 1.15 | 0.08 | 0.07 | 2.11 | 0.10 | 0.18 | 0.78 | 0.09 | 0.38 | 0.17 | 0.17 | 0.15 | 0.36 | 0.19 | 0.26 | 0.74 |
| hm-categories | 11.98 | 10.10 | 10.04 | 30.88 | 854.65 | 2.83 | OOM | 11.12 | 11.75 | 21.18 | 10.27 | 23.74 | 841.04 | 11.35 | OOM | 28.07 |
| ogbn-arxiv | 2.74 | 1.43 | 1.44 | 12.22 | 1.25 | 2.11 | 16.68 | 1.62 | 2.74 | 3.07 | 1.82 | 2.07 | OOM | 2.10 | 16.55 | 3.51 |
| ogbn-products | 94.89 | 149.59 | 149.51 | 219.93 | 142.66 | 84.44 | OOM | 155.02 | 101.84 | 337.85 | 157.88 | 172.14 | 103.64 | 163.52 | OOM | 239.99 |
| pokec-regions | 37.70 | 35.78 | 35.57 | 51.82 | 27.16 | 24.04 | OOM | 38.88 | 42.34 | 78.86 | 40.73 | 43.67 | 25.54 | 43.70 | OOM | 61.64 |
| pubmed | 1.14 | 0.18 | 0.17 | 2.33 | 0.23 | 0.22 | 1.96 | 0.18 | 0.48 | 0.36 | 0.29 | 0.32 | 0.50 | 0.31 | 1.48 | 0.70 |
| tolokers-2 | 1.38 | 0.60 | 0.59 | 3.99 | 1.97 | 0.54 | 12.36 | 0.67 | 0.86 | 1.36 | 0.67 | 1.53 | 1.77 | 1.13 | 12.26 | 1.76 |
| twitch-views | 10.91 | 9.75 | 9.75 | 38.19 | 148.91 | 6.83 | 216.31 | 10.82 | 10.99 | 20.41 | 10.46 | 33.72 | 143.70 | 11.53 | OOM | 19.97 |
| web-traffic | 33.05 | 13.82 | 13.78 | 180.37 | 82664.58 | 38.77 | OOM | 17.54 | 44.95 | 60.83 | 35.80 | 662.34 | 37566.82 | 42.20 | OOM | 68.64 |
| Dataset | Fwd mem | Bwd mem | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 91.19 | 44.42 | 46.75 | 2398.58 | 46.19 | 78.17 | 2688.81 | 63.88 | 118.34 | 83.86 | 86.19 | 2427.34 | 85.44 | 121.42 | 2713.42 | 111.88 |
| avazu-ctr | 1232.80 | 2148.34 | 5452.49 | 3942.12 | 366.35 | 957.50 | 13964.00 | 559.68 | 1288.66 | 2288.59 | 5592.94 | 3255.39 | 506.50 | 1029.65 | 14001.24 | 1919.91 |
| citeseer | 50.79 | 2378.31 | 5974.95 | 2379.71 | 48.78 | 49.67 | 2385.75 | 49.67 | 52.44 | 2380.81 | 5977.45 | 2382.08 | 51.26 | 52.51 | 2387.37 | 52.31 |
| city-reviews | 375.17 | 2054.77 | 5265.95 | 2647.12 | 217.50 | 348.83 | 3814.95 | 273.32 | 456.89 | 2173.79 | 5384.96 | 2710.85 | 335.94 | 476.72 | 3887.60 | 454.53 |
| city-roads-L | 270.09 | 192.88 | 202.82 | 2528.55 | 187.64 | 217.82 | 2732.23 | 225.10 | 340.37 | 299.43 | 309.36 | 2630.84 | 293.65 | 338.83 | 2801.69 | 335.88 |
| city-roads-M | 79.14 | 1888.28 | 5086.88 | 2380.49 | 45.15 | 57.24 | 2472.56 | 60.41 | 107.48 | 1931.02 | 5129.62 | 2421.11 | 87.88 | 106.24 | 2500.43 | 105.38 |
| cora | 18.04 | 2345.69 | 5942.27 | 2347.26 | 16.29 | 17.14 | 2353.69 | 17.04 | 19.39 | 2347.73 | 5944.32 | 2349.17 | 18.32 | 19.46 | 2355.01 | 19.25 |
| hm-categories | 1130.73 | 2242.86 | 5799.52 | 3844.90 | 292.68 | 775.09 | 13616.91 | 472.96 | 1164.83 | 2359.19 | 5915.85 | 3146.70 | 410.86 | 821.70 | 13639.65 | 1794.56 |
| ogbn-arxiv | 310.60 | 2381.67 | 5861.29 | 2548.97 | 182.52 | 263.20 | 3193.35 | 234.80 | 398.77 | 2511.45 | 5992.37 | 2664.10 | OOM | 410.90 | 3276.03 | 385.25 |
| ogbn-products | 9080.94 | 3989.71 | 6688.19 | 12444.09 | 3581.69 | 9823.04 | 70387.41 | 5171.71 | 10778.69 | 6274.39 | 8972.87 | 10547.88 | 5857.19 | 11955.41 | OOM | 13332.66 |
| pokec-regions | 3408.04 | 1876.55 | 4001.39 | 5222.43 | 1520.27 | 3161.69 | 20327.99 | 2169.11 | 4325.63 | 3201.72 | 5327.88 | 5755.51 | 2839.22 | 4565.96 | 21125.26 | 4450.10 |
| pubmed | 62.80 | 2378.01 | 5975.80 | 2382.04 | 48.93 | 55.91 | 2435.27 | 54.52 | 72.72 | 2393.01 | 5990.73 | 2395.88 | 64.53 | 72.78 | 2444.97 | 70.80 |
| tolokers-2 | 61.66 | 2336.09 | 5933.54 | 2406.19 | 18.65 | 63.46 | 2885.80 | 29.97 | 70.66 | 2348.75 | 5947.17 | 2381.82 | 31.26 | 73.84 | 2891.54 | 96.23 |
| twitch-views | 825.61 | 2420.07 | 5959.21 | 3328.11 | 258.45 | 909.20 | 9620.32 | 405.75 | 948.74 | 2596.34 | 6137.54 | 3021.20 | 437.09 | 1061.00 | 9702.41 | 1278.68 |
| web-traffic | 16532.88 | 14738.82 | 15692.57 | 17346.26 | 14614.41 | 15458.88 | 24988.95 | 15430.80 | 17987.15 | 16928.07 | 17882.62 | 19365.88 | 16794.41 | 17934.15 | 26400.25 | 17816.82 |
| Dataset | Fwd mem | Bwd mem | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 140.41 | 71.55 | 73.89 | 2419.92 | 70.80 | 108.93 | 3011.81 | 100.79 | 192.18 | 145.39 | 147.72 | 2489.02 | 146.96 | 195.25 | 3061.03 | 186.46 |
| avazu-ctr | 1288.66 | 2269.07 | 5574.31 | 3960.73 | 405.11 | 1004.81 | 24765.24 | 615.54 | 1400.38 | 2380.79 | 5688.31 | 3348.09 | 603.40 | 1145.17 | 24839.72 | 1994.79 |
| citeseer | 54.04 | 2380.82 | 5976.70 | 2382.17 | 50.40 | 51.70 | 2394.27 | 52.11 | 57.31 | 2386.63 | 5982.86 | 2387.90 | 55.32 | 57.39 | 2398.45 | 57.18 |
| city-reviews | 520.48 | 2137.46 | 5348.63 | 2693.65 | 290.15 | 439.65 | 5097.74 | 382.30 | 674.86 | 2355.43 | 5566.60 | 2893.84 | 517.58 | 694.69 | 5243.05 | 646.07 |
| city-roads-L | 411.17 | 265.77 | 275.71 | 2598.01 | 258.18 | 305.09 | 3007.41 | 330.90 | 551.78 | 475.77 | 485.71 | 2804.49 | 469.79 | 550.44 | 3146.33 | 548.13 |
| city-roads-M | 135.28 | 1917.09 | 5115.69 | 2408.36 | 73.15 | 92.27 | 2593.03 | 102.41 | 191.61 | 2000.69 | 5199.69 | 2490.78 | 157.88 | 190.38 | 2648.76 | 189.38 |
| cora | 20.68 | 2347.30 | 5944.14 | 2348.82 | 17.61 | 18.79 | 2361.72 | 19.03 | 23.36 | 2352.06 | 5949.03 | 2353.49 | 21.63 | 23.42 | 2364.82 | 23.22 |
| hm-categories | 1164.20 | 2347.82 | 5904.48 | 3856.26 | 314.15 | 803.51 | 24140.09 | 507.06 | 1232.54 | 2416.03 | 5972.69 | 3203.54 | 464.53 | 889.91 | 24185.56 | 1839.77 |
| ogbn-arxiv | 473.35 | 2470.10 | 5949.71 | 2630.85 | 263.89 | 365.90 | 3928.17 | 356.86 | 642.90 | 2718.16 | 6197.77 | 2870.82 | OOM | 655.02 | 4093.55 | 628.48 |
| ogbn-products | 11473.22 | 5676.39 | 8374.97 | 13042.09 | 4777.69 | 11318.08 | OOM | 6965.99 | 14367.15 | 9264.39 | 11962.97 | 13537.69 | 8847.19 | 15543.41 | OOM | 15725.35 |
| pokec-regions | 5005.51 | 2804.56 | 4930.72 | 5621.43 | 2319.00 | 4159.06 | 36877.03 | 3367.21 | 6721.83 | 5198.56 | 7324.72 | 7752.34 | 4836.05 | 6962.16 | 38471.56 | 6357.74 |
| pubmed | 82.80 | 2388.20 | 5985.14 | 2391.74 | 59.30 | 67.94 | 2497.88 | 69.71 | 103.09 | 2417.08 | 6014.02 | 2419.94 | 89.35 | 103.16 | 2517.14 | 101.18 |
| tolokers-2 | 72.37 | 2346.00 | 5943.70 | 2409.67 | 24.39 | 70.64 | 3404.24 | 38.98 | 88.90 | 2363.22 | 5961.89 | 2396.17 | 45.61 | 90.70 | 3415.72 | 108.27 |
| twitch-views | 974.33 | 2555.30 | 6094.58 | 3369.15 | 338.62 | 1010.85 | 16422.73 | 528.88 | 1194.18 | 2801.56 | 6340.85 | 3226.42 | 637.52 | 1302.48 | 16586.91 | 1443.20 |
| web-traffic | 19356.88 | 16222.07 | 17176.62 | 18758.61 | 16026.41 | 17224.06 | 34109.31 | 17548.80 | 22223.15 | 20458.07 | 21412.62 | 22896.23 | 20324.41 | 22170.15 | 36931.89 | 22052.82 |
| Dataset | Fwd mem | Bwd mem | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 241.96 | 122.33 | 124.66 | 2469.14 | 121.57 | 172.01 | 3657.81 | 176.96 | 344.09 | 272.33 | 274.66 | 2612.08 | 273.90 | 347.58 | 3756.26 | 338.79 |
| avazu-ctr | 1400.38 | 2343.55 | 5648.80 | 3997.58 | 478.07 | 1097.15 | 46367.72 | 727.26 | 1624.02 | 2566.99 | 5872.24 | 3534.30 | 785.81 | 1364.82 | 46516.69 | 2143.75 |
| citeseer | 60.54 | 2383.24 | 5979.89 | 2384.58 | 53.65 | 55.76 | 2408.83 | 56.98 | 67.57 | 2392.99 | 5989.84 | 2394.26 | 63.44 | 67.64 | 2415.33 | 67.44 |
| city-reviews | 813.86 | 2282.77 | 5495.32 | 2838.43 | 436.84 | 622.67 | 7665.54 | 602.33 | 1114.92 | 2718.71 | 5933.32 | 3256.59 | 884.30 | 1134.75 | 7956.16 | 1085.92 |
| city-roads-L | 686.86 | 403.62 | 413.56 | 2736.93 | 396.02 | 478.20 | 3557.78 | 537.67 | 965.33 | 820.39 | 830.32 | 3151.80 | 814.41 | 963.98 | 3836.18 | 960.86 |
| city-roads-M | 247.28 | 1972.82 | 5171.95 | 2464.09 | 129.15 | 162.33 | 2833.96 | 186.41 | 359.61 | 2140.03 | 5339.95 | 2630.12 | 297.88 | 358.38 | 2945.43 | 357.38 |
| cora | 25.97 | 2349.94 | 5946.50 | 2351.46 | 20.26 | 22.10 | 2377.64 | 22.99 | 31.29 | 2358.45 | 5954.73 | 2359.88 | 28.24 | 31.36 | 2383.51 | 31.15 |
| hm-categories | 1232.41 | 2393.29 | 5950.48 | 3879.00 | 360.68 | 860.88 | 45190.01 | 575.27 | 1368.95 | 2529.71 | 6088.48 | 3317.21 | 580.86 | 1028.97 | 45280.95 | 1930.97 |
| ogbn-arxiv | 806.60 | 2635.48 | 6116.34 | 2797.03 | 430.52 | 573.21 | 5397.83 | 606.80 | 1142.77 | 3131.60 | 6614.34 | 3284.25 | OOM | 1154.90 | 5728.58 | 1129.25 |
| ogbn-products | 16257.22 | 8068.58 | 10766.97 | 14237.94 | 7169.69 | 14308.08 | OOM | 10553.99 | 21543.15 | 15244.58 | 17942.97 | 19518.20 | 14827.19 | 22719.41 | OOM | 20509.35 |
| pokec-regions | 8191.64 | 4397.62 | 6523.78 | 7185.04 | 3912.07 | 6151.49 | 69970.10 | 5756.81 | 11501.03 | 9181.23 | 11307.39 | 11735.01 | 8818.72 | 11741.36 | OOM | 11136.95 |
| pubmed | 122.80 | 2407.38 | 6004.39 | 2410.92 | 79.30 | 93.50 | 2622.89 | 100.08 | 163.09 | 2465.15 | 6062.16 | 2468.01 | 139.72 | 163.90 | 2661.40 | 161.92 |
| tolokers-2 | 96.97 | 2357.36 | 5953.85 | 2415.29 | 36.90 | 85.66 | 4441.60 | 57.23 | 125.41 | 2391.81 | 5988.30 | 2425.64 | 76.91 | 127.73 | 4464.56 | 132.87 |
| twitch-views | 1302.67 | 2719.47 | 6258.76 | 3451.24 | 502.79 | 1216.07 | 30027.56 | 775.14 | 1686.56 | 3211.99 | 6751.28 | 3636.85 | 1047.96 | 1795.00 | 30355.91 | 1771.46 |
| web-traffic | 24999.24 | 19043.25 | 19997.80 | 21579.79 | 18847.59 | 20751.23 | 52346.48 | 21780.57 | 30686.68 | 27511.01 | 28465.57 | 29949.17 | 27377.35 | 30633.69 | 57991.66 | 30516.35 |
| Dataset | Fwd mem | Bwd mem | ||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | DGL | cuSPARSE | cuSPARSE+ ) | FuseGNN | TC-GNN | Ours (WSB/TC) | PyG | Pytorch CSR-SpMM | |
| artnet-exp | 435.75 | 219.23 | 221.56 | 2567.59 | 218.47 | 294.30 | 4950.70 | 322.30 | 634.77 | 514.57 | 516.90 | 2858.20 | 516.14 | 638.26 | 5147.59 | 629.47 |
| avazu-ctr | 1682.29 | 2492.51 | 5797.76 | 4072.06 | 627.04 | 1283.35 | OOM | 950.70 | 2070.91 | 2939.40 | 6244.65 | 3906.70 | 1158.22 | 1811.71 | OOM | 2441.68 |
| citeseer | 74.04 | 2389.74 | 5986.80 | 2391.08 | 60.15 | 63.88 | 2439.61 | 67.24 | 87.57 | 2409.23 | 6006.29 | 2410.50 | 80.20 | 87.64 | 2452.60 | 87.44 |
| city-reviews | 1392.36 | 2573.40 | 5784.57 | 3129.06 | 726.09 | 985.26 | 12800.16 | 1036.21 | 1982.68 | 3445.28 | 6656.45 | 3983.15 | 1607.43 | 2002.51 | 13381.42 | 1953.92 |
| city-roads-L | 1243.17 | 681.77 | 691.71 | 3014.78 | 674.18 | 825.28 | 4658.66 | 954.90 | 1799.78 | 1515.77 | 1525.71 | 3846.57 | 1509.79 | 1798.44 | 5214.35 | 1796.13 |
| city-roads-M | 471.28 | 2084.29 | 5283.95 | 2575.57 | 241.15 | 302.33 | 3315.83 | 354.41 | 695.61 | 2418.70 | 5619.95 | 2908.79 | 577.88 | 694.38 | 3538.77 | 693.38 |
| cora | 36.55 | 2355.58 | 5952.71 | 2357.09 | 25.54 | 28.71 | 2409.19 | 30.93 | 47.16 | 2371.44 | 5968.58 | 2372.88 | 41.46 | 47.22 | 2419.43 | 47.02 |
| hm-categories | 1371.25 | 2484.24 | 6040.89 | 3924.47 | 450.56 | 974.03 | OOM | 711.68 | 1641.78 | 2757.07 | 6313.72 | 3544.36 | 805.57 | 1299.16 | OOM | 2112.86 |
| ogbn-arxiv | 1465.59 | 2966.22 | 6445.84 | 3126.97 | 760.02 | 986.02 | 8337.15 | 1101.04 | 2131.26 | 3958.47 | 7438.08 | 4111.12 | OOM | 2143.38 | 8998.64 | 2117.74 |
| ogbn-products | 25825.22 | 12852.58 | 15550.97 | 18069.63 | 11953.69 | 20288.08 | OOM | 17729.99 | 35895.15 | 27204.58 | 29902.97 | 31478.20 | 26787.19 | 37071.41 | OOM | 34460.41 |
| pokec-regions | 14573.51 | 7588.56 | 9714.72 | 10375.98 | 7103.00 | 10138.96 | OOM | 10543.21 | 21073.83 | 17158.56 | 19284.72 | 19712.34 | 16796.05 | 21314.16 | OOM | 20709.74 |
| pubmed | 196.84 | 2445.89 | 6042.90 | 2449.43 | 116.32 | 140.89 | 2873.05 | 155.61 | 274.15 | 2561.42 | 6158.43 | 2564.28 | 232.27 | 274.96 | 2950.07 | 273.12 |
| tolokers-2 | 140.67 | 2380.33 | 5976.82 | 2426.29 | 58.83 | 113.85 | 6514.03 | 90.25 | 191.04 | 2449.22 | 6045.71 | 2482.65 | 131.73 | 194.04 | 6559.96 | 179.03 |
| twitch-views | 1959.37 | 3047.82 | 6587.11 | 3615.41 | 831.14 | 1626.50 | 57238.60 | 1267.67 | 2671.60 | 4032.86 | 7572.15 | 4457.72 | 1868.83 | 2780.04 | OOM | 2513.90 |
| web-traffic | 36292.88 | 24690.07 | 25644.62 | 27226.61 | 24494.41 | 27808.64 | OOM | 30250.80 | 47627.15 | 41628.07 | 42582.62 | 44066.23 | 41494.41 | 47574.15 | OOM | 47456.82 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuGraph | Ours | DGL | cuGraph | Ours | DGL | cuGraph | Ours | DGL | cuGraph | Ours | |
| artnet-exp | 0.42 | 0.45 | 0.17 | 0.26 | 0.33 | 0.19 | 97.05 | 83.81 | 58.03 | 133.97 | 120.73 | 94.94 |
| avazu-ctr | 10.89 | 22.69 | 1.66 | 0.44 | 0.58 | 0.39 | 847.90 | 907.31 | 301.54 | 903.76 | 963.17 | 357.40 |
| citeseer | 0.33 | 4.75 | 0.08 | 0.24 | 0.31 | 0.15 | 51.60 | 50.62 | 49.58 | 54.04 | 53.06 | 52.02 |
| city-reviews | 1.95 | 3.47 | 0.46 | 0.45 | 0.41 | 0.33 | 381.74 | 344.90 | 246.03 | 490.73 | 453.89 | 355.02 |
| city-roads-L | 0.51 | 0.36 | 0.25 | 0.41 | 0.35 | 0.31 | 307.07 | 264.54 | 222.36 | 411.26 | 368.73 | 326.55 |
| city-roads-M | 0.33 | 0.28 | 0.15 | 0.27 | 0.39 | 0.20 | 93.58 | 76.39 | 59.07 | 135.52 | 118.39 | 101.00 |
| cora | 0.32 | 0.23 | 0.08 | 0.24 | 0.43 | 0.16 | 18.65 | 17.86 | 16.93 | 20.63 | 19.84 | 18.91 |
| hm-categories | 5.80 | 11.40 | 1.57 | 0.31 | 0.32 | 0.23 | 739.79 | 805.50 | 223.02 | 773.90 | 839.61 | 258.39 |
| ogbn-arxiv | 3.16 | 0.73 | 0.40 | 0.84 | 0.51 | 0.34 | 342.07 | 293.82 | 221.32 | 468.07 | 419.82 | 347.32 |
| ogbn-products | 27.82 | 55.25 | 10.25 | 6.59 | 14.26 | 4.68 | 7893.99 | 7618.08 | 3725.95 | 9687.72 | 9411.80 | 5519.76 |
| pokec-regions | 10.79 | 13.76 | 3.91 | 5.10 | 6.36 | 3.07 | 3407.92 | 3025.80 | 1814.16 | 4603.82 | 4221.70 | 3010.06 |
| pubmed | 0.33 | 0.22 | 0.09 | 0.28 | 0.48 | 0.17 | 67.08 | 60.66 | 53.55 | 81.53 | 75.85 | 68.74 |
| tolokers-2 | 0.59 | 0.99 | 0.19 | 0.26 | 0.34 | 0.17 | 47.81 | 48.35 | 17.64 | 56.43 | 57.36 | 26.85 |
| twitch-views | 8.76 | 15.99 | 1.41 | 0.61 | 0.61 | 0.47 | 652.44 | 650.90 | 249.31 | 775.57 | 774.03 | 375.31 |
| web-traffic | 60.85 | 495.45 | 4.29 | 12.44 | 4.59 | 10.52 | 17162.69 | 16329.47 | 15290.86 | 19280.69 | 18447.47 | 17408.86 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuGraph | Ours | DGL | cuGraph | Ours | DGL | cuGraph | Ours | DGL | cuGraph | Ours | |
| artnet-exp | 0.56 | 0.45 | 0.23 | 0.32 | 0.32 | 0.23 | 162.44 | 133.81 | 94.94 | 236.27 | 207.65 | 168.78 |
| avazu-ctr | 11.00 | 21.25 | 2.51 | 0.57 | 1.67 | 0.49 | 947.17 | 981.79 | 359.67 | 1061.17 | 1094.27 | 473.67 |
| citeseer | 0.32 | 0.22 | 0.08 | 0.25 | 0.42 | 0.15 | 55.87 | 53.87 | 52.01 | 60.74 | 58.74 | 56.89 |
| city-reviews | 2.45 | 3.74 | 0.65 | 0.78 | 0.81 | 0.55 | 573.15 | 490.90 | 355.02 | 791.12 | 708.87 | 572.99 |
| city-roads-L | 0.88 | 0.37 | 0.35 | 0.69 | 0.54 | 0.45 | 490.48 | 404.00 | 328.17 | 700.48 | 614.00 | 538.17 |
| city-roads-M | 0.43 | 1.90 | 0.19 | 0.34 | 0.36 | 0.24 | 167.13 | 132.39 | 101.07 | 251.13 | 216.39 | 185.07 |
| cora | 0.33 | 0.22 | 0.08 | 0.24 | 0.33 | 0.15 | 22.12 | 20.51 | 18.91 | 26.08 | 24.47 | 22.88 |
| hm-categories | 6.38 | 11.61 | 2.44 | 0.44 | 0.42 | 0.33 | 798.74 | 850.97 | 255.23 | 866.94 | 919.18 | 323.44 |
| ogbn-arxiv | 3.80 | 0.79 | 0.54 | 1.17 | 0.77 | 0.50 | 557.01 | 458.51 | 343.38 | 805.07 | 706.57 | 591.44 |
| ogbn-products | 45.11 | 59.89 | 17.19 | 12.78 | 31.43 | 9.06 | 11033.56 | 10010.45 | 5519.95 | 14621.56 | 13598.45 | 9107.85 |
| pokec-regions | 17.96 | 14.22 | 6.77 | 9.40 | 12.53 | 6.32 | 5502.90 | 4621.06 | 3012.25 | 7896.90 | 7015.06 | 5406.25 |
| pubmed | 0.32 | 0.26 | 0.12 | 0.27 | 0.32 | 0.16 | 93.10 | 80.66 | 68.74 | 122.73 | 111.03 | 99.11 |
| tolokers-2 | 0.75 | 1.05 | 0.24 | 0.26 | 0.43 | 0.16 | 64.15 | 60.74 | 26.85 | 81.37 | 77.97 | 44.08 |
| twitch-views | 11.04 | 16.97 | 2.29 | 1.09 | 1.09 | 0.84 | 866.00 | 815.08 | 370.53 | 1112.26 | 1061.34 | 616.79 |
| web-traffic | 66.11 | 492.70 | 6.34 | 17.48 | 7.83 | 13.29 | 20867.69 | 19152.06 | 17408.86 | 25103.69 | 23388.06 | 21644.86 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuGraph | Ours | DGL | cuGraph | Ours | DGL | cuGraph | Ours | DGL | cuGraph | Ours | |
| artnet-exp | 0.91 | 0.72 | 0.33 | 0.55 | 0.51 | 0.37 | 293.20 | 233.03 | 171.11 | 443.20 | 383.03 | 321.11 |
| avazu-ctr | 12.98 | 41.36 | 4.65 | 1.06 | 1.10 | 0.80 | 1140.41 | 1130.76 | 469.12 | 1363.85 | 1354.20 | 692.56 |
| citeseer | 0.32 | 0.23 | 0.08 | 0.25 | 0.32 | 0.14 | 64.40 | 60.37 | 56.89 | 74.65 | 70.62 | 67.14 |
| city-reviews | 3.45 | 8.49 | 1.06 | 1.45 | 1.55 | 1.01 | 955.97 | 782.22 | 575.05 | 1393.97 | 1220.22 | 1013.05 |
| city-roads-L | 1.63 | 0.53 | 0.48 | 1.26 | 0.94 | 0.79 | 853.69 | 680.92 | 534.93 | 1270.46 | 1097.69 | 951.70 |
| city-roads-M | 0.73 | 0.35 | 0.24 | 0.58 | 0.60 | 0.37 | 314.10 | 244.39 | 185.07 | 482.10 | 412.39 | 353.07 |
| cora | 0.32 | 0.27 | 0.08 | 0.25 | 0.34 | 0.13 | 29.06 | 25.79 | 22.88 | 36.99 | 33.73 | 30.81 |
| hm-categories | 9.24 | 19.21 | 4.36 | 0.66 | 0.65 | 0.48 | 919.79 | 941.92 | 325.02 | 1057.79 | 1078.86 | 463.02 |
| ogbn-arxiv | 4.97 | 1.35 | 0.85 | 2.26 | 1.39 | 0.91 | 993.03 | 789.89 | 593.32 | 1491.03 | 1287.89 | 1091.32 |
| ogbn-products | 82.42 | 112.56 | 33.40 | 26.48 | 64.93 | 19.19 | 17312.52 | 14794.45 | 9107.95 | 24488.52 | 21970.45 | 16283.85 |
| pokec-regions | 33.70 | 26.59 | 12.70 | 19.60 | 25.95 | 13.36 | 9686.60 | 7809.60 | 5401.86 | 14470.20 | 12593.20 | 10185.46 |
| pubmed | 0.38 | 0.34 | 0.16 | 0.27 | 0.29 | 0.20 | 144.39 | 119.91 | 99.11 | 204.39 | 179.91 | 159.11 |
| tolokers-2 | 0.91 | 1.70 | 0.38 | 0.26 | 0.35 | 0.19 | 94.58 | 83.71 | 45.11 | 130.58 | 119.71 | 80.59 |
| twitch-views | 15.40 | 34.21 | 4.71 | 2.27 | 2.63 | 1.68 | 1297.92 | 1143.43 | 616.79 | 1790.44 | 1635.95 | 1109.31 |
| web-traffic | 83.04 | 904.21 | 9.19 | 35.69 | 16.64 | 26.77 | 28276.05 | 24796.65 | 21640.63 | 36743.81 | 33264.42 | 30108.39 |
| Dataset | Fwd time | Bwd time | Fwd mem | Bwd mem | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| DGL | cuGraph | Ours | DGL | cuGraph | Ours | DGL | cuGraph | Ours | DGL | cuGraph | Ours | |
| artnet-exp | 1.70 | 1.33 | 0.60 | 1.01 | 0.88 | 0.68 | 549.30 | 428.38 | 316.45 | 844.64 | 723.72 | 611.79 |
| avazu-ctr | 21.97 | 85.48 | 9.13 | 1.83 | 1.66 | 1.35 | 1532.27 | 1428.76 | 692.56 | 1979.16 | 1875.64 | 1139.45 |
| citeseer | 0.32 | 0.29 | 0.08 | 0.25 | 0.29 | 0.16 | 81.96 | 73.36 | 67.14 | 101.45 | 93.36 | 87.14 |
| city-reviews | 6.20 | 15.05 | 1.95 | 2.83 | 3.33 | 1.92 | 1717.55 | 1362.84 | 1008.93 | 2589.44 | 2234.72 | 1880.81 |
| city-roads-L | 3.20 | 0.92 | 0.78 | 2.39 | 1.73 | 1.49 | 1584.19 | 1237.07 | 952.17 | 2418.19 | 2071.07 | 1786.17 |
| city-roads-M | 1.36 | 0.50 | 0.37 | 1.04 | 1.09 | 0.66 | 607.11 | 467.33 | 353.07 | 943.11 | 803.33 | 689.07 |
| cora | 0.32 | 0.37 | 0.08 | 0.25 | 0.33 | 0.14 | 43.04 | 36.37 | 30.81 | 58.91 | 52.24 | 46.68 |
| hm-categories | 18.36 | 50.94 | 9.18 | 1.12 | 1.01 | 0.80 | 1156.41 | 1123.92 | 459.85 | 1429.24 | 1396.75 | 732.68 |
| ogbn-arxiv | 7.33 | 2.58 | 1.62 | 3.59 | 2.88 | 1.75 | 1859.21 | 1450.63 | 1087.57 | 2851.46 | 2442.88 | 2079.81 |
| ogbn-products | 164.52 | 226.48 | 66.50 | 53.65 | 133.67 | 38.85 | 29869.13 | 24360.97 | 16283.95 | 44221.13 | 38712.97 | 30635.85 |
| pokec-regions | 67.55 | 53.65 | 26.32 | 40.12 | 53.29 | 28.55 | 18060.50 | 14188.67 | 10188.25 | 27630.50 | 23758.67 | 19758.25 |
| pubmed | 0.60 | 0.51 | 0.21 | 0.44 | 0.42 | 0.30 | 244.22 | 196.42 | 154.64 | 359.75 | 311.95 | 270.17 |
| tolokers-2 | 1.39 | 3.38 | 0.60 | 0.34 | 0.39 | 0.26 | 153.38 | 128.79 | 77.93 | 222.27 | 197.69 | 146.82 |
| twitch-views | 24.54 | 75.88 | 9.82 | 4.90 | 6.13 | 3.73 | 2158.87 | 1800.12 | 1109.31 | 3143.92 | 2785.16 | 2094.35 |
| web-traffic | 116.39 | 1807.62 | 16.34 | 56.23 | 28.66 | 37.85 | 43096.64 | 36087.83 | 30110.86 | 60034.64 | 53025.83 | 47048.86 |