StressDream: Управление видеомоделями мира для надежной оценки и улучшения стратегий
Аннотация
Видео world models (WMs) продемонстрировали потенциал для оценки и улучшения policy путем моделирования реалистичных будущих наблюдений, обусловленных действиями робота. Хотя WMs могут моделировать распределения будущих состояний, оценка и улучшение policy обычно опираются на номинальные представления, которые могут упустить значимые результаты действий робота, если не генерировать чрезмерно большое количество выборок. Чтобы обеспечить надежную оценку и улучшение policy на основе представлений WM, мы предлагаем StressDream, который направляет представления к значимым, но правдоподобным результатам, задаваемым во время inference путем оптимизации начального шума diffusion-based WMs. Однако оптимизация высокоразмерного шума является сложной задачей: оптимизация должна учитывать нюансы, зависящие от сцены целевые события в сгенерированных видео, избегая при этом OOD шума, который приводит к неправдоподобным представлениям. Мы решаем эту задачу с помощью двух взаимодополняющих целей: семантической цели с использованием Vision-Language Model, которая предоставляет информативные градиенты путем анализа сгенерированного видео, и цели правдоподобности, которая предотвращает выход оптимизированного шума за пределы распределения OOD. Используя современные video world models для автономного вождения и манипуляций роботов, мы показываем, что StressDream эффективно направляет представления к значимым, но правдоподобным результатам, задаваемым текстом во время inference, таким как сбои при выполнении задачи, что позволяет проводить надежную оценку и улучшение policy путем выявления действий, чьи правдоподобные будущие состояния включают нежелательные исходы..
Ключевые слова: World Models, Inference-time Steering, Policy Learning and Evaluation
1 Введение
Видео модели мира (WMs), или обученные симуляторы физических сред, привлекли значительный интерес в робототехнике, обещая оценку и улучшение стратегий с существенно менее затратным взаимодействием с реальным миром [1, 117, 78]. По своей сути видео WMs являются генеративными моделями, такими как diffusion и flow matching [52, 59, 73], изучающими распределения будущих наблюдений, обусловленные действиями робота, и тем самым фиксирующими присущую неопределенность физических взаимодействий или поведения других агентов [7, 17, 39, 61] (вверху, Fig. ). Например, в манипуляционной робототехнике падение открытого пакета с большой высоты на стол может привести или не привести к рассыпанию его содержимого, что ведет либо к успеху, либо к провалу задачи; в автономном вождении одно и то же решение транспортного средства может привести к качественно различным результатам в зависимости от реакций окружающих агентов, таких как торможение или поддержание скорости.
Несмотря на изучение богатых распределений будущих исходов, оценка и улучшение стратегии с помощью WMs обычно опираются на номинальные воображаемые сценарии [17, 38, 42, 41], которые могут недостаточно полно исследовать разнообразные исходы, на моделирование которых они обучены. Наивная выборка воображаемых сценариев из WMs может легко упустить критические исходы без генерации чрезмерно большого количества выборок, что делает этот подход плохо подходящим для роли WMs: исследование правдоподобных, высокозначимых исходов действий робота для оценки и улучшения стратегии [128, 91, 108, 99], где под правдоподобностью понимаются исходы, поддерживаемые изученным распределением WM. Например, когда манипулятор роняет открытый пакет с большой высоты над столом, распределение WM может включать исходы как с просыпанием содержимого, так и без него; напротив, когда пакет размещен близко к столу, просыпание может быть маловероятным или отсутствовать в распределении исходов (внизу, Fig. ). Таким образом, способность воображать правдоподобные, высокозначимые исходы позволяет отдавать предпочтение последнему действию при оценке стратегии, в то время как первое действие получает меньший вес или подавляется при улучшении стратегии. Это мотивирует центральный вопрос нашей работы:
Как мы можем эффективно управлять видеомоделями мира на этапе вывода для моделирования правдоподобных результатов с высокой степенью влияния в целях оценки и улучшения стратегий?
Наша ключевая идея заключается в оптимизации начального шума диффузионной WM, направляя генерацию в сторону значимых событий, задаваемых во время вывода (например, разливы или столкновения), в рамках распределения правдоподобных исходов. Проблема, однако, заключается в управлении этой оптимизацией в пространствах шума чрезвычайно высокой размерности (например, M размерностей [38]): оптимизация должна учитывать нюансы, зависящие от сцены целевые события из сгенерированных видео, в то время как наивная оптимизация может легко вывести начальный шум в области вне распределения (OOD) [95, 106], создавая неправдоподобные видео. Для решения этой задачи мы предлагаем StressDream, который объединяет семантическую целевую функцию, использующую Vision-Language Model (VLM), которая анализирует происходящее на сгенерированном видео для направления генерации к целевым событиям, с целевой функцией правдоподобности, удерживающей оптимизированный шум в пределах области распределения. В совокупности StressDream обеспечивает плотные градиентные сигналы для поиска в высокоразмерном пространстве шума, сохраняя при этом правдоподобность генераций, что позволяет видео WM исследовать правдоподобные распределения значимых исходов для надежной оценки и улучшения policy..
Заявление о вкладе. Мы предлагаем StressDream, новый метод управления во время вывода для видео-world models на основе диффузии. Наш алгоритм оптимизирует высокоразмерный начальный гауссов шум, чтобы направлять генерацию к результатам с высоким уровнем воздействия, сохраняя при этом правдоподобность. С помощью экспериментов мы показываем: (i) в контролируемых условиях с доступом к истинной динамике системы StressDream направляет воображение WM к целевым событиям отказа системы только тогда, когда такие исходы правдоподобны; (ii) на современных видео-world models для автономного вождения [38] и робототехнических манипуляций [42], StressDream обеспечивает надежную оценку политики путем обнаружения результатов с высоким уровнем воздействия, таких как отказы при выполнении задачи, со значительно более высокой полнотой (); и (iii) эта надежная оценка улучшает политику за счет продвижения устойчивых действий, которые позволяют избежать потенциальных сбоев, повышая коэффициент успешности политики Vision-Language-Action (VLA) [57] ().
2 Контекст: Видеомодели мира с обусловленностью действиями
Видеомодели мира. Видеомодель мира, обусловленная действиями , параметризованная , моделирует распределения будущих наблюдений , где обозначает время, а — горизонт прогнозирования [42, 91, 108, 70, 65, 125]. Каждое наблюдение состоит из изображений с камер и проприоцептивного состояния , такого как конфигурация суставов робота. Прогноз обусловлен историей наблюдений и последовательностью будущих эго-действий ⟧:
| (1) |
Диффузионные модели как видеомодели мира. Недавние видеомодели мира [38, 42, 125] часто представляют в виде диффузионной модели [52, 101], обучающейся преобразованию между распределением данных и поддающимся анализу распределением шума, как правило, стандартным гауссовским , где — это размерность шума, индексируемая по времени диффузии :
| (2) |
где является убывающей функцией от , а — возрастающей функцией. Генерация происходит в обратном направлении путем итеративного отображения более зашумленного образца в образец с меньшим временем диффузии. :
| (3) |
где — это предсказатель шума (см. Приложение A). Начиная с начальной гауссовской выборки , многократное применение этого обратного обновления порождает предсказанные будущие наблюдения .
Начальный шум как управляющая переменная. Следуя (3), что соответствует ODE потока вероятностей [103], для фиксированных входных данных обусловливания , воображаемые сценарии являются детерминированной функцией начального шума: Таким образом, вся стохастичность при генерации определяется начальным шумом, что подразумевает, что выбор начального шума управляет тем, какое видео генерируется из WMs.
3 Настройка: Оценка и улучшение стратегии с помощью видеомоделей мира ⟦K0⟧
Оценка и улучшение стратегий с помощью видеомоделей мира. Имея обусловленную действиями видеомодель мира , мы стремимся оценивать последовательности действий-кандидатов путем моделирования их будущих результатов, что затем может быть использовано для оценки стратегии [91, 108, 70] и ее улучшения [42, 41, 99]. Предсказанные варианты будущего оцениваются с помощью критериальной функции на этапе вывода , которая определяет, возникают ли в сгенерированных видео правдоподобные результаты, оказывающие значительное влияние на оценку и улучшение стратегии. Эти оценки могут быть использованы для улучшения стратегий путем выбора действий, позволяющих избежать таких результатов [130, 48], или путем обучения стратегии с использованием воображения модели мира [42, 41]⟧.
Однако, когда при одной и той же последовательности действий возможны несколько вариантов будущего, надежная стратегия [80, 5] должна учитывать распределение исходов, которые являются правдоподобными при действии робота.:
| (4) |
где внутренняя оптимизация выбирает гауссовский шум для направления генерации WM в сторону наихудшего правдоподобного будущего, которое максимизирует критерий, в то время как внешняя оптимизация выбирает устойчивую последовательность действий, которая поддерживает низкий уровень критерия во всех правдоподобных будущих состояниях, даже при наихудших исходах. Для внешней оптимизации могут использоваться различные методы: может представлять собой дискретное множество в решателе на основе выборки [130] или непрерывное пространство действий, по которому оптимизируется policy [41]. Однако решение внутренней оптимизации является сложной задачей, так как оно требует оптимизации в многомерном пространстве шума.
Управление воображением посредством оптимизации шума на этапе вывода. Поскольку начальный шум выступает в качестве управляющей переменной для генерации WMs (разд. 2), цель внутренней оптимизации соответствует направлению воображения WM к результату с высокой степенью влияния, который остается правдоподобным в рамках обученной модели. Однако, поскольку оценка каждого шума требует дорогостоящего процесса удаления шума, повторная случайная выборка крайне неэффективна и, вероятно, пропустит редкие, но правдоподобные критические исходы в рамках ограниченного бюджета выборки. Вместо этого мы используем градиент дифференцируемой функции критерия для более эффективного управления генерацией, оптимизируя начальный шум напрямую посредством градиентного подъема.:
| (5) |
где обозначает размер шага. Хотя этот градиентный подъем первого порядка требует небольшого количества итеративных обновлений, каждое из которых включает проходы вперед и назад как через WM, так и через функцию критерия, плотный градиентный сигнал делает его существенно более эффективным, чем случайная выборка нулевого порядка, для обнаружения шумов, которые вызывают правдоподобную генерацию видео с высоким уровнем воздействия [106, 60, 34].
Проблема: Пространство шума высокой размерности. Хотя градиентная оптимизация в (5) позволяет управлять генерацией диффузионных моделей на этапе вывода [106, 34], её применение к видео world models сопряжено с трудностями, поскольку их пространства шума имеют чрезвычайно высокую размерность, например, М в задачах вождения [38] и К в задачах манипуляции [42]. Оптимизация должна направлять генерацию к значимым, зависящим от сцены целевым событиям, сохраняя при этом правдоподобность в рамках изученного распределения WM. Однако наивная оптимизация может легко вывести шум в области вне распределения (OOD) гауссовских шумов, создавая неправдоподобные видео (Рис. ), а критерий на этапе тестирования должен быть дифференцируемым, учитывая при этом нюансы, относящиеся к задаче события, которые варьируются в зависимости от сцены. Более того, решение (5) неэффективно, поскольку точные градиенты требуют обратного распространения ошибки через итеративный процесс шумоподавления..
4 StressDream: Управление высокоразмерными видеомоделями мира
Для решения проблем управления видео world models мы предлагаем StressDream, который определяет дифференцируемый критерий оптимизации путем объединения семантической целевой функции с использованием Vision-Language Models (VLMs) и целевой функции правдоподобности, предотвращающей OOD шум: . Семантическая целевая функция использует текстовые спецификации высокозначимых исходов во время inference для оценки того, происходят ли целевые события в сгенерированном видео (разд. 4.1). Целевая функция правдоподобности сохраняет статистические свойства априорного распределения стандартного гауссовского шума, тем самым поддерживая правдоподобность генераций WM (разд. 4.2). Наконец, мы аппроксимируем градиент шума, чтобы избежать полного обратного распространения ошибки через итеративный процесс шумоподавления, что обеспечивает эффективную оптимизацию (разд. 4.3⟧).
4.1 Семантическая цель: управление в сторону целевых событий с помощью градиентов VLM
Поскольку видео WMs работают в различных сценах и задачах, значимые целевые события для управления могут меняться в зависимости от контекста стратегии, что требует семантической цели, способной дифференцируемо оценивать, происходят ли зависящие от сцены целевые события в сгенерированных видео. Поэтому мы используем общую способность понимания видео модели VLM в качестве семантической цели. Учитывая текстовую подсказку во время вывода , описывающую целевой значимый результат, VLM измеряет, насколько хорошо сгенерированное видео соответствует подсказке. Например, в робототехнических манипуляциях можно указать «кофейные зерна рассыпаются», в то время как при вождении можно указать «происходит столкновение».”
Для получения дифференцируемой оценки мы используем Qwen-VL [8] и даем ему команду вывести один токен, да или нет, указывающий на то, соответствует ли значению . Затем мы определяем как разность логарифмов вероятностей токенов:
| (6) |
Использование вероятностей одного токена LLM делает целевую функцию дифференцируемой, обеспечивая богатые градиентные сигналы для оптимизации многомерного шума, который генерирует целевое событие во время вывода..
4.2 Целевая функция правдоподобности: удержание многомерного шума в типичном множестве
Диффузионные модели обучаются генерировать выборки из шума, взятого из гауссовского априорного распределения. Когда шум покидает типичное множество [25, 13, 83], где находится большинство выборок шума во время обучения, результирующий шум вне распределения (OOD) может приводить к созданию неправдоподобных видео, которые маловероятны в рамках распределения WM или имеют сниженное визуальное качество. Важно отметить, что в пространствах высокой размерности типичное множество не совпадает с областью наибольшей плотности вероятности: некоторые векторы шума, такие как нулевой вектор, могут иметь высокую плотность, но крайне маловероятны для выборки из гауссовского априорного распределения (см. Приложение B.1 для получения более подробной информации). Поскольку градиентная оптимизация шума может смещать шум за пределы этого типичного множества [95, 106, 34, 96, 49], мы используем целевую функцию правдоподобности, которая побуждает шум оставаться в пределах типичного множества гауссовского априорного распределения, используя комбинацию функций шума, которые фиксируют ключевые статистические показатели многомерного гауссовского шума: .
Концентрация нормы. Во-первых, поскольку квадрат нормы гауссовского шума подчиняется хи-квадрат распределению, , он резко концентрируется вокруг размерности шума [95]. Поэтому мы регуляризуем отклонения радиуса шума от типичной гауссовской оболочки:
Изотропия. Хотя концентрация нормы обеспечивает типичность в глобальном масштабе, оптимизированный шум может по-прежнему содержать локальные корреляции или структурированные координатные паттерны, которые маловероятны при априорном распределении i.i.d. Gaussian [106]. Чтобы стимулировать покомпонентную независимость, мы случайным образом переставляем элементы и разбиваем их на подвекторов , где и . При априорном распределении Gaussian эти подвекторы должны вести себя как i.i.d. выборки из , и поэтому их эмпирический второй момент должен быть близок к . Таким образом, мы штрафуем отклонения от блочной изотропии как , усредненные по нескольким случайным перестановкам.
Спектральная белизна. Даже когда шум остается типичным в координатном пространстве, оптимизация может приводить к появлению артефактов в частотной области [30]. Поскольку гауссов шум имеет плоский ожидаемый спектр мощности [104, 112], мы стремимся к тому, чтобы шум оставался спектрально белым. Пусть обозначает унитарное двумерное дискретное преобразование Фурье, примененное к пространственным измерениям каждого среза шума, и вычислим спектр мощности . Мы агрегируем в пространственно-частотных бинов, чтобы получить усредненные по бинам мощности . Чтобы сохранить спектральную плоскостность, мы минимизируем дисперсию этих усредненных по бинам мощностей, , где — средняя мощность по всем бинам..
4.3 Аппроксимация градиентов шума для эффективного управления ⟦K0⟧
Оптимизация шума в (5) требует вычисления градиента критерия по отношению к начальному шуму, где обозначает один шаг шумоподавления в (3). Хотя diffusion models в принципе дифференцируемы, обратное распространение ошибки через полный итеративный процесс шумоподавления (например, шагов [14]) может привести к высоким затратам памяти и затуханию градиента [33, 3]. Чтобы сделать оптимизацию эффективной, мы применяем score-distillation [3] (Приложение B.4), который аппроксимирует градиент по отношению к шуму, используя градиент в сгенерированном образце:
| (7) |
где — скалярный коэффициент. Данная аппроксимация требует только обратного распространения ошибки через дифференцируемую функцию критерия, позволяя избежать полного обратного распространения через итеративный процесс шумоподавления.
В итоге, StressDream оптимизирует начальный шум, как в 5, используя градиент, который объединяет аппроксимацию градиента, семантическую целевую функцию (VLM) и целевую функцию правдоподобия (typical set):
| (8) |
где коэффициенты настраиваются в зависимости от WM, размерности шума и VLM.
5 Пример исследования: управление видеомоделью мира для автомобиля Дубинса
Сначала мы изучаем StressDream в контролируемых условиях, где динамика системы и неопределенность известны. Поскольку мы знаем истинную динамику, такая настройка позволяет нам проверить, может ли управление WM эффективно выявлять сценарии будущего с высоким уровнем воздействия (то есть сбои) только тогда, когда они возможны в рамках системы.
Непослушный 3D Dubins car. Мы рассматриваем основанную на изображениях конфигурацию дискретного 3D Dubins car с состоянием , непрерывным действием угловой скорости , фиксированной скоростью и временным шагом . Непослушный Dubins car вносит неопределенность путем случайного изменения знака управляющего воздействия: с вероятностью и в противном случае:
| (9) |
Каждое состояние визуализируется как RGB-изображение, отображающее окружающую среду и транспортное средство. В данной конфигурации вместо на основе VLM мы используем показатель безопасности, определенный как , который формирует круговое множество отказов радиуса с центром в начале координат:
Видеомодель мира. Мы обучаем WM на офлайн-наборе данных из случайных траекторий наблюдений и действий. Мы обучаем предиктора показателей безопасности для регрессии истинного значения оценки по изображению, а также обучаем диффузионную модель мира, , для генерации одношагового будущего наблюдения , обусловленного текущим наблюдением и действием. Результирующая размерность шума составляет .
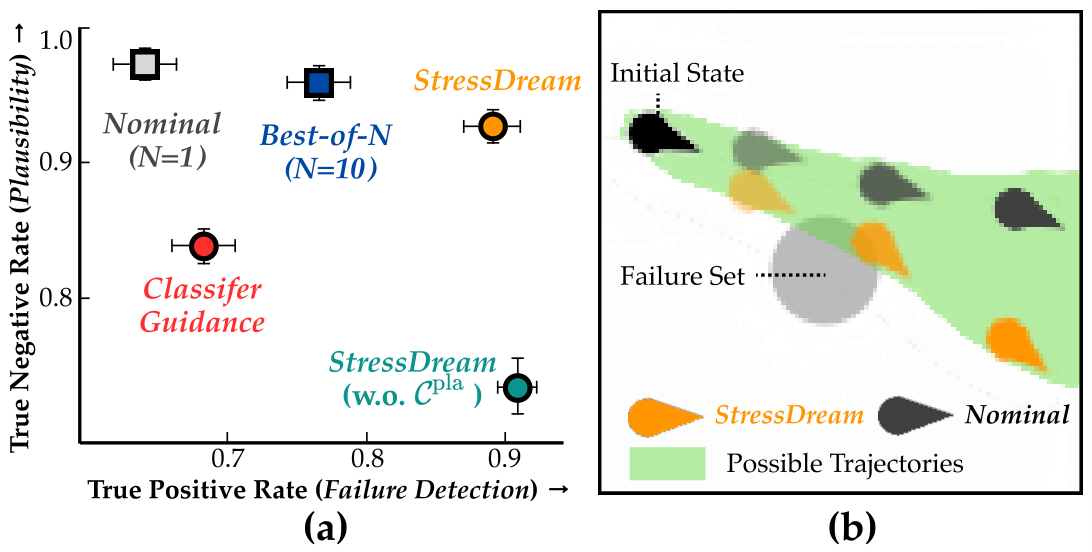
Настройка эксперимента. Мы стремимся обнаруживать последовательности действий, которые имеют вероятность попадания в набор отказов, используя воображение WM. Мы создаем оценочный набор данных из случайных начальных состояний и последовательностей действий. Для каждой траектории мы вычисляем минимальный показатель безопасности, соответствующий действительности, достижимый при стохастической динамике в (9), и помечаем его как положительный, если минимальный показатель, соответствующий действительности, ниже нуля, что указывает на то, что траектория может попасть в набор отказов. Затем мы выполняем развертывание world-model с разомкнутым контуром, используя только начальное изображение и последовательность действий, и классифицируем воображаемую траекторию как отказ, то есть положительную, если ее минимальный прогнозируемый показатель безопасности на протяжении всего развертывания ниже нуля..
Базовые модели. StressDream управляет воображением путем минимизации предсказанного показателя безопасности для шагов оптимизации. Мы проводим сравнение с выборкой без оптимизации: Nominal (=) и Best-of-N (=). Мы проводим абляционное исследование StressDream без и сравниваем с classifier guidance (CG) [26, 69], который применяет градиенты во время удаления шума вместо оптимизации начального шума..
StressDream надежно обнаруживает сбои только тогда, когда они правдоподобны. Рис. 1 показывает, что StressDream точно выявляет потенциальные сбои в воображаемых сценариях WM, достигая высокого уровня истинно положительных результатов, то есть правильно идентифицируя траектории, которые могут привести к сбою, при сохранении высокого уровня истинно отрицательных результатов, то есть не классифицируя ошибочно безопасные траектории как сбои. Напротив, StressDream без целевой функции правдоподобия в разд. 4.2 дает низкий уровень истинно отрицательных результатов, что указывает на то, что без ограничения типичного множества воображаются неправдоподобные сбои. CG аналогичным образом создает множество ложноположительных результатов путем прямого изменения траектории шумоподавления, генерируя неправдоподобные воображаемые сценарии. Методы случайной выборки (Nominal, Best-of-N) генерируют правдоподобные сценарии, но менее эффективны в выявлении редких возможных сбоев по сравнению со StressDream, часто пропуская их даже при использовании нескольких выборок..
6 Эксперименты: надежная оценка и улучшение стратегии
В этом разделе мы проверяем StressDream для надежной оценки и улучшения стратегий с использованием современных видео world models как в автономном вождении [38], так и в робототехнических манипуляциях [42]⟧.
Автономное вождение. Мы используем Vista [38], которая предсказывает будущих кадров фронтальной камеры с частотой , обусловленных будущими путевыми точками в качестве действий, с размерностью шума . Мы проводим SFT модели на наборе данных PhysicalAI-Autonomous-Vehicles (PAI-AV) [86] и наборе данных Nexar Collision Prediction Dataset [81], которые включают разнообразные сценарии вождения, такие как столкновения. Мы проводим оптимизацию в течение шагов с использованием Qwen2.5-VL-7B-Instruct [10], дообученной с помощью Wolf [67] и X-CLIP [76]⟧.
Роботизированная манипуляция. Мы используем Ctrl-World [42], обученную в среде DROID [62], которая предсказывает будущих кадров с камер с разрешением , обусловленных действиями по позиционированию суставов, с . Мы рассматриваем шесть задач манипуляции с частыми контактами (см. рис. 6) и собираем приблизительно траекторий телеуправления для каждой задачи, содержащих как успешные, так и неудачные попытки, для дообучения модели (SFT). Мы оптимизируем шум в течение шагов, используя Qwen3-VL-4B-Instruct [9], предоставляя видео с трех ракурсов вместе с промптом, описывающим сбой в выполнении задачи (подробности в приложении D.1⟧).
6.1 Надежная оценка стратегий с использованием современных видео World Models
Сначала мы исследуем, позволяет ли StressDream проводить надежную оценку стратегии путем эффективного управления воображением WM в сторону значимых, но правдоподобных результатов, задаваемых во время вывода. В качестве базовой линии мы проводим сравнение со случайной генерацией (Best-of-N), которая выбирает несколько вариантов воображения без оптимизации при том же бюджете, что и у StressDream, и выбирает тот, у которого самый высокий балл..
Настройка оценки. Мы генерируем воображаемые сценарии на основе начального наблюдения и последовательности действий , а затем оцениваем, соответствует ли сгенерированное видео текстовой спецификации целевого события, заданной во время инференса. Для вождения мы отбираем пар изображение–действие–текст из набора данных PAI-AV [86] по категориям критически важных для безопасности событий (см. Приложение D.3), а также примеров неизбежных столкновений [81]. Каждый промпт описывает целевое событие, которое еще не произошло в начальном наблюдении, но происходит в пределах горизонта прогнозирования. Для манипуляций мы собираем траекторий сбоев по различным задачам в качестве оценочного набора данных и проверяем, могут ли воображаемые сценарии WM, построенные на основе начальных изображений и последовательностей действий, надежно выявлять сбои (см. Приложение D.2⟧).
Метрики оценки. Для вождения мы сообщаем о соответствии цели и качестве видео, используя отложенный оценщик, WorldModelBench [68]. Соответствие цели измеряет, соответствует ли видео текстовому описанию целевого события, в то время как качество видео служит прокси-показателем правдоподобности. Для манипуляций мы помечаем каждую генерацию как успех или неудачу на основе суждения человека. (См. Приложение D.4)
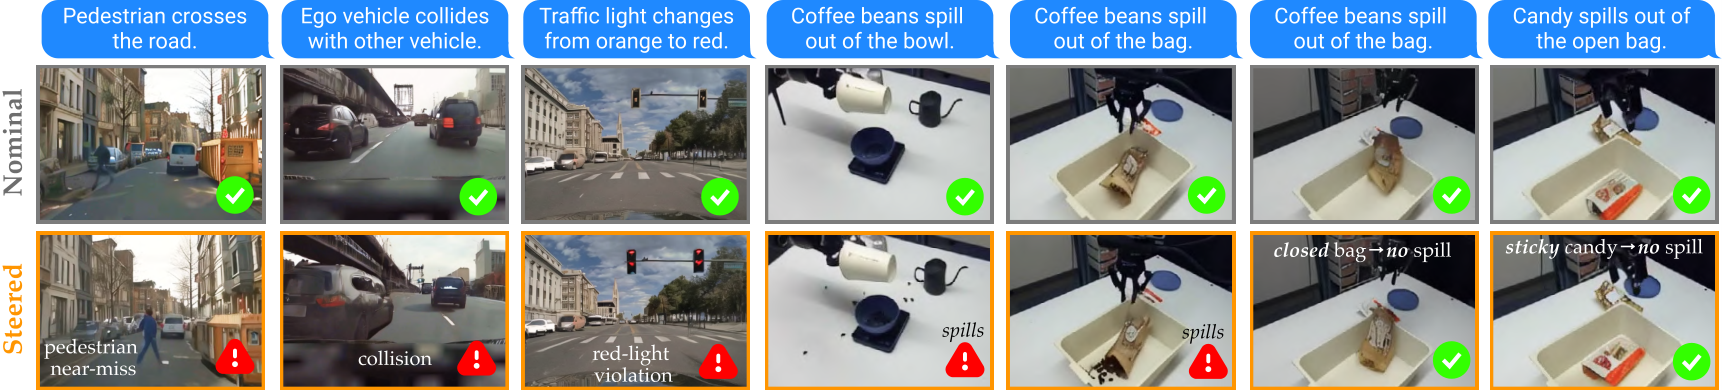
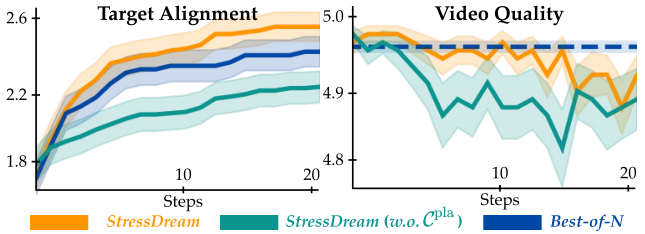
StressDream надежно обнаруживает высокозначимые исходы в воображаемых сценариях. Рис. 2 сравнивает номинальные и управляемые генерации. StressDream правдоподобно генерирует видео, соответствующие спецификациям целевых критических для безопасности или аварийных событий во время инференса, которые упускаются при номинальном воображении, что позволяет проводить надежную оценку последовательностей действий через воображение WM. Рис. 3 показывает, что без ограничения типичного множества показатели целевого выравнивания и качества видео снижаются, что указывает на то, что целевая функция правдоподобия помогает сохранить правдоподобность. В задачах манипуляции StressDream обнаруживает события сбоя задачи в воображении с более высокой полнотой, тогда как случайные генерации часто бывают чрезмерно оптимистичными и пропускают возможные сбои, как показано на рис. 4. Дополнительные результаты представлены в Приложении E.1 и Website⟧.
Управление основано на правдоподобных исходах. Мы исследуем, остается ли управление обоснованным правдоподобными исходами, поддерживаемыми распределением WM, а не галлюцинированием неправдоподобных вариантов будущего. Чтобы проверить это, мы направляем генерации в сторону событий столкновения, используя как дообученную на столкновениях модель Vista, так и базовую модель Vista, которая не обучалась на событиях столкновения. Рис. 5 показывает, что базовая модель не может представить исходы столкновений даже при управлении, достигая более низких показателей соответствия цели, чем случайная выборка из дообученной на столкновениях модели. Это указывает на то, что StressDream направляет только к событиям, поддерживаемым распределением исходов WM, а не синтезирует неправдоподобные события. Аналогично, два правых столбца на рис. 2 показывают, что исходы просыпания цели вызываются только тогда, когда они правдоподобны в рамках распределения WM: StressDream не вызывает просыпание для открытого пакета с липкими конфетами или закрытого пакета с кофе, но делает это для открытого пакета с кофе. Поскольку липкие конфеты вряд ли могут просыпаться, а закрытый пакет не обнажает свое содержимое, просыпание не поддерживается распределением WM в этих сценах. Больше деталей и результатов в Приложении E.3⟧.
6.2 Улучшение стратегии с помощью управляемых воображений видеомоделей мира ⟦K0⟧
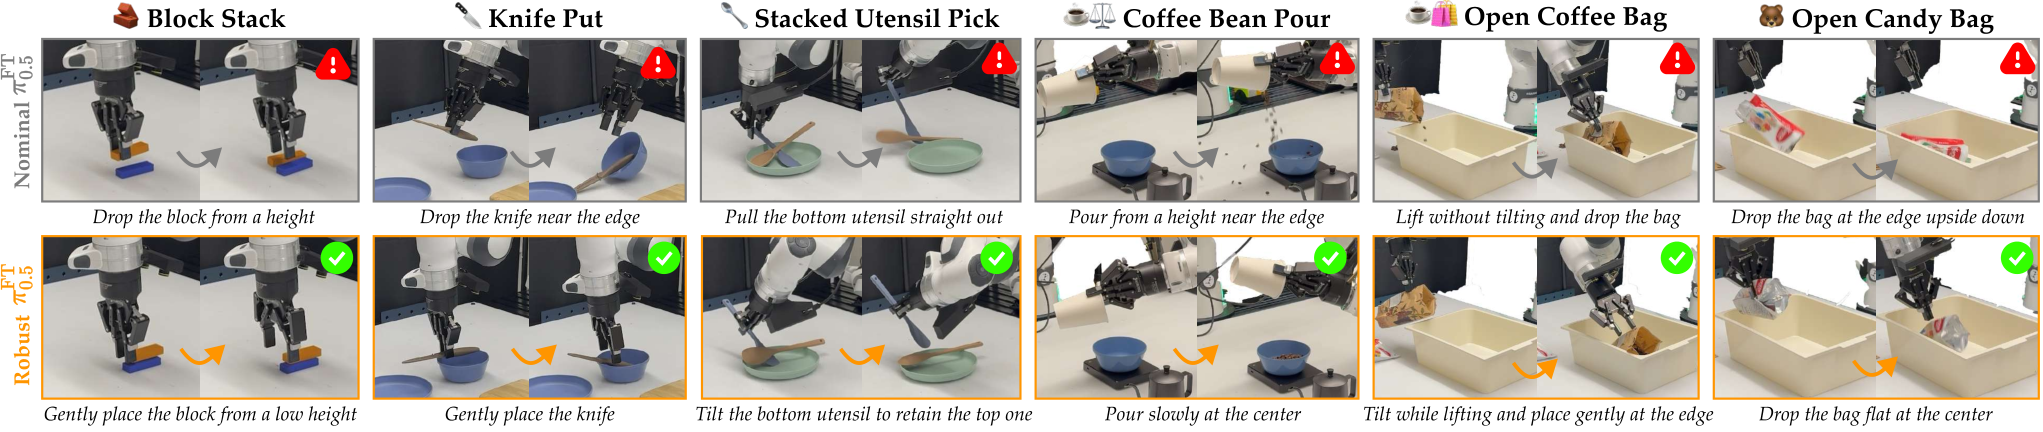
Настройка. Мы исследуем, может ли StressDream улучшить робототехническую стратегию посредством управляемых воображений WM, способствуя принятию надежных действий, которые остаются успешными при распределении результатов. Мы рассматриваем улучшение стратегии поведенческого клонирования, модели Vision-Language-Action (VLA) [57], с оценкой действий в воображениях WM. В частности, мы проводим SFT -droid с использованием успешных демонстраций на задачу, применяя целевую функцию взвешенной регрессии [41], и сравниваем две настройки: Nominal , которая присваивает равномерный вес всем траекториям, и Robust , которая присваивает вес траекториям, остающимся успешными при управлении в сторону сбоев задачи, и вес траекториям, которые терпят неудачу в управляемых воображениях. Это поощряет надежные действия, чье вероятное распределение результатов не включает сбои, одновременно снижая вес рискованных действий, которые могут привести к сбою..
StressDream улучшает политики путем продвижения устойчивых действий. Рис. 6 иллюстрирует развертывания дообученных политик. Устойчивая отдает предпочтение действиям, чьи вероятные исходы не включают сбои в выполнении задачи, что определяется путем управления воображением. Напротив, номинальная предлагает рискованные действия, чье распределение вероятных исходов включает сбои, даже если они случайно привели к успеху во время сбора данных. Рис. 7 показывает показатели успешности на основе развертываний для каждой задачи, демонстрируя, что устойчивая достигает более высокой успешности за счет предложения устойчивых действий, которые позволяют избежать потенциальных сбоев..
7 Заключение
В данной работе мы предлагаем StressDream, который направляет воображение видео-world models к результатам с высоким уровнем воздействия, задаваемым во время inference-time, оставаясь при этом в рамках распределения правдоподобных исходов. StressDream оптимизирует высокоразмерный начальный шум диффузионных видео-world models, используя комбинацию семантических целей и целей правдоподобности: градиенты VLM направляют генерацию к результатам с высоким уровнем воздействия, задаваемым промптами во время inference-time, в то время как ограничения типичного множества сохраняют высокоразмерный шум типичным в рамках гауссовского априорного распределения. Используя WM для автономного вождения и манипуляций роботов, мы демонстрируем, что StressDream эффективно направляет воображение, сохраняя правдоподобность, что позволяет проводить надежную оценку политики путем выявления действий с потенциальными сбоями и улучшать политики, отдавая предпочтение надежным действиям, которые позволяют избежать таких сбоев..
Ограничения. StressDream требует указания результатов с высоким уровнем воздействия с помощью текстовых описаний, поэтому его эффективность зависит от качества промпта и может пострадать от reward hacking, при котором оценка увеличивается без значимых изменений в генерациях [34, 55], что подчеркивает необходимость создания обобщаемых и устойчивых reward models для робототехники [105, 71]. Кроме того, StressDream может не сохранить правдоподобность или не обнаружить релевантные сбои, когда базовый WM ограничен: он может осуществлять управление в рамках ошибочных видео, созданных WM, или не суметь представить целевые результаты, отсутствующие в обучающем распределении WM. Таким образом, наше понятие правдоподобности ограничено тем, что поддерживает WM, и не обязательно подразумевает физическую правдоподобность в реальном мире, что подчеркивает необходимость использования разнообразных данных роботов для обучения высокоточных WM с физически согласованными предсказаниями. Время выполнения также остается значительным, поскольку текущие WM требуют несколько минут на одну генерацию [38, 42], хотя это может быть сокращено за счет эффективных моделей [102, 64, 32]. Мы отсылаем читателей к Приложению F для более подробного обсуждения..
Благодарности
JS выражает благодарность Луке Эйрингу за содержательные дискуссии об оптимизации шума, а также Лассе Петерсу за неоценимые отзывы о тексте работы. Данное исследование было частично профинансировано в рамках премии для молодых преподавателей (YFA) Агентства перспективных оборонных исследовательских проектов (DARPA). Выраженные взгляды, мнения и/или выводы принадлежат автору и не должны интерпретироваться как отражающие официальную позицию или политику DARPA или правительства США. В работе использовались вычислительные мощности Bridges-2 в Питтсбургском суперкомпьютерном центре в рамках выделения ресурсов CIS251277 по программе Координационной экосистемы передовой киберинфраструктуры: Услуги и поддержка (ACCESS), которая поддерживается грантами Национального научного фонда № 2138259, № 2138286, № 2138307, № 2137603 и № 2138296..
Список литературы
- ⟦[1] Н. Агарвал, А. Али, М. Бала, Ю. Баладжи, Э. Баркер, Т. Цай, П. Чаттопадхьяй, Ю. Чен, Ю. Цуй, Ю. Дин и др. (2025) Cosmos: платформа фундаментальных моделей мира для физического AI. arXiv preprint arXiv:2501.03575. Цитируется в: §A.1, §A.3, Appendix F, §1.
- ⟦[2] С. Агравал, Дж. Сео, К. Накамура, Р. Тиан и А. Баджси (2026) AnySafe: адаптация латентных фильтров безопасности во время выполнения посредством параметризации ограничений безопасности в латентном пространстве. В материалах Международной конференции IEEE по робототехнике и автоматизации (ICRA), Цитируется в: §A.1.
- ⟦[3] Д. Ан, Дж. Кан, С. Ли, Дж. Мин, М. Ким, В. Джанг, Х. Чо, С. Пол, С. Ким, Э. Ча и др. (2026) Шум стоит руководства диффузией. В материалах Международной конференции по представлениям в обучении (ICLR), Внешние ссылки: Link Цитируется: §A.1, §B.4, §B.4, §B.4, §4.3⟧.
- ⟦[4] Х. Ай, Ю. Хэ, А. Гу, Р. Салахутдинов, Дж. З. Колтер, Н. М. Боффи и М. Симчовиц (2026) Совместная дистилляция для быстрой оценки правдоподобия и сэмплирования в потоковых моделях. В материалах Международной конференции по представлениям в обучении (ICLR), Внешние ссылки: Link Цитируется: §A.4⟧.
- ⟦[5] П. Акелла, А. Диксит, М. Ахмади, Л. Линдеманн, М. П. Чепмен, Г. Дж. Паппас, А. Д. Эймс и Дж. У. Бердик (2025) Робототехника с учетом рисков: меры хвостового риска в планировании, управлении и верификации [фокус на образовании]. IEEE Control Systems 45 (4), стр. 46–78. Цитируется в: §3.
- ⟦[6] М. С. Альберго и Э. Ванден-Эйнден (2023) Построение нормализующих потоков с помощью стохастических интерполянтов. В Международной конференции по обучению представлениям (ICLR), Внешние ссылки: Link Цитируется: §A.2⟧.
- ⟦[7] Э. Алонсо, А. Джелли, В. Микели, А. Канервисто, А. Сторки, Т. Пирс и Ф. Флёре (2024) Диффузия для моделирования мира: визуальные детали имеют значение в atari. Достижения в системах обработки нейронной информации (NeurIPS) 37, стр. 58757–58791. Цитируется: §A.1, §1.
- ⟦[8] Дж. Бай, С. Бай, С. Ян, С. Ван, С. Тан, П. Ван, Дж. Лин, Ч. Чжоу и Дж. Чжоу (2023) Qwen-vl: универсальная vision-language model для понимания, локализации, чтения текста и многого другого. arXiv preprint arXiv:2308.12966. Цитируется в: §B.3, §D.3, §4.1⟧.
- ⟦[9] С. Бай, Ю. Цай, Р. Чэнь, К. Чэнь, С. Чэнь, Чж. Чэн, Л. Дэн, В. Дин, Ч. Гао, Ч. Гэ, В. Гэ, Чж. Го, Ц. Хуан, Дж. Хуан, Ф. Хуан, Б. Хуэй, С. Цзян, Чж. Ли, М. Ли, М. Ли, К. Ли, Чж. Линь, Дж. Линь, С. Лю, Дж. Лю, Ч. Лю, Ю. Лю, Д. Лю, С. Лю, Д. Лу, Р. Ло, Ч. Люй, Р. Мэнь, Л. Мэн, С. Жэнь, С. Жэнь, С. Сун, Ю. Сунь, Дж. Тан, Дж. Ту, Дж. Вань, П. Ван, П. Ван, Ц. Ван, Ю. Ван, Т. Се, Ю. Сюй, Х. Сюй, Дж. Сюй, Чж. Ян, М. Ян, Дж. Ян, А. Ян, Б. Юй, Ф. Чжан, Х. Чжан, С. Чжан, Б. Чжэн, Х. Чжун, Дж. Чжоу, Ф. Чжоу, Дж. Чжоу, Ю. Чжу и К. Чжу (2025) Технический отчет Qwen3-vl. arXiv preprint arXiv:2511.21631. Цитируется в: §B.3, §E.1, §6.
- ⟦[10] С. Бай, К. Чен, Х. Лю, Дж. Ван, В. Ге, С. Сонг, К. Данг, П. Ван, С. Ван, Дж. Танг и др. (2025) Технический отчет Qwen2.5-vl. arXiv preprint arXiv:2502.13923. Цитируется в: §6⟧.
- ⟦[11] Ф. Барточчони, Э. Рамзи, В. Бенье, С. Венкатараман, Т. Ву, И. Сюй, Л. Шамбон, С. Гидарис, С. Одабаш, Д. Хурых и др. (2025) Vavim и vavam: автономное вождение посредством генеративного видеомоделирования. arXiv препринт arXiv:2502.15672. Цитируется в: §A.1.
- ⟦[12] Х. Бен-Хаму, О. Пуни, И. Гат, Б. Каррер, У. Сингер и Я. Липман (2024) D-flow: дифференцирование через потоки для управляемой генерации. В материалах Международной конференции по машинному обучению (ICML), Внешние ссылки: Link Цитируется: §A.1⟧.
- ⟦[13] M. Betancourt (2017) Концептуальное введение в гамильтонов метод Монте-Карло. arXiv preprint arXiv:1701.02434. Цитируется в: §4.2.
- ⟦[14] А. Блаттманн, Т. Докхорн, С. Кулал, Д. Менделевич, М. Килиан, Д. Лоренц, Й. Леви, З. Инглиш, В. Волети, А. Леттс и др. (2023) Stable video diffusion: масштабирование латентных диффузионных моделей видео на большие наборы данных. arXiv preprint arXiv:2311.15127. Цитируется в: §A.1, §A.3, §C.1, §4.3⟧.
- ⟦[15] Дж. Брюс, М. Д. Деннис, А. Эдвардс, Дж. Паркер-Холдер, Ю. Ши, Э. Хьюз, М. Лай, А. Маваланкар, Р. Стейгервальд, К. Аппс и др. (2024) Genie: генеративные интерактивные среды. В материалах Международной конференции по машинному обучению (ICML), Цитируется в: §A.1.
- ⟦[16] H. Caesar, V. Bankiti, A. H. Lang, S. Vora, V. E. Liong, Q. Xu, A. Krishnan, Y. Pan, G. Baldan, and O. Beijbom (2020) Nuscenes: мультимодальный набор данных для автономного вождения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 11621–11631. Цитируется в: §D.1, §D.1⟧.
- ⟦[17] Б. Чен, Д. Марти Монсо, И. Ду, М. Симховиц, Р. Тедрейк и В. Ситцманн (2024) Диффузионное принуждение: предсказание следующего токена встречается с диффузией по всей последовательности. Достижения в системах нейронной обработки информации (NeurIPS) 37, стр. 24081–24125. Цитируется в: §A.1, §A.3, §1, §1.
- ⟦[18] С. Чен, Л. Ян, Х. Ян, Л. Чен, Г. Хе, К. Ван и Ю. Ли (2024) Найти: дообучение начального распределения шума с помощью оптимизации стратегии для диффузионных моделей. В материалах 32-й Международной конференции ACM по мультимедиа, стр. 6735–6744. Цитируется: §A.1, §A.4.
- ⟦[19] С. Чен, К. Харрисон, И. Ли, А. Дж. Янг, З. Рен, Л. Дж. Рэтлифф, Дж. Дуан, Д. Фокс и Р. Кришна (2026) Topreward: вероятности токенов как скрытые zero-shot награды для робототехники. arXiv preprint arXiv:2602.19313. Цитируется в: §B.3⟧.
- ⟦[20] С. Чен, Х. Го, С. Чжу, Ф. Чжан, З. Хуан, Дж. Фенг и Б. Канг (2025) Video depth anything: согласованная оценка глубины для сверхдлинных видео. В IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), стр. 22831–22840. Цитируется в: §E.1.
- ⟦[21] Т. Чен, Б. Сюй, К. Чжан и К. Гестрин (2016) Обучение глубоких сетей с сублинейными затратами памяти. arXiv preprint arXiv:1604.06174. Цитируется в: §B.4, §B.4.
- ⟦[22] C. Chi, Z. Xu, S. Feng, E. Cousineau, Y. Du, B. Burchfiel, R. Tedrake, and S. Song (2024) Diffusion policy: обучение визуомоторных стратегий посредством диффузии действий. The International Journal of Robotics Research. Цитируется в: §D.5.
- ⟦[23] Х. Чунг, Дж. Ким, М. Т. Макканн, М. Л. Класки и Дж. К. Йе (2023) Диффузионная апостериорная выборка для общих зашумленных обратных задач. В Международной конференции по представлениям обучения (ICLR), Внешние ссылки: Link Цитируется: §A.1⟧.
- ⟦[24] К. Кларк, П. Викол, К. Сверски и Д. Дж. Флит (2024) Прямая дообучение diffusion models на дифференцируемых вознаграждениях. В Международной конференции по представлениям обучения (ICLR), Внешние ссылки: Link Цитируется: §A.1, §B.3.
- ⟦[25] Т. М. Ковер (1999) Элементы теории информации. Джон Уайли энд Санз. Цитируется в: §A.5, §4.2.
- ⟦[26] П. Дхаривал и А. Никол (2021) Диффузионные модели превосходят GAN в синтезе изображений. Достижения в системах нейронной обработки информации (NeurIPS) 34, стр. 8780–8794. Цитируется в: §C.1, §5.
- ⟦[27] З. Дин, К. Джин, Д. Лю, Х. Чжэн, К. К. Сингх, К. Чжан, Ю. Кан, З. Лин и Ю. Лю (2025) Dollar: генерация видео за несколько шагов посредством дистилляции и оптимизации латентного вознаграждения. В материалах Международной конференции IEEE/CVF по компьютерному зрению (ICCV), стр. 17961–17971. Цитируется: §A.1.
- ⟦[28] С. Доминго-Энрич, М. Дроздзал, Б. Каррер и Р. Т. К. Чен (2025) Adjoint matching: дообучение потоковых и диффузионных генеративных моделей с помощью стохастического оптимального управления без памяти. В материалах Международной конференции по представлениям обучения (ICLR), Внешние ссылки: Link Цитируется: §A.1⟧.
- ⟦[29] З. Доу и Ю. Сонг (2024) Диффузионная апостериорная выборка для решения линейных обратных задач: взгляд с точки зрения фильтрации. В Международной конференции по обучению представлениям (ICLR), Цитируется в: §A.1.
- ⟦[30] Р. Дюрал, М. Кёпер и Дж. Кёпер (2020) Следите за своей повышающей сверткой: генеративные глубокие нейронные сети на основе CNN не способны воспроизводить спектральные распределения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 7890–7899. Цитируется в: §4.2.
- ⟦[31] Ф. Эберт, К. Финн, С. Дасари, А. Се, А. Ли и С. Левин (2018) Визуальное предвидение: глубокое обучение с подкреплением на основе моделей для роботизированного управления с использованием зрения. arXiv препринт arXiv:1812.00568. Цитируется в: §A.1.
- ⟦[32] П. Эссер, С. Кулал, А. Блаттманн, Р. Энтезари, Дж. Мюллер, Х. Сайни, Й. Леви, Д. Лоренц, А. Зауэр, Ф. Бозель, Д. Поделл, Т. Докхорн, З. Инглиш и Р. Ромбах (2024) Масштабирование rectified flow transformers для синтеза изображений высокого разрешения. В Международной конференции по машинному обучению (ICML), Внешние ссылки: Link Цитируется: §7⟧.
- ⟦[33] Л. Эйринг, С. Картик, А. Досовицкий, Н. Руис и З. Аката (2025) Шумовые гиперсети: амортизация вычислительных затрат во время вывода в диффузионных моделях. В сборнике трудов конференции Advances in Neural Information Processing Systems (NeurIPS), Цитируется в: §A.1, §A.4, §A.4, Appendix F, Appendix F, §4.3⟧.
- ⟦[34] Л. Эйринг, С. Картик, К. Рот, А. Досовицкий и З. Аката (2024) Reno: улучшение одношаговых моделей преобразования текста в изображение посредством оптимизации шума на основе вознаграждения. Достижения в системах нейронной обработки информации (NeurIPS) 37, стр. 125487–125519. Цитируется в: §A.1, §A.4, §B.1, §B.3, Appendix F, Appendix F, Appendix F, §3, §3, §4.2, §7⟧.
- ⟦[35] И. Фан, О. Уоткинс, И. Ду, Х. Лю, М. Рю, К. Бутилье, П. Аббил, М. Гавамзаде, К. Ли и К. Ли (2023) Dpok: обучение с подкреплением для дообучения диффузионных моделей преобразования текста в изображение. Достижения в системах обработки нейронной информации (NeurIPS) 36, стр. 79858–79885. Цитируется в: §A.1.
- ⟦[36] C. Finn and S. Levine (2017) Глубокое визуальное предвидение для планирования движения робота. В IEEE International Conference on Robotics and Automation (ICRA), стр. 2786–2793. Цитируется в: §A.1.
- ⟦[37] К. Франс, Д. Хафнер, С. Левин и П. Аббил (2025) Одношаговая диффузия с помощью моделей-сокращений. В материалах Международной конференции по обучению представлений (ICLR), Т. 2025, стр. 34668–34684. Цитируется в: §B.6.
- ⟦[38] С. Гао, Дж. Янг, Л. Чен, К. Читта, Ю. Цю, А. Гейгер, Дж. Чжан и Х. Ли (2024) Vista: обобщаемая модель мира для вождения с высокой точностью и универсальной управляемостью. Достижения в системах обработки нейронной информации (NeurIPS) 37, стр. 91560–91596. Цитируется в: §A.1, §A.1, §A.3, §A.3, §A.3, §B.4, §B.6, §D.1, Table 6, §E.1, Appendix F, §1, §1, §1, §2, §3, §6, §6, §7⟧.
- ⟦[39] С. Гао, С. Чжоу, Ю. Ду, Дж. Чжан и К. Ган (2025) AdaWorld: обучение адаптируемых world models с использованием latent actions. В материалах International Conference on Machine Learning (ICML), стр. 18744–18771. Цитируется в: §A.1, §1.
- ⟦[40] Х. Го, Дж. Лю, М. Цуй, Дж. Ли, Х. Ян и Д. Хуан (2024) Initno: улучшение диффузионных моделей преобразования текста в изображение посредством оптимизации начального шума. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 9380–9389. Цитируется в: §A.1.
- ⟦[41] И. Го, Т. Ли, Л. С. Ши, Дж. Чен, П. Лян и К. Финн (2026) Vlaw: итеративное совместное улучшение политики зрение-язык-действие и мировой модели. arXiv preprint arXiv:2602.12063. Цитируется в: §A.1, §A.3, §D.5, §1, §3, §3, §6.2⟧.
- ⟦[42] И. Го, Л. С. Ши, Дж. Чен и К. Финн (2026) Ctrl-world: управляемая генеративная модель мира для манипуляций роботов. В материалах Международной конференции по обучению представлений (ICLR), Внешние ссылки: Link Цитируется в: §A.1, §A.1, §A.3, §A.3, §A.3, §B.4, §D.1, Table 6, Appendix F, §1, §1, §2, §2, §3, §3, §6, §6, §7.
- ⟦[43] Д. Хафнер, Т. Лилликрап, Дж. Ба и М. Норузи (2020) Мечтать об управлении: обучение поведению посредством латентного воображения. В Международной конференции по представлениям в обучении (ICLR), Цитируется: §A.1, §A.3.
- ⟦[44] Д. Хафнер, Т. Лилликрап, И. Фишер, Р. Вильегас, Д. Ха, Х. Ли и Дж. Дэвидсон (2019) Изучение латентной динамики для планирования на основе пикселей. В Международной конференции по машинному обучению (ICML), Цитируется: §A.1.
- ⟦[45] Д. Хафнер, Т. П. Лилликрап, М. Норузи и Дж. Ба (2021) Освоение Atari с помощью дискретных world models. В материалах Международной конференции по обучению представлениям (ICLR), Цитируется в: §A.1.
- ⟦[46] Д. Хафнер, Дж. Пасуконис, Дж. Ба и Т. Лилликрап (2025) Освоение разнообразных задач управления с помощью world models. Nature 640 (8059), стр. 647–653. Внешние ссылки: ISSN 1476-4687 Цитируется в: §A.1, §A.3.
- ⟦[47] Д. Хафнер, У. Ян и Т. Лилликрап (2025) Обучение агентов внутри масштабируемых world models. arXiv preprint arXiv:2509.24527. Цитируется в: §A.1, §B.6, Appendix F⟧.
- ⟦[48] Н. Хансен, Х. Су и Х. Ван (2024) TD-mpc2: масштабируемые, устойчивые world models для непрерывного управления. В Международной конференции по представлениям обучения (ICLR), Цитируется: §A.1, §A.3, §3.
- ⟦[49] А. Харрингтон, А. С. Кепке, С. Картик, Т. Даррелл и А. А. Эфрос (2026) Никогда не поздно: оптимизация шума для восстановления после коллапса в обученных диффузионных моделях. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), Цитируется в: §A.1, §4.2.
- ⟦[50] М. Хассан, С. Стапф, А. Рахими, П. Резенде, Ю. Хагиги, Д. Брюггеманн, И. Катирджиоглу, Л. Чжан, Х. Чен, С. Саха и др. (2025) Gem: обобщаемая мультимодальная модель мира с эго-зрением для управления мелкозернистым эго-движением, динамикой объектов и композицией сцены. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 22404–22415. Цитируется в: §A.1, §A.3, §A.3, §A.3, Appendix F⟧.
- ⟦[51] И. Хэ, Н. Мурата, К. Лай, Ю. Такида, Т. Уэсака, Д. Ким, В. Ляо, Ю. Мицуфудзи, Дж. З. Колтер, Р. Салахутдинов и С. Эрмон (2024) Manifold preserving guided diffusion. В материалах Международной конференции по обучению представлений (ICLR), Внешние ссылки: Link Цитируется: §A.1⟧.
- ⟦[52] Дж. Хо, А. Джейн и П. Аббил (2020) Вероятностные модели диффузии с шумоподавлением. Достижения в системах обработки нейронной информации (NeurIPS) 33, стр. 6840–6851. Цитируется в: §A.1, §A.1, §A.2, §A.2, §1, §2.
- ⟦[53] Дж. Хо и Т. Салиманс (2022) Классификатор-свободное диффузионное управление. arXiv препринт arXiv:2207.12598. Цитируется в: §A.3.
- ⟦[54] П. Холдерит, Д. Чен, Л. Эйринг, И. Шах, Г. Анантараман, Ю. Хе, З. Аката, Т. Яаккола, Н. М. Боффи и М. Симчовиц (2026) Diamond maps: эффективное выравнивание вознаграждения посредством стохастических потоковых отображений. arXiv preprint arXiv:2602.05993. Цитируется в: §A.1, §A.4, Appendix F.
- ⟦[55] И. Хонг, К. Као, Х. Чжоу и К. Се (2026) Понимание взлома вознаграждения в обучении с подкреплением для генерации изображений по тексту. arXiv preprint arXiv:2601.03468. Цитируется в: Appendix F, §7.
- ⟦[56] Д. Сюй, С. Какаде и Т. Чжан (2012) Хвостовое неравенство для квадратичных форм субгауссовских случайных векторов. Электронные сообщения по теории вероятностей. Цитируется в: §B.2.
- ⟦[57] P. Intelligence, K. Black, N. Brown, J. Darpinian, K. Dhabalia, D. Driess, A. Esmail, M. Equi, C. Finn, N. Fusai, et al. (2025) : vision-language-action модель с обобщением в условиях открытого мира. arXiv preprint arXiv:2504.16054. Цитируется в: §1, §6.2.
- ⟦[58] Дж. Джанг, С. Йе, З. Лин, Дж. Сян, Дж. Бьорк, Ю. Фанг, Ф. Ху, С. Хуанг, К. Кундалия, Ю. Лин, Л. Магне, А. Мандлекар, А. Нараян, Ю. Л. Тан, Г. Ванг, Дж. Ванг, К. Ванг, Ю. Сюй, Х. Зенг, К. Женг, Р. Женг, М. Лю, Л. Зеттлмойер, Д. Фокс, Дж. Каутц, С. Рид, Ю. Жу и Л. Фан (2025) DreamGen: раскрытие обобщающей способности в обучении роботов с помощью видео world models. В материалах Conference on Robot Learning (CoRL), Внешние ссылки: Link Цитируется: §A.3⟧.
- ⟦[59] Т. Каррас, М. Айтала, Т. Айла и С. Лайне (2022) Разъяснение пространства проектирования генеративных моделей на основе диффузии. Достижения в системах обработки нейронной информации (NeurIPS) 35, стр. 26565–26577. Цитируется в: §A.1, §A.2, §A.2, §A.2, §A.2, §A.2, §C.1, §1.
- ⟦[60] К. Карунратанакул, К. Причакул, Э. Аксан, Т. Билер, С. Суважанакорн и С. Танг (2024) Оптимизация диффузионного шума может служить универсальными априорными моделями движения. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 1334–1345. Цитируется в: §A.1, §A.4, §3.
- ⟦[61] Т. Керссис, Г. Бертон, Дж. Хе, К. Ю, В. Ма, Д. де Геус, Г. Дуббельман и Л. Чен (2026) Один кадр равен одному токену: эффективное генеративное моделирование мира с помощью дельта-токенов. Препринт arXiv:2604.04913. Цитируется в: §A.1, §1.
- ⟦[62] А. Хазатский, К. Перч, С. Наир, А. Балакришна, С. Дасари, С. Карамчети, С. Насириани, М. К. Срирама, Л. И. Чен, К. Эллис и др. (2024) Droid: крупномасштабный набор данных для манипуляций роботов в реальных условиях. arXiv preprint arXiv:2403.12945. Цитируется в: §D.1, Appendix F, §6.
- ⟦[63] Б. Ким, С. Ум и Дж. К. Йе (2026) Разнообразная генерация изображений по текстовому описанию посредством контрастной оптимизации шума. В Международной конференции по обучению представлений (ICLR), Внешние ссылки: Link Цитируется: §A.1⟧.
- ⟦[64] Д. Ким, К. Лай, В. Ляо, Н. Мурата, Ю. Такида, Т. Уэсака, Ю. Хэ, Ю. Мицуфудзи и С. Эрмон (2024) Модели согласованных траекторий: обучение траектории потока вероятностей ODE в диффузионных моделях. В материалах Международной конференции по представлениям в обучении (ICLR), Т. 2024, стр. 44493–44525. Цитируется в: §7.
- ⟦[65] М. Дж. Ким, Ю. Гао, Т. Лин, Ю. Лин, Ю. Ге, Г. Лам, П. Лян, С. Сонг, М. Лю, К. Финн и Дж. Гу (2026) Cosmos policy: дообучение видеомоделей для визуально-моторного управления и планирования. В материалах Международной конференции по представлениям в обучении (ICLR), Внешние ссылки: Link Цитируется: §A.3, §2.
- ⟦[66] Б. Лоран и П. Массарт (2000) Адаптивная оценка квадратичного функционала посредством выбора модели. Анналы статистики, стр. 1302–1338. Цитируется в: §B.2, §B.2.
- ⟦[67] Б. Ли, Л. Чжу, Р. Тянь, С. Тан, Ю. Чэнь, Ю. Лу, Ю. Цуй, С. Вир, М. Эрлих, Дж. Филион, С. Венг, Ф. Сюэ, Л. Фань, Ю. Чжу, Дж. Каутц, А. Тао, М. Лю, С. Фидлер, Б. Иванович, Т. Даррелл, Дж. Малик, С. Хан и М. Павоне (2025) Wolf: плотное описание видео с помощью фреймворка суммаризации мира. Transactions on Machine Learning Research. Примечание: Внешние ссылки: ISSN 2835-8856, Link Цитируется в: §B.3, §6⟧.
- ⟦[68] Д. Ли, Ю. Фанг, Ю. Чен, С. Янг, С. Цао, Дж. Вонг, М. Луо, Х. Ванг, Х. Йин, Дж. Гонзалез и др. (2025) Worldmodelbench: оценка моделей генерации видео как мировых моделей. В сборнике Advances in Neural Information Processing Systems (NeurIPS), Том 38. Цитируется в: §D.4, §E.1, §E.1, §6.1⟧.
- ⟦[69] У. Ли, С. Сюй, С. Сяо, Дж. Лю, Х. Ян, Г. Ли, З. Ван, З. Фэн, К. Ше, Ю. Лю и др. (2022) Upainting: унифицированная диффузионная генерация текста в изображение с кросс-модальным управлением. arXiv preprint arXiv:2210.16031. Цитируется в: §C.1, §C.1, §5.
- ⟦[70] И. Ли, И. Чжу, Дж. Вэнь, К. Шэнь и И. Сюй (2025) Worldeval: world model как оценщик стратегий роботов в реальном мире. arXiv preprint arXiv:2505.19017. Цитируется в: §A.3, §2, §3.
- ⟦[71] А. Лян, Ю. Коркмаз, Дж. Чжан, М. Хван, А. Анвар, С. Каушик, А. Шах, А. С. Хуан, Л. Зеттлмойер, Д. Фокс, Ю. Сян, А. Ли, А. Бобу, А. Гупта, С. Ту, Э. Бийик и Дж. Чжан (2026) Robometer: масштабирование универсальных робототехнических моделей вознаграждения посредством сравнения траекторий. В Robotics: Science and Systems (RSS), Цитируется в: §D.4, Appendix F, §7.
- ⟦[72] А. Лян, Л. Конг, Т. Ян, Х. Лю, В. Ян, З. Хуан, В. Инь, Дж. Зуо, Ю. Ху, Д. Чжу и др. (2025) WorldLens: полноспектральные оценки мировых моделей вождения в реальном мире. arXiv preprint arXiv:2512.10958. Цитируется в: Figure 19, Figure 19, §E.1, §E.1.
- ⟦[73] И. Липман, Р. Т. К. Чен, Х. Бен-Хаму, М. Никель и М. Ле (2023) Flow matching для генеративного моделирования. В материалах Международной конференции по обучению представлениям (ICLR), Внешние ссылки: Link Цитируется в: §A.1, §A.1, §A.2, §1⟧.
- ⟦[74] Х. Лю, К. Гонг и Цян Лю (2023) Выпрямление и ускорение потока: обучение генерации и переносу данных с помощью выпрямленных потоков. В материалах Международной конференции по представлениям в обучении (ICLR), Внешние ссылки: Link Цитируется в: §A.1⟧.
- ⟦[75] Н. Ма, С. Тонг, Х. Цзя, Х. Ху, Ю. Су, М. Чжан, С. Ян, Ю. Ли, Т. Яаккола, С. Цзя и др. (2025) Масштабирование вычислительных ресурсов на этапе вывода для diffusion models. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 2523–2534. Цитируется в: Appendix F.
- ⟦[76] И. Ма, Г. Сюй, С. Сунь, М. Янь, Дж. Чжан и Р. Цзи (2022) X-clip: сквозное многоуровневое контрастивное обучение для поиска видео и текста. В материалах 30-й международной конференции ACM по мультимедиа, стр. 638–647. Цитируется в: §B.3, §B.3, §D.3, §6⟧.
- ⟦[77] Л. Маес, К. Л. Лидек, Д. Скьер, Я. Лекун и Р. Балестриеро (2026) Leworldmodel: стабильная архитектура совместного эмбеддинг-прогнозирования от пикселей для сквозного обучения. Препринт arXiv:2603.19312. Цитируется в: §A.1.
- ⟦[78] З. Мей, Т. Инь, О. Шоринва, А. Бадитела, З. Чжэн, Дж. Бруно, М. Бланд, Л. Чжа, А. Хэнкок, Дж. Ф. Фисак и др. (2026) Модели генерации видео в робототехнике: приложения, исследовательские задачи, будущие направления. arXiv preprint arXiv:2601.07823. Цитируется в: §A.3, §1.
- ⟦[79] В. Микели, Э. Алонсо и Ф. Флёре (2023) Transformers являются эффективными с точки зрения выборки world models. В материалах Международной конференции по обучению представлениям (ICLR), Цитируется: §A.1.
- ⟦[80] Дж. Моос, К. Хансел, Х. Абдулсамад, С. Старк, Д. Клевер и Дж. Петерс (2022) Робастное обучение с подкреплением: обзор основ и недавних достижений. Machine Learning and Knowledge Extraction 4 (1), стр. 276–315. Цитируется в: §3⟧.
- ⟦[81] Д. Моура, С. Чжу и О. Звития (2025) Набор данных и соревнование по прогнозированию столкновений с видеорегистраторов Nexar. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 2583–2591. Цитируется в: §D.1, §D.3, §6.1, §6⟧.
- ⟦[82] К. Накамура, Л. Питерс и А. Бакси (2025) Обобщение безопасности за пределами предотвращения столкновений посредством анализа достижимости в латентном пространстве. В Robotics: Science and Systems (RSS), Цитируется в: §A.1, §A.3, §B.3⟧.
- ⟦[83] И. Налисник, А. Мацукава, И. У. Те и Б. Лакшминараянан (2019) Обнаружение входных данных вне распределения для глубоких генеративных моделей с использованием типичности. arXiv preprint arXiv:1906.02994. Цитируется в: §A.5, §4.2.
- ⟦[84] З. Новак, Дж. Маколи, Т. Берг-Киркпатрик и Н. Дж. Брайан (2024) DITTO-2: дистиллированная диффузионная оптимизация времени вывода для генерации музыки. В Международном обществе по поиску музыкальной информации (ISMIR), Внешние ссылки: 2405.20289 Цитируется: §A.1, §A.4.
- ⟦[85] З. Новак, Дж. Маколи, Т. Берг-Киркпатрик и Н. Дж. Брайан (2024) DITTO: диффузионная оптимизация времени вывода для генерации музыки. В материалах Международной конференции по машинному обучению (ICML), Внешние ссылки: Link Цитируется: §A.1⟧.
- ⟦[86] Корпорация NVIDIA (2025) Физический искусственный интеллект для автономных транспортных средств. Примечание: https://huggingface.co/datasets/nvidia/PhysicalAI-Autonomous-Vehicles Цитируется в: §D.1, §D.3, §6.1, §6⟧.
- ⟦[87] М. Окуаб и др. (2023) DINOv2: обучение устойчивым визуальным признакам без учителя. Цитируется в: §E.1.
- ⟦[88] Ю. Ошима, М. Сузуки, Ю. Мацуо и Х. Фурута (2025) Согласование текста и видео во время вывода с помощью поиска по лучу в латентном пространстве диффузионных моделей. В сборнике: Достижения в системах обработки нейронной информации (NeurIPS), Внешние ссылки: Link Цитируется в: §A.1⟧.
- ⟦[89] М. Прабхудесаи, Р. Мендонса, З. Цинь, К. Фрагкиадаки и Д. Патак (2024) Выравнивание видеодиффузионных моделей посредством градиентов вознаграждения. arXiv препринт arXiv:2407.08737. Цитируется в: §A.1, Appendix F, Appendix F.
- ⟦[90] М. Псенка, М. Раббат, А. Кришнаприян, Я. Лекун и А. Бар (2026) Параллельное стохастическое градиентное планирование для world models. arXiv preprint arXiv:2602.00475. Цитируется в: §A.1, Appendix F.
- ⟦[91] Дж. Кеведо, А. К. Шарма, Ю. Сун, В. Сурьяванши, П. Лян и С. Ян (2025) WorldGym: world model как среда для оценки стратегий. arXiv preprint arXiv:2506.00613. Цитируется в: §A.1, §A.3, §1, §2, §3.
- ⟦[92] А. Рэдфорд, Дж. У. Ким, К. Халласи, А. Рамеш, Г. Го, С. Агарвал, Г. Састри, А. Аскелл, П. Мишкин, Дж. Кларк и др. (2021) Обучение переносимым визуальным моделям на основе контроля естественным языком. В сборнике: Международная конференция по машинному обучению (ICML), стр. 8748–8763. Цитируется в: §E.1.
- ⟦[93] Н. Реймерс и И. Гуревич (2019) Sentence-bert: получение векторных представлений предложений с использованием сиамских bert-сетей. В материалах конференции 2019 года по эмпирическим методам в обработке естественного языка, Внешние ссылки: Link Цитируется в: §D.3⟧.
- ⟦[94] Л. Рассел, А. Ху, Л. Бертони, Г. Федосеев, Дж. Шоттон, Э. Арани и Г. Коррадо (2025) Gaia-2: управляемая многоракурсная генеративная модель мира для автономного вождения. arXiv preprint arXiv:2503.20523. Цитируется в: §A.1.
- ⟦[95] Д. Сэмюэл, Р. Бен-Ари, Н. Даршан, Х. Марон и Г. Чечик (2023) Исследование латентного пространства с направляющей нормой для генерации изображений по тексту. Достижения в системах обработки нейронной информации (NeurIPS) 36, стр. 57863–57875. Цитируется в: §A.1, §B.1, §1, §4.2, §4.2.
- ⟦[96] Д. Сэмюэл, Р. Бен-Ари, С. Равив, Н. Даршан и Г. Чечик (2024) Генерация изображений редких концептов с использованием предварительно обученных diffusion models. В материалах конференции AAAI по искусственному интеллекту, Цитируется: §A.1, §4.2.
- ⟦[97] Д. Сэмюэл, Б. Мейри, Х. Марон, Й. Тевел, Н. Даршан, С. Авидан, Г. Чечик и Р. Бен-Ари (2025) Молниеносная инверсия и редактирование изображений для диффузионных моделей преобразования текста в изображение. В материалах Международной конференции по представлениям обучения (ICLR), Внешние ссылки: Link Цитируется: §A.1⟧.
- ⟦[98] Дж. Сео, К. Накамура и А. Баджси (2025) Латентные фильтры безопасности с учетом неопределенности для предотвращения сбоев вне распределения. В материалах Конференции по обучению роботов (CoRL), Внешние ссылки: Link Цитируется в: §A.1, §A.3, §B.3, §C.1⟧.
- ⟦[99] А. К. Шарма, Ю. Сун, Н. Лу, Ю. Чжан, Дж. Лю и С. Ян (2026) World-gymnast: обучение роботов с помощью reinforcement learning в world model. arXiv preprint arXiv:2602.02454. Цитируется в: §A.1, §A.3, §1, §3.
- ⟦[100] Р. Синхал, З. Хорвиц, Р. Тихан, М. Рен, З. Ю, К. Маккеоун и Р. Ранганат (2025) Общая структура для масштабирования и управления diffusion models во время вывода. В Международной конференции по машинному обучению (ICML), Внешние ссылки: Link Цитируется: §A.1⟧.
- ⟦[101] Дж. Сонг, К. Менг и С. Эрмон (2021) Denoising diffusion implicit models. В материалах Международной конференции по обучению представлений (ICLR), Внешние ссылки: Link Цитируется в: §A.2, §A.2, §2⟧.
- ⟦[102] Й. Сонг, П. Дхаривал, М. Чен и И. Суцкевер (2023) Модели согласованности. В Международной конференции по машинному обучению (ICML), стр. 32211–32252. Цитируется в: §7.
- ⟦[103] И. Сонг, Дж. Сол-Дикштейн, Д. П. Кингма, А. Кумар, С. Эрмон и Б. Пул (2021) Генеративное моделирование на основе оценок с помощью стохастических дифференциальных уравнений. В материалах Международной конференции по обучению представлений (ICLR), Внешние ссылки: Link Цитируется в: §A.1, §A.2, §A.2, §2⟧.
- ⟦[104] П. Стойка, Р. Л. Мозес и др. (2005) Спектральный анализ сигналов. Том 452, Пирсон Прентис Холл, Аппер-Сэдл-Ривер, Нью-Джерси. Цитируется в: §4.2⟧.
- ⟦[105] Х. Тан, С. Чен, Ю. Сюй, З. Ван, Ю. Джи, К. Чи, Ю. Лю, З. Чжао, Х. Чен, П. Ко и др. (2025) Robo-dopamine: моделирование общего вознаграждения за процесс для высокоточной роботизированной манипуляции. arXiv preprint arXiv:2512.23703. Цитируется в: §7.
- ⟦[106] З. Танг, Дж. Пенг, Дж. Танг, М. Хонг, Ф. Ванг и Т. Чанг (2025) Выравнивание diffusion models на этапе вывода с помощью прямой оптимизации шума. В Международной конференции по машинному обучению (ICML), Внешние ссылки: Link Цитируется в: §A.1, §A.4, §B.1, Appendix F, §1, §3, §3, §4.2, §4.2⟧.
- ⟦[107] G. Team, R. Anil, S. Borgeaud, J. Alayrac, J. Yu, R. Soricut, J. Schalkwyk, A. M. Dai, A. Hauth, K. Millican, et al. (2023) Gemini: семейство высокоэффективных мультимодальных моделей. arXiv preprint arXiv:2312.11805. Цитируется в: §B.3, §D.4, §E.1, §E.2⟧.
- ⟦[108] G. R. Team, K. Choromanski, C. Devin, Y. Du, D. Dwibedi, R. Gao, A. Jindal, T. Kipf, S. Kirmani, I. Leal, et al. (2025) Оценка политик Gemini robotics в симуляторе мира Veo. arXiv preprint arXiv:2512.10675. Цитируется в: §1, §2, §3⟧.
- ⟦[109] В. Цзэн, Дж. Гу, К. Чжан, Х. Мао, М. Лю, Ф. Шкурти и Л. Йен-Чен (2025) Масштабируемая оценка стратегий с помощью видео World Models. arXiv preprint arXiv:2511.11520. Цитируется в: §A.3⟧.
- ⟦[110] М. Уэхара, Ю. Чжао, К. Блэк, Э. Хаджирамезанали, Г. Скалиа, Н. Л. Диамант, А. М. Ценг, Т. Бьянкалани и С. Левин (2024) Тонкая настройка диффузионных моделей непрерывного времени как управление с энтропийной регуляризацией. arXiv preprint arXiv:2402.15194. Цитируется в: §A.1.
- ⟦[111] М. Уэхара, Ю. Чжао, К. Ван, С. Ли, А. Регев, С. Левин и Т. Бьянкалани (2025) Выравнивание во время вывода в diffusion models с помощью генерации, управляемой вознаграждением: учебное пособие и обзор. arXiv preprint arXiv:2501.09685. Цитируется в: §A.1.
- ⟦[112] С. В. Васеги (2008) Продвинутая цифровая обработка сигналов и шумоподавление. Джон Уайли энд Санз. Цитируется в: §4.2⟧.
- ⟦[113] А. Вагенмейкер, Ю. Чжан, М. Накамото, С. Парк, В. Ягуб, А. Нагабанди, А. Гупта и С. Левин (2025) Управление вашей diffusion policy с помощью обучения с подкреплением в латентном пространстве. В материалах Conference on Robot Learning (CoRL), Внешние ссылки: Link Цитируется в: §A.1, §A.4, Appendix F⟧.
- ⟦[114] Дж. Уокер, К. Дёрш, А. Гупта и М. Хеберт (2016) Неопределенное будущее: прогнозирование по статичным изображениям с использованием вариационных автокодировщиков. В материалах Европейской конференции по компьютерному зрению (ECCV), стр. 835–851. Цитируется в: §A.1.
- ⟦[115] Б. Уоллес, М. Данг, Р. Рафайлов, Л. Чжоу, А. Лоу, С. Пурушвалкам, С. Эрмон, К. Сюн, С. Джоти и Н. Наик (2024) Выравнивание диффузионных моделей с использованием прямой оптимизации предпочтений. В материалах конференции IEEE/CVF по компьютерному зрению и распознаванию образов (CVPR), стр. 8228–8238. Цитируется: §A.1, §A.4.
- ⟦[116] Б. Уоллес, А. Гокул, С. Эрмон и Н. Наик (2023) Сквозная оптимизация латентного пространства диффузионных моделей улучшает направляющее воздействие классификатора. В материалах Международной конференции по компьютерному зрению IEEE/CVF (ICCV), стр. 7280–7290. Цитируется в: §A.1, §A.4.
- ⟦[117] Т. Ван, А. Ван, Б. Ай, Б. Вен, К. Мао, К. Се, Д. Чен, Ф. Ю, Х. Чжао, Дж. Янг и др. (2025) Wan: открытые и передовые крупномасштабные генеративные модели видео. arXiv preprint arXiv:2503.20314. Цитируется в: §A.3, §1.
- ⟦[118] И. Ван, В. Ло, Дж. Бай, И. Цао, Т. Че, К. Чен, И. Чен, Дж. Даймонд, И. Дин, В. Дин и др. (2025) Alpamayo-r1: объединение рассуждений и прогнозирования действий для обобщаемого автономного вождения в условиях длинного хвоста. arXiv preprint arXiv:2511.00088. Цитируется в: §D.3.
- ⟦[119] Т. Видемер, Ю. Ли, П. Викол, С. С. Гу, Н. Матарезе, К. Сверски, Б. Ким, П. Джаини и Р. Гейрхос (2025) Видеомодели являются zero-shot обучающимися и рассуждающими системами. arXiv preprint arXiv:2509.20328. Цитируется в: §A.3.
- ⟦[120] Дж. Ву, Ю. Гао, З. Йе, М. Ли, Л. Ли, Х. Го, Дж. Лю, З. Сюэ, Х. Хоу, В. Лю и др. (2025) Rewarddance: масштабирование вознаграждения в визуальной генерации. arXiv preprint arXiv:2509.08826. Цитируется в: §B.3.
- ⟦[121] Л. Ву, Б. Триппе, К. Наэсет, Д. Блей и Дж. П. Каннингем (2023) Практическая и асимптотически точная условная выборка в диффузионных моделях. Достижения в системах нейронной обработки информации (NeurIPS) 36, стр. 31372–31403. Цитируется в: §A.1.
- ⟦[122] П. Ву, А. Эсконтрела, Д. Хафнер, П. Аббил и К. Голдберг (2023) Daydreamer: world models для обучения физических роботов. В материалах Conference on Robot Learning (CoRL), стр. 2226–2240. Цитируется в: §A.1⟧.
- ⟦[123] И. Ву, Р. Тянь, Г. Свами и А. Бакси (2025) От предвидения к размышлению: управление политикой с использованием VLM в контуре посредством латентного выравнивания. В Robotics: Science and Systems (RSS), Цитируется в: §B.3.
- ⟦[124] К. Сюй, Т. К. Нгуен, Э. Диксон, К. Родригес, П. Миллер, Р. Ли, П. Шах, Р. Амбрус, Х. Нишимура и М. Иткина (2025) Можем ли мы обнаруживать сбои без данных о сбоях? обнаружение сбоев во время выполнения с учетом неопределенности для стратегий обучения с подражанием. В Robotics: Science and Systems (RSS), Цитируется в: §C.3.
- ⟦[125] Т. Инь, З. Мэй, З. Чжэн, М. Ямане, Д. Ван, Дж. Ситс, С. М. Бейтман, Л. Чжа, А. Бадитела, О. Шоринва и др. (2026) PlayWorld: обучение моделей мира роботов на основе автономной игры. arXiv препринт arXiv:2603.09030. Цитируется в: §A.3, §A.3, §2, §2.
- ⟦[126] Дж. Юань, С. Чжан, Ф. Фридрих, Н. Бельтран-Велес, М. Холл, Р. Аскари-Хеммат, С. Хань, Н. Баллас, М. Дроздзал и А. Ромеро-Сориано (2026) Согласование физики видеогенеративных моделей с латентными мировыми моделями во время вывода. arXiv preprint arXiv:2601.10553. Цитируется в: §A.1, Appendix F.
- ⟦[127] К. Чжай, У. Сингх, А. Татипелли, С. Чакраборти, А. К. Саху, Ф. Хуанг, А. С. Беди и М. Шах (2025) Mira: на пути к смягчению взлома вознаграждения при выравнивании диффузионных моделей t2i во время вывода. arXiv preprint arXiv:2510.01549. Цитируется в: §A.1.
- ⟦[128] К. Чжан, З. Тан, Х. Ху, Х. Пан, Х. Го, Ю. Лю, Дж. Хуан, Л. Юань, К. Чжан, Х. Лонг и др. (2025) Epona: авторегрессионная диффузионная модель мира для автономного вождения. В материалах Международной конференции IEEE/CVF по компьютерному зрению (ICCV), стр. 27220–27230. Цитируется в: §1.
- ⟦[129] У. Чжан, Г. Ван, Дж. Сун, Ю. Юань и Г. Хуан (2023) Storm: эффективные стохастические world models на базе transformers для обучения с подкреплением. Advances in Neural Information Processing Systems (NeurIPS) 36, стр. 27147–27166. Цитируется в: §A.1⟧.
- ⟦[130] Г. Чжоу, Х. Пан, Я. Лекун и Л. Пинто (2025) DINO-WM: world models на основе предобученных визуальных признаков обеспечивают zero-shot планирование. В материалах Международной конференции по машинному обучению (ICML), Внешние ссылки: Link Цитируется в: §A.1, §3, §3⟧.
- ⟦[131] И. Чжу, А. Джоши, П. Стоун и И. Чжу (2022) VIOLA: обучение с подражанием для манипуляций на основе зрения с априорными предложениями объектов. Препринт arXiv:2210.11339. Внешние ссылки: Document Цитируется в: §D.5⟧.
Веб-сайт проекта
Видеорезультаты и интерактивные демонстрации доступны по адресу junwon.me/StressDream/. Коды доступны по адресу https://github.com/CMU-IntentLab/StressDream⟧.
Приложение
Appendix A Контекст
A.1 Связанные работы
Мировые модели для робототехники. Мировые модели стали многообещающей парадигмой для робототехники, позволяющей прогнозировать будущие состояния непосредственно на основе высокоразмерных сенсорных наблюдений, обусловленных действиями [36, 31, 44, 122, 130, 79, 15, 1, 77]. Благодаря генерации синтетических траекторий они доказали свою эффективность для обучения стратегий на основе зрения [43, 45, 46, 47, 82, 2, 99, 41], планирования в латентном пространстве [130, 90] и оценки стратегий [48, 42, 91]. Достижения в моделях генерации видео [14], которые создают реалистичные и временно согласованные прогнозы, еще больше повысили выразительность мировых моделей в разнообразных сценариях реального мира, особенно при дообучении (fine-tuned) на данных воплощения (embodiment data) для обусловливания действий [38, 50, 42]. Мировые модели обычно работают в условиях частичной наблюдаемости, что естественным образом порождает неопределенность и мультимодальность в будущих прогнозах [114, 129, 61], особенно в таких условиях, как манипуляции с частыми контактами [42] или автономное вождение [38, 94, 11, 50]. В частности, подходы, основанные на диффузии и flow-matching [52, 59, 73], показали высокую эффективность в моделировании высокоразмерных сложных сред благодаря своей способности улавливать богатые мультимодальные распределения будущих наблюдений [7, 17, 39, 61]. Несмотря на это, многие существующие методы с использованием мировых моделей либо полагаются на номинальные развертки (rollouts) без рассуждения о распределении вероятных будущих состояний [17, 42, 98], либо используют детерминированные мировые модели, которые не могут представить такое разнообразие [130, 77], тем самым не учитывая явным образом риски, возникающие из-за неопределенного будущего..
Управление генеративными моделями во время инференса. Управление во время инференса для диффузионных [52, 103] или flow-matching [73, 74] моделей направлено на то, чтобы направить предобученную генеративную модель к выборкам, которые максимизируют вознаграждение во время инференса [106, 110, 111, 54]. Хотя прямая дообучение (SFT) диффузионных моделей с целевыми функциями вознаграждения может быть эффективной для выравнивания по вознаграждению [35, 115, 89, 24, 110, 28], это дорого, сложно, привязано к конкретному вознаграждению [106, 54] и может привести к отклонению модели от исходного распределения данных [33]. Напротив, управление во время инференса оставляет предобученную модель неизменной и вместо этого модифицирует процедуру сэмплирования [23, 51, 106, 111, 100, 126], например, посредством классификаторного руководства [103] или методов сэмплирования на основе частиц, таких как Sequential Monte Carlo (SMC) [121, 29, 88, 54]. Одним из наиболее актуальных направлений является оптимизация шума, которая оптимизирует шум, сэмплированный в процессе шумоподавления [116, 40, 60, 34, 85, 106]. Предыдущие работы показали, что это может улучшить качество изображения [40, 18, 33], имитировать эффекты диффузионного руководства [3], генерировать редкие [95, 96, 97] или разнообразные концепты [63], а также адаптировать диффузионные политики в робототехническом управлении [113]. Однако центральной проблемой, особенно когда пространство шума становится высокоразмерным, является шум вне распределения: выборки могут достигать высокого вознаграждения, переставая при этом находиться в носителе предобученного распределения, как только шум отклоняется от априорного [95, 12, 106, 34, 127, 33, 49]. Более того, эти методы часто требуют обратного распространения градиентов вознаграждения через процесс шумоподавления; на практике многие поэтому полагаются на step-distilled модели, чтобы сделать обратное распространение вычислительно приемлемым [84, 34, 33, 27], в то время как недавние работы предлагают многошаговую дистилляцию оценок (score distillation) для более эффективной аппроксимации градиентов вознаграждения к начальному шуму [3]. Наш подход использует оптимизацию начального шума для управления видео-моделями мира с обусловленностью по действиям [38, 42] с помощью практического решения для высокоразмерной оптимизации шума..
A.2 Диффузионные модели
Современные генеративные модели часто основаны на формулировках диффузии или согласования потоков, которые генерируют выборки из шума путем моделирования обученного дифференциального уравнения. В этом разделе подробно рассматривается формулировка диффузионной модели из разд. 3, которая служит основой для современных видео-моделей мира, способных генерировать высококачественные видео. Для краткости мы опускаем обусловливание на на протяжении всего текста..
Путь прямой вероятности. Диффузионные модели на основе оценки [52, 59, 101] и модели сопоставления потоков [6, 73] определяют генеративные модели , процесс выборки которых может быть описан стохастическим или обыкновенным дифференциальным уравнением (SDE или ODE). Сеть шумоподавления , которая параметризует эту динамику, обучается восстанавливать обратный генеративный процесс, как правило, путем прогнозирования оценки распределения возмущенных данных, внесенного шума или условного векторного поля.
Начиная с чистых данных и изотропного гауссовского шума , прямой процесс, индексируемый временем диффузии , определяет возмущенный образец как
| (10) |
Для параметризаций с сохранением дисперсии, таких как DDPM, граничные условия удовлетворяют , , и , . В более общем случае мы требуем лишь того, чтобы конечное состояние было доминируемым шумом. Типичные примеры включают график сохранения дисперсии в DDPM [52], где , и график взрывной дисперсии в EDM [59], где и увеличивается с диффузионным временем.
Цель обучения. Денойзер обучается восстанавливать внедренный гауссов шум из возмущенного будущего наблюдения, обусловленного историей наблюдений и последовательностью действий. С параметризацией предсказания шума,
| (11) |
где представляет собой зависящий от времени весовой коэффициент [59]. Параметризации чистого образца, оценки и скорости линейно эквивалентны [59, 103]; мы принимаем в качестве предсказателя шума, и данный анализ переносится на другие параметризации.
Генерация посредством детерминированных обновлений ODE. Во время инференса генерация начинается с начального образца гауссовского шума и итеративно отображается в чистый образец путем следования обратной ODE потока вероятностей. Детерминированное обновление, используемое в (3), можно рассматривать как шаг Эйлера первого порядка для данной ODE, где DDIM [101] и EDM [59] являются репрезентативными примерами. Учитывая текущий зашумленный образец , предсказанный чистый образец получается путем инвертирования прямого пути (10):
| (12) |
Затем образец переводится на следующий, менее зашумленный момент времени путем повторного применения прямого пути к с использованием предсказанного шума в качестве направления шума.:
| (13) |
Итерация этого детерминированного обновления от до определяет процесс генеративного моделирования . Подстановка (12) в (13) позволяет восстановить обновление шумоподавления в (3⟧).
ОДУ потока вероятностей и детерминизм начального шума. В пределе непрерывного времени детерминированные обновления в (13) соответствуют дискретизации Эйлера для ОДУ потока вероятностей, связанного с прямым путем в (10) [103, 59]. Данное ОДУ переносит выборки из гауссовского априорного распределения в распределение данных вдоль детерминированных траекторий. Таким образом, сгенерированная выборка может быть записана как где обозначает детерминированный сэмплер, индуцированный обученным шумоподавителем. Это делает сгенерированную выборку детерминированной и дифференцируемой функцией начального шума, что обосновывает использование в качестве управляющей переменной и позволяет распространять градиенты последующих критериев через сэмплер.
A.3 Видеомодели мира с обусловленностью на действия
Видеомодели мира для робототехники продемонстрировали потенциал в оценке и улучшении стратегий путем моделирования сложных для описания систем непосредственно на основе высокоразмерных сенсорных наблюдений [78]. В манипуляционной робототехнике, например, модель мира может предвидеть, как объекты могут рассыпаться, соскальзывать или опрокидываться во время физического взаимодействия, основываясь на данных с камер [82, 98, 119]. В автономном вождении она может моделировать будущее развитие сцены в сложных условиях, фиксируя взаимодействия агентов и критически важные для безопасности ситуации непосредственно в пространстве изображений [38, 50]. Эти возможности могут способствовать оценке и улучшению стратегий визуомоторного управления в симуляции, снижая зависимость от дорогостоящих, трудоемких и потенциально небезопасных испытаний в реальном мире [78, 125]⟧.
Stable Video Diffusion. Недавние видео world models часто строятся на основе моделей генерации видео [1, 117], которые продемонстрировали высокую способность к синтезу реалистичных и временно согласованных видео. Вместо обучения с нуля многие современные подходы используют инициализацию из крупномасштабных диффузионных моделей видео с последующей донастройкой на специализированных наборах данных, таких как вождение или манипуляции роботов. Широко используемой основой является Stable Video Diffusion (SVD) [14] — латентная диффузионная модель для генерации видео из изображений. SVD использует архитектуру энкодер-декодер для отображения RGB-кадров в обученное латентное пространство, где и обозначают высоту и ширину изображения. Затем диффузионная модель обучается удалять шум из латентных представлений видео, следуя целевой функции вида в (11), а сгенерированные латентные представления декодируются обратно в RGB-видеокадры с использованием декодера.
Обусловливание действиями. Для робототехнических приложений видео-модели мира обусловливаются действиями, чтобы обеспечить возможность контролируемой генерации будущего [38, 42]. Эти действия могут соответствовать будущим элементам управления транспортным средством или траекториям в автономном вождении [38, 50], либо последовательностям действий робота, таким как позы рабочего органа, команды положения суставов или низкоуровневые команды управления в манипуляционной робототехнике [42, 65]. В обозначениях (11), шумоподавитель обусловливается предысторией и действиями, так что сгенерированное будущее ограничено согласованностью как с наблюдаемой предысторией, так и с заданной последовательностью действий. В то время как более ранние модели мира часто изучали латентную динамику на основе траекторий наблюдений-действий, специфичных для задачи [43, 46, 48], современные диффузионные видео-модели мира, построенные на SVD, обычно начинают с предобученной видео-диффузионной модели и дообучают её на данных, обусловленных действиями. При обучении с условным отсевом (conditional dropout) эти модели также могут использовать классификатор-свободное руководство (classifier-free guidance) во время сэмплирования для поиска компромисса между визуальной реалистичностью и управляемостью действиями [53]⟧.
Обусловливание по истории. Для генерации согласованных будущих кадров, которые остаются непротиворечивыми по отношению к обусловливающим наблюдениям, современные видео world models включают историю наблюдений несколькими способами. Некоторые методы внедряют обусловливающие кадры путем замены соответствующих зашумленных латентных кадров на чистые наблюдаемые латентные представления во время процесса sampling [38]; другие используют прогрессивный или авторегрессионный sampling с покадровыми графиками шума для стимулирования причинно-следственной структуры во времени [17, 50]; а некоторые предоставляют разреженные кадры истории или memory tokens в качестве дополнительных входных данных сети посредством обусловливания на основе attention [42]. Эти механизмы помогают сохранить временную непрерывность, поддерживать согласованность сгенерированного будущего с наблюдаемой историей, обеспечивая авторегрессионную генерацию видео на более длительный горизонт за счет обусловливания будущих предсказаний на предыдущих наблюдениях или сгенерированных кадрах..
Применение: Оценка и улучшение стратегий. Видеомодели мира с обусловленностью на действия могут поддерживать обучение роботов без многократных запусков в реальном мире, обеспечивая масштабируемую генерацию данных, планирование, оценку стратегий и их улучшение. Поскольку современные передовые модели генерации видео часто работают медленно и требуют больших объемов памяти, их обычно используют автономно, а не для планирования в реальном времени. Предыдущие работы в основном использовали видеопрогнозирование с обусловленностью на действия двумя способами: (i) использование воображаемых запусков для оценки или оптимизации стратегий без повторных испытаний на оборудовании [91, 42, 109, 70, 125], и (ii) генерация синтетических траекторий для аугментации данных или SFT стратегий [42, 58, 99, 41, 125]. В частности, недавние работы сообщают, что видеомодели мира могут служить симуляторами для оценки visuomotor стратегий в замкнутом контуре, при этом прогнозируемая производительность коррелирует с показателями успеха в реальном мире [42]. Аналогичным образом, стратегии могут быть улучшены с использованием видеомоделей мира либо посредством обучения с подкреплением внутри воображаемых запусков [99], либо путем поиска успешных синтетических траекторий, которые затем используются для SFT стратегии [41]⟧.
Хотя наш метод может быть применен в этих более широких условиях, наши эксперименты сосредоточены конкретно на ценности управления видео world models для надежной оценки и улучшения policy. Вместо оценки полной роботизированной policy в замкнутом цикле мы оцениваем траектории-кандидаты, которые могли бы быть созданы policy, и оцениваем их потенциальные риски сбоев. Аналогичным образом, вместо улучшения policy посредством исследования в замкнутом цикле внутри world model, мы используем управляемую world model для выявления подверженных сбоям экспертных траекторий и перевзвешиваем их во время fine-tuning policy..
A.4 Управление генеративными моделями во время вывода
Учитывая генеративную модель , которая отображает начальный образец шума в сгенерированный образец , оптимизация во время вывода (inference-time optimization) направлена на поиск генераций, максимизирующих заданный пользователем критерий , при сохранении правдоподобности сгенерированных образцов с помощью регуляризатора , который штрафует генерации, отклоняющиеся от исходного распределения модели. Это можно записать как
| (14) |
Естественный способ реализации этой цели заключается в адаптации самой генеративной модели таким образом, чтобы она осуществляла выборку из распределения, смещенного в сторону вознаграждения.,
| (15) |
который увеличивает вес образцов с высоким критерием, оставаясь при этом близким к исходному распределению модели. Однако прямая донастройка генератора часто непрактична для управления во время вывода: критерий может меняться в зависимости от задач или пользователей, а донастройка требует значительных вычислительных затрат для каждого нового критерия. Более того, сохранение близости к исходному распределению может потребовать оценок плотности, которые являются невыполнимыми или чрезмерно дорогими для многомерных генеративных моделей [115, 4]. В результате адаптация модели может отклониться от исходного распределения данных и приводить к созданию неправдоподобных генераций [33, 54].
Оптимизация начального шума. Оптимизация начального шума, напротив, сохраняет генеративную модель неизменной и оптимизирует только входной шум в соответствии с критерием на этапе вывода, оцениваемым на сгенерированном образце.:
| (16) |
Данная формулировка позволяет задавать произвольные критерии во время вывода ⟦BROKEN_K0⟧ без изменения параметров модели. Если оптимизированный шум остается правдоподобным в рамках исходного гауссовского априорного распределения, то результирующая генерация по-прежнему индуцируется распределением предобученной модели, поэтому дополнительная регуляризация самого сгенерированного образца не требуется..
Когда является дифференцируемой, оптимизация может быть решена путем обратного распространения ошибки через диффузионный сэмплер [116, 60, 34]. Для недифференцируемых критериев в предыдущих работах оцениваются градиенты критерия [106], оптимизация амортизируется с помощью гиперсети [33] или управление формулируется как задача обучения с подкреплением [18, 113]. Поскольку обратное распространение ошибки через множество итеративных шагов шумоподавления является вычислительно затратным, в ряде методов диффузионные модели дополнительно дистиллируются в одношаговые генераторы, чтобы сделать оптимизацию более управляемой [34, 84, 33]⟧.
A.5 Типичное множество многомерного гауссовского шума
Типичное множество описывает область, в которой выборки из распределения с высокой вероятностью должны находиться. Это, следовательно, понятие вероятностной массы, а не просто плотности вероятности [25, 83]. Для случайного вектора , пусть обозначает совместную плотность полного -мерного гауссовского априорного распределения. -типичное множество может быть записано как
| (17) |
где — дифференциальная энтропия одномерного стандартного гауссовского распределения. Одномерная энтропия возникает из-за того, что априорное стандартное гауссовское распределение факторизуется по координатам, . Таким образом, — это среднее количество информации на координату, аналогичное эмпирической энтропии для i.i.d. последовательности. Для изотропного гауссовского априорного распределения,
| (18) |
Следовательно, типичность подразумевает . В пространствах высокой размерности выборки из распределения Гаусса концентрируются на тонкой оболочке радиусом приблизительно , а не вблизи моды. Это иллюстрирует ключевое различие между плотностью и типичностью: нулевой вектор обладает наибольшей плотностью при априорном распределении Гаусса, но крайне маловероятен для выборки в пространствах высокой размерности. Хотя распределение Гаусса имеет полную поддержку на , большая часть его вероятностной массы концентрируется на малом подмножестве этого пространства по мере роста . Эквивалентно, типичная выборка характеризуется не только своим правдоподобием, но и совокупностью выборочных статистик, значения которых близки к их математическим ожиданиям при априорном распределении Гаусса..
Appendix B Управление видеомоделями мира во время вывода ⟦K0⟧
B.1 Регуляризация шума внутри типичного множества многомерного гауссовского распределения
В этом разделе мы подробно рассматриваем разд. 4.2, где мы накладываем ограничения типичного множества в процессе оптимизации шума. В многомерных гауссовских распределениях области высокой плотности вероятности не обязательно совпадают с областями высокой вероятностной массы, где концентрируются типичные выборки. Например, нулевой вектор имеет наибольшую плотность в стандартном гауссовском распределении, однако он почти никогда не встречается при выборке в высоких размерностях; вместо этого типичные выборки лежат на тонкой оболочке с квадратом нормы приблизительно . Мы называем эту область высокой массы типичным множеством. Как показано на рис. 8, типичное множество отличается от области высокой плотности, и выборка шума вне типичного множества может привести к неправдоподобным генерациям. Это различие важно для diffusion models, которые обучаются удалять шум из выборок, инициализированных из типичного гауссовского шума. Если оптимизация смещает начальный шум в сторону нетипичных областей априорного распределения с низкой массой, denoiser может быть оценен на входных данных, редко встречавшихся во время обучения, что приведет к ошибкам аппроксимации и, как следствие, к неправдоподобным или OOD генерациям..
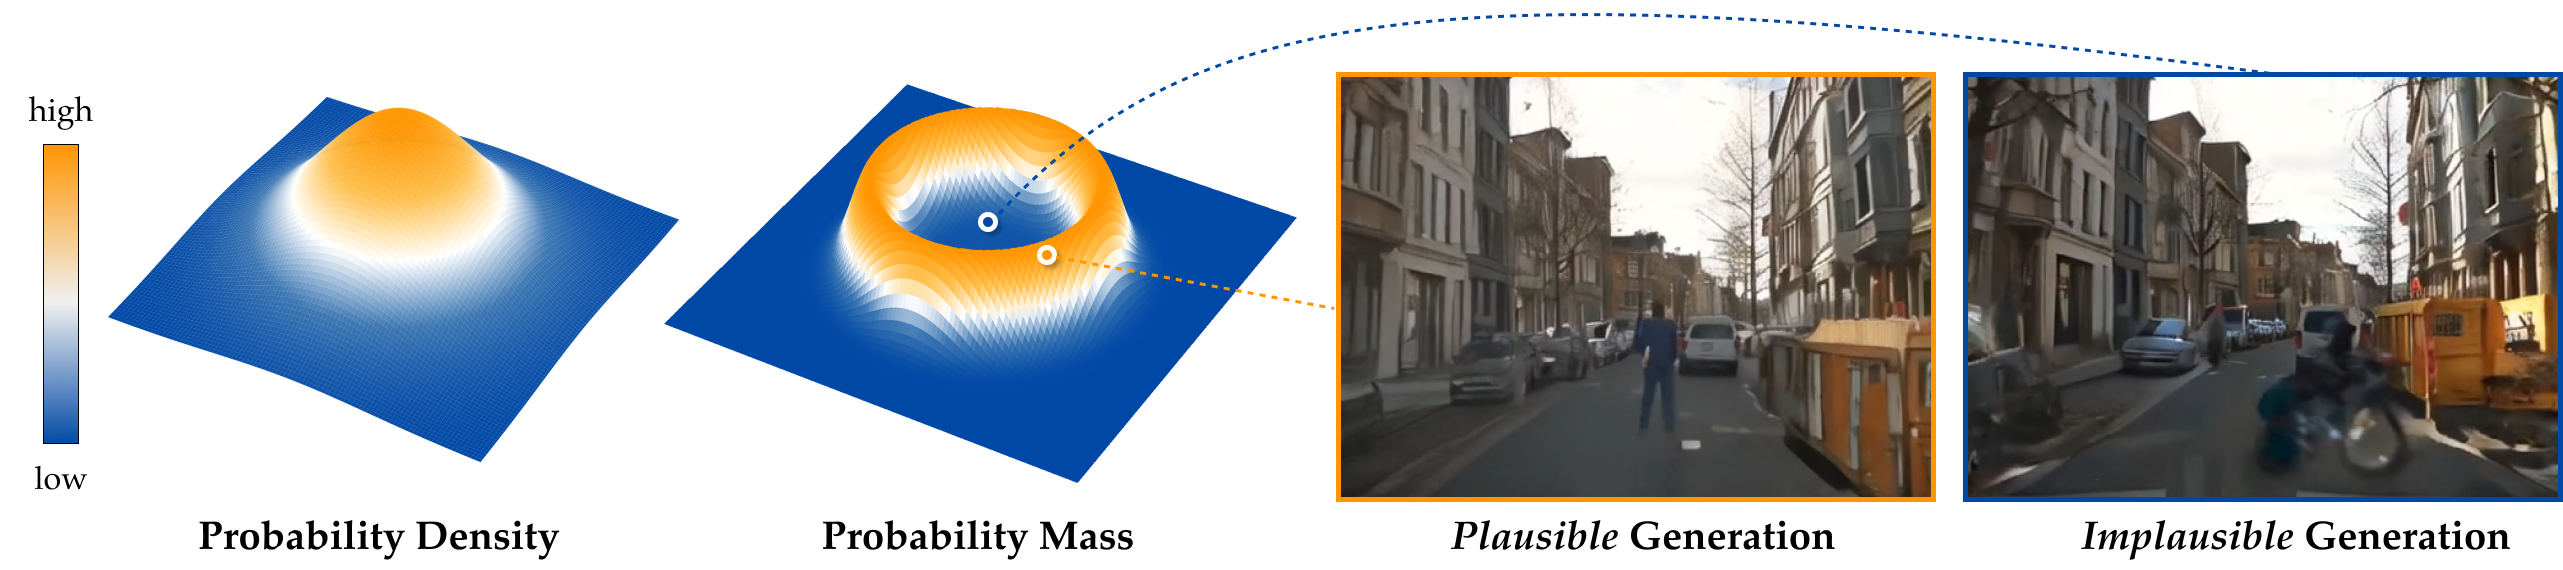
Распространенный способ поощрения типичности заключается в регуляризации нормы оптимизированного шума, поскольку гауссовские выборки демонстрируют сильную концентрацию нормы в пространствах высокой размерности. В ряде предыдущих методов было установлено, что регуляризации на основе нормы достаточно для сохранения правдоподобности при генерации с помощью diffusion models [95, 34, 106]. Однако норма отражает лишь одну из многочисленных статистических характеристик гауссовской выборки. На практике мы обнаружили, что дополнительные ограничения типичности важны для высокоразмерных video world models. Таким образом, как описано в Sec. 4.2, мы регуляризируем несколько статистических характеристик оптимизированного шума, включая концентрацию нормы, изотропность и спектральную белизну, каждая из которых обоснована свойствами концентрации высокоразмерных гауссовских выборок..
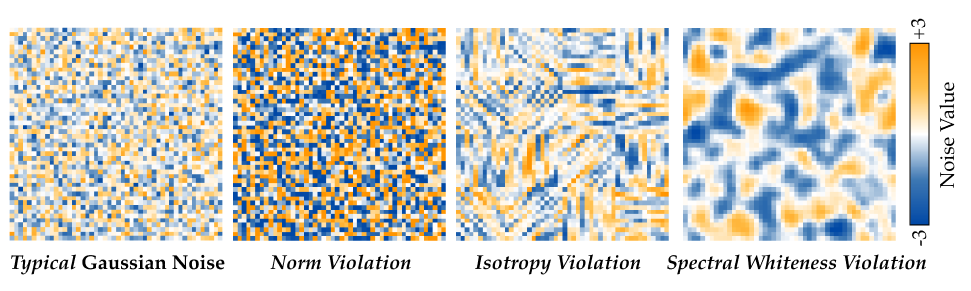
На рис. 9 представлены примеры гауссовского шума, визуализированные в виде двумерных изображений, где каждый нетипичный образец нарушает одну из статистических характеристик типичного гауссовского множества. Нарушение концентрации нормы приводит к появлению шума с глобально смещенными значениями по сравнению с типичным гауссовским шумом. Нарушение изотропности вносит локальные координатные паттерны, которые не встречаются в типичном i.i.d. шуме, в то время как нарушение спектральной белизны порождает структурированные, небелые паттерны в частотной области..
B.2 Концентрация регуляризаторов типичного множества Гаусса
Концентрация нормы. Для гауссовского шума , квадратичная норма удовлетворяет , и, следовательно, резко концентрируется вокруг . Эквивалентно, евклидова норма, или радиус , концентрируется вокруг . Более того, если , то следует хи-распределению с степенями свободы, стандартное отклонение которого остается ограниченным независимо от и приближается к при . Таким образом, хотя типичный радиус растет как , абсолютная ширина оболочки, содержащей большую часть гауссовской вероятностной массы, остается приблизительно постоянной. Это обосновывает штрафование отклонений от типичной гауссовской оболочки по радиусу:
Lemma 1 (Норма концентрации гауссовского шума).
Пусть . Тогда для любого ,
Эквивалентно, вероятность того, что лежит вне этой типичной нормативной оболочки, составляет не более .
Доказательство.
Поскольку , его координаты являются независимыми стандартными нормальными случайными величинами. Следовательно,
Пусть . Согласно неравенству Лорана–Массара [66], для любого ,
Принимая , каждое хвостовое событие имеет вероятность не более . Следовательно, согласно объединению границ, с вероятностью не менее ,
Деление на дает
Подстановка завершает доказательство. ∎
Corollary 1 (Масштаб регуляризатора радиальной нормы с высокой вероятностью).
Для
у нас есть, для любого , с вероятностью не менее ,
Следовательно,
с высокой вероятностью.
Доказательство.
Согласно лемме 1, с вероятностью не менее ,
Пусть . Поскольку
мы получаем
Возведение обеих частей в квадрат дает желаемую границу. ∎
Corollary 2 (Независимая от размерности ширина гауссовой оболочки).
Пусть с . Тогда стандартное отклонение ограничено независимо от :
Более конкретно, следует хи-распределению с степенями свободы, и
Доказательство.
Поскольку и , случайная величина подчиняется хи-распределению с степенями свободы. Хи-распределение имеет моменты
Следовательно,
Эта дисперсия остается ограниченной по мере роста и, по сути, сходится к . Следовательно
показывая, что ширина гауссовой оболочки асимптотически не зависит от размерности. ∎
Концентрация изотропии. Теперь мы покажем, что регуляризатор изотропии мал с высокой вероятностью при гауссовском априорном распределении. Пусть , и предположим . Мы случайным образом переставляем координаты и разбиваем их на блоков
Поскольку гауссов априор имеет независимые и одинаково распределенные координаты, данная случайная перестановка не меняет распределение, и блоки удовлетворяют ⟦BROKEN_K0⟧
Таким образом, их эмпирический второй момент
должны быть близки к при гауссовском априорном распределении. Мы измеряем отклонения от этой блочной изотропии, используя
Lemma 2 (Малая вероятность анизотропной гауссовой блочной ковариации).
Существует универсальная константа такая, что для любого , если , то
Доказательство.
Для каждой записи ,
Во-первых, рассмотрим диагональные члены. Поскольку ,
Для внедиагональных членов произведения имеют нулевое среднее и единичную дисперсию. Следовательно
Следовательно,
Деление на дает
Что касается утверждения о высокой вероятности, отметим, что каждый диагональный элемент представляет собой среднее значение центрированных субоптимальных случайных величин, а каждый внедиагональный элемент является средним значением произведений независимых гауссовских величин, которые также являются субоптимальными. Следовательно, согласно концентрационному неравенству типа Бернштейна [56], для всех элементов,
для , где является универсальной константой. Применяя объединение границ для записей и принимая
мы получаем, с вероятностью не менее ,
Следовательно,
Деление на дает
с вероятностью не менее , для универсальной константы . ∎
Это показывает, что нормированный штраф изотропии мал при использовании априорного распределения Гаусса во время обучения, когда . В отличие от концентрации нормы, которая ограничивает только общую энергию , штраф изотропии также препятствует неравным дисперсиям координат и ненулевым внедиагональным корреляциям. Таким образом, он обнаруживает структурированные координатные паттерны, которые все еще могут иметь типичную глобальную норму, но маловероятны при априорном распределении Гаусса с независимыми и одинаково распределенными величинами..
Концентрация спектральной белизны. Изотропный регуляризатор проверяет, имеют ли случайно сгруппированные координаты приблизительно единичную ковариацию, но он не исключает напрямую структуру пространственных частот. Например, оптимизированный шум может обладать избыточной низкочастотной энергией, создавая гладкие пространственные паттерны, или избыточной высокочастотной энергией, создавая осциллирующие артефакты. При априорном распределении i.i.d. Gaussian шум должен быть спектрально белым: его энергия должна быть равномерно распределена по пространственным частотам..
Чтобы формализовать это, рассмотрим один пространственный срез шума и пусть
— это его дискретное преобразование Фурье, где — ортонормированный базис Фурье. Для вещественнозначного шума это можно интерпретировать как эквивалентный вещественный синусно-косинусный базис. Поскольку стандартное нормальное распределение инвариантно относительно вращения,
Таким образом, ни одна полоса частот не должна систематически содержать больше энергии, чем другая. Отдельные мощности Фурье зашумлены, но усреднение по достаточно большим частотным интервалам концентрируется.
Пусть — непересекающиеся частотные интервалы, и определим среднюю мощность в каждом интервале как
Мы штрафуем отклонения от плоского бинированного спектра, используя ⟦BROKEN_K0⟧
Lemma 3 (Малая вероятность нетипичной спектральной энергии).
Пусть , и пусть , где представляет собой ортонормированное дискретное преобразование Фурье. Пусть — непересекающиеся частотные интервалы, и определим как указано выше. Пусть
Затем, для любого ,
Доказательство.
Поскольку является ортонормированной, а стандартное гауссовское распределение инвариантно относительно вращения,
Таким образом, в эквивалентном вещественном ортонормированном представлении Фурье коэффициенты Фурье являются независимыми стандартными нормальными случайными величинами.
Для каждого частотного бина ,
Согласно неравенству Лорана–Массара [66] и объединению границ по бинам, с вероятностью не менее , для всех ,
Начиная с , мы имеем
Более того,
Следовательно, для каждого бина,
Подстановка этого в определение регуляризатора дает
Эквивалентно,
что доказывает утверждение. ∎
Лемма 3 показывает, что штраф за спектральную белизну мал при гауссовском априорном распределении, когда каждый частотный бин содержит достаточно много коэффициентов. Таким образом, большое значение указывает на нетипичную структуру пространственных частот. Этот регуляризатор дополняет изотропность: изотропность проверяет ковариацию после случайной группировки координат, тогда как спектральная белизна проверяет, равномерно ли распределена энергия по пространственным частотам..
B.3 Vision-Language Models как общий критерий во время вывода ⟦K0⟧
Вместо обучения специфичной для задачи функции вознаграждения или классификатора отказов для узкого набора событий [82, 98], мы используем VLM в качестве верификатора на этапе вывода, который может гибко задавать цели управления в различных сценах и категориях событий [123]. Это особенно полезно для видео-world models общего назначения, возможные варианты будущего которых могут сильно различаться в зависимости от сцены и контекста действий..
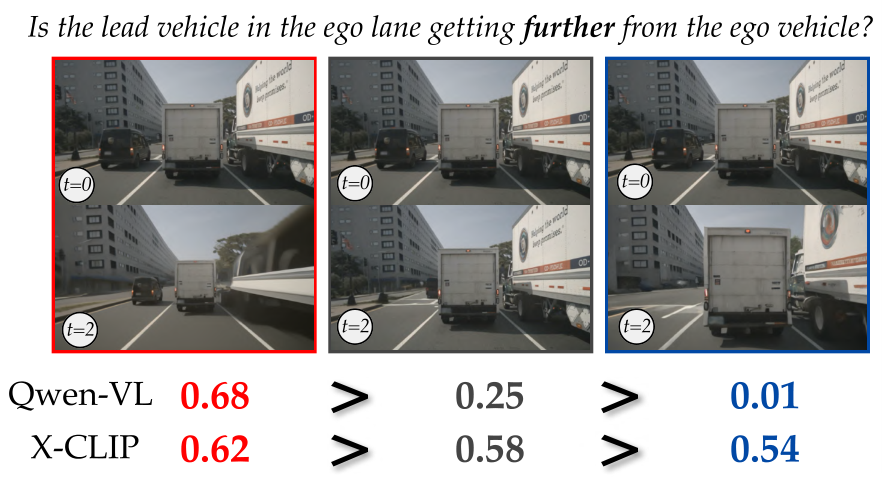
VLM также предоставляют семантически значимые градиентные сигналы: специализированные модели вознаграждения, обученные на ограниченных наборах данных, могут не охватывать обширное пространство возможных генераций видео, что делает их уязвимыми к reward hacking [24, 34], при котором оптимизация увеличивает вознаграждение за счет состязательных или визуально бессмысленных изменений, а не за счет воспроизведения целевого события. Напротив, поскольку VLM обучены на крупномасштабных визуально-языковых данных, они могут предоставлять более общий семантический сигнал о том, отображает ли сгенерированное видео указанное событие [120].
Поскольку наш метод опирается на плотные градиентные сигналы от VLM, мы используем модели с открытым исходным кодом, а не оценщики на основе API [107], несмотря на мощные возможности понимания сцены у современных проприетарных моделей. Мы применяем различные VLM для автономного вождения и манипуляций роботов, основываясь на семантической структуре каждой предметной области..
Автономное вождение. В автономном вождении целевые события, которыми мы стремимся управлять, часто зависят от временных взаимосвязей между агентами, такими как движение пешеходов, перемещение транспортных средств или изменения относительного расстояния. Мы эмпирически обнаружили, что готовые модели Qwen [8] менее надежны в понимании сцен вождения и их временной структуры. Поэтому мы используем модель Qwen2.5-VL, дообученную на видеозаписях автономного вождения с помощью 67, что обеспечивает улучшенное понимание сцен вождения. Мы также используем X-CLIP [76], который, как мы выяснили, эффективно улавливает временные взаимосвязи. Как показано на рис. 10, для трех сгенерированных видео, где относительное расстояние до впереди идущего автомобиля увеличивается, остается неизменным или уменьшается, как дообученная модель Qwen, так и X-CLIP [76] присваивают оценки, которые правильно различают эти случаи. Для моделей в стиле CLIP мы определяем позитивный промпт и негативный промпт . Мы встраиваем оба промпта и сгенерированное видео в общее пространство эмбеддингов и используем разницу в косинусных сходствах в качестве целевой функции управления.:
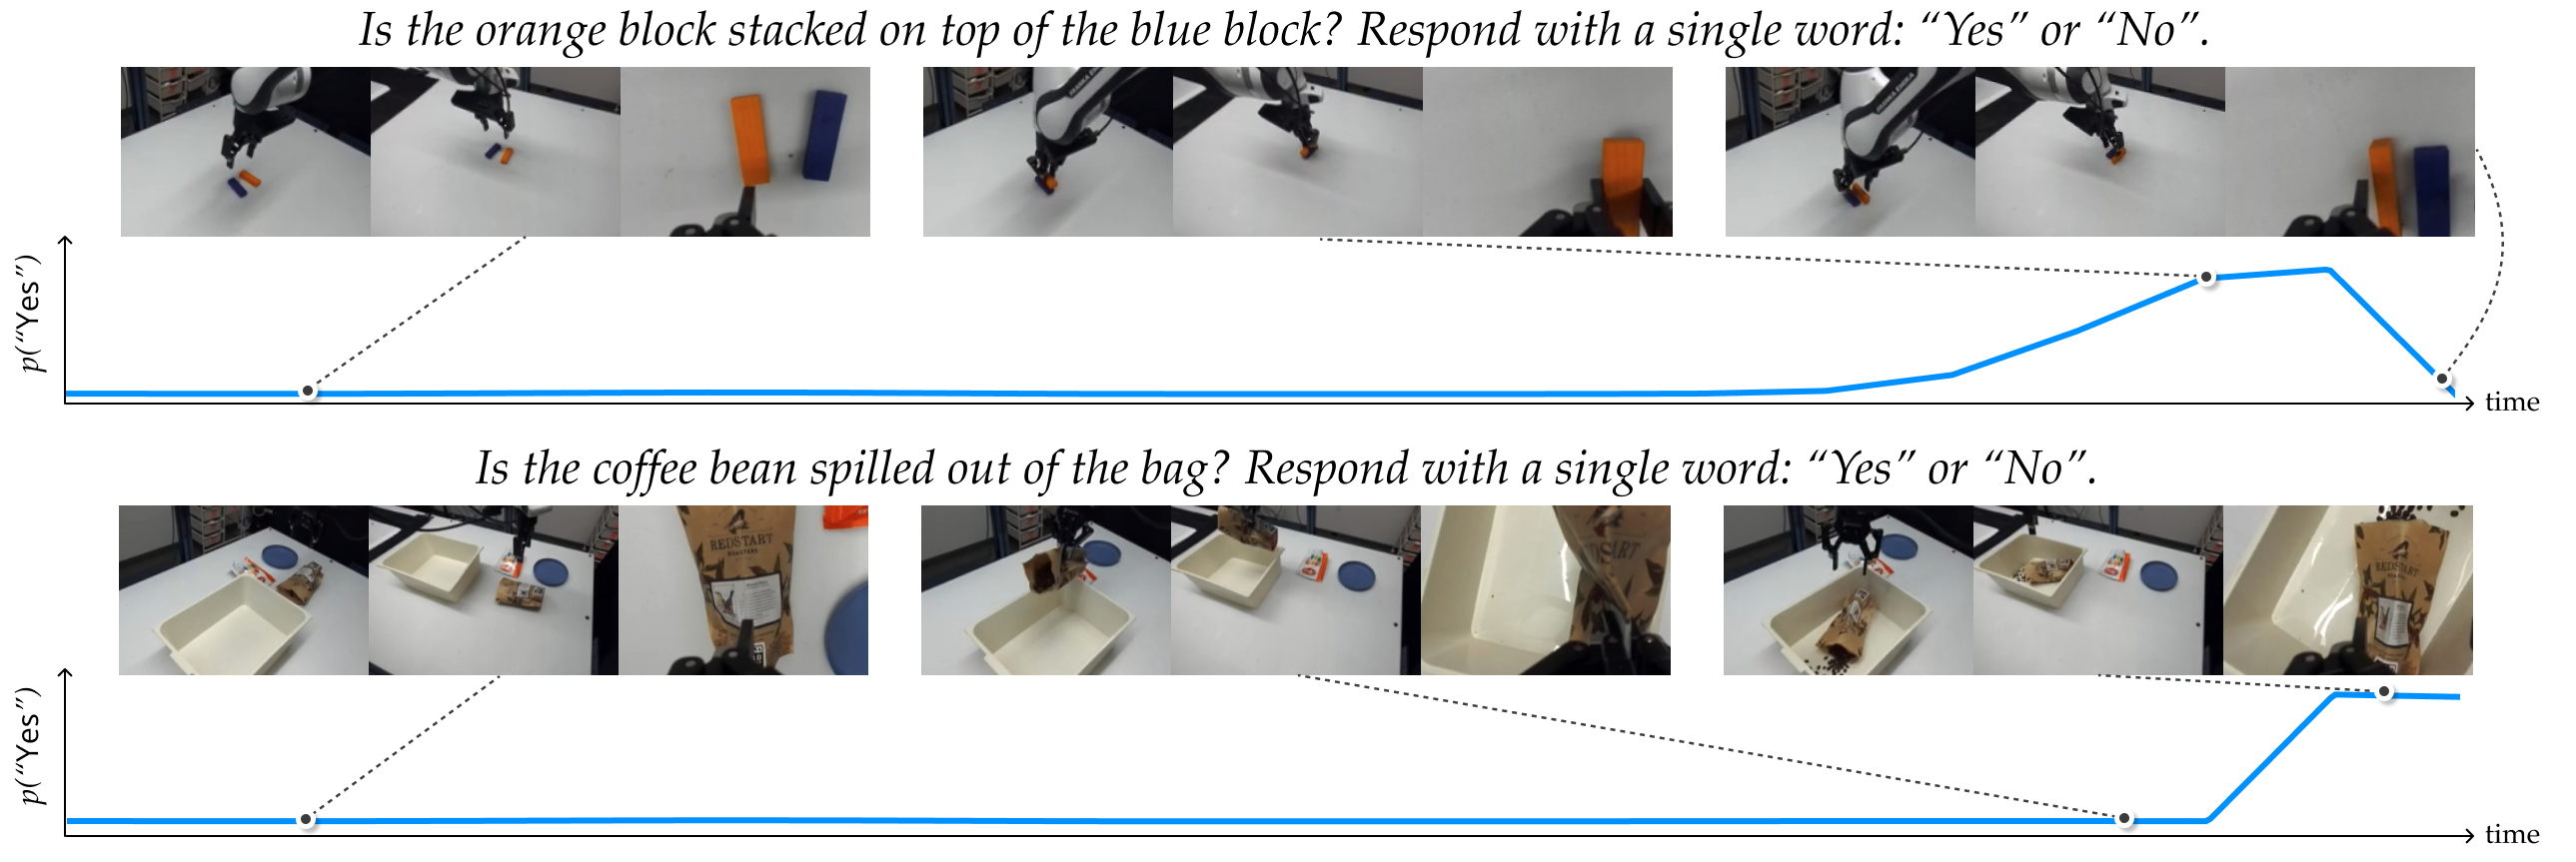
Роботизированные манипуляции. В настольных манипуляциях наша цель управления фокусируется на обнаружении событий сбоя задачи по сгенерированным видео. Мы используем Qwen3-VL [9] с текстовой подсказкой, которая определяет условие сбоя, и вычисляем оценку на основе вероятности токена целевого ответа, подобно недавним подходам к обобщаемому моделированию вознаграждения [19]. Рис. 11 показывает, что оценка модели идентифицирует релевантные для задачи события в нужные моменты на сгенерированных видео. Мы предоставляем пятифреймовые видео, сгенерированные world model, в качестве входных данных и выполняем обратное распространение плотных градиентных сигналов через видео. Мы обнаружили, что использование всех трех видов с камер одновременно необходимо для надежной оценки: для одной и той же сцены и текстовой подсказки использование одной точки обзора приводит к значительно более плохому обнаружению событий сбоя. Мы также обнаружили, что модели в стиле CLIP, включая X-CLIP [76], менее эффективны в понимании этих сцен манипуляций..
B.4 Дистилляция оценок для аппроксимации градиентов начального шума
В этом разделе обосновывается аппроксимация градиента, используемая в (8). Для удобства чтения мы опускаем переменные обусловливания . Пусть детерминированный сэмплер определяет обратную траекторию
где каждый шаг шумоподавления следует обновлению в (3):
Для дифференцируемого критерия точный градиент начального шума получается с помощью правила дифференцирования сложной функции:
где произведение упорядочено вдоль обратной траектории шумоподавления. Якобиан каждого шага равен
Таким образом, точное обратное распространение ошибки требует умножения на все якобианы денойзера и сохранения полного графа вычислений процесса шумоподавления..
Пропорционально-якобиева аппроксимация. Ahn et al. [3] эмпирически наблюдают, что якобиан денойзера является приблизительно диагональным и часто ведет себя как зависящий от временного шага множитель единичной матрицы. В рамках идеализированной аппроксимации
якобиан сэмплера становится
Подстановка этого в точное цепное правило дает
Это приближение, используемое в основном тексте: вместо дифференцирования через сэмплер мы вычисляем градиент критерия по отношению к сгенерированному чистому латентному представлению и используем его в качестве масштабированного прокси-значения для градиента начального шума.
Вариант с диагональным якобианом. Если якобиан денойзера является диагональным, но не в точности пропорциональным единичной матрице,
тогда то же самое выведение дает диагональный предобуславливатель
где
Скалярная аппроксимация является, таким образом, практическим упрощением: она предполагает, что диагональные элементы изменяются достаточно медленно, чтобы их усредненный эффект мог быть поглощен размером шага оптимизации.
Связь с MSD с остановкой градиента. Многошаговая дистилляция оценок [3] сохраняет траекторию прямого шумоподавления неизменной, но применяет оператор остановки градиента к выходным данным шумоподавителя во время обратного распространения ошибки. В наших обозначениях версия одного шага шумоподавления с остановкой градиента имеет вид
где является тождественным преобразованием при прямом проходе и имеет нулевую производную при обратном проходе. Таким образом, это исключает из обратного прохода, оставляя только явную линейную зависимость от :
При той же аппроксимации пропорционального якобиана, как полные градиентные, так и стоп-градиентные произведения якобианов являются скалярными кратными единичной матрицы:
Следовательно, градиент с остановкой градиента и полный градиент сэмплера различаются главным образом за счет скалярных множителей, зависящих от временного шага. Наша аппроксимация использует этот же принцип, но применяет его непосредственно для оптимизации начального шума: градиент критерия чистого латентного представления используется в качестве прокси-направления для градиента начального шума, при этом неизвестный скаляр поглощается и скоростью обучения.
Эффективность аппроксимации градиента для оптимизации шума. Аппроксимация градиента шума обеспечивает эффективное управление на основе градиента без обратного распространения через итеративный процесс шумоподавления крупномасштабных диффузионных моделей видео. Однако она опирается на предположение, что якобиан диффузионного сэмплера является приблизительно диагональным [3]. Действительно, предыдущие работы по оптимизации шума для генерации текста в изображение часто полагаются на одношаговые дистиллированные генераторы, чтобы сделать оптимизацию шума вычислительно доступной без дифференцирования через полный итеративный процесс сэмплирования..
Поэтому мы эмпирически оцениваем, обеспечивает ли это приближение полезный градиентный сигнал в пространстве начального шума для генерации высоконаградных выборок в пространстве вывода. Рис. 12 показывает средний балл VLM в процессе оптимизации шума для управления генерациями Vista [38] в разд. 6.1. Балл увеличивается на протяжении всей оптимизации, что указывает на то, что аппроксимированный градиент может улучшить целевую функцию VLM в пространстве вывода путем обновления только начального шума. На GPU H100 с ГБ видеопамяти вычисление полного градиента через траекторию шумоподавления непрактично даже с использованием gradient checkpointing [21], тогда как предложенное приближение делает оптимизацию осуществимой..
Для Ctrl-World [42], где полный градиент шума может быть вычислен на GPU H100 с использованием gradient checkpointing [21], мы сравниваем оптимизацию шума с аппроксимацией градиента и без нее. Рис. 13 показывает, что аппроксимированный градиент успешно повышает оценку VLM, тогда как оптимизация с полным градиентом не приводит к ее улучшению. Мы предполагаем две возможные причины. Во-первых, обратное распространение ошибки через шагов шумоподавления может привести к неточным или затухающим градиентам из-за вычислений с ограниченной точностью. Во-вторых, хотя градиент VLM вычисляется в видеопространстве с относительно высокой численной точностью, процесс шумоподавления обычно выполняется с более низкой точностью из-за ограничений памяти, что может дополнительно снизить качество градиента..
B.5 Детали реализации
Мы суммируем общую процедуру StressDream в алгоритме 1. Для повышения стабильности оптимизации мы используем как глобальное отсечение нормы градиента, так и покоординатное отсечение градиента. Мы дополнительно отслеживаем евклидову норму шума и проецируем её обратно на типичную оболочку с нормой всякий раз, когда она отклоняется более чем на . Этот порог является консервативным: стандартное отклонение гауссовой нормы составляет приблизительно в пространствах высокой размерности, как показано в следствии 2, поэтому интервал содержит более типичных гауссовых выборок. Кроме того, мы исключаем импульс в оптимизаторе, поскольку накопленные обновления могут легко вывести шум за пределы типичного множества..
B.6 Временная сложность
Мы анализируем временную сложность предложенного алгоритма управления world model. Пусть обозначает стоимость одного шага шумоподавления, а — количество шагов шумоподавления, используемых видео world model. Одно детерминированное генерирование стоит Пусть обозначает стоимость оценки верификатора, такого как критерий на основе VLM, для сгенерированного видео.
| Method | Time Complexity |
|---|---|
| Nominal generation | |
| Best-of- | |
| StressDream | |
| StressDream w/o Grad. Approx. (Sec.4.3) |
Таблица 1 сравнивает номинальную генерацию, Best-of- сэмплирование и StressDream при одинаковом бюджете в сэмплированных кандидатов или итераций управления. По сравнению с Best-of- сэмплированием, StressDream добавляет затраты на вычисление градиента верификатора на каждой итерации управления. Однако благодаря аппроксимации градиента в разд. 4.3, StressDream позволяет избежать обратного распространения через полную траекторию шумоподавления, поэтому дополнительные затраты в основном сводятся к обратному проходу через верификатор, представленному вторым членом . Без этой аппроксимации дифференцирование через -шаговый сэмплер добавляет обратный проход через траекторию шумоподавления, существенно увеличивая как объем вычислений, так и потребление памяти..
На практике при использовании Vista [38] с шагами шумоподавления на одном графическом процессоре H100 одна генерация занимает примерно – минут, в то время как оптимизация шума с итерациями занимает около минут. Поскольку основные затраты приходятся на генерацию видео, ожидается, что время выполнения StressDream сократится с появлением более быстрых видео world models, таких как shortcut [37, 47] модели.
Appendix C Непослушный Автомобиль Дубинса
C.1 Детали реализации
Видеомодель мира. Мы реализуем видеомодель мира для среды автомобиля Naughty Dubins, используя латентную диффузионную архитектуру в стиле SVD меньшего масштаба [14], обученную с помощью формулировки EDM [59]. Вслед за 98, каждое наблюдение представляет собой отрендеренное RGB-изображение, показывающее транспортное средство и круговое множество отказов в центре среды..
| World Model Hyperparameter | Value |
|---|---|
| Image Resolution | |
| Latent Dimension | 1024 |
| Prediction Horizon | 1 |
| Action Dimension | 1 (continuous) |
| VAE Base Channels | 32 |
| VAE Latent Channels | 4 |
| Denoiser Hidden Dims. | [32, 64, 128] |
| Denoising Steps | 5 |
| , | 0.002, 80.0 |
| EDM | 7 |
| Batch Size | 128 |
| Training Epochs | 100 |
| Learning Rate |
Мы обучаем модель на офлайн-наборе данных траекторий наблюдений и действий, сгенерированных из случайных начальных состояний и случайных действий, где каждая траектория аннотирована истинным запасом безопасности. Каждая траектория завершается через временных шагов или раньше, если истинная - или -позиция выходит за границы среды . Энкодер отображает наблюдения в латентные представления , которые декодируются обратно в RGB-наблюдения с помощью легковесного декодера. Мы обучаем латентный автоэнкодер с целевой функцией реконструкции и обучаем предсказатель запаса до отказа , используя регрессионную функцию потерь относительно истинного запаса безопасности. Затем мы обучаем латентную диффузионную модель переходов для генерации следующего латентного состояния, обусловленного текущим латентным состоянием и действием. В наших экспериментах мы используем одношаговое латентное предсказание , что дает размерность латентного пространства и шума . Во время инференса мы используем сэмплер Эйлера с шагами шумоподавления. Гиперпараметры мировой модели сведены в таблицы 2.
Настройка оценки. Мы оцениваем управление на авторегрессионных развертках видео world model. Каждая развертка начинается с начального изображения траектории оценки и обусловлена соответствующей последовательностью действий. Мы присваиваем метку ground-truth каждой траектории оценки, используя Monte Carlo развертки истинной неопределенной динамики в (9). Для каждого начального состояния и последовательности действий мы выбираем траекторий ground-truth. Мы помечаем траекторию как положительную, если по крайней мере одна выбранная траектория входит в набор отказов, что указывает на возможность отказа..
| Steering Hyperparameter | Value |
|---|---|
| Optimization Iterations | 10 |
| Step Size in (8) | 1.0 |
| Gradient Scaling Coefficient in (8) | 10.0 |
| Norm Concentration Coefficient | 1.0 |
| Isotropy Coefficient | 0.5 |
| Isotropy Regularizer Subvector Size | 16 |
| Isotropy Regularizer Permutation Number | 100 |
| Spectral Coefficient | 5.0 |
Мы помечаем её как отрицательную, если ни одна из выбранных траекторий не входит в набор отказов. Это позволяет нам оценить, выявляет ли пессимистичное управление действительно склонные к отказам траектории, избегая при этом ложных отказов на траекториях, которые фактически являются безопасными при истинной динамике. Мы управляем сгенерированным развертыванием, используя гиперпараметры в Таблице 3. Поскольку эта установка является маломасштабной, мы используем полный градиент без аппроксимации. Это позволяет нам напрямую оценить эффект оптимизации начального шума и предложенных регуляризаторов, не внося дополнительную ошибку аппроксимации от оценщика градиента..
Базовый метод: Classifier Guidance. Мы также проводим сравнение с classifier guidance [26, 69], который модифицирует процесс шумоподавления на каждом шаге диффузии с использованием градиента критерия отказа. Однако в контексте world-model такое руководство сложно применить напрямую. Предсказатель отказов обучается на чистых латентных состояниях, а не на зашумленных промежуточных состояниях диффузии. Следовательно, оценка напрямую на может давать ненадежные градиенты, в то время как точное руководство потребовало бы обратного распространения ошибки через denoiser на каждом шаге шумоподавления..
Чтобы сделать классификаторное управление вычислительно приемлемым, мы используем аппроксимацию чистого латентного представления за один шаг [69]. Учитывая зашумленное латентное представление , мы оцениваем соответствующее чистое латентное представление путем инвертирования пути прямого диффузионного процесса:
Затем градиент направляющего воздействия вычисляется на этом приблизительно очищенном латентном представлении:
что позволяет избежать обратного распространения ошибки через сеть шумоподавления, однако это может привести к возникновению смещения, поскольку одношаговый прогноз очищенного изображения может не совпадать с итоговым сгенерированным латентным представлением после полной траектории шумоподавления. Данная проблема особенно выражена в моделях мира с обусловливанием по действиям, где небольшие ошибки при управлении генерацией могут привести к получению латентных представлений с высокой вероятностью сбоя, которые не согласуются с последовательностью действий или выученной динамикой..
Результаты: Пессимистичное управление. Рис. 14 отражает средний минимальный показатель безопасности по воображаемым траекториям для экспериментов в разд. 5. StressDream эффективно направляет воображение к более низким показателям безопасности, которые тесно коррелируют с минимально достижимыми показателями безопасности эталонной системы, что говорит о том, что воображение WM может предоставлять значимые сигналы для оценки стратегии. Напротив, CG и StressDream без целевой функции правдоподобия предсказывают неправдоподобно низкие показатели безопасности, что указывает на их способность чрезмерно смещать генерации за пределы правдоподобных исходов..
C.2 Абляция: Оптимистичное управление ⟦K0⟧
В то время как в разд. 5 основное внимание уделяется пессимистичному управлению для обнаружения потенциальных входов в набор отказов, мы также проводим абляцию противоположного направления, выполняя оптимистичное управление. В частности, мы меняем знак целевой функции управления так, чтобы оптимизация искала воображаемые траектории с более высокими показателями безопасности. Рис. 15 показывает результирующий максимальный показатель безопасности для каждой воображаемой траектории вместе с максимальным показателем безопасности, достижимым при стохастической динамике с достоверными данными, в качестве горизонтальной линии отсчета. Результаты согласуются с выводами в разд. 5: StressDream может эффективно управлять world model, в данном случае в сторону оптимистичных исходов, сохраняя при этом сгенерированные траектории в пределах, правдоподобно ограниченных неопределенностью достоверных данных. Напротив, удаление регуляризаторов или использование classifier guidance также может повысить воображаемый показатель безопасности, но часто приводит к чрезмерно оптимистичным генерациям, которые выходят за рамки того, что является правдоподобным при динамике системы с достоверными данными..
C.3 Абляция: влияние целевой функции правдоподобности
Мы проводим абляционное исследование влияния регуляризаторов из разд. 4.2 на поддержание правдоподобности генераций или их соответствие распределению. В отличие от видео world models, обученных на данных масштаба интернета, эта контролируемая среда предоставляет нам доступ к обучающему распределению, позволяя напрямую проверить, сохраняет ли steering согласованность генераций с распределением, использованным при обучении. Мы приводим оценки типичности оптимизированного начального шума, включая логарифм вероятности хи-квадрат для квадрата нормы шума, значение регуляризатора изотропности и значение регуляризатора спектральной белизны. Мы также по отдельности удаляем каждый регуляризатор, чтобы оценить его вклад..
Эмпирическая оценка плотности. Мы дополнительно оцениваем, остаются ли сгенерированные выборки в пределах распределения, путем подгонки суррогата плотности на основе flow-matching в латентном пространстве наблюдений [124]. Пусть обозначает латентное представление наблюдения из обучающего набора данных. Мы обучаем векторное поле flow-matching , которое переносит латентные представления из обучающей выборки в стандартный гауссов шум. В частности, для и определим линейную интерполяцию
Векторное поле обучается предсказывать смещение к конечной точке Гаусса:
Учитывая сгенерированное латентное представление , мы оцениваем соответствующую ему гауссову конечную точку с помощью одношагового прогноза из :
Если находится внутри распределения, то должно быть близко к выборке из . Поскольку логарифмическая плотность Гаусса пропорциональна , мы используем
в качестве латентной оценки OOD. Более высокая оценка указывает на то, что сгенерированное латентное представление находится дальше от распределения закодированных внутрираспределительных наблюдений. Эта основанная на плотности оценка OOD дополняет регуляризаторы шумового пространства, проверяя, остаются ли результирующие сгенерированные выборки правдоподобными, а не только оптимизированный начальный шум..
Результаты. В таблице 4 представлены значения регуляризатора начального шума и латентные OOD-оценки сгенерированных выборок. Концентрация нормы измеряется минимальной логарифмической вероятностью хи-квадрат для нормы шума, где более высокие значения указывают на более типичный гауссов шум. Изотропность и спектральная белизна являются значениями регуляризатора, где более низкие значения являются предпочтительными..
| Method | Norm Conc. | Isotropy | Spectral White. | OOD Score |
|---|---|---|---|---|
| Nominal | ||||
| Best-of- | ||||
| Classifier Guidance | ||||
| StressDream | ||||
| Ablations without regularization | ||||
| StressDream (w/o all reg.) | ||||
| StressDream (w/o ) | ||||
| StressDream (w/o ) | ||||
| StressDream (w/o ) | ||||
StressDream со всеми регуляризаторами сохраняет статистику шума близкой к номинальной генерации, поддерживая при этом низкий показатель OOD. Напротив, управление без регуляризации приводит к появлению крайне нетипичного шума и существенно более высоким показателям OOD, что свидетельствует о выходе оптимизированных генераций за пределы обучающего распределения. Классификаторное руководство (classifier guidance) сохраняет начальную статистику шума близкой к номинальной, поскольку оно модифицирует траекторию шумоподавления, а не начальный шум, однако оно все равно увеличивает показатель OOD, что указывает на то, что поуровневое руководство может выталкивать сгенерированные выборки в неправдоподобные области. Удаление отдельных регуляризаторов также увеличивает показатель OOD по сравнению с использованием всех регуляризаторов, что подчеркивает важность сочетания концентрации нормы, изотропии и спектральной белизны..
Appendix D Детали эксперимента
D.1 Видео модели мира
Гиперпараметры. В таблице 6 и таблице 6 обобщены гиперпараметры видео world model и оптимизации шума для автономного вождения и манипуляций роботов соответственно. Для world model вождения Vista [38]11 1 https://github.com/OpenDriveLab/Vista одна генерация создает будущих кадров с частотой Hz. Входными данными действия является -мерный вектор, представляющий будущую траекторию эго-автомобиля «вид сверху» в виде четырех будущих путевых точек. Для Ctrl-World [42]22 2 https://github.com/Robert-gyj/Ctrl-World видео подвергаются субдискретизации до Hz, а входные данные действия состоят из команд положения суставов и захвата. Поскольку каждое предсказание генерирует будущих кадров, размерность действия составляет . Чтобы представить более длинные траектории манипуляций, мы используем авторегрессионную генерацию, где последний сгенерированный кадр используется в качестве начального обусловливающего кадра для следующего окна предсказания..
| Hyperparameter | Value |
|---|---|
| Number of Cameras | 1 |
| Image Resolution | |
| Video Frequency | 10 Hz |
| Prediction Horizon | 25 |
| Noise Dimension | 921,600 |
| Action Dimension | 8 |
| Denoising Steps | 50 |
| CFG Scale | 2.5 |
| Optimization Iterations | 20 |
| Step Size | 1.0 |
| Gradient Scaling | 300.0 |
| Norm Coefficient | 0.5 |
| Isotropy Coefficient | 10.0 |
| Isotropy Subvector Size | 192 |
| Isotropy Permutations | 1,000 |
| Spectral Coefficient | 100.0 |
| Hyperparameter | Value |
|---|---|
| Number of Cameras | 3 |
| Image Resolution | |
| Video Frequency | 5 Hz |
| Prediction Horizon | 5 |
| Noise Dimension | 57,600 |
| Action Dimension | |
| Denoising Steps | 50 |
| CFG Scale | 2.0 |
| Optimization Iterations | 10 |
| Step Size | 1.0 |
| Gradient Scaling | 100.0 |
| Norm Coefficient | 0.2 |
| Isotropy Coefficient | 0.1 |
| Isotropy Subvector Size | 240 |
| Isotropy Permutations | 1,000 |
| Spectral Coefficient | 100.0 |
Fine-tuning. Мы обнаружили, что fine-tuning базовых чекпоинтов видео world models важен для правдоподобного моделирования редких событий, релевантных задаче, таких как столкновения или рассыпание кофейных зерен, а также для выравнивания распределений во время обучения и тестирования с целью улучшения качества видео. Хотя базовые модели обучаются на разнообразных наборах данных, таких как nuScenes [16] или DROID [62], их сгенерированные варианты будущего могут страдать от снижения точности динамики и визуального качества при оценке в наших специфических сценариях. Поэтому мы проводим fine-tuning каждой видео world model в течение небольшого количества итераций на данных, релевантных задаче..
| Task | Block Stack | Knife Put | Stacked Utensil Pick | Coffee Bean Pour | Open Coffee Bag | Open Candy Bag |
|---|---|---|---|---|---|---|
| # Trajectories |
Для автономного вождения мы проводим дообучение видеомодели мира, используя подмножество набора данных PhysicalAI-Autonomous-Vehicles (PAI-AV) [86], nuScenes [16] и Nexar Collision Prediction Dataset [81]. Мы проводим обучение в течение итераций с размером пакета . Для манипуляций мы дообучаем Ctrl-World, используя траектории телеуправления, которые включают как успешные, так и неудачные случаи. Мы используем скорость обучения , размер пакета и проводим обучение в течение итераций. В таблице 7 суммировано количество траекторий телеуправления, использованных для каждой задачи манипуляции..
D.2 Роботизированная манипуляция: детали задачи
Мы описываем настройки задач манипуляции, критерии, используемые для определения успеха или неудачи, а также языковые подсказки, используемые для управления генерируемыми будущими состояниями. Визуальные примеры настроек задач показаны на рис. 6 и на project website.
Укладка блоков. Два блока Дженга, один оранжевый и один синий, размещены на столе. Перед роботом стоит задача уложить оранжевый блок поверх синего. Траектория считается успешной, если оранжевый блок остается поверх синего, и неудачной, если робот не смог уложить блок или если оранжевый блок упал после укладки. VLM prompt: Блоки уложены друг на друга? Ответьте одним словом: Yes или No.
Положить нож. На столе размещены легкая пластиковая миска и нож. Перед роботом стоит задача взять нож и положить его внутрь миски, не уронив ни один из предметов. Эта задача сложна, так как нож имеет неравномерный центр масс и сложную форму, а легкая миска может легко опрокинуться. Траектория считается успешной, если нож помещен в миску и остается там, и неудачной, если нож выпадает или миска опрокидывается. VLM prompt: Нож помещен внутрь синей миски и не выпал? Ответьте одним словом: Yes или No.
Захват столового прибора из стопки. Синий нож и красная ложка лежат друг на друге на зеленой тарелке, причем красная ложка находится поверх синего ножа. Роботу дается указание поднять синий нож, оставив красную ложку на тарелке. Траектория считается успешной, если синий нож успешно поднят, а ложка осталась на тарелке, и неудачной, если синий нож не был поднят или если ложка упала с тарелки. Таким образом, робот должен убрать нижний столовый прибор, безопасно оставив верхний на тарелке. VLM prompt: Находится ли красная ложка на зеленой тарелке? Ответьте одним словом: Yes или No.
Насыпание кофейных зерен. Миска находится на кофейных весах, а в чашке лежат кофейные зерна. Перед роботом стоит задача пересыпать кофейные зерна из чашки в миску на весах. Траектория считается успешной, если кофейные зерна насыпаны в миску без просыпания, и неудачной, если какие-либо кофейные зерна просыпались на стол. VLM prompt: Просыпаны ли кофейные зерна на стол? Ответьте одним словом: Да или Нет.
Открытый пакет с кофе. На столе находится открытый пакет с кофе с переменным и частично невидимым количеством кофейных зерен внутри, а также контейнер. Роботу дается указание поместить пакет с кофе в контейнер. Траектория считается неудачной, если какие-либо кофейные зерна высыпаются из пакета в контейнер или на стол. Таким образом, робот должен избегать просыпания во время подъема, переноски и помещения пакета в контейнер. VLM prompt: Is the coffee bean spilled? Respond with a single word: Yes or No.
Открыть пакет с конфетами. Открытый пакет жевательного мармелада лежит на столе, и роботу дается указание поместить его внутрь контейнера, не рассыпав содержимое. По сравнению с кофейными зернами, жевательный мармелад более липкий и тяжелый, что создает меньший риск выпадения из пакета. Траектория считается успешной, если мармелад остается внутри пакета, и неудачной, если хотя бы часть мармелада высыпается. VLM prompt: Рассыпаются ли конфеты из открытого пакета? Ответьте одним словом: Yes или No.
D.3 Автономное вождение: курирование данных для оценки
Для оценки управления в видео world models для автономного вождения мы подготовили набор для оценки на основе датасета PAI-AV [86]. Мы фокусируемся на сценариях, в которых будущее развитие событий неопределенно или зависит от взаимодействия, таких как переход пешеходов, перестроение транспортных средств, изменение сигналов светофора и поведение при знаке «Стоп». В таблице 8 обобщены категории событий и промпты верификатора, используемые для Qwen-VL [8] и X-CLIP [76]. Для X-CLIP первое текстовое описание рассматривается как описание положительного события, в то время как остальные описания используются в качестве отрицательных альтернатив..
Для извлечения фрагментов-кандидатов из крупномасштабного набора данных мы сначала извлекаем цепочки рассуждений VLM из Alpamayo-R1 [118] на фрагментах PAI-AV. Затем мы встраиваем эти цепочки, используя Sentence-BERT [93], и извлекаем топ- фрагментов, чьи эмбеддинги наиболее близки к текстовым описаниям каждой категории событий. После этого аннотаторы-люди проверяют, происходит ли целевое событие в каждом извлеченном фрагменте, и размечают время возникновения события. Поскольку видео world model генерирует с будущего, мы выбираем кадр за с до аннотированного времени события в качестве начального наблюдения для оценки. Аналогичным образом мы формируем оценочный набор из фрагментов столкновений из Nexar Collision Prediction Dataset [81] путем случайной выборки из предоставленных аннотаций столкновений..
| Event Category | Qwen-VL Prompt | X-CLIP Text Descriptions |
|---|---|---|
| Pedestrian Crossing | You are a driving assistant interpreting sequential frames from a car’s front camera. There is a pedestrian in front of the ego vehicle. Is it true that a pedestrian crosses in front of the ego vehicle? Reply with exactly one word: ’Yes’ if a pedestrian crosses in front of the ego vehicle, or ’No’ if a pedestrian crossing in front of the ego vehicle is not happening. | Positive: A pedestrian in front of the ego vehicle is crossing the road. Negative: A pedestrian in front of the ego vehicle is not crossing the road. Negative: There is no pedestrian in front of the ego vehicle. |
| Cyclist Crossing Crosswalk | You are an expert driving assistant interpreting sequential frames from a car’s front camera. Does a cyclist in front of the ego vehicle cross a crossway? Reply with exactly one word: ’Yes’ if a cyclist crosses a crossway, or ’No’ if a cyclist crosses a crossway is not happening. | Positive: A cyclist in front of the ego vehicle crosses a crossway. Negative: A cyclist in front of the ego vehicle does not cross a crossway. |
| Vehicle Merging from Adjacent Lane | You are an expert driving assistant interpreting sequential frames from a car’s front camera. Does a vehicle in the [leftright] lane merge into the ego vehicle’s lane? Reply with exactly one word: ’Yes’ if a vehicle in the [leftright] lane merges into the ego vehicle’s lane, or ’No’ if a vehicle in the [leftright] lane merges into the ego vehicle’s lane is not happening. | Positive: A vehicle in the [leftright] lane merges into the ego vehicle’s lane. Negative: A vehicle in the [leftright] lane does not merge into the ego vehicle’s lane. Negative: A vehicle in the [leftright] lane does not move. |
| Opposing Vehicle Stops at Intersection | You are an expert driving assistant interpreting sequential frames from a car’s front camera. Does an opposing vehicle at the intersection stop? Reply with exactly one word: ’Yes’ if an opposing vehicle at the intersection stops, or ’No’ if an opposing vehicle at the intersection stops is not happening. | Positive: An opposing vehicle at the intersection stops. Negative: An opposing vehicle at the intersection does not stop. Negative: An opposing vehicle at the intersection keeps moving. |
| Lead Vehicle Closing Distance | You are an expert driving assistant interpreting sequential frames from a car’s front camera. Is the lead vehicle getting closer to the view of the front camera? The leading vehicle is the vehicle ahead in view only on the same lane, not in the other lane. Reply with exactly one word: ’Yes’ if the lead vehicle is getting closer to the view of the front camera, or ’No’ if the lead vehicle is not getting closer to the view of the front camera. | Positive: Ego vehicle is getting closer to the leading vehicle Negative: The leading vehicle is getting further away from the ego vehicle Negative: The distance between the ego vehicle and the leading vehicle is not changing |
| Lead Vehicle Pulling Away | You are an expert driving assistant interpreting sequential frames from a car’s front camera. Is the lead vehicle getting further from the view of the front camera? The leading vehicle is the vehicle ahead in view only on the same lane, not in the other lane. Reply with exactly one word: ’Yes’ if the lead vehicle is getting further from the view of the front camera, or ’No’ if the lead vehicle is not getting further from the view of the front camera. | Positive: The leading vehicle is getting further away from the ego vehicle Negative: Ego vehicle is getting closer to the leading vehicle Negative: The distance between the ego vehicle and the leading vehicle is not changing |
| Traffic Signal Changing | You are an expert driving assistant interpreting sequential frames from a car’s front camera. Initially, the [redorangegreen] traffic light is on. Is it true that, in the driving scene, the traffic signal visible in the front camera is [redorangegreen]? Reply with exactly one word: ’Yes’ if the traffic signal is [redorangegreen], or ’No’ if the traffic signal is not [redorangegreen]. | Positive: The traffic signal is [redorangegreen]. Negative: The traffic signal is [redorangegreen]. Negative: The traffic signal is [redorangegreen]. Negative: The traffic signal is off. |
| Front Vehicle Stop-Sign Violation | You are an expert driving assistant interpreting sequential frames from a car’s front camera. In the driving scene, the ego vehicle is driving on the road, following the front car. Is it true that, in the driving scene, the front car did not stop at the stop sign? Reply with exactly one word: ’Yes’ if a front car did not stop at the stop sign, or ’No’ if a front car stopped at the stop sign. | Positive: The vehicle in front does not stop at the stop sign. Negative: The vehicle in front stops at the stop sign. |
| Ego-Vehicle Collision | You are a driving safety assistant analyzing sequential frames from a dashcam. The clip shows 2.5 seconds of a driving scene recording. Is a collision or crash between the ego vehicle and another vehicle occurring? A collision means the ego vehicle crashes into another vehicle visible in the front. Reply with exactly one word: ’Yes’ if the ego vehicle collides with another vehicle, or ’No’ if the situation is safe. | Positive: The ego vehicle collides with another vehicle. Negative: The ego vehicle does not collide with another vehicle. Negative: There is no collision between the ego vehicle and another vehicle. |
D.4 Метрики оценки
Автономное вождение. Для оценки управления мы используем отложенные метрики, которые не применяются во время оптимизации. Это важно, поскольку управляемая генерация может повысить показатель оптимизации, не создавая при этом значимого или правдоподобного изменения в видео. Поэтому мы оцениваем два взаимодополняющих аспекта: (i) соответствие цели, то есть четко ли сгенерированное видео отображает целевое событие, описанное текстовой подсказкой, и (ii) правдоподобность, то есть остается ли сгенерированное видео физически обоснованным и свободным от серьезных визуальных артефактов, указывающих на генерацию вне распределения..
Для автономного вождения мы используем WorldModelBench (WMB) [68], который оценивает генерации видео мировыми моделями, используя как критерии соответствия текстовым подсказкам, так и критерии качества видео. Мы используем WMB, поскольку он включает данные вождения в свое распределение оценки и, эмпирически, предоставляет значимые баллы относительно того, соответствуют ли сгенерированные видео вождения целевой подсказке и остаются ли они визуально правдоподобными. WMB сообщает три оценки: следование инструкциям , соблюдение физики и согласованность со здравым смыслом . Мы используем оценку следования инструкциям для измерения целевого соответствия, а соблюдение физики и согласованность со здравым смыслом используем в качестве прокси-показателей для правдоподобности генерации..
Кроме того, мы приводим оценку соответствия целевому показателю от внешнего судьи VLM. Этот судья используется только для оценки и не применяется во время steering. Мы используем следующий шаблон промпта с Gemini [107] для получения оценки соответствия :
Вы являетесь экспертом-оценщиком мировых моделей для автономного вождения. Ваша ЕДИНСТВЕННАЯ задача — оценить, насколько видео соответствует текстовой инструкции. Игнорируйте проблемы визуального качества, такие как размытость, мерцание, искажения или низкое разрешение: это ожидаемые артефакты генерации мировых моделей, и они НЕ должны влиять на вашу оценку. ТЕКСТОВОЕ ОПИСАНИЕ: {prompt} КРИТЕРИИ ОЦЕНКИ (0-10): 10: Видео четко и полностью соответствует текстовому описанию. 7-9: Видео соответствует текстовому описанию, но с незначительными отклонениями (например, немного неверное направление или тайминг). 4-6: Видео лишь отдаленно связано с текстовым описанием, но конкретное действие не происходит. 1-3: Видео полностью не связано с текстовым описанием. 0: Содержание видео полностью не связано с текстовым описанием..
Роботизированные манипуляции. Мы используем оценку человеком, чтобы определить, соответствует ли каждая сгенерированная траектория успеху или неудаче выполнения задачи. Мы дополнительно приводим баллы от Robometer [71], универсальной модели вознаграждения для робототехники. Однако мы полагаемся на оценку человеком как на основной показатель для более точной оценки сгенерированных траекторий, поскольку модели вознаграждения предоставляют непрерывные баллы и требуют prompt engineering для вывода об успехе задачи..
D.5 Fine-tuning -droid Политика
Мы проводим SFT политики -droid 3 https://github.com/Physical-Intelligence/openpi, используя экспертных траекторий на задачу с целевой функцией взвешенного flow-matching [41]. После направления воображаемого развертывания каждой траектории в сторону сбоя задачи, мы присваиваем вес траекториям, классифицированным как успешные, и вес траекториям, направленным к сбою. Мы используем два ракурса камеры, состоящие из наручной камеры и одной камеры от третьего лица. Веса применяются как к функции потерь при SFT, так и к выборке набора данных. Мы используем действия в виде позиций суставов для SFT, хотя базовая политика изначально была обучена на действиях в виде скоростей суставов, поскольку наш контроллер [131] не поддерживает управление скоростью суставов. Мы проводим SFT предобученной контрольной точки в течение k шагов на одном GPU H100. Во время инференса мы используем горизонт действий с разомкнутым контуром . Мы обнаружили, что обучение diffusion policy [22] с нуля показывает плохие результаты в этих условиях, вероятно, из-за насыщенного контактами характера наших задач и ограниченного размера набора данных для SFT. Напротив, SFT -droid обеспечивает значительно лучшее поведение и отчетливо имитирует экспертные демонстрации после SFT..
Appendix E Дополнительные результаты
E.1 Надежная оценка стратегии посредством управления видеомоделью мира ⟦K0⟧
В этом разделе мы приводим дополнительные результаты для разд. 6.1. Оценка сосредоточена на управлении генерацией видео в world models в сторону заданных текстом событий отказа в каждой сцене, что позволяет проводить надежную оценку предложенных политикой последовательностей действий посредством пессимистичных представлений world model. Мы измеряем как целевое соответствие, то есть насколько хорошо сгенерированные видео соответствуют промпту об отказе, так и правдоподобность, то есть остаются ли генерации визуально и физически обоснованными. Полные результаты, включая видео и интерактивные демонстрации, доступны на project website.
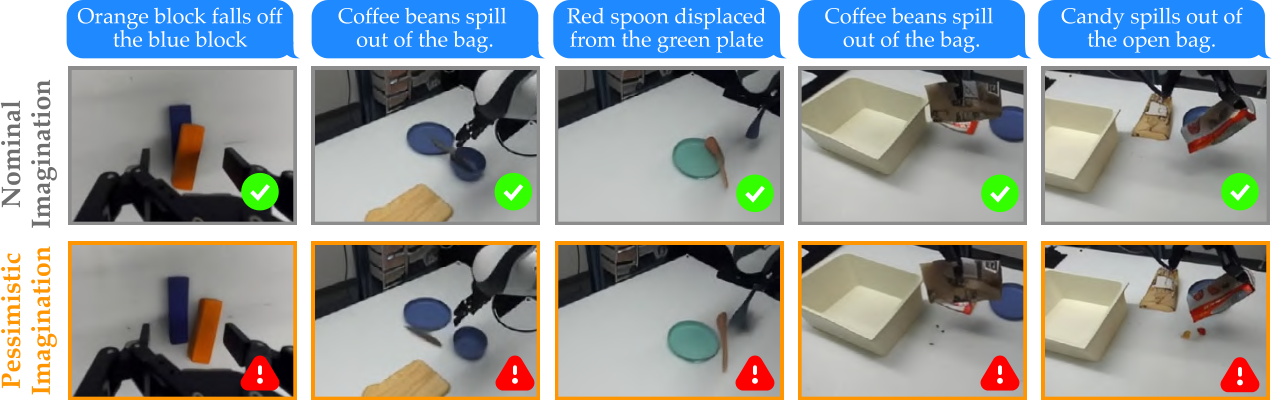
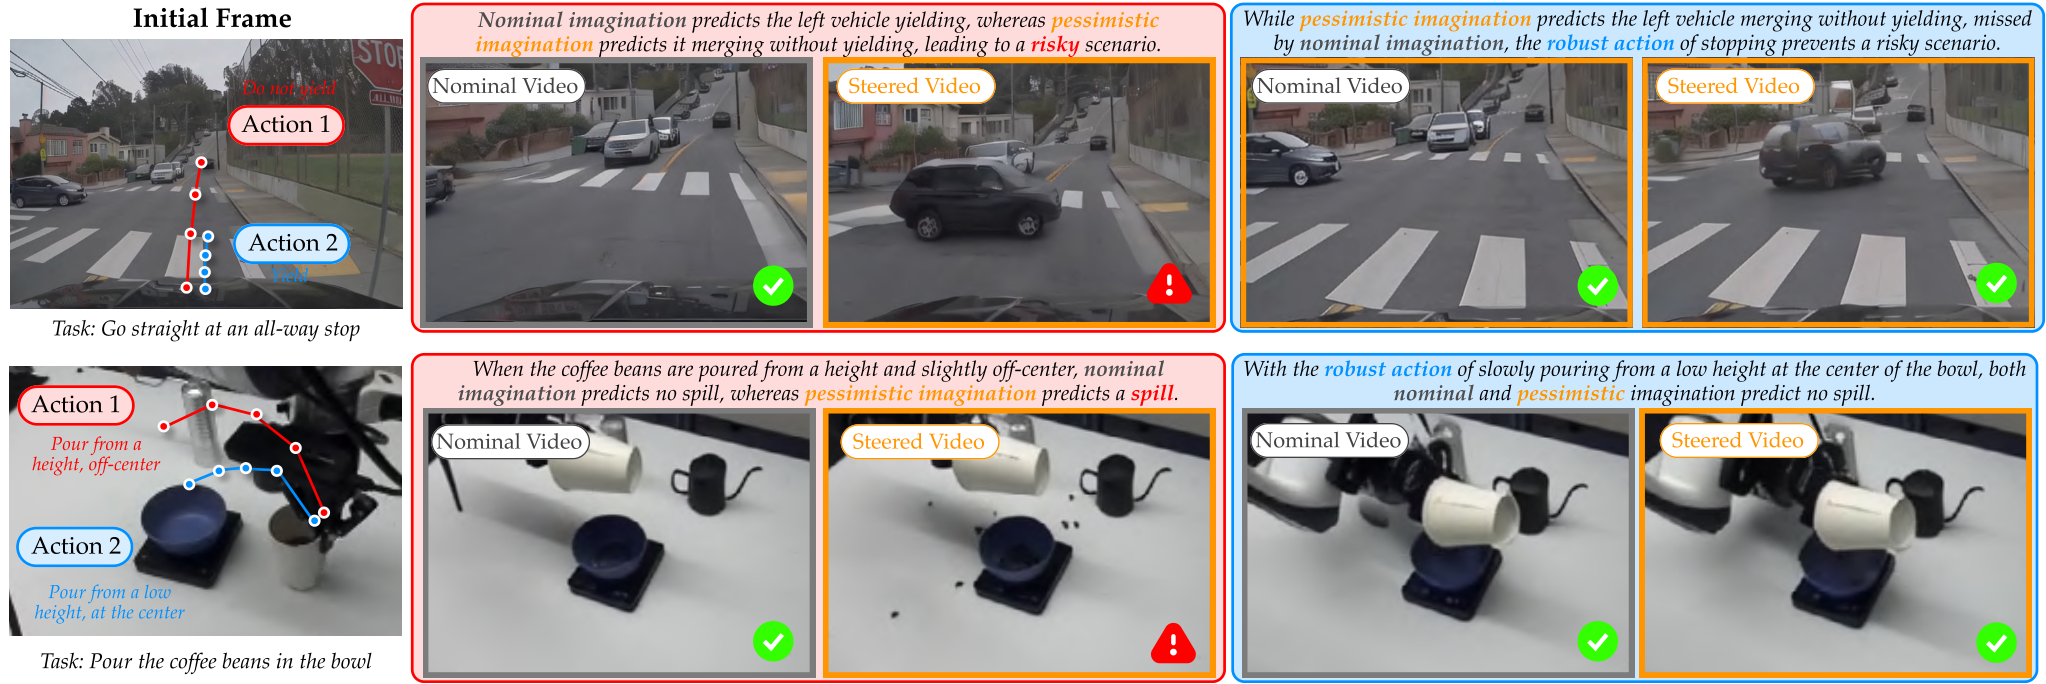
Надежная оценка стратегии с помощью пессимистичных представлений. Рис. 16 демонстрирует дополнительные результаты для внутренней оптимизации в (4) на задачах робототехнических манипуляций. Для одной и той же истории наблюдений и последовательности действий номинальные представления часто не предсказывают события отказа, тогда как StressDream генерирует правдоподобные варианты будущего с отказом задачи на основе тех же входных данных. Это позволяет проводить надежную оценку стратегии с использованием видео world model путем обнаружения возможных отказов через синтетические траектории, без необходимости многократных запусков на аппаратном обеспечении. Напротив, номинальная генерация может пропустить такие отказы, поскольку она может выбирать варианты будущего без отказов, даже когда отказ возможен. Аналогично, рис. 17 показывает, что для различных последовательностей действий-кандидатов StressDream с пессимистичным управлением (steering) может выявлять потенциальные отказы или критически важные для безопасности события в представленном будущем, в то время как надежные последовательности действий остаются безопасными даже при пессимистичном представлении. Это поддерживает надежную оценку и выбор действий за счет использования видео world model в качестве предиктивной модели для планирования и управления..
Подробные результаты: Видеомодель мира вождения. Рис. 18 демонстрирует полные количественные результаты управления видеомоделью мира вождения [38], оцененные с помощью WorldModelBench (WMB) [68] и Gemini-3.0 [107]. На двух верхних графиках измеряется соответствие целей между сгенерированными видео и текстовыми подсказками управления, в то время как на двух нижних графиках представлены метрики качества видео WMB. По обеим метрикам соответствия StressDream с оптимизацией шума более эффективно повышает показатели соответствия целевым событиям, чем базовые модели со случайной генерацией, что указывает на то, что предложенная процедура управления надежно направляет генерацию видеомодели мира к желаемым событиям. В то же время предложенное ограничение типичного множества помогает поддерживать правдоподобность: хотя качество видео немного снижается на более поздних этапах оптимизации, наш метод неизменно сохраняет лучшее качество как по показателям здравого смысла, так и по показателям физических законов, по сравнению с управлением без регуляризации..
Ограничения типичного множества сохраняют правдоподобность управляемых видеогенераций. Мы оценили правдоподобность управляемых генераций по оценкам на основе VLM, таким как оценки здравого смысла и физических законов в WorldModelBench [68]. Чтобы дополнительно оценить роль целевой функции правдоподобности в разд. 4.2, мы дополнительно оцениваем сгенерированные видео вождения с использованием WorldLens [72]. Мы фокусируемся на метриках качества генерации, которые оценивают, являются ли сгенерированные видео визуально реалистичными, временно стабильными и семантически согласованными, без необходимости использования изображений с нескольких ракурсов или размеченных данных. В отличие от оценок на основе VLM, эти метрики вычисляются на основе аналитических признаковых мер44 4 WorldLens также представляет обученную оценку видео, полученную на основе крупномасштабных человеческих аннотаций реалистичности мира, физической правдоподобности и поведенческой безопасности; однако, поскольку эта модель еще не выпущена..
В частности, мы оцениваем согласованность объектов, расхождение глубины и временную согласованность. Согласованность объектов использует признаки DINO [87] для измерения того, сохраняют ли динамические объекты постоянную текстуру, форму и структуру с течением времени. Расхождение глубины измеряет временную стабильность представлений глубины, полученных из сгенерированных видео с помощью DepthAnything [20]. Временная согласованность измеряет покадровую стабильность в изученном пространстве внешнего вида с использованием кодировок CLIP [92]. Мы отсылаем читателей к приложению WorldLens [72] для получения подробных определений метрик. На рис. 19 показаны оценки качества генерации WorldLens для генераций мировых моделей вождения. В соответствии с метриками качества видео WMB, качество генерации имеет тенденцию снижаться на более поздних этапах оптимизации шума. Однако использование предложенных ограничений типичного множества существенно смягчает эту деградацию, сохраняя согласованность объектов, стабильность глубины и временную согласованность по сравнению с управлением без регуляризации..
Подробные результаты: обнаружение сбоев в робототехнических манипуляциях. Рис. 21 содержит результаты обнаружения сбоев по задачам для видео-world models в робототехнике. Управление осуществляется с использованием оценок Qwen3-VL [9], вычисленных на основе промптов о сбоях в задачах, в то время как результаты обнаружения оцениваются относительно меток успеха и неудачи на уровне траекторий из набора данных. По всем задачам StressDream обнаруживает значительно больше траекторий, склонных к сбоям, чем номинальная генерация или Best-of- сэмплирование..
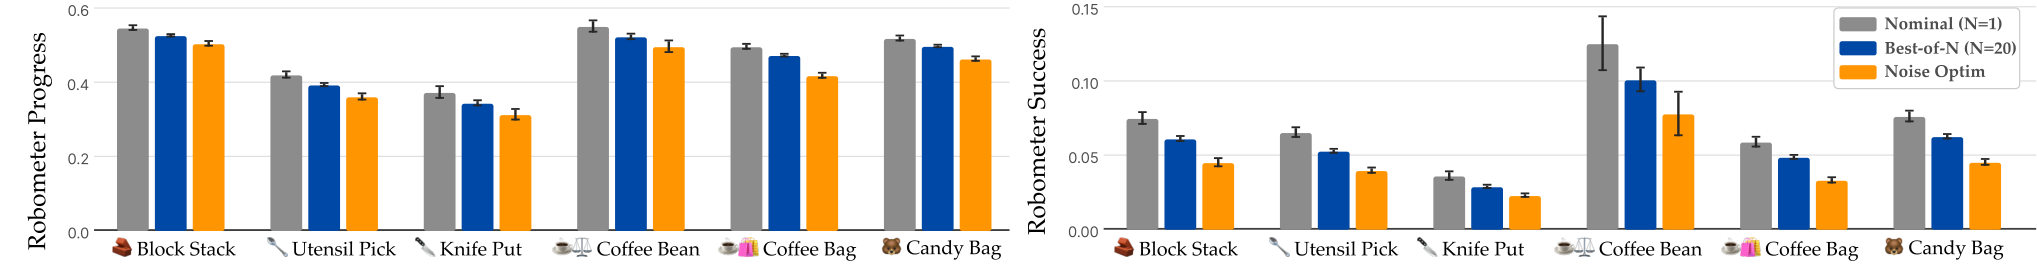
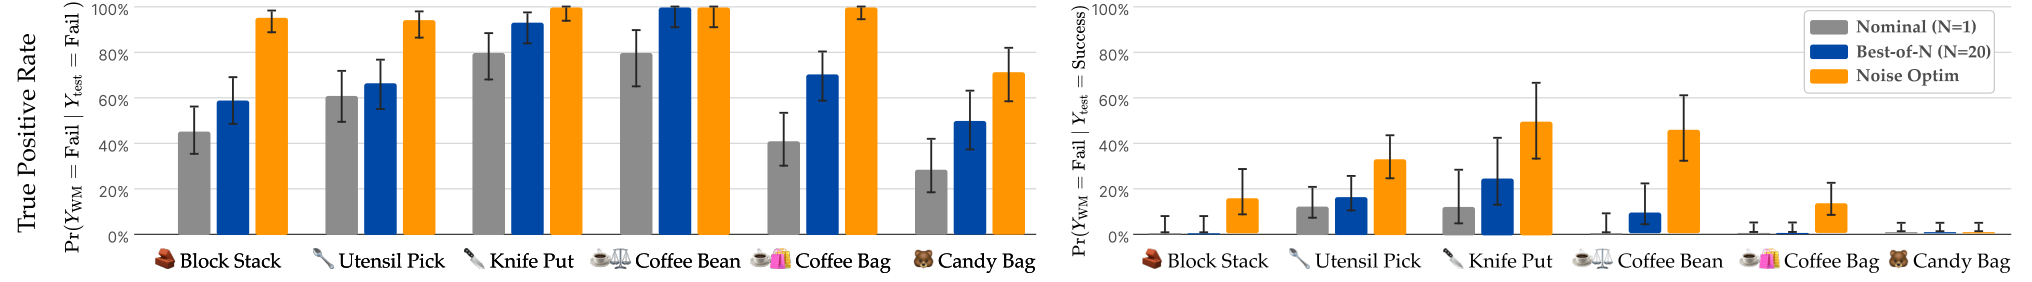
На рис. 21 также показано, что StressDream иногда предсказывает сбои для траекторий, помеченных в наборе данных как успешные. Это не следует интерпретировать строго как частоту ложноположительных результатов: траектория, которая была успешной во время сбора данных, все еще может быть рискованной из-за ненаблюдаемых факторов в условиях частичной наблюдаемости. Качественно многие из этих помеченных траекторий соответствуют рискованному поведению, что позволяет предположить, что пессимистичное воображение обеспечивает более надежный способ оценки стратегий. В то же время StressDream не помечает все успешные траектории как сбойные, что указывает на то, что метод все еще может идентифицировать надежные траектории, которые остаются безопасными даже при пессимистичном воображении world models. Эти надежные траектории затем могут быть приоритизированы для улучшения стратегии, вместо того чтобы полагаться на демонстрации, которые могли быть успешными только по чистой случайности..
E.2 StressDream Может эффективно обнаруживать редкие, длиннохвостые события
Наши основные эксперименты оценивают, может ли StressDream генерировать видео, соответствующие спецификации во время вывода, сохраняя при этом правдоподобность более эффективно, чем случайная выборка. Это особенно важно для видео-моделей мира, которые работают в пространствах высокой размерности, где целевая генерация затруднена: редкие события часто занимают сложные, мультимодальные и низковероятностные области генеративного распределения, что делает случайную выборку крайне неэффективной с точки зрения количества выборок. В этом разделе мы задаем дополнительный вопрос: может ли StressDream эффективно обнаруживать редкие события в целевом распределении путем оптимизации начального шума с помощью руководства VLM?
Для оценки этого мы выбираем примеров для оценки из событий вождения с «длинным хвостом» в оценочном наборе, включая переход пешеходов, смену сигналов светофора и столкновения. В качестве базовой линии мы генерируем случайных выборок и сообщаем о лучшем результате среди них, в то время как StressDream выполняет шагов оптимизации. Мы оцениваем показатели соответствия целевым параметрам сгенерированных видео с помощью Gemini-3.0 [107]. Рис. 22 показывает, что StressDream более эффективен в обнаружении редких событий, чем случайная выборка. Даже с выборками метод Best-of- sampling не достигает показателя соответствия целевым параметрам, полученного с помощью StressDream. Это говорит о том, что оптимизация первого порядка в многомерном пространстве шума позволяет обнаруживать редкие события с «длинным хвостом» более эффективно, чем поиск нулевого порядка посредством случайной выборки..
E.3 StressDream Направляет только к правдоподобным результатам
Мы дополнительно подробно рассматриваем эксперименты в разд. 6.1, изучая, остаются ли управляемые генерации обоснованными в рамках правдоподобных результатов world model. В частности, мы сравниваем driving world model, дообученную на данных о столкновениях, с базовой моделью без такого дообучения. Как показано на рис. 5, базовая модель выдает низкие показатели соответствия текста и видео для событий столкновения, даже по сравнению со случайной выборкой из модели, дообученной на столкновениях, поскольку столкновения не представлены в ее прогностическом распределении и, следовательно, не могут быть правдоподобно воображены..
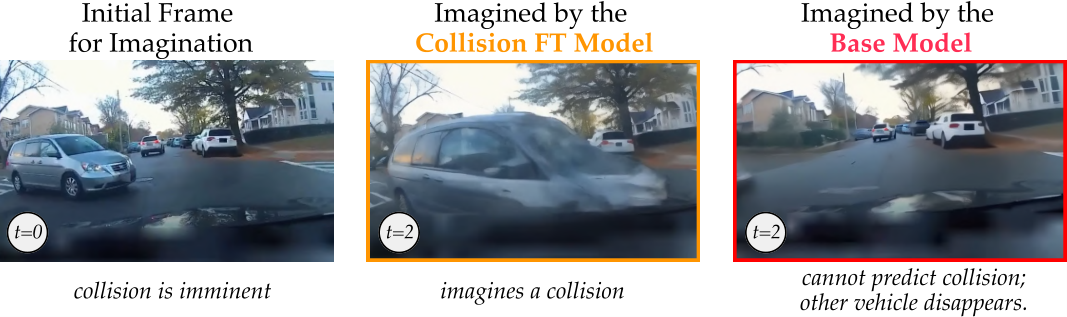
На рис. 23 представлен качественный пример воображения вблизи события столкновения с использованием базовой модели и модели, дообученной на сценариях столкновений. Базовая модель не может вообразить столкновение и вместо этого галлюцинирует, что другой автомобиль исчезает со сцены. Напротив, дообученная модель, чье предсказательное распределение включает события столкновений, корректно воображает столкновение. Это подтверждает наше утверждение о том, что когда оптимизированный шум остается близким к априорному распределению Гаусса, управление порождает выборки, которые по-прежнему поддерживаются распределением world model, а не являются произвольными галлюцинациями. В этом смысле оптимизация шума отличается от простого принудительного выравнивания во время inference через классификатор или целевую функцию дообучения, что может легче вывести генерацию за пределы многообразия..
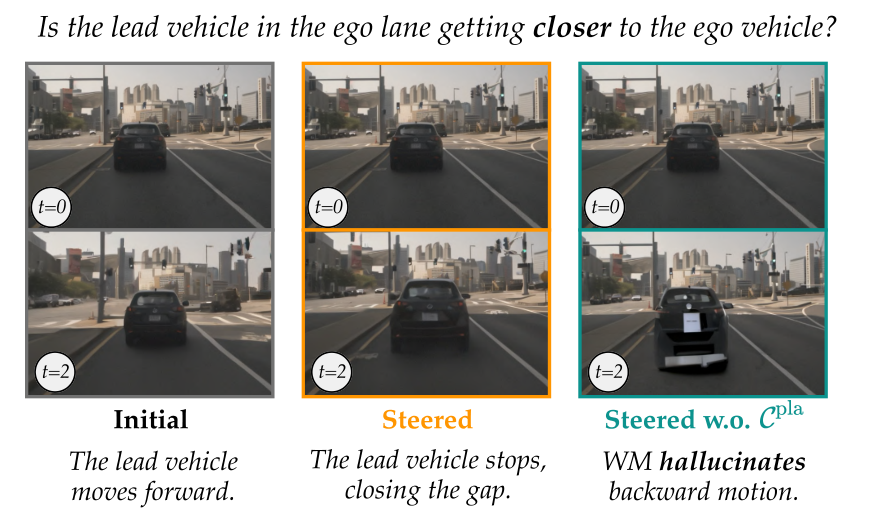
Аналогично, на рис. 24 показан пример управления генерацией WM для вождения таким образом, чтобы расстояние между эго-транспортным средством и впереди идущим транспортным средством уменьшалось. В начальной генерации впереди идущее транспортное средство движется вперед, примерно сохраняя дистанцию до эго-транспортного средства. В управляемой генерации впереди идущее транспортное средство вместо этого остается неподвижным, в то время как эго-транспортное средство продолжает движение, что приводит к сокращению дистанции. Хотя расстояние могло бы быть сокращено еще сильнее, если бы впереди идущее транспортное средство двигалось назад, такое поведение крайне маловероятно в обычном сценарии вождения. Соответственно, управляемая генерация выбирает правдоподобный исход с остановкой впереди идущего транспортного средства, а не неправдоподобный исход с его движением задним ходом. Напротив, когда управление выполняется без целевой функции правдоподобия, генерация создает нереалистичные артефакты, такие как искаженное движение форм транспортных средств назад..
E.4 Устойчивое улучшение стратегии
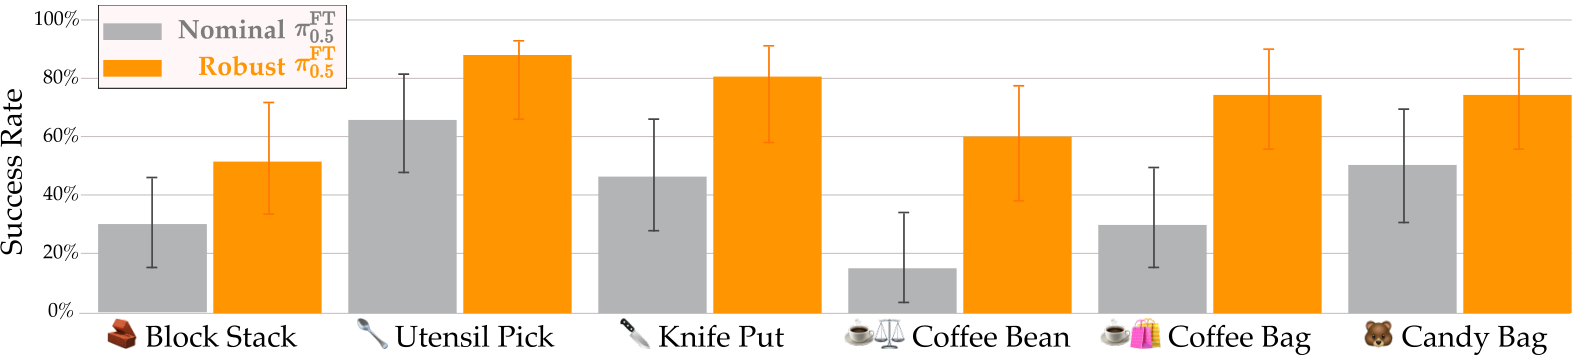
На рис. 25 представлены показатели успешности по задачам для политики -droid, дообученной с использованием воображения видео-world-models (разд. 6.2). По всем задачам политика Robust достигает более высоких показателей успешности, чем политика Nominal . Это говорит о том, что пессимистичное воображение помогает выявлять и снижать вес демонстраций, склонных к ошибкам, тем самым способствуя выбору действий, которые остаются успешными..
Appendix F Ограничения и дискуссия
Субоптимальность оптимизации шума. Хотя StressDream предоставляет практическую реализацию управления воображением видео WM посредством оптимизации шума на основе градиента, оптимизированный шум все еще может быть субоптимальным. Оптимизацию в StressDream следует рассматривать как локальное уточнение начального шума, а не как глобальный поиск по всем возможным будущим состояниям. Исчерпывающий поиск в многомерном пространстве шума невыполним: если , то , поэтому , и, следовательно, концентрируется вокруг . Напротив, среднее расстояние между начальным и оптимизированным шумами в наших экспериментах намного меньше, что указывает на то, что StressDream выполняет локальное уточнение, а не глобальное исследование. Ограничения типичного множества делают градиентные обновления надежными в основном в пределах умеренной локальной области; чрезмерно большие обновления могут вывести шум за пределы распределения и сделать генерации неправдоподобными. Естественным расширением является объединение поиска в стиле Best-of- с уточнением на основе градиента [75, 126] или обучение функции ценности [54] для управления процессом удаления шума. Наконец, для видео WM, требующих авторегрессионных разверток, последующие генерации зависят от ранее сгенерированных будущих состояний. Таким образом, оптимальное решение потребовало бы совместной оптимизации последовательности шумов по сегментам развертки, но текущая реализация решает эту задачу последовательно..
Сохранение правдоподобности. StressDream сохраняет правдоподобность путем регуляризации оптимизированного шума, побуждая его оставаться в типичном множестве многомерного гауссовского распределения. Однако наше понятие правдоподобности определяется относительно изученного распределения WM: оно предполагает, что генерации из гауссовского шума являются правдоподобными в рамках WM. Таким образом, StressDream может продолжать управление в пределах результатов, поддерживаемых WM, но не может исправить базовую WM, которая уже создает физически неправдоподобные генерации. Можно было бы включить метрики качества видео или физической согласованности как часть цели управления [89, 34, 33], чтобы явно сместить генерации в сторону более качественных представлений. И наоборот, StressDream также не может представить результаты, которые могут быть правдоподобными в реальном мире, но отсутствуют в распределении WM. Это подчеркивает важность обучения WM на разнообразных данных взаимодействия, включая сбои и редкие исходы, а не только на данных об успешных операциях [62], чтобы их прогностические распределения могли поддерживать оценку и улучшение стратегии..
Вычислительная неэффективность. Хотя StressDream является выборочно-эффективным для генерации правдоподобных целевых результатов по сравнению со случайной выборкой за счет использования плотных градиентов VLM, время его выполнения по-прежнему в основном ограничено генерацией видео WM, что может занимать несколько минут на одну симуляцию с текущими моделями [38, 50, 42, 1]. Методы Inference-time steering для генерации текста в изображение часто снижают эти затраты с помощью step-distilled или shortcut моделей, которые генерируют выборки за один или несколько шагов шумоподавления, делая как оптимизацию шума, так и вычисление градиента более управляемыми [34, 33]. Наш метод ортогонален этим достижениям: по мере того как видео WM становятся быстрее, StressDream напрямую выигрывает от повышения эффективности выборки, а shortcut модели могут обеспечить более точные вычисления градиента без опоры на текущую аппроксимацию. Еще одним многообещающим направлением является амортизация итеративной оптимизации путем обучения генератора шума для фиксированных целевых результатов, аналогично 33, 113, однако обеспечение ограничений типичного множества в многомерном пространстве начального шума остается сложной задачей. Наконец, StressDream несет дополнительные накладные расходы из-за обратного распространения ошибки через функцию критерия, что делает каждый шаг оптимизации более затратным (Приложение B.6 для получения более подробной информации). Тем не менее, случайная выборка по-прежнему требует оценки сгенерированных образцов с помощью дорогостоящих верификаторов, поэтому систематическое управление в рамках ограниченного бюджета выборки остается полезным для обнаружения высокоэффективных результатов из WM..
Взлом вознаграждения. Хотя наша градиентная оптимизация с использованием градиента Vision-Language-Model эмпирически эффективна, она иногда может приводить к взлому вознаграждения, при котором критерий возрастает, не вызывая значимых изменений в сгенерированном видео [34, 106, 55]. В предыдущих работах эта проблема решается путем объединения нескольких функций вознаграждения или добавления метрик качества изображения/видео, которые напрямую штрафуют вырожденные генерации [34, 89]. StressDream также может включать эти стратегии. Однако на практике мы наблюдаем, что критерии на основе VLM, обученные на данных интернет-масштаба, значительно более устойчивы, чем функции вознаграждения, изученные с нуля: они, как правило, присваивают высокие баллы только тогда, когда целевое событие семантически очевидно в сгенерированном видео, в то время как изученные вознаграждения для конкретных задач более подвержены состязательным артефактам. Это ограничение может быть дополнительно смягчено за счет более эффективных архитектур видео WM с надежными латентными представлениями [90], shortcut/distilled diffusion models с меньшим количеством шагов шумоподавления [47] и более сильных моделей вознаграждения с лучшим пониманием видео и устойчивостью к состязательным артефактам [71]. Более того, StressDream требует указания целевых результатов с высоким уровнем воздействия с помощью текстовых промптов, которые, возможно, придется адаптировать для каждой сцены, а эффективность критерия зависит от качества промпта (см. Приложение B.3).