Устойчивость без складок: параллельное моделирование и устойчивое MPC для сертифицированного манипулирования деформируемыми объектами
Аннотация
Мы представляем CORD-SLS, метод управления в реальном времени для безопасной манипуляции деформируемыми объектами, с акцентом на веревки и ткань. В его основе лежит параллельный на GPU дифференцируемый симулятор со сглаживанием контактов, который обеспечивает эффективное градиентное планирование при прерывистом контакте. Для надежного соблюдения ограничений в условиях неопределенности модели и сенсорики мы разработали параллельный на GPU алгоритм робастного MPC с обратной связью по выходу, работающий в реальном времени и планирующий с использованием этого симулятора. Мы также показываем, что симулятор ускоряет model-based RL для обучения нейросетевых стратегий манипуляции. Для повышения робастности в реальных условиях мы используем conformal prediction для калибровки границ визуальной обратной связи и ошибок восприятия для MPC, создавая достижимые трубки, которые обеспечивают безопасное управление с высокой вероятностью. Мы оцениваем CORD-SLS на высокоразмерных задачах манипуляции веревками и тканью с частыми контактами в симуляции и на аппаратном обеспечении, включая обход препятствий, прокладку маршрута, складывание и разглаживание. Во всех сценариях CORD-SLS достигает миллисекундной скорости планирования, превосходя базовые методы по безопасности, скорости и успешности выполнения задач..
Ключевые слова: манипуляция, дифференцируемое моделирование, управление на основе моделей и RL
1 Введение
Манипулирование деформируемыми объектами, такими как веревки и ткань, важно для критически важных с точки зрения безопасности и производительности приложений в домашних роботах, логистике и хирургии [56]. Тем не менее, управление этими объектами затруднено: деформируемым объектам часто не хватает компактных представлений состояний, а удобные аппроксимации, такие как ткань на основе сеток, требуют планирования с учетом множества степеней свободы и высокоразмерной нелинейной динамики. Манипулирование также требует принятия решений о том, где и когда осуществлять контакт, а также соблюдения ограничений, например, избегания препятствий, достижения целей и выполнения задач, несмотря на неопределенность в динамике и восприятии. Симуляторы могут предоставить полезные модели для планирования такого поведения, если они достаточно быстры, точны и удобны для планировщика. Однако предыдущие работы оставляют разрыв между масштабируемым планированием, динамикой деформируемых контактов и робастностью. Классические методы планируют задачи с помощью геометрических абстракций, но создают планы с разомкнутым контуром с ограниченной робастностью. Обученные политики могут планировать в визуальных или латентных пространствах, но им не хватает гарантий робастности, и они требуют длительного обучения. Дифференцируемые симуляторы обеспечивают быстрое планирование на основе градиентов, но разрывные градиенты, возникающие из-за наивных формулировок контактов, могут препятствовать эффективному обнаружению контактов, необходимому для манипулирования..
Чтобы устранить эти пробелы, мы предлагаем CORD-SLS (Contact-smoothed Output-feedback Robust control of Deformables via System Level Synthesis) — фреймворк для дифференцируемого моделирования в реальном времени и надежного планирования манипуляций с деформируемыми объектами на основе восприятия. Сначала мы разрабатываем параллельный на GPU дифференцируемый симулятор со сглаживанием контактов, обеспечивающий удобные для планирования градиенты при скорости моделирования в реальном времени. Затем мы выполняем планирование с помощью этого симулятора посредством параллельного на GPU метода надежного MPC, основанного на System Level Synthesis (SLS), что позволяет осуществлять планирование в реальном времени в многомерных условиях. Для обработки неопределенности восприятия мы вводим параллельную на GPU формулировку SLS с обратной связью по выходу для надежного управления на основе зрения. Мы также показываем, что симулятор может ускорить MBRL, позволяя обучать нейронные стратегии управления эффективным с точки зрения выборки способом через аналитические градиенты стратегии. Наконец, мы калибруем основанные на данных границы неопределенности наихудшего случая для надежного MPC, обеспечивая вероятностные гарантии надежности в реалистичных условиях. Наш вклад заключается в следующем::
- ⟦• Параллельный на графическом процессоре, дифференцируемый, работающий в реальном времени симулятор деформируемых объектов со сглаживанием контактов.
- ⟦• Параллельный на графическом процессоре метод синтеза в реальном времени робастных стратегий управления с обратной связью по выходу для манипуляции деформируемыми объектами посредством SLS с ограничениями достижимости, а также метод MBRL для обучения нейронных стратегий управления, ускоряемый за счет аналитических градиентов стратегии из симулятора.
- ⟦• Реальная реализация на основе технического зрения с использованием отслеживания ключевых точек, а также калибровки границ ошибок восприятия и модели с помощью conformal prediction (CP) для обеспечения безопасности с высокой вероятностью.
- ⟦• Оценка на задачах манипуляции веревкой и тканью с частыми контактами в симуляции и на аппаратном обеспечении (обход препятствий, складывание и разглаживание), превосходящая базовые методы по безопасности, скорости и успешности выполнения задач.
2 Родственные работы
Моделирование деформируемых объектов
Динамика на основе положений (PBD) и её расширение, XPBD, моделируют деформируемые объекты путем проецирования частиц на геометрические ограничения, что обеспечивает быстрое и стабильное моделирование [38, 39, 33]. Однако методы на основе PBD достигают устойчивости ценой физической точности: эффективная жесткость зависит от шага по времени и количества итераций решателя, а существующие дифференцируемые варианты не полностью решают проблему контакта и трения между жесткими и деформируемыми телами. Для деформируемых линейных объектов (DLO) были разработаны более физически обоснованные модели. В частности, формулировки стержней Коссера и дискретных упругих стержней учитывают изгиб, кручение, растяжение и сдвиг, а также были расширены для обработки фрикционного контакта [18, 27, 7, 6]. Дифференцируемые симуляторы стержней поддерживают идентификацию системы, но менее пригодны для управления в условиях интенсивных контактов, поскольку планирование требует явного обнаружения режима контакта [12]. Для моделирования ткани методы, основанные на дискретных оболочках, оболочках Кирхгофа-Лява и проективной динамике, эффективно моделируют тонкие поверхности и могут включать сухой фрикционный контакт [19, 51, 34]. Однако невыпуклость разрешения контактов часто приводит к несогласованным градиентам в дифференцируемых симуляторах ткани [30, 29]. Наш метод использует выпуклую формулировку контакта и сглаженную динамику для улучшения обнаружения контактов во время планирования, создавая градиенты, направленные на поиск контакта, в то время как прямое развертывание и выполнение используют негладкую динамику для сохранения точности [46, 47, 28]⟧.
Планирование
Планирование манипуляций с деформируемыми объектами затруднено из-за тесной взаимосвязи восприятия, динамики и управления [56], а модели должны находить компромисс между точностью и скоростью [21, 4]. В отличие от обучения с подражанием [43, 41], планировщики не требуют данных от экспертов. Классические планировщики используют упрощенные геометрические абстракции для повышения скорости [5, 40], а современные гибридные методы сочетают глобальное планирование с локальным управлением или упрощенной динамикой [36, 50]. Эти методы повышают вычислительную эффективность, но приводят к созданию планов с разомкнутым контуром, обладающих ограниченной устойчивостью. Обученные модели прогнозируют перцептивную или латентную динамику [44, 61, 54, 35, 26] для планирования, но требуют обширного обучения и не имеют гарантий устойчивости. Более высокоуровневые абстракции, такие как латентные дорожные карты, расширяют горизонты планирования и могут кодировать контактные переходы [32, 53, 31], но зависят от библиотек навыков, специфичных для конкретных задач. Дифференцируемые симуляторы позволяют выполнять планирование на основе градиентов [10, 60, 11, 57], однако разрывные градиенты препятствуют обнаружению контактов при планировании [11, 46, 28]. Наш метод вместо этого использует сглаживание контактов для планирования через контакт без использования специализированных навыков, одновременно учитывая ограниченную ошибку модели при переносе из симуляции в реальность [8]⟧.
Безопасность и устойчивость изучены в меньшей степени. Некоторые методы планируют номинально безопасные движения [20, 60] или используют барьерные функции для переопределения небезопасных действий [48, 1]; однако они опираются на приближенные модели без учета модельной ошибки, обеспечивают только локальные корректировки и не решают задачу обнаружения контактов. Методы достижимости оценивают безопасность DLO [59], но не учитывают планирование с интенсивными контактами или манипуляции с тканью в условиях ошибок восприятия. Другие методы повышают устойчивость за счет областей доверия модели [37], уточнения градиента в возмущенных системах DLO [16] или демонстраций MPC [49], но им не хватает формальных гарантий и планирования с интенсивными контактами. Хотя безопасное управление с обратной связью по выходу рассматривалось в недавних работах [55, 13, 14], эти методы с трудом масштабируются до высокоразмерных пространств состояний деформируемых объектов. В отличие от них, мы объединяем дифференцируемое моделирование, сглаживание контактов и робастное MPC с обратной связью по выходу посредством SLS, создавая градиенты поиска контактов при робастном учете неопределенности модели и восприятия. Мы опираемся на параллельную на GPU достижимость [17] через SLS [2, 23], расширяя ее за пределы обратной связи по полному состоянию. В отличие от существующих медленных методов SLS с обратной связью по выходу, ограниченных CPU [25], наш параллельный на GPU решатель обеспечивает робастное управление в реальном времени..
3 Постановка задачи
Мы рассматриваем известное представление состояния для деформируемого объекта (например, трехмерные координаты звеньев для веревки или узлов сетки для ткани), приводимого в действие управляющим сигналом и подчиняющегося неопределенной динамике (1a), где . Чтобы учесть задержку восприятия, мы моделируем систему как наблюдаемую с помощью неопределенных измерений с временной задержкой в соответствии с картой наблюдений (1b),
где и и и являются ограниченными возмущениями. Мы стремимся разработать 1) дифференцируемый симулятор деформируемых объектов, который аппроксимирует динамику (1a), оставаясь при этом удобным для планирования и обучения, и 2) эффективный и робастный алгоритм планирования и управления, который использует этот симулятор для решения задач MPC с учетом достижимости для безопасного манипулирования деформируемыми объектами. Мы рассматриваем две конкретные задачи:
Задача 1. Дифференцируемый симулятор деформируемых объектов со сглаживанием контактов. Разработать симулятор для деформируемых линейных объектов и тканей, который 1) является дифференцируемым, 2) параллельным на GPU и 3) предоставляет информативные градиенты для планирования и обучения стратегий через контакты, определяя динамику планировщика.
| (2) |
Задача 2. MPC с учетом достижимости для робастного манипулирования деформируемыми объектами. Оптимизируйте номинальную траекторию состояния и управления длиной , которая является допустимой для динамики симулятора (2), совместно с причинно-следственным контроллером обратной связи по выходу , где стабилизирует истинную динамику деформируемого объекта (1a) относительно , используя историю наблюдений, и обеспечивает выполнение ограничений на состояние и управление в замкнутом контуре .
4 Метод
Мы разрабатываем дифференцируемый симулятор деформируемых объектов со сглаживанием контактов для планирования на основе градиентов (разд. 4.1), параллельную на графическом процессоре структуру SLS с обратной связью по выходу, которая использует его для обеспечения надежного управления в реальном времени в условиях неопределенности восприятия (разд. 4.2), стратегию model-based RL с эффективным использованием выборок для обучения нейронных стратегий манипулирования, ускоряемую аналитическими градиентами стратегии из дифференцируемого симулятора (разд. 4.3), и процедуру калибровки на основе CP для преобразования изученных ошибок восприятия в гарантии достижимости трубки с высокой вероятностью (разд. 4.4⟧).
4.1 Дифференцируемый симулятор деформируемых объектов со сглаживанием контактов
Существующие симуляторы деформируемых объектов часто предполагают, что деформируемые объекты остаются прикрепленными к роботу, или полагаются на явные схемы пошагового интегрирования по времени, которые требуют малых шагов по времени для численной устойчивости. В отличие от них, мы представляем новый симулятор, который корректно учитывает переключение между неактивными и активными ограничениями, используя при этом неявную схему пошагового интегрирования по времени, сохраняя при этом дифференцируемость..
Рассмотрим узловую систему с узлами, чьи трехмерные координаты вместе с приводимыми степенями свободы (DoFs) образуют вектор конфигурации , где . Для упругой энергии соответствующая внутренняя упругая сила задается выражением . В рамках квазистатического допущения система удовлетворяет
| (3) |
где — матрица масс, — внешние обобщенные силы, включая гравитацию, действующую на узловую систему, и силы привода, приложенные к управляемым DoFs, — -я сила связи, — дискретный временной шаг, а — соответствующий якобиан связи. Как упругие силы, так и силы связи вычисляются на следующем временном шаге, что дает неявную схему временного шага для повышения численной устойчивости. Для голономных связей, таких как захват, жестко взаимодействующий с узловой системой, мы предполагаем, что активная связь обеспечивает фиксацию захвата. Следующая конфигурация и сила связи должны удовлетворять условию комплементарности
| (4) |
где якобиан ограничений определяется как . Для контактных ограничений мы используем выпуклую релаксацию Анитеску [3]. Здесь конфигурация следующего шага и контактная сила удовлетворяют
| (5) |
где — это знаковое расстояние контактной пары , — конус трения, а — его двойственный конус.
Решатель симуляции Мы решаем динамику в (3) с учетом голономных и контактных ограничений в (4) и (5), используя двухэтапную процедуру. Первый этап вычисляет отклик системы при голономных ограничениях, в то время как второй этап разрешает контактные взаимодействия. На первом этапе мы находим промежуточную конфигурацию , удовлетворяющую
| (6) |
где обозначает количество голономных связей, а представляет собой диагональную матрицу жесткости, связанную с -й голономной связью. Когда связь активна, выбирается достаточно большим для обеспечения (4); в противном случае . (6) решается с использованием метода Ньютона и неявно определяет отображение из текущей конфигурации в промежуточную конфигурацию . На втором этапе мы решаем задачу оптимизации
| (7) | ||||
Условия KKT для (7) восстанавливают ограничение контакта в (5) вместе с , что соответствует линеаризации динамики относительно промежуточной конфигурации . При наличии пары решение (6)–(7) дает следующую конфигурацию . Решатели для (6)–(7) реализованы в JAX, что позволяет выполнять матричные разложения с ускорением на GPU..
Дифференцирование через симуляцию Для получения градиентов через динамику мы дифференцируем через задачи оптимизации в (6) и (7). Вместо дифференцирования через развернутые итерационные решатели мы применяем неявное дифференцирование. Для задачи первого этапа (6) пусть обозначает входные данные для динамики. Дифференцирование неявного уравнения, определяющего , дает
| (8) |
Для задачи второго этапа (7) мы дифференцируем её условия KKT, обозначенные как , по отношению к . Это дает
| (9) |
где обозначает матрицу Каруша-Куна-Таккера задачи оптимизации. Таким образом, симулятор можно рассматривать как дифференцируемый слой. Для скалярной целевой функции сопряженное значение относительно определяется как
| (10) |
Данное выражение естественным образом определяет пользовательский обратный проход для слоя симулятора. Начиная с сопряженного значения , мы сначала решаем линейную систему, включающую , и вычисляем векторно-якобиево произведение с , чтобы получить сопряженное значение . Затем мы решаем вторую линейную систему, включающую , и вычисляем векторно-якобиево произведение с , чтобы получить сопряженное значение . Поскольку факторизации и являются побочными результатами прямого решения, обратный проход не требует дополнительных затрат..
Сглаживание контактов. Динамика контактов часто демонстрирует проблему исчезающего градиента: до момента активации контакта управляющие воздействия, связанные с приводимыми в движение степенями свободы, не оказывают влияния на состояние деформируемого объекта [28]. В результате градиентные оптимизаторы могут стагнировать из-за отсутствия информативных градиентных сигналов, не достигая поставленной цели..
Для решения этой проблемы мы используем идею суррогатных градиентов [15], в которой градиент, используемый для планирования, заменяется суррогатным оценщиком, не соответствующим истинному градиенту, полученному путем дифференцирования через физическое развертывание. Это вносит контролируемое смещение в обмен на улучшенную градиентную информацию в режимах, где истинный градиент неинформативен. Голономное ограничение в (4) активно только тогда, когда , и в этот момент ненулевая матрица жесткости используется в (6) для обеспечения выполнения ограничения. Это переключение между неактивными и активными ограничениями приводит как к разрывам, так и к затухающим градиентам. Чтобы сгладить этот переход, мы переопределяем как , где — параметр сглаживания. По мере эта формулировка приближается к исходному поведению активации, подобному индикаторной функции..
Контактное ограничение в 5, которое кодирует режимы отсутствия контакта, статического трения и скольжения, аналогичным образом вводит разрывные и исчезающие градиенты. Мы сглаживаем это путем релаксации условия дополняемости в 5 до , что восстанавливает исходное ограничение дополняемости при . Сглаженная динамика используется исключительно для вычисления градиента, а негладкая динамика используется для прямого моделирования, что позволяет сохранить точность модели..
4.2 Симулятор-информированный параллельный на графическом процессоре SLS с обратной связью по выходу
Для планирования устойчивых стратегий обратной связи по выходу для деформируемого объекта мы стремимся приближенно решить идеализированную задачу оптимизации (11), чтобы получить стратегию обратной связи по выходу ,
| (11) | ||||||||
где , обозначает множество возможных начальных условий, определяет безопасное множество. Хотя мы рассматриваем нелинейные ограничения в разд. 5, для упрощения обозначений мы описываем метод для случая аффинных ограничений. Нелинейные ограничения могут быть надежно соблюдены с использованием подхода [58]. Динамика и наблюдения определены в (1). Для эффективного решения (11) мы расширяем GPU-SLS [17], который ограничен обратной связью по состоянию (т.е. требует полного знания состояния), до настройки с обратной связью по выходу, основываясь на [25]. Следуя [25], задачу синтеза SLS с обратной связью по выходу можно записать как,
| (12a) | ||||
| s.t. | (12b) | |||
| (12c) | ||||
| (12d) | ||||
| (12e) | ||||
где и обозначают линеаризации моделей динамики и наблюдений относительно номинальной траектории , обозначает построчную евклидову норму, а и представляют собой соответствующие масштабирующие коэффициенты линеаризованных возмущений состояния и наблюдений. Матрица обозначает оператор блочного сдвига вниз с на первой поддиагонали и нулями в остальных позициях. Операторы замкнутого отклика и характеризуют распространение возмущений процесса и наблюдений соответственно посредством ограничения (12c), а определяет ширину достижимой трубки. (12d)–(12e) вычисляют достижимые трубки с обратной связью по выходу при наличии возмущений и и используют их для сужения ограничений таким образом, чтобы достижимое множество замкнутой системы оставалось внутри . Для решения (12), [25] декомпозирует оптимизацию на три этапа: 1) генерация номинальной траектории , 2) оптимизация контроллера обратной связи по состоянию и, наконец, 3) оптимизация контроллера обратной связи по выходу . Первые два этапа обрабатываются непосредственно с помощью GPU-SLS [17]. Поэтому мы фокусируемся на параллельной реализации третьего этапа, выражая рекурсии наблюдателя как ассоциативные операторы, что позволяет использовать параллельное префиксное сканирование на GPU. Оптимальное решение для выходного контроллера может быть найдено с помощью одной обратной рекурсии Калмана,
| (13) | ||||
где обозначает неопределенность начального состояния, а независимые прямые распространения,
| (14) |
Матрицы и могут быть затем собраны с использованием и
| (15) |
И (13), и (14) требуют последовательного выполнения умножений плотных матриц на протяжении всего горизонта планирования. В связи с этим мы используем параллельные ассоциативные сканирования на GPU. Мы определяем условную функцию ценности, , и правила комбинации,
| (16) | ||||
с начальными значениями как
| (17) |
Затем мы можем восстановить коэффициенты усиления Калмана посредством прямого параллельного ассоциативного сканирования, используя (16)–(17) для восстановления , а затем из (13). Чтобы извлечь , мы используем аналогичную процедуру и определяем распространение условного наблюдателя для каждого введения возмущения с правилом комбинации и инициализацией . Мы получаем решение для (14) с помощью прямого параллельного ассоциативного сканирования, и , решая зависящий от наблюдателя замкнутый отклик за логарифмическое время, что аналогично сложности GPU-SLS.
4.3 Ускорение обучения с подкреплением на основе моделей посредством аналитических градиентов стратегии (APG)
Дифференцируемый симулятор, предложенный в разд. 4.1, может быть использован для поддержки обучения с подкреплением (RL) на основе моделей несколькими способами; здесь мы укажем два из них. Во-первых, он может генерировать экспертные траектории для управления обучением стратегий. Это особенно полезно при манипулировании деформируемыми объектами с частыми контактами, где разреженные вознаграждения и прерывистые контакты могут сделать исследование с нуля крайне неэффективным с точки зрения выборки. Во-вторых, за счет включения симулятора со сглаженными контактами в качестве дифференцируемого слоя (10), прямые градиенты стратегии могут направлять стратегии к обнаружению и поддержанию контакта с меньшей зависимостью от стохастического исследования, повышая стабильность и эффективность выборки при обучении стратегий. Мы обозначаем этот вариант MBRL нашего метода как APG, поскольку он использует аналитические градиенты стратегии для ускорения обучения стратегий, и оценивается в разд. 5⟧.
4.4 Калиброванные гарантии достижимости посредством конформного прогнозирования ⟦K0⟧)
Формулировка SLS в разд. 4.2 требует наличия множеств неопределенности для динамики замкнутого контура и модели наблюдения для подтверждения безопасности реальной системы (1). Однако на аппаратном уровне независимые метки для истинного возмущения процесса или ошибки оценки состояния, как правило, недоступны. Вместо этого мы измеряем расхождение между следующим наблюдением, предсказанным моделью, и следующим наблюдением, полученным от системы восприятия, и используем CP для калибровки совокупной ошибки одношагового прогнозирования в координатах контроллера. В нашей реализации (разд. 5) система восприятия оценивает полное состояние веревки по изображениям RGB-D. Таким образом, в (1b) мы принимаем , следовательно с , где — это граница ошибки измерения в худшем случае, исходящая из спецификаций точности камеры. Мы определяем воспринимаемое состояние как зашумленную оценку полного состояния, используемую контроллером. Хотя физическая система развивается в латентном пространстве , наша реализация SLS выполняет планирование по ; откалиброванный с помощью CP остаток подтверждает трубки для , которые консервативно расширяются на для получения трубок истинного состояния..
Пусть — это отложенный калибровочный набор переходов воспринимаемых состояний, где — следующее воспринимаемое состояние; эквивалентно, выборка представляет собой . Мы определяем оценки несоответствия , и пусть — это отсортированные оценки. Для уровня покрытия траектории на горизонте , установим и , с , если индекс превышает . Множество CP для следующего воспринимаемого состояния имеет вид . Мы применяем SLS к суррогату воспринимаемого состояния , с . Это откалиброванная модель оценки полного состояния, используемая контроллером, а не независимо идентифицированная модель шума процесса для латентного состояния . Пусть и обозначают результирующие трубки достижимости воспринимаемого состояния и управления. Предполагая взаимозаменяемость между оценками остатков замкнутого контура и калибровочными оценками, CP и робастный SLS обеспечивают (доказательство в приложении A).⟧):
Theorem 1 (Ограничение истинного состояния с помощью трубок CP ⟦K0⟧).
Пусть с , и определим . Предположим, что конформная калибровка и робастный SLS синтез дают трубки воспринимаемого состояния и управления и , удовлетворяющие . Тогда истинные траектории состояния и управления удовлетворяют ⟧.
Соответственно, мы определяем трубку истинного состояния как . Таким образом, для обеспечения ограничений безопасности истинного состояния достаточно наложить ужесточенное условие воспринимаемого состояния . Зависящие от состояния границы неопределенности могут быть включены путем замены скалярного радиуса на откалиброванную границу, зависящую от состояния, например, путем адаптации [45] к условиям воспринимаемого состояния.
5 Результаты
Мы сравниваем CORD-SLS и APG с MPPI [52] и методами обучения с подкреплением без модели (а именно, PPO [42]) в задачах манипуляции деформируемыми объектами, эмпирически подтверждаем устойчивость нашего решателя с обратной связью по выходу и оцениваем эффективность нашего метода на аппаратном обеспечении..
| Task | Method | Dynamics Evaluations Count | Execution Time Per-Step [s] | Safety Rate [%] | Goal Error [m] |
| Lift Rope | Ours | 5400 | 0.050 0.001 | 100.0 0.0 | 0.0548 0.0003 |
| MPPI | 1024000 | 0.177 0.043 | 100.0 0.0 | 0.0681 0.0038 | |
| PPO | 16000000 | 0.0004 0.0001 | 96.5 0.2 | 0.0587 0.0016 | |
| APG | 16000000 | 0.0004 0.0001 | 100.0 0.0 | 0.0573 0.0017 | |
| Drag Rope | Ours | 13500 | 0.070 0.012 | 99.9 0.1 | 0.0360 0.0077 |
| MPPI | 2560000 | 0.234 0.018 | 1.0 0.1 | 0.0814 0.0034 | |
| PPO | 40000000 | 0.0004 0.0001 | 97.0 0.4 | 0.0320 0.0092 | |
| APG | 40000000 | 0.0004 0.0001 | 93.0 0.4 | 0.0302 0.0061 | |
| Fold cloth | Ours | 3400 | 0.758 0.107 | 100.0 0.0 | 0.0611 0.0072 |
| MPPI | 64000 | 18.81 6.11 | 64.0 6.1 | 0.0738 0.0079 | |
| Flatten cloth | Ours | 3400 | 0.711 0.077 | 100.0 0.0 | 0.0234 0.0089 |
| MPPI | 64000 | 11.10 4.66 | 80.0 0.2 | 0.0526 0.0102 |
Сравнение эталонных тестов симуляции
См. Прил. F для сравнения нашего дифференцируемого симулятора с предыдущими симуляторами [12, 11] по точности и времени выполнения. Мы показываем, что наш симулятор достигает сопоставимой точности, ускоряя прямое моделирование и вычисление Якобиана до 700 и 2000 раз соответственно. Эта эффективность, наряду с интеграцией сглаживания контактов, обеспечивает частоту управления в реальном времени и низкую ошибку достижения цели в наших экспериментах по планированию деформируемых объектов, которые мы обсудим далее..
Сравнение эталонных тестов планирования в задачах манипуляции деформируемыми объектами
Мы проводим сравнительный анализ нашего подхода на четырех задачах манипуляции деформируемыми объектами, представленных на рис. 2. В задаче подъема веревки пара захватов должна установить контакт с веревкой, чтобы активировать голономную связь, необходимую для ее подъема. Наш метод использует градиенты динамики для направления действий в сторону установления контакта. В отличие от него, MPPI требует значительно большего количества оценок динамики для определения действий, приводящих к контакту, что приводит к увеличению времени выполнения. Среди методов RL, APG использует дифференцируемую динамику для вычисления градиентов стратегии, в то время как PPO инициализируется с помощью 10 экспертных демонстраций, сгенерированных CORD-SLS, что позволяет ему решить задачу в рамках того же бюджета взаимодействий. Без этой предварительной инициализации стратегия PPO не может установить контакт с веревкой после того же количества взаимодействий со средой и, следовательно, не справляется с выполнением задачи..
В задаче перемещения веревки захват должен установить контакт с веревкой и транспортировать ее в целевое местоположение, избегая препятствия. CORD-SLS явным образом учитывает возмущения и вычисляет траекторные трубки (Рис. 2(b), см. Прил. D для полных снимков трубок), обеспечивая надежное избегание препятствий. Хотя избегание препятствий закодировано как штраф в функции стоимости MPPI, лучшие выбранные траектории часто проходят через препятствие, что приводит к очень низкому уровню безопасности. Дальнейшее увеличение штрафа за препятствие приводит к тому, что веревка остается вблизи своего начального положения. APG находит политику с более низкой стоимостью, чем PPO, с меньшим количеством выборок симулятора (Рис. 6b, Прил. C), но оба метода RL демонстрируют нарушения ограничений, поскольку они не учитывают явным образом возмущения во время выполнения..
Для задач складывания и разглаживания ткани, несмотря на многомерное пространство состояний (300 степеней свободы), параллелизованный на GPU симулятор и решатель SLS позволяют вычислять каждое обновление MPC менее чем за одну секунду (см. прил. D для достижимых трубок). MPPI, для сравнения, требует значительно большего количества оценок динамики для достижения сопоставимой производительности, что приводит к увеличению времени выполнения, а также к более высоким показателям ошибки достижения цели и нарушения ограничений. Мы не включаем базовые модели RL для этих задач, поскольку система ткани с 300 степенями свободы находится в режиме, где оптимизация траектории в режиме реального времени остается выполнимой, в то время как обучение нейронной стратегии становится чрезмерно затратным с точки зрения выборки..
Выходная обратная связь
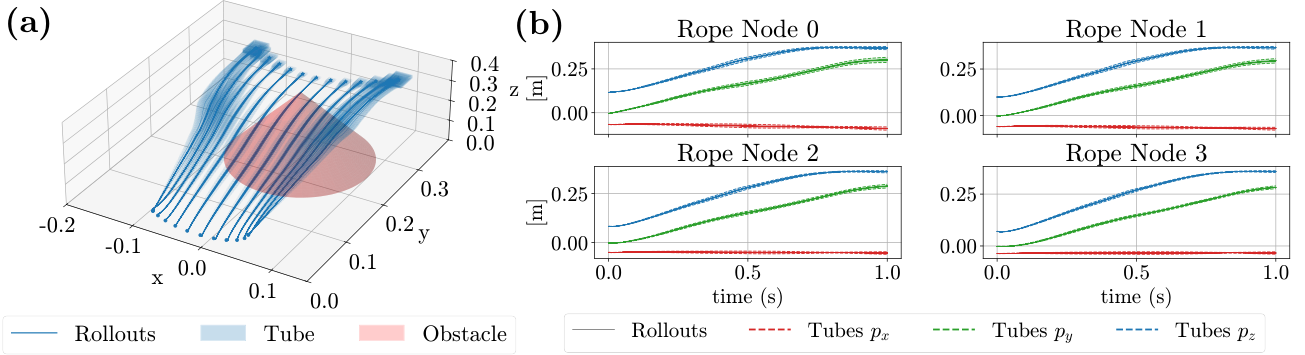
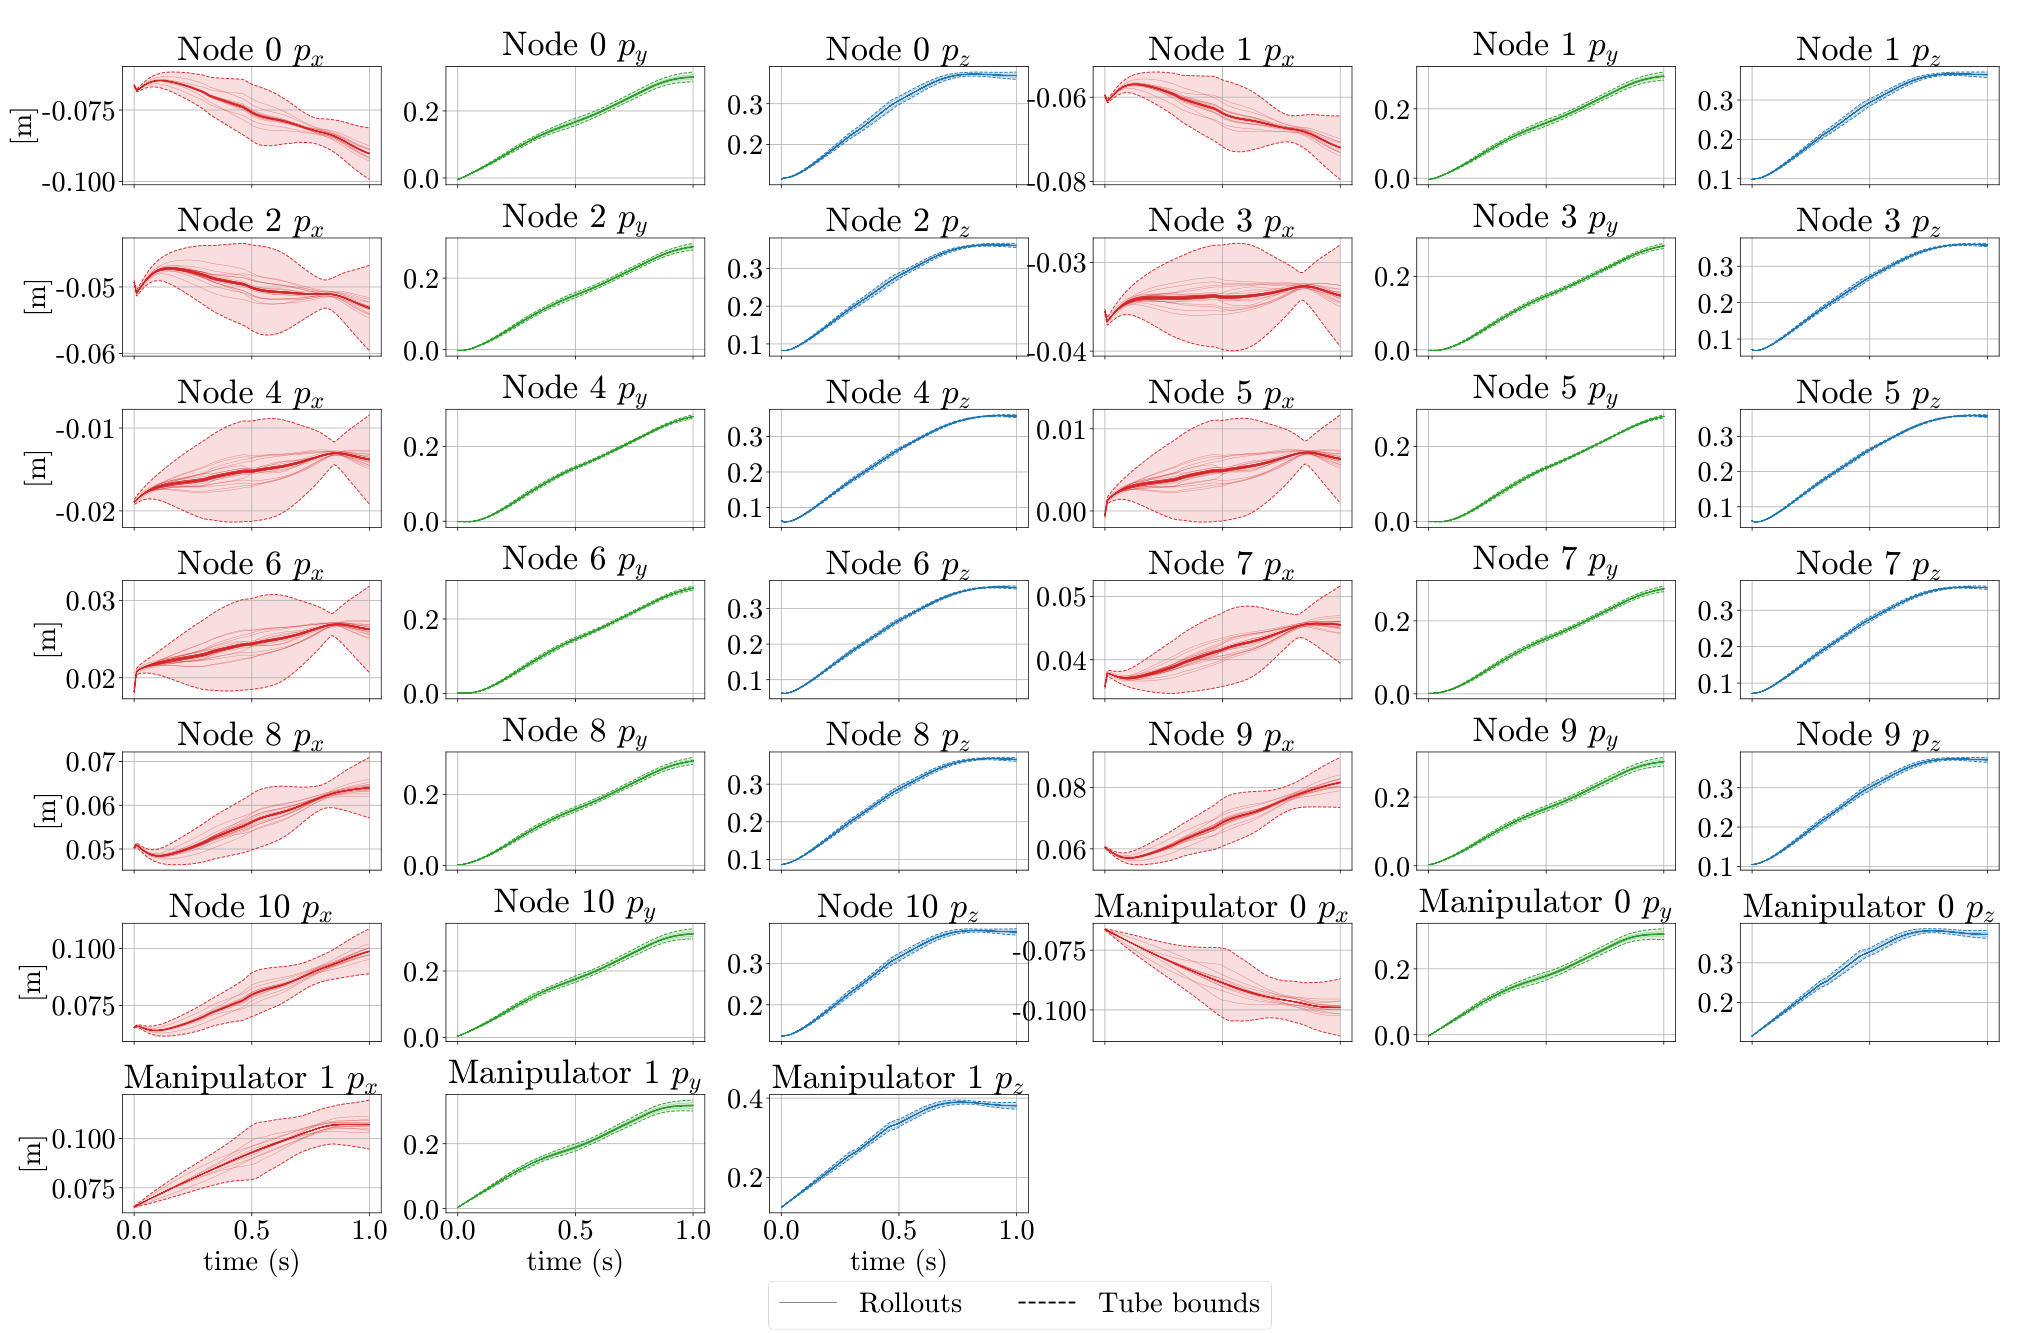
На рис. 3 мы ставим перед контроллером задачу надежного перемещения веревки через препятствие с учетом симулированного шума измерений и динамического шума. На рис. 3(a) мы показываем надежные трубки и траекторию, вычисленные нашим решателем, которые учитывают динамическую неопределенность и неопределенность измерений. На рис. 3(b) мы показываем подмножество надежных трубок для 4 узлов веревки и их развертки, дополнительно иллюстрируя, что контроллер остается устойчивым к шуму измерений и динамическому шуму на протяжении всего выполнения..
Аппаратное обеспечение
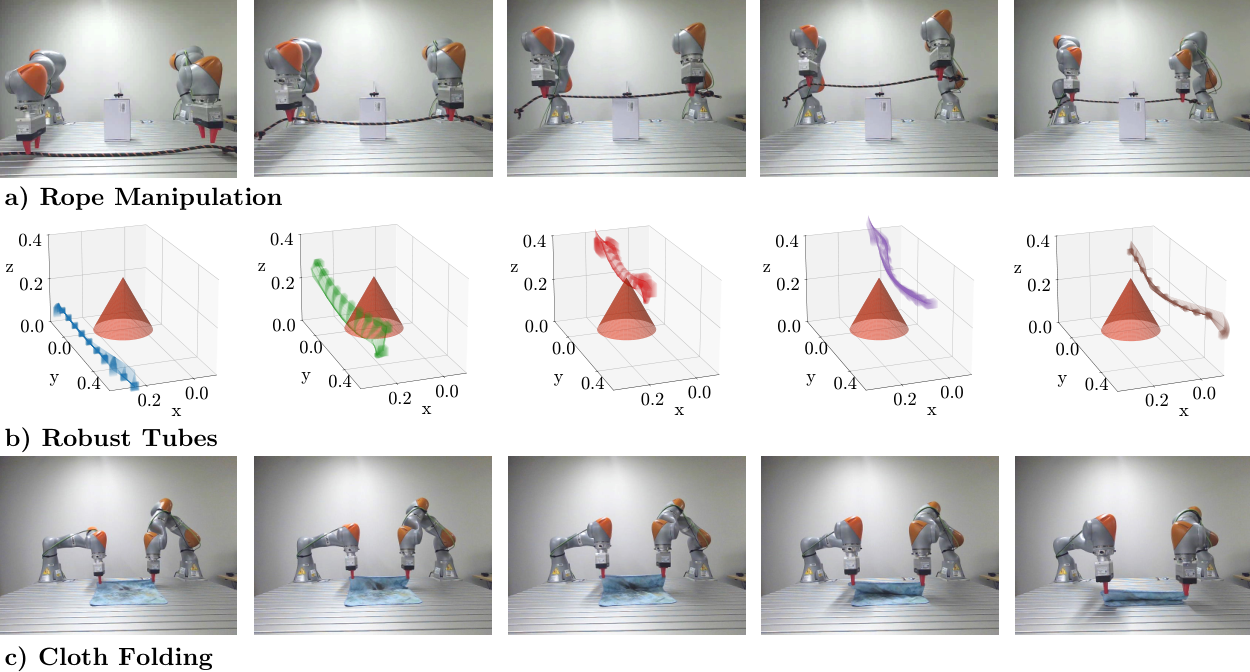
Наконец, мы проверяем наш подход на аппаратном обеспечении. Как показано на рис. 1, мы рассматриваем две задачи манипулирования деформируемыми объектами: манипулирование веревкой с препятствием и складывание ткани. Для обеих задач мы оцениваем состояние, используя RGB-D наблюдения, где SAM [9] инициализирует и привязывает ключевые точки, которые затем отслеживаются в режиме реального времени с помощью TAPNext++ [22]. Затем мы используем эти позы ключевых точек для аппроксимации и реконструкции полного состояния объекта. Более подробную информацию о конвейере восприятия см. в приложении B. Эксперименты проводятся с двумя манипуляторами KUKA LBR iiwa, при этом решатель MPC работает на графическом процессоре NVIDIA RTX4070 Ti. Чтобы откалибровать границу CP, мы применяем 100 случайных управлений на аппаратном обеспечении и сравниваем предсказанные и измеренные одношаговые переходы состояний. Затем мы используем округленный эмпирический радиус ошибки 0,03 м, который покрывает 87% калибровочных остатков. На рис. 1(a) мы показываем, что благодаря гладкости контактов и дифференцируемости нашего симулятора манипуляторы способны вступать в контакт с веревкой и перемещать ее через препятствие. На рис. 1(b) мы визуализируем надежные трубки, сгенерированные в выбранные моменты времени, которые учитывают как динамическую неопределенность, так и неопределенность измерений, показывая, что мы остаемся в безопасности, несмотря на неопределенность. Наконец, на рис. 1(c) мы показываем, как манипуляторы успешно завершают задачу складывания ткани, демонстрируя, что наш симулятор и решатель применимы к задачам с высокоразмерными деформируемыми объектами..
6 Обсуждение, ограничения и заключение
В данной статье представлена CORD-SLS, структура для безопасного манипулирования деформируемыми объектами с частыми контактами, которая объединяет дифференцируемое моделирование, надежное управление с обратной связью по выходу с ускорением на GPU и калибровку неопределенности на основе данных. Благодаря плавной контактной динамике, дифференцируемому моделированию и конформному прогнозированию, CORD-SLS обеспечивает оптимизацию траектории в реальном времени для многомерных деформируемых объектов при прерывистом контакте, сохраняя при этом высокую вероятность безопасности..
Ограничения
Сглаживание контактов вносит погрешности вблизи моментов перехода контактов, с которыми можно справиться с помощью [28]. Восприятие деформируемых объектов остается сложной задачей в условиях окклюзии и сложных топологий, что может быть решено за счет более совершенных конвейеров восприятия, таких как многоракурсное RGB-D зондирование или обученные выходные уравнения. Наконец, использование памяти для систем более высокой размерности и длинных горизонтов становится узким местом, что стимулирует использование низкоранговых операторов отклика SLS..
Список литературы
- ⟦[1] Б. Аксой и Дж. Т. Вен (2025) Планирование и управление манипуляцией деформируемыми линейными объектами. IEEE Transactions on Automation Science and Engineering. Цитируется в: §2.
- ⟦[2] Дж. Андерсон, Дж. К. Дойл, С. Х. Лоу и Н. Матни (2019) Синтез на системном уровне. Annual Reviews in Control 47, стр. 364–393. Цитируется в: §2.
- ⟦[3] М. Анитеску (2006) Оптимизационное моделирование динамики негладких жестких многотельных систем. Математическое программирование 105 (1), стр. 113–143. Цитируется в: §4.1.
- ⟦[4] В. Э. Арриола-Риос, П. Гулер, Ф. Фикучелло, Д. Крагич, Б. Сичилиано и Дж. Л. Уайатт (2020) Моделирование деформируемых объектов для роботизированных манипуляций: учебное пособие и обзор. Frontiers in Robotics and AI 7, стр. 82. Цитируется в: §2.
- ⟦[5] О. Б. Баязит, Дж. Лиен и Н. М. Амато (2002) Вероятностное дорожное планирование движения для деформируемых объектов. В материалах Международной конференции IEEE по робототехнике и автоматизации 2002 года (Кат. № 02CH37292), Том 2, стр. 2126–2133. Цитируется в: §2.
- ⟦[6] М. Бергоу, Б. Одоли, Э. Вуга, М. Вардецки и Э. Гринспун (2010) Дискретные вязкие нити. ACM Transactions on graphics (TOG) 29 (4), стр. 1–10. Цитируется в: §2.
- ⟦[7] М. Бергоу, М. Вардецки, С. Робинсон, Б. Одоли и Э. Гринспун (2008) Дискретные упругие стержни. В ACM Siggraph 2008 Papers, стр. 1–12. Цитируется в: §2⟧.
- ⟦[8] Д. Бланко-Мулеро, О. Барбани, Г. Алкан, А. Коломе, К. Торрас и В. Кирки (2024) Сравнительный анализ разрыва между симуляцией и реальностью при манипулировании тканью. IEEE Robotics and Automation Letters 9 (3), стр. 2981–2988. Цитируется в: §2.
- ⟦[9] Н. Карион, Л. Густафсон, Ю. Ху, С. Дебнат, Р. Ху, Д. Сурис, К. Ряли, К. В. Алвала, Х. Хедр, А. Хуанг и др. (2025) Sam 3: сегментация всего с помощью концептов. arXiv preprint arXiv:2511.16719. Цитируется в: §5.
- ⟦[10] С. Чен, Ю. Сюй, К. Ю, Л. Ли и Д. Сюй (2024) Дифференцируемые частицы для манипулирования деформируемыми объектами общего назначения. arXiv preprint arXiv:2405.01044. Цитируется в: §2⟧.
- ⟦[11] С. Чен, Ю. Сюй, К. Ю, Л. Ли, С. Ма, З. Сюй и Д. Сюй (2022) Daxbench: сравнительный анализ манипуляций с деформируемыми объектами с использованием дифференцируемой физики. arXiv препринт arXiv:2210.13066. Цитируется в: Table 2, Table 2, Appendix F, §2, §5.
- ⟦[12] И. Чен, И. Чжан, З. Брей, Т. Чжан, И. Чен, Дж. Ву и Р. Васудеван (2024) Дифференцируемые дискретные упругие стержни для моделирования деформируемых линейных объектов в реальном времени. arXiv preprint arXiv:2406.05931. Цитируется в: Table 2, Table 3, Table 3, Appendix F, §2, §5.
- ⟦[13] Г. Чоу, Н. Озай и Д. Беренсон (2022) Безопасное планирование движения с обратной связью по выходу на основе изображений с использованием обученных модулей восприятия и теории сжатия. В сборнике: Международный семинар по алгоритмическим основам робототехники, стр. 349–367. Цитируется в: §2.
- ⟦[14] Г. Чоу и Р. Тедрейк (2023) Синтез устойчивых визуомоторных стратегий пониженного порядка для нелинейных систем посредством оптимизации сумм квадратов. В материалах 62-й конференции IEEE по принятию решений и управлению (CDC) 2023 года, стр. 624–631. Цитируется в: §2.
- ⟦[15] О. Деволдер, Ф. Глинер и Ю. Нестеров (2014) Методы первого порядка для гладкой выпуклой оптимизации с неточным оракулом. Математическое программирование 146 (1), стр. 37–75. Внешние ссылки: ISSN 1436-4646 Цитируется в: §4.1⟧.
- ⟦[16] Дж. Энвалл и С. Корош (2026) Устойчивое манипулирование деформируемыми линейными объектами. IEEE Robotics and Automation Letters. Цитируется в: §2⟧.
- ⟦[17] Дж. Фанг и Г. Чоу (2026) Безопасное крупномасштабное робастное нелинейное MPC за миллисекунды посредством синтеза системного уровня с ограничениями достижимости на графическом процессоре. Препринт arXiv:2604.07644. Цитируется в: §2, §4.2, §4.2⟧.
- ⟦[18] М. Газзола, Л. Х. Дадте, А. Г. Маккормик и Л. Махадеван (2018) Прямые и обратные задачи в механике мягких нитей. Royal Society Open Science 5 (6), стр. 171628. Цитируется в: §2.
- ⟦[19] Э. Гринспун, А. Н. Хирани, М. Десбрун и П. Шрёдер (2003) Дискретные оболочки. В материалах симпозиума ACM SIGGRAPH/Eurographics по компьютерной анимации 2003 года, стр. 62–67. Цитируется в: §2.
- ⟦[20] Дж. Хуан, С. Чу, С. Ма и К. В. С. Ау (2023) Манипуляция деформируемыми объектами с ограничениями с использованием планирования наборов путей и отслеживания. IEEE Transactions on Robotics 39 (6), стр. 4671–4690. Цитируется в: §2.
- ⟦[21] П. Хименес (2012) Обзор планирования манипуляций с деформируемыми объектами на основе моделей. Robotics and computer-integrated manufacturing 28 (2), стр. 154–163. Цитируется в: §2.
- ⟦[22] С. Юнг, А. Жолус, М. Зундермейер, К. Дёрш, Р. Горошин, Д. Дж. Тан, С. Чандар, Р. Трибель и Ф. Томбари (2026) TAPNext++: что дальше для отслеживания любой точки (tap)?. arXiv preprint arXiv:2604.10582. Цитируется в: §5.
- ⟦[23] А. П. Лиман, Дж. Кёлер, А. Занелли, С. Беннани и М. Н. Цайлингер (2025) Робастное нелинейное оптимальное управление посредством синтеза на системном уровне. IEEE Transactions on Automatic Control. Цитируется в: §2⟧.
- ⟦[24] А. П. Лиман, Дж. Кёлер и М. Н. Цайлингер (2025) Гарантированно робастное нелинейное MPC посредством обратной связи по возмущению. arXiv preprint arXiv:2509.18760. Цитируется в: Appendix D.
- ⟦[25] А. П. Лиман, С. Чжан, М. Н. Цайлингер и Г. Чоу (2026) VISION-SLS: безопасное управление на основе восприятия с использованием изученных визуальных представлений посредством System Level Synthesis. arXiv preprint arXiv:2604.24894. Цитируется в: §2, §4.2, §4.2.
- ⟦[26] С. Ли, З. Ай, Т. Ву, Х. Ли, В. Динг и Х. Сюй (2024) Deformnet: моделирование латентного пространства и прогнозирование динамики для манипулирования деформируемыми объектами. В материалах Международной конференции IEEE по робототехнике и автоматизации (ICRA) 2024 года, стр. 14770–14776. Цитируется по: §2.
- ⟦[27] У. Ли и Г. Чоу (2025) Выпуклая формулировка податливого контакта между нитями и твердыми телами. arXiv preprint arXiv:2509.13434. Цитируется в: §2⟧.
- ⟦[28] У. Ли и Г. Чоу (2026) Сертифицированное градиентное манипулирование с частыми контактами посредством достижимых трубок с ошибкой сглаживания. arXiv препринт arXiv:2602.09368. Цитируется в: §2, §2, §4.1, §6⟧.
- ⟦[29] И. Ли, Т. Ду, К. Ву, Дж. Сюй и В. Матусик (2022) DiffCloth: дифференцируемая симуляция ткани с сухим контактным трением. ACM Transactions on Graphics 42 (1), стр. Статья 2. Цитируется в: §2.
- ⟦[30] Дж. Лян, М. Лин и В. Колтун (2019) Дифференцируемое моделирование ткани для обратных задач. В сборнике Advances in Neural Information Processing Systems, Том 32. Цитируется в: §2.
- ⟦[31] Х. Лин, К. Ци, Ю. Чжан, З. Хуан, К. Фрагкиадаки, Ю. Ли, К. Ган и Д. Хелд (2022) Планирование с использованием пространственно-временной абстракции на основе облаков точек для манипулирования деформируемыми объектами. arXiv preprint arXiv:2210.15751. Цитируется в: §2.
- ⟦[32] М. Липпи, П. Поклукар, М. К. Велле, А. Варава, Х. Инь, А. Марино и Д. Крагич (2020) Дорожная карта латентного пространства для визуального планирования действий при манипулировании деформируемыми и жесткими объектами. В материалах Международной конференции IEEE/RSJ по интеллектуальным роботам и системам (IROS) 2020 года, стр. 5619–5626. Цитируется в: §2.
- ⟦[33] Ф. Лю, Э. Су, Дж. Лу, М. Ли и М. К. Йип (2022) Дифференцируемое робототехническое манипулирование деформируемыми веревочными объектами с использованием податливой динамики на основе положения. Препринт arXiv:2202.09714. Цитируется в: §2.
- ⟦[34] М. Ли, Дж. Жув, Л. Буасье и Ф. Бертай-Дескуб (2020) Проективная динамика с сухим фрикционным контактом. ACM Transactions on Graphics 39 (4), стр. Article 57. Цитируется в: §2⟧.
- ⟦[35] Х. Ма, Д. Хсу и В. С. Ли (2022) Изучение динамики латентных графов для визуального манипулирования деформируемыми объектами. В материалах Международной конференции по робототехнике и автоматизации 2022 года (ICRA), стр. 8266–8273. Цитируется в: §2.
- ⟦[36] Д. МакКонахи, А. Добсон, М. Руан и Д. Беренсон (2020) Манипулирование деформируемыми объектами путем чередования прогнозирования, планирования и управления. Международный журнал исследований в области робототехники 39 (8), стр. 957–982. Цитируется в: §2.
- ⟦[37] П. Митрано, Д. Макконахи и Д. Беренсон (2021) Обучение доверию к ненадежным моделям в неструктурированном мире для манипулирования деформируемыми объектами. Science Robotics 6 (54), стр. eabd8170. Цитируется в: §2⟧.
- ⟦[38] М. Мюллер, Б. Хайдельбергер, М. Хенникс и Дж. Рэтклифф (2007) Динамика на основе позиционирования. Журнал визуальной коммуникации и представления изображений 18 (2), стр. 109–118. Цитируется в: §2.
- ⟦[39] М. Жуань, Д. Макконахи и Д. Беренсон (2018) Учет направленной жесткости и ограничений при управлении манипуляцией деформируемыми объектами без физического моделирования. В материалах Международной конференции IEEE/RSJ по интеллектуальным роботам и системам (IROS) 2018 года, стр. 512–519. Цитируется в: §2.
- ⟦[40] М. Саха и П. Исто (2006) Планирование движения для роботизированного манипулирования деформируемыми линейными объектами. В материалах конференции 2006 IEEE International Conference on Robotics and Automation, 2006. ICRA 2006., стр. 2478–2484. Цитируется в: §2.
- ⟦[41] Г. Салхотра, И. А. Лю, М. Домингес-Куне и Г. С. Сухатме (2022) Обучение манипулированию деформируемыми объектами на основе экспертных демонстраций. IEEE Robotics and Automation Letters 7 (4), стр. 8775–8782. Цитируется в: §2.
- ⟦[42] Дж. Шульман, Ф. Вольски, П. Дхаривал, А. Рэдфорд и О. Климов (2017) Алгоритмы проксимальной оптимизации стратегии. arXiv препринт arXiv:1707.06347. Цитируется в: §5.
- ⟦[43] Д. Сейта, П. Флоренс, Дж. Томпсон, Э. Куманс, В. Синдхвани, К. Голдберг и А. Зенг (2021) Обучение переупорядочиванию деформируемых кабелей, тканей и мешков с помощью целевых сетей-транспортеров. В материалах Международной конференции IEEE по робототехнике и автоматизации (ICRA) 2021 года, стр. 4568–4575. Цитируется в: §2.
- ⟦[44] Б. Шен, З. Цзян, К. Чой, С. Саварезе, Л. Дж. Гибас, А. Анандкумар и И. Чжу (2024) Действенно-обусловленная неявная визуальная динамика для манипулирования деформируемыми объектами. Международный журнал исследований в области робототехники 43 (4), стр. 437–455. Цитируется в: §2⟧.
- ⟦[45] А. Сринивасан, А. Лиман и Г. Чоу (2026) Безопасность за пределами обучающих данных: робастное MPC вне распределения посредством конформного синтеза на системном уровне. arXiv preprint arXiv:2602.12047. Цитируется в: §4.4.
- ⟦[46] Х. Дж. Су, М. Симчовиц, К. Чжан и Р. Тедрейк (2022) Дают ли дифференцируемые симуляторы лучшие градиенты стратегии?. В Международной конференции по машинному обучению, стр. 20668–20696. Цитируется в: §2, §2.
- ⟦[47] Х. Дж. Т. Су, Т. Панг и Р. Тедрейк (2022) Объединенные градиенты через контакт посредством рандомизированного сглаживания. IEEE Robotics and Automation Letters 7 (2), стр. 4000–4007. Цитируется в: §2.
- ⟦[48] И. Тан, С. Чу, Дж. Хуан и К. С. Ау (2024) Основанное на обучении MPC с защитным фильтром для манипулирования деформируемыми линейными объектами с ограничениями. IEEE Robotics and Automation Letters 9 (3), стр. 2877–2884. Цитируется в: §2.
- ⟦[49] Х. Ван, З. Донг, Т. Чжу, Х. Лей, В. Ши, З. Чжан, В. Луо, В. Ван, Х. Чен и Дж. Хуанг (2025) Роботизированное манипулирование деформируемыми объектами посредством демонстраций, сгенерированных с помощью NMPC, в глубоком обучении с подкреплением. IEEE Transactions on Automation Science and Engineering 22, стр. 23566–23578. Цитируется в: §2.
- ⟦[50] С. Ван, М. Леонетти и М. Догар (2025) Упрощение модели с учетом целей для манипулирования одномерными и двумерными деформируемыми объектами. IEEE Transactions on Robotics. Цитируется в: §2.
- ⟦[51] Дж. Вен и Дж. Барбич (2023) Оболочки Кирхгофа-Лява с произвольными гиперупругими материалами. ACM Transactions on Graphics 42 (6), стр. Статья 174. Цитируется в: §2.
- ⟦[52] Дж. Уильямс, А. Олдрич и Э. А. Теодору (2017) Управление на основе прогностических интегральных путей: от теории к параллельным вычислениям. Журнал руководства, управления и динамики 40 (2), стр. 344–357. Цитируется в: §5.
- ⟦[53] Дж. Ямада, С. Чжун, Дж. Коллинз и И. Познер (2024) D-cubed: оптимизация траектории на основе латентной диффузии для ловкого манипулирования деформируемыми объектами. arXiv препринт arXiv:2403.12861. Цитируется в: §2.
- ⟦[54] У. Ян, А. Вангипурам, П. Аббил и Л. Пинто (2021) Обучение предиктивным представлениям для деформируемых объектов с использованием контрастивного оценивания. В сборнике: Конференция по обучению роботов, стр. 564–574. Цитируется в: §2.
- ⟦[55] С. Янг, Г. Дж. Паппас, Р. Мангарам и Л. Линдеманн (2023) Безопасное управление на основе восприятия в условиях стохастической неопределенности датчиков с использованием конформного прогнозирования. В материалах 62-й конференции IEEE по принятию решений и управлению (CDC) 2023 года, стр. 6072–6078. Цитируется в: §2.
- ⟦[56] Г. Инь, А. Варава и Д. Крагич (2021) Методы моделирования, обучения, восприятия и управления для манипулирования деформируемыми объектами. Science Robotics 6 (54), стр. eabd8803. Цитируется в: §1, §2.
- ⟦[57] Э. Йошида, К. Аюсава, И. Г. Рамирес-Альпизар, К. Харада, К. Дюриез и А. Хеддар (2015) Оптимальное планирование движения на основе моделирования для деформируемого объекта. В материалах международного семинара IEEE по передовой робототехнике и ее социальному воздействию (ARSO) 2015 года, стр. 1–6. Цитируется в: §2.
- ⟦[58] С. Чжан, К. Чиу, А. П. Лиман и Г. Чоу (2025) Устойчиво ограниченные динамические игры для неопределенной нелинейной динамики. arXiv препринт arXiv:2509.16826. Цитируется в: §4.2.
- ⟦[59] И. Чжан и С. Ли (2025) Сертифицированно безопасное манипулирование деформируемыми линейными объектами посредством совместного прогнозирования формы и натяжения. arXiv preprint arXiv:2505.13889. Цитируется в: §2⟧.
- ⟦[60] И. Чжан, Ф. Лю, С. Лян и М. Йип (2024) Достижение автономного манипулирования тканью с помощью оптимального управления посредством дифференцируемой регуляризации с учетом физики и ограничений безопасности. В материалах Международной конференции IEEE по робототехнике и автоматизации (ICRA) 2024 года, стр. 9931–9938. Цитируется в: §2, §2.
- ⟦[61] З. Чжан, С. Чу, Ю. Тан, Л. Чжао, Дж. Хуан, З. Цзян и К. С. Ау (2025) Манипулирование упругопластическими объектами с использованием трехмерной занятости и прогностического управления на основе обучения. IEEE Robotics and Automation Letters. Цитируется в: §2⟧.
Приложения
Ниже представлен обзор наших приложений. В приложении A мы приводим доказательство теоремы 1, которое показывает, как конформные трубки воспринимаемого состояния подразумевают удержание истинного состояния после расширения трубок на величину границы ошибки восприятия. В приложении B мы приводим дополнительные сведения об аппаратных конвейерах восприятия, используемых для экспериментов по манипулированию веревкой и складыванию ткани, включая настройку камер, сегментацию на основе SAM3, отслеживание ключевых точек TAPNext++, реконструкцию RGB-D, аппроксимацию сплайнами и процедуры реконструкции состояния. В приложении C мы приводим дополнительные результаты обучения с подкреплением, сравнивающие PPO и APG в задачах подъема и перетаскивания веревки, демонстрируя повышенную эффективность выборки, достигнутую за счет дифференцирования через наш симулятор. В приложении D мы приводим дополнительные визуализации трубок MPC с обратной связью по состоянию для задач перетаскивания веревки и складывания ткани, а также обсуждаем, как перепланирование влияет на взаимосвязь между выполненными траекториями и ранее вычисленными робастными трубками. В приложении E мы приводим дополнительные визуализации трубок с обратной связью по выходу для задачи манипулирования веревкой, демонстрируя развертывания при случайных динамических и измерительных возмущениях под управлением робастного контроллера на основе восприятия, синтезированного с помощью CORD-SLS. В приложении F мы сравниваем наш дифференцируемый симулятор с предыдущими методами с точки зрения точности и скорости моделирования..
Appendix A Доказательства
Для удобства мы переформулируем теорему 1, а затем приведем доказательство.
Theorem A.1 (Удержание истинного состояния с помощью конформных трубок воспринимаемого состояния).
Пусть с , и определим . Предположим, что конформная калибровка и робастный синтез SLS дают трубки воспринимаемого состояния и управления и , удовлетворяющие . Тогда истинные траектории состояния и управления удовлетворяют .
Доказательство.
В случае, если и для всех , мы имеем
С момента ,
для всех . Событие включения воспринимаемого состояния имеет вероятность не менее , поэтому событие включения расширенного истинного состояния имеет ту же нижнюю границу вероятности. ∎
Appendix B Восприятие
Мы более подробно описываем аппаратные экспериментальные установки и архитектуру восприятия для эксперимента по манипулированию веревкой, а затем для эксперимента по складыванию ткани. Для обоих экспериментов мы используем два манипулятора Kuka iiwa с приводами Schunk для захвата. Мы используем два компьютера: один, оснащенный NVIDIA RTX4090, отвечает за работу конвейера восприятия и связь с манипуляторами, а другой, оснащенный NVIDIA RTX4070 Ti Super, предназначен для работы решателя. Два компьютера взаимодействуют через ROS2 посредством Ethernet-соединения..
Мы устанавливаем две камеры глубины Orbbec Gemini 336L в рабочую зону: одна камера направлена на переднюю часть рабочей зоны, а другая — на заднюю. Обе камеры и манипуляторы откалиброваны для передачи измерений в единой системе координат рабочей станции..
B.1 Веревка
Мы используем плетеную веревку диаметром приблизительно 1 см и общей длиной 1,5 метра. Чтобы разместить веревку в пределах рабочего пространства, мы связываем оба конца веревки, уменьшая ее эффективную длину примерно до 0,8 м. Для нашей модели симуляции мы используем 10 звеньев.
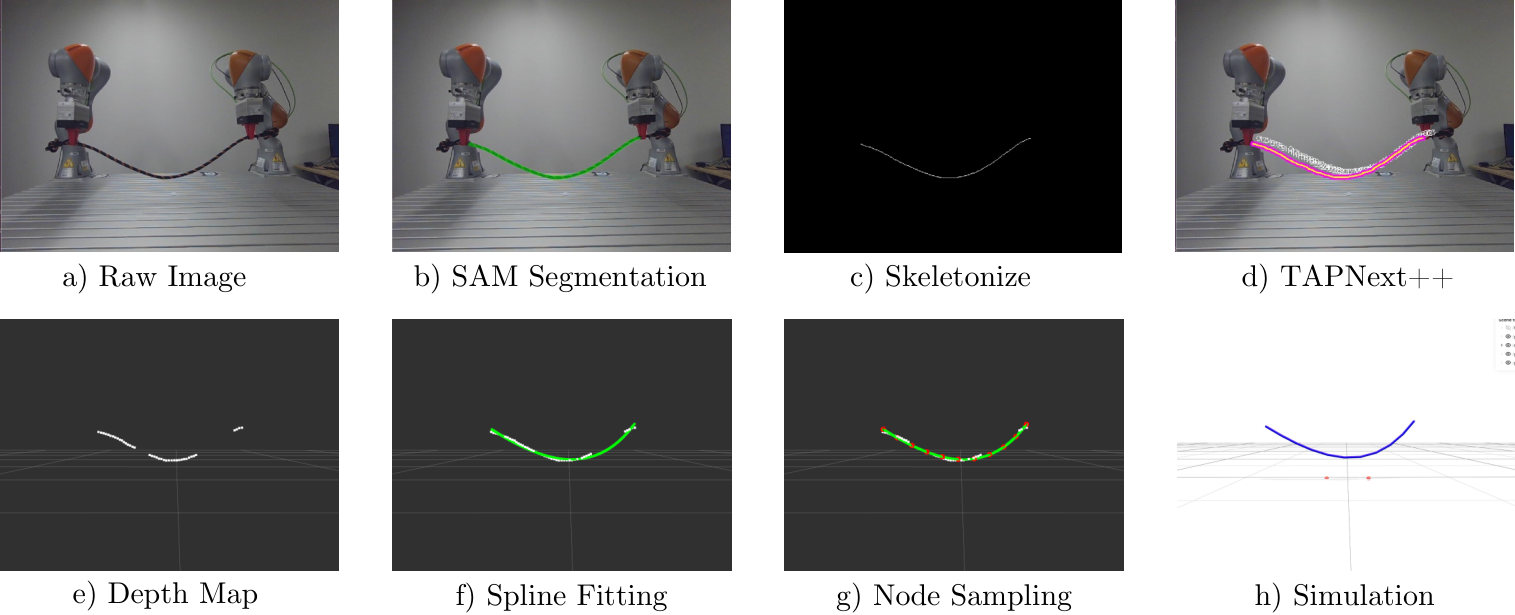
Наш основной конвейер восприятия объединяет семантическую сегментацию с отслеживанием ключевых точек. На рис. 4 мы показываем снимки нашего конвейера восприятия. Сначала мы используем Segment Anything Model 3 (SAM3) с подсказкой «rope» для сегментации веревки на RGB-изображении. Полученная маска скелетируется для создания центральной линии шириной в один пиксель вдоль веревки. Затем мы выбираем фиксированное количество точек вдоль этой центральной линии и используем их для инициализации и периодического повторного привязывания трекера TapNext++. Получая эти RGB-пиксели, TapNext++ отслеживает движение этих ключевых точек по кадрам видео, обеспечивая непрерывное отслеживание ключевых точек веревки между обновлениями сегментации..
Такая гибридная конструкция помогает сбалансировать семантическую устойчивость и эффективность выполнения. Хотя SAM3 обеспечивает обнаружение веревки на основе концепций, в наших экспериментах мы обнаружили, что один вывод занимает примерно 200 мс, что создает слишком большую задержку для аппаратного управления в реальном времени. TapNext++, с другой стороны, работает с меньшей задержкой и отслеживает ключевые точки веревки кадр за кадром, но со временем может отклоняться, поскольку не опирается на язык или семантику объектов. Поэтому мы используем SAM3 периодически для повторной инициализации или перепривязки TapNext++, в то время как TapNext++ обеспечивает отслеживание ключевых точек с более высокой частотой между обновлениями SAM3..
Отслеженные двумерные ключевые точки затем сопоставляются с картой глубины для восстановления их трехмерных положений в системе координат рабочей станции. Чтобы уменьшить шум и преобразовать эти измерения в представление состояния, используемое в нашем симуляторе, мы аппроксимируем трехмерные точки сплайном и выполняем передискретизацию вдоль сплайна в соответствии с требуемой длиной сегмента веревки. В результате мы получаем полную оценку состояния веревки в виде упорядоченной последовательности трехмерных узлов с фиксированным расстоянием между сегментами..
Мы обнаружили, что частота перепривязки SAM3 создает компромисс между надежностью и временем выполнения. Запуск SAM3 один раз в секунду приводит к тому, что TapNext++ работает с частотой примерно 15 Гц, в то время как запуск SAM3 один раз в 5 секунд позволяет TapNext++ работать с частотой примерно 25 Гц. Такое замедление, вероятно, связано с тем, что SAM3 конкурирует с TapNext++ за память графического процессора и ресурсы ядра. Хотя этот конвейер работает эмпирически, результирующая скорость восприятия все еще ниже, чем у решателя, время решения которого в среднем составляет менее 20 мс. В результате решатель иногда приходится задерживать, чтобы позволить системе восприятия наверстать упущенное..
Для устранения этого узкого места в виде задержки мы также внедряем более быстрый конвейер реконструкции веревки, который жертвует некоторой точностью восприятия ради более высокой частоты управления. На начальном этапе захвата, когда веревка неподвижна, мы используем полный конвейер сегментации и отслеживания для оценки состояния веревки. После того как манипуляторы захватывают веревку, мы реконструируем ее, используя известные положения захватов и известную длину веревки между двумя манипуляторами. Эта реконструкция предполагает, что форма веревки определяется преимущественно гравитационным провисанием. Хотя это приближение менее точно, чем прямое восприятие, оно обеспечивает достаточно разумную оценку конфигурации веревки при существенно более высоких частотах, что делает его более подходящим для управления с обратной связью..
B.2 Ткань
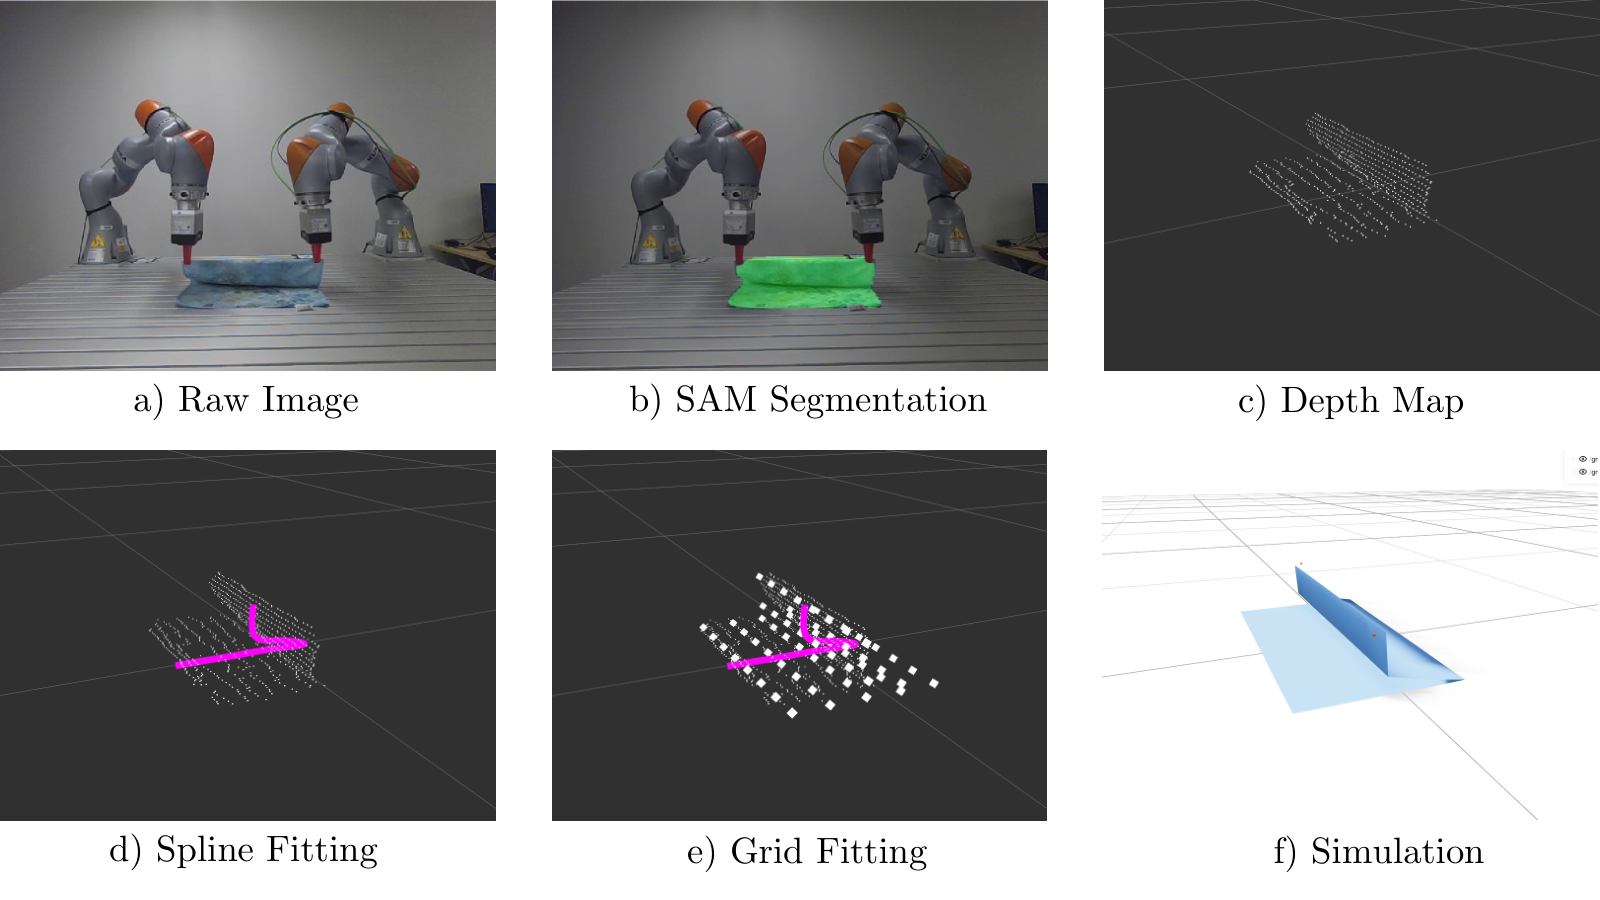
Мы используем ткань размером приблизительно 38 см x 38 см. Для нашей модели симуляции ткань дискретизирована в сетку 7 x 7 ячеек, что соответствует решетке из 8 x 8 узлов и дает в общей сложности 64 узла ткани. Полное состояние имеет размерность (), состоящую из 3D-позиций узлов ткани и двух 3D-позиций захватов..
Оценка состояния ткани является более сложной задачей, чем оценка состояния веревки, из-за ее более высокой размерности, высокой деформируемости и частого самоперекрытия. Чтобы сделать оценку состояния для складывания ткани более управляемой, мы упрощаем восприятие, предполагая, что координаты (x) и (z) являются постоянными вдоль каждого ряда ткани. Другими словами, каждый ряд представлен как прямая линия, охватывающая ширину ткани в направлении (y), что сводит задачу оценки состояния к восстановлению геометрии осевой линии по рядам. Чтобы сделать физическую задачу согласованной с этим подходом, мы ограничиваем положение захватов при оптимизации так, чтобы они различались в плоскости (x) и (z) не более чем на 5 см. Мы обобщаем и показываем снимки конвейера восприятия (рис. 5).
Наш конвейер восприятия ткани следует той же общей структуре, что и конвейер восприятия веревки. Сначала мы пропускаем необработанные изображения через конвейер сегментации SAM3, используя подсказку «cloth». Полученная маска сегментации сопоставляется с картой глубины для восстановления трехмерных точек на видимой поверхности ткани. Однако во время складывания части ткани могут быть перекрыты сложенным слоем и, следовательно, не видны фронтальной камере и ее камере глубины. Чтобы справиться с этим, мы проецируем восстановленные точки на плоскость (x)-(z), получая распределение двумерных точек, и аппроксимируем эти точки сплайном центральной линии. Используя этот сплайн, мы вычисляем общую длину дуги и сравниваем ее с ожидаемой длиной ткани. Если длина дуги значительно меньше известной длины ткани, мы рассматриваем недостающую длину как перекрытую часть ткани..
Наконец, мы подгоняем узлы сетки, соответствующие тканевой решетке, к видимому облаку точек и добавляем дополнительные узлы сетки позади видимой ткани для учета перекрытых областей. Затем это реконструированное состояние передается в симулятор для планирования..
Appendix C Сходимость обучения RL
На рис. 6 мы сравниваем скорость сходимости PPO и APG в задачах подъема веревки и перетаскивания веревки. Благодаря дифференцируемости нашего симулятора, APG может использовать аналитические градиенты стратегии, полученные путем дифференцирования через симулятор, что ускоряет эффективность обучения. PPO, с другой стороны, не может использовать эту градиентную информацию. В обеих задачах APG сходится к более низким затратам быстрее, чем PPO. Это улучшение обусловлено динамикой со сглаженным контактом, которая обеспечивает оценки градиента с меньшей дисперсией и повышает эффективность выборки. В частности, в задаче подъема веревки APG сходится к тем же затратам, что и PPO, в среднем за 45,95% (медиана 36,01%) меньшее количество шагов, чем PPO, и за 16,63% (медиана 27,43%) меньшее количество шагов для задачи перетаскивания веревки. Эти результаты демонстрируют, что наш дифференцируемый симулятор может быть использован для ускорения обучения стратегий RL..
Appendix D Трубки MPC с обратной связью по состоянию
На рис. 7 показаны трубки достижимости для задачи перетаскивания веревки, представленной на рис. 2(b), на выбранных шагах MPC, наложенные на траекторию (темная линия), реализованную с помощью замкнутого контура MPC с перепланированием. Мы отмечаем, что в условиях MPC выполненная траектория может не совпадать с трубками, вычисленными на предыдущих временных шагах, поскольку контроллер выполняет перепланирование после каждого шага выполнения. Возмущения и конечный горизонт прогнозирования могут привести к тому, что последующие оптимизации выберут траекторию с меньшими затратами, которая отклоняется от ранее запланированного пути и связанной с ним робастной трубки. Для обеспечения гарантированной робастной рекурсивной допустимости может быть применен такой подход, как [24]. В качестве альтернативы, развертки с использованием робастного контроллера обратной связи, созданного с помощью SLS, гарантированно остаются внутри вычисленных трубок, но только в пределах конечного горизонта, для которого был синтезирован контроллер, как показано на рис. 9, где представлены трубки для полного горизонта..
На рис. 8 показаны трубки достижимости для задачи складывания ткани, представленной на рис. 2(c), на выбранных шагах MPC. Ограничение лимитирует высоту ткани до 3 см в направлении . Поскольку MPC перепланирует траекторию после каждого шага выполнения, исполняемая траектория не обязательно остается внутри трубок, вычисленных на предыдущих временных шагах. Тем не менее, за счет соблюдения ограничений на предсказания в виде трубок во время каждого перепланирования, контроллер надежно удовлетворяет ограничению по высоте на протяжении всей задачи..
Appendix E Трубки выходной обратной связи
Мы показываем трубки для всех 39 состояний для эксперимента с обратной связью по выходу на рис. 3. Прогоны оцениваются при случайных динамических и измерительных возмущениях, в то время как управляющие воздействия генерируются робастным наблюдателем-контроллером, синтезированным с помощью CORD-SLS..
Appendix F Сравнение симуляторов
В таблице 2 представлены показатели времени выполнения прямого моделирования и вычисления якобиана динамики для веревки из 20 узлов и ткани из 100 узлов. Наш симулятор стабильно демонстрирует самое быстрое время выполнения среди сравниваемых дифференцируемых симуляторов. Кроме того, предварительная факторизация матриц значительно снижает накладные расходы на вычисление градиента, делая время вычисления якобиана динамики сопоставимым с прямым моделированием..
DEFORM [12] демонстрирует более низкую скорость симуляции, поскольку его вычислительный конвейер не скомпилирован в код, исполняемый непосредственно на графическом процессоре. DaXBench [11] использует различные методы симуляции для веревок и ткани, применяя метод материальных точек (MPM) для веревок и масс-пружинную модель для ткани, что приводит к различным вычислительным затратам..
| Forward simulation [ms] | Dynamics Jacobian computation [ms] | ||
| Rope | Ours | 1.095 0.162 | 5.198 2.533 |
| DEFORM [12] | 49.03 20.04 | 2128.81 55.14 | |
| DaXBench [11] | 786.48 76.23 | 11561.57 122.07 | |
| Cloth | Ours | 15.08 1.209 | 10.06 0.983 |
| DaXBench [11] | 21.71 0.722 | 110.19 2.663 |
Далее мы проводим сравнительный анализ точности симуляции нашего метода по отношению к DEFORM. Для создания эталонного набора данных мы собираем 100 образцов рандомизированных манипуляционных действий на аппаратном обеспечении, одновременно запуская наш конвейер восприятия для оценки состояния веревки. Для каждого образца мы записываем текущее состояние, управляющее воздействие и результирующее следующее состояние, т.е. (). Мы отмечаем, что из-за задержки в конвейере восприятия мы не можем напрямую наблюдать мгновенное состояние после действия и, следовательно, не можем надежно зафиксировать переходные колебания или динамику, обусловленную инерцией. Вместо этого записанное следующее состояние соответствует установившейся конфигурации веревки после затухания движения, что делает набор данных более репрезентативным для квазистатического поведения..
Мы оцениваем оба симулятора в двух конфигурациях. Во-первых, мы приводим точность одношагового прогнозирования базового симулятора, измеряемую как среднее L2-расстояние между предсказанным и наблюдаемым следующими состояниями. Во-вторых, мы оцениваем каждый симулятор с дополненной обученной остаточной моделью. Оригинальная структура DEFORM использует обученный остаток, состоящий из сетевой архитектуры для компенсации ошибок моделирования. Чтобы обеспечить справедливое сравнение, мы обучаем идентичную остаточную архитектуру для обоих симуляторов, используя ту же процедуру обучения и гиперпараметры. Набор данных разделен на 70% обучающих и 30% валидационных данных, и мы приводим среднюю ошибку валидации для моделей с остаточной коррекцией. Для всех экспериментов мы устанавливаем длину веревки равной 0.8м и дискретизируем ее на 10 звеньев.
Ключевое различие между нашим методом и симулятором DEFORM заключается в том, что DEFORM сформулирован как полностью динамический симулятор, тогда как наш метод предполагает квазистатическое поведение. Следовательно, прямое сравнение одного шага прямого моделирования было бы некорректным, поскольку записанные аппаратные данные соответствуют установившимся равновесным конфигурациям, а не переходным процессам. Поэтому, чтобы учесть это расхождение при оценке DEFORM, после выполнения заданной команды мы многократно распространяем динамику с нулевым управляющим воздействием до тех пор, пока веревка не придет в равновесную конфигурацию. Это позволяет получить прогнозы, согласующиеся с квазистатическими состояниями, наблюдаемыми нашей системой восприятия..
В таблице 3 обобщена итоговая точность одношагового прогнозирования. DEFORM достигает примерно на 7% меньшей ошибки прогнозирования, чем наш симулятор. Этот разрыв в производительности ожидаем, поскольку DEFORM моделирует дополнительные физические степени свободы, включая деформацию кручения, посредством формулировки дискретных упругих стержней, в то время как наш симулятор использует модель упругой энергии, которая учитывает только деформацию растяжения и изгиба. В результате некоторые эффекты деформации более высокого порядка не представлены явно, что приводит к потере точности модели. Тем не менее, мы отмечаем, что вычислительная эффективность нашего симулятора и планировщика обеспечивает быстрое перепланирование во время выполнения, позволяя системе оперативно компенсировать неточности моделирования и возмущения. Наконец, мы показываем, что оба симулятора выигрывают от использования обученной модели остаточной коррекции, при этом DEFORM сохраняет небольшое преимущество благодаря своей более сильной базовой физической модели..